

Od George Teixeiry, generálního ředitele a prezidenta společnosti DataCore Software
V roce 2012 je fráze „velká data“ na rtech každého, stejně jako virtualizace před pěti lety. Stejně jako u virtualizace a cloud computingu existuje spousta humbuku, který zastírá důležitější diskuse o IT výzvách, potřebných dovednostech a o tom, jak skutečně vybudovat infrastrukturu, která dokáže podporovat efektivní technologie velkých dat.
Když lidé básnili o zázracích virtualizace, neuvědomovali si nové požadavky na výkon a enormní nárůst úložné kapacity potřebné k podpoře serverových a desktopových iniciativ. Potřeba vyššího výkonu a nepřetržité dostupnosti měla vysokou cenu a je zřejmé, že dopad na rozpočet následně zpozdil nebo zhatil mnoho projektů.
Tyto problémy se nyní řeší zaváděním virtualizace úložišť, která využívá inovace v oboru ve výkonu, vede k větší komoditizaci drahého zařízení a automatizuje správu úložišť pomocí nových technologií, jako je například podnikový software pro automatické vrstvení.
Stejná dynamika funguje znovu, tentokrát jen s velkými daty.
Firmy zabývající se business intelligence by vás rády přesvědčily, že jednoduše nalepíte jejich analytické platformy na framework Hadoop a BINGO – máte aplikaci pro velká data. Realita je taková, že produkční nasazení Hadoopu ve velkých podnicích prakticky neexistuje. Prostě není mnoho lidí, kteří těmto novým technologiím rozumí a dokáží je využít. Navíc ekosystém podpůrných technologií a metodologií je stále příliš nezralý, což znamená, že toto odvětví prochází bolestivým procesem pokusů a omylů, stejně jako tomu bylo s virtualizací před pěti lety. Podceňování požadavků na úložiště se opět stává hlavní překážkou jejich přijetí, protože letitá praxe „házení problému na hardware“ vytváří často neudržitelné náklady a složitost.
Řečeno na rovinu, velká data nevyžadují jen velké úložiště – vyžadují velké chytré úložiště. Bohužel hrozí, že toto odvětví zopakuje velké chyby minulosti!
Než se pustím do technologií, dovolte mi poukázat na největší výzvu, které čelíme při vstupu do světa velkých dat – potřebujeme vychovávat lidi, kteří budou řídit a implementovat užitečné systémy pro velká data. Nedávný článek ve Forbesu naznačil, že naše školy nedrží krok s požadavky na vzdělávání, které velká data přinášejí. Myslím, že následující pasáž problém dobře shrnuje: „Čelíme obrovskému nedostatku lidí, kteří by nejen zvládali velká data, ale především měli znalosti a dovednosti k vytváření hodnoty z dat – a to při zvládání neustálé tsunami. Jak agregovat a filtrovat data, jak je prezentovat, jak je analyzovat, abyste získali poznatky, jak tyto poznatky využít k podpoře rozhodování a jak je pak z pohledu odvětví integrovat do svého obchodního procesu?“
A nyní zpět k technologiím produktů, které budou mít zásadní vliv – zejména těm, které se týkají správy úložišť v rámci tohoto nového paradigmatu.
Jak všichni víme, došlo k explozi v nárůstu objemu dat a tradiční přístupy ke škálování ukládání a zpracování dat začaly dosahovat výpočetních, provozních a ekonomických limitů. Je zapotřebí nový přístup k inteligentní správě a uspokojení potřeb rychle rostoucích datových sad, pokud jde o výkon a dostupnost. Ještě před několika lety bylo prakticky neslýchané, aby organizace hovořily o škálování nad několik stovek terabajtů, nyní se diskuse zabývají několika petabajty. Také v minulosti se firmy rozhodovaly archivovat velké procento svého obsahu na pásky. V dnešním světě zaměřeném na sociální média a služby na vyžádání to však již není proveditelné. Uživatelé nyní požadují okamžitý přístup a nebudou tolerovat zpoždění při obnově dat z pomalých nebo vzdálených páskových úložišť.

Okamžité uspokojení je heslem dne a výkon je klíčový.
Nové úložné systémy musí automaticky a bez přerušení migrovat data z jedné generace systému do druhé, aby efektivně řešily dlouhodobou archivaci. K tomuto problému se přidává i potřeba distribuovat úložiště mezi více datových center, ať už pro zotavení po havárii, nebo pro umístění obsahu blíže k uživatelům, kteří o něj požadují informace, aby se minimalizovala latence a zlepšila doba odezvy.
To je obzvláště důležité pro výkon aplikací, které jsou klíčové pro každodenní chod firmy, jako jsou databáze, plánování podnikových zdrojů a další transakční úlohy. Kromě dat, která tyto aplikace náročné na zdroje produkují, se IT oddělení musí vypořádat s masivním rozsahem nových médií, jako je Facebook a YouTube. Tradiční úložné systémy nejsou pro řešení těchto problémů příliš vhodné, takže IT architektům nezbývá nic jiného než se pokusit vyvinout vlastní řešení nebo se potýkat se složitými a málo výkonnými systémy.
Úložné systémy jsou v prostředí velkých dat a cloudu velmi náročné, protože byly navrženy pro nasazení na stále větších úložných polích, obvykle umístěných na jednom místě. Tyto špičkové proprietární systémy mají vysokou cenu, pokud jde o kapitálové a provozní náklady, stejně jako o agilitu a závislost na dodavateli. Nabízejí nedostatečné mechanismy pro vytvoření společného, centrálně spravovaného fondu zdrojů. To nechává IT architekta řešit problém s množstvím individuálních úložných systémů, obvykle složených z různých značek, typů a modelů, což vyžaduje odlišný přístup k replikaci napříč lokalitami a nějakou formu vlastní správy.
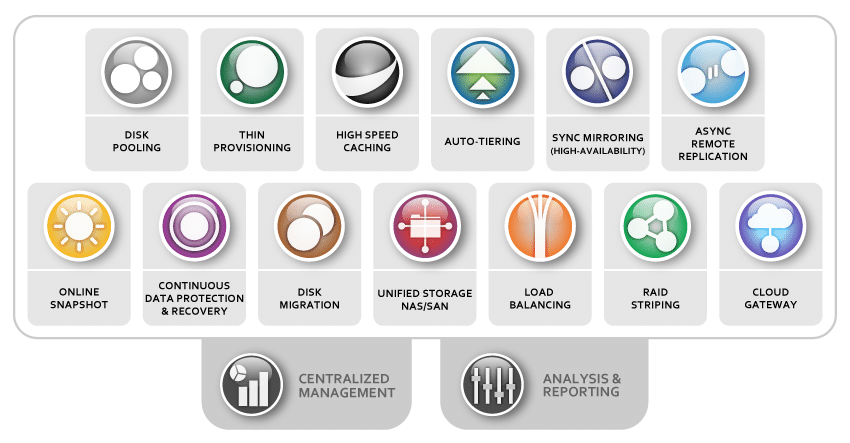
S ohledem na to je třeba řešit čtyři zásadní problémy:
- Správa virtuálních zdrojů a flexibilita: K transformaci současné krajiny monolitických, nezávislých řešení do virtuálního fondu úložných zdrojů, který zahrnuje a využívá širokou škálu dnes dostupného hardwaru a zařízení pro ukládání dat, je zapotřebí chytrý software. Vysoké kapitálové a provozní náklady: Pro snížení provozních nákladů je nezbytné dosáhnout vyšší produktivity prostřednictvím automatizace a centralizované správy. Stejně důležité je, aby společnosti měly větší možnost komoditizovat a umožnit zaměnitelnost hardwaru, což je klíčové pro nákladově efektivní škálovatelnost úložiště. Nikdo si nemůže dovolit investovat „velké peníze“ do dražších „velkých“ řešení ve světě velkých dat. Hypervizory, jako jsou VMware a Microsoft Hyper-V, zvýšily kupní sílu uživatelů. Dnes se používání serveru Dell, HP, IBM nebo Intel stalo do značné míry osobní preferencí společností. Stejný přístup je vyžadován i pro úložiště a vedl k potřebě hypervizorů.
- Škálovatelnost vyžaduje výkon a nepřetržitou dostupnost: S rostoucím objemem úložiště dat a s rostoucím počtem aplikací, uživatelů a systémů, které je třeba obsluhovat, rostou paralelně i požadavky na vyšší výkon a dostupnost. Už nejde o to, kolik se toho vejde do velkého úložiště, ale o to, jak využít nové technologie k rychlejšímu a responzivnějšímu ukládání dat. Stejně tak, bez ohledu na to, jak spolehlivé může být jedno úložiště, se nedá srovnávat s mnoha systémy, které spolupracují na různých místech, aby zajistily nejvyšší úroveň kontinuity provozu, bez ohledu na použitý hardware.
- Dynamické versus statické úložiště: Je také zřejmé, že již nedokážeme držet krok s optimalizací podnikových dat pro maximální výkon a kompromisy mezi náklady. Automatizace softwaru je nyní klíčová. Technologie, jako je thin-provisioning, který zahrnuje více úložných zařízení, jsou nezbytné pro větší efektivitu a lepší využití úložných aktiv. Výkonné celopodnikové funkce, které fungují napříč různými třídami a typy úložišť, se stávají nutností. Pro migraci z jedné třídy úložiště do druhé je nutné automatizované vrstvení úložiště. V důsledku toho jsou sofistikované hypervizory úložišť klíčové, bez ohledu na to, zda je migrace dat a I/O provozu nejlépe z vysokorychlostní dynamické paměti RAM, disků SSD, disků nebo dokonce od poskytovatelů cloudových úložišť.
Náročné aplikace nyní potřebují úložný systém, který může začít v malém, ale snadno se škáluje na mnoho petabajtů. Musí to být systém, který dokáže rychle obsluhovat obsah a zvládat rostoucí pracovní zátěž tisíců uživatelů denně. Musí být také mimořádně snadno použitelný, co nejvíce automatizovaný a musí se vyhnout vysoké míře specializovaných znalostí pro jeho nasazení nebo ladění. Snad nejdůležitější je, že musí změnit paradigma úložiště z pevně stanoveného v jednom poli nebo umístění na rozptýlený, ale centrálně spravovaný systém, který dokáže aktivně ukládat, načítat a distribuovat obsah kdekoli je potřeba. Dobrou zprávou je, že úložné hypervizory, jako je SANsymphony-V od DataCore, poskytují snadno použitelné a škálovatelné řešení pro IT architekty, kteří čelí velkému množství dat protékajícím moderní společností.
Ano, velká data nabízejí velký potenciál. Jen se ujistěte, že tentokrát máme správné úložiště, abychom se vyhnuli opakování velkých chyb z minulosti.
George Teixeira je generálním ředitelem a prezidentem společnosti DataCore Software . Platforma softwaru jako infrastruktury této společnosti řeší velký problém brzdění virtualizačních iniciativ tím, že eliminuje překážky související s úložištěm, které virtualizaci činí příliš obtížnou a drahou. Autora můžete kontaktovat na adrese George.Teixeira@DataCore.com.


 Amazon