

Na konferenci Google Cloud Next společnost Google oznámila své akcelerátory umělé inteligence nové generace: TPU 8t „Sunfish“ pro trénování a TPU 8i „Zebrafish“ pro inferenci, spolu s novou strukturou datových center Virgo. Z blogových příspěvků společnosti Google je zřejmé, že tyto čipy jsou optimalizovány pro „agentickou éru“: trénování modelů směsi expertů v měřítku stovek tisíc čipů a následná obsluha stejných modelů s nízkou latencí a agresivními cílovými cenami za token. 8t a 8i jsou dva architektonicky odlišné čipy, které sdílejí hostitelskou platformu a strukturu, ale liší se kapacitou paměti, pamětí SRAM na čipu, topologií propojení a specializací na čipu. 8t je postaven pro husté násobení matic (matmul) ve velkém měřítku, zatímco 8i je postaven na mezipaměti KV na křemíku a kolektivní latenci na token.
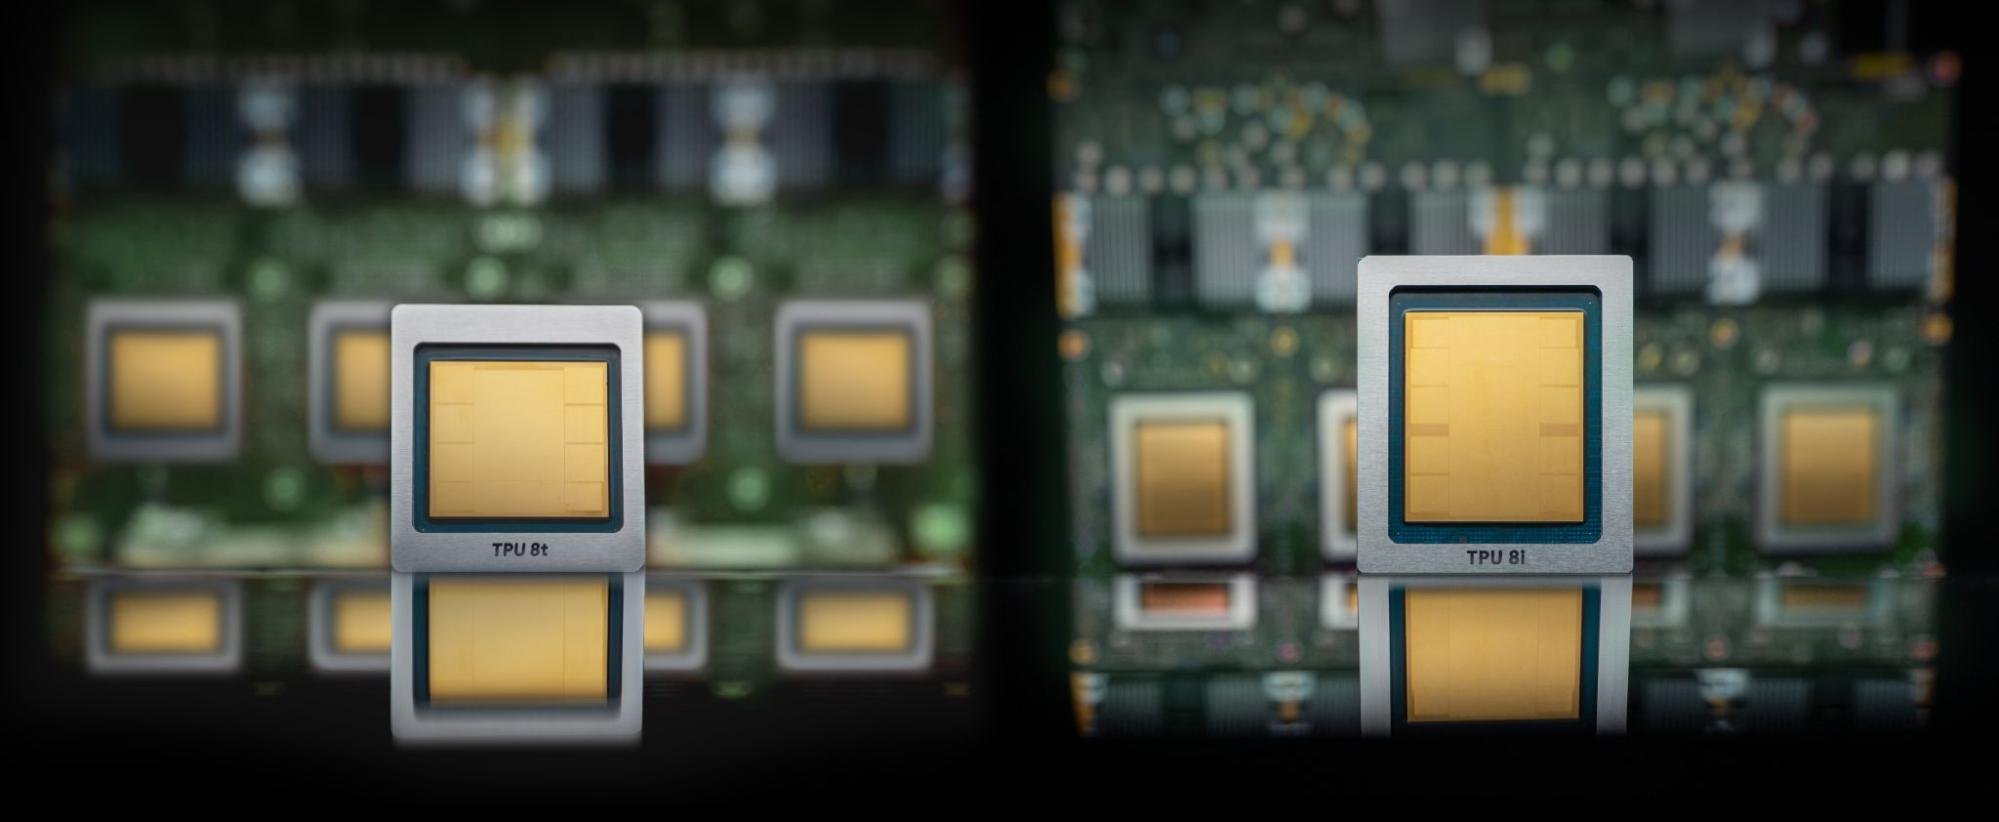
Jeden 8t superpod se škáluje na 9 600 čipů, pojme 2 PB HBM a poskytuje 121 EFLOPS výpočetního výkonu FP4, což je téměř 3x více než na pod oproti superpodu Ironwood. 8i kombinuje 288 GB HBM s 384 MB paměti SRAM na čipu (3x Ironwood) v rámci škálovatelné domény s 1 152 čipy a v oblasti LLM inference si nárokuje o 80 % lepší poměr výkonu na dolar než Ironwood. Virgo propojuje obě rodiny čipů do jediné struktury datového centra, která propojuje více než 134 000 8t čipů s neblokující šířkou pásma bisekce 47 Pb/s, s až 4x větší šířkou pásma na akcelerátor a o 40 % nižší latencí bez zatížení než předchozí generace.
Co je to vlastně TPU
Než se pustíme do samotné osmičky, trochu si ujasněme, co je TPU a jak se liší od GPU, protože osmička designových rozhodnutí dává smysl pouze v tomto kontextu.
Tensor Processing Unit je vlastní ASIC, který Google iteruje od roku 2015. Každá generace byla postavena na stejné základní myšlence: namísto dynamického plánování tisíců malých jader, jak to dělá GPU, se TPU zaměřuje na malý počet velmi velkých MXU (jednotek pro násobení matic), napájených ze softwarově spravovaného zápisníku SRAM na čipu a řízených kompilátorem s předstihem. Každý čip obsahuje několik TensorCores, z nichž každé je postaveno na jedné velké MXU se systolickým polem, plus menší sadu SparseCores vyhrazených pro nepravidelné vyhledávání gather-scatter, které dominují vkládání doporučení. Data tečou z HBM přes zápisník, přes MXU, zpět do zápisníku a zase ven, přičemž vektorová procesorová jednotka (Vector Processing Unit) se stará o aktivace, normalizace a redukce. Neexistuje žádný hardwarový plánovač warp, žádná hierarchie mezipaměti L1 nebo L2 ve smyslu GPU a žádné dynamické odesílání.
Výhodou tohoto návrhu je efektivita v husté lineární algebře. Díky předem připravenému kompilátoru, který rozhoduje o tom, kde se nachází každý tenzor a kdy se každý kolektiv spustí, nedochází k jitteru způsobenému chybou mezipaměti ani k dani z plánování warpů, což je důležitější, než se zdá, když desítky tisíc čipů musí zůstat synchronizovány prostřednictvím kolektivu. Využití FLOP v reálném světě na TPU pro dobře vyladěné trénovací úlohy bývá vyšší než na tradičních GPU. Nevýhodou je, že cokoli, co se čistě nemapuje na velké husté matmuly, konkrétně dynamické tvary, nepravidelné vzory řídkosti, směrování MoE s nerovnoměrným rozložením tokenů nebo grafové neuronové sítě, je obtížnější efektivně vyjádřit. TPU také historicky nesly méně HBM na čip než jejich protějšky na GPU a měly mnohem užší podporu frameworků. XLA a JAX jsou prvotřídní; PyTorch až donedávna vyžadoval překladovou vrstvu; navíc kompilátor, běhové prostředí, síťové knihovny a softwarový stack pro více podů zůstávají v rámci Googlu uzavřeným zdrojovým kódem.
Řídkost je nejčistším příkladem filozofického rozdílu mezi GPU a TPU a důvod je spíše strukturální než marketingový. NVIDIA podporuje strukturovanou řídkost 2:4 na jádrech Tensor od dob Ampere a na papíře je výkon pro řídké úlohy dvojnásobný oproti hustým úlohám. Jádro Tensor je v podstatě dispečerská jednotka: přijímá explicitní operandy na instrukci MMA, takže přidání varianty řídkého MMA, která přijímá komprimovaný blok 2 ze 4 plus indexová metadata, je přímočarým rozšířením stávající instrukční sady. V každém cyklu hardware načítá do pole multiplikátoru pouze nenulové hodnoty a jejich indexy, přičemž nuly implicitně přeskakuje.
Systolické pole funguje opačně. Každý PE (procesní prvek) počítá každý cyklus, přičemž operandy procházejí polem v uzamčeném kroku přes přímé cesty mezi registry z jednoho PE do druhého. Právě tento deterministický tok dat je důvodem, proč pramení výhoda energetické účinnosti oproti SIMT: žádné opakované čtení SRAM, žádná režie odesílání instrukcí, maximální opětovné použití operandů. Znamená to ale také, že hardware nemůže přeskočit prvek s nulovou hodnotou za cyklus, aniž by přerušil pipeline.

Zdroj: Google
TPU mohou stále využívat řídkost na úrovni dlaždic; pokud je celá dlaždice o velikosti MXU tvořena samými nulami, kompilátor na ní neplánuje práci. Rozhodnutí Googlu nepřidat hardwarovou akceleraci pro strukturovanou řídkost je však úmyslné. Přidání strukturované řídkosti M:N do systolického pole lze dosáhnout pomocí několika technik, z nichž každá má jiné kompromisy. Jedna taková technika vyžaduje kompresní jednotku umístěnou mezi SRAM a vstupními porty pole. Systolické pole je však pipeline, nikoli dispečer. Jeho efektivita je zaručena tím, že operandy přicházejí v deterministické kadenci, přičemž každý procesní prvek je v každém cyklu zaneprázdněn. Povolení přeskakování operandů vyvolává jednu ze dvou nákladů. Zastavení pipeline na nulách, což maže výhodu efektivity, která architekturu původně motivovala. Nebo přidání specializovaného dekompresního hardwaru pro rekonstrukci streamu s plnou šířkou z komprimovaného vstupu před jeho vstupem do pole, což by spotřebovávalo plochu čipu a zvyšovalo latenci.
Zdroj: AWS
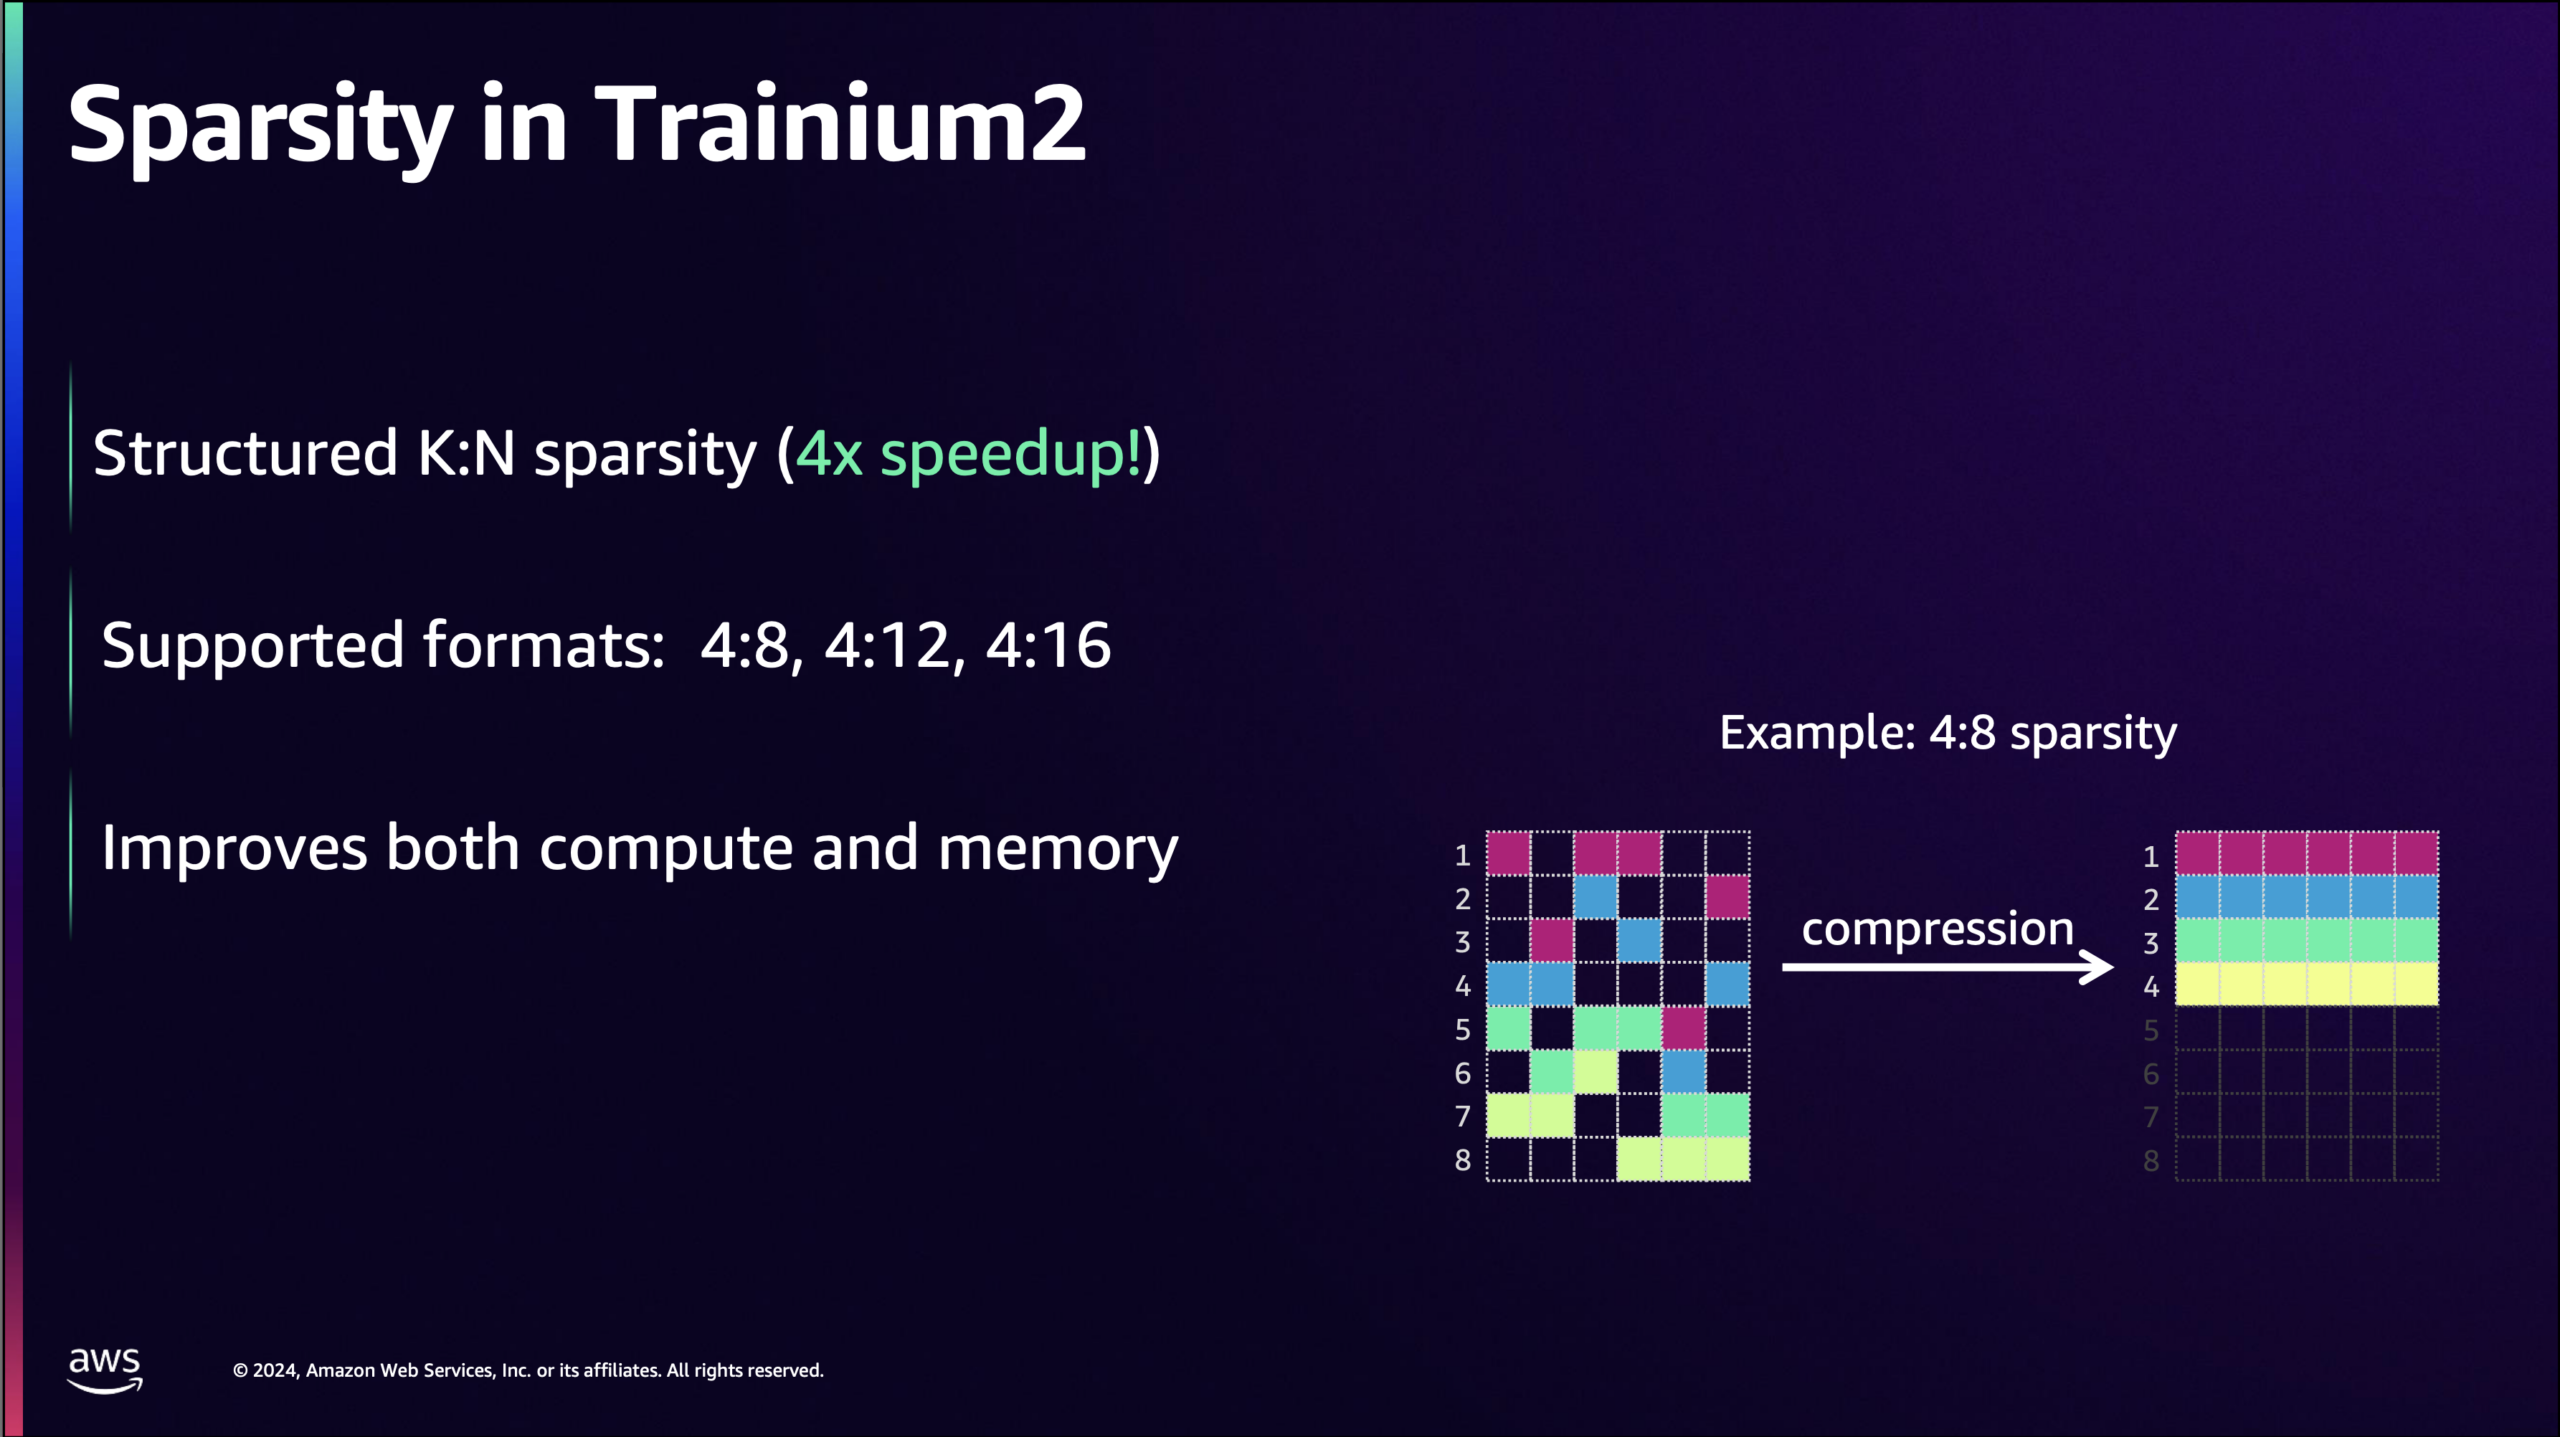
Některé akcelerátory kombinují systolická pole s hardwarovou podporou pro řídkost. AWS jeden z nich vytvořila s NeuronCore-v3, enginem uvnitř Trainium2 a Trainium3. Implementace ukazuje, jak vypadá hardwarově řídké systolické pole. Tenzorový engine NeuronCore-v3 je systolické pole o rozměrech 128×128, které pracuje se stacionární váhovou maticí a maticí aktivace streamování, přičemž dimenze kontrakce je zarovnána s dimenzí oddílu pole. V řídkém režimu se vstupní datová cesta rozšiřuje z 2×128 prvků na cyklus na hustých BF16 a FP16 na 5×128 prvků na cyklus a stacionární strana napájí data z komprimované reprezentace váhové matice, nikoli z původních hustých vah. Při kompilaci je váhový tenzor zpracován do formátu M:N. Z každých N souvislých prvků podél dimenze kontrakce se zachová pouze M s kompaktním kódováním bitové masky, jejichž pozice jsou nenulové. Komprimovaná vyrovnávací paměť ukládá pouze hodnoty M, zmenšené faktorem N/M. Když se provede instrukce matmul, hardware přečte komprimované váhy a pomocí bitové masky směruje odpovídající aktivace ze stacionární dlaždice ke správným procesním prvkům. PE, které by byly vynásobeny nulou, pro daný slot nedostanou práci. Protože vyhledávání a směrování bitové masky probíhá v dekompresoru, který napájí pole, a nikoli v samotném poli, pipeline udržuje plnou propustnost na nenulových hodnotách, místo aby se zastavil na nulách.
Násobení hustých matic není to jediné, co TPU dělá. Již několik generací zahrnují TPU vedle TensorCores také SparseCore. SparseCore je doménově specifický engine určený pro nepravidelné přístupové vzory gather-scatter, které definují modely doporučení. Model hodnocení YouTube nebo model relevance reklam ve vyhledávání se nepodobá transformátoru hustých matic. Většina jeho parametrů se nachází v tabulkách pro vkládání dat, které se mohou pohybovat od stovek gigabajtů až po petabajty, a většinu jeho výpočetního času věnuje provádění malých vyhledávání z těchto tabulek, lehké transformaci načtených hodnot a kombinování výsledků. Tento přístupový vzor je nejhorším případem pro MXU a jen o málo lepším pro hierarchii mezipaměti GPU. SparseCores jsou vyladěny právě pro toto: vysoce propustné operace gather-scatter proti tabulkám pro vkládání dat rezidentním v HBM, s hardwarovou podporou pro operace deduplikace a kombinování, na kterých závisí zbytek vkládacího procesu. Stejný hardware také pomáhá s expertním směrováním MoE, protože jakmile výběr top-k vygeneruje expertní indexy, zbytek procesu směrování (permutace tokenů expertem, jejich odesílání mezi čipy, shromažďování expertních výstupů zpět a provádění vážené redukce) se řídí stejným vzorem shromažďování/rozptylu/redukce jako vkládací kanál, přičemž podpora řazení SparseCore pokrývá samotný krok top-k.
S ohledem na to uvádíme tato oznámení.
TPU 8t „Sluneční rybka“
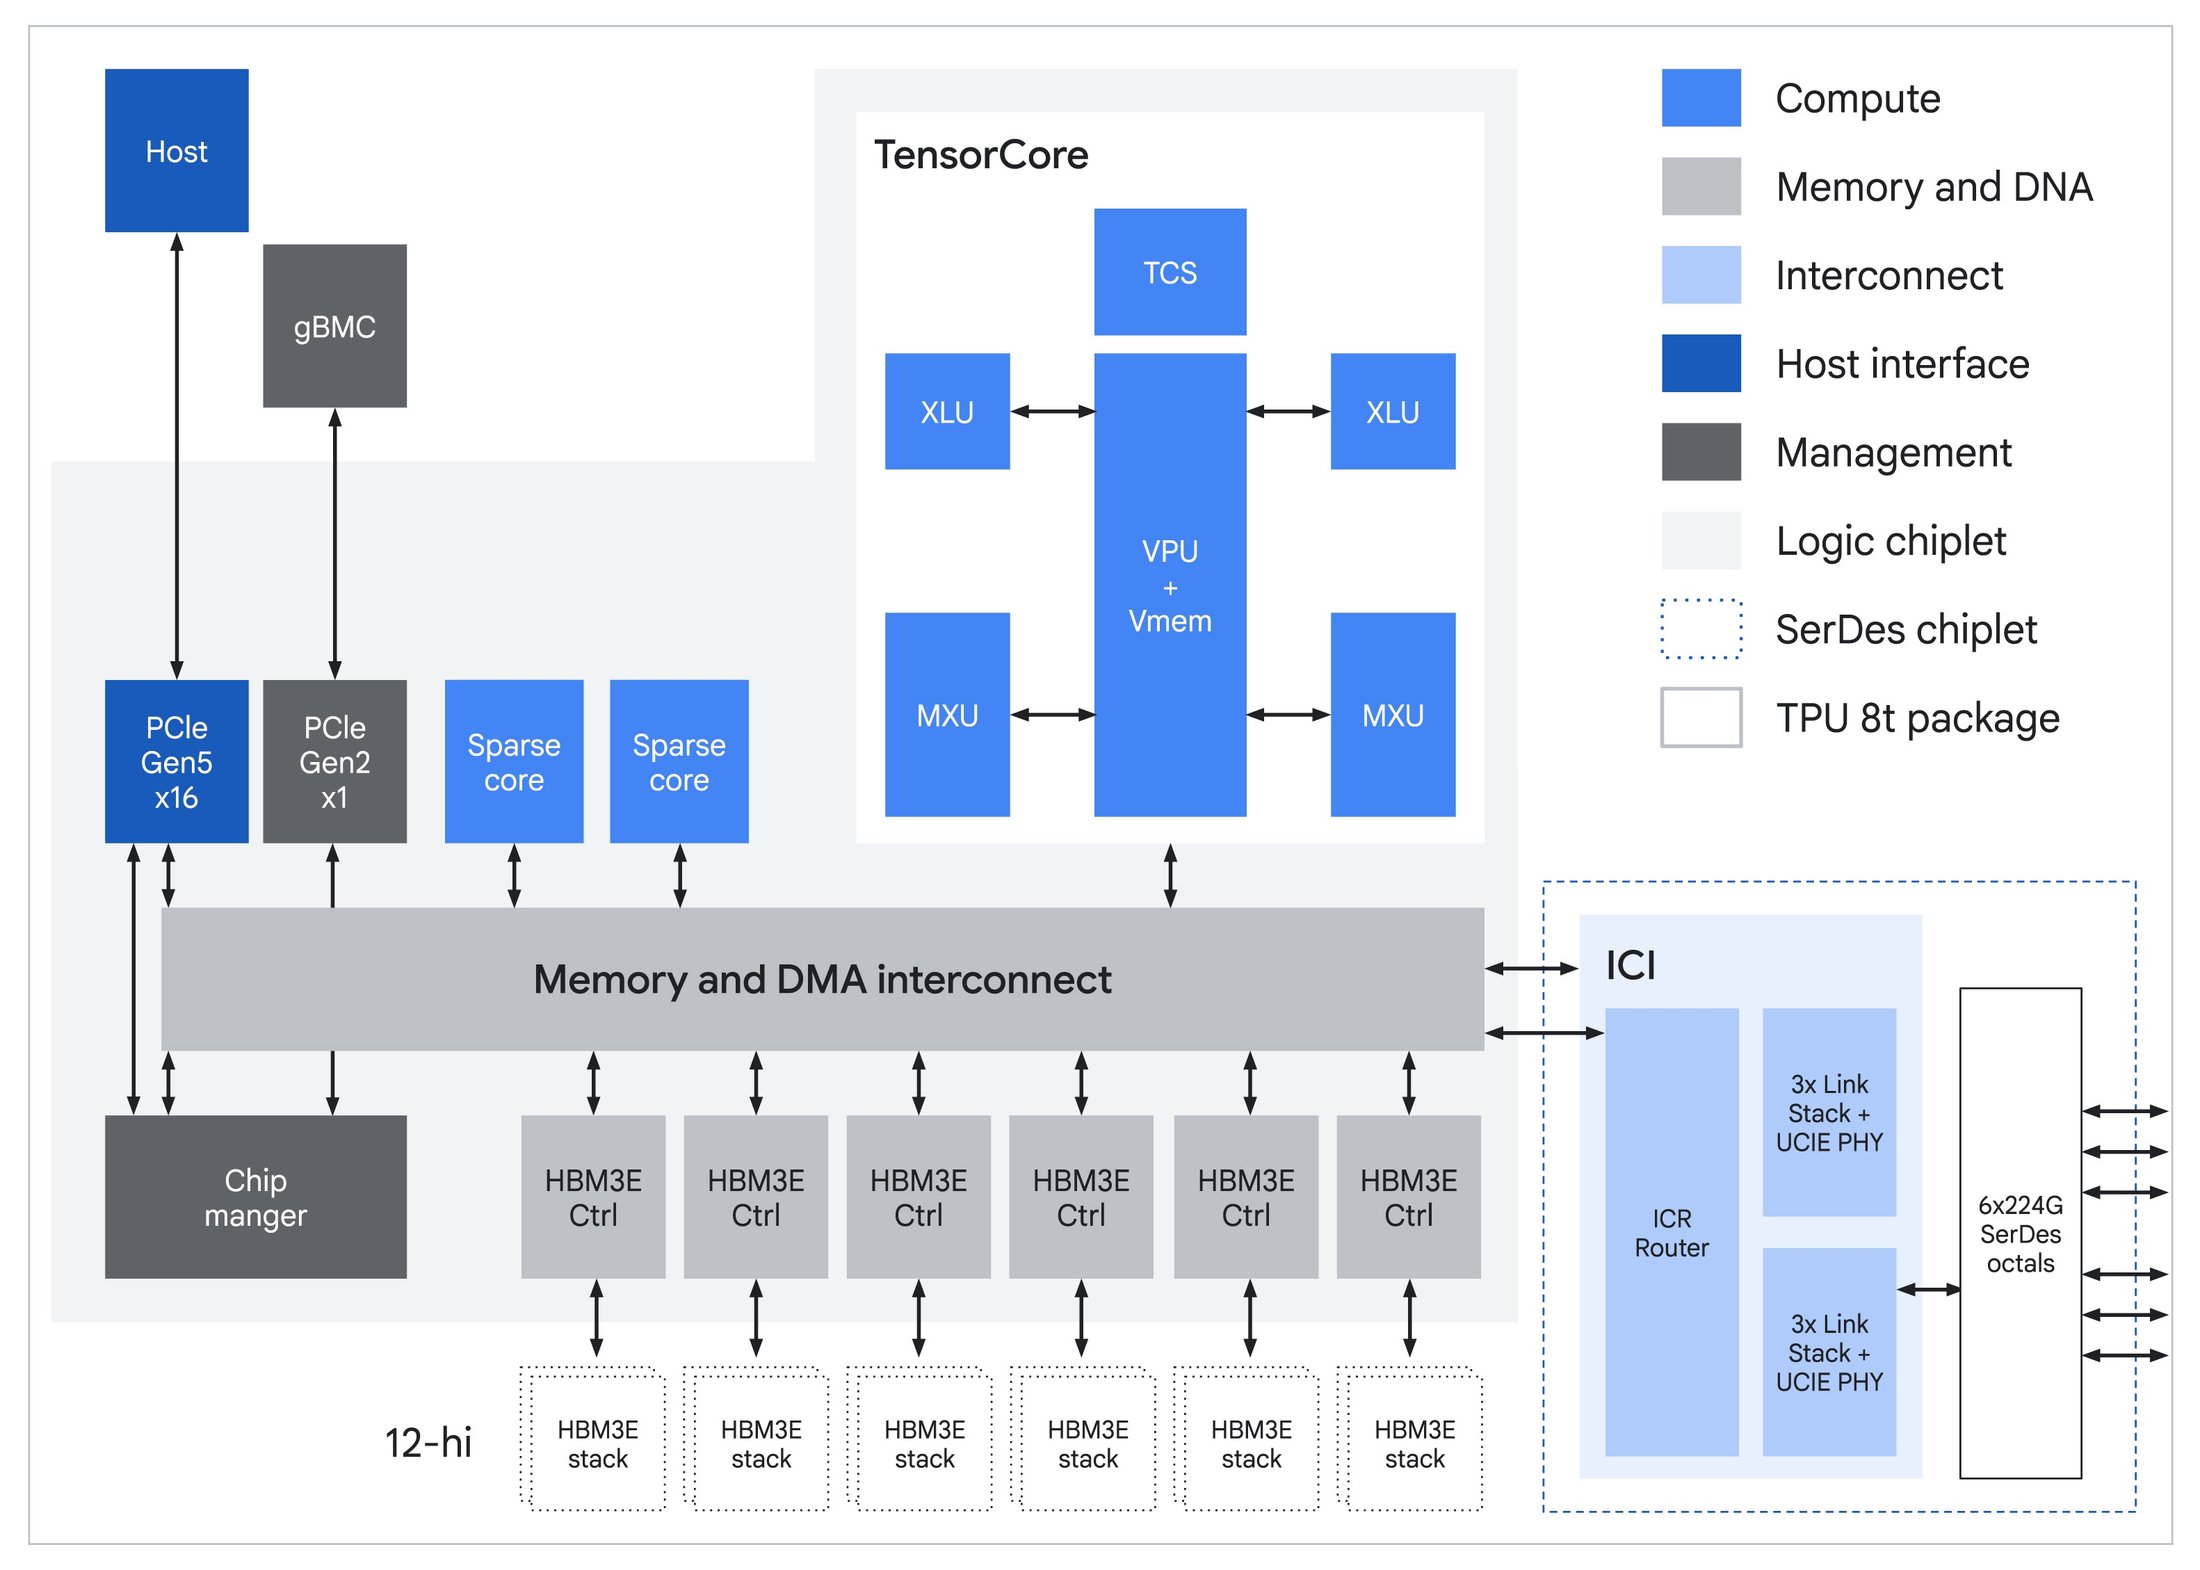
První oznámený čip, TPU 8t s kódovým označením Sunfish, je trénovací. Generační krok od Ironwoodu sleduje ve většině ohledů očekávanou trajektorii: více paměti, větší šířka pásma, nativní podpora pro užší datové typy. Každý čip nese jedno TensorCore napájené šesti 12-Hi HBM3e stacky s celkovou kapacitou 216 GB s přenosovou rychlostí 6.5 TB/s, což je nárůst oproti 192 GB u Ironwoodu na osm stacků. Paměť Vmem SRAM na čipu zůstává na 128 MB.
Nativní FP4 v MXU je zdrojem většiny výpočetního skoku. Spouštění matmulů ve 4bitovém namísto 8bitovém zdvojnásobuje propustnost na cyklus pro stejné fyzické pole, což je způsob, jakým se Google dostane z 4.6 PFLOPS FP8 od Ironwoodu na 12.6 PFLOPS FP4 od 8t. Trénování se smíšenou přesností stále uchovává hlavní kopii vah FP32 pro krok optimalizace; FP4 zmenšuje pracovní tenzory, které spotřebovávají většinu výpočetního času.
Zdroj: Google
Příběh propojení je přímočarý. Šířka pásma ICI se zdvojnásobí na 19.2 Tb/s na čip, superpod s 9 600 čipy agreguje 2 PB HBM a 121 EFLOPS a topologie 3D torusu je zachována. Torus má smysl pro trénování, protože hraniční úlohy jsou dominovány kolektivy přátelskými k kruhu: all-reduces pro datový a tenzorový paralelismus, all-gathers a reduce-scatters pro FSDP a pipeline-paralelní point-to-point sens. Všechny tyto funkce se čistě mapují na osy torusu.
Google si také ponechává SparseCores, které jsou od verze 4 dodávány na každém TPU. Jejich původním účelem byly doporučovací modely ve stylu DLRM, kde většina výpočetního času jde na nepravidelný gather-scatter proti masivním vkládacím tabulkám. Stejný hardware také zpracovává směrování MoE. JAX zpřístupňuje ragged all-to-all a odpovídající ragged_dot jako operace první třídy, ve kterých může každý čip odeslat různě velký blok každému peerovi. To odpovídá skutečnému tvaru odesílání MoE, protože směrování top-k je závislé na datech a počet tokenů proudících ke každému expertovi se v každém kroku liší. Kompilátor slučuje nepravidelnou komunikaci a nepravidelný expertní matmul do jedné plánované operace, zatímco SparseCore zpracovává okolní řazení a permutaci. Vzhledem k tomu, že směs expertů je nyní dominantní architekturou v hraničních modelech, tento hardware prokazuje svou hodnotu v každé moderní tréninkové úloze, nejen v úlohách s reklamami a hodnocením, pro které byl původně navržen.
Toto jsou evoluční kroky. Větší změny představují TPUDirect a přechod na hostitele založené na platformě Axion, které obojí řeší úzká hrdla, jež se projevují až na hranici možností.
TPUDirect RDMA a úložiště TPUDirect
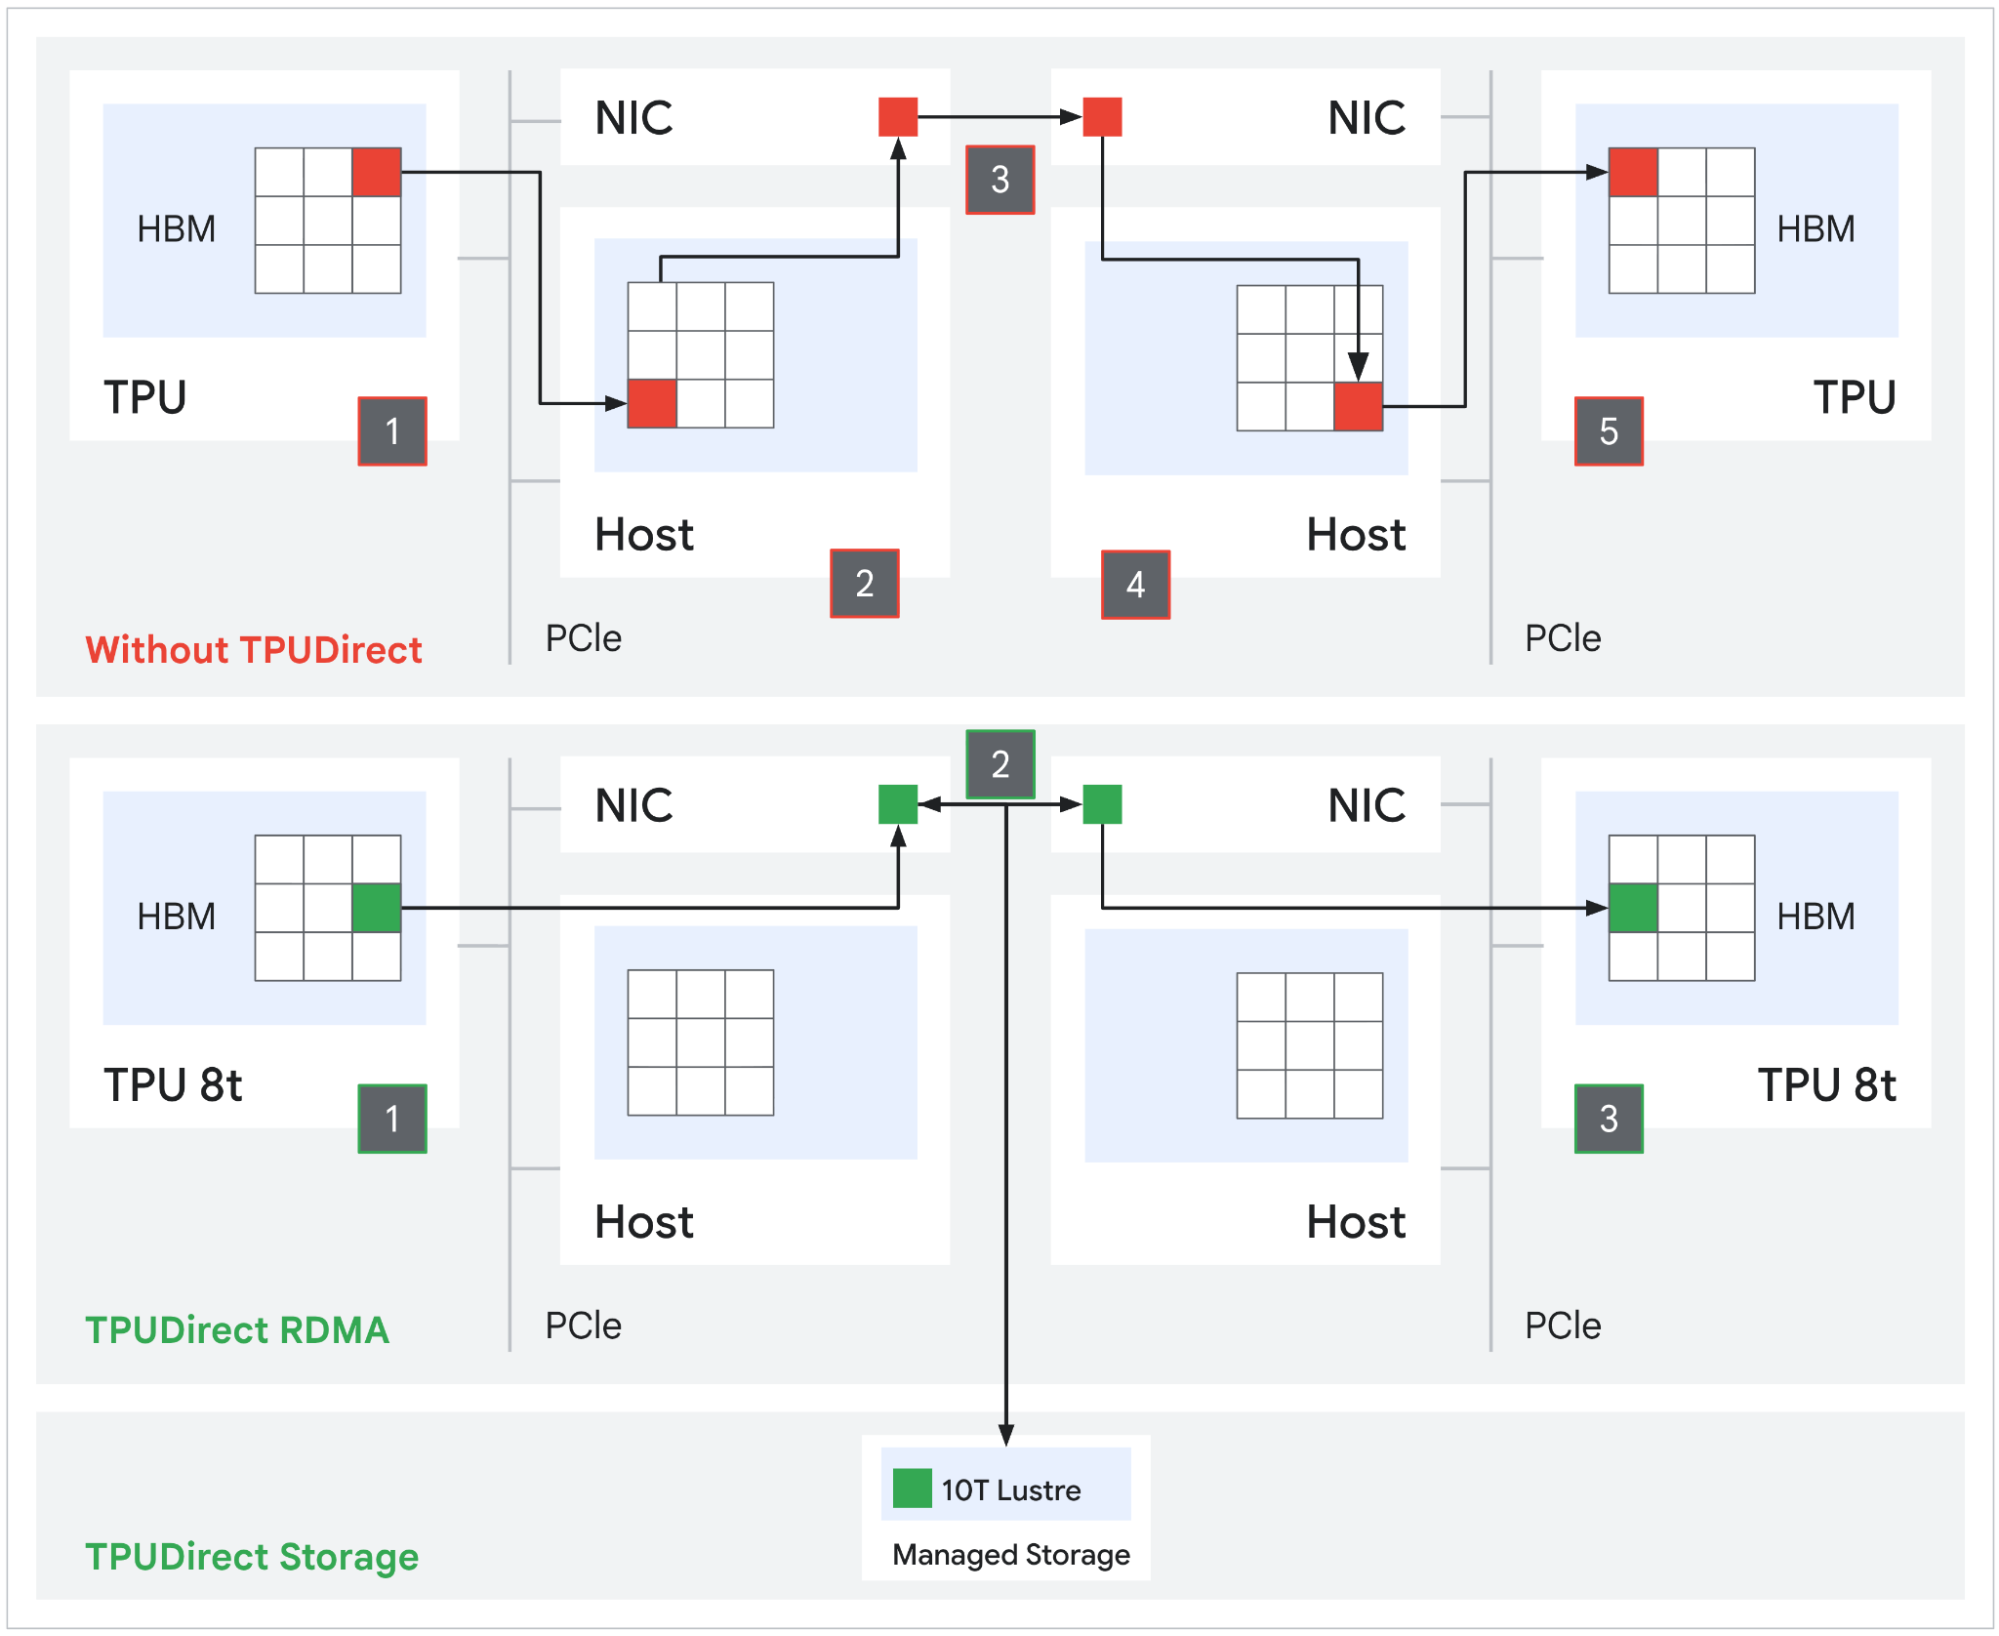
Předchozí generace TPU používaly pro síťové a úložné I/O procesy cestu zprostředkovanou hostitelem: pakety nejprve přistávaly v hostitelské DRAM paměti a poté je samostatný DMA kopíroval do TPU HBM. To jsou dvě paměťové transakce s hostitelským CPU ve smyčce. TPUDirect RDMA eliminuje vyrovnávací paměť pro odesílání dat. Síťová karta čte a zapisuje TPU HBM přímo přes PCIe peer-to-peer, čímž odstraňuje hostitele z datové cesty. NVIDIA nabízí ekvivalentní funkci s GPUDirect RDMA již léta a uvádí zhruba 10násobné zlepšení oproti cestě zprostředkované hostitelem. Google nyní dosahuje stejného výsledku i na straně TPU.
Zdroj: Google
Úložiště TPUDirect rozšiřuje stejný princip na perzistentní úložiště. Tenzory se pohybují přímo mezi TPU HBM a Managed Lustre celkovou rychlostí 10 TB/s, což podle Googlu poskytuje 10krát rychlejší přístup k úložišti než ekvivalentní cesta na Ironwoodu. Na hraničním měřítku, kde kontrolní body mohou dosahovat stovek terabajtů, je rozdíl v tom, zda vícetýdenní trénovací běh streamuje kontrolní body a datové sady rychlostí linky, nebo zastaví kanál MXU čekáním na hostitelské I/O operace.
Hostitelé Arm Axion
Každá předchozí generace TPU běžela na hostitelích x86 třetích stran. 8t je první, který používá vlastní procesor Axion od Googlu, CPU založený na Arm Neoverse V2, jako systémovou záhlaví. Úloha hostitelského CPU v TPU podu je reálná a v hraničním měřítku se stává obtížnější: řídí vstupní kanál, dekóduje a promíchává datové sady o velikosti několika petabajtů, spravuje řídicí rovinu JAX/XLA, serializaci kontrolních bodů a koordinuje odesílání SPMD napříč tisíci čipy. Pokud se hostitel zastaví, MXU zůstane nečinný.
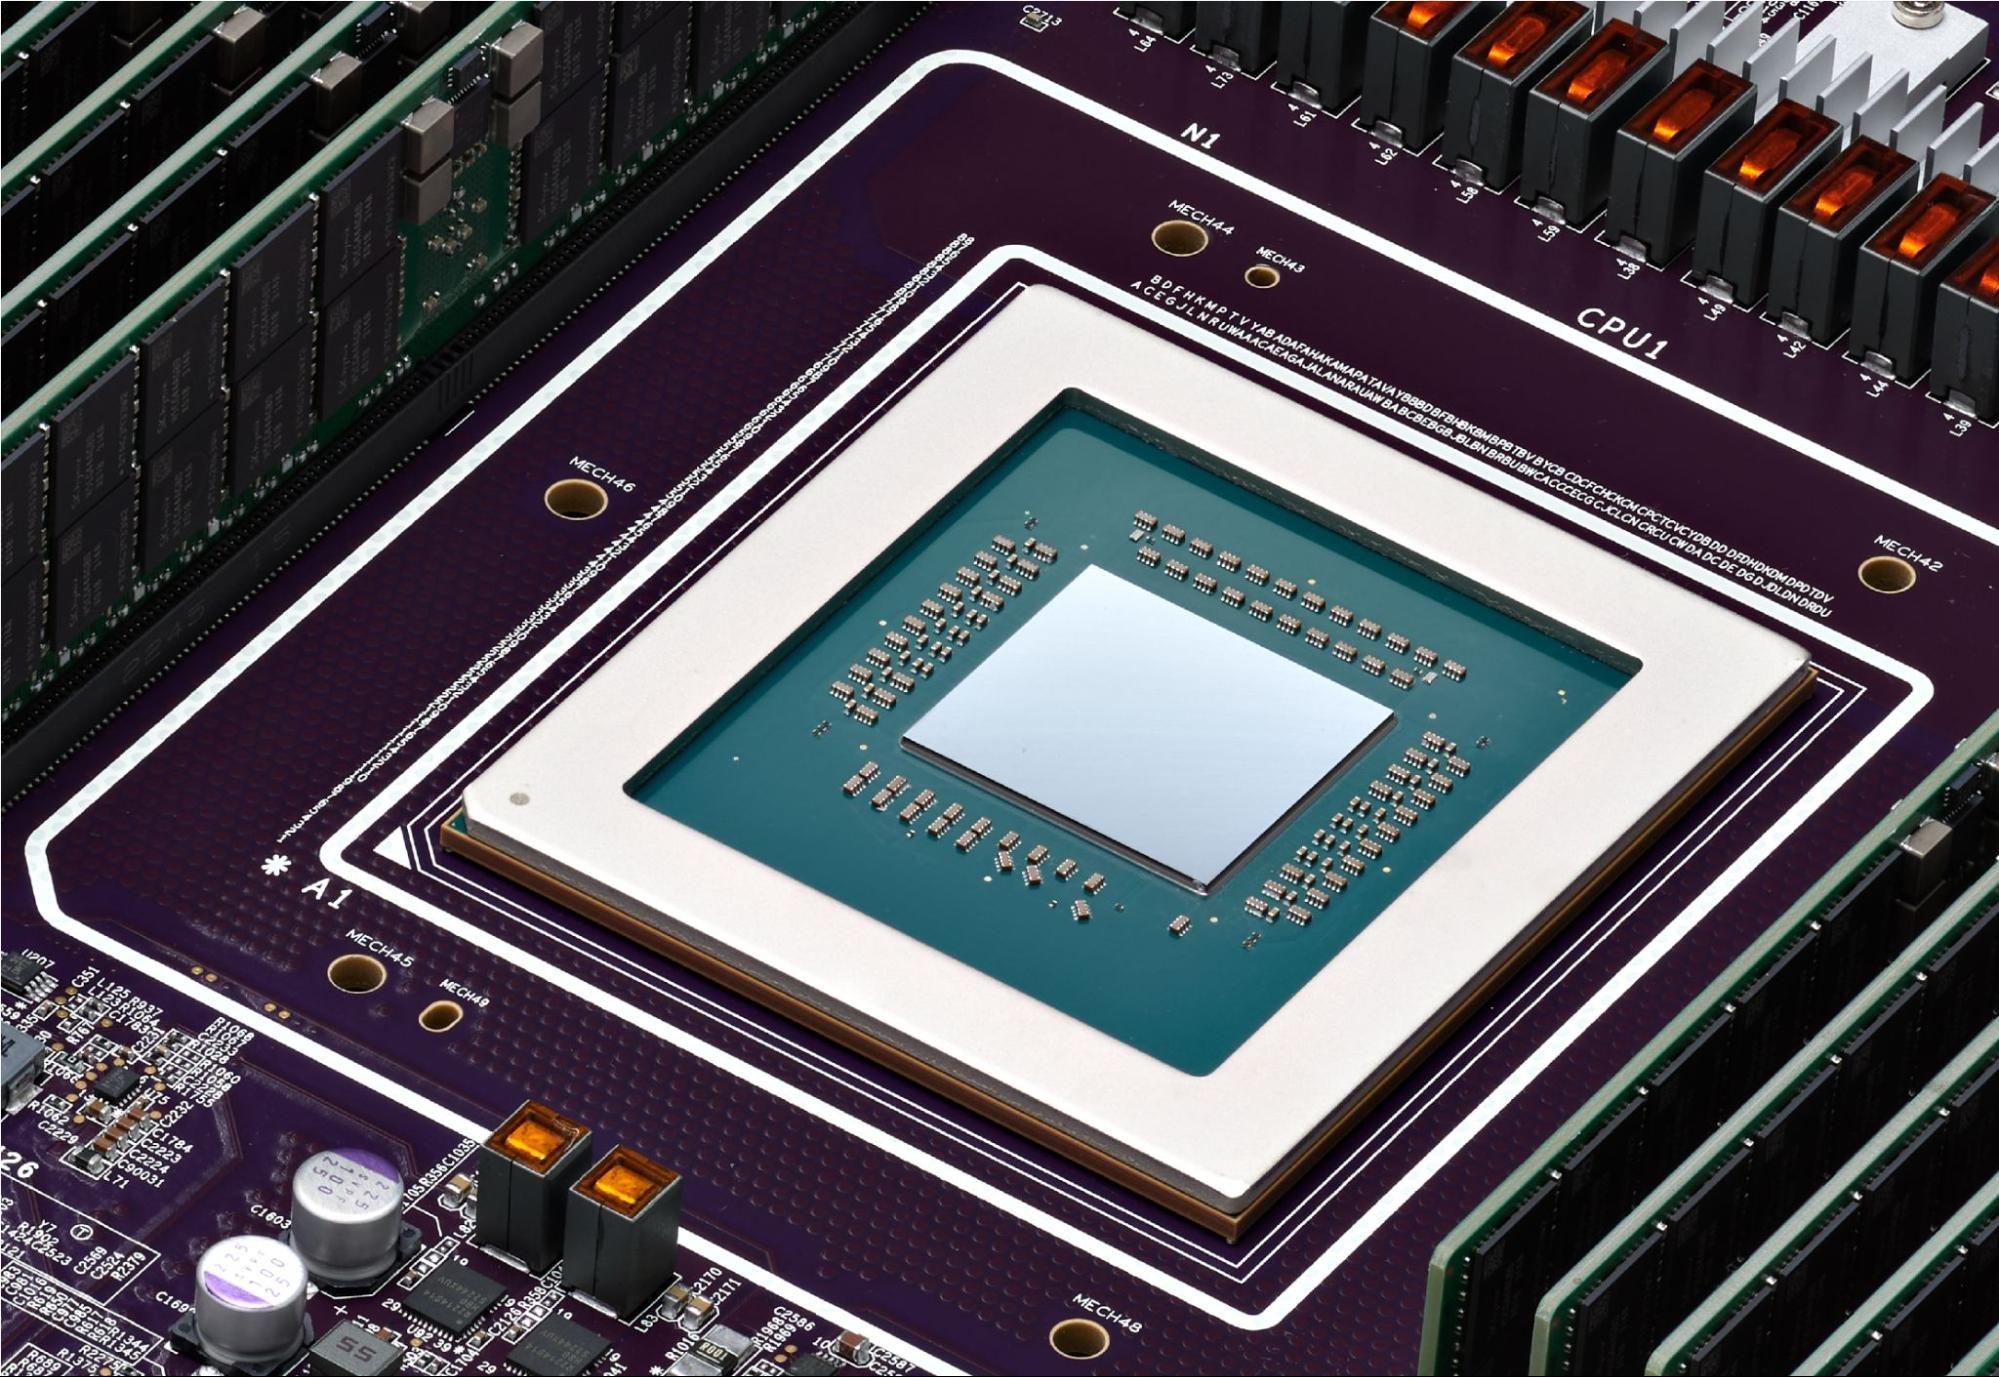
Google konkrétně uvádí izolaci NUMA s technologií Axion na platformě 8t jako mechanismus, který zabraňuje úniku jitteru na straně hostitele do synchronizovaných kolektivních fází trénování. Při 9 600 čipech na pod se i malé výpadky na hostitele sčítají a vedou k měřitelné ztrátě propustnosti. TPUDirect se stará o stranu datové cesty tím, že hostitele vyřazuje z hromadných přenosů. Axion se stará o stranu řídicí cesty tím, že každému TPU poskytuje dostatečnou vyhrazenou šířku pásma CPU, aby se předzpracování nikdy nestalo úzkým hrdlem. Google také zvýšil poměr fyzických hostitelů Axion na server na platformě osmé generace, což poskytuje orchestrační režii, která se škáluje s počtem čipů, větší prostor než konfigurace hostitele od Ironwoodu.
TPU 8i „Zebřička“
Inferenční čip sdílí hostitelskou platformu Axion od 8t, nativní FP4 a generování paměti HBM3e, ale křemík pod ním cílí na jiné úzké hrdlo. Trénování je vázáno na výpočetní výkon; inferenční dekódování je vázáno na šířku pásma paměti. Z toho vyplývá většina architektonických rozdílů 8i.
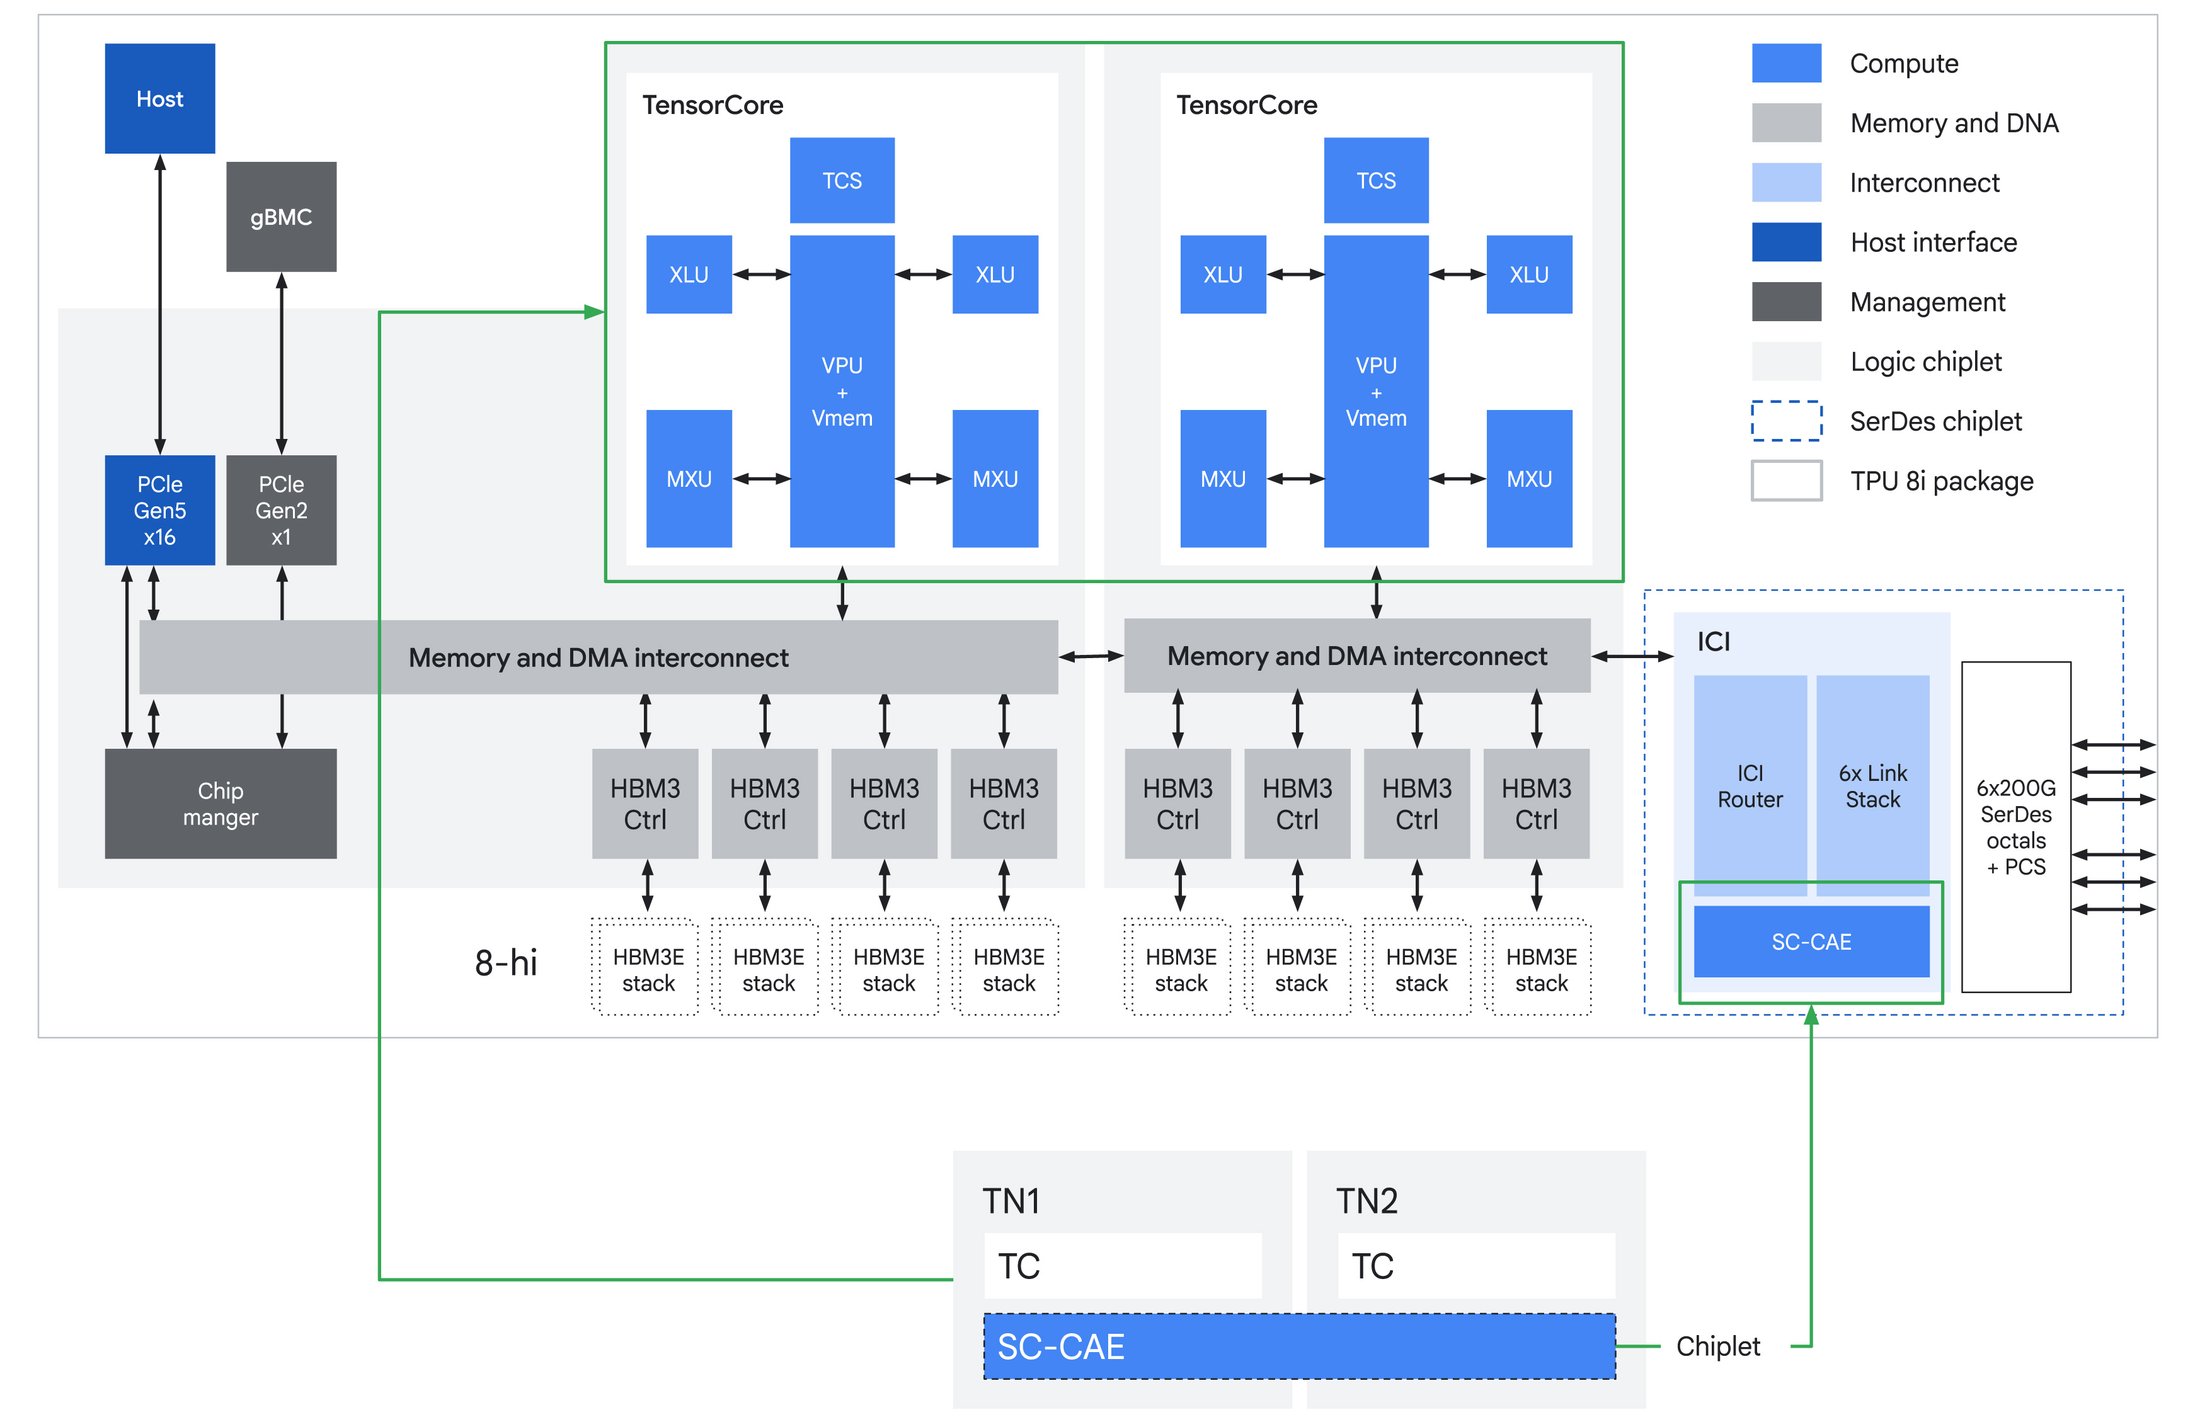
Největší změnou je paměť SRAM na čipu. 8i obsahuje 384 MB Vmem, což je třikrát více než Ironwood. Důvodem, proč je to důležité, je mezipaměť KV. Během dekódování s dlouhým kontextem vyžaduje každý vygenerovaný token čtení akumulovaných stavů klíč-hodnota z předchozích tokenů. Na většině akcelerátorů toto čtení pochází z HBM, což znamená, že propustnost dekódování je omezena šířkou pásma paměti, nikoli výpočetním výkonem. 8i je dimenzována tak, aby uchovávala smysluplné stopy mezipaměti KV výhradně na křemíku. Šířka pásma SRAM na čipu je zhruba o řád vyšší než u HBM, takže každé čtení KV obsluhované ze SRAM namísto HBM znamená kratší latenci na token a vyšší počet tokenů za sekundu při stejném výkonu.
Zdroj: Google
Konfigurace TensorCore je dalším významným rozdílem. Zatímco 8t používá jedno TensorCore s 12.6 PFLOPS, 8i rozděluje výpočetní výkon mezi dvě TensorCore s kombinovaným výkonem 10.1 PFLOPS. Nižší špičková propustnost zní jako snížení třídy dat, dokud neuvážíte, jak inference ve skutečnosti vypadá na úrovni čipu. Trénovací úlohy jsou dominovány dávkami: velké matmuly amortizují fixní režijní náklady a jedna velká MXU dokáže udržet využití téměř v špičce. Dekódování inference je opak. Velikosti dávek jsou malé, výpočetní okna na token jsou krátká a čip tráví podstatný zlomek svého času kolektivy, vzorkováním a směrováním spíše než čistým matmulem. Jeden velký engine se během těchto nepravidelných mezer zastaví. Rozdělení na dvě TensorCore umožňuje 8i efektivněji překrývat výpočetní fáze, přičemž každé TensorCore je napájeno ze svých vlastních čtyř přímo připojených zásobníků HBM, což v celém balíčku činí celkem 288 GB s rychlostí 8.6 TB/s. Výsledkem je vyšší trvalé využití u dávek, které skutečně běží v interaktivním režimu.
Na úrovni škálovatelné domény se 1 024 aktivních čipů v podu Boardfly agreguje na zhruba 295 TB HBM, 384 GB SRAM na čipu a 10.3 EFLOPS výpočetního výkonu FP4. Číslo SRAM je pro inferenci nejdůležitější: 384 GB mezipaměti na čipu v celé doméně stačí k udržení značného stavu KV bez kontaktu s HBM, což je to, co umožňuje dlouhodobé poskytování služeb s nízkou latencí.
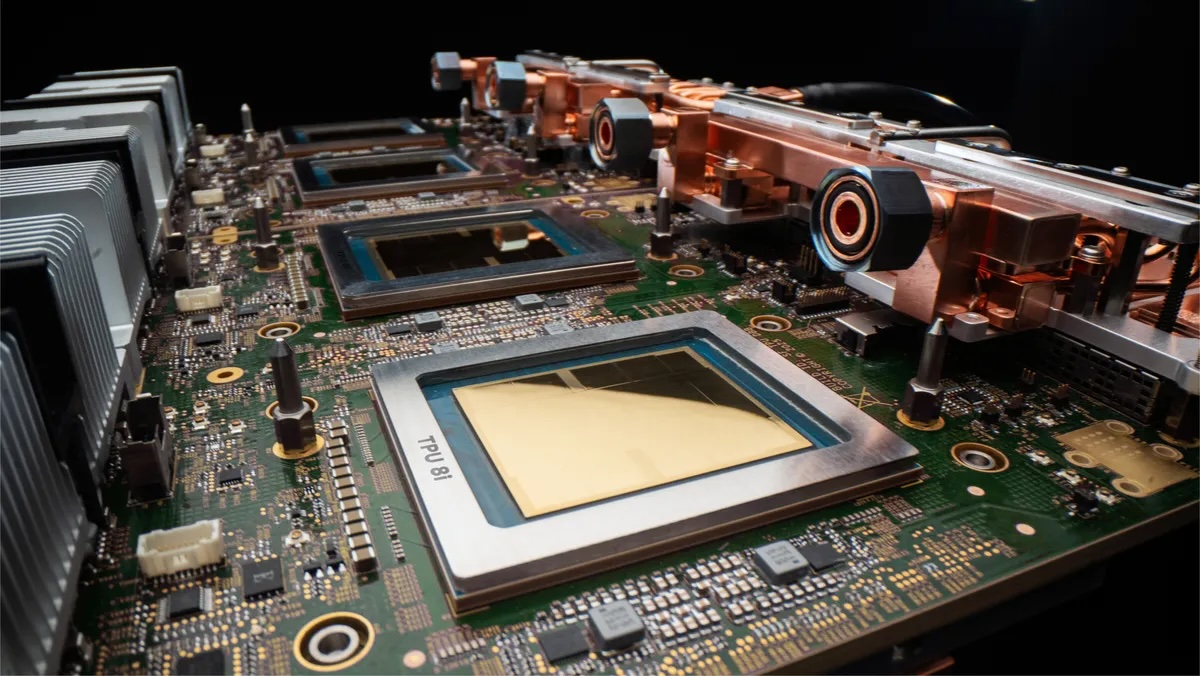
Hostitelská strana se řídí stejnou logikou. Google uvádí, že ve srovnání s Ironwoodem zvýšil počet fyzických hostitelů Axion na server na platformě 8i. Inferenční servery stráví netriviální zlomek času na token tokenizací, logikou vzorkování, směrováním, dávkováním a orchestrací běhu agentů. Tyto režijní náklady se škálují spíše podle souběžnosti než podle velikosti modelu a při rychlosti požadavků, kterou generují agentní úlohy, se hostitel může stát úzkým hrdlem. Jednoduchým řešením je více CPU hostitele na akcelerátor.
Kolektivní akcelerační engine
Další významnou změnou na čipu je Collectives Acceleration Engine, který nahrazuje čtyři SparseCores, které Ironwood používal. SparseCores zvládají směrování a vyhledávání MoE pomocí specializovaného hardwaru pro sběr a rozptyl, takže jejich odstranění z inferenčního čipu signalizuje, že 8i optimalizuje pro jiné úzké hrdlo.
Úzkým hrdlem CAE je kolektivní latence. Každý dekódovaný token vyžaduje synchronizaci zúčastněných čipů: výstupy pozornosti musí být redukovány na všechny, metadata směrování expertů musí být vysílána a vzorkované tokeny se musí šířit do dalšího kroku. Na GPU k této koordinaci dochází softwarově prostřednictvím NCCL, která plánuje kolektivy jako sekvenci spuštění jádra a síťových operací. Na architektuře 8i je CAE specializovaný křemík sedící na vlastním čipu vedle TensorCores a zpracovávající tyto synchronizační primitivy hardwarově.
Google uvádí až 5x nižší kolektivní latenci na čipu oproti Ironwoodu. U trénovacích dávek by toto zlepšení pohltil výpočetní čas; kolektivní latence je jen malým zlomkem kroku. U malých dávek a krátkých oken interaktivní inference na token může kolektivní latence dominovat času na token, takže 5x snížení se projeví v počtu tokenů za sekundu a ceně za token.
8i se také přesouvá z 3D topologie torusu k tomu, co Google nazývá Boardfly, hierarchické topologii inspirované Dragonfly, která vyměňuje šířku pásma kolektivního kruhu za latenci typu all-to-all. Boardfly si podrobněji probereme níže.
Topologie Boardfly
8i používá jinou topologii než 8t, protože trénování a inference mají odlišné komunikační vzorce.
3D torus je ideální pro kruhové kolektivy: každý čip má šest sousedů, data rotují v kruhu a žádný čip nesměruje libovolný provoz. Trénování je dominováno těmito kruhově přátelskými vzory, a proto 8t zachovává torus. Kruhová redukce se dokonale mapuje na jednu osu torusu. Hraniční úlohy obvykle umisťují datový paralelismus na jednu osu, tenzorový paralelismus na druhou a pipeline paralelismus na třetí. Topologie a pracovní zátěž jsou sladěny.
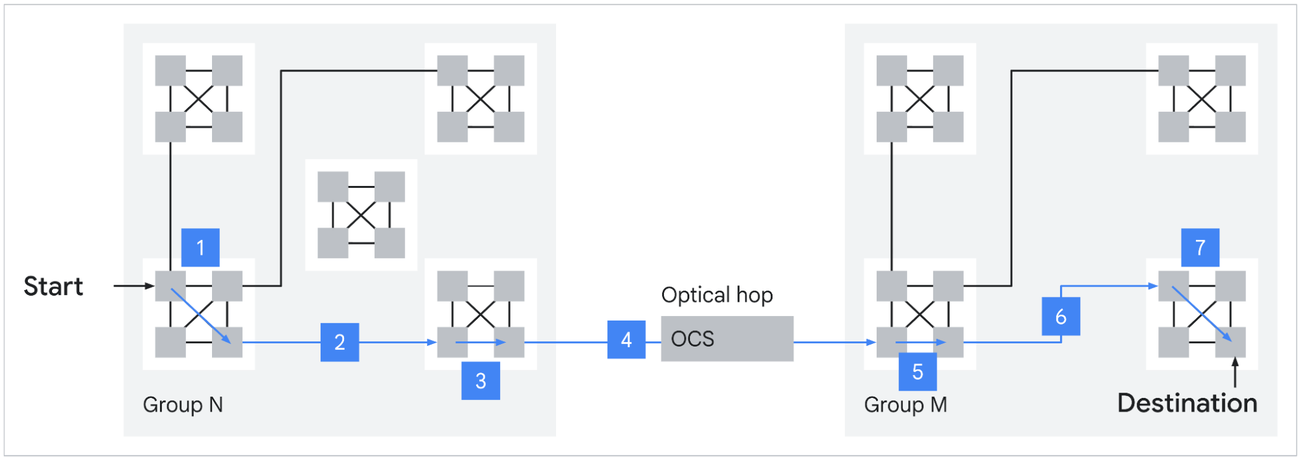
Inference obsluhující rozsáhlý model MoE má odlišný komunikační profil. Experti jsou připnuti na mnoho čipů a každý dekódovaný token spustí komunikaci „všichni ke všem“: tokeny musí dosáhnout svých přiřazených expertů roztroušených po celé síti a výstupy expertů se musí vrátit. Nejedná se o kruh. Jde o libovolný provoz typu point-to-point a na 3D torusu s 1,024 čipy je nejhorší cesta mezi libovolnými dvěma čipy 16 skoků. Google nám tuto matematiku rozebírá: „V 3D torusu jsou uzly uspořádány v mřížce, kde se každý rozměr ovíjí jako kruh. Aby se paket dostal k nejvzdálenějšímu možnému čipu v konfiguraci 8 x 8 x 16 (1024 čipů), musí urazit polovinu vzdálenosti každého kruhu:“
3D torus = 8/2(X) + 8/2(Y) + 16/2(Z) = 16 skoků
Ačkoli je torus vysoce efektivní pro komunikaci mezi sousedy, typickou pro husté trénování, vytváří daň z latence pro komunikační vzorce mezi všemi. V éře modelů uvažování a MoE, kde jakýkoli čip může potřebovat komunikovat s jakýmkoli jiným čipem, aby směroval token, je tento počet skoků důležitý.“
U interaktivních služeb citlivých na latenci tyto dodatečné skoky posouvají latenci tokenu mimo jeho SLO.
Zdroj: Google
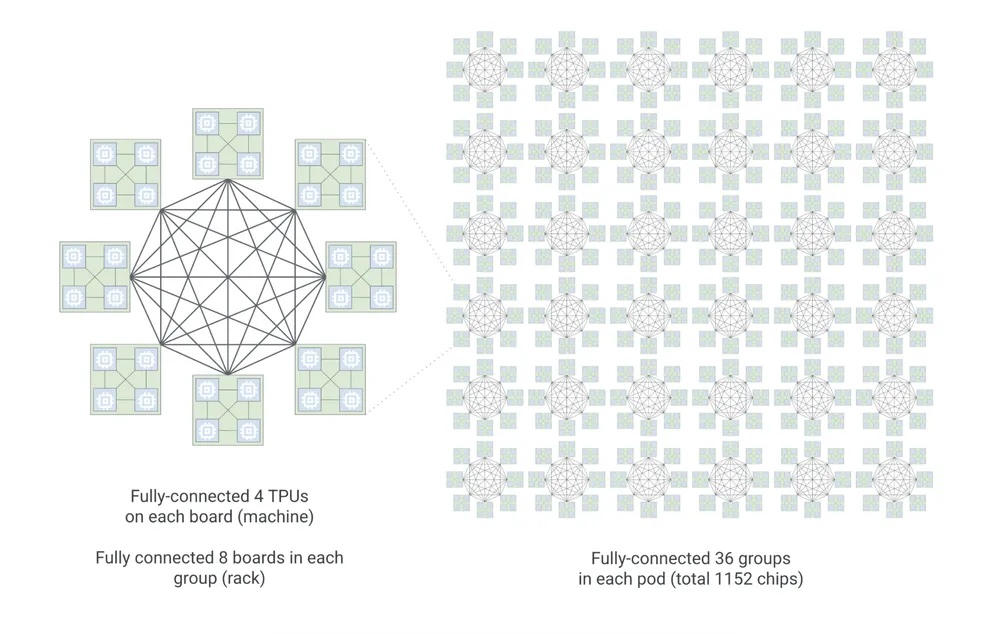
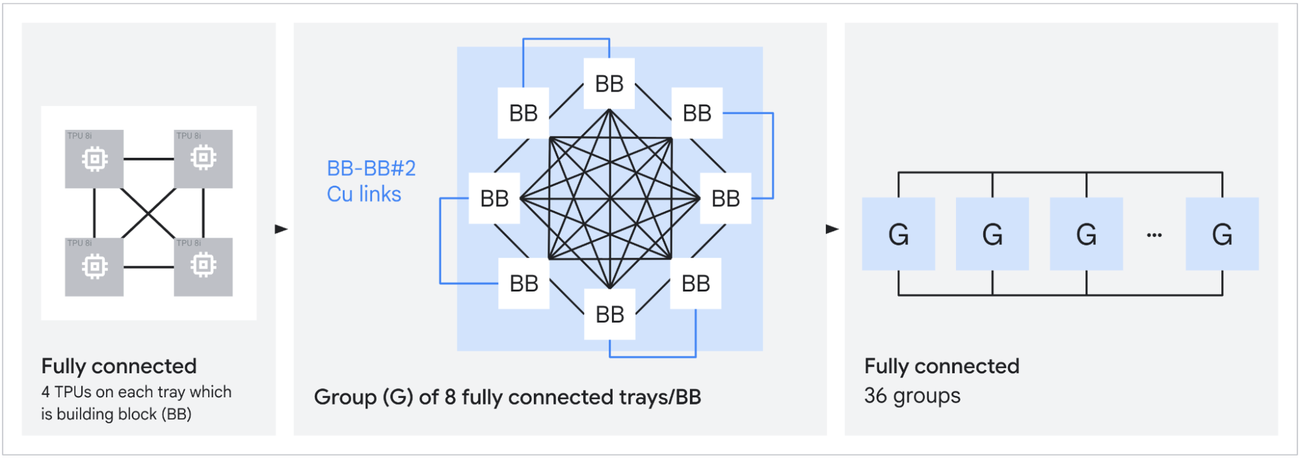
Boardfly je hierarchie inspirovaná firmou Dragonfly, která je navržena tak, aby tento průměr zmenšila. Struktura má tři úrovně. Stavebním blokem je kruh se čtyřmi čipy a 16 externími připojeními. Osm z těchto stavebních bloků tvoří skupinu, plně propojenou měděnými kabely s 11 spoji na skupinu. Třicet šest skupin je propojeno pomocí optických přepínačů a tvoří tak pod. Výsledkem je škálovatelná doména s 1 152 čipy (1 024 aktivních) s maximálně 7 meziskoky mezi libovolnými dvěma čipy, což je o 56 % méně než u torusu. Google tvrdí, že to vede až k 50% zlepšení latence pro komunikačně náročné úlohy, jako je MoE all-to-all.
Větší škálovatelná doména je také důležitá pro replikaci expertů. Více čipů na ICI fabric znamená, že každý expert ve velké MoE může být replikován vícekrát, což vyhlazuje nerovnováhu směrování a udržuje latenci dekódování rovnoměrnou, když je distribuce tokenů vychýlená. Směrování top-k je závislé na datech; někteří experti uvidí v daném kroku více tokenů než jiní. Replikace tuto odchylku absorbuje. Šířka pásma ICI byla zdvojnásobena na 19.2 Tb/s na čip, částečně kvůli zvládnutí výsledného provozu.
Síť Panny
Superpod s 9 600 čipy je velký, ale trénovací běhy na hranici hranic vyžadují stále více. Virgo je škálovatelná infrastruktura, která propojuje superpody v datovém centru a zpracovává provoz RDMA typu východ-západ mezi pody, když úloha přeroste jednu škálovatelnou doménu.
Jedna síťová struktura Virgo propojuje více než 134 000 8t čipů s neblokující bisekční šířkou pásma 47 Pb/s, což je až 4x větší šířka pásma na akcelerátor a o 40 % nižší latence bez zatížení ve srovnání s předchozí generací. Architektura je plochá, dvouvrstvá neblokující topologie postavená na přepínačích s vysokým radixem s multiplanárním designem a nezávislými řídicími doménami.
Tradiční Clos fabrics na vyšších úrovních převyšují požadavky na porty, aby udržely počet portů a náklady na zvládnutelné úrovni. To funguje dobře, když většina provozu směřuje sever-jih, což je vzorec v univerzálním cloudu: klienti se obracejí na load balancery, load balancery na aplikační servery, aplikační servery na úložiště. Trénovací úlohy AI probíhají téměř výhradně ve směru východ-západ, čip-k-čipu napříč fabric a kolektivy jsou rozděleny do dvou vrstev. Jakýkoli převyšující požadavek na jakékoli úrovni přechází přímo do doby trénovacího kroku. Plochý dvouvrstvý design Virgo s přepínači s vysokým radixem eliminuje úzké hrdlo na páteřní úrovni tím, že vytváří přepínače s dostatečným počtem portů na ASIC, aby ukončily smysluplnou část fabric ve dvou skokech.
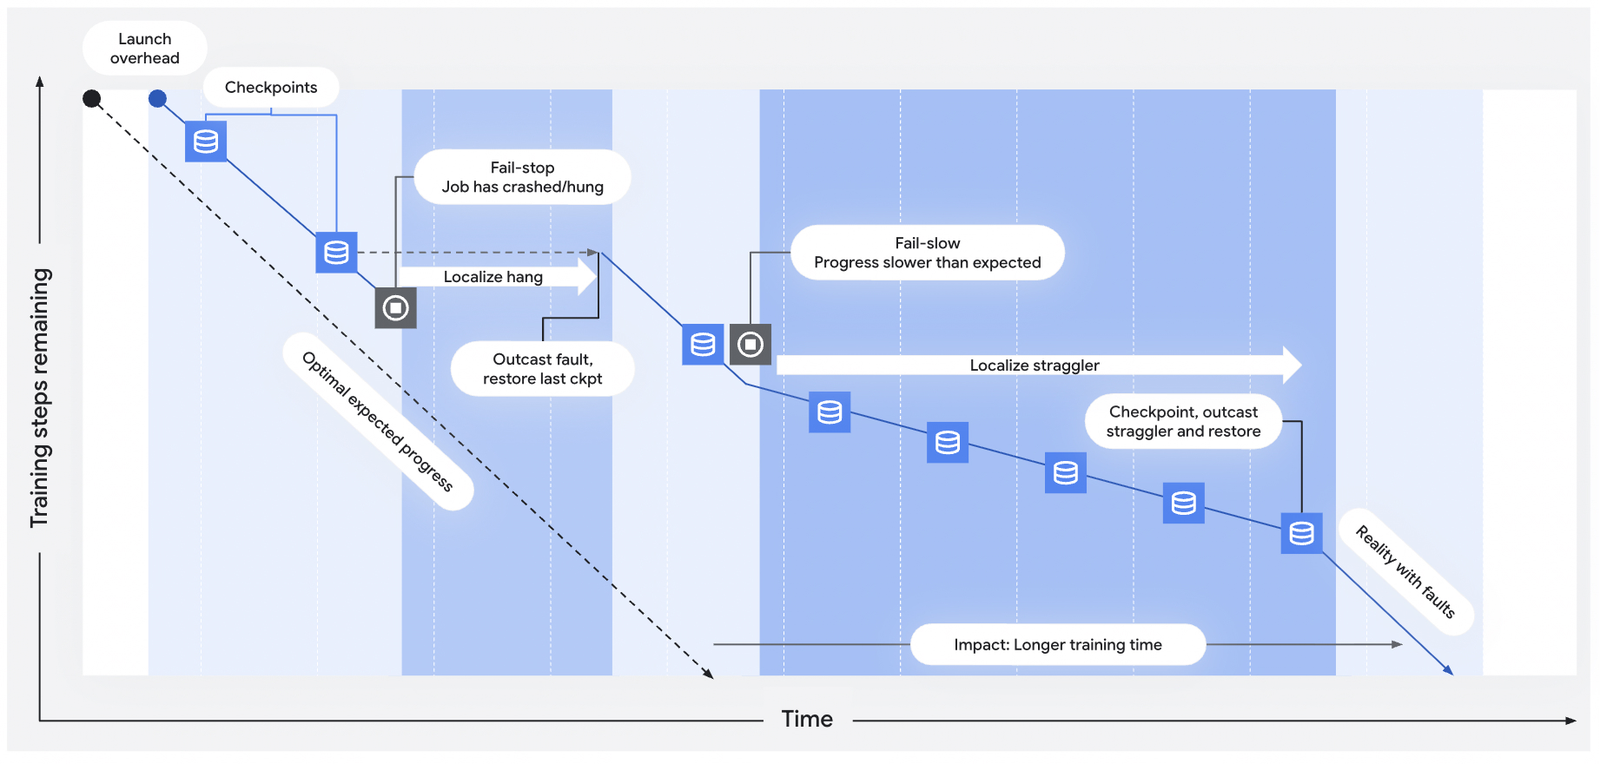
V tomto měřítku je důležitá spolehlivost a silně závisí na optických přepínačích založených na MEMS od Googlu. OCS umožňuje Googlu překonfigurovat fyzickou topologii mezi úlohami bez nutnosti jakéhokoli přepojování a, co je důležitější, obejít vadné čipy nebo spoje během běhu. Když je detekována chyba, OCS dokáže přemapovat postiženou část struktury během milisekund, čímž eliminuje potřebu ručního zásahu. Submilisekundová telemetrie zajišťuje automatickou detekci opozdilců a zablokování. Kombinace rychlé detekce a přesměrování založeného na OCS optimalizuje průměrnou dobu mezi přerušeními a průměrnou dobu do obnovy v měřítku více než 100 000 čipů, kde se statistická jistota nějaké chyby během několikatýdenního běhu blíží 100 %. Cílová propustnost 97 %, kterou Google uvádí pro 8t pody, závisí na této infrastruktuře. Stejná technologie OCS se objevuje v celém stacku TPU: propojuje kostky do superpodů na vrstvě ICI, propojuje skupiny Boardfly na vrstvě 8i scale-up a zpracovává provoz mezi pody na vrstvě Virgo.
Při 134 000 čipech dosahuje celkový výpočetní výkon zhruba 1 690 EFLOPS FP4, což je asi 1.7 ZFLOPS. Google uvádí, že architektura podporuje téměř lineární škálování až pro milion čipů v jednom logickém trénovacím clusteru, ačkoli současná nasazení tohoto limitu ještě nedosáhla.
Jupiter a škálování pro více datových center
Virgo zpracovává provoz akcelerátorů v datovém centru typu východ-západ, ale není tou nejvyšší platformou. Jupiter je stávající severojižní infrastrukturou Googlu, nyní ve své páté generaci, která zpracovává front-endový provoz a přístup k distribuovaným úložným a výpočetním zdrojům. Jupiter nebyl na konferenci Cloud Next oznámen; je to stávající infrastruktura, na které 8. generace staví.
Nejnovější iterace Jupiteru nabízí bisekční šířku pásma 13 Pb/s na budovu datového centra s dostupností 99.999 %, a to pomocí přepínačů Apollo MEMS OCS spotřebovávajících zhruba 108 W na OCS oproti zhruba 3 000 W u ekvivalentního elektrického paketového přepínače. Toto je struktura, která propojuje datová centra Googlu s okolním světem a mezi sebou navzájem.
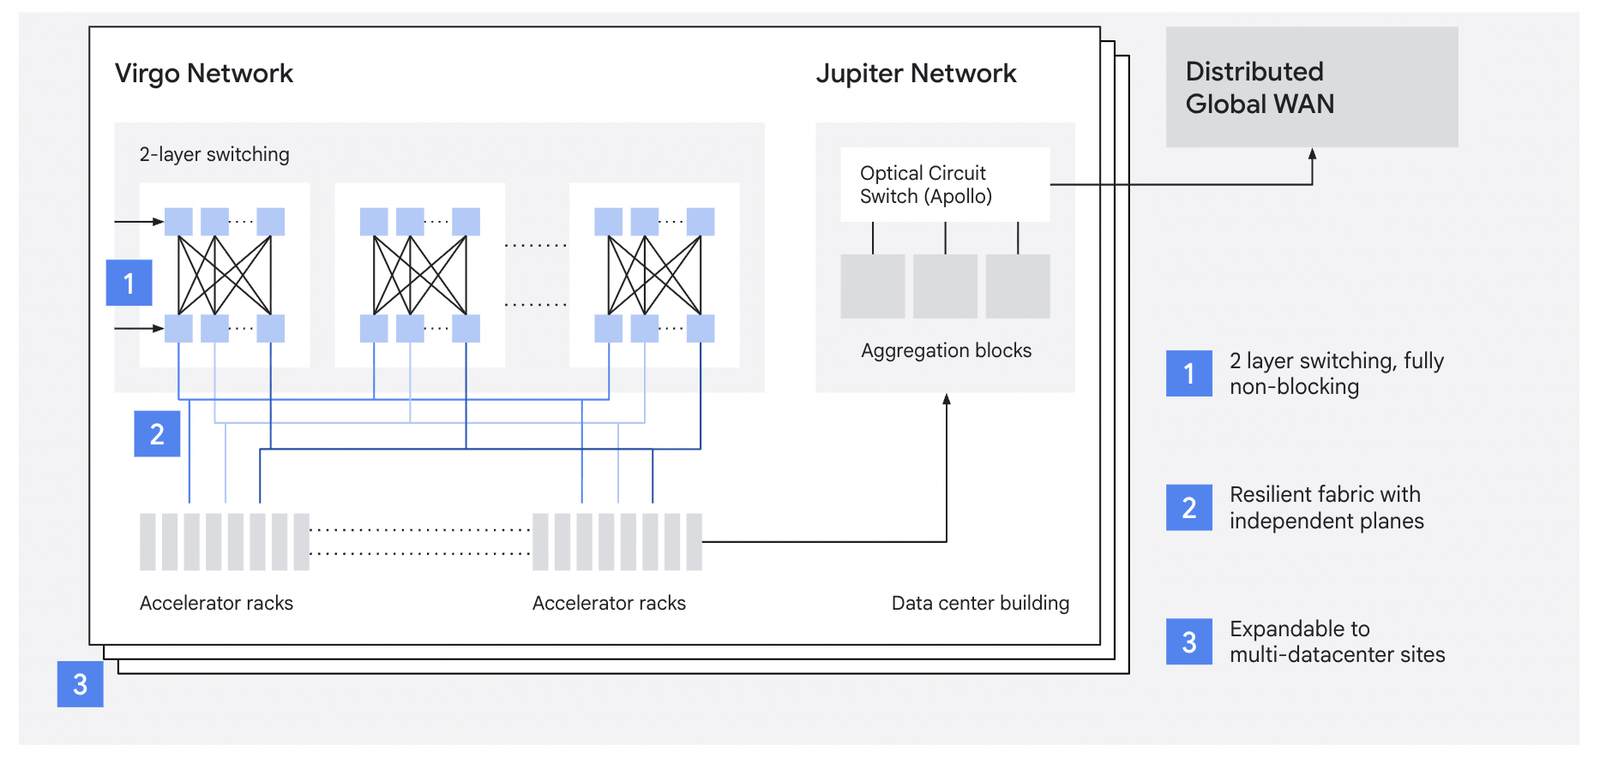
Pro trénovací běhy, které překračují výkon a prostor jednoho datového centra, je Jupiter tím, co umožňuje škálování napříč více lokalitami. Kombinace je vrstvená: ICI v rámci podu, Virgo mezi pody v rámci lokality, Jupiter mezi lokalitami. Softwarový stack Google Pathways dokáže řešit úlohy napříč těmito doménami s více datovými centry jako jeden logický cluster.
S výkonem ~1.7 ZFLOPS je jedna Virgo fabric největším oznámeným klastrem pro trénování umělé inteligence. Více Virgo fabric propojených systémem Jupiter dokáže adresovat více než milion TPU čipů, což je rozsah, na který Google cílí, i když ho současná nasazení ještě nedosáhla.
Výkon a využití
Hrubé FLOPy jsou méně důležité než zlomek těch FLOPů, které produkují užitečnou práci. Google uvádí cílovou hodnotu 97% propustnosti pro 8t superpody, což znamená, že 97 % času na stěně je stráveno produktivními výpočty spíše než obnovou, zastavením nebo koordinační režií. Toto číslo závisí na toleranci chyb založené na OCS a telemetrii v submilisekundách, které jsou uvedeny výše.
Druhou proměnnou je využití modelových FLOP (MFU). MFU měří, jaký zlomek špičkových teoretických FLOP čip skutečně zvládne při reálném zatížení. SemiAnalysis odhaduje, že při 40% TPU MFU klesají náklady na efektivní trénovací FLOP zhruba o 62 % ve srovnání s GB300 NVL72, s bodem zvratu zhruba 15% TPU MFU. Veřejně zveřejněné ekonomické údaje o TPU společnosti Anthropic naznačují, že fungují výrazně nad touto hodnotou zvratu. Kombinace vysokého výkonu (udržování čipů v chodu) a konkurenceschopného MFU (udržování čipů v chodu) je to, co umožňuje TPU TCO fungovat ve velkém měřítku.
Kde 8 sedí
Porovnání TPU 8 se současnými a nadcházejícími platformami NVIDIA vyžaduje pečlivou pozornost k jednotlivým jednotkám. NVIDIA uvádí šířku pásma NVLink jako agregovanou obousměrnou; B200 s rychlostí 1.8 TB/s u NVLink 5 je 900 GB/s na směr. FLOPy NVIDIA jsou obvykle řídké 2:4; husté je to poloviční poměr. Čísla TPU od Googlu jsou husté a obousměrné. Při čtení jakéhokoli srovnání zkontrolujte, zda je šířka pásma jednosměrná nebo obousměrná a zda jsou FLOPy husté nebo řídké.
FP4 na čip s výkonem 8t a hustotou 12.6 PFLOPS se nachází mezi řídkými 10 PFLOPS u GB200 (hustota 5 PFLOPS) a řídkými 20 PFLOPS u GB300 (hustota 15 PFLOPS). Srovnání na čip je blízké. Srovnání s horizontálním škálováním nikoli. Rack GB300 NVL72 nese 72 GPU v jedné doméně NVLink. Superpod s výkonem 8t se skládá z 9 600 čipů v jednom 3D torusu. To je 133x více čipů v jedné kolektivní doméně, což je mezera, která odděluje platformy pro hraniční trénink.
NVIDIA se nezastavuje. Vera Rubin dodá ve druhé polovině roku 2026 s 50 PFLOPS inference NVFP4 na pouzdro (ačkoli SemiAnalysis zpochybnil, zda toto číslo předpokládá adaptivní kompresi), 288 GB HBM4 s rychlostí 22 TB/s a NVLink 6 s rychlostí 3.6 TB/s obousměrně. Rubin Ultra ve druhé polovině roku 2027 propojí čtyři reticle matrix pro až 100 PFLOPS FP4 a 1 TB HBM4e na pouzdro. Kyber NVL576 propojí 576 GPU Rubin Ultra v jednom racku s inferencí 15 EFLOPS FP4. To začíná zužovat výhodu Googlu v oblasti škálování, i když 576 GPU je stále o řád menší než 8t superpod.
Kde 8 vede: velikost domény pro škálování (9 600 čipů oproti 72 GPU, neboli 576 po Kyberu), škálování na jedné fabrice (134 000+ čipů při 47 Pb/s), deterministická latence ze statického plánování XLA a celkové náklady na vlastnictví (TCO) pro úlohy, které odpovídají modelu TPU.
Kde 8 laťkuje: kapacita HBM na čip (216 GB oproti 288 GB HBM4 u Rubinu), řídkost (NVIDIA má hardwarovou cestu 2:4, Google ne) a šířka ekosystému (CUDA, cuDNN, TensorRT-LLM a stack s podporou PyTorch se u NVIDIA dostanou jako první; nativní PyTorch na TPU je stále v preview verzi).
Obě platformy jsou žádané. Společnost Meta údajně jedná o multimiliardové dohodě na nasazení procesorů Google TPU ve svých datových centrech, která by začala v roce 2027, s potenciálním pronájmem cloudových procesorů TPU již v roce 2026. Zároveň Google Cloud oznámil instance A5X postavené na platformě NVIDIA Vera Rubin NVL72, škálovatelné na 80 000 grafických procesorů Rubin v rámci jednoho webu a 960 000 grafických procesorů v rámci více webů. Google obojí buduje ve velkém měřítku.
Zabalit
Osmá generace TPU se skládá ze dvou čipů namísto jednoho, je postavena pro to, jak dnes vypadá rozsáhlé školení a agentní inference, a nikoli pro univerzální úlohy umělé inteligence. 8t posouvá škálování na 9 600 čipů na superpod a škálování na více než 134 000 čipů na Virgo fabric. 8i vyměňuje SparseCores za křemík pro kolektivní akceleraci a 3D torus za Boardfly, aby splnila cíle latence požadované pro služby MoE ve velkém měřítku. Plán společnosti NVIDIA s Vera Rubin, Rubin Ultra a Kyber některé z těchto rozdílů v letech 2026-2027 zmenší, ale výhoda domény škálování prozatím přetrvává. Pro hraniční laboratoře, které provozují modely se smíšenými experty na stovkách tisíc čipů, je 8 důvěryhodnou alternativou k Grace Blackwell a diskuse Mety naznačují, že trh to začíná zohledňovat.


 Amazon