

Během prezentace na konferenci ISC 23 společnost Intel zdůraznila své vedoucí postavení v oblasti vysoce výkonných výpočtů (HPC) a umělé inteligence (AI), představila své portfolio budoucích produktů HPC a AI a oznámila ambiciózní plány na mezinárodní spolupráci, jejímž cílem je využít superpočítač Aurora k vývoji generativních modelů AI pro vědu a společnost.
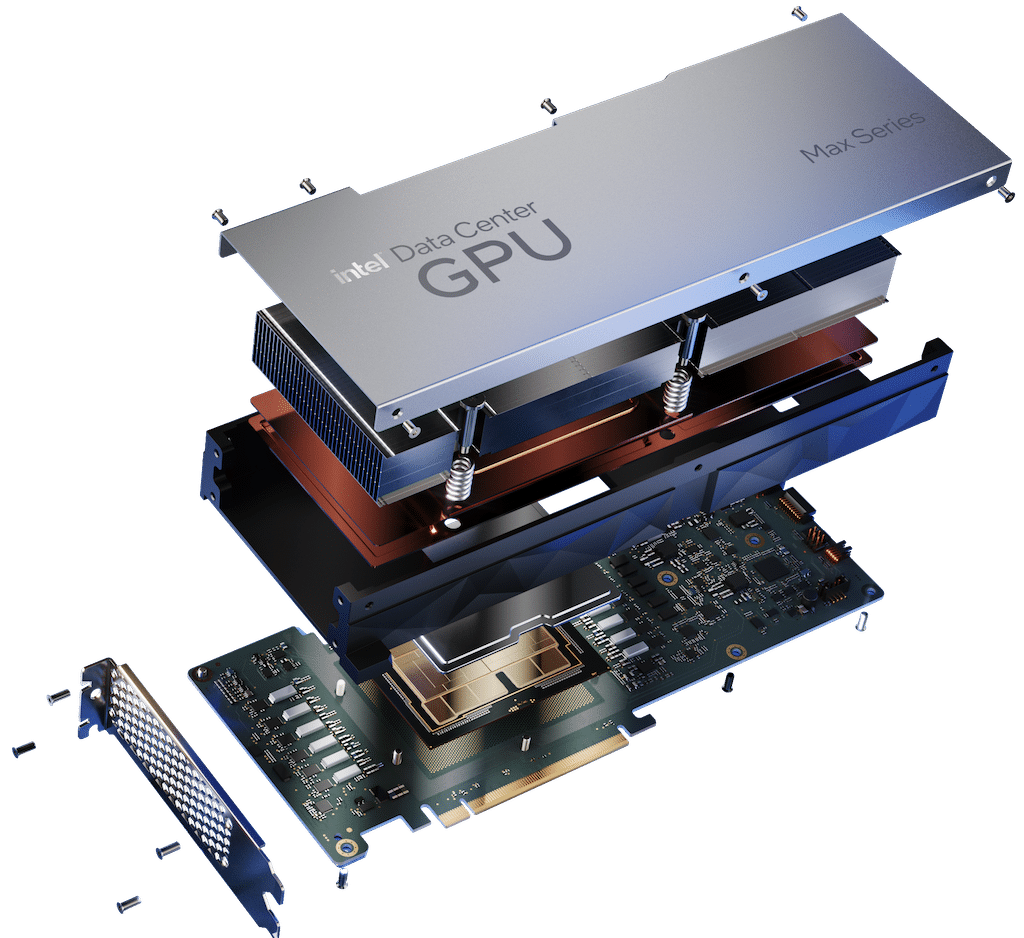
Konkurenční výkon překonal očekávání, přičemž výsledky Intelu byly jasnými vítězi nad konkurencí. Grafická karta Intel Data Center GPU Max Series překonala kartu NVIDIA H100 PCIe v průměru o 30 procent v různých úlohách. Nezávislé výsledky od dodavatele softwaru Ansys ukázaly 50% zrychlení grafické karty Max Series oproti H100 v HPC aplikacích akcelerovaných umělou inteligencí.
Procesor Xeon řady Max vykázal v benchmarku HPCG (High-Performance Conjugate Gradients) 65% zlepšení ve srovnání s procesorem AMD Genoa a spotřebovával méně energie. Oblíbený procesor HPC, škálovatelný procesor Intel Xeon 4. generace, dosáhl průměrného 50% zrychlení oproti procesoru AMD Milan4. Nejnovější cluster Xeon HPC 4. generace od společnosti BP vykázal 8násobné zvýšení výkonu oproti procesorům předchozí generace se zlepšenou energetickou účinností. Akcelerátor hlubokého učení Gaudi2 si vedl konkurenceschopně v oblasti hlubokého učení, trénování a inference, s až 2.4x rychlejším výkonem než procesor NVIDIA A100.
Procesory nové generace a grafické karty optimalizované pro umělou inteligenci
Jeff McVeigh, viceprezident společnosti Intel a generální ředitel skupiny Super Compute Group, představil procesory Intel nové generace, které jsou navrženy tak, aby splňovaly vysoké požadavky na šířku pásma paměti. Společnost Intel vyvinula pro Granite Rapids nový typ modulů DIMM – Multiplexer Combined Ranks (MCR). MCR dosahuje rychlosti 8 800 megatransferů za sekundu na základě paměti DDR5 a šířky pásma paměti přes 1.5 terabajtu/sekundu (TB/s) v systému se dvěma sockety.
Společnost Intel také odhalila nový subsystém od společnosti Supermicro, optimalizovaný pro umělou inteligenci, založený na grafických procesorech x8 Max Series, který je navržen tak, aby urychlil trénink hlubokého učení. Očekává se, že výrobci originálního vybavení (OEM) nabídnou řešení s podsystémy OAM x4 a x8 GPU řady Max a kartami PCIe někdy v létě.
Grafické procesory Intel nové generace řady Max, Falcon Shores, poskytnou zákazníkům flexibilitu implementace kombinací CPU a samostatných GPU na úrovni systému pro nové a neustále se měnící pracovní zátěže budoucnosti. Systém Falcon Shores využívá modulární architekturu založenou na dlaždicích, která mu umožňuje:
- Podpora datových typů HPC a AI od FP64 do BF16 a FP8.
- Umožňuje až 288 GB paměti HBM3 s celkovou šířkou pásma až 9.8 TB/s a výrazně vylepšeným vysokorychlostním I/O.
- Posilte programovací model CXL.
- Prezentujte jednotné programovací rozhraní GPU prostřednictvím oneAPI.
Generativní umělá inteligence pro vědu
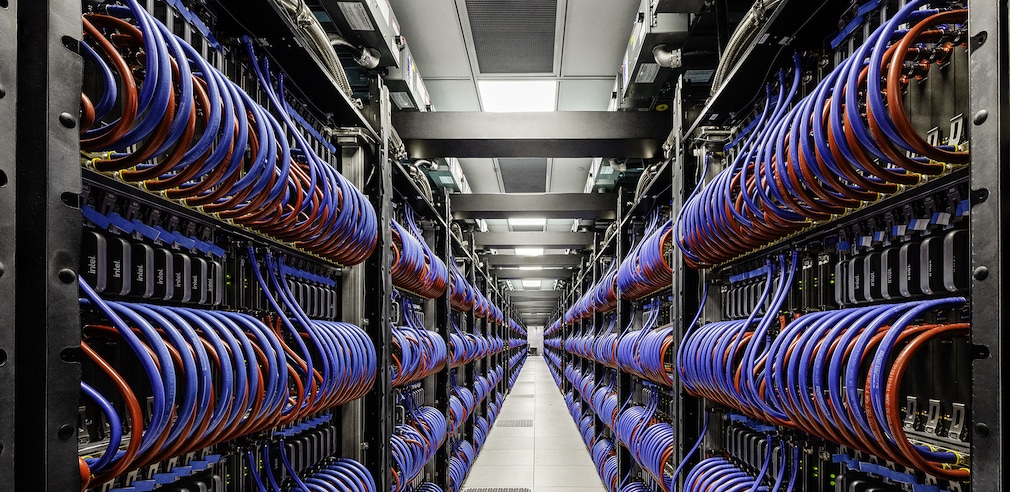
Národní laboratoř Argonne ve spolupráci se společnostmi Intel a HPE oznámila plány na vytvoření série generativních modelů umělé inteligence pro vědeckovýzkumnou komunitu. Tyto generativní modely umělé inteligence pro vědu budou trénovány na obecném textu, kódu, vědeckých textech a strukturovaných vědeckých datech z biologie, chemie, materiálových věd, fyziky, medicíny a dalších zdrojů.
Výsledné modely (s až 1 bilionem parametrů) budou použity v řadě vědeckých aplikací, od návrhu molekul a materiálů až po syntézu znalostí napříč miliony zdrojů, aby navrhly nové a zajímavé experimenty v systémové biologii, chemii polymerů a energetických materiálech, klimatologii a kosmologii. Model bude také použit k urychlení identifikace biologických procesů souvisejících s rakovinou a dalšími nemocemi a k navržení cílů pro návrh léčiv.
Pro rozvoj projektu stojí Argonne v čele mezinárodní spolupráce, která zahrnuje:
- Intel
- HPE
- Laboratoře Ministerstva energetiky
- Americké a mezinárodní univerzity
- Neziskové organizace
- Mezinárodní partneři
Očekává se, že Aurora při svém uvedení na trh letos nabídne více než dva exaflopy špičkového výpočetního výkonu s dvojitou přesností.
Výhody aplikace HPC od OneAPI
Nejnovější nástroje Intel oneAPI zrychlují HPC aplikace díky odlehčení GPU OpenMP, rozšiřují podporu pro OpenMP a Fortran a urychlují umělou inteligenci a hluboké učení prostřednictvím optimalizovaných frameworků, včetně TensorFlow a PyTorch, a nástrojů umělé inteligence, což umožňuje vyšší výkon.
Programování pro více architektur je pro programátory snazší díky implementaci SYCL v jazyce oneAPI, pluginům oneAPI pro procesory NVIDIA a AMD vyvinutým společností Codeplay a nástroji Intel DPC++ Compatibility Tool, který migruje kód z CUDA do SYCL a C++, kde se obvykle 90–95 procent kódu migruje automaticky. Výsledný kód SYCL vykazuje srovnatelný výkon se stejným kódem běžícím v nativních systémových jazycích NVIDIA a AMD. Data ukazují, že kód SYCL pro astrofyzikální aplikaci DPEcho běžící na grafické kartě Max Series překonává stejný kód CUDA na NVIDIA H100 o 48 procent.


 Amazon