

Společnost CTERA zveřejnila zprávu o ukládání studených dat (The Cold Data Storage Report), analýzu 16 petabajtů živých produkčních dat napříč 856 skenováními sdílených souborů v podnikových NAS prostředích, včetně regulovaných odvětví. Hlavním číslem je, že aktivně je využíváno pouze 4.4 % uložené kapacity, což je na stránce zprávy definováno jako upravené během 90denního období. Zbytek je uložen v chladném prostředí: 83.1 % celkové kapacity se nachází v souborech, které nebyly upraveny déle než rok, 97.5 % jednotlivých souborů nebylo během této doby upraveno, 88 % nebylo přístupných déle než rok a pouze 9.9 % uložených dat bylo dotčeno během daného 90denního období. Zpráva CTERA tvrdí, že podniky provozují svou nejdražší úložnou vrstvu jako de facto archiv a že se za to účtuje na třech místech: náklady, bezpečnostní riziko a kvalita toho, co systémy umělé inteligence načítají.
Primární úložiště jako náhodný archiv
Nic z toho není nový problém; IT má zkratku ROT (redundantní, zastaralé nebo triviální) už léta. Zpráva uvádí čísla, kterými se vyjadřuje multiplikátor. Chladné soubory na primárním poli spotřebovávají flashovou nebo hybridní kapacitu a poté procházejí každým zálohovacím průchodem, snapshotem a replikační úlohou, která chrání danou vrstvu, takže zdroje potřebné k udržení kapacity se škálují s daty, která nikdo nečte. „Když se aktivně využívá pouze 4.4 % kapacity, podniky provozují svou nejdražší úložnou vrstvu jako to, co je v podstatě chladný archiv. To vytváří multiplikační efekt v nákladech na úložiště a ochranu dat, bezpečnostním riziku a nyní i v kvalitě informací dostupných systémům umělé inteligence,“ řekl Aron Brand, technický ředitel společnosti CTERA. Jeho receptem je umístění: „Odpovědí není jen smazat stará data; jde o to, lépe se rozhodovat o tom, kam tato data patří. Informace lze uchovávat a chránit, aniž by musely ležet na drahém primárním úložišti.“ To je stejný signál poptávky, který stojí za růstem archivních vrstev, který jsme letos zaznamenali u dodávek LTO.
Bezpečnostní rizika a kvalita načítání dat pomocí umělé inteligence
Neaktivní data obvykle zůstávají ve stejných sdílených složkách přístupných v síti se stejnými přístupovými právy jako data, která lidé používají každý den, takže uživatelé a aplikace mají přístup k mnohem více informacím, než kolik vyžaduje jejich každodenní provoz. Přesunutí těchto dat z aktivní vrstvy zmenší množství citlivého materiálu vystaveného v souborových systémech, aniž by se změnilo to, co je uchováváno.
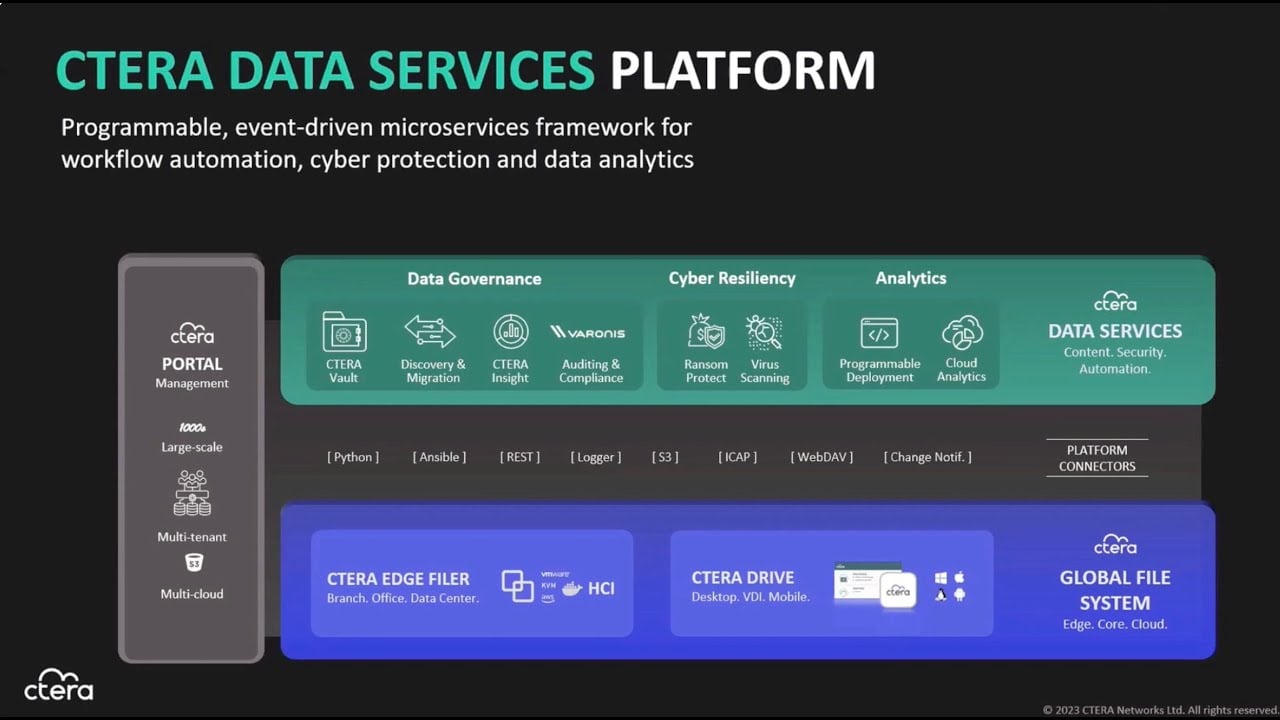
Bod připravenosti na umělou inteligenci je novější. Vzhledem k tomu, že organizace zaměřují nástroje pro vyhledávání a vyhledávání na své archivy, velké objemy historického nebo zastaralého materiálu soutěží se současnými dokumenty o relevanci a model je jen tak spolehlivý, jako to, co načítá. CTERA se na tomto směru již nějakou dobu zaměřuje; její integrace n8n zpřístupňuje souborová data pracovním postupům umělé inteligence a její Fusion Direct cílí na soubory a objekty pro procesy umělé inteligence. Zpráva se čte jako argument pro vyčištění korpusu před jeho indexováním těmito procesy. Celá zpráva je k dispozici od CTERA za registračním formulářem.


 Amazon