

Společnost Lightbits Labs, která vynalezla NVMe přes TCP, se přesouvá k inferenčnímu softwaru s Inferrou, enginem pro orchestraci KV mezipaměti, který bude mít svou veřejnou premiéru zítra, 15. září, na summitu AI Infra Summit v Santa Claře. Software virtualizuje paměť GPU napříč úrovněmi úložiště DRAM a NVMe a přeměňuje KV mezipaměť na perzistentní datovou vrstvu, takže stavy pozornosti pro úlohy s dlouhým kontextem a více relacemi se nemusí vejít do HBM ani se přepočítávat, když vypadnou. Lightbits uvádí až 16krát více souběžných inferenčních relací na stávajících GPU, více než 100násobné zlepšení latence oproti předběžnému načítání stavů pozornosti namísto jejich přepočítávání a kontextová okna až 10 milionů tokenů a uvádí, že engine již běžel v zákaznických beta programech, včetně jednoho s OVH.
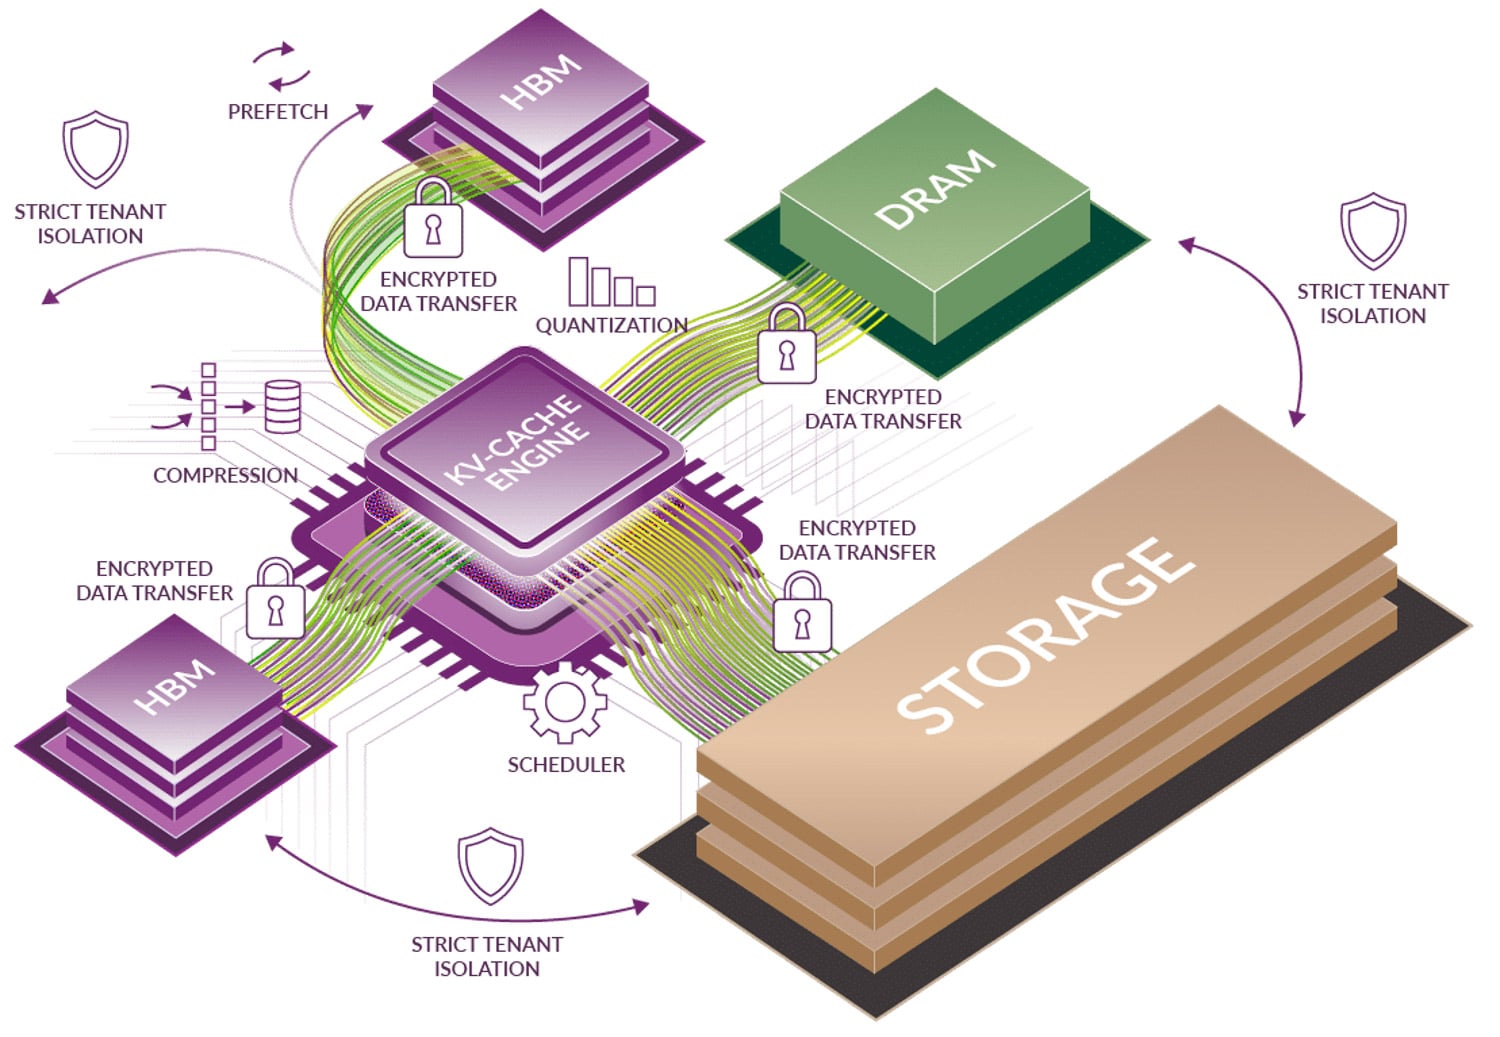
Předběžné načtení místo přepočtu
Úzké hrdlo, na které se Inferra zaměřuje, je to, kterým jsme se setkali v našem článku o přesunu KV mezipaměti do flash paměti: s rostoucí délkou kontextu a násobením relací KV mezipaměť přeroste paměť GPU a obslužný zásobník ji buď vymaže a později přepočítá prefill, nebo omezí počet relací, které může GPU pojmout. Obě cesty spalují cykly GPU na práci, která již byla provedena. Inferra udržuje mezipaměť aktivní napříč paměťovými a úložnými vrstvami a prediktivní prefetcher přitahuje stavy pozornosti zpět k GPU dříve, než je model potřebuje. Lightbits uvádí, že tento přístup snižuje jak čas do prvního tokenu (TTFT), tak čas na výstupní token (TPOT), a uváděná 100násobná hodnota je zlepšení latence oproti přepočítávání těchto stavů od nuly.
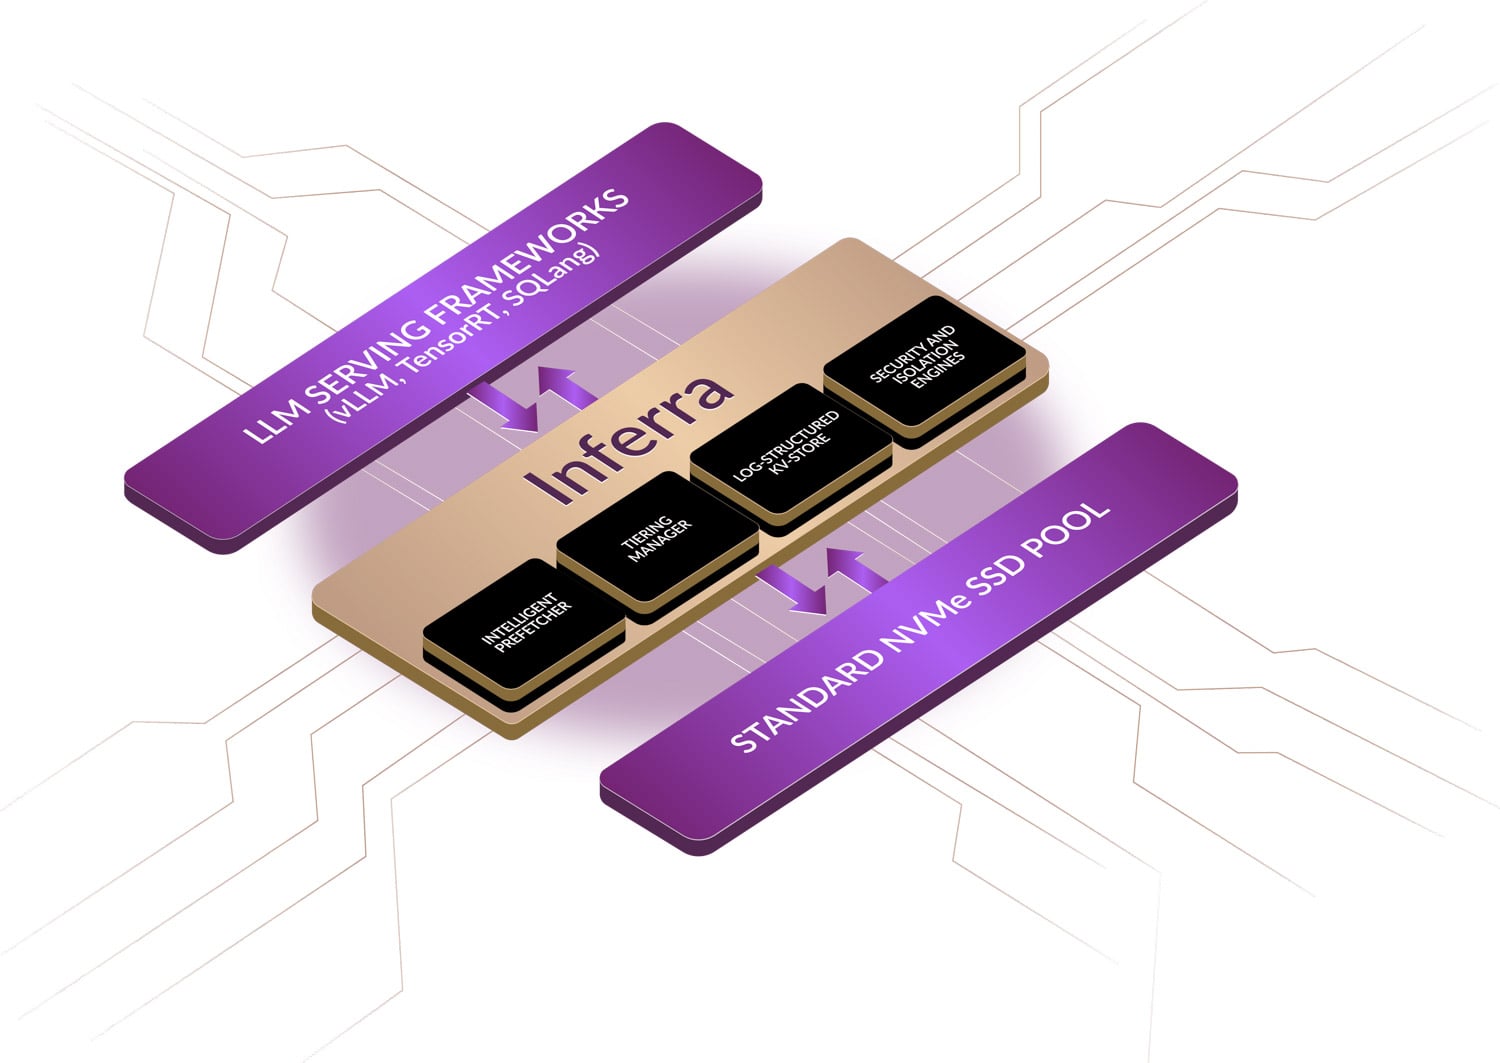
Blokové schéma společnosti Lightbits rozkládá čtyři části: inteligentní prefetcher, správce vrstvení, úložiště KV se strukturou protokolů a bezpečnostní a izolační enginy, které se nacházejí mezi výše uvedeným obslužným frameworkem a standardním fondem NVMe SSD níže. Společnost uvádí vLLM, TensorRT a SGLang jako podporované obslužné frameworky a tvrdí, že engine je nezávislý na GPU a SSD. Úložiště se strukturou protokolů je to, co dělá flash vrstvu praktickou pro mezipaměť, která se neustále mění, protože sekvenčně přidává aktualizace a uchovává malé náhodné zápisy z disků. V naší recenzi Solidigm D7-PS1030 jsme se podívali na to, jak si v této roli vede disk s kapacitou 3 DWPD . Na straně více klientů Lightbits popisuje bezpečnou izolaci klientů a inteligentní správu mezipaměti napříč sdílenou inferenční infrastrukturou se šifrovaným přenosem mezi vrstvami, což umožňuje neocloudu předat jeden fond KV mnoha zákazníkům s konzistentními SLA.
Avigdor Willenz, spoluzakladatel a předseda společnosti Lightbits Labs, označil spuštění za odklon od úložišť určených pro tréninkové procesy. Inference „je zcela odlišné paradigma,“ řekl, „a dodatečné vybavení starších tréninkových a úložných systémů za účelem řešení úzkého hrdla mezipaměti KV jednoduše nefunguje. Byla postavena pro jinou éru. Inferru jsme od základů navrhli speciálně pro řešení problému s efektivitou GPU a ta se již osvědčila v zákaznických beta programech.“
OVH, Solidigm a ukázky ze stánku 219
Společnost OVH je jmenovaným zákazníkem beta testu. „Díky inteligentnímu vrstvení mezipaměti KV od společnosti Inferra jsme byli schopni prokázat značné zvýšení využití GPU, což nám umožnilo poskytnout našim zákazníkům škálovatelnější a nákladově efektivnější základ pro jejich úlohy agentů AI a RAG,“ uvedl Yaniv Fdida, produktový a technologický ředitel společnosti OVH. Společnost Solidigm spustila engine ve své centrální laboratoři AI na discích D7-PS1010 a Avi Shetty, viceprezident společnosti pro ekosystémy, řešení a tržní podporu, uvedl, že výsledky „ukázaly, jak síťové úložiště s inteligentní virtualizací softwarové vrstvy může prorazit paměťovou stěnu pro rozsáhlou kontextovou agentskou AI.“ Toto spárování síťového NVMe poolu se softwarovou vrstvou je domácí oblastí společnosti Lightbits; její blokové úložiště LightOS je postaveno na NVMe/TCP od roku 2019.
Ramesh Chettuvetty, senior viceprezident pro produkty a obchod s umělou inteligencí ve společnosti Lightbits, nazval Inferru „prvním enginem pro akceleraci mezipaměti KV na světě, který eliminuje nečinné GPU a poháněje kontextová okna až 10 milionů tokenů na komoditním hardwaru“ a uvedl, že „poskytuje okamžitou návratnost investic a generuje čisté pozitivní úspory od prvního dne“. To jsou tvrzení dodavatele před jakýmkoli nezávislým testováním a vydání neuvádí cenu, balení ani datum obecné dostupnosti; engine je dnes v beta verzi pro zákazníky. Lightbits během summitu provozuje živé ukázky výsledků hustoty relací a latence na stánku 219 a zveřejnil analyzátor efektivity podů pro týmy, které chtějí modelovat úspory GPU oproti svému vlastnímu clusteru před jeho rezervací.


 Amazon