

Společnost Meta představila svou nejnovější inovaci v oblasti umělé inteligence, Llama 4, což je sada modelů, které vylepšují možnosti multimodální inteligence. Llama 4 je založena na architektuře Mixture-of-Experts (MoE), která nabízí výjimečnou efektivitu a výkon.
Pochopení modelů MoE a řídkosti
Modely směsi expertů (MoE) se výrazně liší od tradičních hustých modelů, kde celý model zpracovává každý vstup. V modelech MoE je pro každý vstup aktivována pouze podmnožina celkových parametrů, označovaná jako „experti“. Tato selektivní aktivace závisí na charakteristikách vstupu, což modelu umožňuje dynamicky alokovat zdroje a zvyšovat efektivitu.
Řídkost je základním konceptem v modelech MoE, který udává poměr neaktivních parametrů pro konkrétní vstup. Modely MoE mohou výrazně snížit výpočetní náklady využitím řídkosti a zároveň zachovat nebo zvýšit výkon.
Seznamte se s rodinou Llama 4: Scout, Maverick a Behemoth
Sada Llama 4 se skládá ze tří modelů: Llama 4 Scout, Llama 4 Maverick a Llama 4 Behemoth. Každý model je navržen tak, aby vyhovoval různým případům použití a požadavkům.
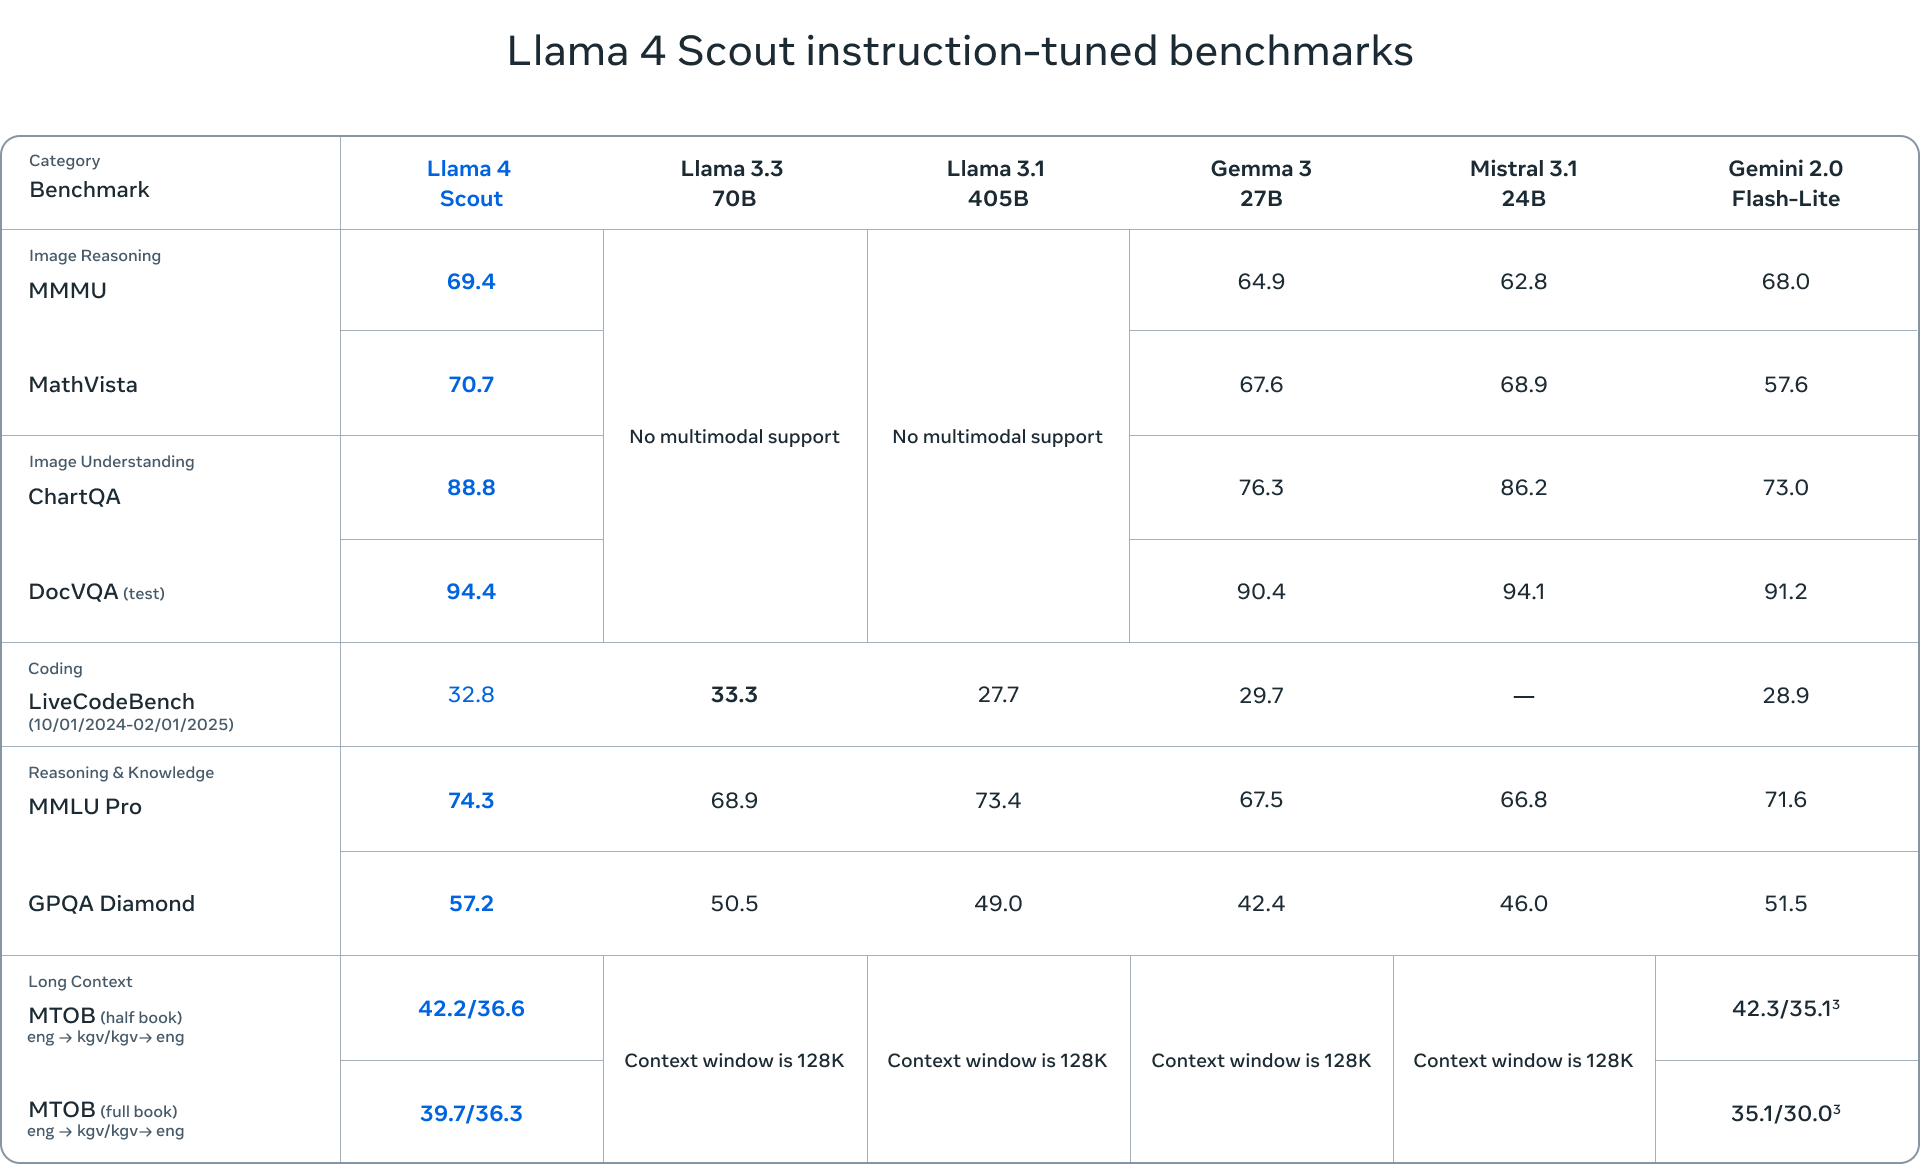
- Llama 4 Scout je kompaktní model se 17 miliardami aktivních parametrů a celkovými 109 miliardami parametrů napříč 16 experty. Je optimalizován pro efektivitu a může běžet na jediné grafické kartě NVIDIA H100 (FP4 Quantized). Scout se pyšní působivým kontextovým oknem s 10 miliony tokenů, což ho činí ideálním pro aplikace vyžadující pochopení dlouhodobého kontextu.
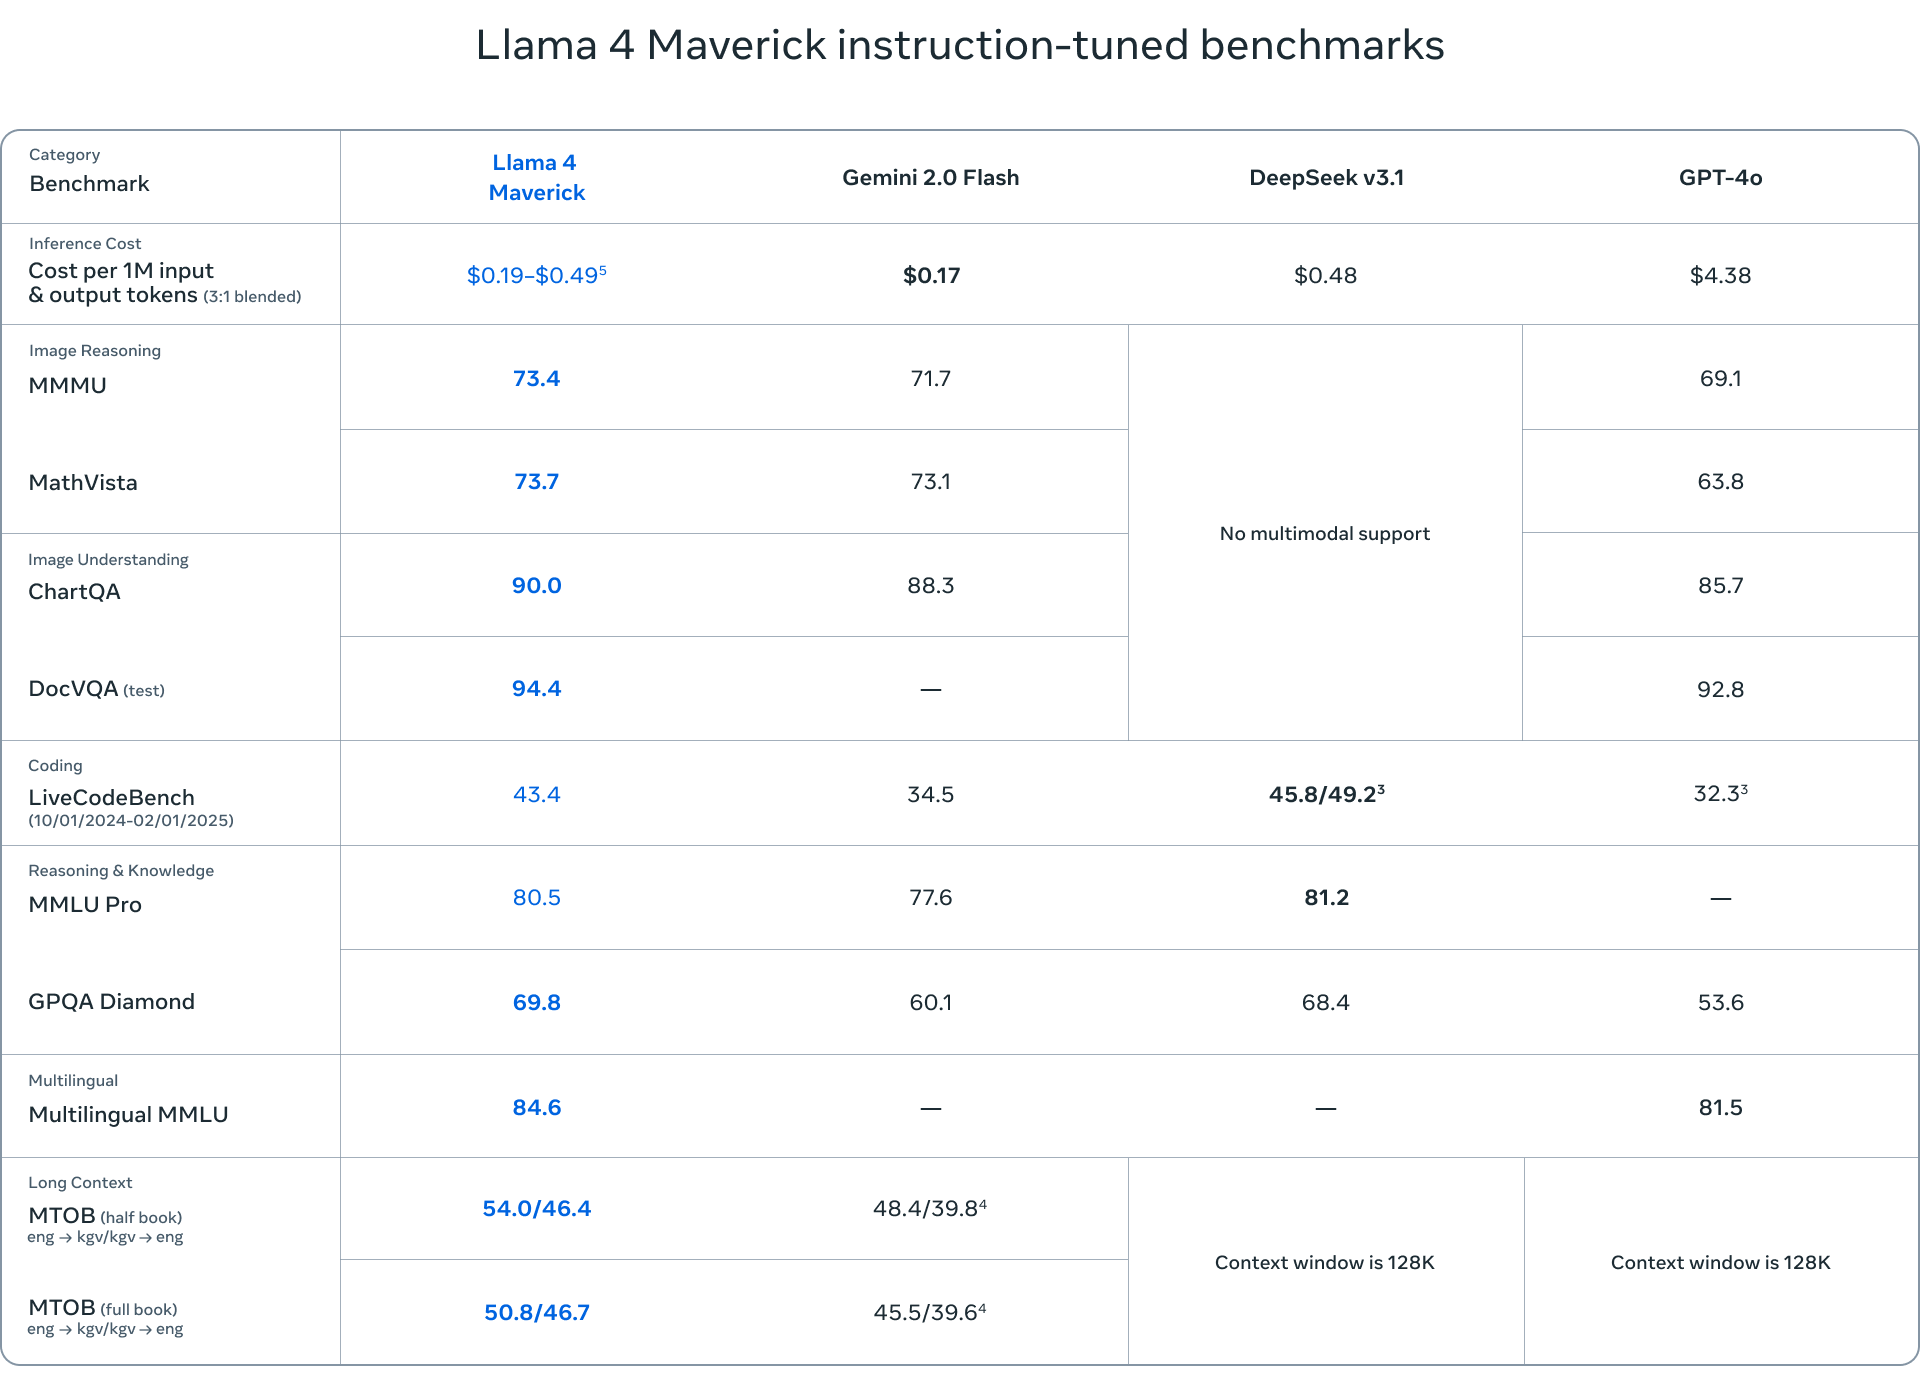
- Llama 4 Maverick je robustnější model se stejnými 17 miliardami aktivních parametrů, ale se 128 experty, celkem 400 miliard parametrů. Maverick vyniká v multimodálním porozumění, vícejazyčných úlohách a kódování a překonává konkurenty, jako jsou GPT-4o a Gemini 2.0 Flash.
- Llama 4 Behemoth je největším modelem v sadě s 288 miliardami aktivních parametrů a téměř 2 biliony celkových parametrů napříč 16 experty. Ačkoli je Behemoth stále ve fázi testování, již prokázal špičkový výkon v různých benchmarkech a překonal modely jako GPT-4.5 a Claude Sonnet 3.7.
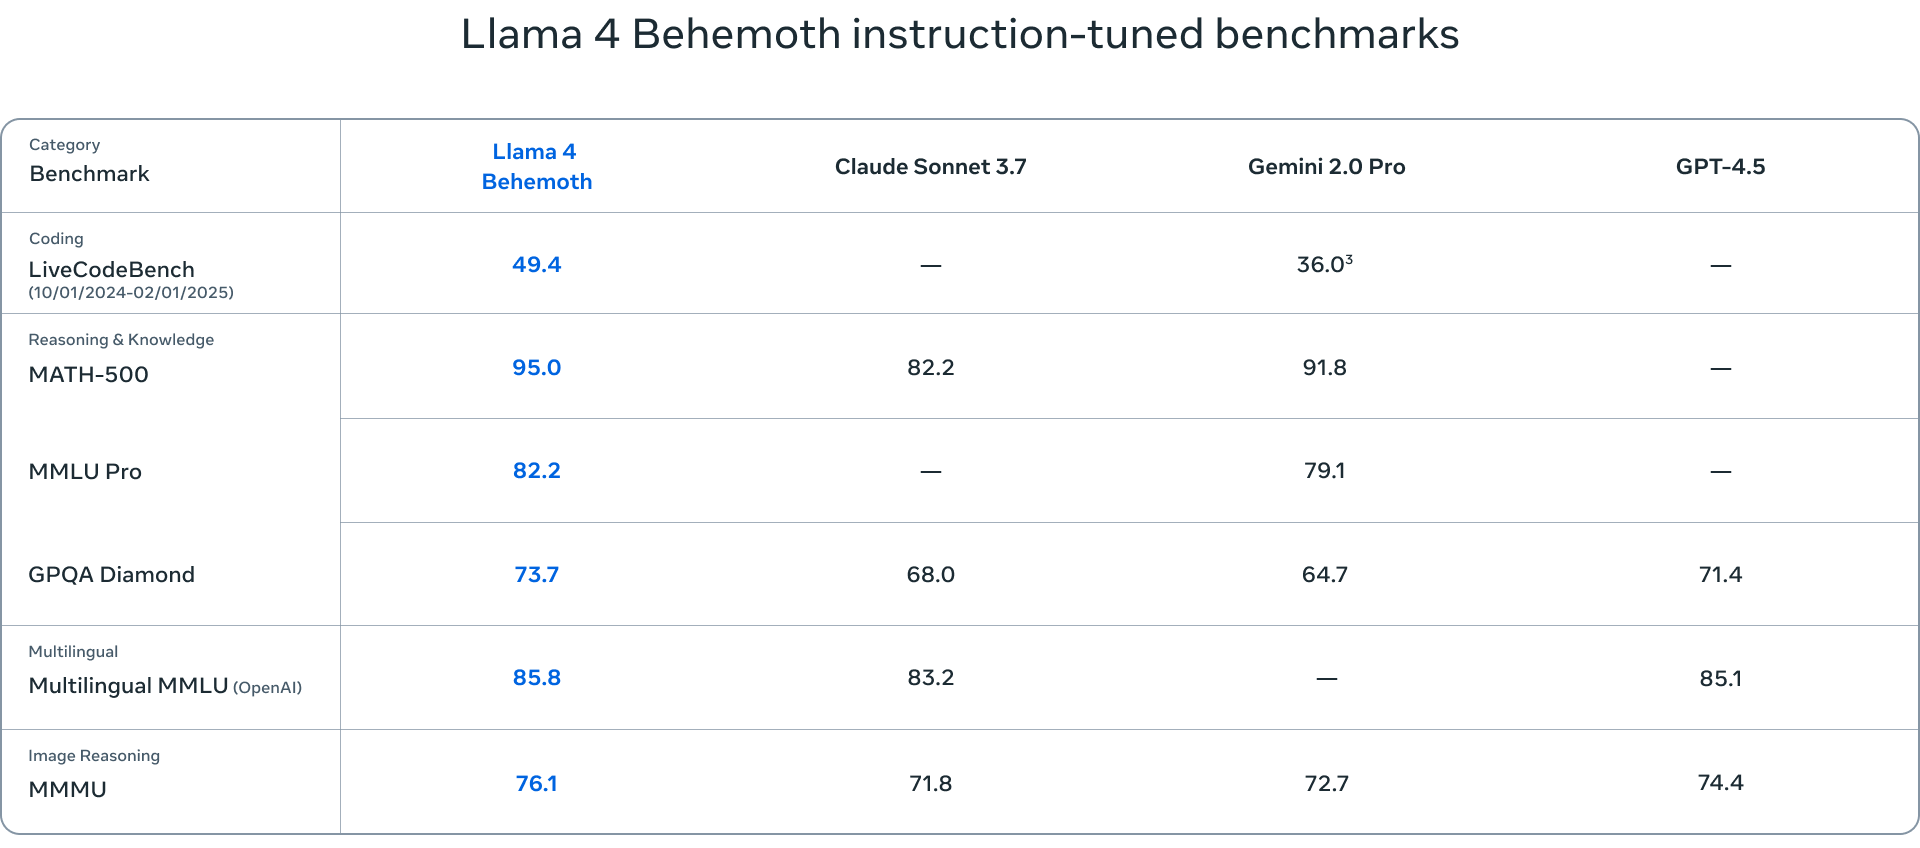
Referenční hodnoty použité k vyhodnocení modelů Llama 4 pokrývají řadu úkolů, včetně porozumění jazyku (MMLU – Massive Multitask Language Understanding, GPQA – Google-Proof Question Answering), řešení matematických problémů (MATH – Mathematical Problem-Solving, MathVista – benchmark pro matematické řešení problémů ve vizuálních kontextech) a multimodálního porozumění (MMMU – Massive Multimodal Multitask Understanding). Tyto standardní benchmarky poskytují komplexní posouzení schopností modelů a pomáhají identifikovat oblasti, ve kterých vynikají nebo vyžadují další zlepšení.
Role učitelských modelů v Llama 4
Model učitele je velký, předtrénovaný model, který vede menší modely a předává jim své znalosti a schopnosti prostřednictvím destilace. V případě Llama 4 funguje Behemoth jako model učitele a destiluje své znalosti jak Scout, tak Maverick. Proces destilace zahrnuje trénování menších modelů tak, aby napodobovaly chování modelu učitele, což jim umožňuje učit se z jeho silných a slabých stránek. Tento přístup umožňuje menším modelům dosáhnout působivého výkonu a zároveň být efektivnější a škálovatelnější.
Důsledky a budoucí směry
Vydání Llama 4 představuje významný milník v oblasti umělé inteligence s dalekosáhlými důsledky pro výzkum, vývoj a aplikace. Historicky byly modely Llama katalyzátorem následného výzkumu a inspirovaly různé studie a inovace. Očekává se, že vydání Llama 4 bude v tomto trendu pokračovat a umožní výzkumníkům stavět na modelech a jemně je ladit tak, aby řešily složité úkoly a výzvy.
Mnoho modelů bylo doladěno a postaveno na modelech Llama, což demonstruje všestrannost a potenciál architektury Llama. Verze Llama 4 pravděpodobně tento trend urychlí, protože výzkumníci a vývojáři využívají modely k vytváření nových a inovativních aplikací. To je významné, protože Llama 4 je silná verze modelu a umožní širokou škálu výzkumných a vývojových aktivit.
Za zmínku stojí, že modely Llama 4, podobně jako jejich předchůdci, nepoužívají myšlení. Budoucí verze řady Llama 4 by proto mohly být potenciálně následně trénovány na uvažování, což by dále zlepšilo jejich výkon.


 Amazon