

Konference o technologiích grafických procesorů (GTC) společnosti NVIDIA se po několika letech vrací osobně, konkrétně jako virtuální událost. Je to fantastická událost pro inovátory, výzkumníky, vědce i technologické nadšence, kde se mohou seznámit s nejnovějšími technologiemi od tohoto technologického giganta. Letošní NVIDIA GTC 2024, v technologické komunitě velmi očekávaná, představuje nejnovější průlomy v oblasti umělé inteligence, hlubokého učení, autonomních vozidel a nové architektury Blackwell.
Zde jsou nejdůležitější body pondělního projevu generálního ředitele společnosti NVIDIA Jensena Huanga. Týkal se nové architektury Blackwell od společnosti NVIDIA, sítí, pokroku v kvantových výpočtech a aktualizací softwarového balíku.
NVIDIA Blackwell
Šest průlomových technologií připravených předefinovat zrychlené výpočty je jádrem inovací společnosti Blackwell. NVIDIA nastavuje nový standard, od vylepšení zpracování dat až po revoluci v designu léčiv a další. Známí dodavatelé technologií, jako jsou Amazon a Microsoft, se již řadí do fronty v očekávání transformačního potenciálu společnosti Blackwell.
Pojďme se blíže podívat na inženýrský zázrak, kterého NVIDIA dokázala. Grafické procesory Blackwell obsahují ohromujících 208 miliard tranzistorů na dvou čipech, což je možné díky využití procesu TSMC 4NP s limitem dvou mřížek. Tento přístup posouvá hranice výroby polovodičů a zavádí nový způsob propojení čipů s ohromujícím rozhraním 10 TB/s. Tento krok směrem k návrhu čipů odráží ambice společnosti NVIDIA posouvat se za tradiční hranice.
| Specifikace | H100 | B100 | B200 |
| Maximální paměť | 80GB HBM3 | 192 GB HBM3e | 192 GB HBM3e |
| Paměťová šířka pásma | 3.35 TB/s | 8 TB/s | 8 TB/s |
| FP4 | - | 14 PFLOPS | 18 peflopů |
| FP6 | - | 7 PFLOPS | 9 PFLOPS |
| FP8/INT8 | 3.958 PFLOPS/POPS | 7 PFLOPS/POPS | 9 PFLOPS/POPS |
| FP16/BF16 | 1979 TFLOPS | 3.5 PFLOPS | 4.5 PFLOPS |
| TF32 | 989 TFLOPS | 1.8 PFLOPS | 2.2 PFLOPS |
| FP64 | 67 TFLOPS | 30 TFLOPS | 40 TFLOPS |
| Spotřeba Max Power | 700W | 700W | 1000W |
Poznámka: Všechna čísla zde představují výkon pro výpočty s řídkými maticemi.
Nejde jen o osazení větším počtem tranzistorů. Zavedení výpočetních schopností FP4 a FP6 přináší novou úroveň efektivního trénování modelů, i když s mírným kompromisem ve výkonu modelu. Tento kompromis je specifickým aspektem platformy a odráží složité vyvažování mezi efektivitou a přesností.
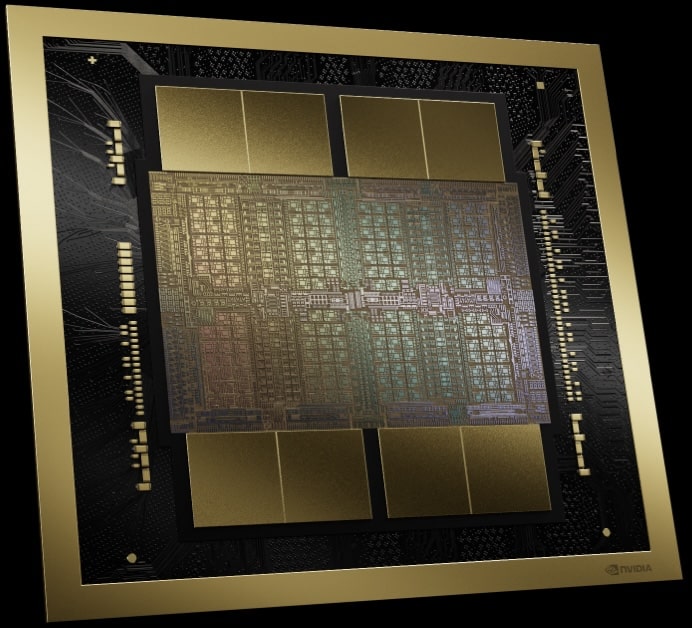
Transformerový engine druhé generace v Blackwellu umožňuje skokový nárůst výpočetních schopností, šířky pásma a velikosti modelu při použití FP4, což přináší vylepšení, která jsou zásadní pro budoucnost vývoje umělé inteligence. Integrace PCIe Gen6 a nové paměťové technologie HBM3e navíc přináší podstatné zvýšení šířky pásma, které ve spojení s NVLink páté generace zdvojnásobuje šířku pásma oproti předchozí generaci na ohromujících 1.8 TB/s.
Jednou z nejzajímavějších novinek je RAS Engine, který zvyšuje spolehlivost, dostupnost a provozuschopnost v rámci rozsáhlých nasazení umělé inteligence. Tato inovace by mohla výrazně zlepšit využití modelových flopů a řešit tak jednu z klíčových výzev při škálování aplikací umělé inteligence.
S technologií Blackwell přináší NVIDIA nové možnosti důvěrných výpočetních technologií, včetně první grafické karty (GPU) s podporou Trusted Execution Environment (TEE)-I/O v oboru, která rozšiřuje TEE za hranice CPU na GPU. To zajišťuje bezpečné a rychlé zpracování soukromých dat, což je klíčové pro trénování generativní umělé inteligence. Tato inovace je obzvláště významná pro odvětví, která se zabývají předpisy o ochraně soukromí nebo důvěrnými informacemi. Technologie NVIDIA Blackwell Confidential Computing poskytuje bezkonkurenční zabezpečení bez kompromisů ve výkonu a nabízí téměř identickou propustnost jako nešifrované režimy. Tato vylepšení nejen zabezpečuje rozsáhlé modely umělé inteligence, ale také umožňuje důvěrné trénování umělé inteligence a federované učení, čímž chrání duševní vlastnictví v oblasti umělé inteligence.
Dekompresní engine v NVIDIA Blackwell představuje významný skok v oblasti datové analýzy a databázových pracovních postupů. Tento engine dokáže dekomprimovat data ohromující rychlostí až 800 GB/s, což výrazně zvyšuje výkon datové analýzy a zkracuje dobu potřebnou k získání nových poznatků. Ve spolupráci s pamětí HBM3e s rychlostí 8 TB/s a vysokorychlostním propojením NVLink-C2C zrychluje databázové dotazy, díky čemuž je Blackwell v benchmarkových testech dotazů 18krát rychlejší než CPU a 6krát rychlejší než předchozí GPU NVIDIA. Tato technologie podporuje nejnovější kompresní formáty a staví NVIDIA Blackwell mezi dodavatele datové analýzy a vědecké poznatky, což drasticky zrychluje komplexní analytický proces.
Navzdory technickým zázrakům vzbuzuje tvrzení společnosti NVIDIA o až 25násobném snížení provozních nákladů a spotřeby energie pro inferenci LLM pochybnosti, zejména vzhledem k nedostatku podrobných údajů o spotřebě energie. Toto tvrzení, ačkoli je pozoruhodné, by mohlo být dále upřesněno, aby se plně posoudil jeho dopad.
Stručně řečeno, platforma Blackwell od společnosti NVIDIA je důkazem neúnavné snahy společnosti posouvat hranice možností v oblasti umělé inteligence a výpočetní techniky. Díky svým revolučním technologiím a ambiciózním cílům není Blackwell jen krokem, ale obrovským skokem vpřed, který slibuje podnítit různé pokroky v různých odvětvích. Jak se ponořujeme hlouběji do této éry zrychlených výpočtů a generativní umělé inteligence, inovace společnosti NVIDIA mohou být katalyzátorem další průmyslové revoluce.
NVIDIA Blackwell HGX
Společnost NVIDIA aktualizovala svou řadu serverů a základních desek HGX s využitím architektury Blackwell. Tento významný vývoj oproti předchozím modelům přináší přesvědčivou změnu, která výrazně snižuje celkové náklady na vlastnictví a zároveň působivě zvyšuje výkon. Srovnání je pozoruhodné – při porovnání FP8 s FP4 dochází k pozoruhodnému 4.5násobnému zvýšení výkonu. I při porovnání FP8 s jeho předchůdcem se výkon téměř zdvojnásobí. Nejde jen o hrubou rychlost; jde o skok vpřed v efektivitě paměti, který ukazuje 8násobný nárůst celkové šířky pásma paměti.
| Specifikace | HGX H100 | HGX H200 | HGX B100 | HGX B200 |
| Maximální paměť | 640GB HBM3 | 1.1TB HBM3e | 1.5TB HBM3e | 1.5TB HBM3e |
| Paměťová šířka pásma | 7.2 TB/s | 7.2 TB/s | 8 TB/s | 8 TB / s |
| FP4 | - | - | 112 PFLOPS | 144 PFLOPS |
| FP6 | - | - | 56 PFLOPS | 72 PFLOPS |
| FP8/INT8 | 32 PFLOPS/POPS | 32 PFLOPS/POPS | 56 PFLOPS/POPS | 72 PFLOPS/POPS |
| FP16/BF16 | 16 PFLOPS | 16 PFLOPS | 28 PFLOPS | 36 PFLOPS |
NVIDIA Grace-Blackwell SuperChip
Ponoříme se hlouběji do složitostí nejnovějšího oznámení společnosti NVIDIA se zaměřením na GB200, základní kámen arzenálu platformy Blackwell. Vzhledem k tomu, že NVIDIA neustále posouvá hranice vysoce výkonných výpočtů, představuje GB200 významný vývoj v nabídce jejích GPU, který spojuje špičkovou technologii se strategickým pokrokem v oblasti konektivity a škálovatelnosti. GB200 obsahuje dvě GPU B200; tato konfigurace se liší od předchozí generace GH200, která disponovala individuálním propojením mezi GPU a CPU Grace. Tentokrát jsou obě GPU B200 propojeny se stejným CPU Grace prostřednictvím 900GB/s propojení čip-k-čipu (C2C).
| Specifikace | GH200 | GB200 |
| Maximální paměť | 144 GB HBM3e | 384 GB HBM3e |
| Paměťová šířka pásma | 8 TB/s | 16 TB/s (agregát) |
| FP4 | - | 40 PFLOPS |
| FP6 | - | 20 PFLOPS |
| FP8/INT8 | 3.958 PFLOPS/POPS | 20 PFLOPS |
| FP16/BF16 | 1979 TFLOPS | 10 PFLOPS |
| TF32 | 989 TFLOPS | 5 PFLOPS |
| FP64 | 67 TFLOPS | 90 TFLOPS |
| PCIe Lanes | 4x PCIe Gen 5 x16 | 2x PCIe Gen 6 x16 |
| Spotřeba Max Power | 1000W | 2700W |
# Poznámka: Všechna čísla zde představují výkon pro výpočty s řídkými maticemi.
Na první pohled se může rozhodnutí zachovat 900GB/s C2C propojení z předchozí generace jevit jako omezení. Tato konstrukční volba však podtrhuje promyšlenou strategii, která využívá stávající technologie a zároveň připravuje cestu pro nové úrovně škálovatelnosti. Architektura GB200 umožňuje komunikaci až s 576 GPU rychlostí 1.8 TB/s, a to díky páté generaci NVLink. Tato úroveň propojení je klíčová pro budování masivně paralelních výpočetních prostředí nezbytných pro trénování a nasazení největších a nejsložitějších modelů umělé inteligence.
Aktualizace síťového stacku NVIDIA
Díky integraci GB200 s nejnovějšími síťovými technologiemi NVIDIA vyvolávají ethernetové platformy Quantum-X800 InfiniBand a Spectrum-X800 zajímavé otázky ohledně konektivity a šířky pásma. Zmínka o rychlosti 800 Gb/s naznačuje, že NVIDIA zkoumá výhody, které může PCIe Gen6 přinést.
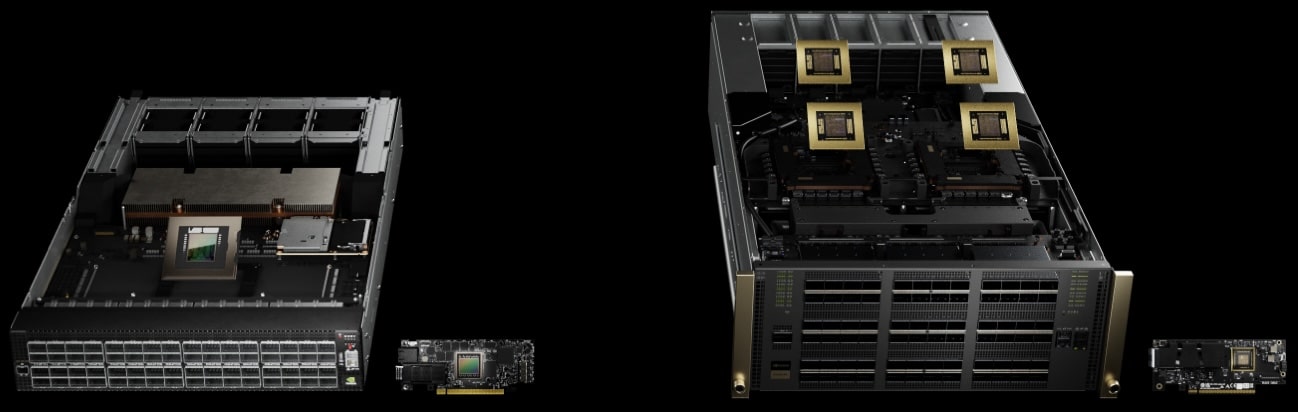
Konfigurace GB200 s duálním grafickým procesorem a pokročilými síťovými možnostmi představuje vizi společnosti NVIDIA pro budoucnost HPC. Tato vize se netýká jen hrubého výkonu jednotlivých komponent, ale také toho, jak lze tyto komponenty propojit v ucelený a škálovatelný systém. Umožněním vyššího stupně propojení a udržováním rovnováhy mezi výpočetním výkonem a rychlostí přenosu dat se NVIDIA zabývá některými z nejzásadnějších výzev ve výzkumu a vývoji umělé inteligence, zejména při zvládání exponenciálně rostoucích velikostí modelů a výpočetních nároků.
NVIDIA NVLink a přepínače NVLink páté generace
Pátá generace NVLink představuje významný milník v oblasti vysoce výkonných výpočtů a umělé inteligence. Tato technologie zvyšuje schopnost propojení a komunikace mezi grafickými procesory (GPU), což je klíčový aspekt pro rychle se vyvíjející požadavky na základní modely v umělé inteligenci.
Pátá generace NVLink zvyšuje kapacitu konektivity GPU na 576 GPU, což je podstatný nárůst oproti předchozímu limitu 256 GPU. Toto rozšíření je doprovázeno zdvojnásobením šířky pásma ve srovnání s předchůdcem, což je zásadní vylepšení pro výkon stále složitějších základních modelů umělé inteligence.
Každý spoj Blackwell GPU se pyšní dvěma vysokorychlostními diferenciálními páry, podobně jako GPU Hopper, ale dosahuje efektivní šířky pásma na spoj 50 GB/s v každém směru. Tyto GPU jsou vybaveny 18 spoji NVLink páté generace, což poskytuje ohromující celkovou šířku pásma 1.8 TB/s. Tato propustnost je více než 14krát vyšší než u současného PCIe Gen 5.
Další pozoruhodnou funkcí je přepínač NVIDIA NVLink, který podporuje šířku pásma GPU 130 TB/s v jediné doméně NVLink s 72 GPU (NVL72), což je klíčové pro paralelismus modelů. Tento přepínač také poskytuje čtyřnásobné zvýšení efektivity šířky pásma díky nové podpoře protokolu NVIDIA Scalable Hierarchical Aggregation and Reduction Protocol (SHARP) FP8.
Kromě toho NVIDIA Unified Fabric Manager (UFM) doplňuje přepínač NVLink tím, že poskytuje robustní a osvědčenou správu pro výpočetní strukturu NVLink.
Exascale výpočetní technika v racku
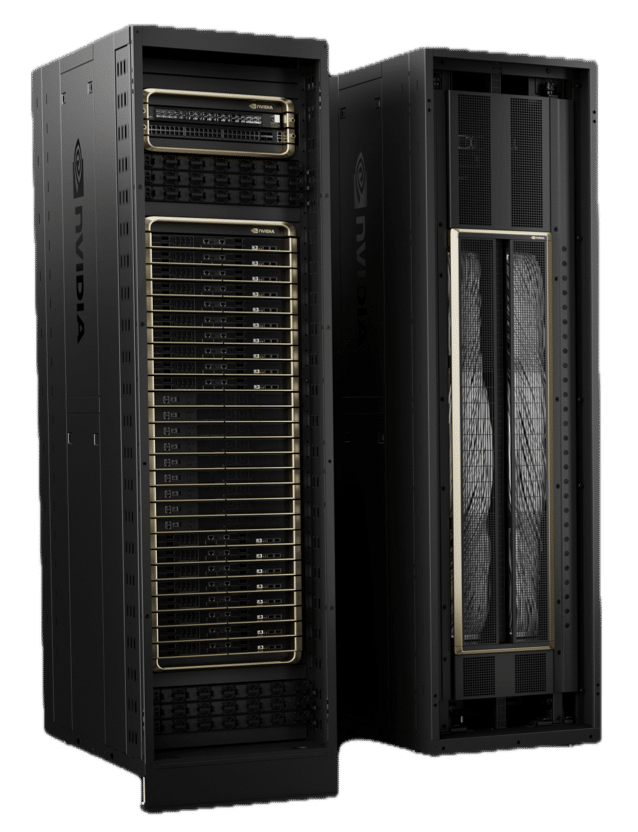
DGX GB200 NVL72, který staví na impozantních základech položených jeho předchůdcem, GraceHopper GH200 NVL32, není jen upgradem; je to základní pokrok, který rozšiřuje možnosti výpočetního výkonu a efektivity. Platforma DGX GB200 NVL72 představuje ohromující pokrok napříč všemi oblastmi. Každý systém DGX GB200 NVL72 se skládá z 18 uzlů GB200 SuperChip, z nichž každý obsahuje 2 uzly GB200.
Tato platforma více než zdvojnásobuje počet grafických procesorů (GPU) z 32 na 72 a mírně zvyšuje počet procesorů (CPU) z 32 na 36. Pozoruhodný je však skok v paměti, která se zvýšila z 19.5 TB na působivých 30 TB. Toto rozšíření se netýká pouze významnějších čísel, ale také umožnění nové úrovně výpočetních schopností, zejména při zpracování nejsložitějších modelů a simulací umělé inteligence.
Jedním z nejúžasnějších vylepšení je skok ve výpočetním výkonu. Platforma se ve srovnání s výkonem FP4 zvýšila ze 127 PetaFLOPS na 1.4 ExaFLOPS, což představuje přibližně 11násobný nárůst. Toto srovnání dokazuje odhodlání společnosti NVIDIA posouvat hranice přesnosti a rychlosti, zejména v oblasti umělé inteligence a strojového učení. Nicméně i při srovnání FP8 s FP8 dosahuje platforma 5.6násobného nárůstu, ze 127 PetaFLOPS na 720PF, což podtrhuje významný pokrok v efektivitě a výpočetním výkonu.
Závazek udržovat kompletně vodou chlazený systém odráží zaměření společnosti NVIDIA na udržitelnost a optimalizaci výkonu. Tento přístup zvyšuje provozní efektivitu systému a je v souladu s širšími trendy v oboru směrem k ekologičtějším technologiím datových center.
NVIDIA DGX SuperPOD s technologií NVIDIA GB200 Grace Blackwell Superchips
Společnost NVIDIA také oznámila svůj superpočítač s umělou inteligencí nové generace, DGX SuperPOD, vybavený 8 systémy NVIDIA GB200 NVL72 Grace Blackwell. Toto impozantní zařízení je navrženo pro zpracování modelů s biliony parametrů a může se pochlubit výkonem 11.5 exaflopů superpočítačového výkonu umělé inteligence s přesností FP4 v rámci své kapalinou chlazené architektury pro rackové použití. Každý systém GB200 NVL72 obsahuje 36 superčipů NVIDIA GB200, což slibuje 30násobné zvýšení výkonu oproti svým předchůdcům H100 pro velké úlohy inference jazykových modelů.
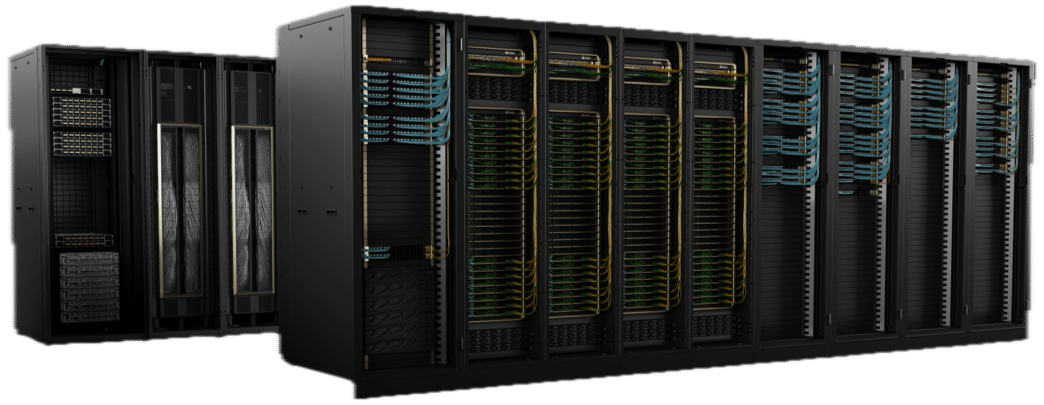
Podle Jensena Huanga, generálního ředitele společnosti NVIDIA, si DGX SuperPOD klade za cíl stát se „továrnou průmyslové revoluce umělé inteligence“.
Kvantový simulační cloud
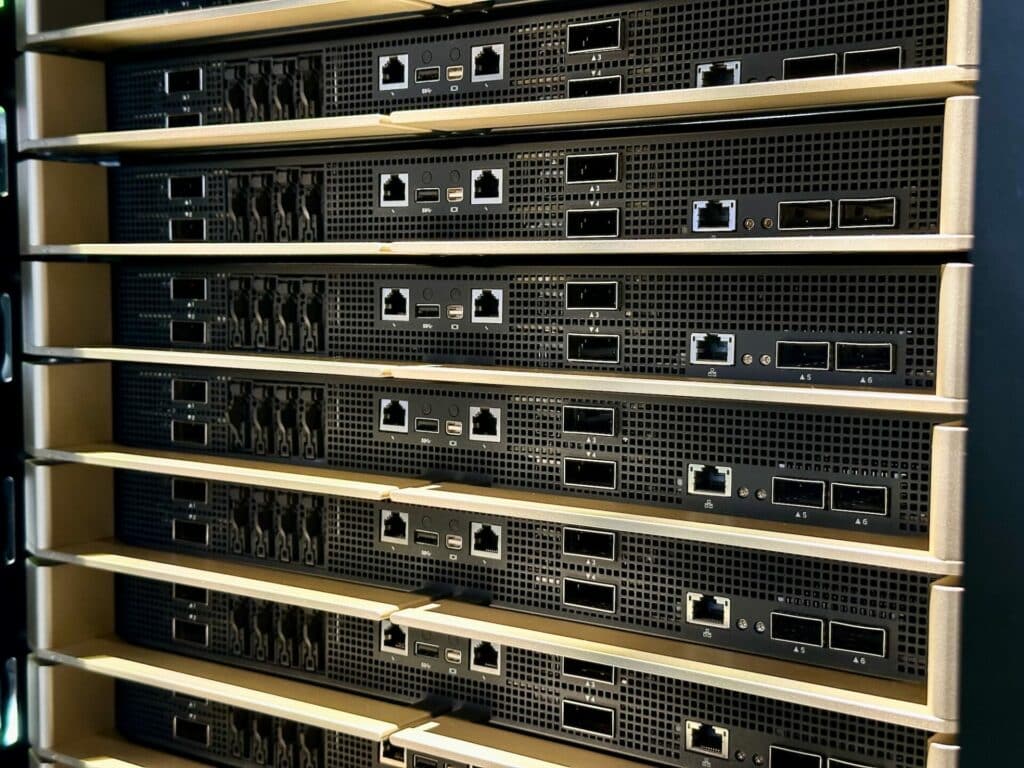
Společnost NVIDIA také představila službu Quantum Simulation Cloud, která umožňuje výzkumníkům zkoumat kvantové výpočty v různých vědeckých oblastech. Tato služba, založená na open-source platformě CUDA-Q, nabízí výkonné nástroje a integrace pro tvorbu a testování kvantových algoritmů a aplikací. Spolupráce s Univerzitou v Torontu a společnostmi jako Classiq a QC Ware zdůrazňuje snahu společnosti NVIDIA o urychlení inovací v oblasti kvantových výpočtů.
Softwarový stack NVIDIA NIM
Dalším významným oznámením bylo spuštění softwarového stacku NVIDIA NIM, který nabízí desítky generativních mikroslužeb umělé inteligence na podnikové úrovni. Tyto služby umožňují firmám vytvářet a nasazovat vlastní aplikace na svých platformách, optimalizovat inferenci na populárních modelech umělé inteligence a vylepšovat vývoj pomocí mikroslužeb NVIDIA CUDA-X pro širokou škálu aplikací. Jensen Huang zdůraznil potenciál těchto mikroslužeb transformovat podniky napříč odvětvími v subjekty poháněné umělou inteligencí.
Výpočetní systémy OVX
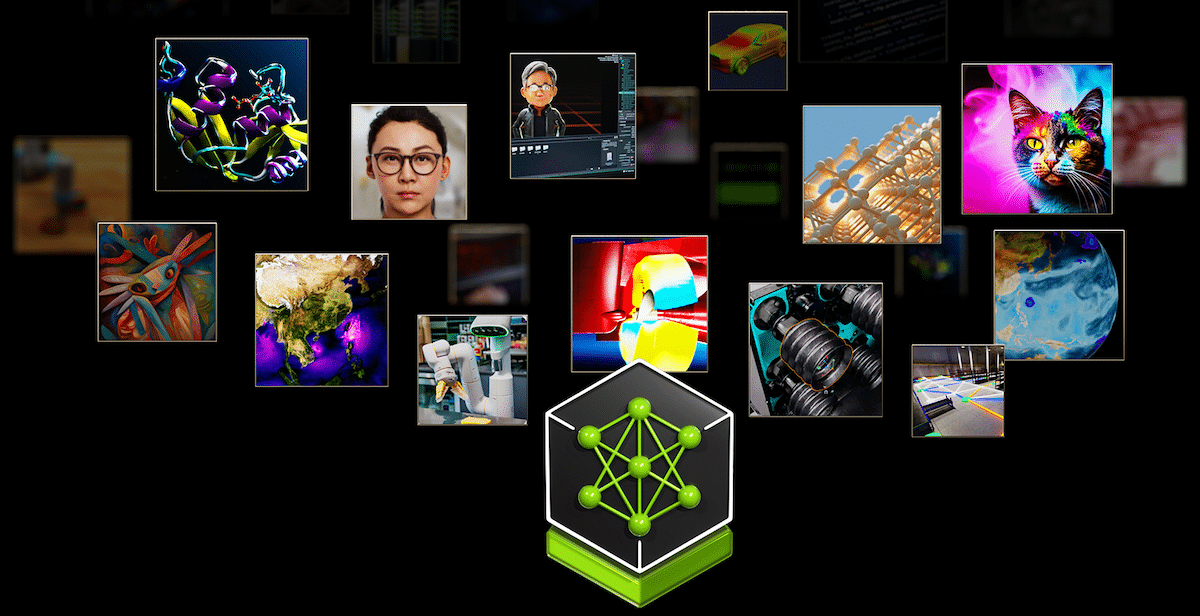
V reakci na rychlý růst generativní umělé inteligence v různých odvětvích představila společnost NVIDIA výpočetní systémy OVX, řešení určené pro zefektivnění komplexních úloh s umělou inteligencí a graficky náročných úloh. Společnost NVIDIA si uvědomuje klíčovou roli vysoce výkonného úložiště v nasazení umělé inteligence a zahájila program ověřování partnerů v oblasti úložišť s předními přispěvateli, jako jsou DDN, Dell PowerScale , NetApp, Pure Storage a WEKA.
Nový program standardizuje proces, kterým partneři ověřují svá úložná zařízení, a zajišťuje tak optimální výkon a škálovatelnost pro podnikové úlohy s umělou inteligencí. Prostřednictvím přísného testování NVIDIA jsou tyto úložné systémy ověřovány podle různých parametrů, které odrážejí náročné požadavky aplikací umělé inteligence.
Servery OVX s certifikací NVIDIA, poháněné grafickými procesory NVIDIA L40S a integrované s komplexním softwarovým a síťovým řešením, navíc nabízejí flexibilní architekturu, která se hodí do různých prostředí datových center. Tento přístup nejen zrychluje výpočetní procesy v místě ukládání dat, ale také uspokojuje jedinečné potřeby generativní umělé inteligence a zajišťuje efektivitu a nákladovou efektivitu. Servery NVIDIA OVX jsou vybaveny robustními grafickými procesory, které nabízejí vylepšené výpočetní schopnosti, vysokorychlostní přístup k úložišti a nízkolatenční síťové připojení. To je obzvláště důležité pro náročné aplikace, jako jsou chatboti a vyhledávací nástroje, které vyžadují rozsáhlé zpracování dat.
Servery OVX s certifikací NVIDIA, které jsou v současné době k dispozici a dodávány od globálních dodavatelů, jako jsou GIGABYTE, Hewlett Packard Enterprise, Lenovo a Supermicro, představují významný krok vpřed ve zvládání komplexních úloh s umělou inteligencí a slibují výkon, zabezpečení a škálovatelnost na podnikové úrovni.
Závěrečné myšlenky
Kromě toho se objevila oznámení v oblasti automobilového průmyslu, robotiky, zdravotnictví a generativní umělé inteligence. Všechna tato oznámení ukazují neúnavnou snahu společnosti NVIDIA o inovace a nabídku pokročilých nástrojů a platforem, které posouvají budoucnost umělé inteligence a výpočetní techniky v mnoha oblastech. Všechna jsou vysoce technická a složitá, zejména v případě kvantových výpočtů a softwarových verzí. Sledujte analýzy oznámení, jakmile se dozvíme více informací o každé z těchto nových verzí.


 Amazon