

Společnost Comino nám nedávno poslala k recenzi nejnovější verzi Comino Grando, osazenou osmi grafickými kartami NVIDIA RTX PRO 6000 Blackwell, každá s 96 GB VRAM, což představuje celkem 768 GB paměti GPU. Comino jsme recenzovali již v roce 2024, osazenou šesti grafickými kartami RTX 4090 s celkovou kapacitou 144 GB paměti GPU, a také verzi s grafickými kartami NVIDIA H100 . Tato nejnovější aktualizace představuje podstatný generační skok jak v kapacitě paměti, tak v rozsahu úloh, které platforma zvládne.
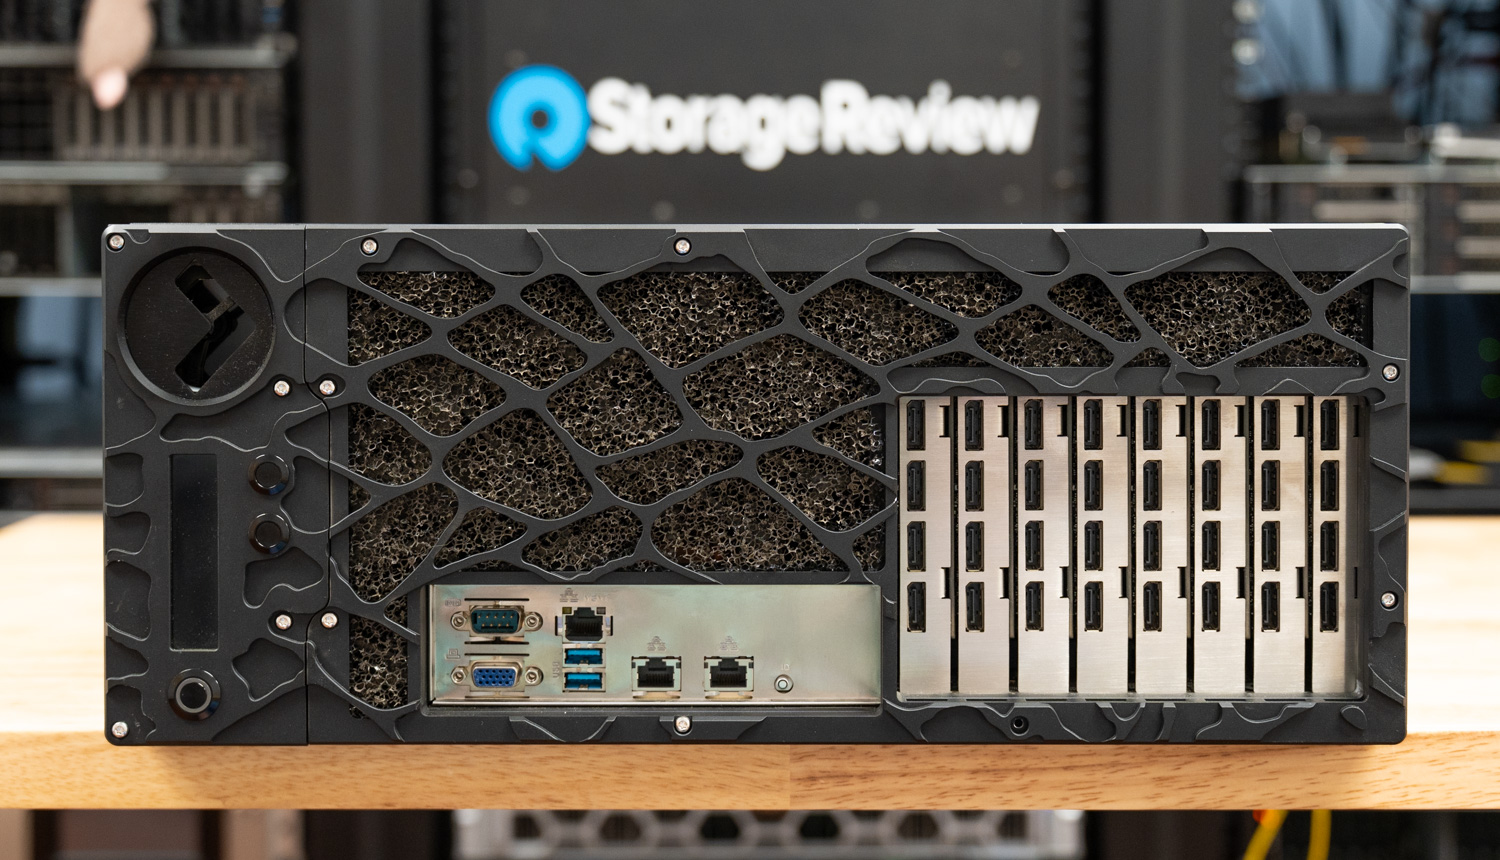
Grando je účelová 4U platforma navržená tak, aby vyřešila kritický konflikt mezi výpočetním výkonem GPU s vysokou hustotou a správou tepla. Zatímco standardní vzduchem chlazené šasi se hroutí pod trvalými nároky na TDP 600 W a více u moderních profesionálních grafických karet, Grando volí zásadně odlišný přístup, postavený od základů na kapalinou chlazené architektuře schopné odvádět masivních 6.5 kW nepřetržitého tepla. Nejedná se o dodatečnou úpravu ani dodatečnou myšlenku; celé šasi, od obráceného uspořádání základní desky až po barevně odlišený systém rychlospojek, bylo navrženo kolem chladicího okruhu.
Výsledkem je platforma, která dokáže v jediném 4U šasi udržet osm profesionálních grafických procesorů s plným TDP, běžících 24 hodin denně, 7 dní v týdnu v okolním prostředí s teplotou 3–38 °C, bez tepelného škrcení, bez akustického náporu vysokootáčkového vzduchového chlazení a bez kompromisů v oblasti provozuschopnosti. Pro organizace, které ve velkém měřítku nasazují inferenci umělé inteligence, strojové učení nebo vysoce výkonné simulační úlohy, nabízí Grando něco skutečně vzácného: server, který vás nežádá, abyste si vybrali mezi hustotou, teplotou a spolehlivostí.
Specifikace Comino Grando
Níže uvedená tabulka ukazuje fyzické specifikace a podporované hardwarové konfigurace pro platformu Comino Grando.
| Specifikace / Funkce | Comino Grando |
|---|---|
| Server a racková pracovní stanice Comino Grando | |
| Chladicí výkon | 6.5 kW (maximálně 6 500 W při teplotě nasávaného vzduchu 20 °C) |
| Základní desky | Až do EATX a EBB |
| GPU (server) | Až 8; NVIDIA: RTX A6000, RTX 6000 ADA, RTX PRO 6000, A40, L40, L40S, A100, H100, H200 |
| GPU (rackové pracovní stanice) | Až 6; NVIDIA: 3090, 4090, 5080, 5090, RTX A6000, RTX 6000 ADA, RTX PRO 6000, A40, L40, L40S, A100, H100, H200; AMD: W7800, W7900 |
| procesory | Až 2; Jeden socket: Intel Xeon W-2400/2500 a 3400/3500, Intel Xeon Scalable 4. generace, 5. generace, XEON 6, AMD Threadripper PRO 5000WX, 7000WX, 9000WX, AMD EPYC 9004/9005 Duální patice: Intel Xeon Scalable 4. a 5. generace, XEON 6, AMD EPYC 9004/9005 |
| RAM | Až 2TB |
| Jednotky M2 | Až 8x NVME |
| Skladování | Krabice pro hot-swap na zadním panelu: až 4x hot-swap SSD (4x 7mm nebo 2x 15mm) a až 4 další (4x 7mm nebo 2x 15mm) místo 4. zdroje; Vnitřní klec 3.5″ až pro 4x 3.5″ nebo 4x 2.5″ 15 mm nebo 12x 2.5″ 7 mm; Interní 2.5″ sloty: až 4x 2.5″ SSD 7 mm |
| Napájení a provozní napětí | Až 4x 2000W Hot Swap CRPS při 180-264V Až 4x 1000W Hot Swap CRPS při 90-140V Redundantní režimy: 4+0, 3+1, 2+2 |
| Hladina hluku | 39 dB až 70 dB |
| Lan | Až 2x 10 Gb/s na základní desce a až 400 Gb/s v síti PCIe |
| OS | Ubuntu / Windows 11 (Pro/Home) / Windows Server |
| Fyzikální a chladicí specifikace | |
| Tekuté chlazení | CPU s VRM a GPU s GDDR a VRM |
| Nádrž | Comino custom 450ml s integrovanými pumpičkami |
| Fanoušků | 3x Ultra High Flow 6200 ot./min (vysoká hladina hluku) nebo 3x vysoký průtok 3000 ot./min (nízká hladina hluku) |
| Instalace | Montáž do 19″ racku nebo samostatná pracovní stanice |
| Požadovaný prostor ve racku | 4U |
| Velikost | 439 x 681 x 177 mm (bez úchytů a vyčnívajících částí) |
| Hmotnost | 4 GPU: 49 kg (netto), 67 kg (hrubá hmotnost) 6 GPU: 52 kg (netto), 70 kg (hrubá hmotnost) 8 GPU: 55 kg (netto), 72 kg (hrubá hmotnost) |
| Rozsah provozních a skladovacích teplot | Skladovací teplota: -5..50 °C / 23..122 °F Provozní: 3..38 °C / 38..100 °F |
| Monitorovací systém Comino (CMS) | |
| Přehled | Řídicí deska se senzory a softwarem pro monitorování v reálném čase |
| Klíčové výhody | Monitorování chladicího systému a CPU/GPU, webové rozhraní, protokol chladicího systému, centralizované monitorování pro pracovní skupiny |
| Senzory a připojená zařízení | Teplota (vzduch a chladicí kapalina), % vlhkost, napětí, průtok chladicí kapaliny, hladina chladicí kapaliny v nádržce, ventilátory, čerpadla, základní deska, displej a tlačítka |
| Možnosti integrace | Zaveďte monitorování pomocí REST API a odesílejte data ze senzorů do monitorovacího softwaru (např. Zabbix, Grafana) nebo databází (např. InfluxDB). |
| Technické požadavky na redakční systém (CMS) | |
| OS | Windows 11 / 10 Ubuntu 22.04/20.4 (Závislost pro Ubuntu: cílový systém musí mít nainstalované utility nvidia-smi a sensors) |
| Internetové prohlížeče | Mozilla Firefox, Google Chrome, Chromium, Apple Safari, Microsoft Edge (Pozor: Internet Explorer 11 není podporován) |
| Pevný disk | 300MB |
| Verze firmwaru řídicí jednotky | 1.0.6 nebo novější |
| Verze řídicí desky s plošnými spoji | 2.xx.xx |
Návrh, konstrukce a hustota GPU
Rozložení a rozmístění podvozku
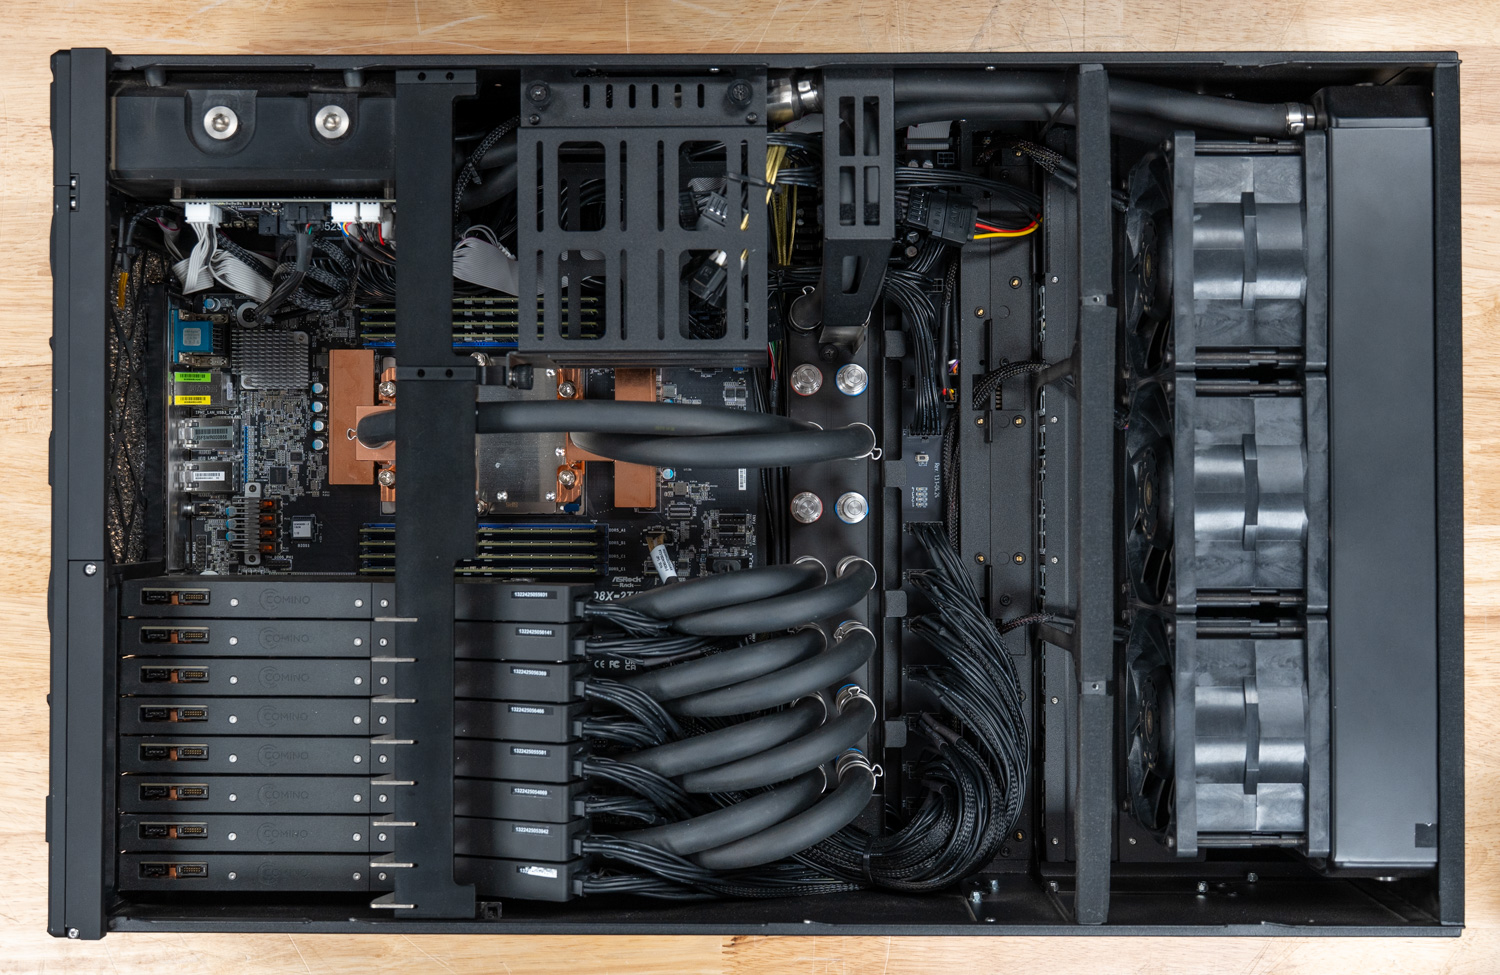
Grando Server je mistrovským příkladem v optimalizaci prostoru s rozměry 17.3 x 26.8 x 6.97 palce (4U). Na rozdíl od tradičních serverů je zadní strana základní desky umístěna v přední části šasi, čímž se obrací konvenční vnitřní uspořádání. To zajišťuje, že vzduchem chlazené komponenty, jako jsou moduly RAM a VRM, dostávají co nejchladnější nasávaný vzduch, než se dostane k chladiči kapalinového chlazení v zadní části.
Samotné šasi je vyrobeno podle stejných přísných standardů a vyznačuje se pevnou ocelovou konstrukcí s matně černým práškovým lakováním naneseným uvnitř i vně. Tato záměrná volba se vztahuje i na trubky, kabely, chladič a pájecí masku desky plošných spojů, což odráží jasný záměr dosáhnout čisté a profesionální estetiky. Systém navíc podporuje všestranné nasazení a bezproblémově funguje buď jako 19palcová jednotka montovatelná do racku, nebo jako samostatná stolní jednotka. V závislosti na konfiguraci váží 148 až 159 liber.
Chladicí desky a vodní bloky pro GPU
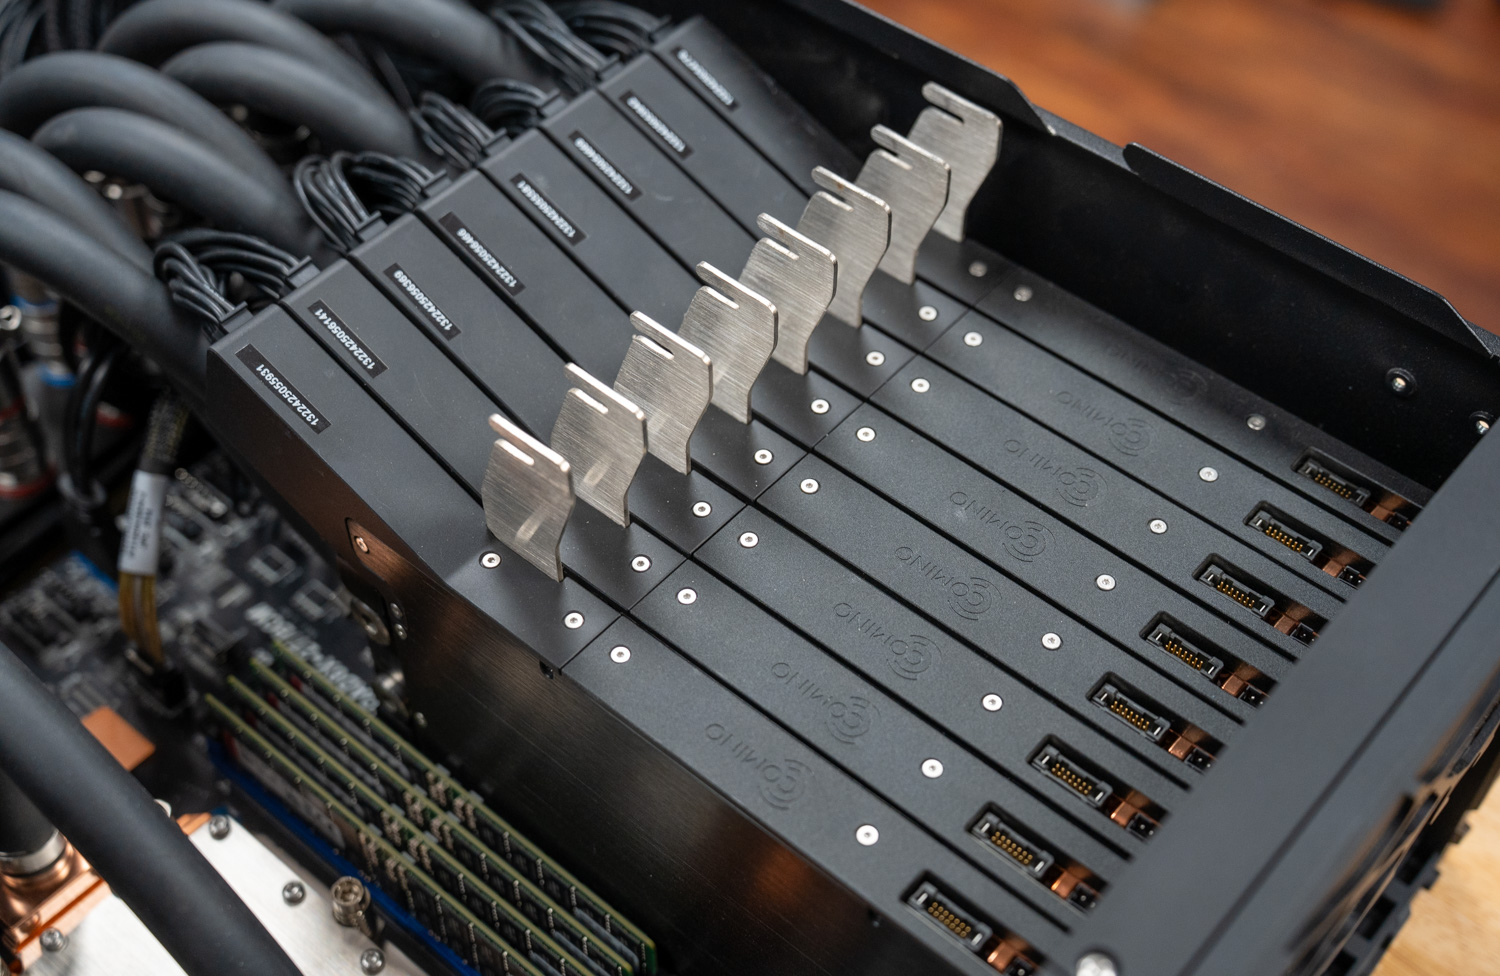
Jádrem desky Grando jsou proprietární měděné vodní bloky, které chladí nejen grafický čip, ale i další komponenty, jako jsou paměť a regulátory napětí. Každá grafická karta se dodává jako standardní karta, na kterou Comino montuje vlastní sestavu chladicí desky. V praxi tento tenkoprofilový design zmenšuje každou kartu na jeden slot, což umožňuje umístit šest nebo dokonce osm profesionálních grafických karet vedle sebe v jednom 4U šasi. Náš testovaný kus byl dodáván s osmi kartami NVIDIA RTX PRO 6000 Blackwell, každá s TDP 600 W, což má za následek celkovou potřebu chlazení 4 800 W při plném zatížení.
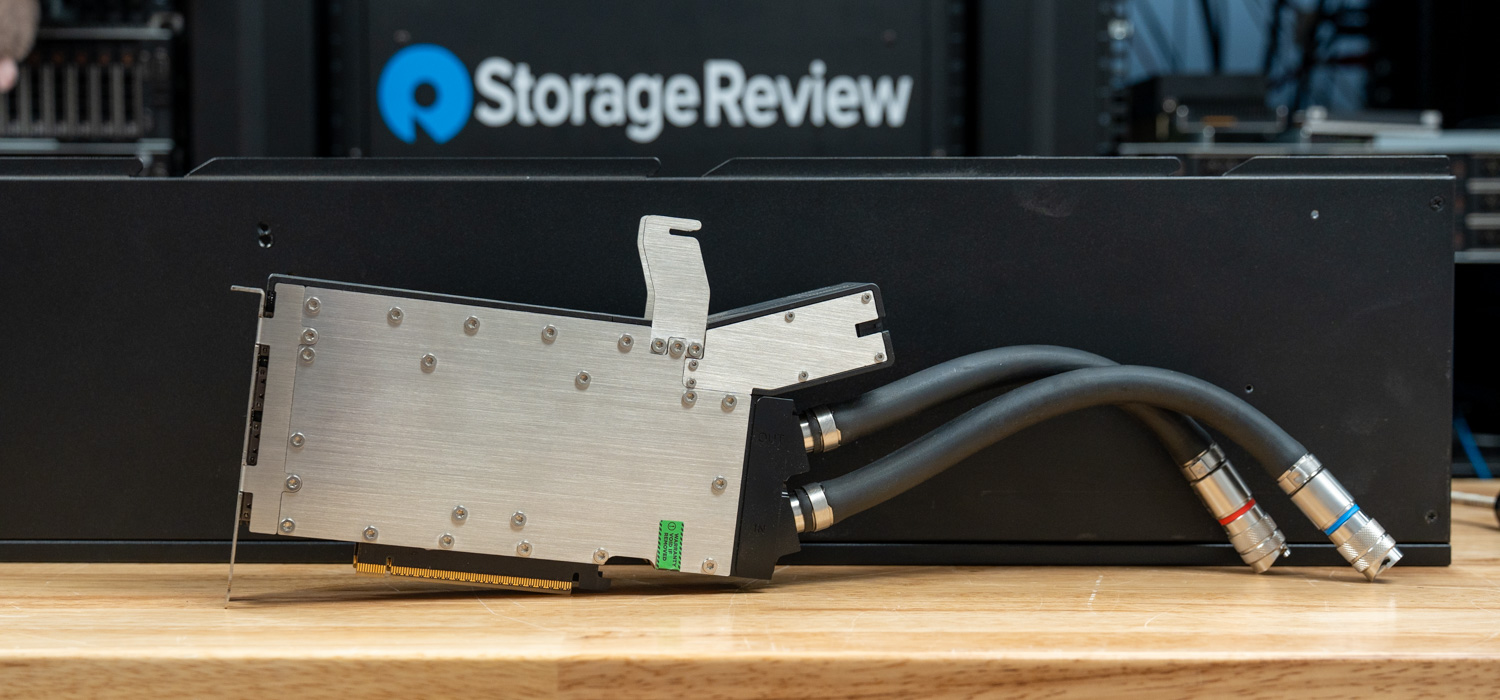
Dosažení osmi jednoslotové hustoty grafických karet jako u Comina by bylo s chlazením vzduchem téměř nemožné, protože standardní karty NVIDIA RTX PRO 6000 zabírají dva sloty a vyžadují značné proudění vzduchu. Naproti tomu tyto karty s vlastním chlazením zabírají pouze jeden slot. Chladicí desky jsou robustní, což kartě znatelně zvyšuje hmotnost, ale tato hmotnost odráží kvalitu a chladicí výkon požadovaný na této úrovni.
Každý pár grafických karet (GPU) je propojen specializovaným dílčím rozdělovačem, který obě karty spojuje do jednoho vstupního a výstupního připojení k hlavnímu rozdělovači chladicí kapaliny. Tento párový přístup zjednodušuje celkovou architekturu okruhu, snižuje počet připojení na hlavním rozdělovači a umožňuje technikovi odpojit jeden pár rychlospojek a vyjmout tak dvě karty najednou, což dále zefektivňuje údržbu.
Rozvod vody a rozdělovač
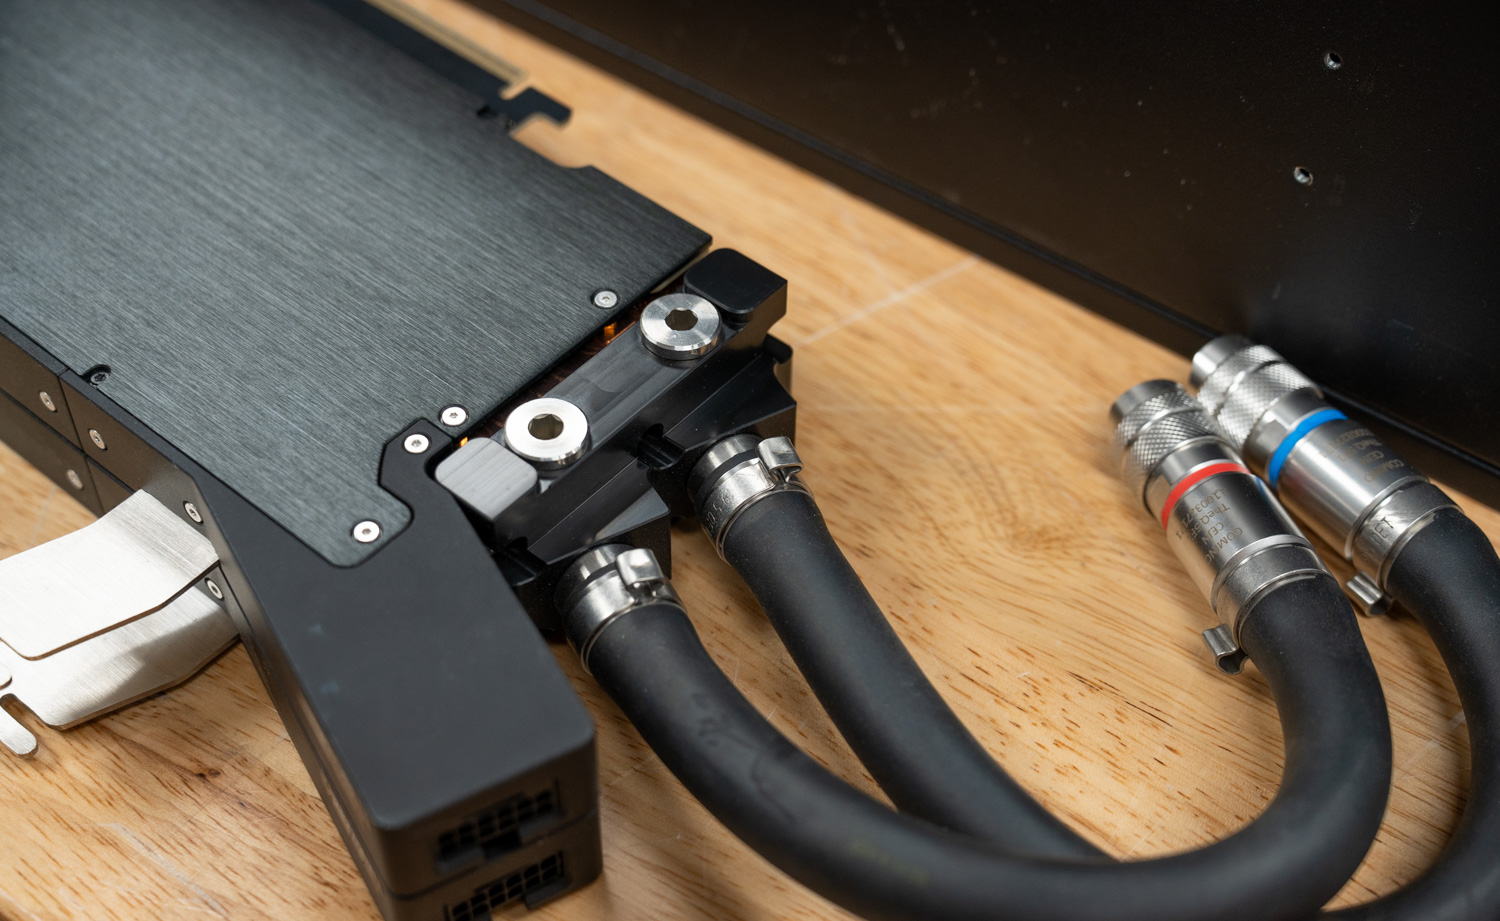
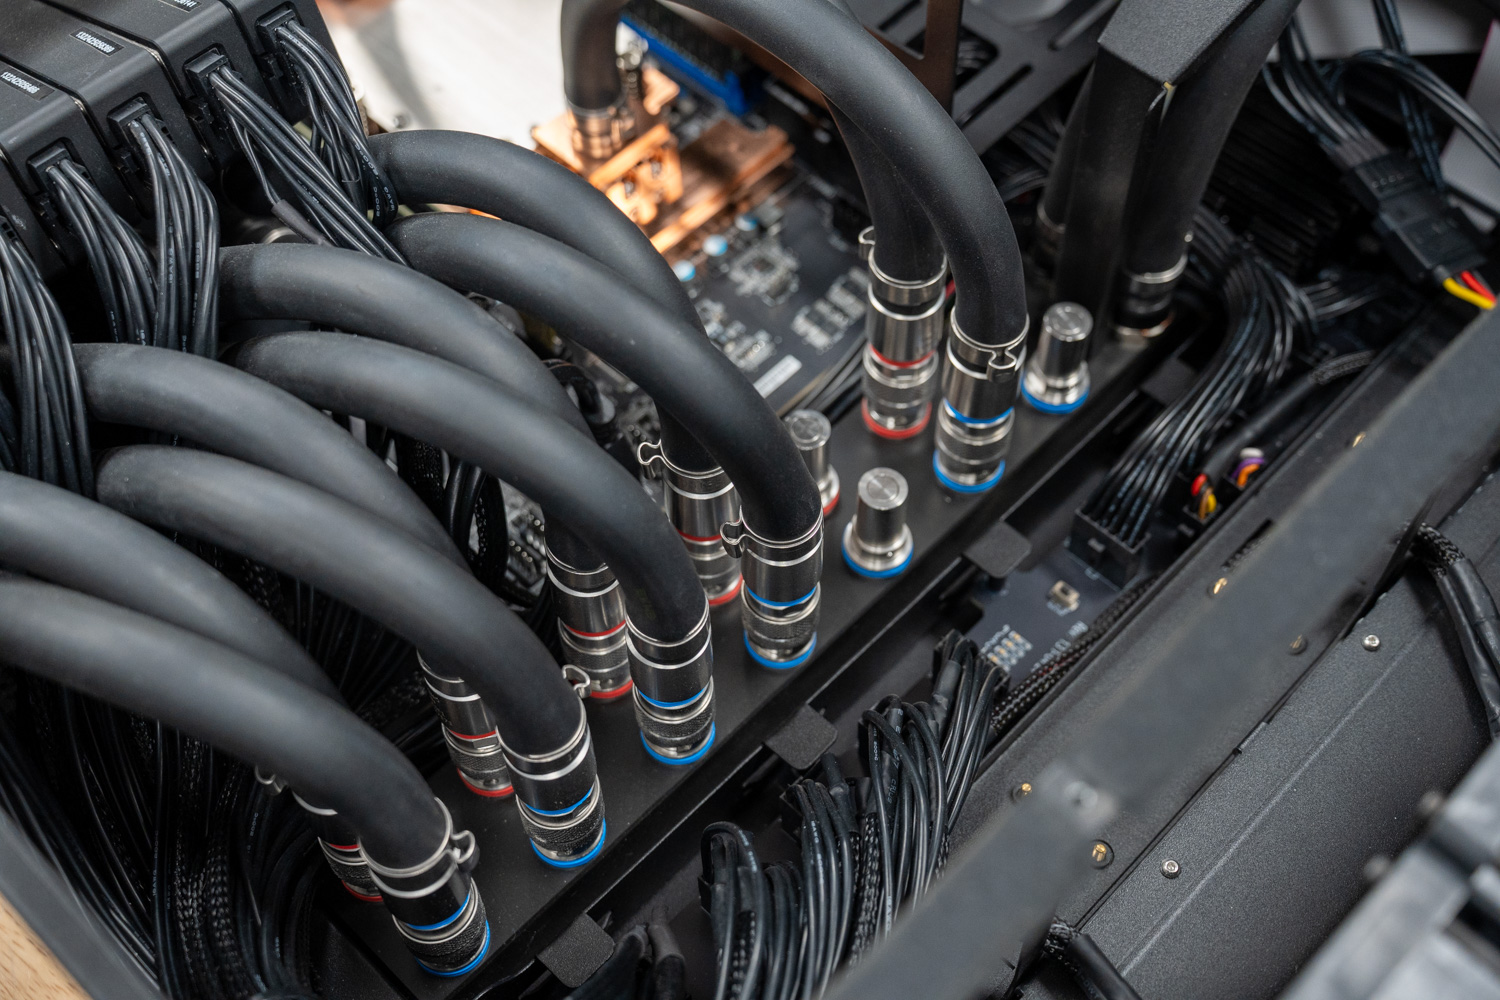
Uprostřed systému se nachází velké rozdělovací potrubí vody, které dodává chladnou kapalinu ke každé chladicí desce GPU a CPU a zajišťuje zpětnou cestu k chladiči. Všechna spojení mezi rozdělovacím potrubím a GPU a CPU využívají rychlospojky Comino „TheQ“. Tyto nerezové bezodkapové armatury jsou barevně označeny červenými a modrými kroužky, které jasně identifikují horkou a studenou stranu okruhu, a tím eliminují jakékoli nejasnosti během instalace nebo servisu.
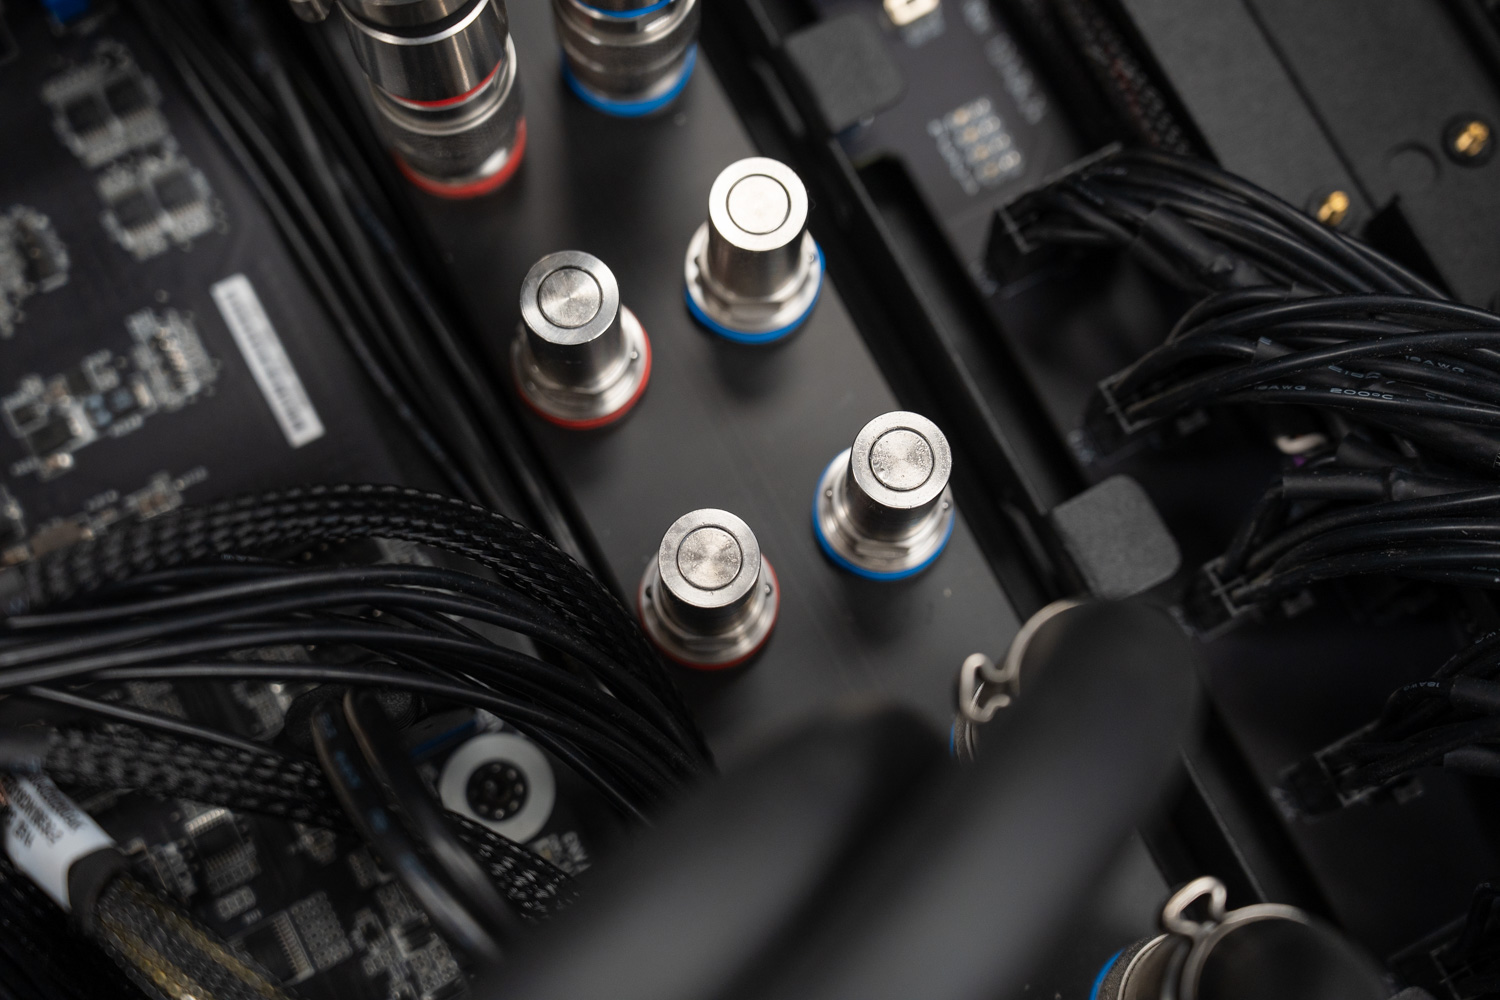
Po odpojení zanechávají na dosedací ploše minimální zbytky, což technikům umožňuje vyjmout nebo vyměnit jednotlivé grafické karty (GPU) nebo procesory (CPU) bez nutnosti vypouštění 450ml nádržky nebo zbytku okruhu. Grando tak přináší jednoduchost údržby vzduchem chlazených systémů na vysoce výkonnou platformu chlazenou kapalinou.
Chlazení CPU a paměti
CPU a jeho regulátory napětí také těží z vyhrazené chladicí desky připojené přímo k chladicímu okruhu, což zabraňuje tomu, aby se procesor stal úzkým hrdlem při intenzivním zatížení s více GPU. Náš testovaný kus byl dodáván s základní deskou AMD Turin/Genoa s jedním 48jádrovým procesorem AMD EPYC 9474F. Chladicí deska odráží kvalitu chladicích desek karty, je vyrobena z masivní mědi a zajištěna nerezovými kovovými prvky.
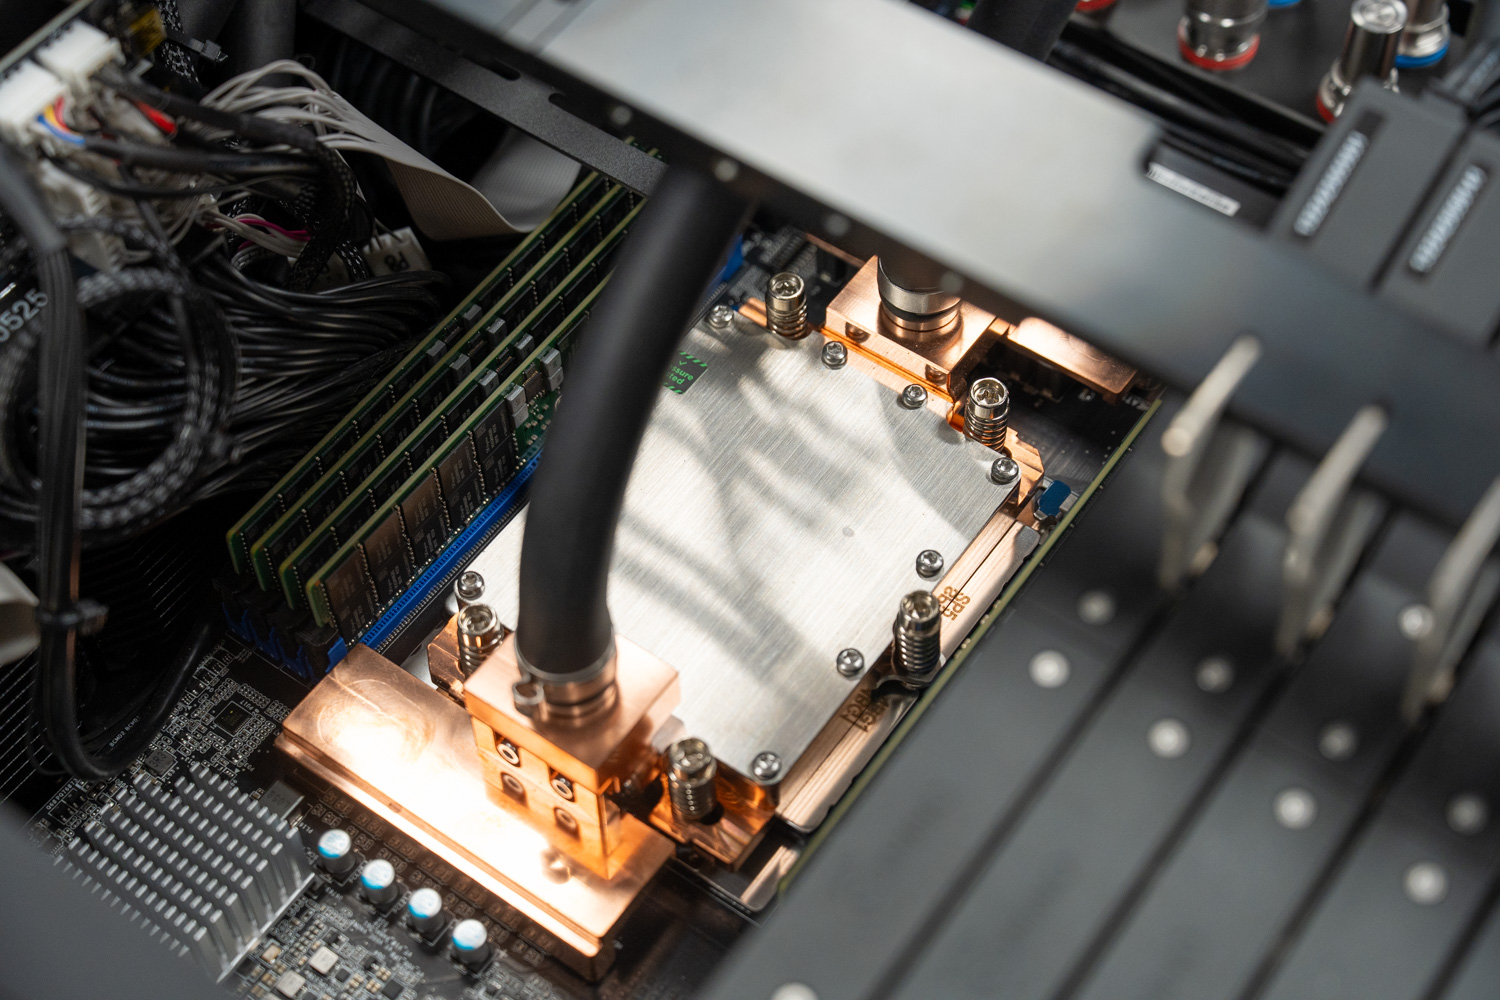
Po obou stranách procesoru se nachází osm plně obsazených slotů DRAM, které podporují konfigurace až do 2 TB RAM. Náš testovaný kus byl vybaven 512 GB paměti DDR5 RAM. Nad oblastí grafického a procesorového procesoru se kolmo k nim rozprostírá podpůrná lišta, která zajišťuje citlivé komponenty, jako jsou grafické karty, a udržuje tuhost šasi během přepravy.
Chladič a ventilátory
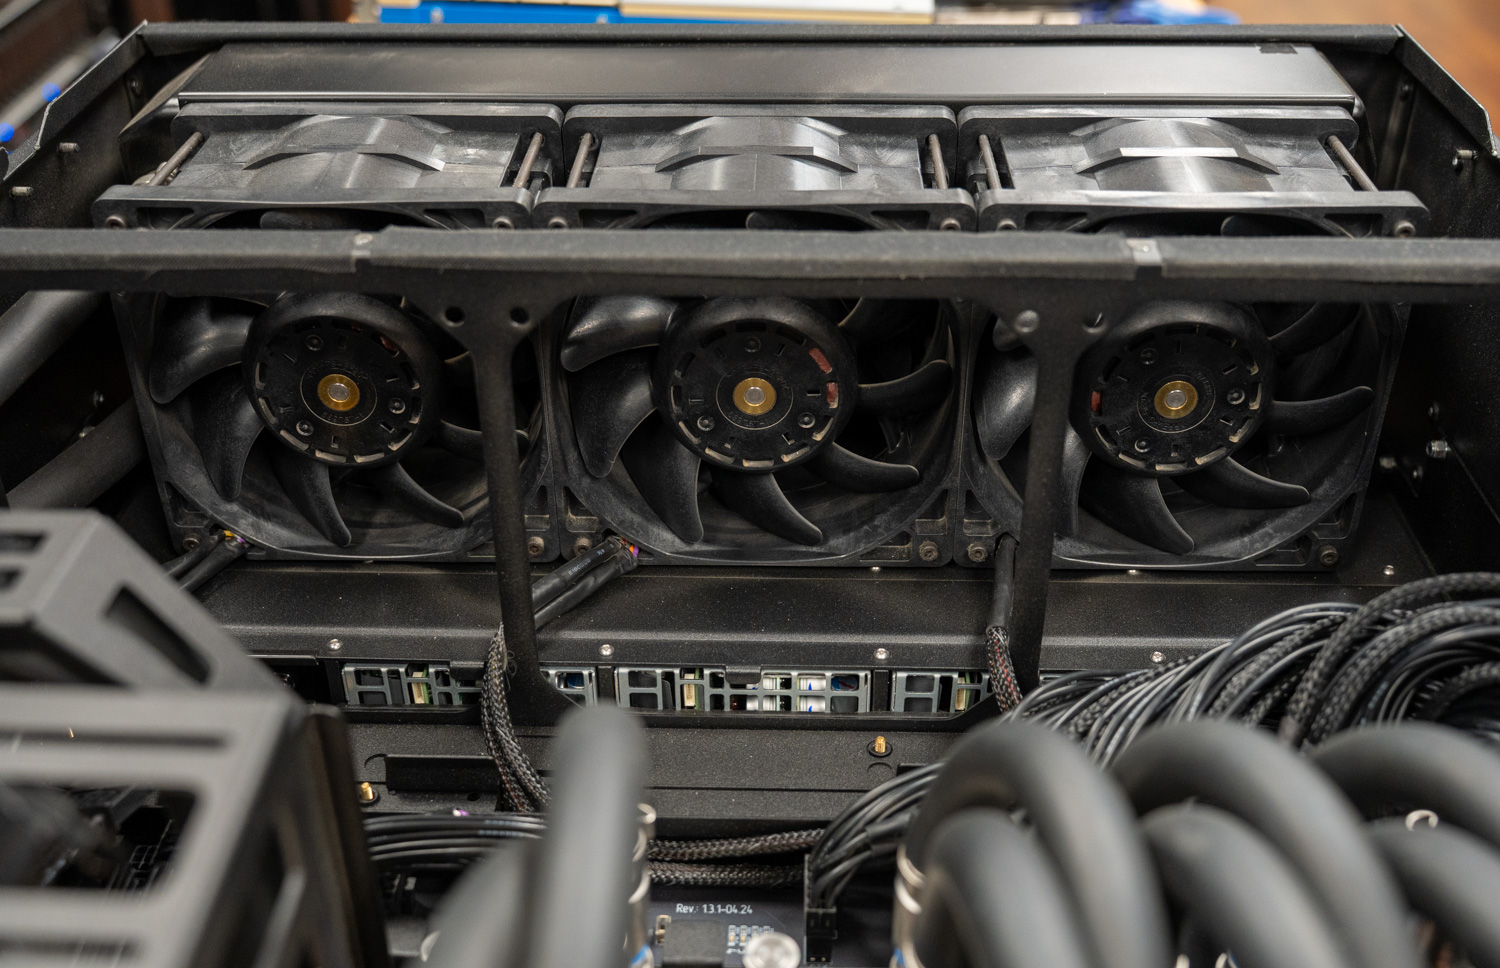
Chlazení zajišťuje velký trojitý 140mm chladič namontovaný v zadní části šasi, spárovaný se třemi vysokorychlostními 140mm ventilátory schopnými dosáhnout 6 200 ot./min a průtoku vzduchu až 1 000 m³/h. Hustý žebrovaný svazek tlustého chladiče podtrhuje tepelný prostor navržený v platformě, která je v naší konfiguraci konstruována tak, aby odváděla až 6.5 kW trvalého tepla.
Asi nejpřekvapivější je, že i přes takové zatížení a rychlosti ventilátorů se jednotce daří udržet si přijatelnou hladinu hluku, s hladinou hluku přes 70 dB při plném výkonu. To je na poměry pracovních stanic hlučné, ale u systému odvádějícího tepelný výkon malé elektrické pece to bývá znatelně omezené, což svědčí o tom, jak efektivně kapalinový okruh Comina odvádí teplo od komponent.
Přední panel a telemetrický displej
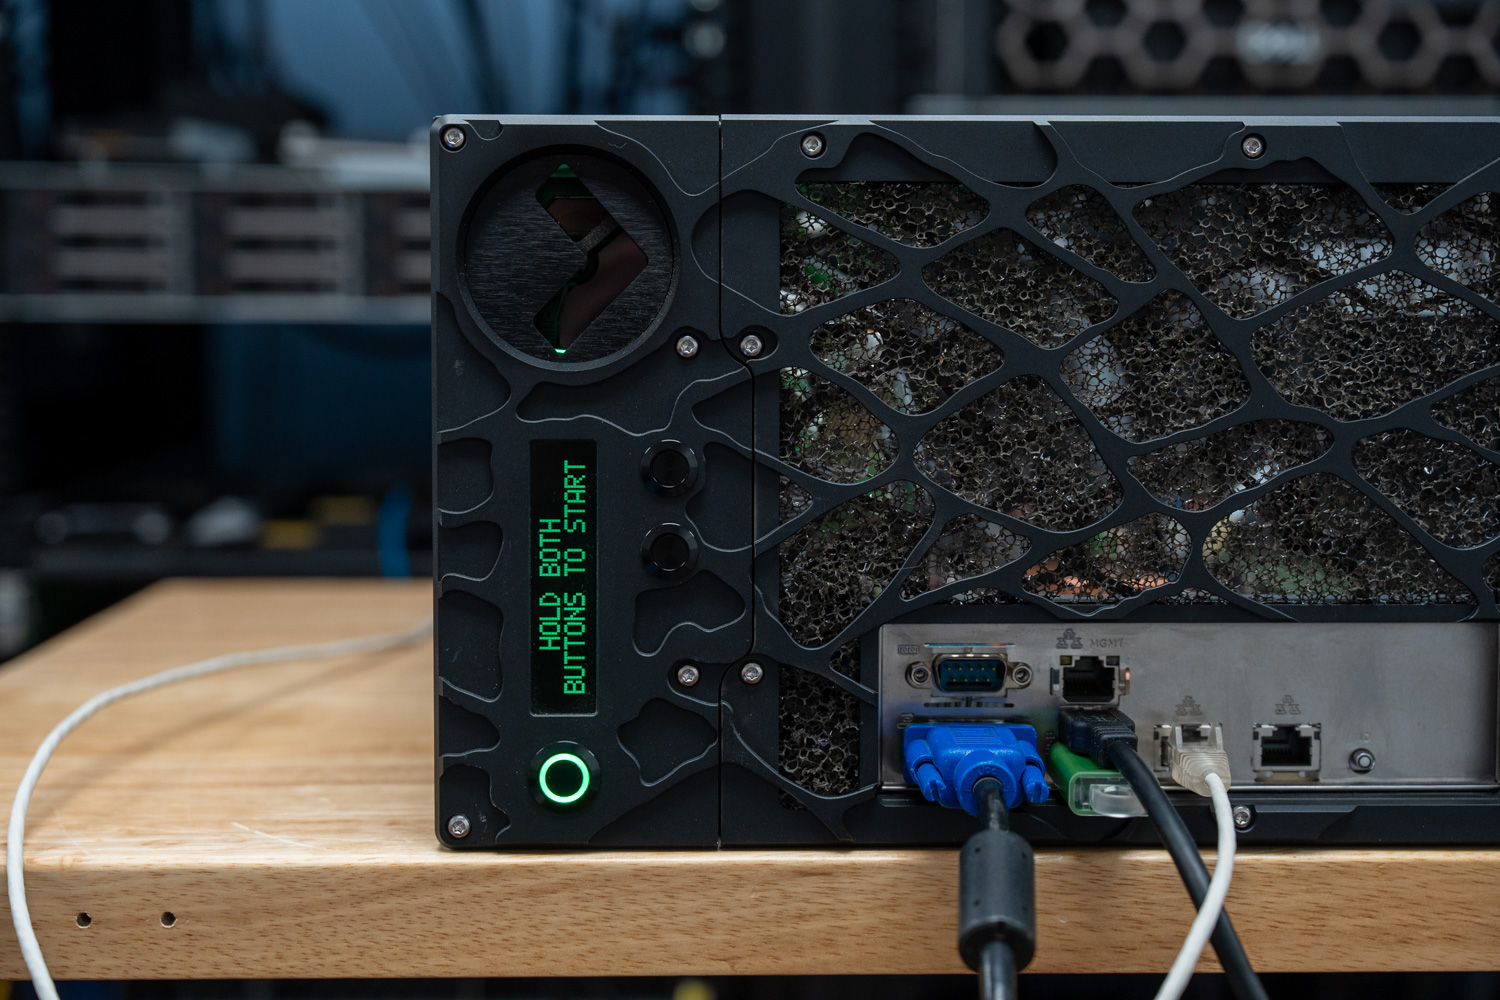
Na předním panelu LED displej zobrazuje v reálném čase klíčová telemetrická data, včetně stavu čerpadla, teploty okolního vzduchu, teploty chladicí kapaliny a otáček ventilátoru. Uživatelé se v nabídce pohybují pomocí podsvícených tlačítek na chladicím modulu a krátkými stisknutími procházejí dostupná data. Dlouhým stisknutím tlačítka PB2 se otevírají další větve nabídky, včetně Příkazů, Servisních nastavení a Protokolu událostí. Přední I/O panel navíc obsahuje port VGA pro výstup na displej, sériový port, několik portů USB a síťová připojení pro připojení periferních zařízení a dalších zařízení.
Architektura napájení a úložiště
Napájení a redundance
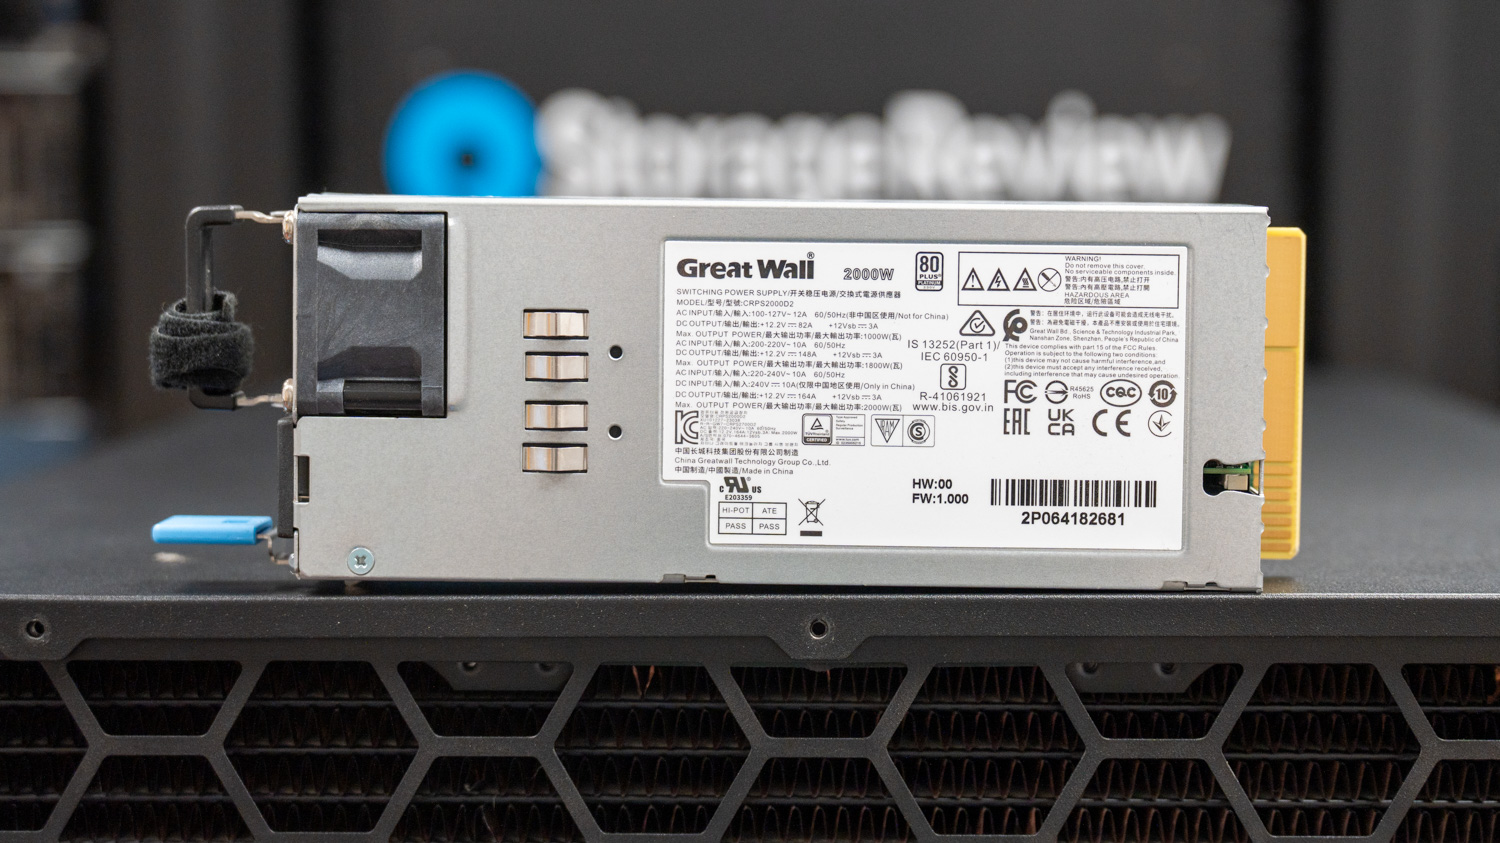
Podpora této úrovně výpočetních výkonů vyžaduje stejně robustní napájení. Grando podporuje až čtyři hot-swap 1000W nebo 2000W CRPS moduly v redundantní konfiguraci, které poskytují až 8.0 kW při 180–264 V. Díky podpoře redundantních režimů 4+0, 3+1 a 2+2 dokáže systém tolerovat selhání napájecího zdroje a zároveň udržovat nepřetržitý provoz pro úlohy AI a HPC 24/7.
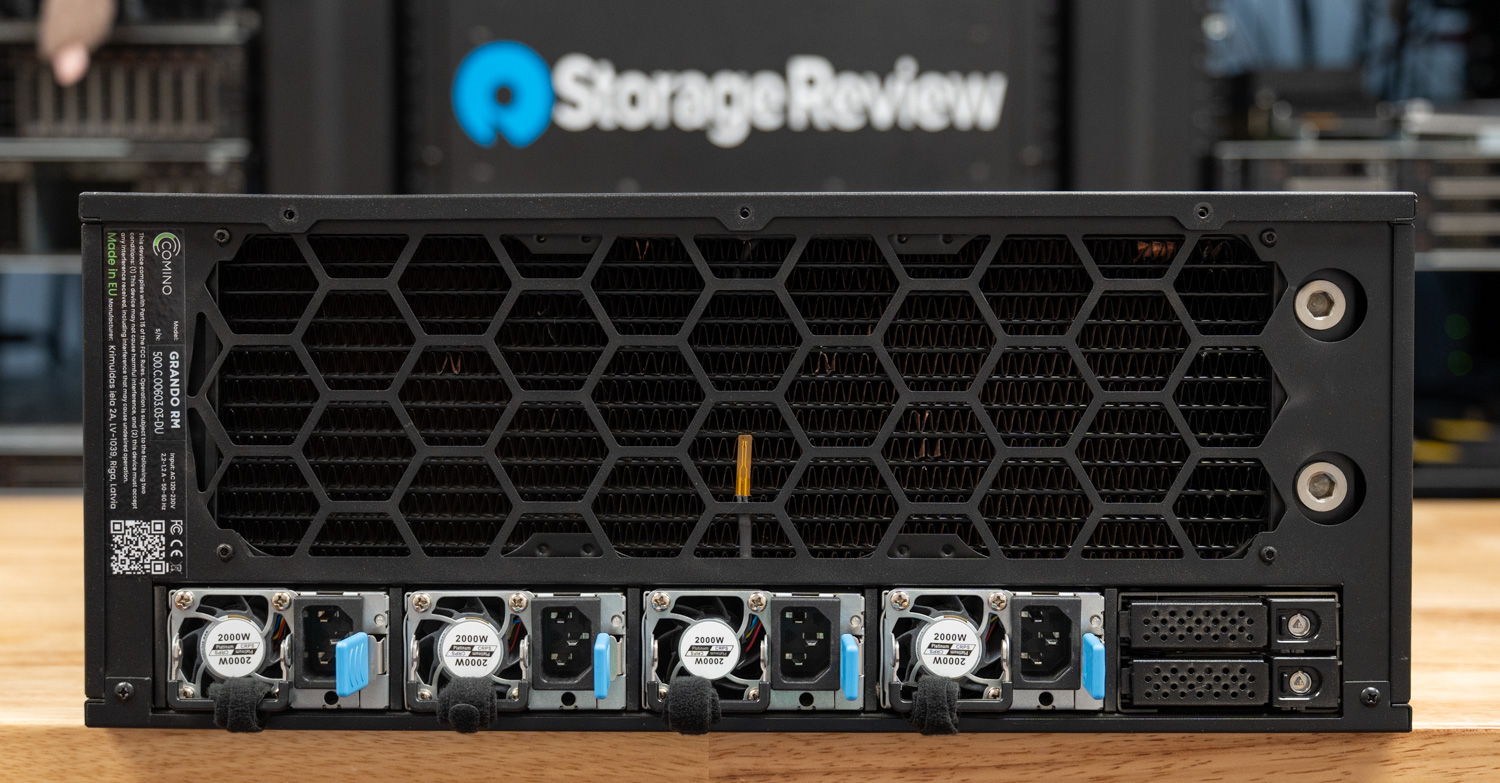
Náš recenzovaný kus byl dodáván se čtyřmi hot-swap napájecími zdroji Great Wall 80 Plus Platinum s výkonem 2000 W, které tvoří plnou konfiguraci s výkonem 8.0 kW.
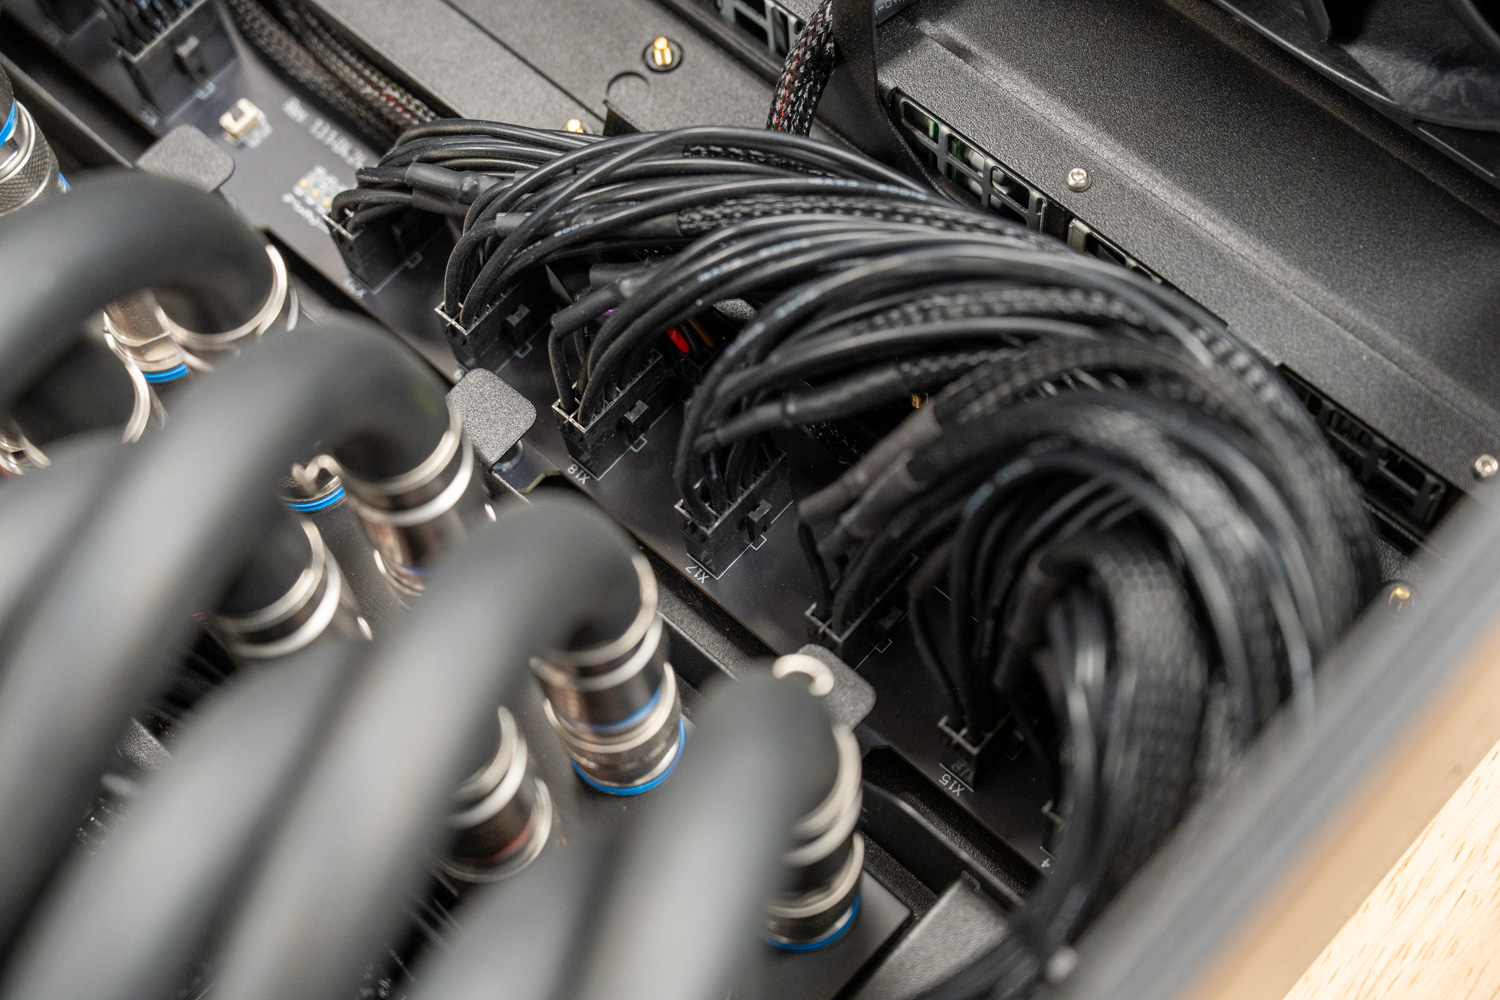
Napájení každé grafické karty (GPU) probíhá přes centralizovanou 12pinovou rozvodnou desku, která je umístěna mezi polem GPU a hlavním kabelovým vedením. Grando používá tuto rozvodnou desku ke konsolidaci příchozích napájecích zdrojů a jejich následnému rozvětvení ke každé grafické kartě organizovaným a prostorově efektivním způsobem.
PCIe, úložiště a sítě
Grando pohodlně podporuje šest GPU bez kompromisů v šířce pásma slotů a šasi lze škálovat na plnou konfiguraci s osmi kartami pro maximální hustotu. Základní deska ASRock Rack GENOAD8X-2T/BCM od společnosti Comino nabízí sedm slotů x16 a jeden x8 PCIe Gen 5, což znamená, že sedm z osmi GPU běží na plné šířce pásma x16 a osmá karta pracuje na x8. Jedná se o kompromis mezi počtem linek PCIe, které může jednopaticový procesor podporovat, a neochotou společnosti Comino přidat velikost, cenu a složitost přepínače PCIe. Přechod na základní desku se dvěma sockety by sice poskytl více linek PCIe, ale nabídl by ještě méně slotů, protože druhý socket by v tomto prostorově omezeném provedení zabíral místo, které by jinak využívaly sloty PCIe.
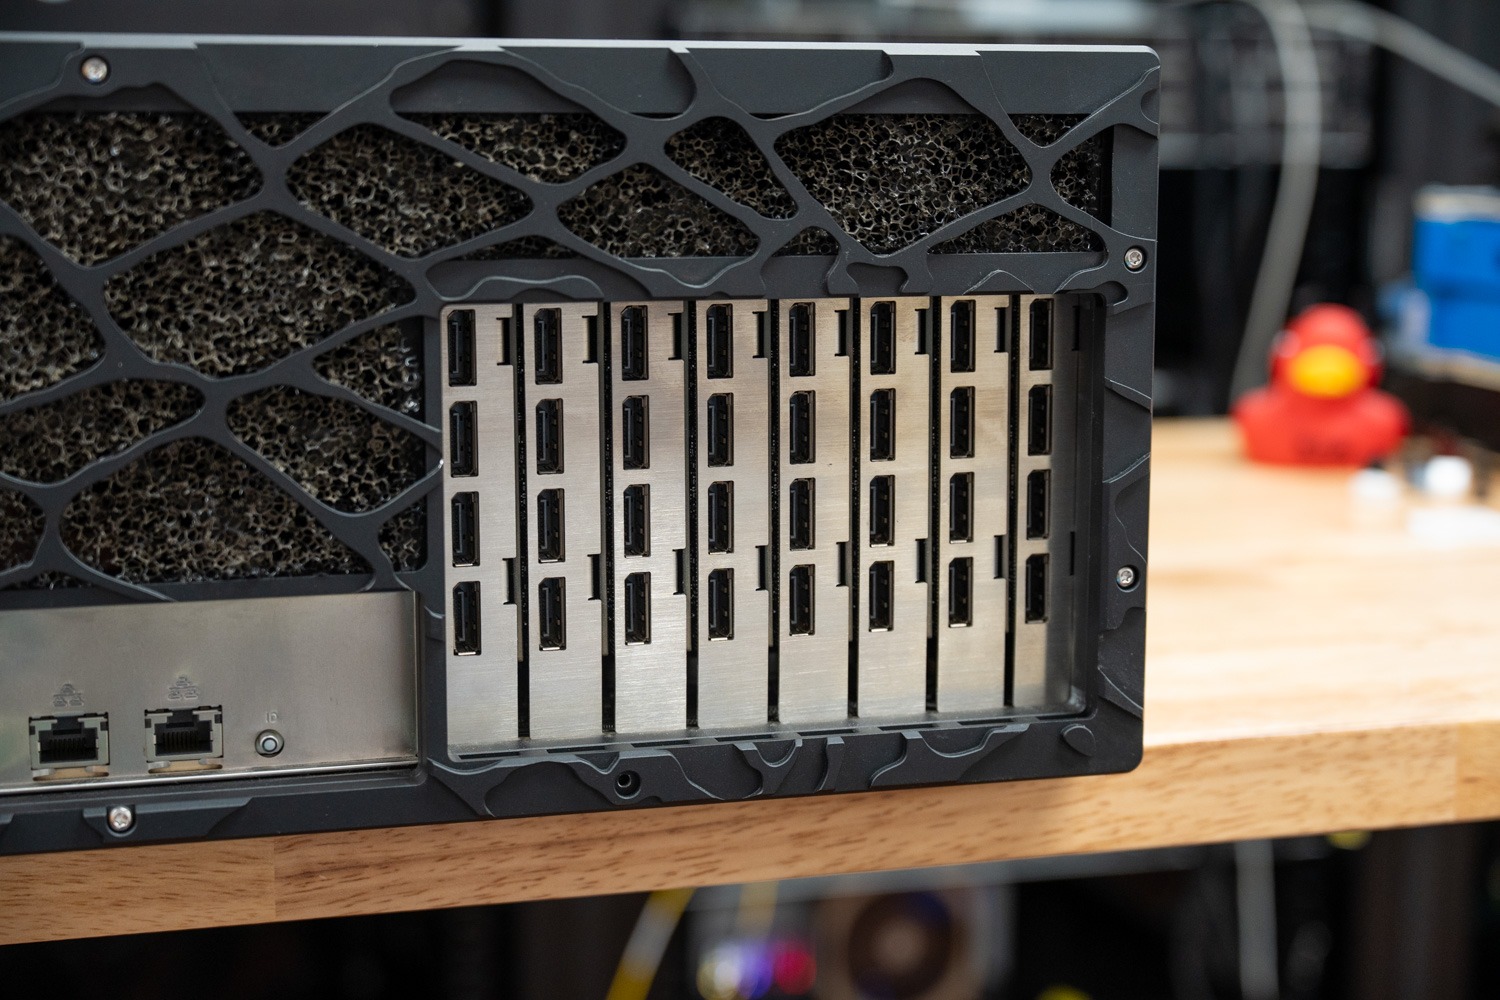
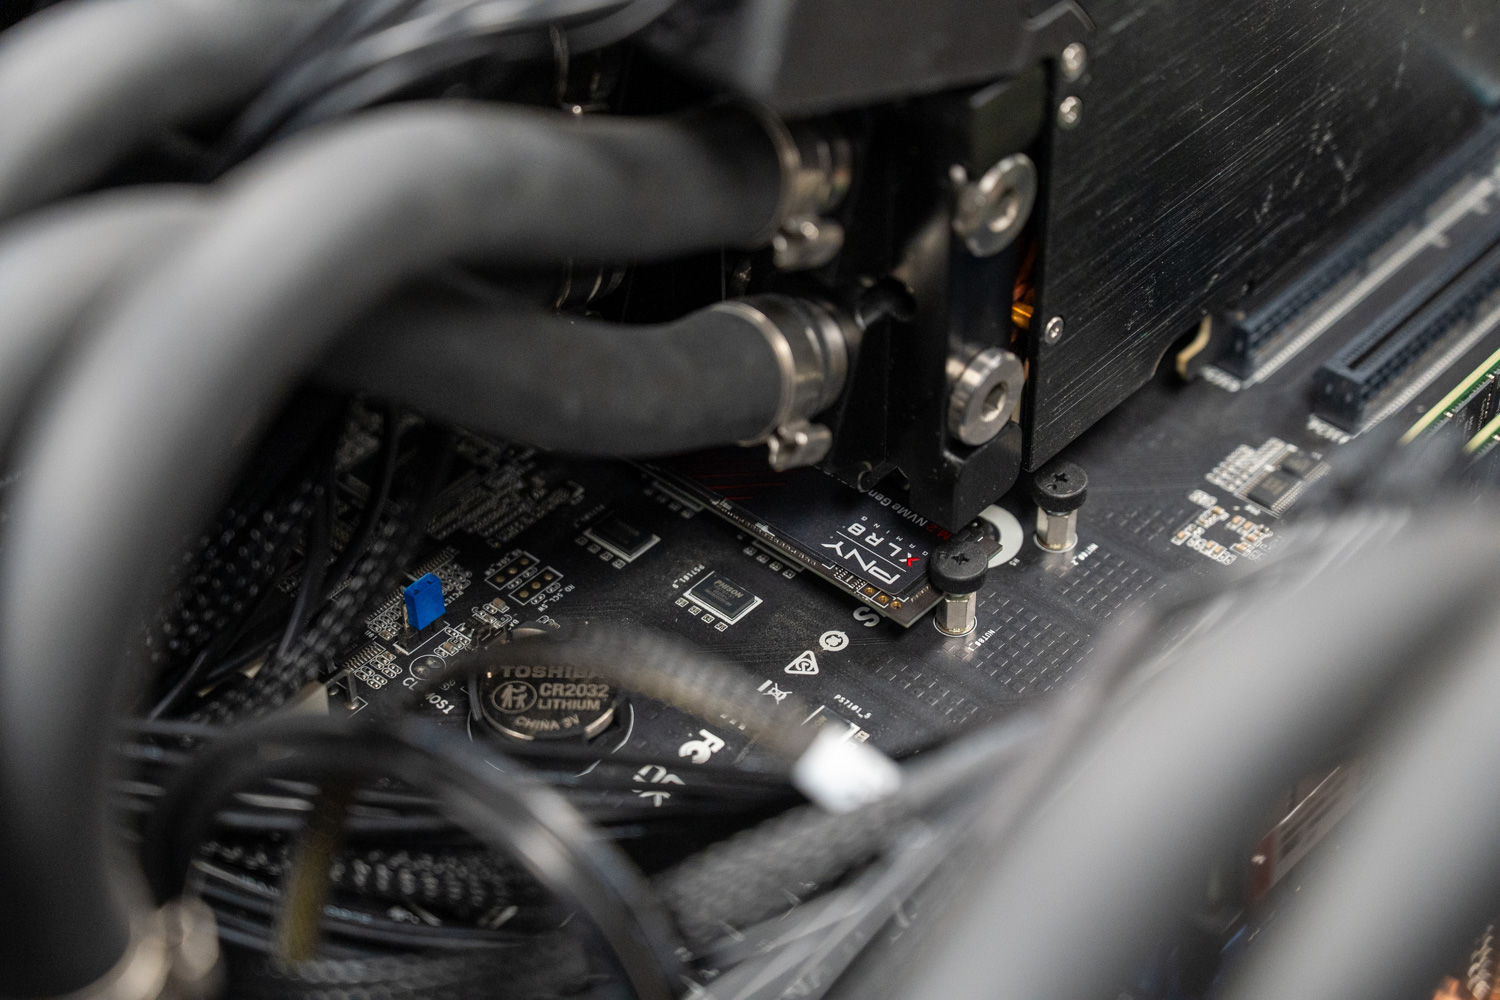
Provoz osmi grafických karet v systému s jedním socketem spotřebovává lví podíl dostupných linek PCIe, což s sebou nese určité kompromisy. Náš testovaný kus, založený na procesoru AMD Genoa, má k dispozici celkem 128 linek PCIe Gen 5. Vzhledem k tomu, že osm grafických karet spotřebovává 120 z těchto linek, je zbývajících 8 linek rozděleno po čtyřech do každého slotu M.2 SSD, takže není možné současně provozovat osm grafických karet a plný počet disků NVMe v zadní části šasi připojených přes dva konektory MCIO. V naší plné konfiguraci s 8 grafickými kartami byly pro úložiště k dispozici pouze 2 sloty M.2. Administrátoři, kteří potřebují dodatečnou kapacitu NVMe spolu s maximální hustotou grafických karet, by si měli být vědomi toho, že přidání zadního úložiště NVMe s možností výměny za chodu prostřednictvím zadních panelů spotřebuje další linky PCIe a deaktivuje část kapacity grafických karet v jejich systému.
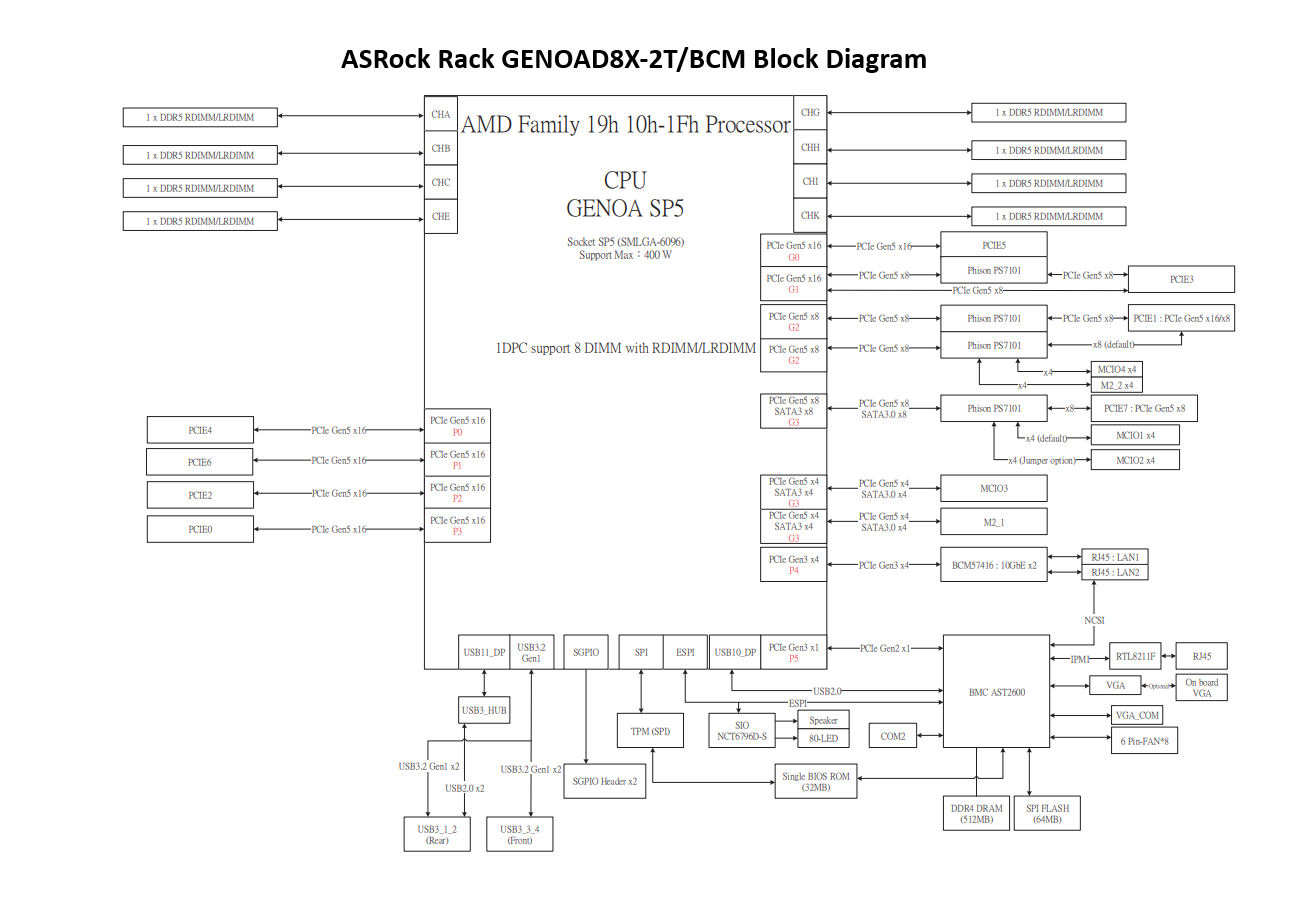
Blokové schéma základní desky ASRock Rack GENOAD8X-2T/BCM zobrazující CPU, sloty PCIe Gen 5, kanály DIMM, sloty M.2, BMC, USB, SATA a síťová připojení.
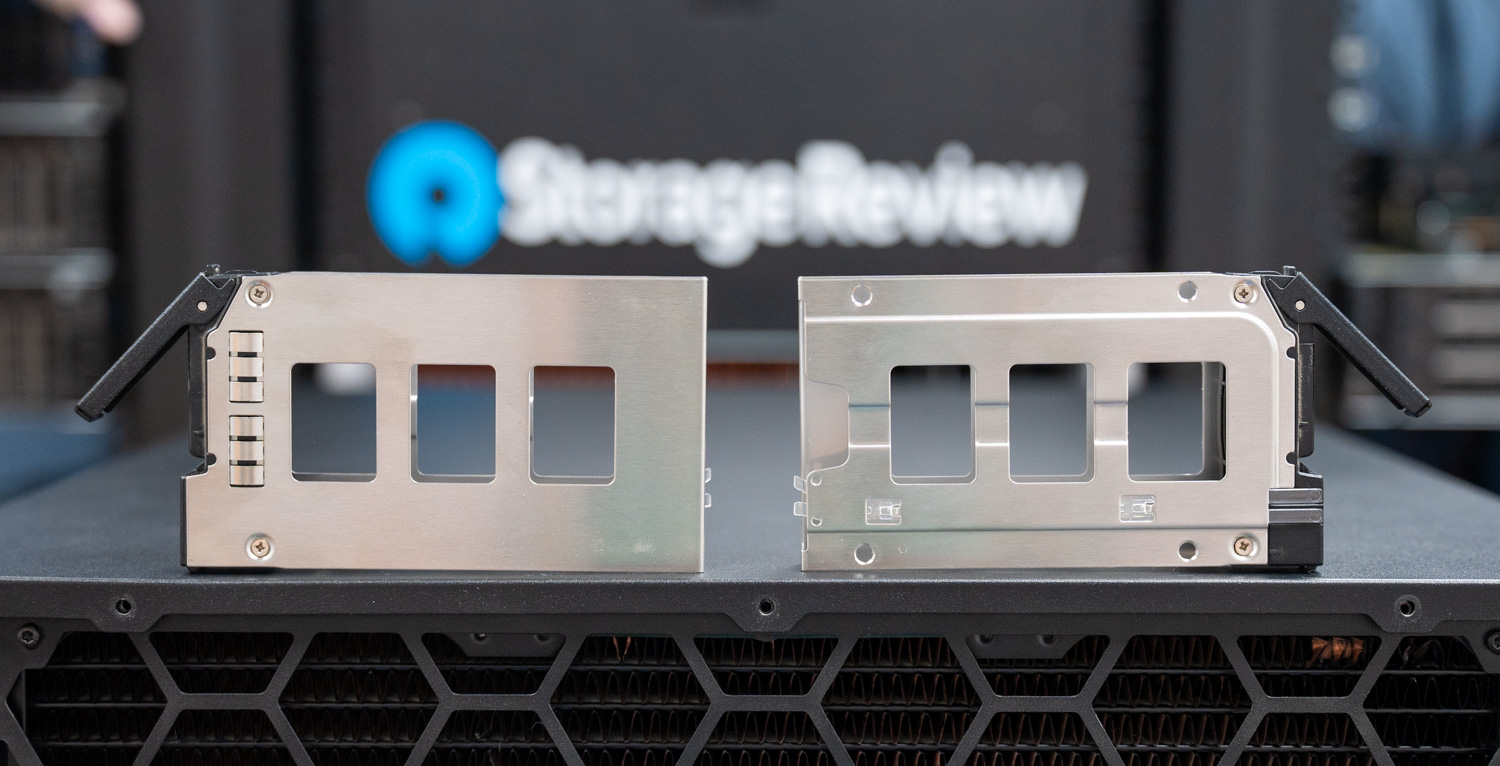
Úložiště je však stejně modulární a rozsáhlé, i když konfigurace ovlivňuje rozpočet na linky PCIe pro grafické karty, což se vyplatí zvážit s ohledem na zamýšlený případ použití. Zadní panel našeho recenzovaného kusu obsahuje 2.5palcovou klec pro disky, která podporuje až čtyři 2.5palcové SSD disky v konfiguraci 4x 7mm nebo 2x 15mm, s volitelnou druhou sadou až čtyř disků, která je k dispozici místo čtvrtého slotu pro zdroj. Protože náš recenzovaný kus vyžadoval pro podporu plné konfigurace s 8 grafickými kartami všechny čtyři pozice pro napájecí zdroje, měli jsme přístup pouze k první ze dvou pozic pro výměnu za provozu. Interně šasi podporuje 3.5palcovou klec, která pojme až čtyři 3.5palcové disky, čtyři 2.5palcové 15mm disky nebo až dvanáct 2.5palcových 7mm disků a čtyři další interní 2.5palcové 7mm sloty pro SSD disky, pokud jsou nakonfigurovány.
Pro síťové připojení jsou na základní desce standardně k dispozici dva integrované porty RJ45 10 Gb/s s čipem Broadcom BCM57416 a dále dedikovaný port pro správu gigabitového Ethernetu IPMI. Administrátoři mohou šířku pásma dále zvýšit instalací síťových karet PCIe s rychlostí až 400 Gb/s pro vysokorychlostní konektivitu fabric. Je však třeba poznamenat, že další síťové karty PCIe obsazují sloty pro grafické karty, což snižuje maximální počet grafických karet, které systém může hostovat.
Vzdálená správa a systémová inteligence
Pro ochranu hardwaru a optimalizaci výkonu systém obsahuje monitorovací systém Comino (CMS). Samostatná autonomní řídicí deska řídí CMS a slouží jako „mozek“ serveru, nezávisle na hlavním operačním systému. V praxi tato řídicí jednotka čte údaje z komplexní řady senzorů, které v reálném čase sledují teplotu vzduchu a chladicí kapaliny, vlhkost, průtok chladicí kapaliny a hladiny v nádržích. Důležité je, že tato autonomní konstrukce umožňuje CMS provádět autodiagnostiku a spouštět nouzová vypnutí při detekci úniku nebo poruchy čerpadla, čímž chrání drahý interní hardware před poškozením.
Webové grafické uživatelské rozhraní zajišťuje každodenní správu a poskytuje správcům jasný přehled o výkonu chlazení, provozuschopnosti a spotřebě energie CPU a GPU v reálném čase. Pro nasazení v podnikovém měřítku se CMS také připojuje k centralizovaným monitorovacím nástrojům prostřednictvím REST API, jako jsou Zabbix, Grafana a InfluxDB. Tyto funkce společně pomáhají správcům udržovat 3leté meziservisní období a udržovat server v provozu s maximální účinností bez tepelného škrcení, a to i v prostředích s vysokými okolními teplotami.
Za hranicemi umělé inteligence: Kreativní a inženýrské aplikace
Zatímco naše testování se zaměřovalo na úlohy inference umělé inteligence, Grando slouží stejně tak praktické roli pro kreativní profesionály a inženýry, kteří potřebují značné lokální výpočetní výkony na GPU. Celkových 768 GB VRAM na osmi grafických kartách RTX PRO 6000 odemyká možnosti, kterým se běžné konfigurace pracovních stanic nemohou rovnat.
FX umělci a profesionálové v oblasti pohyblivé grafiky mohou vykreslovat složité scény s masivními sadami textur výhradně ve VRAM, čímž eliminují úzká hrdla s výměnou disků, která trápí produkce s 8K záběry nebo prostředí s vysokým počtem polygonů. CAD inženýři provádějící výpočetní dynamiku tekutin nebo strukturální simulace se mohou vypořádat se sestavami nebývalé složitosti, aniž by své modely rozdělovali do více běhů. Z této hustoty paměti GPU a výpočetní techniky těží videoeditoři pracující s vícestreamovými 8K RAW časovými osami, koloristé aplikující redukci šumu založenou na strojovém učení v plném rozlišení a 3D umělci, kteří lokálně vykreslují finální snímky s trasou, místo aby čekali na dostupnost cloudové farmy.
Grando nevyžaduje plnou konfiguraci s osmi grafickými kartami. Comino nabízí platformu v konfiguracích se čtyřmi, šesti a osmi grafickými kartami, přičemž všechny varianty jsou k dispozici k okamžitému odeslání. Menší studia, nezávislí tvůrci a technické týmy si mohou přizpůsobit svou investici aktuálním potřebám a zároveň si zachovat jasnou možnost upgradu s rostoucím objemem práce.
Kompromisy mezi platformami: Hustota vs. rozšiřitelnost
Kompaktní design Granda nabízí výjimečnou hustotu grafických karet a tepelný management ve standardním 4U prostoru, ale tato hustota s sebou nese architektonické kompromisy, které je třeba před nasazením pochopit.
Šasi pojme základní desky s formáty EATX a EEB, ale ne rozšířené serverové desky, které se nacházejí v tradičních dvoupaticových platformách. To omezuje celkový počet linek PCIe dostupných pro periferie mimo pole GPU. V naší konfiguraci s osmi GPU je 128 linek PCIe Gen 5 procesoru AMD EPYC téměř výhradně spotřebováno GPU, takže zbývá jen malá šířka pásma pro další úložiště NVMe nebo vysokorychlostní sítě mimo integrované porty 10GbE.
To je v kontrastu s platformami s osmi grafickými kartami, které jsme recenzovali od společností Dell, HPE a Supermicro. Tyto systémy využívají větší šasi, konfigurace s dvěma sokety a topologii přepínačů PCIe, které podporují výrazně větší konektivitu periferních zařízení. Obvykle obsahují čtyři až osm dalších síťových karet (NIC) nebo procesorových jednotek (DPU) vedle plného počtu grafických karet (GPU) a osm nebo více pozic NVMe s možností výměny za provozu, což je činí vhodnými pro distribuované inferenční úlohy, které vyžadují propojení fabric s vysokou šířkou pásma.
Tato rozšířená funkce je však spojena se značnými náklady. Odběr energie přesahuje 8 kW. Tepelné zátěže vyžadují specializovanou chladicí infrastrukturu datových center. Minimální hlučnost brání nasazení mimo účelově postavené strojovny. A dodací lhůty se často prodlužují o šest až osmnáct měsíců kvůli přetrvávajícím omezením dodávek podnikových platforem GPU.
Grando zaujímá jinou pozici. Pro organizace, které upřednostňují rychlé nasazení, snadno spravovatelná operační prostředí a inferenční nebo kreativní pracovní zátěž před rozsáhlým distribuovaným školením, jsou kompromisy často příznivé. Týmy, které potřebují svůj hardware hned, v prostředí, se kterým mohou skutečně pracovat, mohou shledat přístup Grando k hustotě praktičtějším než čekání ve frontě na platformu, kterou nemohou realisticky nasadit, jakmile dorazí.
Výsledky testování výkonu Comino Grando
Konfigurace systému
- Podvozek: Comino Grando
- Základní deska: ASRock Rack GENOAD8X-2T/BCM
- CPU: AMD EPYC 9474F 48C
- Paměť: 512 GB DDR5
- GPU: 8x NVIDIA RTX PRO 6000
- Skladování: M.2 SSD
Claude Code Serving – MiniMax M2.5
Kromě tradičních benchmarků inferenčních LLM metod jsme chtěli vyhodnotit, jak dobře si tento hardware vede v agentním kódovacím pracovním postupu, konkrétně při obsluhování více souběžných relací Claude Code pomocí lokálně hostovaného modelu. Tento případ použití se přímo vztahuje k produktivitě vývojového týmu: kolik inženýrů může současně používat asistenta kódování s umělou inteligencí obsluhovaného z jednoho uzlu, než se zážitek z ní zhorší?
Abychom to otestovali, vytvořili jsme benchmarkový systém, který generuje datovou sadu středně obtížných kódovacích problémů (jako je implementace LRU cache, vytvoření CLI todo aplikace, napsání převodníku Markdown a vytvoření REST API) a spouští každou relaci Claude Code v samostatném kontejneru Dockeru na lokálním serveru vLLM. Mezi relacemi a inferenčním koncovým bodem se nachází transparentní proxy, která zachycuje metriky pro každou instanci Claude Code na požadavek. Použitým modelem byl MiniMax M2.5, poskytovaný prostřednictvím vLLM na osmi grafických procesorech NVIDIA RTX PRO 6000 systému. I když se nejedná o nejlépe hodnocený kódovací model ve veřejných žebříčcích, M2.5 je schopný model, který mnoho uživatelů, včetně našich přátel vývojářů, používá lokálně.
Jako referenční bod používáme průměrnou propustnost výstupu Claude Opus 4.6 od Anthropic přes OpenRouter.ai, jednu z nejpopulárnějších směrovacích služeb pro přístup k produkčnímu API. Tato základní hodnota je přibližně 37 tokenů za sekundu na požadavek API.
Měřili jsme dvě klíčové metriky: průměrný počet výstupních tokenů za sekundu na relaci Claude Code (co každý vývojář zažívá) a souhrnný počet výstupních tokenů za sekundu napříč všemi relacemi (celková práce, kterou server vyprodukuje).
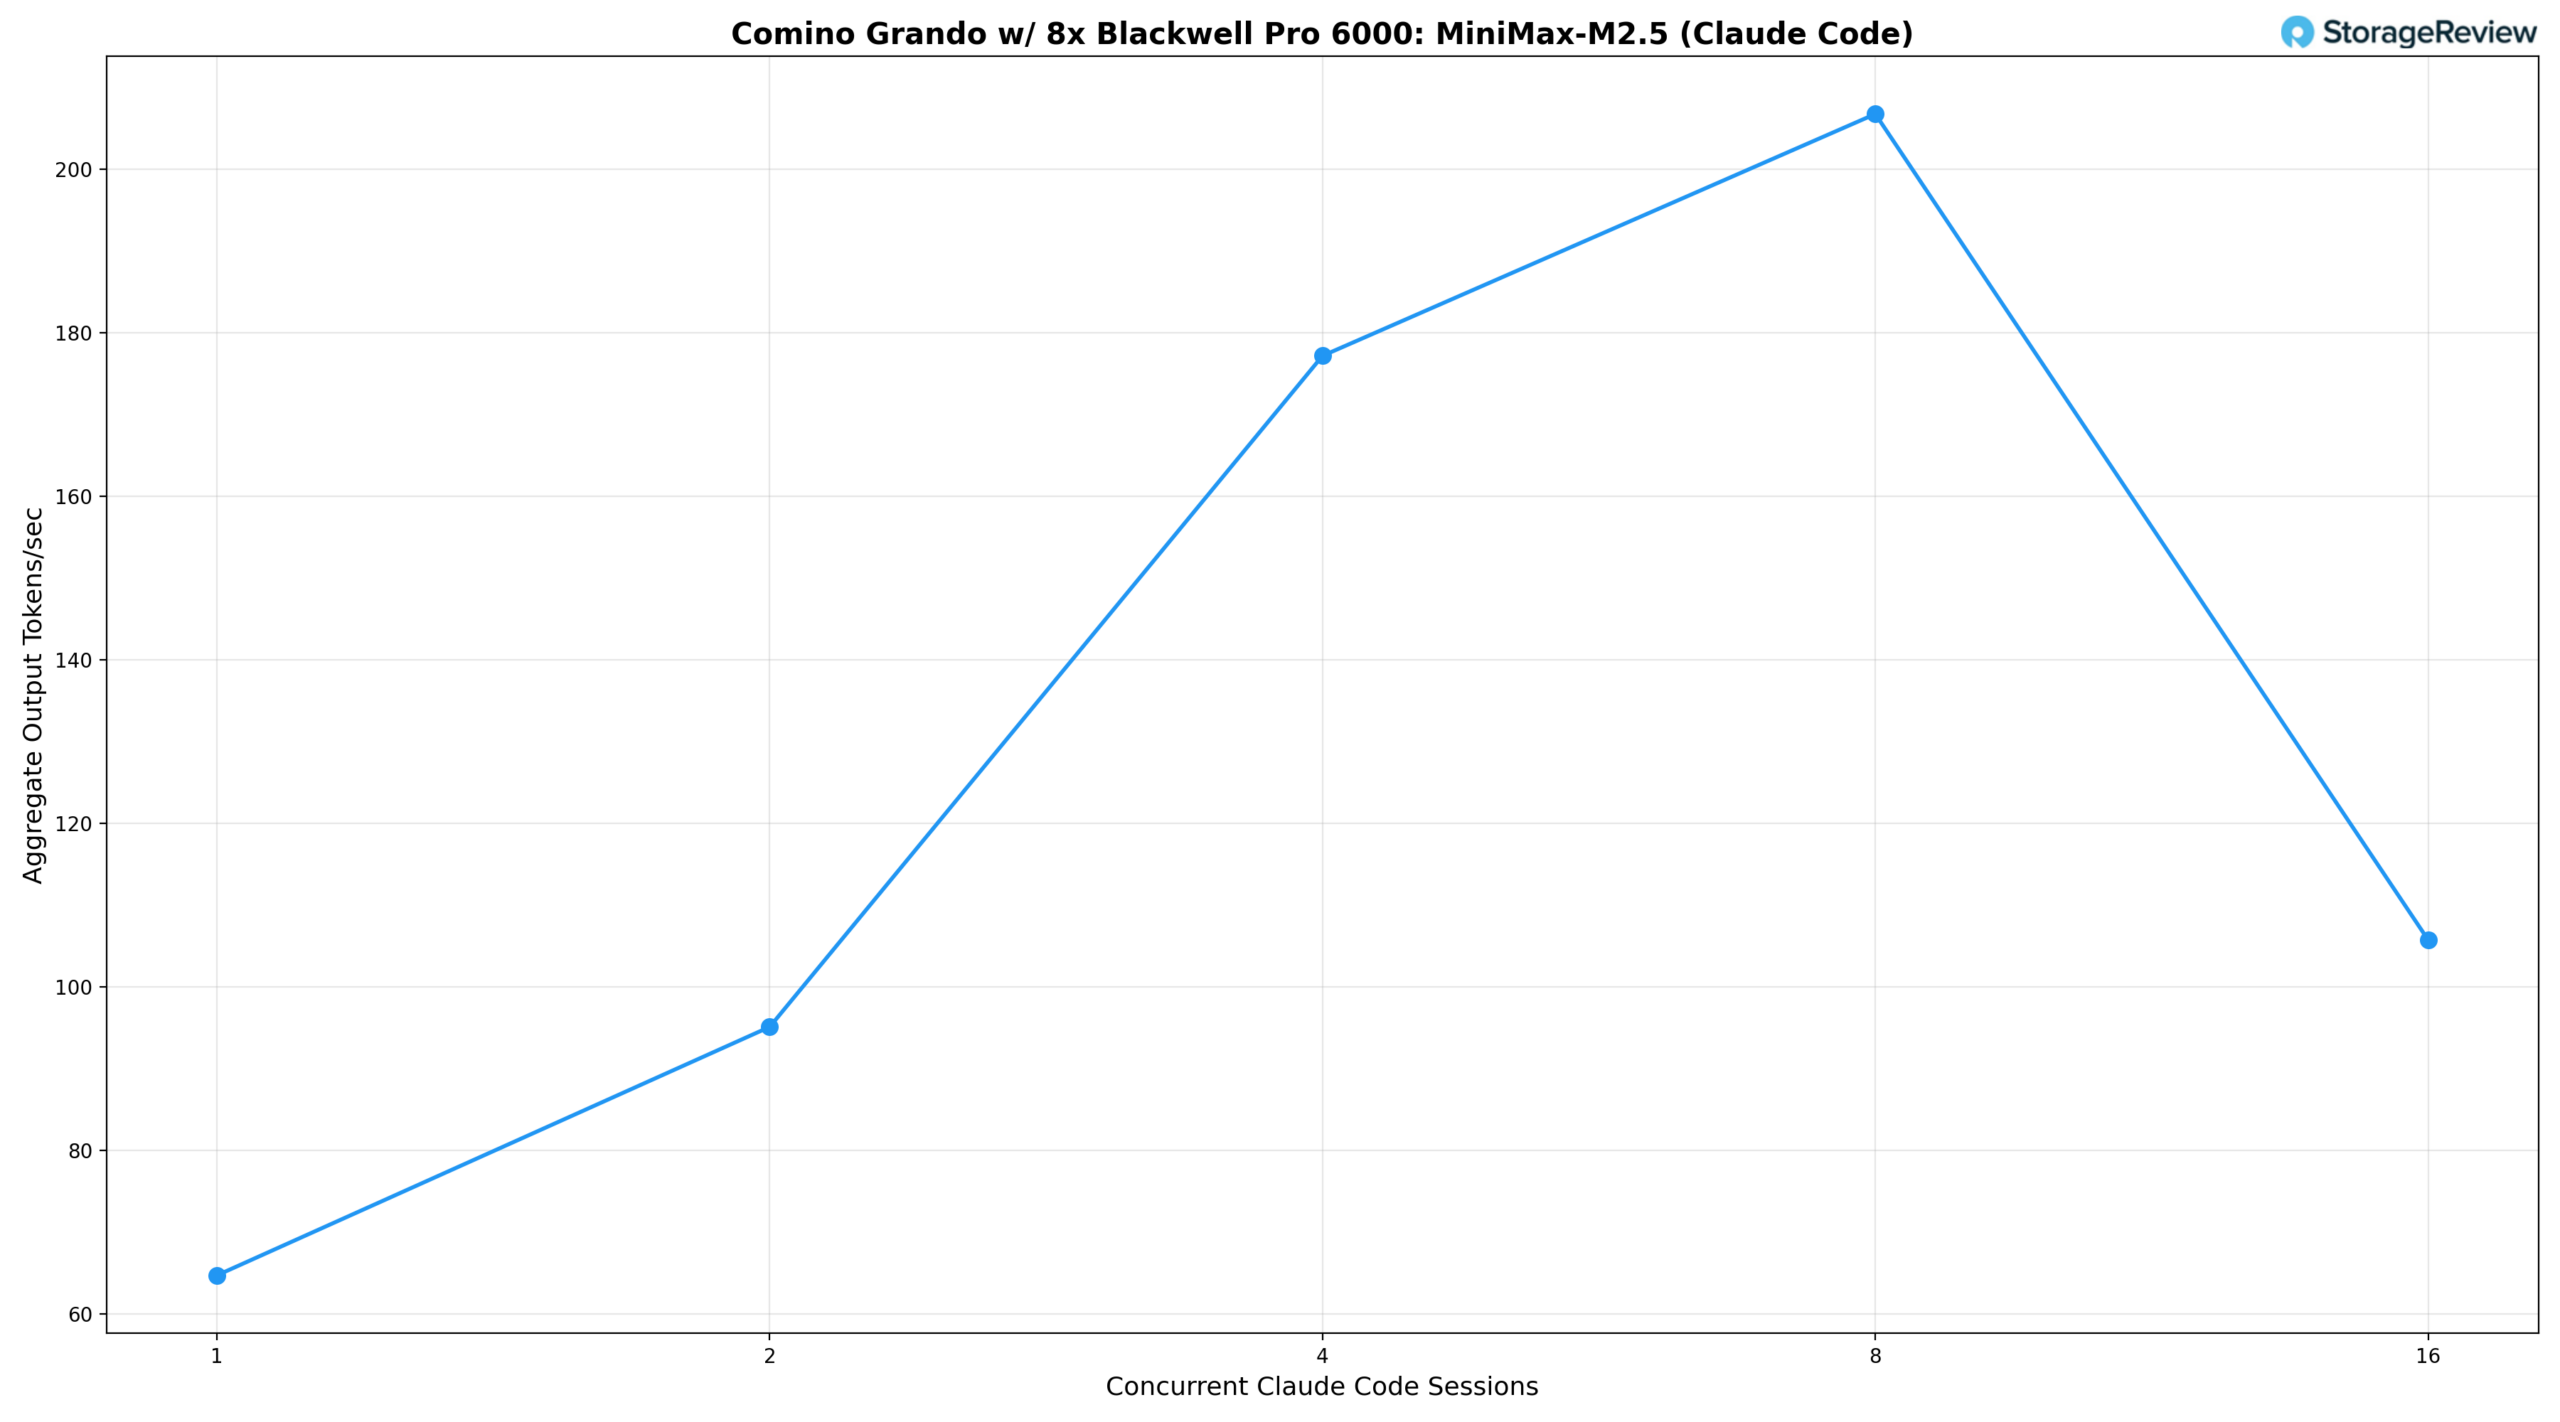
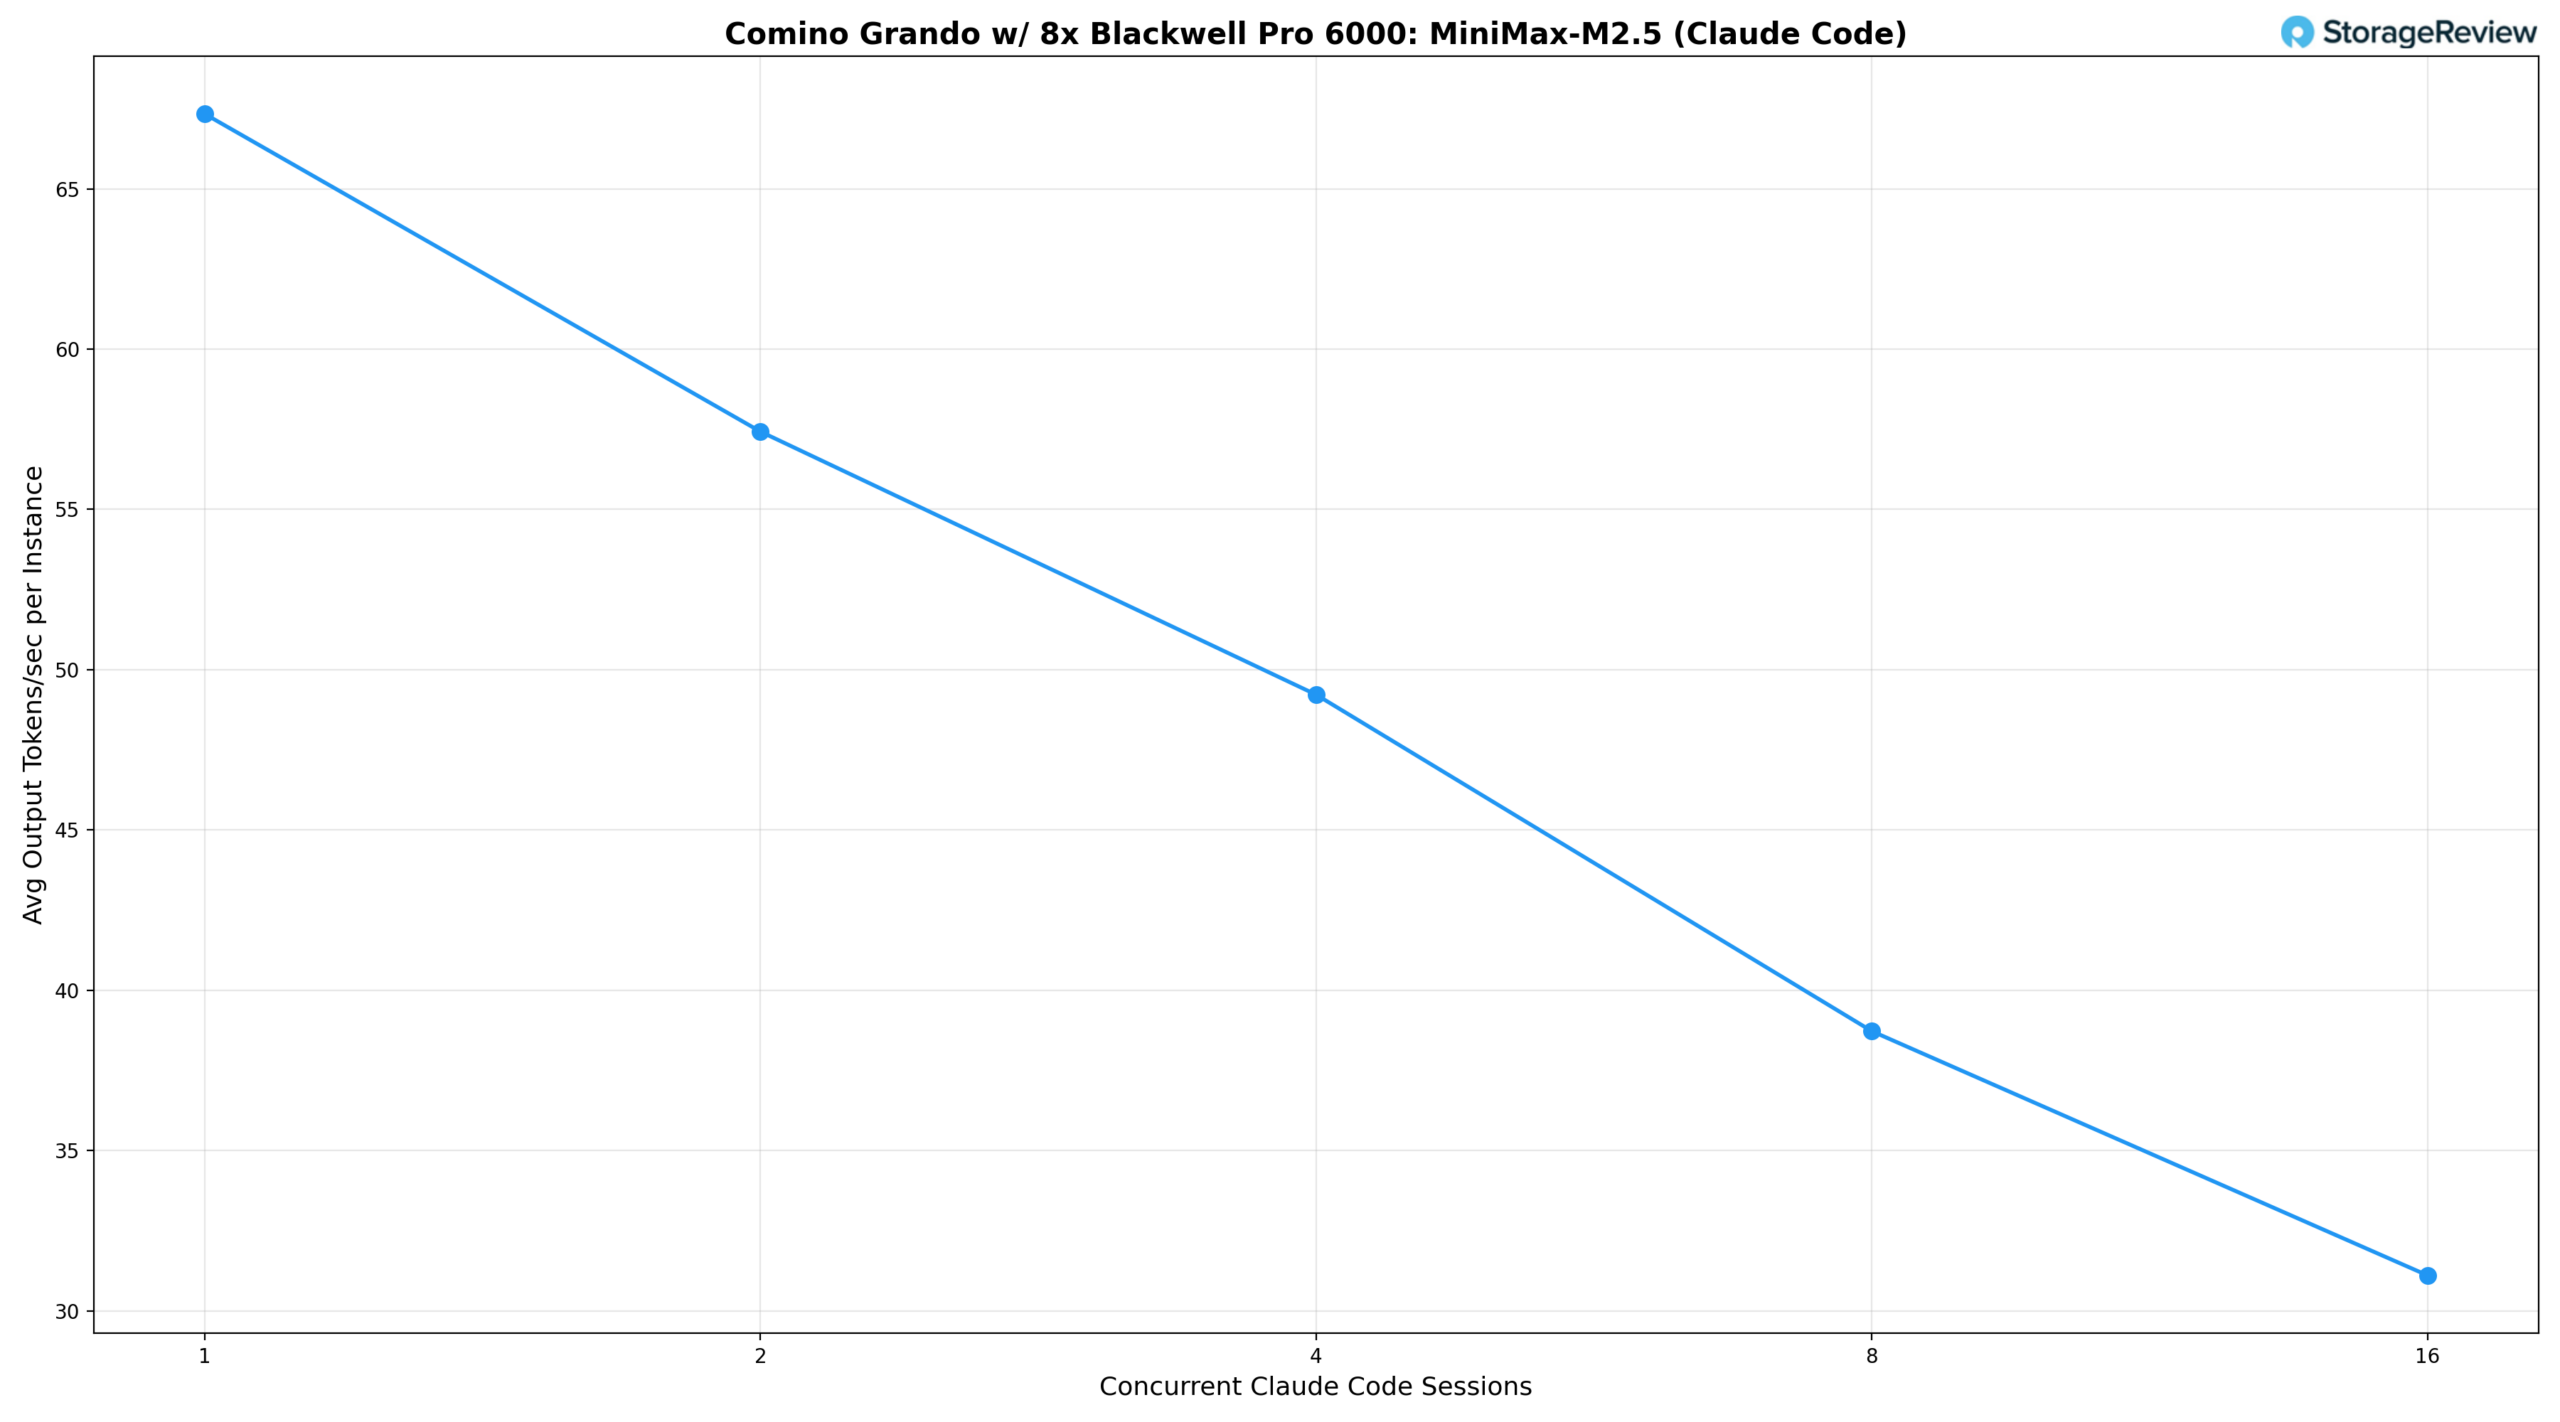
Na základě výsledků dosahuje jedna souběžná relace Claude Code výkonu 67.3 tok/s na uživatele a celkového výstupu 64.7 tok/s. Při dvou relacích propustnost na instanci mírně klesá na 57.4 tok/s, zatímco celkové výstupy stoupají na 95.1 tok/s, protože dávkování vLLM začíná amortizovat režie. Čtyři souběžné relace si udržují 49.2 tok/s na uživatele, což je stále vysoce responzivní zážitek pro interaktivní kódovací pracovní postupy, zatímco celkové výstupy dosahují 177.2 tok/s. Osm relací představuje ideální hodnotu pro celkové výstupy s vrcholem 206.7 tok/s, zatímco propustnost na instanci se ustálí na 38.7 tok/s, což je úroveň, která zůstává pohodlná pro generování kódu v reálném čase a iteraci.
Při 16 souběžných relacích systém vykazuje klasický kompromis v dávkovém zpracování: propustnost na instanci klesá na 31.1 tok/s a celkový výstup klesá na 105.8 tok/s. To naznačuje, že při této úrovni souběžnosti model 230B MiniMax M2.5 posouvá hranice toho, co osm GPU dokáže zvládnout, aniž by to způsobilo významnou latenci pro každého uživatele. Celkový pokles z 8 na 16 relací odráží spíše nároky na šířku pásma paměti velké architektury MoE při velkém zatížení simultánního dekódování než neefektivitu plánování.
Pro organizace, které vyhodnocují samostatně hostovanou infrastrukturu umělé inteligence pro vývojářské nástroje, je Grando silným argumentem. S modelem 230B na hranici možností dokáže pohodlně obsloužit až osm simultánních relací Claude Code s propustností, která se cítí skutečně interaktivní, s rychlostí na uživatele přesahující 38 toků/s při maximálním souhrnném výkonu. Týmy čtyř až osmi inženýrů mohou pracovat s téměř optimální propustností bez znatelného snížení odezvy.
Kapalinou chlazená architektura také činí tuto úroveň výpočetní kapacity praktickou v prostředích, kde tradiční servery s grafickými procesory (GPU) nemohou fungovat. Systém běží dostatečně tiše, aby se dal umístit do kanceláře startupu, malé strojovny nebo vyhrazeného rohu otevřeného pracovního prostoru. Vzduchem chlazené systémy s podobnou hustotou GPU obvykle dosahují 90 dB nebo více, což je dostatečně hlučné na to, aby vyžadovalo vyhrazený prostor v datovém centru nebo minimálně uzavřenou serverovnu s kvalitním akustickým zpracováním. Grando může koexistovat s týmem, který jej používá. V kombinaci s plnou lokalitou dat, žádnými náklady na API za token a úplnou kontrolou nad výběrem modelu nabízí samostatně hostovanou cestu, která se škáluje s rostoucím vývojovým týmem, aniž by vyžadovala infrastrukturu datového centra nebo zvyšování nákladů na synchronizované připojení.
Online poskytování vLLM – Výkon inference LLM
vLLM je jeden z nejpopulárnějších vysoce výkonných inferenčních a obslužných enginů pro LLM. Online benchmark vLLM hodnotí reálný výkon tohoto inferenčního enginu při souběžných požadavcích. Simuluje produkční zátěž odesíláním požadavků na běžící server vLLM s konfigurovatelnými parametry, jako je frekvence požadavků, délka vstupních a výstupních dat a počet souběžných klientů. Benchmark měří klíčové metriky, včetně propustnosti (tokeny za sekundu), doby do prvního tokenu a doby na výstupní token (TPOT), což pomáhá uživatelům pochopit, jak si vLLM vede za různých podmínek zátěže.
Testovali jsme výkon inference napříč komplexní sadou modelů zahrnujících různé architektury, škály parametrů a kvantizační strategie, abychom vyhodnotili propustnost za různých profilů souběžnosti.
Shrnutí výsledků
| Model | Přesnost | Stejné (256/256) | Předvyplňování - silné (8k/1k) | Dekódovací náročné (1k/8k) |
|---|---|---|---|---|
| Comino Grando s 8× RTX PRO 6000 Blackwell — výsledky inference vLLM (tok/s, vrchol při BS=256) | ||||
| GPT-OSS 20B | ep_dp1 | 17,280 | 32,061 | 11,187 |
| GPT-OSS 120B | ep_dp1 | 11,726 | 21,636 | 7,570 |
| Llama 3.1 8B Pokyn | FP8 | 12,109 | 20,137 | 7,353 |
| Llama 3.1 8B Pokyn | FP4 | 11,954 | 20,206 | 7,239 |
| Llama 3.1 8B Pokyn | BF16 | 11,752 | 17,346 | 6,155 |
| Kodér Qwen3 30B A3B | FP8 | 10,985 | 16,659 | 4,907 |
| Kodér Qwen3 30B A3B | BF16 | 10,588 | 16,680 | 4,829 |
| Mistral Malý 3.1 24B | BF16 | 8,925 | 11,846 | 4,975 |
| MiniMax M2.5 (230B) | ep_dp1 | 5,753 | 7,357 * | 2,555 |
| Všechny hodnoty jsou v tok/s, maximální propustnost při BS=256. *MiniMax M2.5 s vysokým předplněním dosáhl vrcholu při BS=128 (7 357 tok/s); BS=256 dosáhla 7 141 tok/s. | ||||
GPT-OSS 120B a 20B
Modelová řada GPT-OSS byla testována v konfiguracích 120B i 20B na Comino Grando.
GPT-OSS 120B
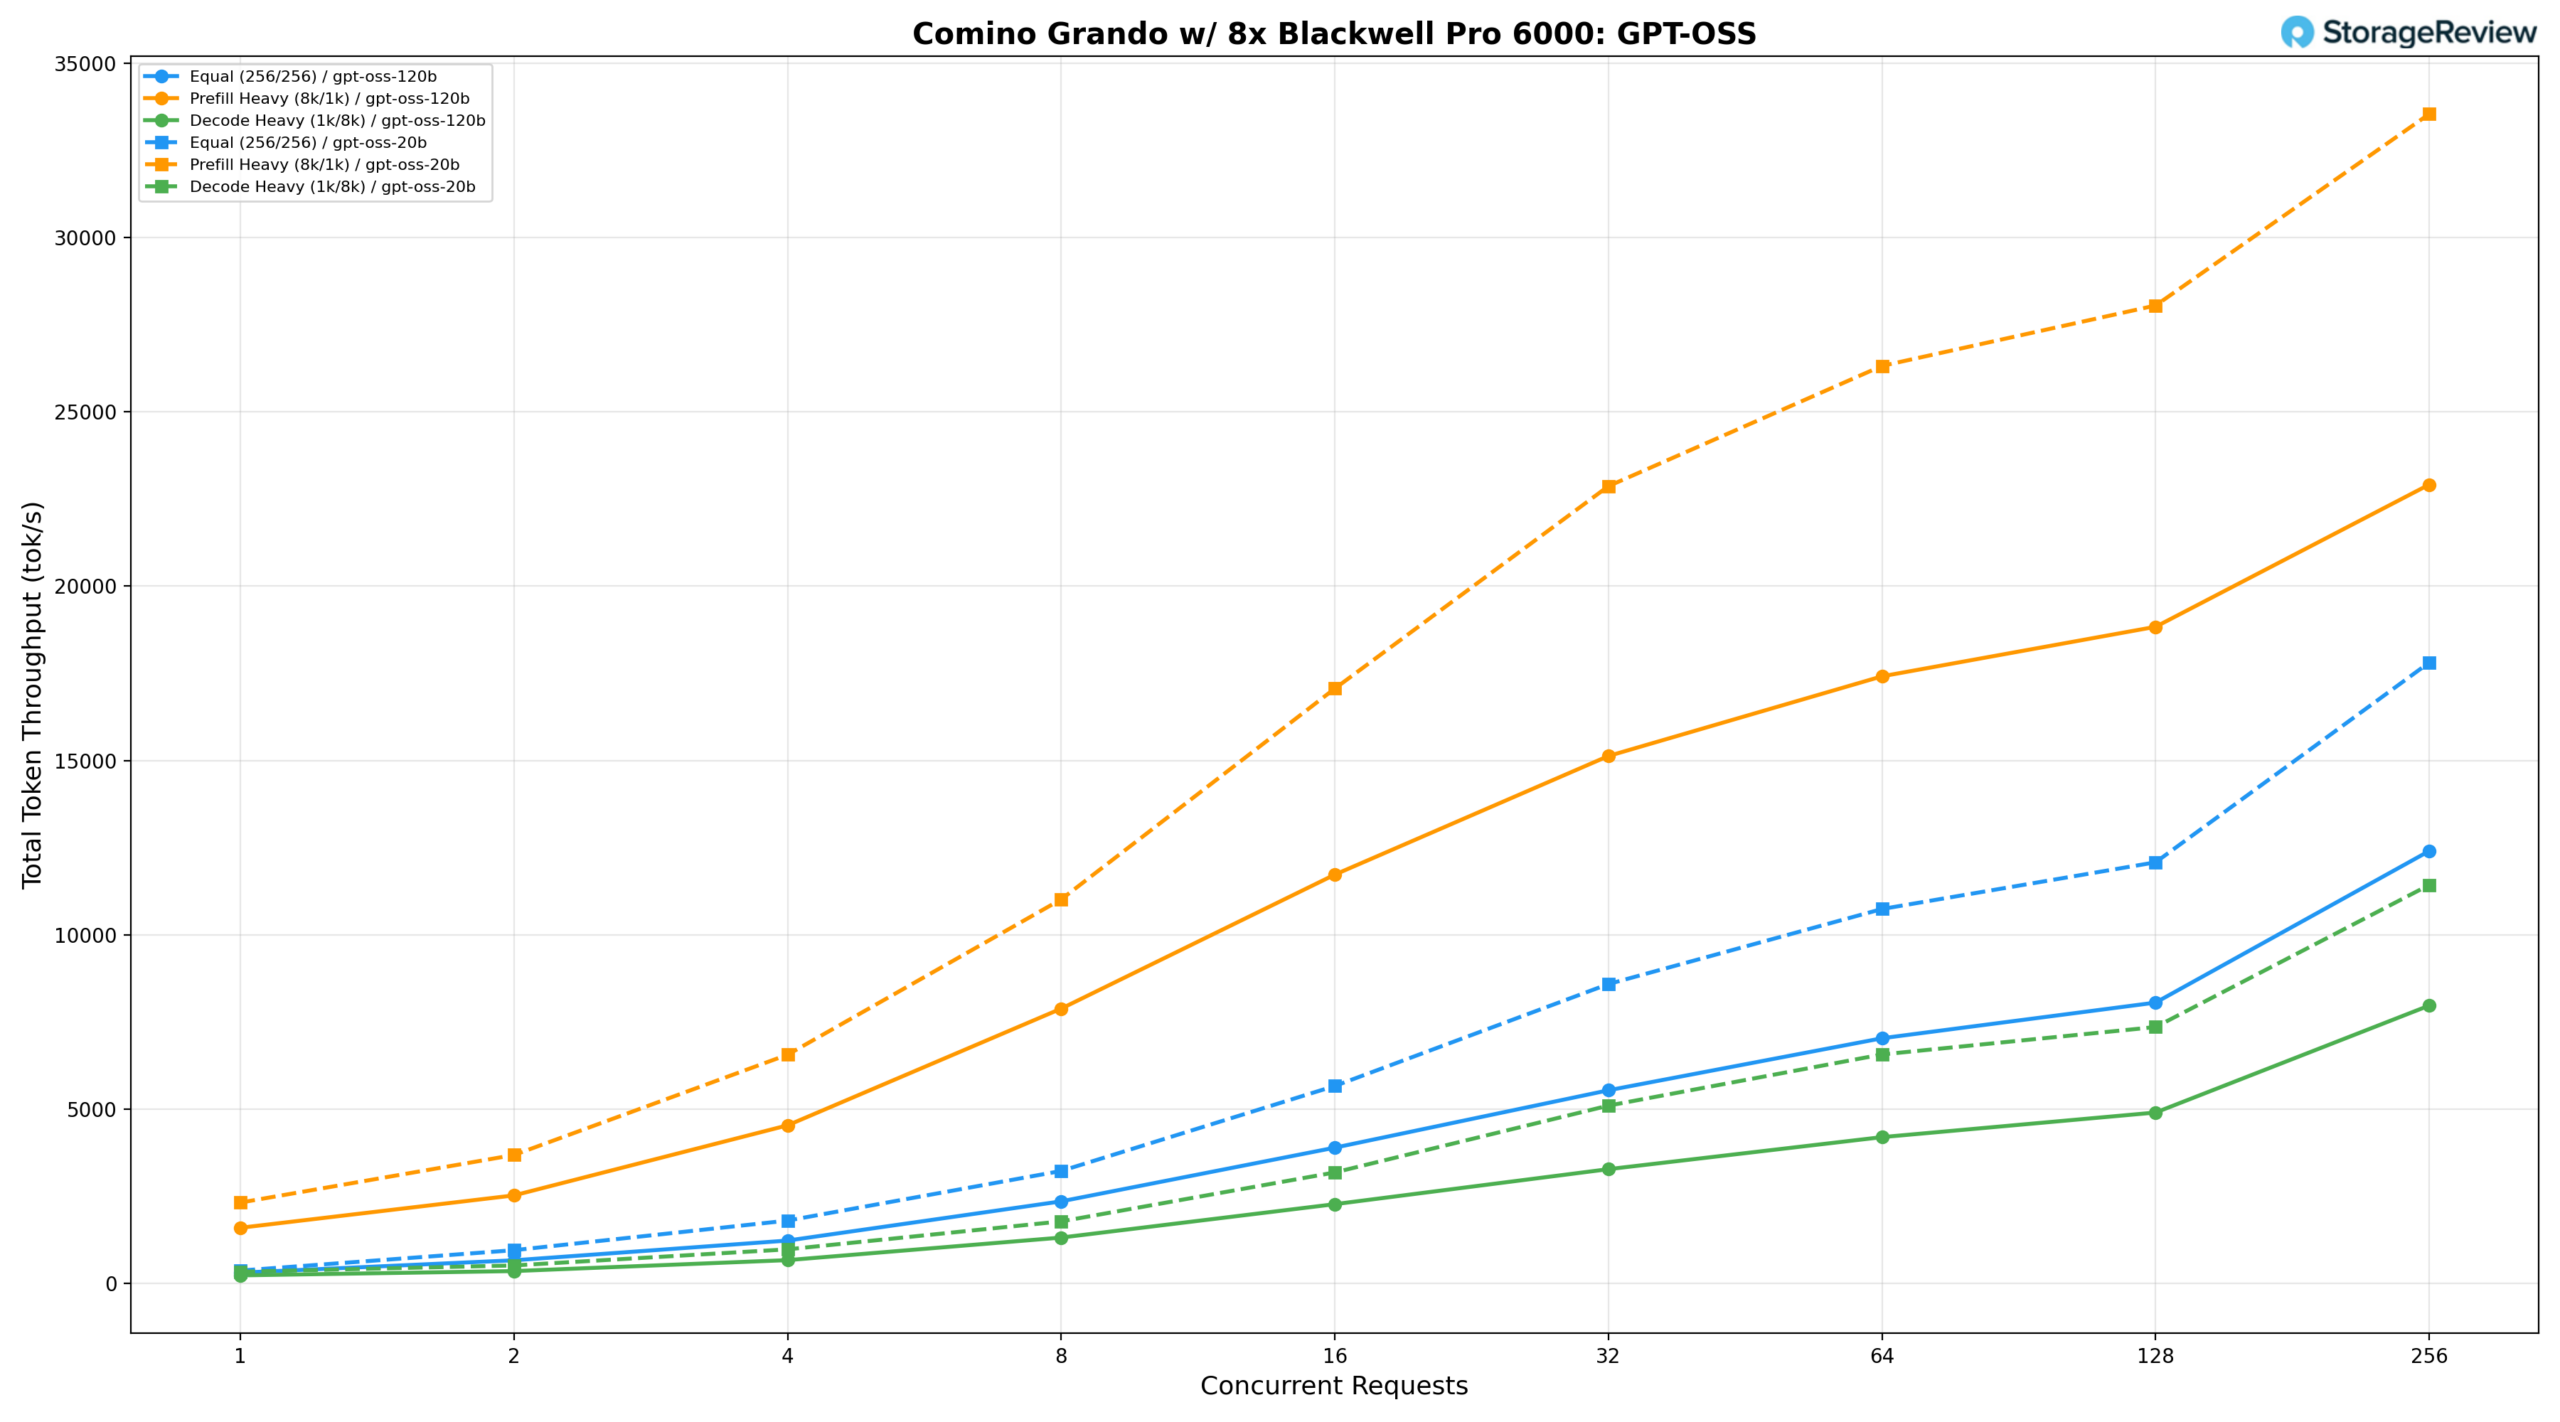
Při stejném zatížení (256/256) dosahuje model 120B rychlosti 268.85 tok/s při BS=1, dosahuje 6 666,23 tok/s při BS=64 a vrcholí na 11 726,04 tok/s při BS=256. Model s vysokou zátěží před naplněním (8k/1k) začíná na 1 375,69 tok/s, stoupá na 16 374,19 tok/s při BS=64 a 17 944,55 tok/s při BS=128 a vrcholí na 21 636,41 tok/s při BS=256. Model s vysokou zátěží dekódování (1k/8k) roste ze 196.28 tok/s při BS=1 na 7 569,97 tok/s při BS=256, s dobře kontrolovanou latencí při nižších úrovních souběžnosti.
GPT-OSS 20B
Model 20B dosahuje při stejném zatížení 334.80 tok/s při BS=1, dosahuje 10 303,56 tok/s při BS=64 a vrcholí na 17 280,12 tok/s při BS=256. S vysokým počtem předplnění začíná na 2 007,90 tok/s, stoupá na 24 990,46 tok/s při BS=64 a 26 866,25 tok/s při BS=128, s vrcholem 32 060,72 tok/s při BS=256, což je nejvyšší absolutní zaznamenaná propustnost předplnění u obou velikostí modelu. Dekódovací propustnost se zvyšuje z 286.08 tok/s při BS=1 na 11 187,36 tok/s při BS=256, což přináší zhruba 1.5× vyšší dekódovací propustnost než 120B při maximální souběžnosti a zároveň si zachovává nižší latenci.
Instrukce Qwen3 Coder 30B A3B a instrukce FP8
Model Qwen3-Coder-30B-A3B-Instruct byl testován s přesností BF16 i FP8.
Instrukce Qwen3-Coder-30B-A3B (BF16)
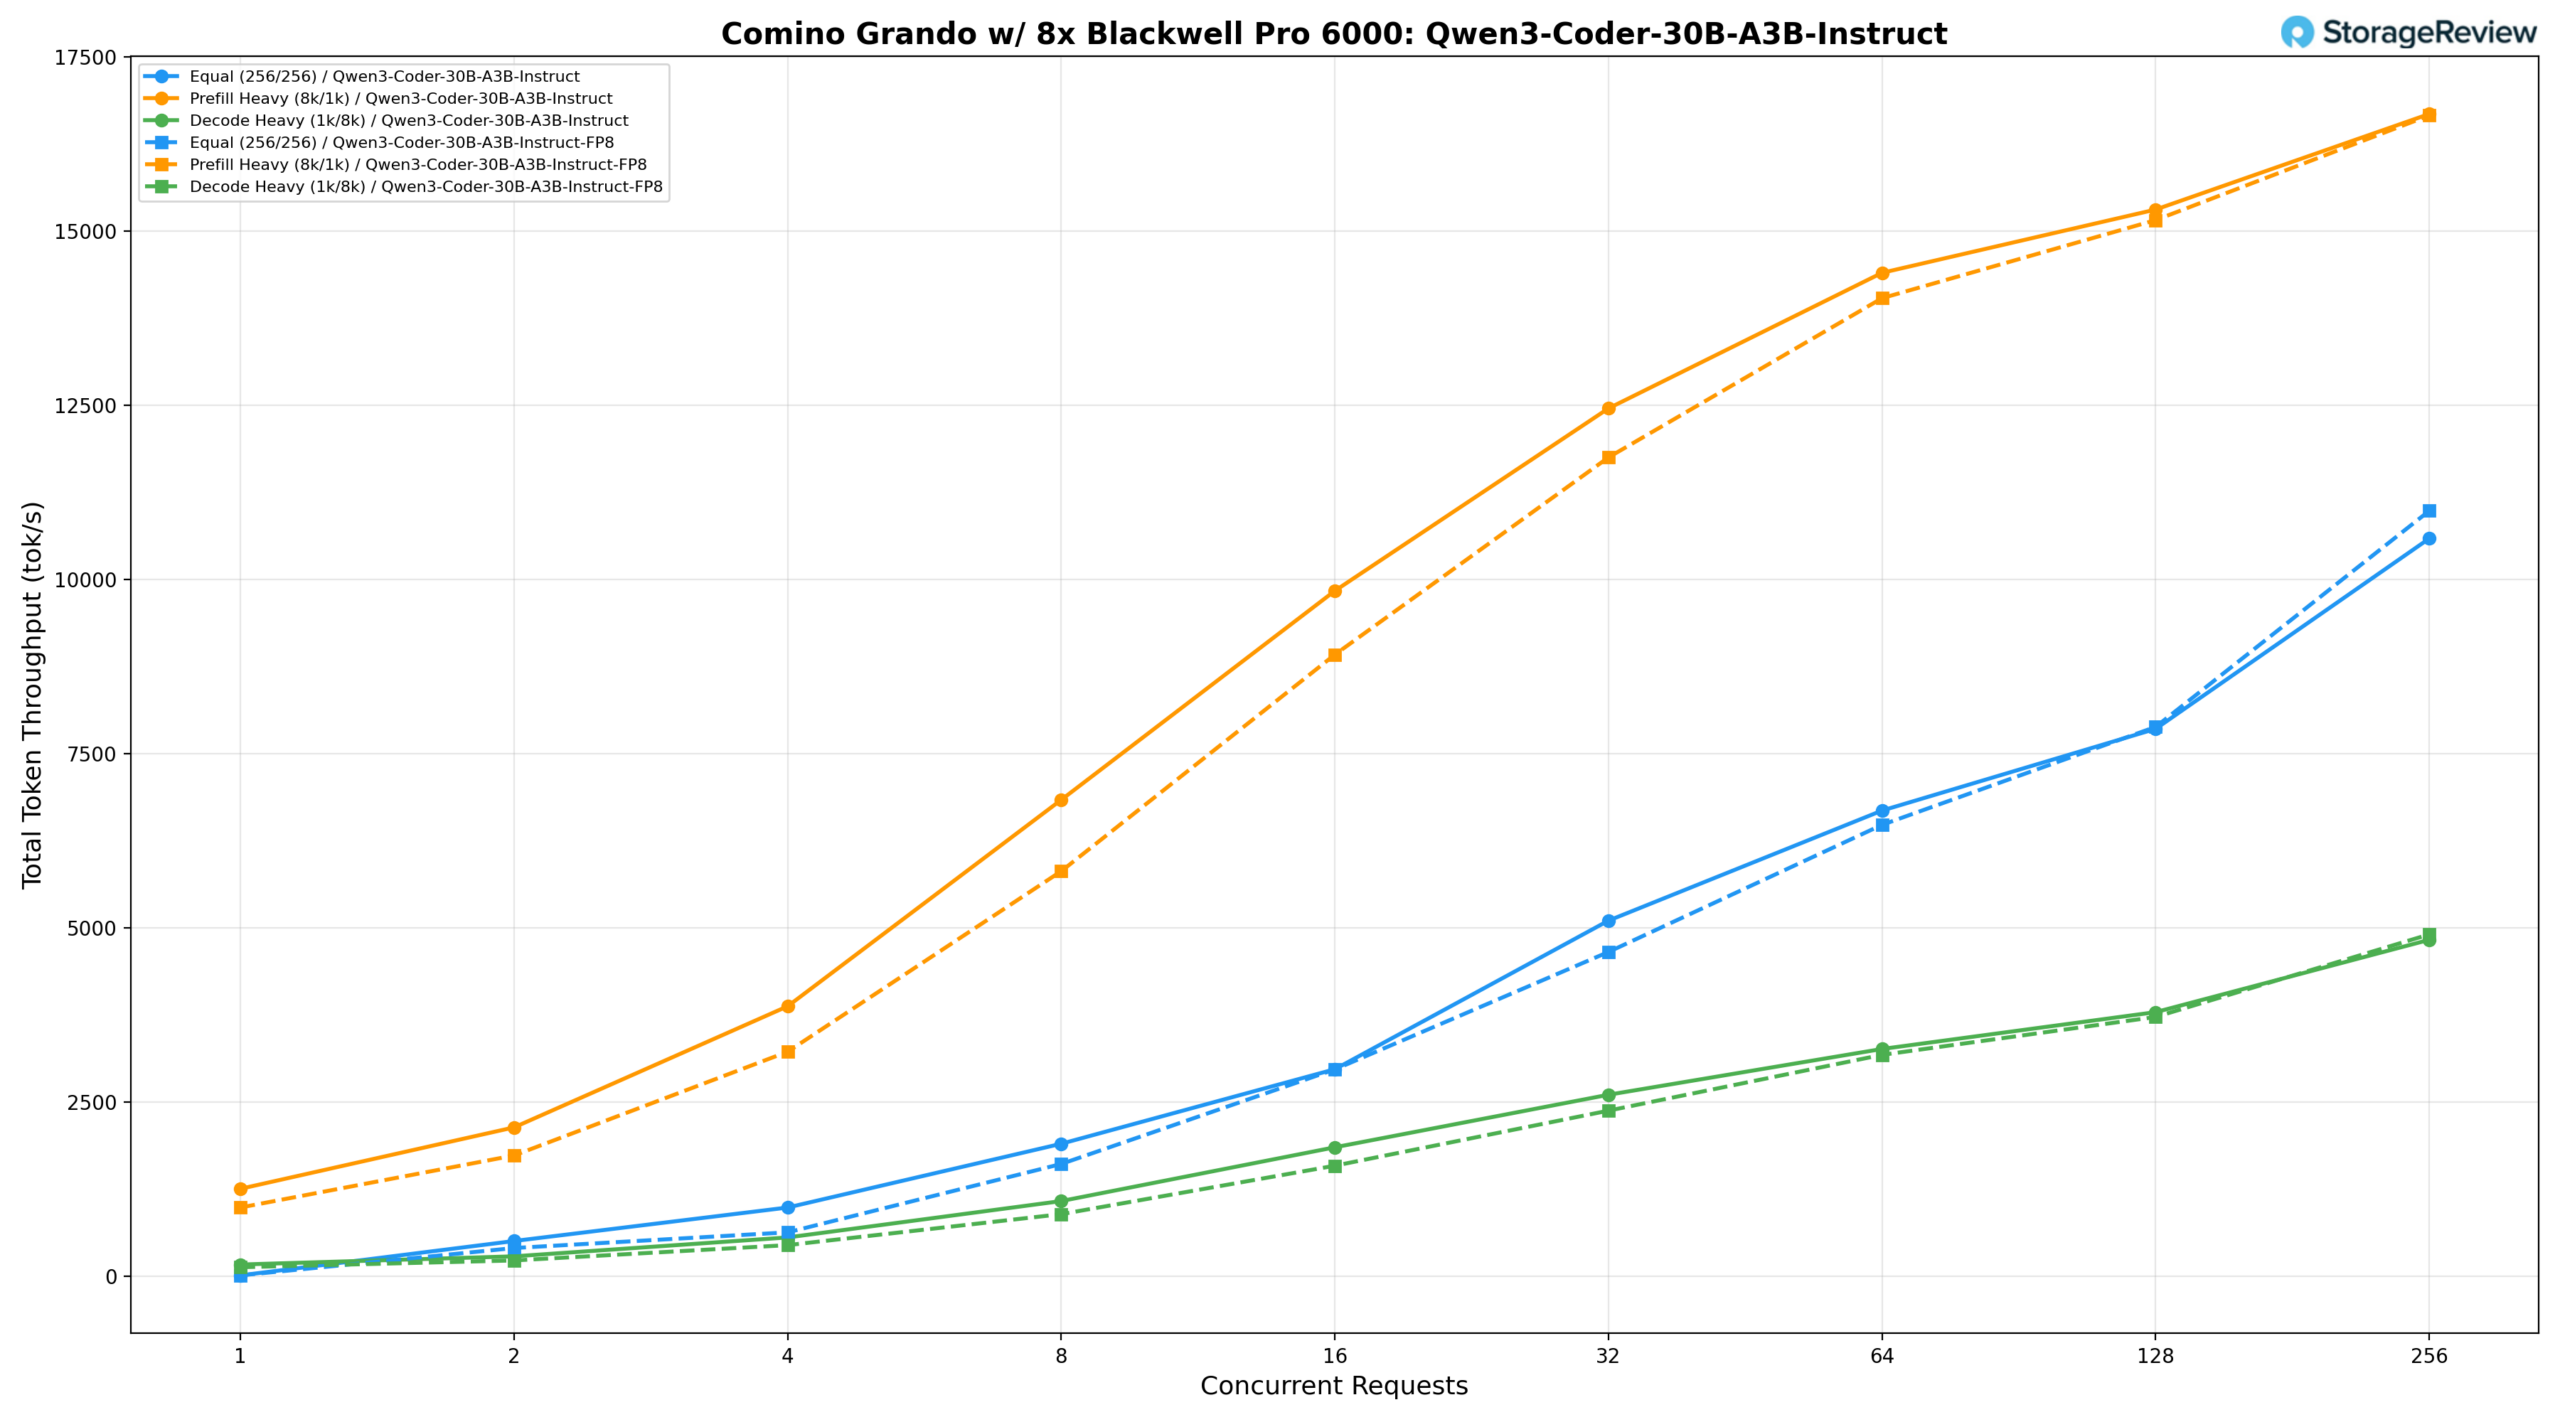
Při stejném zatížení (256/256) dosahuje model BF16 rychlosti 1 902,32 tok/s při BS=8, dosahuje 6 683,58 tok/s při BS=64 a vrcholí na 10 587,56 tok/s při BS=256. Rychlost s vysokým předběžným naplněním (8k/1k) začíná na 1 256,03 tok/s při BS=1, stoupá na 14 400,57 tok/s při BS=64 a 15 308,35 tok/s při BS=128 a vrcholí na 16 679,52 tok/s při BS=256. Dekódovací rychlost (1k/8k) se zvyšuje ze 169.19 tok/s při BS=1 na 4 828,82 tok/s při BS=256, s dobře kontrolovanou latencí při nižších úrovních souběžnosti.
Instrukce Qwen3-Coder-30B-A3B (FP8)
Model FP8 poskytuje propustnost srovnatelnou s BF16 ve většině scénářů, přičemž stejné zatížení dosahuje 6 478,54 toků/s při BS=64 a vrcholí na 10 984,61 toků/s při BS=256, což je mírné zlepšení oproti BF16 při maximální souběžnosti. Model s vysokým počtem předběžných naplnění začíná na 987.48 toků/s při BS=1, stoupá na 14 036,46 toků/s při BS=64 a 15 156,69 toků/s při BS=128 a vrcholí na 16 658,98 toků/s při BS=256. Dekódovací rychlost vzrostla ze 130.70 tok/s při BS=1 na 4 906,51 tok/s při BS=256, čímž nepatrně překonala BF16 při maximální souběžnosti, zatímco obě konfigurace zůstávaly v celém zbytku rozsahu souběžnosti úzce spárované.
Mistral Small 3.1 24B Instruct 2503
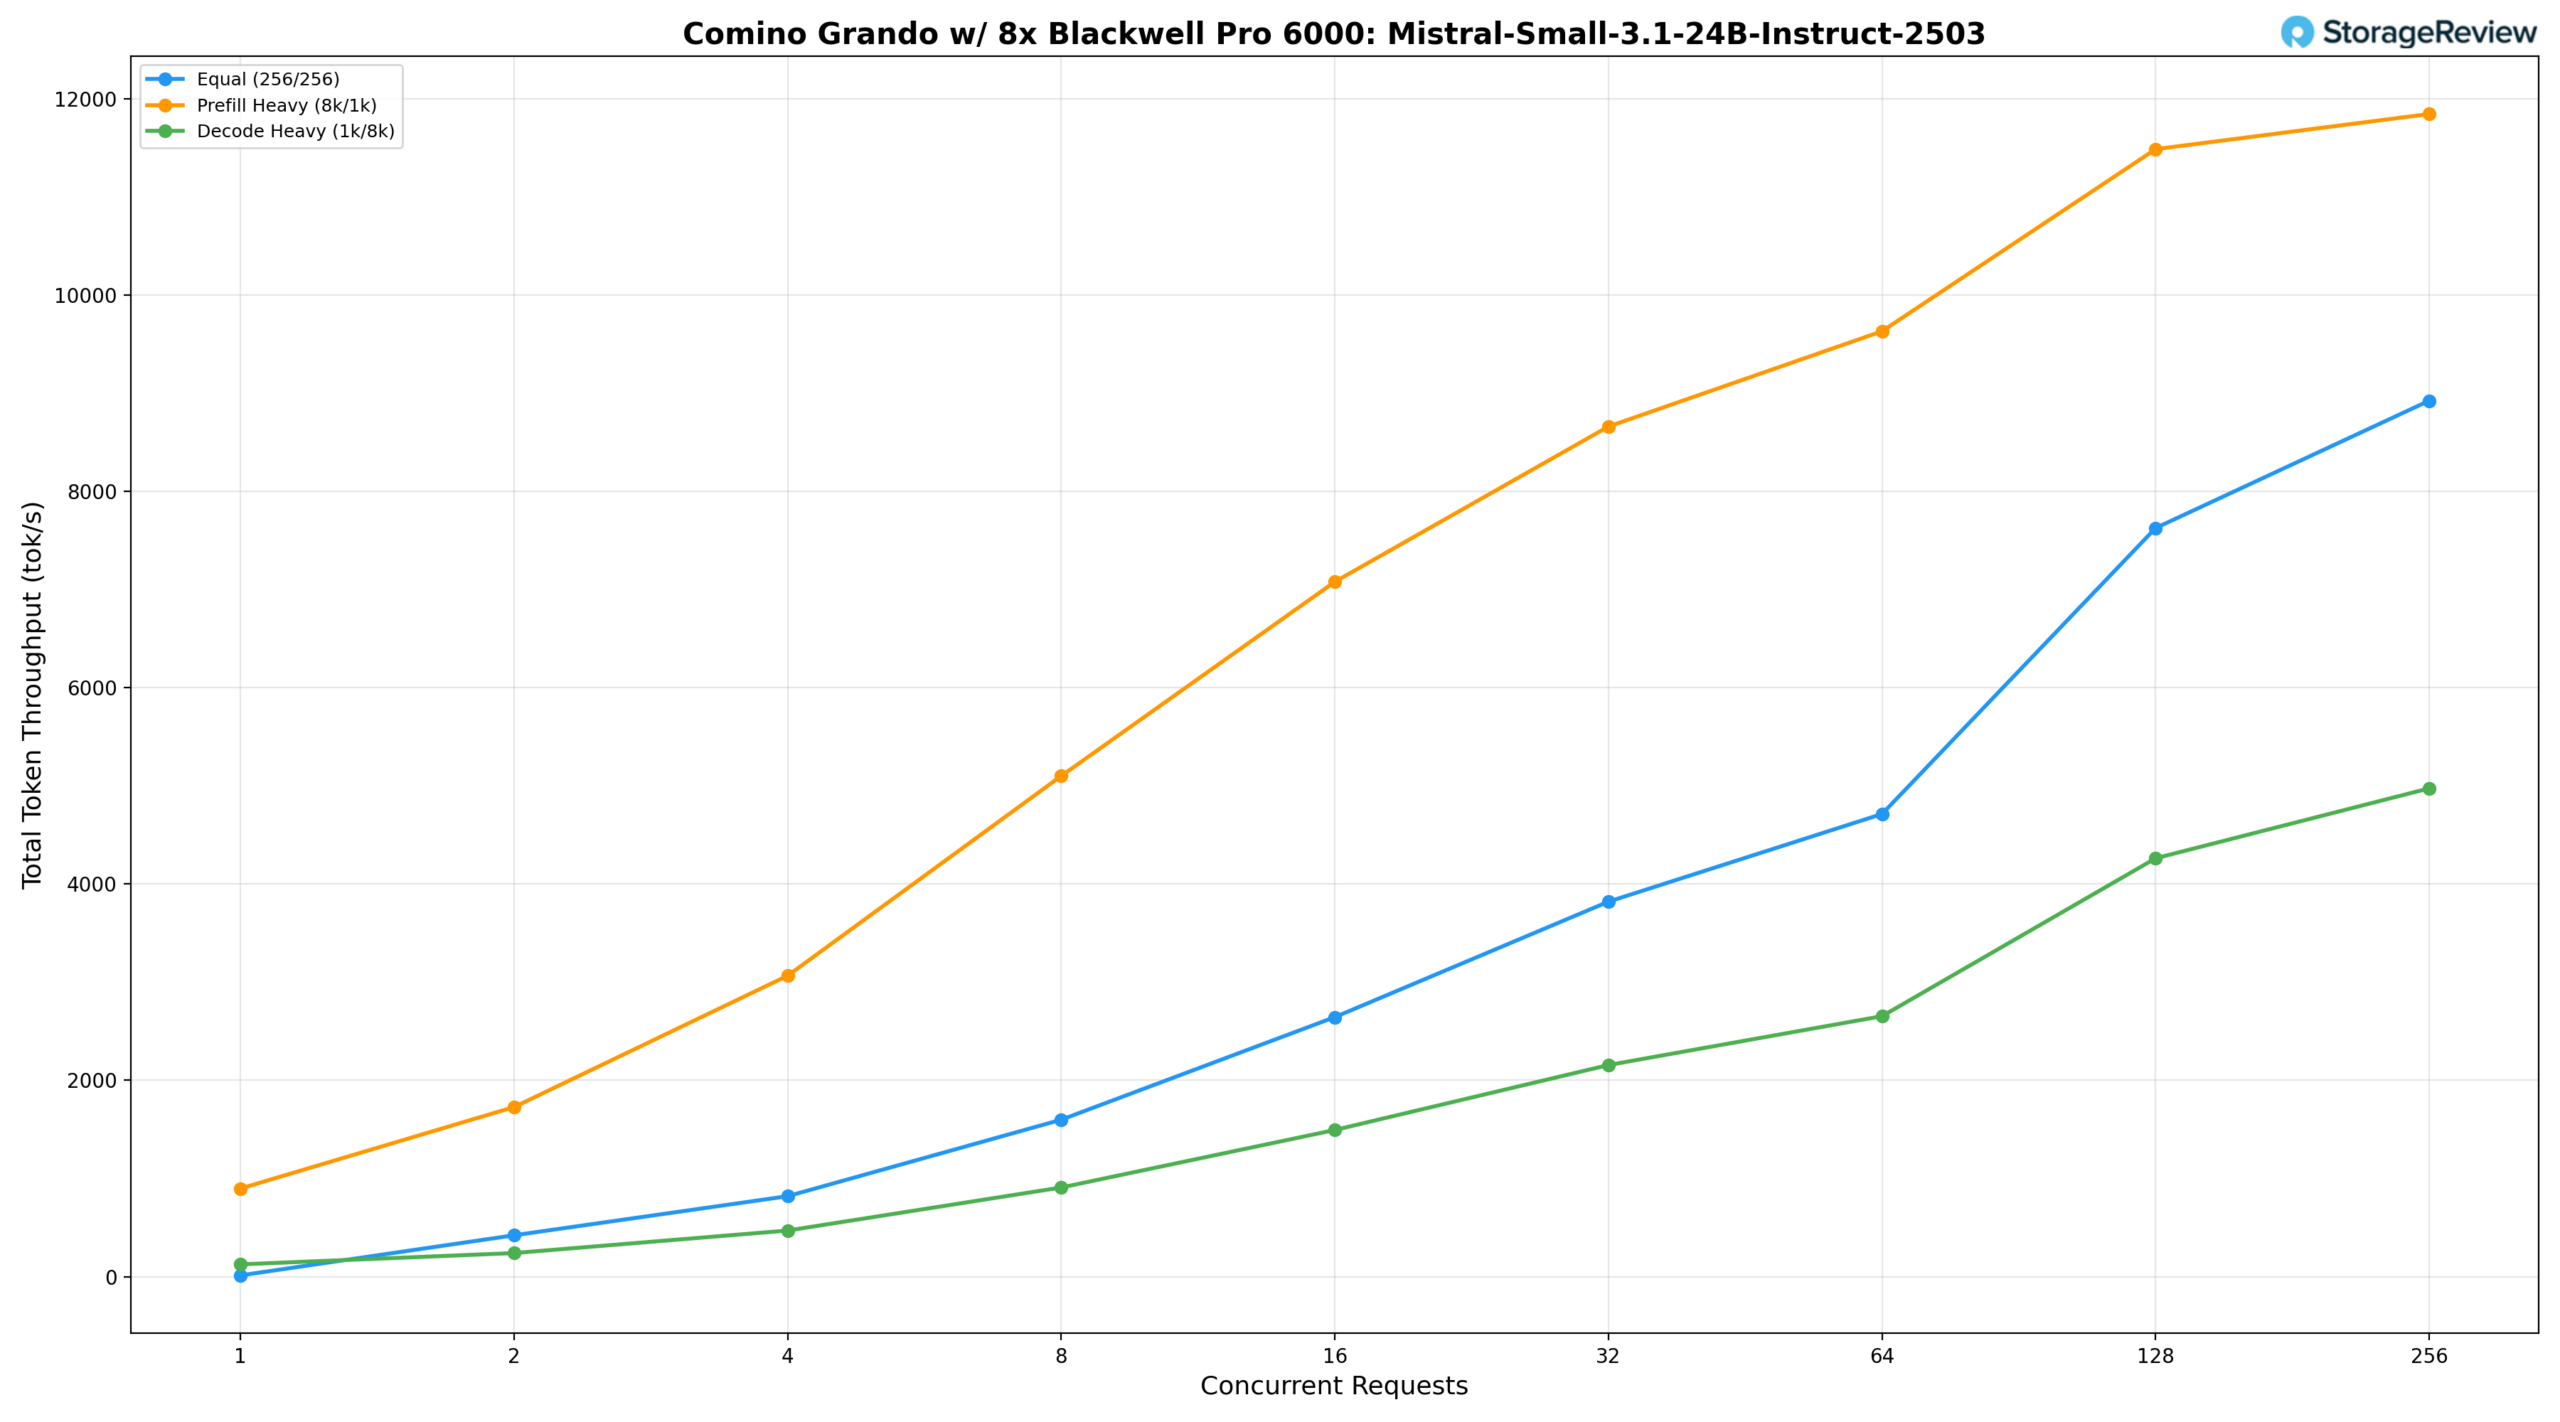
Při stejném zatížení (256/256) model poskytuje 1 598,79 tok/s při BS=8, dosahuje 4 713,84 tok/s při BS=64 a silně se škáluje na 8 925,12 tok/s při BS=256. Model s vysokým počtem předběžných naplnění (8k/1k) začíná na 897.84 tok/s při BS=1, stoupá na 9 632,58 tok/s při BS=64 a 11 488,13 tok/s při BS=128, s vrcholem 11 846,15 tok/s při BS=256. Dekódovací rychlost (1k/8k) roste ze 124.98 tok/s při BS=1 na 2 653,82 tok/s při BS=64, poté se znatelně zrychluje při vyšších úrovních souběžnosti, dosahuje 4 262,53 tok/s při BS=128 a vrcholí na 4 975,06 tok/s při BS=256, což odráží schopnost modelu udržet si vysokou dekódovací propustnost s rostoucí souběžností.
Llama 3.1 8B Pokyn
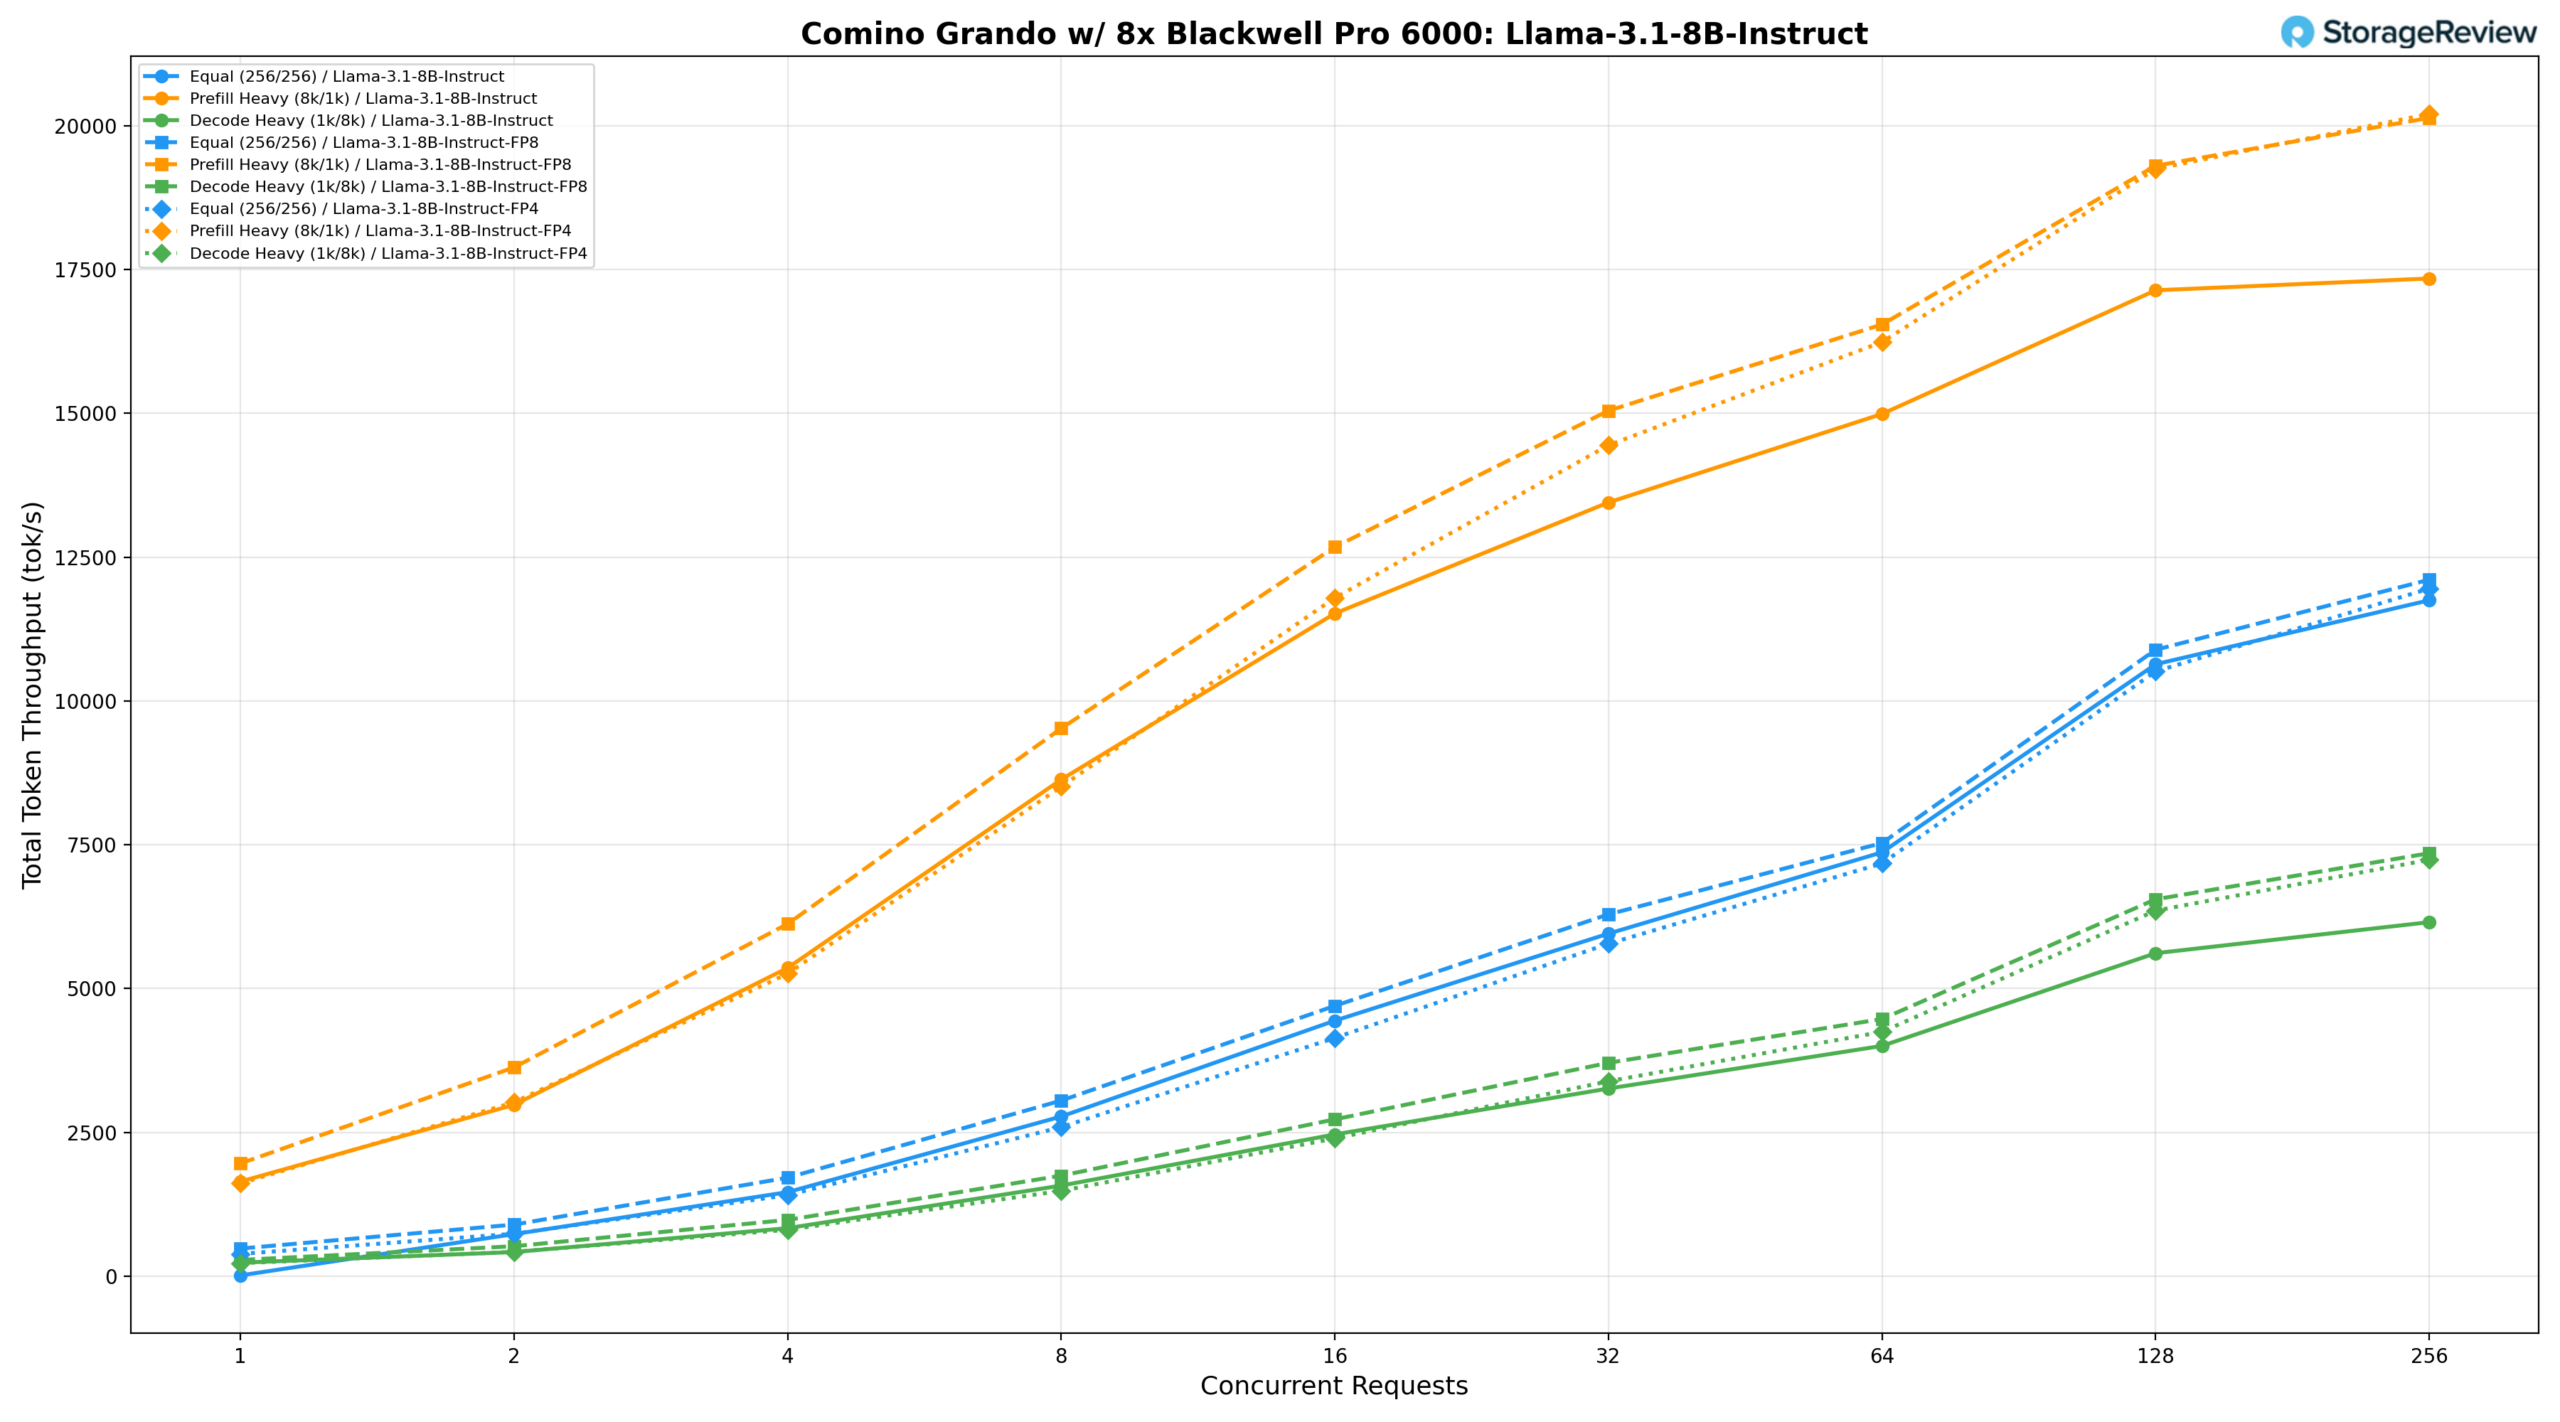
Model Llama-3.1-8B-Instruct byl testován ve třech konfiguracích s vysokou přesností na serveru Comino, což poskytlo jasný přehled o tom, jak kvantizace ovlivňuje propustnost pro tuto velikost modelu.
Lama 3.1 8B Instrukce BF16
Při stejném zatížení (256/256) dosahuje model BF16 rychlosti 2 776,42 tok/s při BS=8, dosahuje 7 369,01 tok/s při BS=64 a vrcholí na 11 751,56 tok/s při BS=256. Rychlost s vysokým přednaplněním (8k/1k) začíná na 1 645,29 tok/s při BS=1, stoupá na 14 990,47 tok/s při BS=64 a 17 140,71 tok/s při BS=128 a vrcholí na 17 345,80 tok/s při BS=256. Rychlost s vysokým dekódováním (1k/8k) se zvyšuje z 234.78 tok/s při BS=1 na 6 154,73 tok/s při BS=256.
Lama 3.1 8B Instrukce FP8
Kvantizace FP8 přináší smysluplné zvýšení napříč všemi scénáři. Stejná pracovní zátěž dosahuje 7 530,39 tok/s při BS=64 a vrcholí na 12 108,98 tok/s při BS=256. Zátěž s vysokým obsahem předplnění stoupá na 16 546,53 tok/s při BS=64 a 19 306,49 tok/s při BS=128, s vrcholem 20 137,35 tok/s při BS=256, což je zhruba 16% nárůst oproti BF16 při maximální souběžnosti. Zátěž s vysokým obsahem dekódování dosahuje vrcholu na 7 353,40 tok/s při BS=256, přibližně o 19 % více než BF16.
Lama 3.1 8B Instrukce FP4
FP4 nabízí propustnost, která je při vyšších úrovních souběžnosti úzce srovnatelná s FP8, i když při nižších velikostech dávek mírně zaostává. Stejná pracovní zátěž dosahuje vrcholu 11 954,40 tok/s při BS=256 a náročné předfillování dosahuje svého nejvyššího bodu při 20 205,57 tok/s při BS=256, čímž těsně poráží FP8 při maximální souběžnosti. Náročné dekódování dosahuje vrcholu 7 239,29 tok/s při BS=256 a po celou dobu zůstává v rozmezí několika procent od FP8, což z FP4 činí přesvědčivou volbu, když je prioritou efektivita paměti, aniž by došlo k významné oběti propustnosti.
MiniMax M2.5
MiniMax-M2.5 230B, testovaný na Comino Grando, byl největším a nejnáročnějším modelem, který jsme použili.
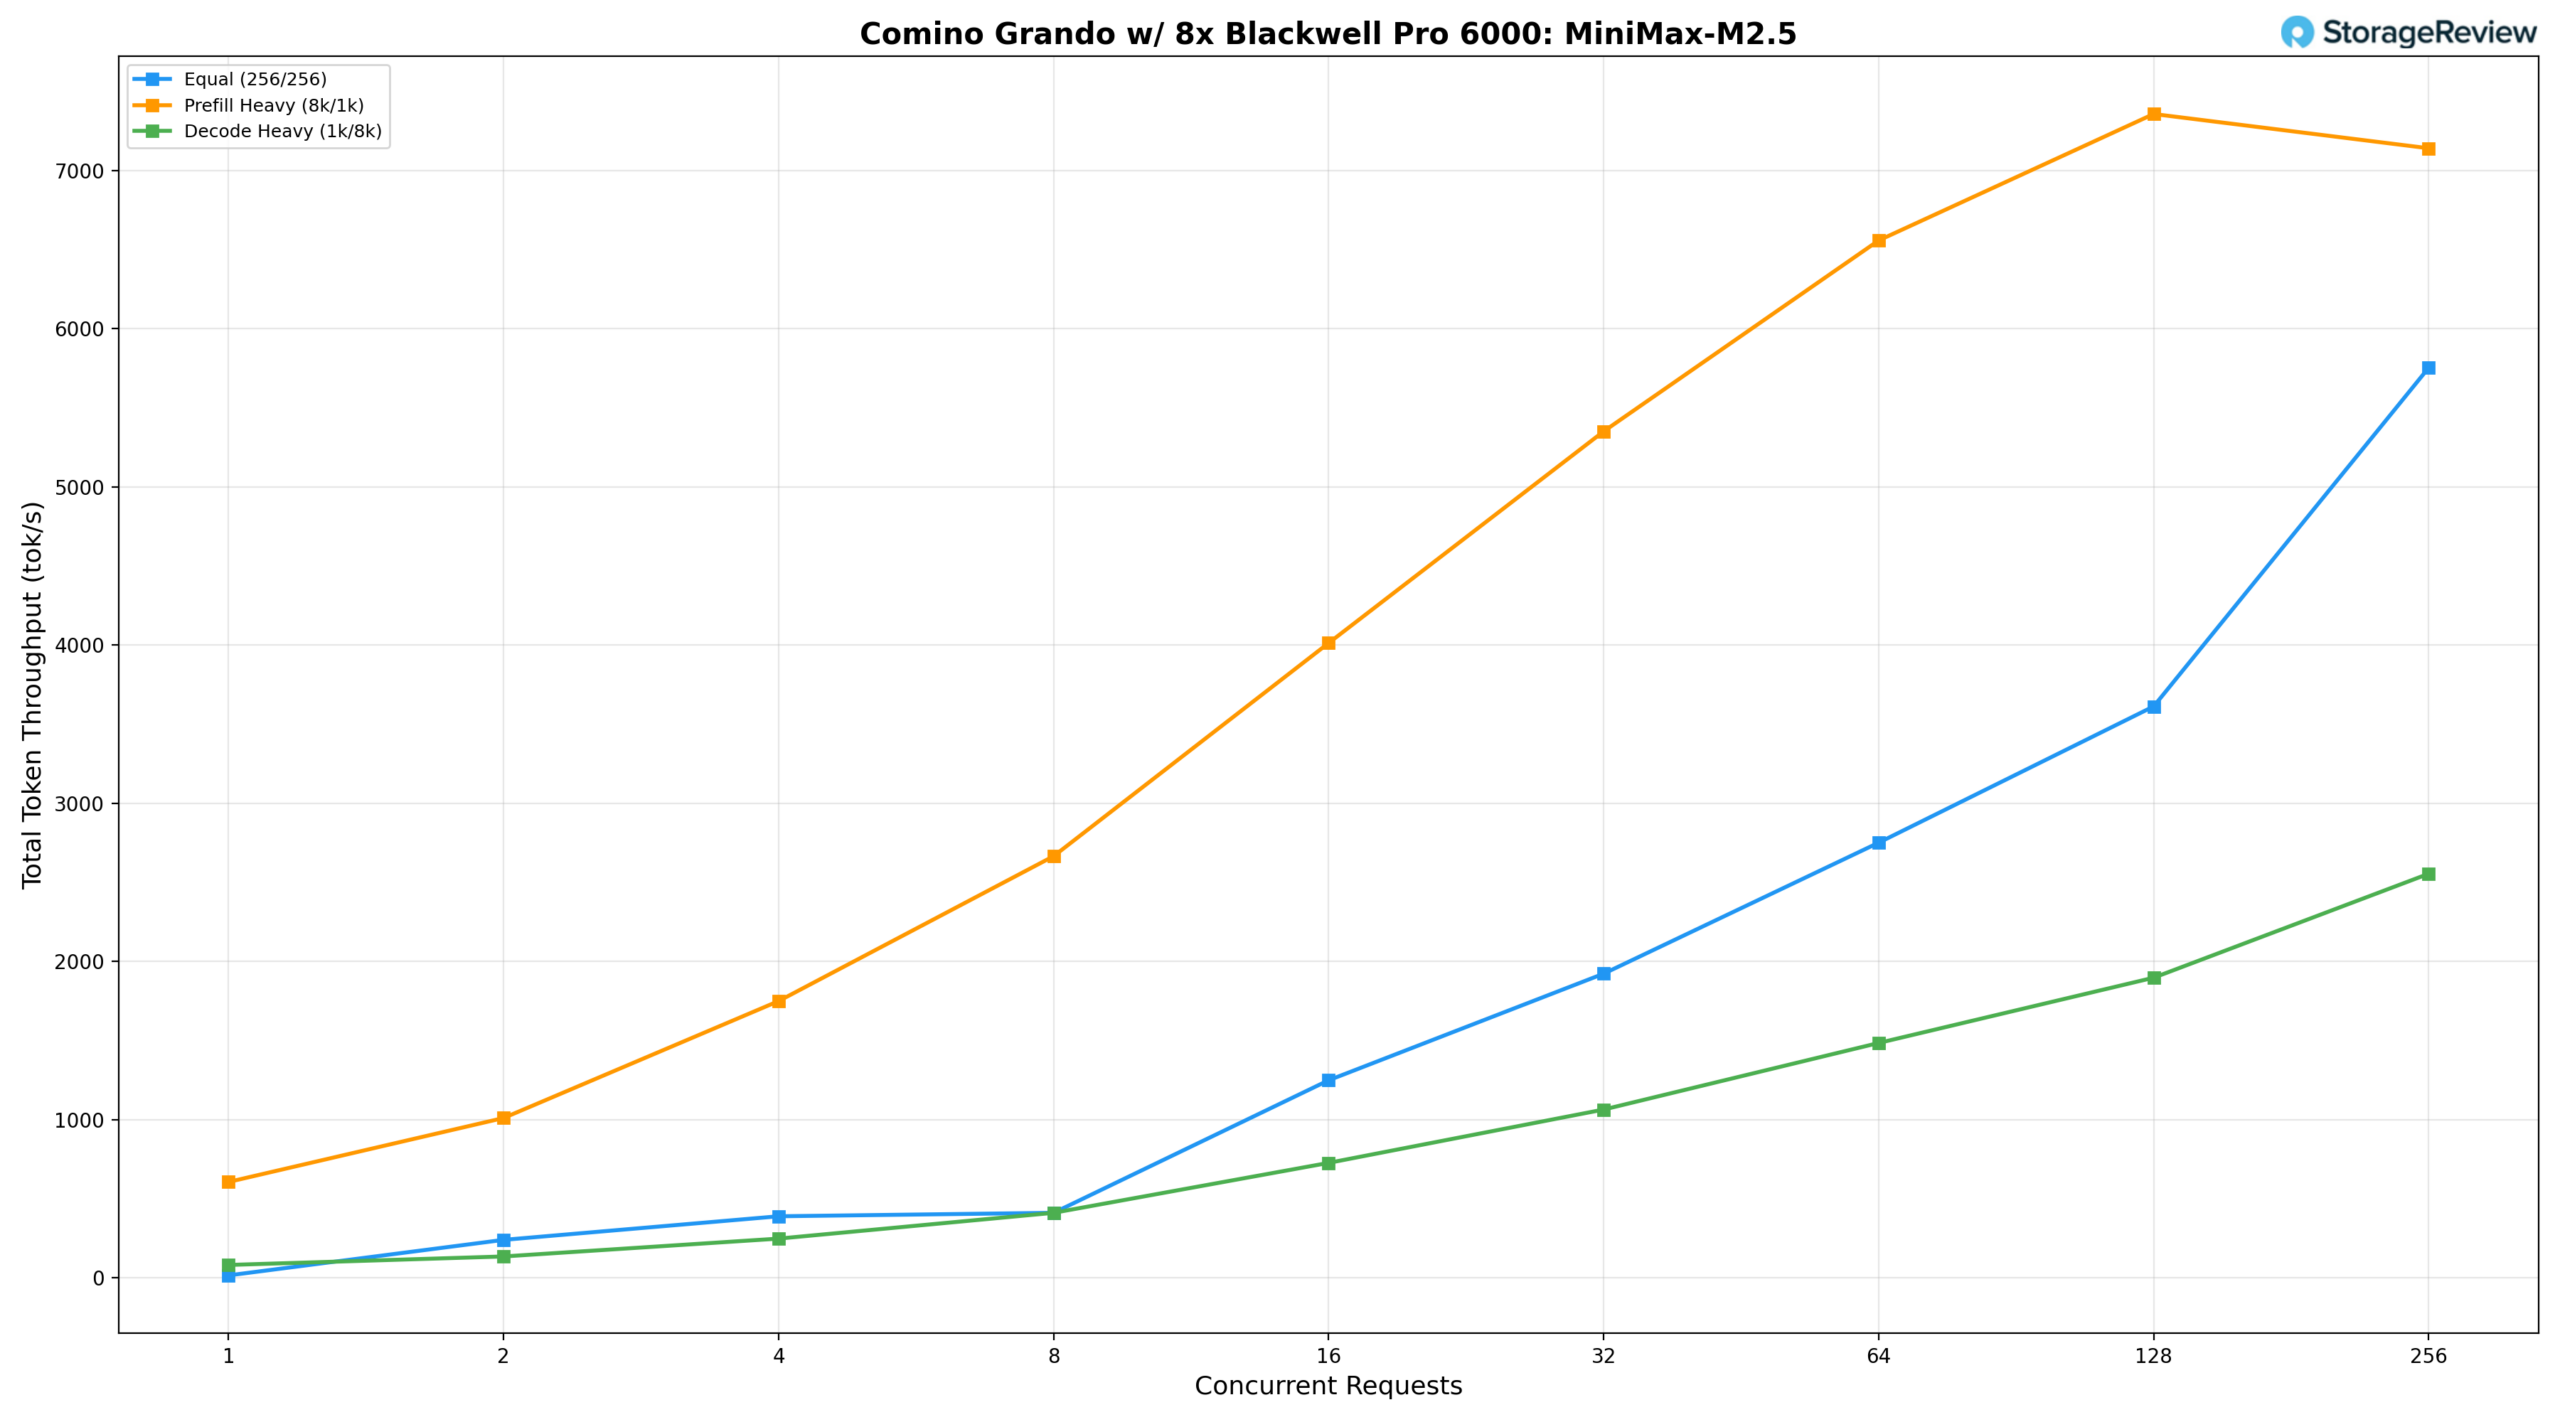
Při stejném zatížení (256/256) model začíná na 16.35 tok/s při BS=1, dosahuje 2 751,25 tok/s při BS=64 a silně se škáluje při vyšší souběžnosti, vrcholí na 5 753,24 tok/s při BS=256. Model s vysokým počtem předběžných naplňování (8k/1k) začíná na 606.97 tok/s při BS=1, stabilně stoupá na 5 351,02 tok/s při BS=32 a 6 557,92 tok/s při BS=64, dosahuje svého vrcholu na 7 357,26 tok/s při BS=128, než mírně klesá na 7 140,74 tok/s při BS=256, což naznačuje, že se model blíží saturaci v propustnosti předběžného naplňování za hranicí BS=128. Dekódovací rychlost (1k/8k) konzistentně roste z 82.21 tok/s při BS=1 na 1 485,28 tok/s při BS=64, s vrcholem 2 554,87 tok/s při BS=256, což odráží očekávané nároky na šířku pásma paměti architektury 230B MoE při trvalém dekódovacím zatížení.
Závěr
Comino Grando lze nejlépe chápat jako systém navržený tak, aby odemkl plný potenciál osmi grafických karet NVIDIA RTX PRO 6000. Každé hlavní konstrukční rozhodnutí, od obráceného uspořádání základní desky až po chladicí smyčku a integrovaný monitorovací stack, má zajistit, aby tyto grafické karty mohly nepřetržitě fungovat s plným TDP 600 W bez tepelných nebo energetických omezení.
Grando není přesvědčivé jen s ohledem na jednotlivou funkci, ale na to, jak je celý systém propojen. Kapalinové chlazení není žádným dodatečným přídavkem; je to architektura. Napájení je redundantní, hot-swappable a škálovatelné na zátěž 4 800 W osmi 600W karet s rezervou. Monitorovací systém jde nad rámec pouhého hlášení teplot; autonomně chrání hardware, když se něco pokazí. Nic zde nepůsobí jako dodatečná myšlenka.
Výkonnostní čísla tuto soudržnost posilují. Napříč rozmanitou sadou modelů, od Llama 3.1 8B až po 230B MiniMax M2.5, Grando dosáhlo hodnot propustnosti, které jsou pro samostatně hostovanou platformu srovnatelné. Testování souběžnosti Claude Code dále zdůraznilo praktickou hodnotu: osm inženýrů může spouštět simultánní agentní kódovací relace na lokálně hostovaném modelu 230B interaktivními rychlostmi, s propustností na uživatele přesahující 38 tok/s při maximálním souhrnném výkonu. Týmy o čtyřech až osmi členech mohou pracovat s téměř optimální propustností bez znatelné degradace.
Hodnota této konfigurace přesahuje rámec inference umělé inteligence. S 96 GB paměti VRAM na GPU a hustým škálováním pro více GPU je platforma stejně vhodná pro náročné kreativní i inženýrské úlohy, včetně renderování vizuálních efektů, rozsáhlých simulací a komplexních CAD pipeline. Systém lze škálovat na konfigurace se čtyřmi a dvěma GPU, což zpřístupňuje tuto úroveň výkonu menším studiím a týmům, které stále vyžadují hustotu pracovních stanic.
Grando se od podnikových platforem s osmi grafickými kartami, které jsme recenzovali, nejvíce liší v praktičnosti nasazení. Tyto systémy nabízejí větší prostor pro linky PCIe, více slotů pro síťové karty a hlubší konektivitu úložiště, ale také vyžadují vyhrazenou infrastrukturu datového centra, spotřebovávají více než 8 kW a jejich dodací lhůty se mohou protáhnout na více než rok. Grando vyměňuje část této rozšiřitelnosti periferních zařízení za systém, který běží dostatečně tiše, aby sdílel místnost se svými uživateli, rozptyluje méně tepla do okolního prostředí a je dodáván ihned. Pro organizace, které upřednostňují rychlé nasazení a snadno spravovatelná operační prostředí před maximální konektivitou fabric, je tento kompromis příznivý.
Stránka produktu – Comino Grando
Konfigurátor Comino – Strana
Žebříček: Comino Grando RTX PRO 6000 drží pozici Extreme Pick v našem žebříčku Nejlepší stolní počítače pro lokální AI.


 Amazon