

Automatizované vrstvení úložišť je již léta nezbytným řešením pro podniky, které chtějí efektivně spravovat rozložení svých datových center a zároveň snižovat celkové náklady na vlastnictví (TCO). Strategie je jednoduchá: používat algoritmy a zásady automatického vrstvení a uchovávat aktivní data na primárním úložišti, zatímco neaktivní data přesouvat do levnějších kategorií úložišť. V posledních letech se vrstvení cloudu ukázalo jako robustní a cenově efektivní řešení, které řídí přesun neaktivních dat do levného objektového úložiště v cloudu. S řadou ThinkSystem DM umožňuje Lenovo podnikům spravovat data a cloudové alternativy pomocí inteligentního úložného řešení. Tato cloudová strategie úspěšně řeší kapacitu, agilitu a zabezpečení v hybridních cloudových prostředích, aniž by byla ohrožena správa, zabezpečení nebo výkon.
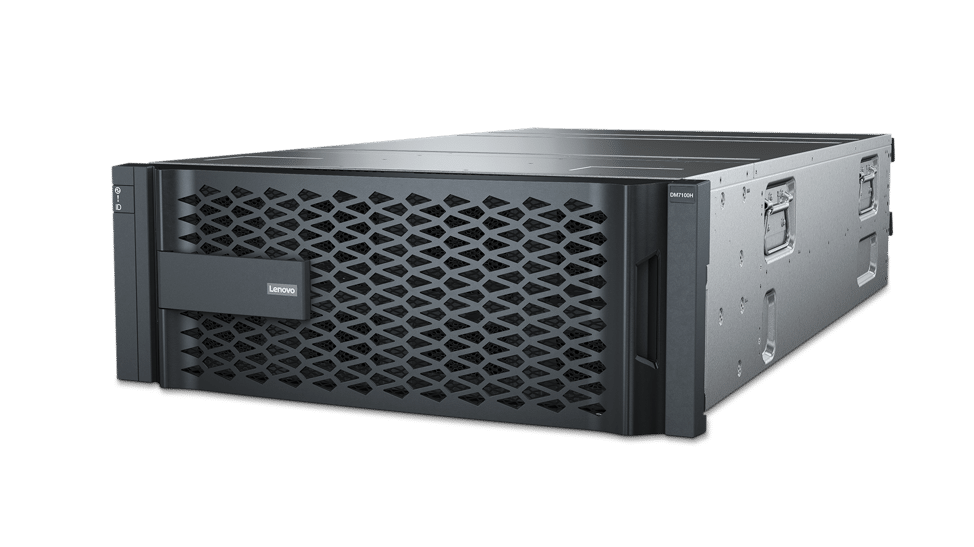
Tento článek popisuje, jak řešení Lenovo ThinkSystem Storage Solutions a řada DM nabízejí komplexní strategii pro datová centra, od lokálních úložišť až po cloud. Nejprve se dotkneme některých základních konceptů týkajících se ukládání dat, vrstvení cloudu a nových výzev v oblasti správy úložišť. Podíváme se na ekosystém správy dat Lenovo a na to, jak se společnost s řadou DM odlišuje na trhu s úložišti. Také se podrobně podíváme na software ONTAP a zásady vrstvení úložišť FabricPool. A nakonec si v naší laboratoři ukážeme nastavení a ověření cloudového vrstvení Lenovo.
V tradičním modelu datového centra začíná podnik s růstem shromažďovat kritická data a soubory ve svých prostorách. Tato data však časem zestárnou a jsou zřídkakdy přístupná, což ubírá cenný výkon a kapacitu primárního a sekundárního úložiště a má dopad na kritické úlohy. Archivace těchto dat byla v minulosti pro podniky praktickým řešením; tímto způsobem však nejsou data okamžitě k dispozici v případě, že jsou náhle potřeba.
Tento problém zvýšil povědomí IT organizací o nutnosti zvážit úrovně úložišť s různými charakteristikami kapacity, nákladů a výkonu. Musí také uznat a být připraveny splnit požadavky na růst dat v různých cloudových prostředích. Odpovědí je vrstvení cloudu a je nutné ho v moderních úložných architekturách zvážit. V opačném případě rozšiřující se datová stopa převýší investici, kterou firma vynaložila na vysoce výkonné primární úložiště ve svém datovém centru.
Cloud jako úložná vrstva
S tím, jak se zpřístupňují pokročilejší technologie, lze stávající úložné vrstvy podle potřeby transformovat a přidávat další, aby se architektura vícevrstvého úložiště dále diverzifikovala. Cloud otevřel IT organizacím nové možnosti a umožnil poskytovat úložná řešení od poskytovatelů veřejného cloudu jako další (nižší) vrstvu. Pokud bude cloud dobře navržen a realizován, bude vynikajícím a levnějším řešením než nižší on-premise vrstva.
V primárních úložných vrstvách, které využívají flash pro extrémně vysoký výkon, by mohlo být přibližně 50 % neaktivních dat alokováno do cloudu. Do této kategorie často patří snapshoty a nestrukturovaná data, včetně kriticky důležitých aplikací. V sekundárních vrstvách by až 90 % neaktivních dat uložených v úložišti mohlo tvořit zálohy. Všechna tato cenná, ale jen občas přístupná data by mohla být také přesunuta do cloudu. Mezi oblíbené cloudové poskytovatele a služby, které jsou připraveny vrstvit neaktivní data, patří Azure Blob Storage, AWS S3 a Google Cloud Storage.
Stejně jako u automatizovaného vrstvení úložiště v místních systémech můžeme vytvářet zásady a pravidla pro správu dat v cloudu. Tyto podmínky nám umožňují přenášet soubory přímo z místního úložiště do veřejného cloudu. Zásady se aplikují několika způsoby. Data lze například přesouvat na základě přípony souboru, vzorů obsažených v názvu souboru nebo podle toho, jak často je soubor v daném období přístupný. Tato poslední možnost je pravděpodobně nejlepším scénářem, kdy jsou souborům a blokům úložiště přiřazeny hodnoty teploty, přičemž nově zapsaná data jsou označena jako „horká“ a neaktivní jako „studená“. Implementací sady zásad vrstvení úložiště lze „studená“ data rychle přesunout do cloudu spouštěním pravidel na vyžádání nebo podle plánu.
Nové výzvy v oblasti správy úložišť
Hlavní výzvy, které se dnes na trhu objevují v oblasti správy dat v hybridním cloudu, zahrnují objem a rozmanitost, rychlost dat a integritu dat.
Objemy dat rostou téměř exponenciálním tempem. IT organizace se musí postarat nejen o růst dat, ale i o jejich růst a správu v různých prostředích. Objem a rozmanitost generovaných dat jsou i nadále ohromující. Bez možností ukládat, kategorizovat a zpracovávat tato data v hybridním cloudovém řešení organizace přicházejí o důležité informace o svých zákaznících a podnikání. Navíc se předpokládá, že objemy dat se do roku 2025 zvýší desetkrát (přibližně o 163 ZB), a to díky internetu věcí a edge technologiím. Pokud jsou data nejcennějším aktivem, musí se s nimi zacházet opatrně a musí být schopna poskytovat informace pro cílená rozhodnutí a zároveň umožňovat pohled do budoucnosti. Navíc nalezení efektivnějších způsobů zpracování těchto dat tak, aby se proměnila v hodnotu, je zásadní pro nákupní rozhodnutí zákazníků.
IT hrozby se také vyvíjejí – a udržování bezpečnosti infrastruktury je neustálý boj. Dobrou bezpečnostní strategií je vybudovat pevný základ založený na přesné znalosti, kdy, kde a jak jsou data uložena. Tento druh strategie pomáhá firmám vyhnout se rostoucím nákladům spojeným s úniky dat, stejně jako s novým malwarem, katastrofami a předpisy, které představují významná rizika pro provoz. Zabezpečení dat je pro podniky naprosto důležité, ať už jde o ochranu před ztrátou dat nebo zajištění jejich integrity. Zde Lenovo pokrývá všechny možnosti a zaručuje, že data jejích zákazníků budou vždy chráněna.
Řešení úložišť Lenovo ThinkSystem
Předvídání nového vývoje je také náročné, stejně jako držet krok s nejlepší strategií pro ukládání dat a cloud. Toto odvětví však již vynaložilo obrovské investice do výzkumných ekosystémů a platforem, které podnikům přinášejí hodnotu a příležitosti. Společnost Lenovo učinila další strategický krok pro odvětví ukládání dat a přizpůsobila své řešení tak, aby splňovalo hlavní výzvy pozorované v oblasti správy dat. Tento chytrý krok od Lenova si klade za cíl poskytnout svým zákazníkům dokonalé řešení a nabízí jedinečnou kombinaci produktů a služeb, které firmám umožní co nejlépe využít hybridní cloud.
Lenovo je jednou z unikátních technologických společností na trhu, která poskytuje komplexní řešení pro datová centra prostřednictvím Lenovo Data Center Group (DCG). Lenovo dále poskytuje komplexní zabezpečení a správu softwaru prostřednictvím svého ekosystému Intelligent Device Group (IDG). Díky těmto nabídkám a řadě Lenovo ThinkSystem DM mohou podniky vylepšit svou infrastrukturu a zvládnout jakoukoli pracovní zátěž běžící v jejich prostředích.
Řada ThinkSystem DM je vlajkovou lodí mezi úložnými řešeními od společnosti Lenovo, která nabízí všestrannou sadu pro správu strukturovaných i nestrukturovaných dat. Zahrnuje řešení od základních až po vyšší střední třídy a poskytuje datově bohaté funkce, jako je integrovaná redukce dat, ochrana dat a zabezpečení dat. Každá z řad DM dokáže poskytovat integrované hybridní cloudové funkce pro řešení poskytovatelů veřejného cloudu. Současně Lenovo rozšiřuje svou komplexní nabídku NVMe s nedávno uvedenou řadou DM7100F a koncem letošního roku plánuje rozšířit nabídku komplexních NVMe i na základní úlohy, aby zákazníci mohli vytvořit celopodnikovou NVMe infrastrukturu.
FabricPools
Sada pro správu dat řady DM sjednocuje správu dat napříč flashovými úložišti, diskovými systémy a cloudovými úložišti a zjednodušuje tak úložná prostředí. Tento komplexní software se snadno používá a je vysoce flexibilní, je navržen pro efektivní ukládání dat a disponuje robustními funkcemi pro správu dat a bezproblémovou integrací do cloudu. Celkově si řada DM klade za cíl zjednodušit nasazení a správu dat a vylepšit podnikové aplikace, tj. je připravena na budoucnost datových infrastruktur.
Vedle integrované funkce správy dat je k dispozici technologie FabricPool Cloud Tiering. Umožňuje automatizované vrstvení dat do nízkonákladových úrovní objektového úložiště S3, které se nacházejí buď v místních podmínkách, nebo ve veřejném cloudu. Na rozdíl od manuálního vrstvení FabricPool automatizuje vrstvení dat, čímž snižuje náklady na úložiště. Aktivní data zůstávají na vysoce výkonných discích a neaktivní data jsou vrstvena do objektového úložiště, přičemž se zachovává funkčnost a datová efektivita řady DM.
FabricPool podporuje širokou škálu poskytovatelů veřejného cloudu a jejich úložných služeb. Patří mezi ně Amazon S3, Alibaba Cloud Object Storage Service, Microsoft Azure Blob Storage, Google Cloud Storage, IBM Cloud Object Storage a privátní cloudy. Zákazníci budou také těžit ze zachování integrovaných funkcí pro redukci dat při přesunu dat do cloudu a z cloudu. To šetří náklady na přepravu, když je třeba data přesunout zpět z cloudu. Integrované šifrování dat navíc chrání data jak při přesunu do cloudu, tak i po jeho uložení v cloudu. Tím je zajištěno, že v celém procesu vrstvení cloudu nebudou žádné zranitelnosti.
Zásady FabricPoolu
FabricPool má dva primární případy použití: znovuzískání kapacity primárního úložiště nebo zmenšení velikosti sekundárního úložiště. V tomto článku se zaměříme na možnost znovuzískání kapacity primárního úložiště. Existují tři různé a jedinečné zásady pro vrstvení cloudu primárního úložiště: automatické vrstvení, pouze snímky a vrstvení všech úložišť.
Udržování zřídka používaných dat spojených s produktivním softwarem, dokončenými projekty a starými datovými sadami na primárním úložišti představuje neefektivní využití vysoce výkonného flash úložiště. Vrstvení těchto dat do úložiště objektů je snadný způsob, jak získat zpět stávající flash kapacitu a snížit množství požadované kapacity v budoucnu. Zásady automatického vrstvení přesouvají všechny studené bloky ve svazku do cloudové vrstvy. Pokud jsou bloky studených dat na cloudové vrstvě čten náhodným čtením, stanou se horkými a přenesou se do lokální vrstvy. Pokud jsou bloky studených dat na cloudové vrstvě čten sekvenčním čtením, jako jsou ta spojená s indexovými a antivirovými kontrolami, bloky studených dat na cloudové vrstvě zůstanou studené a nebudou zapsány do lokální vrstvy.
Snapshoty mohou často zabírat více než 10 % typického úložného prostředí. Ačkoli jsou tyto kopie k určitému bodu v čase nezbytné pro ochranu dat a zotavení po havárii, používají se jen zřídka a představují neefektivní využití vysoce výkonné flash paměti. Zásady vrstvení pouze pro snapshoty pro FabricPool představují snadný způsob, jak znovu získat úložný prostor ve flash úložišti. Během našeho testování byla k testování cloudových operací vrstvení použita zásada pouze pro snapshoty. Bloky studených snapshotů na svazku, které nejsou sdíleny s aktivním souborovým systémem, jsou přesunuty do cloudové vrstvy. Pokud jsou bloky studených dat na cloudové vrstvě přečteny, stanou se horkými a přenesou se do lokální vrstvy.
Jedním z nejběžnějších použití FabricPoolu je přesun celých objemů dat do cloudu. Dokončené projekty, starší reporty nebo historické záznamy jsou ideálními kandidáty pro vrstvení do nízkonákladového objektového úložiště. Přesun celých objemů se provádí nastavením zásady All Tiering na objemu. Tato zásada se primárně používá se sekundárními daty a objemy pro ochranu dat. Lze ji však také použít k vrstvení všech dat ve objemech pro čtení/zápis.
Data ve svazcích používající zásadu All Tiering jsou okamžitě označena jako studená a co nejdříve přesunuta do cloudu. Není třeba čekat na minimální počet dní, než se data přesunou do studené a vrstvené vrstvy. Pokud jsou bloky studených dat na cloudové vrstvě přečteny, zůstanou studené a nezapíší se zpět do lokální vrstvy.
Lenovo nabízí také čtvrtou možnost vrstvení, která se příhodně nazývá „Žádná“ politika vrstvení. V této politice nejsou žádná data vrstvena, což umožňuje uchovávat vše ve flash paměti. Dobrým příkladem jejího použití jsou snapshoty v prostředích DevOps, kde se často používají předchozí kopie k určitému bodu v čase.
Konfigurace vrstvení cloudového úložiště Lenovo
Abychom otestovali možnosti a některé funkce úložného řešení Lenovo pro cloud, nainstalovali jsme v naší laboratoři model DM7000F.
Nejprve jsme vytvořili úložný kontejner pomocí Azure Blob Storage, našeho cloudového řešení pro tento test. Opět je dobré zmínit širokou škálu možností dostupných od Lenovo, které zahrnují Alibaba Cloud, Amazon S3, Google Cloud, IBM Cloud a další. Během testu bylo cílem použít Microsoft Azure Blob Storage pro cloud jako cloudovou vrstvu pro FabricPool. Jakmile jsme dokončili nastavení cloudového úložiště, nastal čas přihlásit se do grafického rozhraní DM7000.
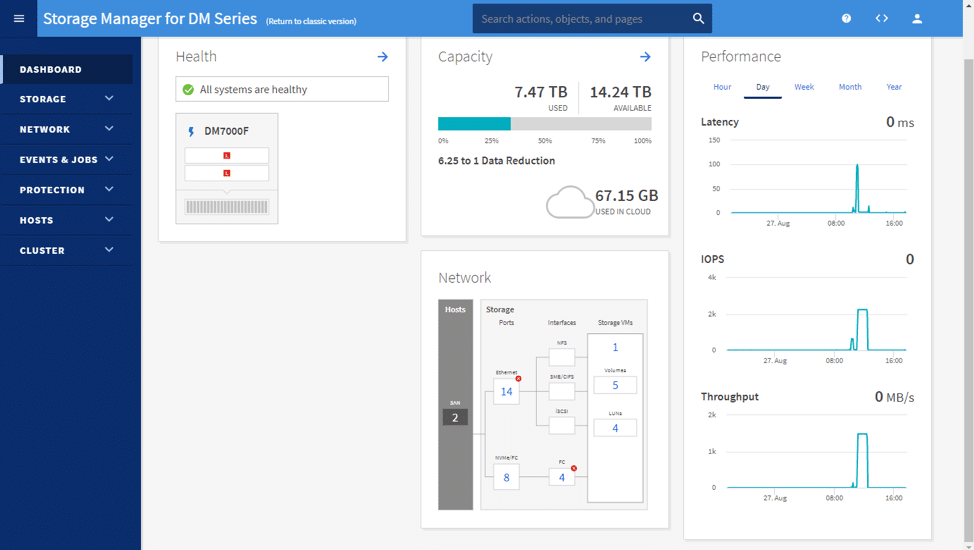
Po přihlášení se zobrazí výchozí stránka Dashboard. Dashboard zobrazuje stav, kapacitu, výkon a informace o síti daného pole.
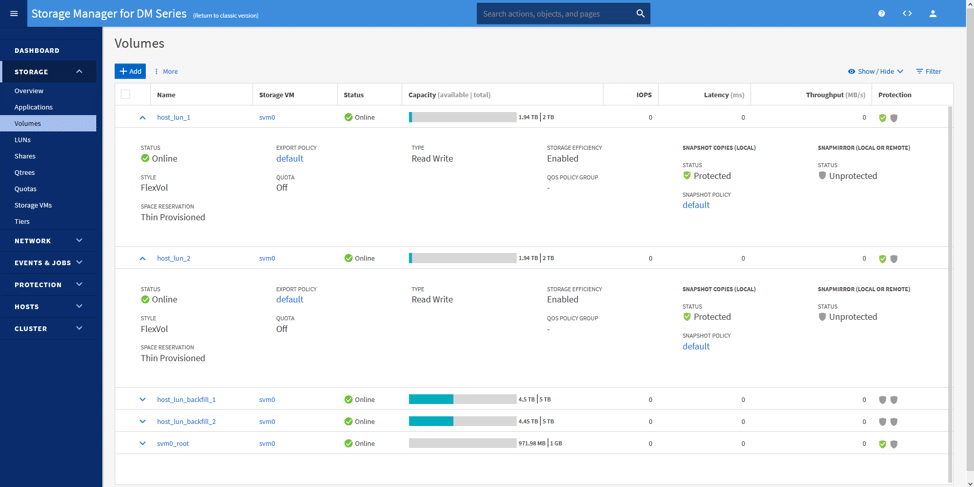
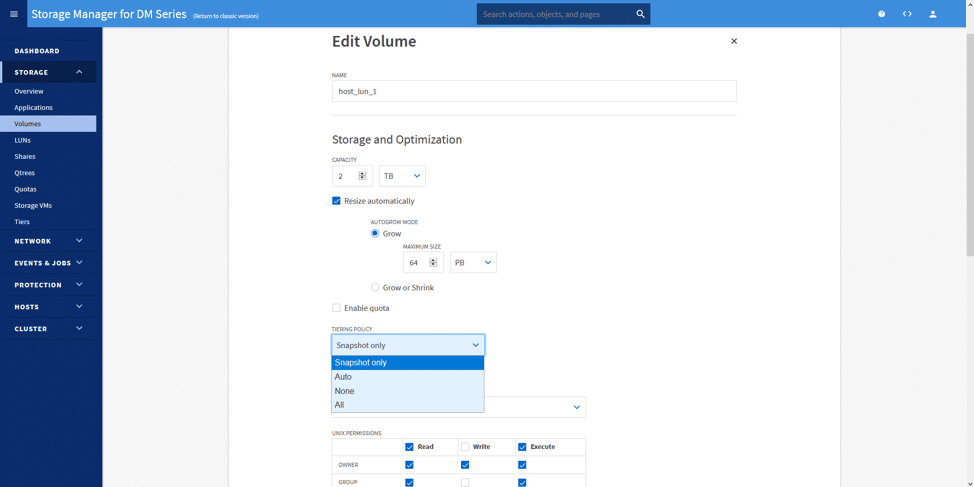
Poté jsme vytvořili dva svazky (jeden na řadič) a dva virtuální počítače (jeden pro každý svazek). Plán byl nechat tyto virtuální počítače běžet a pak je chvíli nečinně používat. Obrázek níže ukazuje použité svazky: host_lun_1 a host_lun_2.
Při úpravě nebo vytváření svazku můžeme vybrat požadovanou zásadu vrstvení. Zde jsme vybrali možnost Pouze snímek. Výběrem této zásady vrstvení se naše data (která se po každém snímku zobrazují jako studená) přesunou do úložiště Azure Blob Storage vytvořeného v intervalu na pozadí. Interval běží ve vlastním čase a předpovídá, kdy budou úlohy nejméně ovlivněny.
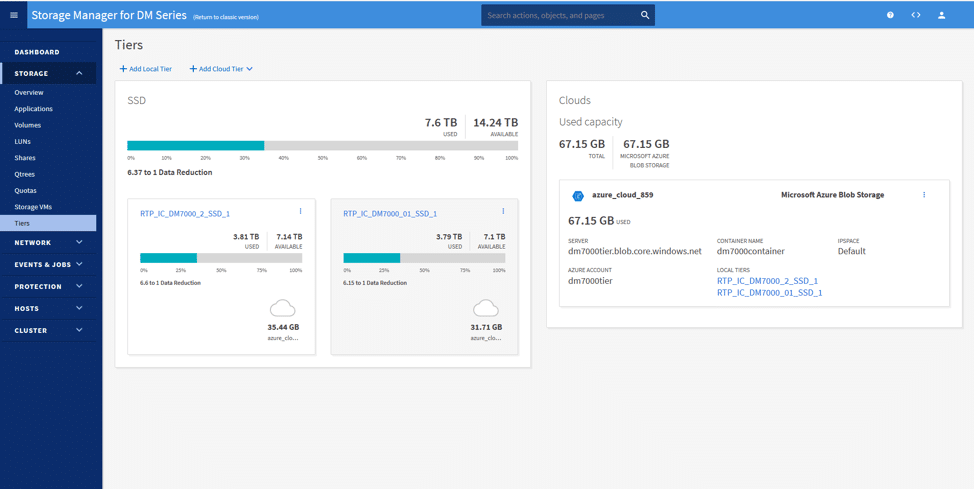
Na stránce Úrovně můžeme přidat naši cloudovou vrstvu z veřejných cloudů. Zde jsme připojili prostředek Azure Blob Storage a propojili ho se dvěma lokálními vrstvami úložiště. Na obrázku níže vidíte dva prostředky připojené k Azure.
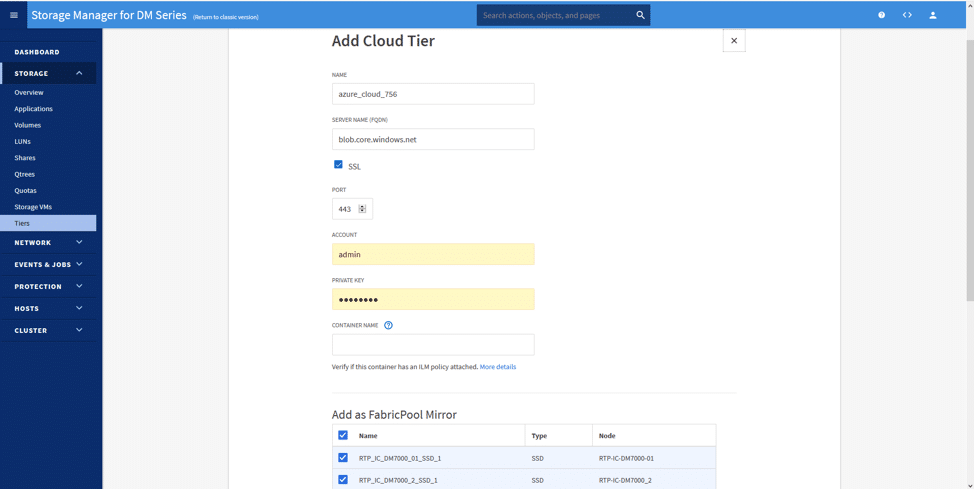
Konfigurace je jednoduchá; kliknutím na tlačítko Přidat cloudovou vrstvu a výběrem požadovaného cloudu (v tomto scénáři Azure) můžeme cloudovou vrstvu okamžitě nastavit.
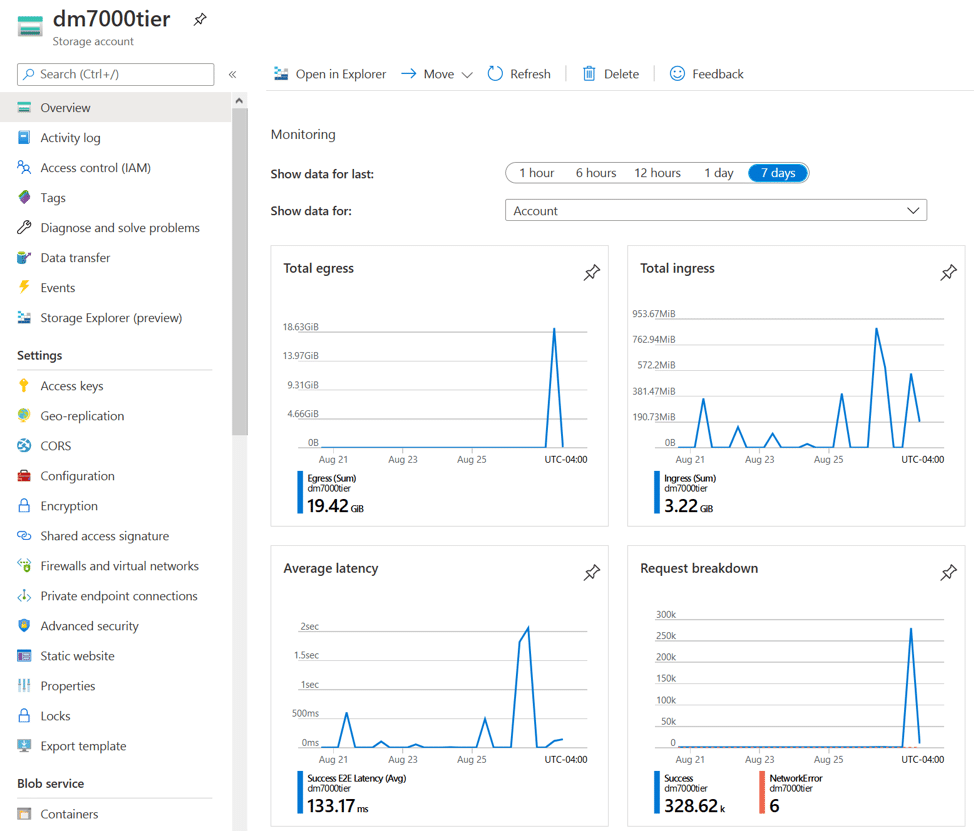
Nakonec jsme chtěli na našem řídicím panelu účtu Azure Storage zobrazit jak data vstupující do Azure (příchozí), tak i data přesouvaná (výstupní). Malé špičky zobrazené každý den představují nové snímky dat přenášených do Azure. Na druhou stranu špičky výstupních dat zobrazují odchozí data, což ilustruje obnovení snímku ze svazku pro vrácení zpět.
Závěrečné myšlenky
Obecně je cloud a správa dat širokým a neustále se vyvíjejícím tématem mezi podniky. Lenovo chce poskytovat řešení, která zákazníky připraví na měnící se potřeby, ať už v datových centrech nebo v hybridních cloudových prostředích. My ve StorageReview jsme docela ohromeni přístupem společnosti Lenovo k jejím úložným polím. Prostřednictvím tohoto hodnocení jsme si vyzkoušeli, jak funguje vrstvení dat do cloudu ze Storage Manageru pro řadu DM a jak se cenná flash kapacita získává zpět nebo rozšiřuje do cloudu. Důležité je, že úložný systém DM7000F poskytuje tuto flexibilitu bez nutnosti jakýchkoli změn v infrastruktuře. Funkce se navíc snadno implementuje.
S podporou společností DCG a IDG vidíme Lenovo v silné pozici na trhu s datovými úložišti. Jejich úložná řešení umožňují zákazníkům nakupovat to, co potřebují dnes, a zároveň využívat cloud k uspokojení budoucích požadavků na růst dat. Konečným výsledkem je, že vrstvení cloudu Lenovo sníží náklady a umožní firmám flexibilitu, kterou si přejí při zvažování investice do úložiště.
Úložná pole Lenovo ThinkSystem řady DM
Tuto zprávu sponzoruje společnost Lenovo. Veškeré názory a stanoviska v této zprávě vyjadřují náš nezaujatý pohled na daný produkt (produkty).


 Amazon