

Vždy, když se řekne NVIDIA DGX Spark, se jako první objeví dvě věci. První je hlavní specifikace: 128 GB unifikované paměti v desktopovém zařízení za zhruba 4 000 dolarů, což je číslo, které by se ještě před dvěma lety zdálo nepravděpodobné umístit na stůl inženýra. Druhou je 200GB síť na zadní straně jednotky. Přítomnost skutečné struktury datového centra na stolním zařízení je to, co lidi nutí se přiklánět k lepšímu, protože to znamená něco víc než jen rychlejší pracovní stanici v jednom zařízení. Znamená to schopnost propojit Sparky a fyzicky replikovat, což je takový druh víceuzlového uspořádání, které dříve bývalo výhradně v racku.
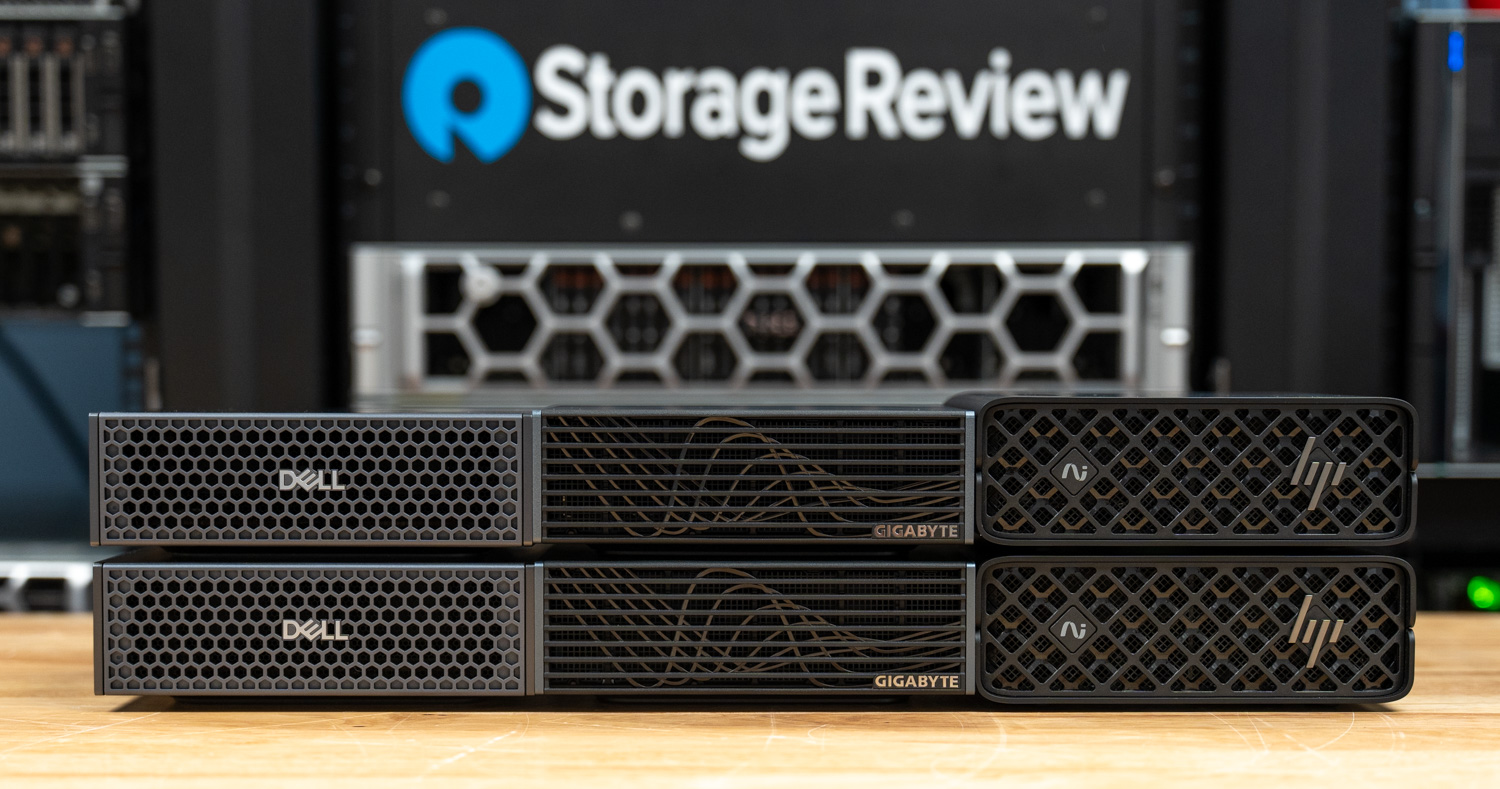
Tato recenze zkoumá tuto schopnost. Porovnáváme distribuovanou inferenci napříč všemi třemi implementacemi OEM Spark, které máme k dispozici, spárujeme je do dvouuzlových clusterů propojených přes 200Gb fabric a projdeme variantami modelů a třemi tvary pracovních zátěží. Také provádíme záměrnou metodologickou volbu, jak je model rozdělen mezi dvě kategorie, která se liší od výchozího doporučení společnosti NVIDIA, a obhajujeme ji daty. Předtím však dva kontextové prvky formují vše, co následuje: síť, která clustering vůbec umožňuje, a důvody, proč jej člověk může nebo nemusí chtít používat.
200GB Fabric
Implementaci sítě jsme podrobně probrali v naší původní recenzi DGX Spark, ale základy stojí za to zopakovat, protože na nich v této recenzi závisí vše. Zadní strana každého Spark obsahuje dvě klece QSFP56 poháněné integrovanou kartou NVIDIA ConnectX-7 SmartNIC. Na papíře tyto dvě klece naznačují 400 GB celkové konektivity, ale skutečným stropem je PCIe: ConnectX-7 je sídlí za dvojicí linek Gen5 x4 a platforma dosahuje maximální využitelné šířky pásma 200 GB, bez ohledu na to, jak jsou klece zapojeny. Jedna osazená klec QSFP56 vám již poskytuje plných 200 Gb, které zařízení podporuje, takže druhý port slouží spíše pro flexibilitu topologie než pro dodatečnou propustnost.
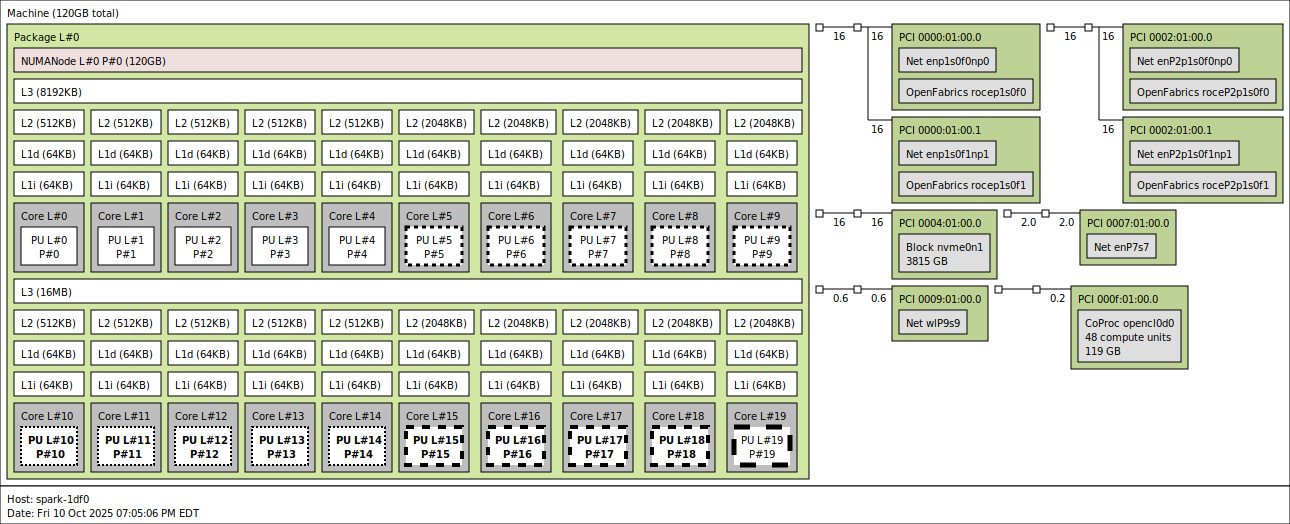
Tato flexibilita se projevuje ve třech běžných konfiguracích. Nejjednodušší je jeden 200GB port používaný jako přímé propojení Spark-Spark, což je přesně to, co specifikuje ověřená dvouuzlová konfigurace NVIDIA a co jsme použili pro tuto recenzi. Druhou jsou dva 100Gb porty, které vytvářejí kruhovou topologii mezi Sparky pro clusterování bez přepínače. Třetí je konfigurace s rozdělenými rolími, kde jedna cage jde do peer Sparku pro clusterování a druhá jde do vysokorychlostního úložiště přes NVMe-oF, což je užitečné, když se pracovní datová sada nevejde na interní NVMe Sparku.
NVIDIA prodává Spark ve třech konfiguracích, které přímo odpovídají způsobu využití dané sítě. Jeden Spark pro práci na jednotlivých stolních počítačích, ověřený cluster se dvěma Sparky přímo připojený přes 200Gb fabric pro rozšířené modely a od letošního vydání GTC také čtyřjednotková konfigurace, kterou NVIDIA veřejně předvedla v reakci na poptávku uživatelů po překonání limitu dvou uzlů. Konfigurace se dvěma Sparky je ta, kterou NVIDIA aktivně propaguje, kterou většina čtenářů skutečně nasadí a o které se domníváme, že představuje rozumnou horní hranici pro produkční styl inference na tomto hardwaru. Je to také konfigurace, kterou tato recenze komplexně porovnává.
Proč vůbec dochází k klastrovým jiskrám
Zřejmý důvod pro clusterování Sparks je stejný jako pro jakýkoli jiný cluster: jeden 128GB box nemůže pojmout všechny důležité modely. Roztažení modelu se 120B parametry na dva boxy otevírá třídu úloh, které by se jinak nehodily. To je hlavní případ použití a je to ten, který je nejvíce demonstrován.
Méně zřejmým důvodem, a pravděpodobně tím důležitějším pro skutečnou zákaznickou základnu společnosti NVIDIA na této platformě, je učení. NVIDIA pozicionuje Spark jako vstupní bod. Jejich oficiální dokumentace , ukázkové notebooky a partnerské playbooky považují tento box za výukový nástroj. Zahrnují prvotřídní návody pro vše od spuštění předpřipraveného modelu za lokálním chatovacím rozhraním přes spuštění kódovacího asistenta na hostovaném koncovém bodu až po jemné ladění malých modelů a tvorbu end-to-end aplikací v PyTorch a JAX. Cílem je, aby se někdo, kdo nikdy v životě nenapsal jádro CUDA, mohl dostat z nuly k funkčnímu pracovnímu postupu AI u svého stolu za víkend, a totéž platí pro inženýry v oblasti mimo strojové učení, kteří chtějí samostatný sandbox, který plně ovládají. Dvouklastrový Spark rozšiřuje tuto výukovou plochu na území více uzlů: tatáž osoba se nyní může také naučit, jak se ve skutečnosti chovají tenzorový paralelismus, pipeline paralelismus a kolektivní komunikační knihovny, a to se sítí, která je dostatečně reálná, aby odhalila skutečná úzká hrdla.
Co však v žádném z vlastních prezentací NVIDIA nápadně chybí, je tvrzení, že Spark je určen pro produkční inferenční služby. Jensen hovořil o společném návrhu hardwaru a softwaru téměř v každém hlavním projevu v posledních několika letech a tento princip platí i zde. Každá platforma NVIDIA je optimalizována pro specifický tvar pracovní zátěže a Spark je optimalizován pro individuální průzkum a učení, nikoli pro obsluhu provozu. Naše předchozí recenze Sparku již ukázaly, že platforma je u většiny inferenčních úloh silně omezena šířkou pásma paměti a síť toto omezení pouze zostřuje, jakmile se clusteruje. Jediné 200Gb připojení, i když je pro stolní počítač působivé, je výrazně pomalejší než připojení PCIe Gen5 x16 v rámci jednoho šasi a kolektivní komunikační vzorce, které fungují čistě napříč dvojicí grafických procesorů datových center propojených pomocí NVLink, se netransplantují na 200Gb fabric bez skutečných penalizací z latence.
To je skutečný důvod, proč NVIDIA tak dlouho omezovala oficiálně podporovanou konfiguraci na dva Sparky a proč byla demonstrace čtyř jednotek na GTC reakcí na poptávku uživatelů, nikoli organickým rozšířením produktu. Nic nebrání tomu, aby softwarový stack běžel na čtyřech nebo osmi uzlech, a několik uživatelů a platform publikovalo výsledky z větších clusterů. Výkonnostní čísla z těchto experimentů obecně nejsou lichotivá: dominantní nákladovou stránkou se stává inter-uzlová struktura a kolektivní výkon prudce klesá, a navíc propustnost na uživatele na konci těchto konfigurací může klesnout na jednociferný rozsah tokenů za sekundu u jakéhokoli modelu dostatečně velkého na to, aby cluster vůbec ospravedlnil. V tomto okamžiku je nastavení funkčně spíše výukovou laboratoří než servisní platformou.
Nic z toho není míněno jako odmítnutí. Clustering Sparks je skutečně vynikající způsob, jak si rozvinout intuici pro distribuovanou inferenci a trénování, která je jinak uvězněna za hardwarem datových center za stovky tisíc dolarů, a vzdělávací hodnota schopnosti skutečně vidět bubliny v pipeline, redukovat úzká hrdla a kompromisy v paralelismu na systému, který vlastníte, je značná. Naším vlastním následným plánem bylo posunout to dále trénováním malého modelu s parametry 1B nebo sub-1 B od nuly na duálním clusteru Spark s nastavením zvoleným tak, aby co nejvěrněji odráželo podmínky, za kterých funguje skutečný distribuovaný předtrénovací běh, abychom mohli přesně ukázat, kde tato třída clusterů dává a kde nedává smysl. Tento projekt je momentálně odložen, zatímco pracujeme na dalších materiálech, které jste možná již viděli, a čekáme na optiku našeho nového 800Gb laboratorního jádrového přepínače. Očekáváme, že se k němu vrátíme, jakmile se laboratorní sestavení ustálí.
Následující část se zaměřuje na případ použití, pro který je konfigurace s dvojitým Sparkem nejodolnější: distribuovaná inference modelů dostatečně velkých na to, aby vyžadovala obě zařízení, porovnaná napříč všemi třemi OEM implementacemi, které máme k dispozici. Než se dostaneme k číslům pro jednotlivé modely, v další části se vysvětluje, proč tato čísla uvádíme v konfiguraci paralelní s pipeline, nikoli v konfiguraci paralelní s tenzorem, kterou vlastní dokumentace NVIDIA obvykle používá jako výchozí.
Testování výkonu
Proč uvádíme paralelní postup potrubí, nikoli paralelní postup tenzoru
Publikované průvodce DGX Spark společností NVIDIA a většina jejich referenčních materiálů se při popisu škálování modelu mezi dvěma Spark boxy spoléhají na tenzorový paralelismus (TP). TP rozděluje každé násobení matic mezi obě GPU, takže každá vrstva běží na obou zařízeních současně a dílčí výsledky jsou po každém bloku pozornosti a MLP sloučeny pomocí all-reduce. Pipeline paralelismus (PP) se ubírá jinou cestou: model rozděluje na poloviny po vrstvách, první polovinu umístí na jeden box a druhou polovinu na druhý a poté mezi nimi streamuje aktivace. Každý požadavek stále prochází celým modelem, ale v daném okamžiku pouze jeden box provádí výpočty pro daný token, zatímco druhý pracuje na další mikrodávce.
Kompromis se omezuje na to, co se přenáší po drátě. Duální Spark stack propojuje oba systémy prostřednictvím 200GbE linky ConnectX-7, která je pro síťovou linku rychlá, ale pomalá ve srovnání s šířkou pásma paměti v rámci jednoho Sparku. TP-redukce se aktivuje dvakrát na transformační vrstvu, takže 80vrstvý model s TP=2 generuje 160 výměn mezi boxy pro každý jednotlivý token výstupu, přičemž každá z těchto výměn blokuje další výpočet. PP=2 předává aktivace pouze jednou na token, ve spoji mezi dvěma polovinami modelu. Na 200GbE lince s netriviální latencí tento rozdíl dominuje všemu ostatnímu.
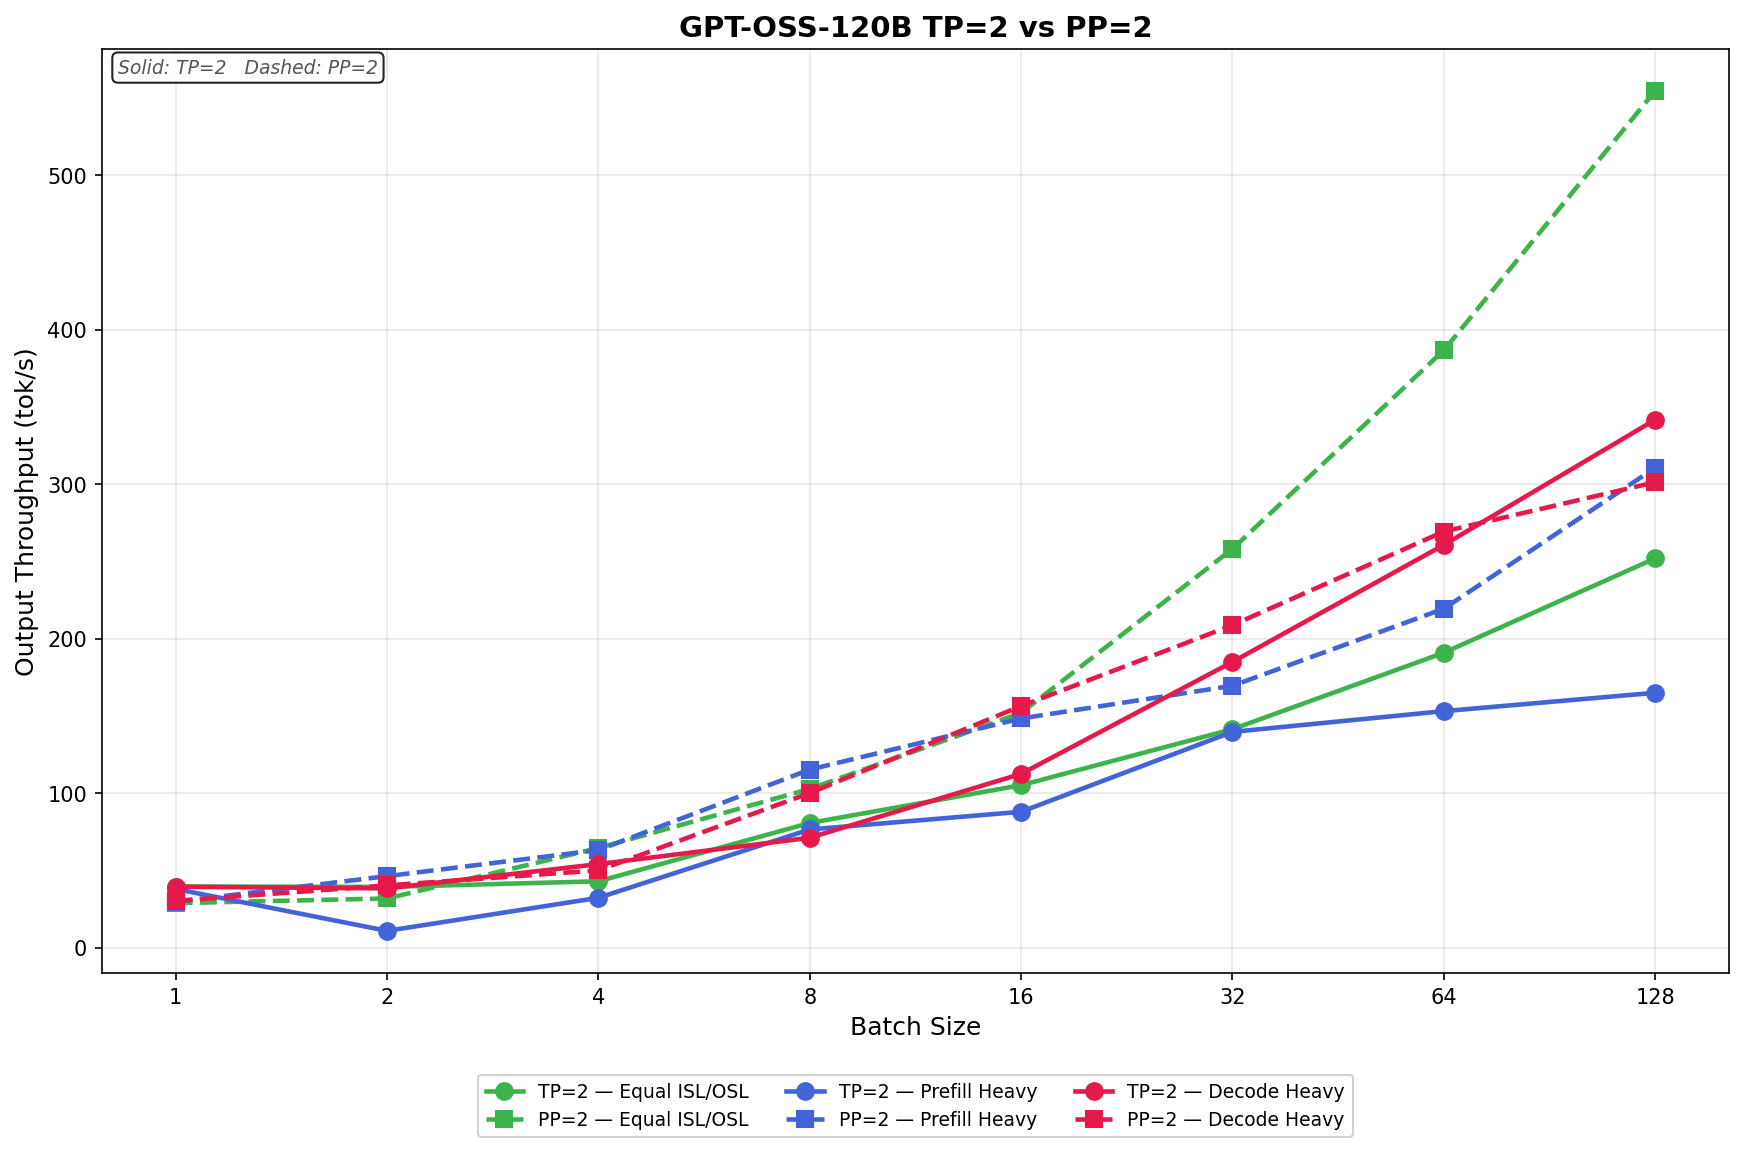
Naše měření GPT-OSS-120B to jasně potvrzují. Mimo velikost dávky 1, kde je pracovní zátěž příliš malá na to, aby pokryla režii kterékoli ze strategií, se PP=2 ujímá vedení a udržuje si ho s rostoucí souběžností. V pracovní zátěži Equal ISL/OSL dosahuje TP=2 252.01 tok/s při velikosti dávky 128, zatímco PP=2 se na stejném hardwaru vyšplhá na 554.69 tok/s, což je 2.20násobná výhoda. Scénář Prefill Heavy vykazuje stejný tvar, přičemž PP=2 končí na 310.63 tok/s oproti TP=2 na 164.99 tok/s. Scénář Decode Heavy je z těchto tří nejblíže, ale PP=2 stále vede od velikosti dávky 8 do velikosti dávky 64 a při velikosti dávky 128, kde dlouhý výstup 8K zesiluje náklady na bublinu v pipeline, předává zpět pouze mírný náskok.
TP=2 má úzké okno, ve kterém vítězí. Při velikosti dávky 1 v každém scénáři poskytuje TP malou, ale skutečnou výhodu: 39.55 tok/s vs. 28.79 tok/s v režimu Equal, 37.97 vs. 29.60 v režimu Prefill Heavy a 39.42 vs. 30.28 v režimu Decode Heavy. S jedním požadavkem ve provozu neexistuje žádná druhá mikrodávka, která by udržovala fázi nečinného kanálu zaneprázdněnou, takže PP platí za prázdný slot v každém kroku, zatímco TP může používat obě GPU na jediném existujícím tokenu. Pro tento režim je vytvořeno doporučení TP od NVIDIA: interaktivní serving jednoho streamu, kde latence u prvního a jediného požadavku záleží více než agregovaná propustnost. Pokud je nasazení skutečně ve stylu chatu, s jedním uživatelem na zařízení a s omezenými cíli TTFT, je TP=2 správným rozhodnutím a to je také v souladu s tím, jak NVIDIA vnímá Spark.
Pro úlohy, které obsluhují infrastrukturu ve velkém měřítku s dávkovou inferencí a mnoha souběžnými požadavky, je paralelismus pipeline vhodnější při škálování napříč oblastmi, zejména pokud se nepoužívají strategie jako Expert Parallelism. 200GbE fabric nedokáže udržet provoz TP na token typu all-reduce, aniž by výpočetní kapacita zůstala nečinná, a jakmile je velikost dávky 4 nebo 8, náklady PP na bublinu mizí v ustáleném stavu. Proto je každé číslo na model ve zbytku tohoto článku uváděno s TP=1 a PP=2. Právě tato konfigurace ve skutečnosti představuje to, co může duální nasazení Spark poskytnout, když je požádáno o skutečnou práci.
Záměrně jsme zvolili GPT-OSS-120B jako hlavní graf TP vs. PP, protože ukazuje největší rozdíl. Chceme však také ukázat, že to neplatí pro všechny modely a že tyto parametry závisí na parametrech modelu. Llama-3.1-8B-Instruct na BF16 vypráví mnohem konzervativnější příběh. Model je dostatečně malý, takže výpočet každé vrstvy je rychlý a provoz TP při všech redukcích je odpovídajícím způsobem nízký. Naproti tomu náklady na koordinaci na krok u PP jsou fixní bez ohledu na velikost modelu. Výsledkem je, že TP=2 si udržuje náskok téměř v celém dávkovém průběhovém cyklu. V Equal ISL/OSL vede TP=2 od velikosti dávky 1 (23.2 vs 13.4 tok/s) až po velikost dávky 32 (388.7 vs 349.3 tok/s) a prohrává pouze u velikosti dávky 64 (524.8 vs 638.2 tok/s) a velikosti dávky 128 (679.2 vs 1 047,1 tok/s). Prefill Heavy se řídí stejným vzorem, s TP=2 vpředu až do velikosti dávky 32, než PP=2 převezme kontrolu u 64 a 128. Decode Heavy je nejrozhodnější: TP=2 vítězí u každé jednotlivé velikosti dávky a končí na 366.7 tok/s oproti 330.5 tok/s pro PP=2 při velikosti dávky 128.
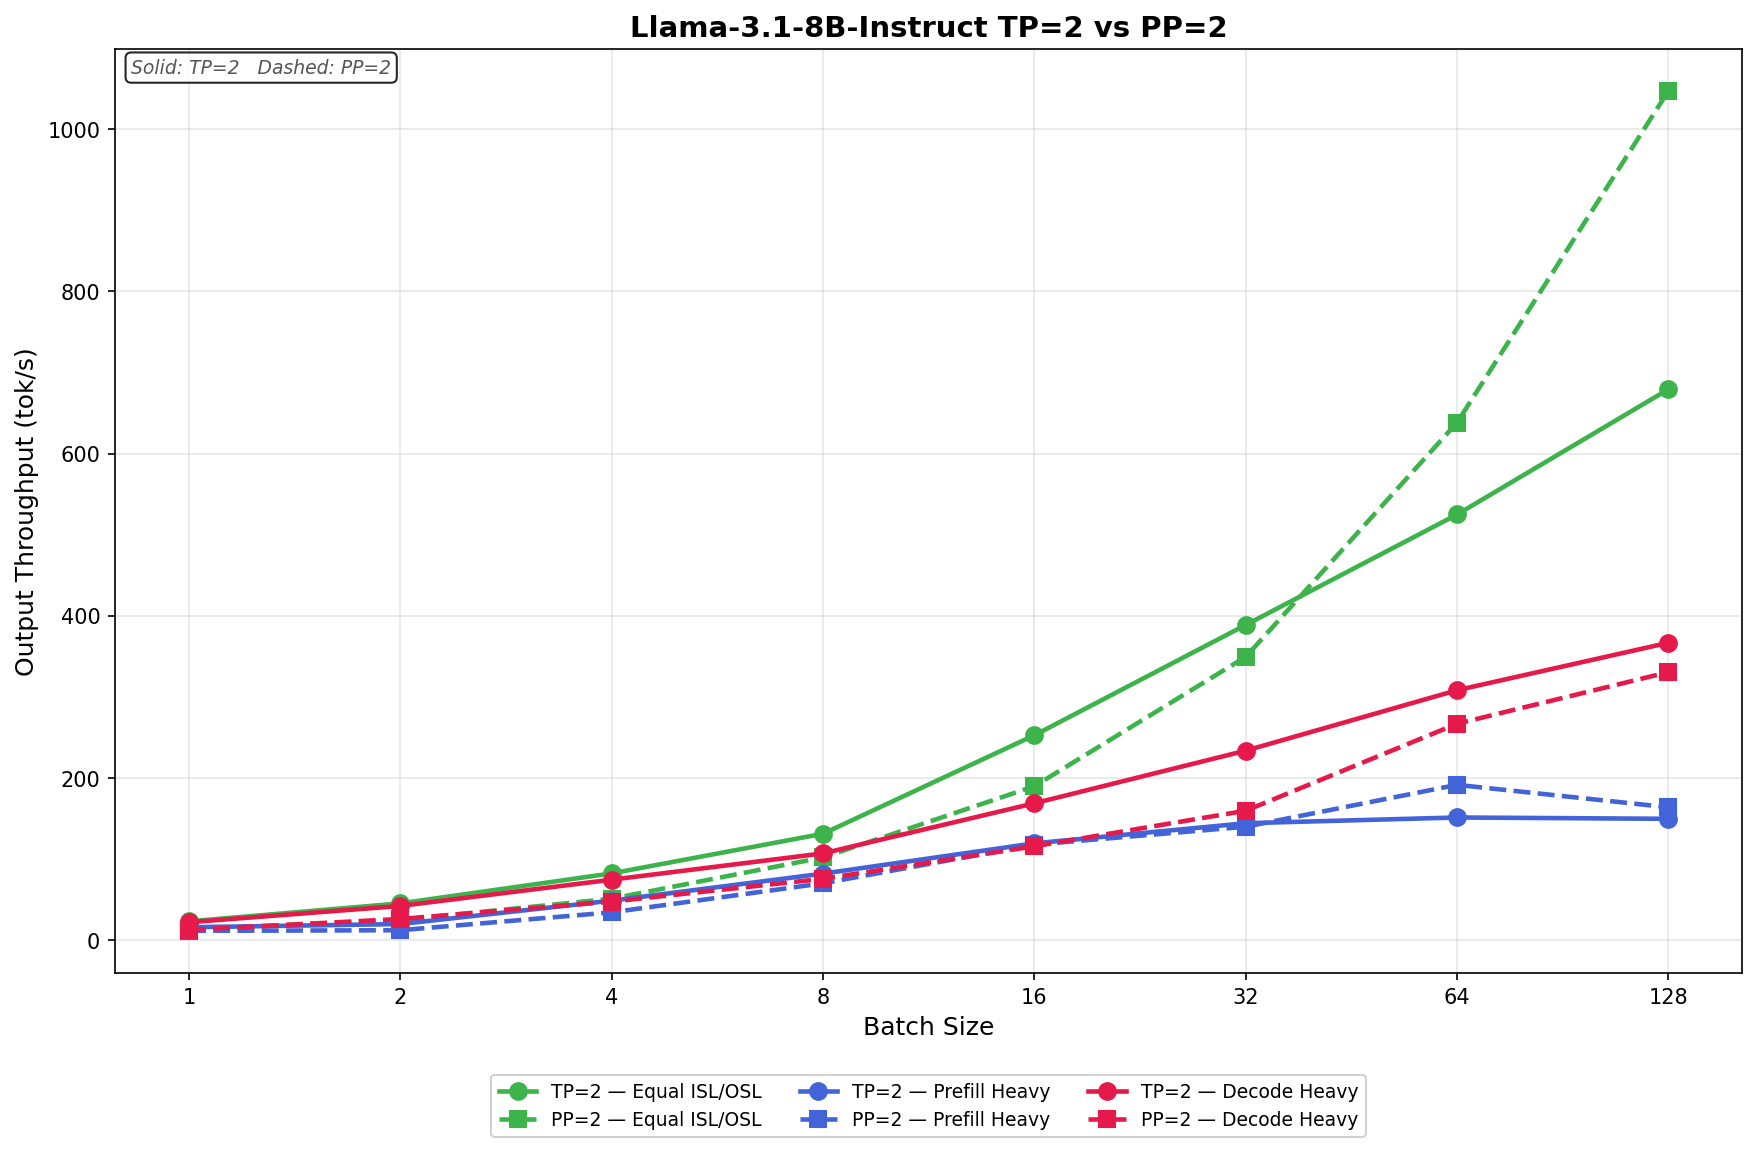
Tento protipříklad spíše posiluje, než aby mu odporoval, základní mechaniku. PP=2 vítězí pouze tehdy, když jsou dávky dostatečně velké, aby naplnily pipeline a plně amortizovaly náklady na bublinu, a když je samotný model dostatečně malý, aby TP-ova redukce na vrstvu byla levná; tento bod křížení je posunut dále. Výsledek Decode Heavy je také konzistentní: delší výstupní sekvence znamenají více dekódovacích kroků, více bublin pipeline splácených po sobě a menší okno pro PP, aby dorovnal rozdíl. Jinými slovy, stejná fyzika, která dává PP 2.20násobné vítězství na GPT-OSS-120B při velikosti dávky 128, také vysvětluje, proč vyhrává pouze u dvou nejvyšších velikostí dávek na modelu 8B a nikdy nevyhrává v dekódovacím rozběhu.
GPT-OSS-120B
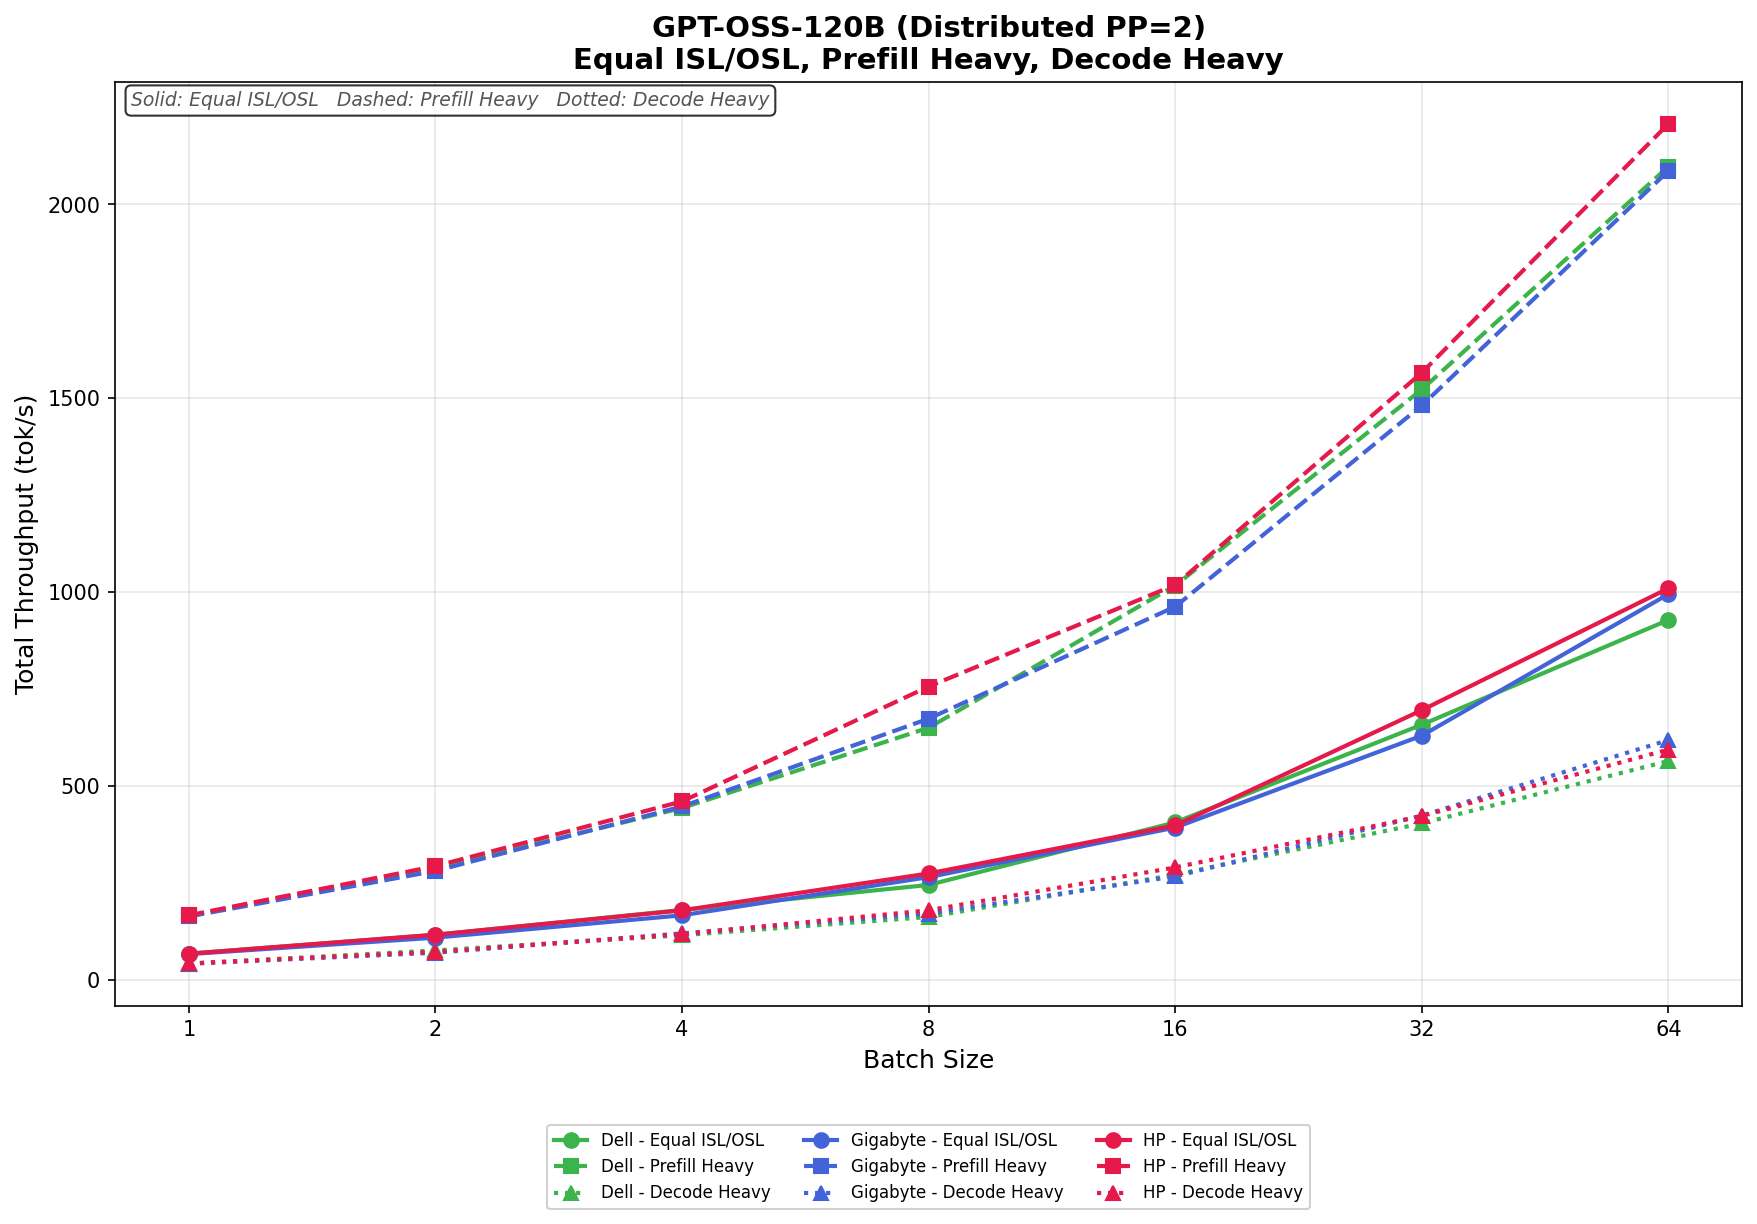
V režimu Equal ISL/OSL začíná Dell na 67.06 tokách/s a škáluje se až na 927.93 toků/s s velikostí dávky 64. GIGABYTE začíná mírně níže na 65.77 tokách/s, ale končí silněji na 994.53 tokách/s, zatímco HP vede skupinu na vrcholu s 1 009,75 toky/s. Rozpětí zůstává po většinu období těsné, přičemž HP se od velikosti dávky 32 dostává do vedení.
V testu Prefill Heavy se propustnost zvyšuje mnohem agresivněji napříč všemi oblastmi. Dell se škáluje ze 164.42 tok/s na 2 097,80 tok/s, GIGABYTE se posouvá ze 162.96 tok/s na 2 086,72 tok/s a HP dosahuje nejsilnějšího výsledku, když se vyšplhal ze 165.95 tok/s na 2 208,16 tok/s. HP vede téměř u všech velikostí dávek, zatímco Dell a GIGABYTE zůstávají úzce seskupeny, zejména u dávek o velikosti 32 a 64.
V Decode Heavy je celkový výkon nižší, jak se dalo očekávat u dekódovací zátěže. Dell se pohybuje od 41.20 tok/s do 563.98 tok/s, GIGABYTE se zvyšuje od 40.83 tok/s do 617.96 tok/s a HP se pohybuje od 41.63 tok/s do 593.56 tok/s. GIGABYTE má nejlepší výsledky s velikostí dávky 64, zatímco HP vede ve středním rozsahu a Dell zůstává blízko, ale mírně zaostává ve vyšší souběžnosti.
GPT-OSS-20B
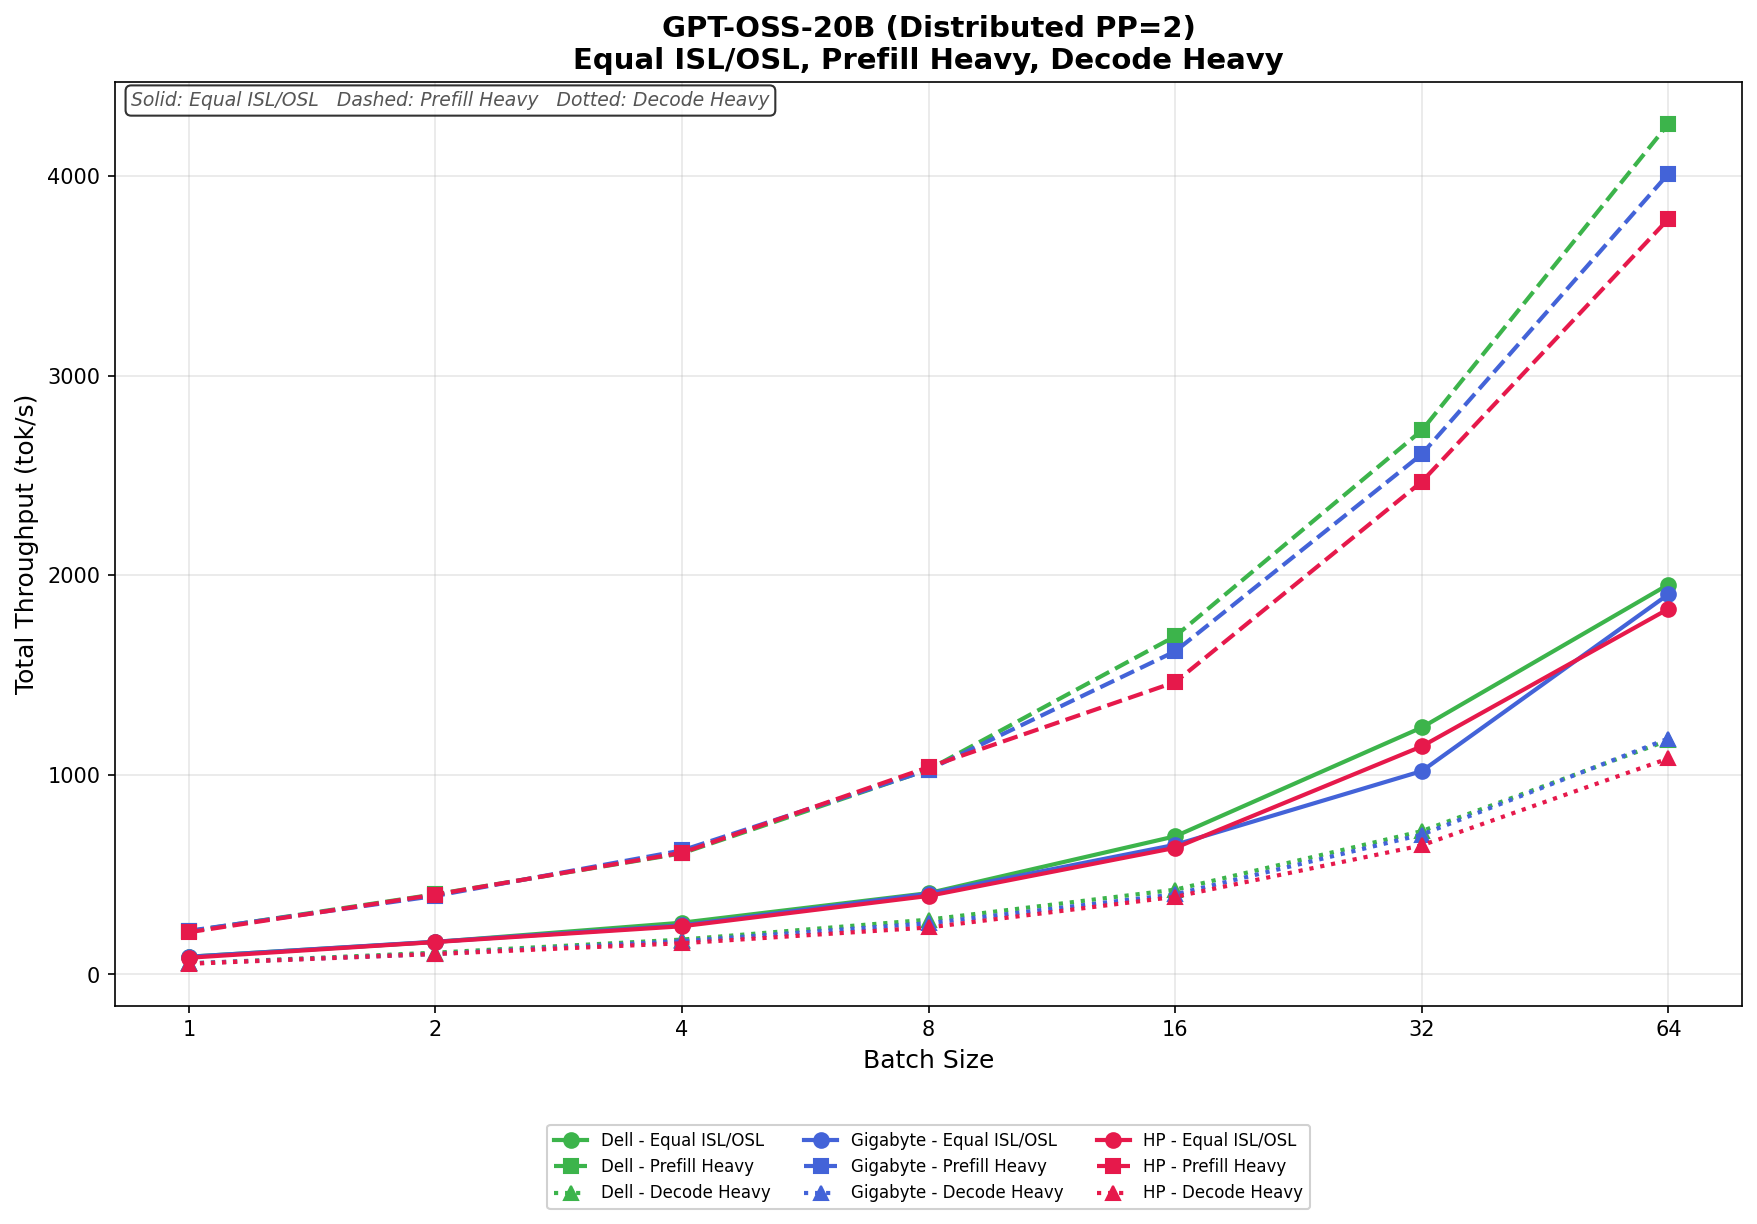
V kategorii Equal ISL/OSL vede Dell ve většině případů, kdy se jeho výkon zvýšil z 88.73 tok/s u dávky o velikosti 1 na 1 953,55 tok/s u dávky o velikosti 64. GIGABYTE ho těsně následuje a zvyšuje se z 88.42 tok/s na 1 904,62 tok/s, zatímco HP se pohybuje od 83.49 tok/s do 1 831,45 tok/s. Dell si udržuje celkově nejsilnější škálování v horní hranici, zejména od dávky o velikosti 16 výše.
V testu Prefill Heavy se propustnost u všech tří systémů agresivně zvyšuje. Dell v tomto testu dosahuje nejvyššího výsledku, a to z 216.05 tok/s na 4 261,96 tok/s při velikosti dávky 64. GIGABYTE následuje s 4 011,86 tok/s, zatímco HP dosahuje 3 785,25 tok/s. Tyto tři systémy zůstávají úzce seskupeny při menších velikostech dávek, ale Dell se začíná oddělovat u velikosti dávky 16 a rozšiřuje si náskok po zbytek testu.
V Decode Heavy je škálování pozvolnější, ale zůstává silné napříč všemi platformami. Dell se pohybuje od 54.88 tok/s do 1 173,31 tok/s, GIGABYTE se škáluje od 55.24 tok/s do 1 181,94 tok/s a HP se zvyšuje z 53.20 tok/s na 1 082,23 tok/s. GIGABYTE těsně poráží Dell v nejvyšší velikosti dávky, zatímco HP za oběma systémy zaostává ve vyšších úrovních souběžnosti.
Základna instrukcí Llama 3.1 8B
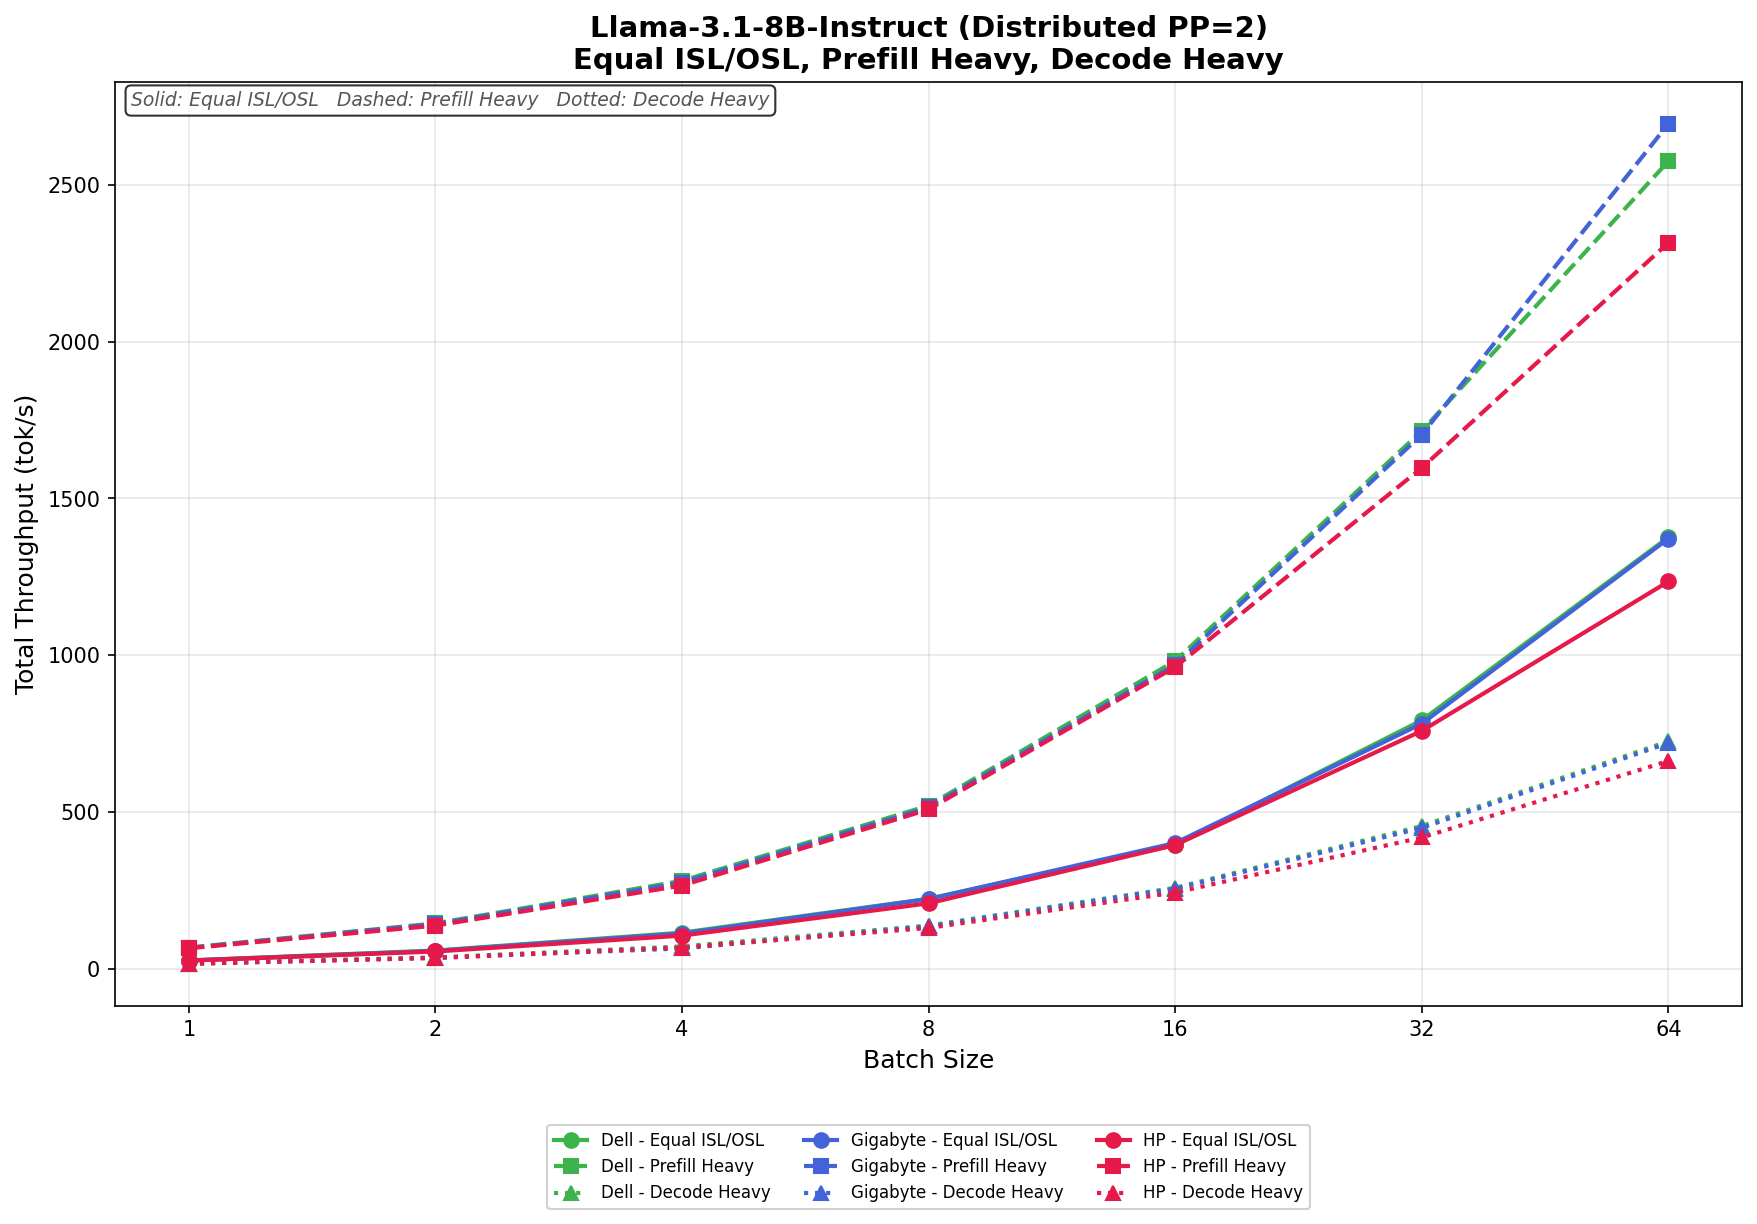
V režimu Equal ISL/OSL se Dell při velikosti dávky 64 pohybuje od 27.69 tok/s do 1 376,38 tok/s, což je těsně před GIGABYTE, jehož výkon se pohybuje od 27.23 tok/s do 1 372,27 tok/s. HP v průběhu celého měření mírně zaostává, a to od 26.89 tok/s do 1 235,32 tok/s. Všechny tři systémy si velmi těsně sledují výkon dávky 16, než Dell začne otevírat malý náskok při vyšších úrovních souběžnosti.
V testu Prefill Heavy se propustnost agresivně zvyšuje s rostoucí velikostí dávek. Dell se zvýší z 68.60 tok/s na 2 575,25 tok/s, zatímco GIGABYTE nakonec dosáhne nejlepšího výsledku, z 67.49 tok/s na 2 694,25 tok/s při velikosti dávky 64. HP dosáhne 2 315,15 tok/s a zůstává tak konkurenceschopný, ale při vyšších velikostech dávek konzistentně zaostává za Dellem a GIGABYTE. GIGABYTE se ujímá vedení v horní hranici, zejména u dávek o velikosti 64 a více.
V Decode Heavy zůstává škálování stabilní v celém rozsahu. Dell se pohybuje od 17.19 tok/s do 726.22 tok/s, GIGABYTE od 16.96 tok/s do 720.57 tok/s a HP se pohybuje od 16.79 tok/s do 663.31 tok/s. Dell a GIGABYTE zůstávají po většinu testu téměř identické, přičemž Dell má těsný náskok na nejvyšších úrovních souběžnosti. Zároveň HP mírně zaostává ve větších dávkách.
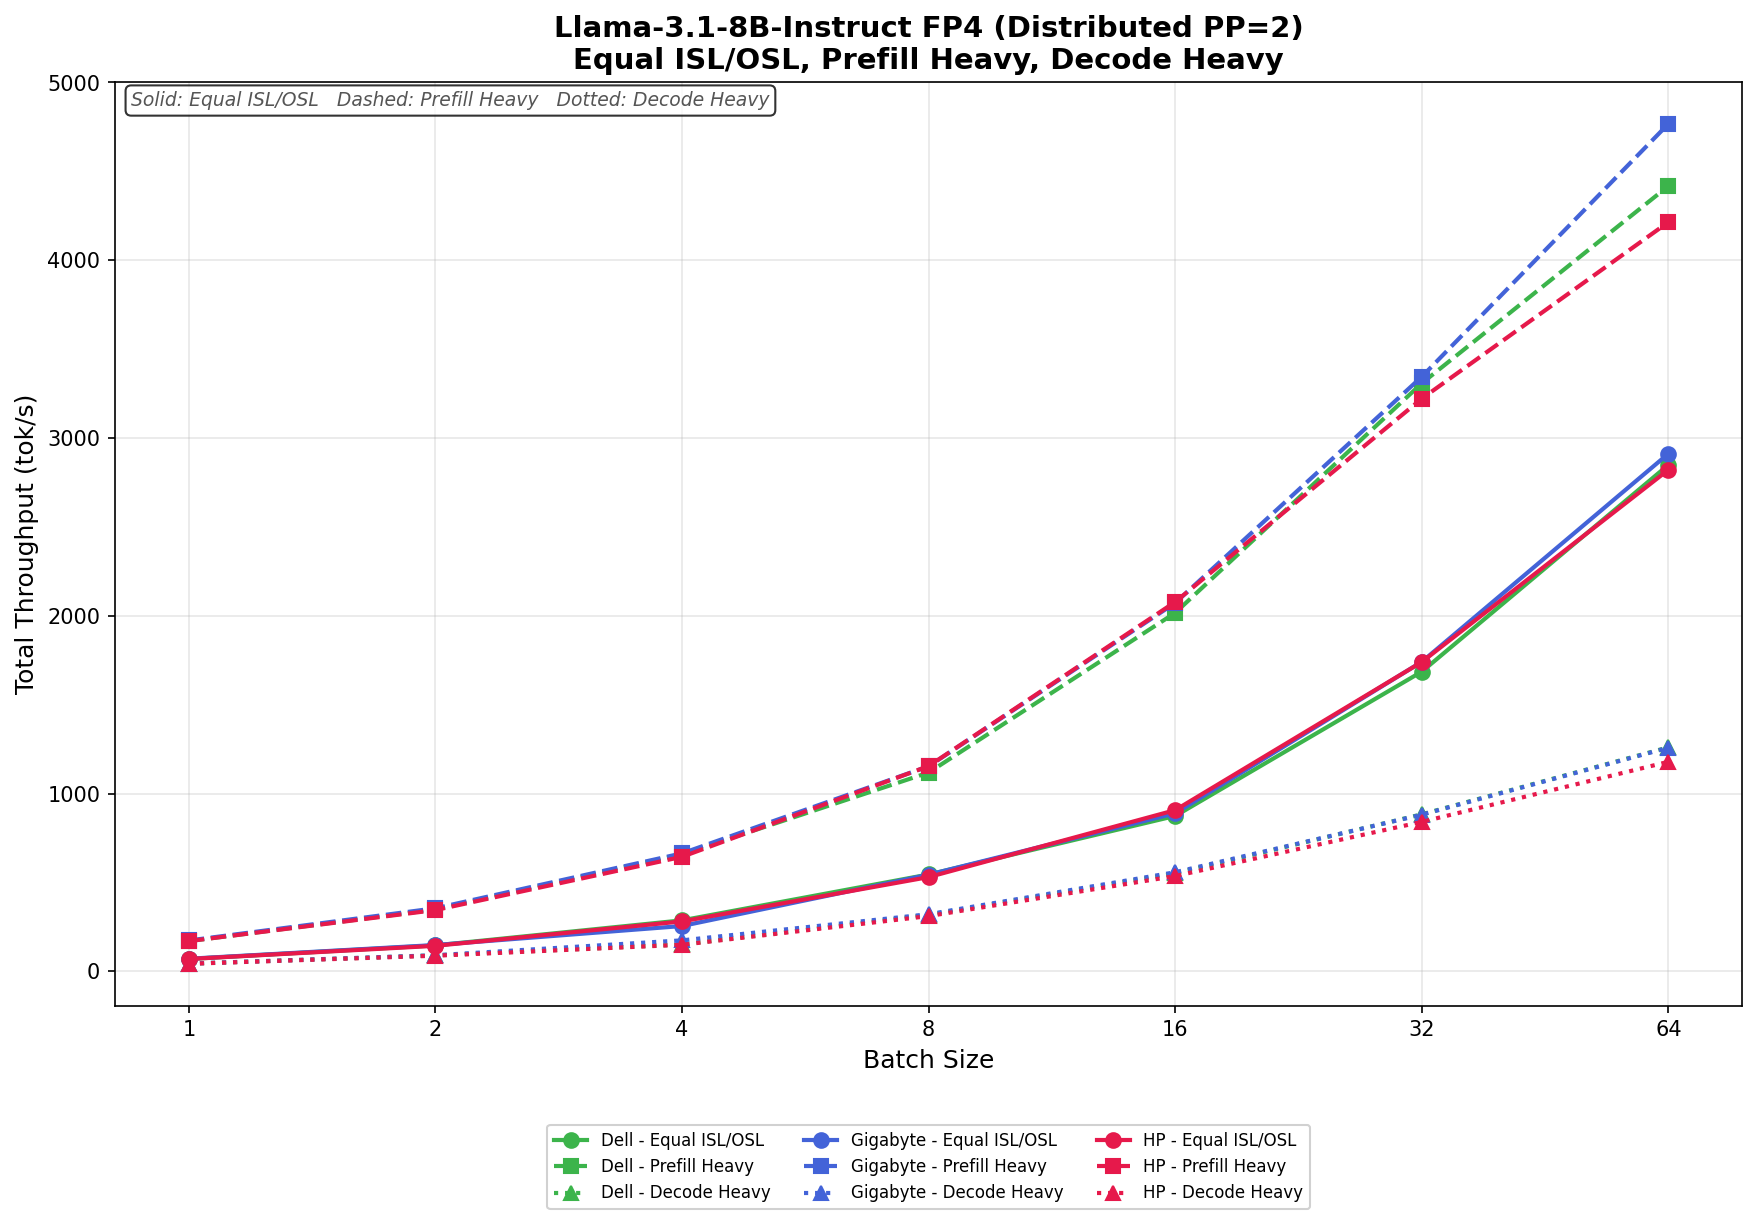
Lama 3.1 8B Instrukce FP4
V režimu Equal ISL/OSL se Dell při velikosti dávky 64 škáluje z 69.71 tok/s na 2 849,20 tok/s, zatímco GIGABYTE mírně vede a dosahuje nárůstu ze 70.92 tok/s na 2 912,03 tok/s. HP zůstává konkurenceschopný s pohybem od 69.52 tok/s do 2 821,50 tok/s. Tyto tři systémy zůstávají v rámci celé pracovní zátěže úzce seskupeny, přičemž při vyšších úrovních souběžnosti se objevuje pouze malé oddělení.
V režimu Prefill Heavy se škálování stává mnohem agresivnějším, zejména u větších dávek. Dell se zvyšuje ze 170.09 tok/s na 4 417,65 tok/s, zatímco GIGABYTE dosahuje nejsilnějšího výsledku ve skupině, když se při velikosti dávky 64 vyšplhal ze 173.55 tok/s na 4 767,43 tok/s. HP škáluje ze 170.12 tok/s na 4 214,57 tok/s. GIGABYTE se začíná oddělovat od ostatních po velikosti dávky 32 a v této pracovní zátěži dosahuje nejvyšší horní propustnosti.
V testu Decode Heavy si všechny tři systémy opět po většinu testu úzce podobají. Dell se pohybuje od 43.19 tok/s do 1 260,24 tok/s, GIGABYTE se zvyšuje od 43.53 tok/s do 1 258,05 tok/s a HP se zvyšuje z 42.54 tok/s na 1 178,74 tok/s. Dell a GIGABYTE si efektivně střídají vedení v závislosti na velikosti dávek, zatímco HP mírně zaostává za oběma systémy v nejvyšších úrovních souběžnosti.
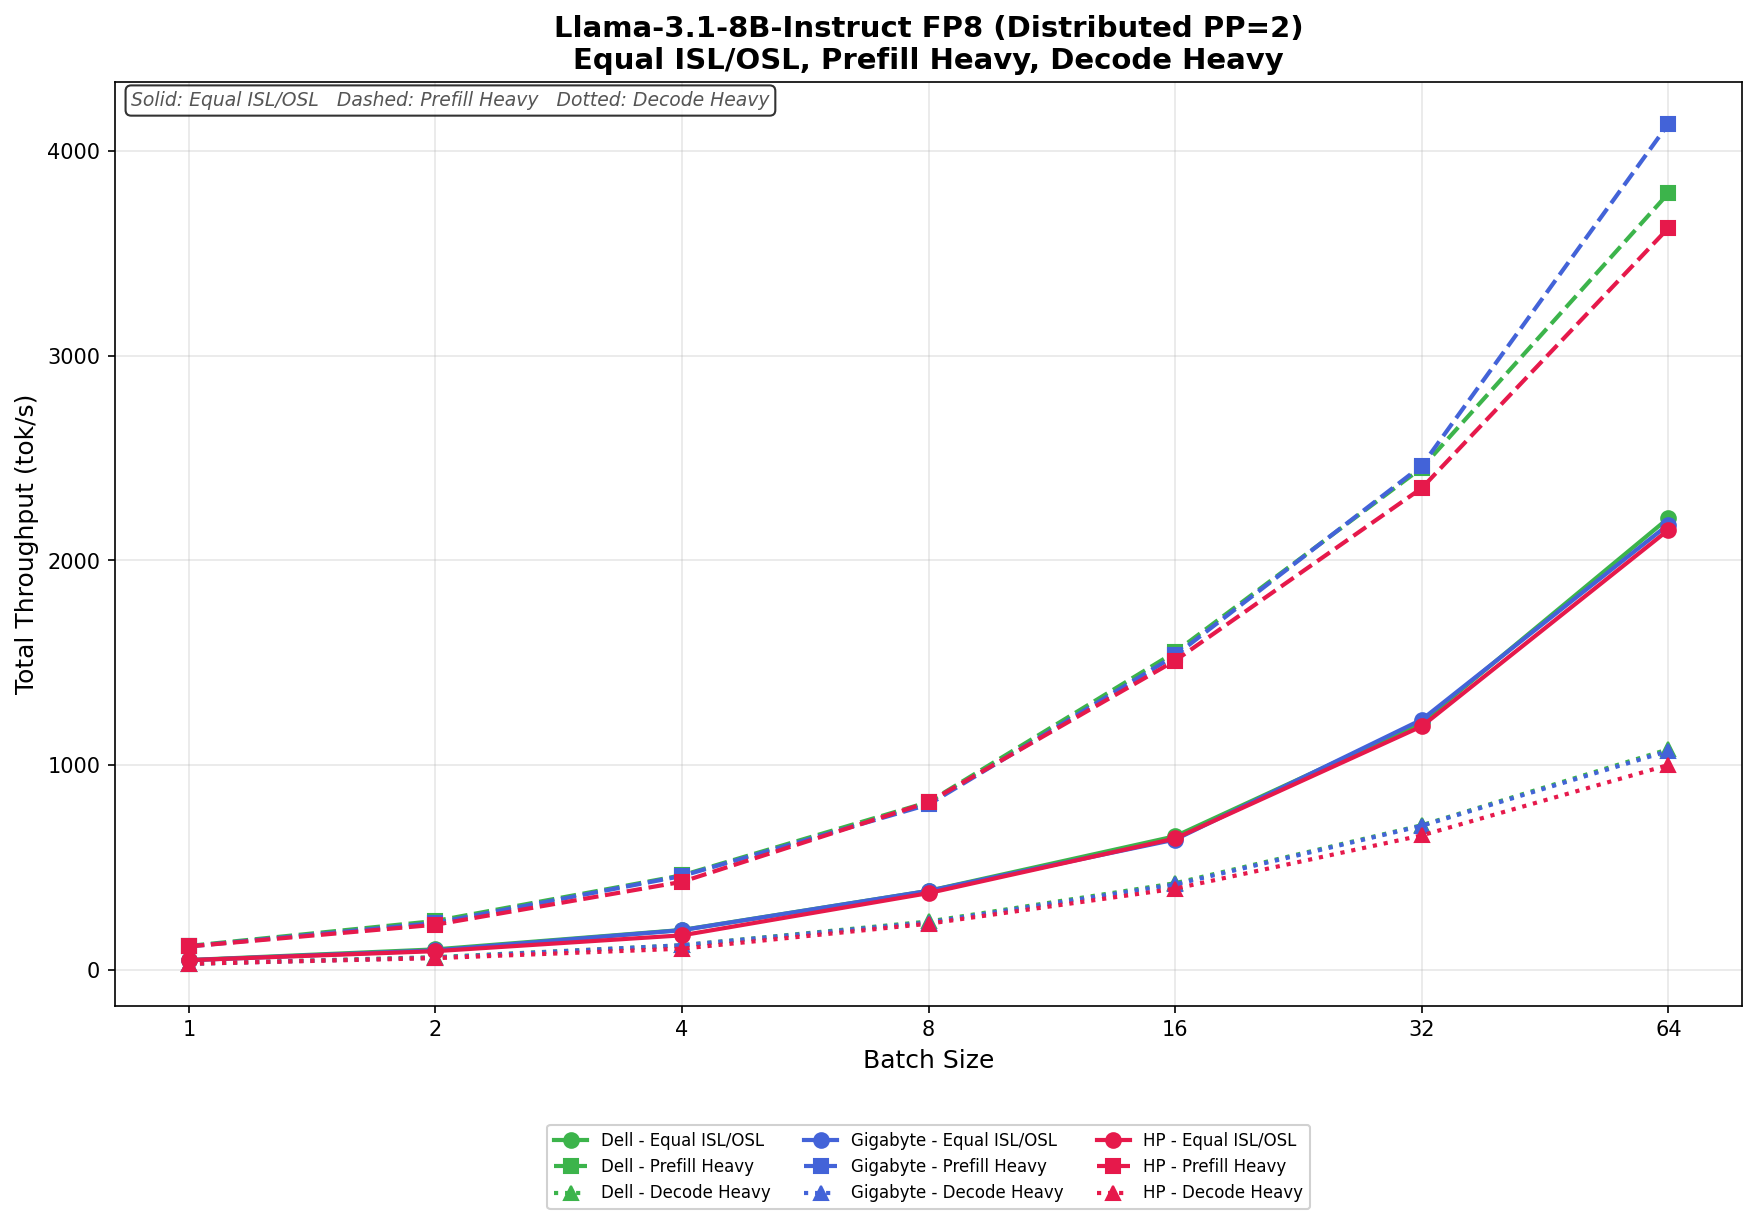
Lama 3.1 8B Instrukce FP8
V režimu Equal ISL/OSL se Dell při velikosti dávky 64 škáluje z 46.93 tok/s na 2 206,52 tok/s, zatímco GIGABYTE se pohybuje od 46.16 tok/s do 2 175,44 tok/s. HP těsně následuje a zvyšuje se z 46.40 tok/s na 2 149,15 tok/s. Celkový rozptyl zůstává v průběhu testu úzký, přičemž všechny tři systémy si udržují téměř identické chování při škálování až do velikosti dávky 32.
V režimu Prefill Heavy se propustnost zvyšuje agresivněji s rostoucí souběžností. Dell vzrostl ze 115.85 tok/s na 3 794,52 tok/s, zatímco GIGABYTE zaznamenal nejlepší celkový výsledek, a to ze 113.34 tok/s na 4 133,76 tok/s při velikosti dávky 64. HP dosahoval 3 624,73 tok/s. GIGABYTE si začíná budovat výraznější náskok při vyšších velikostech dávek, zejména od velikosti dávky 32 výše.
V Decode Heavy zůstávají tři systémy úzce seskupené při nízkých úrovních souběžnosti, než se při vysoké úrovni souběžnosti objeví malé odstupy. Dell se pohybuje od 29.11 tok/s do 1 077,07 tok/s, GIGABYTE se škáluje od 28.64 tok/s do 1 068,92 tok/s a HP se zvyšuje z 28.68 tok/s na 1 000,20 tok/s. Dell si udržuje těsný náskok ve většině úloh, přičemž GIGABYTE je těsně za ním, zatímco HP mírně zaostává při větších velikostech dávek.
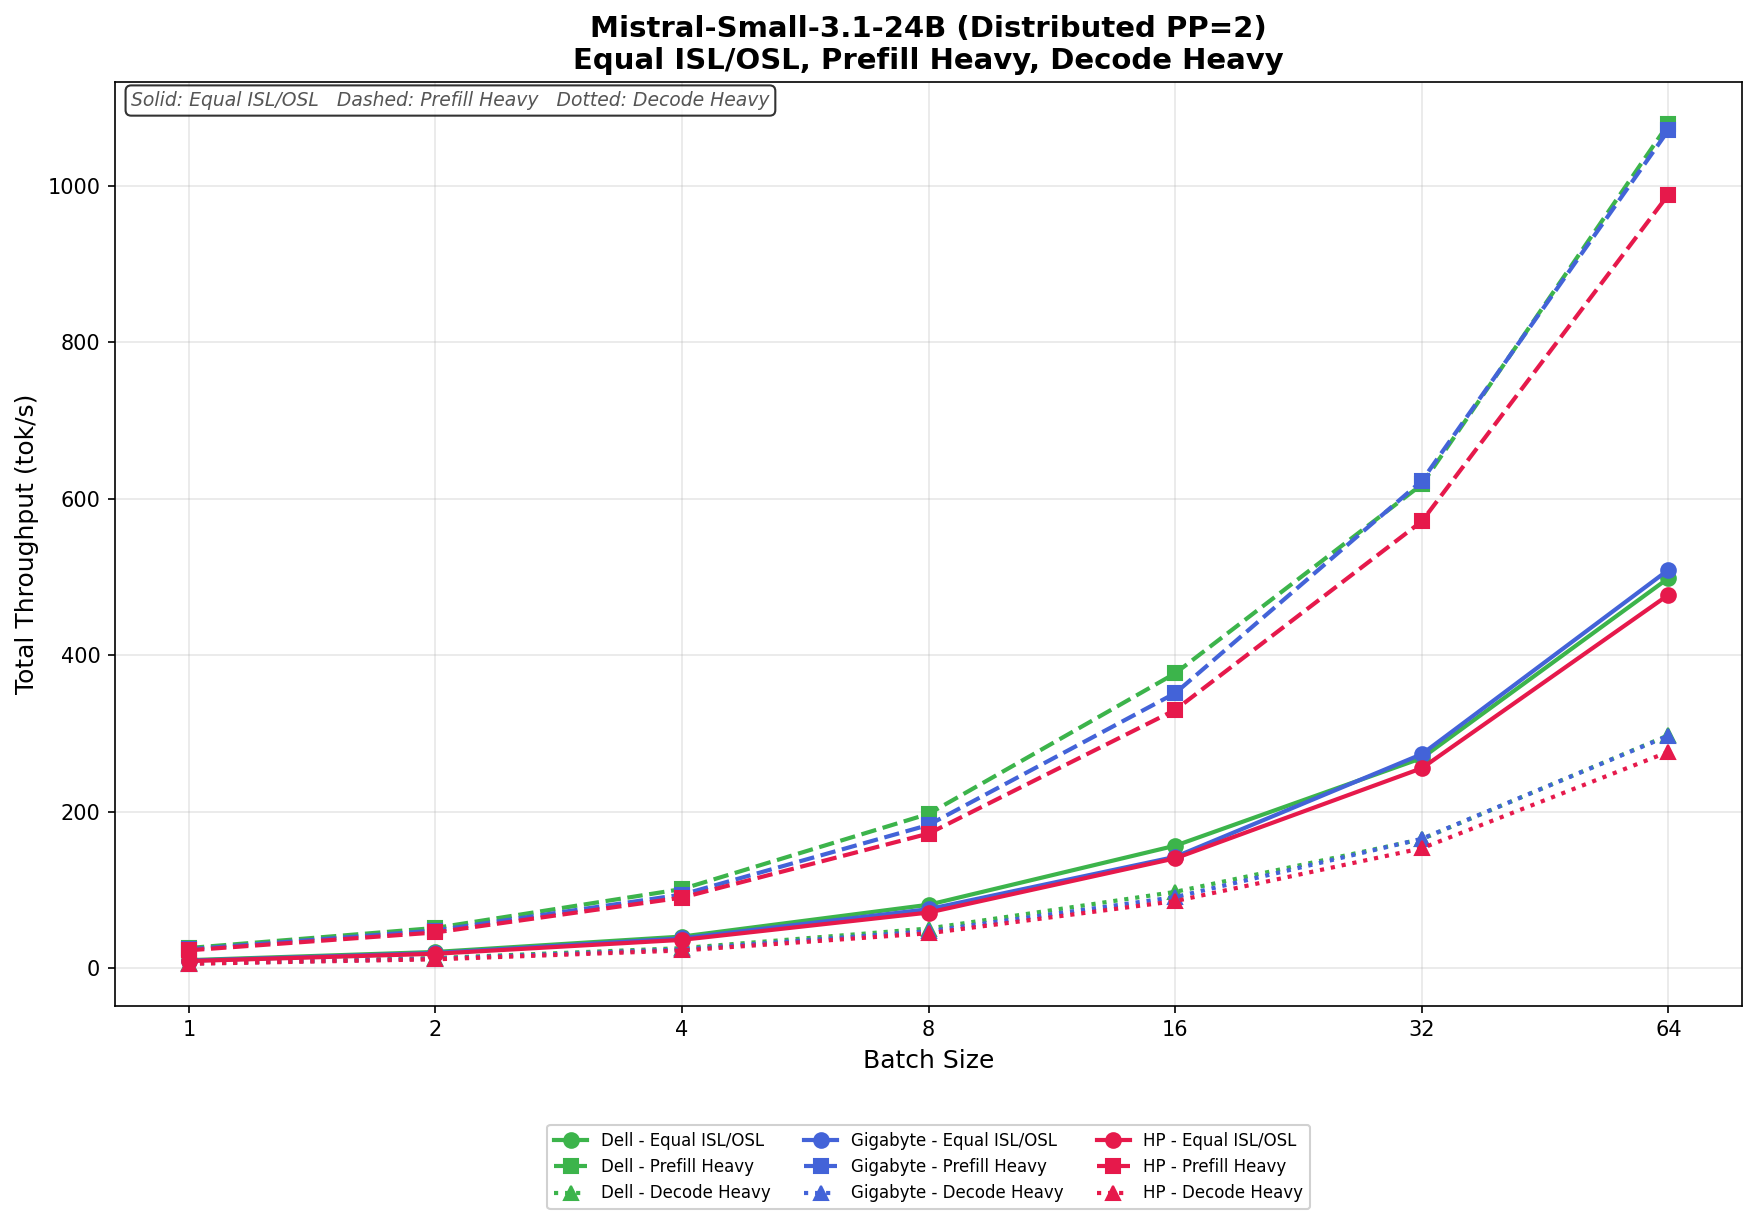
Mistral Malý 3.1 24B
V režimu Equal ISL/OSL se Dell při velikosti dávky 64 škáluje z 10.41 tok/s na 498.56 tok/s, zatímco GIGABYTE mírně vede na horní hranici s nárůstem z 9.76 tok/s na 509.18 tok/s. HP mírně zaostává za oběma systémy s hodnotami v rozmezí od 9.25 tok/s do 477.25 tok/s. Rozdíl mezi systémy zůstává v celém rozsahu zatížení relativně malý, zejména na nižších a středních úrovních souběžnosti.
V režimu Prefill Heavy se škálování podstatně zlepšuje napříč všemi třemi systémy. Dell se zvyšuje z 25.91 tok/s na 1 079,19 tok/s, zatímco GIGABYTE se škáluje z 24.25 tok/s na 1 071,07 tok/s. HP dosahuje 988.82 tok/s s velikostí dávky 64. Dell a GIGABYTE zůstávají po většinu testování téměř identické, přičemž Dell má mírnou výhodu na nejvyšší úrovni souběžnosti.
V testu Decode Heavy zůstává propustnost celkově výrazně nižší, jak se dalo očekávat u dekódovací zátěže u většího modelu. Dell se pohybuje od 6.49 tok/s do 297.82 tok/s, GIGABYTE se zvyšuje od 6.10 tok/s do 297.23 tok/s a HP se zvyšuje z 5.77 tok/s na 276.55 tok/s. Dell a GIGABYTE jsou v průběhu testu na stejné úrovni, zatímco HP za oběma systémy ve větších dávkách konzistentně mírně zaostává.
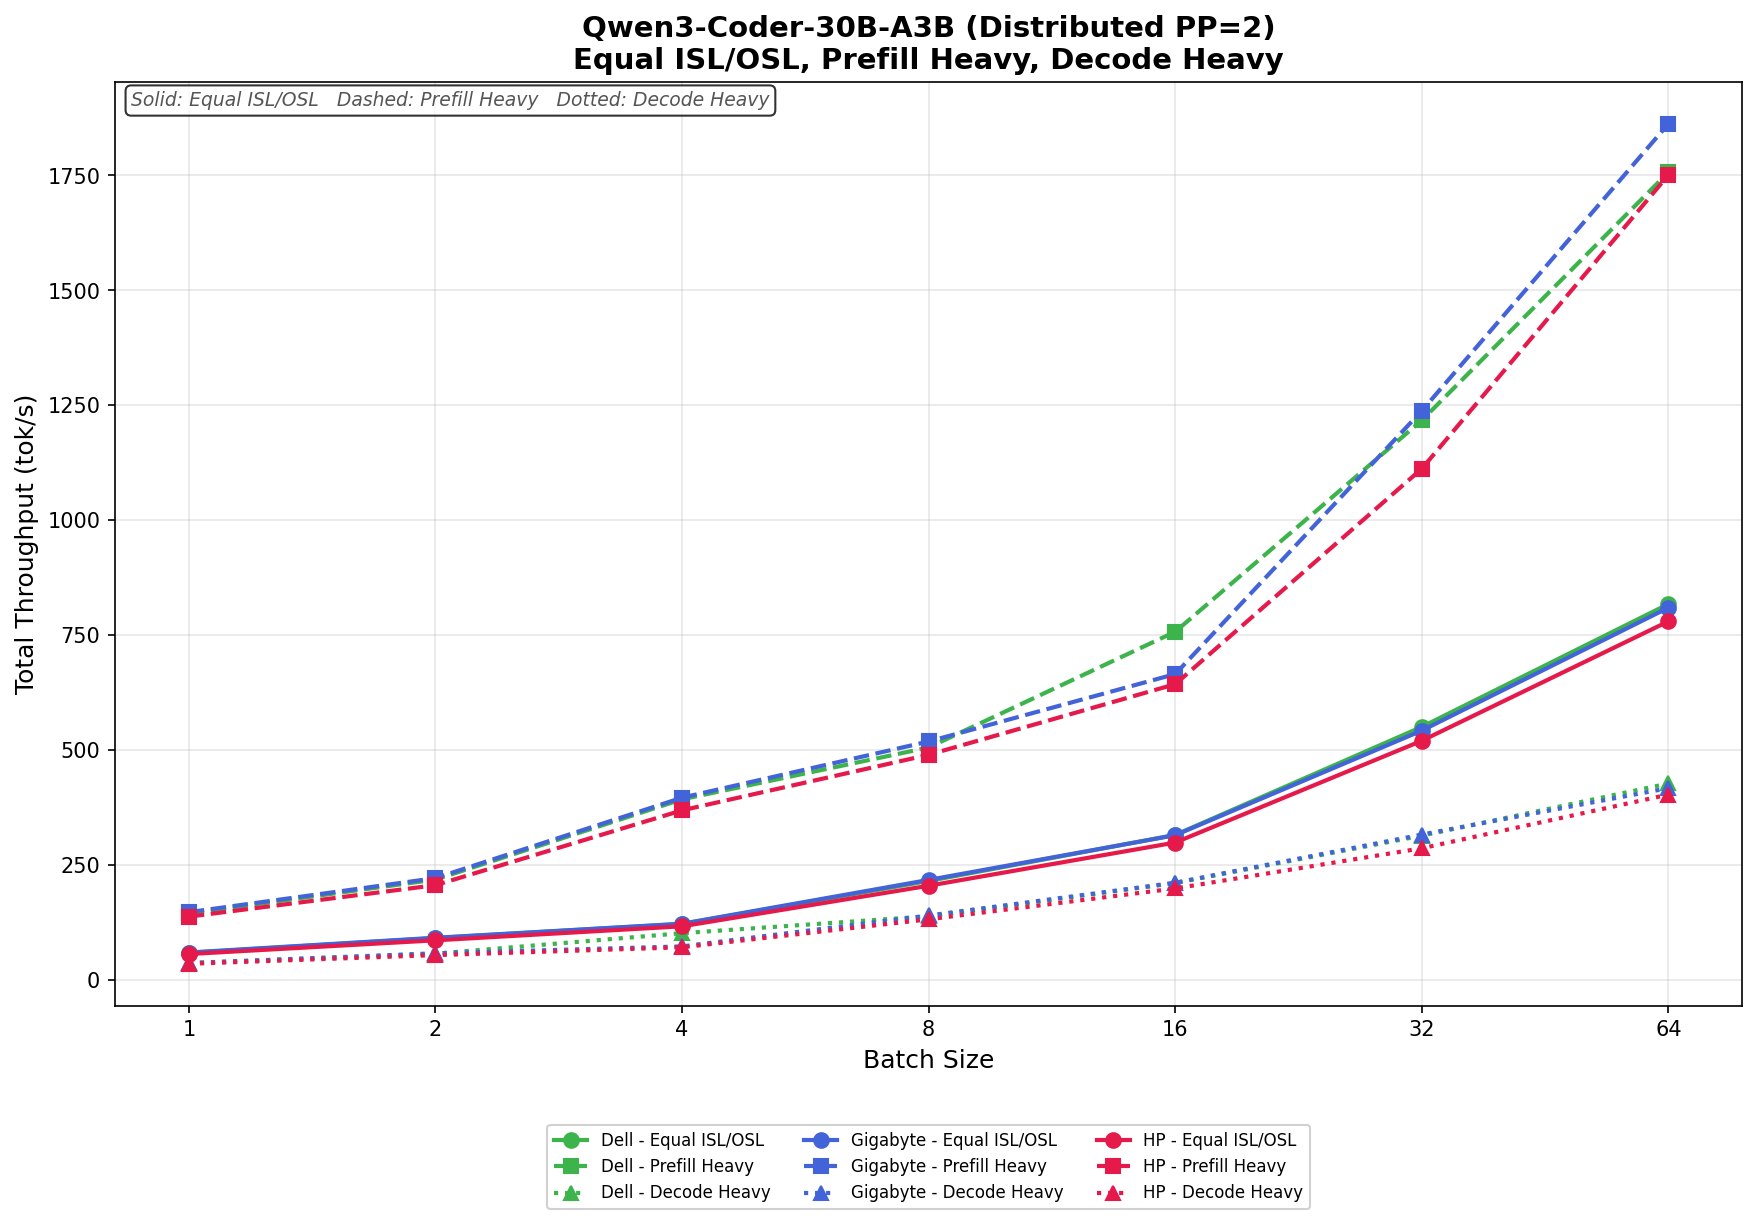
Kodér Qwen3 30B A3B Base
V režimu Equal ISL/OSL se Dell při velikosti dávky 64 pohybuje od 59.05 tok/s do 817.82 tok/s, zatímco GIGABYTE se pohybuje od 59.81 tok/s do 809.88 tok/s. HP za oběma systémy mírně zaostává a zvyšuje se z 56.51 tok/s na 780.21 tok/s. Výkon mezi Dellem a GIGABYTE zůstává po většinu testování téměř identický, s malými odchylkami pouze při vyšších velikostech dávek.
V testu Prefill Heavy se propustnost výrazně zvyšuje s rostoucí souběžností. Dell vzrostl ze 144.81 tok/s na 1 756,99 tok/s, zatímco GIGABYTE zaznamenal nejsilnější celkové škálování, které se zvýšilo ze 147.55 tok/s na 1 862,40 tok/s při velikosti dávky 64. HP dosáhl 1 751,17 tok/s a zůstal tak konkurenceschopný, ale v horní hranici mírně zaostával za dalšími dvěma systémy. GIGABYTE si od velikosti dávky 32 vybudoval mírný náskok, který si udržel i v závěrečné fázi testu.
V Decode Heavy si všechny tři systémy opět po většinu pracovní zátěže úzce podobají. Dell se pohybuje od 36.69 tok/s do 427.48 tok/s, GIGABYTE se škáluje od 36.92 tok/s do 417.42 tok/s a HP se zvyšuje z 35.30 tok/s na 403.32 tok/s. Dell si udržuje malou výhodu u nejvyšších velikostí dávek, zatímco HP mírně zaostává za Dellem i GIGABYTE v pracovní zátěži zaměřené na dekódování.
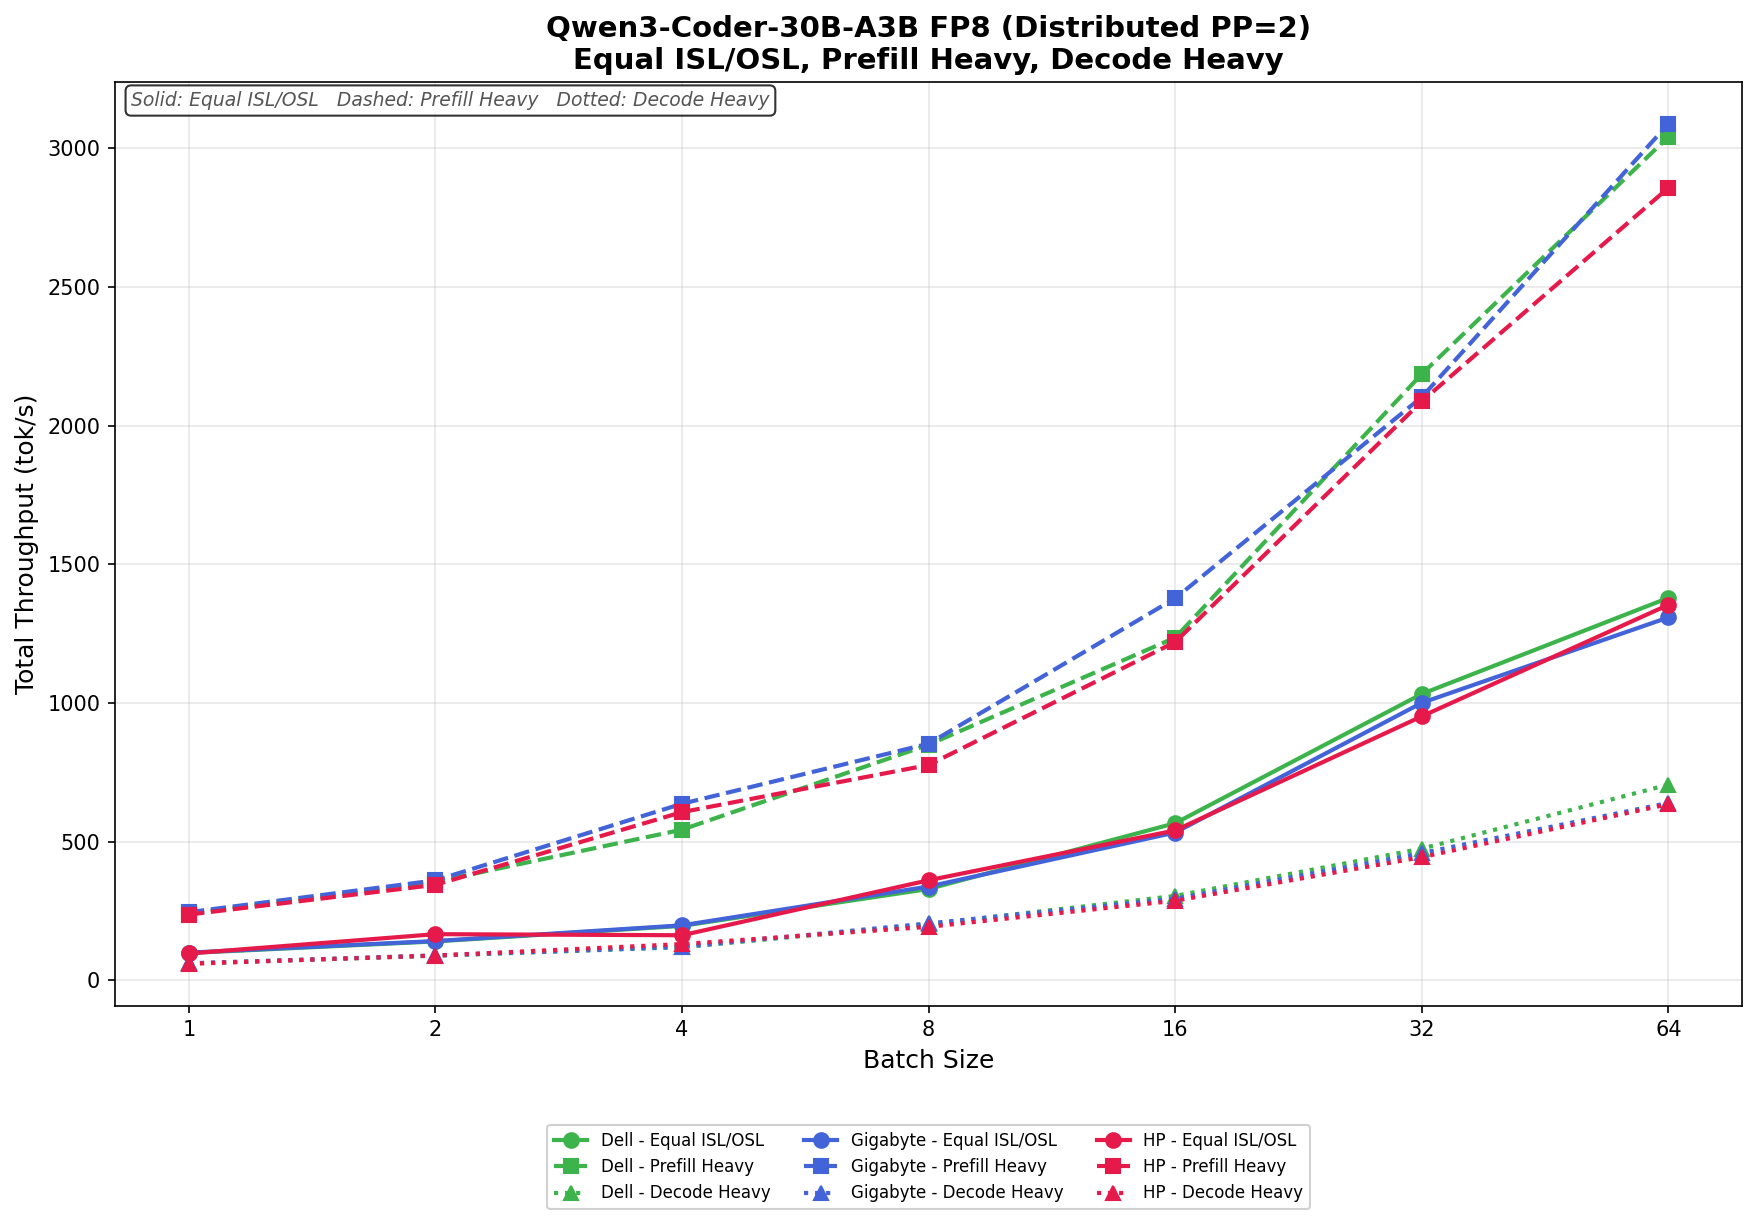
Kodér Qwen3 30B A3B FB8
V režimu Equal ISL/OSL se Dell při velikosti dávky 64 pohybuje od 98.65 tok/s do 1 379,26 tok/s, zatímco GIGABYTE se pohybuje od 100.20 tok/s do 1 308,79 tok/s. HP zůstává po celou dobu konkurenceschopný a jeho výkon se zvyšuje z 97.06 tok/s na 1 354,23 tok/s. HP krátce vede v několika nižších a středních velikostech dávek, ačkoli Dell končí s nejsilnější celkovou propustností ve vyšší třídě.
V testu Prefill Heavy se propustnost agresivně zvyšuje napříč všemi třemi systémy. Dell vzrostl z 240.43 tok/s na 3 041,72 tok/s, zatímco GIGABYTE zaznamenal nejlepší celkový výsledek, a to z 245.92 tok/s na 3 088,62 tok/s při velikosti dávky 64. HP dosáhl 2 857,80 tok/s. GIGABYTE si od velikosti dávky 4 vybudoval znatelný náskok a udržel si ho po zbytek testování.
V Decode Heavy má Dell celkově nejsilnější škálování v horní hranici. Dell se pohybuje od 60.91 tok/s do 705.77 tok/s, zatímco GIGABYTE škáluje od 61.53 tok/s do 639.80 tok/s a HP se zvyšuje z 59.85 tok/s na 635.25 tok/s. HP krátce vede v menších dávkách, ale Dell se dostává do vedení ve větších úrovních souběžnosti a končí s nejsilnější dekódovací propustností ve skupině.
Souhrn špičkového výkonu systémů s dvojitým zapalováním
Níže uvedená tabulka shrnuje maximální propustnost výstupu tokenů pozorovanou během testování distribuovaného PP=2 na systémech Dell, GIGABYTE a HP s duálním Sparkem. Každá hodnota představuje nejvyšší naměřenou propustnost výstupu (tok/s) dosaženou pro daný scénář pracovní zátěže při testované velikosti dávky. Tučně vyznačené hodnoty označují systém s nejvyšším výkonem v rámci daného scénáře pracovní zátěže.
| Model | Scénář (BS – 64) | Špičkový výstup Dell | Špičkový výkon GIGABYTE | Špičkový výkon HP |
|---|---|---|---|---|
| Modely GPT-OSS | ||||
| GPT-OSS-120B | Stejné ISL/OSL | 463.97 tok/s | 497.26 tok/s | 504.88 tok/s |
| GPT-OSS-120B | Silné předplnění | 419.56 tok/s | 417.34 tok/s | 441.63 tok/s |
| GPT-OSS-120B | Dekódovat těžké | 451.18 tok/s | 494.37 tok/s | 474.85 tok/s |
| GPT-OSS-20B | Stejné ISL/OSL | 976.77 tok/s | 952.31 tok/s | 915.72 tok/s |
| GPT-OSS-20B | Silné předplnění | 852.39 tok/s | 802.37 tok/s | 757.05 tok/s |
| GPT-OSS-20B | Dekódovat těžké | 938.65 tok/s | 945.55 tok/s | 865.78 tok/s |
| Modely lam | ||||
| Lama-3.1-8B-Pokyn | Stejné ISL/OSL | 689.53 tok/s | 687.48 tok/s | 618.87 tok/s |
| Lama-3.1-8B-Pokyn | Silné předplnění | 515.45 tok/s | 539.27 tok/s | 463.39 tok/s |
| Lama-3.1-8B-Pokyn | Dekódovat těžké | 581.43 tok/s | 576.91 tok/s | 531.07 tok/s |
| Lama-3.1-8B-FP4 | Stejné ISL/OSL | 1427.39 tok/s | 1458.86 tok/s | 1413.51 tok/s |
| Lama-3.1-8B-FP4 | Silné předplnění | 884.22 tok/s | 954.23 tok/s | 843.57 tok/s |
| Lama-3.1-8B-FP4 | Dekódovat těžké | 1008.98 tok/s | 1007.23 tok/s | 943.73 tok/s |
| Lama-3.1-8B-FP8 | Stejné ISL/OSL | 1105.42 tok/s | 1089.85 tok/s | 1076.68 tok/s |
| Lama-3.1-8B-FP8 | Silné předplnění | 759.50 tok/s | 827.40 tok/s | 725.51 tok/s |
| Lama-3.1-8B-FP8 | Dekódovat těžké | 862.33 tok/s | 855.81 tok/s | 800.78 tok/s |
| Modely Mistral a Qwen | ||||
| Mistral-Small-3.1-24B | Stejné ISL/OSL | 249.77 tok/s | 255.09 tok/s | 239.09 tok/s |
| Mistral-Small-3.1-24B | Silné předplnění | 216.01 tok/s | 214.38 tok/s | 197.92 tok/s |
| Mistral-Small-3.1-24B | Dekódovat těžké | 238.44 tok/s | 237.97 tok/s | 221.41 tok/s |
Závěr
Nejužitečnější zjištění z tohoto kola testování má málo společného s tím, který výrobce OEM se ujal vedení v jaké zátěži. Napříč všemi testovanými modely a tvary zátěží si tři implementace Spark od společností Dell, GIGABYTE a HP vedly v úzkém pásmu. U konkrétních velikostí šarží se objevily malé náskoky, ale žádná platforma nezískala úplné vítězství a žádná platforma trvale nezaostávala. Kupující, kteří si vybírají mezi těmito třemi, by se měli při rozhodování založit na konstrukci šasi, tepelném chování, záručních podmínkách a podpoře, spíše než na deltách benchmarků, které se blíží rozdílům mezi jednotlivými běhy, které jakýkoli systém stolního počítače produkuje při trvalé zátěži.
Zajímavější výsledek je metodologický. Na 200GbE fabric spojující dva Sparky je volba mezi tenzorovým paralelismem a paralelismem pipeline důležitější než jakýkoli rozdíl mezi třemi OEM a pro dávkovou inferenci při jakékoli rozumné souběžnosti je paralelismus pipeline vhodnější. Provoz TP=2 s redukci na vrstvu nepřežije cestu přes linku ConnectX-7, aniž by výpočetní systém zůstal nečinný, a náklady na bublinu pipeline u PP=2 se amortizují do ustáleného streamu, jakmile dávka naplní pipeline. Dokumentace NVIDIA standardně používá TP z obhajitelného důvodu: jejich primární pozicí pro Spark je interaktivní obsluha jednoho streamu s těsným TTFT, což je jediný režim, kde TP=2 jednoznačně vítězí. V okamžiku, kdy se pracovní zátěž jeví spíše jako obsluha infrastruktury než chatovacího rozhraní, kalkul se obrátí.
Tato inverze posiluje to, co Spark je a co není. Dvouuzlový cluster Spark je vývojová a vzdělávací platforma, která umožňuje jedinému inženýrovi vidět chování distribuované inference na vlastní oči v síti dostatečně rychle, aby napodobila skutečnou strukturu datového centra, ale zároveň dostatečně omezená, aby odhalila úzká hrdla, která produkční nasazení obcházejí ve velkém měřítku.
Větší konfigurace Sparku stojí za to prozkoumat samostatně, s pracovními zátěžemi a strategiemi paralelismu vhodnými pro dané měřítko, a tuto práci máme v plánu. Samostatně se další experiment, který je zařazen za tímto, přesouvá od inference k trénování: model s parametry pod 1 miliardu trénovaný od nuly na duálním Spark clusteru, nakonfigurovaný tak, aby zrcadlil distribuované předtrénovací podmínky mnohem větších systémů. Tato práce je pozastavena, zatímco čekáme na optiku pro náš nový 800Gb laboratorní jádrový přepínač, a očekáváme, že ji zveřejníme, jakmile bude nové jádro online.


 Amazon