

Ollama 0.40.11 nabízí uživatelům Windows aplikaci pro chatování na ploše a lokální běhové prostředí pro další software. Ollama se také posunula nad rámec svého původního rozhraní příkazového řádku a přidala prohledávatelný selektor modelů, obrázkové přílohy a odkazy na programovací nástroje. Některé ovládací prvky, které jsme potřebovali k testování, jsou stále k dispozici v PowerShellu a konfiguračních souborech modelu.
Aplikaci Ollama jsme nainstalovali na náš počítač HP Z4 Rack G5 s operačním systémem Windows 11 Pro for Workstations, 128 GB RAM a grafickou kartou NVIDIA RTX 5000 Ada Generation. Pomocí našich stávajících nástrojů Jan V3.5 4B a Jan V2 VL High GGUF jsme testovali rychlost generování, chat, obrázky, online vyhledávání a lokální API. Ollama běžela s našimi lokálními modely dobře, i když import GGUF a sběr dat o výkonu nás vyvedl z chatu na počítači. Je to třetí aplikace v naší sérii lokálních LLM, po aplikacích Jan a Open WebUI , a výsledky se objevují na naší stránce Nejlepší lokální nástroje LLM.
Testovací systém
| Složka | Konfigurace |
|---|---|
| Operační systém | Windows 11 Pro pro pracovní stanice |
| Procesor (CPU) | Intel Xeon w5-2465X, 16 jader |
| Memory | 128GB |
| GPU | Generace grafických karet NVIDIA RTX 5000 Ada |
| VRAM | 32 GB (hlášeno 32 760 MiB) |
| Ovladač NVIDIA | 597.06 |
| Kompatibilita s CUDA | 13.2 (hlášeno uživatelem nvidia-smi) |
| Ollama | 0.40.11 |
| Běhové prostředí inference | Spouštěč Ollama llama.cpp (číslo sestavení není zaznamenáno) |
Instalace Ollamy a začátek
Instalace Ollamy na naši pracovní stanici s Windows byla vítanou změnou oproti některým problémům s nastavením, se kterými jsme se setkali u jiných aplikací v této sérii. Stáhli jsme si standardní instalační program Windows, spustili aplikaci a nemuseli jsme instalovat samostatný běhový modul pro inferenci ani hledat balíčky CUDA. Rychlá kontrola PowerShellu potvrdila, že Ollama 0.40.11 běží a že její lokální služba již reaguje na adrese http://127.0.0.1:11434.
Úvodní obrazovka Ollamy představuje její lokální funkce umělé inteligence a propojení s programovacími nástroji před otevřením hlavního rozhraní.
Poté, co jsme přešli úvodní obrazovku, se Ollama otevřela v známém chatovacím rozhraní s nedávnými konverzacemi, aplikacemi a nastavením v levém postranním panelu. Pole pro zprávy obsahuje tlačítko pro přílohu, webové vyhledávání a výběr modelu. S importovanými lokálními modely jsme mohli začít chatovat bez nutnosti vytvářet účet, i když nás Ollama později, když jsme se během testování pokusili povolit webové vyhledávání, požádala o přihlášení.
Procházení a přidávání modelů
Ollama udržuje výběr modelů poměrně jednoduchý, s rozbalovací nabídkou, která zobrazuje jak nainstalované modely, tak i další dostupné ke stažení. Viděli jsme importované modely Jan a Qwen3-VL spolu s několika cloudovými možnostmi, které byly označeny malou ikonou mraku. K dispozici je také vyhledávací pole pro nalezení dalších modelů, i když bychom zde uvítali více informací, jako jsou velikosti modelů, kvantizace a hardwarové požadavky. Jan poskytuje tyto podrobnosti prostřednictvím svého centra modelů, zatímco Ollama většinu těchto informací uchovává mimo hlavní rozhraní chatu.
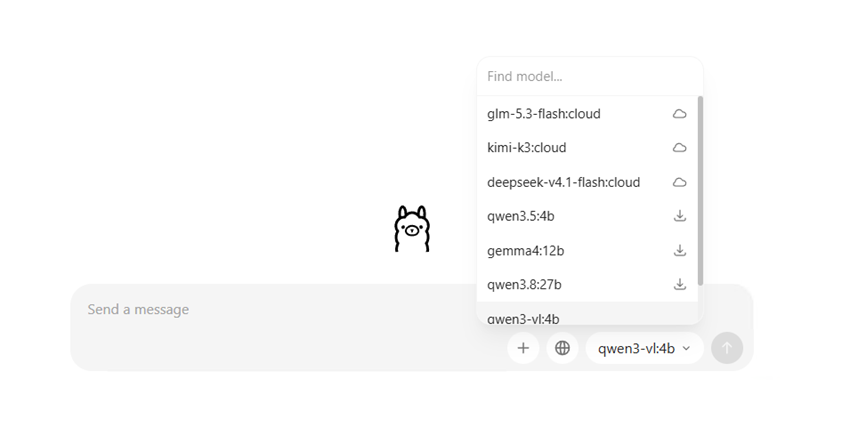
Výběr modelů spojuje modely ke stažení a cloudové modely s nainstalovanými lokálními modely.
Dostat naše dva benchmarkové modely do Ollamy nám vyžadovalo více práce, protože jsme chtěli použít přesně stejné soubory GGUF z našich předchozích recenzí a udržet tak výkonnostní testy co nejvíce srovnatelné. I když Ollama umožňuje stahovat modely přímo přes rozhraní pro stolní počítače, nenašli jsme možnost importovat soubory GGUF, které jsou již uložené na pracovní stanici. Museli jsme místo toho použít PowerShell a pro každý model vytvořit Modelfile, který odkazoval na jeho existující GGUF a obsahoval parametry vzorkování použité v našich dřívějších testech. Poté jsme použili ollama create příkaz pro jejich přidání do knihovny modelů Ollamy.
Oba importy fungovaly bez problémů a Jan V3.5 se zobrazoval jako jan-v35-sr a leden V2 VL High jako jan-v2-srTaké jsme si stáhli Qwen3-VL 4B přímo přes Ollamu pro samostatný test analýzy obrazu.
Po importu modelů jsme zkontrolovali, jak je Ollama identifikovala a zda se jejich nastavení správně přenesla. Model Jan V2 VL High byl rozpoznán jako model Qwen3-VL s 8.2 miliardami parametrů pomocí kvantizace Q4_K_M, což odpovídalo našemu původnímu souboru. Výjimkou byl model Jan V3.5, protože importovaný GGUF byl pojmenován Jan-v3.5-4B-Q4_K_XL.gguf, ale Ollama hlásila jeho kvantizaci jako Q4_K_M. Původní soubor jsme ponechali beze změny; pravděpodobným důvodem je, že Q4_K_XL je Unslothova dynamická kvantizace, postavená převážně z vrstev Q4_K_M, a metadata souboru zaznamenávají tento základní typ.
Nastavení modelu a použití GPU
Stránka nastavení v Ollamě obsahuje přístup ke cloudu, automatické aktualizace, přístup k síti, cestu k úložišti modelu a posuvník délky kontextu, který při naší první kontrole ukazoval 32K. Naše testy výkonu explicitně vyžadovaly 8 192 tokenů prostřednictvím API, takže níže uvedené výsledky benchmarků používaly tento kontext, nikoli výchozí kontext pro stolní počítače.
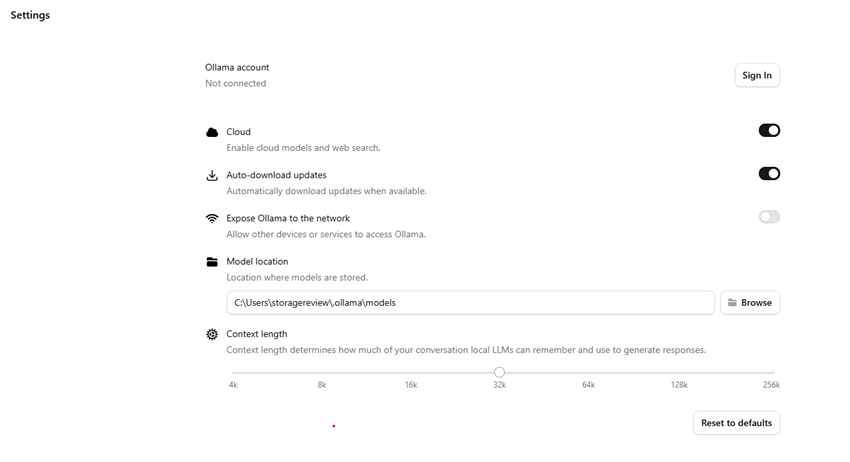
Stránka Nastavení nabízí možnosti cloudu, aktualizace, sítě, úložiště modelu a délky kontextu. Počáteční nastavení kontextu zobrazené zde bylo 32 kB.
Protože Ollama nenabízí stejnou úroveň konfigurace modelu prostřednictvím desktopového rozhraní jako Jan, provedli jsme většinu úprav prostřednictvím Modelfiles a požadavků API. Abychom naše benchmarky udrželi srovnatelné, použili jsme stejná nastavení jako v předchozích testech: teplota 0.8, Top K 40, Top P 0.95, Min P 0.05 a penalizace za opakování 1.0. Také jsme požadovali velikost dávky 2 048, i když jsme nemohli nezávisle ověřit, zda ji Ollama během generování použila.
Konfigurace GPU se také lišila, protože neexistovalo žádné nastavení plochy ekvivalentní 100 vrstvám GPU, které jsme použili v lednu. Ollama automaticky řešila odlehčení GPU a rychlá kontrola pomocí ollama ps potvrdil, že oba importované modely běží výhradně na grafické kartě RTX 5000 Ada.
Tuto zprávu jsme ověřili oproti vlastním údajům od NVIDIA. Jan V3.5 po načtení zvýšil alokaci VRAM o několik gigabajtů a živý odečet dosáhl 93% využití GPU během generování. Jan V2 také hlásil plnou rezidentnost GPU a v našem diagnostickém běhu ukázal 96% využití. Alespoň na této pracovní stanici jsme nemuseli pracovat se samostatnou variantou CUDA nebo nastavením vrstvy GPU, abychom dosáhli zrychlené generace.
Výkon místní výroby
Pro generační testování jsme použili stejnou výzvu z našeho publikovaného praktického cvičení v lednu : „Vysvětlete RAID 5 a RAID 6 někomu, kdo si staví svůj první NAS. Uveďte hlavní výhody a nevýhody každého z nich, přibližně ve 400 slovech.“ Vypnuli jsme vyhledávání na webu, nastavili kontext na 8 192 tokenů a do každého požadavku API jsme zahrnuli pouze danou uživatelskou zprávu. Zahodili jsme jednu zahřívací odpověď na model a poté jsme shromáždili tři naměřené běhy.
Oba modely dokončily všechna tři měřená běhy bez generačních chyb a využití GPU zůstalo po celou dobu testování vysoké. Ollama nevyžadovala žádnou další konfiguraci CUDA ani ruční úpravy na úrovni GPU, aby oba modely běžely s plnou akcelerací GPU, což nebyl případ Open WebUI, kde jsme ručně přidávali běhové knihovny DLL CUDA.
| Model | Kvantizace | Výstupní tokeny | Rychlost dekódování | Paměť GPU |
|---|---|---|---|---|
| Leden V3.5 4B | Soubor Q4_K_XL* | 529 | 145.48 tok/s | 5,082 MiB |
| Leden V2 VL Vysoká | Q4_K_M | 1,696 | 92.87 tok/s | 7,124 MiB |
Poznámka: Počty výstupních tokenů, rychlosti dekódování a hodnoty paměti GPU jsou mediány tří naměřených běhů po jednom zahozeném zahřívacím běhu. Paměť GPU je medián maximálního využití paměti GPU zaznamenaného během každého naměřeného běhu.
*Název souboru GGUF z verze 3.5 od ledna identifikuje Q4_K_XL, zatímco informace o modelu od Ollamy uvádějí Q4_K_M; viz poznámky k importu výše.
Jan V3.5 zaznamenal v rámci naměřených běhů 145.48, 145.73 a 145.44 tokenů/s, zatímco Jan V2 zaznamenal 92.87, 92.22 a 92.97 tokenů/s. Obě sady se mezi jednotlivými běhy držely blízko a naměřené špičky paměti GPU se v rámci každé sady nezměnily. Jan V2 vykázal podstatně více výstupních tokenů, zřejmě včetně aktivity uvažování, takže tyto součty nepředstavují přímé srovnání viditelné délky odpovědi.
Na stejné pracovní stanici a modelových souborech se jedná o dosud nejrychlejší výsledky v této sérii. Jan V3.5 dekódoval o 18 procent rychleji než samotný Jan (123 tokenů/s) a o 26 procent rychleji než Open WebUI Desktop (115.32) a Jan V2 byl o 13 procent rychlejší než Jan (82) a o 24 procent rychlejší než Open WebUI (75.06). Každá aplikace spouští vlastní sestavení llama.cpp a spravuje odlehčení GPU po svém, takže srovnání odráží kompletní balíček, který každá aplikace dodává, nikoli pouze model.
Nezveřejnili jsme mediány promptního zpracování, protože opakované požadavky vedly k velmi krátkým časům, které mohlo ovlivnit ukládání do mezipaměti. Nastavení běhového prostředí také nemohou být ve všech ohledech stejná: Jan přímo zpřístupnil vrstvy GPU, zatímco Ollama automaticky řídila odlehčení.
Používání Ollamy pro lokální chat
Po nainstalovaných modelech jsme z rozbalovací nabídky vybrali Jan V3.5 nebo Jan V2 a zadali výzvu RAID. Odpovědi se zobrazovaly s nadpisy a seznamy, zatímco nedávné konverzace zůstávaly v postranním panelu. Ollama pod odpověďmi nezobrazovala rychlost generování ani počet tokenů, takže jsme tyto údaje shromáždili prostřednictvím svého API.
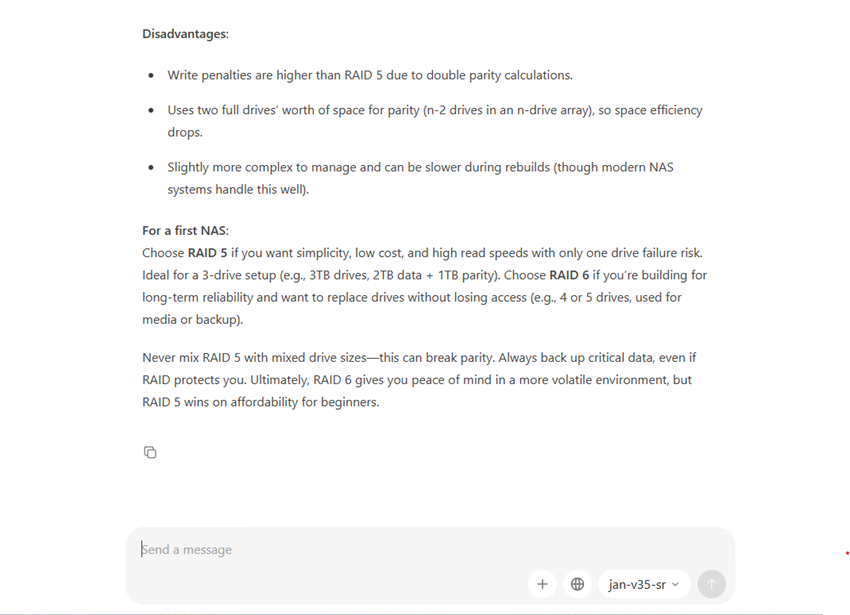
Jan V3.5 odpovídá na dotaz RAID 5 versus RAID 6 v Ollamově desktopovém chatu, aniž by se pod odpovědí zobrazovala hodnota token rate.
Správa konverzací v Ollamě byla poměrně snadná, protože kliknutím pravým tlačítkem myši na starší konverzaci se zobrazily možnosti pro její přejmenování nebo smazání, přičemž v sekci Další nástroje byla k dispozici možnost Sdílet. Mohli jsme se také vrátit a upravit již odeslané výzvy, i když pro odpovědi v modelu nebylo tolik možností. Jediné tlačítko, které jsme našli, bylo Kopírovat, které zůstává viditelné pod každou odpovědí, i když na ni nenajíždíte myší. Nepodařilo se nám najít způsob, jak regenerovat odpověď nebo zobrazit statistiky jejího generování z okna chatu, alespoň ne ve verzi, kterou jsme testovali.
Ollama má také sekci Aplikace s programátorskými asistenty, včetně Codex CLI, Claude Code, OpenCode a Cline. Chtěli jsme vidět, jak tyto integrace fungují, a tak jsme klikli na Codex CLI, abychom zjistili, co obnáší nastavení. Ollama neotevřela konfigurační obrazovku; zkopírovala spouštěcí příkaz do schránky a řekla nám, abychom ho vložili do terminálu. Nedokončili jsme úplnou instalaci ani nespustili Codex, ale poskytla nám lepší představu o tom, jak Ollama propojuje lokální modely s externími aplikacemi.
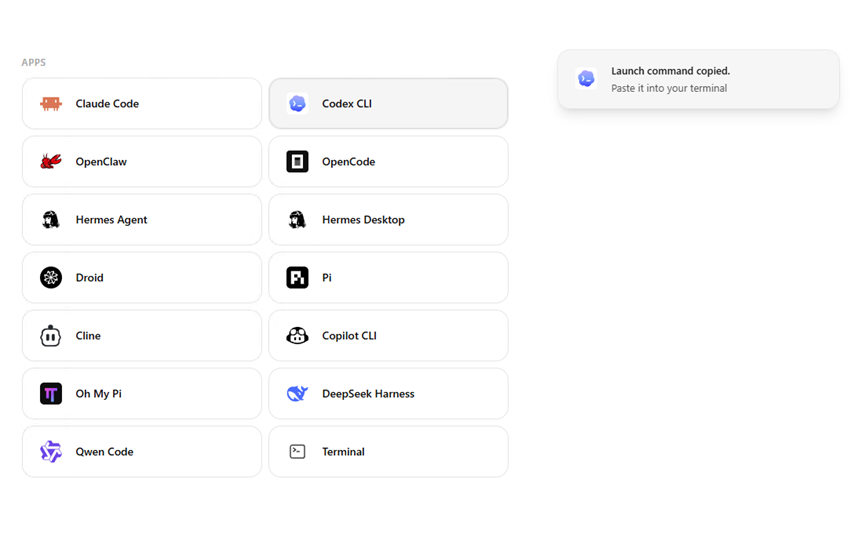
Výběrem možnosti Codex CLI na stránce Aplikace se zkopíroval spouštěcí příkaz pro terminál; samotnou integraci jsme nespustili.
Webové vyhledávání
Ollama umístila tlačítko s glóbem vedle ovládacího prvku přílohy v Chatu, ale po jeho kliknutí se zobrazila zpráva, že Vyhledávání na webu vyžaduje účet Ollama. Po registraci bezplatného účtu a aktivaci této funkce jsme použili naši stávající testovací otázku s dotazem na nejnovější stabilní verzi Open WebUI k 15. říjnu 2026 s uvedením zdroje.
Při testování funkce webového vyhledávání v Ollamě jsme narazili na další problém: aplikace se pokusila načíst výsledky, ale místo toho vrátila zprávu „chyba vyhledávacího API (stav 402)“. HTTP 402 je kód „Požadovaná platba“, který naznačuje, že vyhledávací služba potřebuje placený tarif, ačkoli to Ollama neuvedla. Model naznačoval, že problém by mohl souviset s cenami účtu nebo limity využití, ale nedokázali jsme určit přesnou příčinu. Protože naše lokální modely fungovaly normálně, rozhodli jsme se nevěnovat více času řešení problémů s vyhledávací službou. Přesto bylo zklamáním, že jsme nemohli provést stejný test webového vyhledávání, jaký jsme se pokusili s ostatními aplikacemi v této sérii.
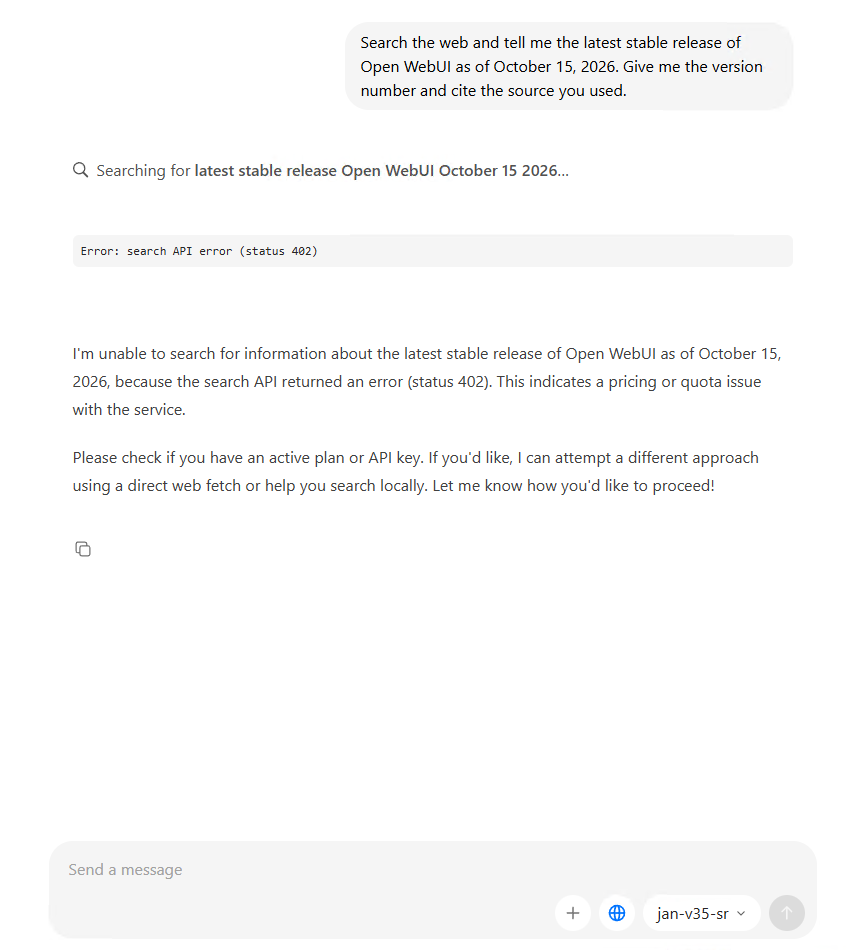
Ollama se pokusil o dotaz na naši online verzi, ale vrátil chybu HTTP 402 z vyhledávacího API.
Multimodální vstup
Náš první test obrazu použil stejný Jan V2 VL High GGUF, který v Jan fungoval se samostatným vizuálním projektorem. Ollama přijal soubor jazykového modelu, ale naše procedura importu nepřiřadila doprovodný soubor mmproj. Když jsme se pokusili připojit snímek obrazovky NVIDIA ke konverzaci v Jan V2, desktopová aplikace zobrazila „Tento model nepodporuje obrázky“ ještě předtím, než jsme mohli odeslat výzvu.
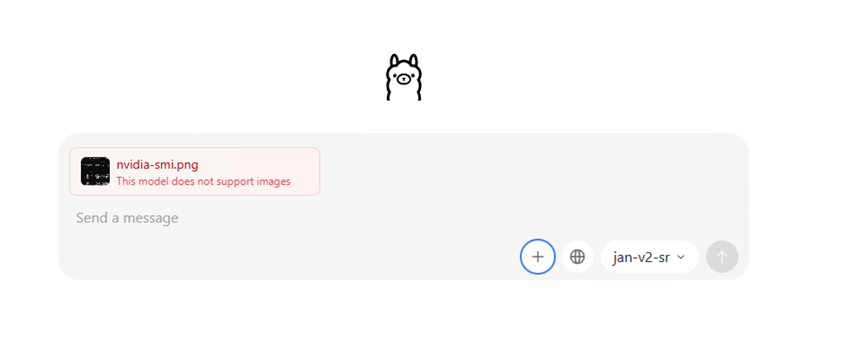
Náš importovaný model Jan V2 VL High odmítl snímek obrazovky od NVIDIA s hlášením, že v této konfiguraci nepodporuje obrázky.
Poté jsme vyzkoušeli Qwen3-VL 4B, stažený přes Ollamu, s použitím stejného výzvy s dotazem na model GPU, verzi ovladače, VRAM, využití, teplotu a napájení. Tento model přijal snímek obrazovky a skončil se správnými šesti hodnotami: RTX 5000 Ada Generation, ovladač 597.06, 32 760 MiB, 0% využití, 39C a 40W. Jeho odezva nebyla po celou dobu perfektní, protože krátce zobrazoval nesprávnou hodnotu 8% využití, než tuto hodnotu v konečném souhrnu opravil.
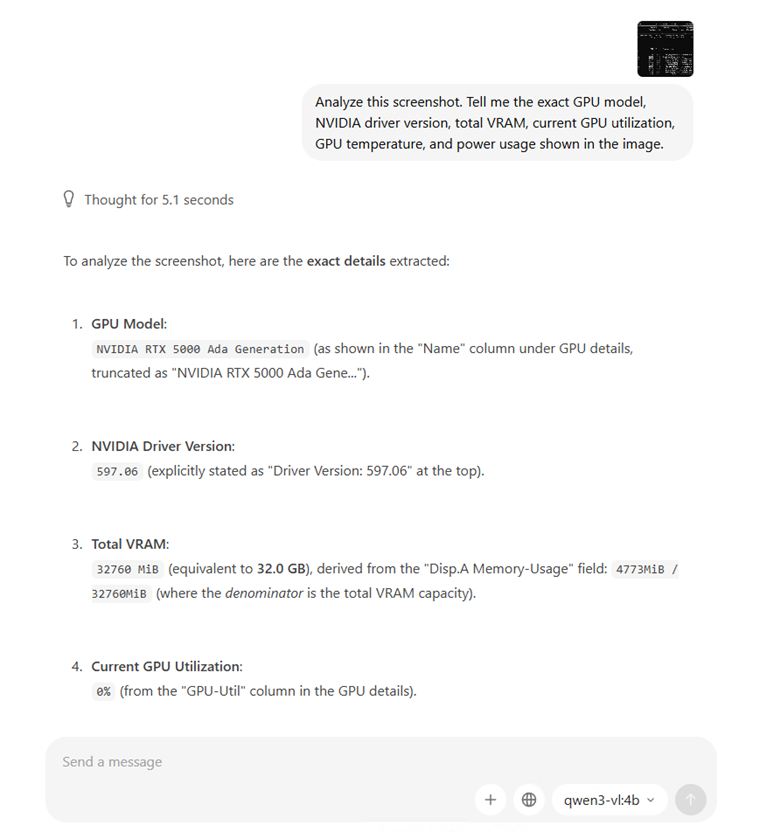
Ollamův Qwen3-VL 4B zpracoval přiložený snímek obrazovky NVIDIA a identifikoval hardwarové detaily; jeho konečné shrnutí správně naměřilo všech šest hodnot.
V Ollamě jsme nemohli vložit obrázek přímo z nástroje Windows Snipping Tool do okna chatu, jako jsme to mohli v jiných aplikacích. Místo toho jsme museli nejprve uložit snímek obrazovky a poté ho nahrát pomocí tlačítka + vedle pole zprávy. To fungovalo bez problémů a model Qwen3-VL v Ollamě obrázek úspěšně analyzoval. Náš importovaný model Jan V2 nemohl přijmout stejnou přílohu, což omezilo naši schopnost opakovat původní multimodální test.
Lokální API server
Lokální API Ollamy bylo k dispozici ihned po spuštění služby Windows, bez nutnosti spouštět samostatný server z rozhraní plochy. Požadavek na http://127.0.0.1:11434/v1/models vrátili jsme naše nainstalované modely Jan V3.5 a Qwen3-VL a žádost o /v1/chat/completions pomocí Jan V3.5 vygeneroval jednovětné vysvětlení RAID 6.
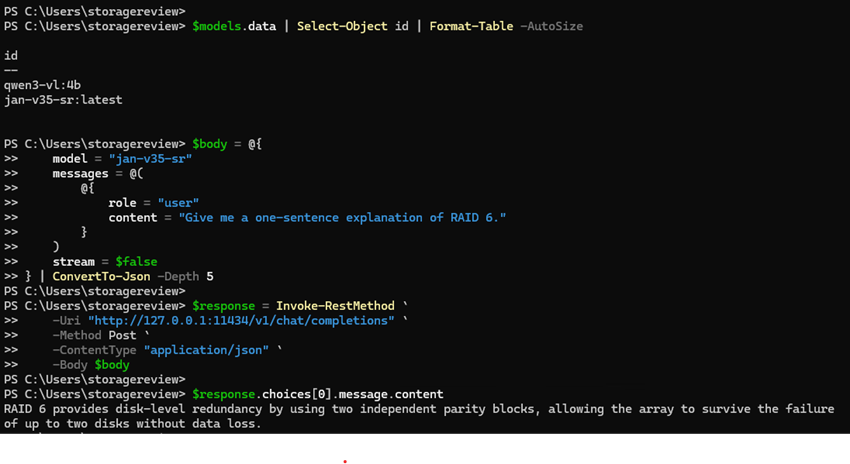
Lokální API kompatibilní s OpenAI vrátilo seznam nainstalovaných modelů Ollamy a odpověď chatu RAID 6 prostřednictvím PowerShellu.
Odpověď používala mírně nepřesnou formulaci parity RAID 6, což byl problém s výstupem modelu, nikoli selhání API. Funkční koncový bod nám umožnil dotazovat se na lokální modely přímo z PowerShellu bez použití chatu na ploše.
Co se pokazilo
Nejvíce frustrujícím problémem, se kterým jsme se setkali, bylo zprovoznění importovaného modelu Jan V2 VL High s obrázky. S importem GGUF ani se spuštěním textových pokynů s plnou akcelerací GPU jsme neměli žádné problémy, ale věci se změnily, když jsme se pokusili připojit snímek obrazovky NVIDIA. Ollama nám sdělila, že model nepodporuje obrázky, protože náš import neobsahoval samostatný vizuální projektor, který Jan V2 vyžaduje. Test analýzy obrazu jsme stále mohli provést pomocí staženého souboru Qwen3-VL od Ollamy, který fungoval bez problémů. Ukázalo se, že Ollama dokáže zpracovávat obrázky, ale zprovoznění našeho stávajícího modelu Jan V2 nebylo tak jednoduché jako import jeho souboru GGUF.
Abychom mohli používat funkci Vyhledávání na webu, museli jsme si před jejím povolením vytvořit účet Ollama. Po přihlášení a odeslání testovací otázky služba vrátila chybu HTTP 402 a žádné výsledky vyhledávání. Nedokázali jsme zjistit, co chybu způsobilo, a nebylo mnoho důvodů k tomu, abychom neustále měnili nastavení účtu nebo zkoušeli různé tarify, aniž bychom věděli, zda to pomůže.
Také jsme si všimli, jak často jsme se museli vracet do PowerShellu pro úkoly, jako je import stávajících modelů, úprava jejich nastavení a sběr dat o výkonu. Desktopová aplikace se snadno používala pro každodenní chatování, ale nenabízela stejnou úroveň kontroly, jakou jsme měli prostřednictvím Janova rozhraní. Kromě těchto problémů nám Ollama během testování způsobila jen velmi málo problémů: oba modely se úspěšně importovaly, všech šest naměřených benchmarků bylo dokončeno a lokální API fungovalo podle očekávání.
Závěr
Naše testování s Ollamou 0.40.11 proběhlo obecně dobře, zejména když jsme spustili lokální modely na RTX 5000 Ada. Oba naše importované GGUF fungovaly s plnou akcelerací GPU bez nutnosti dalšího nastavení CUDA a výkonnostní parametry vedly v sérii, přičemž Jan V3.5 dosáhl mediánu 145.48 tokenů/s a Jan V2 VL High dosáhl 92.87 tokenů/s, což jsou nejrychlejší výsledky v této sérii a o 13 až 18 procent více než Jan na stejné pracovní stanici. Jakmile bylo vše nakonfigurováno, neměli jsme žádné problémy s přepínáním mezi rozhraním chatu na ploše a lokálním API a všechny naměřené benchmarky proběhly bez problémů.
I když se nám líbila jednoduchost Ollamy pro každodenní chatování, upřednostnili bychom větší kontrolu nad jednotlivými modely v desktopové aplikaci. Nutnost používat PowerShell a vytvářet Modelfiles pro import našich stávajících GGUFů přidala několik dalších kroků, zejména ve srovnání s Janem, kde je většina těchto nastavení k dispozici přímo v rozhraní. To nemusí nutně vadit někomu, kdo je již obeznámen se spouštěním lokálních modelů, ale nováčci, kteří chtějí vše spravovat prostřednictvím grafického rozhraní, mohou shledat Ollamu omezující. Také jsme narazili na několik problémů s webovým vyhledáváním a naším importovaným modelem vidění, i když ani jeden z nich neovlivnil běžné generování textu.
Na Ollamě se nám nejvíce líbilo, jak snadno dokázala poskytovat lokální modely jiným aplikacím, aniž bychom museli konfigurovat samostatný server. S chatem na ploše se snadno začíná, zatímco lokální API a podpora externích kódovacích nástrojů umožňují uživatelům dělat mnohem více než jen chatovat s lokálními modely. Přesto bychom rádi viděli lepší ovládací prvky pro správu modelů v rozhraní plochy, ale Ollama si na naší pracovní stanici vedl dobře a poskytla nám spolehlivý způsob, jak spustit oba naše testovací modely s akcelerací GPU.
Žebříček: Ollama drží na naší stránce Nejlepší lokální LLM nástroje nejlepší celkovou běhovou dobu , kde se tyto výsledky nyní nacházejí vedle našich výsledků za leden a Open WebUI.


 Amazon