

Podniková infrastruktura umělé inteligence se posunula od optimalizace trénovacích modelů k jejich obsluze, což mění ekonomiku. Trénink je kapitálový projekt s koncovým bodem. Inference je produkční úloha, která běží tak dlouho, dokud je služba aktivní, s výstupem měřeným v tokenech. Toto je problém tokenomiky, kterému nyní čelí operátoři umělé inteligence: jakmile jsou GPU zařazeny do racku a je stanoven rozpočet na napájení, podnikání závisí na tom, kolik tokenů hardware produkuje.
V dlouhých, vícenásobných úlohách se stejný kontext opakovaně prochází modelem s tím, jak se konverzace rozrůstají. GPU již jednou zaplatilo za zpracování těchto tokenů, ale když je mezipaměť KV vymazána, systém musí tento kontext znovu předvyplnit. To nutí nepřítele k přepočítání. V jakémkoli měřítku se nejedná o chybu zaokrouhlování. Jsou to náklady vrácené zpět jako energie, čas GPU, růst fronty nebo dodatečný hardware.
Reflexivním řešením je koupit více nejdražších zdrojů v racku: více GPU, více DRAM. Ale přepočet již vytvořil něco znovupoužitelného. Mezipaměť KV jsou jen data; lze ji levně ukládat a načítat, přičemž se vymění malé náklady na opětovné načítání za drahé výpočty před naplnění, kterým se vyhne. Otázkou tedy není, zda mezipaměť ponechat, ale kde ji uchovávat, a to je stejně tak otázka nákladů jako výkonu. VRAM je nejrychlejší a nejvzácnější vrstva; jakmile se nasytí, inferenční server začne vyřazovat mezipaměti. DRAM kupuje rezervu za prudce a rychle rostoucí cenu. Flash je oblast, kde se matematika může změnit: jistě pomalejší než DRAM, ale mnohem levnější na terabajt, s dostatečnou kapacitou pro uložení kontextu, který jsou rychlejší vrstvy nuceny zahodit, což je rozdíl mezi přepracováním celé konverzace a jejím pouhým zpětným načtením.
Abychom změřili dopad, vytvořili jsme na serveru Dell PowerEdge XE7740 vícenásobné agentní testovací zatížení a udrželi jsme model, GPU a obslužný zásobník konstantní. Číslo, na kterém záleží pro každého, kdo dimenzuje systém, je to, co se stane po naplnění paměťových vrstev. Od tohoto bodu si flash paměť udržela celkem zhruba 30 000 tokenů za sekundu, ve srovnání se 17 000 u DRAM, což je 94 % jejího vlastního maxima, zatímco úroveň DRAM klesla na 42 %. Obě úrovně odlehčení překonaly ve špičce s velkým náskokem základní hodnotu pouze pro VRAM (2.9x u DRAM a 2.2x u flash paměti), ale vrchol je přesně tam, kde se úroveň DRAM brzy vyčerpá. Nejdražší paměť si vrchol kupuje; flash paměť si ho udrží, jak kontext neustále roste.
Než se pustíme do výsledků, je vhodné si ujasnit, co je KV mezipaměť, proč se zaplňuje a proč se výkon inference začíná hroutit, když systém nemá kde levněji ji uchovávat.
Key Takeaways
- Flash paměť zvládne to, co DRAM nezvládne: Všechny tři konfigurace fungují identicky, dokud paměťový tlak nevynutí vyřazení paměti. VRAM se nasytí jako první a vrstva 512GB DRAM se zhruba po 45 minutách běhu zaplní a začne s vyřazením paměti. Od tohoto bodu flash paměť udrží celkem přibližně 30 000 tokenů za sekundu oproti 17 000 tokenům DRAM, což je 94 % jejího maxima, zatímco DRAM klesla na 42 %.
- Offload obnovuje propustnost ztracenou při přepočítávání: Ve vrcholné fázi zvýšilo odlehčení mezipaměti KV celkovou propustnost až 2.9krát oproti základní úrovni pouze s VRAM na úrovni DRAM a 2.2krát na flash. Zisk plyne z vynechání opětovného předfillu, protože kontext, který GPU již vypočítala, se načítá zpět z úrovně odlehčení, nikoli se znovu sestavuje.
- Nejvíce rozdíl pocítí vracející se uživatelé: Latence prvního tokenu v nejhorším případě při obnovené relaci byla 13.9 sekundy na základní úrovni pouze s VRAM oproti 3.2 sekundám na flash paměti. Odlehčení zátěže udržuje tuto latenci v rámci hranice, kterou interaktivní uživatel zvládne využít.
- Provoz agentů prodražuje vystěhování: Týdenní provoz instrumentovaného Claude Code zahrnoval 98.16 % čtení z mezipaměti a pouze 0.02 % skutečně studeného vstupu.
- KV offload je úloha s vysokou zápisovou zátěží, která vyžaduje disky s vysokou odolností: Každý token, který model vygeneruje, zapíše položku KV a TTL churn neustále přepisuje vrstvu. Při naší trvalé rychlosti zápisu dosahuje testované zrcadlené pole RAID10 zhruba 3.2 zápisů na disk denně, což klesá na přibližně 1.6 DWPD v pruhovaném formátu RAID0, což se blíží hodnocení 3 DWPD u D7-PS1030. Definujícím omezením flash vrstvy je odolnost, nikoli kapacita nebo rychlost, a protože mezipaměť je jednorázová, je takto náročné zatěžování disku zaměřeného na zápis přijatelnou výměnou.
Jak funguje inference
Modely velkých jazyků jsou autoregresní: každý výstupní token je podmíněn každým tokenem, který se objevil před ním. Mechanismus pozornosti implementuje toto podmínění výpočtem (pro každý token v sekvenci) vektoru dotazu (Q), který je porovnán s vektory klíčů (K) a hodnot (V) každého předchozího tokenu. Výstup pozornosti je vážená kombinace hodnot, přičemž váhy pocházejí ze skalárních součinů QK.
Když dorazí požadavek, nelze na výzvu odpovědět, dokud pro každý token v ní neexistují tenzory K a V. Tímto prvním krokem je předvyplnění: engine provede výzvu modelem v jednom paralelním průchodu a zapíše výsledné tenzory K a V do paměti. Předvyplnění je tedy vázáno na výpočetní výkon a jeho latence se škáluje s délkou výzvy.
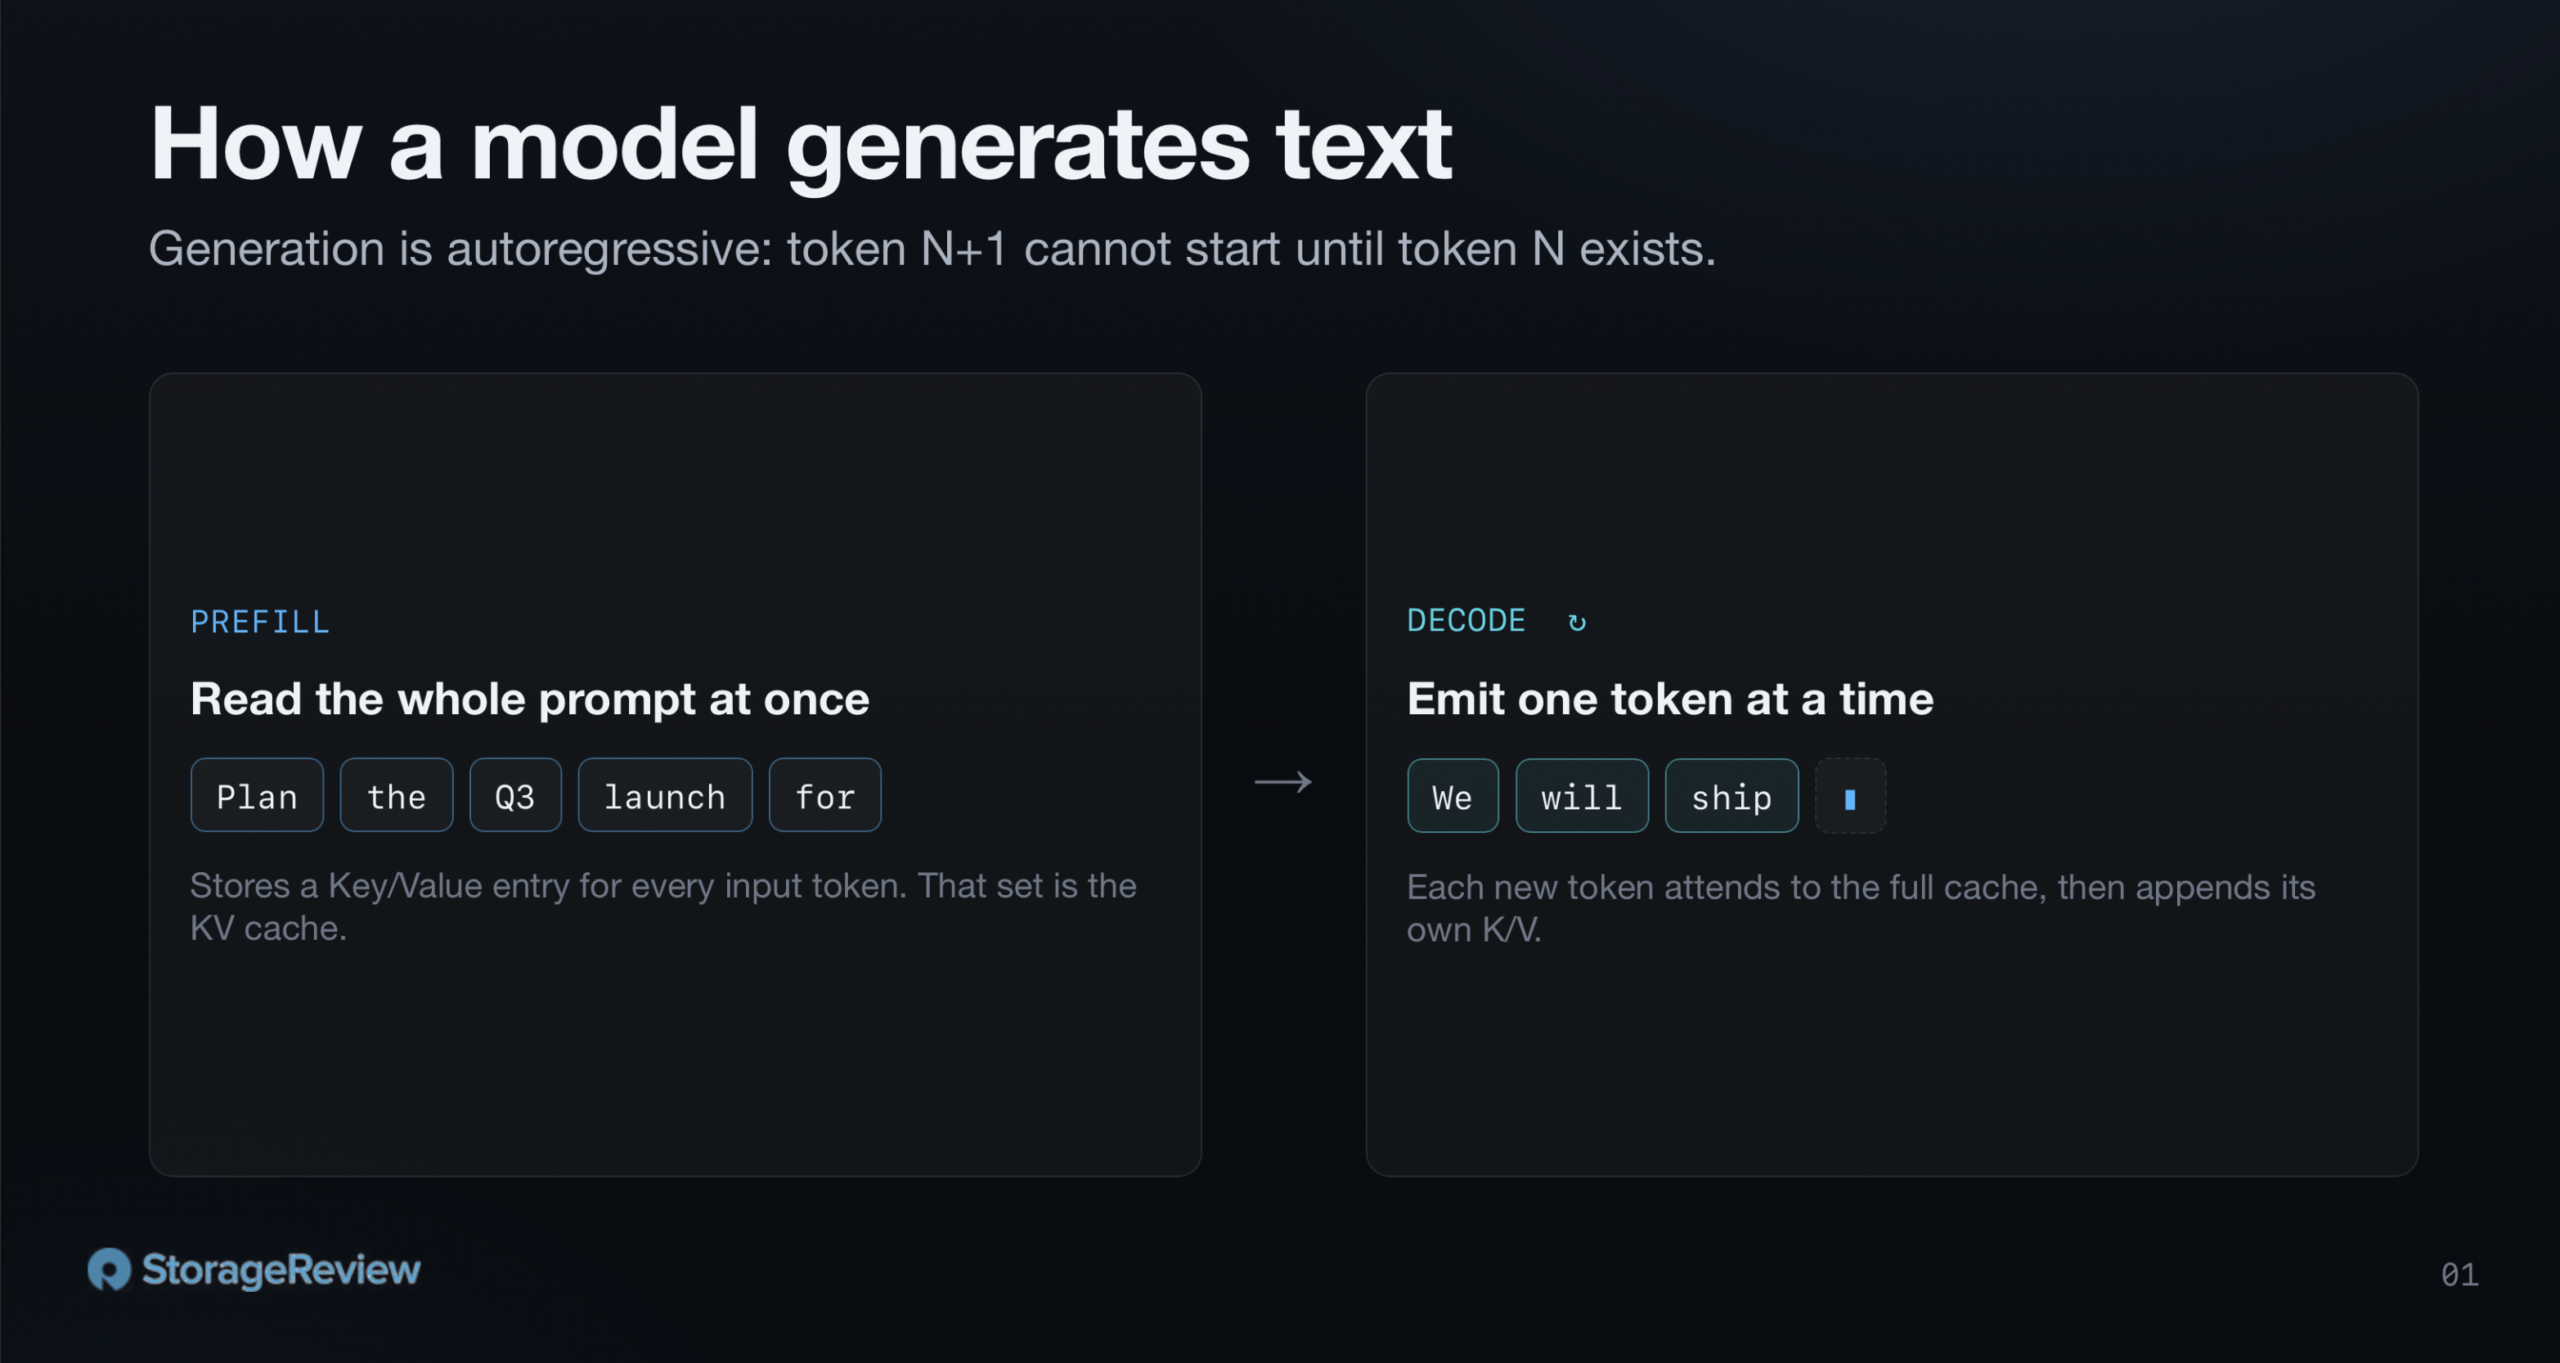
Jakmile je předvyplňování dokončeno, engine vysílá odpověď jeden token po druhém. Každý nový token přečte zpět K a V všech předchozích tokenů, vypočítá svůj výstup pozornosti a zapíše své vlastní K a V do paměti pro další krok. Touto druhou fází je dekódování. Je sekvenční a omezená na šířku pásma paměti, protože generování každého tokenu vyžaduje načtení uložených tenzorů K a V pro všechny předchozí tokeny z paměti a výpočet pozornosti nad nimi před zapsáním tenzorů K a V nového tokenu pro budoucí kroky.
Tenzory K a V z obou fází tvoří KV mezipaměť. Bez nich by generování n+1. tokenu v každém kroku přepočítávalo klíče a hodnoty pro všech n předchozích tokenů, což je kvadratická výpočetní složitost. S nainstalovanou mezipamětí každý nový token počítá pouze své vlastní K a V a zbytek čte z paměti, takže náklady na token zůstávají lineární.
Jak vypadá provoz agentů
Lidé často popisují inferenci jako omezenou šířkou pásma paměti, protože dekódování dominuje uživatelsky viditelné části odpovědi. Skutečná rovnováha mezi těmito dvěma fázemi závisí na pracovní zátěži. Krátký výzva požadující dlouhý esej je náročná na dekódování; dlouhý agentický výzva požadující malou úpravu JSON je náročná na předvyplňování. Která strana dominuje, určuje, co je zatěžováno, když je mezipaměť špatně spravována.
Tvar problému přepočtu vyplývá z této rovnováhy a „agentní“ pokrývá širokou škálu vzorců použití. Agentní kódování je v současnosti jedním z nejpopulárnějších těchto vzorců a v žebříčcích OpenRouter představuje významnou část použitých tokenů. Pro kvantifikaci reprezentativního případu jsme vybavili Claude Code protokolováním OpenTelemetry (OTEL) a exportovali jsme týdenní záznamy do Grafany. Rozdělení provozu tokenů podle typu je uvedeno níže. Poznámka: Toto použití Claude Code je na modelu Claude Opus 4.8 s délkou kontextu 1 milion, přičemž se pracuje na více kódovacích projektech najednou.
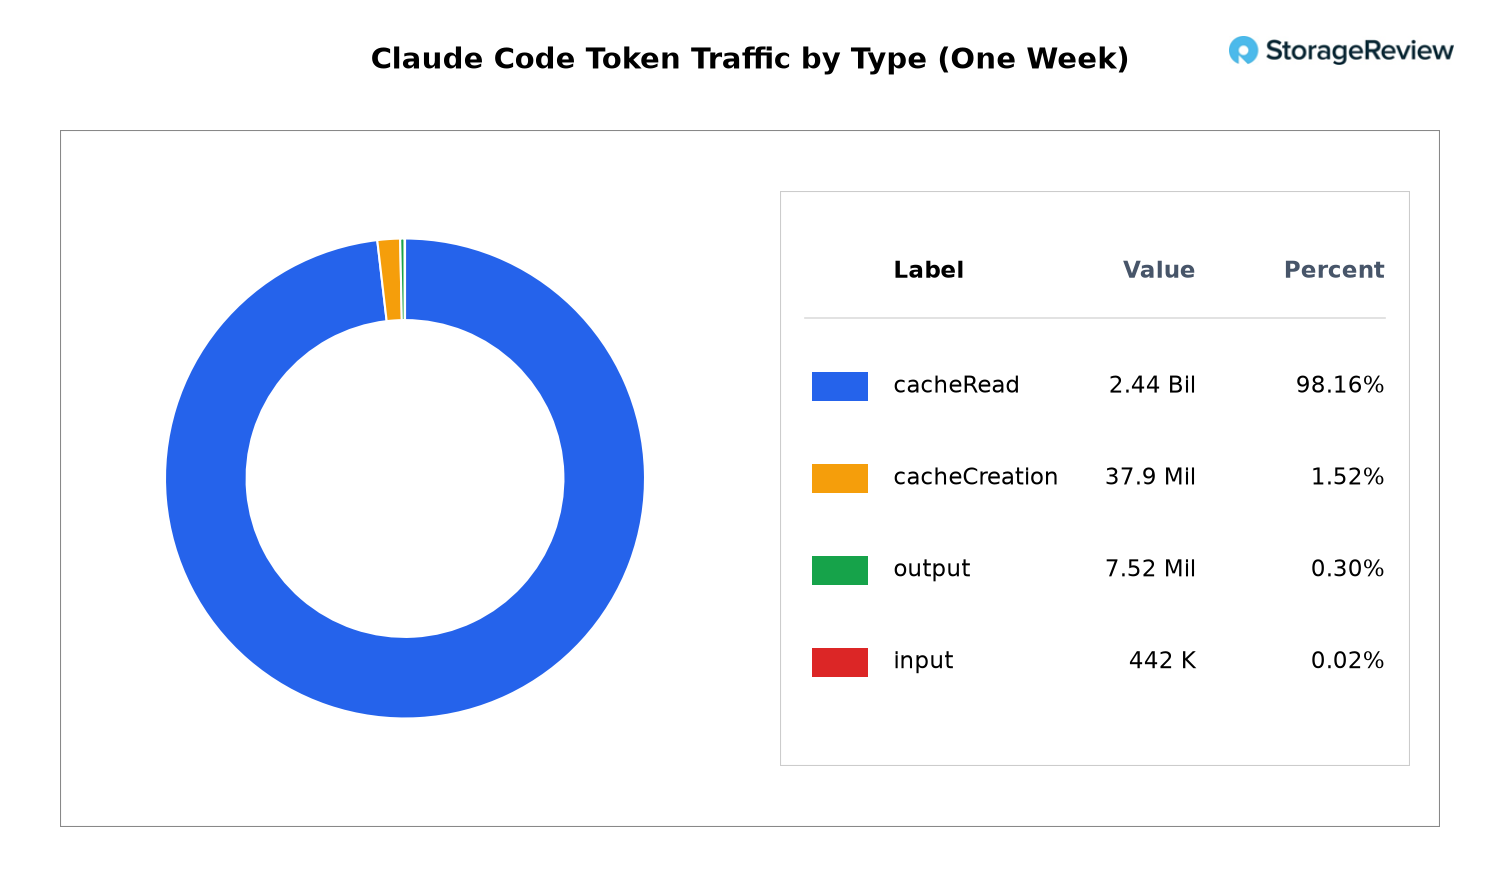
Čtení z mezipaměti tvořilo 98.16 % veškerého provozu tokenů. Vytvoření mezipaměti (dříve pozorovaný prefix, který byl znovu předvyplněn, protože jeho záznam vypršel) bylo 1.52 %. Výstupní tokeny tvořily 0.30 %. Skutečně studené vstupní tokeny tvořily 0.02 %.
V pracovní zátěži, kde 98 % provozu tvoří čtení z mezipaměti, znamená vyřazení bez odlehčení opětovné předběžné naplnění většiny práce, kterou měl systém vykonat. Úzké hrdlo se přesouvá z dekódovací šířky pásma, což je fáze obvykle optimalizovaná, na předběžné výpočty, které GPU již provedla v dřívějších fázích. Ve skutečnosti je docela běžné vidět deagregované obslužné architektury, které ve velkém měřítku provozují více předběžných workerů než dekódovacích workerů ze stejného důvodu: předběžné naplnění je fáze hradlování.
Číslo 98 % představuje mix provozu jednoho uživatele. Krátkodobý chat by vykazoval více studeného provozu. Systém rozšířený o vyhledávání, který v každém kole znovu vkládá různé dokumenty, by to také ukázal. Obecný tvar platí všude, kde jsou konverzace dlouhé, prefixy stabilní a uživatelé se stále vracejí do stejného kontextu.
Kde se mezipaměť nachází a co se stane, když se naplní
Kde se tato mezipaměť skutečně nachází a co se stane, když v ní dojde místo? Po načtení modelových vah se veškerá zbývající VRAM stane prostorem mezipaměti KV, rozděleným na bloky pevné velikosti, a při spuštění vám engine sdělí, kolik tokenů může pojmout. Tento pool je jediné místo, kde může mezipaměť existovat ve standardním nastavení bez KV Offloadingu.
Servery s grafickými procesory (GPU) jsou drahé a produktem jsou tokeny, takže cílem je udržovat je v provozu nepřetržitě. To znamená, že GPU musí být zatíženo malou frontou požadavků čekajících na zpracování, aby výpočetní výkon nestál v klidu, a zároveň je fronta vyvažována tak, aby latence odezvy zůstala v rámci cíle úrovně služeb (SLO). Ne každý požadavek spotřebuje celé své kontextové okno, takže mnoho dokončených klíčových požadavků (KV) zůstává samostatně uloženo v mezipaměti VRAM. Při trvalém zatížení se však tato mezipaměť zaplní a jakmile se tak stane, starší položky se odstraní, aby se uvolnilo místo.
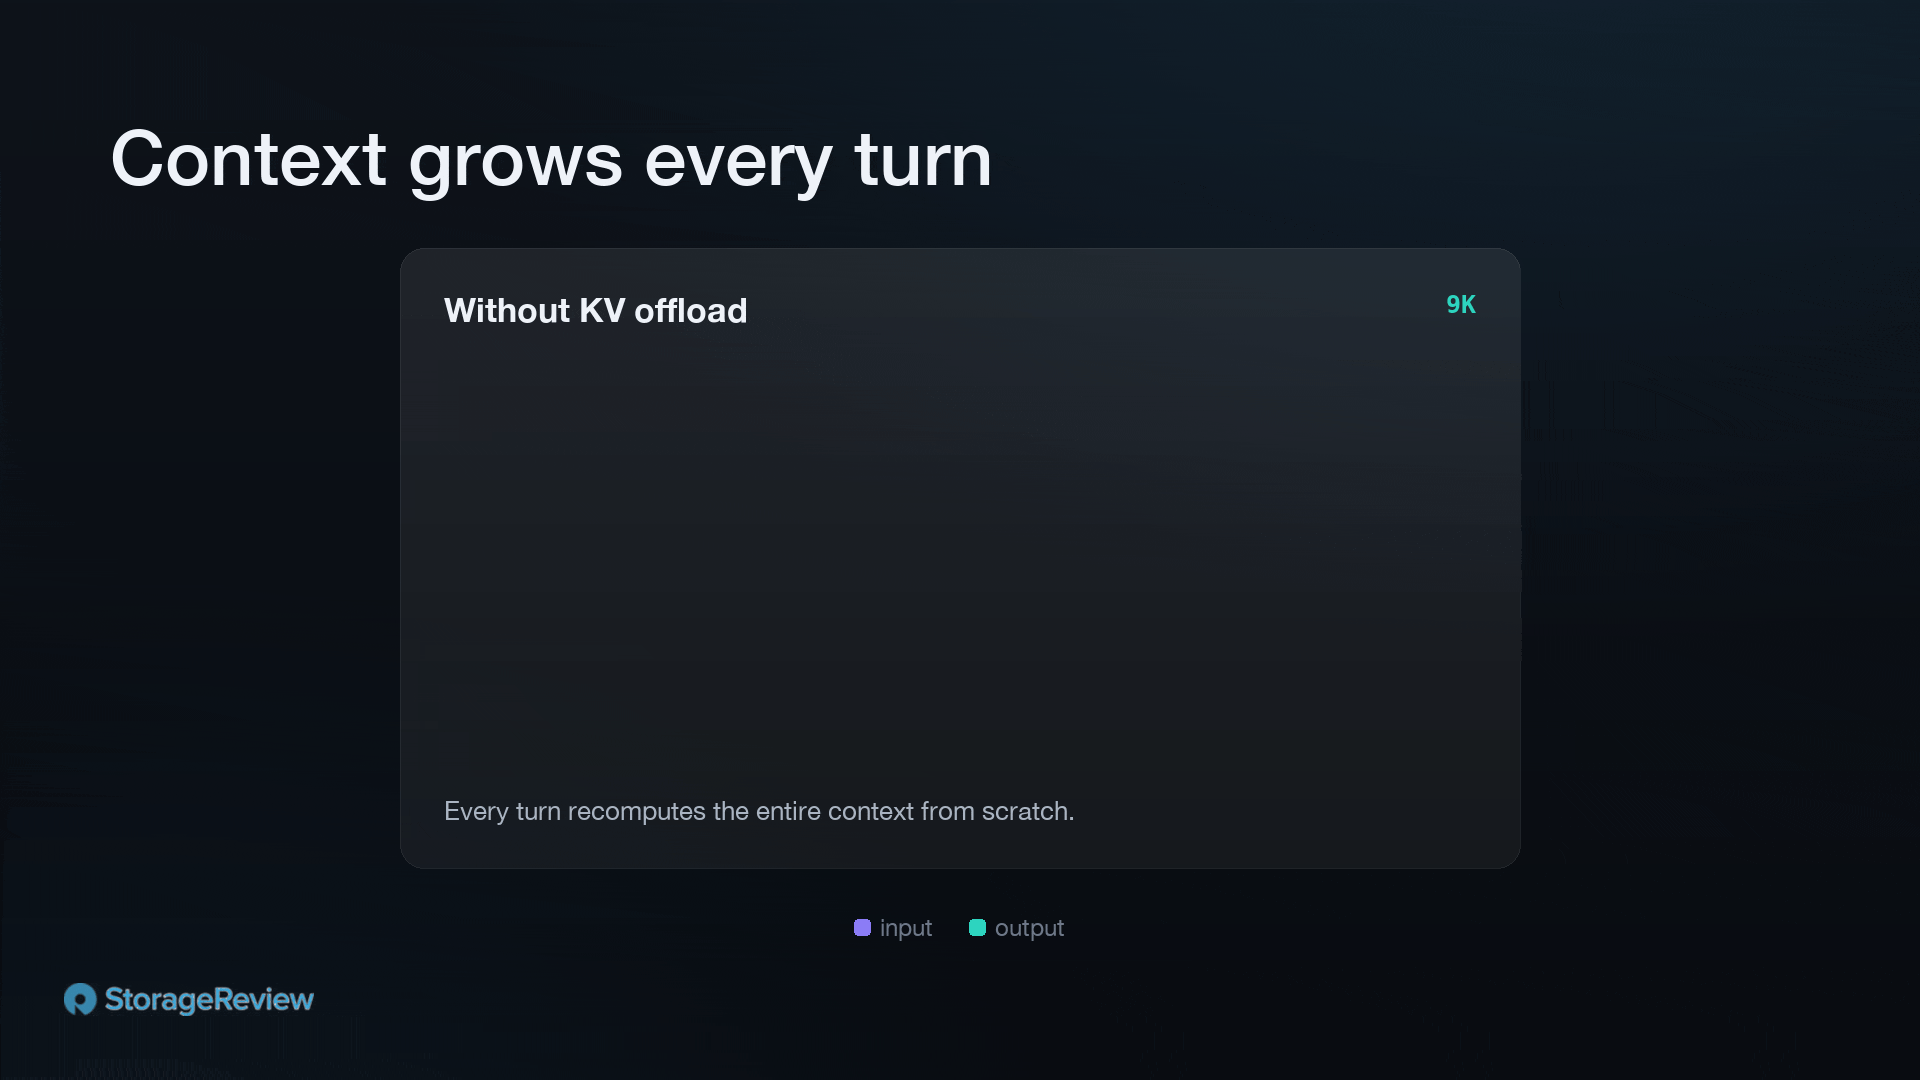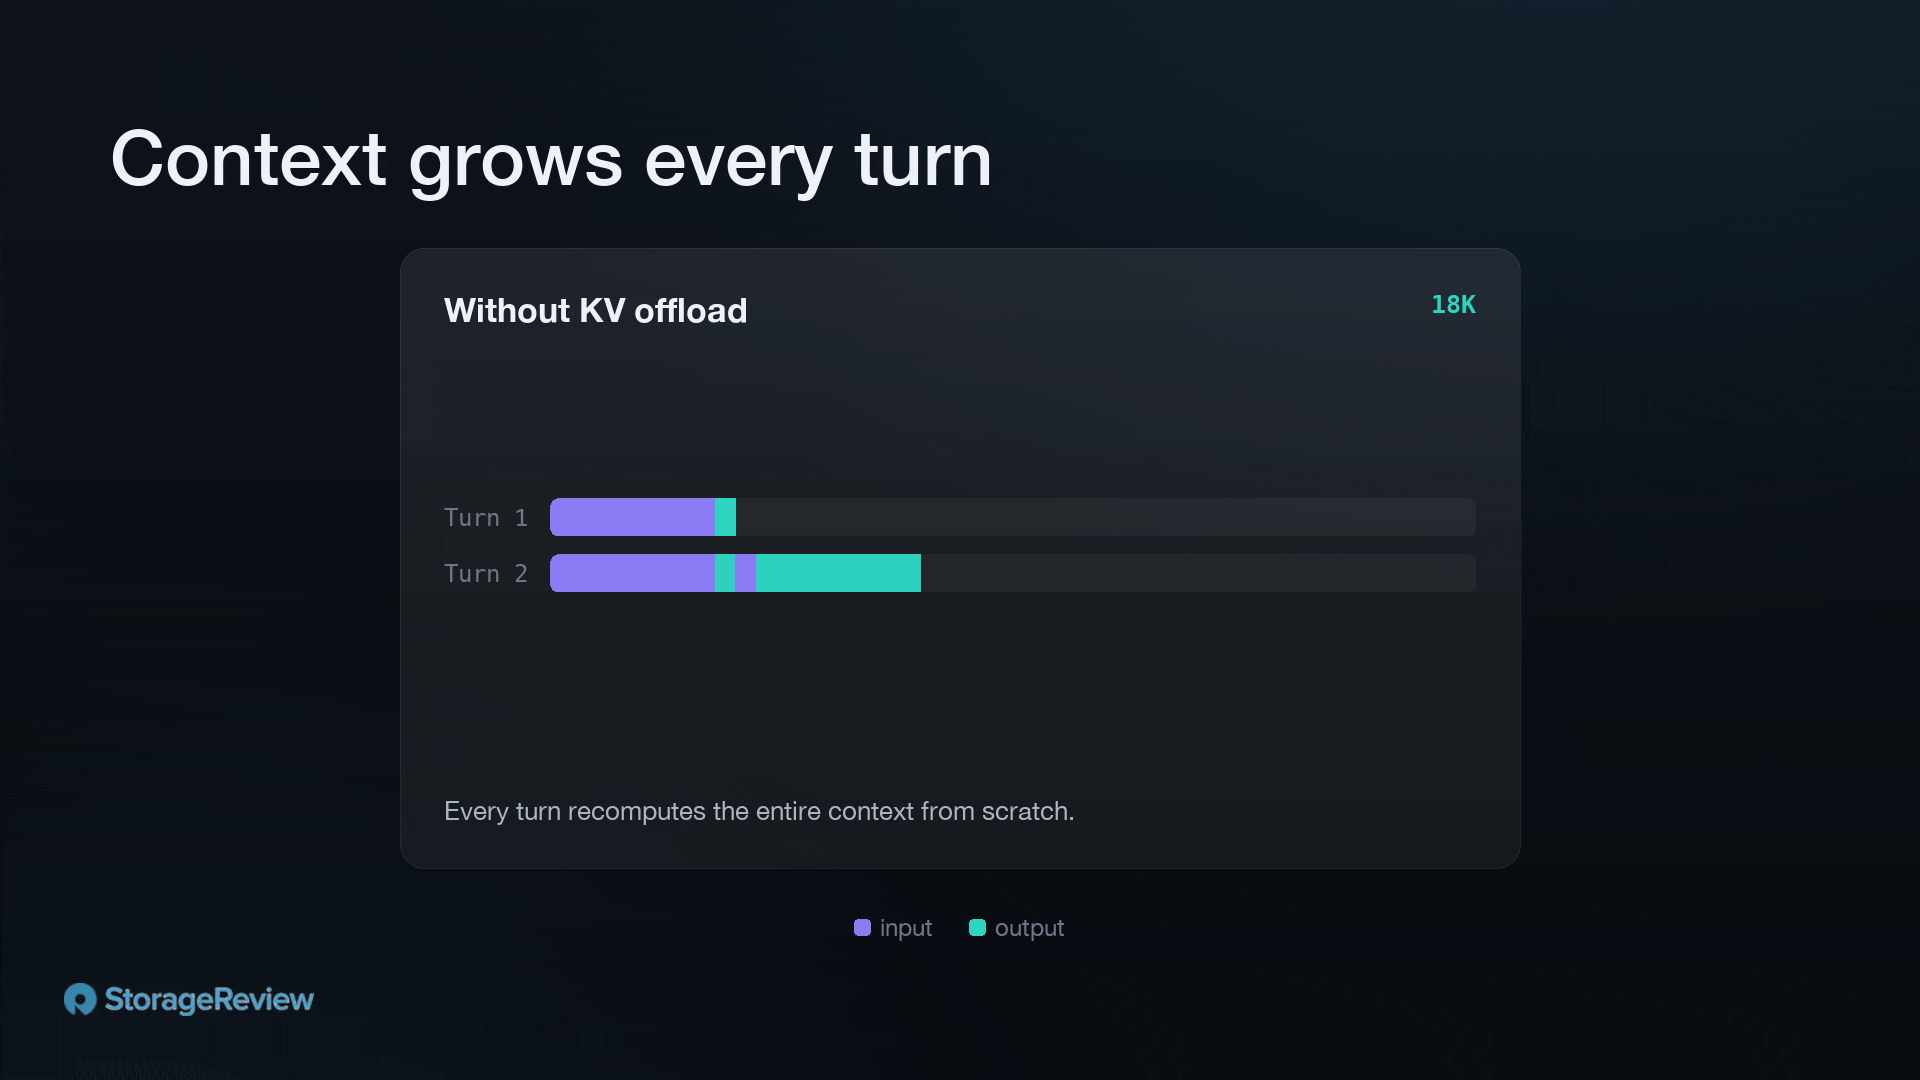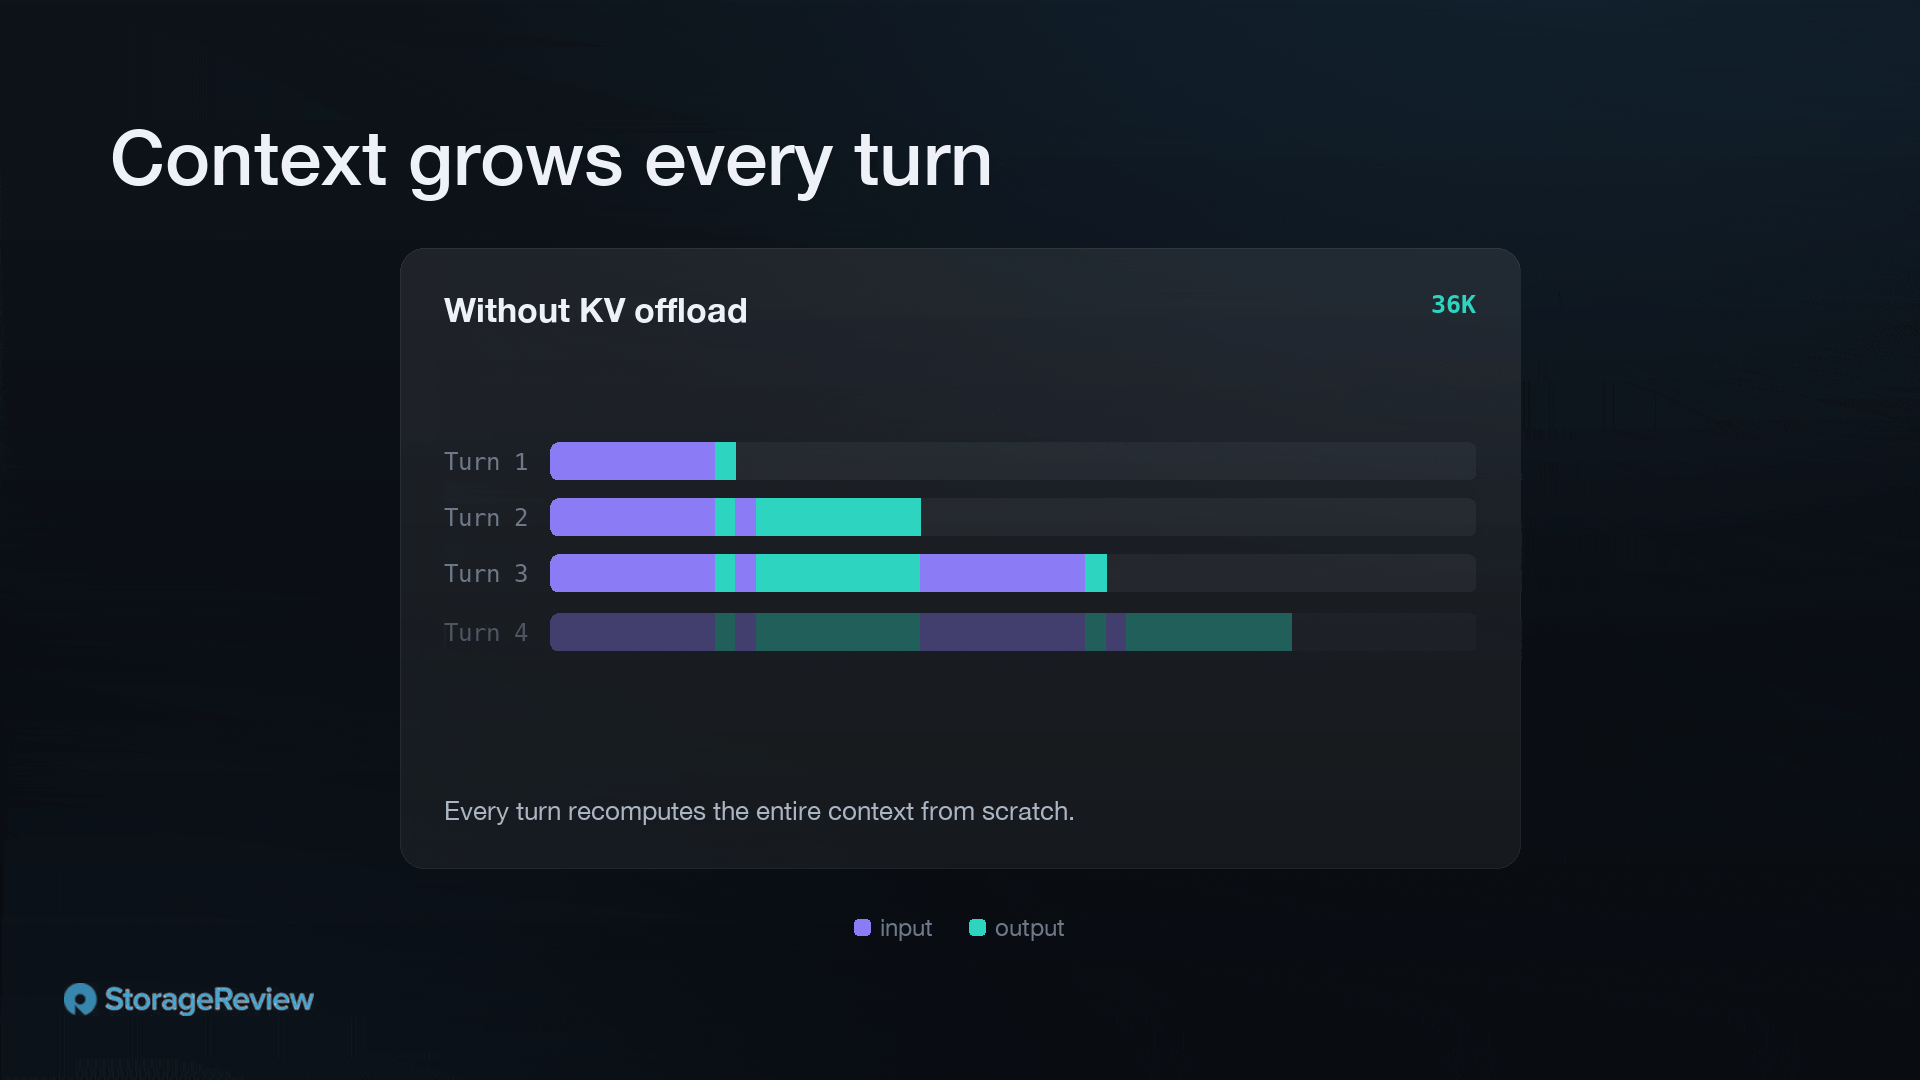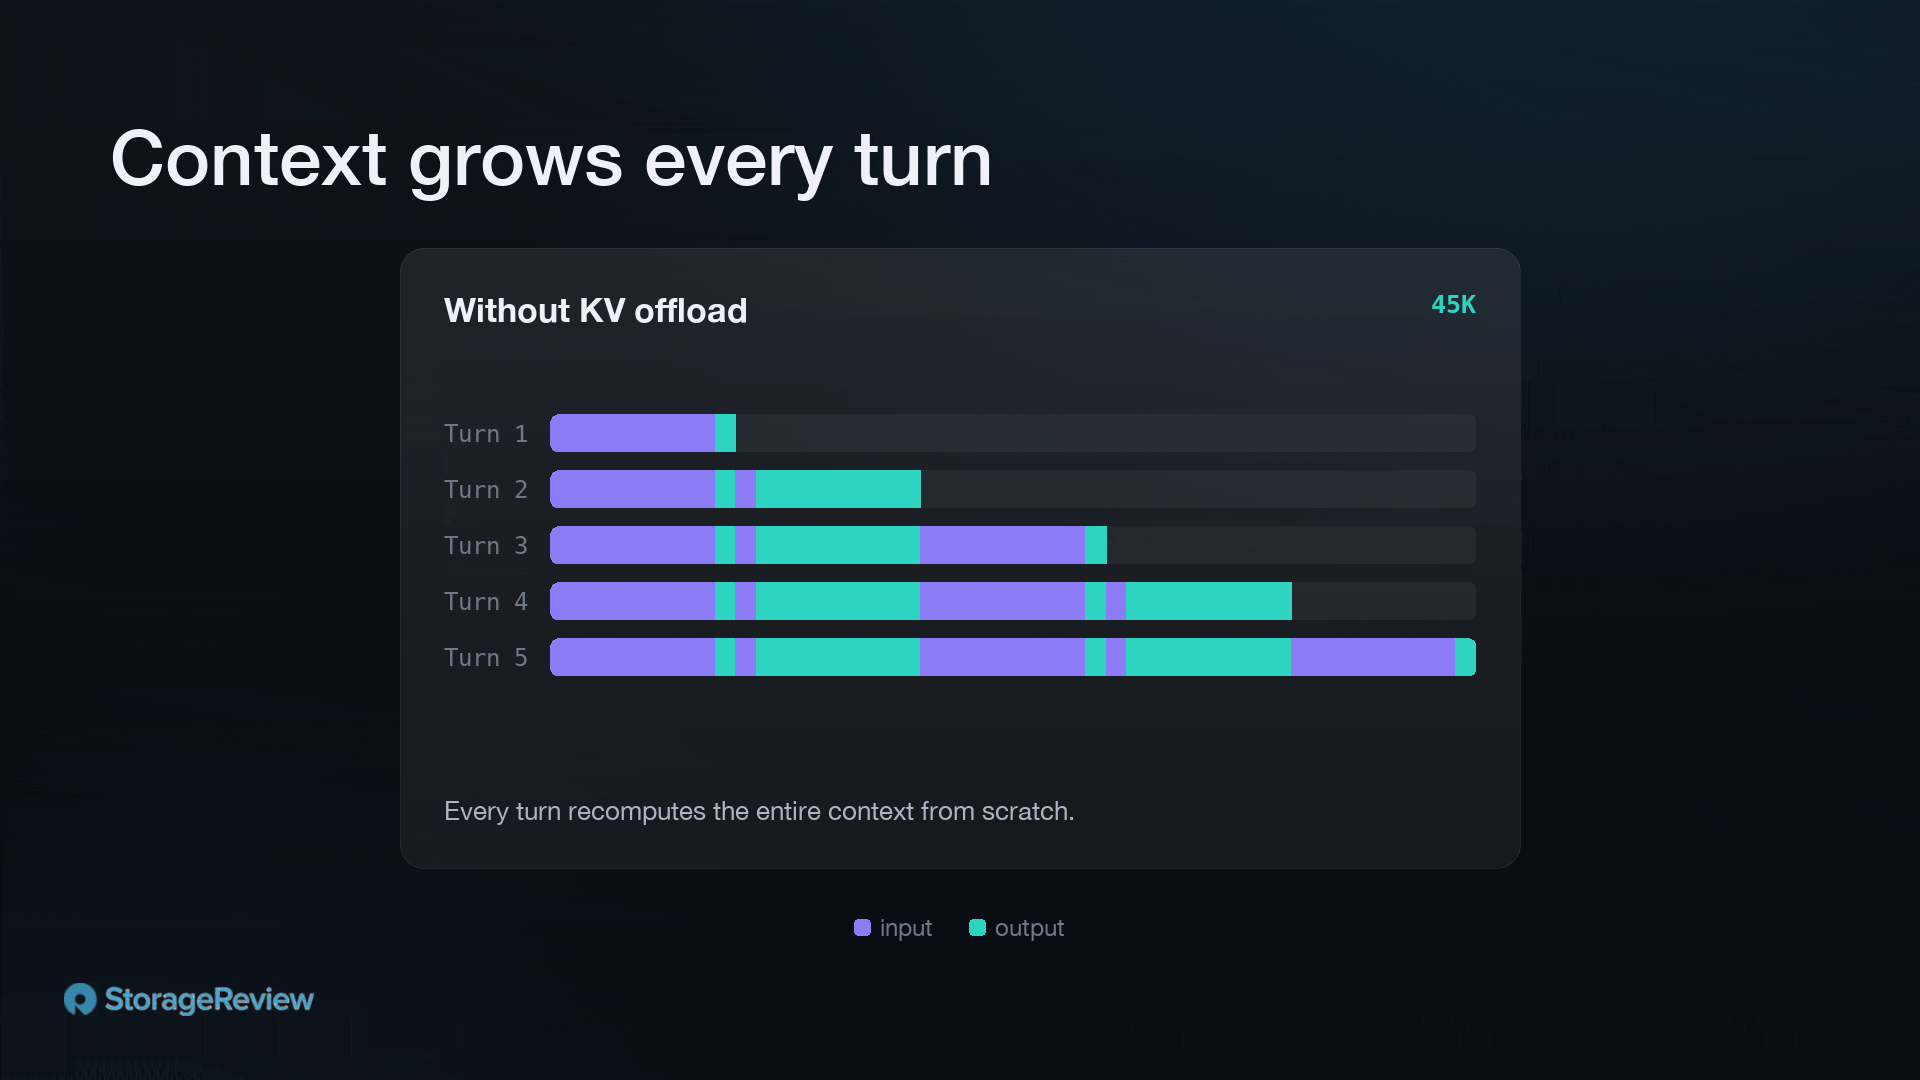
V ideálním světě byste každou odpověď odpověděli jednou a byli byste na tom. Modely ale zatím nejsou tak dobré, takže spouštíme agentní smyčky, v nichž se s uživatelem nebo mezi agenty přepínáme tam a zpět. Když přijde další tah, pokud jeho KV ještě není uložen v mezipaměti, engine znovu zpracuje celou dosavadní konverzaci včetně nových tokenů. Kontext každého předchozího tahu je znovu procházen modelem a výpočet, který GPU již na těchto tokenech provedl, je proplacen podruhé, potřetí a další výpočet pro každé další kolo. Tato část cvičení je naprosté plýtvání.
Jaké změny se mění při odkládání mezipaměti KV
Místo vyřazování v okamžiku, kdy se VRAM zaplní, funkce offload postupně přesouvá mezipaměti v hierarchii níže: z VRAM do systémové paměti a na SSD. Hot working set zůstává ve VRAM; položky, které se již nevejdou, jsou přesunuty do systémové paměti a pokud se systémová paměť zaplní, jsou znovu přesunuty na SSD nebo do síťového úložiště. Skutečné vyřazování je vzácné a je způsobeno spíše uživatelem nastavenou dobou trvání (TTL) než tlakem na paměť.
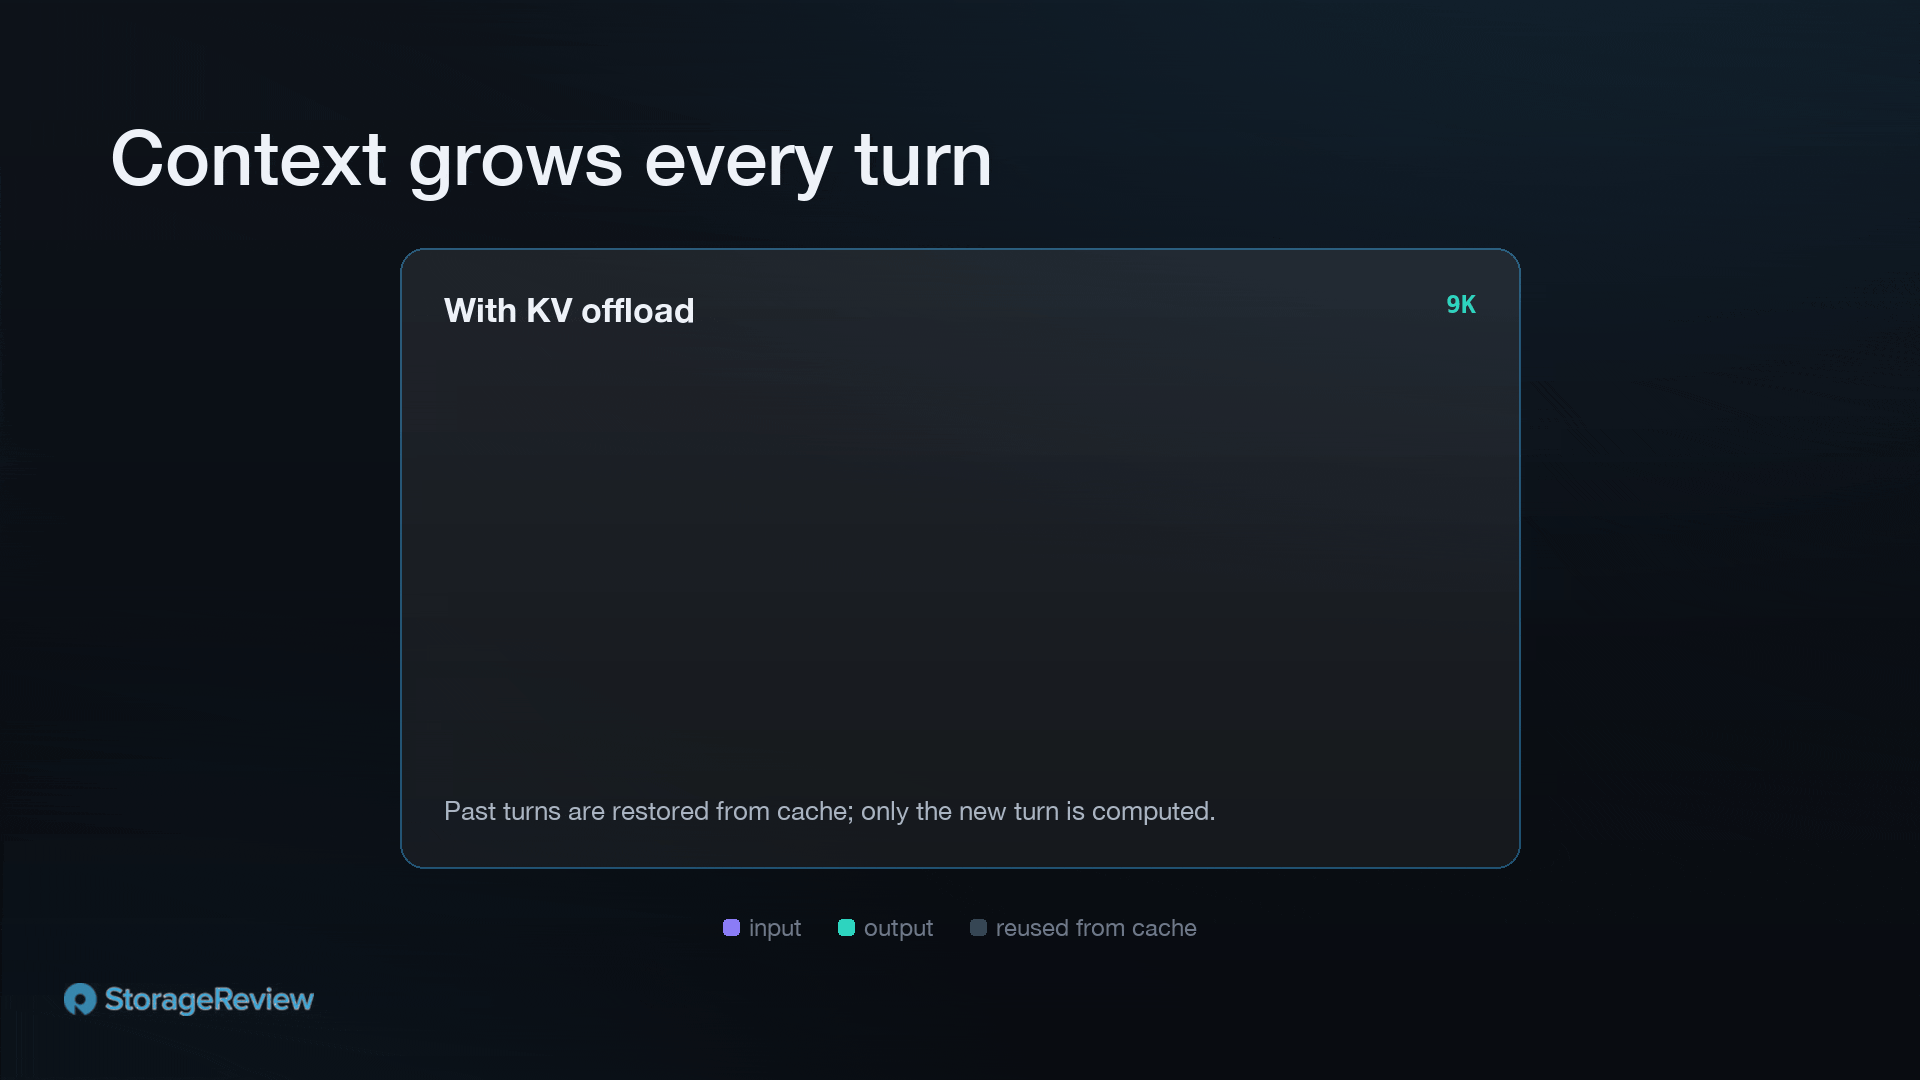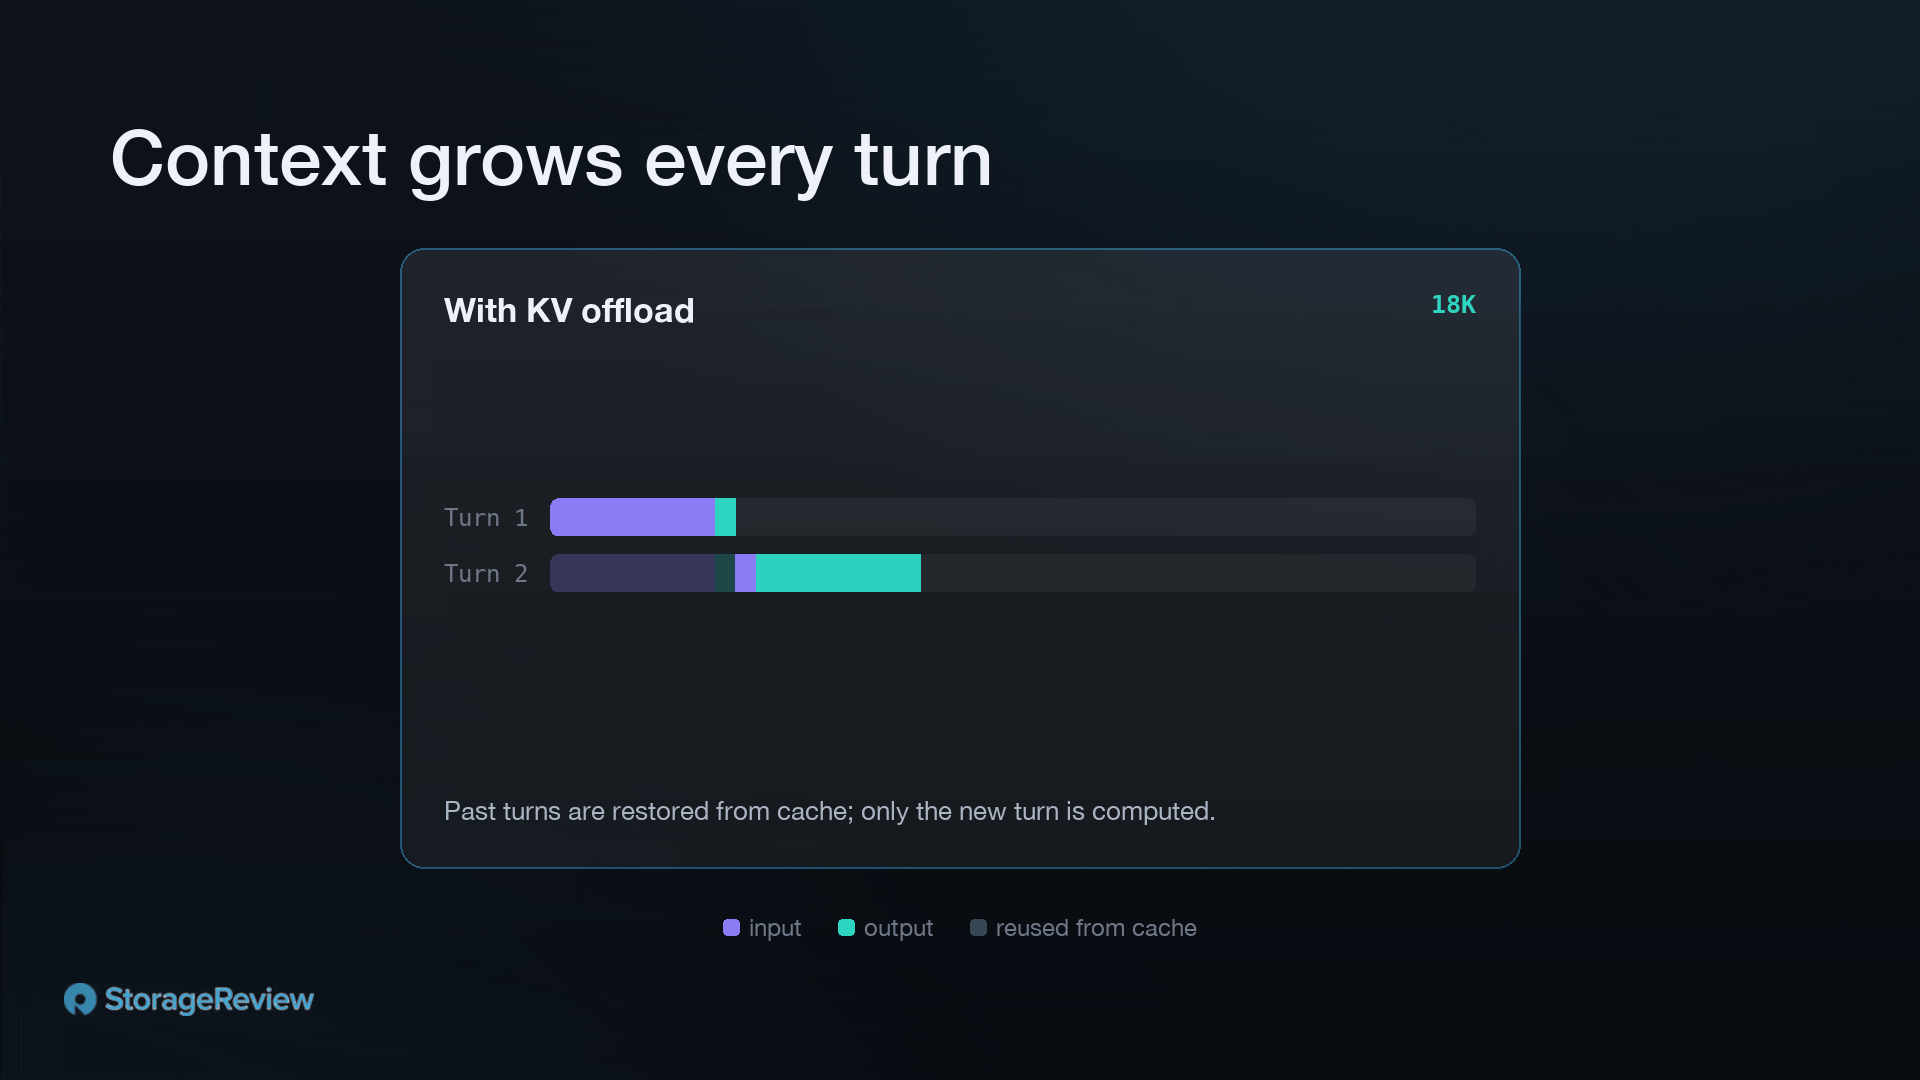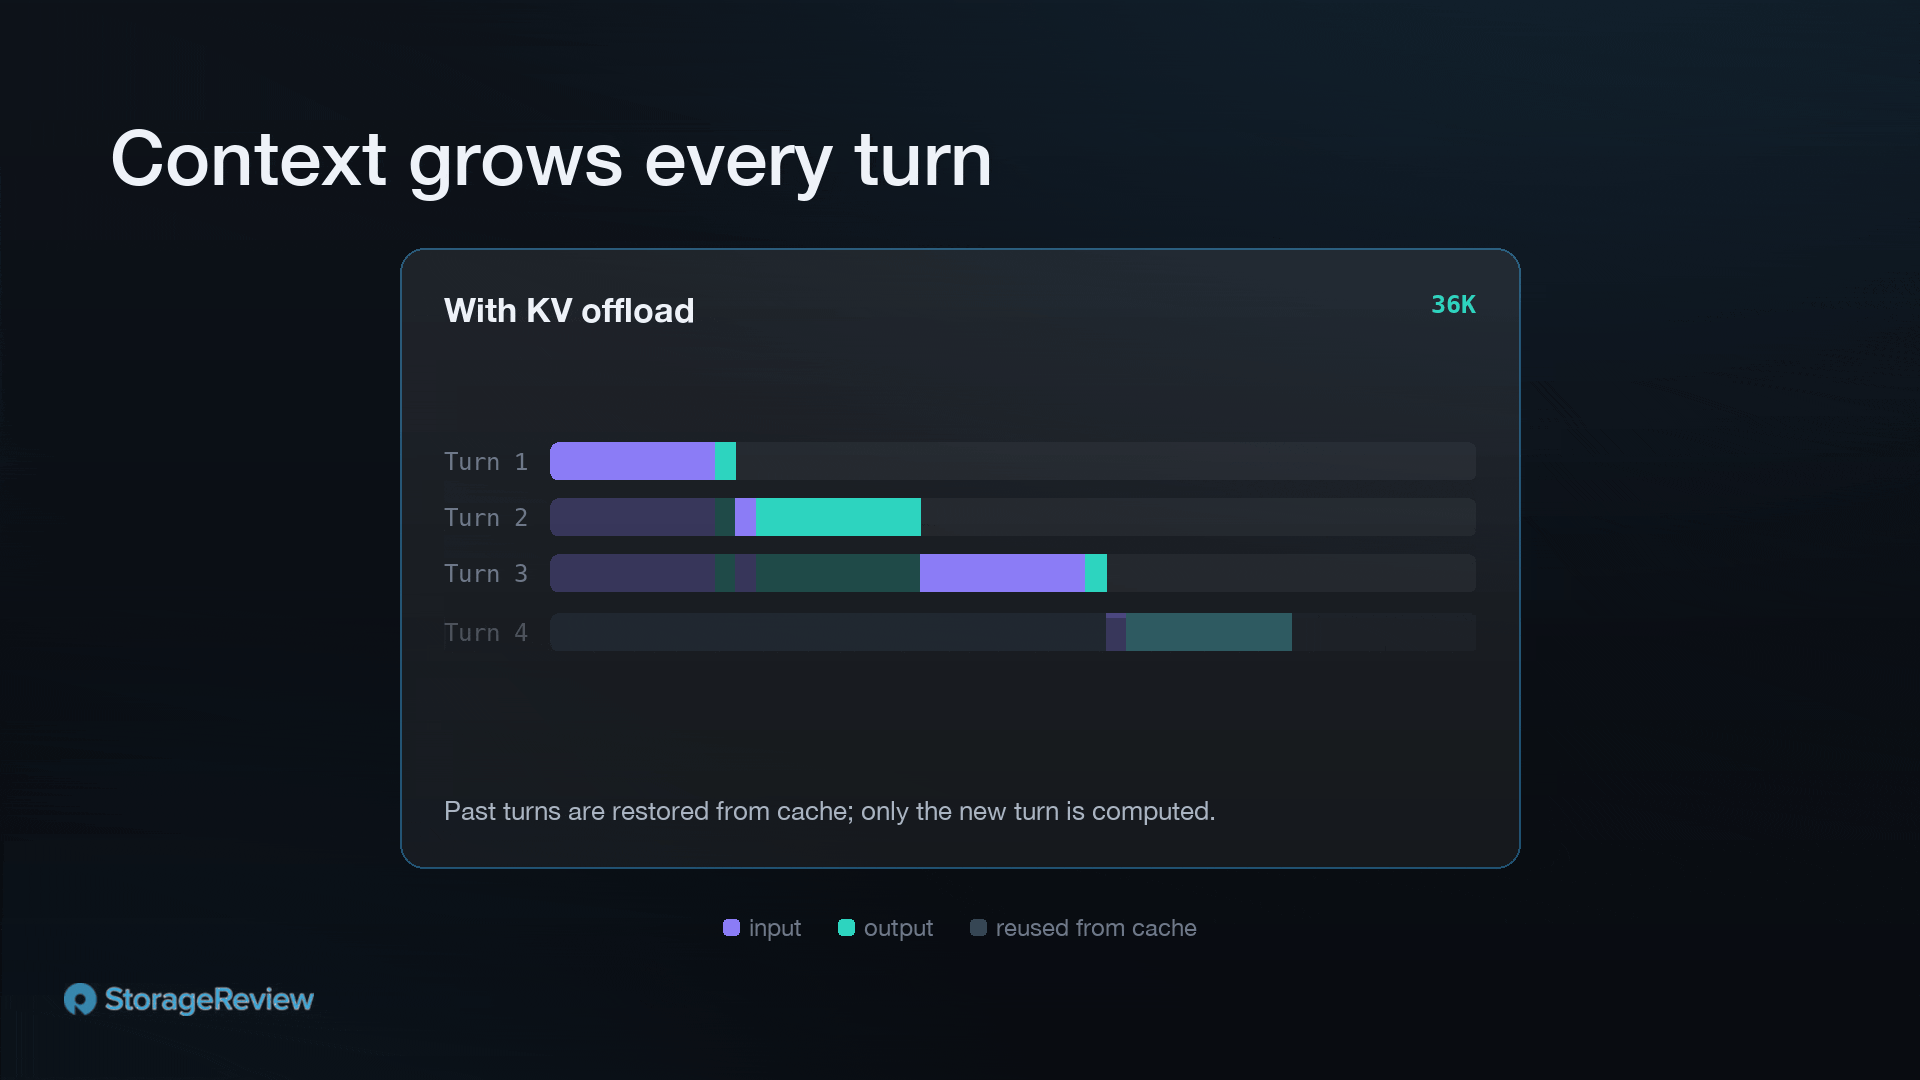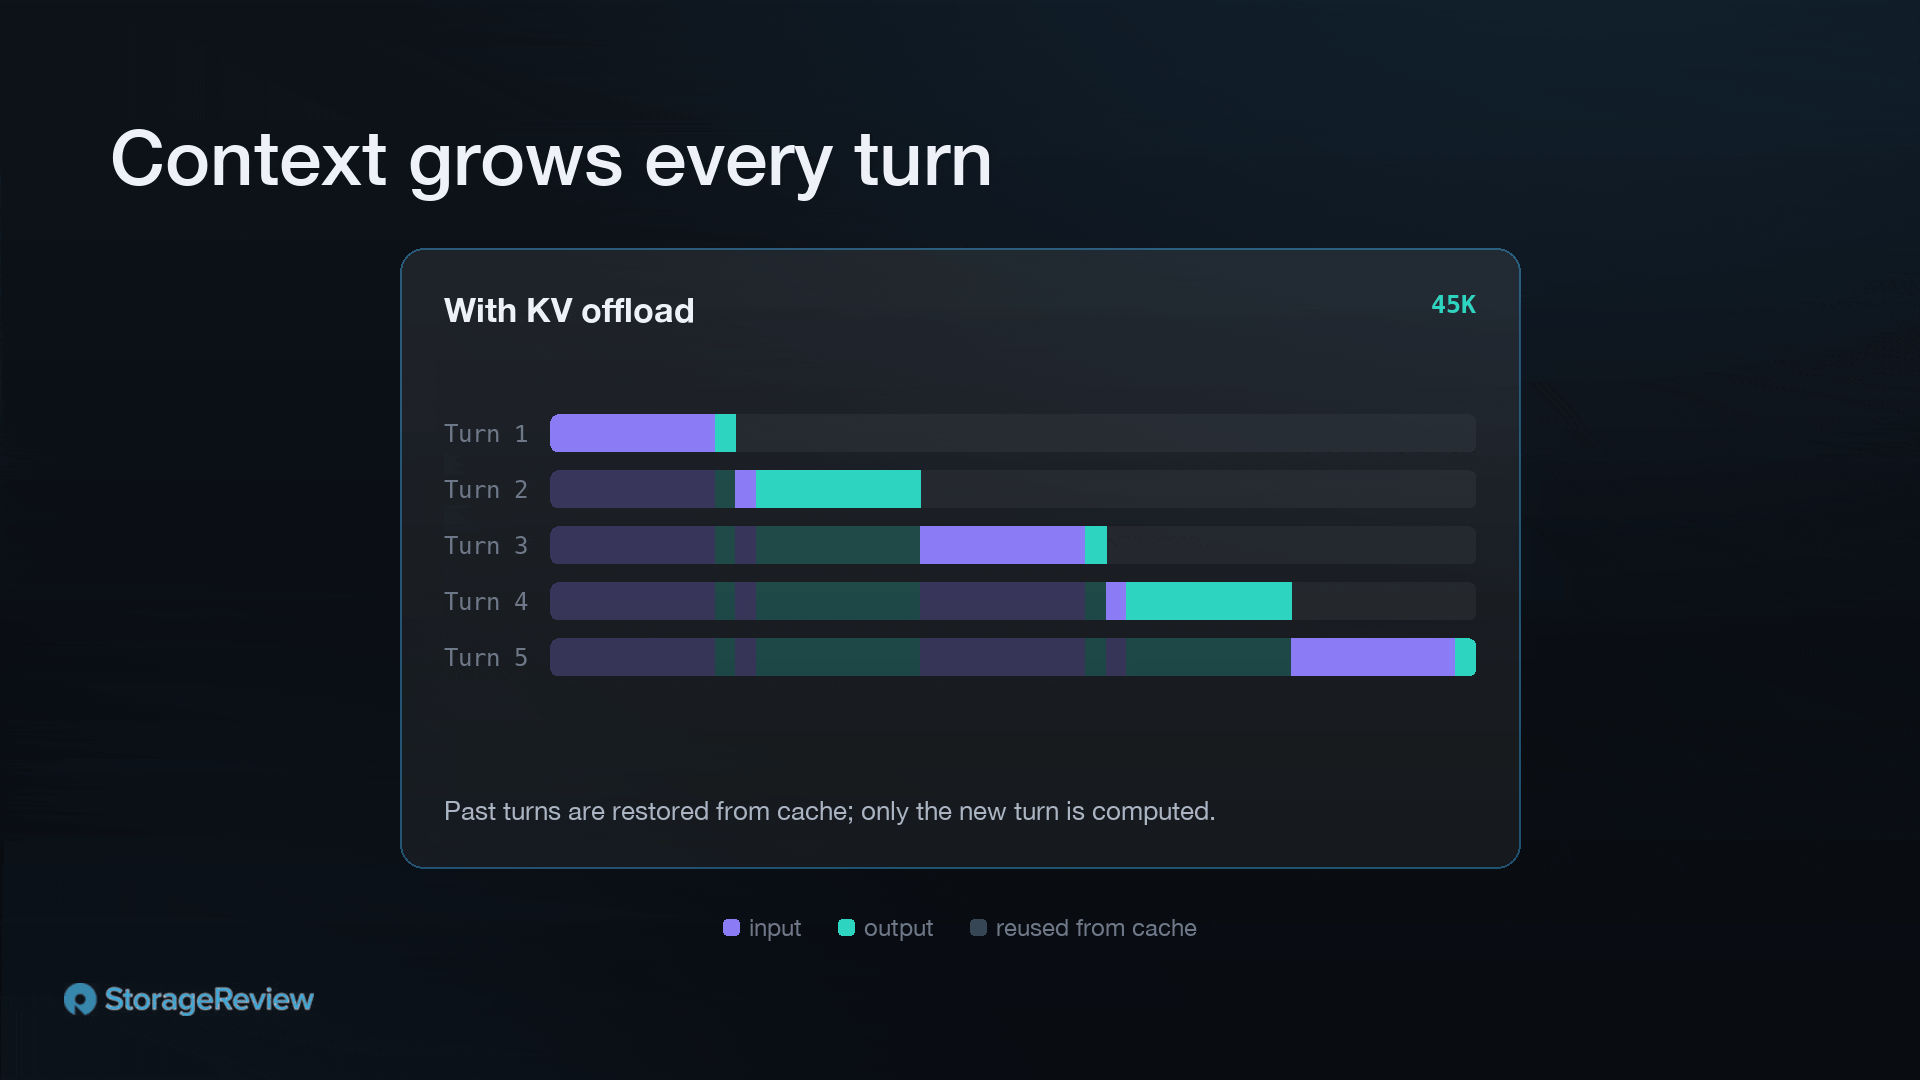
Když přijde další kolo, místo přepočítávání desítek tisíc tokenů kontextu načítáme KV zpět z RAM nebo flash úložiště. Opětovné načítání ze systémové paměti má sice malou penalizaci k latenci, ale je mnohem levnější a rychlejší než opakování předběžného naplnění. Opětovné načítání z NVMe je o něco pomalejší než načítání z DRAM, ale stále mnohem rychlejší než přepočet, který nahrazuje. Kapacita úložiště je relativně levná; výpočetní výkon GPU nikoli, takže výměna malé latence opětovného načítání na začátku kola za účelem přeskočení několikasekundového přepočtu je celkově pozitivní.
Jak jsme testovali
Toto jsme otestovali v naší laboratoři. Konfigurace systému byla následující:
- Server: Dell PowerEdge XE7740
- GPU: 4x NVIDIA RTX PRO 6000 Blackwell Server Edition (96 GB)
- Systémová paměť: 1 TB DDR5 (16 x 64 GB 5200 MT/s DDR5)
- Úložiště: 8x disků Solidigm PS1030 12.8 TB E3.S (RAID10)
- Servírovací stack: vLLM 0.22.0 s LMCache 0.5.0
- Model: MiniMax-M2.7
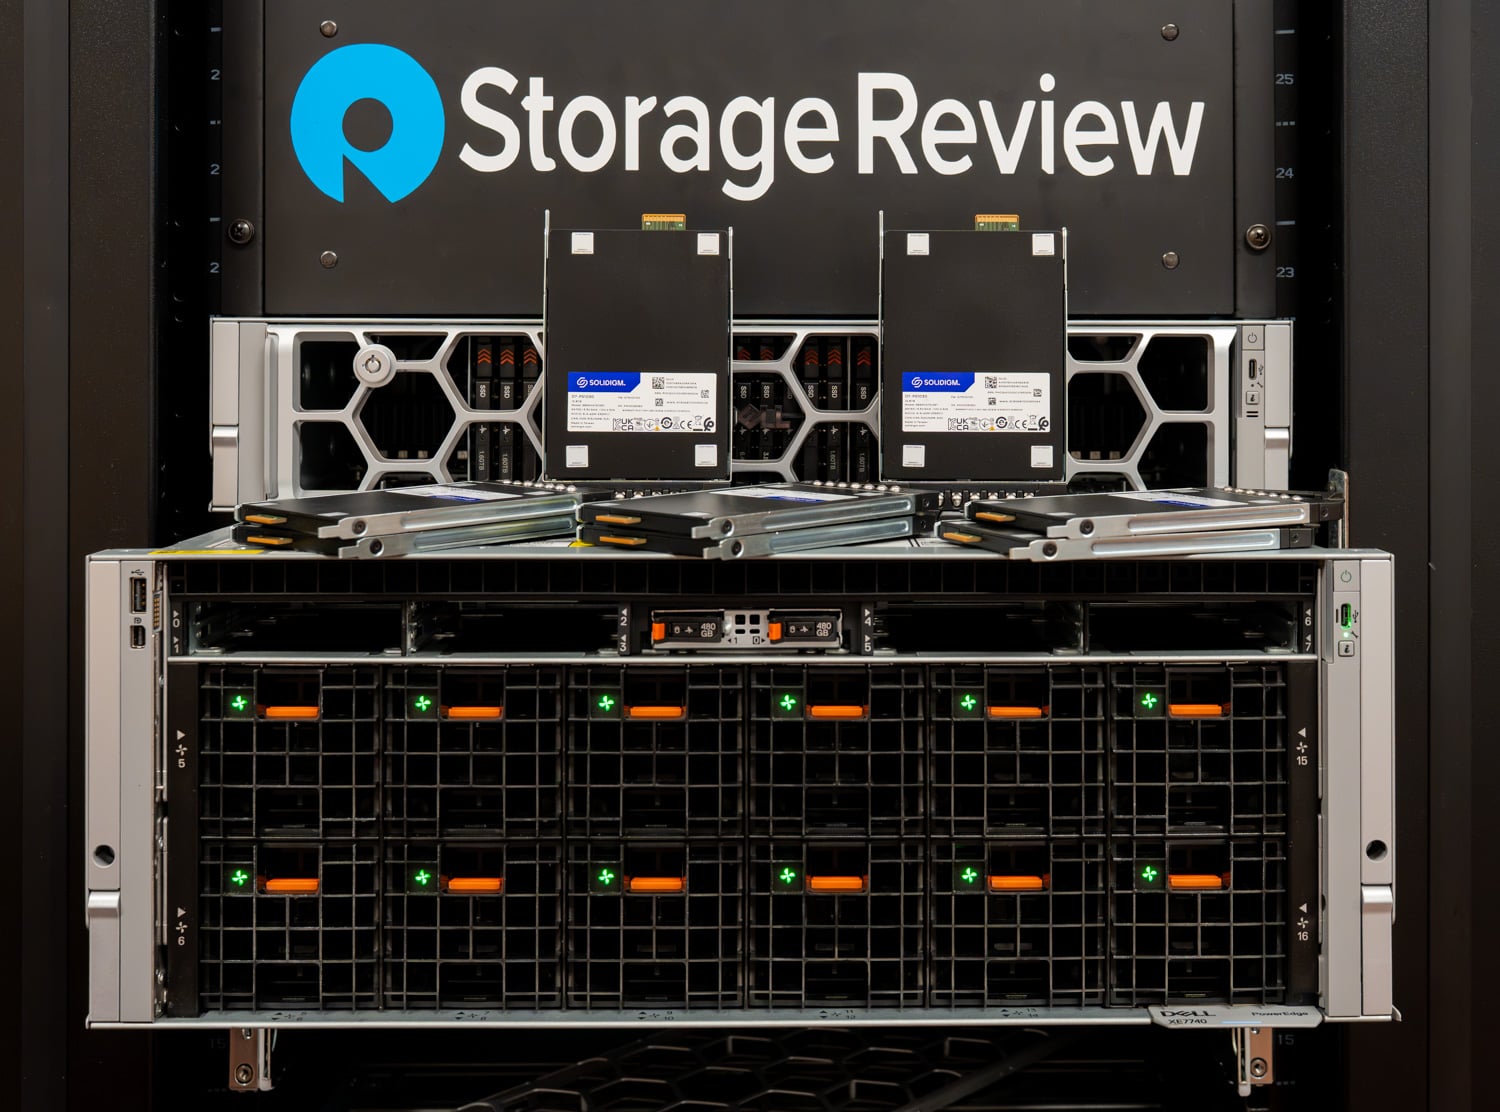
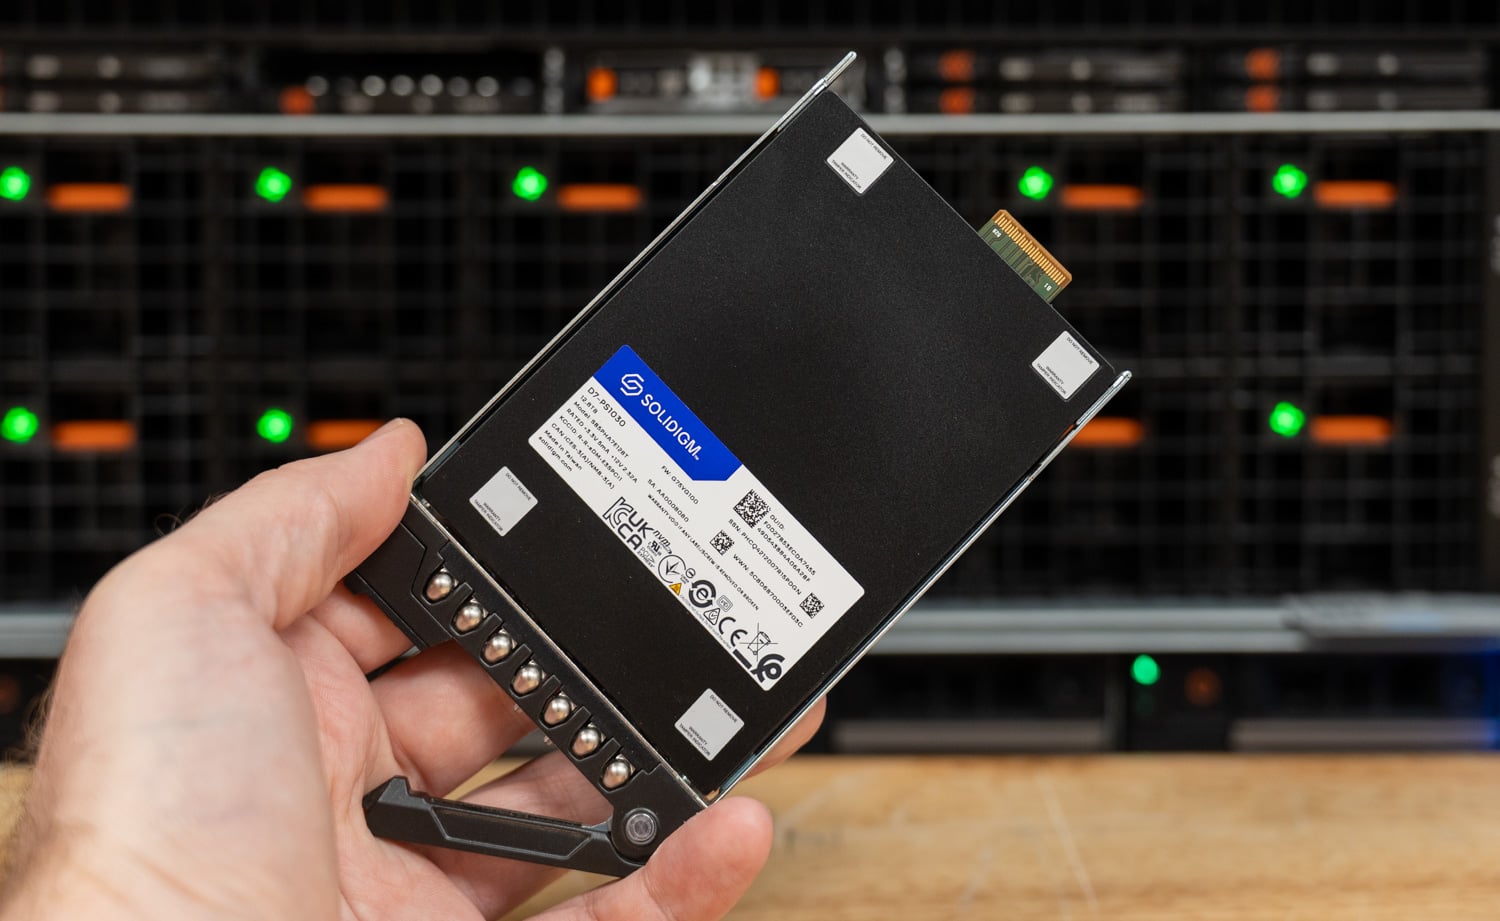
Testovací platforma se pro tuto pracovní zátěž perfektně hodí. Dell PowerEdge XE7740 je určen pro podnikové inference s využitím umělé inteligence, šasi PCIe Gen5, které podporuje až 8 grafických karet s dvojitou šířkou. Konfigurace se čtyřmi grafickými kartami, kterou jsme testovali, je jednou z nejoblíbenějších prodávaných konfigurací. Poskytuje dostatečnou kapacitu akcelerátoru pro širokou škálu inference a zároveň ponechává prostor v jednom boxu pro škálování až na osm karet s rostoucí poptávkou. Každá NVIDIA RTX PRO 6000 Blackwell Server Edition přispívá 96 GB paměti GDDR7, takže čtyři karty obslouží značný objem paměti VRAM, než jakákoli mezipaměť musí opustit GPU. Pod ní je umístěna vrstva offloadu s osmi 12.8TB disky Solidigm D7-PS1030 v RAID10, vysoce odolná flash paměť Gen5, která je vhodná pro trvalé zápisy, které generuje vrstva mezipaměti KV. A konečně, zvolený model MiniMax-M2.7 byl v době testování jedním z nejlepších modelů s otevřeným kódováním, které se hodily do naší konfigurace se čtyřmi grafickými kartami.
Testovali jsme tři konfigurace:
- Základní verze VRAM, standardní vLLM bez odlehčení zátěže, kde vše, co se vejde do VRAM, je uloženo v mezipaměti a vše ostatní je vyřazeno.
- Přesun LMCache do systémové paměti s alokací 512 GB pro přesun.
- Přesun LMCache do flash paměti s lokálním polem RAID10 NVMe jako vrstvou pro přesun, v čele s 64GB RAM staging bufferem.
Pracovní zátěž jsme modelovali na reálném agentním kódovacím provozu, spíše než na fixním syntetickém prefixovém sweepování. Tento provoz je zaměřen na předvyplňování a na dekódování s rozsáhlým opětovným použitím prefixů. Relace přicházejí jako Poissonův proces s frekvencí λ = 2.5 relace za minutu. Každá relace probíhá v několika kolech. V každém kole model přijímá krátké doplnění, obvykle výsledek nástroje nebo příkazu o 250 až 600 tokenech a občas čtení souboru o 1 500 až 3 500 tokenech. Odpovídá krátkou odpovědí, obvykle 40 až 200 tokeny volání nástrojů nebo stručného zdůvodnění a občas blokem kódu o 400 až 900 tokenech. Délky tahů jsou chvěny o ±100 tokenů. Relace monotónně rostou směrem ke stropu kontextu 64 kB tokenů, což je řadí do režimu hlubokého kontextu, kde pracovní sada přerůstá VRAM. Stejná nastartovaná zátěž pohání všechny tři úrovně, každá s 3minutovým zahříváním mezipaměti.
Rychlá poznámka ke konfiguraci paměti: XE7740 byl v dodávce vybaven 2 TB paměti DDR5, což je špičková sestava určená pro pokrytí řady projektů a cena před zavedením pamětí v roce 2026 dělala z takového množství DRAM velmi odlišnou položku. Původní konfigurace byla nadměrně specifikována ve srovnání s tím, co by si organizace dnes objednala se čtyřmi grafickými kartami, takže abychom to udělali realističtější, odstranili jsme 1 TB paměti a ponechali jeden DIMM na kanál, abychom zachovali maximální propustnost paměti.
Jedna metodologická poznámka k flash paměti: běhy využívaly lokální diskový backend LMCache s požadovaným 64GB RAM staging bufferem před polem. Objem KV uchovávaný na flash paměti v průběhu běhu výrazně překročil celkovou DRAM hostitele, takže trvalé výsledky odrážejí spíše obsluhu disku než paměť hostitele.
Výkon
Propustnost při zatížení
Celková propustnost obsluhy za běh, jakmile pracovní sada KV překročí kapacitu jednotlivých vrstev:
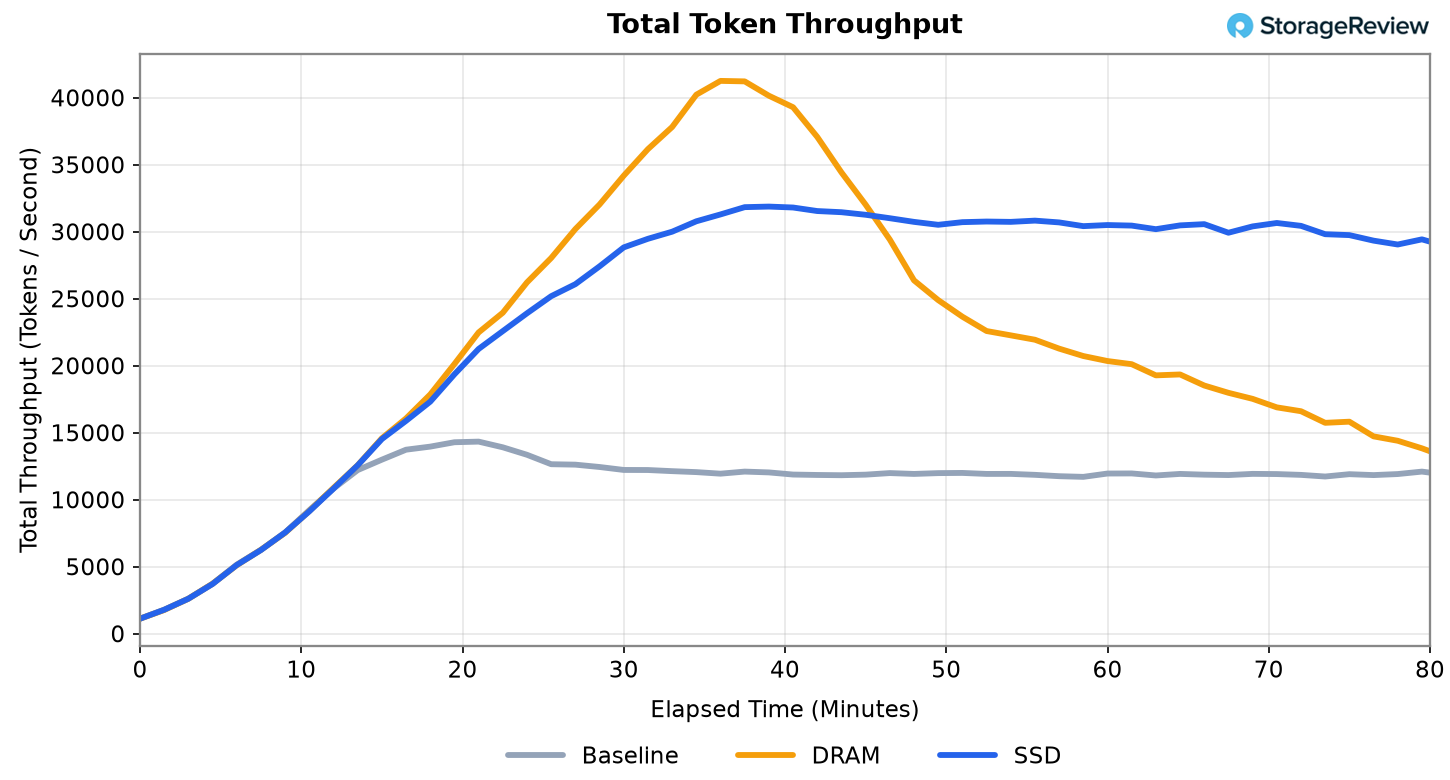
Každá úroveň se během prvních 10 minut, zatímco se mezipaměti stále plní, navyšuje společně, v podstatě bez rozdílu ve výkonu. Poté, jak se paměťové úrovně plní, se oddělují. Základní režim pouze s VRAM se nejprve zastaví: jakmile se VRAM nasytí, ustálí se na přibližně 12 000 tokenech za sekundu. Každá nová relace vymaže starší a vytlačená mezipaměť musí být po návratu dané relace znovu vybudována od nuly, takže větší část každé sekundy jde na opětovné přednaplnění a menší na dekódování.
Úrovně DRAM a SSD tuto plató stále překračují, protože dokud se jejich mezipaměti nenaplní, obsluhují téměř každý prefix z paměti nebo disku, místo aby jej přepočítávaly. Čas, který základní linie spotřebovává při opětovném naplnění, se místo toho věnuje generování nových tokenů.
Ve vrcholné fázi dosahovalo offload až 2.9násobku celkové propustnosti základní úrovně na úrovni DRAM (+188 %) a 2.2násobku na úrovni flash (+122 %). Než pracovní sada přeroste VRAM, všechny tři konfigurace se od sebe dostanou do vzdálenosti jednoho procenta. Nic se nevyřazuje, takže offload nemá co obnovit. Výhoda se projeví pouze tehdy, když tlak na paměť vynutí vyřazování, a roste s mírou, do jaké je server zatížen.
Argumenty pro větší vrstvu se projeví, jakmile se DRAM zaplní. Při tomto zatížení se 512GB RAM cache nasytí zhruba po 45 minutách běhu a od té chvíle musí začít s jejím vyhazováním. Vracející se prefixy minou a znovu se přednaplní, což je přesně ten přepočet, kterému se měla cache vyhnout. Vrstva SSD s terabajty rezervy nikdy nenarazí na tuto hranici. Za hranicí překročení zvládne flash paměť celkem přibližně 30 000 tokenů za sekundu, ve srovnání se zhruba 17 000 tokeny u DRAM, což představuje 75% výhodu v propustnosti pro SSD, jakmile dojde RAM. Jinými slovy, po saturaci vrstva DRAM dosáhla pouze 42 % své maximální propustnosti, zatímco vrstva SSD dosáhla 94 %. Toto je žebříček kapacity, na kterém se celé cvičení spouští: VRAM dojde jako první, vrstva 512 GB DRAM dojde později a vrstva úložiště měřená v terabajtech spíše než v gigabajtech se ve skutečnosti nikdy nevyčerpá, takže kontext zůstává poskytován dlouho poté, co jej rychlejší úrovně musely začít vyhazovat.
Jedna výhrada k čtení tohoto čísla celkové propustnosti: desítky tisíc tokenů za sekundu, které uvádí, nepředstavují rychlost, s jakou GPU tokeny počítají; z velké části se jedná o rychlost obsluhy úrovně odlehčení. Celková propustnost počítá každý vstupní token předběžného naplnění a každý výstupní dekódovací token, který každý požadavek nese. Ale s nainstalovanou mezipamětí zásah načte KV prefixu zpět z DRAM nebo flash paměti, místo aby jej znovu předběžně naplnil na GPU.
Omezení počtu na výstupní tokeny, tedy na tu část propustnosti, na kterou uživatel skutečně čeká, poskytuje jasnější obrázek:
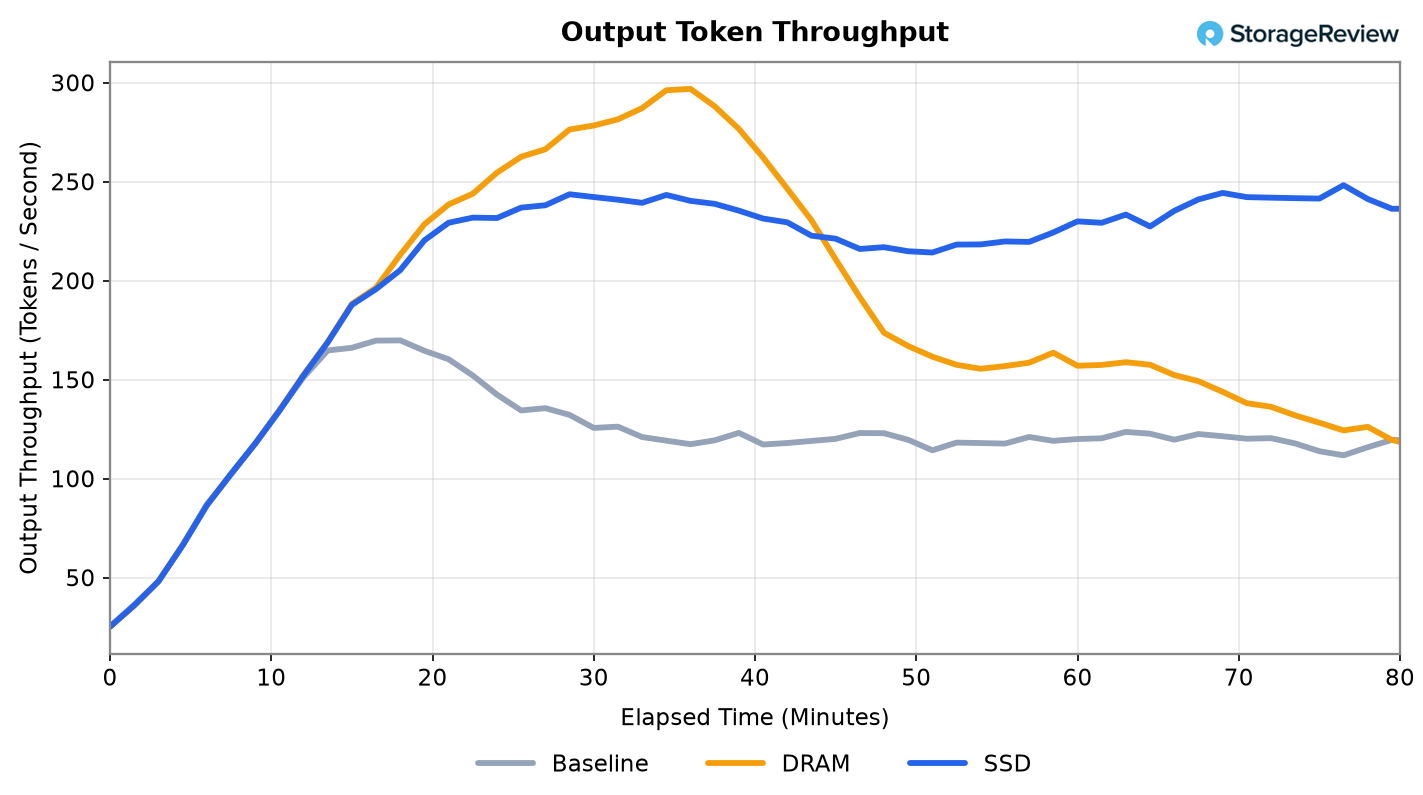
U výstupních tokenů se tři úrovně opět při plnění mezipamětí shodují a poté se v místě křížení rozdělují. Vrstva DRAM dosahuje vrcholu kolem 300 tokenů za sekundu, což je o 75 % více než základní úroveň, a klesá zpět, jakmile začne docházet k jejich vyprazdňování; flash paměť se po zbytek běhu drží kolem 250 tokenů, což je o 46 % více než základní úroveň. Linky RAM a SSD zůstávají zhruba o 10 % vzdálené od sebe, dokud se DRAM nenasytí; poté se mezera zvětšuje.
Latence prvního tokenu: Na co uživatel čeká
Propustnost měří agregovanou produkci tokenů. Doba do prvního tokenu měří, co vidí jednotlivý uživatel: dobu čekání od stisknutí tlačítka Odeslat do doby, než se první token vrátí. Vykreslujeme ji v průběhu běhu, v mediánu, jak pracovní sada roste a každá úroveň se plní.
Dokud jsou mezipaměti v mezipaměti, všechny tři úrovně vrátí první token přibližně za půl sekundy. Poté se rozcházejí ve stejném pořadí, v jakém se rozcházela jejich propustnost. Základní linie se láme jako první: na začátku běhu překročí 10 sekund, zatímco vrstva DRAM zůstává pod 1sekundovým TTFT mnohem déle, dokud se jejích 512 GB nezaplní kolem 45minutové hranice. Poté se její latence snižuje, jakmile začne vyřazovat a přepočítávat. Vrstva SSD degraduje nejpomaleji a v druhé polovině běhu má nejnižší latenci ze všech tří.
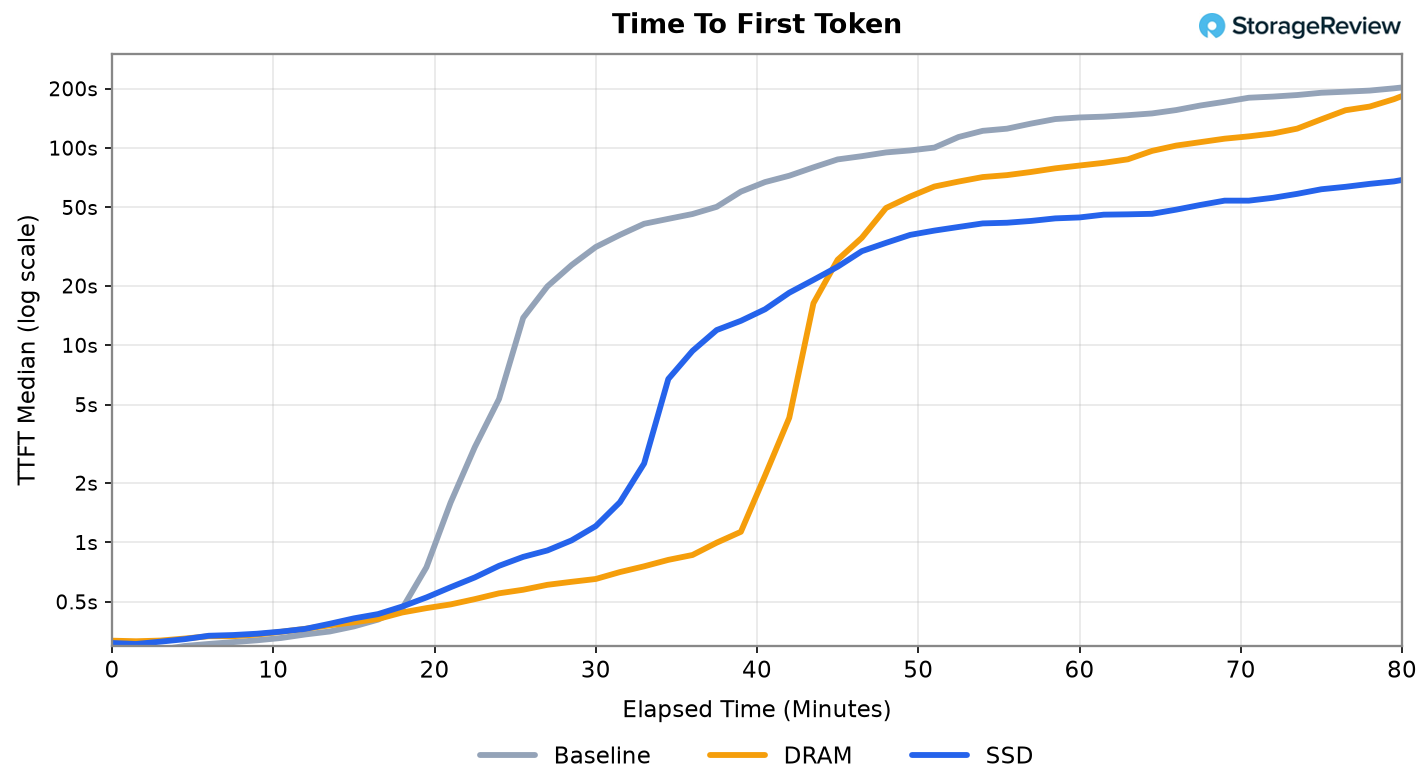
Toto otočení je argumentem vrstvení v malém měřítku. DRAM vítězí v latenci, pokud se pracovní sada do této vrstvy vejde; flash vítězí v latenci, když se jí nevejde, protože stále uchovává kontext, který vrstva DRAM začala zahazovat.
Problém vracejících se uživatelů
Výše uvedené hodnoty latence pokrývají tahy v rámci nepřetržité relace. Případ vracejícího se uživatele je jiný: relace se pozastaví uprostřed konverzace, je nečinná asi patnáct minut a poté pokračuje tam, kde skončila. Modelovali jsme ji s kohortou, která se po zhruba 20 tazích přepnula do nečinnosti a byla oživena o 15 minut později, což je dostatečně dlouho na to, aby zaneprázdněný server mezitím procházel ostatní provoz svými mezipaměťmi. Jedenáct takových oživení dopadlo v rámci měřicího okna každé úrovně a protože pracovní zátěž je na všech úrovních rozdělena identicky, stejných jedenáct relací se oživilo v každém běhu, což poskytuje srovnání tahu obnovení. Níže uvedený graf znázorňuje medián času prvního tokenu pro každou úroveň v normálním tahu oproti tahu obnovení, přičemž vous označuje nejhorší obnovení ve vzorku.
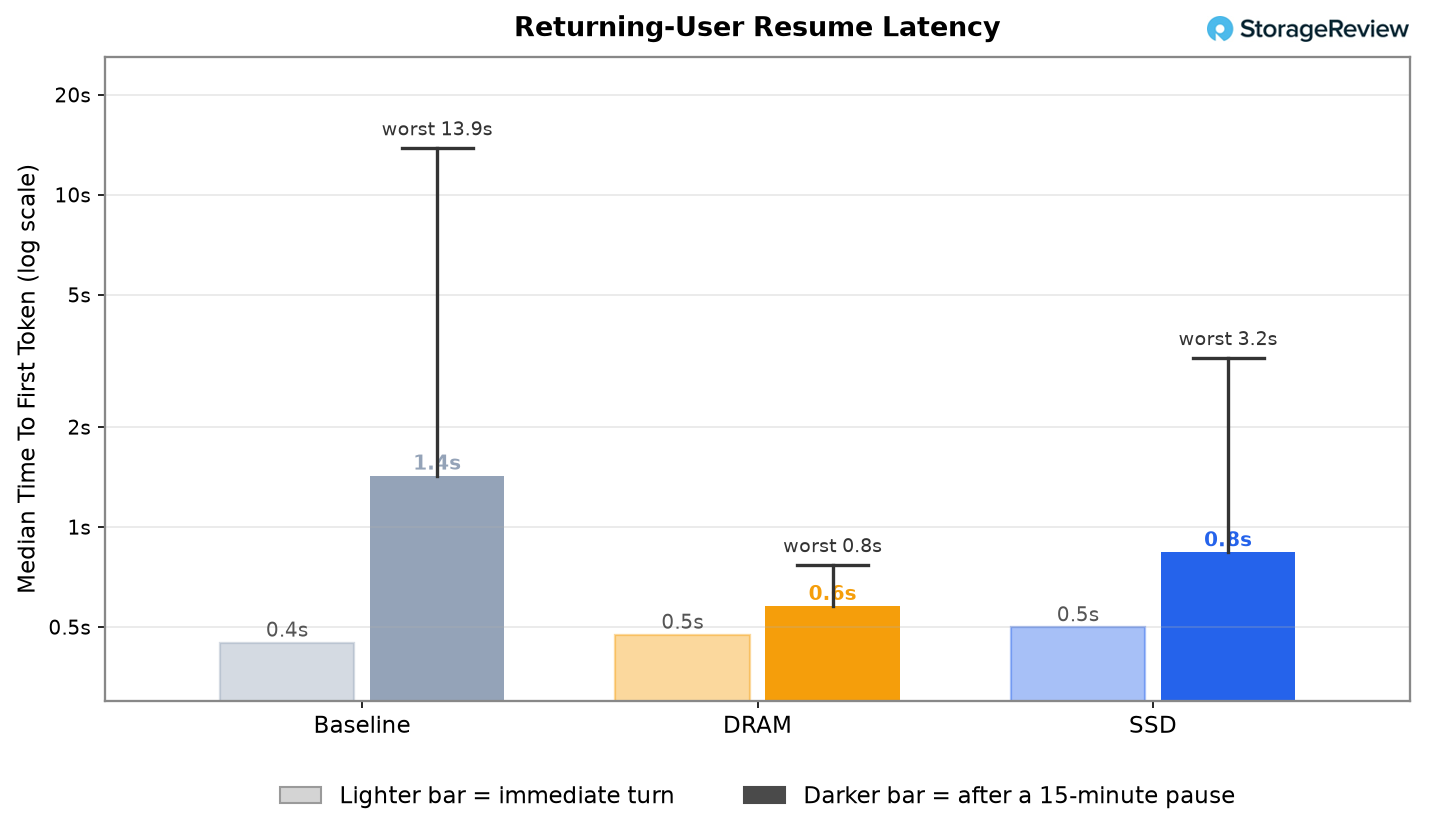
V mediánu čísla pouze potvrzují to, co předpovídají mechaniky, a úrovně se nacházejí v očekávaném pořadí. DRAM vede: nečinná relace se obnoví za 0.6 sekundy, což je sotva více než 0.5 sekundy, které trvá normální kolo. SSD je druhý s 0.8 sekundami; víme, že načítání NVMe je pomalejší než načítání DRAM, a to je částečně to, co zde prochází. Základní hodnota pouze s VRAM je nejpomalejší s 1.4 sekundami; protože nebylo kam uvolnit paměť, prefix nečinné relace byl z paměti GPU odstraněn pro živý provoz a první kolo zpět ho musí znovu vypočítat. V nejlepším případě je celý rozptyl jen asi sekunda.
Nejlepší případ není ten, kde se volba provádí. Nejhorší z jedenácti oživení v každé úrovni je: 0.8 sekundy na DRAM, 3.2 sekundy na SSD a 13.9 sekundy na základní úrovni. Zda je čtrnáctisekundové čekání na první token tolerovatelné, nebo se jedná o tvrdé porušení SLO, závisí na službě, ale u čehokoli interaktivního je to druhá možnost a pouze úrovně odlehčení udržují tuto dobu čekání v rámci hranice, kterou uživatel vydrží. Rozšiřuje se také v kontextu, protože náklady na přepočet se škálují s tím, kolik historie si vracející se uživatel nashromáždil: v hlubších kontextech testu propustnosti sahá základní doba čekání hluboko za 14 sekund, zatímco DRAM a SSD stále podléhají pouze omezenému opětovnému načítání.
Výběr a dimenzování KV cache
Obě úrovně odlehčení překonávají základní úroveň pouze VRAM s velkým náskokem a cestou k ní se umístily blízko sebe. Rozdíl je malý, protože zisk v propustnosti spočívá pouze v uvolnění VRAM a stejné množství se uvolní, ať už se uvolněná mezipaměť dostane do DRAM nebo na SSD. Propustnosti nezáleží na tom, ze které úrovně se mezipaměť vrátila. Latenci záleží, protože načítání DRAM je rychlejší než načítání NVMe, ale obě jsou levné ve srovnání s přepočítáním stejné KV od nuly.
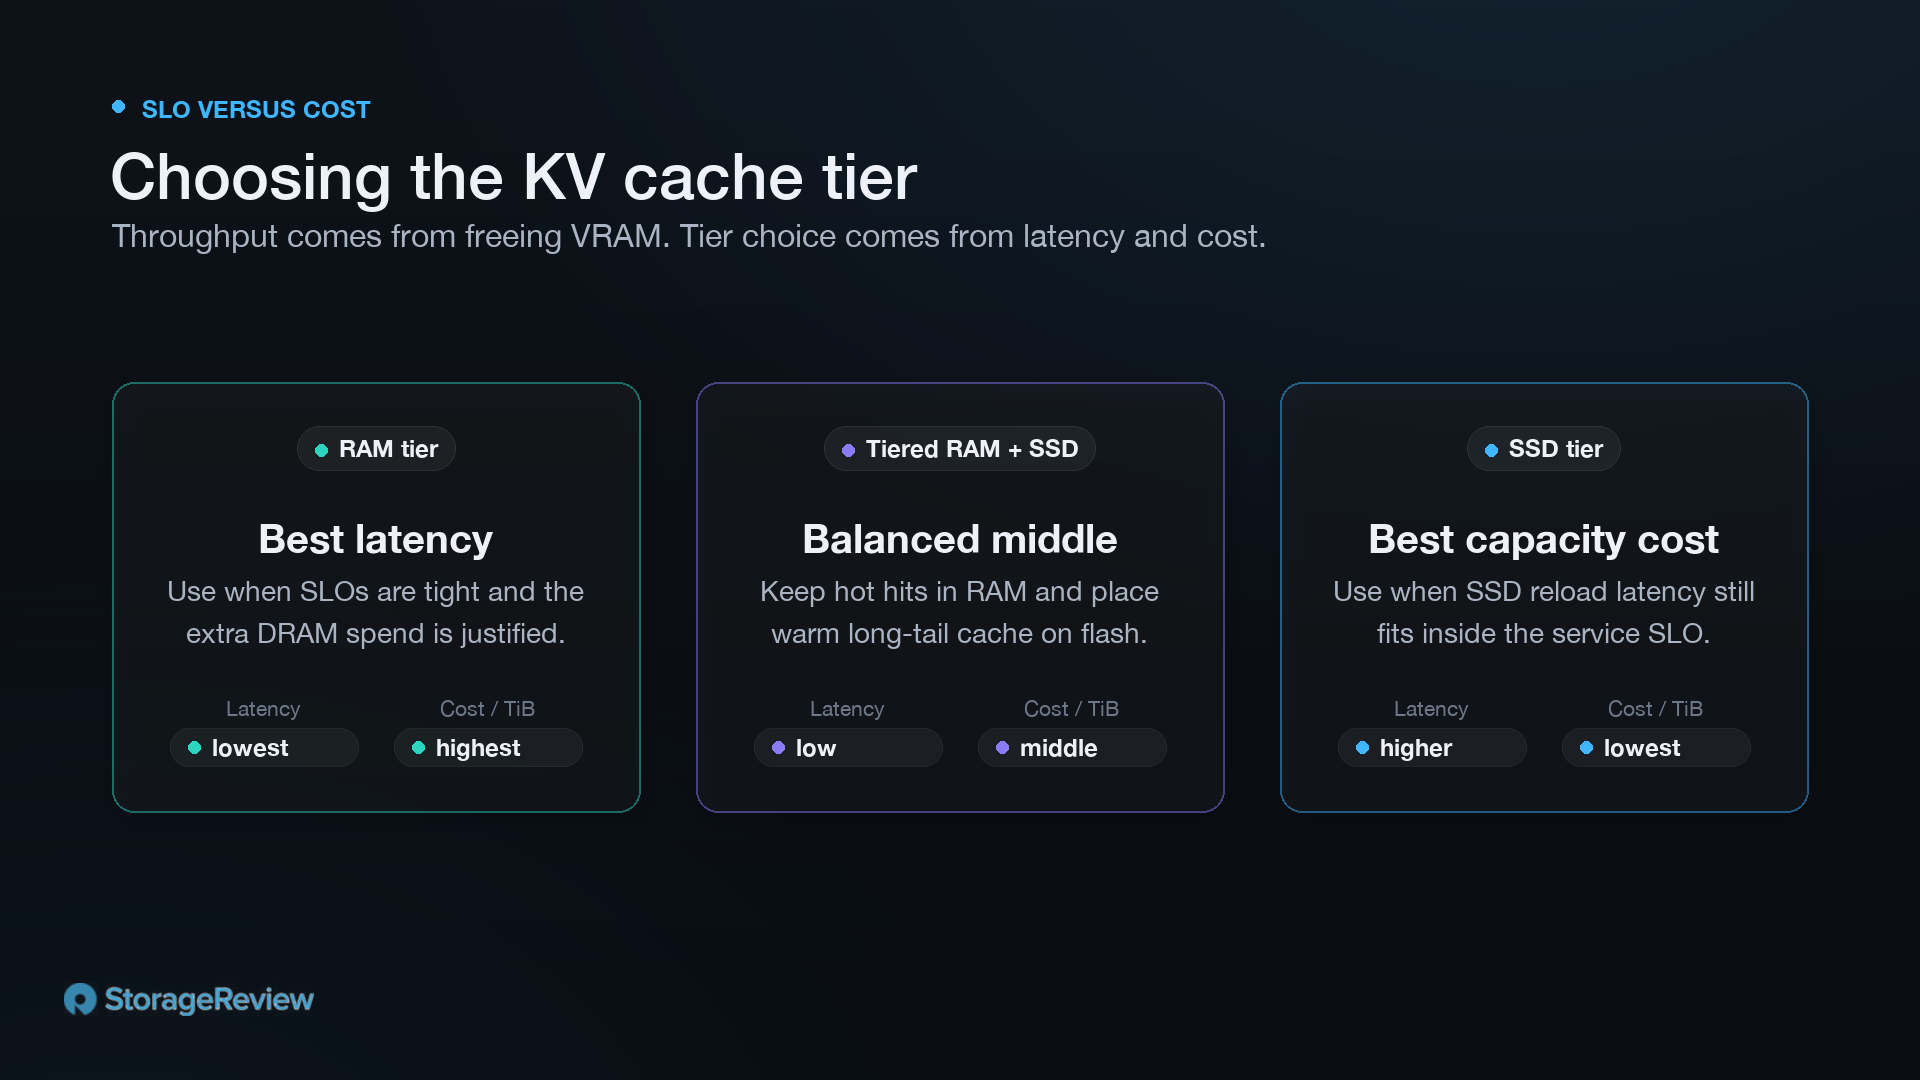
Volba mezi těmito dvěma možnostmi je kompromisem mezi SLO a náklady, který závisí na tom, co operátor optimalizuje. Uchovávání celé vytížené mezipaměti v paměti RAM sice přináší nejlepší latenci, ale představuje to velké kapitálové náklady za relativně malé zvýšení latence oproti flash paměti. Vrstvení je střední cestou: menší vrstva paměti RAM, která absorbuje kritické zásahy z hlediska latence tam, kde jsou důležité, s úložnou vrstvou za ní, která obsahuje teplejší dlouhodobé mezipaměti, které se nemusí vracet během několika set milisekund.
Dalším způsobem, jak uvažovat o KV mezipamětech, je jejich velikost. Velikost úložné vrstvy se omezuje na maximální propustnost tokenů, kterou může dané nastavení unést. Objem KV, který si systém musí udržet, je propustnost vynásobená TTL položek mezipaměti. Každý vytvořený token zapíše položku KV, takže matematika je prostě rychlost, s jakou tokeny dorazí, vynásobená dobou jejich uchování. Dvě výchozí hodnoty TTL v produkčním prostředí jsou pět minut a jedna hodina.
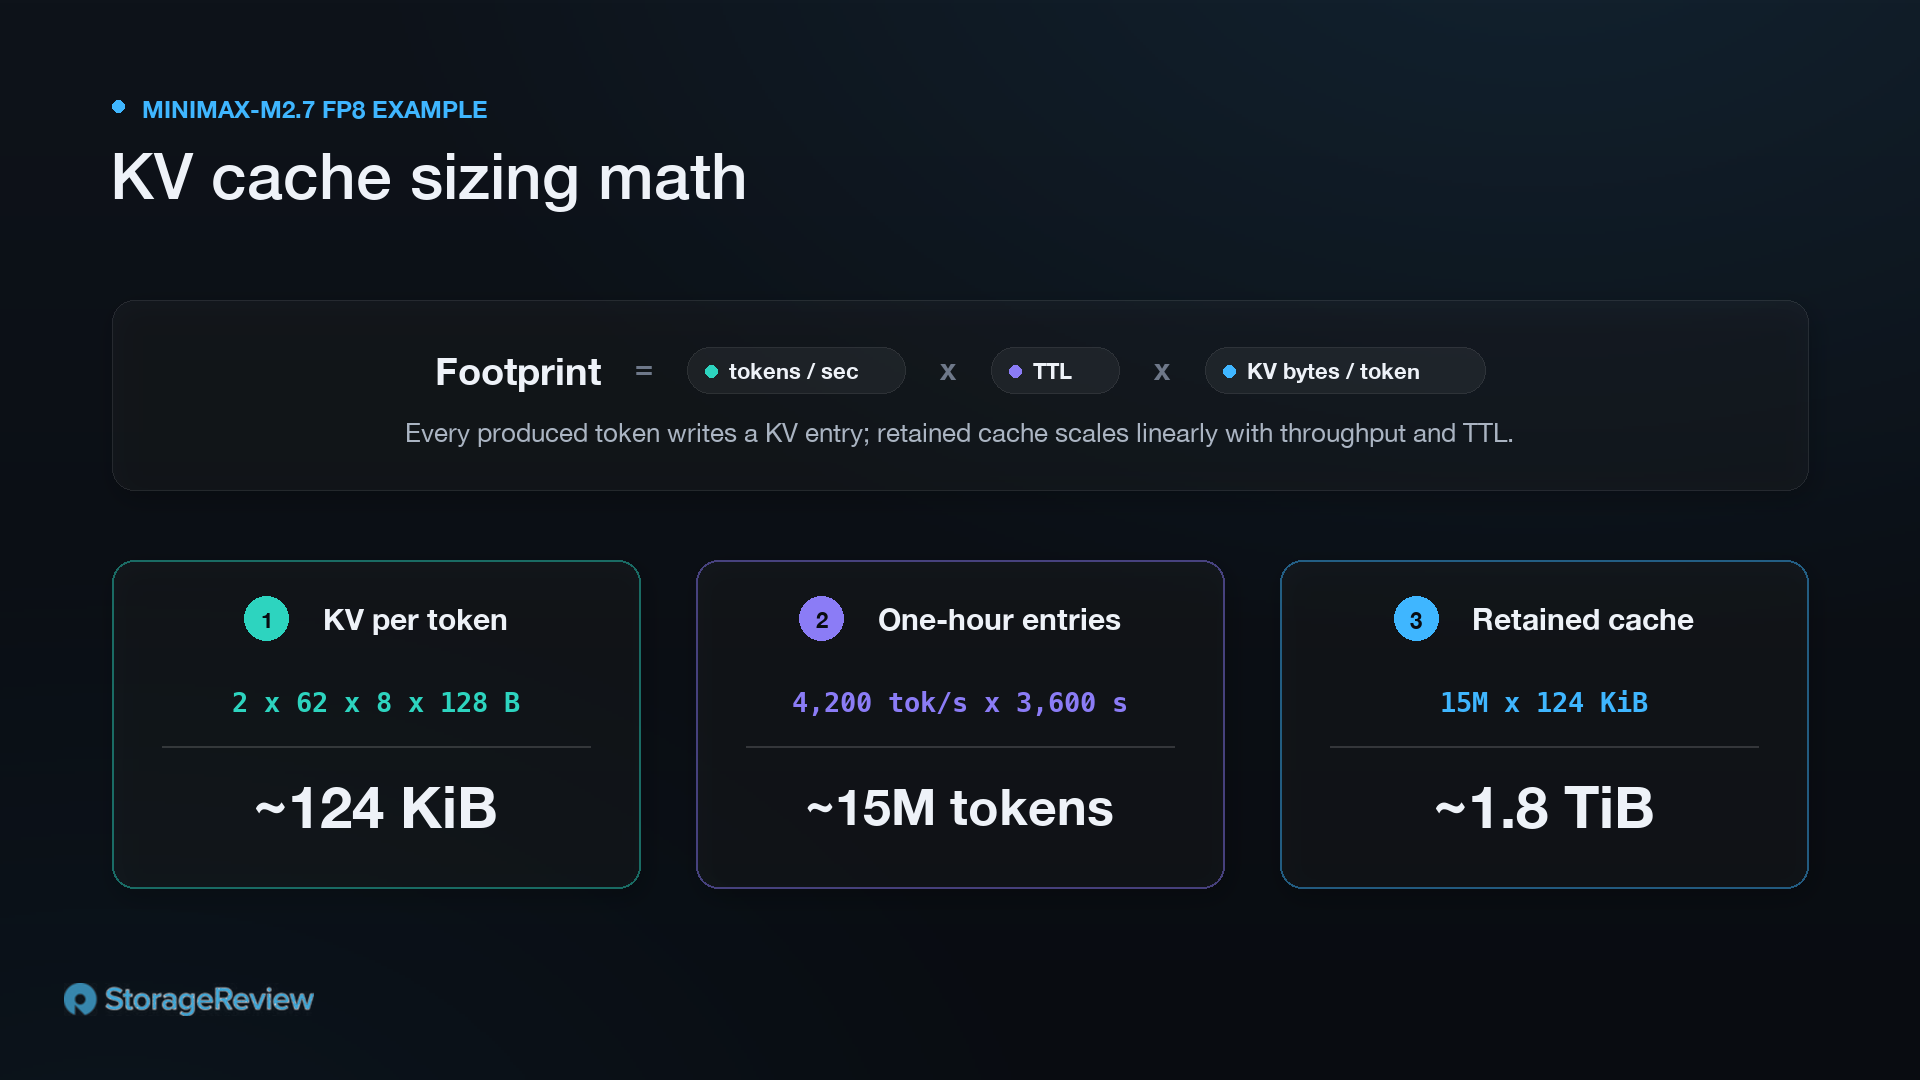
Vypočítáme velikost mezipaměti KV pro MiniMax-M2.7 v FP8, jak je zde testováno. Při jednom bajtu na prvek KV je položka na token 2 × 62 × 8 × 128 bajtů, což je zhruba 124 KiB. Toto zobecňuje na jakýkoli transformátor skupinové pozornosti dotazu: KV na token je vrstvy × KV-hlavy × rozměr-hlavy × 2 (pro K a V) × bajty-dtypu, takže model s více vrstvami nebo KV hlavami zapíše proporcionálně více na token. V tomto středním provozním bodě (zhruba 4 200 tokenů za sekundu na úrovni RAM) vytvoří hodina uchování přibližně 15 milionů tokenů mezipaměti, což při 124 KiB na token odpovídá asi 1.8 TB. To je hodně DRAM a zvyšuje to náklady na sestavení.
S ohledem na to se volba úrovně řídí požadavky na SLO a rozpočtem. Pokud je SLO dostatečně volné, aby latence opětovného načítání na úrovni SSD dopadla dovnitř, může druhá vrstva mezipaměti KV být umístěna pouze na úložišti, přičemž před ní je pouze tenká vyrovnávací paměť RAM pro staging, kterou konektory vyžadují. Náklady na úložiště jsou nízké: špičkový provoz KV během všech našich testů byl 4.1 GB/s pro zápis v mírném provozním bodě a 1.1 GB/s pro čtení, oproti stropu naměřenému pomocí fio zhruba 114 GB/s. Pole RAID10, které jsme použili, mělo k dispozici šířku pásma přibližně 28krát více, takže flash paměť se nestává úzkým hrdlem, i když se XE7740 škáluje na svých plných osm GPU a přebírá větší souběžnou zátěž. Tato rezerva umožňuje operátorovi poskytovat vrstvu spíše pro kapacitu než pro rychlost. Každý přidaný terabajt D7-PS1030 prodlužuje TTL a pracovní sadu, kterou systém uchovává rezidentní, a větší rezidentní mezipaměť znamená více zamezení přepočítávání a více obsloužených tokenů.
Omezením, které tuto úroveň definuje, je odolnost. Mezipaměť pro odlehčení dat (KV offload cache) je velmi náročná na zápis: každý token, který model vygeneruje, zapíše položku KV a TTL churn neustále přepisuje vrstvu, takže disky v podstatě nikdy nepřestávají zapisovat. V našem osmidiskovém poli dosahovaly trvalé rychlosti zápisu 1.9 GB/s a v testovaném rozložení RAID10 zrcadlení zdvojnásobuje to, co médium absorbuje, což odpovídá zhruba 3.2 zápisům na disk denně na každém 12.8TB disku, což je mírně nad trvalým hodnocením 3 DWPD u D7-PS1030. Pro primární úložiště by to znamenalo diskvalifikaci, ale v tomto případě je to přijatelné. Mezipaměť je ze své podstaty jednorázová a režim selhání opotřebovaného disku je přepočet, nikoli ztráta dat. RAID0 je pro tuto úroveň pravděpodobně pro některé vhodnější, protože se prokládá na všech osm disků, takže se nic nezapisuje dvakrát, a snižuje se tak rychlost médií na přibližně 1.6 DWPD, což je pohodlně v rámci hodnocení. Ať tak či onak, závěr platí: tato pracovní zátěž spotřebovává výdrž rychleji než cokoli jiného v krabici, dedikované disky s vysokou výdrží nesou zlomek kapacity, kterou daná úroveň potřebuje, a právě tato kombinace dělá z disku zaměřeného na zápis s vysokou kapacitou, jako je PS1030, správnou volbu.
Tokeny za dolar
Sekce o výkonu ukázala, že flash paměť si zachovává většinu propustnosti a udržuje latenci prvního tokenu, kterou DRAM nemůže udržet, jakmile pracovní sada přeroste paměť. Z komerčního hlediska je to důležité kvůli nákladům na vrstvu, která provádí úschovu. Snadným řešením pro přepočet je koupit více této drahé DRAM v systému; argument s odlehčením zátěže funguje pouze tehdy, je-li úložná vrstva smysluplně levnější na jednotku kapacity.
Nejjasnější verzí mezery je kapacita, nikoli cena. 512GB DRAM offload vrstva se zaplnila a začala se vyřazovat; flash vrstva, měřená v terabajtech, se tak nestalo. Žádný praktický rozpočet na DRAM nedokáže umístit desítky terabajtů KV cache vedle GPU, takže po určité délce kontextu se nerozhoduje mezi rychlou DRAM versus flash, ale mezi flash versus zahozením kontextu, což je právě vyřazování, které v první řadě stojí propustnost a latenci.
Co se týče ceny, podnikové flash paměti se dlouhodobě prodávají za zlomek ceny DRAM za terabajt, což je strukturální rozdíl, který vyplývá z víceúrovňových, 3D vrstvených článků NAND oproti konstrukci DRAM s jedním tranzistorem a jedním kondenzátorem. Paměťová krize v roce 2026 prudce zvýšila obě ceny a smluvní ceny NAND v průběhu roku rostly přinejmenším stejně rychle jako DRAM, takže se nejedná o případ, kdy by flash paměti zlevňovaly, zatímco DRAM prudce rostou. I při dnešních nadsazených úrovních však rozdíl v cenách na terabajt přetrvává a flash paměti zůstávají jedinou úrovní, kde je k dispozici terabajtová kapacita mezipaměti za cenu, která odpovídá rozpočtu na služby.
Propustnost a náklady ukazují stejný směr. Na hranici, kde flash paměť získala náskok, udržovala více tokenů za sekundu než úroveň DRAM, ne méně, takže se nejedná o výměnu propustnosti za kapacitu, ale o poskytování většího množství kapacity na médiích, která stojí méně za terabajt. V přepočtu tokenů za sekundu na dolar je to velký náskok ve prospěch flash paměti a rozšiřuje se tím i nutnost delšího uchování kontextu, protože přesně tam dochází DRAM a flash paměť ne.
DRAM zůstává tou správnou vrstvou, dokud se do ní hodí pracovní sada, a tenká vyrovnávací paměť RAM, kterou konektory vyžadují, je stále umístěna před flash pamětí. Přidání dalších GPU nebo DRAM pamětí však stojí nejvíce na terabajt, aby se dosáhlo špičkového výkonu, který daná úloha potřebuje, pouze dokud se nezaplní mezipaměť. Přesun zátěže nebo vrstvení do flash paměti udržuje většinu tohoto výkonu a zároveň uchovává kontext na dobu neurčitou, za cenu za terabajt, která je cenově dostupná. Konečné rozhodnutí však nakonec závisí na požadavcích SLO pro optimalizovanou pracovní zátěž.
Závěr
U inferenčních úloh je tokenomika celou konverzací. Token je produkt a přepočet je plýtvání: GPU již tento kontext jednou vytvořilo a je nuceno ho znovu sestavit. Nejvíce je v sázce obsluha agentů, protože náš týden instrumentovaného provozu Claude Code ukázal, že 98.16 % tokenů bylo čtení z mezipaměti, kontext, který GPU již vypočítalo a jinak by jej při každém vyřazení znovu sestavilo. Odlehčení mezipaměti KV převádí předběžné výpočty, které by šly na přestavbu této historie, na nové tokeny. Na XE7740 se to ukázalo jako až 2.9násobek celkové propustnosti obsluhy základní úrovně pouze VRAM při vysoké zátěži, přičemž model, GPU a engine zůstaly konstantní. Tam, kde se vrstva DRAM naplnila a znovu klesla, si flash paměť udržela tuto propustnost s kapacitou, které se DRAM nemůže rovnat.
Nic z toho však nekončí potřebu DRAM. Pro krátké, pulzní úlohy, kdy se relace zahájí, krátce běží a ukončí dříve, než její mezipaměť přeroste paměť, je DRAM tou správnou úrovní a odlehčení mezipaměti KV přidává jen málo. Pracovní sada vyhovuje, latence je nejlepší dostupná a není co odstraňovat.
Tento profil však vnímáme jako výjimku, kde postačuje pouze vrstva DRAM. Většina produkčních inferencí nyní běží dlouho a nepřetržitě: agenti s více otočeními, velké kontexty, stabilní souběžnost, uživatelé, kteří se vracejí do stejné relace. V takovém případě pracovní sada přeroste jakoukoli paměťovou vrstvu, kterou si operátor může dovolit zprovoznit, mezipaměť je vymazána a GPU se vrátí k práci a znovu vytvoří kontext, který již vytvořila. To je nákladný režim selhání a je běžný.
Pro tyto úlohy se odlehčení mezipaměti KV do flash paměti vyplácí hned na dvou frontách. Udržuje GPU v provozu, místo aby znovu počítaly staré, což je tokenomická efektivita, kterou celé toto cvičení měří, a umisťuje kapacitu, která to umožňuje, na nákladově nejefektivnější odolnou úroveň v systému. Důsledkem, na kterém záleží nejvíce v sestavovacím listu, je to, co se odstraní: server, který se spoléhá na flash paměť pro mezipaměť, může být specifikován s mnohem menší pamětí DRAM a s cenou paměti z roku 2026 je to jedna z největších dostupných úspor v cenové nabídce. Token je produkt a pro úlohy s dlouhým kontextem, které nyní dominují v obsluze, je cesta efektivní z hlediska tokenů ta, která přestane platit za dvojitou produkci stejných tokenů, a tato cesta vede přes flash paměť.
SSD úložiště Solidigm pro umělou inteligenci
Tuto zprávu sponzoruje společnost Solidigm. Veškeré názory a stanoviska vyjádřené v této zprávě vycházejí z našeho nezaujatého pohledu na daný produkt (produkty).


 Amazon