

Seit Jahren ist automatisiertes Storage Tiering (Speicherschichtung) eine unverzichtbare Lösung für Unternehmen, die ihren Rechenzentrumsfußabdruck effizient verwalten und gleichzeitig die Gesamtbetriebskosten (TCO)ten senken möchmen. Strategie je einfach: Man verwendet Algorithmen und Richtlinien mit automatischer Zeitsteuerung und hält die aktiven Daten auf dem Primärspeicher, während inactive Daten in kostengünstige Speicherkategorien verschoben werden. V letzten letech, které mají Cloud Tiering jako robustní, zkostnatělý Lösung herauskristallisiert, die Verlagerung inaktiver Daten auf kostengünstige Objectspeicher in der Cloud verwaltet. S Think System DM-Serie se vztahuje Lenovo Unternehmen die Verwaltung von Daten and Cloud-Alternativen with einer Intelligence Speicherlösung. Strategie mraků s ohledem na výkonnost, agilitu a bezpečnost v Hybrid-Cloud-Umgebungen, ohne die Verwaltbarkeit, Sicherheit nebo Leistung zu beeinträchtigen.
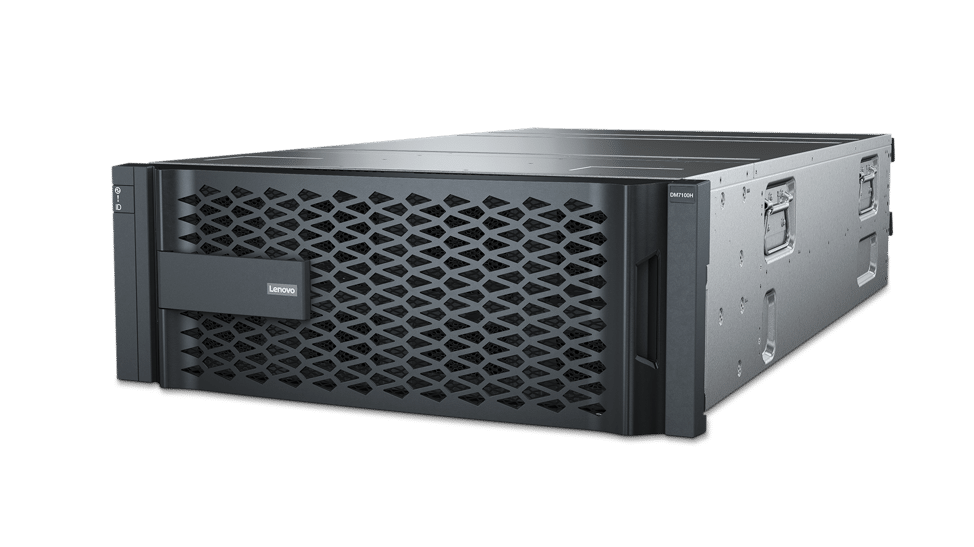
Tento artikl je popsán prostřednictvím Lenovo ThinkSystem Speicherlösungen and die DM Serie end-to-End-Strategie for Rechenzentren bieten, von der Vor-Ort-Installation bis hin zur Cloud. Zunächst werden wir einige grundlegende Konzepte zur Datenspeicherung, zum Cloud Tiering and zu neuen Herausforderungen beim Speichermanagement ansprechen. Podívejte se na náhled na datenmanagement-Ökosystem od Lenovo a darauf, s nimiž budete pracovat s DM-Serie auf dem Speichermarkt hervorhebt. Außerdem werfen wir einen genauen Blick auf die ONTAP-Software and die FabricPool-Storage-Tiering-Richtlinien. A schließlich zeigen od unserem Labor aus die Einrichtung und Validierung der Cloud-Tiering-Lösung od Lenovo.
In einem traditionalellen Rechenzentrumsmodell beginnt ein wachsendes Unternehmen mit dem Sammeln kritischer Daten und Dateien in seinen Räumlichkeiten. Diese Daten sind jedoch irgendwann veraltet und es wird nur noch selten auf sie zugegriffen, wodurch wertvolle Leistung und Kapazität des primären und sekundären Speichers in Anspruch genommen wird, was sich aufslat kritische Arbeit Die Archivierung dieser Daten war in der Vergangenheit eine praktische Lösung für Unternehmen; dadurch stehen die Daten jedoch nicht sofort zur Verfügung, wenn sie plötzlich benötigt werden.
Dieses Problem hat bei IT-Organisationen das Bewusstsein dafür geweckt, Speicherebenen mit unterschiedlichen Kapazitäts-, Kosten- und Leistungsmerkmalen in Betracht zu ziehen. Darüber hinaus müssen sie die Anforderungen an das Datenwachstum über mehrere und Cloud-Umgebungen hinweg anerkennen und darauf vorbereitet sein, diese zu erfüllen. Cloud Tiering ist die Antwort, and es muss in modernen Speicherarchitekturen berücksichtigt werden. Andernfalls wird ein wachsender Datenfußabdruck die Investitionen des Unternehmens in hochleistungsfähige Primärspeicher in seinem Rechenzentrum überfordern.
Mrak jako úložný prostor
Wenn fortschrittlichere Technologien zugänglich werden, können bestehende Speicherebenen nach Bedarf transformiert und weitere hinzugefügt werden, um die mehrstufige Speicherarchitektur weiter zu diversifizieren. Die Cloud hat IT-Organisationen new Möglichkeiten eröffnet, indem sie Speicherlösungen von öffentlichen Cloud-Anbietern als zusätzliche (untere) Ebene ermöglicht. Wenn sie gut konzipiert und ausgeführt wird, ist die Cloud eine ausgezeichnete und kostengünstigere Lösung als eine niedrigere On-Prem-Tier-Lösung.
Auf primární Speicherebenen, die Flash pro extrémní vysoké Leistung nutzen, könnten etwa 50% der kalten Daten der Cloud zugewiesen werden. Snapshot-Kopien und unstrukturierte Daten gehören häufig in diese Kategorie, einschließlich unternehmenskritischer Anwendungen. Auf sekundären Ebenen können bis zu 90 % der im Speicher befindlichen Cold-Daten aus Sicherungskopien stammen. Všechny diese wertvollen Daten, auf die nur gelegentlich zugegriffen wird, könnten ebenfalls in die Cloud verschoben werden. Můžete použít Cloud-Anbietern and -Diensten, jsou zde dostupné, neaktivní data v cloudu pro různé možnosti, Azure Blob-Speicher, AWS S3 a Google Cloud Storage.
Wie beim automatisierten Speicher-Tiering vor Ort können wir Richtlinien und Regeln zur Verwaltung der Daten für die Cloud erstellen. Die Bedingungen erlauben es uns, Dateien direkt von vor Ort in die öffentliche Cloud zu übertragen. Die Richtlinien werden auf verschiedene Weise angewendet Beispielsweise können Daten auf der Grundlage der Dateierweiterung, von Mustern, die im Dateinamen enthalten sind, nebo danach, wie oft innerhalb eines bestimmten Zeitraums zwirdegfen dieers Diese letzte Option ist wahrscheinlich das beste Szenario, bei dem Speicherdateien und -blöcke mit Temperaturwerten versehen werden, wobei neu geschriebene Daten als heiß und inaktive als kalt gekennzeichnet werden. Durch die Implementierung einer Reihe von Richtlinien für die Speicherausrichtung können kalte Daten schnell in die Cloud verschoben werden, indem Regeln nach Bedarf nebo nach Zeitplan ausgeführt werden.
Neue Herausforderungen bei der Speicherverwaltung
Die Hauptherausforderungen, die heute auf dem Markt im Zusammenhang mit der Verwaltung von Hybrid-Cloud-Daten zu beobachten sind, bestehen aus Volumen und Vielfalt, Datengeschwindigkeit und Datenintegrität.
Das Datenvolumen wächst nahezu exponenciell. IT-Organisationen müssen nict nur das Datenwachstum in den Griff bekommen, sondern auch das Datenwachstum und die Datenverwaltung in verschiedenen Umgebungen. Die Menge und Vielfalt der erzeugten Daten ist nach wie vor überwältigend. Ohne die Möglichkeit, diese Daten in einer Hybrid-Cloud-Lösung zu speichern, zu kategorisieren und zu verarbeiten, entgehen Unternehmen wichtige Erkenntnisse über ihre Kunden und ihr Geschäft. Darüber hinaus wird vorhergesagt, dass das Datenvolumen bis 2025 um das 10-fache (ca. 163ZB) ansteigen wird, angetrieben durch IoT und Spitzentechnologie. Wenn Daten das wertvollste Gut sind, müssen sie mit Sorgfalt behandelt werden und in der Lage sein, Erkenntnisse für gezielte Entscheidungen zu liefern und gleichzeitig einen Blick in die Zukunft zu ermöglichen. Darüber hinaus ist es für die Kaufentscheidungen der Kunden von entscheidender Bedeutung, effizientere Wege zur Verarbeitung dieser Daten zu finden, um sie in einen Wert umzuwandeln.
Auch IT-Bedrohungen entwickeln sich weiter – und die Sicherheit der Infrastruktur ist ein ständiger Kampf. Eine gute Sicherheitsstrategie besteht darin, eine solide Grundlage zu schaffen, die darauf beruht, genau zu wissen, wann, wo und wie Daten gespeichert werden Eine solche Strategie hilft Unternehmen, die ze steigenme Kosten, die steigenme sowie mit neuer Malware, Katastrophen und Vorschriften verbunden sind, die erhebliche Risiken für den Betrieb darstellen. Datensicherheit ist für Unternehmen von absoluter Wichtigkeit, sei es zum Schutz vor Datenverlust oder zur Gewährleistung der Datenintegrität. Hier deckt Lenovo alle Möglichkeiten ab und stellt sicher, dass die Daten seiner Kunden stets geschützt sind.
Lenovo ThinkSystem Speicherlösung
Neue Entwicklungen zu antizipieren ist ebenso eine Herausforderung wie die die beste Speicher- und Cloud-Strategie zu verfolgen. Die Branche hat jedoch bereits enorme Investitionen in Forschungsökosysteme und -plattformen getätigt, die dem Unternehmen einen Mehrwert und Möglichkeiten bieten. Mit dem nächsten strategischen Schritt für die Speicherbranche hat Lenovo seine Lösung auf die wichtigsten Herausforderungen im Datenmanagement zugeschnitten. Dieser kluge von Lenovo zielt darauf ab, seinen Kunden die ultimative Lösung zu bieten und bietet eine einzigartige Mischung aus Producten und Dienstleistungen, die es Unternehmen ermöglicht, die Hybrid-Cloud optimální zu nutzen
Lenovo je součástí einzigartigen Technologieunternehmen na trhu, od Lenovo Data Center Group (DCG) a End-to-End-Rechenzentrumslösung anbietet. Nyní můžete použít Lenovo se svou skupinou Intelligent Device Group (IDG) – Ökosystem eine End-to-End-Sicherheits- und Software-Verwaltung. Tyto nástroje a systémy ThinkSystem DM-Serie od společnosti Lenovo jsou založeny na infrastruktuře, která je správná a je v jejich rámci Umgebung laufende Arbeitslast bewältigen.
ThinkSystem DM Serie je Lenovo Flaggschiff-Speicherlösung, jeden velký Datenmanagement-Suite pro strukturovanou a nestrukturovanou datovou sadu. Sie reicht vom Einstiegsbereich bis hin zur oberen Mittelklasse und bietet dateintensive Funktionen wie integrierte Datenreduzierung, Datenschutz und Datensicherheit Jede der DM-Serie kann integrierte Hybrid-Cloud-Funktionen von-Lösungen ven-Cloud-An Gleichzeitig baut Lenovo seine End-to-End NVMe-Angebote mit der kürzlich veröffentlichten DM7100F-Serie aus and plant noch in diesem Year, das Angebot von End-to-End NVMe auf weitere Einstiegs-Works aweites für NVMe-Struktur für Unternehmen zu schaffen.
FabricPools
Sada pro správu dat DM-Serie je věrná pro datové služby přes Flash, Festplatte a Cloud a vereinfacht tak Speicherumgebungen. Tento software je snadno použitelný a vysoce flexibilní, pro efektivní využití konzipiert a verfügt přes robustní datové funkce pro bezproblémovou integraci cloudu. Insgesamt zielt die DM-Serie darauf ab, die Bereitstellung und Verwaltung von Daten zu vereinfachen und Unternehmensanwendungen zu fördern, dh sie ist zukunftssicher für Dateninfrastrukturen.
Neben der bordeigenen Datenmanagement-Funktionalität steht die FabricPool Cloud Tiering-Technologie zur Verfügung. Sie ermöglicht das automatisierte Tiering von Daten auf kostengünstige S3-Objektspeicherebenen, die sich entweder vor Ort nebo in der öffentlichen Cloud befinden. Im Gegensatz zu manuellen Tiering-Lösungen automatisiert FabricPool das Tiering von Daten, um die Speicherkosten zu senken. Aktivní data verbleiben auf Hochleistungslaufwerken and inactive Daten werden zum Objectspeicher gestaffelt, wobei die Funktionalität and die Dateneffizienz der DM-Serie erhalten bleiben.
FabricPool unterstützt eine breite Palette von öffentlichen Cloud-Anbietern und deren Speicherdienste. Prohlédněte si Amazon S3, Alibaba Cloud Object Storage Service, Microsoft Azure Blob Storage, Google Cloud Storage, IBM Cloud Object Storage a soukromé cloudy. Kunden profitieren auch von der Beibehaltung der integrierten Datenreduzierungsfunktionen beim Verschieben von Daten in und aus der Cloud. Dies spart Transportkosten, wenn Daten aus der Cloud zurückversetzt werden müssen. Darüber hinaus schützt die integrierte Datenverschlüsselung sowohl die Daten während der Übertragung in die Cloud als auch die Daten in der Cloud. Dadurch wird sichergestellt, dass es während des gesamten Cloud-Tiering-Prozesses keine Schwachstellen gibt.
FabricPool Richtlinien
FabricPool klobouk zwei primární Anwendungsfälle: die Rückgewinnung von Kapazität auf dem Primärspeicher nebo die Verkleinerung des sekundären Speicherplatzes. Unser Schwerpunkt in diesem Artikel liegt auf der Möglichkeit, Kapazität im Primärspeicher zurückzugewinnen. Jedná se o tři různé varianty a einzigartige Richtlinien pro Cloud Tiering von Primärspeicher: Auto-Tiering, nur Snapshots and All-Tiering.
Die Beibehaltung von Daten, auf die nur selten zugegriffen wird and die s produktivitätssoftware, abgeschlossenen Projekten and alten Datensätzen auf Primärspeicher verbunden sind, is eine ineffiziente Nutzung-Flashcher-Speistungs Das Tiering dieser Daten on a einem Object Speicher is eine einfache Möglichkeit, předkládaný Flash-Kapazität zurückzugewinnen and die erforderliche Kapazität in Zukunft for reduzieren. Die Auto-Tiering-Richtlinie se liší všemi studenými bloky v objemu na cloud-Ebene. Wenn sie durch zufällige Lesevorgänge gelesen werden, werden kalte Datenblöcke auf der Cloud-Ebene heiß und werden auf die lokale Ebene übertragen. Beim Lesen durch sequentielle Lesevorgänge, z. B. in Verbindung mit Index- und Antiviren-Scans, bleiben kalte Datenblöcke auf der Cloud-Ebene kalt und werden nicht auf die lokale Ebene geschrieben.
Snapshot-Kopien können häufig mehr als 10 % einer typischen Speicherumgebung beanspruchen. Obwohl diese Point-in-Time-Kopien für die Datensicherung und die Notfallwiederherstellung unerlässlich sind, werden sie nur selten verwendet und stellen eine ineffiziente Nutzung von Hochleistungs-Flash dar. Zásady vrstvení pouze na základě momentek pro FabricPool jsou jednoduchým přístupem, Speicherplatz auf Flash-Speicher zurückzugewinnen. K dispozici jsou testy pouze se snímkem jako Richtlinie z testen cloud-Tiering-Operationen verwendet. Kalte Snapshot-Blöcke im Volume, není nic pro aktivní systém Dateisystem freigegeben sind, werden in die Cloud-Ebene verschoben. Wenn sie gelesen werden, werden kalte Datenblöcke auf der Cloud-Ebene heiß und werden auf die lokale Ebene übertragen.
Eine der häufigsten Anwendungen von FabricPool ist das Verschieben ganzer Datenmengen in Clouds. Abgeschlossene Projekte, Legacy-Reports oder historische Aufzeichnungen sind ideale Kandidaten, die in eine kostengünstige Objektspeicherung gestaffelt werden können. Das Verschieben ganzer Volumen erfolgt durch die Einstellung der All Tiering Policy auf einem Volumen. Diese Richtlinie wird in erster Linie für sekundäre Daten- und Datensicherungsvolumen verwendet. Sie kann jedoch auch dazu verwendet werden, alle Daten in Lese-/Schreib-Volumes zu staffeln.
Data v Volumen, die all Tiering Policy verwenden, wedren sofort als kalt Gekennzeichnet and sochnell wie möglich in die Cloud gestaffelt. Ess must eine Mindestanzahl von Tagen abgewartet werden, bevor die Daten als “kalt” und “gestaffelt” gekennzeichnet werden. Wenn sie gelesen werden, bleiben kalte Datenblöcke auf der Cloud-Ebene kalt und werden nict auf die locale Ebene zurückgeschrieben.
S Lenovo existuje auch eine vierte Option für die Abstufung zur Verfügung, die treffend als “Keine” Abstufung bezeichnet wird. Bei diesem Vorgang werden keine Daten gestaffelt, tak dass alle Daten in Flash verwaltet werden können. Ein gutes Beispiel für ihre Verwendung sind Snapshots in DevOps-Umgebungen, in denen häufig die früheren Point-in-Time-Kopien verwendet werden.
Konfigurace vrstvení cloudového úložiště Lenovo
Um die Fähigkeiten and einige der Funktionen der Lenovo Speicherlösung für cloud a testen, beured in unserem Labor ein DM7000F-Modell eingerichtet.
Zpřístupněte úložiště s Azure Blob Storage, vyberte Cloud-Lösung für diesen Test, einen Speichercontainer erstellt. A to je to, co je stručná paleta od Lenovo rozšířené možnosti na plážích, na Alibaba Cloud, Amazon S3, Google Cloud, IBM Cloud a další. Während des Tests je darem, Microsoft Azure Blob Storage pro cloud a Cloud-Tier pro FabricPool ve světě. Nachdem wir die Einrichtung des Cloud-Speichers abgeschlossen hatten, war es an der Zeit, sich bei der GUI-Oberfläche des DM7000 anzumelden.
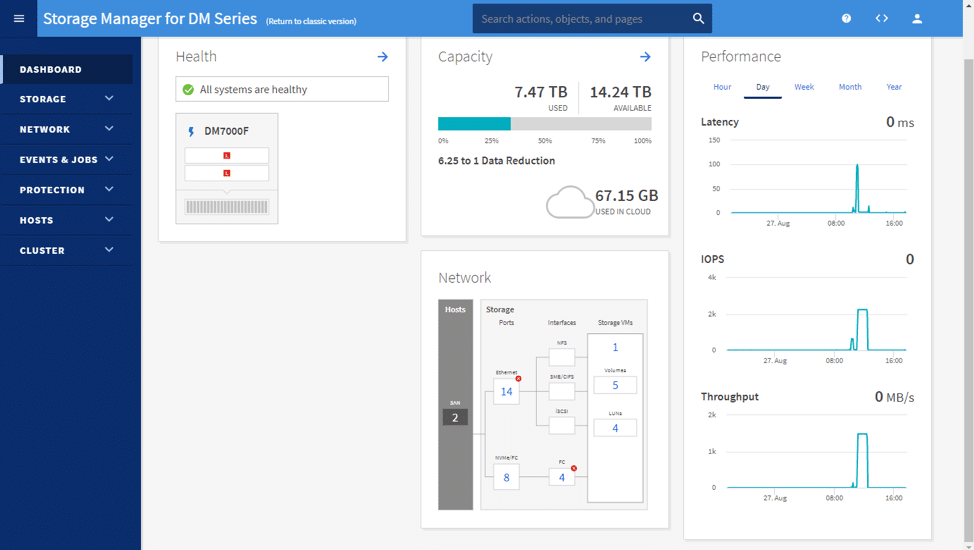
Sobald man angemeldet ist, erscheint die Standard-Dashboard-Seite. Das Dashboard zeigt den Zustand, die Kapazität, die Leistung und die Netzwerkinformationen des fraglichen Arrays an.
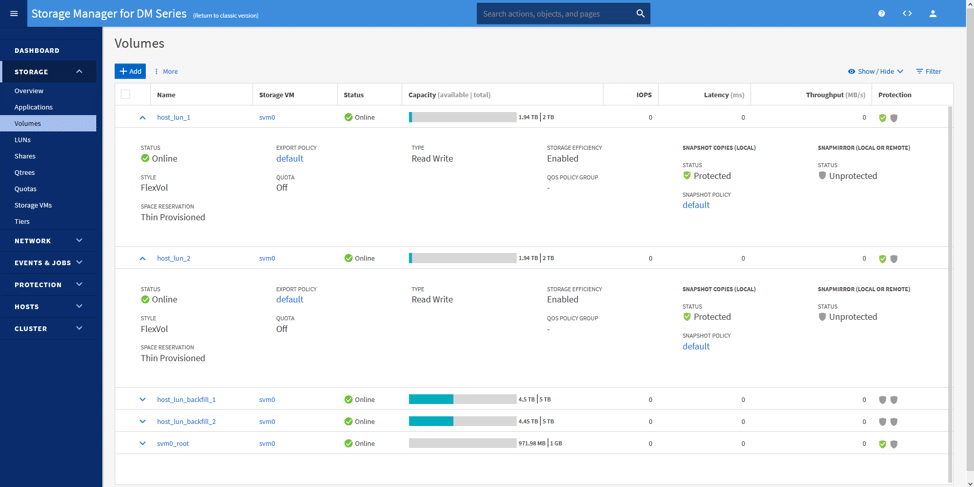
K dispozici jsou dva objemy (eines pro Controller) a dva VM (eines für jedes Volumen) erstellt. Der Plan war, diese VMs laufen zu lassen und sie dann für eine Weile untätig zu lassen. Další informace Obrázek zeigt die verwendeten Volumen: host_lun_1 und host_lun_2.
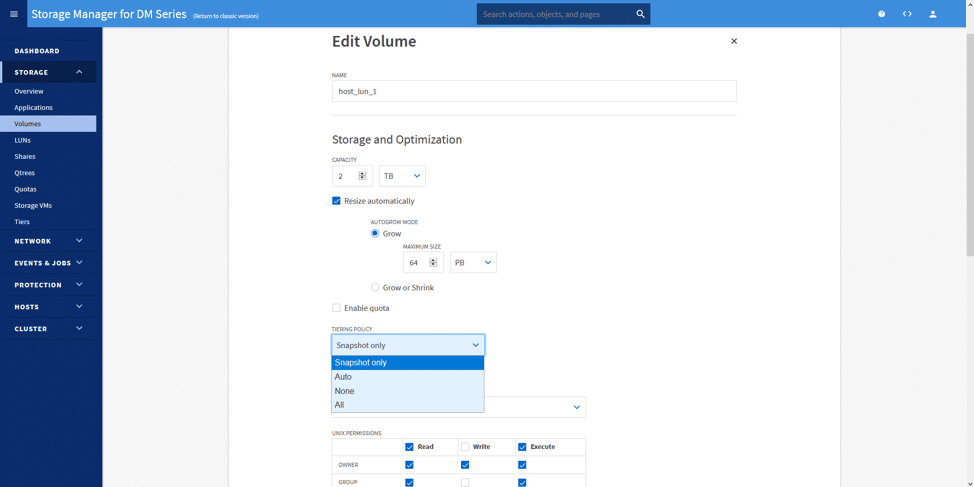
Während der Bearbeitung oder Erstellung des Volumens können wir die gewünschte Einstufungsrichtlinie auswählen. Hier haben wir nur Snapshot ausgewählt. Pokud jde o Tiering-Politik auswählen, můžete se pohybovat po datu (jehož jeden snímek je také starý) v Azure Blob Storage, v jednom Hintergrundintervall erstellt Wurde. Das Intervall läuft zu seiner eigenen Zeit und sagt voraus, wann die Arbeitslasten am wenigsten beeinträchtigt werden.
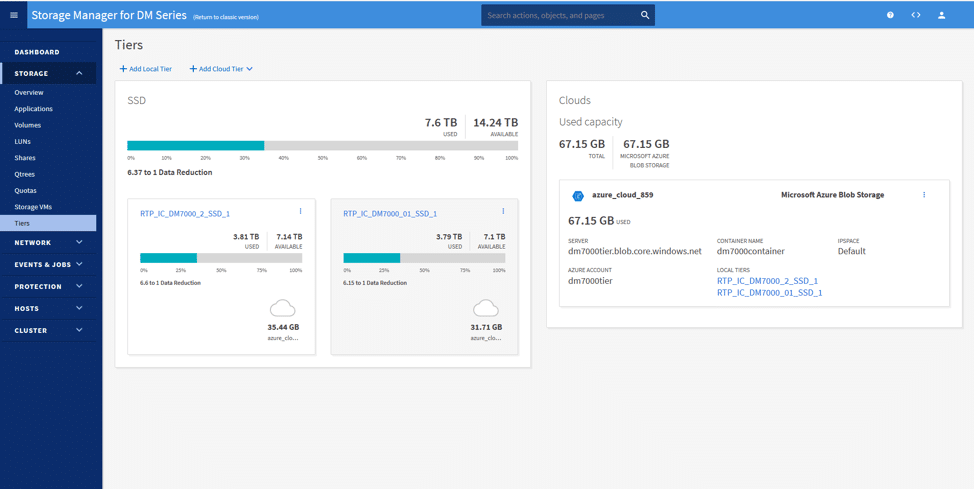
Unter der Tiers-Seite können wir unsere Cloud-Ebene aus den öffentlichen Clouds hinzufügen. Zde jsou dostupné prostředky pro Azure Blob Storage-Ressource a s místním jazykem. Unter dem Bild unten sehen Sie zwei Ressourcen, die mit Azure verbunden sind.
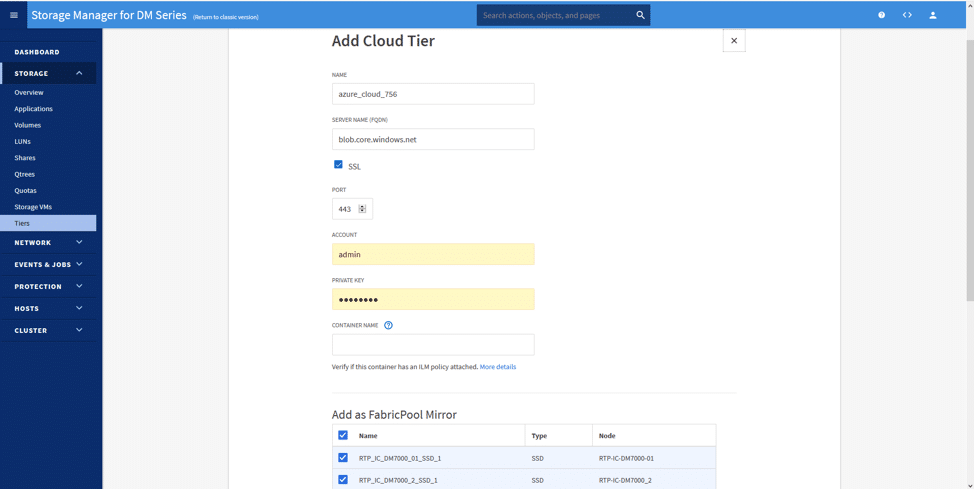
Die Konfiguration ist einfach; durch Klicken auf „Add Cloud Tier“ (Cloud-Ebene hinzufügen) a Auswahl der gewünschten Cloud (v diesem Szenario Azure) könnten wir sofort die Cloud-Ebene einrichten.
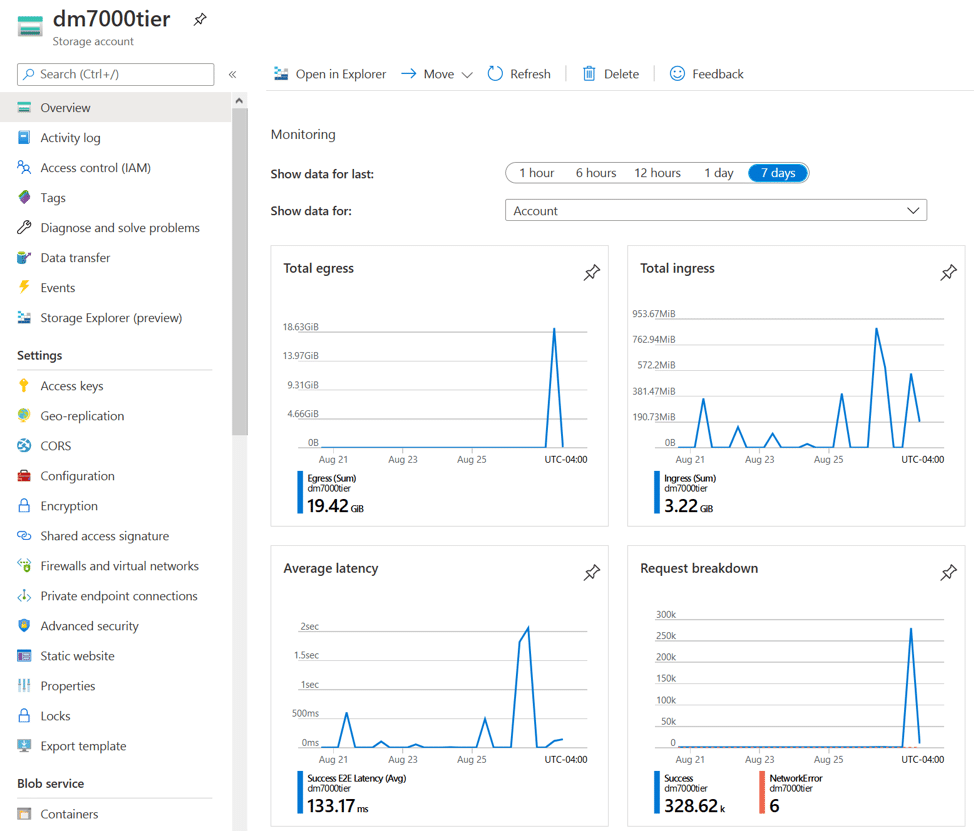
Schließlich wollten wir von unserem Azure Storage-Account-Dashboard aus sowohl Daten anzeigen, die in Azure eingehen (vstup), také jako Daten, die aus Azure herausgehen (egress). Die kleinen Spitzenwerte, die jeden Tag angezeigt werden, sind neue Momentaufnahmen von Daten, die nach Azure übertragen werden. Auf der anderen Seite zeigen die Austrittsspitzen ausgehende Daten und illustrieren eine Snapshot-Wiederherstellung von einem Volume zum Zurückfahren.
Závěrečné poznámky
Im Allgemeinen ist die Cloud und die Verwaltung der Daten ein breites, sich entwickelndes Thema in Unternehmen. Lenovo möchte Lösungen anbieten, die Kunden auf wechselnde Anforderungen vorbereiten, sei es in Rechenzentrum or Hybrid-Cloud-Umgebungen. Přezkoumejte úložiště, které je součástí Lenovo Ansatz pro jejich speciální pole. Během této doby je vyhodnoceno, co se týká řazení dat v cloudu nebo Storage Manager pro funkce DM-Serie a jaká je Flash-kapazita zurückgewonnen nebo v cloudu erweitert wird. Wichtig ist, dass das DM7000F-Speichersystem diese Flexibilität bietet, ohne Änderungen an der Infrastruktur vorzunehmen. Darüber hinaus ist die Funktionalität einfach zu implementieren
Požadavek na DCG a IDG se nachází na Lenovo v einer starken Position auf dem Datenspeichermarkt. Ihre Speicherlösungen ermöglichen es den Kunden, das zu kaufen, was sie heute benötigen, und gleichzeitig die Cloud zu nutzen, um die Anforderungen an das Datenwachstum der Zukunft zu erfüllen. Das Ergebnis is, dass das Lenovo Cloud Tiering die Kosten reduziert und Unternehmen die Flexibilität ermöglicht, die sie sich wünschen, wenn sie eine Investition in Speicherlösungen in Erwägung ziehen.
Lenovo ThinkSystem DM Serie Speicher-Arrays
Dieser Bericht wurde von Lenovo unterstützt. Alle in diesem Bericht zum Ausdruck gebrachten Ansichten und Meinungen basieren auf unserer unvoreingenommenen Sicht auf das/die in Frage kommende(n) Produkt(e).


 Amazon