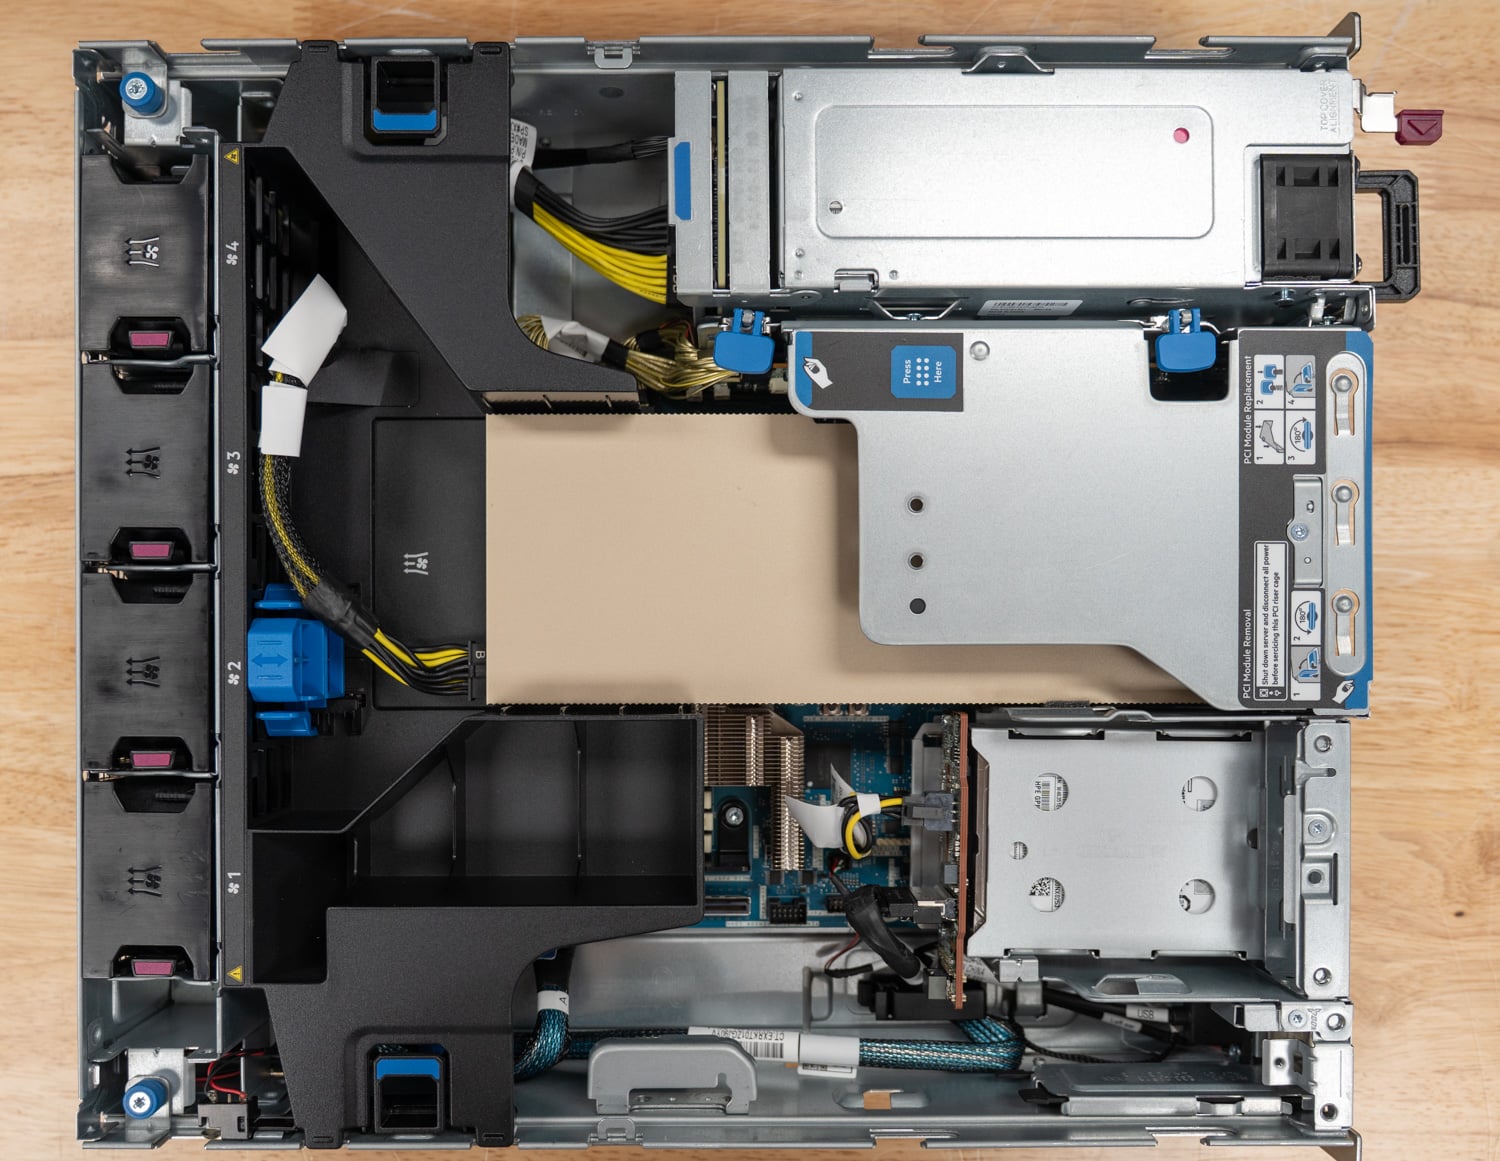
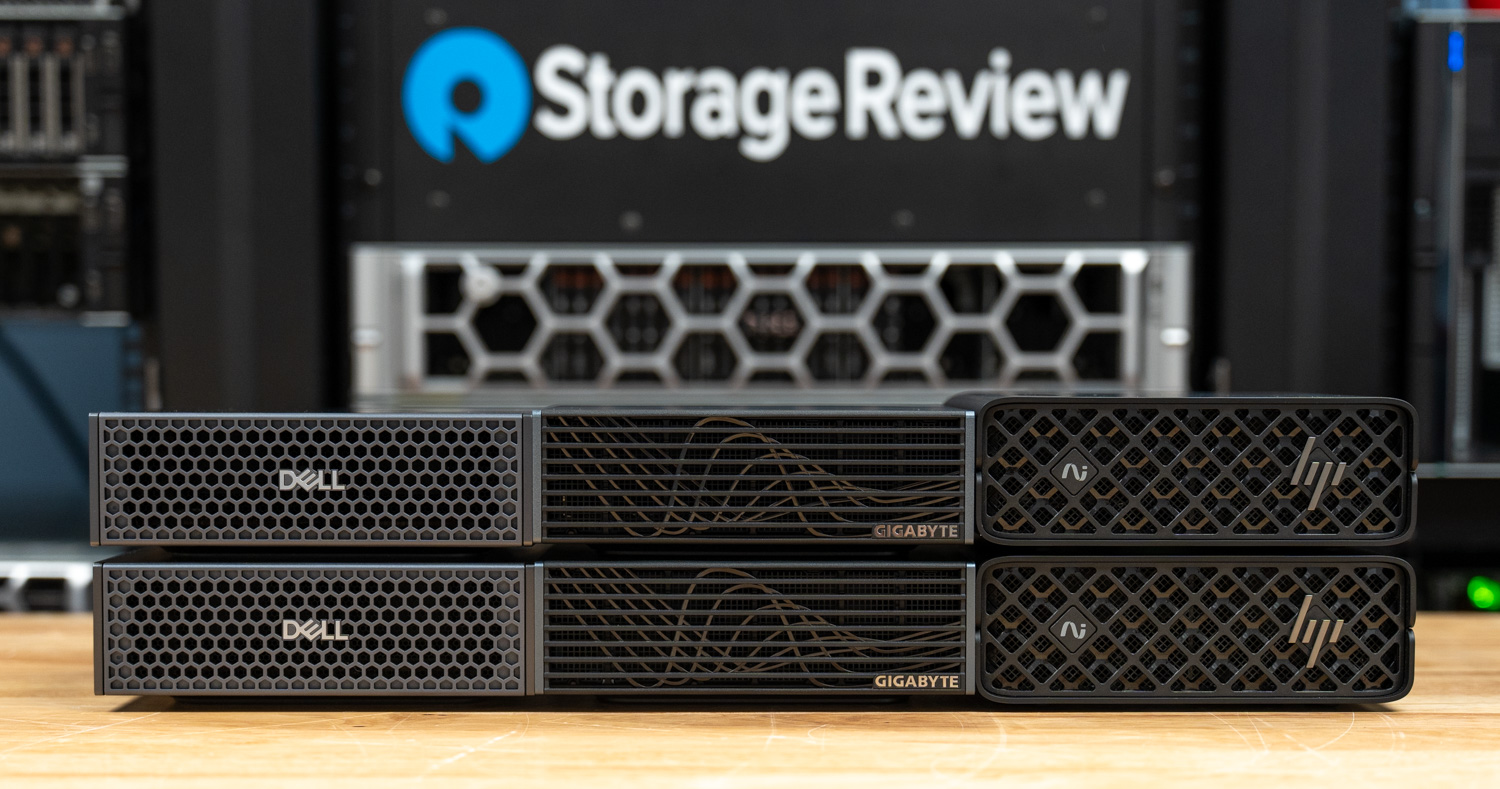
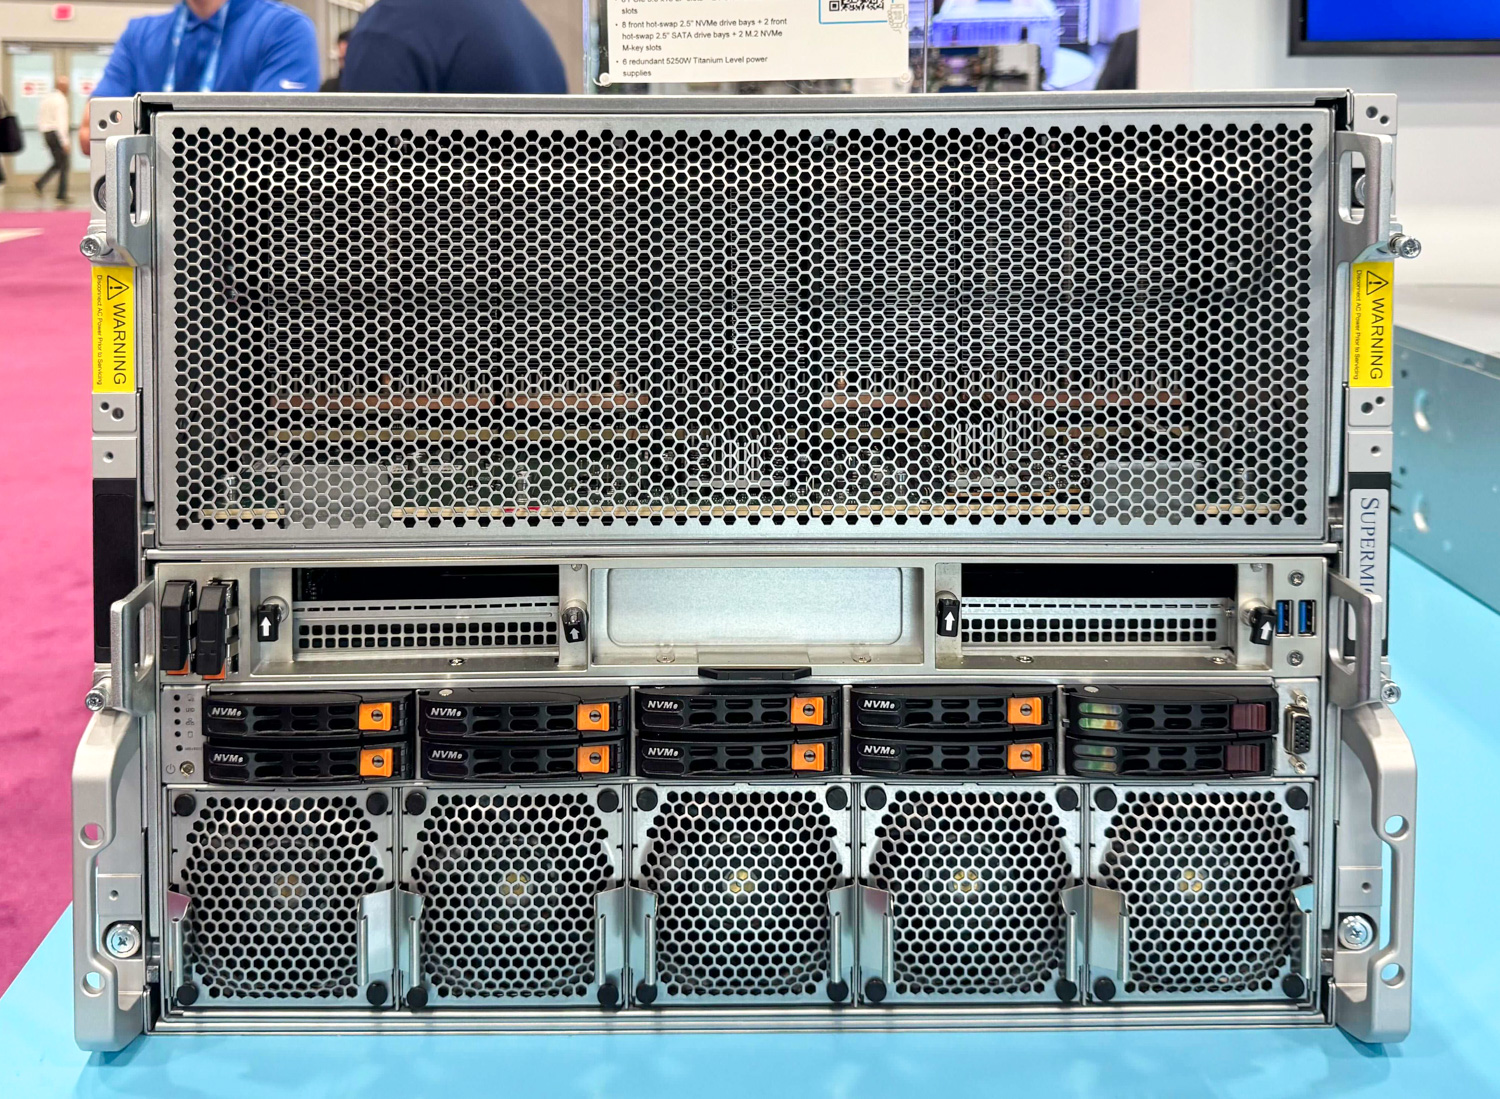
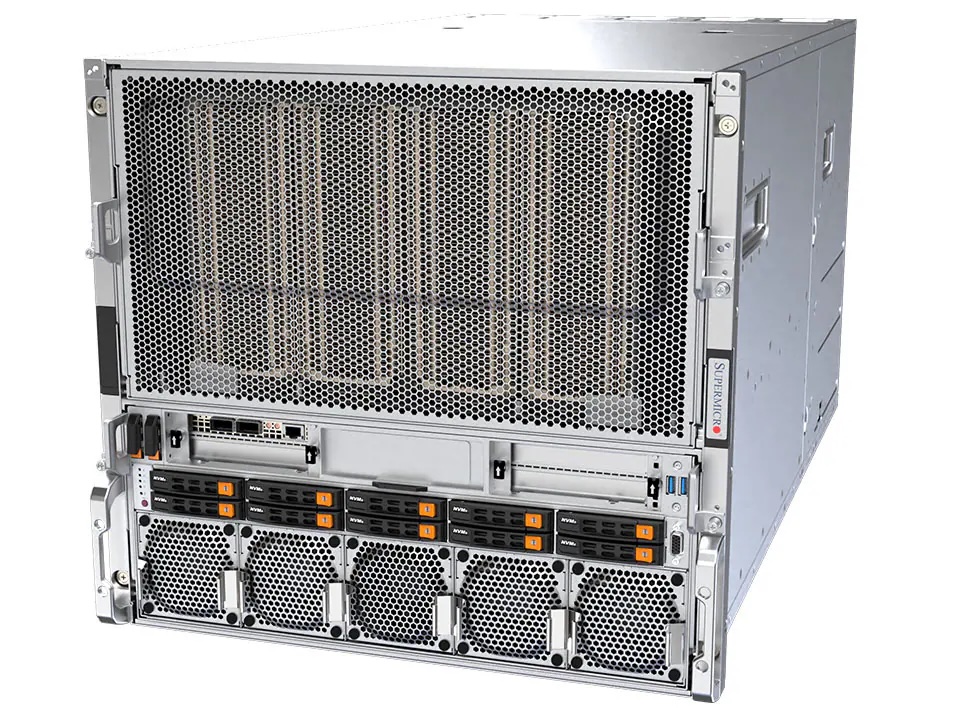
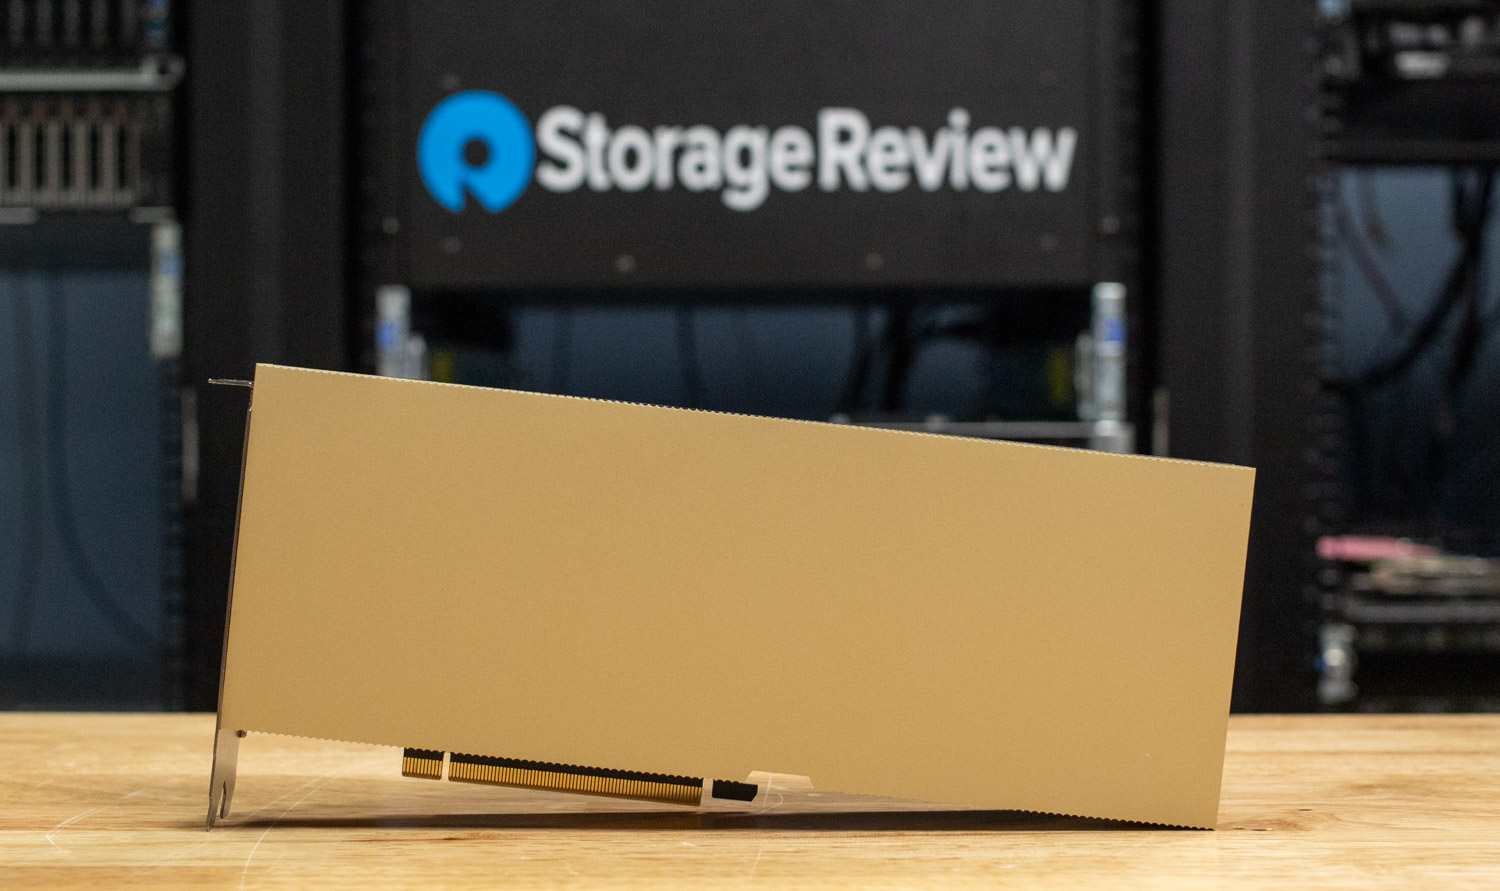
Unsere aktuellen KI-Systemtests konzentrieren sich auf Inferenz-Serving im Labor. Dabei werden Open-Weight-Modelle der Familien Llama, Qwen, DeepSeek und gpt-oss über vLLM oder SGLang ausgeführt und hinsichtlich Durchsatz und Latenz des ersten Tokens gemessen. Die Tests reichen vom Edge bis zum vollständigen GPU-Knoten: Die NVIDIA RTX PRO 4500 Server Edition lieferte im Vergleich zum Vorgängermodell L4, das sie ersetzen sollte, in einem HPE ProLiant DL145 Gen11 die durchschnittliche Ausgabemenge an Tokens pro Sekunde – bei einem um etwa 105 W höheren Stromverbrauch. Die Versionen von DGX Spark von Dell, GIGABYTE und HP führten verteilte Inferenz als Zwei-Knoten-Cluster über das 200-GbE-Fabric durch. Im Rahmen von Supermicro JumpStart konnten wir ein System mit NVIDIA HGX B200 und AMD Instinct MI350X praktisch testen. Der Speicher wird gleich behandelt, da der Datenpfad darüber entscheidet, wie stark die GPUs ausgelastet sind. Daher messen wir den GPUDirect Storage-Durchsatz mit GDSIO und testen die KV-Cache-Auslagerung in den Flash-Speicher für Workloads mit langem Kontext und agentenbasierte Anwendungen.
Wenn Sie Hardware für KI dimensionieren, finden Sie auf der Seite „Beste Server“ unsere aktuellen Empfehlungen für KI-Inferenz und Edge Computing auf Basis der Daten aus diesen Tests, auf der Seite „Beste Enterprise SSDs“ die Laufwerke, die die GPUs mit Strom versorgen, und auf der Seite „Beste Speicherarrays“ die KI-Speicherplattformen hinter Trainingsclustern und Neoclouds.




 Amazon