StorageReview.com
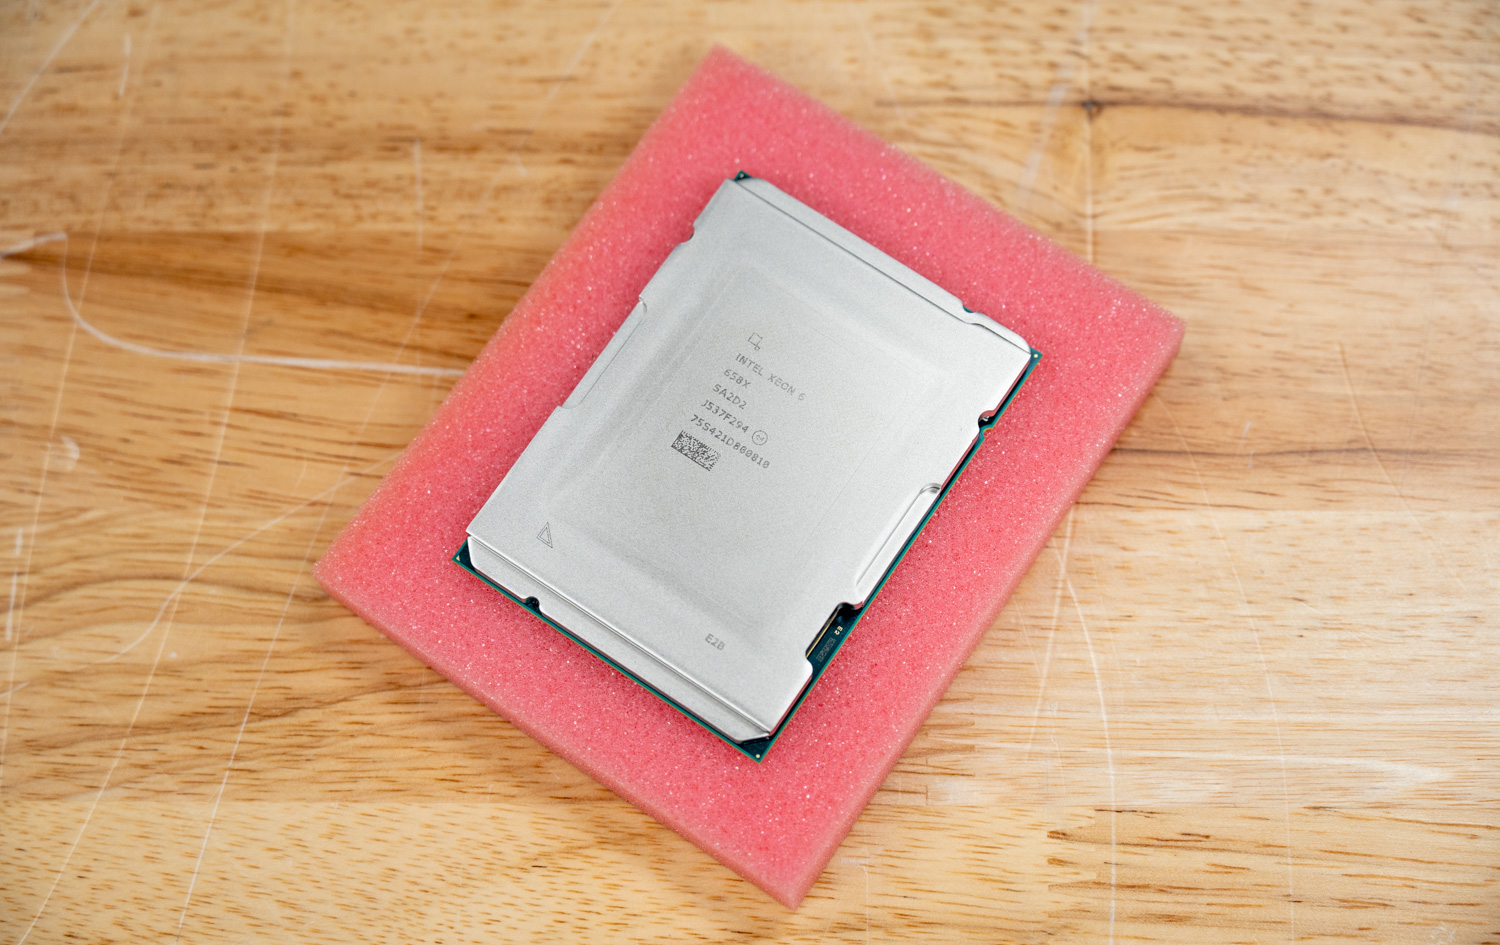
Intel Xeon 6 Prozessor auf antistatischem Schaumstoff im StorageReview-Labor, eine der beiden x86 CPU-Familien, die oneDNN für PyTorch abdecken wird
Unternehmen  ◇  Software

AMD und Intel machen oneDNN zum Standardpfad für x86-Systeme in PyTorch, integrieren ZenDNN und gleichen KI-Rechenerweiterungen ab.

AMD und Intel haben angekündigt, ihre Optimierungsarbeiten für x86-CPUs in PyTorch in oneDNN, der Open-Source-Bibliothek für Deep Learning der Unified Acceleration Foundation (UXL), zusammenzuführen und diese als Standard-Open-Source-Bibliothek für die x86-Beschleunigung in PyTorch festzulegen. AMD integriert seine ZenDNN-Optimierungen in oneDNN und ist der UXL beigetreten.
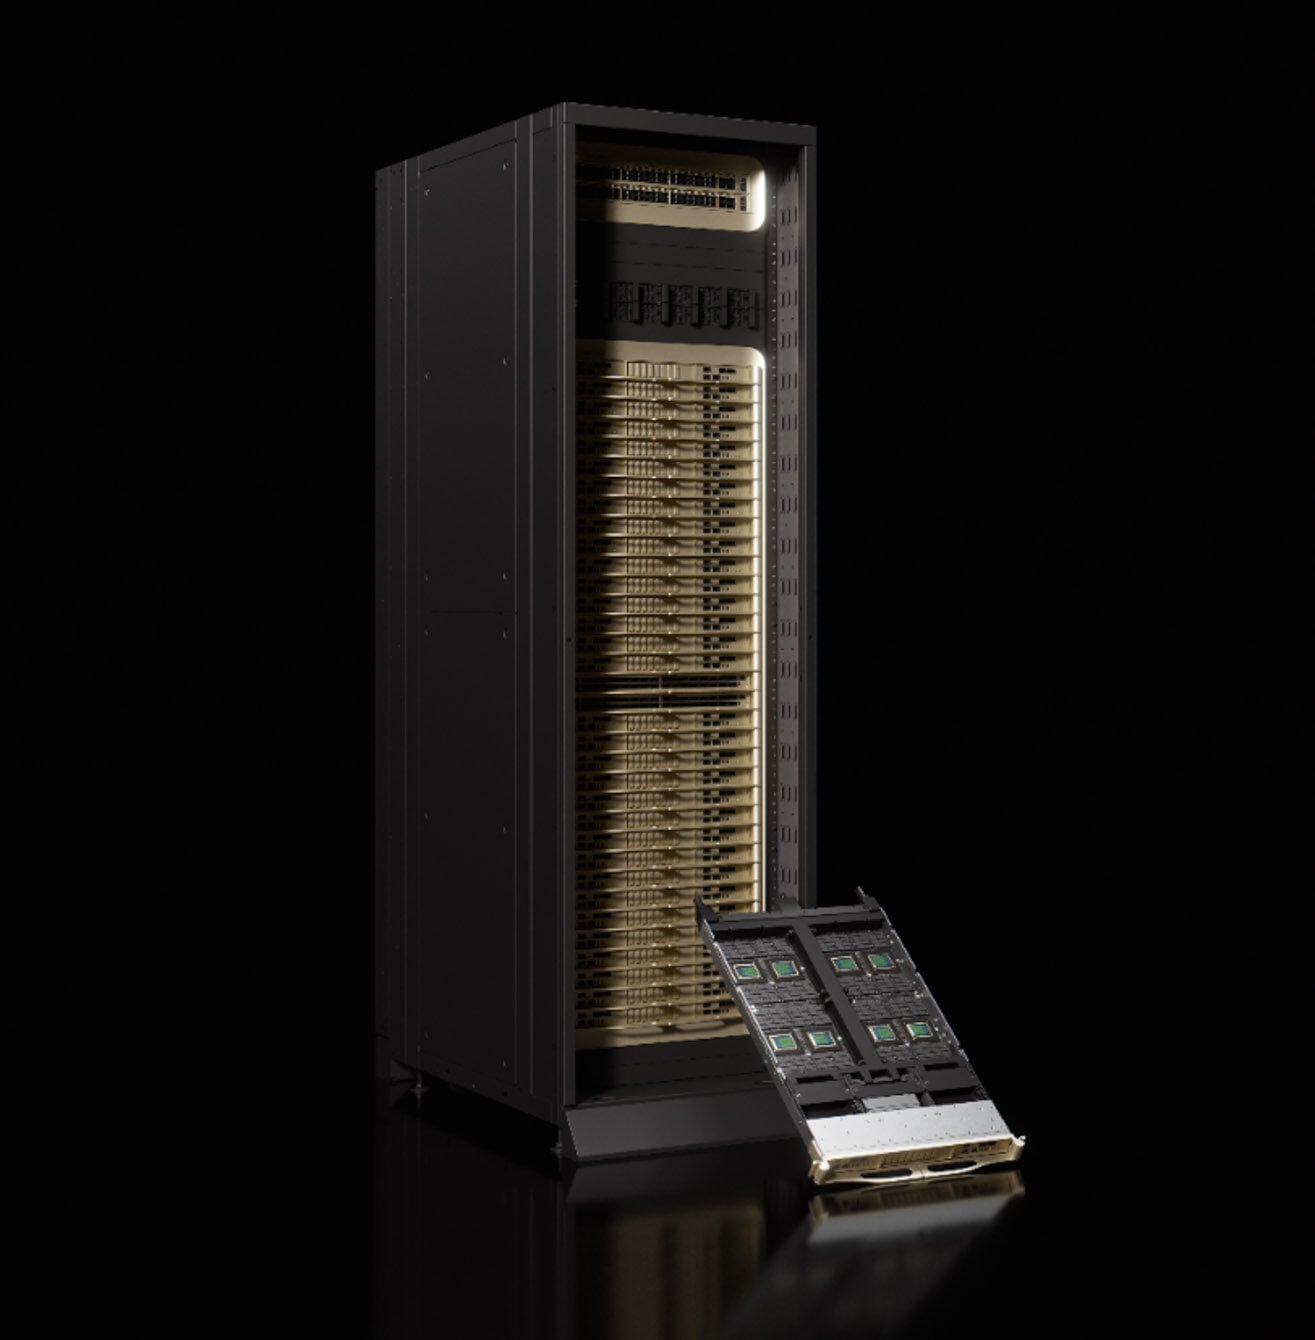
NVIDIA-Rendering eines Vera-CPU-Racks mit herausgezogenem Recheneinsatz, auf dem die Prozessorsockel zu sehen sind.
AI  ◇  Unternehmen

Supermicro NVIDIA Vera CPU-Rack: 256 Vera-CPUs, 400 TB LPDDR5X-Speicher und 22,500 Agent-Sandboxes in einem flüssigkeitsgekühlten 48U-Gehäuse mit 208 kW Leistung.

Supermicro hat heute das NVIDIA Vera CPU-Rack vorgestellt, ein 48 HE großes, vollständig flüssigkeitsgekühltes Rack mit Platz für 256 NVIDIA Vera CPUs, 22,528 Kerne und 45,056 Threads. Laut Supermicro unterstützt es bis zu 22,500 gleichzeitige Agenten-Sandboxes. Es ist das neueste Mitglied des Portfolios der Data Center Building Block Solutions (DCBBS) und für den Betrieb neben bestehenden Systemen konzipiert.

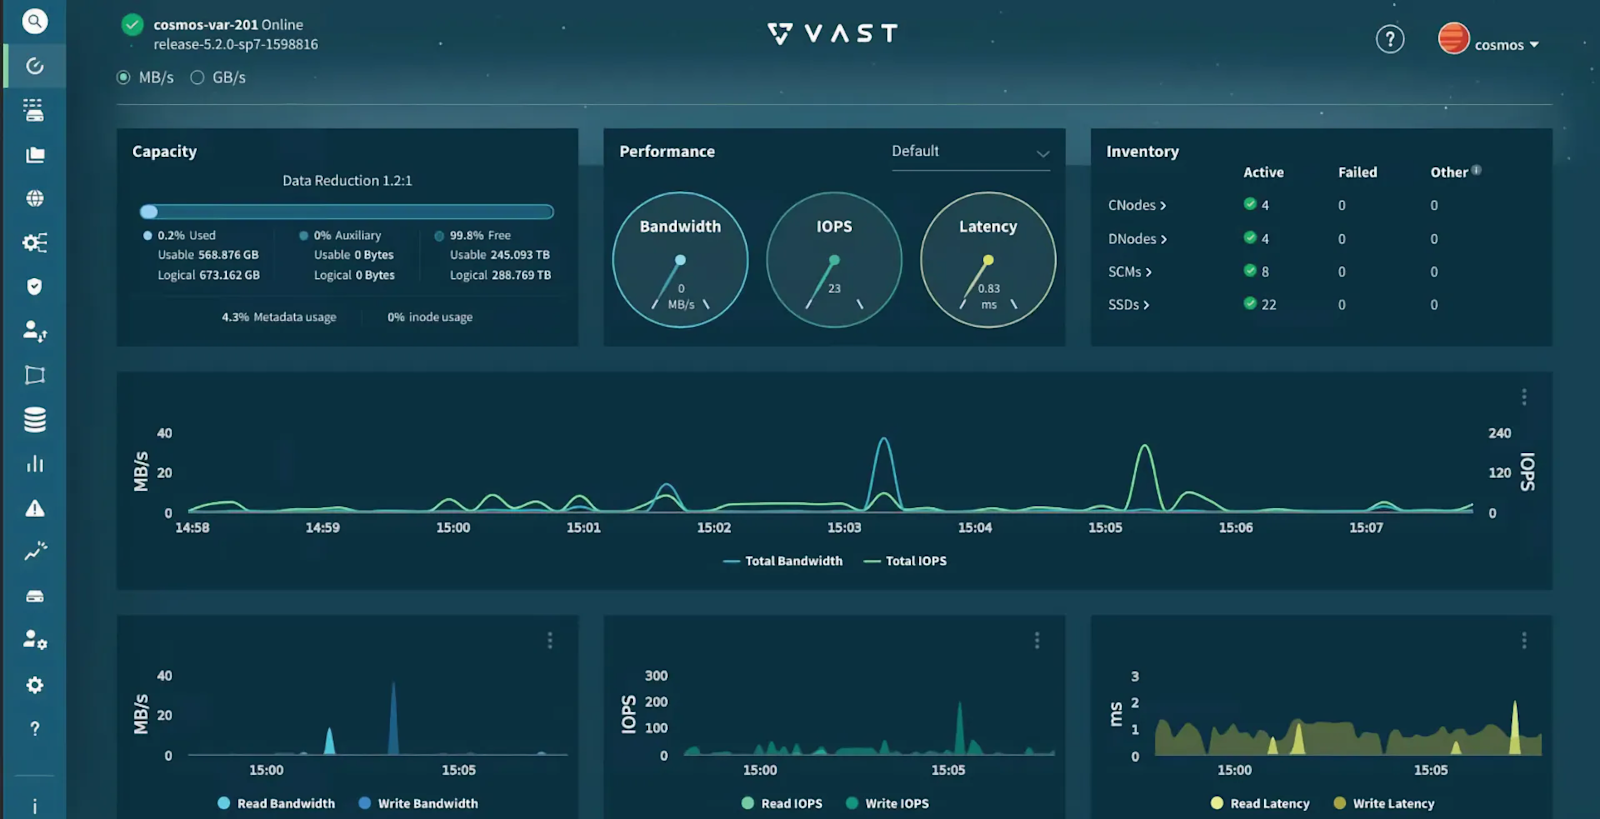
Das Dashboard des VAST-Managementsystems auf einem StorageReview-Laborcluster zeigt Kapazität, Bandbreite, IOPS und Latenz an – die Telemetrieschicht des VAST Agent Sandbox Foundation Stack.
AI  ◇  Unternehmen

Der VAST Agent Sandbox Foundation Stack stellt NVIDIA OpenShell Sandboxes auf Zero-Copy-Klonen bereit und protokolliert jeden Tool-Aufruf.

VAST Data kündigte auf der NVIDIA GTC Berlin gemeinsam mit NVIDIA den Agent Sandbox Foundation Stack an, eine Referenzarchitektur, die NVIDIA NemoClaw-Agenten in NVIDIA OpenShell-Sandboxes auf dem VAST AI-Betriebssystem ausführt. OpenShell übernimmt die isolierte Ausführung und die Durchsetzung von Richtlinien für jeden Agenten, während VAST die Komponenten verwaltet, die auch nach dem Ende der Sandbox bestehen bleiben müssen: die Agenten-IDs.

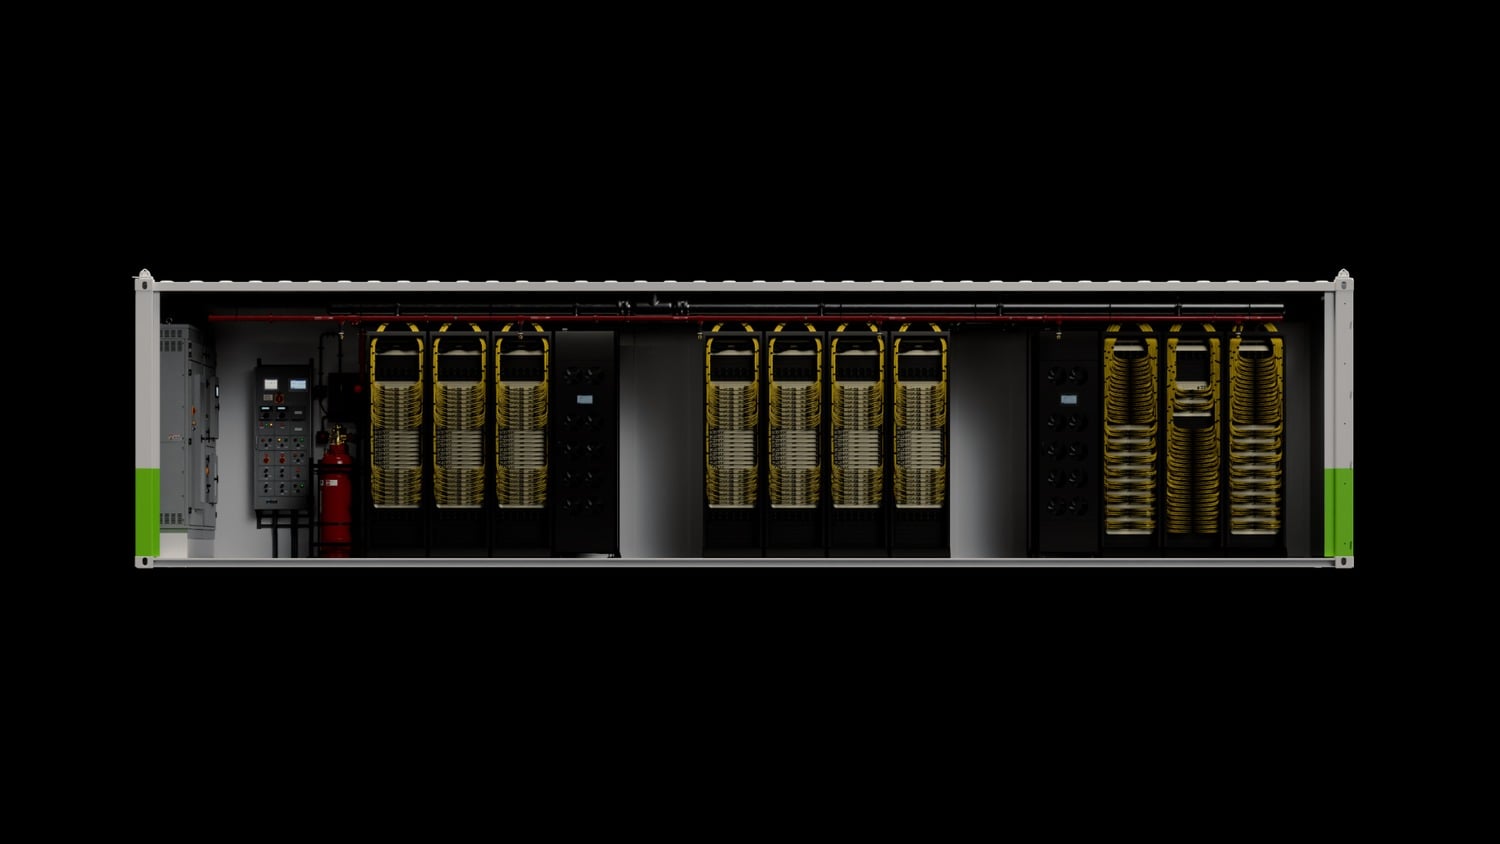
NVIDIA DSX POD-Rendering: Ein aufgeschnittener Schiffscontainer zeigt drei Gruppen von Vera Rubin-Racks mit gelber Verkabelung, Stromverteilung und Feuerlöschanlagenschränken am linken Ende.
AI  ◇  Unternehmen

NVIDIA GTC Berlin: 14-tägige DSX POD KI-Fabriken, ein 2.5-facher Substrat-Ausbau und die OpenShell-Referenzarchitektur

Die heutigen Ankündigungen von NVIDIA auf der GTC Berlin umfassen containerisierte Vera-Rubin-Infrastruktur, eine 2.5-fache Erweiterung der Substratversorgung und Software für das Energiemanagement und die Agentensicherheit in KI-Fabriken sowie Programme für Telekommunikation, autonome Fahrzeuge, Robotik und das Gesundheitswesen. Die wichtigste Zahl ist ein Einsatzziel: NVIDIA gibt an, dass sein neues DSX-POD-Referenzdesign die Betriebskosten einer KI-Fabrik deutlich senkt.

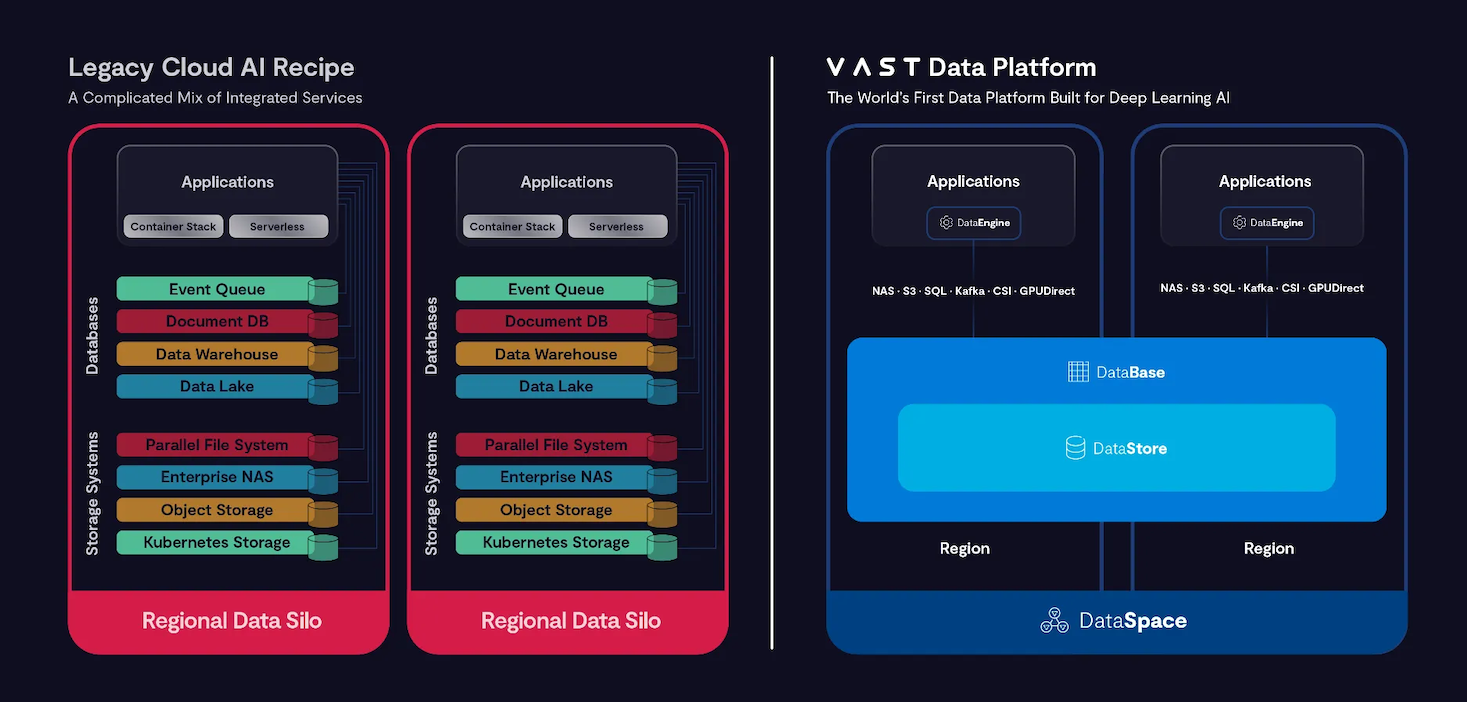
Das VAST-Data-Diagramm vergleicht einen herkömmlichen Cloud-KI-Stack mit separaten Datenbanken und Speichersystemen in regionalen Silos mit den Datenbank-, Datenspeicher- und Datenbereichsschichten der VAST-Data-Plattform, die sich über Regionen erstrecken.
AI  ◇  Unternehmen

DeepL setzt das VAST-KI-Betriebssystem für das Training von Sprachübersetzungen ein und erwartet die dreifache Kapazität seiner bestehenden NVMe-SSD.

VAST Data gab bekannt, dass DeepL das VAST AI-Betriebssystem als Datengrundlage für die Forschungsumgebungen seiner schriftlichen und Echtzeit-Sprachübersetzung einsetzt. Basierend auf den aktuellen Implementierungsplänen erwartet DeepL etwa die dreifache Speicherkapazität der bereits verwendeten NVMe-Hardware und wird VASTs SyncEngine für die Migration nutzen.

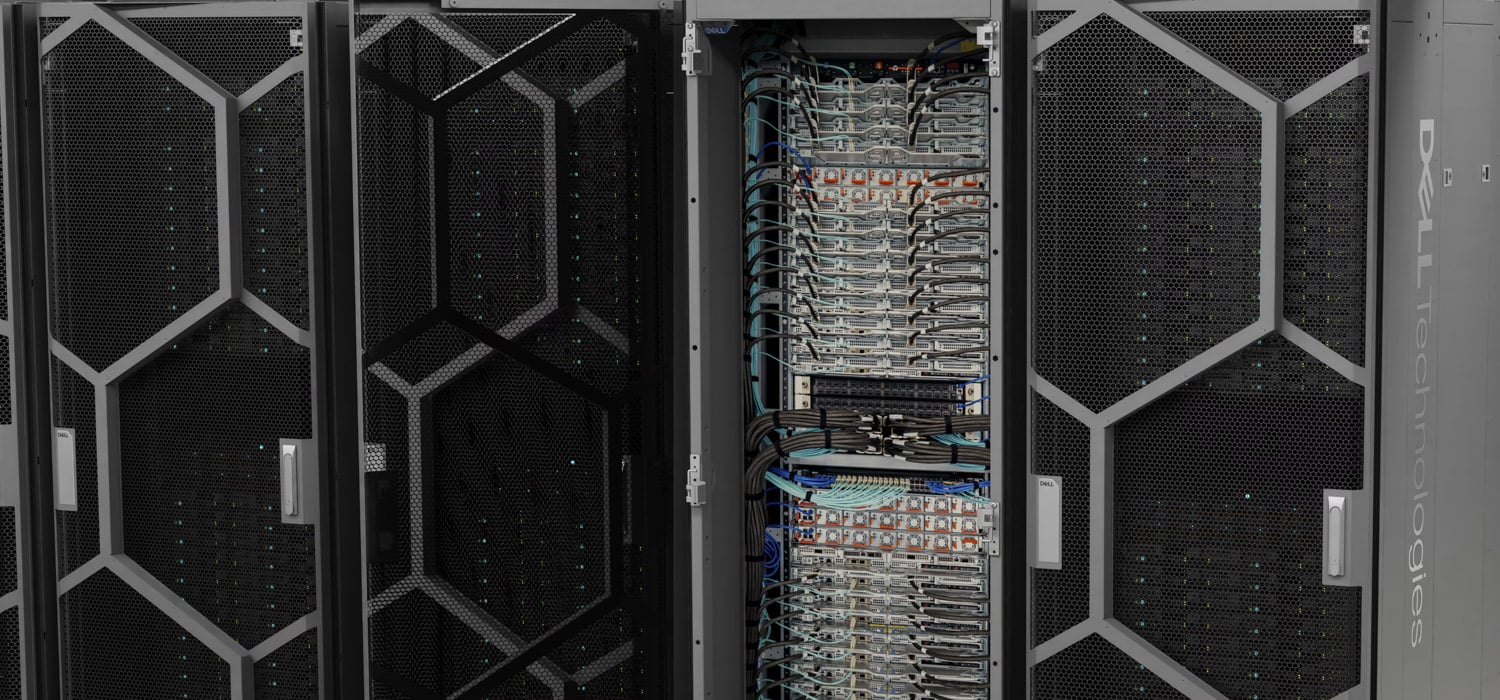
Dell Integrated Rack Scalable Systems-Schränke mit geöffnetem Mittelrack, das eine Säule mit PowerEdge M7725-Einschüben und Verkabelung zeigt – die Rack-Hardware hinter der Dell AI Factory mit NVIDIA
AI  ◇  Unternehmen

Dell AI Factory mit NVIDIA erweitert sein Angebot um ein Vera Rack mit 256 CPUs, ein Groq 3 LPU Inference Rack und einen GB10 Desktop mit 64 GB RAM.

Dell Technologies hat heute auf der NVIDIA GTC Berlin gemeinsam mit NVIDIA die Dell AI Factory erweitert. Vorgestellt wurden ein 48U PowerEdge M9882 Rack mit 256 NVIDIA Vera CPUs für die Ausführung agentenbasierter Workloads, das Rack-Scale-Inferenzsystem PowerEdge XE9810 auf Basis von Groq 3 LPUs, ein luftgekühlter Vera-Server mit zwei Sockeln, ein Dell Pro Precision mit 64 GB RAM und GB10-Speicher sowie ein weiteres Set.

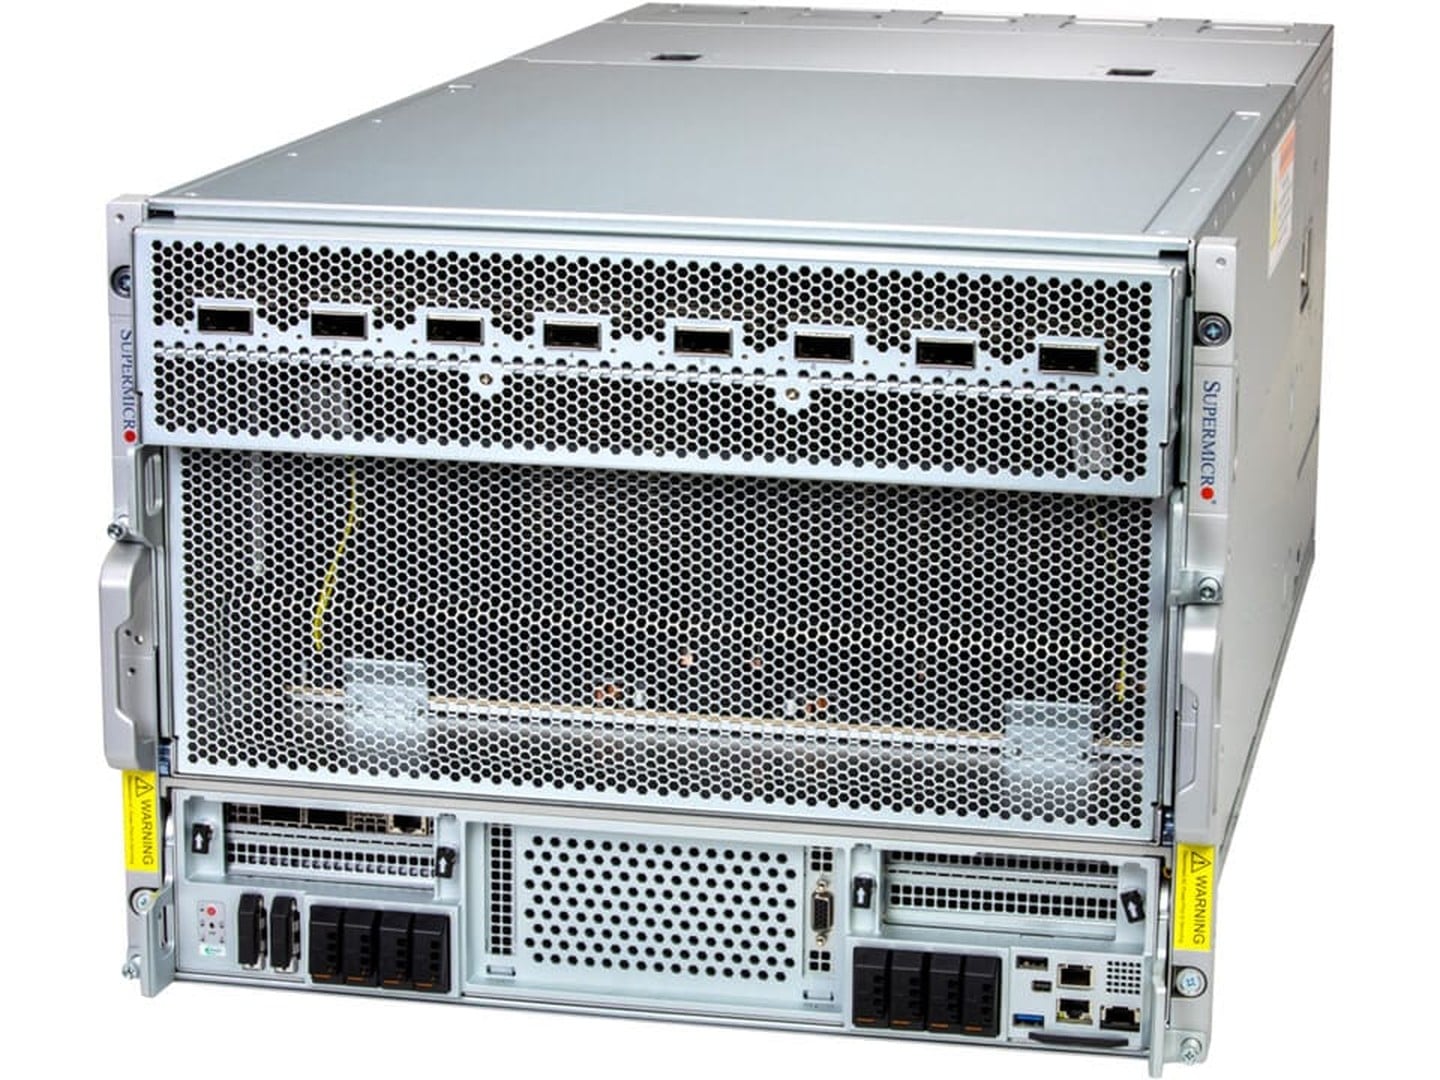
Supermicro AS-8126GS-NB3RT 8U GPU-Server mit NVIDIA HGX B300 Acht-GPU-Basisplatine, Vorderansicht mit E1.S- und M.2-Laufwerksschächten, eine der Serverklassen hinter dem privaten Nutanix-Inferenzsystem.
AI  ◇  Unternehmen

Nutanix Private Inference System mit Supermicro setzt auf acht NVIDIA B300 Blackwell Ultra GPUs pro Knoten hinter dedizierten NX Management- und Speicherclustern; Auslieferung Anfang 2027

Nutanix kündigte heute auf der NVIDIA GTC Berlin drei Kooperationen an: ein gemeinsam mit Supermicro entwickeltes privates Inferenzsystem, das auf Servern mit acht NVIDIA B300 Blackwell Ultra GPUs pro Knoten basiert, Day-Zero-Unterstützung für NVIDIA Vera CPUs ab NKP Bare Metal und einen Multitenant-Stack mit Netris, der die Mandantenisolation auf das physische Netzwerk ausdehnt.

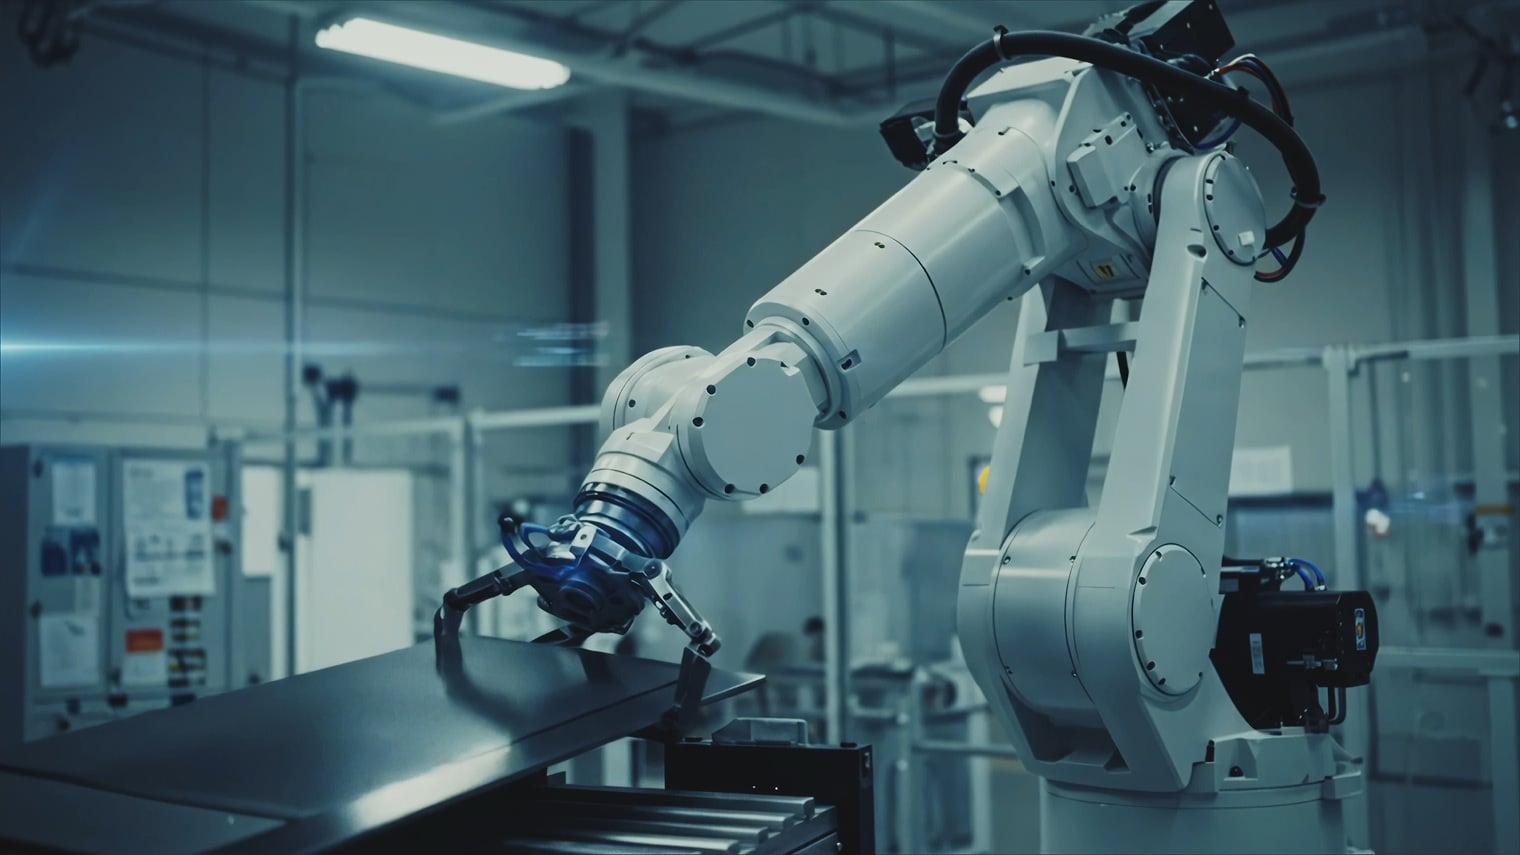
Industrieroboterarm entnimmt ein Teil von einem Tisch in einer Fabrikzelle – CoreWeaves Hauptbild für Physical AI Launchables.
AI  ◇  Unternehmen

CoreWeave Physical AI Launchables bündelt Isaac Sim, CARLA und MuJoCo unter einem einzigen Befehl mit einem sechsschichtigen Zero-Trust-KI-Framework.

CoreWeave hat heute auf der NVIDIA GTC Berlin Physical AI Launchables und das CoreWeave Zero Trust AI Framework vorgestellt. Launchables ist ein Katalog getesteter, sofort einsatzbereiter Vorlagen für Robotik- und autonome Fahrzeugwerkzeuge. Jede Vorlage wird mit einem einzigen Befehl gestartet und kombiniert Umgebungen für NVIDIA Isaac Sim, CARLA, MuJoCo, NVIDIA AlpaSim und NVIDIA Cosmos 3 mit optimierten Codierungsagenten-Fähigkeiten.

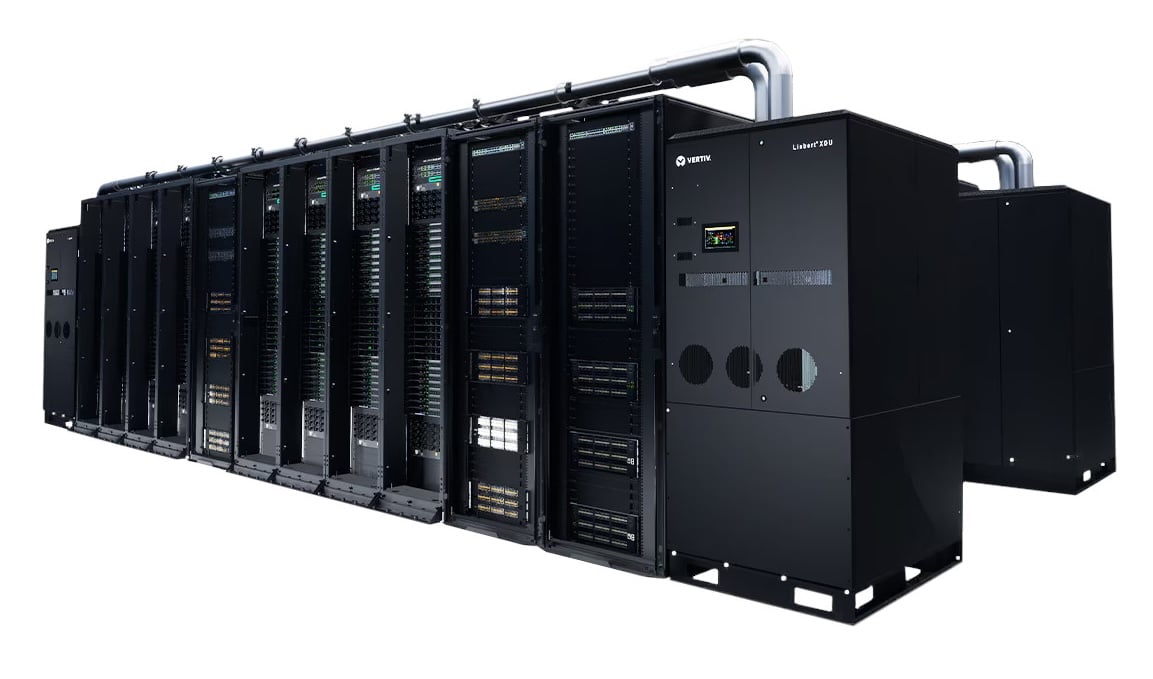
HPE AI Factory mit NVIDIA-Rendering einer Reihe von Rechenracks mit Vertiv Liebert XDU-Kühlmittelverteilungseinheiten am Ende der Reihe
AI  ◇  Unternehmen

HPE Private Cloud AI erweitert sein Angebot um MCP-Server, gemischte H200- und RTX PRO 6000-Cluster sowie ein NVIDIA Vera Rack mit 256 CPUs.

HPE hat heute auf der NVIDIA GTC Berlin in Zusammenarbeit mit NVIDIA Updates für die HPE AI Factory angekündigt. Die meisten Änderungen betreffen HPE Private Cloud AI. Entwickler, unabhängige Softwareanbieter und KI-Agenten erhalten über Produktions-APIs und MCP-Server (Model Context Protocol) kontrollierten Zugriff auf die Inferenzfunktionen, Modelle und Pipelines der Plattform. Cluster können nun verschiedene Funktionen kombinieren.

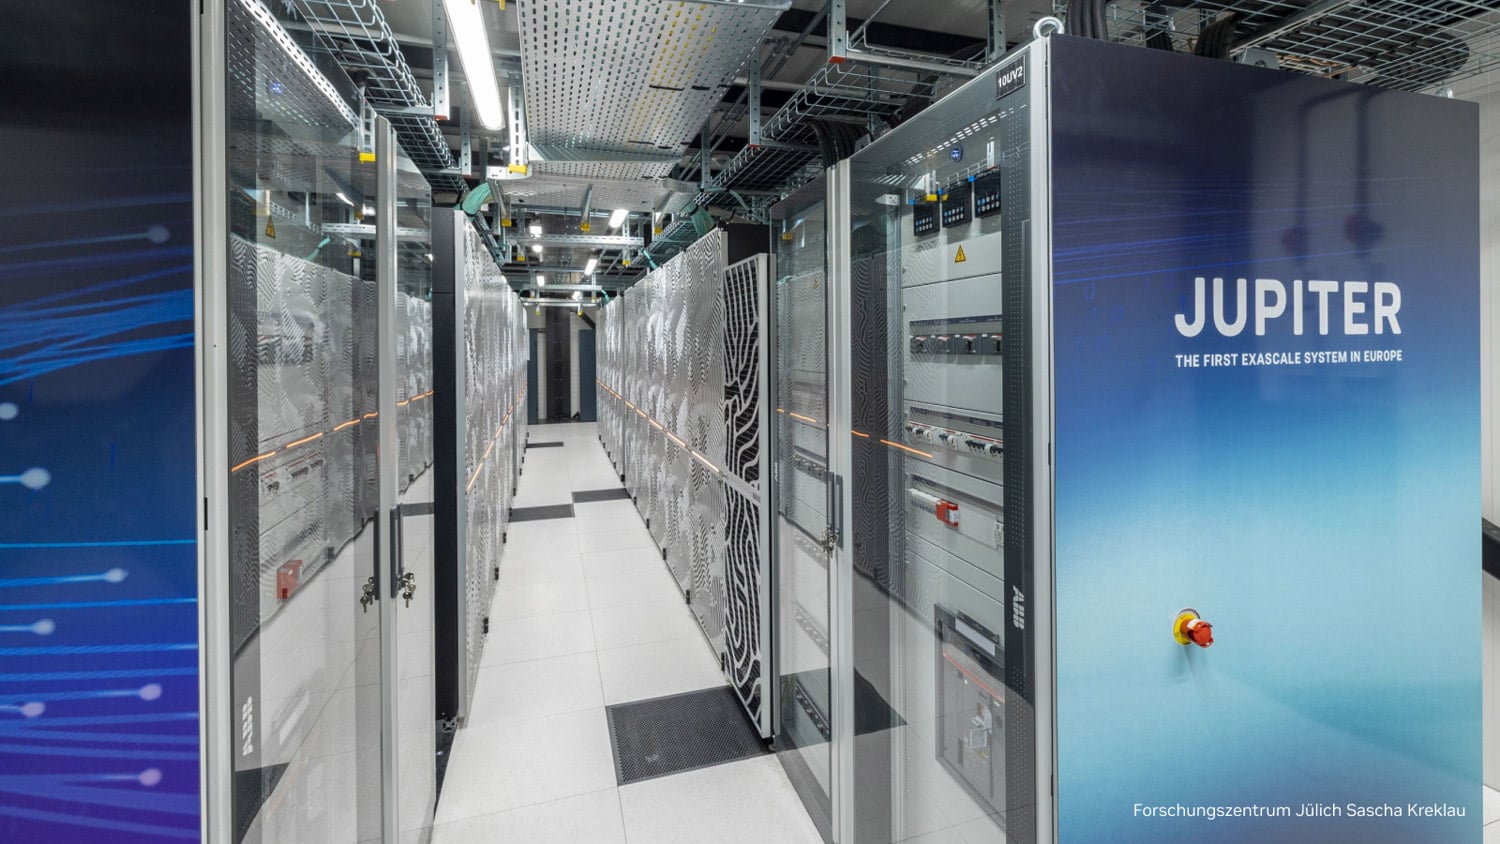
JUPITER-Supercomputer-Rackgang im Forschungszentrum Jülich mit einem JUPITER-Panel, dem ersten Exascale-System in Europa, am Endschrank
AI  ◇  Unternehmen

NVIDIA JUPITER Quantensimulationsmodelle eines fehlertoleranten 104-Qubit-Prozessors auf 8,192 GH200-GPUs und 512 TiB

NVIDIA hat auf JUPITER, Europas erstem Exascale-Supercomputer am Jülich Supercomputing Centre, eine 104-Qubit-Simulation eines fehlertoleranten Quantenprozessors mit 8,192 GH200-GPUs durchgeführt. Die Simulation, die im Vorfeld der GTC Berlin angekündigt wurde, modelliert die Kultivierung magischer Zustände – eine Methode zur Erzeugung der Nicht-Clifford-Zustände, die ein fehlertoleranter Computer während logischer Operationen benötigt – unter realistischem Hardware-Rauschen.