

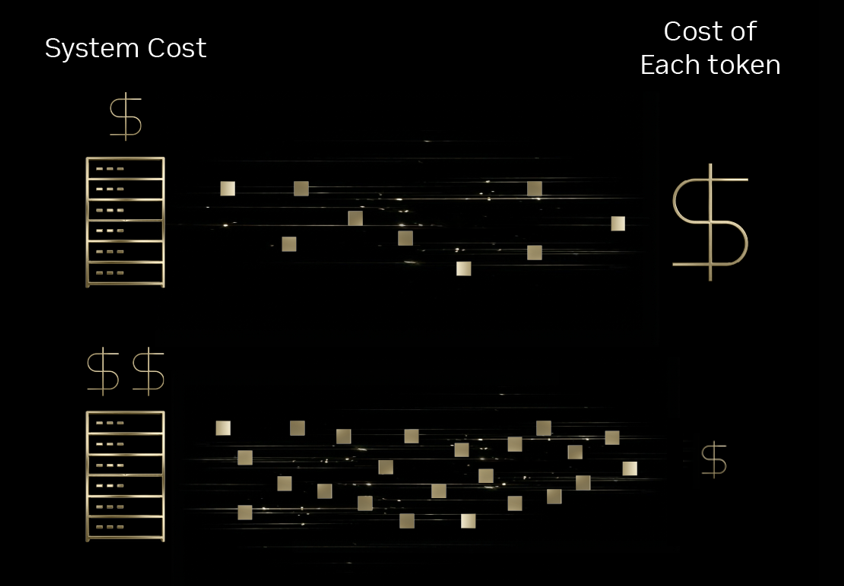
Die grundlegende Intelligenzeinheit in modernen KI-Interaktionen ist der Token. Ob für klinische Diagnostik, interaktive Spieldialoge oder autonome Kundenservice-Agenten – die Skalierbarkeit dieser Anwendungen hängt maßgeblich von der Tokenomics ab. Aktuelle Daten des MIT zeigen, dass Fortschritte bei der Infrastruktur und der algorithmischen Effizienz die Inferenzkosten jährlich um bis zu das Zehnfache senken. Führende Anbieter von Inferenzlösungen, darunter Baseten, DeepInfra, Fireworks AI und Together AI, nutzen nun die NVIDIA Blackwell-Plattform, um diese Effizienzsteigerungen zu erzielen und die vorherige Hopper-Generation oft um ein Vielfaches zu übertreffen.
Effizienzsteigerung im Gesundheitswesen durch Baseten und Sully.ai
Im Gesundheitswesen beeinträchtigen administrative Aufgaben wie die medizinische Kodierung und Dokumentation die Patientenversorgung erheblich. Sully.ai begegnet diesem Problem durch den Einsatz von KI-Agenten zur Automatisierung dieser Routineaufgaben. Zuvor stieß das Unternehmen bei der Verwendung proprietärer, quelloffener Modelle auf Engpässe, darunter unvorhersehbare Latenzzeiten und Inferenzkosten, die das Umsatzwachstum überstiegen.
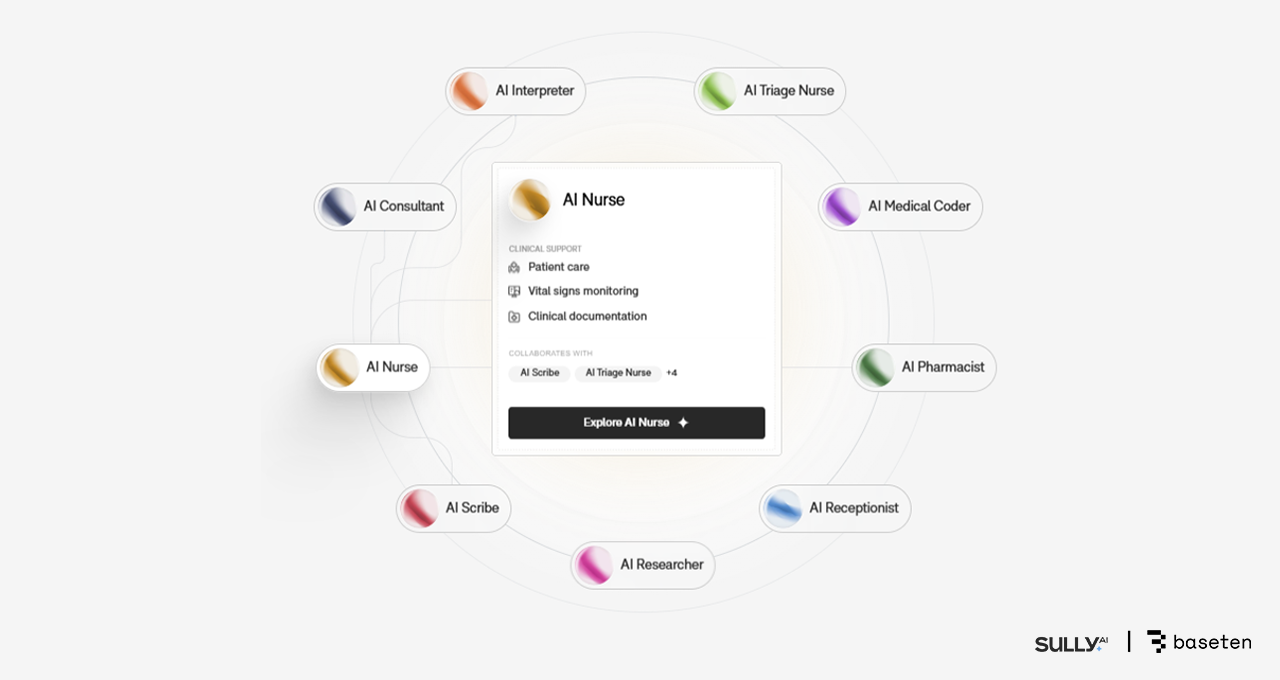
Durch die Migration zur Model-API von Baseten, die Open-Source-Modelle auf NVIDIA Blackwell GPUs nutzt, konnte Sully.ai die Inferenzkosten um 90 Prozent senken. Baseten optimierte den Stack mit dem NVFP4-Datenformat, TensorRT-LLM und dem NVIDIA Dynamo-Inferenzframework. Der Übergang führte zu einer 2.5-fachen Steigerung des Durchsatzes pro Dollar im Vergleich zu Hopper und einer Verbesserung der Antwortzeiten um 65 Prozent. Bislang hat die Implementierung Ärzten durch die Automatisierung der manuellen Dateneingabe über 30 Millionen Minuten Zeit gespart.
Gaming-Performance mit DeepInfra und Latitude
Latitude, die Entwickler von AI Dungeon und der Voyage-RPG-Plattform, stehen vor besonderen Skalierungsherausforderungen, da jede Spieleraktion eine Inferenzanfrage erfordert. Für ein reibungsloses Spielerlebnis sind geringe Latenz und eine kosteneffiziente Token-Übermittlung unerlässlich. Durch den Einsatz umfangreicher Mixture-of-Experts-Modelle (MoE) auf der Blackwell-basierten Infrastruktur von DeepInfra konnte Latitude die Kosten deutlich senken.
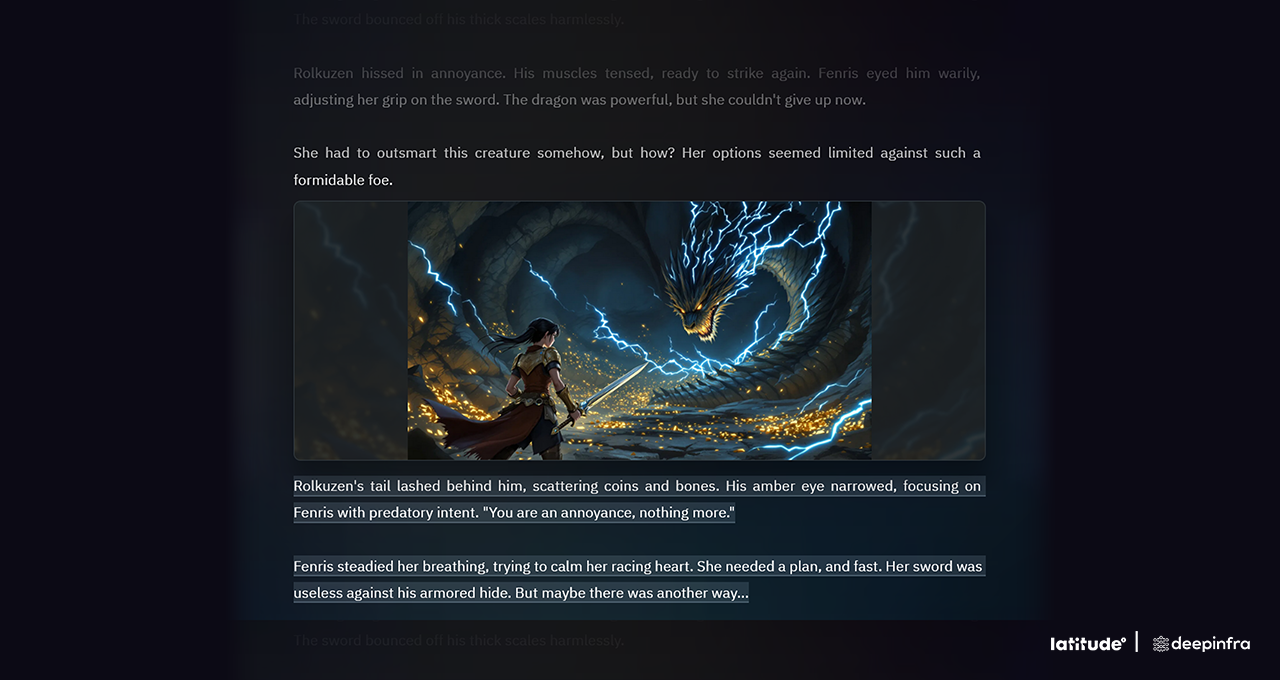
DeepInfra senkte die Kosten pro Million Token von 20 Cent auf Hopper auf 10 Cent auf Blackwell. Durch die Nutzung des nativen, niedrigpräzisen NVFP4-Formats von Blackwell konnten die Kosten weiter auf 5 Cent pro Million Token halbiert werden. Diese vierfache Verbesserung ermöglicht es Latitude, komplexere Modelle einzusetzen und Lastspitzen abzufangen, ohne die Benutzerfreundlichkeit oder Genauigkeit zu beeinträchtigen.
Skalierung agentenbasierter Workflows mit Fireworks AI und Sentient
Sentient Labs entwickelt Open-Source-KI-Systeme für logisches Denken, wie beispielsweise Sentient Chat, das Multiagenten-Workflows orchestriert. Diese komplexen Interaktionen lösen häufig eine Kaskade autonomer Aufgaben aus, was einen erheblichen Infrastrukturaufwand verursacht. Durch die Nutzung der Inferenzplattform von Fireworks AI auf NVIDIA Blackwell konnte Sentient die Kosteneffizienz im Vergleich zu Hopper-basierten Implementierungen um 25 bis 50 Prozent steigern.
Der gesteigerte Durchsatz pro GPU ermöglichte es Sentient, massive Parallelität zu bewältigen. Während einer rasanten Markteinführungsphase verarbeitete die Plattform innerhalb von 24 Stunden 1.8 Millionen Nutzer auf der Warteliste und bearbeitete in einer einzigen Woche 5.6 Millionen Anfragen. Der für Blackwell optimierte Stack gewährleistete trotz des hohen Anfragevolumens eine konstant niedrige Latenz.
Enterprise-Sprachunterstützung über Together AI und Decagon
Decagon bietet KI-Agenten für den Kundensupport in Unternehmen, wo Sprachinteraktionen Reaktionszeiten im Subsekundenbereich erfordern, um praktikabel zu sein. Together AI hostet Decagons Multimodell-Sprachstack auf NVIDIA Blackwell und implementiert Optimierungen wie spekulative Dekodierung und das Caching wiederholter Gesprächselemente.
Diese technischen Verbesserungen reduzierten die Antwortzeiten auf unter 400 Millisekunden, selbst bei Anfragen mit Tausenden von Tokens. Durch die Kombination von Open-Source- und Eigenentwicklungen mit Blackwells Hardware-Software-Co-Design senkte Decagon die Kosten pro Anfrage im Vergleich zu proprietären Closed-Source-Alternativen um das Sechsfache.
Die Zukunft der Tokenomics
Der Übergang zu NVIDIA Blackwell, insbesondere zum GB200 NVL72-System, markiert einen Wendepunkt in der großflächigen Implementierung von MoE-basierten Reasoning-Modellen. Die Fähigkeit der Plattform, die Kosten pro Token um das Zehnfache zu senken, resultiert aus der tiefen Integration von Rechen-, Netzwerk- und Softwareebenen. Die kommende NVIDIA Rubin-Plattform wird diesen Trend voraussichtlich fortsetzen und im Vergleich zur Blackwell-Architektur eine weitere zehnfache Verbesserung der Leistung und Token-Kosteneffizienz erzielen.


 Amazon