

MLCommons hat MLPerf Inference v6.1 veröffentlicht. Mit 30 teilnehmenden Organisationen und 486 Ergebnissen aus Rechenzentren und Edge-Umgebungen verzeichnet diese Runde einen neuen Teilnehmerrekord. Zwei neue Tests ergänzen die Suite: eine End-to-End-RAG-Pipeline für Rechenzentren und ein Edge Agentic Inference Benchmark für Einzelplatzgeräte. Die Ergebnisse enthalten die ersten von Experten begutachteten Zahlen für NVIDIAs Vera Rubin NVL72, AMDs Instinct MI350P, Intels Arc Pro B70 und AMDs Ryzen AI Max+ 395. Laut MLCommons ist das beste DeepSeek-R1-Ergebnis pro Beschleuniger im Server-Szenario 5.7-mal besser als in Version 5.1 vor einem Jahr, und das beste VLM-Ergebnis hat sich in den sechs Monaten seit Version 6.0 um das 2.99-Fache verbessert.
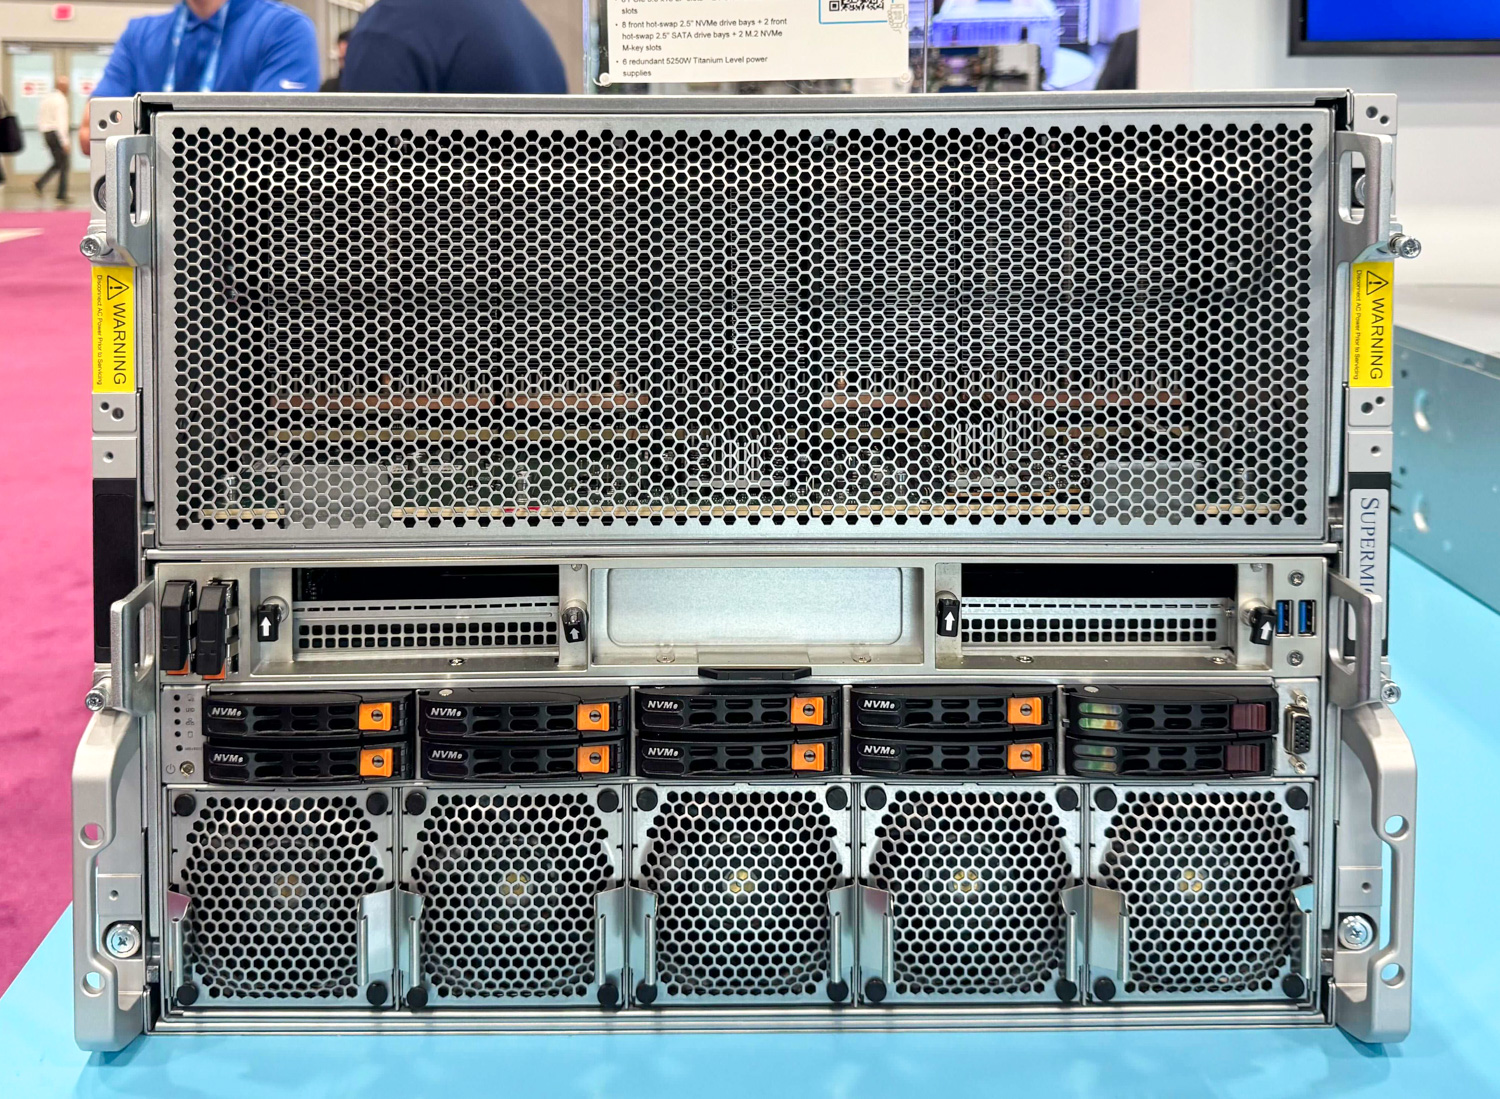
Zwei neue Tests: End-to-End-RAG und Edge-Agenten-Inferenz
Der End-to-End RAG-Benchmark misst eine vollständige Pipeline zur Beantwortung von Fragen, die mehrere Modelle und eine Vektordatenbank umfasst. Die Referenzimplementierung verwendet vier Modelle gleichzeitig: gpt-oss-120B übernimmt die Zerlegung von Anfragen, die Überprüfung der Relevanz und die Generierung von Antworten; gpt-oss-20B bewertet die abgerufenen Dokumente; e5-base-v2 erzeugt Einbettungen; und ColBERTv2 führt ein Reranking der Textpassagen durch. Das Korpus besteht aus 107,484 Textpassagen, die aus 2,515 HTML-Dateien extrahiert wurden; die Fragen sind 824 Multi-Hop-Aufgaben aus Googles FRAMES-Datensatz; und jede Aufgabe kann bis zu fünf Abrufrunden durchlaufen, bevor die Pipeline entscheidet, dass genügend Evidenz vorhanden ist. Zwei Metriken werden ermittelt: Dokumente pro Sekunde für den Aufbau der FAISS HNSW-Vektordatenbank und Aufgaben pro Sekunde für die Beantwortung von Fragen gegen diese Datenbank. Ein Llama 3.1-8B-Wertungsrichter bewertet die endgültigen Antworten anhand eines Zielwerts von 97% Genauigkeit; die Bewertung erfolgt ohne Zeitbegrenzung.
Der Edge Agentic Inference Benchmark zielt auf das Codierungsassistenten-Muster ab, das sich auf Workstations und Desktop-KI-Systeme ausgebreitet hat. Das Modell ist Qwen3.6-27B (mit deaktiviertem Thinking), ausgeführt als Q4_K_M GGUF unter llama.cpp aus der Referenzbibliothek, mit einem Kontextfenster von 32 Bytes pro Zug. Die Leistungsmessung besteht aus der Aufzeichnung von 20 agentenbasierten Codierungstrajektorien aus SWE-bench Verified mit insgesamt 1,007 Zügen. Diese werden in einem einzigen Datenstrom mit einer gleichzeitig laufenden Anfrage ausgeführt – so, wie ein Entwickler einen Agenten auf einem Laptop ausführt. Die gemessene Metrik ist die mittlere Latenz pro Zug, zusammen mit den Verteilungen für die Zeit bis zum ersten Token und die Zeit pro Ausgabetoken. Die Genauigkeit wird separat mit BFCL v4 auf 97 % des Referenzwertes begrenzt. MLCommons hat das Framework von seinem kommenden MLPerf Agentic Datacenter Benchmark übernommen.
„Wir haben den End-to-End-RAG-Test hinzugefügt, da die Beantwortung von Anfragen sich deutlich weiterentwickelt hat und nicht mehr nur auf einem Korpus trainierte LLM-Modelle umfasst. Die Beteiligten müssen die tatsächliche Leistungsfähigkeit der heute entwickelten, mehrstufigen und mehrkomponentigen Pipelines verstehen“, so Miro Hodak, Co-Vorsitzender der MLPerf-Arbeitsgruppe Inferenz. „Ebenso haben wir den Edge-Agentic-Inferenztest eingeführt, da komplexe Inferenzsysteme mit agentenbasierten Eigenschaften zunehmend auf Edge-Computing-Geräten ausgeführt werden, was unsere Kunden vor neue Herausforderungen hinsichtlich der Leistungsfähigkeit stellt.“
Die Runde erweitert außerdem die spekulative Dekodierungsunterstützung, die bisher auf DeepSeek-R1 beschränkt war, auf den GPT-OSS-Benchmark im interaktiven Szenario und definiert ein neues interaktives Szenario für den VLM-Test mit auf etwa 1.5 Sekunden angestrebten Antworten.
Neue Siliziumchips – vom Desktop bis zum Rack
NVIDIAs Vera Rubin NVL72 feiert sein Debüt bei MLPerf in der Preview-Kategorie. Die Plattform wurde von NVIDIA und Nebius auf Basis des VR200 NVL72 eingereicht. NVIDIA berichtet von einem bis zu 2.5-fach höheren Token-Durchsatz als beim GB300 NVL72 auf DeepSeek-R1 in Offline-, Server- und interaktiven Szenarien mit TensorRT-LLM und bis zu 3.7-fach höherem Durchsatz beim Qwen3-Vision-Sprachmodell mit vLLM und NVIDIA Dynamo. Diese Werte stammen von NVIDIA im Vergleich zur Vorgängergeneration. Die Preview-Einstufung deutet darauf hin, dass die Plattform voraussichtlich in der nächsten Runde kommerziell verfügbar sein wird.
AMD erweiterte seine Teilnahme am MLPerf Inference 6.1-Wettbewerb auf sechs Modellfamilien für Sprachverarbeitung, logisches Schlussfolgern, Text-zu-Video-Konvertierung und Empfehlungsfunktionen und setzte dabei die Instinct-Chips MI355X, MI350X und die neue PCIe-Karte MI350P ein. Der auf dem MI355X basierende Crusoe-Cluster mit 512 GPUs wird im Folgenden zusammen mit AMDs eigener Analyse der Ergebnisse vorgestellt.
Intels Arc Pro B70 kommt in einem Vier-GPU-Knoten mit insgesamt 128 GB VRAM zum Einsatz, den Intel für Llama 3.1-8B, Llama 2-70B, gpt-oss-120B, Whisper und den neuen E2E-RAG-Test verwendet. Laut Intel verbesserte sich gpt-oss-120B im Serverbetrieb um 36 % und im Offline-Betrieb um 27 % gegenüber Version 6.0 auf derselben Hardware. Auf CPU-Seite gibt Intel an, dass der Durchsatz des Xeon 6980P Llama 3.1-8B Servers gegenüber Version 6.0 auf identischem Silizium um das 2.4-Fache gestiegen ist – ein rein softwareseitiger Zuwachs.
Der Ryzen AI Max+ 395 wurde von Atlas Inference veröffentlicht, einem erstmaligen Anbieter, der die neue Edge Agentic-Workload sowohl auf einem NVIDIA DGX Spark als auch auf einem AMD Strix Halo Desktop mit derselben Engine und demselben Quantisierungsrezept ausgeführt hat. Atlas meldet 20.1 Token pro Sekunde auf dem DGX Spark, wobei alle 1,007 Runden in unter 64 Minuten abgeschlossen wurden, und 19.63 Token pro Sekunde auf dem Strix Halo. Das ist ein geringerer Unterschied als bei unseren Tests von Ryzen AI Halo und DGX Spark mit Standard-Laufzeitumgebungen zwischen den beiden Plattformen – genau das Ergebnis, das der neue Benchmark liefern soll.
Größer, vielfältiger und dezentralisierter
Die Anzahl der Multi-Node-Einreichungen erreichte in dieser Runde einen Rekordwert, verglichen mit null in Version 4.0. Drei davon stechen besonders hervor. Crusoe, ebenfalls ein Erstteilnehmer, betrieb mit AMD das größte System in der Geschichte von MLPerf Inference: 512 Instinct MI355X GPUs auf 64 Knoten in einem Standard-RoCE-Ethernet-Netzwerk, eingereicht für gpt-oss-120b und DeepSeek-R1. AMD berichtet von 5.75 Millionen Token pro Sekunde im Offline-Szenario und 5.39 Millionen im Server-Szenario auf gpt-oss-120b von diesem Cluster sowie 2.90 Millionen offline und 2.41 Millionen im Server-Szenario auf DeepSeek-R1, was AMD als den höchsten aggregierten Token-Durchsatz in der Geschichte von MLPerf bezeichnet, wobei der Durchsatz von 1 bis 64 Knoten nahezu linear skaliert. Der gpt-oss-120b-Lauf diente dem Modell als 512 unabhängige Einzel-GPU-Replikate in nativem MXFP4; DeepSeek-R1 nutzte SGLang mit einer Acht-GPU-Replika pro Knoten. AMD verweist separat auf eine GPT-OSS-120B-Einreichung mit 72 GPUs, die eine Skalierungseffizienz von 95 % und 1 Million Token pro Sekunde erreicht – dieselben Werte, die bereits für MI355X in Version 6.0 erzielt wurden.
Cisco reichte das erste herstellerübergreifende heterogene System für den Benchmark ein. Es bündelte acht NVIDIA H200- und acht AMD Instinct MI350X-GPUs zu einem einzigen Inferenzpool über ein Cisco Silicon One G200-Fabric – denselben Ansatz mit gemischten Beschleunigern, den Cisco über seine Secure AI Factory anbietet . Der geografisch verteilte Beitrag kam von MangoBoost in Zusammenarbeit mit Dell: Vier Standorte auf zwei Kontinenten, gehostet von MangoBoost, Dell, TensorWave und Microsoft Azure, erstreckten sich über den Pazifik und liefen als ein einziger Endpunkt mit einer von MangoBoost angegebenen Skalierungseffizienz von 97 %. MangoBoost beansprucht außerdem die ersten Ergebnisse mit getrennter Vorbefüllung und Dekodierung auf AMD Instinct-GPUs.
In anderen Ergebnissen meldet CoreWeave 1.16 Millionen Token pro Sekunde auf GB300 NVL72, wobei der Offline-Durchsatz pro GPU seit Version 6.0 um 17 % gestiegen ist. HPE gibt 8,500 Token pro Sekunde und GPU auf DeepSeek-R1 auf zwei Compute XD690-Servern mit Blackwell Ultra an. Google konzentrierte sich bei seiner Einreichung auf DeepSeek-R1 und begründete dies mit dem Branchentrend hin zu großen Mixture-of-Experts-Modellen. gpt-oss-120b verzeichnete mit 112 Einreichungen die meisten aller MLPerf-Workloads.
Die zwei CDNA-4-Formfaktoren von AMD: OAM und Dual-Slot PCIe
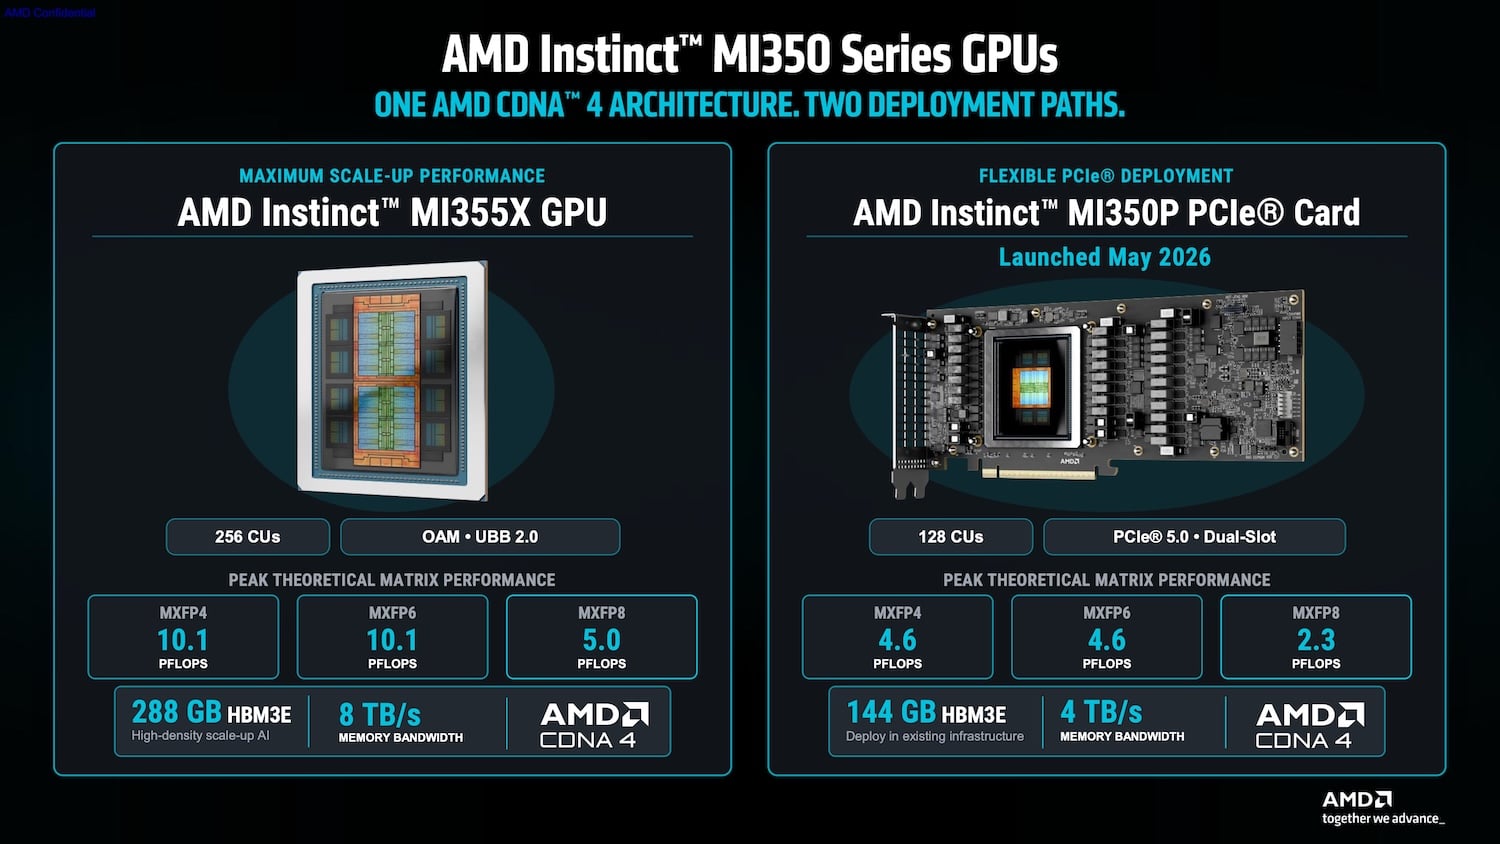
Die CDNA-4-Architektur von AMD ist in zwei Bauformen verfügbar, um den spezifischen Anforderungen von Rechenzentren hinsichtlich Stromversorgung und Kühlung gerecht zu werden. Das Flaggschiff Instinct MI355X ist für hochdichte Rechenknoten konzipiert und nutzt einen OAM-Formfaktor auf einer OCP Universal Baseboard (UBB 2.0)-Plattform. Es bietet 256 Recheneinheiten, 288 GB HBM3E-Speicher und eine aggregierte Speicherbandbreite von 8 TB/s. Die theoretische Spitzenleistung der MXFP4- und MXFP6-Matrixberechnung liegt bei bis zu 10.1 PFLOPS. Die neu eingeführte Instinct MI350P nutzt dieselbe CDNA-4-Architektur als Dual-Slot-PCIe-5.0-Erweiterungskarte für Standard-Enterprise-Gehäuse. Sie beherbergt 128 Recheneinheiten, 144 GB HBM3E-Speicher, eine Bandbreite von 4 TB/s und erreicht eine theoretische Spitzenleistung der MXFP4- und MXFP6-Matrixberechnung von bis zu 4.6 PFLOPS.
Softwaregetriebene Generationsverbesserung auf identischem Silizium
Softwareoptimierungen in AMD ROCm v7 führten zu messbaren Durchsatzsteigerungen auf identischer MI355X-Hardware innerhalb eines einzelnen MLPerf-Zyklus. Tests auf einem Acht-GPU-MI355X-Knoten zeigten einen Anstieg des GPT-OSS-120B-Durchsatzes um 28 % im Offline-Szenario und um 38 % im Server-Szenario, während die WAN-2.2-SingleStream-Leistung um 70 % verbessert wurde. Im Cluster-Maßstab erzielten 72 MI355X-Beschleuniger in MLPerf 6.1 einen höheren Gesamtdurchsatz im GPT-OSS-120B-Test als eine 94-GPU-Konfiguration aus Runde 6.0. In von AMD veröffentlichten Vergleichstests übertraf der Acht-GPU-MI355X die eingereichten Ergebnisse gegenüber NVIDIA B200 und B300 im GPT-OSS-120B-Test, während der 72-GPU-Cluster NVIDIAs GB200-Einreichung übertraf.
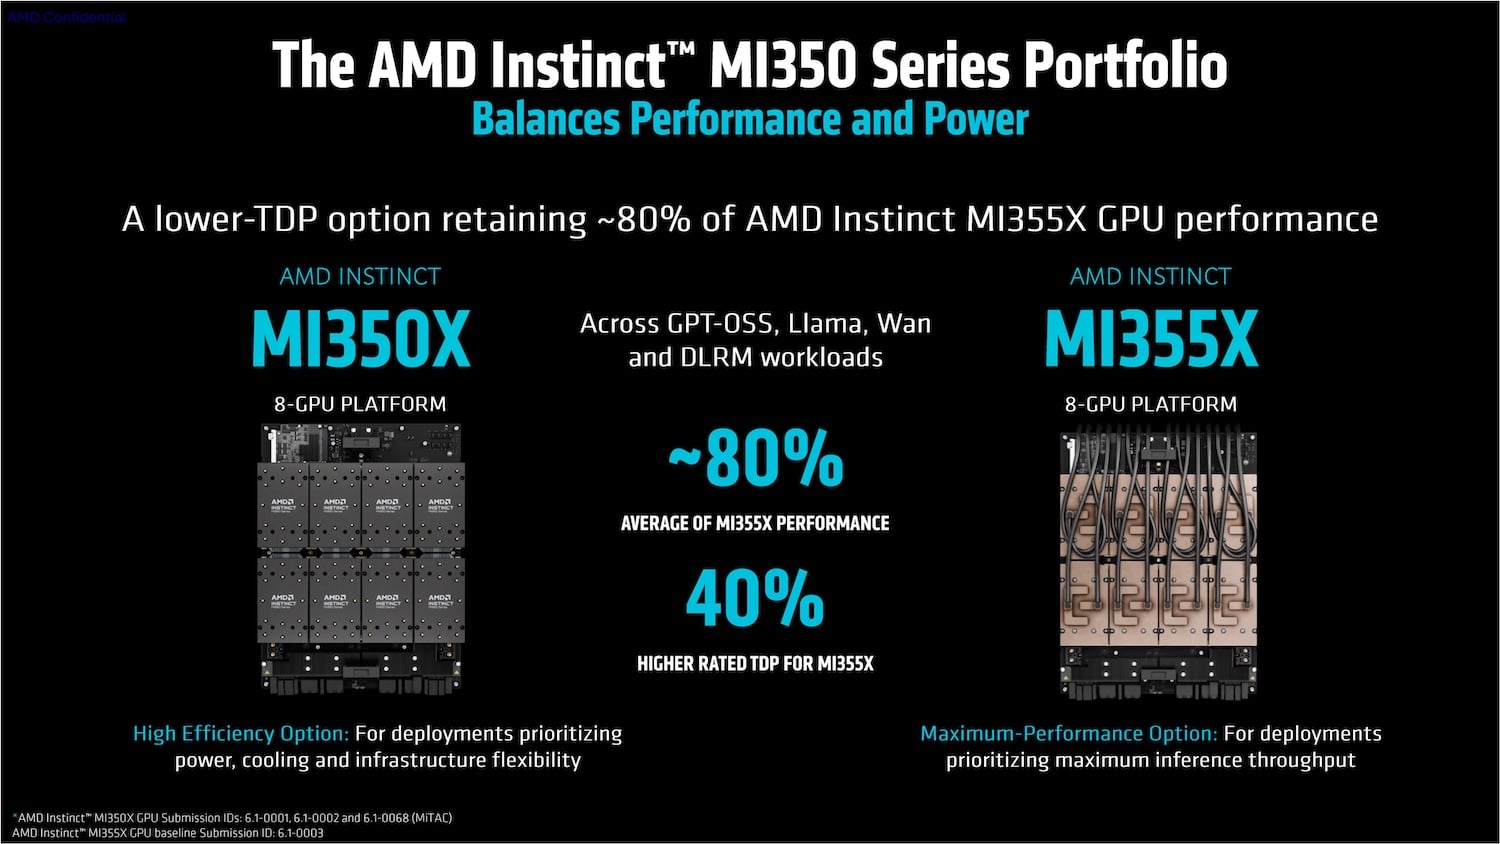
In der ersten MLPerf-Runde erzielte die Dual-Slot-Karte MI350P in fünf geschlossenen Workloads führende Ergebnisse im Vergleich zu ausgewählten Einreichungen der NVIDIA RTX PRO 6000 Server Edition und der H200 NVL. Für Umgebungen mit begrenztem Strom- und Kühlbudget erreichte ein System mit acht GPUs, die MI350X, bei GPT-OSS-, Llama-, WAN- und DLRM-Workloads etwa 80 % der Benchmark-Leistung der MI355X-Plattform, obwohl die TDP der MI355X um 40 % höher ist. Eine von Signal65 in Auftrag gegebene Studie ergab, dass diese Durchsatzwerte innerhalb festgelegter Latenzgrenzen zu geringeren Betriebskosten pro Dokument und einem höheren Token-Output pro Dollar führen.
AMD-Partnerergebnisse und das Korea-USA-Cluster
AMD gibt an, dass vergleichbare MI355X-Einsendungen von sieben Partnern – Dell Technologies, Oracle, Hewlett Packard Enterprise, Supermicro, MangoBoost, Crusoe und MiTAC – im Durchschnitt innerhalb von 4 % der Ergebnisse des Referenzsystems lagen, wobei einige Läufe diese erreichten oder sogar leicht übertrafen.
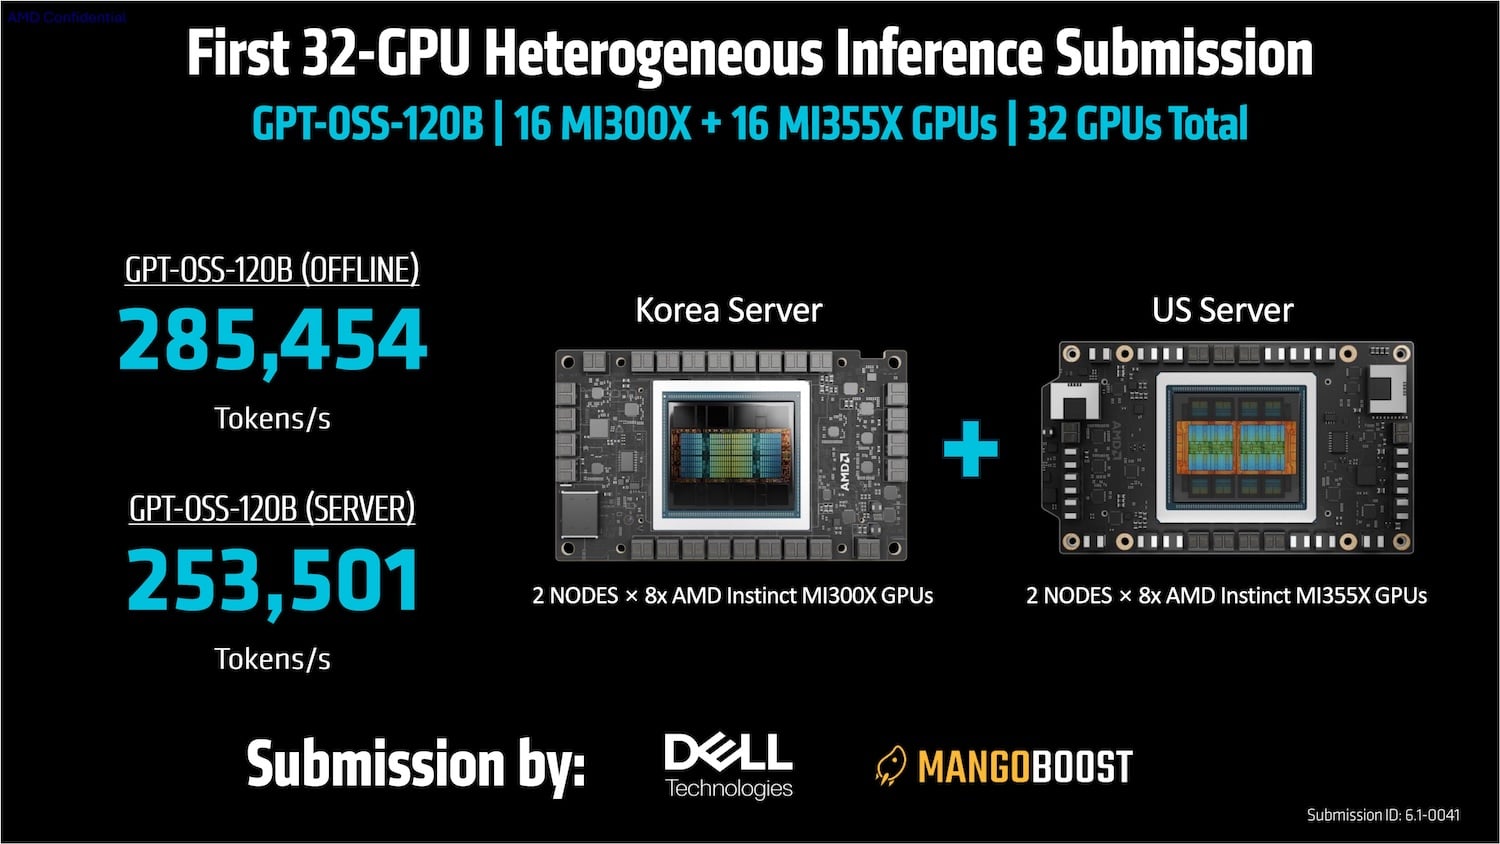
Der oben erwähnte Eintrag von MangoBoost und Dell ist die erste heterogene 32-GPU-Serverkonfiguration im Benchmark. Sie verbindet 16 Instinct MI300X-GPUs der vorherigen Generation in Korea mit 16 Instinct MI355X-GPUs in den USA zu einem einheitlichen GPT-OSS-120B-Endpunkt. Die Split-Cluster-Konfiguration erreichte 285,454 Offline-Token pro Sekunde und 253,501 Server-Token pro Sekunde. Die Tests wurden mit ROCm 7 durchgeführt. AMD sieht ROCm 10 mit den Profiling-Tools vLLM, SGLang und ROCm.AI als zukunftsweisend für die HBM4-basierte MI400-Serie und die nachfolgende MI500-Generation.
Das Harness, das die MLPerf-Inferenz im Rechenzentrum ersetzt
In dieser Runde nutzten 16 der 30 Einreicher die API-zentrierte Testumgebung von MLPerf, im Vergleich zu nur einem Einreicher mit offener Division in Version 6.0. Die Testumgebung verwendet eine echte Client/Server-Architektur über Standard-APIs für einen gehosteten Endpunkt – die übliche Vorgehensweise bei Datacenter-Inference. Sie umfasst bereits den neuen Edge Agentic Test, VLM-Interactive, gpt-oss, DeepSeek-R1, Llama 3.1-8B und Text-to-Video. Sie bildet die Grundlage für MLPerf Endpoints, das ab Oktober 2026 fortlaufende Einreichungen ermöglicht und 2027 MLPerf Inference als Datacenter-Benchmark ablöst. Normalisierte Ergebnisse und erweiterte agentenbasierte Workloads sind für Endpoints v1.0 geplant.
„Zukünftig werden MLPerf Endpoints die Inferenz in unserer Benchmark-Familie für Rechenzentren ersetzen. Die schnelle Akzeptanz unseres API-zentrierten Frameworks wird diesen Übergang reibungslos gestalten“, so David Kanter, Leiter von MLPerf. Die sechs Erstteilnehmer dieser Runde sind Atlas Inference, Crusoe, Orrick Industries, ScitiX, VibeHPC sowie der Einzelbeitragende Naeem Khoshnevis vom Kempner Institute der Harvard University, der ein Ergebnis für den H200 Llama 3.1-8B-Benchmark eingereicht hat.
Die Inferenzrunde folgt den vor zwei Wochen veröffentlichten Ergebnissen von MLPerf Storage v3.0. Vollständige Datacenter- und Edge-Tabellen sowie ergänzende Daten der Einreicher sind auf den MLCommons-Ergebnisseiten verfügbar.


 Amazon