

Die ASUS ExpertCenter Pro ET900N G3 ist die zweite GB300 DGX Station, die wir getestet haben, und die erste, die wir im Labor in die Hand nehmen konnten; unsere Tests der MSI XpertStation WS300 wurden remote durchgeführt. Sie verwendet denselben NVIDIA-Chip, den wir in der MSI XpertStation WS300 getestet haben: einen Grace Blackwell Ultra Desktop Superchip mit 72 Grace-Kernen, eine B300-GPU, 252 GB HBM3e, 496 GB LPDDR5X und eine ConnectX-8 SuperNIC mit zwei 400GbE-Anschlüssen. ASUS verpackt diese bewährte Plattform in einem kompakten Tower, der speziell für den Einsatz am Schreibtisch konzipiert wurde, und bietet einige Extras, die in der WS300 nicht vorhanden sind: zwei Tragegriffe an der Oberseite, einen separaten Lüfter für die ConnectX-8-Optikkäfige und ein 1,600-Watt-Netzteil mit 80 PLUS Titanium-Zertifizierung.
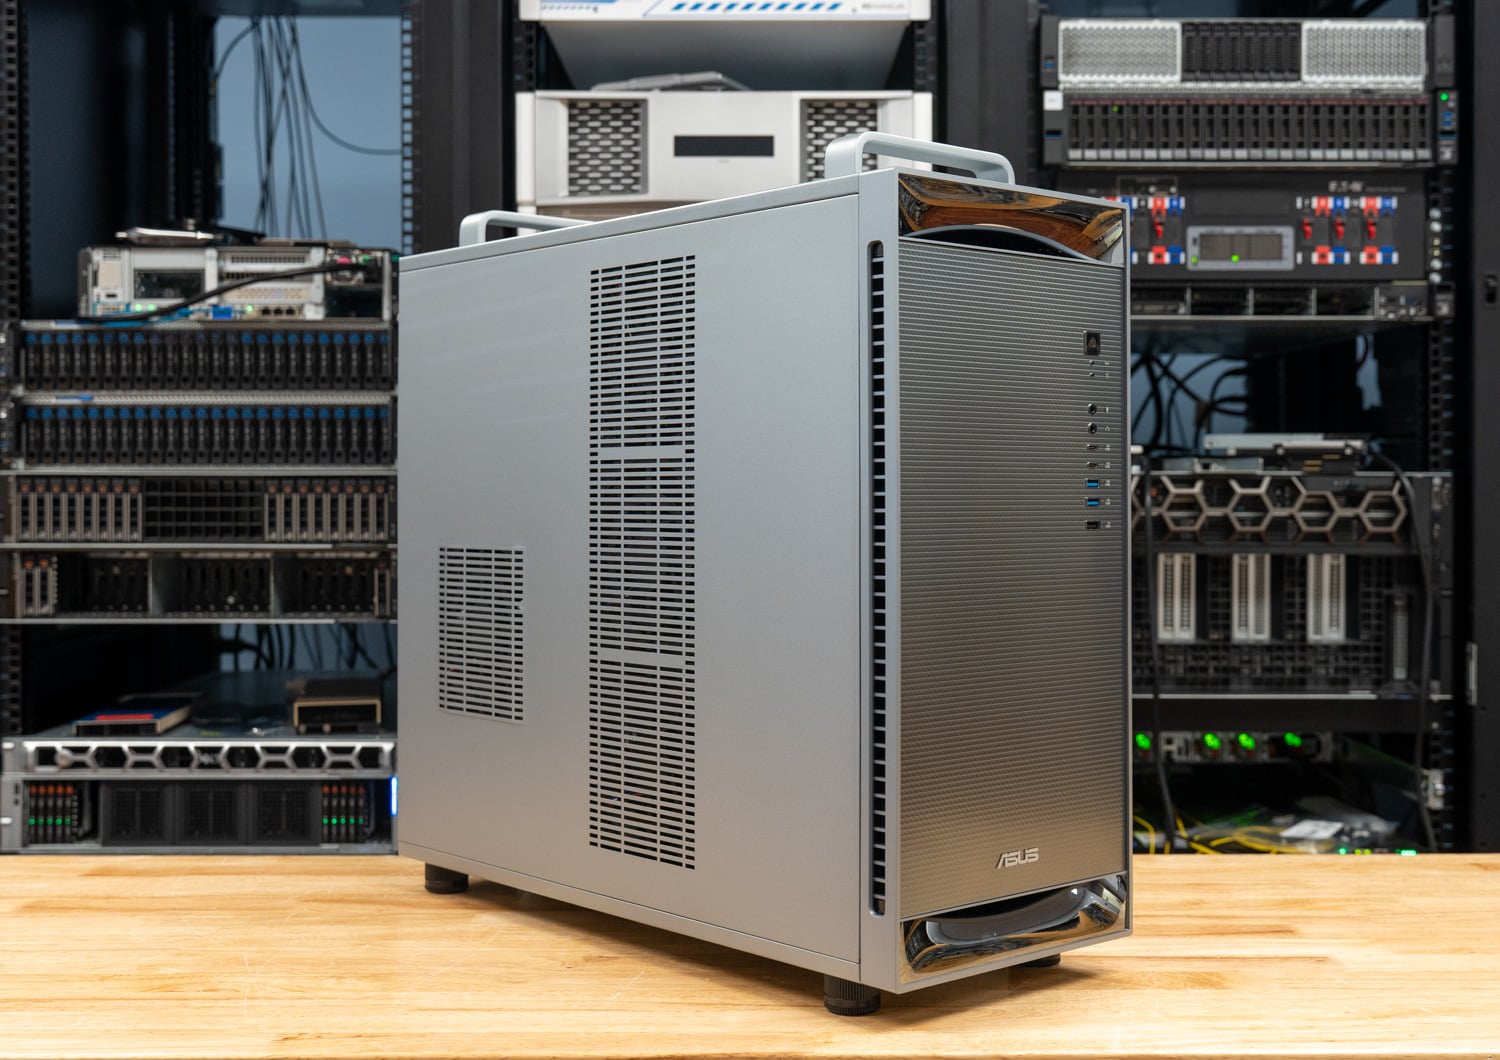
ASUS hat uns den ET900N G3 mit einer installierten RTX PRO 2000 für etwa eine Woche Benchmark-Tests, Fotoaufnahmen und Funktionsprüfungen ins Labor geschickt. Die Plattform selbst, das B300-Mainboard, Grace, NVLink-C2C, MIG und die Funktion der DGX Station werden im WS300-Test ausführlich behandelt. Dieser Test konzentriert sich darauf, was ASUS um den Superchip herum entwickelt hat und ob die Ergebnisse mit denen des ersten von uns getesteten GB300-Towers mithalten können.
ASUS ExpertCenter Pro ET900N G3 Spezifikationen
| Normen | ASUS ExpertCenter Pro ET900N G3 |
|---|---|
| Plattformübersicht | |
| Superchip | NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip |
| CPU | NVIDIA Grace, 72 Arm Neoverse V2-Kerne |
| GPU | NVIDIA Blackwell Ultra (B300), bis zu 20 PFLOPS NVFP4 mit Sparsity |
| CPU-GPU-Verbindung | NVLink-C2C, 900 Gbit/s bidirektional |
| Memory | |
| Kohärentes Gedächtnis | 748GB |
| GPU-Speicher | 252 GB HBM3e, 7.1 TB/s |
| CPU-Speicher | 496 GB LPDDR5X, 396 GB/s, 4x SOCAMM |
| Lagerung | |
| Boot-Laufwerke | 2x M.2 2280 PCIe 5.0 x4 (Key M), bestückt mit 2x 2 TB NVMe im RAID 1-Verbund |
| Erweiterungslaufwerke | 2x M.2 2280 (Key M), PCIe 6.0 x4 laut ASUS, werkseitig geöffnet |
| Netzwerken | |
| SuperNIC | NVIDIA ConnectX-8, 2x QSFP112 400GbE |
| Ethernet | 1x Marvell 10GbE 1x Realtek 1GbE (BMC) |
| Expansion | |
| PCIe-Steckplätze | 1x PCIe 5.0 x16 2x PCIe 5.0 x16 (x8 Signale) |
| Zusätzliche GPU | Bis zu einer NVIDIA RTX PRO Blackwell-Karte; das Testgerät wurde mit einer RTX PRO 2000 Blackwell-Karte ausgeliefert. |
| I / O | |
| Vorderreifen | 2x USB 10 Gbit/s Typ-C 2x USB 10 Gbit/s Typ-A 1x USB 2.0 Kopfhörer- und Mikrofonbuchsen |
| Hinterreifen | 4x USB 10 Gbit/s Typ-A 1x Micro-USB COM (BMC serielle Konsole) 1x Mini DisplayPort (BMC) 3x Audiobuchsen |
| Management und Sicherheit | |
| BMC | ASPEED AST2600 mit AMI MegaRAC Firmware, IPMI und Redfish |
| Sicherheit | Onboard TPM 2.0 |
| Leistung und Kühlung | |
| Labor-Stromversorgungen | 1x 1,600W ATX, 80 PLUS Titanium |
| Kühlung: | Geschlossene AIO-Flüssigkeitskühlung (laut ASUS) mit Kühlplatten auf dem GB300, SOCAMM und ConnectX-8; Radiatoren vorne und oben, Gehäuselüfter hinten, dedizierter Lüfter über den QSFP112-Käfigen |
| Umgebungstemperaturbereich | 10C bis 35C |
| Software und Formfaktor | |
| Betriebssystem | Ubuntu mit NVIDIA-KI-Entwicklertools; ASUS kündigt Unterstützung für die KI-Entwicklung unter Windows an |
| Abmessungen | 584 x 232 x 565 mm (23.0 x 9.1 x 22.3 Zoll), wie von ASUS angegeben. |
| Gewicht | 27 kg netto, 32 kg brutto |
Designen und Bauen
ASUS präsentiert den ET900N G3 als Business-Workstation mit einem Gehäuse in gebürstetem Silber, einer dunklen Mesh-Front, verchromten Kappen und Füßen sowie einem ASUS-Logo im unteren Bereich der Vorderseite. Die Abmessungen entsprechen den Vorgaben der Plattform: 584 x 232 x 565 mm laut ASUS-Angaben. Damit ist er etwas höher und schmaler als der WS300 mit 529 mm Höhe, 570 mm Tiefe und 246 mm Breite. Mit 27 kg ist er kein System, das man mal eben so transportiert. Hier kommt die erste ASUS-spezifische Lösung ins Spiel: Zwei Metallgriffe an der Oberseite – einer vorne und einer hinten – ermöglichen es zwei Personen, den Tower auf einen Schreibtisch oder in einen Transportwagen zu heben, ohne die Seitenwände berühren zu müssen. Sie wirken an einem Bürorechner zunächst etwas deplatziert, bis man einmal einen GB300-Tower durch ein Labor tragen musste.
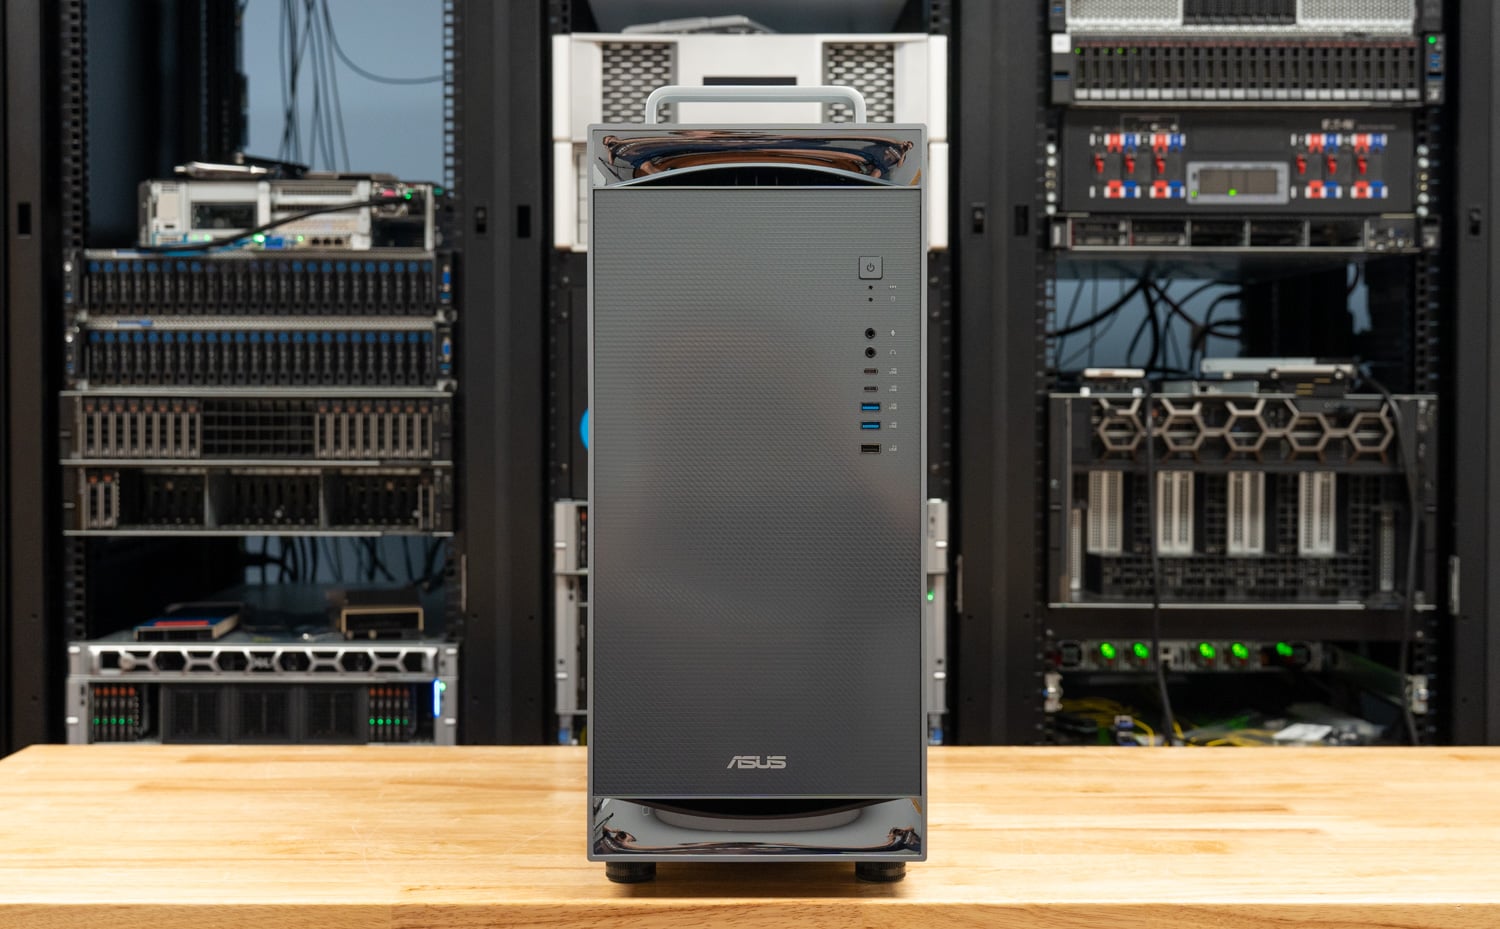
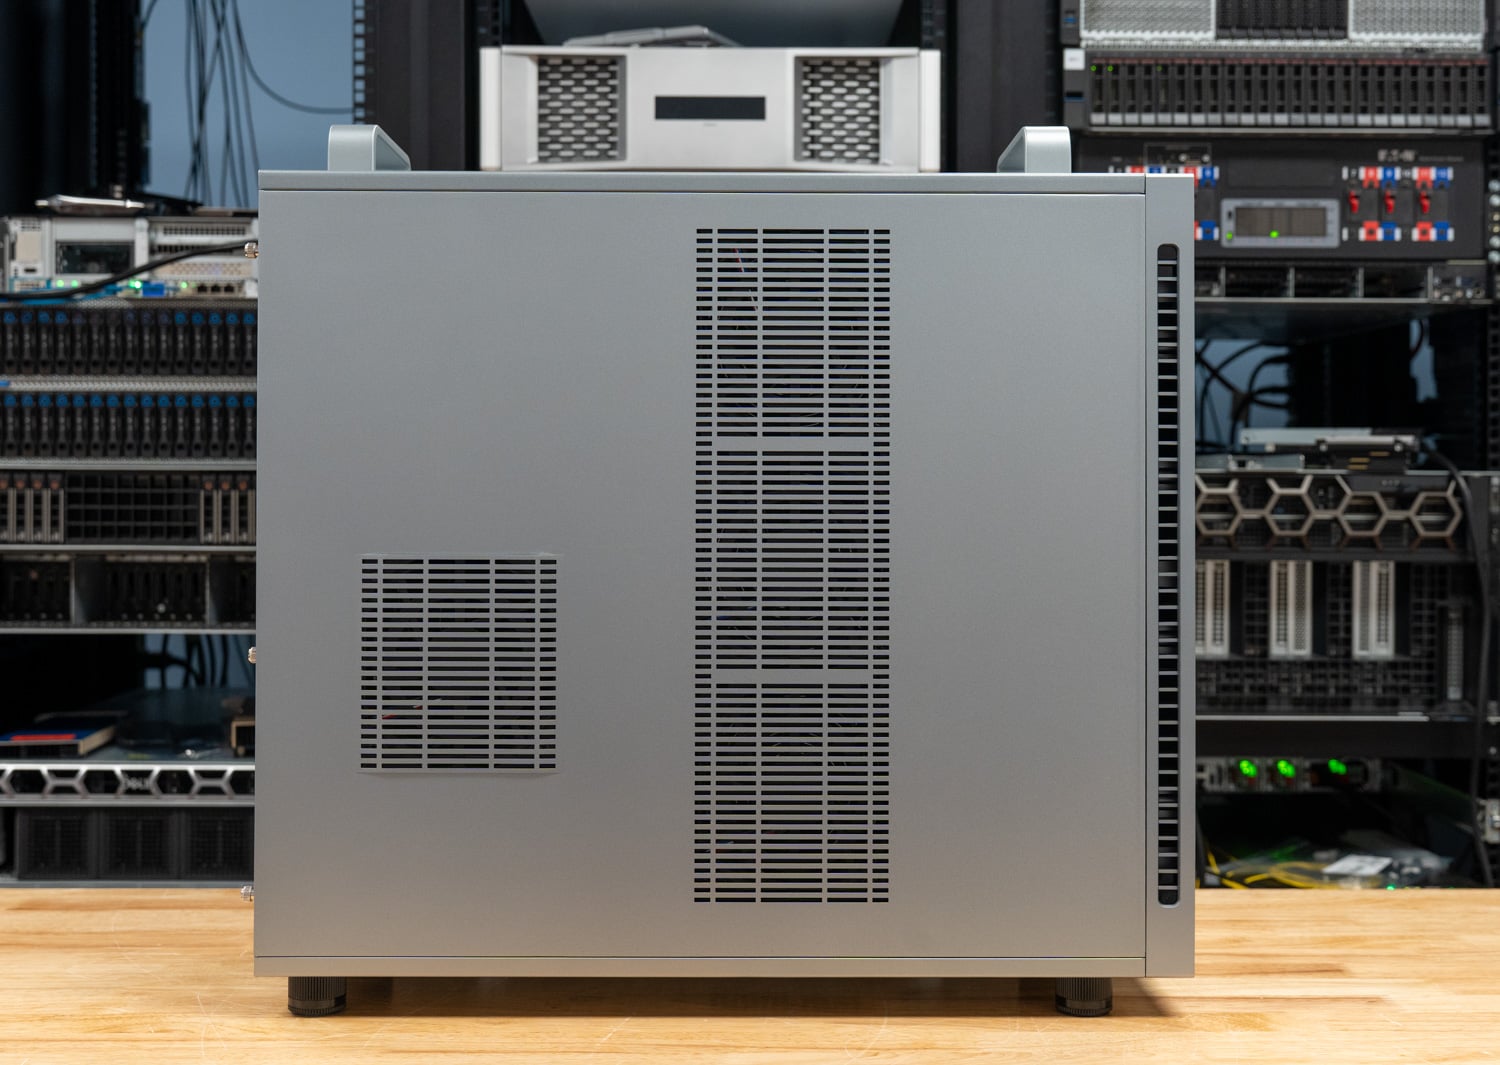
Die Vorderseite verfügt über den Ein-/Ausschalter, zwei USB-A-Anschlüsse (10 Gbit/s), zwei USB-C-Anschlüsse (10 Gbit/s), einen USB-2.0-Anschluss sowie separate Kopfhörer- und Mikrofonbuchsen. Diese sind alle in einem vertikalen Streifen oben rechts im Gitter angeordnet. Die Seitenwand besteht aus einer großen, belüfteten Fläche mit einer langen, perforierten Säule im vorderen Bereich für den Lufteinlass des Radiators und einem kleineren, quadratischen Gitter im hinteren Bereich, das mit den Systemlüftern fluchtet. Es gibt kein Sichtfenster und keine Beleuchtung, was der Zielgruppe entgegenkommt.
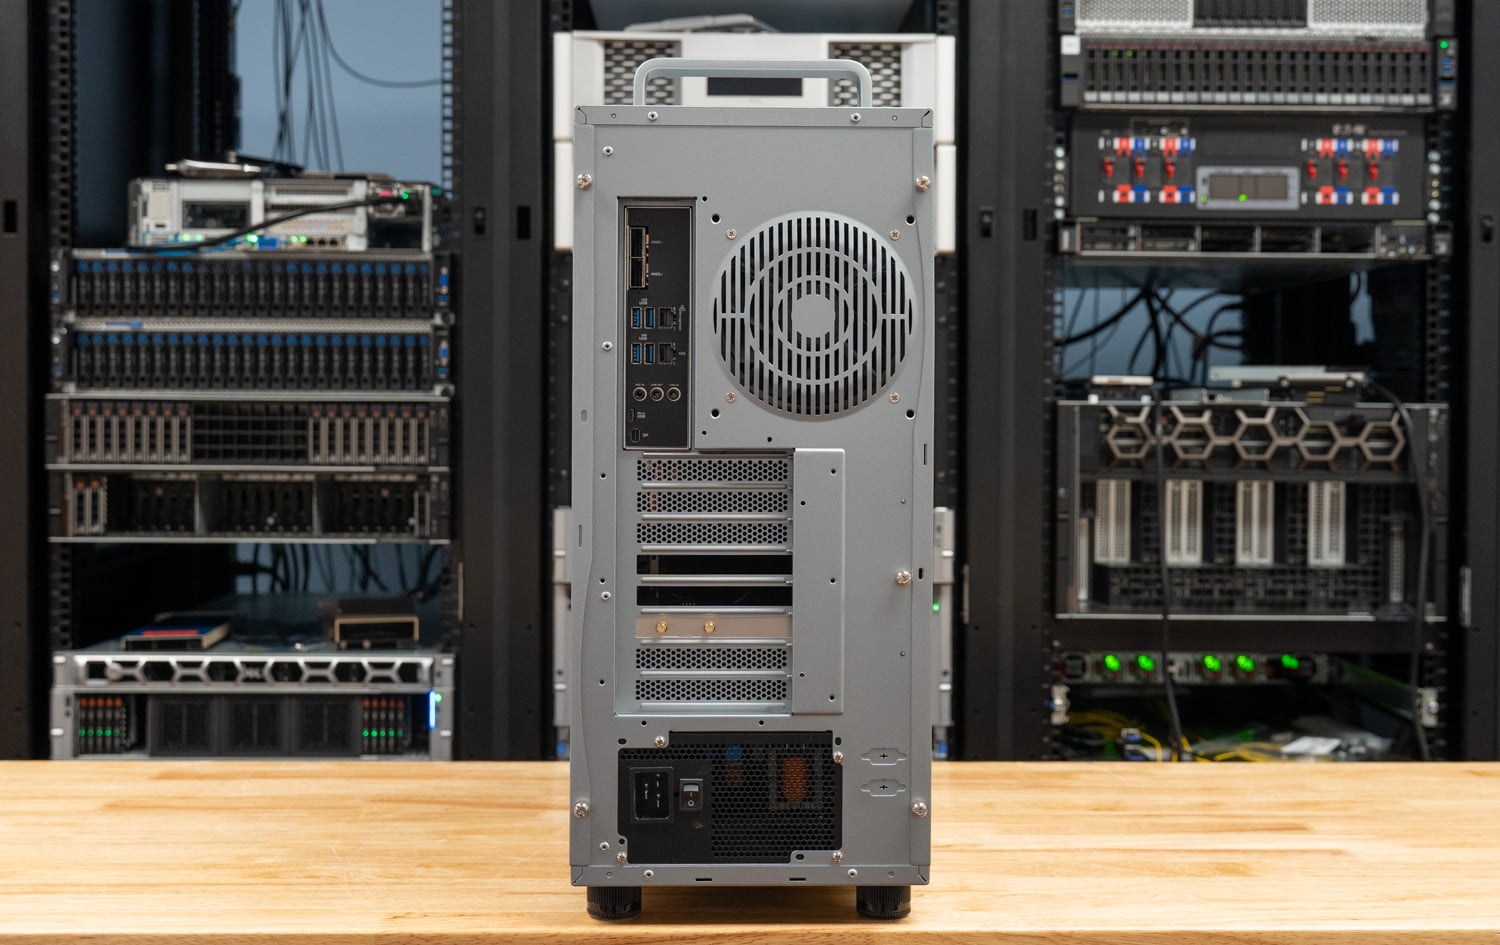
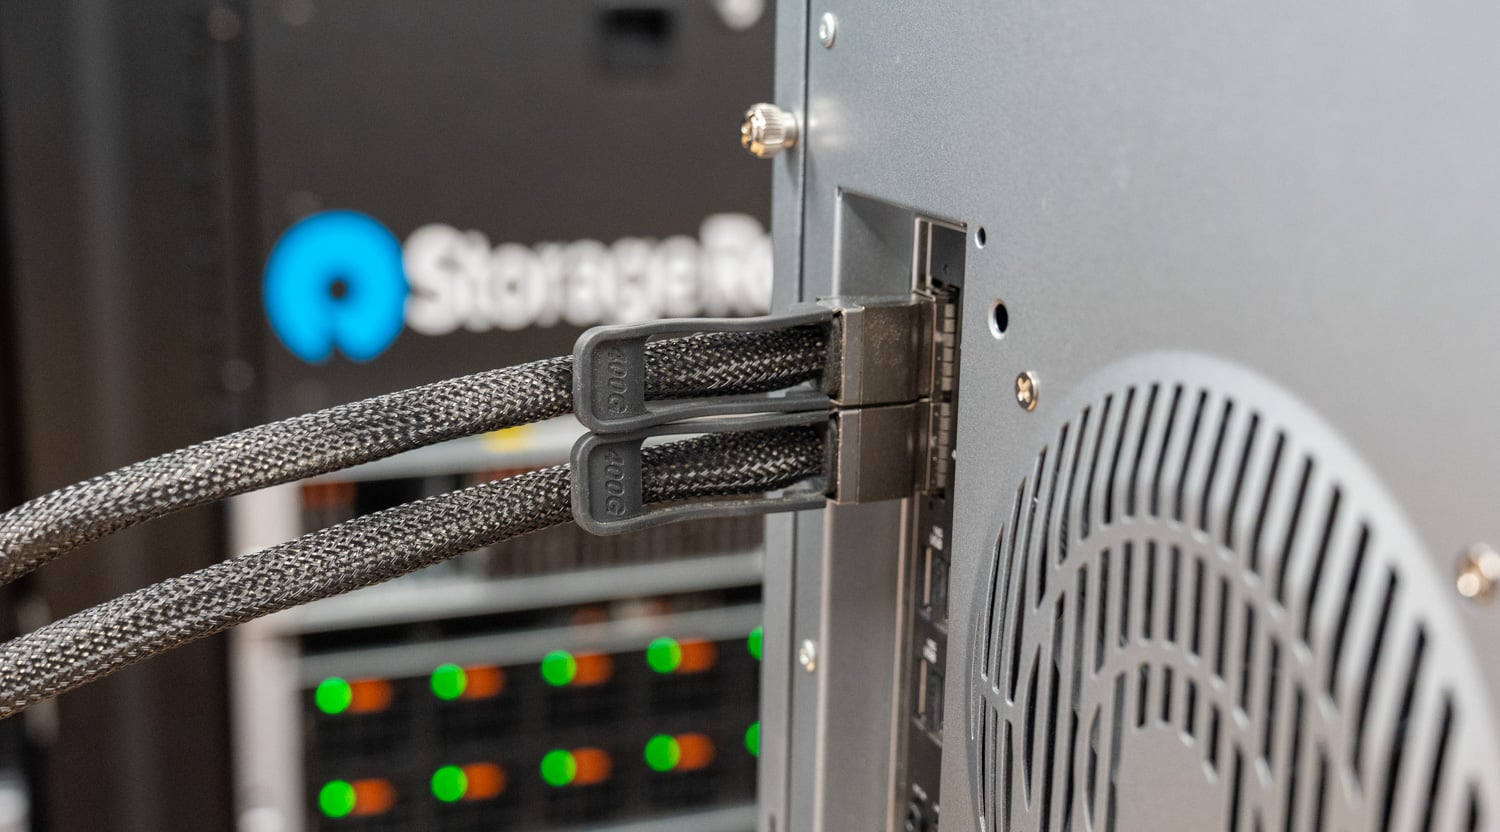
Auf der Rückseite trennt das Layout die Workstation-Anschlüsse von der darunterliegenden Serverhardware. Der obere Bereich beherbergt die vier 10-Gbit/s-USB-A-Anschlüsse, die 10-GbE- und 1-GbE-RJ45-Buchsen, die drei Audiobuchsen, den Micro-USB-Konsolenanschluss des BMC und den Mini-DisplayPort, der vom BMC für die Einrichtung angesteuert wird. Die beiden QSFP112-Steckplätze für den ConnectX-8 befinden sich oben auf der I/O-Blende; daneben ein Lüfter; die drei Erweiterungssteckplatzabdeckungen verlaufen mittig; und das Netzteil mit seinem C19-Anschluss befindet sich unten. Wie beim WS300 ist der Mini-DisplayPort ein BMC-Ausgang für die Ersteinrichtung und Fehlerbehebung; wer mit diesem System einen Desktop-Modus nutzen möchte, benötigt die RTX-Pro-Grafikkarte.
Innenansicht des ET900N G3
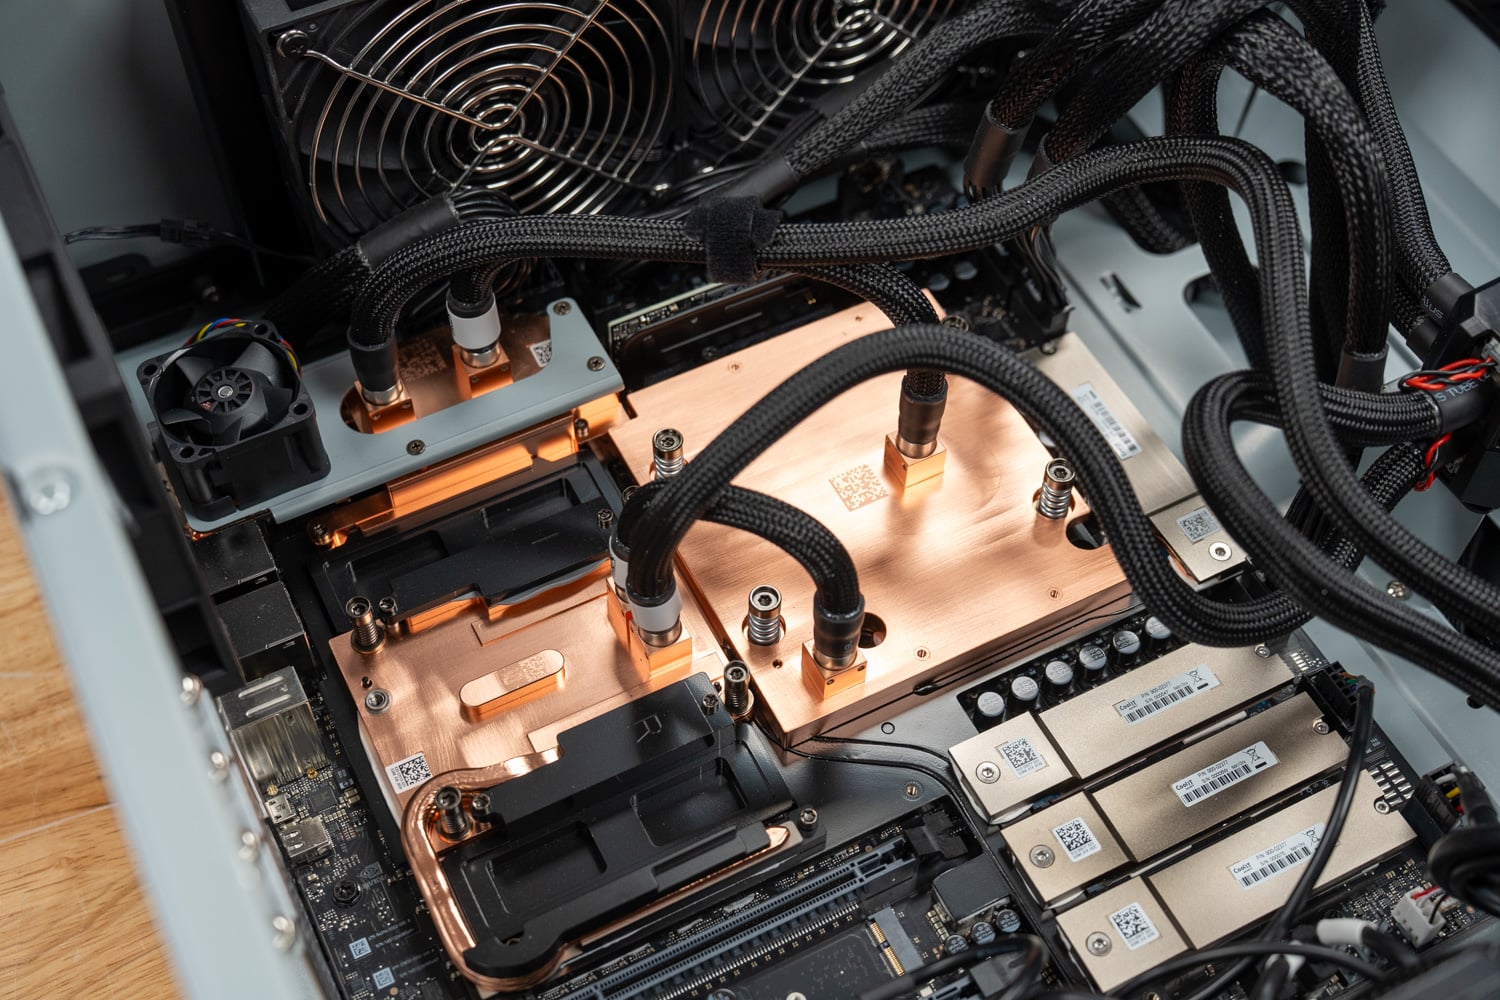
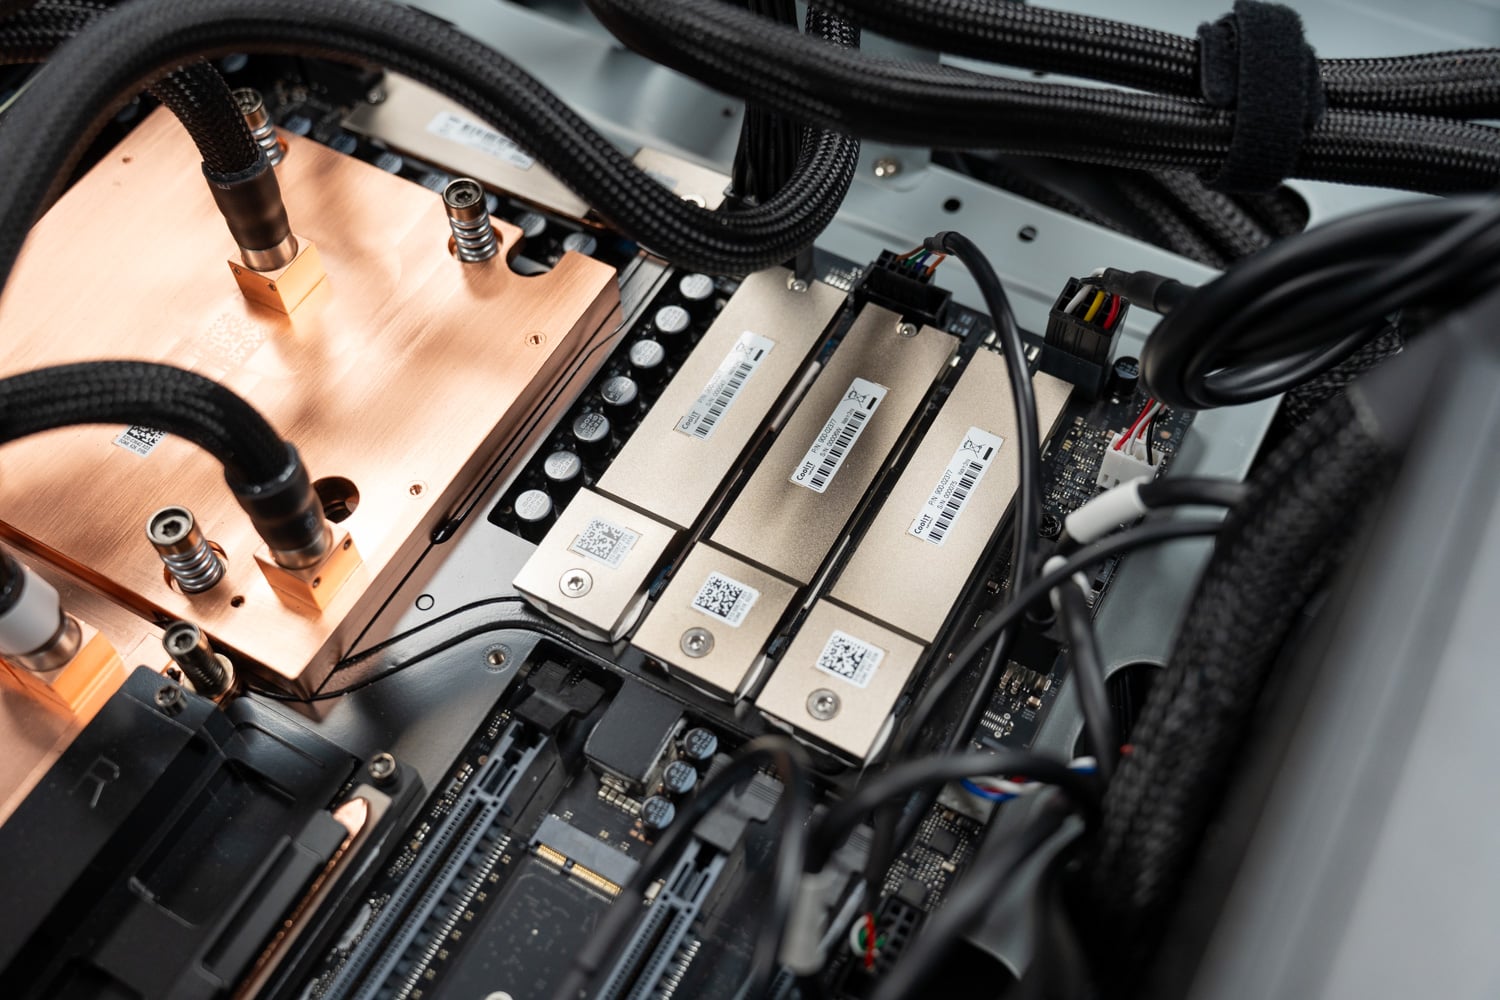
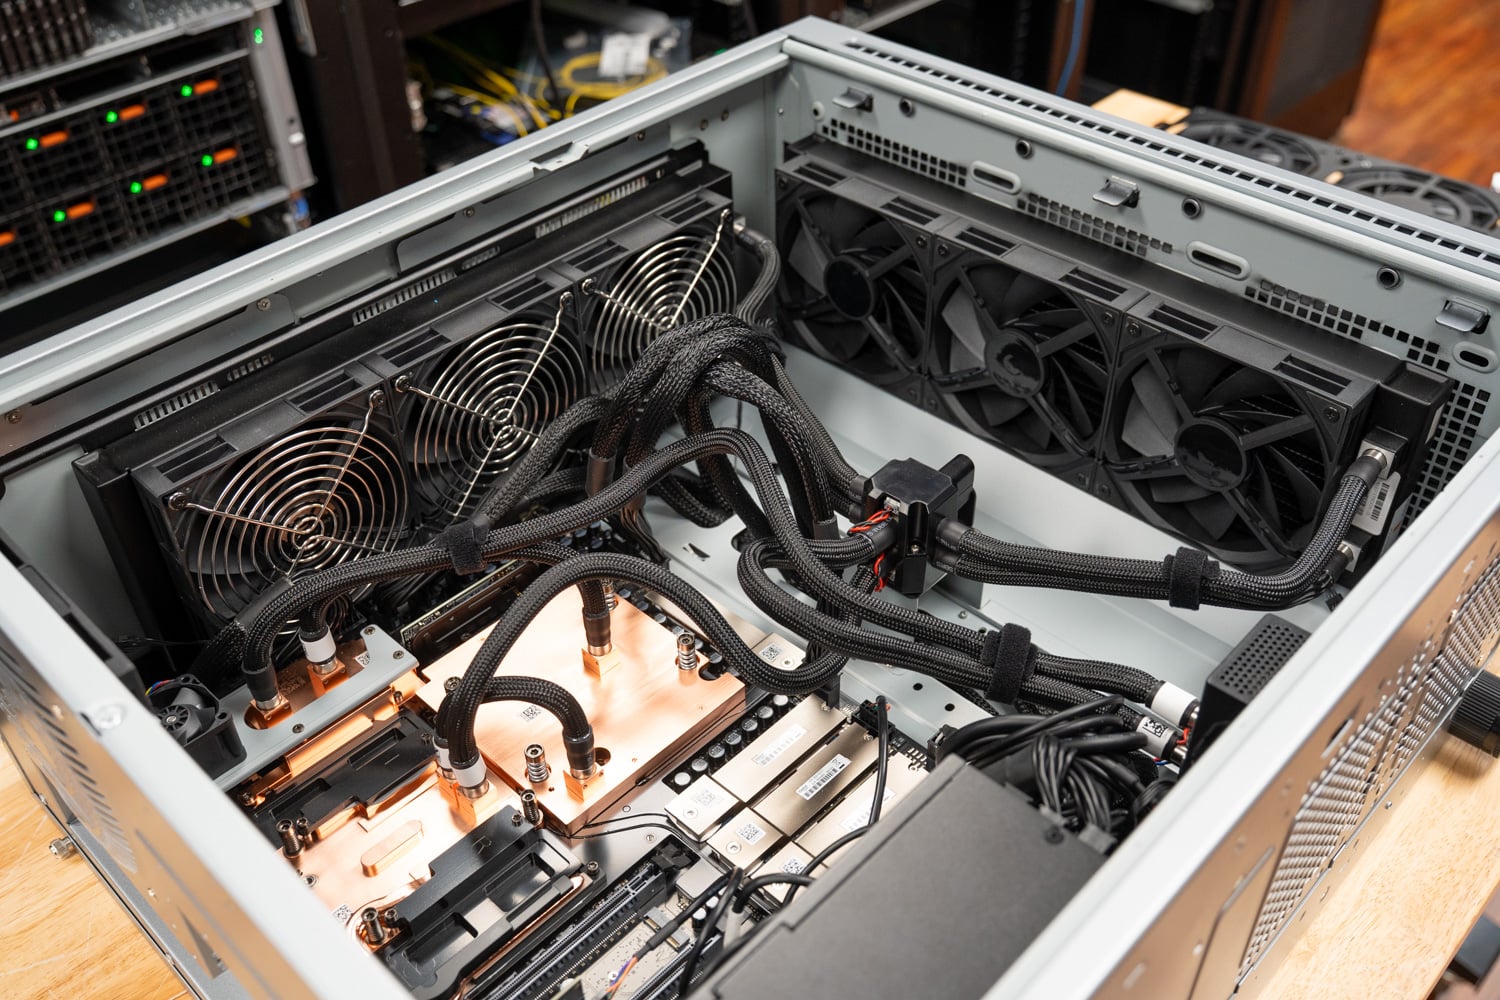
Mit abgenommener Seitenwand wirkt das ET900N G3 wie ein enger Verwandter des WS300, was angesichts des identischen NVIDIA-Mainboards nicht überrascht. Der GB300 Superchip befindet sich links im Gehäuse unter einer Kupfer-Kühlplatte, daneben die SOCAMM-Module unter eigenen Kupferplatten und der ConnectX-8 unter einem dritten Block in der Nähe der hinteren Anschlüsse. Geflochtene Schläuche führen von den Blöcken zu einem Verteiler am Gehäusequerträger und von dort zu den Radiatoren. Die drei PCIe-Steckplätze in voller Länge befinden sich unterhalb des Superchips, das Netzteil in der unteren vorderen Ecke, und eine Metallabdeckung verdeckt den Kabelverlauf an der Unterseite.
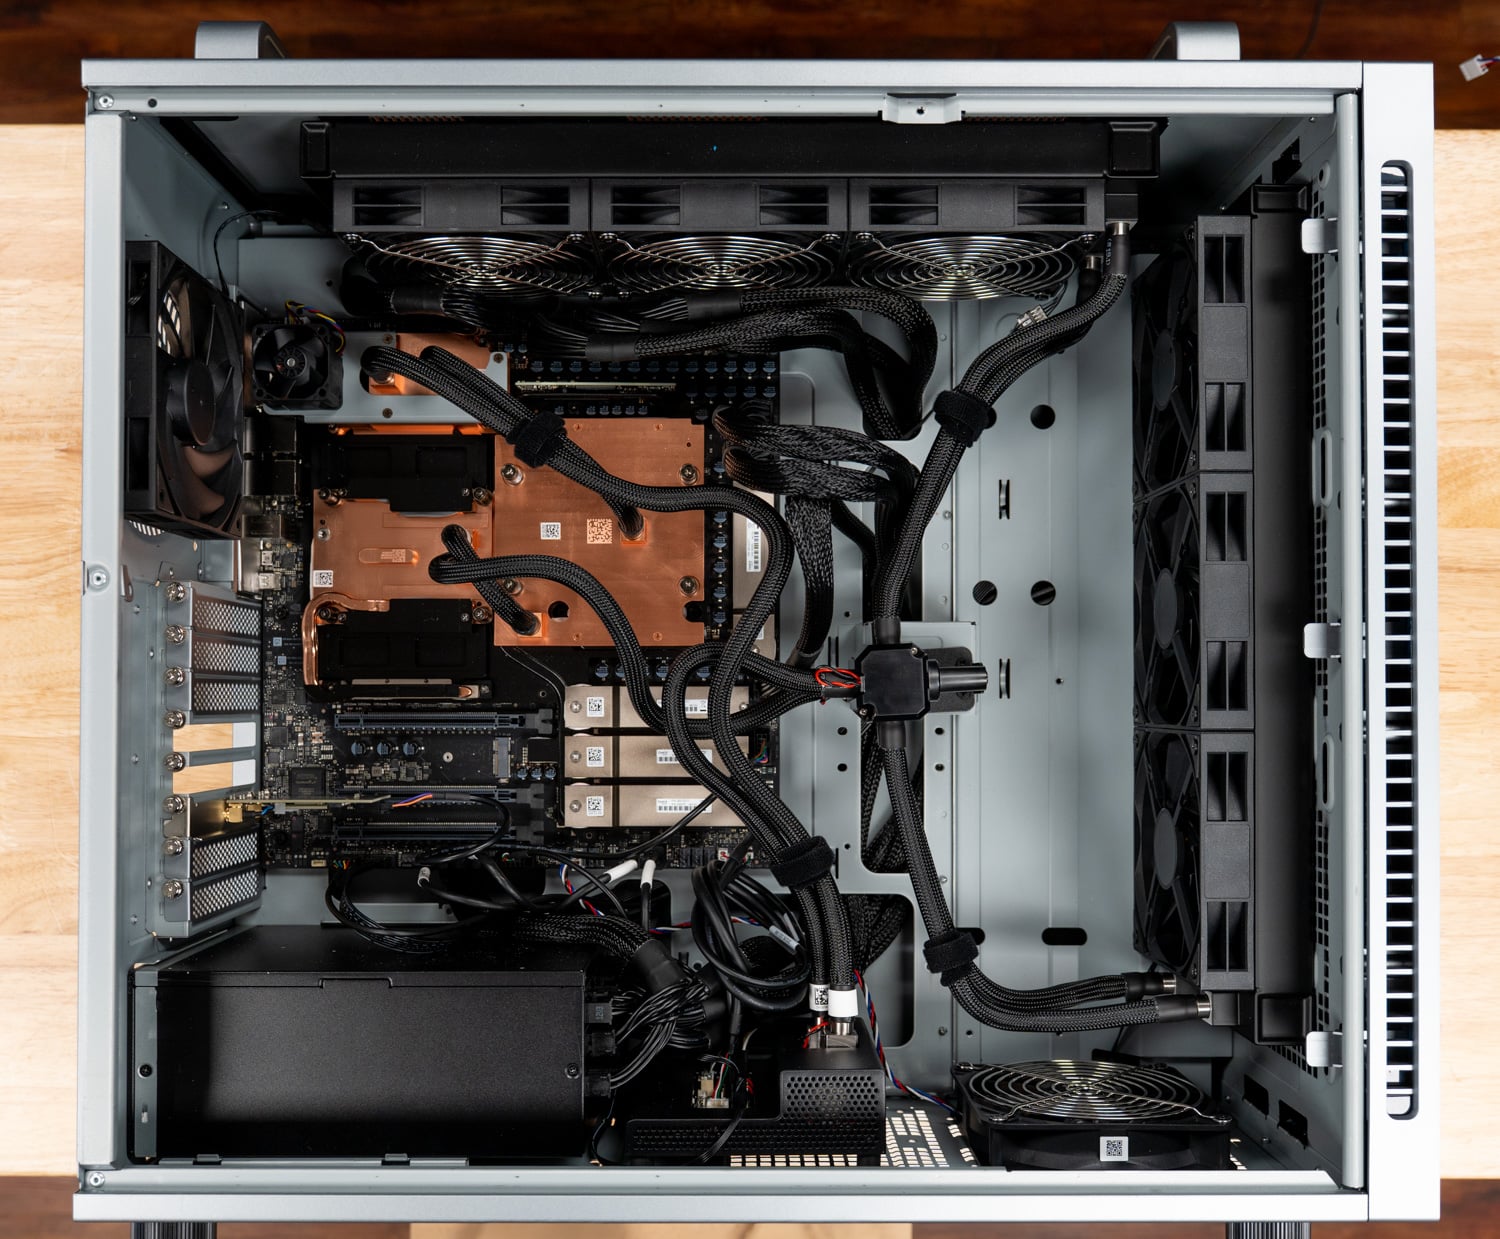
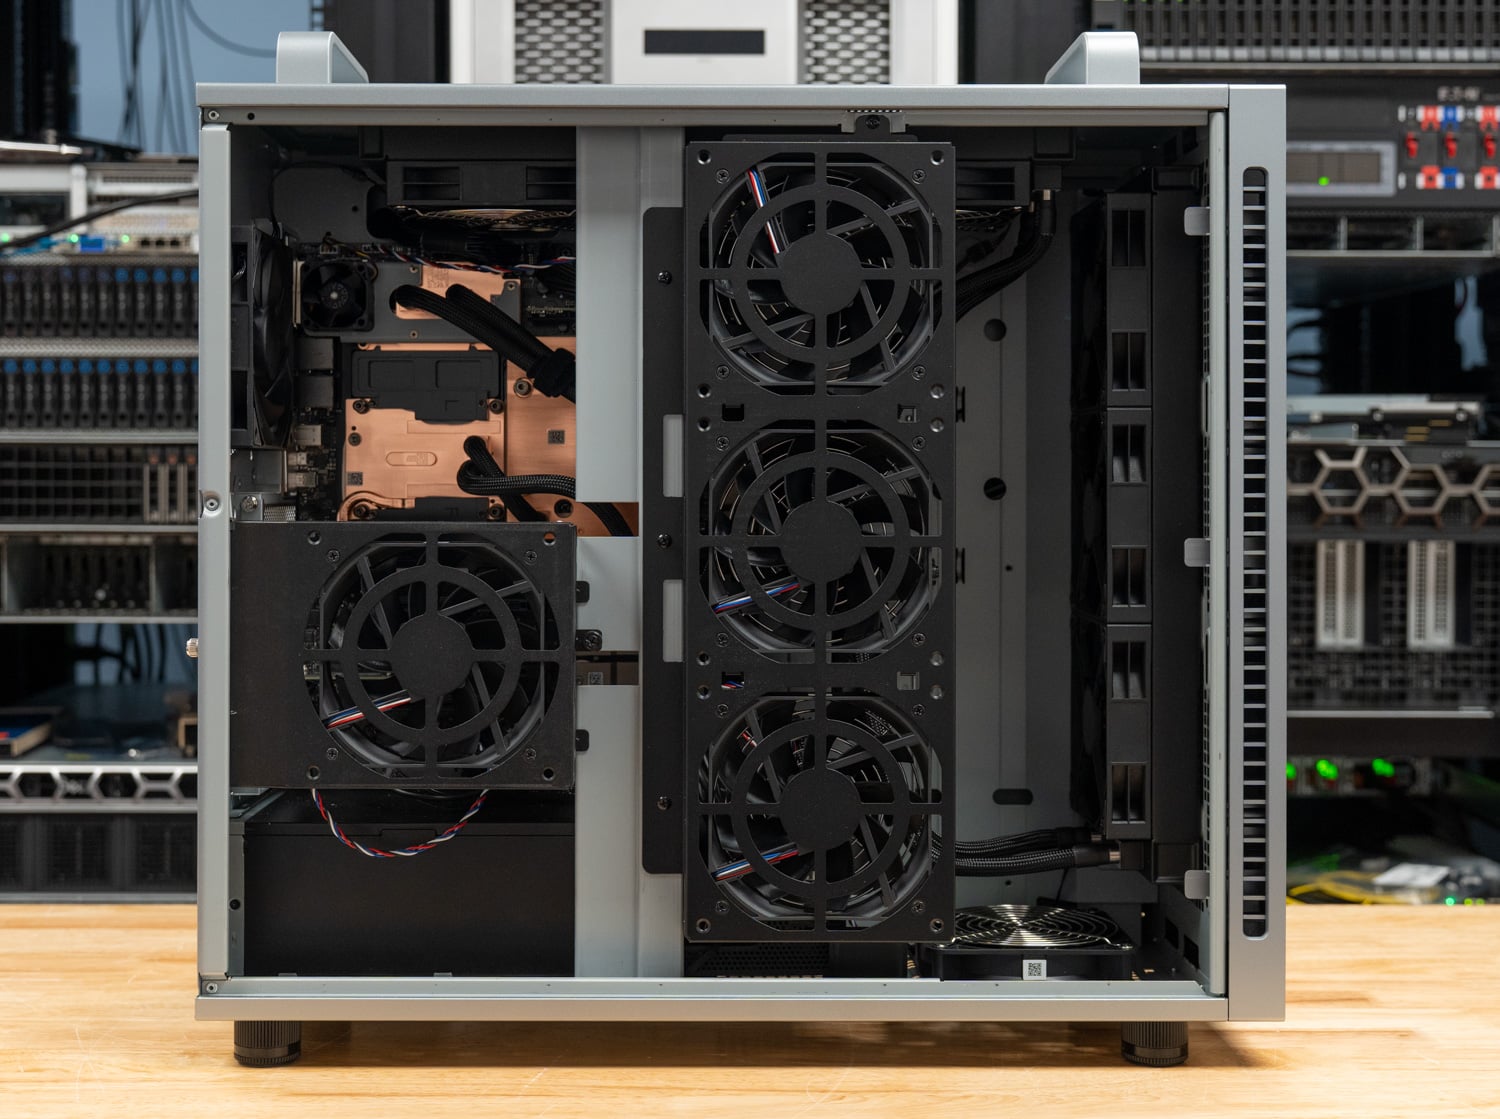
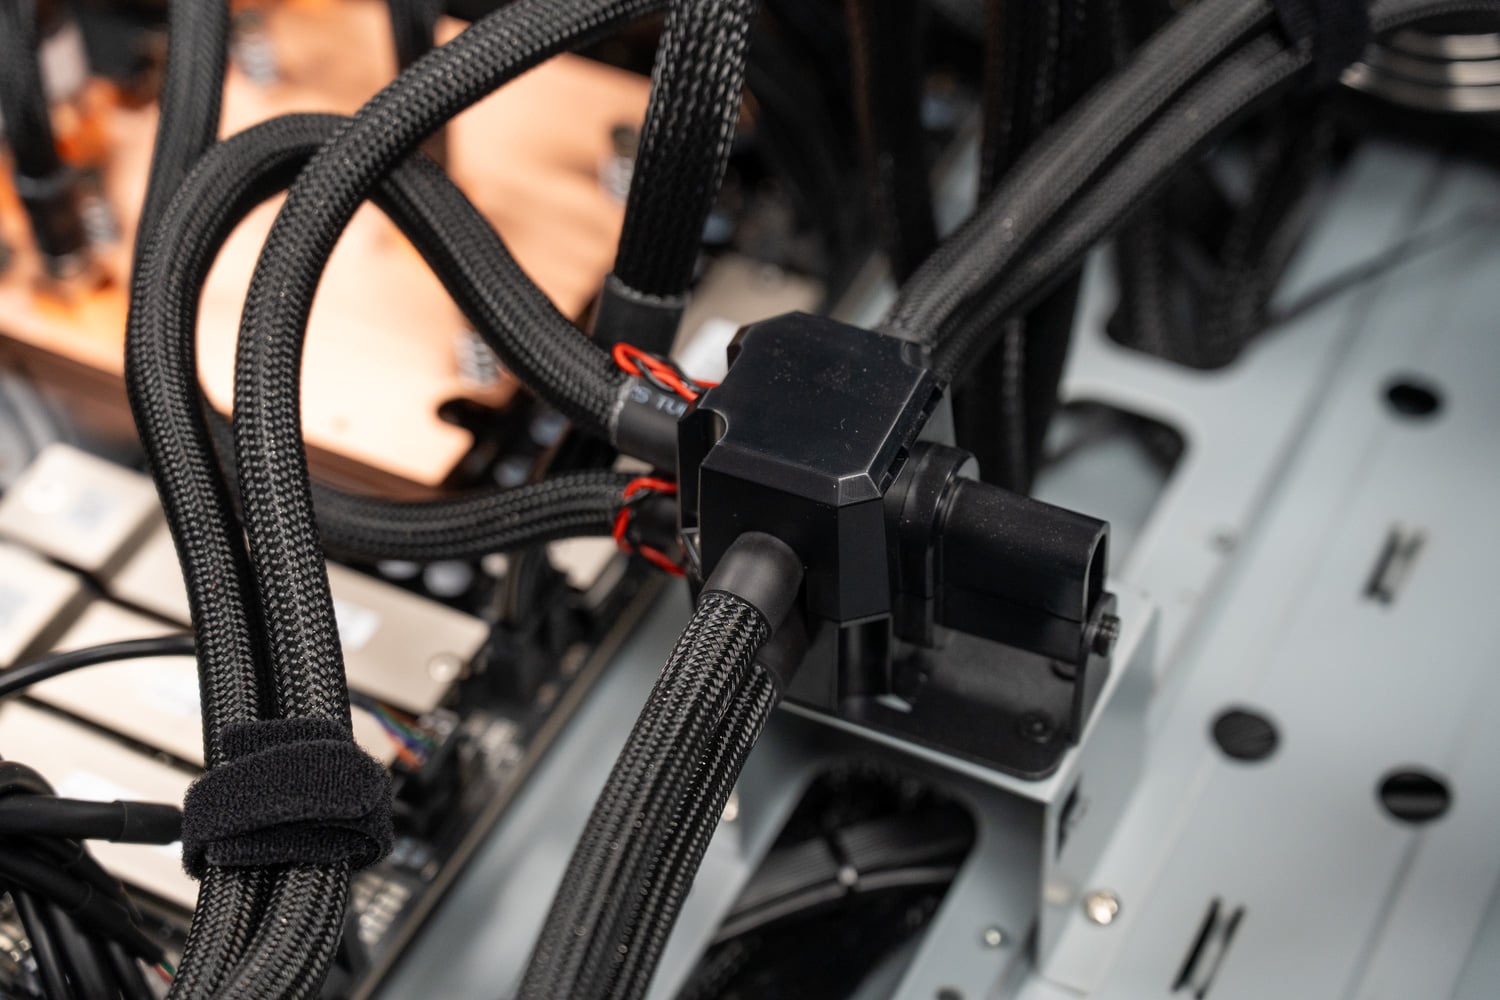
Die Anordnung im Inneren entspricht der des WS300: Ein Radiator ist vertikal hinter dem Frontgitter montiert, ein zweiter darüber, jeweils mit einer Lüfterreihe, plus ein Gehäuselüfter hinten. Die Kühlmittelleitungen sind ummantelt und mit Klettbändern am Querträger befestigt. Der Verteiler bündelt die Leitungen der vier Kühlplatten, sodass nur zwei Leitungen zu jedem Radiator führen.
Der Optikfan
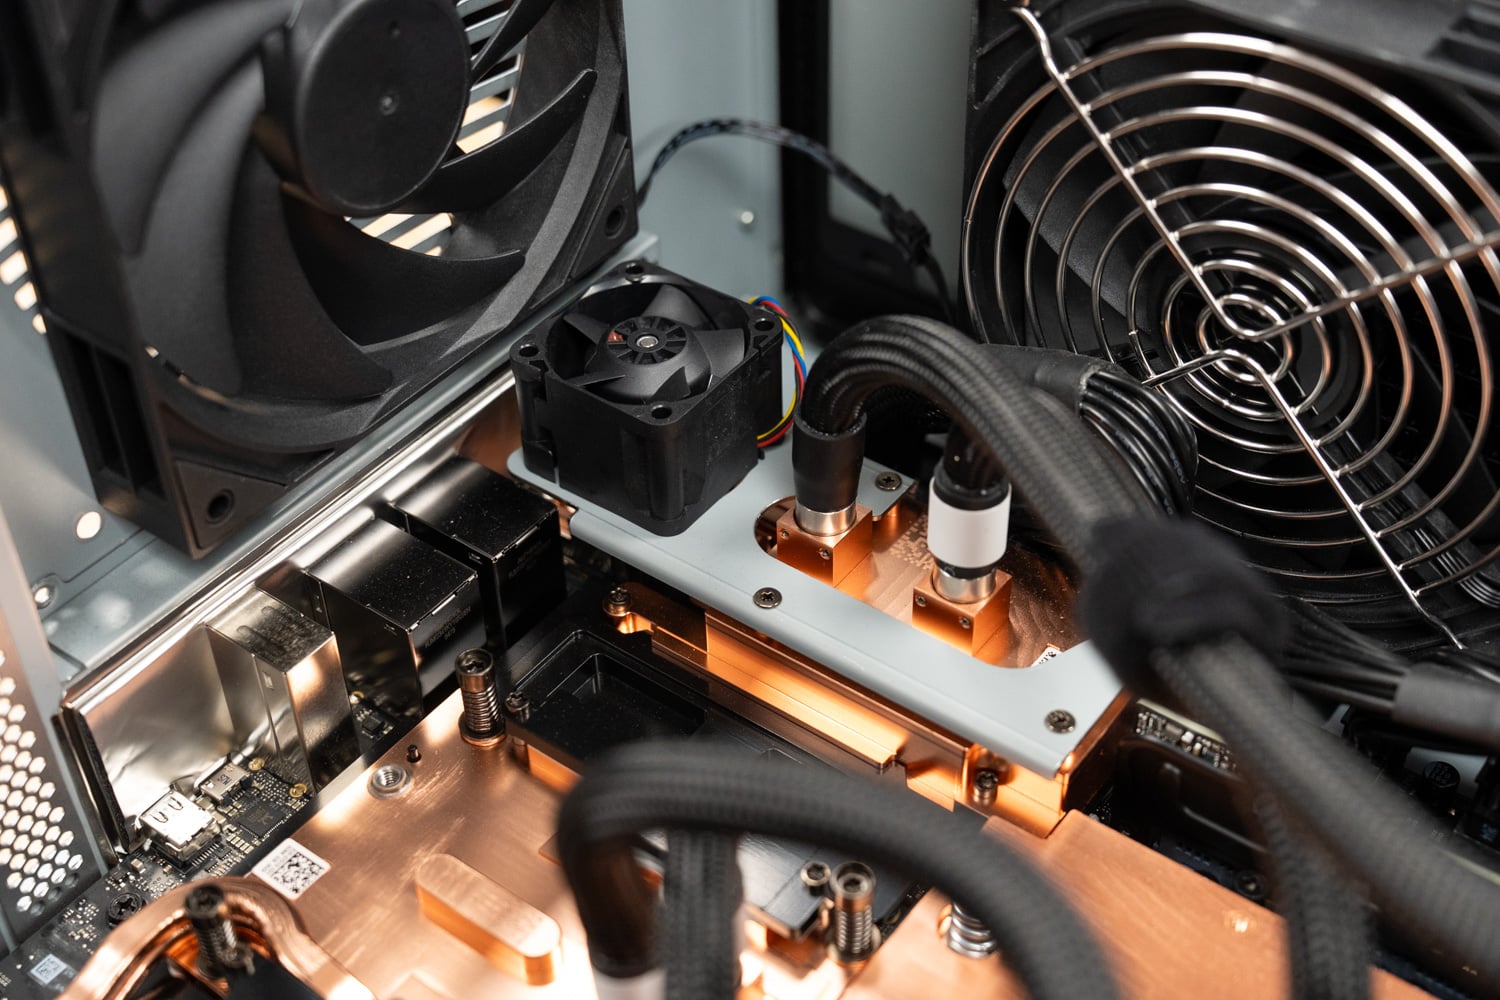
Das einzige Kühlelement, das im WS300 kein Äquivalent hat, ist ein kleiner Lüfter, der an einer Halterung über der ConnectX-8-Kühlplatte montiert ist und auf die QSFP112-Einschübe gerichtet ist. Der Flüssigkeitskreislauf kühlt zwar den SuperNIC-Chip selbst, aber die optischen 400G-Transceiver erzeugen ihre eigene Wärme und befinden sich in Metallkäfigen, die die Kühlplatte nur durch Wärmeleitung erreichen kann. In anderen Tests haben wir festgestellt, dass sich die ConnectX-8 unter Dauerlast erwärmt und auch die Optiken selbst heiß werden können. Daher ist ein separater Luftstrom über die Käfige ein sinnvolles Designelement für alle, die den ET900N G3 stundenlang über Glasfaser betreiben möchten. Bei Verwendung von DACs, wie wir ihn für eine noch laufende detaillierte Untersuchung von Cluster-Inferenz an eine zweite GB300-Station angeschlossen haben, hat der Lüfter weniger zu tun.
Speicherung, Erweiterung und Stromversorgung
ASUS lieferte das ET900N G3 mit einer einzelnen 2-TB-NVMe-SSD für das Betriebssystem und die NVIDIA-Software aus, die in den beiden M.2-2280-Steckplätzen über PCIe 5.0 x4 an Grace angeschlossen ist. Das zweite Steckplatzpaar ist an den integrierten PCIe-Switch des ConnectX-8 angeschlossen und wurde leer ausgeliefert.
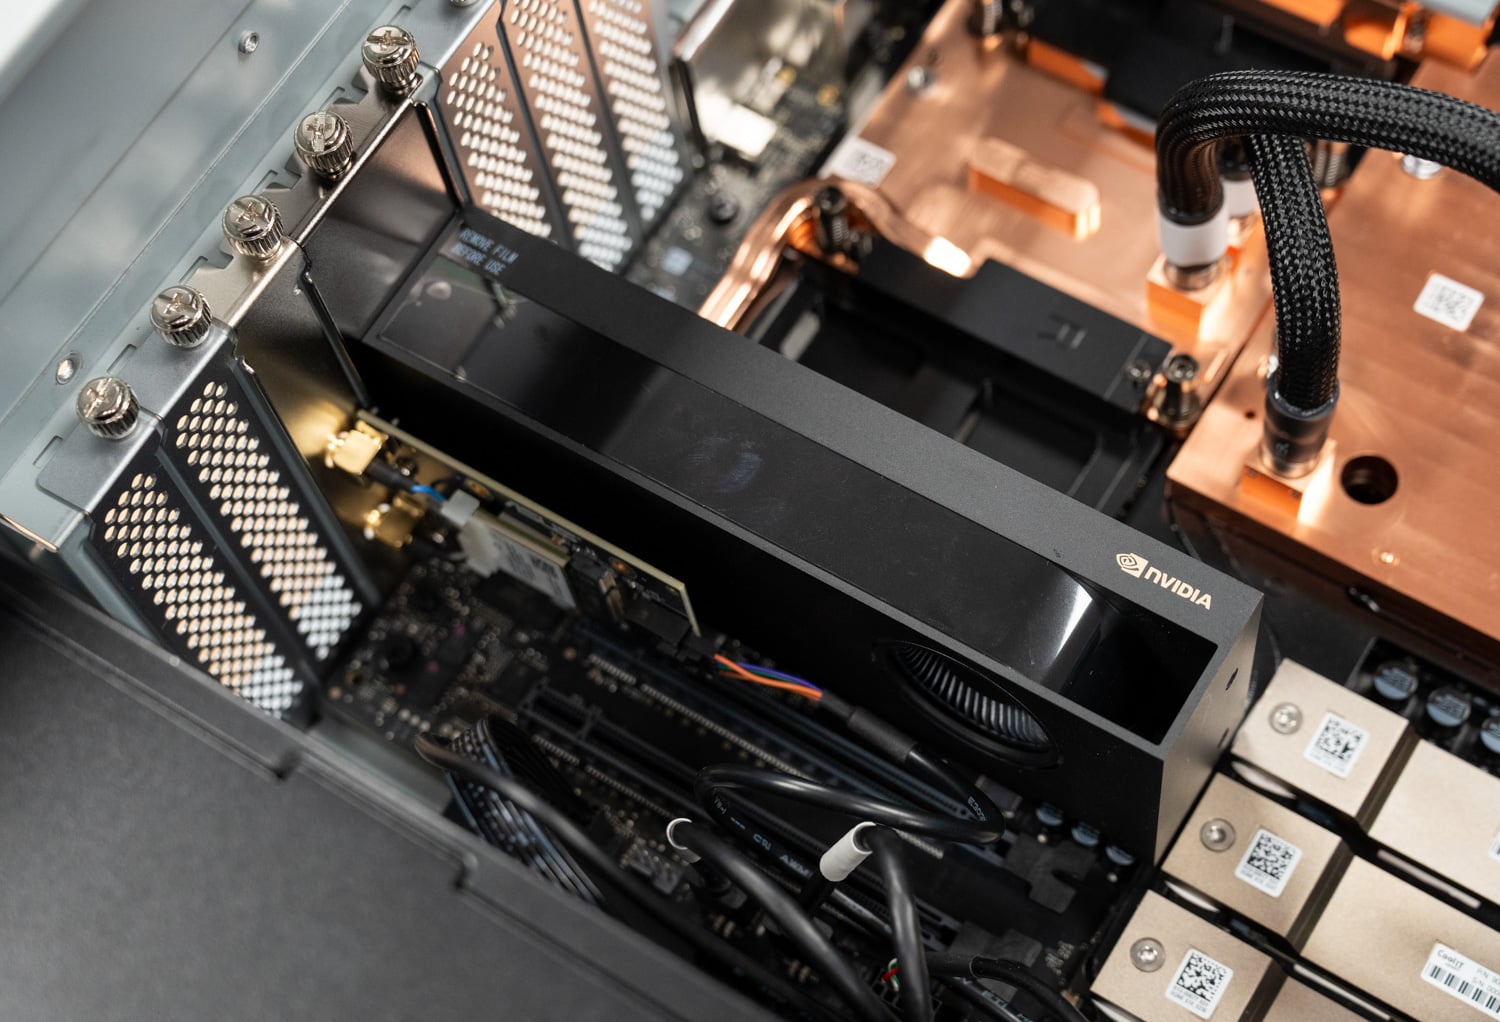
Unser Testgerät wurde mit einer NVIDIA RTX PRO 2000 Blackwell im PCIe 5.0 x16-Steckplatz geliefert, einer der von ASUS angegebenen Konfigurationen. Die Karte ermöglicht die Bildausgabe, ohne das Leistungsbudget des GB300 wesentlich zu belasten. ASUS gibt an, dass das Gehäuse bis zu einer RTX PRO Blackwell-Karte aufnehmen kann. Wir haben die RTX PRO 2000 vor den Benchmarks entfernt, um dem Superchip die volle Leistung zur Verfügung zu stellen – dieselbe Bedingung wie beim WS300. Wir haben in diesem Gehäuse keine leistungsstarke RTX PRO-Karte getestet; dies und die Auswirkungen auf das gemeinsame Leistungsbudget werden wir in einem zukünftigen Test der GB300 Station genauer betrachten.
Das Netzteil ist ein 1,600-Watt-ATX-Netzteil, das von ASUS mit 80 PLUS Titanium zertifiziert ist – eine Stufe über dem Platinum-Standard des WS300. Titanium erfordert eine Effizienz von 94 % bei 50 % Last und 115 V Eingangsspannung, im Vergleich zu 92 % bei Platinum. Es ist die einzige Stufe, die eine Untergrenze bei 10 % Last festlegt. Daher sollte das ET900N G3 unter Volllast mit dem GB300 einige zehn Watt weniger verbrauchen. Die Leistungsaufnahme wird weiterhin aufgeteilt: Grace, der B300-Chipsatz, die Pumpen, Lüfter, der Speicher und jede RTX PRO-Karte beziehen die gleichen 1,600 Watt. NVIDIAs vsloshd-Dienst passt die Leistungsaufnahme zwischen dem Superchip und einer zusätzlichen GPU an deren jeweiligen Bedarf an, ohne feste Obergrenze. Diese Vorgehensweise wurde bereits im Test des WS300 erläutert und gilt auch hier. Für Installationen in Nordamerika ist weiterhin ein dedizierter 20-A-Stromkreis erforderlich.
Konnektivität
Die beiden QSFP112-Ports des ConnectX-8 dienen als Verbindung des ET900N G3 zu allen anderen Komponenten: Speicher, einer zweiten DGX-Station oder einem Cluster-Fabric. Diese Ports sind im Labor bereits im Einsatz: Der ET900N G3 ist über 400G-DACs mit einer zweiten GB300-Station verbunden, um eine detaillierte Analyse der Cluster-Inferenz zu veröffentlichen. Der 10-GbE-Marvell-Port verarbeitet den normalen Host-Datenverkehr, und der Realtek-1-GbE-Port ist dem BMC zugeordnet.
Testnotizen
Alle Ergebnisse in diesem Testbericht stammen von dem von ASUS an unser Labor gelieferten Gerät mit der Standard-Speicherkonfiguration: 252 GB HBM3e und 496 GB LPDDR5X. Das System lief ohne installierte RTX PRO-Karte, sodass dem GB300 Superchip die volle Beschleunigerleistung zur Verfügung stand und die Bedingungen unseren WS300-Tests entsprachen. Software-Stack, vLLM-Konfiguration, Workload-Profile und Parallelitäts-Sweep sind identisch mit denen des WS300, sodass die beiden Systeme direkt vergleichbar sind. Dieser Testbericht konzentriert sich ausschließlich auf die Leistung; Stromverbrauch und Temperatur wurden an diesem Gerät nicht gemessen.
Die Workloads entsprechen den beiden vLLM-Live-Inferenzprofilen, die wir auf jedem lokalen KI-System ausführen: ein gleichmäßiger Workload mit 512 Eingabe- und 512 Ausgabetoken sowie ein Workload mit hohem Prefill-Anteil mit 8,192 Eingabe- und 1,024 Ausgabetoken, der zwischen einem und 128 parallelen Datenströmen variiert wird. Für die Modelle der Spitzenklasse vergleichen wir mit einem Dell PowerEdge XE7740 GPU-Server, der mit zwei oder vier RTX PRO 6000 -Karten ausgestattet ist – die nächstliegende Einzelplatzlösung für diese Prüfpunkte. Für die kleineren Modelle vergleichen wir mit einer einzelnen RTX PRO 6000 im selben XE7740, einem einzelnen H200 NVL in einem Dell PowerEdge R770 und einem GB10 DGX Spark , repräsentiert durch den Acer Veriton GN100 – demselben Spark, den wir im WS300-Test verwendet haben. Die unten aufgeführten ET900N G3-Werte sind die exakten Werte aus den Testprotokollen. Die Vergleichswerte werden aus unseren Ergebnisdiagrammen abgelesen.
Inferenzleistung
Frontiermodelle auf dem kohärenten Speicherpool
Der Hauptgrund für die Existenz des GB300 ist die Unterstützung von Modellen beidseits der 252-GB-HBM3e-Grenze des B300. Daher beginnen wir mit vier Vergleichspunkten, die diesen Bereich abdecken: DeepSeek V4 Flash und MiniMax M2.7 passen problemlos in den HBM-Speicher, MiniMax M3 passt gerade so und lagert einen Teil seiner Leistung auf Grace-Speicher aus, und GLM-5.2 lagert etwa die Hälfte seiner Leistung aus. Auf der anderen Seite jeder Tabelle befindet sich die jeweils nächstliegende Alternative in einem einzigen Gehäuse: RTX PRO 6000-Karten im PowerEdge XE7740, wobei bei Bedarf Leistung auf den Host-Speicher ausgelagert wird.
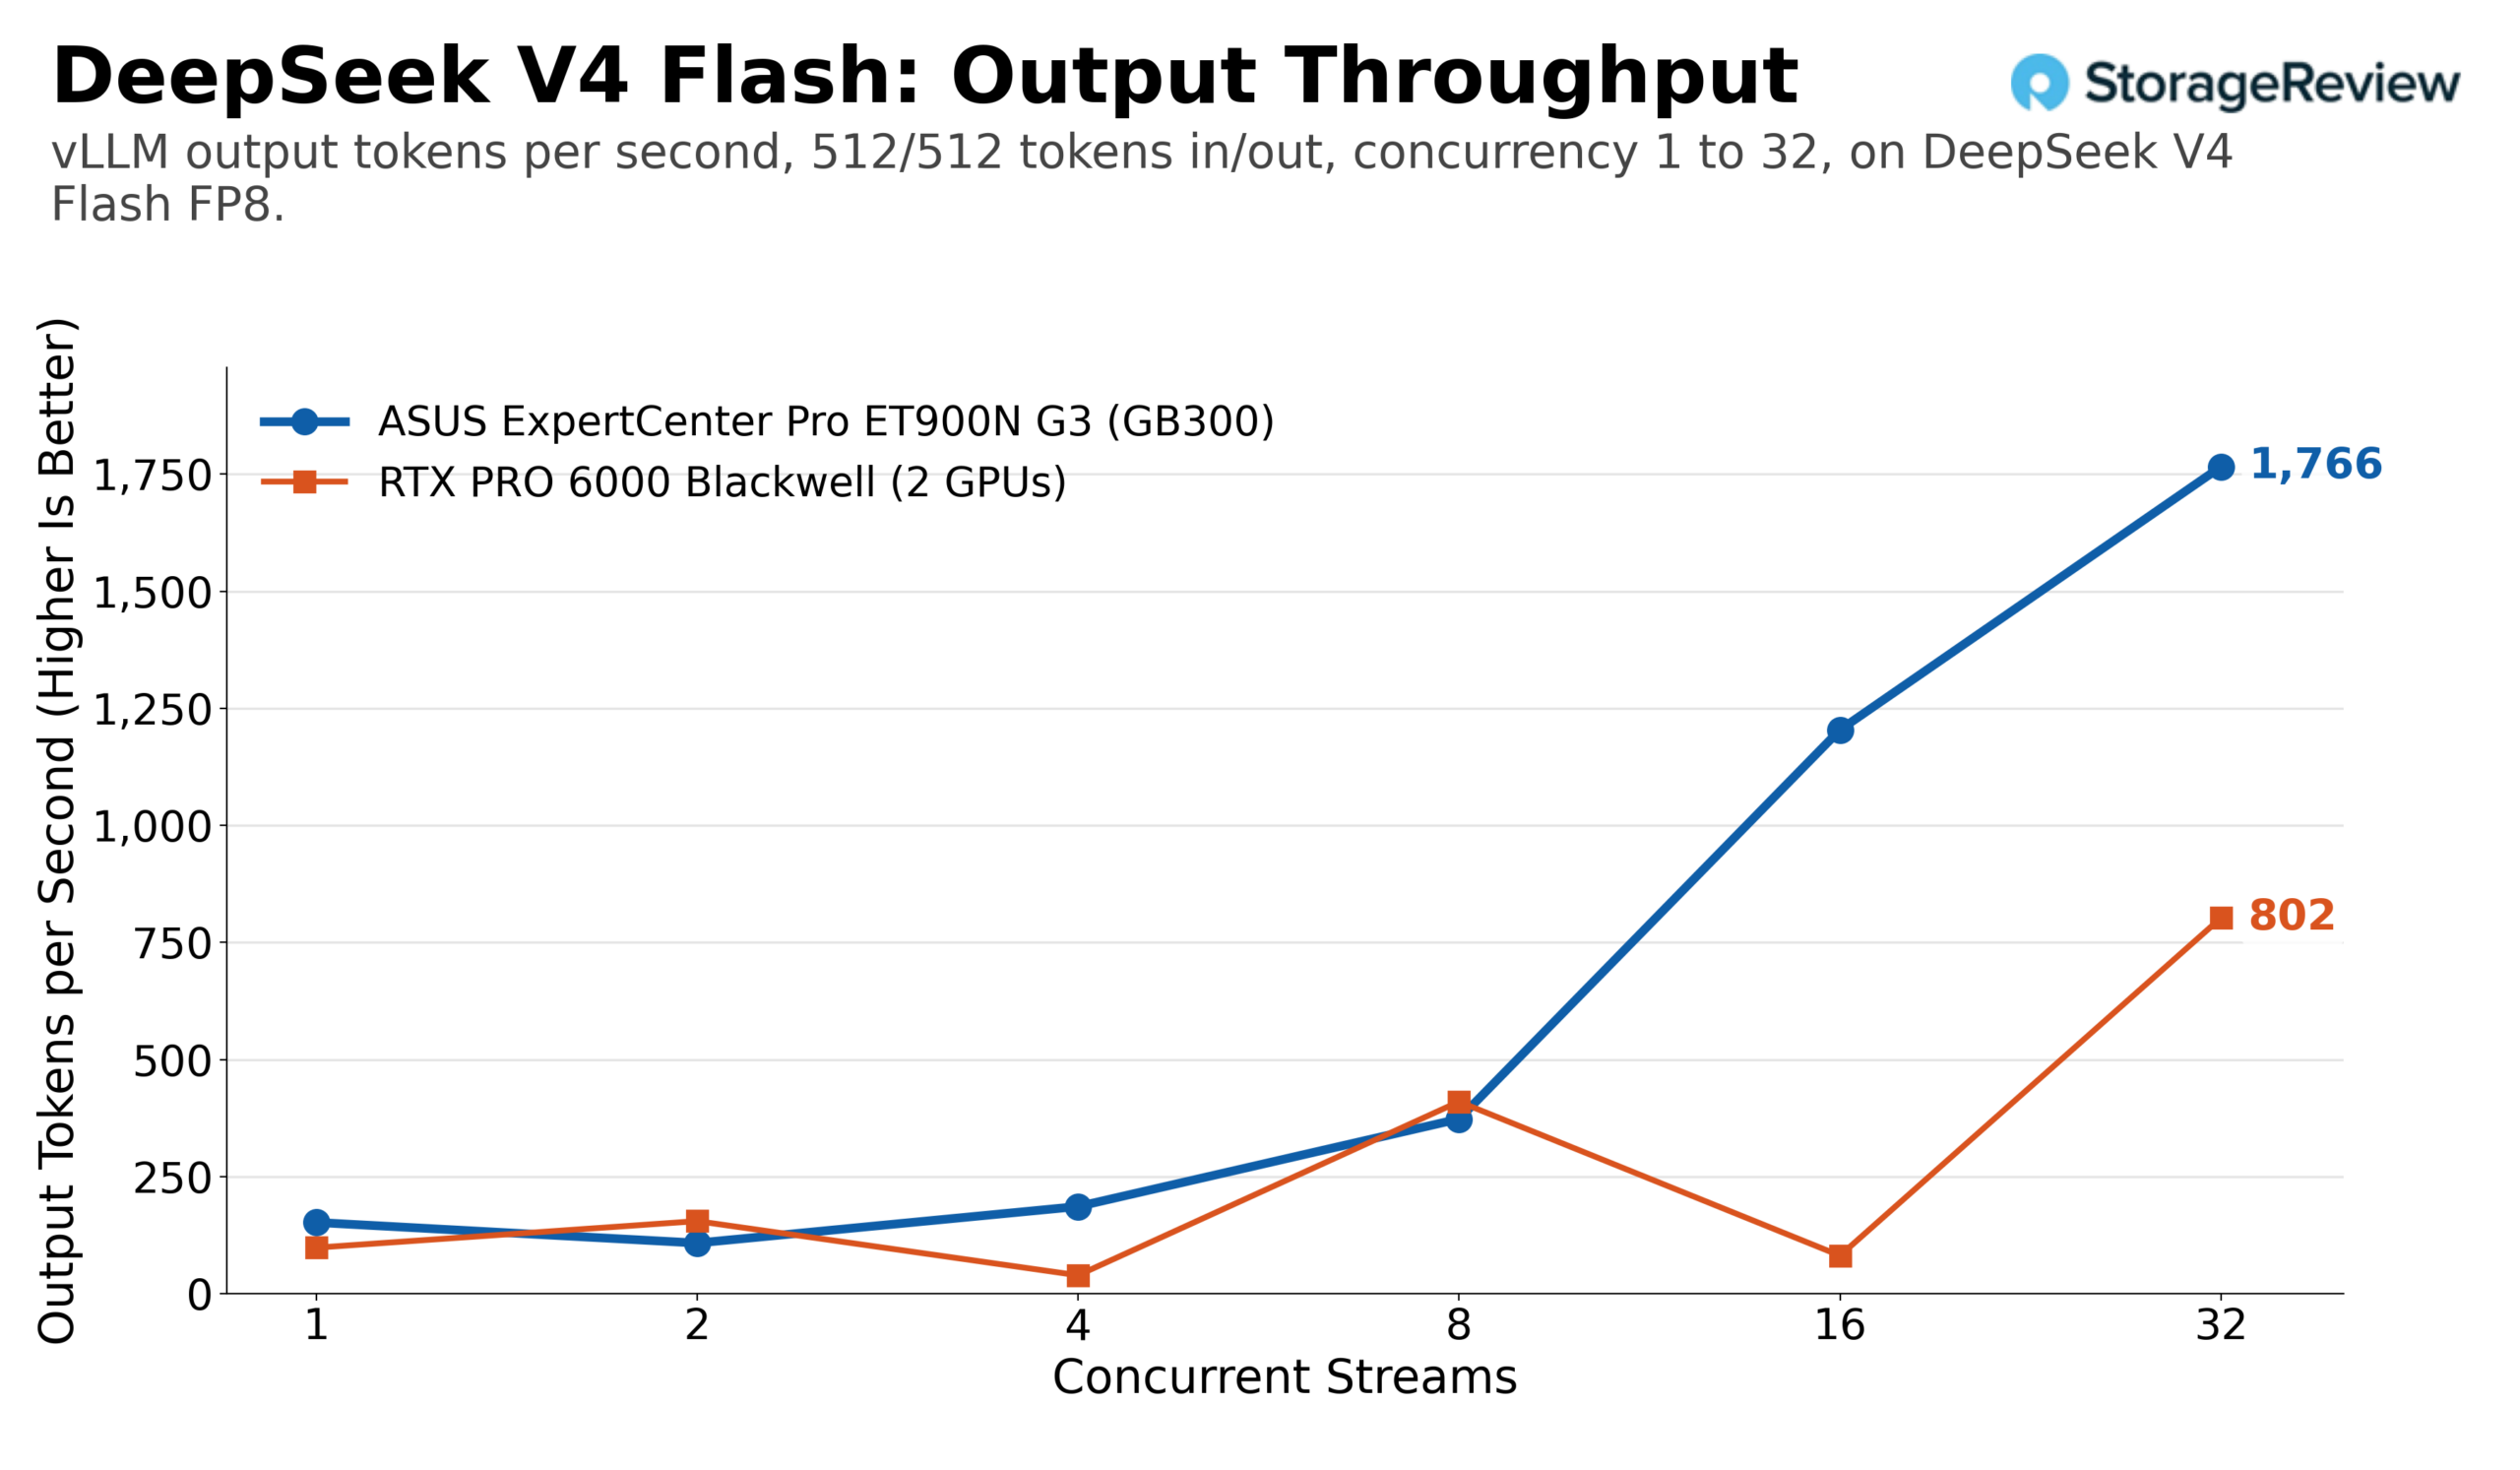
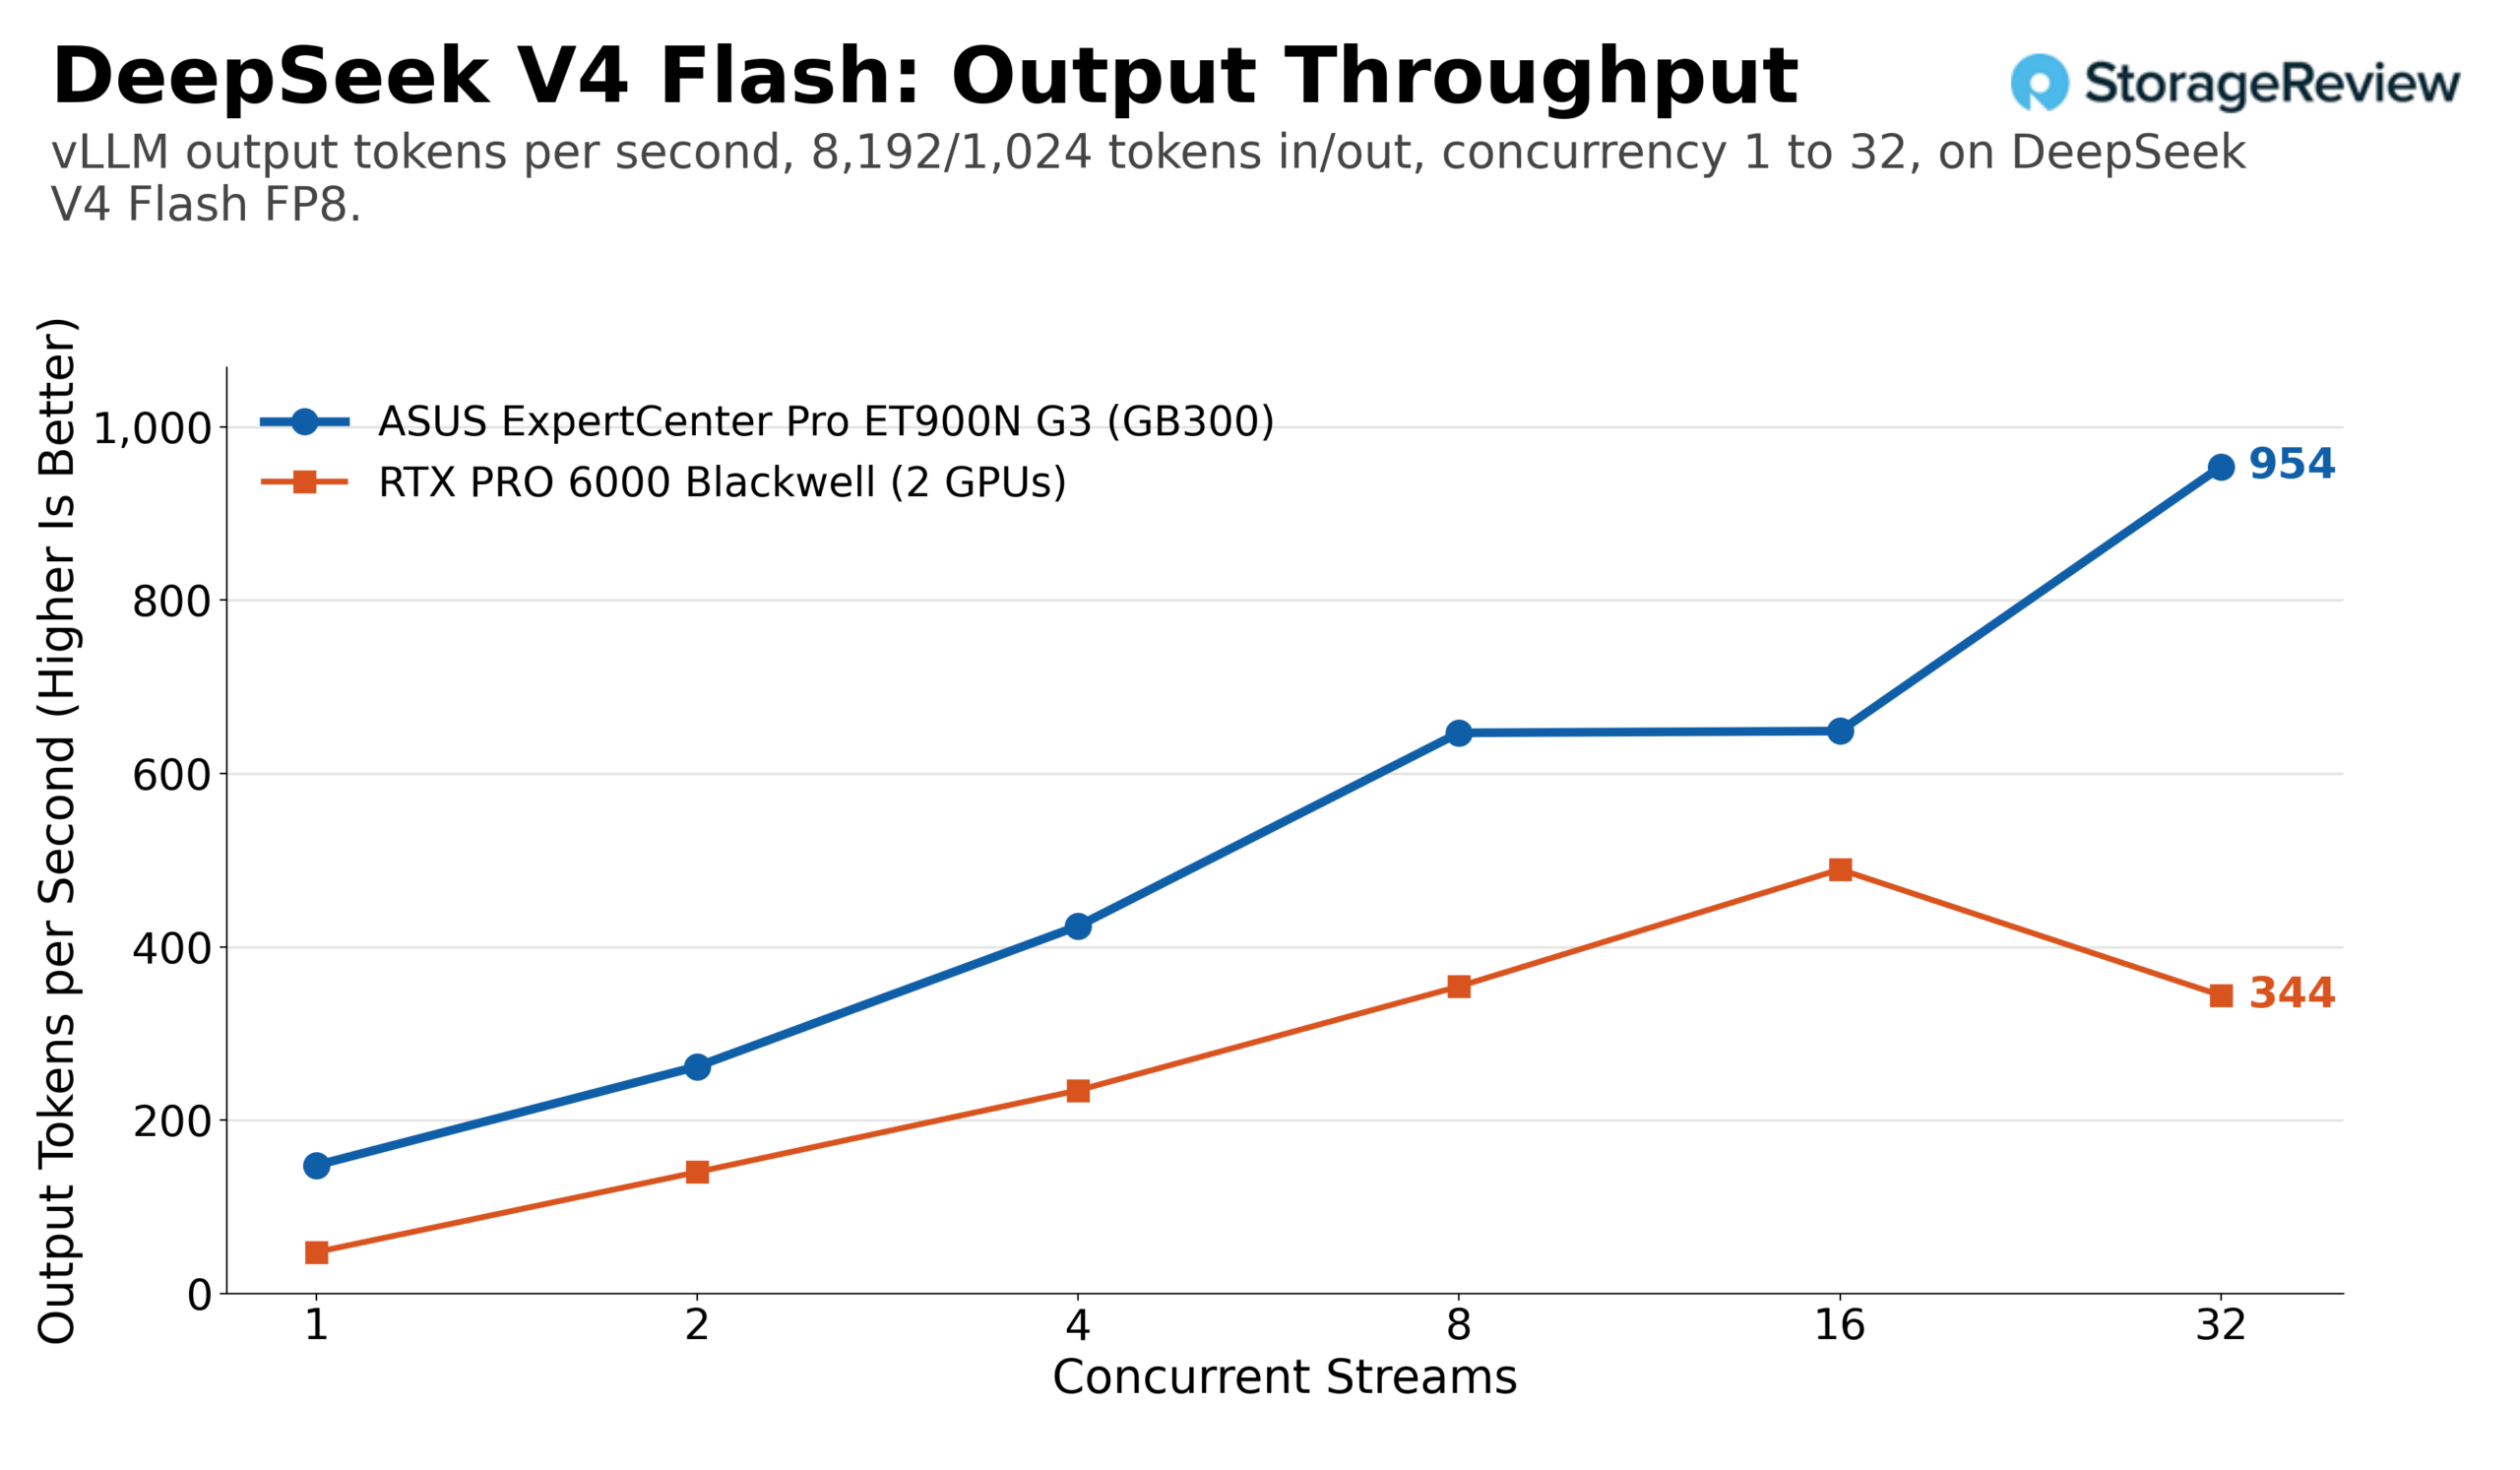
DeepSeek V4 Flash ist der einfachste Fall: ein nativer FP8-Checkpoint von ca. 20 GB, den die B300 problemlos verarbeitet. Der Ausgabedurchsatz stieg bei gleicher Arbeitslast von 152 Token pro Sekunde mit einem Stream auf 1,766 mit 32 Streams, was einen Gesamt-Token-Durchsatz von 3,532 ergab. Im Profil mit hohem Prefill-Anteil steigerte die ET900N G3 ihren Durchsatz von 148 auf 954 Ausgabetoken pro Sekunde, mit insgesamt 8,587 Token. Zwei RTX PRO 6000-Karten erreichten bei gleicher Arbeitslast Spitzenwerte von fast 800 Ausgabetoken pro Sekunde und etwa 490 bei langen Eingabeaufforderungen, wobei die Leistung bei geringer Parallelität ungleichmäßig verlief.
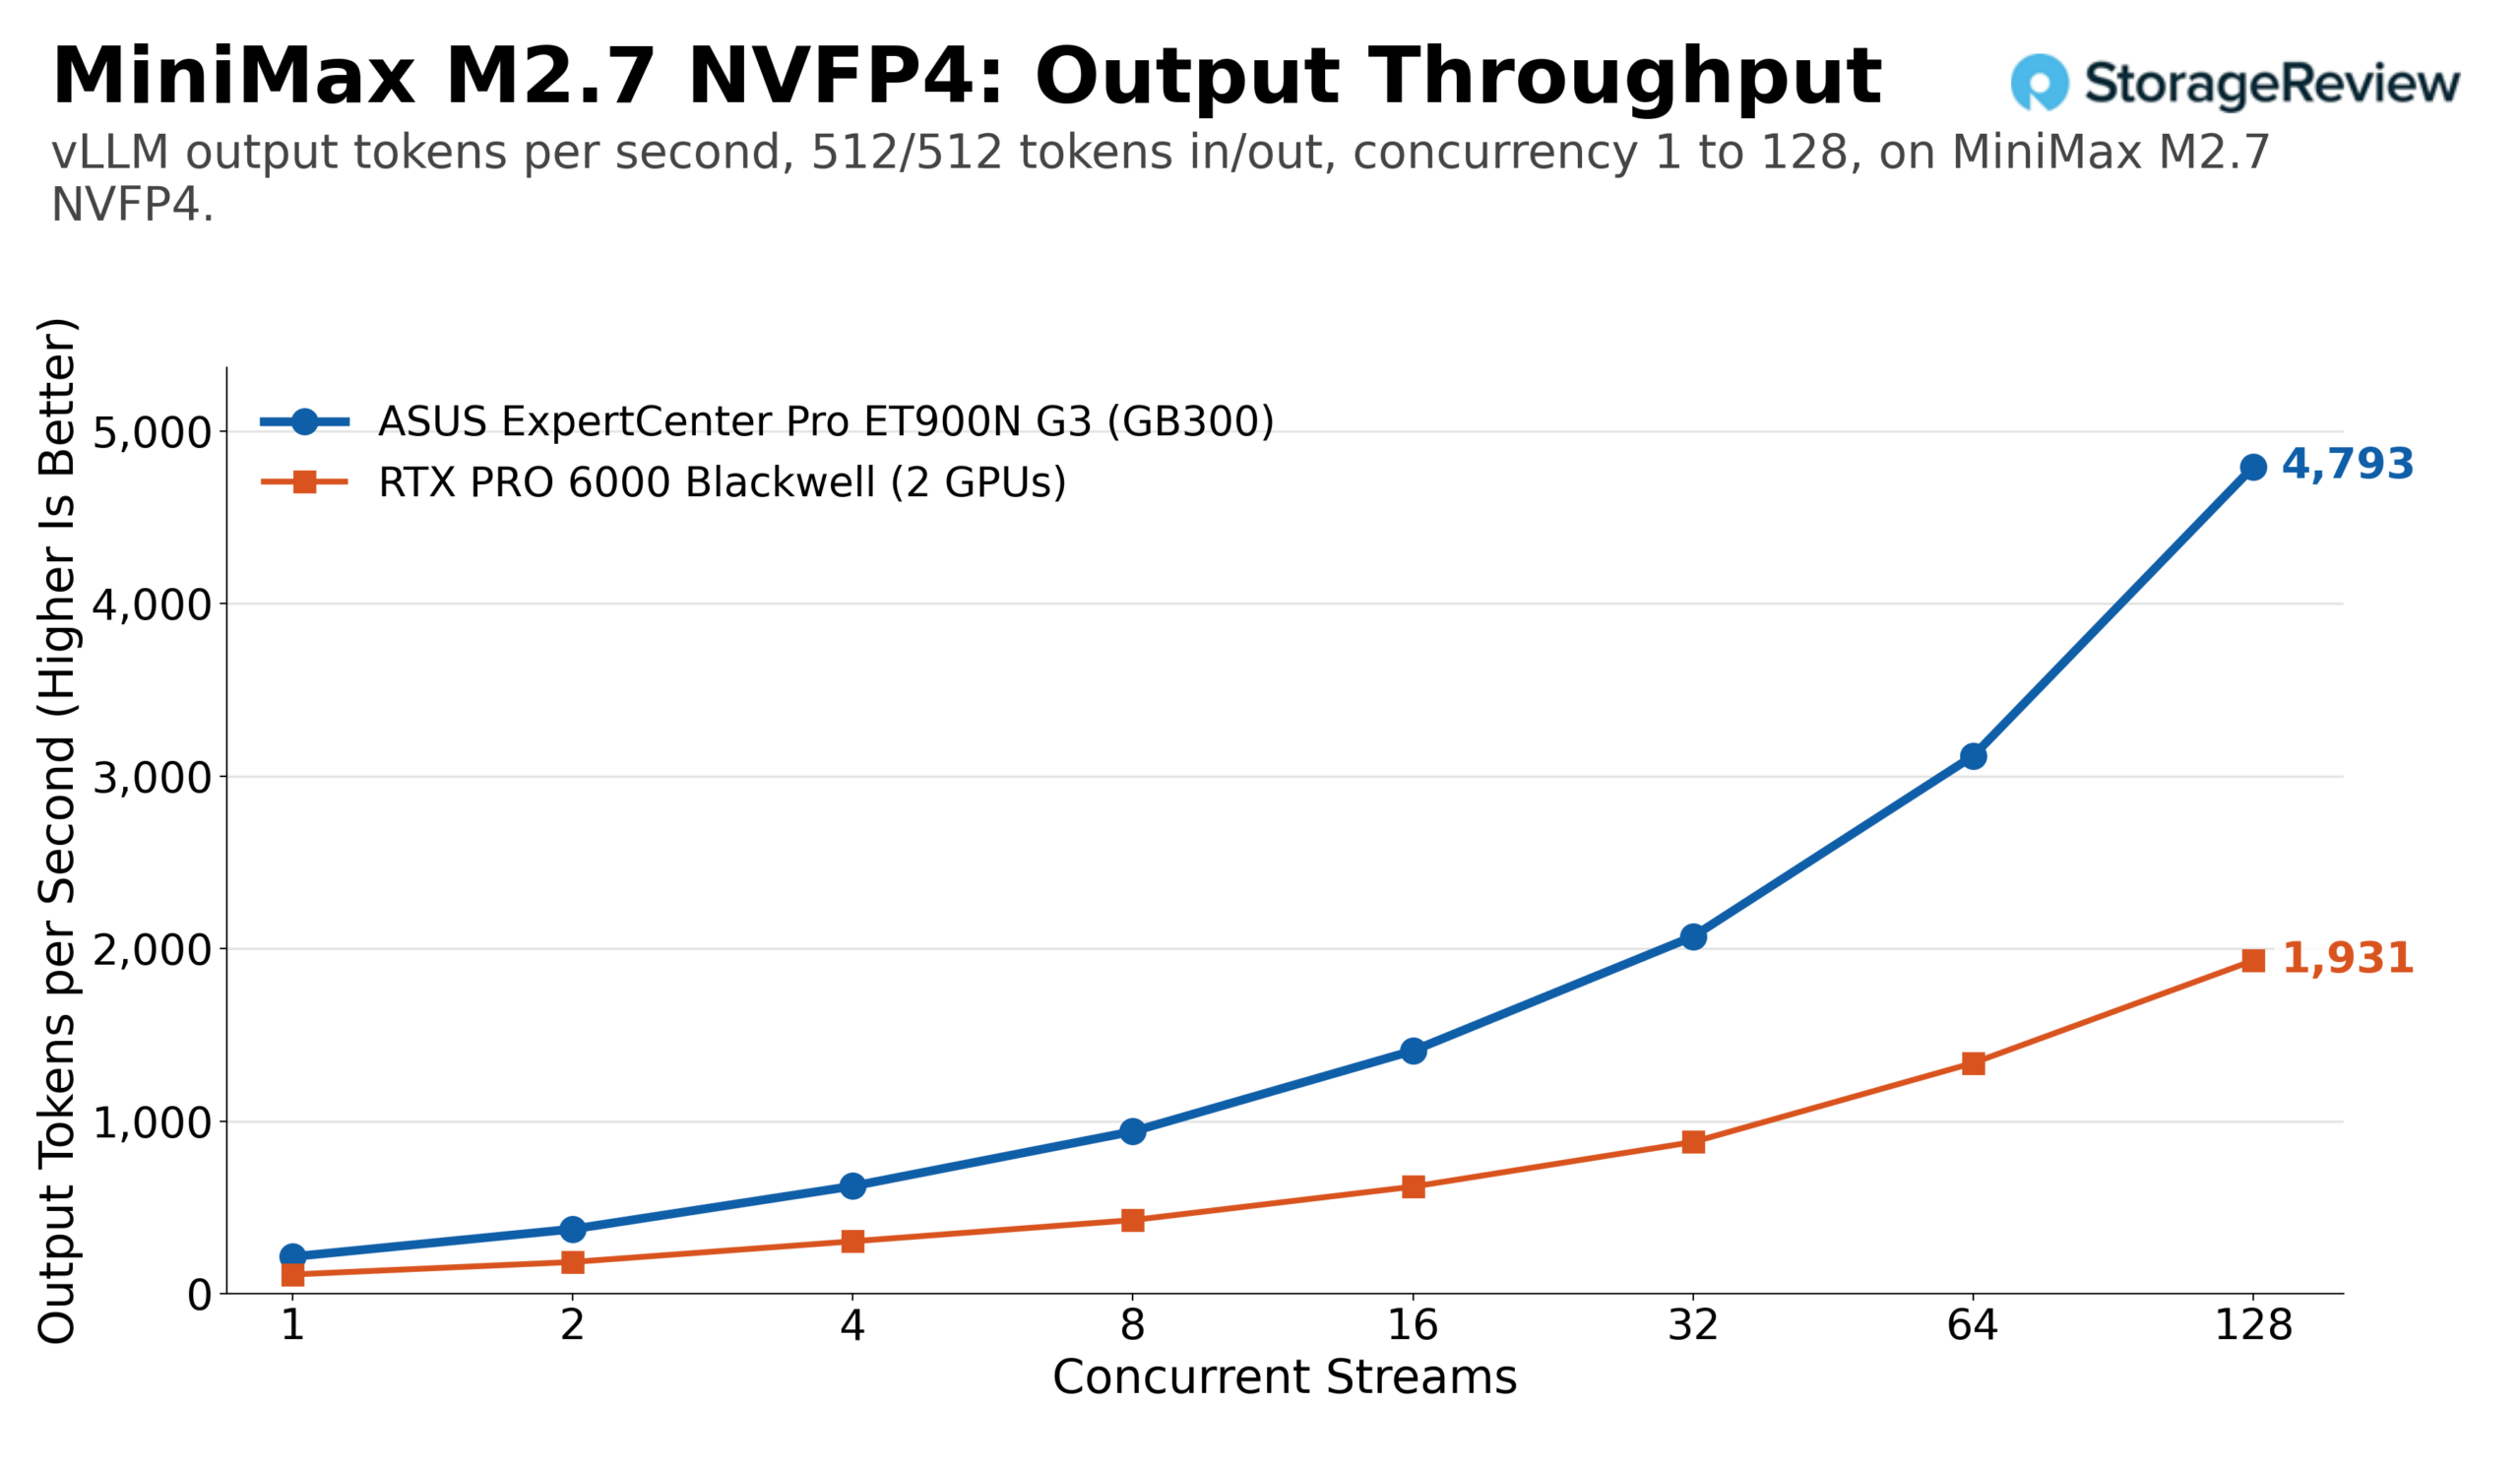
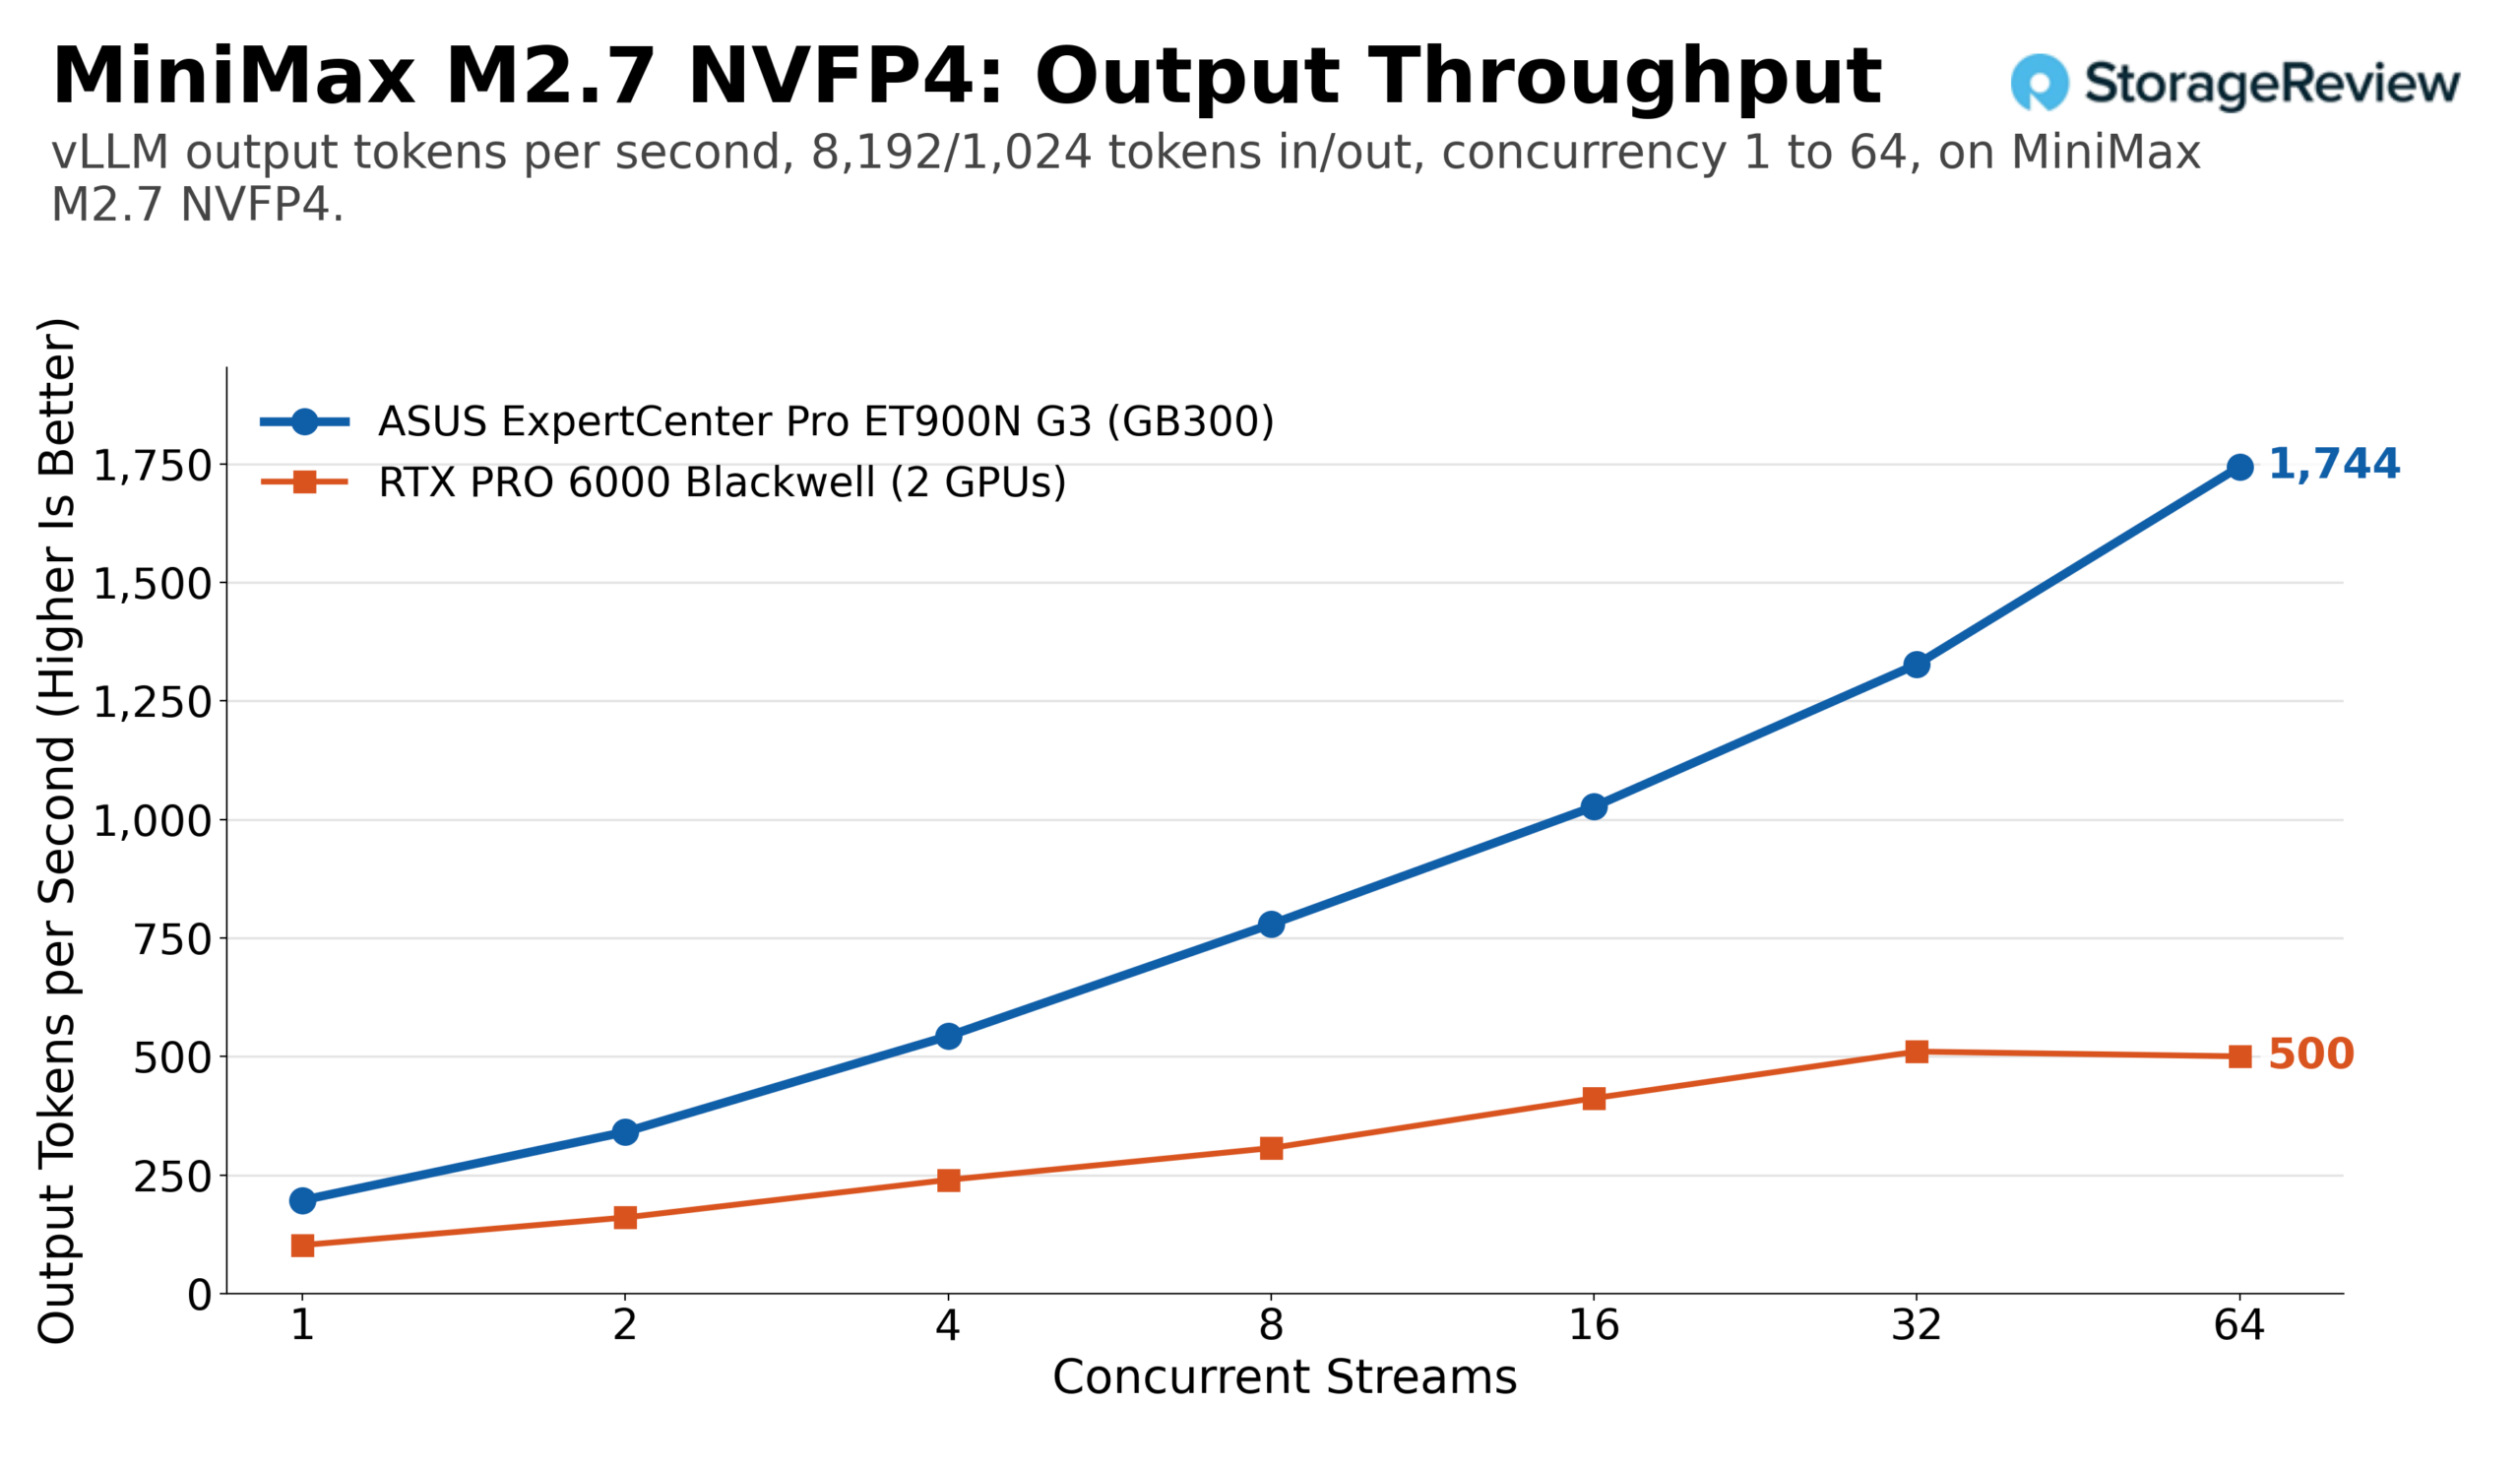
MiniMax M2.7 in NVIDIAs NVFP4-Quantisierung belegt etwa 125 GB HBM und skalierte am stärksten von allen vier. Bei gleicher Arbeitslast stieg die Ausgabeleistung von 214 Token pro Sekunde bei einem Stream auf 4,793 bei 128 Streams, der Gesamtdurchsatz erreichte 9,586. Der Testlauf mit hohem Prefill-Anteil skalierte auf 1,744 Ausgabetoken pro Sekunde und 15,700 Gesamttoken pro Sekunde bei 64 Streams. Zwei RTX PRO 6000-Karten zeigten ein ähnliches Verhalten mit weniger als der Hälfte der Leistung und erreichten bei gleicher Arbeitslast maximal knapp 1,930 Ausgabetoken pro Sekunde und bei langen Eingabeaufforderungen etwa 510.
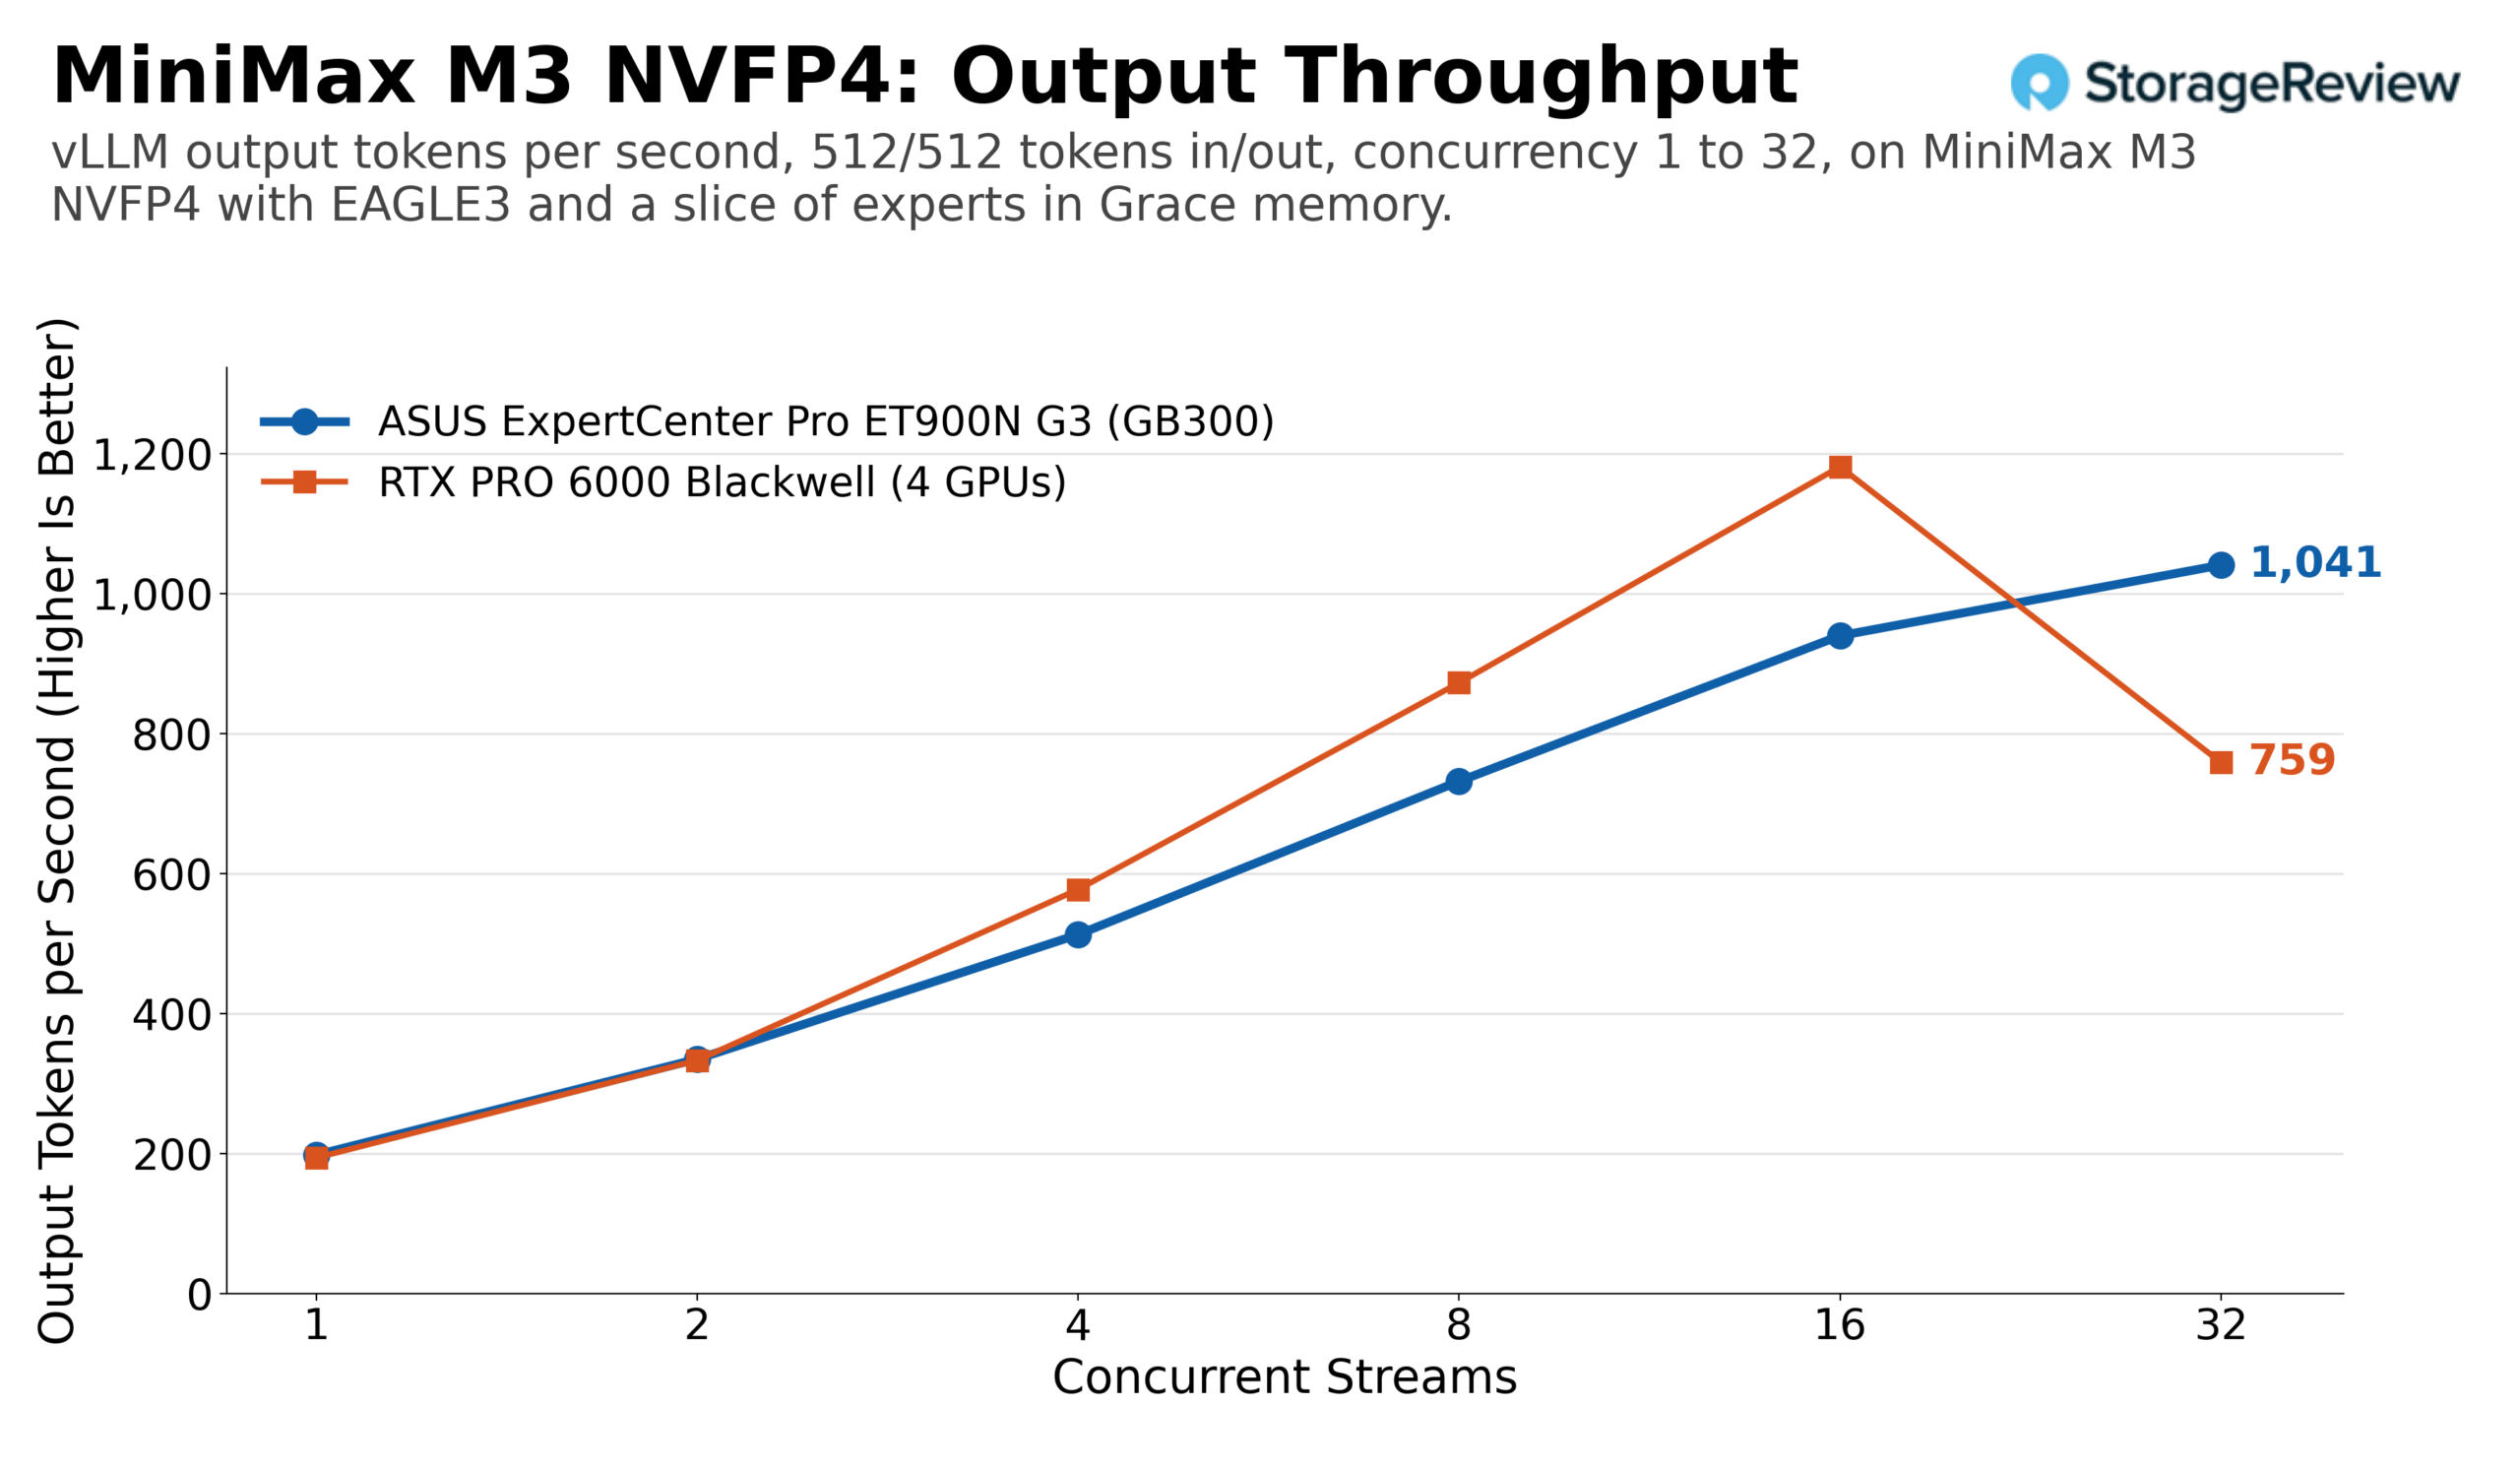
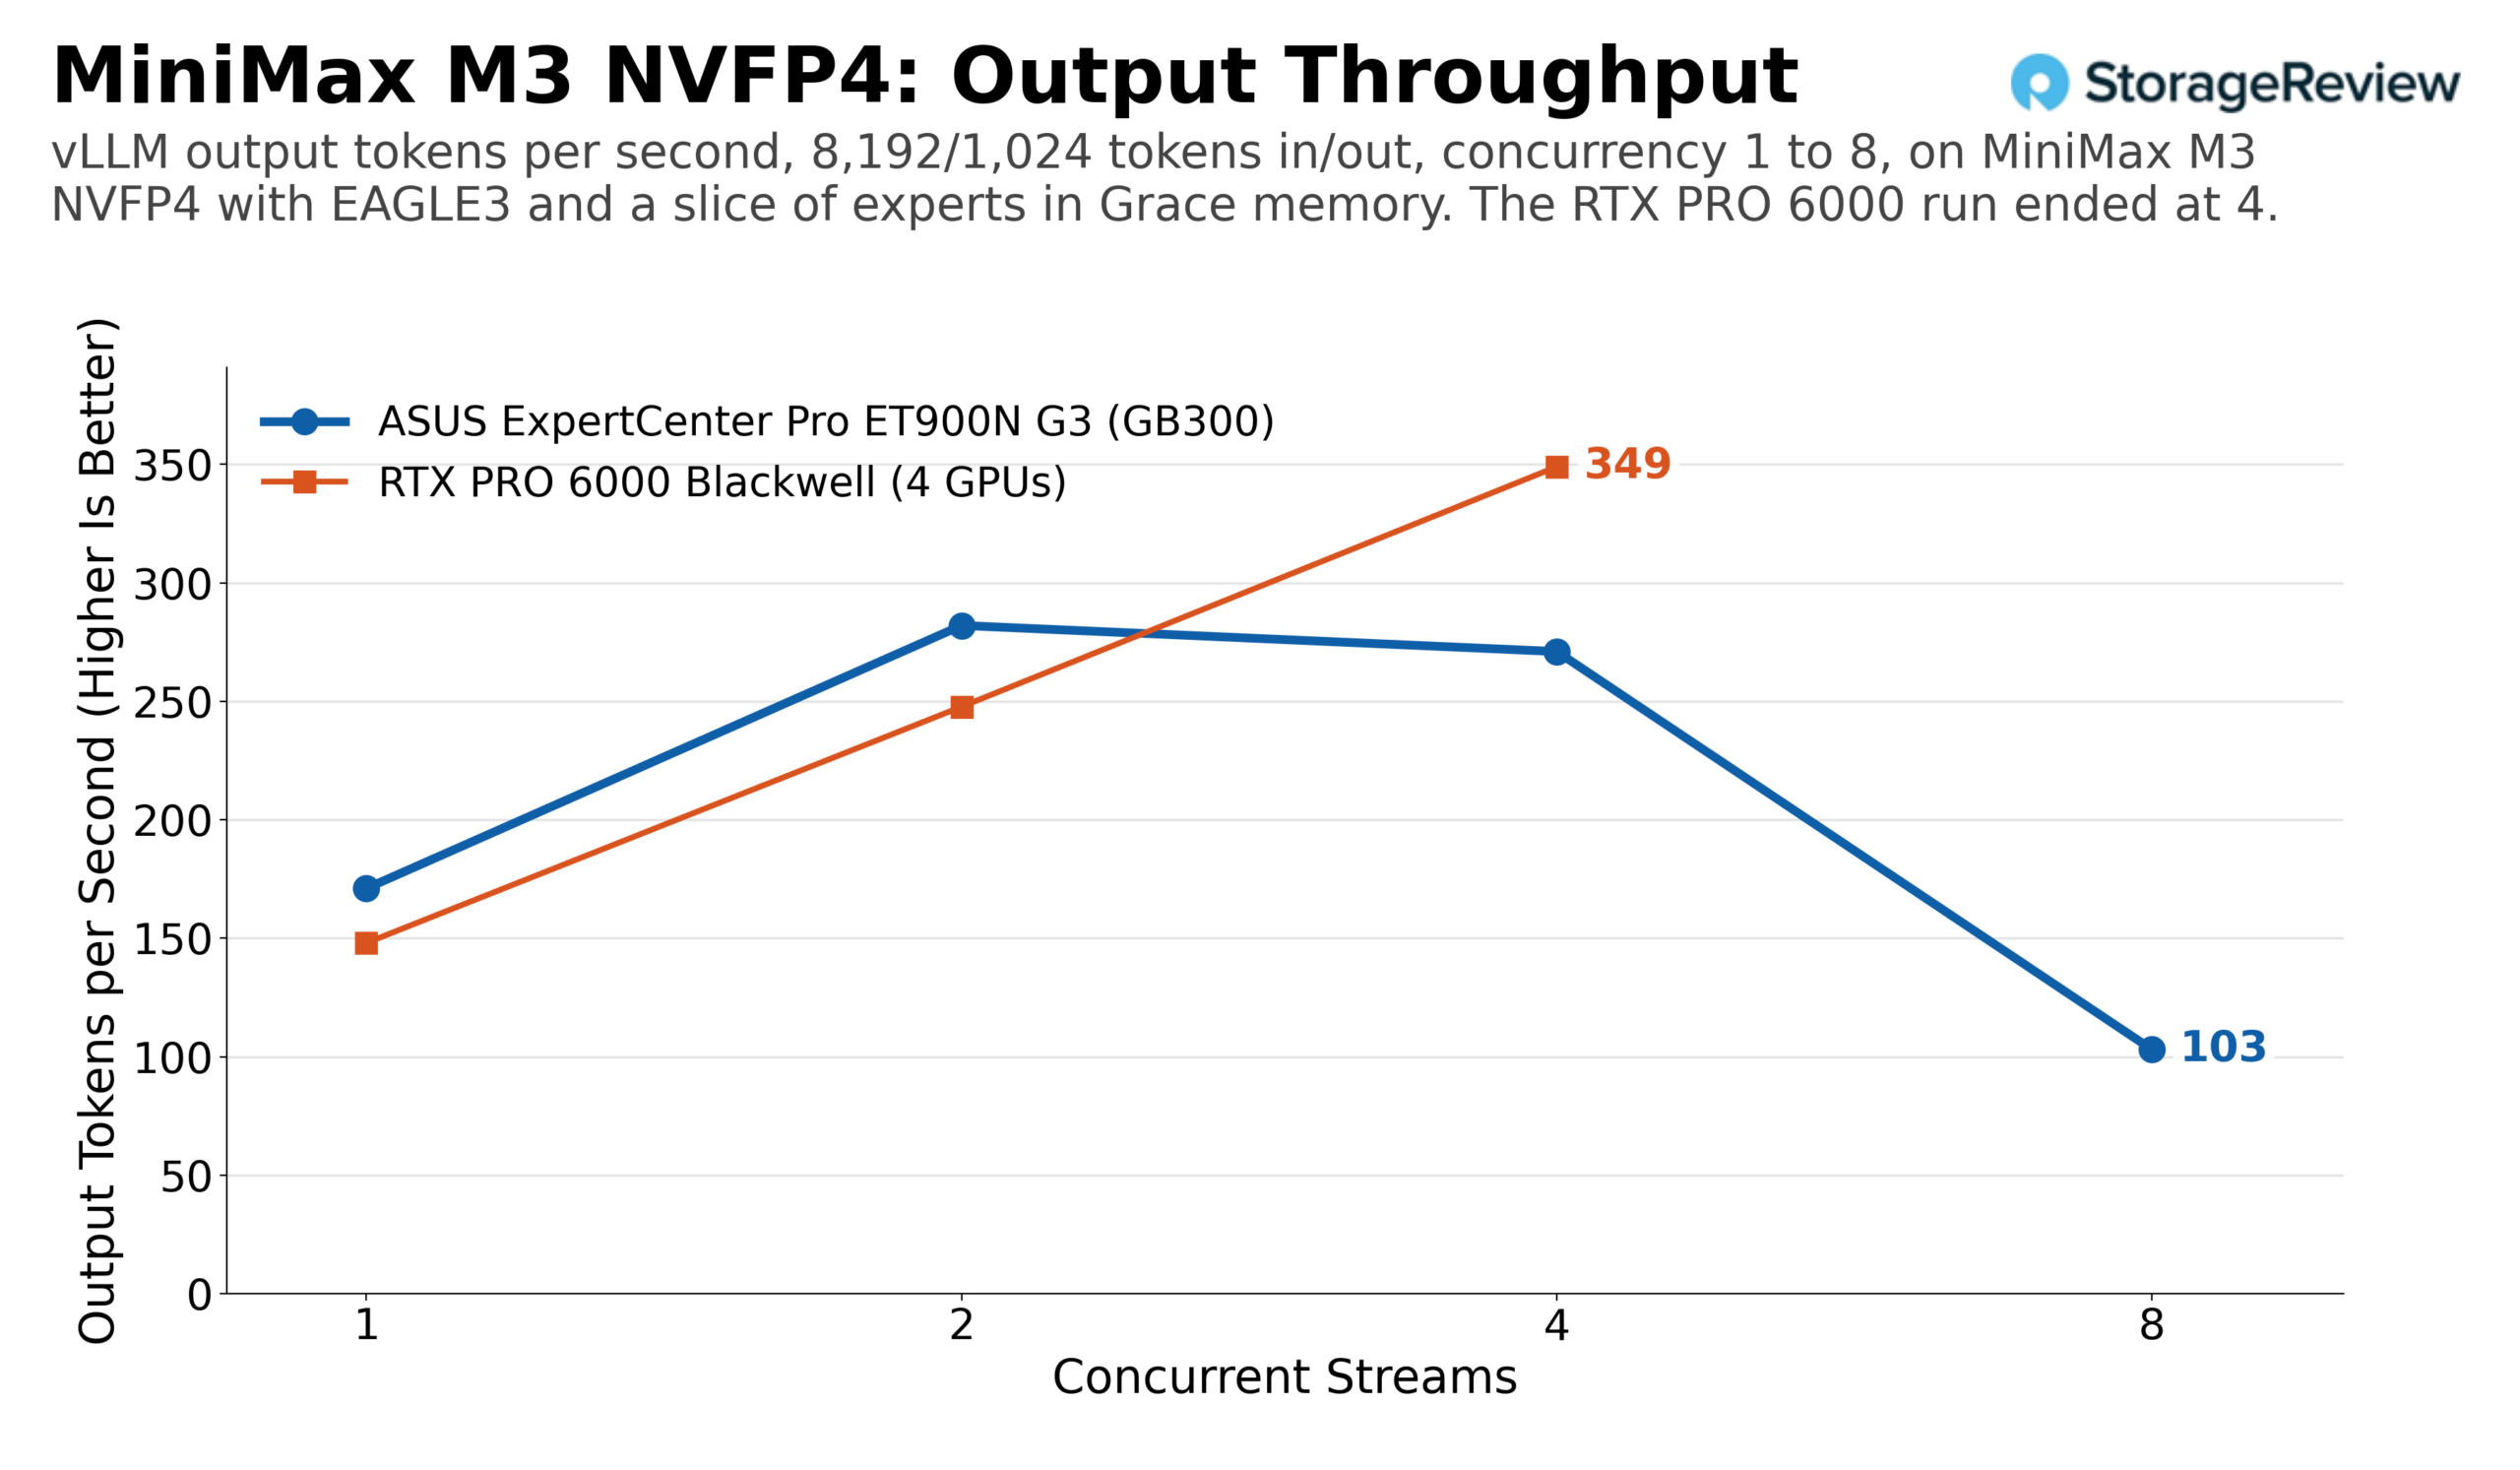
MiniMax M3 zeigt, wie es ist, wenn der Speicher gerade so voll ausgenutzt wird. Der NVFP4-Checkpoint ist kleiner als 252 GB, aber auch die Laufzeitumgebung und der KV-Cache benötigen Speicherplatz. Daher befindet sich ein Teil der Experteninformationen im Grace-Speicher, und jeder Dekodierungsschritt, der diese Informationen betrifft, durchläuft NVLink-C2C. Mit spekulativer EAGLE3-Dekodierung erreichte die ET900N G3 bei gleicher Arbeitslast 1,041 Ausgabetoken pro Sekunde bei 32 Streams. Das Profil mit hohem Prefill-Anteil erreichte einen Spitzenwert von 282 bei zwei Streams, hielt sich bei vier Streams bei 271 und fiel bei acht Streams auf 103, da die langen Prompts den verbleibenden Cache belegten. Vier RTX PRO 6000-Karten mit demselben spekulativen Decoder hielten bis zu acht Streams mit und zogen bei 16 Streams mit etwa 1,180 Ausgabetoken pro Sekunde davon, bevor sie bei 32 Streams wieder auf etwa 760 zurückfielen. Bei hohem Prefill-Anteil erreichte die Vier-Karten-Box mit vier Datenströmen etwa 349 Ausgabetoken pro Sekunde, verglichen mit den 271 der Station. Ein Modell, das sich direkt an der HBM-Grenze befindet, ist das einzige in diesem Set, bei dem 384 GB VRAM auf vier Karten mit 252 GB HBM plus Offload konkurrieren.
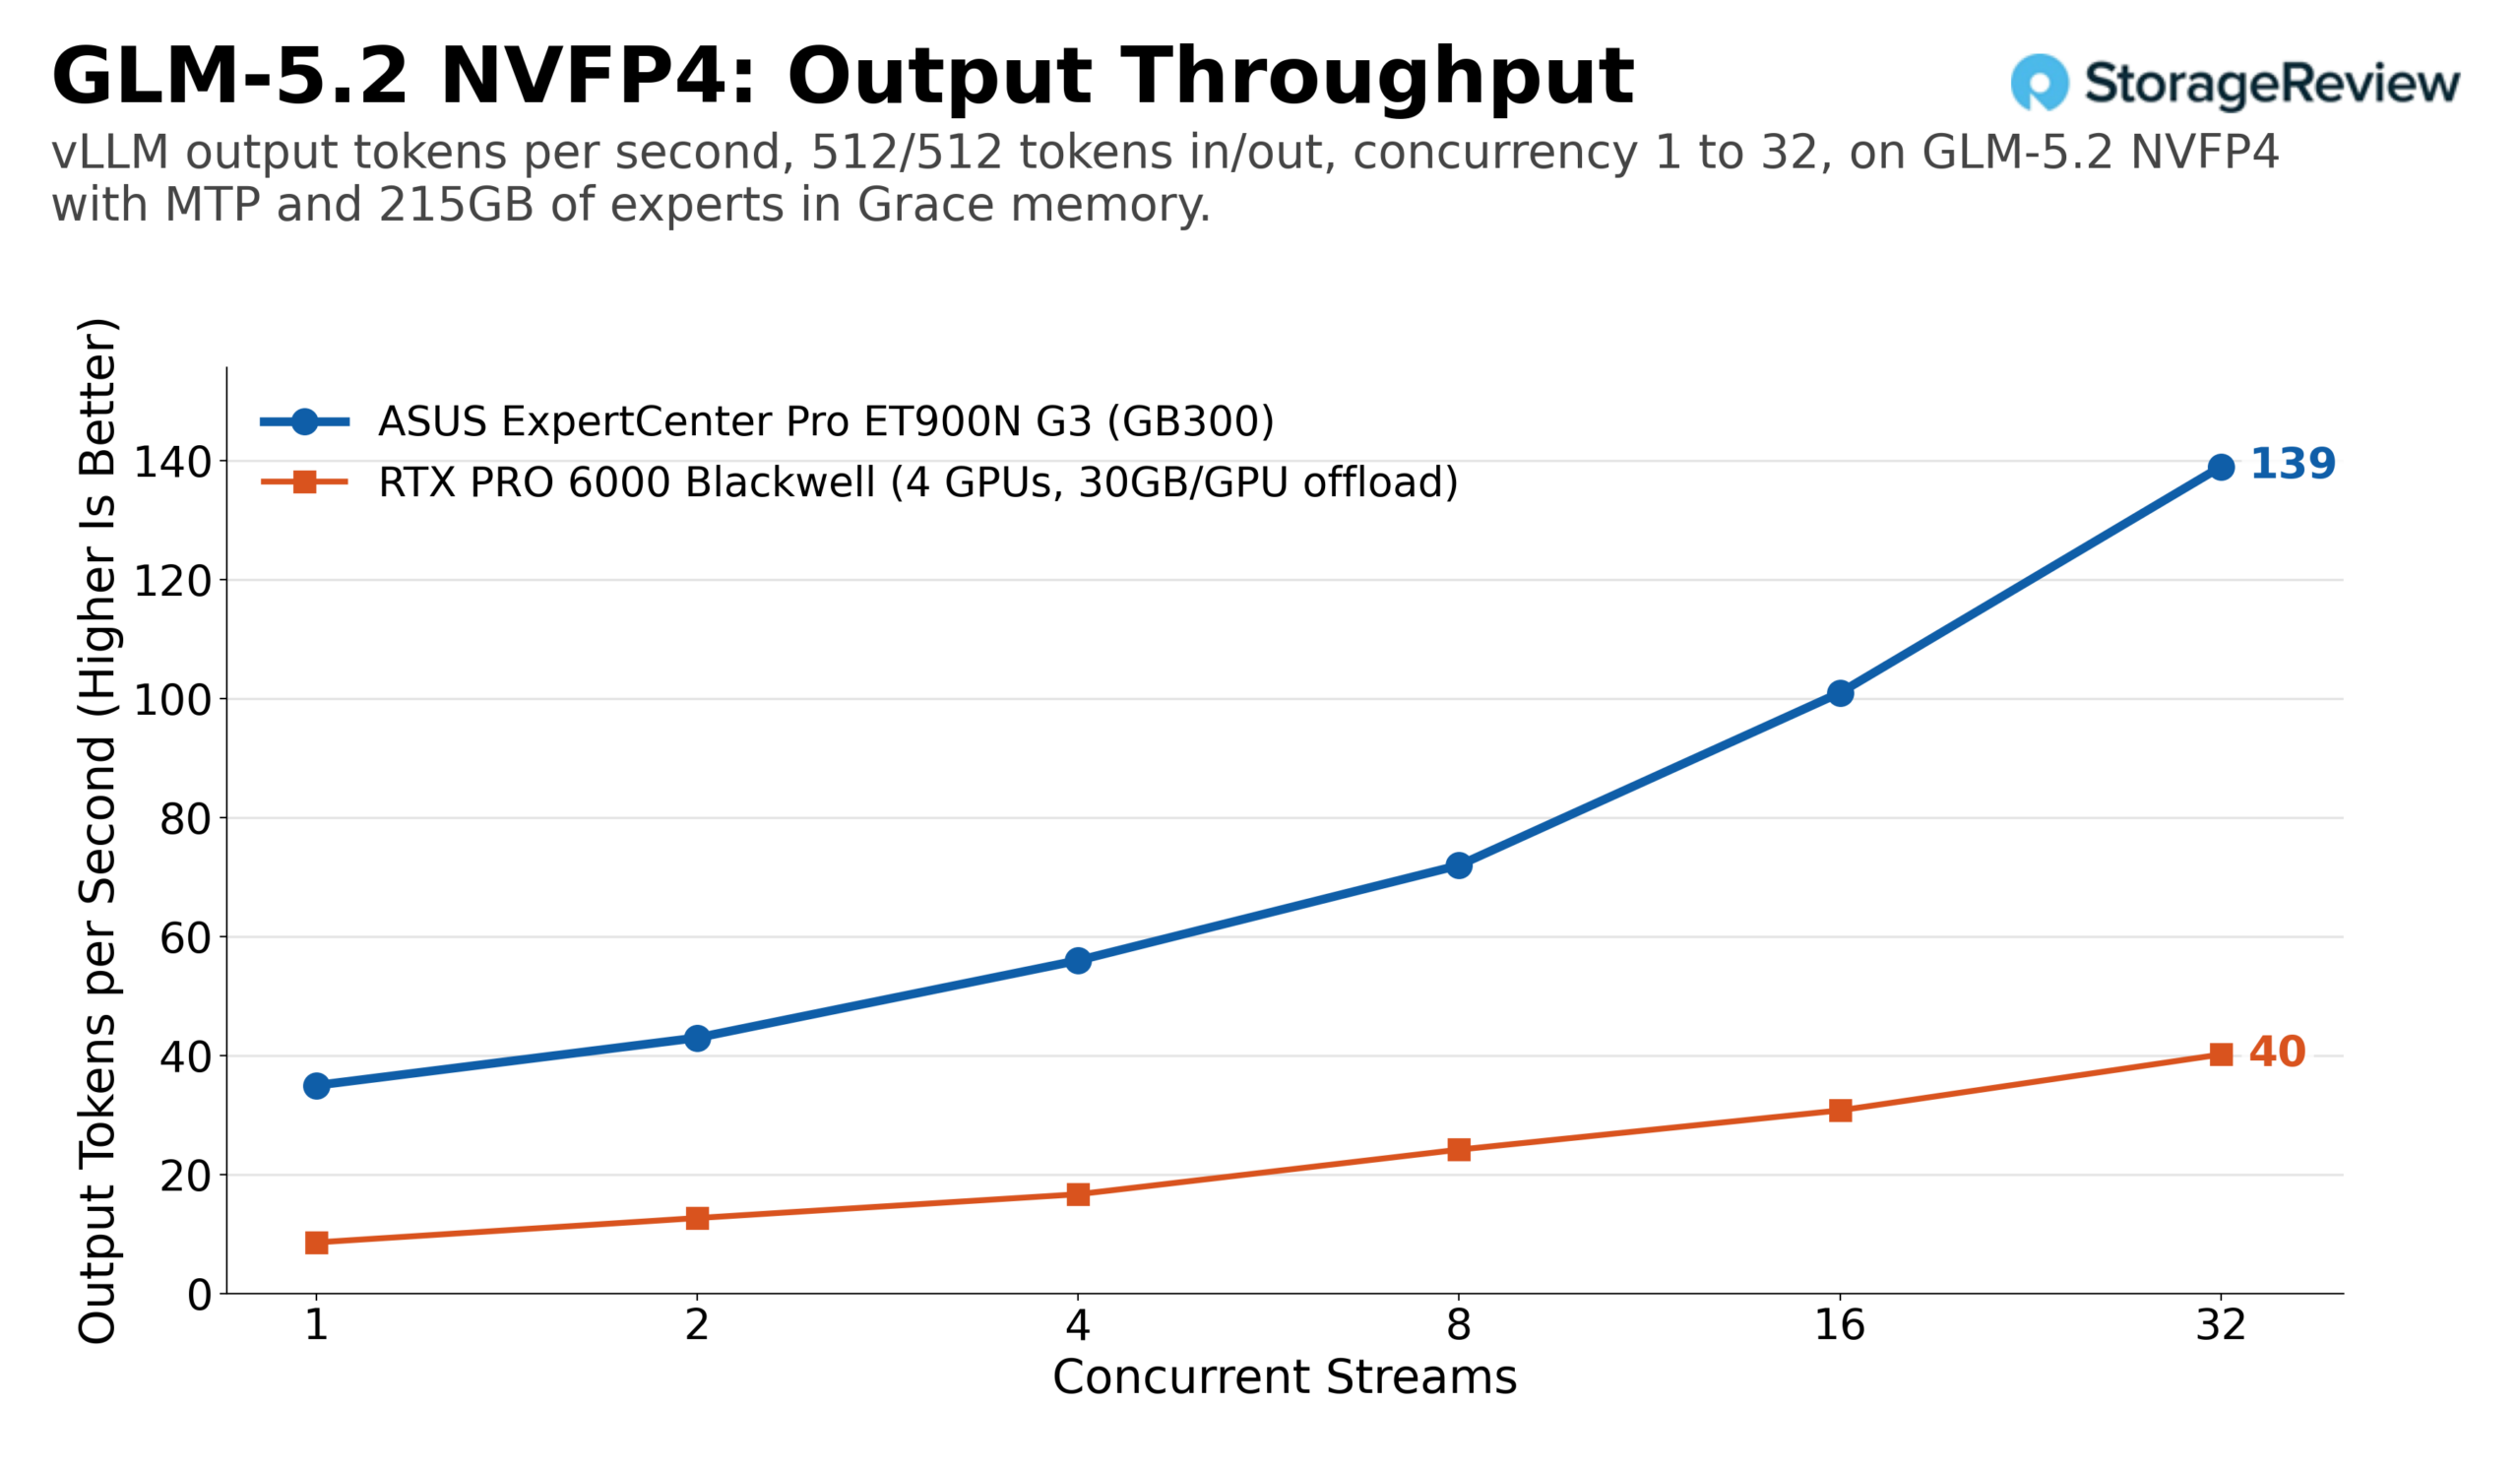
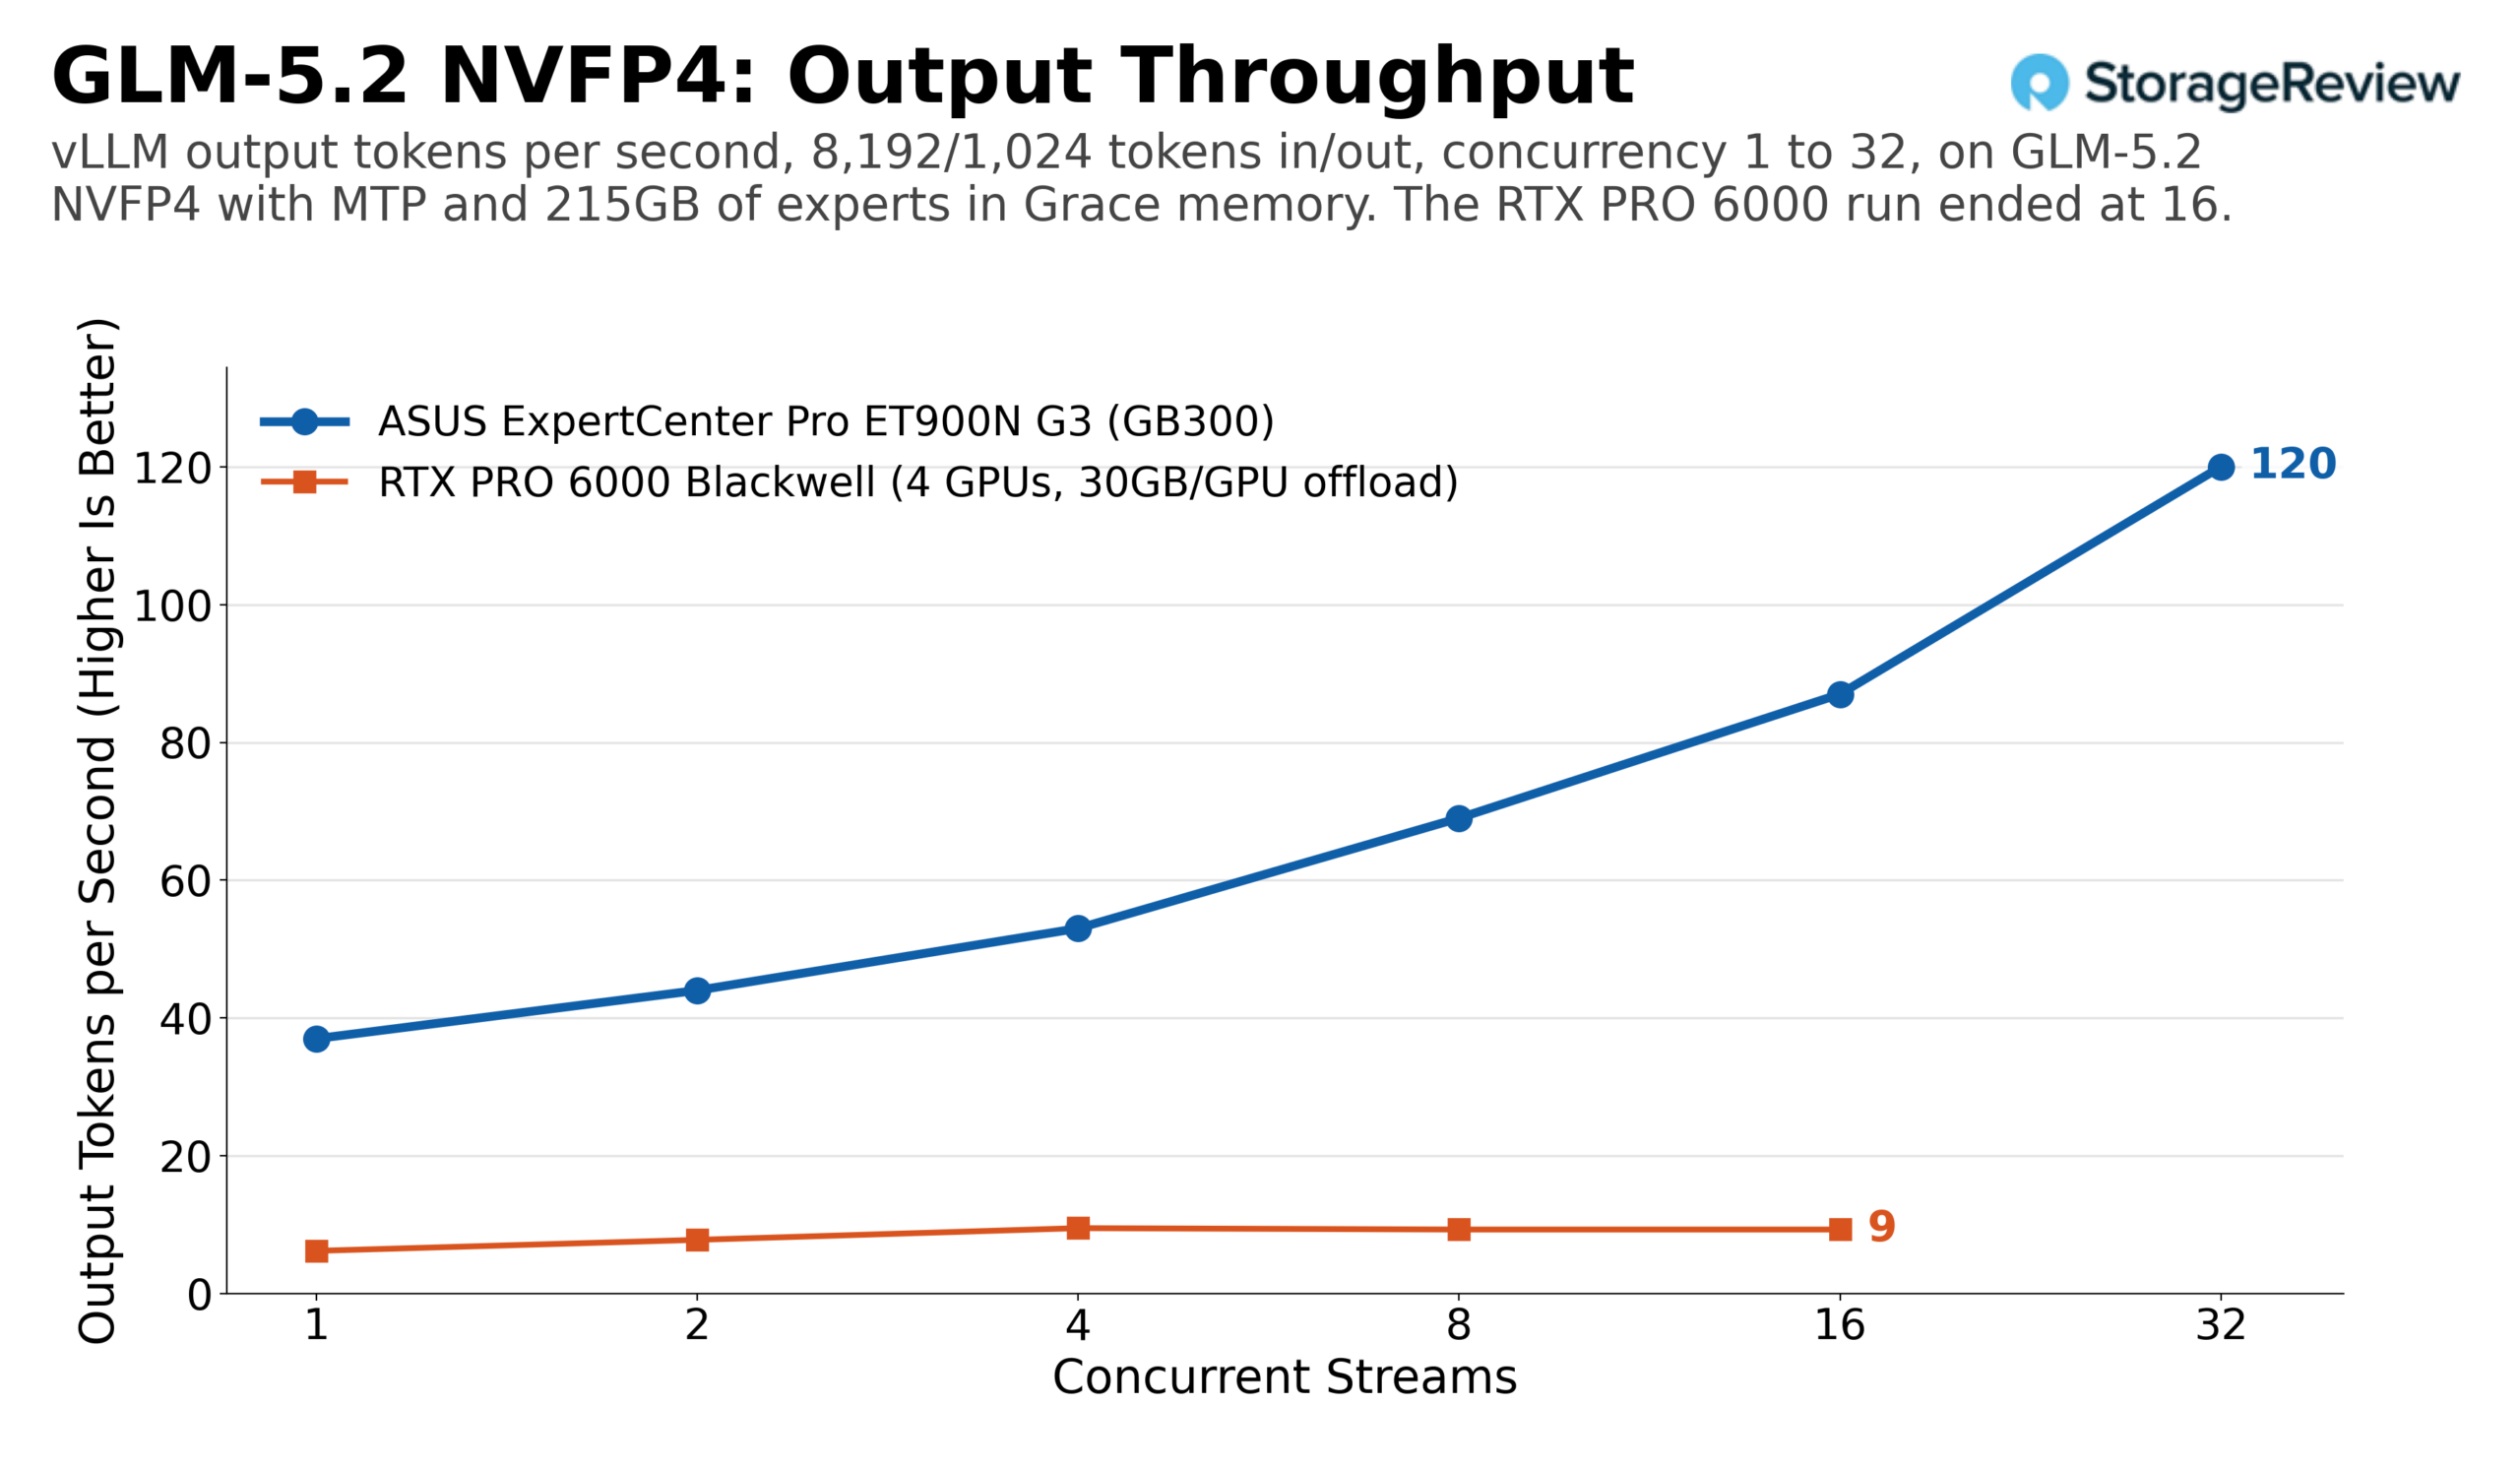
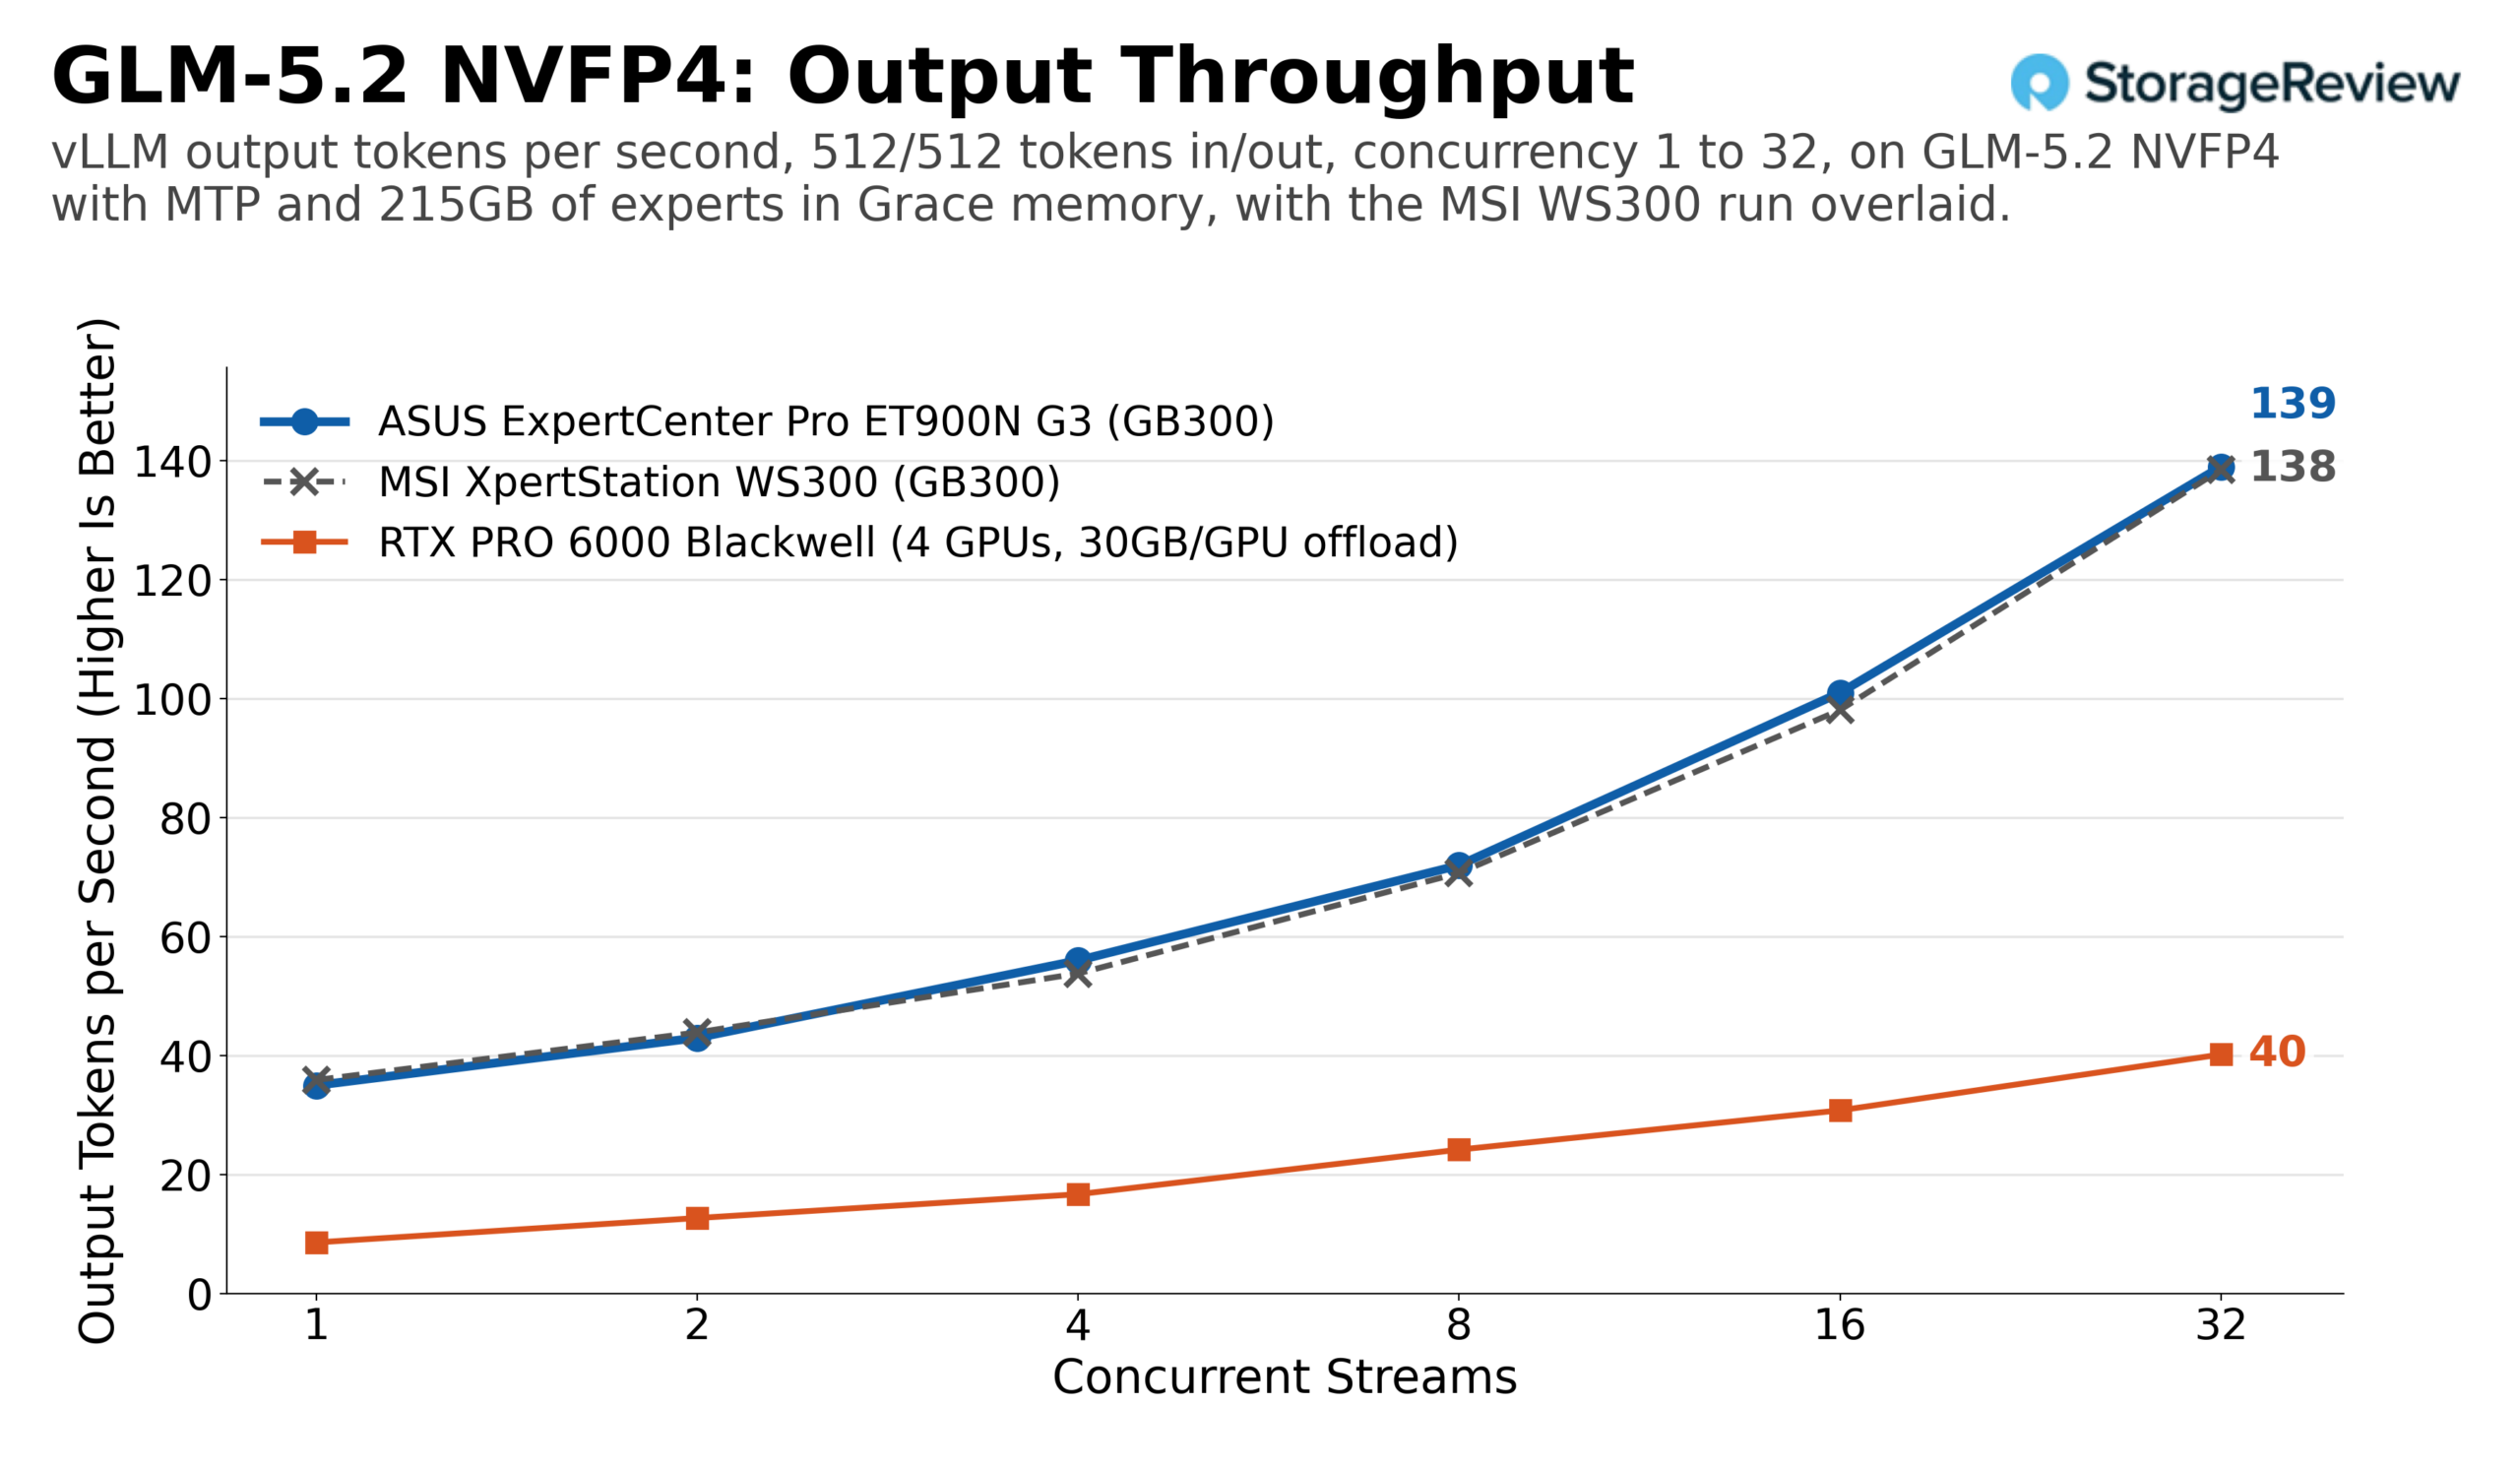
GLM-5.2 ist der Anwendungsfall, der nur durch den kohärenten Pool ermöglicht wird. Der NVFP4-Checkpoint speichert ca. 215 GB an Expertengewichten im Grace-Speicher mit spekulativer MTP-Dekodierung. Die ET900N G3 erreichte bei gleicher Auslastung 35 Ausgabetoken pro Sekunde für einen Stream und 139 für 32 Streams, wobei der Gesamtdurchsatz 277 erreichte. Im Profil mit hohem Prefill-Aufkommen lief der Sweep mit 32 Streams und erreichte 120 Ausgabetoken pro Sekunde und insgesamt 1,079 Token. Vier RTX PRO 6000-Karten, die jeweils ca. 30 GB in den Hostspeicher auslagerten, schafften ca. 40 Ausgabetoken pro Sekunde bei 32 Streams, wobei sich der Wert bei längeren Eingabeaufforderungen ab vier Streams auf ca. 9 bis 10 einpendelte. Keines der beiden Systeme lässt ein 433-GB-Modell schnell erscheinen, aber der 396 GB/s LPDDR5X-Speicher und der 900 GB/s NVLink-C2C-Pfad des GB300 zu ausgelagerten Experten skalieren weiter, wo der über vier PCIe-Karten angeschlossene Hostspeicher aufhört.
Im Vergleich zum MSI WS300 liegen die Ergebnisse des Spitzenmodells ET900N G3 in allen Vergleichspunkten innerhalb von etwa 1 %: 1,766 Ausgabetoken pro Sekunde auf DeepSeek V4 Flash mit 32 Streams auf beiden Towern, 4,793 gegenüber 4,801 auf MiniMax M2.7 mit 128 Streams, 1,041 auf MiniMax M3 mit 32 Streams auf beiden Towern und 139 auf GLM-5.2 mit 32 Streams auf beiden Towern.
Gemeinsame Modelle mit der RTX PRO 6000, der H200 NVL und der DGX Spark
Die zweite Hälfte der Benchmarks verwendet Modelle, die klein genug sind, um auf jedem System eingesetzt werden zu können: GPT-OSS-20B und 120B in nativem MXFP4; Llama 3.1 8B in BF16 und FP8; Mistral Small 24B in BF16 und FP8; und Qwen3 Coder 30B in BF16 und FP8. Neu im Vergleich zum WS300-Test ist eine einzelne H200 NVL, NVIDIAs 141-GB-Hopper-Karte, die dem Vergleich einen Rechenzentrumsbeschleuniger der vorherigen Generation hinzufügt.
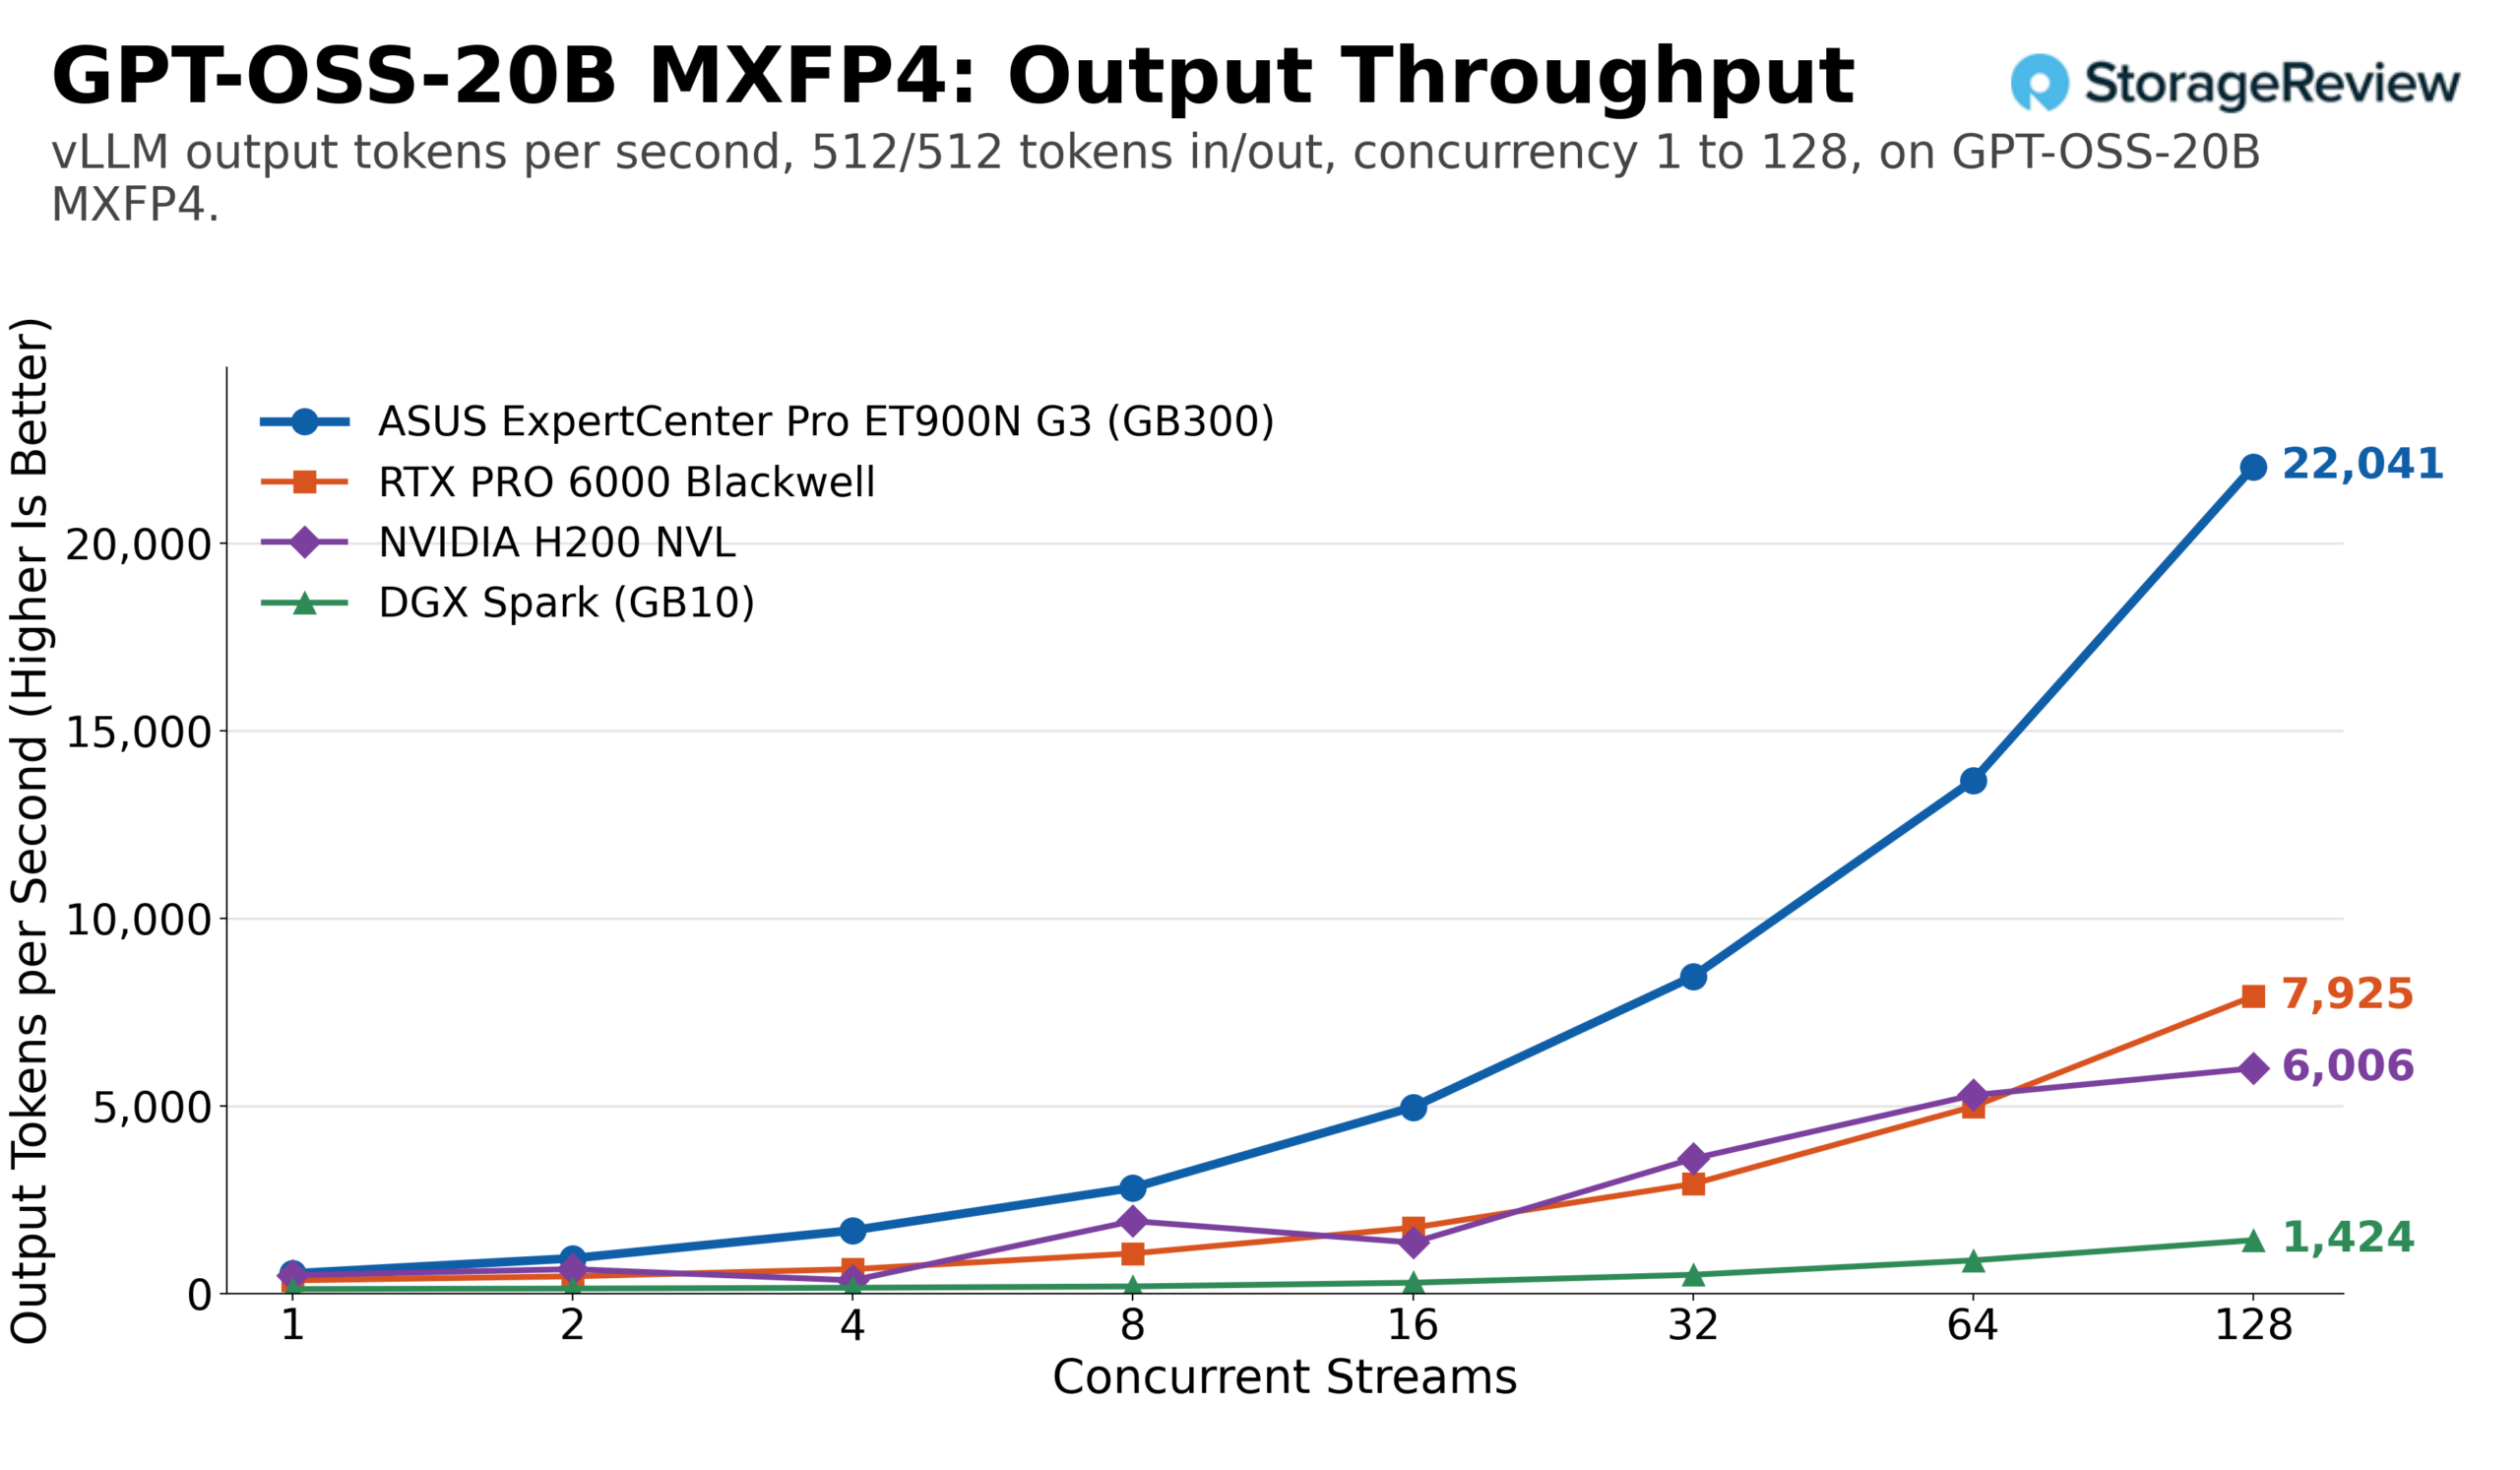
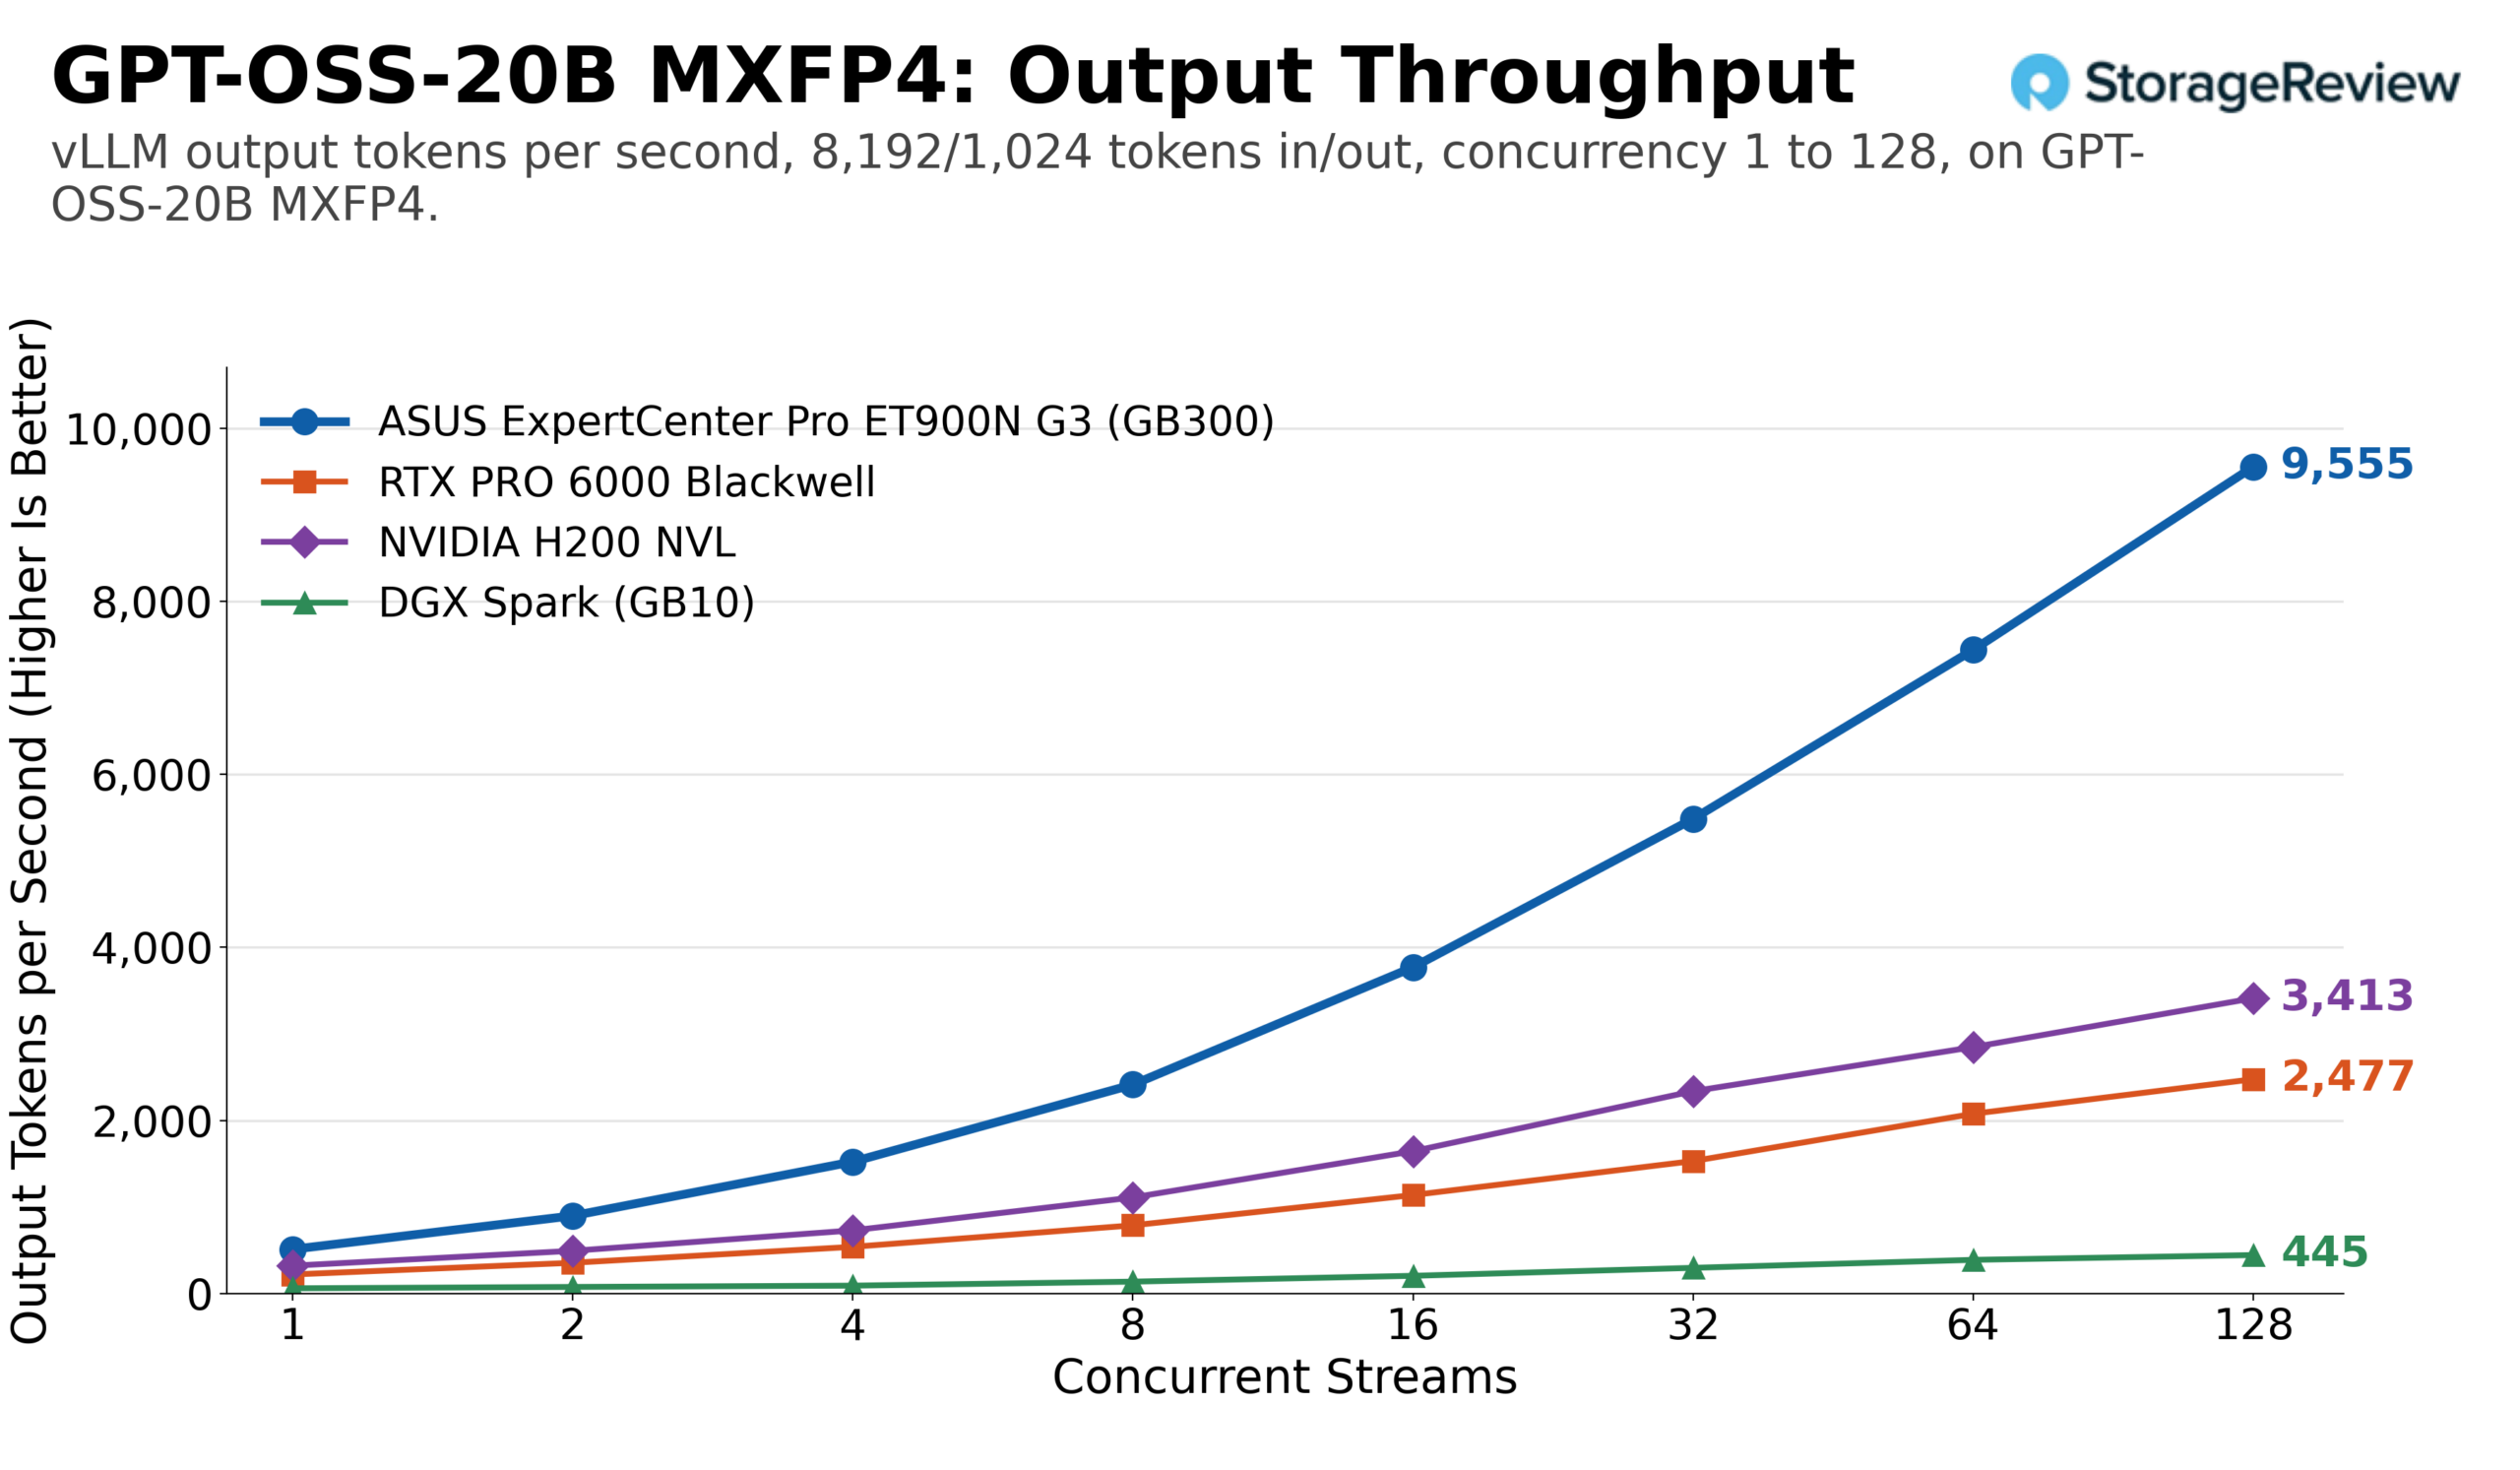
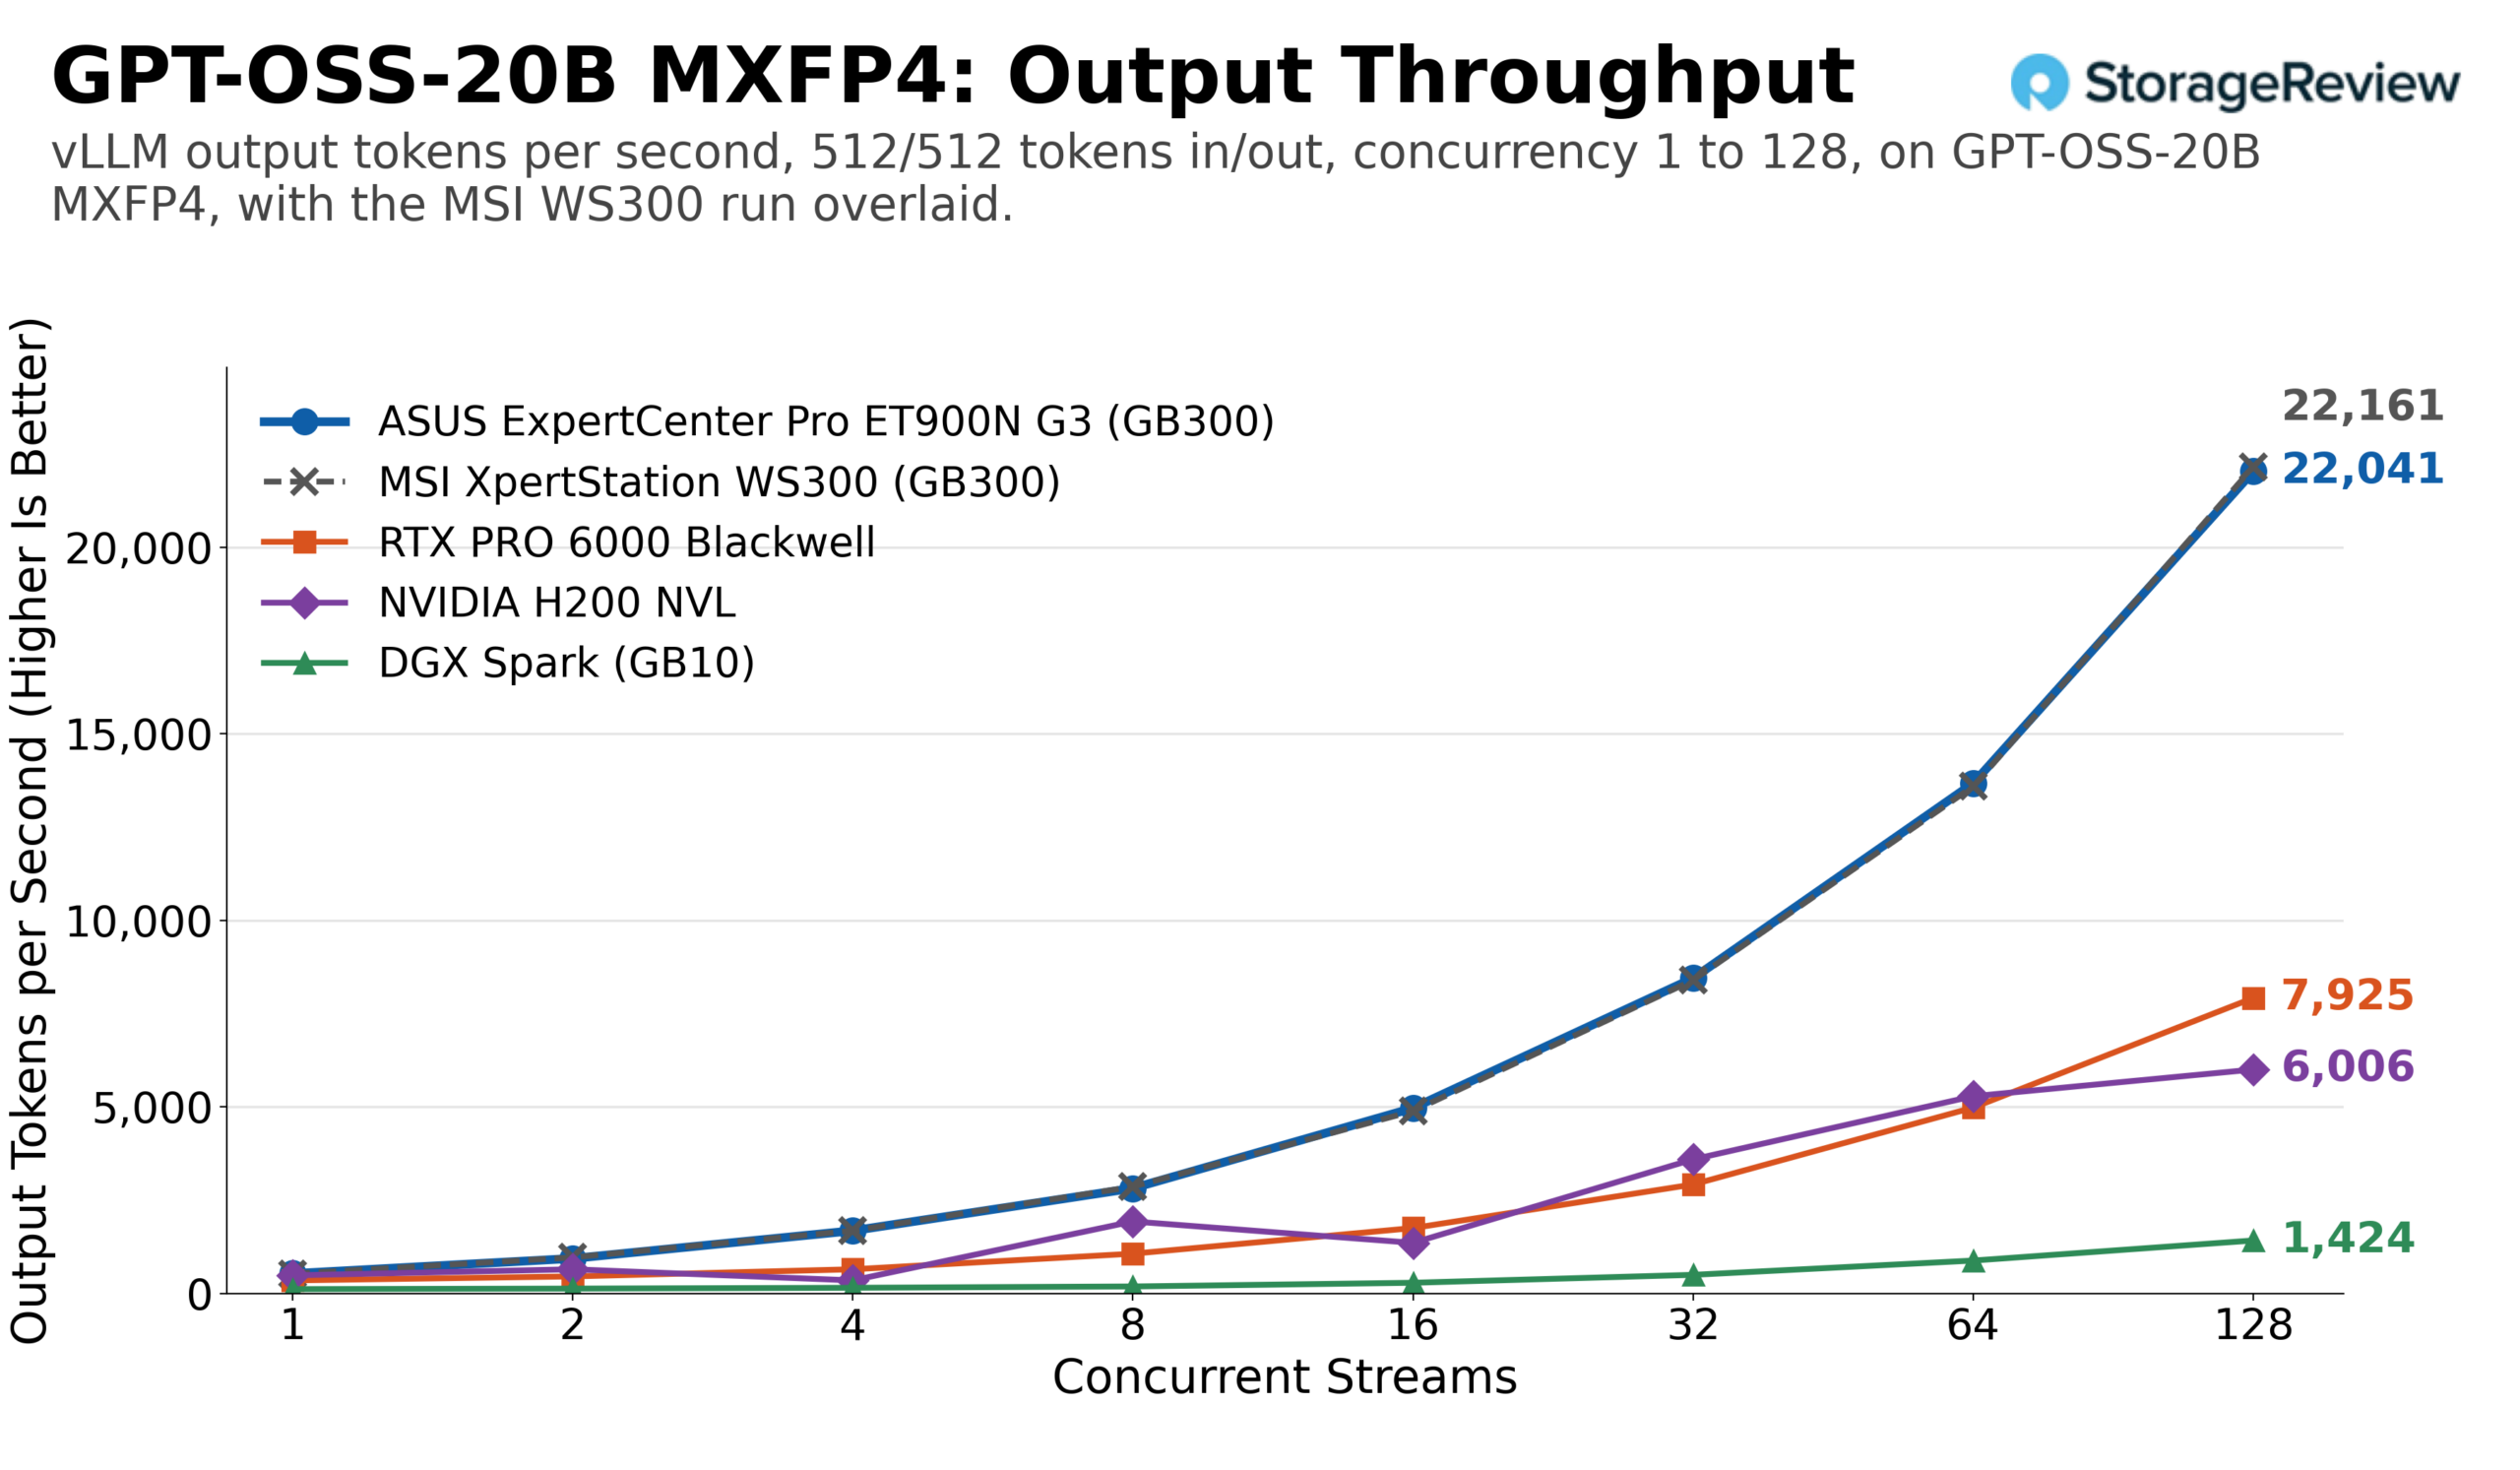
Der GPT-OSS-20B ist der am einfachsten zu testende Test der Reihe, ein Prüfpunkt, den jedes System problemlos besteht. Bei gleicher Arbeitslast erreichte die ET900N G3 eine Ausgabeleistung von 22,041 Token pro Sekunde bei 128 Streams bzw. insgesamt 44,082, verglichen mit etwa 7,920 für die RTX PRO 6000, 6,010 für die H200 NVL und 1,420 für die DGX Spark. Im Einzelstream-Modus erzeugte die Station 536 Ausgabetoken pro Sekunde, verglichen mit 354 der Grafikkarte, 489 der H200 und 120 der Spark. Das Profil mit hohem Prefill-Anteil vergrößerte den Abstand: 9,555 Ausgabetoken pro Sekunde und insgesamt 85,994 bei 128 Streams für die Station, während die RTX PRO 6000 bei etwa 2,480, die H200 NVL bei 3,410 und die Spark bei 445 lagen.
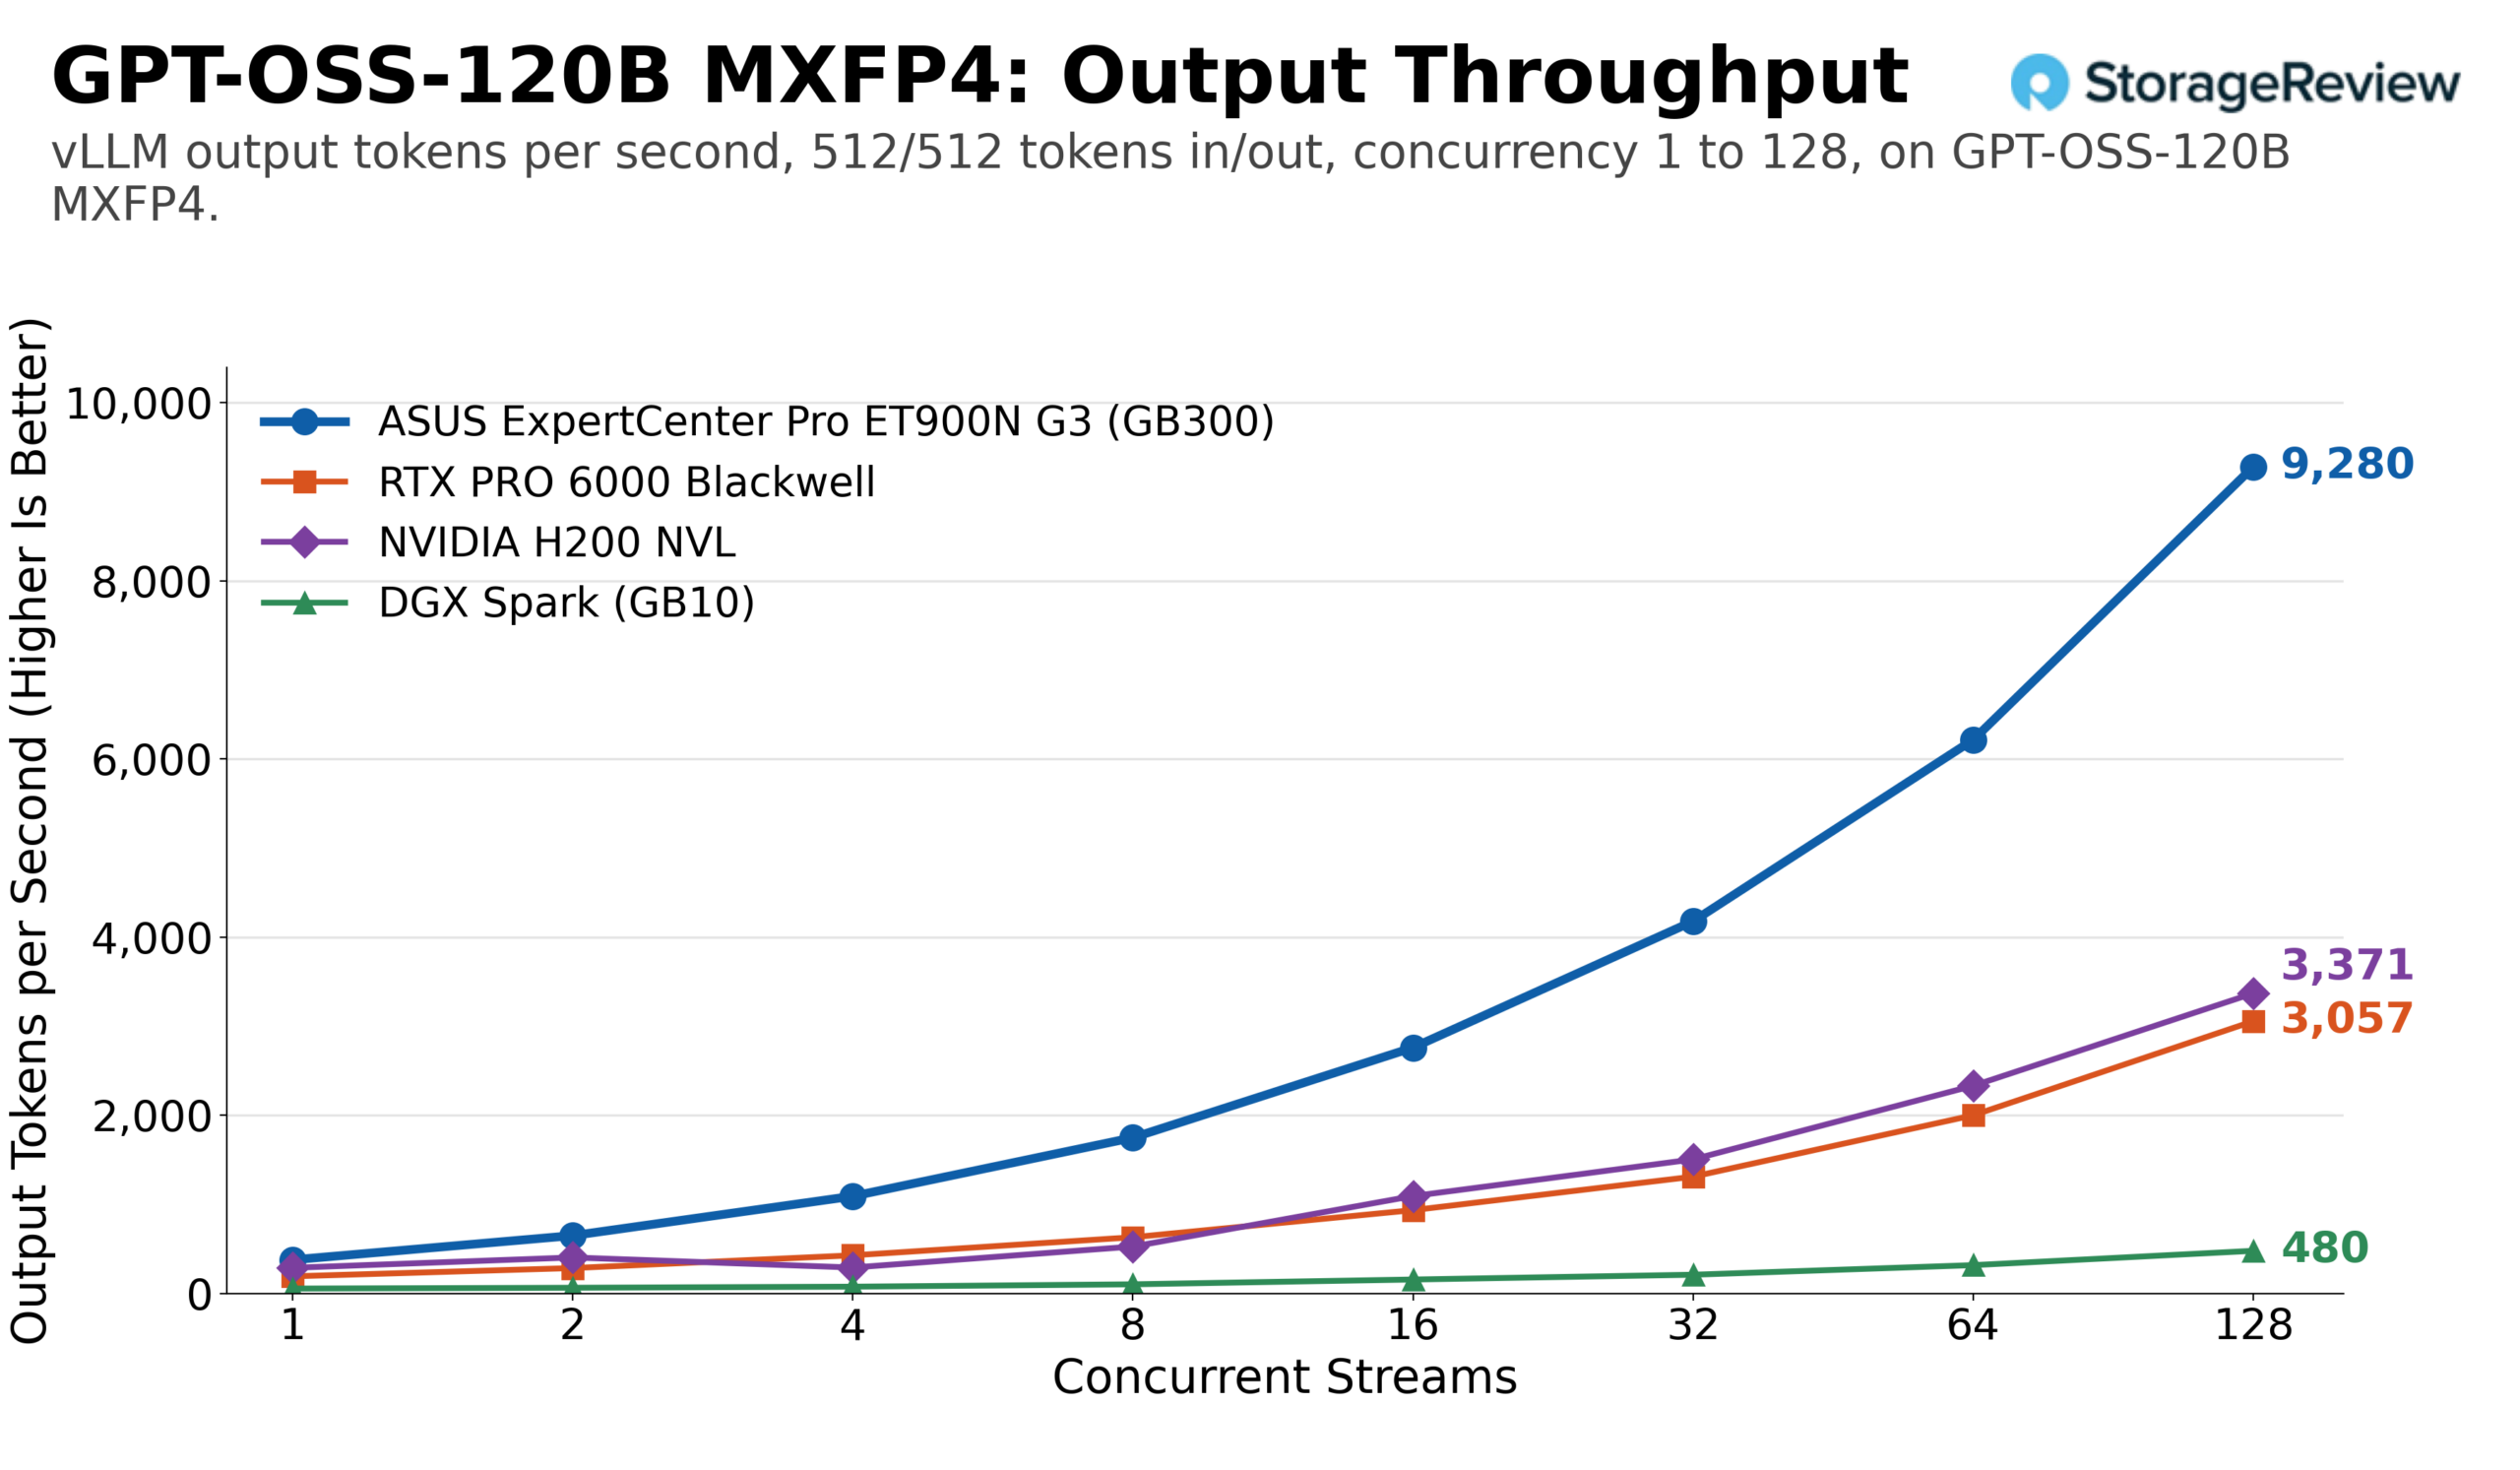
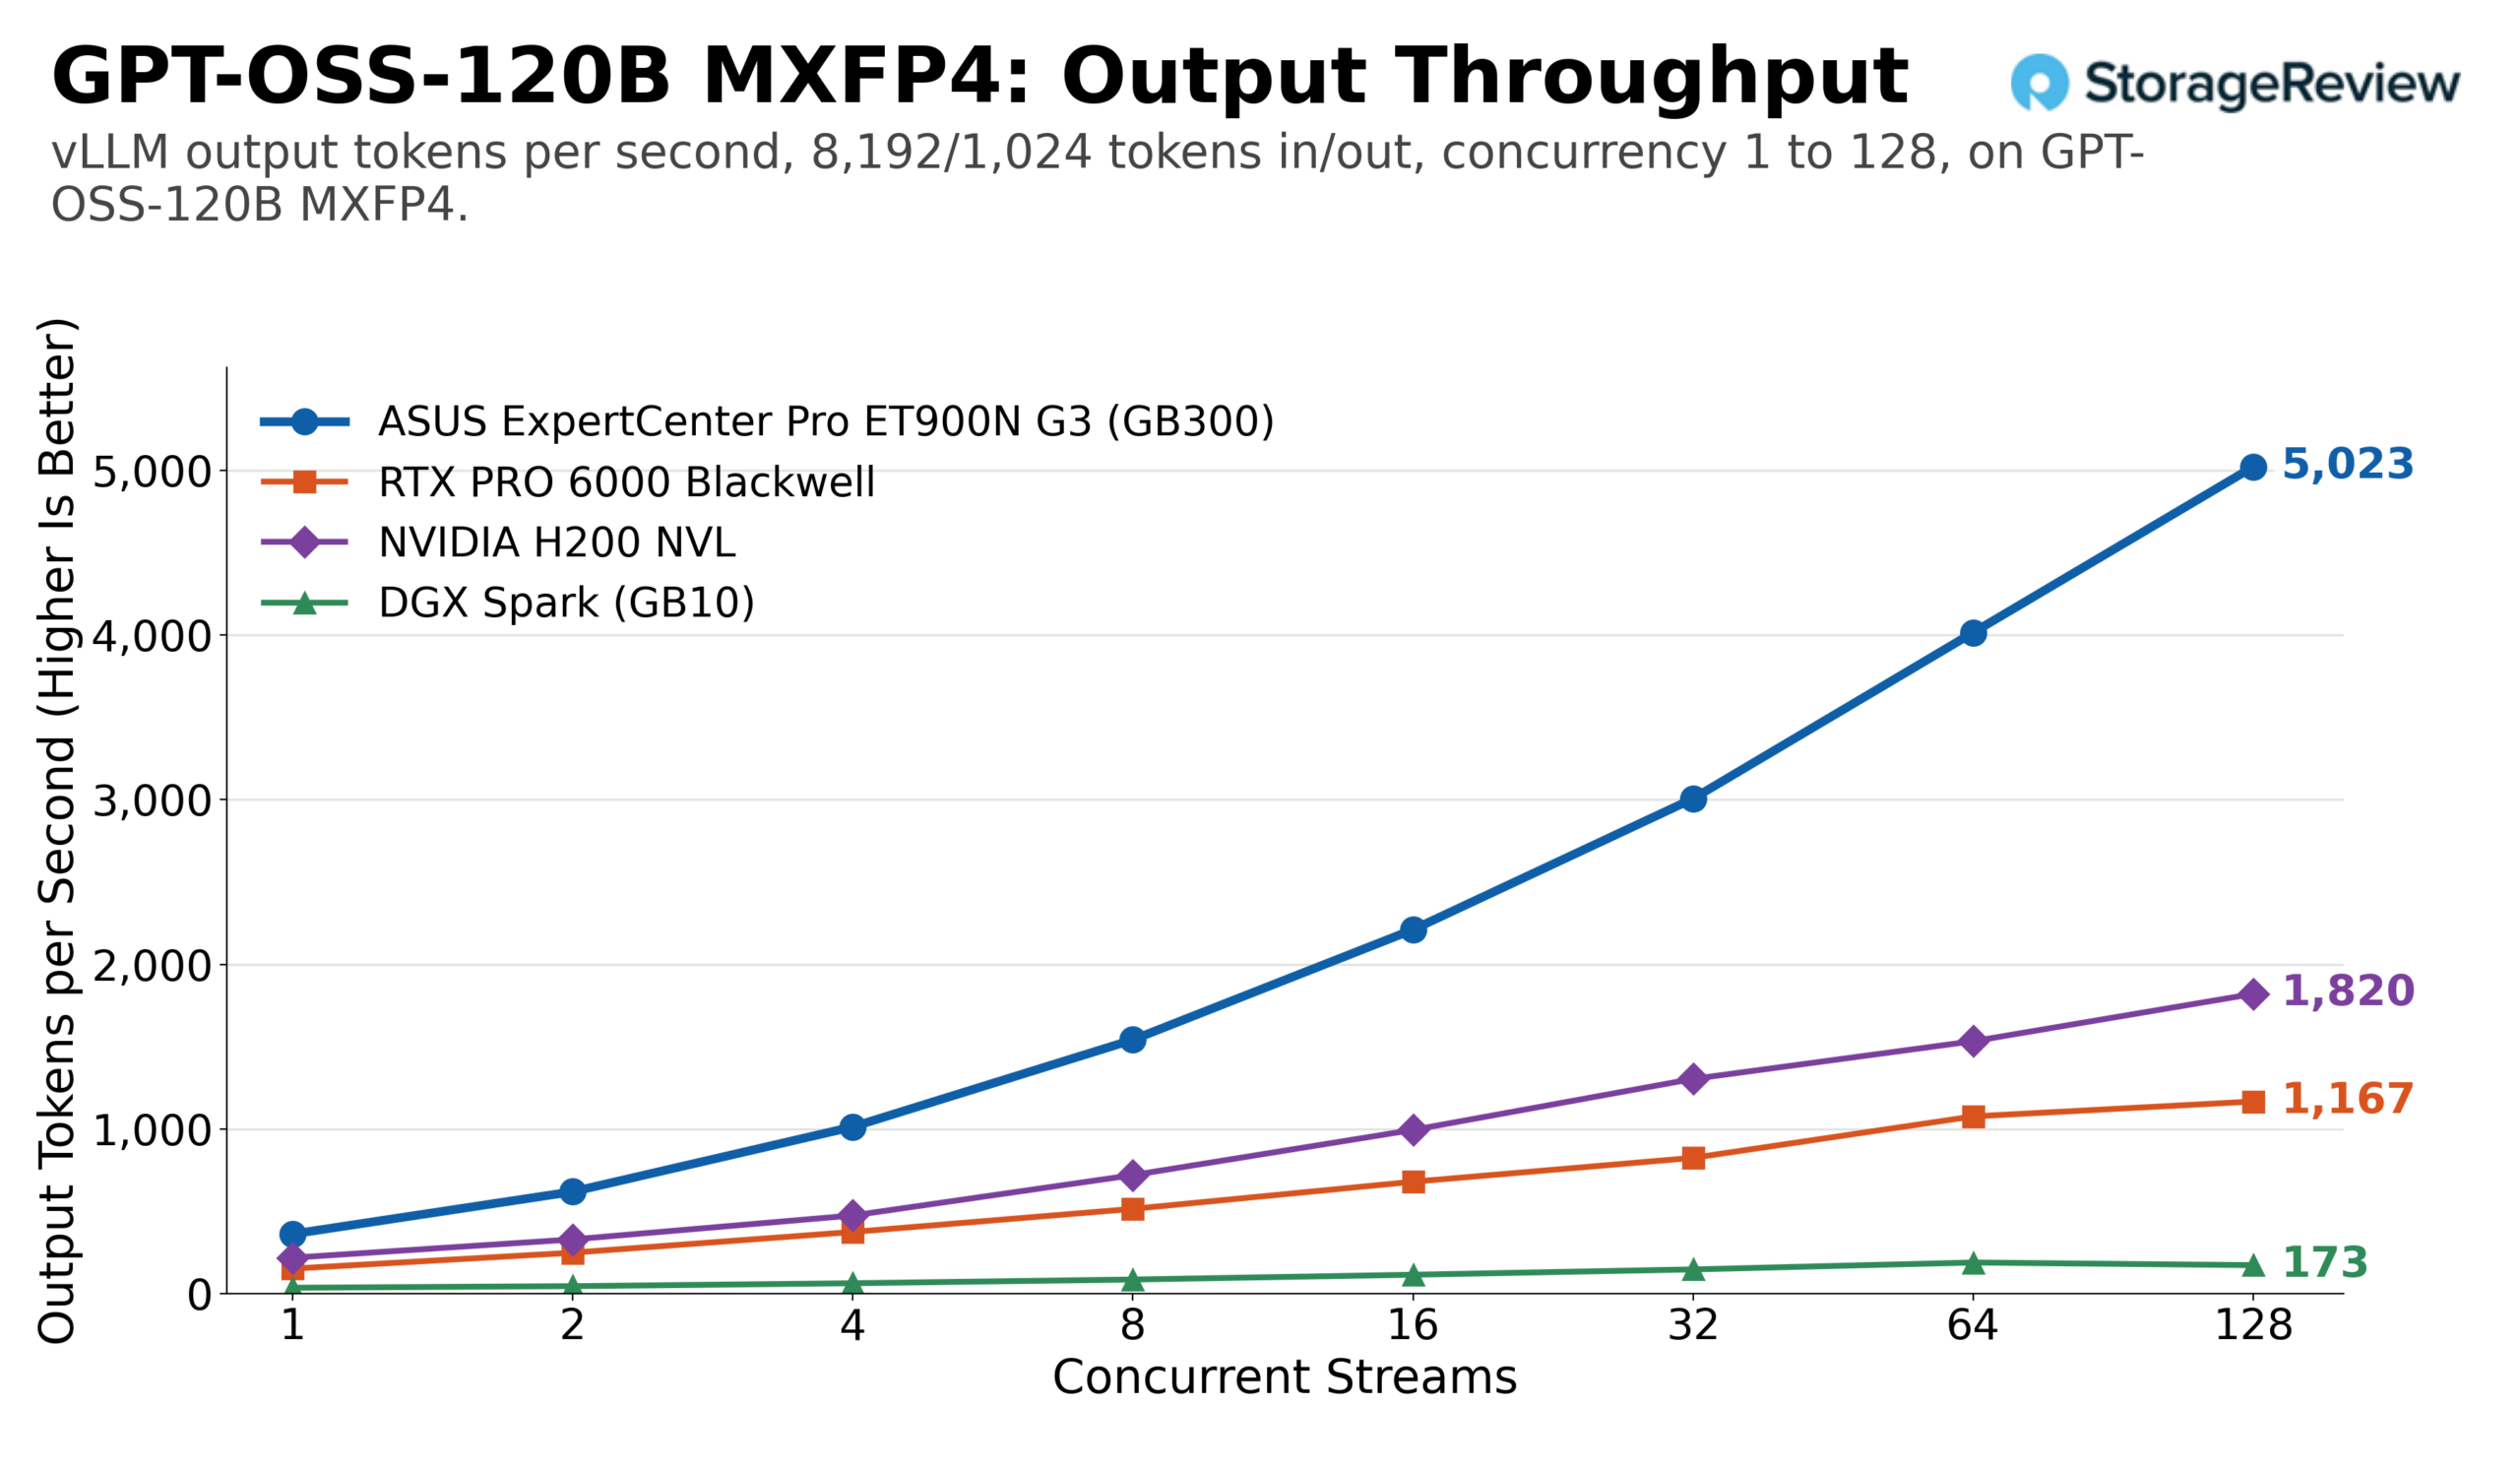
GPT-OSS-120B markiert den Punkt, an dem die Speicheroptimierung beginnt. Die ET900N G3 erreichte bei gleicher Arbeitslast und 128 Streams 9,280 Ausgabetoken pro Sekunde – etwa das Dreifache der RTX PRO 6000 mit 3,060, das 2.8-Fache der H200 NVL mit 3,370 und mehr als das 19-Fache der Spark mit 480. Bei längeren Eingabeaufforderungen stießen die kleineren Systeme frühzeitig an die Grenzen ihres KV-Cache-Spielraums: Die RTX PRO 6000 erreichte maximal etwa 1,170 Ausgabetoken pro Sekunde und die H200 NVL knapp 1,820, während die Station bei 128 Streams weiterhin höhere Werte erzielte und schließlich 5,023 erreichte, was einem Gesamtdurchsatz von 45,205 Token pro Sekunde entspricht.
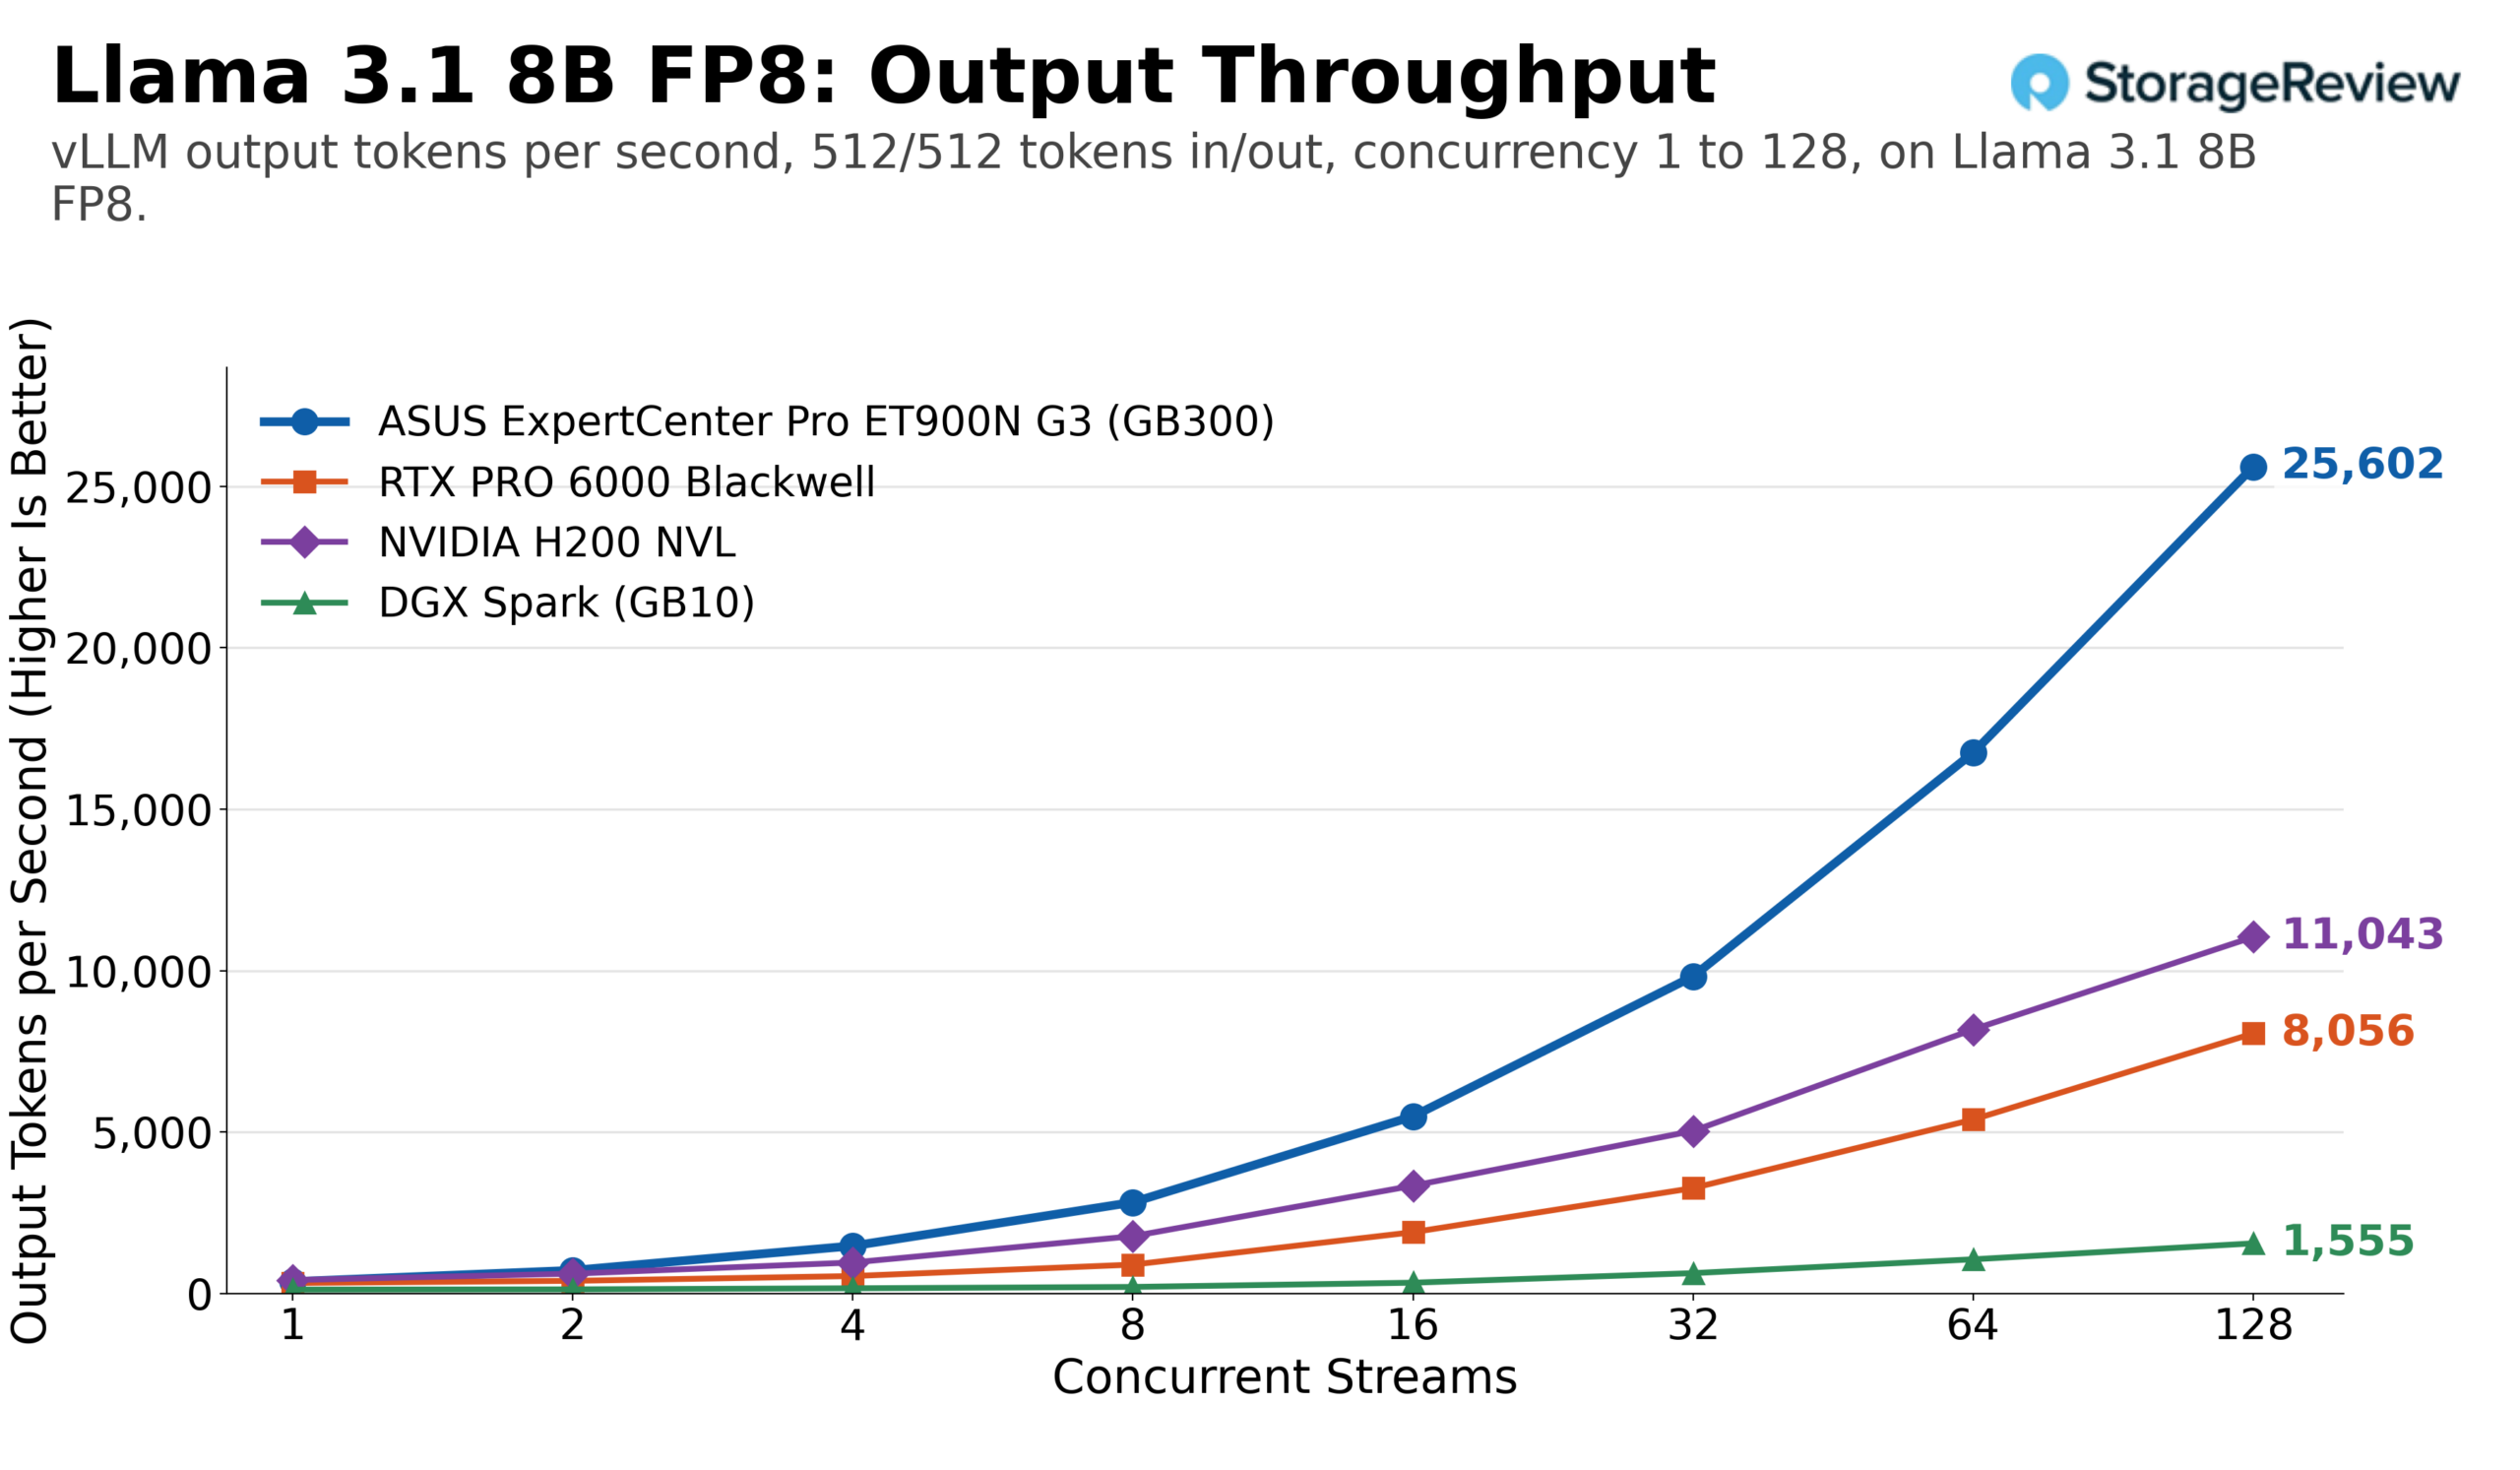
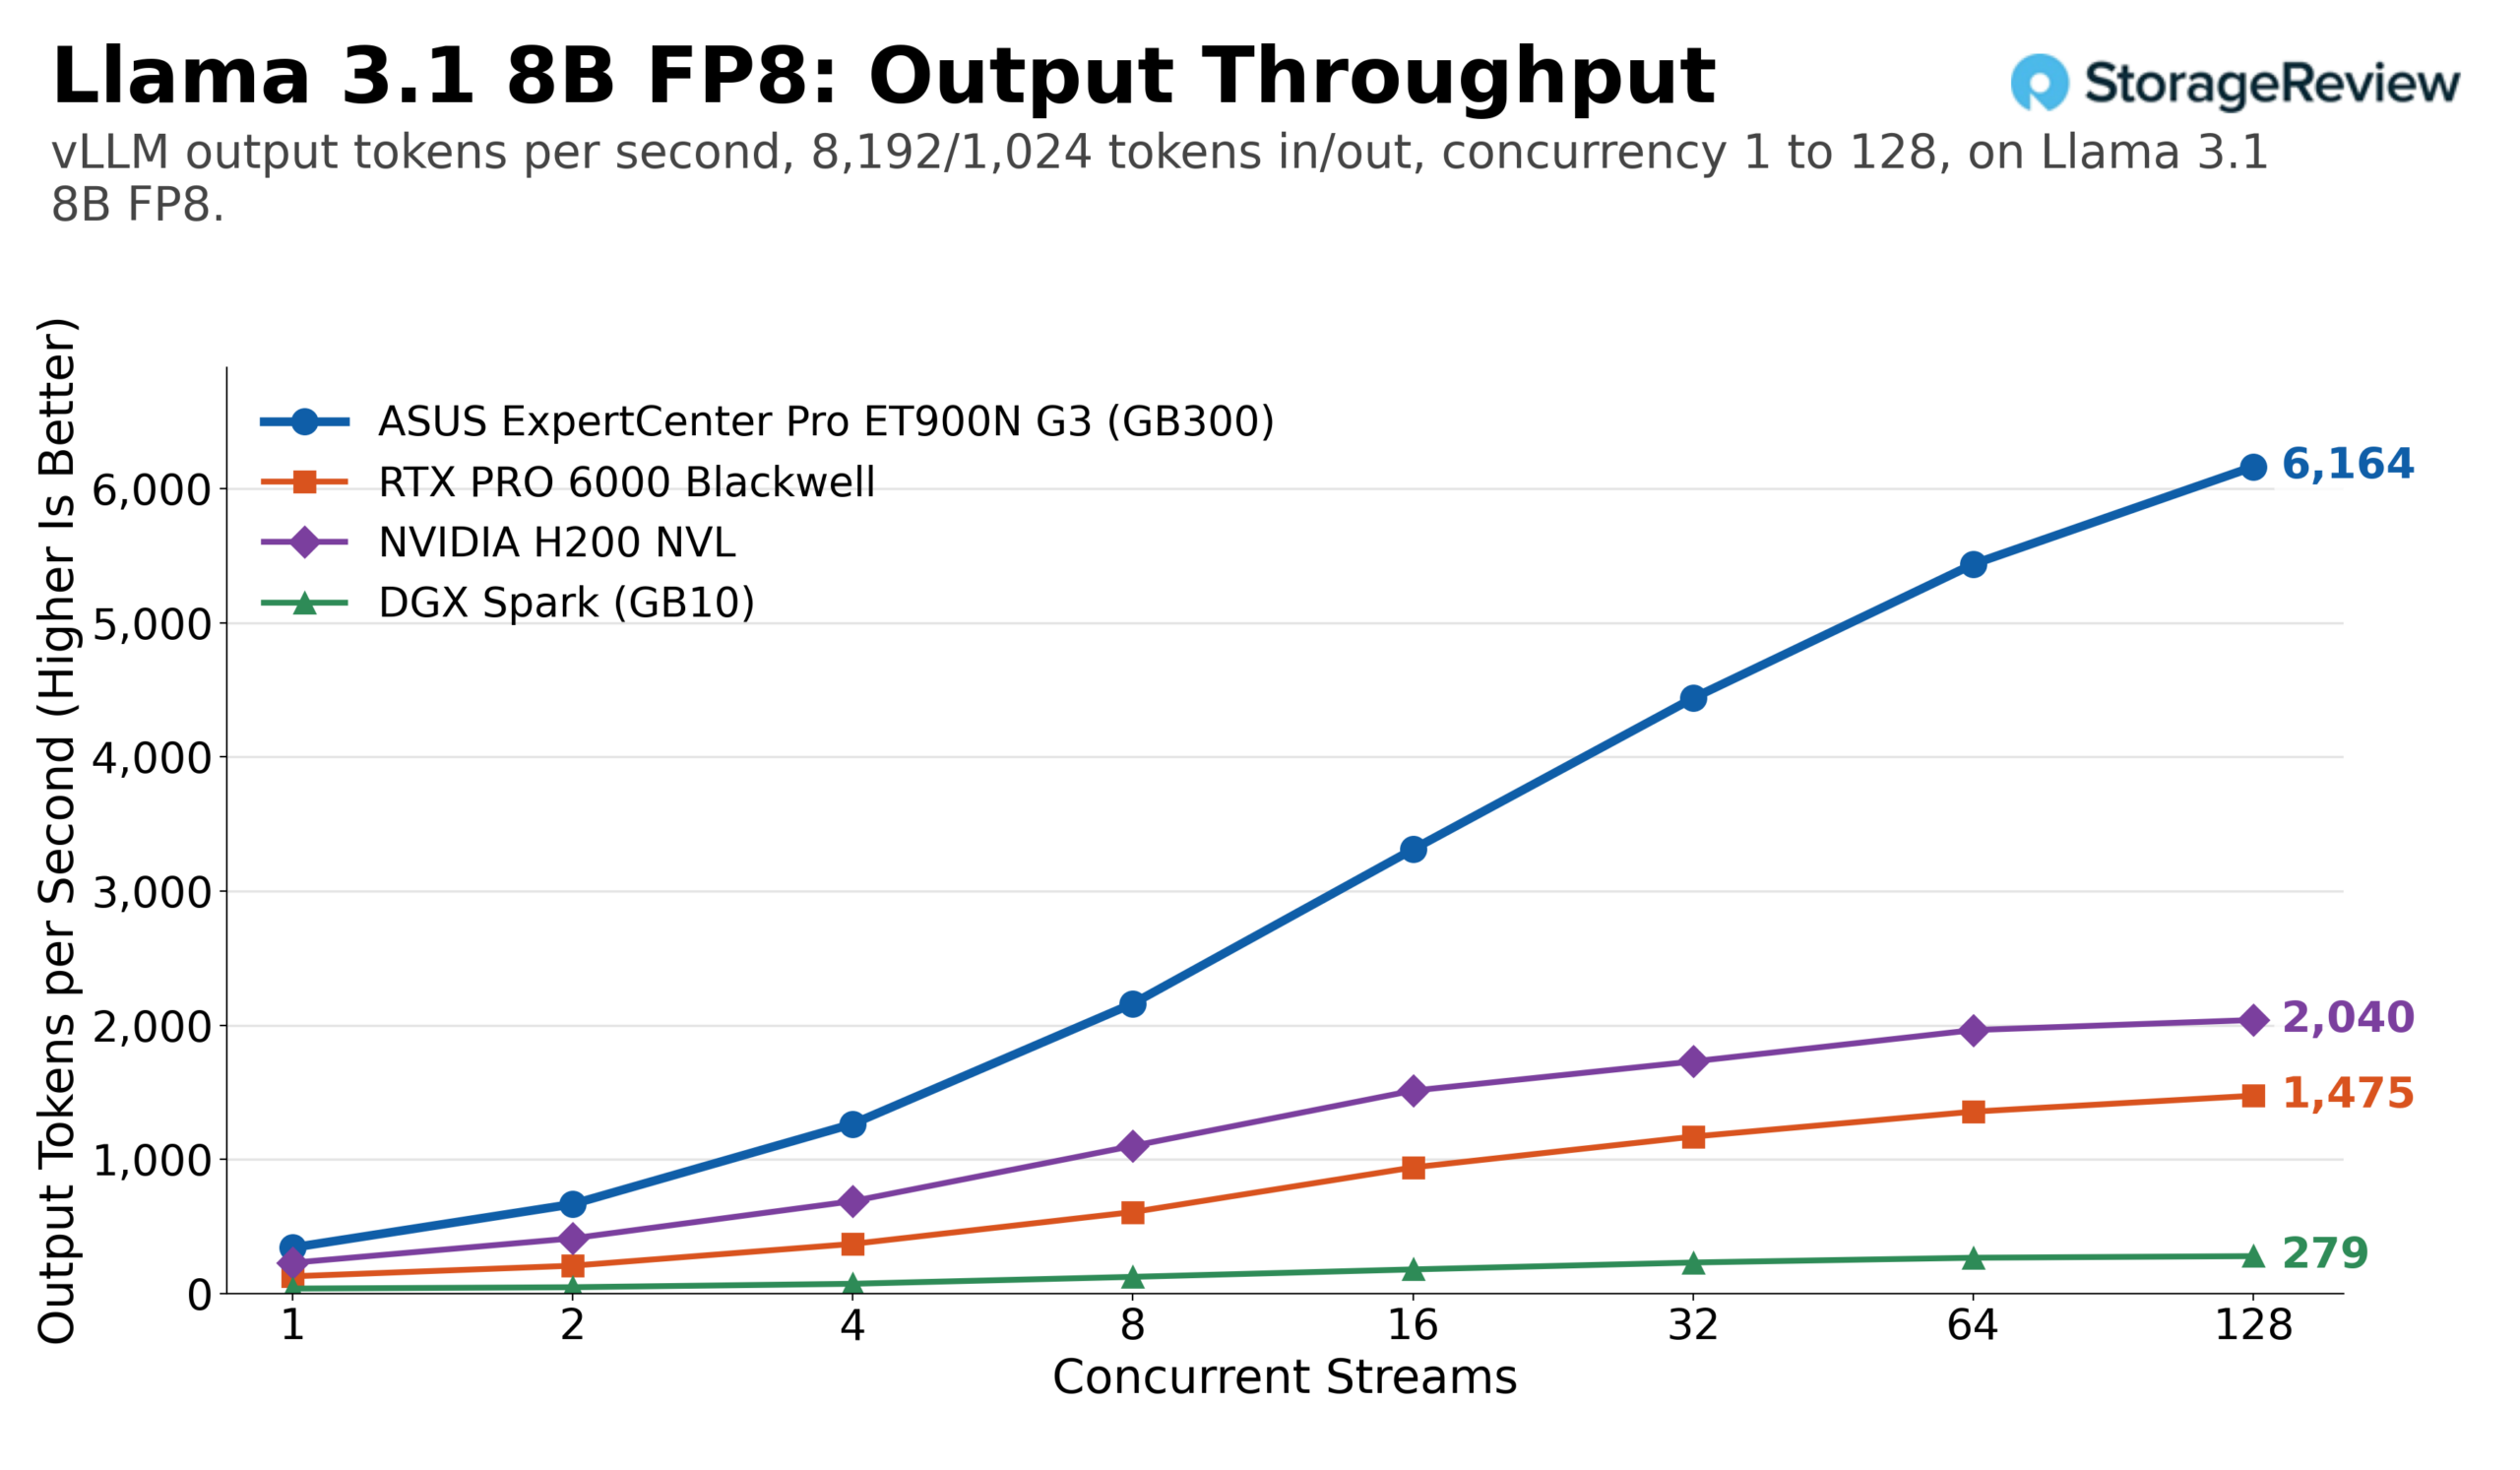
Llama 3.1 8B bei FP8 ist der höchste Einzelwert im Testfeld. Die ET900N G3 erreichte bei gleicher Arbeitslast 25,602 Ausgabetoken pro Sekunde über 128 Streams, insgesamt 51,205, verglichen mit etwa 8,060 bei der RTX PRO 6000 und 11,040 bei der H200 NVL. Der Wechsel von BF16 zu FP8 steigerte die Leistung der Station um etwa 50 % (von 17,074 auf 25,602), während die RTX PRO 6000 um etwa 70 % und die H200 NVL um etwa 37 % zulegten. Das Profil mit hohem Prefill-Anteil komprimierte alle Werte: Die Station erreichte 6,164 Ausgabetoken pro Sekunde, die Grafikkarte 1,480 und die H200 2,040.
Mistral Small 24B im FP8-Modus erzielte die größten Leistungsunterschiede. Die ET900N G3 erreichte bei gleicher Arbeitslast einen Spitzenwert von 11,075 Ausgabetoken pro Sekunde, das 3.4-Fache der RTX PRO 6000 mit 3,240, das 2.4-Fache der H200 NVL mit 4,610 und fast das 20-Fache der Spark mit 559. Bei längeren Eingabeaufforderungen erreichte die RTX PRO 6000 einen Spitzenwert von 32 Streams und etwa 480 Ausgabetoken pro Sekunde, bevor die Leistung wieder abfiel; die H200 NVL erreichte maximal etwa 854 und die Station 2,302 bei 128 Streams.


Beim Qwen3 Coder 30B, einem Modell mit Expertenwissen und wenigen aktiven Parametern, verringert sich der Leistungsunterschied bei Einzelstreams. Bei gleicher Auslastung und einem Stream lieferte die RTX PRO 6000 etwa 232 Ausgabetoken pro Sekunde, die Station 319 und die H200 NVL 308. Im Batch-Modus ändert sich das Bild: Bei 128 Streams erreichte die ET900N G3 12,439 Ausgabetoken pro Sekunde im FP8-Modus, das 3.1-Fache der Karte mit 3,990 und das 1.7-Fache der H200 NVL mit 7,450. Im Profil mit hohem Prefill-Anteil erreichte die Station 3,837 Ausgabetoken pro Sekunde, während die RTX PRO 6000 bei 64 Streams einen Spitzenwert von etwa 880 und die H200 NVL etwa 1,820 erreichte.


Bei den gemeinsam genutzten Modellen erreichte die ET900N G3 bei voller Parallelität das 2.8- bis 3.4-Fache einer einzelnen RTX PRO 6000 und das 1.7- bis 3.7-Fache einer H200 NVL. Der Abstand zu beiden vergrößerte sich bei längeren Eingabeaufforderungen, da der KV-Cache an seine Grenzen stieß. Im Vergleich zur WS300 liegen diese vier Modelle erneut innerhalb von 1 %: 22,041 gegenüber 22,161 auf GPT-OSS-20B, 9,280 gegenüber 9,294 auf GPT-OSS-120B, 11,075 gegenüber 11,157 auf Mistral Small FP8 und 12,439 gegenüber 12,425 auf Qwen3 Coder FP8. Der vollständige Vergleich aller 14 Modelle, einschließlich der drei Modelle mit größeren Unterschieden, folgt im nächsten Abschnitt.
Zwei Tower, ein Baseboard: ASUS ET900N G3 vs. MSI WS300
Die ET900N G3 und die MSI XpertStation WS300 basieren auf demselben NVIDIA GB300 DGX Station-Mainboard und sind in zwei OEM-Gehäusen verbaut. Beide wurden mit denselben 14 Modellen, denselben zwei Workloads und demselben Parallelitätstest auf demselben vLLM-Build getestet. Die folgende Grafik vergleicht den maximalen Durchsatz der ET900N G3 über alle Modelle hinweg mit dem der WS300.
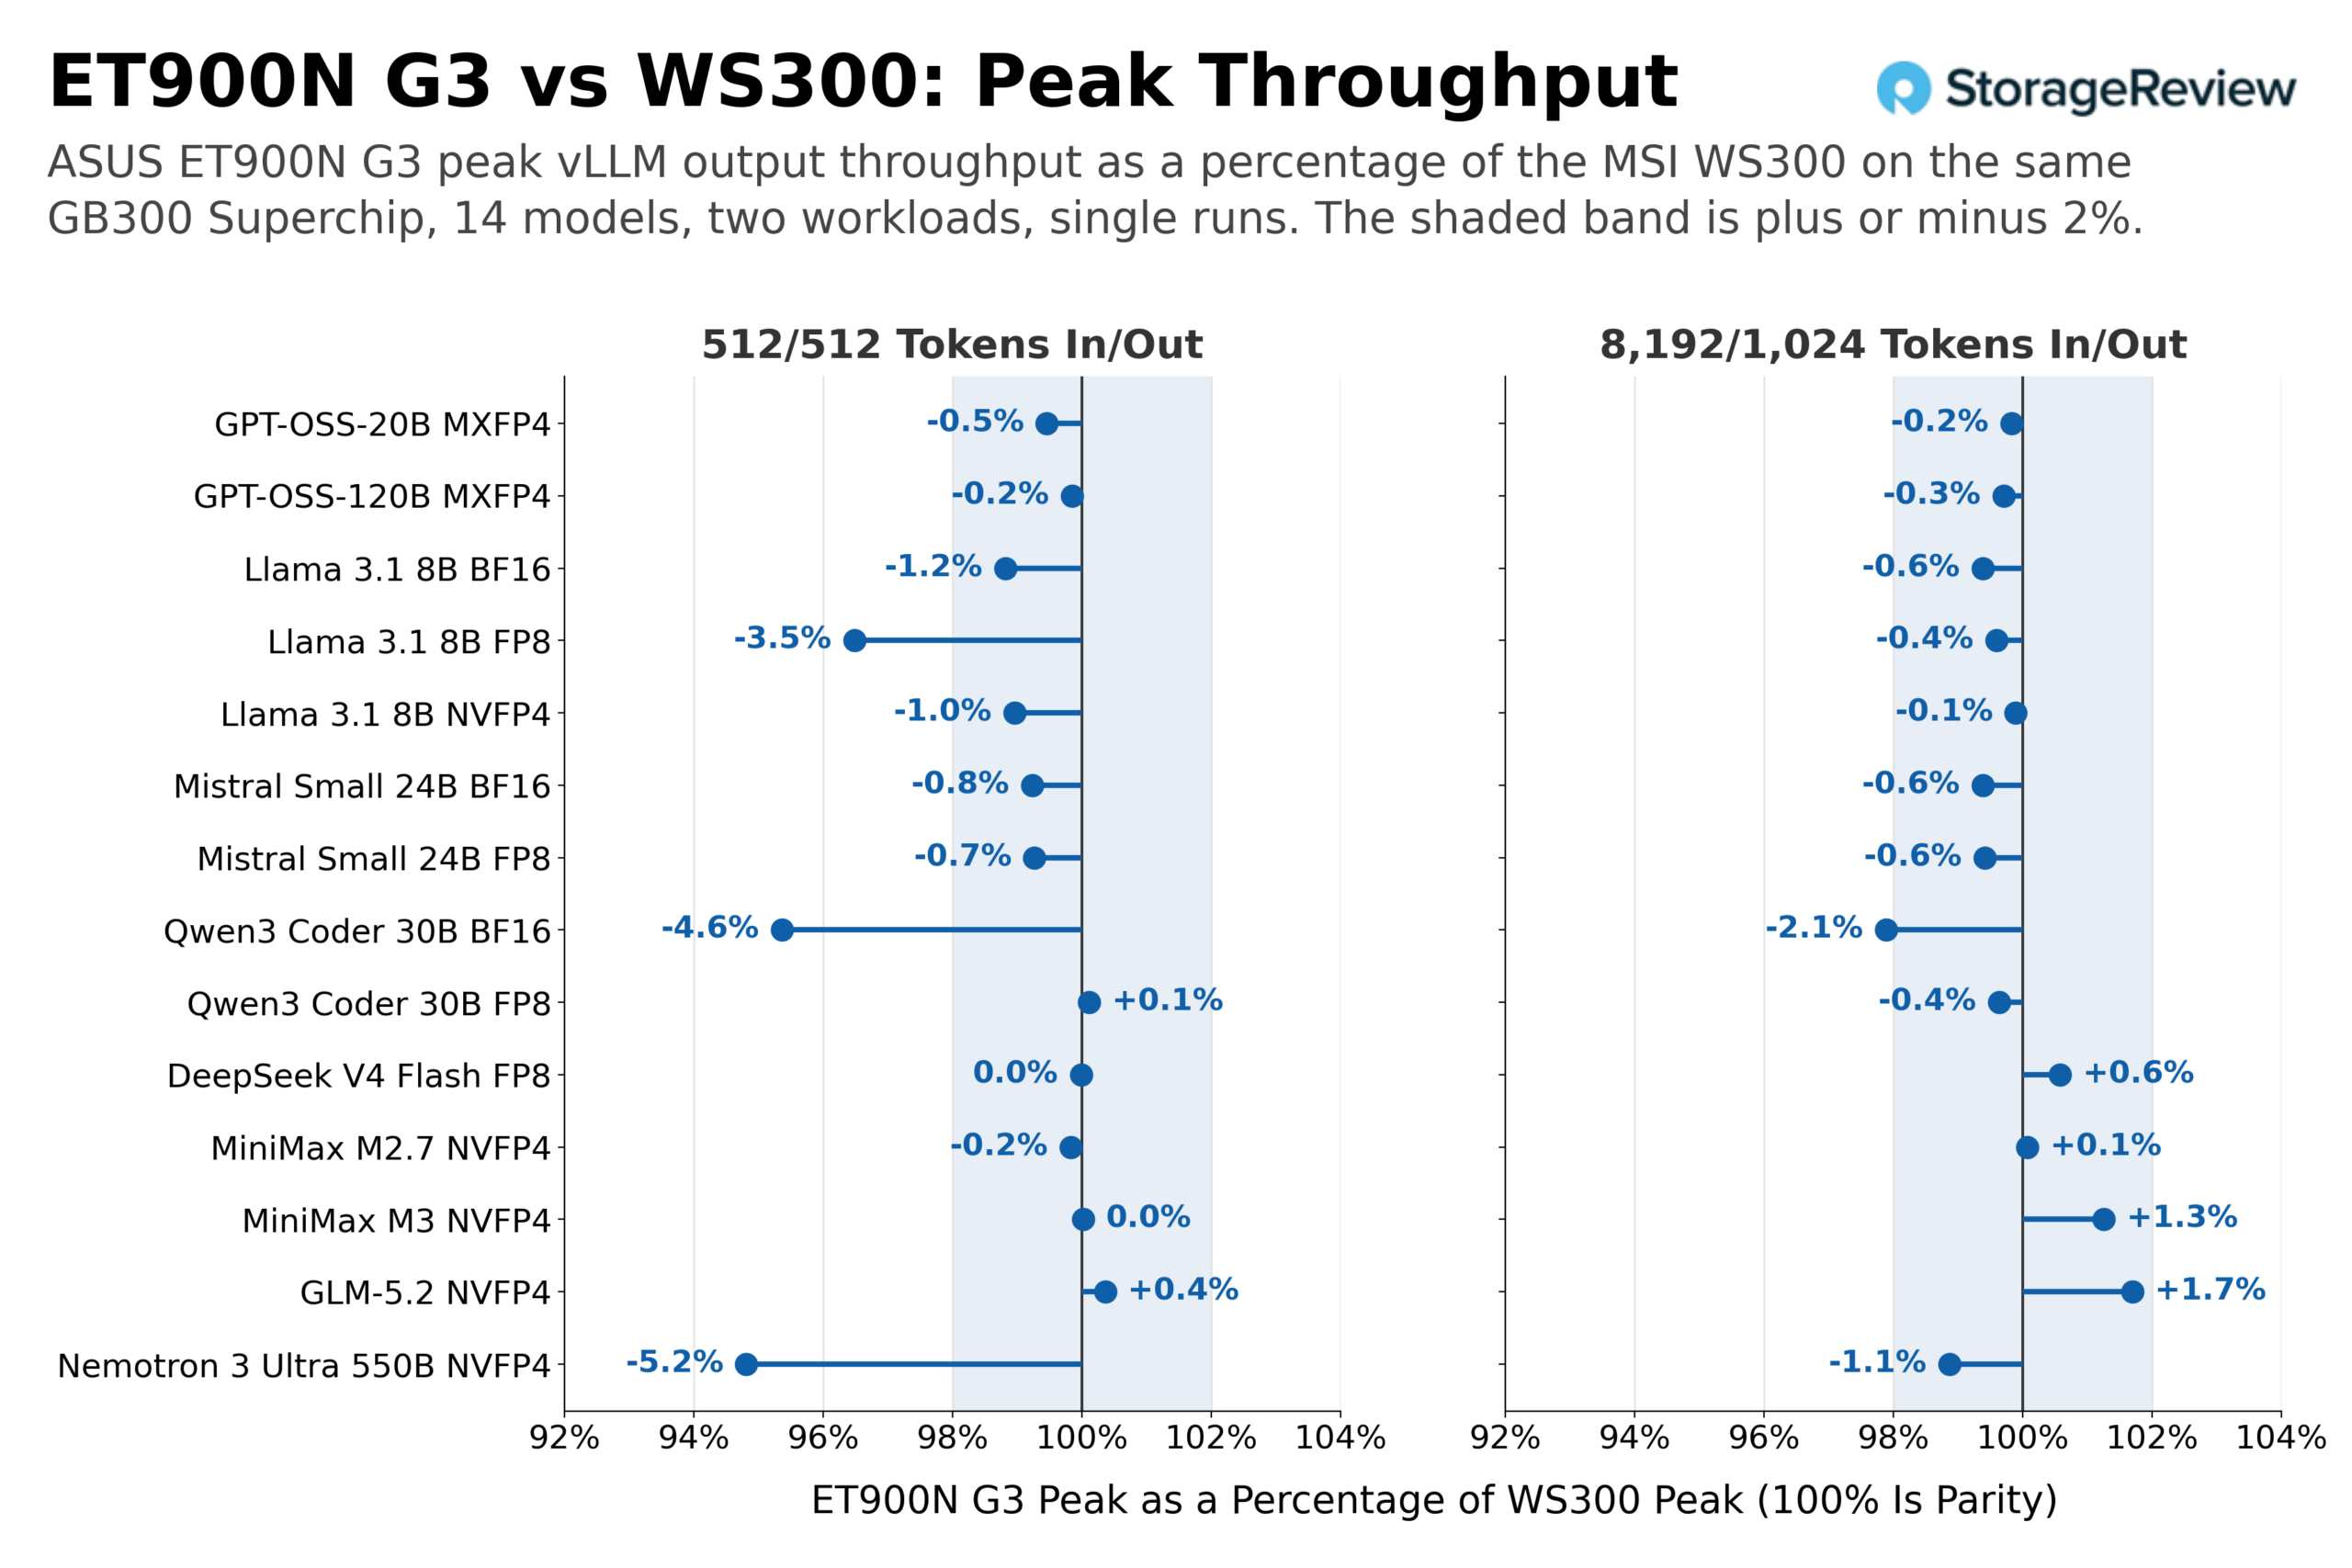
Von den 28 Modell-Workload-Paaren liegen 24 innerhalb einer Spanne von 2 %, wobei die meisten davon nur einen Bruchteil eines Prozents zugunsten des WS300 ausmachen. Vier liegen außerhalb dieser Spanne, drei davon bei gleicher Workload: Llama 3.1 8B FP8 mit 3.5 % unter dem WS300 (25,602 gegenüber 26,536 Ausgabetoken pro Sekunde), Qwen3 Coder 30B BF16 mit 4.6 % darunter (10,000 gegenüber 10,486) und Nemotron 3 Ultra 550B mit 5.2 % darunter (159 gegenüber 168), sowie erneut Qwen3 Coder 30B BF16 mit 2.1 % darunter bei den langen Prompts. Alle hier angegebenen Werte basieren auf einem einzelnen Durchlauf pro Tower, daher lässt sich eine Differenz von 2 bis 5 % bei drei von 14 Modellen nicht allein auf das Chassis zurückführen. Wir erfassen lediglich die Daten und die Differenz zwischen den beiden Modellen. Die Modelle, die auf dem zusammenhängenden Speicherpool MiniMax M3 und GLM-5.2 basieren, erreichen bei beiden Arbeitslasten gleiche oder bessere Ergebnisse; dies ist unserer Ansicht nach das wichtigste Ergebnis für die Plattform: Der Grace-Offload-Pfad funktioniert im ASUS-Gehäuse genauso gut wie im MSI-Gehäuse.
| Modell | WS300 512/512 | ET900N G3 512/512 | Delta | WS300 8,192/1,024 | ET900N G3 8,192/1,024 | Delta |
|---|---|---|---|---|---|---|
| GPT-OSS-20B MXFP4 | 22,161 | 22,041 | -0.5 % | 9,572 | 9,555 | -0.2 % |
| GPT-OSS-120B MXFP4 | 9,294 | 9,280 | -0.2 % | 5,038 | 5,023 | -0.3 % |
| Lama 3.1 8B BF16 | 17,278 | 17,074 | -1.2 % | 3,520 | 3,498 | -0.6 % |
| Llama 3.1 8B FP8 | 26,536 | 25,602 | -3.5 % | 6,189 | 6,164 | -0.4 % |
| Llama 3.1 8B NVFP4 | 28,698 | 28,400 | -1.0 % | 6,744 | 6,737 | -0.1 % |
| Mistral Small 24B BF16 | 7,922 | 7,861 | -0.8 % | 1,643 | 1,633 | -0.6 % |
| Mistral Small 24B FP8 | 11,157 | 11,075 | -0.7 % | 2,316 | 2,302 | -0.6 % |
| Qwen3 Coder 30B BF16 | 10,486 | 10,000 | -4.6 % | 3,830 | 3,749 | -2.1 % |
| Qwen3 Coder 30B FP8 | 12,425 | 12,439 | + 0.1% | 3,851 | 3,837 | -0.4 % |
| DeepSeek V4 Flash FP8 | 1,766 | 1,766 | 0.0% | 948 | 954 | + 0.6% |
| MiniMax M2.7 NVFP4 | 4,801 | 4,793 | -0.2 % | 1,743 | 1,744 | + 0.1% |
| MiniMax M3 NVFP4 | 1,041 | 1,041 | 0.0% | 278 | 282 | + 1.3% |
| GLM-5.2 NVFP4 | 138 | 139 | + 0.4% | 118 | 120 | + 1.7% |
| Nemotron 3 Ultra 550B NVFP4 | 168 | 159 | -5.2 % | 142 | 140 | -1.1 % |
GPT-OSS-20B, der dichteste Fall im Set, und GLM-5.2, der Offload-Fall, zeigen die Überlappung ohne Verhältnis: Bei beiden folgt der Lauf des WS300 Punkt für Punkt dem Lauf des ET900N G3.
Dieser Vergleich dient als Grundlage für weitere Tests mit GB300-Tower-PCs. Als Nächstes testen wir den HP ZGX, weitere folgen. Jeder Tower durchläuft denselben Messzyklus, sodass etwaige Unterschiede zwischen den OEM-Implementierungen hier – in einem Diagramm pro Tower – sichtbar werden. Die Diagramme der einzelnen Modelle enthalten die Rohdaten.
Fazit
Das ASUS ExpertCenter Pro ET900N G3 erfüllt die Erwartungen an eine zweite Implementierung einer Referenzplattform: Es bestätigt die Leistung der ersten. In 14 Modellen und zwei Workloads lag der maximale vLLM-Durchsatz in 24 von 28 Vergleichen innerhalb von 2 % des Wertes der MSI XpertStation WS300 – von 1,766 Output-Tokens pro Sekunde bei DeepSeek V4 Flash bis zu 22,041 bei GPT-OSS-20B. Vier Einzelmessungen wichen dabei um 2 bis 5 % ab. Auch GLM-5.2 mit 215 GB Experts in Grace-Speicher wurde mit Raten bewältigt, die selbst vier RTX PRO 6000-Karten nicht erreichten. Der GB300 Superchip setzt die Messlatte hoch, und ASUS hat hier ganze Arbeit geleistet.
ASUS bietet praktische Vorteile: Dank der Griffe lässt sich der 27 kg schwere Tower von zwei Personen bequem bewegen, ohne die Seitenwände festhalten zu müssen. Der Lüfter über den QSFP112-Steckplätzen behebt ein potenzielles Problem bei der längeren Nutzung von 400G-Glasfaserverbindungen. Das Titanium-Netzteil reduziert den Stromverbrauch um einige Watt. Die Arm-Host-Architektur, der 20-A-Stromkreis, der ausschließlich über den BMC verfügbare Display-Ausgang und das gemeinsame Leistungsbudget von 1,600 W bei Verwendung einer großen Grafikkarte sind plattformspezifische Gegebenheiten, die für beide Tower gleichermaßen gelten.
Die GB300 DGX Station ist nach wie vor das leistungsfähigste Gerät, das wir je auf einem Schreibtisch aufgestellt haben, und ASUS hat mit seiner Version eine gute Möglichkeit geschaffen, sie zu erwerben.
Auf unserem Die besten Desktop-PCs für lokale KI leaderboard, the ET900N G3 now stands alongside the WS300 as a tested alternative in the Best GB300 System slot.



 Amazon