

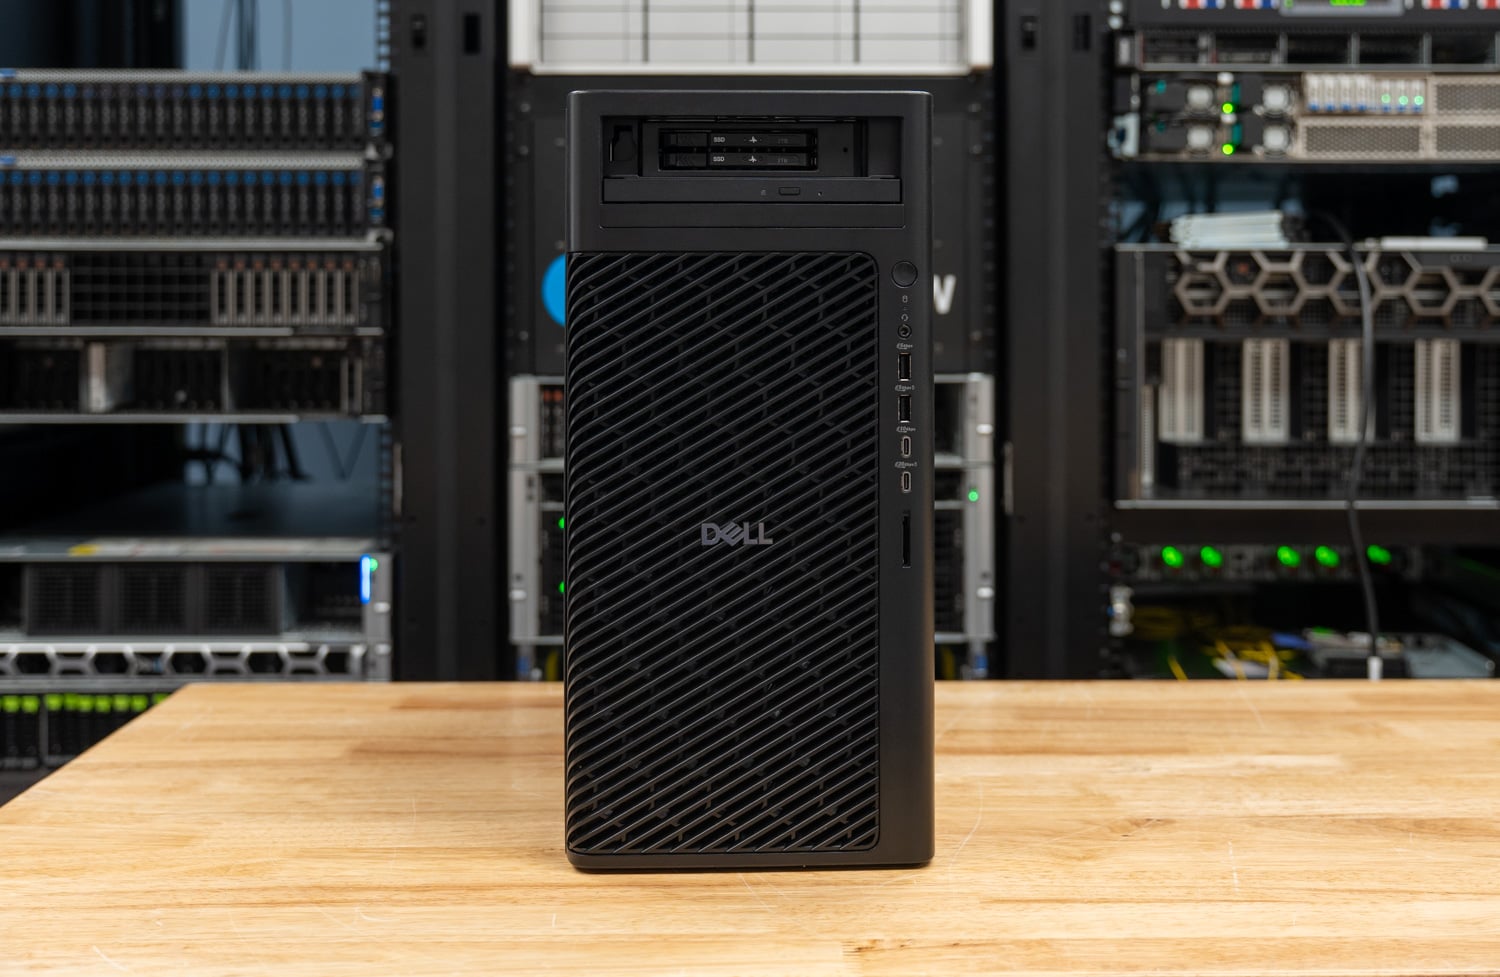
Der Dell Pro Precision 9 T2 ist die Xeon-Version des Single-GPU-Towers, den wir vor einem Jahr als Dell Pro Max Tower T2 getestet haben . Er kommt mit zwei Neuerungen: einem neuen Namen, da Dell seine Workstations wieder unter der Marke Precision vertreibt, und einer neuen Plattform. Intels Xeon 6 ersetzt den Core Ultra 9 285K im gleichen 32-Liter-Gehäuse. Unser Testgerät war mit dem 24-Kern-Xeon 658X, 128 GB DDR5-6400 RDIMM ECC, der 300-Watt-Grafikkarte RTX PRO 6000 Blackwell Max-Q und zwei 2-TB-E3.S-Gen5-Festplatten im FlexBay-Striping an der Vorderseite ausgestattet. Auf Dell.com kostet er in dieser Konfiguration etwa 28,300 US-Dollar.
Wir haben die Tests als Matrix durchgeführt: Das Pro Precision 9 T2 führte unsere vollständige Testsuite mit der mitgelieferten Max-Q-Grafikkarte und anschließend mit der 600-Watt-RTX PRO 6000 Blackwell aus unserem Pro Max Tower T2 durch. Auch das Core-basierte T2-System testete beide Grafikkarten. Daher sind alle untenstehenden Ergebnisse in vier Spalten unterteilt, wobei jedes Paar eine Variable isoliert: die CPU-Plattform oder die Leistungsaufnahme der GPU. Die Testsuite entspricht derjenigen, die letzte Woche auf den RTX Spark Notebooks zum Einsatz kam , ergänzt um einige hier erstmals verwendete Funktionen.
Der Xeon bietet zwar höheren Durchsatz, geht aber mit höherer Latenz einher. Der Pro Precision 9 T2 erreichte im Cinebench 2026 Multi-Core-Test 12,322 Punkte gegenüber 8,856 Punkten beim Core T2, kompilierte LLVM in 140.2 Sekunden gegenüber 182.5 Sekunden und las im STREAM Triad-Test 122,233 MB/s gegenüber 33,003 MB/s. Sein Single-Core-Cinebench-Wert von 454.1 liegt hinter dem des 285K mit 564.4 Punkten zurück, und sein Speedometer-Wert von 36.8 liegt hinter dem des 285K mit 46.3 Punkten. Die 600-W-Grafikkarte erhöht die Leistung bei der LLM-Dekodierung um etwa 7 bis 20 Prozent und bei der Prompt-Verarbeitung und Diffusion um 20 bis 39 Prozent, und im Xeon-Tower kostet sie die CPU 4 bis 5 Prozent bei der All-Core-Auslastung.
Wichtige Erkenntnisse
- Xeon 6 ist eine Durchsatzplattform in einem Single-Socket-Tower: 12,322 Punkte im Cinebench 2026 Multi-Core-Test, 39 Prozent mehr als der Core Ultra 9 285K im gleichen Gehäuse, 289.6 GIPS in 7-Zip gegenüber 174.8, DGEMM mit 1,638 GFLOPS gegenüber 768 und die 3.7-fache Speicherbandbreite durch vier Kanäle DDR5-6400.
- Die 285K ist nach wie vor führend in Sachen Geschwindigkeit pro Thread: Der Xeon liegt im Cinebench-Single-Core-Test 20 Prozent, im Speedometer-Test 21 Prozent und im Single-Threaded-Python-Test 20 bis 31 Prozent zurück, mit einer Core-to-Core-Latenz von 56.2 ns gegenüber 38.1 ns.
- Die GPU bestimmt die KI-Ergebnisse, und die 600-Watt-Karte verdient ihre Leistung durch Eingabeaufforderungen: MLPerf Llama 3.1 8B generiert 230.9 Token pro Sekunde mit der Max-Q-Karte und 252.8 mit der 600W-Karte, während die Zeit bis zum ersten Token von 0.082 auf 0.059 Sekunden sinkt und Qwen-Image 20B ein 1024×1024-Bild in 19.7 Sekunden gegenüber 26.1 Sekunden rendert.
- Die 600-Watt-Karte belastet die CPU des Xeon um 4 bis 5 Prozent: Der Cinebench-Multi-Core-Wert sank von 12,322 auf 11,705 und der 30-minütige Dauerlauf von 12,328 auf 11,764, wobei die Steady-State-Taktraten von 4,274 auf 4,178 MHz zurückgingen; der gleiche Tausch hatte beim Core T2 keine Auswirkungen.
- E3.S im FlexBay, gestreift von VROC by Graid: Der vordere Laufwerksschacht bietet Platz für zwei E3.S Gen5-Laufwerke – eine Premiere für eine Tower-Workstation in unserem Labor. Dells RAID0-Bootoption erstellt daraus mit VROC von Graid Technology ein 4,097 GB großes Volume. Der Stripe erreicht sequentielle Lesegeschwindigkeiten von 9,332 MB/s und Spitzenwerte von 840.1 IOPS bei zufälligen 4K-Lesezugriffen. Zum Vergleich: Die einzelne Gen5 M.2-SSD im Core T2 erzielt 1.78 Millionen IOPS.
Von Pro Max bis Pro Precision
Dell hatte die Bezeichnung Precision Anfang 2025 eingestellt, als alle Workstations zu Dell Pro Max wurden, und sie nun wieder eingeführt. Am 7. Oktober benannte Dell seine Desktop-PCs GB10 und GB300 von Dell Pro Max in Dell Pro Precision um. Auf Dell.com wird der Pro Precision 9 T2 neben den neuen Tower-PCs T4 und T6 unter derselben Marke geführt. Pro Max bleibt für die Core-basierten Geräte erhalten. Der Core Ultra Tower, den wir letztes Jahr getestet haben, wird weiterhin als Dell Pro Max Tower T2 angeboten, und der hier getestete Xeon Tower ist der Dell Pro Precision 9 T2, Modell PW9T2260.
Die Modelle T4 und T6 wurden mit der Umbenennung ebenfalls auf Xeon 6 umgestellt, und Dell positioniert die drei Tower-Serien nach Erweiterungsmöglichkeiten. Der Pro Precision 9 T4 (PW9T4260) unterstützt dieselben Prozessoren bis hin zum 86-Kern-Xeon 698X, bietet zusätzlich 16 DIMM-Steckplätze für bis zu 4 TB DDR5-6400-Speicher auf allen acht Speicherkanälen und kann mit einer einzelnen 600-W-RTX-PRO-6000-Grafikkarte oder zwei Max-Q-Karten an einem 1500-W-Netzteil betrieben werden. Optional ist ein 2400-W-Gehäuse erhältlich.
Das Pro Precision 9 T6 (PW9T6260) ist das Topmodell mit sechs Steckplätzen, einem 2400-Watt-Netzteil und Platz für zwei 600-Watt-RTX-PRO-6000-Karten, drei Max-Q-Karten oder bis zu fünf RTX-PRO-5000-Karten. Das T2 ist das Einstiegsmodell der Familie mit einer einzelnen GPU und Vierkanal-Anbindung.
Die korrekte Namensgebung ist wichtig, da die beiden Tower äußerlich identisch sind: Sie teilen sich das gleiche 32-Liter-Gehäuse (387 x 187.7 x 438 mm), die gleiche Frontblende und den gleichen FlexBay-Einschub sowie die gleichen RTX PRO 6000 Blackwell-Optionen im Dell-Konfigurator. Der Unterschied liegt also im Mainboard. Während der Pro Max Tower T2 mit dem 24-Kern-Prozessor Core Ultra 9 285K und vier DIMM-Steckplätzen für ungepufferten DDR5-Speicher ausgestattet ist, setzt der Pro Precision 9 T2 auf Intels Xeon 6 für Workstations – die Granite Rapids-WS- Plattform, die wir im Juni als reines Mainboard getestet haben – mit Registered-ECC-Speicher, mehr PCIe-Lanes und einem 250-Watt-Prozessor in der Top-Konfiguration.

Dell bietet im Pro Precision 9 T2 sechs Xeon-6-Prozessoren an, vom 12-Kern-Xeon 634 mit 150 W bis zum 24-Kern-658X mit 250 W (unser Testgerät). Der Aufpreis für den 658X beträgt 1,560 US-Dollar. Der 658X verfügt über 24 Kerne und 48 Threads mit einem Basistakt von 3.0 GHz und einem Turbotakt von 4.9 GHz. Er besitzt 144 MB L3-Cache, das Dreifache der 36 MB des 285K, und unterstützt AVX-512 und AMX, die der 285K nicht bietet. Der Chip verfügt über acht DDR5-6400-Kanäle und 128 Gen5-Lanes. Das T2 bietet vier DIMM-Steckplätze und fünf Erweiterungssteckplätze, die größeren Modelle T4 und T6 bieten die restlichen Steckplätze.
| Plattform | Dell Pro Precision 9 T2 (wie getestet) | Dell Pro Max Tower T2 (wie getestet) |
|---|---|---|
| Prozessor | Intel Xeon 658X, 24 Kerne / 48 Threads, 3.0 bis 4.9 GHz, 144 MB L3-Cache, 250 W | Intel Core Ultra 9 285K, 24 Kerne / 24 Threads (8P + 16E), bis zu 5.7 GHz, 36 MB L3-Cache, 125 W |
| Befehlssätze | AVX-512, AMX | AVX2 (kein AVX-512), Intel AI Boost NPU |
| Memory | 4 x 32 GB DDR5-6400 RDIMM ECC (vier Kanäle; maximal 1 TB) | 4 x 32 GB DDR5-4400 ECC UDIMM |
| Expansion | Gen5 x16, Gen5 x4, Gen4 x16, zwei Gen4 x8 (eines davon elektrisch) | Gen5 x16, ein Gen4 x4 und zwei Gen3 x4 |
| Boot-Speicher wie getestet | 2 x 2 TB E3.S Gen5 NVMe im vorderen FlexBay, RAID 0 (VROC von Graid Technology), 4,097 GB | 2 TB SK hynix PCB01 M.2 Gen5 (Einzellaufwerk) |
| Interner M.2 | 3 x M.2 2280 Gen5 | 1 x Gen5 und 2 x Gen4 M.2 |
| Energieversorgung | 750 W Standardleistung; 500 W oder 1500 W optional (1500 W im Test) | 360 W, 500 W oder 1500 W (80 Plus Platinum) |
| Grafik wie getestet | RTX PRO 6000 Blackwell Max-Q (300 W) im Auslieferungszustand; 600-W-Karte ebenfalls getestet | RTX PRO 6000 Blackwell (600W) im Auslieferungszustand; Max-Q-Karte ebenfalls getestet |
| Fahrgestell | 387 x 187.7 x 438 mm, 11.6 bis 21.8 kg | 387 x 187.7 x 438 mm, 8.17 bis 23 kg |
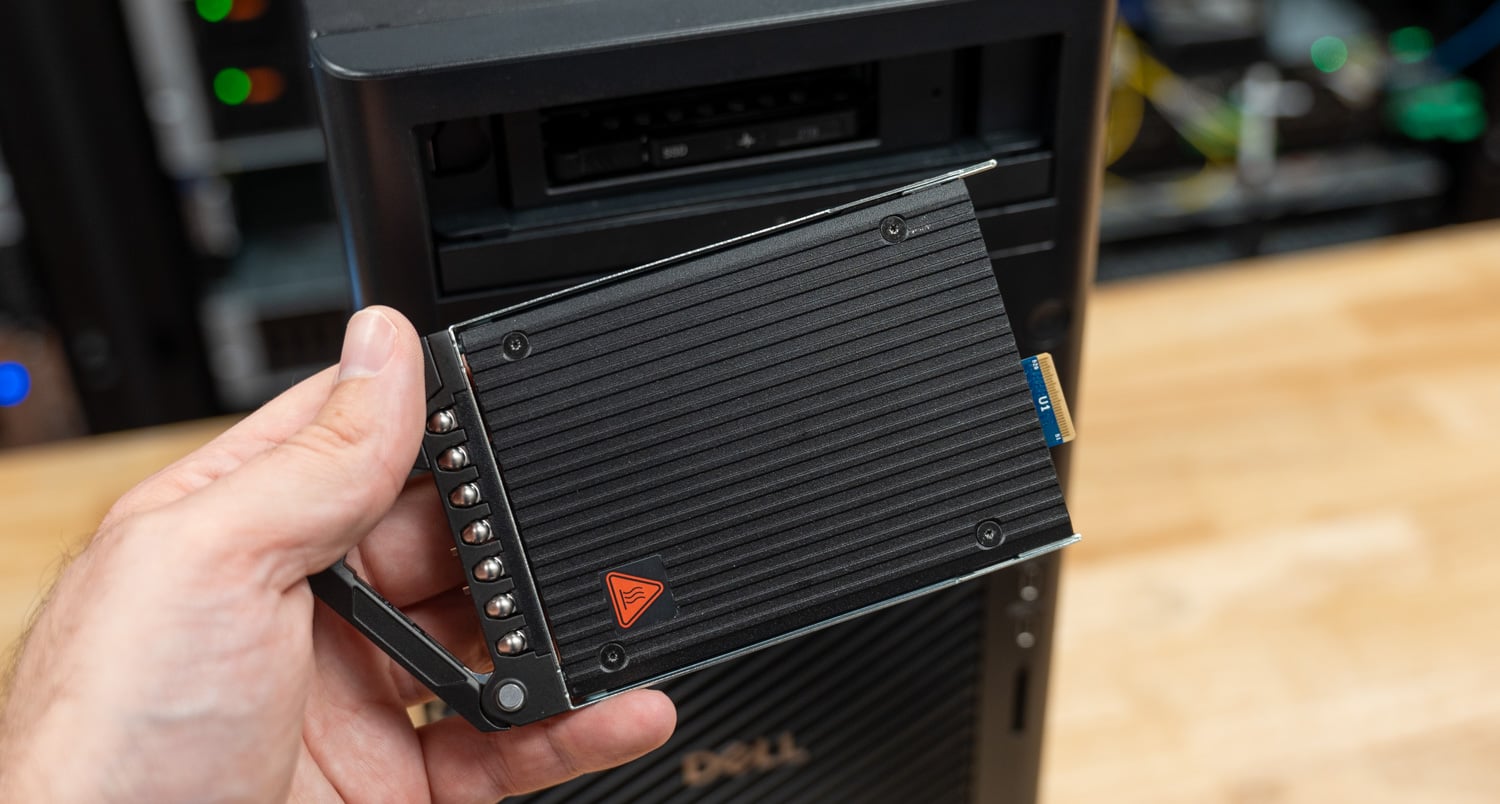
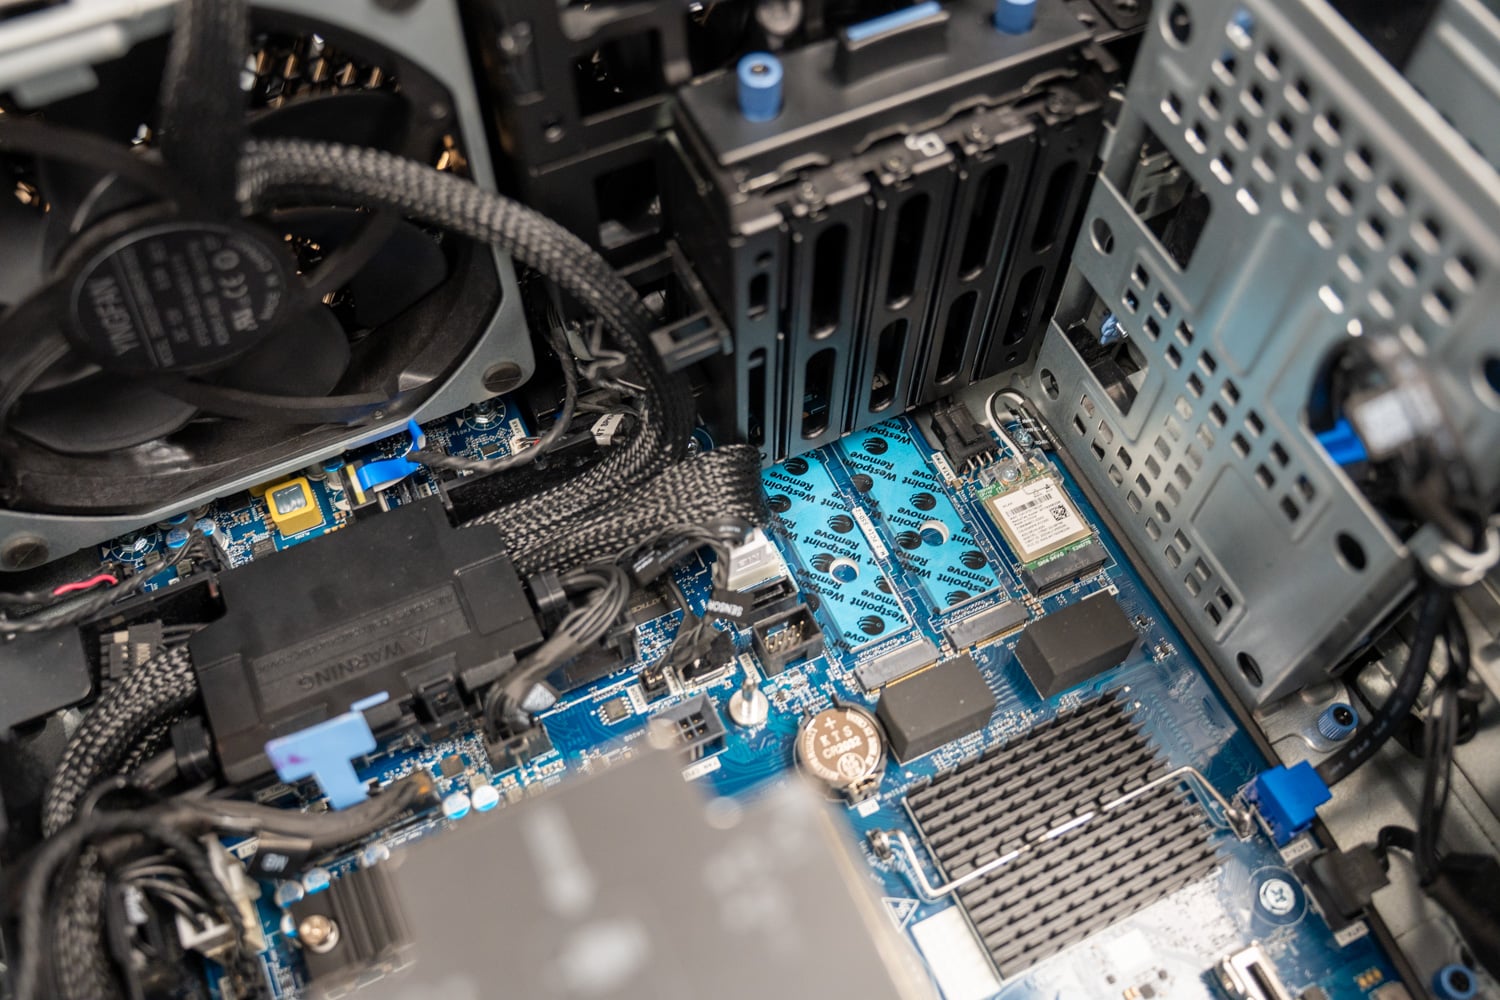
Der Core T2 bootete von einer einzelnen M.2-SSD, während unser Pro Precision 9 T2 mit Dells FlexBay NVMe-Bootkonfiguration ausgestattet war: zwei im laufenden Betrieb austauschbare E3.S Gen5-SSDs hinter der Frontblende, die per RAID 0 zu einem 4,097 GB großen RAID-Verbund zusammengefasst wurden. E3.S ist der Enterprise-Formfaktor, den wir uns von Tower-Herstellern gewünscht haben, da er die Speicherkapazität deutlich über M.2 hinaus erweitert und die SSDs von vorne zugänglich sind, ohne dass das Gehäuse geöffnet werden muss. Die RAID-Schicht basiert auf VROC von Graid Technology , dem Intel VROC-Code, den Graid letztes Jahr übernommen und auf der Computex neu vorgestellt hat. Dies ist die erste Workstation in unserem Labor, die damit ausgeliefert wird.

Die 600-Watt-Karte benötigt etwas mehr Platz; die Max-Q-Variante nicht. Unser Testgerät wurde mit einem Intel E810-XXV Dual-Port-25GbE-Adapter im Steckplatz neben der GPU ausgeliefert. Um die 600-Watt-RTX PRO 6000 einzubauen, mussten wir diesen entfernen, da der Kühler der Karte den Platz und die Stromversorgung des benachbarten Steckplatzes belegt. Käufer, die die Grafikkarte mit voller Leistung und eine schnelle Netzwerkkarte wünschen, sollten die Steckplatzbelegung vor der Bestellung planen. Ein 1500-Watt-Netzteil ist hierfür die einzig sinnvolle Wahl. Unser Testgerät war mit der 1500-Watt-Variante ausgestattet, ein Upgrade für 40 US-Dollar gegenüber dem standardmäßigen 750-Watt-Netzteil.
Aufbau und Design
Das Pro Precision 9 T2 verwendet denselben werkzeuglos montierbaren Tower wie die Pro Max-Version. Es verfügt über ein durchgehendes Mesh-Frontgitter für die Luftzufuhr, einen seitlichen Verschluss und eine unverlierbare Rändelschraube für die Seitenwand sowie den FlexBay und das optionale Slim-Laufwerk hinter der unteren Blende. Dell gibt das Leergewicht des Gehäuses mit 11.6 kg und das konfigurierte Gewicht mit bis zu 21.8 kg an. Unser Testgerät mit dem 1500-W-Netzteil, dem Kühler der 658X und einer Dual-Slot-Grafikkarte liegt im oberen Bereich dieser Gewichtsskala.

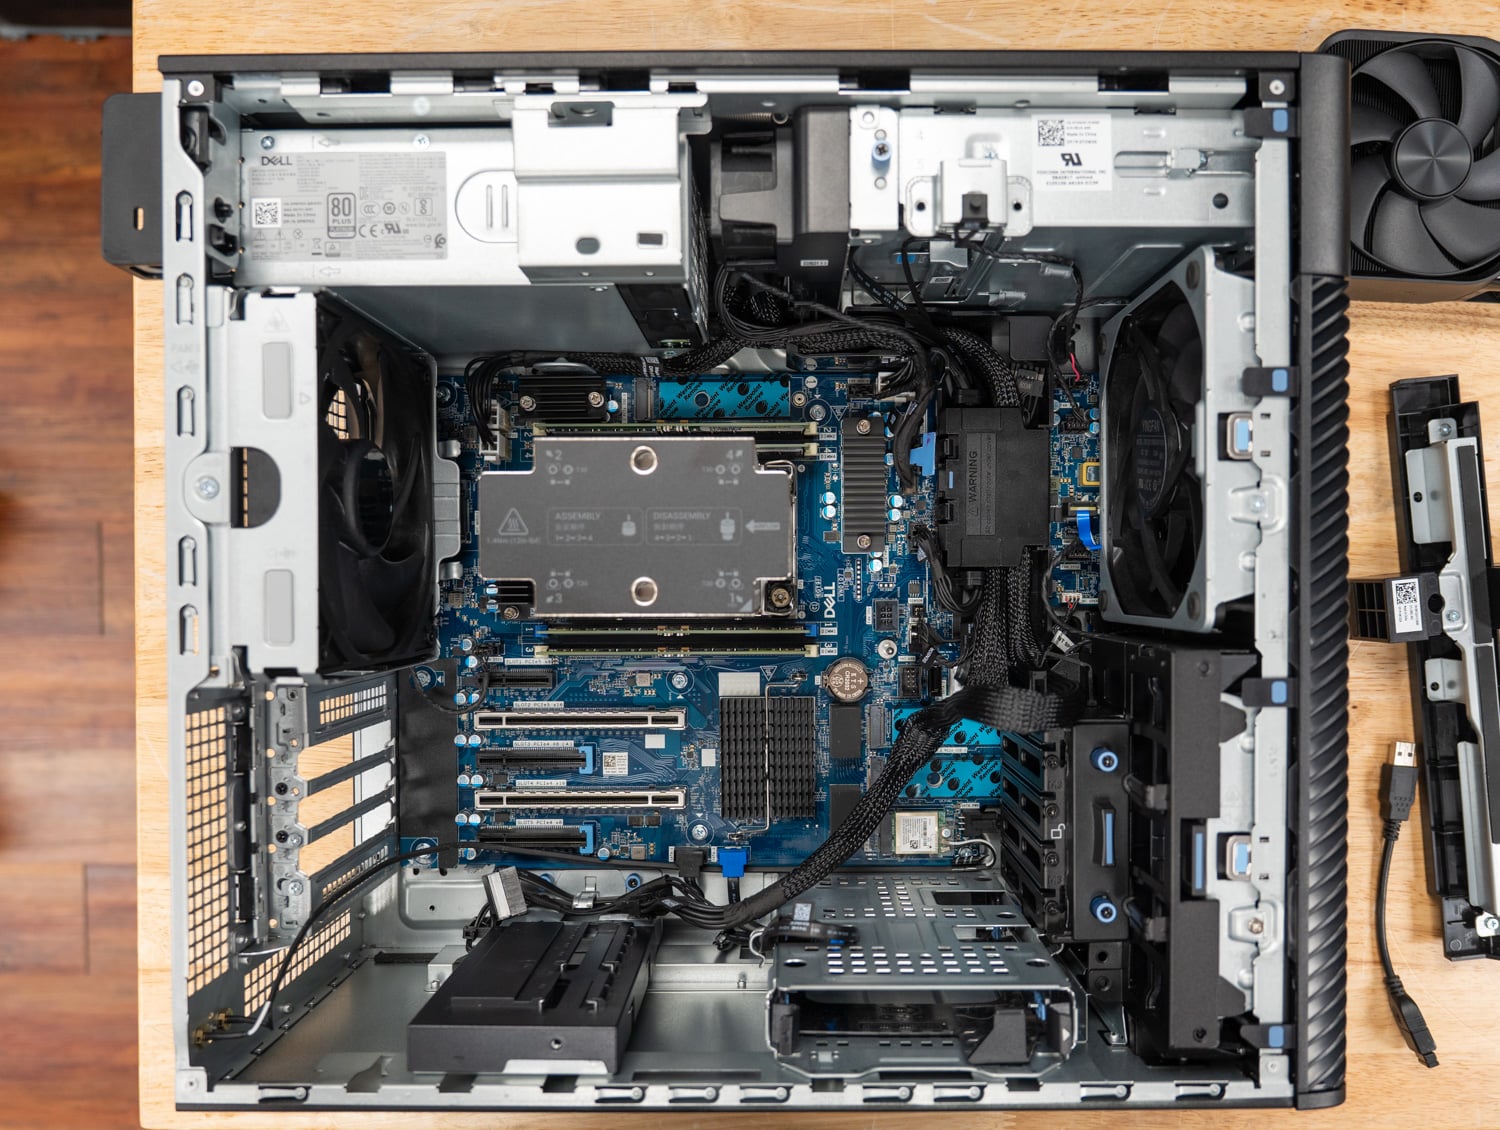
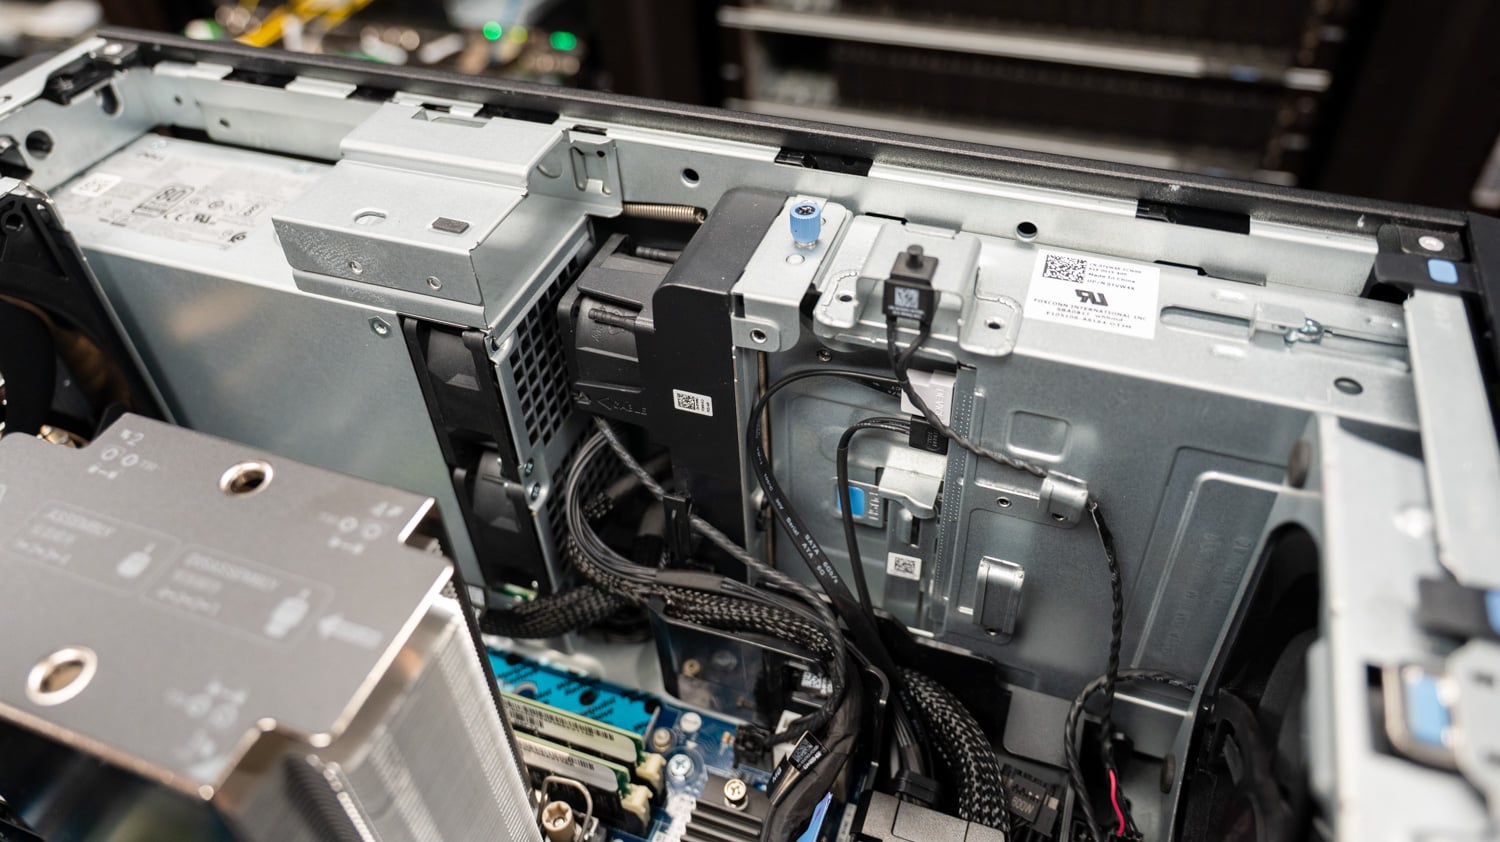
Das Gehäuseinnere ist auf optimale Luftzirkulation ausgelegt, und Dell lenkt die Luft präzise dorthin, wo sie benötigt wird. Die große Kühlabdeckung, die die DIMMs kühl hält und die warme Luft der CPU direkt aus dem Gehäuse abführt, verfügt über einen integrierten Lüfter. Bei geöffnetem Gehäuse lässt sich erkennen, wie die Abdeckung in die Gehäusekonstruktion integriert ist: Ihre Unterkante ruht auf der GPU-Halterung und schmiegt sich passgenau an die Seitenabdeckung an.
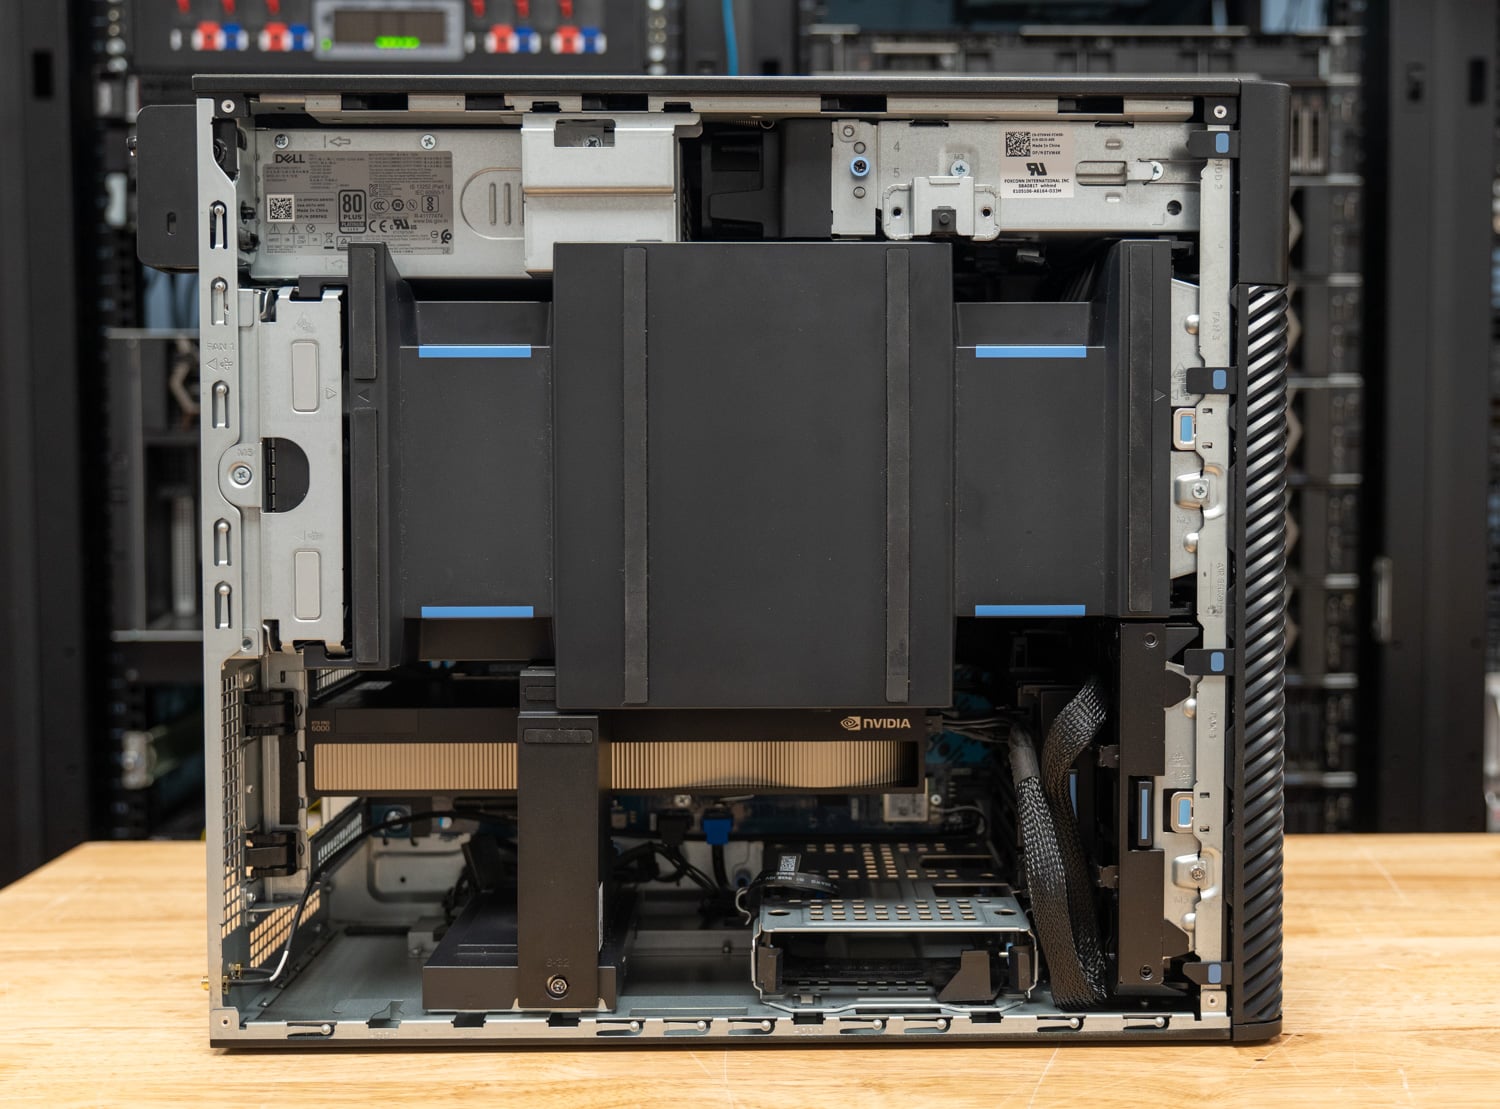
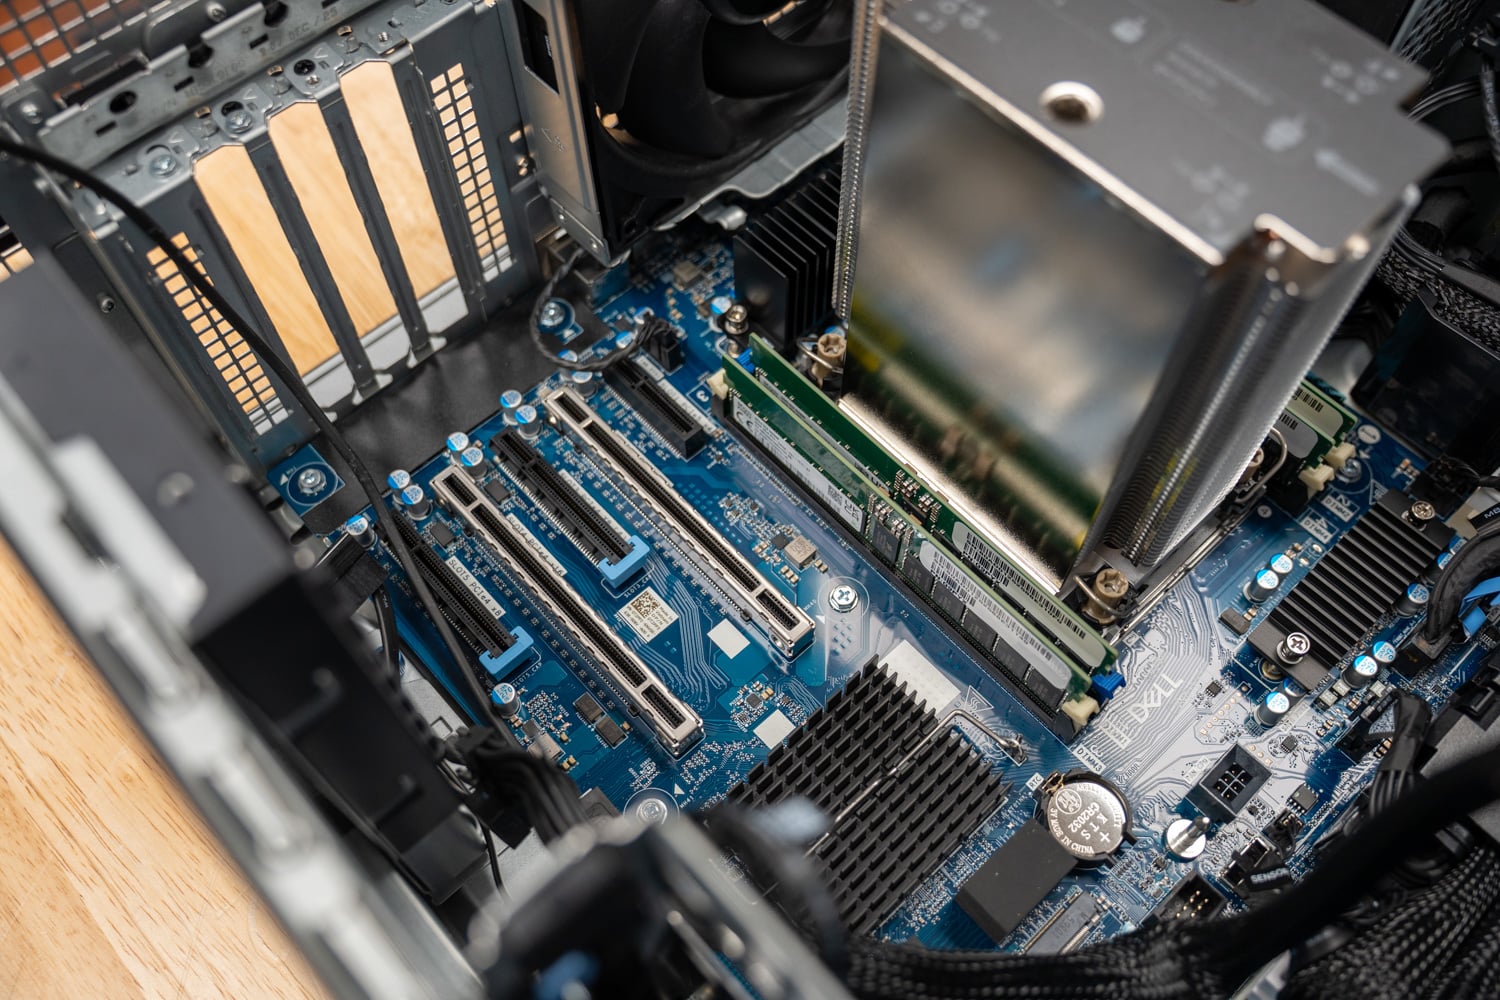
Das Innenlayout entspricht dem des Pro Max Towers: Prozessor und vier DIMM-Steckplätze befinden sich über dem Erweiterungsbereich, die GPU im Gen5 x16-Steckplatz wird an ihrem hinteren Ende von einer Halterung fixiert, und das Netzteil ist hinten mit einem Griff für werkzeugloses Entfernen montiert. Alle fünf Steckplätze sind in voller Höhe: Steckplatz 2 ist der Gen5 x16-Steckplatz für die GPU, Steckplatz 1 ist ein Gen5 x4-Steckplatz, und die anderen drei sind Gen4-Steckplätze, ein x16-Steckplatz und zwei offene x8-Steckplätze für eine Netzwerkkarte, eine Speicherkarte oder eine zweite GPU. Drei interne M.2 2280 Gen5-Steckplätze und zwei 3.5-Zoll-SATA-Einschübe befinden sich hinter dem vorderen E3.S-Einschub.
Die Frontanschlüsse umfassen eine Headset-Buchse, einen 20-Gbit/s-USB-C-Anschluss mit PowerShare, einen 10-Gbit/s-USB-C-Anschluss, zwei USB-A-Anschlüsse und einen optionalen SD-Kartensteckplatz. Auf der Rückseite befinden sich ein Audioausgang, 20-Gbit/s- und 10-Gbit/s-USB-C-Anschlüsse, zwei USB-2.0-Anschlüsse mit SmartPower, zwei USB-A-Anschlüsse mit 5 Gbit/s, ein 1-Gbit/s-Ethernet-Anschluss, ein optionaler Modulsteckplatz für eine 5-Gbit/s-Netzwerkkarte oder zwei weitere USB-A-Anschlüsse sowie ein optionaler serieller Anschluss. Unser Testgerät war zusätzlich mit der MediaTek MT7925 Wi-Fi-7-Karte im internen M.2-2230-Steckplatz und der Intel E810-XXV 25-Gbit/s-Ethernet-Karte ausgestattet, die ursprünglich für die 600-W-GPU entwickelt wurde.

Dell Pro Precision 9 T2 Spezifikationen
| Normen | Dell Pro Precision 9 T2 (PW9T2260) |
|---|---|
| Plattformübersicht | |
| -Prozessor-Optionen | Intel Xeon 634 (12 Kerne, 150 W), 636 (12 Kerne, 170 W), 638 (16 Kerne, 180 W), 654 (18 Kerne, 200 W), 656 (20 Kerne, 210 W), 658X (24 Kerne / 48 Threads, 144 MB L3-Cache, 250 W) Xeon 658X im Test |
| Memory | DDR5 RDIMM ECC, 5600 oder 6400 MT/s, vier Steckplätze, bis zu 1 TB (4 x 256 GB) 128 GB (4 x 32 GB) DDR5-6400 im Test |
| Grafikoptionen | NVIDIA RTX A400, A1000, RTX PRO 2000 / 4000 / 4500 / 5000 / 6000 Blackwell (600 W) / 6000 Blackwell Max-Q (300 W), A800 Active; AMD Radeon Pro W7400; Dual- und Triple-Konfigurationen auf ausgewählten Karten RTX PRO 6000 Blackwell Max-Q Workstation Edition, 96 GB GDDR7, wie getestet |
| Lagerung | Front FlexBay: bis zu zwei E3.S-/NVMe-Laufwerke plus optionales Slim-ODD oder ein 3.5-Zoll-SATA-Einschub Intern: 3 x M.2 2280 Gen5 NVMe, 2 x 3.5-Zoll-SATA RAID: Intel VMD mit VROC von Graph Technology (RAID0-Boot, internes RAID0) 2 x 2 TB E3.S Gen5 NVMe im RAID 0 (4,097 GB) wie getestet |
| Expansion | Steckplatz 1: Gen5 x4; Steckplatz 2: Gen5 x16; Steckplatz 3: Gen4 x8 (x4 elektrisch, offen); Steckplatz 4: Gen4 x16; Steckplatz 5: Gen4 x8 (offen); M.2 2230 für Wi-Fi |
| I / O | |
| Frontanschlüsse | 1 x USB-C 20 Gbit/s mit PowerShare, 1 x USB-C 10 Gbit/s, 1 x USB-A 5 Gbit/s mit PowerShare, 1 x USB-A 5 Gbit/s, Kopfhöreranschluss, optionaler SD-Kartensteckplatz |
| Hintere Anschlüsse | 1 x USB-C 20 Gbit/s, 1 x USB-C 10 Gbit/s, 2 x USB 2.0 (SmartPower), 2 x USB-A 5 Gbit/s, Audioausgang, 1 x RJ45 1 Gbit/s, optionales 5-Gbit/s- oder Dual-USB-A-Modul, optionale serielle Schnittstelle |
| Netzwerk wie getestet | Intel E810-XXV DA2 Dual-Port 25GbE SFP28 (entfernt für die 600-W-GPU); MediaTek MT7925 Wi-Fi 7, Bluetooth 5.4 |
| Kraft und Körperlichkeit | |
| Energieversorgung | 750 W Standardleistung; 500 W oder 1500 W optional; 1500 W im Test |
| Abmessungen | 387 x 187.7 x 438mm (15.23 x 7.38 x 17.24-Eingang) |
| Gewicht | Mindestgewicht 11.6 kg (25.57 lb) bis Höchstgewicht 21.8 kg (48.06 lb). |
| Betriebssystem | Windows 11 Pro für Workstations (wie getestet) oder Ubuntu Linux 24.04 LTS |
| Verwaltung und Sicherheit | Intel vPro, TPM 2.0, Gehäuseöffnungsschalter, abschließbare Blendenoptionen, Kensington-Steckplatz |
| Preis | Dell.com Basiskonfiguration 3,978 US-Dollar (Xeon 634, 16 GB, RTX A400, 256 GB, 750 W); ca. 28,300 US-Dollar in der getesteten Konfiguration (Xeon 658X, 128 GB DDR5-6400, RTX PRO 6000 Max-Q, 2 x 2 TB Gen5 FlexBay-Festplatten im RAID 0-Verbund, 1500 W, 25 GbE, Wi-Fi 7), Preise auf Dell.com vom 19. Oktober 2026 |
Dieser Preis hat zwei Einschränkungen. Im Dell.com-Konfigurator werden die FlexBay-Laufwerke als 2-TB-M.2-2280-Gen5-Module zu je 1,700 US-Dollar aufgeführt, während in unserem Testgerät E3.S-Laufwerke verbaut sind. Wir haben Dell gefragt, wann die E3.S-Option online verfügbar sein wird. Dell gibt offen zu, dass nur wenige Business-Workstations zum Online-Preis gekauft werden. Daher sollten Sie die 28,300 US-Dollar als Obergrenze betrachten, unter der Mengen- und Vertragspreise liegen. Arbeitsspeicher und Grafikkarte machen 19,090 US-Dollar aus, wobei die Grafikkarte unabhängig von der gewählten Variante (300 W oder 600 W) gleich viel kostet.
Dell gibt den Preis dieses Testgeräts mit 31,700 US-Dollar an. Dieser Preis beinhaltet zusätzlich zum von uns ermittelten Preis den E810-XXV 25GbE-Adapter, Wi-Fi 7, das optische Laufwerk und drei Jahre ProSupport.
Testaufbau und Methodik
Alle Ergebnisse in diesem Test stammen von sr-client 1.2, unserer skriptbasierten Benchmark-Suite für Windows-Clients. Die Tests wurden im vollständigen Profil mit dem werkseitigen Windows-Image von Dell, den Dell-Treibern und dem NVIDIA-Treiber 596.71 auf allen vier Konfigurationen durchgeführt. Die Suite verwendet überall die gleichen Einstellungen: Windows-Energiemodus auf „Höchste Leistung“, alle Energiespar- und Bildschirmabschalt-Timer deaktiviert, Windows-Firewall und Benutzerkontensteuerung deaktiviert, VBS und Speicherintegrität wie ausgeliefert aktiviert. Jedes Ergebnis ist der Median mehrerer Durchläufe. Tests, deren Streuung 2 Prozent überschreitet, werden wiederholt, bevor sie akzeptiert werden.
Die vier unten aufgeführten Konfigurationen bestehen aus zwei Towern und zwei GPUs. Der Pro Precision 9 T2 lief mit der kompletten Testsuite, zunächst mit der Max-Q-Karte und anschließend mit der 600-W-RTX PRO 6000 Blackwell aus unserem Pro Max Tower T2. Der Pro Max Tower T2 nutzte beide Karten nacheinander. Daher unterscheiden sich die GPU-Spalten innerhalb eines Towers nur in der verwendeten Karte und die Tower-Spalten innerhalb einer GPU nur in der Plattform. Der Core T2 verfügt über die mitgelieferte 2-TB-Gen5-M.2-SSD, der Xeon T2 über seinen E3.S-Strip mit zwei Laufwerken. Die Zeilen zu Speicher und Modellladung vergleichen daher die jeweiligen Konfigurationen.
| Konfiguration | CPU | Memory | GPU | Bootlaufwerk | Betriebssystem und Energiemodus |
|---|---|---|---|---|---|
| Dell Pro Precision 9 T2 (PW9T2260), Max-Q | Intel Xeon 658X, 24 Kerne / 48 Threads, 250 W | 128 GB DDR5-6400 RDIMM ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, 300 W, 96 GB | 2 x 2 TB E3.S Gen5 NVMe, VROC RAID0 (4,097 GB Boot-Volume) | Windows 11 Pro für Workstations 25H2, Beste Leistung |
| Dell Pro Precision 9 T2 (PW9T2260), 600 W | Intel Xeon 658X, 24 Kerne / 48 Threads, 250 W | 128 GB DDR5-6400 RDIMM ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Workstation Edition, 600 W, 96 GB | 2 x 2 TB E3.S Gen5 NVMe, VROC RAID0 (4,097 GB Boot-Volume) | Windows 11 Pro für Workstations 25H2, Beste Leistung |
| Dell Pro Max Tower T2 (FCT2250), Max-Q | Intel Core Ultra 9 285K, 24 Kerne / 24 Threads, 125 W | 128 GB DDR5-4400 ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, 300 W, 96 GB | SK hynix PCB01 2TB, Gen5 x4 | Windows 11 Pro 26H2, Beste Leistung |
| Dell Pro Max Tower T2 (FCT2250), 600 W | Intel Core Ultra 9 285K, 24 Kerne / 24 Threads, 125 W | 128 GB DDR5-4400 ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Workstation Edition, 600 W, 96 GB | SK hynix PCB01 2TB, Gen5 x4 | Windows 11 Pro 26H2, Beste Leistung |
Mehrere Tests werden hier erstmals vorgestellt, beginnend mit dem LLM-Serving-Test. Dieser führt den llama-Server mit vier Modellen aus und variiert die Parallelität von einer Anfrage bis zur maximalen Anzahl an Anfragen, die in den GPU-Speicher passen. Er misst den Gesamt- und den nutzerbezogenen Durchsatz, die Zeit bis zum ersten Token und die Zeit pro Ausgabetoken. Der Bildgenerierungstest rendert 1024×1024-Bilder mit FLUX.2 klein 4B, Z-Image Turbo 6B und Qwen-Image 20B mit den Gewichtungen Q4_0, Q8_0 und BF16 und bewertet die quantisierten Ausgaben anhand von PSNR und SSIM im Vergleich zu BF16, um Geschwindigkeit und Genauigkeit zu vergleichen. Der Test des Codierungsagenten läuft nun auf Crush, und der Test „Agent neben Nutzer“ verwendet eine überarbeitete Methode, die den Browser-Benchmark auf drei vollständige Durchläufe beschränkt.
Drei Bezeichnungen tauchen in den Tabellen wiederholt auf, beginnend mit „N/A“, was bedeutet, dass ein Test für die Hardware nicht relevant ist: SMT-Single-Core-Tests auf dem 285K, der kein SMT besitzt, und die OpenBLAS-Top-Core-Klassenzeilen auf dem Xeon, dessen 24 Kerne eine Klasse bilden. „Partial“ kennzeichnet ein Ergebnis, das die Testsuite mit einem Hinweis akzeptiert hat, meist eine Codierungsagenten-Stufe, bei der einer von drei Testläufen fehlgeschlagen ist. Da die Desktop-PCs weder CPU- noch GPU-Temperaturen an den Sensorpfad der Testsuite übermittelten, werden in diesem Bericht die durchschnittlichen CPU-Taktraten pro Test anstelle einer Temperaturtabelle angegeben.
Lokale KI-Leistung
Mit 96 GB GDDR7 in jeder Konfiguration ist die Speicherkapazität ausreichend, und alle Stufen unserer lokalen KI-Testsuite laufen auf allen vier Karten. Die Ergebnisse verteilen sich daher entlang der GPU-Leistungsgrenze: Wo ein Test durch die Speicherbandbreite begrenzt ist, liegen die Max-Q- und die 600-W-Karten nahe beieinander, wo die Rechenleistung den Ausschlag gibt, hat die 600-W-Karte die Nase vorn. Die CPU-Plattform spielt selten eine Rolle, und wenn doch, ist die Richtung bemerkenswert.
MLPerf Client v2.0
Der MLPerf-Client verwendet Llama 3.1 8B und Phi-4-mini in fünf Eingabeaufforderungskategorien und meldet die Zeit bis zum ersten Token sowie die Token-Rate danach als geometrisches Mittel über alle Kategorien. Als Engine dient in jeder Konfiguration llama.cpp auf CUDA. In den Agentenszenarien fungiert Llama 3.1 8B als Datenanalyse-Agent und als Softwareentwicklungs-Agent und ruft über mehrere Runden hinweg verschiedene Tools auf.

| MLPerf Client v2.0 | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Llama 3.1 8B, Zeit bis zum ersten Token, geometrisches Mittel (s, niedriger ist besser) | 0.082 | 0.059 | 0.082 | 0.060 |
| Llama 3.1 8B, Token-Rate, geometrischer Mittelwert (Token/s) | 230.9 | 252.8 | 230.0 | 246.7 |
| Phi-4-mini, Zeit bis zum ersten Token, geometrisches Mittel (s, niedriger ist besser) | 0.045 | 0.034 | 0.044 | 0.034 |
| Phi-4-mini, Tokenrate, geometrisches Mittel (Token/s) | 345.9 | 379.0 | 351.0 | 374.3 |
| Data Analyst Agent, End-to-End (s, je niedriger, desto besser) | 17.5 | 15.7 | 16.2 | 14.4 |
| Datenanalyst-Agent, Token-Rate (Token/s) | 202.9 | 223.9 | 202.3 | 218.4 |
| SWE-Agent, End-to-End (s, je niedriger, desto besser) | 16.2 | 14.9 | 14.6 | 13.5 |
| SWE-Agent, Token-Rate (Token/s) | 197.5 | 214.6 | 195.5 | 210.2 |
Die Max-Q-Karte erreichte in Llama 3.1 8B 230.9 Token pro Sekunde im Xeon-Tower und 230.0 im Core-Tower sowie 345.9 bzw. 351.0 Token pro Sekunde im Phi-4-mini-Test – bei gleicher GPU und identischer Rechenleistung. Die 600-Watt-Karte steigerte diese Werte im Xeon-Tower auf 252.8 bzw. 379.0 Token pro Sekunde, was einem Zuwachs von etwa 9 Prozent entspricht, und reduzierte die Zeit bis zum ersten Token in Llama von 0.082 auf 0.059 Sekunden, eine Verbesserung um 28 Prozent. Da die Verarbeitung von Prompts rechenintensiv und die Dekodierung bandbreitenlimitiert ist und beide Karten denselben Speicher nutzen, macht sich die Leistungsbegrenzung beim ersten Token deutlich stärker bemerkbar als bei den folgenden.
Die CPU-Plattform kommt in den Agentenszenarien zum Tragen. Der Datenanalysten-Agent benötigte auf dem Core T2 mit Max-Q-Karte 16.2 Sekunden und auf dem Xeon T2 17.5 Sekunden, der Softwareentwickler-Agent 14.6 Sekunden gegenüber 16.2 Sekunden. Die Tool-Aufrufphasen des Xeon dauerten jeweils etwa 1.5 Sekunden länger. Die Token-Raten stimmen innerhalb von 1 Prozent überein; der Unterschied liegt also in den Tools, die zwischen den Modellaufrufen auf der CPU ausgeführt werden. Die schnelleren Kerne des 285K sind hier schneller.
Modell wird geladen
Dieser Test misst die Laufzeit eines lokalen Modells in Ollama vom Laufwerk bis zum ersten generierten Token, sowohl im Kaltbetrieb (Dateicache geleert) als auch im Warmbetrieb (Datei bereits im Speicher). Er gibt an, wie schnell das Laufwerk während des Kaltbetriebs gelesen wurde, wann die Gewichte im GPU-Speicher eintrafen und berechnet eine Effizienzkennzahl, die die Lesegeschwindigkeit während des Ladevorgangs mit der sequenziellen Maximalkapazität des Laufwerks von 1 MB vergleicht. Mit 96 GB VRAM laufen alle drei Stufen: gpt-oss:20b mit 12.8 GB, Qwen3.6-35B-A3B mit 21.1 GB und gpt-oss:120b mit 60.9 GB.

| Modell laden (Speicherabbildung aktiviert) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| gpt-oss:20b, Kaltstart des ersten Tokens (s, niedrigere Werte sind besser) | 9.68 | 9.02 | 7.41 | 7.23 |
| gpt-oss:20b, Warmladen des ersten Tokens (s, niedrigere Werte sind besser) | 7.52 | 7.18 | 6.60 | 6.61 |
| gpt-oss:20b, Ankunft im GPU-Speicher, kalt (s, niedriger ist besser) | 4.44 | 4.33 | 3.00 | 2.95 |
| Qwen3.6-35B-A3B, Kaltladung des ersten Tokens (s, niedriger ist besser) | 13.31 | 12.32 | 11.62 | 11.01 |
| Qwen3.6-35B-A3B, Warmlast auf erstes Token (s, niedriger ist besser) | 11.63 | 10.75 | 10.35 | 9.99 |
| gpt-oss:120b, Kaltstart des ersten Tokens (s, niedrigere Werte sind besser) | 32.06 | 32.44 | 28.54 | 28.11 |
| gpt-oss:120b, Warmladen des ersten Tokens (s, niedrigere Werte sind besser) | 27.18 | 26.49 | 25.58 | 25.73 |
| gpt-oss:120b, Lesedurchsatz während der Kaltstartphase (MB/s) | 9,875 | 9,106 | 11,633 | 11,248 |
| gpt-oss:120b, Ankunft im GPU-Speicher, kalt (s, niedriger ist besser) | 11.33 | 11.57 | 7.74 | 7.63 |
| gpt-oss:120b-Ladevorgang nach dem Wechsel von gpt-oss:20b (s, niedriger ist besser) | 14.30 | 13.97 | 11.89 | 11.93 |
| Laufwerksobergrenze, DiskSpd 1 MB sequenzielles Lesen (MB/s) | 11,306 | 11,296 | 11,563 | 11,646 |
Der Core T2 lädt jedes Modell schneller, und das liegt am Laufwerk. gpt-oss:120b erreichte auf dem Core T2 sein erstes Token in 28.54 Sekunden (im Vergleich zu 32.06 Sekunden auf dem Xeon T2). Die 61 GB an Gewichtungen trafen in 7.74 Sekunden im GPU-Speicher ein, gegenüber 11.33 Sekunden. Das einzelne PCB01-Laufwerk lieferte die Daten mit 11,633 MB/s, genau an seiner maximalen DiskSpd-Geschwindigkeit von 11,563 MB/s, während der E3.S-Stripe 9,875 MB/s erreichte, bei einer eigenen maximalen Geschwindigkeit von 11,306 MB/s. Das RAID-Volume liest große Blöcke fast so schnell wie das einzelne Laufwerk, kann diese Geschwindigkeit aber über den speicherabgebildeten Ladepfad von Ollama nicht aufrechterhalten.
Bei warmen Lasten verringert sich die Differenz auf ein bis zwei Sekunden, da die Datei bereits im Arbeitsspeicher liegt und nur noch der Transfer in den VRAM und die Einrichtung von llama.cpp ausstehen: 27.18 Sekunden auf dem Xeon T2 gegenüber 25.58 Sekunden für gpt-oss:120b und 7.52 Sekunden gegenüber 6.60 Sekunden für gpt-oss:20b. Die Leistungsbegrenzung der GPU hat erwartungsgemäß keinen konsistenten Einfluss auf die Ladezeit.
Kodieragent
Crush, ein Terminal-Codierungsagent, steuert ein lokales, von Ollama bereitgestelltes Modell durch eine festgelegte Codierungsaufgabe in einem fixierten Repository. Bis zu drei Durchläufe sind nötig, um die elf Tests des Repositorys zu bestehen. Wir berichten über die mittlere Laufzeit der drei Durchläufe, die Anzahl der erfolgreichen Durchläufe und die Generierungsrate. Die Laufzeit hängt davon ab, wie viele Tool-Aufrufe und Token das Modell verwendet, was von Durchlauf zu Durchlauf variiert. Daher ist die Generierungsrate der aussagekräftigere Hardware-Vergleich. Der Test „Agent neben Benutzer“ lässt Agent und Speedometer gleichzeitig laufen und misst, wie stark sich die beiden gegenseitig verlangsamen.

| Crush-Codierungsagent | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Tier S, gpt-oss:20b, 64K Kontext | ||||
| Wandzeit, Median (s, niedriger ist besser) | 55.1 | 99.8 | 57.2 | 43.2 |
| Erfolge (von 3) | 3 | 2 | 3 | 2 |
| Erzeugungsrate (tok/s) | 214.1 | 237.9 | 218.0 | 237.7 |
| Tier M, Qwen3.6-35B-A3B, 64K Kontext | ||||
| Wandzeit, Median (s, niedriger ist besser) | 35.2 | 27.0 | 86.7 | 32.1 |
| Erfolge (von 3) | 3 | 3 | 3 | 3 |
| Erzeugungsrate (tok/s) | 234.5 | 242.9 | 223.3 | 245.8 |
| Tier L, Qwen3.6-35B-A3B, 128K Kontext | ||||
| Wandzeit, Median (s, niedriger ist besser) | 38.1 | 30.6 | 74.1 | 58.8 |
| Erfolge (von 3) | 3 | 3 | 3 | 3 |
| Erzeugungsrate (tok/s) | 222.9 | 237.0 | 231.1 | 252.8 |
| Tier W, gpt-oss:120b, 128K Kontext | ||||
| Wandzeit, Median (s, niedriger ist besser) | 49.1 | 37.9 | 56.6 | 30.8 |
| Erfolge (von 3) | 3 | 3 | 3 | 3 |
| Erzeugungsrate (tok/s) | 160.9 | 177.1 | 158.5 | 174.4 |
| Agent neben dem Benutzer (gpt-oss:20b und Speedometer zusammen) | ||||
| Geschwindigkeitsmesser neben dem Agenten (Punktzahl) | 36.6 | 36.7 | 43.2 | 45.2 |
| Geschwindigkeitsanzeige verlangsamt sich (x, je niedriger, desto besser) | 1.005 | 1.011 | 1.053 | 1.044 |
| Agentengenerierungsrate neben dem Tachometer (tok/s) | 218.2 | 231.6 | 212.4 | 229.2 |
| Agentenverlangsamung (x, je niedriger, desto besser) | 1.006 | 1.009 | 1.023 | 0.998 |
Alle Konfigurationen schlossen alle drei Durchläufe der Tier-W-Aufgabe mit gpt-oss:120b, dem größten Modell der Testreihe, erfolgreich ab. Dabei wurden im Xeon-Tower 160.9 bis 177.1 Token pro Sekunde und im Core-Tower 158.5 bis 174.4 Token pro Sekunde generiert, wobei die 600-W-Karte jeweils etwa 10 Prozent der Leistung ausmachte. Auch die Qwen3.6-Aufgaben liefen überall einwandfrei mit 223 bis 253 Token pro Sekunde. Das Modell gpt-oss:20b zeigte hingegen Schwierigkeiten: Die Tier-S-Aufgabe verlor in zwei der vier Konfigurationen einen von drei Durchläufen, und ihre 128K-Kontext-Tier-M-Aufgabe (nicht dargestellt) verlor überall mindestens einen Durchlauf – ein Verhalten, das durch die Hardware nicht beeinflusst wird.
Das gleichzeitige Ausführen des Agenten und eines Browser-Benchmarks kostet auf einem Tower mit dedizierter GPU und 24 freien Kernen nahezu keine Ressourcen. Der Speedometer-Wert sank beim Xeon T2 um das 1.005-Fache und beim Core T2 um das 1.053-Fache, während der Agent lief. Die Generierungsrate des Agenten veränderte sich in allen Fällen um maximal 2 Prozent. Der Speedometer-Wert des Xeon T2 von 36.6 liegt neben dem Agenten niedriger als der des Core T2 von 43.2, aus demselben Grund, aus dem er auch ohne Agent niedriger ist: die Taktfrequenz pro Kern des 285K.
Retrieval-Augmented Generation
Unser RAG-Test bettet 20,963 SQuAD v1.1-Passagen mit nomic-embed-text ein, ermittelt die fünf besten Passagen für jede der 2,000 Fragen und beantwortet 400 davon mit Phi-4-mini. Dabei werden die Übereinstimmung und der F1-Wert im Vergleich zu den Referenzantworten bewertet. Da die Modelle klein sind, misst der Test die gesamte Pipeline, einschließlich der CPU-seitigen Vektorsuche zwischen den GPU-Phasen.

| RAG | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Wandaufnahmezeit, 20,963 Passagen (s, niedriger ist besser) | 128.5 | 125.5 | 108.1 | 103.0 |
| Einbettungsrate (Token/s) | 29,875 | 30,592 | 35,165 | 37,508 |
| Abfragezeit, p50 (ms, je niedriger, desto besser) | 30.6 | 27.2 | 23.4 | 18.7 |
| Antwort, Phi-4-Mini-Zeit bis zum ersten Token, p50 (s, niedriger ist besser) | 0.099 | 0.087 | 0.089 | 0.083 |
| Antwort, prompte Verarbeitung (tok/s) | 20,318 | 26,549 | 21,356 | 26,619 |
| Antwort, Erzeugungsrate (tok/s) | 296.4 | 337.8 | 324.3 | 344.1 |
| Frage zu beantworten, S. 50 (s, niedriger ist besser) | 0.152 | 0.133 | 0.130 | 0.120 |
| Rückrufquote bei 5 (%) | 82.7 | 82.7 | 82.7 | 82.7 |
| Antwort F1 (%) | 74.65 | 74.65 | 74.65 | 74.65 |
Der Core T2 durchläuft diese Pipeline schneller. Er verarbeitete den Korpus in 108.1 Sekunden (gegenüber 128.5 Sekunden beim Xeon T2 mit derselben Max-Q-Karte), rief ihn in 23.4 ms ab (gegenüber durchschnittlich 30.6 ms) und beantwortete eine Frage in 0.130 Sekunden (gegenüber 0.152 Sekunden). Sowohl das Einbetten als auch das Abrufen von Daten sind CPU-intensive Phasen, die dem 285K zugutekommen. Die 600-W-Karte steigerte die Verarbeitungsgeschwindigkeit von Eingabeaufforderungen auf beiden Plattformen um 25 bis 30 Prozent, von 20,318 auf 26,549 Token pro Sekunde beim Xeon T2. Die Genauigkeit war in allen vier Konfigurationen identisch, wie es bei gleichen Modellen und einer Temperatur von 0 °C zu erwarten ist.
LLM-Dienstleistung
Der Servertest verwendet llama-server mit Ministral 3 3B und 8B (4,096 Token pro Eingabeaufforderung, 1,024 Token pro Ausgabe), Qwen3.8 27B und gpt-oss 120B (8,192 Token pro Eingabeaufforderung). Dabei werden so viele Slots wie möglich nach der Gewichtung im GPU-Speicher verfügbar sind, und die Parallelität wird von einer Anfrage bis zu dieser Grenze erhöht. Wir berichten über den Gesamtdurchsatz (Eingabe- und Ausgabetoken zusammen), den Ausgabedurchsatz, die Zeit bis zum ersten Token und die Zeit pro Ausgabetoken im Median. Auf einer 96-GB-Karte belegt gpt-oss 120B 64 Slots mit 22.5 GiB KV-Cache, Qwen3.8 27B acht und die beiden Ministral-Modelle jeweils vier.

| llama-server, gpt-oss 120B, 8,192-Token-Eingabeaufforderungen, 1,024-Token-Ausgaben | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| 1 gleichzeitig: Ausgabedurchsatz (Token/s) | 160.6 | 182.7 | 158.4 | 179.0 |
| 1 gleichzeitig: Zeit bis zum ersten Token, Median (ms, niedriger ist besser) | 1,241 | 918 | 1,238 | 923 |
| 1 gleichzeitig: Zeit pro Ausgabetoken, Median (ms, niedriger ist besser) | 5.03 | 4.58 | 5.11 | 4.70 |
| 8 gleichzeitig: Gesamtdurchsatz (Token/s) | 2,088 | 2,460 | 2,154 | 2,534 |
| 8 gleichzeitig: Ausgabe pro Benutzer (Token/s) | 29.0 | 34.2 | 29.9 | 35.2 |
| 8 gleichzeitig: Zeit bis zum ersten Token, Median (ms, niedriger ist besser) | 2,847 | 2,152 | 2,856 | 2,121 |
| 64 gleichzeitig: Gesamtdurchsatz (Token/s) | 3,296 | 3,805 | 3,531 | 4,220 |
| 64 gleichzeitig: Ausgabe pro Benutzer (Token/s) | 5.7 | 6.6 | 6.1 | 7.3 |
| 64 gleichzeitig: Zeit bis zum ersten Token, Median (ms, niedriger ist besser) | 4,315 | 3,491 | 4,607 | 3,622 |
| 64 gleichzeitig: Zeit pro Ausgabetoken, Median (ms, niedriger ist besser) | 163.0 | 141.3 | 152.7 | 126.3 |
Ein einzelner Benutzer erhält gpt-oss 120B mit 160.6 Token pro Sekunde auf der Max-Q-Karte und 182.7 Token pro Sekunde auf der 600W-Karte. Das erste Token trifft nach einer 8,192 Token umfassenden Aufforderung nach 1,241 bzw. 918 ms ein. Durch die Auslastung der Karte mit 64 gleichzeitigen Anfragen konnte der Gesamtdurchsatz auf 3,296 Token pro Sekunde auf der Max-Q-Karte und 3,805 Token pro Sekunde auf der 600W-Karte erhöht werden. Dies ging mit einem Mehrverbrauch von 5.7 bzw. 6.6 Token pro Sekunde pro Benutzer und Wartezeiten von 4.3 bzw. 3.5 Sekunden für das erste Token einher. Die Kurve flacht zwischen 4 und 32 gleichzeitigen Anfragen ab und steigt bei 64 Anfragen wieder sprunghaft an, wo die Batchverarbeitung die langen Aufforderungen schließlich ausgleicht.

| llama-server, Ausgabedurchsatz bei maximaler Parallelität (tok/s) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Ministerial 3 3B Argumentation, 4 gleichzeitig | 562.5 | 600.4 | 576.8 | 625.3 |
| Ministerial 3 8B Argumentation, 4 gleichzeitig | 375.8 | 445.1 | 377.9 | 446.3 |
| Qwen3.8 27B, 8 gleichzeitig | 153.1 | 189.6 | 152.2 | 187.3 |
| gpt-oss 120B, 64 gleichzeitig | 366.3 | 422.8 | 392.3 | 468.9 |
| Durchsatz pro Anfrage (Token/s) | ||||
| Ministerial 3 3B Reasoning | 232.1 | 241.8 | 232.1 | 246.0 |
| Ministerial 3 8B Reasoning | 165.0 | 183.3 | 164.1 | 180.4 |
| Qwen3.8 27B | 54.0 | 63.7 | 54.1 | 63.0 |
| gpt-oss 120B | 160.6 | 182.7 | 158.4 | 179.0 |
Das dichte Qwen3.8 27B ist mit 54.0 Token pro Sekunde auf dem Max-Q das langsamste Modell für einen einzelnen Benutzer, da jedes Token alle 27 Milliarden Parameter durchläuft. Das gemischt-aus-Experten-gpt-oss 120B hingegen ist trotz vierfacher Festplattengröße 3.0-mal schneller. Der Vorteil der 600-Watt-Karte ist beim dichten Modell mit 24 Prozent bei acht gleichzeitigen Anfragen am größten und beim Ministral 3B mit etwa 7 Prozent am geringsten. Die beiden Prozessoren liegen überall innerhalb von etwa 3 Prozent, außer im Fall von 64 gpt-oss-Anfragen. Hier liegt der Core T2 mit beiden Karten 7 bis 11 Prozent vorn, sodass die CPU-seitige Serverlast bei dieser Batchgröße die schnelleren Kerne begünstigt.
Bilderzeugung
Der Bildgenerierungstest rendert 1024×1024-Bilder mit drei Diffusionsmodellen und drei Gewichtungsgenauigkeiten und gibt die Zeit pro Bild, die Rauschunterdrückungsrate und den von den Gewichten belegten GPU-Speicher an. Zusätzlich wird derselbe Seed mit BF16 gerendert und die Ergebnisse der Q4_0- und Q8_0-Ausgaben anhand von PSNR und SSIM bewertet, wodurch sich die Kosten der Quantisierung quantifizieren lassen.

| Bildgenerierung, 1024×1024 | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| FLUX.2 klein 4B, 4 Schritte | ||||
| Q8_0: Sekunden pro Bild (je niedriger, desto besser) | 1.66 | 1.37 | 1.59 | 1.30 |
| Q8_0: Bilder pro Minute | 36.2 | 43.7 | 37.6 | 46.0 |
| BF16: Sekunden pro Bild (je niedriger, desto besser) | 1.60 | 1.34 | 1.55 | 1.27 |
| Z-Image Turbo 6B, 8 Schritte | ||||
| Q8_0: Sekunden pro Bild (je niedriger, desto besser) | 3.82 | 2.89 | 3.78 | 2.82 |
| Q8_0: Bilder pro Minute | 15.7 | 20.7 | 15.9 | 21.3 |
| BF16: Sekunden pro Bild (je niedriger, desto besser) | 3.61 | 2.76 | 3.56 | 2.68 |
| Qwen-Image 20B, 20 Schritte | ||||
| Q4_0: Sekunden pro Bild (je niedriger, desto besser) | 25.60 | 19.11 | 25.57 | 18.97 |
| Q8_0: Sekunden pro Bild (je niedriger, desto besser) | 26.08 | 19.66 | 26.02 | 19.42 |
| BF16: Sekunden pro Bild (je niedriger, desto besser) | 26.17 | 20.45 | 26.05 | 20.28 |
| Q8_0: Bilder pro Minute | 2.30 | 3.05 | 2.31 | 3.09 |
| BF16: GPU-Speicher für Gewichte (GiB) | 45.3 | 45.3 | 45.3 | 45.3 |
Diffusion ist rechenintensiv, was die 600-W-Karte deutlich zeigt: Qwen-Image 20B bei Q8_0 benötigte auf dem Max-Q 26.1 Sekunden pro Bild und auf der 600-W-Karte im Xeon-Tower 19.7 Sekunden – ein Zuwachs von 33 Prozent bei den Bildern pro Minute. Z-Image Turbo legte um 32 Prozent und FLUX.2 klein um 21 Prozent zu. Die CPU-Plattform ist hier irrelevant, da die beiden Tower in allen Zeilen außer „Server Start“ innerhalb eines Prozents voneinander liegen. Beim Server Start benötigt das RAID-Volume des Xeon T2 einige Sekunden länger zum Laden der Gewichte.
| Quantisierungsgenauigkeit im Vergleich zu BF16 (gleicher Seed) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| PSNR (dB, je höher, desto besser) / SSIM (je höher, desto besser) | ||||
| FLUX.2 klein 4B, Q4_0 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 |
| FLUX.2 klein 4B, Q8_0 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 |
| Z-Image Turbo 6B, Q4_0 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 |
| Z-Image Turbo 6B, Q8_0 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 |
| Qwen-Image 20B, Q4_0 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 |
| Qwen-Image 20B, Q8_0 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 |
Die Fidelity-Zeilen sind in allen vier Konfigurationen identisch, da die Ausgabe von den Gewichtungen und nicht von der Hardware abhängt. Q8_0 reproduziert das BF16-Bild mit einem SSIM von 0.938 bis 0.987 und einem PSNR von 28 bis 36 dB, während Q4_0 auf einen SSIM von 0.75 bis 0.79 und einen PSNR von 18 bis 22 dB abfällt, was ein anderes Bild ergibt. Auf einer 96-GB-Karte gibt es keinen Speichergrund, diese Modelle unterhalb von Q8_0 zu betreiben; die BF16-Gewichtungen von Qwen-Image passen in 45.3 GiB, und BF16 wurde auf allen drei Modellen genauso schnell oder sogar etwas schneller gerendert als mit Q8_0, da der Q8_0-Pfad Zeit für die Dequantisierung benötigt.
CPU-Leistung
Die beiden Prozessoren teilen sich die Spitzenplätze in unserem CPU-Testfeld deutlich. Bei Tests, die alle Kerne nutzen, liegt der Xeon 658X in den meisten Fällen mit 27 bis 150 Prozent vorn. Je breiter die Vektoren und je höher der Speicherverkehr, desto größer sein Vorsprung. Läuft ein Test mit nur einem oder wenigen Threads, gewinnt der Core Ultra 9 285K dank seines 5.7 GHz schnellen P-Kerns mit 13 bis 31 Prozent gegenüber einem 4.9 GHz schnellen Xeon-Kern mit höherer Cache- und Speicherlatenz. Der Einfluss der 600-Watt-GPU auf die Ergebnisse des Xeon-Tests unter Auslastung aller Kerne wird in den jeweiligen Tabellen erläutert und im Abschnitt „Taktfrequenzen“ zusammengefasst.
Cinebench 2026 und Dauerbelastung
Cinebench 2026 rendert eine Szene mit Maxons Redshift-Engine auf der CPU und misst die Leistung auf einem Kern, auf einem SMT-Kern (zwei Threads auf einem physischen Kern) und auf mehreren Kernen. Anschließend führen wir eine Schleife durch, die den Durchlauf auf mehreren Kernen etwa 30 Minuten lang wiederholt und den stabilen Zustand mit dem ersten Durchlauf vergleicht.

| Cinebench 2026 (Punkte, je höher, desto besser) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Einzelprozessor | 454.1 | 455.6 | 564.4 | 564.5 |
| SMT-Einzelkern | 599.1 | 601.0 | Nicht verfügbar (keine SMT) | Nicht verfügbar (keine SMT) |
| Mehrkern | 12,322 | 11,705 | 8,856 | 8,838 |
| Anhaltende Schleife, erster Durchlauf | 12,201 | 11,731 | 8,717 | 8,788 |
| Anhaltende Schleife, stationärer Zustand | 12,328 | 11,764 | 8,825 | 8,844 |
| Stationärer Zustand / erster Durchgang | 1.010 | 1.003 | 1.012 | 1.006 |
| Dauerschleife, stationärer CPU-Takt (MHz) | 4,274 | 4,178 | 4,669 | 4,690 |
Der 658X erreichte mit installierter Max-Q-Karte im Multi-Core-Test 12,322 Punkte, 39 Prozent mehr als der 285K mit 8,856 Punkten, und hielt den Wert von 12,328 Punkten über den 30-minütigen Testlauf konstant, ein Prozent über dem ersten Wert. Im Single-Thread-Test kehrt sich das Ergebnis um: Der 285K erzielte 564.4 Punkte gegenüber 454.1 Punkten des Xeon. Um den Single-Thread-Wert des 285K zu übertreffen, benötigt man zwei Threads auf einem Xeon-Kern (599.1 Punkte).
Der Einbau der 600-W-Grafikkarte steigerte den Multi-Core-Score des Xeon auf 11,705 Punkte und den Steady-State-Score auf 11,764 Punkte, was einem Rückgang von 5 Prozent entspricht. Der Steady-State-Takt sank dabei von 4,274 auf 4,178 MHz. Der Core T2 zeigte keine derartige Veränderung (8,856 bzw. 8,838 Punkte). Da die Tests in keinem der beiden Tower-Systeme die CPU- oder GPU-Temperaturen erfassten, lässt sich nicht feststellen, ob der 250-W-Prozessor durch die Wärmeentwicklung der 600-W-Karte oder durch eine gemeinsame Leistungsaufnahme an Leistung verliert. Fest steht lediglich, dass er mit der größeren Grafikkarte im Gehäuse in jedem All-Core-Test 4 bis 5 Prozent weniger Leistung erzielt.
7-Zip
Der integrierte Benchmark von 7-Zip misst den Durchsatz der LZMA-Komprimierung und -Dekomprimierung in Gigainstruktionen pro Sekunde, einmal pro Thread und einmal auf einem einzelnen Kern. LZMA basiert auf hohem Integer-Durchsatz, Sprungvorhersage sowie geringer Cache- und Speicherlatenz und belohnt daher die Anzahl der Kerne und einen schnellen Speicherpfad stärker als die Vektorbreite.

| 7-Zip (GIPS, je höher, desto besser) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Alle Themen | ||||
| Gesamt | 289.6 | 288.9 | 174.8 | 175.7 |
| Komprimieren | 276.4 | 273.5 | 151.5 | 151.9 |
| Dekomprimieren | 303.0 | 304.4 | 198.1 | 199.4 |
| Ein Thread | ||||
| Gesamt | 8.74 | 8.05 | 10.82 | 10.83 |
| Komprimieren | 8.66 | 7.80 | 9.31 | 9.31 |
| Dekomprimieren | 8.83 | 8.30 | 12.33 | 12.34 |
Bei 48 Threads erreichte der Xeon 289.6 GIPS gegenüber 174.8 GIPS beim 285K mit 24 Threads, was einem Vorsprung von 66 Prozent entspricht. Die Komprimierung lag mit 82 Prozent und die Dekomprimierung mit 53 Prozent vorn. Bei einem Thread führte der 285K mit 10.82 GIPS gegenüber 8.74 GIPS. Mit der 600-Watt-Karte im Xeon-Tower vergrößerte sich der Abstand auf 8.05 GIPS, was den niedrigeren Taktraten dieser Konfiguration entspricht.
Blender, HandBrake und LLVM
Blender 4.5 rendert die Szenen „Monster“, „Schrottplatz“ und „Klassenzimmer“ mit Cycles auf der CPU. HandBrake kodiert 60 Sekunden eines 4K60-Clips softwareseitig mit x265 (HEVC, mittlere Voreinstellung, Qualität 22) und SVT-AV1 (Voreinstellung 8, Qualität 30). Der LLVM-Test kompiliert den vollständigen LLVM-21.1.4-Baum mit Clang und Ninja – die längste All-Core-Last der Testreihe.

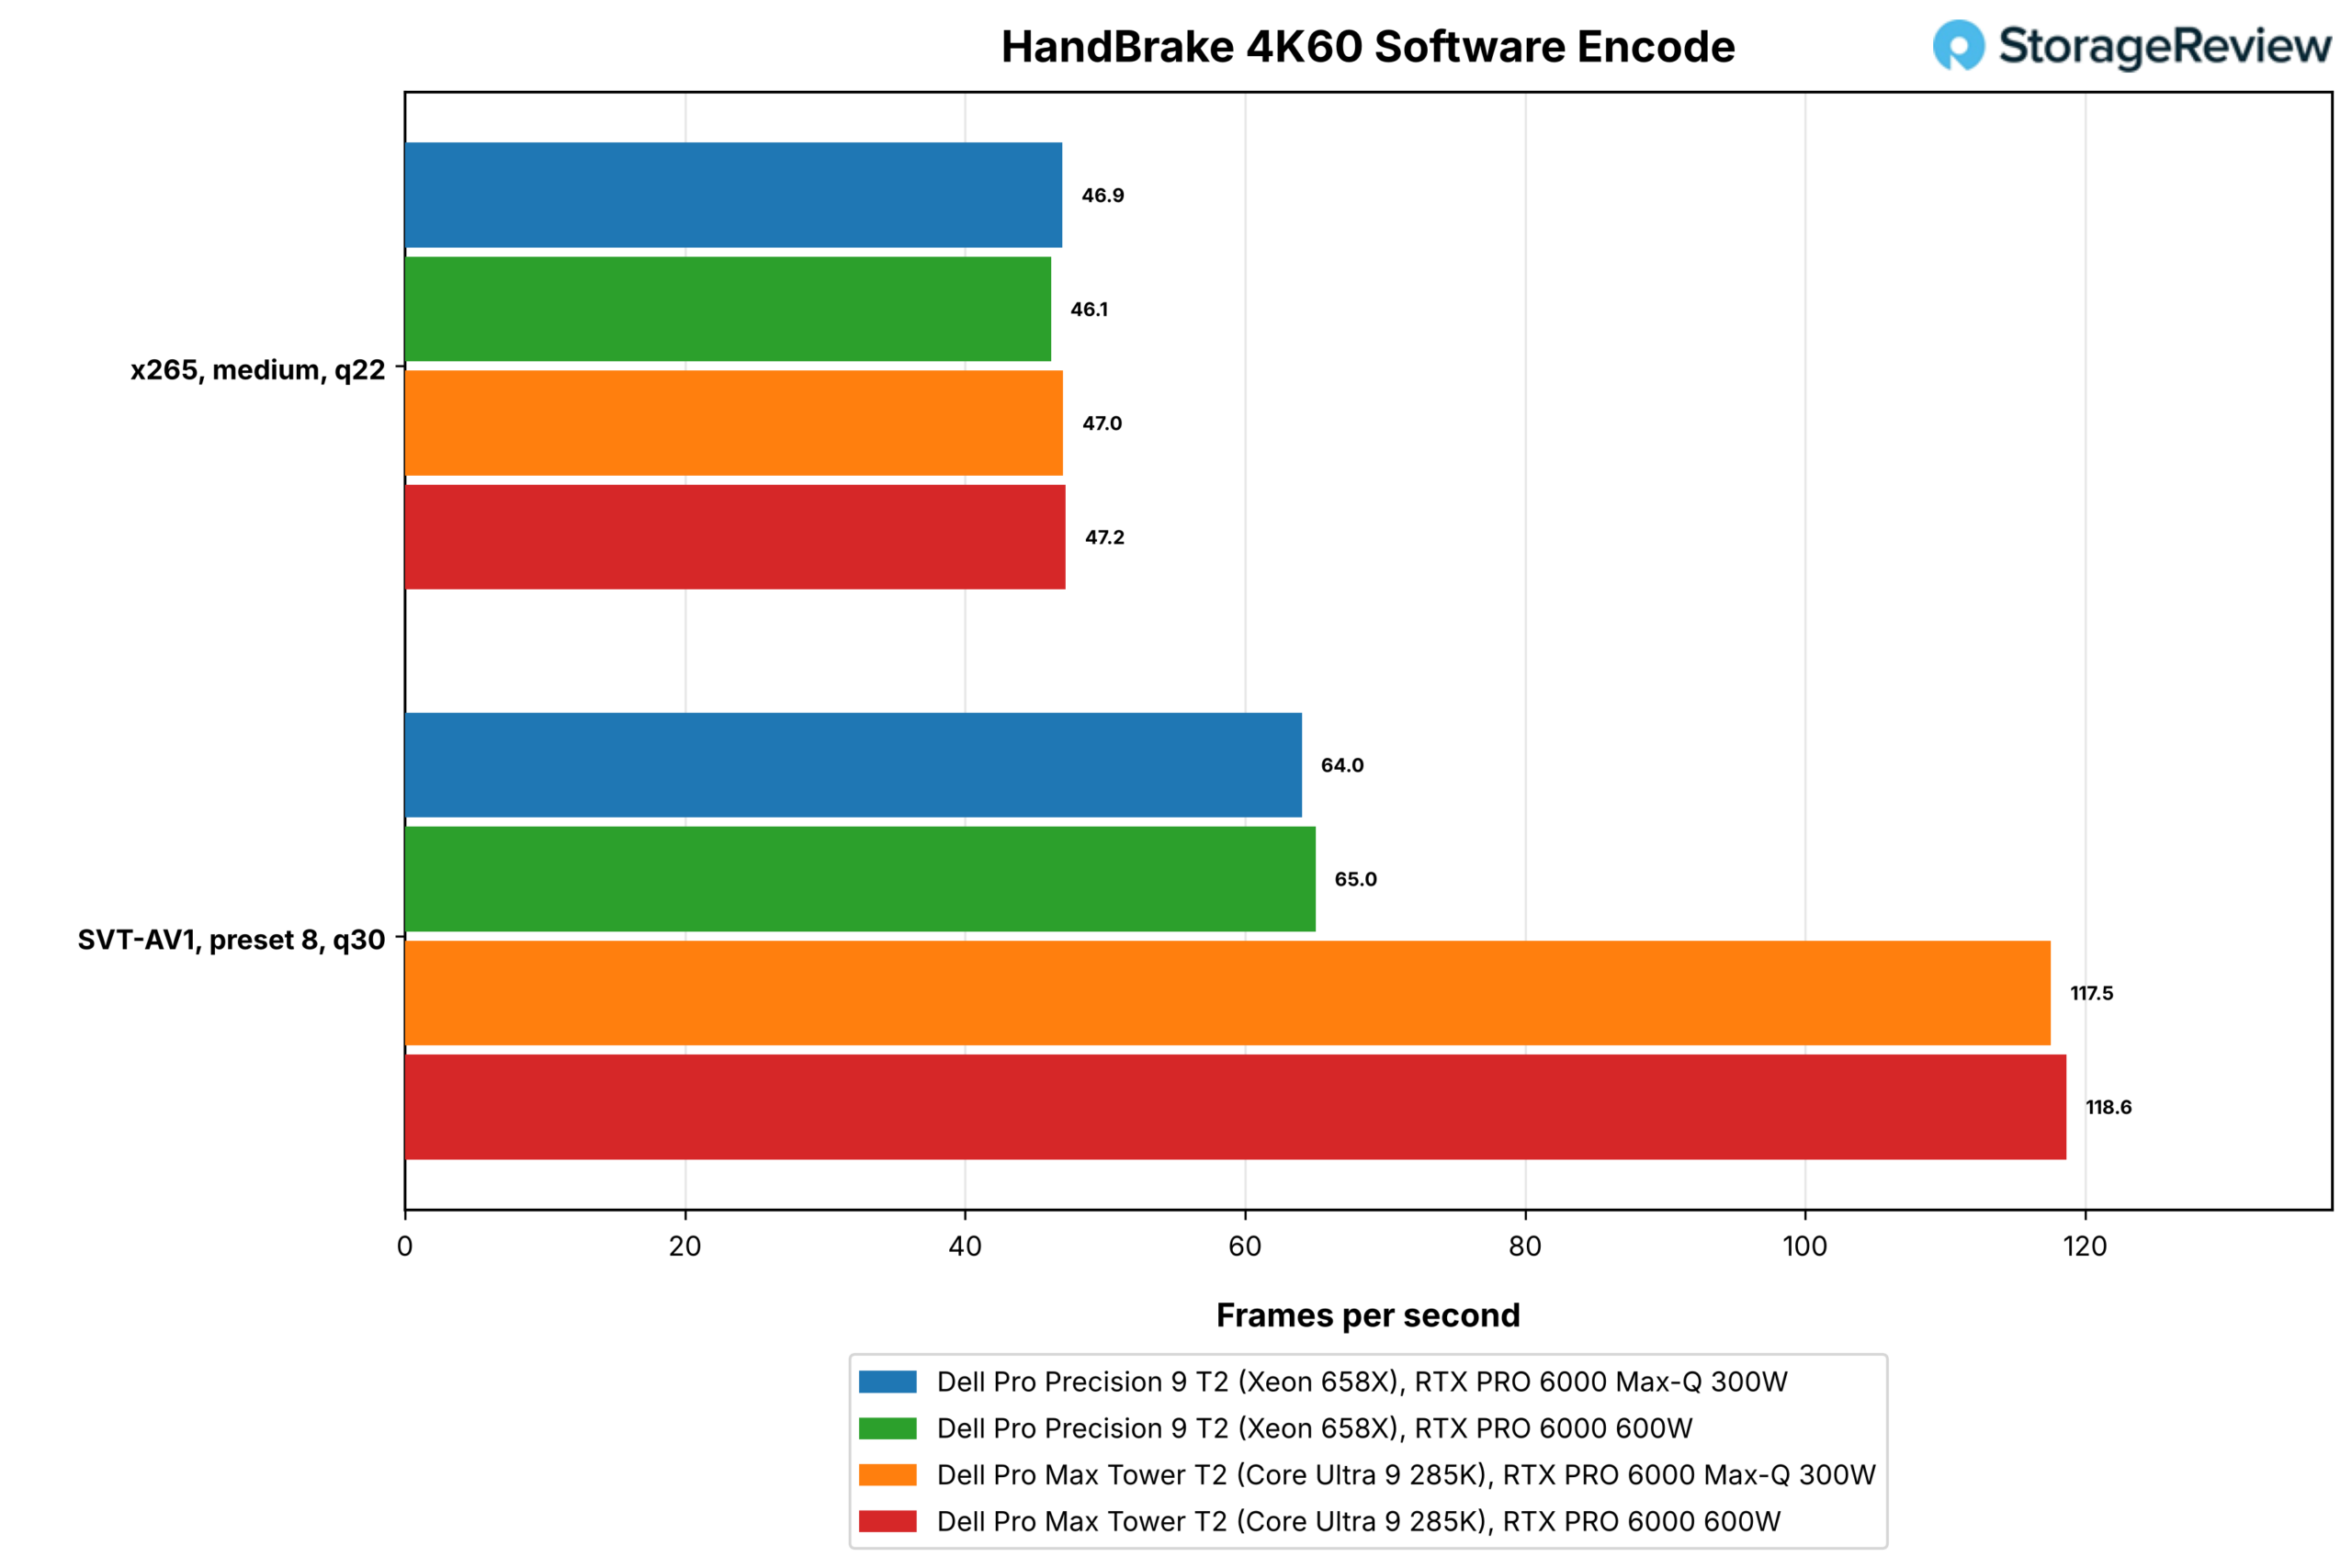
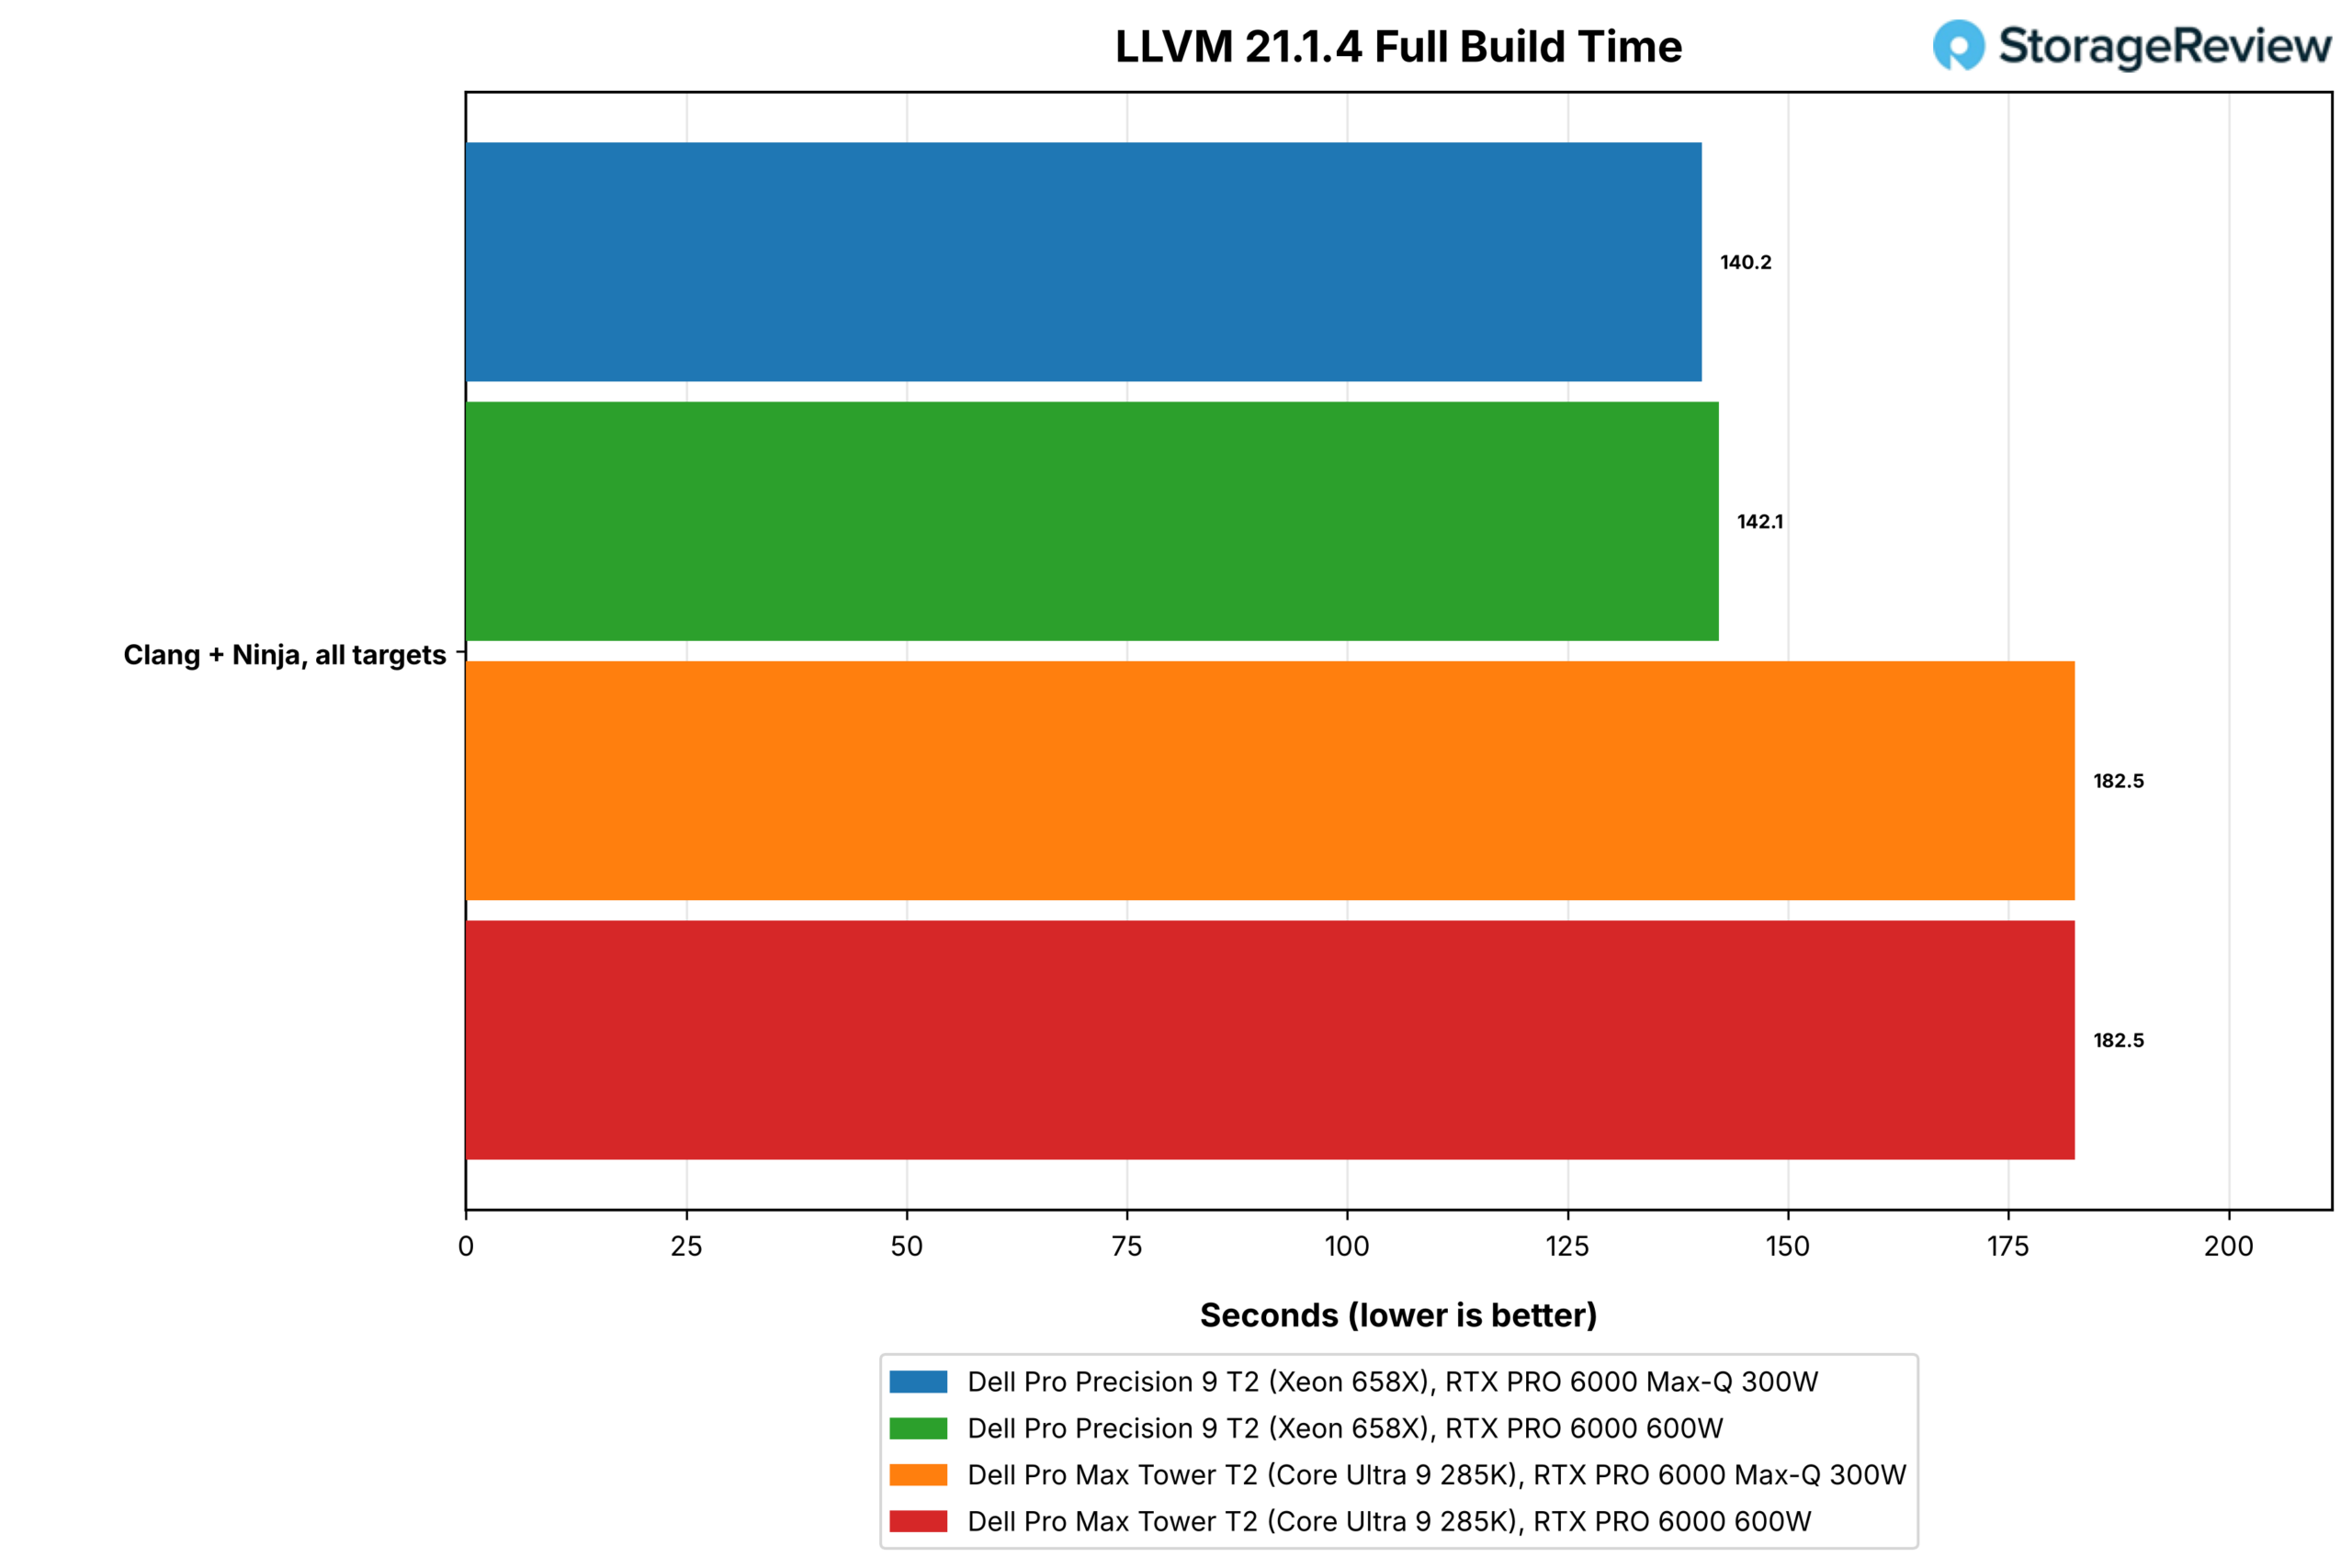
| Test | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Blender 4.5 Monster (Samples/Minute, je höher, desto besser) | 366.2 | 339.0 | 259.6 | 257.7 |
| Blender 4.5 Junkshop (Proben/Min.) | 238.1 | 228.0 | 166.2 | 166.8 |
| Blender 4.5 Klassenzimmer (Beispiele/Minute) | 187.2 | 169.2 | 132.5 | 132.3 |
| HandBrake x265, mittel, q22 (fps, höher ist besser) | 46.9 | 46.1 | 47.0 | 47.2 |
| HandBrake SVT-AV1, Voreinstellung 8, q30 (fps) | 64.0 | 65.0 | 117.5 | 118.6 |
| LLVM 21.1.4 Build (s, niedriger ist besser) | 140.2 | 142.1 | 182.5 | 182.5 |
Der Xeon rendert „Monster“ mit 366.2 Samples pro Minute gegenüber 259.6 beim 285K – ein Vorsprung von 41 Prozent, der in allen drei Szenen innerhalb von zwei Punkten bleibt. LLVM kompilierte er in 140.2 Sekunden gegenüber 182.5 Sekunden, 23 Prozent weniger Zeit. Mit der installierten 600-Watt-Grafikkarte sanken die Blender-Ergebnisse des Xeon um 7 bis 10 Prozent – die höchste Kartenleistung aller getesteten CPUs.
HandBrake teilte sich entlang der Encoder-Linien auf: x265 lief bei der mittleren Voreinstellung mit 46.9 fps auf dem Xeon und 47.0 fps auf dem 285K, ein Gleichstand, während SVT-AV1 bei der Voreinstellung 8 mit 64.0 fps auf dem Xeon und 117.5 fps auf dem 285K lief.
Wir haben einen Nachmittag mit der Analyse dieser Lücke verbracht, und das Ergebnis ist threadspezifisch. Der Encoder erreicht bei dieser Voreinstellung maximal Parallelitätsstufe 6 und beansprucht auf dem Xeon die Arbeitslast von etwa neun logischen Prozessoren. Die Verwendung von AVX2- statt AVX-512-Kerneln brachte keine Verbesserung (63.8 statt 63.9 fps), und die Beschränkung auf einen Thread pro physischem Kern führte zu einer um 2 Prozent geringeren Leistung (62.6 fps). Weder der Vektorpfad noch die SMT-Planung sind also die Ursache. Verbleibend ist der Xeon-Kern selbst und das Mesh zwischen den Kernen, was ein pipelined Encoder, der auf Übergaben zwischen den Stufen wartet, in jedem Frame spürbar macht.
Stockfish, Primesieve, Python und der Browser
Stockfishs integrierter Benchmark misst die Schachsuchgeschwindigkeit in Millionen Knoten pro Sekunde. Primesieve zählt die Primzahlen unter 10^12 auf allen Threads und unter 10^11 auf einem einzelnen Thread. PyPerformance führt drei CPython-Benchmarks (Go, nbody und regex_compile) auf einem einzigen schnellen Kern aus, und Speedometer 3.1 misst die Reaktionsfähigkeit von Webanwendungen in Microsoft Edge.
| Test | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Stockfischbank, alle Gewinde (MNPs, je höher, desto besser) | 40.87 | 39.17 | 30.10 | 30.63 |
| Stockfischbank, ein Thread (MNPs, je höher, desto besser) | 1.65 | 1.60 | 1.99 | 1.99 |
| primesieve 1e12, alle Threads (s, niedriger ist besser) | 7.69 | 7.51 | 6.77 | 6.84 |
| Primesieve 1e11, ein Thread (s, niedriger ist besser) | 10.09 | 10.76 | 8.72 | 8.72 |
| PyPerformance go (ms, niedriger ist besser) | 91.4 | 91.0 | 64.8 | 64.9 |
| PyPerformance nbody (ms, niedrigere Werte sind besser) | 68.3 | 68.8 | 54.3 | 53.8 |
| PyPerformance regex_compile (ms, niedrigere Werte sind besser) | 88.6 | 90.5 | 61.1 | 61.2 |
| Speedometer 3.1, Edge (Punktzahl, je höher, desto besser) | 36.8 | 37.3 | 46.3 | 46.5 |
Stockfish erreichte auf dem Xeon mit 48 Threads 40.87 Mnps gegenüber 30.10 Mnps auf dem 285K. Bei einem Thread lag der 285K mit 1.99 Mnps gegenüber 1.65 Mnps vorn. Primesieve ist der einzige All-Thread-Test, den der 285K mit 6.77 Sekunden gegenüber 7.69 Sekunden für sich entscheiden konnte, da sein Sieb im Cache liegt und sowohl mit der Taktfrequenz als auch mit der Anzahl der Kerne skaliert. Die Single-Thread-Ergebnisse gehen allesamt an den 285K (13 bis 31 Prozent): PyPerformance go in 64.8 ms gegenüber 91.4 ms, regex_compile in 61.1 ms gegenüber 88.6 ms und Speedometer in 46.3 ms gegenüber 36.8 ms.
Dieser Browserwert ist der, den ein Käufer am Arbeitsplatz spürt. Ein Speedometer-Wert von 36.8 ist zwar absolut gesehen immer noch schnell, liegt aber ein Fünftel unter dem des Core-Towers im gleichen Gehäuse. Wer sich für den Xeon aufgrund seines Durchsatzes entscheidet, sollte daher erwarten, dass die interaktive Nutzung des Rechners etwas langsamer ist als bei einem Core-Ultra-Desktop.
GROMACS, OpenBLAS und Speicher
GROMACS führt die Molekulardynamiksimulation mit benchMEM auf 16 Kernen in vier Rank-and-Thread-Layouts aus und gibt die simulierte Zeit in Nanosekunden pro Tag für das beste Layout an. Unser OpenBLAS-Test führt eine HPL-ähnliche LU-Lösung mit doppelter Genauigkeit bei drei Problemgrößen und eine DGEMM-Matrixmultiplikation auf allen Kernen durch, zusätzlich auf dem 285K nur auf dessen acht P-Kernen; die 24 Kerne des Xeon bilden eine Klasse, daher sind diese Zeilen nicht relevant. STREAM misst die kontinuierliche Speicherbandbreite, und die Latenzzeilen messen einen einzelnen Speicherzugriff zwischen den Kernen.

| Test (je höher, desto besser) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| GROMACS benchMEM, bestes Layout (ns/Tag) | 47.39 | 47.91 | 37.30 | 37.07 |
| OpenBLAS LU N=10000, alle Kerne (GFLOPS) | 570.3 | 517.3 | 519.7 | 523.1 |
| OpenBLAS LU N=20000, alle Kerne (GFLOPS) | 1,208.6 | 1,100.6 | 633.2 | 631.8 |
| OpenBLAS LU N=40000, alle Kerne (GFLOPS) | 1,659.2 | 1,613.7 | 667.9 | 669.5 |
| OpenBLAS LU N=20000, nur P-Kerne (GFLOPS) | Nicht zutreffend (ein Kernfach) | Nicht zutreffend (ein Kernfach) | 515.2 | 517.7 |
| OpenBLAS DGEMM M=8000, alle Kerne (GFLOPS) | 1,637.8 | 1,750.9 | 768.2 | 767.6 |
| OpenBLAS DGEMM M=8000, nur P-Kerne (GFLOPS) | Nicht zutreffend (ein Kernfach) | Nicht zutreffend (ein Kernfach) | 565.3 | 566.5 |
Hier kommen AVX-512, 144 MB L3-Cache und vier Kanäle DDR5-6400 zum Einsatz. DGEMM erreichte auf dem Xeon 1,638 GFLOPS gegenüber 768 GFLOPS auf dem 285K. Die Lösung mit N=40000 LU, die 11.9 GB durch den Speicher streamt, erzielte 1,659 GFLOPS gegenüber 668 GFLOPS – das 2.5-Fache des Core-Towers. Das Ergebnis des 285K verbessert sich kaum von N=20000 auf N=40000, da er ab diesem Zeitpunkt an die Bandbreitengrenze stößt, während der Xeon weiter skaliert. GROMACS auf 16 Kernen war mit 47.39 ns/Tag 27 Prozent schneller als der Xeon.

| Test | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| STREAM-Kopie (MB/s, je höher, desto besser) | 106,698 | 106,512 | 39,477 | 39,426 |
| STREAM-Skala (MB/s) | 105,368 | 105,180 | 39,788 | 39,801 |
| STREAM Hinzufügen (MB/s) | 119,520 | 119,332 | 36,324 | 36,306 |
| STREAM-Triade (MB/s) | 122,233 | 122,135 | 33,003 | 33,014 |
| Speicherlatenz, 1 GiB Puffer, 4 KiB Seiten (ns, niedriger ist besser) | 148.3 | 147.8 | 135.2 | 135.4 |
| Latenz zwischen den Kernen, Mittelwert aller Paare (ns, niedriger ist besser) | 56.2 | 56.0 | 38.1 | 38.2 |
| Latenz zwischen den Kernen, minimales Paar (ns) | 4.6 | 4.6 | 18.6 | 18.6 |
| Latenz zwischen Kernen, maximales Paar (ns) | 65.7 | 66.8 | 44.7 | 44.5 |
STREAM Triad erreichte auf dem Xeon T2 122,233 MB/s und auf dem Core T2 33,003 MB/s – die 3.7-fache Bandbreite. Dies wurde durch vier Kanäle DDR5-6400 RDIMM gegenüber vier Kanälen DDR5-4400 UDIMM auf einer Plattform erreicht, die mit ihren DIMMs nicht mithalten kann. Der Preis dafür ist die Latenz: 148.3 ns zum Speicher beim Xeon gegenüber 135.2 ns beim 285K und durchschnittlich 56.2 ns zwischen den Kernen gegenüber 38.1 ns. Der minimale Wert von 4.6 ns beim Xeon wurde für zwei SMT-gesteuerte Kerne auf einem Kern ermittelt, der maximale Wert von 65.7 ns für einen Datentransfer über das gesamte Mesh-Netzwerk.
Gaming
SuperTuxKart 1.5 führt seinen integrierten Benchmark in 1080p-Vollbildauflösung mit den höchsten Voreinstellungen und deaktiviertem VSync aus. Wir geben die durchschnittliche und die stabile Bildrate an. Bei dieser Auflösung hat die GPU ausreichend Leistungsreserven, sodass das Ergebnis dem der CPU entspricht. Der Test repräsentiert die vielen professionellen Viewports, die denselben Einschränkungen unterliegen. Der NVENC-Durchlauf unseres Kodierungstests konnte auf diesen Systemen nicht abgeschlossen werden und wird daher nicht aufgeführt.

| SuperTuxKart 1.5, 1080p Ultra, V-Sync aus (FPS, höher ist besser) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Durchschnittlich | 304.6 | 323.2 | 359.1 | 383.5 |
| Charakteristische | 304 | 322 | 354 | 376 |
| Steady | 161 | 174 | 122 | 135 |
Der Core T2 erreichte mit der Max-Q-Karte durchschnittlich 359.1 fps gegenüber 304.6 fps beim Xeon T2 – der Unterschied zeigt sich erneut in der Single-Thread-Leistung. Der Xeon-Tower hingegen bot eine höhere, stabilere Bildrate von 161 fps gegenüber 122 fps und wies weniger Einbrüche auf. Die 600-W-Karte steigerte die durchschnittliche Bildrate beider Tower um etwa 6 Prozent.
Uhren unter Last
Keiner der beiden Testtürme meldete CPU- oder GPU-Temperaturen über den Sensorpfad der Testsuite. Daher wird die üblicherweise veröffentlichte Temperaturtabelle hier durch den mittleren CPU-Takt während jedes Tests ersetzt. Dieser Wert erklärt den Einfluss der 600-W-Grafikkarte auf den Xeon. Mit der installierten Max-Q-Karte erreichte die 658X im 30-minütigen Dauertest 4,269 MHz und in den kürzeren All-Core-Tests 4,040 bis 4,480 MHz. Mit der 600-W-Grafikkarte im Gehäuse liefen die meisten dieser Tests mit bis zu 300 MHz niedrigeren Taktraten und erzielten insgesamt schlechtere Ergebnisse.
| Mittlerer CPU-Takt während des Tests (MHz) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Cinebench 2026 | 4,477 | 4,470 | 4,789 | 4,786 |
| Dauerschleife | 4,269 | 4,182 | 4,663 | 4,682 |
| 7-Zip | 4,414 | 4,307 | 4,854 | 4,837 |
| Stockfisch | 4,291 | 3,995 | 4,749 | 4,741 |
| Mixer | 4,258 | 4,253 | 4,582 | 4,552 |
| HandBrake | 4,188 | 4,180 | 4,601 | 4,622 |
| LLVM-Build | 4,202 | 4,258 | 4,582 | 4,585 |
| GROMACS | 4,288 | 4,290 | 4,664 | 4,694 |
| BLAS öffnen | 4,039 | 3,979 | 4,766 | 4,761 |
| STREAM | 4,321 | 4,326 | 4,687 | 4,676 |
| Ursieb | 4,441 | 4,268 | 4,814 | 4,810 |
| MLPerf-Client | 4,191 | 4,138 | 3,814 | 3,686 |
| Codierungsagent | 4,134 | 4,100 | 4,239 | 4,213 |
| LLM-Dienst | 4,261 | 4,169 | 4,229 | 4,209 |
| Bilderzeugung | 4,044 | 4,008 | 3,702 | 3,837 |
| RAG | 4,178 | 4,197 | 4,172 | 4,108 |
| SuperTuxKart | 4,239 | 4,211 | 4,637 | 4,649 |
Stockfish fiel von 4,291 auf 3,995 MHz, Primesieve von 4,441 auf 4,268, 7-Zip von 4,414 auf 4,307 und die Sustained Loop von 4,269 auf 4,182, während die 285K in jedem All-Core-Test unabhängig von der Grafikkarte innerhalb von 20 MHz von sich selbst lief.
Der mittlere Takt allein erklärt nicht alles. Cinebench und Blender lagen im Durchschnitt nur 10 MHz unter ihren Max-Q-Werten und verloren dennoch 5 bis 10 Prozent ihrer Taktfrequenz. Dies deutet auf kurzzeitige Schwankungen hin, die der Mittelwert pro Test ausgleicht. Die 658X verbraucht bis zu 250 W, die 600-W-Karte weitere 600 W. Beide geben die Wärme über denselben 32-Liter-Kühlkörper hinter einem Lufteinlass an der Vorderseite ab. Ob die Begrenzung durch die thermische Reserve des Prozessors oder durch eine Leistungsbegrenzung der Plattform bedingt ist, werden wir in einem nächsten Test mit externer Leistungs- und Temperaturmessung klären. Käufer, die Anwendungen mit hoher CPU-Auslastung durchführen, sollten wissen, dass die Max-Q-Konfiguration die schnellere CPU-Konfiguration ist.
Speicherleistung
Unser Speichertest von fio vergleicht die vier Eckpunkte des Systems mit der Systemfestplatte bei 5 GB und 25 GB Speicherbedarf, dem Dateisystem und erneut dem Rohdatenträger. Die Ergebnisse für 25 GB werden hier dargestellt. Beim Core T2 ist die Systemfestplatte eine einzelne 2-TB-Festplatte vom Typ SK hynix PCB01 mit Gen5 x4-Verbund. Beim Pro Precision 9 T2 handelt es sich um die beiden E3.S Gen5-Festplatten im FlexBay, die von VROC by Graid Technology zu einem 4,097 GB großen RAID0-Volume zusammengefasst wurden. BitLocker war bei allen vier Konfigurationen deaktiviert, daher messen die Zeilen im Dateisystem NTFS und die RAID-Ebene, nicht die Verschlüsselung.


| fio, 25 GB Speicherkapazität, QD32 | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Sequenzielles Lesen 128K, Dateisystem (MB/s) | 9,332 | 9,255 | 11,377 | 11,406 |
| Sequenzielles Lesen 128K, Rohgerät (MB/s) | 10,782 | 10,675 | 11,186 | 11,444 |
| Sequenzielles Schreiben 128K (MB/s) | 6,507 | 6,496 | 7,401 | 7,371 |
| 1 MB Vorfüllung gelesen, QD32 (MB/s) | 4,617 | 4,679 | 6,440 | 6,346 |
| Zufälliges Lesen von 4K, Dateisystem, Spitzenwert (IOPS) | 840,075 | 853,615 | 1,778,576 | 1,756,968 |
| Zufälliges Lesen von 4K, Rohgerät, Spitzenwert (IOPS) | 1,107,862 | 1,120,737 | 2,297,681 | 2,294,800 |
| Zufälliges Schreiben 4K, Spitzenwert (IOPS) | 557,512 | 550,505 | 957,461 | 921,774 |
| Rohdaten / zufälliges Lesen im Dateisystem | 1.32x | 1.31x | 1.29x | 1.31x |
| Zufälliges Lesen von 4K, 4 Jobs, p99 Latenz (µs, niedriger ist besser) | 506 | 485 | 183 | 185 |
| Zufälliges Lesen von 4K, 16 Jobs, p99.99 Latenz (µs, niedriger ist besser) | 15,270 | 23,462 | 676 | 676 |
| Zufälliger Schreibvorgang 4K, 4 Jobs, p99 Latenz (µs, niedriger ist besser) | 610 | 594 | 228 | 228 |
| Maximale Antriebstemperatur (°C) | Nicht verfügbar (hinter RAID) | Nicht verfügbar (hinter RAID) | 50 | 57 |
Der Stripe ist nicht schneller als das einzelne Laufwerk und liegt bei kleinen Blöcken deutlich zurück. Die beiden E3.S-Laufwerke lesen sequenziell 9,332 MB/s über NTFS und 10,782 MB/s vom Rohdatenvolumen, verglichen mit 11,377 MB/s bzw. 11,186 MB/s beim PCB01. Die Schreibgeschwindigkeit beträgt 6,507 MB/s gegenüber 7,401 MB/s. Bei zufälligen 4K-Lesezugriffen erreichte das Volumen Spitzenwerte von 840.1 IOPS über das Dateisystem und 1.11 MB vom Rohdatenvolumen, verglichen mit 1.78 MB/s bzw. 2.30 MB/s beim einzelnen Laufwerk. Die zufälligen Schreibzugriffe lagen bei 557.5 IOPS gegenüber 957.5. Das Verhältnis von Rohdaten- zu Dateisystemzugriffen beträgt auf beiden Laufwerken etwa 1.3, sodass NTFS auf beiden Laufwerken gleich viel kostet. Der Unterschied liegt in der VROC-Schicht, die beiden Pfaden zugrunde liegt.
Die Latenzwerte sind wie folgt: Bei 16 Jobs benötigten die langsamsten 0.01 % der zufälligen Lesevorgänge auf dem Volume 15.3 ms, verglichen mit 0.68 ms auf dem einzelnen Laufwerk. Die Leselatenz (p99) bei 4 Jobs betrug 506 µs gegenüber 183 µs. Software-RAID über zwei NVMe-Geräte führt bei jedem E/A-Vorgang zu einem zusätzlichen CPU-Aufruf, was sich in den fio-CPU-Messwerten widerspiegelt: 80 % bei sequenziellen Durchläufen gegenüber 40 % auf dem Core T2. Da das Volume die SMART-Daten der Laufwerke ausblendet, konnte die Testumgebung deren Temperatur nicht protokollieren.
Nichts davon macht den FlexBay zur falschen Wahl. Er bietet dem T2 von vorne zugängliche, im laufenden Betrieb austauschbare Laufwerke in einem Formfaktor, der Kapazitäten ermöglicht, die mit M.2 nicht erreichbar sind. Ein 4-TB-Boot-Volume von zwei Laufwerken ist zudem sehr praktisch. Käufer, deren Arbeitslast aus zufälligen E/A-Operationen mit kleinen Blöcken, einer lokalen Datenbank oder einem stark zwischengespeicherten Modellverzeichnis besteht, sollten sich jedoch ein einzelnes E3.S-Laufwerk ohne Striping oder die internen M.2-Steckplätze ansehen. Dort zeigen die Ergebnisse des Core T2, was ein einzelnes Gen5-Laufwerk in diesem Gehäuse leistet.
Fazit
Der Dell Pro Precision 9 T2 ist im Grunde ein Pro Max Tower T2 mit Workstation-Prozessor, und die Testergebnisse bestätigen genau die Erwartungen der Käufer. Im gleichen 32-Liter-Gehäuse liefert der Xeon 658X 39 Prozent mehr Cinebench-Multi-Core-Leistung, die 3.7-fache Speicherbandbreite, die doppelte DGEMM-Rate und einen 24-Kern-Prozessor mit 48 Threads, AVX-512, AMX, Registered ECC-Speicher und der Möglichkeit, auf bis zu 1 TB zu erweitern. Bei Single-Thread-Anwendungen, von PrimeSieve bis Python, bietet er 13 bis 31 Prozent mehr Leistung – ein Vorteil, den vor allem Nutzer bemerken werden, die viel Zeit am Bildschirm oder Terminal verbringen.
Die Entscheidung für die richtige GPU soll Käufern bei diesem Testbericht helfen. Die Max-Q- und die 600-Watt-RTX-PRO-6000-Karten verfügen über 96 GB Speicher und weisen Dekodierzeiten auf, die sich um 7 bis 20 Prozent unterscheiden. Die 600-Watt-Karte punktet mit schnellerer Verarbeitung, wodurch die Zeit bis zum ersten Token um mindestens ein Drittel sinkt, und schnellerer Bilddarstellung, wodurch Bilder 20 bis 34 Prozent schneller ankommen.
Im Xeon-Tower kostet die 600-Watt-Karte den Prozessor bei Volllast 4 bis 5 Prozent und benötigt den benachbarten Steckplatz, was in unserem Testgerät den Ausbau des 25-GbE-Adapters erforderlich machte. Für einen Tower, dessen Besitzer neben lokalen Modellen auch CPU-Renderings und Simulationen durchführt, ist die von Dell mitgelieferte Max-Q-Karte die ausgewogene Wahl. Für einen Tower, der einem Team Modelle bereitstellt oder den ganzen Tag Bilder rendert, lohnt sich hingegen die 600-Watt-Karte mit dem zusätzlichen Steckplatz und dem 1500-Watt-Netzteil.
Das E3.S-Laufwerk im FlexBay ist genau der Formfaktor, den wir uns seit Jahren für einen Tower gewünscht haben; VROC von Graid Technology ist eine zuverlässige Ergänzung für den RAID-Stack. Es ist bei kleinen, zufälligen E/A-Operationen langsamer als die einzelne M.2-SSD im Core T2, etwa halb so schnell bei 4K-Lese- und Schreibvorgängen. Käufer, die kein RAID-basiertes Boot-Volume benötigen, könnten stattdessen eine einzelne E3.S-SSD oder die internen M.2-Steckplätze in Betracht ziehen.
Andererseits eröffnet die Verfügbarkeit von E3.S SSDs mit Speicherkapazitäten von über 60 TB Nutzern mit extremen Datennutzungsanforderungen eine völlig neue Welt, die zuvor externe Gehäuse oder die Einrichtung eines gemeinsam genutzten Speichervolumens erfordert hätte, wobei der Preis von Flash-Speichern die praktische Grenze darstellte.
Der Pro Precision 9 T2 kostet laut Dell.com in der aktuellen Konfiguration rund 28,300 US-Dollar, noch vor den Mengenrabatten für Geschäftskunden. Damit liegt er etwa 4,500 US-Dollar über dem gleich konfigurierten Pro Max Tower T2: Mit einem i7-285K, 128 GB DDR5-4400 ECC-RAM, einer RTX PRO 6000, einer 2-TB-SSD der 5. Generation und einem 1500-W-Netzteil kostet er zusammen etwa 23,800 US-Dollar. Die GPU- und Speicheroptionen der beiden Tower unterscheiden sich nur um 900 US-Dollar. Das zweite FlexBay-Laufwerk macht 1,700 US-Dollar dieser Differenz aus, der Rest entfällt auf die Xeon-Plattform.
Was man damit kauft, ist ein Single-Socket-Tower, der sich unter Volllast wie ein kleiner Server verhält, und das bei der gleichen Stellfläche wie ein Desktop-PC – und genau das ist der Grund für die Rückkehr des Namens Precision.
Bestenliste: The Dell Pro Precision 9 T2 holds Best Overall Desktop Workstation on our Die besten Desktop-Workstations leaderboard, and its RTX PRO 6000 results also appear on our Die besten Enterprise-GPUs Bord.



 Amazon