

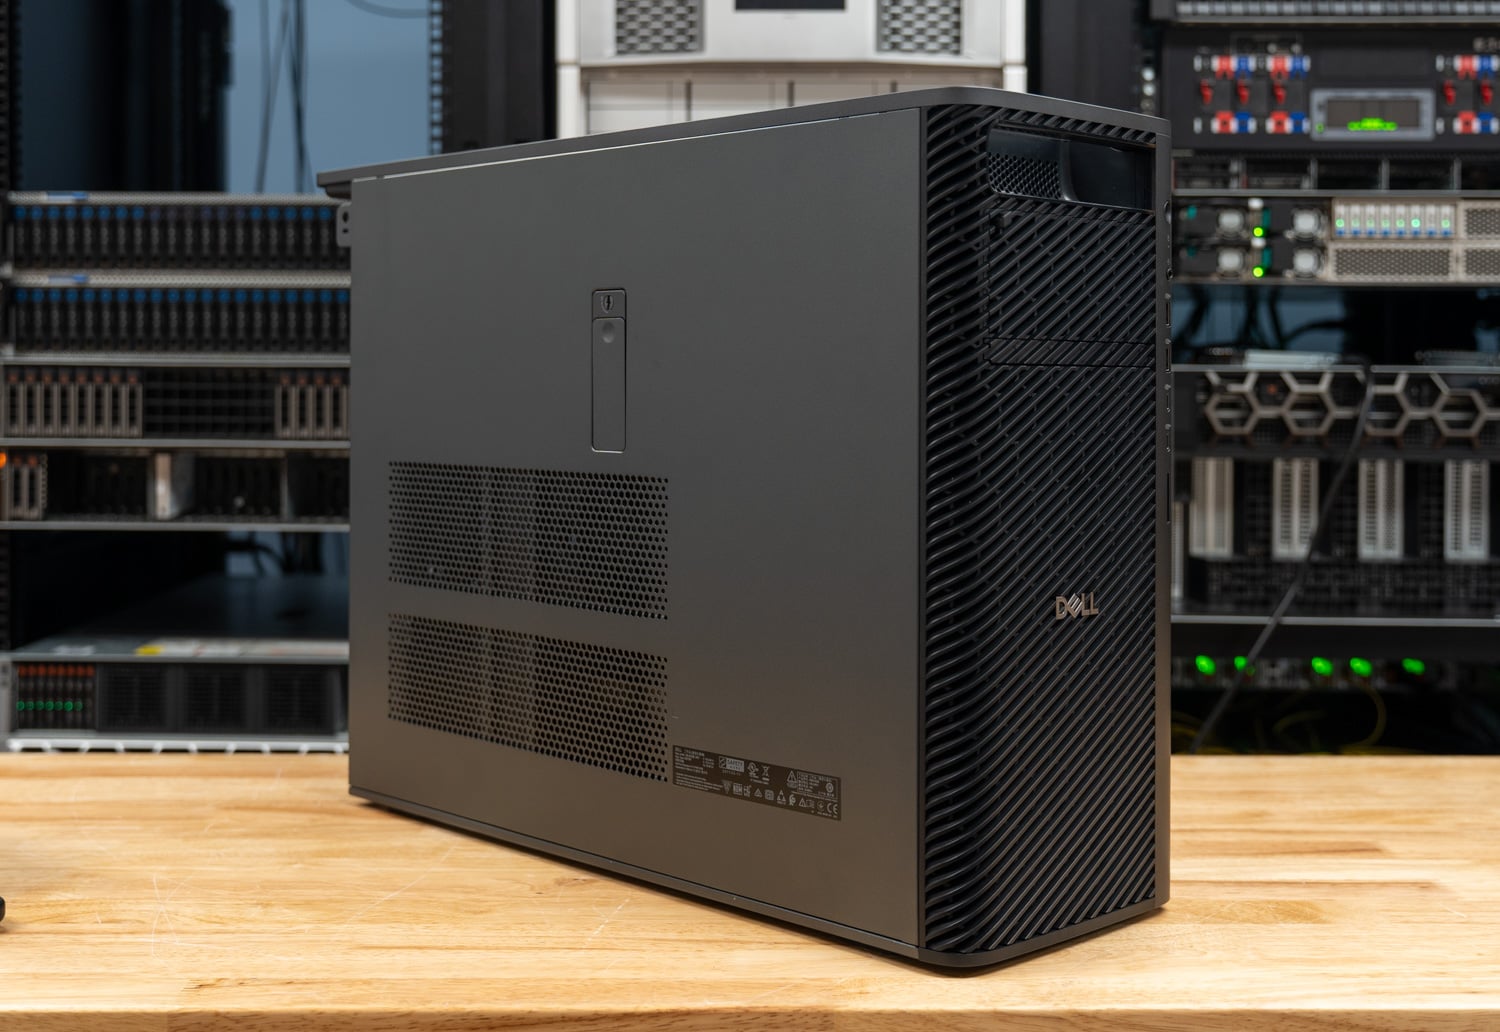
Der Dell Pro Precision 9 T4 ist der Single-Socket-Tower an der Spitze der Dell Pro Precision-Reihe. Unser Testgerät ist für lokale KI in einem Umfang konfiguriert, der von den meisten Workstations nicht erreicht wird. Es kombiniert Intels 86-Kern-Xeon 698X mit 256 GB DDR5-6400 ECC-Speicher, zwei 300-Watt-NVIDIA RTX PRO 6000 Blackwell Max-Q-Grafikkarten mit je 96 GB GDDR7-Speicher, zwei 2-TB-Gen5-SSDs und einem Dual-Port-25GbE-Adapter. Die Stromversorgung erfolgt über ein 2400-Watt-Netzteil. Auf Dell.com kostet das Gerät in dieser Konfiguration rund 66,600 US-Dollar.
Wichtige Erkenntnisse
- Zwei GPUs machen aus einem Modell, das nicht auf eine Karte passt, ein brauchbares. MiniMax M2.7 mit 129.3 GB generierte 83.7 Token pro Sekunde für einen Benutzer, wenn diese auf beide RTX PRO 6000-Karten verteilt wurden. Das ist das 2.8-fache der 30.3 Token pro Sekunde, die mit einer Karte und dem Rest des Modells im Systemspeicher erzielt wurden.
- Die zweite GPU steigerte die Serverleistung um das 1.85- bis 2.02-Fache und die Einbettungsleistung um das 1.92-Fache. Die Spitzenleistung von llama.cpp stieg auf Ministral 3 3B von 582.5 auf 1,176.1 Token pro Sekunde und auf gpt-oss 120B mit einem Server pro GPU von 424.8 auf 787.9, und das Einbetten von einer Million Wikipedia-Passagen sank von 890 auf 464 Sekunden.
- Eine zweite GPU verkürzte eine LoRA-Epoche um 37 Prozent. Eine LoRA-Epoche auf Ministral 3 8B dauerte 31.5 Minuten auf einer GPU und 19.7 Minuten auf zwei GPUs und endete mit Verlusten von 1.169 bzw. 1.167.
- Bei der Speicherbandbreite hat der Xeon des T4 die Nase vorn. STREAM Triad erreichte 328 GB/s, 53 Prozent mehr als der Threadripper PRO 9995WX im Precision 7875, und der T4 beendete den OpenFOAM drivAer-Solve in 293 Sekunden gegenüber 556 und einen 10 Milliarden Stellen umfassenden y-cruncher-Lauf in 53.9 Sekunden gegenüber 83.7.
- Der Precision 7875 ist führend bei rechenintensiven CPU-Aufgaben. Der Threadripper mit 96 Kernen war bei 7-Zip 37 Prozent schneller und bei Blender Monster 30 Prozent schneller. Außerdem schloss er den LLVM-Build in 43.7 Sekunden ab, im Vergleich zu 58.4 Sekunden.
Wo das Pro Precision 9 T4 positioniert ist
Dell positioniert die T4 als Flaggschiff unter den Single-Socket-Tower-Workstations für Unternehmen mit höchsten Anforderungen an Rechenleistung und Erweiterbarkeit. KI-Entwicklung, Ingenieursimulation und wissenschaftliches Rechnen stehen dabei ganz oben auf der Liste der Anwendungsbereiche. Sie ist oberhalb der Dell Pro Precision 9 T2 positioniert , die dieselbe Granite Rapids-WS Xeon 6 Workstation-Plattform in einem kleineren Gehäuse mit einer GPU nutzt. Die T4 bietet zusätzlich die leistungsstärksten Achtkanal-Prozessoren mit bis zu 86 Kernen und je nach Modell Platz für bis zu vier Grafikkarten.
Die Prozessoroptionen auf Dell.com beginnen beim 12-Kern-Xeon 634 und reichen über den 64-Kern-Xeon 696X bis hin zum 86-Kern-Xeon 698X in unserem Testgerät. Dieser verfügt über 336 MB Cache, einen Basistakt von 2.0 GHz, einen maximalen Takt von 4.8 GHz und eine TDP von 350 W. Der Arbeitsspeicher ist mit bis zu 4 TB DDR5-RDIMM auf 16 Steckplätzen erhältlich, wobei in unserem Testgerät acht davon mit 32-GB-Modulen mit 6400 MT/s bestückt sind. Die Grafikoptionen beginnen bei einer einzelnen RTX A400, die Anzahl der Grafikkarten variiert je nach Modell: Der Dell-Konfigurator listet vier RTX A1000-Karten, drei RTX PRO 4000 Blackwell-Karten, zwei 300-W-RTX-PRO-6000-Max-Q-Karten oder eine 600-W-RTX-PRO-6000 auf.
Die Basiskonfiguration ist auf Dell.com für 5,925 US-Dollar gelistet. Unsere Konfiguration beinhaltet zusätzlich 8,300 US-Dollar für den Xeon 698X, 15,000 US-Dollar für 256 GB Arbeitsspeicher und 30,820 US-Dollar für die beiden RTX PRO 6000 Max-Q-Grafikkarten – ohne Speicher, Netzwerk und das 36-monatige ProSupport-Upgrade, das Dell bei dieser Konfiguration automatisch hinzufügt.
Aufbau und Design
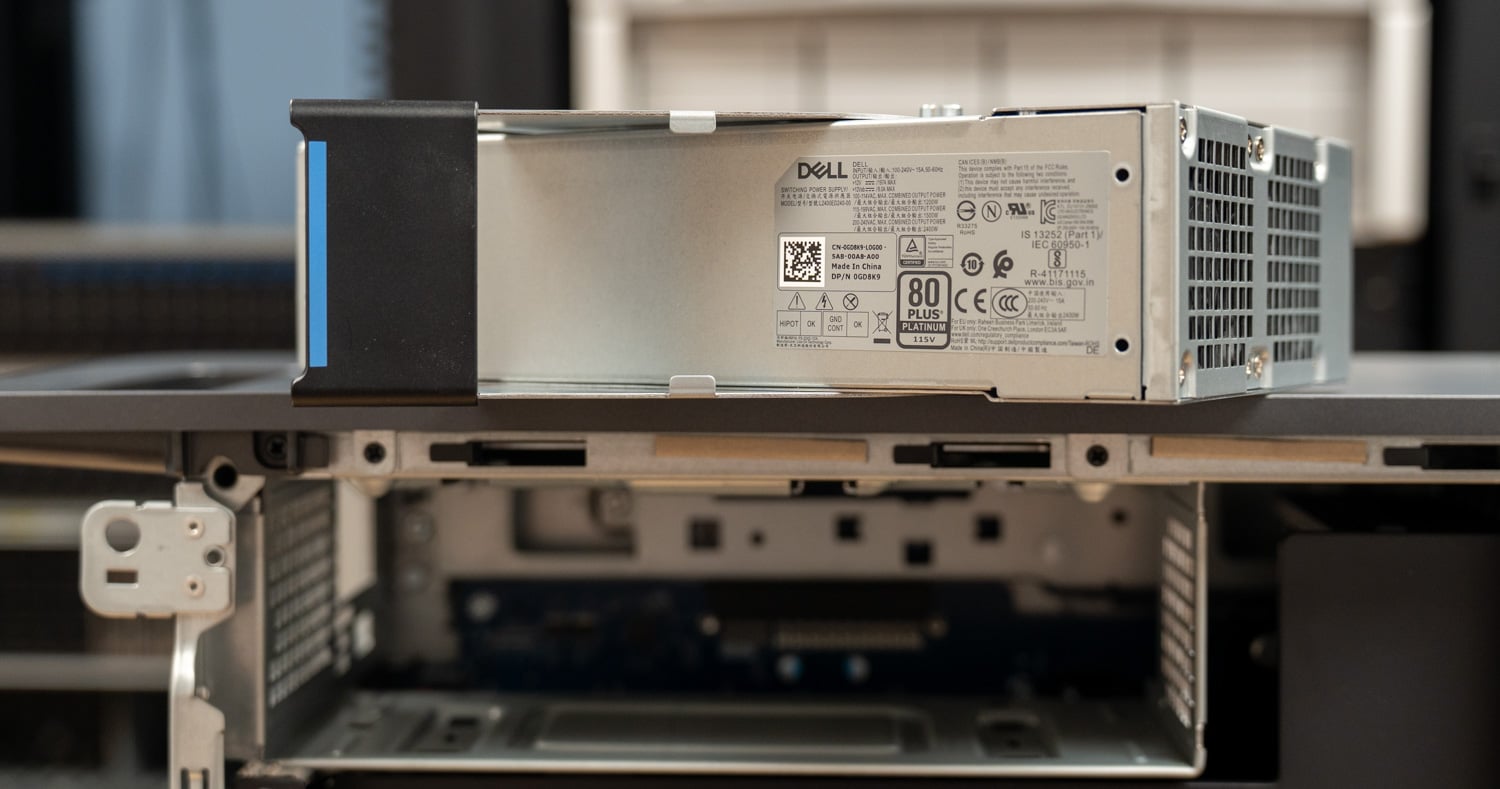
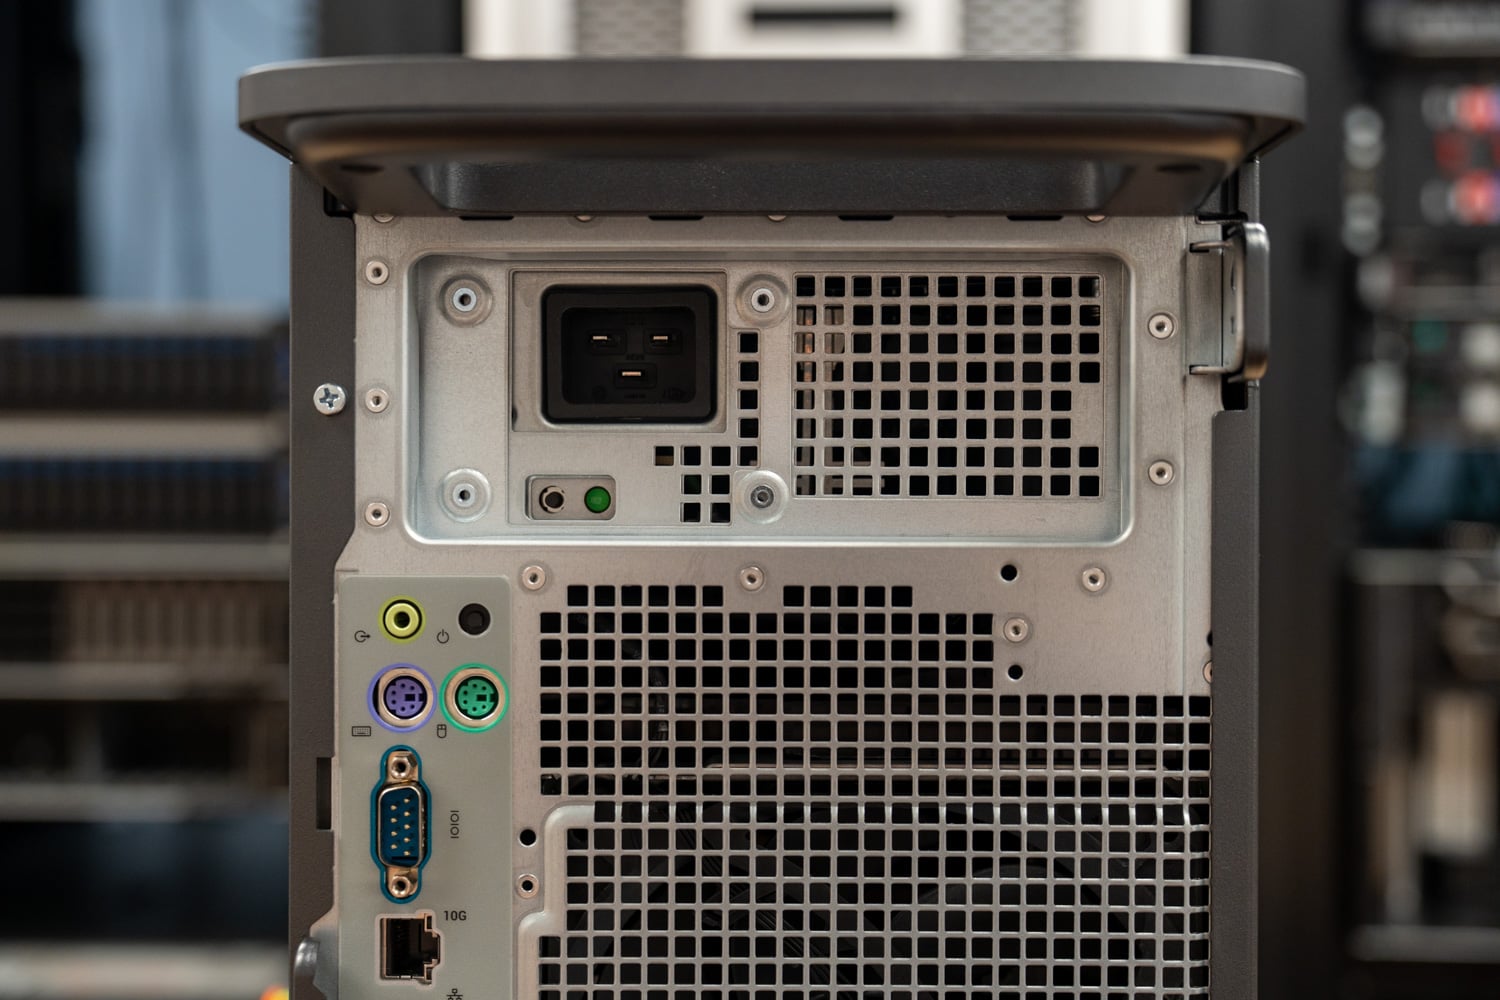
Der T4 ist ein Full-Tower mit einer Höhe von 449.8 mm, einer Breite von 203.7 mm und einer Tiefe von 617.5 mm. Dell gibt das Gewicht je nach Konfiguration mit 24.1 kg (Minimum) und 33.6 kg (Maximum) an. Unser Testgerät ist mit dem 2400-Watt-Platinum-Netzteil ausgestattet, das der Dell-Konfigurator für die Konfiguration mit zwei RTX PRO 6000-Grafikkarten auswählt. Bei leichteren Konfigurationen kommt standardmäßig ein 1500-Watt-Netzteil zum Einsatz.
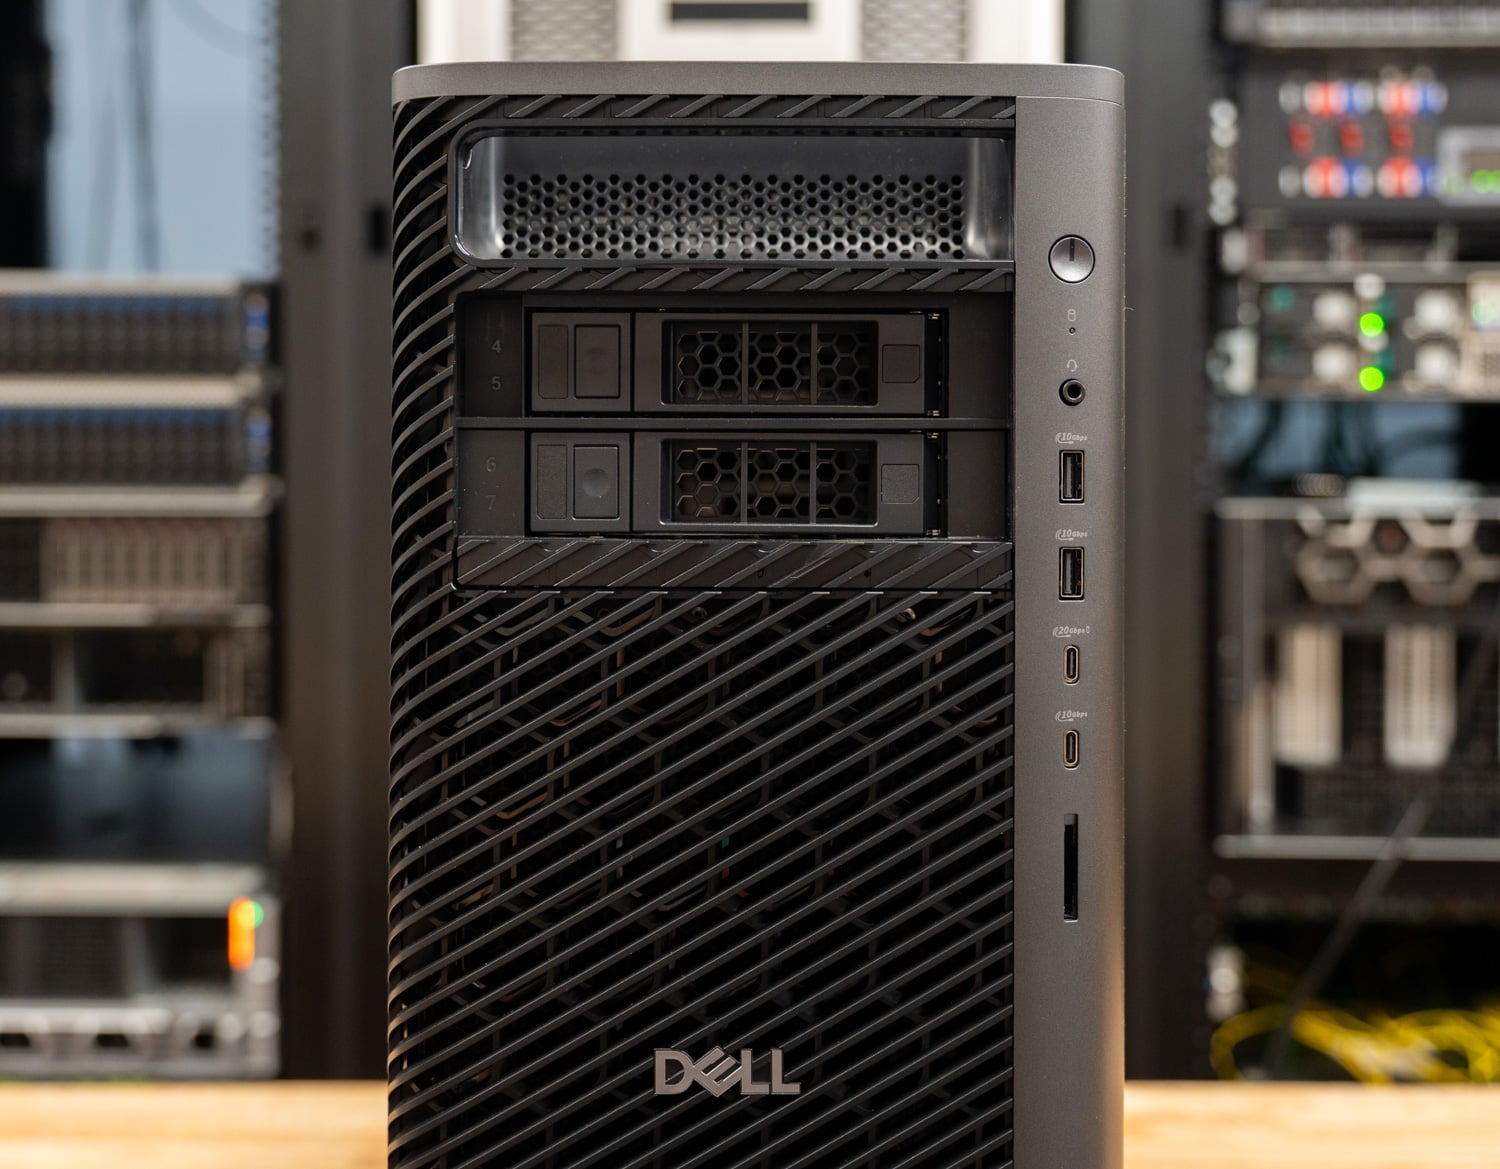
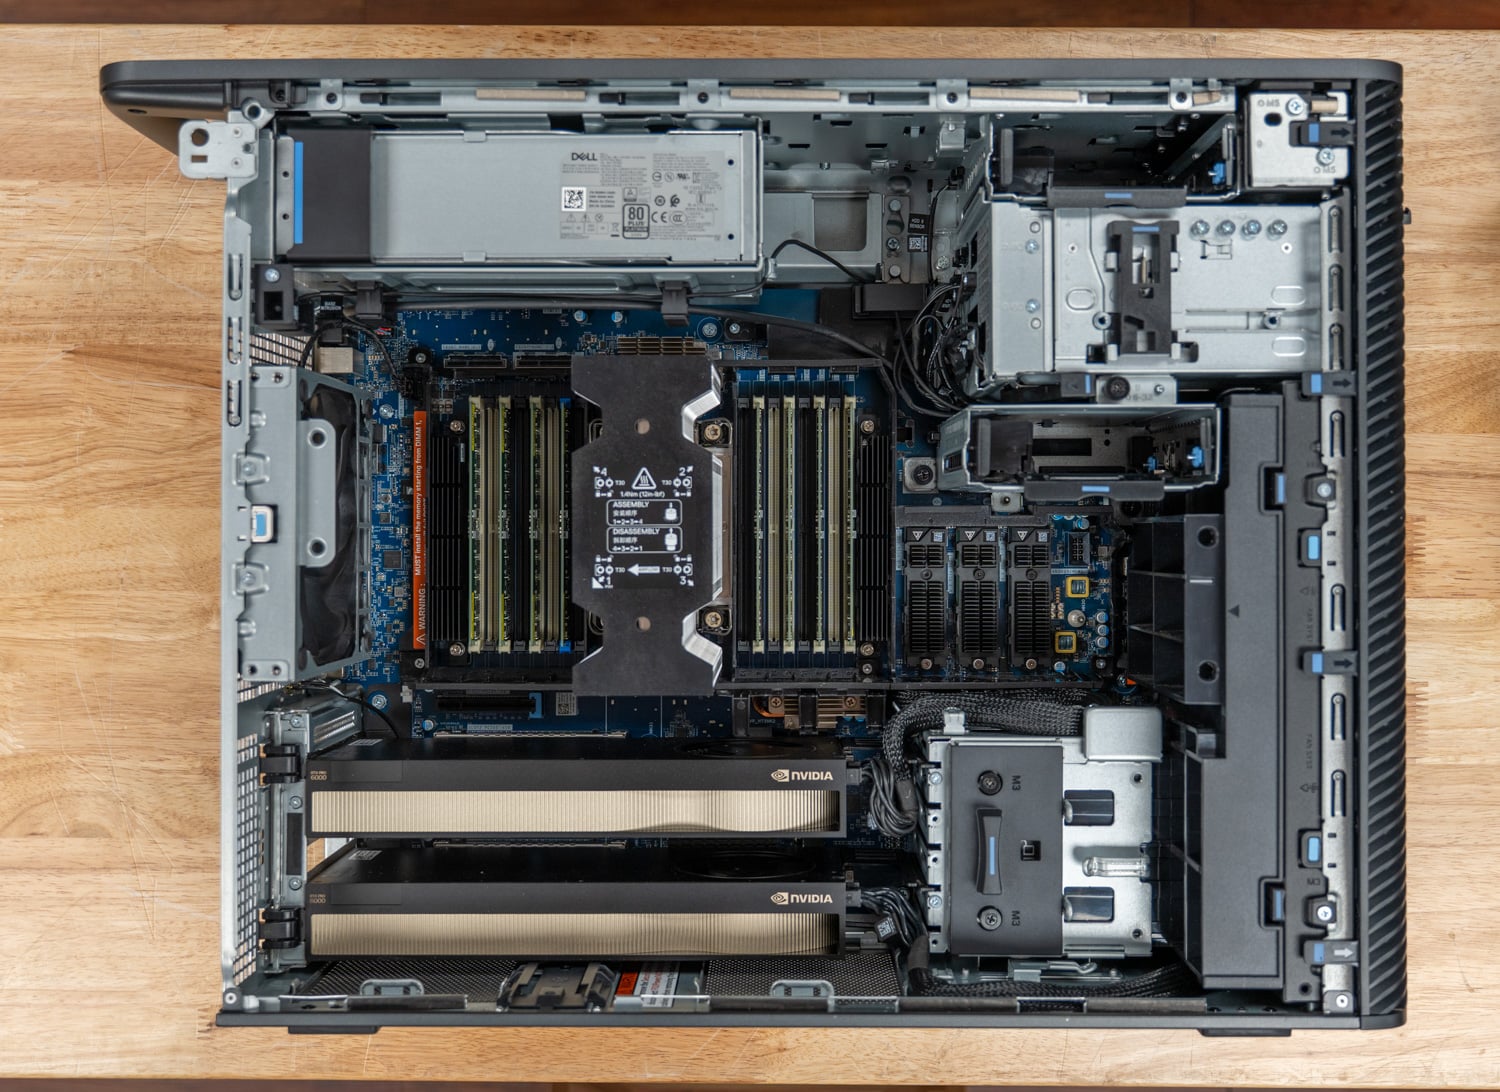
Die Wartungsfreundlichkeit ist eine Stärke des T4. Dies beginnt mit dem werkzeuglosen Zugang über einen Riegel an der Seitenwand und dem 2400-Watt-Netzteil, das sich per Hand aus der oberen Rückseite des Gehäuses herausziehen lässt. Alle anderen Komponenten, einschließlich Grafikkarten und SSDs, lassen sich mit einem Kreuzschlitzschraubendreher entnehmen. Die blauen Markierungen von Dell kennzeichnen die manuell zu entnehmenden Teile. Im Test erwies sich die Plattform als einfach für den mobilen Einsatz zu reparieren, was bei einer Workstation dieser Preisklasse ein wichtiger Faktor ist.
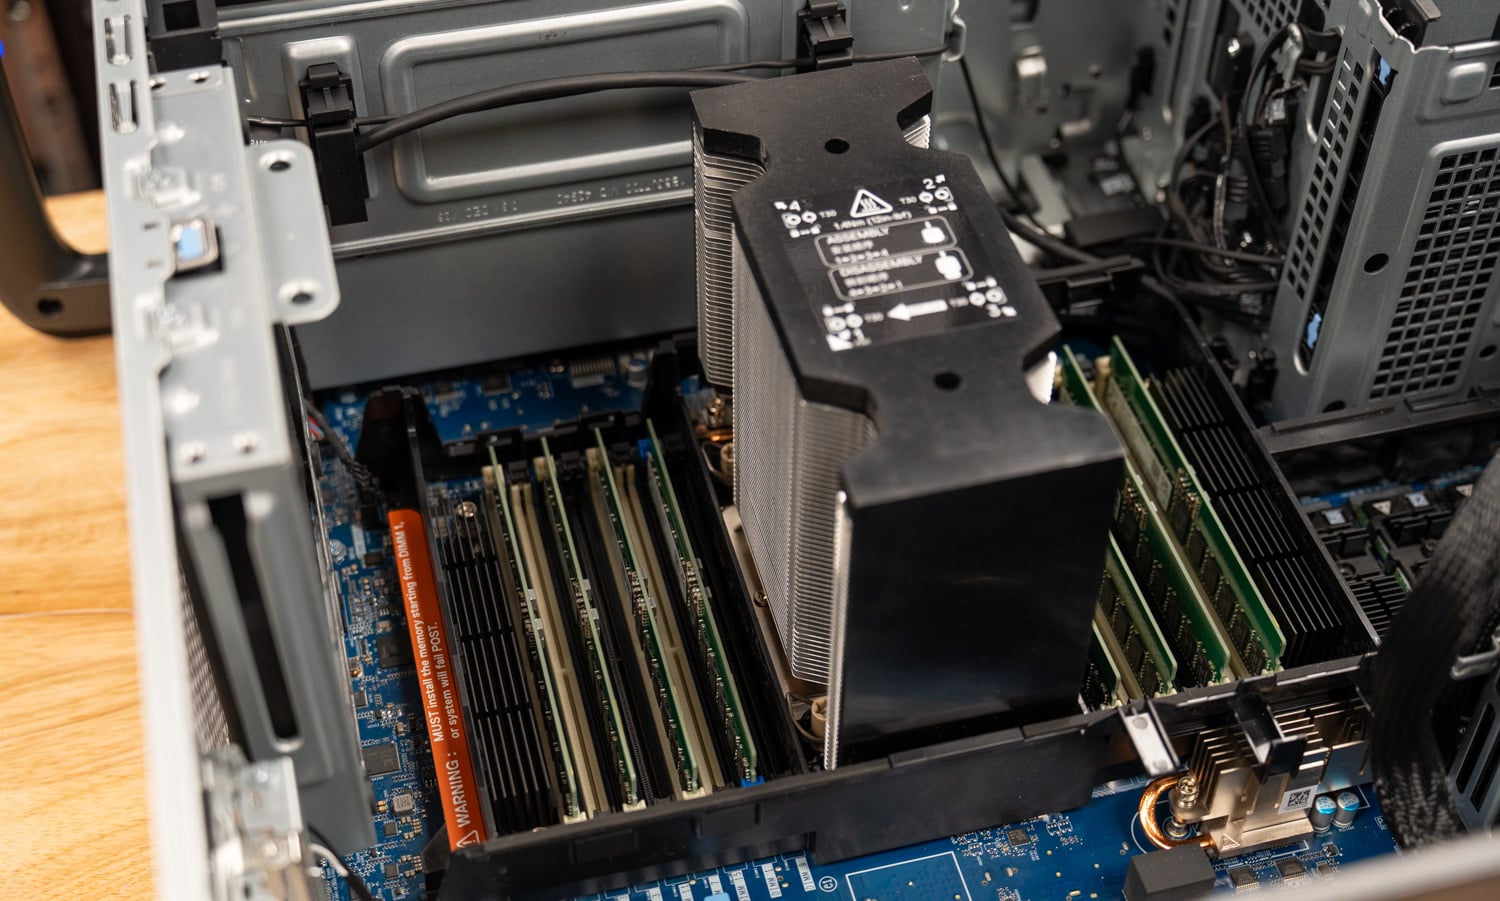
Die Kühlung ist die beste, die wir bisher von Dell in dieser Tower-Klasse gesehen haben. Die Luft strömt von vorne nach hinten, und große, passgenaue Abdeckungen leiten sie über Prozessor und Arbeitsspeicher, wobei dieser Bereich vom PCIe-Bereich getrennt bleibt. Die beiden 300-Watt-Grafikkarten werden daher von einem separaten Luftstrom versorgt und nehmen keine Wärme vom 350-Watt-Xeon auf. Mit montierten Abdeckungen befinden sich zwei Lüfter zwischen Prozessorbereich und Grafikkartenschacht. Die Baugruppe verfügt über die gleichen blauen Kontaktpunkte und lässt sich zum Zugriff auf den Arbeitsspeicher herausnehmen.
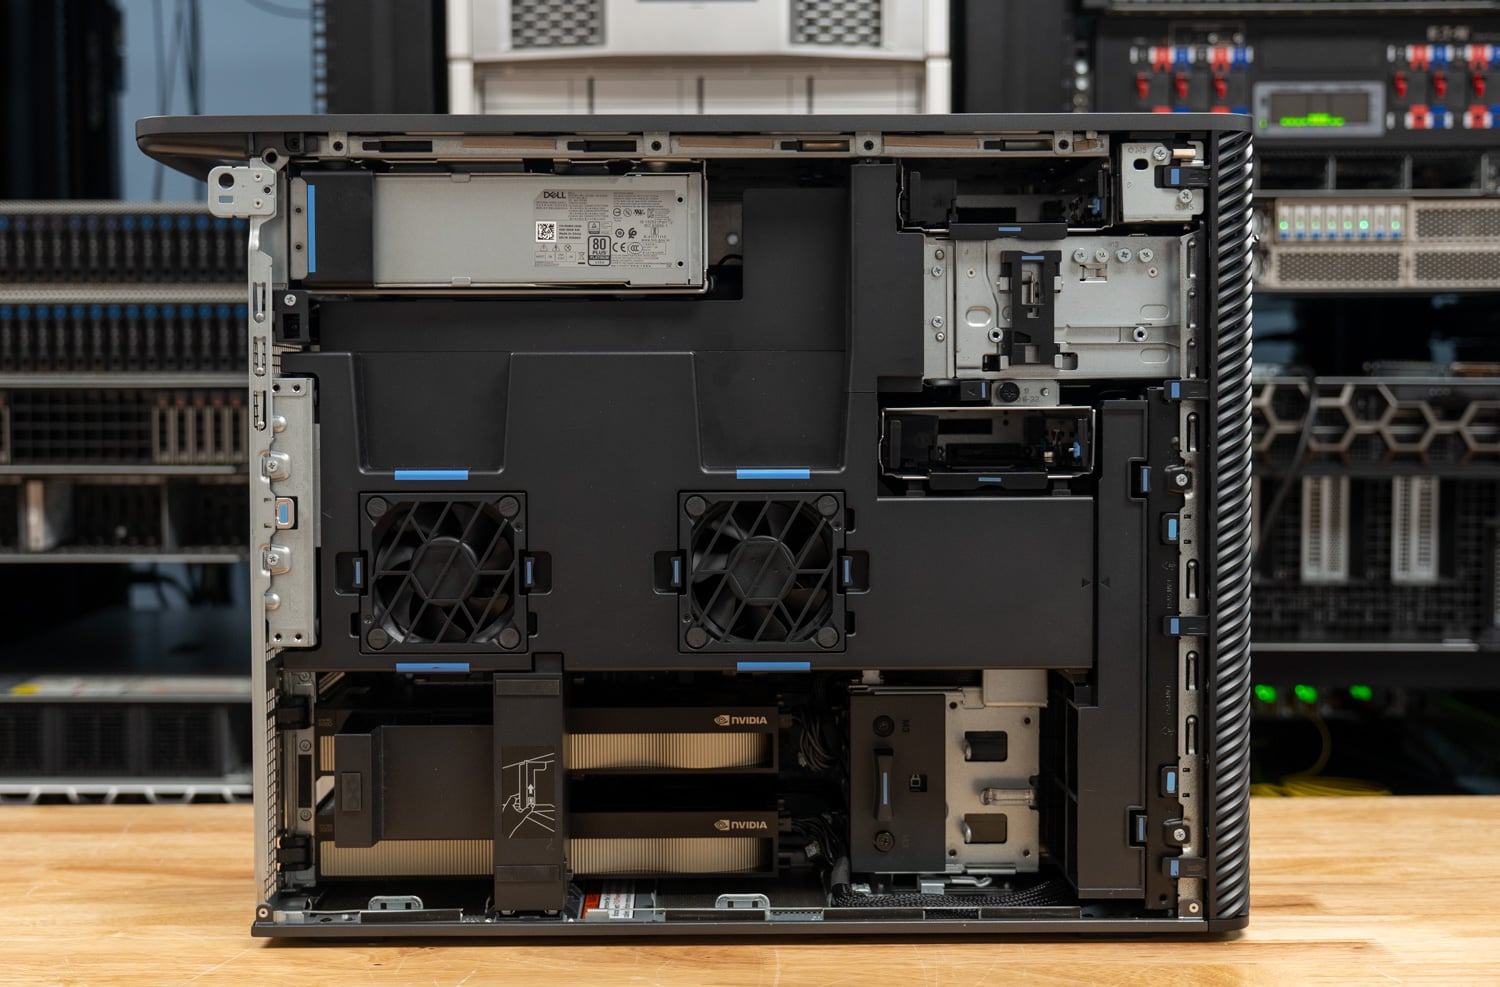
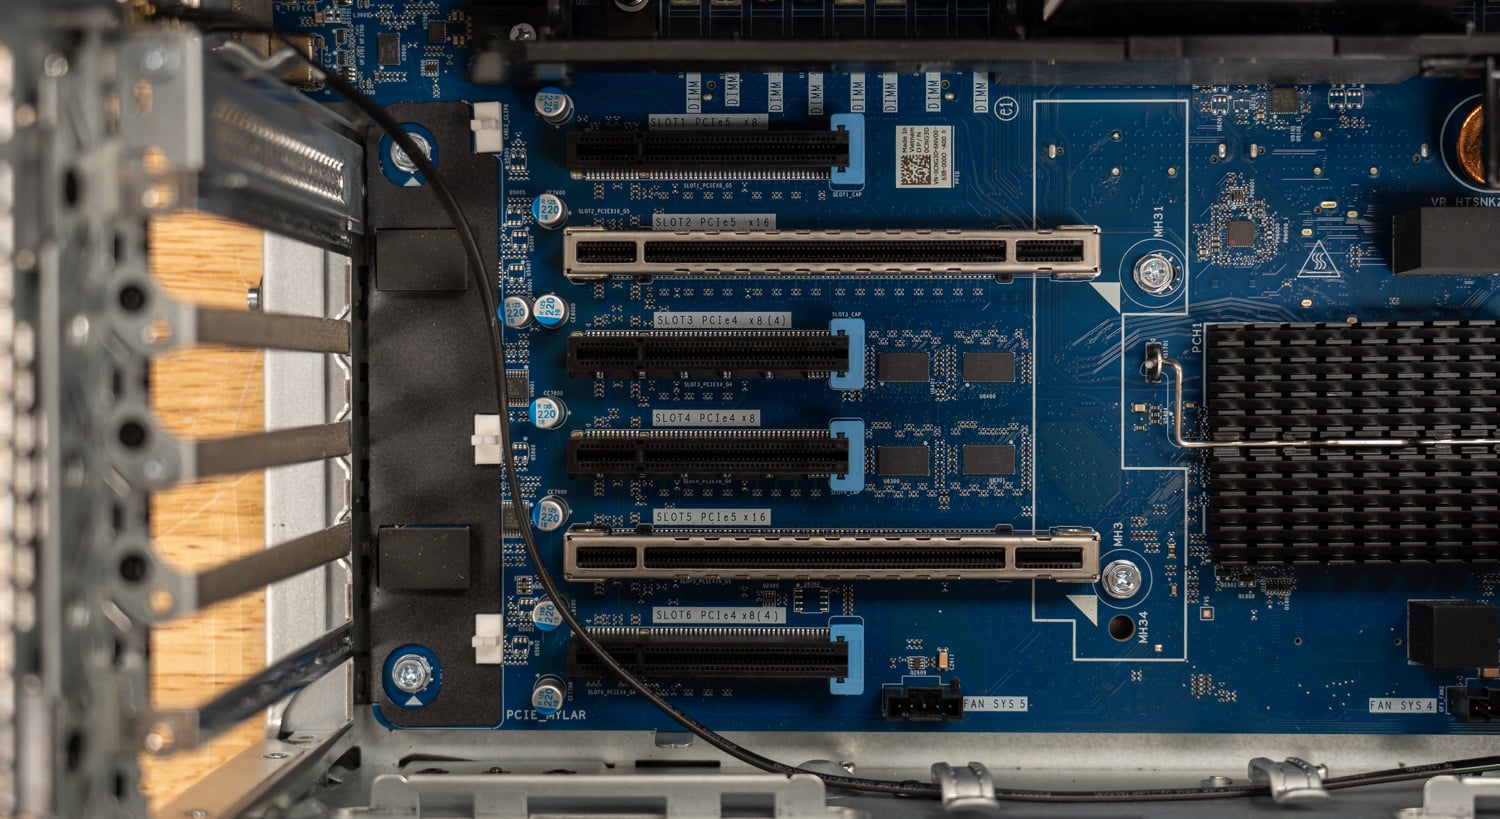
Die Erweiterungsmöglichkeiten werden über sechs PCIe-Steckplätze in voller Höhe bereitgestellt: zwei Gen5 x16-Steckplätze für die GPUs, ein Gen5 x8-Steckplatz, ein Gen4 x8-Steckplatz und zwei Gen4-Steckplätze mit x8-Anschlüssen und x4-Verkabelung. Für Speicher stehen drei interne M.2 Gen5-Steckplätze und ein Gen4-Steckplatz, zwei interne 3.5-Zoll-SATA-Einschübe sowie ein FlexBay an der Vorderseite zur Verfügung, der bis zu vier NVMe-SSDs oder zwei 3.5-Zoll-Laufwerke aufnehmen kann. Optional kann ein Slimline-Laufwerk installiert werden. Unser Testsystem bootet von einer internen 2-TB-Gen5-SSD und verfügt über eine weitere 2-TB-Gen5-SSD in einem internen M.2-Steckplatz.
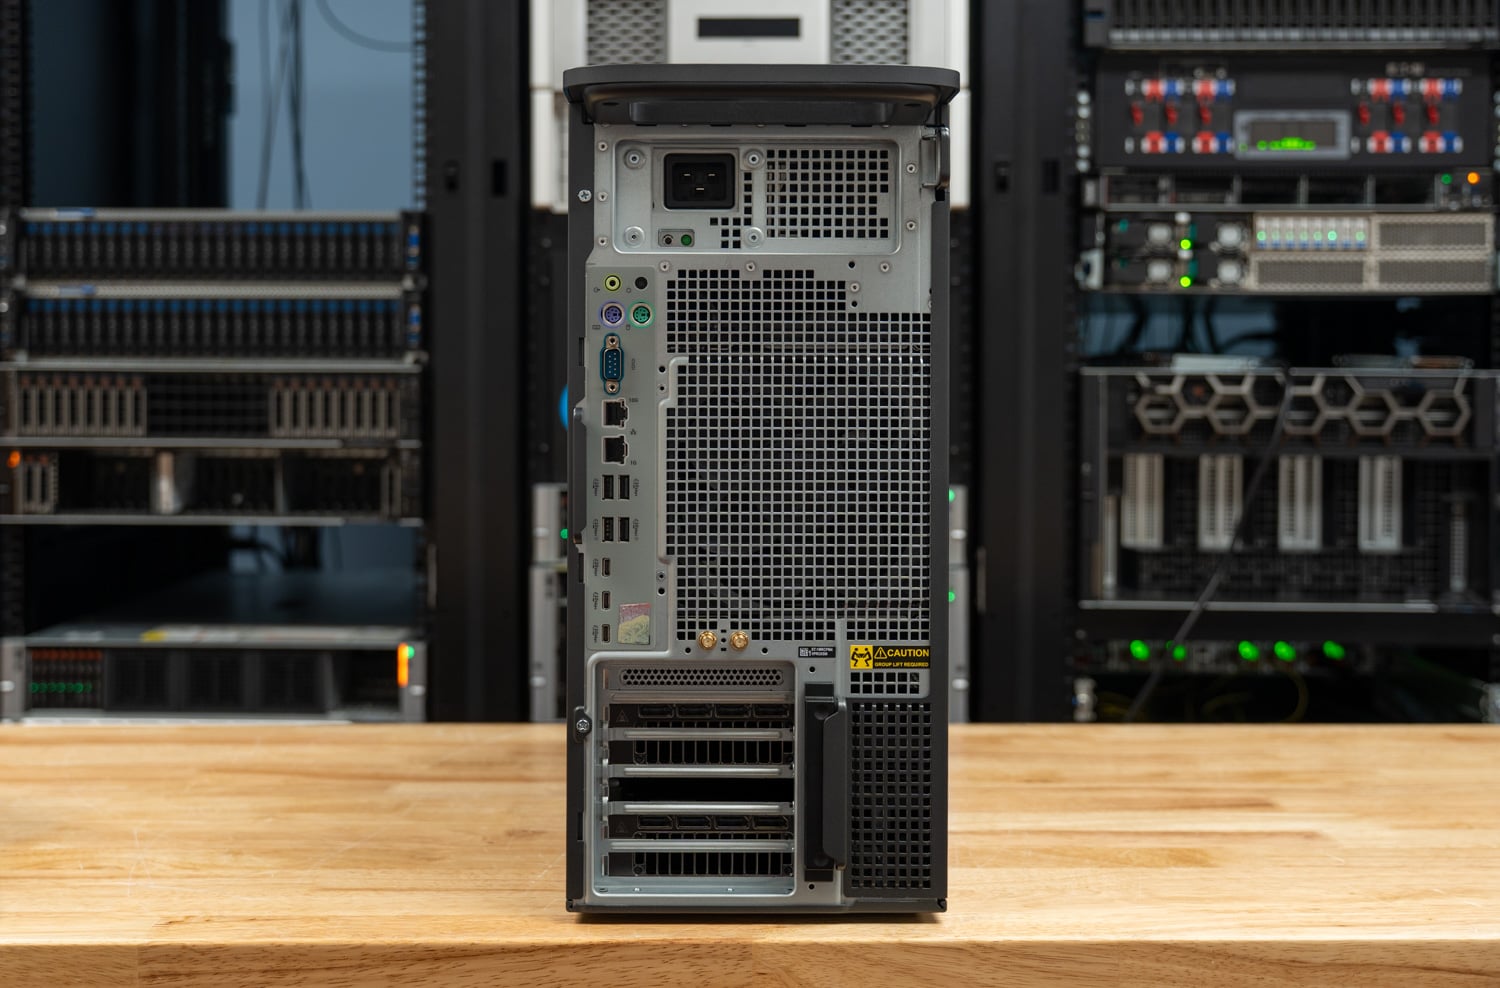
Die Vorderseite verfügt über eine Headset-Buchse, zwei 10-Gbit/s-USB-A-Anschlüsse, einen 20-Gbit/s-USB-C-Anschluss mit PowerShare, einen 10-Gbit/s-USB-C-Anschluss und einen optionalen SD-Kartensteckplatz. Die Rückseite bietet 10-Gbit/s- und 1-Gbit/s-RJ-45-Anschlüsse, vier 10-Gbit/s-USB-A-Anschlüsse, zwei 10-Gbit/s-USB-C-Anschlüsse, einen 20-Gbit/s-USB-C-Anschluss, eine serielle Schnittstelle, zwei PS/2-Anschlüsse und einen Line-Out-Anschluss. Unser Testgerät ist zusätzlich mit dem Intel E810-XXV Dual-Port 25GbE SFP28-Adapter, MediaTek Wi-Fi 7 MT7925 mit Bluetooth 5.4, einem Speicherkartenleser und der Dual-USB-C-Erweiterungskarte von Dell ausgestattet.
Die Sicherheits- und Verwaltungsfunktionen umfassen TPM 2.0, Dell SafeBIOS, Gehäuseeinbruchserkennung, Unterstützung für selbstverschlüsselnde Laufwerke, sicheres Löschen im BIOS und Intel vPro Enterprise. Laut Dell bestehen die wichtigsten Komponenten des T4 zu bis zu 85 Prozent aus recyceltem Kunststoff, die Griffe zu 90 Prozent aus recyceltem Aluminium und das Gehäuse zu 11 Prozent aus recyceltem Stahl. Die Konfiguration ist ENERGY STAR-zertifiziert.
Dell Pro Precision 9 T4 Spezifikationen
| Normen | Dell Pro Precision 9 T4 (wie getestet) |
|---|---|
| Plattform | |
| Modell | Dell Pro Precision 9 T4 (PW9T4260) |
| Prozessor | Intel Xeon 698X, 86 Kerne, 172 Threads, 336 MB Cache, 2.0 GHz Basistakt, bis zu 4.8 GHz, 350 W |
| Prozessoroptionen | Xeon 634 (12 Kerne) bis Xeon 698X (86 Kerne) |
| Memory | 256 GB (8 x 32 GB) DDR5-6400 RDIMM ECC 16 Steckplätze, bis zu 4 TB |
| Grafiken | 2x NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, je 96 GB GDDR7, je 300 W |
| Betriebssystem | Windows 11 Pro für Workstations (getestet auf Ubuntu 26.04.1 LTS) |
| Lagerung | |
| Wie konfiguriert | 2x 2TB M.2 2280 Gen5 x4 TLC SED (beide in internen M.2-Steckplätzen) |
| Interne Steckplätze | 3x M.2 2230/2280 Gen5 NVMe 1x M.2 2230/2280 Gen4 NVMe 2x 3.5-Zoll-SATA |
| FlexBay | Bis zu 4 NVMe-Laufwerke plus optionales Slim-ODD oder 2x 3.5-Zoll-SATA-Laufwerke |
| Erweiterung und Konnektivität | |
| PCIe-Steckplätze | 2x Gen5 x16 1x Gen5 x8 1x Gen4 x8 2x Gen4 x8 (x4 elektrisch) |
| Netzwerken | Intel E810-XXV Dual-Port 25GbE SFP28 (Erweiterungssteckplatz) Onboard 10GbE und 1GbE RJ-45 MediaTek Wi-Fi 7 MT7925, Bluetooth 5.4 |
| Frontanschlüsse | 1x USB-C 20 Gbit/s mit PowerShare 1x USB-C 10 Gbit/s 2x USB-A 10 Gbit/s Headset-Anschluss Optionaler SD-Kartensteckplatz |
| Anschlüsse an der Rückseite | 1x USB-C 20 Gbit/s 2x USB-C 10 Gbit/s 4x USB-A 10 Gbit/s Seriell, 2x PS/2, Line-Out |
| Kraft und Körperlichkeit | |
| Labor-Stromversorgungen | 2400W Platinum (1500W Option) |
| Abmessungen | 449.8 x 203.7 x 617.5 (17.70 x 8.01 x 24.31) |
| Gewicht | 24.1 kg bis 33.6 kg (53.1 bis 74.1 lb) je nach Konfiguration |
| Garantie | ProSupport mit Vor-Ort-Service nach Ferndiagnose, 36 Monate |
| Preis | 5,925 USD Basis Ungefähr 66,600 US-Dollar in der konfigurierten Ausführung (Dell.com) |
Testaufbau und Methodik
Wir testen High-End-Workstations unter Linux. Alle vier Systeme in diesem Test liefen mit Ubuntu 26.04.1 LTS auf Kernel 7.0.0-43 mit NVIDIA-Treiber 595.99.02, CUDA 13, llama.cpp Build b11716 und Ollama 0.40.3 im Linux-Leistungsprofil „Performance“. Die Ergebnisse stammen von drei Tools: sr-client für lokale KI- und Client-Workloads, sr-harness für Kompilierung, Komprimierung, Kryptografie, Webservering und y-cruncher sowie sr-suite r5.28 für GROMACS, OpenFOAM, ClickHouse, Valkey und Speicherbandbreite. Jedes Ergebnis ist der Median mehrerer Durchläufe.
Alle vier Systeme liefen mit dem BIOS-Wärmemodus „Ultra Performance“, und das T4 lief mit BIOS 1.2.0. Der T4-Test verwendete sr-harness 3.3, das Precision 7875 3.5 und beide T2 3.6, wobei für alle Versionen die gleiche Testkonfiguration verwendet wurde.
Alle Vergleichssysteme sind Dell-Tower mit RTX PRO 6000 Blackwell-Grafikkarte. Der Dell Precision 7875 kombiniert den 96-Kern-Prozessor Threadripper PRO 9995WX mit denselben zwei RTX PRO 6000 Max-Q-Grafikkarten und 512 GB DDR5-5600-Arbeitsspeicher und ist damit das vergleichbarste System. Der Dell Pro Precision 9 T2 ist mit dem 24-Kern-Prozessor Xeon 658X und einer Max-Q-Grafikkarte ausgestattet, und der Dell Pro Max Tower T2 verwendet den 24-Kern-Prozessor Core Ultra 9 285K mit der 600-Watt-RTX PRO 6000. Dies verdeutlicht den Leistungszuwachs pro GPU durch die höhere Leistungsaufnahme.
| Konfiguration | CPU | Memory | GPU | Test Drive | BIOS-Thermalmodus |
|---|---|---|---|---|---|
| Dell Pro Precision 9 T4 | Xeon 698X, 86 Kerne | 256 GB DDR5-6400 (8 Kanäle) | 2x RTX PRO 6000 Max-Q (300W) | 2 TB SK hynix PCB01 Gen5 | Ultra Performance |
| Dell Präzision 7875 | Threadripper PRO 9995WX, 96 Kerne | 512 GB DDR5-5600 (8 Kanäle) | 2x RTX PRO 6000 Max-Q (300W) | 2 TB Samsung Gen4 | Ultra Performance |
| Dell Pro Precision 9 T2 | Xeon 658X, 24 Kerne | 128 GB DDR5-6400 (4 Kanäle) | 1x RTX PRO 6000 Max-Q (300W) | Samsung PM9E1 Gen5, 2-TB-Festplatten im Striping-Verbund | Ultra Performance |
| Dell Pro Max Tower T2 | Core Ultra 9 285K, 24 Kerne | 128 GB DDR5-4400 (2 Kanäle) | 1x RTX PRO 6000 (600W) | 2 TB Samsung PM9F1 Gen4 | Ultra Performance |
Lokale KI-Leistung
Jedes System hier ist mit mindestens einer RTX PRO 6000 Blackwell mit 96 GB GDDR7 ausgestattet. Die Ergebnisse mit einer einzelnen GPU messen daher die Leistung der Karte, ihre Leistungsaufnahme und die Geschwindigkeit der Anbindung durch die Plattform. Die zwei GPUs des T4 sind sein Alleinstellungsmerkmal. Unsere Tests mit zwei GPUs führen jedes Modell, sofern zutreffend, auf drei verschiedene Arten durch: zwei unabhängige Server, einer pro GPU, zur Messung des Durchsatzes; ein Modell, das nach Schichten auf beide Karten aufgeteilt ist; und beim MiniMax M2.7 eine Karte, während die restlichen Komponenten im Systemspeicher liegen.
LLM-Server auf einer GPU
| llama.cpp-Server, eine GPU (Ausgabe Token/s, je höher, desto besser) | Dell Pro Precision 9 T4 | Dell Präzision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| Ministerial 3 3B, eine Anfrage | 240.5 | 252.6 | 243.8 | 261.6 |
| Ministral 3 3B, Gipfel | 582.5 | 637.6 | 602.6 | 658.8 |
| Ministerial 3 8B, eine Anfrage | 166.8 | 171.1 | 167.3 | 194.5 |
| Ministral 3 8B, Gipfel | 383.6 | 398.9 | 384.9 | 477.5 |
| Qwen3.8 27B, eine Anfrage | 54.9 | 55.4 | 53.8 | 64.5 |
| Qwen3.8 27B, Peak | 158.1 | 162.8 | 155.8 | 194.7 |
| gpt-oss 120B, eine Anfrage | 166.9 | 171.2 | 164.5 | 193.0 |
| gpt-oss 120B, Peak | 424.8 | 458.4 | 413.1 | 520.7 |
| gpt-oss 120B, eine Anfrage, Zeit bis zum ersten Token (ms, je niedriger, desto besser) | 1,189 | 1,181 | 1,213 | 844 |
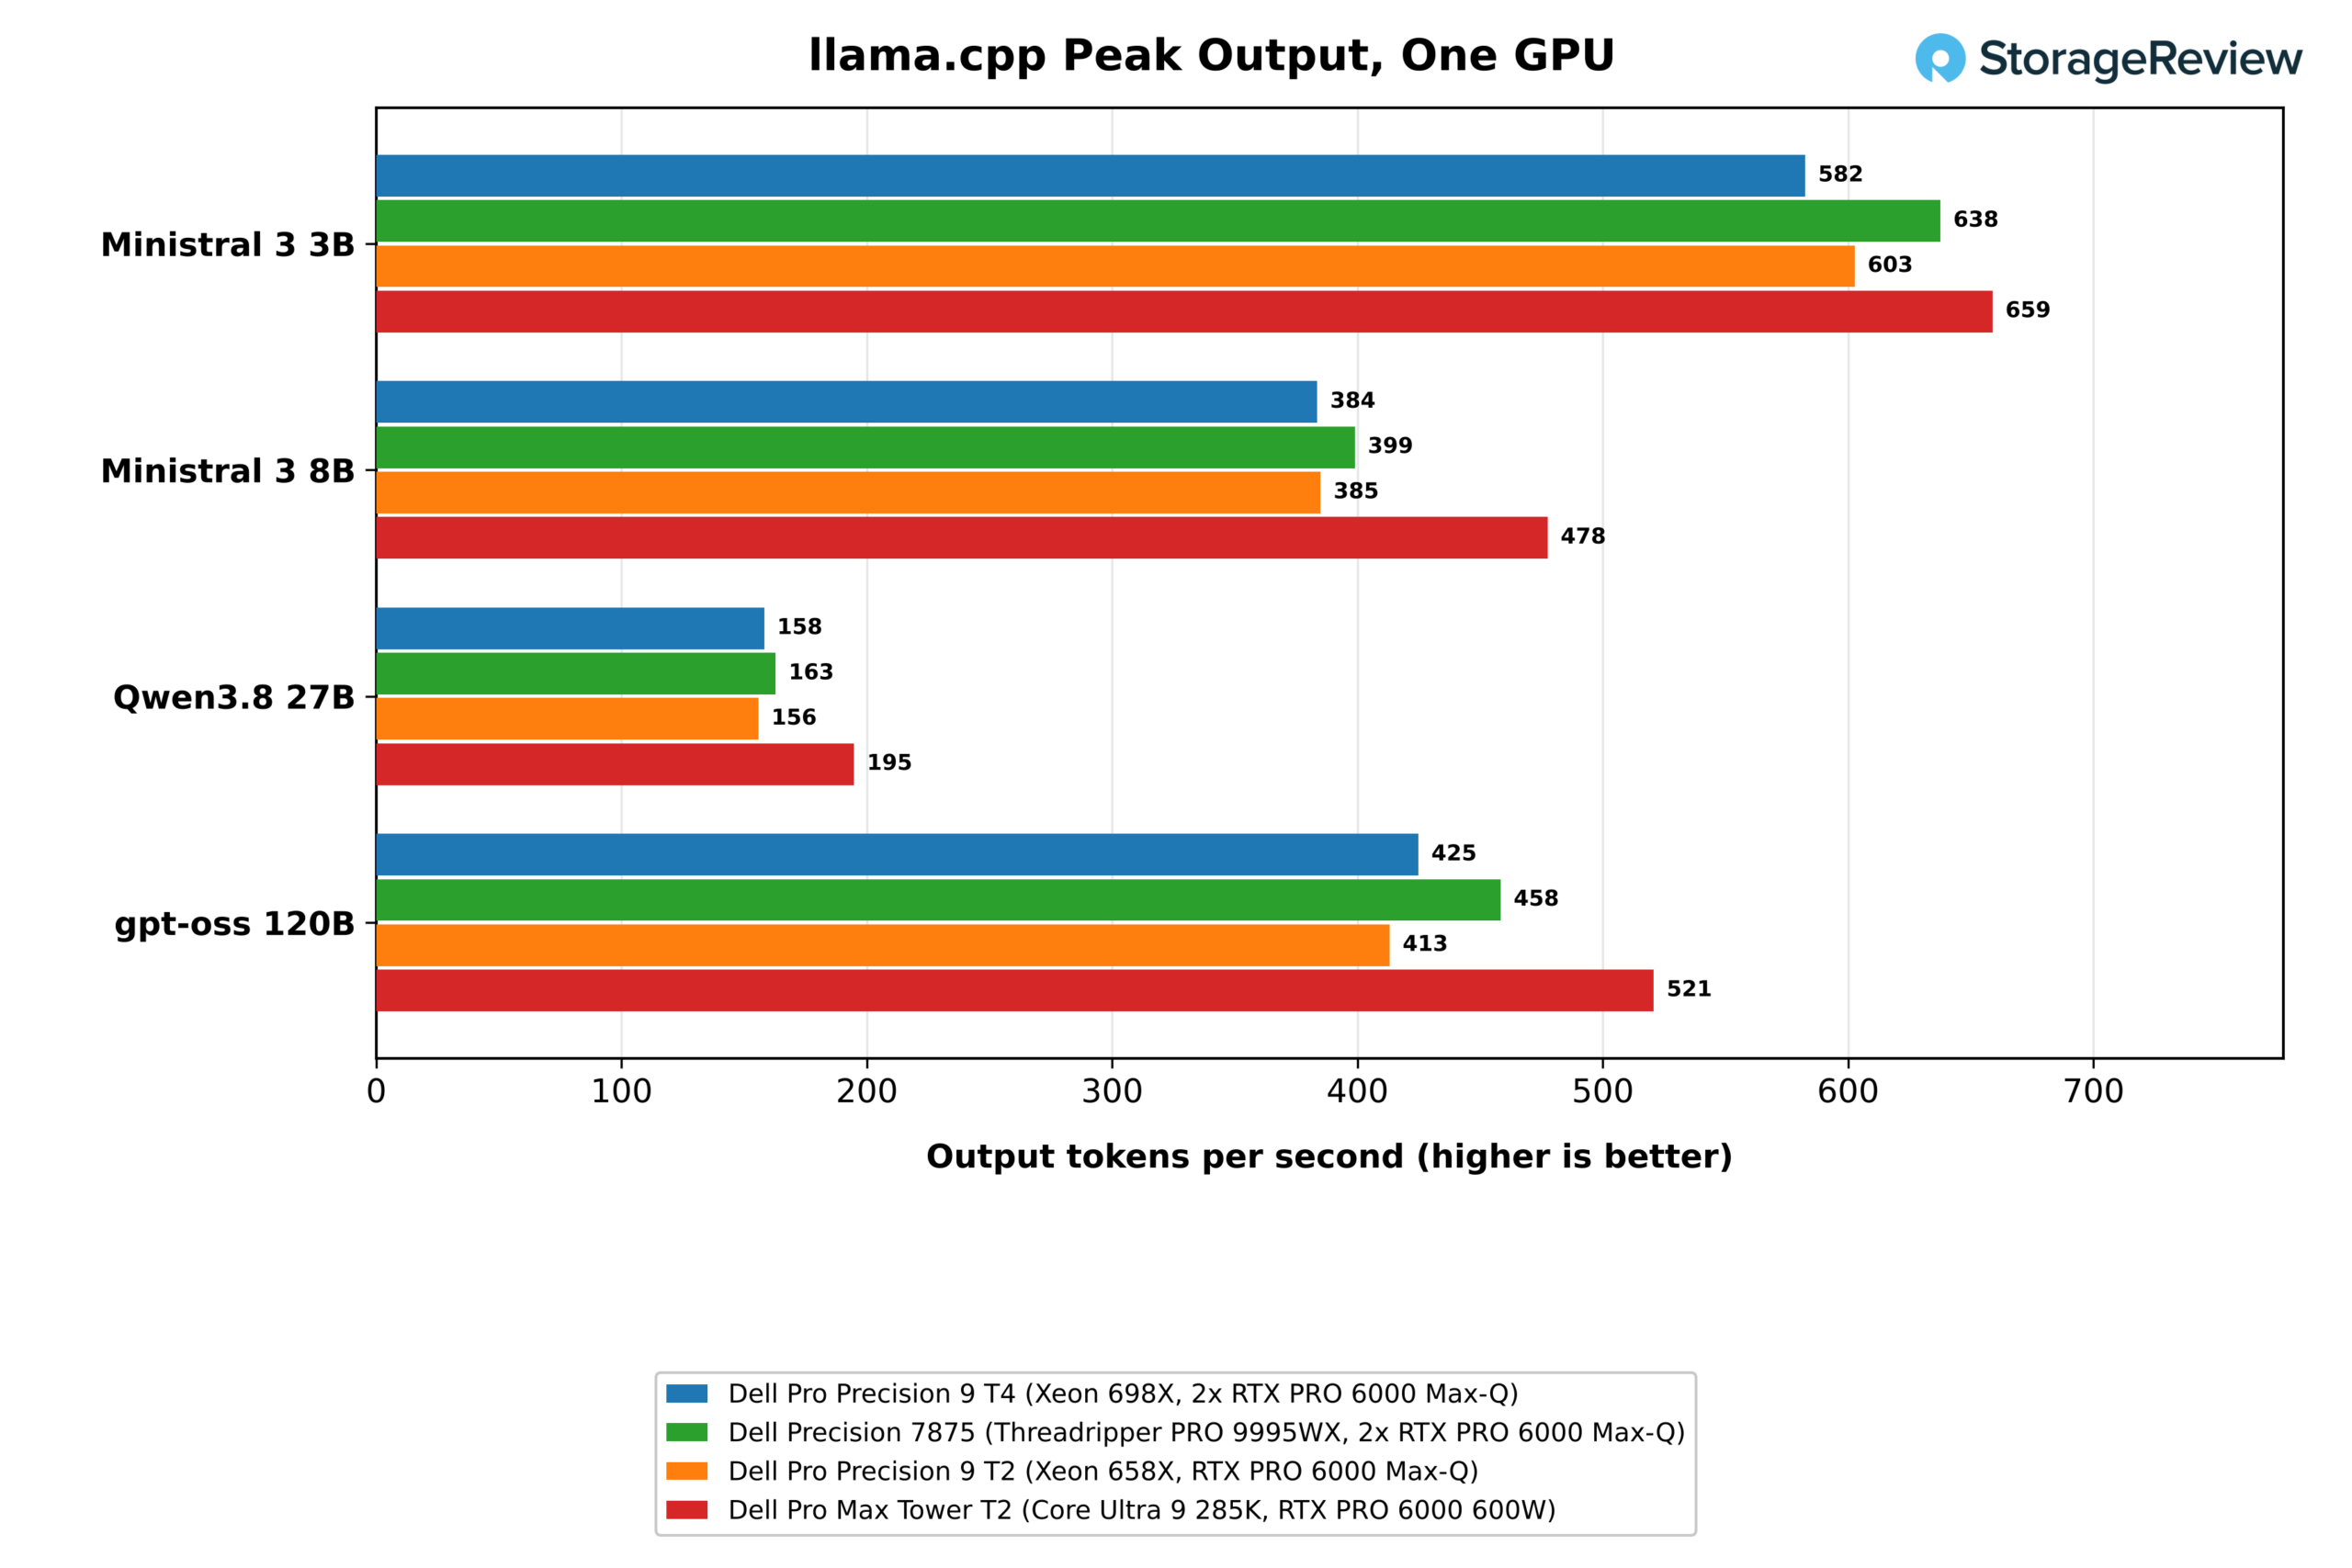
Auf einer einzelnen GPU erreicht die T4 die Leistungsgrenze von 300 W. Sie generierte 166.9 Token pro Sekunde für einen Benutzer auf gpt-oss 120B und erreichte einen Spitzenwert von 424.8 Token pro Sekunde bei 64 gleichzeitigen Anfragen. Dies entspricht den Werten der identischen Max-Q-Karte des Precision 7875 in allen vier Modellen und liegt innerhalb von 1 bis 9 Prozent. Die Leistung ist vergleichbar mit der des Pro Precision 9 T2. Die 600-W-Karte im Pro Max Tower T2 ist in allen Modellen im Spitzenwert 13 bis 25 Prozent schneller und erreicht 520.7 Token pro Sekunde auf gpt-oss 120B.
Zwei GPUs: Replikate und geteilte Modelle
| llama.cpp-Server, zwei GPUs (Ausgabe Token/s, je höher, desto besser) | Dell Pro Precision 9 T4 | Dell Präzision 7875 |
|---|---|---|
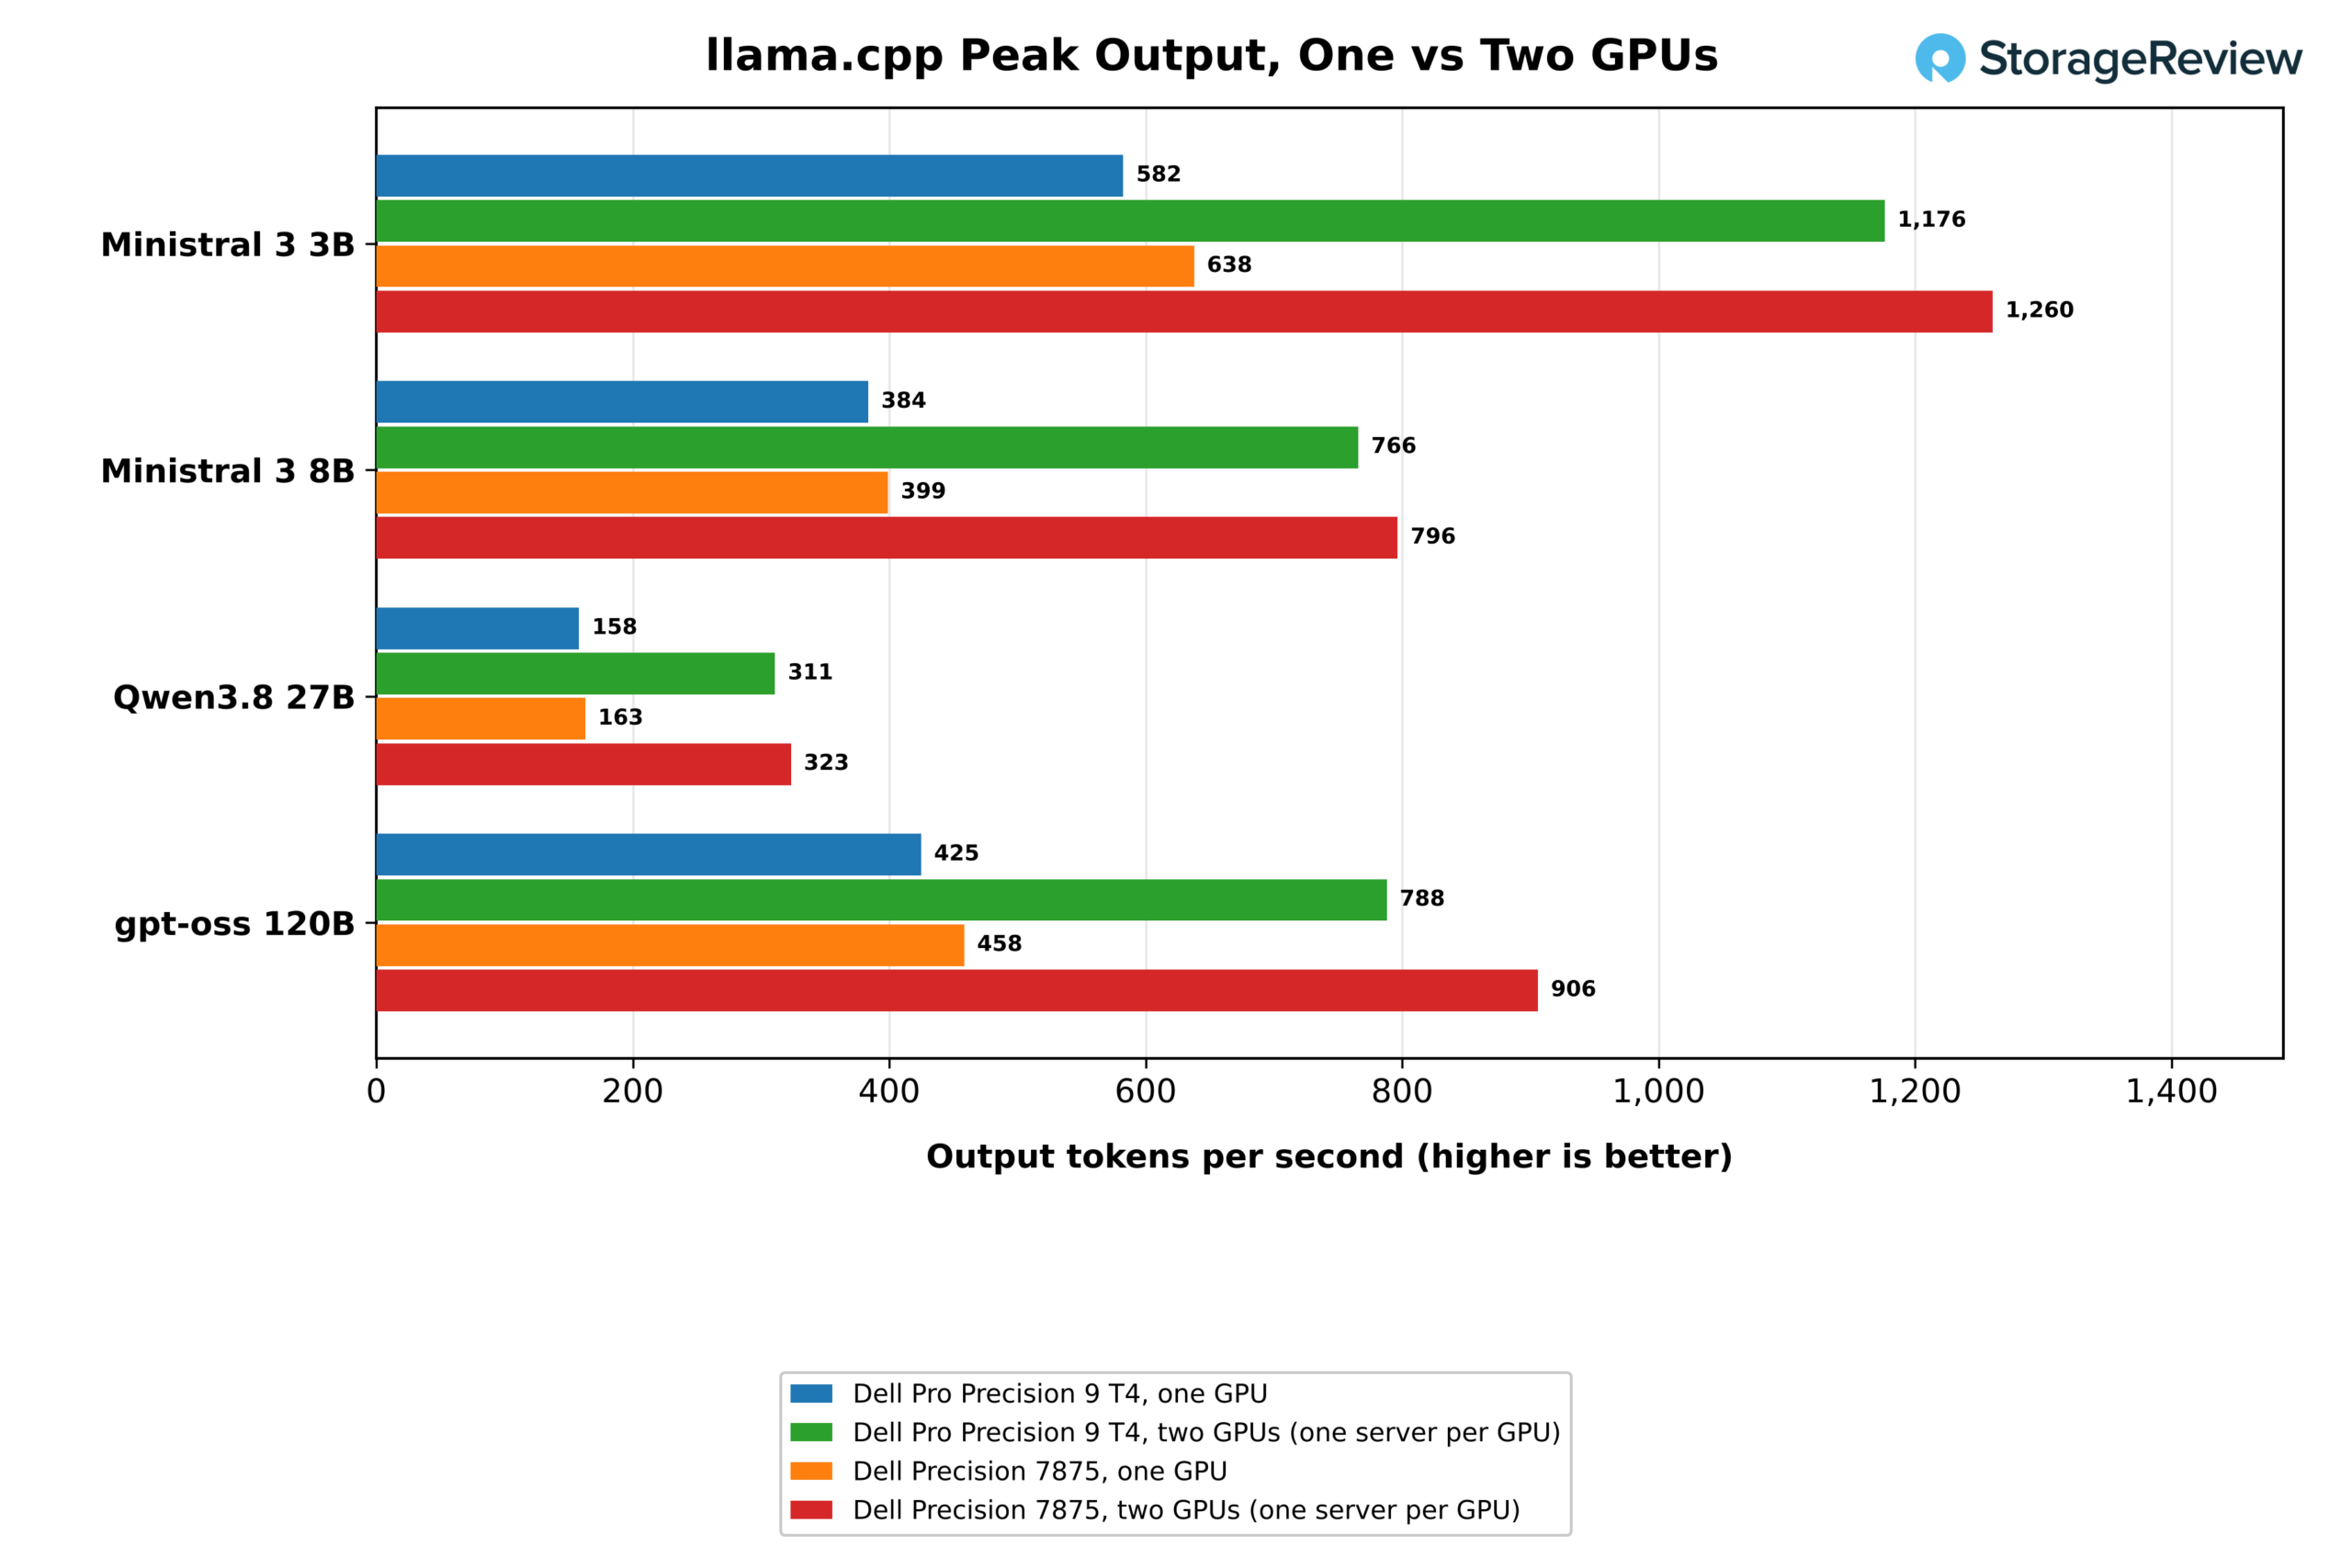
| Ministral 3 3B, Spitzenlast, ein Server pro GPU | 1,176.1 | 1,260.2 |
| Ministral 3 8B, Spitzenlast, ein Server pro GPU | 765.7 | 796.4 |
| Qwen3.8 27B, Spitzenwert, ein Server pro GPU | 310.8 | 323.2 |
| gpt-oss 120B, Spitzenwert, ein Server pro GPU | 787.9 | 905.8 |
| gpt-oss 120B, eine Anfrage, aufgeteilt nach Schicht | 170.6 | 182.4 |
| gpt-oss 120B, Peak, aufgeteilt nach Schicht | 539.2 | 619.4 |
Der Betrieb eines Servers pro GPU steigerte die Spitzenleistung des T4 über alle vier Modelle hinweg um das 1.85- bis 2.02-Fache. Die Spitzenleistung erhöhte sich beim Ministral 3 3B von 582.5 auf 1,176.1 Token pro Sekunde, beim 8B-Modell von 383.6 auf 765.7 und beim Qwen3.8 27B von 158.1 auf 310.8, was einer Steigerung um das 1.97- bis 2.02-Fache entspricht. gpt-oss 120B skalierte beim T4 um das 1.85-Fache auf 787.9 Token pro Sekunde und beim Precision 7875 um das 1.98-Fache auf 905.8. Letzterer erreichte seinen Spitzenwert bei 128 gleichzeitigen Anfragen, während der T4 maximal 64 Anfragen verzeichnete.
Die Aufteilung von gpt-oss 120B nach Layern auf beide Karten ist die langsamere Methode, die zweite GPU zu nutzen, wenn das Modell bereits auf eine Karte passt. Sie erreichte bei einem einzelnen Benutzer 170.6 Token pro Sekunde, was nur 3 Prozent unter dem Wert einer einzelnen Karte liegt, und einen Spitzenwert von 539.2 Token pro Sekunde, 27 Prozent mehr als eine einzelne GPU, aber deutlich weniger als die 787.9 Token pro Sekunde, die zwei Replikate lieferten. Das aufgeteilte Layout ist besonders geeignet für Modelle, die nicht auf eine einzelne Karte passen, wie beispielsweise die MiniMax M2.7.
| llama.cpp-Server, gpt-oss 120B, 8,192-Token-Eingabeaufforderungen, 1,024-Token-Ausgaben | T4, eine GPU | T4, zwei GPUs, ein Server pro GPU | T4, zwei GPUs, aufgeteilt nach Schicht | Precision 7875, zwei GPUs, ein Server pro GPU |
|---|---|---|---|---|
| 1 gleichzeitig: Gesamtdurchsatz (Token/s) | 1,502 | 1,504 | 1,536 | 1,530 |
| 1 gleichzeitig: Zeit bis zum ersten Token, Median (ms, niedriger ist besser) | 1,189 | 1,180 | 719 | 1,189 |
| 8 gleichzeitig: Gesamtdurchsatz (Token/s) | 2,760 | 4,820 | 3,300 | 4,949 |
| 8 gleichzeitig: Ausgabe pro Benutzer (Token/s) | 38.3 | 66.9 | 45.8 | 68.7 |
| 8 gleichzeitig: Zeit bis zum ersten Token, Median (ms, niedriger ist besser) | 2,654 | 2,523 | 1,622 | 2,472 |
| 64 gleichzeitig: Gesamtdurchsatz (Token/s) | 3,823 | 7,091 | 4,853 | 7,557 |
| 64 gleichzeitig: Ausgabe pro Benutzer (Token/s) | 6.6 | 12.3 | 8.4 | 13.1 |
| 64 gleichzeitig: Zeit bis zum ersten Token, Median (ms, niedriger ist besser) | 3,874 | 3,226 | 2,852 | 2,867 |
Der vollständige Test auf gpt-oss 120B zeigt, wie die zweite Grafikkarte die Kurve beeinflusst, wobei der Gesamtdurchsatz sowohl Eingabe- als auch Ausgabetoken berücksichtigt. Mit einer GPU stieg die Leistung von 1,502 Token pro Sekunde bei einer einzelnen Anfrage auf 2,760 bei acht und 3,823 bei 64 Anfragen, wobei jeder Benutzer 6.6 Ausgabetoken pro Sekunde erhielt. Mit einem Server pro GPU wurden acht Anfragen mit 4,820 und 64 Anfragen mit 7,091 Token pro Sekunde verarbeitet – das 1.85-Fache einer Grafikkarte – was 12.3 Token pro Sekunde und Benutzer entspricht. Die Aufteilung des Modells führte zu einem niedrigeren Spitzenwert von 4,853 Token pro Sekunde, lieferte aber das erste Token eines einzelnen Benutzers in 719 ms statt 1,189 ms.

MiniMax M2.7: Ein Modell, das zu groß für eine Karte ist
| MiniMax M2.7 Q4_K_M, 129.3 GB (höher ist besser, sofern nicht anders angegeben) | Dell Pro Precision 9 T4 | Dell Präzision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
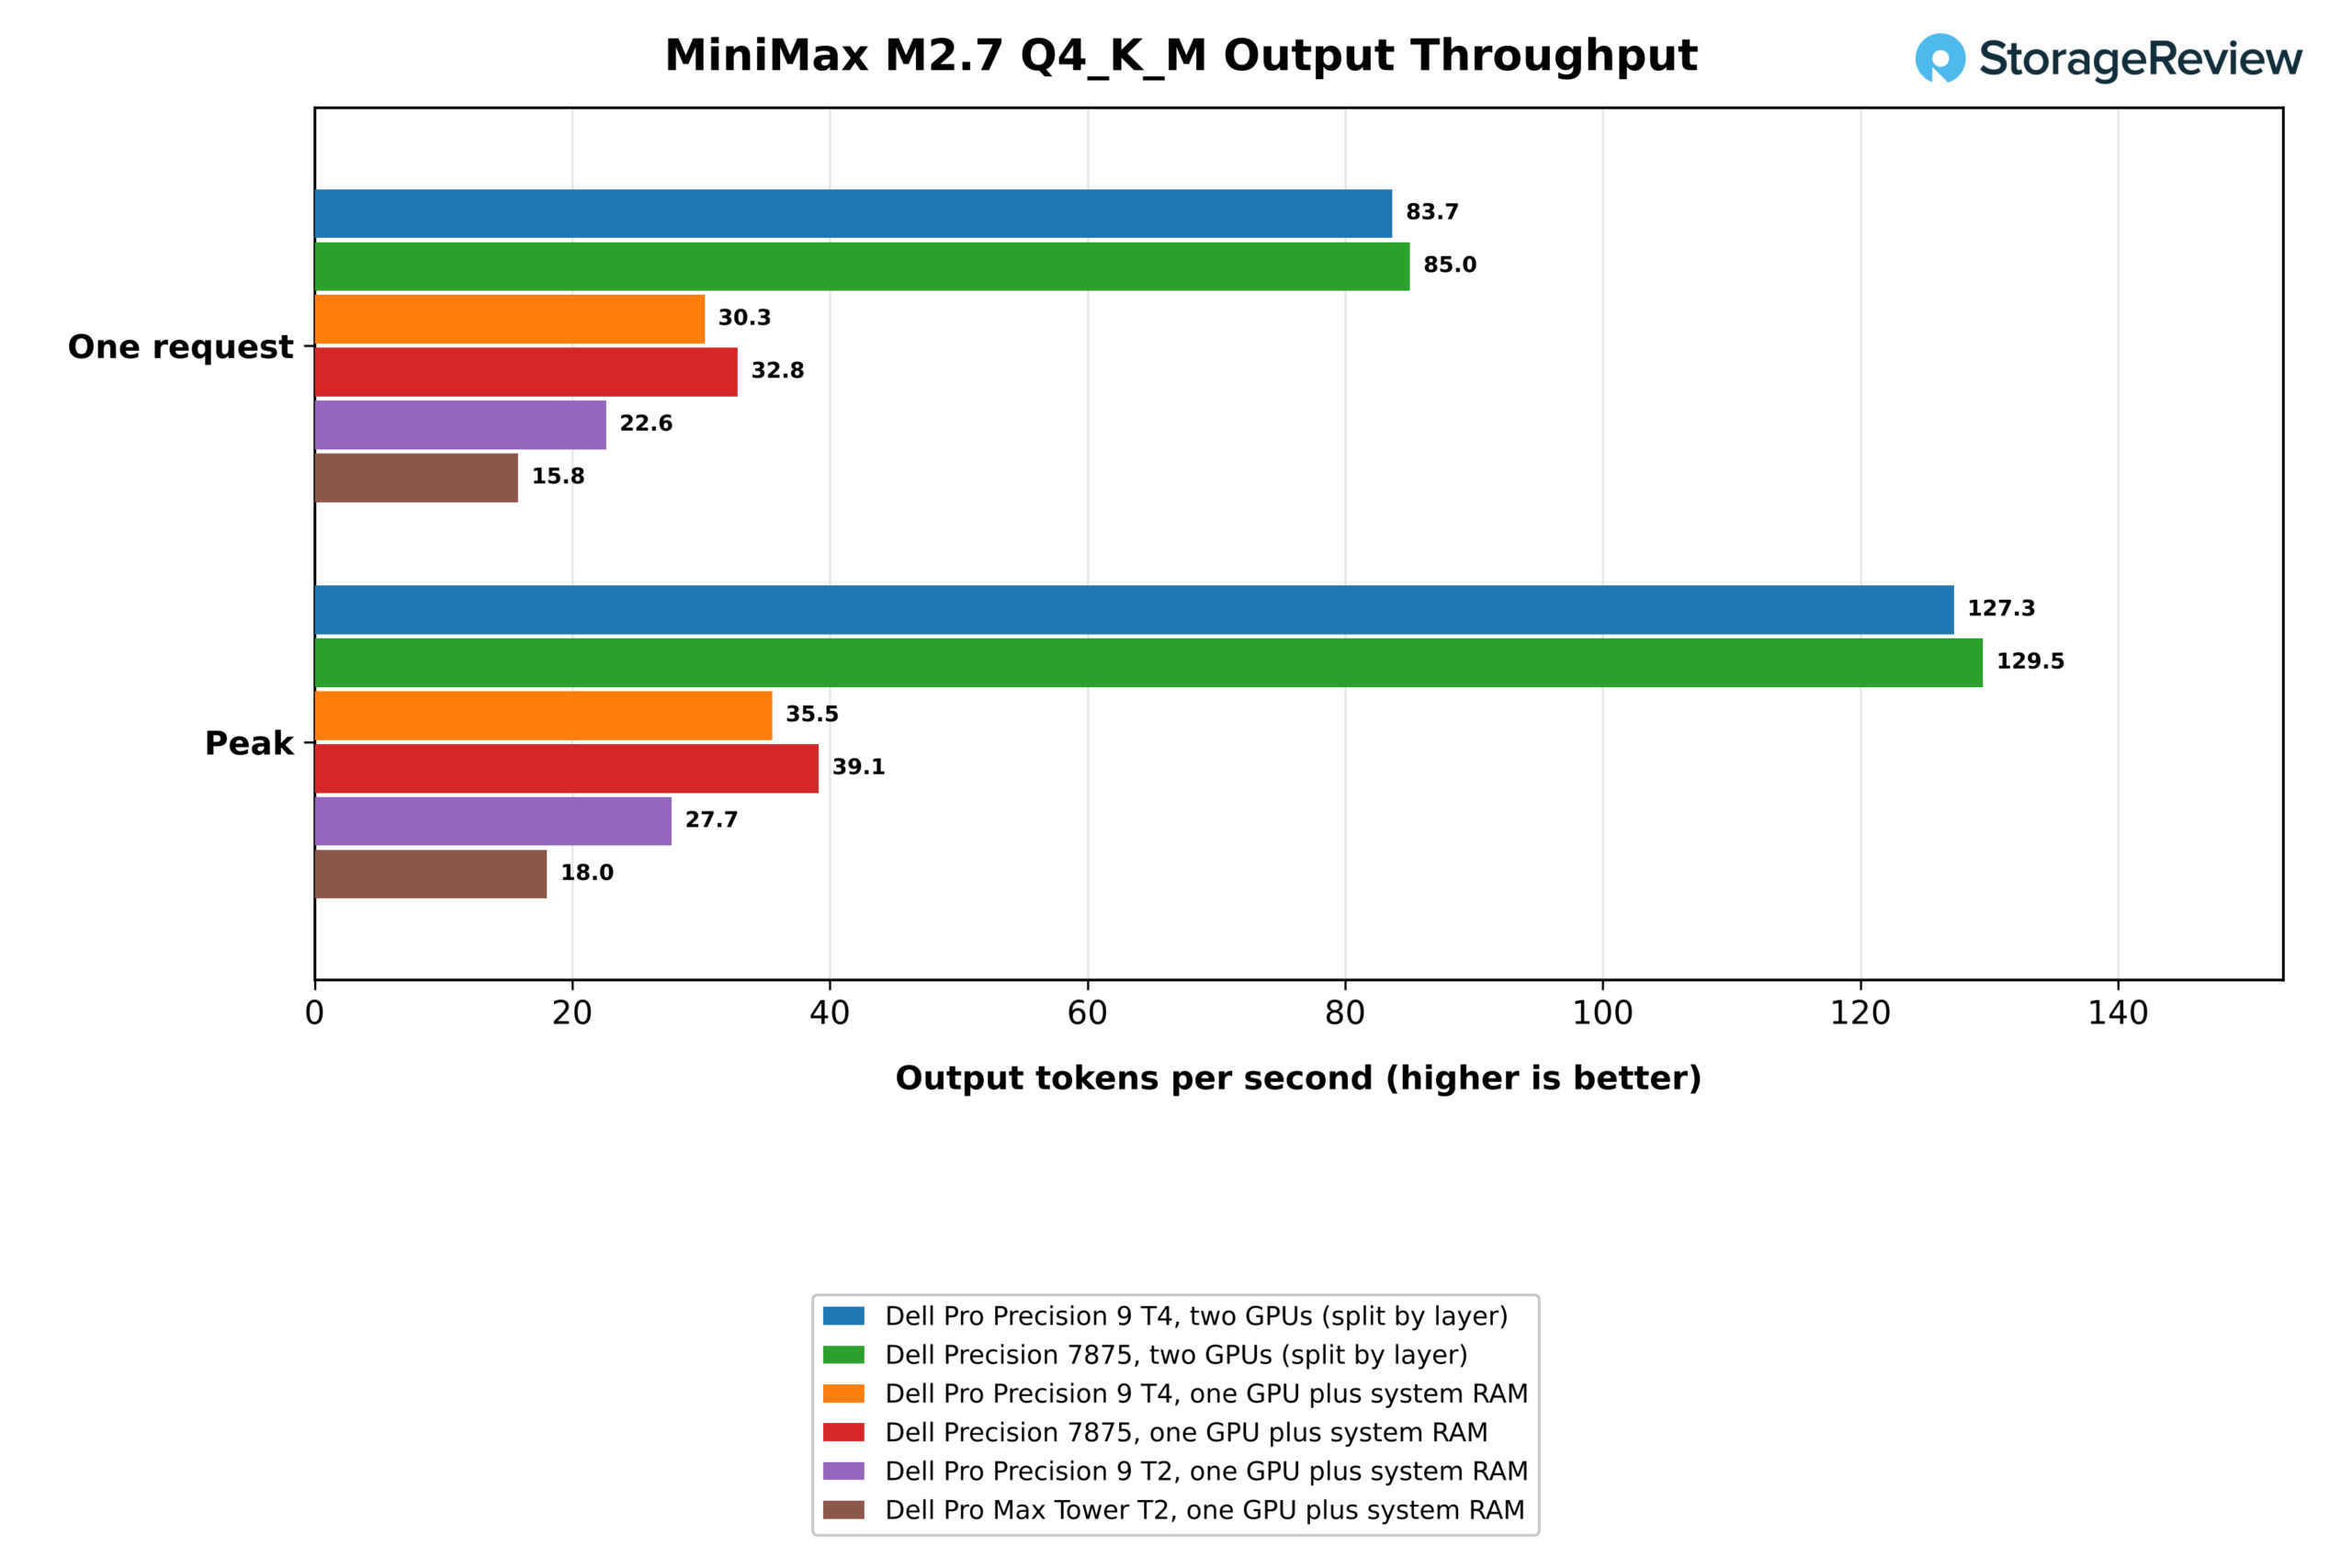
| Eine GPU plus System-RAM, eine Anfrage (Token/s) | 30.3 | 32.8 | 22.6 | 15.8 |
| Eine GPU plus System-RAM, Spitzenwert (Token/s) | 35.5 | 39.1 | 27.7 | 18.0 |
| Eine GPU plus System-RAM, Zeit bis zum ersten Token (ms, niedriger ist besser) | 16,224 | 16,143 | 16,216 | 18,522 |
| Zwei GPUs, aufgeteilt nach Schichten, eine Anfrage (Token/s) | 83.7 | 85.0 | Einzelne GPU | Einzelne GPU |
| Zwei GPUs, aufgeteilt nach Schicht, Spitzenwert (Token/s) | 127.3 | 129.5 | Einzelne GPU | Einzelne GPU |
| Zwei GPUs, aufgeteilt nach Schichten, Zeit bis zum ersten Token (ms, niedriger ist besser) | 3,138 | 3,162 | Einzelne GPU | Einzelne GPU |
| Kaltlast, eine GPU plus RAM (s, je niedriger, desto besser) | 40.5 | 65.8 | 37.6 | 81.1 |
| Kaltlast, zwei GPUs aufgeteilt (s, niedriger ist besser) | 27.6 | 50.7 | Einzelne GPU | Einzelne GPU |
MiniMax M2.7 ist ein Modell mit 230 Milliarden Parametern, das auf der Kombination von Experten basiert. Unsere 4-Bit-Quantisierung benötigt 129.3 GB, mehr als die 96 GB einer RTX PRO 6000. Auf einer einzelnen Karte, wobei der restliche Speicher im Systemspeicher lag, generierte der T4 für einen Benutzer 30.3 Token pro Sekunde und benötigte 16.2 Sekunden, um den ersten Token zurückzugeben. Auf beide Karten verteilt, generierte er 83.7 Token pro Sekunde – 2.8-mal schneller –, gab den ersten Token in 3.1 Sekunden zurück und erreichte einen Spitzenwert von 127.3 Token pro Sekunde gegenüber 35.5.
Die Ergebnisse mit einer GPU zeigen, wie stark die Host-Plattform ins Spiel kommt, sobald ein Modell in den Systemspeicher eingebunden wird. Die acht Kanäle des T4 mit DDR5-6400-Speicher liegen mit 22.6 Token pro Sekunde 34 Prozent vor dem vierkanaligen Pro Precision 9 T2 und mit 15.8 Token pro Sekunde 1.9-mal schneller als der zweikanalige Pro Max Tower T2, obwohl die 600-Watt-Karte des Pro Max Tower T2 in jedem kompatiblen Modell schneller ist. Der Precision 7875 übertraf den T4 mit 32.8 Token pro Sekunde bei 35 Prozent weniger Speicherbandbreite; die Bandbreite allein ist also nicht ausschlaggebend für dieses Ergebnis. Wir geben den gemessenen Vorsprung des 7875 an und haben die Ursache nicht ermittelt.
Modell wird geladen
| Ollama 0.40.3 und llama.cpp Modell laden (s, niedriger ist besser) | Dell Pro Precision 9 T4 | Dell Präzision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| gpt-oss:20b (12.8 GB), kalt | 5.79 | 7.61 | 5.57 | 7.95 |
| gpt-oss:20b, warm | 3.45 | 2.50 | 3.47 | 3.05 |
| gpt-oss:120b (60.9 GB), kalt | 15.16 | 25.80 | 15.16 | 28.18 |
| gpt-oss:120b, warm | 7.49 | 5.01 | 7.87 | 6.81 |
| gpt-oss:120b, cold, eine Kopie auf jeder GPU | 26.47 | 35.55 | Einzelne GPU | Einzelne GPU |
| MiniMax M2.7 (129.3 GB), kalt, eine GPU plus RAM | 40.5 | 65.8 | 37.6 | 81.1 |
| MiniMax M2.7, warm, eine GPU plus RAM | 28.6 | 15.2 | 36.7 | 80.5 |
Bei Kaltstarts begünstigen die Gen5-Laufwerke das Laden von gpt-oss:120b von der SK hynix Gen5 SSD. Der T4 erreichte damit die gleiche Leistung wie der Pro Precision 9 T2 und lag deutlich vor den 25.8 bzw. 28.2 Sekunden des mit Gen4 ausgestatteten Precision 7875 und Pro Max Tower T2. Bei Warmstarts aus dem Seitencache kehrt sich die Reihenfolge um: Hier benötigte der 7875 5.0 Sekunden, der T4 hingegen 7.5 Sekunden. Das gleichzeitige Laden einer Kopie auf jede GPU dauerte beim T4 26.5 Sekunden.
Abrufgestützte Generierung in großem Umfang
| RAG über 1,002,067 Wikipedia-Einträge | Dell Pro Precision 9 T4 | Dell Präzision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| Einbettung, eine GPU (Durchgänge/s) | 1,126 | 1,196 | 1,141 | 1,388 |
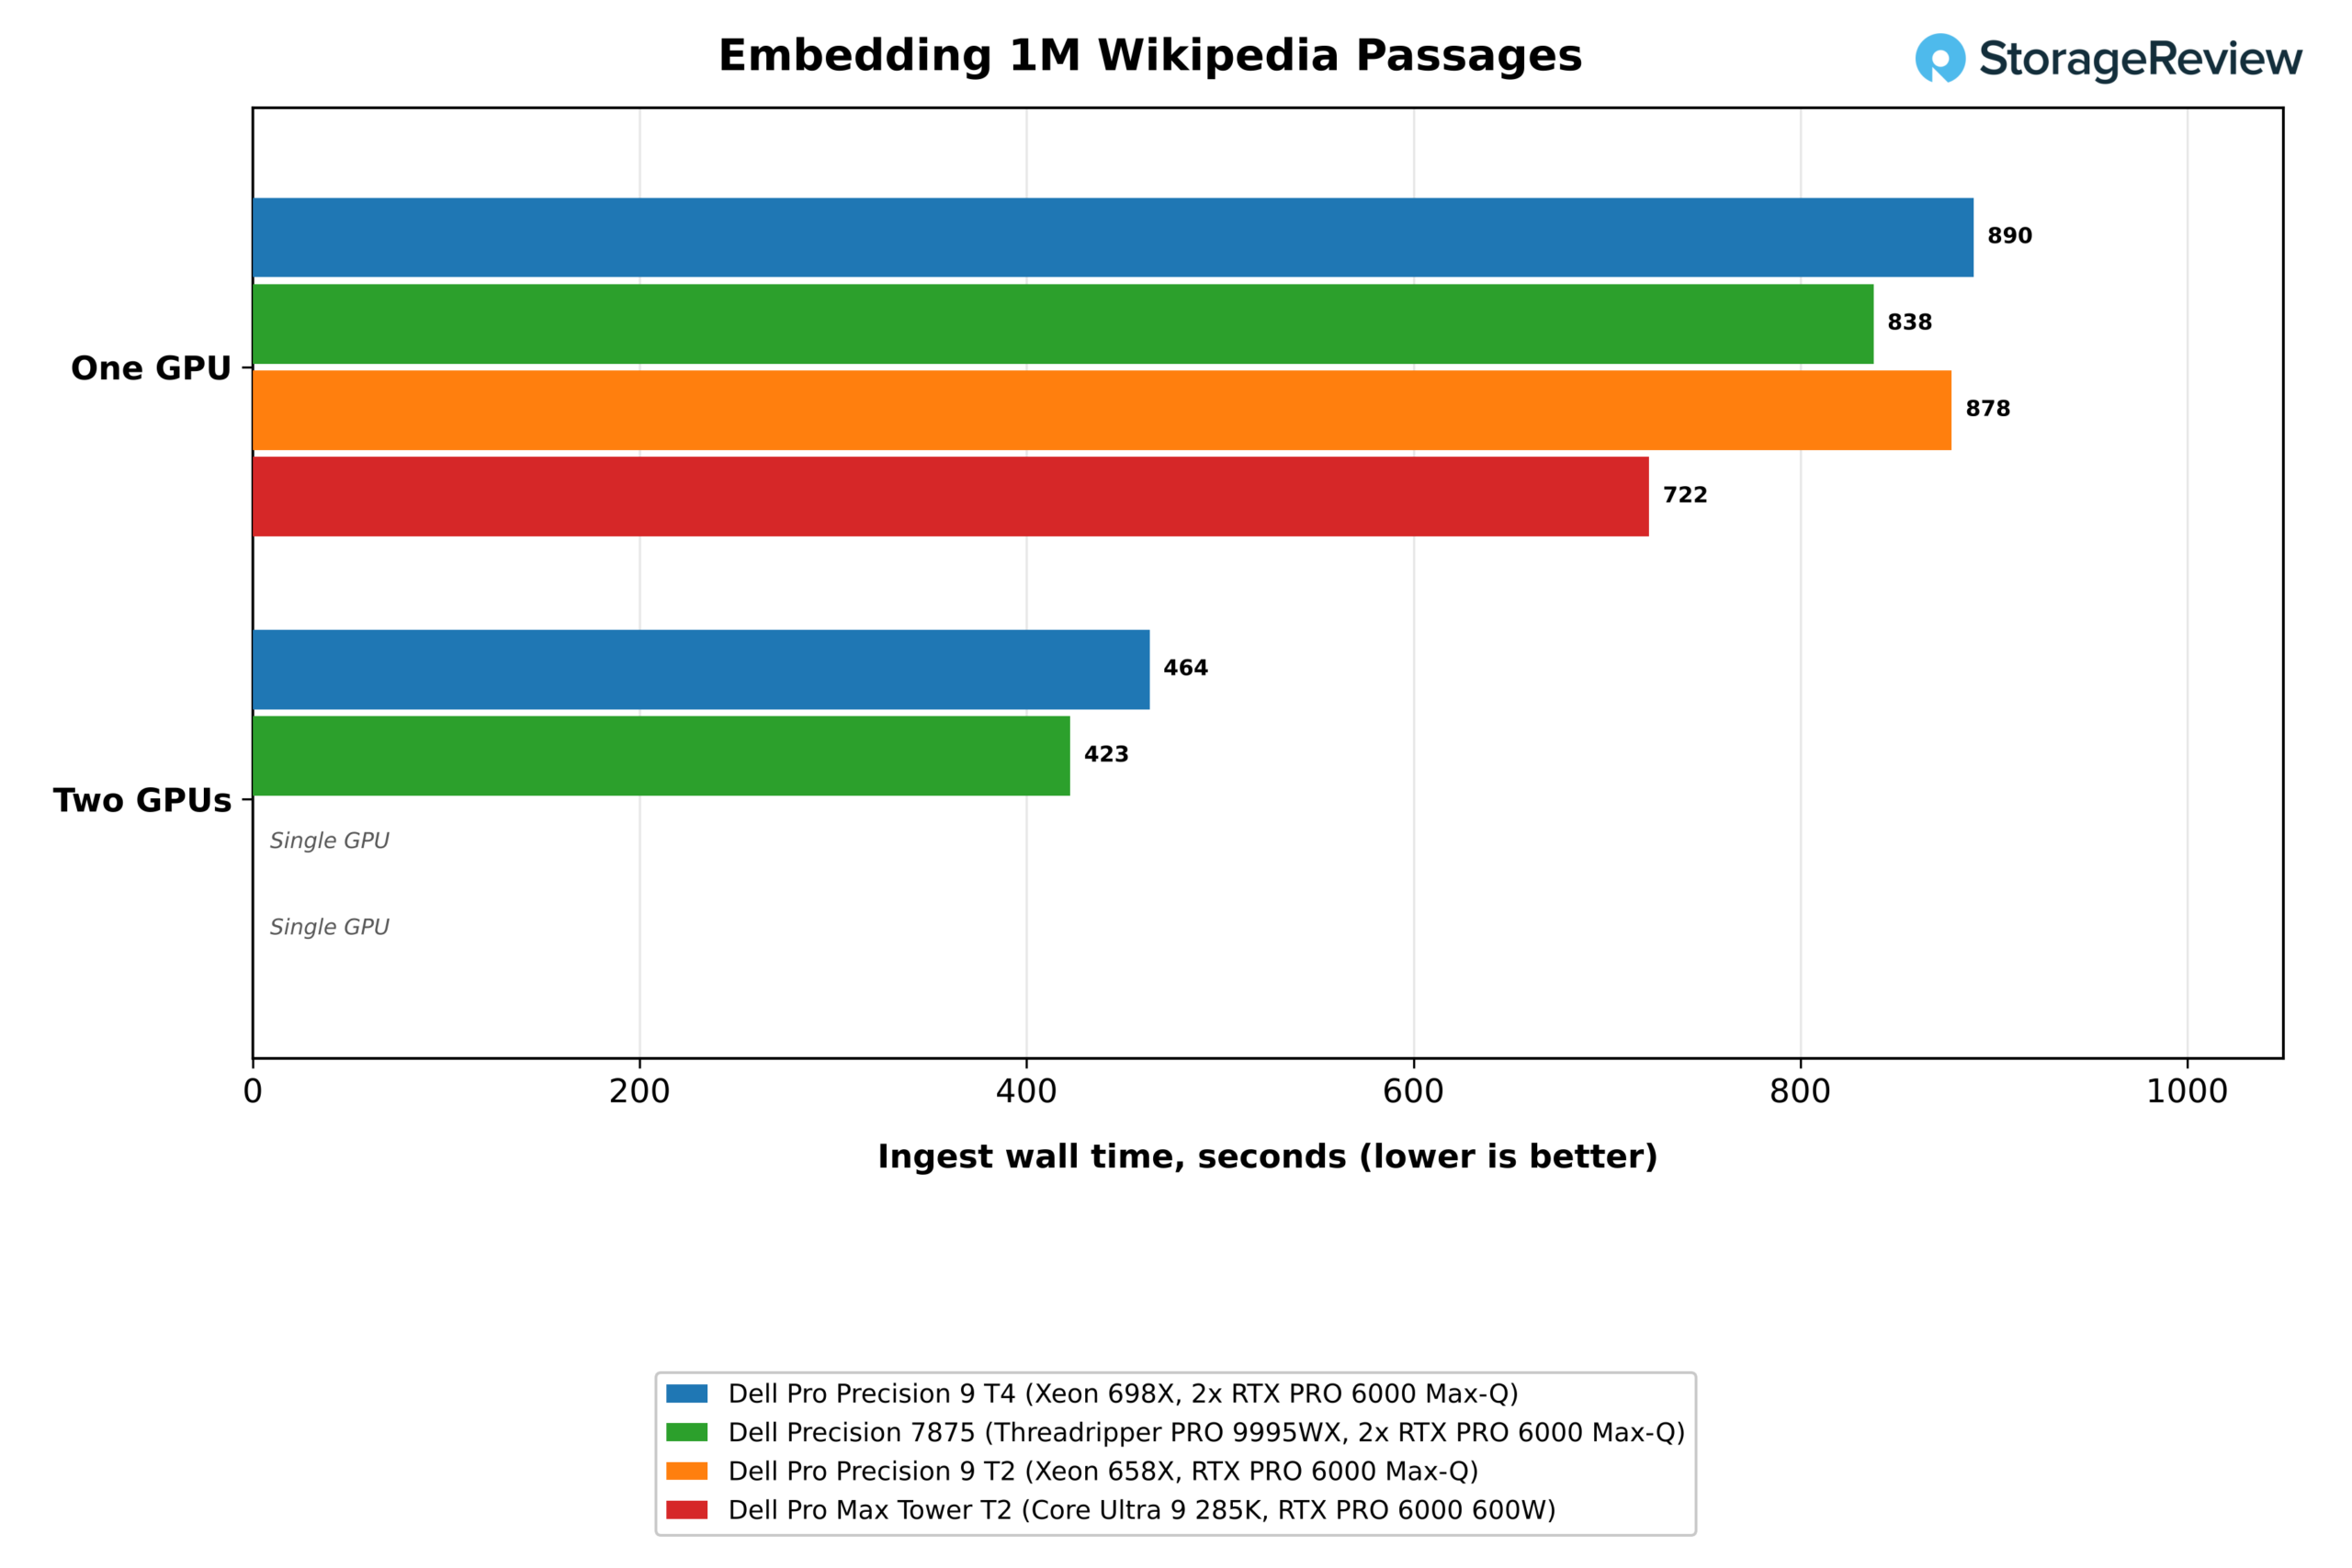
| Einbettungs-Wandzeit, eine GPU (s, je niedriger, desto besser) | 890 | 838 | 878 | 722 |
| Einbettung, zwei GPUs (Durchgänge/s) | 2,162 | 2,371 | Einzelne GPU | Einzelne GPU |
| Einbettungs-Wall-Time, zwei GPUs (s, niedriger ist besser) | 464 | 423 | Einzelne GPU | Einzelne GPU |
| HNSW-Indexaufbau (s, niedriger ist besser) | 27.3 | 34.8 | 46.3 | 118.6 |
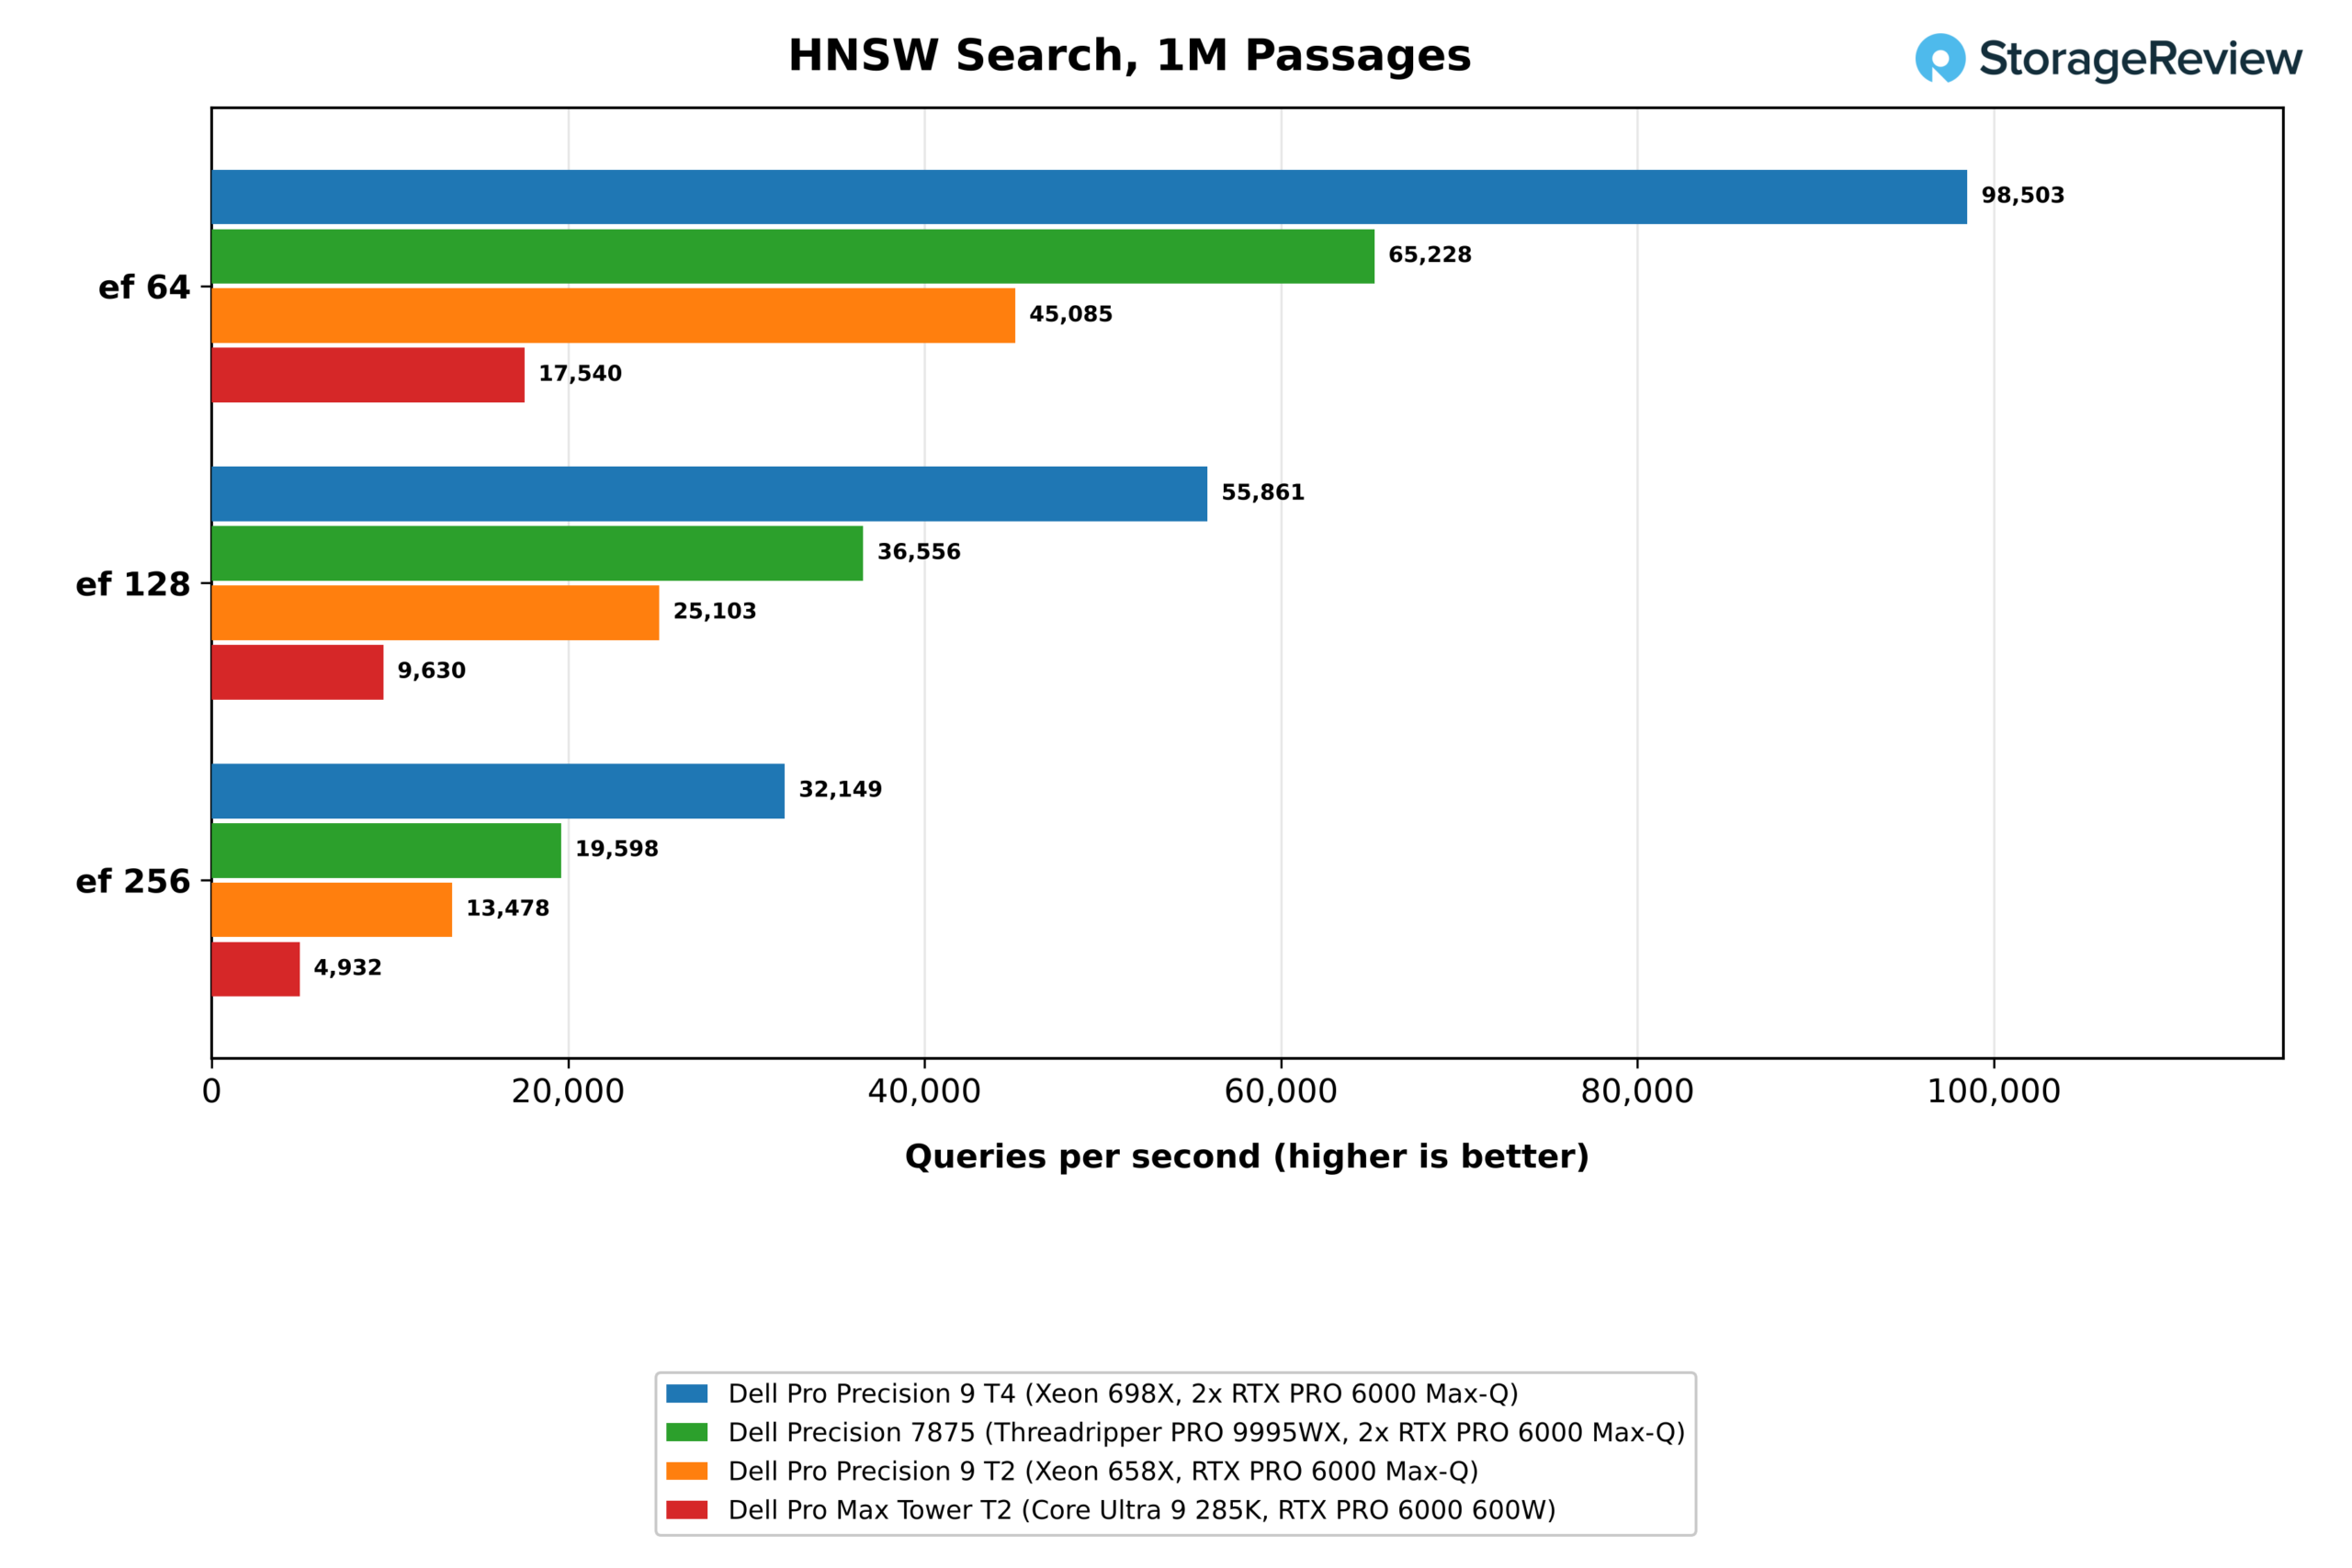
| HNSW-Suche, ef 64 (Anfragen/s) | 98,503 | 65,228 | 45,085 | 17,540 |
| HNSW-Suche, ef 256 (Anfragen/s) | 32,149 | 19,598 | 13,478 | 4,932 |
| Recall@5 vs. exakte Suche, EF 256 (%) | 97.59 | 97.67 | 97.26 | 97.70 |
| Frage zur Beantwortung von S. 50 (s, niedriger ist besser) | 0.123 | 0.082 | 0.117 | 0.095 |
Der RAG-at-scale-Test versteckt SQuAD-Fragen in einer Million Wikipedia-Texten, bettet sie mit nomic-embed-text ein, erstellt einen HNSW-Index und beantwortet die Fragen mit Phi-4-mini. Das Einbetten dauerte 890 Sekunden auf einer T4-GPU und 464 Sekunden auf zwei GPUs – eine Beschleunigung um den Faktor 1.92. Die Precision 7875 benötigte mit zwei Karten 423 Sekunden. Die 600-W-Karte im Pro Max Tower T2 ist mit 722 Sekunden die schnellste einzelne GPU.
Indexaufbau und Vektorsuche laufen auf der CPU, und genau hier liegt die Stärke des T4. Er erstellte den HNSW-Index in 27.3 Sekunden, verglichen mit 34.8 Sekunden beim Precision 7875 und 118.6 Sekunden beim Pro Max Tower T2. Bei einer Effizienzrate (ef) von 64 erreichte er 98,503 Suchanfragen pro Sekunde – das 1.51-Fache der 7875 und das 5.6-Fache des Core-Ultra-Systems. Bei ef 256 verarbeitete er 32,149 Suchanfragen pro Sekunde mit einer Trefferquote von 97.6 % bei exakten Suchen, und die Antworten wurden im Median in 0.12 Sekunden geliefert.
Feintuning
| Ministral 3 8B LoRA, BF16, eine Epoche von Dolly 15k | Dell Pro Precision 9 T4 | Dell Präzision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| Trainingszeit pro Epoche, eine GPU (Minuten, je kürzer, desto besser) | 31.5 | 27.2 | 30.6 | 22.3 |
| Durchsatz, eine GPU (Token/s) | 1,584 | 1,834 | 1,631 | 2,236 |
| Verlust vor und nach dem Training, eine GPU | 1.534 bis 1.169 | 1.534 bis 1.172 | 1.534 bis 1.167 | 1.534 bis 1.167 |
| Epochentrainingszeit, zwei GPUs (Minuten, je niedriger, desto besser) | 19.7 | 18.1 | Einzelne GPU | Einzelne GPU |
| Durchsatz, zwei GPUs (Token/s) | 2,528 | 2,754 | Einzelne GPU | Einzelne GPU |
| Geschwindigkeitssteigerung durch die zweite GPU | 1.60x | 1.50x | Einzelne GPU | Einzelne GPU |
| Verlust nach dem Training, zwei GPUs | 1.167 | 1.168 | Einzelne GPU | Einzelne GPU |
Der LoRA-Test mit einer Epoche optimiert Ministral 3 8B in BF16 auf Dolly 15k über 1,849 Schritte und bewertet alle 100 Schritte 200 zurückgehaltene Beispiele. Jedes System startete mit einem zurückgehaltenen Verlust von 1.534 und erreichte am Ende Werte zwischen 1.167 und 1.172. Der entscheidende Unterschied liegt in der benötigten Epochenzeit. Eine T4-GPU benötigte 31.5 Minuten bei 1,584 Token pro Sekunde und lag damit nur 3 Prozent hinter der Pro Precision 9 T2 mit derselben Max-Q-Karte. Die Precision 7875 benötigte 27.2 Minuten und die 600-W-Karte im Pro Max Tower T2 22.3 Minuten.
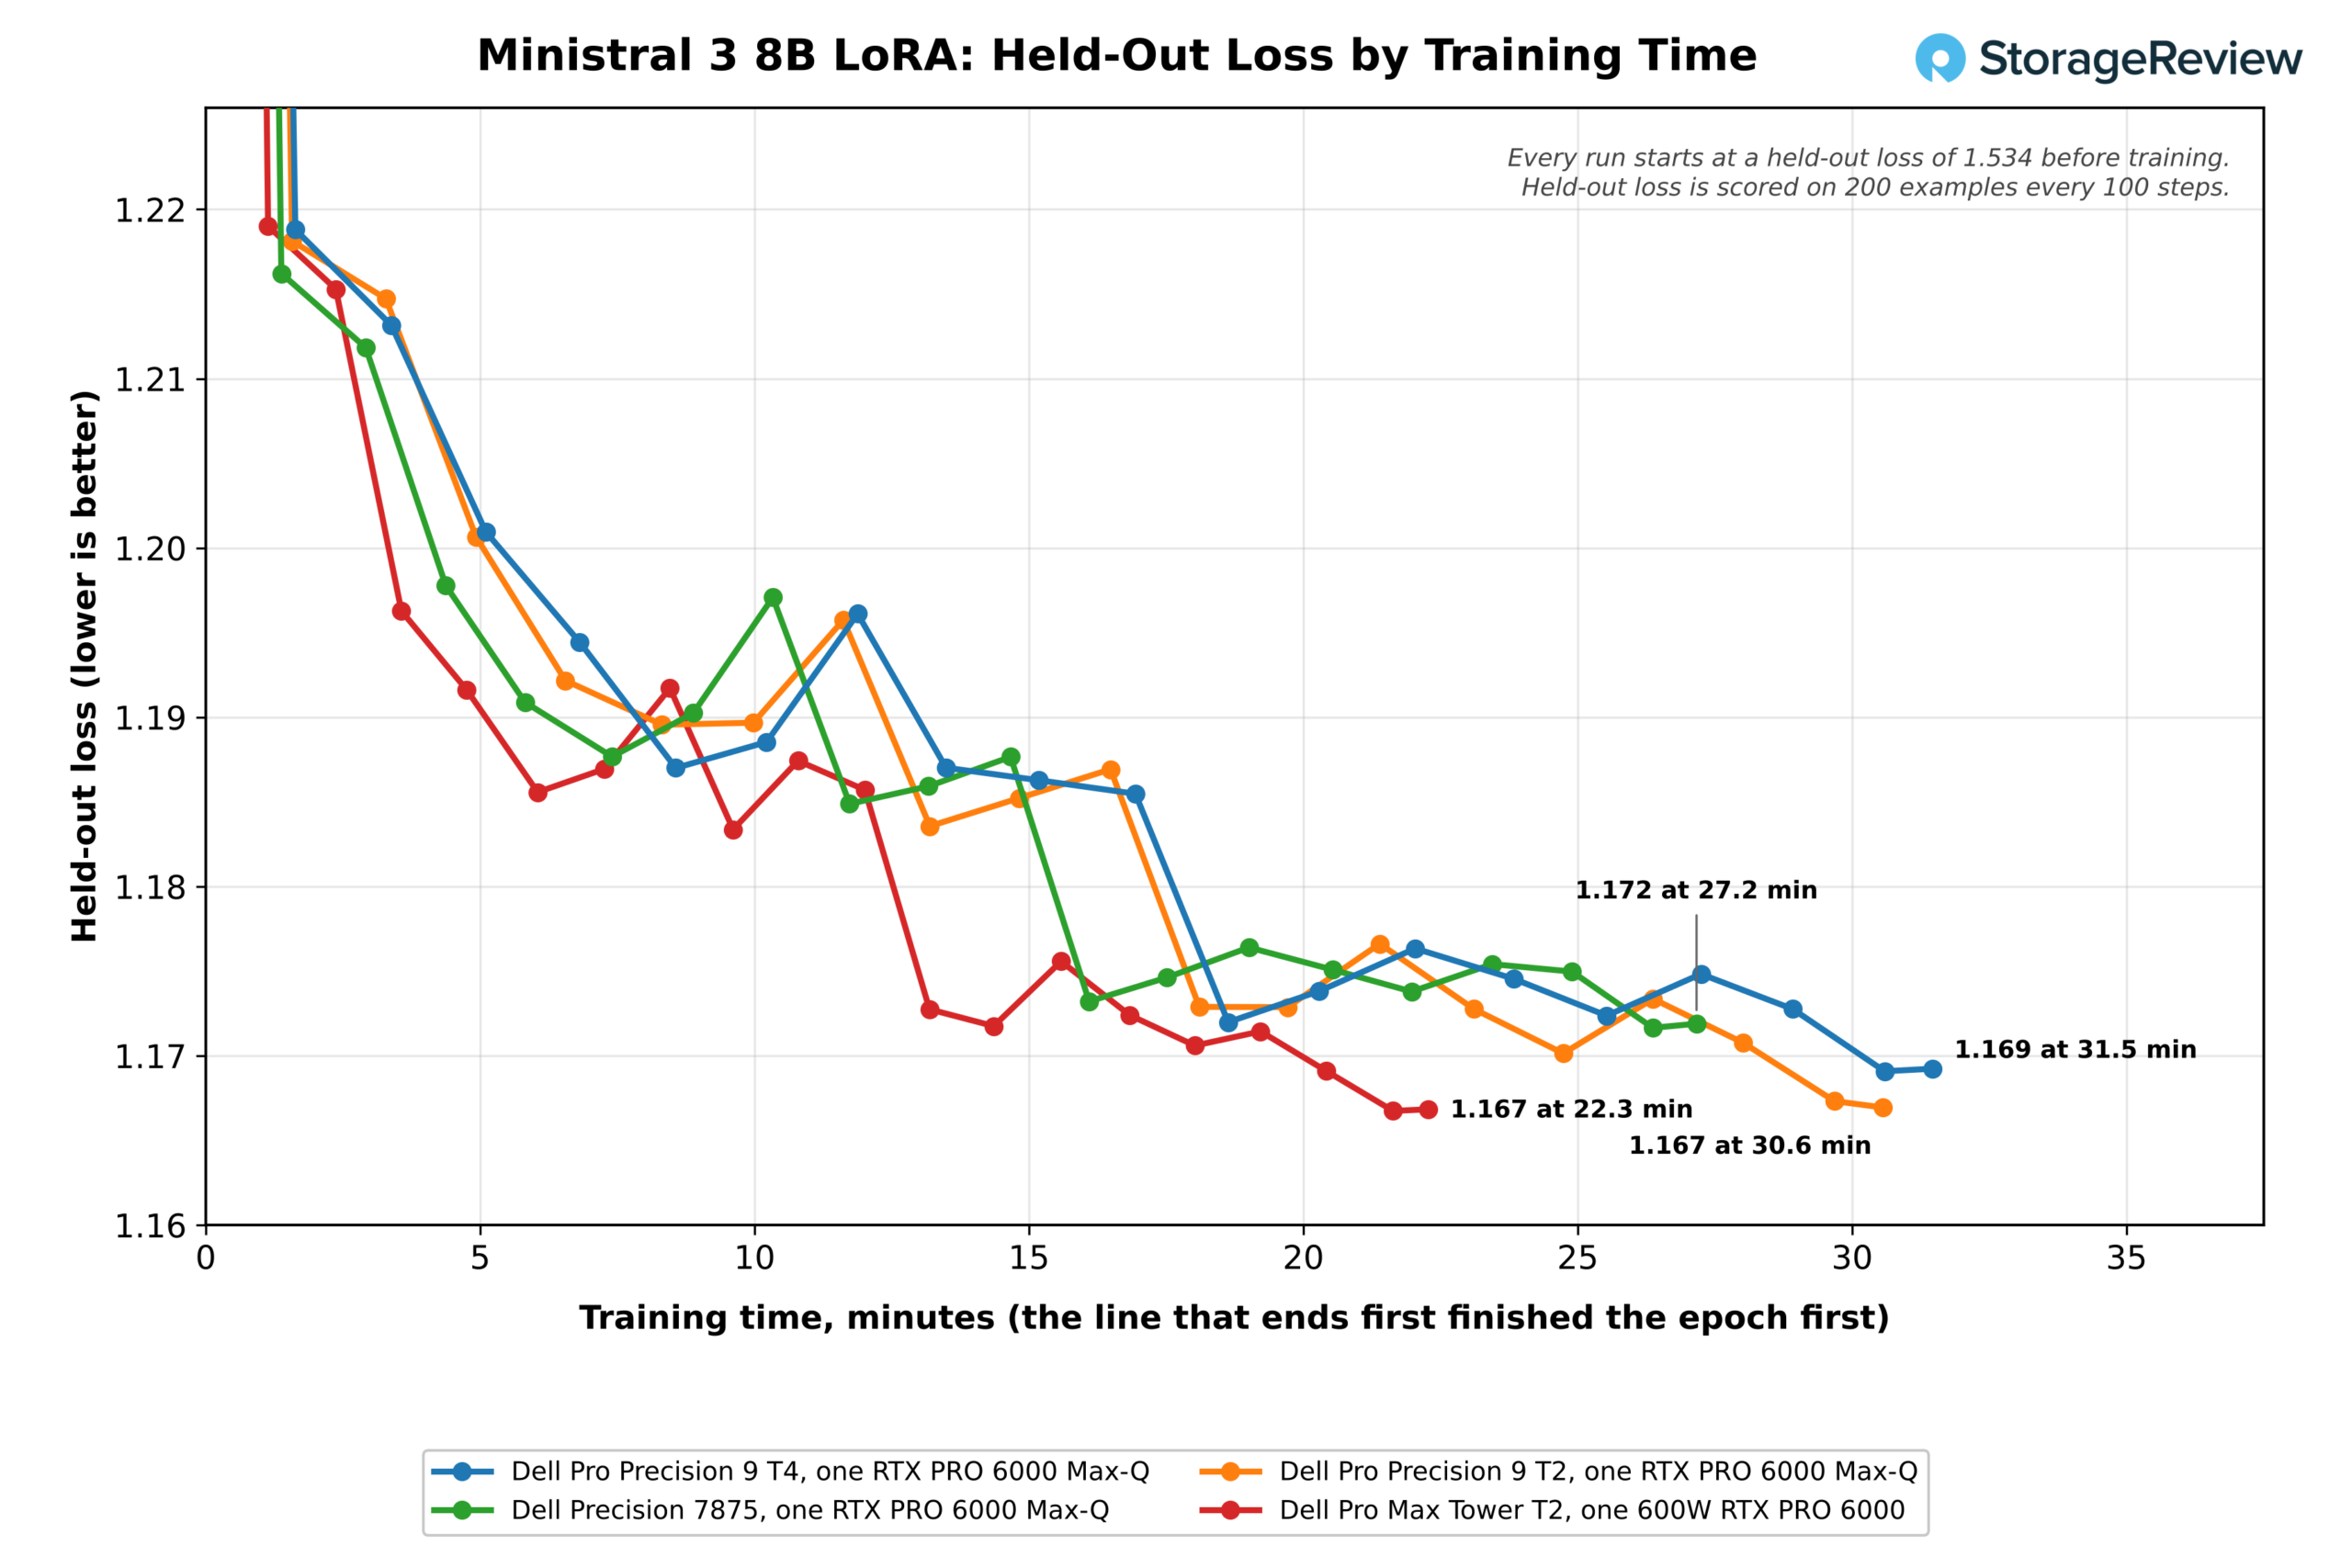
Der Halteverlust auf dem T4 sank in den ersten 100 Schritten (1.6 Minuten Trainingszeit) von 1.534 auf 1.219 und verringerte sich dann im weiteren Verlauf der Epoche auf 1.169. Durch Hinzufügen der zweiten GPU verkürzte sich die Epochenzeit des T4 auf 19.7 Minuten bei 2,528 Token pro Sekunde – eine 1.60-fache Beschleunigung, die die 22.3 Minuten der einzelnen 600-W-Karte unterbot. Der Precision 7875 absolvierte seine Epoche mit zwei GPUs in 18.1 Minuten, was einer 1.50-fachen Beschleunigung entspricht. Die Halteverluste der beiden GPU-Läufe lagen bei 1.167 bzw. 1.168.
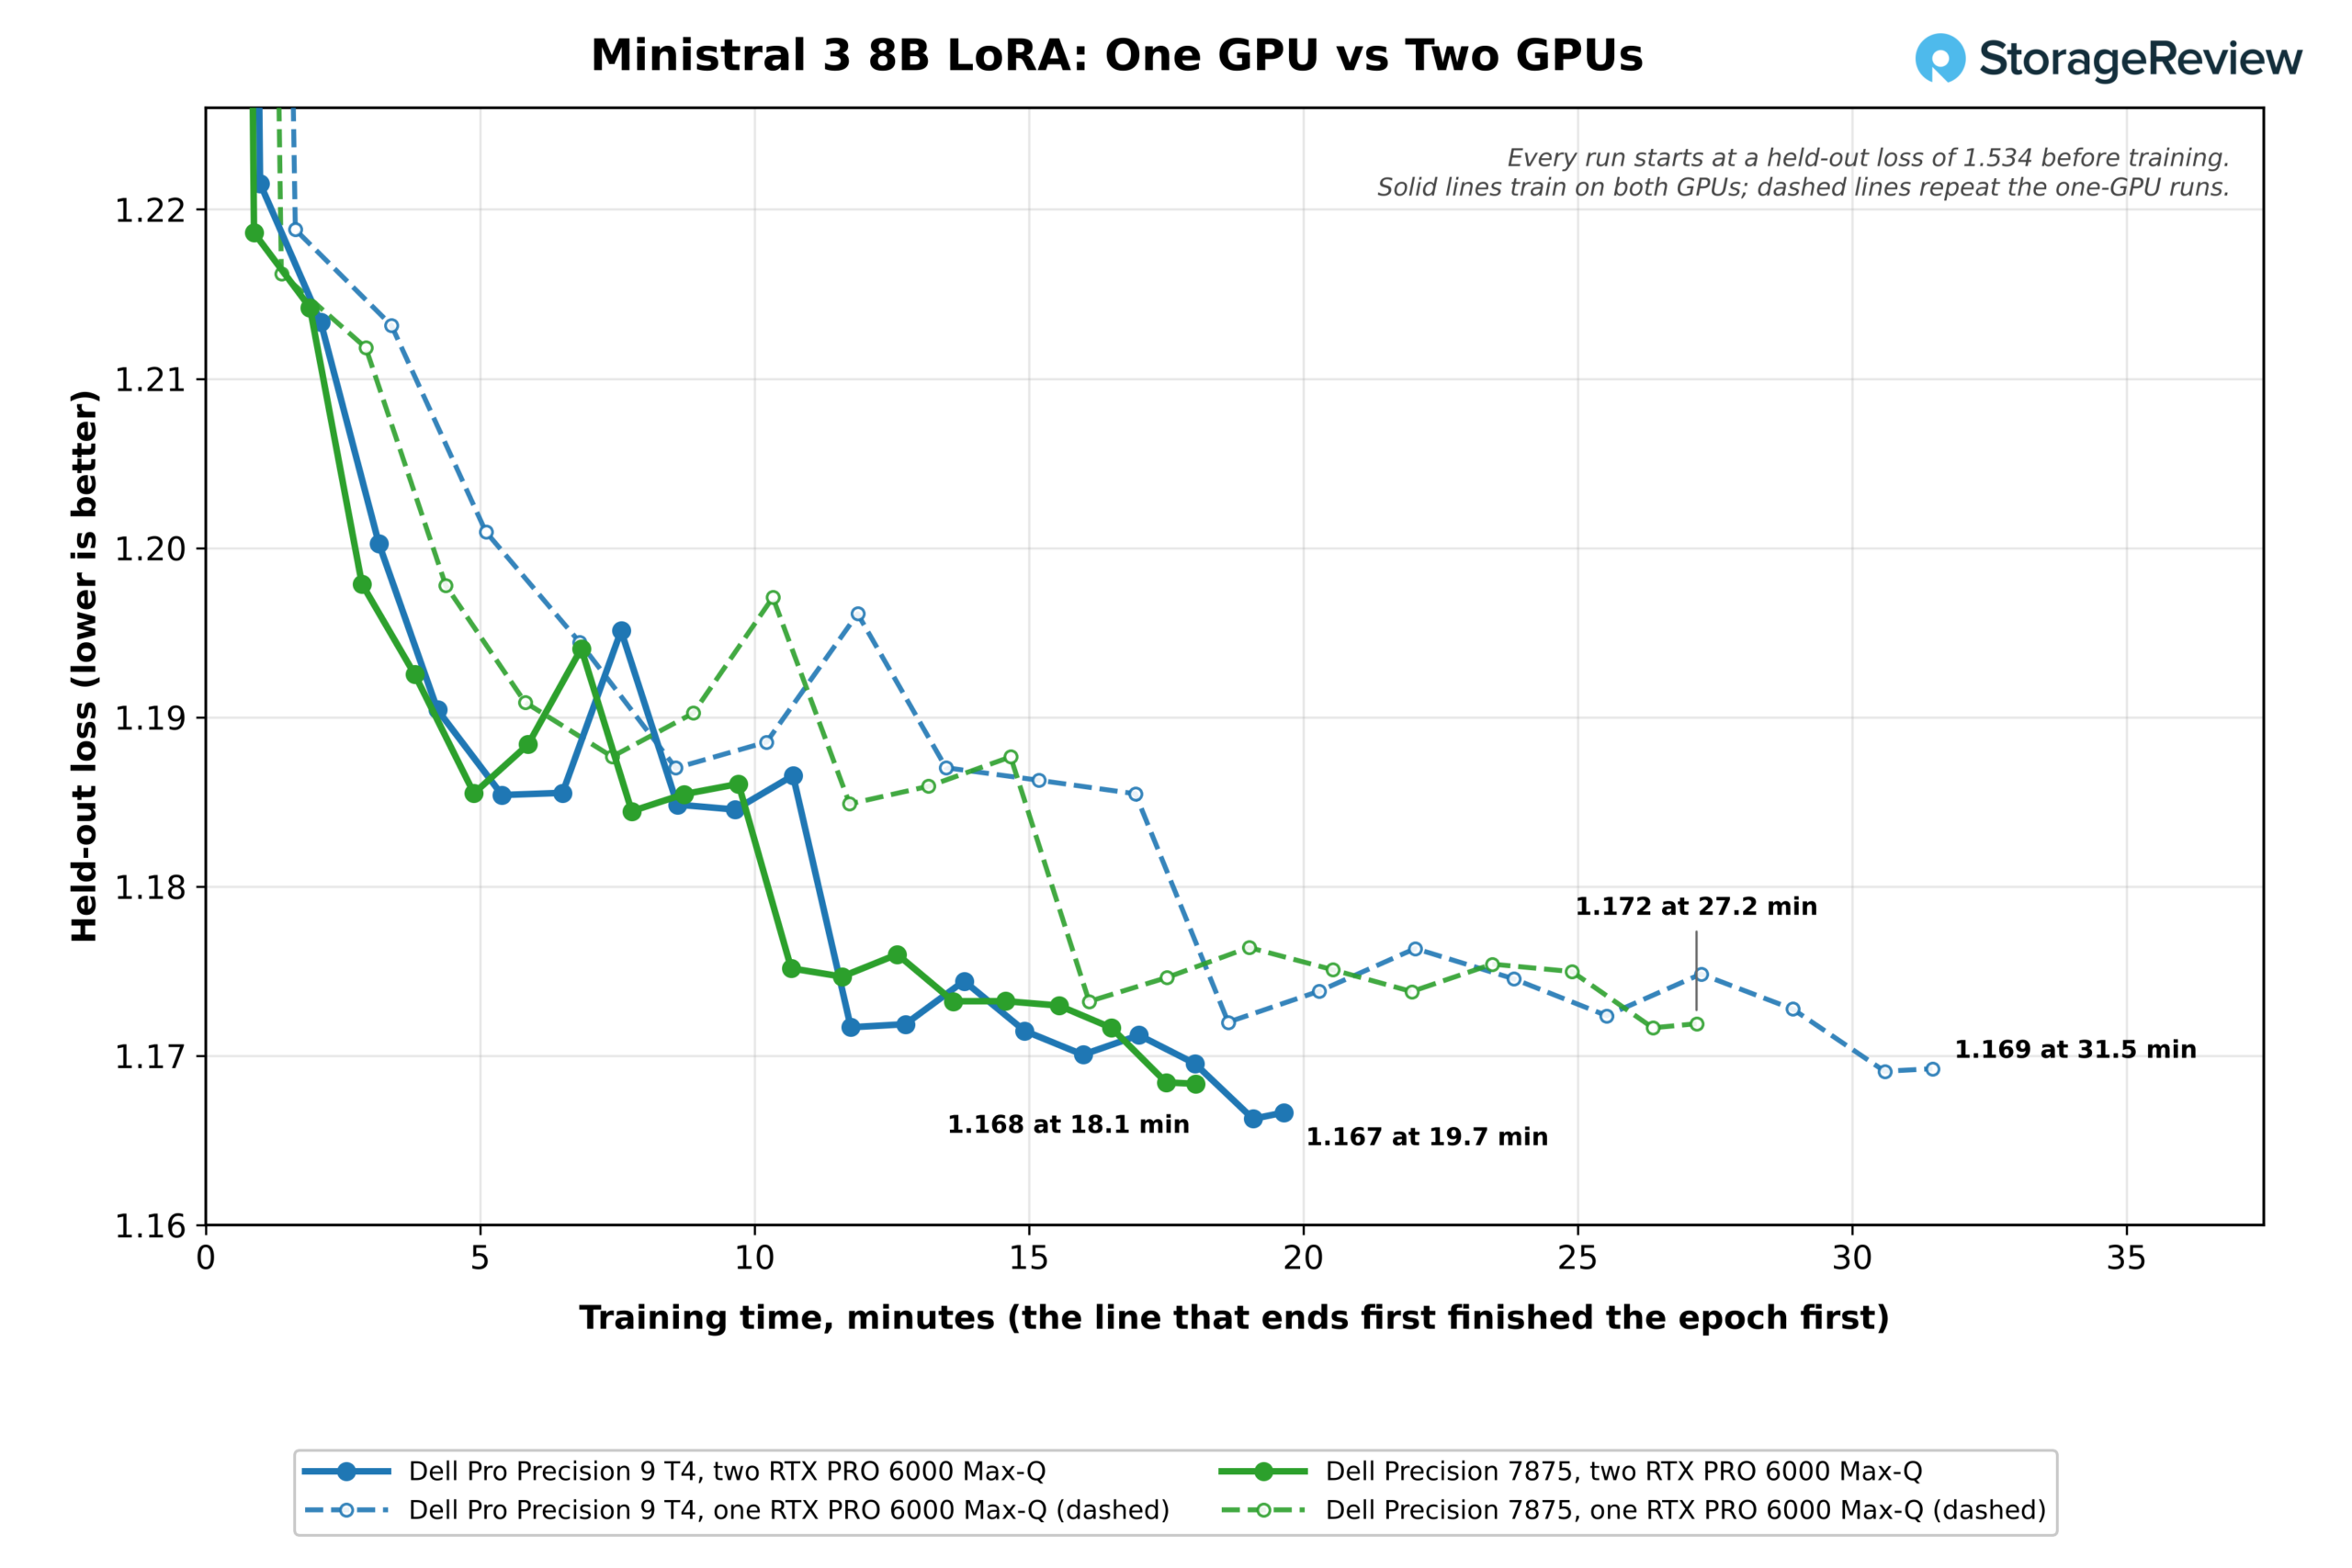
Beide Karten arbeiten datenparallel mit zwei Beispielen pro GPU. Die Gradienten werden in einem globalen Batch von acht Beispielen akkumuliert, wobei eine GPU vier Durchläufe und ein GPU-Paar zwei Durchläufe durchführt. Dadurch sieht der Lauf mit zwei GPUs in jedem Schritt dieselben Beispiele und erzielt denselben Verlustwert. Da in jedem Durchlauf zwei kurze Beispiele pro GPU verwendet werden, hat die zweite Karte wenig zu tun, und der Gradientenaustausch beansprucht einen größeren Anteil der Rechenzeit in jedem Schritt. Die Epoche erreichte einen maximalen GPU-Speicherverbrauch von 19.5 GiB auf einer Karte und 19.7 GiB pro Karte auf zwei Karten – ein Bruchteil der 96 GB großen RTX PRO 6000.
Codierungsagent, kleinskaliges RAG und Bildgenerierung
| Codierungsagent, RAG und Bildgenerierung (je höher, desto besser, sofern nicht anders angegeben) | Dell Pro Precision 9 T4 | Dell Präzision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| Codierungsagent, gpt-oss:20b 64K, erfolgreiche Durchläufe (von 3) | 3 | 2* | 2* | 2* |
| Codierungsagent, gpt-oss:120b 128K, erfolgreiche Durchläufe (von 3) | 3 | 3 | 3 | 3 |
| Codierungsagent, gpt-oss:120b, Generierungsrate (Token/s) | 161.5 | 167.9 | 166.7 | 183.2 |
| RAG, 20,963 Passagen, Aufnahme (Passagen/s) | 304.6 | 433.8 | 392.1 | 371.6 |
| RAG-Antwortgenerierung, Phi-4-mini (Tokens/s) | 372.5 | 410.0 | 402.8 | 415.8 |
| FLUX.2 klein 4B BF16, 1024×1024 (Bilder/Min) | 40.96 | 43.03 | 41.32 | 54.25 |
| Z-Image Turbo 6B BF16 (Bilder/min) | 17.29 | 17.67 | 17.27 | 23.83 |
| Qwen-Image 20B BF16 (Bilder/min) | 2.43 | 2.45 | 2.39 | 3.20 |
*Von der Testsuite gemeldet: Einer der drei Agentenläufe auf diesem System hat nicht alle 11 Tests bestanden.
Die T4 bestand alle Codierungsagentenläufe auf allen Modellstufen, einschließlich aller drei gpt-oss:20b-Läufe im 64K-Kontext, während die anderen drei Systeme zwei von drei Läufen erfolgreich absolvierten. Auf gpt-oss:120b generierte sie 161.5 Token pro Sekunde. Die Bildgenerierung erfolgt auf einer GPU, daher liegt die T4 mit ihren 40.96 Bildern pro Minute auf FLUX.2 klein in BF16 im Bereich der anderen Max-Q-Systeme und hinter der 600W-Karte mit 54.25 Bildern pro Minute.
CPU-Leistung
Die CPU-Ergebnisse vergleichen die 86 Xeon-Kerne des T4 mit den 96 Threadripper-Kernen des Precision 7875, wobei die beiden 24-Kern-Prozessoren des T2 als Referenz dienen. Der Threadripper verfügt über zehn Kerne mehr und bietet 192 Threads gegenüber den 172 Threads des Xeon. Der T4 punktet bei der Speicherbandbreite, der 7875 hingegen bei der Kernanzahl und dem Takt.
Komprimierung, Rendering und Kompilierung
| Test | Dell Pro Precision 9 T4 | Dell Präzision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| 7-Zip, alle Threads (GIPS) | 619.8 | 850.0 | 285.1 | 172.7 |
| 7-Zip, ein Thread (GIPS) | 8.85 | 10.58 | 9.27 | 11.04 |
| Blender 4.5 Monster (Samples/min) | 961.8 | 1,253.8 | 400.7 | 303.0 |
| Blender 4.5 Junkshop (Proben/Min.) | 641.9 | 849.7 | 266.9 | 191.9 |
| Blender 4.5 Klassenzimmer (Beispiele/Minute) | 442.8 | 612.2 | 187.2 | 147.1 |
| HandBrake x265 (fps) | 31.4 | 41.7 | 41.5 | 40.0 |
| HandBrake SVT-AV1 (fps) | 159.4 | 255.8 | 198.5 | 122.6 |
| LLVM 21 Build (s, niedriger ist besser) | 58.4 | 43.7 | 106.4 | 155.9 |
| Linux-Kernel allmodconfig (s, niedrigere Werte sind besser) | 312 | 264 | 537 | 843 |
| OpenSSL AES-256-GCM, alle Threads (GB/s) | 882.6 | 1,139.1 | 371.2 | 137.0 |
| nginx, 1,000 Verbindungen (Anfragen/s) | 414,468 | 467,128 | 323,567 | 153,732 |
Der T4 erreichte 619.8 GIPS in 7-Zip und 961.8 Samples pro Minute in Blender Monster – das 2.2- bzw. 2.4-Fache des 24-Kern-Prozessors Pro Precision 9 T2. Der Precision 7875 war in 7-Zip 37 Prozent und in Blender 30 Prozent schneller. Er schloss den LLVM-Build in 43.7 Sekunden ab (gegenüber 58.4 Sekunden) und den Linux-Kernel-allmodconfig-Build in 264 Sekunden (gegenüber 312 Sekunden). Die Geschwindigkeit pro Kern ist die Schwäche des T4; mit 8.85 GIPS erzielte er den niedrigsten Wert in dieser Gruppe im 7-Zip-Test mit nur einem Thread.
Die x265-Codierung von HandBrake stellt in dieser Tabelle einen Ausreißer dar, was eher am Encoder als am Prozessor liegt. Die anderen drei Systeme erreichten alle zwischen 40.0 und 41.7 fps mit 24 bzw. 96 Kernen. Daher skaliert x265 bei dieser Voreinstellung nicht mit der Kernanzahl, und die 31.4 fps des T4 stimmen mit seiner geringeren Taktfrequenz pro Kern bei den von x265 genutzten Threads überein. Während der Codierung taktete der T4 mit seinen 172 Threads im Durchschnitt mit etwa 1 GHz bei einer Temperatur zwischen 51 °C und 64 °C, was darauf hindeutet, dass der Chip größtenteils im Leerlauf war. SVT-AV1 skalierte besser: 159.4 fps auf dem T4 gegenüber 255.8 fps auf dem 7875.


Speicherbandbreite, Simulation und Mathematik
| Test | Dell Pro Precision 9 T4 | Dell Präzision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| STREAM-Triade (MB/s) | 328,329 | 215,177 | 141,832 | 45,102 |
| OpenFOAM 13 Treiber, 3M Zellen, Lösung (s, niedriger ist besser) | 293 | 556 | 826 | Nicht beendet |
| GROMACS benchPEP, alle Kerne (ns/Tag) | 1.243 | 1.034 | Nicht ausführen | Nicht ausführen |
| GROMACS benchMEM, 16 Kerne (ns/Tag) | 68.09 | 84.94 | 78.03 | 54.26 |
| OpenBLAS DGEMM, alle Kerne (GFLOPS) | 3,664 | 4,745 | 2,319 | 1,063 |
| OpenBLAS LU löst N=20000 (GFLOPS) | 1,660 | 1,172 | 1,616 | 858 |
| y-cruncher Pi, 1B Stellen (s, je niedriger, desto besser) | 4.01 | 7.45 | 8.51 | 24.61 |
| y-cruncher Pi, 10B Stellen (s, je niedriger, desto besser) | 53.9 | 83.7 | 119.2 | 347.9 |
| y-cruncher Pi, 25B Stellen (s, je niedriger, desto besser) | 155.6 | 259.6 | Nicht ausführen | Nicht ausführen |
Acht Kanäle DDR5-6400 ermöglichen dem T4 eine Übertragungsrate von 328 GB/s im STREAM Triad-Test – 53 Prozent mehr als der DDR5-5600 des Precision 7875 und das 2.3-Fache des vierkanaligen Pro Precision 9 T2. Bandbreitenintensive Aufgaben zeigen folgende Ergebnisse: Der T4 löste den OpenFOAM-Fall „driveAer“ mit 3 Millionen Zellen in 293 Sekunden, im Vergleich zu 556 Sekunden beim 7875 und 826 Sekunden beim Pro Precision 9 T2. Der Pro Max Tower T2 schaffte dies nicht innerhalb des 150-Minuten-Limits der Testsuite. Auch den Fall mit 22.6 Millionen Zellen bewältigte der T4 in 6,851 Sekunden.

GROMACS benchPEP, die umfangreiche Molekulardynamiksimulation auf allen Kernen, erreichte auf dem T4 1.243 ns/Tag gegenüber 1.034 ns/Tag auf dem 7875. Die LU-Lösung erzielte 1,660 GFLOPS gegenüber 1,172 GFLOPS. y-cruncher berechnete 10 Milliarden Nachkommastellen von Pi in 53.9 Sekunden gegenüber 83.7 Sekunden auf dem 7875 und 25 Milliarden in 155.6 Sekunden gegenüber 259.6 Sekunden. Dichte Berechnungen, die im Cache verbleiben, begünstigen den Threadripper, der bei OpenBLAS DGEMM mit 4,745 GFLOPS gegenüber 3,664 GFLOPS führend war.


Datenbanken und Dienste
| Test | Dell Pro Precision 9 T4 | Dell Präzision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| ClickBench-Schnelllauf, 43 Abfragen (s, je niedriger, desto besser) | 3.21 | 2.88 | 4.80 | 10.44 |
| ClickBench-Kaltstart, 43 Abfragen (s, je niedriger, desto besser) | 6.45 | 7.09 | 6.92 | 14.22 |
| Valkey-Cache, SET (Anfragen/s) | 666,714 | 1,138,696 | 914,832 | 1,719,108 |
| Valkey-Cache, GET (Anfragen/s) | 865,353 | 1,279,429 | 991,576 | 1,648,278 |
| Stockfisch, alle Threads (Mnps) | 68.21 | 168.27 | 45.44 | 37.42 |
| PyPerformance go (ms, niedriger ist besser) | 74.3 | 66.0 | 72.1 | 56.7 |
ClickHouse führte die 43 ClickBench-Abfragen auf dem T4 in 3.21 Sekunden (im Warmlauf) bzw. 6.45 Sekunden (im Kaltlauf) aus. Im Warmlauf lag der T4 damit 0.33 Sekunden hinter dem 7875, im Kaltlauf hingegen 0.64 Sekunden vorn. Valkey bevorzugt schnelle Kerne gegenüber vielen Kernen, und die 666,714 SET-Anfragen pro Sekunde des T4 liegen hinter allen drei Vergleichssystemen zurück. Der Core Ultra 9 285K im Pro Max Tower T2 führt mit 1.72 Millionen Anfragen. Dieses Muster deckt sich mit den Ergebnissen des T4 im Ein-Kern-Betrieb und sollte bei latenzkritischen Diensten berücksichtigt werden.
Bei voller Auslastung aller 172 Threads und einer durchschnittlichen Prozessortemperatur von 87 °C durchsuchte der T4 in Stockfish 68.21 Millionen Knoten pro Sekunde. Das ist das 1.5-Fache des 48-Thread-Pro Precision 9 T2 und deutlich weniger als die Hälfte der 168.27 Millionen Knoten pro Sekunde des 7875 mit 192 Threads. Der Test brach beim ersten vollständigen Durchlauf des T4 ab; ein erneuter Test ergab diesen Wert. Wir geben das Ergebnis unverändert wieder und haben die Ursache für die schwache Skalierung noch nicht ermittelt.
Speicherleistung
| fio, 25 GiB Speicherbedarf (je höher, desto besser) | Dell Pro Precision 9 T4 | Dell Präzision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| Sequenzielles Lesen 128K (MB/s) | 14,152 | 7,089 | 20,914 * | 7,234 |
| Sequenzielles Schreiben 128K (MB/s) | 10,078 | 5,265 | 12,564 | 6,772 |
| Zufällige Lesevorgänge 4K, Spitzenwert (IOPS) | 2,306,346 | 993,569 | 3,214,066 | 1,538,387 |
| Zufälliges Schreiben 4K, Spitzenwert (IOPS) | 1,830,776 | 787,388 | 2,353,766 | 1,326,030 |
*Von der Testsuite wegen Abweichungen zwischen den einzelnen Läufen nach einem erneuten Durchlauf als fehlerhaft markiert.
Die 2 TB große SK hynix Gen5-Boot-Festplatte des T4 erreichte Lesegeschwindigkeiten von 14,152 MB/s und Schreibgeschwindigkeiten von 10,078 MB/s, was etwa dem Doppelten der sequenziellen Lesegeschwindigkeit der Gen4-Festplatten im Precision 7875 und im Pro Max Tower T2 entspricht. Die Spitzenwerte lagen bei 2.31 Millionen IOPS beim zufälligen Lesen und 1.83 Millionen IOPS beim zufälligen Schreiben. Die sequenzielle Lesegeschwindigkeit des Pro Precision 9 T2 von 20,914 MB/s übertrifft die Kapazität einer Gen5 x4-Verbindung, die für das Testvolume dieses Systems – ein Striping-Array aus Samsung PM9E1 Gen5-Festplatten – ausgelegt ist. Wir testeten nur die Boot-Festplatte des T4; die zweite 2-TB-Festplatte war nicht Teil dieses Tests.

Thermik und Uhren unter Last
| Dell Pro Precision 9 T4 | Maximale CPU-Leistung (°C) | CPU-Mittelwert (°C) | Mittlerer CPU-Takt (MHz) |
|---|---|---|---|
| 7-Zip | 93 | 80.6 | 1,967 |
| Mixer | 91 | 85.7 | 2,587 |
| GROMACS | 96 | 81.3 | 1,313 |
| LLVM-Build | 83 | 74.5 | 2,127 |
| BLAS öffnen | 80 | 62.9 | 1,325 |
| LLM-Dienst | 84 | 65.0 | 924 |
| Feintuning | 71 | 61.2 | 854 |
| RAG im Maßstab | 74 | 64.4 | 987 |
| Lagerung | 64 | 55.4 | 942 |
Im BIOS-Modus „Ultra Performance“ erreichte der Xeon 698X in 7-Zip eine Spitzentemperatur von 93 °C und in GROMACS 96 °C. Die Taktraten in der Tabelle sind Durchschnittswerte aller 172 logischen CPUs. Blender und Stockfish nutzten alle Threads und erreichten eine Taktfrequenz von 2.5 GHz bis 2.6 GHz, was über dem Basistakt des Chips von 2.0 GHz lag. GROMACS und OpenBLAS nutzten 64 bzw. 86 physische Kerne und ließen die restlichen Threads mit etwa 0.8 GHz im Leerlauf, weshalb ihre Durchschnittswerte bei etwa 1.3 GHz liegen. GPU-intensive Anwendungen hielten den Prozessor kühler, mit durchschnittlich 61 °C bis 65 °C während LLM-Serving, Feinabstimmung und RAG, da diese Tests die Grafikkarten stark beanspruchen.

Fazit
Der Dell Pro Precision 9 T4 ist für lokale KI-Anwendungen konzipiert, und die zweite RTX PRO 6000 macht sich hier deutlich bemerkbar. Zwei Max-Q-Karten steigerten den maximalen Durchsatz bei vier Modellen um das 1.85- bis 2.02-Fache und den Einbettungsdurchsatz um das 1.92-Fache. Die Laufzeit einer LoRA-Epoche auf Ministral 3 8B verkürzte sich von 31.5 auf 19.7 Minuten, und die Verarbeitungsgeschwindigkeit von MiniMax M2.7, einem für eine einzelne Karte zu großen Modell, erhöhte sich von 30.3 auf 83.7 Token pro Sekunde für einen einzelnen Benutzer. Auf gpt-oss 120B erreichte ein Server pro GPU 7,091 Token pro Sekunde bei 64 Anfragen. Die Verteilung des Modells auf beide Karten führte zu einer schnelleren Auslieferung des ersten Tokens eines einzelnen Benutzers in 719 ms statt 1,189 ms.

Acht Kanäle DDR5-6400 verschafften dem Xeon 698X eine um 53 Prozent höhere Speicherbandbreite als dem Threadripper PRO 9995WX. Dank dieser Bandbreite erzielte der T4 schnellere Ergebnisse bei OpenFOAM, GROMACS benchPEP, y-cruncher und HNSW-Suchen als der Precision 7875, und der Gen5-Speicher des T4 lud große Modelle schneller. Auch das Gehäuse verdient Lob: Es bietet das beste Kühlkonzept, das wir je von Dell in dieser Klasse gesehen haben, und ermöglicht den werkzeuglosen Zugriff auf das Netzteil.
Der 7875 liegt bei rechenintensiven Rendering-, Komprimierungs- und Kompilierungsaufgaben weiterhin 18 bis 38 Prozent vorn und bei SVT-AV1 sogar 60 Prozent. Die Leistung pro Kern des Xeon war im Vergleich zu allen anderen Systemen dieser Gruppe geringer, was sich bei Valkey und anderen Diensten mit geringer Thread-Auslastung bemerkbar machte. Auch das Feintuning mit einer einzelnen GPU verlief auf dem T4 langsamer: Die LoRA-Epoche benötigte 31.5 Minuten gegenüber 27.2 Minuten beim 7875 und 22.3 Minuten bei der 600-W-Karte im Pro Max Tower T2. Alle Systeme lagen innerhalb von 0.005 Sekunden des gleichen Zeitverlusts.
Mit einem Preis von ca. 66,600 US-Dollar (siehe Dell.com) eignet sich der T4 ideal für Teams, die Modelle lokal bereitstellen, einbetten und feinabstimmen möchten – darunter auch Modelle mit mehr als 96 GB GPU-Speicher – und gleichzeitig speicherintensive Simulationen und Analysen auf demselben Rechner durchführen wollen. Anwender, deren Arbeit hauptsächlich aus Rendering und Kompilierung besteht, profitieren von der höheren Geschwindigkeit der Threadripper-Plattform. Wer nur eine GPU benötigt, findet die gleiche Karte im kleineren Pro Precision 9 T2.

Bestenliste: Der Dell Pro Precision 9 T4 belegt den ersten Platz in unserer Bestenliste der Desktop-PCs für lokale KI (Xeon Tower für lokale KI).


 Amazon