

Die wichtigste Entscheidung für die KI-Infrastruktur vieler Unternehmen im nächsten Jahr wird nicht die Investition in GPUs sein, sondern ein Datenbank-Upgrade. Oracle AI Database 26ai ist die Version mit Langzeitunterstützung, auf die Oracle seine 19c-Nutzerbasis ausrichtet. 26ai integriert die Vektorsuche in dieselbe Engine, die auch die Transaktionen verarbeitet. Da sich der Vektorindex in der Datenbank befindet, werden das Block-Array und das dahinterliegende SAN-Fabric zur KI-Infrastruktur, die neben den bereits verarbeiteten Transaktionen auch den Datenverkehr für Abfragen abwickelt.
Die Datenbank hat sich im Hintergrund der KI verändert.
Oracle hat 26ai genau um diese Idee herum entwickelt: einen nativen Datentyp VECTOR, SQL-Vektorsuchfunktionen, datenbankinterne Modellausführung über ONNX und SELECT AI für Abfragen in natürlicher Sprache – all dies in einer LTS-Version mit über 300 neuen Funktionen. In der Praxis kann ein Datenbankadministrator Einbettungen generieren, diese neben den entsprechenden Zeilen speichern und eine Ähnlichkeitssuche innerhalb desselben Transaktionsbereichs wie eine Auftragsabfrage durchführen. Es ist kein separater Vektorspeicher erforderlich, keine Synchronisierungspipeline muss gewartet werden und es gibt keine zweite Kopie regulierter Daten außerhalb des Audit-Trails.
IBM zitiert IDC zu diesem Trend: „Integrierte Vektordatenbanken sind die eindeutig bevorzugte Plattform zum Speichern und Abfragen von Vektoreinbettungen, da Unternehmen einheitliche, kontrollierte Umgebungen für agentenbasierte KI bevorzugen.“ Die Kunden von IBM und Broadcom möchten die Datenbank, der sie bereits vertrauen, erweitern, bevor sie parallel eine neue Datenbank aufbauen.
Oracle ist mit diesem Ansatz nicht allein. Das Popularitätsranking von DB-Engines vom Oktober 2026 listet die vier führenden relationalen und Multi-Modell-Datenbanken auf: Oracle, MySQL, Microsoft SQL Server und PostgreSQL. Alle vier bieten Vektordatentypen oder Vektorsuche an, entweder nativ oder über Erweiterungen wie pgvector. IBM entschied sich aufgrund der Marktführerschaft von Oracle zunächst für Oracle, die Validierungsarbeit zu beginnen, obwohl die in diesem Artikel angeführten Argumente zur Speichernutzung auch für die anderen Systeme gelten.

Die Argumente für die lokale Speicherung von Blockdaten bleiben auch mit dem Einzug von KI unverändert: Die für den KI-Einsatz entscheidenden Daten, wie Patientenakten, Abrechnungen, Bestellungen und Transaktionen, dürfen nicht ausgelagert werden. Das Kopieren auf eine dedizierte KI-Plattform bedeutet doppelte Speicherkosten, die Akzeptanz von Abweichungen zwischen Kopie und Produktionscluster sowie den Verlust der Kontrollmechanismen, die die ursprüngliche Datenstruktur rechtlich absicherten. Die Speicherung der Daten innerhalb der Datenbank vermeidet all diese Probleme. Das Array, das eine Zeilensuche im Submillisekundenbereich ermöglicht, dient nun gleichzeitig auch einem Vektorähnlichkeits-Scan für einen Arzt und einem Backup-Stream.
IBM Storage und die Fibre Channel (FC)-Gruppe von Broadcom haben sich zum Ziel gesetzt, diesen gemischten Workload-Szenario zu validieren und eine Umgebung um die Oracle AI Database 26ai auf IBM FlashSystem mit Broadcoms Brocade Gen 8 SAN-Fabric und Emulex 64G SecureHBAs aufgebaut . Anschließend bearbeiteten sie die Fragen, die ein Infrastrukturteam gestellt hatte: Wie wirkt sich ein Vektor-Workload, der daneben startet, auf die Transaktionslatenz aus? Welchen Einfluss hat die Fabric-Geschwindigkeit auf den Durchsatz der Vektorsuche? Wie viel Kapazität wird durch Einbettungen belegt? Wie effektiv ist die Ransomware-Erkennung beim Angriff auf ein RMAN-Backup-Volume? Und welche Voraussetzungen müssen erfüllt sein, um einen Host ohne Zoning-Ticket zum SAN hinzuzufügen?
Die Daten befinden sich bereits im Blockspeicher, und jetzt kommt die KI hinzu.
Das alles bedeutet nicht, dass KI-Workloads generell auf Blockspeichern gespeichert werden sollten. Unternehmen werden weiterhin Datei- und Objektspeicher für unstrukturierte Daten verwenden: Dokumente, Bilder, Videos, Trainingsdatensätze und Modell-Checkpoints, die nie in einer Datenbank gespeichert waren und es wahrscheinlich auch nie sein werden. In der folgenden Demonstration im Gesundheitswesen speichert IBM die Rohröntgenbilder im Objektspeicher, während lediglich die Einbettungen und Fallmetadaten in Oracle abgelegt werden. Was sich ändert, ist die Belastung des Speichersystems, das nun mehrere Workloads mit sehr unterschiedlichen E/A-Profilen gleichzeitig verarbeitet.
Die relationale Ebene ist die bekannteste: Millionen zufälliger E/A-Operationen von 4 bis 16 KB pro Sekunde, Zeilenzugriffe und Commits, die in Mikrosekunden erfolgen müssen, hohe Schreibkonkurrenz durch Redo-, Undo- und Checkpoint-Datenverkehr sowie eine vorhersehbare Restlatenz, da eine benutzerorientierte Anwendung darauf wartet. RMAN, das Backup-Tool von Oracle, ist das Gegenteil: ein sequenzieller Datenstrom, der ausreichend Puffer benötigt, um innerhalb seines Zeitfensters abgeschlossen zu werden, ohne die nachfolgende Arbeitslast zu beeinträchtigen. Beide Ebenen sind gut verstanden, und die Arrays von IBM sind darauf optimiert.
Die Vektorschicht ist schwieriger zu charakterisieren, da große Tabellen mit Vektoreinbettungen die Vektorsuche wie eine bandbreitenintensive Arbeitslast erscheinen lassen können: einen umfangreichen sequenziellen Scan. IBMs Charakterisierung des Vektorpfads von Oracle 26ai ähnelt eher OLTP. Jeder Indexzugriff entspricht einem zufälligen Lesevorgang von etwa 4 KB; der Abfragepfad ist IOPS-gebunden und latenzempfindlich, und Lesevorgänge dominieren, da Schreibvorgänge in einer separaten Aufnahme- und Indexierungsphase stattfinden.
Bandbreite ist in Spitzenzeiten entscheidend, etwa beim Indexaufbau oder der erneuten Einbettung eines Korpus, und diese Spitzenzeiten sind oft sehr umfangreich. Diese Aufteilung ist der Kern des Problems gemischter E/A: Auf dem Abfragepfad konkurriert die Vektor-Workload mit Transaktionen um dieselben Warteschlangen, wodurch die Isolation zu einem Qualitätskriterium wird. In diesen Spitzenzeiten stößt die Bandbreite des Systems an ihre Grenzen, wie die später in diesem Artikel dargestellten Ergebnisse des Vergleichs von 32 Gbit/s mit 64 Gbit/s zeigen.
Die validierte Architektur
IBM und Broadcom haben für diese Validierung eine Umgebung im KI-Labor von Broadcom in Colorado aufgebaut. Der Speicher besteht aus einem IBM FlashSystem 9000-Array mit IBM Storage Virtualize 9.1.3 und 24 FlashCore-Modulen, das zwei Brocade Gen 8 G820 SAN-Switches über 64G-Fibre-Channel-Ports ansteuert. Der Datenbank-Host ist ein Dual-Socket-Intel-Xeon-6767P-Server mit zwei 2-Port-Emulex-LPe38102-64G-SecureHBAs, auf dem die Oracle AI Database 26ai auf ASM ohne GPU im Speicherpfad läuft. IBM Storage Insights überwacht das Array.

Wir führten die Fabric- und Kapazitätstests, den Vergleich der Vektorsuche mit 32G und 64G sowie die Footprint-Messungen mit VectorDBBench anhand des BioASQ 1M-Datensatzes ausschließlich auf diesem Host durch. Dieselbe Konfiguration unterstützt auch die Anwendungsworkload. Ein Supermicro 821GE-TNHR mit zwei Xeon Platinum 8470 Prozessoren und acht NVIDIA H100 80GB GPUs hostet die Gesundheitsanwendung und ihr Sprachmodell. Der Software-Stack umfasst Oracles OnNX-In-Database-Embedding, Ollama Serving Llama 3 und NVIDIA cuVS. Ein Broadcom Tomahawk 5 Switch und Thor 2 400GbE NICs verbinden die beiden Server. Die Demonstrationen zu I/O QoS, Mandantenfähigkeit, Ransomware-Erkennung und Gesundheitsanwendungen wurden in dieser Umgebung durchgeführt.

Laut IBM verwendet die FlashSystem-Familie ( 5300 und 5600, 7300 und 7600 sowie 9500 und 9600) dieselbe Storage Virtualize-Software. Die hier demonstrierten Funktionen, darunter I/O-Drosselung, AutoZoning, Ransomware-Erkennung, Policy-basierte Hochverfügbarkeit und Speicherpartitionsmigration, funktionieren mit Oracle AI Database 26ai auf allen diesen Arrays und auf demselben Code-Level identisch. Leistung und Speicherdichte variieren je nach Modell und FlashCore-Modul-Generation. Alle hier genannten Werte beziehen sich daher auf das System, auf dem sie gemessen wurden.
Sicherstellung optimaler OLTP- und Vektor-Workload-Leistung durch I/O-QoS
Die erste Frage, die IBM und Broadcom beantworten wollten, stellt sich jeder Datenbankadministrator bei der Planung einer Vektor-Workload für das Produktionssystem: Was geschieht mit den Kerntransaktionen? IBM führte zwei Demonstrationen auf dem FlashSystem 9000-Array durch und nutzte dabei I/O-Drosselungen auf Volume-Ebene – den Mechanismus hinter IBMs I/O-QoS. Die Datenbank verteilte sich auf 30 Volumes: 15 für die OLTP-Tablespaces (ORCL16 bis ORCL30) unter Swingbench Order Entry mit 192 Benutzern und 15 für die Vektortabellen (ORCL31 bis ORCL45) unter einem synthetischen Generator mit 200 Threads, der die k 500 ähnlichsten Abfragen ausführte. Storage Insights visualisierte die Ergebnisse jeder Volume-Gruppe.
Bei alleinigem Betrieb von OLTP verzeichnete jedes OLTP-Volume konstant 20,500 Operationen pro Sekunde. Nach dem Start des Vektorgenerators stiegen die Vektorvolumes innerhalb einer Minute auf jeweils etwa 73,000 Operationen pro Sekunde, während die OLTP-Volumes auf etwa 13,000 Operationen pro Sekunde sanken – ein Rückgang um 37 Prozent, ohne dass sich auf der Transaktionsseite etwas änderte. Der Vektorsuchpfad verwendet zufällige Lesezugriffe auf 4-KB-Blöcke mit derselben Blockgröße wie die Transaktionen. Daher werden dieselben Warteschlangen verwendet und die vom Array bereitgestellten Daten verarbeitet.

Eine Obergrenze von 45,000 IOPS pro Vektorvolumen, eine Zeile von mkthrottle Über die CLI wurden die Vektorvolumes bis zum Limit ausgereizt, wodurch die OLTP-Leistung wieder auf etwa 17,000 Operationen/s anstieg. Die Aufhebung der Begrenzung kehrte den Effekt um, und nach Abschluss des Vektorlaufs erreichte die OLTP-Leistung wieder 20,500 Operationen/s. Das Dashboard zeigte insgesamt dasselbe an: 1.28 Millionen ungedrosselte IOPS und rund 950,000 unter der Begrenzung, was – bis auf wenige Prozent – der Rate pro Volume multipliziert mit 30 Volumes entspricht.

Die zweite Demo entspricht der Konfiguration, die IBM voraussichtlich im Produktivbetrieb einsetzen wird: Zunächst wurden die Obergrenzen festgelegt (45,000 IOPS pro Vektor-Volume und 20,000 pro OLTP-Volume). Anschließend wurden beide Workloads gleichzeitig gestartet. Die Vektor-Volumes liefen mit maximaler Auslastung, die OLTP-Volumes pendelten sich bei etwa 12,200 Operationen/s ein und blieben während des gesamten Tests konstant. Das Array erreichte 870,000 IOPS (800,000 Lese- und 70,000 Schreibvorgänge) bei einer Latenz von 377 Mikrosekunden und einer Datenrate von 6.9 GB/s bei 25 % CPU-Auslastung. Die Obergrenze für die OLTP-Volumes lag über dem Bedarf der Workloads und wurde nie aktiviert. Sie dient dazu, eine Überlastung einer Seite zu verhindern, die die andere beeinträchtigt.
Swingbench hielt seine 192 Benutzer während des gesamten Testlaufs bei etwa 1.19 Millionen Transaktionen pro Minute (ca. 19,500 TPS). Der Generator war auf maximale Auslastung optimiert, daher ist die Latenz pro Abfrage kein aussagekräftiger Anwendungs-Benchmark. Im 30-minütigen Testlauf wurden 35,672 Abfragen mit 19.8 pro Sekunde ausgeführt, mit einer mittleren Latenz von etwa 10 Sekunden und einem P99-Wert von 14.3 Sekunden bei einem Anwendungs-Timeout von 15 Sekunden. 99 Abfragen (0.28 Prozent) erreichten dieses Timeout, was jedoch von den Transaktionen nicht beeinträchtigt wurde.


Die FlashSystem-Drosselung begrenzt das Datenvolumen des Arrays unabhängig von Host oder Pfad. Optional kann neben der IOPS-Begrenzung auch die Bandbreite begrenzt werden. Sie begrenzt die benachbarten Volumes und reserviert keine Ressourcen. Die Begrenzung dient der Dimensionierung: 15 Vektor-Volumes mit je 45,000 IOPS ergeben einen Vektor-Spielraum von 675,000 IOPS. Dadurch blieb den OLTP-Volumes dieses Arrays ausreichend Kapazität. Bei einem anderen Array oder einer anderen Konfiguration kann sich dieser Wert ändern. Wird die Vektor-Begrenzung so festgelegt, dass die Transaktionen ihre Latenz erreichen, erhält die Vektor-Workload alle Ressourcen oberhalb dieses Wertes.
Ransomware-Erkennung auf aktiven Oracle-Volumes
Eine Sophos-Studie aus dem Jahr 2024 unter 2,974 von Ransomware betroffenen Unternehmen ergab, dass 94 Prozent der Befragten beobachteten, wie Angreifer ihre Backups angriffen. Dieser Angriff war in 57 Prozent der Fälle erfolgreich, und die durchschnittlichen Wiederherstellungskosten lagen dabei achtmal höher. IBM entwickelte den Test nach demselben Prinzip – Backups zuerst, Produktionsdaten erst danach – und richtete den Angriff auf das RMAN-Backup-Ziel, während die Datenbank-Volumes unberührt blieben. RMAN schrieb seine Backup-Sets auf FlashSystem-Volumes, ein Ransomware-Simulator wurde darauf ausgeführt, und das Array bemerkte den Angriff selbstständig, ohne dass ein Host-Agent involviert war.
Die Erkennung erfolgt direkt in den Laufwerken: Die FCM4- und FCM5-FlashCore-Module berechnen bei jedem Schreibvorgang Entropie und Komprimierbarkeit sowie Blockgröße, Adresse und Überschreibungsmuster. Alle zwei Sekunden wird eine Zusammenfassung pro Volume an eine Inferenz-Engine in Storage Virtualize (Version 8.6.3 oder höher mit FCM-Firmware 4.1 oder höher) übermittelt. Das Modell generiert Warnmeldungen in der FlashSystem-GUI und IBM Storage Insights Pro, leitet diese an Storage Defender oder ein SIEM-System weiter und ist eigenständig patchbar. Ein neu trainiertes Modell wird daher als kleines Sicherheitsupdate ohne Firmware-Upgrade bereitgestellt.
Da die Analyse auf dem Modul ausgeführt wird, funktioniert sie auch dann weiter, wenn der Host kompromittiert ist. Verschlüsselte Ausgaben weisen eine hohe Entropie auf und werden nicht mehr komprimiert. Dies zeigt sich in den Statistiken, unabhängig davon, ob der Angreifer Dateierweiterungen ändert, nur jeden zweiten Block verschlüsselt oder die Verschlüsselungsrate verringert, um die Analyse vor einem Endpunktagenten zu verbergen.
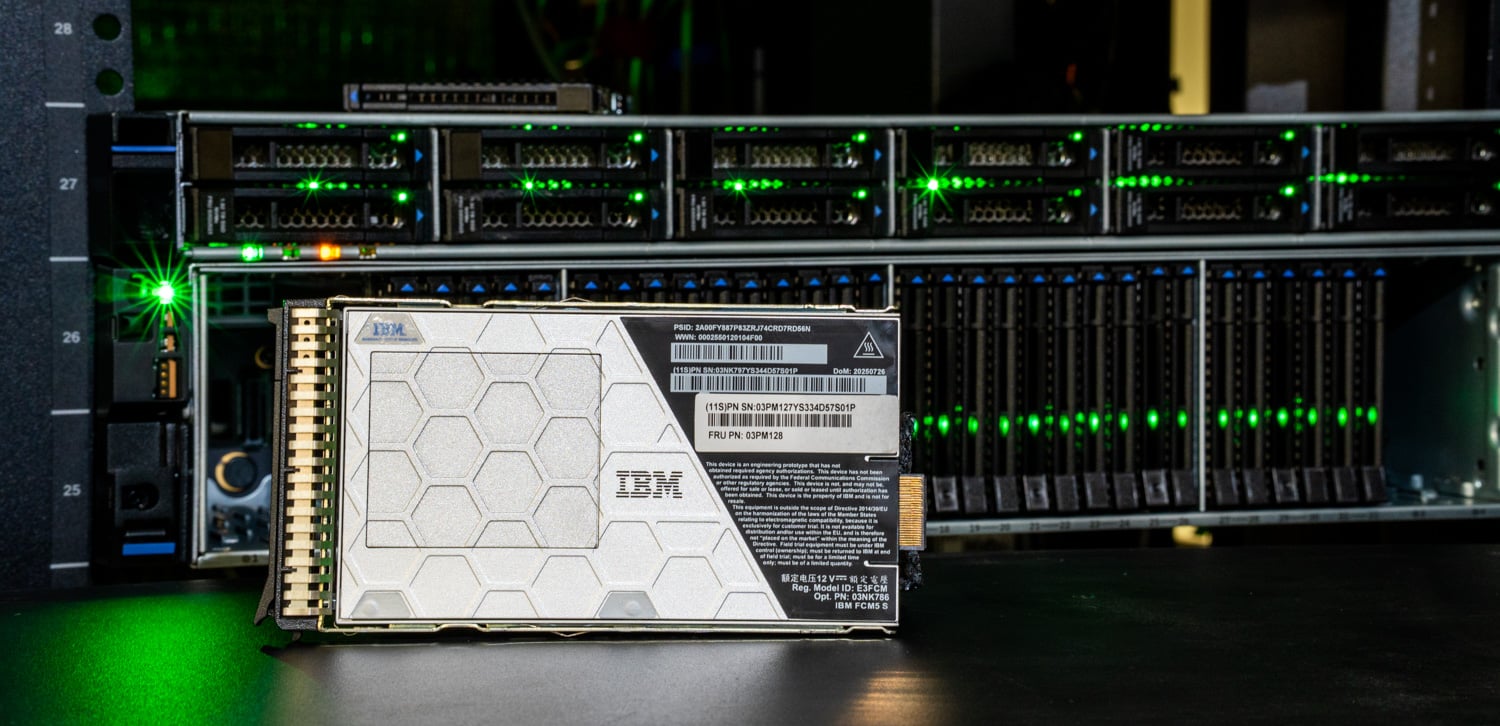
Während der Validierung schrieb RMAN das Backup über 16 parallele Kanäle, wobei jedes Backup-Set auf 150 GB begrenzt war. Die Datenbank befand sich auf 15 x 200-GB-Festplatten pro ASM-Festplattengruppe für OLTP- und Vektordaten. IBM führte den Angriff auf dieses Backup-Ziel durch, und die Warnung erreichte Storage Insights innerhalb von weniger als 60 Sekunden – also innerhalb des von IBM für diese Funktion angegebenen Erkennungsfensters. Storage Insights markierte alle 31 Volumes in der Volume-Gruppe, da eine Warnung auf einem Volume die gesamte Gruppe als Bedrohung kennzeichnet.
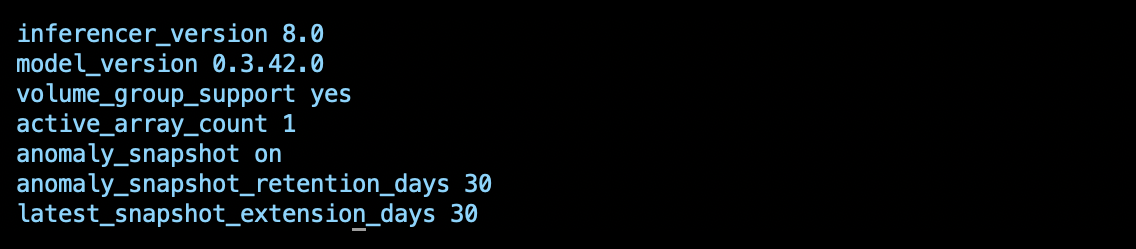
Die Antwort lautet „Geschützte Kopie“, und das Array verarbeitete dies ohne Eingriff eines Bedieners: Das FlashSystem erstellte im Moment des Auftretens der Bedrohung einen unveränderlichen Snapshot der betroffenen Volume-Gruppe und verlängerte gleichzeitig die Aufbewahrungsdauer des letzten bekannten intakten Snapshots. lsanomalydetection Die Ausgabe des Arrays zeigt die zugrundeliegende Konfiguration: Inferenz-Engine 8.0 mit Modell 0.3.42.0, Anomalie-Snapshot aktiviert, 30 Tage Aufbewahrungsdauer für den neuen Snapshot und 30 Tage zusätzlich zum letzten gültigen Snapshot. Storage Virtualize markiert den verdächtigen Snapshot außerdem, sodass niemand Daten daraus wiederherstellen kann. Dadurch bleibt ein sauberer Wiederherstellungspunkt vor Beginn der Verschlüsselung erhalten.
Das Fabric verfügt außerdem über eine Sicherheitsebene. Broadcom integriert Post-Quanten-Kryptographie in Brocade Gen 8, die Emulex SecureHBAs verschlüsseln Daten während der Übertragung zwischen Host und Fabric, und der neue FC-SP-3-Standard der FCIA setzt die quantenfähige Sicherheitsgrundlage für Fibre Channel insgesamt.
SAN-Wachstum ohne Zoning-Tickets: IBM FlashSystem AutoZoning mit Broadcom Target-Driven Zoning
Das Hinzufügen eines Hosts zu einem Fibre Channel SAN erfordert normalerweise ein Ticket und zwei Teams: Der Serveradministrator sammelt die HBA-WWPNs, der SAN-Administrator erstellt die Zonen auf beiden Fabrics manuell, und der Storage-Administrator ordnet den Host den richtigen Zielports zu. Ein falsch eingegebener WWPN führt dazu, dass ein neuer Oracle RAC-Knoten ohne seine Pfade ist. AutoZoning verlagert diese Arbeit auf das Array: FlashSystem kommuniziert direkt mit der Fabric, identifiziert die Initiator-WWPNs, wählt Zielports aus und erstellt die Zonen selbstständig, ohne dass sich jemand an einem Switch anmelden muss.

Diese Funktion basiert auf Brocade Target Driven Zoning (TDZ) und ist seit FlashSystem Software 9.1.2 verfügbar. Sie erfordert Brocade Switches mit Fabric OS 9.1.1 oder höher, wobei TDZ vom Fabric-Administrator an den Switch-Ports, die zu den FlashSystem-Zielports führen, aktiviert sein muss. Diese Aktivierung ist der einzige Schritt, der vom SAN-Team durchgeführt werden muss. AutoZoning greift erst dann auf einen Port ein, wenn dieser Schritt abgeschlossen ist. Anschließend erstellt FlashSystem Peer-Zonen, die es Host-Initiatoren ermöglichen, den Zielport zu erreichen, aber nicht untereinander. Die Zonen erhalten einen eindeutigen IBM_SV_-Namen, der sie als vom Array verwaltet kennzeichnet.
Die Einrichtung beginnt in der Fibre-Channel-Portansicht. Dort wird nun der Switch angezeigt, mit dem jeder Port verbunden ist, ob der Port AutoZone-fähig ist und ob die Verbindung symmetrisch ist (d. h., ob Ports mit derselben ID auf allen Knoten im selben Fabric liegen). Eine Topologieansicht visualisiert dies farblich. Nur grüne Ports sind aktiv, AutoZone-fähig und symmetrisch und unterstützen AutoZone. Asymmetrische Ports bleiben deaktiviert, selbst wenn sie ansonsten geeignet wären, da die Benutzeroberfläche warnt, dass dies die Redundanz und das Failover beeinträchtigen kann.

Die Host-Erstellung beginnt mit einer Liste nicht konfigurierter Hosts, die über FDMI befüllt wird. FDMI meldet den Hostnamen, das Betriebssystem und die Ports jedes HBA an das Fabric. In der IBM-Anleitung öffnete sich der Dialog „Host hinzufügen“ mit dem Servernamen, dem Betriebssystem und beiden HBA-Ports eines Hosts, dem noch keine Zonen zugewiesen waren. Der Administrator wählte einen AutoZone-fähigen Portsatz aus, der die vom Host erreichbaren Zielports definiert, und klickte auf „Hinzufügen“. FlashSystem ordnete die Zielports den Host-Initiatoren zu, übertrug die Zonen auf beide Switches, und der Host ging mit vier Pfaden über zwei Fabrics online.

IBM positioniert AutoZoning für Oracle als Lösung zum Hinzufügen von RAC-Knoten und zum Austausch von HBAs. Da die Funktion Änderungen der Host- oder Speicherkonnektivität erfasst und die Zonendefinitionen entsprechend anpasst, ist nach dem Austausch eines HBAs keine manuelle Neuzonierung erforderlich. Dieselbe Automatisierung kommt zum Einsatz, wenn Hosts für die Migration von Speicherpartitionen oder für Policy-Based HA (PBHA) Pfade zu einem zweiten Array benötigen. Das SAN-Team steuert weiterhin, welche Zielports beteiligt sind, da an einem Port erst dann Aktionen ausgeführt werden, wenn TDZ aktiviert ist. Folglich wartet das Hinzufügen eines Hosts nicht mehr auf eine Zonenänderung.
Betriebsumfeld: PBHA, Grid-Migration, Multi-Tenancy und Platzierung
Policy-Based HA (PBHA) repliziert eine Speicherpartition synchron zwischen zwei FlashSystem-Arrays im Metro-Netzwerk, wobei der Hostzugriff an beiden Standorten aktiv und aktiv ist. Laut IBM ist diese Funktion für einen RPO von null und einen Speicherausfall ausgelegt, den eine korrekt geclusterte Oracle-Bereitstellung ohne Datenverlust übersteht. Sobald der ausgefallene Standort wieder verfügbar ist, werden die Daten resynchronisiert und die Workload ohne Unterbrechung zurückgesetzt.
Die FlashSystem Grid-Funktion ermöglicht die Verwaltung von bis zu 32 FlashSystem-Arrays unter einer zentralen Managementansicht. Die Migration von Speicherpartitionen verschiebt eine Partition mit ihren Volumes, Volume-Gruppen und Hosts von einem Array auf ein anderes, ohne dass es zu Anwendungsunterbrechungen kommt. IBM verweist für Oracle auf die Hardware-Aktualisierung, das Leeren eines Systems vor einem Firmware-Update und das Verschieben einer Vektorpartition auf ein System mit höherer Kapazität, wenn der eingebettete Datensatz wächst. Ein System migriert jeweils eine Partition über Fibre Channel oder High-Speed-Ethernet. Hosts können über Fibre Channel, iSCSI oder NVMe/TCP verbunden werden. Eine bereits für PBHA konfigurierte Partition kann nicht migriert werden.
Der Storage Insights Placement Advisor übernimmt die Planung für dasselbe Grid. Anhand der Kapazität, Wachstumsrate, des E/A-Profils und des Latenzziels einer Workload bewertet er jedes System im Grid, ermittelt die optimale Lösung vor der Bereitstellung und kann bei einem Ungleichgewicht der CPU- oder IOPS-Auslastung eine Migration empfehlen. Migration und Platzierung erfolgen mit Storage Insights Pro, wobei jedes Grid-System demselben Storage Insights-Mandanten zugeordnet ist.

Multi-Tenancy ermöglicht es einem DBA-Team und einem KI-Team, dasselbe Grid gemeinsam zu nutzen, ohne die Administration teilen zu müssen. In der IBM-Anleitung erstellte ein Administrator zwei Mandanten auf demselben Array (Tenant_Scale und Tenant_oracle_ai) und wies jedem ein System, eine Benutzergruppe mit einer Mandantenrolle und einen ersten Benutzer zu. Anschließend wurde für jeden Mandanten eine Speicherpartition mit separater Volume-Gruppe, Volumes und Host-Mappings erstellt. Die GUI bietet die Konfiguration der Replikation an, sobald eine neue Partition erstellt wird. Als Benutzer von Tenant_Scale angemeldet, zeigte die GUI nur die Partition und Ressourcen dieses Mandanten an, nicht jedoch die von Tenant_oracle_ai. Die gleiche Überprüfung von Tenant_oracle_ai aus lieferte dasselbe Ergebnis.
Der Fabric-Dividende: 32G vs. 64G Fibre Channel unter Vektorsuche
Die einzige Variable, die IBM und Broadcom in diesem Test absichtlich veränderten, war die Fabric. Das gleiche Array, der gleiche Host und die gleichen Emulex LPe38102 SecureHBAs führten VectorDBBench zweimal gegen den BioASQ 1M-Datensatz (eine Million 1,024-dimensionale Vektoren aus dem biomedizinischen Frage-Antwort-Korpus) aus: einmal mit den beiden HBA-Ports auf 32 Gbit/s und einmal auf 64 Gbit/s, jeweils über dieselben Brocade G820-Switches. Alle anderen Komponenten, von den 16 ASM-Volumes bis zum 4 GB großen SGA, blieben unverändert. Der einzige Unterschied zwischen den beiden Durchläufen besteht also in der Fibre-Channel-Generation.

Die Suchphase dieses Benchmarks ist ein reiner Lesescan: Der IVF_FLAT-Index von Oracle leitet jede Anfrage an einen Cluster von Partitionen weiter und liest diese vollständig. Bei 1,024-dimensionalen FLOAT32-Vektoren ist dies bandbreitenintensiv. Auf zwei 32-Gbit/s-Ports pendelte sich die Lesegeschwindigkeit des Hosts bei 6.3 GB/s ein, der Leitungsgeschwindigkeit des Paares. Die Suchkurve erreichte bei 20 Threads 43.7 Anfragen pro Sekunde. Auf zwei 64-Gbit/s-Ports las derselbe Host mit 12.5 GB/s und skalierte bis auf 85.0 Anfragen pro Sekunde bei 80 Threads – eine um 95 % höhere Durchsatzrate bei gleichem Speicher.

Die Latenz verdeutlicht den anderen Teil der Geschichte des 64G-Fabrics: Bei einem Thread liegen die beiden Fabrics innerhalb von 8 % beieinander (0.107 Sekunden gegenüber 0.099 Sekunden), da eine einzelne Anfrage nie eine der beiden Leitungen voll auslastet. Ab fünf Threads kommt es jedoch zu einer Warteschlangenbildung im 32G-Fabric: Die durchschnittliche Latenz verdoppelt sich mit jedem Schritt gegenüber dem 64G-Wert, und bei 80 Threads erreicht p99 4.08 Sekunden gegenüber 1.14 Sekunden. Ein ausgelastetes FC-Fabric fällt nicht aus; es reiht jede Anfrage in die Warteschlange ein, und diese Wartezeit schlägt sich in der maximalen Latenz nieder.

Auch die Ladephase veränderte sich: Das Einlesen der Million Vektoren dauerte 94.1 Sekunden auf 32G und 84.5 Sekunden auf 64G, und der Aufbau des IVF_FLAT-Index benötigte 139.6 Sekunden gegenüber 108.4 Sekunden – 28.8 % länger auf der langsameren Architektur. Die Gesamtladezeit betrug somit 233.7 Sekunden gegenüber 193.0 Sekunden. Recall und NDCG lagen in beiden Durchläufen innerhalb von 0.1 % (83.81 % bzw. 84.42 % auf 32G, 83.95 % bzw. 84.56 % auf 64G). Die Architektur beeinflusste also die Geschwindigkeit der Antwortbereitstellung. Für eine Datenbank, die seit ihrer Inbetriebnahme auf 32G läuft, bietet das Upgrade von HBA und Switch eine offensichtliche Möglichkeit zur Leistungssteigerung.
Planung für das Wachstum der Vektorkapazität
Die Vektorsuche verändert die Speicherkapazität, bevor sie die Leistung beeinflusst. Ein Embedding ist eine numerische Kopie eines Datenblocks mit fester Breite. Bei Text ist diese Kopie üblicherweise größer als der beschriebene Datenblock: Ein 1,000 Byte langer Abschnitt wird zu einem 1,024-dimensionalen FLOAT32-Vektor mit 4,096 Byte, bevor die Datenbank eine Zeile hinzufügt. Das Team nennt dies Vektorspeicherverstärkung und hat sie anhand desselben BioASQ-1M-Datensatzes gemessen, der auch für den Fabric-Vergleich verwendet wurde.
Der Quelltext der Millionen Vektoren umfasst 0.90 GB. In Oracle 26ai wurde daraus eine 7.67 GB große Vektortabelle, inklusive ca. 0.3 GB Zeilen-Overhead. Der IVF_FLAT-Index fügte weitere 8.57 GB hinzu, da er eine zweite, gruppierte Kopie jedes Vektors sowie ca. 4 MB an Zentroiden speichert. Der persistente Speicherbedarf im SAN beträgt 16.24 GB, das 18-Fache des Quelltextes, zuzüglich des von Oracle benötigten operativen Speicherplatzes: 15 bis 23 GB TEMP-Speicher während des Indexaufbaus sowie 4 bis 8 GB UNDO- und ca. 15 GB REDO-Speicher während der Datenaufnahme.

Der Multiplikator skaliert mit dem Einbettungsmodell: Broadcom extrapoliert anhand derselben Methode und gibt für ein 768-dimensionales Cohere v3-Modell (ebenfalls gemessen) den Faktor 4.8 an, für ein 384-dimensionales MiniLM den Faktor 9.6 und für ein 4,096-dimensionales Mistral-Modell den Faktor 32.5. Die Chunk-Größe ist ebenso wichtig wie die Breite, da ein breiter Vektor über einen langen Abschnitt weniger stark verstärkt wird als derselbe Vektor über einen kurzen Abschnitt, und quantisierte Indizes den Indexanteil verringern.
Nichts davon ist spezifisch für FlashSystem oder Oracle. Die Verstärkung findet innerhalb der Datenbank statt, bevor das Array auch nur ein Byte verarbeitet. Jeder Vektorindex auf jeder Plattform enthält eine Kopie der Vektoren und muss daher zusammen mit den GPUs in das Kapazitätsbudget einkalkuliert werden, sobald ein Vektorprojekt genehmigt wird. Das Array entscheidet, wie viel von diesem Wachstum es aufnehmen kann: IBMs FlashCore-Modul der fünften Generation bietet Kapazitäten von bis zu 105.6 TB pro Modul. Das entspricht 3.3 PB Rohkapazität in einem 2U-Gehäuse bei den größten FlashSystem-Modellen, effektiv 11.8 PB laut IBM. Eine Vektorschicht kann also über Jahre hinweg an Ort und Stelle wachsen, bevor eine Partition verschoben werden muss.
IBMs Größenmodell für die folgende Anwendung im Gesundheitswesen funktioniert bei Bildern genau umgekehrt: 100 GB Röntgenbilder belegen in der Datenbank etwa 2 GB, da dort nur die Einbettungen und Fallmetadaten gespeichert werden. Text hingegen ist ressourcenintensiv: 100 GB segmentierter klinischer Text erreichen einen Speicherplatz von 860 GB bis 1.2 TB, wobei der Großteil davon im HNSW-Index liegt. Die Größenberechnung basiert auf der Anzahl der Segmente und der Modellbreite; der Quellkorpus ist nur bedingt aussagekräftig. Einbettungen lassen sich zudem weniger stark komprimieren als Zeilen (1.2- bis 2-fach gegenüber 2- bis 4-fach bei relationalen Daten, laut IBM-Erfahrung). Daher kann die Datenreduktion des FlashCore-Moduls nur einen geringeren Teil des Datenwachstums ausgleichen, und jede erneute Einbettung benötigt erneut temporären Speicherplatz.
IBMs praktische Regel lautet: Vor der endgültigen Implementierung messen. Laden Sie 1 bis 5 Prozent des realen Korpus mit dem Produktions-Embedding-Modell und den Chunking-Einstellungen, messen Sie die tatsächliche Größe der Bytes pro Vektor, skalieren Sie diese linear und wiederholen Sie den Vorgang jedes Mal, wenn sich das Modell, die Dimensionsanzahl oder die Chunking-Richtlinie ändert.
End-to-End-KI-Inferenz: Die Anwendung im Gesundheitswesen
IBM entwickelte die Anwendung für diese Validierung als Radiologie- und Gastroenterologie-Assistent namens RAD-AI. Es handelt sich um eine Beispielanwendung mit produktionsnahen Anforderungen. In diesem Beitrag wird eine vollständige Inferenzpipeline auf demselben Array und derselben Architektur demonstriert, die in den vorherigen Abschnitten untersucht wurde. Ein Arzt gibt Alter, Geschlecht und Beschwerden des Patienten ein, lädt ein Röntgenbild des Thorax oder ein Endoskopiebild hoch und erhält einen strukturierten Bericht, der auf den ähnlichsten Fällen im Archiv basiert.
Das Archiv enthält 112,120 Röntgenaufnahmen des Brustkorbs aus dem NIH ChestX-ray14-Datensatz und über 10,000 GI-Endoskopiebilder aus HyperKvasir, darunter Vektoren pro Einzelbild aus 367 vollständigen Endoskopievideos, für mehr als 172,000 bereits eingebettete Fälle. Jedes Bild wird mithilfe eines CLIP ViT-L/14-Modells, das in der Oracle AI Database 26ai über die ONNX-Laufzeitumgebung läuft, in einen 768-dimensionalen Vektor umgewandelt. Die Einbettung erfolgt daher in derselben Transaktion wie die zugehörige Zeile. Die Rohbilder verbleiben im Objektspeicher; die Vektoren und Fallmetadaten werden in Oracle gespeichert.

Bei der Abfrage führt Oracle eine approximative Nächste-Nachbarn-Suche mittels Kosinusdistanz im Archiv durch und gibt die ähnlichsten Fälle zusammen mit ihren ursprünglichen Befunden, Diagnosen und Ergebnissen zurück. Dieser Datensatz bildet den Kontext für Llama 3, das von Ollama auf einer der H100-GPUs des Supermicro-Servers bereitgestellt wird und den Bericht erstellt: eine klinische Priorität, eine Zusammenfassung der Befunde, eine priorisierte Differenzialdiagnose und empfohlene Maßnahmen, wobei die passenden Fälle darunter aufgelistet werden. Die Endoskopie folgt demselben Prozess und fügt eine klinische Notiz hinzu; bei Videoaufnahmen bettet die Pipeline Bild für Bild ein, um eine Läsion entlang des Gastrointestinaltrakts zu verfolgen.
Die Anwendung führt zwei Workloads auf denselben FlashSystem-Volumes aus. Der transaktionale Workload umfasst Anmeldungen, Berichtsspeicherung, Audit-Protokollierung und Sitzungen. Der Vektor-Workload führt wahlfreie Lesezugriffe mit hohem Fan-Out auf die Einbettungstabellen und Fallmetadaten durch und entspricht damit dem Generatorprofil in der I/O-QoS-Demonstration. Die IBM-Bereitstellung drosselt die Volumes gemäß den zuvor beschriebenen Einstellungen, sodass ein Batch-Re-Embedding-Job die Bearbeitung eines Falls durch einen Arzt nicht verzögert. Die oben beschriebene Ransomware-Erkennung und Partitionsmigration gelten unverändert für diese Volumes.

Der ressourcenintensivste Schritt ist die Archivierung. IBM ermittelte dies, indem der vollständige Datensatz mit 112,120 Röntgenbildern des Brustkorbs zweimal mit demselben Modell und demselben VECTOR(768, FLOAT32)-Ziel eingebettet wurde. Mit dem ONNX-Modell, das innerhalb der Datenbank auf den Host-CPUs lief, erreichte die Pipeline 3.41 Bilder pro Sekunde bei 0.272 Sekunden pro Einbettung. Die Verarbeitung des gesamten Datensatzes dauerte 9.1 Stunden. Durch die Verlagerung des Modells in den Container „Oracle Private AI Services“ auf dem zweiten Server konnte der Durchsatz auf 8.55 Bilder pro Sekunde (0.097 Sekunden pro Bild) gesteigert werden, und die gleiche Datenerfassung war in 3.6 Stunden abgeschlossen.

Die Vorverarbeitung (ca. 0.019 Sekunden pro Bild) und das Einfügen in Oracle (unter einer Millisekunde) waren in beiden Durchläufen identisch. Der 2.5-fache Geschwindigkeitszuwachs resultiert daher ausschließlich aus der Auslagerung der Modellausführung. Der Einbettungsdienst von Private AI Services läuft auf einer CPU-ONNX-Laufzeitumgebung, weshalb die H100-Prozessoren dieses Servers bei diesem Test nicht zum Einsatz kamen. Der Zuwachs wurde durch die Auslagerung des Modells vom Datenbankhost erzielt. Der GPU-Anteil der Pipeline besteht im Indexaufbau, der im Folgenden beschrieben wird.
IBM ermittelte diese Werte im Labor in Colorado; wir haben den Test weder durchgeführt noch geprüft. Die praktische Schlussfolgerung ist, dass das erstmalige Einbetten eines Archivs und jedes erneute Einbetten nach einer Modelländerung ein Batch-Prozess ist, der mehrere Stunden in Anspruch nimmt, während der anschließende Abruf ein CPU- und Speicherprozess ist, der nur Millisekunden benötigt.
Derselbe Container übernimmt auch die Indexerstellung. Oracle 26ai kann einen HNSW-Build an den Vector Index Service des Containers senden, der mithilfe von NVIDIA cuVS auf der GPU den Nachbargraphen erstellt, bevor der fertige Index an die Datenbank zurückgegeben wird. Suchvorgänge werden anschließend ohne GPU-Beteiligung ausgeführt. In der IBM-Aufzeichnung dauerte der HNSW-Baseline-Build (32 Nachbarn, efConstruction 200) 8.47 Sekunden in der Datenbank und 2.26 Sekunden mit der Auslagerung – eine Reduzierung um den Faktor 3.7. Dieser Testlauf verwendete eine kleine Beispieltabelle und bestätigt somit, dass der Ansatz in dieser Konfiguration funktioniert. Messungen im klinischen Maßstab stehen noch aus.
Die Anwendung veranschaulicht die in diesem Beitrag beschriebene Arbeitsteilung. Der GPU-Server hostet das Sprachmodell und, während Archivierungs- oder Aktualisierungsvorgängen, die Einbettungs- und Indexierungsdienste. Die Datenbank speichert Vektoren zusammen mit den zugehörigen Datensätzen, während Array und Fabric die Abfrage und Transaktionen verarbeiten. Kein Schritt im Abfrageprozess nutzt eine externe API, und Patientendaten verlassen das Rechenzentrum zu keinem Zeitpunkt.
IBM wählte das Gesundheitswesen als Anwendungsbereich, um das Konzept zu beweisen, und das Muster ist nicht branchenspezifisch. Ersetzt man das Röntgenarchiv durch Abrechnungshistorien, Wartungsberichte oder einen Produktkatalog, bleiben die drei Komponenten gleich: Vektoren werden neben den zugehörigen Datensätzen gespeichert, die Generierung erfolgt auf dem GPU-Server und der Abruf sowie die Transaktionen werden auf einem einzigen Array durchgeführt. Jede Branche, die Inferenz auf bereits vorhandenen Daten durchführt, nutzt dieselbe Architektur.
Was kommt als nächstes
Die Validierung wird auf derselben Hardware fortgesetzt: In Phase 2 wird der KV-Cache der Inferenz-Engine vom GPU-Speicher auf FlashSystem über dasselbe Fibre-Channel-Fabric verschoben, sodass ein Long-Context-Modell einen größeren Teil seines Arbeitssatzes im Zugriff behält. Die nächste Veröffentlichung dieser Reihe beschreibt diese Arbeit. IBM entwickelt außerdem eine inhaltsbasierte Aktualisierungspipeline, bei der IBM Storage Scale AFM und Kafka neue Dokumente in die Onnx-Vektorisierung innerhalb der Datenbank einspeisen, sobald diese eintreffen. Dadurch verfolgt der Vektorindex seine Quellen ohne erneutes Einbetten im Batch-Verfahren. IBM plant zudem, dieselbe Speichervalidierung auf die anderen Multi-Modell-Datenbanken auszuweiten, die die Vektorsuche implementiert haben.
Phase 2 setzt die Sicherheitsebene auch für neue Daten ein. Wenn der KV-Cache auf FlashSystem verschoben wird, durchläuft der Arbeitskontext eines Gesundheitsmodells (einschließlich der Patientenhistorie) dieselben Fibre-Channel-Verbindungen wie der Vektorindex und die Transaktionsdatensätze. Emulex SecureHBAs verschlüsseln die Daten während der Übertragung zwischen Host und Fabric, während die Post-Quanten-Kryptografie von Brocade Gen 8 die Switch-Seite abdeckt. Jede Phase erhöht die Arbeitslast der Fabric, ohne einen Pfad für unverschlüsselte Datenübertragung hinzuzufügen.
Leaderboard: Das IBM-Profil auf unserer Seite „Beste Speichersysteme“ umfasst nun neben Storage Scale auch FlashSystem-Blockspeicher.
Dieser Bericht wird von Broadcom gesponsert. Alle in diesem Bericht geäußerten Ansichten und Meinungen basieren auf unserer unvoreingenommenen Sicht der betreffenden Produkte.



 Amazon