

Die KI-Infrastruktur in Unternehmen hat sich von der Optimierung von Trainingsmodellen hin zu deren Bereitstellung verlagert, was die Wirtschaftlichkeit verändert. Training ist ein Investitionsprojekt mit einem festgelegten Endpunkt. Inferenz hingegen ist eine Produktionslast, die so lange läuft, wie der Dienst verfügbar ist, und deren Output in Token gemessen wird. Genau hier liegt das Tokenomics-Problem, mit dem KI-Betreiber heute konfrontiert sind: Sobald die GPUs installiert und das Leistungsbudget festgelegt ist, hängt der Geschäftserfolg davon ab, wie viele Token die Hardware generiert.
Bei langen, mehrstufigen Arbeitslasten wird derselbe Kontext mit zunehmender Gesprächsdauer wiederholt durch das Modell geleitet. Die GPU hat die Token bereits einmal verarbeitet, aber wenn der KV-Cache geleert wird, muss das System diesen Kontext erneut vorbefüllen. Dadurch muss der Gegner die Daten neu berechnen. Unabhängig vom Umfang ist dies kein vernachlässigbarer Fehler. Es entstehen Kosten in Form von mehr Energie, GPU-Zeit, einer längeren Warteschlange oder zusätzlicher Hardware.
Die naheliegende Lösung wäre, mehr der teuersten Ressourcen im Rack zu kaufen: mehr GPUs, mehr DRAM. Doch die Reberechnung hat bereits etwas Wiederverwendbares hervorgebracht. Der KV-Cache enthält lediglich Daten; er lässt sich kostengünstig speichern und abrufen, wobei die geringen Kosten für das erneute Laden gegen die aufwändige Vorbefüllung eingetauscht werden. Die Frage ist also nicht, ob der Cache beibehalten werden soll, sondern wo er gespeichert werden soll – und das ist ebenso eine Kosten- wie eine Leistungsfrage. VRAM ist die schnellste und knappste Speicherebene; sobald sie gesättigt ist, beginnt der Inferenzserver, Cache-Daten zu entfernen. DRAM bietet zusätzlichen Speicherplatz, allerdings zu einem hohen und schnell steigenden Preis. Bei Flash-Speicher ändert sich die Rechnung: Er ist zwar langsamer als DRAM, aber deutlich günstiger pro Terabyte und bietet genügend Kapazität, um den Kontext zu speichern, den die schnelleren Speicherebenen verwerfen müssen. Das ist der Unterschied zwischen der erneuten Verarbeitung der gesamten Konversation und dem einfachen Auslesen.
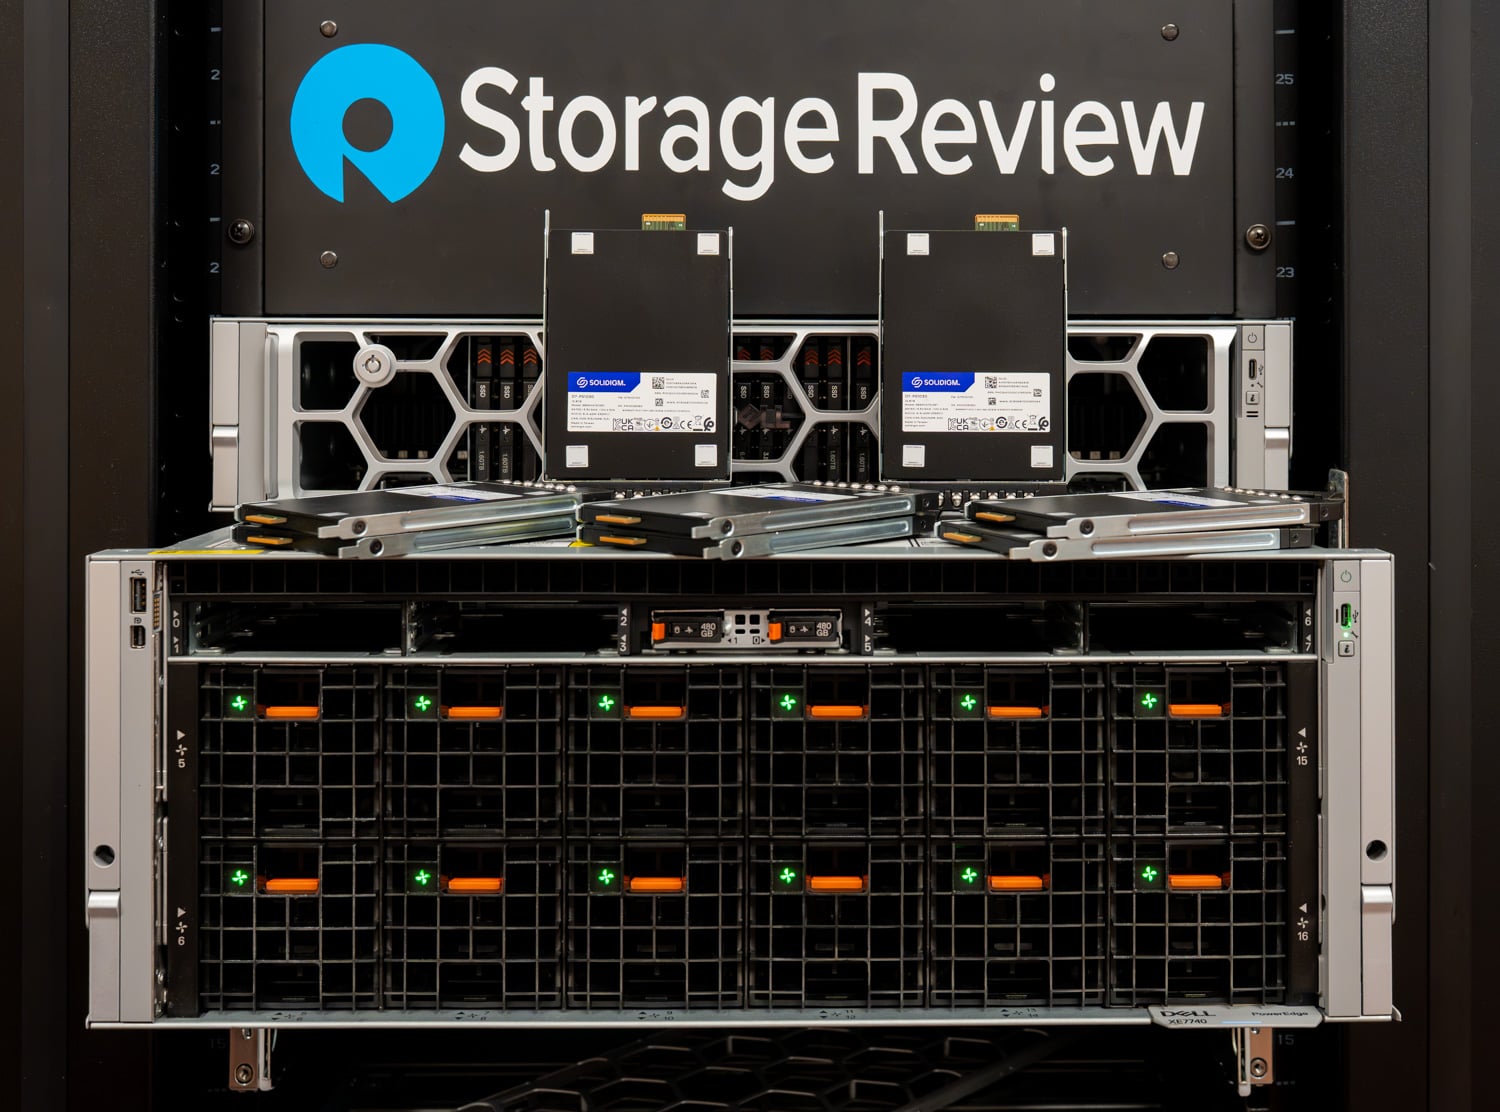
Um die Auswirkungen zu messen, erstellten wir eine mehrstufige agentenbasierte Testlast auf einem Dell PowerEdge XE7740 und hielten Modell, GPUs und Serverarchitektur konstant. Für die Systemdimensionierung ist entscheidend, was passiert, nachdem die Speicherebenen voll ausgelastet sind. Ab diesem Punkt verarbeitete Flash-Speicher weiterhin etwa 30,000 Token pro Sekunde, verglichen mit 17,000 Token pro Sekunde beim DRAM. Flash-Speicher erreichte 94 % seiner Spitzenleistung, während die DRAM-Ebene auf 42 % abfiel. Beide Offload-Ebenen übertrafen die VRAM-basierte Basislinie in der Spitze deutlich (2.9-mal so schnell beim DRAM und 2.2-mal so schnell beim Flash-Speicher). Die Spitzenleistung wird jedoch genau dann erreicht, wenn die DRAM-Ebene fast voll ist. Der teuerste Speicher deckt die Spitzenleistung ab; Flash-Speicher hält sie, während der Kontext weiter wächst.
Bevor wir zu den Ergebnissen kommen, ist es wichtig, genau zu erklären, was der KV-Cache ist, warum er sich füllt und warum die Inferenzleistung einbricht, wenn das System keinen günstigeren Speicherort mehr hat, um ihn zu speichern.
Wichtige Erkenntnisse
- Flash-Speicher können das, was DRAM nicht kann: Alle drei Konfigurationen verhalten sich identisch, bis der Speicherdruck zum Aussortieren von Token führt. Der VRAM ist zuerst voll, und die 512 GB große DRAM-Schicht ist nach etwa 45 Minuten voll und beginnt mit dem Aussortieren. Danach verarbeitet der Flash-Speicher weiterhin etwa 30,000 Token pro Sekunde, verglichen mit 17,000 Token pro Sekunde beim DRAM. Der Flash-Speicher erreicht damit 94 % seiner Spitzenleistung, während die Leistung des DRAM auf 42 % sinkt.
- Offload stellt den durch die Neuberechnung verlorenen Durchsatz wieder her: Im Spitzenbereich steigerte die KV-Cache-Auslagerung den gesamten Durchsatz im Vergleich zur reinen VRAM-Basislinie auf der DRAM-Ebene um das 2.9-Fache und auf dem Flash-Speicher um das 2.2-Fache. Dieser Gewinn resultiert aus dem Wegfall des erneuten Vorbefüllens, da der von der GPU bereits berechnete Kontext aus der Auslagerungsebene zurückgelesen und nicht neu erstellt wird.
- Die wiederkehrenden Nutzer spüren den Unterschied am deutlichsten: Die maximale Latenzzeit beim ersten Token in einer fortgesetzten Sitzung betrug 13.9 Sekunden im VRAM-basierten Vergleich gegenüber 3.2 Sekunden im Flash-Speicher. Die Auslagerung von Arbeitsspeicher (Offloading) sorgt dafür, dass diese Verzögerung innerhalb eines für einen interaktiven Benutzer akzeptablen Rahmens bleibt.
- Der hohe Verkehrsaufkommen macht Zwangsräumungen teuer: Eine Woche lang wurden die Daten des instrumentierten Claude-Code-Verkehrs erfasst. 98.16 % der Daten basierten auf Cache-Lesezugriffen, nur 0.02 % der Daten wurden tatsächlich aus dem Cache geladen.
- KV-Offload ist eine schreibintensive Arbeitslast, die leistungsstarke Laufwerke erfordert: Jeder vom Modell erzeugte Token schreibt einen KV-Eintrag, und die TTL-Churn-Funktion überschreibt die Ebene kontinuierlich. Bei unserer konstanten Schreibrate erreicht das von uns getestete gespiegelte RAID10-Array etwa 3.2 Laufwerksschreibvorgänge pro Tag und Laufwerk. Im RAID0-Verbund sinkt dieser Wert auf etwa 1.6 DWPD und liegt damit im Bereich der 3 DWPD-Angabe des D7-PS1030. Die Ausdauer, nicht Kapazität oder Geschwindigkeit, ist die entscheidende Einschränkung der Flash-Ebene. Da der Cache temporär ist, ist eine so intensive Nutzung eines schreiborientierten Laufwerks ein akzeptabler Kompromiss.
Wie Schlussfolgerungen funktionieren
Große Sprachmodelle sind autoregressiv: Jedes Ausgabetoken ist von jedem vorhergehenden Token abhängig. Der Aufmerksamkeitsmechanismus implementiert diese Abhängigkeit, indem er für jedes Token in der Sequenz einen Anfragevektor (Q) berechnet, der mit den Schlüssel- (K) und Wertvektoren (V) jedes vorhergehenden Tokens abgeglichen wird. Die Ausgabe der Aufmerksamkeit ist eine gewichtete Kombination der Werte, wobei die Gewichte aus den Skalarprodukten von Q und K stammen.
Wenn eine Anfrage eingeht, kann die Eingabeaufforderung erst beantwortet werden, wenn für jedes Token in der Anfrage die entsprechenden K- und V-Tensoren vorliegen. Dieser erste Schritt ist das Vorbefüllen: Die Engine verarbeitet die Eingabeaufforderung in einem einzigen parallelen Durchlauf mithilfe des Modells und speichert die resultierenden K- und V-Tensoren im Speicher. Das Vorbefüllen ist daher rechenintensiv, und seine Latenz skaliert mit der Länge der Eingabeaufforderung.
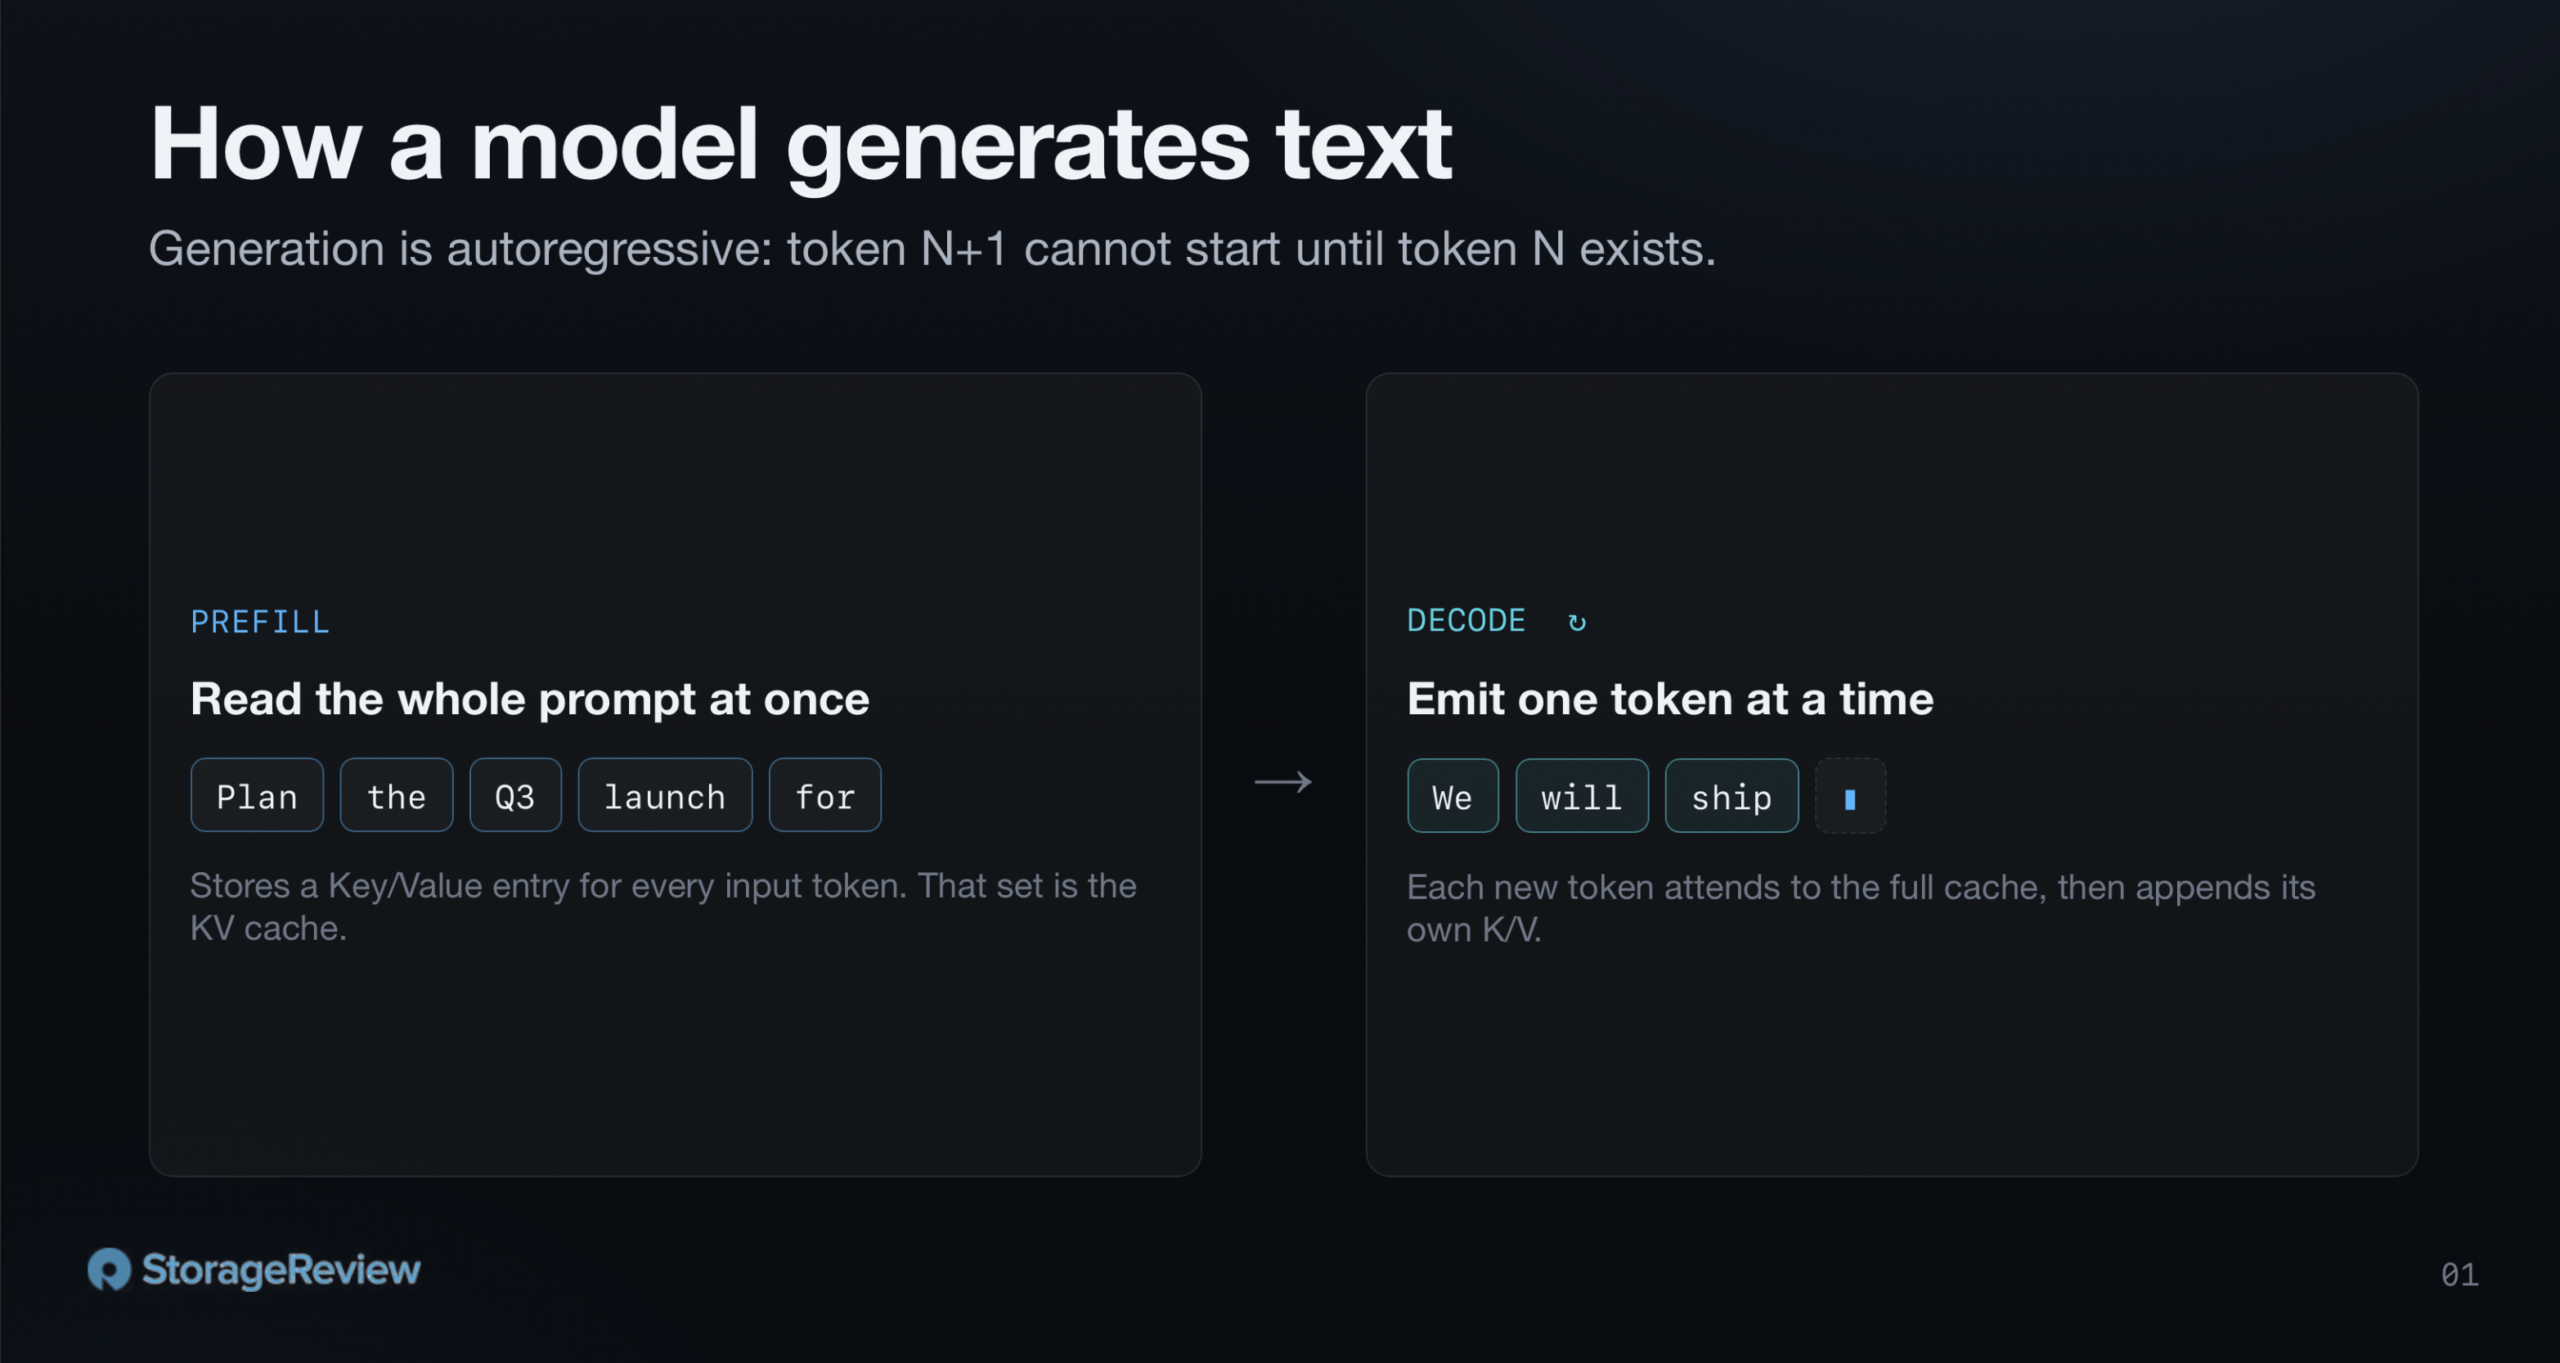
Sobald die Vorbefüllung abgeschlossen ist, gibt die Engine die Antwort Token für Token aus. Jedes neue Token liest die K- und V-Werte aller vorherigen Token, berechnet seinen Aufmerksamkeitswert und speichert seine eigenen K- und V-Werte für den nächsten Schritt im Speicher. Diese zweite Phase ist die Dekodierung. Sie ist sequenziell und speicherbandbreitenbeschränkt, da die Generierung jedes Tokens das Laden der zwischengespeicherten K- und V-Tensoren aller vorherigen Token aus dem Speicher und die Berechnung des Aufmerksamkeitswerts erfordert, bevor die K- und V-Tensoren des neuen Tokens für die folgenden Schritte gespeichert werden können.
Die K- und V-Tensoren beider Phasen bilden den KV-Cache. Ohne diesen Cache müsste bei der Generierung des (n+1)-ten Tokens in jedem Schritt die Schlüssel und Werte aller n vorherigen Token neu berechnet werden, was eine quadratische Rechenkomplexität zur Folge hätte. Dank des Caches berechnet jedes neue Token nur seinen eigenen K- und V-Wert und liest die restlichen Daten aus dem Speicher, sodass die Kosten pro Token linear bleiben.
Wie Agentenverkehr aussieht
Die Inferenz wird oft als speicher- und bandbreitenbegrenzt beschrieben, da die Dekodierung den für den Benutzer sichtbaren Teil einer Antwort dominiert. Das tatsächliche Verhältnis zwischen den beiden Phasen hängt von der Arbeitslast ab. Eine kurze Anfrage nach einem längeren Text erfordert viel Dekodierung; eine lange Anfrage mit einer kleinen JSON-Änderung erfordert viel Vorbefüllung. Welche Phase dominiert, bestimmt, welche bei fehlerhafter Cache-Verwaltung überlastet wird.
Die Form des Neuberechnungsproblems ergibt sich aus diesem Gleichgewicht, und „agentisch“ umfasst ein breites Spektrum an Nutzungsmustern. Agentisches Codieren ist derzeit eines der beliebtesten Muster und macht in den OpenRouter-Bestenlisten einen signifikanten Anteil der verwendeten Token aus. Um einen repräsentativen Fall zu quantifizieren, haben wir Claude Code mit OpenTelemetry (OTEL)-Protokollierung instrumentiert und die Traces einer Woche nach Grafana exportiert. Die Aufschlüsselung des Token-Verkehrs nach Typ ist unten dargestellt. Hinweis: Diese Claude-Code-Nutzung erfolgt auf dem Claude Opus 4.8-Modell mit 1M Kontextlänge, wobei gleichzeitig an mehreren Codierungsprojekten gearbeitet wird.
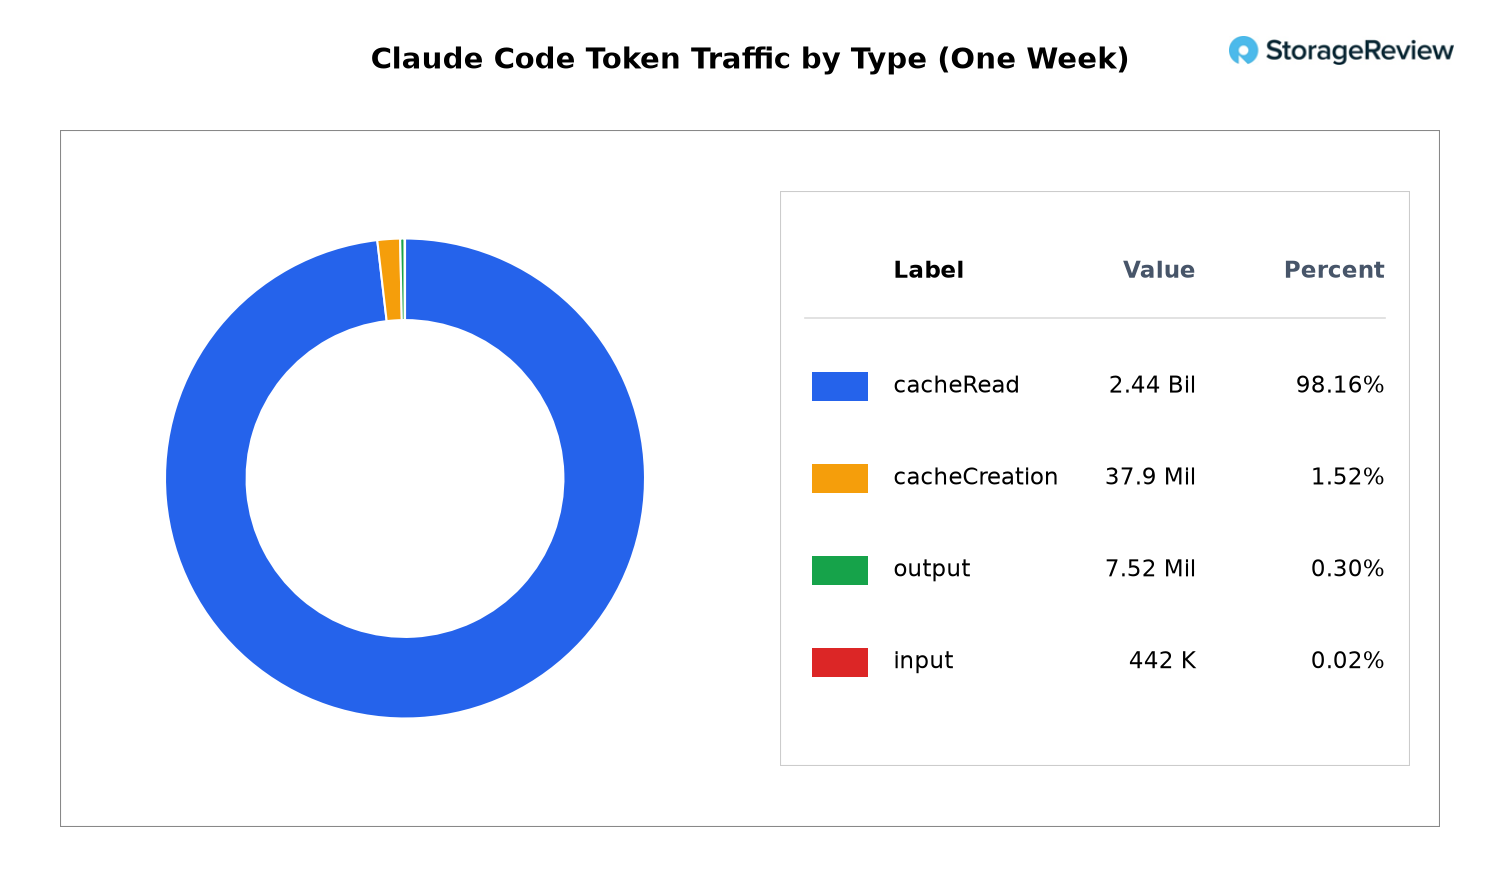
Cache-Lesezugriffe machten 98.16 % des gesamten Token-Verkehrs aus. Die Cache-Erstellung (Erneutbefüllung eines zuvor verwendeten Präfixes aufgrund eines abgelaufenen Eintrags) betrug 1.52 %. Ausgabetoken lagen bei 0.30 %. Tatsächlich nicht verwendete Eingabetoken betrugen 0.02 %.
Bei einer Arbeitslast, bei der 98 % des Datenverkehrs aus Cache-Lesezugriffen bestehen, bedeutet das Entfernen von Caches ohne Auslagerung, dass der Großteil der Arbeit, die das System ausführen wollte, erneut vorab in den Cache geladen werden muss. Der Flaschenhals verlagert sich von der Dekodierungsbandbreite, die üblicherweise optimiert wird, hin zur Vorab-Berechnung, die die GPU bereits in früheren Durchläufen durchgeführt hat. Tatsächlich ist es recht üblich, dass disaggregierte Serverarchitekturen im großen Maßstab mehr Vorab- als Dekodierungs-Worker einsetzen, und zwar aus demselben Grund: Die Vorab-Berechnung ist die entscheidende Phase.
Die 98 % beziehen sich auf den Traffic-Mix eines einzelnen Nutzers. Bei kurzen Chat-Intervallen würde der Anteil an ungenutztem Traffic höher sein. Dasselbe gilt für ein System mit erweiterter Datenabfrage, das in jedem Gesprächsdurchgang unterschiedliche Dokumente einfügt. Das allgemeine Muster bleibt jedoch bestehen, wenn die Konversationen lang sind, die Präfixe stabil bleiben und die Nutzer immer wieder zum selben Kontext zurückkehren.
Wo sich der Cache befindet und was passiert, wenn er voll ist
Wo genau befindet sich dieser Cache, und was passiert, wenn der Speicherplatz knapp wird? Nach dem Laden der Modellgewichte wird der verbleibende VRAM zum KV-Cache-Speicher, der in Blöcke fester Größe partitioniert ist. Beim Start teilt die Engine mit, wie viele Token sie speichern kann. In einer Standardkonfiguration ohne KV-Offloading kann sich der Cache ausschließlich in diesem Bereich befinden.
GPU-Server sind teuer, und Tokens sind das Produkt. Daher ist es wichtig, die Server rund um die Uhr auszulasten. Das bedeutet, die GPU mit einer kleinen Warteschlange von Anfragen zu versorgen, damit die Rechenleistung nicht ungenutzt bleibt. Gleichzeitig wird die Warteschlange so verteilt, dass die Antwortzeiten innerhalb des Service-Level-Ziels (SLO) bleiben. Da nicht jede Anfrage ihr gesamtes Kontextfenster nutzt, bleiben viele abgeschlossene Key-Value-Paare (KVs) im VRAM zwischengespeichert. Unter anhaltender Last füllt sich dieser Cache jedoch, und sobald er voll ist, werden ältere Einträge entfernt, um Platz zu schaffen.
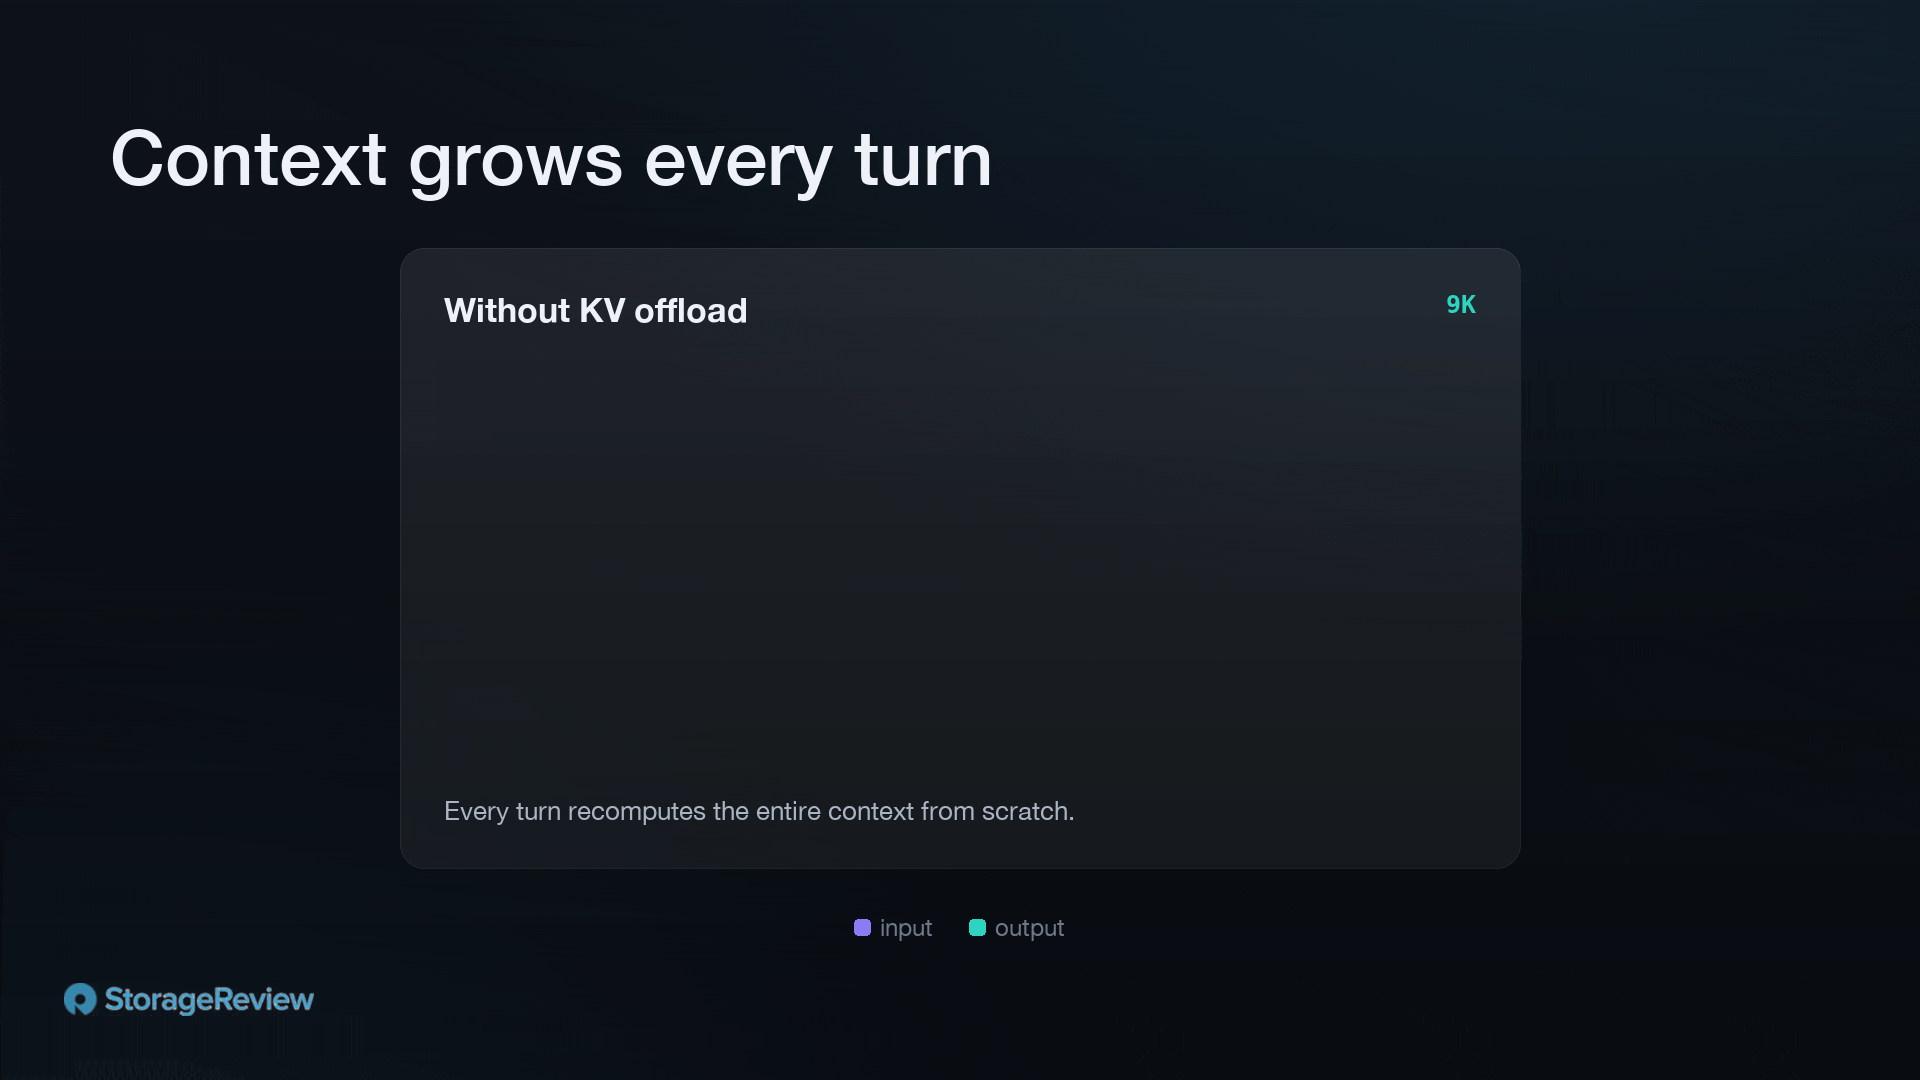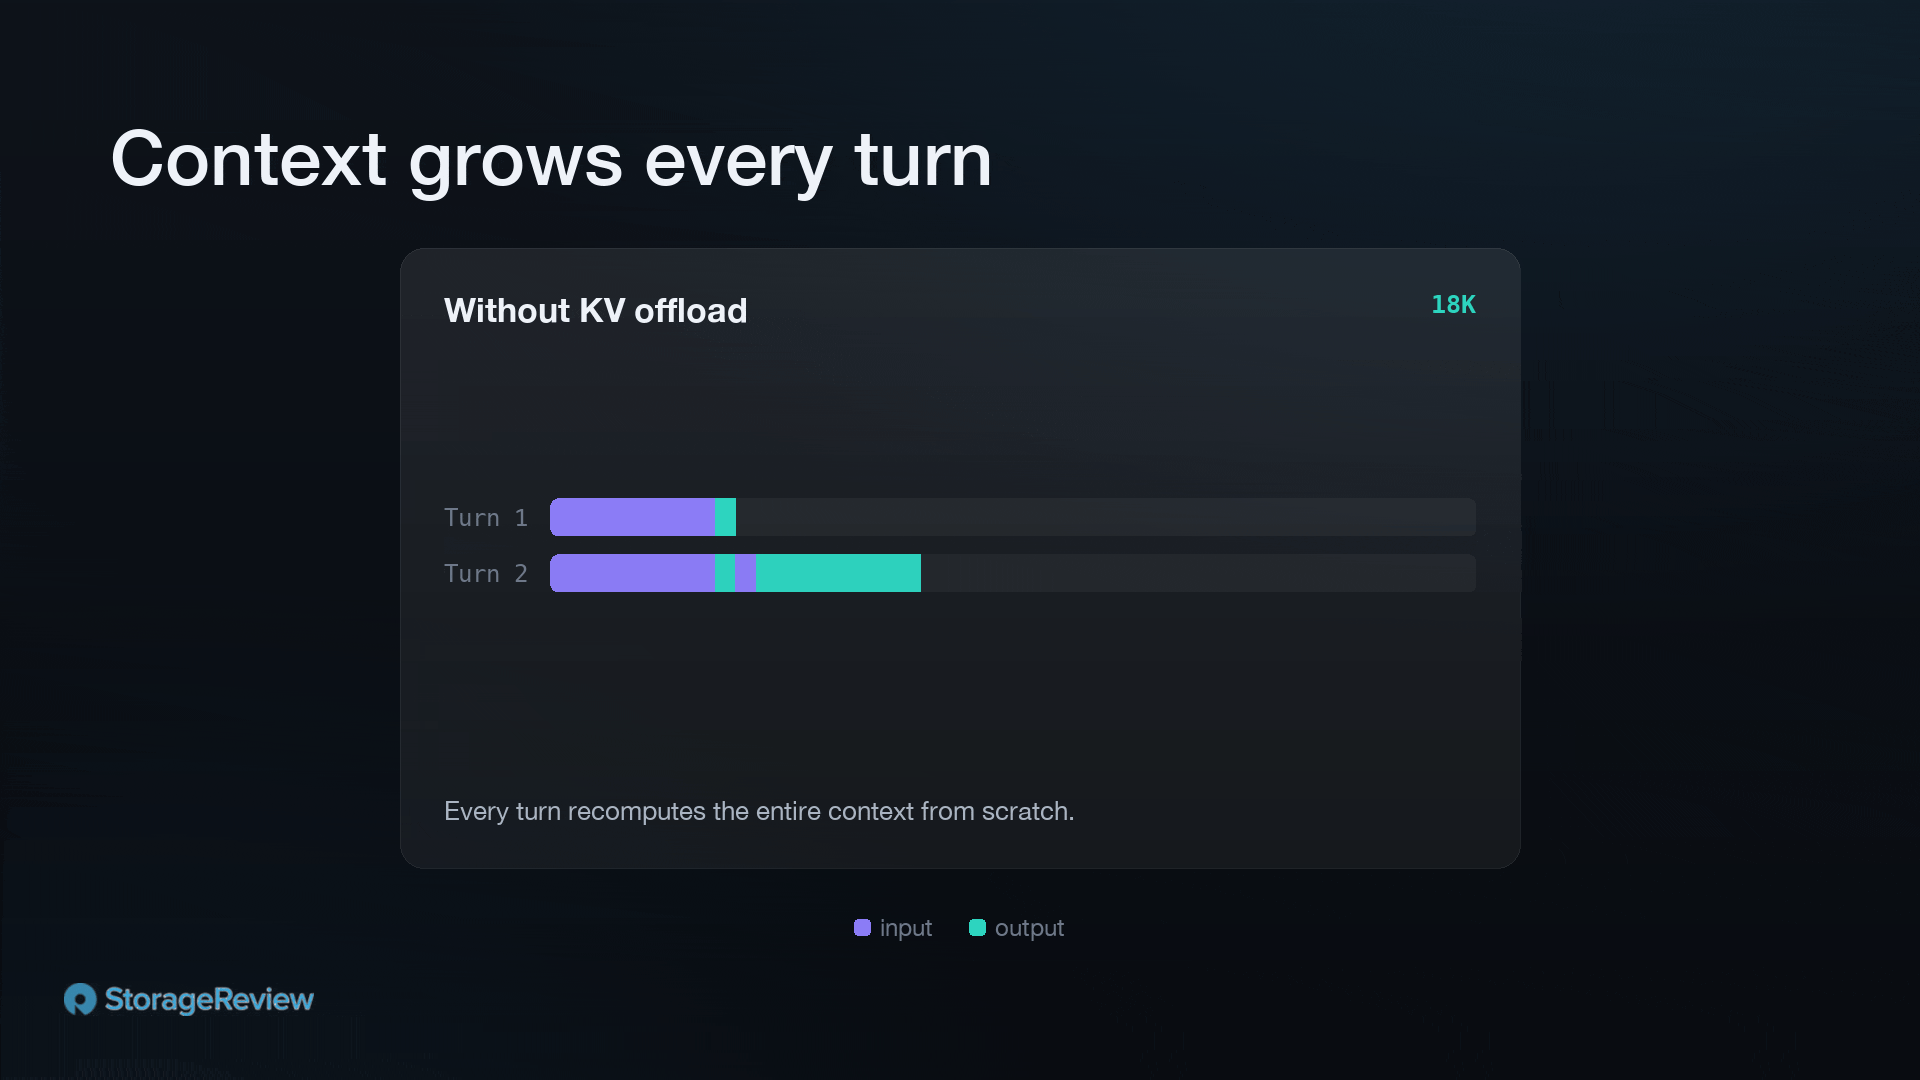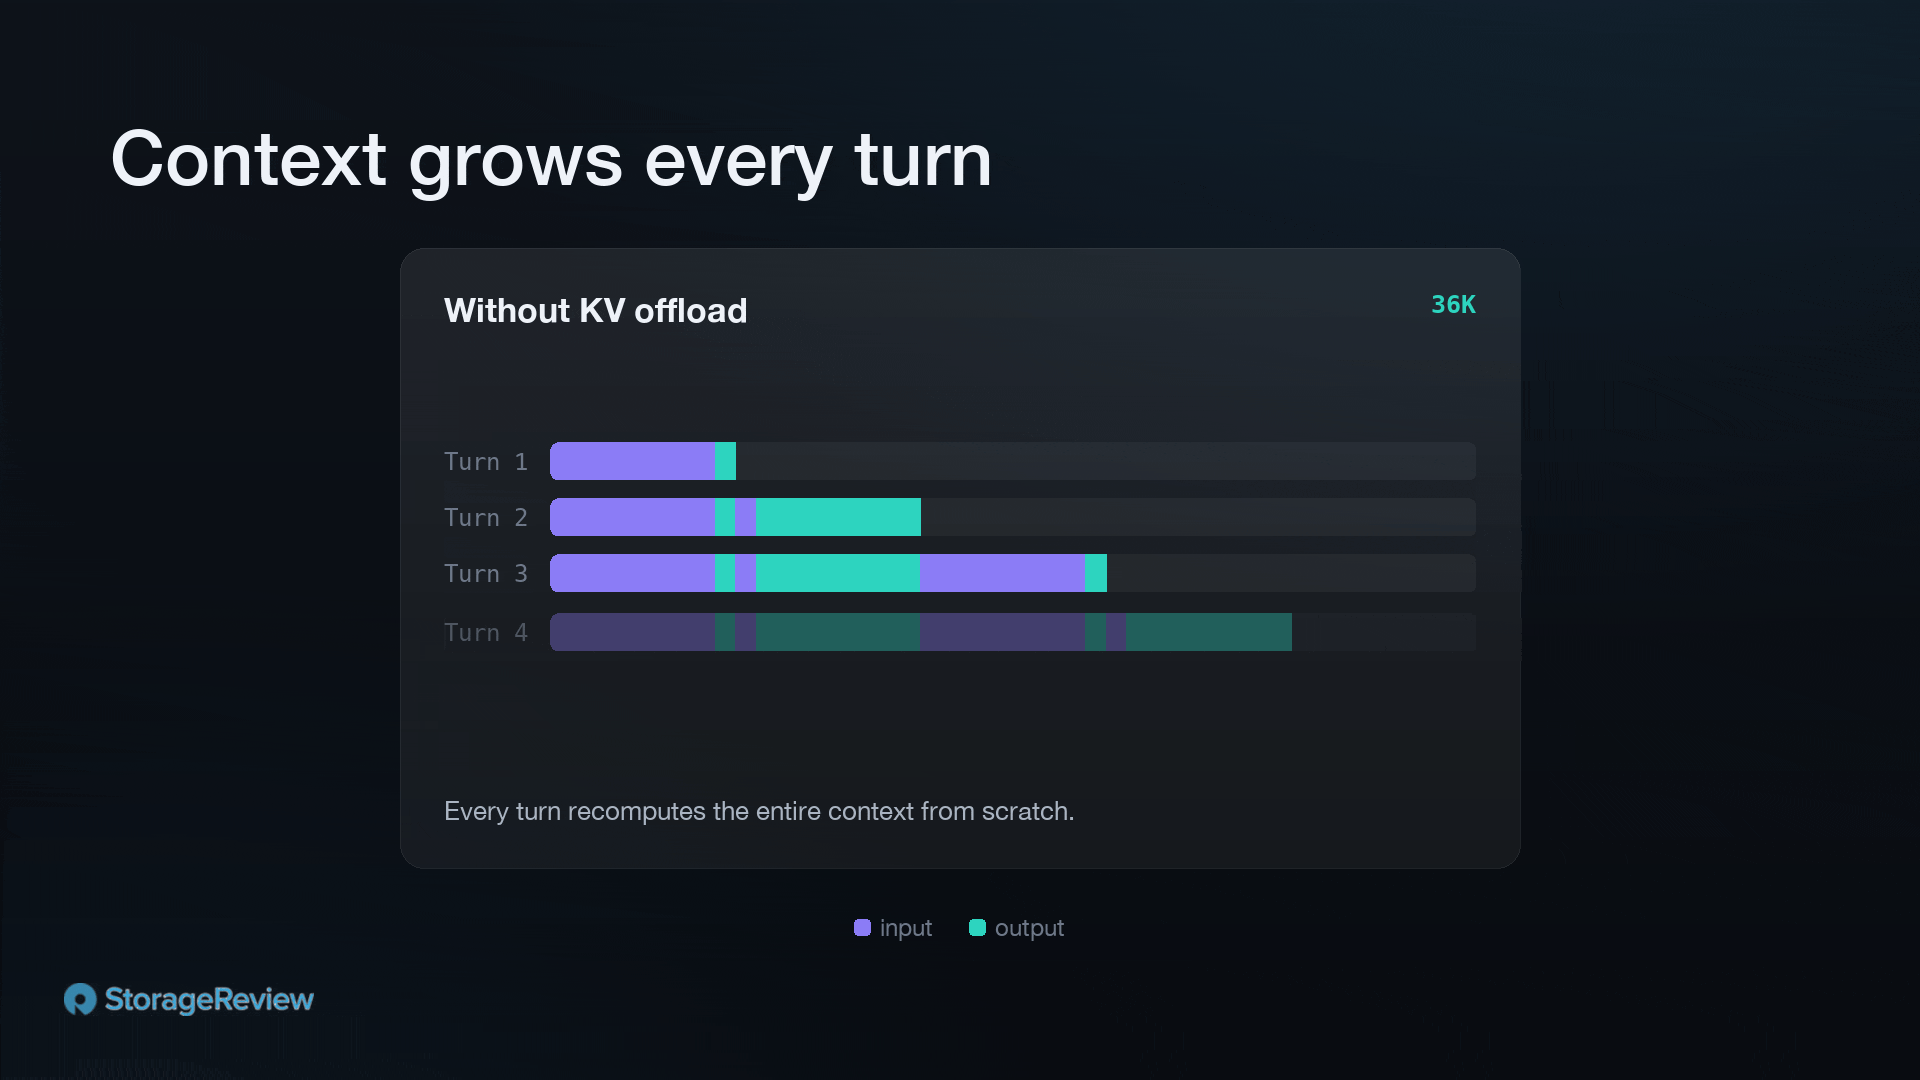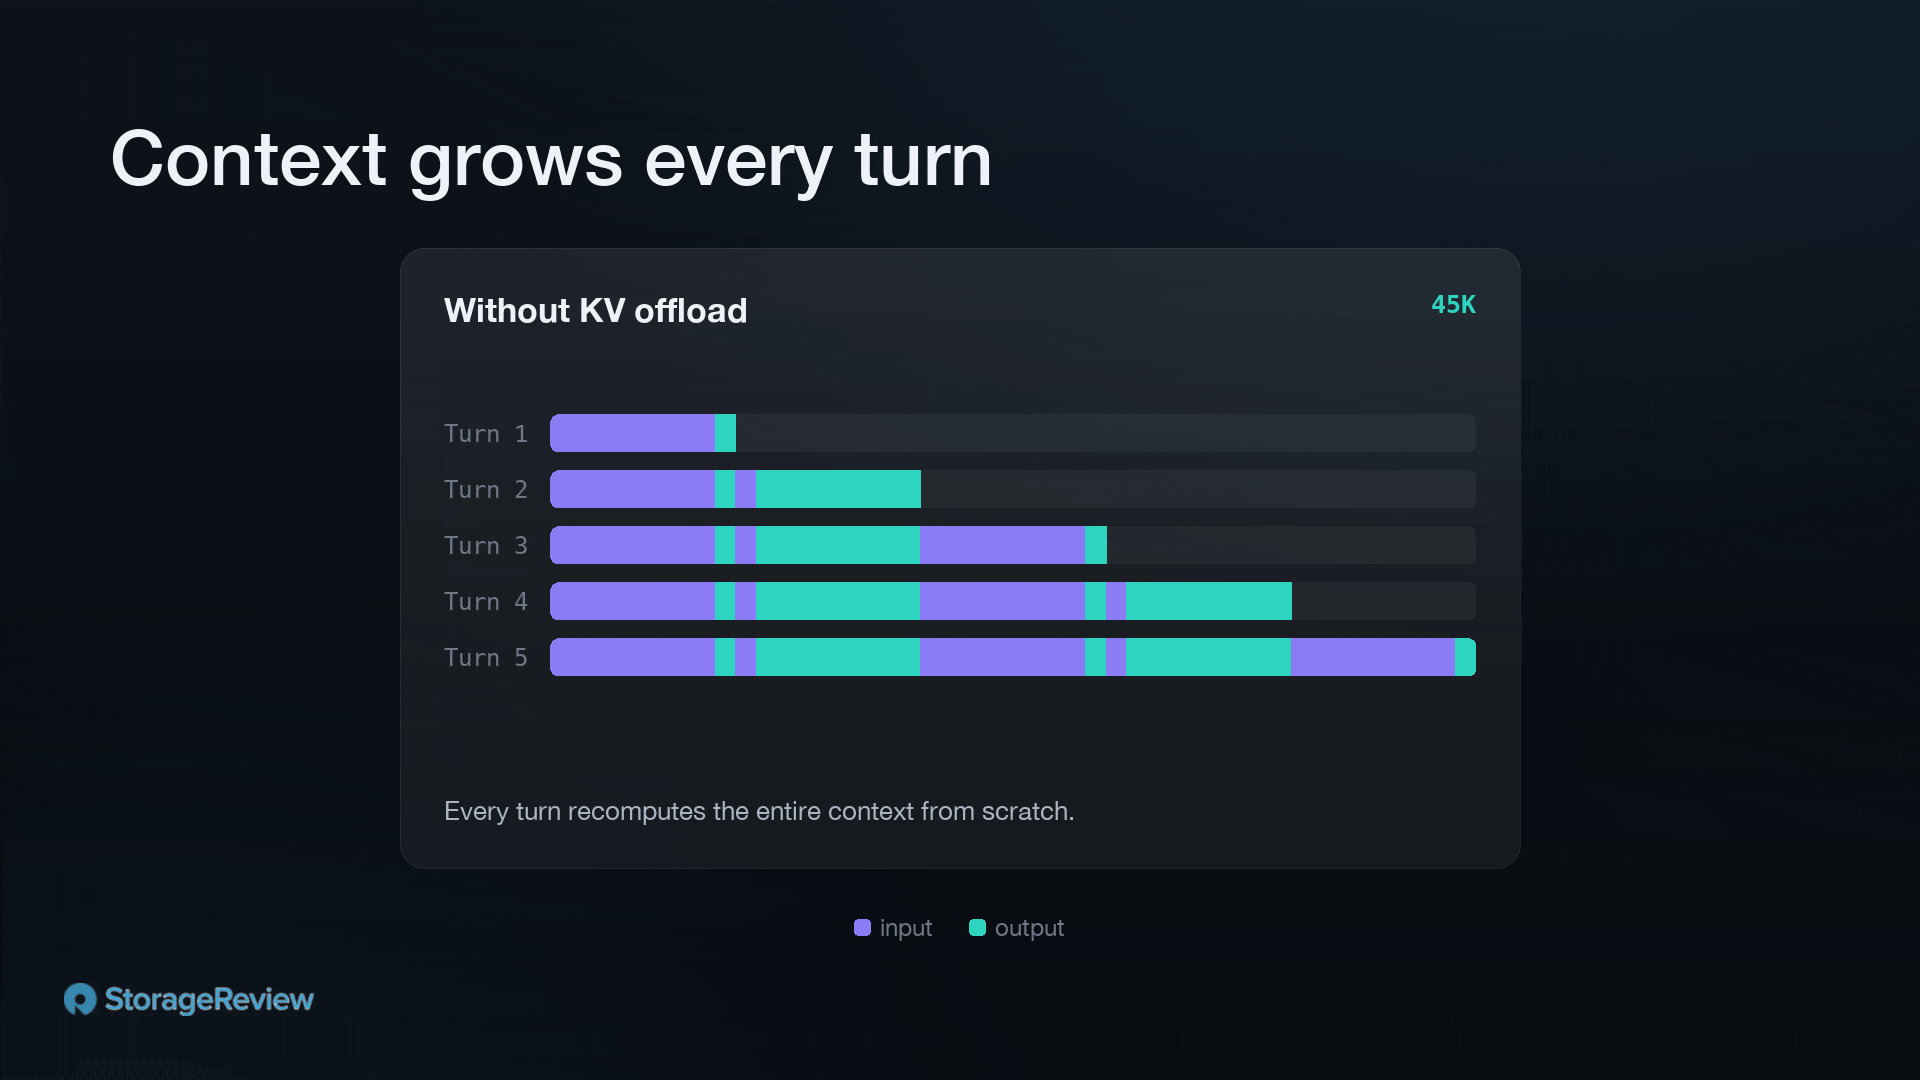
Im Idealfall würde man jede Antwort in einem Schritt verarbeiten und wäre fertig. Da Modelle aber noch nicht so gut sind, verwenden wir agentenbasierte Schleifen, in denen wir mit einem Benutzer oder zwischen Agenten interagieren. Wenn der nächste Zug ansteht und die Schlüssel-Wert-Paare noch nicht zwischengespeichert sind, verarbeitet die Engine die gesamte bisherige Konversation inklusive der neuen Token erneut. Der Kontext jedes vorherigen Zuges wird erneut durch das Modell geleitet, und die Berechnungen, die die GPU bereits für diese Token durchgeführt hat, werden für jeden weiteren Zug ein zweites, drittes und jedes weitere Mal ausgeführt. Dieser Teil des Prozesses ist reine Verschwendung.
Welche Änderungen gibt es beim KV-Cache-Offload?
Anstatt Einträge sofort zu entfernen, sobald der VRAM voll ist, verschiebt Offload die Caches schrittweise hierarchisch: vom VRAM über den Systemspeicher zur SSD. Die häufig benötigten Einträge bleiben im VRAM; Einträge, die nicht mehr hineinpassen, werden in den Systemspeicher verschoben, und wenn dieser voll ist, werden sie erneut auf die SSD oder einen Netzwerkspeicher ausgelagert. Das tatsächliche Entfernen von Einträgen wird seltener und durch eine vom Benutzer festgelegte Gültigkeitsdauer (TTL) anstatt durch Speicherdruck gesteuert.
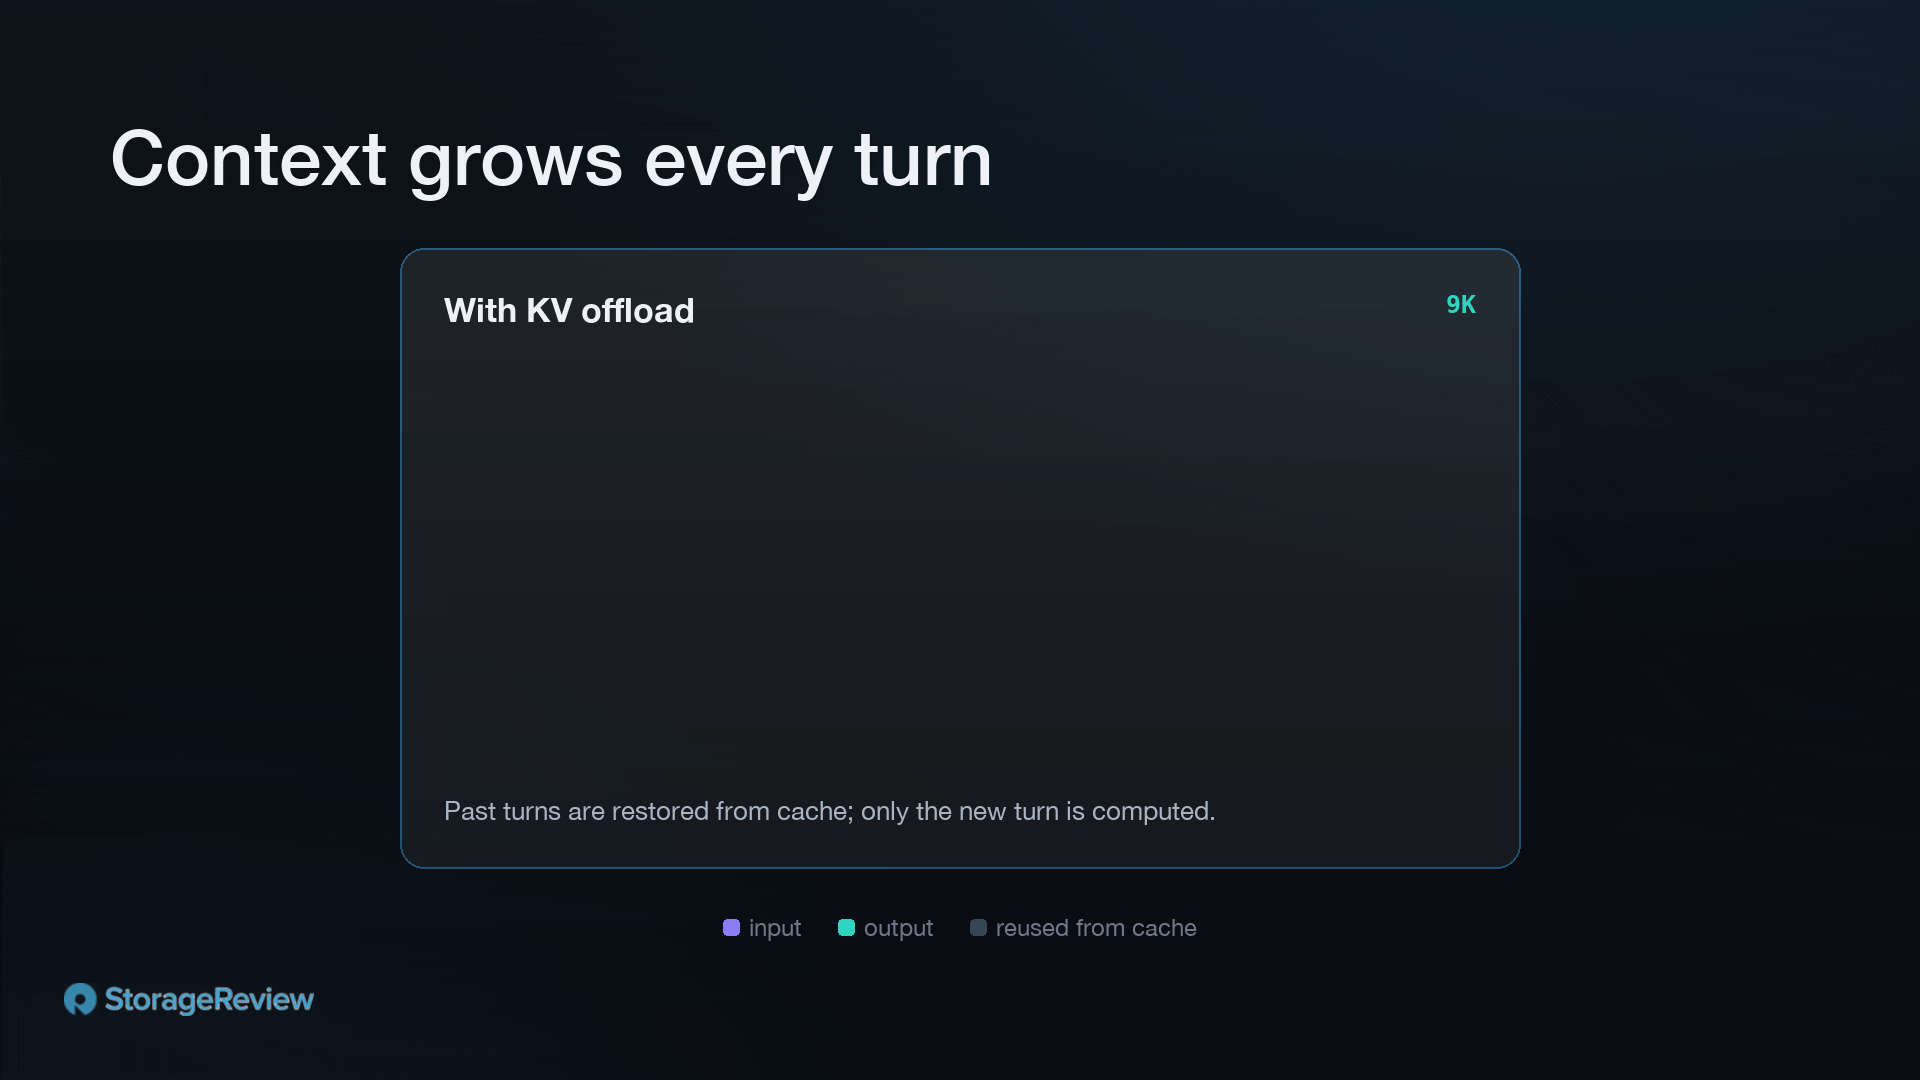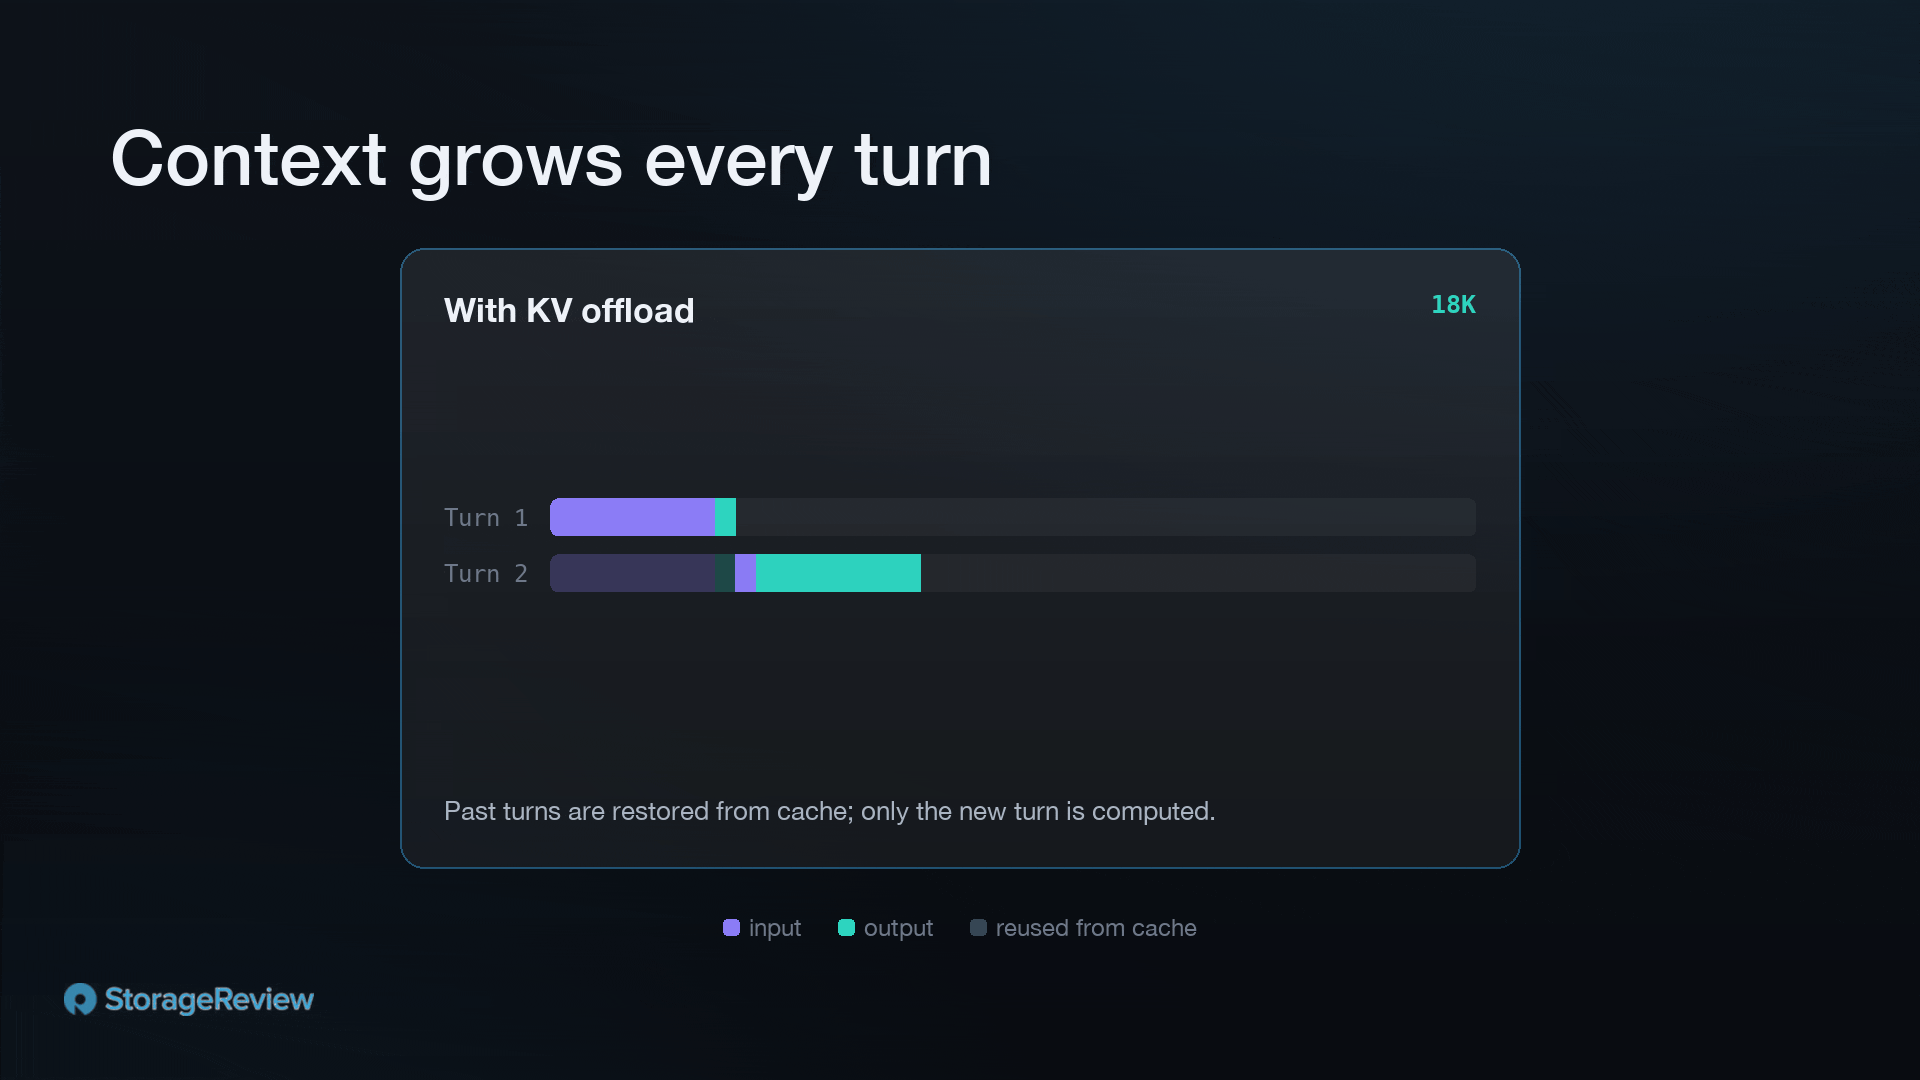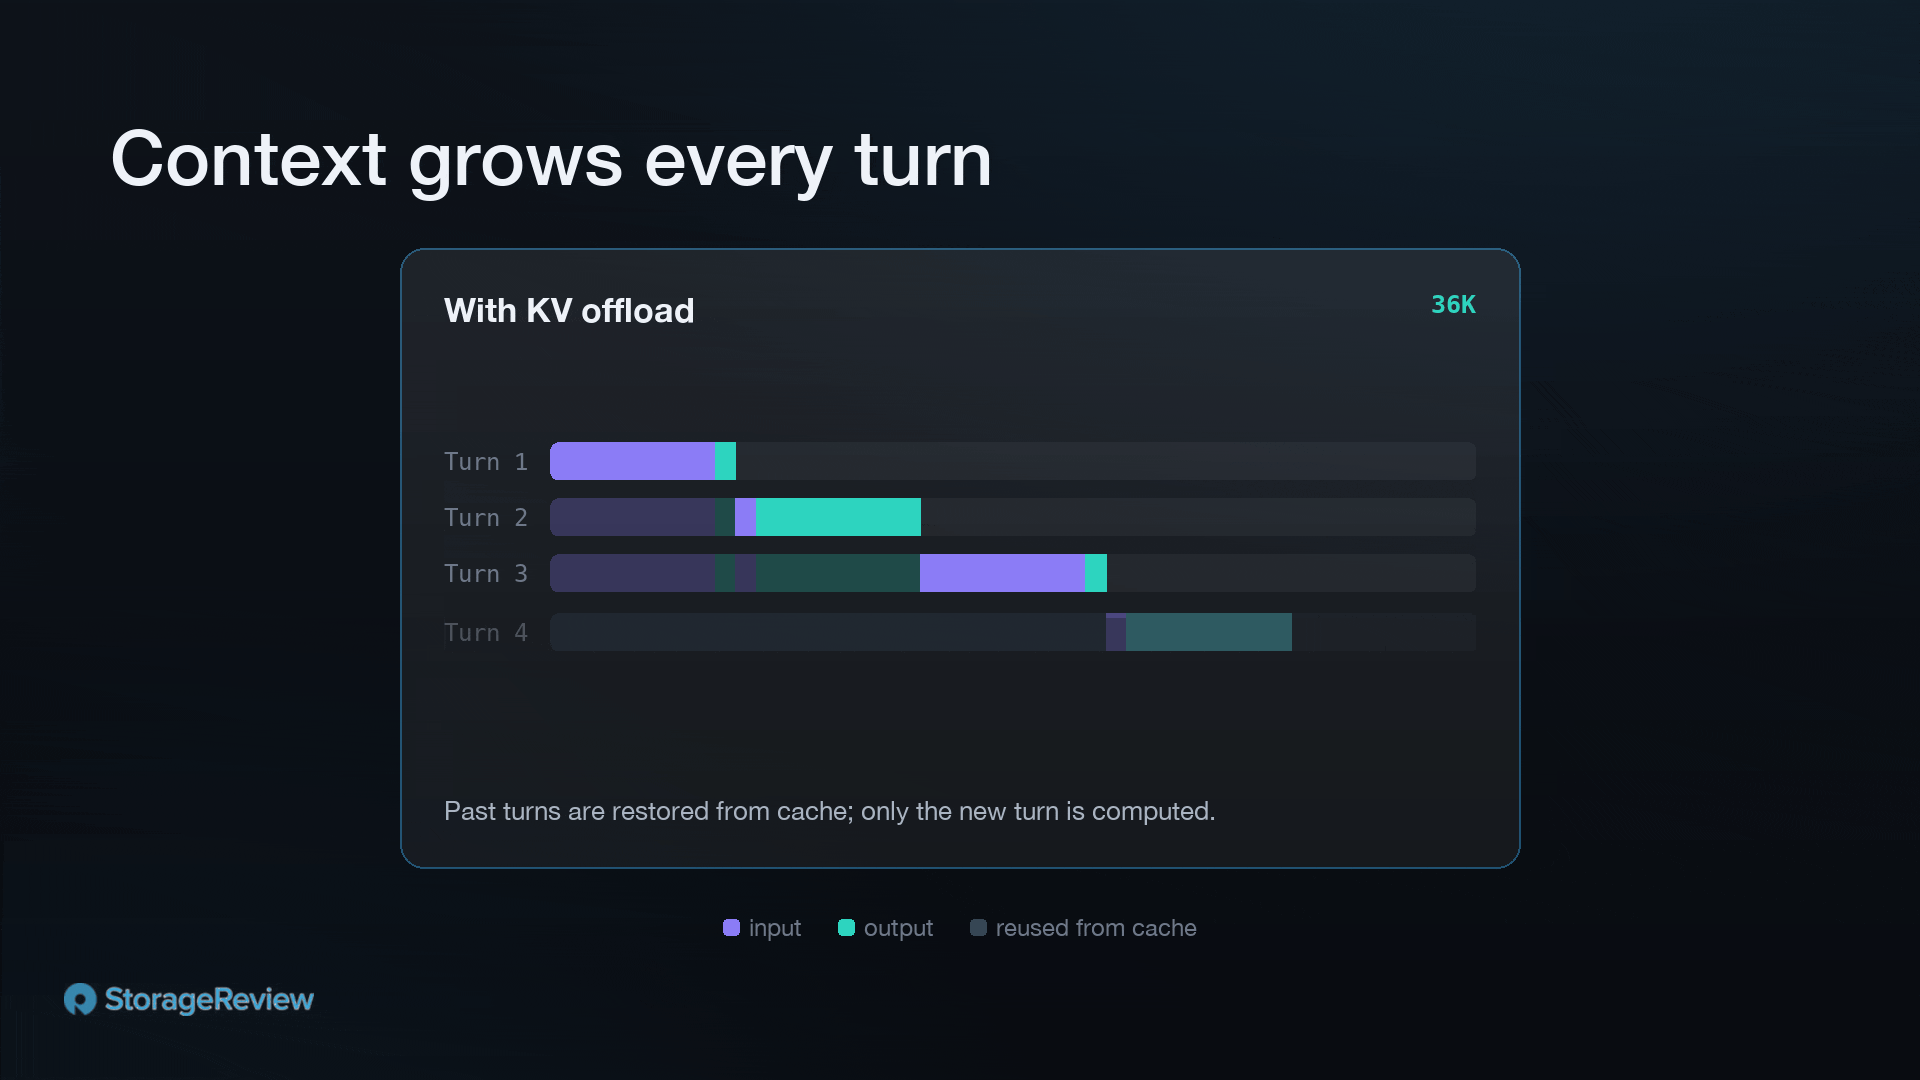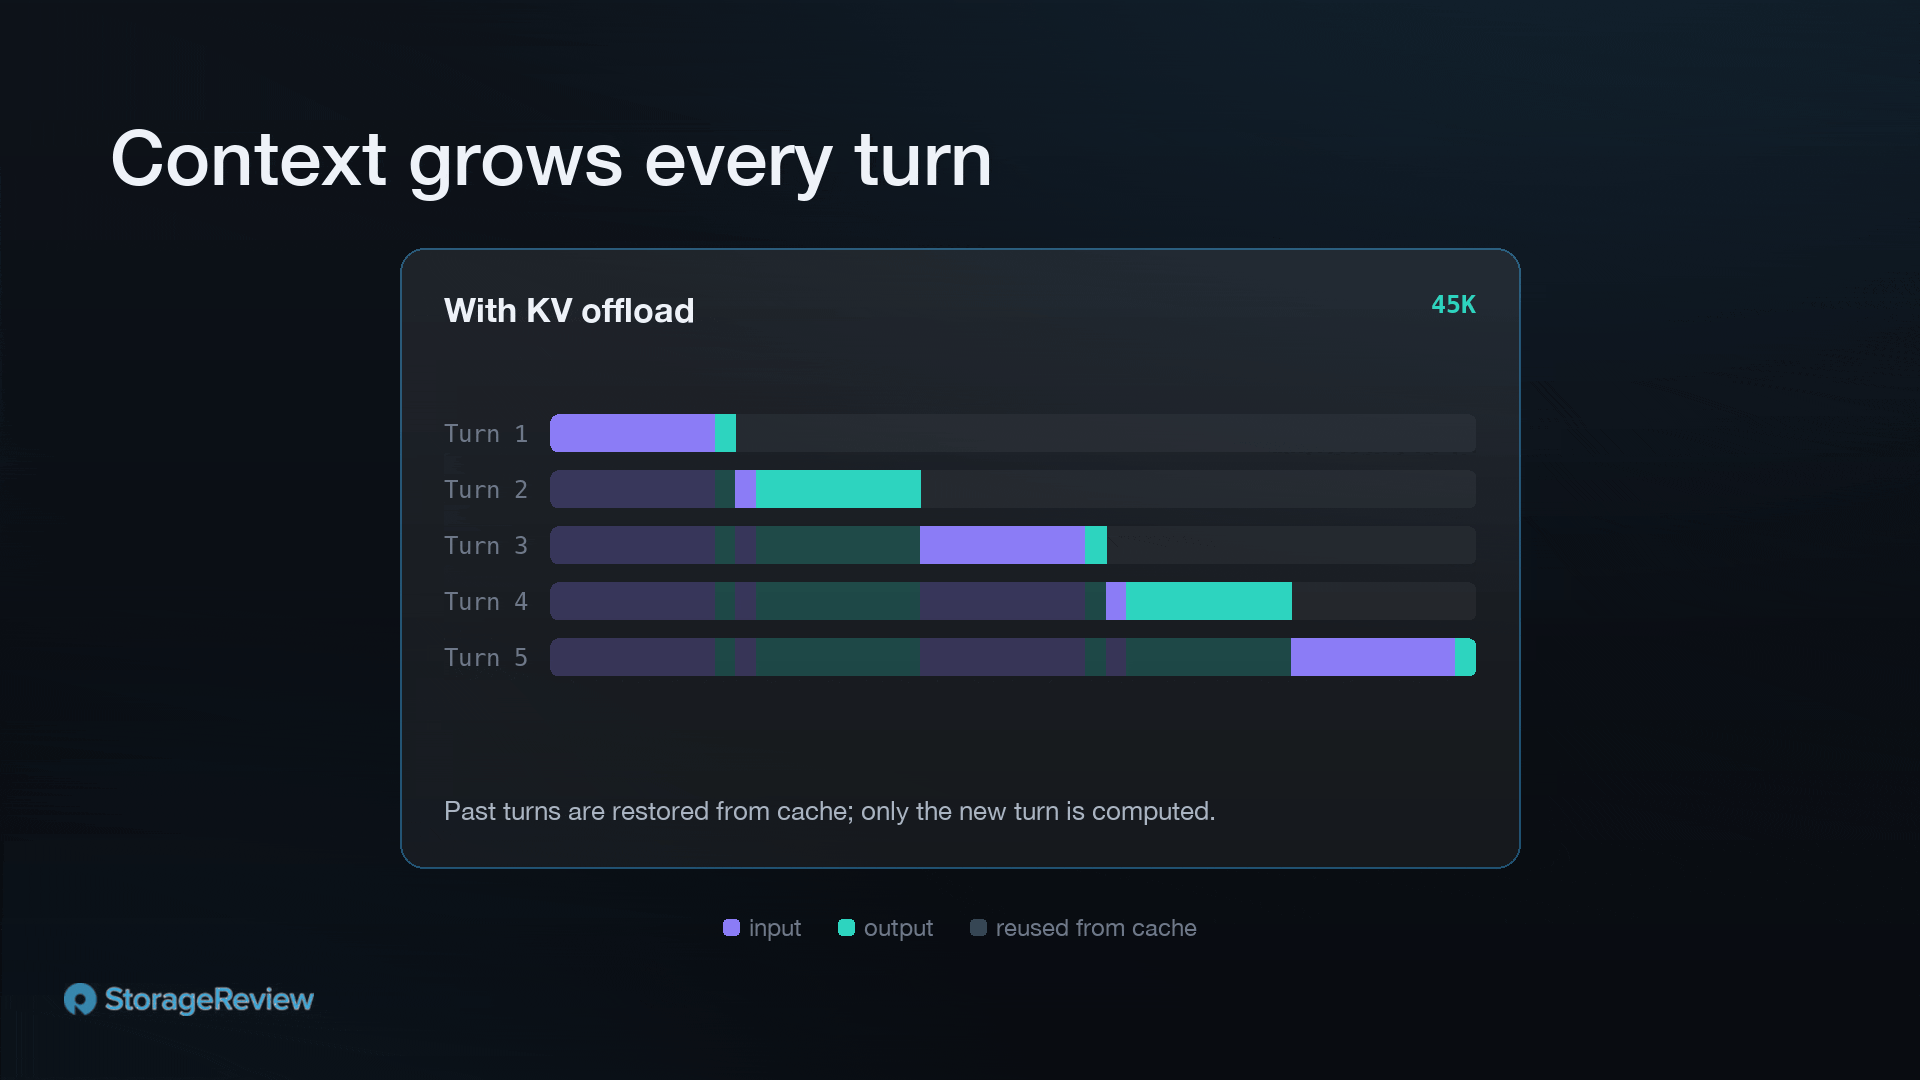
Wenn der nächste Zug beginnt, werden anstatt Zehntausende Kontextdaten neu zu berechnen, die Schlüssel-Wert-Paare aus dem Arbeitsspeicher oder Flash-Speicher geladen. Das Laden aus dem Arbeitsspeicher verursacht zwar eine geringe Verzögerung, ist aber deutlich günstiger und schneller als das erneute Vorbefüllen. Das Laden von NVMe ist etwas langsamer als ein DRAM-Zugriff, aber immer noch wesentlich schneller als die Neuberechnung, die es ersetzt. Speicherkapazität ist relativ günstig; GPU-Rechenleistung hingegen nicht. Daher ist es insgesamt vorteilhaft, die geringe Ladeverzögerung zu Beginn eines Zuges in Kauf zu nehmen, um eine mehrsekündige Neuberechnung zu vermeiden.
Wie wir getestet haben
Wir haben dies in unserem Labor getestet. Die Systemkonfiguration war wie folgt:
- Server: Dell PowerEdge XE7740
- GPUs: 4x NVIDIA RTX PRO 6000 Blackwell Server Edition (96 GB)
- Systemspeicher: 1 TB DDR5 (16 x 64 GB 5200 MT/s DDR5)
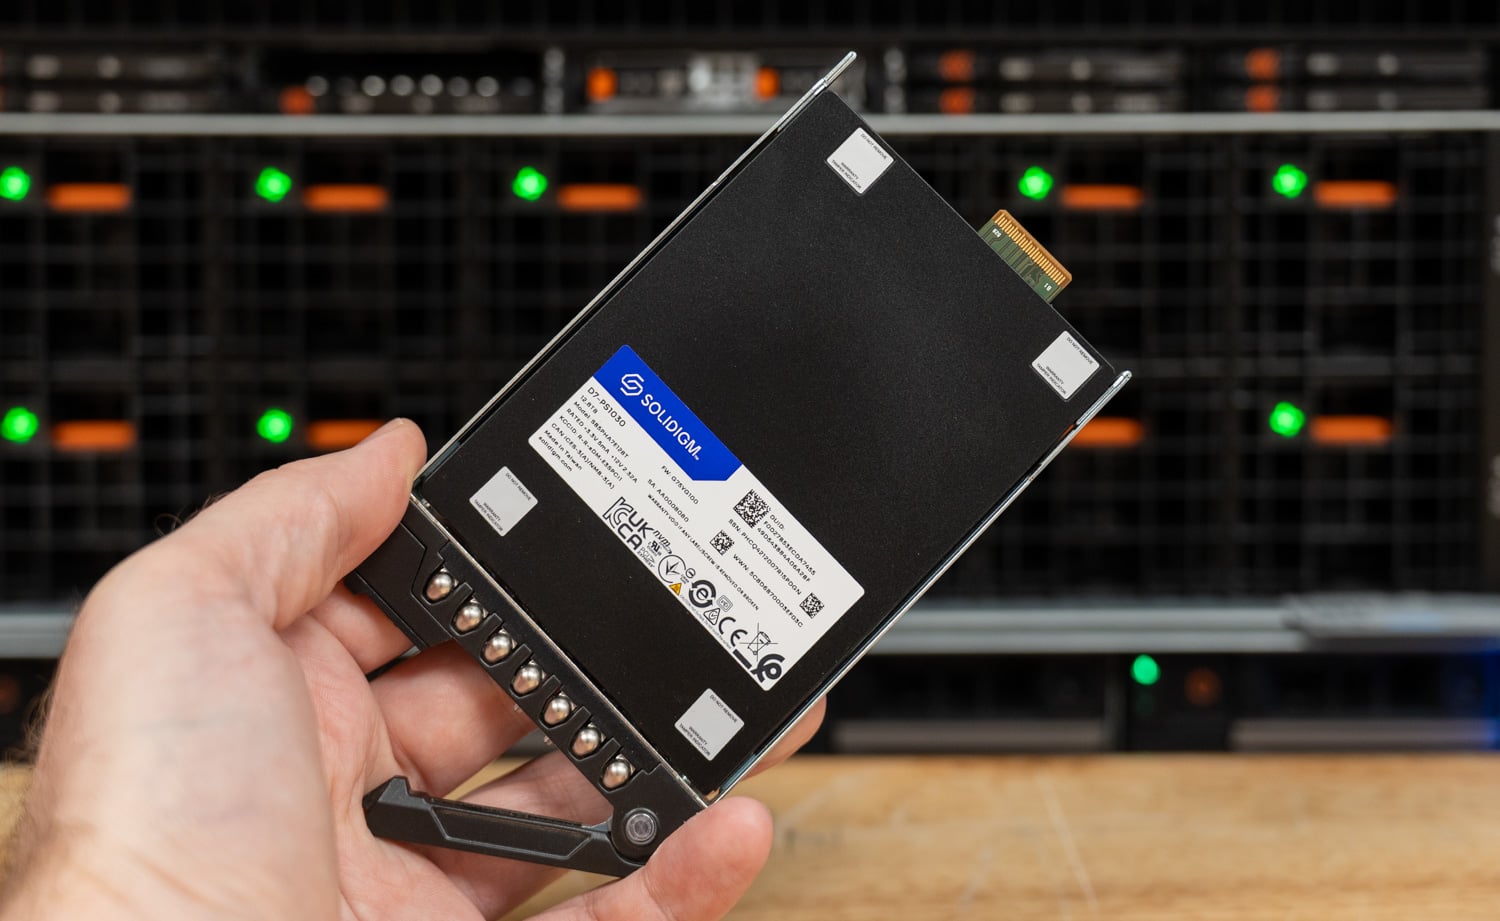
- Speicher: 8x Solidigm PS1030 12.8 TB E3.S Festplatten (RAID10)
- Server-Stack: vLLM 0.22.0 mit LMCache 0.5.0
- Modell: MiniMax-M2.7
Die Testplattform ist optimal für diese Arbeitslast geeignet. Dells PowerEdge XE7740 ist speziell für KI-Inferenz in Unternehmen konzipiert und verfügt über ein PCIe-Gen5-Gehäuse, das bis zu acht GPUs mit doppelter Breite unterstützt. Die von uns verwendete Konfiguration mit vier GPUs zählt zu den beliebtesten. Sie bietet ausreichend Beschleunigerkapazität für ein breites Spektrum an Inferenzanwendungen und lässt gleichzeitig im selben Gehäuse Platz für eine Skalierung auf acht GPUs, wenn der Bedarf steigt. Jede NVIDIA RTX PRO 6000 Blackwell Server Edition steuert 96 GB GDDR7-Speicher bei, sodass vier Karten einen beträchtlichen VRAM-Pool bereitstellen, bevor Cache-Daten die GPU verlassen müssen. Die darunterliegende Offload-Ebene basiert auf acht 12.8 TB großen Solidigm D7-PS1030-Festplatten im RAID 10-Verbund. Diese hochbelastbaren Gen5-Flash-Speicher sind für die kontinuierlichen Schreibvorgänge einer KV-Cache-Ebene geeignet. Und schließlich war die Modellwahl, MiniMax-M2.7, zum Zeitpunkt des Tests eines der besten Open-Source-Modelle, die in unsere Vier-GPU-Konfiguration passten.
Wir haben drei Konfigurationen getestet:
- Eine VRAM-Baseline, Standard-vLLM ohne Offload, bei der alles, was in den VRAM passt, zwischengespeichert und alles andere verdrängt wird.
- LMCache-Auslagerung in den Systemspeicher, wobei 512 GB für die Auslagerung reserviert sind.
- LMCache-Auslagerung auf Flash-Speicher, wobei das lokale RAID10 NVMe-Array als Auslagerungsebene dient und ein 64 GB großer RAM-Staging-Puffer vorgeschaltet ist.
Wir modellierten die Arbeitslast anhand realen agentenbasierten Codierungsverkehrs anstatt eines festen synthetischen Präfix-Sweeps. Dieser Verkehr ist stark auf Vorbefüllung und schwach auf Dekodierung ausgerichtet, mit umfangreicher Präfixwiederverwendung. Sitzungen treffen als Poisson-Prozess mit einer Rate von λ = 2.5 Sitzungen pro Minute ein. Jede Sitzung erstreckt sich über mehrere Durchläufe. In jedem Durchlauf empfängt das Modell einen kurzen Anhang, üblicherweise ein Werkzeug- oder Befehlsergebnis von 250 bis 600 Token, und gelegentlich eine Datei mit 1,500 bis 3,500 Token. Es antwortet mit einer kurzen Antwort, üblicherweise 40 bis 200 Token an Werkzeugaufrufen oder kurzen Begründungen, und gelegentlich einem Codeblock von 400 bis 900 Token. Die Durchlauflängen variieren um ±100 Token. Sitzungen wachsen monoton bis zu einer Obergrenze von 64 Token im Kontext, wodurch sie in den Bereich tiefer Kontexte fallen, in dem der Arbeitsspeicher den VRAM übersteigt. Die gleiche Startlast treibt alle drei Ebenen an, wobei jede Ebene eine 3-minütige Cache-Aufwärmphase hat.
Kurzer Hinweis zur Speicherkonfiguration: Der XE7740 wurde ursprünglich mit 2 TB DDR5-RAM ausgeliefert – eine High-End-Konfiguration für diverse Projekte. Der Preis wurde vor dem Preisanstieg im Jahr 2026 festgelegt, der diese Speichermenge deutlich relativieren würde. Die ursprüngliche Konfiguration war für heutige Anforderungen mit vier GPUs überdimensioniert. Um sie realistischer zu gestalten, haben wir 1 TB Speicher entfernt und jeweils ein DIMM pro Kanal beibehalten, um den maximalen Speicherdurchsatz zu gewährleisten.
Eine methodische Anmerkung zur Flash-Ebene: Die Tests nutzten das lokale Festplatten-Backend von LMCache mit dem erforderlichen 64 GB großen RAM-Staging-Puffer vor dem Array. Der auf dem Flash-Speicher belegte KV-Speicher wuchs im Laufe des Tests deutlich über den gesamten DRAM des Hosts hinaus, sodass die Ergebnisse eher die Laufwerksauslastung als den Hostspeicher widerspiegeln.
Leistung
Durchsatz unter Last
Gesamtdurchsatz der Serverbereitstellung im Laufe der Zeit, wenn die Anzahl der KV-Arbeitssätze die Kapazität der einzelnen Ebenen übersteigt:
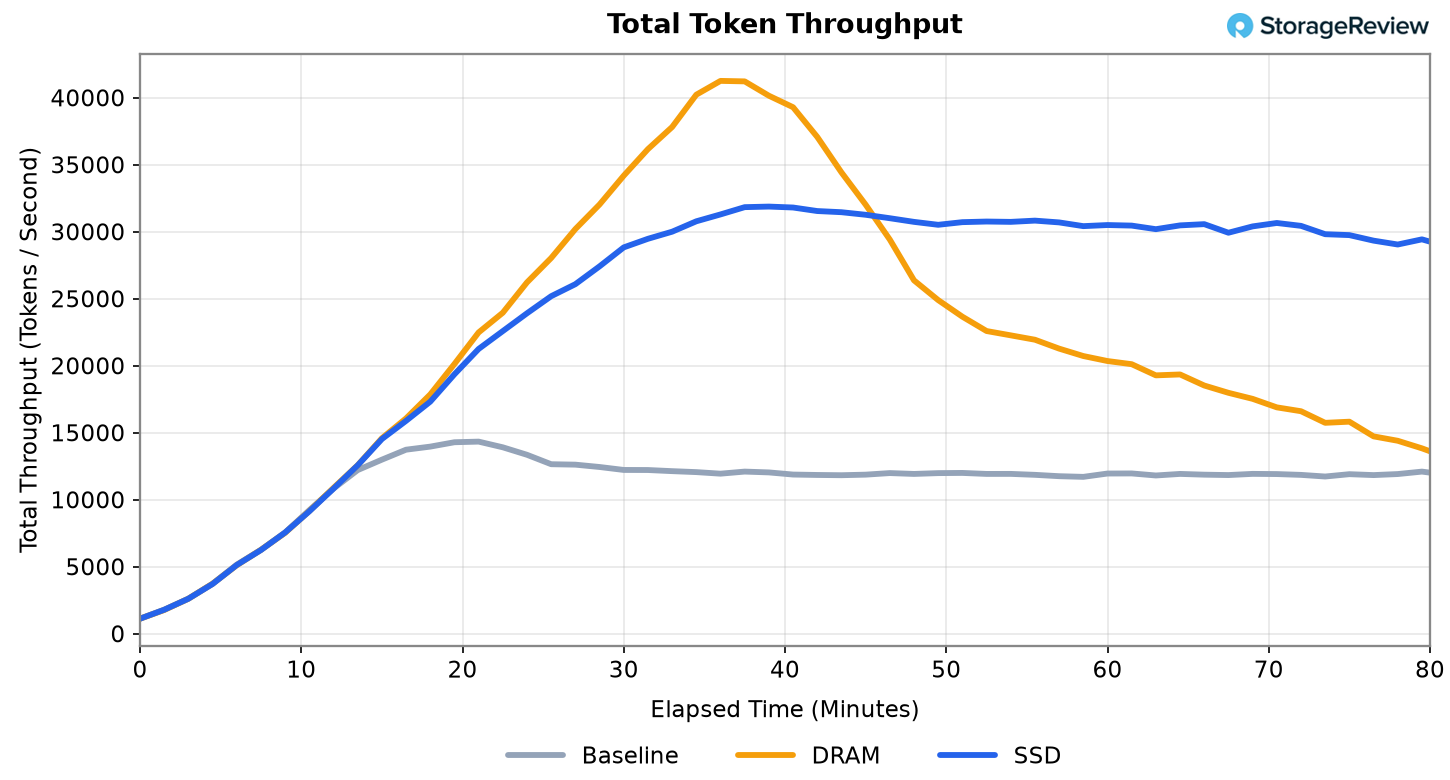
Alle Speicherebenen arbeiten in den ersten 10 Minuten parallel, solange die Caches noch gefüllt werden, wobei es praktisch keinen Leistungsunterschied gibt. Sobald die Speicherebenen voll sind, trennen sie sich. Die reine VRAM-Basislinie stagniert zuerst: Sobald der VRAM gesättigt ist, pendelt sich die Leistung bei etwa 12,000 Token pro Sekunde ein. Jede neue Sitzung verdrängt eine ältere, und der verdrängte Cache muss bei der Rückkehr dieser Sitzung komplett neu aufgebaut werden. Dadurch wird mehr Zeit pro Sekunde für das erneute Vorfüllen und weniger für das Dekodieren aufgewendet.
Die DRAM- und SSD-Speicher übertreffen dieses Plateau deutlich, da sie, solange ihre Caches nicht voll sind, nahezu jedes Präfix aus dem Speicher oder von der Festplatte bedienen, anstatt es neu zu berechnen. Die Zeit, die für das erneute Vorbefüllen benötigt wird, wird stattdessen für die Generierung neuer Token verwendet.
Im Spitzenbereich steigerte die Speicherauslagerung den gesamten Durchsatz der Basiskonfiguration auf der DRAM-Ebene um das 2.9-Fache (+188 %) und auf der Flash-Ebene um das 2.2-Fache (+122 %). Bevor der Arbeitsspeicher den VRAM übersteigt, liegen alle drei Konfigurationen innerhalb eines Prozents beieinander. Da keine Speicherbelegungen erfolgen, gibt es für die Speicherauslagerung nichts zu wiederherstellen. Der Vorteil zeigt sich erst, wenn Speicherdruck eine Speicherbelegung erzwingt, und steigt mit der Auslastung des Servers.
Die Notwendigkeit einer größeren Speicherebene zeigt sich, sobald der DRAM-Cache voll ist. Bei dieser Auslastung ist der 512 GB große RAM-Cache nach etwa 45 Minuten gesättigt und muss dann Daten verdrängen. Zurückgegebene Präfixe gehen verloren und werden neu aufgefüllt – genau die Neuberechnung, die der Cache eigentlich vermeiden sollte. Die SSD-Speicherebene mit Terabytes an Reserve stößt nie an diese Grenze. Jenseits des Übergangs verarbeitet Flash-Speicher weiterhin etwa 30,000 Token pro Sekunde, verglichen mit etwa 17,000 Token pro Sekunde beim DRAM – ein Durchsatzvorteil von 75 % für SSD, sobald der RAM voll ist. Anders ausgedrückt: Nach Erreichen der Sättigung lieferte die DRAM-Speicherebene nur noch 42 % ihres maximalen Durchsatzes, während die SSD-Speicherebene 94 % erreichte. Dies ist die Kapazitätsleiter, auf der das ganze Verfahren basiert: Zuerst ist der VRAM erschöpft, später dann die 512 GB DRAM-Ebene, und eine Speicherebene, die in Terabyte statt in Gigabyte gemessen wird, geht praktisch nie aus, sodass sie Kontextinformationen noch lange bereitstellt, nachdem die schnelleren Ebenen bereits damit begonnen haben, diese zu verwerfen.
Eine wichtige Anmerkung zur Interpretation der Gesamtdurchsatzzahl: Die angegebenen Zehntausende Token pro Sekunde entsprechen nicht der Rate, mit der die GPUs Token berechnen; sie stellen größtenteils die Verarbeitungsrate der Offload-Schicht dar. Der Gesamtdurchsatz berücksichtigt jedes Eingabe-Prefill-Token sowie jedes Ausgabe-Decode-Token, das jede Anfrage enthält. Dank des Caches lädt ein Treffer jedoch den Key-Value-Wert des Präfixes aus dem DRAM oder Flash-Speicher, anstatt ihn auf der GPU neu zu berechnen.
Beschränkt man die Zählung auf die Ausgabetoken, also den Teil des Durchsatzes, auf den ein Benutzer tatsächlich wartet, ergibt sich ein klareres Bild:
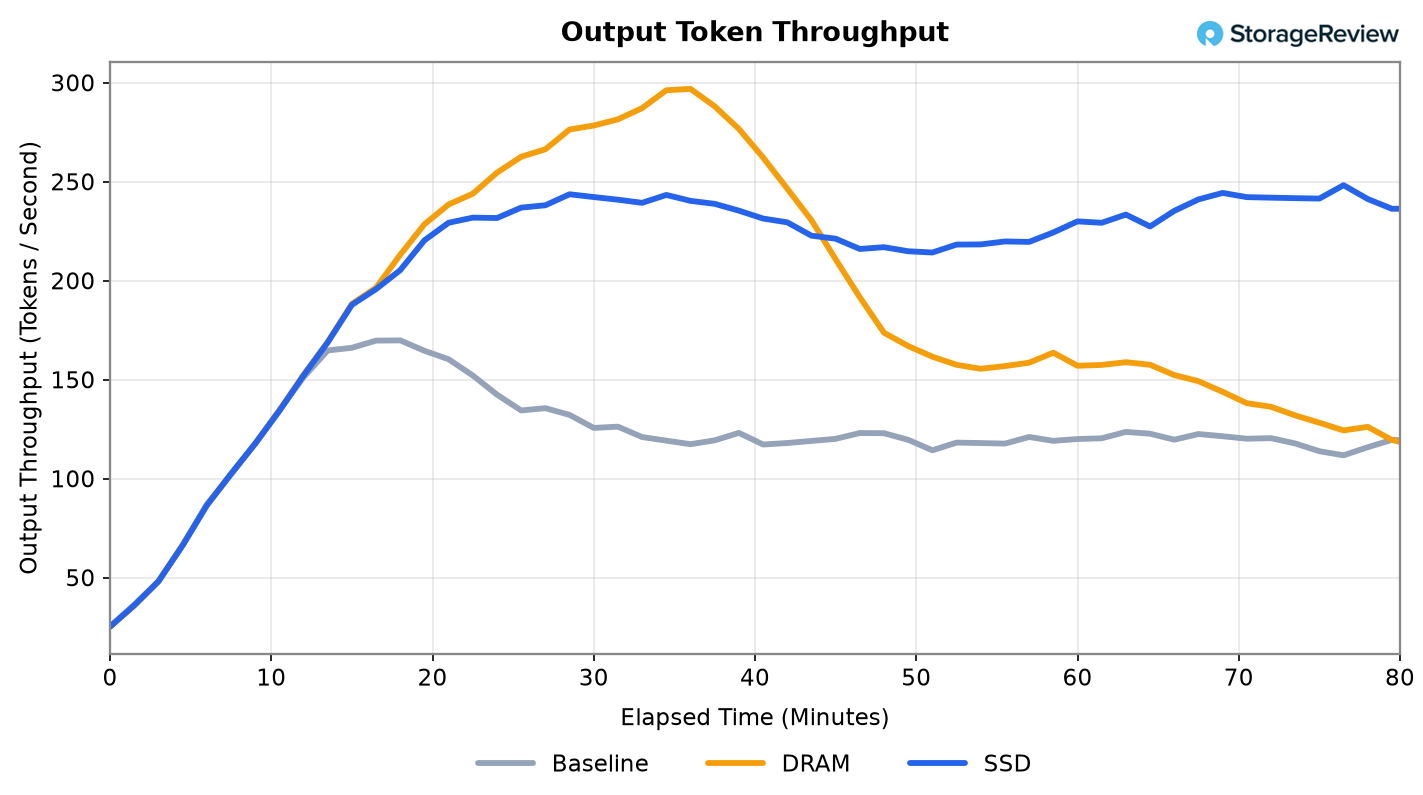
Bei der Ausgabe von Tokens verlaufen die drei Ebenen zunächst parallel, solange die Caches gefüllt sind, und trennen sich dann am Schnittpunkt. Die DRAM-Ebene erreicht einen Spitzenwert von fast 300 Tokens pro Sekunde, was einer Steigerung von 75 % gegenüber dem Basiswert entspricht, und sinkt wieder ab, sobald Tokens verdrängt werden. Die Flash-Ebene hält sich im restlichen Durchlauf bei etwa 250 Tokens pro Sekunde, was einer Steigerung von 46 % gegenüber dem Basiswert entspricht. Die RAM- und SSD-Werte bleiben bis zur Sättigung des DRAM innerhalb von etwa 10 % beieinander; danach vergrößert sich die Differenz.
First-Token-Latenz: Worauf der Benutzer wartet
Der Durchsatz misst die gesamte Tokenproduktion. Die Zeit bis zum ersten Token misst die Wartezeit eines einzelnen Nutzers vom Absenden bis zum Erhalt des ersten Tokens. Wir stellen diesen Wert im Verlauf der Laufzeit, am Median, grafisch dar, während die Menge der Token wächst und die einzelnen Ebenen gefüllt werden.
Solange die Caches die Daten halten, liefern alle drei Ebenen innerhalb von etwa einer halben Sekunde ein erstes Token. Danach weichen ihre Werte voneinander ab, und zwar in der gleichen Reihenfolge wie ihr Durchsatz. Die Basislinie bricht zuerst ein: Sie überschreitet früh im Testlauf die 10-Sekunden-Marke, während die DRAM-Ebene deutlich länger unter einer Sekunde TTFT bleibt, bis ihre 512 GB nach etwa 45 Minuten voll sind. Dann steigt ihre Latenz rapide an, da sie beginnt, Daten zu entfernen und neu zu berechnen. Die SSD-Ebene verschlechtert sich am wenigsten und weist in der zweiten Hälfte des Testlaufs die niedrigste Latenz der drei Ebenen auf.
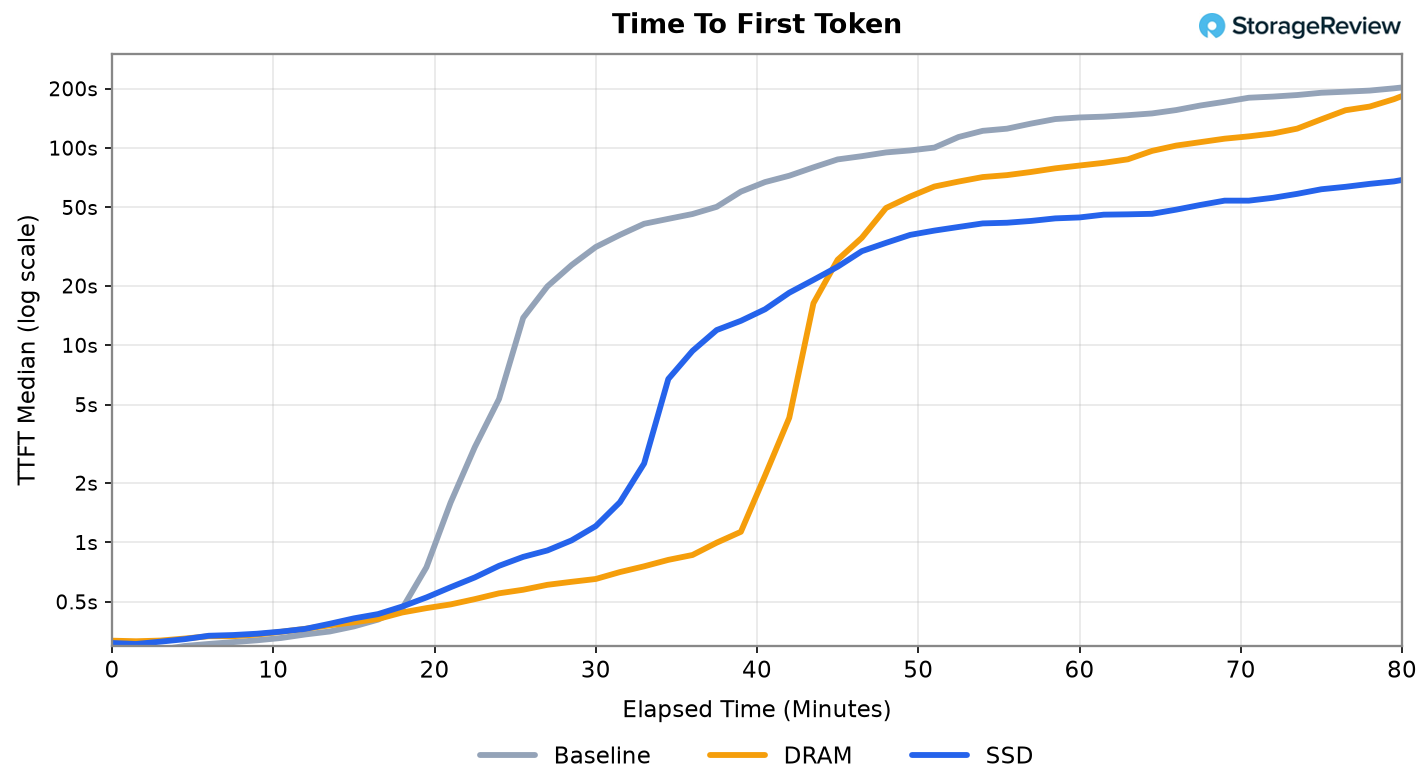
Dieser Umschwung ist die Einteilung in Speichertypen im Kleinen. DRAM ist hinsichtlich der Latenz führend, solange der Arbeitsspeicher in diesen Speichertyp fällt; Flash-Speicher ist in diesem Fall führend, da er noch Kontextinformationen enthält, die der DRAM-Speicher bereits verwirft.
Das Problem der wiederkehrenden Benutzer
Die oben genannten Latenzwerte beziehen sich auf Gesprächsrunden innerhalb einer durchgehenden Sitzung. Anders verhält es sich bei wiederkehrenden Nutzern: Eine Sitzung pausiert mitten im Gespräch, ist etwa 15 Minuten inaktiv und wird dann an der unterbrochenen Stelle fortgesetzt. Wir haben dies mit einer Gruppe von Nutzern modelliert, die nach etwa 20 Gesprächsrunden inaktiv wurde und 15 Minuten später wieder aktiv wurde – genug Zeit, damit ein ausgelasteter Server in der Zwischenzeit anderen Datenverkehr über seine Caches verarbeiten konnte. Elf solcher Wiederbelebungen erfolgten innerhalb des jeweiligen Messfensters. Da die Arbeitslast in allen Ebenen identisch verteilt ist, wurden in jedem Durchlauf dieselben elf Sitzungen wiederbelebt, was einen direkten Vergleich der Wiederaufnahmezeit ermöglicht. Die folgende Grafik vergleicht die mittlere Zeit bis zum ersten Token in jeder Ebene bei einer normalen Gesprächsrunde mit der Zeit bei der Wiederaufnahmezeit. Der Whisker markiert die längste Wiederaufnahmezeit in der Stichprobe.
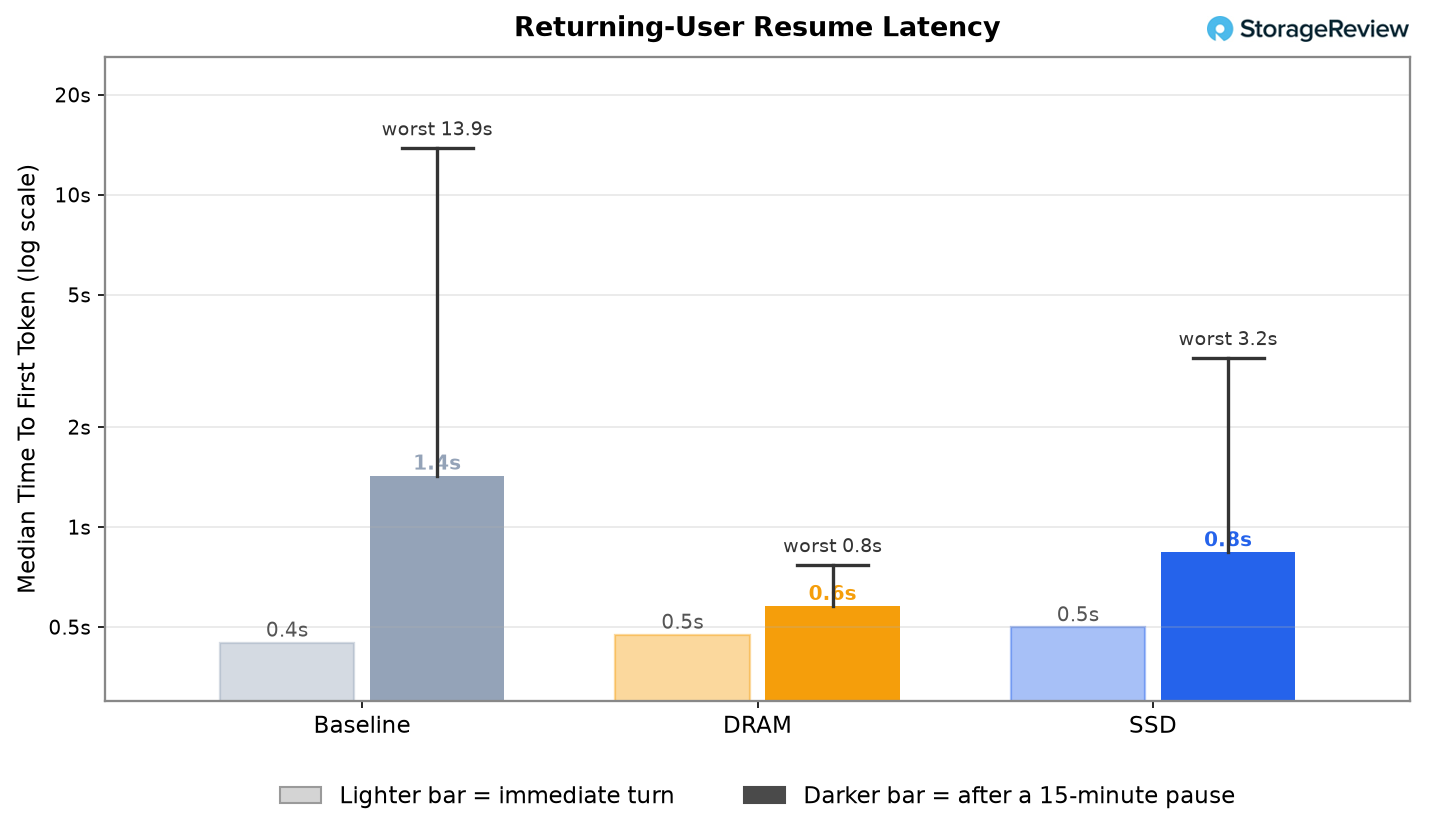
Im Median bestätigen die Zahlen lediglich die Vorhersagen der Mechanik, und die Stufen entsprechen der erwarteten Reihenfolge. DRAM führt: Eine inaktive Sitzung wird in 0.6 Sekunden fortgesetzt, kaum mehr als die 0.5 Sekunden, die ein normaler Vorgang benötigt. SSD folgt mit 0.8 Sekunden; wir wissen, dass ein NVMe-Zugriff langsamer ist als ein DRAM-Zugriff, und das ist ein Teil des hier erkennbaren Unterschieds. Die VRAM-basierte Basislinie ist mit 1.4 Sekunden am langsamsten; da keine Auslagerungsmöglichkeit besteht, wurde das Präfix der inaktiven Sitzung für den laufenden Datenverkehr aus dem GPU-Speicher entfernt, und der erste Vorgang muss es neu berechnen. Im besten Fall beträgt die gesamte Spanne nur etwa eine Sekunde.
Der optimale Fall ist nicht der, in dem die Wahl getroffen wird. Die längsten der elf Wiederbelebungen in jeder Stufe betragen: 0.8 Sekunden bei DRAM, 3.2 Sekunden bei SSD und 13.9 Sekunden im Basiswert. Ob eine Wartezeit von 14 Sekunden auf das erste Token tolerierbar ist oder eine schwerwiegende SLO-Verletzung darstellt, hängt vom Dienst ab. Bei interaktiven Anwendungen trifft Letzteres zu, und nur die Offload-Stufen halten diese Wartezeit in einem für den Benutzer akzeptablen Rahmen. Sie verlängert sich zudem im Kontext, da die Kosten für die Neuberechnung mit der Menge der vom wiederkehrenden Benutzer angesammelten Daten skalieren: In den tieferen Kontexten des Durchsatztests überschreitet die Wartezeit im Basiswert deutlich 14 Sekunden, während DRAM und SSD weiterhin nur eine begrenzte Neuladung verursachen.
Auswahl und Dimensionierung des KV-Caches
Beide Auslagerungsstufen übertreffen die reine VRAM-Basislinie deutlich und liegen dabei nah beieinander. Der geringe Unterschied erklärt sich dadurch, dass der Durchsatzgewinn lediglich auf der Freigabe von VRAM beruht und unabhängig davon, ob der freigegebene Cache im DRAM oder auf der SSD landet, die gleiche Menge freigegeben wird. Der Durchsatz ist also unerheblich, von welcher Stufe der Cache stammt. Die Latenz hingegen schon, da ein DRAM-Zugriff schneller ist als ein NVMe-Zugriff. Im Vergleich zur Neuberechnung desselben Schlüssel-Wert-Paares sind jedoch beide unerheblich.
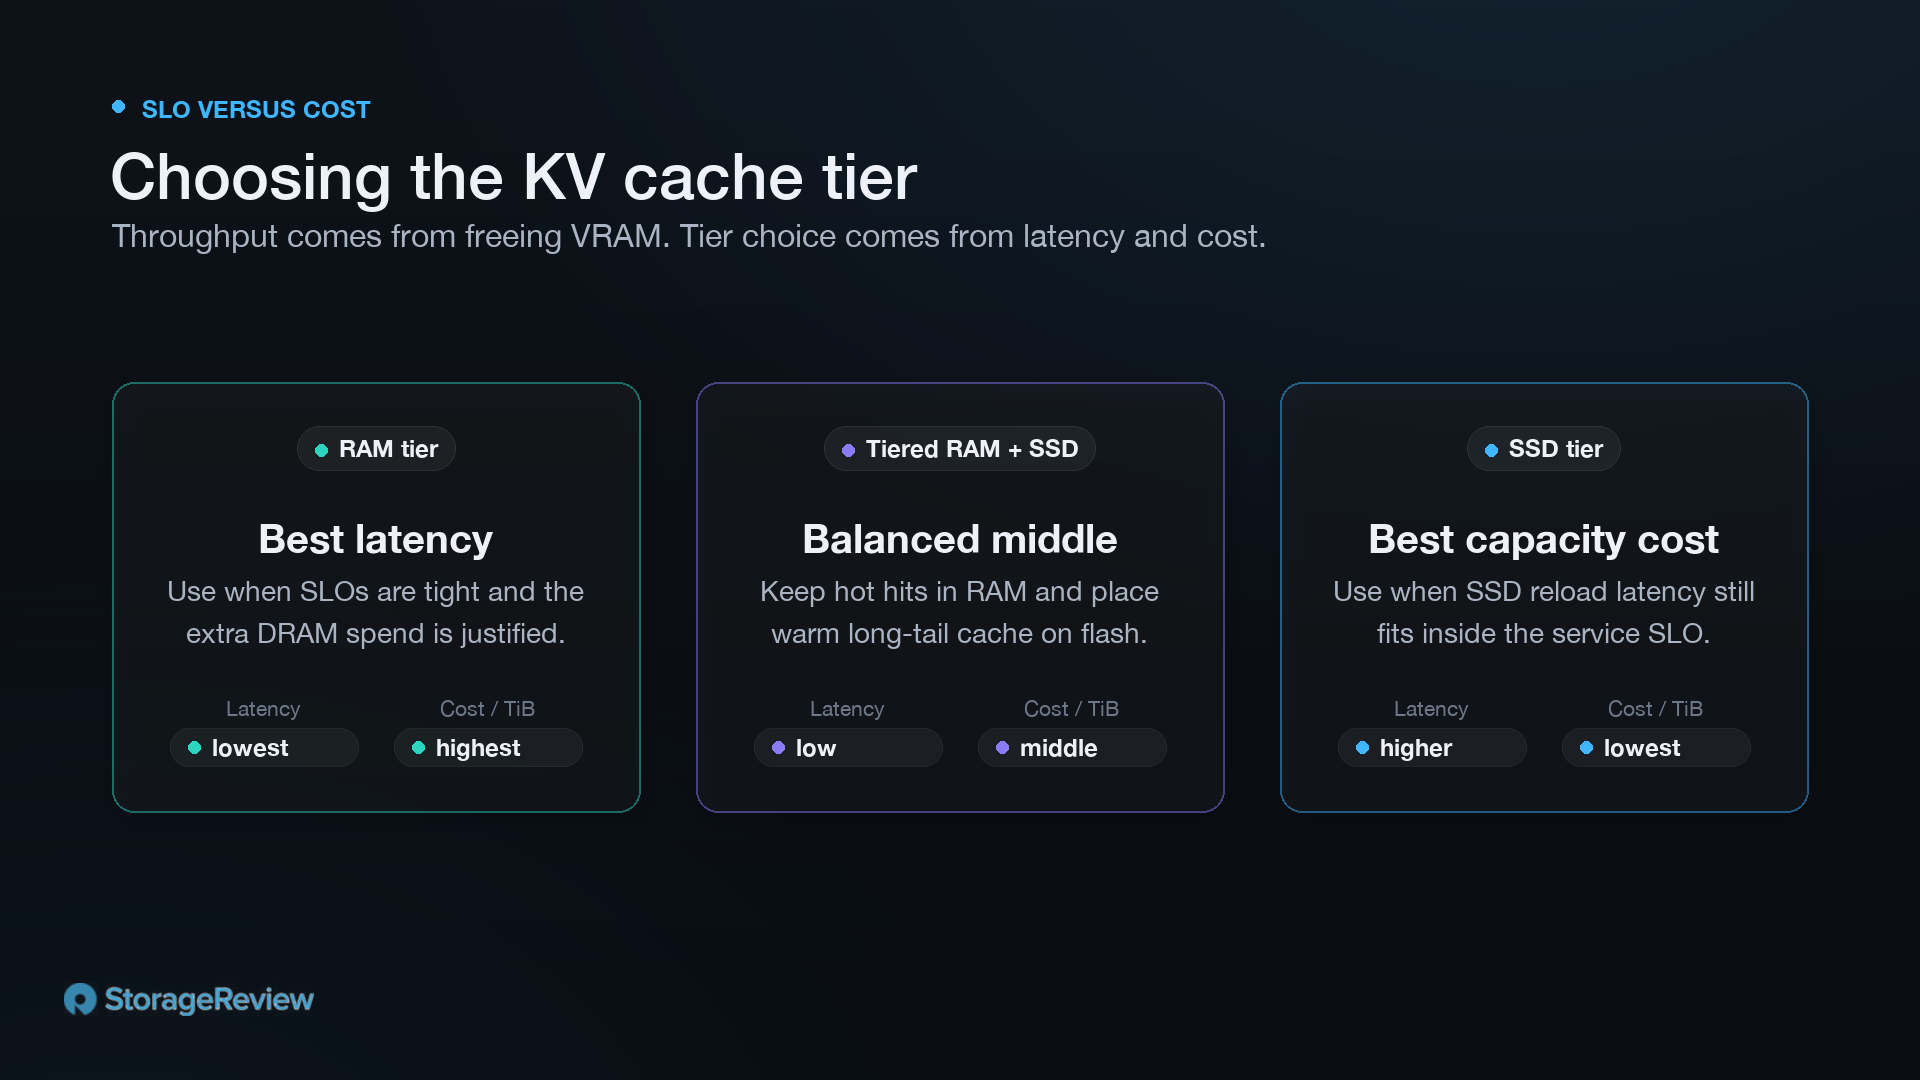
Die Wahl zwischen den beiden Ansätzen ist ein Kompromiss zwischen Service Level Objective (SLO) und Kosten, der davon abhängt, worauf der Betreiber optimiert. Die Speicherung des gesamten ausgelagerten Caches im RAM bietet die beste Latenz, ist aber mit hohen Investitionskosten für einen relativ geringen Latenzgewinn gegenüber Flash-Speicher verbunden. Tiering stellt den Mittelweg dar: Eine kleinere RAM-Ebene fängt latenzkritische Zugriffe dort ab, wo sie relevant sind, während eine darunter liegende Speicherebene die weniger häufig benötigten Daten aus dem Long-Tail-Cache enthält, die nicht innerhalb weniger hundert Millisekunden abgerufen werden müssen.
Eine andere Möglichkeit, KV-Caches zu betrachten, ist ihre Größe. Die Dimensionierung der Speicherebene hängt vom maximalen Token-Durchsatz ab, den das System bewältigen kann. Der vom System benötigte KV-Speicherplatz entspricht dem Durchsatz multipliziert mit der Gültigkeitsdauer (TTL) der Cache-Einträge. Jeder erzeugte Token schreibt einen KV-Eintrag; die Berechnung ergibt sich also aus der Rate der eintreffenden Token multipliziert mit ihrer Aufbewahrungsdauer. Die beiden Standard-TTL-Werte im Produktivbetrieb sind fünf Minuten und eine Stunde.
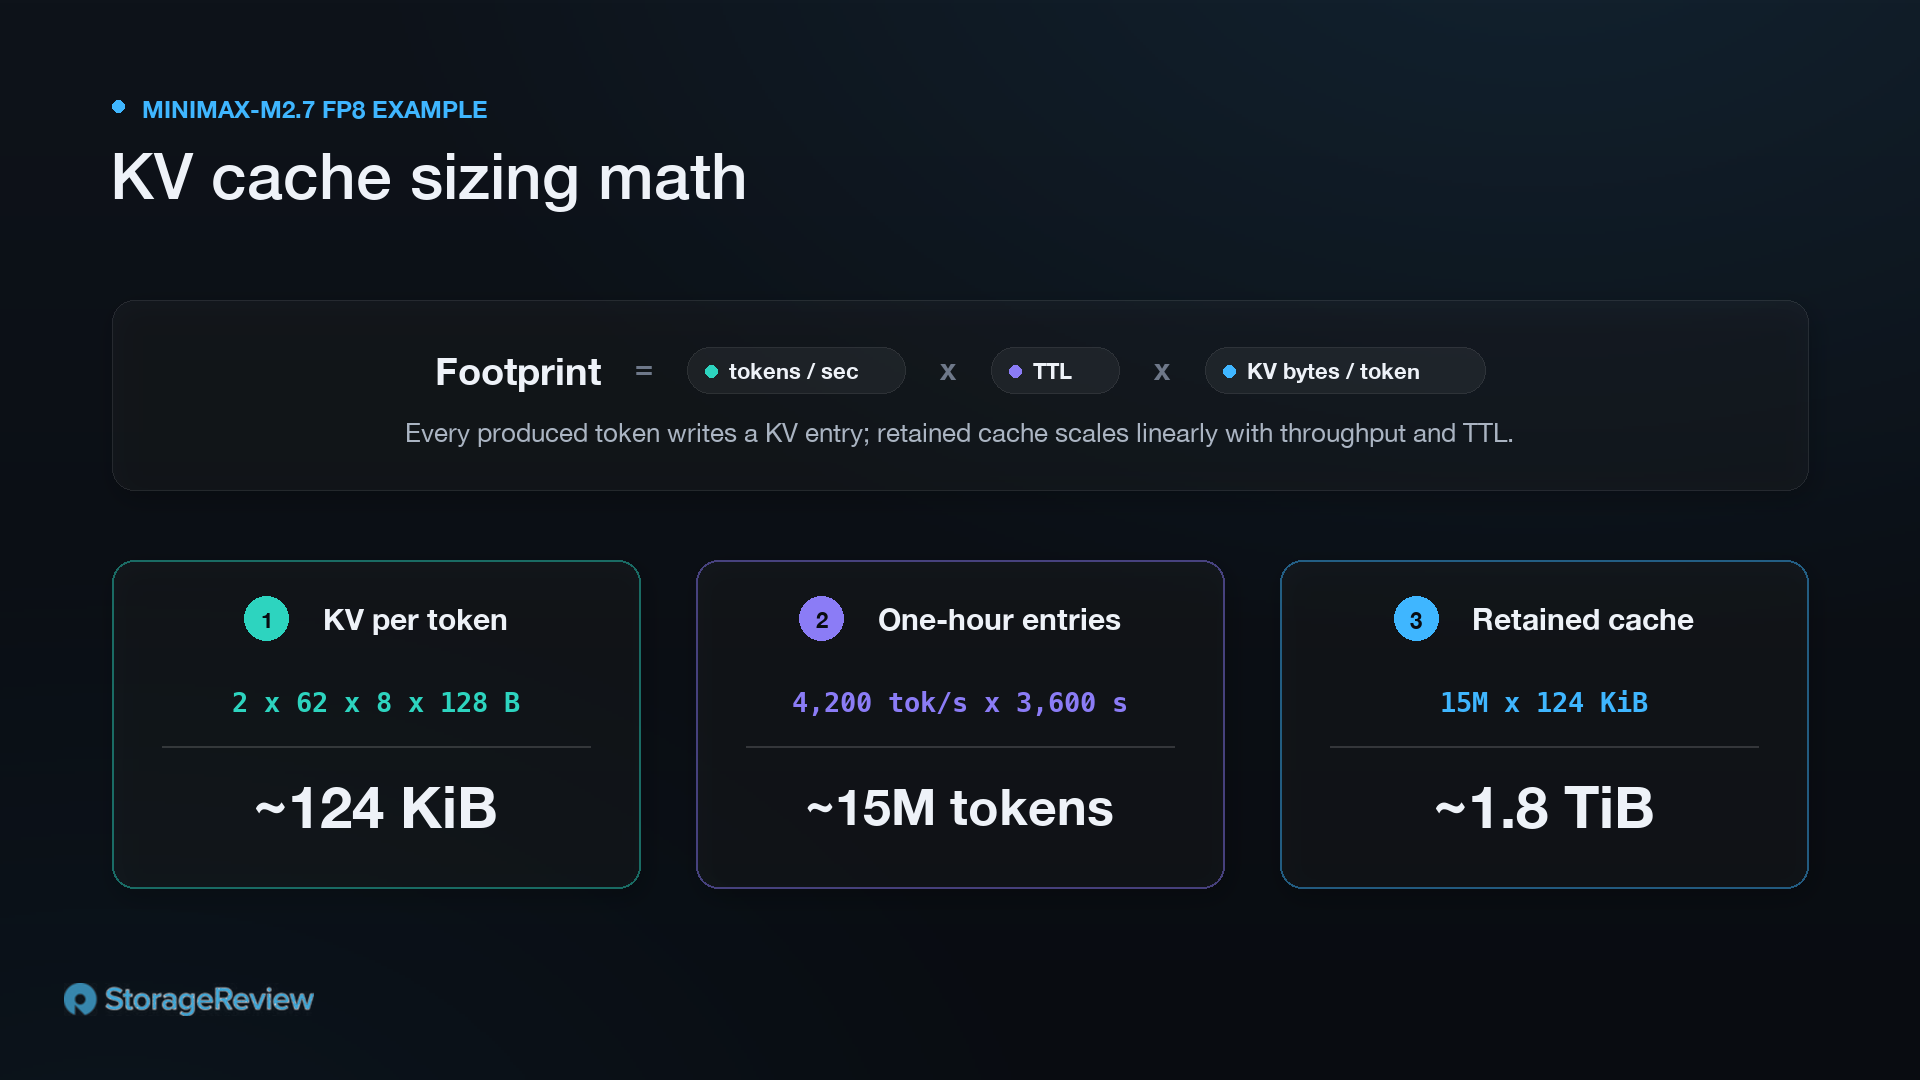
Berechnen wir die KV-Cache-Größe für MiniMax-M2.7 in FP8, wie hier getestet. Bei einem Byte pro KV-Element beträgt der Eintrag pro Token 2 × 62 × 8 × 128 Byte, also etwa 124 KiB. Dies lässt sich auf jeden GATA-Transformer (Grouped Query-Attention) verallgemeinern: Der KV-Speicher pro Token berechnet sich aus Schichten × KV-Köpfe × Kopfdimension × 2 (für K und V) × Datentyp-Bytes. Ein Modell mit mehr Schichten oder KV-Köpfen schreibt also proportional mehr pro Token. Bei der hier verwendeten moderaten Betriebsfrequenz (etwa 4,200 Token pro Sekunde auf der RAM-Ebene) ergeben sich nach einer Stunde Speicherdauer etwa 15 Millionen Cache-Token, was bei 124 KiB pro Token etwa 1.8 TB entspricht. Das ist eine beträchtliche Menge DRAM und treibt die Herstellungskosten in die Höhe.
Vor diesem Hintergrund bestimmen die SLO-Anforderungen und das Budget die Wahl der Speicherebene. Ist das SLO so flexibel, dass die Nachladezeit der SSD-Ebene innerhalb der Vorgaben liegt, kann die zweite KV-Cache-Ebene ausschließlich auf dem Speichermedium platziert werden, lediglich mit dem dünnen RAM-Staging-Puffer, den die Anschlüsse benötigen. Die Speicherkosten sind moderat: Der maximale KV-Datenverkehr während unserer Tests betrug 4.1 GB/s (Schreiben) und 1.1 GB/s (Lesen) im moderaten Betriebspunkt, verglichen mit einem von fio gemessenen Maximalwert von ca. 114 GB/s. Das von uns verwendete RAID10-Array bot eine Bandbreitenreserve von etwa dem Faktor 28, sodass Flash-Speicher auch dann nicht zum Flaschenhals wird, wenn der XE7740 auf seine acht GPUs skaliert und eine höhere gleichzeitige Last bewältigt. Dieser Spielraum ermöglicht es dem Betreiber, die Speicherebene auf Kapazität statt auf Geschwindigkeit zu optimieren. Jedes zusätzliche Terabyte an D7-PS1030 verlängert die TTL und den Arbeitsspeicher, den das System resident hält, und ein größerer residenter Cache bedeutet weniger Neuberechnungen und mehr bediente Token.
Die Beschränkung dieser Stufe liegt in der Ausdauer. Ein KV-Offload-Cache ist sehr schreibintensiv: Jedes vom Modell erzeugte Token schreibt einen KV-Eintrag, und die TTL-Churn-Funktion überschreibt die Stufe permanent, sodass die Laufwerke praktisch ununterbrochen Schreibvorgänge ausführen. In unserem Array mit acht Laufwerken betrug die kontinuierliche Schreibrate 1.9 GB/s. Im getesteten RAID-10-Layout verdoppelt die Spiegelung die Speicherkapazität, was etwa 3.2 Laufwerksschreibvorgängen pro Tag auf jedem 12.8-TB-Laufwerk entspricht – etwas mehr als die angegebene kontinuierliche Schreibrate von 3 DWPD des D7-PS1030. Für primären Speicher wäre dies ungeeignet, ist in diesem Fall jedoch akzeptabel. Der Cache ist systembedingt verbrauchbar, und der Ausfall einer verschlissenen Festplatte besteht in einer Neuberechnung, nicht in Datenverlust. RAID 0 ist für manche Anwender möglicherweise die bessere Wahl für diese Stufe, da es die Daten über alle acht Laufwerke verteilt, sodass nichts doppelt geschrieben wird und die Speicherrate auf etwa 1.6 DWPD sinkt – deutlich innerhalb der Spezifikation. In jedem Fall bleibt die Schlussfolgerung bestehen: Diese Arbeitslast verbraucht die Ausdauer schneller als alles andere im System, dedizierte Hochleistungslaufwerke verfügen nur über einen Bruchteil der Kapazität, die diese Ebene benötigt, und genau diese Kombination macht ein schreiborientiertes Laufwerk mit hoher Kapazität wie das PS1030 zur richtigen Wahl.
Token pro Dollar
Der Abschnitt zur Leistung zeigte, dass Flash-Speicher den Großteil des Durchsatzes beibehält und die Latenz beim ersten Token aufrechterhält, die DRAM nicht mehr erreichen kann, sobald der Arbeitssatz den verfügbaren Speicher übersteigt. Wirtschaftlich relevant sind hier die Kosten der Speicherebene, die die Daten zwischenspeichert. Die einfachste Lösung für das Problem der Neuberechnung ist der Kauf von mehr des teuren DRAM im System; das Argument der Datenauslagerung ist nur dann stichhaltig, wenn die Speicherebene pro Kapazitätseinheit deutlich günstiger ist.
Der größte Unterschied zeigt sich in der Kapazität, nicht im Preis. Die 512 GB große DRAM-Speicherschicht war voll und begann, Daten zu verdrängen; die in Terabytes gemessene Flash-Speicherschicht hingegen nicht. Aus praktischer Sicht ist es nicht möglich, Dutzende von Terabytes KV-Cache direkt neben den GPUs zu platzieren. Daher lautet die Entscheidung ab einer bestimmten Kontextlänge nicht mehr „schneller DRAM versus Flash“, sondern „Flash versus Kontext verwerfen“. Letzteres Verwerfen ist es, was Durchsatz und Latenz überhaupt erst beeinträchtigt.
Preislich gesehen war Enterprise-Flash lange Zeit deutlich günstiger als DRAM pro Terabyte. Dieser strukturelle Unterschied ergibt sich aus den mehrstufigen, dreidimensional gestapelten Zellen von NAND im Vergleich zum Ein-Transistor-Ein-Kondensator-Design von DRAM. Die Speicherknappheit ab 2026 hat beide Preisklassen stark in die Höhe getrieben, und die Vertragspreise für NAND sind im Laufe des Jahres mindestens genauso schnell gestiegen wie die für DRAM. Es handelt sich also nicht um einen Fall, in dem Flash günstiger wurde, während DRAM im Preis schoss. Selbst auf dem heutigen hohen Niveau bleibt der Preisunterschied pro Terabyte bestehen, und Flash ist nach wie vor die einzige Speicherlösung, die Cache-Kapazität im Terabyte-Bereich zu einem budgetgerechten Preis bietet.
Durchsatz und Kosten verhalten sich gleichermaßen. An dem Punkt, an dem Flash die Nase vorn hatte, verarbeitete es mehr Token pro Sekunde als DRAM, nicht weniger. Es tauscht also nicht Durchsatz gegen Kapazität, sondern liefert mehr Durchsatz auf einem Medium, das pro Terabyte weniger kostet. Gemessen an Token pro Sekunde und Dollar ergibt sich daraus ein deutlicher Vorteil für Flash. Dieser Vorteil vergrößert sich, je länger der Kontext erhalten bleiben muss, denn genau hier stößt DRAM an seine Grenzen, Flash hingegen nicht.
DRAM bleibt die richtige Speicherebene, solange der Arbeitsspeicher ausreicht, und der für die Anschlüsse benötigte dünne RAM-Staging-Puffer befindet sich weiterhin vor dem Flash-Speicher. Das Hinzufügen weiterer GPUs oder mehr DRAM ist jedoch pro Terabyte am teuersten, um die Spitzenleistung zu erzielen, die die Arbeitslast nur bis zur Cache-Fläche benötigt. Auslagerung oder Tiering auf Flash erhält den Großteil dieser Leistung und speichert den Kontext dauerhaft zu einem erschwinglichen Preis pro Terabyte. Die endgültige Entscheidung hängt jedoch von den SLO-Anforderungen für die vom Betreiber optimierte Arbeitslast ab.
Fazit
Bei Inferenz-Workloads dreht sich alles um Tokenomics. Das Token ist das Produkt, und die Neuberechnung ist Verschwendung: Die GPU hat diesen Kontext bereits einmal erzeugt und muss ihn erneut aufbauen. Agentic Serving ist besonders relevant, da unsere einwöchige Analyse des Claude-Code-Traffics zeigte, dass 98.16 % der Token Cache-Lesezugriffe waren – Kontext, den die GPU bereits berechnet hatte und ansonsten bei jeder Löschung neu aufbauen würde. KV-Cache-Offload wandelt die Vorbelegungs-Rechenleistung, die sonst für den Wiederaufbau dieser Historie aufgewendet worden wäre, in die Erzeugung neuer Token um. Auf dem XE7740 führte dies unter hoher Last zu einer bis zu 2.9-fachen Steigerung des gesamten Serving-Durchsatzes im Vergleich zur reinen VRAM-Basislinie, wobei Modell, GPUs und Engine konstant gehalten wurden. Während die DRAM-Ebene an ihre Grenzen stieß, hielt der Flash-Speicher diesen Durchsatz mit einer Kapazität aufrecht, die DRAM nicht erreichen kann.
Das alles ändert jedoch nichts an der Notwendigkeit von DRAM. Für kurze, intensive Arbeitslasten, bei denen eine Sitzung geöffnet, kurz ausgeführt und geschlossen wird, bevor ihr Cache den Arbeitsspeicher übersteigt, ist DRAM die richtige Wahl, und KV-Cache-Offloading bringt kaum Vorteile. Der Arbeitsspeicher passt, die Latenz ist optimal, und es gibt nichts zu entfernen.
Dieses Profil betrachten wir jedoch als Ausnahme, bei der eine DRAM-Ebene ausreicht. Die meisten Inferenzprozesse in der Produktion laufen heutzutage lange und kontinuierlich: Agenten mit mehreren Durchläufen, große Kontexte, gleichbleibende Parallelität und Benutzer, die zur selben Sitzung zurückkehren. In solchen Fällen übersteigt der Arbeitsspeicher die Kapazität jeder vom Betreiber bereitgestellten Speicherebene, der Cache wird geleert und die GPU muss erneut den bereits erzeugten Kontext rekonstruieren. Dies ist ein kostspieliger und häufiger Fehler.
Für diese Workloads zahlt sich die Auslagerung des KV-Caches in Flash-Speicher gleich doppelt aus. Die GPUs produzieren dadurch neue Token anstatt alte neu zu berechnen – genau diese Token-Effizienz wird hier gemessen. Außerdem wird die dafür notwendige Kapazität auf der kostengünstigsten, langlebigsten Ebene des Systems bereitgestellt. Der wichtigste Effekt auf die Konfiguration ist die dadurch erzielte Einsparung: Ein Server, der Flash-Speicher für den Cache nutzt, benötigt deutlich weniger DRAM. Angesichts der Speicherpreise im Jahr 2026 ist dies eine der größten Einsparungen im Angebot. Der Token ist das Produkt, und für die heute dominierenden Workloads mit langem Kontext ist der tokeneffizienteste Weg derjenige, der die doppelte Erzeugung derselben Token vermeidet. Dieser Weg führt über Flash-Speicher.
Solidigm SSD-Speicher für KI
Dieser Bericht wird von Solidigm gesponsert. Alle in diesem Bericht geäußerten Ansichten und Meinungen basieren auf unserer unvoreingenommenen Sicht auf das/die betrachtete(n) Produkt(e).


 Amazon