

Actualizado el 19 de agosto de 2026: Primera publicación. La investigación sigue vigente a esta fecha.
Hay cuatro razones para ejecutar un modelo de lenguaje en tu propio hardware en lugar de en una pestaña del navegador, y solo una de ellas es ideológica. Privacidad: un documento que le entregas a un modelo local nunca sale de la máquina, que es toda la conversación para el código del cliente, los contratos, los datos de los pacientes y los productos no lanzados. Estructura de costos: la IA en la nube se mide y las cargas de trabajo de agentes multiplican el número de tokens lo suficientemente rápido como para que una estación de trabajo capaz se amortice por sí sola; el hardware que posees funciona al precio de la electricidad. Disponibilidad: sin límites de velocidad, sin interrupciones, sin correos electrónicos de obsolescencia que cambien tu flujo de trabajo un martes. Y control: el modelo que validaste es el modelo que ejecutas hasta que decidas lo contrario.
El contrapeso es que los modelos de nube de vanguardia siguen siendo más capaces, y para el trabajo de agentes a largo plazo, la diferencia es real. Donde los modelos locales han alcanzado la paridad es en el trabajo limitado: chat, resumen, código de archivo único y preguntas y respuestas sobre documentos. Esto es, precisamente, lo que la mayoría de la gente hace a diario. Si su prioridad es la máxima capacidad a cualquier precio, utilice la nube. Si su prioridad es la privacidad, el coste o el control, lo local es viable hoy en día, y esta página es el mapa.
Ese marco debería definir tu presupuesto de hardware, porque el gasto en IA local es una decisión de memoria antes que cualquier otra cosa. 16 GB de VRAM o 32 GB de memoria unificada cubren la clase de 7 a 8B, que maneja el trabajo limitado mencionado anteriormente. De 24 a 32 GB de VRAM, o 48 GB unificada, alcanzan la clase de 30B donde la codificación agente deja de ser una demostración. De 96 a 128 GB de memoria unificada ejecutan los modelos de más de 100B que se acercan a la calidad de vanguardia. Comprar de más te da una velocidad que quizás no notes; comprar de menos significa que la clase de modelo que querías nunca se cargará. Nuestras tablas de Mejores portátiles para IA local y Mejores ordenadores de sobremesa para IA local clasifican las máquinas por nivel. Esta página explica qué ejecutar en ellas.
El software no ha evolucionado al mismo ritmo que el hardware. Aproximadamente un tercio de las herramientas recomendadas en los resultados de búsqueda actuales ya no funcionan, y la mayoría de las páginas que las recomiendan ni se han dado cuenta.
Esta página realiza un seguimiento de qué herramientas funcionan y en qué hardware, a fecha de agosto de 2026. Por ahora, utilizamos el sistema de estrellas de GitHub para la clasificación, ya que es una señal neutral y verificable, e indicamos cuándo una herramienta es de código cerrado y no tiene estrellas. Cada nombre de herramienta en las tablas enlaza con su descarga oficial. A medida que probamos cada plataforma en el laboratorio, la columna «Guía» se completa con un tutorial práctico de configuración y nuestros propios datos.
Tres reglas para esta página. Primero, distinguimos un modelo local de un agente local . Varios productos se ejecutan en su máquina, mientras que cada llamada de inferencia se dirige a la nube del proveedor; esto es una medida de privacidad, no una capacidad sin conexión, y esas herramientas se enumeran por separado al final en lugar de omitirse. Segundo, cada entrada incluye un mínimo de hardware realista, porque "se ejecuta en una computadora portátil" no tiene sentido sin una cifra de memoria. Tercero, registramos qué productos dejaron de funcionar, con fechas, en las preguntas frecuentes.
Las selecciones
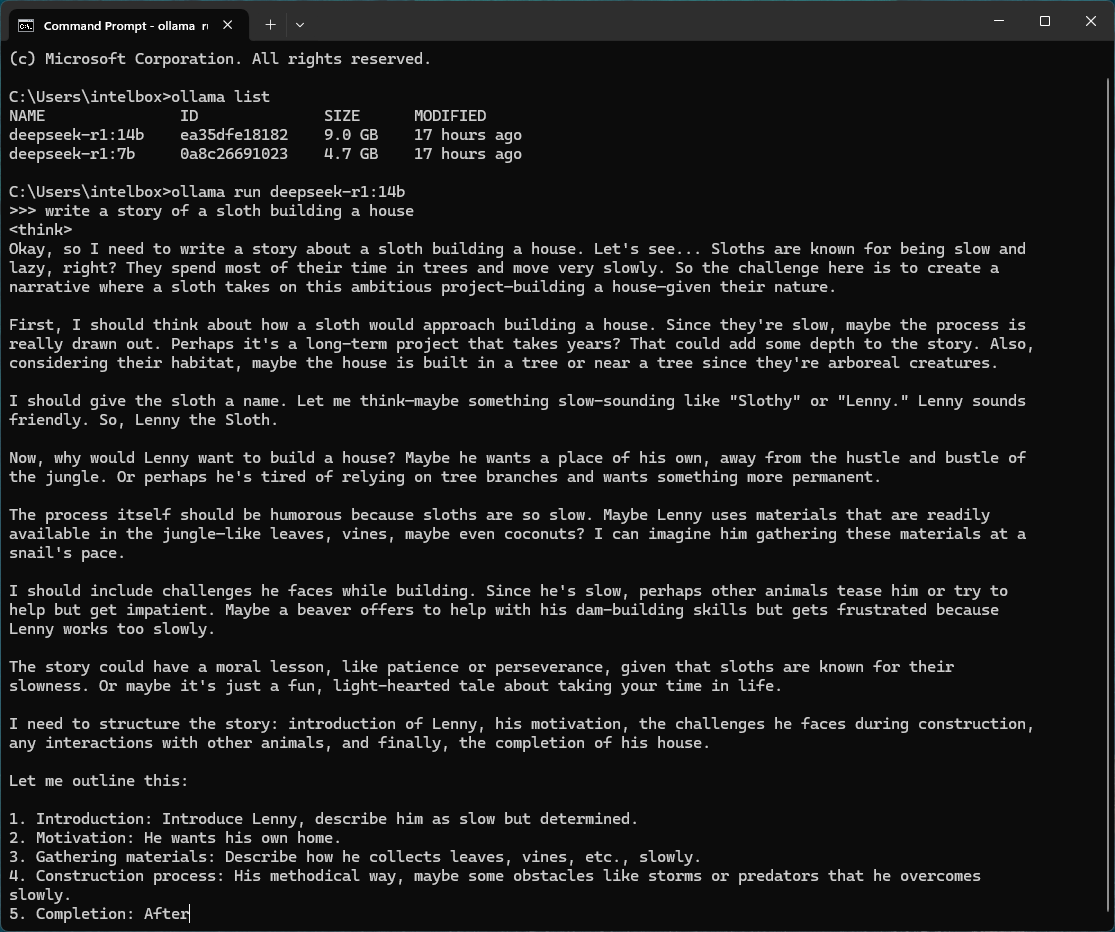
Mejor duración general del programa LLM local: Ollama
La respuesta predeterminada, y la que utilizan la mayoría de las demás herramientas. Con licencia MIT, aproximadamente 179 000 estrellas en GitHub, ahora incluye una interfaz gráfica de usuario (GUI) para escritorio junto con la interfaz de línea de comandos (CLI). Descarga modelos con un solo comando, expone un punto final compatible con OpenAI en localhost y, en enero de 2026, añadió compatibilidad con la API de Anthropic Messages, que es como ahora se conecta Claude Code a un modelo local. Requisitos mínimos: 8 GB de RAM del sistema para un modelo de 3B, 16 GB para modelos de 7-8B y 24 GB de VRAM para modelos de 30B.
Ideal para realizar pruebas de rendimiento de hardware: LM Studio
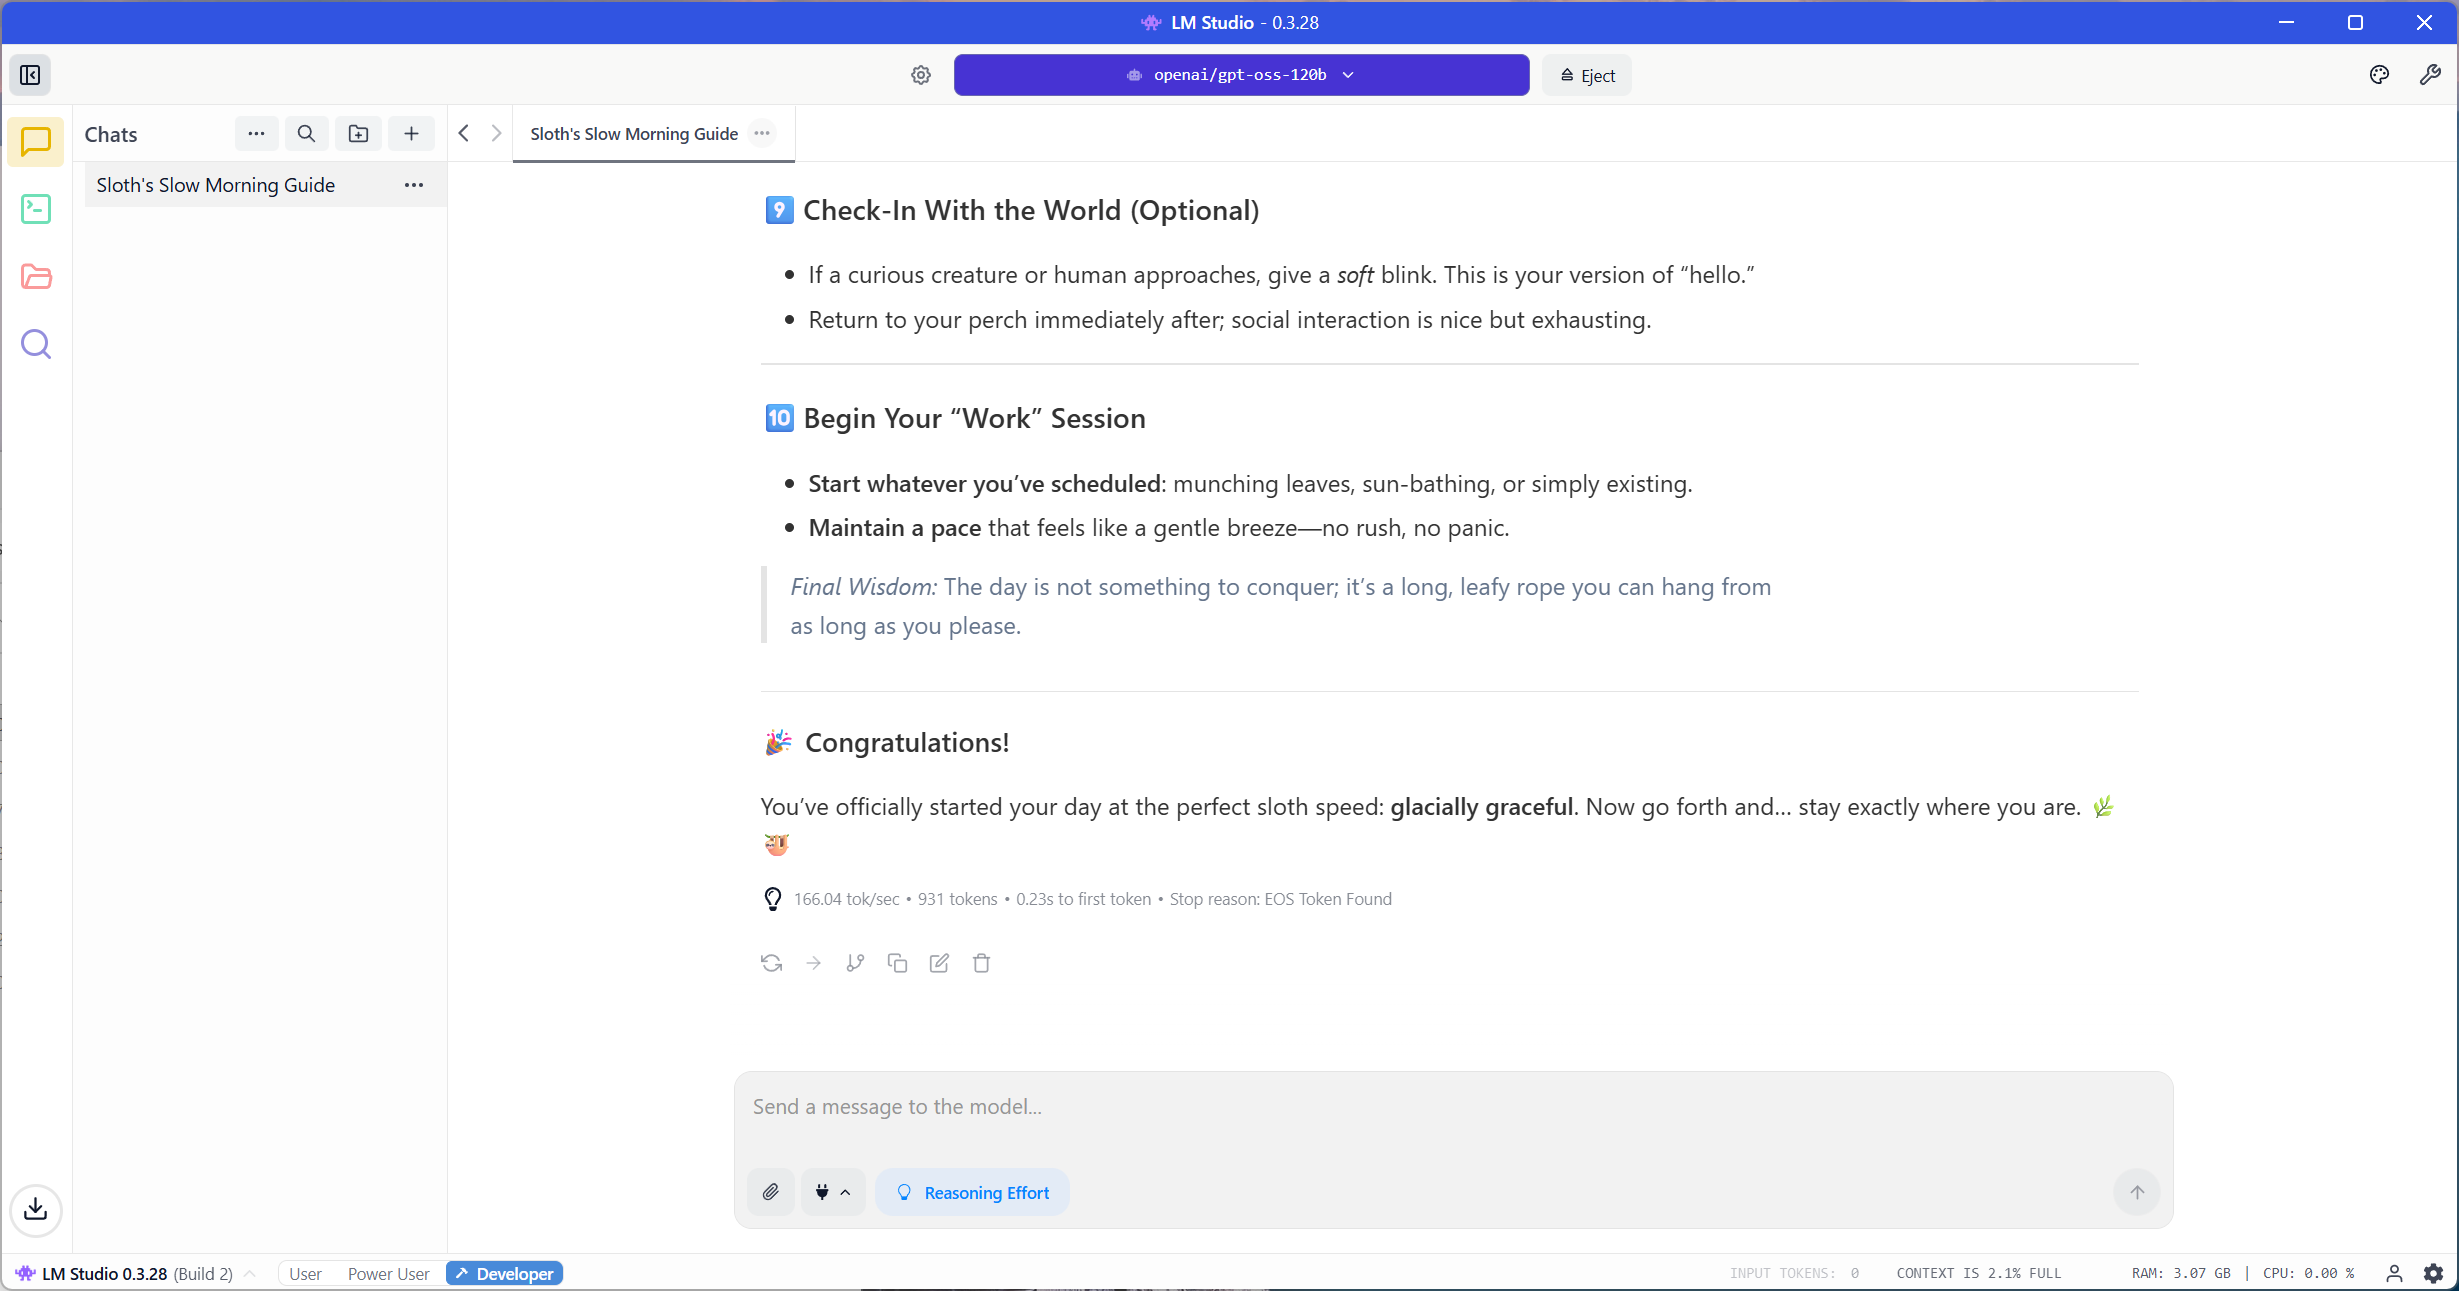
Es de código cerrado, por lo que no tiene un contador de estrellas, pero aun así se ha ganado su lugar. LM Studio incluye llama.cpp y MLX, y expone los controles importantes al medir una máquina en lugar de usarla: capas de descarga de GPU, selección de cuantización, longitud del contexto y comportamiento multi-GPU. Es gratuito para uso comercial desde julio de 2025. Esta es la herramienta detrás de la mayoría de las cifras de tokens por segundo en nuestras placas de estaciones de trabajo y portátiles. Requisitos mínimos: 16 GB de RAM; 24 GB de VRAM o 32 GB de memoria unificada para obtener resultados interesantes.
Mejor motor subyacente: llama.cpp
Casi todo lo demás en esta página es derivado de llama.cpp. Licencia MIT, aproximadamente 124,700 estrellas, con múltiples compilaciones etiquetadas publicadas por día. Es importante para la audiencia de hardware por una razón específica: la lista de backend es enorme, cubriendo CUDA, ROCm, Metal, Vulkan, SYCL, CANN y OpenCL, y los ingenieros de los proveedores ahora contribuyen con optimizaciones directamente a ella. Una mejora de prellenado de Intel Arc en la compilación 8688 valió aproximadamente 5 veces, y todos los usuarios de Ollama y LM Studio la obtuvieron sin instalar nada. Mínimo: se ejecuta solo en CPU; 8 GB de RAM para ser utilizable.
Mejor aplicación de escritorio con enfoque local: Jan
Apache 2.0, aproximadamente 44 100 estrellas, v0.8.4 a julio de 2026. Jan incluye llama.cpp, por lo que no hay que instalar nada más, y funciona incluso sin conexión a internet. Esto puede parecer poco exigente hasta que se comprueba cuántas aplicaciones de esta categoría son clientes en la nube con un campo Ollama. Esta es la aplicación ideal para un compañero que nunca abre una terminal. Su punto débil es la gestión de recursos de documentos (RAG). Requisitos mínimos: 8 GB de RAM.
Mejor documento local RAG: Cualquier cosaLLM
MIT, aproximadamente 64,800 estrellas. Incluye una base de datos vectorial y maneja la fragmentación y la incrustación sin configuración, lo que la convierte en la aplicación de chat de documentos más lista para usar en la clase de escritorio. Dos cosas que no vamos a ocultar: una vulnerabilidad de marzo de 2026 con una calificación CVSS de 9.6 permitía la ejecución remota de código activada por la propia respuesta en streaming del modelo, corregida en la versión 1.11.2, así que actualícela antes de usarla. Y la telemetría viene activada por defecto en una aplicación comercializada como de prioridad local, que se puede desactivar en Configuración. Mínimo: 16 GB de RAM para trabajar con documentos.
Mejor plataforma multiusuario autohospedada: Open WebUI
Aproximadamente 149,000 estrellas y la configuración de recuperación más profunda aquí, con v0.11.0 lanzado en julio de 2026. Es un servidor autoalojado en lugar de una aplicación de escritorio, por lo que Docker es el punto de entrada. Un detalle a tener en cuenta antes de desarrollar sobre él: la licencia cambió en abril de 2025 de BSD-3 a una licencia personalizada que no está aprobada por la OSI, agregando una cláusula que impide eliminar la marca Open WebUI, con una excepción para menos de cincuenta usuarios en cualquier período de treinta días. Ejecútelo sin modificaciones a pequeña escala, y no cambiará nada para usted. Mínimo: un entorno de ejecución separado más 4 GB para el contenedor.
Mejor agente de codificación local: Cline
Apache 2.0, aproximadamente 63 900 estrellas. Cline ha realizado más ingeniería real en la ruta local que cualquier competidor, incluyendo un indicador de sistema compacto diseñado específicamente para Ollama y LM Studio, y llamadas a herramientas nativas por familia de modelos. Su propia documentación es inusualmente sincera sobre dónde la nube aún tiene ventaja. Mínimo: 24 GB de VRAM o 36 GB de memoria unificada, y contexto configurado en 32 KB o superior.
Mejor codificación de terminal sin conexión: Aider
Apache 2.0, con aproximadamente 48 300 estrellas, es arquitectónicamente la opción local más fiable por una razón que vale la pena comprender. Aider no utiliza llamadas a herramientas JSON en absoluto. Analiza formatos de diff y edición de archivos completos a partir de texto plano, lo que evita el modo de fallo exacto que afecta a la mayoría de los agentes en modelos locales. La salvedad es el mantenimiento: un solo autor escribió el 96 % de las confirmaciones, y el ritmo de lanzamiento se ha reducido a aproximadamente una versión estable en 2026. Mínimo: 24 GB de VRAM o 36 GB unificados.
Mejor plataforma de agentes autogestionada: OpenHands
MIT, aproximadamente 84,500 estrellas. OpenHands documenta correctamente los modelos locales y, lo que es más útil, indica cuándo el problema no reside en la configuración: su propia documentación señala que si el agente se comporta como un chatbot o las herramientas fallan constantemente, la limitación reside en el modelo. Requiere un mínimo de 22 KB de contexto y recomienda 32 KB. Mínimo: 24 GB de VRAM para modelos cuantizados o 64 GB de memoria unificada.
La mejor sorpresa gratuita sin conexión: GitHub Copilot CLI
Desde abril de 2026, la CLI de Copilot funciona con Ollama, vLLM y Foundry Local. La autenticación de GitHub es opcional y no se requiere suscripción a Copilot. Al configurar COPILOT_OFFLINE, se detiene toda la telemetría y el contacto de red, y sus subagentes heredan su proveedor local. La mayoría de los artículos comparativos aún lo catalogan como exclusivo de la nube. Tenga en cuenta la diferencia: la extensión del IDE aún envía autocompletado en línea a la nube incluso con la opción de traer su propia clave. Mínimo: un modelo con una ventana de contexto de 128 KB, por lo que se requieren 32 GB de VRAM o 64 GB unificados.
Mejor servidor respaldado por el proveedor: Lemonade
Apache 2.0, con aproximadamente 5,400 estrellas, es la única herramienta de terceros que recomendamos por sus méritos, más que por la fidelidad al hardware. Los ingenieros de AMD se encargan de su mantenimiento y funciona con NVIDIA CUDA, Apple Metal, Vulkan y CPU convencionales, así como con NPU de IA Radeon y Ryzen. Se lanza cada dos semanas aproximadamente y su aplicación de escritorio pasó de Electron a Tauri en abril de 2026. Requisitos mínimos: 16 GB de RAM; procesador Ryzen AI serie 300 o posterior para la ruta de NPU.
Mejor RAG local para todo el sistema de archivos: Nexa AI Hyperlink
De código cerrado y gratuito. Indexa todo el sistema de archivos del dispositivo y proporciona citas en línea. Se incluye en esta lista porque es la única herramienta RAG local nueva con cifras de aceleración publicadas para hardware de consumo: indexación aproximadamente 3 veces más rápida e inferencia 2 veces más rápida en una RTX 5090, con una carpeta de 1 GB que pasa de unos quince minutos a cuatro o cinco. Requisitos mínimos: una GPU RTX moderna; 16 GB de RAM.
Tiempos de ejecución: ¿Qué es lo que realmente ejecuta el modelo?
Este es el motor. Todo lo que aparece en las dos tablas siguientes es una interfaz que interactúa con uno de estos. Ordenados por estrellas de GitHub.
| Runtime | Estrellas | Licencia | Hardware mínimo | Aceleración | Guía |
|---|---|---|---|---|---|
| Ollama | ~ 179,000 | MIT | 8 GB de RAM (3B), 16 GB (7-8B), 24 GB de VRAM (clase 30B) | CUDA, ROCm, Metal, Vulkan | Próximamente |
| llama.cpp | ~ 124,700 | MIT | 8 GB de RAM, solo funciona con la CPU. | CUDA, ROCm, Metal, Vulkan, SYCL, CANN, OpenCL | Próximamente |
| MLX / mlx-lm | ~ 27,500 | MIT | Apple Silicon, 16 GB unificados | Metal; se agregó el backend CUDA en 2026. | Próximamente |
| Estudio LM | Fuente cerrada | Propiedad exclusiva, uso comercial gratuito. | 16 GB de RAM; 24 GB de VRAM o 32 GB unificados. | Paquetes llama.cpp y MLX | Próximamente |
| vllm | Producción al servicio | Apache 2.0 | Suelo realista con 24 GB de VRAM | CUDA, ROCm | Próximamente |
Aplicaciones de escritorio y RAG local
Las aplicaciones que instala un lector. La columna Local-First es la que hay que leer con atención: separa el software que ejecuta un modelo en tu máquina del software que añade un campo para una URL de Ollama.
| Aplicaciones | Estrellas | Licencia | Prioridad a lo local | Hardware mínimo | Guía |
|---|---|---|---|---|---|
| Abrir interfaz de usuario web | ~ 149,000 | Diseño personalizado, no aprobado por la OSI. | Servidor capaz, no de escritorio. | Tiempo de ejecución independiente + 4 GB para el contenedor | Próximamente |
| Cualquier cosaLLM | ~ 64,800 | MIT | Capaz; telemetría activada por defecto | RAM 16GB | Próximamente |
| Ene | ~ 44,100 | Apache 2.0 | Sí, incluye llama.cpp | RAM 8GB | Próximamente |
| Estudio LM | Fuente cerrada | Propiedad | Sí: | 16 GB de RAM; 24 GB de VRAM para ser interesante. | Próximamente |
| Msty | Fuente cerrada | Propietario, nivel gratuito | Sí, paquetes Ollama, MLX, llama.cpp | RAM 8GB | Próximamente |
| Enlace de Nexa AI | Fuente cerrada | De propiedad exclusiva, gratuito | Sí, indexación en el dispositivo | GPU RTX moderna, 16 GB de RAM | Próximamente |
Herramientas de codificación y agentes
Estas son las aplicaciones que más recursos de hardware consumen, ya que el trabajo con agentes requiere una ventana de contexto amplia y sesiones prolongadas. Considere 32 GB de VRAM o 64 GB de memoria unificada como el punto en el que esto deja de ser una demostración.
| Estrellas | Licencia | Ruta local | Hardware mínimo | Guía | |
|---|---|---|---|---|---|
| Manos abiertas | ~ 84,500 | MIT | LM Studio, Ollama, vLLM, SGLang | 24 GB de VRAM o 64 GB unificados; contexto de 32 KB | Próximamente |
| clina | ~ 63,900 | Apache 2.0 | Ollama, LM Studio, compatible con OpenAI | 24 GB de VRAM o 36 GB unificados | Próximamente |
| Ganso | ~ 52,900 | Apache 2.0 | Ollama de primera clase; ahora Fundación Linux | 24 GB de VRAM o 36 GB unificados | Próximamente |
| Aider | ~ 48,300 | Apache 2.0 | Ollama, compatible con OpenAI; no requiere llamada de herramienta. | 24 GB de VRAM o 36 GB unificados | Próximamente |
| Zed | v1.0, abril de 2026 | Apache 2.0 | LM Studio, Ollama, llama.cpp | 24 GB de VRAM o 36 GB unificados | Próximamente |
| CLI del copiloto de GitHub | Fuente cerrada | De propiedad exclusiva, no se requiere suscripción. | Ollama, vLLM, Foundry Local | 32 GB de VRAM o 64 GB unificados; contexto de 128 KB | Próximamente |
Iniciativas de proveedores
Cada fabricante de chips y sistemas operativos lanza algún producto para IA local, y esta categoría merece un apartado propio debido a la confusión en la nomenclatura y la alta tasa de abandono. La tendencia a lo largo de 2026 es consistente: los fabricantes dejaron de competir con las soluciones de terceros y comenzaron a alimentarlas. NVIDIA eliminó sus dos productos de IA local y ahora publica optimizaciones para Ollama, llama.cpp y ComfyUI. AMD colabora con LM Studio. Qualcomm lanzó su capacidad NPU mediante la adaptación de una aplicación de otro fabricante.
Lo único que las herramientas de los proveedores hacen que Ollama y LM Studio no pueden: acceder a la NPU . llama.cpp no tiene un backend para NPU, por lo que en una máquina de IA Snapdragon o Ryzen, esas herramientas dejan el motor neuronal con una utilización del cero por ciento. Si pagaste por 40 a 60 TOPS, solo una ruta del proveedor lo utiliza. Sin embargo, ajusta tus expectativas. Las NPU actualmente alcanzan un máximo de alrededor de 7B modelos, y la ventaja es la duración de la batería en trabajos de modelos pequeños que están siempre activos, no el rendimiento. Una GPU dedicada supera a la NPU en velocidad en todos los casos.
| Proveedor | ¿Qué es? | Tipo | Hardware requerido | Estado | Guía |
|---|---|---|---|---|---|
| Limonada AMD | Servidor, interfaz gráfica de usuario y SDK; ~5,400 estrellas, Apache 2.0 | Aplicación + servidor | 16 GB de RAM; Ryzen AI 300+ para NPU. También funciona con NVIDIA, Apple y CPU. | Activo, envíos aproximadamente cada dos semanas | Próximamente |
| Intel OpenVINO GenAI | Entorno de ejecución y SDK; ~10,700 estrellas | SDK | Core Ultra, serie Arc A/B; 16 GB de RAM | Activo, 2026.3 en agosto de 2026 | Próximamente |
| Modelos de la Fundación Apple | Modelos en el dispositivo expuestos por el sistema operativo | Marco del sistema operativo | Apple Silicon; ya instalado | Activa; abierta a cualquier proveedor en la WWDC 2026. | Próximamente |
| Microsoft Foundry Local | SDK y CLI de inferencia local; ~2,400 estrellas | SDK | Windows, macOS, Linux; NPU/GPU/CPU | GA abril de 2026; catálogo de modelos seleccionados | Próximamente |
| AMD GAIA | Aplicación local LLM para Ryzen AI; ~1,400 estrellas, MIT | Aplicación + SDK | Procesador Ryzen AI serie 300 como mínimo; 16 GB de RAM, 64 GB recomendados. | Activa, v0.20.0 Junio 2026 | Próximamente |
| Zona de juegos de IA Intel | Aplicación de escritorio; ~900 estrellas | Aplicaciones | Arc serie A 8GB+, Arc serie B, Core Ultra | Activo pero aún en fase beta después de dos años. | Próximamente |
| Qualcomm GenieX | Entorno de ejecución GGUF integrado en el dispositivo para la NPU Snapdragon | Runtime | Snapdragon X / X Elite, 8 Elite | Vista previa para desarrolladores, julio de 2026 | Próximamente |
| Proyecto G-Assist de NVIDIA | Asistente 8B integrado en el dispositivo para el control del sistema. | Aplicaciones | Tarjeta gráfica RTX serie 20 o posterior, 6 GB de VRAM. | Activo pero aún etiquetado como prelanzamiento. | Próximamente |
Una aclaración sobre la nomenclatura. El "RTX AI Garage" de NVIDIA suena a producto, pero no lo es; se trata de una serie de artículos en un blog. La plataforma de Microsoft ha cambiado de nombre repetidamente: las API de Copilot Runtime se convirtieron en las API de IA de Windows, Azure AI Foundry pasó a llamarse Microsoft Foundry, y DirectML ahora se encuentra en modo de mantenimiento con solo correcciones de seguridad. Qualcomm AI Hub es un servicio en la nube que aprovisiona dispositivos físicos de forma remota, no algo que se ejecute localmente.
Lo que suele romperse
La mayoría de los informes que indican que los modelos locales "no funcionan" se deben a problemas de configuración, no a problemas del modelo en sí. Cuatro de ellos, en particular, representan una gran parte de estos problemas, y son aspectos que los usuarios de hardware deberían conocer antes de culpar al chip.
1. Ollama utiliza por defecto un contexto de 4,096 tokens. No genera ningún error si se supera este límite. Lo trunca silenciosamente y un bucle de agente se detiene sin problemas. Todos los sistemas de soporte serios requieren más: OpenHands exige al menos 22 000 y recomienda 32 000, Codex necesita 32 000, Copilot CLI necesita 128 000 y Cline establece 262 144. Esta configuración es probablemente la causa más común de los informes de fallos que se encuentran en línea.
2. La cuantización de caché KV degrada específicamente la llamada a herramientas , y lo hace antes de que la calidad general de la salida se vea afectada visiblemente. La documentación de llama.cpp advierte directamente sobre esto. Si está ejecutando un agente, desactívelo.
3. El número de herramientas es un problema grave, no una solución gradual. Por encima de este límite, se consideran aproximadamente cinco o seis herramientas; algunos modelos dejan de emitir llamadas a herramientas JSON válidas y comienzan a incrustar XML en el cuerpo de la respuesta, lo que el sistema interpreta como "ninguna herramienta utilizada". Un agente popular incluía once herramientas por defecto y rompió su propio modelo recomendado hasta principios de 2026. La consecuencia práctica es paradójica: cargar muchos servidores MCP resulta perjudicial para los modelos locales, a diferencia de lo que ocurre con los modelos fronterizos.
4. Q4_K_M es el límite inferior práctico. Por debajo de este valor, la fiabilidad de las llamadas a herramientas disminuye más rápidamente que la calidad general, por lo que el modelo sigue sonando bien aunque no haga nada en absoluto.
La memoria es la restricción
En todas las herramientas de esta página, la pregunta que determina qué se puede ejecutar es cuánta memoria puede procesar el acelerador. Estas son las combinaciones que vemos citadas con mayor frecuencia para trabajos con agentes, y las que pretendemos verificar en el laboratorio.
| Componentes metálicos | Modelo | Footprint | Rendimiento informado |
|---|---|---|---|
| RTX 5090, 32 GB | Qwen3.6-35B-A3B Q4_K_M | ~ 21 GB | 160-180 tok/s, contexto de 262K |
| RTX 5090, 32 GB | Qwen3-Coder-30B-A3B Q4_K_M | ~ 19 GB | 50-90 tok/s en la clase de 24 GB |
| RTX 5090, 32 GB | Devstral Pequeño 24B Q4_K_M | ~ 14 GB | Diseñado específicamente para la llamada de herramientas |
| RTX PRO 6000, 96 GB | GPT-OSS 120B MXFP4 | ~ 63 GB | La clase 100B en una sola tarjeta de estación de trabajo; la GPU de nuestra revisión de laboratorio. |
| Portátil RTX PRO 5000, 24 GB GDDR7 | Qwen3-Coder-30B-A3B Q4_K_M | ~ 19 GB | La GPU para portátil más grande que hemos probado (ThinkPad P16 Gen 3); la clase 30B encaja perfectamente con el contexto. |
| Memoria unificada de 96-128 GB, serie M | gpt-oss-120b Q6_K | ~ 93 GB | 14-20 tok/s; JSON de llamada a herramienta más limpio de cualquier modelo de peso abierto. |
Vale la pena mencionarlo, porque el marketing no lo hace: los modelos de mayor capacidad no son modelos para estaciones de trabajo. GLM-5.2 tiene aproximadamente 744 bytes de parámetros y requiere alrededor de 744 GB en FP8, que es un nodo de centro de datos con ocho GPU. Kimi K2 y DeepSeek V4 pertenecen a la misma categoría. Cualquier guía que recomiende ejecutarlos en una computadora de escritorio está equivocada.
Las cifras de rendimiento anteriores provienen de pruebas publicadas por terceros y material del proveedor, y aún no son resultados de laboratorio de StorageReview. Las reemplazaremos con nuestros propios datos a medida que cada plataforma avance en el proceso de la Guía.
Herramientas basadas en la nube y por qué no están clasificadas aquí.
La mayoría de los usuarios de IA están familiarizados con las populares y fáciles de usar herramientas de IA en línea. Un agente local no es un modelo local. Cada uno de ellos se ejecuta en su máquina, enviando cada consulta de inferencia a la nube del proveedor.
| Soporte para modelos locales | Nota: | |
|---|---|---|
| Cursor | No | La documentación oficial indica que todas las solicitudes se enrutan a través de los servidores de Cursor; las teclas personalizadas solo funcionan con los principales proveedores de nube, y la función de autocompletado con la tecla Tab siempre utiliza modelos de Cursor. Adquirida por SpaceX en 2026. |
| Devin Desktop (antes Windsurf) | No | Renombrado en junio de 2026. Todos los modelos están alojados en la nube. |
| Google Antigravedad | No | La documentación establece explícitamente que no puede utilizar Ollama, LM Studio ni un punto final personalizado. |
| CLI de Géminis | No | El soporte local solo existe en las bifurcaciones de la comunidad. |
| Qodo | No | “On-prem” se refiere a la infraestructura autogestionada que aún se denomina modelos de nube. |
| GitHub Copilot en el IDE | Parcial | El chat puede usar modelos locales; las sugerencias de autocompletado en línea permanecen en la nube incluso con la opción de usar tu propia clave. |
| ChatGPT | No | Las aplicaciones de escritorio y móviles son clientes para los modelos en la nube de OpenAI. Los modelos OpenAI Open-weight gpt-oss se ejecutan localmente, pero a través de los entornos de ejecución mencionados anteriormente, no a través de la aplicación ChatGPT. |
| Claude | No | Las aplicaciones Claude y Cowork se ejecutan en los modelos en la nube de Anthropic. Claude Code puede conectarse a un modelo local a través de la API compatible con Anthropic de Ollama, lo cual funciona, pero es una configuración no compatible. |
| asistentes generales de agencia | No | Las herramientas de esta clase se ejecutan en su máquina, pero dependen de un modelo en la nube para el razonamiento. |
Existe un género muy extendido de guías para conectar Cursor a Ollama. La propia documentación de Cursor las contradice. Si necesitas operar sin conexión, esa distinción es crucial.
¿Qué ocurre con la generación de imágenes y vídeos?
La generación local de imágenes es una de las comunidades más grandes en IA local. ComfyUI, por sí sola, supera a la mayoría de las herramientas clasificadas anteriormente por estrellas de GitHub, y la generación local de vídeo se está convirtiendo en la carga de trabajo de consumo que más VRAM consume. Merece su propia clasificación en lugar de una cuarta categoría añadida a esta, y la tendrá. Hasta entonces, la lógica de hardware de esta página se aplica directamente: el procesamiento de imágenes y vídeo requiere aún más memoria que los modelos de lenguaje, y se aplican los mismos niveles.
Cómo funciona esta página
Tres reglas. Primero, la clasificación se basa por ahora en las estrellas de GitHub. No es lo ideal, pero es neutral, verificable y no nos obliga a fingir que hemos probado cosas que no hemos probado. Las herramientas de código cerrado se marcan como tales en lugar de asignarles una puntuación inventada. A medida que nuestras propias pruebas identifiquen las favoritas, el orden se ajustará para reflejar los resultados medidos, y así lo indicaremos. Segundo, cada entrada incluye un mínimo de memoria, ya que este es el valor que determina si un modelo se carga. Tercero, la columna Guía es un compromiso: cada plataforma recibe una guía práctica de configuración con nuestros datos en nuestro hardware, y el enlace aparece aquí cuando se publica.
Preguntas frecuentes sobre herramientas locales para el programa LLM
¿Con qué herramienta LLM local debería empezar?
Ollama si te sientes cómodo trabajando en una terminal, LM Studio si prefieres una ventana con controles, y Jan si buscas una solución lista para usar que no requiera instalación. Las tres son gratuitas, funcionan completamente sin conexión y utilizan llama.cpp internamente, por lo que el comportamiento del modelo es el mismo. La diferencia radica en la interfaz, no en la velocidad.
¿Qué pasó con NVIDIA ChatRTX, GPT4All y Continue.dev?
Han desaparecido, junto con un número sorprendente de sus pares, y esto es lo más útil que hay que saber antes de seguir una recomendación antigua. NVIDIA ChatRTX fue descontinuado el 21 de enero de 2026, su repositorio fue archivado y su foro de soporte fue bloqueado, sin que se haya nombrado un reemplazo. GPT4All es el caso más complicado: no ha tenido commits en doce meses, y su última versión fue en febrero de 2025, pero el repositorio no está archivado y todavía muestra un gran número de estrellas, por lo que parece estar activo. Solo admitía un conjunto limitado de formatos de cuantización y no puede cargar la mayoría de las versiones de modelos actuales. Continue.dev , que durante dos años fue la recomendación estándar para la codificación de modelos locales, fue adquirido por Cursor y se cerró en junio de 2026. Roo Code cerró en mayo de 2026, Void se archivó en junio de 2026, Twinny en noviembre de 2025 y Reor en marzo de 2026. Khoj dejó de ofrecer su servicio alojado en abril de 2026, aunque la versión autoalojada sigue disponible. En cuanto a los proveedores, Intel IPEX-LLM se archivó en enero de 2026 y se señaló por problemas de seguridad conocidos sin una ruta de migración publicada, y NVIDIA RTX AI Toolkit se declaró obsoleto en noviembre de 2025.
¿Cuánta VRAM necesito para ejecutar un LLM local?
Para chatear, 8 GB de RAM del sistema ejecutan un modelo de 3B, y 16 GB ejecutan un modelo de 7 a 8B de forma aceptable solo con la CPU. Para una velocidad útil, conviene usar el modelo en VRAM o memoria unificada: 16 GB manejan la clase de 7 a 14B, 24 GB alcanzan la clase de 30B en el cuarto cuartil, y 32 GB o más es donde el trabajo de codificación agente deja de ser frustrante. Por encima de eso, la capacidad importa más que el ancho de banda, razón por la cual las máquinas con 96 a 128 GB de memoria unificada ejecutan modelos que ninguna tarjeta gráfica de consumo puede soportar.
¿Las herramientas LLM locales utilizan mi NPU?
Normalmente no. llama.cpp no tiene un backend de NPU, por lo que Ollama y LM Studio dejarán el motor neuronal al cero por ciento en una máquina de IA Snapdragon o Ryzen y se ejecutarán en la CPU o la GPU. Acceder a la NPU actualmente requiere una ruta de proveedor: Qualcomm GenieX, AMD Lemonade con su entorno de ejecución de NPU, Intel OpenVINO o el Neural Engine de Apple a través de los marcos del sistema operativo. Vale la pena saber qué se gana, que es duración de la batería y funcionamiento continuo de bajo consumo en lugar de velocidad. Las NPU también tienen un límite de alrededor de 7B modelos hoy en día, y una GPU dedicada siempre la superará en rendimiento.
¿Debo ejecutar la IA localmente en Windows o en Linux?
Para las aplicaciones de escritorio de esta página, Windows y macOS ofrecen una experiencia más fluida. LM Studio, Jan, AnythingLLM y Ollama se instalan de forma nativa, los controladores de GPU provienen de las fuentes habituales y no se requiere una terminal. Linux se mantiene un nivel por debajo: los motores de servicio de producción, vLLM y SGLang, son Linux-first, el servicio multi-GPU lo asume prácticamente, y algunas de las rutas de aceleración más recientes llegan allí antes que en cualquier otro lugar, incluido el soporte para NPU de IA Ryzen de AMD, que llegó a Linux y requiere un kernel muy reciente. La brecha es menor que antes. AMD unificó sus versiones de ROCm en Windows y Linux en 2026, y WSL2 cubre la mayor parte del resto, que es como las herramientas basadas en Docker, como Open WebUI, funcionan sin problemas en una máquina Windows. La regla práctica: si instala desde la tabla de aplicaciones de escritorio, quédese en el sistema operativo que tiene; si está creando un servidor dedicado o explorando todas las rutas de aceleración, hágalo en Linux.
¿Son los modelos locales lo suficientemente buenos como para reemplazar un modelo en la nube para la programación?
Depende totalmente de la tarea, y la diferencia es más marcada de lo que la mayoría de la cobertura admite. En trabajos limitados, generación de archivos individuales, pruebas unitarias, código repetitivo y explicación de código, los modelos actuales de código abierto en una buena estación de trabajo están prácticamente a la par con los modelos de vanguardia en la nube. En trabajos de largo plazo que requieren agentes, como refactorizaciones de múltiples archivos en un repositorio grande, pierden claramente, y los modos de fallo son desagradables: operaciones nulas silenciosas y trabajo reportado con seguridad que nunca se realizó. Si su razón para usar software local es la privacidad, los requisitos de aislamiento físico o el costo, es viable hoy en día. Si su razón es la capacidad, todavía no lo es.
¿Es más seguro ejecutar un modelo localmente que usar un servicio en la nube?
En cuanto a la residencia de datos, sí, y ese suele ser el objetivo. En cuanto a la seguridad del software, no automáticamente. Una aplicación de IA local con una calificación CVSS de 9.6 en marzo de 2026 podría ejecutar código en el host debido a la propia salida en streaming del modelo, porque la aplicación de escritorio se empaquetó con configuraciones predeterminadas inseguras. Local significa que tus datos permanecen en el mismo lugar. No significa que el software sea robusto, y esta categoría incluye mucho código que cambia rápidamente.
¿Qué es un entorno aislado (sandbox) para agentes de IA y necesito uno para la IA local?
Un entorno aislado (sandbox) es un entorno controlado, generalmente un contenedor o una máquina virtual ligera, donde un agente de IA ejecuta los comandos y el código que genera, impidiendo así que un error o una instrucción maliciosa afecte al sistema anfitrión. Su existencia se debe a que los agentes no solo responden preguntas; ejecutan comandos de shell, editan archivos y navegan por el sistema, y cada una de estas acciones se basa en la salida de un modelo que puede ser manipulado. Ejecutar el modelo localmente no modifica esta lógica. El objetivo del sandboxing es aislar las acciones del agente, no la ubicación del modelo, y la vulnerabilidad de ejecución de código descrita anteriormente demostró precisamente esto en una aplicación con prioridad local. Algunas herramientas de esta página incluyen sandboxing integrado, y aquellas que ejecutan agentes con acceso ilimitado al sistema anfitrión merecen una revisión más exhaustiva antes de que accedan a una máquina importante. A medida que la adopción de agentes se extienda a entornos empresariales, se espera que el sandboxing se convierta en una característica fundamental, y que comencemos a tenerlo en cuenta al evaluar estas herramientas.
¿Puede el hardware local ejecutar cargas de trabajo agenciales con docenas de subagentes?
Esta es la frontera, y la respuesta honesta es que una sola estación de trabajo se queda sin espacio rápidamente. Las cargas de trabajo multiagente generan subagentes que llevan cada uno su propio contexto, y en el lado de la inferencia, cada contexto activo significa su propia caché KV en memoria, por lo que el espacio requerido aumenta con la concurrencia, no solo con el tamaño del modelo. Dónde van esas cachés cuando superan la capacidad de la memoria es un problema de ingeniería en sí mismo; nuestro análisis en profundidad sobre la descarga de caché KV a memoria flash , basado en hardware Dell y Solidigm, es el mejor tratamiento de ese tema que hemos publicado. Una máquina que atiende cómodamente una sesión de agente de clase 30B normalmente puede manejar algunas sesiones paralelas a través de un servidor de procesamiento por lotes antes de que la latencia se degrade; docenas de subagentes concurrentes entran en el terreno de un servidor, con suficiente memoria para mantener muchos contextos activos y un motor de servicio como vLLM diseñado para el procesamiento por lotes continuo. También hay un límite de calidad: los modelos locales ya pierden fiabilidad a medida que aumenta el número de herramientas, y la orquestación multiplica las herramientas y las transferencias. Consideramos que el trabajo con un solo agente o con pocos agentes es una tarea legítima que se realiza en estaciones de trabajo, mientras que las grandes flotas de subagentes requieren infraestructura. Tenemos previsto explorar con mayor profundidad esa frontera, así como el hardware necesario para superarla.


 Amazon