

AMD ha anunciado la Instinct MI350P, una tarjeta aceleradora PCIe dirigida a empresas que desean realizar inferencias de IA en sus propias instalaciones sin necesidad de reconstruir su centro de datos. Esta tarjeta, de doble ranura, ocupa toda la altura y longitud, y está diseñada para servidores estándar con refrigeración por aire. Además, es la primera vez en casi cuatro años que AMD integra un chip Instinct de última generación en un formato compatible con servidores convencionales.
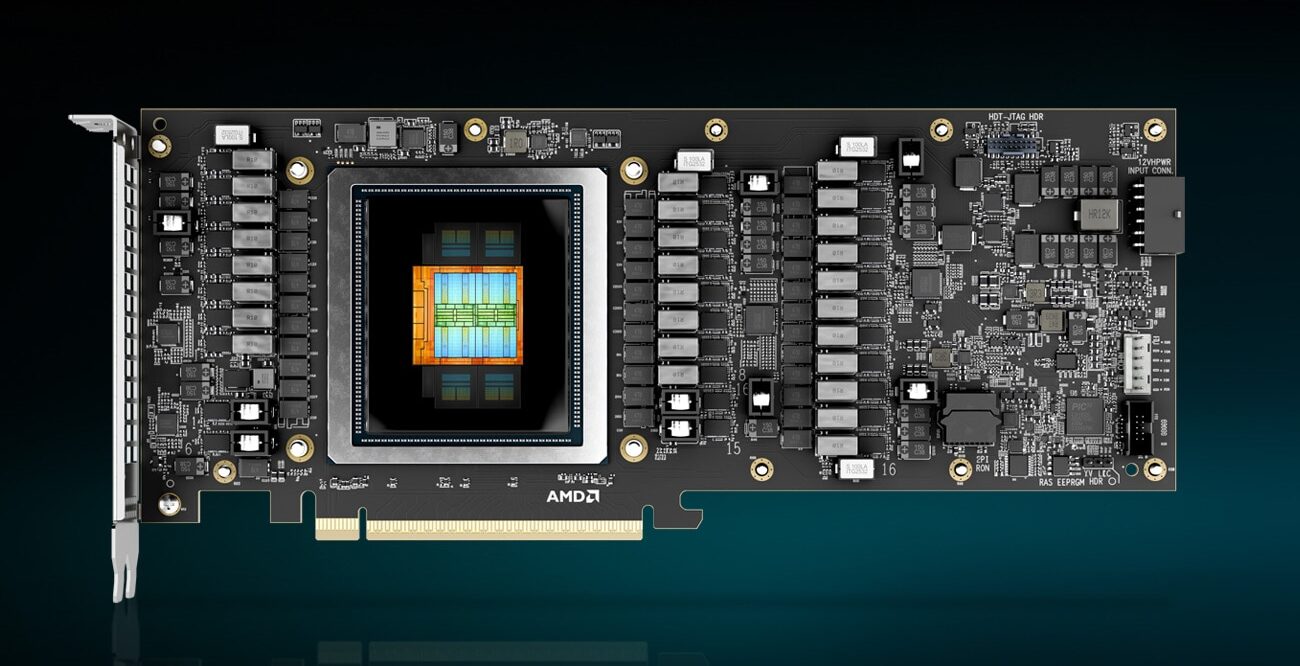
La línea PCIe Instinct prácticamente desapareció tras el lanzamiento del MI210 a principios de 2022. Desde entonces, cada generación (MI300X, MI325X y el OAM MI350X) ha consistido en un módulo OAM con zócalo en una placa base universal, lo que requiere un chasis diseñado específicamente con la alimentación y el flujo de aire necesarios para ocho aceleradores de 1,000 W en una sola bandeja. Esto funciona para los proveedores de servicios en la nube que compran GPU por rack. Sin embargo, no es viable para las empresas que desean realizar inferencias en sus propias instalaciones, pero no pueden o no quieren invertir en un rack de IA personalizado. El MI350P cubre esta necesidad y, por el momento, NVIDIA no cuenta con una tarjeta PCIe de servidor de gama alta en la misma categoría, por lo que AMD domina el segmento por ahora.
Hardware: MI350P vs. MI350X OAM
El MI350P no es un MI350X seleccionado. AMD diseñó un chip más pequeño para él. El MI350X tiene dos chips de E/S, cada uno con cuatro chips aceleradores (XCD), para un total de ocho XCD y 256 unidades de cómputo. El MI350P tiene un solo chip de E/S con cuatro XCD y 128 unidades de cómputo, la mitad del silicio, funcionando a la misma frecuencia máxima de 2.2 GHz que su hermano mayor. La memoria sigue el mismo patrón. Cuatro pilas HBM3E en lugar de ocho. Un bus de 4,096 bits en lugar de un bus de 8,192 bits. 144 GB a 4 TB/s en lugar de 288 GB a 8 TB/s.
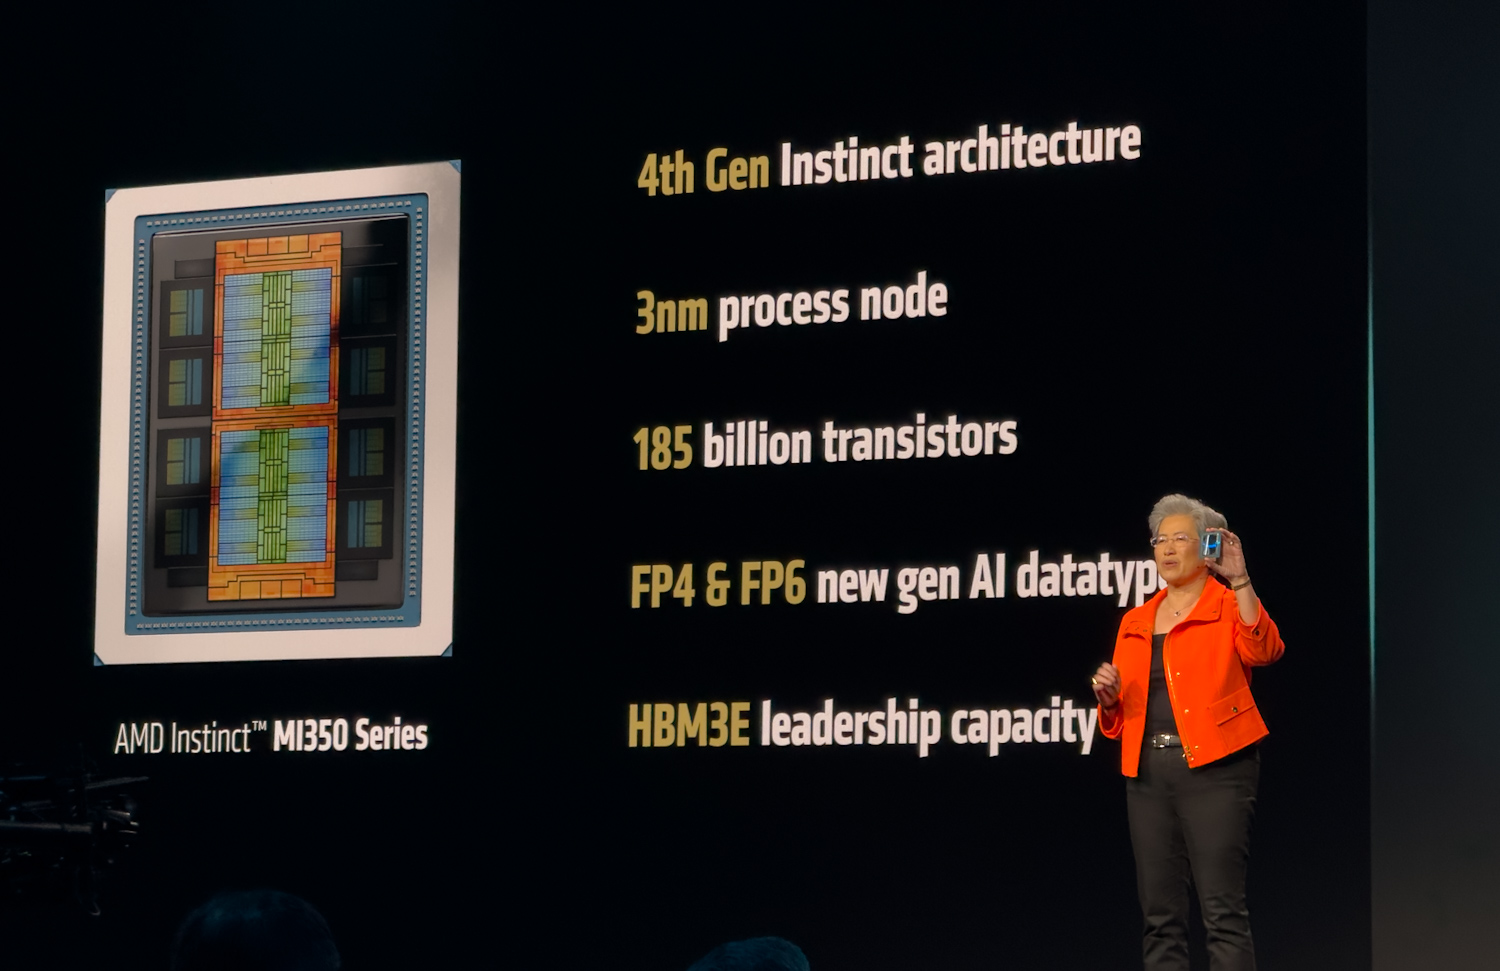
El rendimiento máximo de cálculo también se reduce a la mitad. La MI350P alcanza un máximo de 4,600 TFLOPS en MXFP4 frente a los 9.2 PFLOPS de la MI350X, y 2,300 TFLOPS en FP8 frente a los 4.6 PFLOPS. BF16, FP16 y el resto de la pila de precisión escalan de la misma manera. Es alentador ver que AMD publique cifras de rendimiento entregado junto con el rendimiento máximo. Las cifras entregadas son 2,299 TFLOPS en MXFP4, 1,529 TFLOPS en FP8 y 713 TFLOPS en BF16. Estas cifras reflejan lo que la tarjeta puede hacer realmente dentro de un límite de 600 W, donde las limitaciones de ancho de banda eléctrico y de memoria reducen los picos teóricos.
Analizamos la plataforma MI350X a través del programa Jumpstart de Supermicro y quedamos realmente impresionados por su rendimiento en cargas de trabajo de inferencia. Estamos deseando probar la MI350P y comprobar cómo se comporta la variante PCIe en el chasis de servidor más convencional para el que fue diseñada.
| Tarjeta PCIe AMD Instinct MI350P | ||
|---|---|---|
| Especificación | Entregados (FLOPS) | Pico (TFLOPS) |
| Rendimiento | ||
| BF16 | 713 | 1150 |
| FP16 | 672 | 1150 |
| FP8 | 1529 | 2300 |
| MXFP8 | 1327 | 2300 |
| MXFP6 | 1804 | 4600 |
| MXFP4 | 2299 | 4600 |
| Memoria y particionamiento | ||
| Capacidad de memoria | 144 GB HBM3E | 144 GB HBM3E |
| Memoria BW | 3.6 TB / s | 4.0 TB / s |
| Instancias de GPU | Hasta 4 unidades de 36 GB cada una. | Hasta 4 unidades de 36 GB cada una. |
| Plataforma | ||
| Decodificación de vídeo y JPEG | ||
| Interconexión de escalado de GPU | No se admite | No se admite |
| Producto FF | FHFL de doble ranura refrigerado por aire | FHFL de doble ranura refrigerado por aire |
| Potencia máxima total de la placa (TBP) | 600 W (450W configurable) |
600 W (450W configurable) |
| Host PCIe | PCIe Gen 5 x16 a 128 GB/s | PCIe Gen 5 x16 a 128 GB/s |
La potencia no se reduce exactamente a la mitad. La MI350P tiene una potencia nominal de 600 W TBP, aproximadamente el 60 % de los 1,000 W de la MI350X. 600 W es el límite máximo definido por la especificación PCIe CEM, por lo que la tarjeta funciona a la temperatura máxima que permite la ranura. Hay disponible un modo de 450 W para chasis que no pueden proporcionar la potencia o refrigeración completas, con una ligera reducción del rendimiento. La potencia nominal de 600 W también sitúa a la MI350P en el mismo segmento que la NVIDIA H200 NVL y la RTX Pro 6000 Server, con las que se comparará en este segmento.
A diferencia de la solución NVL4 de NVIDIA con la H200, AMD no expone los enlaces Infinity Fabric de la GPU en la MI350P; todas las comunicaciones colectivas se realizan a través del enlace PCIe Gen5 x16 (128 GB/s).
La historia de la refrigeración por aire con ocho GPU
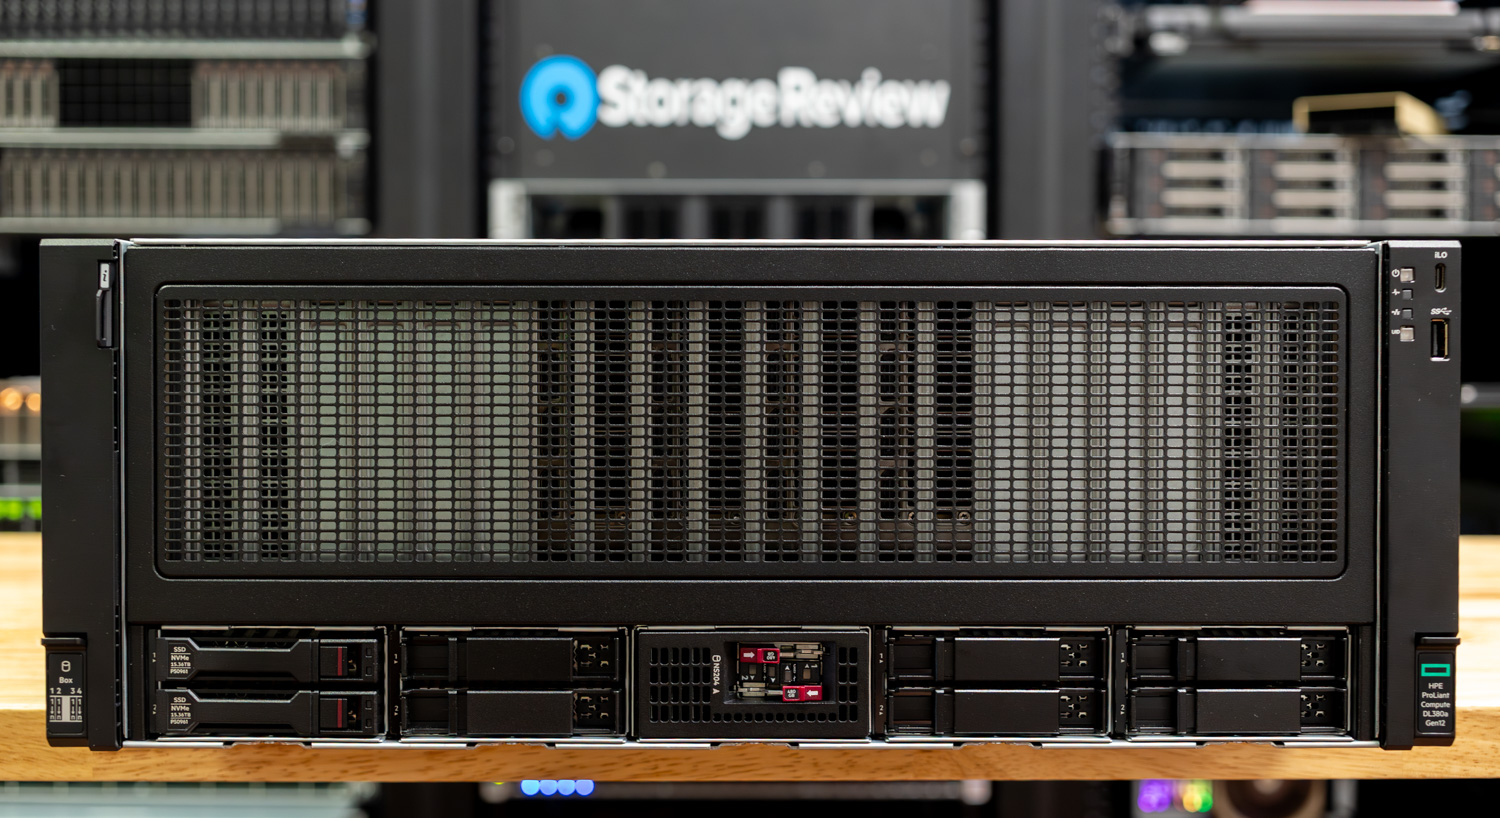
Debido a que la MI350P es una tarjeta PCIe estándar de doble ranura, de altura y longitud completas, se adapta a los servidores que las empresas ya utilizan, incluidas las plataformas de alta densidad con ocho GPU refrigeradas por aire que ahora ofrecen los principales fabricantes. El Dell PowerEdge XE7740 y el HPE ProLiant DL380a Gen12, que ya hemos analizado, son los objetivos obvios. Cada uno está diseñado específicamente para albergar ocho aceleradores de doble ranura FHFL en un chasis refrigerado por aire, con la alimentación y el flujo de aire ya optimizados para tarjetas de 600 W. No requiere rack personalizado, ni circuito de refrigeración líquida, ni placa base OAM.
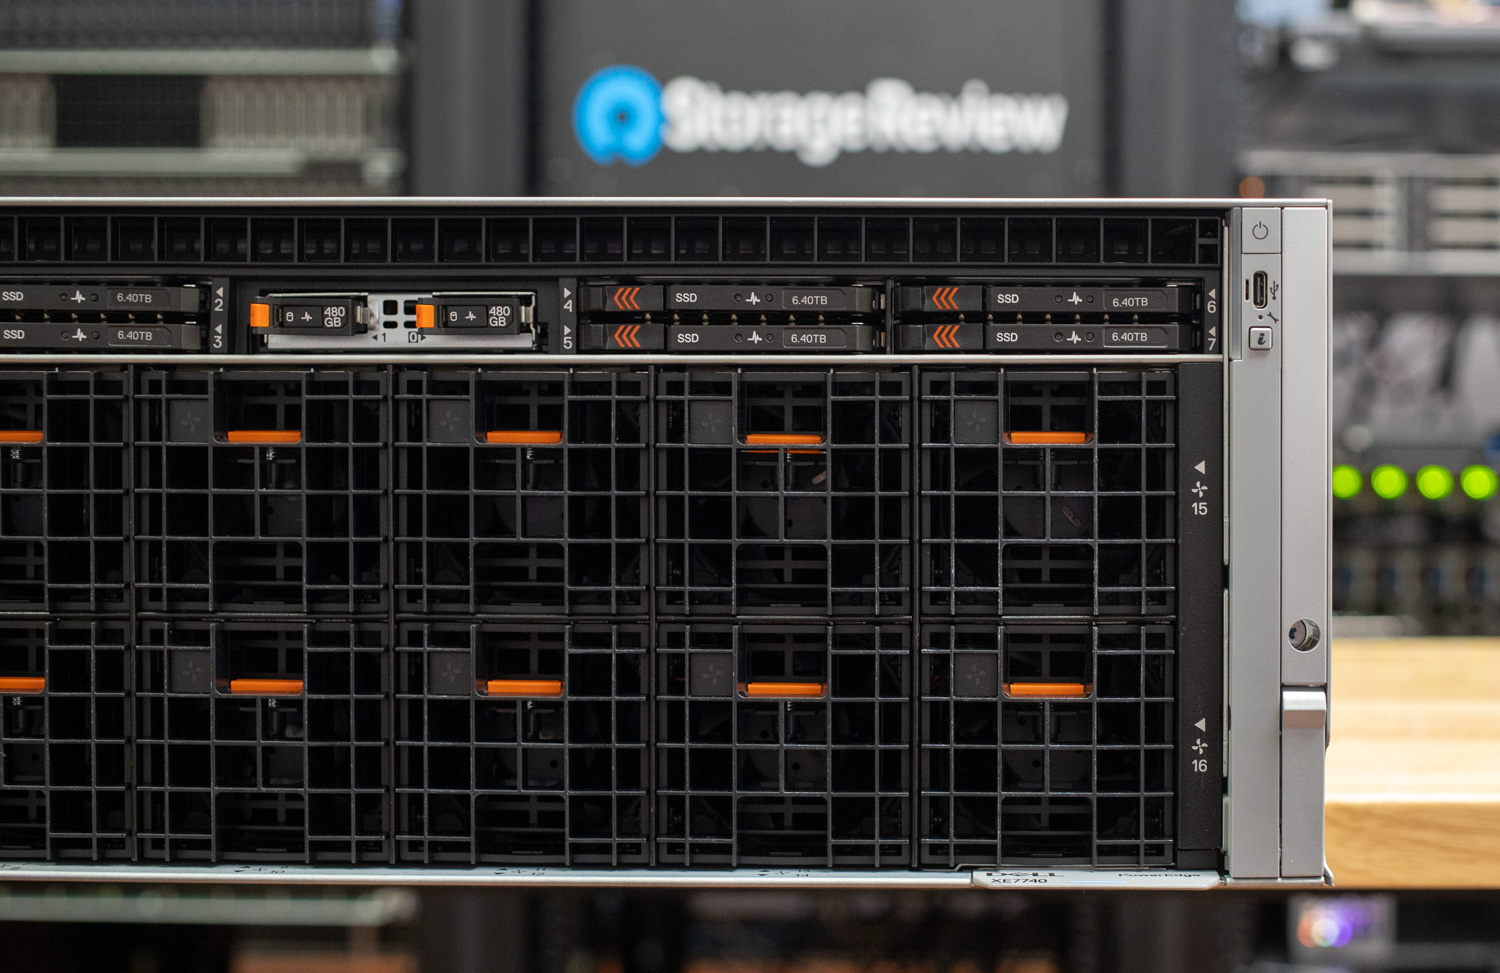
Una configuración MI350P de ocho tarjetas en uno de estos sistemas ofrece 1,152 GB de HBM3E y un ancho de banda de memoria agregado de 32 TB/s en una única caja refrigerada por aire. Para la inferencia en modelos de peso abierto de gran tamaño, esto es suficiente para alojar un modelo de un billón de parámetros en MXFP4 en un solo chasis. Pero, como mencionamos anteriormente, la desventaja es la ausencia de una arquitectura de escalado ascendente. En el OAM MI350X, las GPU se comunican a través de Infinity Fabric mediante la placa base universal. En el MI350P, cada comunicación entre GPU utiliza PCIe Gen5 x16 a 128 GB/s, la misma ruta que se usa para llegar al host. Para cargas de trabajo de inferencia, en particular con fragmentación paralela de tensores dentro de un nodo y paralelismo de datos o pipeline entre nodos, esto es viable. Para el entrenamiento estrechamente acoplado, donde el ancho de banda de reducción total domina el tiempo de paso, la plataforma OAM sigue siendo la respuesta correcta.
Formatos de precisión
Vale la pena hablar de la precisión, aunque ninguno de los formatos compatibles con el MI350P es nuevo. El MI350X tiene el mismo conjunto. La razón por la que sigue siendo importante es que los tipos de datos de escalado de bloques OCP (MXFP8, MXFP6, MXFP4) se han convertido en el estándar para que los laboratorios de modelos de vanguardia entrenen y publiquen modelos. Estos formatos permiten a los laboratorios entrenar con menor precisión con poca o ninguna pérdida de calidad, y las ventajas en la inferencia se aprecian inmediatamente después.
Menor precisión es más rápido. MXFP4 se ejecuta más del doble de rápido que FP8 y aproximadamente cuatro veces más rápido que BF16 en su pico máximo. Esta aceleración se refleja en cargas de trabajo reales. El lanzamiento de gpt-oss de OpenAI hizo evidente el aumento del rendimiento, y modelos de vanguardia como Kimi K2.6 se entrenan de forma nativa con capacidad de cuantización en INT4 desde el principio, en lugar de cuantizarse posteriormente. La otra parte de la historia es la memoria. Los pesos de INT4 y MXFP4 ocupan una cuarta parte del espacio de BF16. Esto significa que los modelos de billones de parámetros pueden caber en un solo servidor de ocho GPU. Para una empresa que desea alojar un modelo de peso abierto grande en sus propias instalaciones, la diferencia es un rack frente a un clúster de varios nodos con toda la red y orquestación que esto implica.
Resumen Final
La mayoría de las empresas que evalúan la IA local se quedan sin energía, refrigeración, densidad de racks o presupuesto antes de agotar su capacidad de procesamiento. Una PCIe Instinct que se integra en la infraestructura de servidores que ya utilizan evita la mayoría de estas limitaciones. NVIDIA no cuenta actualmente con una tarjeta PCIe para servidores de gama alta que pueda competir con ella, lo que le da a AMD vía libre en este segmento mientras dure la situación.
Encontrará información adicional en la página de AMD Instinct.


 Amazon