

MLPerf Inference v5.1 ofrece rigurosos benchmarks para la inferencia de IA en LLM, visión y tareas multimodales. Aquí se presenta el análisis técnico de los resultados de Blackwell Ultra de NVIDIA y de los resultados de Instinct MI300X/MI325X/MI355X de AMD. Incluye datos detallados de benchmarks, optimizaciones de software, estrategias de arquitectura e implicaciones para hiperescaladores y empresas.
Marco de evaluación comparativa MLPerf
Los benchmarks de inferencia de MLPerf sirven como marcador para los aceleradores de IA, proporcionando un método estandarizado y comparable para medir el rendimiento en la clasificación de imágenes, los modelos de lenguaje y los sistemas de recomendación. Para las empresas que implementan GPU a gran escala, estas cifras suelen orientar decisiones de compra masivas.
La inferencia de MLPerf se rige por MLCommons y define las reglas de división cerrada y abierta. Los escenarios incluyen:
- Sin publicarCentrado en el rendimiento (agrupar tantas consultas como sea posible).
- ServerInferencia de múltiples transmisiones que cumple con la latencia.
- Interactivo:TTFT estricto (tiempo hasta el primer token) y TPS (tokens por segundo al percentil 99).
El paquete de carga de trabajo v5.1 incluía:
- Búsqueda profunda-R1: Un modelo de mezcla de expertos 671B (prueba de estrés para inferencia de razonamiento).
- Llama-3.1-405B y 8B:Los LLM más nuevos en múltiples modos de inferencia.
- Susurro:ASR reemplazando a RNN-T.
- Difusión estable XL (SD-XL):IA generativa de texto a imagen.
- Mixtral, DLRMv2, además de cargas de trabajo heredadas como ResNet-50.
Cuando se muestran gráficos de rendimiento (tokens/seg o muestras/seg), estos suelen resaltar el dominio continuo de NVIDIA en cifras absolutas, especialmente por GPU. Sin embargo, el progreso de AMD en eficiencia relativa y fluidez de escalado demuestra que están reduciendo la brecha progresivamente, particularmente en escenarios de servidores e implementaciones multinodo.
Resultados de NVIDIA Blackwell Ultra
Los sistemas Blackwell Ultra alcanzaron un rendimiento récord en todas las nuevas cargas de trabajo. Factores clave:
- Precisión NVFP4: punto flotante personalizado de 4 bits, que acelera DeepSeek y Llama.
- FP8 KV-cache: ahorro de memoria para capas de atención.
- Servicio desagregado: contexto dividido frente a etapas de generación en 72 GPU a través de NVLink de 1,800 GB/s.
- Software: CUDA Graphs, TensorRT-LLM, ADP Balance.
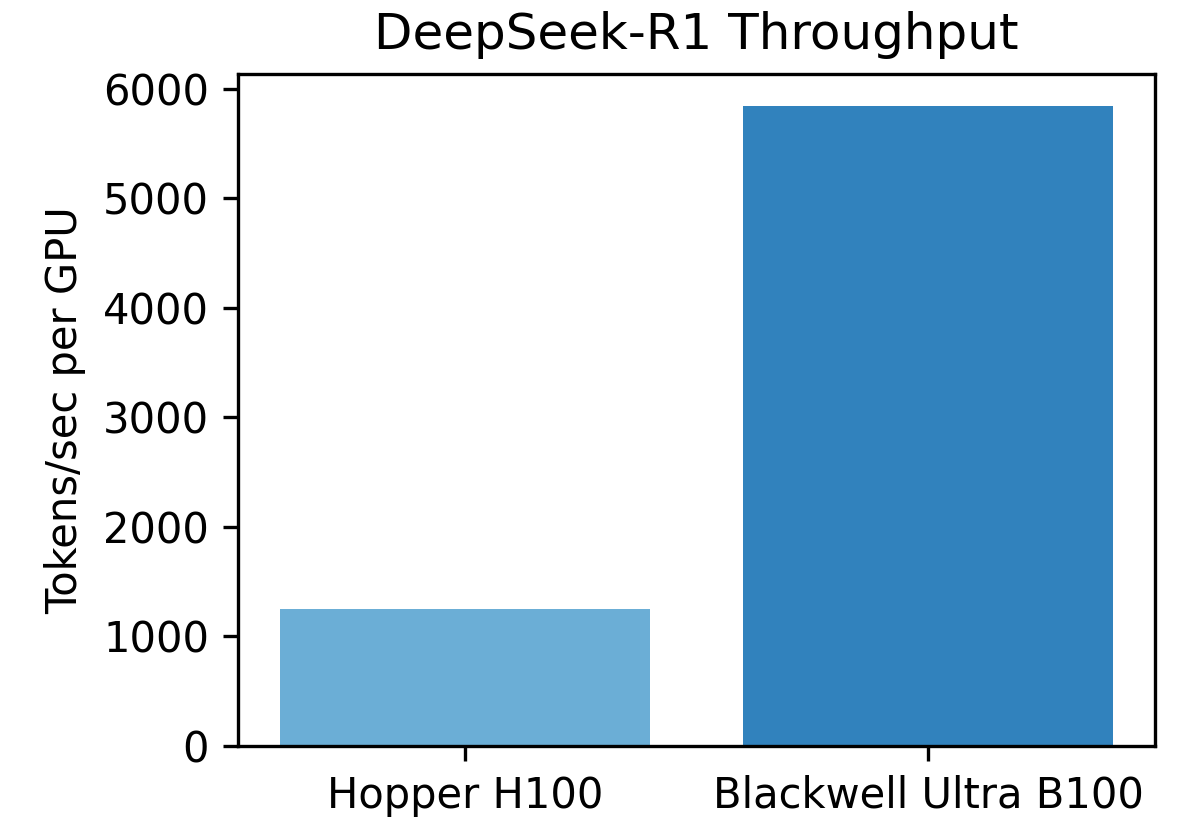
El gráfico de barras a continuación, que compara Hopper y Blackwell Ultra por GPU, muestra un aumento de rendimiento de casi 5 veces en DeepSeek-R1, lo que confirma que los formatos de datos de grano fino (NVFP4) y el ancho de banda de rack escalan linealmente para cargas de trabajo de inferencia masivas. Otra figura, enmarcada en los resultados récord interactivos de Llama-405B, demuestra cómo NVIDIA utiliza la estructura NVLink y el servicio desagregado para mantener los SLA de latencia y, al mismo tiempo, superar los límites de rendimiento anteriores. En resumen: NVIDIA sigue siendo líder del sector en velocidad bruta y cargas de trabajo sensibles a la latencia.
Resultados del AMD Instinct MI300X/MI325X/MI355X
Eficiencia y flexibilidad enfocadas en AMD:
- FP4 en MI355X:ofreciendo un rendimiento de Llama-2.7-2B 70 veces superior al del MI325X FP8.
- Poda estructurada:En Llama-405B, la poda del 21 al 33 % redujo los FLOP sin afectar la precisión, lo que aumentó el rendimiento en un ~82–90 %.
- Descamación:Escalamiento lineal suave comprobado hasta 8 nodos; el primer clúster heterogéneo (4 × MI300X + 2 × MI325X) logró una eficiencia de escalamiento del 94 %.
- Reproducibilidad del ecosistema ROCm:Las presentaciones de los socios se sitúan sistemáticamente entre el 1 % y el 3 % de los propios resultados de AMD.
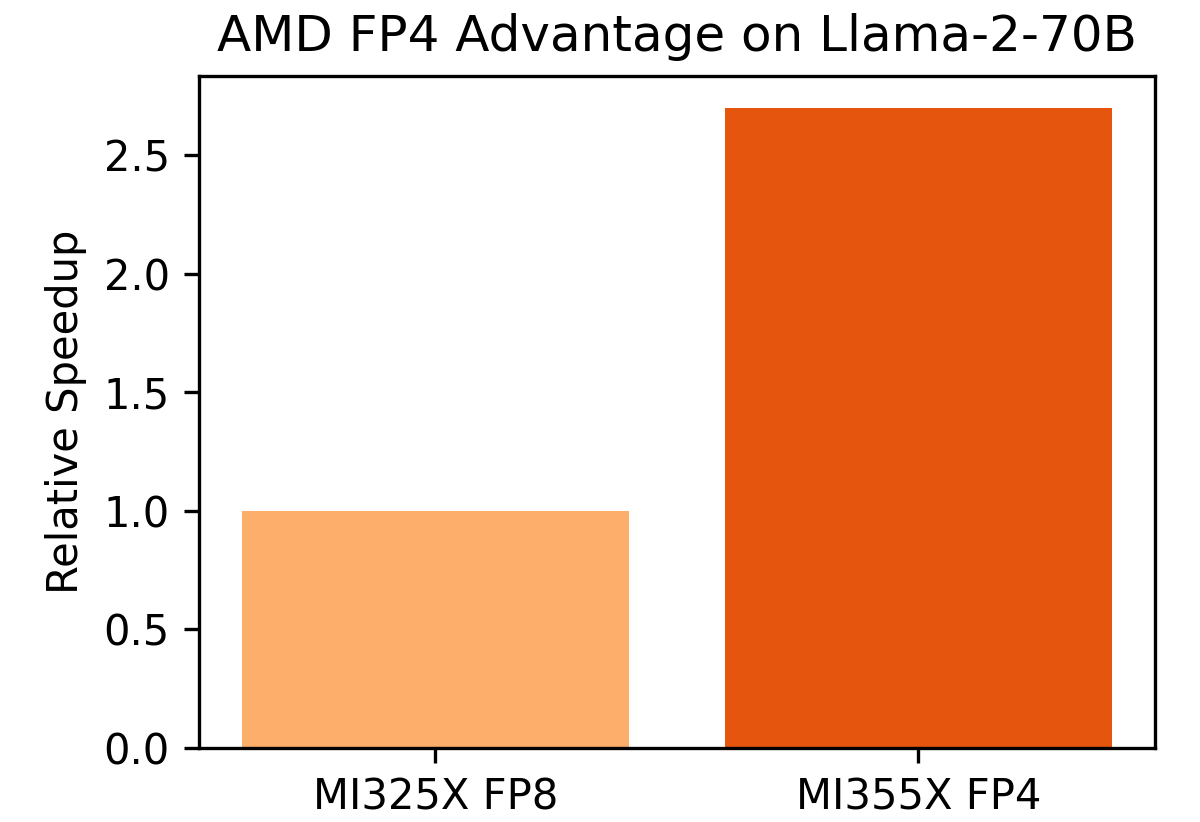
El gráfico anterior que muestra MI325X FP8 vs. MI355X FP4 ilustra los innovadores beneficios del FP4: mayor cantidad de tokens por segundo con una pérdida de precisión mínima, lo que demuestra que el FP4 no es experimental, sino que está listo para su implementación.
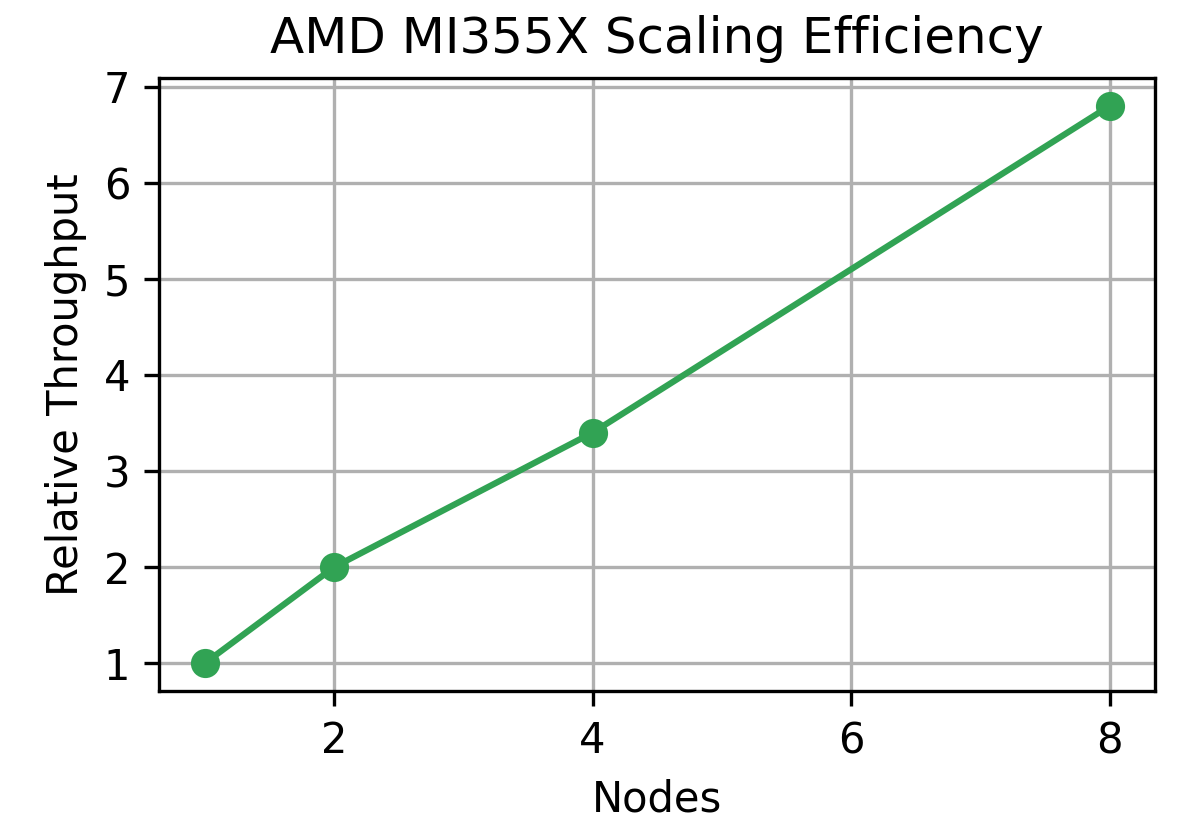
Este gráfico de curva de escalado (1 → 8 nodos) resalta el escalado casi lineal, algo que los proveedores de servicios en la nube valoran, ya que se traduce en costos de expansión predecibles. Por otro lado, el esquema de poda estructurada muestra que AMD no se centra únicamente en la potencia bruta del hardware, sino también en la eficiencia algorítmica, crucial para los clústeres de inferencia del mundo real, que suelen estar limitados por la potencia y el espacio.
Comparación directa entre AMD y NVIDIA
|
Métrico |
NVIDIA Blackwell Ultra |
AMD MI355X |
Notas |
Ganador |
|
Tokens/seg por GPU |
5842 (Búsqueda profunda-R1) |
~2200 (FP4 escalado) |
Mayor rendimiento bruto de NVIDIA |
NVIDIA |
|
Memoria por GPU |
192GB HBM3e |
288GB HBM3e |
AMD instala una GPU única en el modelo 520B |
AMD |
|
Soporte de precisión |
FP16, FP8, NVFP4 |
FP16, FP8, FP4 |
Ambos cables de 4 bits |
Corbata |
|
Tejido de escala |
NVLink de 72 GPU |
Escala de nodos lineales a 8 |
Diferentes estrategias de escala |
Corbata |
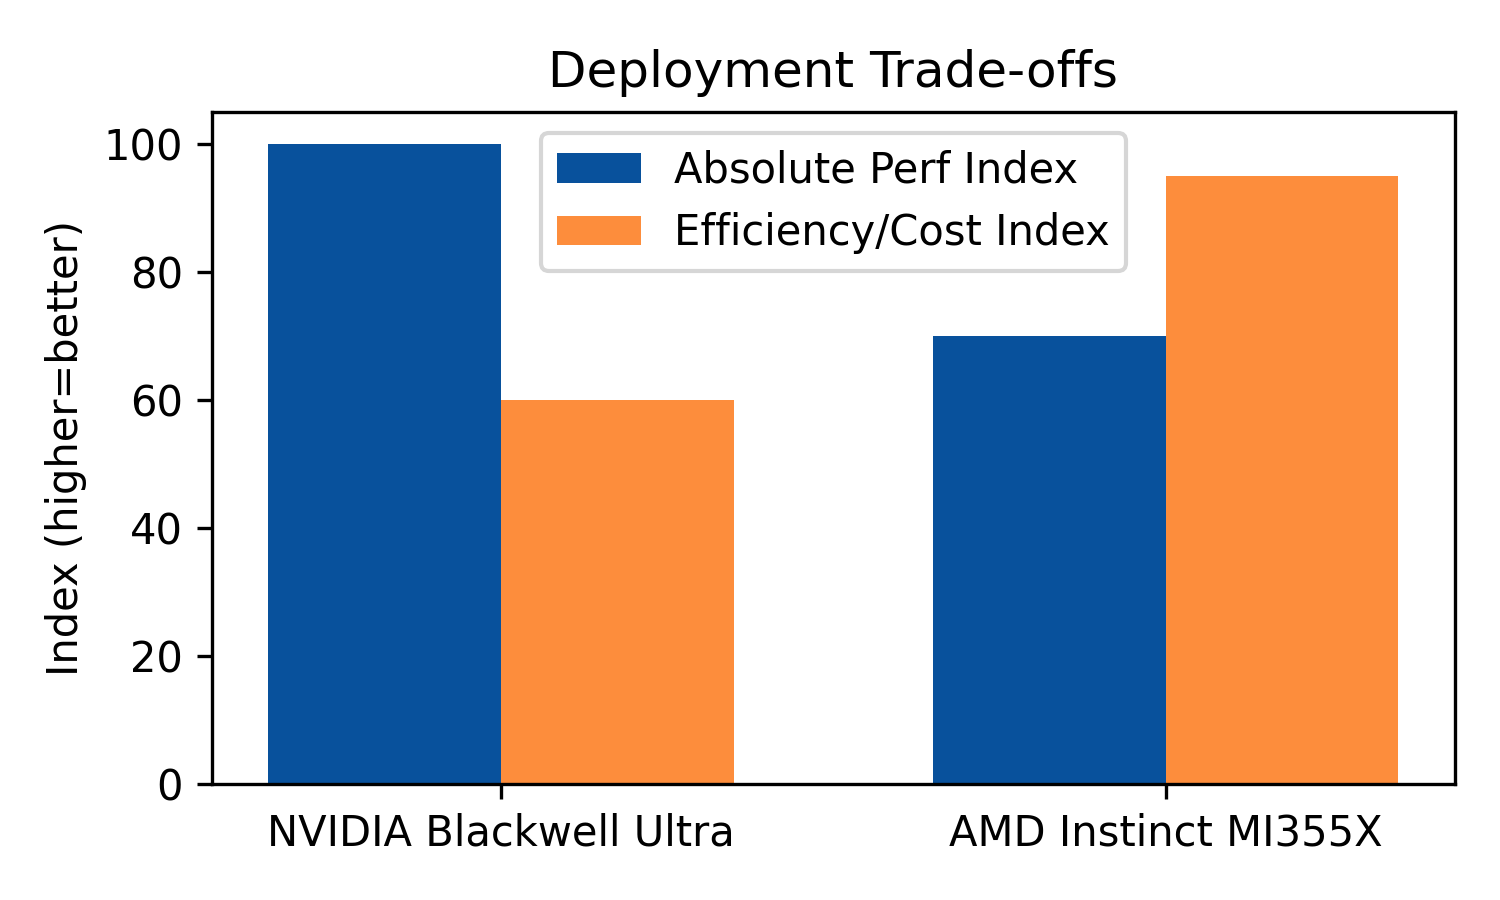
Las visualizaciones en paralelo resaltan las compensaciones.
- NVIDIA domina el rendimiento por GPU, lo que la hace ideal para fábricas de IA donde la densidad de fallas es importante.
- AMD, con mayor memoria (288 GB) y poda FP4, brilla allí donde el costo por token y la flexibilidad de implementación son primordiales.
Implicaciones de la industria
- hiperescaladoresNVIDIA sigue siendo la herramienta predilecta para las fábricas de IA que buscan el máximo rendimiento. Sin embargo, las crecientes innovaciones de eficiencia de AMD permiten un escalado optimizado en costes, lo que resulta atractivo para equilibrar las cargas de trabajo entre niveles.
- Los proveedores de nube:Espere ofertas heterogéneas, niveles de NVIDIA de alto rendimiento frente a pods AMD Kubernetes rentables.
- EmpresasLa poda estructurada, FP4 y la compatibilidad con clústeres heterogéneos permiten a AMD ofrecer una inferencia de modelos de más de 405 B con un menor coste total de propiedad (TCO). Las innovaciones de NVIDIA (servicio desagregado y Dynamo) siguen siendo beneficiosas para aplicaciones sensibles a la latencia (p. ej., chatbots LLM en tiempo real).
- Perspectiva del futuro:Se espera la adopción universal de la inferencia de 4 bits como base, un uso más amplio de grupos de GPU heterogéneos y nuevos diseños de sistemas que incluyan Rubin CPX de NVIDIA para secuencias largas y la expansión ROCm de AMD para cubrir más marcos.
NVIDIA sigue marcando la pauta en rendimiento bruto, con las GPU H200 liderando la inferencia en ResNet-50 y BERT en las pruebas de referencia de la división cerrada. Dicho esto, el MI300 de AMD no se queda atrás, con cifras competitivas en escenarios de servidor y offline, a la vez que muestra importantes mejoras en eficiencia energética. La verdadera historia no es solo que NVIDIA se mantiene en la cima, sino que AMD ha acortado significativamente la distancia en comparación con la ronda anterior de MLPerf. Para los compradores, esto significa que la era de centrarse únicamente en GPUs ecológicas podría haber terminado: ROCm está madurando y el MI300 es viable en implementaciones de inferencia en el mundo real.


 Amazon