

Los proveedores de servicios en la nube a gran escala y los operadores de infraestructura centrados en IA están desarrollando cada vez más aceleradores de IA y unidades de procesamiento de datos (XPU) propias para mantenerse al día con los modelos de lenguaje complejos y las cargas de trabajo de razonamiento a gran escala. Para abordar los desafíos físicos, de memoria y de red que implica el despliegue de silicio propietario a gran escala, NVIDIA ha detallado su interconexión NVLink Fusion y su arquitectura de memoria base personalizada NVHBM . Esta cartera unificada está diseñada para integrar el silicio personalizado con las plataformas de red escalables y de rack MGX existentes de NVIDIA.
El primer participante es Annapurna Labs de Amazon, cuyos planes para NVHBM surgieron junto con la expansión de 2 millones de GPU de la alianza con AWS ; este anuncio proporciona la arquitectura detrás de esa colaboración y nombra a Trainium4 como la primera generación de Trainium con soporte para NVLink Fusion. NVIDIA también está estableciendo una implementación estándar de NVHBM disponible a través de múltiples proveedores de memoria, lo que, según afirma, reduce el esfuerzo de ingeniería para integrar y certificar la memoria de diferentes proveedores. "NVHBM representa un nuevo enfoque arquitectónico para mejorar el rendimiento y la eficiencia de la memoria de alto ancho de banda", dijo Nafea Bshara, vicepresidenta de Annapurna Labs en Amazon. "Esperamos que esta colaboración tecnológica beneficie los futuros diseños de infraestructura de AWS".
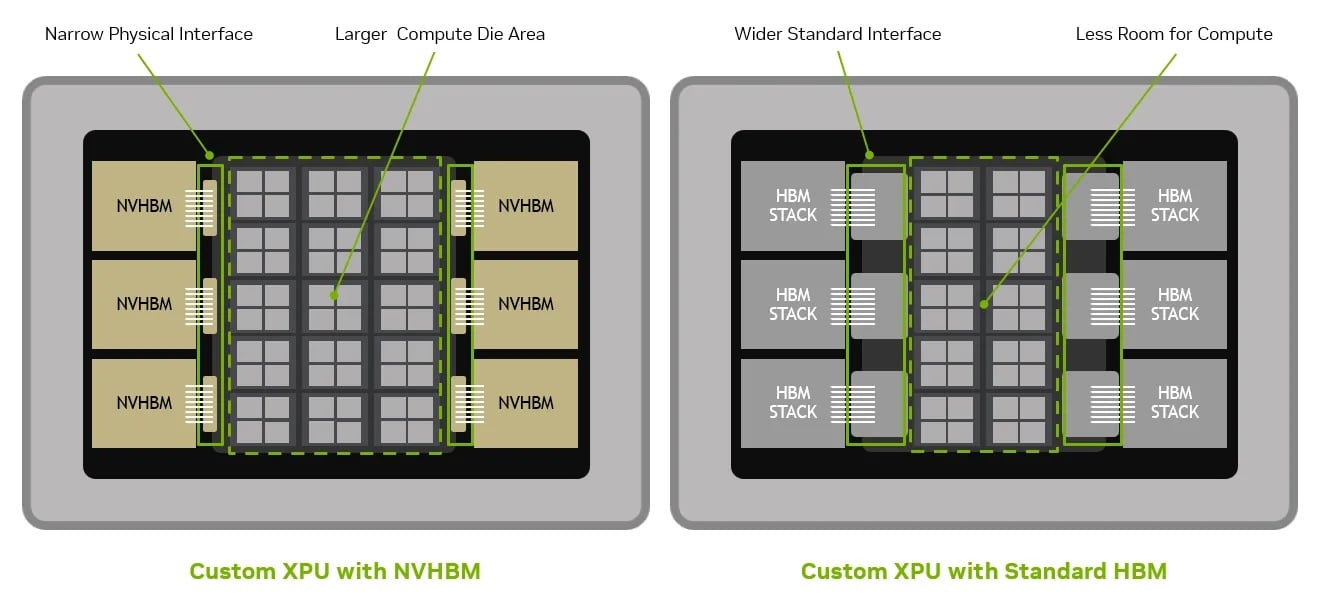
El despliegue de XPU personalizadas en centros de datos de alta densidad requiere equilibrar la lógica de procesamiento, la distribución de energía, la gestión térmica y la memoria de alto ancho de banda. La integración y validación de pilas de memoria de vanguardia suele generar importantes cuellos de botella en el empaquetado y el desarrollo. Mediante NVLink Fusion y NVHBM, los diseñadores pueden aprovechar chips base y propiedad intelectual de interfaz prevalidados, lo que reduce la complejidad de la integración y acelera el tiempo de comercialización.
Optimización del ancho de banda y la latencia de la memoria
Las cargas de trabajo de IA modernas, en particular la inferencia de modelos grandes y las canalizaciones de agentes, exigen un alto rendimiento de la memoria para la lectura de pesos de modelos, activaciones y entradas de caché de clave-valor (KV). NVHBM proporciona un chip base personalizado desarrollado en coordinación con fabricantes de memoria, que ofrece hasta un 30 % más de ancho de banda de memoria por pila en comparación con la especificación estándar JEDEC HBM4E.
| Elemento | Beneficio de NVHBM |
| Ancho de banda | Hasta un 30 % más de ancho de banda de memoria en comparación con la HBM4e estándar. |
| Área | Las conexiones de interfaz más eficientes permiten hasta un 25 % más de área de chip de cómputo para capacidades XPU adicionales. |
| Potencia | Un consumo de energía HBM hasta un 15 % menor en comparación con el HBM4e estándar se traduce en ahorros en miles de XPU. |
Tabla 1. NVHBM aporta tres ventajas principales a nivel de plataforma para los programas aceleradores de IA: mayor ancho de banda de memoria, mayor área de encapsulado y silicio, y menor consumo de energía de HBM.
Este aumento del ancho de banda minimiza la escasez de recursos del motor de cómputo durante las fases de ejecución que requieren mucha memoria. Al acelerar las transferencias de datos entre las pilas HBM y la lógica de cómputo integrada, los aceleradores pueden mantener una mayor utilización y mejorar las tasas de generación de tokens por usuario durante cargas de trabajo de inferencia densas.
Reasignación del área del chip y optimización de la capa física
El espacio disponible en los paquetes de aceleradores modernos es muy limitado, lo que obliga a los diseñadores a equilibrar el espacio entre las ALU de cómputo, los motores de matriz, la SRAM integrada y las interfaces periféricas. Las arquitecturas HBM estándar requieren interfaces físicas amplias que consumen una superficie considerable.
NVHBM soluciona este problema trasladando el controlador de memoria directamente a la pila HBM 3D y utilizando una capa física (PHY) personalizada. Este enfoque reduce hasta un 67 % el área de soporte de la PHY y los periféricos en comparación con las implementaciones HBM4E estándar, a la vez que simplifica el enrutamiento de las pistas del interposer para recuperar hasta un 80 % más de silicio utilizable en todo el diseño. La interfaz de memoria más estrecha libera espacio en el encapsulado, lo que permite a los diseñadores ampliar el chip de cómputo de IA central hasta un 30 % para añadir más núcleos de matriz, unidades vectoriales o jerarquía de caché dentro de un espacio físico fijo.
Eficiencia energética y altura libre a escala de la instalación
La distribución de energía sigue siendo una de las limitaciones más importantes en las operaciones de centros de datos a hiperescala, lo que repercute directamente en el diseño térmico y los requisitos de refrigeración de los aceleradores. NVHBM reduce el consumo de energía de HBM en un 15 % en comparación con HBM4E estándar.
A nivel de silicio, la reducción del consumo de memoria disminuye la presión térmica, lo que proporciona un margen eléctrico adicional para impulsar los núcleos de procesamiento a frecuencias sostenidas más altas. A escala de centro de datos, este ahorro energético se multiplica significativamente. En un centro de datos teórico de 1 gigavatio con unidades de procesamiento de 2,000 vatios, la reducción del consumo de memoria puede liberar suficiente capacidad térmica y eléctrica para soportar hasta 15 000 unidades de procesamiento adicionales.
Integración a escala de rack mediante NVLink Fusion
Mientras que NVHBM optimiza el rendimiento a nivel de paquete individual, NVLink Fusion actúa como puente a nivel de sistema. Mediante el uso de chiplets NVLink Fusion dedicados, las XPU personalizadas pueden conectarse directamente a la estructura de escalado NVLink de sexta generación , unificando todos los aceleradores dentro de un rack en un único dominio coherente de memoria y computación.
Esta arquitectura escalable es fundamental para esquemas de paralelización avanzados como el paralelismo experto (EP) y WideEP, en los que los modelos distribuidos de mezcla de expertos requieren una sincronización de baja latencia de las activaciones y los estados ocultos en múltiples dispositivos físicos. Los procesadores personalizados también pueden conectarse a las CPU del host mediante NVLink-C2C.
Al integrar chips semicustomizados en el ecosistema de hardware y software de NVIDIA, NVLink Fusion permite a los operadores implementar entornos heterogéneos que combinan XPU personalizadas con GPU NVIDIA estándar bajo una arquitectura de rack MGX estandarizada, lo que simplifica las operaciones y el aprovisionamiento de cargas de trabajo.


 Amazon