

A lo largo de varias generaciones de hardware, los proveedores de memoria y redes han identificado distintos cuellos de botella en los clústeres de computación de alto rendimiento. Los fabricantes de memoria se centraron en el ancho de banda de la memoria dentro del paquete, mientras que los proveedores de infraestructura de red abordaron el rendimiento entre chasis y entre racks. Hoy en día, ambas perspectivas han convergido en el mismo cuello de botella: la limitación del ancho de banda que restringe el movimiento de datos entre los nodos de computación distribuidos y los grupos de memoria.
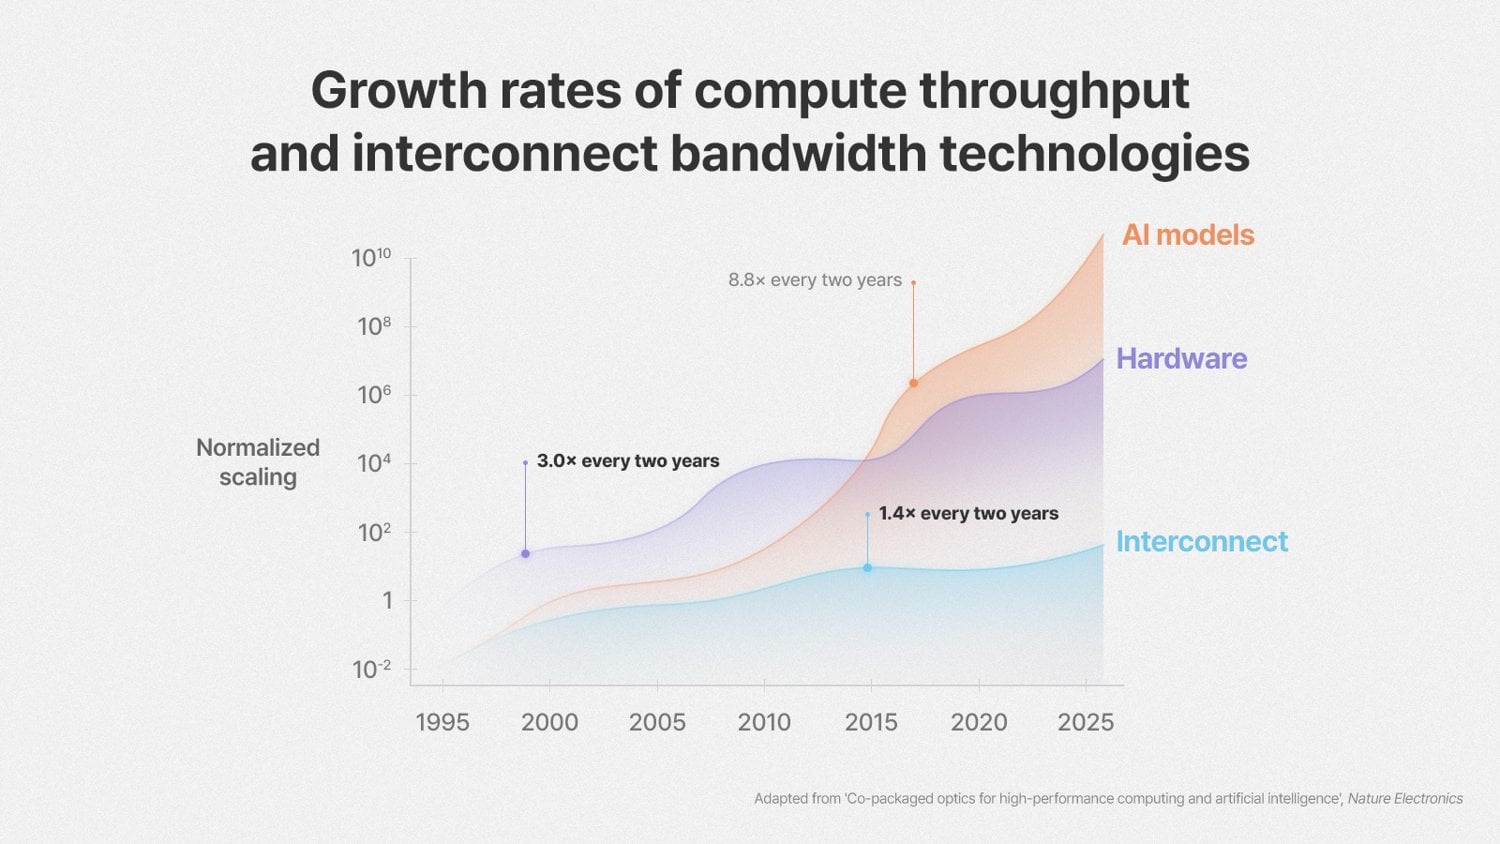
Si bien la memoria de alto ancho de banda (HBM) resolvió eficazmente las limitaciones de ancho de banda a nivel de paquete para los aceleradores de IA individuales, las cargas de trabajo modernas de entrenamiento e inferencia a hiperescala ahora se extienden a través de decenas de miles de procesadores distribuidos en racks y pods. En estas topologías distribuidas, el rendimiento computacional ha aumentado históricamente aproximadamente tres veces cada dos años, mientras que el ancho de banda de interconexión ha aumentado aproximadamente 1.4 veces durante el mismo período. El desequilibrio resultante sitúa el principal cuello de botella de escalabilidad directamente en la capa de interconexión física.
Esta evaluación proviene de un artículo de opinión publicado el 20 de agosto en Nature Electronics , titulado "Óptica integrada para computación de alto rendimiento e inteligencia artificial", cuyos autores son SK hynix y un grupo de investigadores de la Universidad de Virginia, la Universidad de Illinois Urbana-Champaign, el MIT, la Universidad Tecnológica de Nanyang y la Universidad de Yonsei. Seunghoon Hong, líder del equipo de infraestructura de IA de SK hynix, y Kyusang Lee, profesor de la UVA, fueron los autores correspondientes.
| Fase | Resultado |
|---|---|
| Cambio en el cuello de botella de escalado de clústeres de IA | |
| HBM en paquete | Se ha resuelto el cuello de botella de la memoria en el chip/paquete. |
| Rastros de cobre | Se produce atenuación física / límite de potencia fuera del chip |
| Integración del CPO | Converge el tejido óptico directamente sobre el sustrato. |
Para abordar esta limitación, SK hynix, en colaboración con investigadores de la Universidad de Virginia, UIUC, NTU, MIT y la Universidad de Yonsei, publicó un estudio en Nature Electronics titulado "Óptica coempaquetada para computación de alto rendimiento e inteligencia artificial". El artículo detalla cómo la óptica coempaquetada (CPO) y las interconexiones de computación óptica (OCI) deben evolucionar conjuntamente con las arquitecturas de memoria y empaquetado para sustentar la futura escalabilidad de los clústeres.
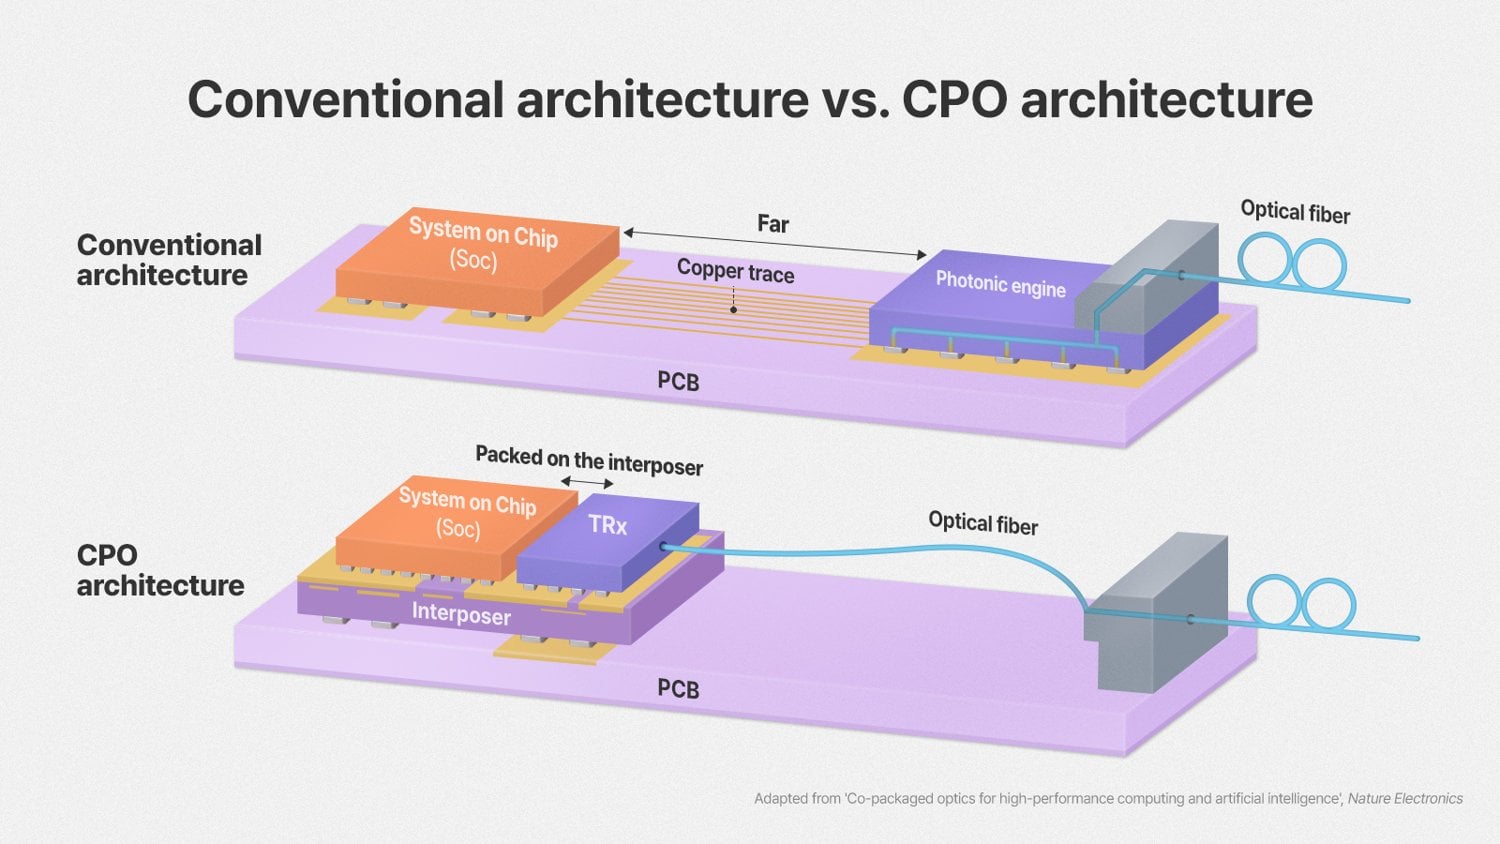
Los límites físicos de las interconexiones de cobre
Las interconexiones eléctricas estándar que utilizan pistas de cobre y cableado de cobre de conexión directa siguen siendo prácticas para distancias físicas cortas. Sin embargo, a medida que aumentan las velocidades de datos, la señalización eléctrica sufre una atenuación de señal severa, pérdida de inserción y un mayor consumo de energía. Gestionar señales de alta velocidad a través de pistas de placa y backplanes más largos requiere circuitos complejos de ecualización y resincronización, lo que introduce latencia adicional y consume una cantidad considerable de energía.
Cómo la óptica coempaquetada cambia el rumbo
CPO contrarresta estas limitaciones físicas montando los transceptores ópticos directamente sobre el mismo sustrato del encapsulado que los procesadores o aceleradores anfitriones. La conversión de señales eléctricas de alta velocidad en canales fotónicos, ubicados justo al lado del silicio de computación, minimiza la longitud de las pistas eléctricas, reduciendo la capacitancia parásita y la degradación de la señal. Esta arquitectura permite una transmisión óptica de baja pérdida y alto ancho de banda a través de placas, bastidores y módulos, manteniendo una mayor densidad de ancho de banda y una mejor inmunidad a las interferencias electromagnéticas.
| Métrico | Especificación objetivo |
|---|---|
| Especificaciones objetivo para nodos CPO | |
| Densidad de ancho de banda del nodo | > 100 Tb/s por nodo |
| Eficiencia energética | < 1 pJ/bit |
| Latencia de interconexión entre chips | <10 ns |
| Vía de integración | Interponedor 2.5D a heterogéneo 3D |
La hoja de ruta proyecta una progresión arquitectónica que va desde los módulos multichip 2D estándar y la integración de interconectores de silicio 2.5D hacia el apilamiento heterogéneo 3D. El hito arquitectónico final consiste en extender los enlaces ópticos directamente al subsistema de memoria.
Mediante el uso de un interponedor fotónico para conectar directamente las pilas de memoria con los motores de procesamiento, los sistemas pueden sortear las limitaciones de enrutamiento convencionales a nivel de placa. Este enfoque permite crear grupos de memoria compartida desagregados y de baja latencia, donde múltiples motores de procesamiento pueden acceder a la capacidad compartida a través de un plano posterior óptico, sin las penalizaciones de serialización y deserialización típicas de las redes tradicionales.
Desafíos de ingeniería para el despliegue comercial
La transición de la tecnología CPO desde las demostraciones de empaquetado avanzado hasta el hardware de producción para centros de datos presenta varios obstáculos de ingeniería aún sin resolver. La integración de dispositivos fotónicos de silicio de baja potencia junto con la lógica host de alta potencia exige un aislamiento térmico sofisticado y diseños avanzados de refrigeración microfluídica o directa al encapsulado.
Además, la industria debe desarrollar protocolos de coherencia estandarizados y de baja latencia, capaces de orquestar transacciones de memoria acopladas ópticamente sin la sobrecarga de software propietario. La comercialización fiable requerirá un codiseño de hardware integral que abarque topologías de chips DRAM, controladores de memoria personalizados, motores fotónicos y empaquetado de sustratos heterogéneos. Para SK hynix, la hoja de ruta óptica se desarrolla paralelamente a la convencional; la compañía presentó en detalle la memoria HBM4 de 16 capas y la memoria NAND de 375 capas con unión de obleas en FMS 2026.


 Amazon