

VAST Data ha ampliado su colaboración con AMD en torno a la infraestructura de IA para proveedores de servicios en la nube y empresas que implementan servicios de entrenamiento, inferencia, generación aumentada de recuperación e IA automatizada. Esta iniciativa combina el sistema operativo VAST AI con procesadores AMD EPYC de sexta generación , GPU AMD Instinct, hardware de red AMD y el software ROCm.
Esta colaboración refleja un cambio de infraestructura más amplio, pasando de clústeres de IA centrados en el entrenamiento a entornos que también deben admitir contexto persistente, inferencia de alta concurrencia y flujos de trabajo de agentes de múltiples turnos. Estas implementaciones hacen mayor hincapié en el movimiento de datos, la gestión de caché de clave-valor, la utilización de la GPU y la capacidad de proporcionar acceso de baja latencia a grandes conjuntos de datos de modelos y contexto.
VAST posiciona su arquitectura Disaggregated Shared Everything (DASE ) como la capa de datos compartidos para estos entornos. La plataforma combina almacenamiento de archivos y objetos, bases de datos, transmisión de eventos y servicios de datos bajo un espacio de nombres global unificado. Además, proporciona capacidades de multitenencia y aislamiento de cargas de trabajo para nubes de IA que gestionan simultáneamente cargas de trabajo de clientes y aplicaciones.
Plataformas EPYC 9006 para sistemas VAST CBox y EBox
VAST ha seleccionado los procesadores AMD EPYC de sexta generación, anteriormente conocidos con el nombre en clave Venice, para sus plataformas CBox y EBox de próxima generación. La compañía planea utilizar estos procesadores en sus sistemas CBox de sexta generación y EBox de tercera generación, que son la base del sistema operativo de IA de VAST.
La compatibilidad con AMD EPYC 9006 introduce la conectividad PCIe Gen6 en la plataforma de hardware VAST. VAST afirma que la nueva interfaz duplica el ancho de banda de E/S generacional, mejorando el rendimiento del almacenamiento de archivos y objetos, a la vez que reduce la latencia para servicios de datos como bases de datos, almacenes de datos y cargas de trabajo de transmisión de eventos, todo ello a través de VAST DataBase y DataEngine.
Para la infraestructura de IA, un mayor ancho de banda de E/S puede ayudar a reducir los cuellos de botella entre los recursos de computación, red y almacenamiento NVMe. Esto es especialmente relevante para la carga de modelos, las canalizaciones de recuperación, el acceso a puntos de control y los flujos de trabajo de caché KV externalizados, donde la capacidad de memoria de la GPU por sí sola es insuficiente para mantener el contexto activo.
La arquitectura de referencia combina Helios, VAST y DriveNets.
VAST, AMD y DriveNets también están desarrollando una arquitectura de referencia de infraestructura de IA basada en la infraestructura de IA a escala de rack AMD Helios, el sistema operativo de IA de VAST y la red DriveNets AI Fabric.

La arquitectura de referencia tiene como objetivo proporcionar orientación para la implementación de cargas de trabajo de entrenamiento de modelos, inferencia, aprendizaje por refuerzo y caché de clave-valor. Incluye consideraciones sobre el dimensionamiento y la disponibilidad para organizaciones que desarrollan centros de IA que requieren infraestructura de datos compartida y redes de alto rendimiento, además de computación mediante GPU.
VAST también mencionó la ampliación de su colaboración con los proveedores de software de inferencia TensorMesh y EmbeddedLLM. El esfuerzo del ecosistema se centra en arquitecturas de inferencia de producción para aplicaciones de IA agentes, aunque no se revelaron detalles específicos sobre las integraciones de productos ni su disponibilidad.
La descarga de caché KV apunta a la inferencia de alta concurrencia.
Un componente central del anuncio es la ampliación de la compatibilidad con la caché KV mediante las GPU AMD Instinct , AMD Infinity Context, el software ROCm y el sistema operativo de IA VAST.
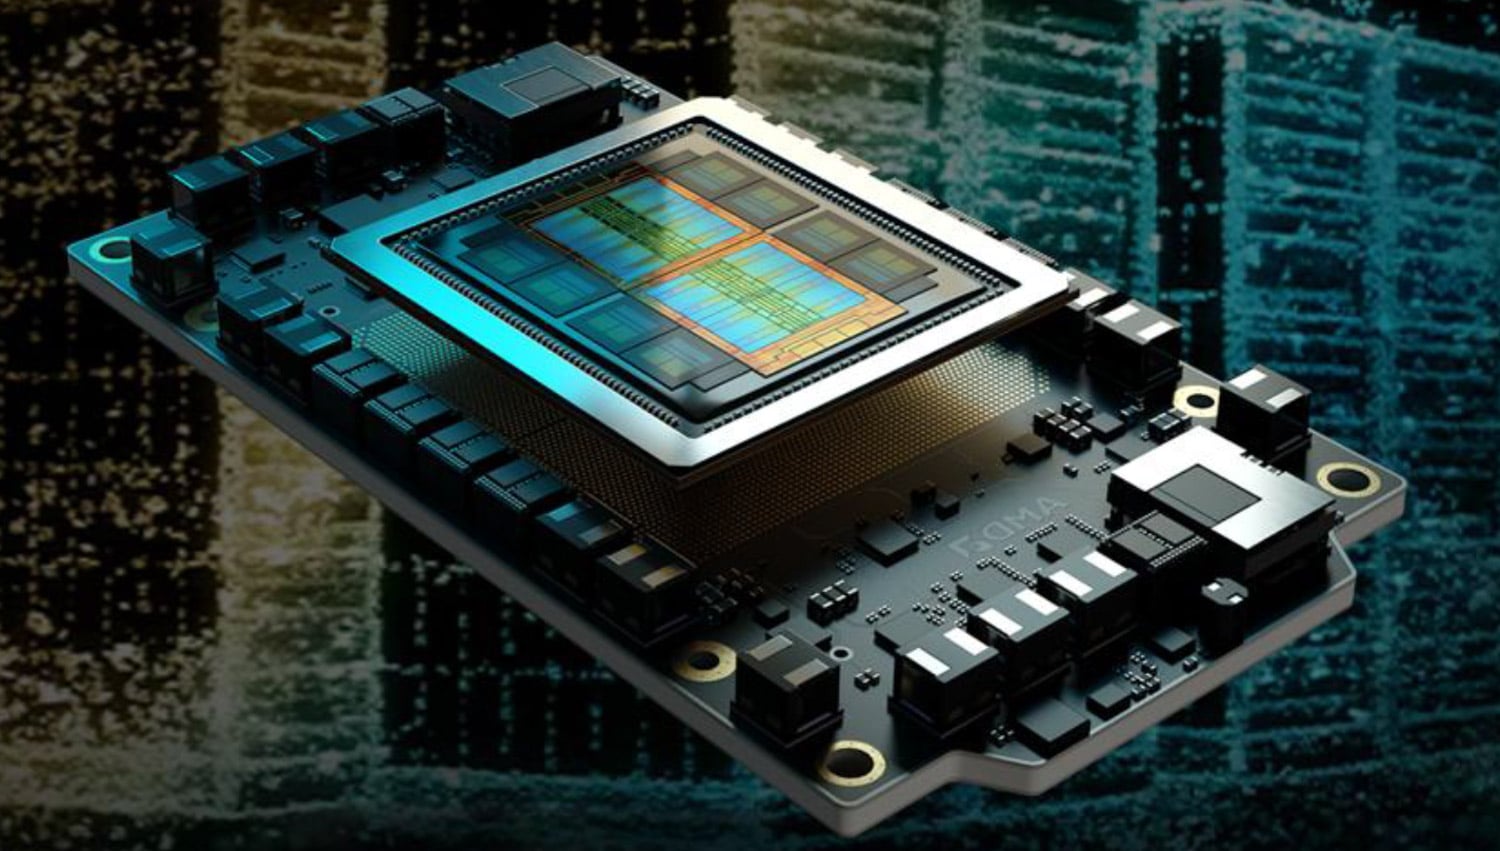
Los datos de caché KV almacenan información intermedia sobre el estado de atención generada durante la inferencia. Conservar estos datos mejora el rendimiento en interacciones de varios turnos y cargas de trabajo con contexto extenso, pero un gran volumen de caché puede consumir una cantidad significativa de memoria de la GPU. Externalizar o almacenar en niveles la caché KV en una plataforma de almacenamiento de alto rendimiento permite liberar memoria de la GPU para cargas de trabajo activas, manteniendo el contexto para solicitudes de inferencia posteriores.
VAST informó de pruebas preliminares con una GPU AMD Instinct MI355X que mostraron una mejora de 9 veces en el tiempo para obtener el primer token y un rendimiento de tokens 9.7 veces mayor al usar VAST para la descarga de caché KV en cargas de trabajo de IA agentes de alta concurrencia. La compañía señaló que estos resultados dependen de la configuración base del hardware, las características de la carga de trabajo y la configuración de almacenamiento.
La integración también aplica las políticas de ciclo de vida de VAST a los datos de caché KV. Esta funcionalidad tiene como objetivo que la información almacenada en caché caduque y se elimine automáticamente, lo cual es relevante cuando el contexto de inferencia contiene datos sensibles, personales o regulados.
Pensando Pollara 400 conecta GPU a almacenamiento compartido
La arquitectura utiliza la tarjeta de red AMD Pensando Pollara 400 AI para conectar las GPU AMD Instinct con el clúster de almacenamiento VAST. Según VAST, la tarjeta de red admite la transferencia de datos de la GPU al almacenamiento mediante NFS sobre TCP y RDMA, lo que permite el acceso a clústeres VAST basados en SSD NVMe para la caché KV y otros requisitos de datos de inferencia.
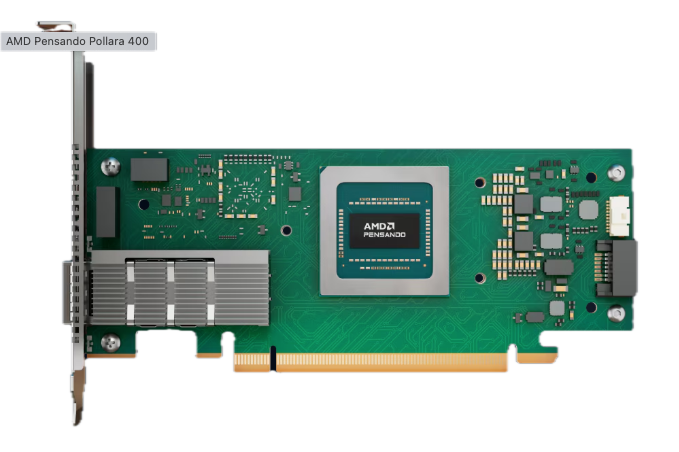
El diseño resultante está pensado para dar soporte a entornos de IA que necesitan escalar la gestión del contexto independientemente de la memoria de la GPU. En lugar de tratar el almacenamiento como una capa de persistencia independiente, VAST posiciona la plataforma como una capa de datos y ejecución capaz de gestionar modelos, bases de datos, datos en tiempo real, datos de archivos y contexto de IA en infraestructuras distribuidas.
Para los proveedores de servicios en la nube de IA, este enfoque busca una mayor utilización de la GPU y una mayor eficiencia operativa a medida que las implementaciones van más allá del alquiler de GPU y el entrenamiento por lotes, hacia la inferencia persistente y los servicios de IA basados en agentes.


 Amazon