

VAST Data ha lanzado una nueva arquitectura de inferencia compatible con la plataforma de almacenamiento de memoria de contexto de inferencia NVIDIA. Este sistema se centra en aplicaciones de IA que implican sesiones continuas multiturno controladas por agentes. VAST presenta esta plataforma como una clase de almacenamiento diseñada para IA, que mejora el acceso a la caché de clave-valor (KV), permite compartir rápidamente el contexto de inferencia entre nodos y mejora la eficiencia energética. El diseño utiliza DPU NVIDIA BlueField-4 y redes Ethernet Spectrum-X, mientras que el sistema operativo de IA VAST (AI OS) proporciona el software necesario para gestionar eficazmente este recurso de infraestructura compartida.
Para obtener más información sobre la importancia de KV Cache, consulte este análisis exhaustivo que realizamos con Pliops.
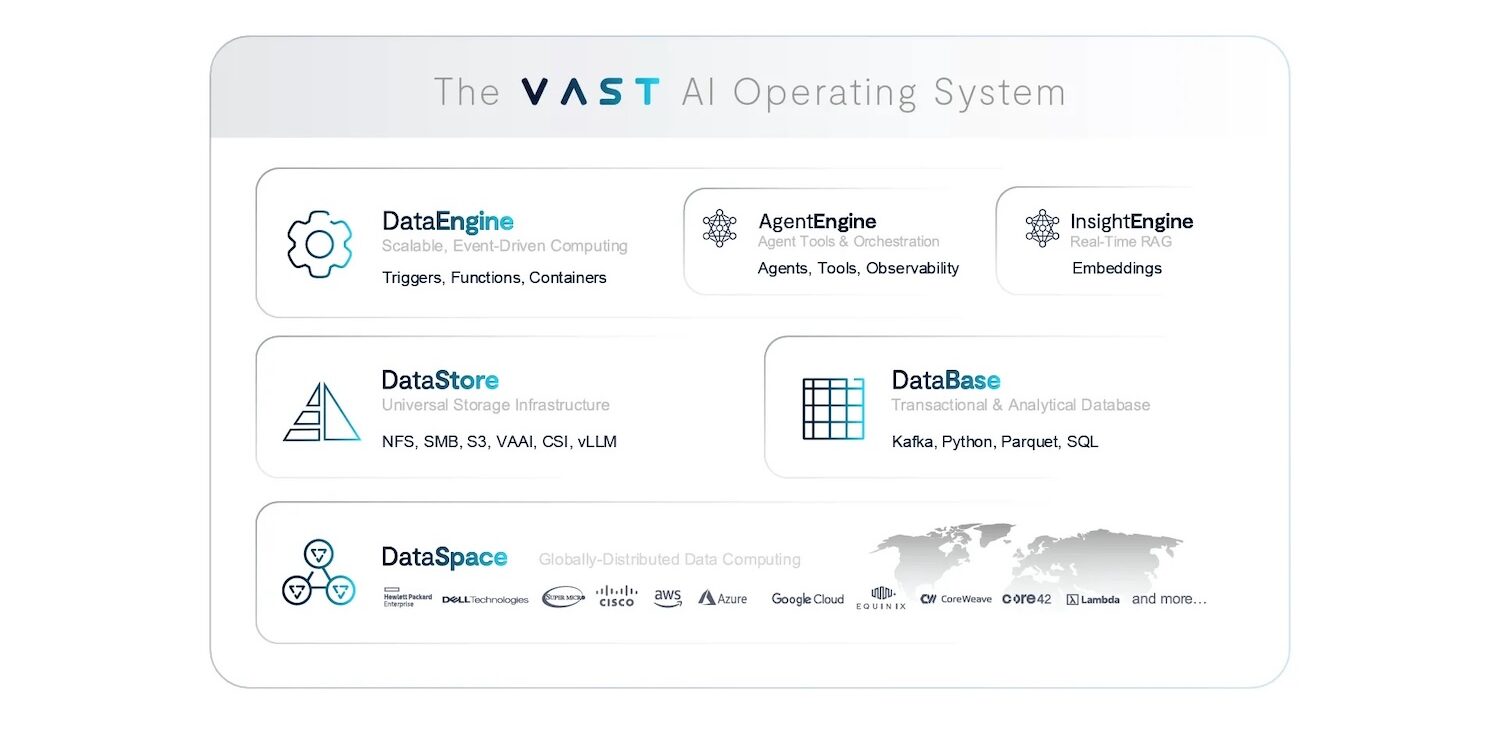
El anuncio señala un cambio en los factores que limitan el rendimiento de la inferencia en aplicaciones del mundo real. A medida que la inferencia evoluciona de simples indicaciones a un razonamiento continuo entre múltiples agentes y usuarios, la idea de que el contexto se mantiene dentro de un único servidor GPU queda obsoleta. En estas situaciones, el rendimiento general depende cada vez más de la calidad del almacenamiento, la restauración, la reutilización, la extensión y el intercambio del historial de inferencia durante las operaciones en curso. La caché KV evoluciona de una optimización interna a una ruta de datos principal, lo que afecta el tiempo hasta el primer token (TTFT), el uso de la GPU y la eficiencia del clúster.
Reconstrucción de la ruta de datos de inferencia alrededor de las DPU
La estrategia de VAST consiste en ejecutar el software VAST AI OS directamente en las DPU NVIDIA BlueField-4. En lugar de considerar los servicios de almacenamiento y contexto como componentes externos a los que se accede mediante un modelo cliente-servidor típico, la arquitectura integra estos servicios de datos directamente en el servidor GPU, donde se produce la inferencia, a la vez que admite configuraciones de nodos de datos dedicados. Este enfoque busca minimizar los cuellos de botella y eliminar las copias y los retrasos innecesarios que ralentizan el rendimiento a medida que aumenta la concurrencia.
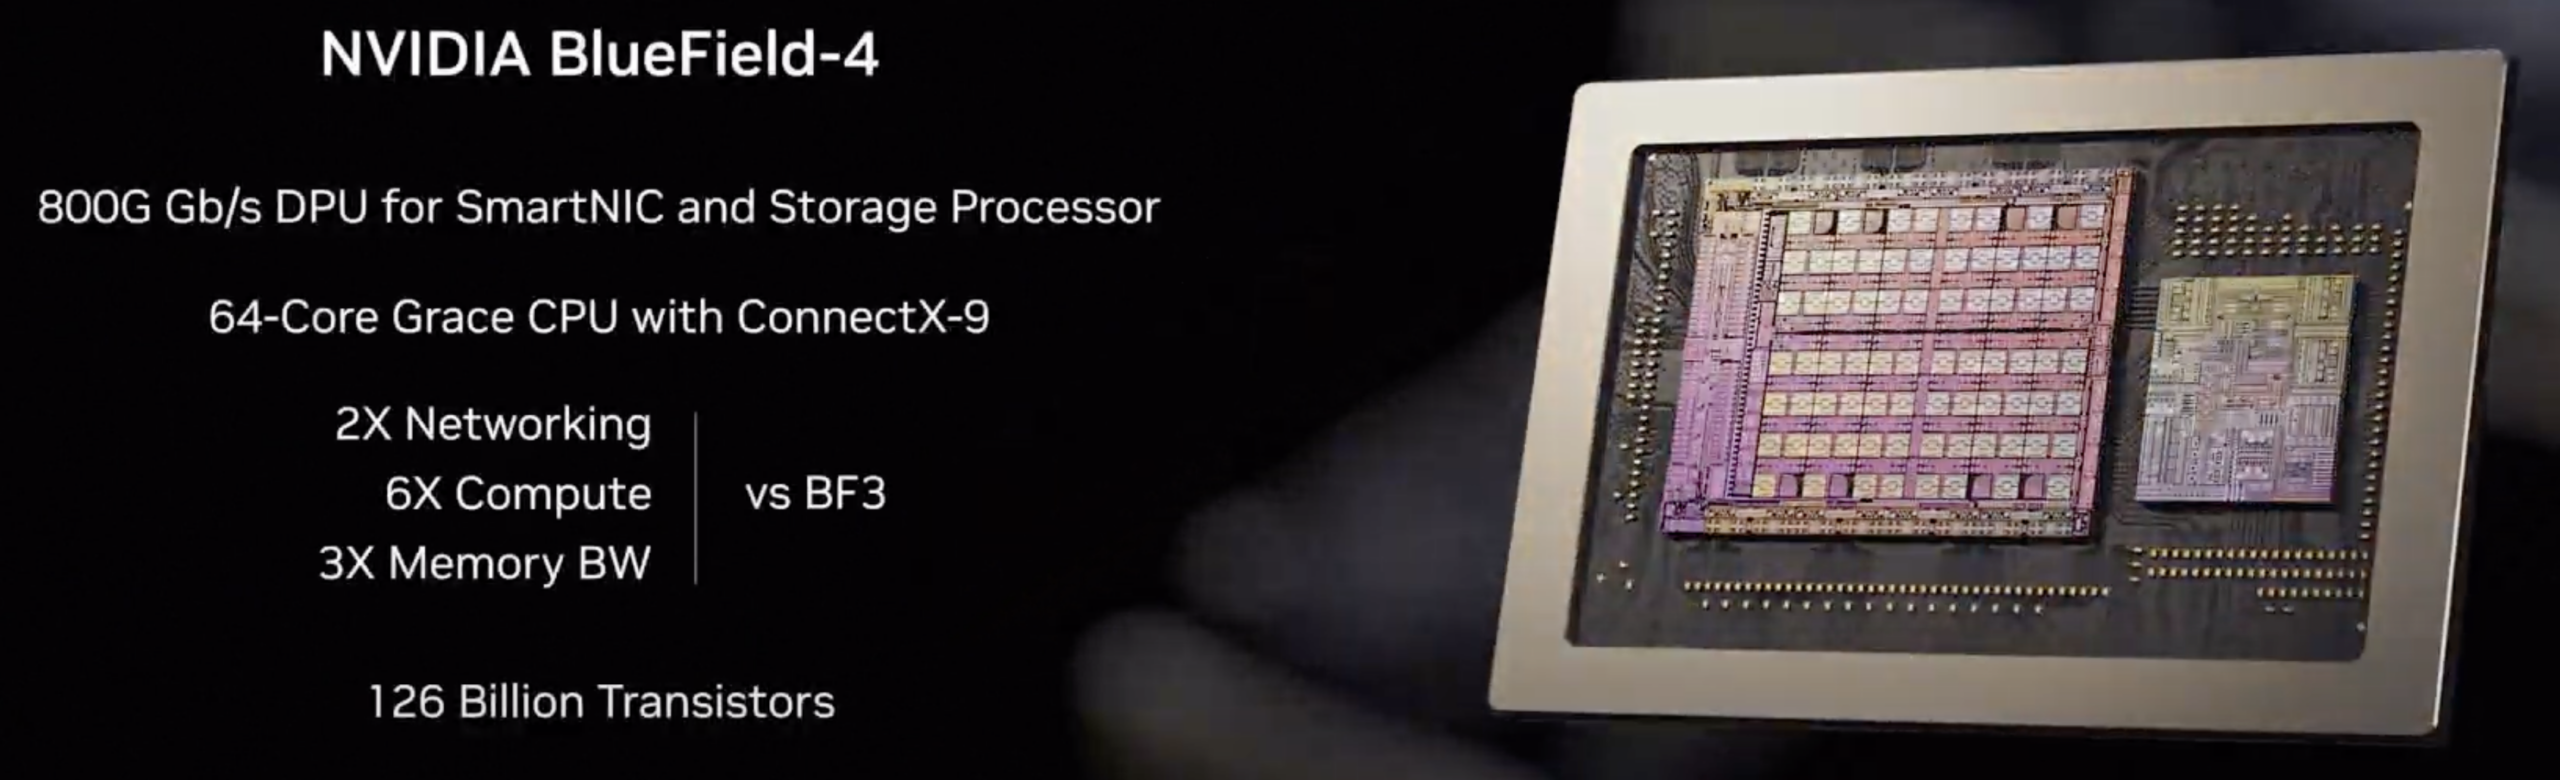
Este diseño nativo de DPU aborda explícitamente las necesidades prácticas de los grandes sistemas de inferencia. Cuando cientos o miles de sesiones se ejecutan simultáneamente, la gestión de la caché KV se convierte en un trabajo continuo de entrada/salida (E/S). El sistema debe leer rápidamente el contexto para mantener las sesiones activas, almacenarlo para uso a largo plazo y compartirlo entre los trabajadores para evitar el procesamiento duplicado cuando la infraestructura canaliza las operaciones por rutas más lentas o requiere una coordinación extensa. El TTFT aumenta, lo que provoca que las GPU esperen en lugar de procesar. VAST afirma que mover el plano de datos al servidor mediante BlueField-4 genera un tráfico de contexto más eficiente, mayor rendimiento y una latencia más fiable, más cerca del bucle de procesamiento de la GPU.
VAST también prioriza una ruta eficiente desde la memoria de la GPU al almacenamiento NVMe persistente mediante estructuras RDMA. Esto permite una transferencia fluida del contexto entre los servidores de la GPU y el almacenamiento, reduciendo la gestión repetitiva de datos, común en los sistemas tradicionales. El objetivo es garantizar que el movimiento del contexto se mantenga en sintonía con las redes de alto rendimiento, minimizando al mismo tiempo la intervención de la CPU y la sobrecarga del cliente.
Contexto compartido y coherente a escala
La nueva arquitectura funciona junto con el diseño paralelo de Todo Compartido Desagregado (DASE) de VAST. VAST explica que esto permite que cada host acceda a un espacio de nombres de contexto compartido y globalmente consistente sin los costos de coordinación que suelen surgir a gran escala. En la inferencia de larga duración basada en agentes, este detalle se vuelve crucial. El contexto no solo es extenso, sino que también se comparte cada vez más.
Los sistemas agenticos suelen requerir el uso simultáneo de herramientas, transferencias entre múltiples agentes y un comportamiento similar al de la memoria durante las interacciones. Esto exige reutilizar el contexto en lugar de recrearlo y compartirlo entre los trabajadores de inferencia, en lugar de vincularlo a un solo nodo. Si los sistemas no pueden mantener la localidad del contexto debido a la programación, el desalojo o la recuperación de fallos, deben restaurar y continuar las sesiones rápidamente sin reprocesar extensos historiales de solicitudes. De esta manera, la caché KV se transforma en un recurso vital del clúster, lo que reduce el reto a facilitar su acceso sin convertirse en un cuello de botella para la sincronización.
La perspectiva de VAST es que la combinación de servicios de datos basados en DPU con una configuración de almacenamiento compartido crea una capa de contexto accesible globalmente que mantiene su eficiencia a medida que aumenta el número de sesiones simultáneas. En lugar de escalar añadiendo secciones de contexto aisladas, la plataforma permite que los clústeres se expandan sin dejar de beneficiarse de la reutilización y el uso compartido.
El contexto como la nueva envolvente del rendimiento
John Mao, ejecutivo de VAST, señaló que la ventaja competitiva de los grandes sistemas de inferencia está cambiando de la mera potencia de cálculo a los sistemas de memoria y contexto. Resumió que los clústeres más eficaces no solo serán aquellos con el pico más alto de FLOPS, sino también aquellos capaces de compartir y gestionar el contexto en tiempo real. También destacó la importancia del acceso instantáneo y bajo demanda al contexto como un factor clave de rendimiento, advirtiendo que sin una rápida recuperación y reutilización del contexto, las GPU permanecen inactivas y la eficiencia se ve afectada.
Esta perspectiva coincide con la experiencia de muchos operadores a medida que los modelos escalan y la duración de las sesiones aumenta. Las flotas de inferencia suelen configurarse para maximizar la producción de tokens, pero la experiencia se ve afectada por la latencia de cola y el TTFT bajo presión. A medida que los avisos se alargan y las sesiones persisten, aumenta el tiempo dedicado a la gestión del contexto. Si el contexto no se puede restaurar o reutilizar rápidamente, se desperdician ciclos de GPU en restablecer el estado o esperar a que se transfieran los datos. El enfoque arquitectónico de VAST trata la caché KV como una infraestructura compartida, lo que reduce estos problemas y mejora la eficiencia general del clúster.
Pasando de la experimentación a la inferencia de producción gobernada
VAST también presenta la plataforma como una transición de implementaciones experimentales a servicios de inferencia listos para producción, incluso en entornos regulados. A medida que la inferencia se convierte en un servicio generador de ingresos con requisitos específicos de seguridad y cumplimiento, la gestión de la caché KV requiere más que velocidad; requiere supervisión.
En sesiones largas, el contexto puede incluir indicaciones sensibles, pasos de razonamiento, resultados de herramientas e información proporcionada por el usuario. Las empresas requieren cada vez más controles de políticas, medidas de aislamiento, registros de auditoría y gestión del ciclo de vida para dicho contexto. VAST afirma que estos servicios de datos nativos de IA están integrados en el sistema operativo de IA, lo que permite a las organizaciones tratar la caché de KV como un recurso gestionable en lugar de un estado temporal.
Desde una perspectiva operativa, VAST busca abordar los desafíos comunes en grandes entornos de inferencia: las tormentas de reconstrucción de contexto que ocurren cuando las cachés se pierden o no se pueden compartir, y el desperdicio de tiempo de GPU cuando el contexto se convierte en el cuello de botella en lugar del cómputo. La compañía cree que mejorar la persistencia y la reutilización del contexto reducirá el recálculo y aumentará el uso, mejorando así tanto el rendimiento por vatio como el rendimiento por dólar a medida que aumentan el tamaño del contexto y la concurrencia de sesiones.
NVIDIA: La gestión del contexto impulsa la economía de escalamiento
Kevin Deierling, vicepresidente sénior de Redes de NVIDIA, enfatizó la importancia del contexto en la IA, comparándolo con la memoria humana. Afirmó que gestionar el contexto eficazmente es esencial para escalar la inferencia multiturno y multiusuario, lo que a su vez cambia la forma en que se gestiona la memoria de contexto a escala. Señaló que VAST Data AI OS, en combinación con NVIDIA BlueField-4, facilita esto al proporcionar una ruta de datos estable y de alto rendimiento a medida que aumentan las cargas de trabajo. Esta colaboración es importante porque integra las DPU y la estructura Ethernet en el contexto de inferencia principal, no solo para el acceso al almacenamiento principal o la red. El punto clave es que el contexto ahora representa un desafío tanto para la red como para el almacenamiento, además de ser un problema de la GPU, y las configuraciones de inferencia modernas requerirán una aceleración enfocada y un movimiento de datos confiable para mantener las GPU funcionando eficientemente.
Si la arquitectura de VAST ofrece los beneficios prometidos, el efecto real se centrará menos en las puntuaciones máximas de referencia y más en la consistencia del rendimiento del servicio: menor TTFT cuando hay muchas sesiones activas, menos caídas de rendimiento a medida que aumenta el contexto, mejor utilización al reducir la reconstrucción del contexto y una ruta más directa hacia la inferencia multinodo, donde compartir el contexto es una ventaja en lugar de una desventaja. Además, impulsa la infraestructura de inferencia hacia un modelo más "nativo de IA", que trata la caché KV como un nivel de memoria gestionada, compatible con NVMe persistente y compartida entre nodos con límites de latencia estrictos.
Conferencia VAST Forward
VAST Data presentará su estrategia en la primera conferencia de usuarios VAST Forward, que se celebrará del 24 al 26 de febrero de 2026 en Salt Lake City, Utah. La compañía tiene previsto ofrecer sesiones técnicas detalladas, laboratorios prácticos y programas de certificación, con la participación de directivos , clientes y socios de VAST .


 Amazon