

El ASUS ExpertCenter Pro ET900N G3 es la segunda estación GB300 DGX que hemos probado y la primera que hemos tenido en nuestras manos en el laboratorio; nuestras pruebas del MSI XpertStation WS300 se realizaron de forma remota. Utiliza el mismo silicio NVIDIA que probamos en el MSI XpertStation WS300: un Grace Blackwell Ultra Desktop Superchip con 72 núcleos Grace, una GPU B300, 252 GB de HBM3e, 496 GB de LPDDR5X y una ConnectX-8 SuperNIC con dos puertos 400 GbE. ASUS integra esa plataforma central fija en una torre compacta diseñada para IA de escritorio, añadiendo algunos detalles que no se encuentran en el WS300: dos asas de transporte en la parte superior, un ventilador dedicado dirigido a las jaulas ópticas ConnectX-8 y una fuente de alimentación de 1,600 W con certificación 80 PLUS Titanium.
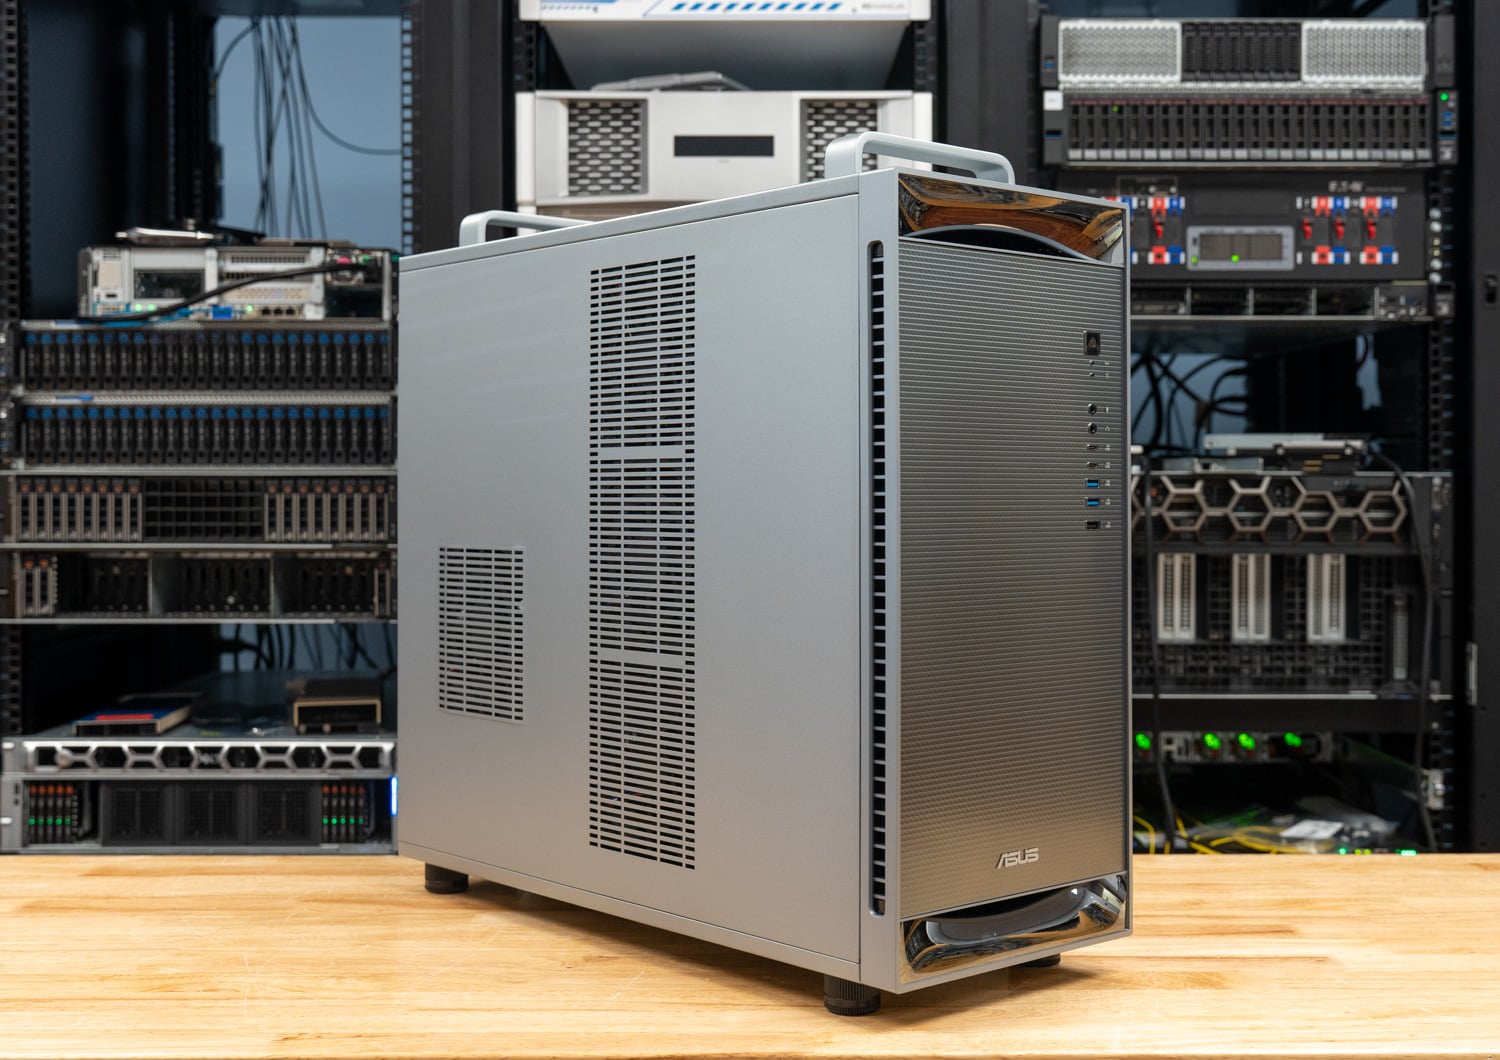
ASUS envió el ET900N G3 al laboratorio durante aproximadamente una semana para realizar pruebas de rendimiento, fotografía y comprobaciones físicas, con una RTX PRO 2000 instalada. En cuanto a la plataforma en sí, la placa base B300, Grace, NVLink-C2C, MIG y la función de la estación DGX, el análisis del WS300 cubre todos esos aspectos. Este análisis se centra en lo que ASUS ha desarrollado en torno al Superchip y en si su rendimiento se mantiene a la altura del de la primera torre GB300 que probamos.
Especificaciones del ASUS ExpertCenter Pro ET900N G3
| Especificación | ASUS ExpertCenter Pro ET900N G3 |
|---|---|
| Descripción general de la plataforma | |
| superchip | NVIDIA GB300 Grace Blackwell Ultra Superchip de escritorio |
| CPU | NVIDIA Grace, 72 núcleos Arm Neoverse V2 |
| GPU | NVIDIA Blackwell Ultra (B300), hasta 20 PFLOPS NVFP4 con dispersión |
| Interconexión CPU-GPU | NVLink-C2C, bidireccional de 900 GB/s |
| Salud Cerebral | |
| Memoria coherente | 748GB |
| Memoria de la GPU | 252 GB HBM3e, 7.1 TB/s |
| Memoria de la CPU | 496 GB LPDDR5X, 396 GB/s, 4x SOCAM |
| Almacenaje | |
| Unidades de arranque | 2x M.2 2280 PCIe 5.0 x4 (clave M), con 2x NVMe de 2TB en RAID 1. |
| Unidades de expansión | 2 ranuras M.2 2280 (clave M), PCIe 6.0 x4 según ASUS, abiertas de fábrica. |
| Networking | |
| SuperNIC | NVIDIA ConnectX-8, 2x QSFP112 400GbE |
| Ethernet | 1x Marvell 10GbE 1x Realtek 1GbE (BMC) |
| Expansión | |
| Ranuras PCIe | 1 x PCIe 5.0 x16 2x PCIe 5.0 x16 (señales x8) |
| GPU adicional | Hasta una tarjeta NVIDIA RTX PRO Blackwell; la unidad de prueba se envió con una RTX PRO 2000 Blackwell. |
| I / O | |
| Frente | 2 puertos USB 10 Gbps Tipo-C 2 puertos USB de 10 Gbps tipo A 1x USB 2.0 Conectores para auriculares y micrófono |
| Atrás | 4 puertos USB de 10 Gbps tipo A 1 puerto Micro-USB COM (consola serie BMC) 1x Mini DisplayPort (BMC) 3 conectores de audio |
| Gestión y seguridad | |
| BMC | ASPEED AST2600 con firmware AMI MegaRAC, IPMI y Redfish |
| Seguridad | TPM 2.0 integrado |
| Energía y enfriamiento | |
| Alimentación eléctrica | 1 fuente de alimentación ATX de 1,600 W, 80 PLUS Titanium |
| Enfriamiento | Refrigeración líquida AIO de circuito cerrado (según ASUS) con placas frías en el GB300, SOCAMM y ConnectX-8; radiadores frontales y superiores, ventilador trasero del chasis, ventilador dedicado sobre las jaulas QSFP112. |
| Temperatura de Funcionamiento | 10C a 35C |
| Software y factor de forma | |
| Sistema operativo | Ubuntu con herramientas de desarrollo de IA de NVIDIA; ASUS afirma que se planea ofrecer soporte para el desarrollo de IA basado en Windows. |
| Dimensiones | 584 x 232 x 565 mm (23.0 x 9.1 x 22.3 pulgadas), según lo especificado por ASUS. |
| Peso | 27 kg netos, 32 kg brutos |
Diseño y construcción
ASUS viste el ET900N G3 como una estación de trabajo empresarial, con un chasis plateado cepillado, un frontal de malla oscura, una tapa y una base con detalles cromados, y el logotipo de ASUS en la parte inferior del frontal. Las proporciones son las que dicta la plataforma: 584 x 232 x 565 mm según la lista de ASUS, lo que resulta un poco más alto y ligeramente más estrecho que el WS300, que mide 529 mm de alto, 570 mm de profundidad y 246 mm de ancho. Con 27 kg, no es un sistema que se mueva con facilidad, y ahí es donde entra en juego la primera decisión específica de ASUS. Dos asas metálicas en el borde superior, una en la parte delantera y otra en la trasera, permiten que dos personas levanten la torre y la coloquen sobre un escritorio o en un carrito sin tener que sujetar los paneles. Parecen un poco fuera de lugar en un equipo de oficina hasta que uno tiene que transportar una torre GB300 por un laboratorio.
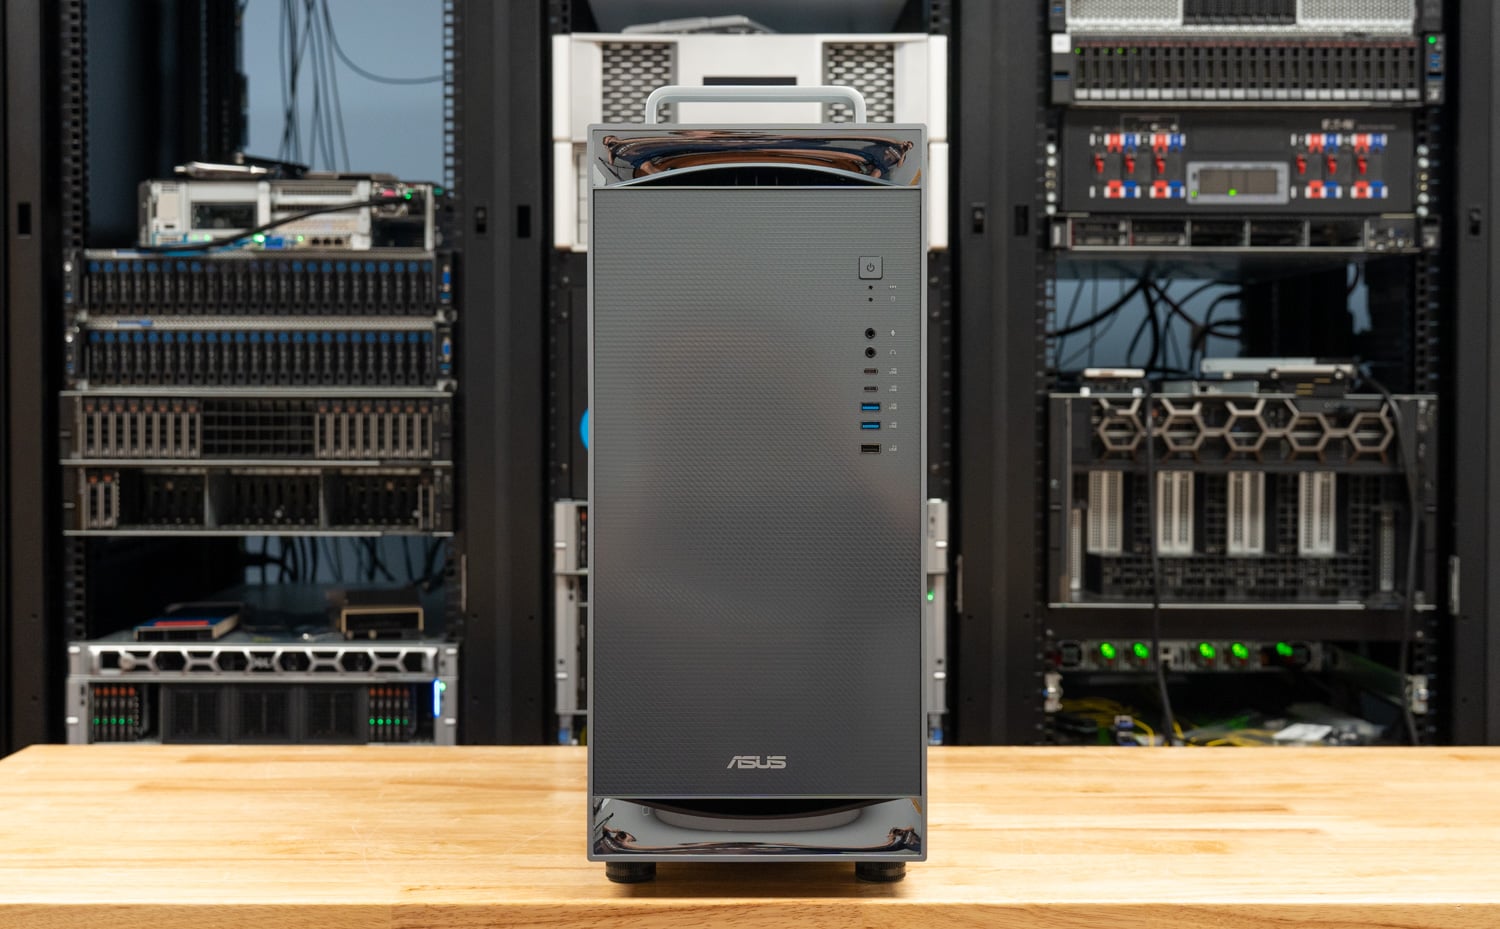
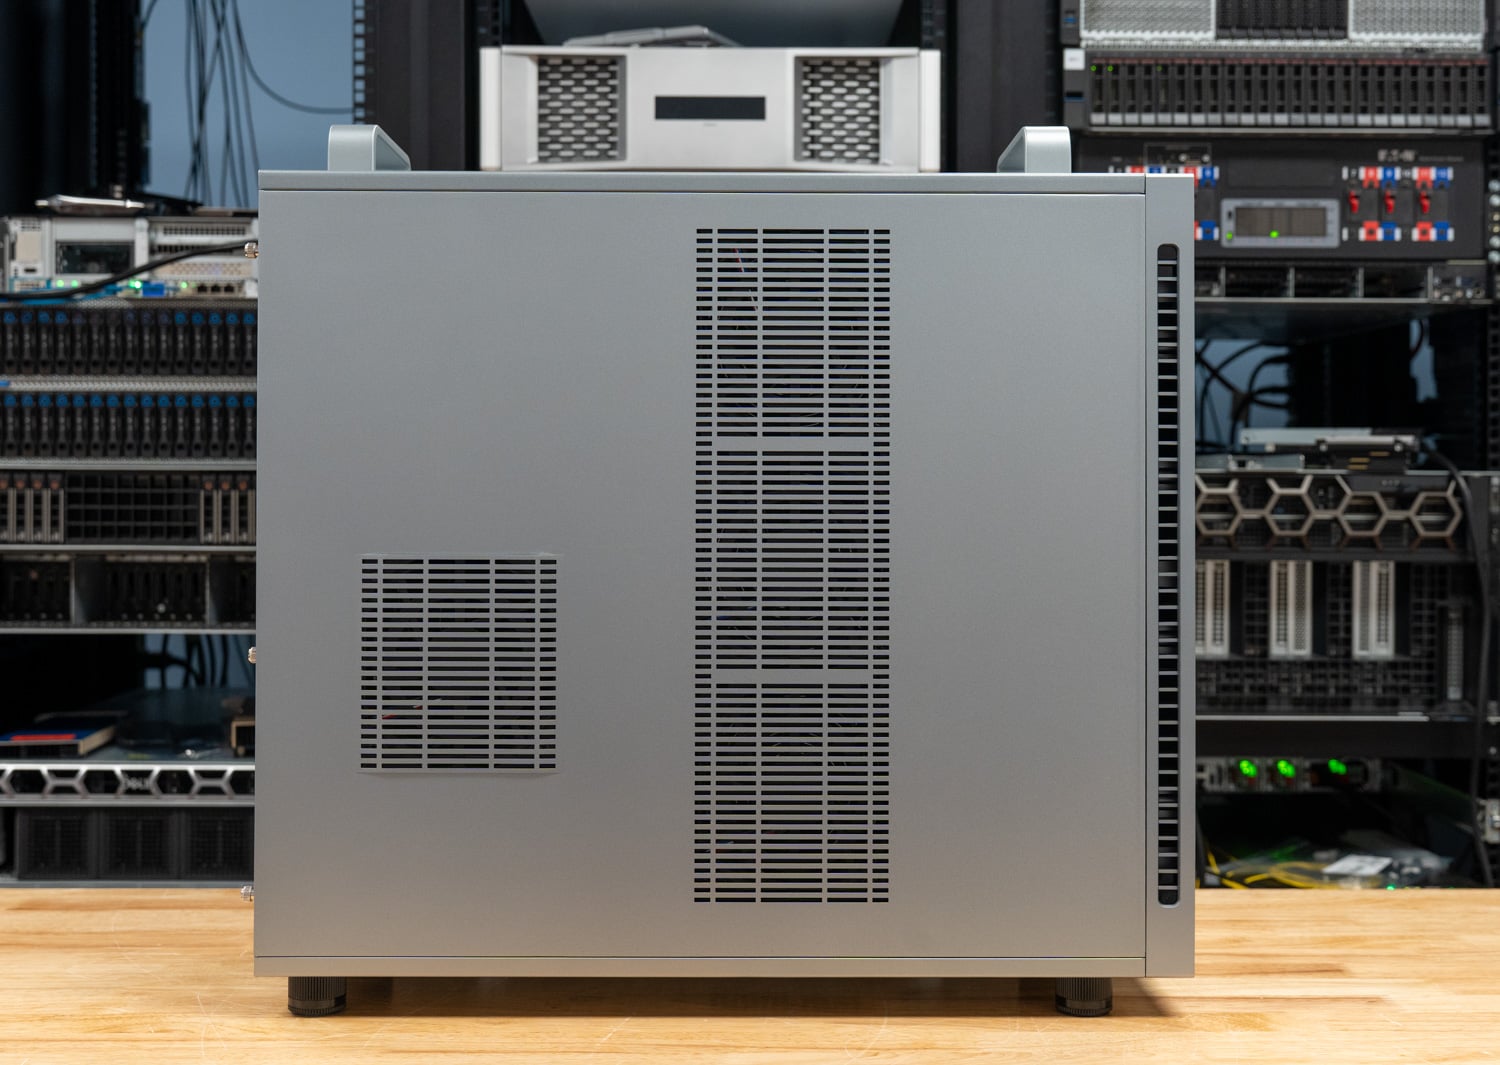
El panel frontal incluye el botón de encendido, dos puertos USB tipo A de 10 Gbps, dos puertos USB tipo C de 10 Gbps, un puerto USB 2.0 y conectores separados para auriculares y micrófono, todos dispuestos en una franja vertical en la parte superior derecha de la rejilla. El panel lateral es una gran placa ventilada, con una columna perforada alargada hacia el frente para la entrada de aire del radiador y una rejilla cuadrada más pequeña hacia la parte posterior que se alinea con los ventiladores del sistema. No tiene ventana ni iluminación, lo cual se ajusta a las necesidades del comprador objetivo.
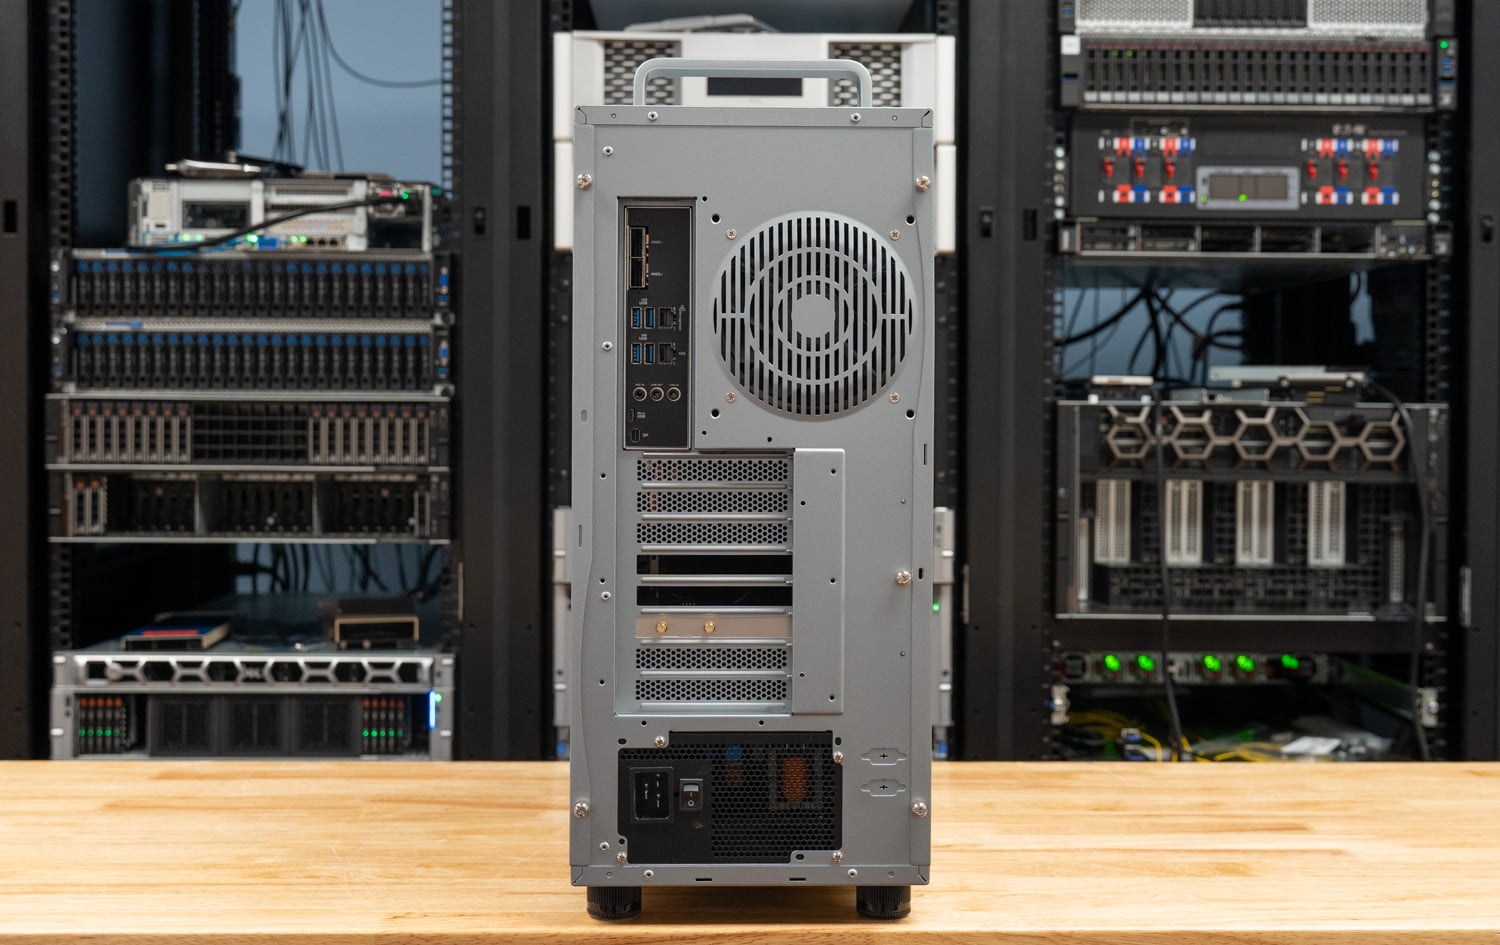
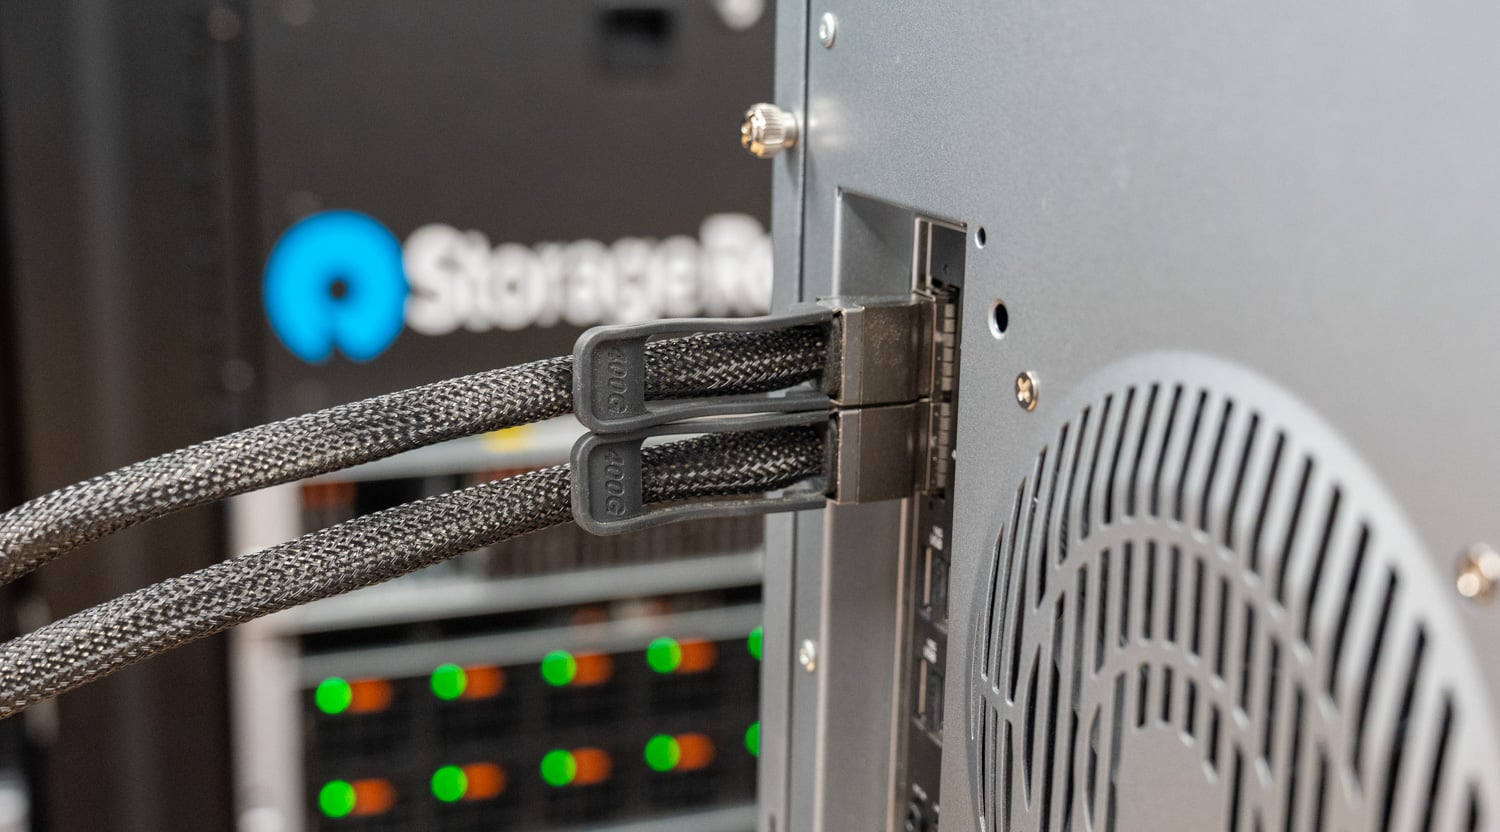
En la parte posterior, la disposición separa la E/S de la estación de trabajo del hardware del servidor que se encuentra debajo. El grupo superior contiene los cuatro puertos USB Tipo A de 10 Gbps, los conectores RJ45 de 10 GbE y 1 GbE, los tres conectores de audio, el puerto de consola Micro-USB del BMC y el Mini DisplayPort que el BMC controla para la configuración. Las dos jaulas QSFP112 para ConnectX-8 se encuentran en la parte superior del panel de E/S; un ventilador de extracción se ubica junto a ellas; las tres tapas de las ranuras de expansión se extienden a lo largo del centro; y la fuente de alimentación con su entrada C19 se encuentra en la parte inferior. Al igual que en el WS300, el Mini DisplayPort es una salida del BMC para la configuración inicial y la resolución de problemas; cualquier persona que desee un escritorio en esta máquina necesita la tarjeta RTX PRO.
Interior del ET900N G3
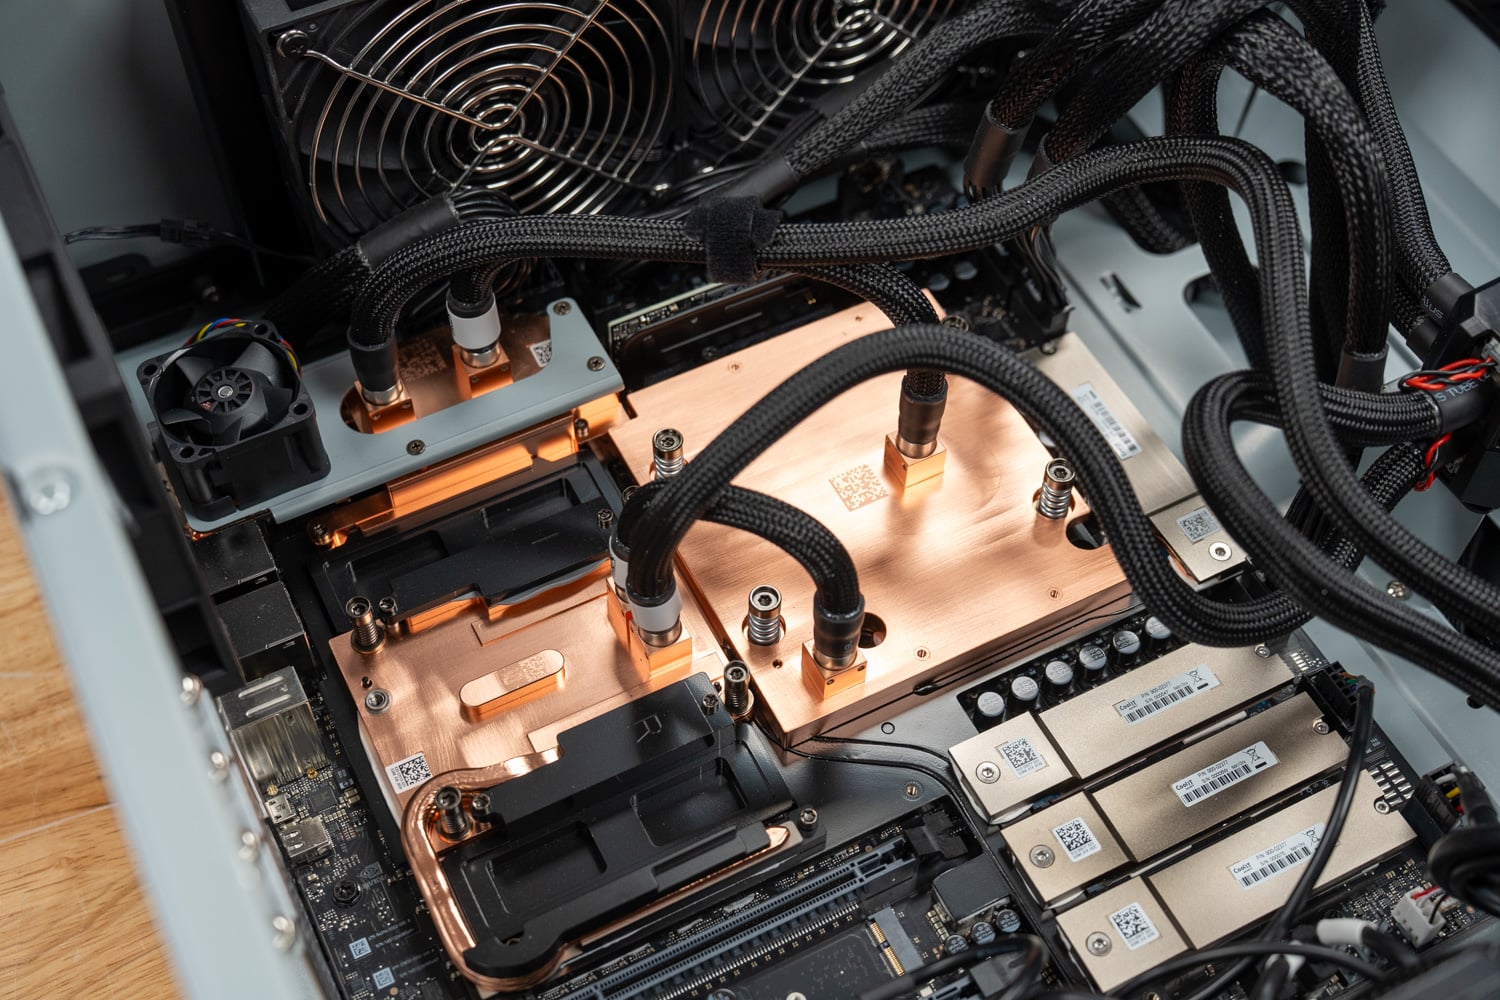
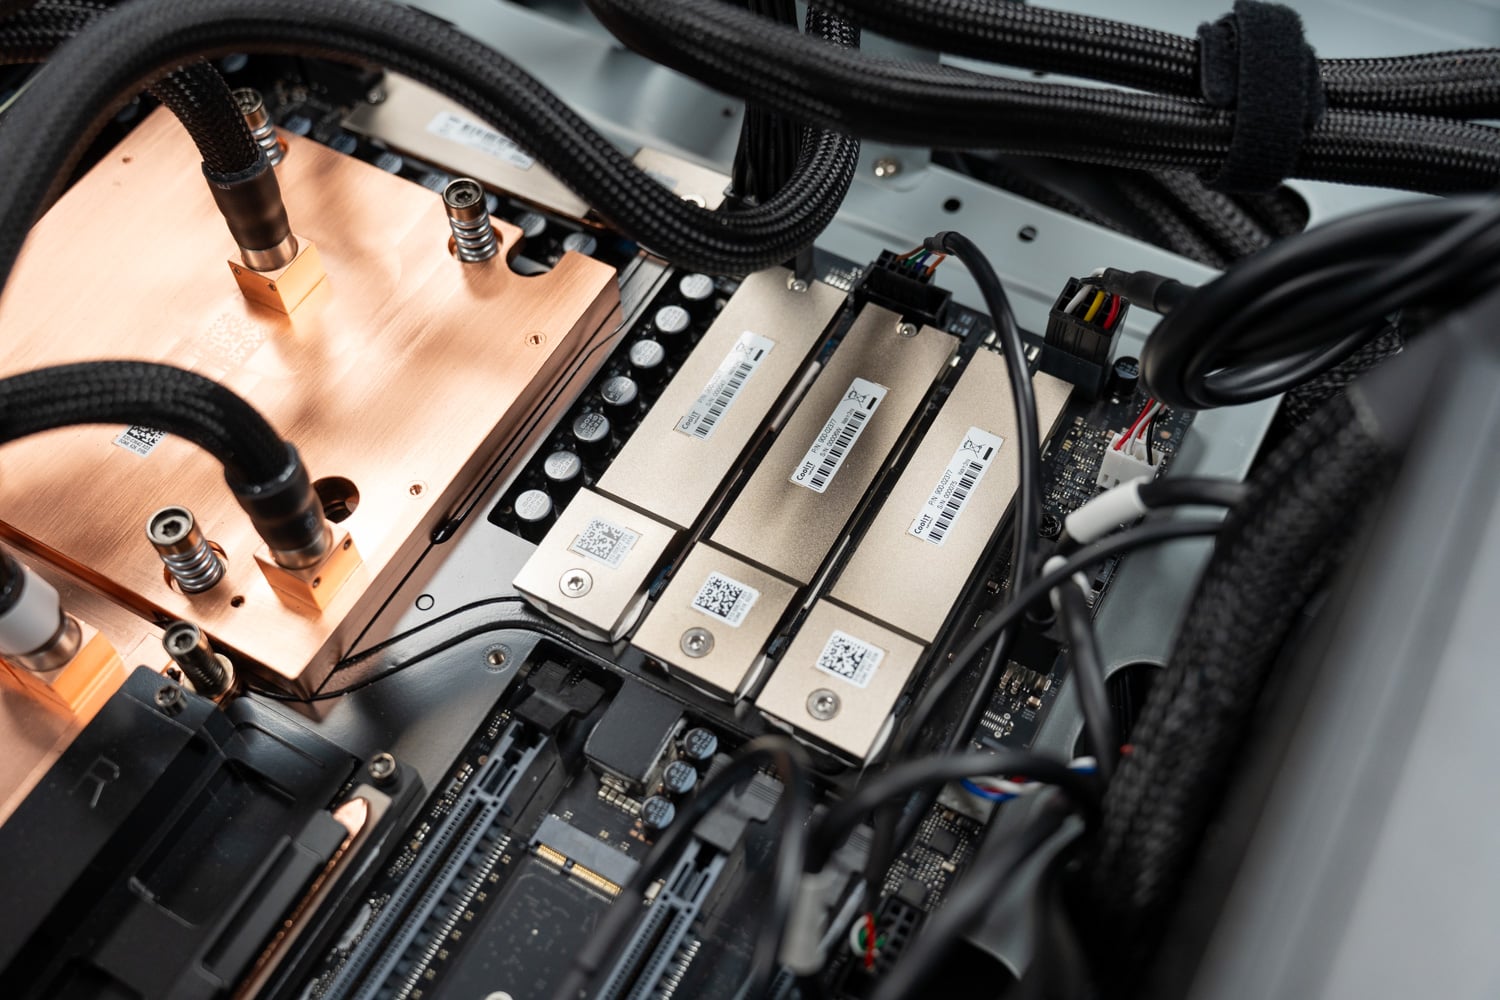
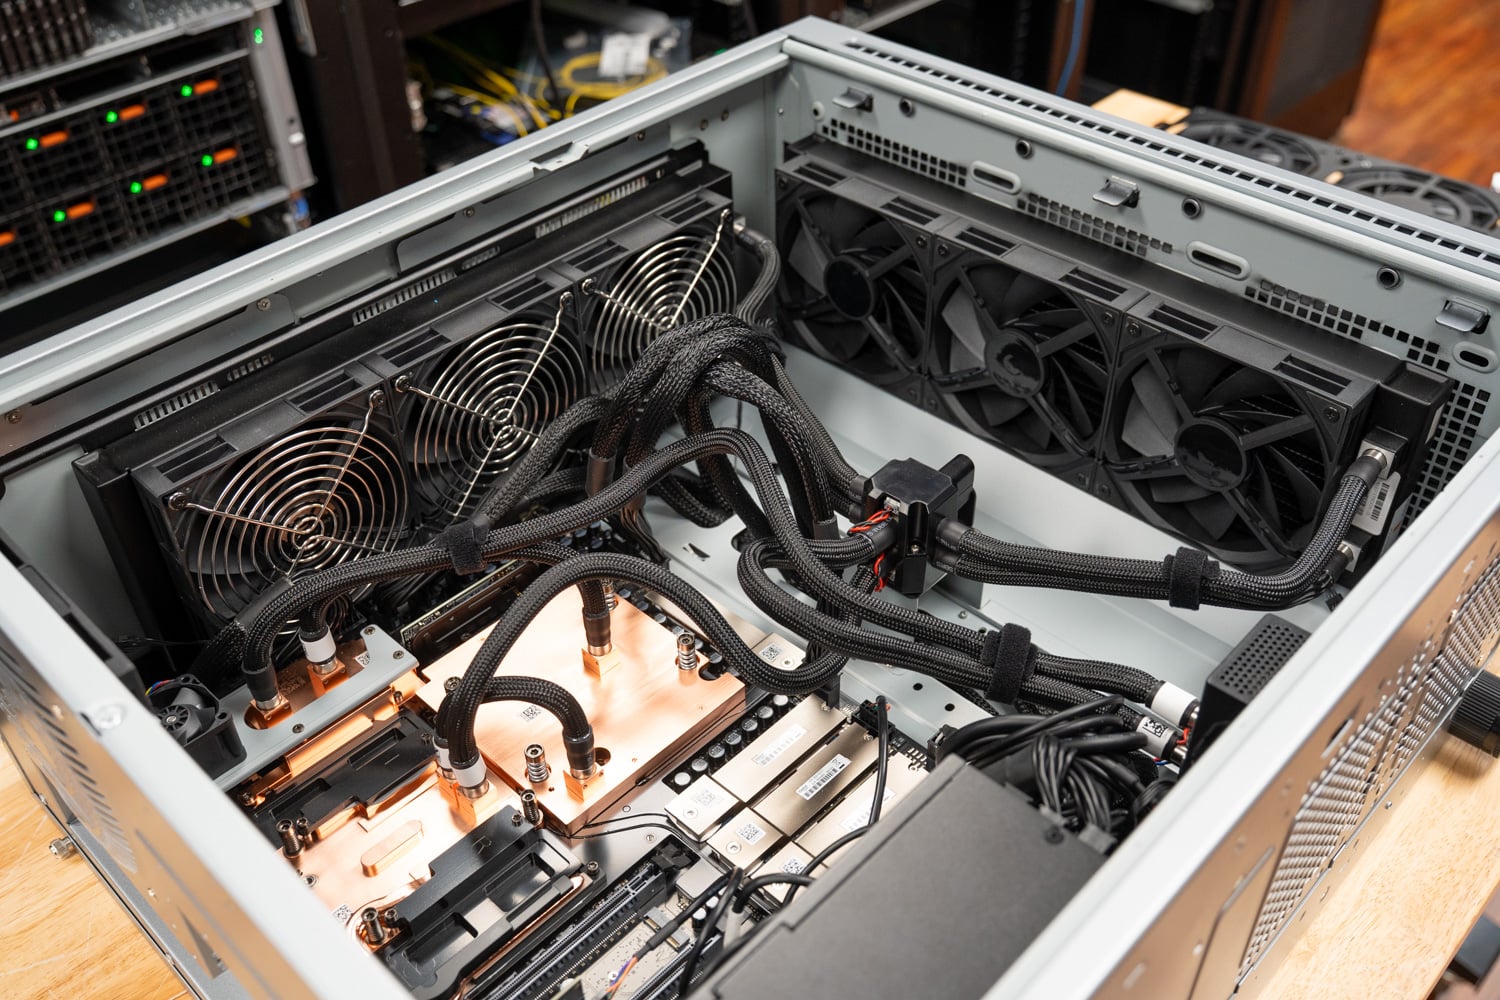
Con el panel lateral retirado, el ET900N G3 parece ser un pariente cercano del WS300, lo cual es de esperar, dado que ambos comparten la misma placa base NVIDIA. El GB300 Superchip se encuentra bajo un conjunto de placa fría de cobre en el lado izquierdo del chasis, con los módulos SOCAMM bajo sus propias placas de cobre a su lado y el ConnectX-8 bajo un tercer bloque cerca de la parte trasera de E/S. Tubos trenzados van desde los bloques hasta un colector de distribución montado en el travesaño del chasis, y de ahí a los radiadores. Las tres ranuras PCIe de longitud completa se encuentran debajo del Superchip, la fuente de alimentación ocupa la esquina frontal inferior y una cubierta metálica cubre el recorrido de los cables a lo largo de la parte inferior.
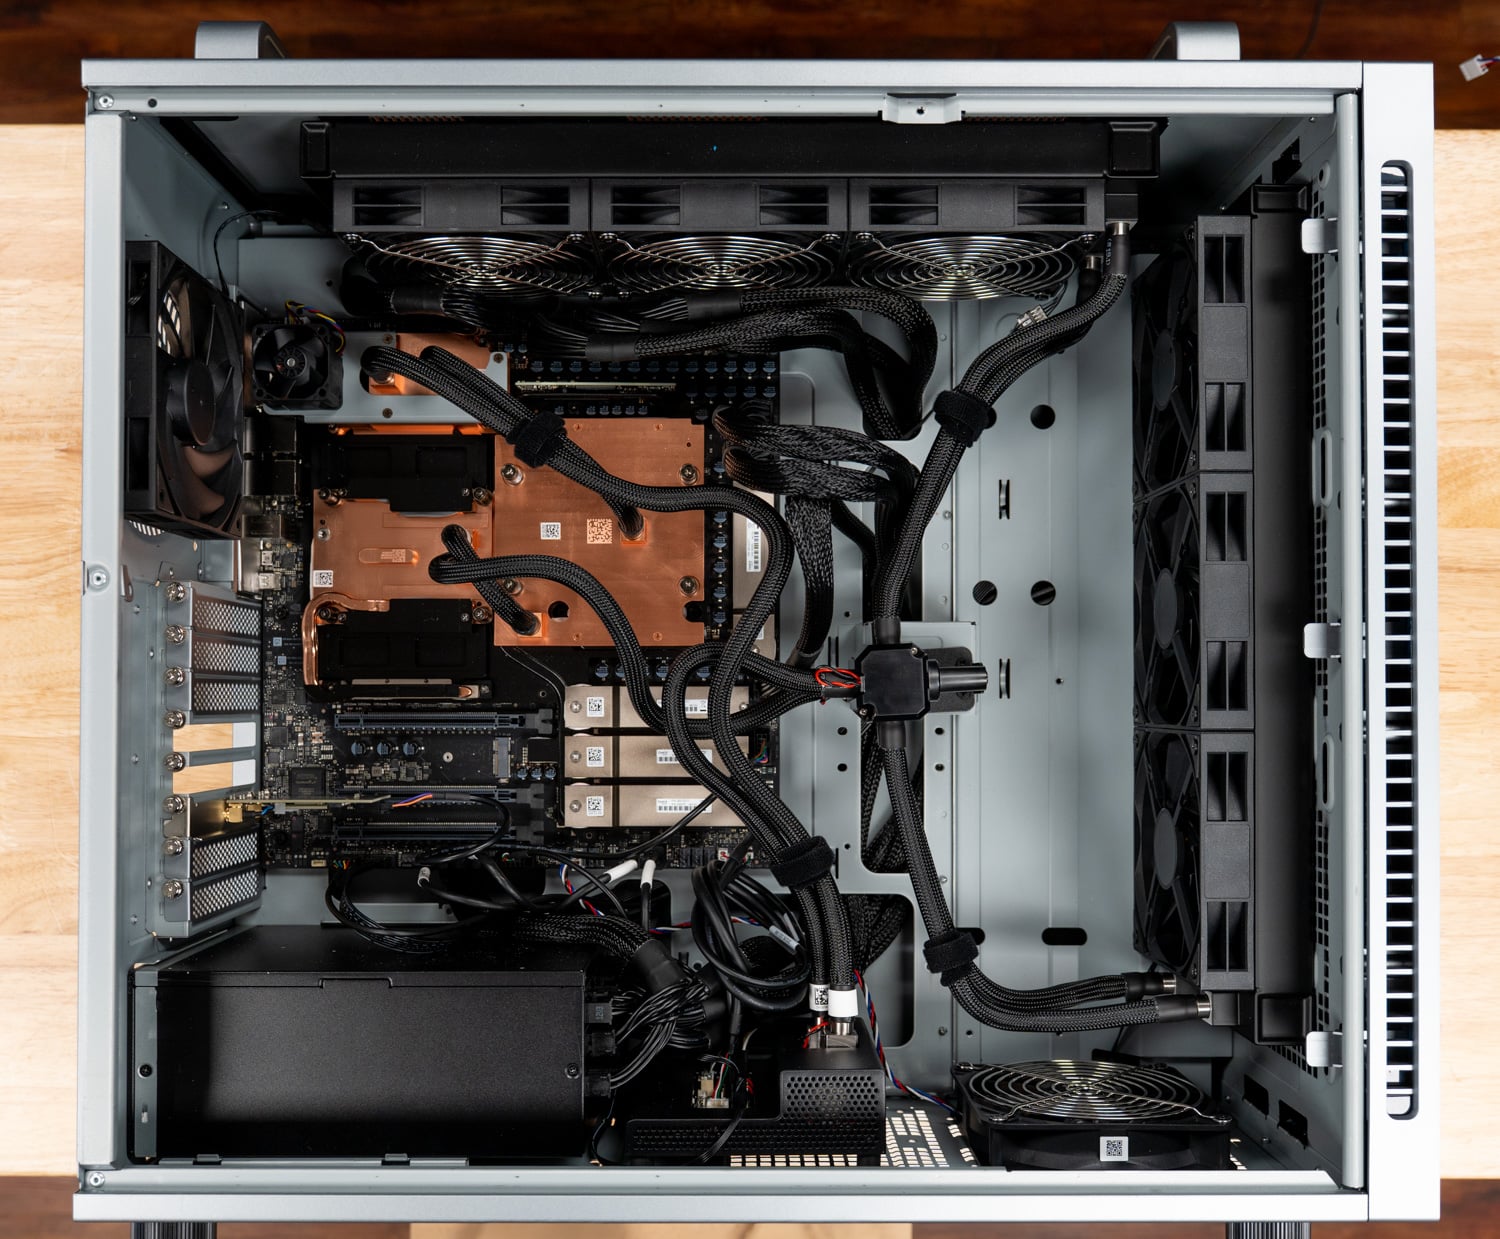
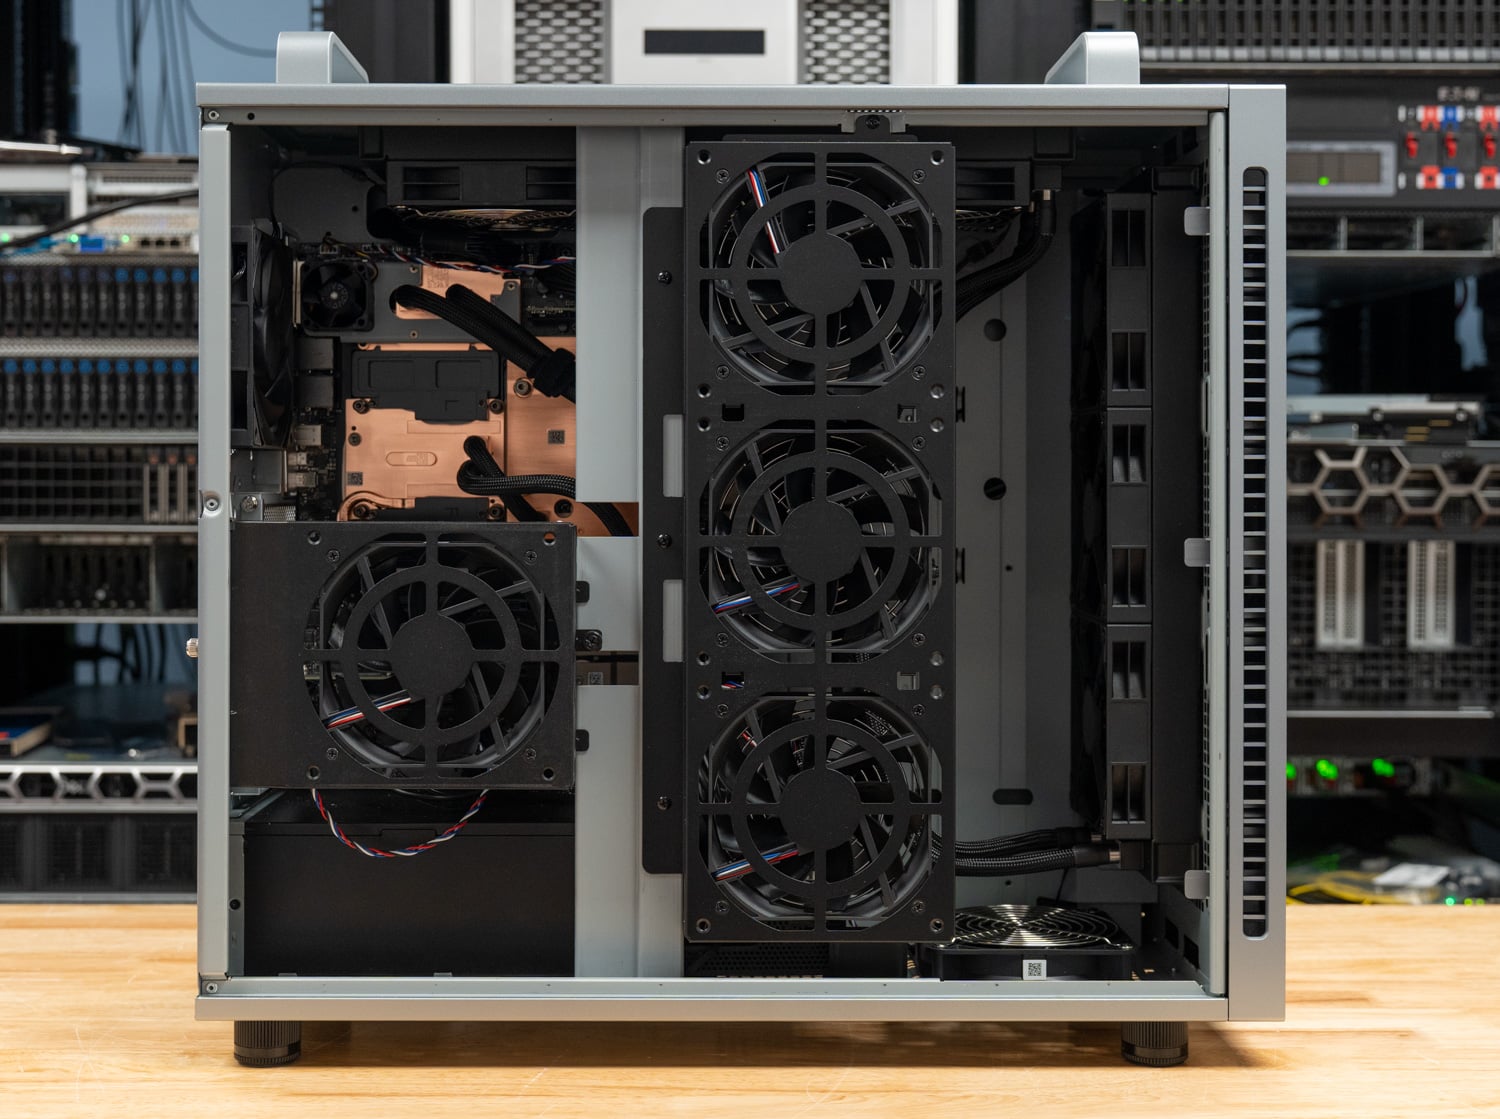
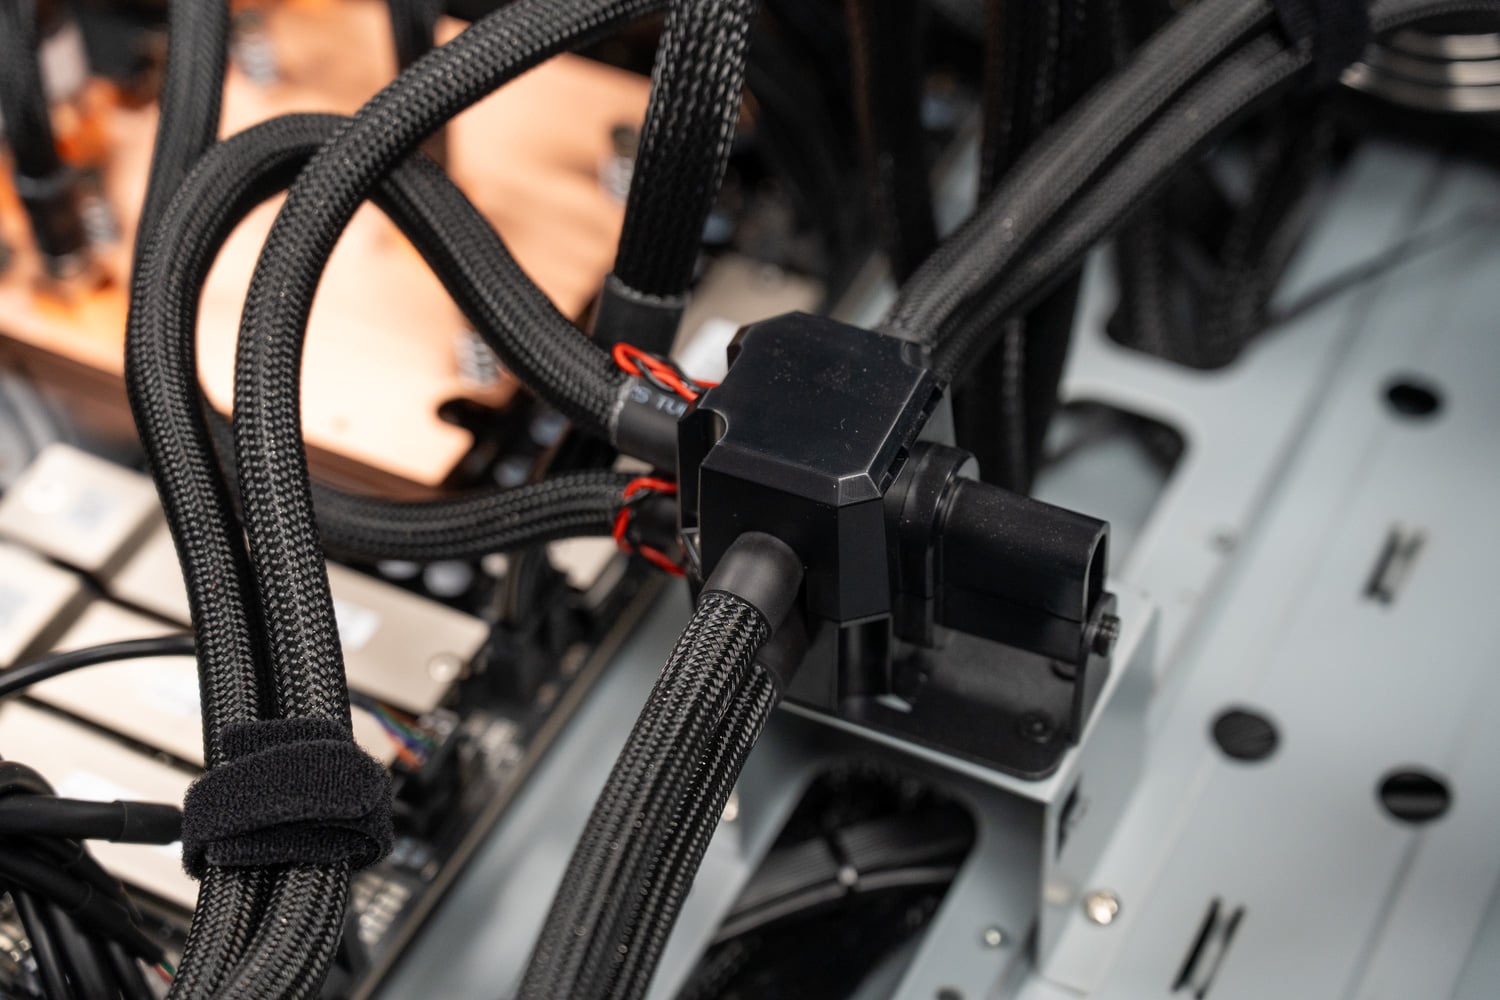
La disposición interna sigue el mismo patrón que la WS300: un radiador montado verticalmente detrás de la rejilla frontal y un segundo en la parte superior, cada uno con una fila de ventiladores, además de un ventilador de chasis en la parte trasera. Las líneas de refrigerante están protegidas con fundas y sujetas al travesaño con correas de velcro, y el colector consolida los conductos de las cuatro placas de refrigeración de manera que solo dos líneas llegan a cada radiador.
El ventilador óptico
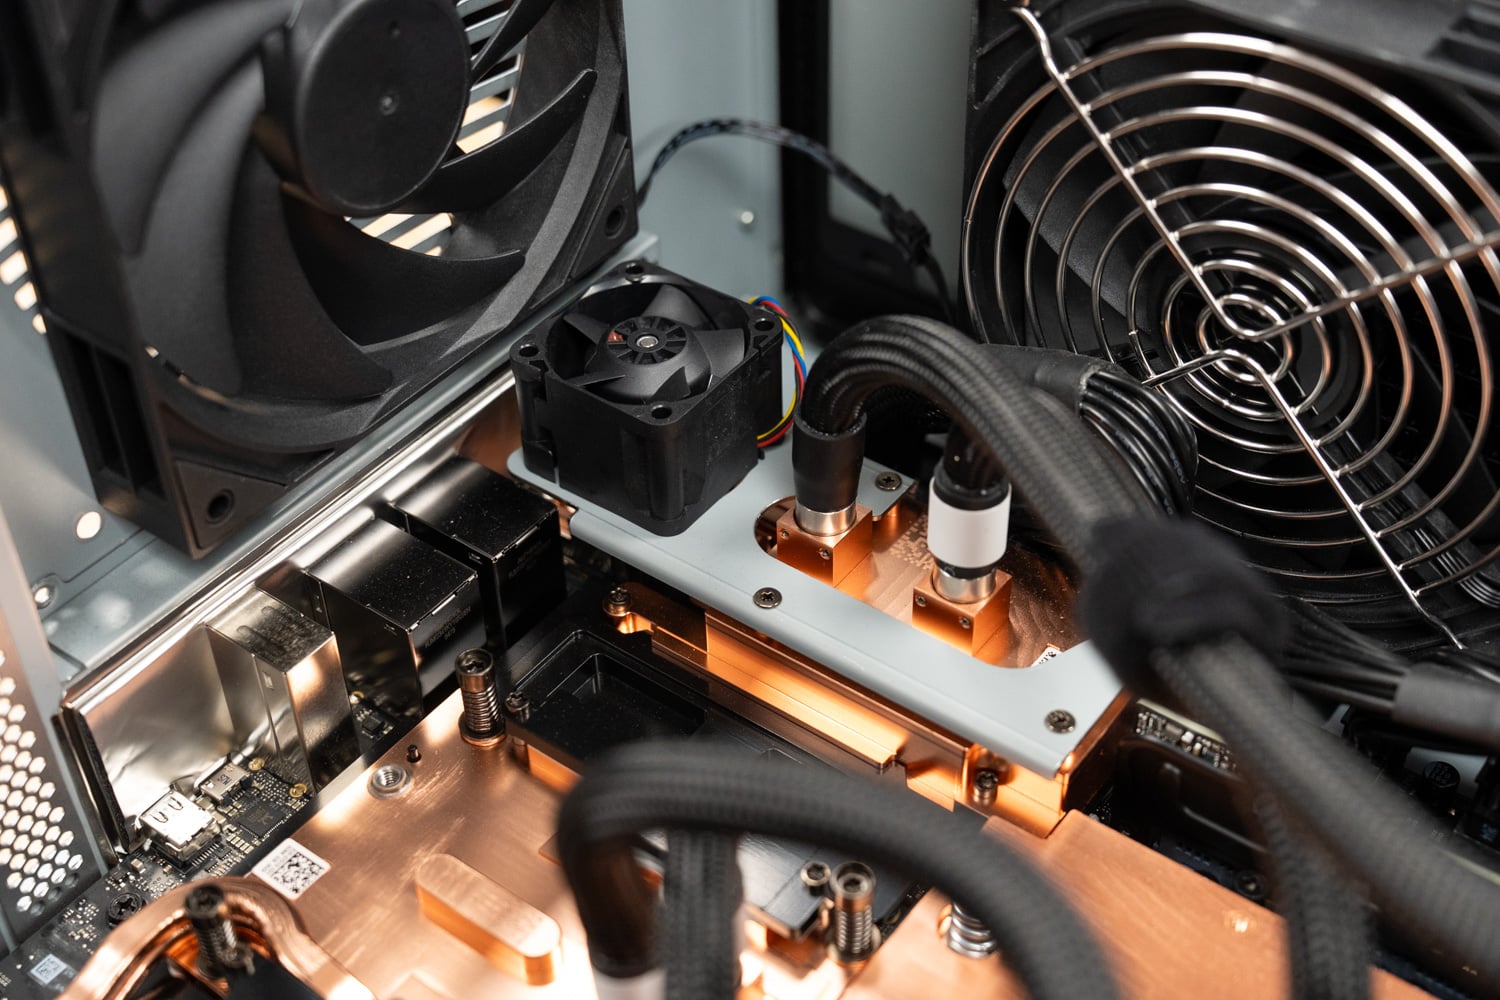
El único elemento de refrigeración que no tiene equivalente en el WS300 es un pequeño ventilador montado en un soporte sobre la placa fría ConnectX-8, dirigido a las jaulas QSFP112. El circuito líquido se encarga del silicio SuperNIC, pero los transceptores ópticos de 400G generan su propio calor y se encuentran en jaulas metálicas a las que la placa fría solo puede llegar por conducción. En otras pruebas , hemos observado que el ConnectX-8 se calienta bajo carga sostenida y que la óptica en sí misma puede alcanzar altas temperaturas, por lo que una ruta de flujo de aire dedicada a través de las jaulas es un elemento de diseño útil para cualquiera que planee usar el ET900N G3 en fibra durante horas seguidas. Con los DAC, que es como lo cableamos a una segunda estación GB300 para un análisis exhaustivo de inferencia en clúster que aún está en curso, el ventilador tiene menos trabajo.
Almacenamiento, expansión y energía
ASUS envió el ET900N G3 con una sola unidad NVMe de 2 TB para el sistema operativo y el software de NVIDIA, en el par de ranuras M.2 2280 conectadas a Grace a través de PCIe 5.0 x4. El segundo par de ranuras se encuentra conectado al conmutador PCIe integrado del ConnectX-8 y se envió vacío.
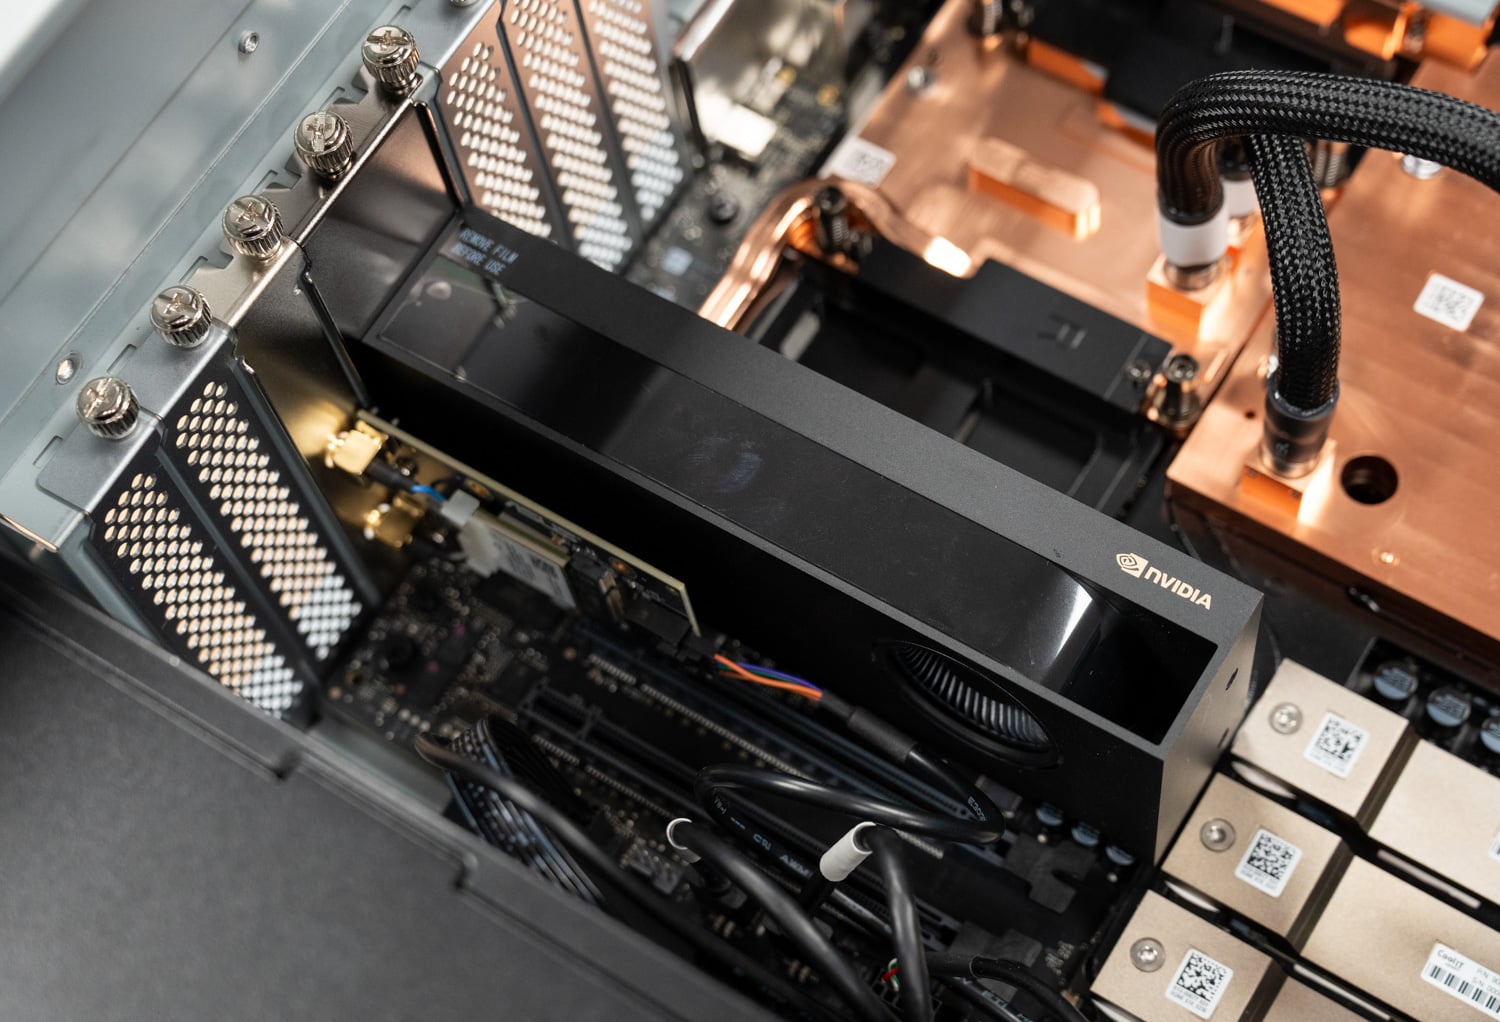
Nuestra unidad de prueba llegó con una NVIDIA RTX PRO 2000 Blackwell en la ranura PCIe 5.0 x16, una de las configuraciones que ASUS ofrece. La tarjeta proporciona salida de vídeo sin consumir significativamente el presupuesto de energía del GB300, y ASUS afirma que el chasis admite hasta una tarjeta RTX PRO Blackwell. Retiramos la RTX PRO 2000 antes de realizar las pruebas de rendimiento para que el Superchip dispusiera de todo el presupuesto del acelerador, la misma condición que utilizamos para el WS300, y no probamos una tarjeta RTX PRO de alta potencia en este chasis; ese enfoque, y su efecto en el presupuesto de energía compartido, es algo que analizaremos en una próxima reseña del GB300 Station.
La fuente de alimentación es una unidad ATX de 1,600 W que ASUS clasifica como 80 PLUS Titanium, un nivel superior a la unidad Platinum de la WS300. Titanium requiere una eficiencia del 94 % con una carga del 50 % en una entrada de 115 V, en comparación con el 92 % de Platinum, y es el único nivel que establece un mínimo en una carga del 10 %, por lo que el ET900N G3 debería desperdiciar algunas decenas de vatios menos en la toma de corriente bajo una carga completa de GB300. El presupuesto sigue siendo compartido: Grace, la B300, las bombas, los ventiladores, el almacenamiento y cualquier tarjeta RTX PRO consumen los mismos 1,600 W, y el servicio vsloshd de NVIDIA cambia el margen de capacidad entre el Superchip y una GPU adicional a medida que cambia su consumo, sin un límite fijo para ninguno. La reseña de la WS300 explica esta política, y no ha cambiado aquí. Un circuito dedicado de 20 A sigue siendo un requisito para las instalaciones en Norteamérica.
Conectividad
Los dos puertos QSFP112 del ConnectX-8 son la conexión del ET900N G3 con el resto de los componentes: almacenamiento, una segunda estación DGX o una estructura de clúster. Estos puertos ya se utilizan en el laboratorio, donde el ET900N G3 está conectado a una segunda estación GB300 mediante DAC de 400G para un análisis exhaustivo de inferencia en clúster que publicaremos por separado. El puerto Marvell de 10 GbE gestiona el tráfico habitual del host, y el puerto Realtek de 1 GbE está dedicado al BMC.
Notas de prueba
Todos los resultados de esta reseña provienen de la unidad que ASUS envió a nuestro laboratorio, con la configuración de memoria de fábrica de 252 GB de HBM3e y 496 GB de LPDDR5X. El sistema se ejecutó sin una tarjeta RTX PRO instalada, por lo que el GB300 Superchip dispuso de la potencia máxima del acelerador, en las mismas condiciones que en nuestras pruebas del WS300. El software, la configuración de vLLM, los perfiles de carga de trabajo y el análisis de concurrencia son los mismos que utilizamos para el WS300, por lo que ambas torres se pueden comparar directamente. Esta reseña se centra únicamente en el rendimiento; no medimos el consumo de energía ni la temperatura de esta unidad.
Las cargas de trabajo son los mismos dos perfiles de inferencia en vivo de vLLM que ejecutamos en cada sistema de IA local: una carga de trabajo igual con 512 tokens de entrada y 512 de salida, y una carga de trabajo con prellenado con 8,192 tokens de entrada y 1,024 de salida, que varía de uno a 128 flujos concurrentes. Para los modelos de escala fronteriza, comparamos con un servidor GPU Dell PowerEdge XE7740 equipado con dos o cuatro tarjetas RTX PRO 6000 , la alternativa de una sola caja más cercana para estos puntos de control. Para los modelos más pequeños, comparamos con una sola RTX PRO 6000 en el mismo XE7740, una sola H200 NVL en un Dell PowerEdge R770 y un GB10 DGX Spark representado por el Acer Veriton GN100 , el mismo Spark que usamos en la revisión del WS300. Las cifras del ET900N G3 a continuación son los valores exactos de los registros de ejecución; Las cifras del sistema de comparación se leen de nuestros gráficos de resultados.
Rendimiento de inferencia
Modelos de frontera en el conjunto de memoria coherente
La razón de ser del GB300 es dar servicio a modelos a ambos lados del límite de 252 GB HBM3e del B300, por lo que comenzamos con cuatro puntos de control que lo abarcan: DeepSeek V4 Flash y MiniMax M2.7 caben en HBM con espacio de sobra, MiniMax M3 apenas cabe y traslada una parte de sus expertos a la memoria Grace, y GLM-5.2 descarga aproximadamente la mitad de su peso. En el otro extremo de cada tabla está la alternativa más cercana de una sola caja: tarjetas RTX PRO 6000 juntas en el PowerEdge XE7740, con descarga de expertos a la memoria del host donde sea necesario.
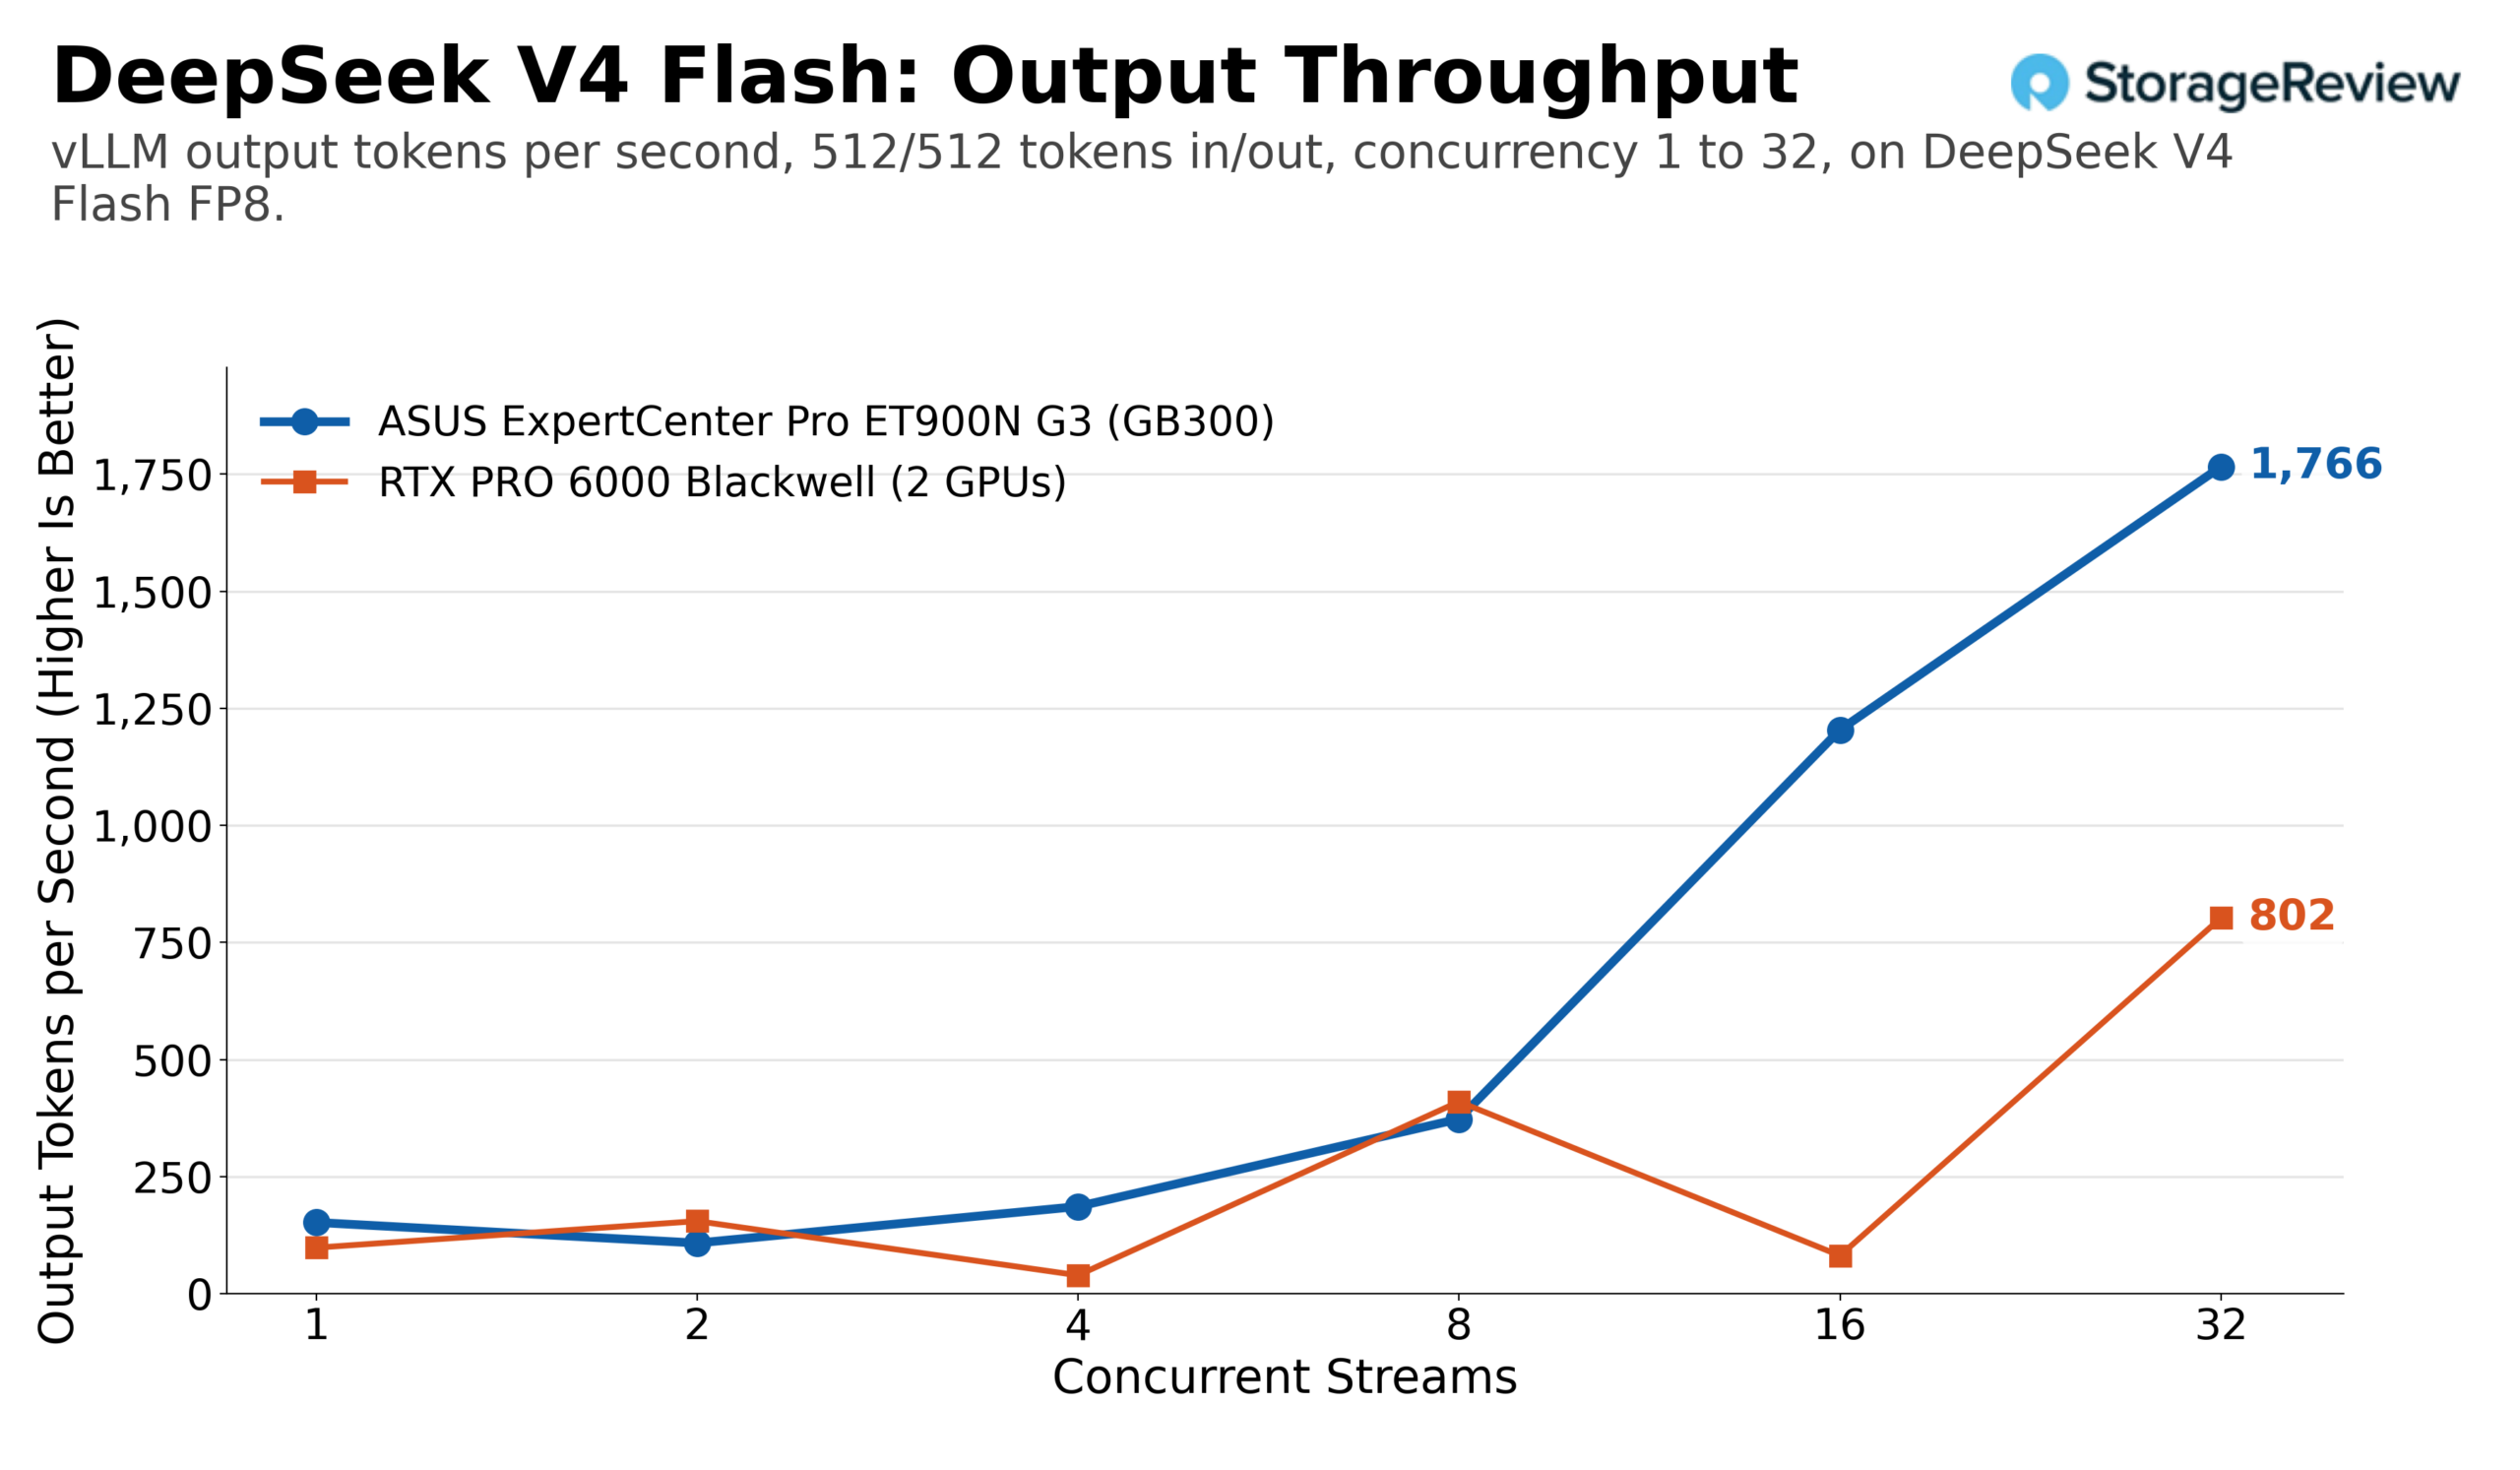
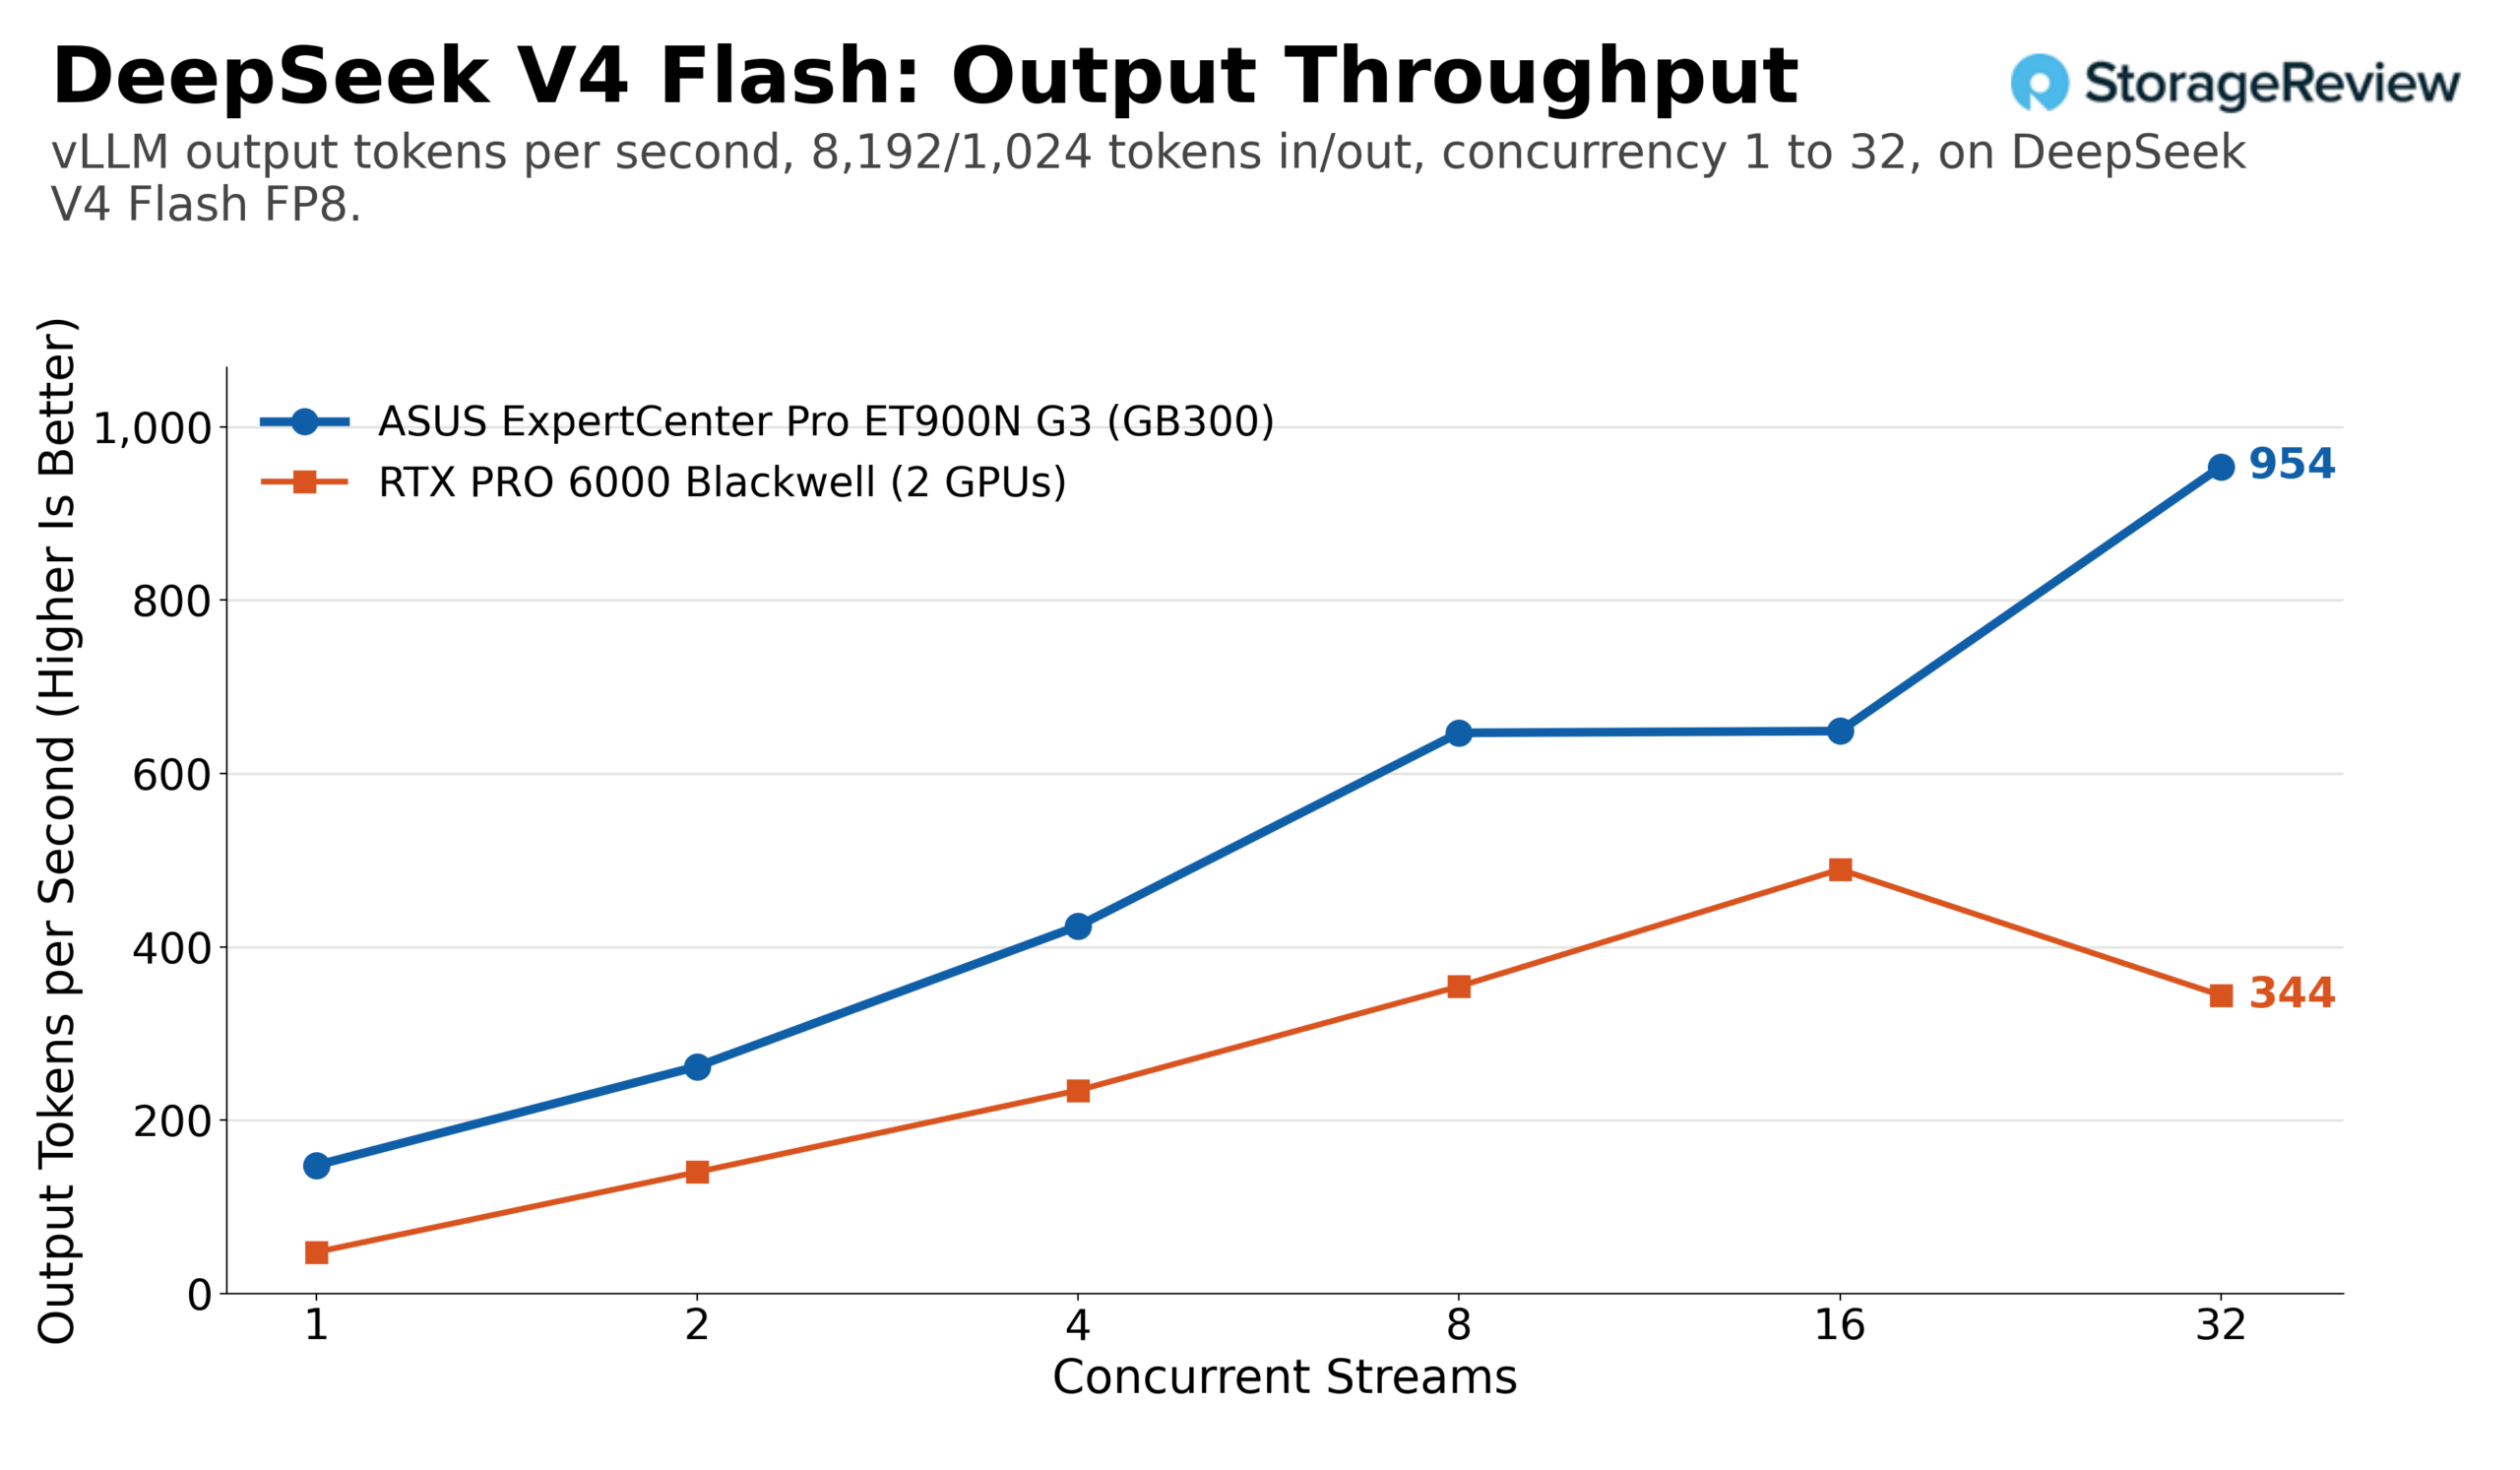
DeepSeek V4 Flash es el caso fácil: un punto de control FP8 nativo de aproximadamente 20 GB que el B300 procesa sin esfuerzo. El rendimiento de salida en la misma carga de trabajo aumentó de 152 tokens por segundo con 1 flujo a 1,766 con 32 flujos, lo que lleva un rendimiento total de tokens a 3,532. En el perfil con mucho prellenado, el ET900N G3 aumentó de 148 a 954 tokens de salida por segundo, con un total de 8,587 tokens. Un par de tarjetas RTX PRO 6000 alcanzaron un pico cercano a los 800 tokens de salida por segundo en la misma carga de trabajo y alrededor de 490 en las indicaciones largas, con una curva irregular a baja concurrencia.
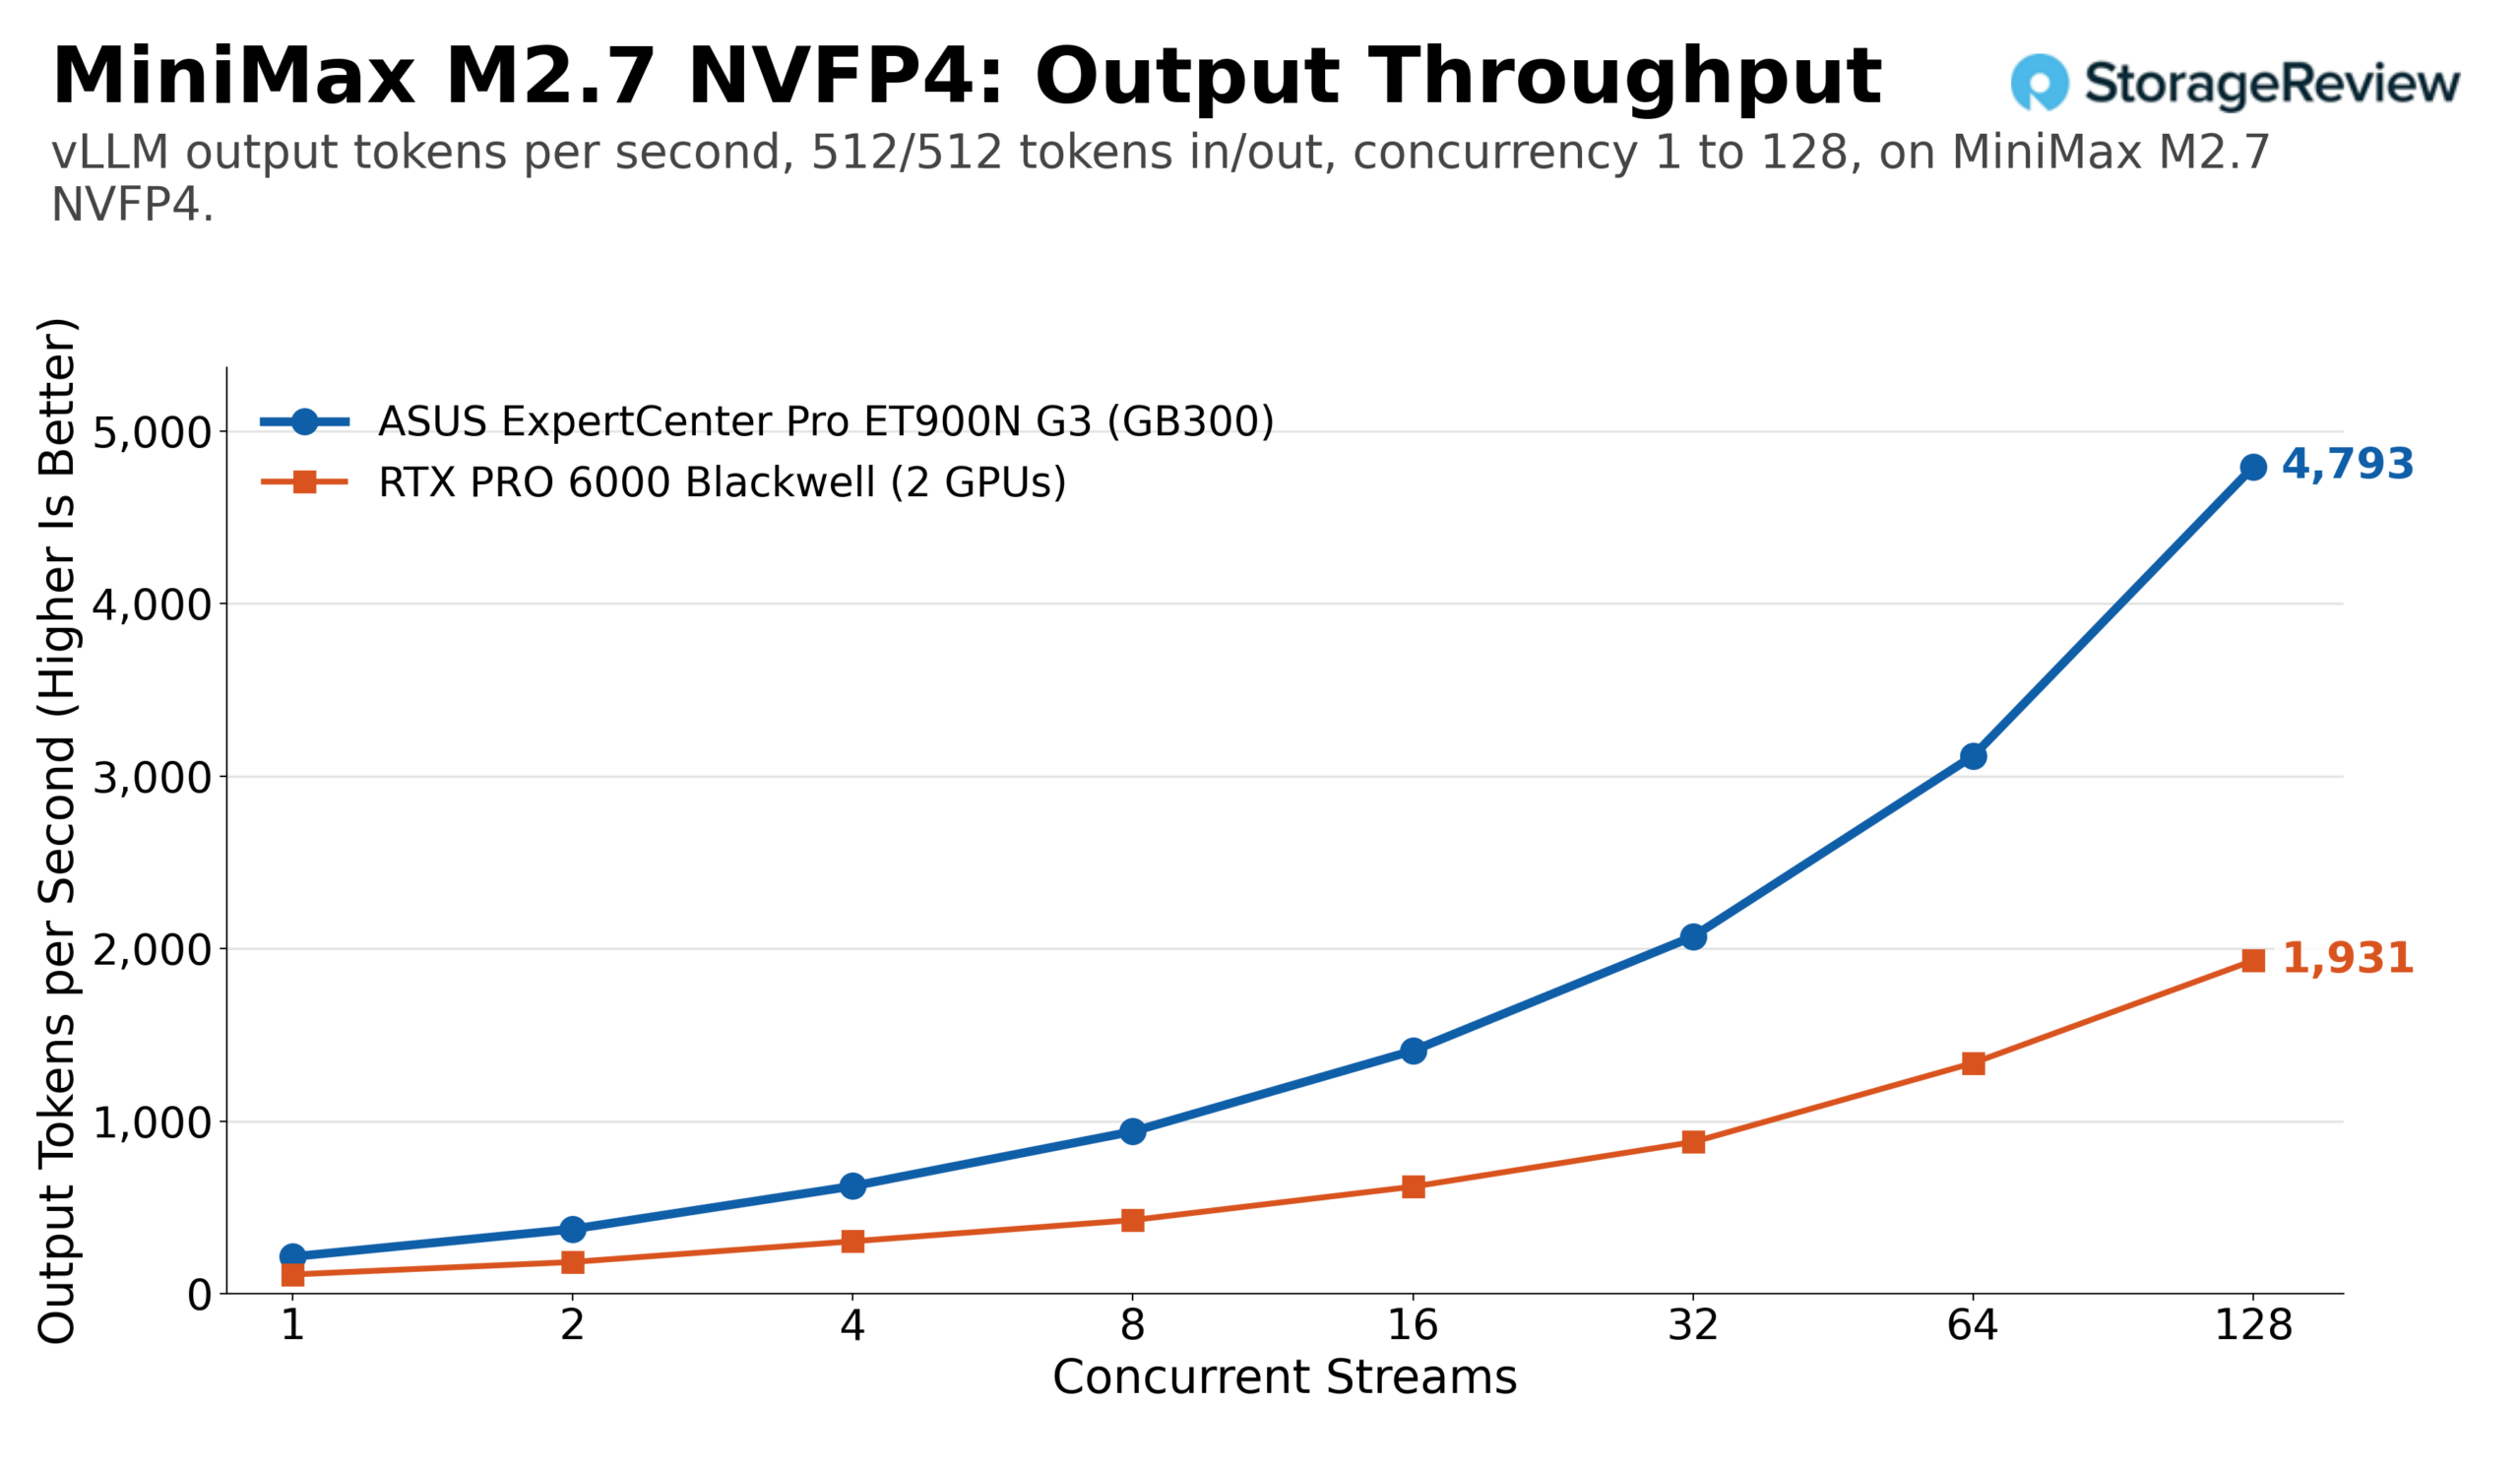
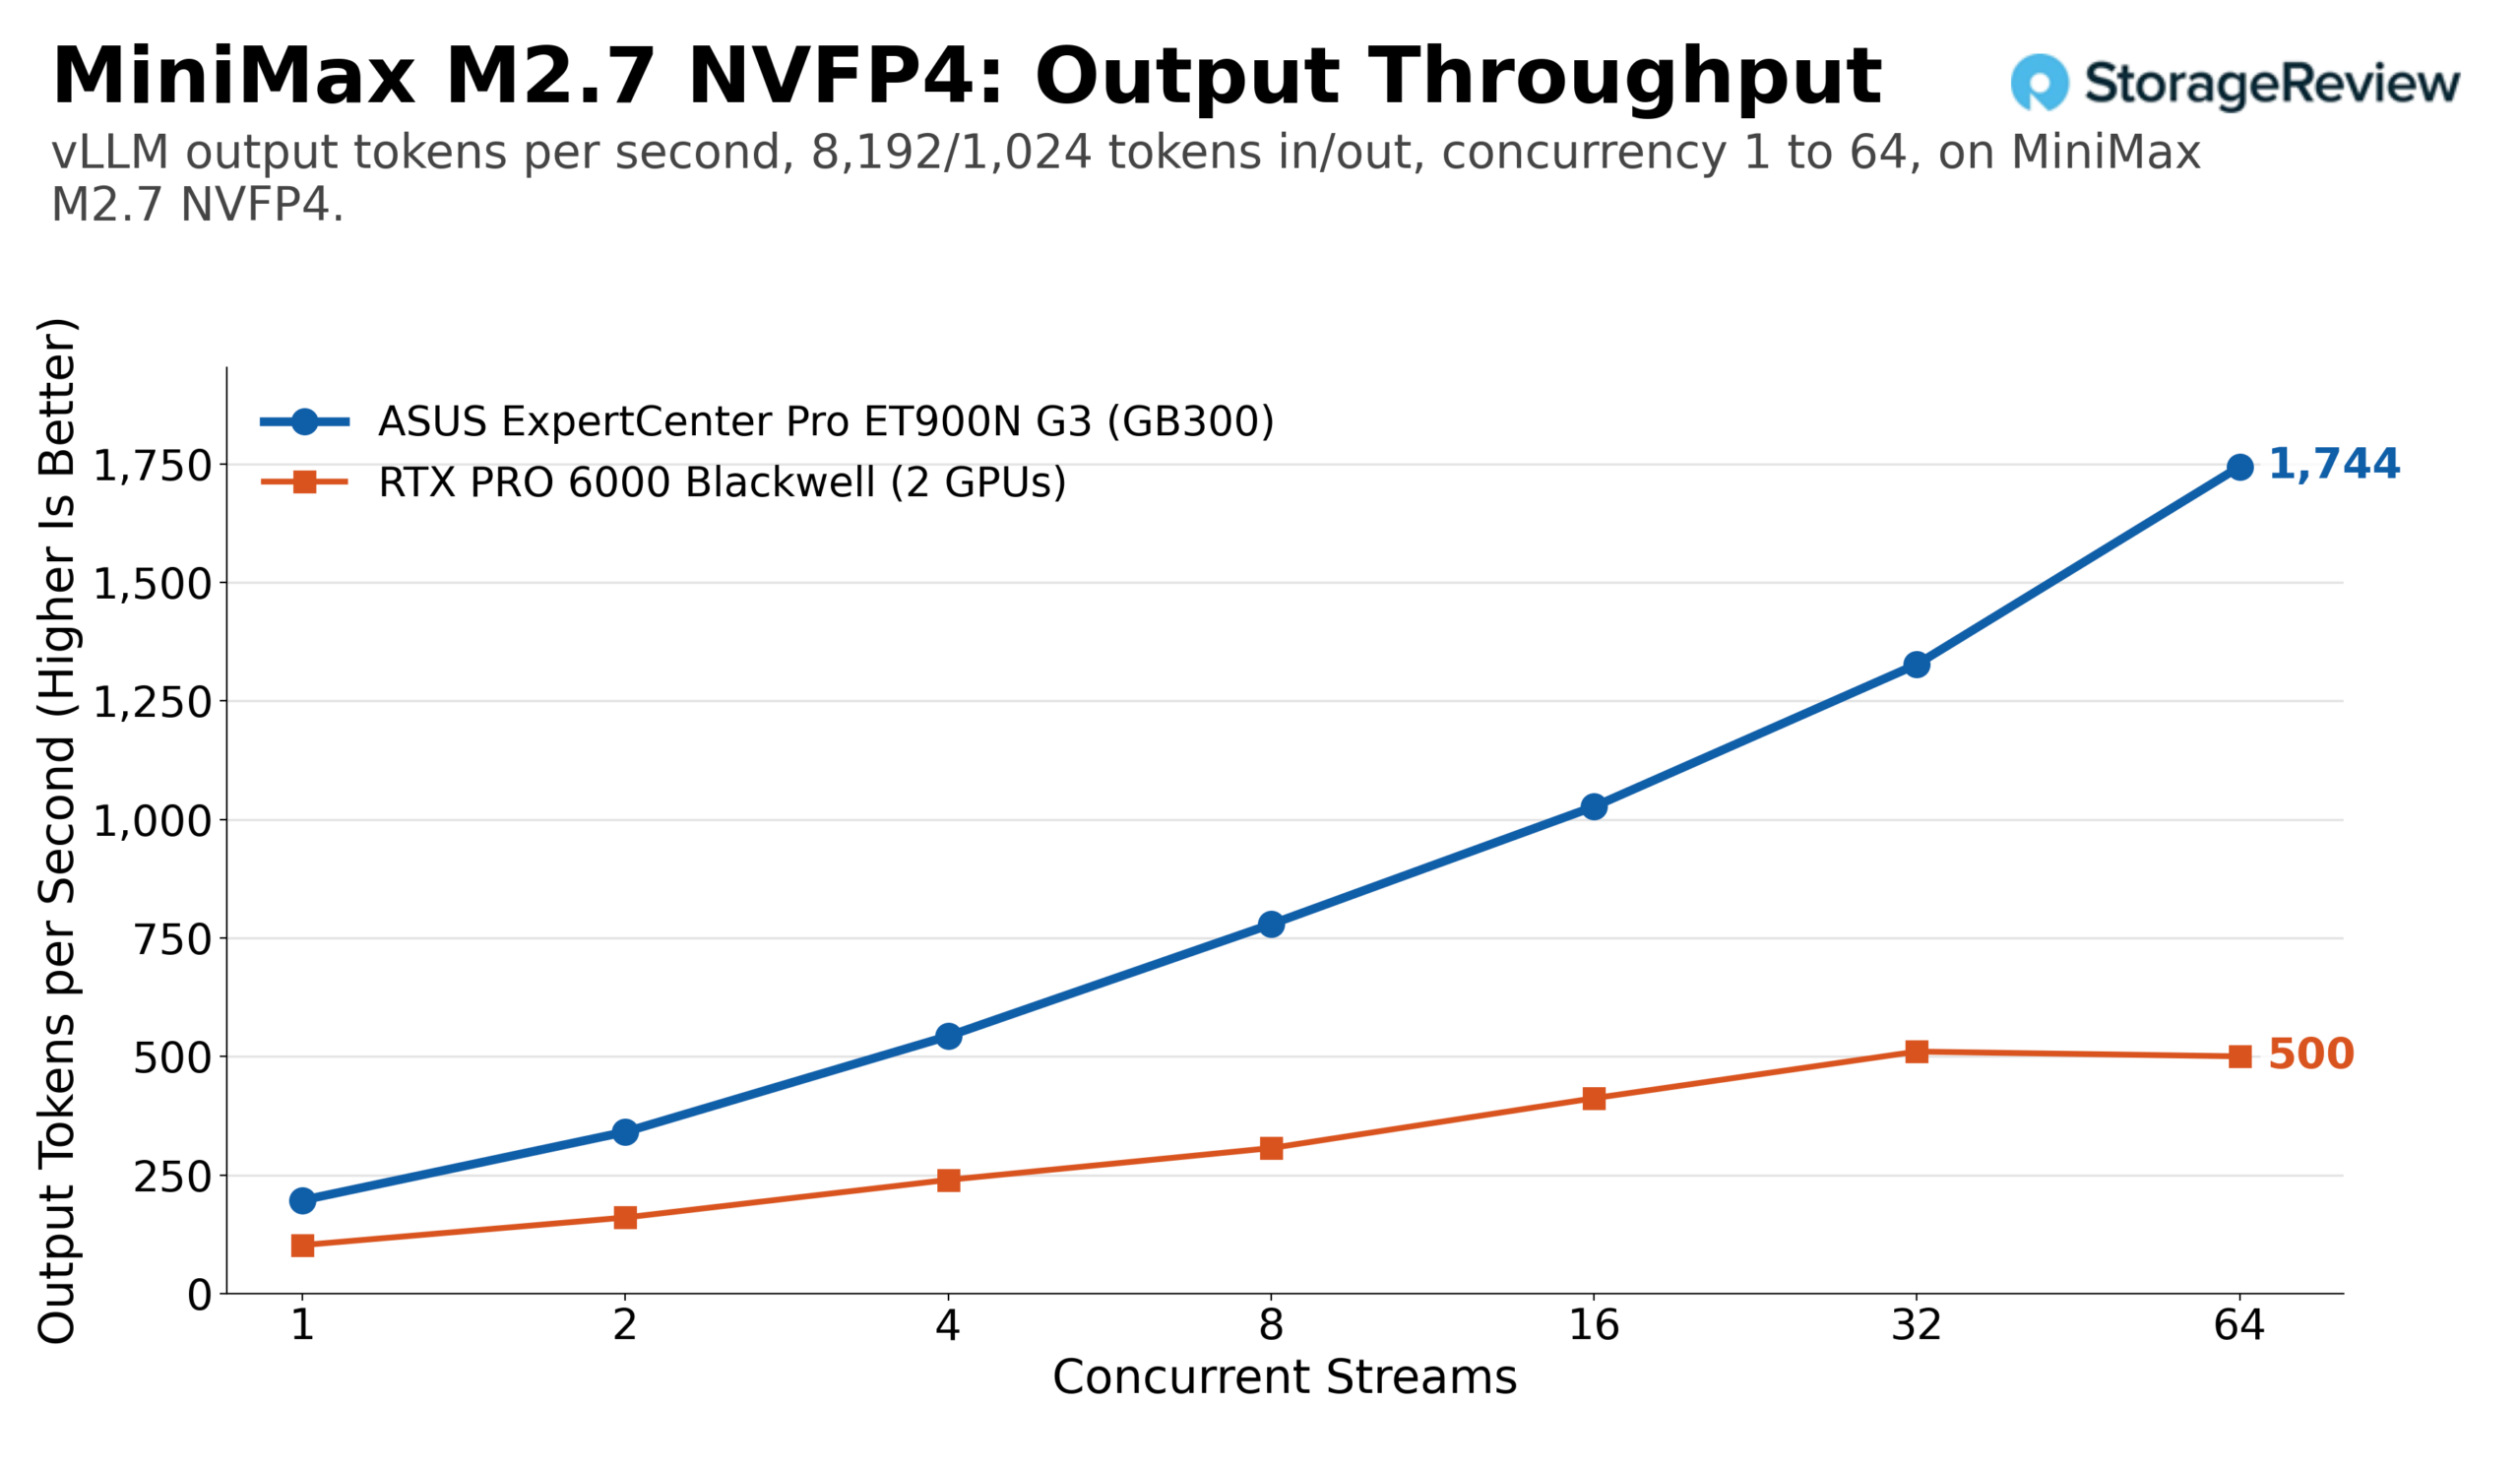
MiniMax M2.7 en la cuantización NVFP4 de NVIDIA ocupa aproximadamente 125 GB de HBM y escaló más que los otros cuatro. La misma carga de trabajo aumentó de 214 tokens de salida por segundo en un flujo a 4,793 en 128 flujos, y el rendimiento total alcanzó 9,586. La ejecución con prellenado intensivo escaló a 1,744 tokens de salida por segundo y 15 700 tokens totales por segundo en 64 flujos. Dos tarjetas RTX PRO 6000 siguieron la misma forma con menos de la mitad de la altura, alcanzando un máximo cercano a 1,930 tokens de salida por segundo en la misma carga de trabajo y alrededor de 510 en las indicaciones largas.
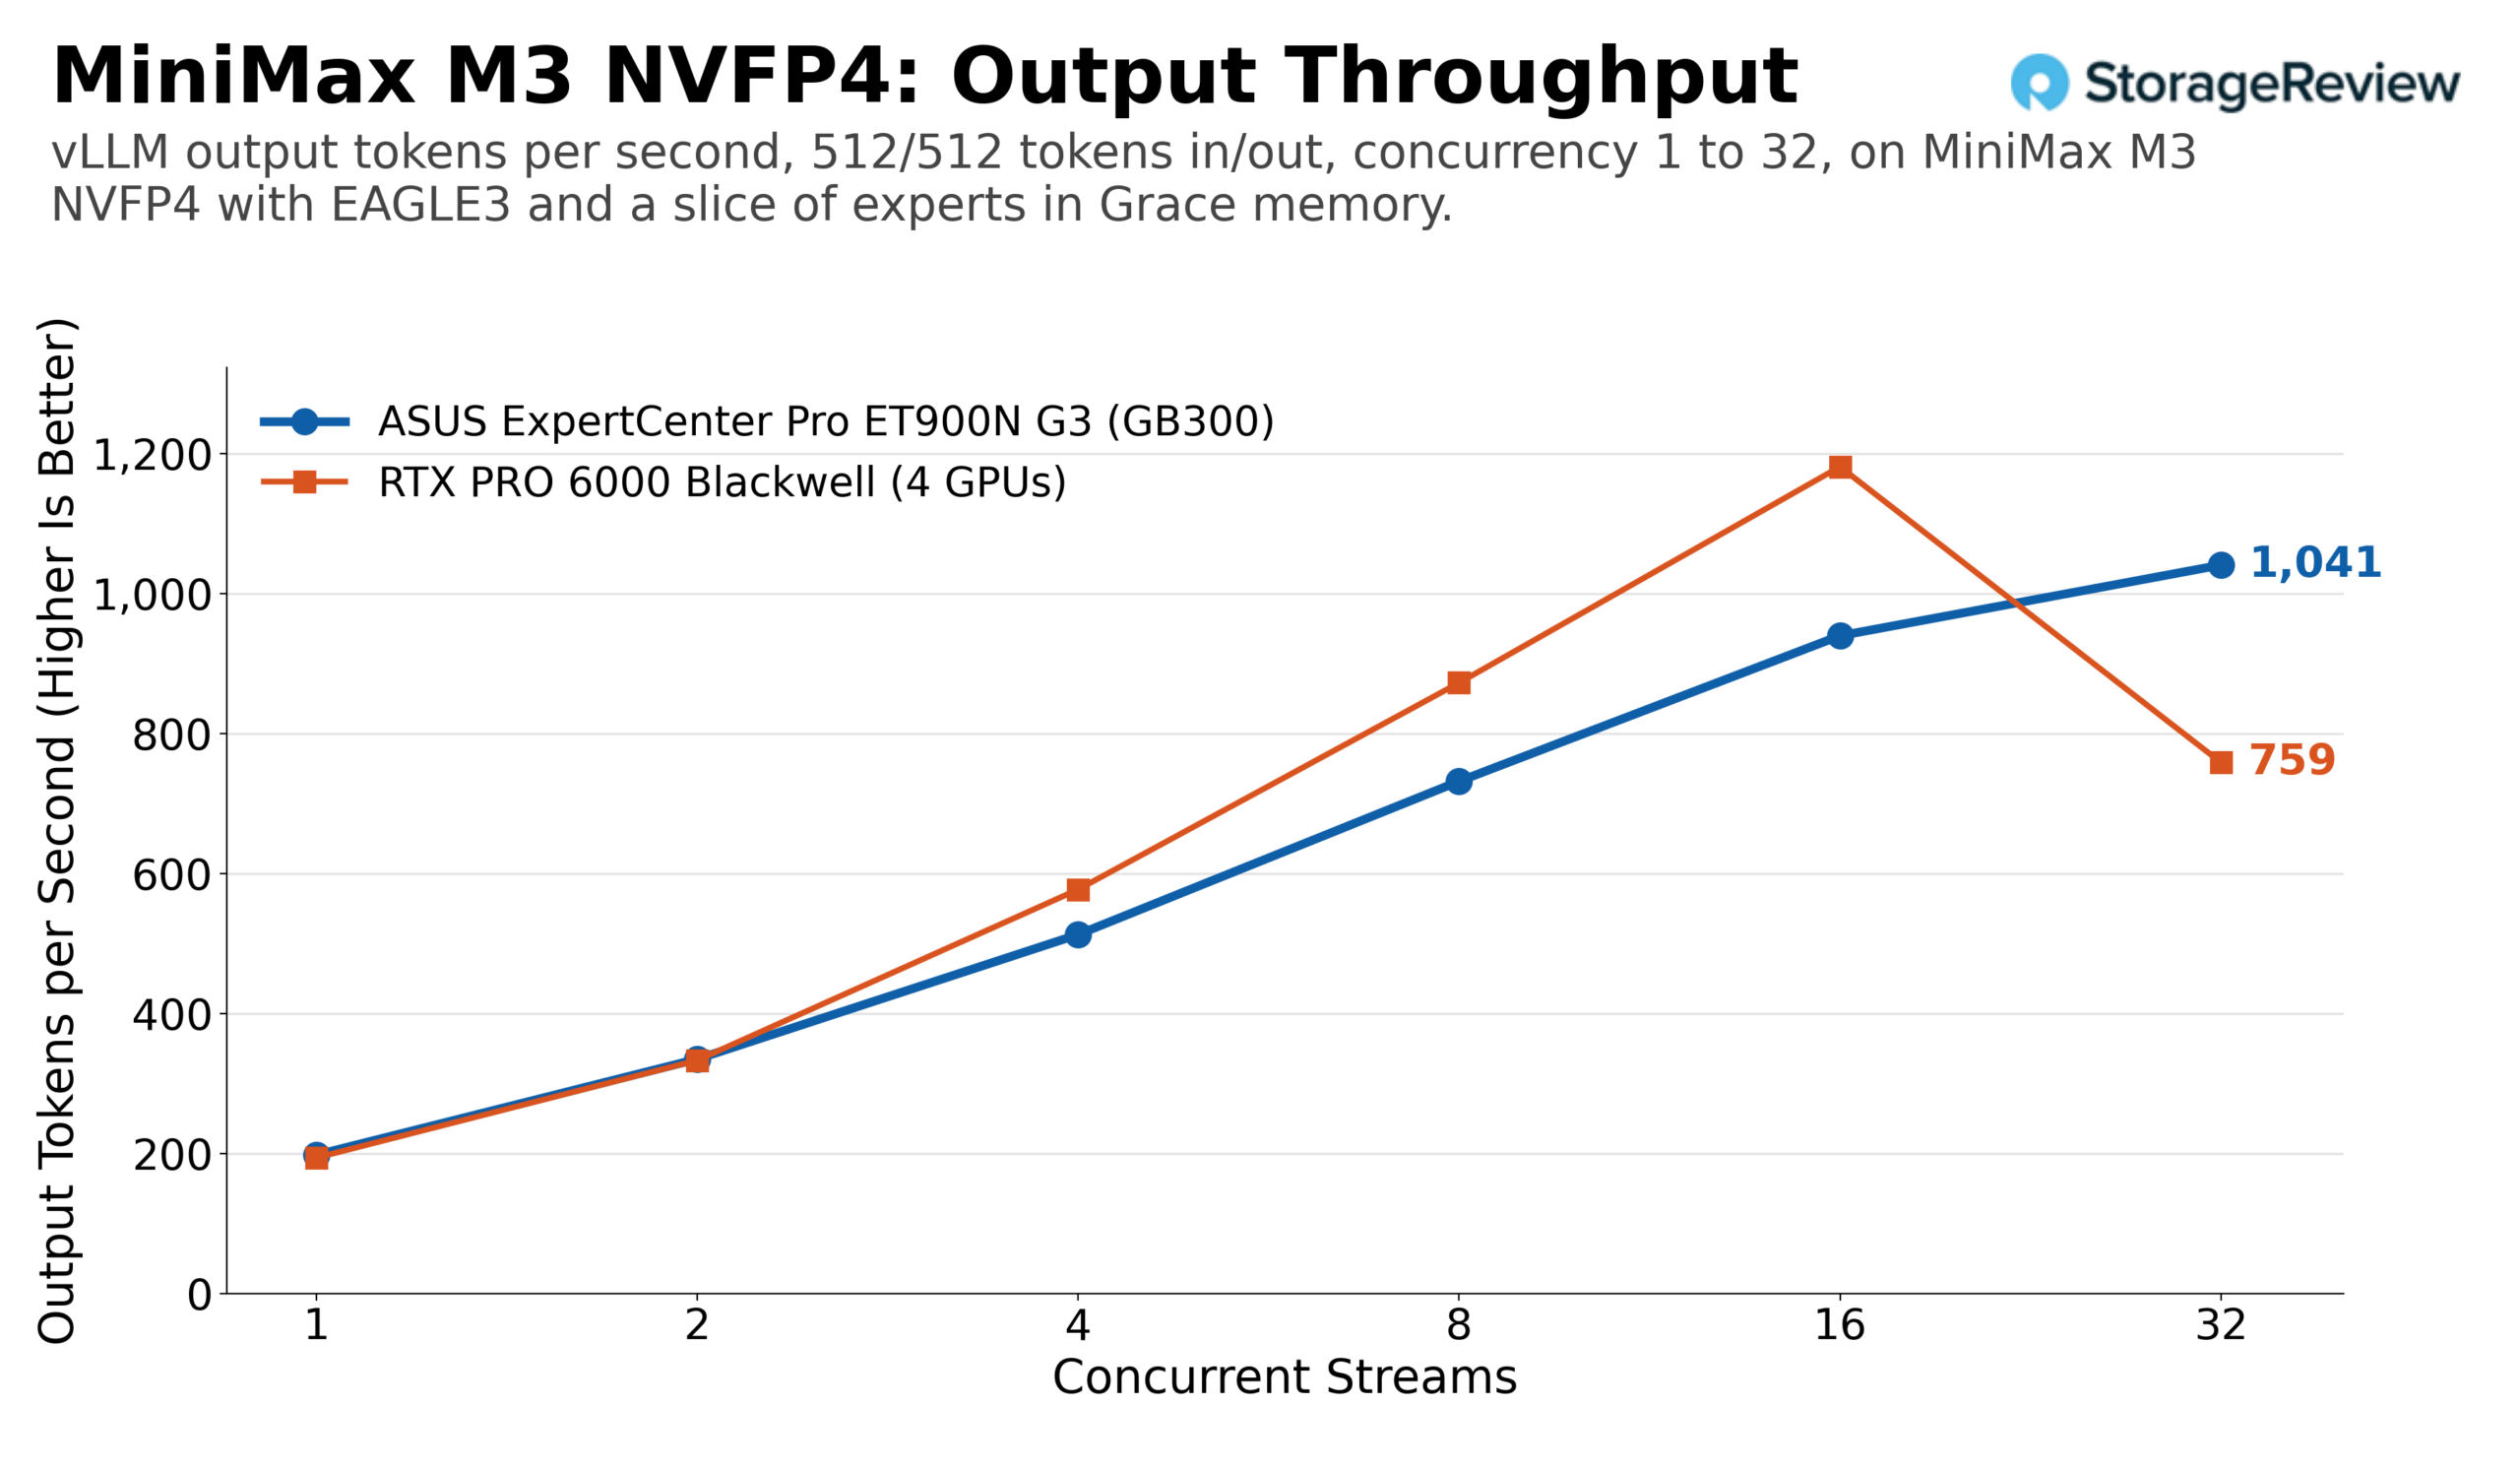
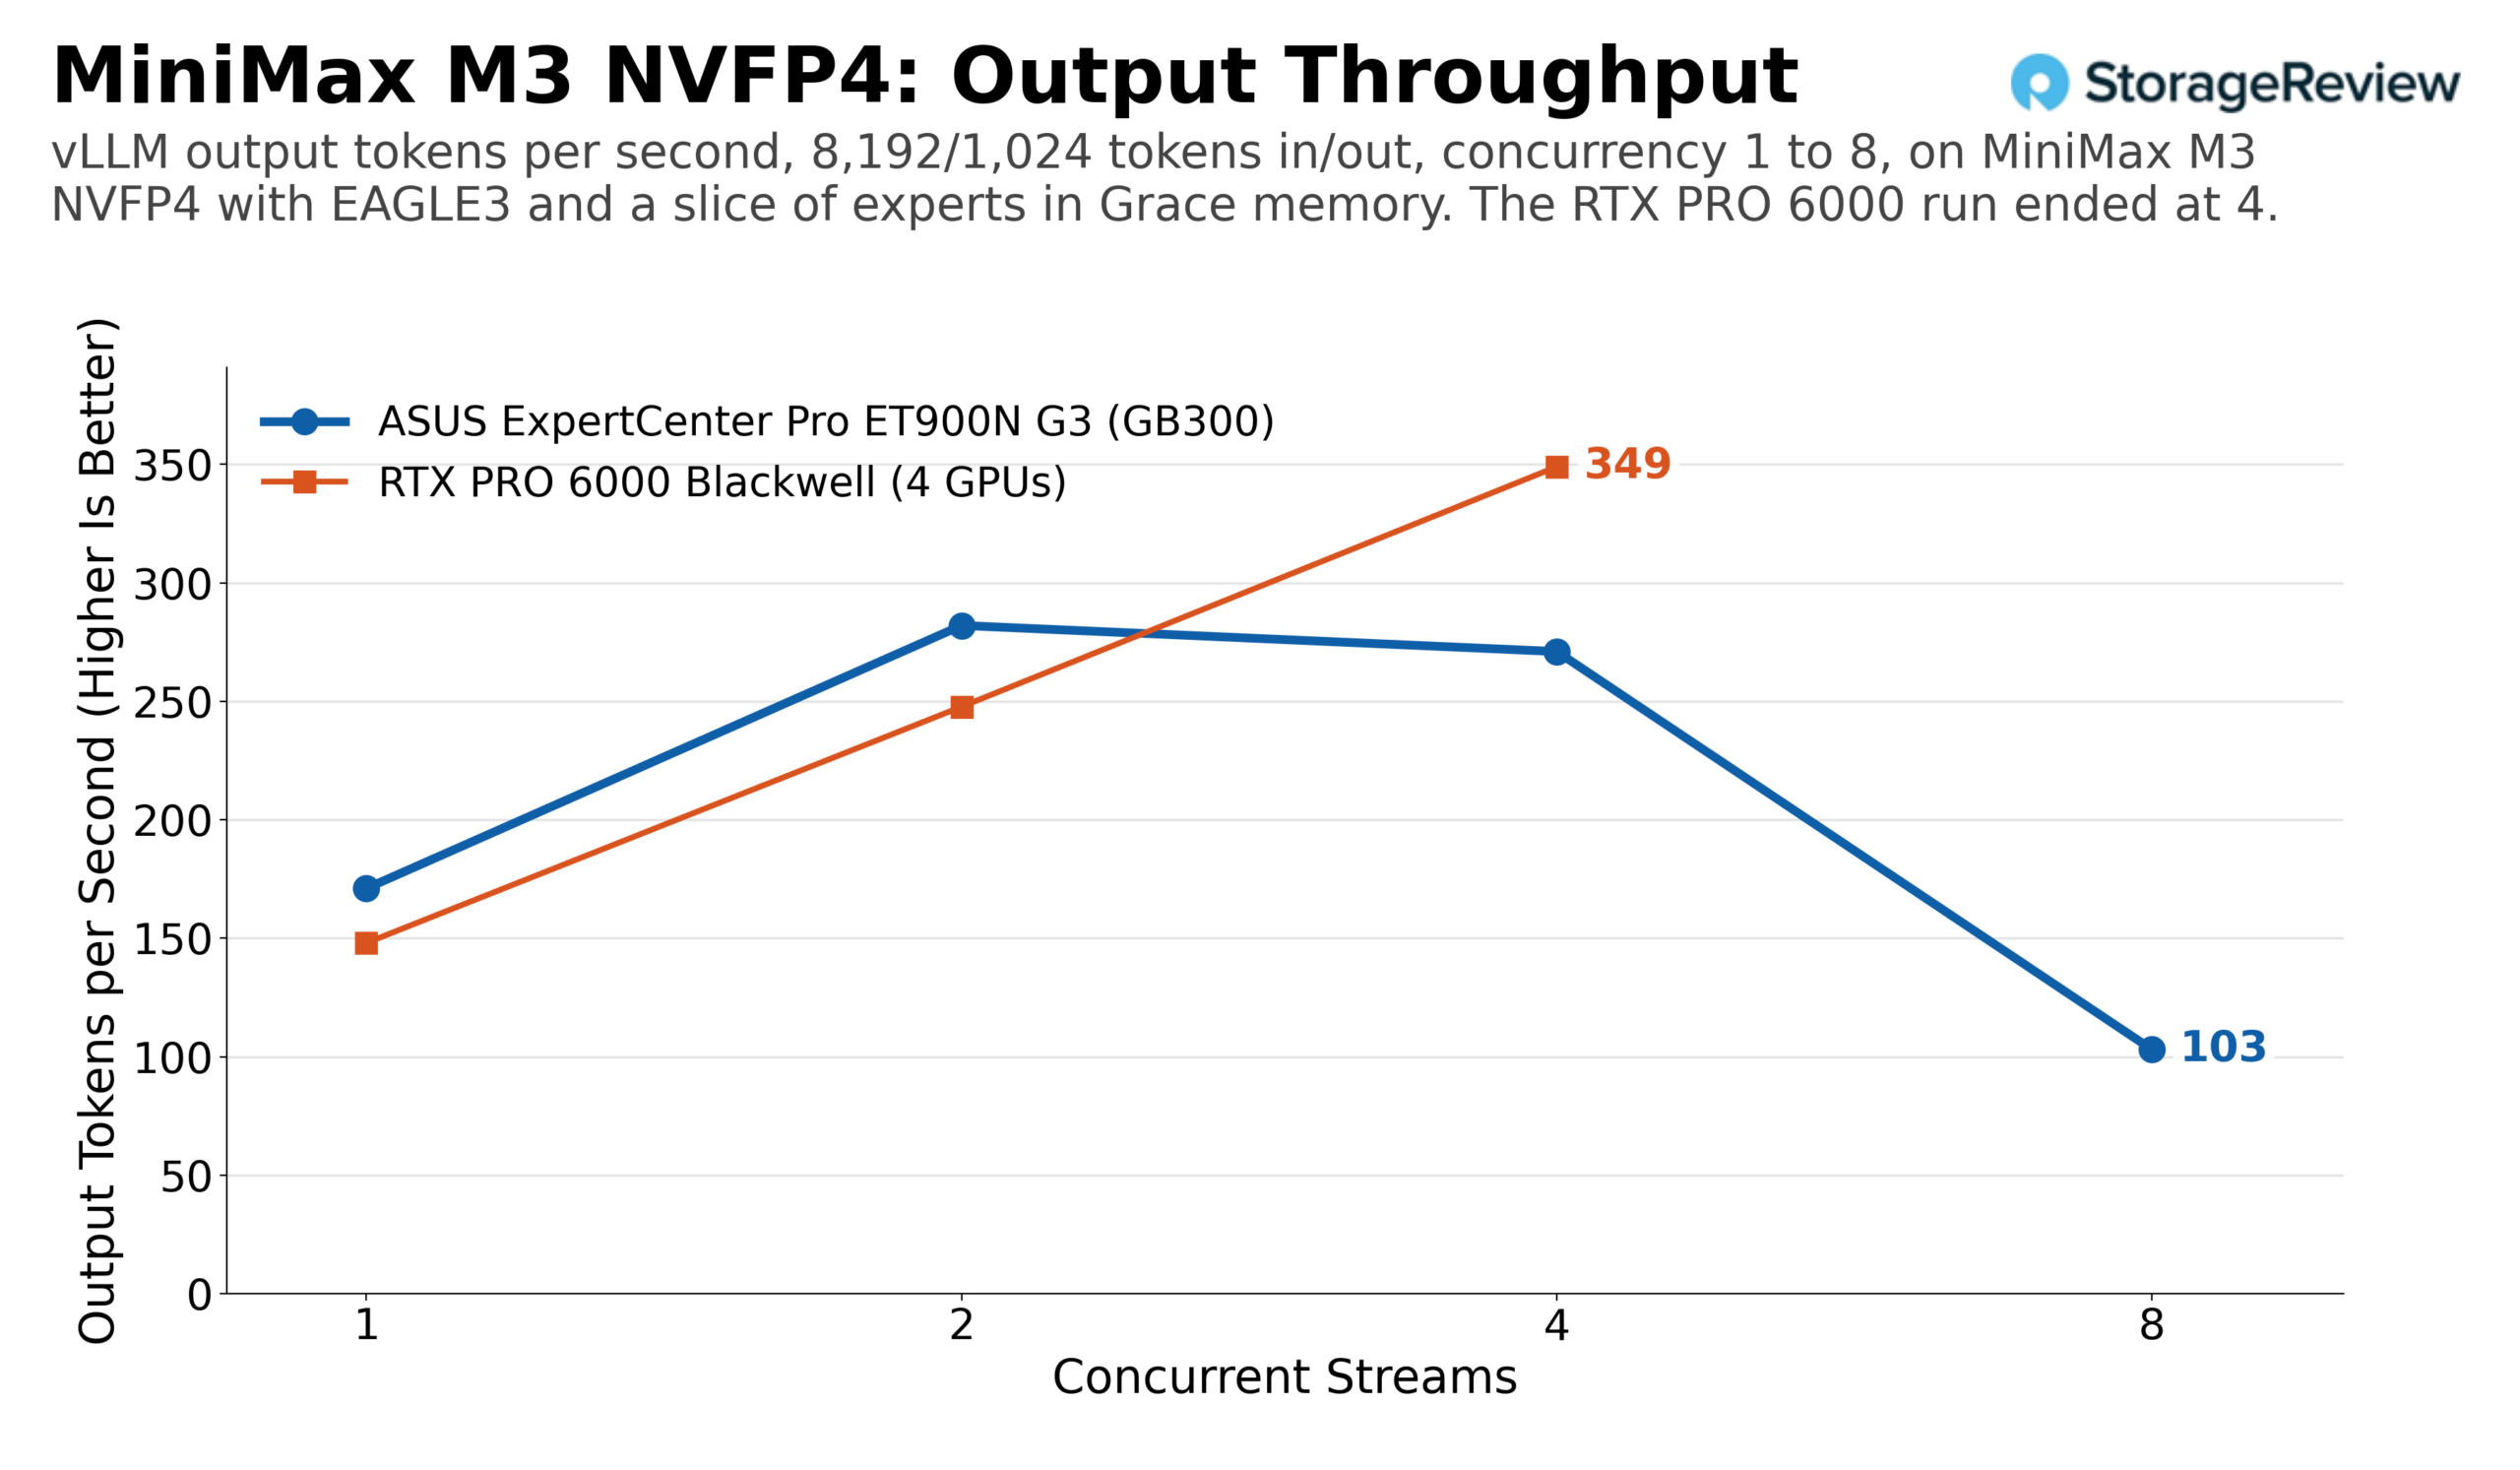
MiniMax M3 muestra lo que es apenas caber en la memoria. El punto de control NVFP4 es menor que 252 GB, pero el tiempo de ejecución y la caché KV también necesitan espacio, por lo que una parte de los expertos reside en la memoria Grace, y cada paso de decodificación que los toca pasa por NVLink-C2C. Con la decodificación especulativa EAGLE3, el ET900N G3 alcanzó 1,041 tokens de salida por segundo en 32 flujos con la misma carga de trabajo, y el perfil con mucho prellenado alcanzó un pico de 282 en dos flujos, se mantuvo en 271 en cuatro y cayó a 103 en ocho a medida que las indicaciones largas consumían la caché restante. Cuatro tarjetas RTX PRO 6000 con el mismo decodificador especulativo mantuvieron el ritmo a través de ocho flujos y se adelantaron en 16 flujos con aproximadamente 1,180 tokens de salida por segundo, luego cayeron a aproximadamente 760 en 32 flujos. En el perfil con precarga intensiva, la caja de cuatro tarjetas contenía aproximadamente 349 tokens de salida por segundo en cuatro flujos, frente a los 271 de la Estación. Un modelo que se sitúa justo en el límite de la memoria HBM es el único lugar en este conjunto donde 384 GB de VRAM en cuatro tarjetas compiten con 252 GB de HBM más descarga.
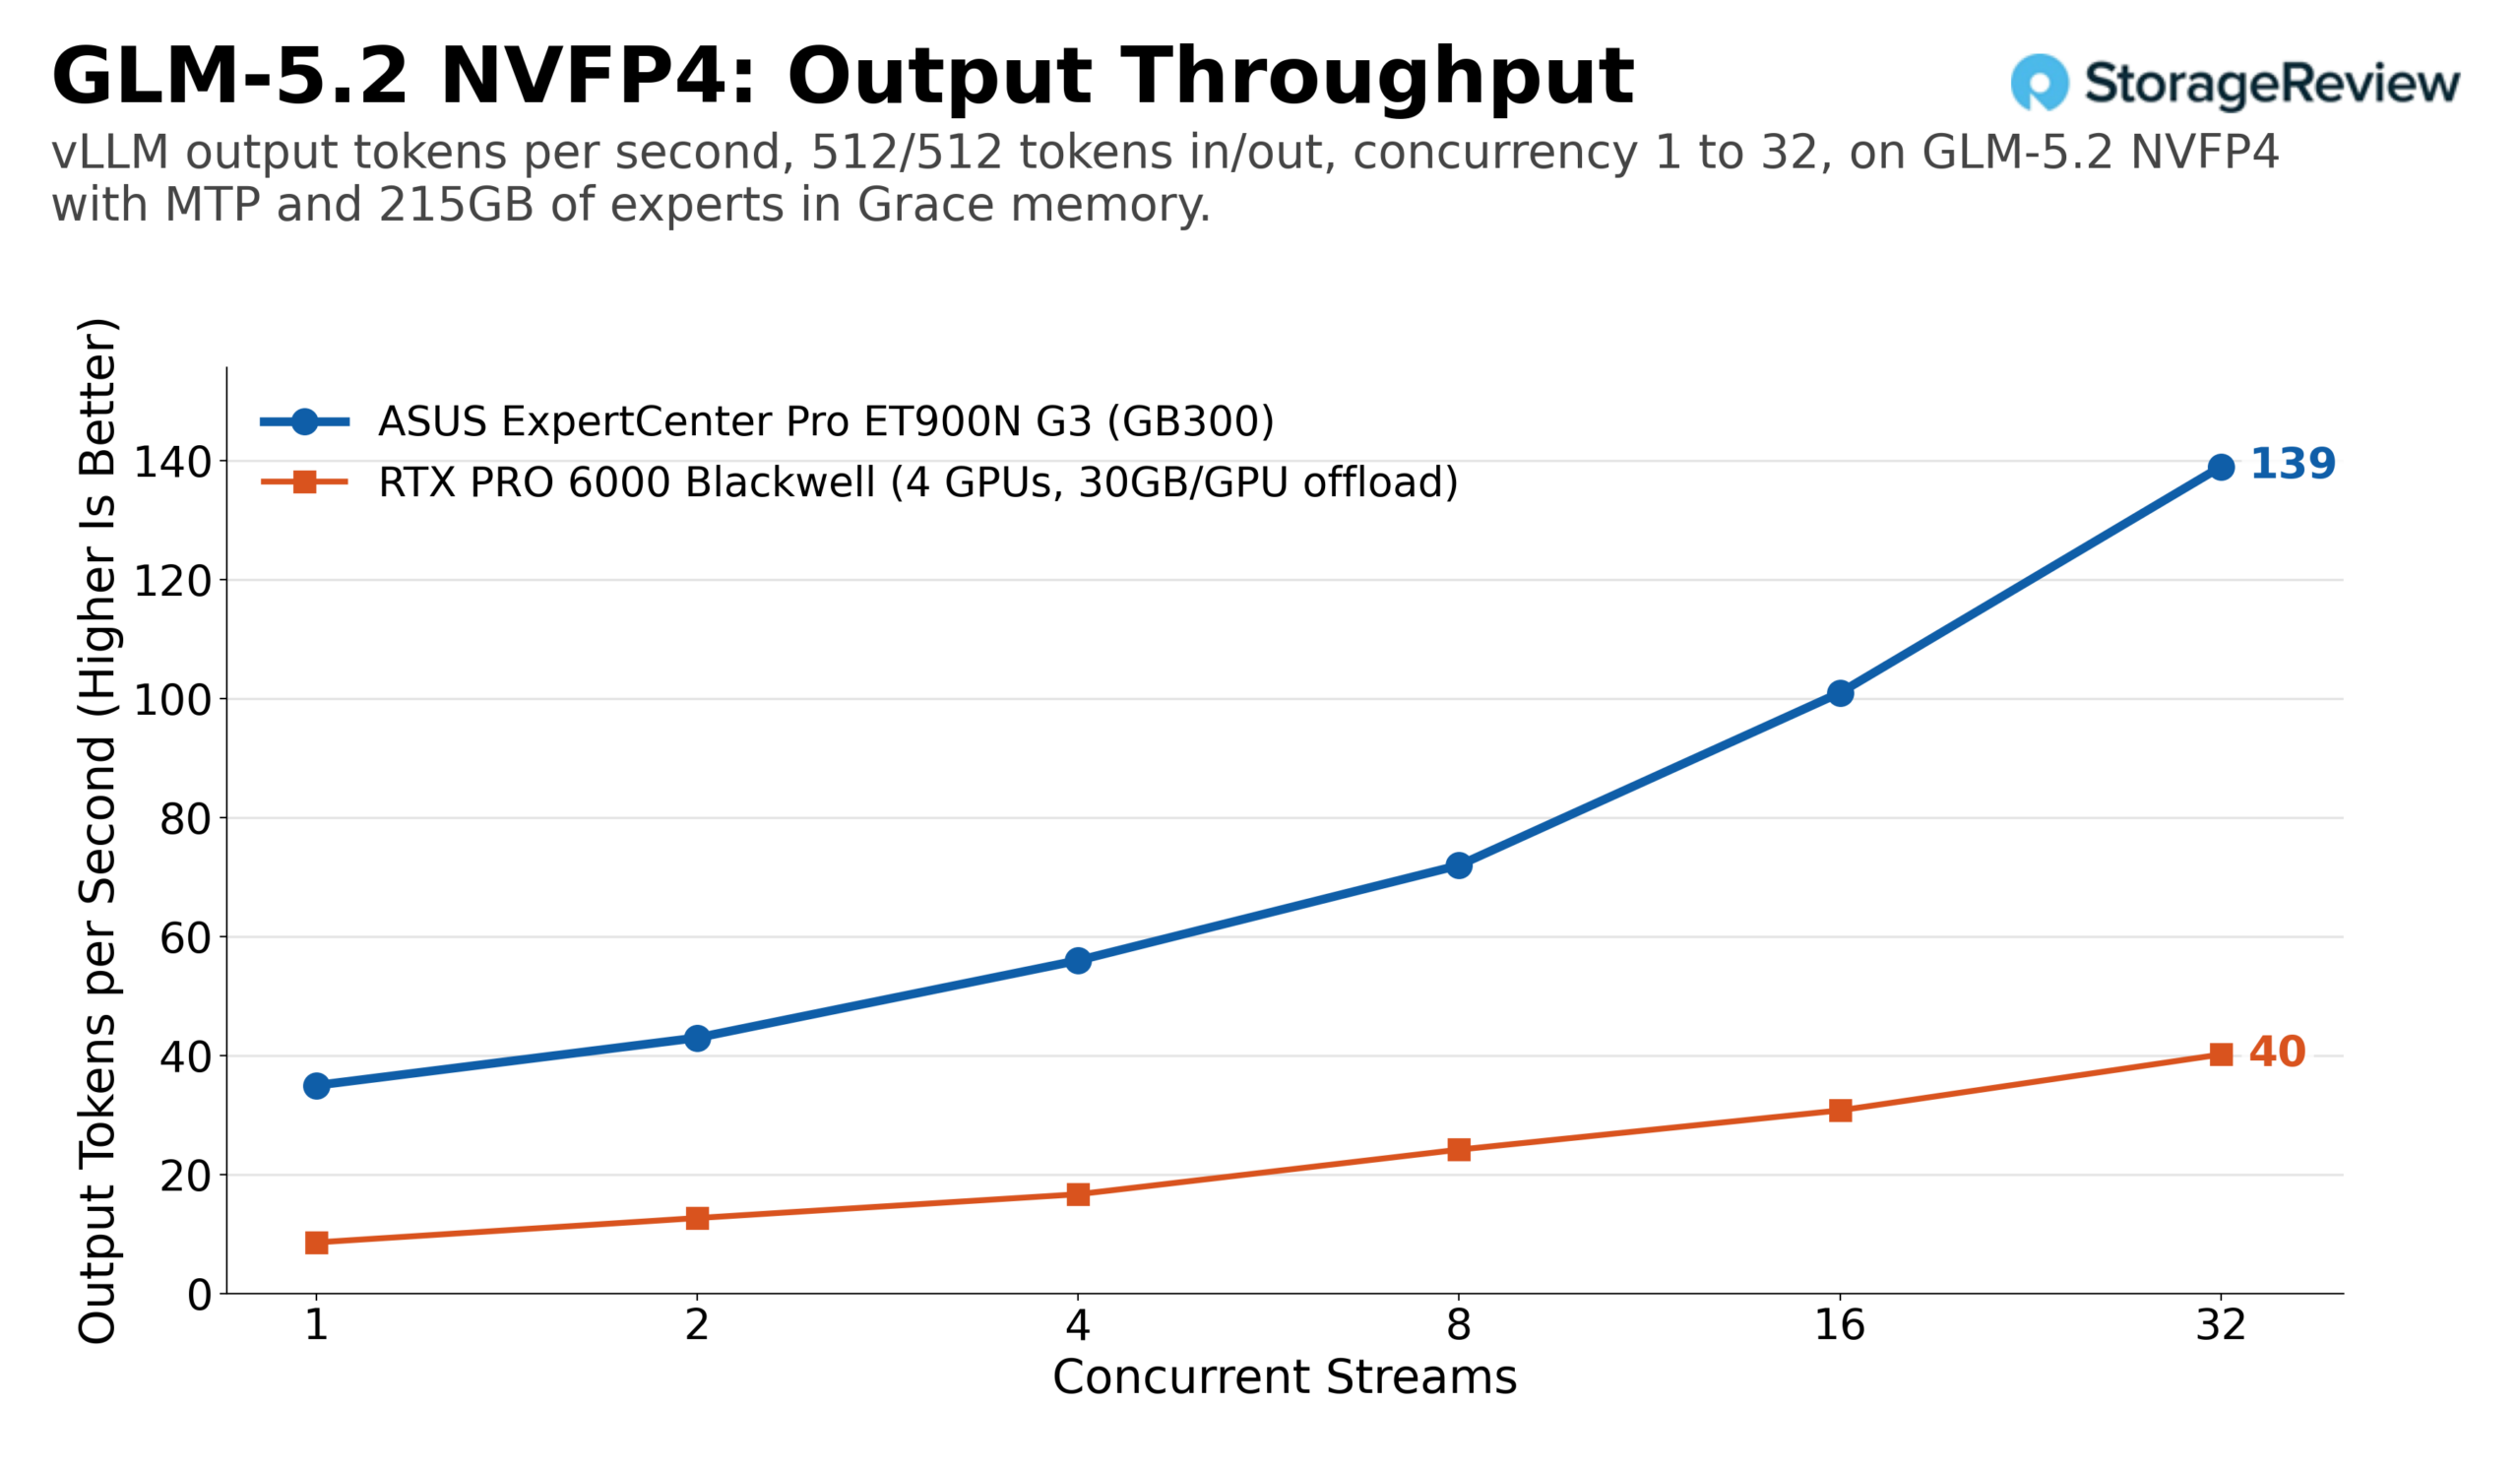
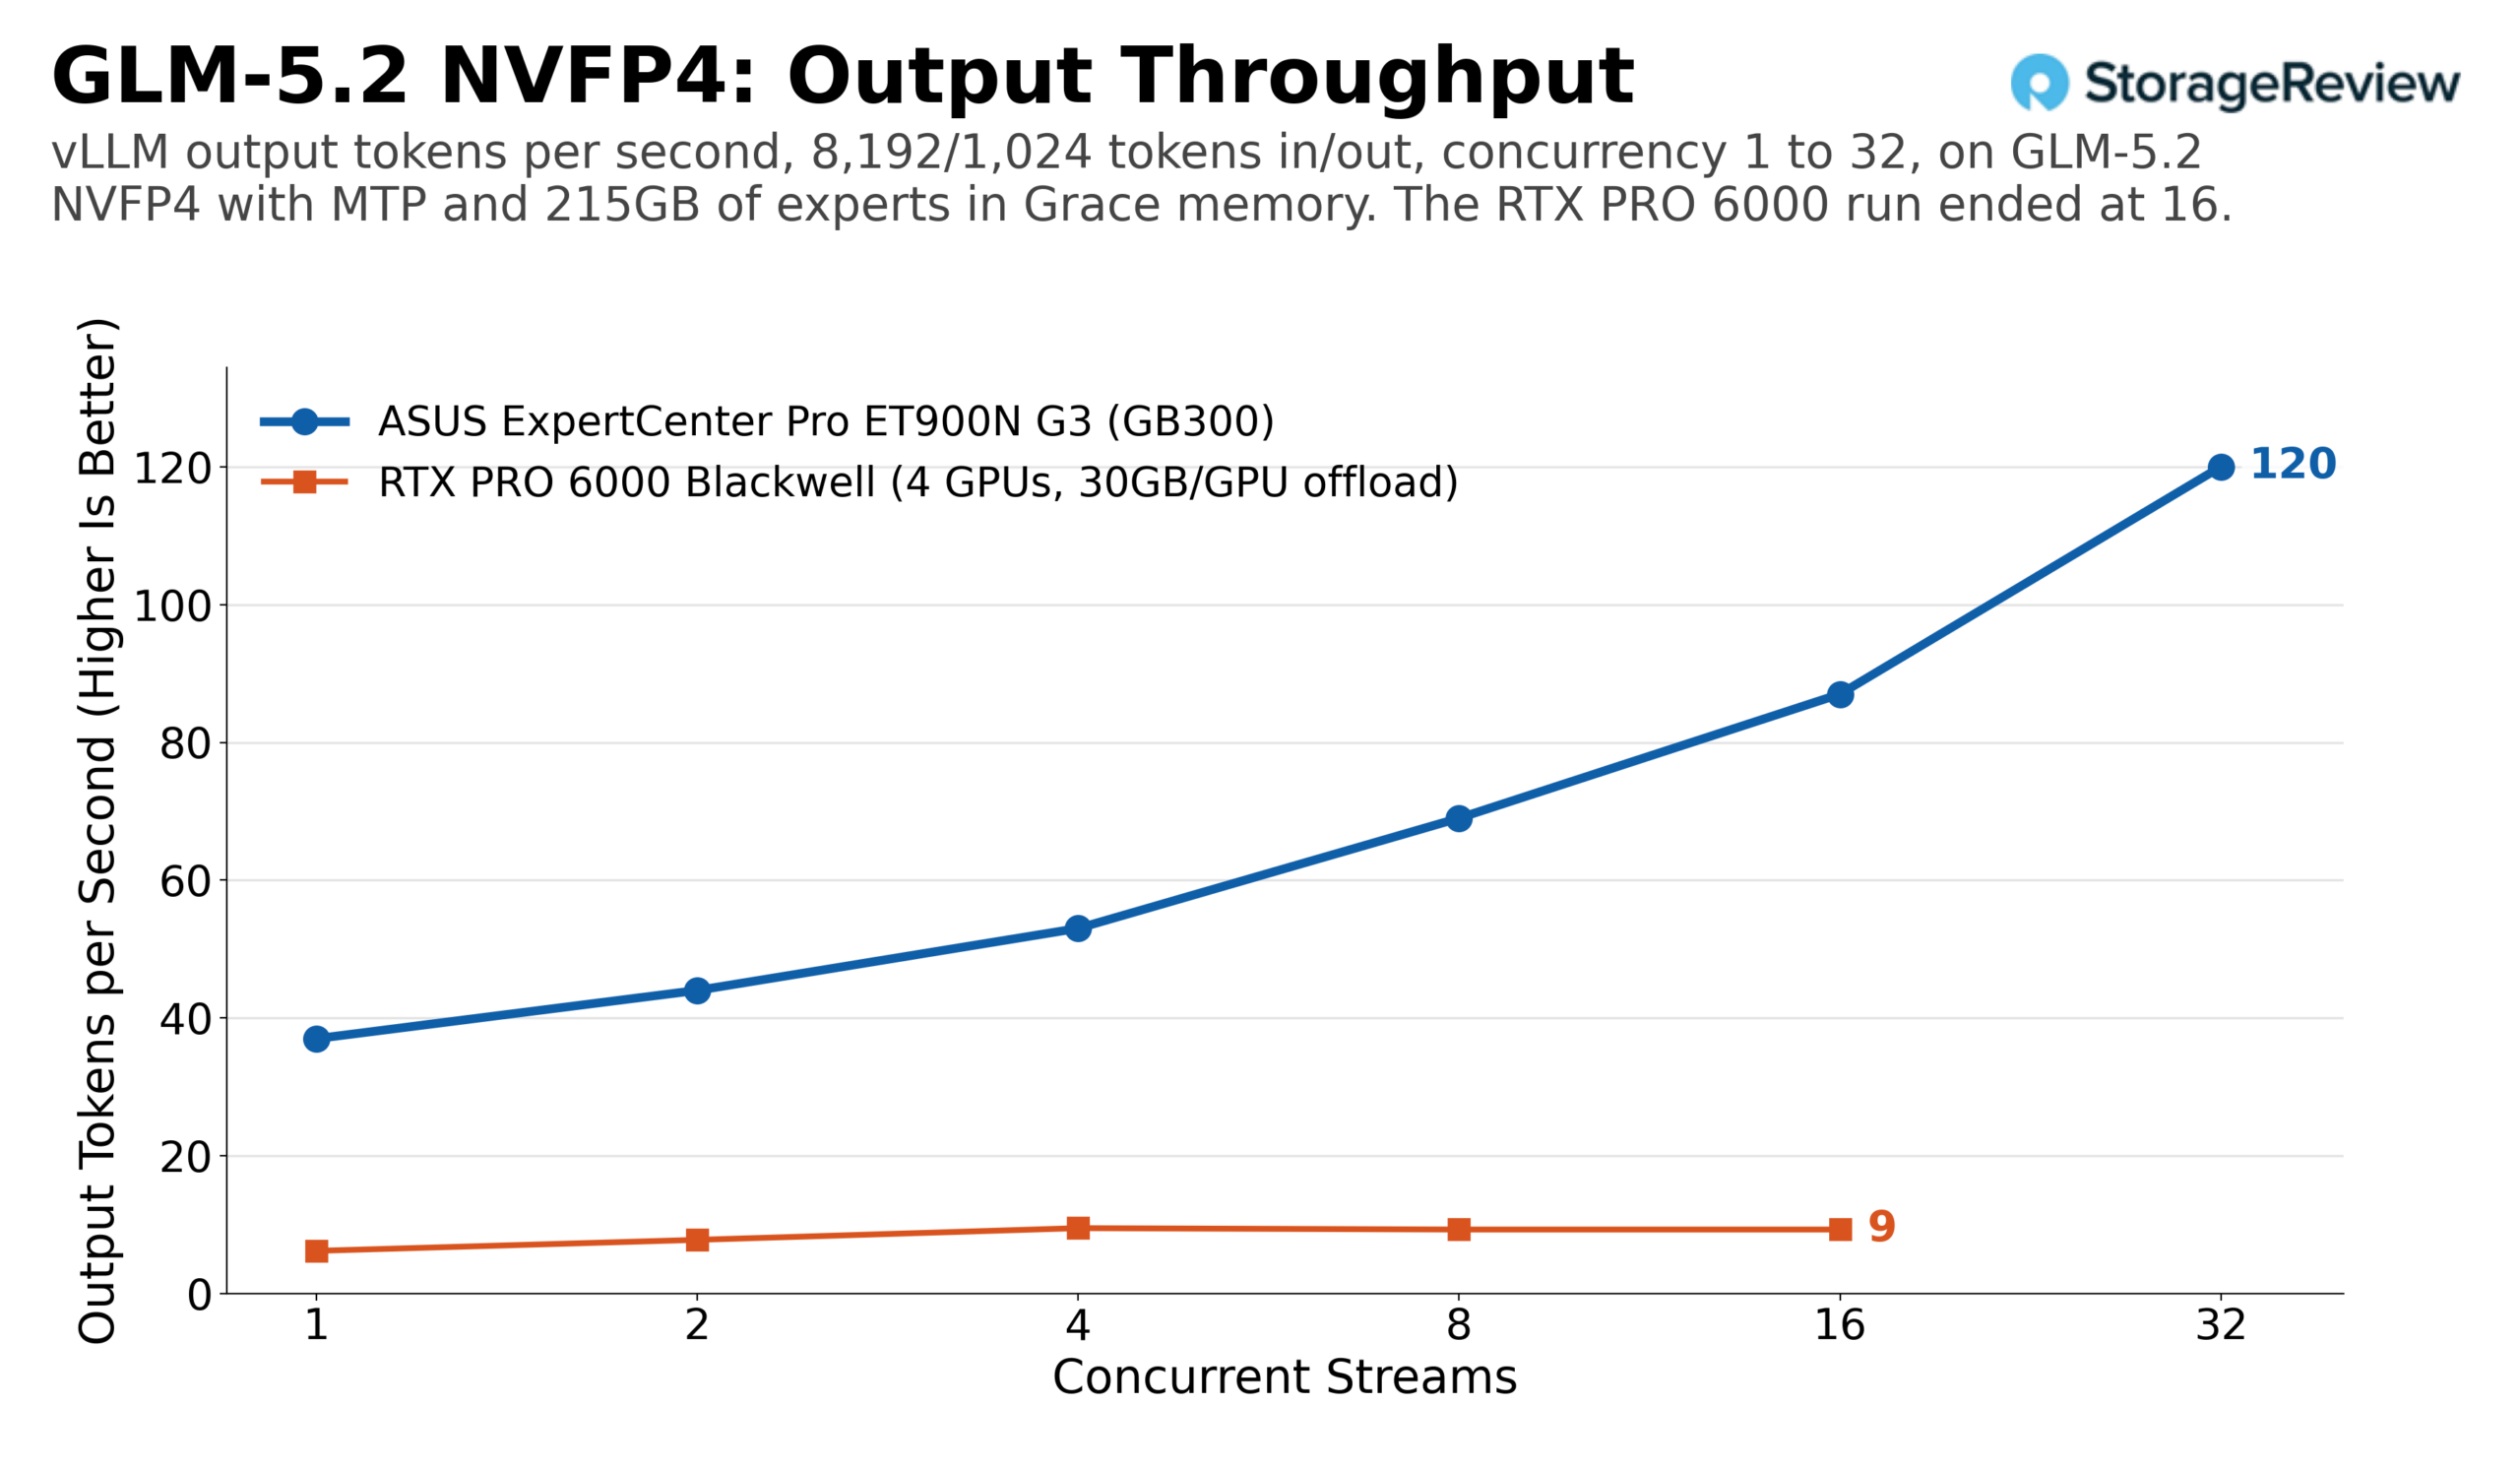
GLM-5.2 es el caso de uso que solo el grupo coherente hace posible. El punto de control NVFP4 mantiene aproximadamente 215 GB de pesos expertos en memoria Grace con decodificación especulativa MTP, y el ET900N G3 lo sirvió a 35 tokens de salida por segundo para un flujo y 139 para 32 flujos en una carga de trabajo igual, con un rendimiento total que alcanzó 277. En el perfil con mucho prellenado, el barrido se extendió a 32 flujos, alcanzando 120 tokens de salida por segundo y 1,079 tokens en total. Cuatro tarjetas RTX PRO 6000, cada una descargando aproximadamente 30 GB a la memoria del host, lograron aproximadamente 40 tokens de salida por segundo en 32 flujos, estabilizándose a aproximadamente 9 a 10 en indicaciones largas a partir de cuatro flujos. Ninguno de los dos sistemas hace que un modelo de 433 GB se sienta rápido, pero la ruta LPDDR5X de 396 GB/s y NVLink-C2C de 900 GB/s del GB300 hacia los expertos en descarga sigue escalando donde la memoria host conectada por PCIe en cuatro tarjetas se detiene.
En comparación con el MSI WS300, los resultados del modelo fronterizo del ET900N G3 se sitúan dentro de un margen de aproximadamente el 1% en todos los puntos que podemos comparar: 1,766 tokens de salida por segundo en DeepSeek V4 Flash a 32 flujos en ambas torres, 4,793 frente a 4,801 en MiniMax M2.7 a 128, 1,041 en MiniMax M3 a 32 en ambos y 139 en GLM-5.2 a 32 en ambos.
Modelos compartidos frente a la RTX PRO 6000, H200 NVL y DGX Spark.
La segunda mitad de las pruebas de rendimiento utiliza modelos lo suficientemente pequeños para que cualquier sistema pueda utilizarlos: GPT-OSS-20B y 120B en MXFP4 nativo; Llama 3.1 8B en BF16 y FP8; Mistral Small 24B en BF16 y FP8; y Qwen3 Coder 30B en BF16 y FP8. Como novedad desde la revisión de la WS300, se incluye una única H200 NVL, la tarjeta Hopper de 141 GB de NVIDIA, lo que añade a la comparación un acelerador para centros de datos de una generación anterior.
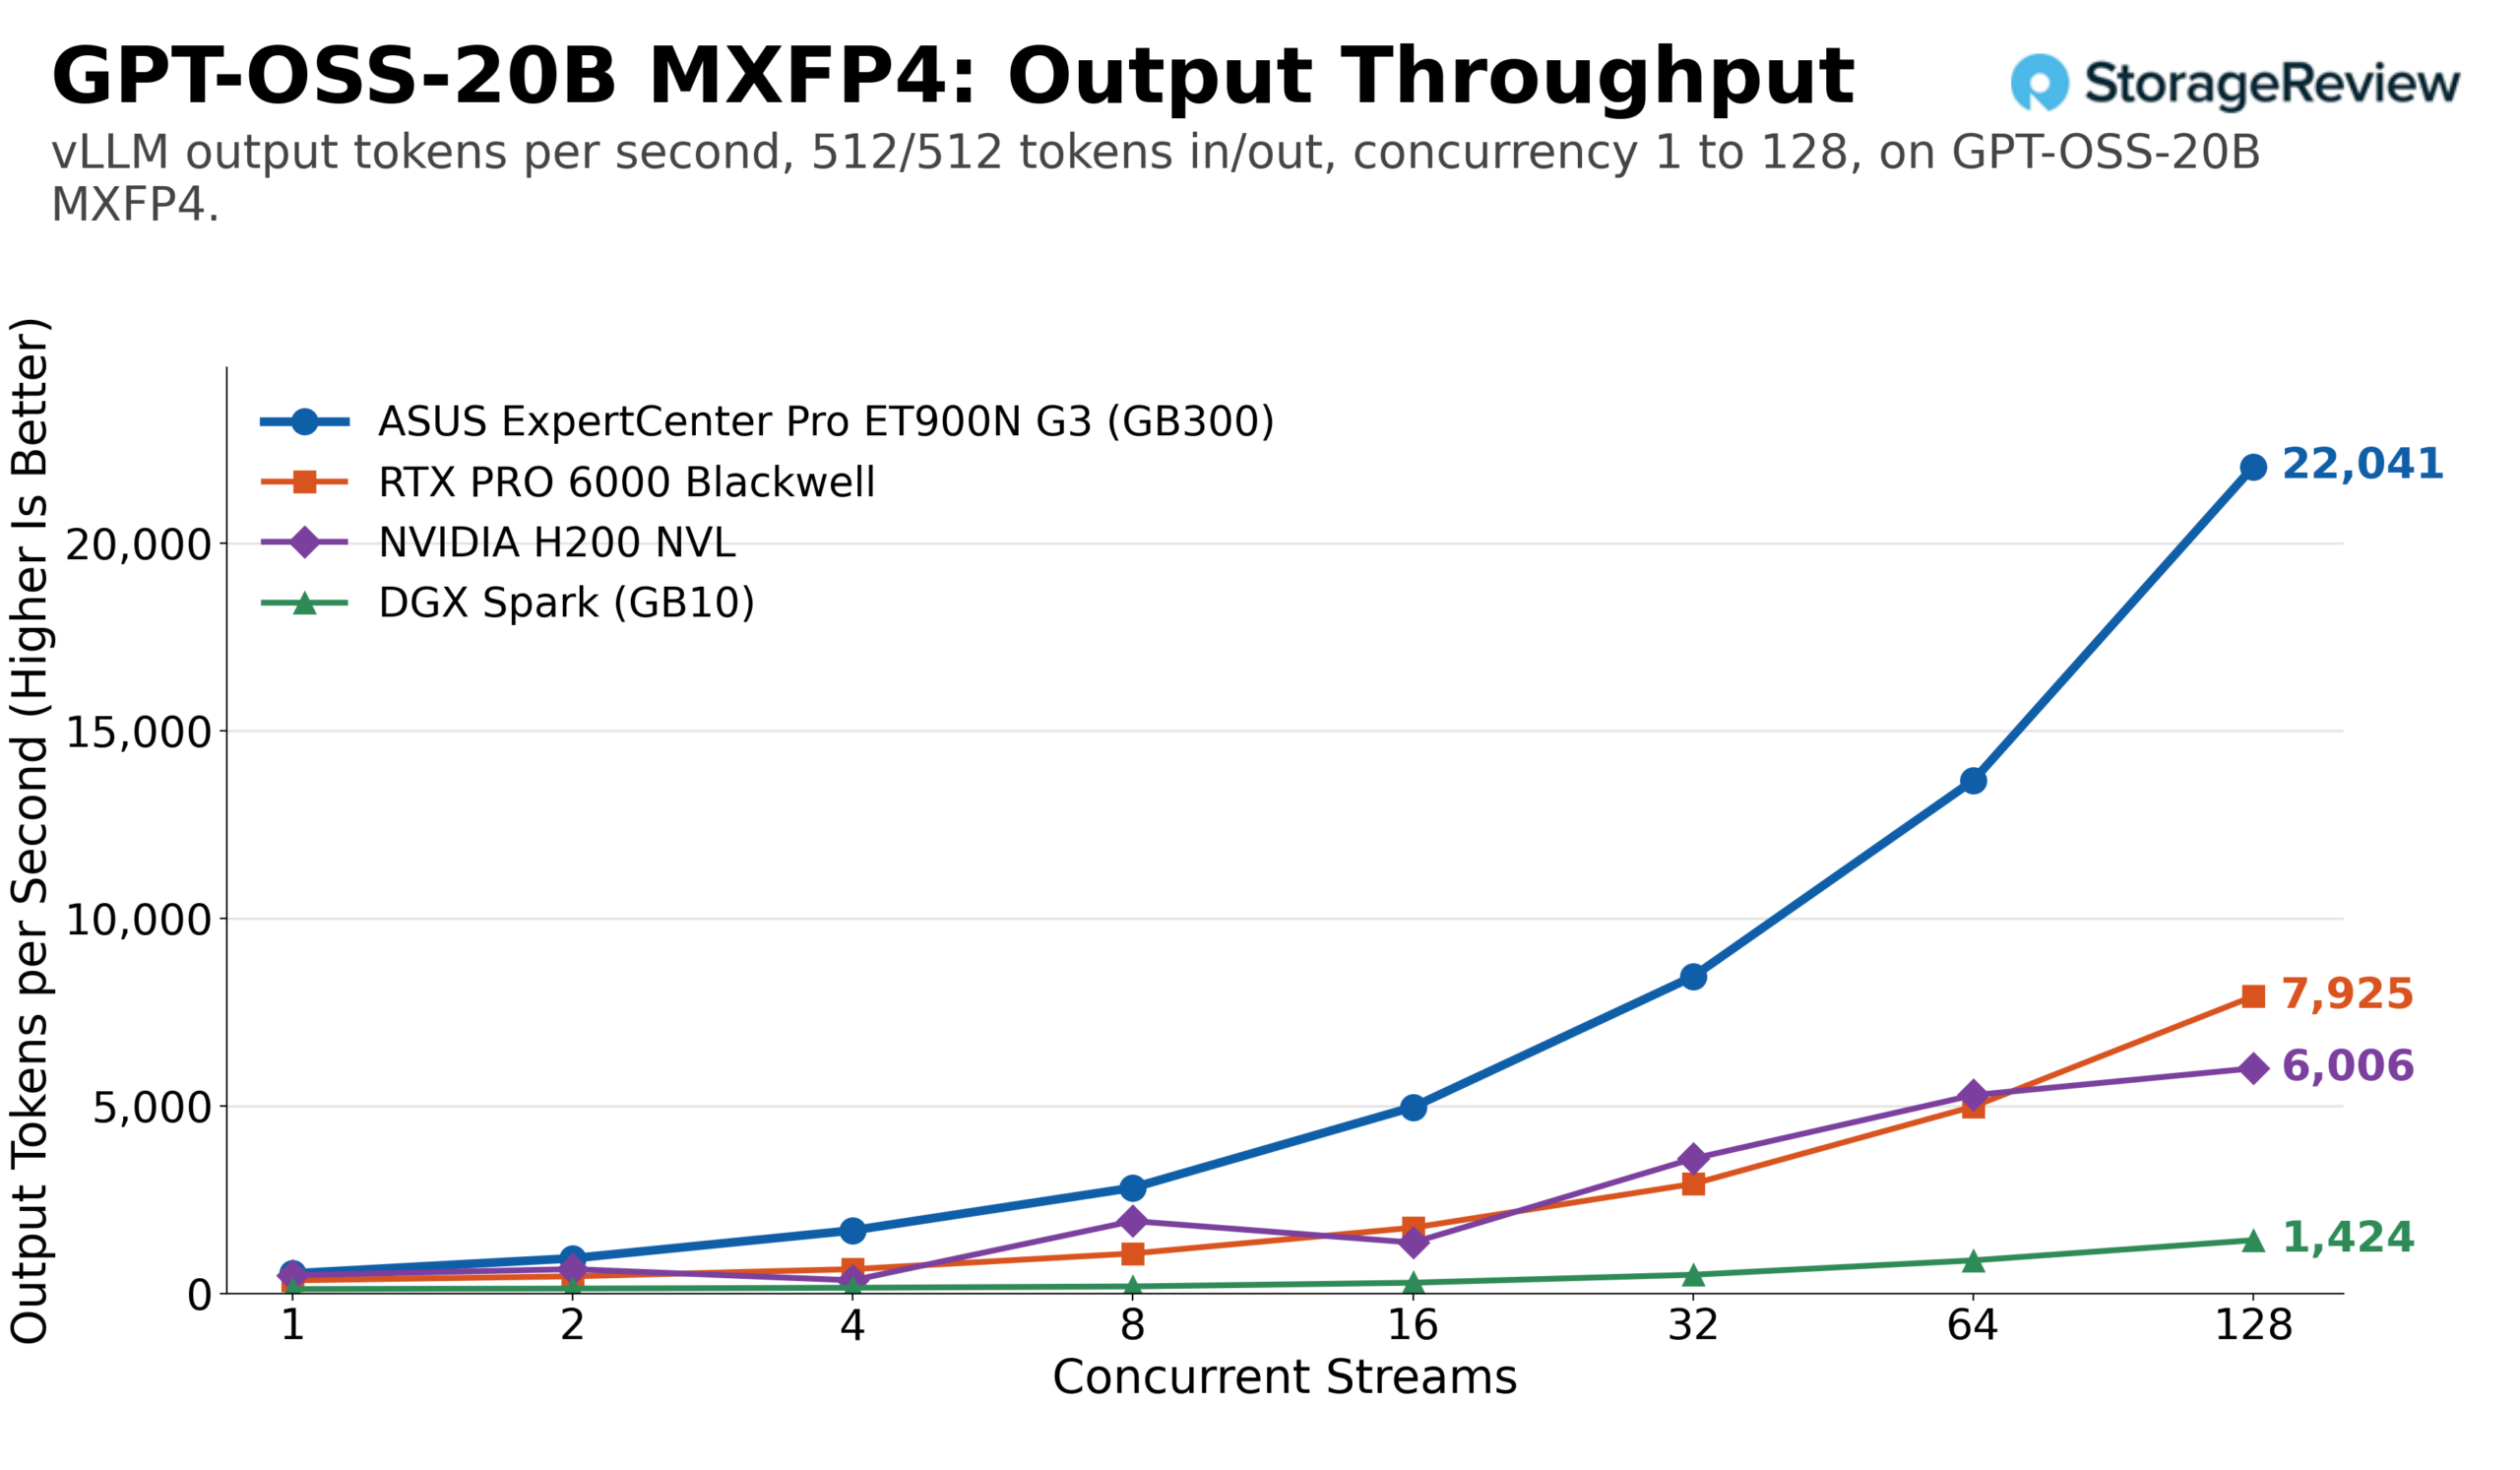
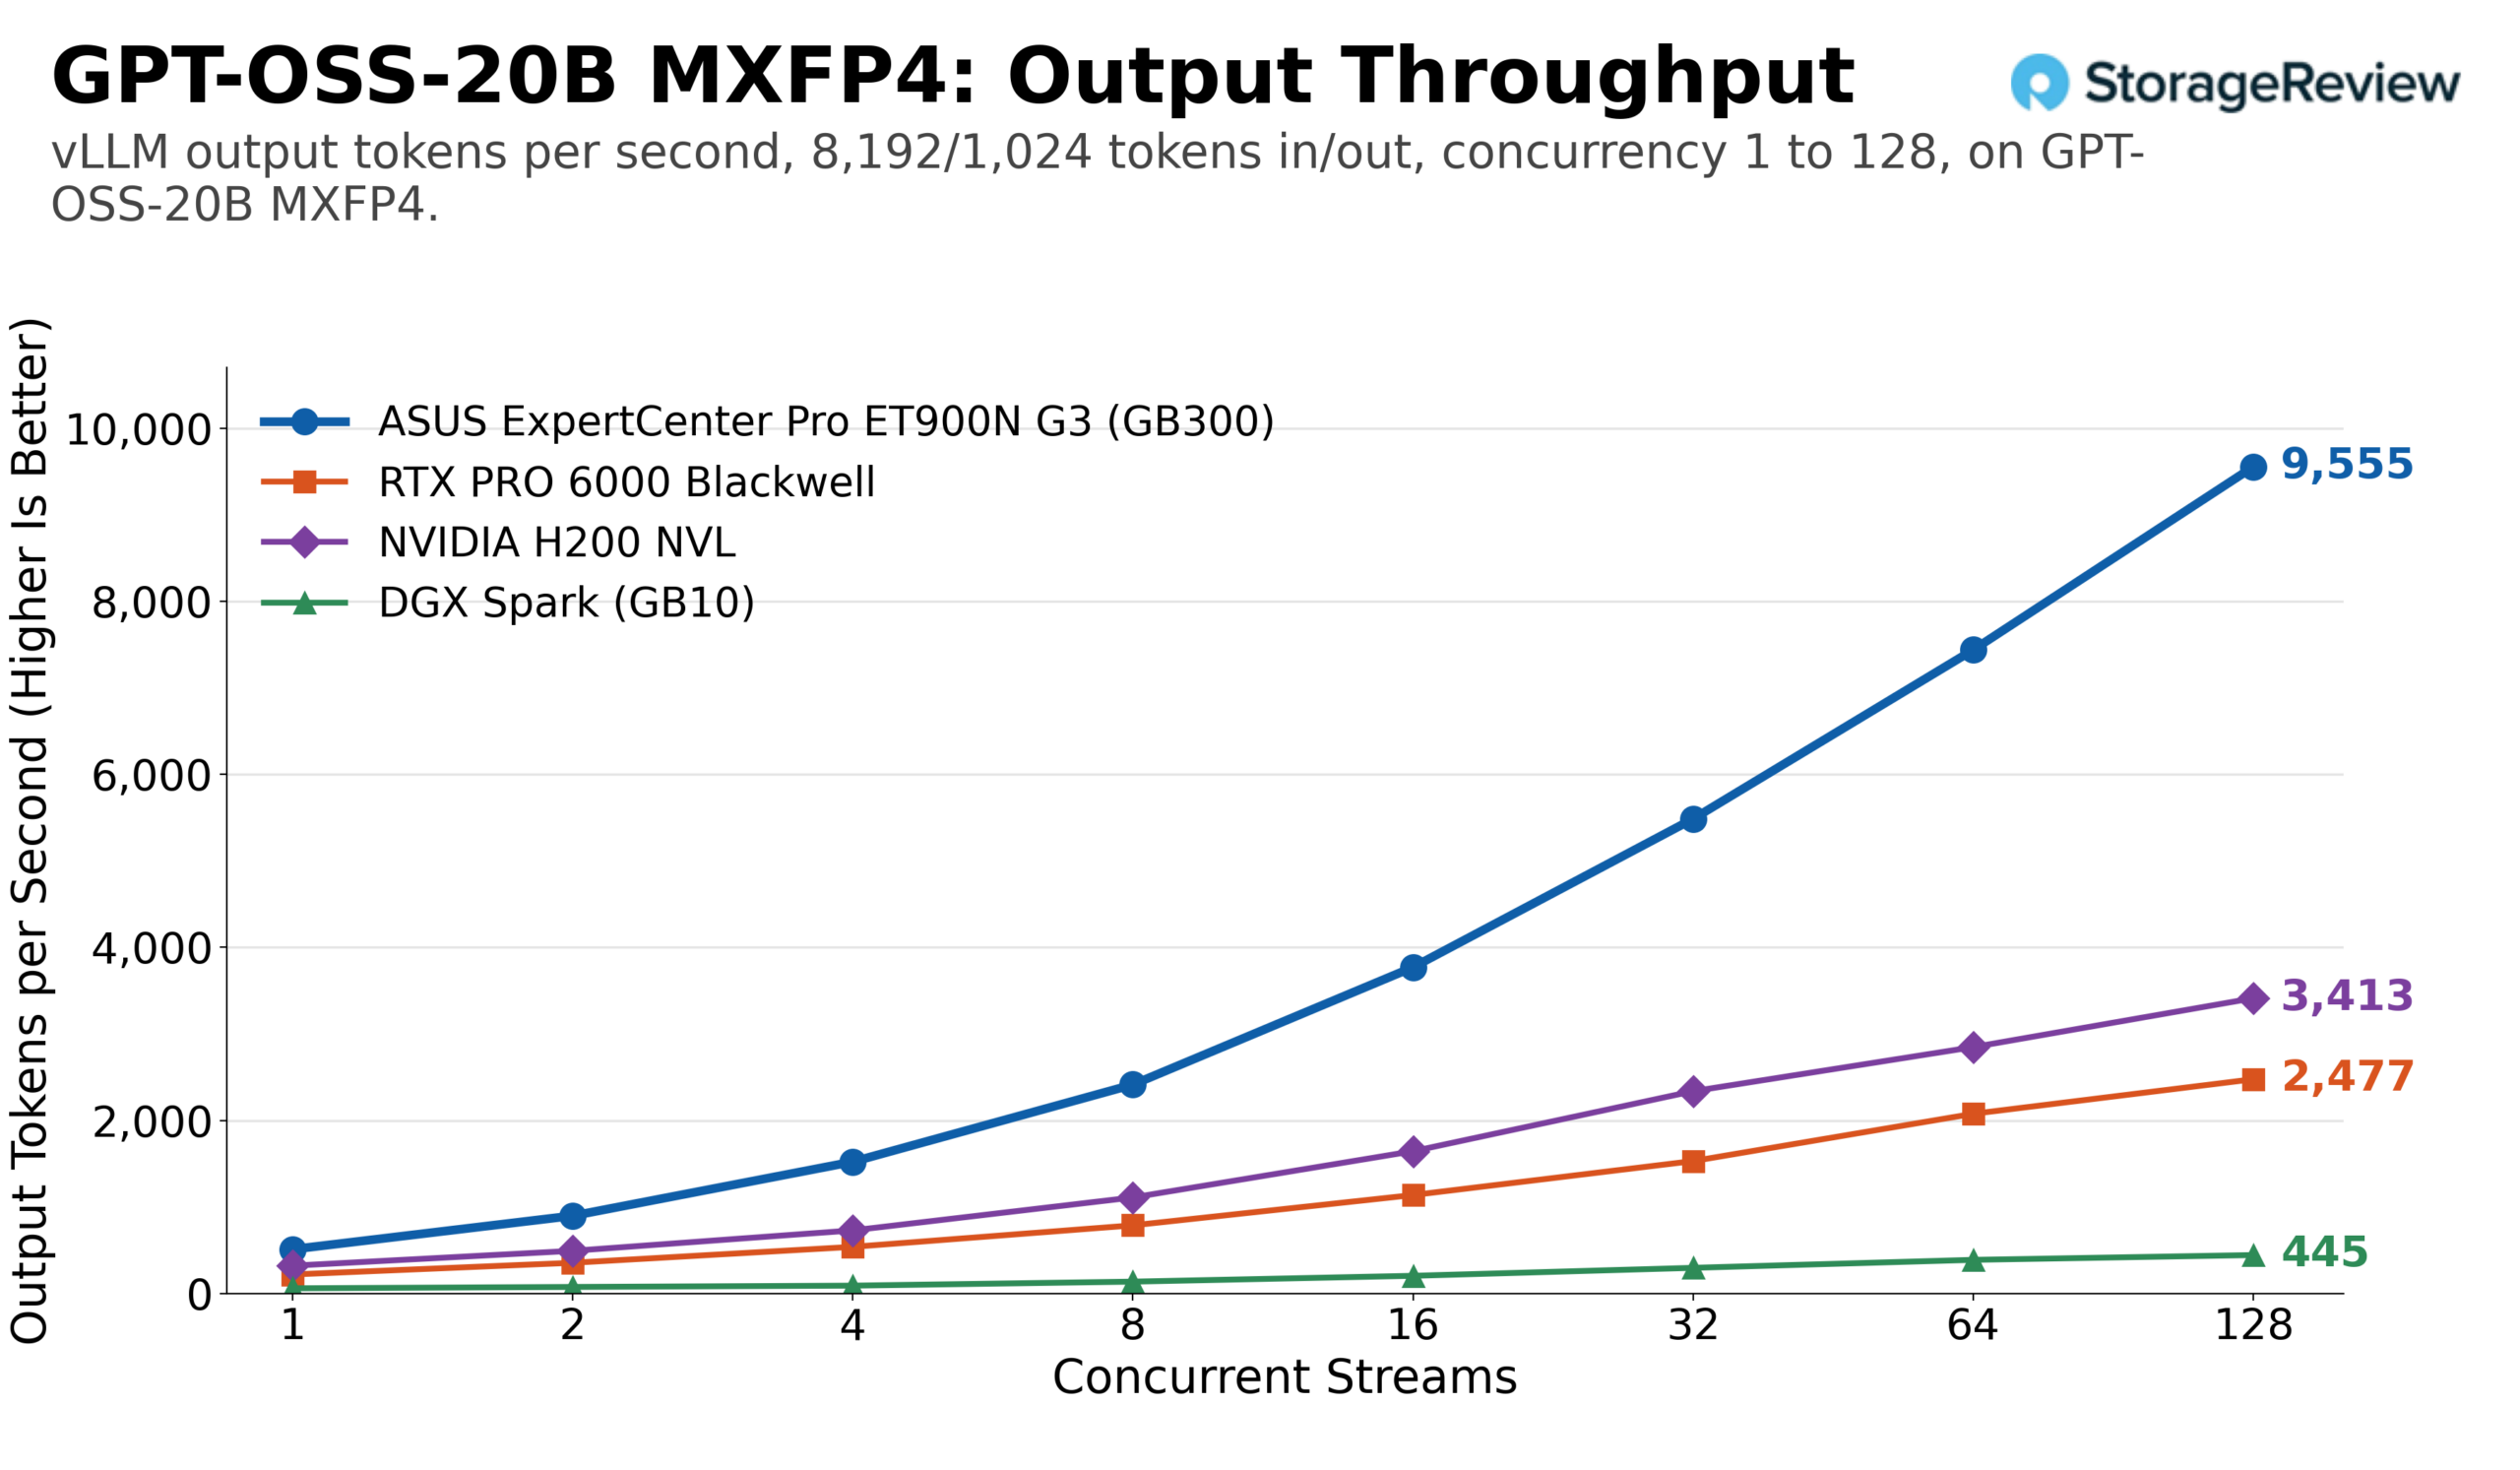
GPT-OSS-20B es la prueba más sencilla del conjunto, un punto de control que todos los sistemas superan sin problemas, y con la misma carga de trabajo, el ET900N G3 alcanzó los 22,041 tokens de salida por segundo en 128 flujos, o 44,082 en total, frente a unos 7,920 para el RTX PRO 6000, 6,010 para el H200 NVL y 1,420 para el DGX Spark. En modo de flujo único, la Station produjo 536 tokens de salida por segundo, en comparación con los 354 de la tarjeta, los 489 de la H200 y los 120 de la Spark. El perfil con precarga amplió la diferencia: 9,555 tokens de salida por segundo y un total de 85,994 en 128 flujos para la Station, con la RTX PRO 6000 en aproximadamente 2,480, la H200 NVL en 3,410 y la Spark en 445.
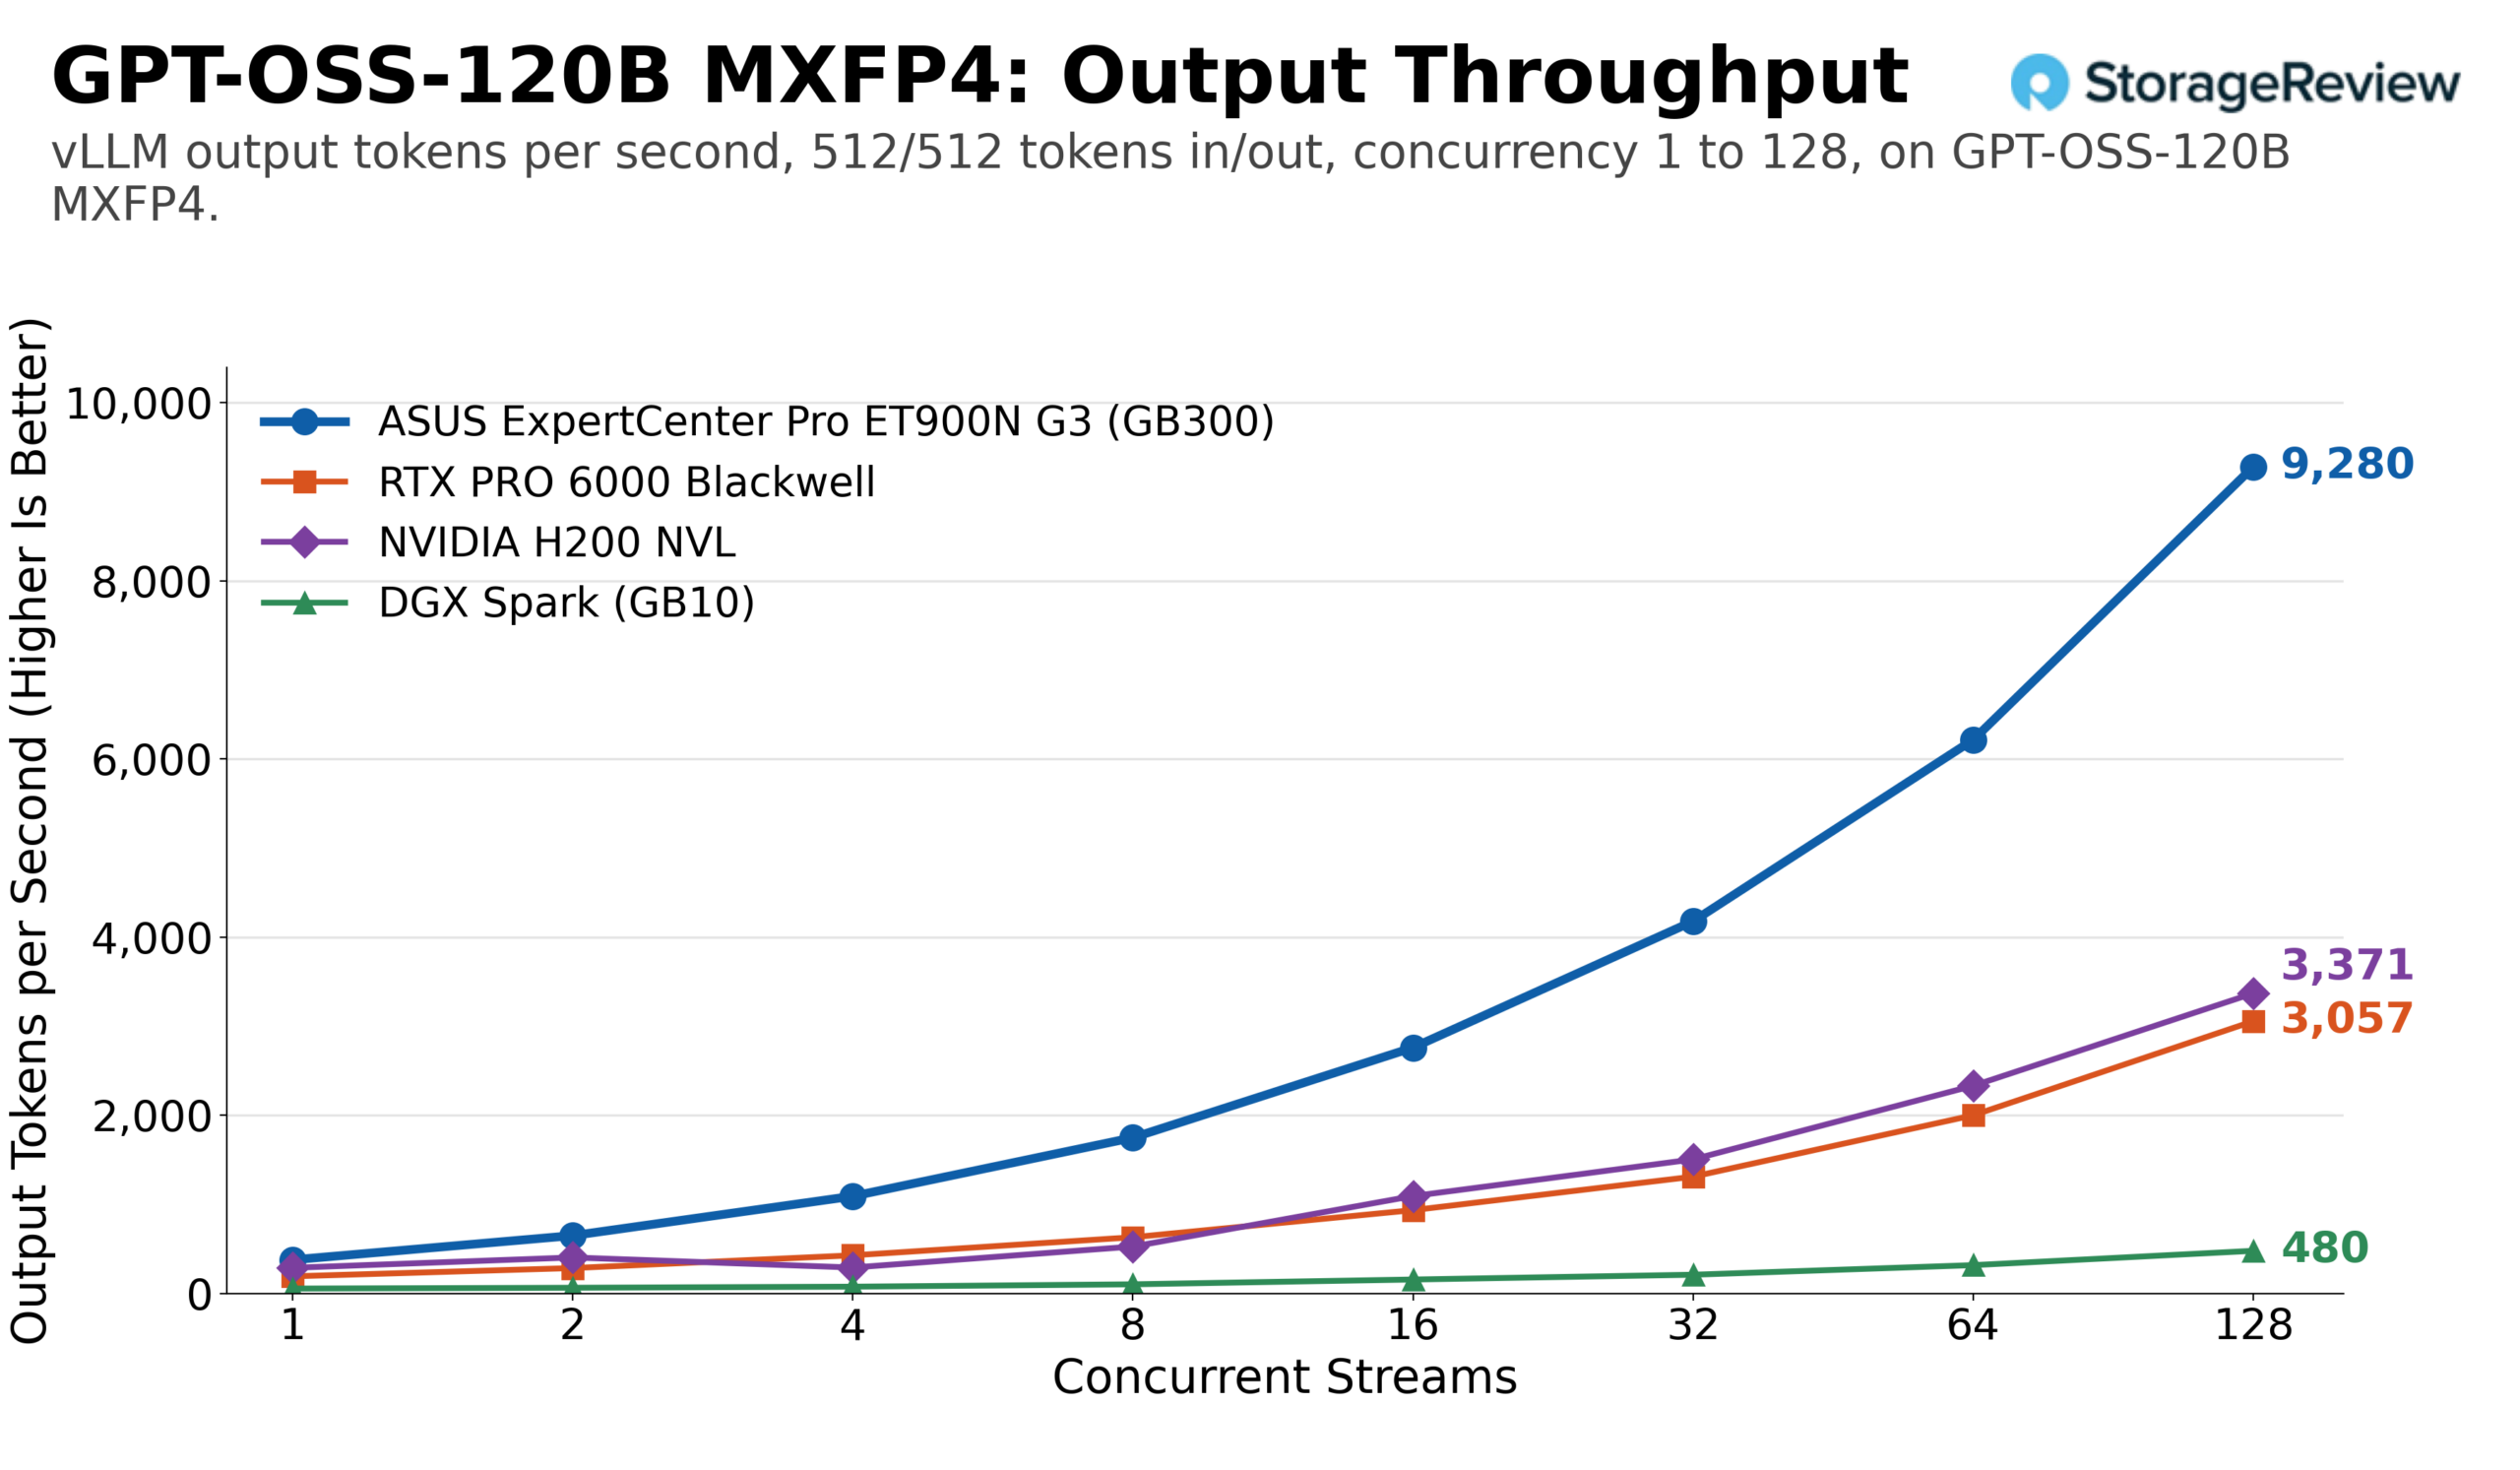
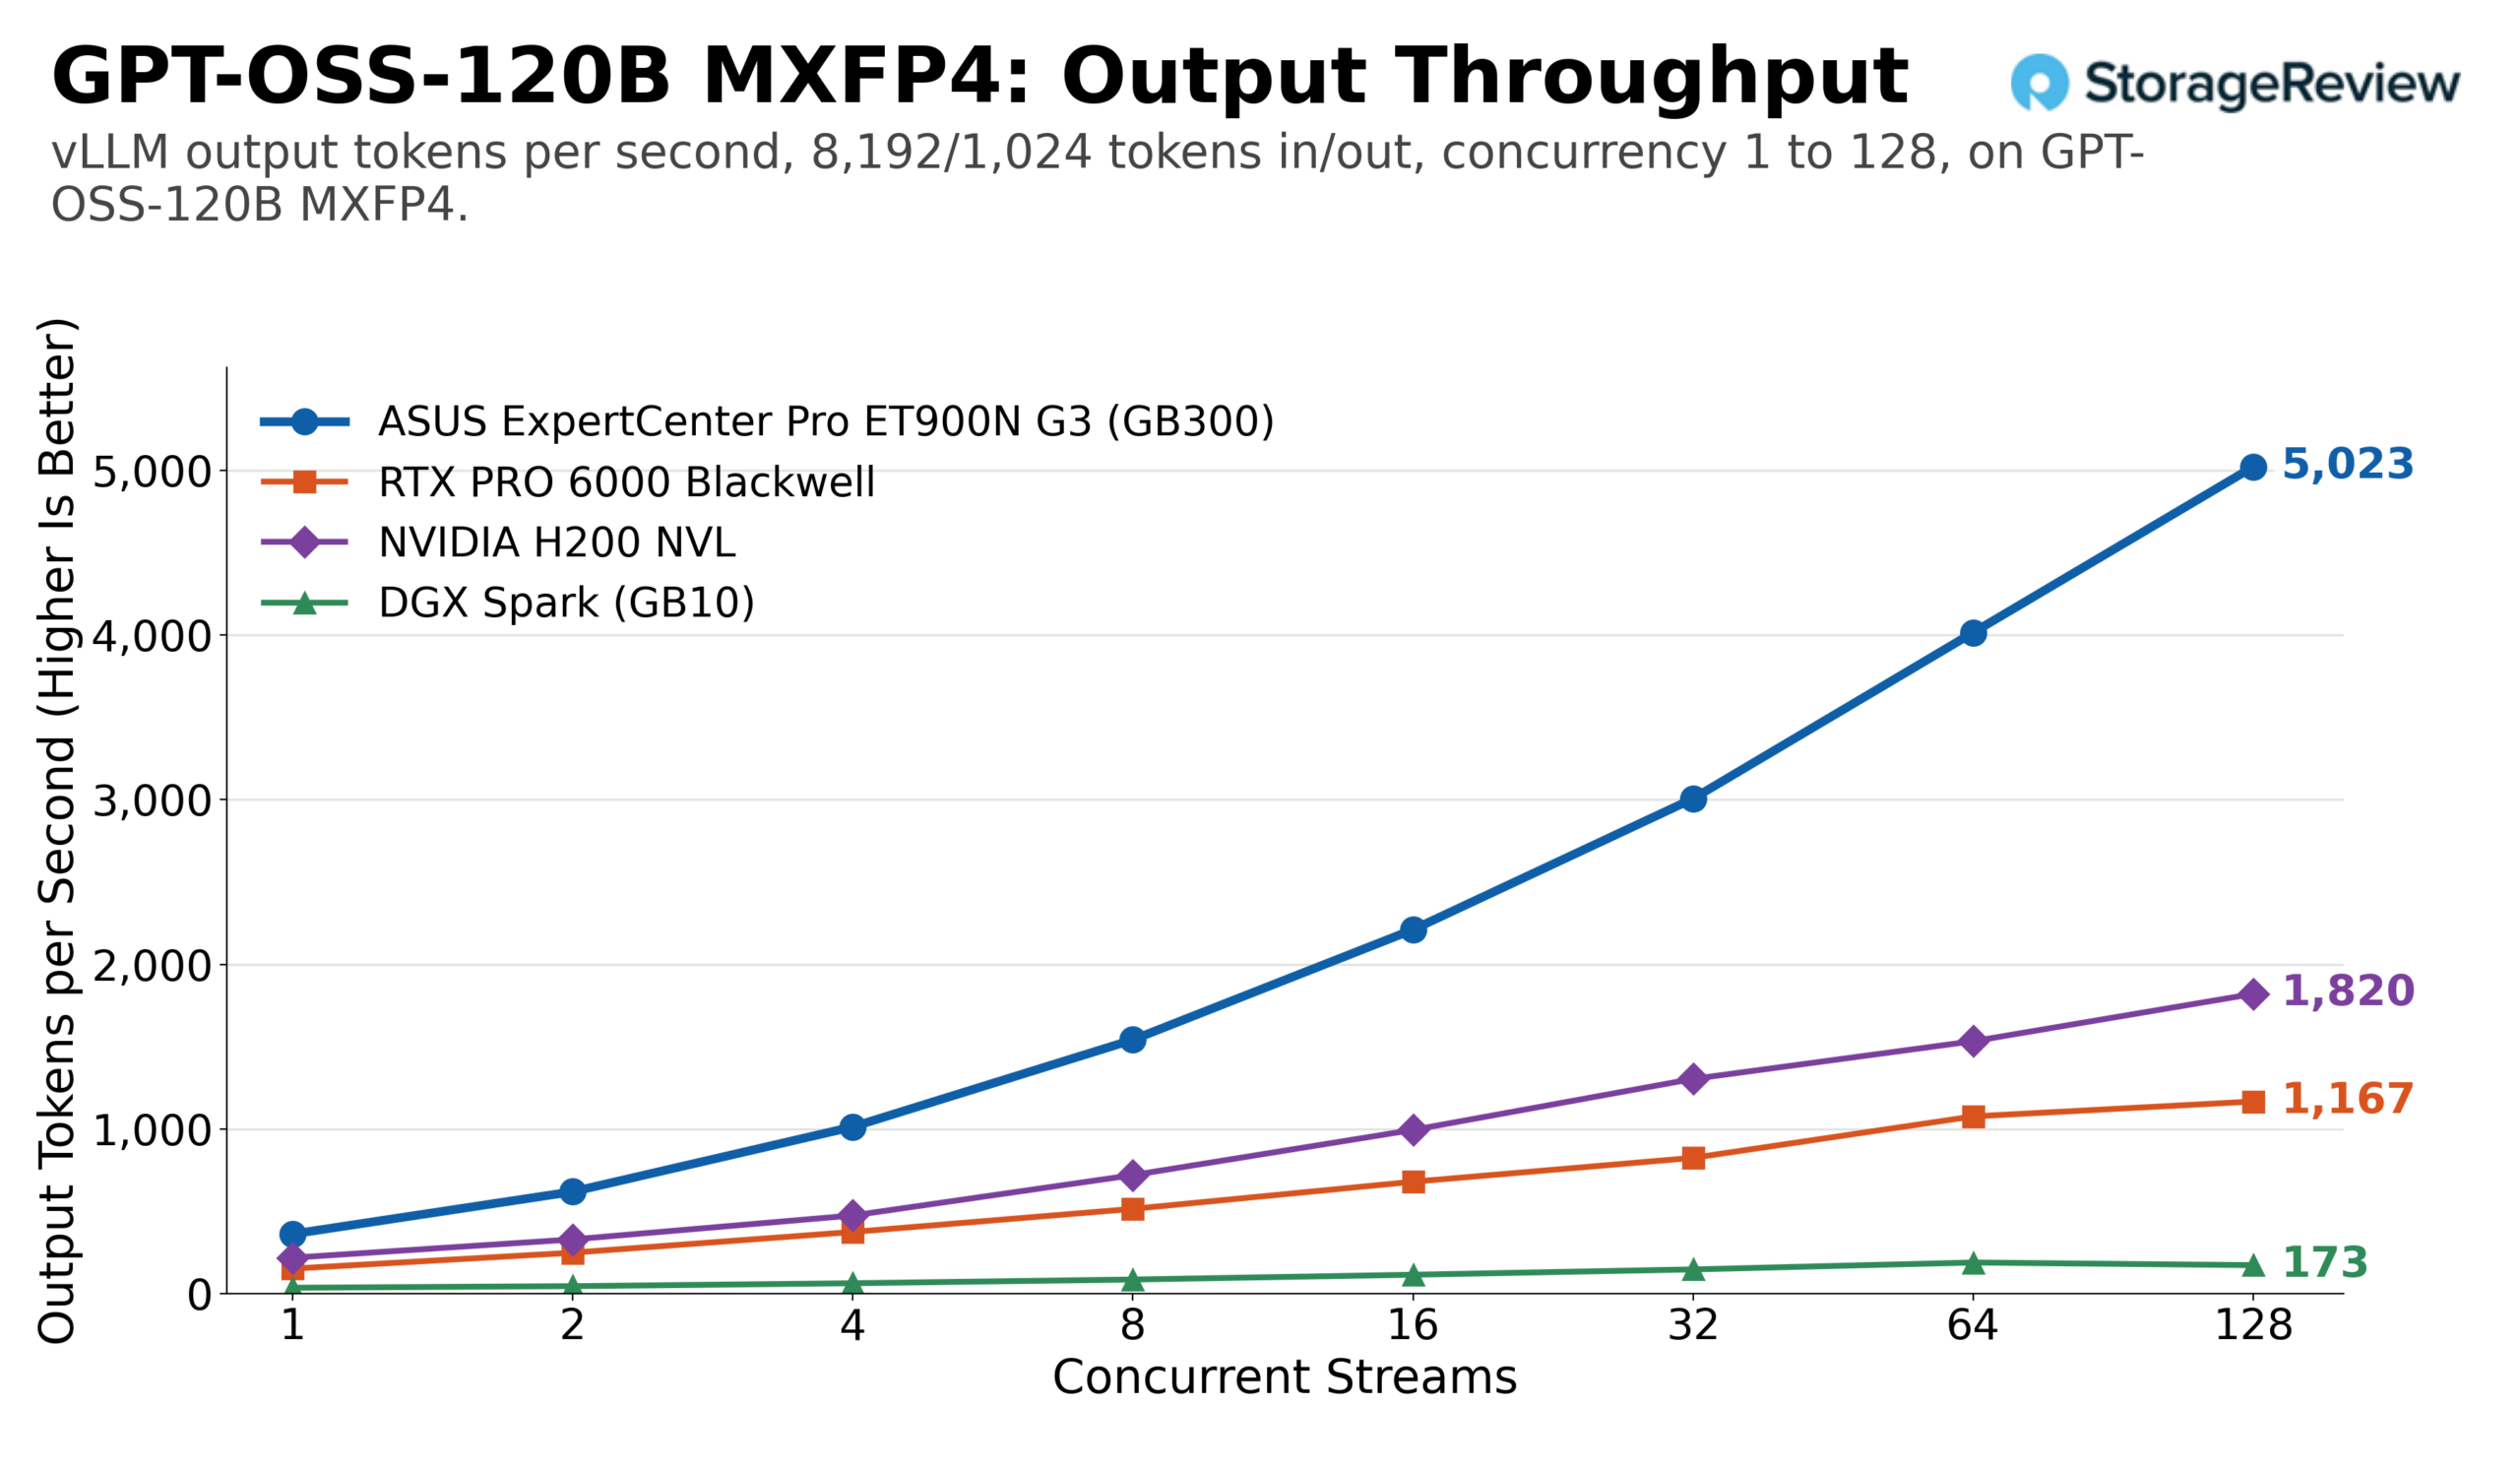
GPT-OSS-120B es donde la memoria comienza a clasificar el campo. El ET900N G3 alcanzó 9,280 tokens de salida por segundo con la misma carga de trabajo a 128 flujos, aproximadamente tres veces el RTX PRO 6000 a 3,060, 2.8 veces el H200 NVL a 3,370 y más de 19 veces el Spark a 480. Bajo indicaciones largas, los sistemas más pequeños se quedaron sin espacio de caché KV rápidamente: el RTX PRO 6000 alcanzó un máximo de alrededor de 1,170 tokens de salida por segundo y el H200 NVL casi 1,820, mientras que la Station seguía aumentando a 128 flujos y terminó en 5,023, con un rendimiento total de 45 205 tokens por segundo.
Llama 3.1 8B en FP8 es el número individual más alto en el conjunto. El ET900N G3 envió 25,602 tokens de salida por segundo en 128 flujos en la misma carga de trabajo, 51,205 en total, en comparación con aproximadamente 8,060 para el RTX PRO 6000 y 11,040 para el H200 NVL. Bajar de BF16 a FP8 aumentó la Estación en aproximadamente un 50% (de 17,074 a 25,602), mientras que el RTX PRO 6000 ganó aproximadamente un 70% y el H200 NVL aproximadamente un 37% con el mismo cambio. El perfil con mucho prefill comprimió todo, con la Estación en 6,164 tokens de salida por segundo, la tarjeta en 1,480 y el H200 en 2,040.
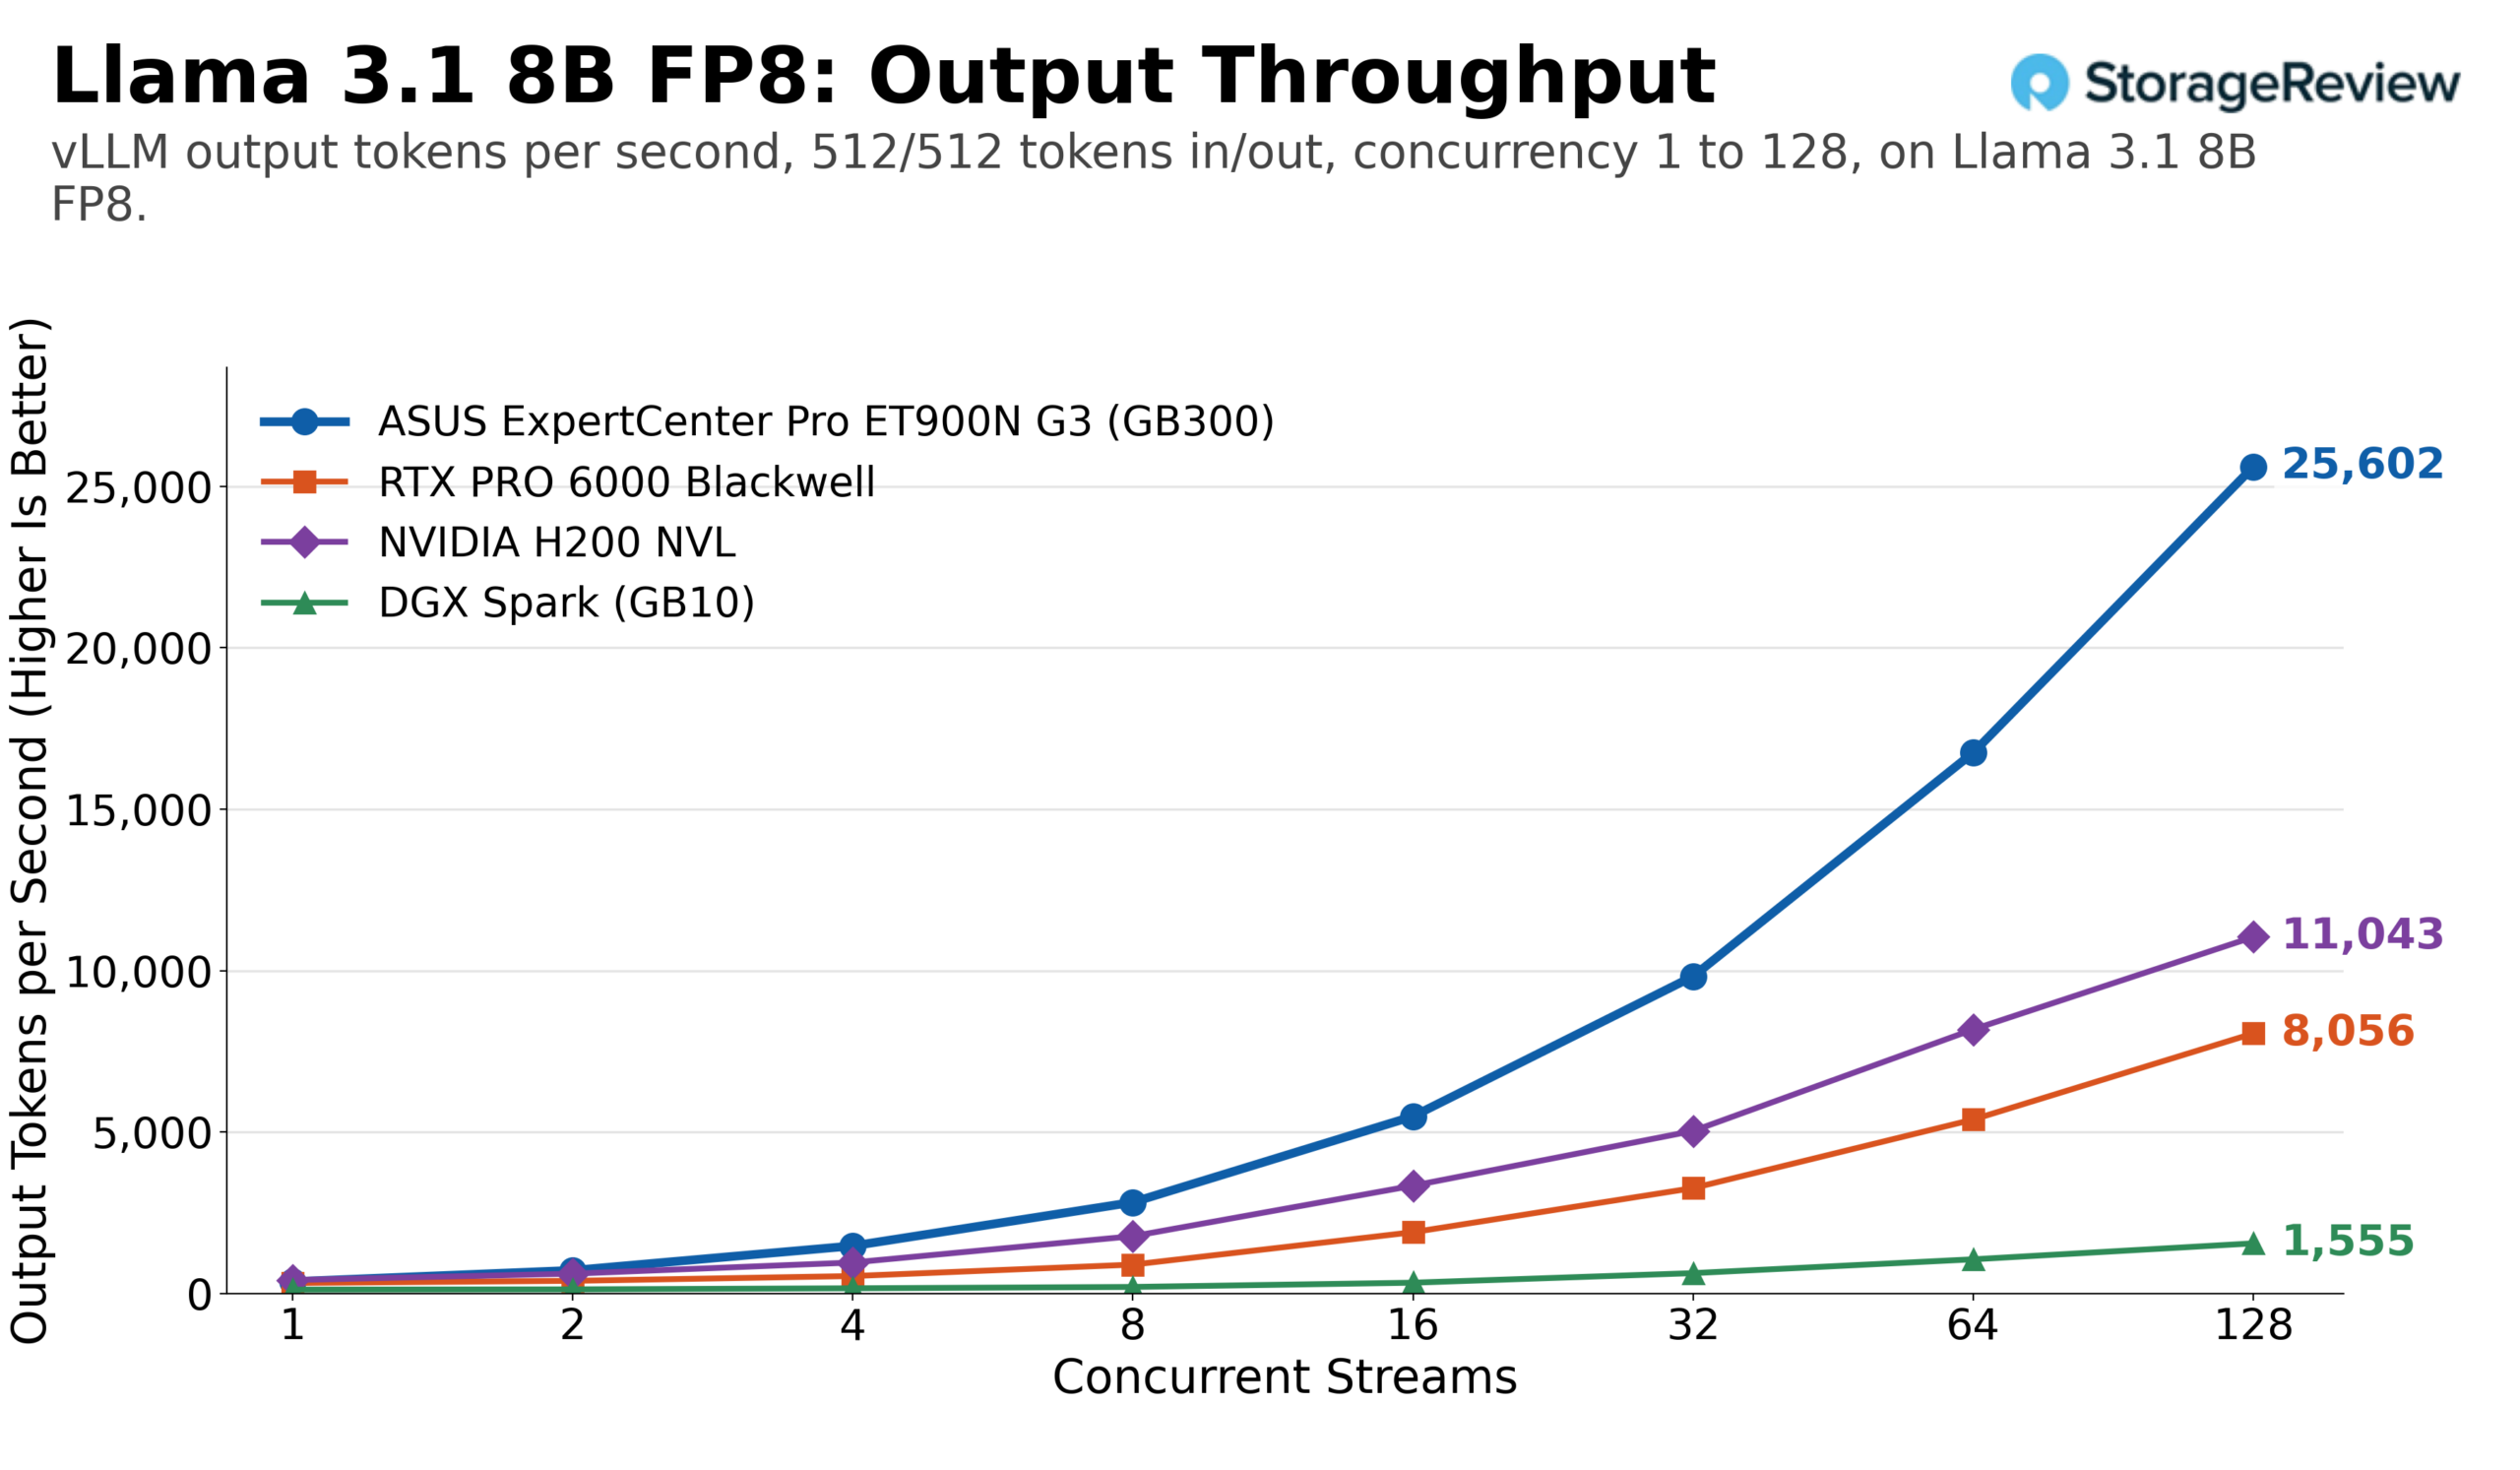
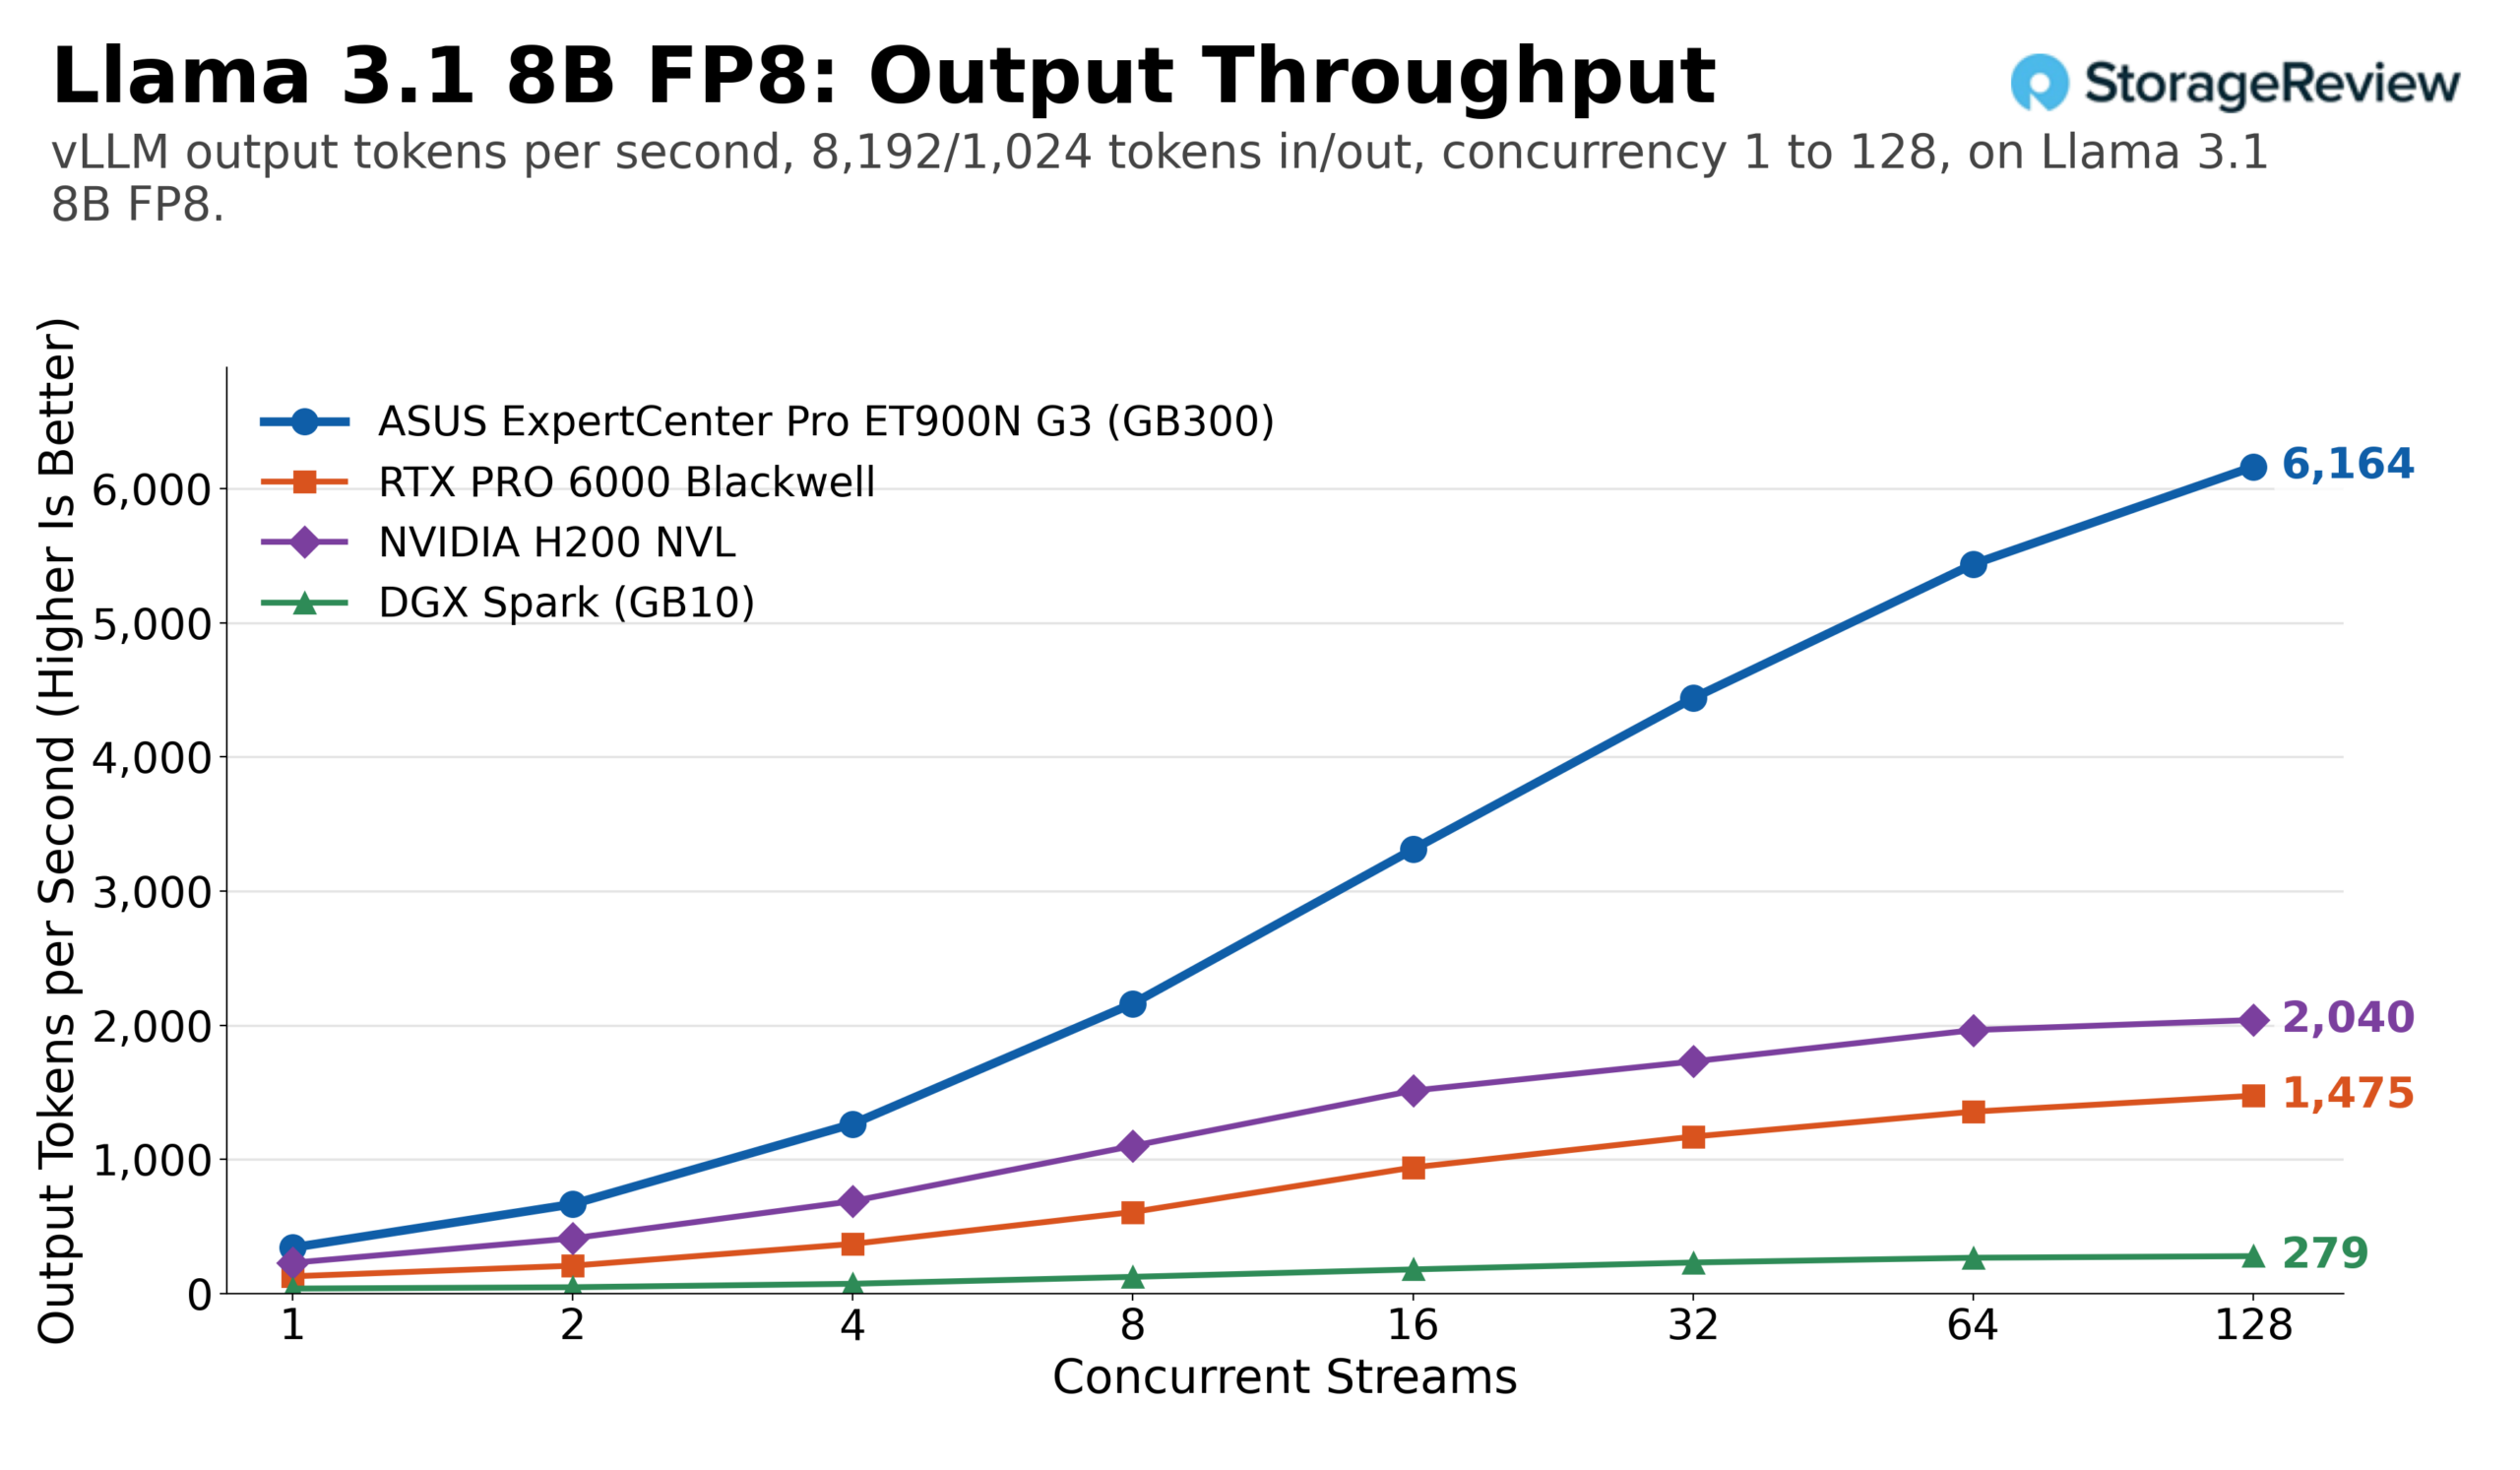
Mistral Small 24B en FP8 produjo las proporciones más amplias. El ET900N G3 alcanzó un pico de 11,075 tokens de salida por segundo con la misma carga de trabajo, 3.4 veces el RTX PRO 6000 (3,240), 2.4 veces el H200 NVL (4,610) y casi 20 veces el Spark (559). Bajo indicaciones largas, el RTX PRO 6000 alcanzó un pico de 32 flujos y unos 480 tokens de salida por segundo antes de disminuir; el H200 NVL llegó a un máximo de unos 854, y la Station alcanzó 2,302 con 128 flujos.


Qwen3 Coder 30B, un modelo de mezcla de expertos con un pequeño número de parámetros activos, es donde se reduce la diferencia de una sola transmisión. Con una sola transmisión y una carga de trabajo igual, la RTX PRO 6000 entregó aproximadamente 232 tokens de salida por segundo, frente a los 319 de la Station y los 308 de la H200 NVL. El procesamiento por lotes restablece el orden: con 128 transmisiones, la ET900N G3 alcanzó 12,439 tokens de salida por segundo en FP8, 3.1 veces la tarjeta (3,990) y 1.7 veces la H200 NVL (7,450). En el perfil con precarga intensiva, la Station alcanzó 3,837 tokens de salida por segundo, mientras que la RTX PRO 6000 alcanzó un pico de aproximadamente 880 con 64 transmisiones, y la H200 NVL de aproximadamente 1,820.


En los modelos compartidos, el ET900N G3 alcanzó un rendimiento de 2.8 a 3.4 veces superior al de una sola RTX PRO 6000 y de 1.7 a 3.7 veces superior al de una H200 NVL en plena concurrencia, con un margen que se amplió con tiempos de espera prolongados a medida que se agotaba su capacidad de caché KV. Frente al WS300, estos cuatro se sitúan de nuevo dentro del 1%: 22,041 frente a 22,161 en GPT-OSS-20B, 9,280 frente a 9,294 en GPT-OSS-120B, 11,075 frente a 11,157 en Mistral Small FP8 y 12,439 frente a 12,425 en Qwen3 Coder FP8. La comparación completa de los 14 modelos, incluidos los tres con mayores diferencias, se encuentra en la siguiente sección.
Dos torres, una placa base: ASUS ET900N G3 vs MSI WS300
El ET900N G3 y el MSI XpertStation WS300 utilizan la misma placa base NVIDIA GB300 DGX Station en dos chasis OEM diferentes. Ambos se sometieron a las mismas 14 pruebas, las mismas dos cargas de trabajo y la misma prueba de concurrencia en la misma compilación vLLM. El siguiente gráfico compara el rendimiento máximo del ET900N G3 en todos los modelos con el del WS300.
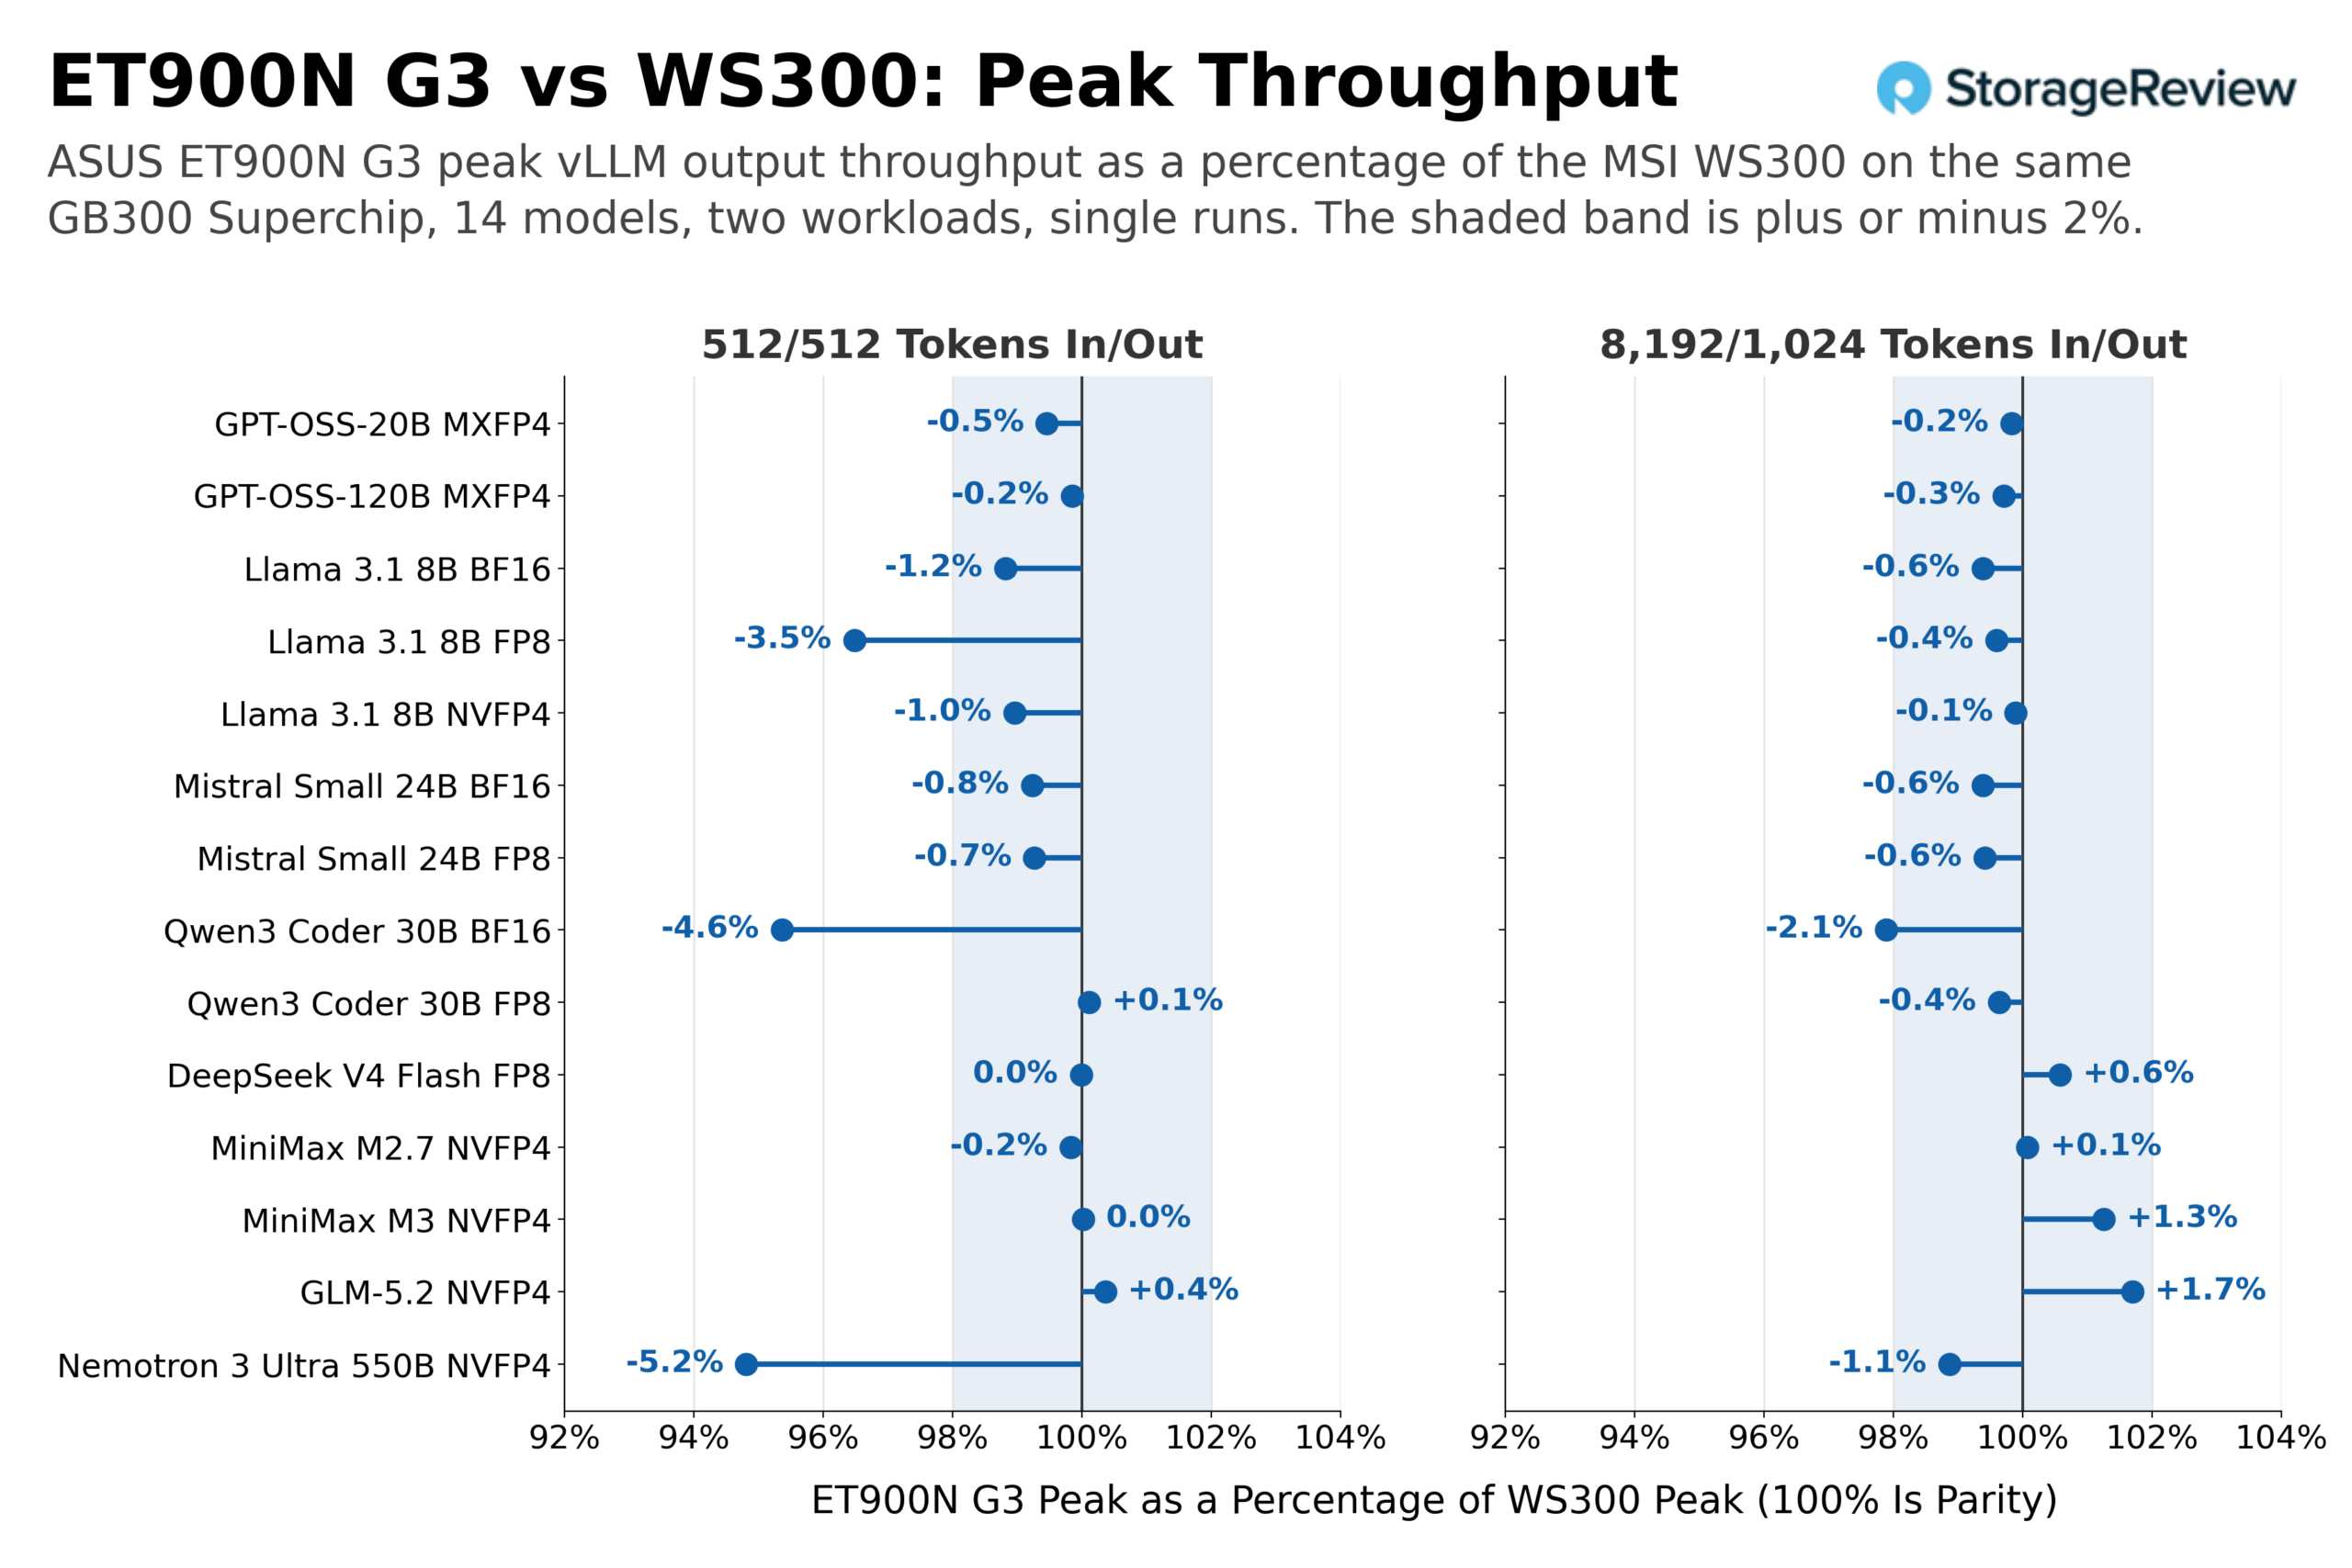
Entre los 28 pares de modelos y cargas de trabajo, 24 se encuentran dentro del 2% entre sí, y la mayoría de ellos son una fracción de un porcentaje a favor del WS300. Cuatro se encuentran fuera de esa banda, tres de ellos con la misma carga de trabajo: Llama 3.1 8B FP8 con un 3.5% menos que el WS300 (25,602 frente a 26,536 tokens de salida por segundo), Qwen3 Coder 30B BF16 con un 4.6% menos (10,000 frente a 10,486) y Nemotron 3 Ultra 550B con un 5.2% menos (159 frente a 168), además de Qwen3 Coder 30B BF16 nuevamente con un 2.1% menos en las indicaciones largas. Cada cifra aquí es una sola ejecución en cada torre, por lo que una diferencia del 2 al 5% entre tres modelos de 14 no es algo que podamos atribuir al chasis; Simplemente estamos registrando los datos y la diferencia entre ambos. Los modelos que dependen del grupo de memoria coherente, MiniMax M3 y GLM-5.2, obtienen resultados iguales o superiores en ambas cargas de trabajo; ese es el resultado que consideramos más importante para la plataforma: la ruta de descarga Grace funciona igual en el chasis de ASUS que en el de MSI.
| Modelo | WS300 512/512 | ET900N G3 512/512 | Delta | WS300 8,192/1,024 | ET900N G3 8,192/1,024 | Delta |
|---|---|---|---|---|---|---|
| GPT-OSS-20B MXFP4 | 22,161 | 22,041 | -0.5% | 9,572 | 9,555 | -0.2% |
| GPT-OSS-120B MXFP4 | 9,294 | 9,280 | -0.2% | 5,038 | 5,023 | -0.3% |
| Llama 3.1 8B BF16 | 17,278 | 17,074 | -1.2% | 3,520 | 3,498 | -0.6% |
| Llama 3.1 8B FP8 | 26,536 | 25,602 | -3.5% | 6,189 | 6,164 | -0.4% |
| Llama 3.1 8B NVFP4 | 28,698 | 28,400 | -1.0% | 6,744 | 6,737 | -0.1% |
| Mistral Pequeño 24B BF16 | 7,922 | 7,861 | -0.8% | 1,643 | 1,633 | -0.6% |
| Mistral Pequeño 24B FP8 | 11,157 | 11,075 | -0.7% | 2,316 | 2,302 | -0.6% |
| Codificador Qwen3 30B BF16 | 10,486 | 10,000 | -4.6% | 3,830 | 3,749 | -2.1% |
| Codificador Qwen3 30B FP8 | 12,425 | 12,439 | + 0.1% | 3,851 | 3,837 | -0.4% |
| DeepSeek V4 Flash FP8 | 1,766 | 1,766 | 0.0% | 948 | 954 | + 0.6% |
| MiniMax M2.7 NVFP4 | 4,801 | 4,793 | -0.2% | 1,743 | 1,744 | + 0.1% |
| MiniMax M3 NVFP4 | 1,041 | 1,041 | 0.0% | 278 | 282 | + 1.3% |
| GLM-5.2 NVFP4 | 138 | 139 | + 0.4% | 118 | 120 | + 1.7% |
| Nemotron 3 Ultra 550B NVFP4 | 168 | 159 | -5.2% | 142 | 140 | -1.1% |
GPT-OSS-20B, el caso denso de mayor rendimiento del conjunto, y GLM-5.2, el caso de descarga, muestran la superposición sin una proporción: en ambos, la ejecución del WS300 sigue punto por punto la del ET900N G3.
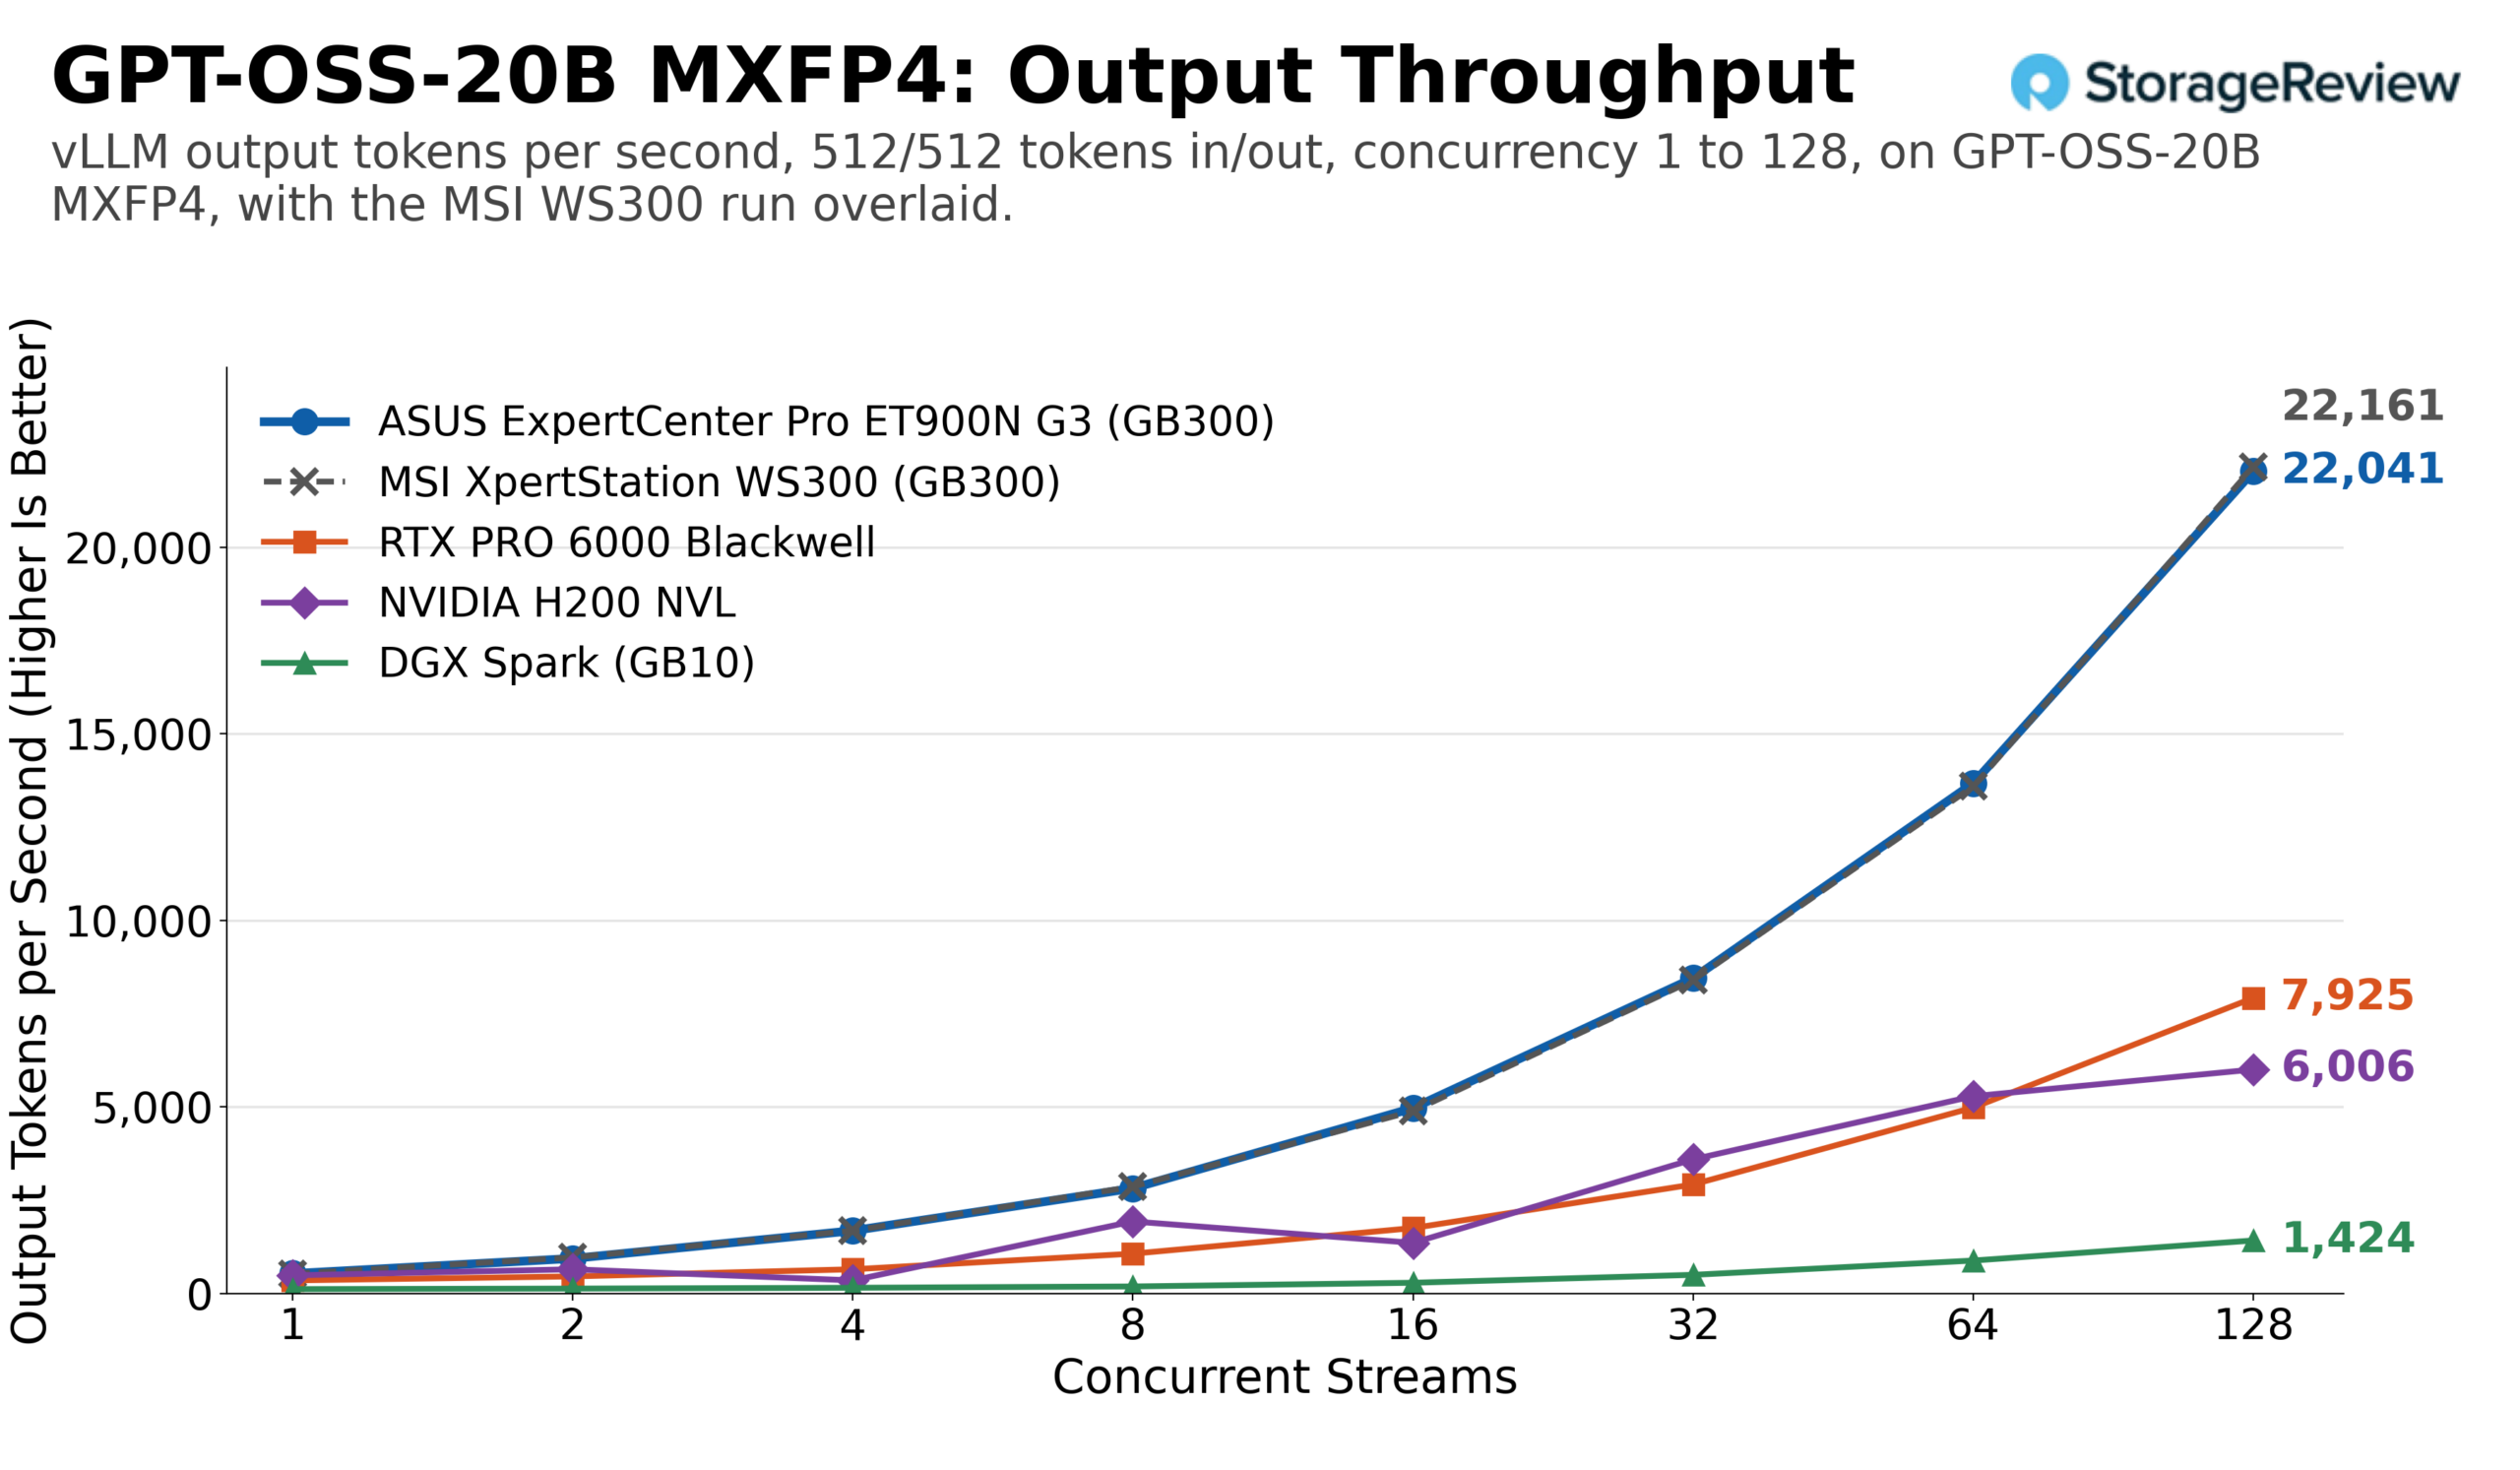
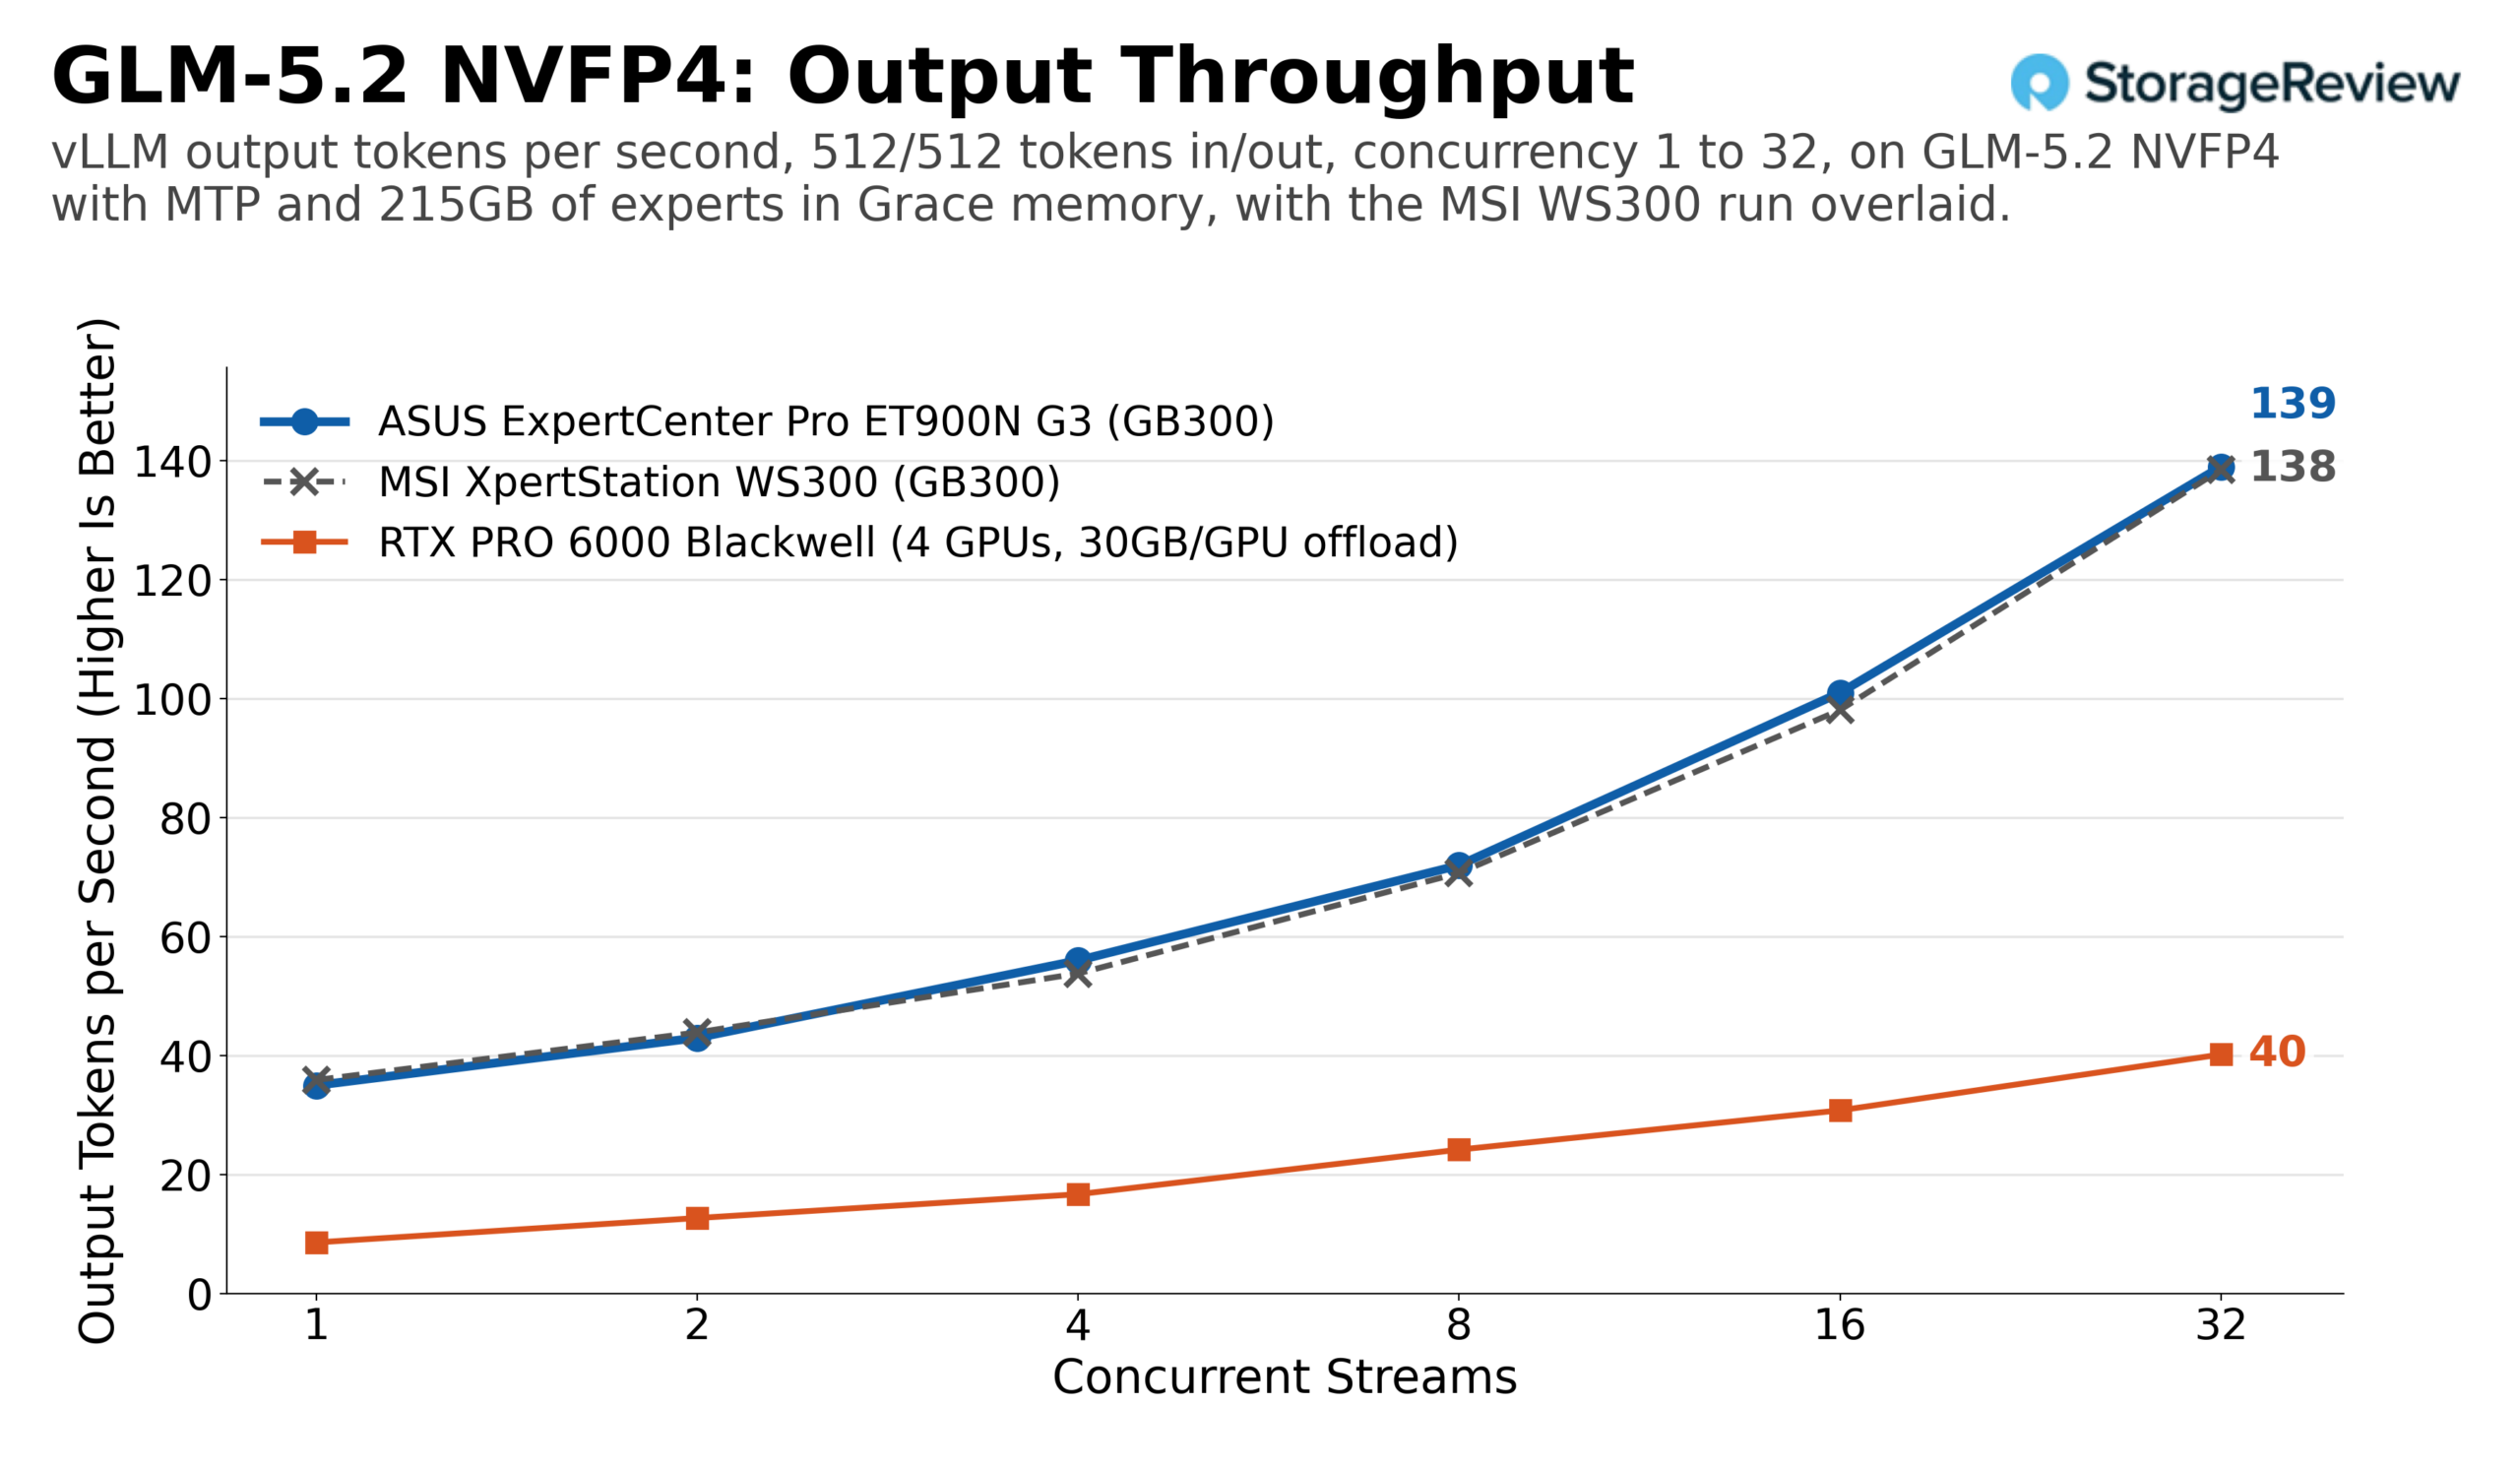
Esta es la comparación que seguiremos utilizando a medida que más torres GB300 lleguen al laboratorio. La ZGX de HP es la siguiente, y le seguirán otras, y todas ejecutan el mismo barrido, por lo que cualquier diferencia entre las implementaciones de los fabricantes se mostrará aquí, en un gráfico por torre, con los gráficos de los modelos mostrando las curvas originales.
Conclusión
El ASUS ExpertCenter Pro ET900N G3 cumple con lo que se espera de una segunda implementación de una plataforma de referencia: confirma la primera. En 14 modelos y dos cargas de trabajo, su rendimiento máximo de vLLM se situó dentro del 2 % del MSI XpertStation WS300 en 24 de 28 comparaciones, desde 1,766 tokens de salida por segundo en DeepSeek V4 Flash hasta 22 041 en GPT-OSS-20B, con cuatro valores atípicos de una sola ejecución entre un 2 % y un 5 % inferiores, y sirvió a GLM-5.2 con 215 GB de expertos en memoria Grace a velocidades que cuatro tarjetas RTX PRO 6000 no pudieron alcanzar. El GB300 Superchip establece el límite, y ASUS hizo un buen trabajo ejecutándolo.
Lo que ASUS añade es práctico: las asas convierten una torre de 27 kg en algo que dos personas pueden mover sin tener que sujetar los paneles, el ventilador sobre las bahías QSFP112 soluciona un problema potencial para quienes utilicen ópticas 400G durante horas, y la fuente de alimentación Titanium reduce el consumo en la toma de corriente. El host Arm, el circuito de 20 A, la salida de vídeo solo para BMC y el presupuesto compartido de 1,600 W cuando se instala una tarjeta gráfica grande son realidades de la plataforma que se aplican por igual a ambas torres.
La estación GB300 DGX sigue siendo el dispositivo más potente que jamás hayamos puesto sobre un escritorio, y ASUS ha hecho que su versión sea una buena forma de adquirirla.
En nuestro Los mejores ordenadores de sobremesa para IA local leaderboard, the ET900N G3 now stands alongside the WS300 as a tested alternative in the Best GB300 System slot.



 Amazon