

No somos ajenos a superar los límites de la computación, pero este lleva el Pi(e). Justo después del hito de 100 billones de dígitos del año pasado, decidimos subir la apuesta y llevar los dígitos conocidos de Pi a 105 billones de dígitos. Eso son 105,000,000,000,000 números después del 3. Hicimos algunas actualizaciones a la plataforma con respecto a la ejecución del año pasado, encontramos algunas cosas sorprendentes en el camino y aprendimos algunas cosas en el proceso, ¡incluido el dígito número 105 billones de Pi;6!
Al lograr un cálculo récord mundial de Pi con 105 billones de dígitos, el laboratorio StorageReview ha subrayado las increíbles capacidades del hardware moderno. Este esfuerzo, impulsado por un sistema AMD EPYC Bergamo 2P de 128 núcleos de vanguardia equipado con 1.5 TB de DRAM y casi un petabyte de SSD Solidigm QLC, representa un logro histórico en tecnología computacional y de almacenamiento.
El desafío
En la carrera digital de 100 billones, encontramos varias limitaciones tecnológicas. La plataforma del servidor, por ejemplo, sólo admitía 16 SSD NVMe en las ranuras frontales. Si bien teníamos mucha potencia de CPU, este cálculo requirió un almacenamiento masivo durante el proceso y en el back-end cuando se generó el archivo TXT final.
Para resolver el problema de almacenamiento la última vez, recurrimos a adaptadores PCIe NVME para insertar otros tres SSD. Luego, para la salida, teníamos un servidor de almacenamiento HDD en RAID0, eso sí, con un recurso compartido iSCSI en el cuadro de cálculo. Esta vez, queríamos ser un poco más “empresariales” con este servidor, así que trajimos a algunos amigos para que nos ayudaran. Curiosamente, no es tan fácil como parece agregar un montón de SSD NVMe a un servidor.
El hardware
El núcleo de esta monumental tarea fue el sistema AMD EPYC 9754 Bergamo de doble procesador, con 128 núcleos cada uno. Los procesadores de AMD, conocidos por su excepcional rendimiento en tareas computacionales de alta complejidad (IA, HPC, análisis de macrodatos) , proporcionaron la potencia necesaria. Complementando esto, se incluyó 1.5 TB de DRAM, lo que garantizó un procesamiento y una transferencia de datos ultrarrápidos. Al mismo tiempo, casi un petabyte de almacenamiento Solidigm QLC ofreció una capacidad y fiabilidad sin precedentes.
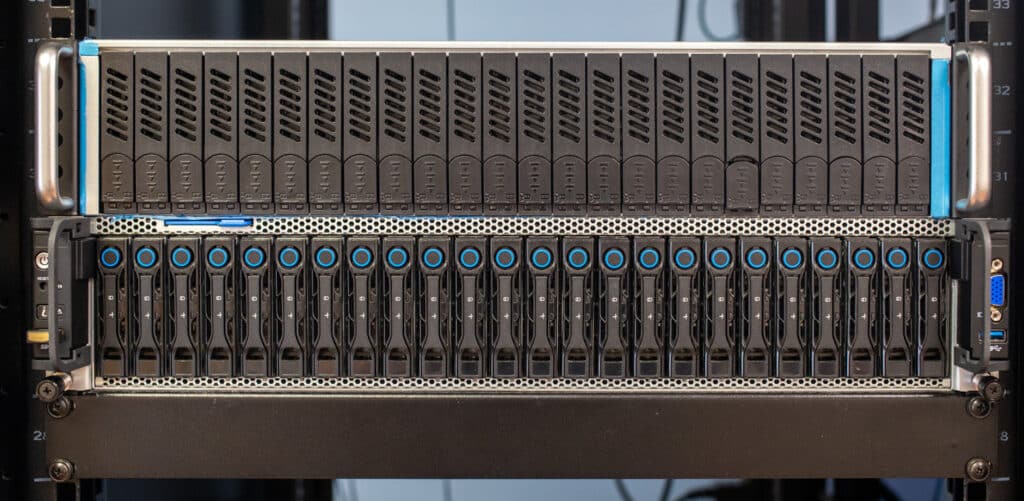
Nuestra plataforma de chasis base siguió siendo la misma que la del año pasado (una caja QCT), pero actualizamos las CPU a chips AMD EPYC 9754 Bergamo. Queríamos buscar una mejora en la velocidad y los decimales y al mismo tiempo evitar el uso de almacenamiento para el cálculo, lo que significaba que teníamos que recurrir a SerialCables para proporcionar un JBOF. Esto presentó algunos desafíos por derecho propio, que detallaremos a continuación.
| Parámetro | Valor |
|---|---|
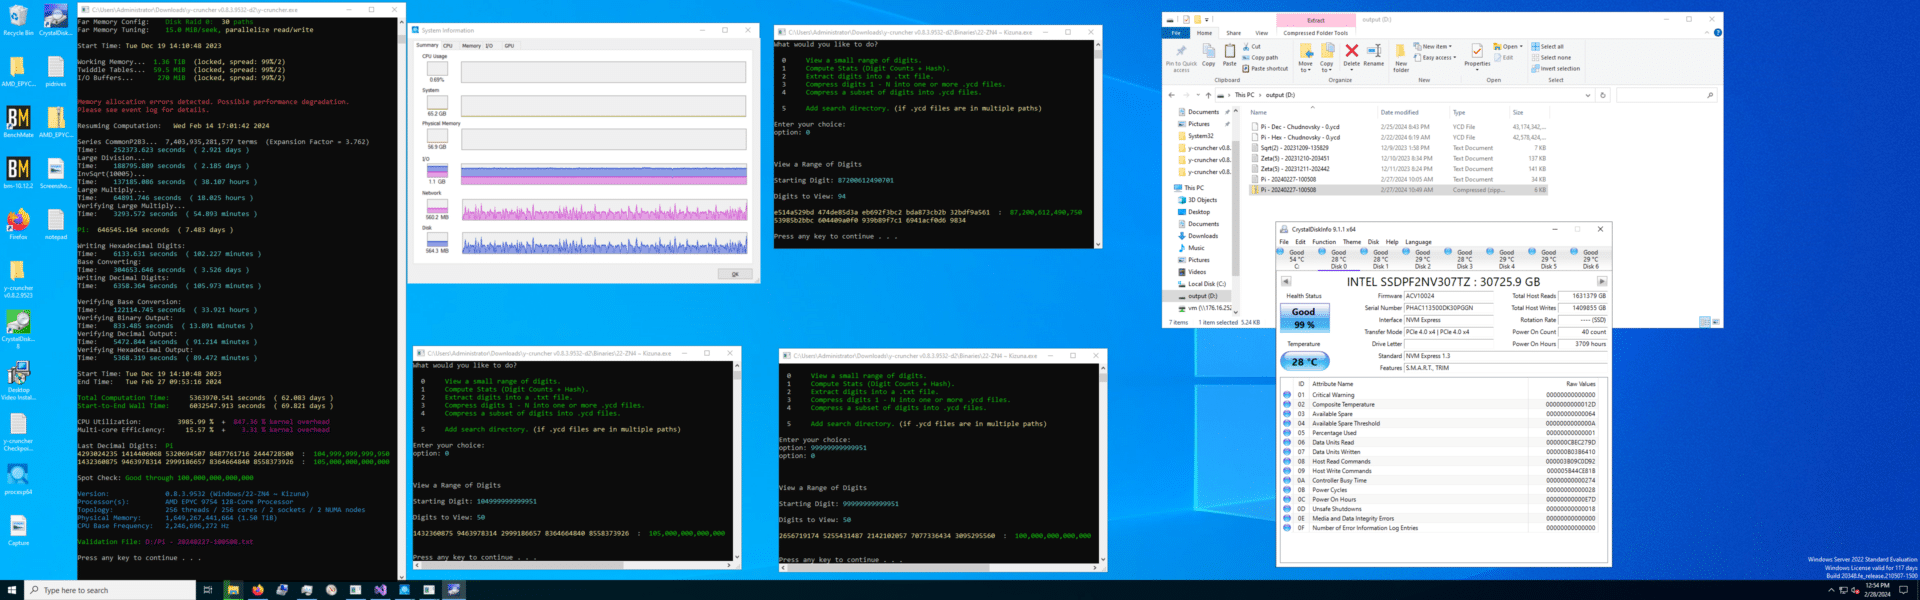
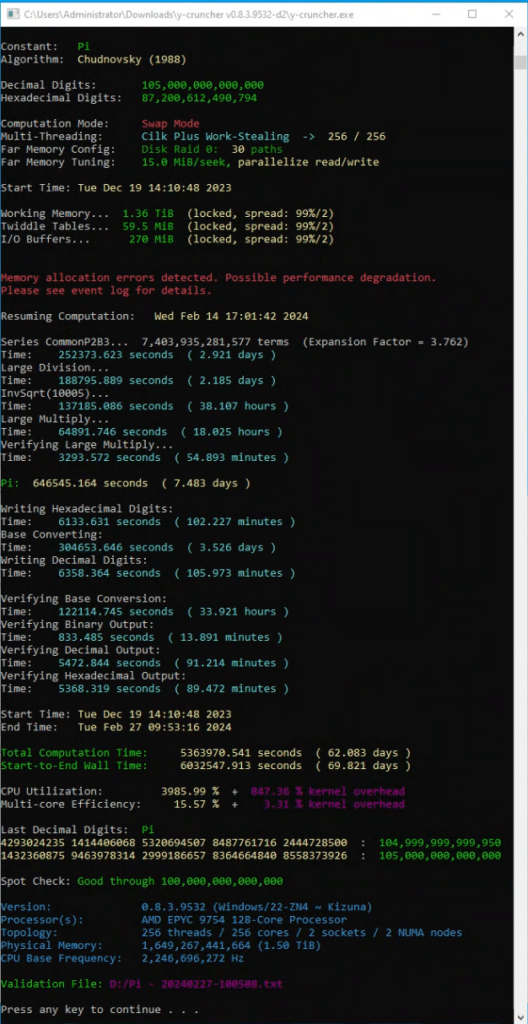
| Fecha de Inicio | Mar 19 dic 14:10:48 2023 |
| Fecha Final | Mar 27 de febrero 09:53:16 2024 |
| Tiempo total de cálculo | 5,363,970.541 segundos / 62.08 días |
| Tiempo de pared de principio a fin | 6,032,547.913 segundos / 69.82 días |
Periodo de cómputo: del 14 de diciembre de 2023 al 27 de febrero de 2024, con una duración total de 75 días.
- UPC: Procesadores duales AMD Epyc 9754 Bergamo, 256 núcleos con multihilo simultáneo (SMT) deshabilitado en BIOS.
- Memoria: 1.5 TB de RAM DDR5.
- Almacenamiento: 36 unidades SSD Solidigm D30.72-P5 de 5316 TB.
- 24 SSD Solidigm D30.72-P5 de 5316 TB en un JBOF de cables serie
- 12 SSD Solidigm D30.72-P5 de 5316 TB en el servidor conectado directamente.
- Sistema operativo: Servidor Windows 2022 (21H2).
El camino hacia los 105 billones
| Parámetro | Valor |
|---|---|
| Constante | Pi |
| Algoritmo | Chudnovsky (1988) |
| Dígitos decimales | 105,000,000,000,000 |
| Dígitos hexadecimales | 87,200,612,490,794 |
| Modo de enhebrado | Cilk Plus Robo de trabajo -> 256 / 256 |
| Memoria de Trabajo | 1,492,670,259,968 (1.36 TiB) |
| La memoria total | 1,492,984,298,368 (1.36 TiB) |
| Punto de control lógico más grande | 157,783,654,587,576 (144 TiB) |
| Uso máximo lógico del disco | 534,615,969,510,896 (486 TiB) |
| Lectura de bytes de disco lógico | 44,823,456,487,834,568 (39.8 PiB) |
| Bytes de disco lógico escritos | 38,717,269,572,788,080 (34.4 PiB) |
Desafíos encontrados
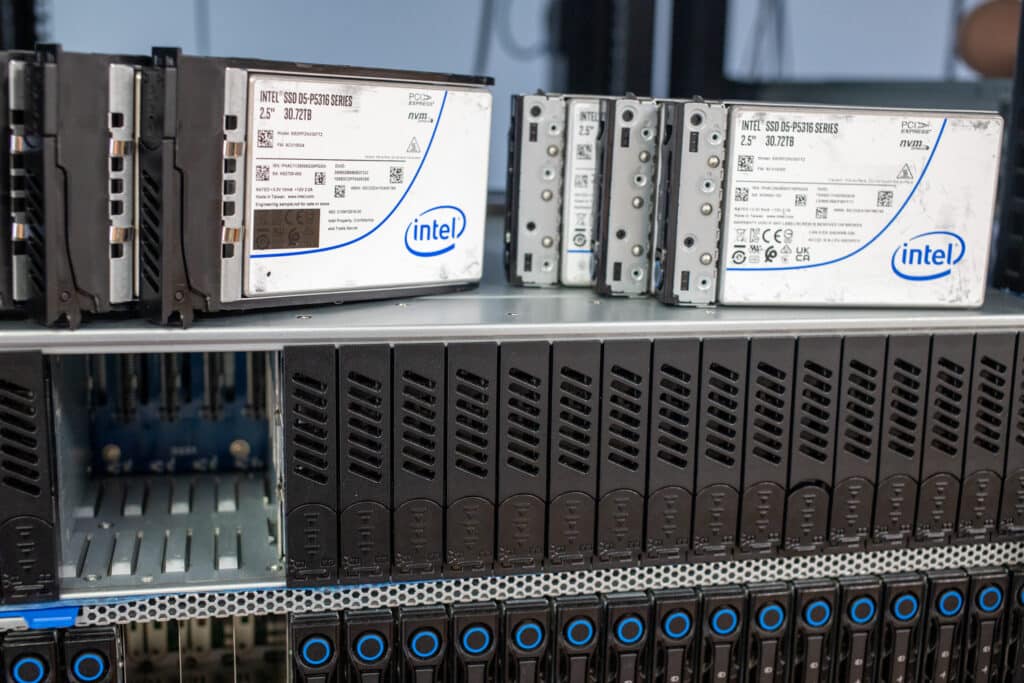
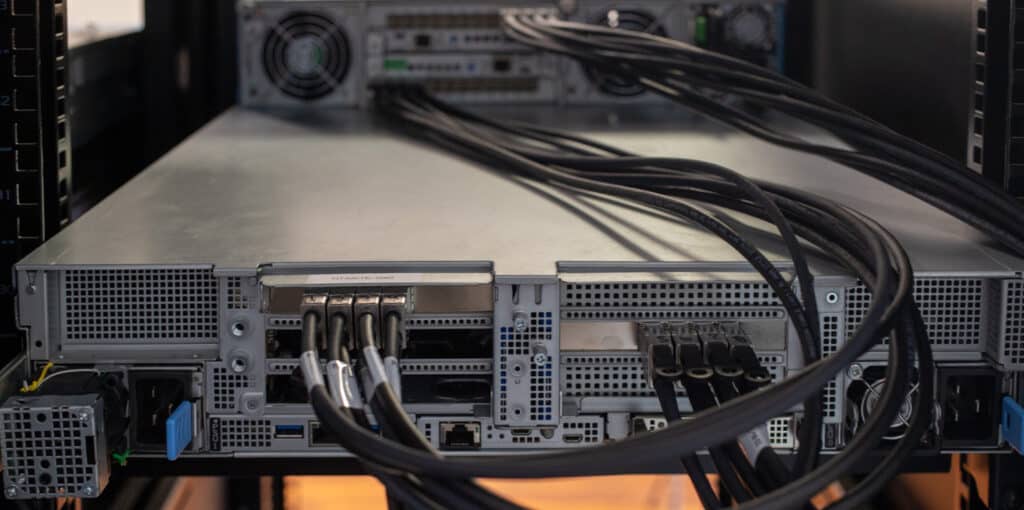
Un nuevo componente para esta ejecución, necesario para ampliar el almacenamiento disponible para los procesadores, fue la adición de un NVMe JBOF. Nuestra plataforma de prueba ofrecía 16 bahías NVMe, con las ocho restantes cableadas solo para SATA. Si bien nuestra ejecución de 100 billones aprovechó tres adaptadores PCIe U.2 internos para ampliar nuestra cantidad de unidades NVMe a 19, no fue óptimo. Para esta nueva ejecución, agregamos un Serial Cables U.2 JBOF de 24 bahías , lo que ayudó significativamente de dos maneras: más almacenamiento de intercambio de cómputo y almacenamiento interno de archivos de salida. ¡Adiós al loco servidor de almacenamiento RAID0 HDD!
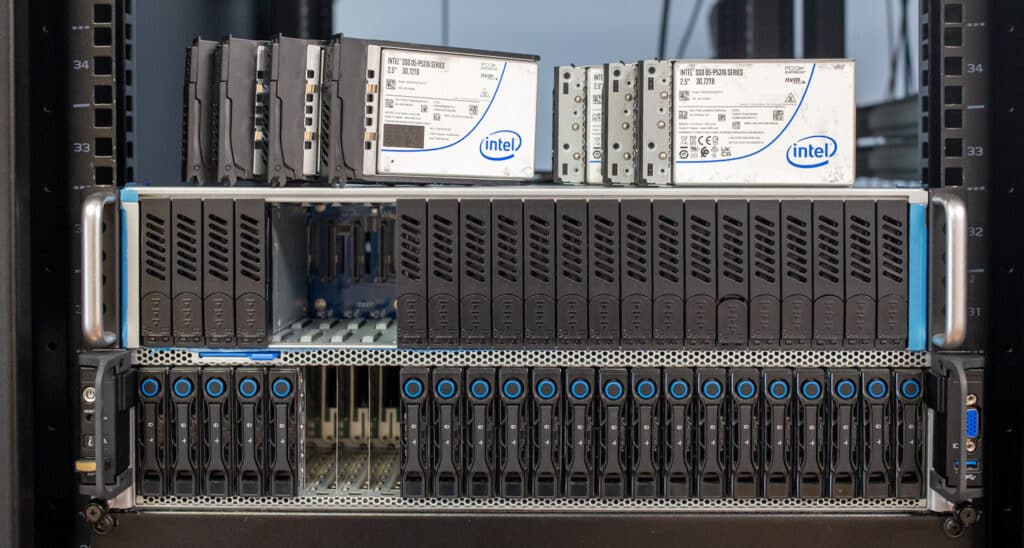
El JBOF de 24 bahías de cables serie nos permitió casi duplicar el número de unidades con respecto a nuestra ejecución original. Asignamos 30 unidades al espacio de intercambio de Y-cruncher, dejando 6 SSD para un volumen de salida RAID5 de Storage Spaces. Una gran ventaja de ese enfoque se produjo durante la etapa de salida, donde no nos frenó la velocidad de una sola conexión de 10 Gb, como la primera iteración de 100T Pi. Si bien el JBOF abordó el problema del recuento total de unidades, introdujo una limitación: el rendimiento de las unidades individuales.
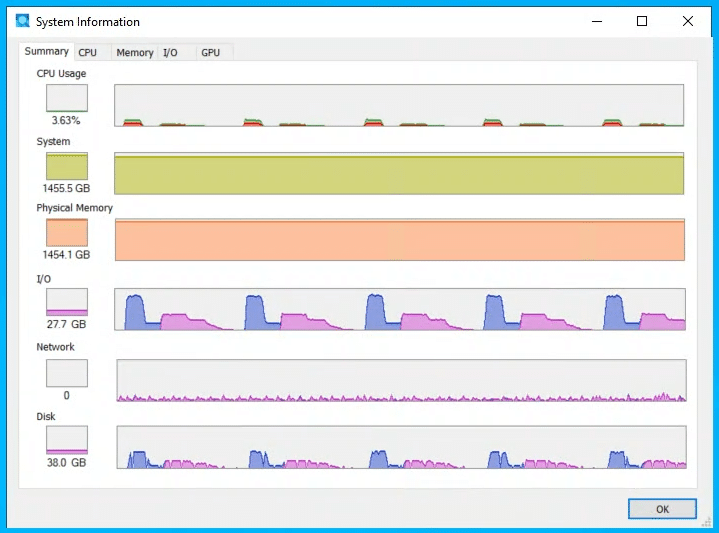
En un servidor con SSD U.2 de conexión directa, hay cuatro carriles PCIe por unidad. Si cada unidad está conectada directamente a la placa base, eso equivale a 96 carriles PCIe para 24 SSD. El ancho de banda total del JBOF está limitado por la cantidad de carriles PCIe que puede conectar al host.
En este caso, utilizamos dos tarjetas host de conmutador PCIe, dividiendo el JBOF en dos grupos de 12 SSD. Luego, cada grupo de 12 SSD compartió 16 carriles PCIe. Si bien seguimos ofreciendo ventajas considerables al conectar los SSD a nuestro host, tuvimos escenarios en los que las unidades de intercambio que se ejecutaban a través del JBOF quedaron detrás de las unidades conectadas directamente al servidor. Esto no es culpa del JBOF. Es solo una limitación técnica o más bien una limitación de con cuántos carriles PCIe puede trabajar el servidor.
Los lectores astutos podrían preguntarse por qué nos detuvimos en 36 SSD en esta versión en lugar de llegar a 40. Es una historia divertida. El espacio PCIe direccionable tiene sus límites en muchos servidores. En nuestro caso, con el recuento de 38 unidades, el último SSD tomó la dirección PCIe del chipset USB y perdimos el control del servidor. Para ir a lo seguro, lo respaldamos en 36 SSD para poder acceder al BIOS o iniciar sesión en el servidor. Superar los límites conduce a algunos descubrimientos sorprendentes.
Información diagnóstica y resolución
El primero de los dos principales desafíos que encontramos estaba relacionado con el rendimiento. Descubrimos que la Ley de Amdahl se ponía en práctica. Surgió un problema peculiar cuando y-cruncher parecía bloquearse en nuestro sistema AMD Bergamo de 256 núcleos durante operaciones de intercambio de gran tamaño. Este bloqueo, caracterizado por la falta de actividad de entrada/salida de la CPU y del disco, desafió las expectativas convencionales sobre el comportamiento del software. Esto nos llevó a profundizar en las complejidades de la computación paralela y las interacciones del hardware.
El proceso de descubrimiento reveló que el programa no estaba realmente bloqueado, sino que operaba con una capacidad muy limitada, ejecutando un solo subproceso en una configuración expansiva de 256 núcleos. Este comportamiento inusual generó dudas sobre el impacto potencial de la Ley de Amdahl, especialmente porque las operaciones involucradas no requerían un uso intensivo de computación y no deberían haber causado retrasos significativos en un sistema equipado con 1.5 TB de RAM.
La investigación dio un giro inesperado cuando el problema se reprodujo en un ordenador de sobremesa doméstico, lo que puso de manifiesto las graves implicaciones de la Ley de Amdahl incluso en sistemas menos complejos. Esto condujo a un análisis más profundo de las causas subyacentes, que reveló un riesgo específico de la CPU en la arquitectura Zen4 relacionado con la superalineación y sus efectos en los patrones de acceso a la memoria.
El problema se vio agravado en los procesadores AMD por un bucle en el código que, debido a su naturaleza simple, debería haberse ejecutado mucho más rápido de lo observado. La causa principal parecía ser el manejo ineficiente del alias de memoria por parte de la unidad de almacenamiento de carga de AMD. La resolución de este complejo problema requirió mitigar el peligro de superalineación mediante la vectorización del bucle usando AVX512 y abordar la desaceleración causada por la Ley de Amdahl con un paralelismo mejorado. Este enfoque integral no solo resolvió el problema inmediato sino que también condujo a optimizaciones significativas en los procesos computacionales de y-cruncher, sentando un precedente para abordar desafíos similares en entornos informáticos de alto rendimiento.
El siguiente problema se encontró en los pasos finales del cálculo, que se detenía inesperadamente y no proporcionaba información sobre la causa del accidente. Se concedió acceso remoto a Alexander Yee y, por primera vez en más de una década, completar un registro Pi requirió la intervención directa del desarrollador.
No participamos en este proceso de diagnóstico, pero se detectó un error crítico de aritmética de punto flotante en la ruta de código AVX512 del algoritmo de multiplicación de N63. Alexander pudo diagnosticar el problema de forma remota , proporcionar un binario corregido y reanudar la ejecución desde un punto de control, lo que culminó en un cálculo exitoso tras implementar correcciones de software cruciales.
Reflexiones y Avanzar
Este esfuerzo ilustra las complejidades e imprevisibilidades de la informática de alto rendimiento. La resolución de estos desafíos estableció un nuevo récord en el cálculo de Pi y proporcionó información valiosa sobre el desarrollo de software y las metodologías de prueba. La última versión de y-cruncher, v0.8.4, incorpora correcciones para los problemas identificados, lo que promete una mayor estabilidad para futuros cálculos.
Calcular Pi con 105 billones de dígitos no fue tarea fácil. Implicó una planificación, optimización y ejecución meticulosas. Aprovechando una combinación de software propietario y de código abierto, el equipo de StorageReview optimizó el proceso algorítmico para aprovechar al máximo las capacidades del hardware, reduciendo el tiempo computacional y mejorando la eficiencia.
Con un rendimiento de lectura saturado PCIe Gen4 y capacidades líderes en la industria de hasta 61.44 TB, los SSD Solidigm QLC ofrecen resultados increíbles. "Imagínese lo que estas unidades pueden permitir en computación de alto rendimiento o aplicaciones intensivas en IA", dijo Greg Matson, vicepresidente de planificación estratégica y marketing de Solidigm. Estamos encantados de que los SSD de Solidigm puedan impulsar el segundo intento récord de Storagereview para calcular pi. Sus esfuerzos demuestran las verdaderas capacidades de las unidades de almacenamiento de Solidigm, abriendo un mundo de posibilidades para aplicaciones de IA con uso intensivo de datos”.
Conclusión
El camino hacia los 105 billones de dígitos de Pi fue mucho más complejo de lo que esperábamos. Tras reflexionar, deberíamos haber esperado encontrar nuevos problemas; después de todo, estamos completando un cálculo que nunca antes se había hecho. Pero con el cálculo de 100 billones completado con una configuración mucho más de “cinta adhesiva y alambre de gallinero”, pensamos que lo habíamos logrado. Al final, fue necesario un esfuerzo de colaboración para que este equipo llegara a la meta.
Si bien nos regocijamos con nuestros socios por esta racha sin precedentes, debemos preguntarnos: "¿Qué significa esto?" Cinco billones más de dígitos de Pi probablemente no supondrán una gran diferencia para las matemáticas. Aún así, podemos trazar algunas líneas entre las cargas de trabajo computacionales y la necesidad de hardware subyacente moderno para soportarlas. Fundamentalmente, este ejercicio refleja que el hardware adecuado marca la diferencia, ya sea un clúster de centro de datos empresarial o una gran instalación de HPC.
Para el cálculo de Pi, nos vimos completamente limitados por el almacenamiento. Si bien las CPU más rápidas ayudan a acelerar los cálculos, el factor limitante para muchos nuevos récords mundiales es la cantidad de almacenamiento local en el equipo. Para esta prueba, nuevamente estamos utilizando las unidades SSD Solidigm D5-P5316 de 30.72 TB para obtener algo más de 1.1 PB de memoria flash sin procesar en el sistema. Estas unidades SSD son la única razón por la que pudimos superar los récords anteriores y alcanzar los 105 billones de dígitos de Pi.
Esto plantea una pregunta interesante. Muchos de nuestros seguidores saben que Solidigm ofrece SSD de 61.44 TB en su modelo D5-P5336 y hasta 30.72 TB en el D5-P5430 , disponibles en diversos formatos y capacidades. Hemos analizado estas unidades y tenemos numerosas publicaciones en redes sociales que muestran su increíble capacidad. Con 32 de estas SSD que alcanzan casi 2 PB de almacenamiento, cabe preguntarse cuánto tiempo se mantendrá el récord mundial de 105 billones de dígitos de Pi. Creemos que no mucho.
Los dígitos decimales más grandes conocidos de Pi
1432360875 9463978314 2999186657 8364664840 8558373926: Dígitos hasta 105,000,000,000,000


 Amazon