

Recientemente, Comino nos envió la última versión del Comino Grando para su análisis, configurada con ocho tarjetas NVIDIA RTX PRO 6000 Blackwell, cada una con 96 GB de VRAM, para un total de 768 GB de memoria GPU. Ya habíamos analizado el Comino en 2024, configurado con seis RTX 4090 , que ofrecían 144 GB de memoria GPU total, así como una versión con NVIDIA H100 . Esta última actualización supone un salto generacional sustancial tanto en la capacidad de memoria bruta como en la variedad de cargas de trabajo que la plataforma puede gestionar.
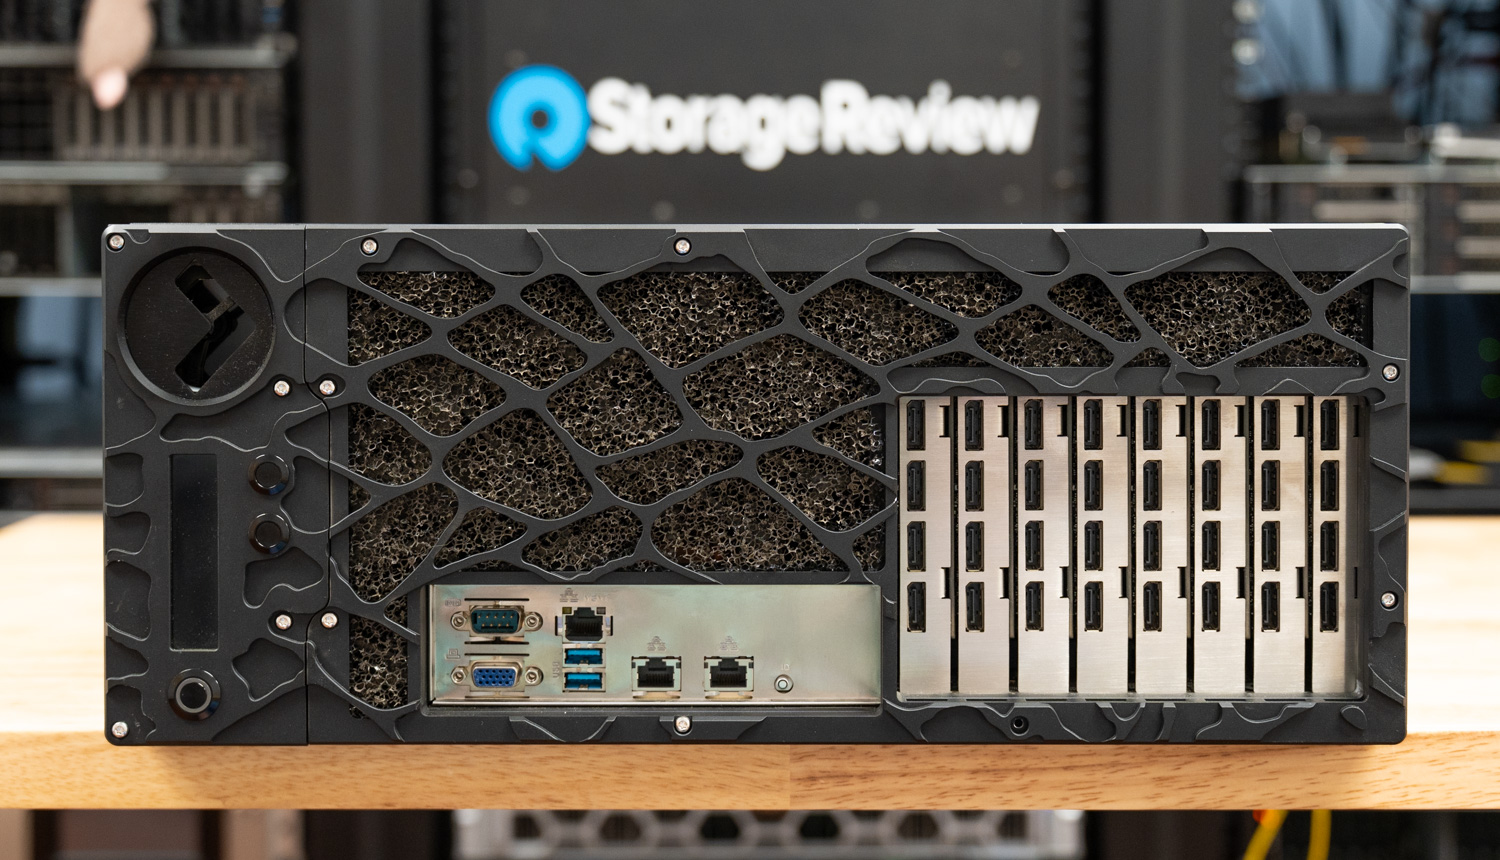
Grando es una plataforma 4U diseñada específicamente para resolver el conflicto crítico entre el procesamiento de GPU de alta densidad y la gestión térmica. Mientras que los chasis estándar con refrigeración por aire se derrumban bajo las demandas sostenidas de TDP de más de 600 W de las tarjetas profesionales modernas, Grando adopta un enfoque fundamentalmente diferente, construido desde cero en torno a una arquitectura de refrigeración líquida capaz de disipar la enorme cantidad de calor continuo de 6.5 kW. Esto no es una adaptación ni una solución improvisada; todo el chasis, desde su disposición invertida de la placa base hasta su sistema de colectores de desconexión rápida codificado por colores, ha sido diseñado en torno al circuito de refrigeración.
El resultado es una plataforma capaz de soportar ocho GPU profesionales de TDP completo en un único chasis 4U, funcionando ininterrumpidamente las 24 horas del día, los 7 días de la semana, en entornos con temperaturas ambiente de entre 3 y 38 °C, sin estrangulamiento térmico, sin el ruido excesivo de la refrigeración por aire a altas revoluciones y sin comprometer la facilidad de mantenimiento. Para las organizaciones que implementan cargas de trabajo de inferencia de IA, entrenamiento de aprendizaje automático o simulación de alto rendimiento a gran escala, Grando ofrece algo realmente excepcional: un servidor que no obliga a elegir entre densidad, gestión térmica y fiabilidad.
Especificaciones del Comino Grando
La tabla que aparece a continuación muestra las especificaciones físicas y las configuraciones de hardware compatibles con la plataforma Comino Grando.
| Especificación / Característica | Comino Grande |
|---|---|
| Servidor y estación de trabajo en rack Comino Grando | |
| Capacidad de refrigeración | 6.5 kW (Máximo 6500 W a 20 °C de temperatura del aire de admisión) |
| Placas base | Hasta EATX y EBB |
| GPU (Servidor) | Hasta 8; NVIDIA: RTX A6000, RTX 6000 ADA, RTX PRO 6000, A40, L40, L40S, A100, H100, H200 |
| GPU (Estación de trabajo en rack) | Hasta 6; NVIDIA: 3090, 4090, 5080, 5090, RTX A6000, RTX 6000 ADA, RTX PRO 6000, A40, L40, L40S, A100, H100, H200; AMD: W7800, W7900 |
| CPUs | Hasta 2; Zócalo único: Intel Xeon W-2400/2500 y 3400/3500, Intel Xeon Scalable de 4.ª y 5.ª generación, XEON 6, AMD Threadripper PRO 5000WX, 7000WX, 9000WX, AMD EPYC 9004/9005 Socket doble: Intel Xeon Scalable de 4.ª y 5.ª generación, XEON 6, AMD EPYC 9004/9005 |
| RAM | Hasta 2TB |
| Unidades M2 | Hasta 8x NVMe |
| Almacenaje | Compartimentos para intercambio en caliente en el panel trasero: hasta 4 SSD de intercambio en caliente (4 de 7 mm o 2 de 15 mm) y hasta 4 más (4 de 7 mm o 2 de 15 mm) en lugar de una cuarta fuente de alimentación; Jaula interna de 3.5″ con capacidad para hasta 4 x 3.5″ o 4 x 2.5″ de 15 mm o 12 x 2.5″ de 7 mm; Ranuras internas de 2.5″: hasta 4 SSD de 2.5″ y 7 mm |
| Fuente de alimentación y tensión de funcionamiento | Hasta 4 fuentes de alimentación CRPS de 2000 W con intercambio en caliente a 180-264 V Hasta 4 fuentes de alimentación CRPS de 1000 W con intercambio en caliente a 90-140 V Modos de redundancia: 4+0, 3+1, 2+2 |
| Nivel de ruido | 39dB-70dB |
| Lan | Hasta 2 x 10 Gbit/s en la placa base y hasta 400 Gbit/s en PCIe. |
| OS | Ubuntu / Windows 11 (Pro/Home) / Windows Server |
| Especificaciones físicas y de refrigeración | |
| Enfriamiento líquido | CPU con VRM y GPU con GDDR y VRM |
| Depósito | Comino personalizado de 450 ml con bomba integrada |
| Ventiladores | 3x Flujo Ultra Alto 6200 RPM (alto nivel de ruido) o 3x Alto caudal 3000 RPM (bajo nivel de ruido) |
| Instalación | Montaje en rack de 19″ o independiente como estación de trabajo. |
| Espacio de rack requerido | 4U |
| Tamaño | 439 x 681 x 177 mm (sin asas ni partes sobresalientes) |
| Peso | 4 GPU: 49 kg (neto), 67 kg (bruto) 6 GPU: 52 kg (neto), 70 kg (bruto) 8 GPU: 55 kg (neto), 72 kg (bruto) |
| Rango de temperatura de funcionamiento y almacenamiento | Almacenamiento: -5..50°C / 23..122°F Funcionamiento: 3-38 °C / 38-100 °F |
| Sistema de Monitoreo de Comino (CMS) | |
| Resumen | Placa controladora con sensores y software para monitorización en tiempo real. |
| Ventajas clave | Sistema de refrigeración y monitorización de CPU/GPU, interfaz web, registro del sistema de refrigeración, monitorización centralizada para grupos de trabajo. |
| Sensores y dispositivos conectados | Temperatura (aire y refrigerante), % de humedad, voltaje, flujo de refrigerante, nivel de refrigerante del depósito, ventiladores, bombas, placa base, pantalla y botones. |
| Posibilidades de integración | Establezca un sistema de monitorización mediante una API REST y envíe los datos de los sensores a un software de monitorización (por ejemplo, Zabbix, Grafana) o a bases de datos (por ejemplo, InfluxDB). |
| Requisitos técnicos de CMS | |
| OS | Windows 11 / 10 Ubuntu 22.04/20.4 (Dependencia para Ubuntu: el sistema de destino debe tener instaladas las utilidades nvidia-smi y sensors). |
| Navegadores Web | Mozilla Firefox, Google Chrome, Chromium, Apple Safari, Microsoft Edge (Atención: Internet Explorer 11 no es compatible) |
| Disco duro | 300MB |
| Versión del firmware del controlador | 1.0.6 o más nuevo |
| Versión de PCB del controlador | 2.xx.xx |
Diseño, construcción y densidad de GPU
Diseño y despliegue del chasis
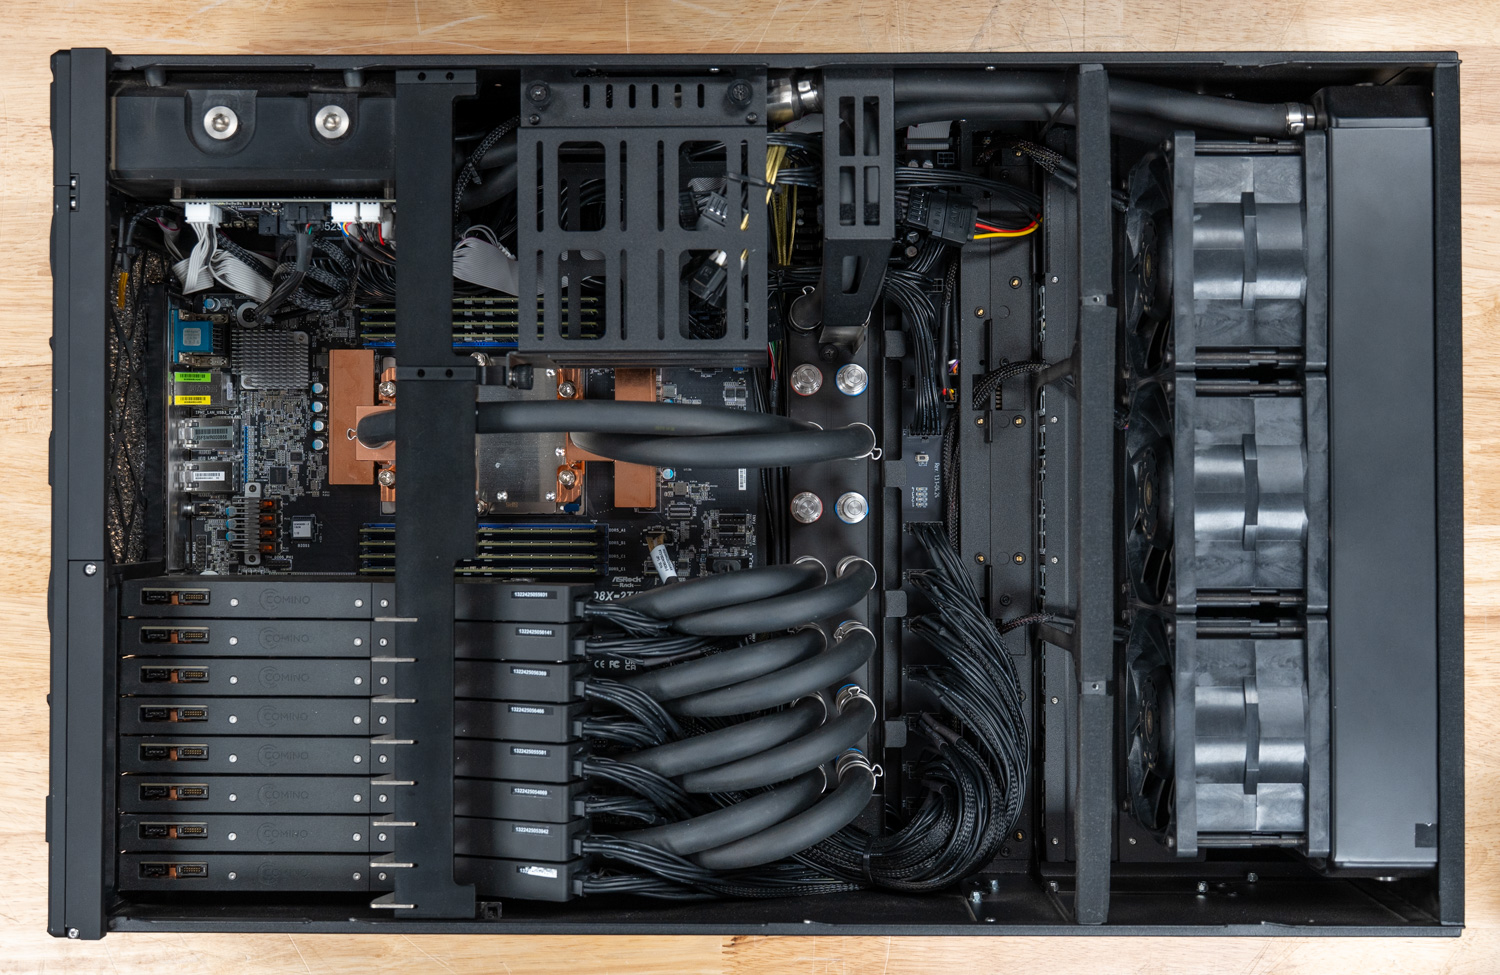
El servidor Grando es un ejemplo de optimización del espacio, con unas dimensiones de 17.3 x 26.8 x 6.97 pulgadas (4U). A diferencia de los servidores tradicionales, sitúa la parte trasera de la placa base en la parte frontal del chasis, invirtiendo la distribución interna convencional. Esto garantiza que los componentes refrigerados por aire, como los módulos de RAM y los VRM, reciban el aire de admisión más frío posible antes de que llegue al radiador de refrigeración líquida situado en la parte trasera.
El chasis está fabricado con el mismo estándar de calidad, con una sólida estructura de acero y un acabado de pintura en polvo negra mate tanto en el interior como en el exterior. Esta cuidada selección se extiende a los tubos, cables, radiador y máscara de soldadura de la placa de circuito impreso, reflejando una clara intención de lograr una estética impecable y profesional. Además, el sistema ofrece una gran versatilidad de instalación, funcionando a la perfección como unidad de montaje en rack de 19 pulgadas o como unidad de sobremesa independiente. Dependiendo de la configuración, su peso oscila entre 148 y 159 kg.
Placas de refrigeración y bloques de agua para GPU
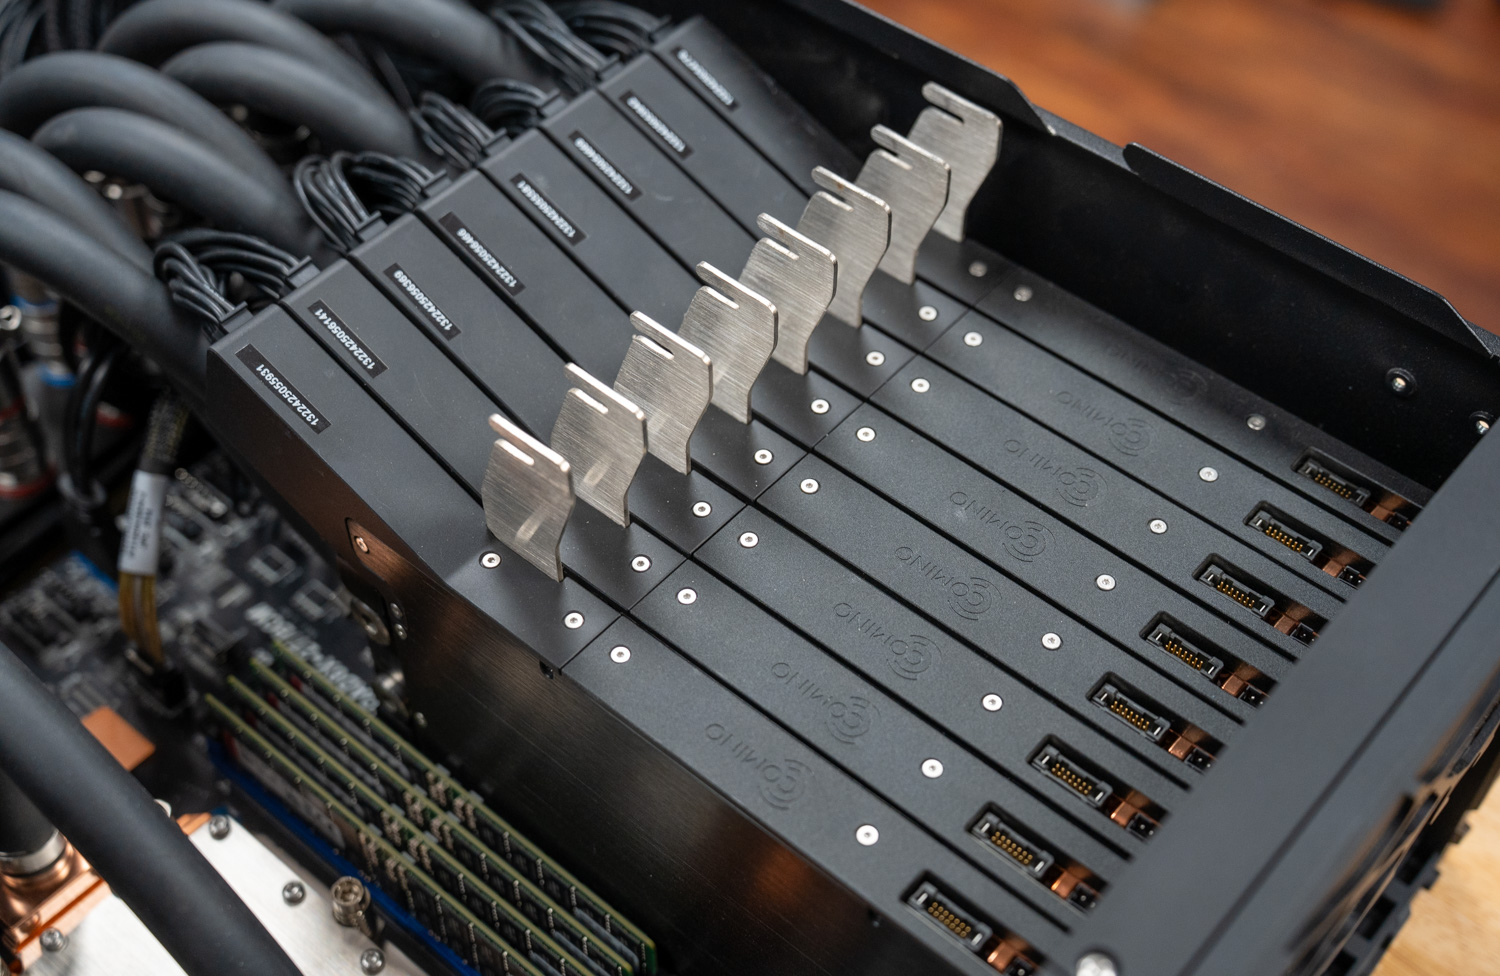
Los bloques de agua de cobre patentados constituyen el núcleo de la densidad de Grando, refrigerando no solo el chip de la GPU, sino también otros componentes como la memoria y los reguladores de voltaje. Cada GPU se suministra como una tarjeta estándar, sobre la cual Comino monta un conjunto de placa fría personalizado. En la práctica, este diseño de perfil delgado reduce cada tarjeta a un espacio de una sola ranura, lo que permite que seis u ocho GPU profesionales se alojen una al lado de la otra dentro de un único chasis 4U. Nuestra unidad de prueba venía con ocho tarjetas NVIDIA RTX PRO 6000 Blackwell, cada una con un TDP de 600 W, lo que resulta en un requerimiento total de refrigeración de 4,800 W a plena carga.
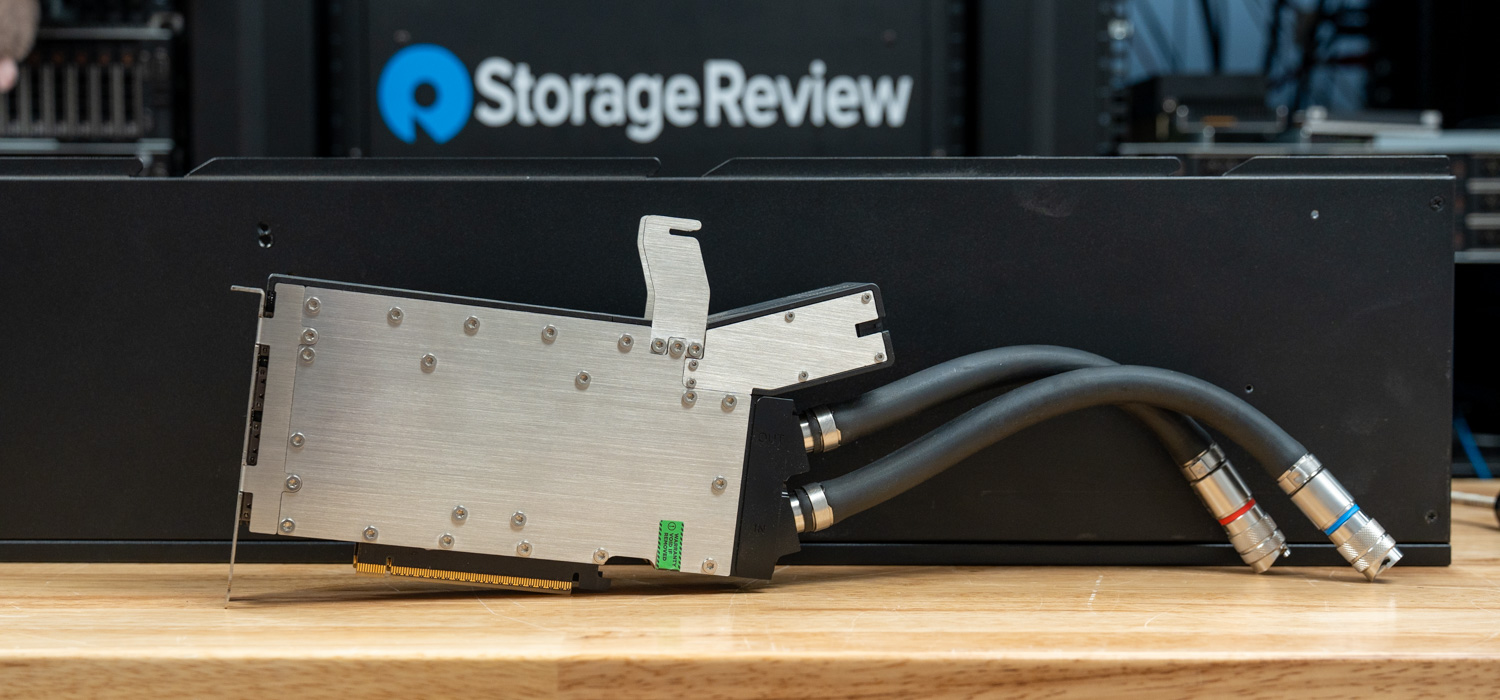
Lograr la densidad de 8 GPU de una sola ranura de la Comino sería prácticamente imposible con refrigeración por aire, ya que las tarjetas NVIDIA RTX PRO 6000 de serie ocupan dos ranuras cada una y requieren un flujo de aire considerable. En cambio, estas tarjetas con refrigeración personalizada ocupan solo una ranura cada una. Las placas de refrigeración son robustas, lo que añade un peso notable a cada tarjeta, pero ese peso refleja la calidad y el rendimiento de refrigeración necesarios a este nivel.
Cada par de GPU se conecta mediante un subcolector dedicado que integra ambas tarjetas en una única conexión de entrada y salida al colector principal de refrigeración. Este sistema de conexión en pares simplifica la arquitectura general del circuito, reduce el número de conexiones en el colector principal y permite al técnico desconectar un único par de acoplamientos de desconexión rápida para retirar dos tarjetas a la vez, lo que agiliza aún más el mantenimiento.
Distribución de agua y colector
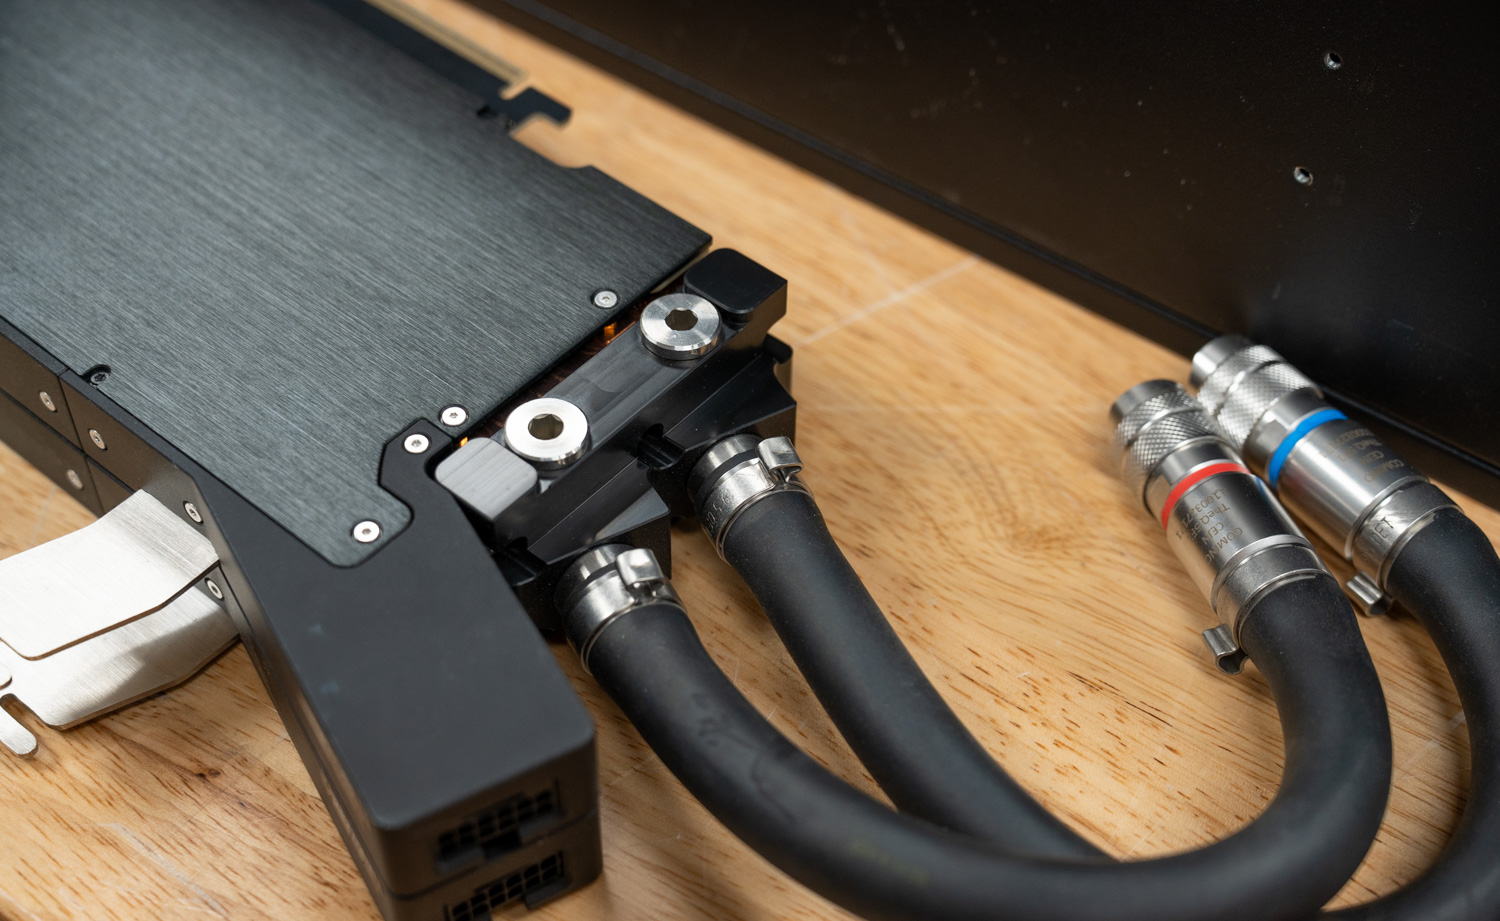
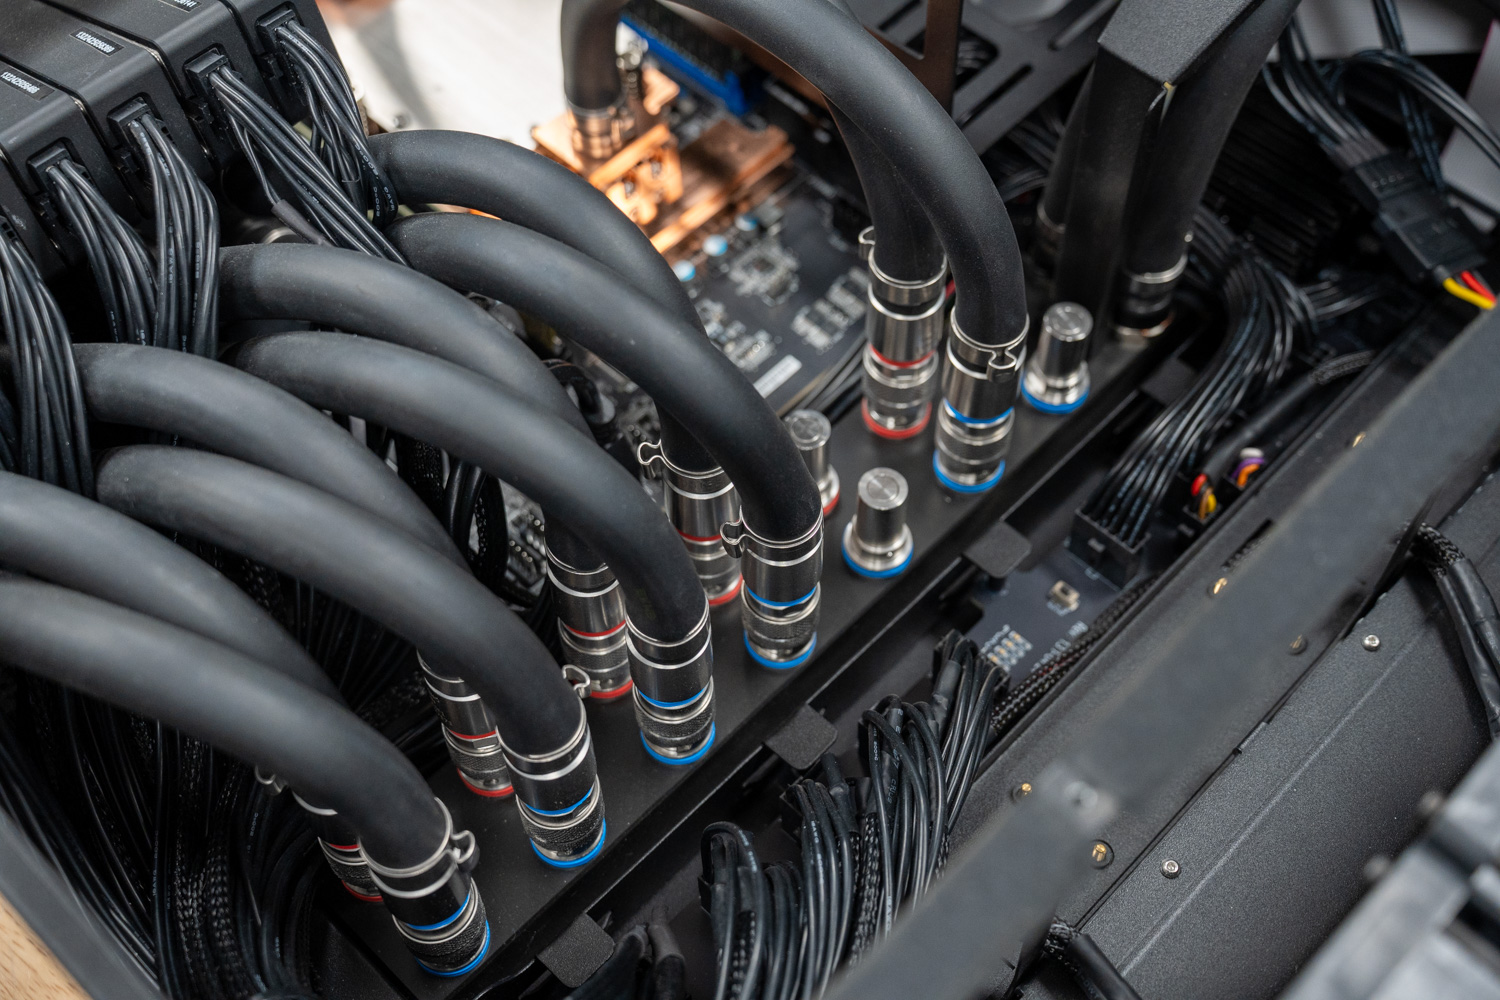
En el centro del sistema se encuentra un gran colector de distribución de agua que suministra líquido refrigerante a cada placa fría de la GPU y la CPU, y proporciona el retorno al radiador. Todas las conexiones entre el colector y las GPU y CPU utilizan acoplamientos de desconexión rápida "TheQ" de Comino. Estos racores antigoteo de acero inoxidable están codificados por colores con anillos rojos y azules para identificar claramente los lados caliente y frío del circuito, eliminando cualquier ambigüedad durante la instalación o el mantenimiento.
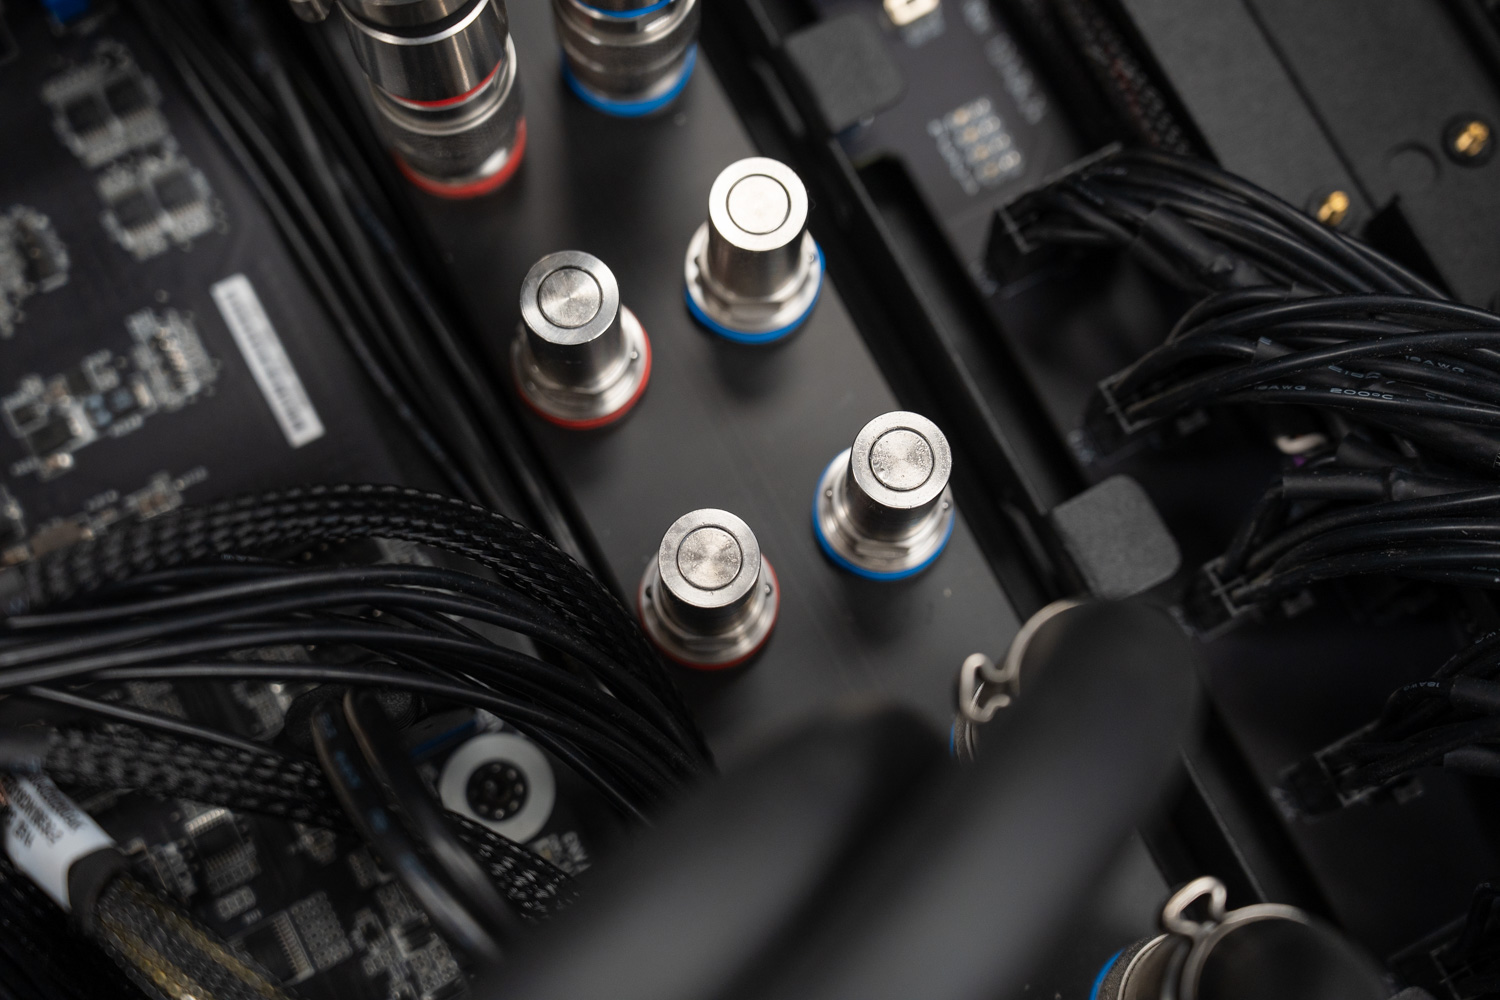
Al desconectarse, dejan un mínimo de residuos en la superficie de contacto, lo que permite a los técnicos extraer o reemplazar tarjetas gráficas individuales o la CPU sin vaciar el depósito de 450 ml ni el resto del circuito. De esta forma, Grando traslada la sencillez de mantenimiento de los sistemas de refrigeración por aire a una plataforma de refrigeración líquida de alto rendimiento.
Refrigeración de la CPU y memoria
La CPU y sus reguladores de voltaje también se benefician de una placa de refrigeración dedicada conectada directamente al circuito de refrigeración, lo que evita que el procesador se convierta en un cuello de botella durante cargas de trabajo intensas con múltiples GPU. Nuestra unidad de prueba venía con una placa AMD Turin/Genoa con un procesador AMD EPYC 9474F de 48 núcleos. La placa de refrigeración refleja la calidad de las placas de refrigeración de la tarjeta, mecanizada en cobre macizo y asegurada con tornillería de acero inoxidable.
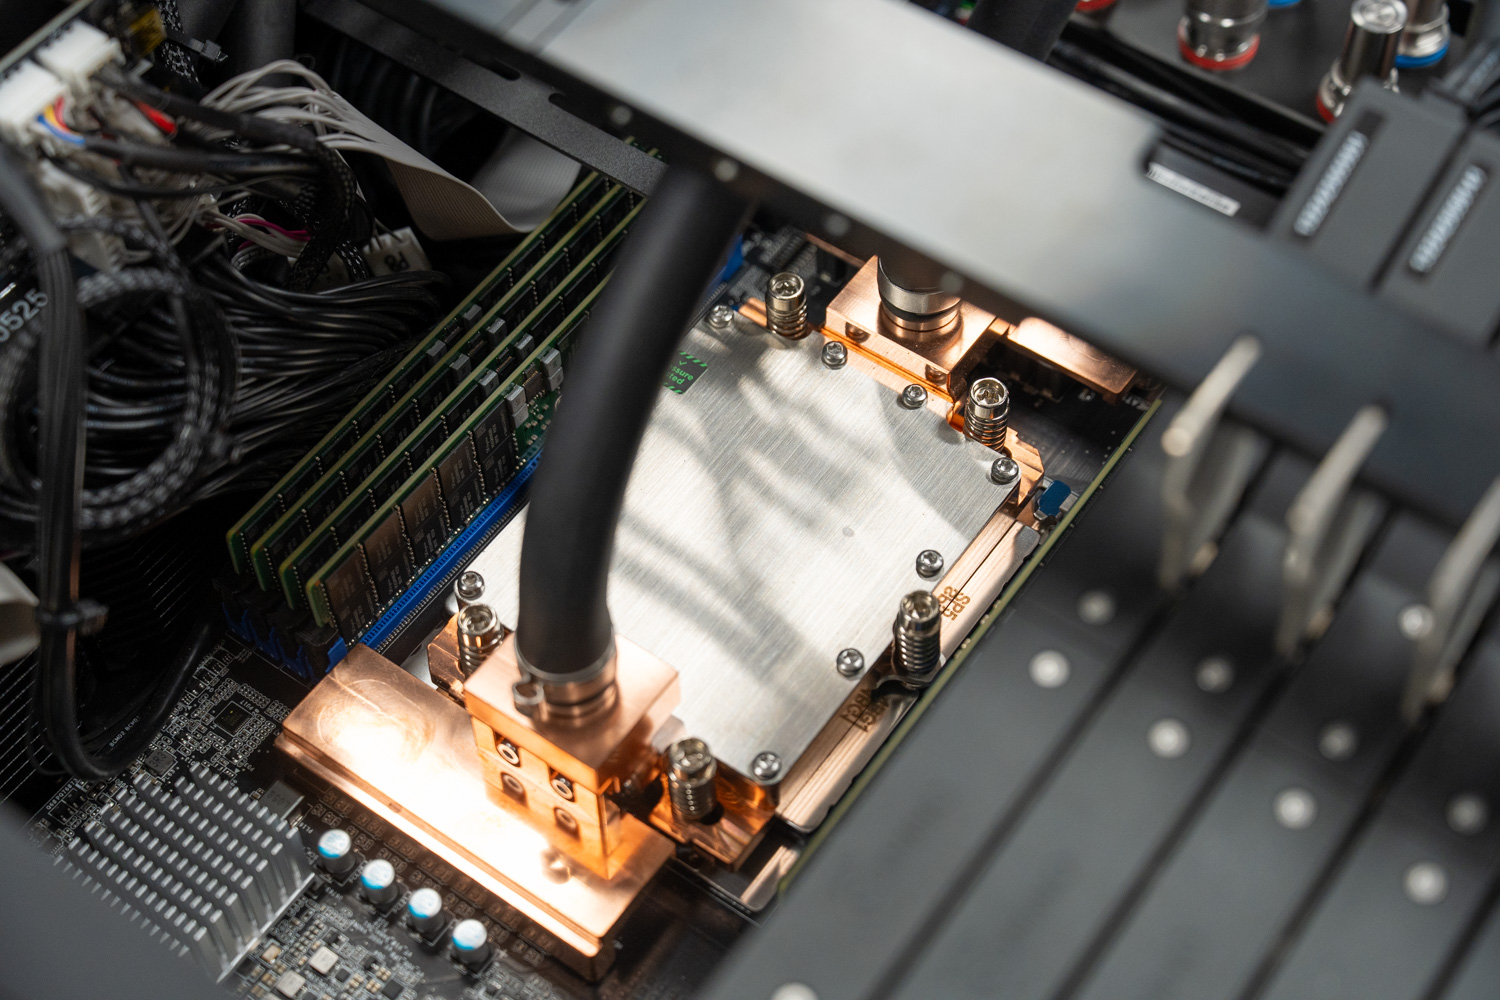
A ambos lados de la CPU se encuentran ocho ranuras DRAM completamente ocupadas que admiten configuraciones de hasta 2 TB de RAM. La unidad que analizamos venía equipada con 512 GB de RAM DDR5. Una barra de soporte se extiende por encima de la GPU y la CPU del chasis, perpendicular a ellas, protegiendo componentes sensibles como la GPU y manteniendo la rigidez del chasis durante el transporte.
Radiador y ventiladores
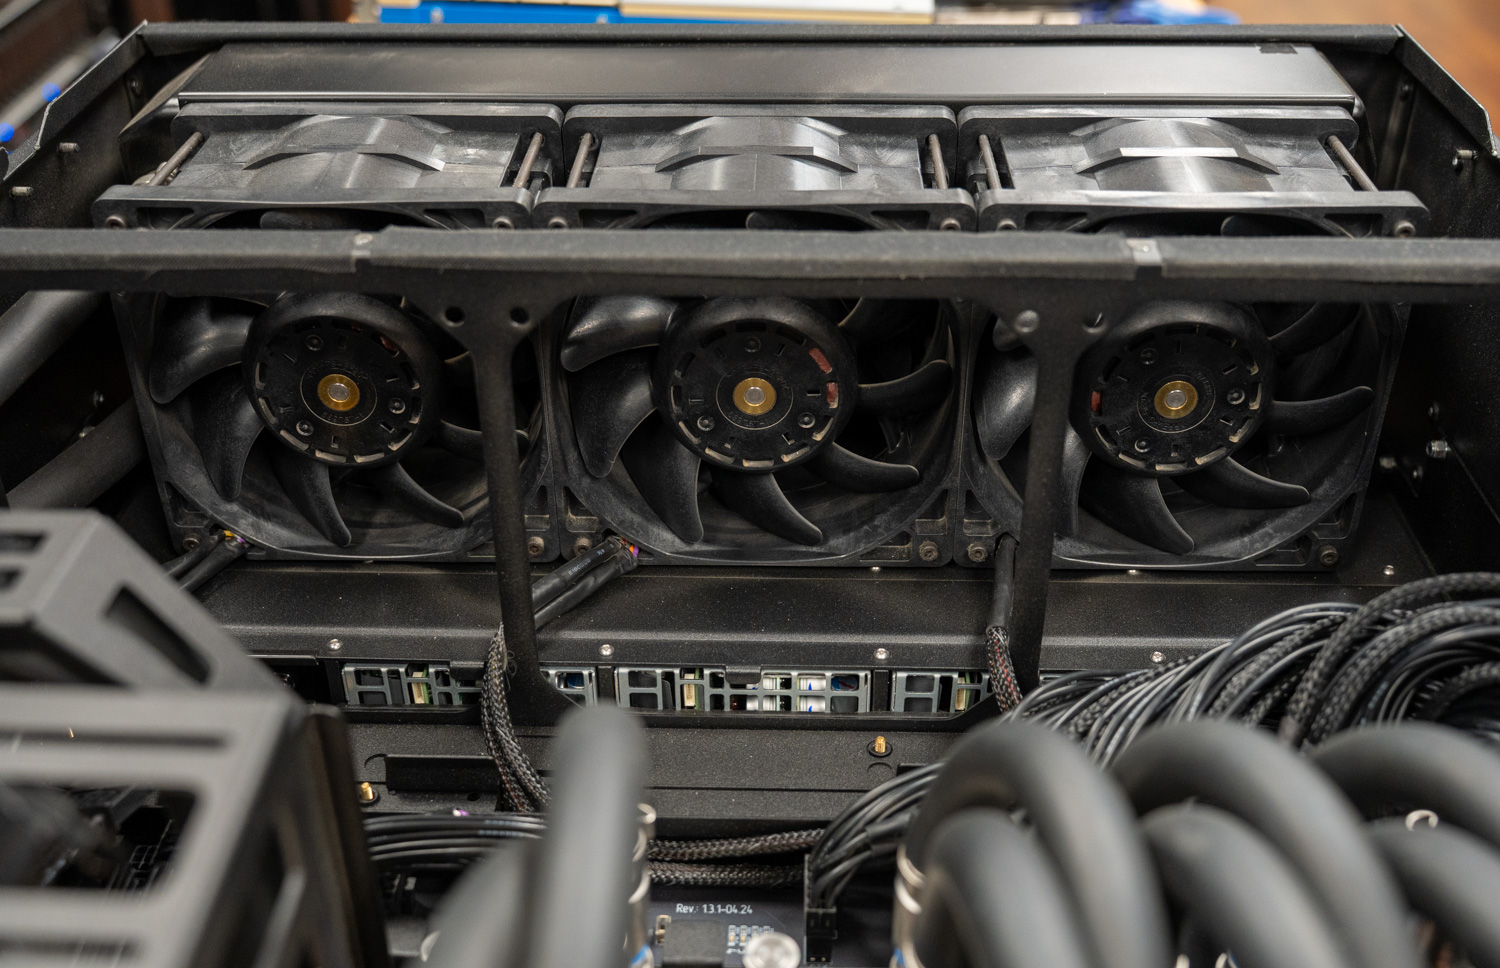
La refrigeración se gestiona mediante un radiador triple de 140 mm de gran tamaño, montado en la parte trasera del chasis, junto con tres ventiladores de alta velocidad de 140 mm capaces de alcanzar las 6,200 RPM y mover hasta 1,000 m³/h de flujo de aire. El denso conjunto de aletas del radiador subraya la capacidad térmica de la plataforma, diseñada para disipar hasta 6.5 kW de calor sostenido en nuestra configuración.
Lo más sorprendente es que, a pesar de la carga de trabajo y la velocidad de los ventiladores, la unidad se mantiene dentro de un nivel de ruido tolerable, con niveles superiores a 70 dB a máxima potencia. Si bien es un nivel alto para una estación de trabajo, resulta notablemente bajo para un sistema que disipa el calor de un pequeño horno eléctrico, lo que demuestra la eficacia con la que el circuito de refrigeración líquida del Comino transfiere el calor de los componentes.
Panel frontal y pantalla de telemetría
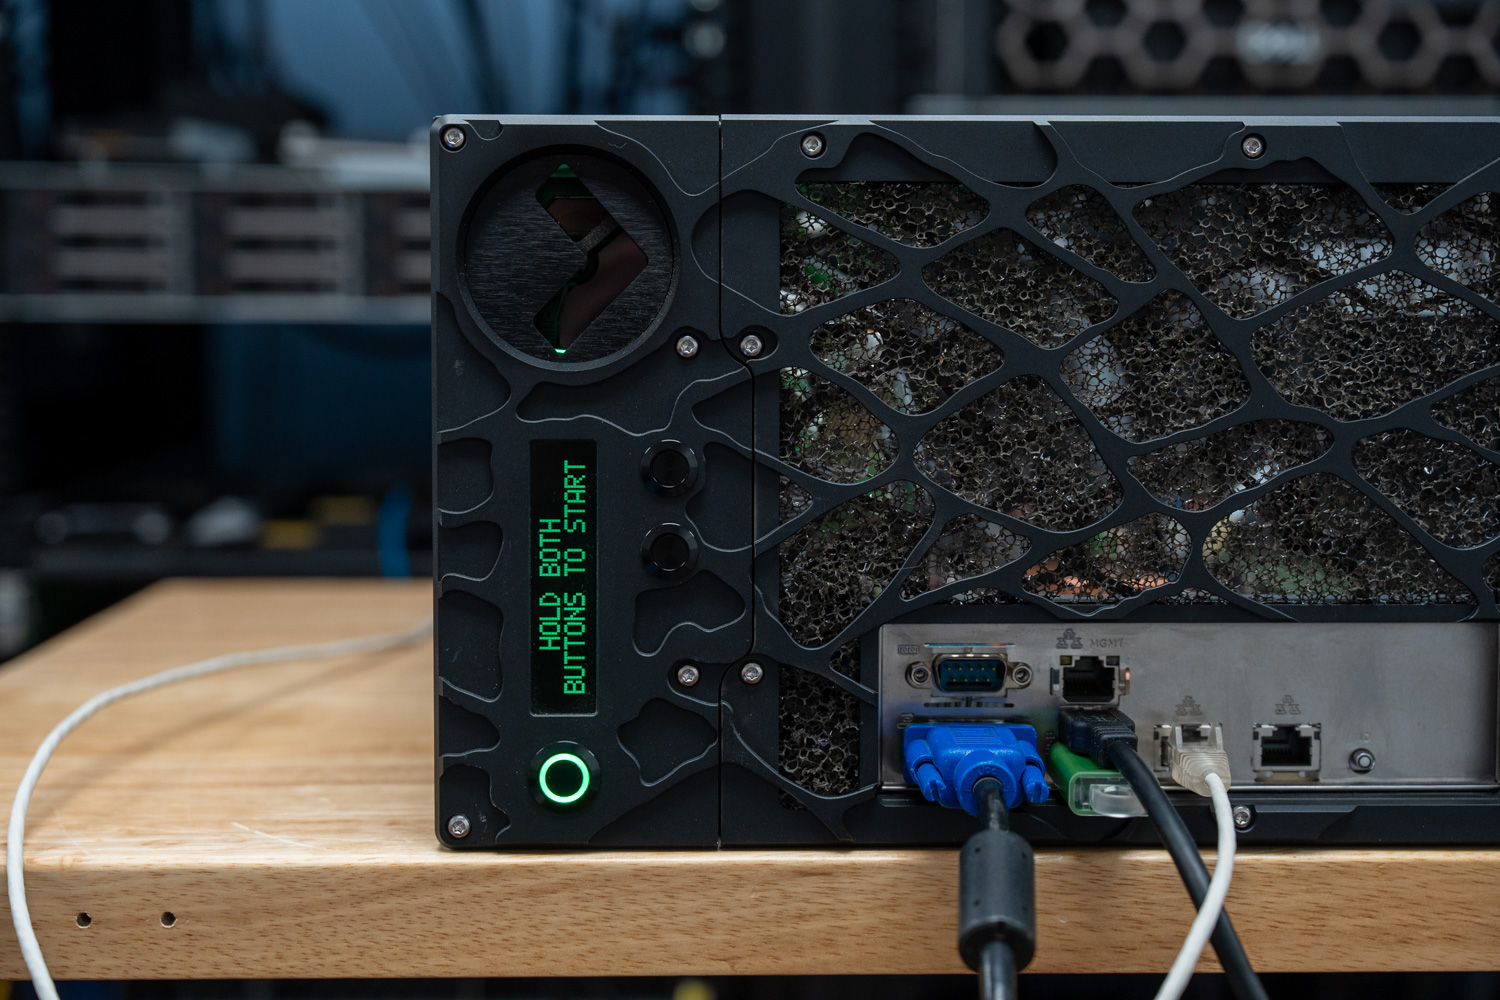
En el panel frontal, una pantalla LED muestra en tiempo real los datos de telemetría clave, como el estado de la bomba, la temperatura ambiente, la temperatura del refrigerante y la velocidad del ventilador. Los usuarios navegan por el menú mediante botones iluminados en el módulo de refrigeración; con pulsaciones cortas se desplazan por los datos disponibles. Una pulsación larga en el botón PB2 abre menús adicionales, como Comandos, Ajustes de servicio y el Registro de eventos. Además, el panel de E/S frontal incluye un puerto VGA para la salida de vídeo, un puerto serie, varios puertos USB y conexiones de red para la conectividad de periféricos y dispositivos.
Arquitectura de potencia y almacenamiento
Suministro de energía y redundancia
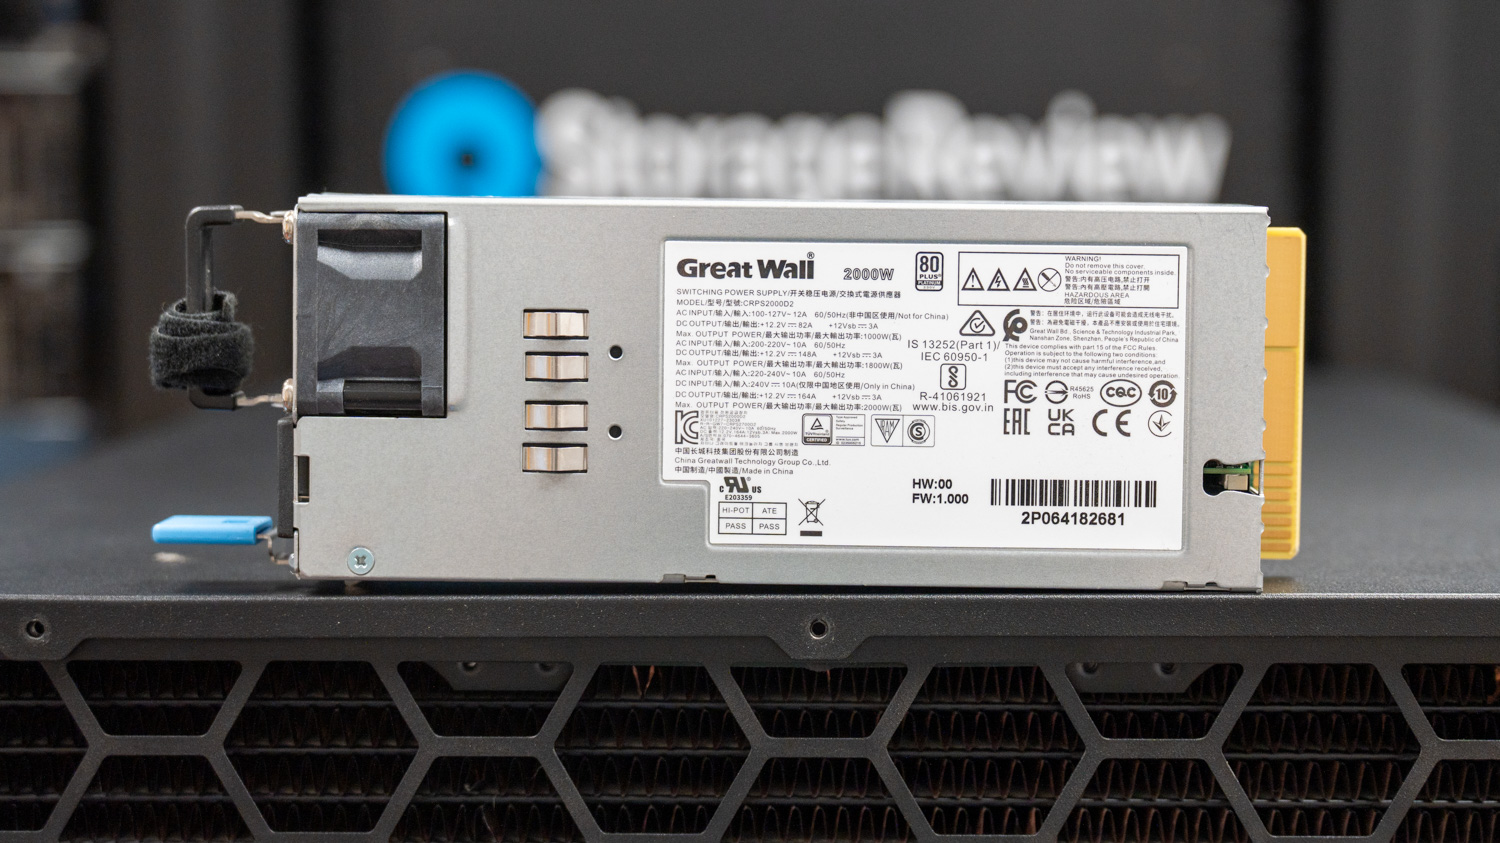
Para soportar este nivel de computación, se requiere un suministro de energía igualmente robusto. El Grando admite hasta cuatro módulos CRPS de 1000 W o 2000 W con intercambio en caliente en una configuración redundante, que proporcionan hasta 8.0 kW a 180–264 V. Gracias a la compatibilidad con los modos de redundancia 4+0, 3+1 y 2+2, el sistema puede tolerar fallos en la fuente de alimentación y mantener un funcionamiento continuo para cargas de trabajo de IA y HPC las 24 horas del día, los 7 días de la semana.
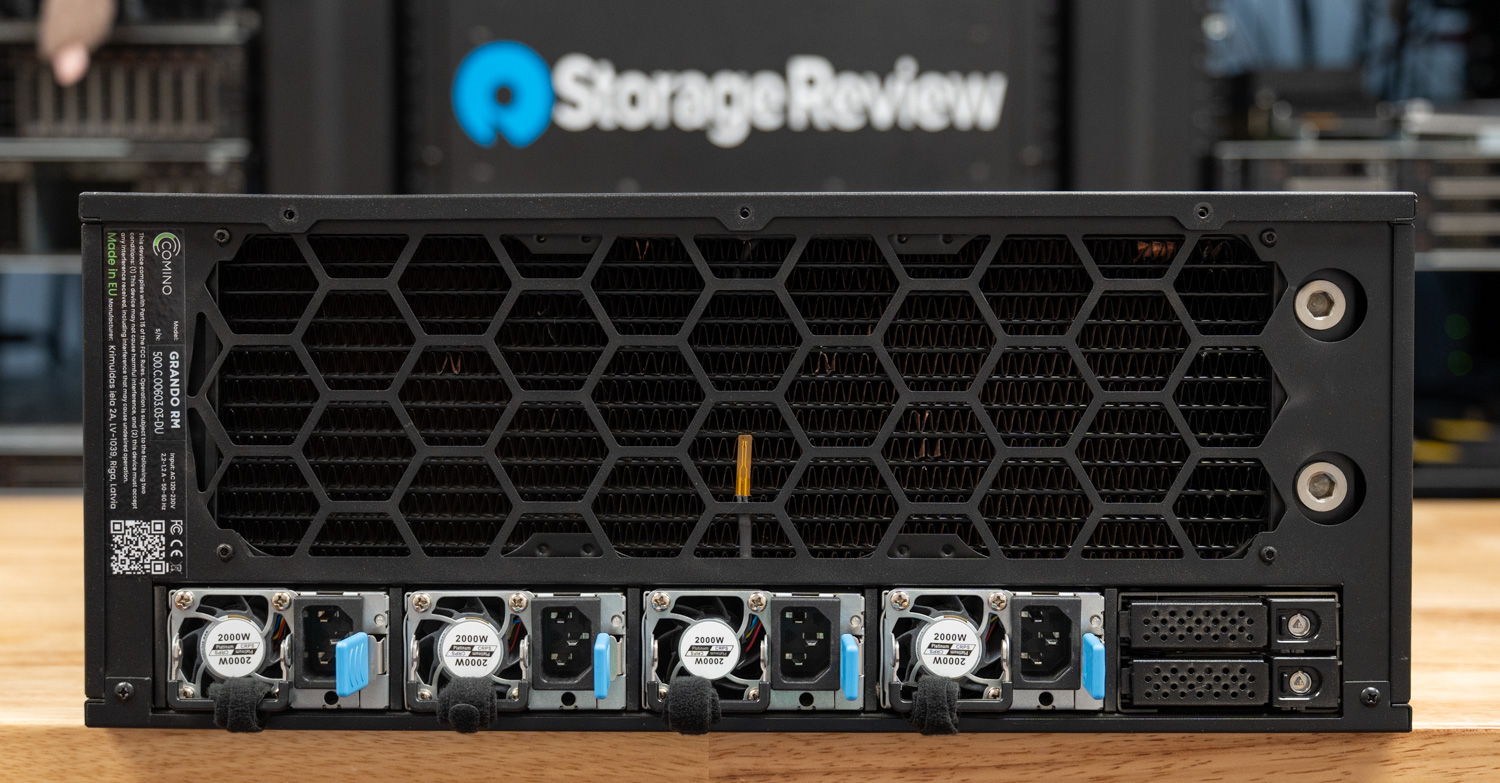
La unidad que recibimos para su análisis venía equipada con cuatro fuentes de alimentación Great Wall de 2000 W con certificación 80 Plus Platinum y sistema de intercambio en caliente, lo que conforma la configuración completa de 8.0 kW.
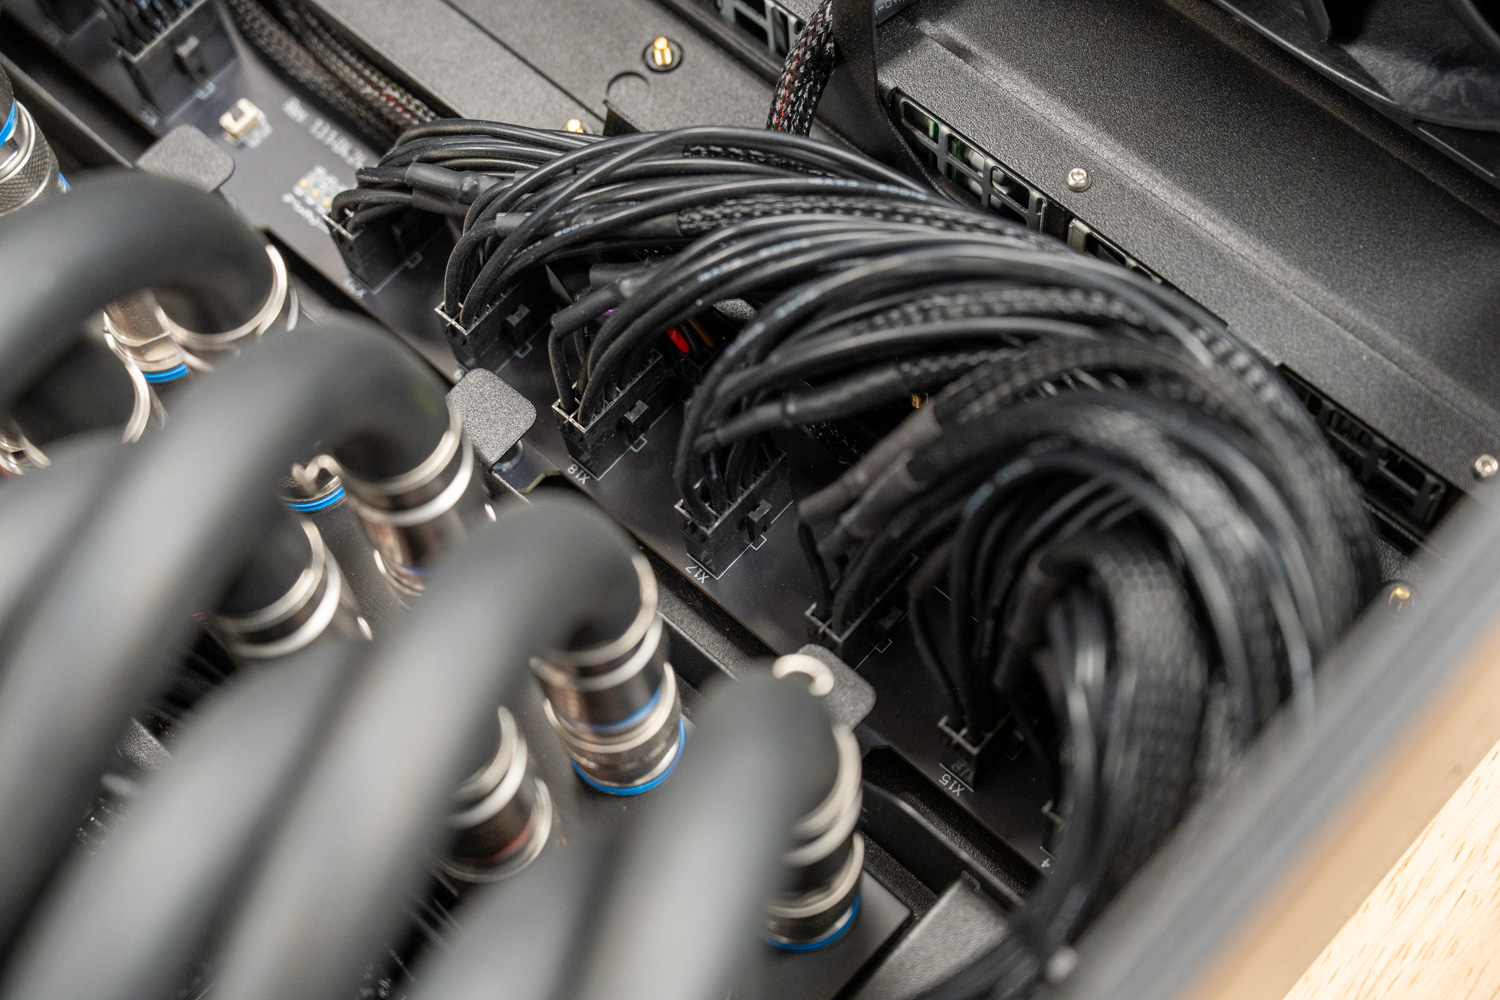
La alimentación eléctrica de cada GPU se realiza a través de una placa de distribución de energía centralizada de 12 pines, ubicada entre el conjunto de GPU y el cableado principal. El Grando utiliza esta placa para consolidar las señales de alimentación entrantes y distribuirlas a cada GPU de forma organizada y optimizando el espacio.
PCIe, almacenamiento y redes
El Grando admite cómodamente seis GPU sin comprometer el ancho de banda de las ranuras, y el chasis se adapta a una configuración completa de ocho tarjetas para una densidad máxima. La placa base ASRock Rack GENOAD8X-2T/BCM del Comino proporciona siete ranuras PCIe Gen 5 x16 y una x8, lo que significa que siete de las ocho GPU funcionan con un ancho de banda x16 completo, mientras que la octava tarjeta funciona a x8. Esto representa una compensación entre la cantidad de líneas PCIe que puede admitir una CPU de un solo socket y la reticencia de Comino a añadir el tamaño, el coste y la complejidad de una placa de conmutación PCIe. Optar por una placa base de doble socket proporcionaría más líneas PCIe, pero ofrecería aún menos ranuras, ya que el segundo socket ocuparía el espacio que de otro modo utilizarían las ranuras PCIe en el formato con espacio limitado.
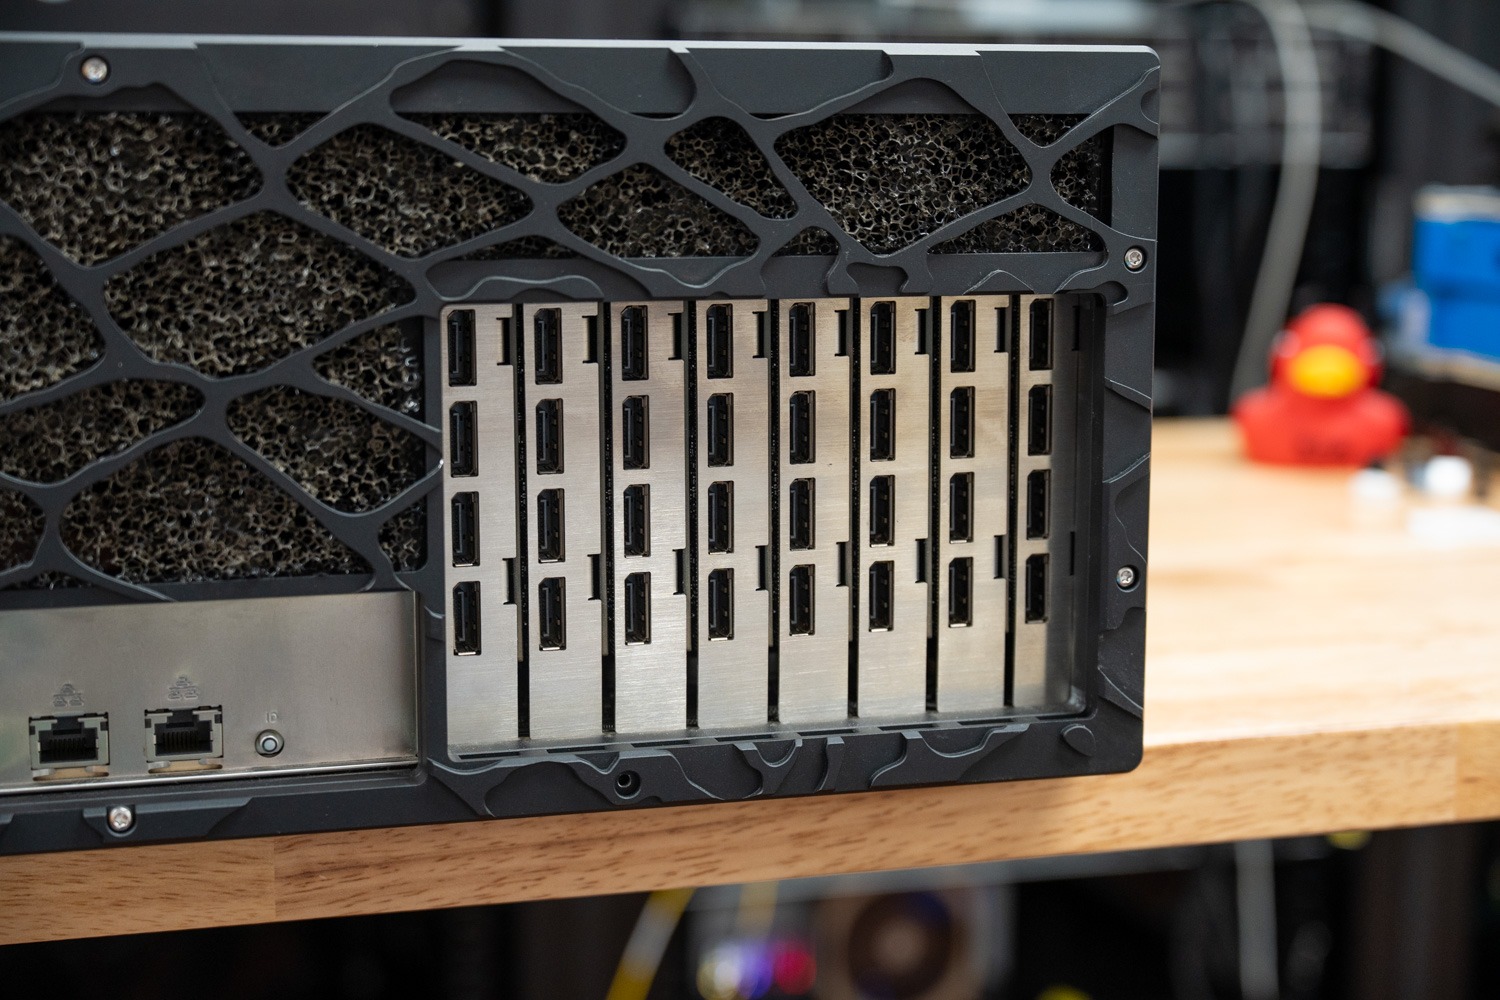
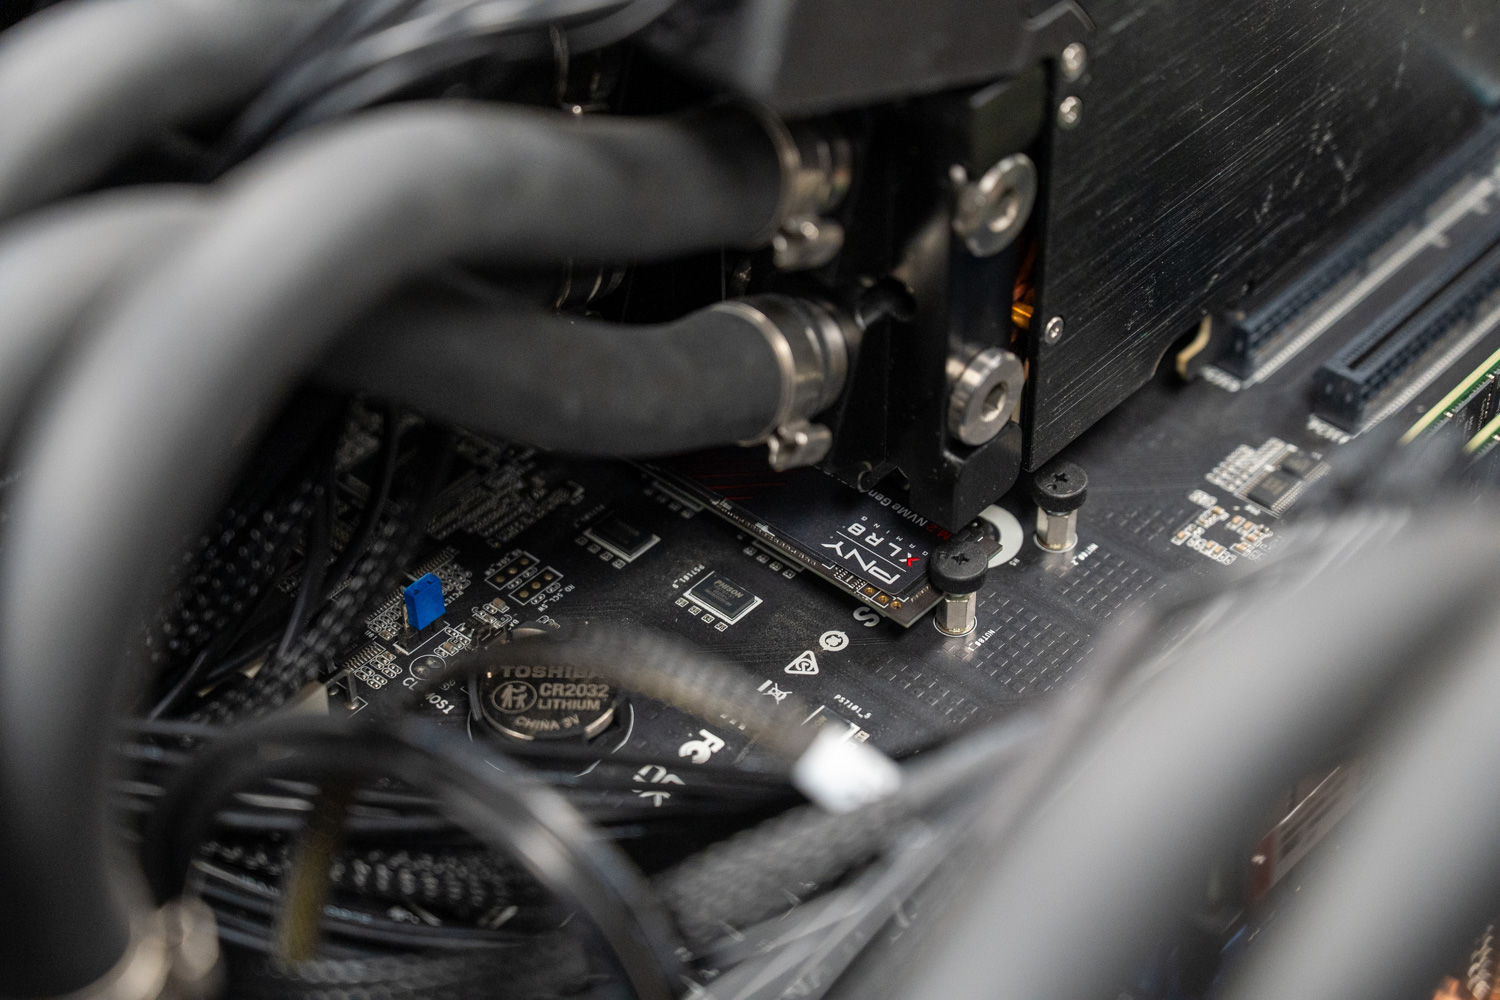
Ejecutar ocho GPU en un sistema de un solo socket consume la mayor parte de los carriles PCIe disponibles, lo que conlleva ciertas limitaciones. Nuestra unidad de prueba, basada en AMD Genoa, dispone de 128 carriles PCIe Gen 5 en total. Con ocho GPU consumiendo 120 de esos carriles, los 8 carriles restantes se dividen x4 entre cada ranura SSD M.2, por lo que no es posible ejecutar simultáneamente ocho GPU y un conjunto completo de unidades NVMe en la parte posterior del chasis conectadas mediante los dos conectores MCIO. En nuestra configuración completa de 8 GPU, solo había 2 ranuras M.2 disponibles para almacenamiento. Los administradores que necesiten capacidad NVMe adicional junto con la máxima densidad de GPU deben tener en cuenta que añadir almacenamiento NVMe de intercambio en caliente en la parte posterior mediante las jaulas del panel trasero consumirá carriles PCIe adicionales y deshabilitará parte de la capacidad de GPU en su sistema.
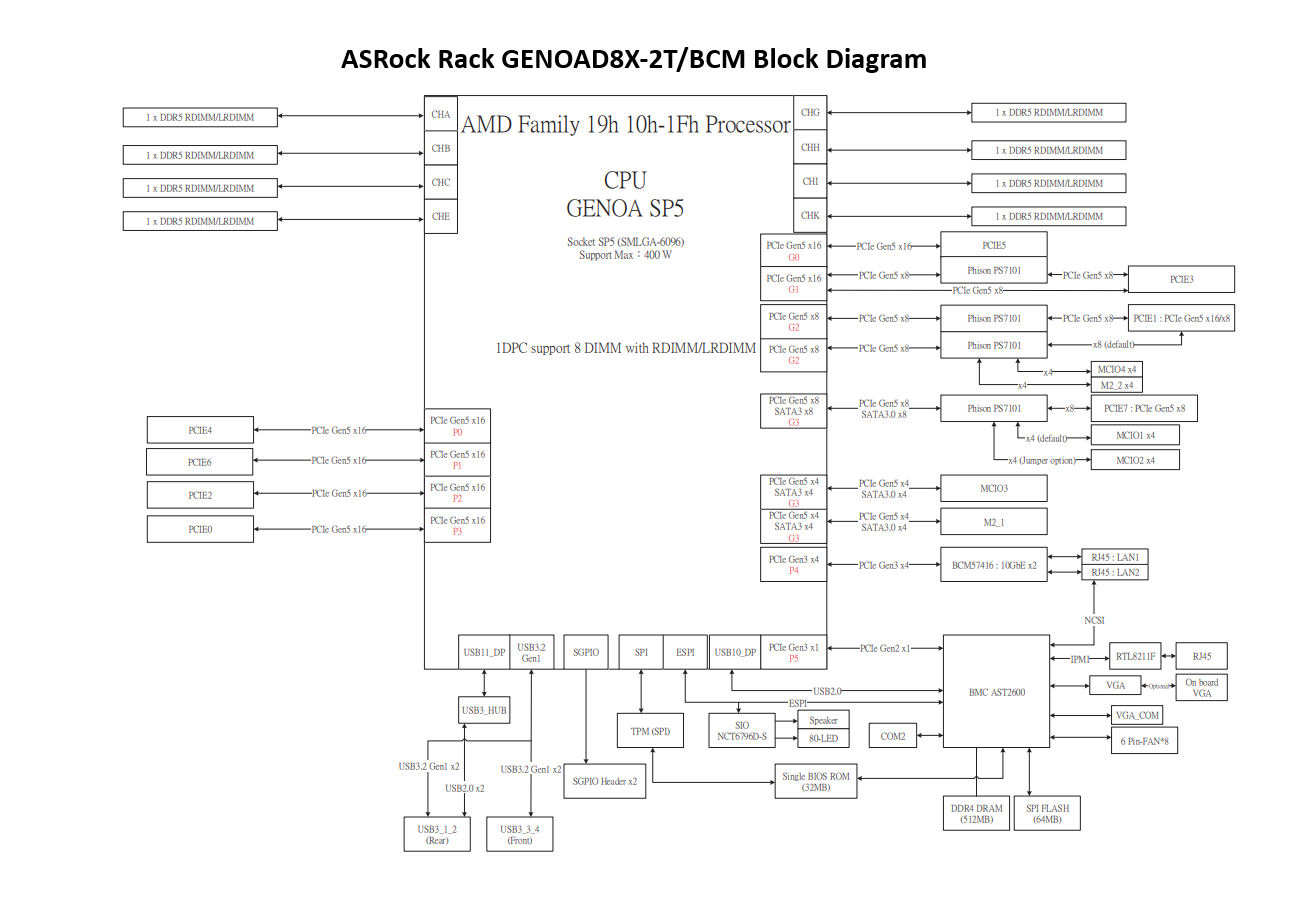
Diagrama de bloques de la placa base ASRock Rack GENOAD8X-2T/BCM que muestra la CPU, las ranuras PCIe Gen 5, los canales DIMM, las ranuras M.2, el BMC, los puertos USB, SATA y las conexiones de red.
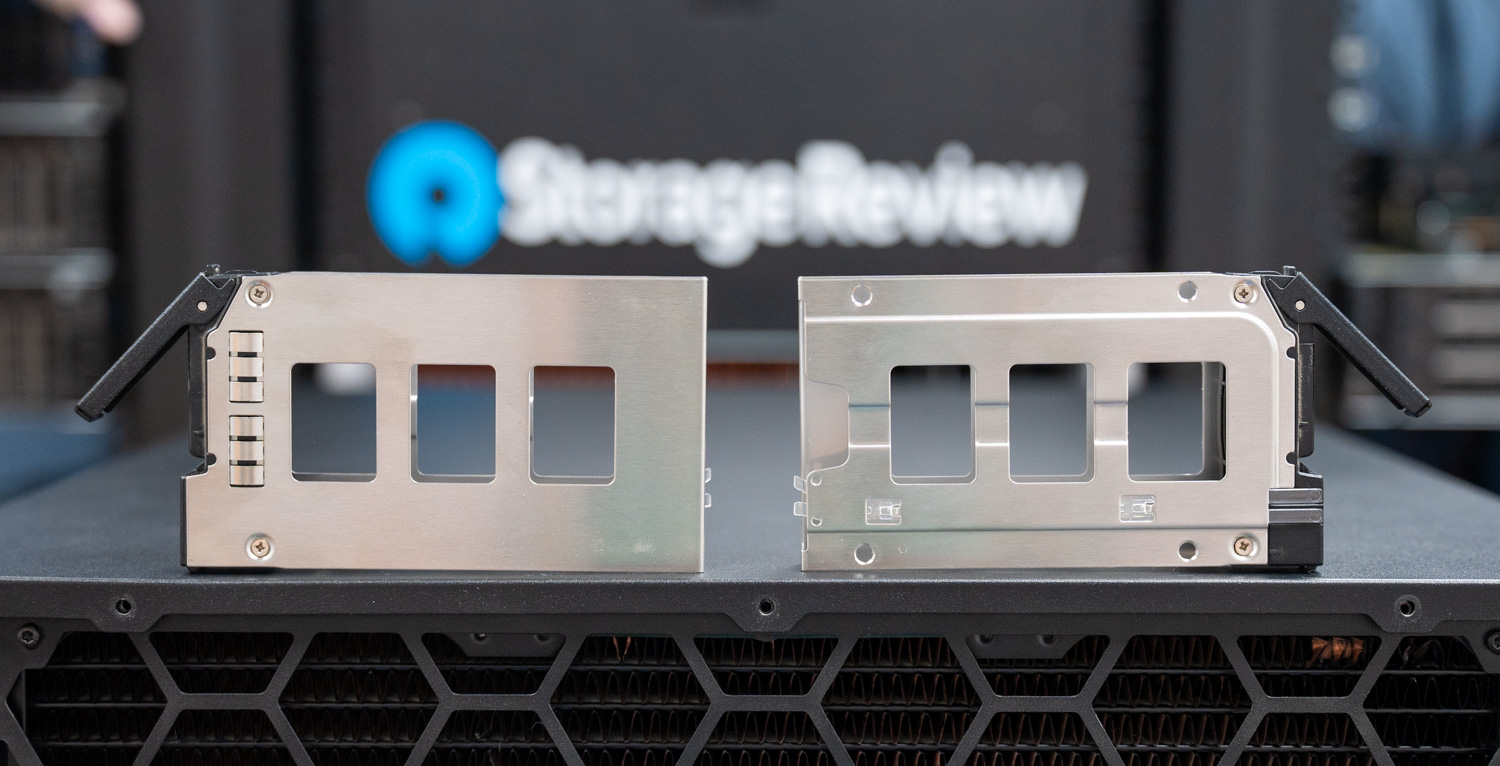
Dicho esto, el almacenamiento es igualmente modular y amplio, aunque la configuración afecta al presupuesto de carriles PCIe para las GPU, lo que conviene tener en cuenta para el caso de uso previsto. El panel trasero de nuestra unidad de prueba cuenta con una caja para unidades de 2.5" que admite hasta cuatro SSD de 2.5" en configuraciones de 4x 7 mm o 2x 15 mm, con un segundo conjunto opcional de hasta cuatro disponible en lugar de la cuarta ranura de la fuente de alimentación. Dado que nuestra unidad de prueba requería las cuatro bahías de la fuente de alimentación para admitir la configuración completa de 8 GPU, solo tuvimos acceso a la primera de las dos bahías de intercambio en caliente. Internamente, el chasis puede admitir una caja de 3.5" que aloja hasta cuatro unidades de 3.5", cuatro unidades de 2.5" de 15 mm" o hasta doce unidades de 2.5" de 7 mm", además de cuatro ranuras internas adicionales para SSD de 2.5" de 7 mm si se configuran.
Para la conectividad de red, la placa base incluye de serie dos puertos RJ45 de 10 Gb/s integrados, gestionados por el Broadcom BCM57416, junto con un puerto de gestión IPMI Gigabit Ethernet dedicado. Los administradores pueden aumentar aún más el ancho de banda instalando tarjetas de red PCIe que admiten hasta 400 Gb/s para una conectividad de red de alto ancho de banda. Sin embargo, cabe destacar que las tarjetas de red PCIe adicionales ocupan ranuras de GPU, lo que reduce el número máximo de GPU que puede alojar el sistema.
Gestión remota e inteligencia de sistemas
Para proteger el hardware y optimizar el rendimiento, el sistema incluye el Sistema de Monitorización Comino (CMS). Una placa controladora independiente y autónoma gestiona el CMS y actúa como el «cerebro» del servidor, independientemente del sistema operativo principal. En la práctica, esta controladora lee una amplia gama de sensores que monitorizan en tiempo real la temperatura del aire y del refrigerante, los niveles de humedad, el caudal del refrigerante y los niveles del depósito. Fundamentalmente, este diseño autónomo permite al CMS realizar autodiagnósticos y activar paradas de emergencia al detectar una fuga o un fallo en la bomba, protegiendo así el costoso hardware interno de posibles daños.
Una interfaz gráfica web gestiona el funcionamiento diario, proporcionando a los administradores una visibilidad clara del rendimiento de la refrigeración, el tiempo de actividad y el consumo energético en tiempo real de la CPU y las GPU. Para implementaciones a escala empresarial, el CMS también se conecta a herramientas de monitorización centralizadas mediante API REST, como Zabbix, Grafana e InfluxDB. En conjunto, estas funcionalidades ayudan a los administradores a mantener un periodo de mantenimiento de 3 años y a que el servidor funcione con la máxima eficiencia sin estrangulamiento térmico, incluso en entornos con altas temperaturas ambiente.
Más allá de la IA: Aplicaciones creativas y de ingeniería
Si bien nuestras pruebas se centraron en cargas de trabajo de inferencia de IA, la Grando cumple una función igualmente práctica para profesionales creativos e ingenieros que necesitan una gran capacidad de procesamiento GPU local. Los 768 GB de VRAM agregados en ocho tarjetas RTX PRO 6000 ofrecen capacidades que las configuraciones de estaciones de trabajo convencionales no pueden igualar.
Los artistas de efectos especiales y los profesionales de gráficos en movimiento pueden renderizar escenas complejas con conjuntos de texturas masivos directamente en la VRAM, eliminando los cuellos de botella del intercambio de discos que afectan a las producciones que utilizan metraje 8K o entornos de alto poligonaje. Los ingenieros CAD que ejecutan dinámica de fluidos computacional o simulaciones estructurales pueden abordar ensamblajes de una complejidad sin precedentes sin tener que dividir sus modelos en múltiples ejecuciones. Los editores de vídeo que trabajan con líneas de tiempo RAW 8K de múltiples flujos, los coloristas que aplican reducción de ruido basada en aprendizaje automático a resolución completa y los artistas 3D que renderizan los finales trazados localmente en lugar de esperar a que estén disponibles en la nube, se benefician de esta densidad de memoria y capacidad de procesamiento de la GPU.
Grando no requiere una configuración completa de ocho GPU. Comino ofrece la plataforma en configuraciones de cuatro, seis y ocho GPU, con todas las variantes disponibles para envío inmediato. Los estudios pequeños, los creadores independientes y los equipos de ingeniería pueden ajustar su inversión a sus necesidades actuales, manteniendo una clara ruta de actualización a medida que aumente la carga de trabajo.
Ventajas y desventajas de las plataformas: densidad frente a capacidad de expansión.
El diseño compacto de Grando ofrece una densidad de GPU y una gestión térmica excepcionales dentro de un formato estándar de 4U, pero esa densidad implica concesiones arquitectónicas que conviene comprender antes de su implementación.
El chasis admite placas base con formatos EATX y EEB, pero no las placas de servidor extendidas que se encuentran en las plataformas tradicionales de doble socket. Esto limita el número total de líneas PCIe disponibles para periféricos más allá del conjunto de GPU. En nuestra configuración de ocho GPU, las 128 líneas PCIe Gen 5 del procesador AMD EPYC son utilizadas casi en su totalidad por las GPU, lo que deja poco ancho de banda para almacenamiento NVMe adicional o redes de alta velocidad más allá de los puertos 10GbE integrados.
Esto contrasta con las plataformas de ocho GPU que hemos analizado de Dell, HPE y Supermicro. Estos sistemas utilizan chasis más grandes, configuraciones de doble socket y topologías de conmutación PCIe para admitir una conectividad periférica significativamente mayor. Por lo general, admiten de cuatro a ocho NIC o DPU adicionales junto con el conjunto completo de GPU, además de ocho o más bahías NVMe de intercambio en caliente, lo que los hace idóneos para cargas de trabajo de inferencia distribuida que requieren interconexiones de tejido de alto ancho de banda.
Sin embargo, esta mayor capacidad conlleva un coste considerable. El consumo energético supera los 8 kW. Las cargas térmicas requieren una infraestructura de refrigeración específica para centros de datos. El nivel de ruido impide su instalación fuera de salas de servidores especialmente diseñadas. Además, los plazos de entrega suelen extenderse de seis a dieciocho meses debido a las constantes limitaciones de suministro de plataformas GPU empresariales.
Grando ocupa una posición diferente. Para las organizaciones que priorizan el despliegue rápido, los entornos operativos gestionables y las cargas de trabajo de inferencia o creatividad sobre el entrenamiento distribuido a gran escala, las ventajas suelen ser evidentes. Los equipos que necesitan su hardware de inmediato, en un entorno con el que puedan trabajar, pueden encontrar que el enfoque de densidad de Grando es más práctico que esperar en una cola por una plataforma que no podrán implementar una vez que esté disponible.
Resultados de las pruebas de rendimiento de Comino Grando
Configuración del Sistema
- Chasis: Comino Grande
- Placa base: Soporte ASRock GENOAD8X-2T/BCM
- UPC: AMD EPYC 9474F 48C
- Memoria: DDR512 de 5 GB
- GPU: 8 x NVIDIA RTX PRO 6000
- Almacenamiento: M.2 SSD
Servidor de código Claude – MiniMax M2.5
Más allá de las pruebas de inferencia LLM tradicionales, queríamos evaluar el rendimiento de este hardware en un flujo de trabajo de codificación con agentes, específicamente al ofrecer múltiples sesiones concurrentes de Claude Code mediante un modelo alojado localmente. Este caso de uso se relaciona directamente con la productividad del equipo de desarrollo: ¿cuántos ingenieros pueden usar simultáneamente un asistente de codificación con IA alojado en un solo nodo antes de que la experiencia se degrade?
Para probar esto, creamos un entorno de evaluación comparativa que genera un conjunto de datos de problemas de codificación de dificultad moderada (como implementar una caché LRU, crear una aplicación CLI de lista de tareas, escribir un convertidor de Markdown y construir una API REST) y ejecuta cada sesión de Claude Code en un contenedor Docker separado contra el servidor vLLM local. Un proxy transparente se sitúa entre las sesiones y el punto final de inferencia, capturando métricas por solicitud para cada instancia de Claude Code. El modelo utilizado fue MiniMax M2.5, servido a través de vLLM en las ocho GPU NVIDIA RTX PRO 6000 del sistema. Si bien no es el modelo de codificación mejor clasificado en las tablas de clasificación públicas, M2.5 es un modelo capaz que muchos usuarios, incluidos nuestros amigos desarrolladores, ejecutan localmente.
Como punto de referencia, utilizamos el rendimiento promedio de salida de Claude Opus 4.6 de Anthropic a través de OpenRouter.ai, uno de los servicios de enrutamiento más populares para el acceso a API en entornos de producción. Este rendimiento de referencia se sitúa en aproximadamente 37 tokens por segundo por solicitud de API.
Medimos dos métricas clave: el promedio de tokens de salida por segundo por sesión de Claude Code (lo que experimenta cada desarrollador) y el total de tokens de salida por segundo en todas las sesiones (el trabajo total que produce el servidor).
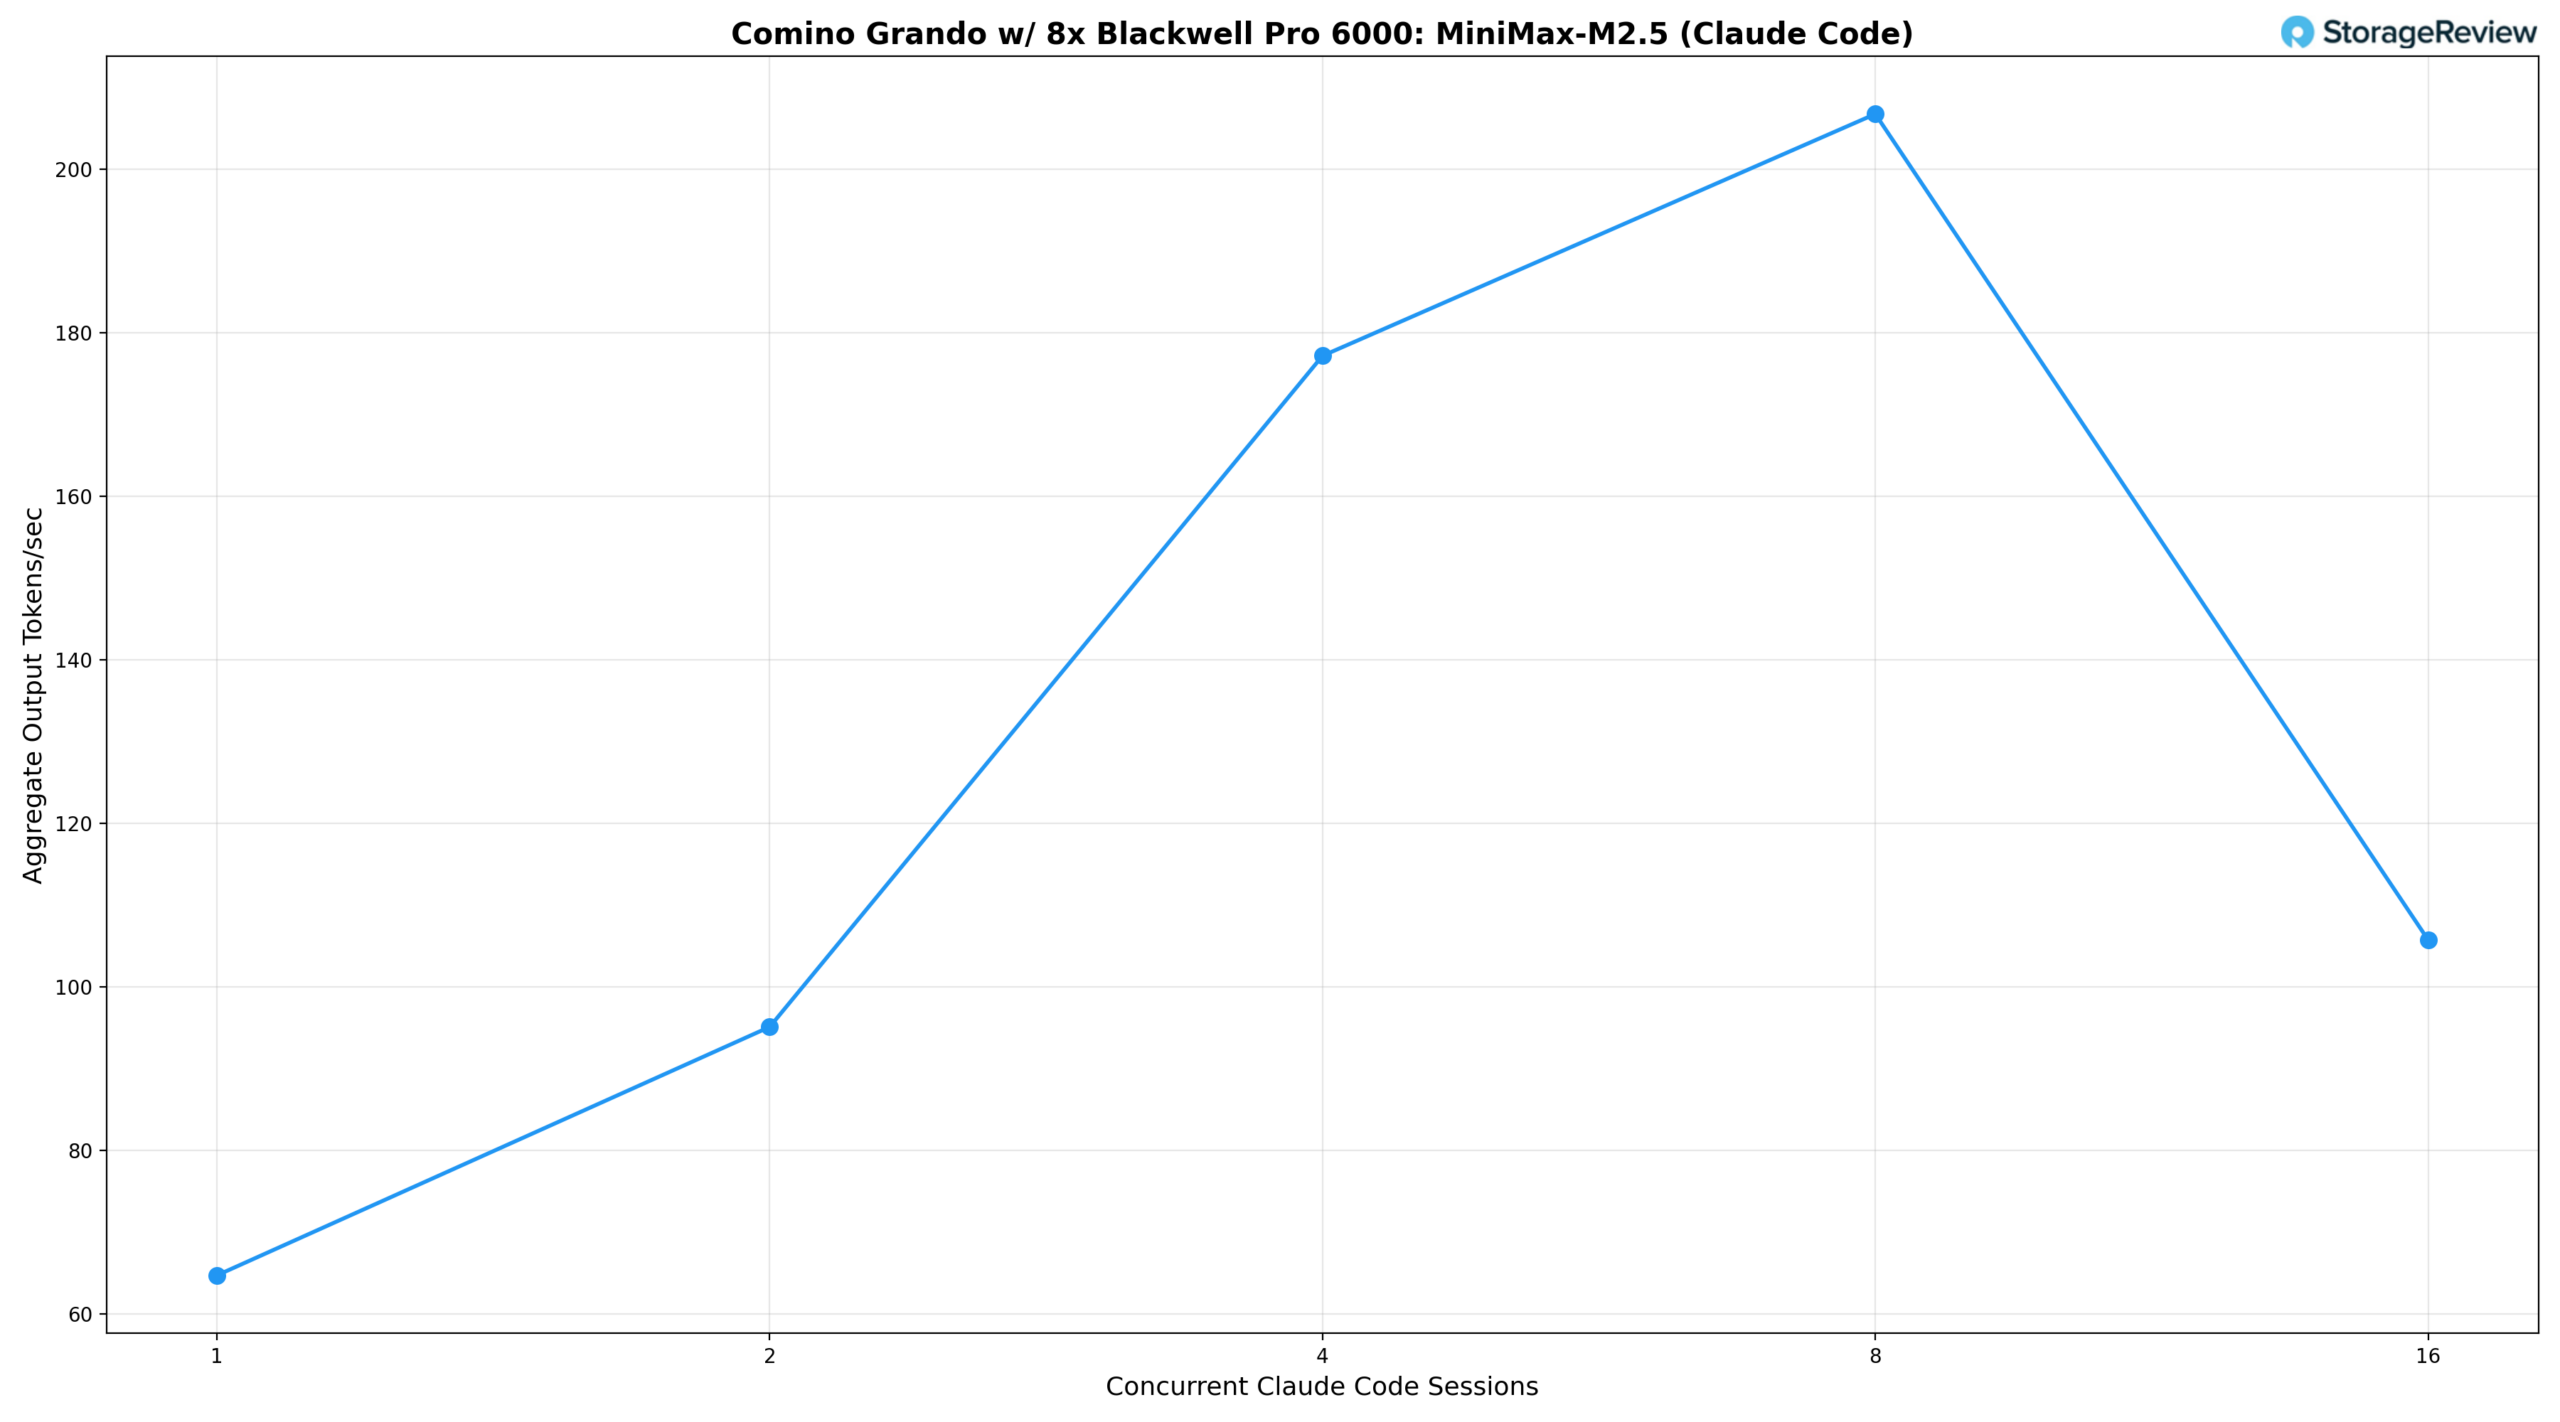
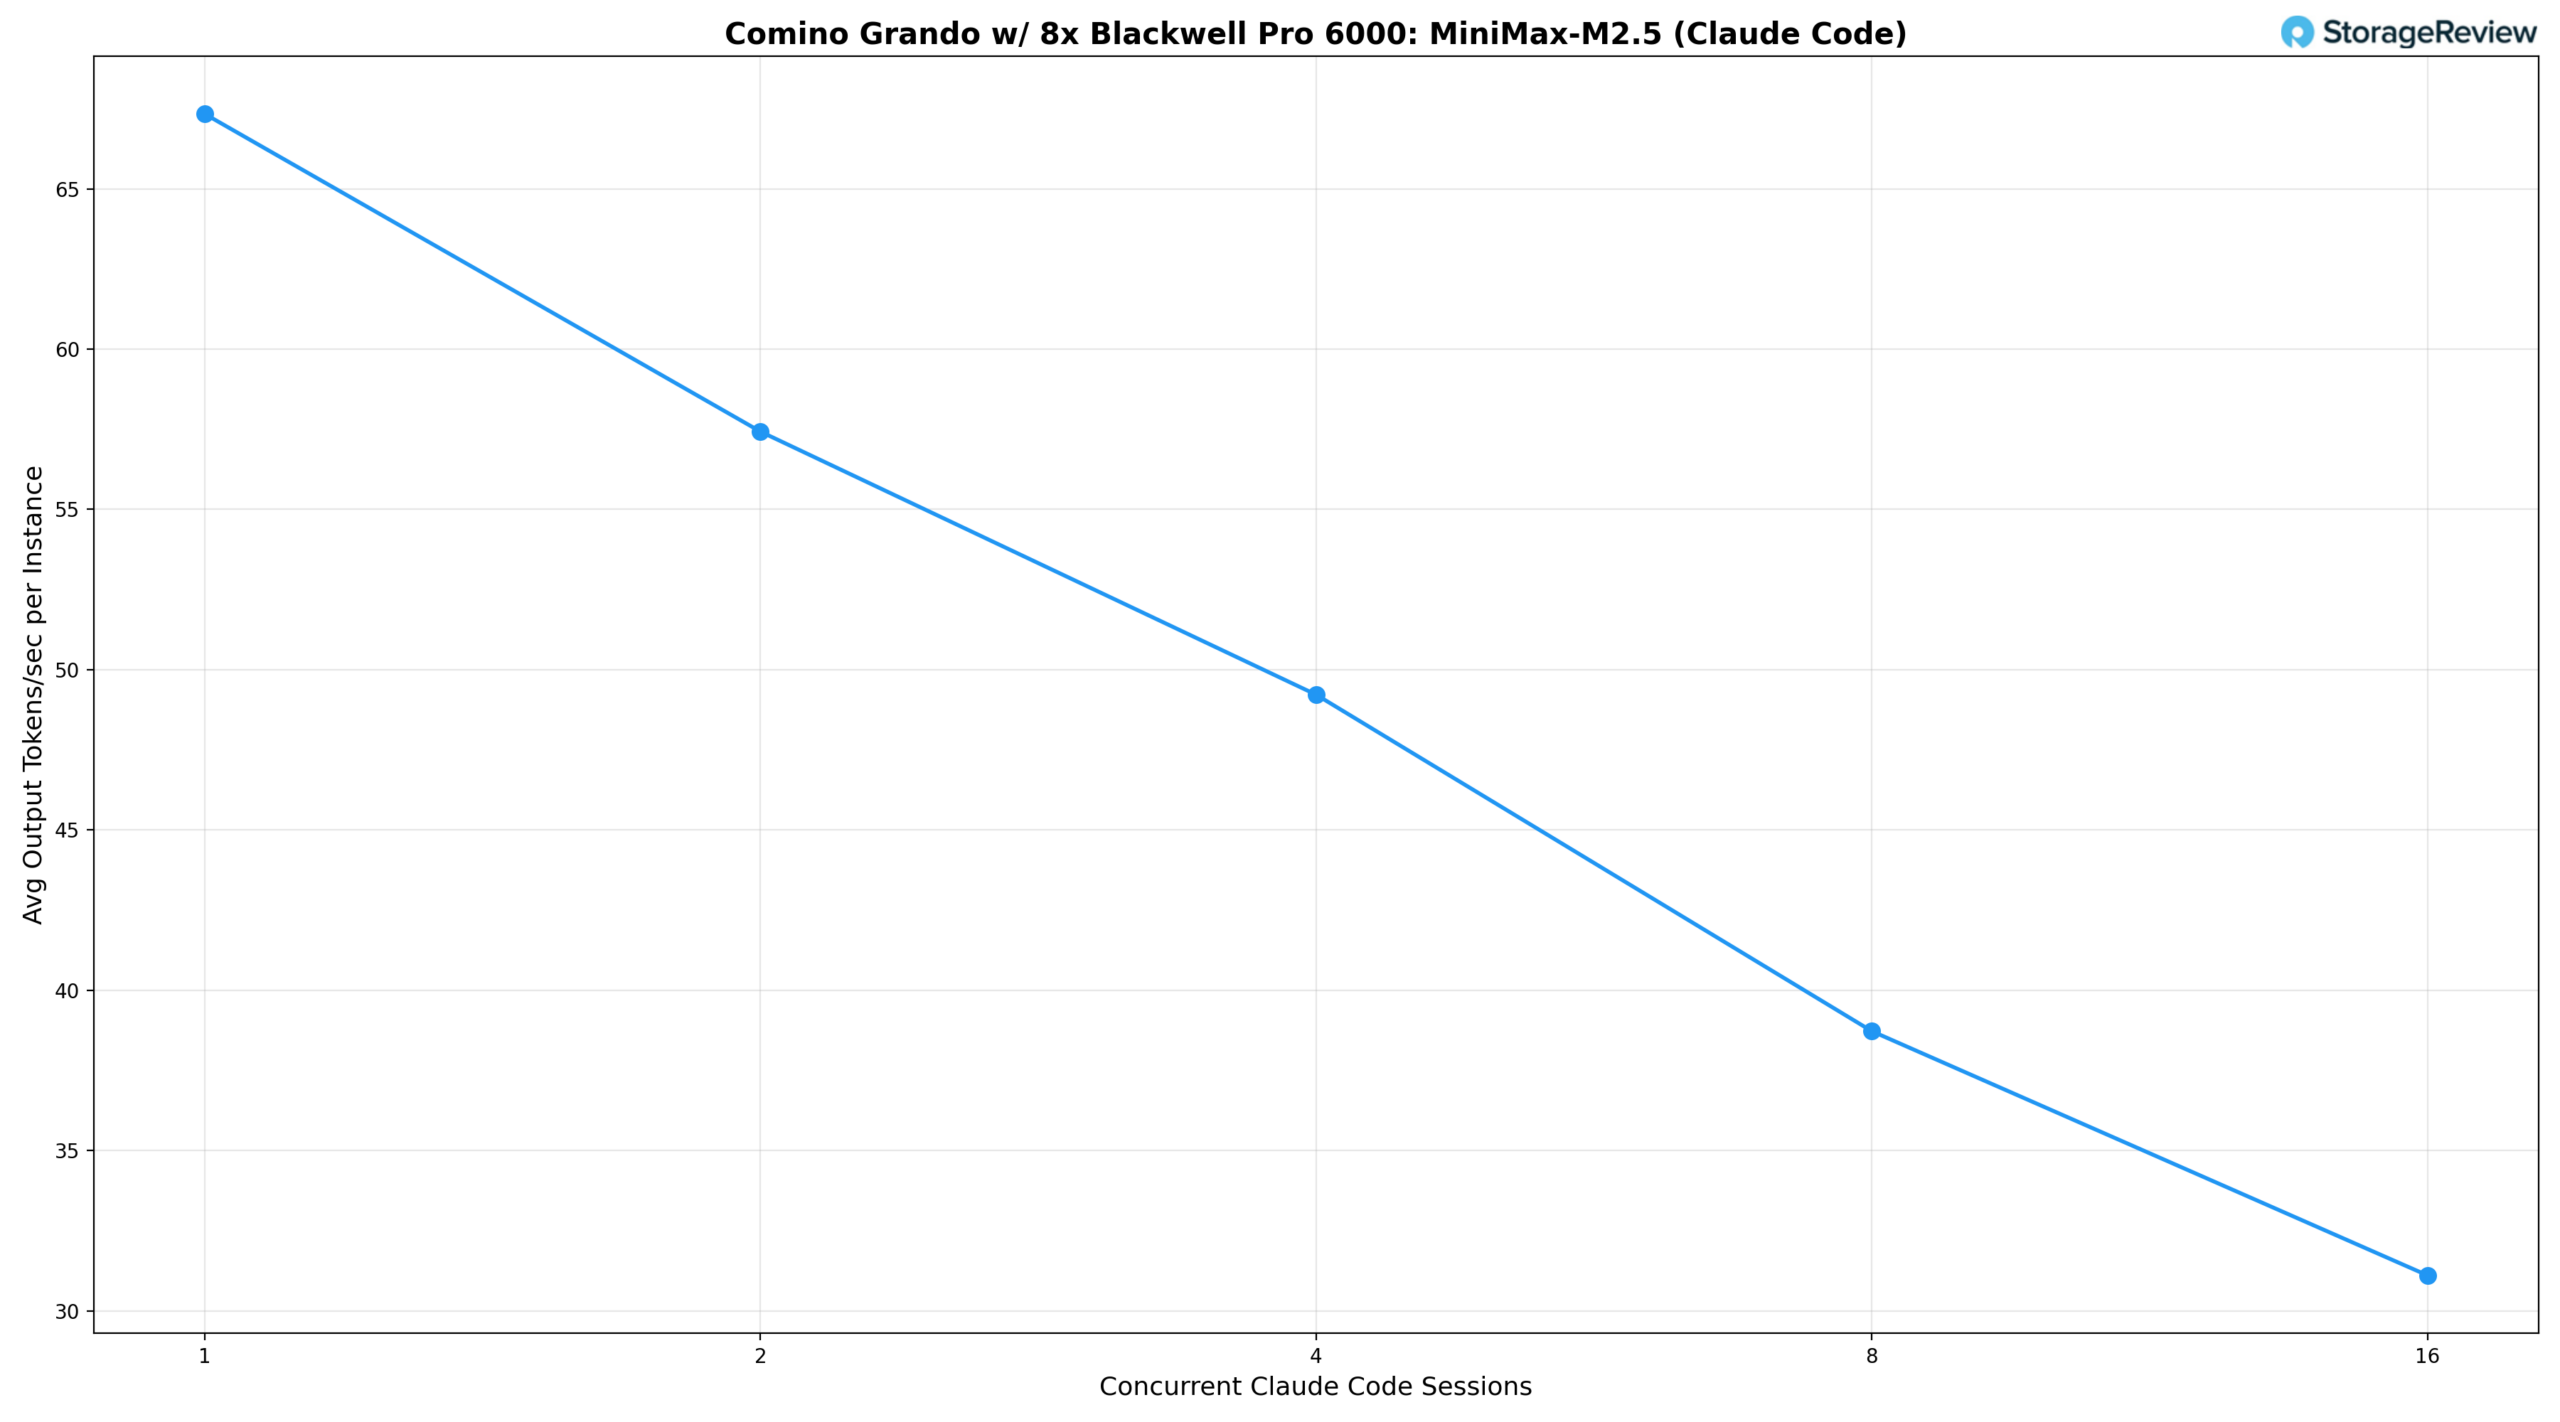
Según los resultados, una única sesión concurrente de Claude Code ofrece 67.3 tok/s por usuario y una producción agregada de 64.7 tok/s. Con dos sesiones, el rendimiento por instancia disminuye ligeramente a 57.4 tok/s, mientras que la producción agregada aumenta a 95.1 tok/s a medida que el procesamiento por lotes de vLLM comienza a amortizar la sobrecarga. Cuatro sesiones concurrentes mantienen 49.2 tok/s por usuario, lo que sigue siendo una experiencia altamente receptiva para flujos de trabajo de codificación interactivos, mientras que el rendimiento agregado alcanza los 177.2 tok/s. Ocho sesiones representan el punto óptimo para la producción agregada, con un pico de 206.7 tok/s en total, mientras que el rendimiento por instancia se estabiliza en 38.7 tok/s, un nivel que sigue siendo cómodo para la generación e iteración de código en tiempo real.
Con 16 sesiones concurrentes, el sistema muestra la clásica disyuntiva del procesamiento por lotes: el rendimiento por instancia cae a 31.1 tok/s y el rendimiento total disminuye a 105.8 tok/s. Esto sugiere que, a este nivel de concurrencia, el modelo 230B MiniMax M2.5 está llevando al límite la capacidad de ocho GPU sin generar una latencia significativa para cada usuario. La disminución total entre 8 y 16 sesiones refleja las exigencias de ancho de banda de memoria de una arquitectura MoE de gran tamaño bajo una carga de decodificación simultánea elevada, en lugar de una ineficiencia en la planificación.
Para las organizaciones que evalúan infraestructuras de IA autogestionadas para herramientas de desarrollo, Grando se presenta como una opción muy atractiva. Con un modelo 230B de última generación, puede gestionar cómodamente hasta ocho sesiones simultáneas de Claude Code con un rendimiento que ofrece una experiencia verdaderamente interactiva, con velocidades por usuario que superan los 38 tok/s en el pico de producción agregada. Equipos de entre cuatro y ocho ingenieros pueden operar con un rendimiento casi óptimo sin una degradación perceptible en la capacidad de respuesta.
La arquitectura de refrigeración líquida también hace que este nivel de computación sea práctico en entornos donde los servidores GPU tradicionales no pueden operar. El sistema funciona con el nivel de ruido suficiente para ubicarse en la oficina de una startup, una pequeña sala de máquinas o un rincón específico de un espacio de trabajo abierto. Los sistemas de refrigeración por aire con una densidad de GPU similar suelen alcanzar los 90 dB o más, lo que requiere un espacio dedicado en un centro de datos o, como mínimo, un armario de servidores cerrado con un tratamiento acústico riguroso. Grando puede coexistir con el equipo que lo utiliza. Combinado con la localización total de datos, la ausencia de costes de API por token y el control absoluto sobre la selección de modelos, ofrece una solución autogestionada que se adapta al crecimiento del equipo de desarrollo sin necesidad de infraestructura de centro de datos ni aumentos de costes proporcionales.
Servicio en línea de vLLM – Rendimiento de inferencia de LLM
vLLM es uno de los motores de inferencia y servicio de alto rendimiento más populares para LLM. La prueba de rendimiento en línea de vLLM evalúa el desempeño real de este motor de inferencia bajo solicitudes concurrentes. Simula cargas de trabajo de producción enviando solicitudes a un servidor vLLM en ejecución, con parámetros configurables como la tasa de solicitudes, la longitud de entrada y salida, y el número de clientes concurrentes. La prueba mide métricas clave, incluyendo el rendimiento (tokens por segundo), el tiempo hasta el primer token y el tiempo por token de salida (TPOT), lo que ayuda a los usuarios a comprender el desempeño de vLLM bajo diferentes condiciones de carga.
Probamos el rendimiento de la inferencia en un conjunto integral de modelos que abarcan varias arquitecturas, escalas de parámetros y estrategias de cuantificación para evaluar el rendimiento en diferentes perfiles de concurrencia.
Resumen de resultados
| Modelo | Precisión | Igual (256/256) | Relleno previo intensivo (8k/1k) | Decodificación intensiva (1k/8k) |
|---|---|---|---|---|
| Comino Grando con 8× RTX PRO 6000 Blackwell — Resultados de inferencia vLLM (tok/s, pico en BS=256) | ||||
| GPT-OSS 20B | ep_dp1 | 17,280 | 32,061 | 11,187 |
| GPT-OSS 120B | ep_dp1 | 11,726 | 21,636 | 7,570 |
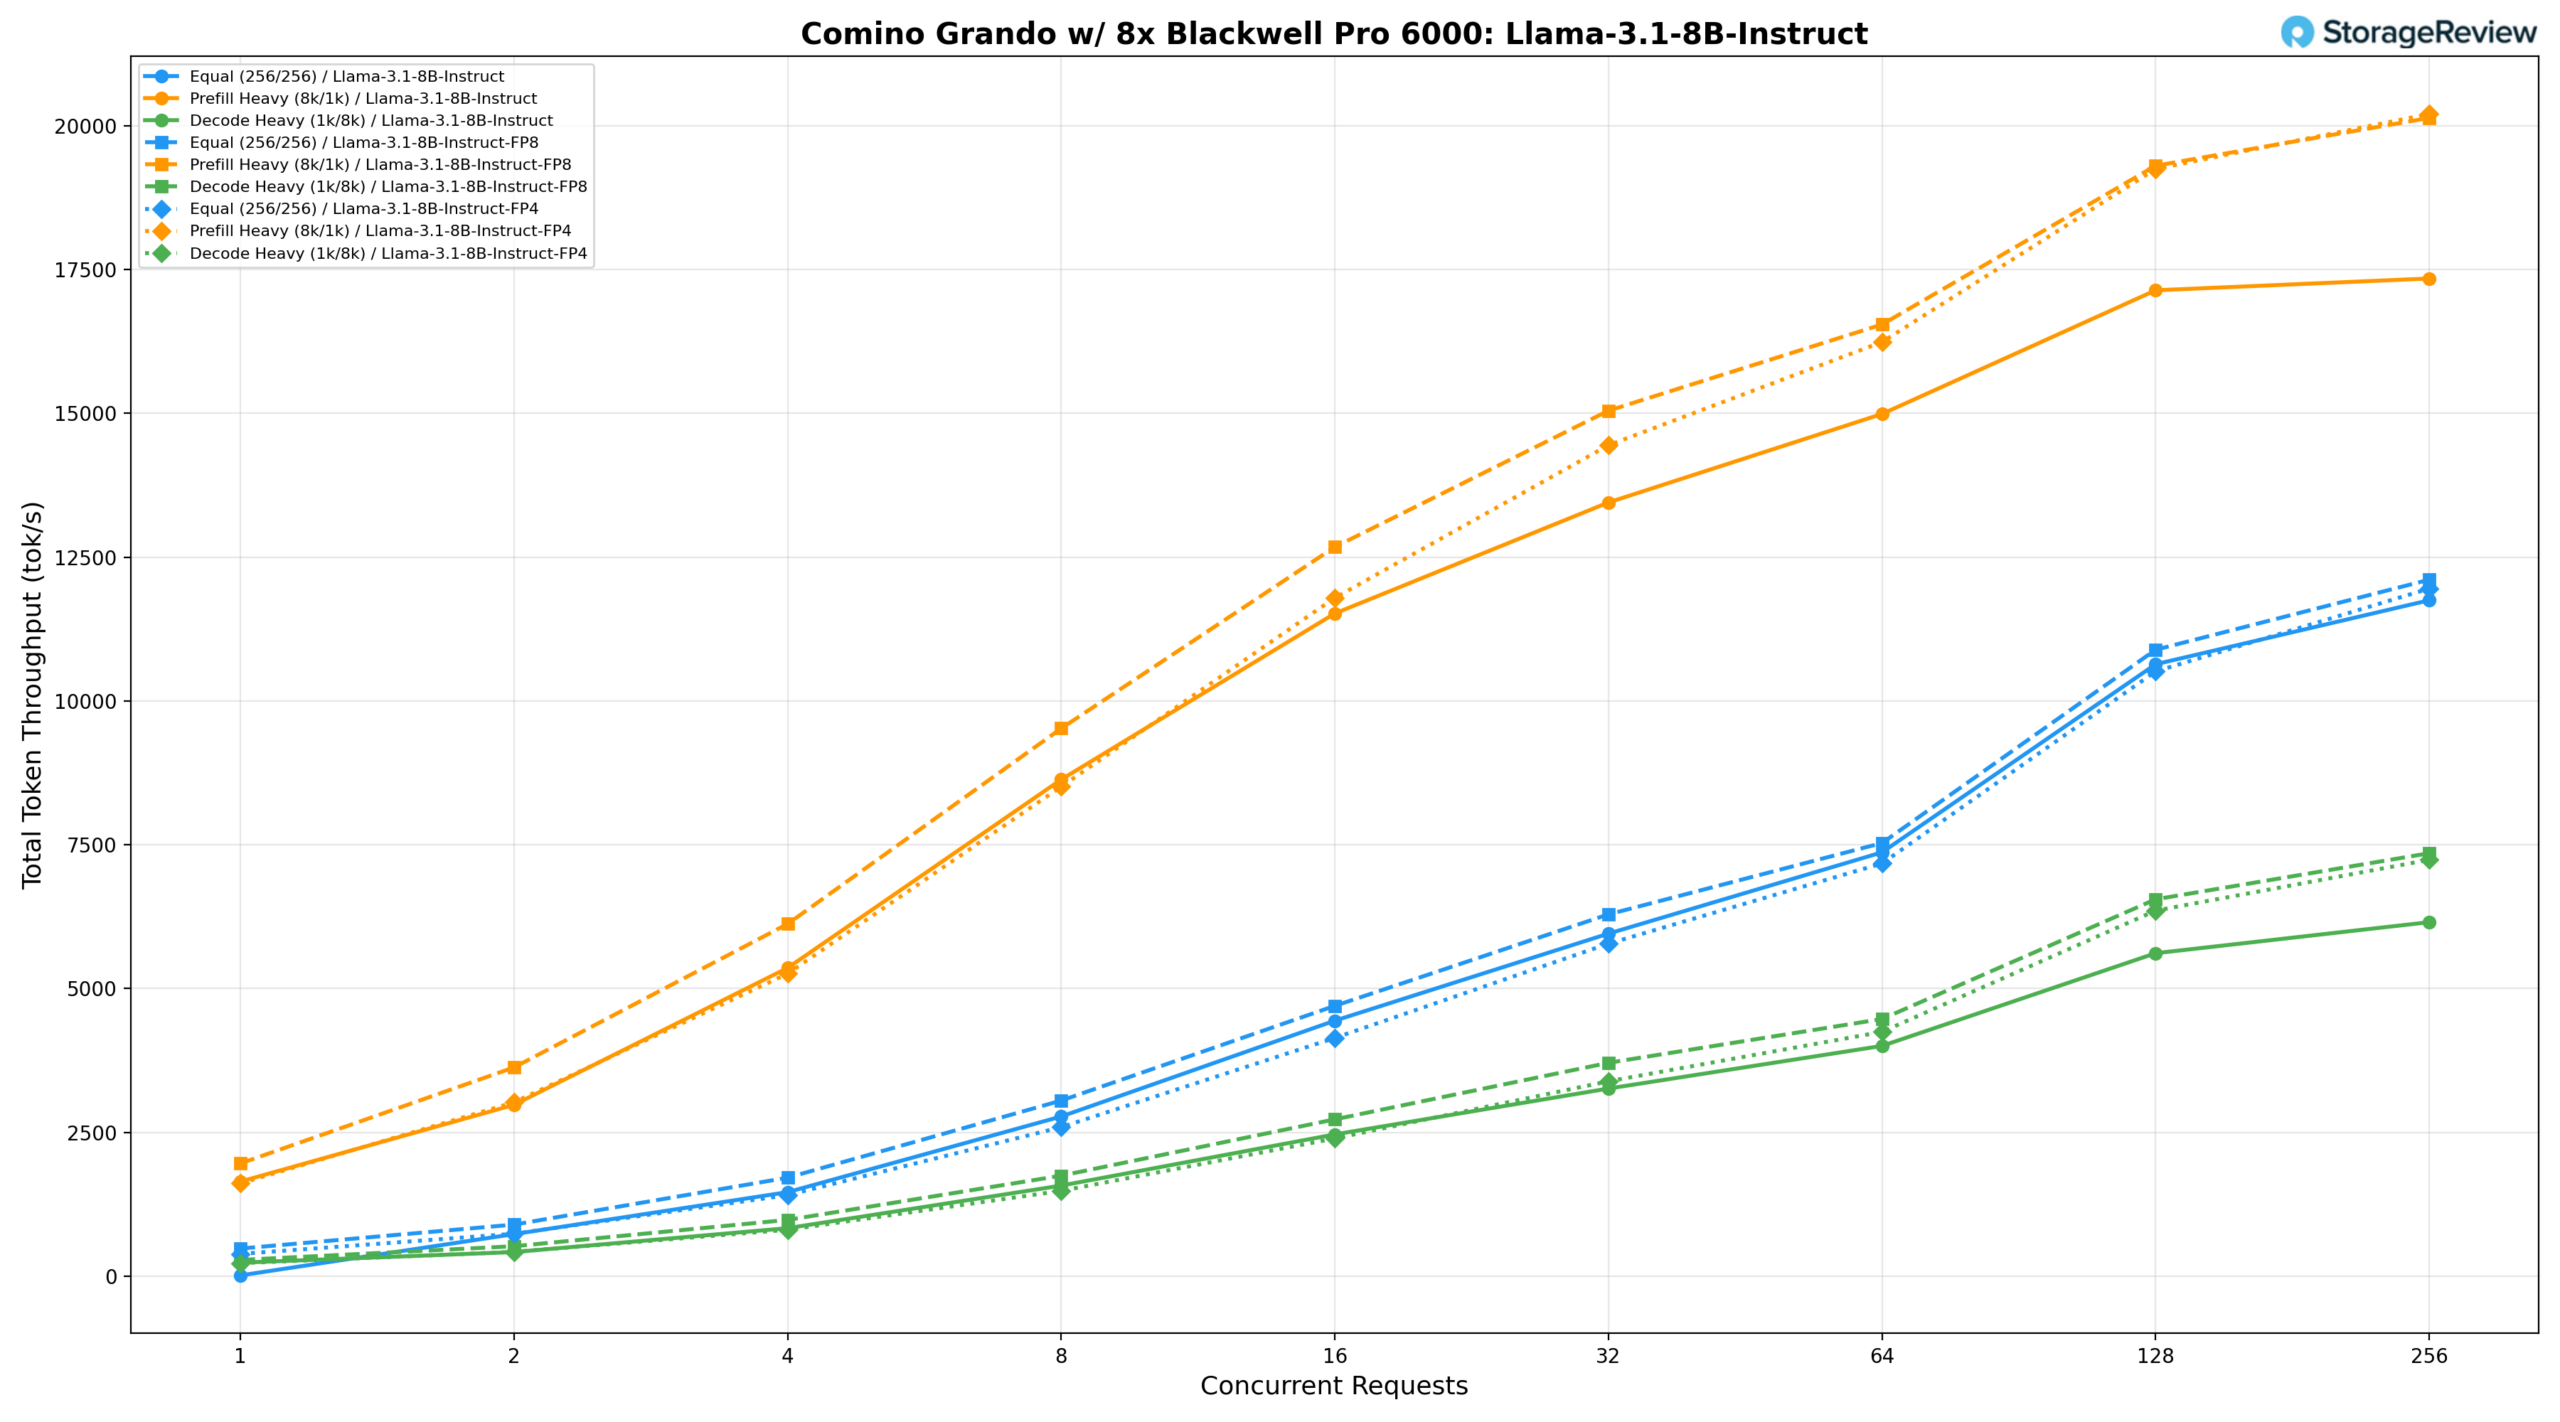
| Llama 3.1 8B Instrucción | FP8 | 12,109 | 20,137 | 7,353 |
| Llama 3.1 8B Instrucción | FP4 | 11,954 | 20,206 | 7,239 |
| Llama 3.1 8B Instrucción | BF16 | 11,752 | 17,346 | 6,155 |
| Codificador Qwen3 30B A3B | FP8 | 10,985 | 16,659 | 4,907 |
| Codificador Qwen3 30B A3B | BF16 | 10,588 | 16,680 | 4,829 |
| Mistral Pequeño 3.1 24B | BF16 | 8,925 | 11,846 | 4,975 |
| MiniMax M2.5 (230B) | ep_dp1 | 5,753 | 7,357* | 2,555 |
| Todos los valores en tok/s, rendimiento máximo en BS=256. *MiniMax M2.5 prefill-heavy alcanzó su máximo en BS=128 (7,357 tok/s); BS=256 fue de 7,141 tok/s. | ||||
GPT-OSS 120B y 20B
La familia de modelos GPT-OSS se probó en configuraciones de 120 bits y 20 bits en el Comino Grando.
GPT-OSS 120B
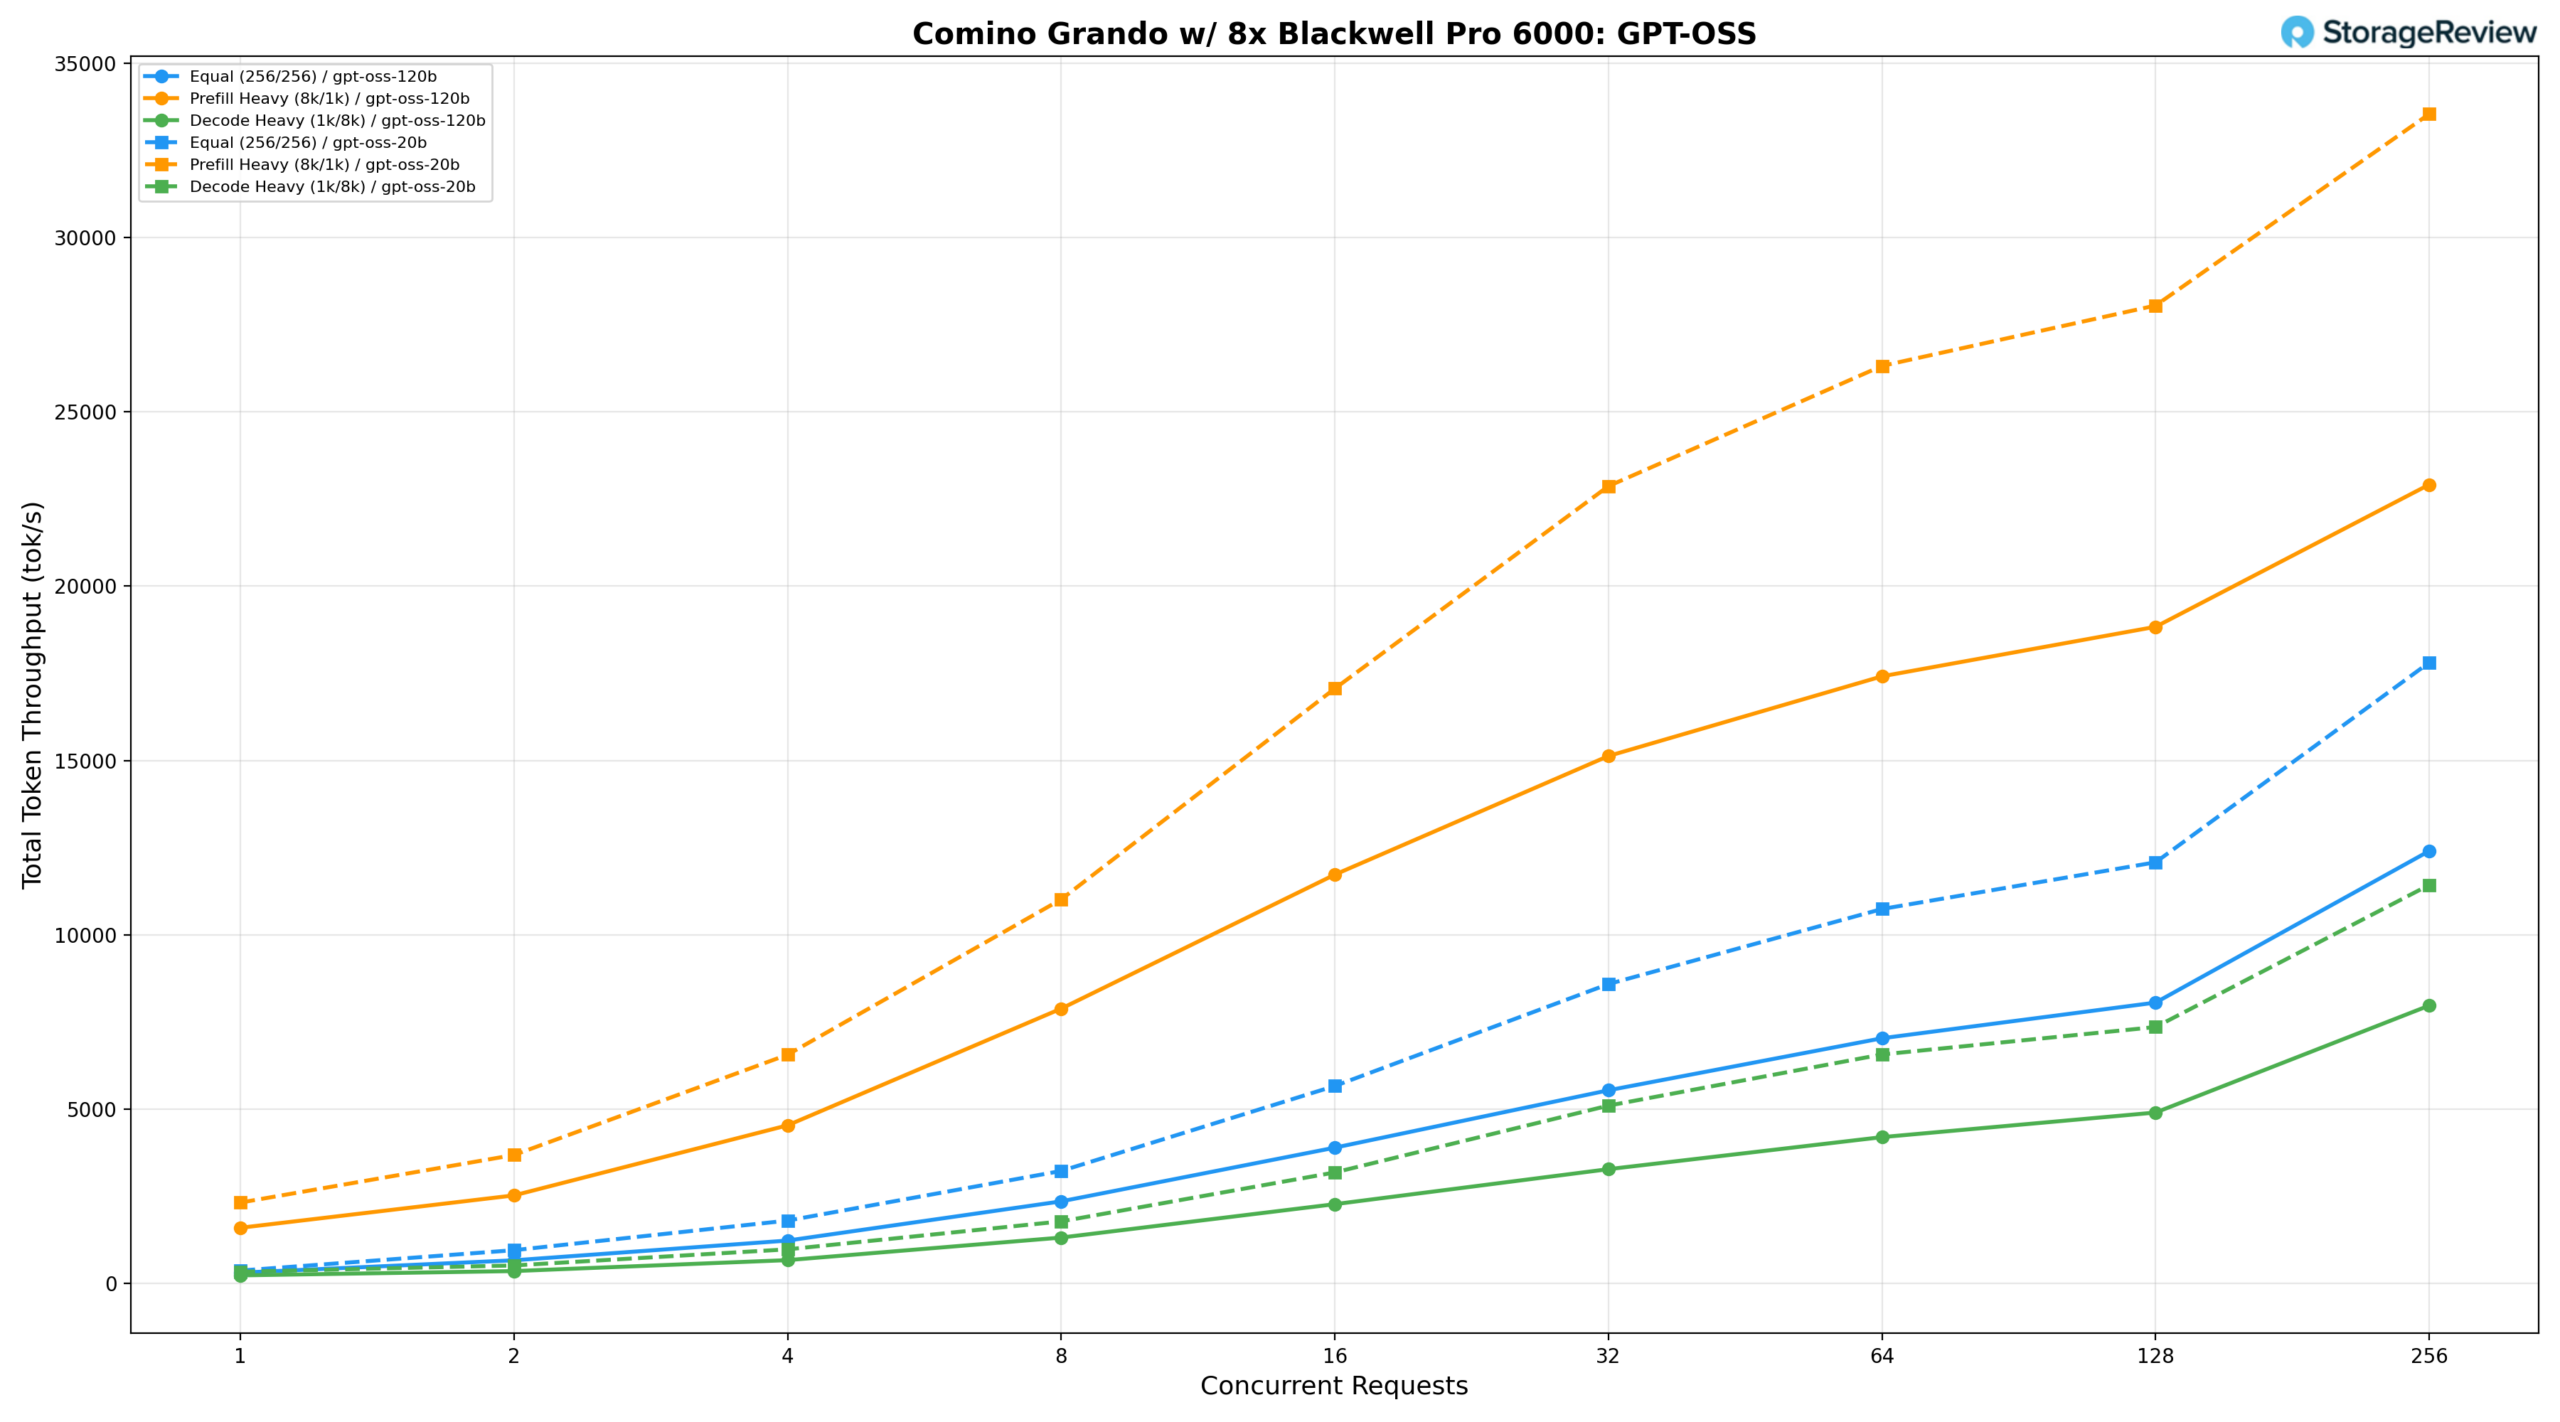
Con una carga de trabajo igual (256/256), el modelo 120B ofrece 268.85 tok/s en BS=1, alcanza 6,666.23 tok/s en BS=64 y llega a un máximo de 11,726.04 tok/s en BS=256. Con una carga de prellenado elevada (8k/1k) comienza en 1,375.69 tok/s, sube a 16,374.19 tok/s en BS=64 y a 17,944.55 tok/s en BS=128, y llega a un máximo de 21,636.41 tok/s en BS=256. La decodificación intensiva (1k/8k) aumenta de 196.28 tok/s en BS=1 a 7,569.97 tok/s en BS=256, con una latencia bien controlada en niveles de concurrencia más bajos.
GPT-OSS 20B
El modelo 20B ofrece 334.80 tok/s en BS=1 bajo una carga de trabajo igual, alcanza 10,303.56 tok/s en BS=64 y llega a un máximo de 17,280.12 tok/s en BS=256. El modelo con precarga intensiva comienza en 2,007.90 tok/s, sube a 24,990.46 tok/s en BS=64 y a 26,866.25 tok/s en BS=128, llegando a un máximo de 32,060.72 tok/s en BS=256, el mayor rendimiento absoluto de precarga registrado en ambos tamaños de modelo. La decodificación intensiva aumenta de 286.08 tok/s en BS=1 a 11,187.36 tok/s en BS=256, ofreciendo aproximadamente 1.5 veces el rendimiento de decodificación del 120B en la concurrencia máxima, al tiempo que mantiene una latencia más ajustada en todo momento.
Instrucciones para Qwen3 Coder 30B A3B e instrucciones para FP8
El modelo Qwen3-Coder-30B-A3B-Instruct se probó con precisión BF16 y FP8.
Qwen3-Coder-30B-A3B-Instruct (BF16)
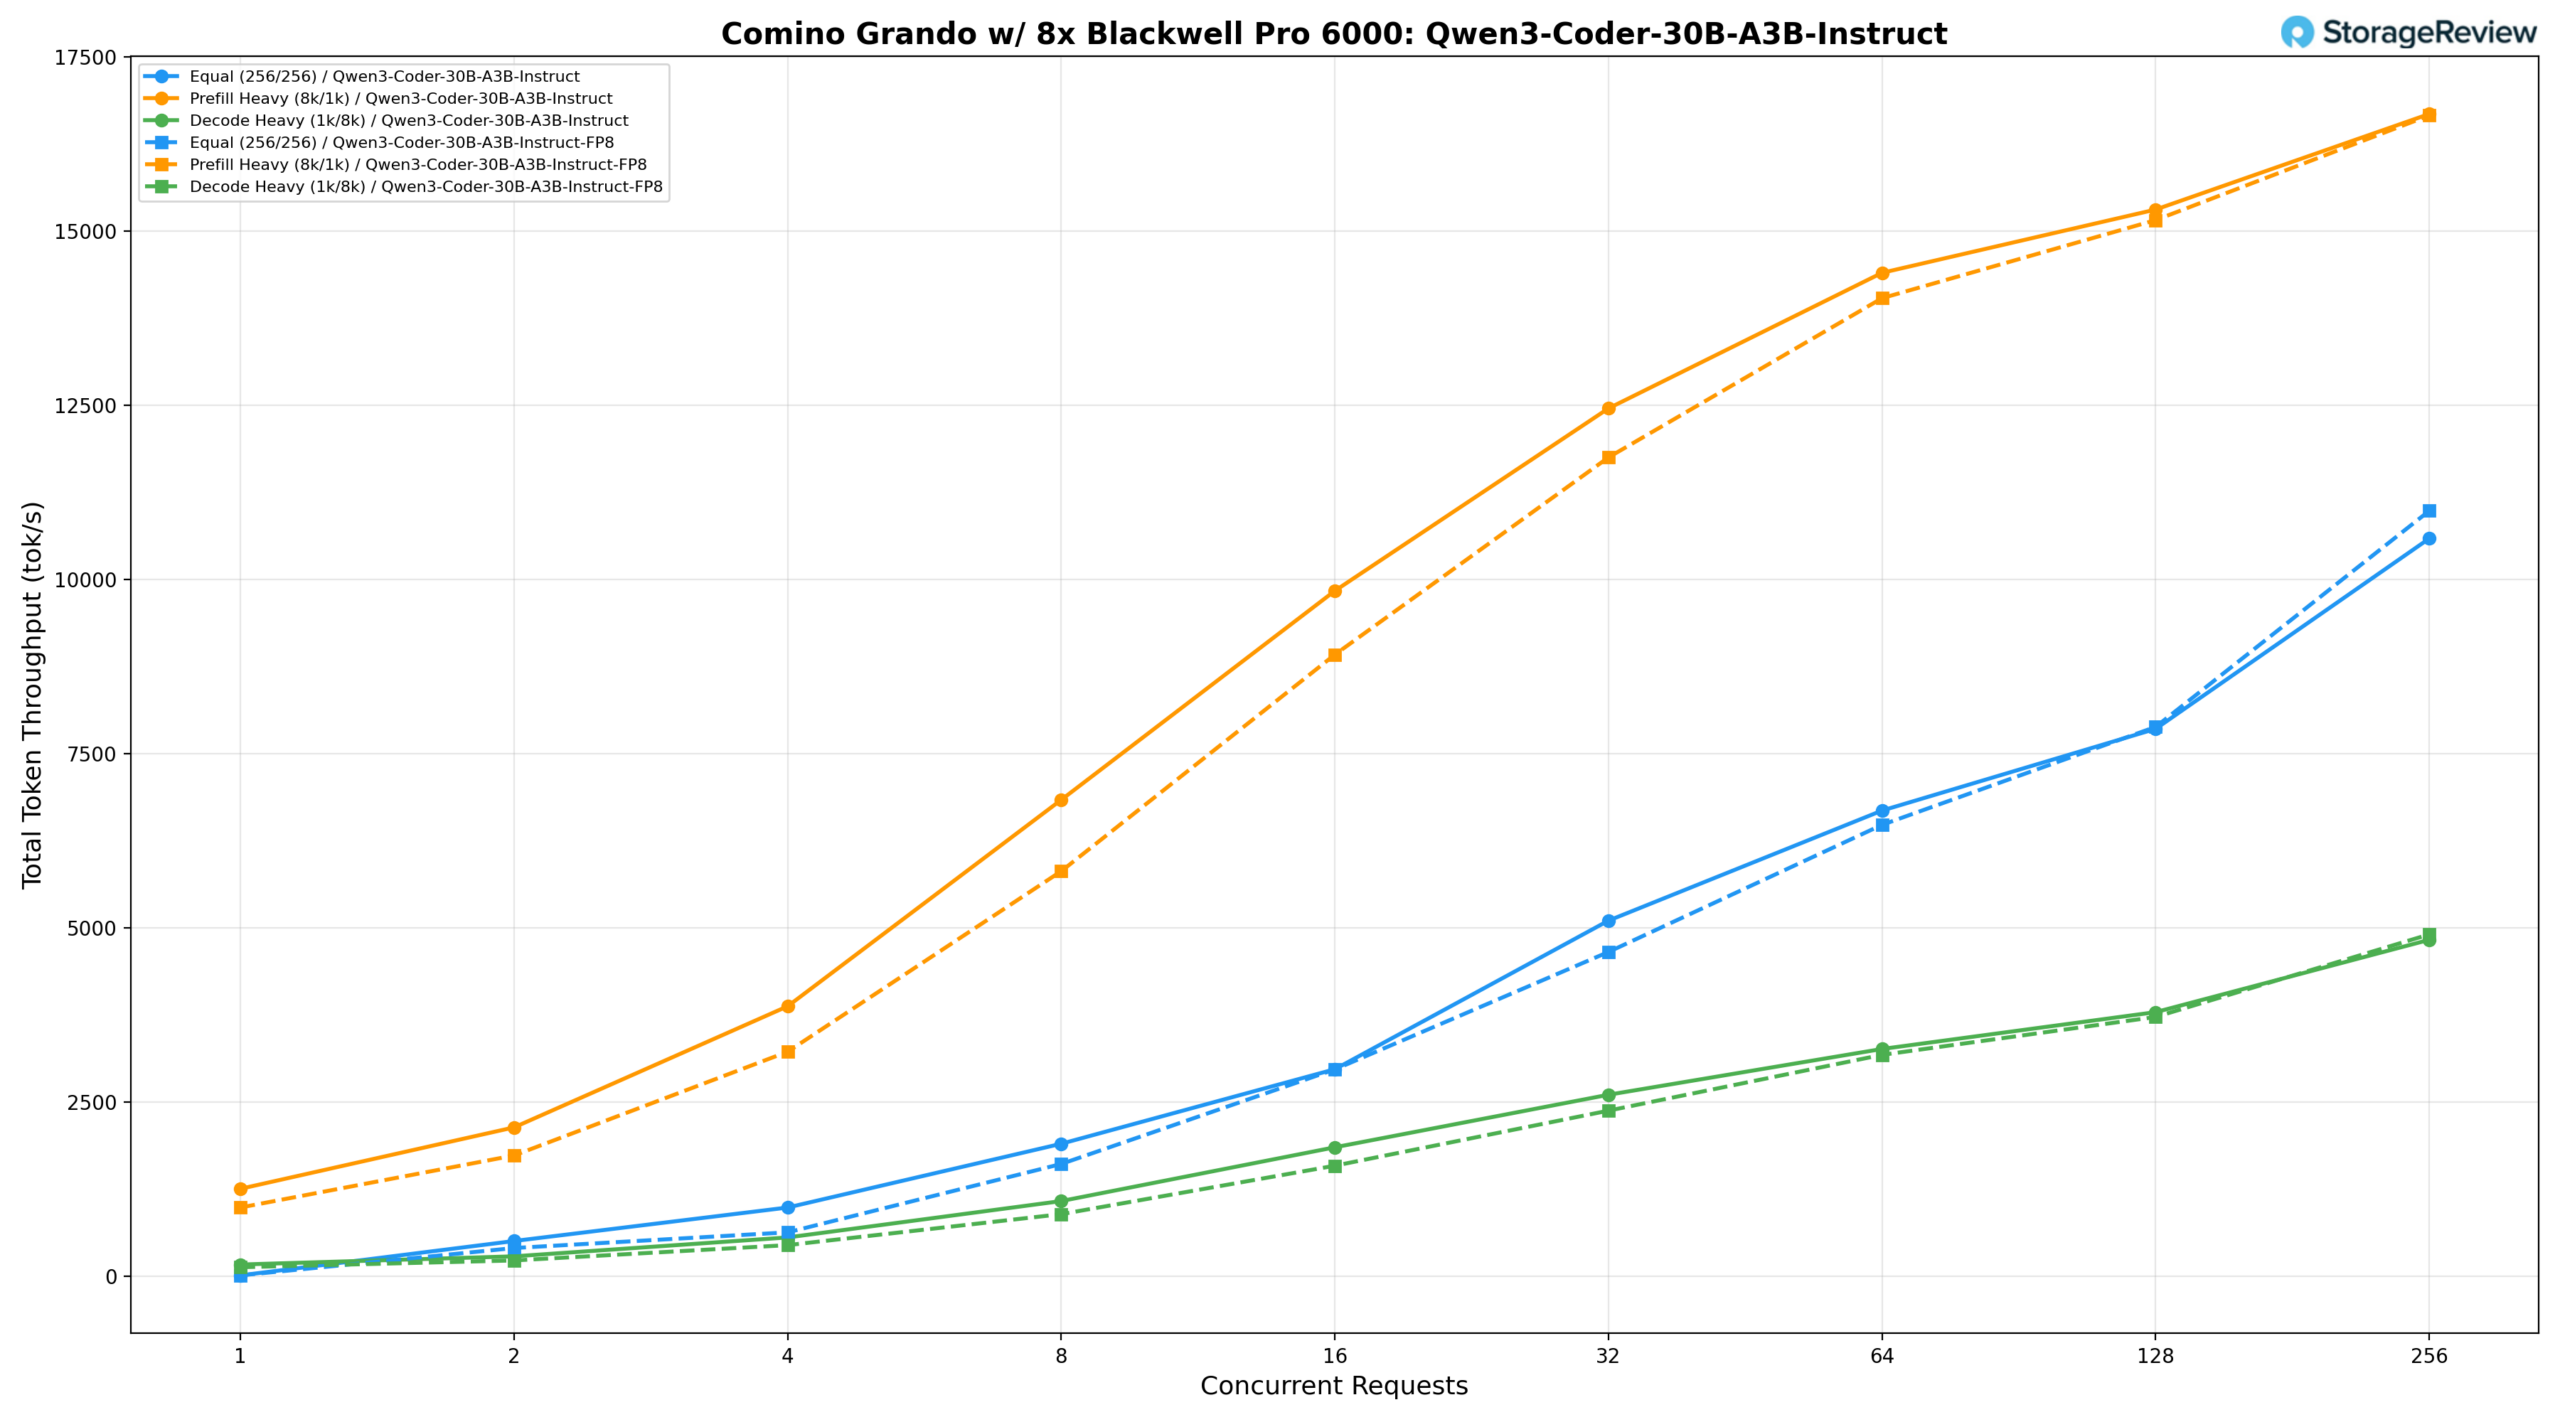
Bajo una carga de trabajo igual (256/256), el modelo BF16 ofrece 1,902.32 tok/s en BS=8, alcanza 6,683.58 tok/s en BS=64 y llega a un máximo de 10,587.56 tok/s en BS=256. El prellenado pesado (8k/1k) comienza en 1,256.03 tok/s en BS=1, sube a 14,400.57 tok/s en BS=64 y 15,308.35 tok/s en BS=128, y llega a un máximo de 16,679.52 tok/s en BS=256. La decodificación intensiva (1k/8k) aumenta de 169.19 tok/s en BS=1 a 4,828.82 tok/s en BS=256, con una latencia bien controlada en niveles de concurrencia más bajos.
Qwen3-Coder-30B-A3B-Instruct (FP8)
El modelo FP8 ofrece un rendimiento comparable al de BF16 en la mayoría de los escenarios, con una carga de trabajo igual que alcanza los 6,478.54 tok/s en BS=64 y un pico de 10,984.61 tok/s en BS=256, una ligera mejora con respecto a BF16 en la concurrencia máxima. El modelo con prellenado intensivo comienza en 987.48 tok/s en BS=1, sube a 14,036.46 tok/s en BS=64 y a 15,156.69 tok/s en BS=128, y alcanza un pico de 16,658.98 tok/s en BS=256. La decodificación intensiva aumenta de 130.70 tok/s en BS=1 a 4,906.51 tok/s en BS=256, superando ligeramente a BF16 en la concurrencia máxima, mientras que las dos configuraciones permanecen muy similares en el resto del rango de concurrencia.
Mistral Pequeño 3.1 24B Instrucción 2503
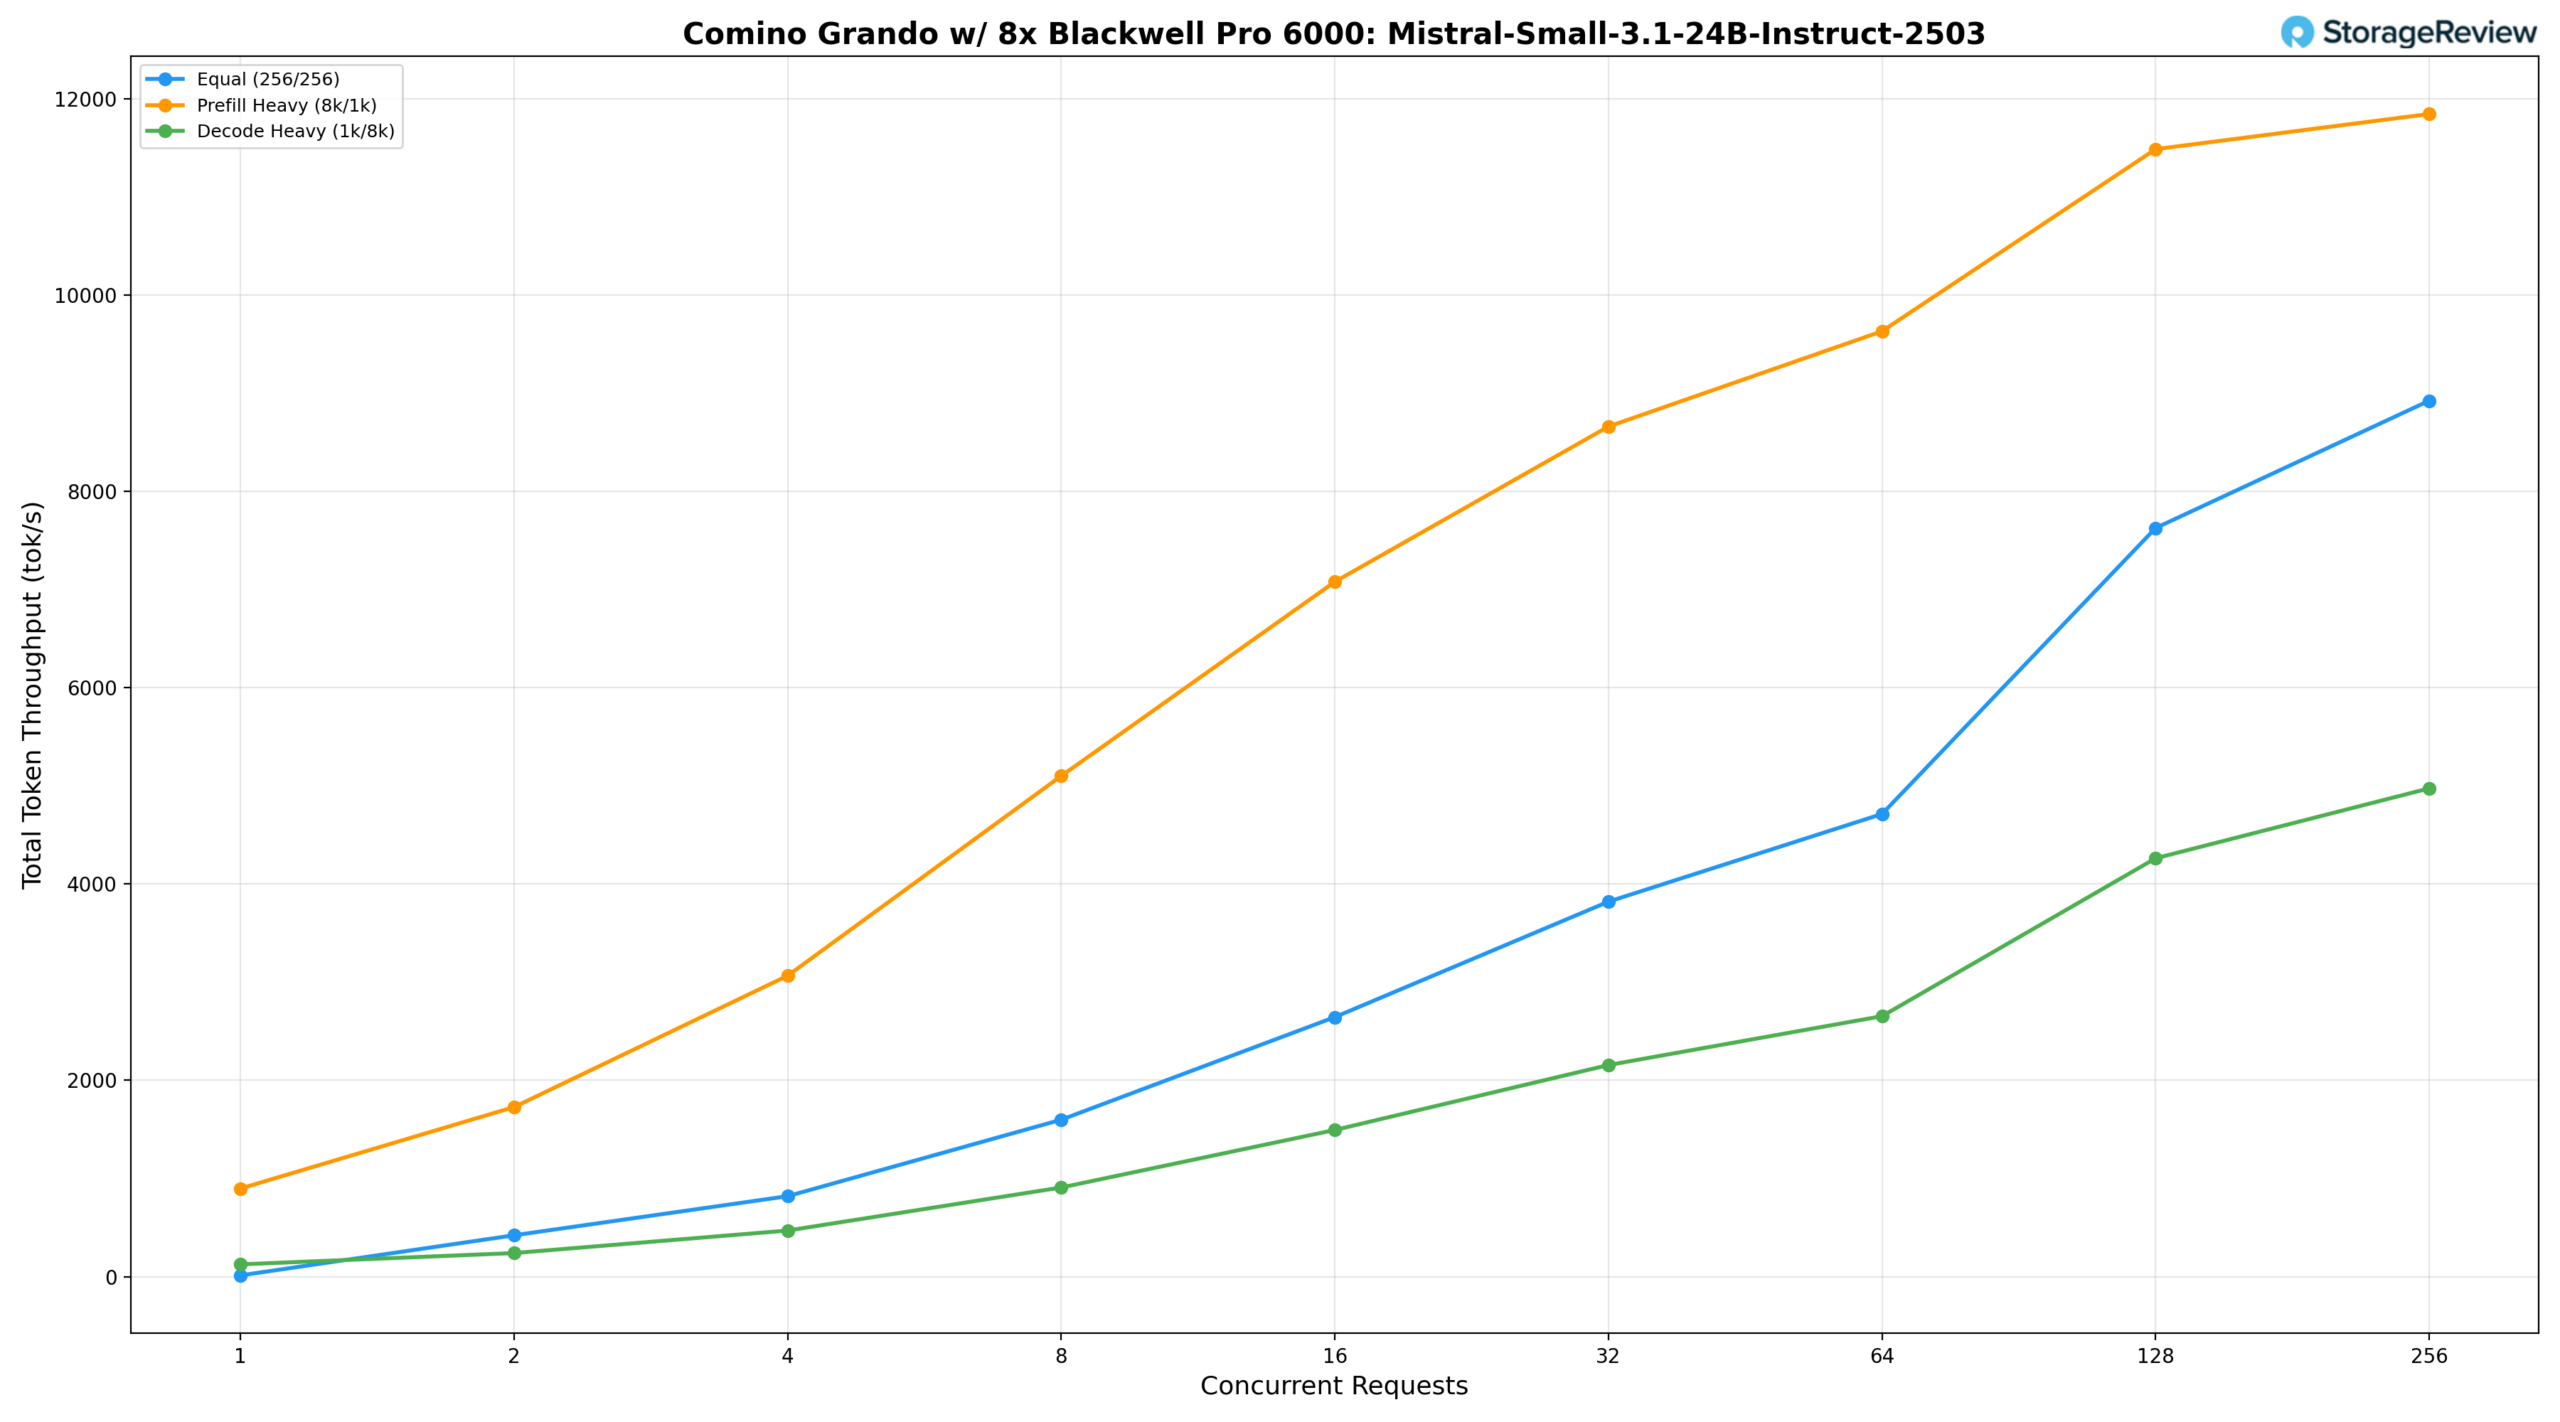
Con una carga de trabajo igual (256/256), el modelo ofrece 1,598.79 tok/s en BS=8, alcanza 4,713.84 tok/s en BS=64 y escala fuertemente hasta 8,925.12 tok/s en BS=256. Con prellenado intensivo (8k/1k) comienza en 897.84 tok/s en BS=1, sube a 9,632.58 tok/s en BS=64 y 11,488.13 tok/s en BS=128, alcanzando un pico de 11,846.15 tok/s en BS=256. La decodificación intensiva (1k/8k) aumenta de 124.98 tok/s en BS=1 a 2,653.82 tok/s en BS=64, luego se acelera notablemente en niveles de concurrencia más altos, alcanzando 4,262.53 tok/s en BS=128 y un pico de 4,975.06 tok/s en BS=256, lo que refleja la capacidad del modelo para mantener un alto rendimiento de decodificación a medida que aumenta la concurrencia.
Llama 3.1 8B Instrucción
El modelo Llama-3.1-8B-Instruct se probó en tres configuraciones de precisión en el Comino, lo que proporcionó una visión clara de cómo la cuantización afecta al rendimiento para este tamaño de modelo.
Llama 3.1 8B Instrucción BF16
Bajo una carga de trabajo igual (256/256), el modelo BF16 ofrece 2,776.42 tok/s en BS=8, alcanza 7,369.01 tok/s en BS=64 y llega a un máximo de 11,751.56 tok/s en BS=256. El prellenado intensivo (8k/1k) comienza en 1,645.29 tok/s en BS=1, sube a 14,990.47 tok/s en BS=64 y 17,140.71 tok/s en BS=128, y llega a un máximo de 17,345.80 tok/s en BS=256. La decodificación intensiva (1k/8k) aumenta de 234.78 tok/s en BS=1 a 6,154.73 tok/s en BS=256.
Llama 3.1 8B Instrucción FP8
La cuantización FP8 ofrece una mejora significativa en todos los escenarios. La carga de trabajo igual alcanza los 7,530.39 tok/s en BS=64 y llega a un máximo de 12,108.98 tok/s en BS=256. El prefill-heavy sube a 16,546.53 tok/s en BS=64 y 19,306.49 tok/s en BS=128, alcanzando un máximo de 20,137.35 tok/s en BS=256, lo que supone una ganancia aproximada del 16 % con respecto a BF16 en la concurrencia máxima. El decode-heavy alcanza un máximo de 7,353.40 tok/s en BS=256, aproximadamente un 19 % por encima de BF16.
Llama 3.1 8B Instrucción FP4
FP4 ofrece un rendimiento muy similar al de FP8 en niveles de concurrencia más altos, aunque se queda un poco atrás en tamaños de lote más pequeños. La carga de trabajo igual alcanza su máximo en 11,954.40 tok/s en BS=256, y la carga de prellenado intensa alcanza su punto más alto en 20,205.57 tok/s en BS=256, superando por poco a FP8 en la concurrencia máxima. La carga de decodificación intensa alcanza su máximo en 7,239.29 tok/s en BS=256, manteniéndose dentro de un pequeño porcentaje de FP8 en todo momento, lo que convierte a FP4 en una opción atractiva cuando la eficiencia de la memoria es una prioridad sin un sacrificio significativo en el rendimiento.
MiniMax M2.5
El MiniMax-M2.5 230B, probado en el Comino Grando, fue el modelo más grande y exigente que utilizamos.
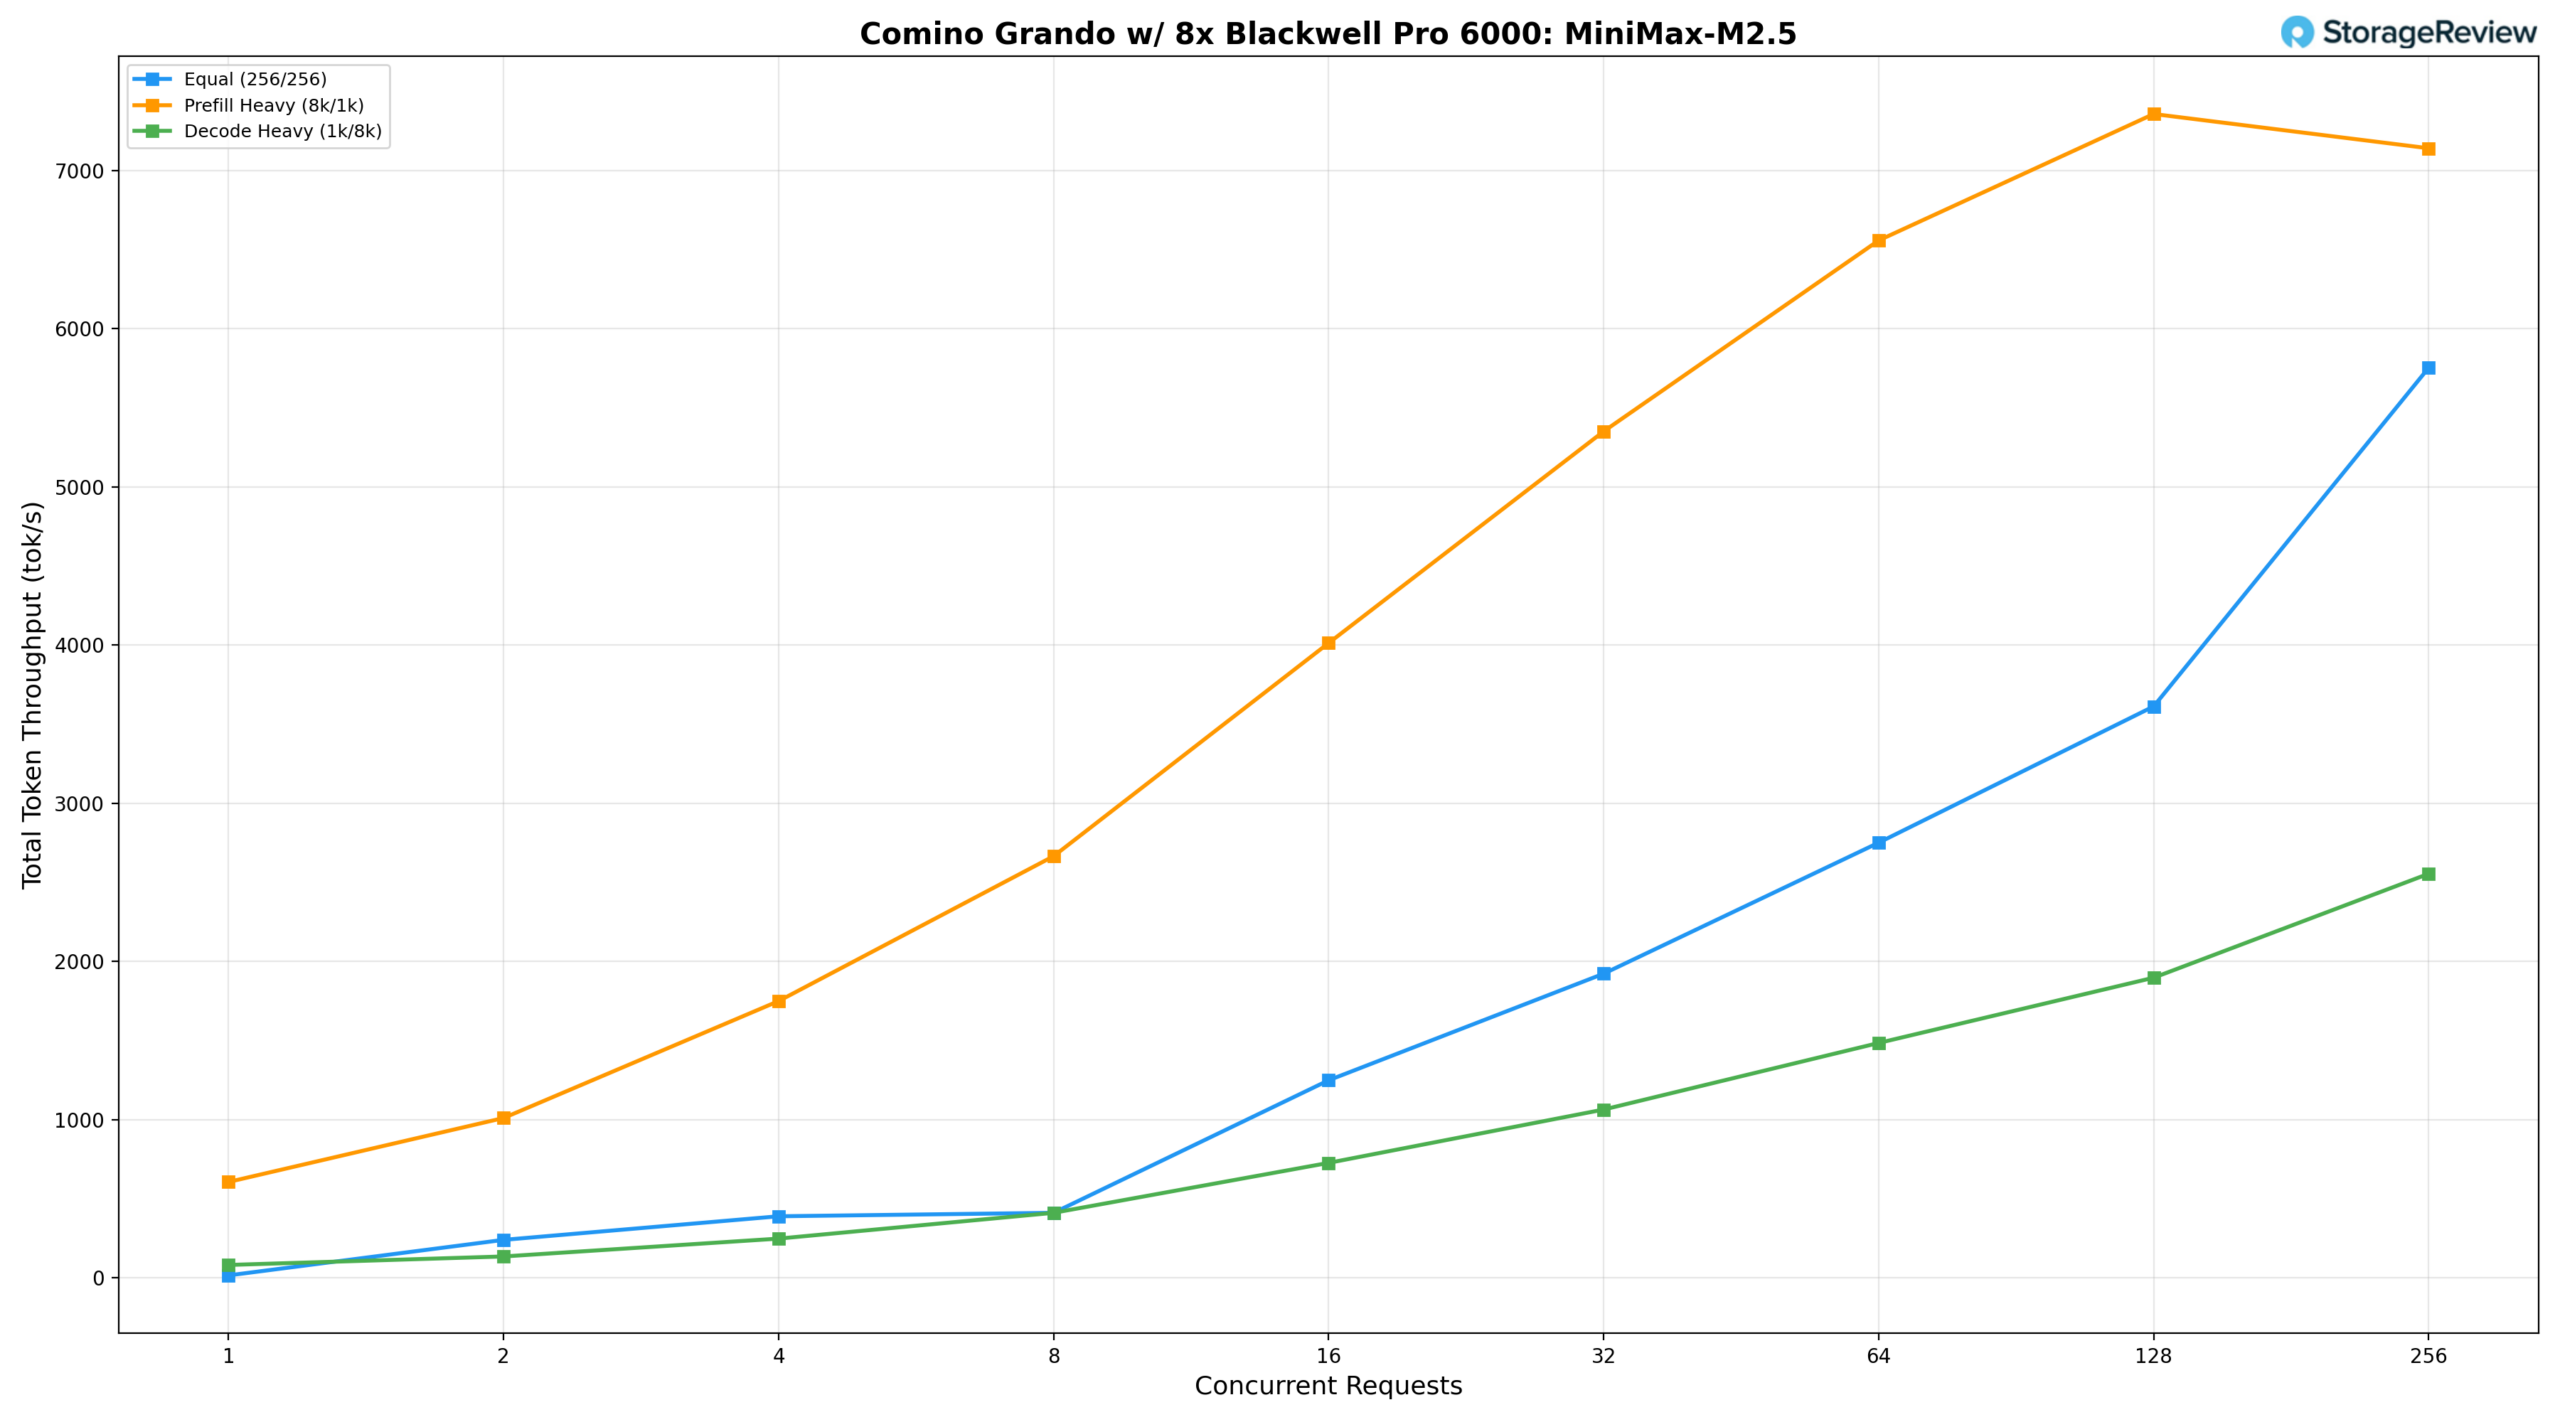
Bajo una carga de trabajo igual (256/256), el modelo comienza en 16.35 tok/s en BS=1, alcanza 2,751.25 tok/s en BS=64 y escala fuertemente a mayor concurrencia, alcanzando un pico de 5,753.24 tok/s en BS=256. Prefill-heavy (8k/1k) comienza en 606.97 tok/s en BS=1, sube constantemente a 5,351.02 tok/s en BS=32 y 6,557.92 tok/s en BS=64, alcanzando su pico en 7,357.26 tok/s en BS=128 antes de disminuir ligeramente a 7,140.74 tok/s en BS=256, lo que sugiere que el modelo se acerca a la saturación en el rendimiento de prefill más allá de BS=128. La decodificación intensiva (1k/8k) aumenta de forma constante desde 82.21 tok/s en BS=1 hasta 1,485.28 tok/s en BS=64, alcanzando un máximo de 2,554.87 tok/s en BS=256, lo que refleja las demandas de ancho de banda de memoria esperadas de una arquitectura MoE de 230 B bajo cargas de trabajo de decodificación sostenidas.
Conclusión
El Comino Grando se entiende mejor como un sistema diseñado específicamente para liberar todo el potencial de ocho GPU NVIDIA RTX PRO 6000. Cada decisión de diseño importante, desde la disposición invertida de la placa base hasta el circuito de refrigeración y el sistema de monitorización integrado, está pensada para garantizar que estas GPU puedan funcionar de forma continua a su TDP máximo de 600 W sin limitaciones térmicas ni de potencia.
Lo que hace que la Grando sea tan atractiva no es ninguna característica aislada, sino la coherencia de todo el sistema. La refrigeración líquida no es un añadido superficial; es parte de su arquitectura. El suministro de energía es redundante, intercambiable en caliente y escalable a la carga de 4,800 W de ocho tarjetas de 600 W, con margen de sobra. El sistema de monitorización va más allá de informar las temperaturas; protege el hardware de forma autónoma cuando algo falla. Nada parece improvisado.
Las cifras de rendimiento refuerzan esa cohesión. En una amplia gama de modelos, desde Llama 3.1 8B hasta el 230B MiniMax M2.5, Grando ofreció cifras de rendimiento que se mantienen sólidas para una plataforma autoalojada. Las pruebas de concurrencia de Claude Code pusieron de relieve su valor práctico: ocho ingenieros pueden ejecutar sesiones de codificación simultáneas en un modelo 230B alojado localmente a velocidades interactivas, con un rendimiento por usuario que supera los 38 tok/s en el pico de producción agregada. Equipos de cuatro a ocho personas pueden operar con un rendimiento casi óptimo sin degradación perceptible.
El valor de esta configuración va más allá de la inferencia de IA. Con 96 GB de VRAM por GPU y una alta capacidad de escalado multi-GPU, la plataforma es igualmente adecuada para cargas de trabajo creativas y de ingeniería de alto nivel, incluyendo renderizado de efectos visuales, simulaciones a gran escala y flujos de trabajo CAD complejos. El sistema se puede adaptar a configuraciones de cuatro y dos GPU, lo que hace que este nivel de rendimiento sea accesible para estudios y equipos más pequeños que aún requieren la densidad de una estación de trabajo.
La principal diferencia de Grando con respecto a las plataformas empresariales de ocho GPU que hemos analizado radica en su practicidad de implementación. Estos sistemas ofrecen mayor capacidad de carriles PCIe, más ranuras NIC y una conectividad de almacenamiento más profunda, pero también requieren una infraestructura de centro de datos dedicada, consumen más de 8 kW y tienen plazos de entrega que pueden superar el año. Grando sacrifica parte de esa capacidad de expansión periférica a cambio de un sistema que funciona con un nivel de ruido suficiente como para compartir una sala con sus usuarios, disipa menos calor al entorno y está disponible de inmediato. Para las organizaciones que priorizan la implementación rápida y los entornos operativos gestionables sobre la máxima conectividad de red, esta compensación resulta ventajosa.
Página del producto – Comino Grando
Configurador de Comono – Página
Clasificación: El Comino Grando RTX PRO 6000 ocupa el puesto de "Elección Extrema" en nuestra clasificación de "Mejores Ordenadores de Sobremesa para IA Local".


 Amazon