

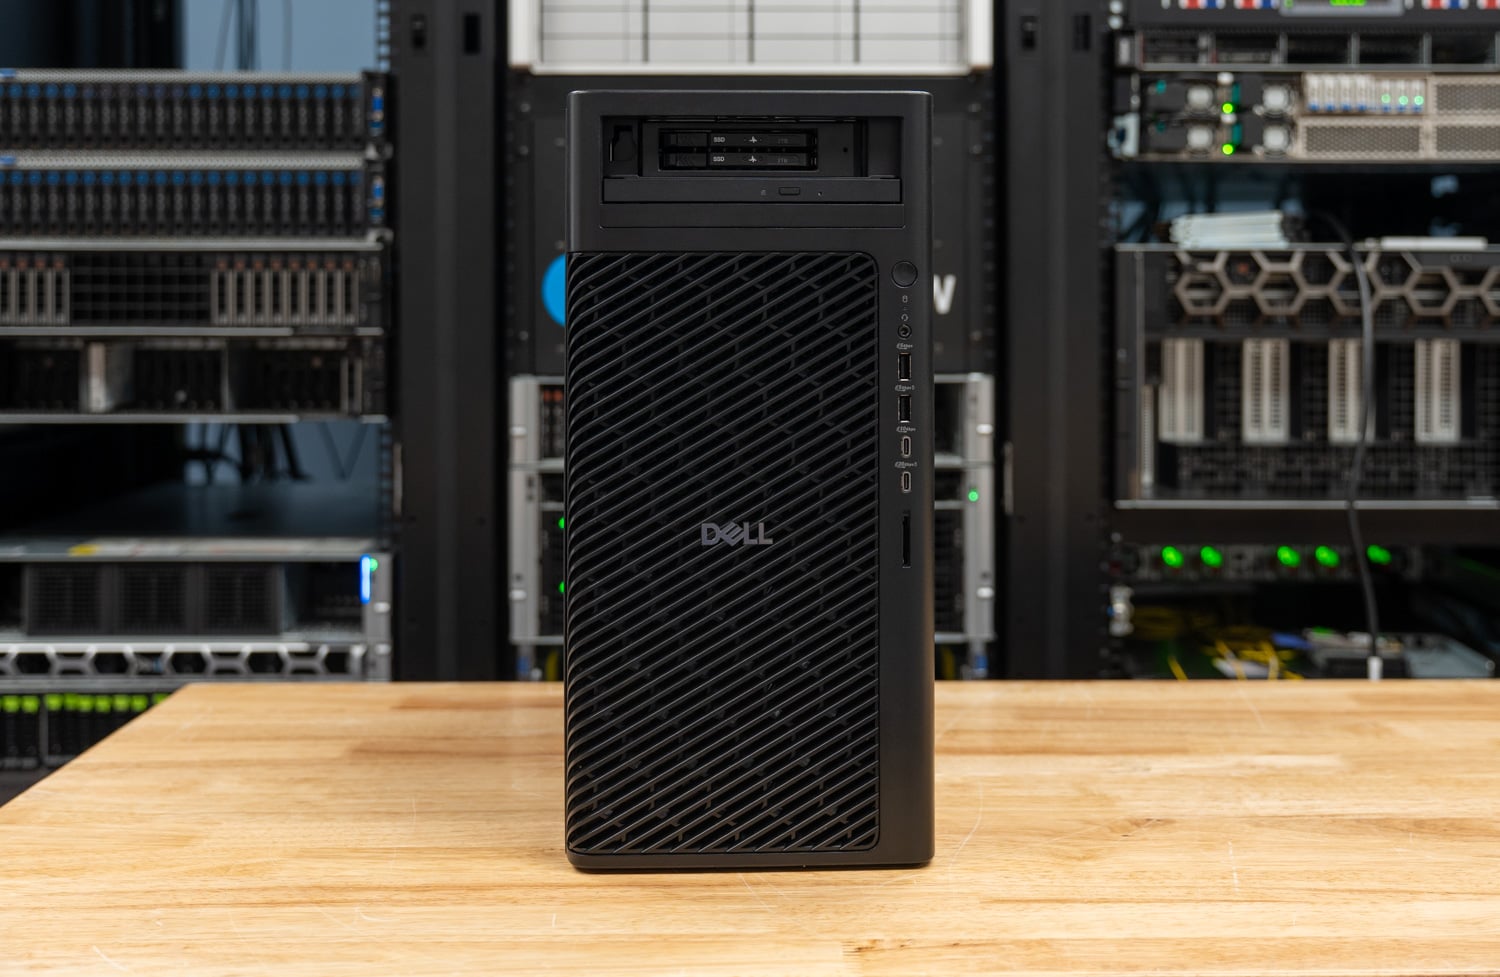
La Dell Pro Precision 9 T2 es la versión Xeon de la torre de una sola GPU que analizamos hace un año como la Dell Pro Max Tower T2 , y llega con dos cambios a la vez: un nuevo nombre, ya que Dell vuelve a unificar sus estaciones de trabajo bajo la marca Precision, y una nueva plataforma, con el procesador Intel Xeon 6 reemplazando al Core Ultra 9 285K dentro del mismo chasis de 32 litros. Nuestra unidad venía con el procesador Xeon 658X de 24 núcleos, 128 GB de memoria DDR5-6400 RDIMM ECC, la tarjeta gráfica RTX PRO 6000 Blackwell Max-Q de 300 W y dos discos duros E3.S Gen5 de 2 TB en configuración strip-up en la bahía FlexBay frontal. Configurada de la misma manera en Dell.com, su precio ronda los 28,300 dólares.
Lo probamos como una matriz: el Pro Precision 9 T2 ejecutó nuestra suite completa con la tarjeta Max-Q con la que venía y de nuevo con la RTX PRO 6000 Blackwell de 600 W extraída de nuestro Pro Max Tower T2, y el T2 basado en Core también ejecutó ambas tarjetas, por lo que todos los resultados a continuación tienen cuatro columnas, y cada par aísla una variable: la plataforma de la CPU o el límite de potencia de la GPU. La suite es la misma que se ejecutó en los portátiles RTX Spark de la semana pasada , con algunas adiciones que se estrenan aquí.
El Xeon compra rendimiento y paga latencia. El Pro Precision 9 T2 obtuvo 12,322 en Cinebench 2026 multinúcleo frente a 8,856 en el Core T2, compiló LLVM en 140.2 segundos frente a 182.5, y leyó 122,233 MB/s en STREAM Triad frente a 33,003, mientras que su puntuación Cinebench de un solo núcleo de 454.1 está por debajo de los 564.4 del 285K y su puntuación Speedometer de 36.8 está por debajo de los 46.3. La tarjeta de 600 W añade entre un 7 y un 20 por ciento en la decodificación LLM y entre un 20 y un 39 por ciento en el procesamiento y difusión de mensajes instantáneos en cualquiera de las torres, y en la torre Xeon le cuesta a la CPU entre un 4 y un 5 por ciento en el trabajo de todos los núcleos.
Puntos Clave
- Xeon 6 es una plataforma de alto rendimiento en una torre de un solo socket: 12,322 en Cinebench 2026 multinúcleo, un 39 por ciento por delante del Core Ultra 9 285K en el mismo chasis, 289.6 GIPS en 7-Zip frente a 174.8, DGEMM a 1,638 GFLOPS frente a 768, y 3.7 veces el ancho de banda de memoria de cuatro canales de DDR5-6400.
- El 285K aún conserva la velocidad por hilo: El Xeon se queda atrás en un 20 por ciento en Cinebench de un solo núcleo, un 21 por ciento en Speedometer y entre un 20 y un 31 por ciento en Python de un solo hilo, con una latencia de núcleo a núcleo de 56.2 ns frente a 38.1.
- La GPU decide los resultados de la IA, y la tarjeta de 600 W obtiene su potencia en función de las indicaciones: MLPerf Llama 3.1 8B genera 230.9 tokens por segundo con la tarjeta Max-Q y 252.8 con la tarjeta de 600 W, mientras que el tiempo hasta el primer token baja de 0.082 a 0.059 segundos y Qwen-Image 20B renderiza una imagen de 1024×1024 en 19.7 segundos frente a 26.1.
- La tarjeta de 600 W sobrecarga el trabajo de la CPU del Xeon entre un 4 y un 5 por ciento: La puntuación multinúcleo de Cinebench bajó de 12,322 a 11,705 y la prueba de bucle sostenido de 30 minutos de 12,328 a 11,764, con frecuencias de reloj en estado estable que bajaron de 4,274 a 4,178 MHz; el mismo cambio no produjo ningún resultado en el Core T2.
- E3.S en FlexBay, con franjas de VROC by Graid: La bahía frontal admite dos unidades E3.S Gen5, una primicia para una estación de trabajo de torre en nuestro laboratorio, y la opción de arranque RAID0 de Dell las integra en un volumen de 4,097 GB con VROC de Graid Technology. La lectura secuencial en franjas alcanza los 9,332 MB/s y un pico de 840 100 IOPS en lecturas aleatorias de 4K, frente a los 1.78 millones de IOPS de la única unidad M.2 Gen5 del Core T2.
De Pro Max a Pro Precision
Dell retiró la denominación Precision a principios de 2025, cuando todas las estaciones de trabajo pasaron a llamarse Dell Pro Max, y ahora la ha recuperado. El 7 de octubre, Dell cambió el nombre de sus equipos de sobremesa GB10 y GB300 de Dell Pro Max a Dell Pro Precision, y Dell.com incluye la Pro Precision 9 T2 junto con las nuevas torres T4 y T6 bajo la misma marca. Pro Max se mantiene para los equipos con procesador Core, por lo que la torre Core Ultra que analizamos el año pasado todavía se vende como Dell Pro Max Tower T2, y la torre Xeon que analizamos aquí es la Dell Pro Precision 9 T2, modelo PW9T2260.
Los modelos T4 y T6 hicieron el mismo cambio a Xeon 6 con el cambio de nombre, y Dell posiciona las tres torres según su capacidad de expansión. La Pro Precision 9 T4 (PW9T4260) utiliza la misma lista de procesadores hasta el Xeon 698X de 86 núcleos, agrega 16 ranuras DIMM para hasta 4 TB de DDR5-6400 en los ocho canales de memoria y admite una tarjeta gráfica RTX PRO 6000 de 600 W o dos tarjetas Max-Q con una fuente de alimentación de 1500 W, con un chasis de 2400 W como opción.
La Pro Precision 9 T6 (PW9T6260) es el modelo tope de gama, con seis ranuras, una fuente de alimentación de 2400 W y espacio para dos tarjetas RTX PRO 6000 de 600 W, tres tarjetas Max-Q o hasta cinco RTX PRO 5000. La T2 es el modelo de entrada de la familia, con una sola GPU y cuatro canales.
La precisión en la nomenclatura es importante porque las dos torres son idénticas externamente, comparten el mismo chasis de 32 litros (387 x 187.7 x 438 mm), el mismo bisel y FlexBay frontal, y las mismas opciones de RTX PRO 6000 Blackwell en el configurador de Dell, por lo que la diferencia radica en la placa base. Mientras que la Pro Max Tower T2 combina el Core Ultra 9 285K de 24 núcleos con cuatro ranuras DIMM de DDR5 sin búfer, la Pro Precision 9 T2 pasa al Intel Xeon 6 para estaciones de trabajo, la plataforma Granite Rapids-WS que analizamos en una placa base sin carcasa en junio, con memoria ECC registrada, más líneas PCIe y un procesador de 250 W en la configuración superior.

Dell ofrece seis procesadores Xeon 6 en la Pro Precision 9 T2, desde el Xeon 634 de 12 núcleos a 150 W hasta el 658X de 24 núcleos a 250 W en nuestra unidad, y el paso del 634 al 658X es una opción de $1,560. El 658X funciona con 24 núcleos y 48 hilos a 3.0 GHz base y 4.9 GHz turbo con 144 MB de L3, tres veces los 36 MB del 285K, y es compatible con AVX-512 y AMX, ninguno de los cuales tiene el 285K. El chip tiene ocho canales DDR5-6400 y 128 líneas Gen5; el T2 tiene cuatro ranuras DIMM y cinco ranuras de expansión, y los T4 y T6 más grandes exponen el resto.
| Plataforma | Dell Pro Precision 9 T2 (según las pruebas realizadas) | Dell Pro Max Tower T2 (tal como se probó) |
|---|---|---|
| Procesador | Procesador Intel Xeon 658X, 24 núcleos / 48 hilos, de 3.0 a 4.9 GHz, 144 MB de caché L3, 250 W. | Procesador Intel Core Ultra 9 285K, 24 núcleos / 24 subprocesos (8P + 16E), hasta 5.7 GHz, 36 MB L3, 125 W |
| conjuntos de instrucciones | AVX-512, AMX | AVX2 (sin AVX-512), NPU Intel AI Boost |
| Salud Cerebral | 4 módulos de memoria DDR5-6400 RDIMM ECC de 32 GB (cuatro canales; capacidad máxima de 1 TB) | 4 módulos UDIMM DDR5-4400 ECC de 32 GB |
| Expansión | Gen5 x16, Gen5 x4, Gen4 x16, dos Gen4 x8 (uno x4 eléctrico) | Gen5 x16, un Gen4 x4 y dos Gen3 x4 |
| Almacenamiento de arranque según lo probado | 2 x 2TB E3.S Gen5 NVMe en la bahía FlexBay frontal, RAID0 (VROC de Graid Technology), 4,097 GB | Disco duro SK hynix PCB01 M.2 Gen5 de 2 TB (unidad única) |
| M.2 interno | 3 x M.2 2280 Gen5 | 1 x Gen5 y 2 x Gen4 M.2 |
| Fuente de alimentación | 750 W de serie; 500 W o 1500 W opcional (1500 W en las pruebas realizadas). | 360 W, 500 W o 1500 W (80 Plus Platinum) |
| Gráficos según las pruebas realizadas | RTX PRO 6000 Blackwell Max-Q (300W) tal como viene de fábrica; también se probó la tarjeta de 600W. | RTX PRO 6000 Blackwell (600W) tal como viene de fábrica; también se probó la tarjeta Max-Q. |
| Chasis | 387 x 187.7 x 438 mm, de 11.6 a 21.8 kg | 387 x 187.7 x 438 mm, de 8.17 a 23 kg |
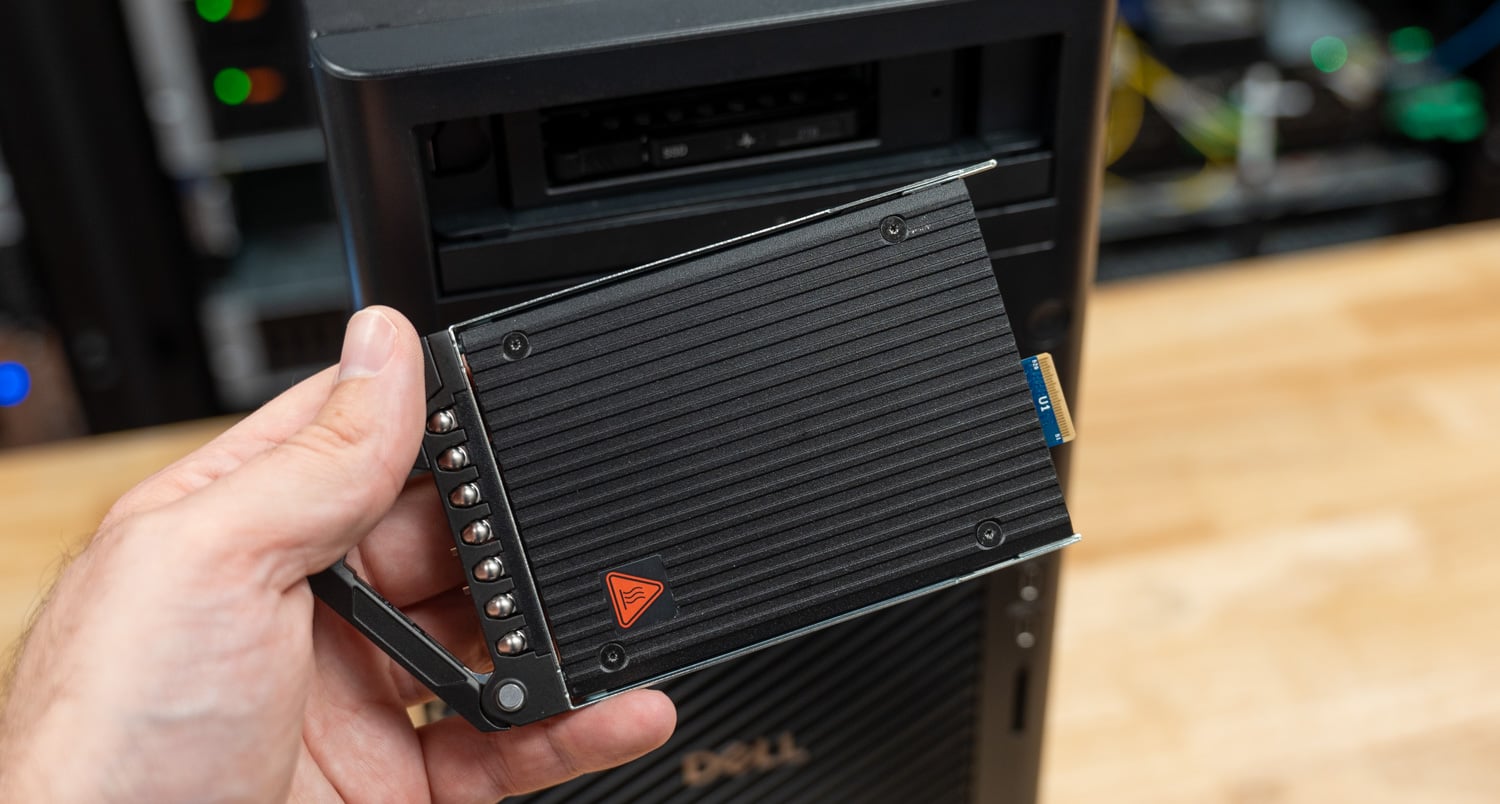
El Core T2 arrancaba desde una única unidad M.2, mientras que nuestro Pro Precision 9 T2 venía con la configuración de arranque FlexBay NVMe de Dell: dos unidades E3.S Gen5 de conexión en caliente detrás del panel frontal, divididas en un volumen de 4,097 GB mediante la opción de arranque RAID0. E3.S es el formato empresarial que hemos estado solicitando a los fabricantes de torres, ya que lleva el límite de capacidad muy por encima de M.2 y las unidades salen por la parte frontal sin necesidad de abrir el chasis. La capa RAID es VROC de Graid Technology , el código VROC de Intel que Graid adquirió el año pasado y relanzó en Computex, y esta es la primera estación de trabajo de nuestro laboratorio que se envía con él.

La tarjeta de 600 W necesita un poco más de espacio; la Max-Q no. Nuestra unidad venía con un adaptador Intel E810-XXV de doble puerto 25 GbE en la ranura junto a la GPU, y para instalar la RTX PRO 6000 de 600 W tuvimos que quitarlo; el disipador de la tarjeta ocupa el espacio de la ranura adyacente, así como la alimentación de la misma. Los compradores que deseen la tarjeta de máxima potencia y una tarjeta de red de alta velocidad deberían planificar la distribución de las ranuras antes de realizar el pedido, y una fuente de alimentación de 1500 W es la única opción razonable; nuestra unidad tenía la opción de 1500 W, una mejora de 40 $ respecto a la fuente de alimentación estándar de 750 W.
Construcción y Diseño
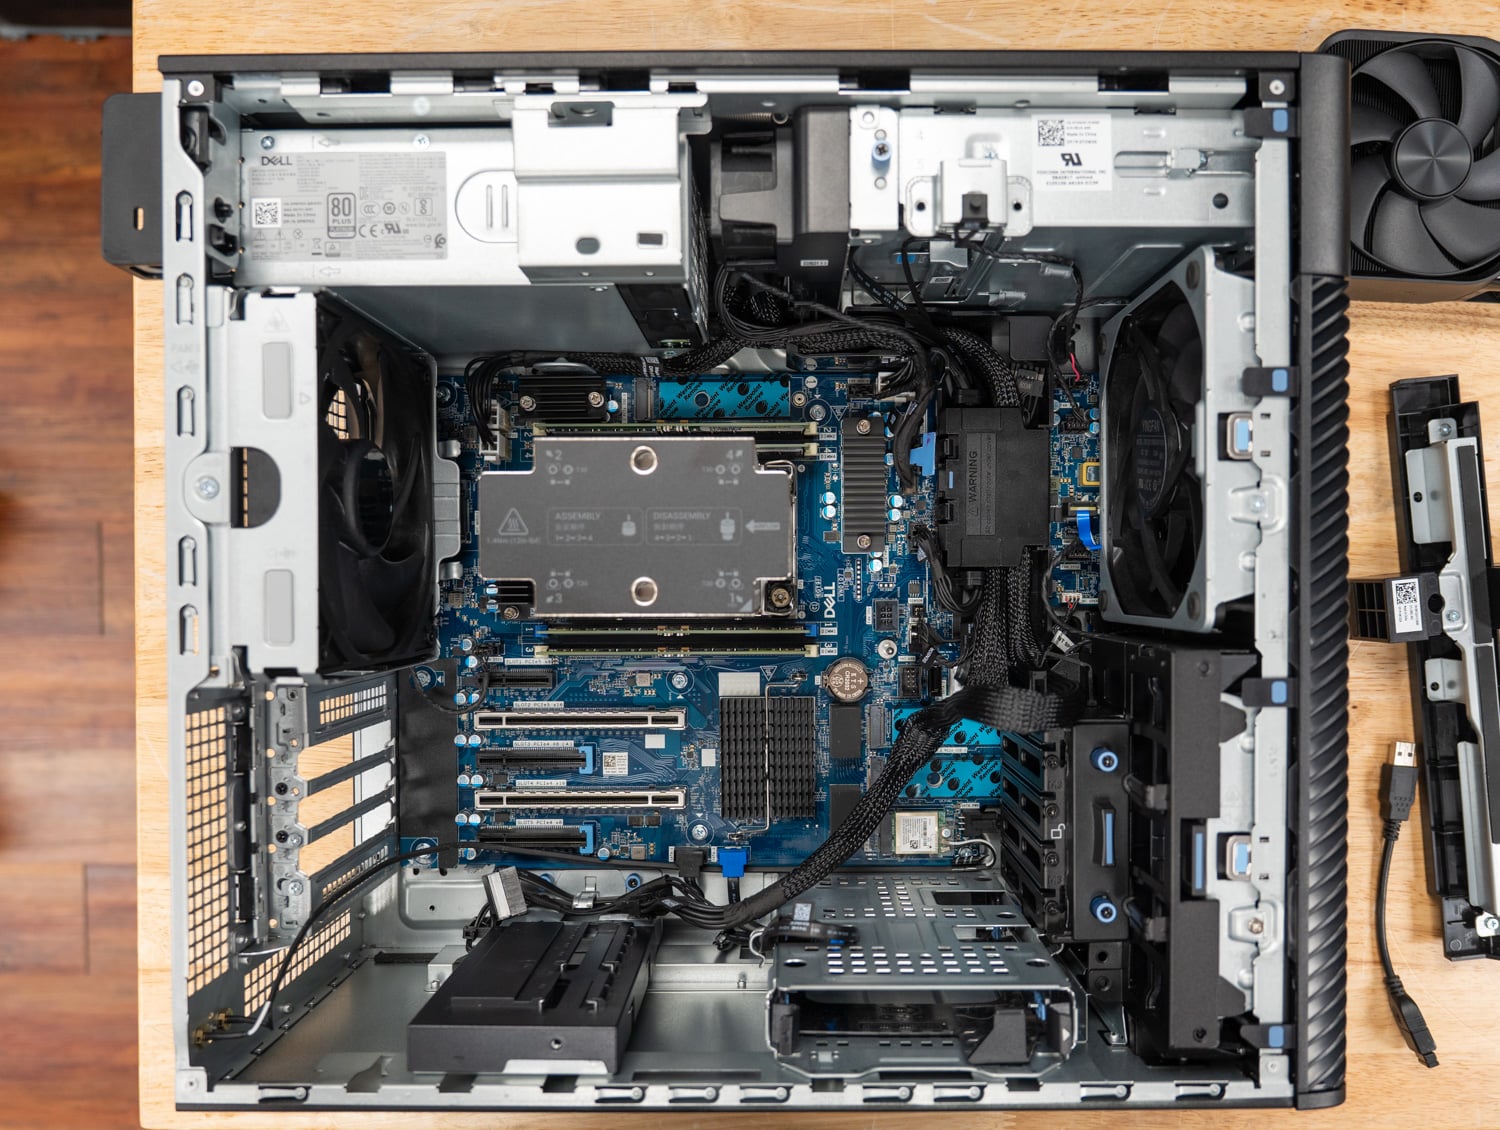
La Pro Precision 9 T2 utiliza la misma torre sin herramientas que la versión Pro Max, con una rejilla frontal de malla de altura completa para la entrada de aire, un pestillo lateral y un tornillo de mariposa cautivo para el panel lateral, y la FlexBay y la unidad óptica delgada opcional detrás del bisel inferior. Dell indica que el chasis pesa 11.6 kg vacío y hasta 21.8 kg configurado, y el nuestro, con la fuente de alimentación de 1500 W, el disipador de la 658X y una GPU de doble ranura, se sitúa en la parte alta de ese rango.

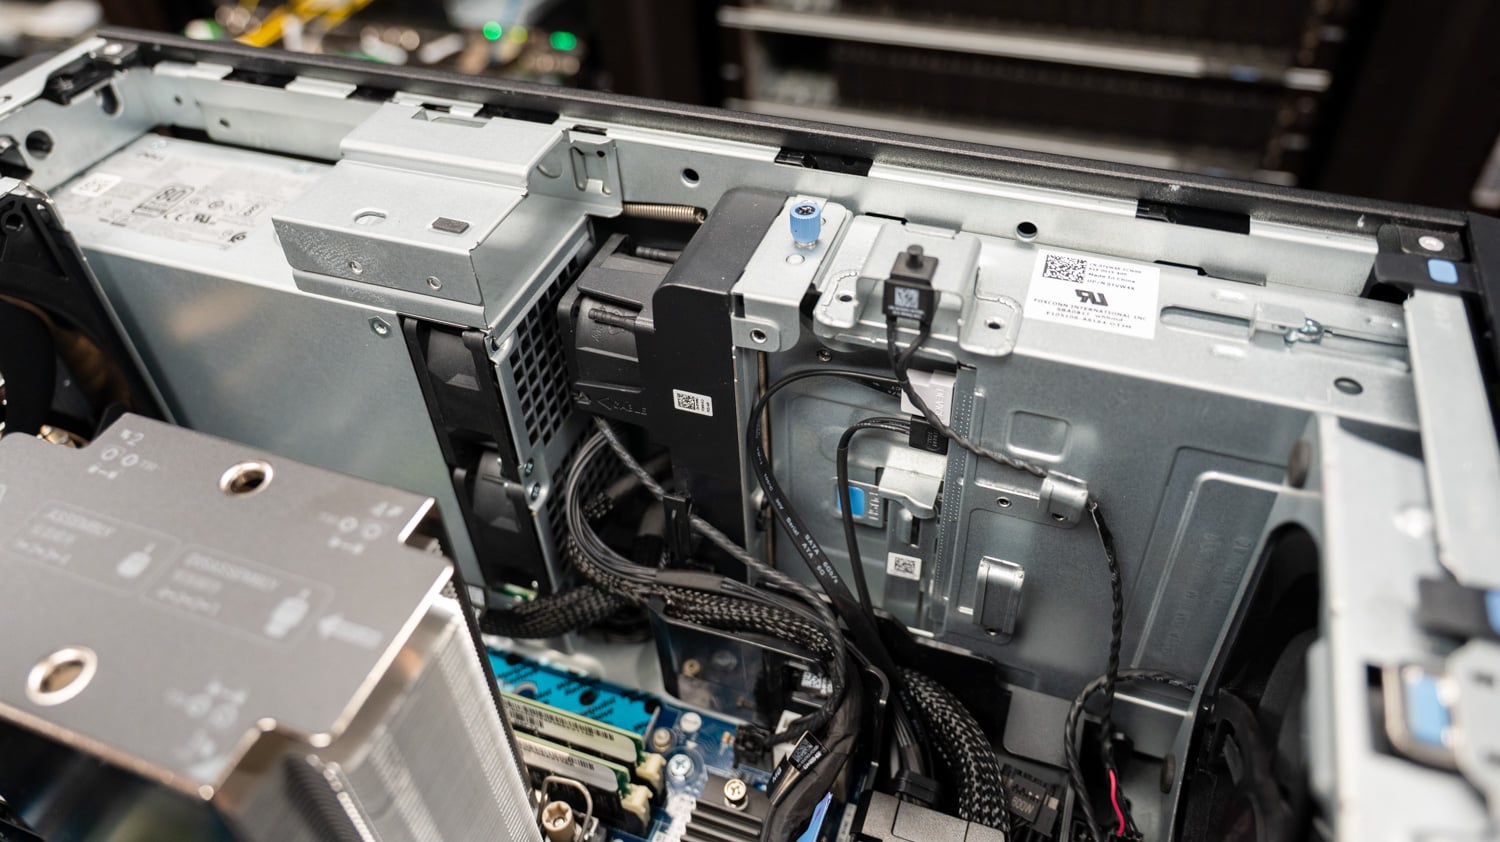
El interior del chasis está diseñado para optimizar el flujo de aire, y Dell lo dirige con precisión hacia donde debe ir. La gran cubierta de refrigeración, que mantiene fríos los módulos DIMM y expulsa el aire caliente de la CPU directamente fuera del chasis, incorpora un ventilador. Con la caja abierta, se puede apreciar cómo la cubierta se integra en la estructura del chasis, apoyando su borde inferior en el soporte de la GPU y ajustándose perfectamente a la cubierta lateral.
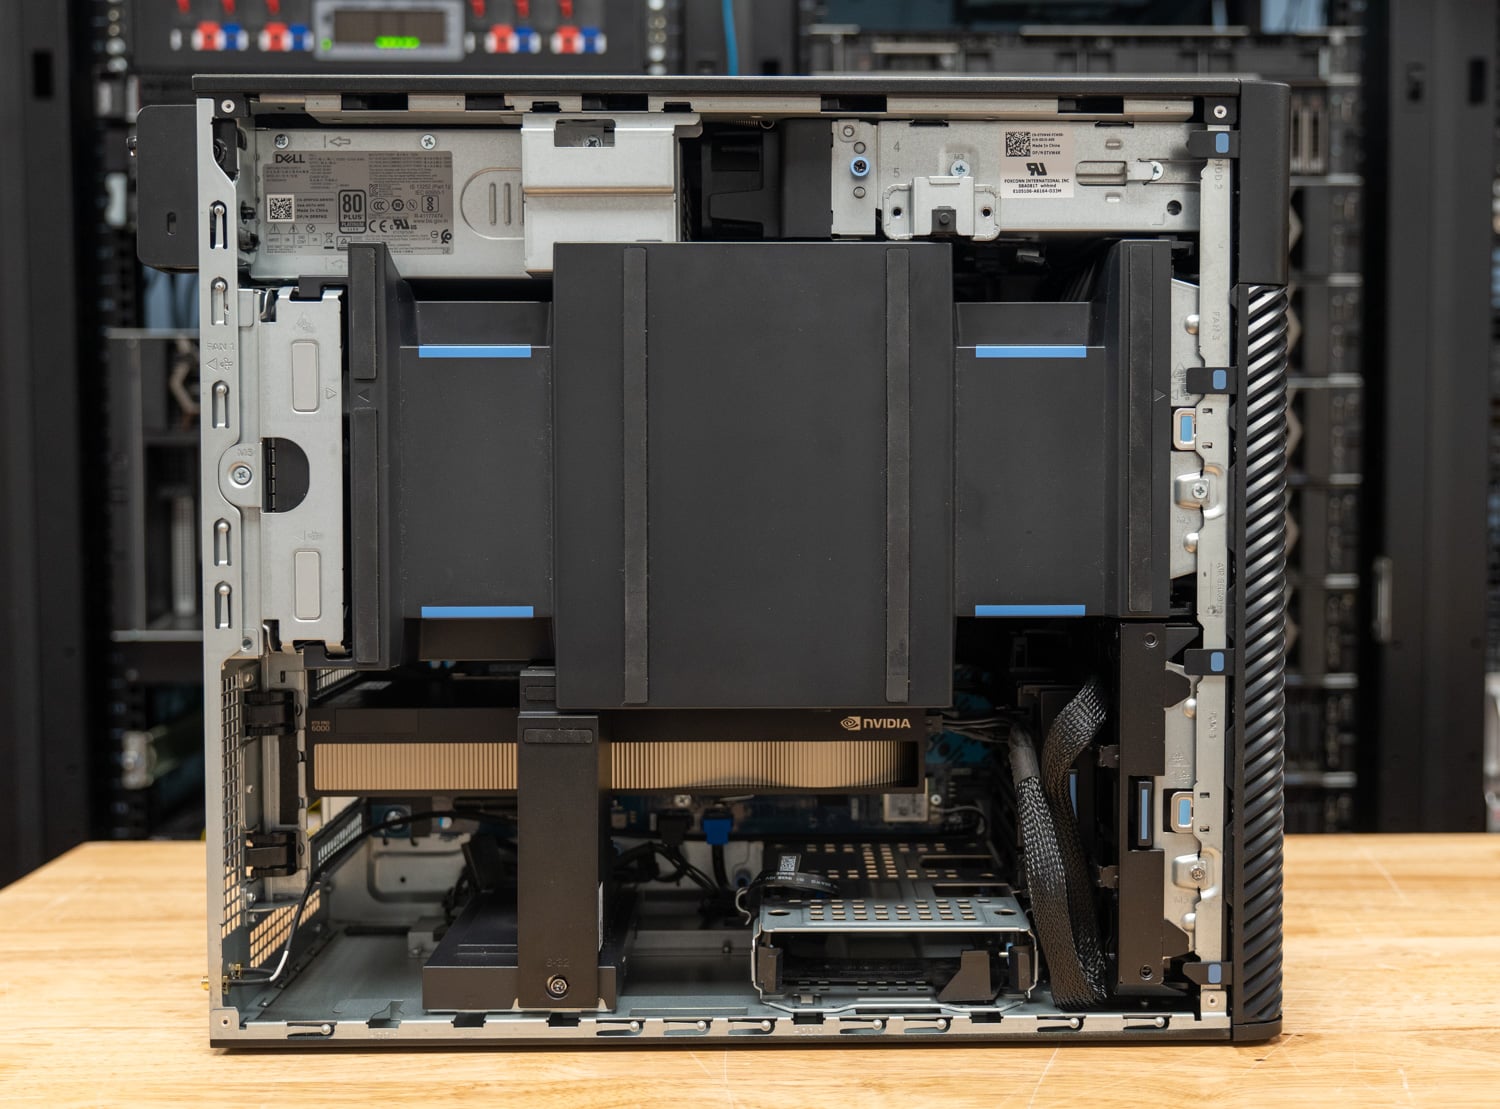
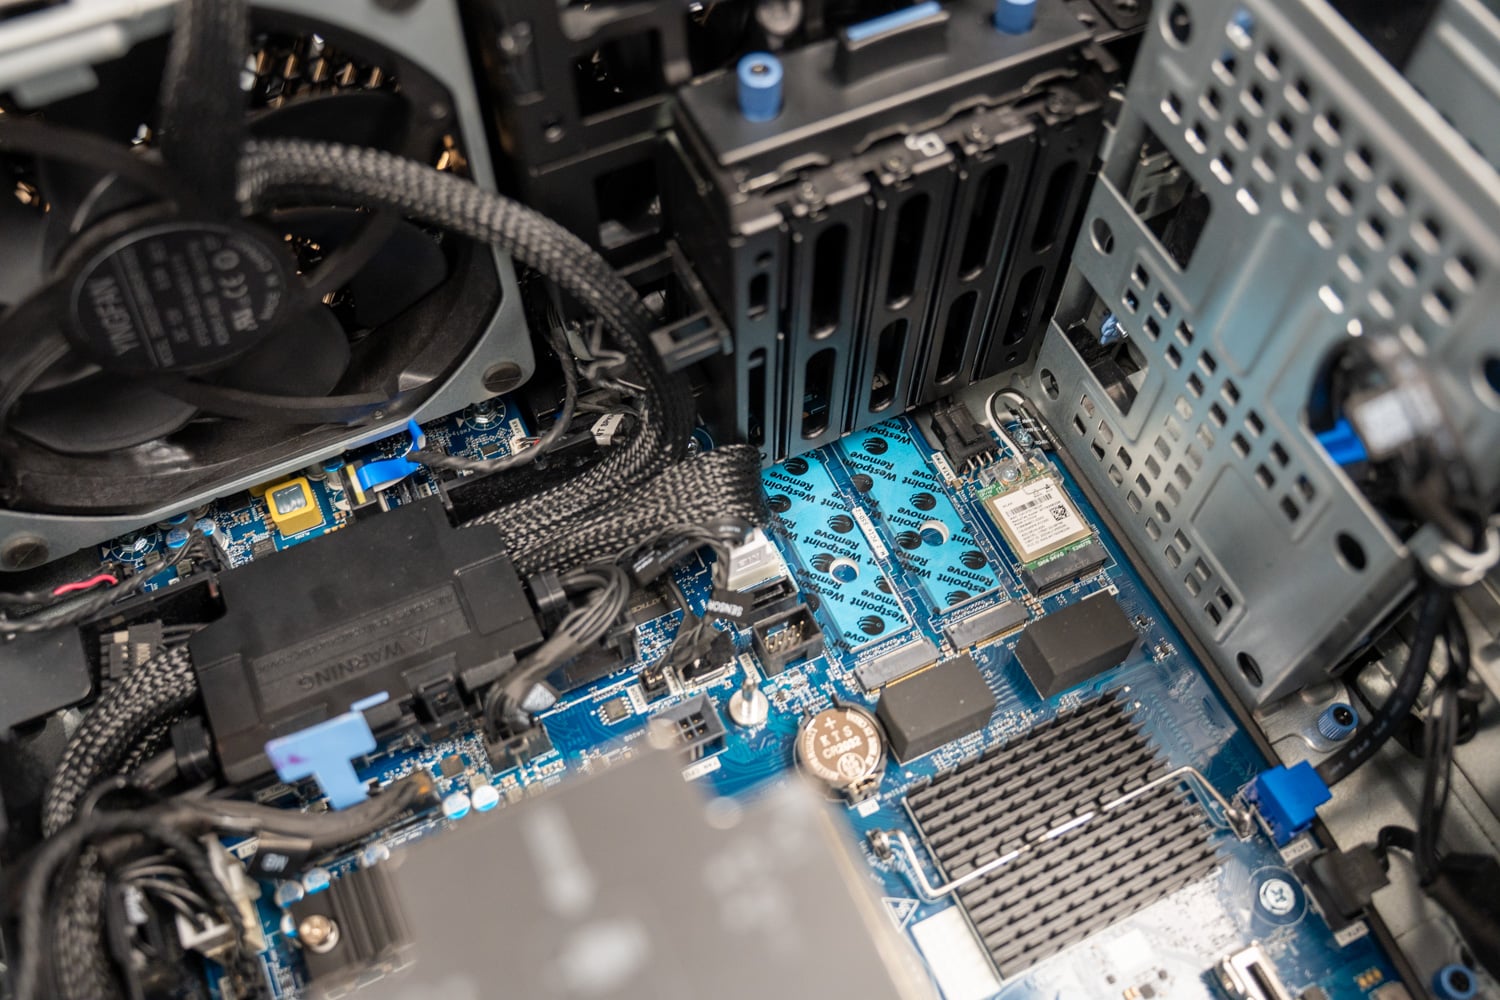
En el interior, la distribución sigue la de la torre Pro Max: el procesador y cuatro ranuras DIMM se encuentran sobre el área de expansión, la GPU en la ranura Gen5 x16 está sujeta en su extremo por un soporte de retención, y la fuente de alimentación se monta en la parte posterior con un asa para su extracción sin herramientas. Las cinco ranuras son de altura completa: la ranura 2 es la Gen5 x16 para la GPU, la ranura 1 es la Gen5 x4, y las otras tres son Gen4, una x16 y dos x8 abiertas, para una NIC, una tarjeta de almacenamiento o una segunda GPU. Tres ranuras internas M.2 2280 Gen5 y dos bahías SATA de 3.5 pulgadas se encuentran detrás de la bahía E3.S frontal.
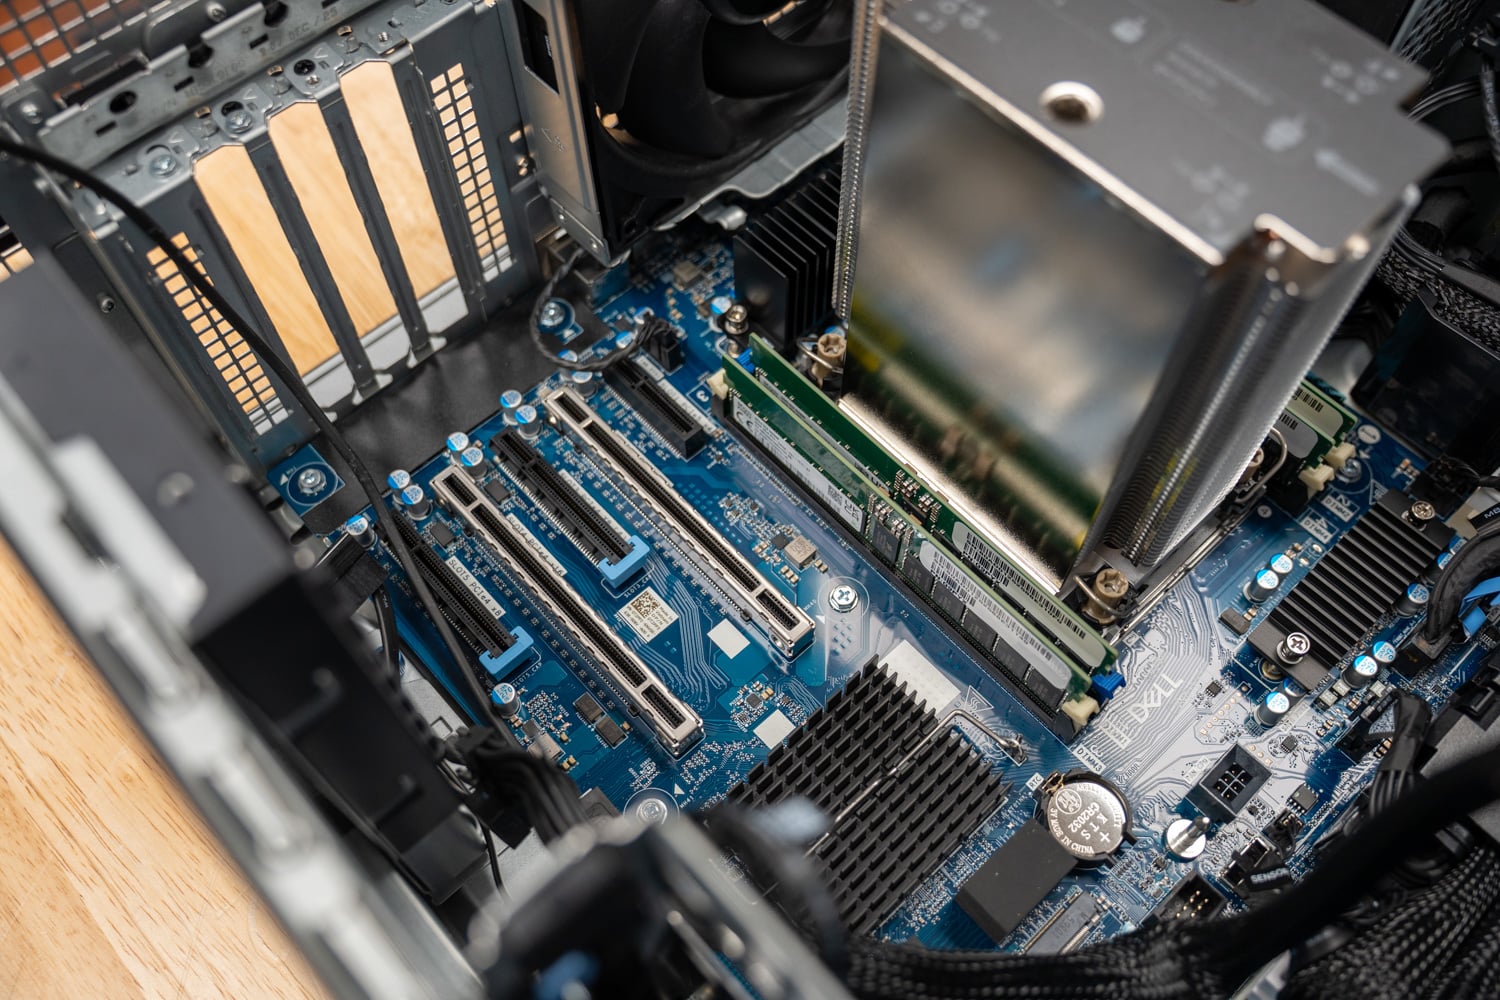
El panel frontal de E/S incluye un conector para auriculares, un puerto USB-C de 20 Gbps con PowerShare, un puerto USB-C de 10 Gbps, dos puertos USB-A y una ranura SD opcional. El panel trasero cuenta con salida de audio, puertos USB-C de 20 Gbps y 10 Gbps, dos puertos USB 2.0 con SmartPower, dos puertos USB-A de 5 Gbps, 1 GbE, una ranura para módulo opcional que admite una tarjeta de red de 5 GbE o dos puertos USB-A adicionales, y un puerto serie heredado opcional. Nuestra unidad incorporaba la tarjeta Wi-Fi 7 MediaTek MT7925 en la ranura interna M.2 2230 y la tarjeta Intel E810-XXV de 25 GbE, la que se lanzó para la GPU de 600 W.

Especificaciones de la Dell Pro Precision 9 T2
| Especificación | Dell Pro Precision 9 T2 (PW9T2260) |
|---|---|
| Descripción general de la plataforma | |
| opciones de procesador | Intel Xeon 634 (12 núcleos, 150 W), 636 (12 núcleos, 170 W), 638 (16 núcleos, 180 W), 654 (18 núcleos, 200 W), 656 (20 núcleos, 210 W), 658X (24 núcleos / 48 hilos, 144 MB L3, 250 W) Xeon 658X según las pruebas realizadas |
| Salud Cerebral | Memoria DDR5 RDIMM ECC, 5600 o 6400 MT/s, cuatro ranuras, hasta 1 TB (4 x 256 GB) 128 GB (4 x 32 GB) DDR5-6400 según las pruebas realizadas. |
| Opciones gráficas | NVIDIA RTX A400, A1000, RTX PRO 2000 / 4000 / 4500 / 5000 / 6000 Blackwell (600W) / 6000 Blackwell Max-Q (300W), A800 Active; AMD Radeon Pro W7400; configuraciones duales y triples en tarjetas seleccionadas RTX PRO 6000 Blackwell Max-Q Workstation Edition, 96 GB GDDR7, tal como se probó. |
| Almacenaje | Bahía FlexBay frontal: hasta dos unidades E3.S/NVMe más una unidad óptica delgada opcional, o una bahía SATA de 3.5 pulgadas. Interno: 3 x M.2 2280 Gen5 NVMe, 2 x SATA de 3.5 pulgadas RAID: Intel VMD con VROC de Graid Technology (arranque RAID0, RAID0 interno) 2 x 2TB E3.S Gen5 NVMe en RAID0 (4,097 GB) según las pruebas realizadas. |
| Expansión | Ranura 1: Gen5 x4; Ranura 2: Gen5 x16; Ranura 3: Gen4 x8 (x4 eléctrico, abierto); Ranura 4: Gen4 x16; Ranura 5: Gen4 x8 (abierto); M.2 2230 para Wi-Fi |
| I / O | |
| Puertos frontales | 1 puerto USB-C de 20 Gbps con PowerShare, 1 puerto USB-C de 10 Gbps, 1 puerto USB-A de 5 Gbps con PowerShare, 1 puerto USB-A de 5 Gbps, conector para auriculares, ranura SD opcional |
| Puertos traseros | 1 puerto USB-C de 20 Gbps, 1 puerto USB-C de 10 Gbps, 2 puertos USB 2.0 (SmartPower), 2 puertos USB-A de 5 Gbps, salida de audio, 1 puerto RJ45 de 1 GbE, módulo opcional de 5 GbE o USB-A dual, puerto serie opcional |
| Redes según las pruebas realizadas | Intel E810-XXV DA2, puerto dual 25GbE SFP28 (retirado para las pruebas con GPU de 600W); MediaTek MT7925, Wi-Fi 7, Bluetooth 5.4 |
| Poder y físico | |
| Fuente de alimentación | 750 W estándar; 500 W o 1500 W opcional; 1500 W según las pruebas realizadas. |
| Dimensiones | 387 x 187.7 x 438mm (15.23 x 7.38 x 17.24 en) |
| Peso | 11.6 kg (25.57 lb) mínimo a 21.8 kg (48.06 lb) máximo |
| Sistema operativo | Windows 11 Pro para estaciones de trabajo (como se probó) o Ubuntu Linux 24.04 LTS. |
| Gestión y seguridad | Intel vPro, TPM 2.0, interruptor de detección de intrusión en el chasis, opciones de bisel con bloqueo, ranura Kensington |
| Precio | Dell.com Configuración básica: $3,978 (Xeon 634, 16 GB, RTX A400, 256 GB, 750 W); aproximadamente $28 300 según las pruebas realizadas (Xeon 658X, 128 GB DDR5-6400, RTX PRO 6000 Max-Q, 2 unidades FlexBay Gen5 de 2 TB en RAID 0, 1500 W, 25 GbE, Wi-Fi 7). Precios de Dell.com al 19 de octubre de 2026. |
Ese precio tiene dos salvedades. El configurador de Dell.com muestra las unidades FlexBay como módulos M.2 2280 Gen5 de 2 TB a 1,700 $ cada uno, mientras que las unidades de nuestra unidad son E3.S, y hemos preguntado a Dell cuándo estará disponible la opción E3.S en línea. Además, Dell reconoce que pocas estaciones de trabajo empresariales se compran al precio web, por lo que conviene considerar los 28 300 $ como un precio máximo por debajo del cual se aplican los precios por volumen y por contrato. La memoria y la GPU representan 19 090 $ de ese total, y la opción de GPU tiene el mismo precio tanto si se elige la tarjeta de 300 W como la de 600 W.
Dell sitúa el precio de esta unidad de prueba en 31,700 dólares, cifra que incluye el adaptador E810-XXV de 25 GbE, Wi-Fi 7, la unidad óptica y tres años de ProSupport, además del precio que hemos calculado.
Configuración de prueba y metodología
Todos los resultados de esta revisión provienen de sr-client 1.2, nuestra suite de evaluación comparativa de clientes Windows con scripts, en su perfil de ejecución completo, utilizando la imagen de fábrica de Windows de Dell con los controladores de Dell y el controlador NVIDIA 596.71 en las cuatro configuraciones. La suite aplica la misma configuración en todas partes: modo de energía de Windows en "Mejor rendimiento", todos los temporizadores de suspensión y apagado de pantalla deshabilitados, Firewall de Windows y avisos de UAC desactivados, VBS e integridad de memoria activados de fábrica. Cada resultado es la mediana de pasadas repetidas, y la suite vuelve a ejecutar una prueba cuya dispersión supera el 2 por ciento antes de aceptarla.
Las cuatro configuraciones que se muestran a continuación son dos torres y dos GPU. El Pro Precision 9 T2 ejecutó la suite completa con su tarjeta Max-Q y nuevamente con la RTX PRO 6000 Blackwell de 600 W de nuestra Pro Max Tower T2, y la Pro Max Tower T2 ejecutó ambas tarjetas alternativamente, por lo que las columnas de GPU dentro de una torre difieren solo en la tarjeta y las columnas de torre dentro de una GPU difieren solo en la plataforma. La unidad del Core T2 es la única M.2 Gen5 de 2 TB con la que venía de fábrica, y la del Xeon T2 es su configuración de dos unidades E3.S, por lo que las filas de almacenamiento y carga de modelos comparan esas configuraciones.
| Configuration | CPU | Salud Cerebral | GPU | unidad de arranque | Sistema operativo y modo de energía |
|---|---|---|---|---|---|
| Dell Pro Precision 9 T2 (PW9T2260), Max-Q | Procesador Intel Xeon 658X, 24 núcleos / 48 hilos, 250 W | Memoria DDR5-6400 RDIMM ECC de 128 GB (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, 300 W, 96 GB | 2 unidades NVMe E3.S Gen5 de 2 TB, VROC RAID0 (volumen de arranque de 4,097 GB) | Windows 11 Pro para estaciones de trabajo 25H2, el mejor rendimiento. |
| Dell Pro Precision 9 T2 (PW9T2260), 600 W | Procesador Intel Xeon 658X, 24 núcleos / 48 hilos, 250 W | Memoria DDR5-6400 RDIMM ECC de 128 GB (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Workstation Edition, 600 W, 96 GB | 2 unidades NVMe E3.S Gen5 de 2 TB, VROC RAID0 (volumen de arranque de 4,097 GB) | Windows 11 Pro para estaciones de trabajo 25H2, el mejor rendimiento. |
| Dell Pro Max Tower T2 (FCT2250), Max-Q | Procesador Intel Core Ultra 9 285K, 24 núcleos / 24 hilos, 125 W | 128 GB DDR5-4400 ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, 300 W, 96 GB | SK hynix PCB01 2TB, Gen5 x4 | Windows 11 Pro 26H2, Mejor rendimiento |
| Dell Pro Max Tower T2 (FCT2250), 600 W | Procesador Intel Core Ultra 9 285K, 24 núcleos / 24 hilos, 125 W | 128 GB DDR5-4400 ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Workstation Edition, 600 W, 96 GB | SK hynix PCB01 2TB, Gen5 x4 | Windows 11 Pro 26H2, Mejor rendimiento |
Varias pruebas debutan aquí, comenzando con LLM serving, que ejecuta llama-server con cuatro modelos y barre la concurrencia desde una solicitud hasta la mayor cantidad que cabe en la memoria de la GPU, informando el rendimiento total y por usuario, el tiempo hasta el primer token y el tiempo por token de salida. La prueba de generación de imágenes renderiza imágenes de 1024×1024 con FLUX.2 klein 4B, Z-Image Turbo 6B y Qwen-Image 20B en Q4_0, Q8_0 y pesos BF16, y califica las salidas cuantificadas contra BF16 con PSNR y SSIM, por lo que la velocidad y la fidelidad van de la mano. La prueba del agente de codificación ahora se ejecuta en Crush, y la prueba del agente junto al usuario utiliza un método revisado que mantiene el benchmark del navegador en tres pasadas completas.
Tres etiquetas se repiten en las tablas, comenzando con N/A, lo que significa que una prueba no se aplica al hardware: SMT de un solo núcleo en el 285K, que no tiene SMT, y las filas de OpenBLAS de la clase de núcleo superior en el Xeon, cuyos 24 núcleos son de una sola clase. Parcial marca un resultado que el conjunto aceptó con una nota, generalmente un nivel de agente de codificación donde una de las tres ejecuciones falló sus pruebas. Ninguno de los equipos de escritorio expuso las temperaturas de la CPU o la GPU a la ruta del sensor del conjunto, por lo que esta revisión informa las frecuencias medias de la CPU por prueba en lugar de una tabla térmica.
Rendimiento de la IA local
Con 96 GB de GDDR7 en todas las configuraciones, la capacidad del modelo está garantizada, y cada nivel de nuestra suite de IA local se ejecuta en las cuatro. Por lo tanto, los resultados se dividen según el límite de potencia de la GPU: cuando una prueba está limitada por el ancho de banda de la memoria, las tarjetas Max-Q y de 600 W rinden muy cerca, y cuando está limitada por la capacidad de cómputo, la tarjeta de 600 W se impone. La plataforma de CPU rara vez influye, y cuando lo hace, la tendencia es digna de mención.
Cliente MLPerf v2.0
MLPerf Client ejecuta Llama 3.1 8B y Phi-4-mini a través de cinco categorías de indicaciones e informa el tiempo hasta el primer token y la tasa de tokens posterior, como una media geométrica en todas las categorías, con llama.cpp en CUDA como motor en cada configuración. Los escenarios de agentes ejecutan Llama 3.1 8B como un agente de analista de datos y un agente de ingeniería de software que llaman a herramientas en múltiples turnos.

| Cliente MLPerf v2.0 | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Llama 3.1 8B, tiempo hasta el primer token, media geométrica (s, cuanto menor sea el valor, mejor) | 0.082 | 0.059 | 0.082 | 0.060 |
| Llama 3.1 8B, tasa de tokens, media geométrica (tok/s) | 230.9 | 252.8 | 230.0 | 246.7 |
| Phi-4-mini, tiempo hasta el primer token, media geométrica (s, cuanto menor sea el valor, mejor) | 0.045 | 0.034 | 0.044 | 0.034 |
| Phi-4-mini, tasa de tokens, media geométrica (tok/s) | 345.9 | 379.0 | 351.0 | 374.3 |
| Analista de datos, de principio a fin (s, cuanto menor sea el número, mejor) | 17.5 | 15.7 | 16.2 | 14.4 |
| Agente analista de datos, tasa de tokens (tok/s) | 202.9 | 223.9 | 202.3 | 218.4 |
| Agente SWE, de extremo a extremo (s, cuanto menor sea el valor, mejor) | 16.2 | 14.9 | 14.6 | 13.5 |
| Agente SWE, tasa de tokens (tok/s) | 197.5 | 214.6 | 195.5 | 210.2 |
La tarjeta Max-Q generó Llama 3.1 8B a 230.9 tokens por segundo en la torre Xeon y 230.0 en la torre Core, y Phi-4-mini a 345.9 y 351.0, que es la misma GPU haciendo el mismo trabajo. La tarjeta de 600 W aumentó esos valores a 252.8 y 379.0 tokens por segundo en la torre Xeon, una ganancia de aproximadamente el 9 por ciento, y redujo el tiempo para el primer token en Llama de 0.082 a 0.059 segundos, una reducción del 28 por ciento. El procesamiento de solicitudes está limitado por la capacidad de cómputo, y la decodificación está limitada por el ancho de banda, y las dos tarjetas comparten la misma memoria, por lo que el límite de potencia se hace mucho más evidente en el primer token que en los siguientes.
Los escenarios de agentes son donde entra en juego la plataforma de CPU. El agente analista de datos finalizó en 16.2 segundos en el Core T2 con la tarjeta Max-Q y en 17.5 segundos en el Xeon T2, mientras que el agente SWE tardó 14.6 segundos frente a 16.2, siendo las fases de llamada a herramientas del Xeon aproximadamente 1.5 segundos más largas en cada caso. Las tasas de token coinciden con una precisión del 1 %, por lo que la diferencia radica en las herramientas que se ejecutan en la CPU entre las llamadas al modelo, donde los núcleos más rápidos del 285K finalizan antes.
Cargando modelo
Esta prueba mide el tiempo que tarda un modelo local en Ollama desde la unidad hasta su primer token generado, tanto en frío (caché de archivos vaciada) como en caliente (archivo ya en memoria), e informa sobre la velocidad de lectura de la unidad durante la carga en frío, el momento en que los pesos llegaron a la memoria de la GPU y una cifra de eficiencia de carga que compara la tasa de lectura durante la carga con el límite secuencial de 1 MB de la unidad. Con 96 GB de VRAM, los tres niveles se ejecutan: gpt-oss:20b a 12.8 GB, Qwen3.6-35B-A3B a 21.1 GB y gpt-oss:120b a 60.9 GB.

| Carga del modelo (mapeo de memoria activado) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| gpt-oss:20b, carga en frío hasta el primer token (s, cuanto menor sea el valor, mejor) | 9.68 | 9.02 | 7.41 | 7.23 |
| gpt-oss:20b, carga en caliente al primer token (s, cuanto menor sea el valor, mejor) | 7.52 | 7.18 | 6.60 | 6.61 |
| gpt-oss:20b, llegada a la memoria de la GPU, frío (s, cuanto menor sea el valor, mejor) | 4.44 | 4.33 | 3.00 | 2.95 |
| Qwen3.6-35B-A3B, carga en frío hasta el primer token (s, cuanto menor sea el valor, mejor) | 13.31 | 12.32 | 11.62 | 11.01 |
| Qwen3.6-35B-A3B, carga en caliente hasta el primer token (s, cuanto menor sea el valor, mejor) | 11.63 | 10.75 | 10.35 | 9.99 |
| gpt-oss:120b, carga en frío hasta el primer token (s, cuanto menor sea el valor, mejor) | 32.06 | 32.44 | 28.54 | 28.11 |
| gpt-oss:120b, carga en caliente al primer token (s, cuanto menor sea el valor, mejor) | 27.18 | 26.49 | 25.58 | 25.73 |
| gpt-oss:120b, rendimiento de lectura durante carga en frío (MB/s) | 9,875 | 9,106 | 11,633 | 11,248 |
| gpt-oss:120b, llegada a la memoria de la GPU, frío (s, cuanto menor sea el valor, mejor) | 11.33 | 11.57 | 7.74 | 7.63 |
| Carga de gpt-oss:120b después de intercambiar desde gpt-oss:20b (s, cuanto menor sea el valor, mejor). | 14.30 | 13.97 | 11.89 | 11.93 |
| Límite de velocidad de la unidad, lectura secuencial de DiskSpd de 1 MB (MB/s) | 11,306 | 11,296 | 11,563 | 11,646 |
El Core T2 carga todos los modelos más rápido, y la razón es la unidad. gpt-oss:120b alcanzó su primer token en 28.54 segundos en frío en el Core T2 frente a 32.06 en el Xeon T2, con los 61 GB de pesos llegando a la memoria de la GPU en 7.74 segundos frente a 11.33. El PCB01 único alimentó la carga a 11,633 MB/s, justo en su techo DiskSpd de 11,563 MB/s, mientras que la franja E3.S la alimentó a 9,875 MB/s frente a un techo propio de 11,306 MB/s. El volumen RAID lee grandes bloques casi tan rápido como la unidad única, pero no mantiene esa velocidad a través de la ruta de carga mapeada en memoria de Ollama.
Las cargas en caliente reducen la diferencia a uno o dos segundos, ya que el archivo ya está en la memoria del sistema y lo que queda es la transferencia a la VRAM y la configuración de llama.cpp: 27.18 segundos en el Xeon T2 frente a 25.58 para gpt-oss:120b, y 7.52 frente a 6.60 para gpt-oss:20b. El límite de potencia de la GPU no produce ninguna diferencia consistente en la carga, como era de esperar.
Agente de codificación
Crush, un agente de codificación de terminal, ejecuta un modelo local gestionado por Ollama en una tarea de codificación fija en un repositorio anclado, con hasta tres rondas para superar las 11 pruebas del repositorio. Informamos del tiempo medio de ejecución de tres ejecuciones, cuántas se completaron con éxito y la tasa de generación. El tiempo de ejecución depende de la cantidad de llamadas a herramientas y tokens que el modelo decide utilizar, lo cual varía de una ejecución a otra, por lo que la tasa de generación ofrece una comparación de hardware más precisa. La prueba con el agente junto al usuario ejecuta el agente y Speedometer simultáneamente e informa de la ralentización que cada uno produce en el otro.

| Agente de codificación Crush | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Nivel S, gpt-oss:20b, contexto de 64K | ||||
| Tiempo de ejecución, mediana (s, cuanto menor sea el valor, mejor) | 55.1 | 99.8 | 57.2 | 43.2 |
| Éxitos (de 3) | 3 | 2 | 3 | 2 |
| Tasa de generación (tok/s) | 214.1 | 237.9 | 218.0 | 237.7 |
| Nivel M, Qwen3.6-35B-A3B, contexto de 64K | ||||
| Tiempo de ejecución, mediana (s, cuanto menor sea el valor, mejor) | 35.2 | 27.0 | 86.7 | 32.1 |
| Éxitos (de 3) | 3 | 3 | 3 | 3 |
| Tasa de generación (tok/s) | 234.5 | 242.9 | 223.3 | 245.8 |
| Nivel L, Qwen3.6-35B-A3B, contexto de 128K | ||||
| Tiempo de ejecución, mediana (s, cuanto menor sea el valor, mejor) | 38.1 | 30.6 | 74.1 | 58.8 |
| Éxitos (de 3) | 3 | 3 | 3 | 3 |
| Tasa de generación (tok/s) | 222.9 | 237.0 | 231.1 | 252.8 |
| Nivel W, gpt-oss:120b, contexto de 128K | ||||
| Tiempo de ejecución, mediana (s, cuanto menor sea el valor, mejor) | 49.1 | 37.9 | 56.6 | 30.8 |
| Éxitos (de 3) | 3 | 3 | 3 | 3 |
| Tasa de generación (tok/s) | 160.9 | 177.1 | 158.5 | 174.4 |
| Agente junto al usuario (gpt-oss:20b y Velocímetro juntos) | ||||
| Velocímetro junto al agente (puntuación) | 36.6 | 36.7 | 43.2 | 45.2 |
| Disminución de la velocidad (x, cuanto menor sea el valor, mejor) | 1.005 | 1.011 | 1.053 | 1.044 |
| Tasa de generación de agentes junto al velocímetro (tok/s) | 218.2 | 231.6 | 212.4 | 229.2 |
| Ralentización del agente (x, cuanto menor sea el valor, mejor) | 1.006 | 1.009 | 1.023 | 0.998 |
Cada configuración completó las tres ejecuciones de la tarea de nivel W con gpt-oss:120b, el modelo más grande de la suite, generando entre 160.9 y 177.1 tokens por segundo en la torre Xeon y entre 158.5 y 174.4 en la torre Core, con la tarjeta de 600 W aportando aproximadamente un 10 por ciento en cada caso. Las tareas Qwen3.6 también superaron las tres en todas partes, con entre 223 y 253 tokens por segundo. gpt-oss:20b es el modelo que falló: la tarea de nivel S perdió una de las tres ejecuciones en dos de las cuatro configuraciones, y su tarea de nivel M de 128K contextos (no mostrada) perdió al menos una ejecución en todas partes, un comportamiento del modelo que el hardware no modifica.
Ejecutar el agente y una prueba de rendimiento del navegador simultáneamente cuesta muy poco en una torre con una GPU dedicada y 24 núcleos disponibles. Speedometer se ralentizó 1.005 veces en el Xeon T2 y 1.053 veces en el Core T2 con el agente en ejecución, y la tasa de generación del agente se movió un 2 por ciento o menos en todos los casos. La puntuación de Speedometer del Xeon T2 de 36.6 junto al agente es inferior a la del Core T2 de 43.2 por la misma razón por la que es inferior por sí solo: la velocidad por núcleo del 285K.
Generación aumentada de recuperación
Nuestra prueba RAG integra 20 963 pasajes de SQuAD v1.1 con nomic-embed-text, recupera los cinco pasajes principales para cada una de las 2,000 preguntas y responde 400 de ellas con Phi-4-mini, obteniendo una puntuación de coincidencia exacta y F1 en comparación con las respuestas de referencia. Los modelos son pequeños, por lo que la prueba mide todo el proceso, incluyendo la búsqueda vectorial en la CPU entre las fases de la GPU.

| RAG | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Tiempo de procesamiento: 20,963 pasajes (s; cuanto menor sea el valor, mejor). | 128.5 | 125.5 | 108.1 | 103.0 |
| Tasa de incrustación (tok/s) | 29,875 | 30,592 | 35,165 | 37,508 |
| Tiempo de consulta de recuperación, p50 (ms, cuanto menor sea el valor, mejor) | 30.6 | 27.2 | 23.4 | 18.7 |
| Respuesta, tiempo Phi-4-mini para el primer token, p50 (s, cuanto menor sea el valor, mejor) | 0.099 | 0.087 | 0.089 | 0.083 |
| Respuesta, procesamiento rápido (tok/s) | 20,318 | 26,549 | 21,356 | 26,619 |
| Respuesta, tasa de generación (tok/s) | 296.4 | 337.8 | 324.3 | 344.1 |
| Pregunta a responder, p50 (s, cuanto menor sea el valor, mejor) | 0.152 | 0.133 | 0.130 | 0.120 |
| Retirada al 5% (%) | 82.7 | 82.7 | 82.7 | 82.7 |
| Respuesta F1 (%) | 74.65 | 74.65 | 74.65 | 74.65 |
El Core T2 es más rápido en esta canalización. Ingirió el corpus en 108.1 segundos frente a 128.5 en el Xeon T2 con la misma tarjeta Max-Q, recuperó en 23.4 ms frente a 30.6 en la mediana, y respondió una pregunta en 0.130 segundos frente a 0.152. Tanto la incrustación como la recuperación tienen etapas limitadas por la CPU, y esas favorecen al 285K. La tarjeta de 600 W aumentó el procesamiento de indicaciones entre un 25 y un 30 por ciento en ambas plataformas, de 20,318 a 26,549 tokens por segundo en el Xeon T2, y la precisión fue idéntica en las cuatro configuraciones, como debería ser con los mismos modelos a temperatura 0.
LLM al servicio
La prueba de servicio ejecuta llama-server con Ministral 3 3B y 8B (4,096 solicitudes de token, 1,024 salidas de token), Qwen3.8 27B y gpt-oss 120B (8,192 solicitudes de token), asigna tantas ranuras como quepan en la memoria de la GPU después de los pesos, y luego barre la concurrencia desde una solicitud hasta ese límite. Informamos el rendimiento total (tokens de solicitud y salida juntos), el rendimiento de salida, el tiempo hasta el primer token y el tiempo por token de salida en la mediana. En una tarjeta de 96 GB, gpt-oss 120B cabe 64 ranuras con 22.5 GiB de caché KV, Qwen3.8 27B cabe ocho, y los dos modelos Ministral caben cuatro en su contexto.

| llama-server, gpt-oss 120B, 8,192 solicitudes de token, 1,024 salidas de token | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| 1 concurrente: rendimiento de salida (tok/s) | 160.6 | 182.7 | 158.4 | 179.0 |
| 1 concurrentes: tiempo hasta el primer token, mediana (ms, cuanto menor sea el valor, mejor) | 1,241 | 918 | 1,238 | 923 |
| 1 concurrentes: tiempo por token de salida, mediana (ms, cuanto menor sea el valor, mejor) | 5.03 | 4.58 | 5.11 | 4.70 |
| 8 concurrentes: rendimiento total (tok/s) | 2,088 | 2,460 | 2,154 | 2,534 |
| 8 concurrentes: producción por usuario (tok/s) | 29.0 | 34.2 | 29.9 | 35.2 |
| 8 concurrentes: tiempo hasta el primer token, mediana (ms, cuanto menor sea el valor, mejor) | 2,847 | 2,152 | 2,856 | 2,121 |
| 64 concurrentes: rendimiento total (tok/s) | 3,296 | 3,805 | 3,531 | 4,220 |
| 64 concurrentes: producción por usuario (tok/s) | 5.7 | 6.6 | 6.1 | 7.3 |
| 64 concurrentes: tiempo hasta el primer token, mediana (ms, cuanto menor sea el valor, mejor) | 4,315 | 3,491 | 4,607 | 3,622 |
| 64 concurrentes: tiempo por token de salida, mediana (ms, cuanto menor sea el valor, mejor) | 163.0 | 141.3 | 152.7 | 126.3 |
Un solo usuario obtiene gpt-oss 120B a 160.6 tokens por segundo en la tarjeta Max-Q y 182.7 en la tarjeta 600W, con el primer token llegando en 1,241 y 918 ms después de una solicitud de 8,192 tokens. Cargar la tarjeta con 64 solicitudes concurrentes aumentó el rendimiento total a 3,296 tokens por segundo en la Max-Q y 3,805 en la tarjeta 600W, a un costo de 5.7 y 6.6 tokens por segundo por usuario y primeros tokens de 4.3 y 3.5 segundos. La curva se estabiliza entre 4 y 32 solicitudes concurrentes y vuelve a saltar en 64, donde el lote finalmente amortiza las largas solicitudes.

| llama-server, rendimiento de salida con la mayor concurrencia posible (tok/s) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Ministral 3 3B Razonamiento, 4 concurrentes | 562.5 | 600.4 | 576.8 | 625.3 |
| Ministral 3 8B Razonamiento, 4 concurrentes | 375.8 | 445.1 | 377.9 | 446.3 |
| Qwen3.8 27B, 8 concurrent | 153.1 | 189.6 | 152.2 | 187.3 |
| gpt-oss 120B, 64 concurrent | 366.3 | 422.8 | 392.3 | 468.9 |
| Rendimiento de salida de una sola solicitud (tok/s) | ||||
| Razonamiento Ministral 3 3B | 232.1 | 241.8 | 232.1 | 246.0 |
| Razonamiento Ministral 3 8B | 165.0 | 183.3 | 164.1 | 180.4 |
| Qwen3.8 27B | 54.0 | 63.7 | 54.1 | 63.0 |
| gpt-oss 120B | 160.6 | 182.7 | 158.4 | 179.0 |
El modelo denso Qwen3.8 27B es el más lento para un solo usuario a 54.0 tokens por segundo en el Max-Q, porque cada token toca los 27 mil millones de parámetros, mientras que el modelo mixto de expertos gpt-oss 120B funciona 3.0 veces más rápido a pesar de ser cuatro veces más grande en disco. La ventaja de la tarjeta de 600 W es mayor en el modelo denso, 24 por ciento con ocho solicitudes concurrentes, y menor en Ministral 3B con alrededor del 7 por ciento. Las dos torres están dentro de un margen de aproximadamente el 3 por ciento en todos los casos excepto en el caso de gpt-oss de 64 solicitudes, donde el Core T2 lideró entre un 7 y un 11 por ciento con cualquiera de las tarjetas, por lo que el trabajo del lado de la CPU del servidor con ese tamaño de lote favorece a los núcleos más rápidos.
Generación de imágenes
La prueba de generación de imágenes renderiza imágenes de 1024 × 1024 píxeles con tres modelos de difusión y tres precisiones de ponderación, e informa del tiempo por imagen, la tasa de reducción de ruido y la memoria de la GPU que ocupan las ponderaciones. También renderiza la misma semilla en BF16 y compara las salidas Q4_0 y Q8_0 con ella mediante PSNR y SSIM, lo que cuantifica el coste de la cuantización en la imagen.

| Generación de imagen, 1024×1024 | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| FLUX.2 klein 4B, 4 pasos | ||||
| Q8_0: segundos por imagen (cuanto menor sea el valor, mejor) | 1.66 | 1.37 | 1.59 | 1.30 |
| Q8_0: imágenes por minuto | 36.2 | 43.7 | 37.6 | 46.0 |
| BF16: segundos por imagen (cuanto menor sea el valor, mejor) | 1.60 | 1.34 | 1.55 | 1.27 |
| Z-Image Turbo 6B, 8 pasos | ||||
| Q8_0: segundos por imagen (cuanto menor sea el valor, mejor) | 3.82 | 2.89 | 3.78 | 2.82 |
| Q8_0: imágenes por minuto | 15.7 | 20.7 | 15.9 | 21.3 |
| BF16: segundos por imagen (cuanto menor sea el valor, mejor) | 3.61 | 2.76 | 3.56 | 2.68 |
| Qwen-Image 20B, 20 pasos | ||||
| Q4_0: segundos por imagen (cuanto menor sea el valor, mejor) | 25.60 | 19.11 | 25.57 | 18.97 |
| Q8_0: segundos por imagen (cuanto menor sea el valor, mejor) | 26.08 | 19.66 | 26.02 | 19.42 |
| BF16: segundos por imagen (cuanto menor sea el valor, mejor) | 26.17 | 20.45 | 26.05 | 20.28 |
| Q8_0: imágenes por minuto | 2.30 | 3.05 | 2.31 | 3.09 |
| BF16: Memoria de GPU para pesos (GiB) | 45.3 | 45.3 | 45.3 | 45.3 |
La difusión depende en gran medida de la capacidad de procesamiento, y la tarjeta de 600 W lo demuestra: Qwen-Image 20B en Q8_0 tardó 26.1 segundos por imagen en la Max-Q y 19.7 en la tarjeta de 600 W en la torre Xeon, lo que supone un aumento del 33 % en imágenes por minuto, mientras que Z-Image Turbo obtuvo un aumento del 32 % y FLUX.2 klein del 21 %. La plataforma de la CPU es irrelevante en este caso, ya que las dos torres se encuentran dentro del 1 % en todas las filas, excepto en el inicio del servidor, donde el volumen RAID del Xeon T2 tarda unos segundos más en cargar los pesos.
| Fidelidad de cuantización frente a BF16 (misma semilla) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| PSNR (dB, cuanto mayor, mejor) / SSIM (cuanto mayor, mejor) | ||||
| FLUX.2 klein 4B, Q4_0 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 |
| FLUX.2 klein 4B, Q8_0 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 |
| Z-Image Turbo 6B, Q4_0 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 |
| Z-Image Turbo 6B, Q8_0 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 |
| Imagen Qwen 20B, Q4_0 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 |
| Imagen Qwen 20B, Q8_0 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 |
Las filas de fidelidad son idénticas en las cuatro configuraciones, ya que la salida depende de los pesos y no del hardware. Q8_0 reproduce la imagen BF16 con un SSIM de 0.938 a 0.987 y un PSNR de 28 a 36 dB, mientras que Q4_0 cae a 0.75 a 0.79 SSIM y 18 a 22 dB, lo que presenta un panorama diferente. En una tarjeta de 96 GB no hay razón de memoria para ejecutar estos modelos por debajo de Q8_0; los pesos BF16 de Qwen-Image caben en 45.3 GiB, y BF16 se renderizó tan rápido como Q8_0 o ligeramente más rápido en los tres modelos, ya que la ruta Q8_0 emplea tiempo en la descuantización.
Rendimiento de CPU
Los dos procesadores dividen nuestra suite de CPU de forma clara. Cuando una prueba utiliza todos los núcleos, el Xeon 658X gana entre un 27 y un 150 por ciento en la mayoría de ellas, y cuanto más amplios son los vectores y mayor es el tráfico de memoria, mayor es su margen. Cuando una prueba se ejecuta en uno o pocos hilos, el Core Ultra 9 285K gana entre un 13 y un 31 por ciento gracias a un núcleo P de 5.7 GHz frente a un núcleo Xeon de 4.9 GHz con mayor caché y latencia de memoria. El efecto de la GPU de 600 W en los resultados de todos los núcleos del Xeon se analiza en cada tabla y se resume en la sección de frecuencia.
Cinebench 2026 y carga sostenida
Cinebench 2026 renderiza una escena con el motor Redshift de Maxon en la CPU y evalúa el rendimiento en un solo núcleo, en un solo núcleo SMT (dos hilos en un núcleo físico) y en múltiples núcleos. A continuación, realizamos un bucle continuo que repite la prueba en múltiples núcleos durante unos 30 minutos y compara el estado estable con la primera pasada.

| Cinebench 2026 (puntos, cuanto mayor sea el puntaje, mejor) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Núcleo simple | 454.1 | 455.6 | 564.4 | 564.5 |
| Núcleo único SMT | 599.1 | 601.0 | No aplica (sin SMT) | No aplica (sin SMT) |
| Multi core | 12,322 | 11,705 | 8,856 | 8,838 |
| Bucle sostenido, primera pasada | 12,201 | 11,731 | 8,717 | 8,788 |
| Bucle sostenido, estado estacionario | 12,328 | 11,764 | 8,825 | 8,844 |
| Estado estacionario / primera pasada | 1.010 | 1.003 | 1.012 | 1.006 |
| Reloj de CPU de estado estacionario y bucle sostenido (MHz) | 4,274 | 4,178 | 4,669 | 4,690 |
El 658X obtuvo una puntuación de 12,322 en pruebas multinúcleo con la tarjeta Max-Q instalada, un 39% más que los 8,856 del 285K, y mantuvo los 12,328 durante la prueba de 30 minutos, un 1% más que en su primera pasada. En un solo núcleo, el orden se invierte: el 285K obtuvo 564.4 puntos frente a los 454.1 del Xeon, y se necesitan dos hilos en un núcleo Xeon, con una puntuación de 599.1, para superar la cifra de un solo hilo del 285K.
Al cambiar a la tarjeta de 600 W, la puntuación multinúcleo del Xeon bajó a 11,705 y su rendimiento en estado estable a 11,764, un 5 % menos, con una frecuencia de reloj en estado estable que pasó de 4,274 a 4,178 MHz. El Core T2 no mostró tal cambio, con 8,856 y 8,838. El conjunto de pruebas no registró las temperaturas de la CPU ni de la GPU en ninguna de las torres, por lo que no podemos afirmar si el procesador de 250 W pierde rendimiento debido al calor de la tarjeta de 600 W o a un presupuesto de energía compartido, solo que pierde entre un 4 y un 5 por ciento en todas las pruebas de todos los núcleos con la tarjeta de mayor potencia en el chasis.
7-Zip
La herramienta de evaluación comparativa integrada de 7-Zip informa el rendimiento de compresión y descompresión LZMA en gigainstrucciones por segundo, una vez en cada hilo y otra vez asignada a un solo núcleo. LZMA se basa en el rendimiento de enteros, la predicción de bifurcaciones y la latencia de la caché y la memoria, por lo que premia la cantidad de núcleos y una ruta de memoria rápida más que el ancho del vector.

| 7-Zip (GIPS, cuanto mayor sea el valor, mejor) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Todos los hilos | ||||
| Total | 289.6 | 288.9 | 174.8 | 175.7 |
| Comprimir | 276.4 | 273.5 | 151.5 | 151.9 |
| Descomprimir | 303.0 | 304.4 | 198.1 | 199.4 |
| Un hilo | ||||
| Total | 8.74 | 8.05 | 10.82 | 10.83 |
| Comprimir | 8.66 | 7.80 | 9.31 | 9.31 |
| Descomprimir | 8.83 | 8.30 | 12.33 | 12.34 |
En 48 hilos, el Xeon obtuvo 289.6 GIPS frente a los 174.8 del 285K en 24, una ventaja del 66 por ciento, con una compresión un 82 por ciento superior y una descompresión un 53 por ciento mayor. En un hilo, el 285K lideró con 10.82 GIPS frente a 8.74, y la diferencia se amplió con la tarjeta de 600 W en la torre Xeon, hasta 8.05, en consonancia con las frecuencias de reloj más bajas a las que funcionaba esa configuración.
Blender, HandBrake y LLVM
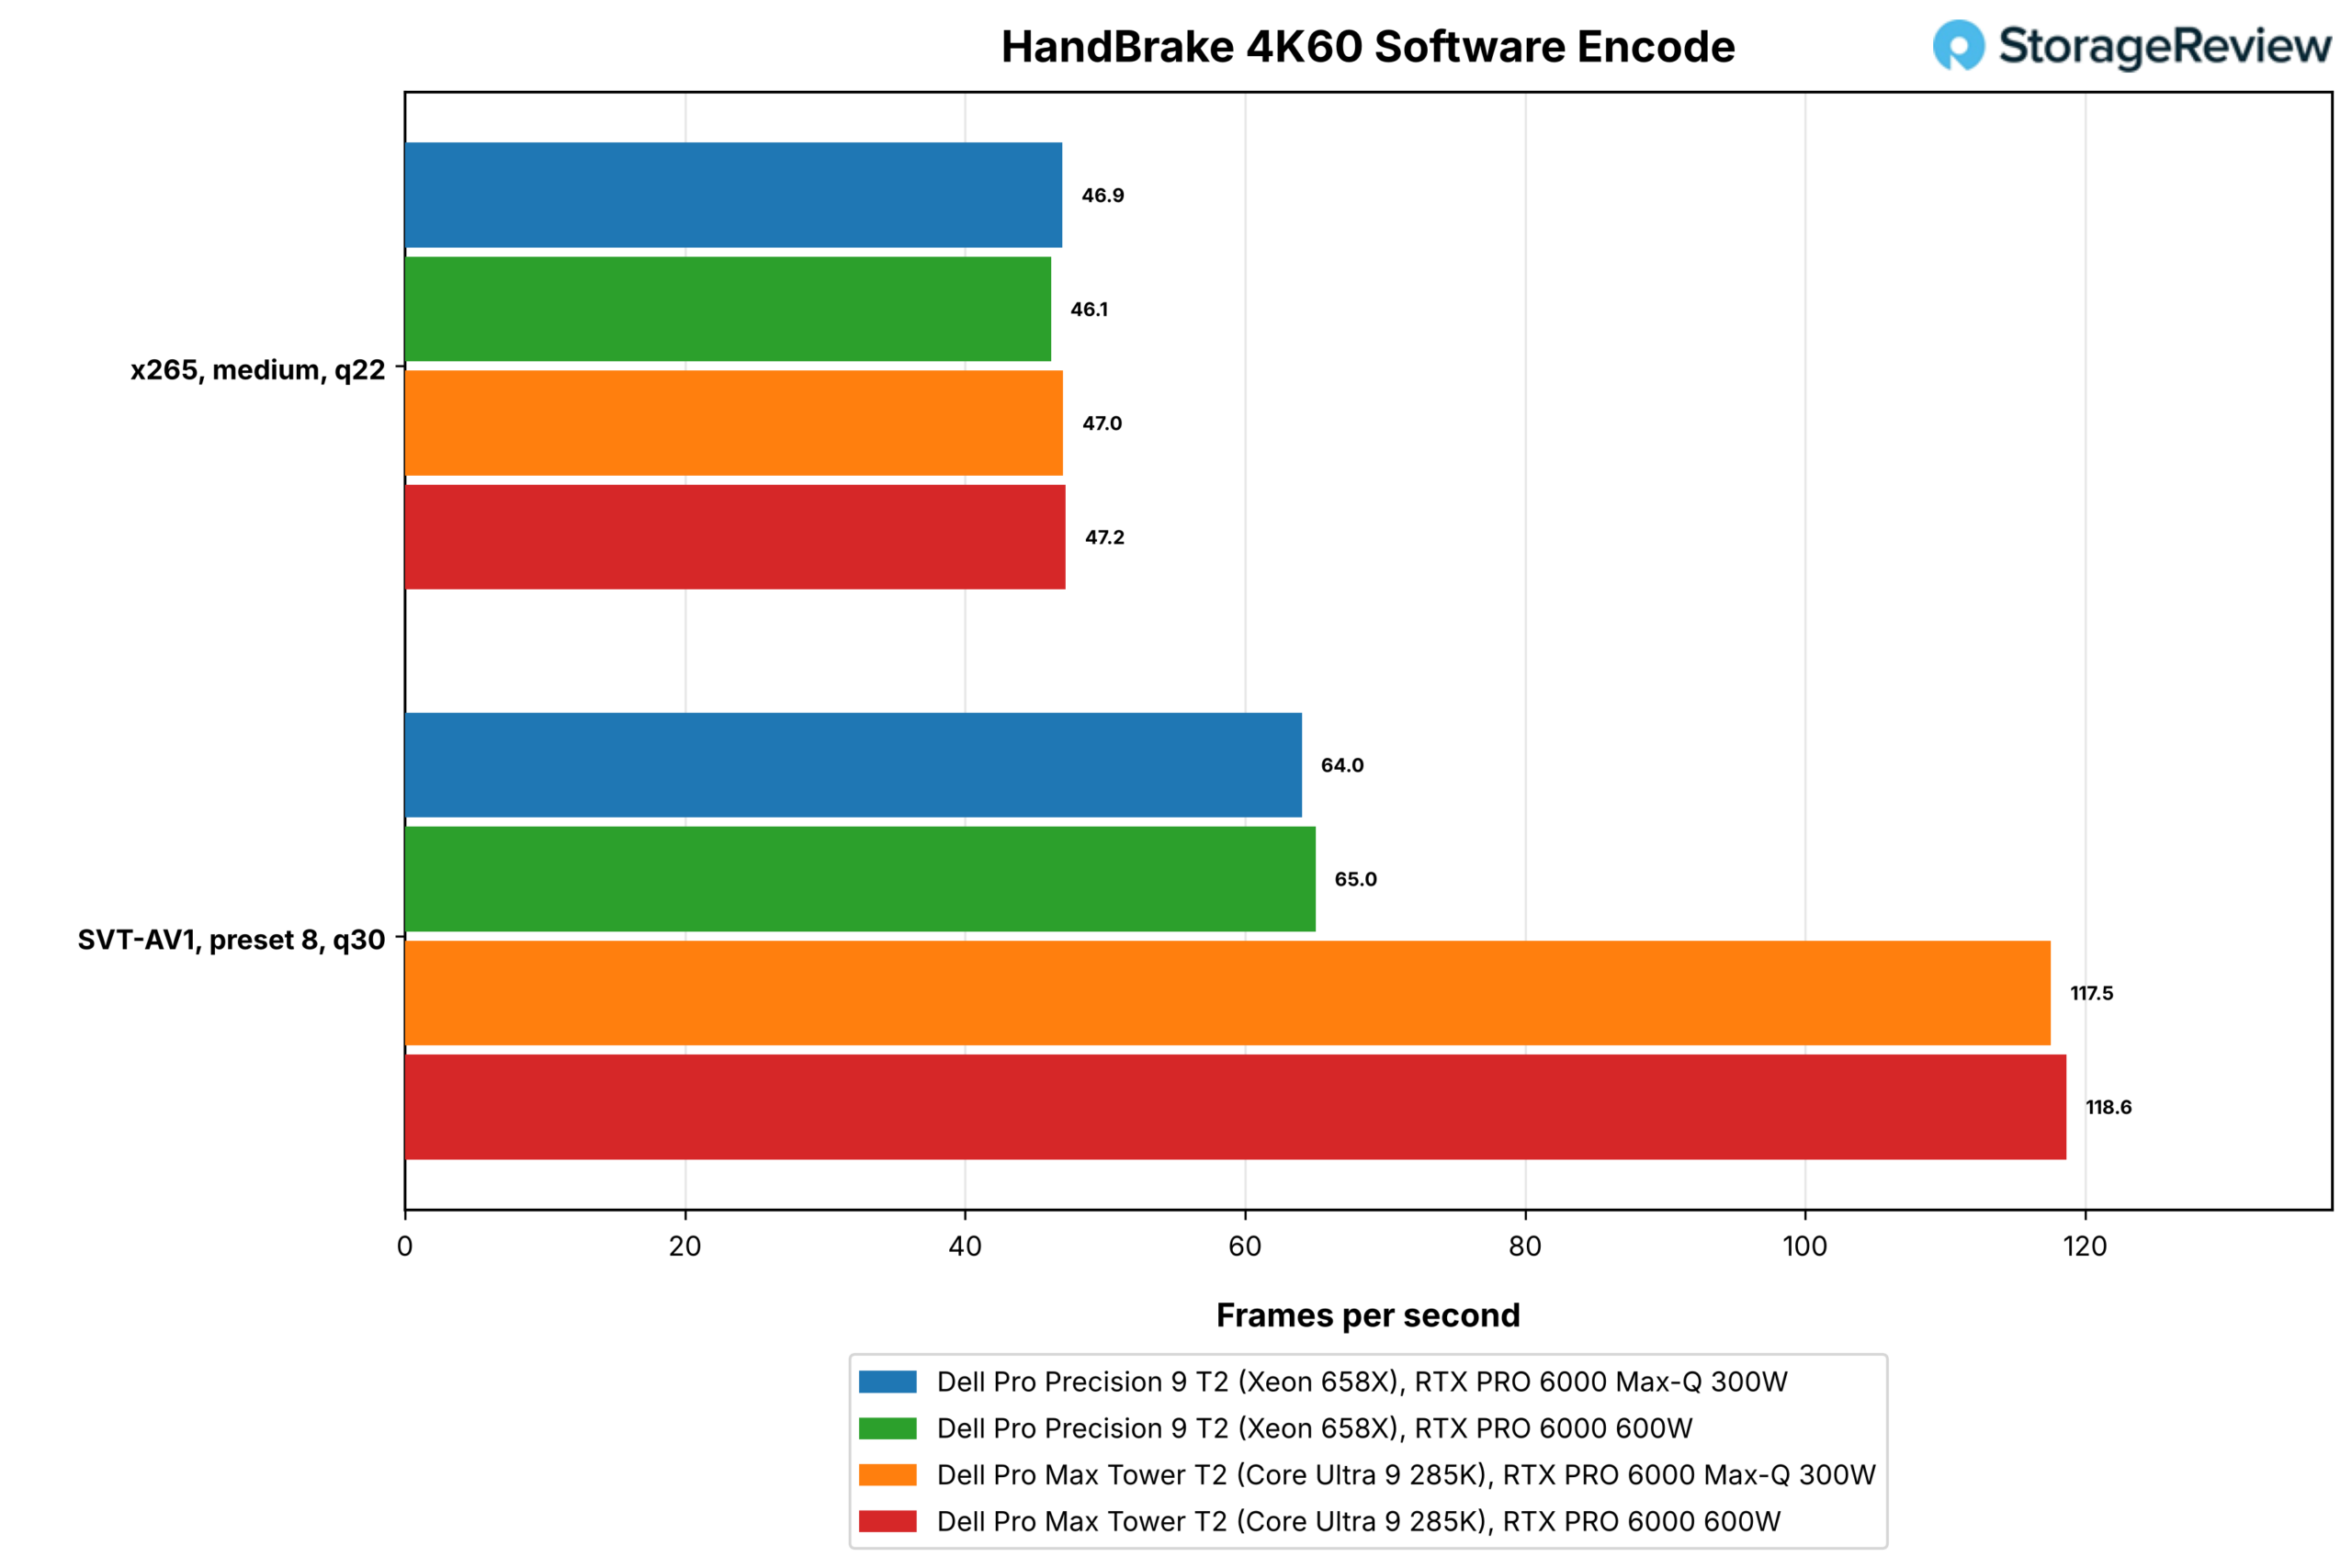
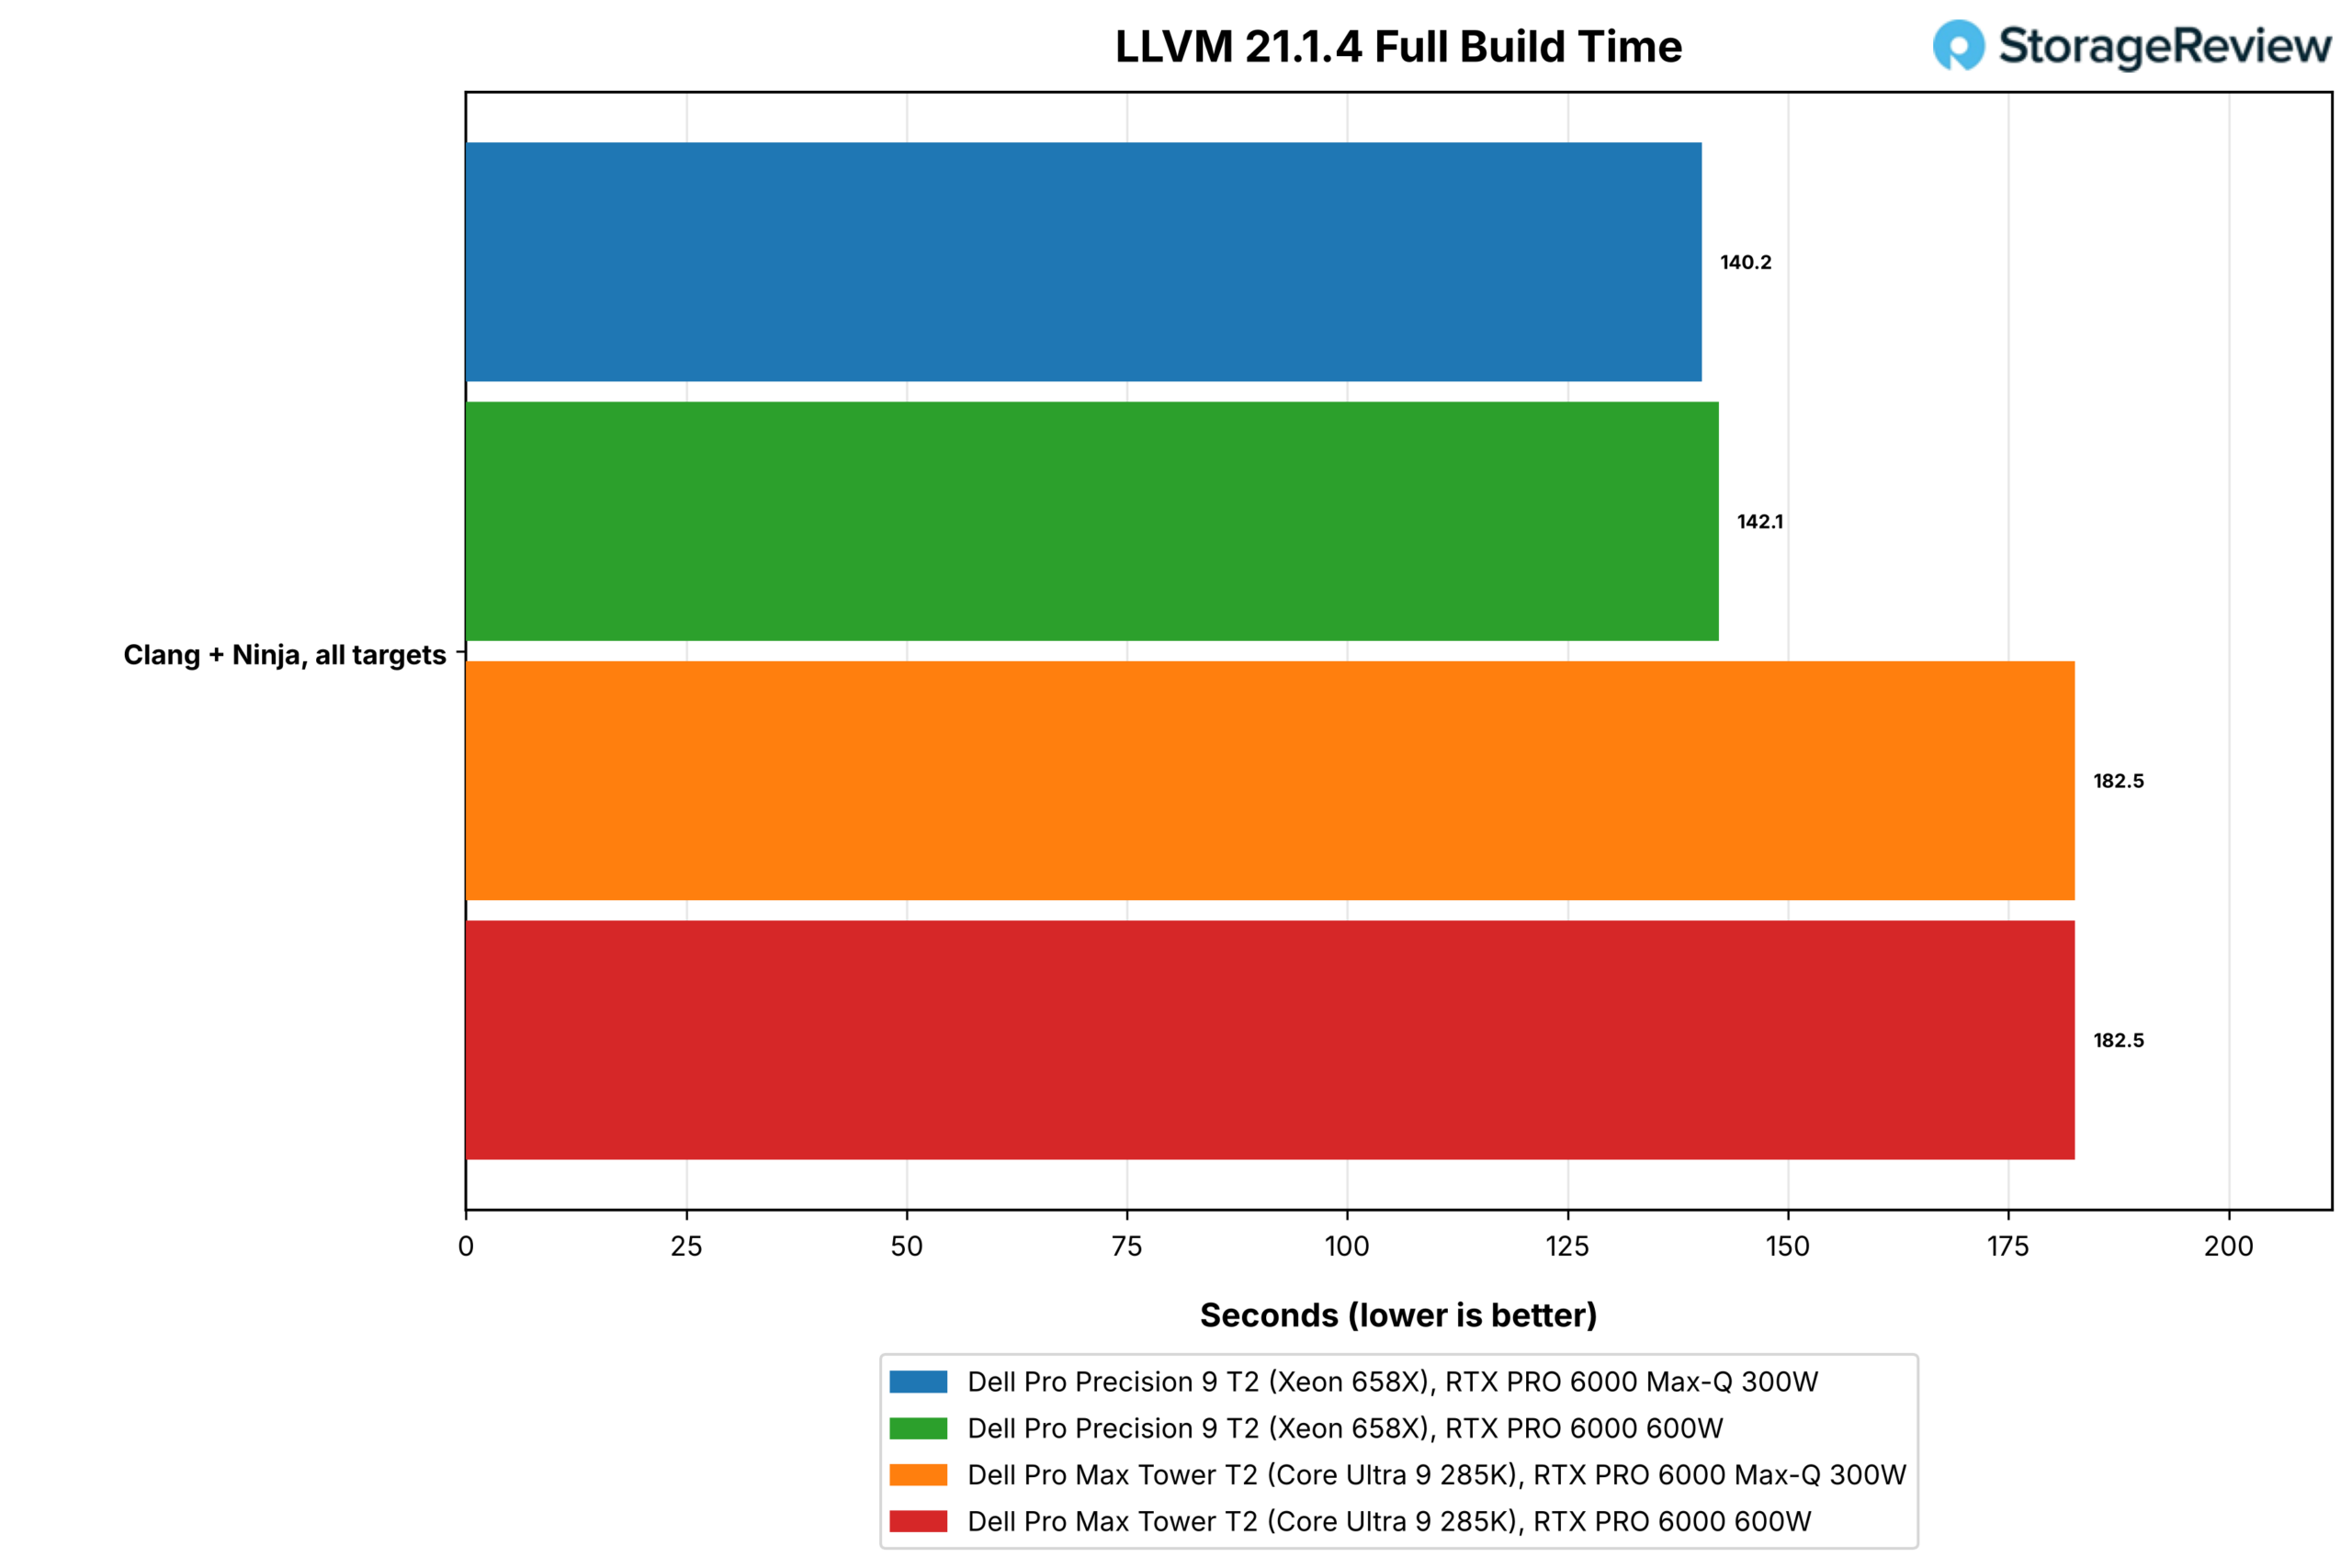
Blender 4.5 renderiza las escenas Monster, Junkshop y Classroom con Cycles en la CPU. HandBrake codifica 60 segundos de un clip 4K60 en software con x265 (HEVC, preajuste medio, calidad 22) y SVT-AV1 (preajuste 8, calidad 30). La prueba LLVM compila el árbol completo de LLVM 21.1.4 con Clang y Ninja, la carga de trabajo más larga que utiliza todos los núcleos en el conjunto de pruebas.

| Prueba | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Blender 4.5 Monster (muestras/min, cuanto mayor sea el valor, mejor) | 366.2 | 339.0 | 259.6 | 257.7 |
| Blender 4.5 Junkshop (muestras/min) | 238.1 | 228.0 | 166.2 | 166.8 |
| Blender 4.5 Classroom (muestras/min) | 187.2 | 169.2 | 132.5 | 132.3 |
| HandBrake x265, medio, q22 (fps, cuanto mayor sea el valor, mejor) | 46.9 | 46.1 | 47.0 | 47.2 |
| HandBrake SVT-AV1, preajuste 8, q30 (fps) | 64.0 | 65.0 | 117.5 | 118.6 |
| Compilación LLVM 21.1.4 (s, cuanto menor sea el número, mejor) | 140.2 | 142.1 | 182.5 | 182.5 |
El procesador Xeon renderizó Monster a 366.2 muestras por minuto frente a las 259.6 del 285K, una ventaja del 41% que se mantiene dentro de dos puntos en las tres escenas, y compiló LLVM en 140.2 segundos frente a los 182.5, un 23% menos de tiempo. Con la tarjeta de 600 W instalada, las puntuaciones de Blender del Xeon cayeron entre un 7% y un 10%, siendo esta la tarjeta más cara de toda la suite de CPU.
HandBrake se dividió según las líneas del codificador: x265 con el ajuste preestablecido medio funcionó a 46.9 fps en el Xeon y a 47.0 en el 285K, un empate, mientras que SVT-AV1 con el ajuste preestablecido 8 funcionó a 64.0 fps en el Xeon frente a 117.5 en el 285K.
Pasamos una tarde analizando esa brecha, y el resultado es por hilo. El codificador alcanza un nivel máximo de paralelismo de 6 con esta configuración y mantiene ocupados unos nueve procesadores lógicos en el Xeon; forzar sus kernels AVX2 en lugar de AVX-512 no cambió nada (63.8 frente a 63.9 fps), y limitarlo a un hilo por núcleo físico resultó en un 2 % más lento (62.6 fps), por lo que ni la ruta vectorial ni la planificación SMT son la causa. Lo que queda es el propio núcleo Xeon y la malla entre núcleos, que un codificador segmentado que espera traspasos entre etapas siente en cada fotograma.
Stockfish, Primesieve, Python y el navegador
Stockfish, con su herramienta de evaluación integrada, informa la velocidad de búsqueda de ajedrez en millones de nodos por segundo. primesieve cuenta los números primos menores de 10^12 en todos los hilos y menores de 10^11 en un solo hilo. PyPerformance ejecuta tres pruebas de rendimiento de CPython (go, nbody y regex_compile) asignadas a un núcleo rápido, y Speedometer 3.1 mide la capacidad de respuesta de las aplicaciones web en Microsoft Edge.
| Prueba | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Banco de pruebas Stockfish, todos los hilos (Mnps, cuanto mayor sea el valor, mejor) | 40.87 | 39.17 | 30.10 | 30.63 |
| Banco Stockfish, un hilo (Mnps, cuanto mayor sea el valor, mejor) | 1.65 | 1.60 | 1.99 | 1.99 |
| Primesieve 1e12, todos los hilos (s, cuanto menor sea el valor, mejor) | 7.69 | 7.51 | 6.77 | 6.84 |
| tamiz primo 1e11, un hilo (s, cuanto menor sea el valor, mejor) | 10.09 | 10.76 | 8.72 | 8.72 |
| PyPerformance go (ms, cuanto menor sea el valor, mejor) | 91.4 | 91.0 | 64.8 | 64.9 |
| PyPerformance nbody (ms, cuanto menor sea el valor, mejor) | 68.3 | 68.8 | 54.3 | 53.8 |
| PyPerformance regex_compile (ms, cuanto menor sea el valor, mejor) | 88.6 | 90.5 | 61.1 | 61.2 |
| Velocímetro 3.1, Edge (puntuación, cuanto mayor sea la puntuación, mejor) | 36.8 | 37.3 | 46.3 | 46.5 |
Stockfish en 48 hilos alcanzó 40.87 Mnps en el Xeon frente a 30.10 en el 285K, y en un hilo el 285K lideró con 1.99 frente a 1.65. primesieve es la única prueba de todos los hilos que gana el 285K, con 6.77 segundos frente a 7.69, ya que su sieve cabe en la caché y escala con el reloj tanto como con los núcleos. Las filas de un solo hilo van todas al 285K por un 13 a 31 por ciento: PyPerformance va en 64.8 ms frente a 91.4, regex_compile en 61.1 frente a 88.6, y Speedometer en 46.3 frente a 36.8.
Esa cifra de velocidad del navegador es la que percibe el comprador en su escritorio. Una puntuación de 36.8 en el Speedometer sigue siendo rápida en términos absolutos, pero está un 20% por debajo de la torre Core en el mismo chasis, y cualquiera que elija el Xeon por su rendimiento debe esperar que la parte interactiva de la máquina sea un poco más lenta que la de un ordenador de sobremesa Core Ultra.
GROMACS, OpenBLAS y memoria
GROMACS ejecuta el caso de dinámica molecular benchMEM en 16 núcleos en cuatro configuraciones de rango e hilo e informa nanosegundos de tiempo simulado por día para la mejor configuración. Nuestra prueba OpenBLAS ejecuta una resolución LU de doble precisión al estilo HPL en tres tamaños de problema y una multiplicación de matriz DGEMM en todos los núcleos, y en el 285K nuevamente solo en sus ocho núcleos P; los 24 núcleos del Xeon son una clase, por lo que esas filas no aplican. STREAM mide el ancho de banda de memoria sostenido, y las filas de latencia miden un solo acceso a la memoria y entre núcleos.

| Prueba (cuanto mayor, mejor) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| GROMACS benchMEM, mejor diseño (ns/día) | 47.39 | 47.91 | 37.30 | 37.07 |
| OpenBLAS LU N=10000, todos los núcleos (GFLOPS) | 570.3 | 517.3 | 519.7 | 523.1 |
| OpenBLAS LU N=20000, todos los núcleos (GFLOPS) | 1,208.6 | 1,100.6 | 633.2 | 631.8 |
| OpenBLAS LU N=40000, todos los núcleos (GFLOPS) | 1,659.2 | 1,613.7 | 667.9 | 669.5 |
| OpenBLAS LU N=20000, solo núcleos P (GFLOPS) | No aplica (una clase básica) | No aplica (una clase básica) | 515.2 | 517.7 |
| OpenBLAS DGEMM M=8000, todos los núcleos (GFLOPS) | 1,637.8 | 1,750.9 | 768.2 | 767.6 |
| OpenBLAS DGEMM M=8000, solo núcleos P (GFLOPS) | No aplica (una clase básica) | No aplica (una clase básica) | 565.3 | 566.5 |
Aquí es donde se combinan AVX-512, 144 MB de L3 y cuatro canales de DDR5-6400. DGEMM alcanzó 1,638 GFLOPS en el Xeon frente a 768 en el 285K, y la resolución N=40000 LU, que transmite 11.9 GB a través de la memoria, se ejecutó a 1,659 frente a 668 GFLOPS, 2.5 veces la torre Core. El resultado del 285K apenas cambia de N=20000 a N=40000 porque está limitado por el ancho de banda para entonces, mientras que el Xeon sigue escalando. GROMACS en 16 núcleos favoreció al Xeon en un 27 por ciento a 47.39 ns/día.

| Prueba | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Copia de STREAM (MB/s, cuanto mayor sea el valor, mejor) | 106,698 | 106,512 | 39,477 | 39,426 |
| Escala de transmisión (MB/s) | 105,368 | 105,180 | 39,788 | 39,801 |
| STREAM Agregar (MB/s) | 119,520 | 119,332 | 36,324 | 36,306 |
| Tríada de flujo (MB/s) | 122,233 | 122,135 | 33,003 | 33,014 |
| Latencia de memoria, búfer de 1 GiB, páginas de 4 KiB (ns, cuanto menor sea el valor, mejor). | 148.3 | 147.8 | 135.2 | 135.4 |
| Latencia entre núcleos, media de todos los pares (ns, cuanto menor sea el valor, mejor). | 56.2 | 56.0 | 38.1 | 38.2 |
| Latencia entre núcleos, par mínimo (ns) | 4.6 | 4.6 | 18.6 | 18.6 |
| Latencia máxima entre núcleos (ns) | 65.7 | 66.8 | 44.7 | 44.5 |
STREAM Triad funcionó a 122,233 MB/s en el Xeon T2 y 33,003 en el Core T2, 3.7 veces el ancho de banda, desde cuatro canales de DDR5-6400 RDIMM frente a cuatro de DDR5-4400 UDIMM en una plataforma que no puede seguir el ritmo de sus DIMM. El costo es la latencia: 148.3 ns a la memoria en el Xeon frente a 135.2 en el 285K, y 56.2 ns entre núcleos en promedio frente a 38.1. El mínimo de 4.6 ns del Xeon es un par de hermanos SMT en un núcleo, y su máximo de 65.7 ns es un viaje a través de la malla.
Sector del juego
SuperTuxKart 1.5 ejecuta su benchmark integrado a 1080p en pantalla completa con la configuración más alta y la sincronización vertical desactivada, y reportamos la tasa de fotogramas promedio y estable. A esta resolución, la GPU tiene margen de sobra, por lo que el resultado sigue al de la CPU, y la prueba representa a muchos visores profesionales que tienen la misma limitación. La fase NVENC de nuestra prueba de codificación no se completó en estos sistemas y se omite.

| SuperTuxKart 1.5, 1080p Ultra, vsync desactivado (fps, cuanto mayor sea el valor, mejor) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Normal | 304.6 | 323.2 | 359.1 | 383.5 |
| Typica | 304 | 322 | 354 | 376 |
| Estable | 161 | 174 | 122 | 135 |
El Core T2 obtuvo un promedio de 359.1 fps con la tarjeta Max-Q frente a los 304.6 del Xeon T2, lo que demuestra una vez más la diferencia en el rendimiento de un solo hilo. Por su parte, la torre Xeon mantuvo una tasa de fotogramas más estable, de 161 fps frente a los 122 de la otra, con menos caídas. La tarjeta de 600 W incrementó el promedio en aproximadamente un 6 % en ambas torres.
Relojes bajo carga
Ninguna de las torres reportó temperaturas de CPU o GPU a través de la ruta de sensores del conjunto, por lo que la tabla térmica que solemos publicar se reemplaza aquí con la frecuencia media de la CPU durante cada prueba, que es el valor que explica el efecto de la tarjeta de 600 W en el Xeon. Con el Max-Q instalado, el 658X mantuvo 4,269 MHz durante el bucle sostenido de 30 minutos y de 4,040 a 4,480 MHz en las pruebas más cortas de todos los núcleos. Con la tarjeta de 600 W en el chasis, la mayoría de esas pruebas se ejecutaron a frecuencias más bajas, hasta en 300 MHz, y todas obtuvieron puntuaciones más bajas.
| Frecuencia media de la CPU durante la prueba (MHz) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Cinebench 2026 | 4,477 | 4,470 | 4,789 | 4,786 |
| Bucle sostenido | 4,269 | 4,182 | 4,663 | 4,682 |
| 7-Zip | 4,414 | 4,307 | 4,854 | 4,837 |
| Pescado de seco | 4,291 | 3,995 | 4,749 | 4,741 |
| Batidora de vaso - Blender | 4,258 | 4,253 | 4,582 | 4,552 |
| HandBrake | 4,188 | 4,180 | 4,601 | 4,622 |
| Compilación LLVM | 4,202 | 4,258 | 4,582 | 4,585 |
| GROMACS | 4,288 | 4,290 | 4,664 | 4,694 |
| AbrirBLAS | 4,039 | 3,979 | 4,766 | 4,761 |
| STREAM | 4,321 | 4,326 | 4,687 | 4,676 |
| primer tamiz | 4,441 | 4,268 | 4,814 | 4,810 |
| Cliente MLPerf | 4,191 | 4,138 | 3,814 | 3,686 |
| Agente de codificación | 4,134 | 4,100 | 4,239 | 4,213 |
| LLM al servicio de | 4,261 | 4,169 | 4,229 | 4,209 |
| Generación de imagen | 4,044 | 4,008 | 3,702 | 3,837 |
| RAG | 4,178 | 4,197 | 4,172 | 4,108 |
| SuperTuxKart | 4,239 | 4,211 | 4,637 | 4,649 |
Stockfish bajó de 4,291 a 3,995 MHz, primesieve de 4,441 a 4,268, 7-Zip de 4,414 a 4,307 y el bucle sostenido de 4,269 a 4,182, mientras que el 285K funcionó dentro de un margen de 20 MHz en todas las pruebas de todos los núcleos, independientemente de la tarjeta.
La frecuencia media no lo explica todo. Cinebench y Blender promediaron dentro de 10 MHz de sus cifras Max-Q y aún perdieron entre un 5 y un 10 por ciento, lo que apunta a pequeñas excursiones que la media por prueba suaviza. El 658X consume hasta 250 W, la tarjeta de 600 W otros 600 W, y ambas expulsan el aire en el mismo volumen de 32 litros detrás de una entrada frontal; si el limitador es el margen térmico del procesador o un límite de potencia de la plataforma es una pregunta que responderemos en nuestra próxima pasada con registro externo de potencia y temperatura. Por ahora, los compradores que ejecutan tareas de CPU en todos los núcleos deben saber que la configuración Max-Q es la más rápida en el lado de la CPU.
Rendimiento de almacenamiento
Nuestra prueba de almacenamiento ejecuta las cuatro esquinas de fio contra la unidad de arranque con huellas de 5 GB y 25 GB, a través del sistema de archivos y nuevamente contra el dispositivo sin formato, y presenta aquí los resultados de 25 GB. En el Core T2, la unidad de arranque es una única SK hynix PCB01 de 2 TB en Gen5 x4; en el Pro Precision 9 T2 son las dos unidades E3.S Gen5 en FlexBay, distribuidas en un volumen RAID0 de 4,097 GB por VROC de Graid Technology. BitLocker estaba desactivado en las cuatro configuraciones, por lo que las filas del sistema de archivos miden NTFS y la capa RAID, no el cifrado.


| fio, huella de 25 GB, QD32 | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600 W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600 W |
|---|---|---|---|---|
| Lectura secuencial 128K, sistema de archivos (MB/s) | 9,332 | 9,255 | 11,377 | 11,406 |
| Lectura secuencial de 128K, dispositivo sin procesar (MB/s) | 10,782 | 10,675 | 11,186 | 11,444 |
| Escritura secuencial 128K (MB/s) | 6,507 | 6,496 | 7,401 | 7,371 |
| Lectura de precarga de 1 MB, QD32 (MB/s) | 4,617 | 4,679 | 6,440 | 6,346 |
| Lectura aleatoria de 4K, sistema de archivos, pico (IOPS) | 840,075 | 853,615 | 1,778,576 | 1,756,968 |
| Lectura aleatoria 4K, dispositivo sin procesar, pico (IOPS) | 1,107,862 | 1,120,737 | 2,297,681 | 2,294,800 |
| Escritura aleatoria 4K, pico (IOPS) | 557,512 | 550,505 | 957,461 | 921,774 |
| Lectura aleatoria sin procesar/del sistema de archivos | 1.32x | 1.31x | 1.29x | 1.31x |
| Lectura aleatoria de 4K, 4 trabajos, latencia p99 (µs, cuanto menor sea el valor, mejor). | 506 | 485 | 183 | 185 |
| Lectura aleatoria de 4K, 16 trabajos, latencia p99.99 (µs, cuanto menor sea el valor, mejor). | 15,270 | 23,462 | 676 | 676 |
| Escritura aleatoria de 4K, 4 trabajos, latencia p99 (µs, cuanto menor sea el valor, mejor). | 610 | 594 | 228 | 228 |
| Temperatura máxima del variador (°C) | No disponible (detrás de RAID) | No disponible (detrás de RAID) | 50 | 57 |
La franja no es más rápida que la unidad individual, y en bloques pequeños está muy por detrás. Las dos unidades E3.S leen 9,332 MB/s secuencialmente a través de NTFS y 10,782 del volumen sin procesar, frente a 11,377 y 11,186 para la PCB01, y escriben 6,507 MB/s frente a 7,401. En lecturas aleatorias de 4K, el volumen alcanzó un pico de 840.1K IOPS a través del sistema de archivos y 1.11M sin procesar, frente a 1.78M y 2.30M para la unidad individual, y escrituras aleatorias a 557.5K IOPS frente a 957.5K. La relación sin procesar a sistema de archivos es de aproximadamente 1.3x en ambos, por lo que NTFS cuesta lo mismo en cada uno; la diferencia es la capa VROC que se encuentra debajo de ambas rutas.
La latencia de cola es la siguiente: con 16 trabajos, el 0.01 por ciento más lento de lecturas aleatorias tardó 15.3 ms en el volumen frente a 0.68 ms en la unidad única, y la latencia de lectura p99 de 4 trabajos fue de 506 µs frente a 183. El RAID por software en dos dispositivos NVMe añade un salto de CPU a cada E/S, y las lecturas de CPU de fio lo muestran, en un 80 por ciento en las pasadas secuenciales frente a un 40 por ciento en el Core T2. El volumen también oculta los datos SMART de las unidades, por lo que el conjunto de pruebas no pudo registrar su temperatura.
Nada de esto convierte a FlexBay en una mala elección. Ofrece unidades T2 con acceso frontal y conexión en caliente en un formato que se adapta a capacidades que M.2 no puede alcanzar, y un volumen de arranque de 4 TB con dos unidades resulta muy práctico. Sin embargo, esto significa que un comprador cuya carga de trabajo consista en E/S aleatorias de bloques pequeños, una base de datos local o un directorio de modelos con mucha caché, debería considerar una sola unidad E3.S sin la configuración en franjas, o bien las ranuras M.2 internas, donde los resultados del Core T2 demuestran el rendimiento de una unidad Gen5 en este chasis.
Conclusión
La Dell Pro Precision 9 T2 es la Pro Max Tower T2 con un procesador de estación de trabajo, y los datos de las reseñas indican que es exactamente lo que los compradores pueden esperar. En el mismo chasis de 32 litros, el Xeon 658X ofrece un 39 % más de rendimiento multinúcleo en Cinebench, 3.7 veces más ancho de banda de memoria, el doble de velocidad DGEMM y un procesador de 24 núcleos y 48 hilos con AVX-512, AMX, memoria ECC registrada y una ruta de hasta 1 TB. Ofrece entre un 13 % y un 31 % menos de rendimiento en tareas de un solo hilo, desde primesieve hasta Python, algo que los usuarios que pasan el día frente a una ventana gráfica o una terminal notarán.
La decisión sobre la GPU es el objetivo principal de este análisis. Las tarjetas Max-Q y RTX PRO 6000 de 600 W comparten 96 GB de memoria y decodifican con una diferencia de entre el 7 y el 20 por ciento. La tarjeta de 600 W destaca por su procesamiento rápido, donde el tiempo para obtener el primer token se reduce en un tercio o más, y por su difusión, donde las imágenes llegan entre un 20 y un 34 por ciento más rápido.
En la torre Xeon, la tarjeta de 600 W también reduce el rendimiento del procesador entre un 4 y un 5 % en tareas que utilizan todos los núcleos y requiere la ranura contigua, lo que en nuestra unidad implicó retirar el adaptador de 25 GbE. Para una torre cuyo propietario ejecuta renderizados y simulaciones de CPU, así como modelos locales, la tarjeta Max-Q que incluye Dell es la opción más equilibrada; para una que proporciona modelos a un equipo o renderiza imágenes durante todo el día, la tarjeta de 600 W justifica el espacio que ocupa y la fuente de alimentación de 1500 W.
El E3.S en la bahía FlexBay es el formato que llevábamos años deseando en una torre; VROC de Graid Technology es una combinación fiable para la configuración RAID. Es más lento en operaciones de E/S aleatorias pequeñas que la unidad M.2 individual del Core T2, aproximadamente la mitad en lecturas y escrituras de 4K, y un comprador que no necesite un volumen de arranque RAID podría considerar una unidad E3.S o las ranuras M.2 internas.
Por otro lado, con las unidades SSD E3.S superando ahora los 60 TB, los usuarios con casos de uso de datos extremos tienen acceso a un mundo completamente nuevo que antes habría implicado el uso de carcasas externas o la instalación de un volumen de almacenamiento compartido, con el precio de la memoria flash como límite práctico.
Con un precio aproximado de 28,300 dólares en Dell.com, antes de los descuentos por volumen que ven la mayoría de los compradores empresariales, la Pro Precision 9 T2 cuesta unos 4,500 dólares más que una Pro Max Tower T2 configurada de la misma manera hoy: un procesador de 285 KB, 128 GB de memoria DDR5-4400 ECC, la tarjeta gráfica RTX PRO 6000, una unidad Gen5 de 2 TB y una fuente de alimentación de 1500 W suman aproximadamente 23,800 dólares, con las opciones de GPU y memoria de ambas torres con una diferencia de tan solo 900 dólares. La segunda unidad FlexBay supone una diferencia de 1,700 dólares, y el resto corresponde a la plataforma Xeon.
Lo que se obtiene es una torre de un solo socket que se comporta como un pequeño servidor bajo carga de todos los núcleos, con el mismo tamaño que un ordenador de sobremesa, y ese es el motivo del regreso del nombre Precision.
Clasificación: La Dell Pro Precision 9 T2 ostenta el título de Mejor Estación de Trabajo de Escritorio en General en nuestra clasificación de Mejores Estaciones de Trabajo de Escritorio , y sus resultados con la RTX PRO 6000 también aparecen en nuestra tabla de Mejores GPU Empresariales.



 Amazon