

El Proyecto Battlematrix de Intel representa una atractiva propuesta para la infraestructura de IA accesible, que aporta una considerable capacidad de memoria de GPU a los chasis de las estaciones de trabajo mediante un diseño multi-GPU. Desarrollada en torno a la GPU profesional Battlemage Arc Pro B60, esta plataforma está dirigida a organizaciones que buscan implementar grandes modelos de lenguaje localmente sin costes de suscripción a la nube ni preocupaciones por la privacidad de los datos. Con hasta 192 GB de VRAM distribuidos en ocho GPU en un solo sistema, Battlematrix se posiciona como una alternativa relativamente rentable a otros ecosistemas de GPU profesionales para cargas de trabajo de inferencia de IA.
Ver esta publicación en Instagram
Lo que distingue a Battlematrix de las configuraciones tradicionales de estaciones de trabajo es el diseño de doble GPU de Intel, que integra dos GPU B60 completas en una sola placa de circuito impreso (PCB) que requiere compatibilidad con la bifurcación PCIe. Este enfoque optimizado para la densidad permite configuraciones que, de otro modo, requerirían placas base para servidores, mientras que los 24 GB de GDDR6 por GPU de la Arc Pro B60 la hacen especialmente adecuada para modelos de transformador con uso intensivo de memoria. Las primeras pruebas revelan un potencial prometedor, aunque la optimización del software aún está por debajo de las capacidades del hardware.
Divulgación
Las pruebas se realizaron con las primeras revisiones de software y controladores, incluyendo las ramas de desarrollo de Intel LLM Scaler. Además, nuestra plataforma de prueba utiliza procesadores AMD EPYC en lugar de la plataforma Xeon de Intel. Intel posiciona Battlematrix como una solución completamente Intel con procesadores Xeon 6, y los sistemas de producción con CPU Intel podrían mostrar un rendimiento superior al que sugieren nuestros resultados. Los lectores deben considerar estos resultados preliminares, teniendo en cuenta que la madurez del software y la optimización de la plataforma deberían mejorar a lo largo de 2026.
Especificaciones y arquitectura
| Especificación | Detail |
|---|---|
| Colección de productos | Gráficos Intel® Arc™ Pro serie B |
| Nombre clave | Mago de batalla |
| Arquitectura GPU | Xe2 (TSMC N5) |
| Xe-colores | 20 |
| Procesar rebanadas | 5 |
| Unidades de trazado de rayos | 20 |
| Motores XMX | 160 |
| Motores vectoriales Xe | 160 |
| Reloj gráfico | 2400 MHz |
| Reloj gráfico (modo LP) | 2000 MHz |
| Rendimiento de GPU FP32 | 12.28 TFLOPS |
| Rendimiento máximo de la GPU (INT8) | 197 |
| Potencia total de la placa (TBP) | 200 W |
| Salud Cerebral | 24 GB GDDR6 |
| interfaz de memoria | 192 bits |
| ancho de banda de memoria | 456 GB / s |
| velocidad de la memoria | 19 Gbps |
| Interfaz PCIe | PCIe 5.0 x8 |
| Pantallas compatibles | 4 |
| Salida de gráficos | HDMI 2.1 | DP2.1 (UHBR 13.5) | DP2.1 (UHBR 10) |
| Resolución máxima (HDMI) | 7680 x 4320 @ 120Hz |
| Resolución máxima (DP) | 7680 x 4320 @ 60Hz |
| Frecuencia de actualización variable HDMI | Sí: |
| Sincronización adaptativa VESA | Sí: |
| Codificación/decodificación H.264 / H.265 / AV1 | Sí: |
| Soporte de trazado de rayos | Sí: |
| Soporte de una API | Sí: |
| Soporte OpenVINO | Sí: |
| Compatibilidad con Intel IPEX | Sí: |
| Compatibilidad con Intel XeSS | Sí: |
El Intel Arc Pro B60 comparte su base de silicio con el sector centrado en los juegos Intel Arco B580Ambos utilizan la misma matriz, fabricada con el proceso de 5 nm de TSMC. Este chip de 272 mm² contiene 19.6 millones de transistores e integra 20 núcleos Xe2, que se anuncian para ofrecer 12.28 TFLOPS de computación FP32 y 197 TOPS de rendimiento de IA INT8 por GPU. La diferencia clave reside en la configuración de la memoria: mientras que el B580 se entrega con 12 GB de GDDR6, el B60 duplica su capacidad hasta los 24 GB.
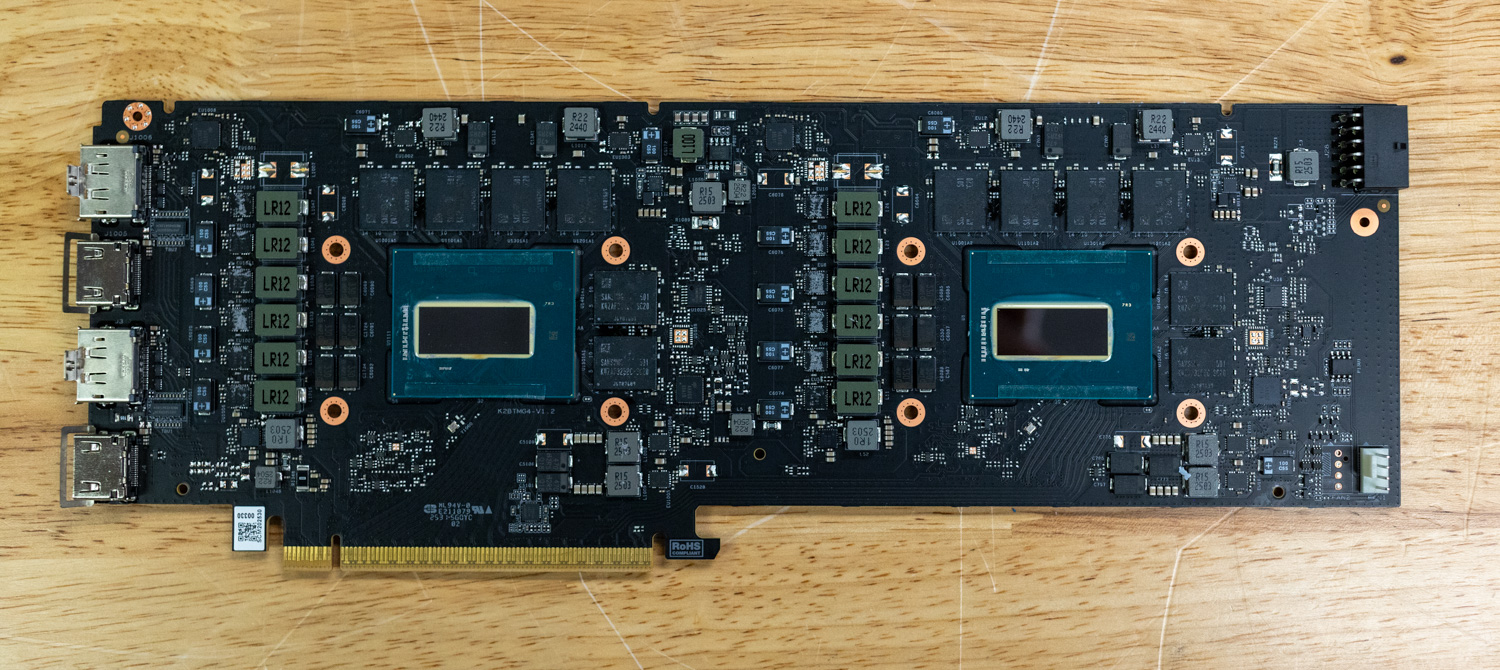
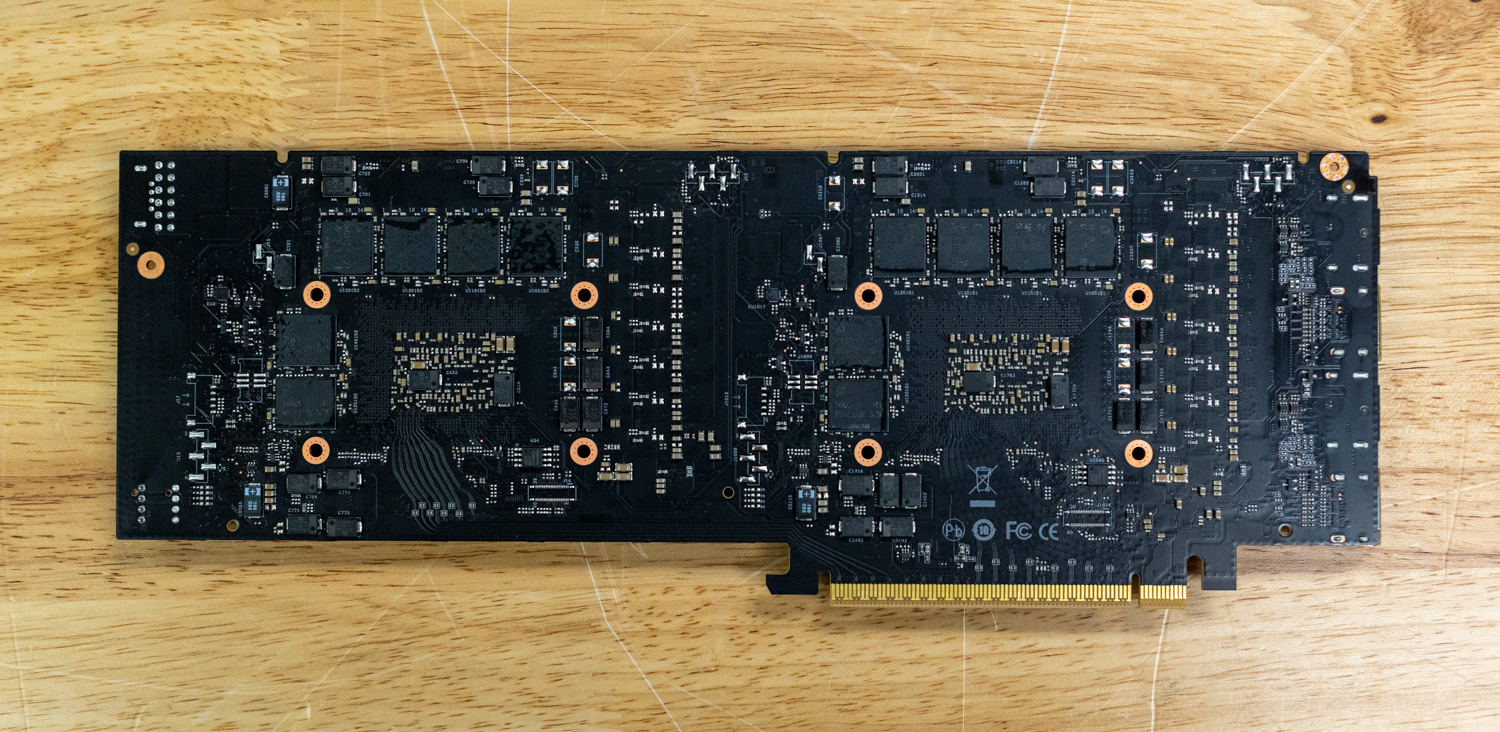
Cada GPU B60 opera a 2,400 MHz en una interfaz de memoria de 192 bits, lo que proporciona 456 GB/s de ancho de banda por GPU. La arquitectura cuenta con 160 motores de IA XMX (Xe Matrix Extensions) por GPU, diseñados específicamente para acelerar las operaciones matriciales en la inferencia de IA.
Diseño de GPU dual y bifurcación PCIe
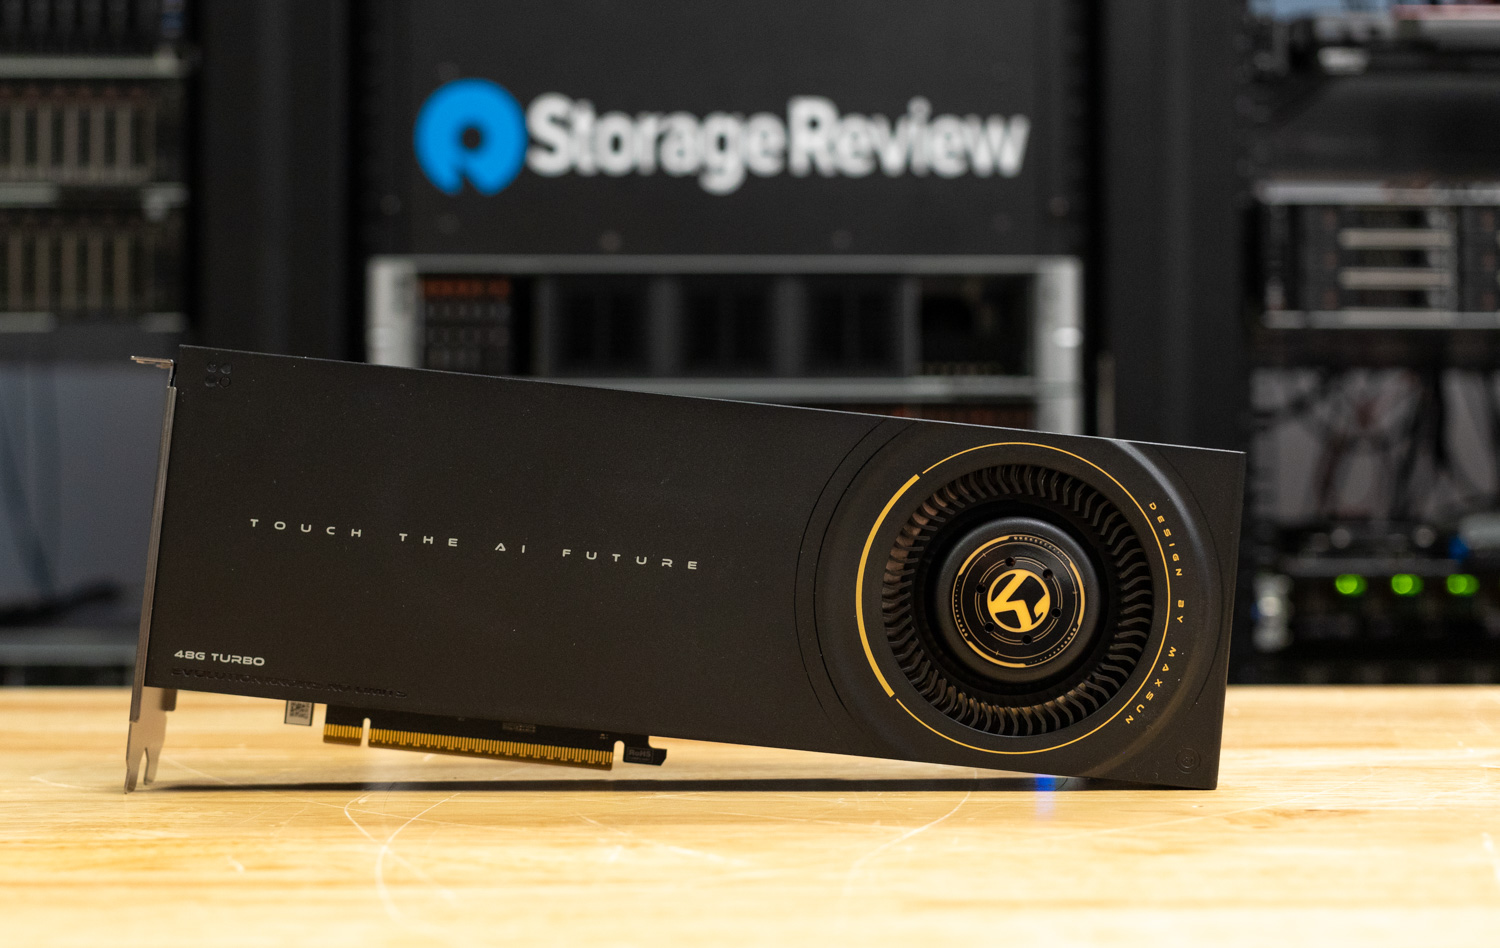
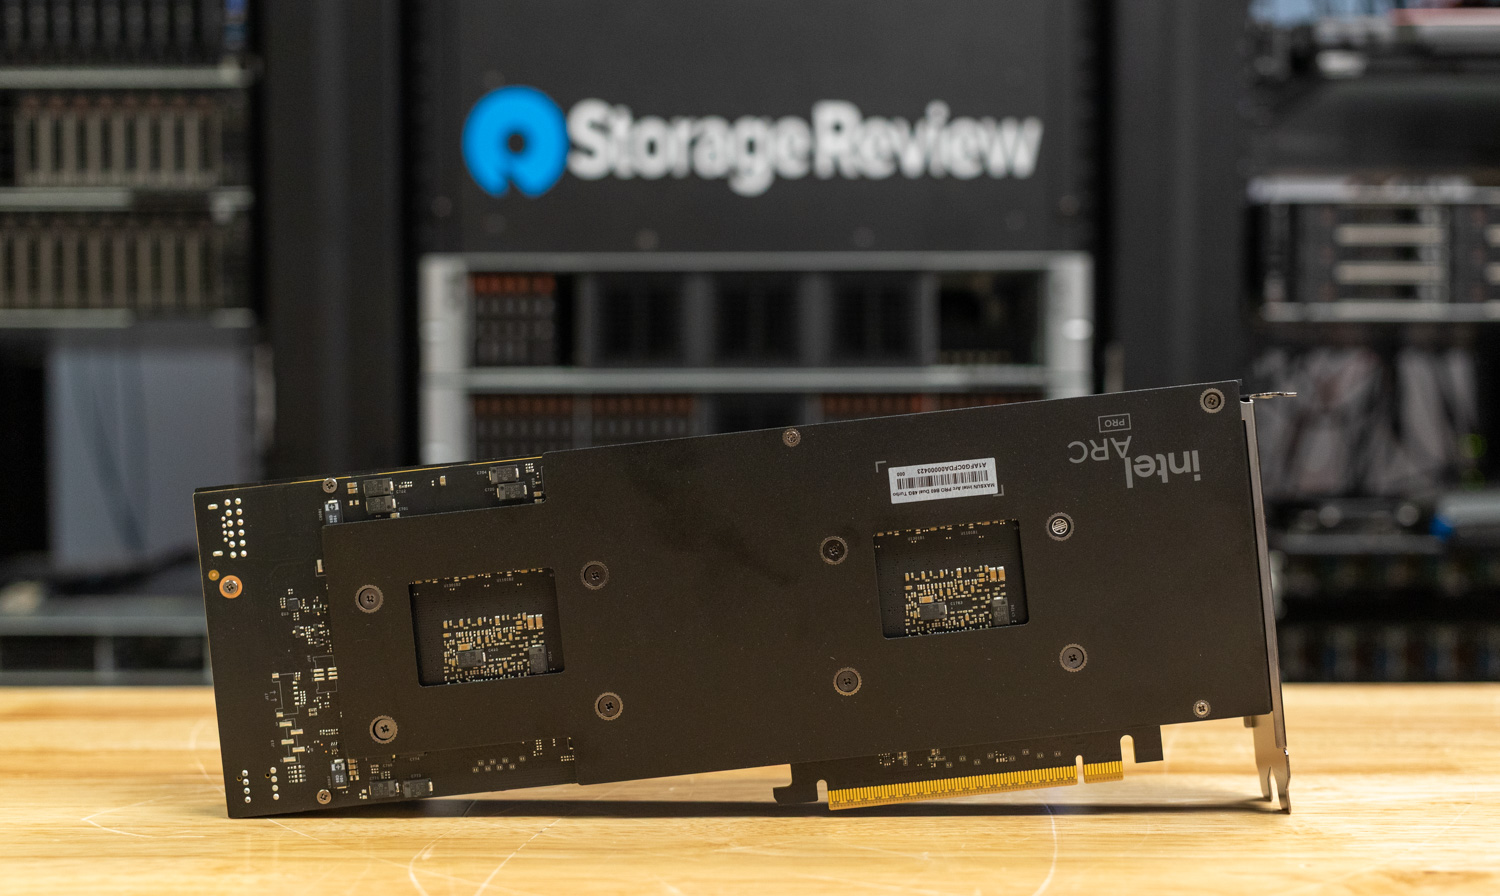
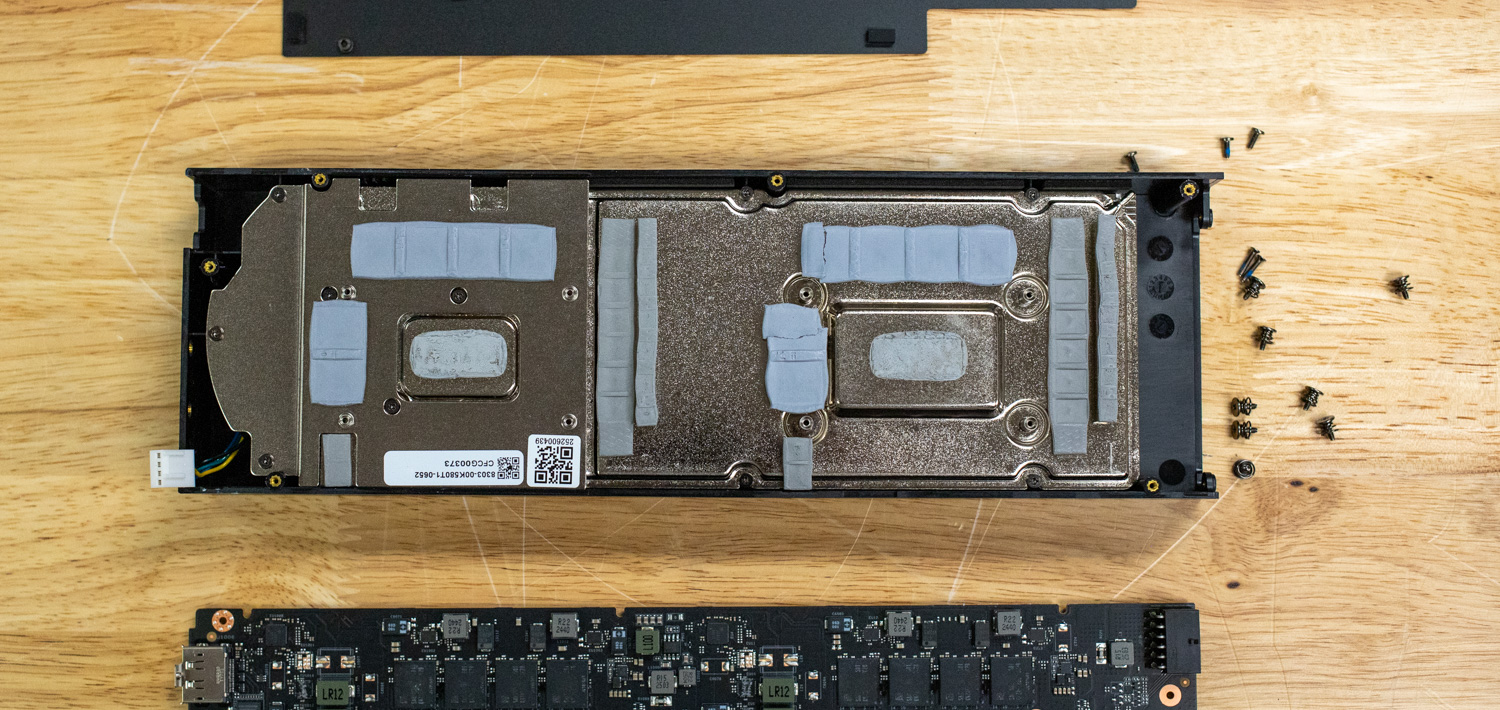
La Maxsun Arc Pro B60 Dual 48G Turbo ejemplifica la estrategia de densidad de Intel: dos GPU completas montadas en una sola tarjeta de doble ranura, conectadas de forma independiente mediante interfaces PCIe 5.0 x8. A diferencia de los diseños tradicionales de doble GPU que combinan chips para funcionar como una sola GPU, cada GPU B60 se presenta como un dispositivo discreto al sistema, lo que requiere compatibilidad de la placa base con la bifurcación PCIe x8/x8. Una única ranura x16 se divide eléctricamente en dos conexiones x8, con cada GPU recibiendo un ancho de banda dedicado.
La interfaz PCIe 5.0 x8 ofrece un ancho de banda bidireccional de 128 GB/s por GPU, igualando a la PCIe 4.0 x16. La configuración de doble tarjeta mide 300 mm de longitud, ocupa dos ranuras con refrigeración tipo turbina y consume una potencia total de 400 W a través de un único conector de 12 V-2×6 con una potencia nominal de 600 W.
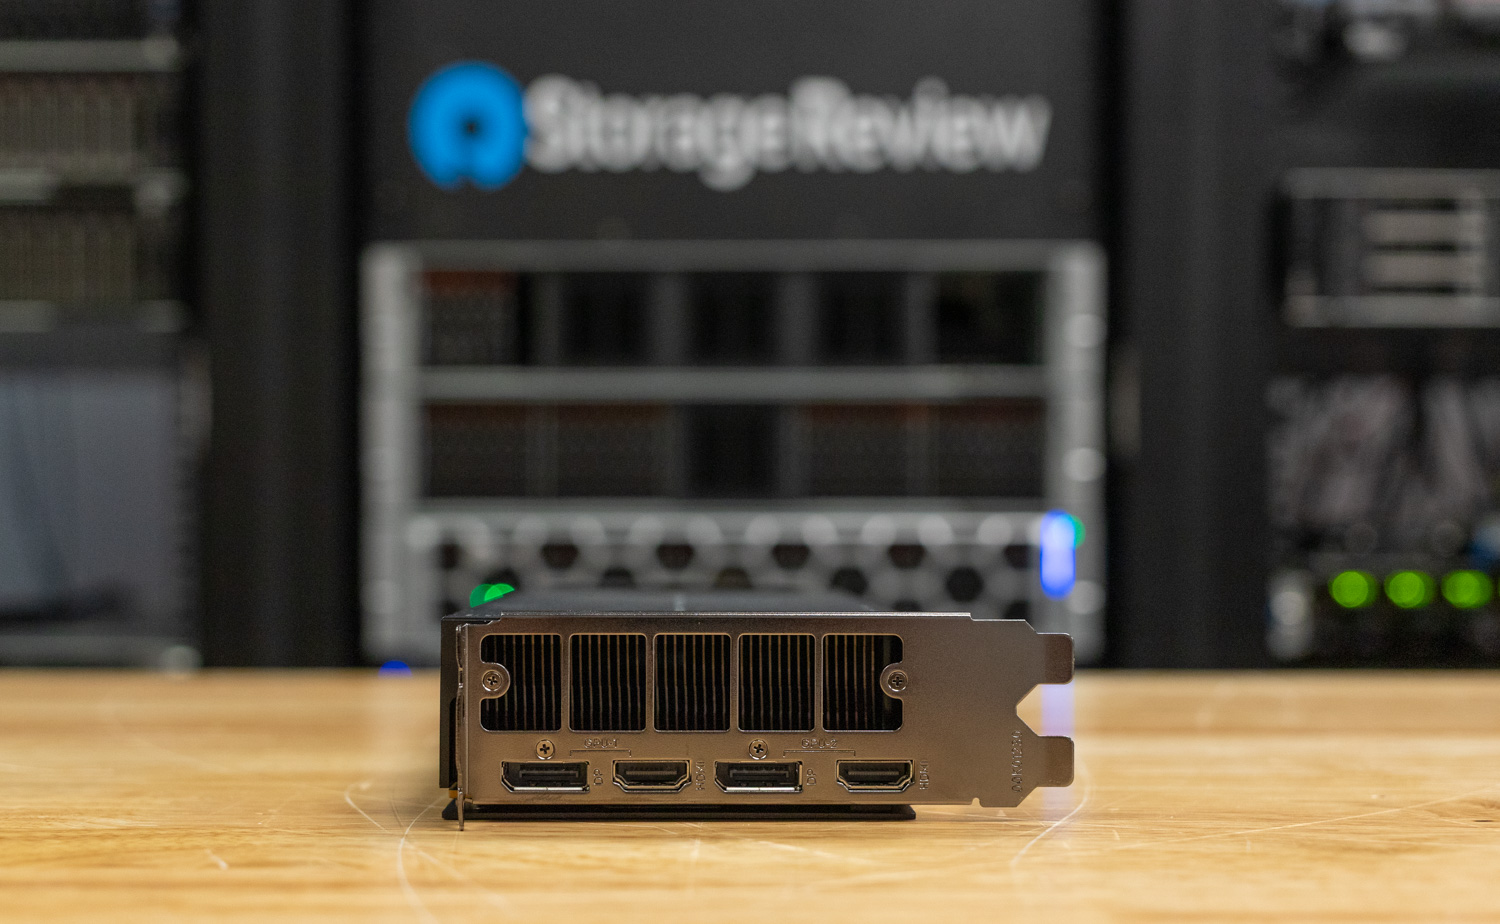
Cada tarjeta dual proporciona cuatro salidas de pantalla: dos puertos DisplayPort 2.1 UHBR20 y dos puertos HDMI 2.1a, uno por GPU, lo que permite configuraciones de salida de vídeo discreta para entornos de escritorio virtualizados o sistemas multiusuario. Es importante destacar que solo se puede usar una de las dos salidas de pantalla a la vez para cada GPU.
Ver esta publicación en Instagram
Configuración de Battlematrix de ocho GPU
La especificación de referencia Battlematrix de Intel admite hasta ocho GPU Arc Pro B60 en un chasis de estación de trabajo, lo que se logra mediante el uso de cuatro tarjetas de doble GPU. Esta configuración ofrece:
- 192 GB de VRAM total del sistema (8 × 24 GB)
- 1,280 motores de IA XMX
- 1,576 INT8 TOPS cálculo agregado
- 3.6 TB / s ancho de banda de memoria combinado
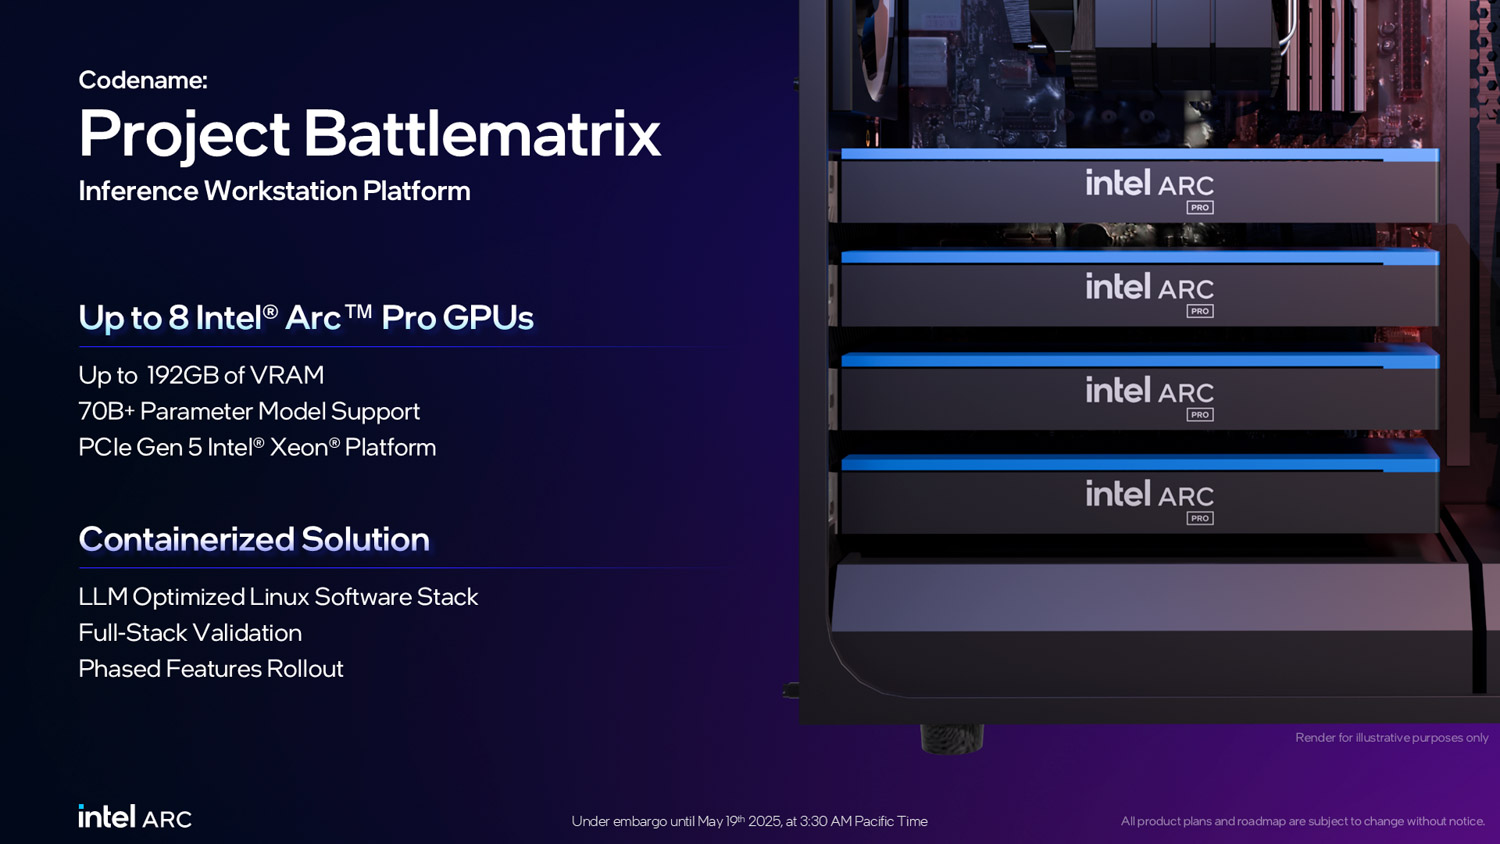
La plataforma requiere placas base con cuatro ranuras PCIe 5.0 x16 que admitan bifurcación, y la especificación Battlematrix también incluirá un procesador Xeon 6; sin embargo, actualmente no hay disponible otra información sobre la configuración de Battlematrix.
Casos de uso y propuesta de valor
Público objetivo
El Proyecto Battlematrix de Intel se dirige a tres segmentos de mercado: equipos de desarrollo de IA que requieren infraestructura local, organizaciones de ingeniería de software que implementan flujos de trabajo asistidos por IA con bases de código sensibles, y organizaciones que buscan alternativas rentables a los servicios de inferencia en la nube. La propuesta de valor principal de la plataforma se centra en la soberanía de los datos y las ventajas del coste total de propiedad (TCO) frente a las suscripciones multianuales a la nube.
Desarrollo de agentes e inteligencia artificial privada
La principal fortaleza de la plataforma Battlematrix radica en soportar flujos de trabajo de desarrollo para modelos de lenguaje grandes que requieren ventanas de contexto extensas y cantidades sustanciales de parámetros.
Los equipos de desarrollo que crean sistemas agentísticos se benefician especialmente del margen de memoria disponible. Las implementaciones de agentes RAG suelen mantener varios componentes simultáneamente en la memoria de la GPU: el modelo de lenguaje base, los modelos de incrustación para la búsqueda vectorial y los modelos de reordenamiento. Además, los flujos de trabajo agentísticos realizan razonamiento en varios pasos, uso de herramientas y autocorrección, generando importantes ventanas de contexto mediante la iteración. Un agente de codificación que analiza una gran base de código puede acumular más de 100 000 tokens a lo largo de su ciclo de vida operativo.
VDI del futuro y juegos virtualizados
La hoja de ruta de Intel incluye la compatibilidad con SR-IOV (virtualización de E/S de raíz única) en las GPU Arc Pro B60, lo que transforma el hardware en una plataforma gráfica multiusuario. SR-IOV permite subdividir una GPU física en varias GPU virtuales, cada una de las cuales puede asignarse a máquinas virtuales independientes con acceso directo al hardware y espacios de memoria aislados.
Esta capacidad permite escenarios de Infraestructura de Escritorio Virtual (VDI) sin licencia, en los que un único sistema Battlematrix de ocho GPU admite decenas de usuarios simultáneos con aceleración de GPU dedicada para aplicaciones CAD, edición de vídeo o juegos de nivel moderado. Las soluciones VDI tradicionales requieren costosas licencias, además de hardware, que a menudo requieren GPU profesionales o para centros de datos más costosas. El compromiso de Intel con la virtualización sin licencia elimina este gasto operativo.
Precio y propuesta de valor
Intel anunció que el Arc Pro B60 tendrá un precio aproximado de $600 por GPU. Para las pruebas iniciales y el desarrollo, las configuraciones de una o dos tarjetas (de $600 a $1,200) ofrecen puntos de entrada accesibles. Una sola tarjeta de dos GPU con 48 GB de VRAM ofrece capacidad suficiente para modelos cuantizados y cubre una parte sustancial de las aplicaciones LLM de código abierto más populares.
La configuración Maxsun Dual Arc Pro B60 Dual 48G Turbo que probamos cuesta $1,200 directamente de Maxsun, según el anuncio original de Intel. Sin embargo, las recientes fluctuaciones en los precios de la memoria podrían afectar este precio.
Valor excepcional a precios de entrada
Las configuraciones de una o dos tarjetas ofrecen una excelente relación calidad-precio para equipos pequeños, desarrolladores individuales y aficionados al bricolaje. Con un precio de $600 por 24 GB de memoria GPU y $1,200 por 48 GB, esta plataforma supera considerablemente a las alternativas profesionales con GPU, que suelen costar al menos el doble.
Esta propuesta de valor resuena particularmente para las organizaciones que exploran la integración de IA sin comprometer los presupuestos empresariales.
Rendimiento de referencia del servicio en línea de vLLM
vLLM es el motor de inferencia y servicio de alto rendimiento más popular para servidores LLM. El benchmark de servicio en línea de vLLM es una herramienta de evaluación del rendimiento que mide el rendimiento real del servicio bajo solicitudes concurrentes. Simula cargas de trabajo de producción enviando solicitudes a un servidor vLLM en ejecución con parámetros configurables como la tasa de solicitudes, la longitud de entrada/salida y el número de clientes concurrentes. El benchmark mide métricas clave, como el rendimiento (tokens por segundo), el tiempo hasta el primer token (TTFT) y el tiempo por token de salida (TPOT), lo que ayuda a los usuarios a comprender el rendimiento de vLLM en diferentes condiciones de carga.
Plataforma de prueba:
- Servidor: Supermicro AS-4125GS-TNRT
- procesadores: AMD EPYC 9374F
- Memoria: 512 GB Samsung 4800 MT/s DDR5
- GPU: 4x Maxsun MS-Intel ARC Pro B60 Dual 48G Turbo
Compatibilidad y limitaciones de la cuantificación
Estas GPU deberían destacar en la inferencia de baja precisión dirigida a la cuantificación INT4 para un rendimiento óptimo. Sin embargo, debido a la versión de desarrollo muy temprana del LLM Scaler de Intel que estábamos probando, solo los modelos GPT OSS entrenados inicialmente con el formato de microescalado MXFP4 funcionaron correctamente. Otros formatos de cuantificación, como INT4 estándar, FP8 y AWQ, no se iniciaron correctamente. Esta limitación limitó significativamente nuestra capacidad para probar exhaustivamente estas GPU, aunque esperamos una mayor compatibilidad con la cuantificación a medida que la pila de software madure.
Probamos la mayoría de los modelos con dos configuraciones: la configuración Battlematrix completa de ocho GPU y la cantidad mínima de GPU necesarias para que el modelo se adapte a la memoria. Esta comparación revela características de escalado interesantes, especialmente en lo que respecta a la sobrecarga de comunicación con tamaños de lote más pequeños.
Tipos de datos de microescalamiento
El microescalado representa un enfoque de cuantificación avanzado que aplica factores de escala de grano fino a pequeños bloques de ponderaciones, en lugar de una cuantificación uniforme en grandes grupos de parámetros. El formato MXFP4 implementa esta técnica mediante una representación en coma flotante bloqueada, donde cada bloque de microescala comparte un exponente común como factor de escala, lo que preserva la precisión numérica y logra una precisión de 4 bits. Una ventaja clave del tipo de datos MXFP4 es que la cuantificación de modelos a INT4 no degrada significativamente la calidad de la respuesta, a diferencia de la cuantificación desde formatos de mayor precisión como BF16. Los modelos GPT OSS se ejecutan con cuantificación INT4 en los B60, ya que no son compatibles de forma nativa con MXFP4.
OpenAI GPT-OSS 20B
El modelo de parámetros 20B demuestra claramente el fenómeno de la sobrecarga de comunicación. Con un tamaño de lote de 1, una sola GPU proporciona 49.22 tok/s por usuario, en comparación con tan solo 22.83 tok/s cuando se distribuye entre las ocho GPU. La configuración de una sola GPU ofrece un rendimiento superior al doble. Sin embargo, la configuración de ocho GPU destaca en mayor concurrencia, alcanzando un rendimiento total de 511.99 tok/s con un tamaño de lote de 16.
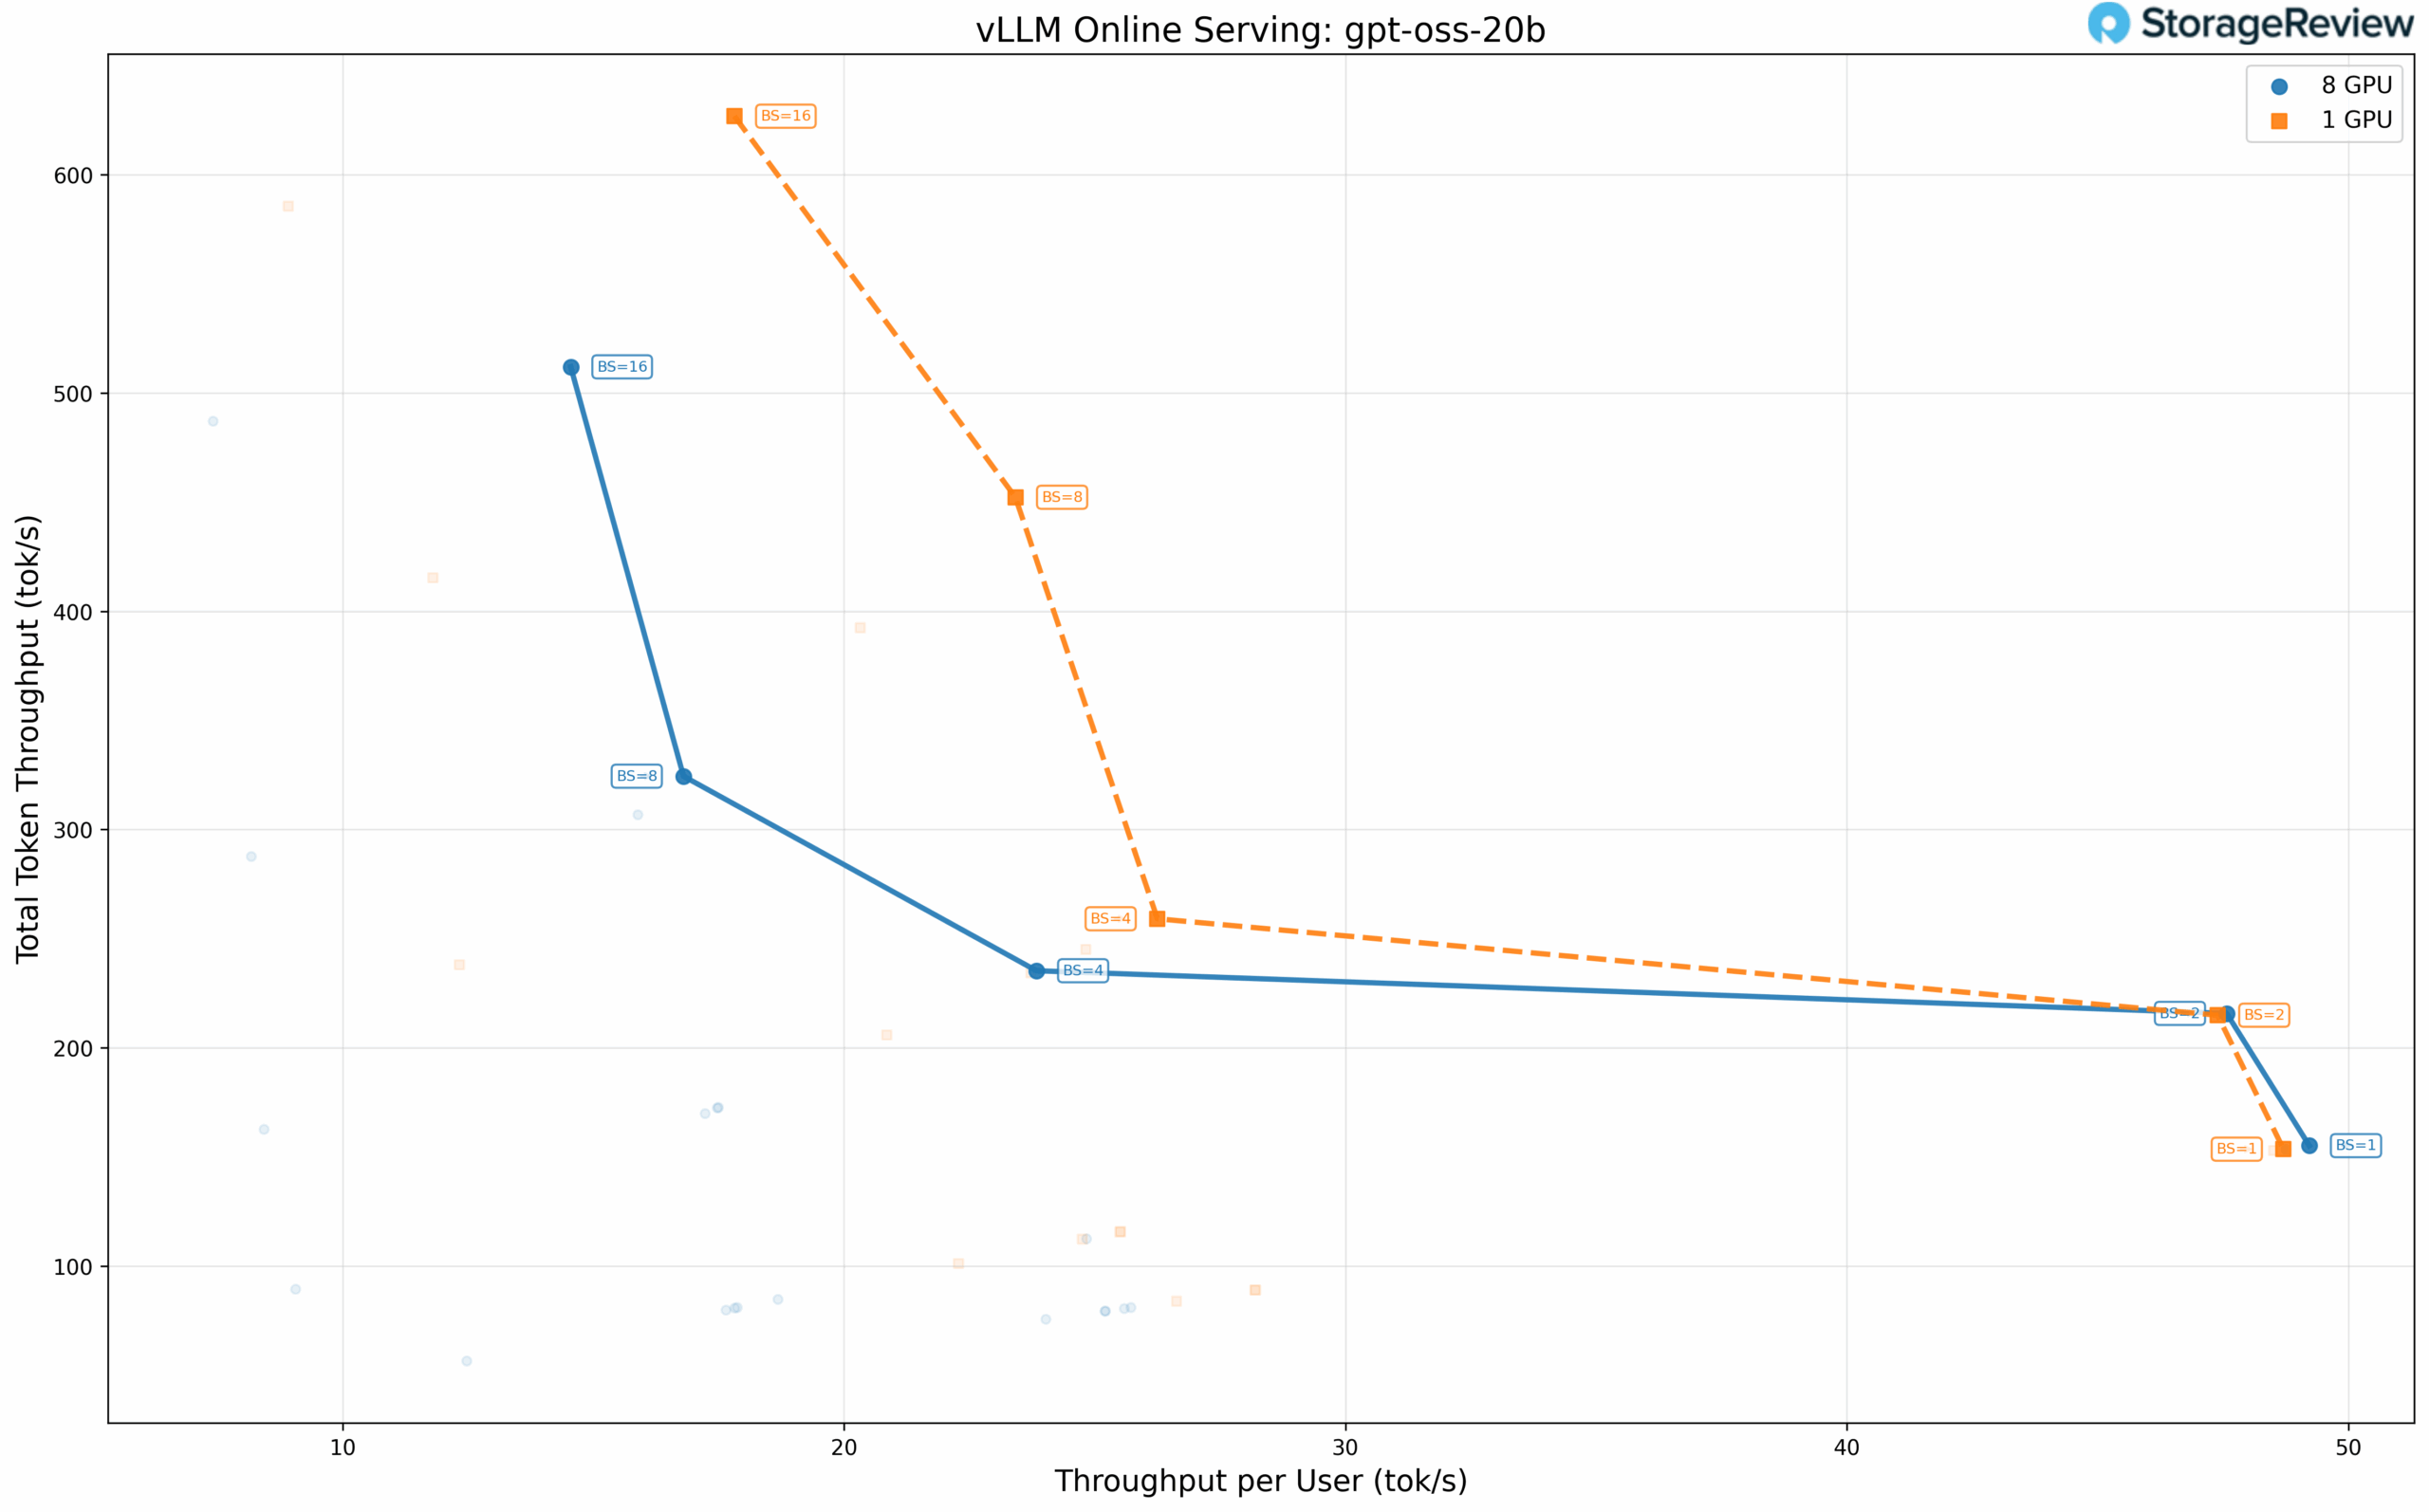 La configuración mínima de GPU logra un mayor rendimiento total con un tamaño de lote de 16: 626.84 tok/s con TP=4 frente a 511.99 tok/s con TP=8. Este resultado, contradictorio, subraya que, para modelos y longitudes de contexto que se adaptan cómodamente a menos GPU, añadir más hardware genera una sobrecarga de comunicación sin mejoras proporcionales en el rendimiento.
OpenAI GPT-OSS 120B
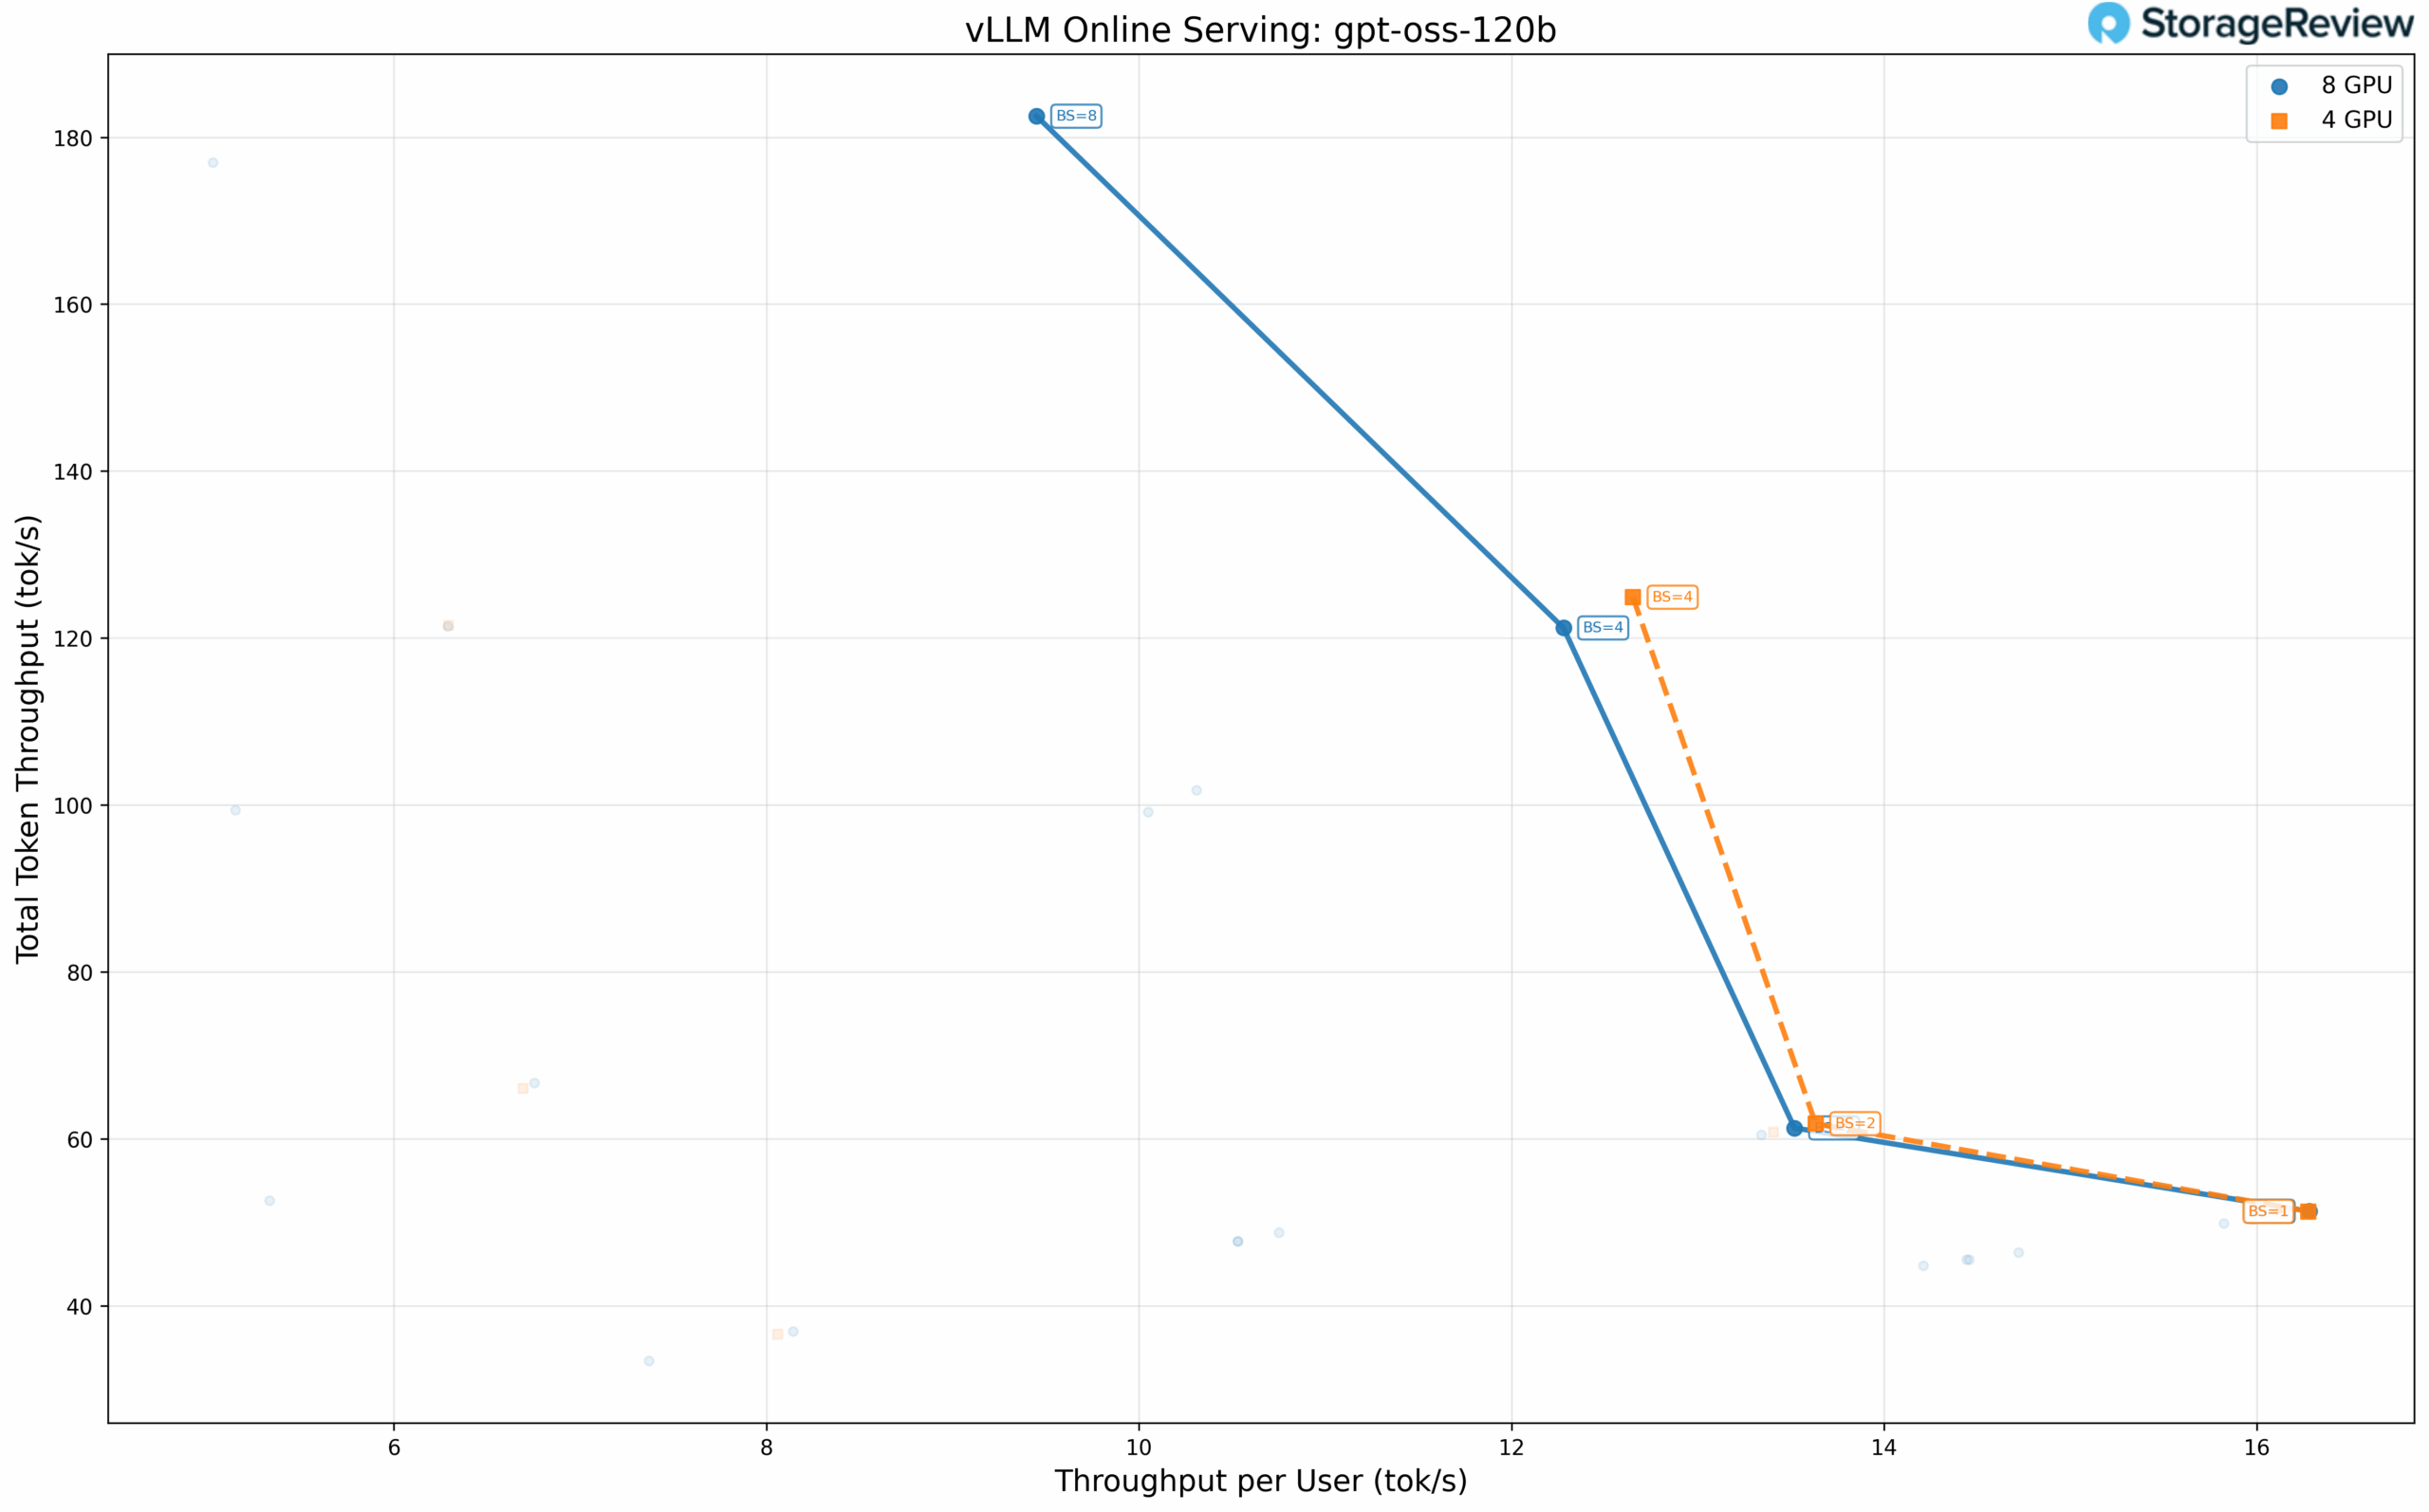
El modelo 120B, de mayor tamaño, requiere al menos 4 GPU, lo que elimina la comparación con una sola GPU. El rendimiento entre las configuraciones de cuatro y ocho GPU converge más estrechamente, con un rendimiento por usuario prácticamente idéntico en el tamaño de lote 1 (16.28 tok/s para ambos). La configuración de ocho GPU ofrece mejoras modestas en tamaños de lote mayores gracias al paralelismo de datos.
Mezcla de expertos: Qwen3 Coder 30B-A3B
Las arquitecturas MoE dispersas mantienen un gran número de parámetros y activan solo un subconjunto durante la inferencia. Qwen3 Coder 30B-A3B activa aproximadamente 3 millones de parámetros por token de su conjunto completo de 30 millones, lo que lo hace popular para implementaciones de asistentes de codificación locales.
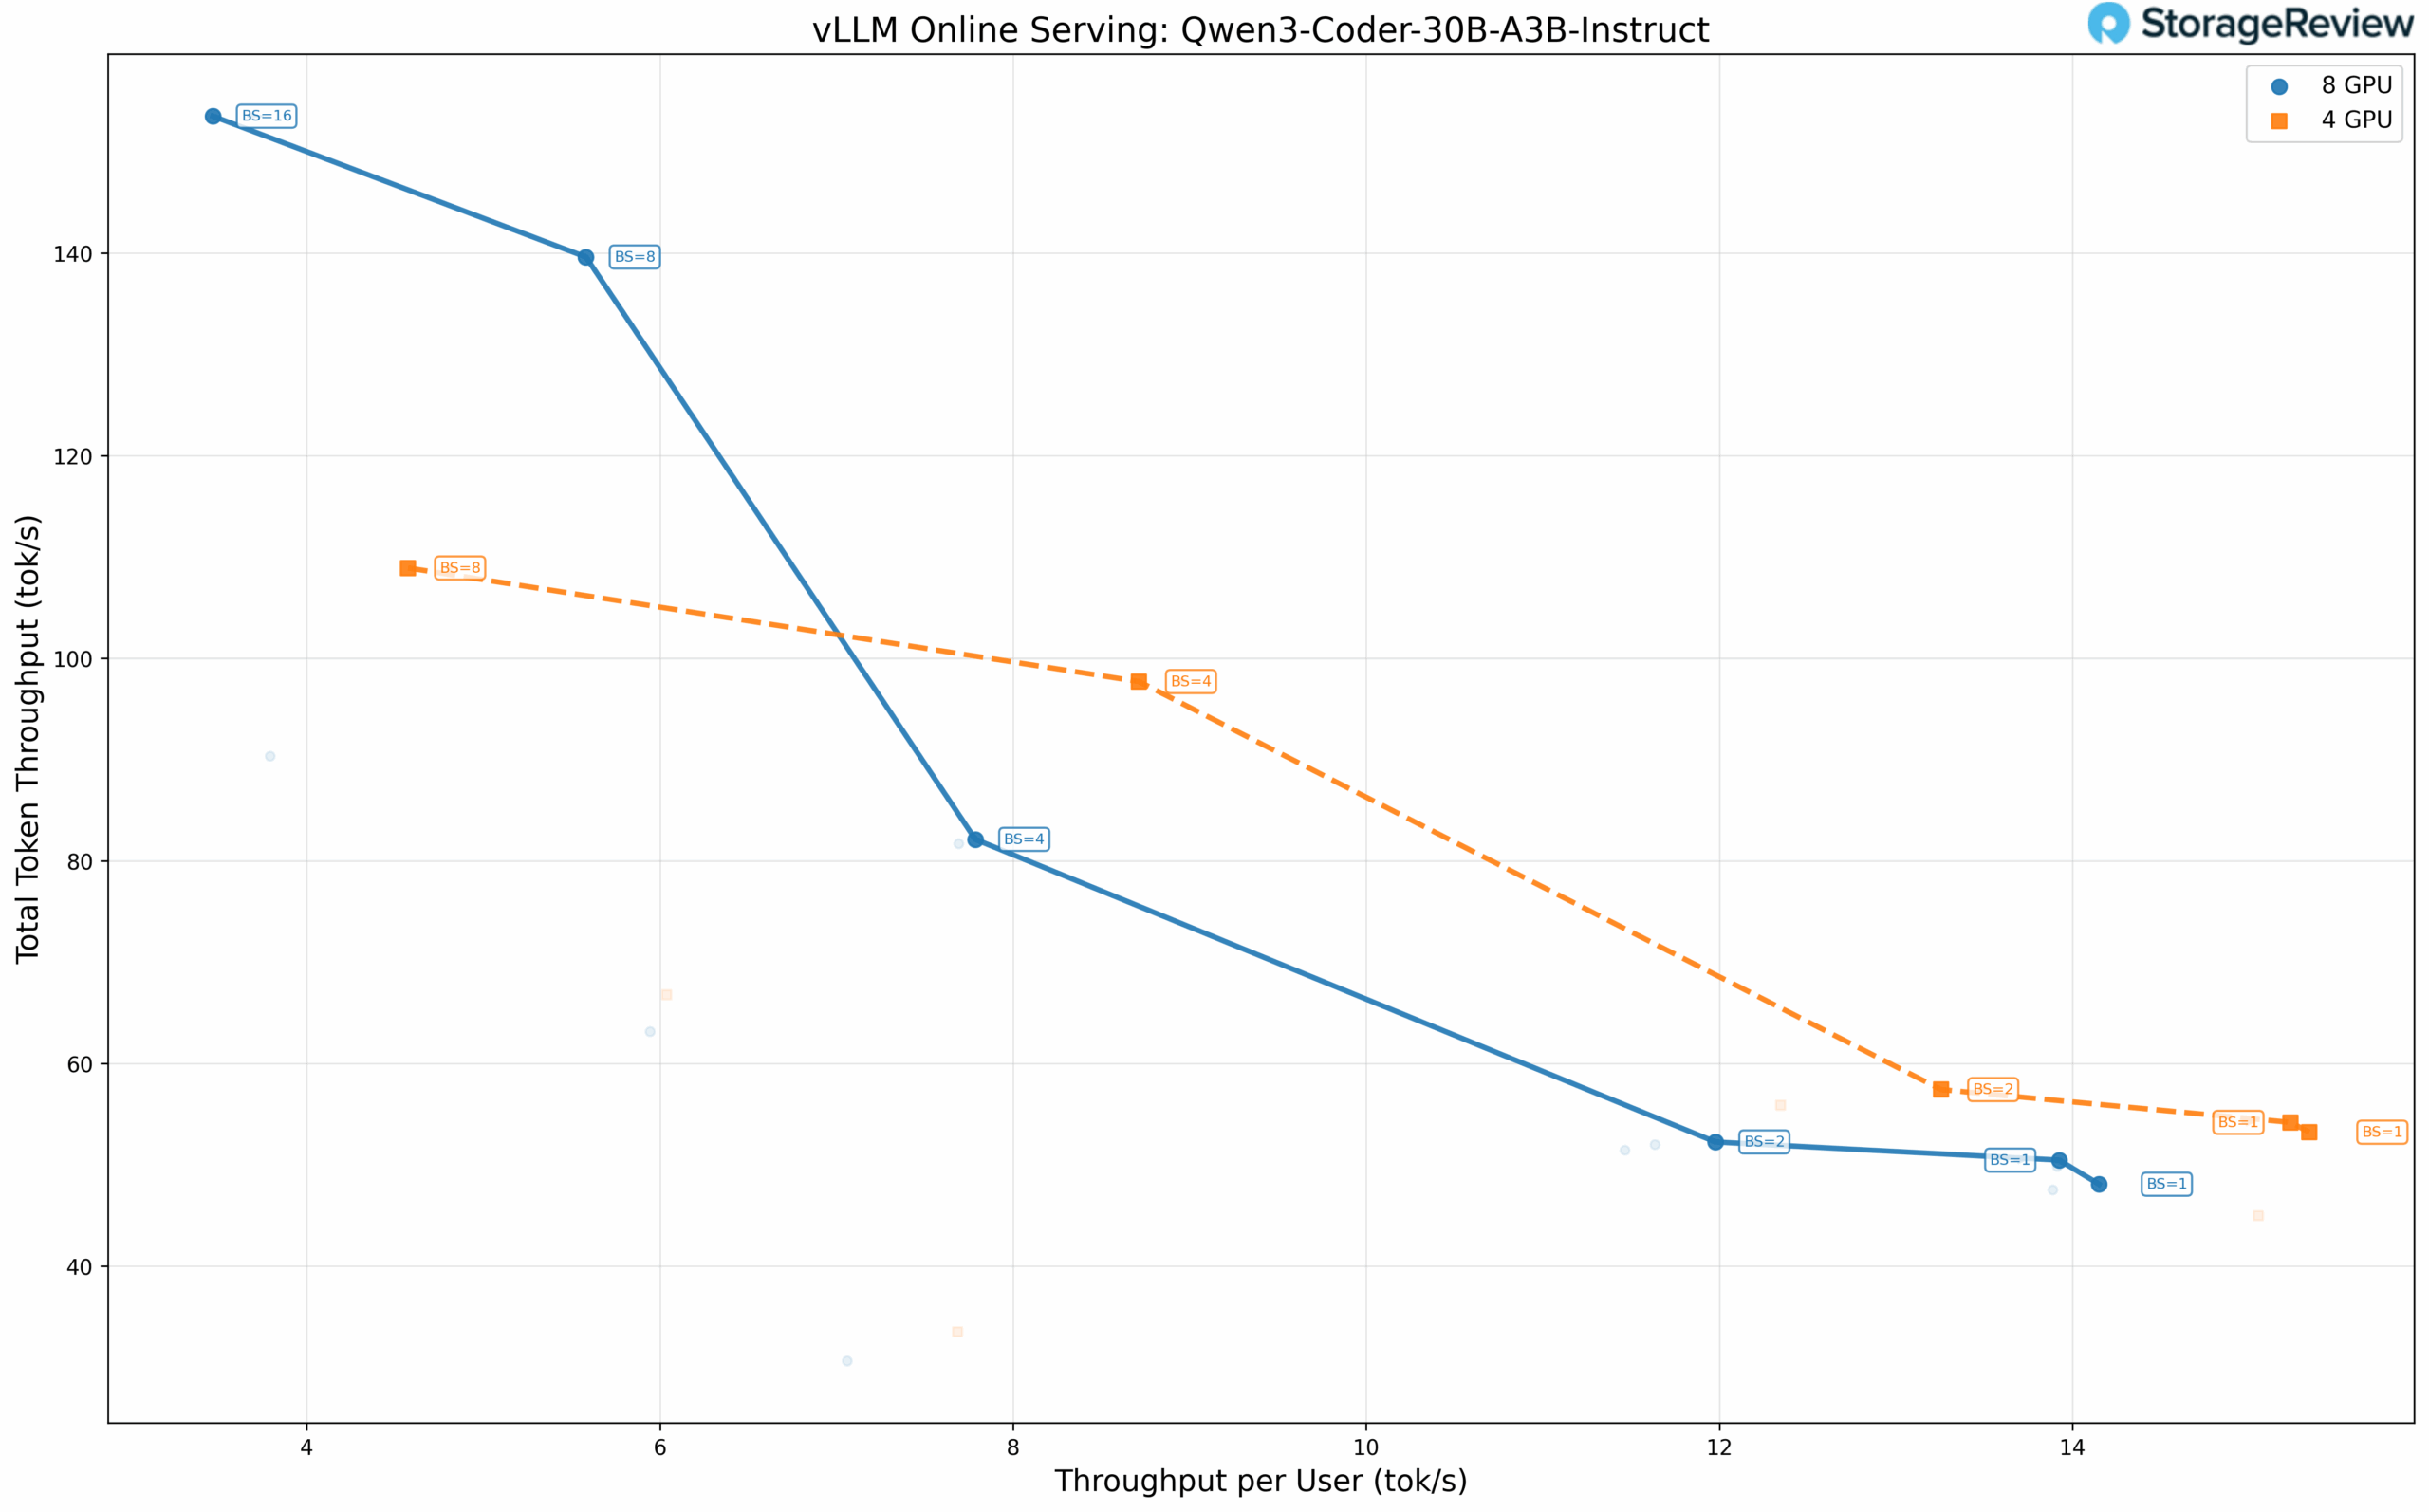
Al realizar pruebas con precisión BF16, la configuración de cuatro GPU vuelve a demostrar ventajas con tamaños de lote más pequeños. El rendimiento por usuario alcanza los 15.34 tok/s con un TP=4, frente a los 14.15 tok/s con un TP=8, con un tamaño de lote de 1.
Modelos densos
Los modelos densos siguen la arquitectura LLM convencional, donde todos los parámetros y activaciones se utilizan durante la inferencia, lo que resulta en un procesamiento computacionalmente más intensivo que sus contrapartes dispersas. Sin la cuantización INT4 en funcionamiento durante nuestro período de prueba, estos modelos se ejecutaron con una precisión BF16.
Llama 3.1 8B Instrucción
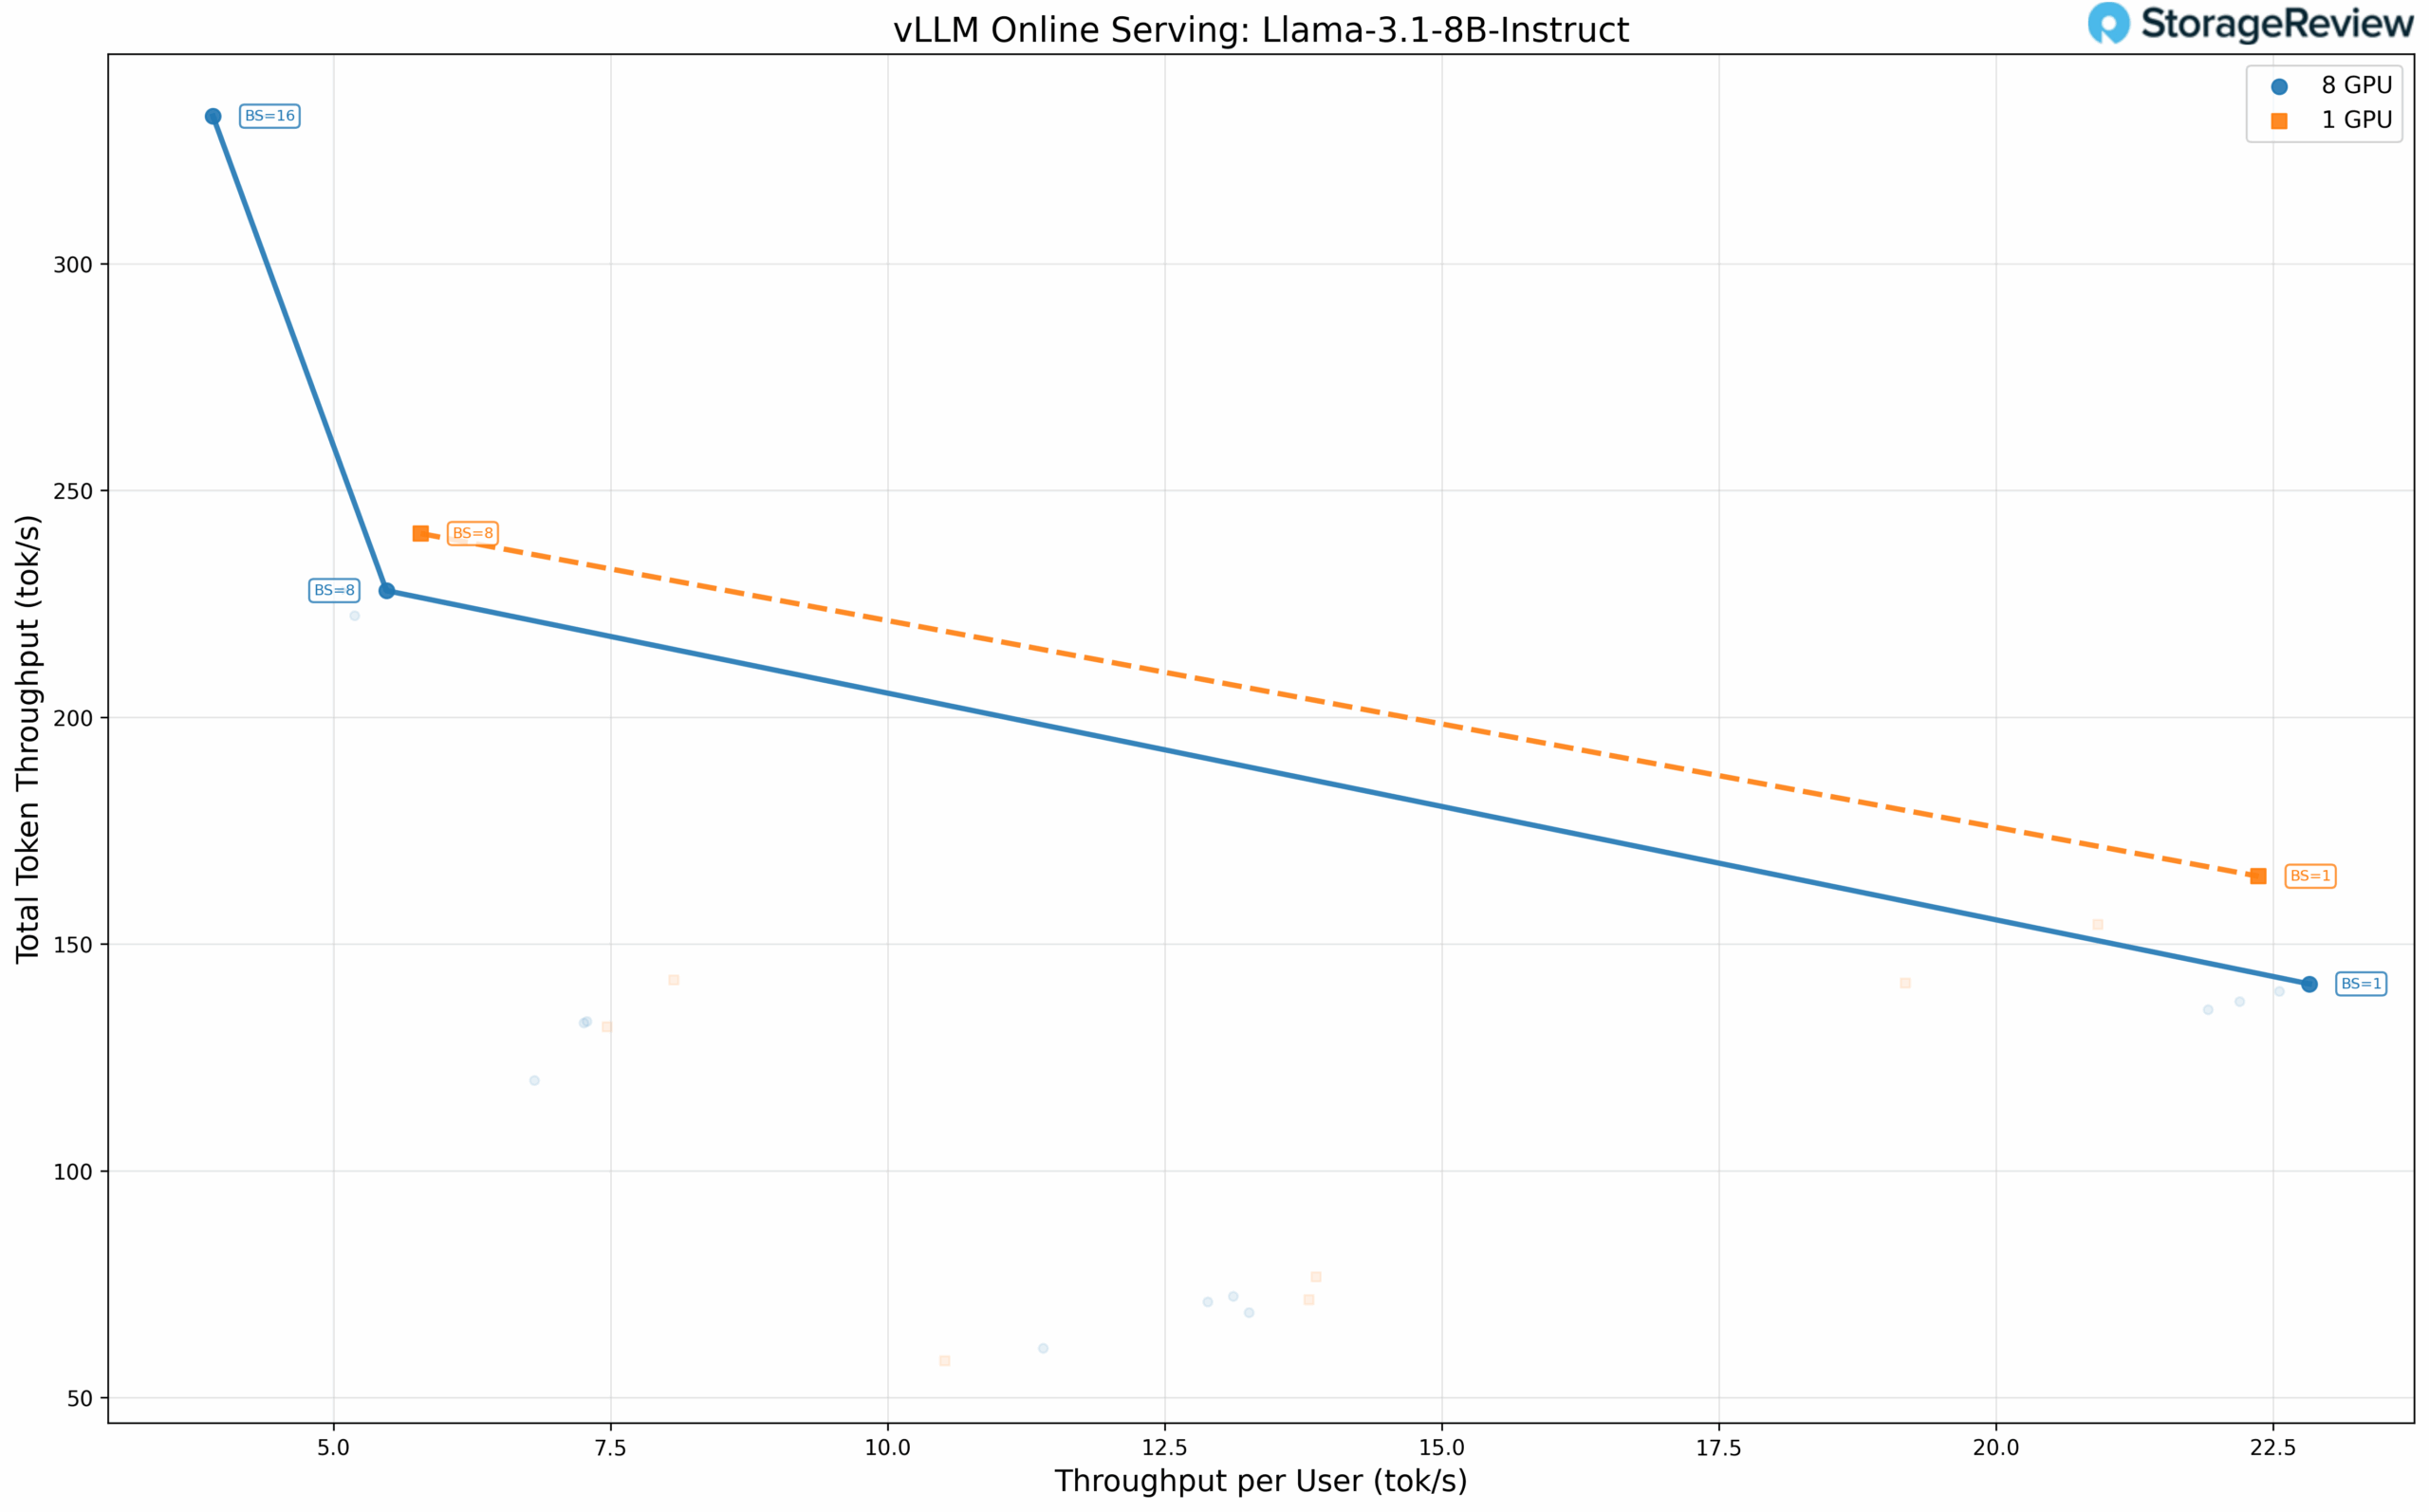
El modelo compacto 8B se adapta perfectamente a una sola GPU, pero se probó en distintas configuraciones para caracterizar el comportamiento de escalado. Los resultados confirman el patrón: cuatro GPU ofrecen un rendimiento total de 240.48 tok/s con un tamaño de lote de 8, en comparación con los 227.90 tok/s con ocho GPU con el mismo tamaño de lote. El rendimiento por usuario con un tamaño de lote de 1 se mantiene prácticamente idéntico (22.37 tok/s frente a 22.83 tok/s).
Mistral Small 3.1 24B Instrucción
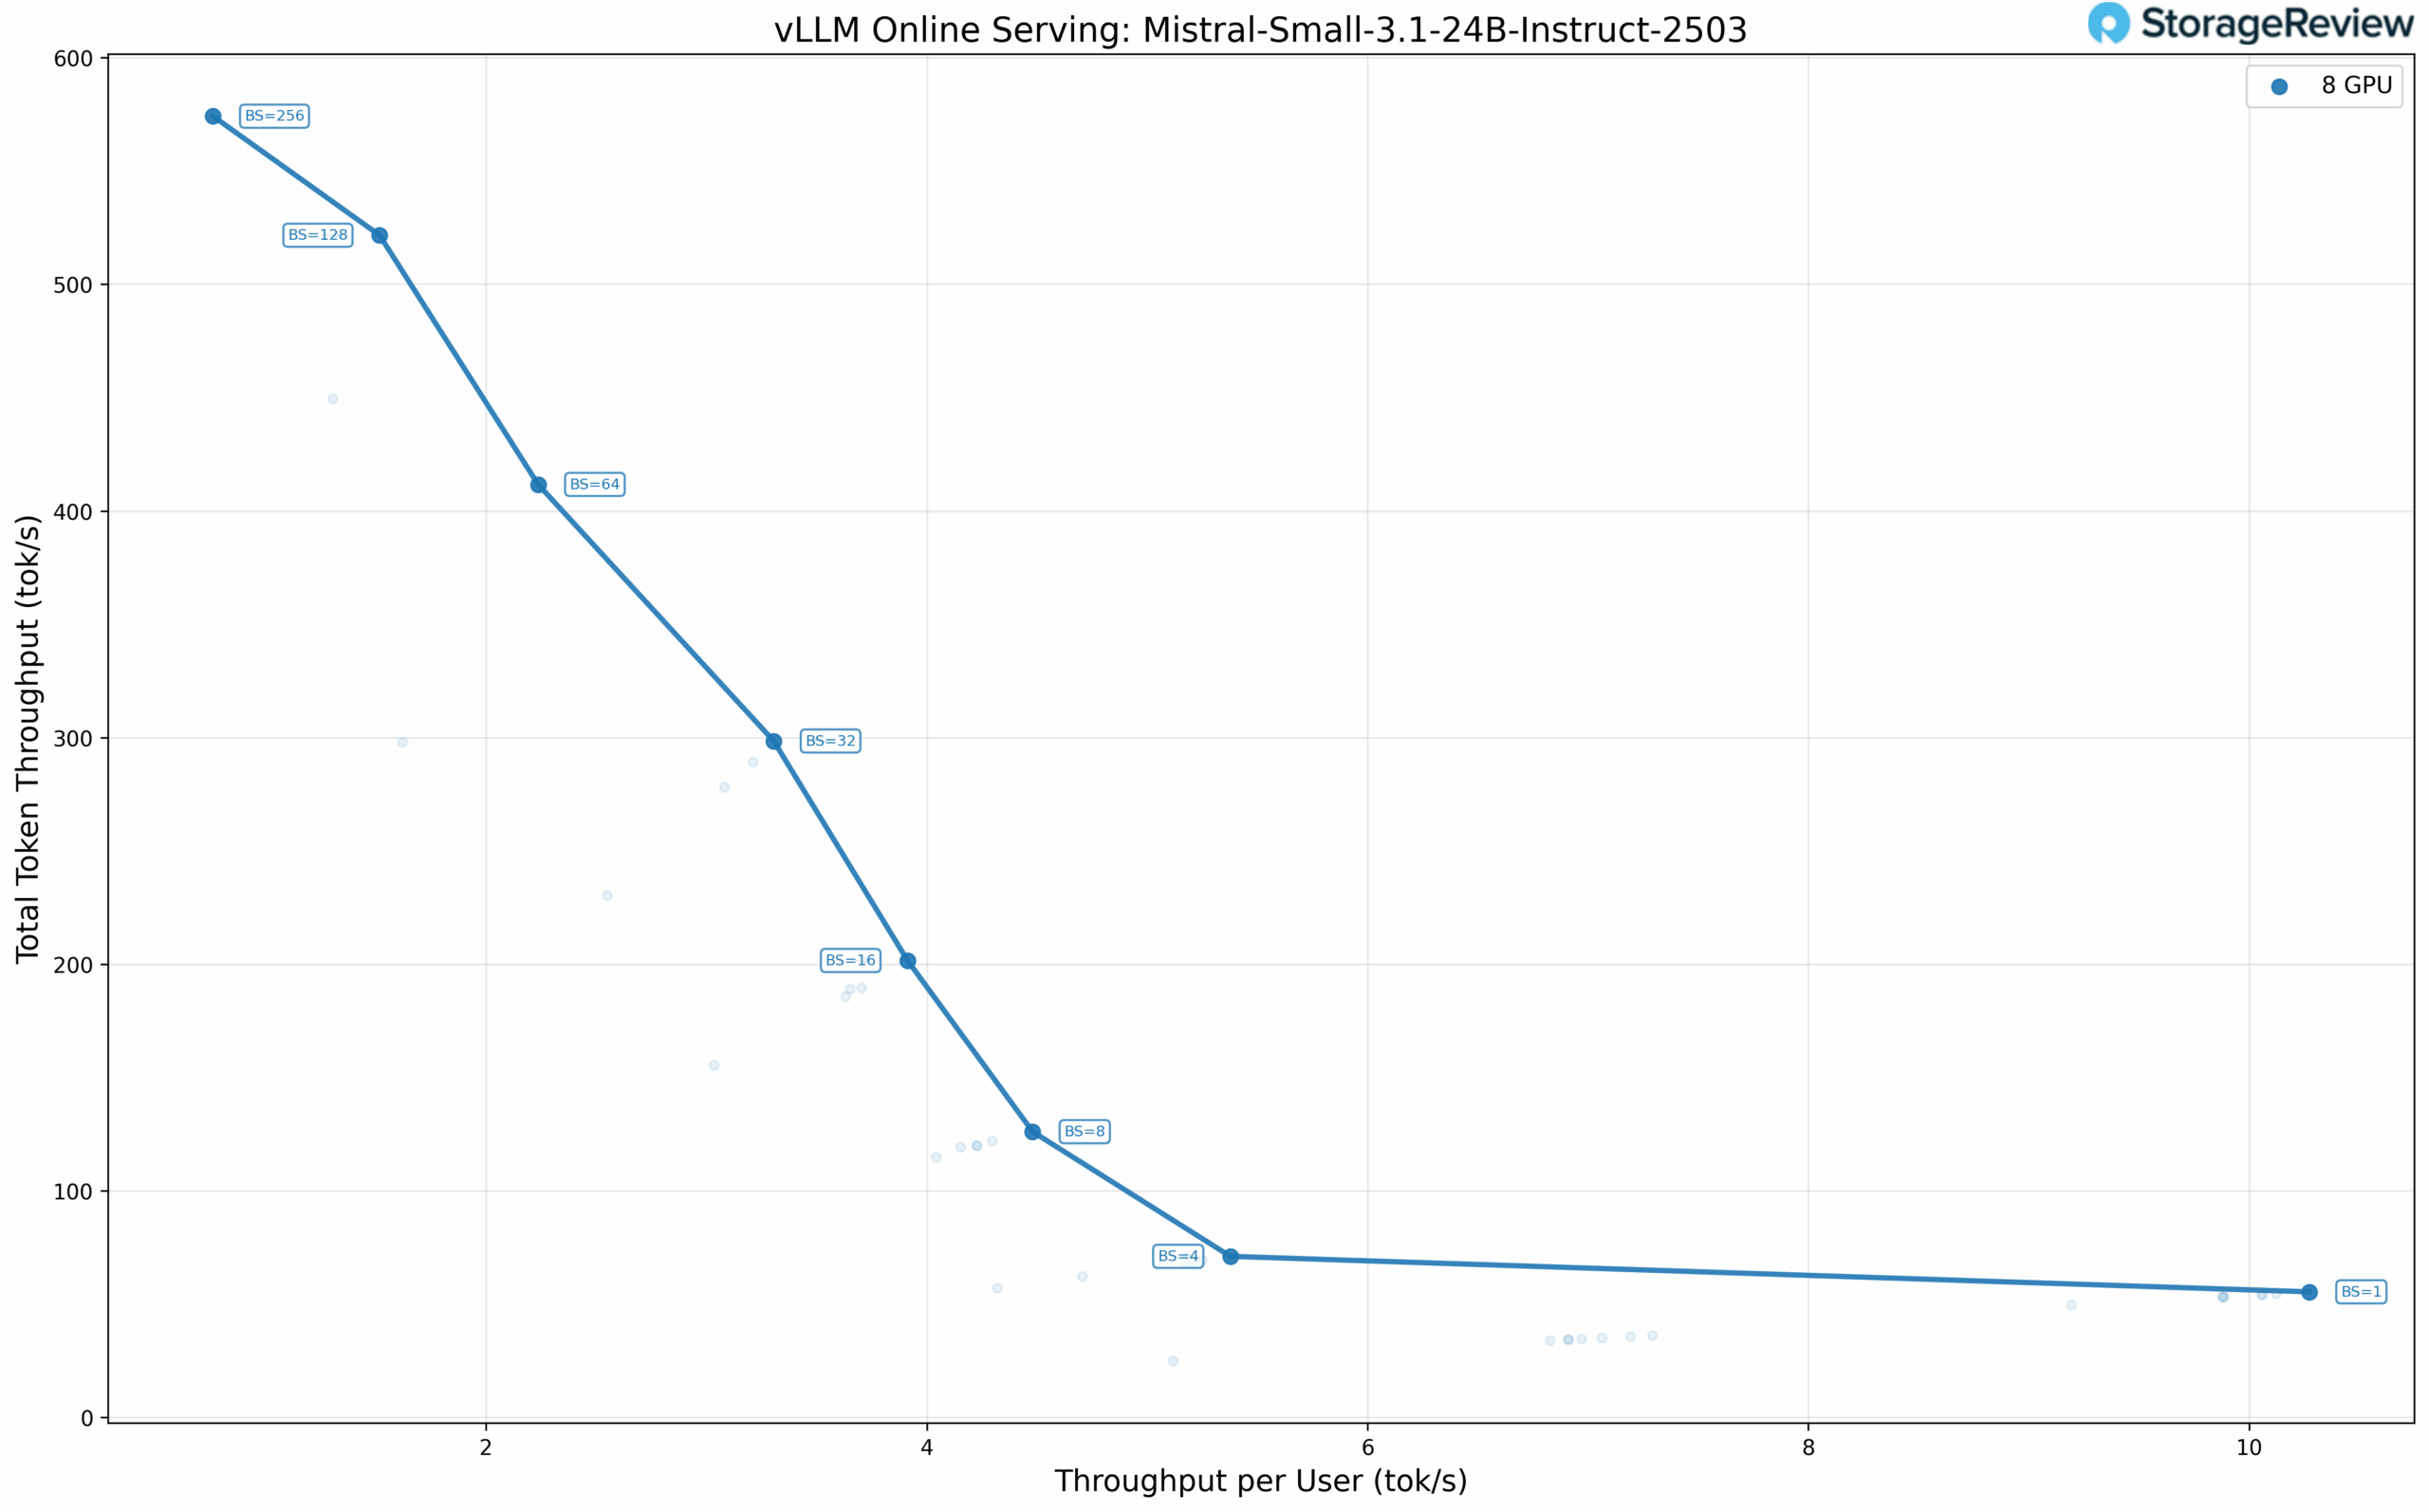
El modelo Mistral de 24B representa una carga de trabajo más exigente. Con una precisión de BF16, el modelo logra un sólido escalamiento del rendimiento con lotes de mayor tamaño, alcanzando 574.16 tok/s con un tamaño de lote de 256 en las ocho GPU.
Hallazgos
En todos los modelos probados se observa un patrón consistente: con tamaños de lote pequeños y nuestra configuración de 256 tokens de entrada/salida, usar la cantidad mínima de GPU necesarias para ajustar el modelo ofrece un mejor rendimiento por usuario que distribuirlo entre las ocho GPU . La sobrecarga de comunicación entre GPU a través de PCIe, incluso a velocidades de PCIe 5.0, introduce una latencia que supera los beneficios de la paralelización en escenarios de un solo usuario o de baja concurrencia.
Este hallazgo tiene implicaciones prácticas para la planificación de la implementación. Las organizaciones que ejecutan asistentes de codificación monousuario o flujos de trabajo de agentes de baja concurrencia pueden funcionar con configuraciones de GPU más pequeñas y aun así obtener un rendimiento aceptable. La configuración completa de Battlematrix de ocho GPU es más ventajosa para cargas de trabajo de inferencia por lotes, generación de datos sintéticos o escenarios de servicio de alta concurrencia donde el rendimiento total es más importante que la latencia por solicitud, especialmente al utilizar modelos más grandes que requieren más memoria.
Experiencia con Arc Pro B60s
En las pruebas limitadas que realizamos, la experiencia fue notablemente sencilla. Poner las tarjetas en funcionamiento fue sencillo, y configurar LLM-Scaler, la rama de desarrollo de vLLM compatible con Battlemage, resultó igualmente sencillo. Sin embargo, el software se encuentra en una fase muy temprana de desarrollo. Al comenzar las pruebas, no pudimos recuperar ninguna estadística de GPU, y más allá del paralelismo tensorial, no tuvimos éxito con otras estrategias de paralelismo, como el paralelismo experto o el paralelismo de pipeline, para escalar entre múltiples sistemas. Dicho esto, preveíamos estas limitaciones, dado el estado de prelanzamiento del software.
El tema de la refrigeración generó un debate considerable tras nuestro primer vídeo en YouTube , y muchos comentaristas expresaron su preocupación por el posible sobrecalentamiento de las tarjetas en nuestra plataforma de pruebas abierta. Al no disponer de monitorización térmica, finalmente trasladamos las tarjetas a un chasis de servidor para garantizar un flujo de aire adecuado. Tenemos previsto probar el rendimiento de la refrigeración en la configuración de estación de trabajo para nuestro análisis completo, ya que la configuración final de Battlematrix, tal como se muestra en las imágenes promocionales de Intel, coloca estas tarjetas en un chasis de estación de trabajo muy juntas.
En cuanto al formato, estas tarjetas son ligeramente más largas que las GPU estándar para estaciones de trabajo, lo que puede dificultar la compatibilidad con la carcasa. Sin embargo, encajan perfectamente en los chasis de servidor, ya que la mayoría de estos ofrecen espacio adicional en el borde delantero de la tarjeta para los soportes.
Planes de pruebas futuras
Planeamos revisar Intel Battlematrix y realizar una revisión más exhaustiva tras el lanzamiento completo y la disponibilidad general de las B60. Evaluaremos el rendimiento de la inferencia LLM mediante pruebas adicionales de vLLM en una amplia gama de modelos y configuraciones de implementación. Aunque no se muestra en esta vista previa, observamos que estas GPU, en su estado actual de software, tienen un mejor rendimiento en operaciones de prellenado que en decodificación. La revisión completa profundizará en las cargas de trabajo de inferencia con gran cantidad de prellenado y decodificación para caracterizar este comportamiento.
La comunidad de laboratorios domésticos ha mostrado interés en utilizar estas GPU para una de las cargas de trabajo más populares: los servidores multimedia. Planeamos probarlas con Plex y posiblemente Jellyfin con los miembros de nuestro servidor de Discord . También tenemos en mente cargas de trabajo profesionales, como SolidWorks y Autodesk, para pruebas de rendimiento CAD. Además, planeamos analizar SR-IOV con Proxmox para implementar un servidor VDI multiusuario para que los miembros de Discord evalúen la densidad de escritorios concurrentes y los juegos en la nube.
Conclusión
Arc Pro B60 Battlematrix de Intel es una plataforma atractiva que permite acceder a memoria GPU de alta capacidad a precios de estación de trabajo. El diseño de doble GPU aborda las limitaciones de densidad, la asignación de 24 GB por GPU se adapta a las cargas de trabajo de inferencia LLM, y su estructura de precios crea alternativas atractivas a los ecosistemas de GPU profesionales consolidados. Para las organizaciones que priorizan la soberanía de los datos y la rentabilidad sobre el rendimiento de vanguardia, esta plataforma merece ser considerada.
La madurez del software sigue siendo la principal limitación. La inversión de Intel en la optimización del framework mediante LLM Scaler y el continuo perfeccionamiento de los controladores demuestra su compromiso de mantener la línea de GPU Arc como un valor considerable.
Se desconoce qué tan popular será la configuración Battlematrix de ocho GPU en comparación con el increíble rendimiento que ofrece NVIDIA DGX Spark . La verdadera historia podría estar en las configuraciones de una o dos tarjetas, donde los precios de entrada de entre 600 y 1,200 dólares reducen drásticamente las barreras para explorar la infraestructura de IA privada.
Continuaremos ampliando nuestras pruebas a medida que lleguen las actualizaciones de controladores y los marcos de software maduren. Si deseas probarlas tú mismo, únete a nuestro servidor de Discord , donde tenemos un servidor comunitario con acceso limitado a la versión B60.


 Amazon