

El Lenovo ThinkSystem SR650 V4 es un servidor en rack 2U de 2 sockets, flexible y potente, diseñado para satisfacer las necesidades de sectores como servicios en la nube, telecomunicaciones y computación de alto rendimiento (HPC). Ya sea para optimizar cargas de trabajo escalables o para asegurar el futuro de su centro de datos con computación de alta densidad, el SR650 V4 ofrece mejoras significativas respecto a su predecesor, el SR650 V3.

Diferencias entre Lenovo SR650 V4 y SR650 V3
TÉRMICO
Las capacidades del procesador marcan una de las mejoras más significativas del SR650 V4. Mientras que el SR650 V3 utilizaba procesadores escalables Intel Xeon de 4.ª generación, el SR650 V4 incorpora la plataforma Intel Xeon 6 (anteriormente denominada "Granite Rapids"). Nuestro análisis se centra en la arquitectura de núcleos P (núcleos de alto rendimiento), diseñada específicamente para cargas de trabajo con un uso intensivo de recursos. El V4 admite uno o dos procesadores con hasta 86 núcleos P por zócalo (hasta 172 subprocesos), lo que ofrece velocidades de núcleo más altas (hasta 4 GHz) y TDP de hasta 350 W.
Esta transición permite a las organizaciones gestionar aplicaciones más exigentes por servidor, reduciendo su espacio físico. La arquitectura crea una base sólida para la virtualización y las operaciones de bases de datos intensivas. Además, la arquitectura del V4 admite un enorme ancho de banda PCIe, con hasta 88 líneas PCIe 5.0 por procesador, esencial para alimentar adaptadores de red modernos de alta velocidad y matrices de almacenamiento NVMe sin cuellos de botella.
| Modelo de CPU | Núcleos / Hilos | Frecuencia base | Turbo máximo | L3 caché | TDP |
|---|---|---|---|---|---|
| 6787P | 86 / 172 | 2.0 GHz | 3.8 GHz | 336 MB | 350 W |
| 6781P | 80 / 160 | 2.0 GHz | 3.8 GHz | 336 MB | 350 W |
| 6767P | 64 / 128 | 2.4 GHz | 3.9 GHz | 336 MB | 350 W |
| 6761P | 64 / 128 | 2.5 GHz | 3.9 GHz | 336 MB | 350 W |
| 6760P | 64 / 128 | 2.2 GHz | 3.8 GHz | 320 MB | 330 W |
| 6747P | 48 / 96 | 2.7 GHz | 3.9 GHz | 288 MB | 330 W |
| 6745P | 32 / 64 | 3.1 GHz | 4.3 GHz | 336 MB | 300 W |
| 6741P | 48 / 96 | 2.5 GHz | 3.8 GHz | 288 MB | 300 W |
| 6740P | 48 / 96 | 2.1 GHz | 3.8 GHz | 288 MB | 270 W |
| 6737P | 32 / 64 | 2.9 GHz | 4.0 GHz | 144 MB | 270 W |
| 6736P | 36 / 72 | 2.0 GHz | 4.1 GHz | 144 MB | 205 W |
| 6732P | 32 / 64 | 3.8 GHz | 4.3 GHz | 144 MB | 350 W |
| 6731P | 32 / 64 | 2.5 GHz | 4.1 GHz | 144 MB | 245 W |
| 6730P | 32 / 64 | 2.5 GHz | 3.8 GHz | 288 MB | 250 W |
| 6724P | 16 / 32 | 3.6 GHz | 4.3 GHz | 72 MB | 210 W |
| 6714P | 8 / 16 | 4.0 GHz | 4.3 GHz | 48 MB | 165 W |
| 6530P | 32 / 64 | 2.3 GHz | 4.1 GHz | 144 MB | 225 W |
| 6527P | 24 / 48 | 3.0 GHz | 4.2 GHz | 144 MB | 255 W |
| 6521P | 24 / 48 | 2.6 GHz | 4.1 GHz | 144 MB | 225 W |
| 6520P | 24 / 48 | 2.4 GHz | 4.0 GHz | 144 MB | 210 W |
| 6517P | 16 / 32 | 3.2 GHz | 4.2 GHz | 72 MB | 190 W |
| 6515P | 16 / 32 | 2.3 GHz | 3.8 GHz | 72 MB | 150 W |
| 6511P | 16 / 32 | 2.3 GHz | 4.2 GHz | 72 MB | 150 W |
| 6507P | 8 / 16 | 3.5 GHz | 4.3 GHz | 48 MB | 150 W |
| 6505P | 12 / 24 | 2.2 GHz | 4.1 GHz | 48 MB | 150 W |
Salud Cerebral
En cuanto a la memoria, el SR650 V4 mejora significativamente las capacidades del V3, maximizando el rendimiento del subsistema. Admite velocidades de memoria DDR5 de hasta 6400 MHz (1 DIMM por canal), un avance sustancial respecto al límite de 4800 MHz de la generación anterior. El sistema cuenta con 32 ranuras DIMM (16 por procesador) distribuidas en ocho canales de memoria por procesador. Admite módulos RDIMM estándar, módulos RDIMM 3DS y los nuevos módulos DIMM de rango multiplexado (MRDIMM), que pueden operar a velocidades de hasta 8000 MHz para aplicaciones que requieren un gran ancho de banda. Con 256 GB de módulos RDIMM 3DS, el servidor admite una impresionante memoria total del sistema de 8 TB.

Además, la versión V4 incorpora compatibilidad con la expansión de memoria CXL 2.0 (Compute Express Link). Los administradores pueden instalar hasta 12 módulos de memoria CXL en las bahías de unidades E3.S (específicamente, el formato E3.S 2T). Esto permite al sistema ampliar la capacidad de memoria y el ancho de banda más allá de los límites tradicionales de los procesadores conectados, reduciendo la latencia de cómputo para cargas de trabajo de próxima generación y el costo total de propiedad (TCO) al utilizar menos memoria.
Almacenaje
Las capacidades de almacenamiento del Lenovo SR650 V4 demuestran una transición hacia una densidad NVMe de alto rendimiento y formatos flexibles. Si bien es compatible con unidades de 3.5 y 2.5 pulgadas, el V4 incorpora una amplia compatibilidad con el formato NVMe E3.S. El sistema admite hasta 32 unidades E3.S de 1 TB o 12 unidades E3.S de 2 TB, lo que ofrece mayor densidad y una gestión térmica mejorada en comparación con las unidades SSD U.2 tradicionales.

Fundamentalmente, el V4 admite conectividad NVMe directa sin sobresuscripción (1:1), lo que garantiza que el almacenamiento de alta velocidad no se vea afectado por el uso compartido de carriles PCIe. La inclusión de opciones de unidad de arranque M.2 con intercambio en caliente mejora aún más la facilidad de mantenimiento.
Networking
Para la red, el SR650 V4 cuenta con dos ranuras OCP 3.0 dedicadas, ambas compatibles con PCIe Gen 5 x16. Esta actualización clave permite redes redundantes de alta velocidad (p. ej., dos puertos de 200 GbE o un solo puerto de 400 GbE) sin consumir las ranuras elevadoras PCIe estándar. La transición a PCIe 5.0 duplica el ancho de banda teórico (32 GT/s frente a 16 GT/s), lo que permite al V4 gestionar el tráfico de red más exigente en la nube y la IA.

Energía y enfriamiento
El SR650 V4 ofrece opciones de alimentación mejoradas, desde 800 W hasta 3200 W, disponibles en niveles de eficiencia Titanium y Platinum. El sistema también admite opciones de -48 V CC y HVAC/HVDC para satisfacer las necesidades específicas de los centros de datos.

Para gestionar el calor generado por los procesadores y la memoria con alto TDP, Lenovo presenta las opciones de refrigeración líquida Neptune. El módulo "Compute Complex Neptune Core" utiliza refrigeración líquida de circuito abierto para disipar el calor de los procesadores, la memoria y los reguladores de voltaje, lo que permite capturar más del 80 % del calor del servidor y reducir significativamente los costes de refrigeración del centro de datos.
En general, el SR650 V4 ofrece un sólido avance en rendimiento, densidad y eficiencia térmica para entornos empresariales modernos.
Lenovo ThinkSystem SR650 V4 Especificaciones
| Especificación | Detalles |
|---|---|
| Especificaciones del Sistema | |
| Factor de forma | Rack 2U |
| Procesador | Hasta 2 Intel Xeon serie 6700/6400 (núcleos P); hasta 86 núcleos por CPU; hasta 350 W TDP |
| Salud Cerebral | 32 ranuras DIMM (16 por procesador); admite RDIMM TruDDR5 de hasta 6400 MHz y MRDIMM de hasta 8000 MHz |
| Expansión de memoria | Admite módulos de memoria CXL 2.0 en formato E3.S 2T (hasta 12 DIMM) |
| Memoria máxima | Memoria del sistema de hasta 8 TB (utilizando RDIMM 3DS de 256 GB) |
| Bahías de unidad de disco | Frente: Hasta 24 NVMe/SAS/SATA de 2.5″, 16 SAS/SATA de 3.5″ o 32 NVMe E3.S Medio: Hasta 8 conectores de 2.5″ de intercambio simple Trasera: Hasta 8 unidades de 2.5″ o 4 de 3.5″ intercambiables en caliente |
| Controlador de almacenamiento | Hasta 36 puertos NVMe integrados (conectividad 1:1); compatibilidad con RAID/HBA |
| Interfaces de red | Dos ranuras OCP 3.0 SFF con interfaz de host PCIe 5.0 x16 |
| Ranuras de expansión PCI | Hasta 10 ranuras PCIe 5.0 (traseras); ranuras PCIe frontales opcionales |
| Soporte GPU | Hasta 10 GPU de ancho simple o 2 GPU de ancho doble |
| Puertos | Frente: Puerto de diagnóstico externo, USB opcional y Mini-DP Trasera: 2x USB 3.0, 1x VGA, 1x RJ-45 de gestión, serie opcional |
| Enfriamiento | Hasta 6 ventiladores intercambiables en caliente (redundancia N+1); módulos de refrigeración líquida Neptune opcionales |
| Alimentación eléctrica | Hasta dos fuentes de alimentación CA/CC redundantes intercambiables en caliente (800 W–3200 W) |
| Gestión de sistemas | Controlador XClarity 3 (XCC3); XCC3 Premier opcional |
| Características de seguridad | TPM 2.0, raíz de confianza PFR (NIST SP800-193), intrusión en el chasis, bisel bloqueable |
| Sistemas operativos | Servidor Microsoft Windows, RHEL, SLES, Servidor Ubuntu |
| Garantía | Garantía base de 3 años (configurable) |
| Dimensiones | 87 mm (3.4 pulgadas) de alto x 440 mm (17.3 pulgadas) de ancho x 800 mm (31.5 pulgadas) de profundidad |
| Peso | Peso máximo: 38.8 kg (85.5 libras) |
Diseño y fabricación del Lenovo ThinkSystem SR650 V4
El Lenovo ThinkSystem SR650 V4 es una plataforma 2U estándar que aprovecha al máximo su espacio físico, equilibrando la densidad de componentes con el flujo de aire y la facilidad de mantenimiento. El chasis mide 3.4 cm de alto, 17.3 cm de ancho y 31.5 cm de profundidad, con un peso máximo configurado de 85.5 kg. Estas dimensiones lo sitúan a la par de otros servidores empresariales 2U, a la vez que ofrecen la profundidad suficiente para CPU de alto rendimiento, configuraciones de memoria densa y placas base de almacenamiento flexibles.
El diseño industrial ThinkSystem de Lenovo se reconoce al instante, con un chasis de acero rígido y un etiquetado claro y funcional. En el interior, la distribución es limpia y funcional, priorizando la ventilación directa, las zonas modulares para componentes y el acceso sin herramientas para el mantenimiento rutinario. La construcción general se percibe robusta y bien diseñada, reflejando una plataforma diseñada para el funcionamiento continuo en entornos de centros de datos, más que para el atractivo estético.
Panel frontal
El panel frontal es altamente configurable. Nuestro sistema de prueba está equipado con una placa base para unidades de 2.5 pulgadas y 8 bahías, pero el chasis se escala fácilmente a 16 o incluso 24 bahías con un mínimo esfuerzo. Los clientes también pueden optar por bahías de 3.5 pulgadas para una mayor capacidad bruta o por las nuevas opciones de placa base E3.S para una densidad NVMe de alto rendimiento. La compatibilidad con AnyBay permite la coexistencia de unidades SAS, SATA y NVMe en la misma caja, lo que proporciona una gran flexibilidad para implementaciones de almacenamiento mixto.

El panel frontal incluye controles esenciales para el operador: un botón de encendido, un botón de identificación y LED de estado que indican el estado del sistema y la actividad de la red. Una pestaña de información extraíble proporciona acceso rápido a la etiqueta de acceso a la red XCC y al número de serie. La conectividad local opcional incluye un puerto Mini DisplayPort y puertos USB para acceder al carrito de emergencia, lo cual resulta fundamental para la resolución de problemas en centros de datos con poca iluminación.
Panel trasero
La parte trasera del chasis está diseñada para una máxima densidad de E/S. Admite hasta 10 ranuras PCIe Gen 5, según la configuración de la tarjeta vertical. La inclusión de dos ranuras OCP 3.0 libera las tarjetas verticales PCIe estándar para otras tarjetas complementarias, como GPU o controladores de almacenamiento.
Además de la expansión, el panel trasero alberga el puerto de red de administración BMC integrado, dos puertos USB-A y una salida VGA para acceso a la consola local. Las dos fuentes de alimentación intercambiables en caliente están montadas en la parte trasera, lo que facilita el mantenimiento sin afectar el flujo de aire ni las configuraciones de expansión.
Interno
Internamente, el diseño es limpio y optimizado para la ventilación. 32 ranuras DIMM flanquean dos zócalos de CPU, dispuestos para mantener una refrigeración sin obstrucciones de adelante hacia atrás gracias a un banco de seis ventiladores hot-swap de alto rendimiento en la parte frontal del chasis. Los ventiladores se reemplazan fácilmente sin herramientas, ya que la bandeja se puede extraer completamente sin herramientas. Al extraer la bandeja, se proporciona acceso directo y sin obstrucciones al área de almacenamiento AnyBay, lo que simplifica el mantenimiento, las actualizaciones y los cambios de backplane.

El cableado de almacenamiento se distribuye ordenadamente a lo largo de los laterales del chasis para evitar bloquear el flujo de aire hacia las CPU y la memoria. En las configuraciones con módulos de refrigeración líquida Neptune, la distribución interna cambia ligeramente para acomodar los circuitos de refrigeración, pero la capacidad de mantenimiento del núcleo se mantiene alta. El módulo de la unidad de arranque M.2 está montado en el deflector de aire o la caja de la unidad, lo que permite un fácil acceso sin necesidad de retirar otros componentes.
Controlador XClarity 3
El SR650 V4 incorpora el nuevo controlador XClarity Controller 3 (XCC3). Este motor de gestión ofrece una mejora significativa del rendimiento con respecto a las generaciones anteriores, con tiempos de arranque más rápidos y una interfaz HTML5 más ágil. El gestor de recursos de la plataforma proporciona telemetría detallada sobre el estado de la alimentación y la temperatura, lo que ayuda a los administradores a optimizar la eficiencia del centro de datos.
XCC3 admite una amplia gama de funciones de administración remota, como control remoto (KVM), montaje de medios virtuales y actualizaciones de firmware. La interfaz es intuitiva y ofrece una vista del panel de control del estado del sistema, los eventos activos y el inventario de hardware. Para la automatización, XCC3 es totalmente compatible con las API REST de Redfish.
Lenovo ThinkSystem SR650 V4 Rendimiento
Esta sección examina los resultados de las pruebas de rendimiento de Blender, y-cruncher, vLLM y Phoronix. Las pruebas iniciales se realizaron en el Lenovo ThinkSystem SR650 V4 equipado con procesadores Intel Xeon 6740P, lo que nos permitió evaluar la arquitectura de núcleo P centrada en el rendimiento de la plataforma y su rendimiento general bajo cargas de trabajo limitadas por la CPU. A mitad de la revisión, ajustamos la configuración del sistema para permitir las pruebas aceleradas por la GPU. La transición fue sencilla, gracias al kit de actualización de habilitación de GPU de Lenovo, que incluye ventiladores de alto rendimiento, disipadores mejorados, una cubierta de flujo de aire revisada y elevadores compatibles con GPU diseñados para admitir aceleradores de mayor potencia. La instalación no requirió cambios significativos en el chasis y se integró perfectamente con el diseño del sistema existente.
Con los componentes mejorados de refrigeración y flujo de aire instalados, añadimos una GPU NVIDIA L40S a la plataforma. Esto nos permitió ampliar las pruebas para incluir cargas de trabajo aceleradas por GPU, como el renderizado de GPU de Blender y benchmarks centrados en la inferencia, manteniendo la estabilidad térmica y un comportamiento constante del sistema. La naturaleza modular de la actualización resalta la flexibilidad del SR650 V4, lo que le permite pasar fácilmente de una configuración de CPU orientada a la eficiencia a una plataforma equilibrada de CPU y GPU, ideal para cargas de trabajo de computación mixtas.
Configuración del Lenovo ThinkSystem SR650 V4:
- UPC: 2 procesadores Intel Xeon 6740P
- Memoria: 1 TB de RAM
- Almacenamiento: 4 SSD de 960 GB
- GPU: Nvidia L40S
Blender 4.5
Blender es una aplicación de modelado 3D de código abierto. Esta prueba de rendimiento se ejecutó con la utilidad Blender Benchmark. La puntuación se mide en muestras por minuto; los valores más altos indican un mejor rendimiento.
En la prueba de rendimiento de CPU de Blender, el Lenovo ThinkSystem SR650 V4 ofrece un rendimiento de renderizado sólido en todas las escenas, con 1136.99 muestras por minuto en Monster, 707.60 en Junkshop y 562.53 en Classroom. Los resultados reflejan un sólido escalado multihilo gracias a los dos procesadores Intel Xeon 6740P, con un rendimiento constante a medida que aumenta la complejidad de la escena.
| CPU de Blender (muestras por minuto; cuanto más alto, mejor) | Lenovo ThinkSystem SR650 V4 (2 procesadores Intel Xeon 6740P, 1 TB de RAM) |
|---|---|
| Monster | 1136.99 |
| chatarrería | 707.60 |
| Aulas | 562.53 |
En la prueba de rendimiento de Blender CPU sin SMT, el SR650 V4 muestra una mejora significativa en el rendimiento de renderizado, alcanzando 4686.40 muestras por minuto en Monster, 2223.96 en Junkshop y 2385.98 en Classroom. Los resultados de la GPU destacan la capacidad del sistema para acelerar cargas de trabajo de renderizado complejas, ofreciendo un rendimiento sustancialmente mayor en comparación con el renderizado solo con CPU.
| CPU Blender (sin SMT) (Muestras por minuto; cuanto más alto, mejor) | Lenovo ThinkSystem SR650 V4 (2 procesadores Intel Xeon 6740P, 1 TB de RAM) |
|---|---|
| Monster | 4686.40 |
| chatarrería | 2223.96 |
| Aulas | 2385.98 |
trituradora
y-cruncher es un programa multihilo y escalable que calcula Pi y otras constantes matemáticas hasta billones de dígitos. Desde su lanzamiento en 2009, se ha convertido en una aplicación popular de benchmarking y pruebas de estrés para overclockers y entusiastas del hardware.
En el análisis de problemas, Lenovo escala con fluidez a medida que aumenta el tamaño del problema, lo que destaca el sólido rendimiento de computación multihilo y el ancho de banda de memoria de la plataforma. Con dos procesadores Intel Xeon 6740P y 1 TB de RAM, el sistema completa un cálculo Pi de 1 billón de dígitos en poco más de 20 segundos y mantiene una eficiencia constante hasta 25 billón de dígitos, en 362 segundos. Los resultados muestran un escalamiento predecible bajo presión sostenida de CPU y memoria, lo que convierte al SR650 V4 en la opción ideal para cargas de trabajo matemáticas intensas y escenarios de pruebas de estrés.
| Y-Cruncher (tiempo total de cálculo) | Lenovo ThinkSystem SR650 V4 (2 procesadores Intel Xeon 6740P, 1 TB de RAM) |
|---|---|
| 1 mil millones | 20.715 s |
| 2.5 mil millones | 44.412 s |
| 5 mil millones | 81.937 s |
| 10 mil millones | 152.743 |
| 25 mil millones | 362.566 |
vLLM Online: Rendimiento de inferencia LLM
vLLM es el motor de inferencia y servicio de alto rendimiento más popular para LLM. El benchmark de servicio en línea de vLLM es una herramienta de evaluación del rendimiento que mide la capacidad de servicio real de este motor de inferencia bajo solicitudes concurrentes. Simula cargas de trabajo de producción enviando solicitudes a un servidor vLLM en ejecución con parámetros configurables, como la tasa de solicitudes, la longitud de entrada/salida y el número de clientes concurrentes. El benchmark mide métricas clave, como el rendimiento (tokens por segundo), el tiempo hasta el primer token y el tiempo por token de salida (TPOT), lo que ayuda a los usuarios a comprender el rendimiento de vLLM en diferentes condiciones de carga.
Probamos el rendimiento de la inferencia en un conjunto integral de modelos que abarcan varias arquitecturas, escalas de parámetros y estrategias de cuantificación, y evaluamos el rendimiento bajo diferentes perfiles de concurrencia.
Rendimiento del modelo denso
Los modelos densos siguen la arquitectura LLM convencional, en la que todos los parámetros y activaciones se utilizan durante la inferencia, lo que resulta en un procesamiento computacionalmente más intensivo que sus contrapartes dispersas. Para evaluar exhaustivamente las características de rendimiento en las distintas escalas del modelo y las estrategias de cuantificación, realizamos pruebas comparativas con múltiples configuraciones de modelos densos de la familia Llama 3.1 8B.
Llama 3.1 8B Precisión FP8
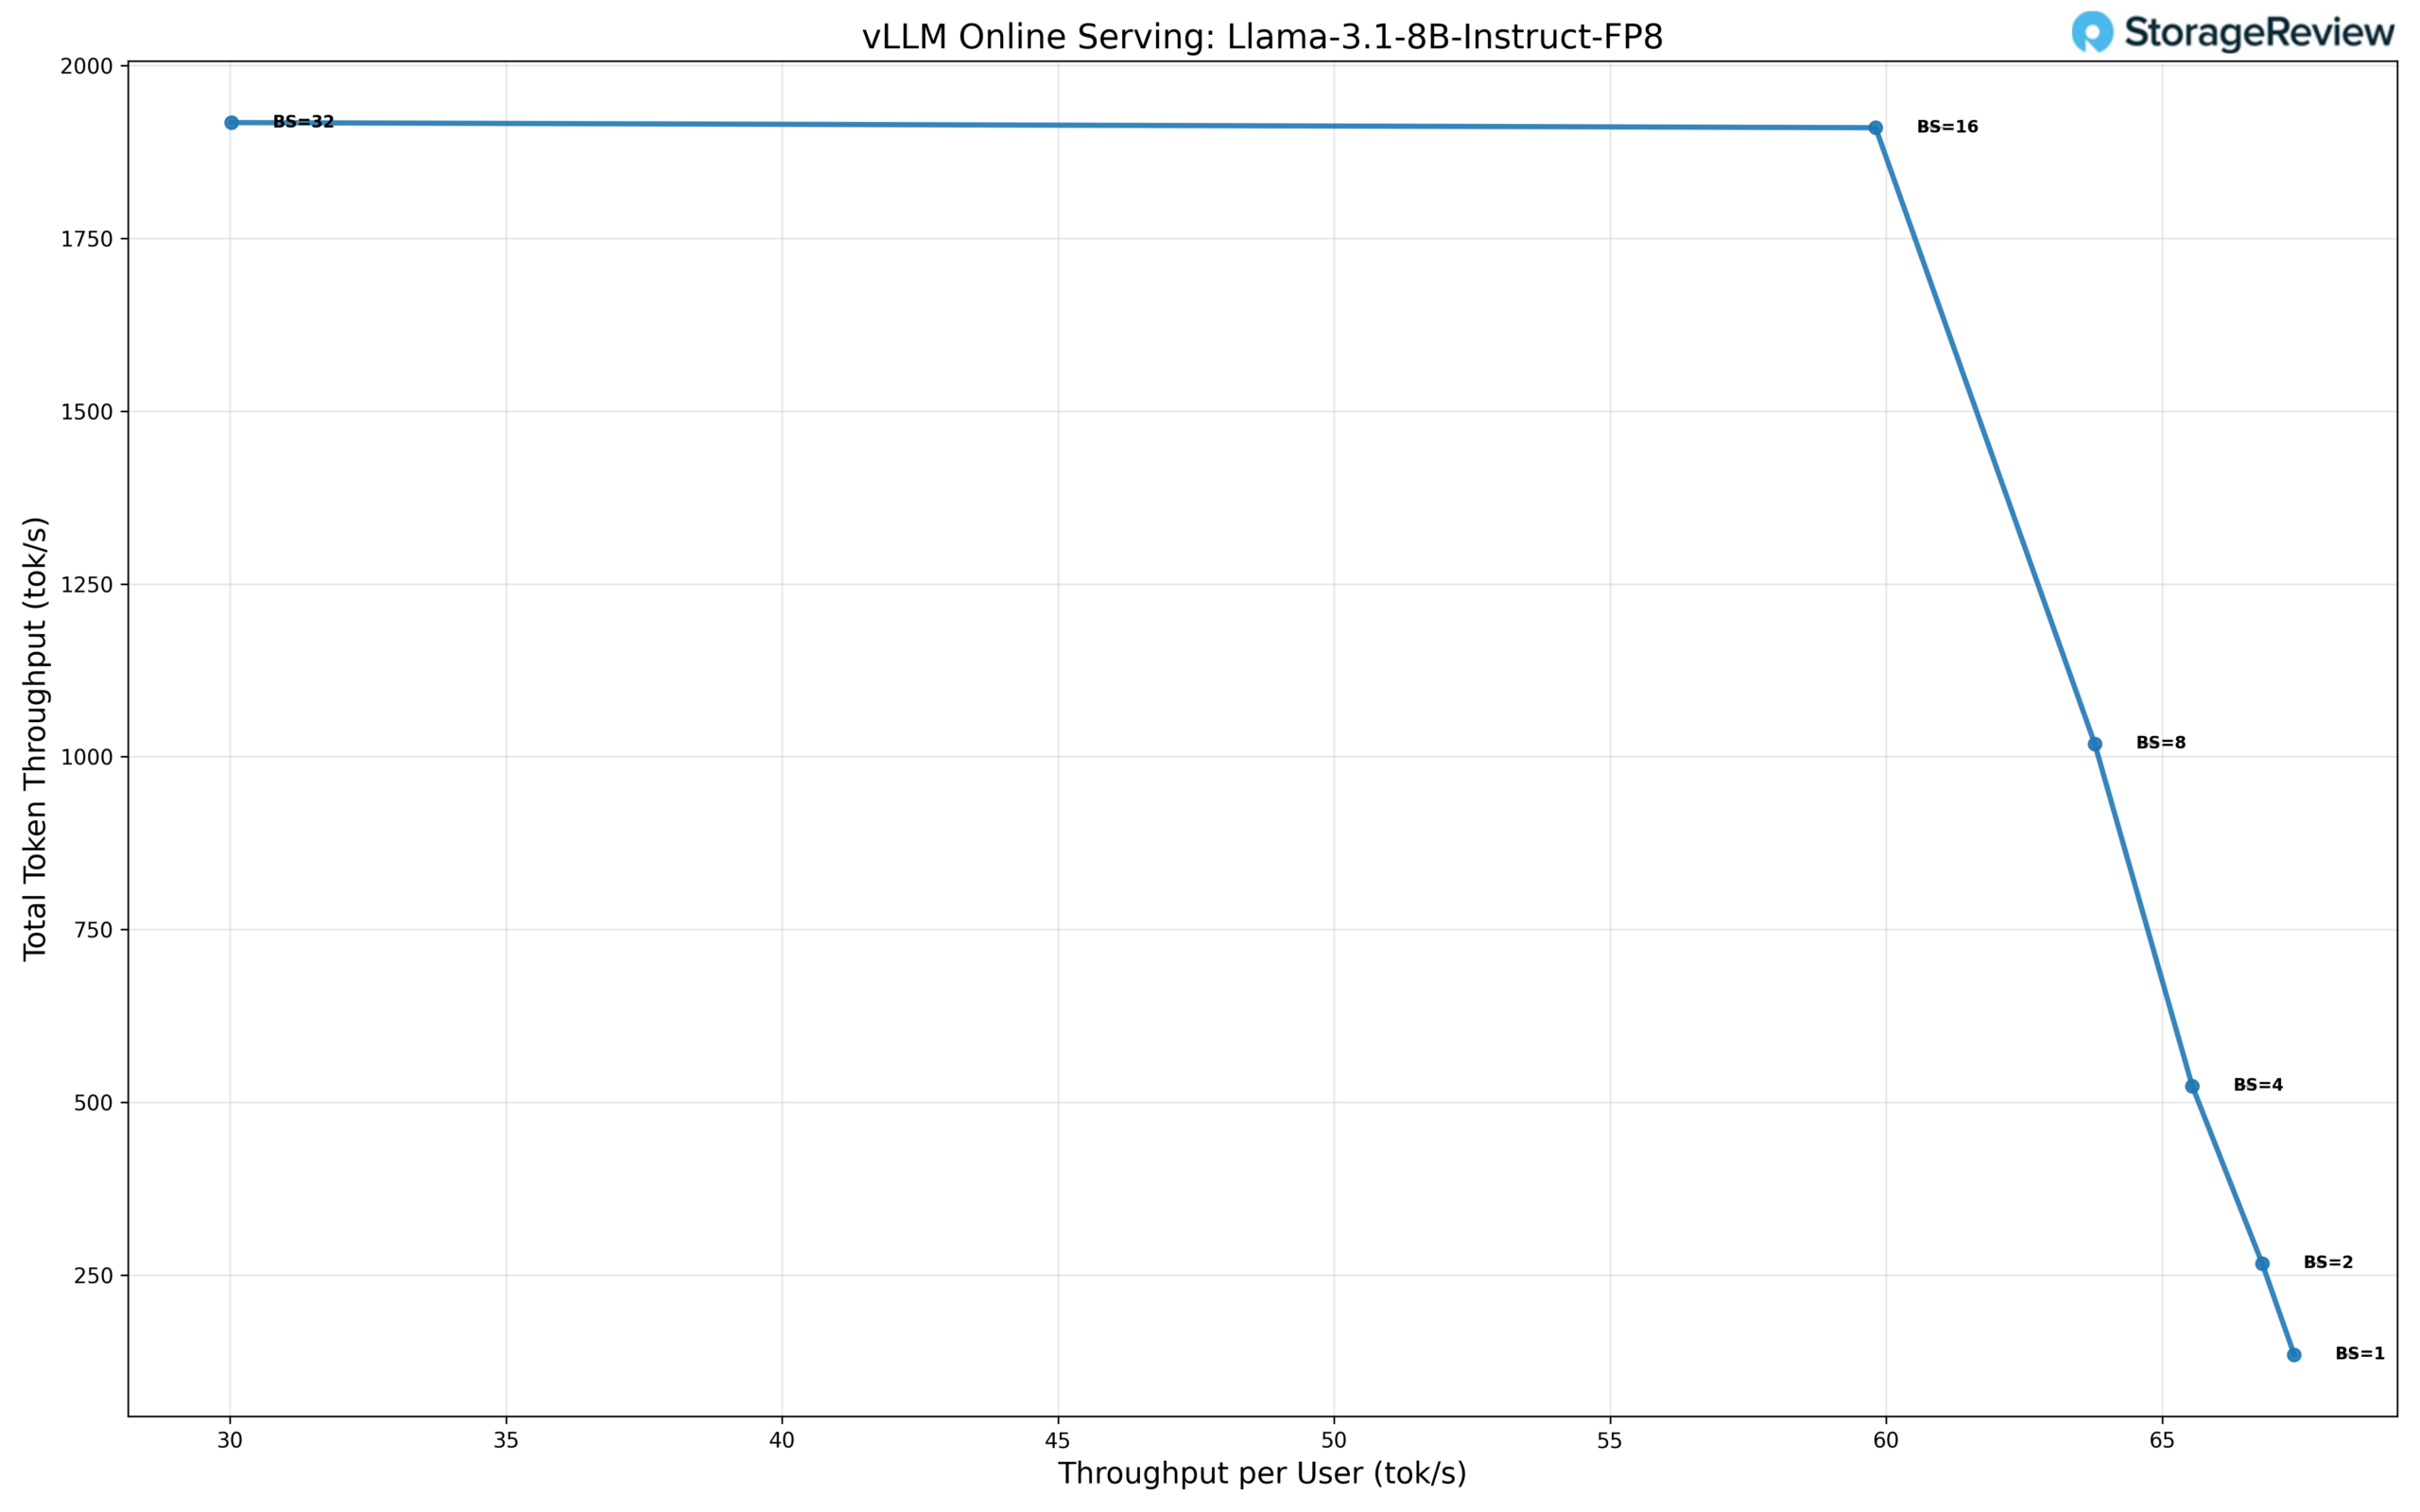
El modelo Llama 3.1 8B, ejecutado con precisión FP8, presenta un perfil de escalado diferente al de la configuración de precisión estándar, priorizando la eficiencia con niveles de concurrencia moderados y compensando el rendimiento máximo con lotes de mayor tamaño. Con concurrencia de un solo usuario (BS=1), el modelo ofrece 67.8 tok/s por usuario, con un rendimiento total de 135.6 tok/s y un TPOT de aproximadamente 3.1 ms, lo que establece una línea base de flujo único inferior a la de precisión completa.
A medida que aumenta el tamaño del lote, el rendimiento total escala rápidamente, mientras que el rendimiento por usuario disminuye de forma controlada. Con BS=2, el rendimiento aumenta a un total de 271 tok/s, con 66.8 tok/s por usuario. Con BS=4, el rendimiento total alcanza los 523 tok/s, y con BS=8, el modelo entrega 1,017 tok/s, con 63.6 tok/s por usuario. La latencia se mantiene estable a pesar de estos bajos niveles de concurrencia, lo que hace que FP8 sea ideal para escenarios de inferencia multiusuario ligeros.
El escalado continúa hasta BS=16, donde el modelo mantiene un rendimiento total de 1,918 tok/s, con 60.0 tok/s por usuario. En BS=32, el rendimiento total se estabiliza en aproximadamente 1,920 tok/s, y el rendimiento por usuario desciende a 30.0 tok/s. Esta estabilización indica que la configuración FP8 alcanza su punto de saturación antes que la precisión estándar, priorizando la eficiencia y la previsibilidad sobre el rendimiento agregado máximo.
En general, FP8 logra un aumento de aproximadamente 14 veces en el rendimiento total desde BS=1 hasta su pico en BS=16-32. La latencia se mantiene constante hasta BS=16 y luego se estabiliza junto con el rendimiento a mayor concurrencia, lo que convierte a FP8 en una opción práctica para cargas de trabajo de inferencia equilibradas y sensibles a la latencia, en lugar de un escalado por lotes extremo.
Llama 3.1 8B Precisión estándar
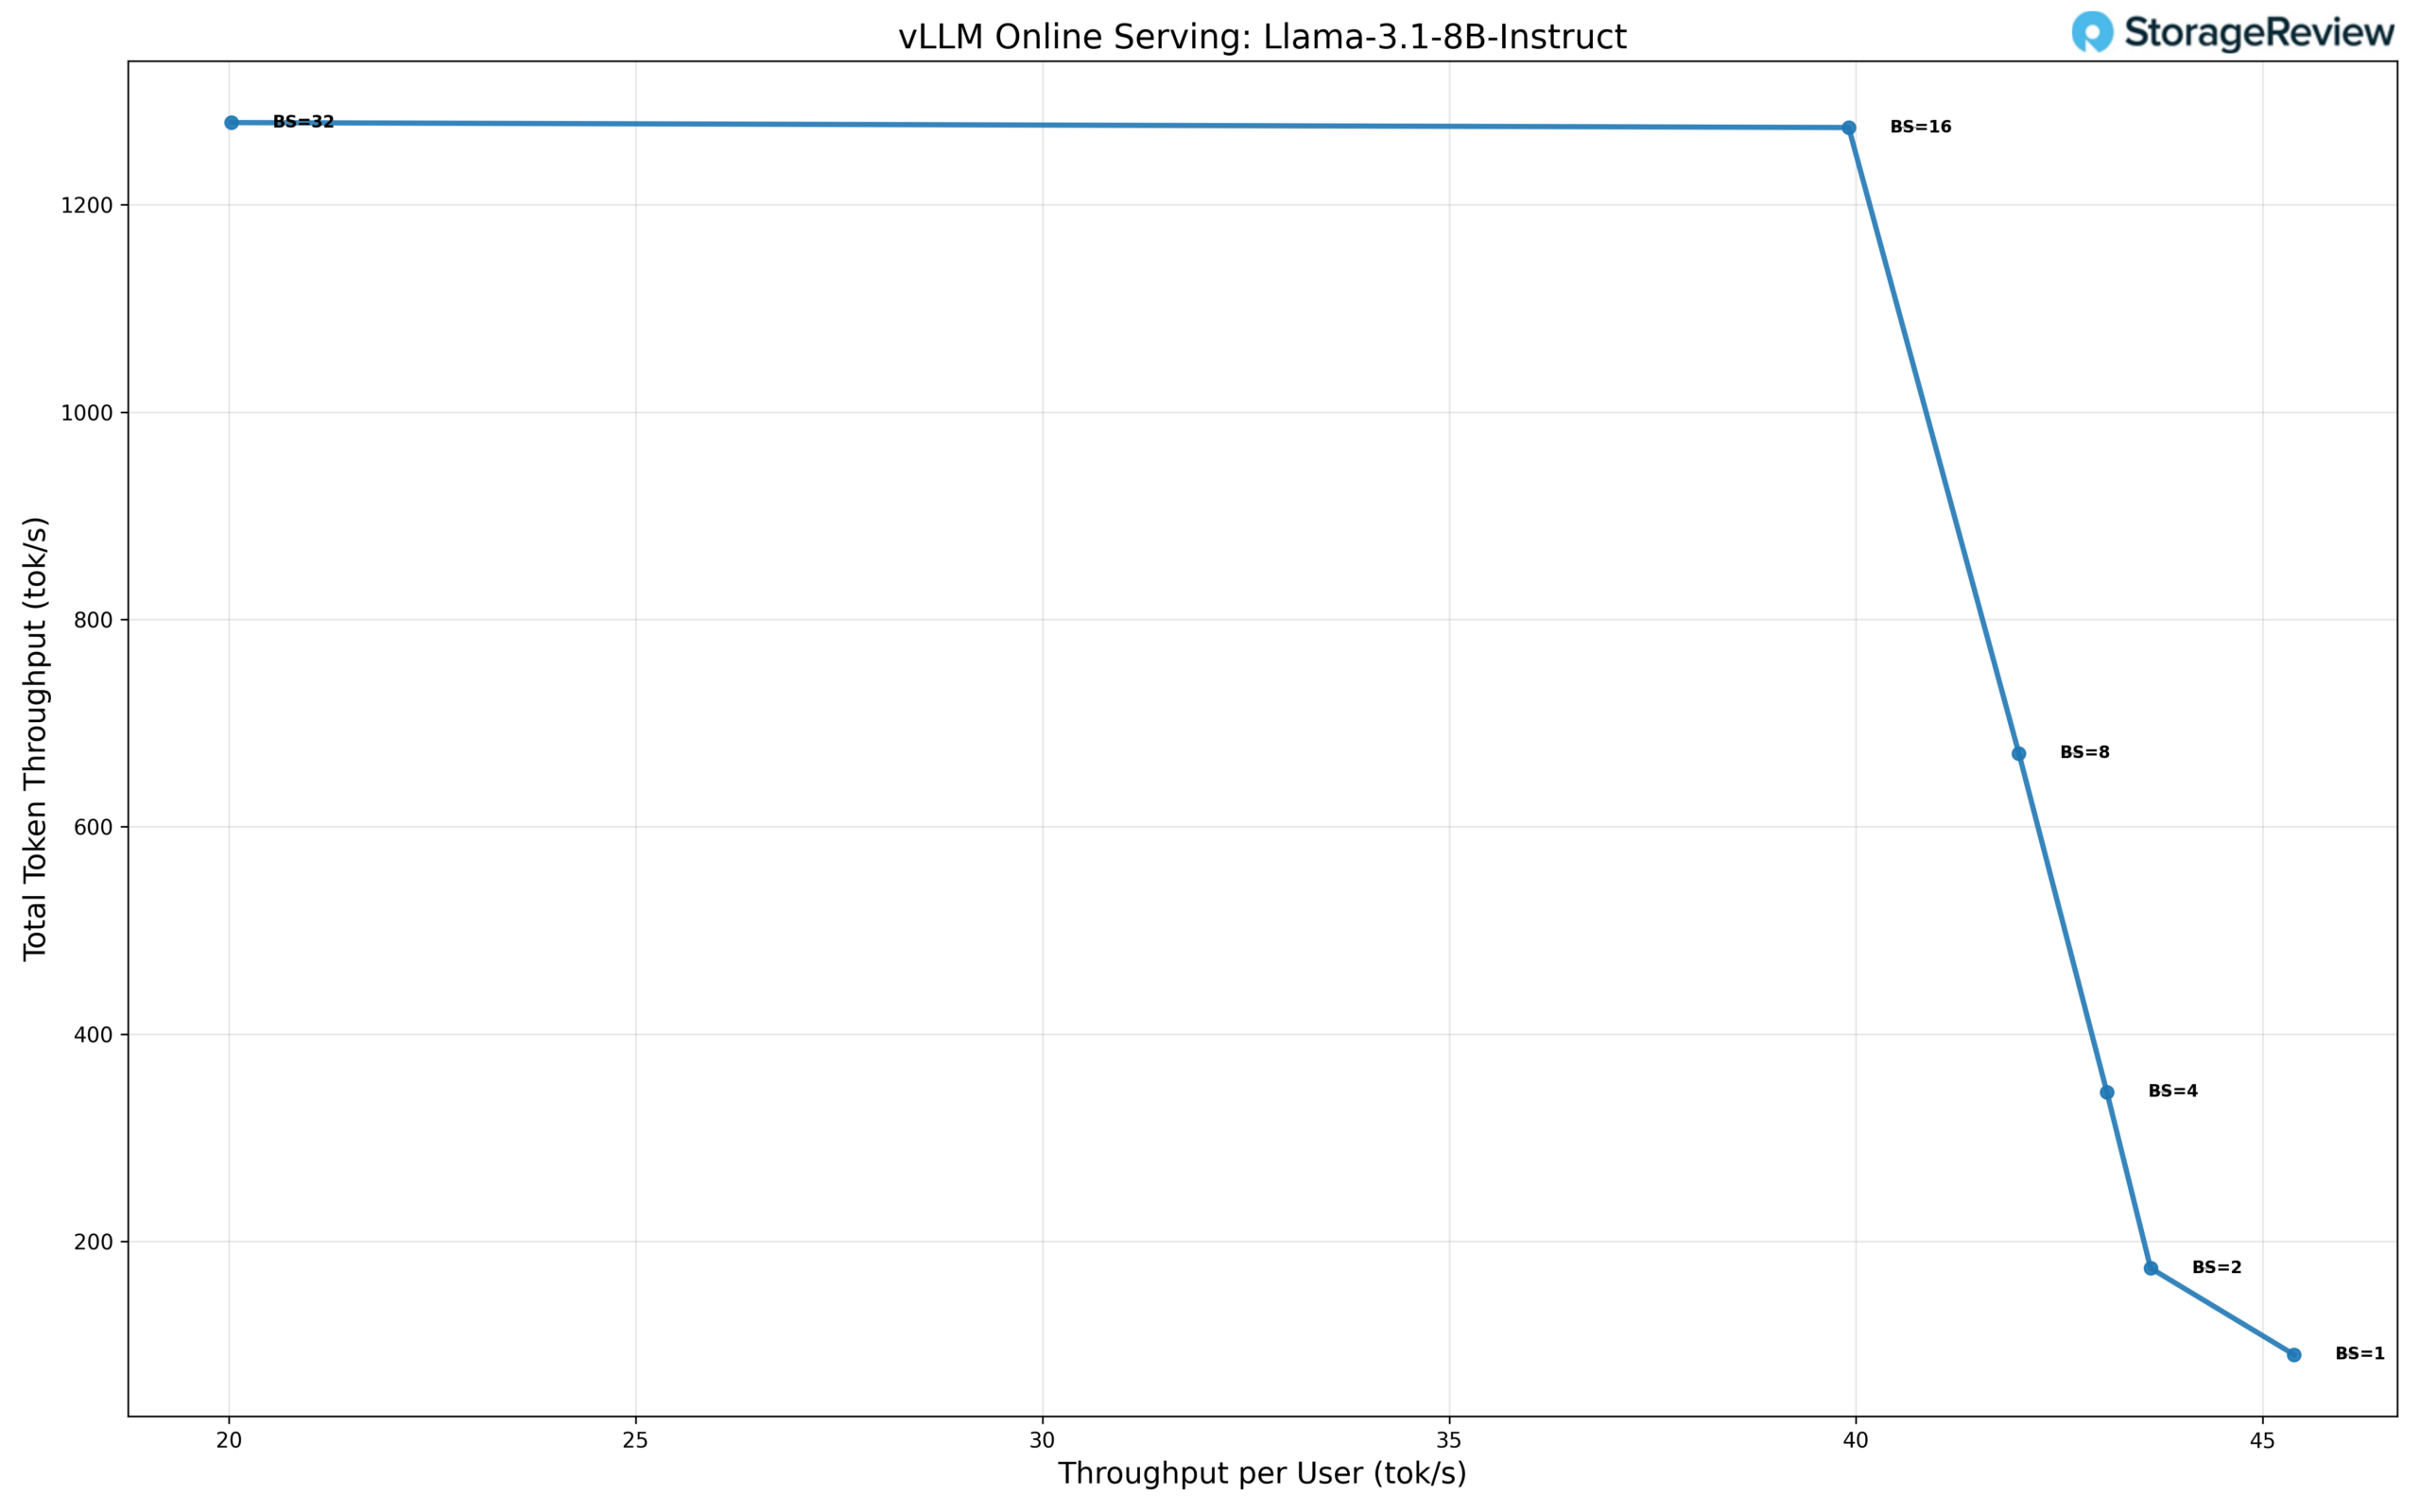
Con precisión estándar, el modelo Llama 3.1 8B muestra un comportamiento de escalamiento predecible a niveles de concurrencia bajos, con un sólido rendimiento por usuario en lotes pequeños y un aumento constante del rendimiento agregado a medida que aumenta la concurrencia. En una operación de un solo usuario (BS=1), el modelo ofrece aproximadamente 45.8 tok/s por usuario, lo que genera un rendimiento total de 91.6 tok/s y establece una base sólida para cargas de trabajo sensibles a la latencia.
A medida que aumenta la concurrencia, el rendimiento total escala eficientemente, mientras que el rendimiento por usuario disminuye gradualmente. En BS=2, el rendimiento total asciende a 176 tok/s, con 44.0 tok/s por usuario, y en BS=4, alcanza los 344 tok/s, con 43.0 tok/s por usuario. Este comportamiento continúa hasta BS=8, donde el modelo mantiene un rendimiento total de 672 tok/s, con 42.0 tok/s por usuario, lo que indica una buena utilización sin una degradación significativa del rendimiento por usuario.
El escalado continúa hasta BS=16, donde el rendimiento total alcanza un máximo de aproximadamente 1,280 tok/s, con 40.0 tok/s por usuario. En BS=32, el rendimiento total se mantiene prácticamente estable en torno a 1,280 tok/s, mientras que el rendimiento por usuario cae a 20.0 tok/s, lo que indica la saturación del flujo de ejecución. Esta meseta sugiere que, con precisión estándar, el modelo alcanza su punto óptimo de funcionamiento alrededor de BS=16, equilibrando el rendimiento y la capacidad de respuesta.
En general, la precisión estándar logra un aumento de aproximadamente 14 veces en el rendimiento total desde BS=1 hasta su valor máximo, con un rendimiento estable por usuario a través de niveles de concurrencia moderados. Este perfil hace que la precisión estándar sea ideal para implementaciones que priorizan una latencia constante y un escalado predecible sobre una expansión de lotes agresiva.
Rendimiento del modelo disperso
Los modelos dispersos, en particular las arquitecturas de Mezcla de Expertos (MoE), son un enfoque emergente para escalar eficientemente los modelos de lenguaje. Estas arquitecturas mantienen un alto número total de parámetros, activando solo un subconjunto de parámetros por token, lo que potencialmente ofrece un mejor rendimiento por parámetro activo.
Rendimiento del Qwen3-Coder-30B-A3B FP8
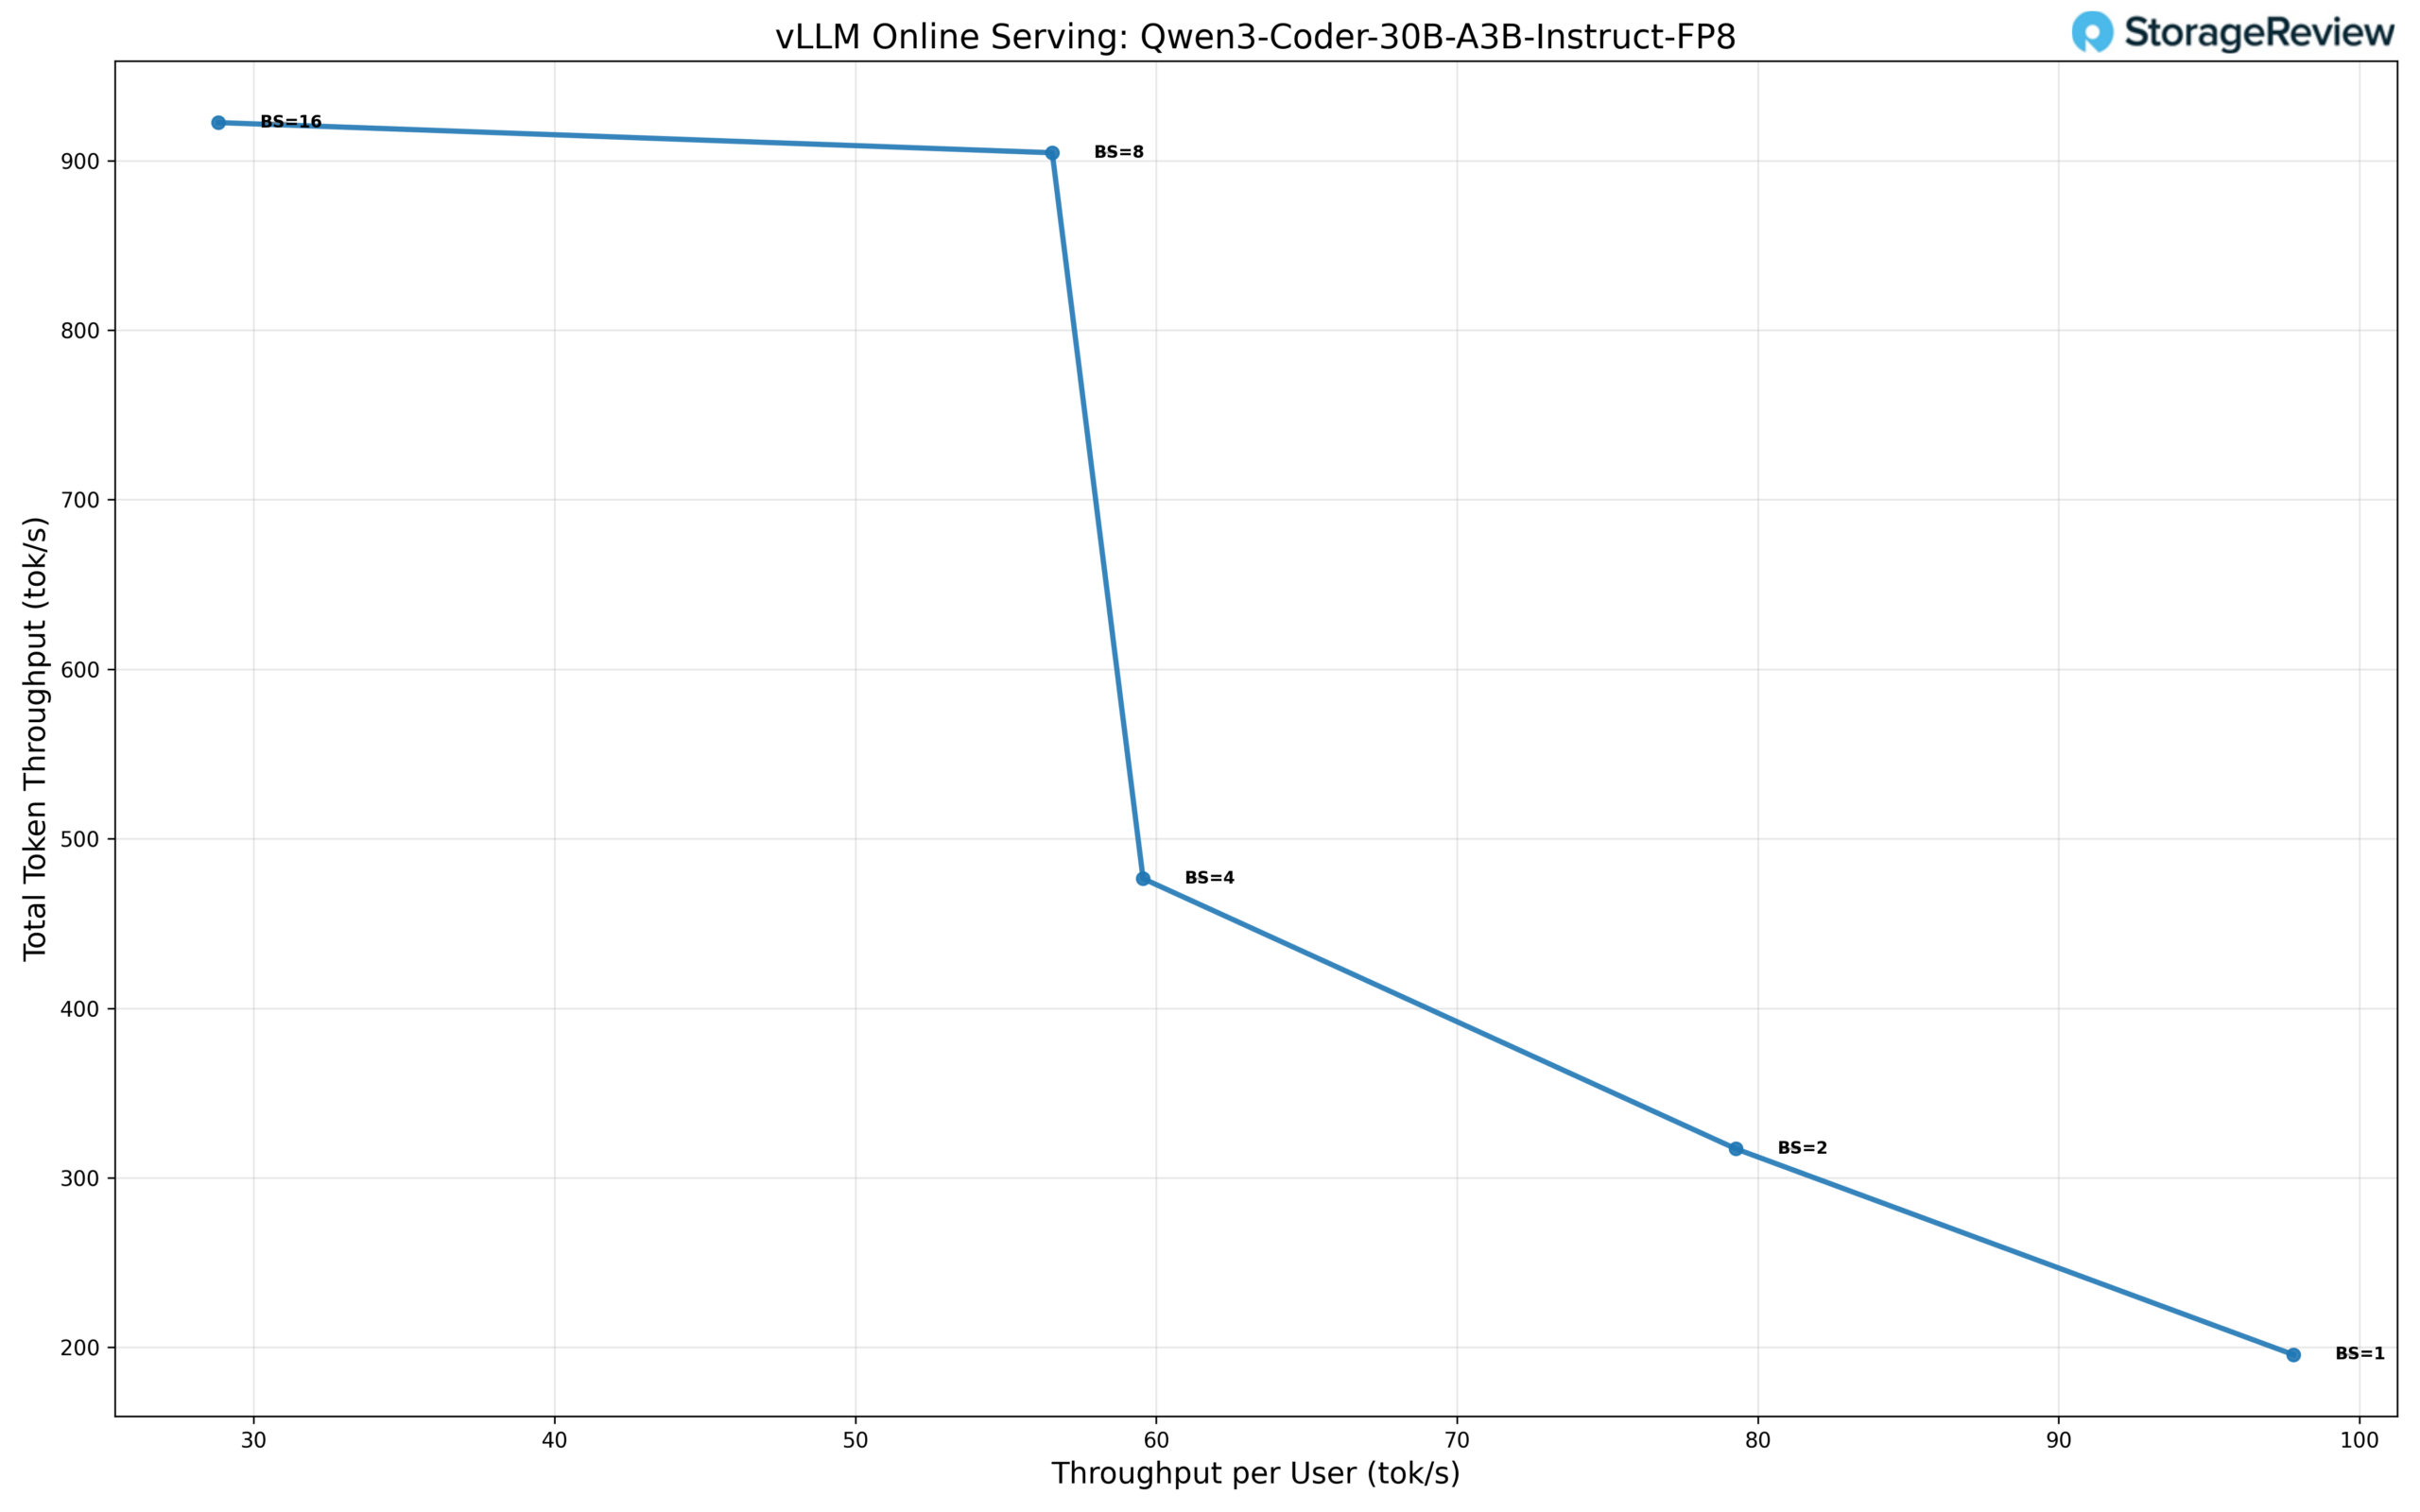
El modelo Qwen3-Coder-30B-A3B, ejecutado con precisión FP8, presenta un perfil de escalamiento optimizado para una concurrencia moderada, ofreciendo un alto rendimiento por usuario y alcanzando la saturación antes que modelos más pequeños. En funcionamiento con un solo usuario (BS=1), el modelo alcanza aproximadamente 98 tok/s por usuario, con un rendimiento total de 196 tok/s, lo que establece una línea base alta para un solo flujo que refleja la optimización del modelo para cargas de trabajo de generación de código.
A medida que aumenta la concurrencia, el rendimiento total escala eficientemente, mientras que el rendimiento por usuario disminuye de forma controlada. Con BS=2, el rendimiento total asciende a 317 tok/s, con 79 tok/s por usuario, y con BS=4, el modelo ofrece un rendimiento total de 477 tok/s, con 59 tok/s por usuario. Estos resultados muestran una utilización eficaz de los recursos informáticos disponibles mediante un procesamiento por lotes de bajo a moderado, sin una degradación abrupta de la capacidad de respuesta por usuario.
El modelo alcanza su rendimiento agregado máximo en BS=8, manteniendo un rendimiento total de aproximadamente 905 tok/s, con 56 tok/s por usuario. El escalado continúa ligeramente hasta BS=16, donde el rendimiento total aumenta ligeramente a 920 tok/s, mientras que el rendimiento por usuario disminuye a 29 tok/s, lo que indica la saturación del flujo de inferencia. Más allá de este punto, la concurrencia adicional proporciona ganancias mínimas en el rendimiento total, pero impacta significativamente el rendimiento por usuario.
En general, Qwen3-Coder-30B-A3B FP8 ofrece un aumento aproximado de 4.7 veces en el rendimiento total desde BS=1 hasta su pico en BS=16. Las características de latencia y rendimiento sugieren que esta configuración es ideal para cargas de trabajo de codificación multiusuario moderadas que requieren un alto rendimiento por solicitud. Aun así, el escalado extremo por lotes no es el objetivo principal.
Rendimiento de tipos de datos de microescala
El microescalado representa un enfoque de cuantificación avanzado que aplica factores de escala de grano fino a pequeños bloques de ponderaciones, en lugar de una cuantificación uniforme en grandes grupos de parámetros. El formato NVFP4 de NVIDIA implementa esta técnica mediante una representación en coma flotante bloqueada, donde cada bloque de microescala de 8 a 32 valores comparte un exponente típico como factor de escala. Este enfoque granular preserva la precisión numérica a la vez que logra una representación de 4 bits, manteniendo el rango dinámico, crucial para las arquitecturas de transformador. El formato se integra con la arquitectura Tensor Core de NVIDIA, lo que permite un cálculo eficiente de precisión mixta con descompresión sobre la marcha durante las operaciones matriciales.
Rendimiento de GPT-OSS-20b
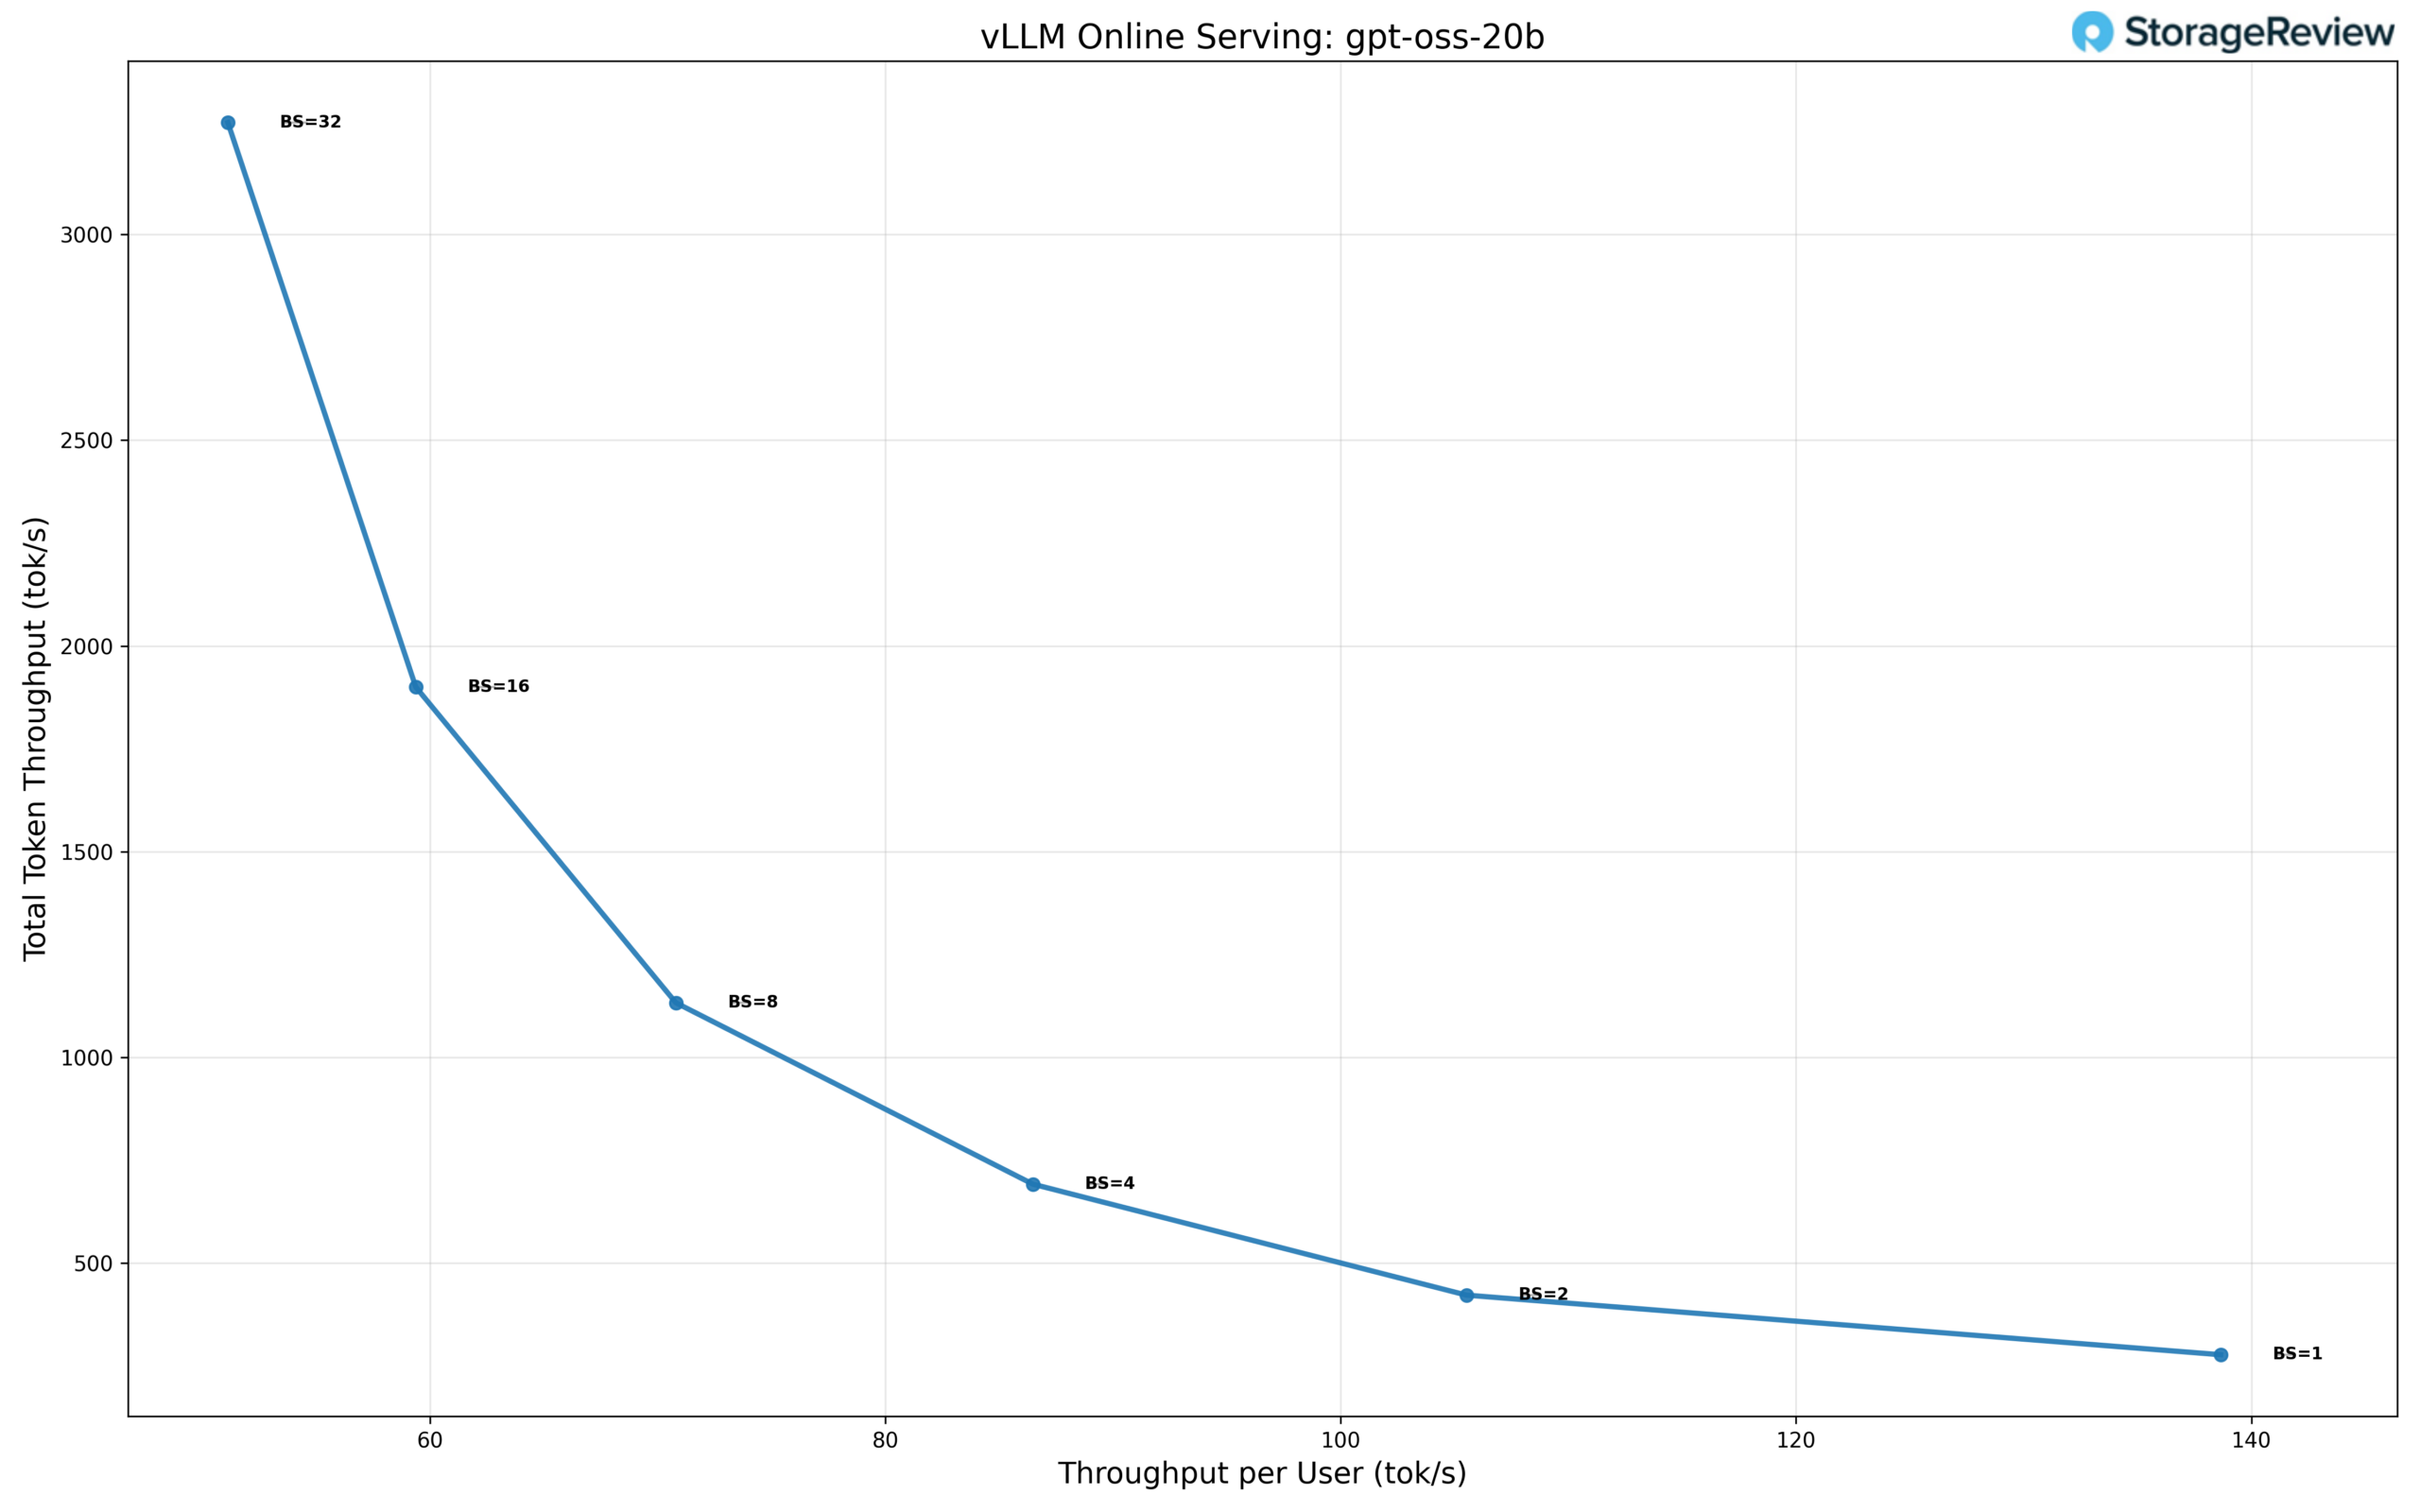
El modelo gpt-oss-20b demuestra sólidas características de escalabilidad a medida que aumentan los niveles de concurrencia, con un rendimiento agregado particularmente alto en lotes de mayor tamaño. En concurrencia de un solo usuario (BS=1), el modelo ofrece aproximadamente 138 tok/s por usuario, lo que resulta en un rendimiento total de 276 tok/s, estableciendo una base sólida para la inferencia de flujo único.
A medida que aumenta la concurrencia, el rendimiento total aumenta drásticamente, mientras que el rendimiento por usuario disminuye según lo previsto. Con BS=2, el rendimiento total asciende a 420 tok/s, con 105 tok/s por usuario, y con BS=4, alcanza un total de 690 tok/s, con 86 tok/s por usuario. Esta progresión constante indica un uso eficiente de los recursos informáticos disponibles mediante un procesamiento por lotes de bajo a moderado.
El escalado continúa hasta BS=8, donde el modelo alcanza un rendimiento total de aproximadamente 1,120 tok/s a 70 tok/s por usuario, y hasta BS=16, donde el rendimiento total aumenta a 1,900 tok/s, con 60 tok/s por usuario. Estos resultados muestran que gpt-oss-20b mantiene un rendimiento por usuario relativamente alto incluso con el aumento de la concurrencia, lo que lo hace ideal para escenarios de servicio multiusuario.
El modelo alcanza su rendimiento agregado máximo en BS=32, con un rendimiento total aproximado de 3,250 tok/s, mientras que el rendimiento por usuario disminuye a 50 tok/s. Esto representa un aumento de 11.8 veces en el rendimiento total en comparación con el rendimiento de un solo usuario. Si bien el rendimiento por usuario continúa disminuyendo con tamaños de lote mayores, la eficiencia general de escalado se mantiene sólida, lo que indica que el modelo se beneficia de una mayor concurrencia sin alcanzar un punto de saturación precoz.
En general, gpt-oss-20b presenta un perfil de escalado equilibrado, que combina un alto rendimiento con un solo usuario y un sólido escalado por lotes. Esto lo convierte en una opción atractiva para implementaciones que requieren una inferencia individual ágil y un alto rendimiento agregado con una carga multiusuario más alta.
Puntos de referencia de Phoronix
Phoronix Test Suite es una plataforma de benchmarking automatizada de código abierto que admite más de 450 perfiles de prueba y más de 100 suites de pruebas a través de OpenBenchmarking.org. Gestiona todo, desde la instalación de dependencias hasta la ejecución de pruebas y la recopilación de resultados, lo que la hace ideal para comparaciones de rendimiento, validación de hardware e integración continua.
Ancho de banda de memoria de flujo
El SR650 V4 entregó 369.6 GB/s de ancho de banda de memoria, lo que demostró un sólido rendimiento para cargas de trabajo con uso intensivo de datos y confirmó un rendimiento saludable de la memoria multicanal.
Compresión de 7 cremalleras
Con 584,499 MIPS, el sistema registró un excelente rendimiento de compresión y descompresión, lo que refleja una sólida eficiencia de múltiples núcleos y una fuerte capacidad de cálculo de números enteros.
Compilación del kernel
El servidor completó la compilación del kernel allmod en 256.175 segundos, un resultado respetable que resalta su capacidad para manejar compilaciones paralelas y flujos de trabajo de desarrolladores de manera eficiente.
Apache Web Server
Con 61,654 R/s, el SR650 V4 mostró un sólido rendimiento de servicio web, manteniendo un alto rendimiento de solicitudes adecuado para alojamiento front-end o pilas de virtualización livianas.
Verificación de OpenSSL
Al alcanzar 712.6 mil millones de bytes por segundo, la plataforma demostró un sólido rendimiento de verificación criptográfica, lo que confirma la capacidad de la CPU para realizar operaciones seguras con muchos certificados.
| Puntos de referencia de Phoronix | Lenovo Think System SR650 V4 |
|---|---|
| Transmite | 369,58.3 MB / s |
| 7 cremalleras | 584,499 MIPS |
| Compilación del kernel (allmod) | 256.175 Segundos |
| Apache (solicitudes por segundo) | 61,654.47 rupias por segundo |
| SSL abierto | 712,633,776,990 bytes/s |
Conclusión
El ThinkSystem SR650 V4 es el tipo de actualización de plataforma que importa, ya que no se trata solo de un cambio de CPU. Lenovo aprovechó esta generación para impulsar mejoras significativas en áreas que limitan las implementaciones en el mundo real: ancho de banda de memoria, disponibilidad de líneas PCIe, densidad de almacenamiento y la capacidad de adaptar la configuración según las necesidades. La transición a Intel Xeon 6 ofrece más opciones de núcleo y mayor margen de E/S por zócalo. Además, el trabajo de plataforma, que incluye una DDR5 más rápida con compatibilidad con MRDIMM y expansión CXL opcional, le da al SR650 V4 la posibilidad de seguir siendo relevante a medida que las cargas de trabajo consumen más memoria.
En cuanto al almacenamiento, a pesar de nuestra limitada configuración de análisis con U.2, la apuesta de Lenovo por E3.S ofrece una mayor densidad NVMe con conectividad 1:1 y características térmicas más limpias, en línea con la forma en que se construye la infraestructura moderna, especialmente para pilas de virtualización que requieren más memoria flash local y para canales adyacentes a la IA, donde la alimentación de las GPU es tan importante como el cómputo bruto. Las dos ranuras OCP 3.0 Gen5 x16 también suponen una mejora práctica: permite implementar redes de alto rendimiento sin sacrificar las ranuras PCIe que preferirías reservar para aceleradores, almacenamiento o adaptadores especializados.
Si utiliza el SR650 V3 y se siente limitado por la velocidad de la memoria, el margen de PCIe o la densidad de NVMe, el SR650 V4 es un avance convincente. Conserva la facilidad de mantenimiento y la configurabilidad que popularizaron la línea SR650, a la vez que añade la plataforma que ayuda a los equipos de TI a evitar quedar acorralados. Ya sea que esté construyendo un clúster de virtualización, modernizando servicios de escalamiento horizontal o ensamblando un nodo de CPU/GPU equilibrado, el SR650 V4 cumple con los requisitos importantes y deja espacio para lo que viene después.
Clasificación: La L40S probada aquí ocupa el primer lugar en nuestra clasificación de las mejores GPU empresariales para inferencia de uso general.


 Amazon