

Hasta ahora, nos hemos adentrado en Microsoft Azure Stack HCI , la implementación local del servicio en la nube Azure de Microsoft. Azure Stack HCI puede considerarse una plataforma que combina lo mejor de ambos mundos. Incluye todas las herramientas de administración de Azure, como Azure Monitor, Azure Security Center, Azure Update Management, Azure Network Adapter y Azure Site Recovery, al tiempo que almacena los datos localmente y cumple con ciertas normativas. Azure Stack HCI se divide en tres partes: arquitectura definida por software, servicios de Azure y hardware.
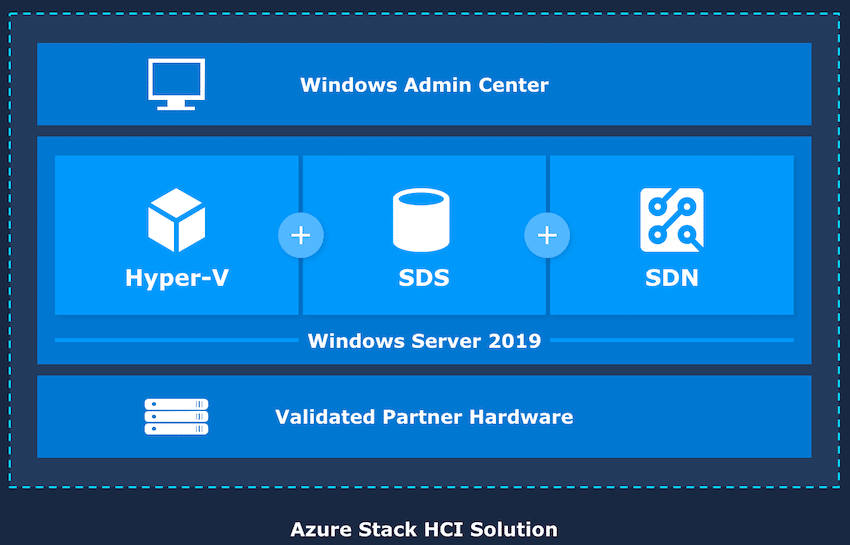
Elegir el hardware adecuado es fundamental, como detallamos en nuestro artículo « La importancia del hardware en Microsoft Azure Stack HCI ». El primer paso para implementar Azure Stack HCI es encontrar un proveedor de hardware certificado, en este caso, DataON. DataON mantiene una sólida colaboración con Microsoft e Intel desde hace varios años y plasma esta colaboración en la configuración de hardware para Azure Stack HCI con procesadores Intel Select. Un aspecto interesante de la colaboración con Intel es la posibilidad de aprovechar la plataforma PMEM de la compañía (y, por supuesto, sus procesadores más recientes) con Azure Stack HCI.
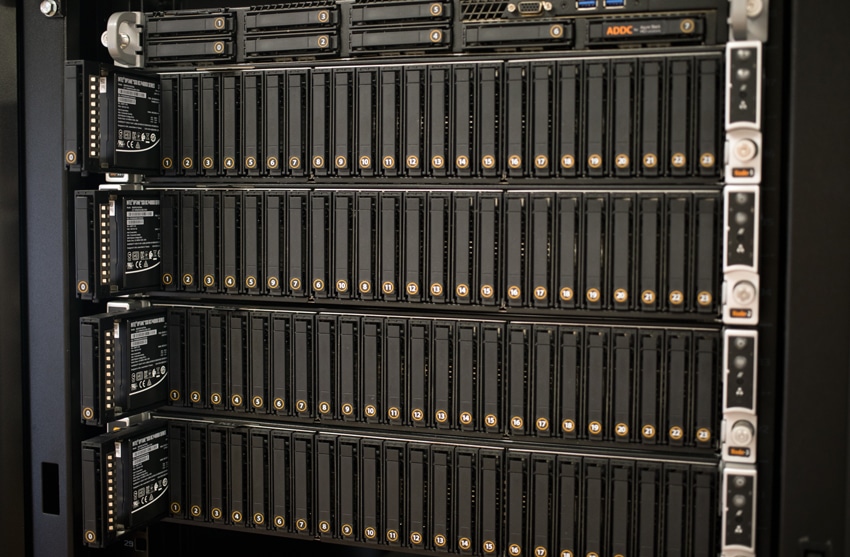
En muchos casos, las soluciones DataON HCI Intel Select se configuran y envían en su propio rack, listas para implementarse de inmediato. Este método de entrega es particularmente útil en el perímetro, donde la infraestructura de TI existente es limitada o inexistente. En el laboratorio de StorageReview, implementamos los cuatro nodos de computación y almacenamiento, el controlador de dominio y los conmutadores como se muestra en el diagrama a continuación.
Construcción y Diseño
El clúster HCI de Microsoft Azure Stack que revisamos se basa en la plataforma DataON HCI-224 All Flash NVMe. Estos servidores tienen un tamaño de 2U con bahías de 24 NVMe en la parte delantera, lo que ofrece una gran expansión en la parte trasera para componentes basados en PCIe. El etiquetado es alto en contraste con los caddies de unidades de color negro mate, lo que facilita la detección de unidades específicas si llega el momento de cambiarlas. Todo está etiquetado, lo cual no es tan raro, pero el alcance del etiquetado sí lo está. Nuestra implementación tiene cada nodo etiquetado (del 1 al 4), así como una serie de otros elementos que facilitan la implementación y la administración en el centro de datos.
Nuestra configuración vino equipada con 48 SSD NVMe, o 12 por nodo. Estos incluyeron cuatro SSD Intel Optane P375X de 4800 GB y ocho SSD Intel P4510 de 2 TB.
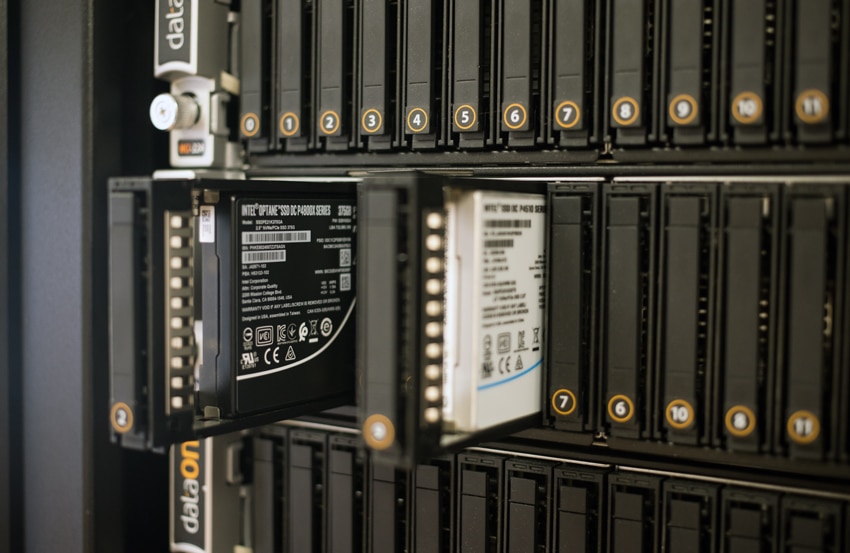
En la parte posterior, tenemos dos NIC Mellanox Connect-X 100 de dos puertos de 5 G, lo que proporciona una conexión completamente redundante a través de dos conmutadores Mellanox de 100 G (SN2100) para el tráfico de red de clúster. En nuestra fotografía de estudio no se muestran todas las conexiones con el etiquetado completo en cada extremo del cable de red apropiado para permitir un cableado sin errores en la etapa de implementación.
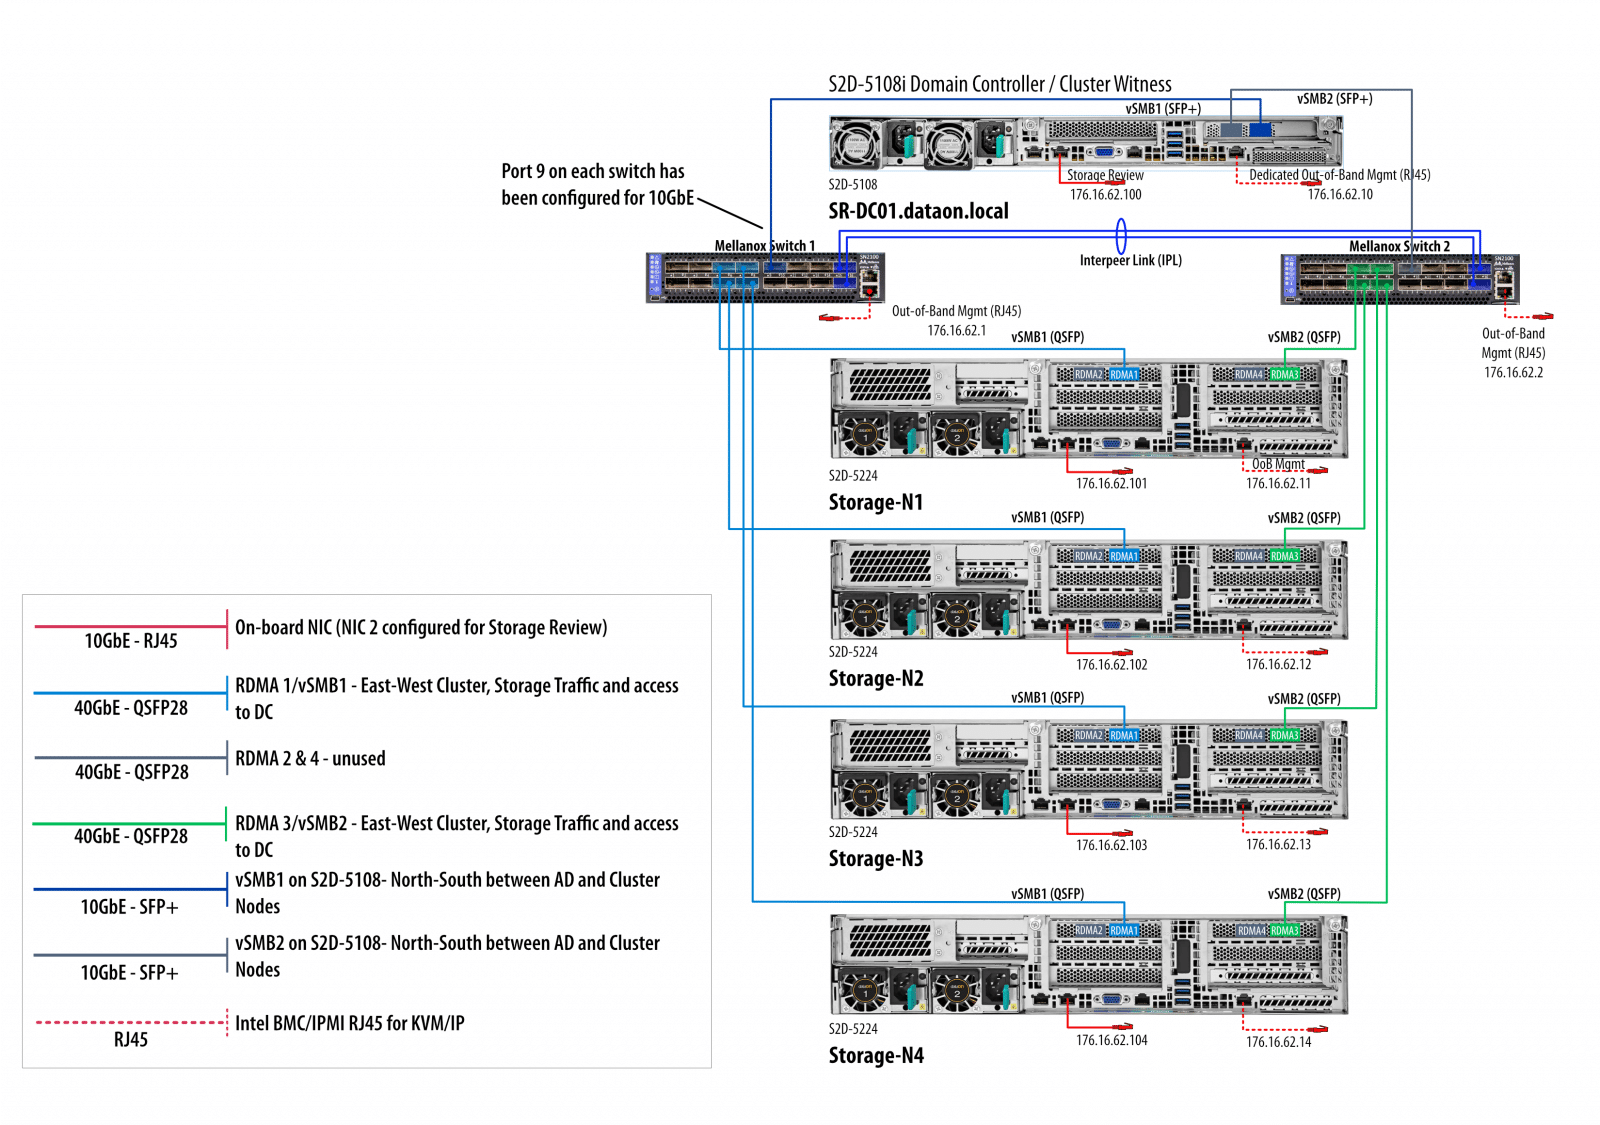
Antes de esto, nunca habíamos recibido una solución con este nivel de documentación en la etiqueta. Microsoft y DataON hacen que la implementación de Azure Stack sea un proceso sencillo para que los clientes puedan comenzar a operar de inmediato. Cada cable está codificado por color para el uso específico y etiquetado para el lugar donde va cada extremo. Combinado con la hoja personalizada que DataON proporciona a los clientes, casi garantiza una implementación sin errores. En nuestra implementación, el sistema estaba preconfigurado con direcciones IP antes del envío, con las direcciones IP para administración e IPMI etiquetadas.
Gestión y Usabilidad
Para los compradores que ejecutan una tienda Hyper-V que opera en Windows Server, Microsoft Azure Stack HCI será una transición fácil. Muchas de las mismas herramientas de administración están implementadas, y muchas ofrecen un flujo de trabajo más integrado y simple. En nuestro proceso de revisión, aprovechamos tanto el Administrador de clústeres de conmutación por error de Windows para administrar el clúster HCI de DataOn, como el Centro de administración de Windows para monitorear las cargas de trabajo y ver cómo se estaban desempeñando.
Mirando más del nivel de nodo primero a través de una sesión de Escritorio remoto de Microsoft (RDP) iniciada en uno de los nodos, observamos el Administrador de clústeres de conmutación por error de Windows. Esto brinda tanto capacidades de administración a nivel de nodo como visibilidad a nivel de clúster. Este tipo de acceso estaría más orientado a la implementación inicial, donde el monitoreo diario se realizaría desde el Centro de administración de Windows.
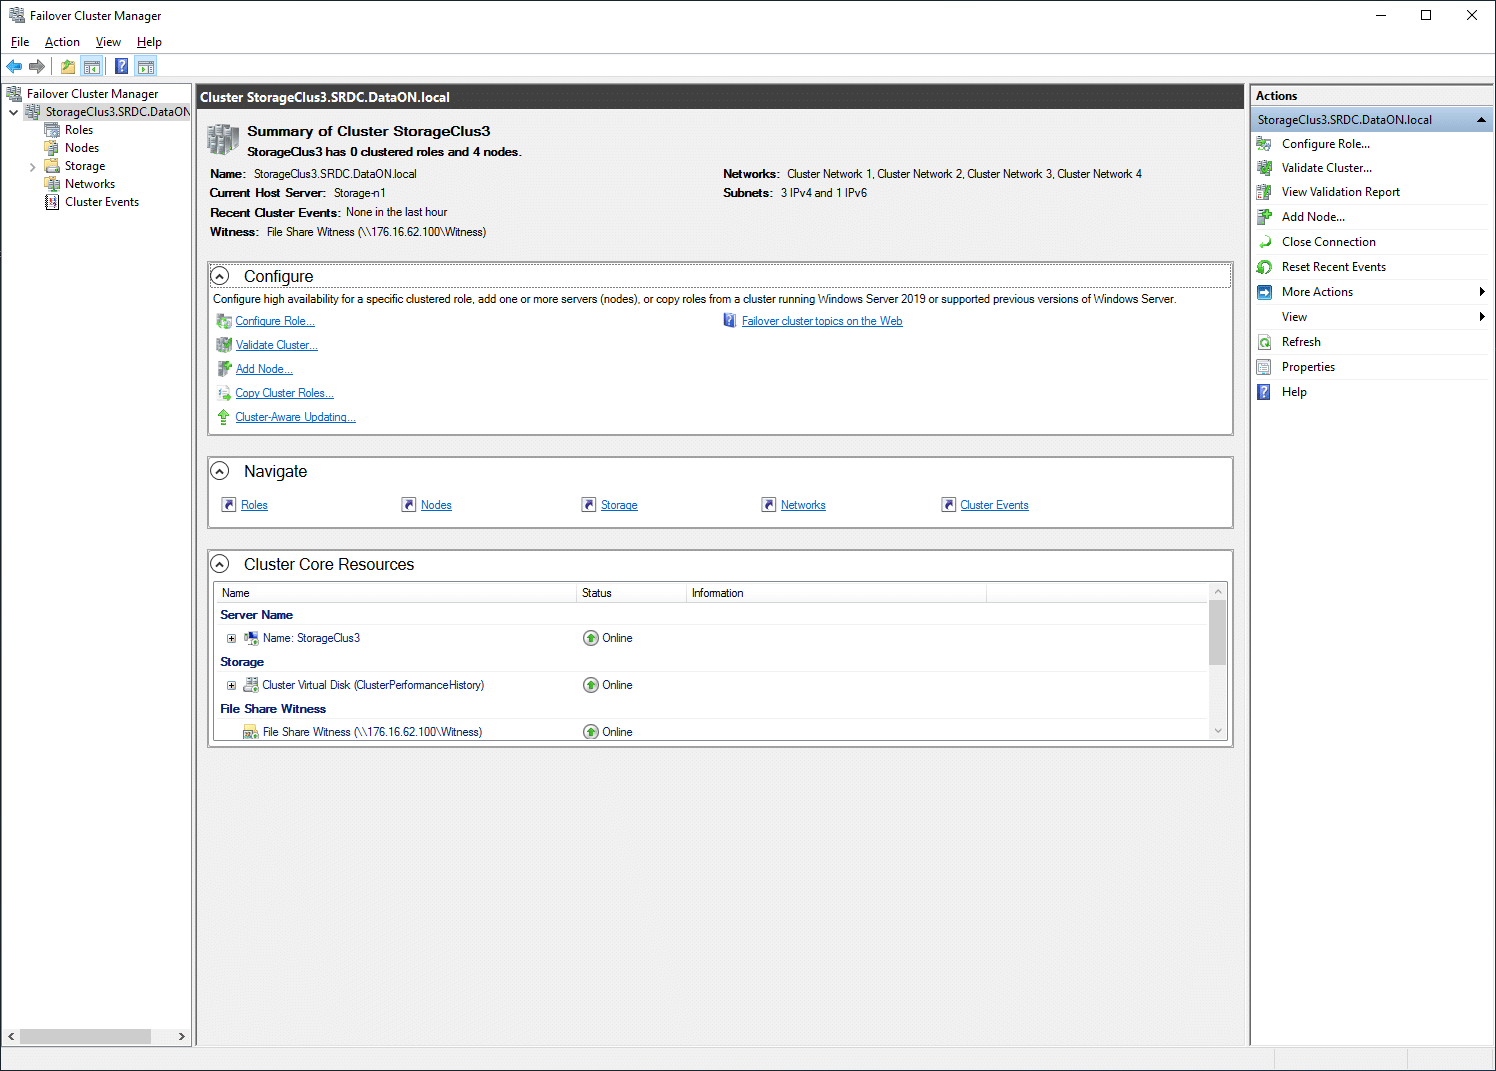
Primero, hacemos clic en nuestro clúster particular y obtenemos información general sobre él, la capacidad de configurarlo y una mirada a los recursos. Esto brinda una vista resumida del clúster seleccionado, lo que le permite ver dónde están los problemas y comenzar a profundizar en áreas específicas.
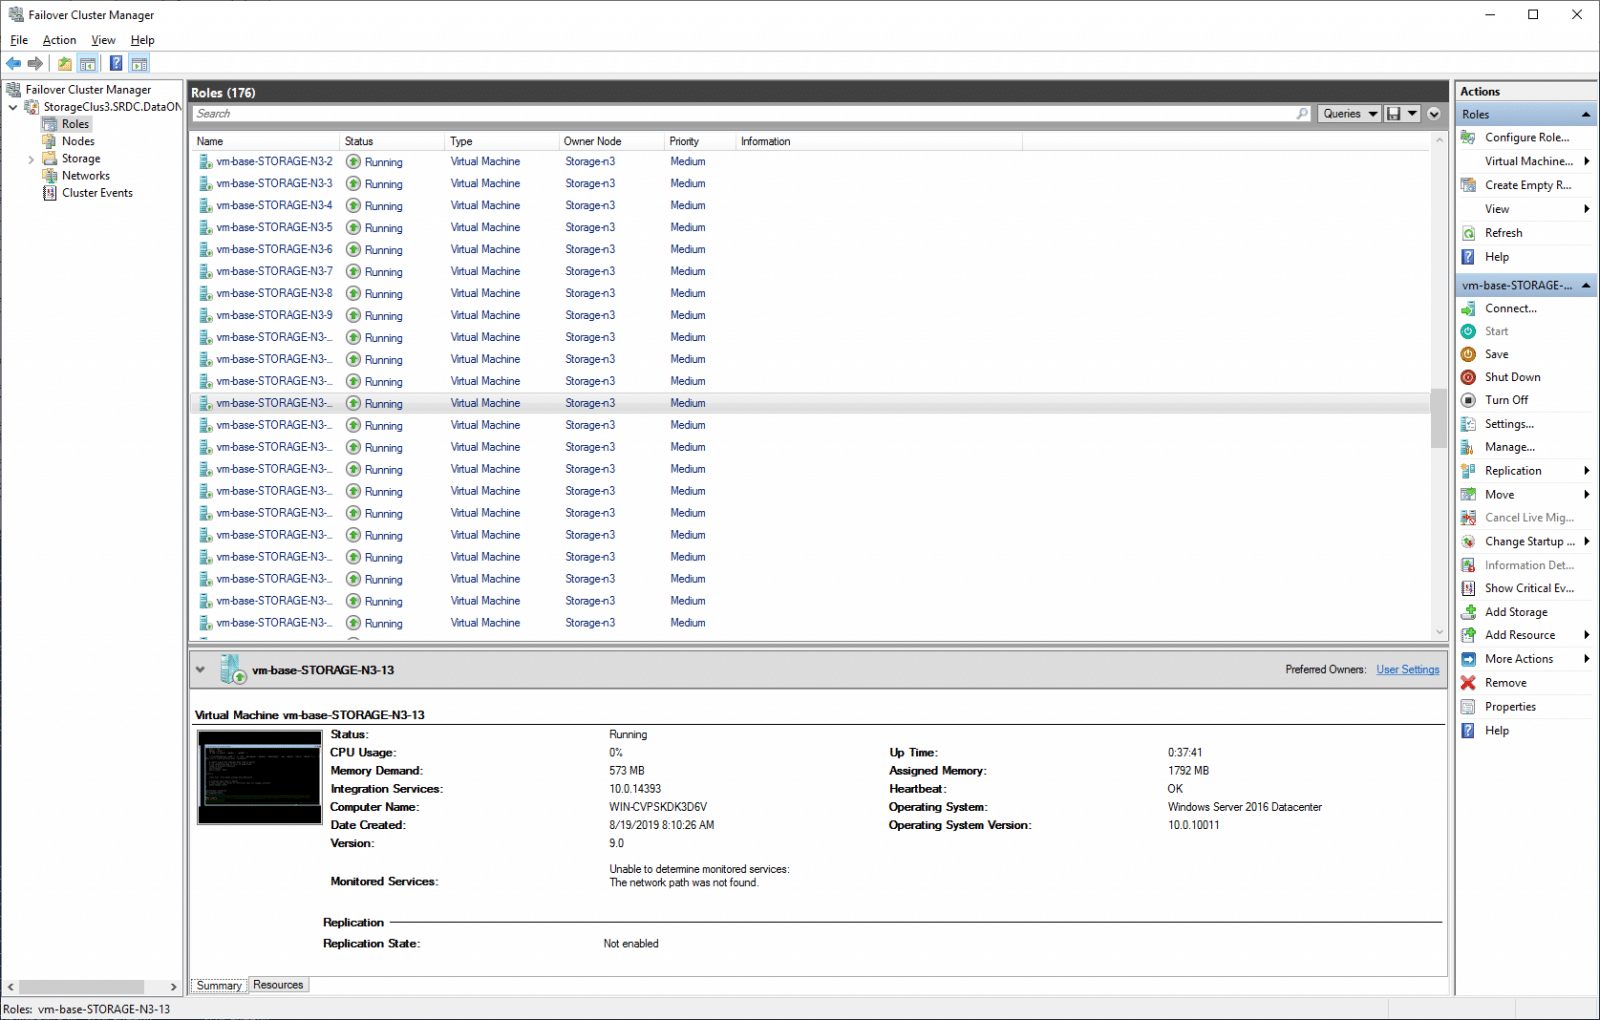
El siguiente paso son los roles de conmutación por error. Aquí podemos ver todas las máquinas virtuales Hyper-V que se ejecutan en el clúster. Se muestran las muchas máquinas virtuales de vmfleet que usamos para realizar pruebas de estrés en el clúster.
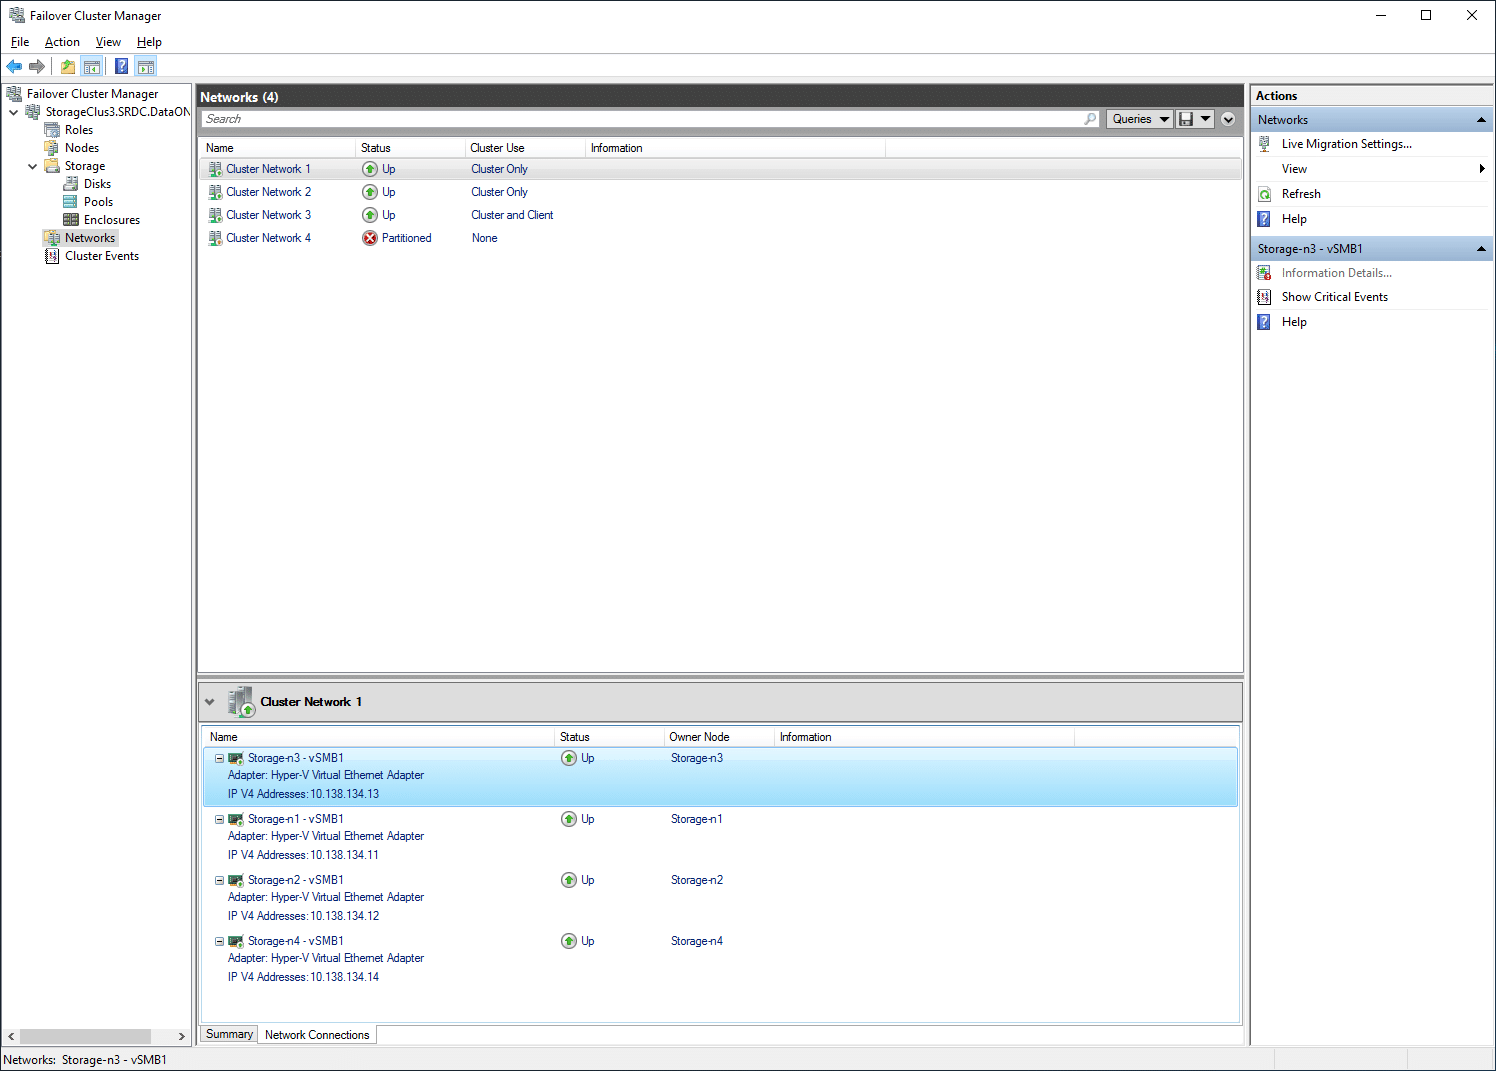
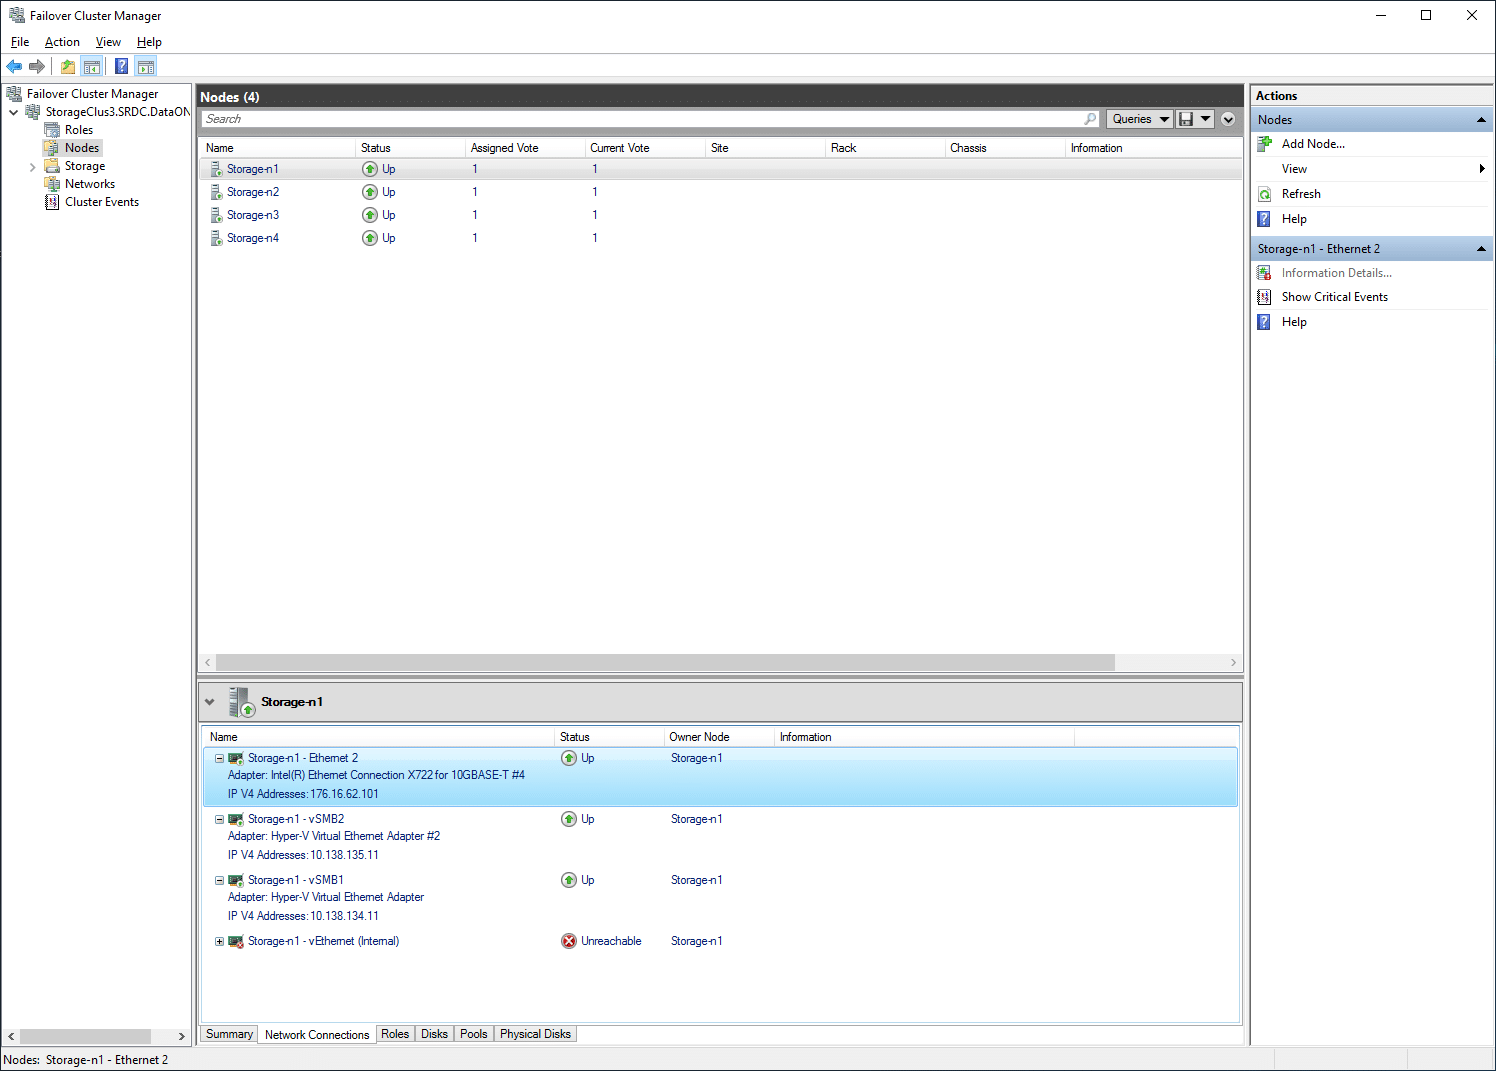
Redes nos permite ver qué redes de clúster están disponibles y el estado de cada una. La selección de una red de clúster le permite ver la tarjeta de red subyacente asociada con ella, así como su dirección IP.
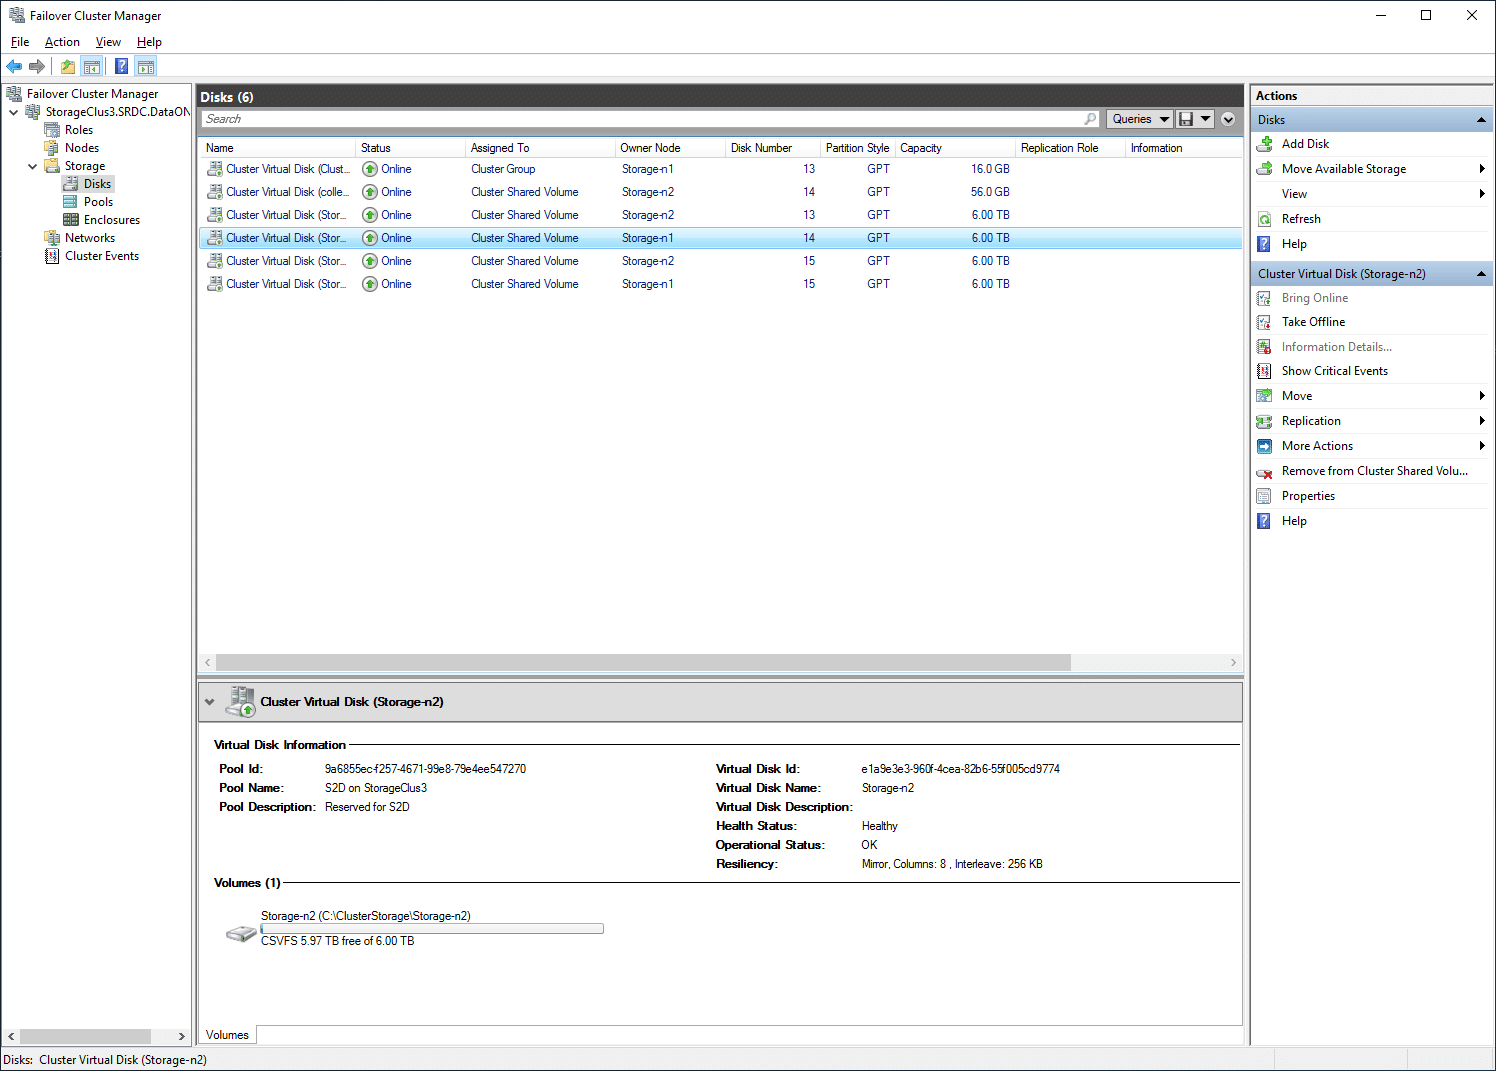
En la opción de almacenamiento se encuentran Discos, grupos y gabinetes. Para los discos, se puede hacer clic en los discos virtuales y obtener información como el estado, dónde está asignado, el nodo propietario, el número de disco, el estilo de la partición y la capacidad. Los usuarios también pueden profundizar un poco más con aún más información presentada como ID, nombre y descripción del grupo, así como ID, nombre y descripción del disco virtual, estado operativo y de salud, y resistencia.
Los grupos son similares, con la información de ciertos grupos de almacenamiento, como el estado, la salud, el nodo propietario, los estados operativos y la capacidad general, así como el espacio libre y usado.
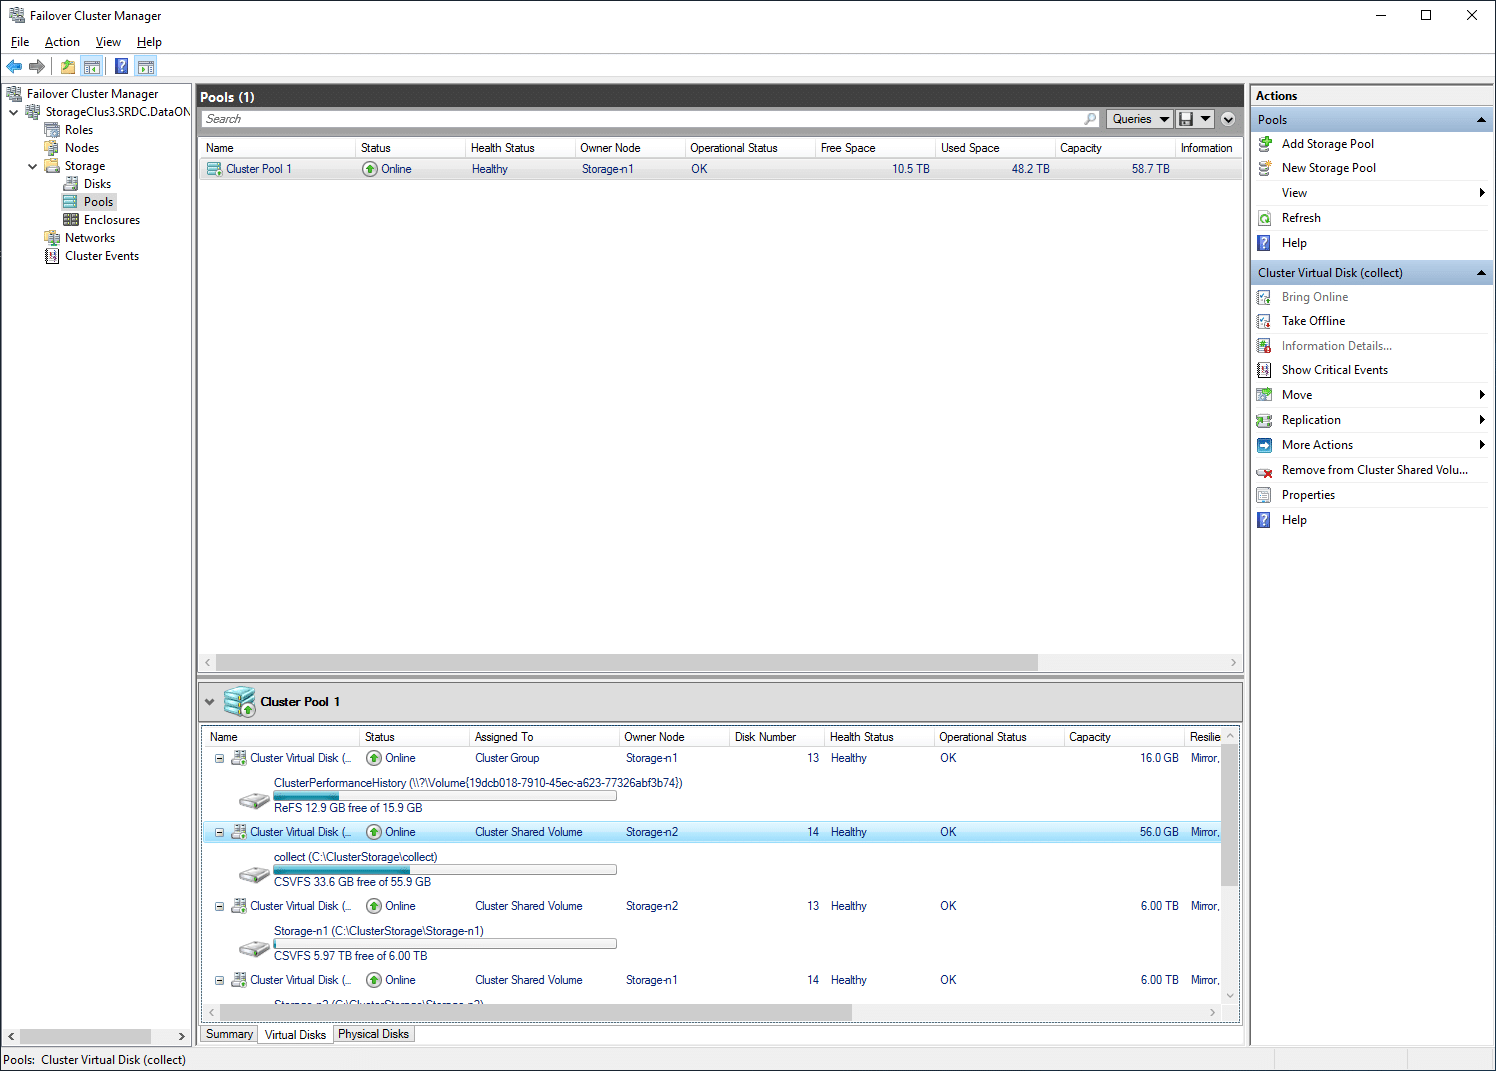
En Nodos, se pueden ver fácilmente todos los nodos del clúster y su estado.
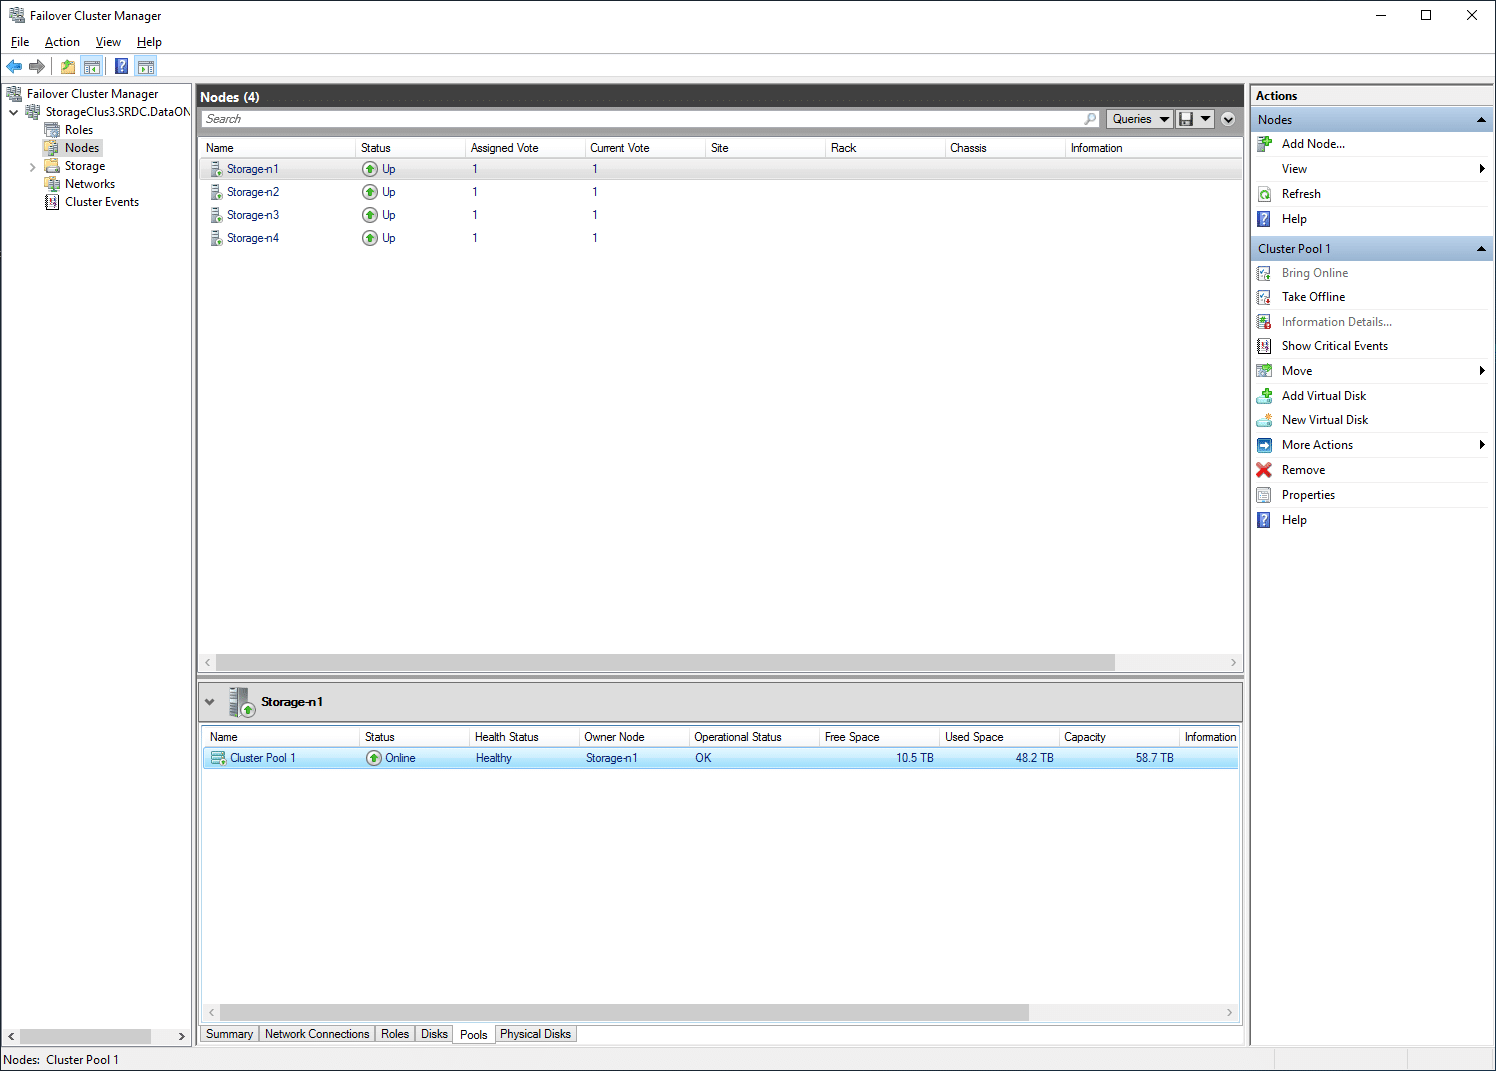
A la derecha, se puede cambiar a discos de conmutación por error y ver el disco individual para un nodo determinado en la parte inferior.
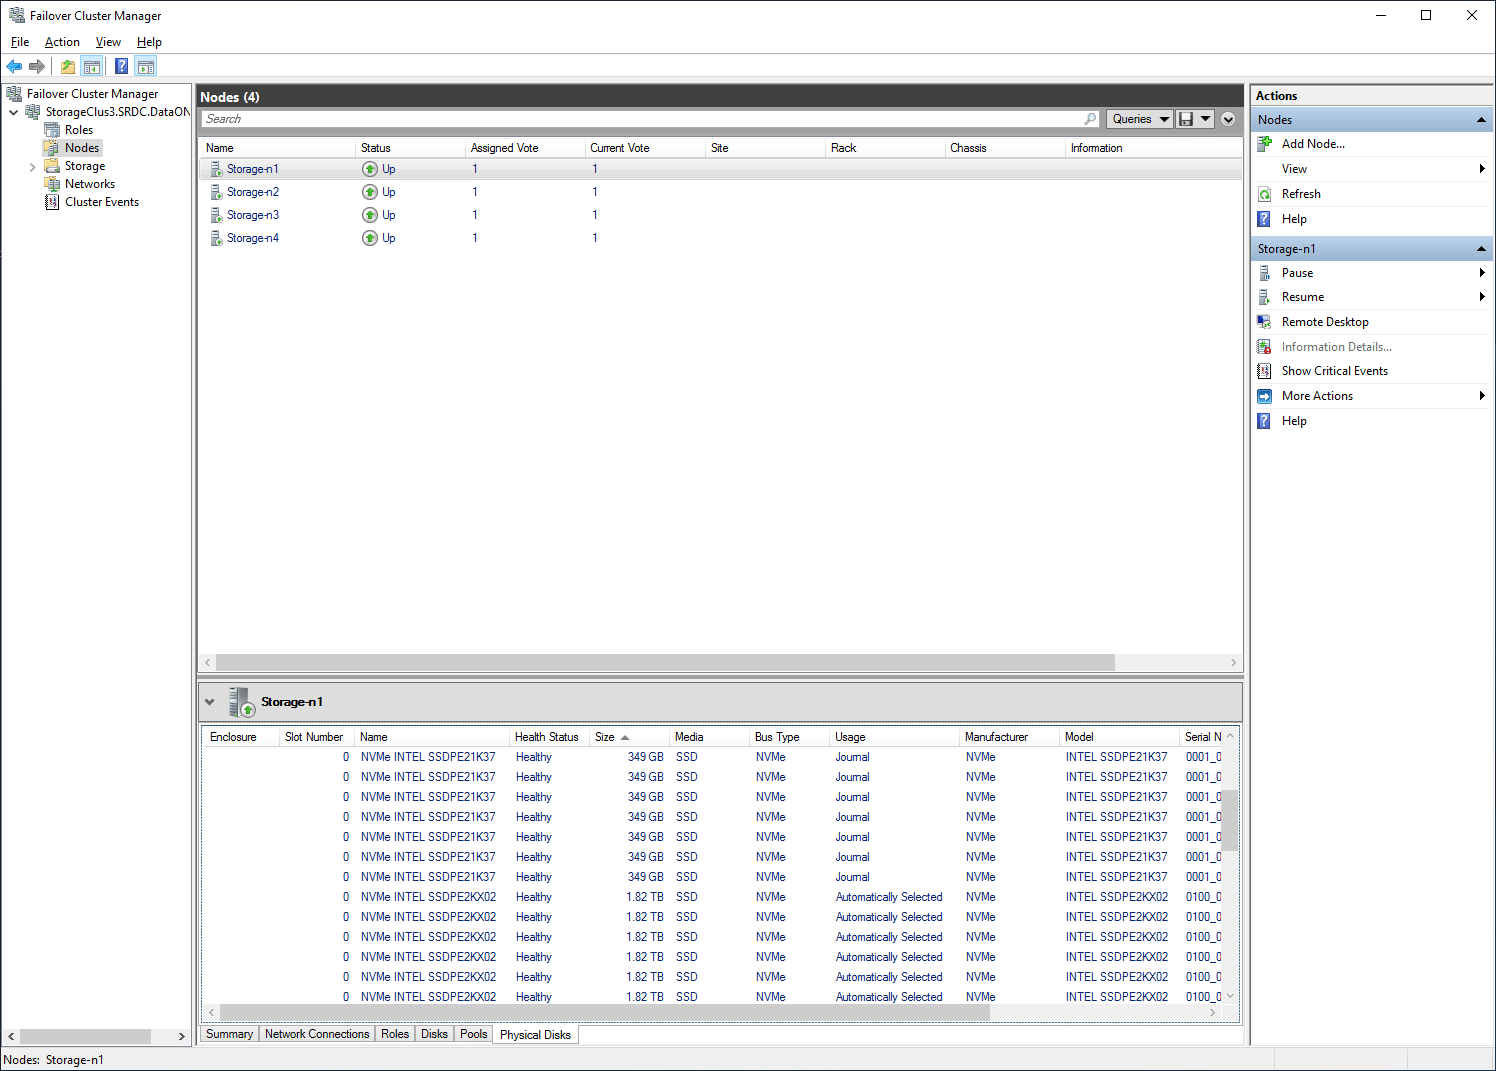
Desde la misma barra lateral, también se puede ver la red de un nodo determinado.
Si bien Windows Failover Cluster Manager es un aparato de administración más "minucioso", requiere que los usuarios se conecten a través de Windows Remote Desktop a un servidor (u otro servidor conectado a ese clúster) para trabajar con él. Si bien este estilo de administración está bien para muchos usos, Microsoft facilitó las cosas con una nueva plataforma llamada Centro de administración de Windows. A diferencia de Failover Cluster Manager, Windows Admin Center está completamente basado en un navegador web, lo que facilita la conexión desde cualquier computadora o tableta en el lugar de trabajo. También ofrece un aspecto y una sensación modernizados y estéticamente agradables, lo que hace que la supervisión diaria sea una tarea más agradable. Ofrece una mirada a gran parte de la misma información, con un mayor enfoque en el monitoreo de actividad que el Administrador de clústeres de conmutación por error no ofrece en la misma medida.
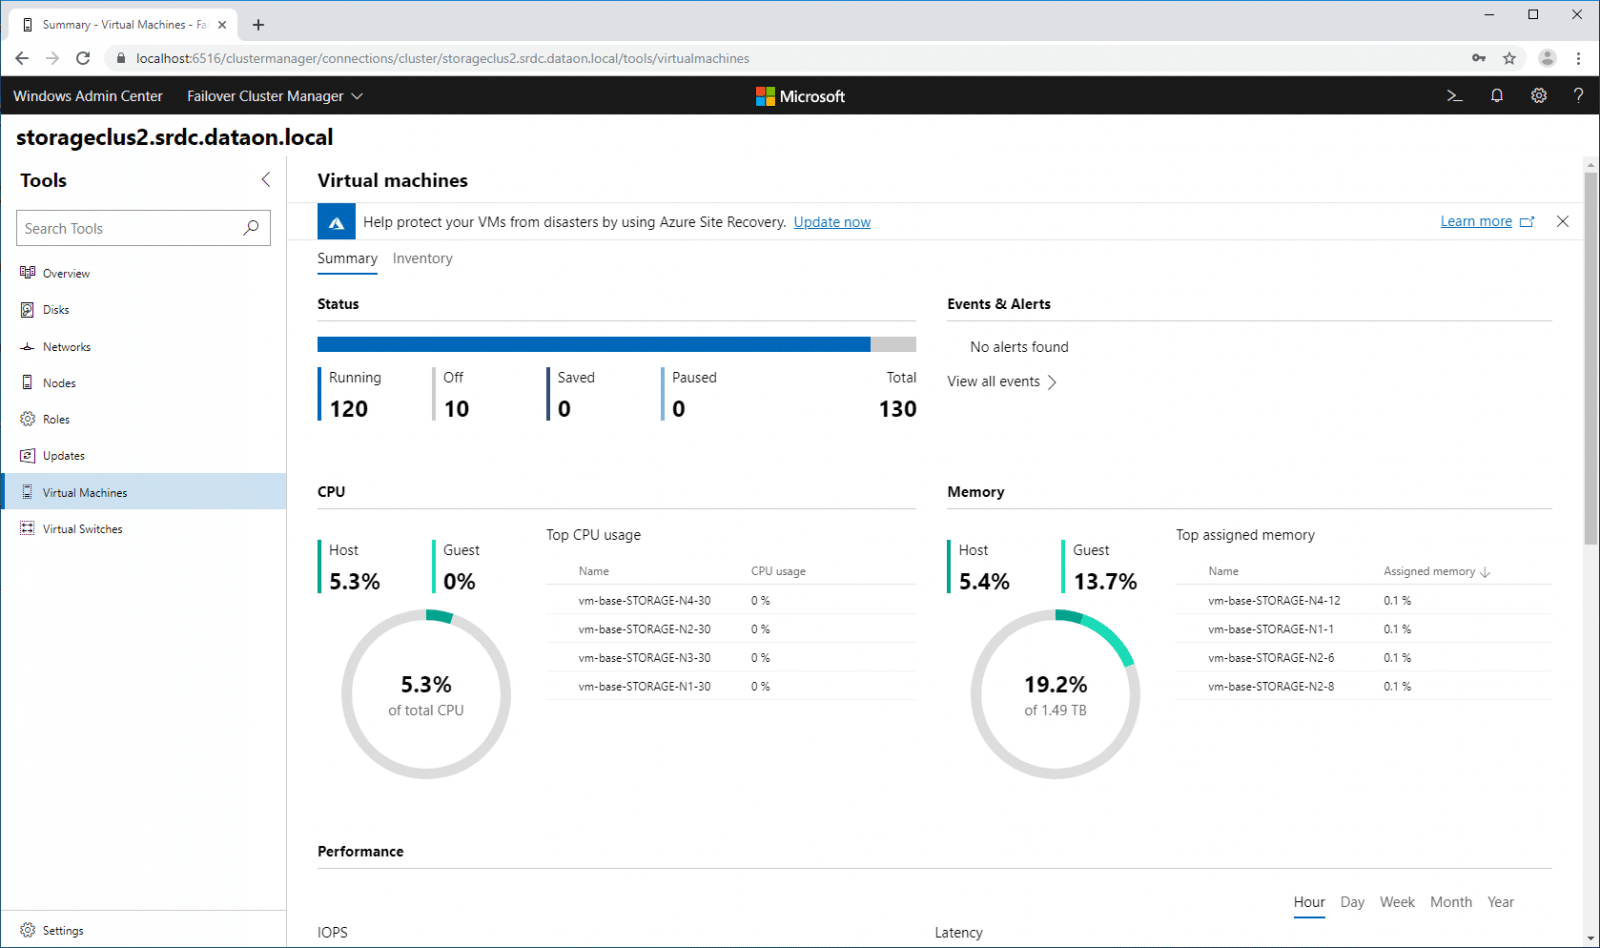
Una vez que Windows Admin Center está asociado con un clúster, puede profundizar en áreas específicas para ver y administrar operaciones. Aquí vemos información general sobre el rendimiento informático del clúster, que realiza un seguimiento de los recursos generales que utilizan las máquinas virtuales.
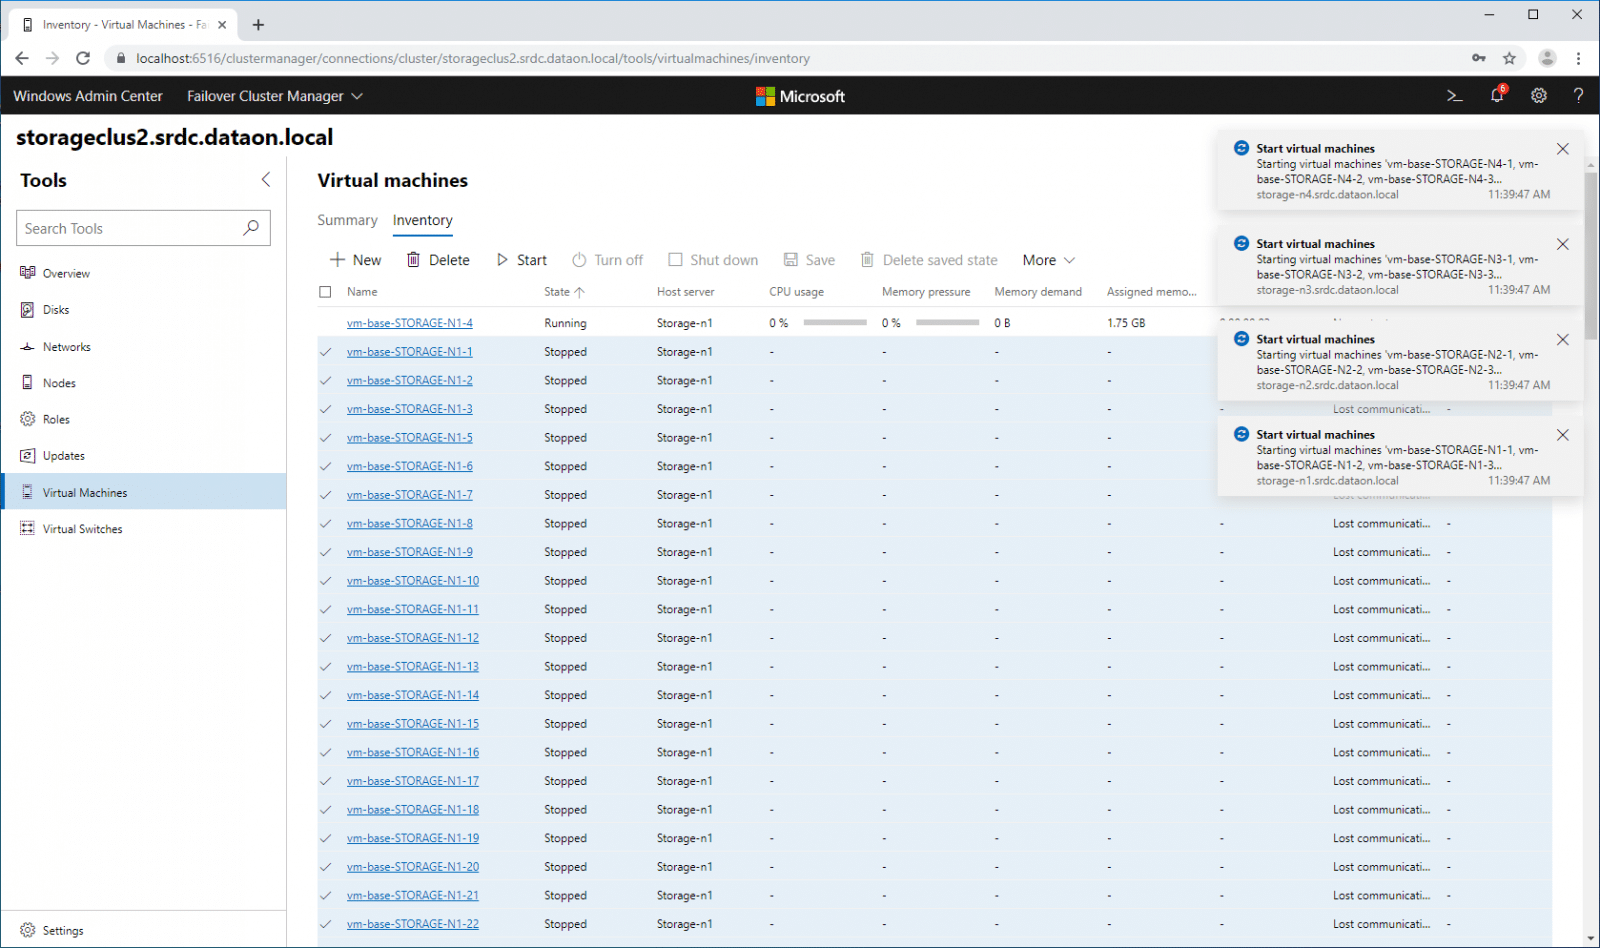
Si bien el Centro de administración de Windows es excelente para ver la actividad, aún puede interactuar con las máquinas virtuales en su clúster. A continuación, encendemos varias máquinas virtuales de vmfleet.
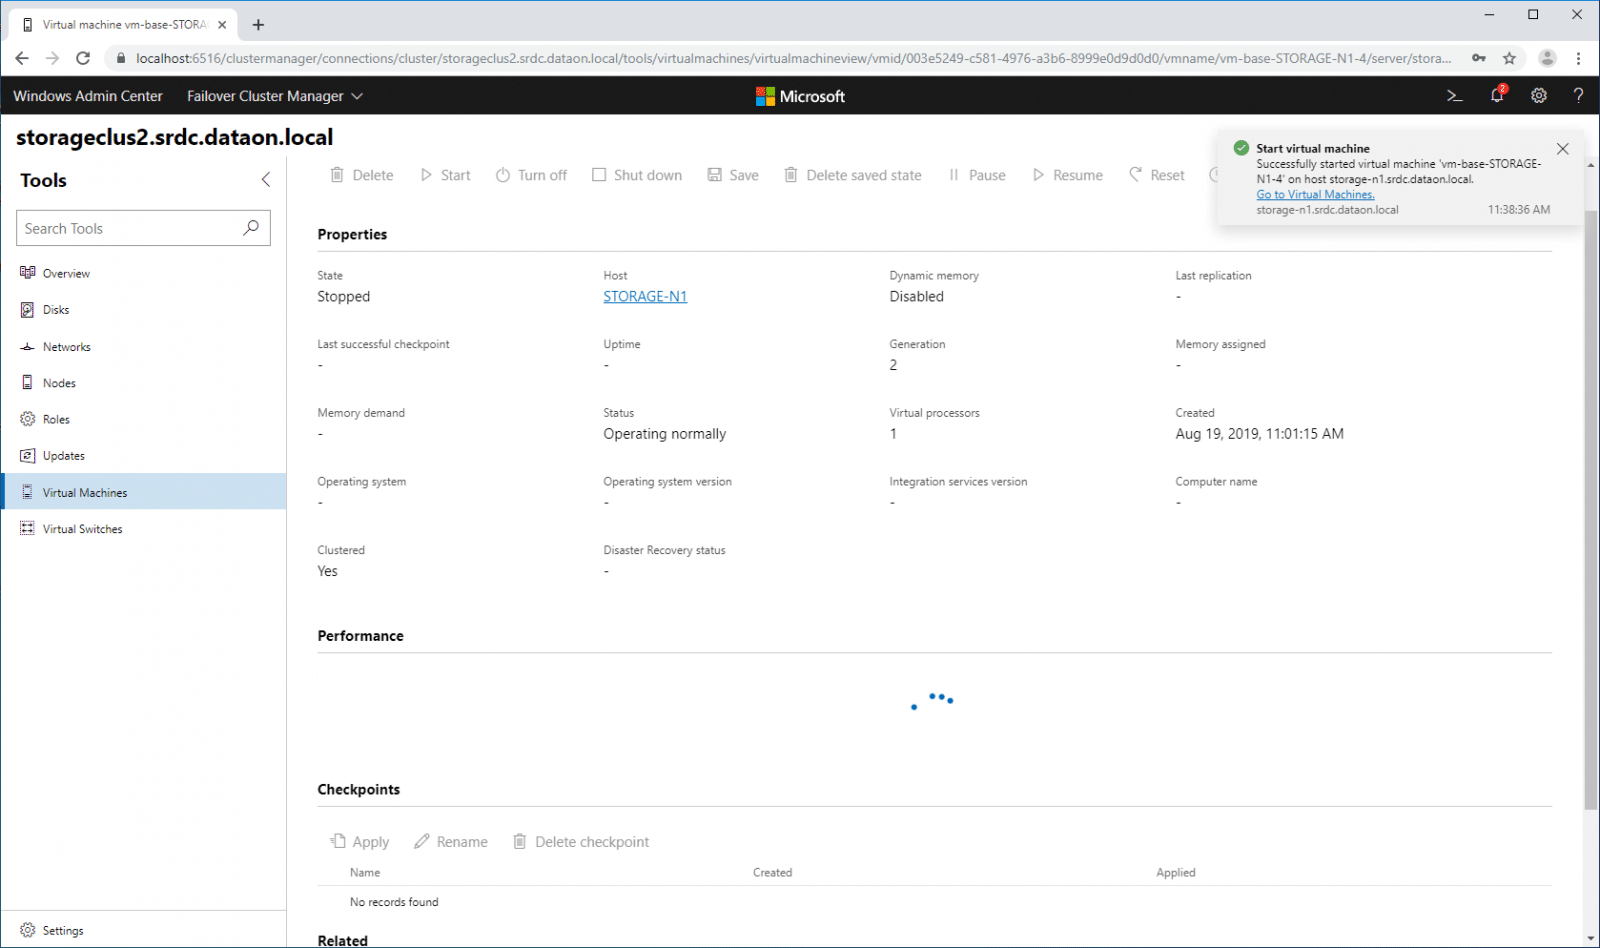
Los usuarios también pueden profundizar en la información de máquinas virtuales específicas.
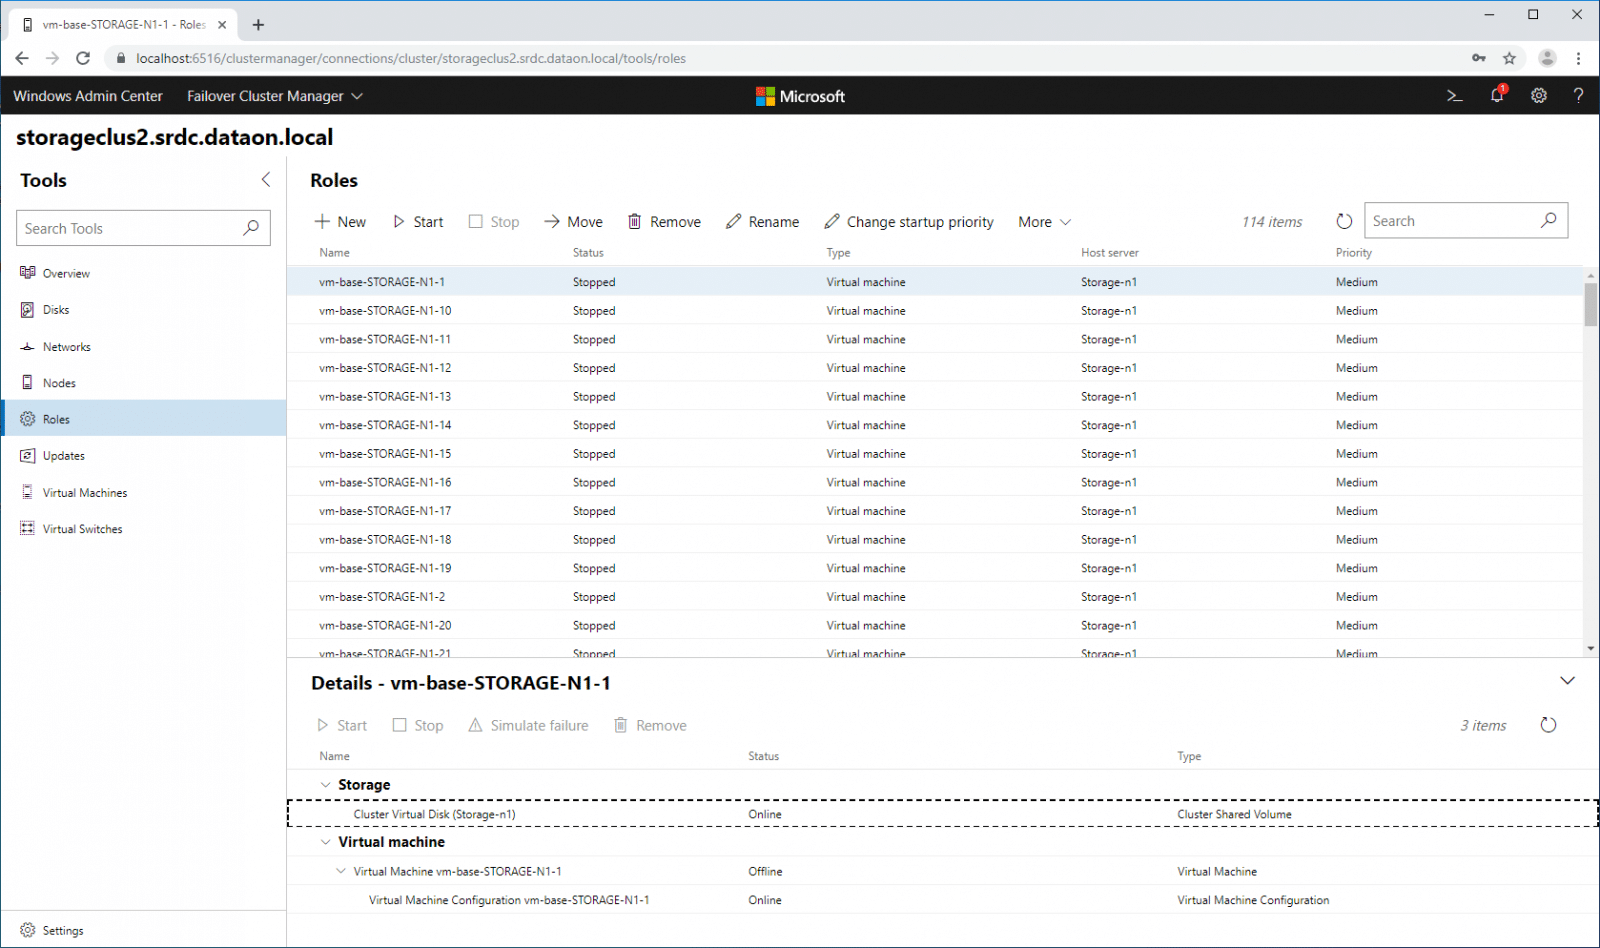
En roles, obtenemos una interpretación ligeramente diferente de los roles, pero la mayor parte de la misma información clave.
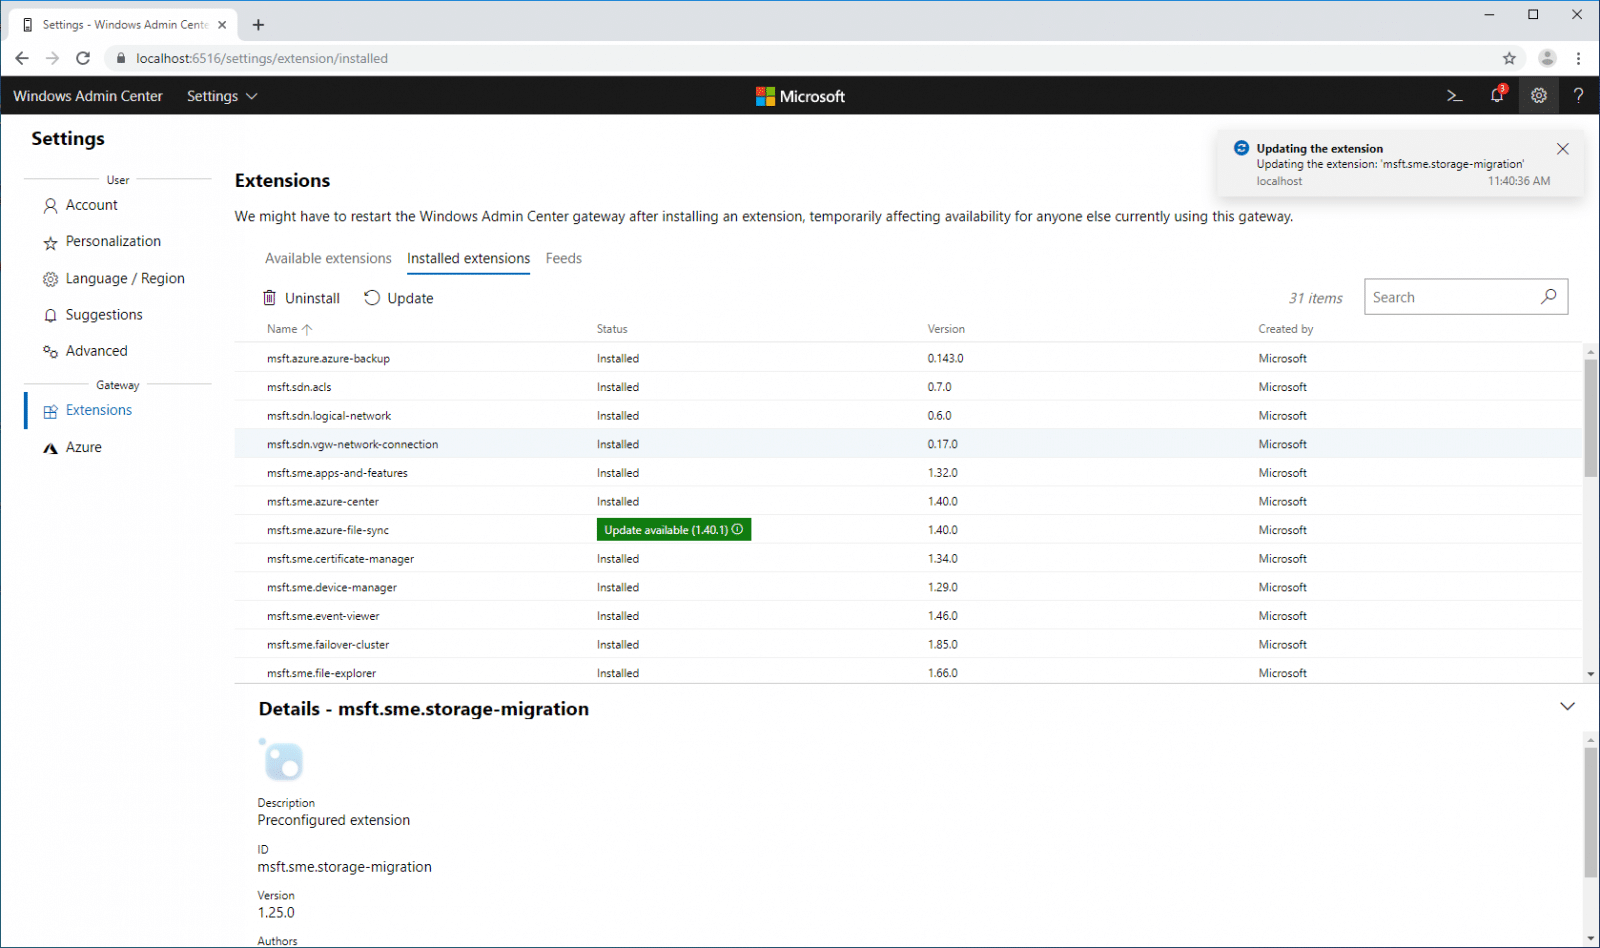
En la configuración, los usuarios pueden descargar, instalar y actualizar extensiones para Azure.
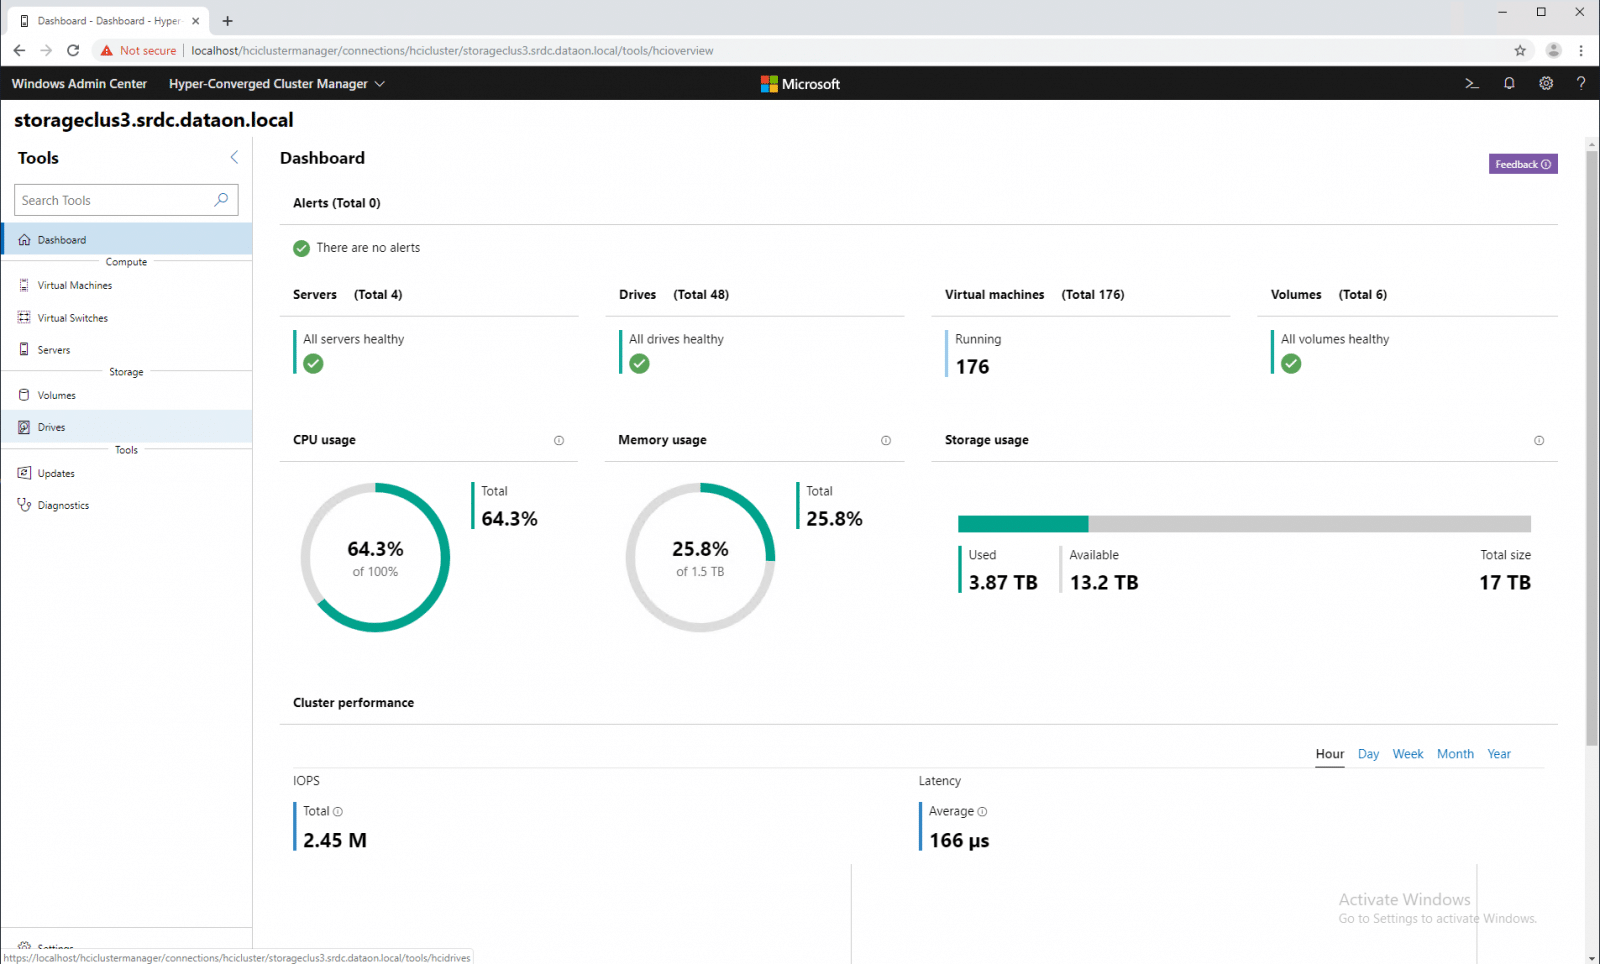
A través del Centro de administración de Windows, también podemos ingresar al Administrador de clústeres hiperconvergentes para observar más de cerca la computación y el almacenamiento. Abrimos el Panel que tiene información general como la cantidad de servidores, unidades, VM, volúmenes, así como el uso de CPU, memoria y almacenamiento. A lo largo de la parte inferior del tablero se encuentra el rendimiento del clúster que se desglosa en un marco de tiempo específico, IOPS y latencia.
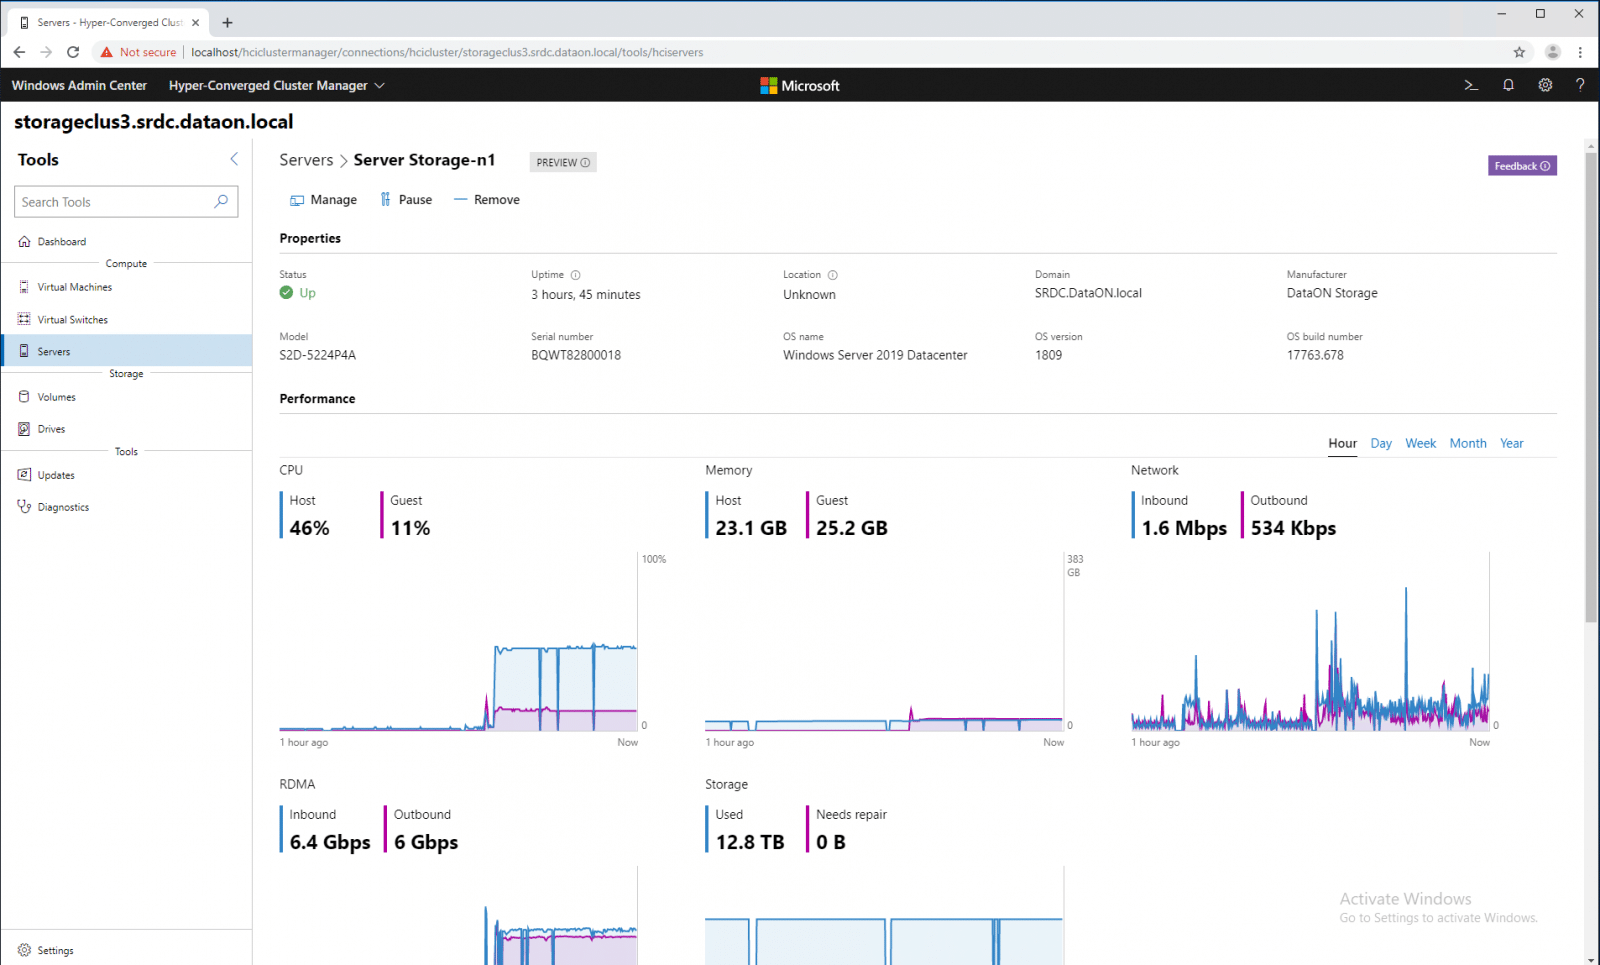
Bajo computación, los administradores pueden profundizar en los propios servidores para la administración, incluida la eliminación del servidor del clúster. Aquí hay información general sobre el servidor utilizado, como el tiempo de actividad, la ubicación, el dominio, el fabricante, el modelo, el número de serie, el nombre del sistema operativo, la versión y el número de compilación. Además, los usuarios pueden observar el rendimiento específico del servidor.
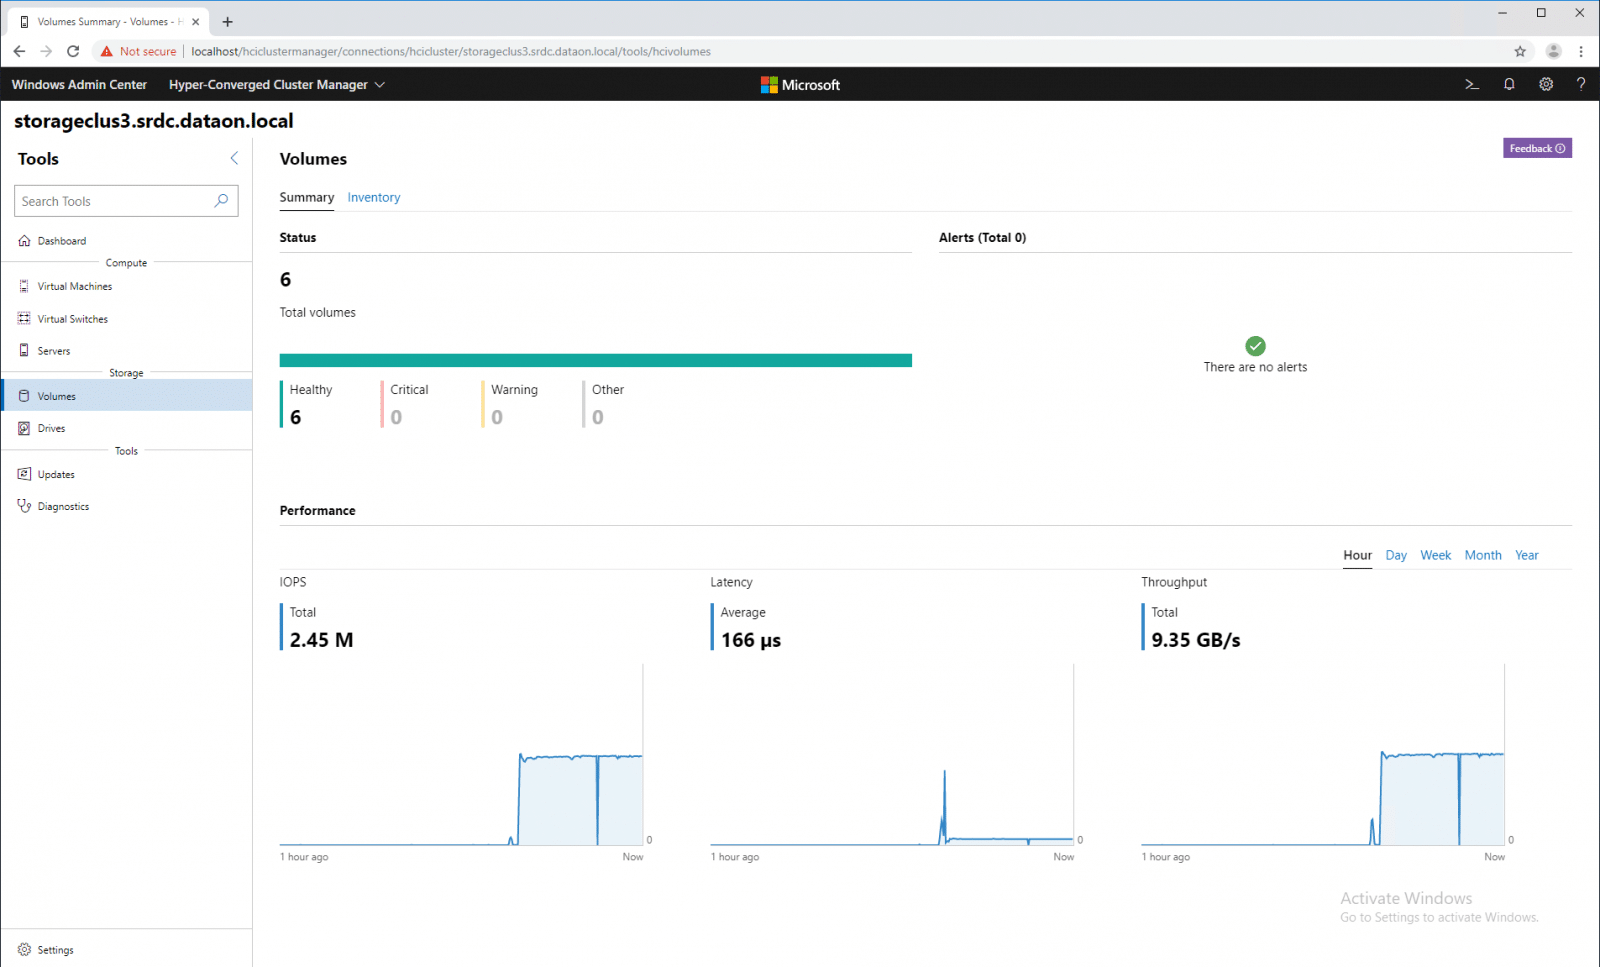
Al hacer clic en la pestaña Volúmenes, los usuarios acceden a un resumen de todos los volúmenes del clúster. El estado de los volúmenes está codificado por colores: verde para saludable, rojo para crítico y amarillo para advertencia. También se realiza un seguimiento del rendimiento de todos los volúmenes, desglosado por marco de tiempo y en IOPS, latencia y rendimiento.
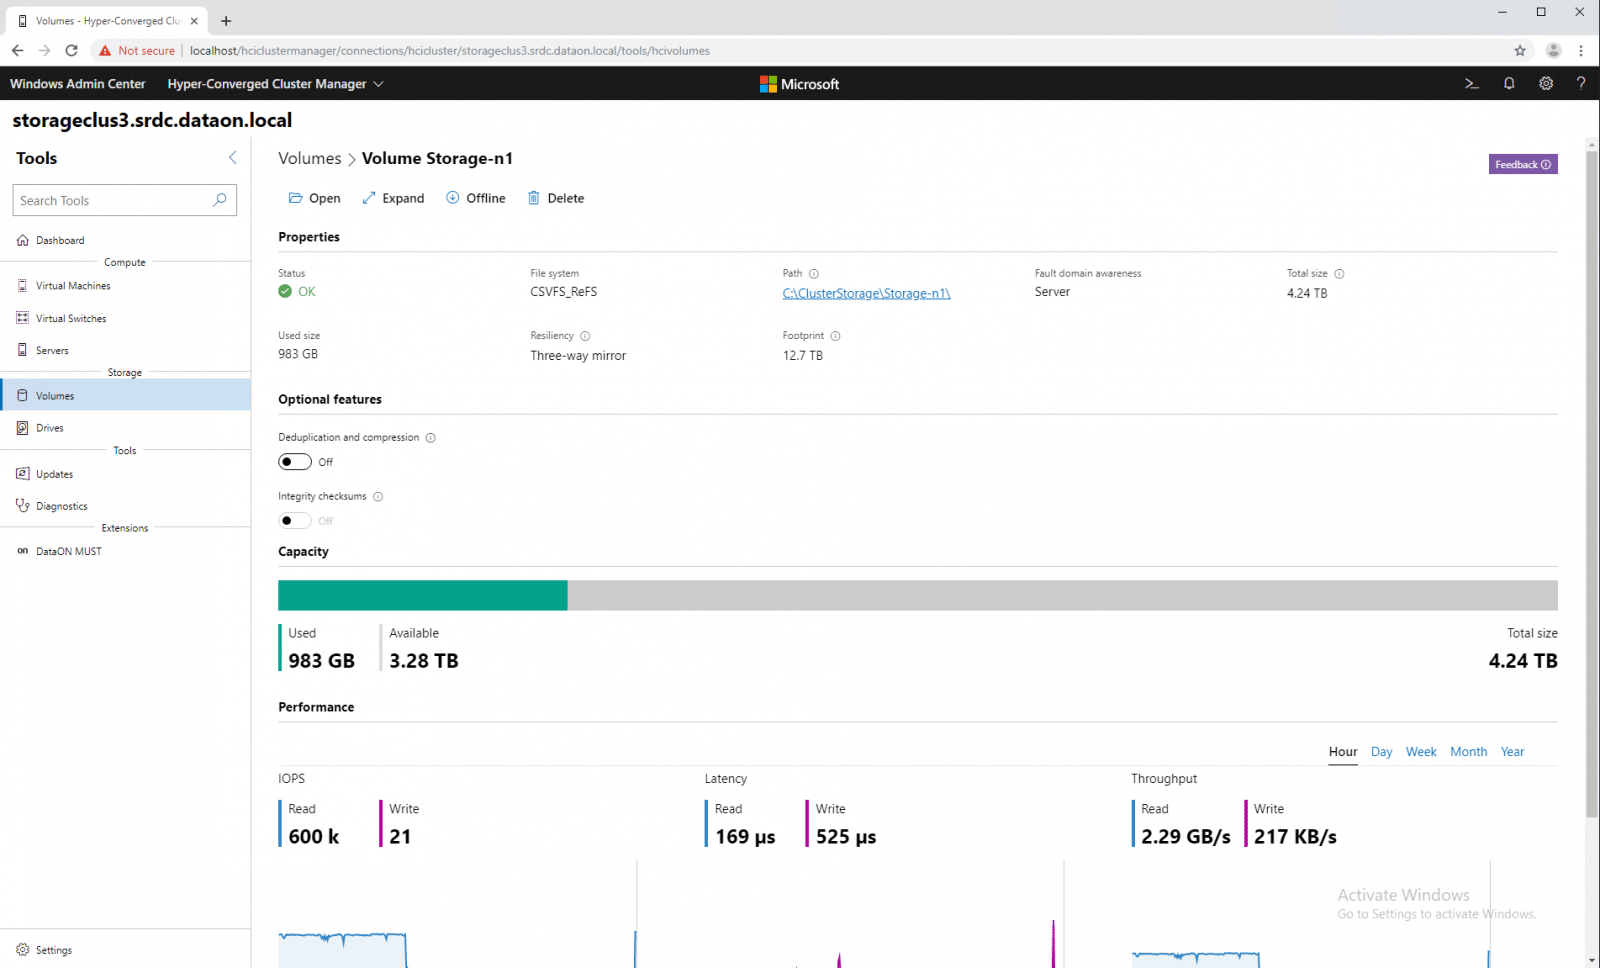
Profundizar en un solo volumen brinda propiedades específicas del volumen, incluido el estado, el sistema de archivos, la ruta, el conocimiento del dominio de fallas, el tamaño total, el tamaño utilizado, la resistencia y el espacio. Hay funciones opcionales (deduplicación y compresión, así como sumas de verificación de integridad) que se pueden activar o desactivar aquí. La capacidad se muestra gráficamente, mostrando la utilizada frente a la disponible. Y de nuevo, vemos rendimiento.
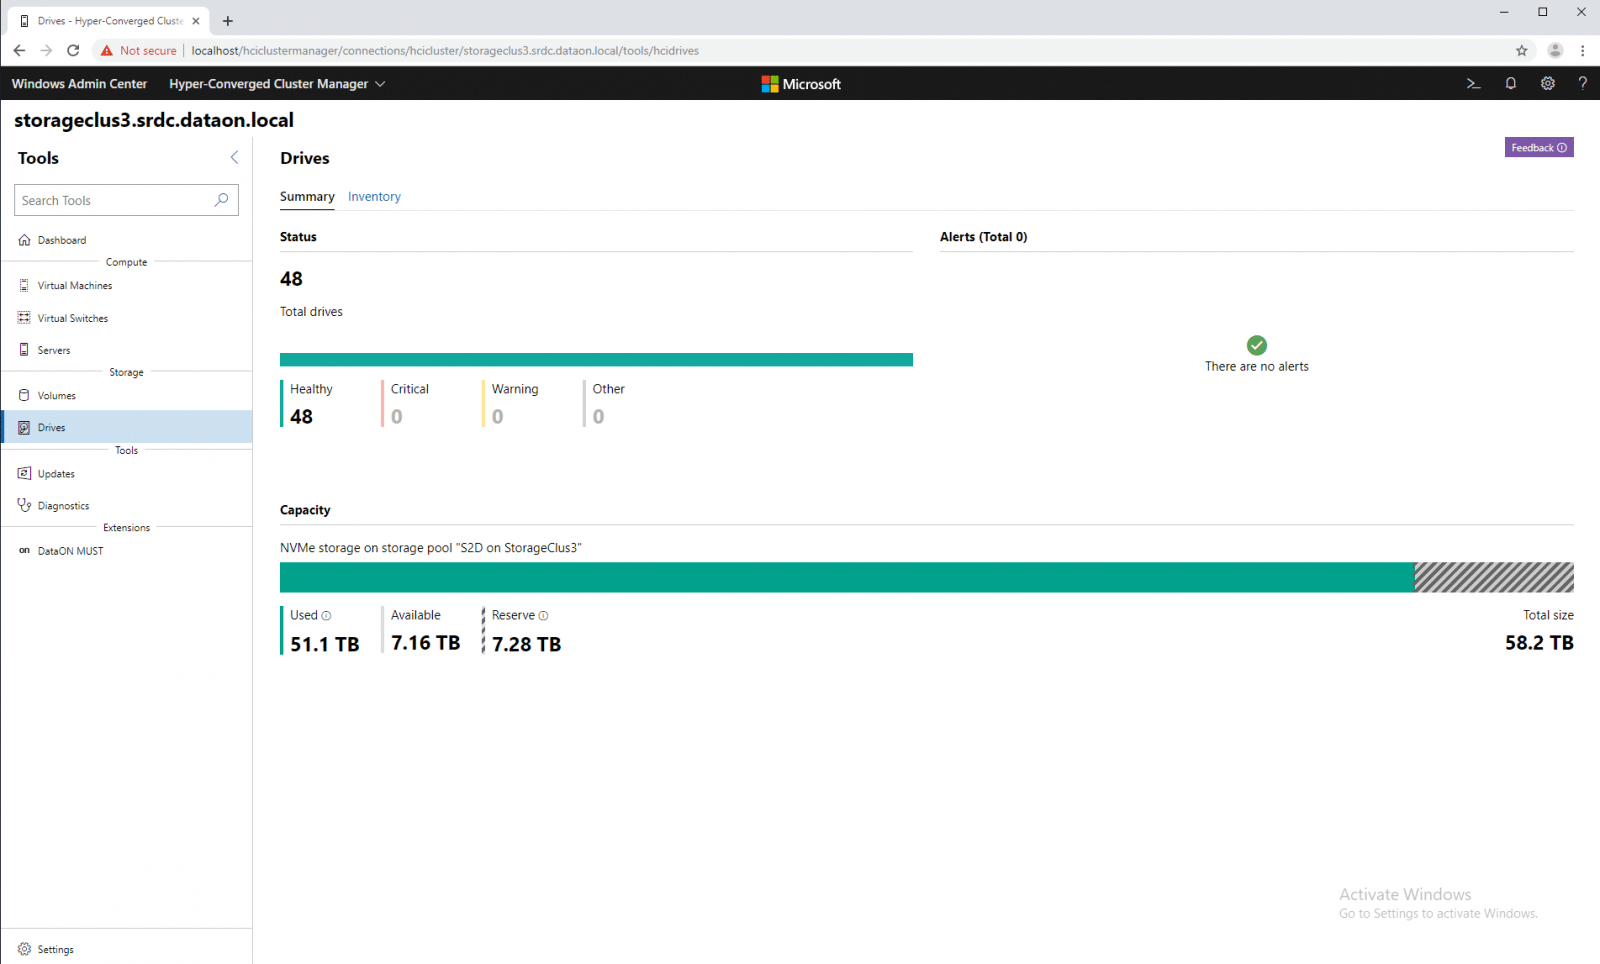
En la pestaña Unidades, obtenemos un resumen de todas las unidades del sistema. Aquí vemos el número total de unidades y si hay o no alertas con el mismo código de color que los volúmenes. También podemos ver la capacidad: utilizada, disponible y reserva.
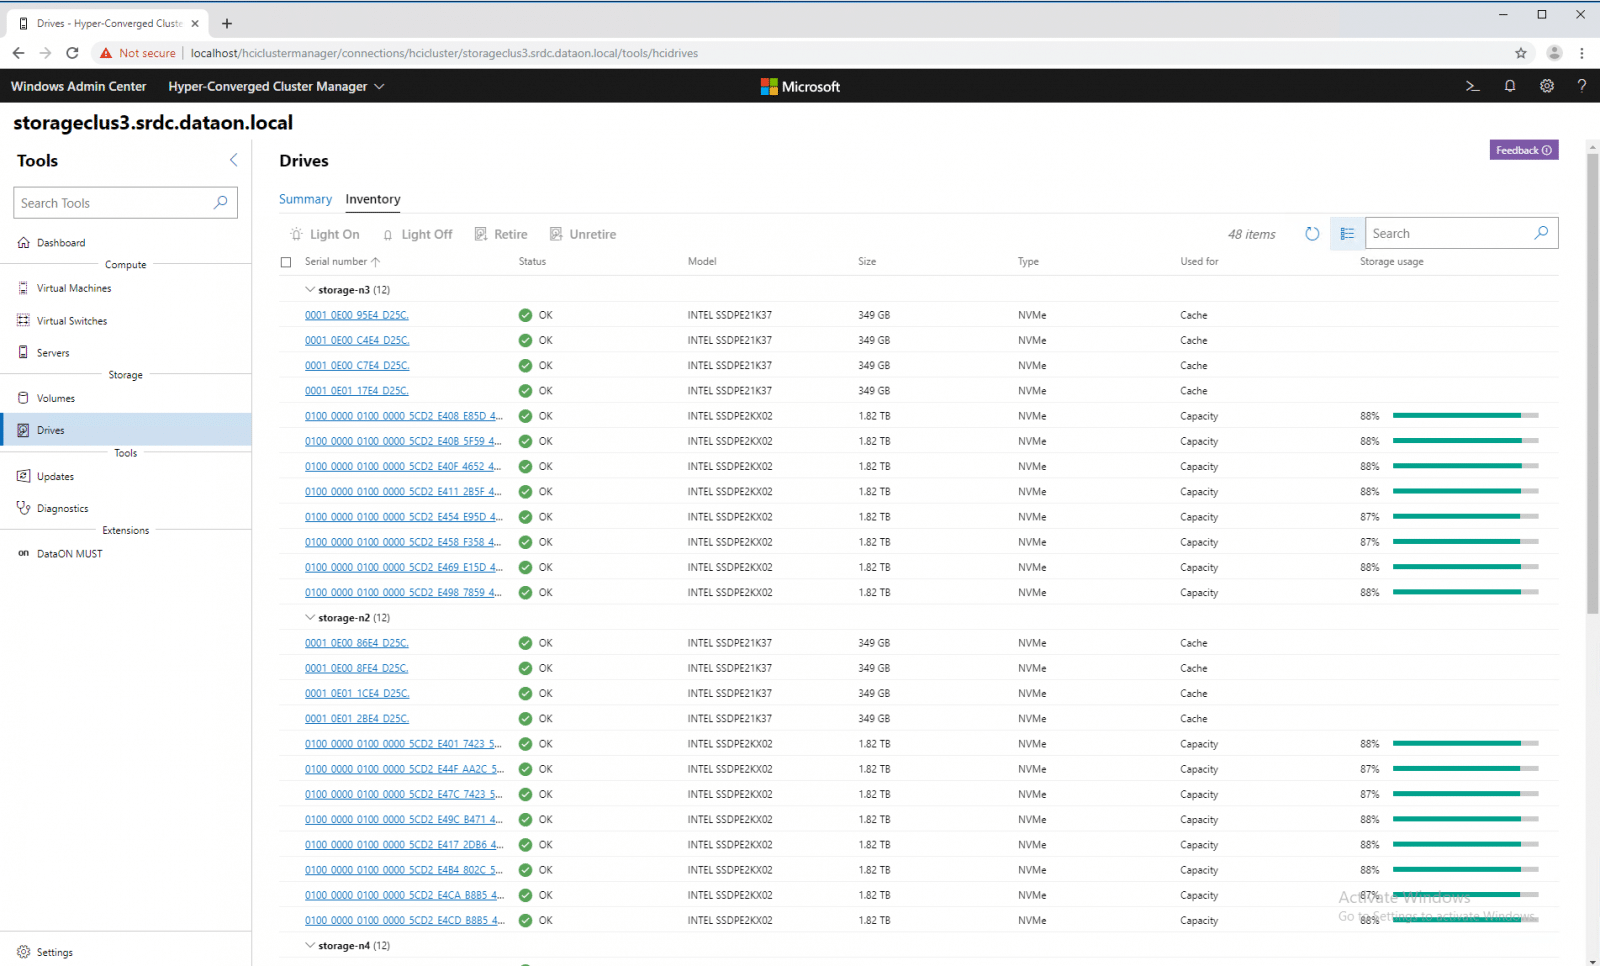
Al hacer clic en Inventario, obtenemos una lista de todas las unidades y varios detalles. Los detalles incluyen el estado de la unidad, su modelo, el tamaño de la capacidad, el tipo, para qué se utiliza y la cantidad de almacenamiento utilizada.
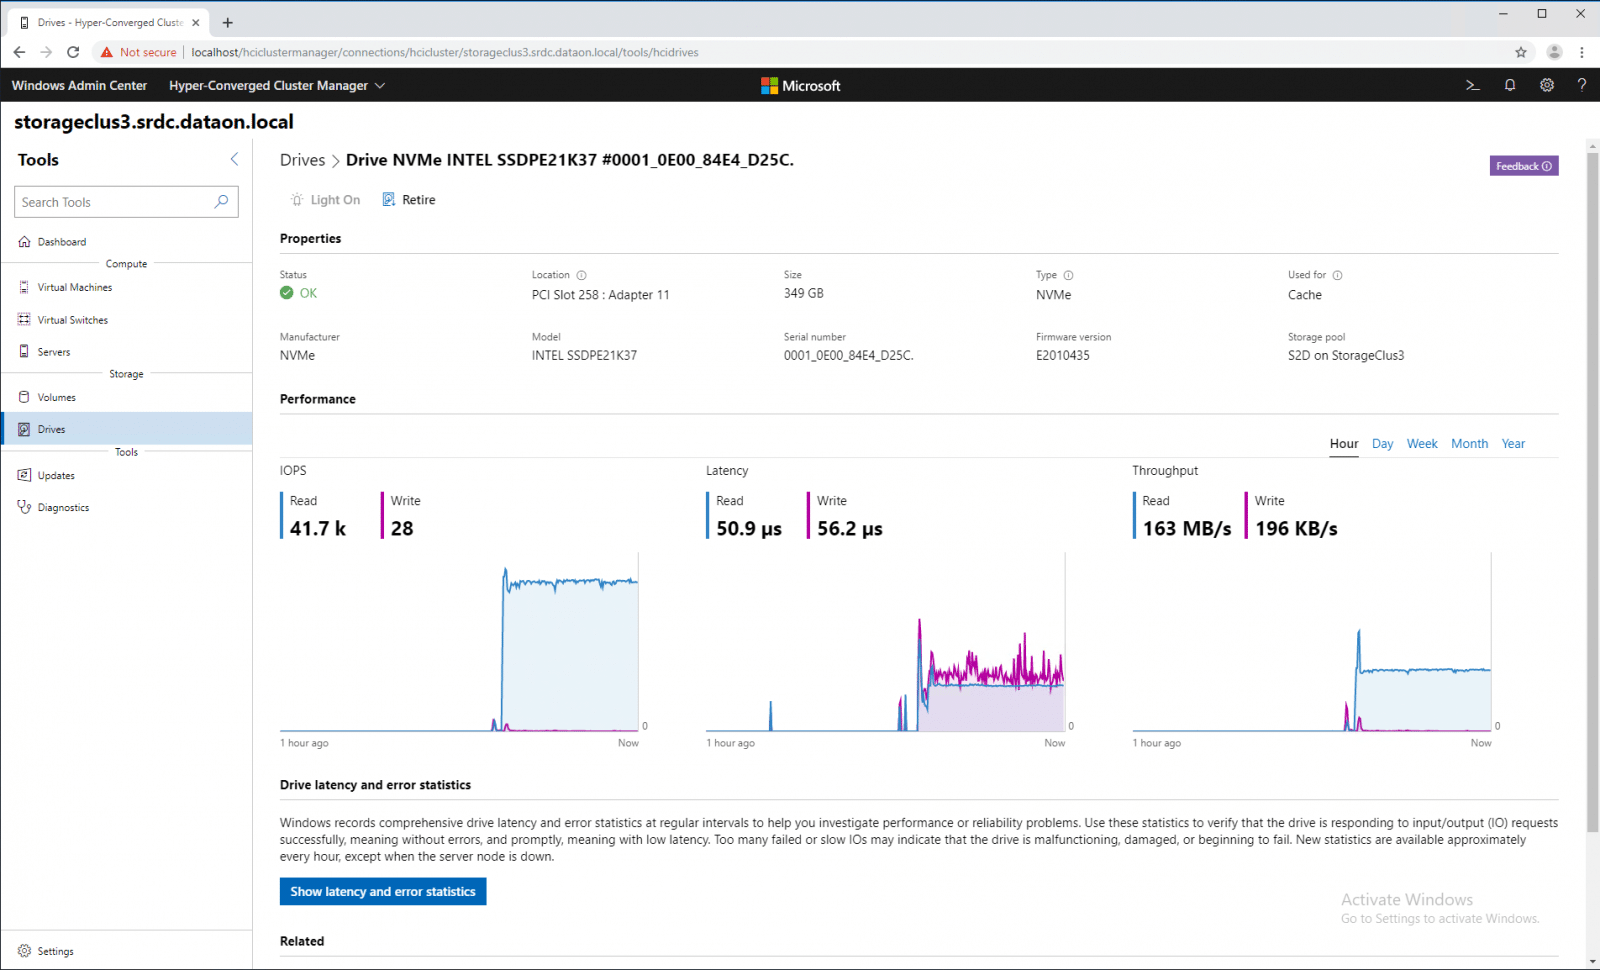
Podemos profundizar en una sola unidad y ver propiedades como el estado, la ubicación, el tamaño, el tipo, el uso, el fabricante, el modelo, el número de serie, la versión del firmware y el grupo de almacenamiento en el que se encuentra. Podemos ver la cantidad de capacidad utilizada versus disponible para la unidad individual y su rendimiento en IOPS, latencia y rendimiento.
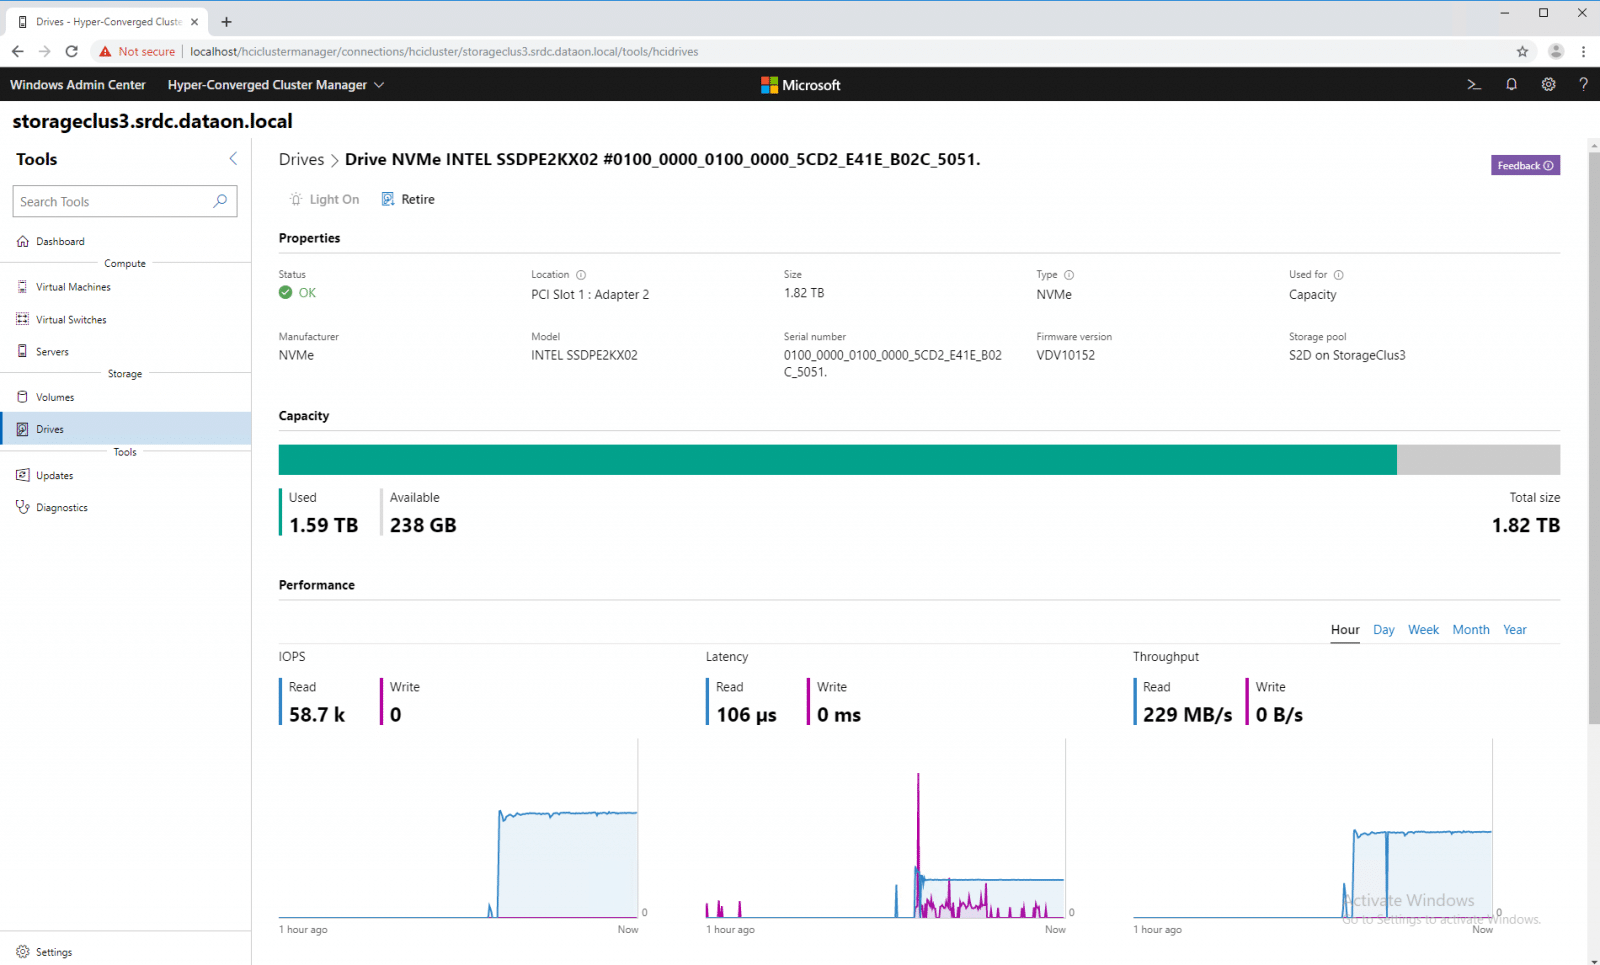
Debajo del rendimiento también podemos ver la latencia de la unidad y las estadísticas de error.
Rendimiento
El rendimiento dentro del ecosistema de Microsoft Azure Stack siempre ha sido excelente, un punto fuerte que se ha abierto camino desde los días de los espacios de almacenamiento. Con eso en mente, analizamos algunas cargas de trabajo de evaluación comparativa comunes en esta revisión para permitir a los usuarios ver qué tan bien se compara esta plataforma con otras soluciones de HCI en el mercado. Con eso en mente, usamos cargas de trabajo para enfatizar tamaños de bloques pequeños aleatorios, así como transferencias de bloques grandes para mostrar el potencial que puede ofrecer esta solución de Microsoft. En nuestra revisión de Azure Stack HCI, aprovechamos vmfleet para las pruebas comparativas de rendimiento, mientras que en VMware o Linux sin sistema operativo, usamos vdbench.
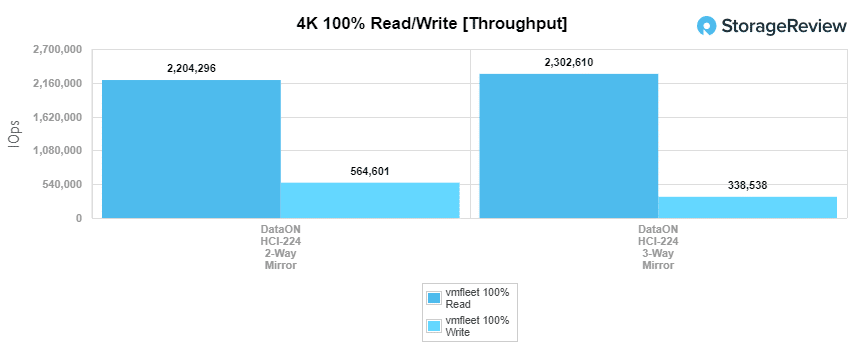
Para el rendimiento aquí, probamos el sistema con un espejo de 2 vías y un espejo de 3 vías. El espejo se refiere al método de protección de datos (ya sea dos copias o tres copias). Obviamente, con más copias, los usuarios perderán algo de capacidad. Desde una perspectiva de rendimiento, 3 vías deberían generar mejores lecturas a través del aumento del paralelismo y 2 vías es mejor para el rendimiento de escritura con un tercio menos de tráfico de red.
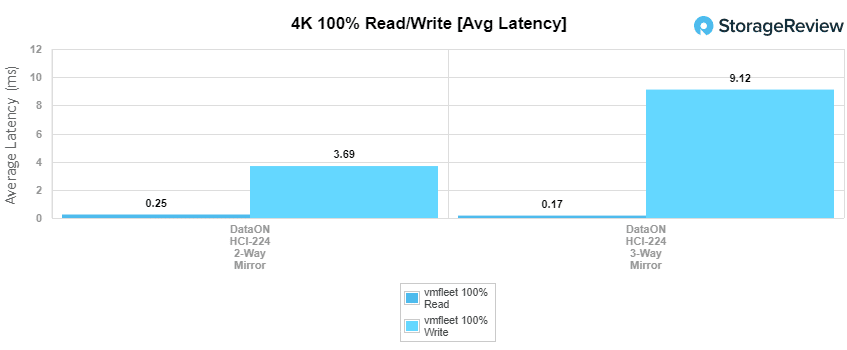
Para nuestra prueba aleatoria de 4K, el espejo bidireccional registró un rendimiento de lectura de 2 2,204,296 247 IOPS con una latencia promedio de 564,601 µs y un rendimiento de escritura de 3.69 3 IOPS con una latencia promedio de 2,302,610 ms. El servidor de 170 vías obtuvo un rendimiento de lectura de 338,538 9.12 521 IOPS con una latencia promedio de 4 µs y de escritura, fue un rendimiento de 202 XNUMX IOPS con una latencia promedio de XNUMX ms. Para poner algo de esto en perspectiva, la oferta de vSAN de VMware que usa dos SSD Optane y cuatro SSD de capacidad NVMe por nodo midió XNUMX XNUMX IOPS XNUMXK de lectura en su punto máximo y XNUMX XNUMX IOPS de escritura.
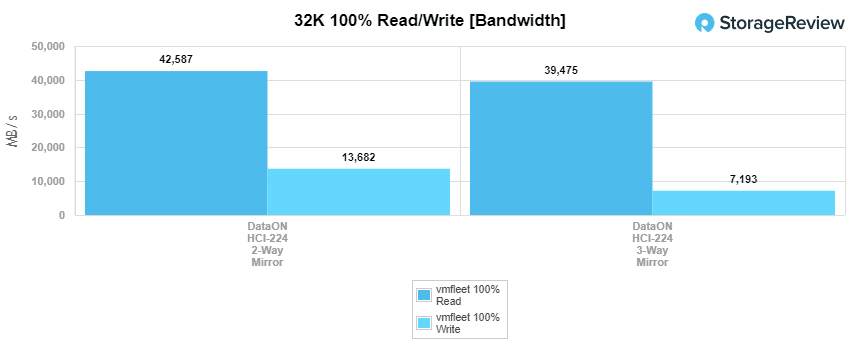
A continuación, observamos nuestro punto de referencia secuencial de 32K. Para las lecturas, vimos el 2-way hit 42.59 GB/s y el 3-way hit 39.48 GB/s. Para escrituras, la HCI nos dio 13.8 GB/s para el bidireccional y 2 GB/s para el tridireccional.
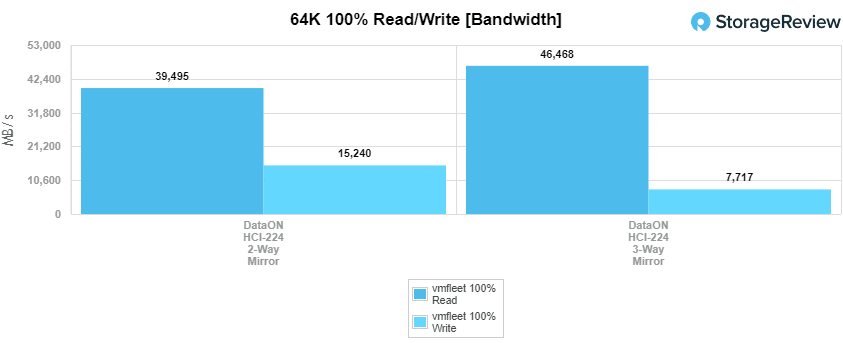
Continuando con nuestro trabajo secuencial, pasamos a nuestras pruebas de 64K. Aquí, el bidireccional alcanza los 2 GB/s de lectura y 39.5 GB/s de escritura y el tridireccional alcanza los 15.24 GB/s de lectura y 3 GB/s de escritura. En comparación con vSAN, las diferencias de ancho de banda de lectura ni siquiera se acercan, donde el ancho de banda en sus pruebas alcanzó un poco más de 46.47 GB/s con un tamaño de bloque de 7.72 K. El ancho de banda de escritura tuvo una diferencia similar, donde vSAN superó los 5.3 GB/s.
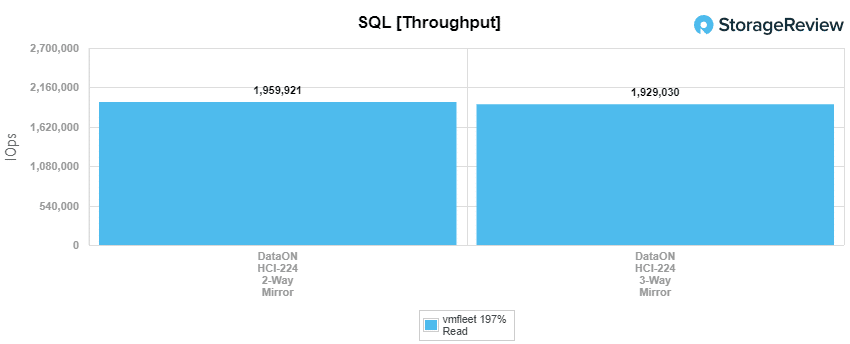
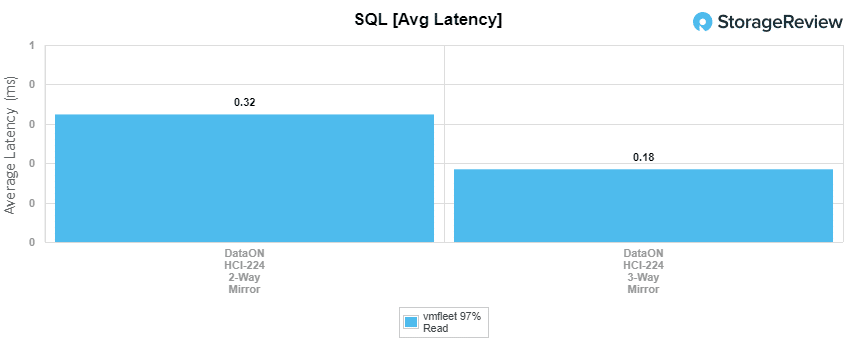
Nuestro próximo punto de referencia es SQL con rendimiento mixto de lectura/escritura. Aquí, el bidireccional tuvo un rendimiento de 2 1,959,921 324 IOPS con una latencia promedio de 3 µs. El 1,929,030-way alcanzó 185 IOPS con una latencia promedio de 2 µs. La carga de trabajo de SQL es otra área en la que Azure Stack HCI puede mostrar su fortaleza, midiendo poco menos de 321 millones de IOPS, mientras que vSAN de VMware en el mismo perfil de carga de trabajo midió XNUMX XNUMX IOPS.
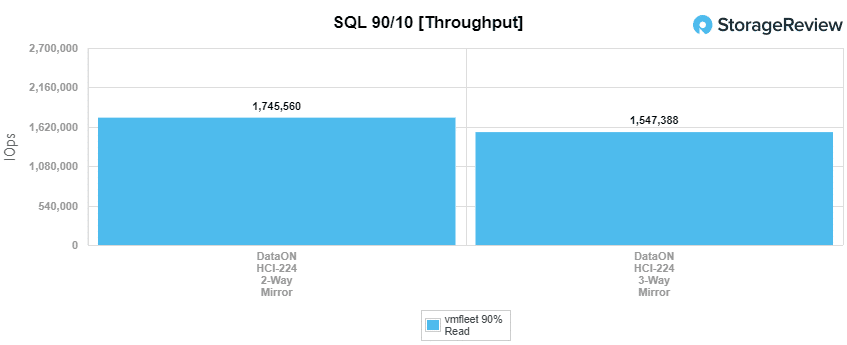
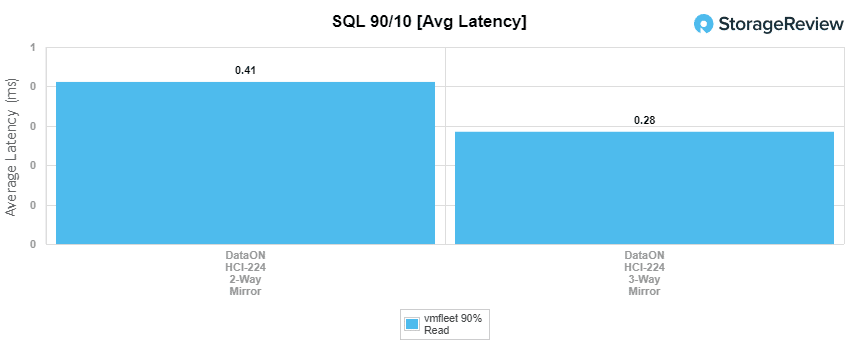
Con SQL 90-10, el bidireccional alcanzó 2 1,745,560 411 IOPS con una latencia promedio de 3 µs y el tridireccional tuvo 1,547,388 285 XNUMX IOPS y XNUMX µs de latencia.
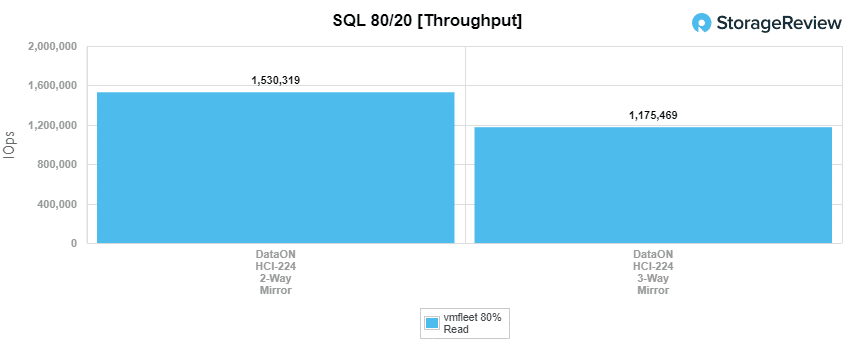
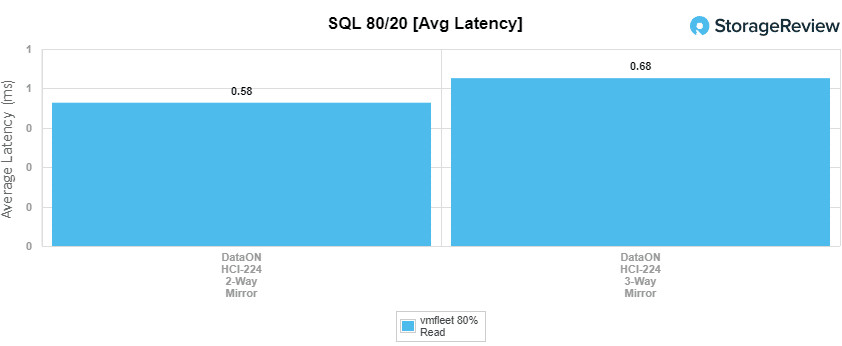
Para SQL 80-20, el bidireccional tuvo un rendimiento de 2 1,530,319 581 IOPS a 3 µs de latencia. El 1,175,469-way alcanzó 681 IOPS y XNUMXµs de latencia.
ESPECIFICACIONES
El siguiente es nuestro punto de referencia SPECsfs 2014 SP2, una nueva prueba para nosotros aquí. SPECsfs es un conjunto de referencia que mide el rendimiento y el tiempo de respuesta del servidor de archivos. El punto de referencia nos brinda un método estandarizado para comparar el rendimiento entre diferentes plataformas de proveedores. El punto de referencia opera estableciendo una escala e incrementando hasta que el punto de latencia es demasiado grande para las especificaciones del punto de referencia. Aquí observamos la escala que se puede hacer hasta que se infringen los 11 ms, así como el ancho de banda que alcanza el servidor cuando falla el número de latencia.
Primero veremos la latencia aquí, ya que arrojará más luz sobre por qué el ancho de banda se detuvo donde lo hizo en la segunda parte. La escala y sus latencias tanto para 2 vías como para 3 vías se encuentran en la siguiente tabla:
| SPECsfs Latencia (ms) | ||
|---|---|---|
| SCALE | Espejo bidireccional DataON HCI-224 | Espejo bidireccional DataON HCI-224 |
| 100 | 0.243 | 0.262 |
| 200 | 0.329 | 0.371 |
| 300 | 0.466 | 0.499 |
| 400 | 0.636 | 0.699 |
| 500 | 0.753 | 0.896 |
| 600 | 0.953 | 1.083 |
| 700 | 1.113 | 1.314 |
| 800 | 1.326 | 1.557 |
| 900 | 1.501 | 1.826 |
| 1000 | 1.88 | 2.167 |
| 1100 | 2.061 | 2.807 |
| 1200 | 2.323 | 4.64 |
| 1300 | 2.749 | 8.557 |
| 1400 | 5.47 | 10.449 |
| 1500 | 8.616 | 11.285 (fallo) |
| 1600 | 10.485 | 11.414 (fallo) |
| 1700 | 11.069 | |
| 1800 | 11.697 (fallo) | |
| 1900 | 12.51 (fallo) | |
Como se puede ver, ambas configuraciones comenzaron cerca de los 250 µs, la de 2 vías ligeramente por debajo y permaneciendo así durante todo el tiempo. A una escala de 1500, el 3-way falló yendo a 11.285ms dándole un rango de 262µs a 10.45ms. El bidireccional falló en una escala de 2 alcanzando 1800 ms, lo que le da un rango de 11.7 µs a 243 ms.
La siguiente tabla muestra el ancho de banda para cada configuración en cada compilación, con la falla mencionada anteriormente en la latencia.
| Ancho de banda SPECsfs (KB/s) | ||
| SCALE | Espejo bidireccional DataON HCI-224 | Espejo bidireccional DataON HCI-224 |
| 100 | 300897 | 300880 |
| 200 | 600372 | 600857 |
| 300 | 901672 | 902964 |
| 400 | 1202779 | 1203106 |
| 500 | 1504492 | 1503394 |
| 600 | 1805952 | 1806455 |
| 700 | 2105973 | 2108432 |
| 800 | 2408183 | 2406171 |
| 900 | 2710895 | 2707106 |
| 1000 | 3007499 | 3009280 |
| 1100 | 3308648 | 3308168 |
| 1200 | 3608244 | 3610219 |
| 1300 | 3910414 | 3888303 |
| 1400 | 4212976 | 4026720 |
| 1500 | 4513454 | 4000079 (fallo) |
| 1600 | 4587183 | 4229678 (fallo) |
| 1700 | 4621067 | |
| 1800 | 4630352 (fallo) | |
| 1900 | 4569824 (fallo) | |
En cuanto al ancho de banda, ambas configuraciones funcionaron codo con codo con intervalos de 300 MB/s hasta que la de 3 vías falló la latencia con su ancho de banda de paso final de 4.02 GB/s, y la de 2 vías tuvo un ancho de banda de paso final de 4.62 GB/s. s.
Conclusión
Hacía tiempo que no profundizábamos tanto en la plataforma de almacenamiento de Microsoft, y nos alegra mucho estar de vuelta. Con la renovada solución Microsoft Azure Stack HCI, Microsoft ha logrado algo tan básico y fundamental que es fácil subestimarlo. Microsoft ha simplificado al máximo su solución HCI, sin añadir ninguna capa adicional que perjudique el rendimiento. Como se puede apreciar en nuestros datos, el clúster DataON que hemos estado probando ha alcanzado un rendimiento excepcional, el más rápido que hemos visto en un clúster HCI de 4 nodos para el mercado medio. Cabe mencionar que ni siquiera estamos probando el hardware más reciente y avanzado de DataON. Si bien esta configuración, con unidades SSD Intel Optane DC, es sin duda muy potente, DataON ofrece soluciones más rápidas que aprovechan las CPU Intel Xeon de segunda generación, la memoria persistente y una conectividad de red más rápida. El hecho de que haya aún más rendimiento disponible en una solución Azure Stack HCI es emocionante, pero también es importante recordar que la solución puede reducirse a implementaciones tan pequeñas como HCI de dos nodos que se pueden configurar sin conmutadores para una solución de borde o para pymes de bajo costo.
Profundizando en los números de rendimiento, el clúster HCI de Microsoft Azure Stack pudo ofrecer una increíble cantidad de E/S y ancho de banda. En el ámbito de las cuatro esquinas, medimos más de 2.3 millones de IOPS 4K de lectura aleatoria con una configuración de duplicación de 3 vías y 338 4 IOPS de escritura aleatoria 2K. Si necesita un mayor rendimiento de escritura, una configuración de espejo bidireccional pudo aumentar las velocidades de escritura aleatoria de 4K a 564k IOP. Sin embargo, mirar el ancho de banda es donde Microsoft Azure Stack realmente brilla. En nuestra carga de trabajo de transferencia secuencial de bloques de 64K, la duplicación bidireccional midió 2 GB/s de lectura y 39.5 GB/s de escritura, mientras que la duplicación tridireccional midió 15.24 GB/s de lectura y 3 GB/s de escritura. Esto supera con creces lo que hemos medido en clústeres de HCI anteriores.
En general, la solución Azure Stack HCI de Microsoft demostró ser simple de implementar, fácil de administrar y con un rendimiento excepcional, todo lo que desea. DataON, como socio de una solución, se destacó al proporcionar una construcción llave en mano, ofreciendo hardware construido según las especificaciones con instrucciones claras que finalmente se vende en una configuración que puede estar lista y funcionando en muy poco tiempo. Los clientes pueden incluso omitir el cableado en muchos casos, por lo que realmente se reduce a la necesidad específica. Sin embargo, de cualquier manera, Azure Stack HCI combinado con Intel Optane, SSD Intel NVMe y redes Mellanox 100G demostraron ser una fuerza a tener en cuenta.


 Amazon