

En agosto, NVIDIA dividió su oferta de escritorio Blackwell en dos categorías para profesionales: estación de trabajo y servidor. La tarjeta RTX PRO 6000 para estación de trabajo está diseñada para creadores, ingenieros y desarrolladores de IA que requieren la máxima capacidad de procesamiento y VRAM en una torre o chasis de escritorio. La RTX PRO 6000 Blackwell Server Edition está diseñada para servidores en rack y nodos de inferencia o renderizado sin interfaz gráfica en centros de datos. Ahora que tenemos la tarjeta para estación de trabajo en el banco de pruebas, podemos centrarnos en ella en esta reseña.
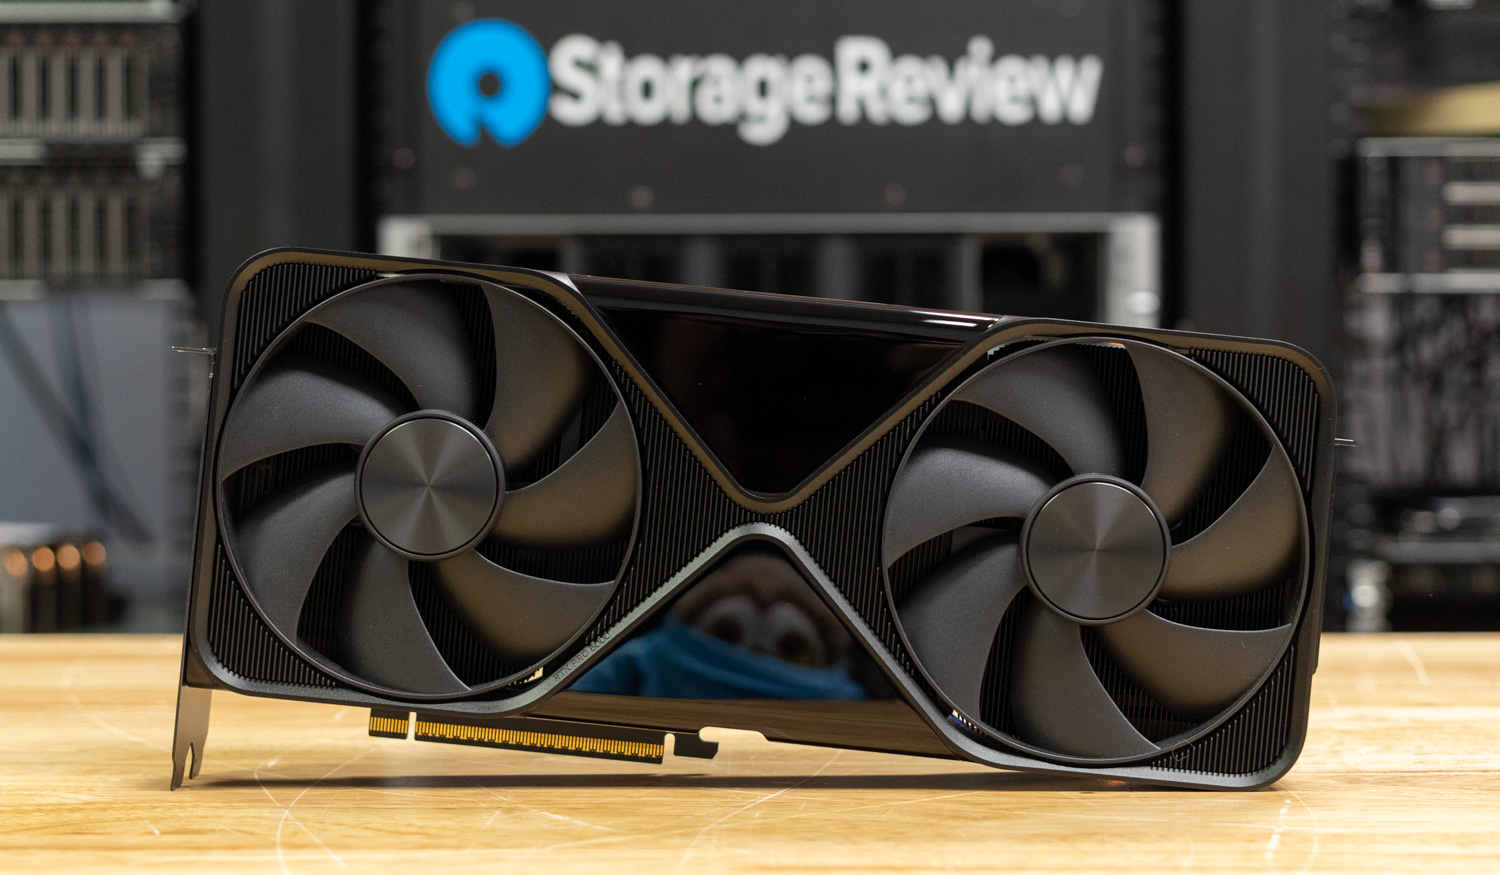
Por $8,500, la RTX PRO 6000 ofrece una GB202 completa con 24,064 núcleos CUDA, 752 núcleos Tensor de quinta generación, 188 núcleos RT de cuarta generación y 96 GB de memoria GDDR7 ECC. Su atractivo es evidente. Ofrece una capacidad de memoria inigualable por las tarjetas gráficas de consumo, controladores profesionales y un formato de doble ranura compatible con estaciones de trabajo reales sin requisitos especiales de alimentación ni flujo de aire.
NVIDIA posiciona esta GPU para flujos de trabajo mixtos. Esto incluye inferencia LLM local con contexto extenso, renderizado de escenas extensas, simulación compleja y plataformas de investigación multiGPU. Los detalles prácticos son clave. La tarjeta utiliza una interfaz PCIe 5.0 x16 estándar, ofrece cuatro salidas DisplayPort 2.1b para visualización de alta resolución y alta frecuencia de actualización, y proporciona un TDP configurable de 600 W, lo que permite a los integradores optimizar la temperatura, la acústica o la densidad.
Nuestro objetivo es evaluar el rendimiento de esta versión de estación de trabajo en el laboratorio en inteligencia artificial, renderizado y computación general, y cuantificar el impacto del grupo de 96 GB en las capacidades de un solo nodo de escritorio.
NVIDIA RTX PRO 6000: Estación de trabajo vs. Edición para servidor
Las variantes de la RTX PRO 6000 parten de la misma base Blackwell GB202, por lo que su capacidad matemática básica resulta familiar en teoría. La diferencia radica en cómo y dónde se diseñaron. La tarjeta de estación de trabajo que estamos probando es una placa autónoma, con refrigeración activa y doble ranura, con cuatro salidas DisplayPort 2.1b y controladores de nivel de estudio. Se integra en una estación de trabajo de torre o de escritorio, controla paneles locales y ejecuta aplicaciones DCC y CAD con certificación ISV junto con CUDA, TensorRT y cuDNN. Si los flujos de trabajo combinan trabajo interactivo con ventanas gráficas, visualización local e IA integrada, esta es la opción que mantiene todo en un solo chasis con acústica y temperatura predecibles.
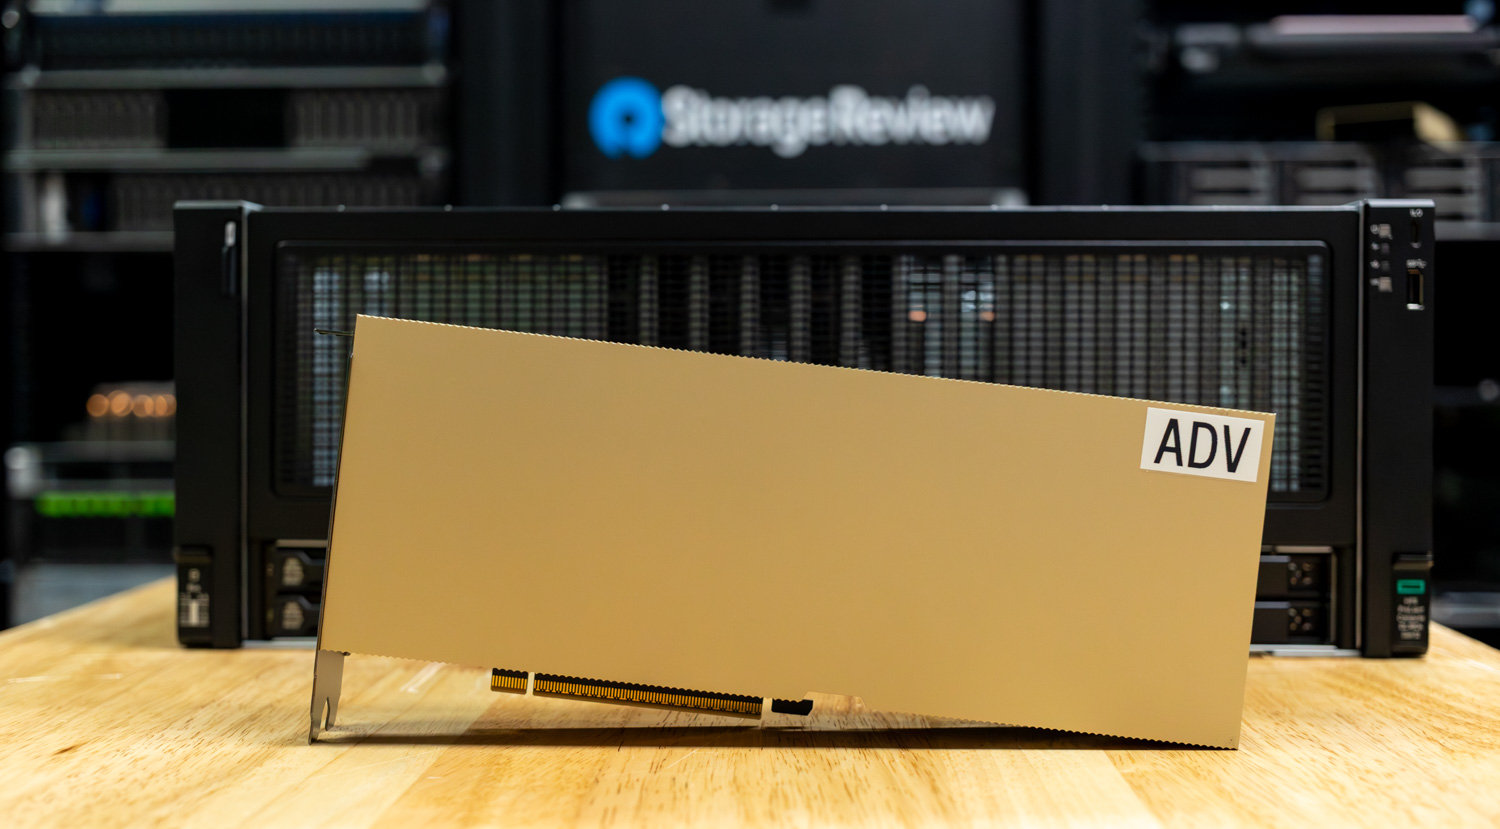
La RTX PRO 6000 Blackwell Server Edition está diseñada para un propósito completamente diferente. Se trata de una configuración sin monitor, con montaje en rack, pensada para servidores, que ofrece flujo de aire de adelante hacia atrás y capacidades de administración remota. No dispone de salidas de vídeo activas, ya que las tareas se programan a través de la red y los resultados se consumen de forma remota. El firmware, la alimentación y los perfiles térmicos están optimizados para un funcionamiento continuo 24/7 mediante un programador, generalmente combinado con NVIDIA AI Enterprise, orquestación de contenedores y acceso directo al hipervisor. En resumen, el modelo de estación de trabajo es la opción ideal cuando los creadores e ingenieros necesitan visualizar y manipular su trabajo localmente, a la vez que ejecutan grandes lotes de inferencia o simulación. La edición para servidores resulta más adecuada para escalar nodos idénticos en una cola de espera en un centro de datos, donde cada vatio, cable y ruta de flujo de aire debe ajustarse al plan de servicio del fabricante.
Especificaciones de NVIDIA RTX PRO 6000
La siguiente tabla describe las especificaciones de la NVIDIA RTX PRO 6000 en comparación con la RTX 5090 y la RTX 4090 de la generación anterior de Ada Lovelace.
| Comparación de GPU | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 |
| Nombre de la GPU | GB202 | GB202 | AD102 |
| Arquitectura de interiores | Pozo negro 2.0 | Pozo negro 2.0 | Ada Lovelace |
| Tamaño del proceso | 5 nm | 5 nm | 5 nm |
| Transistores | 92,200 millones de | 92,200 millones de | 76,300 millones de |
| Densidad | 122.9 M/mm² | 122.9 M/mm² | 125.3 M/mm² |
| Die Tamaño | mm² 750 | mm² 750 | mm² 609 |
| Ancho de la ranura | Ranura doble | Ranura doble | Triple ranura |
| Dimensiones | 304 mm x 137 mm x 40 mm | 304 mm x 137 mm x 48 mm | 304 mm x 137 mm x 61 mm |
| TDP | 600 W | 575 W | 450 W |
| Resultados | 4x DisplayPort 2.1b | 1 HDMI 2.1b, 3 DisplayPort 2.1b | 1x HDMI 2.1, 3x DisplayPort 1.4a |
| Conectores de potencia | 1x 16-pin | 1x 16-pin | 1x 16-pin |
| Interfaz de bus | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 4.0 x16 |
| Reloj base | 1590 MHz | 2017 MHz | 2235 MHz |
| Boost Clock | 2617 MHz | 2407 MHz | 2520 MHz |
| Reloj de memoria | 1750 MHz (28 Gbps efectivos) | 2209 MHz (28 Gbps efectivos) | 1313 MHz (21 Gbps efectivos) |
| Tamaño de la memoria | 96 GB | 32 GB | 24 GB |
| Tipo de memoria | GDDR7 ECC | GDDR7 | GDDR6X |
| Bus de memoria | 512 bits | 512 bits | 384 bits |
| ancho de banda de memoria | 1.79 TB / s | 1.79 TB / s | 1.01 TB / s |
| Núcleos CUDA | 24,064 | 21,760 | 16,384 |
| Núcleos tensoriales | 752 | 680 | 512 |
| ROP | 192 | 192 | 176 |
| Recuento SM | 188 | 170 | 128 |
| RT Cores | 188 | 170 | 128 |
| L1 caché | 128 KB (por SM) | 128 KB (por SM) | 128 KB (por SM) |
| L2 caché | 128 MB | 88 MB | 72 MB |
| Tasa de píxeles | 502.5 GPixel / s | 462.1 GPixel / s | 443.5 GPixel / s |
| Tasa de textura | 1,968.0 GTexel / s | 1,637 GTexel / s | 1,290 GTexel / s |
| FP16 (mitad) | 126.0 TFLOPS (1:1) | 104.8 TFLOPS (1:1) | 82.58 TFLOPS (1:1) |
| FP32 (flotante) | 126.0 TFLOPS | 104.8 TFLOPS | 82.58 TFLOPS |
| FP64 (doble) | 1.968 TFLOPS (1:64) | 1.637 TFLOPS (1:64) | 1,290 GFLOPS (1:64) |
| Precio de lanzamiento (USD) | $8,500 | $1,999 | $1,599 |
Construcción y Diseño
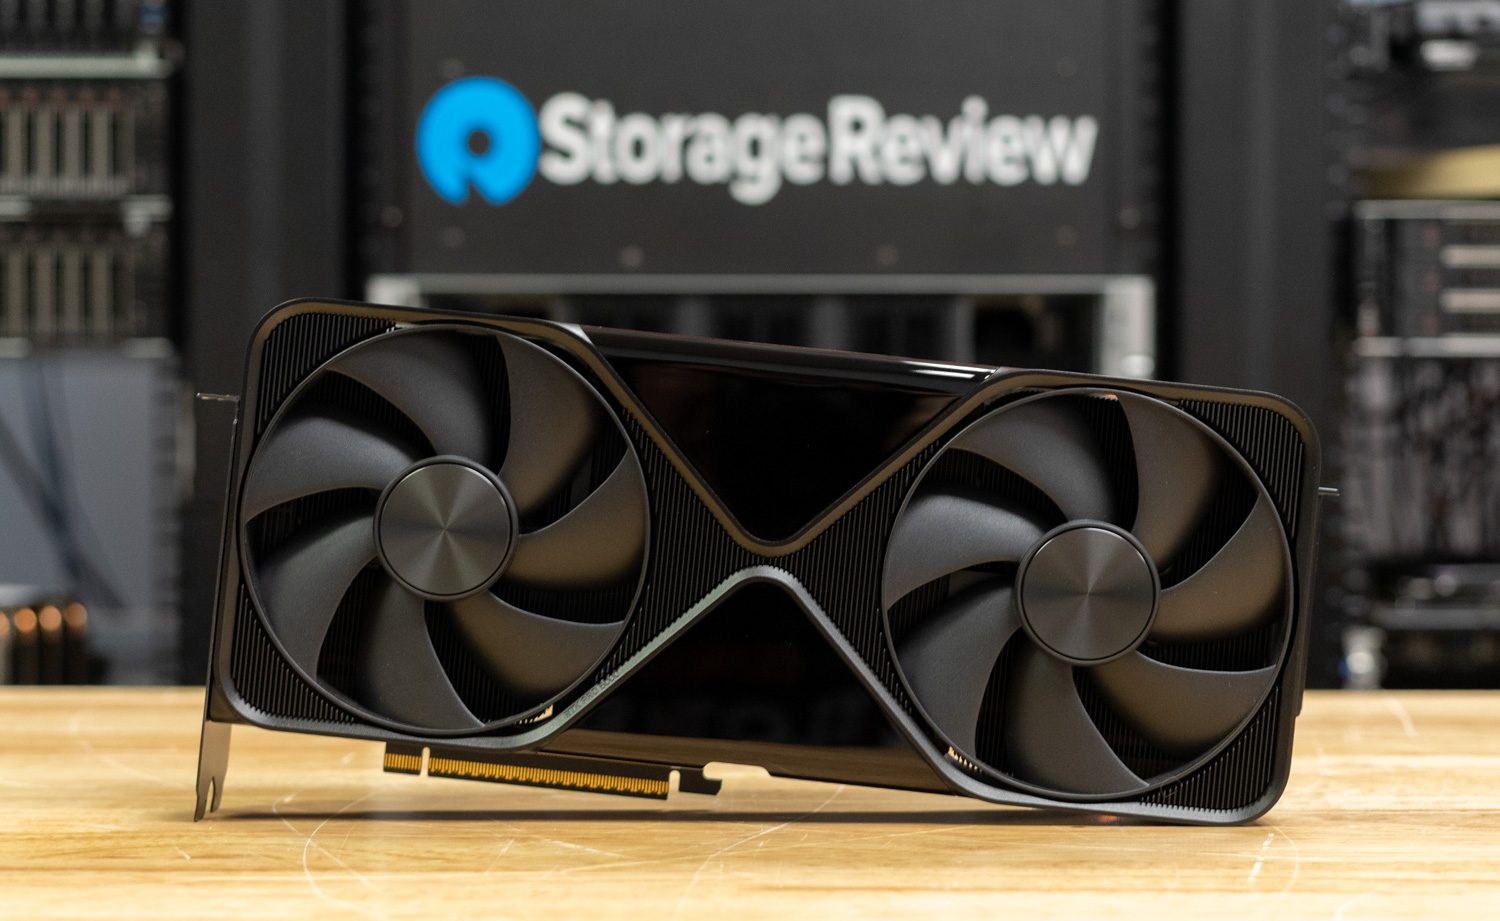
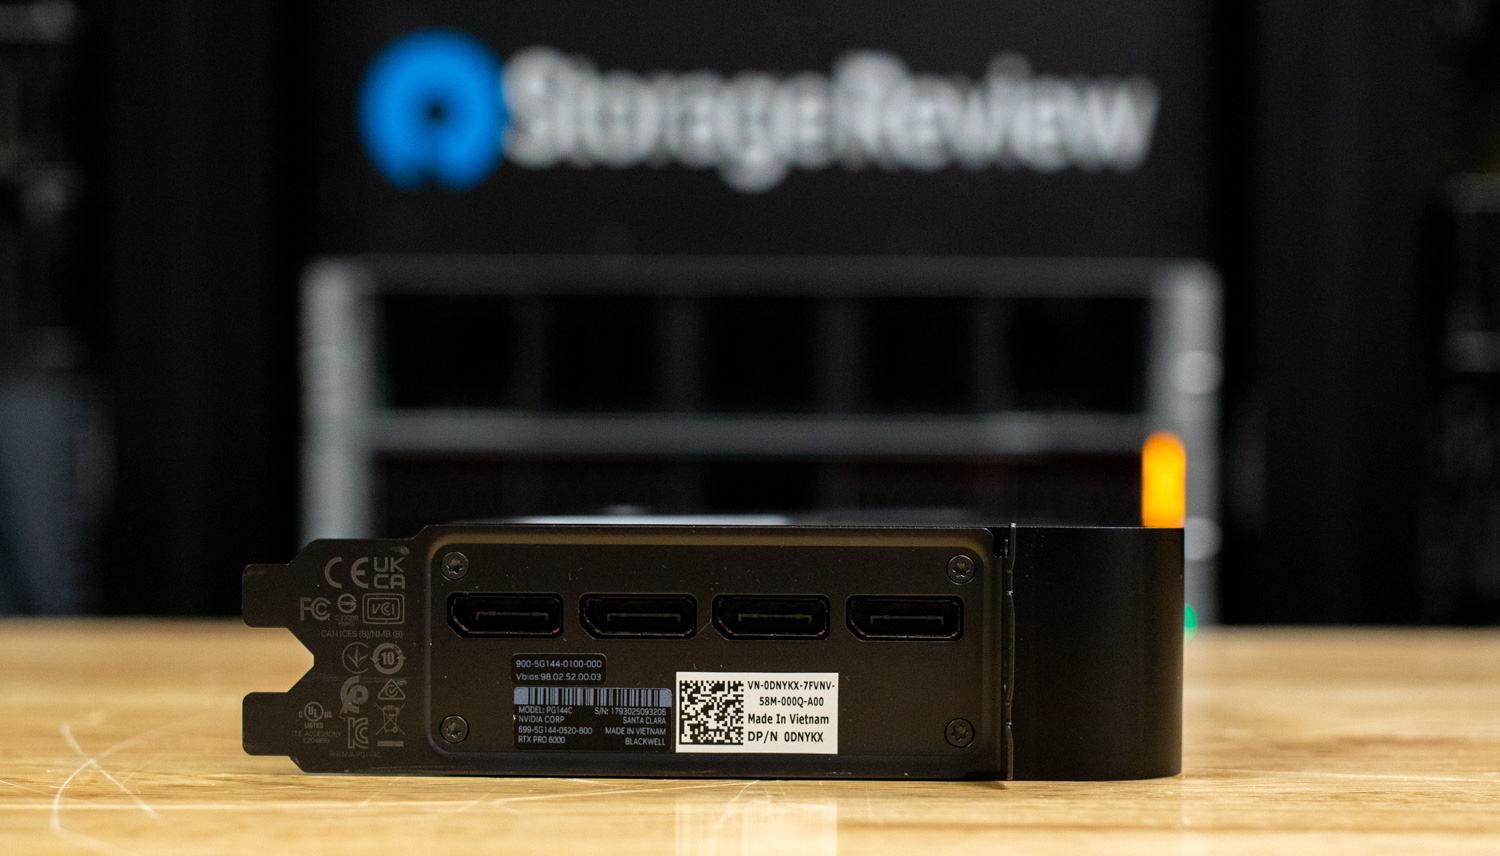
La GPU para estaciones de trabajo RTX PRO 6000 conserva el diseño limpio y funcional de NVIDIA, como se aprecia en la RTX 5090 FE, con un acabado negro mate industrial y una distribución de ventiladores de doble eje optimizada para entornos de estaciones de trabajo. Cada ventilador está diseñado para impulsar el flujo de aire a través de la cámara de vapor 3D de tamaño completo, lo que ayuda a mantener el equilibrio térmico bajo cargas de trabajo sostenidas. Con unas dimensiones de 304 mm × 137 mm × 40 mm, se integra perfectamente en una configuración de doble ranura, ofreciendo una densidad de rendimiento excepcional gracias a su TDP de 600 W.
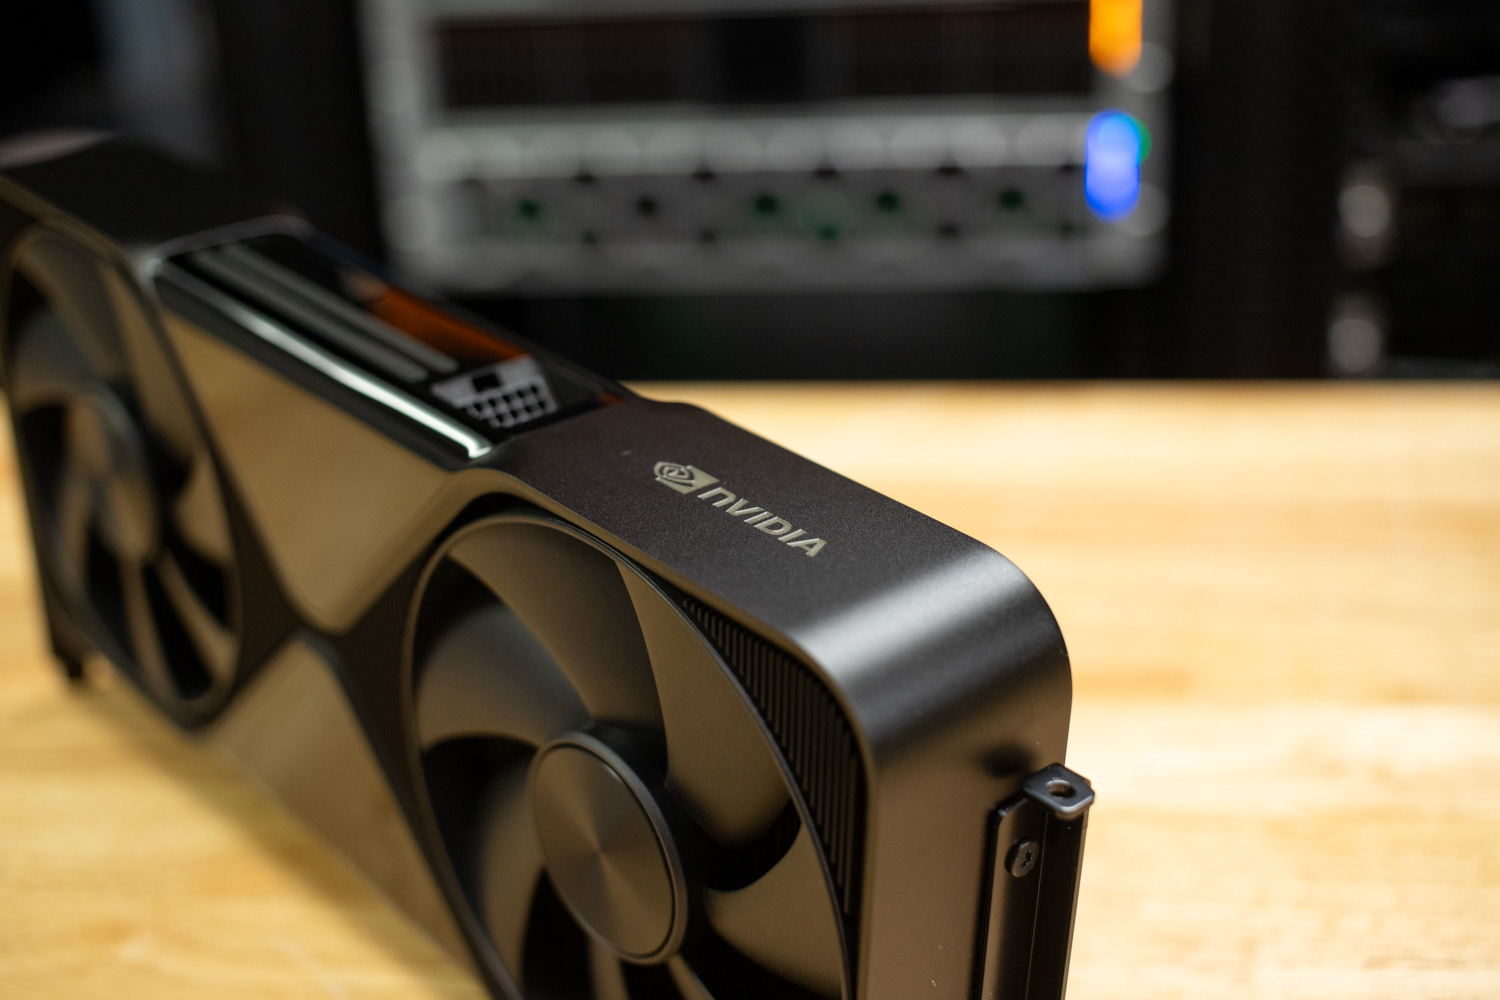
En el borde superior, el PRO 6000 cuenta con un único conector de alimentación de 16 pines, que proporciona la corriente necesaria para sus 96 GB de memoria GDDR7 y la arquitectura Blackwell 2.0 completa. La calidad de construcción se siente premium y rígida, con una cubierta de aluminio que canaliza el aire eficientemente a través del conjunto de aletas. La sutil marca NVIDIA complementa la estética profesional, sin RGB ni detalles de juego, lo que enfatiza la fiabilidad y el rendimiento en chasis de estaciones de trabajo con altas exigencias térmicas.
En cuanto a E/S, NVIDIA ofrece cuatro salidas DisplayPort 2.1b, lo que garantiza la compatibilidad con configuraciones 8K multimonitor, flujos de trabajo HDR con precisión de color y entornos de renderizado avanzados. El uso de DisplayPort 2.1b sobre HDMI refleja su orientación profesional, con un ancho de banda mejorado para pantallas de alta resolución y alta frecuencia de actualización.
Test de rendimiento
Para evaluar el rendimiento de nuestra NVIDIA RTX PRO 6000, la comparamos directamente con las tarjetas gráficas de consumo estrella de NVIDIA: la RTX 5090 Founders Edition y la RTX 4090 Founders Edition. Las pruebas se realizaron con una combinación de cargas de trabajo profesionales y basadas en IA para evaluar tanto la potencia de procesamiento como el rendimiento de las aplicaciones en el mundo real. Las pruebas de rendimiento incluyeron UL Procyon AI Text Generation, UL Procyon AI Image Generation, LuxMark, Geekbench 6 y V-Ray, lo que proporcionó una visión general equilibrada del rendimiento de renderizado, inferencia y productividad.
Además de estas cargas de trabajo estándar, también realizamos pruebas específicas diseñadas para mostrar los 96 GB de memoria GDDR7 en el RTX PRO 6000, demostrando sus ventajas en el manejo de modelos grandes, conjuntos de datos de alta resolución y cargas de trabajo de visualización profesional donde la capacidad y el rendimiento sostenido son fundamentales.
- RTX PRO 6000
- GeForce RTX 5090FE
- GeForce RTX 4090FE
- RTX 6000 ADA
Para aprovechar al máximo las ventajas de la nueva NVIDIA RTX PRO 6000, utilizamos nuestra plataforma AMD ThreadRipper. Este sistema, tal como está configurado, ofrece una CPU de 64 núcleos y un circuito de refrigeración líquida. Cuenta con una gran potencia de CPU subyacente para que la GPU pueda trabajar sin restricciones. La configuración completa del sistema se muestra a continuación.
Plataforma de prueba StorageReview AMD ThreadRipper
- Placa base: ASUS Pro WS TRX50-SAGE WIFI
- UPC: AMD Ryzen Threadripper 7980X de 64 núcleos
- RAM: 32 GB DDR5 4800 MT/s
- Almacenamiento: Samsung 2 Pro de 980TB
- OS: Windows 11 Pro para estaciones de trabajo
UL Procyon: Generación de texto con IA
El benchmark de generación de texto con IA de Procyon optimiza las pruebas de rendimiento de modelos LLM de IA mediante un método de evaluación conciso y consistente. Permite realizar pruebas repetidas en múltiples modelos LLM, minimizando la complejidad de modelos de gran tamaño y factores variables. Desarrollado en colaboración con líderes en hardware de IA, optimiza el uso de aceleradores de IA locales para evaluaciones de rendimiento más fiables y eficientes. Los resultados que se muestran a continuación se obtuvieron mediante TensorRT.
En las cuatro pruebas de modelos, la NVIDIA RTX PRO 6000 lideró constantemente. Empezando por Phi, la PRO 6000 obtuvo una puntuación general de 6,775, superando a la RTX 5090 con 5,749, a la RTX 4090 con 4,958 y a la RTX 6000 Ada con 4,508. Su mayor velocidad de generación de tokens (325.9 tokens/s) y su menor latencia (0.182 s hasta el primer token) subrayan su capacidad de respuesta en la generación de texto en tiempo real y en cargas de trabajo de IA basadas en chat.
La tendencia continuó con Mistral, donde el PRO 6000 registró 7,346, manteniendo un margen sustancial sobre el 5090 (6,267), el 4090 (5,094) y el 6000 Ada (4,255). Su rendimiento de 271.8 tokens/s demuestra las ventajas de su mayor capacidad de memoria de 96 GB y la optimización de la estación de trabajo para la inferencia de alto contexto.
En Llama3, el PRO 6000 se mantuvo a la cabeza con una puntuación de 6,501, en comparación con los 6,104 de la RTX 5090, los 4,849 de la 4090 y los 4,026 de la 6000 Ada. Esto destaca la consistencia de la arquitectura Blackwell de NVIDIA, ya que el PRO 6000 mantiene ventajas de rendimiento a medida que las cargas de trabajo de los transformadores aumentan en complejidad y longitud de contexto.
Finalmente, en Llama2, que enfatiza la inferencia de contexto largo y el rendimiento sostenido, la PRO 6000 alcanzó 8,008, mientras que las 5090, 4090 y 6000 Ada se quedaron atrás con 6,591, 5,013 y 3,957, respectivamente. Incluso con el aumento de la longitud de las secuencias y los tiempos de inferencia, la PRO 6000 mantuvo un claro dominio tanto en velocidad como en estabilidad, completando ejecuciones más rápido y con un rendimiento más fluido que cualquier otra GPU probada.
| UL Procyon: Generación de texto con IA | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| Puntuación general de Phi | 6,775 | 5,749 | 4,958 | 4,508 |
| Tiempo de salida de Phi hasta el primer token | 0.182 s | 0.244 s | 0.255 s | 0.288 s |
| Tokens de salida Phi por segundo | 325.855 tok/s | 314.435 tok/s | 244.343 tok/s | 228.359 tok/s |
| Duración total de Phi | 9.498 s | 10.280 s | 12.872 s | 13.869 s |
| Puntuación general de Mistral | 7,346 | 6,267 | 5,094 | 4,255 |
| Tiempo de salida de Mistral hasta el primer token | 0.229 s | 0.297 s | 0.322 s | 0.419 s |
| Tokens de salida de Mistral por segundo | 271.779 tok/s | 255.945 tok/s | 183.266 tok/s | 166.633 tok/s |
| Duración total del Mistral | 11.493 s | 12.593 s | 17.010 s | 19.092 s |
| Puntuación general de Llama3 | 6,501 | 6,104 | 4,849 | 4,026 |
| Tiempo de salida de Llama3 al primer token | 0.218 s | 0.234 s | 0.259 s | 0.348 s |
| Tokens de salida por segundo de Llama3 | 226.407 tok/s | 214.285 tok/s | 150.039 tok/s | 138.620 tok/s |
| Duración total de Llama3 | 13.554 s | 14.304 s | 19.991 s | 22.062 s |
| Puntuación general de Llama2 | 8,008 | 6,591 | 5,013 | 3,957 |
| Tiempo de salida de Llama2 al primer token | 0.307 s | 0.419 s | 0.500 s | 0.679 s |
| Tokens de salida por segundo de Llama2 | 145.595 tok/s | 134.502 tok/s | 92.853 tok/s | 78.532 tok/s |
| Duración total de Llama2 | 20.712 s | 23.018 s | 32.448 s | 38.923 s |
UL Procyon: Generación de imágenes de IA
El benchmark de generación de imágenes Procyon AI proporciona un método consistente y preciso para medir el rendimiento de la inferencia de IA en diversos tipos de hardware, desde NPU de bajo consumo hasta GPU de gama alta. Incluye tres pruebas: Stable Diffusion XL (FP16) para GPU de gama alta, Stable Diffusion 1.5 (FP16) para GPU de potencia moderada y Stable Diffusion 1.5 (INT8) para dispositivos de bajo consumo. El benchmark utiliza el motor de inferencia óptimo para cada sistema, lo que garantiza resultados justos y comparables.
Partiendo de Stable Diffusion 1.5 (FP16), la NVIDIA RTX PRO 6000 obtuvo una impresionante puntuación general de 8,869, superando a la RTX 5090 (8,193), a la RTX 4090 (5,260) y a la RTX 6000 Ada (4,230). La PRO 6000 completó la generación de imágenes en 11.27 segundos, con un promedio de 0.705 segundos por imagen, lo que la convierte en la más rápida de esta prueba. Esto demuestra cómo su optimización para estaciones de trabajo y sus 96 GB de memoria GDDR7 permiten una salida sostenida y de alta precisión sin comprometer la eficiencia.
En la prueba Stable Diffusion 1.5 (INT8), que mide el rendimiento de la inferencia cuantificada ligera, todas las GPU obtuvieron un rendimiento similar. La PRO 6000 obtuvo una puntuación de 79 064, casi idéntica a la de la RTX 5090 (79 272), mientras que superó a la RTX 4090 (62 160) y a la RTX 6000 Ada (55 901). Dado que las cargas de trabajo INT8 dependen menos del ancho de banda y la capacidad de la memoria, las diferencias fueron mínimas, pero la PRO 6000 mantuvo resultados consistentes con un tiempo de generación promedio de 0.395 segundos por imagen.
La prueba Stable Diffusion XL (FP16) somete a las GPU a ejecuciones de inferencia más largas y exigentes que exigen tanto la memoria como el rendimiento de cómputo sostenido. En esta prueba, la PRO 6000 obtuvo una puntuación general de 6,991, justo por detrás de los 7,179 de la RTX 5090, pero muy por delante de los 5,025 de la RTX 4090 y los 3,043 de la RTX 6000 Ada. Mantuvo un tiempo total de renderizado de 85.8 segundos, o 5.36 segundos por imagen, lo que demuestra que la PRO 6000 gestiona cargas de trabajo de generación extendidas de forma eficiente y sin ralentizaciones.
| UL Procyon: Generación de imágenes con IA | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| Difusión estable 1.5 (FP16) – Puntuación general | 8,869 | 8,193 | 5,260 | 4,230 |
| Difusión estable 1.5 (FP16) – Tiempo total | 11.274 s | 12.204 s | 19.011 s | 23.639 s |
| Difusión estable 1.5 (FP16): velocidad de generación de imágenes | 0.705 s/image | 0.763 s/image | 1.188 s/image | 1.477 s/image |
| Difusión estable 1.5 (INT8) – Puntuación general | 79,064 | 79,272 | 62,160 | 55,901 |
| Difusión estable 1.5 (INT8) – Tiempo total | 3.162 s | 3.154 s | 4.022 s | 4.472 s |
| Difusión estable 1.5 (INT8): velocidad de generación de imágenes | 0.395 s/image | 0.394 s/image | 0.503 s/image | 0.559 s/image |
| Stable Diffusion XL (FP16): puntuación general | 6,991 | 7,179 | 5,025 | 3,043 |
| Difusión estable XL (FP16): tiempo total | 85.819 s | 83.573 s | 119.379 s | 197.172 s |
| Stable Diffusion XL (FP16): velocidad de generación de imágenes | 5.364 s/image | 5.223 s/image | 7.461 s/image | 12.323 s/image |
Blender 4.4
Blender es una aplicación de modelado 3D de código abierto. Esta prueba de rendimiento se ejecutó con la utilidad Blender Benchmark. La puntuación se mide en muestras por minuto; los valores más altos indican un mejor rendimiento.
En las tres pruebas, la NVIDIA RTX PRO 6000 se impuso, demostrando las ventajas de su arquitectura Blackwell y su mayor capacidad de memoria. En la prueba Monster, la PRO 6000 obtuvo 7,870.17 muestras por minuto, superando a la RTX 5090 con 7,421.50, seguida por la RTX 4090 y la RTX 6000 Ada con 5,733.97 y 5,632.60, respectivamente.
En el entorno Junkshop, la PRO 6000 mantuvo su liderazgo con 4,158.91 muestras por minuto, en comparación con las 3,980.15 de la RTX 5090, las 2,827.83 de la RTX 4090 y las 2,663.77 de la RTX 6000 Ada. Finalmente, en el entorno Classroom, que suele priorizar tanto el sombreado como la eficiencia de la memoria, la PRO 6000 alcanzó 4,041.11 muestras por minuto, superando una vez más las 3,732.63 de la RTX 5090 y superando significativamente a la RTX 4090 y la RTX 6000 Ada, con 2,909.35 y 2,818.83, respectivamente.
| Blender 4.4 (cuanto más alto, mejor) | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| Monster | 7,870.17 | 7,421.50 | 5,733.97 | 5,632.60 |
| chatarrería | 4,158.91 | 3,980.15 | 2,827.83 | 2,663.77 |
| Aulas | 4,041.11 | 3,732.63 | 2,909.35 | 2,818.83 |
luxmark
Luxmark es una prueba de rendimiento de GPU que utiliza LuxRender, un renderizador de trazado de rayos de código abierto, para evaluar el rendimiento de un sistema al gestionar escenas 3D con un alto nivel de detalle. Esta prueba es especialmente relevante para evaluar la capacidad de renderizado gráfico de servidores y estaciones de trabajo, especialmente en aplicaciones de efectos visuales y visualización arquitectónica, donde la simulación de luz precisa es crucial.
En la prueba de escena gastronómica, la NVIDIA RTX PRO 6000 lideró con una puntuación de 24 287, superando a la RTX 5090 con 23 141, seguida por la RTX 4090 y la RTX 6000 Ada con 17 171 y 14 873, respectivamente. Esto demuestra cómo la PRO 6000 mantiene un rendimiento fluido de trazado de rayos en cargas de trabajo con geometría e iluminación altamente detalladas, sin pérdida de estabilidad ni limitación térmica.
En la exigente escena Hall, que enfatiza la geometría a gran escala y la iluminación global compleja, el PRO 6000 nuevamente aseguró el resultado más alto con 52,588, apenas por delante de los 51,725 del RTX 5090, y muy por encima del RTX 4090 (38,887) y el RTX 6000 Ada (32,132).
| Luxmark (cuanto más alto, mejor) | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| Puntaje de alimentos | 24,287 | 23,141 | 17,171 | 14,873 |
| Puntuación del Hall | 52,588 | 51,725 | 38,887 | 32,132 |
Geekbench 6
Geekbench 6 es una herramienta de evaluación comparativa multiplataforma que mide el rendimiento general del sistema. El navegador de Geekbench permite comparar cualquier sistema con ella.
En esta prueba, la NVIDIA RTX PRO 6000 obtuvo una puntuación OpenCL de GPU de 384,158, superando a la RTX 5090 (374,807), la RTX 4090 (333,384) y la RTX 6000 Ada (336,882). Esta mayor puntuación de la PRO 6000 refleja su diseño optimizado para estaciones de trabajo, un mayor ancho de banda de memoria y una pila de controladores profesional, que en conjunto permiten un rendimiento consistente en una amplia gama de cargas de trabajo con un alto consumo de recursos.
| Geekbench (cuanto más alto, mejor) | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| Puntuación de GPU OpenCL | 384,158 | 374,807 | 333,384 | 336,882 |
V-Ray
V -Ray Benchmark mide el rendimiento de renderizado de CPU, GPU NVIDIA o ambas, utilizando los motores avanzados de V-Ray 6. Emplea pruebas rápidas y un sistema de puntuación sencillo para que los usuarios puedan evaluar y comparar las capacidades de renderizado de sus sistemas. Es una herramienta esencial para profesionales que buscan información precisa sobre el rendimiento.
En nuestras pruebas, la NVIDIA RTX PRO 6000 obtuvo 12 128 vpaths, lo que la sitúa entre la RTX 5090, que lideró con 14 764, y la RTX 4090, que obtuvo 10 847. La RTX 6000 Ada se quedó ligeramente por detrás, con 10 766. Si bien la RTX 5090 mantuvo una ligera ventaja en esta prueba de renderizado con uso intensivo de la GPU, la PRO 6000 demostró un rendimiento sólido y consistente, lo que refuerza su optimización orientada a estaciones de trabajo y su eficiencia sostenida bajo cargas de renderizado completas.
| V-Ray (cuanto más alto, mejor) | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| rutas virtuales | 12,128 | 14,764 | 10,847 | 10,766 |
Prueba de inferencia multimodelo de LM Studio
Para esta ronda de pruebas, utilizamos LM Studio para evaluar el rendimiento de la NVIDIA RTX PRO 6000 en una gama de modelos de lenguajes de programación grandes y populares, como GPT-OSS 120B, Gemma 3 (4B, 12B y 27B), Llama 3.1 (8B y 70B) y Llama 3.3 70B. Cada modelo recibió la misma instrucción:
“Escribe un trabajo académico de 500 palabras sobre la historia de los perezosos”.
El enfoque principal de esta prueba está en los tokens por segundo (rendimiento) y el tiempo total (duración de finalización), que juntos resaltan la eficiencia con la que el RTX PRO 6000 maneja diferentes tamaños y complejidades de modelos en condiciones de generación idénticas.
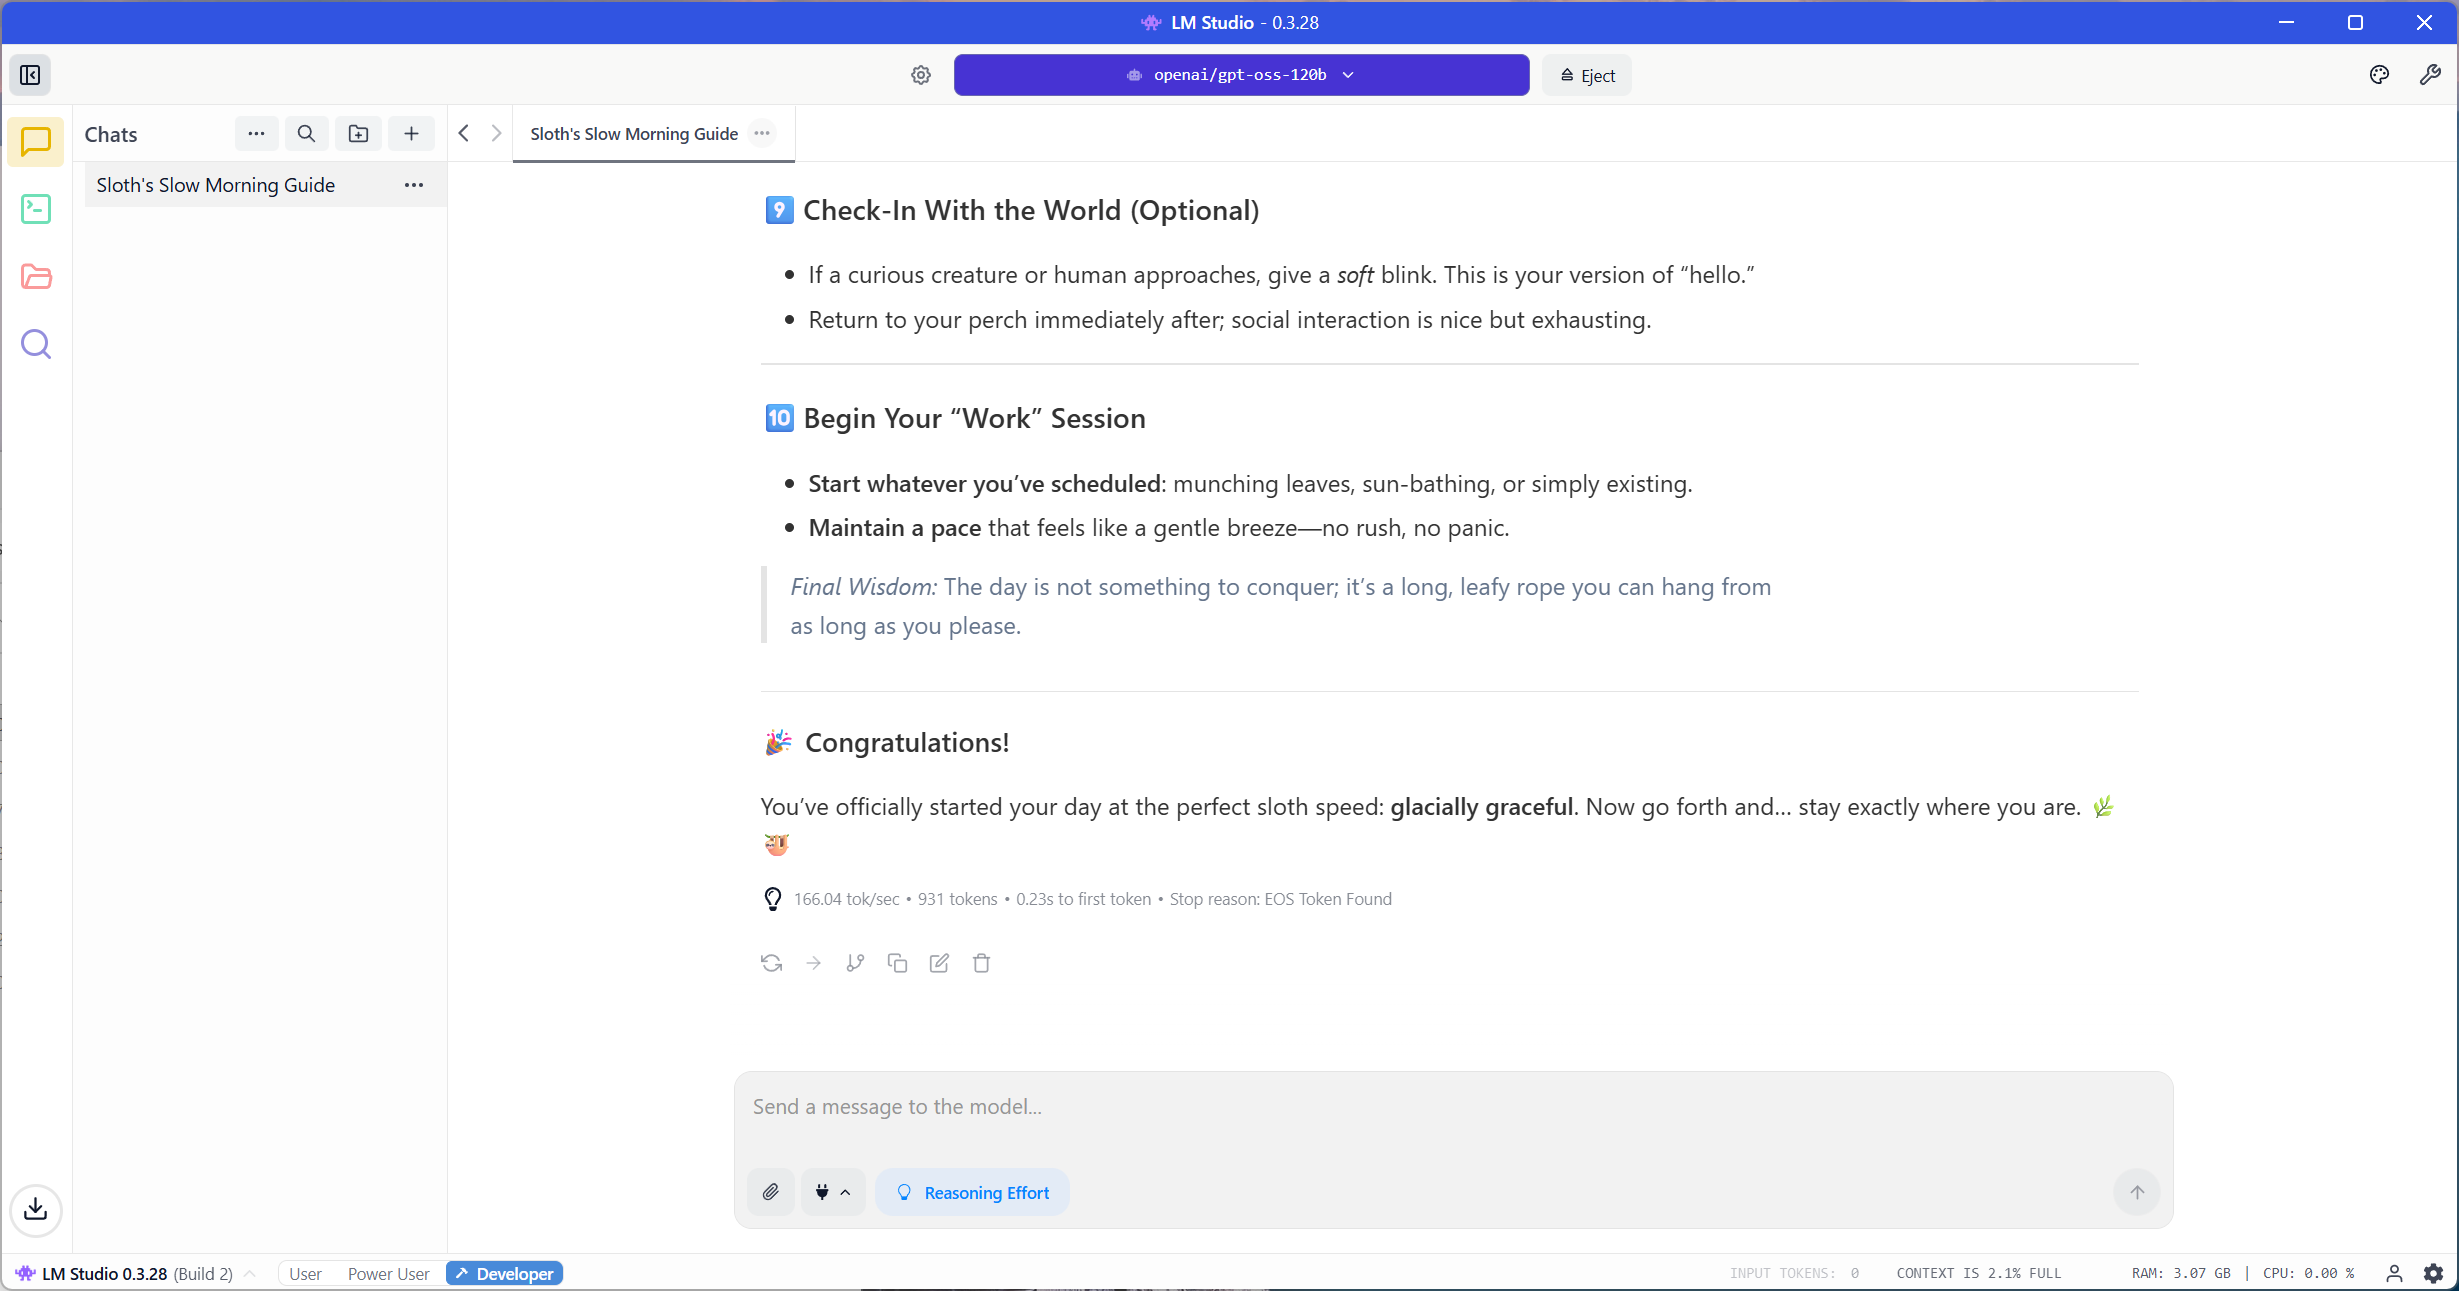
En las pruebas de inferencia de LM Studio, NVIDIA RTX PRO 6000 demostró un excelente rendimiento y escalabilidad en una amplia gama de tamaños de modelos, desde modelos más pequeños de parámetros 4B hasta configuraciones masivas de clase 120B.
El punto culminante de esta prueba fue el OpenAI GPT-OSS 120B, donde la RTX PRO 6000 produjo 163.1 tokens por segundo y completó la generación de 500 palabras en 9.54 segundos. Este resultado es destacable porque tarjetas como la RTX 5090 no pueden cargar ni ejecutar un modelo de 120B y, a menudo, no pueden procesar ni siquiera modelos de 70B debido a la limitada VRAM. Los 96 GB de memoria GDDR7 de la PRO 6000 le permiten procesar estos enormes modelos localmente, lo que la convierte en una GPU excepcional entre las estaciones de trabajo.
En modelos más pequeños, el Gemma 3.4 B alcanzó el mayor rendimiento, completando la tarea a 226.7 tokens por segundo en 3.51 segundos. El Llama 3.1 8B Instruct le siguió de cerca, con 197.1 tokens por segundo y un tiempo total de 4.17 segundos. Estas ejecuciones demuestran la gran eficiencia y la rápida respuesta del PRO 6000 en cargas de trabajo de inferencia de rango medio.
En el extremo superior, los modelos Llama 3.1 70B Instruct y Llama 3.3 70B promediaron alrededor de 31.8 tokens por segundo con tiempos de generación totales de 27.2 segundos y 25.3 segundos, mostrando una salida constante a pesar de su gran tamaño.
En general, la RTX PRO 6000 ofrece una estabilidad, un rendimiento y una capacidad excepcionales al ejecutar modelos a gran escala. Su capacidad de memoria de 96 GB le permite gestionar cargas de trabajo que superan los límites de las GPU de consumo, lo que la convierte en una excelente opción para desarrolladores, investigadores y profesionales que necesitan un rendimiento local fiable para la IA avanzada y el desarrollo de modelos generativos.
| LM Studio (Resultados de inferencia de modelos) | |||||||||
|---|---|---|---|---|---|---|---|---|---|
| Nombre de Modelo | Tokens/seg | Tiempo hasta el primer token(s) | Tiempo total (s) | Tokens de aviso | Tokens previstos | Fichas totales | |||
| OpenAI GPT-OSS 120B | 163.15 | 0.193 | 9.543 | 81 | 1,557 | 1,638 | |||
| Gema 3 4B | 226.73 | 0.113 | 3.51 | 25 | 796 | 821 | |||
| Gema 3 12B | 117.15 | 0.068 | 8.06 | 25 | 944 | 969 | |||
| Gema 3 27B | 68.06 | 0.221 | 12.048 | 25 | 820 | 845 | |||
| Meta Llama 3.1 8B Instruir | 197.07 | 0.062 | 4.171 | 49 | 822 | 871 | |||
| Meta Llama 3.1 70B Instruir | 31.84 | 0.159 | 27.227 | 49 | 867 | 916 | |||
| MetaLlama 3.3 70B | 31.74 | 0.323 | 25.329 | 49 | 804 | 853 | |||
Consumo de energía de NVIDIA RTX PRO 6000
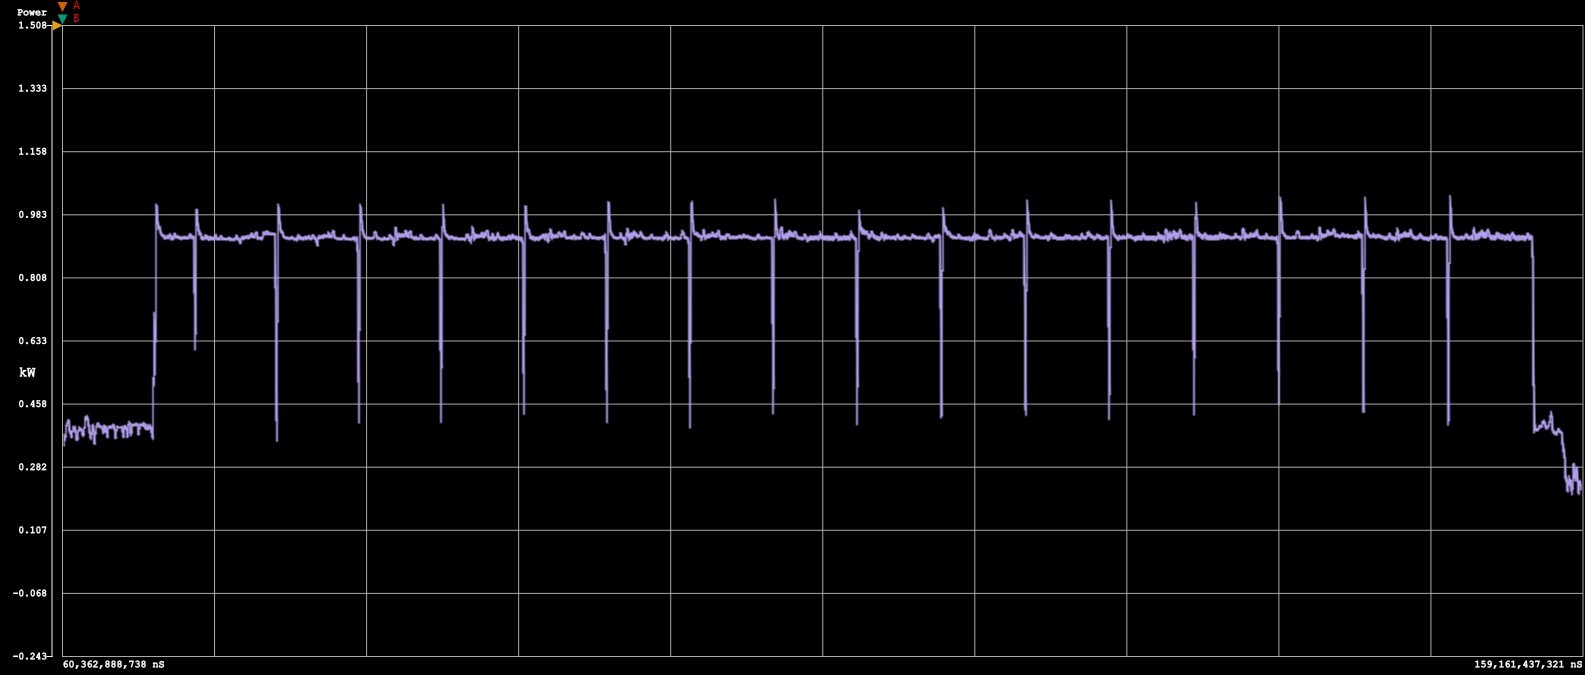
Para evaluar la eficiencia real de las cargas de trabajo de IA, utilizamos el benchmark de generación de imágenes de IA de UL Procyon, específicamente la prueba Stable Diffusion XL FP16. Esta prueba se centra en el intervalo entre la segunda y la última imagen generada, capturando el tiempo necesario para completar el intervalo, el consumo de energía máximo y sostenido, y la potencia del sistema en reposo tras la finalización.
Durante nuestras pruebas, la RTX PRO 6000 mantuvo un consumo promedio del sistema de 918.5 W bajo carga sostenida, alcanzando un máximo de 1,036.3 W, y estableciéndose en 152.3 W en reposo una vez finalizada la carga de trabajo. El intervalo completo de la prueba duró 5.3 segundos, consumiendo un total de 1.35 Wh. Estos resultados muestran una excelente relación potencia-rendimiento para una GPU de nivel de estación de trabajo, manteniendo el consumo bien controlado y manteniendo un alto rendimiento durante cargas de trabajo de inferencia prolongadas.
En comparación con otras GPU, la RTX PRO 6000 se acerca mucho a la RTX 4090 en consumo total de energía, manteniendo un tiempo de finalización más rápido, y supera significativamente a la RTX 6000 Ada tanto en eficiencia energética como en velocidad. Curiosamente, las nuevas tarjetas Blackwell, que comparten el chip GB202, presentan características de eficiencia muy similares bajo esta carga de trabajo, con solo pequeñas diferencias en el consumo total de energía, probablemente debido al mayor TDP de la PRO 6000. Esto indica que la última generación de NVIDIA continúa perfeccionando el rendimiento por vatio en lugar de modificarlo drásticamente.
| Potencia de imagen utilizada en Stable Diffusion XL FP16 (cuanto menor, mejor) | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| Energía consumida | 1.35Wh | 1.16Wh | 1.35Wh | 1.76Wh |
| Duración del exámen | Años 5.3 | Años 5.1 | Años 7.3 | Años 12.6 |
Conclusión
La NVIDIA RTX PRO 6000 es, en conjunto, la GPU para estaciones de trabajo más potente disponible para flujos de trabajo profesionales, ofreciendo un rendimiento de clase de centro de datos en un formato de escritorio. Con un precio de venta al público de aproximadamente $8,500 al momento de la prueba, está dirigida a equipos que requieren confiabilidad, alta densidad de computación y una gran cantidad de memoria ECC para trabajo de producción. Con 24,064 núcleos CUDA, 752 núcleos Tensor, 96 GB de memoria GDDR7 ECC y arquitectura Blackwell, gestiona cargas de trabajo que superan los límites prácticos de tarjetas de consumo como la GeForce RTX 5090 o la 4090. Si bien las pruebas de rendimiento individuales pueden mostrar que una tarjeta de consumo la supera en velocidad bruta, en conjunto, considerando la capacidad, la estabilidad, los controladores y la compatibilidad con ISV, la RTX PRO 6000 es la opción más adecuada para uso profesional.
Para IA y ML, el conjunto de 96 GB es la clave. Permite una inferencia de contexto extensa y puntos de control locales muy grandes, lo cual demostramos ejecutando modelos de clase de 70 B a 120 B, manteniendo un alto nivel de tokens por segundo. El renderizado y la simulación también se benefician del mayor ancho de banda de memoria y caché L2, lo que ofrece un rendimiento predecible y sostenido en Blender, V-Ray y LuxMark bajo cargas extendidas.
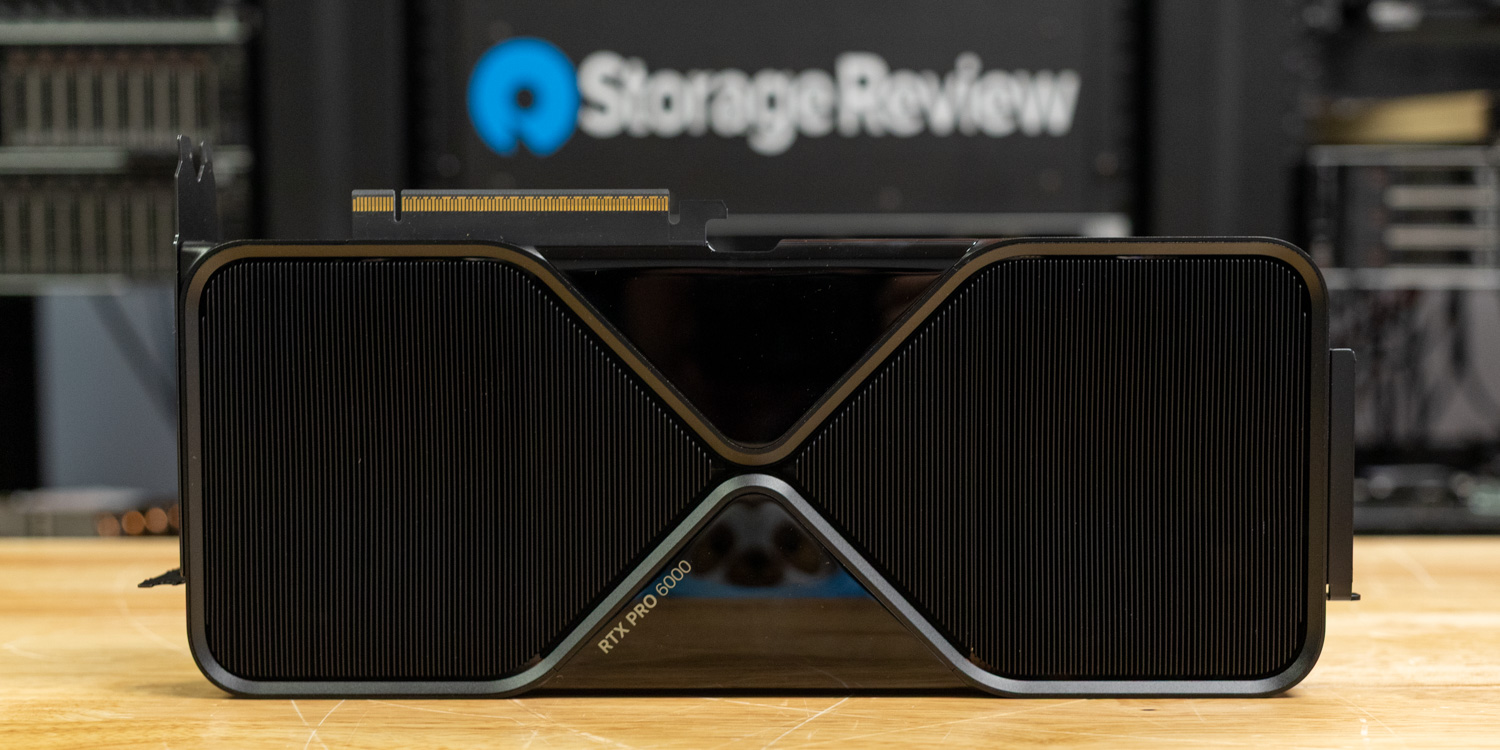
La tarjeta es compatible con estaciones de trabajo reales. Cuenta con un diseño de doble ranura con una interfaz PCIe 5.0 x16, cuatro salidas DisplayPort 2.1b y una única entrada de alimentación de 16 pines. Se recomienda una fuente de alimentación de alta calidad y un buen flujo de aire en el chasis para soportar los 600 W de potencia de la placa. La compatibilidad con varias GPU también es sencilla, con compatibilidad OEM e ISV para de 2 a 8 GPU en las pilas de IA, renderizado y computación.
Si su trabajo implica LLM de contexto largos, escenas muy grandes o simulación de alta precisión en un solo nodo, la RTX PRO 6000 justifica su prima con una capacidad y una consistencia que otras tarjetas no pueden igualar.


 Amazon