

La demanda de contenido de video rápido y de alta calidad nunca ha sido tan alta. En el panorama mediático actual, se espera que pequeños equipos de noticias, creadores de contenido independientes y equipos de producción de eventos capturen, editen y publiquen material de calidad profesional en tiempo real, a menudo sin el apoyo de un equipo de posproducción ni una infraestructura centralizada.
Por eso, la búsqueda de IA local, proporcionada a través de sistemas de producción en el borde, se está volviendo indispensable, a medida que la cantidad de material audiovisual crece exponencialmente y la necesidad de reutilizarlo aumenta. Al permitir que los equipos trabajen directamente con el material en el punto de captura, los flujos de trabajo en el borde eliminan los cuellos de botella y permiten a los creadores dedicar menos tiempo a buscar y gestionar material audiovisual, y más a producir el mejor contenido posible.
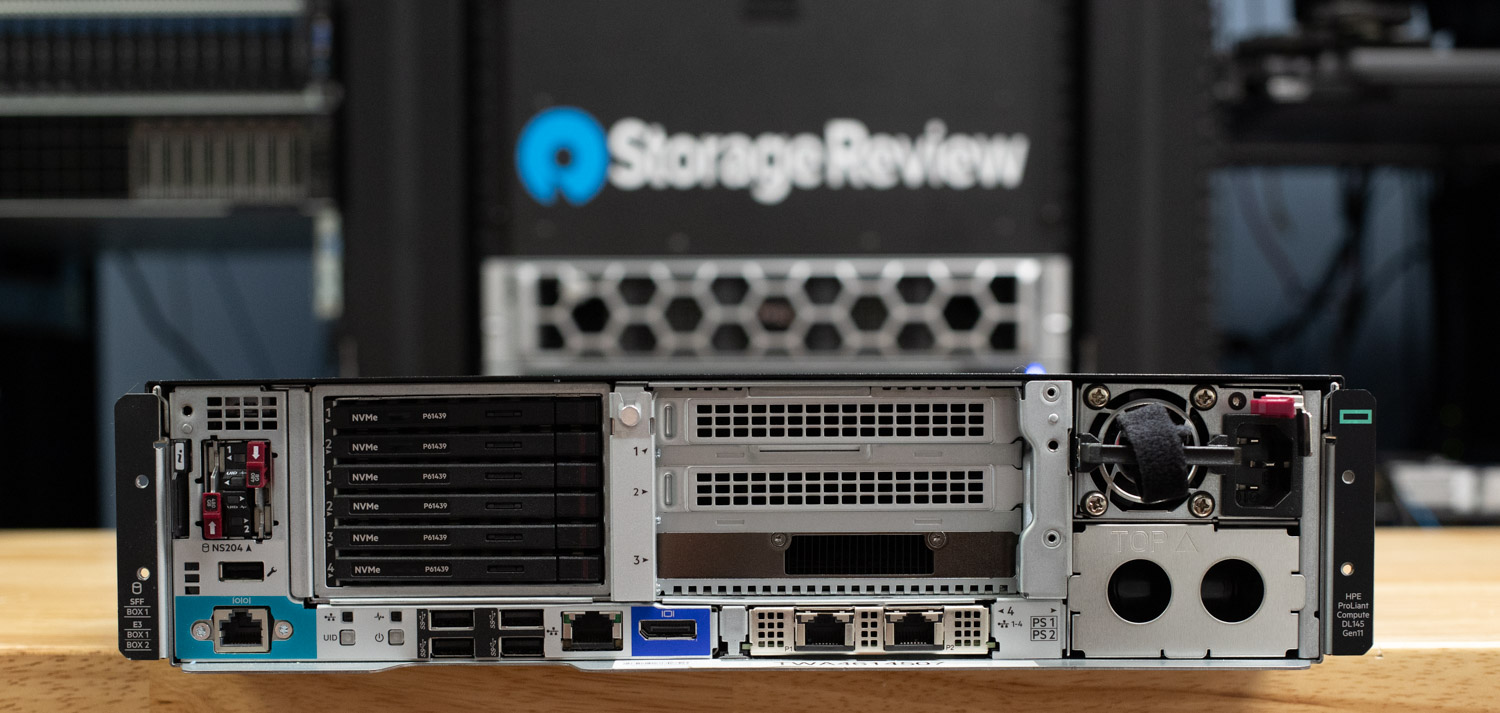
Axle AI , una plataforma de automatización y gestión de activos multimedia impulsada por IA, está diseñada específicamente para este flujo de trabajo descentralizado y dinámico. Al combinarse con hardware líder en la industria, como el servidor HPE ProLiant DL145 Gen11, una GPU NVIDIA L4 y unidades SSD Solidigm PCIe Gen5, el resultado es un entorno de producción potente y portátil. Ofrece capacidades multimedia profesionales con asistencia de IA incluso a los equipos más reducidos.
Descripción general de la arquitectura del sistema
El servidor de borde HPE ProLiant DL145 Gen11 es un candidato ideal para implementaciones de Axle AI en entornos de campo y eventos con limitaciones de espacio, energía y refrigeración. Con su diseño 2U de profundidad reducida de tan solo 16 cm, este servidor está diseñado específicamente para su portabilidad e instalación en espacios reducidos, como racks móviles y cajas de transporte. A diferencia de los equipos empresariales tradicionales, admite un rango de temperatura de funcionamiento extendido de -5 °C a 55 °C, lo que lo hace ideal para entornos menos controlados. A pesar de su tamaño compacto, ofrece características de clase empresarial como alimentación redundante y opciones de unidad de arranque, lo que lo hace ideal para equipos que necesitan una infraestructura robusta con capacidad para el borde sin la sobrecarga del hardware de tamaño completo.
En cuanto a la CPU, el DL145 admite procesadores AMD EPYC serie 8004 (Siena), con soporte para entre ocho y 64 núcleos. Nuestro sistema de prueba está equipado con el EPYC 8434P, que ofrece 48 núcleos y 96 hilos. Con un TDP de 200 W, logra un excelente equilibrio entre eficiencia y potencia de cálculo, lo que lo hace ideal para cargas de trabajo intensivas. El procesador admite 96 líneas PCIe 5.0 y ofrece seis canales de memoria DDR5, lo que permite velocidades de hasta 4800 MT/s con un excelente ancho de banda de memoria. Si bien los requisitos mínimos para Axle AI exigen al menos 16 núcleos de CPU y 32 GB de RAM, nuestra configuración supera con creces estos requisitos con 48 núcleos y 256 GB de memoria DDR5.
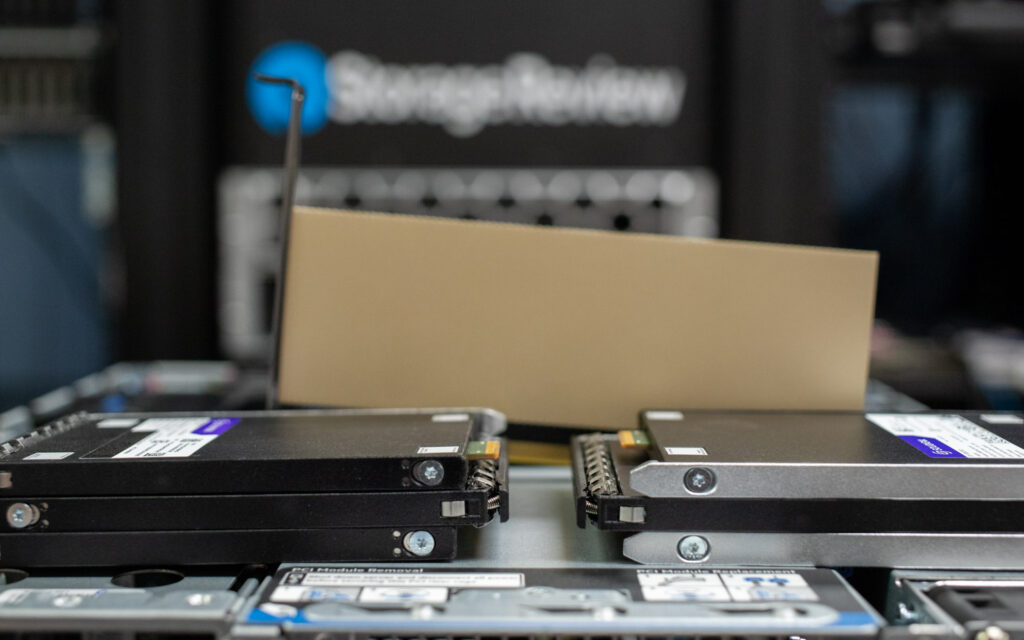
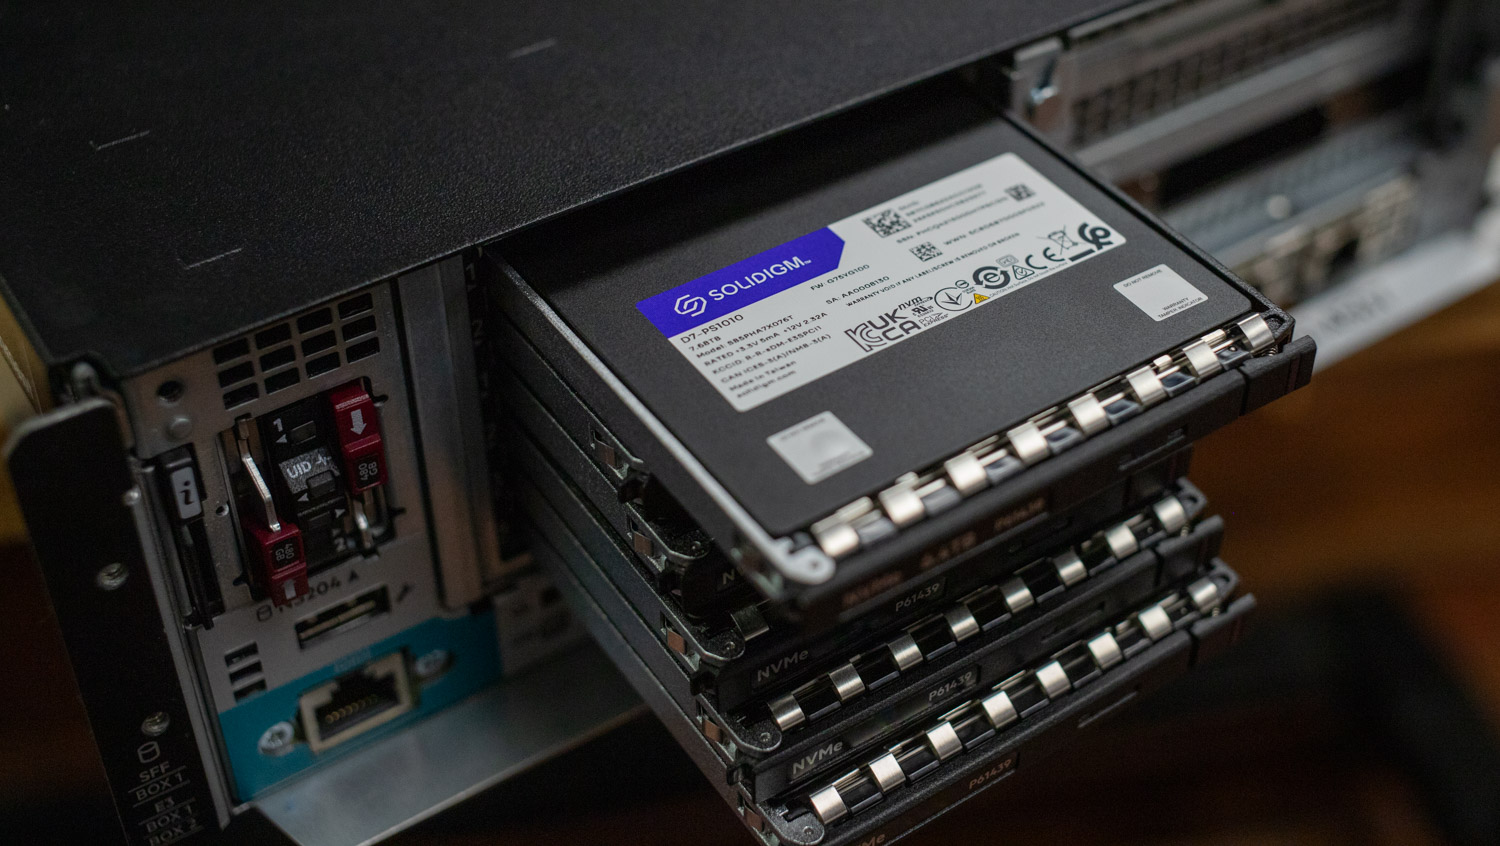
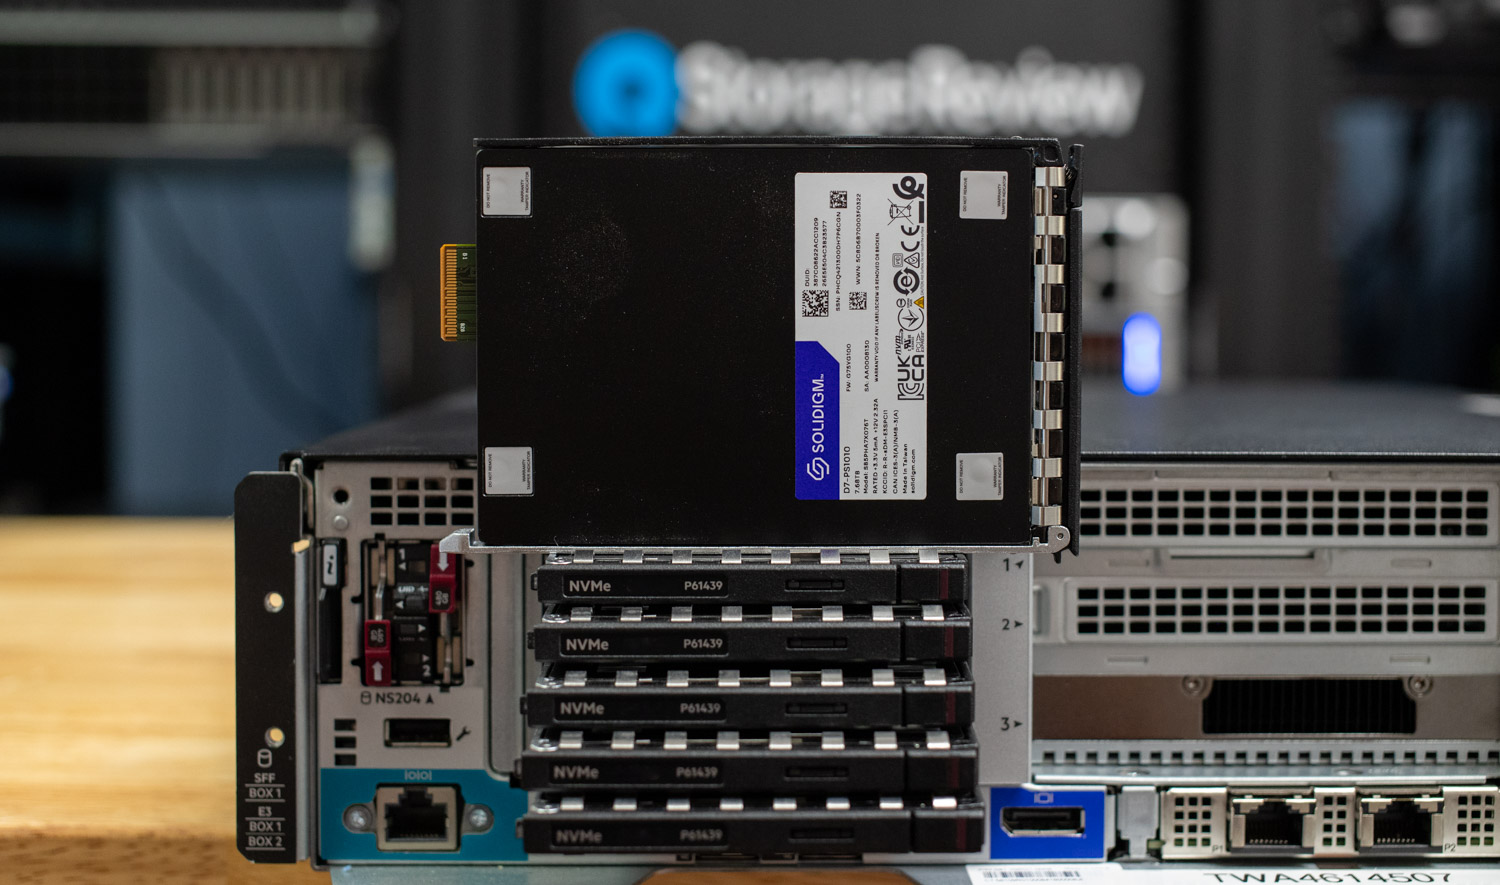
El rendimiento del almacenamiento es fundamental en cualquier canalización multimedia, y el DL145 admite hasta seis unidades NVMe EDSFF E3.S para satisfacer estas demandas. En nuestra configuración, utilizamos seis SSD Solidigm D7-PS1010 E3.S, cada una con una capacidad de 7.68 TB. Estas unidades PCIe 5.0 x4 ofrecen velocidades de lectura de hasta 14,500 10,000 MB/s y de escritura de 46 50 MB/s, lo que se combina para un almacenamiento de alta velocidad de casi 15.36 TB. Diseñadas para flujos de trabajo de IA y multimedia, estas SSD ofrecen una eficiencia energética impresionante y pueden ofrecer hasta un 92 % más de rendimiento en fases específicas del canalización en comparación con las unidades NVMe convencionales. Para equipos que requieren capacidad adicional, esta configuración puede escalar hasta XNUMX TB por unidad, lo que proporciona un total combinado de XNUMX TB de almacenamiento rápido y denso en un formato compacto.
El DL145 admite hasta tres GPU de una sola ranura, y en nuestra configuración, implementamos una única NVIDIA L4, un acelerador de bajo consumo basado en la arquitectura Ada Lovelace. Diseñado para el procesamiento de vídeo, la inferencia de IA, la computación visual y las cargas de trabajo de virtualización, el L4 ofrece un rendimiento robusto con un consumo de tan solo 72 vatios. Cuenta con 24 GB de VRAM GDDR6 y se conecta mediante una interfaz PCIe 4.0 x16 para alimentación y datos. Axle AI recomienda un mínimo de 16 GB de VRAM, y el L4 supera con creces esta recomendación con 8 GB adicionales, lo que garantiza un amplio margen para tareas multimedia de alta resolución y operaciones basadas en IA.
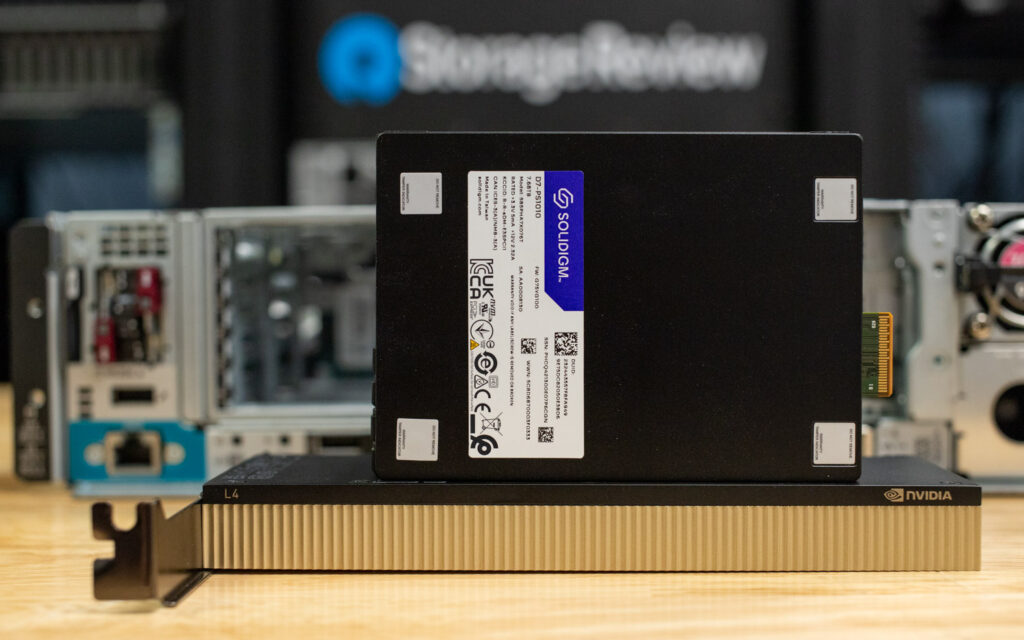
GPU de ranura única Nvidia L4
Para la capa de aplicación, implementamos Axle AI MAM y Axle AI Tags mediante el entorno virtual Proxmox (8.3.5). El sistema está configurado con dos máquinas virtuales dedicadas: una que ejecuta Axle AI MAM y la otra que ejecuta Axle AI Tags. Esta estructura proporciona una clara separación entre la gestión de medios y el procesamiento de metadatos con IA, a la vez que permite una comunicación fluida entre los componentes.
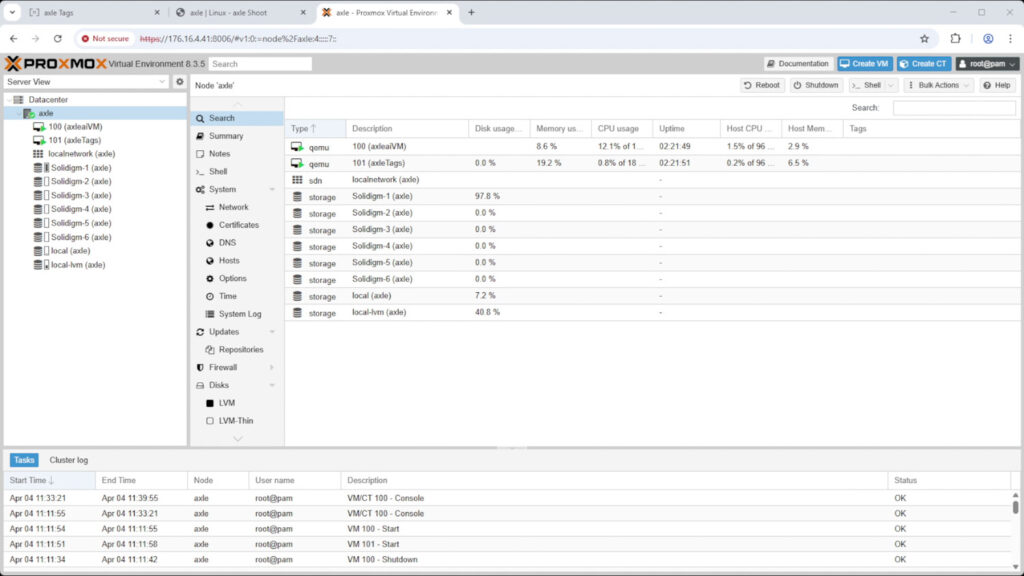
Resumen del entorno y hardware de Proxmox
Junto con MAM, Axle AI Tags ofrece capacidades de IA locales, como búsqueda vectorial semántica, reconocimiento de objetos y logotipos, y detección facial entrenable. Se implementa en un contenedor Docker y aprovecha la GPU NVIDIA L4 mediante PCIe para una inferencia eficiente en tiempo real. La interfaz de entrenamiento y administración basada en navegador permite un ajuste flexible, y su diseño modular es compatible con configuraciones de hardware Intel/NVIDIA o AMD/NVIDIA. Si bien está totalmente integrado con MAM en nuestra configuración, Axle AI Tags también ofrece compatibilidad con la API REST para su uso con otras plataformas.
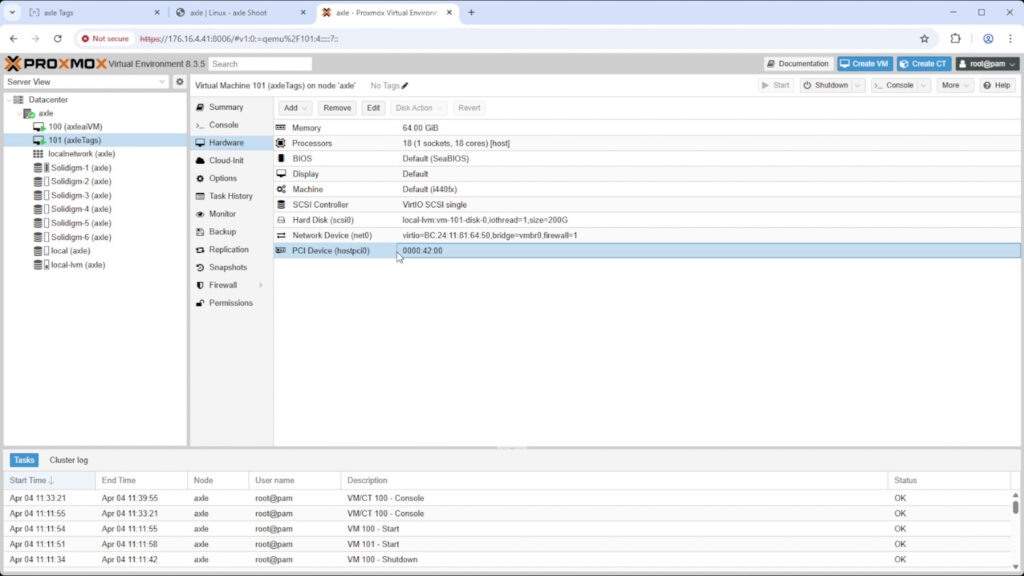
Configuración de hardware de la máquina virtual Axle AI Tags
Las unidades Solidigm PS1010 se montan en la máquina virtual Axle AI MAM, lo que garantiza un acceso rápido y de baja latencia al material. Al virtualizar toda la pila y asignar recursos informáticos dedicados a cada componente, esta configuración ofrece mayor tiempo de actividad, mejor gestión de recursos y compatibilidad multiusuario, mucho más allá de lo que una sola estación de trabajo podría ofrecer. Esto la hace ideal para un entorno de producción colaborativo de alto volumen.
Juntos, estos componentes forman una solución de hardware totalmente integrada que permite flujos de trabajo multimedia rápidos, locales y basados en IA. Es una plataforma eficiente y lista para el trabajo en campo para equipos remotos que requieren un rendimiento fiable donde el espacio y la energía son limitados, pero donde el procesamiento de IA sigue siendo esencial.
Rendimiento de HPE ProLiant DL145 Gen11
Antes de profundizar en las pruebas de rendimiento, la siguiente tabla describe la configuración del sistema del HPE ProLiant DL145 Gen11. Si bien las pruebas con Axle AI se realizaron en una instalación virtualizada con Proxmox, el sistema se migró a Ubuntu Server 22.04.5 para medir el rendimiento del almacenamiento en nuestras pruebas GDSIO y FIO.
| HPE ProLiant DL145 Gen 11 | Descripción general del hardware |
|---|---|
| CPU | Un solo AMD EPYC 8434P |
| RAM | DDR256 ECC de 5 GB |
| Almacenaje | 6 unidades SSD Solidigm D7-PS1010 E3s de 7.68 TB |
| Almacenamiento de arranque | Puerto NS204 ocupado dos veces (Samsung PM2A480 M.9 de 3 GB) |
| GPU | NVIDIA L4 única |
| Sistema operativo | Ubuntu Server 22.04.5 |
Máximo rendimiento sintético
La prueba FIO es una herramienta de benchmarking flexible y potente que se utiliza para medir el rendimiento de dispositivos de almacenamiento, incluyendo SSD y HDD. Evalúa métricas como el ancho de banda, las IOPS (operaciones de entrada/salida por segundo) y la latencia bajo diversas cargas de trabajo, como operaciones de lectura/escritura secuenciales y aleatorias. Esta prueba está diseñada para capturar el rendimiento máximo y someter el sistema de almacenamiento a múltiples cargas de trabajo, lo que la hace especialmente útil para comparar diferentes dispositivos o configuraciones. En este caso, se realizó una prueba de superficie completa, utilizando toda la capacidad de las unidades para obtener una visión completa de su rendimiento sostenido.
En la prueba de lectura secuencial con bloques de 128 K, el sistema alcanzó un ancho de banda de 56.4 GB/s y 430,000 1.78 IOPS sostenidas con una latencia media de 45.4 milisegundos. El rendimiento de escritura secuencial con el mismo tamaño de bloque alcanzó los 346,000 GB/s, con 2.22 4 IOPS y una latencia media de 46.6 milisegundos. En operaciones de lectura aleatoria con bloques de 11.4 K, el sistema alcanzó los 0.269 GB/s con 4 millones de IOPS y una baja latencia media de 29.1 milisegundos, lo que demuestra el alto potencial de rendimiento de la matriz de almacenamiento NVMe en condiciones de acceso intensivo. Las operaciones de escritura aleatoria a 7.1 K alcanzaron los 0.432 GB/s, con XNUMX millones de IOPS y una latencia media de XNUMX milisegundos, lo que confirma una sólida capacidad de escritura sostenida incluso con acceso fragmentado.
| Resumen del benchmark HPE DL145 Gen 11 FIO | Ancho de banda – GB/s | IOPS | Latencia promedio |
|---|---|---|---|
| Lectura secuencial (128K) | 56.4 GB / s | 430k | 1.78 ms |
| Escritura secuencial (128K) | 45.4 GB / s | 346k | 2.22 ms |
| Lectura aleatoria (4 KB) | 46.6 GB / s | 11.4 m | 0.269 ms |
| Escritura aleatoria (4K) | 29.1 GB / s | 7.1 m | 0.432 ms |
Almacenamiento directo de GPU
Una de las pruebas que realizamos en este banco de pruebas fue la prueba Magnum IO GPU Direct Storage (GDS). GDS es una función desarrollada por NVIDIA que permite a las GPU ignorar la CPU al acceder a datos almacenados en unidades NVMe u otros dispositivos de almacenamiento de alta velocidad. En lugar de enrutar los datos a través de la CPU y la memoria del sistema, GDS permite la comunicación directa entre la GPU y el dispositivo de almacenamiento, lo que reduce significativamente la latencia y mejora el rendimiento de los datos.
Cómo funciona el almacenamiento directo en GPU
Tradicionalmente, cuando una GPU procesa datos almacenados en una unidad NVMe, los datos primero deben pasar por la CPU y la memoria del sistema antes de llegar a la GPU. Este proceso genera cuellos de botella, ya que la CPU se convierte en un intermediario, lo que agrega latencia y consume valiosos recursos del sistema. El almacenamiento directo en la GPU elimina esta ineficiencia al permitir que la GPU acceda a los datos directamente desde el dispositivo de almacenamiento a través del bus PCIe. Esta ruta directa reduce la sobrecarga asociada con el movimiento de datos, lo que permite transferencias de datos más rápidas y eficientes.
Las cargas de trabajo de IA, especialmente las que implican aprendizaje profundo, requieren un uso intensivo de datos. El entrenamiento de redes neuronales de gran tamaño requiere el procesamiento de terabytes de datos, y cualquier retraso en la transferencia de datos puede provocar que las GPU se subutilicen y que los tiempos de entrenamiento sean más prolongados. El almacenamiento directo en la GPU aborda este desafío al garantizar que los datos se entreguen a la GPU lo más rápido posible, lo que minimiza el tiempo de inactividad y maximiza la eficiencia computacional.
Además, GDS es particularmente beneficioso para cargas de trabajo que implican la transmisión de grandes conjuntos de datos, como el procesamiento de video, el procesamiento de lenguaje natural o la inferencia en tiempo real. Al reducir la dependencia de la CPU, GDS acelera el movimiento de datos y libera recursos de la CPU para otras tareas, lo que mejora aún más el rendimiento general del sistema.
Lectura secuencial GDSIO
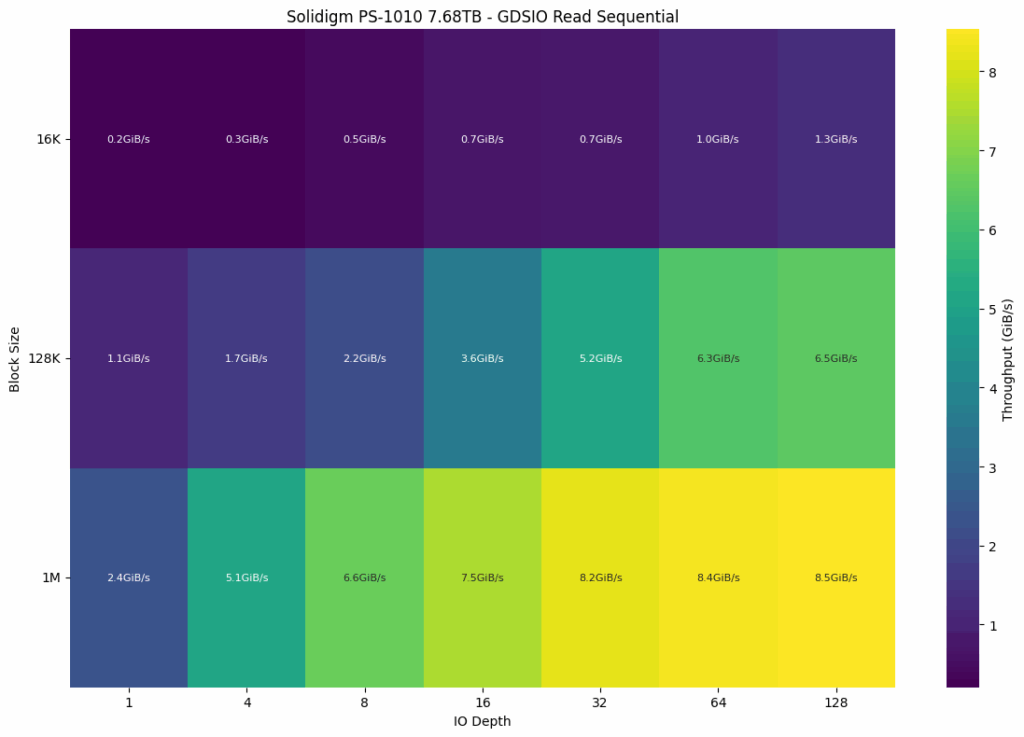
En la prueba de lectura secuencial GDSIO de la unidad Solidigm PS1010 de 7.68 TB, el rendimiento aumentó significativamente tanto con el tamaño de bloque como con la profundidad de E/S. Con el tamaño de bloque más pequeño, de 16 K, el rendimiento comenzó en tan solo 0.2 GiB/s con una profundidad de cola de 1 y aumentó gradualmente hasta 1.3 GiB/s con una profundidad de cola de 128, lo que muestra una escalabilidad limitada a esa granularidad. Al aumentar hasta bloques de 128 K, el rendimiento mejoró aún más drásticamente, comenzando en 1.1 GiB/s y alcanzando 6.5 GiB/s con la profundidad máxima. Los mejores resultados se obtuvieron con un tamaño de bloque de 1 M, donde el rendimiento alcanzó inicialmente 2.4 GiB/s y alcanzó un máximo de 8.5 GiB/s con una profundidad de cola de 128, lo que indica que el perfil de rendimiento óptimo de la unidad se logra con lecturas secuenciales grandes y colas más profundas.
Escritura secuencial GDSIO
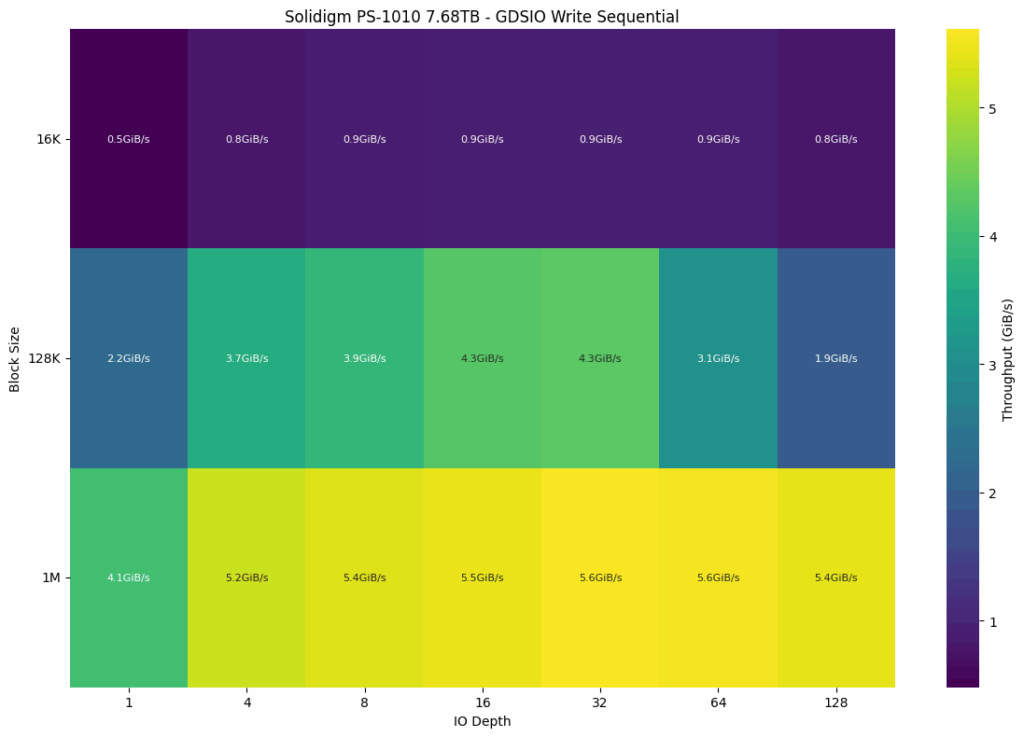
El rendimiento de escritura secuencial en Solidigm PS1010 muestra una sólida escalabilidad con bloques de mayor tamaño, pero muestra cierta regresión con profundidades de cola más altas en cargas de trabajo de tamaño medio. Con el bloque más pequeño de 16 K, la velocidad de escritura comenzó en 0.5 GiB/s y alcanzó un ligero pico de 0.9 GiB/s entre las profundidades de cola 8 y 64, antes de descender ligeramente a 0.8 GiB/s en la profundidad 128. Con bloques de 128 K, el rendimiento comenzó en 2.2 GiB/s, mejoró hasta un máximo de 4.3 GiB/s en la profundidad 32 y luego disminuyó a tan solo 1.9 GiB/s en la cola más profunda, lo que indica una posible saturación o limitación de la escritura. El mejor rendimiento sostenido se logró con tamaños de bloque de 1M, donde el rendimiento escaló limpiamente de 4.1 GiB/s en la profundidad 1 a 5.6 GiB/s en las profundidades 32 y 64, manteniéndose estable hasta 128.
Resumen de GDSIO
Esta tabla ofrece un desglose claro de las métricas de rendimiento de GDSIO para latencia e IOPS recopiladas en el SSD Solidigm D7-PS1010, medidas con tamaños de bloque de 16 128, 1 128 y 128 M, con una profundidad de E/S de 16. Con una profundidad de cola de 1.549, la latencia y las IOPS aumentan de forma predecible con el tamaño del bloque. La lectura del bloque de 82.3 2.429 tuvo un promedio de 52.6 ms con 128 2.414 IOPS, mientras que la latencia de escritura fue de 52.9 ms con 8.050 15.9 IOPS. Con bloques de 1 14.643, la latencia de lectura aumentó a 8.7 ms (23.030 5.6 IOPS) y la de escritura a XNUMX ms (XNUMX XNUMX IOPS). Con XNUMX M, la latencia de lectura alcanzó los XNUMX ms con XNUMX IOPS, y la de escritura a XNUMX ms con XNUMX IOPS.
| Gráfico GDSIO (promedios de tamaño de bloque de 16 128, 1 XNUMX y XNUMX XNUMX) | HPE DL145 Gen 11 (6 SSD Solidigm D7-PS1010 E3s de 7.68 TB) |
|---|---|
| (Tamaño de bloque de 16 K, profundidad de 128 E/S) Lectura promedio | 1.3 GiB/s (1.549 ms) IOPS: 82.3 K |
| (Tamaño de bloque de 16 K, profundidad de E/S de 128) Escritura promedio | 0.8 GiB/s (2.429 ms) IOPS: 52.6 K |
| (Tamaño de bloque de 128 K, profundidad de 128 E/S) Lectura promedio | 6.5 GiB/s (2.414 ms) IOPS: 52.9 K |
| (Tamaño de bloque de 128 K, profundidad de E/S de 128) Escritura promedio | 1.9 GiB/s (8.050 ms) IOPS: 15.9 K |
| (Tamaño de bloque de 1 M, profundidad de 128 E/S) Lectura promedio | 8.5 GiB/s (14.643 ms) IOPS: 8.7 K |
| (Tamaño de bloque de 1 M, profundidad de E/S de 128) Escritura promedio | 5.4 GiB/s (23.030 ms) IOPS: 5.6 K |
Producción de medios al límite
¿Qué es Axle AI?
Axle AI es una plataforma de gestión de activos multimedia (MAM) local basada en IA que simplifica los flujos de trabajo de vídeo para equipos de medios pequeños y medianos. Automatiza tareas clave, como la ingesta, el etiquetado y la búsqueda de contenido, sin el coste ni la complejidad de los sistemas MAM tradicionales. Diseñada para ofrecer velocidad y facilidad de uso, Axle AI permite a los equipos gestionar y distribuir contenido de forma más eficiente, tanto en la oficina como trabajando a distancia.
La plataforma soporta todo el proceso de producción. Ingiere automáticamente el metraje, crea proxies, aplica metadatos basados en IA mediante funciones como reconocimiento de objetos, detección facial y búsqueda semántica, y se integra con las herramientas de edición estándar del sector, como Adobe Premiere Pro y DaVinci Resolve. Esto permite a los equipos localizar, editar y publicar contenido rápidamente sin cuellos de botella ni retrasos.
Casos de uso del mundo real
Diversos equipos de medios, como emisoras, documentalistas, departamentos de vídeo corporativo, agencias de marketing y productores de eventos en directo, confían en Axle AI. Estos equipos suelen trabajar en múltiples ubicaciones y requieren acceso fiable a sus bibliotecas multimedia sin necesidad de una infraestructura compleja.
Con Axle AI, los usuarios pueden colaborar remotamente mediante una interfaz basada en navegador que proporciona acceso instantáneo a contenido multimedia proxy. Los editores pueden empezar a editar el material inmediatamente en sus sistemas de edición no lineal (NLE) preferidos, mientras que los productores y las partes interesadas revisan, etiquetan y aprueban los clips en tiempo real (sin necesidad de grandes transferencias de archivos ni conocimientos técnicos especializados).
Ya sea un equipo de cinco o cincuenta personas, Axle AI permite flujos de trabajo más rápidos y eficientes. Su interfaz sencilla, su rápida implementación y su compatibilidad con los sistemas de almacenamiento existentes la convierten en una solución inteligente para la producción multimedia distribuida de gran volumen.
La ferviente demanda de redes sociales instantáneas ha acelerado drásticamente el ritmo de producción de medios. Existe una mentalidad de "si no eres el primero, eres el último", especialmente en lo que respecta a eventos en vivo y la creación de contenido en torno a ellos. Las empresas de medios necesitaban una forma eficiente de organizar y revisar rápidamente grandes cantidades de material. Herramientas como Axle AI, con su capacidad de escalar a pequeñas operaciones, permiten que este flujo de trabajo sea práctico sobre el terreno. Al combinarse con el flujo de trabajo adecuado, como cámaras que pueden grabar proxies y material sin procesar simultáneamente, las posibilidades de eficiencia aumentan.
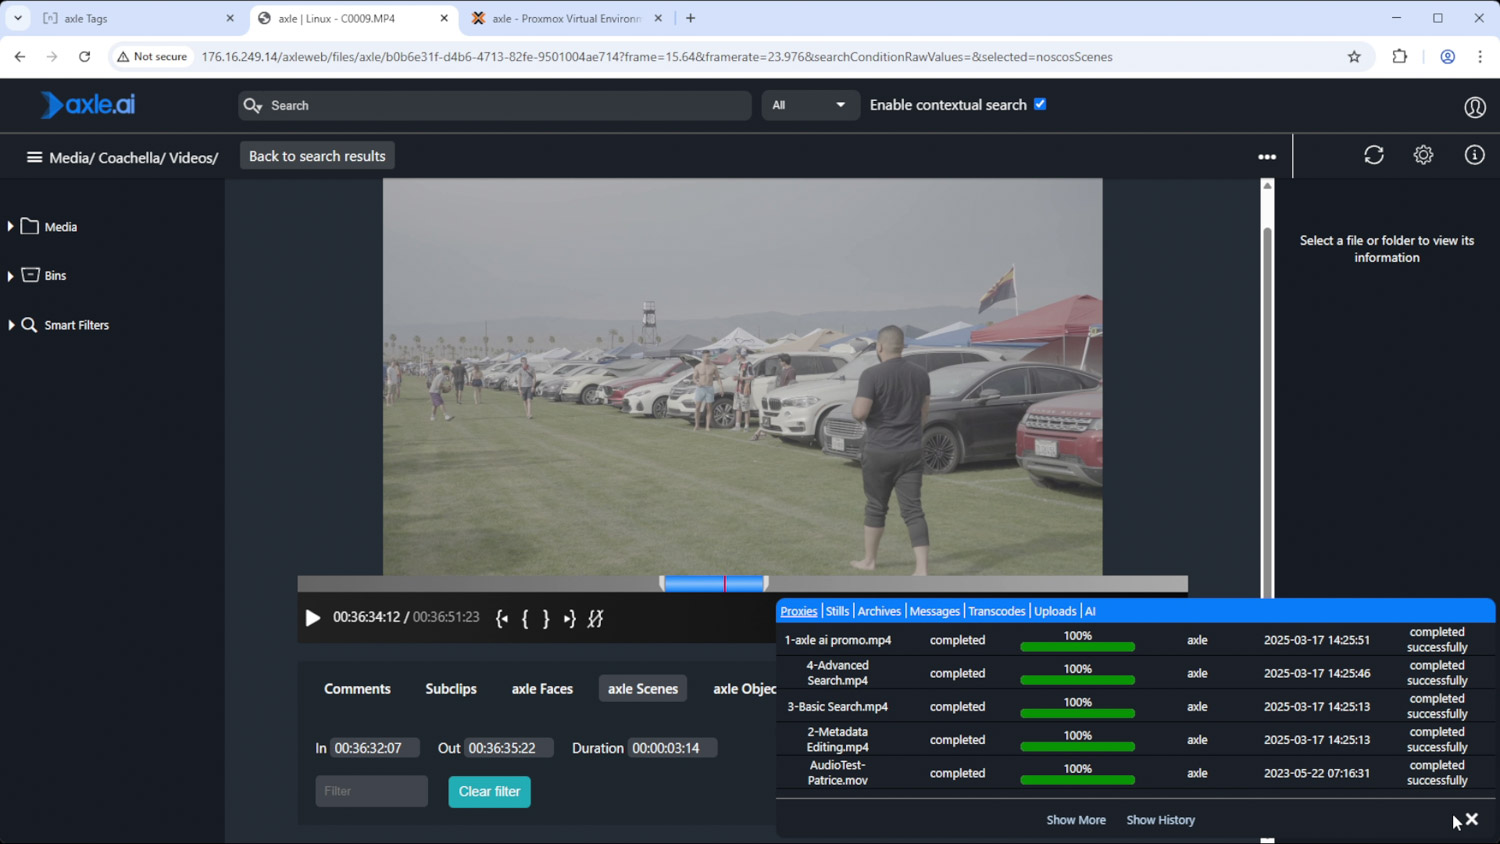
Guardar contenido proxy de alta y baja resolución al capturar y procesar archivos proxy más pequeños inmediatamente en Axle AI Tags permite buscar en todo el material casi al instante. Los editores pueden ponerse a trabajar de inmediato gracias a la integración de Axle AI con la mayoría de los principales editores no lineales (NLE), como Adobe Premiere Pro, DaVinci Resolve y Avid Media Composer. Además, esto facilita enormemente la tarea del equipo de producción, permitiéndoles centrarse en otras tareas o evitar el agotamiento.
Tradicionalmente, el registro ha sido uno de los aspectos más laboriosos y frecuentemente omitidos del flujo de trabajo de captura de medios. Axle AI registra los medios automáticamente con descripciones de escena generadas por IA, en lugar de solo los tradicionales campos de metadatos. Esto permite al editor leer el contenido de un clip antes de revisarlo. También proporciona herramientas de búsqueda semántica, que permiten a editores y productores encontrar rápidamente material relevante mediante conceptos y temas, en lugar de depender de etiquetas específicas.
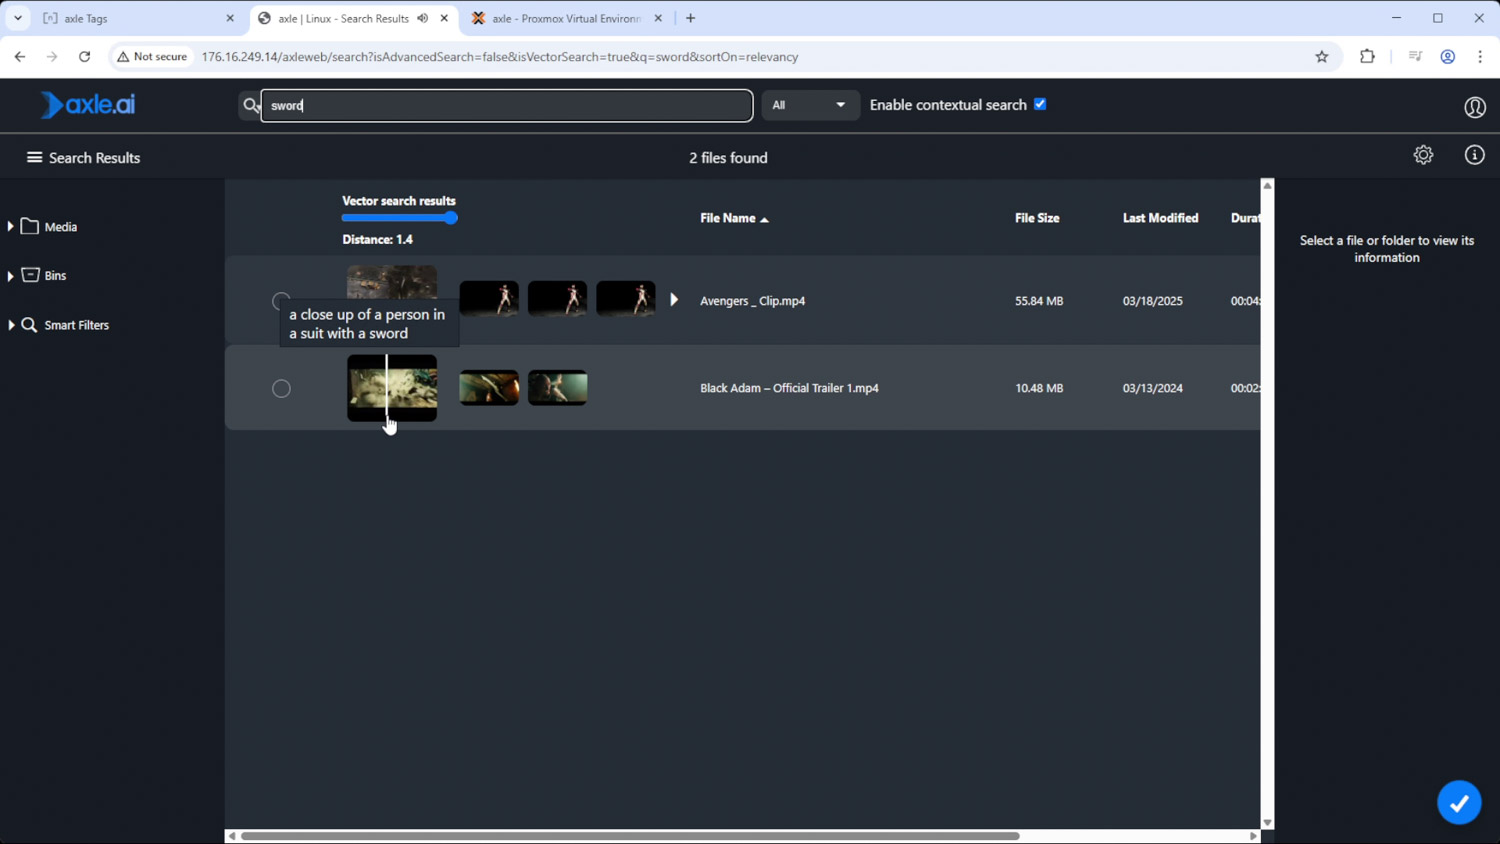
La escalabilidad también es clave, ya que no todos los trabajos requieren una producción multimedia in situ y a un ritmo acelerado. Axle AI puede configurarse en un sistema estacionario más potente con acceso al material atrasado de una empresa de medios a través de una red compartida. Esto permite a editores y productores encontrar material relevante con mayor rapidez, o incluso descubrir material que quizás no habían considerado antes y que se ha "perdido" en los archivos. Los creadores de contenido y las emisoras pueden beneficiarse significativamente de este tipo de índice de material atrasado, generando más valor a partir de material que, de otro modo, permanecería inactivo en un servidor. Si bien no es infalible, puede dar a las empresas de medios una ventaja en algunos de los aspectos más laboriosos del proceso de creación de medios.
El HPE ProLiant DL145 Gen11 sirve como base de hardware para esta implementación de IA en el borde, ofreciendo un equilibrio excepcional entre densidad de cómputo, rendimiento de almacenamiento y aceleración de GPU en un espacio compacto. Equipado con un procesador AMD EPYC 48P de 8434 núcleos de la serie 8004 de bajo consumo, este sistema está optimizado para cargas de trabajo multihilo, manteniendo un bajo consumo de energía. La configuración incluye 256 GB de RAM y una única GPU NVIDIA L4, un acelerador altamente eficiente ideal para la inferencia de IA en el borde. El almacenamiento se proporciona con seis SSD Solidigm D7-PS1010 E3.S, cada uno con una capacidad de 7.68 TB, que proporcionan un amplio almacenamiento flash de alto rendimiento para recursos multimedia y cargas de trabajo con uso intensivo de metadatos. Con compatibilidad con hasta tres GPU de ancho simple y un total de seis unidades E3.S, el DL145 Gen11 está bien posicionado para escalar con casos de uso exigentes de video e IA. Esta configuración enfatiza la importancia de ensamblar cuidadosamente los componentes de hardware modernos, incluidos CPU, GPU y SSD, para permitir un rendimiento excepcional para los flujos de trabajo de IA centrados en el borde, como los que impulsa Axle AI.
Conclusión
Axle AI está transformando la forma de producir contenido de video, especialmente para equipos que trabajan en tiempo real con recursos limitados. Al combinar la gestión inteligente de recursos multimedia con potentes herramientas de inferencia, Axle AI permite un nivel de automatización y capacidad de respuesta que los sistemas MAM tradicionales no pueden igualar. Al combinarse con el servidor edge HPE ProLiant DL145 Gen11, la GPU NVIDIA L4 y las unidades SSD Solidigm Gen5, el equipo que construimos proporciona un entorno compacto y de alto rendimiento, optimizado para los flujos de trabajo multimedia modernos. Ya sea en campo o como parte de un flujo de trabajo de edición híbrido, esta configuración proporciona una forma escalable y eficiente de ingerir, etiquetar, buscar y entregar contenido de video más rápido que nunca, sin comprometer la calidad ni el control. Para los equipos que deben mantenerse a la vanguardia en un panorama de contenido dinámico, la combinación de infraestructura edge y flujos de trabajo asistidos por IA ofrece una importante ventaja competitiva.



 Amazon