

Updated November 3, 2026: The AMD Instinct MI350P joins Also Tested from our first look at 450W, and its two-card results join Scale-Out Configurations; it ranks once it completes the Ministral 3 ladder at 600W. Published October 14, 2026. Five PCIe accelerators ranked on one vLLM container and one model set, with the H100 NVL and the MI350P in Also Tested; the H200 NVL carries a power note explained below.
Chaque accélérateur présenté sur cette page a été testé par le laboratoire de StorageReview sous forme de carte PCIe individuelle. Le marché des GPU d'entreprise se divise entre les modules HGX et OAM destinés aux centres de données dédiés à l'IA et les cartes d'extension pour serveurs 2U et 4U déjà en service dans la plupart des centres de données. Cette page traite uniquement de ces dernières : les GPU pour centres de données que vous pouvez commander via un configurateur de serveur standard et installer dans une baie existante.
Il s'agit du marché de l'inférence d'entreprise, et l'inférence d'entreprise correspond à la charge de travail sur laquelle chaque carte est classée. Chaque sélection renvoie à l'analyse contenant les données, et le classement est basé sur le même test appliqué à chaque carte.
Ce test est le service en ligne vLLM, la pile sur laquelle s'exécute la plupart des inférences d'entreprise, piloté de 1 à 32 flux simultanés sur chaque carte, et jusqu'à 128 sur les deux cartes Hopper, sur quatre modèles dans le même conteneur NGC vLLM 26.08 (vLLM 0.27.1 sur CUDA 13.4.1) et le même pilote 595.71.05.
Cinq des six cartes ont fonctionné sur notre serveur Dell PowerEdge R770 à la puissance maximale fournie par ce serveur à un emplacement GPU ; la RTX PRO 6000 a fonctionné sur notre Dell Pro Max Tower T2 avec le même conteneur et le même pilote. Le classement ci-dessous s'est avéré constant sur tous les modèles et pour les deux configurations de requêtes testées ; il ne reflète donc pas uniquement les performances maximales.
Dans cette catégorie, la mémoire est plus déterminante que la puissance de calcul. Une carte de 24 ou 32 Go convient aux petits et moyens modèles pour les conversations de courte durée, mais son cache KV s'épuise dès que les requêtes longues s'accumulent. Une carte de 48 ou 96 Go est idéale pour les modèles de taille moyenne, avec une capacité suffisante pour la gestion simultanée de plusieurs instances. Enfin, les cartes HBM de 94 ou 141 Go permettent aux modèles de 70 à 120 octets de se concentrer sur un seul GPU. La sélection est organisée selon cette répartition, et la FAQ en bas de page répond aux questions comparatives les plus fréquentes des acheteurs, comme la comparaison entre la RTX PRO 6000 et le H100, ou encore la différence entre une alimentation de 450 W et une de 600 W dans un format 2U.
En bref
Le nombre de jetons produits par seconde provient de l'instruction FP8 de Ministral 3 14B, exécutée sur 32 flux simultanés (point le plus lourd pour chaque carte), sur les formats de chat 512 entrées/512 sorties et de document 8 192 entrées/1 024 sorties. FP8 correspond à la puissance de calcul maximale atteignable par MAMF (en TFLOPS), une mesure GEMM dense et soutenue, et non à la puissance de calcul maximale du fournisseur.
| Catégories | Accélérateur | Mémoire / Bande passante | Emplacements / Puissance testée | Chat 512/512 (tok/s) | Document 8K/1K (tok/s) | MAMF FP8 (TFLOPS) | Revue complète |
|---|---|---|---|---|---|---|---|
| Meilleur accélérateur IA PCIe global | NVIDIA H200 NVL* | 141 Go HBM3e / 4.8 To/s | Double emplacement / 450 W* | 3,435 | 1,038 | 1,262 | Test du ET900N G3 (données H200 NVL) |
| Meilleur GPU d'inférence d'entreprise | NVIDIA RTX PRO 6000 Blackwell Server Edition | 96 Go GDDR7 / 1.6 To/s | Double emplacement / 600 W (capteur de 450 W également testé) | 2,283 | 608 | 774 | Test de la RTX PRO 6000 |
| Meilleure carte graphique à simple emplacement | NVIDIA RTX PRO 4500 Blackwell Server Edition | 32 Go GDDR7 / 800 Go/s | Emplacement unique / 165 W | 1,107 | 190 | 280 | Test de la RTX PRO 4500 SE |
| Meilleure carte graphique d'inférence grand public encore disponible | Nvidia L40S | 48 Go GDDR6 / 864 Go/s | Double emplacement / 350 W | 995 | 230 | 369 | Examen du RTX PRO 4500 SE (données L40S) |
| Meilleure carte à slot pour 1U et Edge | Nvidia L4 | 24 Go GDDR6 / 300 Go/s | HHHL à un seul emplacement / 72 W | 364 | 42 | 116 | Révision L4 |
La carte mère H200 NVL a été testée à 450 W, la puissance maximale fournie par un emplacement GPU Dell PowerEdge R770. La carte est conçue pour une consommation de 600 W, mais nous ne l'avons pas testée à cette puissance ; les valeurs indiquées sur cette page représentent donc une valeur minimale. Les chiffres concernant la RTX PRO 6000 proviennent de la version Workstation ; NVIDIA indique une consommation de 600 W pour les deux versions, et leurs performances sont identiques lors de nos tests. La version Server est la carte mère passive, sans écran, équipée du même GPU et de la même mémoire.
Les choix
Meilleur accélérateur IA PCIe toutes catégories confondues : NVIDIA H200 NVL
La H200 NVL est la carte d'extension la plus rapide que nous ayons testée, et la seule de cette page à maintenir des performances supérieures à 32 flux. Avec 32 flux simultanés sur Ministral 3 14B FP8, elle a traité 3 435 jetons de sortie par seconde, contre 3 096 pour la H100 NVL et 2 283 pour la RTX PRO 6000. L'écart s'est creusé avec l'augmentation du nombre de flux simultanés : 7 336 jetons par seconde à 128 flux, seuil auquel les cartes RTX avaient déjà atteint leurs limites. Sur un format de document de 8 192 jetons, les 141 Go de mémoire HBM3e n'ont jamais été insuffisants, et la carte a affiché des performances supérieures de 21 à 23 % à celles de la H100 NVL sur tous les modèles, à nombre de flux simultanés égal.
L'avance du H200 face à la carte Blackwell est plus importante que ne le suggèrent les fiches techniques. À 32 flux, le H200 affichait des performances supérieures de 50 à 81 % à celles de la RTX PRO 6000 sur les trois modèles FP8 et BF16. En entrée 8K, il atteignait 1 038 jetons par seconde sur le modèle 14B, contre 608 pour la RTX. Ceci s'explique par le fait que le décodage des flux HBM à 4.8 To/s est impossible avec 1.6 To/s de GDDR7.
Deux ou quatre cartes assurent la liaison NVLink à 900 Go/s, une performance qu'aucune autre carte présentée ici n'offre. Nos résultats NVLink pour la H200 sont comparés à ceux de la RTX PRO 6000 et de la GB300 DGX Station dans le test de l'ET900N G3, où la Station a atteint 22 041 jetons de sortie par seconde sur GPT-OSS-20B avec 128 flux, contre 6 022 pour cette carte.
La consommation électrique est un point crucial pour un acheteur de serveur 2U : cette carte a fonctionné à la puissance maximale de 450 W autorisée par un emplacement PowerEdge R770, et sa capacité de 600 W n'a pas encore été testée dans notre laboratoire. Le seul cas où elle ne présente aucun avantage est la version NVFP4 de Qwen3.8-27B, où la carte ne dispose pas de matériel FP4 et où la déquantification vLLM est effectuée à la volée, aboutissant à 467 jetons par seconde contre 616 pour la RTX PRO 6000. Privilégiez-la pour sa mémoire et sa bande passante, essentielles pour un déploiement de 70 à 120 octets.
Lisez le test de l'ASUS ET900N G3, qui inclut nos résultats H200 NVL
Meilleure carte graphique pour l'inférence en entreprise : NVIDIA RTX PRO 6000 Blackwell Server Edition
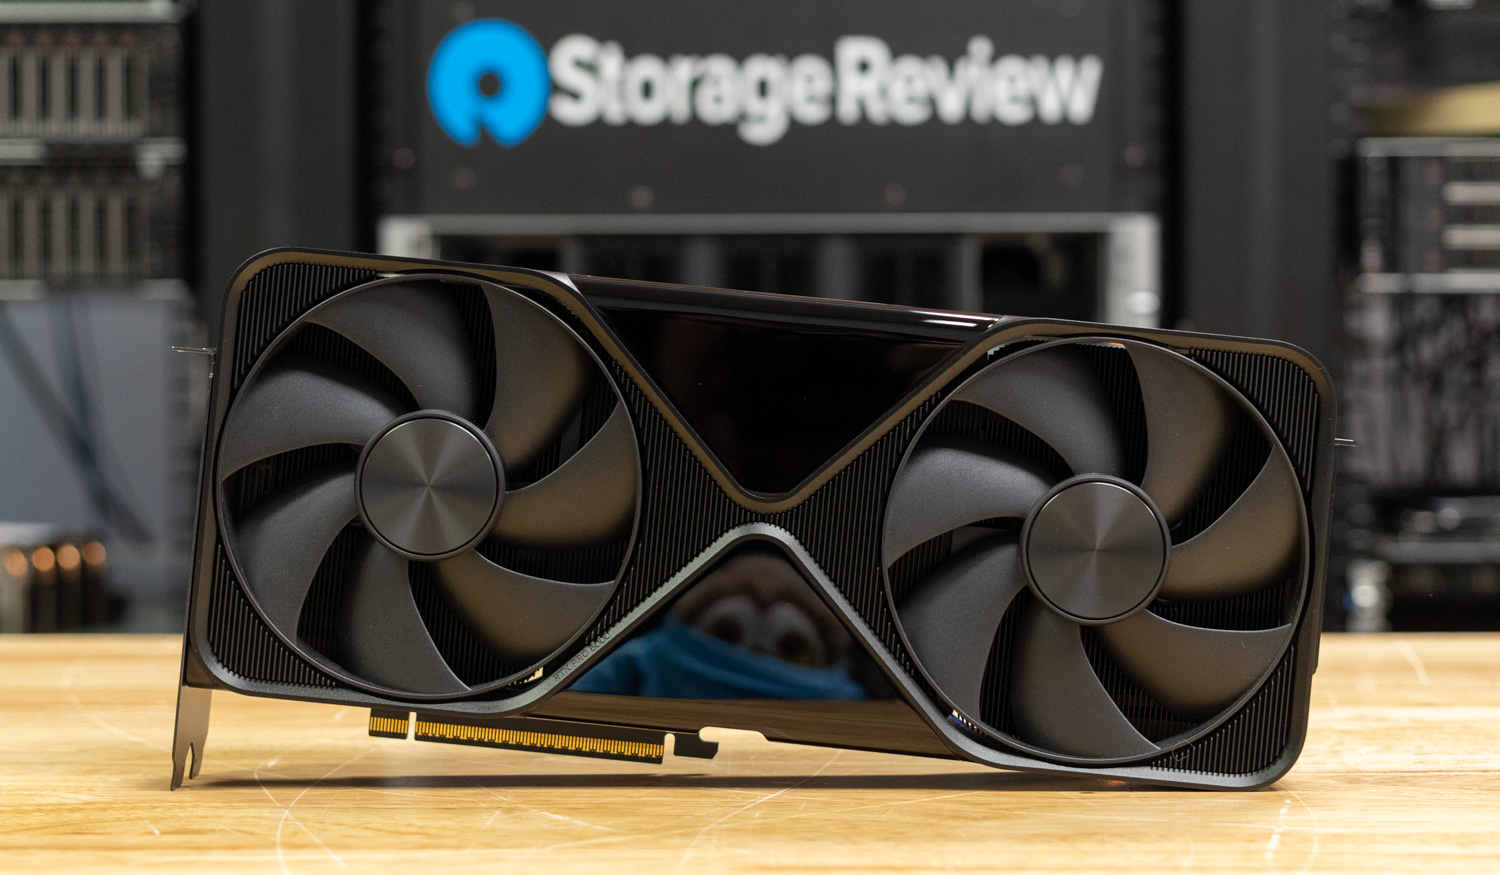
La RTX PRO 6000 est le GPU d'inférence d'entreprise présenté sur cette page : la carte Blackwell conçue pour les serveurs d'inférence 2U et 4U que les entreprises achètent actuellement, avec la plus grande mémoire tampon d'images en dessous du niveau HBM et l'ensemble de fonctionnalités le plus étendu de toutes les cartes présentées ici. À 600 W, il fournissait 2 283 jetons de sortie par seconde à 32 flux sur Ministral 3 14B FP8, 2 139 sur le modèle 8B et 4 155 sur le 3B, soit environ 2 fois le RTX PRO 4500 à contexte court et 2.7 fois à 3.5 fois à une entrée 8K, où ses 96 Go continuent de grimper jusqu'à 32 flux tandis que les cartes de 32 Go et 48 Go s'aplatissent.
Dans MAMF, il a atteint 774 TFLOPS en FP8 et 1 481 en NVFP4, le chiffre FP4 le plus élevé de la page.
La limite de 450 W indique à l'acheteur d'un serveur 2U la valeur des 150 W restants. Limitée à 450 W, la puissance maximale fournie par un emplacement PowerEdge R770, la carte a perdu entre 2 et 5 % de performances à court terme et entre 4 et 9 % à long terme, sans que son résultat FP8 MAMF ne soit affecté. À cette limite, elle fournit 4.8 jetons de sortie par seconde et par watt nominal sur le modèle 14B, contre 3.8 à 600 W. C'est pourquoi l'acheteur d'un serveur 2U ne perd que très peu à l'utiliser à cette puissance.
C'est également la seule carte de cette page dotée de cœurs RT, de quatre encodeurs et décodeurs, et de sorties d'affichage. Un serveur qui combine inférence, rendu, transcodage ou stations de travail virtuelles sous vGPU dispose donc d'une seule carte pour toutes ces fonctions. Nos mesures proviennent de la version Workstation installée dans une tour Dell Pro Max T2. NVIDIA annonce une consommation de 600 W pour les deux versions, leurs performances sont identiques lors de nos tests, et la version Server est la version passive sans écran, équipée du même GPU GB202 et de 96 Go de GDDR7 avec ECC.
Également dans notre laboratoire : quatre cartes Server Edition dans le HPE ProLiant DL380a Gen12 , deux et quatre cartes dans le Dell PowerEdge XE7740 dans le test ET900N G3 , la carte unique dans le Dell Pro Max Tower T2 qui a produit les chiffres ci-dessus, les cartes Max-Q 300 W et 600 W dans le Dell Pro Precision 9 T2 , où la carte 600 W a coûté au Xeon 4 à 5 % sur le travail du processeur tous les cœurs, huit cartes et 768 Go dans le Comino Grando , et deux cartes Max-Q dans le Dell Precision 7875 et le HP Z8 Fury G6i.
Lire le test complet de la NVIDIA RTX PRO 6000
Meilleure carte graphique à simple emplacement : NVIDIA RTX PRO 4500 Blackwell Server Edition

La RTX PRO 4500 Server Edition offre un débit L40S à partir d'une carte à un seul emplacement de 165 W, ce qui représente le compromis que la plupart des serveurs grand public attendaient. Avec 32 flux simultanés sur la carte de chat, elle égalait ou surpassait la L40S sur tous les modèles FP8 et BF16 : 1 107 contre 995 jetons par seconde sur Ministral 3 14B FP8 et 2 006 contre 1 988 sur le modèle 3B, pour une carte dont la puissance représente 47 % de celle de la L40S et qui possède deux fois moins d’emplacements. Par rapport à la L4 qu’elle remplace, elle était 2.8 à 3.6 fois plus rapide pour une puissance 2.3 fois supérieure, et un châssis 2U pouvant accueillir quatre cartes double emplacement peut en contenir huit.
La limite est de 32 Go : avec 8 192 jetons en entrée, la carte affichait des performances inférieures de 17 à 33 % à celles de la L40S, et ses courbes se sont aplaties à huit flux, tandis que la carte de 48 Go continuait de grimper jusqu'à 16, car c'était le cache KV, et non la puissance de calcul, qui était saturé. De plus, il s'agit d'une carte pleine hauteur et pleine longueur avec un connecteur à 16 broches ; par conséquent, les boîtiers 1U et demi-hauteur de la L4 ne sont pas compatibles sans un châssis conçu pour les cartes FHFL.
L'autre point à noter, commun à toutes les cartes testées sur cette version vLLM, est la prise en charge NVFP4 : sous Qwen 3.8-27B, la 4500 a produit 320 jetons par seconde à 32 flux, tandis que son matériel FP4 atteignait 569 TFLOPS sous MAMF. L'avantage du FP4 se situe donc au niveau GEMM et n'a pas encore atteint la pile de service. Deux partitions MIG de 16 Go, le calcul confidentiel et le vGPU 20 complètent les fonctionnalités pour centres de données dont ne dispose pas la version Workstation de cette même carte.
Également dans notre laboratoire : la même carte face au L4 à l’intérieur d’un serveur HPE ProLiant DL145 Gen11 , le test de serveur edge qui a précédé celui-ci.
Lire le test complet de la carte graphique NVIDIA RTX PRO 4500 Blackwell Server Edition
Meilleure carte graphique grand public pour l'inférence encore disponible : NVIDIA L40S

La L40S a été la carte graphique grand public de référence pendant deux ans, et ses 48 Go sont la raison pour laquelle elle figure encore sur une page de l'ère Blackwell. Sur la forme du chat, il a servi 995 jetons de sortie par seconde sur 32 flux sur Ministral 3 14B FP8, 1 005 sur le modèle 8B et 1 988 sur le 3B.
Cela représente moins de 12 % des performances de la RTX PRO 4500 sur tous les plans, et la surpasse sur le format d'image 8K avec 230 points contre 190 pour le modèle 14 Go, 277 points contre 185 pour le modèle 8 Go et 475 points contre 384 pour le modèle 3 Go. Ses performances continuent de progresser jusqu'à 16 flux simultanés en contexte long, là où la carte 32 Go plafonne à huit.
Cette carte mémoire consomme 350 W, occupe deux emplacements PCIe 4.0 et ne prend pas en charge le calcul FP4. Sur la version NVFP4 de Qwen3.8-27B, elle a atteint 480 jetons par seconde grâce à la déquantification, soit 1.5 fois plus que la RTX 4500 sur cette version logicielle. Ses performances MAMF maximales sont de 220 TFLOPS en BF16 et de 369 TFLOPS en FP8, soit un peu moins de la moitié de celles de la RTX PRO 6000. Pour un parc de serveurs fonctionnant déjà avec des L40S et dont les charges de travail sont de longue durée, il n'est pas encore nécessaire de la remplacer. Pour un nouveau serveur 2U, la RTX 4500 simple emplacement offre les mêmes performances avec deux fois moins d'emplacements et une consommation deux fois moindre.
Également dans notre laboratoire : une seule L40S dans le Lenovo ThinkSystem SR650 V4 , et la partie graphique de la carte dans notre L40S pour Omniverse.
Consultez nos résultats concernant le L40S dans le test de la RTX PRO 4500 Server Edition.
Meilleure carte graphique à slot pour 1U et Edge : NVIDIA L4
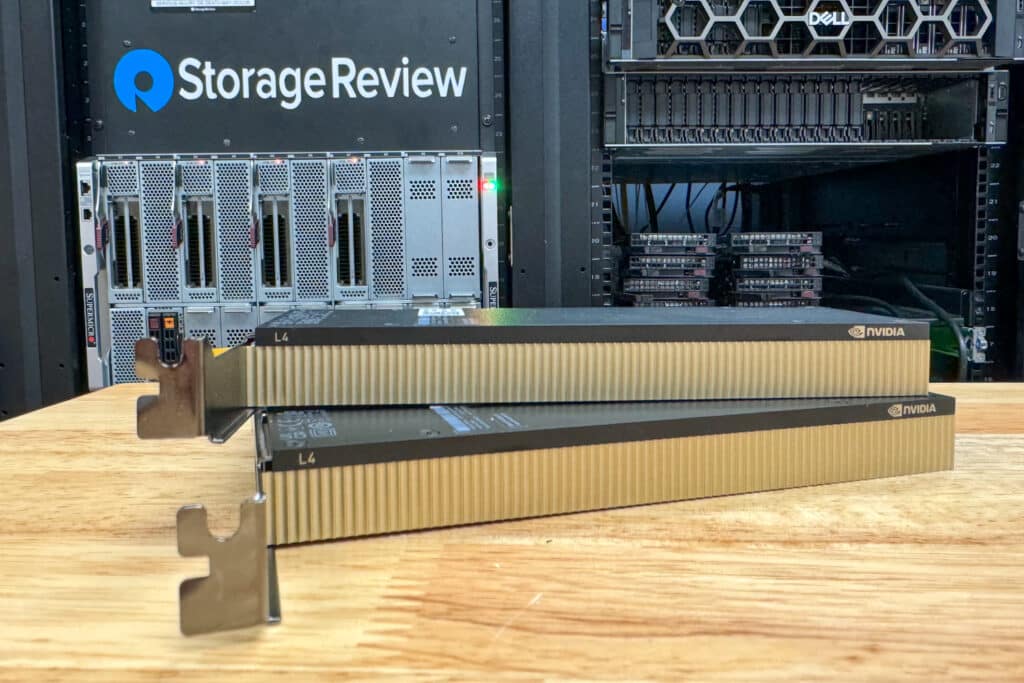
La L4 est la seule carte de cette page qui tire son alimentation du slot et qui s'insère dans une baie demi-hauteur, ce qui la limite aux serveurs 1U et aux boîtiers de bord où rien de plus récent ne peut entrer. À 72 W, il a fourni 364 jetons de sortie par seconde à 32 flux sur Ministral 3 14B FP8, 279 sur le modèle 8B et 704 sur le 3B, et ses 5.1 jetons de sortie par seconde par watt nominal sur le modèle 14B battent le L40S à 2.8 et le RTX PRO 6000 à 600 W à 3.8.
Ses plafonds MAMF de 50 TFLOPS en BF16 et de 116 en FP8 sont les plus bas ici, et il n'a pas de chemin FP4, donc le modèle NVFP4 27B ne convenait pas à ses 24 Go.
Le traitement des contextes longs s'arrête là : avec une mémoire de 8 192 jetons, les performances du cache L4 sont restées constantes sur quatre flux, quel que soit le modèle, entre 34 et 130 jetons par seconde, car les mémoires de 24 Go et 300 Go/s ne peuvent gérer simultanément qu'un nombre très limité de contextes de 8 Ko. La RTX PRO 4500 Server Edition est 2.8 à 3.6 fois plus rapide, mais elle nécessite un emplacement FHFL et un câble à 16 broches ; par conséquent, un parc de cartes L4 dans un châssis 1U ou demi-hauteur ne peut pas être remplacé directement. Lors de notre test comparatif de la RTX PRO 4500 Edge, les deux cartes ont été mesurées au sein d'un serveur HPE ProLiant DL145 Gen11, où la 4500 a affiché des performances 2.7 fois supérieures à celles du cache L4.
Également dans notre laboratoire : le L4 en périphérie du Dell PowerEdge XR7620 , quatre L4 dans le Dell PowerEdge T560 et la carte face à la RTX PRO 4500 dans le HPE ProLiant DL145 Gen11.
Lire le test complet du NVIDIA L4
Également testé
NVIDIA H100 NVL
Le H100 NVL a exécuté la même échelle dans le même R770 et figure dans la section « Également testé » uniquement parce qu'il n'a pas d'homologue Hopper sur cette page pour servir de référence dans une catégorie. Une génération auparavant, elle était encore 36 à 61 % plus rapide que la RTX PRO 6000 à concurrence égale sur les modèles FP8 et BF16 que nous avons testés.
Sur le même R770, avec le même conteneur, il a traité 3 096 jetons de sortie par seconde sur 32 flux avec Ministral 3 14B FP8, 3 449 avec le modèle de raisonnement 8B et 5 873 avec le modèle 3B. Il a ensuite été mis à l'échelle à 128 flux, comme son successeur, atteignant 6 038 avec le modèle 14B. Son résultat MAMF de 1 047 TFLOPS en FP8 est supérieur de 35 % aux 774 TFLOPS de la RTX PRO 6000.
La mémoire HBM3 de 94 Go à 3.9 To/s en est la raison. Sur le modèle 14B, elle a atteint 859 jetons par seconde à 32 flux, soit 41 % de plus que la RTX PRO 6000 à 600 W, avec une courbe de performances similaire à celle du H200, mais avec une consommation réduite de 21 à 23 %. Deux cartes fonctionnent en pont via NVLink à 600 Go/s, configuration décrite dans notre test du Comino Grando H100. La carte consomme entre 350 et 400 W et se présente sous la forme d'un boîtier passif double slot compatible avec les mêmes risers que le L40S.
Là où elle pêche, c'est au même endroit que la H200 : elle ne prend pas en charge les points de contrôle NVFP4. Pour un acheteur ayant besoin de capacité HBM et disposant d'un devis pour une H100 NVL, les données indiquent qu'elle reste la deuxième carte d'extension la plus rapide que nous ayons testée, juste derrière la H200 NVL mentionnée précédemment.
Également dans notre laboratoire : la même paire de NVL H100 dans notre R770 a alimenté le test de stockage direct GPU Graid SupremeRAID AE.
Lire le test complet du Comino Grando H100
AMD Instinct MI350P

The MI350P is AMD’s first new PCIe Instinct card in four years, and it sits in Also Tested because it has not yet run the ranking ladder above. That ladder uses the NGC container and the Ministral 3 model set; our first look ran the card on stock vLLM for ROCm at 450W in a 2U PowerEdge R7725, against a 600W rating. It carries 144GB of HBM3E at 4TB/s, the most memory of any PCIe accelerator we have tested, 3GB above the H200 NVL.
On the tests that overlap, it lands between the two NVIDIA cards. MAMF reached 1,120 TFLOPS in FP8 and 2,228 in block-scaled FP4 at 450W, 36 to 38 percent above the 600W RTX PRO 6000 at every precision in that review’s runs and behind the H200 NVL in BF16 and FP8. On GPT-OSS-120B at 128 streams on the chat shape, one card served 5,057 output tokens per second against 3,064 for the RTX PRO 6000 and 3,376 for the H200 NVL, and on 512-token prompts it beat the RTX PRO 6000 by 35 to 65 percent on every FP8, BF16, and GPT-OSS model.
The H200 NVL stays 4 to 18 percent ahead on the dense FP8 and BF16 models at 128 streams on chat prompts, and on 8,192-token prompts the MI350P trails it by 25 to 58 percent on the same models and flattens by 16 streams on Llama 3.1 8B and MiniMax M2.7. Its two-card results, where a pair holds MXFP4 builds of MiniMax M3 and GLM-5.2 that take four RTX PRO 6000s, ran on ROCm 7.2.3 and appear under Scale-Out Configurations.
It ranks once it completes the Ministral 3 ladder at 600W in a PowerEdge XE7745, which Dell supports with eight MI350Ps. Until then, for a buyer whose models sit between 96GB and 144GB, it is one of two PCIe cards that keep them on a single GPU, and the only one past 141GB.
Read the AMD Instinct MI350P first look
Configurations à extension horizontale
Sur cette page, chaque carte obtient son classement individuellement. Les résultats de plusieurs cartes sont présentés ici comme des configurations, sans classement, car elles utilisent différents modèles et logiciels et ne peuvent être comparées entre elles ni comparées au classement des cartes individuelles ci-dessus. Chaque ligne indique le résultat mesuré et l'évaluation correspondante.
| Configuration | Hôte | Résultat mesuré | Stack | Matériau |
|---|---|---|---|---|
| 4x NVIDIA RTX PRO 6000 Blackwell Server Edition (384 Go) | Dell PowerEdge XE7740 | MiniMax M3 NVFP4 : 1 181 jetons de sortie/s à 16 flux, 759 à 32 (512/512) | NGC vLLM 26.08, décodage spéculatif MTP | Test du ET900N G3 |
| 4x NVIDIA RTX PRO 6000 Blackwell Server Edition (384 Go) | HPE ProLiant DL380a Gen12 | GPT-OSS-120B NVFP4, TP4 : 4 016 jetons/s au lot 64, 3 956 au lot 32 ; Llama 3.2 90B Vision : 1 372 jetons/s au lot 128 | vLLM service en ligne | Test du DL380a Gen12 |
| 2x NVIDIA RTX PRO 6000 Blackwell Server Edition (192 Go) | Dell PowerEdge XE7740 | MiniMax M2.7 NVFP4 : 1 932 jetons de sortie/s sur 128 flux (512/512), 511 sur 8K/1K | NGC vLLM 26.08 | Test du ET900N G3 |
| 4x Intel Gaudi 3 PCIe (512 Go HBM) | Dell PowerEdge XE7740 | Llama 3.1 70B, TP4 : environ 3 600 jetons/s au total pour 128 requêtes simultanées (1 024/1 024) ; les chemins FP8 sont plus lents que BF16 sur cette version. | Intel vLLM fork 2.7.1 sur Gaudi Docker 1.22.2 | Test du XE7740 (sponsorisé par Dell) |
| 2x AMD Instinct MI350P (288GB), 450W per card | Dell PowerEdge R7725 | MiniMax M3 MXFP4: 998 output tokens/s at 16 streams, 1,509 at 32 (512/512); DeepSeek-V4-Flash FP8: 1,081 output tokens/s at 32 streams (512/512), 621 on 8K/1K | vLLM on ROCm 7.2.3 | MI350P First Look |
Au moment du test, la version vLLM d'Intel n'avait pas encore optimisé ses chemins FP8, et les performances en FP8 étaient inférieures à celles en BF16. Le résultat du MiniMax M3 montre les limites de l'extension PCIe sur un modèle qui intègre à peine 384 Go : quatre cartes ont surpassé une seule station GB300 DGX à 16 flux, puis ont été devancées à 32 flux lorsque les longues requêtes ont consommé le cache.
Au-delà de la machine à sous
Les modèles dépassant les 141 Go sur une seule carte, ou nécessitant une charge de service de plusieurs dizaines de flux avec un point de contrôle de classe 400 octets, ne sont plus disponibles sur le marché des cartes d'extension. La gamme GB300 DGX Station figure dans notre classement des meilleurs ordinateurs de bureau pour l'IA locale , où un GPU Blackwell Ultra avec 252 Go de HBM3e côtoie le H200 NVL. Les systèmes HGX B200 et AMD Instinct MI350X, présentés dans nos tests Supermicro JumpStart, sont quant à eux classés dans la catégorie des meilleurs serveurs . Ces systèmes sont évalués en tant que systèmes complets, et non en tant que cartes graphiques, et ne sont donc pas inclus dans ce classement.
Comment nous classons
Trois règles régissent chaque classement de StorageReview. Premièrement, seules les cartes testées en laboratoire sont prises en compte : toute carte non testée peut être mentionnée, mais ne peut figurer dans une catégorie. Deuxièmement, les cartes sont testées individuellement dans un système hôte compatible, à la puissance fournie par ce système, et cette puissance est indiquée pour chaque carte ; la remarque concernant la H200 NVL ci-dessus est le seul cas où la puissance nominale et la puissance mesurée diffèrent.
Troisièmement, les cartes pour stations de travail sont exclues de cette page, à une exception près : lorsque NVIDIA vend le même silicium comme composant serveur et que les deux présentent des caractéristiques identiques, la carte pour station de travail est prise en compte, et cela est précisé dans l’entrée.
Le classement est établi à partir du débit de sortie du serveur en ligne vLLM, de la charge de travail d'inférence d'entreprise, à concurrence égale sur un ensemble de modèles partagé. En cas d'égalité, le format des documents (8 192 jetons) et les résultats de calcul MAMF servent de critères de départage, tandis que la capacité mémoire détermine le niveau de viabilité. Les fournisseurs n'ont pas accès au classement avant sa publication, aucun placement sur cette page n'est payant et toute citation d'un contenu sponsorisé est clairement identifiée. Les nouvelles fiches sont ajoutées au fur et à mesure qu'elles réussissent le même test sur le même conteneur, et l'historique des modifications en haut de page enregistre chaque changement.
Software stacks change every few weeks, so each figure on this page comes from the run that set the ranking, and later reviews may report newer runs of the same card. We re-rank when a newer run changes the order, not when a number moves.
FAQ sur les GPU d'entreprise
Quelle est la meilleure carte graphique pour l'inférence en entreprise ?
Pour les serveurs d'inférence 2U et 4U que la plupart des entreprises achètent, la RTX PRO 6000 Blackwell Server Edition, car elle combine 96 Go, la plus grande capacité de calcul FP4 que nous ayons mesurée sur une carte PCIe, MIG, vGPU et des moteurs graphiques et vidéo dans une carte qui ne perd que 2 à 9 % de son débit aux 450 W fournis par un emplacement standard.
La carte H200 NVL est la plus rapide lorsque la mémoire et la bande passante déterminent la charge de travail ; elle a d'ailleurs dominé tous les modèles testés. Un déploiement basé sur des modèles de 70 à 120 bits avec une forte concurrence devrait donc commencer par celle-ci. La RTX PRO 4500 Server Edition est le choix idéal lorsque le slot est simple largeur ou que la consommation électrique est de 165 W.
RTX PRO 6000 vs H100 NVL : laquelle est la plus rapide pour l’inférence ?
Le H100 NVL est de 36 à 61 % plus rapide à concurrence égale sur les modèles FP8 et BF16 exécutés dans le même conteneur vLLM, et de 41 à 52 % plus rapide sur les documents de 8 192 jetons, car ses 94 Go de mémoire HBM3 à 3.9 To/s décodent plus rapidement que ses 96 Go de GDDR7 à 1.6 To/s. La RTX PRO 6000 l'emporte sur les points de contrôle NVFP4, où le H100 ne dispose pas de matériel FP4 ; de plus, elle est la seule des deux à offrir des capacités graphiques, vidéo et d'affichage. Optez pour le H100 NVL pour un débit élevé sur les modèles FP8 et BF16 ; choisissez la RTX PRO 6000 pour une charge de travail mixte ou en prévision d'une migration vers le FP4.
H100 NVL vs H200 NVL : la mise à niveau vaut-elle le coup ?
Le H200 NVL a affiché des performances supérieures de 10 à 12 % à celles du H100 NVL avec 32 flux simultanés (format de chat) et de 21 à 23 % avec 128 flux simultanés (format de document de 8 192 jetons), avec 141 Go de mémoire contre 94 Go et un débit de 4.8 To/s contre 3.9 To/s. Ces chiffres correspondent à une consommation de 450 W pour le H200, la puissance maximale fournie par un emplacement R770 2U. Sa consommation de 600 W n'ayant pas été testée dans notre laboratoire, l'écart observé représente un minimum. La différence de capacité est le critère de choix principal pour la plupart des acheteurs : un modèle de classe 120 octets au format FP8, d'une capacité de 141 Go, nécessite deux H100 NVL.
L40S vs RTX PRO 6000 : qu’est-ce que la carte plus puissante permet d’obtenir ?
En situation de faible charge, la RTX PRO 6000 a affiché un débit de sortie 2.1 à 2.3 fois supérieur à celui de la L40S avec 32 flux sur le serveur Ministral. Avec 8 192 jetons en entrée, ce ratio est passé à 2.2 à 2.6, la carte de 48 Go atteignant la saturation de son cache KV à 16 flux, tandis que celle de 96 Go continuait de progresser. La 6000 intègre également du matériel FP4, le PCIe 5.0 et une mémoire MIG avec quatre partitions de 24 Go, pour une consommation de 600 W contre 350 W. Pour les applications nécessitant une charge de longue durée ou un environnement multi-utilisateurs, elle représente le meilleur choix. En revanche, pour des sessions de chat de faible intensité avec la même puissance que la L40S, la RTX PRO 4500 (simple emplacement) est plus comparable.
L4 vs RTX PRO 4500 : faut-il mettre à niveau un parc de cartes L4 ?
La RTX PRO 4500 Server Edition a affiché un débit de sortie 2.8 à 3.6 fois supérieur à celui de la L4 en contexte court sur notre R770 et 2.7 fois supérieur sur un HPE ProLiant DL145 Gen11, avec une consommation de 165 W contre 72 W et 32 Go de mémoire contre 24 Go. Le problème réside dans les dimensions : la 4500 est une carte pleine hauteur et pleine longueur avec un connecteur 16 broches, tandis que la L4 est une carte demi-hauteur alimentée par un emplacement dédié. Par conséquent, les serveurs 1U et les boîtiers périphériques compacts construits autour de la L4 ne sont pas compatibles avec la 4500. Optez pour une mise à niveau si votre châssis dispose d'un emplacement pleine hauteur ; conservez la L4 dans le cas contraire.
RTX PRO 6000 Server Edition vs Workstation Edition : quelle est la différence ?
Même GPU GB202, 96 Go de GDDR7 avec ECC et une consommation de 600 W : NVIDIA les évalue de manière identique et nos tests confirment leurs performances. C’est pourquoi les données de la version Workstation sont utilisées à la place de celles de la version Server sur cette page. La version Server est passive et sans écran, conçue pour optimiser la ventilation du châssis et dotée des fonctionnalités pour centres de données telles que MIG, le calcul confidentiel et le vGPU. La version Workstation, quant à elle, bénéficie d’un refroidissement actif et de quatre sorties DisplayPort. Un acheteur de serveur privilégiera la version Server ; les performances restent néanmoins identiques.
Quelle est la différence entre un GPU PCIe et un module SXM ou HGX ?
Un accélérateur PCIe est une carte d'extension qui s'insère dans un emplacement standard et consomme entre 72 W et 600 W. C'est pourquoi il s'intègre aux serveurs 2U et 4U déjà installés en rack. La communication entre les cartes s'effectue via PCIe ou un pont NVLink. Les modules SXM et OAM sont soudés à une carte mère au sein de systèmes dédiés tels que les plateformes HGX B200 ou MI350X. Ils consomment entre 700 W et 1 400 W par GPU et sont interconnectés via un réseau maillé NVLink ou Infinity Fabric complet. Cette page présente le premier type d'accélérateur ; le second est abordé sur nos cartes mères pour serveurs et ordinateurs de bureau dédiés à l'IA locale.
De combien de mémoire GPU un serveur d'inférence a-t-il besoin ?
Cela dépend du modèle et du contexte. Sur cette page, les cartes de 24 Go et 32 Go ont géré sans problème des modèles de 3 à 14 milliards de jetons avec une longueur de chat donnée et ont été aplaties sur quatre à huit flux avec une entrée de 8 192 jetons ; la carte de 48 Go a continué à gérer jusqu'à 16 flux, celle de 96 Go n'a jamais manqué de ressources avec les mêmes modèles, et la carte NVL H200 de 141 Go a pris en charge GPT-OSS-120B sur une seule carte lors de nos tests ET900N G3. Commencez par dimensionner les poids, puis le cache KV en fonction de la concurrence prévue, et considérez les travaux à contexte long ou multi-tenant comme nécessitant au moins 48 Go de mémoire.
La différence entre une alimentation de 450 W et une de 600 W a-t-elle une importance dans un serveur 2U ?
Less than the rating gap suggests, on the one card we have measured both ways. Capped to 450W, the most a PowerEdge R770 slot delivers, the RTX PRO 6000 gave up 2 to 5 percent of output throughput at short context and 4 to 9 percent at long context, and its FP8 MAMF result did not change, which returned 25 percent of its power budget for a 2 to 9 percent cost. The H200 NVL on this page was tested at 450W for the same reason, and its full 600W result has not yet been measured. The AMD Instinct MI350P in our first look also ran at 450W in a 2U PowerEdge R7725, against a 600W rating, and we will measure the difference in a PowerEdge XE7745.


 Amazon