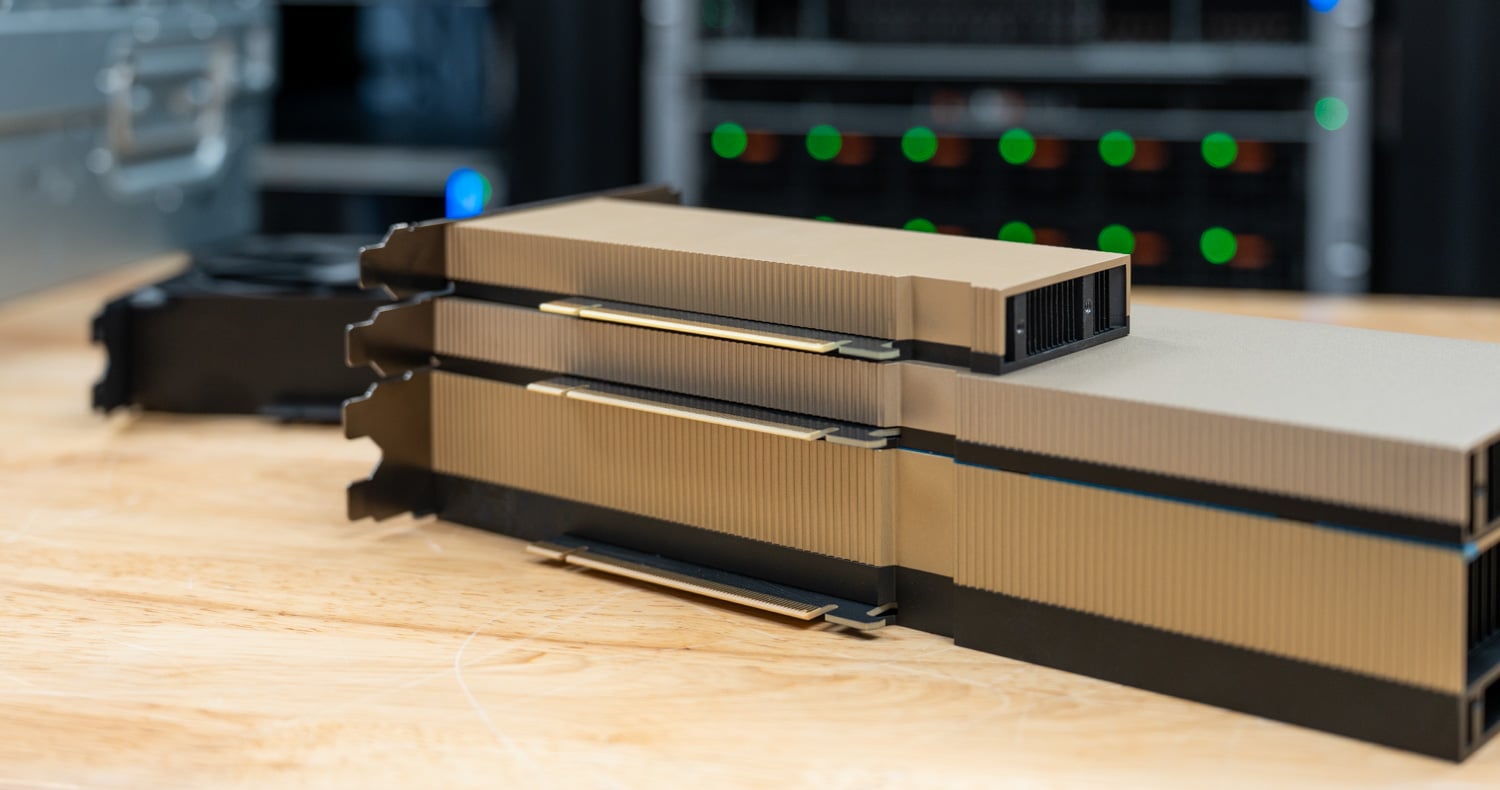
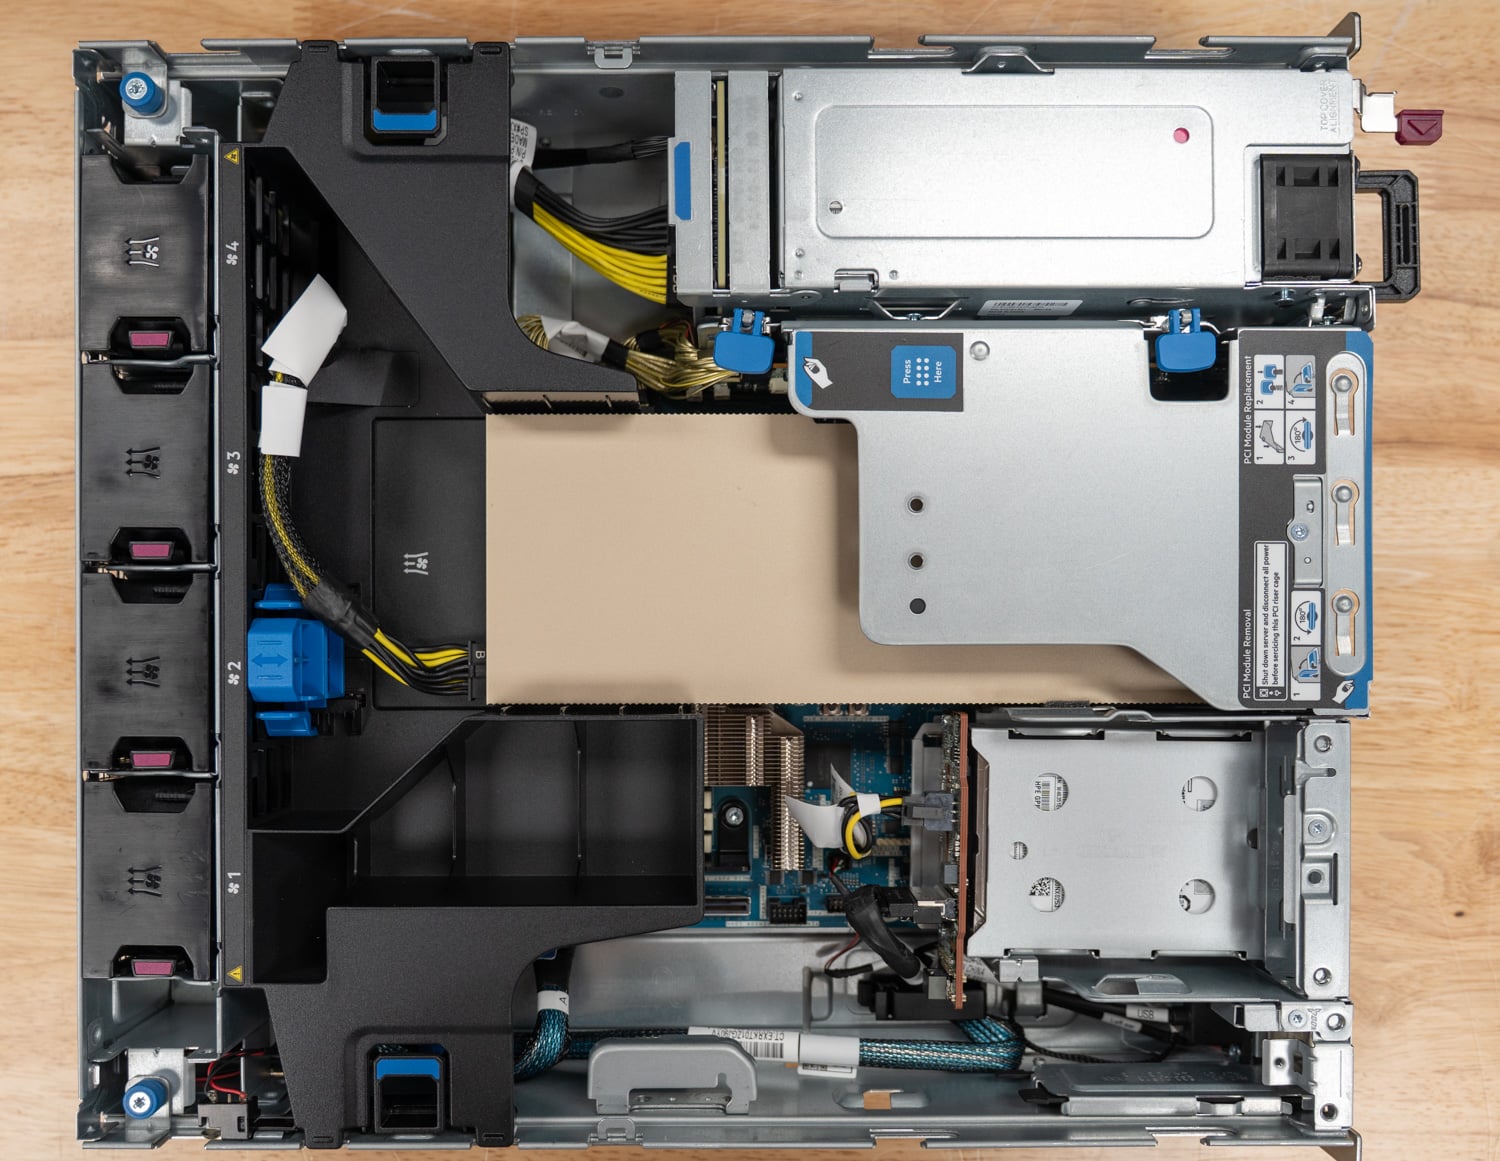
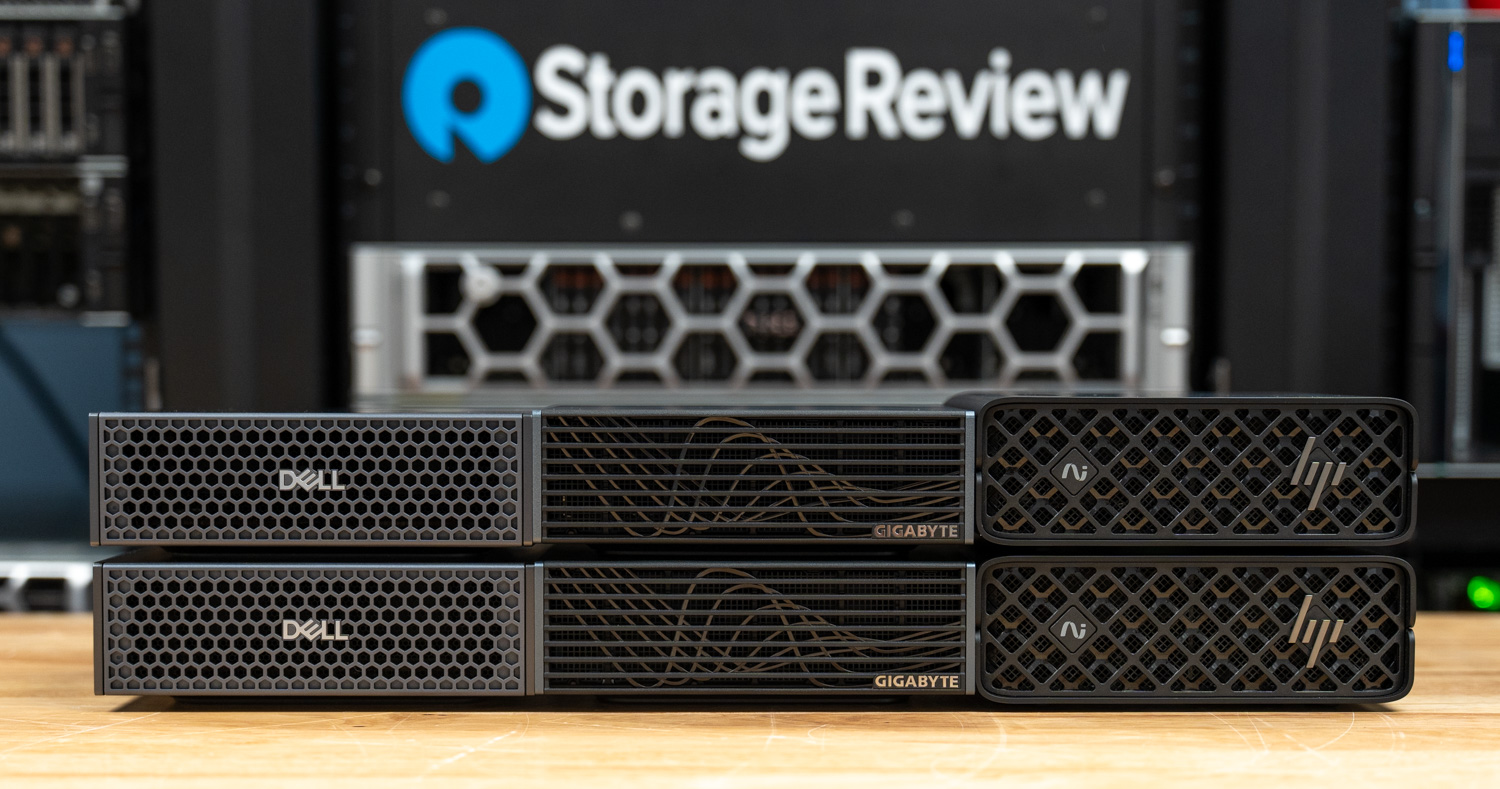
Nos tests actuels de systèmes d'IA portent sur l'inférence en laboratoire, avec des modèles à poids ouverts des familles Llama, Qwen, DeepSeek et gpt-oss exécutés via vLLM ou SGLang et mesurés en termes de débit de sortie et de latence du premier jeton. La couverture s'étend de la périphérie au nœud GPU complet : la NVIDIA RTX PRO 4500 Server Edition a fourni un débit médian de jetons de sortie par seconde 2.7 fois supérieur à celui du processeur L4 qu'elle remplaçait au sein d'un serveur HPE ProLiant DL145 Gen11, pour une consommation électrique supérieure d'environ 105 W ; les versions Dell, GIGABYTE et HP de DGX Spark ont exécuté l'inférence distribuée sous forme de clusters à deux nœuds sur une infrastructure 200 Gb/s ; et Supermicro JumpStart nous a permis de prendre en main un système composé d'une carte NVIDIA HGX B200 et d'un système AMD Instinct MI350X. Le stockage bénéficie du même traitement car le chemin de données détermine le niveau d'activité de ces GPU. Nous mesurons donc le débit de stockage GPUDirect avec GDSIO et testons le déchargement du cache KV vers la mémoire flash pour les charges de travail à contexte long et les charges de travail d'agents.
Si vous dimensionnez du matériel pour l'IA, la page « Meilleurs serveurs » présente nos choix actuels en matière d'inférence IA et de périphérie sur la base des données de ces évaluations, la page « Meilleurs SSD d'entreprise » couvre les disques qui alimentent les GPU et la page « Meilleurs systèmes de stockage » couvre les plateformes de stockage IA qui sous-tendent les clusters d'entraînement et les néoclouds.




 Amazon