

Lors de l'ISC 2026, DDN a annoncé un élargissement important de son portefeuille de plateformes de données IA et HPC, en introduisant de nouvelles capacités matérielles, logicielles et de plateforme conçues pour améliorer l'utilisation des GPU, accélérer l'inférence IA et simplifier les déploiements d'infrastructures IA à grande échelle.
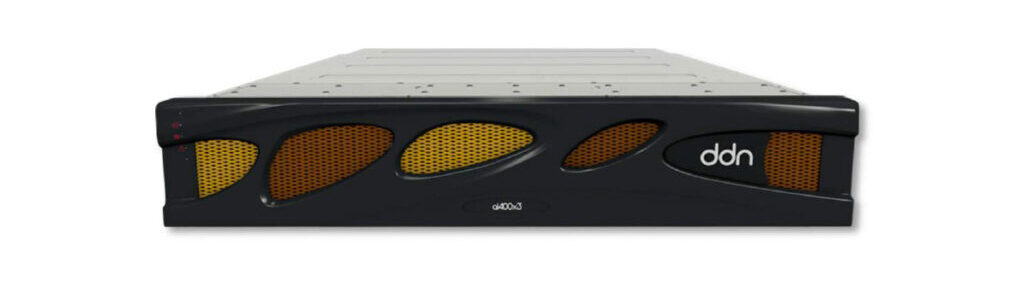
Les annonces comprennent le système de stockage AI400X3M, la disponibilité générale de la technologie d'accélération de cache KV distribuée de DDN intégrée à NVIDIA Dynamo , et de nouvelles fonctionnalités de sécurité, d'observabilité et de gestion de l'infrastructure pour l'ensemble des plateformes de données IA de l'entreprise.
DDN a indiqué que ces mises à jour visent à éliminer les goulots d'étranglement tout au long du pipeline de données d'IA, notamment la préparation des données, l'entraînement des modèles, l'inférence, la génération augmentée par la recherche (RAG), les modèles de raisonnement et les charges de travail d'IA agentielle. L'entreprise s'attache à améliorer l'efficacité de son infrastructure en optimisant l'utilisation des GPU tout en réduisant la consommation d'énergie et les coûts d'infrastructure.
Alex Bouzari, PDG et cofondateur de DDN, a déclaré que les infrastructures d'IA modernes nécessitent bien plus que de simples ressources de calcul. Il a souligné que la gestion efficace des données, la sécurité et la visibilité opérationnelle sont devenues des composantes essentielles des déploiements d'IA en production. Les dernières versions de l'entreprise visent à améliorer l'efficacité des GPU, à réduire les coûts d'inférence et à accélérer l'obtention du premier jeton.
L'AI400X3M cible la densité de performances en IA et HPC
L'annonce met en avant l'AI400X3M, le dernier appareil construit sur le système de fichiers parallèle EXAScaler de DDN.
Spécifications de l'AI400X3M
| Performances | |
| Performances de lecture séquentielle | Jusqu'à 190 Go/s |
| Performances d'écriture séquentielle | Jusqu'à 110 Go/s |
| Lecture aléatoire des IOPS | 8M |
| Caractéristiques du système | |
| Plateforme complète | Appliance EXAScaler clé en main pour système de fichiers parallèle partagé destiné à l'IA avec contrôleurs de stockage actifs/actifs |
| Ports hôtes par appareil | 4x XDR/400GbE OSFP ou 8 ports NDR200/200GbE QSFP112 |
| Assistance Drive | 24 emplacements doubles 2.5 pouces, remplaçables à chaud PCIe G5 NVMe |
| Options de capacité | 120/250/500 To et 1 Po/2 Po utilisables |
| Fonctionnalités standard du firmware | Cartographie et masquage des LUN, répartition intelligente des écritures, QoS en lecture, vérification/correction de l'intégrité des données, options d'interface (CLI, GUI, API Python), syslog sortant incluant la prise en charge RELP, messages de changement d'état (par e-mail et traps SNMP) |
| Sécurité et conformité | |
| Sécurité | IEC/EN/UL/CSA 62368-1, GB4943 |
| EMC | EN 55032 Classe A, EN 55035, EN 61000-3-2, EN 61000-3-3, FCC Partie 15 Classe A, VCCI Classe A, ICES-003 Classe A, GB/T9254 Classe A, BSMI Classe A |
| Environnemental | RoHS, REACH, DEEE, ERP Lot9X |
| Attributs physiques | |
| Facteur de forme | Montage en rack 2U |
| Dimensions | Hauteur: 3.43 ″ (87mm) Largeur: 17.56 "(446mm) Profondeur : 856 mm (33.7 po) sans lunette ; 895 mm (35.2 po) au total Rail de rack réglable : 26.75″ à 34.0″ (680–860 mm) |
| Poids | 44 kg à vide ; 49 kg maximum |
| Alimentation et refroidissement | |
| Tension d'entrée | 200–240 V 50/60 Hz |
| Alimentation | 2 entrées IEC60320-C20 remplaçables à chaud et redondantes |
| Environnement d'exploitation | |
| Plage de température | 5 ° C à 30 ° C (° F à 41 86 ° F) |
| Humidité relative | 8% -80% sans condensation |
| Altitude | 3 117 pi (950 m) à 30 °C — 10 000 pi (3 048 m) à 23 °C |
La plateforme offre un débit allant jusqu'à 190 Go/s et des performances de lecture jusqu'à 35 % supérieures à la génération précédente. DDN prend également en charge des configurations évolutives jusqu'à 30 Po dans une seule baie, tout en intégrant la prise en charge des disques hybrides combinant stockage flash et disque dur pour un équilibre optimal entre performances, capacité et coût.
Ce dispositif est conçu pour l'entraînement de modèles d'IA, l'inférence, la sauvegarde de données, la simulation HPC et d'autres charges de travail hautement parallèles où le débit de stockage influe directement sur l'utilisation du GPU. Sa disponibilité générale est prévue pour la fin du troisième trimestre 2026.
Cache KV distribué désormais disponible pour tous
Suite à une présentation en avant-première lors de la NVIDIA GTC 2026, DDN a officiellement lancé son architecture d'accélération de cache KV distribuée, intégrant NVIDIA Dynamo. Cette fonctionnalité est disponible à la fois sur la plateforme de stockage objet Infinia et sur le système de fichiers EXAScaler.
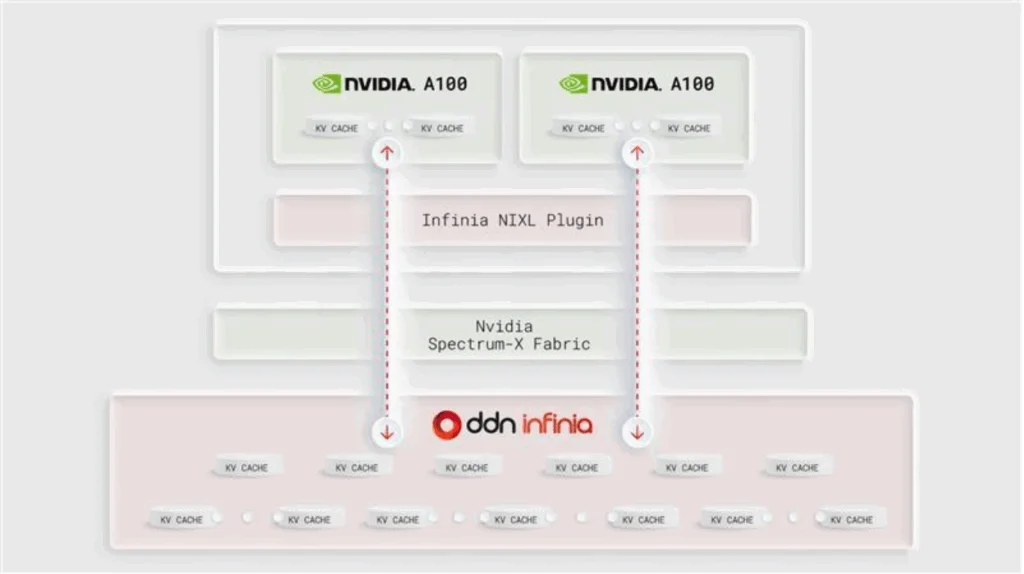
Plutôt que de s'appuyer sur la mémoire GPU locale pour le contexte du modèle, l'architecture distribuée stocke et récupère les données du cache KV à partir de la plateforme de données de DDN, réduisant ainsi les goulots d'étranglement de la mémoire pendant l'inférence.
DDN a annoncé que sa plateforme prend en charge NVIDIA Dynamo, vLLM et d'autres frameworks d'inférence modernes, tout en permettant le partage d'un cache KV distribué entre plusieurs nœuds d'inférence. L'entreprise revendique un chargement du cache KV jusqu'à 55 fois plus rapide pour les charges de travail d'inférence à grande échelle, ainsi qu'une meilleure utilisation du GPU, une génération de jetons plus rapide et des coûts d'infrastructure réduits pour les déploiements de modèles de langage de grande envergure.
Cette technologie vise à améliorer l'inférence à long terme, la génération augmentée par la récupération, les modèles de raisonnement et les flux de travail d'IA agentielle qui accèdent de manière répétée à de vastes contextes de modèles.
Pipeline de données IA unifié
DDN a également présenté sa stratégie plus large consistant à combiner le stockage d'objets Infinia pour l'inférence avec EXAScaler pour l'entraînement des modèles et la mise en place de points de contrôle dans une infrastructure de données d'IA unique.
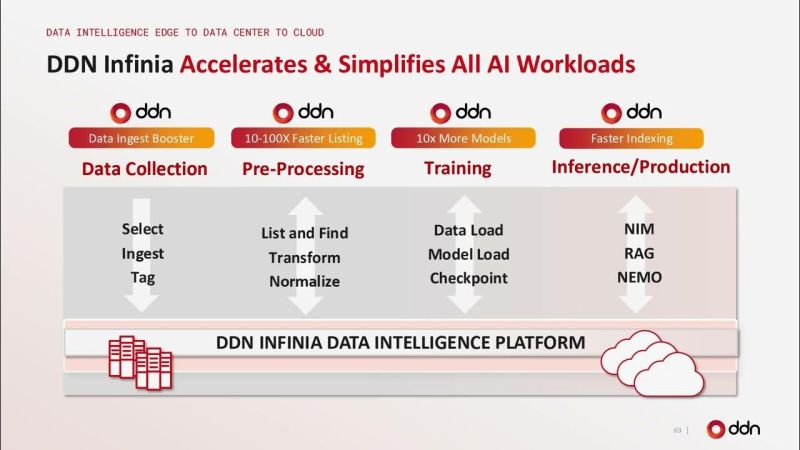
L'entreprise a indiqué qu'Infinia offre des opérations de métadonnées à faible latence, une forte concurrence et des performances objet optimisées pour les charges de travail intensives en inférence, tandis qu'EXAScaler continue de prendre en charge les environnements d'entraînement haute performance. Ensemble, ces plateformes visent à éliminer les silos de données et à maintenir une utilisation élevée du GPU tout au long du cycle de vie de l'IA.
Nouvelles fonctionnalités de sécurité et d'infrastructure
Les améliorations supplémentaires apportées à la plateforme sont axées sur les exigences de déploiement en entreprise, notamment la mutualisation bare metal, le chiffrement et la gestion des clés basés sur KMIP, l'intégration de VictoriaLogs pour une visibilité opérationnelle et des API mutualisées étendues.

Côté stockage, DDN a introduit l'épinglage intelligent des fichiers et les Hot Pools accélérés par la mémoire NAND, permettant ainsi de conserver les données fréquemment utilisées sur la mémoire flash tout en transférant automatiquement les données moins utilisées vers des disques durs moins coûteux. L'entreprise a indiqué que ces fonctionnalités sont conçues pour améliorer l'efficacité du stockage tout en réduisant les besoins en capacité de mémoire flash.
Poursuite de l'expansion de l'IA dans le cloud
DDN a également souligné l'adoption continue de ses offres d'infrastructure d'IA cloud, notamment les développements Managed Lustre annoncés avec Google Cloud et un déploiement Salesforce qui utilise Google Cloud Managed Lustre optimisé par EXAScaler.
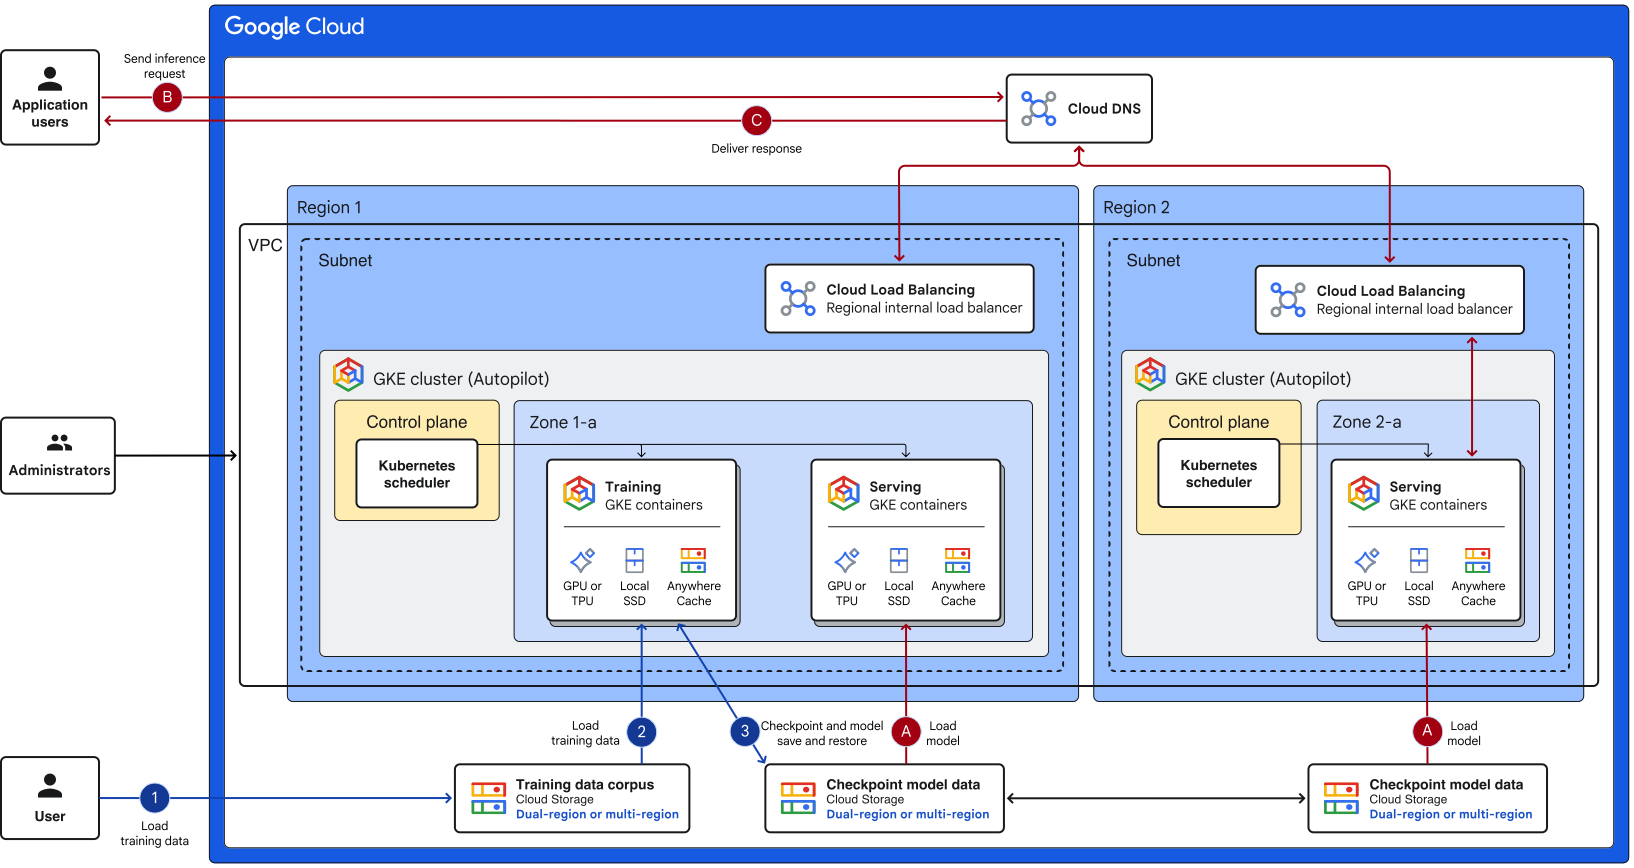
Selon DDN, la mise en œuvre de Salesforce a permis d'accélérer l'entraînement des modèles de 1.5 fois, de réduire la latence d'E/S de 75 % et de diminuer les coûts d'entraînement de 42 %, démontrant ainsi l'impact de la réduction des goulots d'étranglement du stockage dans les environnements d'IA à grande échelle.
Avec ces dernières annonces, DDN continue d'étendre son portefeuille au-delà du stockage parallèle pour inclure l'orchestration des données IA, l'accélération de l'inférence et la gestion de l'infrastructure, positionnant ainsi ses plateformes pour prendre en charge les déploiements d'IA d'entreprise, de cloud, de recherche et souverains fonctionnant à grande échelle sur GPU.


 Amazon