

Equinix a renforcé son partenariat avec NVIDIA et noué une nouvelle collaboration avec Together AI pour lancer Equinix Inference Exchange. Conçue comme une architecture d'inférence IA distribuée pour les déploiements en entreprise, la plateforme vise à rapprocher les charges de calcul des principaux référentiels de données, des utilisateurs finaux et des applications opérationnelles. Annoncée conjointement à Equinix Fabric One lors de l'événement Equinix Horizon, cette initiative combine les architectures matérielles d'entreprise de NVIDIA, la plateforme de modélisation open source de Together AI et l'infrastructure d'interconnexion mondiale d'Equinix afin de résoudre les problèmes de latence, de souveraineté des données et de congestion du réseau.
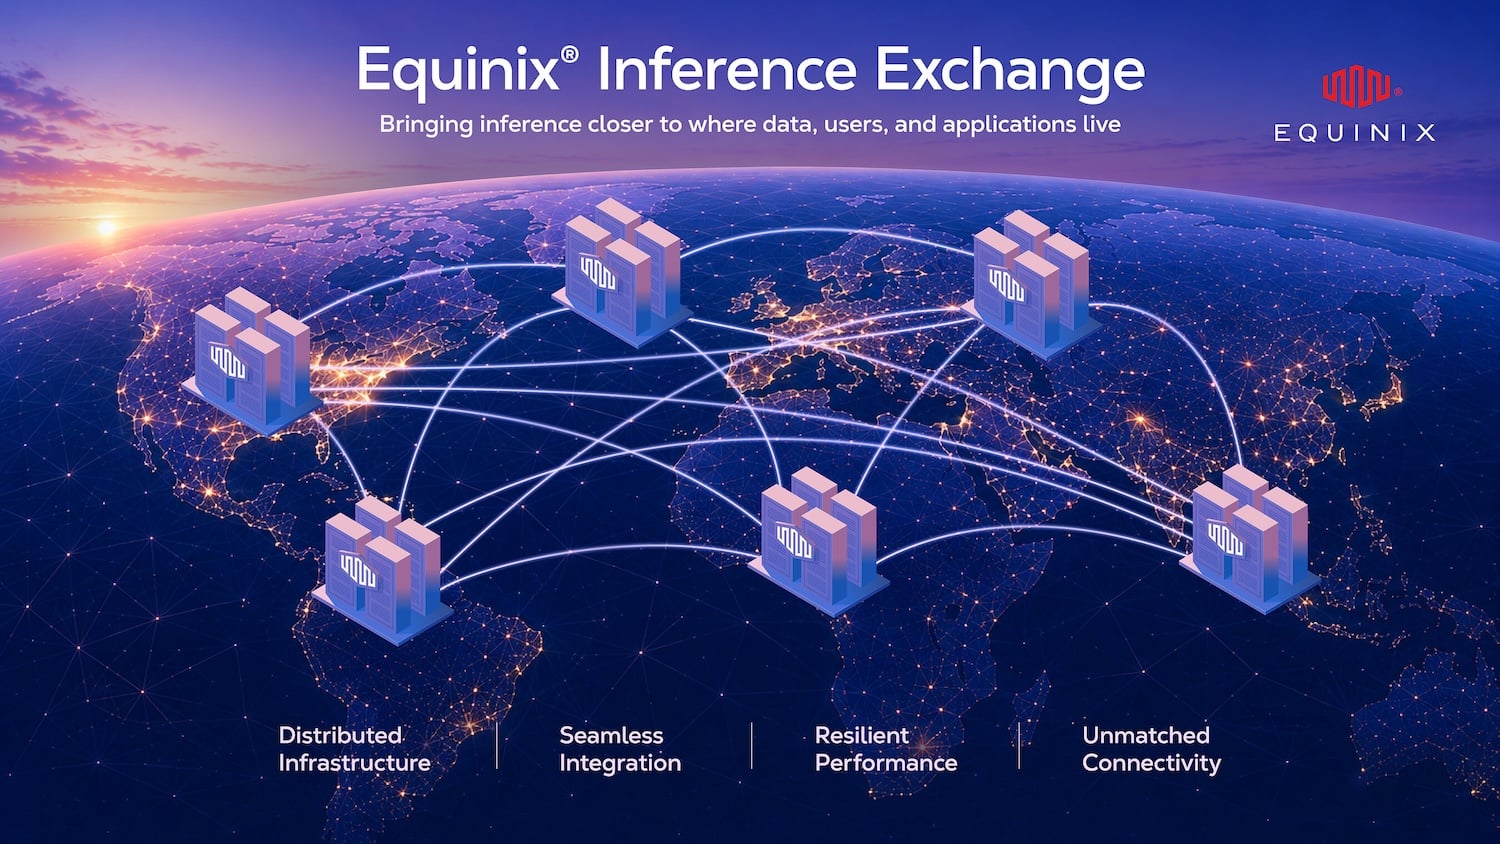
Aborder l'inférence distribuée et la gravité des données
À mesure que les initiatives d'IA en entreprise passent de la validation de prototypes à la production à haut débit, le placement des inférences détermine le coût global, la latence de réponse et la conformité. Rapprocher l'exécution des modèles des sources de données réduit le coût du transport des données via les clouds publics tout en garantissant des profils de latence prévisibles. Cependant, la gestion d'une infrastructure distribuée dans des environnements hétérogènes engendre des coûts opérationnels et une complexité réseau accrus.
Equinix surmonte cet obstacle opérationnel en s'appuyant sur son infrastructure de plus de 280 datacenters répartis dans 77 métropoles, 230 points d'accès au cloud et un réseau de plus de 10 500 entreprises interconnectées. Avec huit des dix principaux fournisseurs de modèles d'IA et neuf des dix principaux clouds d'IA déjà opérationnels au sein de ses infrastructures, la plateforme Equinix fait office de couche d'agrégation neutre pour les pipelines d'IA distribués.
Architecture et intégration de la pile
La pile Equinix Inference Exchange est structurée en trois couches distinctes couvrant le calcul, le logiciel et l'infrastructure physique :
Equinix gère l'infrastructure physique et d'interconnexion de base. Cela inclut la fourniture d'énergie, des capacités de refroidissement liquide avancées, l'exploitation des installations en deuxième ligne et l'interconnexion privée aux réseaux, aux clouds publics et aux plateformes SaaS via Equinix Fabric.
NVIDIA fournit la couche de calcul et de validation de référence, offrant une infrastructure d'IA d'entreprise conçue pour un débit de jetons élevé et des coûts d'inférence réduits par requête.
Together AI fournit la couche logicielle d'inférence qui prend en charge plus de 200 modèles open source. La plateforme supporte à la fois les environnements mutualisés pour une efficacité de calcul globale et les topologies mono-locataires dédiées pour les charges de travail nécessitant une capacité isolée.
En acheminant le trafic via Equinix Fabric, la plateforme réduit les délais d'obtention du premier jeton (TTFT) pour les utilisateurs régionaux tout en établissant des chemins d'interconnexion privés entre le stockage sur site et les points de terminaison du modèle.
Objectifs de déploiement en entreprise et disponibilité
La plateforme cible trois topologies de déploiement principales. Pour l'inférence en périphérie de réseau métropolitain, les organisations peuvent exécuter des modèles dans des hubs métropolitains locaux, bénéficiant ainsi de réponses API à faible latence tout en conservant une gestion centralisée et des interconnexions privées. Pour la migration de modèles open source, l'architecture facilite la transition des API propriétaires fermées vers des modèles de base open source, réduisant la dépendance vis-à-vis des fournisseurs tout en tirant parti des infrastructures réseau existantes. Enfin, pour l'IA souveraine et les exigences de conformité, la structure distribuée permet aux entreprises des secteurs réglementés de maintenir l'exécution des inférences et le traitement des données au sein de zones géographiques spécifiques, contribuant ainsi au respect des exigences strictes en matière de résidence et de gouvernance des données.
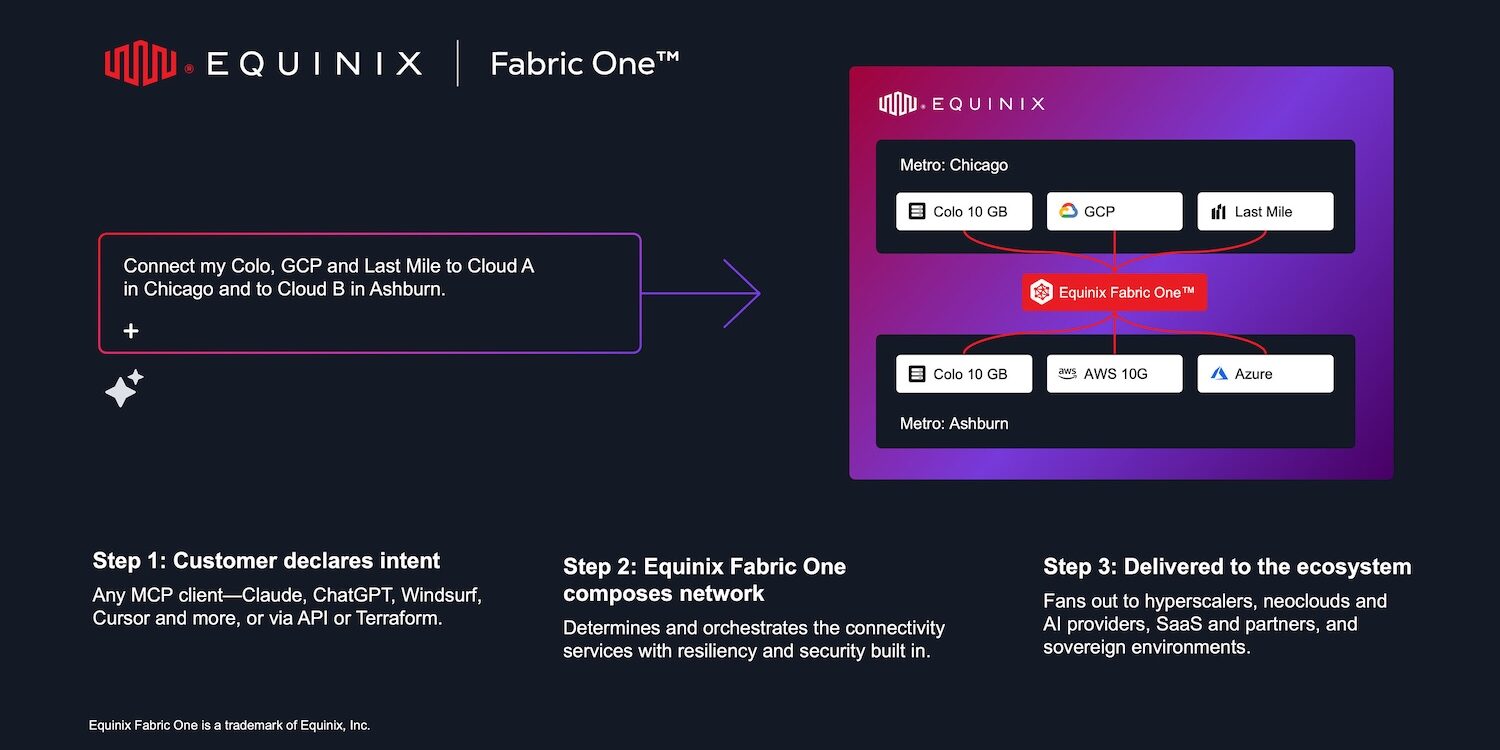
Les dirigeants d'Equinix, de NVIDIA et de Together AI ont souligné que cette intégration établit une infrastructure d'inférence à haut débit et indépendante des fournisseurs, qui équilibre les performances de calcul et l'agilité opérationnelle.
La plateforme Equinix Inference Exchange devrait être disponible pour les entreprises au cours du premier trimestre 2027.


 Amazon