

Des chercheurs de l'Université Carnegie Mellon ont publié une étude axée sur la fiabilité sur le terrain des SSD, l'étude est intitulée "Une étude à grande échelle des défaillances de la mémoire flash sur le terrain". L'étude a été menée à l'aide des centres de données de Facebook sur quatre ans et des millions d'heures de fonctionnement. L'étude examine comment les erreurs se manifestent et vise à aider les autres à développer de nouvelles solutions de fiabilité du flash.
Comme nous le disons depuis un certain temps ici à StorageReview, le flash offre plusieurs avantages en termes de performances, de densité et de consommation d'énergie, le principal inconvénient étant le coût. Alors que de nombreux SSD revendiquent une bonne longévité et fiabilité, il n'y a pas eu d'études majeures sur le terrain jusqu'à présent.
Bien que des fournisseurs spécifiques et des lecteurs spécifiques n'aient pas été mentionnés, Facebook en utilise beaucoup dans leur niveau de données à chaud, l'étude a noté le type de plate-forme sur laquelle le SSD était utilisé (cela a été défini comme une combinaison de la capacité de l'appareil utilisée dans le système , la technologie PCIe utilisée et le nombre de SSD dans le système), il s'agissait de plates-formes de label AF. Les plates-formes avaient une capacité de 720 Go à 3.2 To, avaient deux générations de PCIe (versions 1 et 2), certaines utilisaient un SSD, d'autres en employaient deux, et la durée de fonctionnement s'étendait de six mois à plus de deux ans.
Les chercheurs ont utilisé des registres pour garder une trace du fonctionnement du SSD similaire aux données SMART. Les valeurs brutes ont été collectées une fois par heure, analysées sous une forme pouvant être organisée dans une table Hive, puis un groupe de machines a effectué une agrégation parallélisée des données stockées dans Hive à l'aide de tâches MapReduce. À partir de là, les chercheurs ont pu surveiller le taux d'erreurs sur les bits, le taux d'échec des SSD et le nombre d'erreurs, la corrélation entre les différents SSD (en particulier sur les plates-formes qui avaient plus d'un SSD) et le rôle des facteurs internes et externes.
Les conclusions tirées de l'étude comprennent :
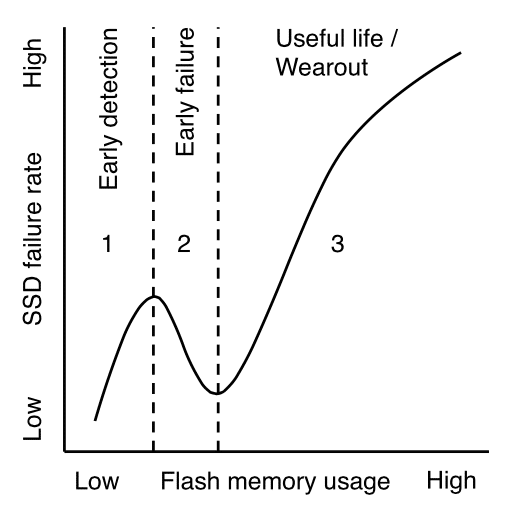
- Les SSD passent par plusieurs périodes de défaillance distinctes - détection précoce, défaillance précoce, durée de vie utile et usure - au cours de leur cycle de vie, correspondant à la quantité de données écrites sur les puces flash.
- L'effet des erreurs de perturbation de lecture n'est pas une source prédominante d'erreurs dans les SSD examinés.
- La disposition clairsemée des données dans l'espace d'adressage physique d'un SSD (par exemple, des données allouées de manière non contiguë) entraîne des taux de défaillance élevés du SSD ; la disposition dense des données (par exemple, des données contiguës) peut également avoir un impact négatif sur la fiabilité dans certaines conditions, probablement en raison de modèles d'accès contradictoires.
- Des températures plus élevées entraînent une augmentation des taux d'échec, mais le font surtout pour les SSD qui n'utilisent pas de techniques de limitation.
- La quantité de données signalées comme étant écrites par le logiciel système peut exagérer la quantité de données réellement écrites sur les puces flash, en raison des techniques de mise en mémoire tampon et de réduction de l'usure au niveau du système.
Bien que l'étude n'indique pas qu'un lecteur ou un type de lecteur est meilleur qu'un autre, il reste intéressant de voir comment les SSD fonctionnent dans le monde réel sous une utilisation intensive. Cette étude ouvre la porte à la fois à de futures études sur l'utilisation des SSD ainsi qu'à de nouvelles technologies qui pourraient rendre les SSD encore plus fiables ou durer beaucoup plus longtemps.
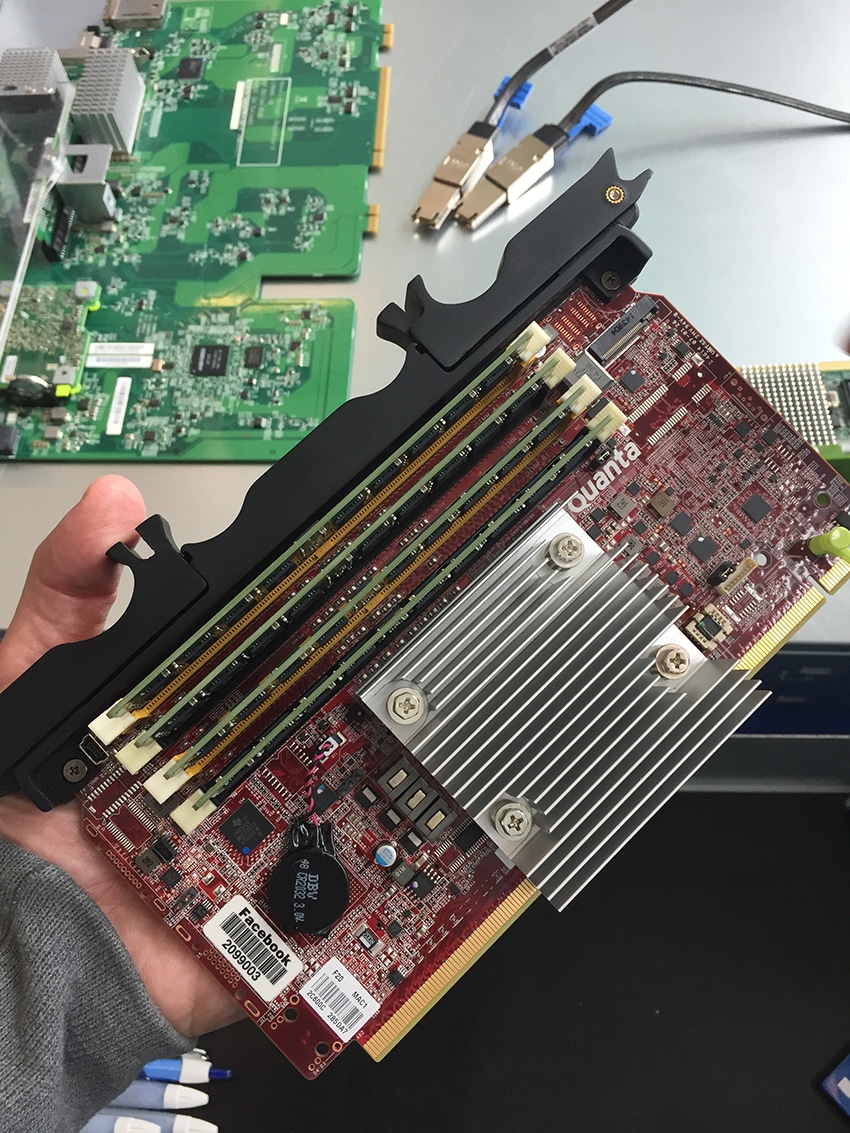
De son côté, Facebook continue de faire évoluer l'architecture de ses serveurs pour intégrer des données telles que celles issues de l'étude de Carnegie Mellon. Sa plateforme Yosemite, récemment annoncée , illustre parfaitement comment Facebook exploite la technologie Flash dans des formats non traditionnels, du moins pour les centres de données, afin d'obtenir des performances optimales tout en privilégiant la réduction du coût total de possession.


 Amazon