

MLCommons a publié MLPerf Inference v6.1. Cette édition établit un record de participation avec 30 organisations participantes et 486 résultats pour les datacenters et l'edge computing. Deux nouveaux tests rejoignent la suite : un pipeline RAG de bout en bout pour les datacenters et un benchmark d'inférence agentique pour les appareils monopostes. Les résultats incluent les premières données validées par les pairs pour les processeurs graphiques NVIDIA Vera Rubin NVL72, AMD Instinct MI350P, Intel Arc Pro B70 et AMD Ryzen AI Max+ 395. Concernant les progrès réalisés, MLCommons indique que le meilleur résultat DeepSeek-R1 par accélérateur, dans un environnement serveur, est 5.7 fois supérieur à celui de la version 5.1 sortie il y a un an, et que le meilleur résultat VLM a été multiplié par 2.99 au cours des six mois écoulés depuis la version 6.0.
Deux nouveaux tests : RAG de bout en bout et inférence d’agents de périphérie
Le benchmark End-to-End RAG évalue un pipeline complet de question-réponse, composé de plusieurs modèles et d'une base de données vectorielles. L'implémentation de référence utilise quatre modèles : gpt-oss-120B gère la décomposition des requêtes, la vérification de la suffisance des données et la génération des réponses ; gpt-oss-20B évalue les documents extraits ; e5-base-v2 produit les plongements lexicaux ; et ColBERTv2 réorganise les passages. Le corpus comprend 107 484 passages, extraits de 2 515 fichiers HTML ; les questions sont 824 tâches multi-sauts issues du jeu de données FRAMES de Google ; chaque tâche peut effectuer jusqu'à 5 itérations de recherche avant que le pipeline ne considère les données comme suffisantes. Deux métriques sont calculées : le nombre de documents par seconde pour la construction de la base de données vectorielles FAISS HNSW, et le nombre de tâches par seconde pour répondre aux questions posées sur cette base. Un juge Llama 3.1-8B évalue les réponses finales avec un objectif de précision de 97 %, et cette évaluation n'est pas chronométrée.
Le benchmark Edge Agentic Inference cible le modèle d'assistant de codage déployé sur les stations de travail et les boîtiers d'IA de bureau. Le modèle utilisé est Qwen3.6-27B (avec l'option « thinking off »), exécuté comme un Q4_K_M GGUF sous l'interface llama.cpp de la référence, avec une fenêtre de contexte de 32 Ko servie par tour. La charge de travail de performance consiste en une relecture enregistrée de 20 trajectoires de codage agentic issues de SWE-bench Verified, totalisant 1 007 tours, exécutées en flux continu avec une seule requête à la fois, à l'image d'un développeur exécutant un agent sur un ordinateur portable. La métrique rapportée est la latence moyenne par tour, accompagnée des distributions du temps d'obtention du premier jeton et du temps par jeton de sortie. La précision est évaluée séparément par BFCL v4 à 97 % du score de référence. MLCommons a adapté le framework de son prochain benchmark MLPerf Agentic pour centres de données.
« Nous avons ajouté le test RAG de bout en bout car il est clair que la réponse aux requêtes a évolué au-delà d'un simple modèle linéaire mixte entraîné sur un corpus ; les parties prenantes doivent comprendre les performances réelles des pipelines multi-étapes et multi-composants actuellement en développement », a déclaré Miro Hodak, coprésident du groupe de travail Inférence de MLPerf. « De même, nous avons ajouté le test d'inférence Edge Agentic car les systèmes d'inférence complexes dotés de propriétés d'agent sont de plus en plus souvent hébergés sur des dispositifs de calcul en périphérie, ce qui crée de nouveaux défis de performance auxquels nos clients sont confrontés aujourd'hui. »
Ce cycle étend également la prise en charge du décodage spéculatif, auparavant limitée à DeepSeek-R1, au benchmark GPT-OSS dans le scénario interactif, et définit un nouveau scénario interactif pour le test VLM avec des réponses ciblées à environ 1.5 seconde.
Nouvelles puces en silicium, du bureau au rack
La plateforme Vera Rubin NVL72 de NVIDIA fait ses débuts sur MLPerf dans la catégorie « Aperçu », soumise par NVIDIA et par Nebius sur sa plateforme VR200 NVL72. NVIDIA annonce un débit de jetons jusqu'à 2.5 fois supérieur à celui de la GB300 NVL72 sur DeepSeek-R1, dans des scénarios hors ligne, serveur et interactifs avec TensorRT-LLM, et jusqu'à 3.7 fois supérieur sur le modèle vision-langage Qwen3 avec vLLM et NVIDIA Dynamo. Ces comparaisons sont effectuées par NVIDIA par rapport à sa génération précédente, et la désignation « Aperçu » indique que la plateforme devrait être commercialisée lors de la prochaine session.
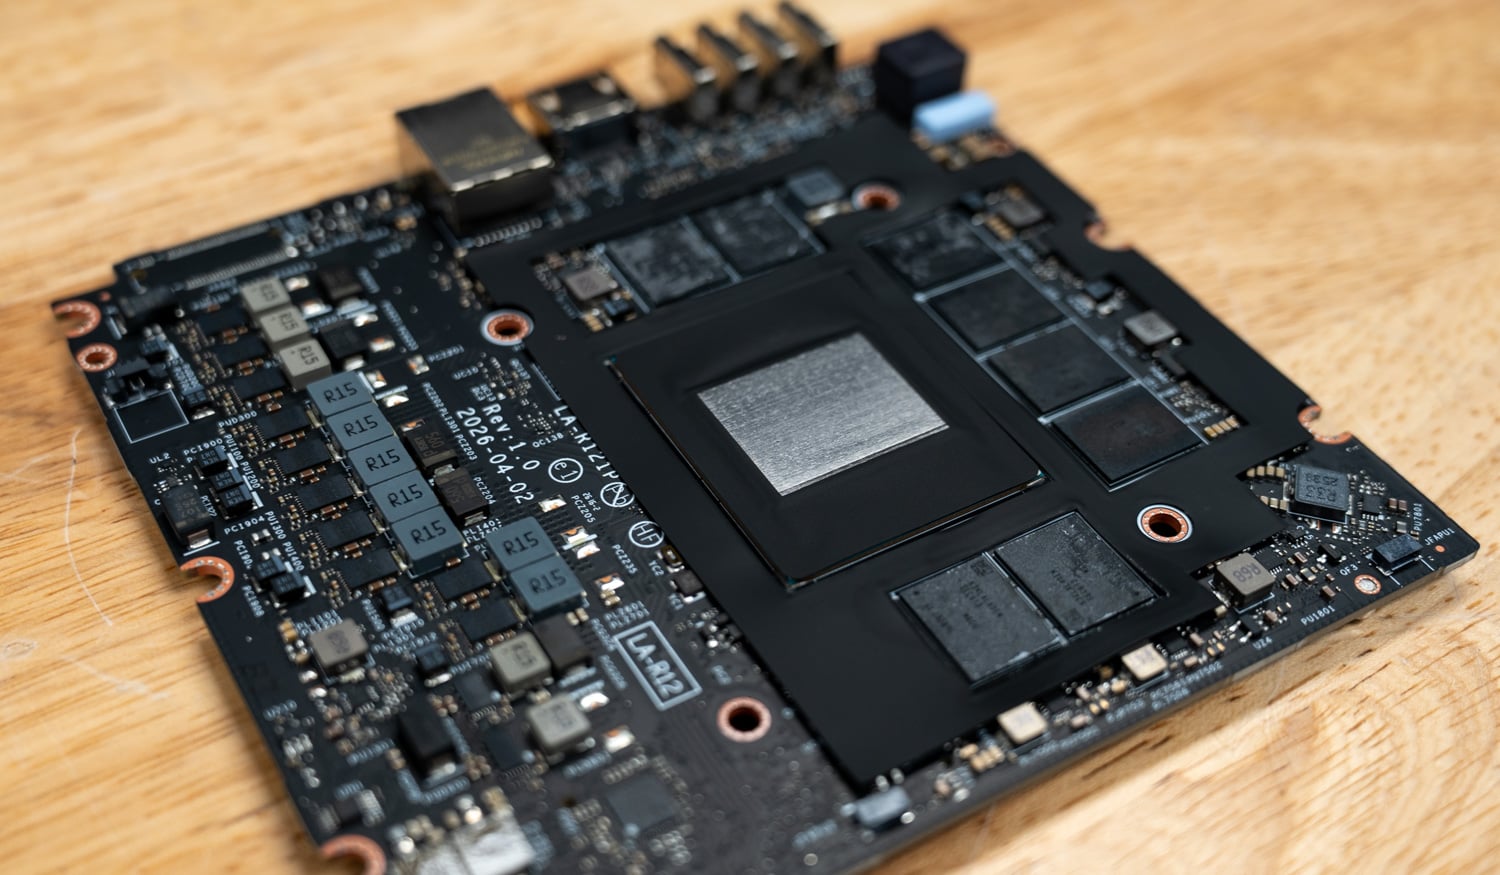
AMD a étendu sa participation au concours MLPerf Inference 6.1 à six familles de modèles couvrant le traitement du langage, le raisonnement, la conversion texte-vidéo et les recommandations, en déployant les cartes graphiques Instinct MI355X, MI350X et la nouvelle carte PCIe MI350P. Le cluster Crusoe à 512 GPU, construit sur la MI355X, est présenté ci-dessous, ainsi que l'analyse détaillée des résultats d'AMD.
La carte mère Intel Arc Pro B70 est disponible en version quatre GPU avec 128 Go de VRAM combinée. Intel l'a utilisée pour les tests Llama 3.1-8B, Llama 2-70B, gpt-oss-120B, Whisper et le nouveau test E2E-RAG. Intel annonce une amélioration de 36 % des performances de gpt-oss-120B sur serveur et de 27 % hors ligne par rapport à la version 6.0 sur la même configuration matérielle. Côté processeur, Intel indique que le débit serveur du Xeon 6980P Llama 3.1-8B a été multiplié par 2.4 par rapport à la version 6.0 sur une puce identique, un gain purement logiciel.
Le Ryzen AI Max+ 395 apparaît dans les résultats d'Atlas Inference, un nouvel utilisateur qui a testé la nouvelle charge de travail Edge Agentic sur une plateforme NVIDIA DGX Spark et une plateforme AMD Strix Halo, avec le même moteur et la même recette de quantification. Atlas indique un taux de 20.1 jetons par seconde sur la DGX Spark, avec un temps de calcul de 1 007 itérations inférieur à 64 minutes, et de 19.63 jetons par seconde sur la Strix Halo. L'écart est plus faible que celui que nous avions constaté entre les deux plateformes avec des configurations standard lors de nos tests des Ryzen AI Halo et DGX Spark , et c'est précisément le type de résultat que ce nouveau benchmark est censé mettre en évidence.
Plus grand, plus diversifié et plus réparti
Les soumissions multi-nœuds ont atteint un niveau record cette année, contre zéro lors de la v4.0, et trois se distinguent particulièrement. Crusoe, un autre nouvel utilisateur, a exécuté le plus grand système de l'histoire de l'inférence MLPerf avec AMD : 512 GPU Instinct MI355X répartis sur 64 nœuds sur une infrastructure Ethernet RoCE standard, soumis pour gpt-oss-120b et DeepSeek-R1. AMD annonce 5.75 millions de jetons par seconde en mode hors ligne et 5.39 millions en mode serveur sur gpt-oss-120b à partir de ce cluster, et 2.90 millions hors ligne et 2.41 millions en mode serveur sur DeepSeek-R1, ce qu'AMD qualifie de débit de jetons agrégé le plus élevé de l'histoire de MLPerf, avec une mise à l'échelle du débit quasi linéaire de 1 à 64 nœuds. L'exécution de gpt-oss-120b a servi le modèle sous la forme de 512 répliques indépendantes mono-GPU en MXFP4 natif ; DeepSeek-R1 utilisait SGLang avec une réplique de huit GPU par nœud. Par ailleurs, AMD cite une soumission GPT-OSS-120B à 72 GPU avec une efficacité de mise à l'échelle de 95 % et 1 million de jetons par seconde, soit le même résultat obtenu avec MI355X dans la version 6.0.
Cisco a soumis le premier système hétérogène multi-fournisseurs de ce benchmark, combinant huit GPU NVIDIA H200 et huit GPU AMD Instinct MI350X au sein d'un pool d'inférence unique sur une infrastructure Cisco Silicon One G200. Il s'agit de la même approche d'accélération mixte qu'elle commercialise via sa solution Secure AI Factory . La contribution géographiquement distribuée provient de MangoBoost et Dell : quatre sites répartis sur deux continents, hébergés par MangoBoost, Dell, TensorWave et Microsoft Azure, couvrant la zone Pacifique et fonctionnant comme un seul point de terminaison avec une efficacité de mise à l'échelle de 97 % selon MangoBoost. MangoBoost revendique également les premiers résultats désagrégés de préremplissage/décodage sur GPU AMD Instinct.
Parmi les autres résultats, CoreWeave annonce un débit cumulé de 1.16 million de jetons par seconde sur GB300 NVL72, avec un débit hors ligne par GPU en hausse de 17 % depuis la version 6.0. HPE, quant à elle, affiche 8 500 jetons par seconde et par GPU sur DeepSeek-R1, répartis sur deux serveurs Compute XD690 équipés de Blackwell Ultra. Google a axé sa soumission sur DeepSeek-R1, soulignant l'évolution du secteur vers des modèles de grande taille combinant plusieurs experts. La charge de travail gpt-oss-120b a quant à elle recueilli 112 soumissions, soit le plus grand nombre parmi toutes les charges de travail MLPerf.
Les deux formats CDNA 4 d'AMD : OAM et PCIe double emplacement
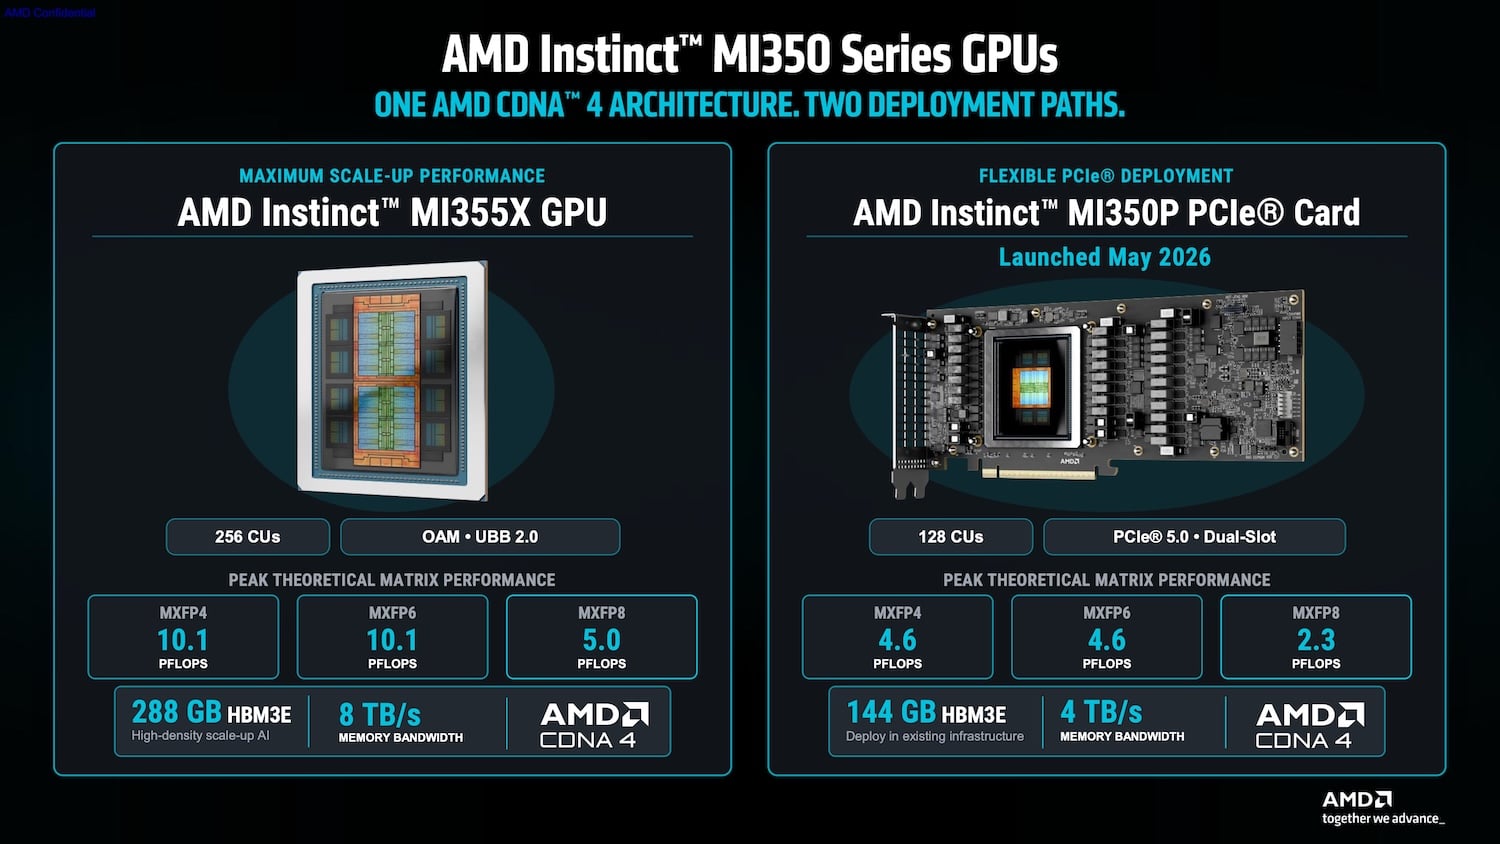
L'architecture CDNA 4 d'AMD est disponible en deux formats physiques pour répondre aux contraintes spécifiques de consommation et de refroidissement des centres de données. Le modèle phare Instinct MI355X cible les nœuds de calcul haute densité grâce à son format OAM sur une plateforme OCP Universal Baseboard (UBB 2.0). Il offre 256 unités de calcul, 288 Go de mémoire HBM3E et une bande passante mémoire agrégée de 8 To/s. Il délivre jusqu'à 10.1 PFLOPS de puissance de calcul théorique maximale pour les matrices MXFP4 et MXFP6. Le nouveau modèle Instinct MI350P intègre cette même puce CDNA 4 dans une carte d'extension PCIe 5.0 double emplacement pour châssis d'entreprise standard. Il embarque 128 unités de calcul, 144 Go de mémoire HBM3E, une bande passante de 4 To/s et délivre jusqu'à 4.6 PFLOPS de puissance de calcul théorique maximale pour les matrices MXFP4 et MXFP6.
Amélioration générationnelle pilotée par logiciel sur silicium identique
Les optimisations logicielles d'AMD ROCm v7 ont permis d'obtenir des gains de débit mesurables sur du matériel MI355X identique lors d'un seul cycle MLPerf. Les tests effectués sur un nœud MI355X à huit GPU ont montré une augmentation du débit GPT-OSS-120B de 28 % en mode hors ligne et de 38 % en mode serveur, tandis que les performances Wan-2.2 SingleStream ont progressé de 70 %. À l'échelle d'un cluster, 72 accélérateurs MI355X, testés lors de la version 6.1 de MLPerf, ont atteint un débit GPT-OSS-120B agrégé supérieur à celui d'une configuration à 94 GPU obtenue lors de la version 6.0. Dans les comparatifs publiés par AMD, le MI355X à huit GPU a obtenu les meilleurs résultats face aux NVIDIA B200 et B300 sur GPT-OSS-120B, tandis que le cluster à 72 GPU a surpassé les performances de NVIDIA sur GB200.
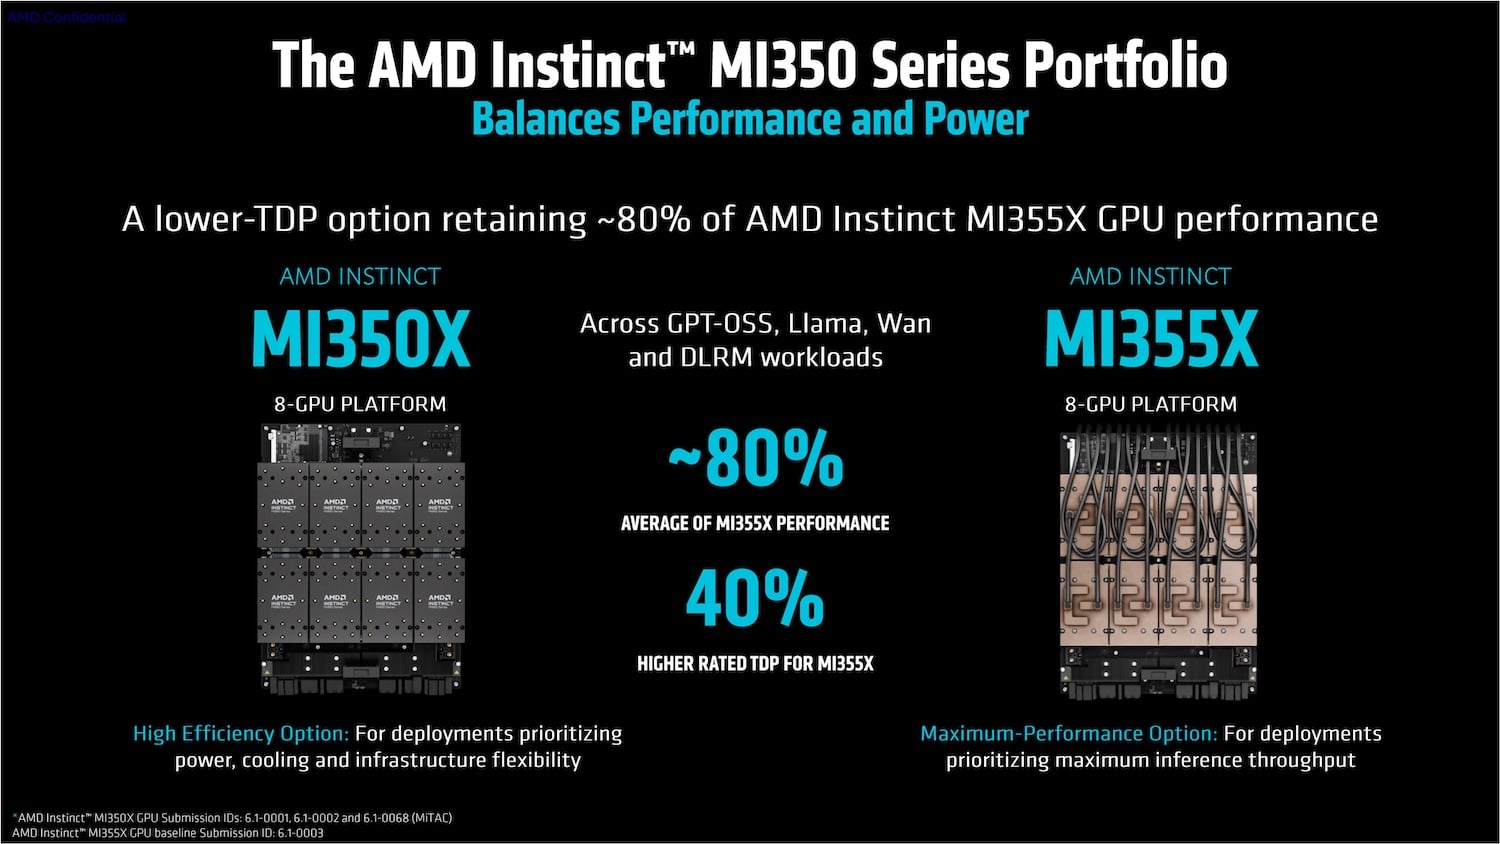
Lors de son premier test MLPerf, le MI350P à double emplacement a été soumis à cinq charges de travail fermées, affichant des résultats supérieurs à ceux des NVIDIA RTX PRO 6000 Server Edition et H200 NVL. Pour les déploiements sensibles à la consommation d'énergie et au refroidissement, un système MI350X à huit GPU a maintenu environ 80 % des performances de référence de la plateforme MI355X sur les charges de travail GPT-OSS, Llama, WAN et DLRM, malgré un TDP nominal supérieur de 40 % pour le MI355X. Une étude commandée par Signal65 a démontré que ces performances se traduisaient par un coût opérationnel par document inférieur et un rendement par dollar supérieur, tout en respectant les limites de latence.
Résultats des partenaires d'AMD et le cluster Corée-États-Unis
AMD affirme que les résultats comparables obtenus avec le MI355X par sept partenaires (Dell Technologies, Oracle, Hewlett Packard Enterprise, Supermicro, MangoBoost, Crusoe et MiTAC) se situent en moyenne à moins de 4 % de ceux de son système de référence, certains tests les égalant ou les dépassant légèrement.
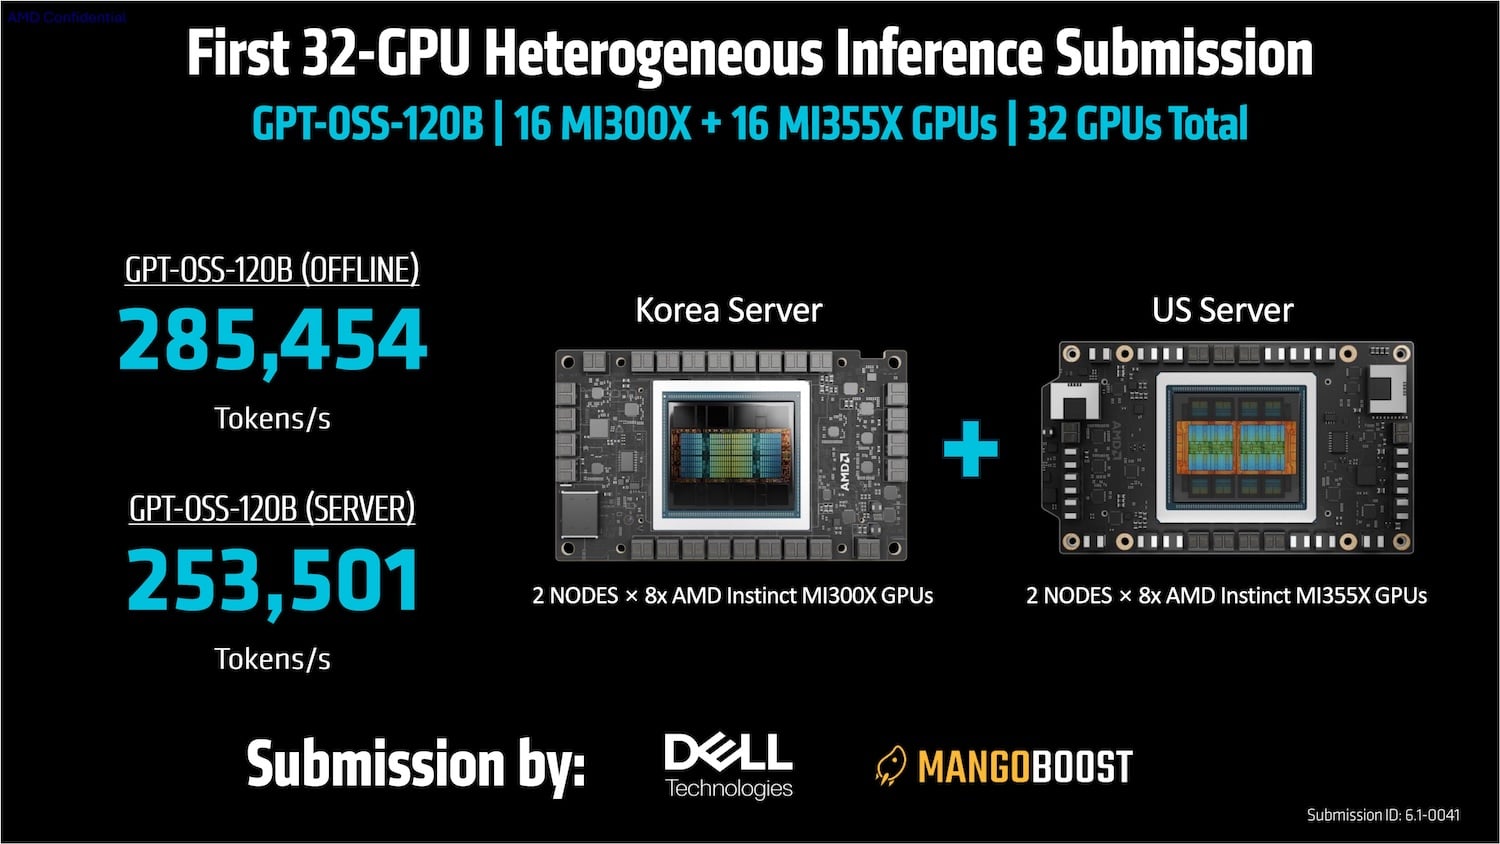
La configuration MangoBoost et Dell mentionnée ci-dessus est la première configuration de serveur hétérogène à 32 GPU de ce benchmark. Elle associe 16 GPU Instinct MI300X de génération précédente en Corée à 16 GPU Instinct MI355X aux États-Unis pour former un point de terminaison GPT-OSS-120B unifié. Cette configuration à cluster partagé a généré 285 454 jetons hors ligne par seconde et 253 501 jetons serveur par seconde. Les tests ont été effectués sur ROCm 7. AMD recommande la sortie de ROCm 10 , avec les outils de profilage vLLM, SGLang et ROCm.AI, comme solution d'avenir, en attendant la série MI400 basée sur HBM4 et la génération MI500 qui suivra.
Le système qui remplace l'inférence MLPerf dans le centre de données
Seize des trente participants ont utilisé la plateforme MLPerf centrée sur les API lors de cette session, contre un seul participant de la division ouverte lors de la version 6.0. Cette plateforme exécute une véritable architecture client/serveur via des API standard sur un point de terminaison hébergé, ce qui correspond au déploiement de l'inférence en centre de données. Elle intègre déjà le nouveau test Edge Agentic, VLM-Interactive, gpt-oss, DeepSeek-R1, Llama 3.1-8B et la conversion de texte en vidéo. Elle constitue la base de MLPerf Endpoints, qui ouvrira les soumissions continues à la demande en octobre 2026 et remplacera MLPerf Inference comme benchmark pour les centres de données en 2027. La version 1.0 d'Endpoints prévoit des résultats normalisés et des charges de travail agentic étendues.
« À l'avenir, MLPerf Endpoints remplacera Inference dans notre gamme de benchmarks pour datacenters, et l'adoption rapide de notre plateforme axée sur les API facilitera grandement cette transition », a déclaré David Kanter, responsable de MLPerf. Les six nouveaux participants à cette session sont Atlas Inference, Crusoe, Orrick Industries, ScitiX, VibeHPC et Naeem Khoshnevis, contributeur individuel du Kempner Institute de Harvard, qui a soumis un résultat unique pour le benchmark H200 Llama 3.1-8B.
Ce cycle d'inférence fait suite aux résultats de MLPerf Storage v3.0 publiés il y a deux semaines, et les tableaux complets des centres de données et des périphériques, ainsi que les suppléments des soumissionnaires, sont disponibles sur les pages de résultats de MLCommons.


 Amazon