

NVIDIA a intégré CUDA-Q Logical à sa plateforme open source CUDA-Q, une couche d'orchestration pour le développement d'applications s'exécutant sur des ordinateurs quantiques tolérants aux pannes. Cette intégration s'accompagne de deux résultats intéressants. Fermilab indique que l'outil a permis de réduire le cycle de conception d'un algorithme tolérant aux pannes de cinq mois à trois semaines. Iceberg Quantum l'a utilisé pour démontrer que le matériel à qubits de spin de Diraq peut atteindre 1 000 qubits logiques avec 150 000 qubits physiques, soit environ dix fois moins que l'estimation précédente de Diraq. Ces deux résultats, publiés en avant-première par les laboratoires et les fournisseurs impliqués, constituent les premières données concrètes pour un outil destiné à la prochaine étape de l'informatique quantique, où les qubits logiques corrigés d'erreurs remplaceront les qubits physiques.
Pourquoi la conception conjointe constitue un goulot d'étranglement
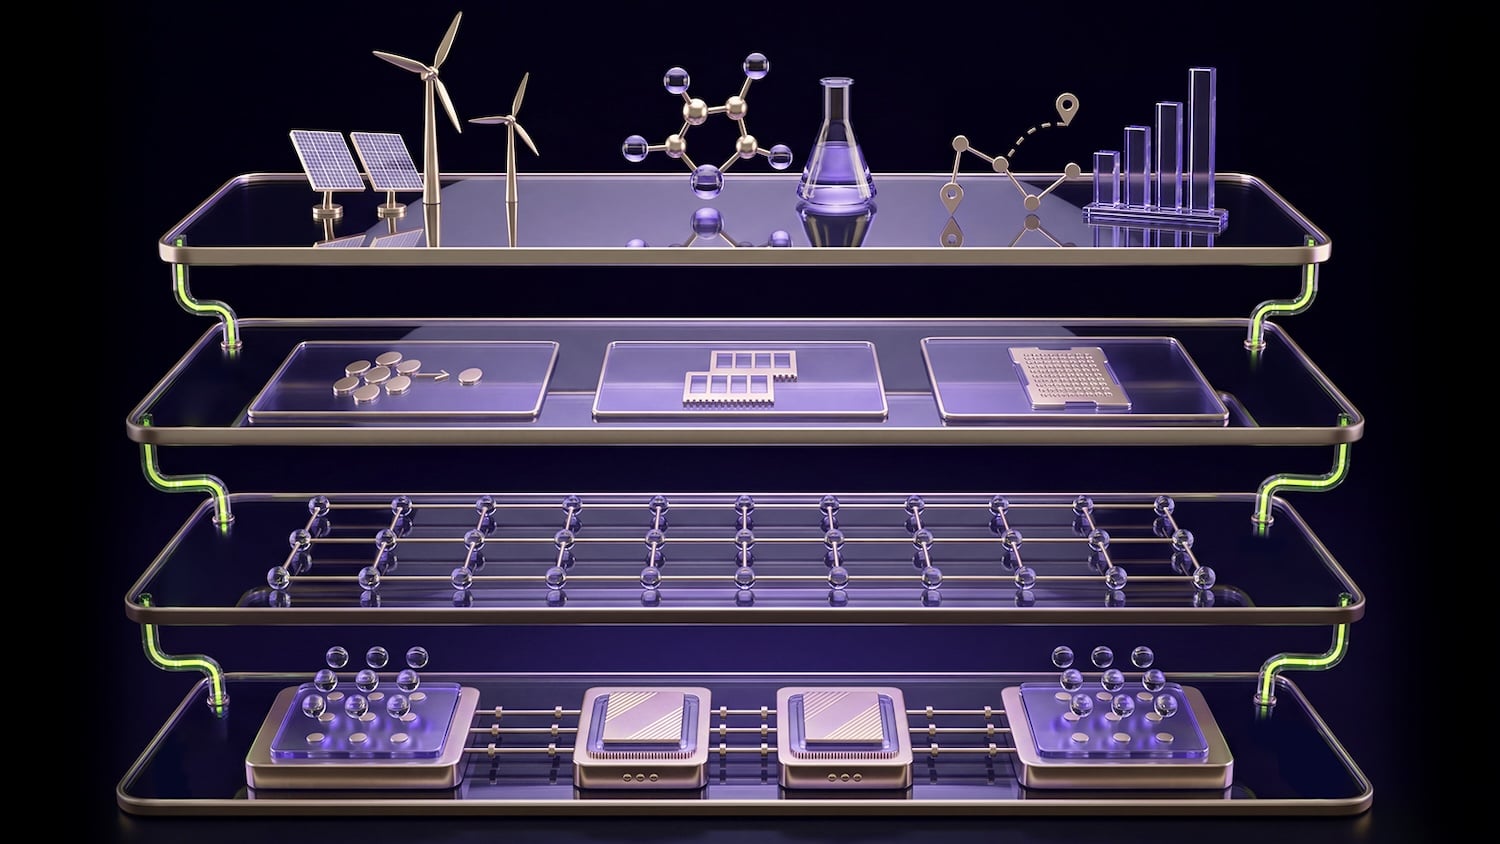
Les processeurs tolérants aux pannes, basés sur des qubits logiques, rendent possible l'informatique quantique utile car ils surmontent les erreurs inhérentes aux qubits physiques et peuvent exécuter les calculs complexes nécessaires à la découverte de médicaments, à la modélisation financière et à la science des matériaux. Concevoir une application pour un tel système implique de gérer simultanément l'algorithme, le code de correction d'erreurs, l'architecture matérielle et le reste du processeur quantique. NVIDIA indique que la modification de l'un de ces éléments peut impacter les ressources nécessaires à l'application. CUDA-Q Logical permet aux chercheurs de décrire tous ces composants simultanément et de tester différentes configurations afin de trouver celle qui offre les meilleures performances avec les qubits logiques.
« L’informatique quantique entre dans l’ère des qubits logiques, et les chercheurs ont besoin d’une plateforme ouverte et personnalisable capable de représenter tous les aspects d’un système tolérant aux pannes », a déclaré Timothy Costa, vice-président et directeur général de la division quantique chez NVIDIA. NVIDIA cite le Fermi National Accelerator Laboratory, Infleqtion, IQM Quantum Computers, QCDesign, Quantum Motion et les Sandia National Laboratories parmi les fabricants et laboratoires d’unités quantiques qui l’utilisent déjà.
Iceberg transpose son architecture qLDPC sur les qubits de spin de Diraq
Le résultat le plus marquant provient d'Iceberg Quantum, qui a utilisé CUDA-Q Logical pour modéliser son architecture de correction d'erreurs Pinnacle sur le matériel à qubits de spin en silicium de Diraq. Pinnacle est un code de contrôle de parité à faible densité quantique (qLDPC), une famille de codes qui promet une surcharge bien moindre que le code de surface, mais qui est généralement supposée nécessiter un matériel plus complexe. Selon le document de Diraq, la modélisation a démontré que Pinnacle peut fonctionner sur son matériel sans exiger beaucoup plus de la plateforme qu'une approche basée sur le code de surface. La connectivité non locale est confinée aux blocs de traitement modulaires et les calendriers de transfert des qubits sont optimisés de sorte que ce transfert ne contribue pas davantage au budget d'erreurs que les portes logiques physiques. Le nombre de qubits physiques, calculé en tenant compte du matériel, correspond à moins de 5 % des chiffres de l'article original sur Pinnacle. C'est ainsi que les deux entreprises arrivent à 1 000 qubits logiques à partir de 150 000 qubits physiques, chiffre que Diraq présente désormais dans son livre blanc « The Case for Silicon » et qui est environ dix fois inférieur à son estimation précédente. Le PDG de Diraq, Andrew Dzurak, a parlé d'une augmentation d'un ordre de grandeur des performances logiques projetées de chaque appareil.
Fermilab réduit son temps de développement de cinq mois à trois semaines
Fermilab a utilisé CUDA-Q Logical lors de ses premiers travaux afin de valider des résultats antérieurs et d'évaluer les exigences physiques en qubits, les temps d'exécution et autres ressources pour différentes approches de correction d'erreurs et différents matériels. Le laboratoire affirme que cela a permis de transformer la conception de systèmes tolérants aux pannes en un flux de travail informatique reproductible et vérifiable, et de réduire le développement des algorithmes de cinq mois à trois semaines, soit une accélération de 7 fois. « Grâce à CUDA-Q Logical, notre équipe a exploré différentes combinaisons de ressources en seulement trois semaines, contre environ cinq mois habituellement nécessaires pour la mise en place d'une infrastructure spécialisée », a déclaré Anna Grassellino, directrice technique de Fermilab et directrice du Centre des matériaux et systèmes quantiques supraconducteurs.
Le benchmark QUOPS de Sandia est disponible en CUDA-Q.
En plus de la couche d'orchestration, NVIDIA fournit une implémentation de référence de QUOPS, un benchmark multiplateforme et indépendant du matériel, développé par les Laboratoires nationaux Sandia, qui mesure les progrès vers une informatique quantique tolérante aux pannes et à grande échelle. Le domaine s'est principalement évalué à l'aide de métriques physiques de qubits telles que le nombre de qubits, la fidélité des portes et le temps de cohérence ; QUOPS vise à évaluer la capacité d'un système à exécuter des charges de travail utiles. Sandia a publié une prépublication avant l'IEEE Quantum Week, présentant les premiers résultats QUOPS pour les QPU de Google, IBM et Quantinuum. « Nous avons créé QUOPS précisément dans ce but, et nous sommes ravis de voir son utilisation par les fournisseurs et les clients du secteur de l'informatique quantique », a déclaré Timothy Proctor, codirecteur du Laboratoire de performance quantique de Sandia, faisant référence à la nécessité de suivre et de prévoir la croissance des capacités des ordinateurs quantiques.
Le reste de la pile GPU quantique
Cette même annonce fait le point sur l'adoption des technologies quantiques par NVIDIA. Diraq a utilisé NVIDIA Ising, que NVIDIA présente comme la première famille de modèles ouverts pour la conception et le déploiement d'IA au service du calcul quantique, afin de calibrer son processeur à qubits de silicium. Anyon Computing, Quandela et Quantum Machines se sont appuyés sur NVQLink, l'architecture ouverte de NVIDIA permettant de coupler des QPU à des supercalculateurs GPU. Quantum Machines a d'ailleurs réalisé une démonstration d'intégration au Centre israélien de calcul quantique. IonQ a fait état de progrès concernant DQAOA-GPT, un framework d'IA générative quantique ; MITRE a publié des travaux sur les jumeaux numériques de capteurs quantiques accélérés par GPU ; Phasecraft utilise cuQuantum pour construire ce qu'elle décrit comme la plus grande base de données moléculaires émulées générée par un solveur de valeurs propres quantiques variationnel ; enfin, UCLA et Caltech travaillent sur les séquences de contrôle nécessaires à l'exécution d'applications quantiques.
Ce calendrier place la couche logicielle de NVIDIA au même niveau que les feuilles de route matérielles que nous suivons, notamment la stratégie d'IBM pour une machine tolérante aux pannes en 2029 et le Nighthawk r2 à 120 qubits présenté au CSCS . CUDA-Q Logical est disponible dès maintenant sur GitHub , et l'implémentation de référence QUOPS est fournie avec CUDA-Q ; le dépôt de benchmarks de Sandia est publié séparément.


 Amazon