

Les hyperscalers et les opérateurs d'infrastructures spécialisés en IA développent de plus en plus d'accélérateurs d'IA et d'XPU propriétaires pour gérer les grands modèles de langage et les charges de travail de raisonnement complexes. Afin de relever les défis physiques, de mémoire et de réseau liés au déploiement à grande échelle de puces propriétaires, NVIDIA a détaillé son interconnexion NVLink Fusion et son architecture de mémoire personnalisée NVHBM . Cette solution unifiée est conçue pour assurer la compatibilité des puces personnalisées avec les plateformes réseau évolutives et les racks MGX existants de NVIDIA.
Le premier à adopter cette technologie est Annapurna Labs d'Amazon, dont les projets NVHBM ont été dévoilés en même temps que l' extension du partenariat AWS à 2 millions de GPU . Cette annonce présente l'architecture sous-jacente à ce partenariat et désigne Trainium4 comme la première génération Trainium compatible avec NVLink Fusion. NVIDIA met également en place une implémentation NVHBM standard disponible auprès de plusieurs fournisseurs de mémoire, ce qui, selon l'entreprise, simplifie l'intégration et la qualification de la mémoire entre les différents fournisseurs. « NVHBM représente une nouvelle approche architecturale pour améliorer les performances et l'efficacité de la mémoire à large bande passante », a déclaré Nafea Bshara, vice-président d'Annapurna Labs chez Amazon. « Nous sommes impatients de voir cette collaboration technologique profiter aux futures architectures d'infrastructure AWS. »
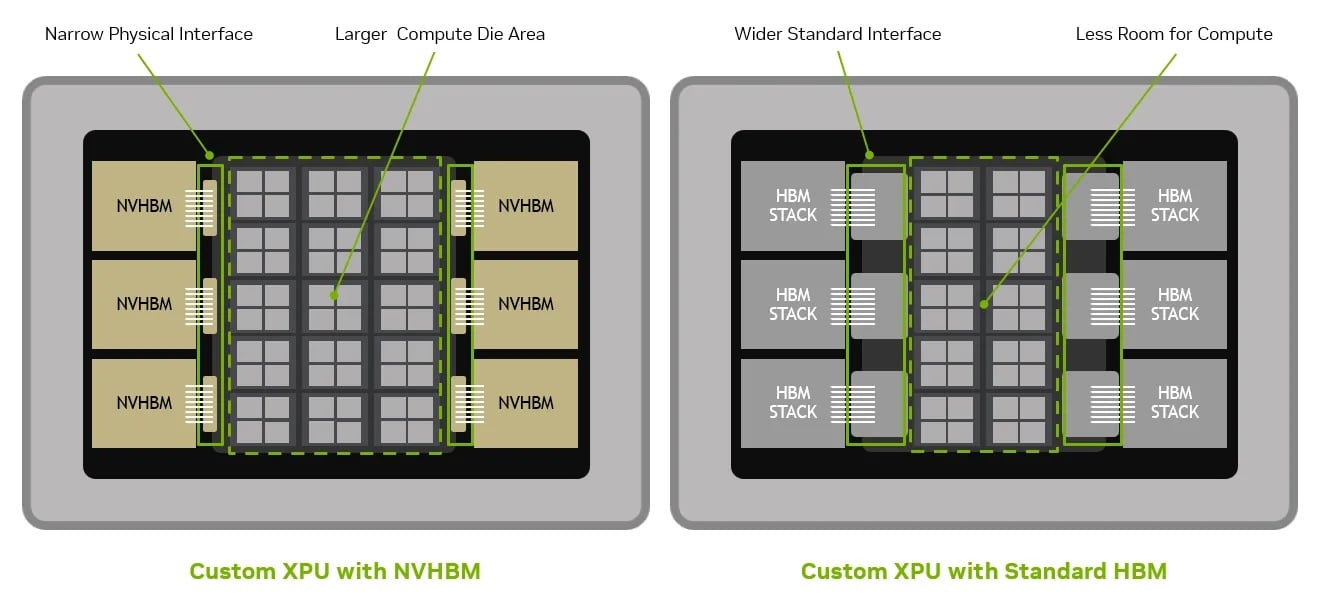
Le déploiement d'unités de traitement de calcul (XPU) personnalisées dans des centres de données haute densité exige un équilibre entre la logique de calcul, la distribution d'énergie, la dissipation thermique et la mémoire à large bande passante. L'intégration et la qualification de mémoires de pointe engendrent souvent d'importants goulots d'étranglement au niveau du packaging et du développement. Grâce à NVLink Fusion et NVHBM, les concepteurs peuvent exploiter des puces de base et des blocs IP d'interface pré-validés, ce qui réduit la complexité d'intégration et accélère la mise sur le marché.
Optimisation de la bande passante et de la latence de la mémoire
Les charges de travail modernes d'IA, notamment l'inférence de modèles complexes et les pipelines d'agents, exigent un débit mémoire élevé pour la lecture des poids, des activations et des entrées du cache clé-valeur (KV) des modèles. NVHBM propose une puce de base personnalisée, développée en collaboration avec les fabricants de mémoire, offrant une bande passante mémoire par pile jusqu'à 30 % supérieure à celle de la spécification standard JEDEC HBM4E.
| Fonctionnalité | Avantages NVHBM |
| Bande passante | Jusqu'à 30 % de bande passante mémoire supplémentaire par rapport à la mémoire HBM4e standard. |
| Région | Des interfaces plus efficaces permettent d'augmenter jusqu'à 25 % la surface de la puce de calcul pour des fonctionnalités XPU supplémentaires. |
| Tuning Moteur | Une consommation d'énergie HBM jusqu'à 15 % inférieure à celle de la HBM4e standard se traduit par des économies pour des milliers d'unités XPU. |
Tableau 1. La technologie NVHBM apporte trois principaux avantages au niveau de la plateforme aux programmes d'accélération de l'IA : une bande passante mémoire plus élevée, une surface de boîtier et de silicium plus importante et une consommation d'énergie HBM réduite.
Cette augmentation de la bande passante minimise la saturation du moteur de calcul lors des phases d'exécution gourmandes en mémoire. En accélérant les transferts de données entre les piles HBM et la logique de calcul embarquée, les accélérateurs peuvent maintenir une utilisation plus élevée et améliorer les taux de génération de jetons par utilisateur lors de charges de travail d'inférence denses.
Réallocation de la surface de la puce et optimisation de la couche physique
L'espace disponible sur les puces des accélérateurs modernes est strictement limité, ce qui oblige les concepteurs à optimiser l'espace entre les unités arithmétiques et logiques de calcul, les moteurs matriciels, la mémoire SRAM intégrée et les interfaces périphériques. Les architectures HBM standard nécessitent des interfaces physiques larges qui occupent une surface importante.
La technologie NVHBM résout ce problème en intégrant directement le contrôleur mémoire dans la pile HBM 3D et en utilisant une couche physique (PHY) personnalisée. Cette approche permet de réduire jusqu'à 67 % la surface occupée par la couche physique et les périphériques par rapport aux implémentations HBM4E standard, tout en simplifiant le routage des pistes de l'interposeur et en récupérant jusqu'à 80 % de silicium utilisable supplémentaire. L'interface mémoire plus étroite libère de l'espace dans le boîtier, permettant aux concepteurs d'étendre la puce de calcul IA centrale jusqu'à 30 % afin d'ajouter davantage de cœurs matriciels, d'unités vectorielles ou de hiérarchie de cache, le tout dans un format physique fixe.
Efficacité énergétique et marge de manœuvre à l'échelle de l'installation
La distribution de l'énergie reste l'une des contraintes les plus importantes dans l'exploitation des centres de données hyperscale, influant directement sur la conception thermique et les exigences de refroidissement des accélérateurs. La technologie NVHBM réduit la consommation d'énergie de la mémoire HBM de 15 % par rapport à la mémoire HBM4E standard.
Au niveau du silicium, la réduction de la consommation d'énergie de la mémoire diminue la pression thermique, offrant ainsi une marge de manœuvre électrique supplémentaire pour faire fonctionner les cœurs de calcul à des fréquences soutenues plus élevées. À l'échelle d'un centre de données, ces économies d'énergie sont considérables. Dans un centre de données théorique de 1 gigawatt utilisant des unités de calcul XPU de 2 000 watts, la réduction de la consommation d'énergie de la mémoire peut libérer suffisamment de capacité thermique et électrique pour prendre en charge jusqu'à 15 000 unités XPU supplémentaires.
Intégration à l'échelle du rack via NVLink Fusion
Tandis que NVHBM optimise les performances au niveau de chaque composant, NVLink Fusion assure la liaison au niveau système. Grâce à des chiplets NVLink Fusion dédiés, les XPU personnalisés peuvent se connecter directement à l' architecture NVLink de sixième génération , unifiant ainsi tous les accélérateurs d'un rack en un seul domaine de mémoire et de calcul cohérent.
Cette architecture évolutive est essentielle pour les schémas de parallélisation avancés tels que le parallélisme expert (EP) et WideEP, dans lesquels les modèles distribués de mélange d'experts nécessitent une synchronisation à faible latence des activations et des états cachés sur plusieurs dispositifs physiques. Des processeurs personnalisés peuvent également se connecter aux processeurs hôtes via NVLink-C2C.
En intégrant des puces semi-personnalisées dans l'écosystème matériel et logiciel NVIDIA plus vaste, NVLink Fusion permet aux opérateurs de déployer des environnements hétérogènes qui combinent des XPU personnalisées avec des GPU NVIDIA standard sous une architecture de rack MGX standardisée, simplifiant ainsi les opérations et la gestion des charges de travail.


 Amazon