

Dans une démonstration étonnante de prouesses informatiques, l'équipe du StorageReview Lab a établi un record mondial consécutif en calculant pi à un nombre incroyable de 202,112,290,000,000 105 XNUMX XNUMX XNUMX chiffres. Cette réalisation remarquable éclipse le précédent record de XNUMX XNUMX milliards de chiffres, également détenu par l'équipe. Il présente les capacités inégalées du calcul haute performance moderne et des plates-formes matérielles de base correctement conçues.
Un exploit informatique sans précédent
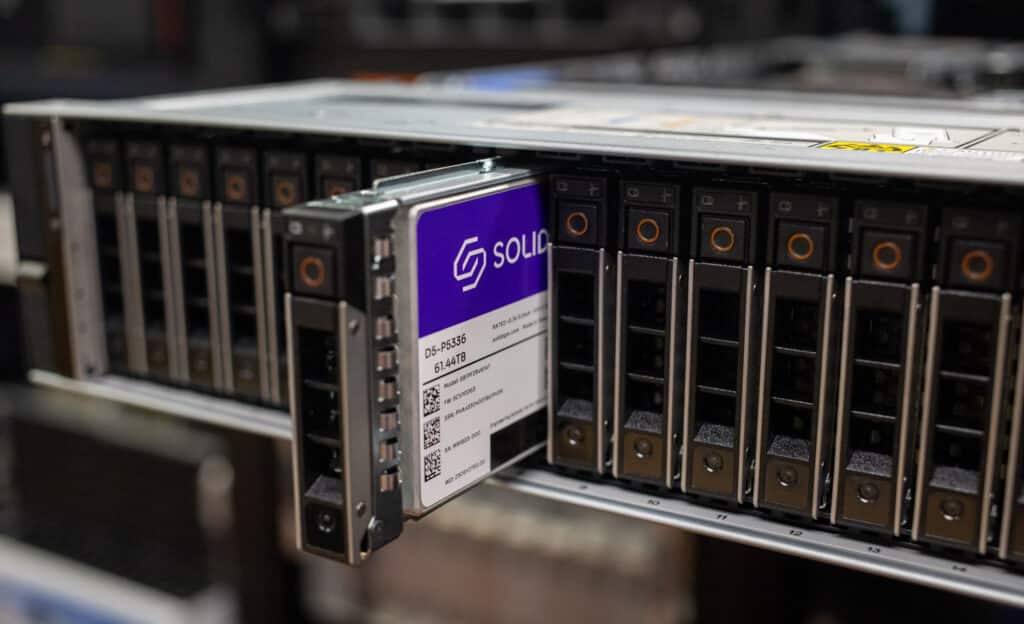
L'équipe du laboratoire StorageReview a utilisé une configuration de pointe pour réaliser cet exploit. Grâce à des processeurs Intel Xeon 8592+ et des SSD NVMe Solidigm P5336 de 61.44 To, elle a exécuté un calcul quasi continu pendant 85 jours, consommant près de 1.5 pétaoctet d'espace réparti sur 28 SSD Solidigm. Ce projet novateur témoigne de progrès considérables en matière de puissance de calcul et d'efficacité.
« Ce nouveau record met en évidence le potentiel extraordinaire de l'infrastructure informatique haute performance actuelle », a déclaré Jordan Ranous, l'architecte système de l'équipe StorageReview Lab. « En franchissant cette étape, nous établissons non seulement de nouvelles références en mathématiques computationnelles, mais ouvrons également la voie à de futures innovations dans diverses disciplines scientifiques et techniques. »
En mars 2024, l'équipe du laboratoire StorageReview a établi un record mondial en calculant pi avec 105 billions de décimales . Grâce à un système biprocesseur AMD EPYC doté de 256 cœurs et de près d'un pétaoctet de SSD Solidigm QLC, l'équipe a surmonté d'importants défis techniques, notamment les limitations de mémoire et de stockage. Cette performance remarquable a démontré les capacités du matériel moderne et a fourni des informations précieuses pour l'optimisation des systèmes de calcul haute performance.
« Non seulement les disques Solidigm et le serveur Dell PowerEdge R760 ont fonctionné à merveille ensemble, mais la quasi-absence d'intervention lors de cette nouvelle tentative de record a été un changement bienvenu après les difficultés rencontrées lors de notre précédente tentative », a déclaré Kevin O'Brien, directeur du laboratoire StorageReview. « Après les épreuves traversées lors du dernier test pour atteindre 105 000 milliards de chiffres, je suis ravi que nous ayons choisi cette plateforme pour ce record majeur », a-t-il ajouté. Pour plus de détails sur la précédente tentative d'établir un nouveau record à 105 000 milliards de chiffres et les défis rencontrés, vous pouvez consulter l'article complet ici.
Cours de CompSci et de mathématiques
Lorsque nous avons commencé à chercher des moyens amusants de tester des SSD de grande capacité, la réponse évidente se trouvait dans nos critiques de processeurs et de systèmes : y-cruncher. Lorsque vous utilisez de l'espace de swap pour des calculs approfondis, l'espace requis est d'environ 4.7 : 1 sur les chiffres, donc 100 470 milliards de chiffres nécessitent environ XNUMX TiB d'espace. Sans entrer dans les détails des mathématiques et de l'informatique, y-cruncher, l'algorithme de Chudnovsky, est basé sur une série à convergence rapide dérivée de la théorie des fonctions modulaires et des courbes elliptiques. Le cœur de l’algorithme repose sur les séries infinies suivantes :
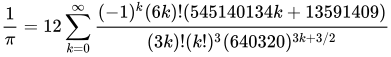
La question numéro un que nous avons reçue concernant nos calculs 100T et 105T était : « D'accord, ce n'est pas grave. Pourquoi cela prend-il autant de temps et nécessite-t-il autant de mémoire ? » Cette question faisait partie d'autres préoccupations ennuyeuses concernant l'open source et les capacités de programmation d'Alex Yee. Prenons du recul et regardons cela du point de vue du système.
Le calcul d’un nombre important de chiffres de Pi, tel que 100 4 milliards, nécessite un espace considérable en raison des opérations arithmétiques importantes impliquées. Le défi réside principalement dans la multiplication de grands nombres, ce qui nécessite intrinsèquement une mémoire importante. Par exemple, les meilleurs algorithmes pour multiplier des nombres à N chiffres nécessitent environ XNUMXN octets de mémoire, dont la plupart servent d'espace de travail. Cette mémoire doit être accédée plusieurs fois pendant le calcul, transformant le processus en une tâche gourmande en E/S disque plutôt qu'en une tâche liée au processeur.
La formule de Chudnovsky, largement utilisée pour calculer de nombreux chiffres de Pi, nécessite des opérations arithmétiques approfondies. Ces opérations de multiplication, de division et de mise au carré sont souvent réduites à de grandes multiplications. Historiquement, les supercalculateurs utilisaient des algorithmes AGM qui, bien que plus lents, étaient plus faciles à mettre en œuvre et bénéficiaient de la force brute de nombreuses machines. Cependant, les progrès modernes ont déplacé le goulot d’étranglement de la puissance de calcul vers la vitesse d’accès à la mémoire.
Les unités logiques arithmétiques (ALU) et les unités à virgule flottante (FPU) du processeur gèrent ces grands nombres de multiplication de la même manière que la multiplication manuelle sur papier, en les divisant en opérations plus petites et gérables. Auparavant, les calculs Pi étaient liés au calcul, mais la puissance de calcul actuelle dépasse les vitesses d'accès à la mémoire, ce qui fait du stockage et de la fiabilité des facteurs critiques dans la définition des enregistrements Pi. Par exemple, peu de différence de performances a été observée entre notre machine Intel à 128 cœurs et un AMD Bergamo à 256 cœurs ; l'accent était mis sur l'efficacité des E/S disque.
Les SSD Solidigm jouent un rôle crucial dans ces calculs, non pas en raison de leur vitesse inhérente mais en raison de leur densité de stockage exceptionnelle. Les disques NVMe grand public peuvent stocker jusqu'à 4 To dans un petit volume, tandis que les SSD d'entreprise empilent ces puces pour une capacité encore plus grande. Bien que QLC NAND puisse être plus lent que d'autres types de mémoire flash, le parallélisme de ces SSD denses offre une bande passante globale plus élevée, ce qui les rend idéaux pour les calculs Pi à grande échelle.
SSD Solidigm QLC NVMe, au service de la folie
Bon, si vous êtes encore là, il suffit de savoir que lorsque les nombres à calculer sont trop grands pour tenir en mémoire, les ordinateurs doivent utiliser des algorithmes logiciels pour le calcul multiprécision. Ces algorithmes décomposent les grands nombres en segments plus petits et effectuent la division à l'aide de techniques spécifiques. C'est là qu'interviennent les SSD NVMe Solidigm P5336 de 61.44 To. y-cruncher prend ces segments, les accumule d'abord en mémoire système, puis les transfère dans un espace disque temporaire.
N'oubliez pas que nous avons besoin d'environ 4.7 : 1 pour l'échange, car chaque partie de cette formule effrayante doit être représentée par de très nombreux bits.
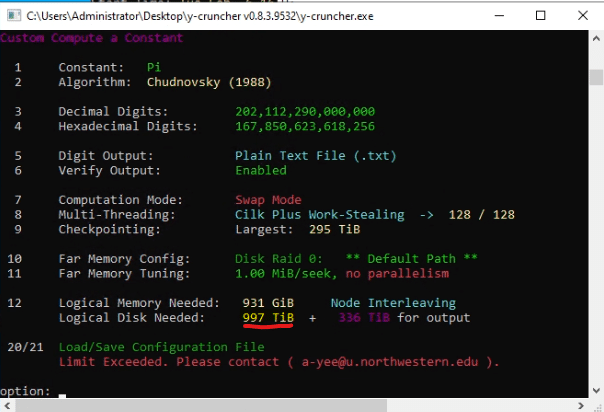
y-cruncher a un estimateur intégré pour la quantité d'espace disque nécessaire (toujours étiqueté disque*toux*) que nous avons trouvé parfaitement précis dans cette exécution et dans les exécutions précédentes.
Bien qu'il soit possible d'ajouter des disques durs ou du stockage objet, la capacité brute n'est qu'un élément d'une équation très complexe, comme nous l'avons constaté lors de notre premier test. La possibilité de disposer d'un stockage suffisamment grand et rapide à proximité du dispositif de calcul est un thème récurrent chez StorageReview ces derniers temps, avec l'essor de l'IA. Les performances de l'espace d'échange constituent le principal goulot d'étranglement dans ce calcul. Le NVMe à connexion directe offre les meilleures performances disponibles, et bien que certaines options puissent afficher le débit le plus rapide par périphérique, notre baie QLC, de grande taille et à très haute densité, s'est avérée largement à la hauteur.
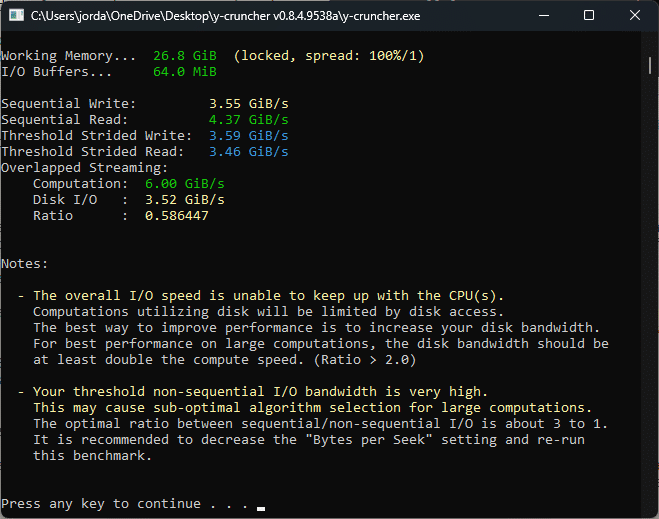
Performances du disque grand public et du processeur. PAS le système d'enregistrement
y-cruncher intègre un outil d'analyse comparative qui vous permet d'explorer tous les paramètres et d'ajuster les réglages afin d'optimiser les performances de votre système de disques. C'est un point crucial. La capture d'écran ci-dessus montre que cet outil fournit des informations sur les performances de ce système grand public, notamment la vitesse de traitement du processeur et les performances du SSD.
Alex propose une documentation très complète , mais en résumé, après plusieurs semaines de tests, nous avons constaté que laisser y-cruncher interagir directement avec les disques est la meilleure solution. Nous avons testé des cibles réseau, des disques derrière une carte RAID SAS, des cartes RAID NVMe et des cibles iSCSI. Lorsque y-cruncher gère le matériel, les performances sont nettement supérieures. L'iSCSI semble également acceptable, mais nous ne l'avons testé que pour le fichier de sortie, qui peut utiliser « Direct IO » pour cette interaction. Le code RAID en mode swap est manifestement bien conçu, et nos tests ainsi que nos échanges avec le développeur nous permettent de déduire qu'il fonctionne avec les disques à un niveau bas.
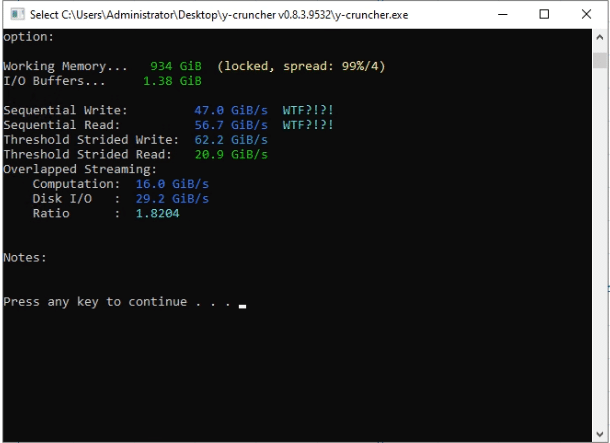
Les disques Solidigm de 61.44 To commencent à émerger comme la meilleure réponse à de nombreux problèmes dans ce domaine. En exécutant le benchmark sur notre système, nous constatons que les disques fonctionnent conformément aux spécifications en lecture et en écriture. Nous avons spécifiquement sélectionné les processeurs Intel pour qu'ils soient aussi proches du rapport disque/calcul optimal de 2:1. Il s'agit du ratio optimal, vous ne perdez donc pas de temps sur le processeur à attendre que les disques fonctionnent. À mesure que la technologie des disques devient plus rapide, nous pouvons effectuer des exécutions plus étendues et plus rapides en sélectionnant des processeurs à nombre de cœurs plus élevé.
Serveur Dell PowerEdge R760 « personnalisé »
Comme dit le proverbe, la troisième fois est un charme. Ce n'est pas notre premier rodéo à battre des records avec Pi ; nous avons tiré les leçons de nos deux premières itérations pour créer la meilleure plateforme Pi. Notre première version exploitait un serveur 2U avec 16 baies NVMe et trois traîneaux SSD internes. Avec des SSD Solidigm P30.72 de 5316 To, nous avons contenu le stockage d'échange pour y-cruncher, mais nous avons dû exploiter un serveur de stockage basé sur un disque dur pour le fichier de sortie. Ce n’était pas optimal, surtout à la fin de la phase de rédaction. Notre deuxième plate-forme utilisait le même serveur, avec un JBOF NVMe externe connecté, ce qui nous donnait une baie NVMe supplémentaire, mais au prix d'un câblage sensible et de performances déséquilibrées. L'inconvénient des deux plates-formes était de devoir s'appuyer sur du matériel externe tout au long du fonctionnement du y-cruncher, au prix d'une puissance supplémentaire et de points de défaillance supplémentaires.
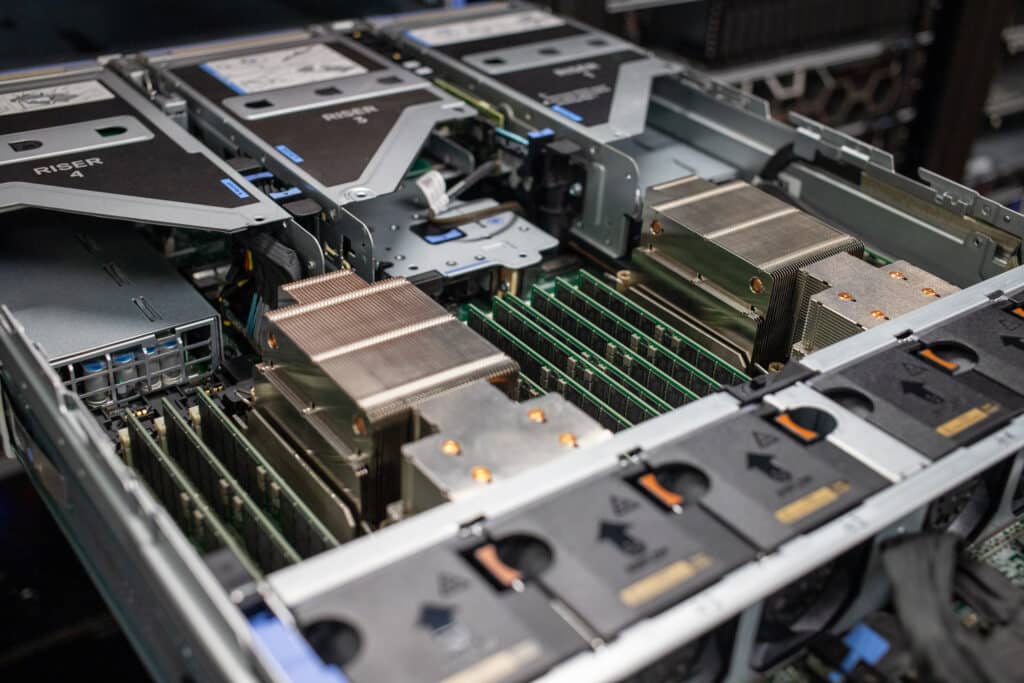
Pour cette exécution, nous voulions exploiter un seul serveur NVMe entièrement direct et disposer de suffisamment d'espace pour notre stockage d'échange et notre stockage de sortie y-cruncher sous un même toit en tôle. Entrez dans le Dell PowerEdge R760 avec le fond de panier de disques directs NVMe à 24 baies. Cette plate-forme exploite un commutateur PCIe interne pour que tous les disques NVMe communiquent simultanément avec le serveur, évitant ainsi tout besoin de matériel supplémentaire ou de périphériques RAID. Nous avons ensuite reconstitué une configuration de montage PCIe à partir de plusieurs R760 dans notre environnement de laboratoire, nous donnant quatre emplacements PCIe à l'arrière pour des SSD NVMe supplémentaires montés en U.2. Un avantage était de retirer des dissipateurs thermiques plus grands sur un autre R760, ce qui nous donnait autant de marge de turbo-boost que possible. Le refroidissement liquide direct est arrivé dans notre laboratoire un mois trop tard pour être mis en œuvre dans cette analyse.
« Le calcul de pi à plus de 202 billions de décimales réalisé par l'équipe du laboratoire StorageReview, grâce au processeur Intel Xeon de 5e génération, souligne la puissance et l'efficacité de ces processeurs. Tirant parti du nombre accru de cœurs et des fonctionnalités de performance avancées du processeur Xeon de 5e génération, cette performance remarquable établit une nouvelle référence en calcul mathématique et continue d'ouvrir la voie à des innovations dans divers domaines scientifiques et d'ingénierie », a déclaré Suzi Jewett, directrice générale des produits de processeurs Intel Xeon de 5e génération chez Intel.
Bien que vous puissiez techniquement commander une configuration Dell exactement comme celle utilisée dans cette exécution, ce n'était pas quelque chose qu'ils avaient sous la main et qui devait être reconstitué. (Peut-être que Michael exécutera un lot « Pi » de R760 en édition limitée avec cette configuration exacte, une peinture personnalisée et le logo SR.)
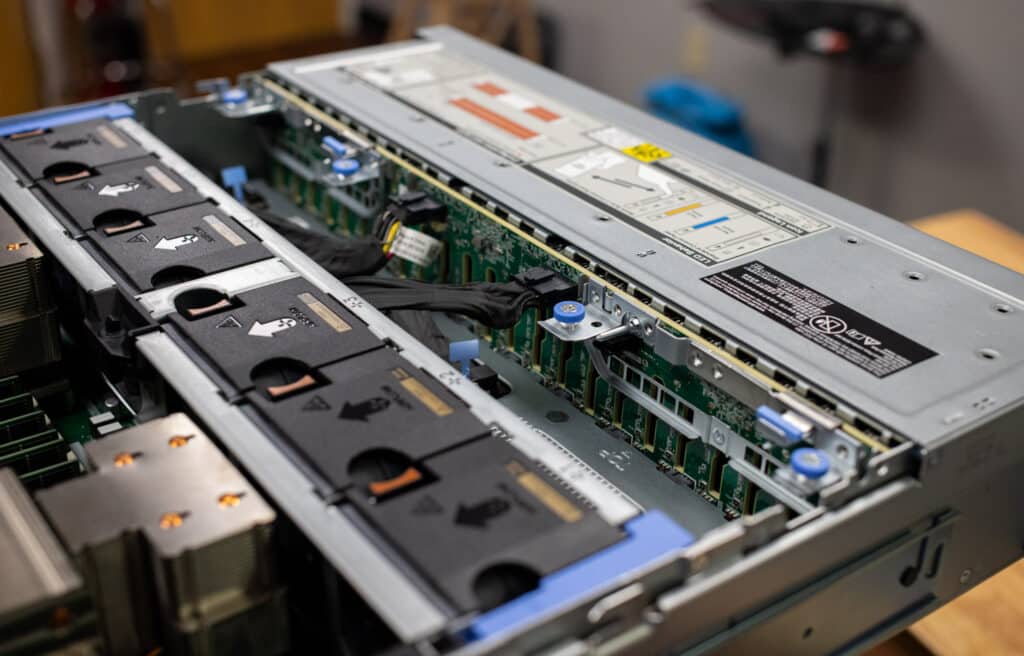
La taille de l’alimentation électrique était également essentielle pour cette exécution. Alors que la plupart penseraient immédiatement que les processeurs consomment la majeure partie de l’énergie, avoir 28 SSD NVMe sous un même toit représente un impact considérable sur la consommation d’énergie. Notre version exploitait les blocs d’alimentation de 2400 2800 W, qui, en fin de compte, fonctionnaient à peine. Nous avons eu quelques moments de consommation d'énergie à un niveau quasi critique où nous aurions été sous-alimentés si le système avait interrompu une connexion d'alimentation. Cela a frappé très tôt ; la consommation d'énergie est montée en flèche tandis que les charges du processeur atteignaient leur maximum et que le système augmentait l'activité d'E/S sur tous les SSD. Si c’était à refaire, les modèles XNUMXW auraient été privilégiés.
Spécifications de performance
Points forts techniques
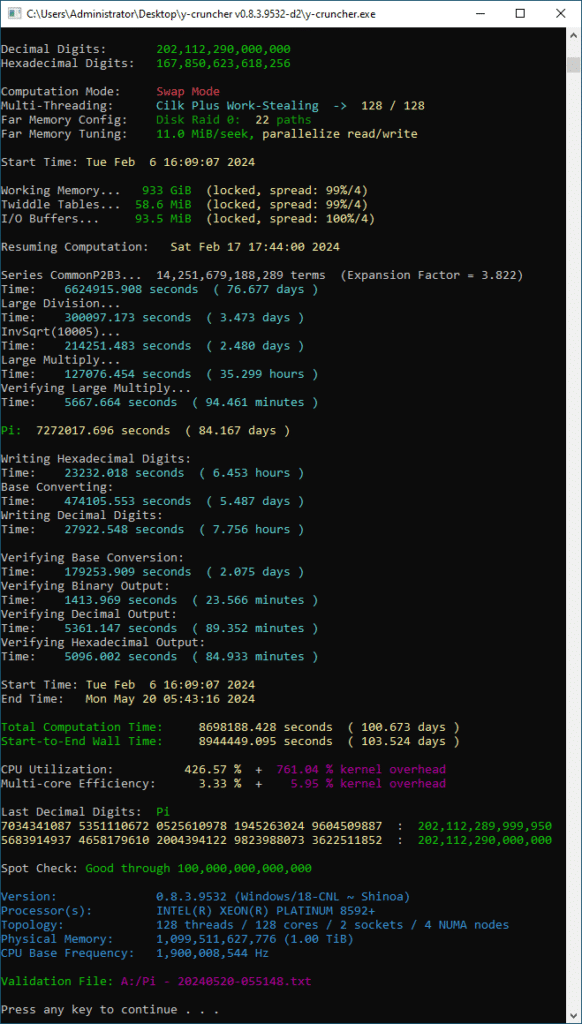
- Total des chiffres calculés: 202,112,290,000,000
- Matériel utilisé: Dell PowerEdge R760 avec 2 processeurs Intel Xeon 8592+, 1 To de DRAM DDR5, 28 x Solidigm 61.44 To P5336
- Logiciels et algorithmes: y-cruncher v0.8.3.9532-d2, Chudnovsky
- Stockage de données: 3.76 Po écrits par lecteur, 82.7 Po sur les 22 disques pour la matrice d'échange
- Durée du calcul: 100.673 jours
télémétrie y-cruncher
- Plus grand point de contrôle logique : 305,175,690,291,376 278 XNUMX XNUMX XNUMX (XNUMX Tio)
- Utilisation maximale du disque logique : 1,053,227,481,637,440 958 XNUMX XNUMX XNUMX (XNUMX Tio)
- Octets de disque logique lus : 102,614,191,450,271,272 91.1 XNUMX XNUMX XNUMX XNUMX (XNUMX PiB)
- Octets de disque logique écrits : 88,784,496,475,376,328 78.9 XNUMX XNUMX XNUMX XNUMX (XNUMX PiB)
- Date de début : mar. 6 février 16:09:07 2024
- Date de fin : lundi 20 mai 05:43:16 2024
- Pi : 7,272,017.696 84.167 XNUMX secondes, XNUMX jours
- Temps de calcul total : 8,698,188.428 100.673 XNUMX secondes, XNUMX jours
- Durée du mur du début à la fin : 8,944,449.095 103.524 XNUMX secondes, XNUMX jours
Le plus grand chiffre connu de Pi est 2, à la position 202,112,290,000,000 XNUMX XNUMX XNUMX XNUMX (deux cent deux mille milliards, cent douze milliards, deux cent quatre-vingt-dix millions).
Implications plus larges
Même si calculer pi avec un si grand nombre de chiffres peut sembler un défi abstrait, les applications pratiques et les techniques développées au cours de ce projet ont des implications considérables. Ces avancées peuvent améliorer diverses tâches informatiques, de la cryptographie aux simulations complexes en physique et en ingénierie.
Le récent calcul de pi à 202 1.720 milliards de chiffres met en évidence des progrès significatifs en matière de densité de stockage et de coût total de possession (TCO). Notre configuration a atteint un étonnant 2 2.4 pétaoctets de stockage SSD NVMe dans un seul châssis XNUMXU. Cette densité représente un bond en avant dans les capacités de stockage de données, en particulier si l'on considère que la consommation électrique totale a culminé à seulement XNUMX kW en pleine charge du processeur et du disque.
Cette efficacité énergétique contraste avec les performances d'enregistrement HPC traditionnelles qui consomment beaucoup plus d'énergie et génèrent une chaleur excessive. La consommation d'énergie augmente de façon exponentielle lorsque vous prenez en compte des nœuds supplémentaires pour les systèmes de stockage évolutifs si vous devez étendre le stockage partagé de faible capacité par rapport au stockage local haute densité. La gestion de la chaleur est essentielle, en particulier pour les petits centres de données et les armoires de serveurs. Le refroidissement des systèmes d'enregistrement HPC traditionnels n'est pas une mince affaire, car il nécessite des refroidisseurs de centre de données capables de consommer plus d'énergie que l'équipement fonctionnant seul. En minimisant la consommation d'énergie et la production de chaleur, notre configuration offre une solution plus durable et plus gérable pour les petites entreprises. En prime, la majeure partie de notre analyse a été réalisée avec un refroidissement à l'air frais.
Pour mettre cela en perspective, imaginez les défis auxquels sont confrontés ceux qui utilisent un stockage partagé en réseau et des plates-formes non optimisées. Ces configurations nécessiteraient un ou plusieurs refroidisseurs de centre de données pour contrôler les températures. Dans ces environnements, chaque watt économisé se traduit par moins de refroidissement requis et des coûts opérationnels réduits, ce qui fait de notre approche haute densité et faible consommation un choix idéal. Un autre avantage essentiel de l’exploitation d’une plate-forme simple et efficace pour une exécution record est la protection de l’ensemble de la configuration avec du matériel de batterie de secours. Comme mentionné précédemment, vous auriez besoin de batteries de secours pour les serveurs de calcul, la commutation, les serveurs de stockage, les refroidisseurs et les pompes à eau pour le maintenir en vie pendant une bonne partie de l'année.
Dans l’ensemble, cette réalisation record met en valeur le potentiel des technologies HPC actuelles et souligne l’importance de l’efficacité énergétique et de la gestion thermique dans les environnements informatiques modernes.
Assurer l’exactitude : la formule Bailey-Borwein-Plouffe
Calculer Pi à 202 XNUMX milliards de chiffres est une tâche monumentale, mais garantir l’exactitude de ces chiffres est tout aussi crucial. C’est là qu’intervient la formule Bailey-Borwein-Plouffe (BBP).
La formule BBP nous permet de vérifier les chiffres binaires de pi au format hexadécimal (base 16) sans avoir besoin de calculer tous les chiffres précédents. Ceci est particulièrement utile pour recouper des sections de notre calcul massif.
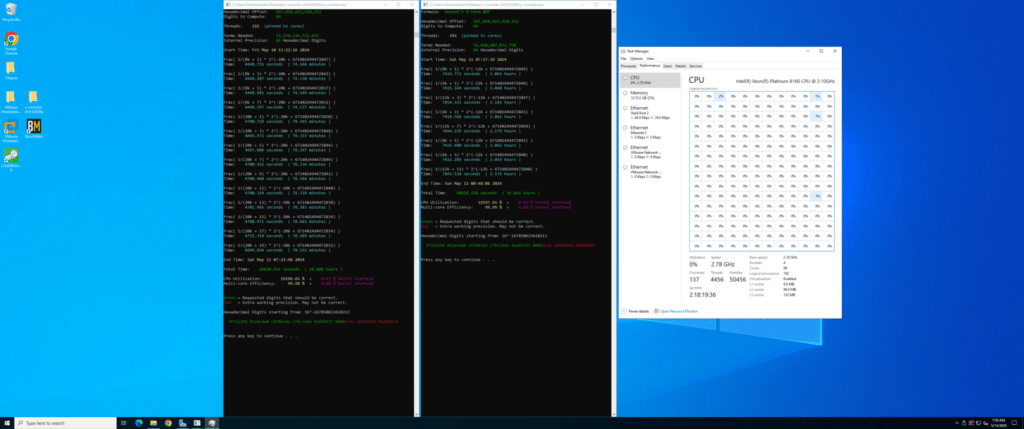
Deux des calculs de vérification.
Voici une explication simplifiée :
- Sortie hexadécimale: Nous générons d'abord les chiffres de pi en hexadécimal lors du calcul principal. La formule BBP peut calculer directement n’importe quel chiffre individuel arbitraire de pi en base 16. Vous pouvez le faire avec d'autres programmes comme GPUPI, mais y-cruncher a également une fonction intégrée. Si vous préférez une approche open source, les formules sont bien connues.
- Vérification croisée: Nous pouvons comparer ces résultats avec notre calcul principal en calculant indépendamment les positions spécifiques des chiffres hexadécimaux de pi avec la formule BBP. S’ils correspondent, cela indique fortement que toute notre séquence est correcte. Nous avons effectué cette vérification croisée plus de six fois ; en voici deux.
Par exemple, si notre calcul principal produit les mêmes chiffres hexadécimaux que ceux obtenus à partir de la formule BBP à différents points, nous pouvons affirmer en toute confiance l'exactitude de nos chiffres. Cette méthode n’est pas seulement théorique ; il a été pratiquement appliqué dans tous les calculs pi importants, garantissant la robustesse et la fiabilité des résultats.
R= Résultat officiel de l'exécution, V= Résultat de la vérification
- R: f3f7e2296 822ac6a8c9 7843dacfbc 1eeb4a5893 37088*
- V: *3f7e2296 822ac6a8c9 7843dacfbc 1eeb4a5893 370888
Les lecteurs attentifs remarqueront que les vérifications issues des captures d'écran et de la comparaison ci-dessus sont légèrement décalées (*). Bien que cela ne soit pas nécessaire, puisque la valeur hexadécimale serait affectée à la fin, nous avons également effectué quelques vérifications ponctuelles à d'autres emplacements (comme 100 billions et 105 billions de chiffres) afin de garantir la cohérence des résultats. S'il est théoriquement possible de calculer n'importe quel chiffre décimal de pi à l'aide d'une méthode similaire, il est difficile de savoir si cela permettrait d'obtenir une précision supérieure à 100 millions de chiffres, ni même si le calcul serait suffisamment efficace, plutôt que d'utiliser la méthode de Chudnovsky pour obtenir tous les chiffres. (Si Eric Weisstein voit ceci, qu'il me contacte ; j'aimerais bien essayer.)
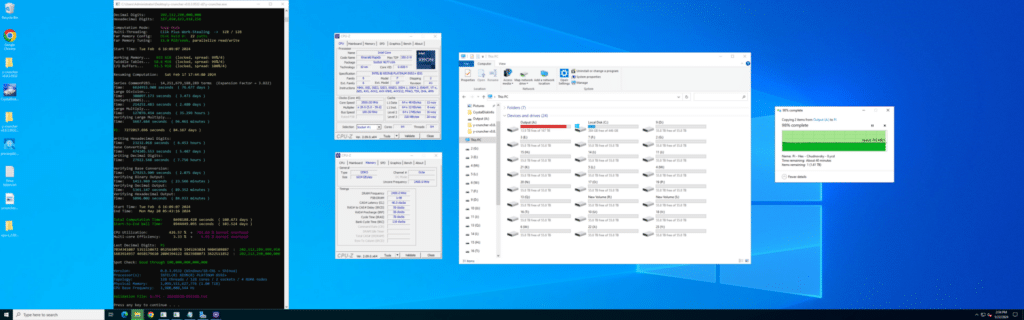
En intégrant ce processus de recoupement mathématique, nous pouvons garantir l’intégrité de notre calcul record de 202 XNUMX milliards de chiffres pi, démontrant ainsi notre précision informatique et notre engagement en faveur de l’exactitude scientifique.
La route à suivre
La réussite du calcul de pi à plus de 202 8592 milliards de chiffres par l'équipe du laboratoire StorageReview témoigne des progrès remarquables dans le domaine du calcul haute performance et de la technologie de stockage. Cet exploit record, utilisant les processeurs Intel Xeon 760+ dans nos SSD Dell PowerEdge R61.44 et Solidigm XNUMX To QLC NVMe, met en évidence les capacités du matériel moderne à gérer des tâches complexes et gourmandes en ressources avec une efficacité sans précédent. Le succès du projet met non seulement en valeur les prouesses de l'équipe StorageReview, mais souligne également le potentiel de l'infrastructure HPC actuelle à repousser les limites des mathématiques computationnelles et d'autres disciplines scientifiques.
« Ce nouveau record du monde de calcul de Pi est une performance remarquable, car la charge de calcul est aussi intense que nombre de charges de travail d'IA actuelles. Les SSD Solidigm D5-P5336 de 61.44 To ont une fois de plus démontré que la combinaison performante d'une capacité ultra-élevée, de performances de lecture PCIe 4 saturées et d'une capacité d'écriture de plusieurs pétaoctets permet de gérer et d'exploiter pleinement les applications les plus exigeantes d'aujourd'hui », a déclaré Greg Matson, vice-président du groupe Stockage pour centres de données de Solidigm. « Nous sommes ravis d'avoir pu contribuer à cette nouvelle tentative de record de calcul de Pi avec nos partenaires de Dell Technologies et les experts de StorageReview. »
Cet effort offre également des informations précieuses sur l’optimisation de la densité de stockage et de l’efficacité énergétique, ouvrant la voie à des solutions informatiques plus durables et plus faciles à gérer. Alors que nous continuons à explorer les possibilités du HPC, les leçons tirées de ce projet seront sans aucun doute le moteur des innovations futures, bénéficiant à divers domaines, de la cryptographie à l'ingénierie. La réussite de l'équipe du StorageReview Lab constitue un jalon dans l'histoire du calcul, démontrant que nous pouvons atteindre de nouveaux sommets en matière de découverte scientifique et de progrès technologique avec la bonne combinaison de matériel et d'expertise.
Remerciements
L'équipe du StorageReview Lab remercie Solidigm, Dell Technologies, Intel et y-cruncher Alex Yee pour leur soutien indéfectible et leurs contributions à ce projet.


 Amazon