

WhiteFiber commercialise désormais WhiteFiber Continuum, transformant ainsi le supercluster GPU à deux sites initialement présenté sous le nom de Projet Redwood en juillet en un produit déployable par les entreprises. WhiteFiber présente Continuum comme sa solution de réseau inter-centres de données la plus performante et la première architecture de supercluster GPU distribuée disponible sur le marché. Cette solution relie des centres de données géographiquement séparés en un seul supercluster GPU logique, et WhiteFiber affirme qu'elle élimine les contraintes de bande passante et de débit quant au déploiement des infrastructures d'IA.
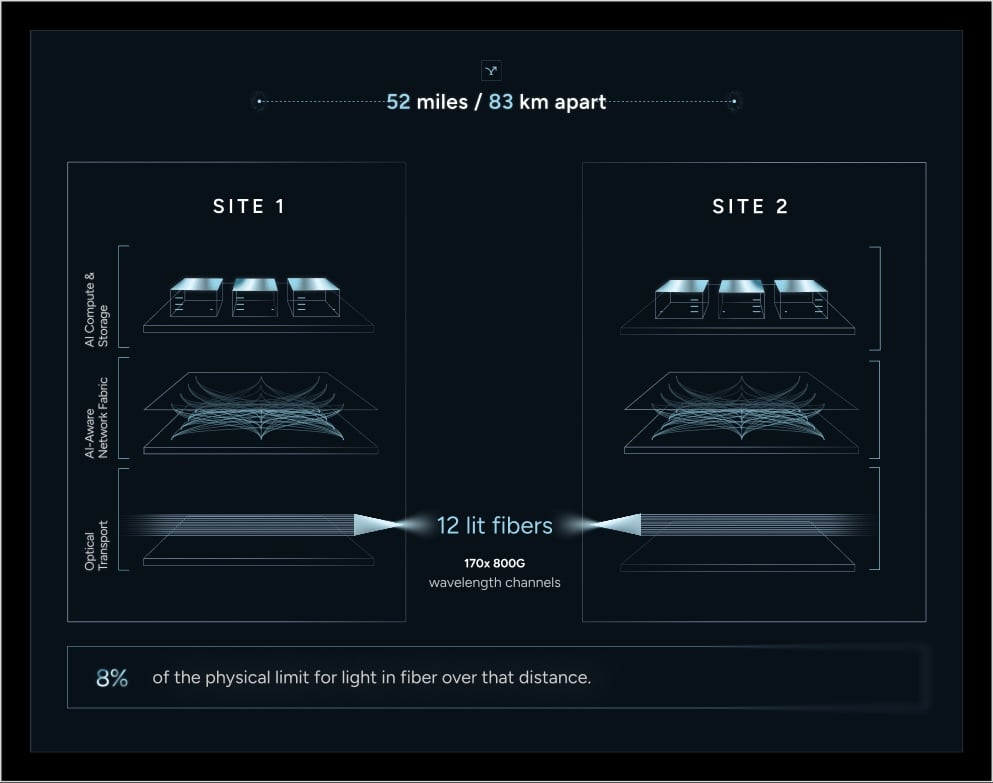
Continuum s'étend sur deux installations QTS certifiées HITRUST, distantes de 83 kilomètres et reliées par 12 brins de fibre noire Zayo. Le réseau est assuré par DriveNets AI Fabric, tandis que WEKA NeuralMesh fournit l'infrastructure de stockage et de mémoire pour l'ensemble du cluster. WhiteFiber annonce une bande passante agrégée de 136 Tbit/s, répartie sur 170 canaux de longueur d'onde 800G, avec une latence aller-retour garantie de 0.9 milliseconde, inférieure à 8 % de la limite physique de la lumière dans la fibre sur cette distance. Les résultats de R&D de juillet ont mesuré 111.2 Tbit/s sur une partie du spectre de la fibre. WhiteFiber indique que la conception atteindra 136 Tbit/s une fois les longueurs d'onde supplémentaires mises en service, et des tests sur l'ensemble du spectre sont en cours pour confirmer les spécifications commerciales garanties. L'entreprise a déposé des demandes de brevet pour la mise en œuvre sous-jacente.
« WhiteFiber Continuum est la solution d'infrastructure à un problème auquel le secteur est confronté depuis des années : la distance géographique qui limite les capacités d'un cluster », a déclaré Sam Tabar, PDG de WhiteFiber. « Nous la proposons aujourd'hui aux entreprises qui ont besoin d'une puissance de calcul IA performante à grande échelle, conforme aux exigences réglementaires et qui ne soit pas affectée par un problème sur un site. »
Infrastructure d'IA DriveNets sur une liaison de 83 km
DriveNets fournit l'infrastructure IA Ethernet reliant les deux sites, rôle qu'elle avait déjà tenu lors des travaux de R&D de juillet. « L'infrastructure IA Ethernet de DriveNets offre des performances optimales, même dans les environnements les plus exigeants, à large bande passante et faible latence. Elle garantit ainsi une circulation efficace des données au sein des superclusters, une utilisation maximale des GPU et une efficacité énergétique optimale », a déclaré Yossi Kikozashvili, vice-président Produit et responsable de la commercialisation de l'infrastructure IA chez DriveNets. La page produit de WhiteFiber indique que les deux sites acheminent du trafic en direct simultanément et que seuls les gradients des modèles transitent par la liaison inter-sites. Une tâche unique peut donc s'exécuter sur l'ensemble du cluster ou être divisée en charges de travail indépendantes réparties entre les sites en fonction de la demande.
WEKA NeuralMesh en tant que couche de données partagée
WEKA fournit l'infrastructure de stockage et de mémoire via NeuralMesh , offrant ainsi à Continuum une base unique de stockage et de mémoire répartie sur ses deux sites. Liran Zvibel, cofondateur et PDG de WEKA, a déclaré : « Un supercluster n'est unifié que si ses données le sont. » Il a ajouté : « NeuralMesh de WEKA fournit à Continuum une infrastructure de stockage et de mémoire unique et performante sur l'ensemble de ses sites, permettant ainsi aux GPU situés à plusieurs kilomètres de distance de fonctionner comme si les données étaient locales. »
Agrégation de puissance et contrôle des limites des données réglementaires
Continuum permet aux infrastructures télécoms et métropolitaines disposant de capacités de puissance et de fibre optique excédentaires de contribuer à un supercluster GPU logique unique. WhiteFiber présente cette solution comme un moyen de transformer les ressources inutilisées des opérateurs télécoms et métropolitains en capacité pour les charges de travail d'inférence et d'agents du dernier kilomètre. Les entreprises peuvent utiliser la même architecture pour mutualiser les GPU sur plusieurs sites et dépasser les limites de puissance et d'espace d'un campus unique, en ajoutant des capacités d'entraînement et d'inférence supplémentaires sans déployer de nouvelle infrastructure. Pour les secteurs réglementés, WhiteFiber affirme que Continuum maintient les charges de travail sensibles au sein de leur juridiction d'origine, tandis que le basculement et la mutualisation des calculs s'effectuent entre les sites. De plus, comme aucun site ne constitue un point de défaillance unique, la solution est conçue pour que les entraînements se poursuivent même en cas de panne d'un site.
WhiteFiber indique que des sites supplémentaires peuvent rejoindre le même cluster logique au fil du temps en utilisant la même approche de mise en réseau, et organise une présentation technique de l'architecture avec DriveNets et WEKA le 14 octobre.


 Amazon