

La mini-station de travail Acer Veriton GN100 AI fait partie des systèmes basés sur Spark que nous évaluons actuellement. Tous ces systèmes sont construits autour du superprocesseur NVIDIA GB10 Grace Blackwell. À l'instar des autres, la GN100 est conçue pour offrir une puissance de calcul IA de niveau centre de données dans un format de bureau compact, permettant ainsi aux développeurs et aux chercheurs d'exécuter et d'affiner leurs modèles localement, sans dépendre entièrement de l'infrastructure cloud.
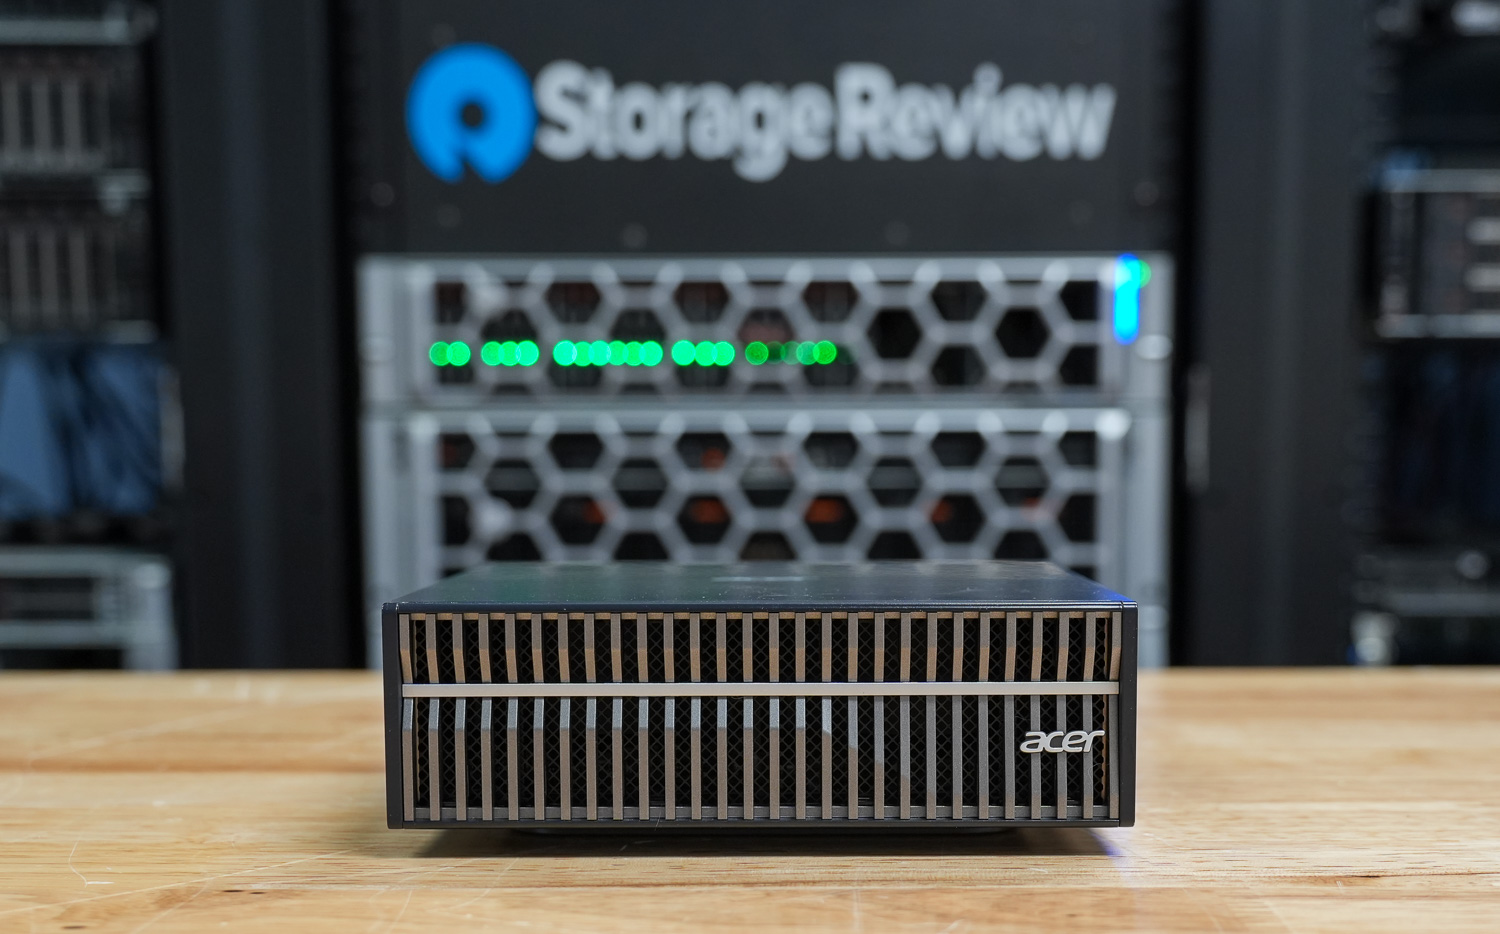
Dans cette configuration, le GN100 associe le processeur GB10 à 20 cœurs basé sur l'architecture Arm à une carte graphique intégrée Blackwell, offrant jusqu'à 1 pétaFLOPS de performances IA FP4. Il est équipé de 128 Go de mémoire unifiée LPDDR5x et d'un SSD NVMe PCIe Gen5 de 4 To, fournissant la bande passante mémoire et le débit de stockage nécessaires aux grands modèles de langage, aux flux de travail d'IA générative et aux expérimentations nécessitant le traitement de données volumineuses.
Comme les autres systèmes Spark de ce groupe, le GN100 prend en charge l'exécution locale d'IA tout en permettant l'extension système à système via la carte réseau intelligente NVIDIA ConnectX-7 intégrée. Deux unités peuvent être connectées pour prendre en charge des charges de travail de modèles plus importantes qu'avec un seul appareil.
Le système est livré avec le système d'exploitation NVIDIA DGX et la suite logicielle d'IA complète préinstallés, ce qui le rend prêt à être déployé immédiatement dans des environnements de développement et de recherche.
Spécifications de l'Acer Veriton GN100 AI
| Spécifications | Acer Veriton GN100 AI (GB10) |
|---|---|
| Dimensions et poids | |
| Hauteur | 2 " |
| Largeur | 5.9 " |
| Profondeur | 5.9 " |
| Poids | 2.65 kg |
| Processeur | |
| Type de processeur | NVIDIA GB10 (Grace Blackwell Superchip) (20 cœurs) |
| Graphiques intégrés | GPU NVIDIA Blackwell (intégré) |
| Mémoire | |
| Type de mémoire | LPDDR5x (mémoire système unifiée) |
| Configuration de la mémoire | 128 Go LPDDR5x, mémoire système unifiée |
| Bande passante mémoire | 273 Go/s (8533 MT/s) |
| Système d'exploitation | |
| Systèmes d'exploitation pris en charge | Système d'exploitation NVIDIA DGX |
| Ports et emplacements externes | |
| Ports réseau | Un port RJ45 (10GbE) Carte réseau NVIDIA ConnectX-7 (200G × 2 QSFP) |
| Ports USB | Trois ports USB 3.2 Gen 2×2 Type-C (20 Gbit/s) Un port USB 3.2 Gen 2×2 Type-C avec PD intégré |
| Port(s) vidéo | Un port HDMI 2.1a |
| Port de l'adaptateur secteur | USB Type-C (PD IN) |
| Emplacement de sécurité | Un verrou Kensington |
| Sans-fil | |
| WiFi | WiFi 7 (AW-EM637, 2×2) |
| Bluetooth | Bluetooth 5.4 |
| Stockage | |
| options de stockage | Jusqu'à 4 To SSD NVMe (PCIe Gen5) |
| Adaptateur secteur | |
| Type | Adaptateur externe 240 W (USB Type-C) |
Conception et développement de l'Acer Veriton GN100 AI
La face avant du Veriton GN100 est dominée par une rangée de lamelles verticales qui s'étend sur toute la largeur du châssis. Une ligne horizontale souligne la grille, lui conférant un aspect unique par rapport aux autres systèmes basés sur Spark que nous avons testés.
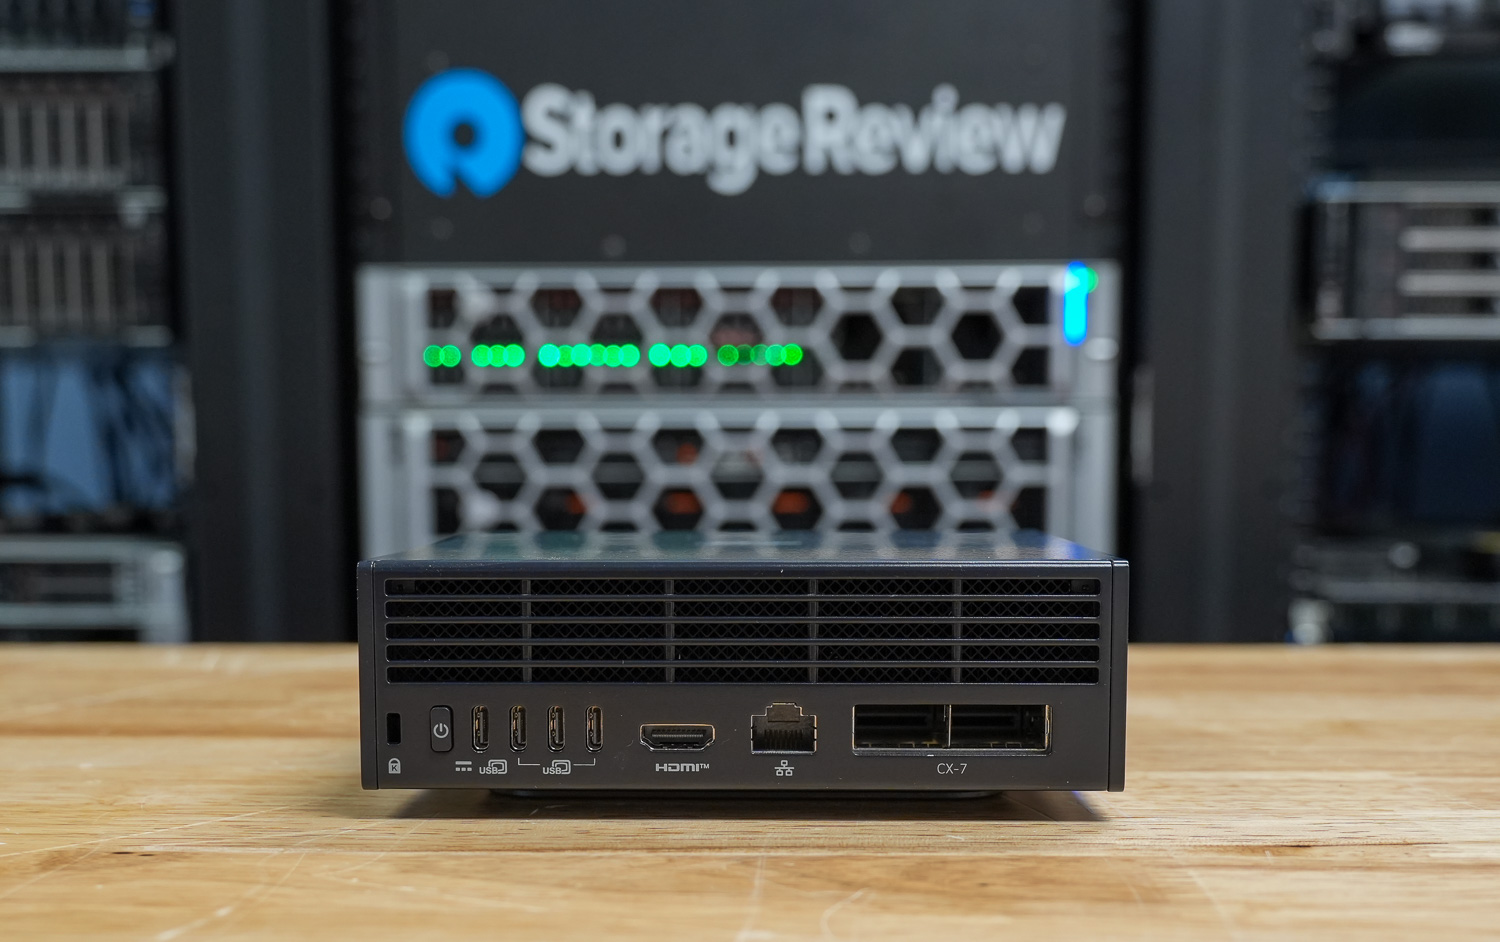
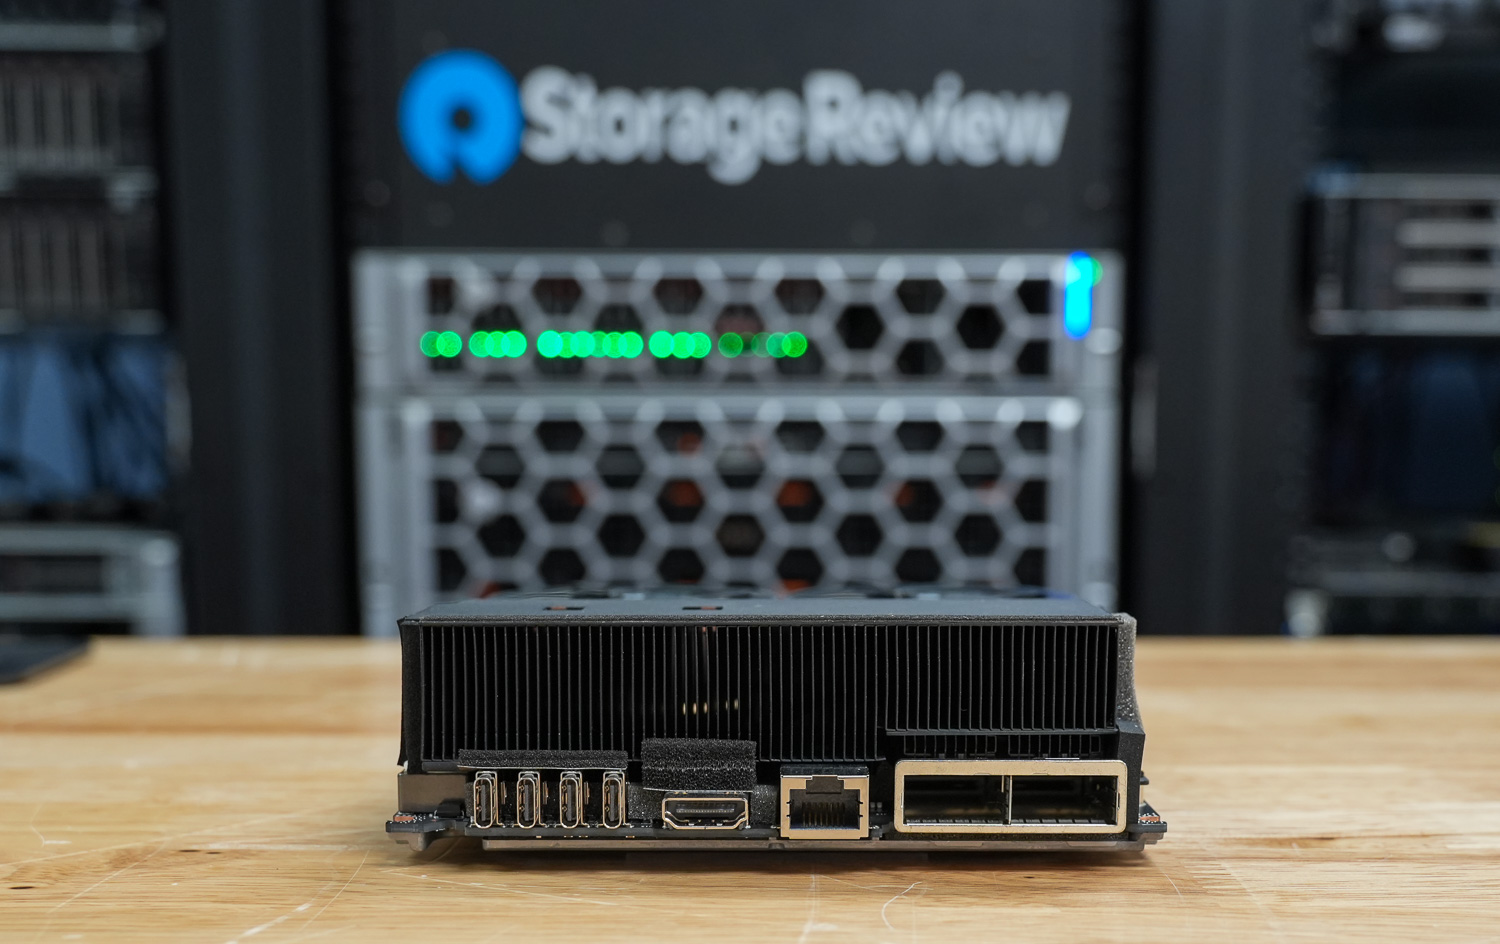
Tous les principaux connecteurs d'entrée/sortie sont situés à l'arrière du système. Acer propose quatre ports USB 3.2 Type-C, dont un compatible avec l'alimentation, ainsi qu'un port HDMI 2.1b pour la sortie vidéo. La connectivité réseau comprend un port Ethernet RJ-45 et une carte réseau intelligente NVIDIA ConnectX-7, permettant une connexion haut débit et la mise en réseau du système. La connectivité sans fil inclut le Wi-Fi 7 et le Bluetooth 5.1 ou version ultérieure. Un emplacement pour verrou Kensington est disponible pour la sécurité physique.
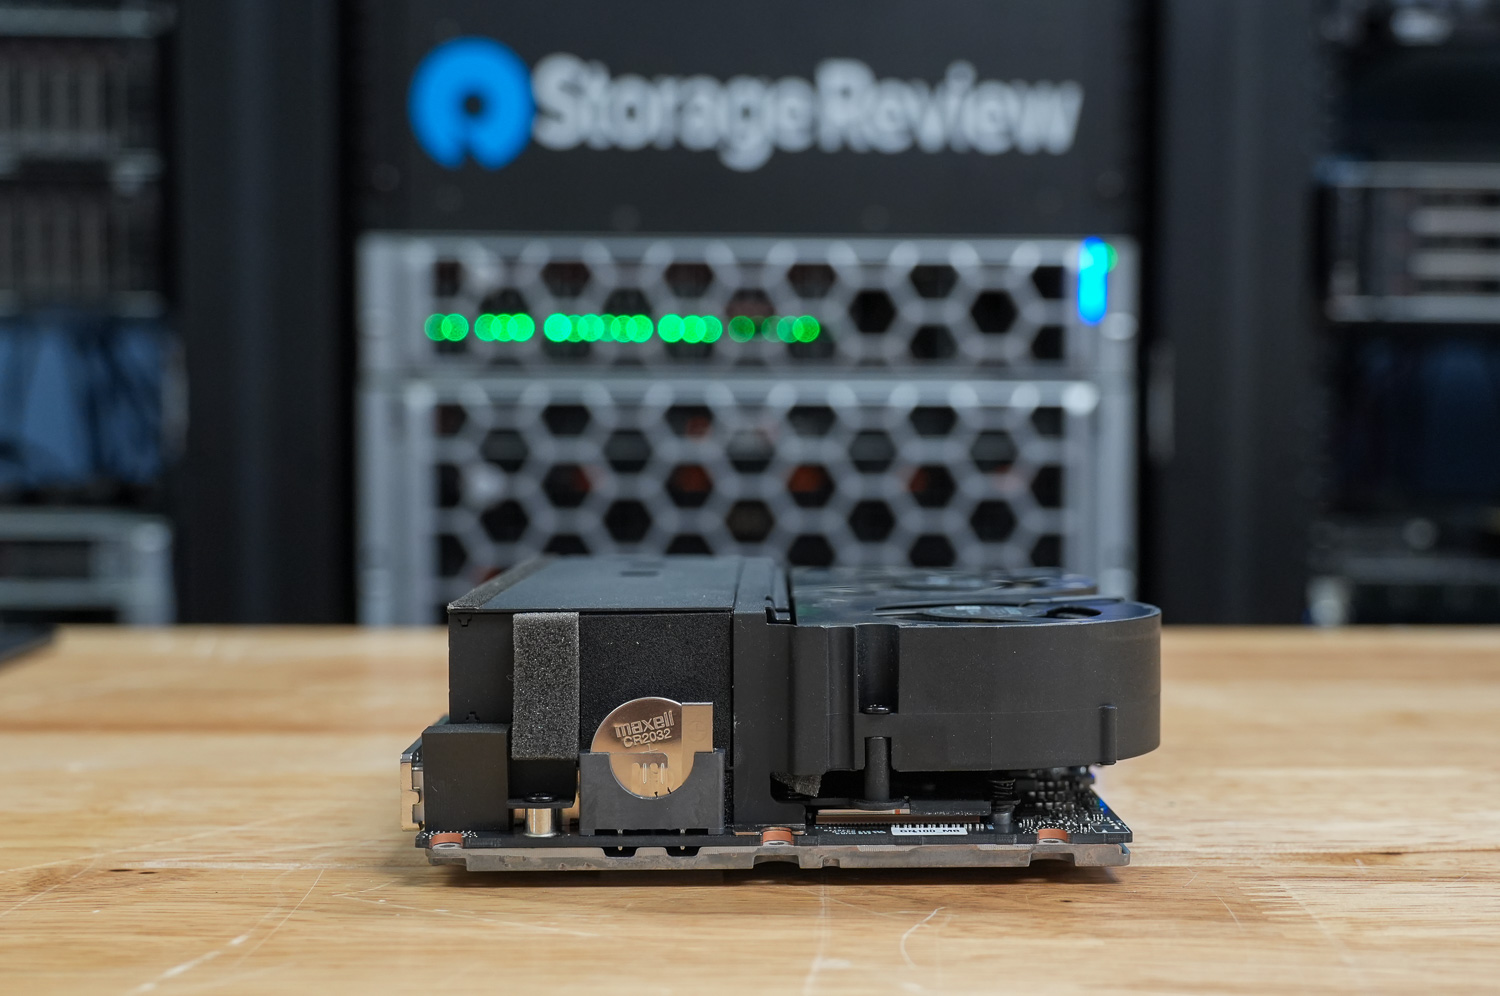
On peut voir ici le blindage métallique et la plaque structurelle qui recouvre l'intégralité du châssis, servant à la fois de cadre de renfort et de dissipateur thermique. En bas à gauche se trouve un emplacement SSD M.2 2242 NVMe facilement accessible, fixé par une seule vis et partiellement dissimulé sous la plaque métallique.
Pour accéder à la partie inférieure du boîtier Acer, retirez les vis périphériques afin de soulever proprement le panneau inférieur. Une fois à l'intérieur, l'agencement est simple et bien organisé, offrant une vue directe sur le système de refroidissement, l'espace de stockage et les composants de la carte mère. La plaque inférieure elle-même est robuste et contribue à la rigidité générale du châssis.
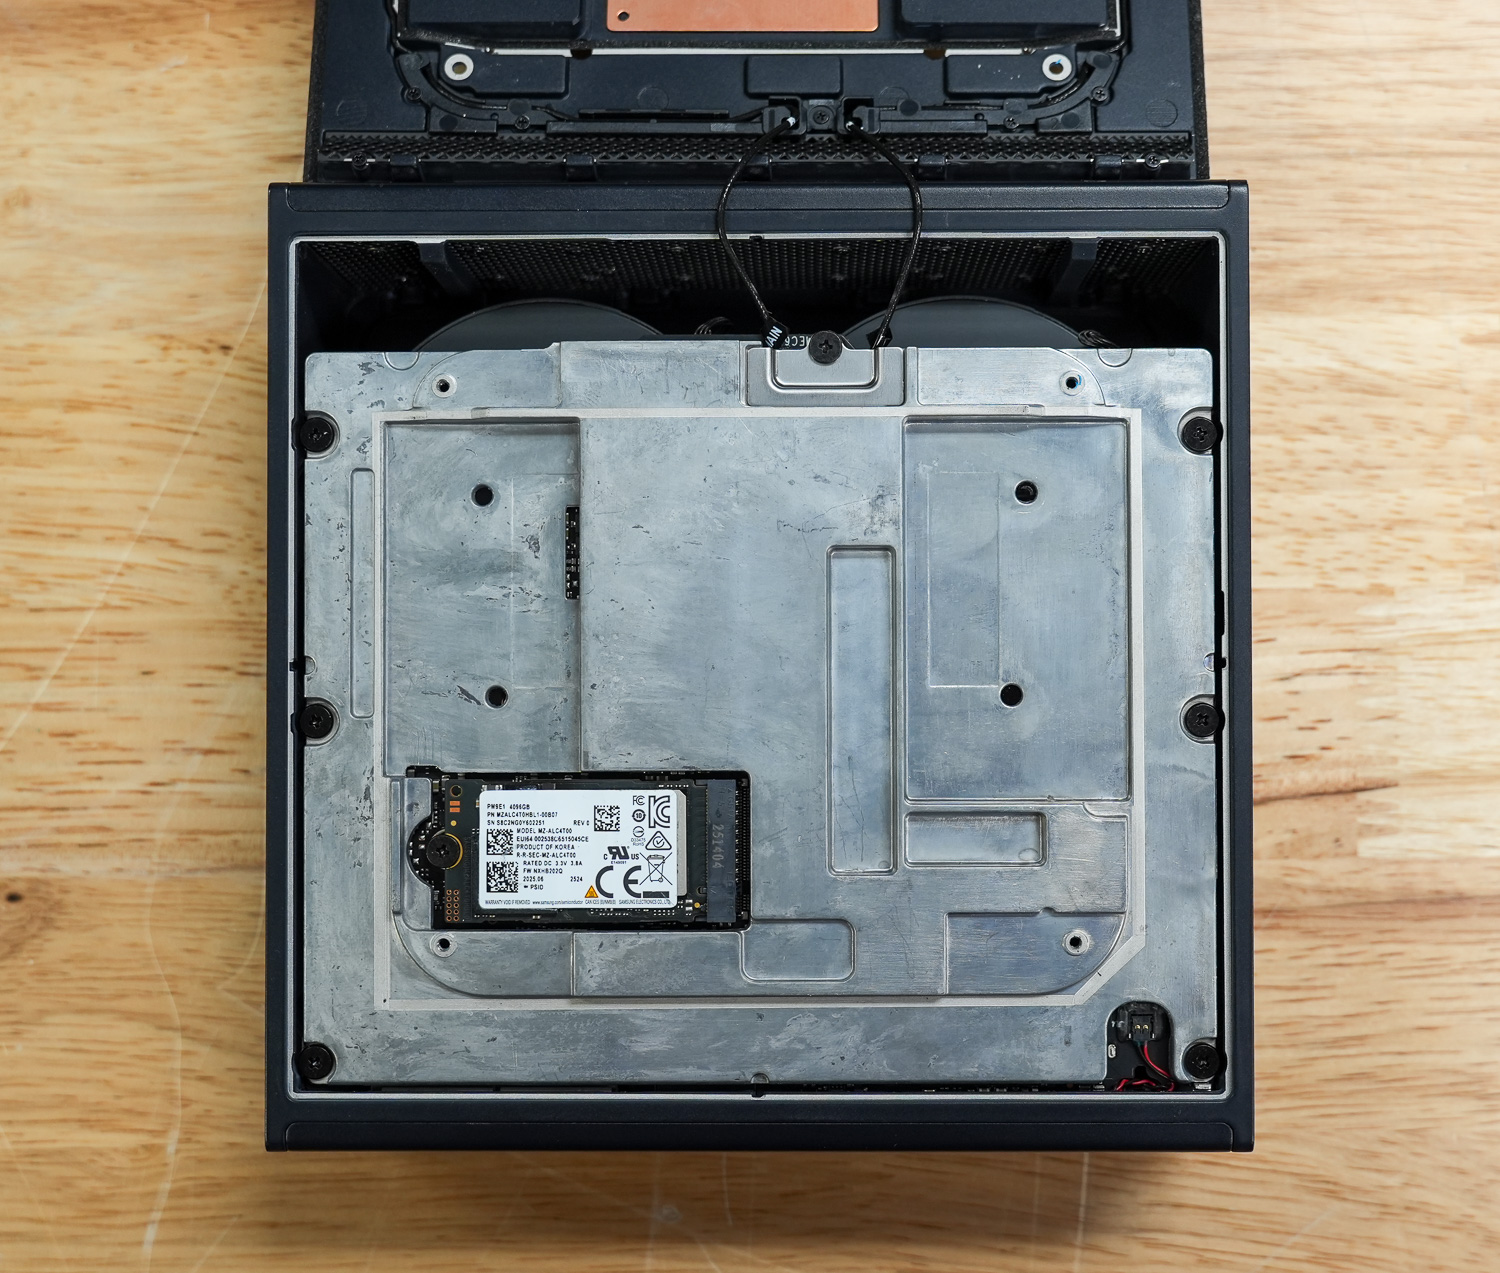
Comparé aux autres systèmes Spark que nous avons testés, Acer adopte ici une approche légèrement différente. Au lieu de la plaque inférieure en métal peint plus raffinée que l'on retrouve sur la Founders Edition et plusieurs modèles OEM, Acer utilise une plaque inférieure en métal coulé brut. La finition est moins polie, laissant apparaître la texture du moulage, mais la plaque reste épaisse et robuste. Sur le plan fonctionnel, elle remplit toujours la même fonction de cadre de renfort et de dissipateur thermique secondaire, même si ce choix de fabrication témoigne clairement d'une philosophie de conception et de maîtrise des coûts différente.
Tests thermiques de l'Acer Veriton GN100 AI
Pour évaluer les performances thermiques de l'Acer Veriton GN100 AI, nous les avons comparées à celles de la Founders Edition et de modèles de fabricants comme Dell, ASUS et GIBABYTE. Nous avons analysé ce sujet plus en détail dans notre article Spark sur les tests thermiques.
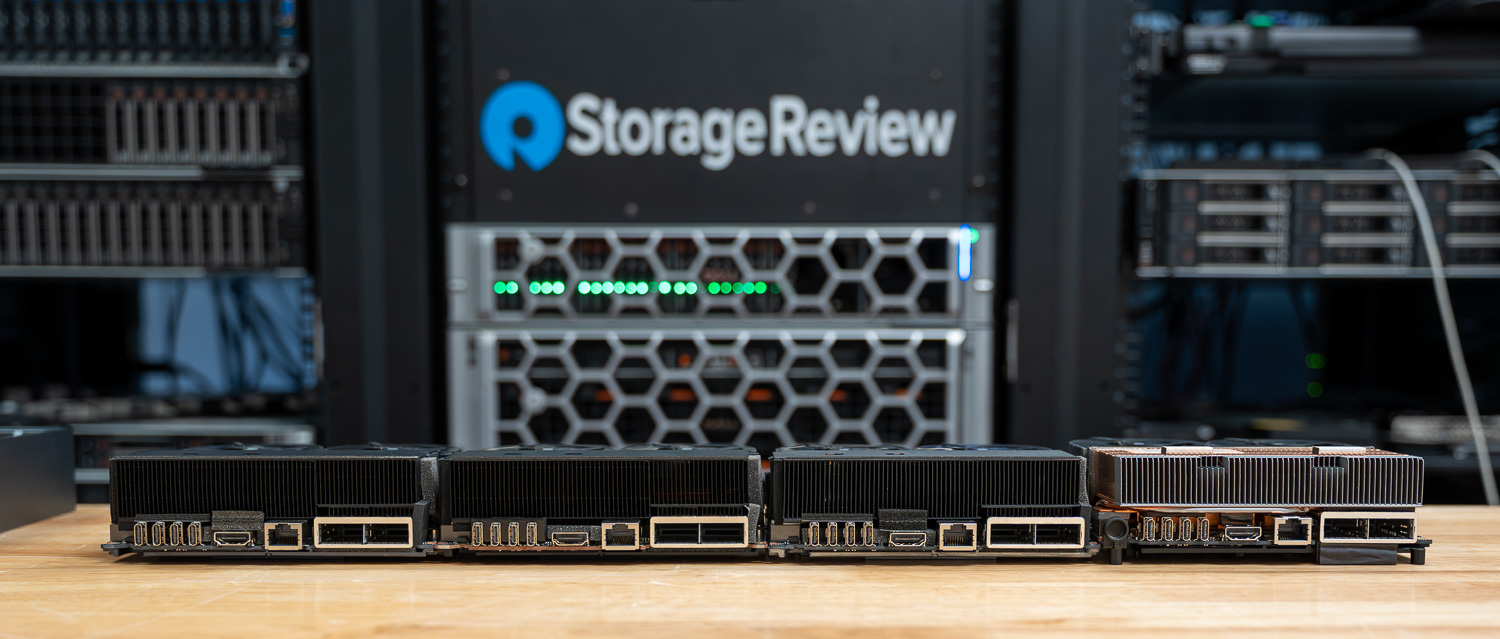
Nous avons surveillé l'ensemble du système sur une période donnée, avec trois phases de charge de travail et une augmentation progressive de l'utilisation sur environ une heure. Cela nous a permis d'observer le système en utilisation prolongée et à différents niveaux de charge. Nous avons surveillé les températures du processeur, du GPU, du réseau et des disques NVMe, ainsi que la consommation électrique totale.
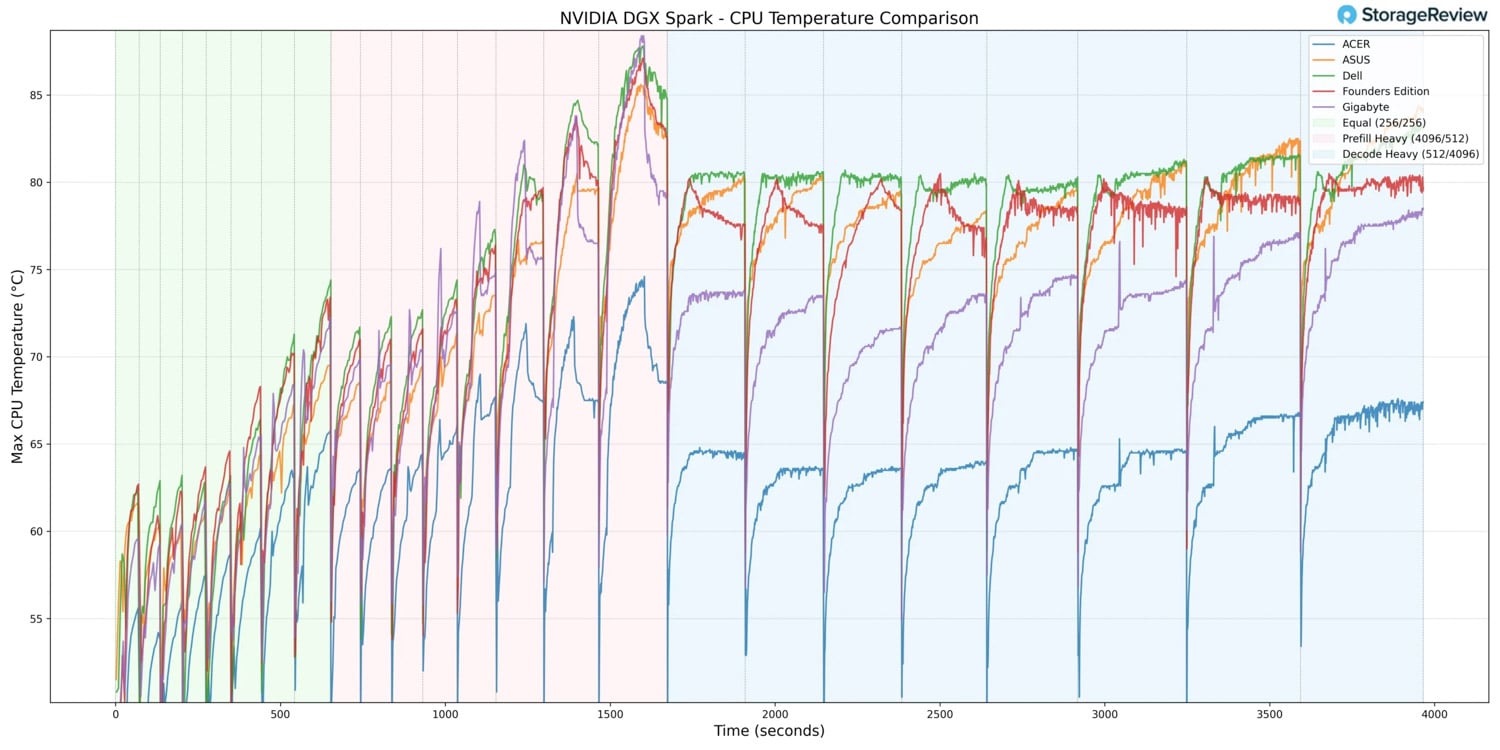
Température CPU
Lors des tests thermiques du processeur, le système Acer a atteint une température maximale de 74.7 °C pendant une activité de pré-remplissage intensive. Cela représente l'une des températures maximales les plus basses observées dans le groupe de comparaison, ce qui témoigne d'une gestion thermique particulièrement efficace.
Lors du passage à des phases d'ISL/OSL égales et à des phases de décodage intensif soutenues, la température du processeur est restée bien maîtrisée, sans augmentation brutale. Au lieu d'atteindre les 80 °C observés sur certains systèmes concurrents, Acer a maintenu une température de fonctionnement stable plus basse, témoignant d'une marge de refroidissement importante sous charge de calcul prolongée.
En conditions de faible charge ou d'inactivité, le processeur a enregistré une température minimale de 37.8 °C. Cette valeur de référence est cohérente avec les performances globales de l'ensemble du système et confirme l'efficacité du système de refroidissement d'Acer, aussi bien au repos qu'en pleine charge.
Globalement, Acer a affiché l'un des profils thermiques de processeur les plus bas du groupe, tant en phase de pointe qu'en phase soutenue.
Température GPU
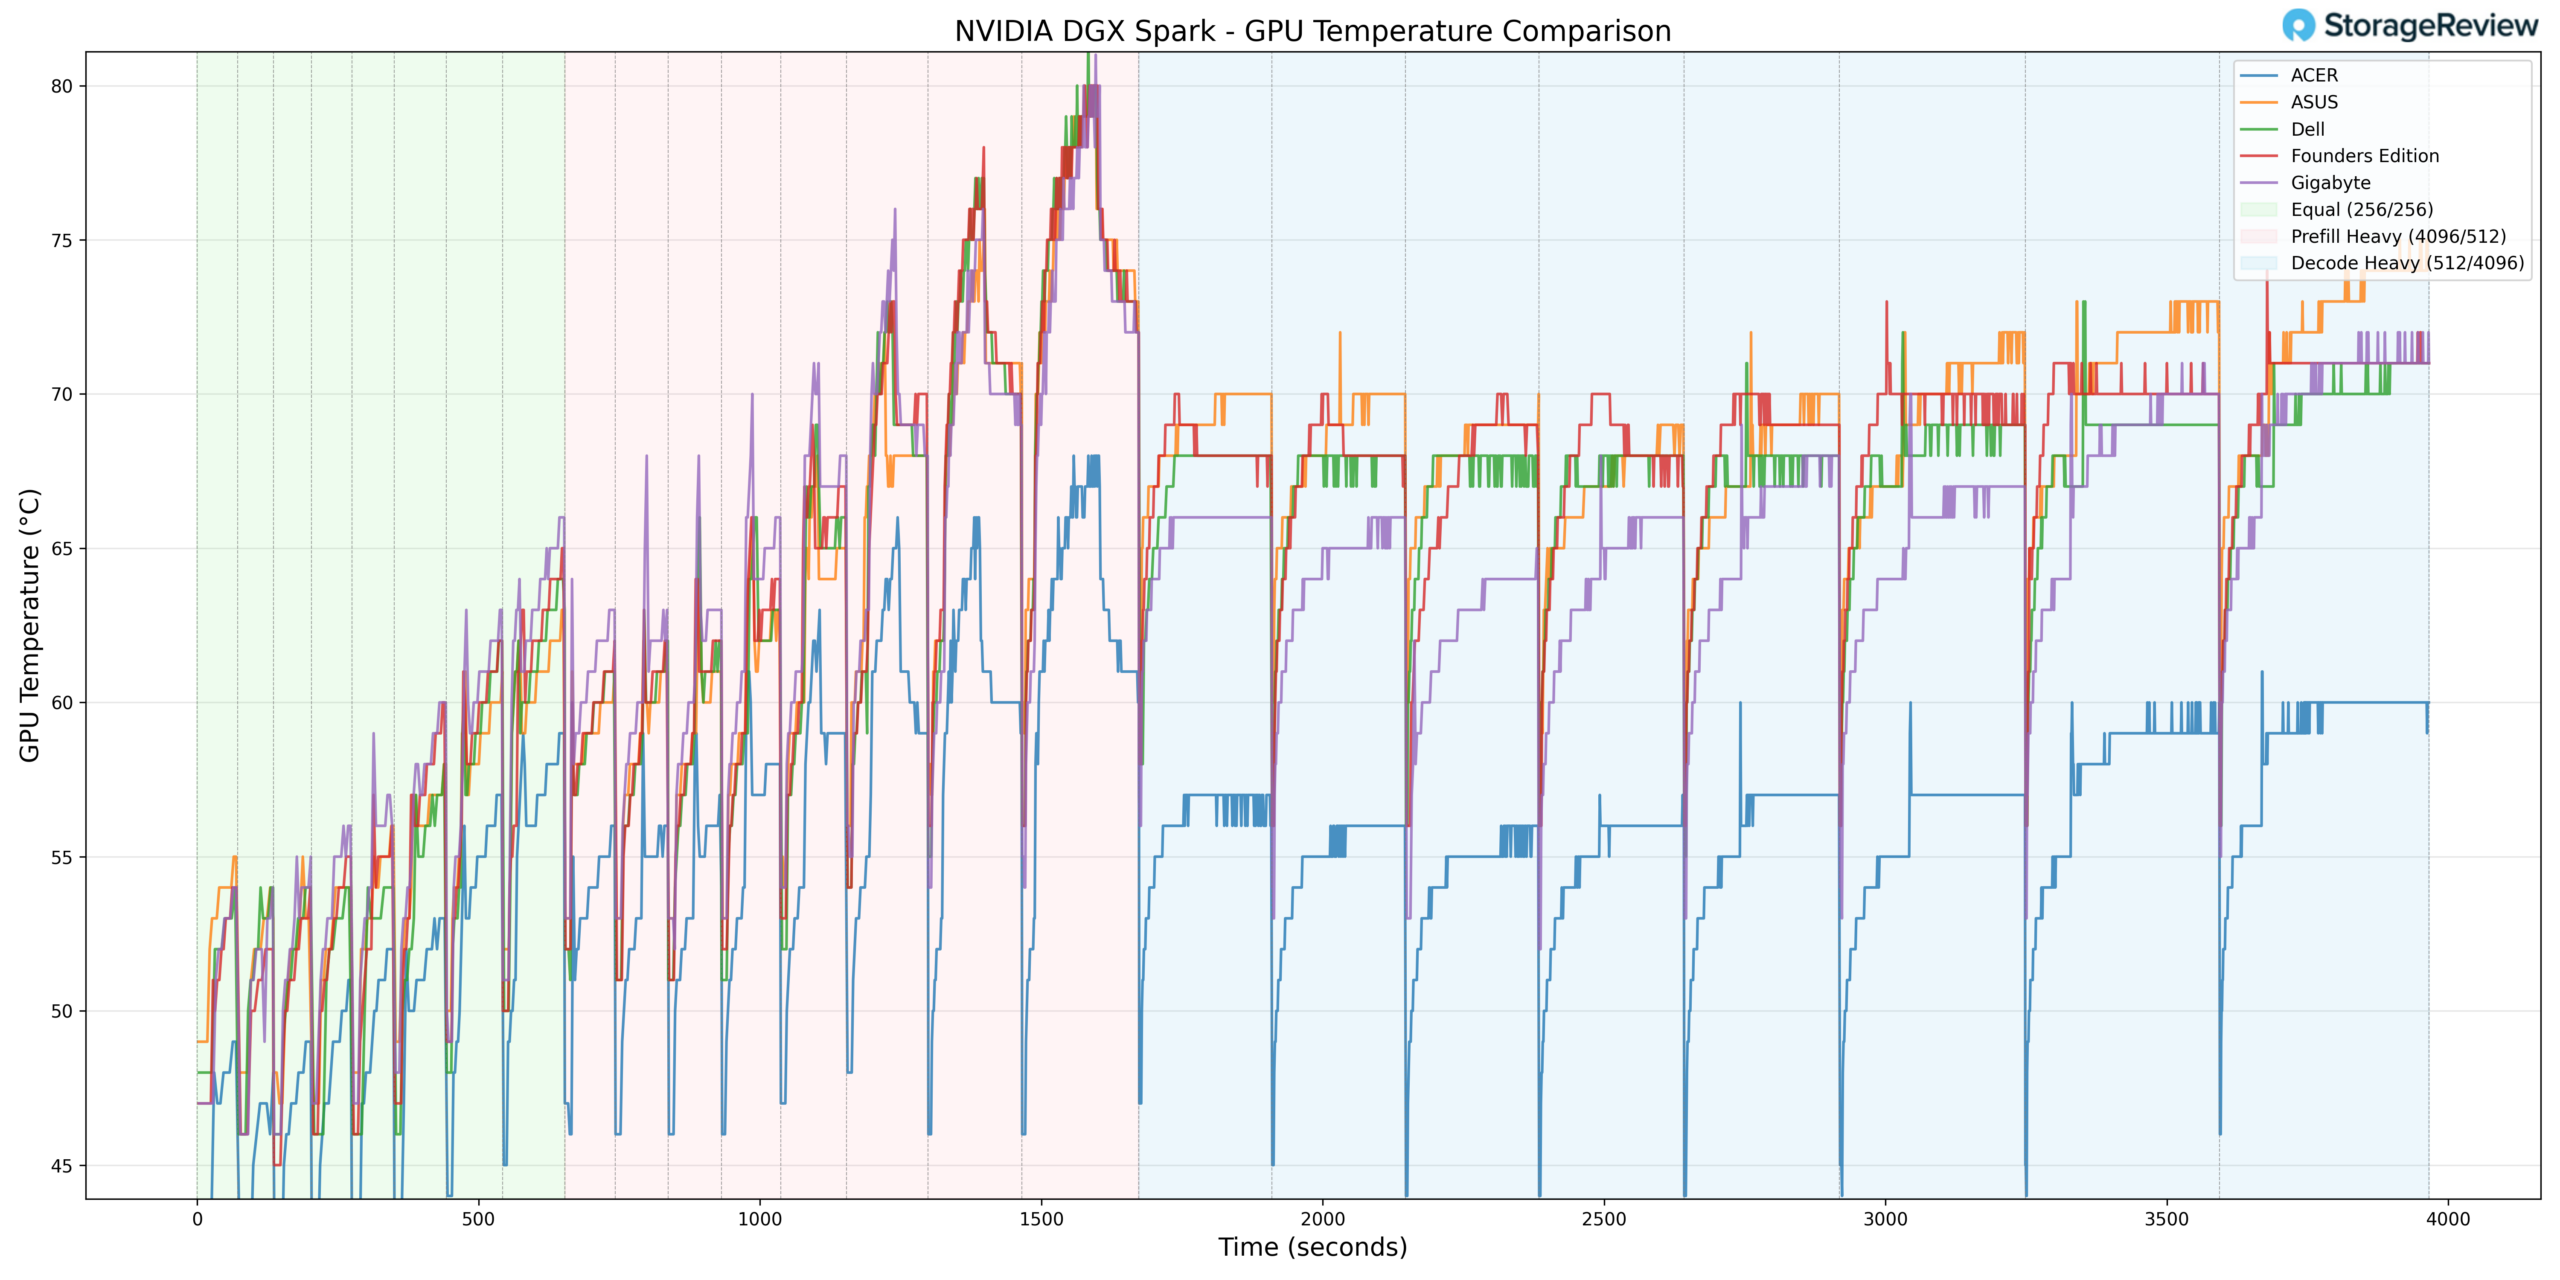
La température du GPU a suivi une tendance similaire à la modération. Lors de l'accélération Prefill Heavy, le GPU a atteint une température maximale de 69 °C, ce qui est nettement inférieur à celle de plusieurs implémentations concurrentes lors d'activités en rafale.
À mesure que la charge de travail progressait vers les phases ISL/OSL égales et de décodage intensif, le GPU s'est stabilisé dans une plage contrôlée sans pics thermiques notables. Le système a démontré un comportement constant lors d'un décodage soutenu, maintenant une large marge en dessous des limites de fonctionnement supérieures.
La température minimale du GPU enregistrée était de 35°C pendant les phases de charge légère, ce qui représente l'une des valeurs de référence les plus basses en veille de la pile.
Dans l'ensemble, Acer a présenté l'une des implémentations GPU les plus performantes, tant en cas de pics de charge que de charges de travail soutenues.
Température NVMe
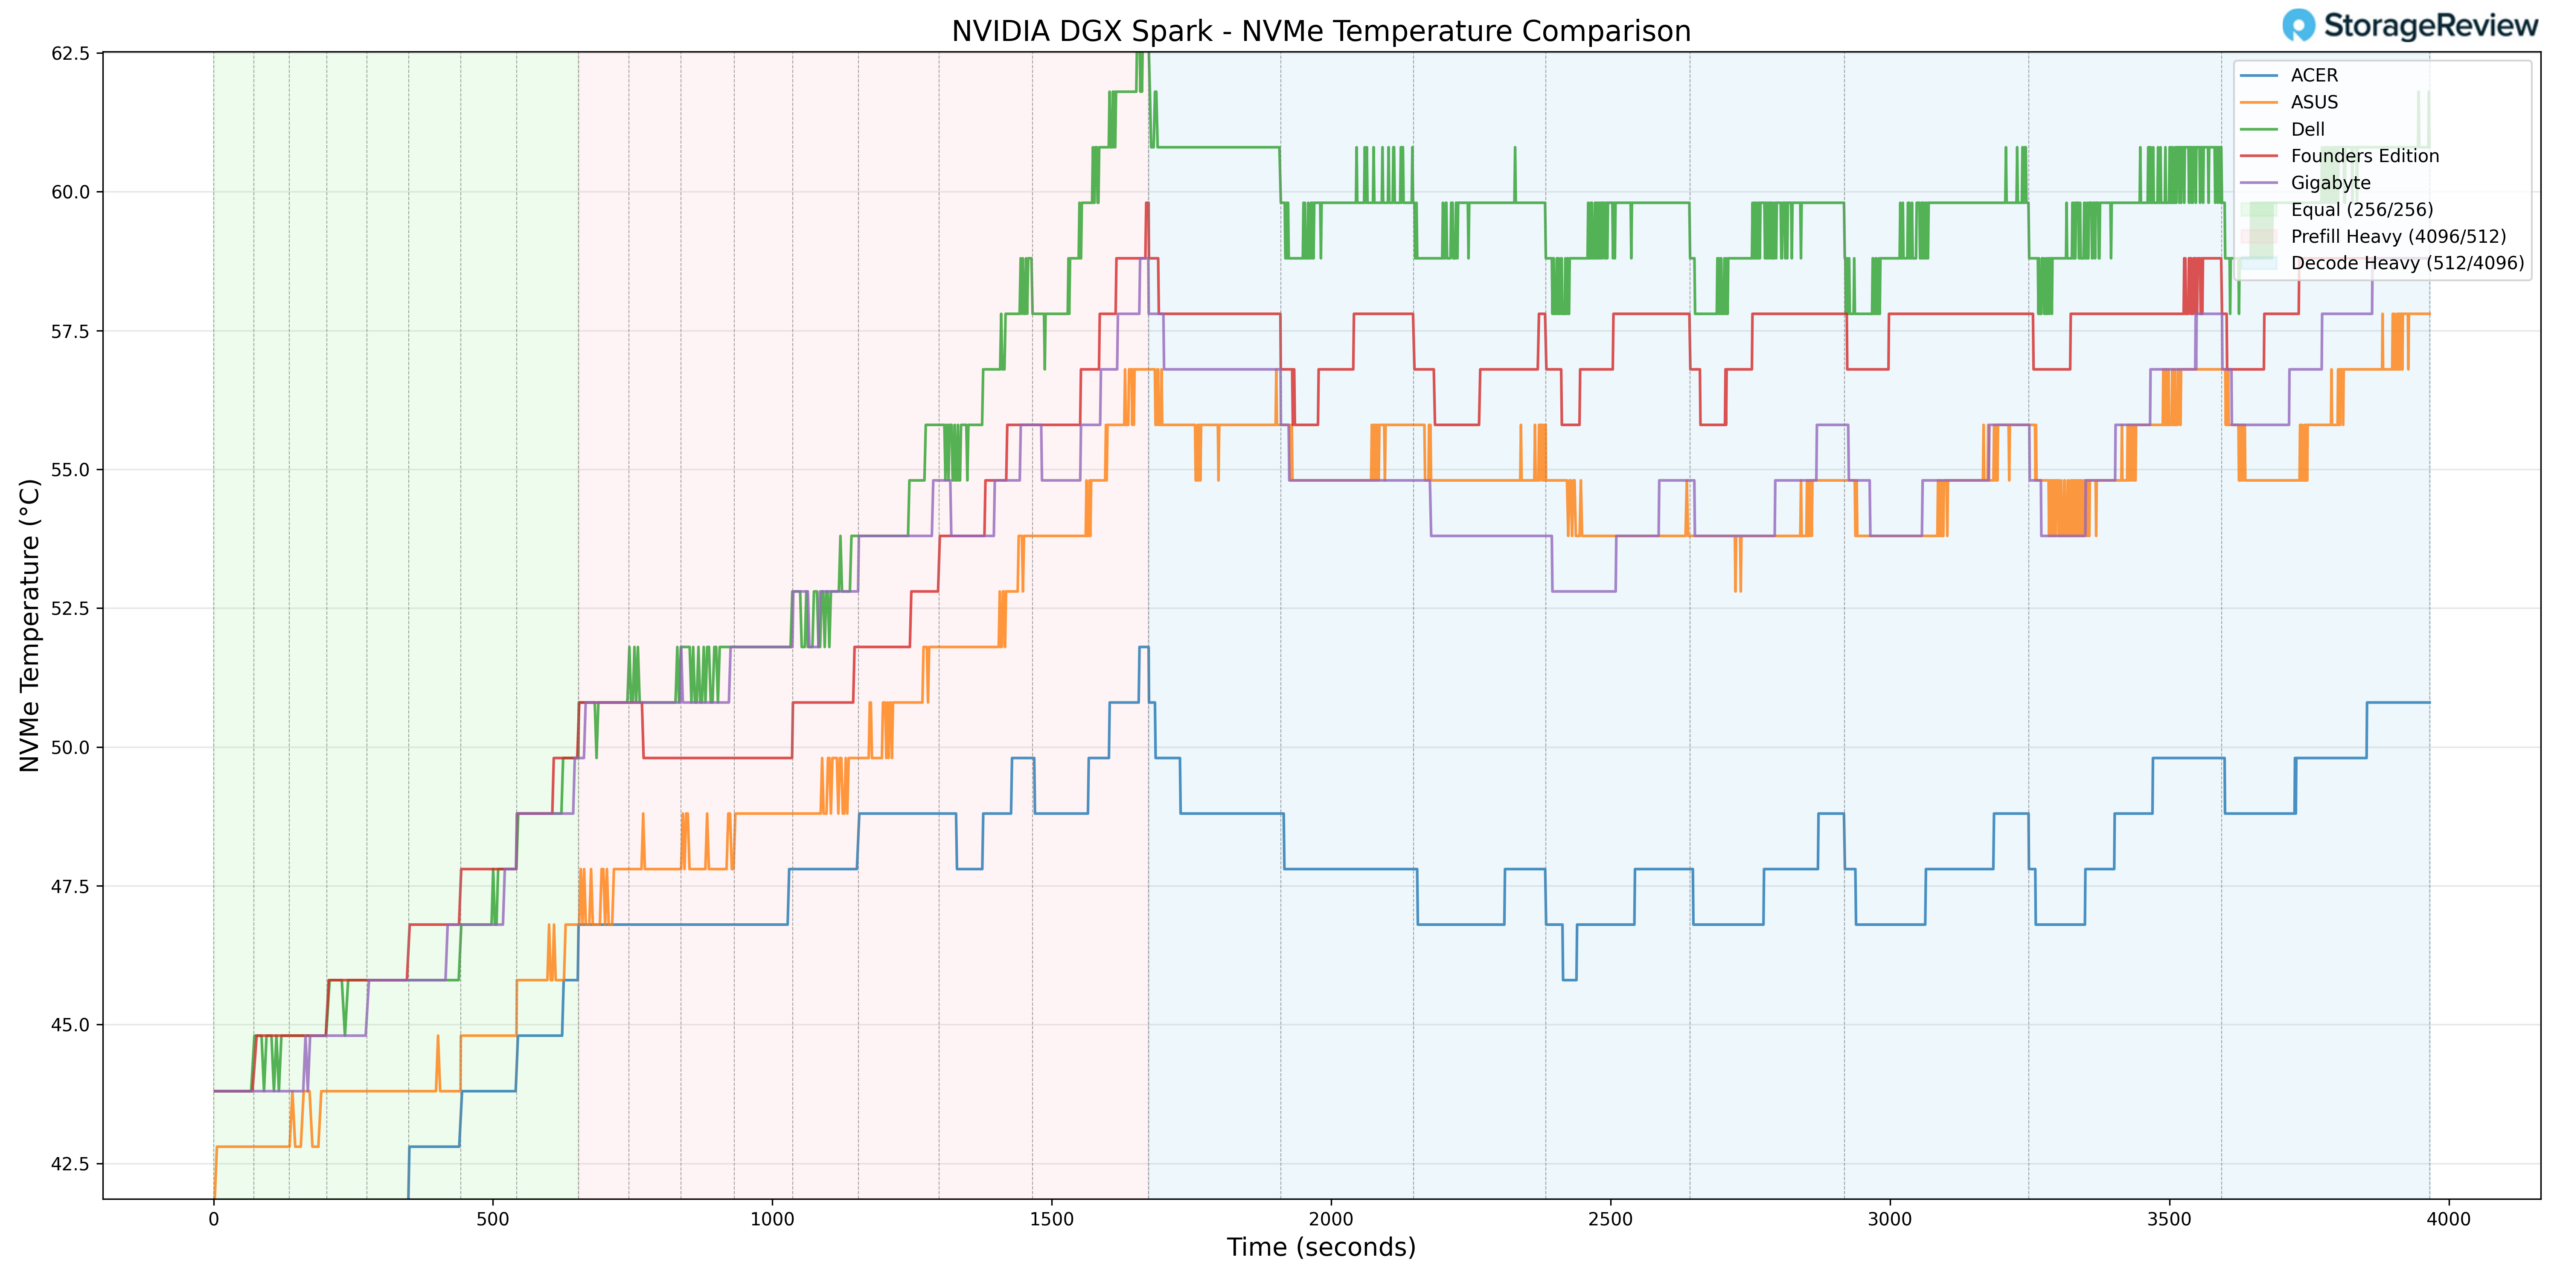
Les températures de stockage sont restées largement conformes aux spécifications tout au long des tests. Le disque NVMe a atteint une température maximale de 56.8 °C lors des phases de charge de travail les plus intenses, restant ainsi largement en dessous des seuils de limitation thermique habituels et s'alignant sur les résultats de stockage plus modérés obtenus par le groupe.
En cas d'inactivité ou d'utilisation légère, la température du NVMe est tombée à 36.8 °C, indiquant que le sous-système de stockage n'est pas soumis à des contraintes thermiques en cas de faible charge.
Globalement, Acer a maintenu des températures NVMe compétitives, associant des températures basses et soutenues à un comportement de base stable.
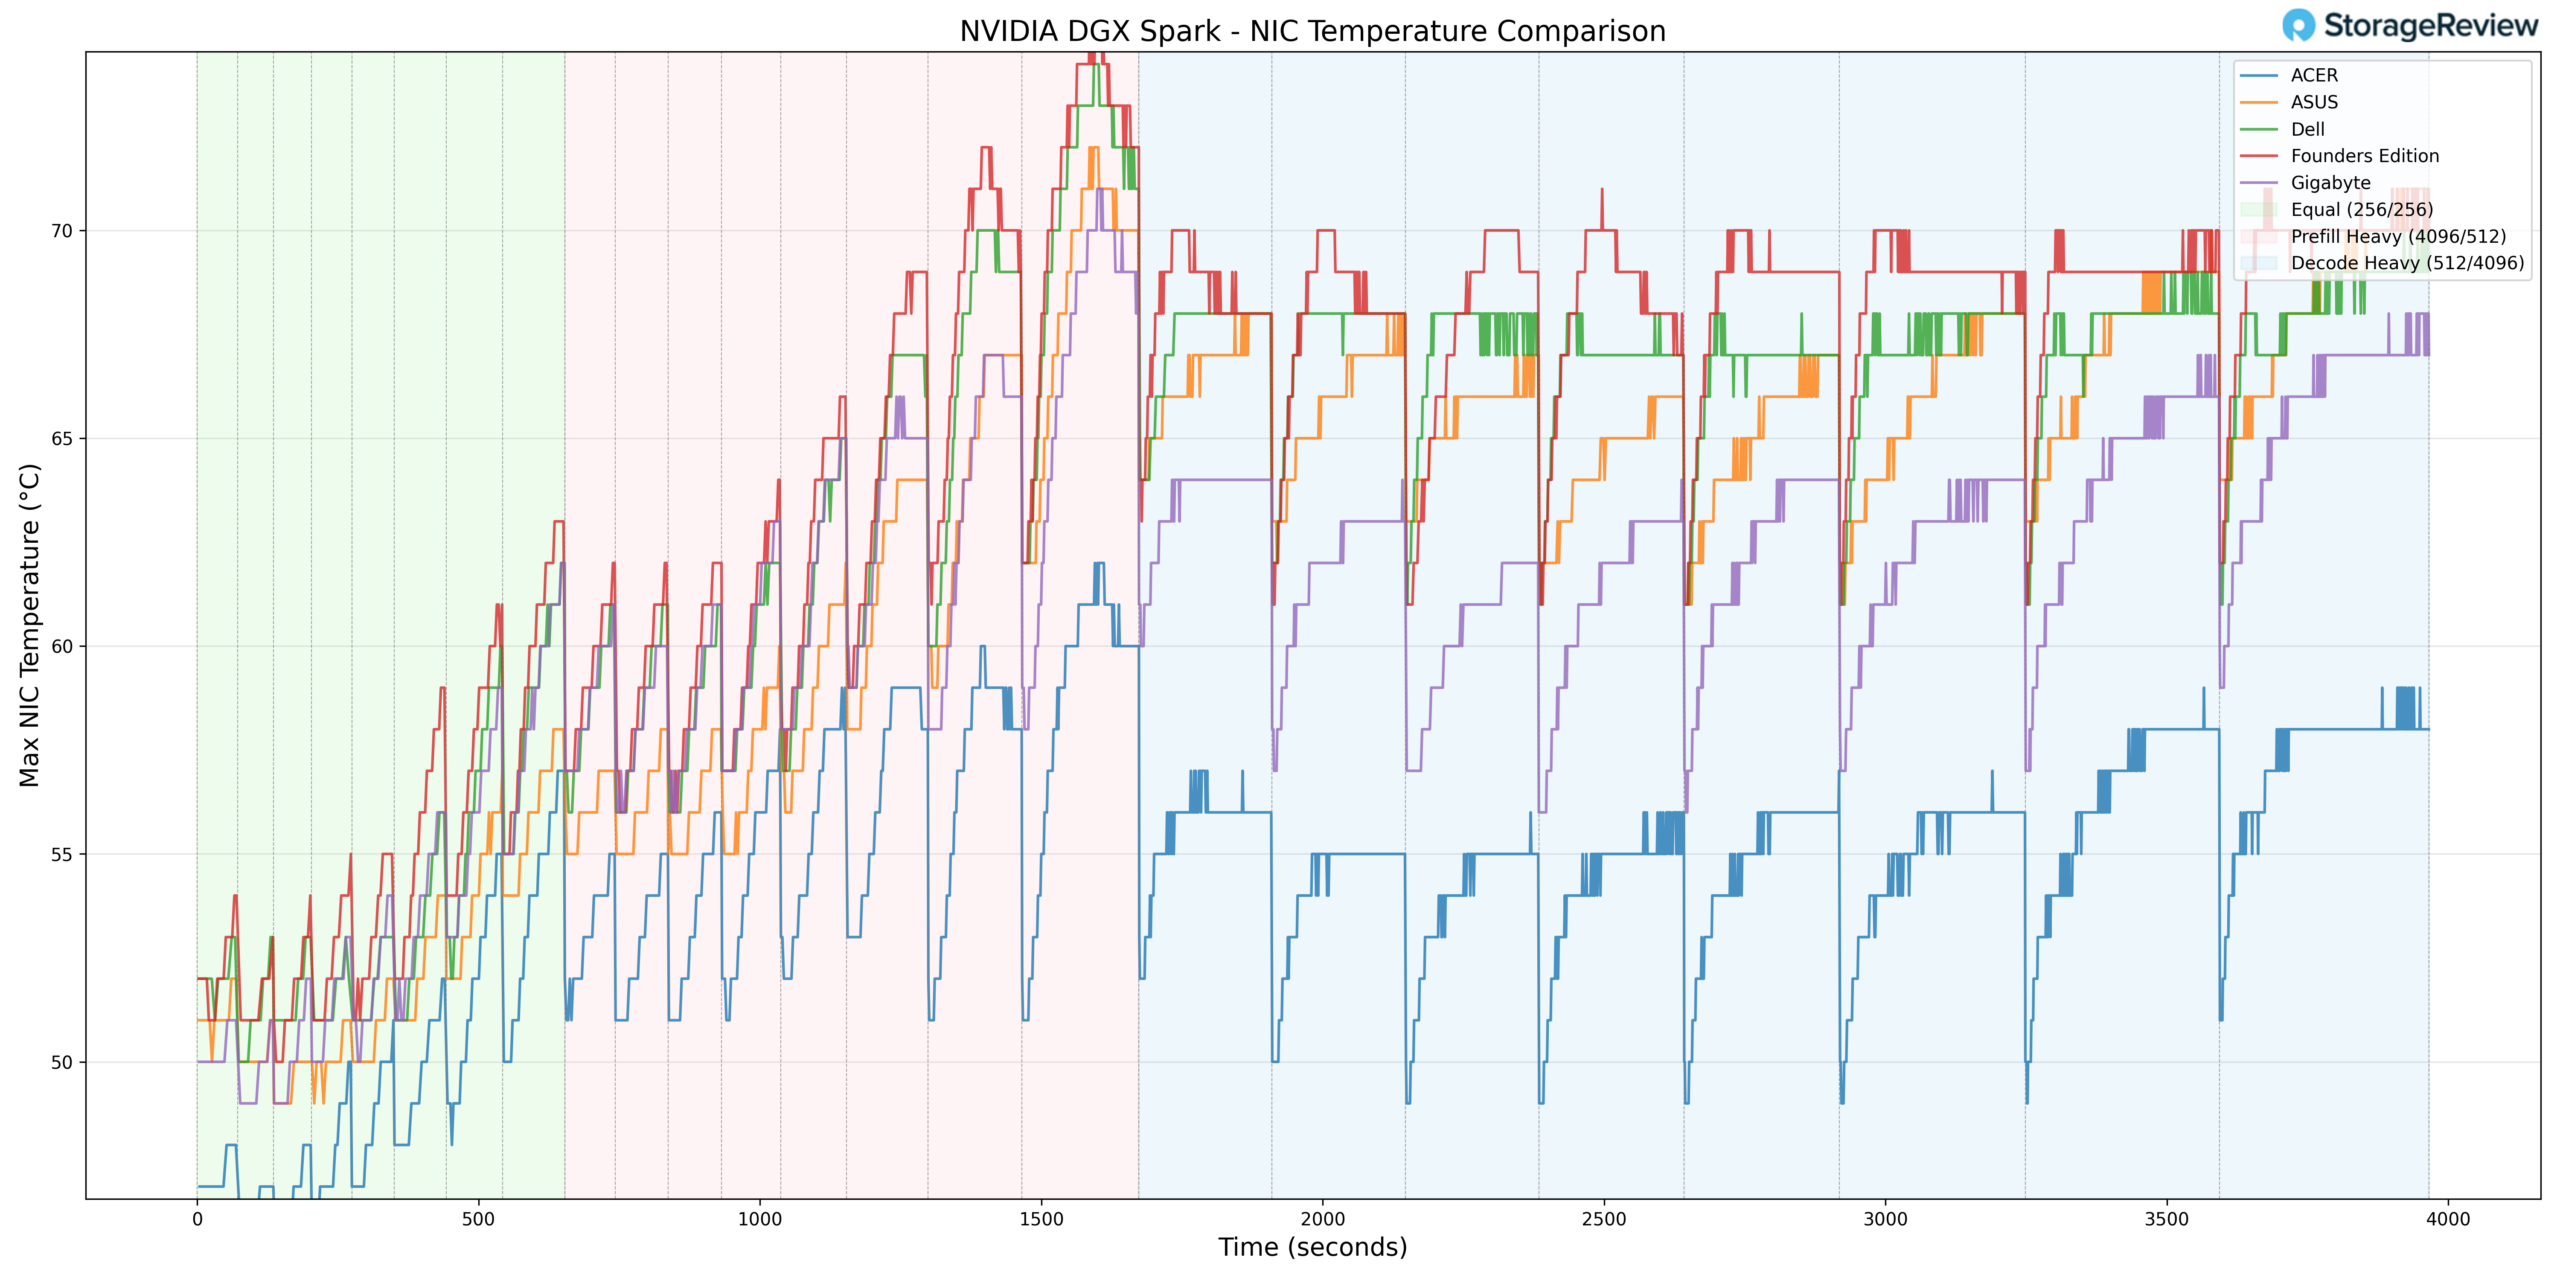
Température NIC
La température du processeur a atteint un pic de 61 °C lors des phases de charge de travail les plus intenses. Cela représente l'une des températures maximales les plus basses observées dans le groupe de comparaison, ce qui suggère une circulation d'air efficace ou un positionnement optimal des composants au sein du châssis.
La température minimale du NIC enregistrée était de 39°C pendant les phases plus légères, reflétant à nouveau un comportement thermique de base robuste.
Tout au long des tests, le contrôleur réseau a suivi proportionnellement la demande de charge de travail sans mise à l'échelle excessive.
Consommation électrique du GPU
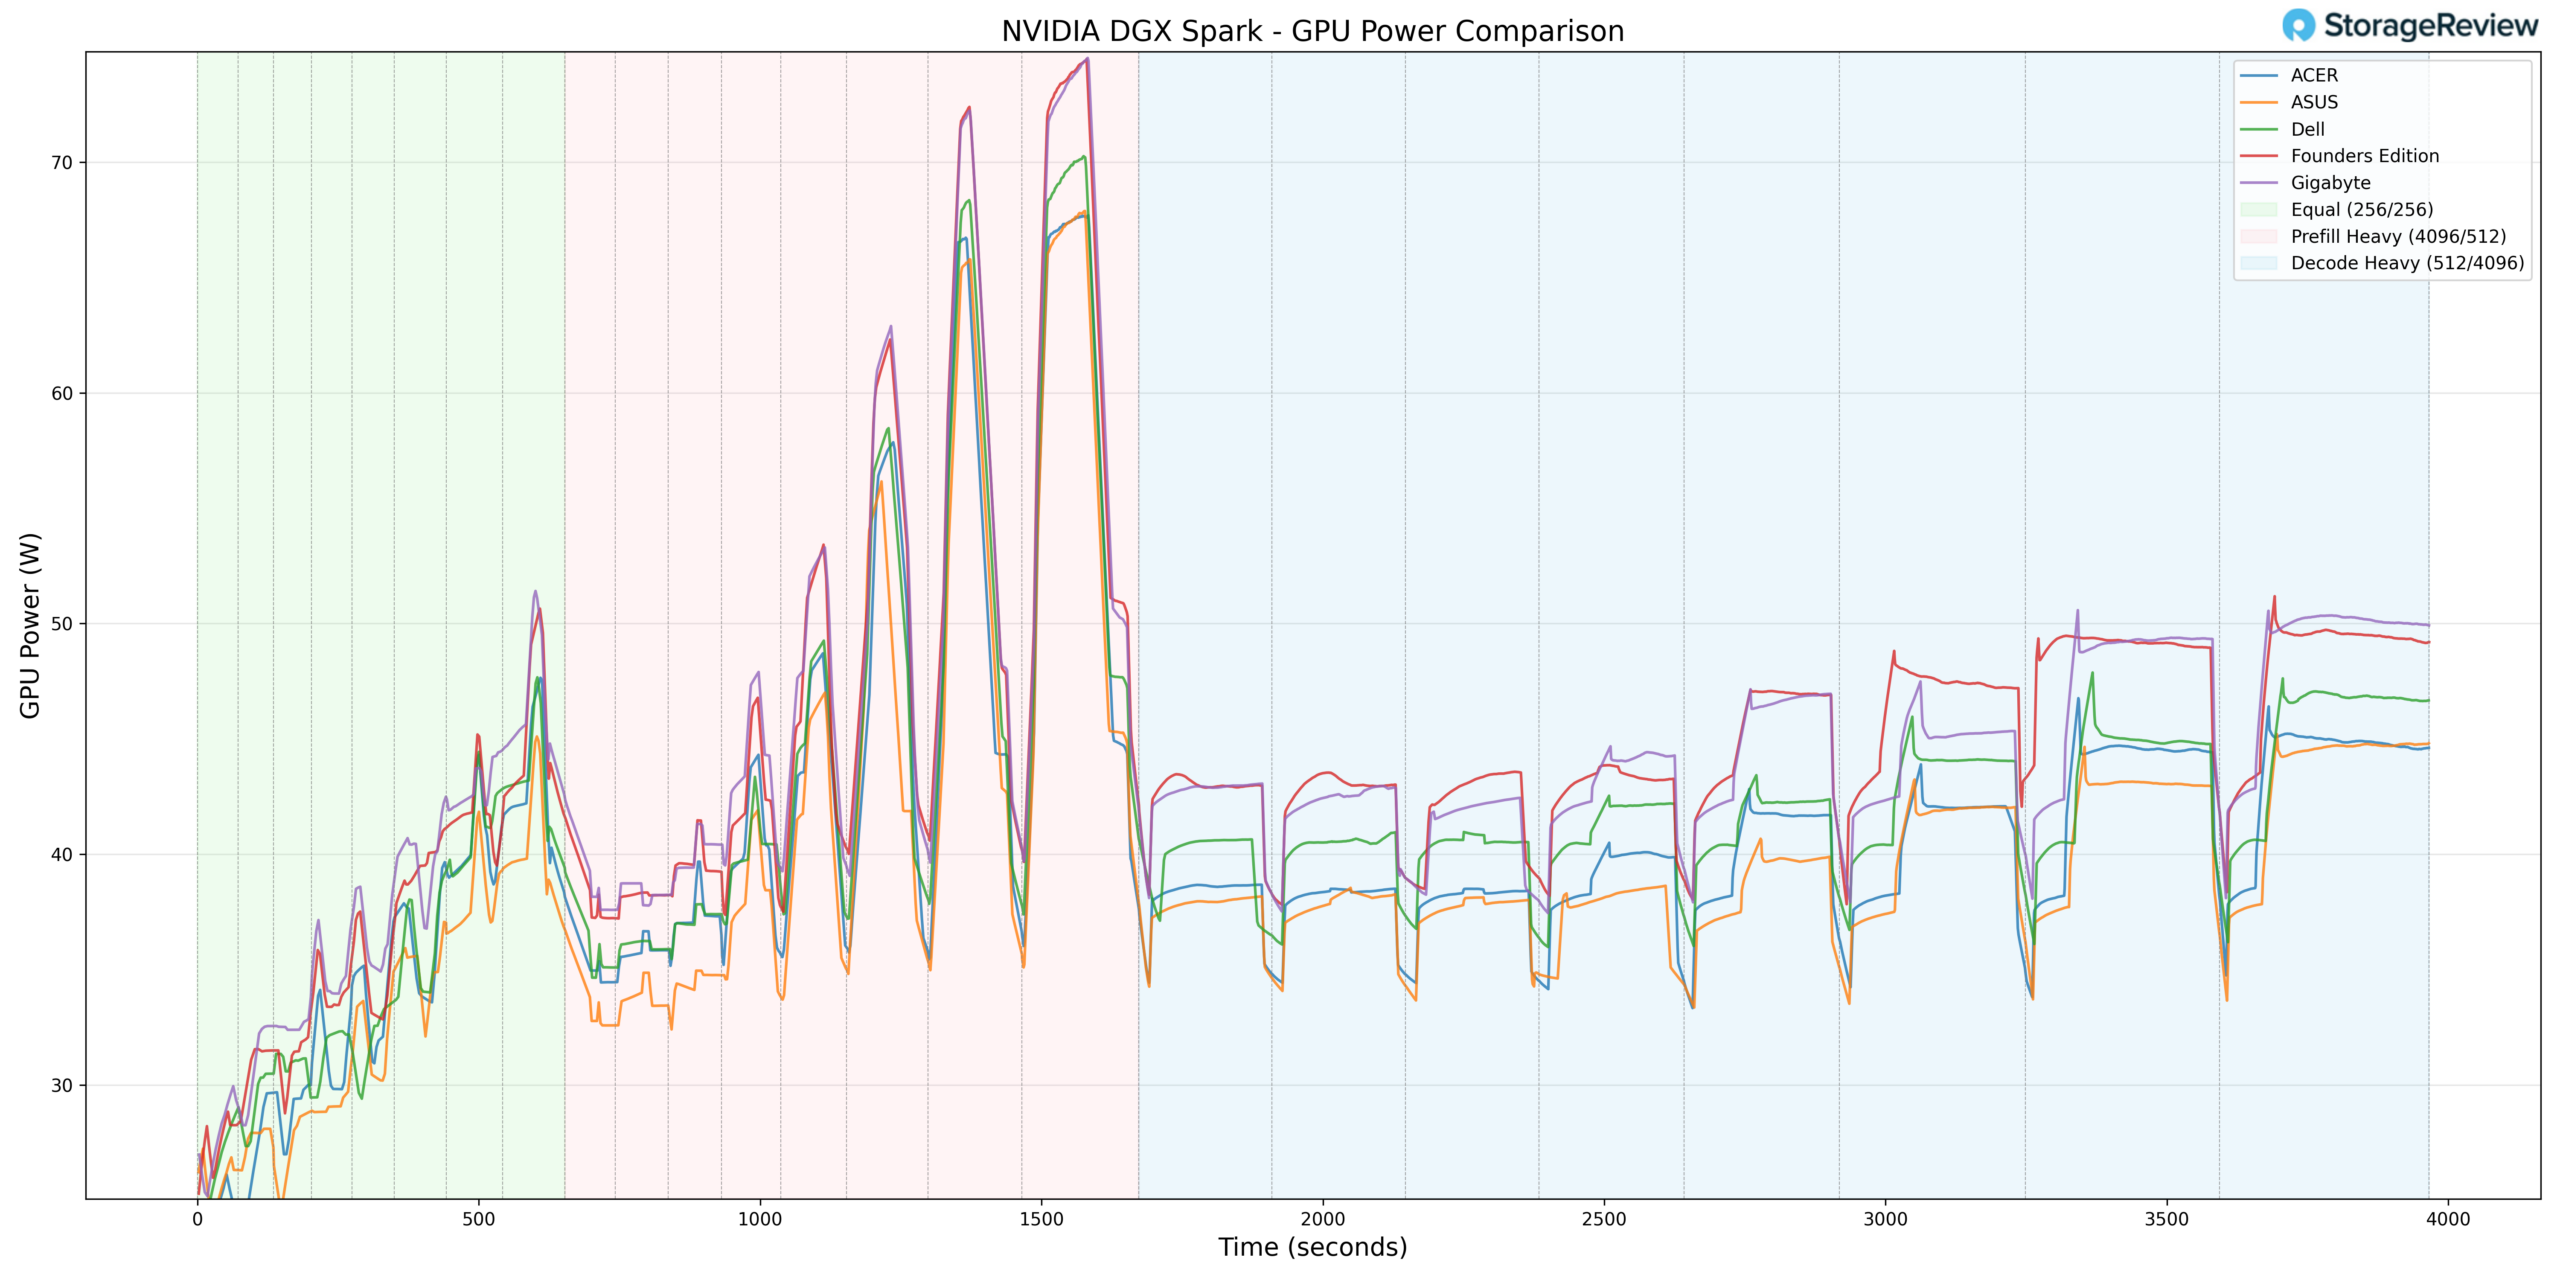
La consommation électrique du GPU a atteint un pic de 69.18 W lors des transitions de pré-remplissage intensif. Cela place Acer légèrement en dessous des seuils de consommation les plus élevés observés au sein de la gamme GB10.
La réduction de la consommation électrique maximale est directement liée au profil thermique plus froid du GPU d'Acer. Plutôt que de pousser la consommation à son maximum, Acer semble privilégier un équilibre entre performances et efficacité thermique, ce qui se traduit par des températures des composants constamment plus basses lors des pics d'utilisation.
Lors de charges de travail de décodage soutenues, la consommation d'énergie s'est stabilisée en fonction de la demande et est restée prévisible.
Résumé thermique
Lors de la surveillance du processeur, de la carte graphique, du SSD NVMe et de la carte réseau, l'Acer GB10 a affiché le profil thermique global le plus bas du groupe de comparaison. Le processeur a atteint un pic de 74.7 °C et la carte graphique de 69 °C lors des pics d'utilisation, tandis que le SSD NVMe est resté sous les 57 °C et la carte réseau a culminé à 61 °C. La consommation électrique de la carte graphique a atteint un maximum de 69.18 W, légèrement inférieur aux valeurs les plus élevées observées dans la configuration.
Globalement, la solution d'Acer privilégie l'efficacité thermique et la stabilité durable, en conservant une marge de manœuvre importante lors des transitions de charge de travail agressives tout en offrant des performances constantes sous une charge prolongée.
Tests de performance de l'Acer Veriton GN100
Pour évaluer l'Acer Veriton GN100, nous avons testé les unités Spark à l'aide du benchmark vLLM Online Serving, le moteur d'inférence et de diffusion à haut débit le plus répandu pour les grands modèles de langage. Ce benchmark simule des charges de travail de production réelles en envoyant des requêtes simultanées à un serveur vLLM en cours d'exécution et en mesurant des indicateurs clés, tels que le débit total de jetons (jetons par seconde), le temps d'obtention du premier jeton et le temps de traitement par jeton de sortie, sous différentes conditions de charge.
Nos tests ont porté sur un large éventail de modèles, des architectures denses aux types de données à micro-échelle. Ils ont évalué les performances dans trois scénarios de charge de travail : ISL/OSL égaux, préremplissage intensif et décodage intensif. Ces scénarios représentent différents modèles de service réels, allant de charges d'entrée/sortie équilibrées à un traitement des invites gourmand en ressources de calcul et à une génération de jetons limitée par la bande passante mémoire.
Outre l'Acer Veriton GN100, nous avons comparé les performances du NVIDIA Founders Edition Spark à celles de systèmes OEM d'ASUS, Dell et GIGABYTE. Cela nous a permis de situer les résultats d'Acer dans un contexte concurrentiel plus large et de déterminer ses points forts, ses points faibles ou ses points faibles selon les modèles et les types de charges de travail.
GPT-OSS-120B
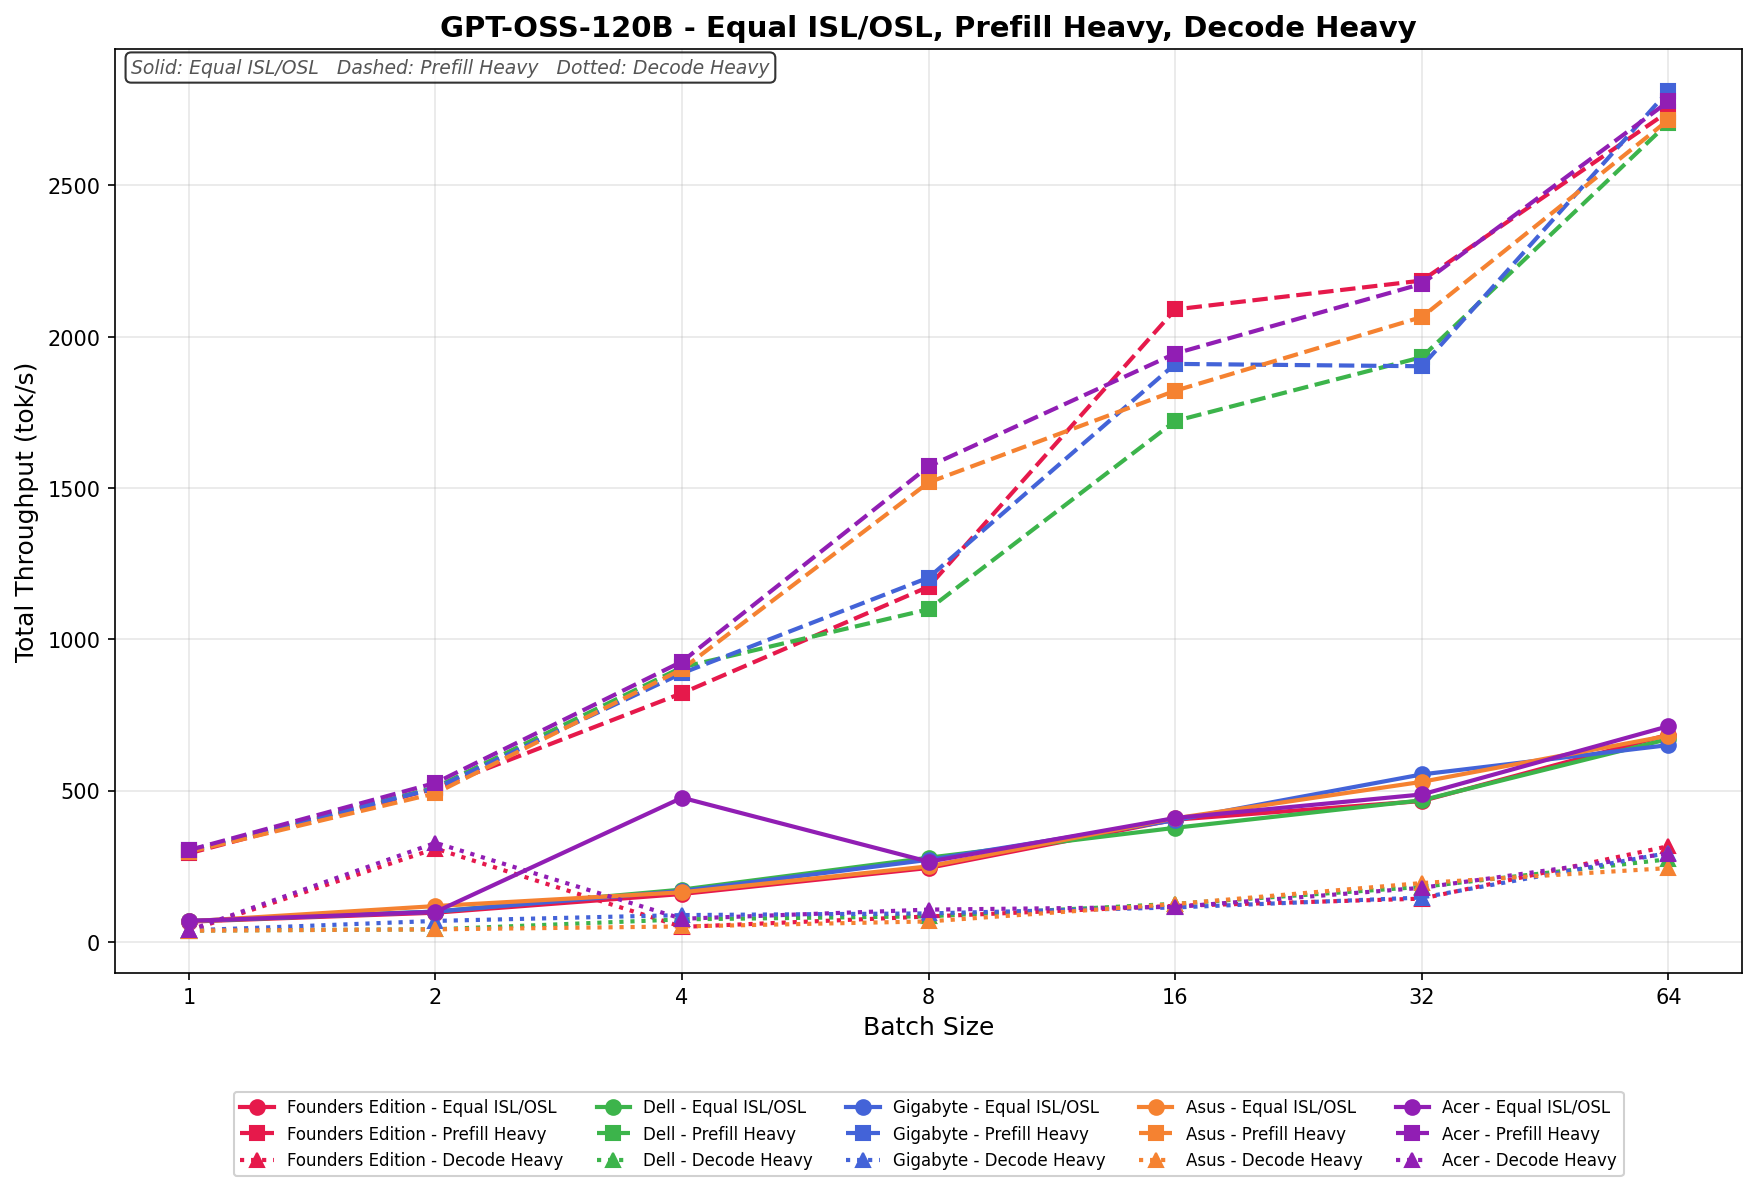
En mode ISL/OSL égal, le débit de l'Acer varie de 69.65 à 713.18 tok/s selon la taille du lot. Ce débit présente une certaine variabilité pour les petits lots avant de se stabiliser et d'augmenter de façon constante à partir du lot 8 jusqu'au lot 64.
Le Prefill Heavy commence à 303.61 tok/s et grimpe à 2 777,56 tok/s pour une taille de lot de 64. La mise à l'échelle est forte et progressive tout au long, avec une croissance particulièrement agressive jusqu'au lot 8 et des gains continus pour les tailles de lot plus importantes.
Le débit de décodage intensif varie de 38.38 à 292.41 tok/s, avec une augmentation progressive et constante tout au long du traitement par lots. Les petits lots présentent une certaine variabilité avant que le débit ne se stabilise et n'augmente régulièrement à partir du 16e lot.
GPT-OSS-20B
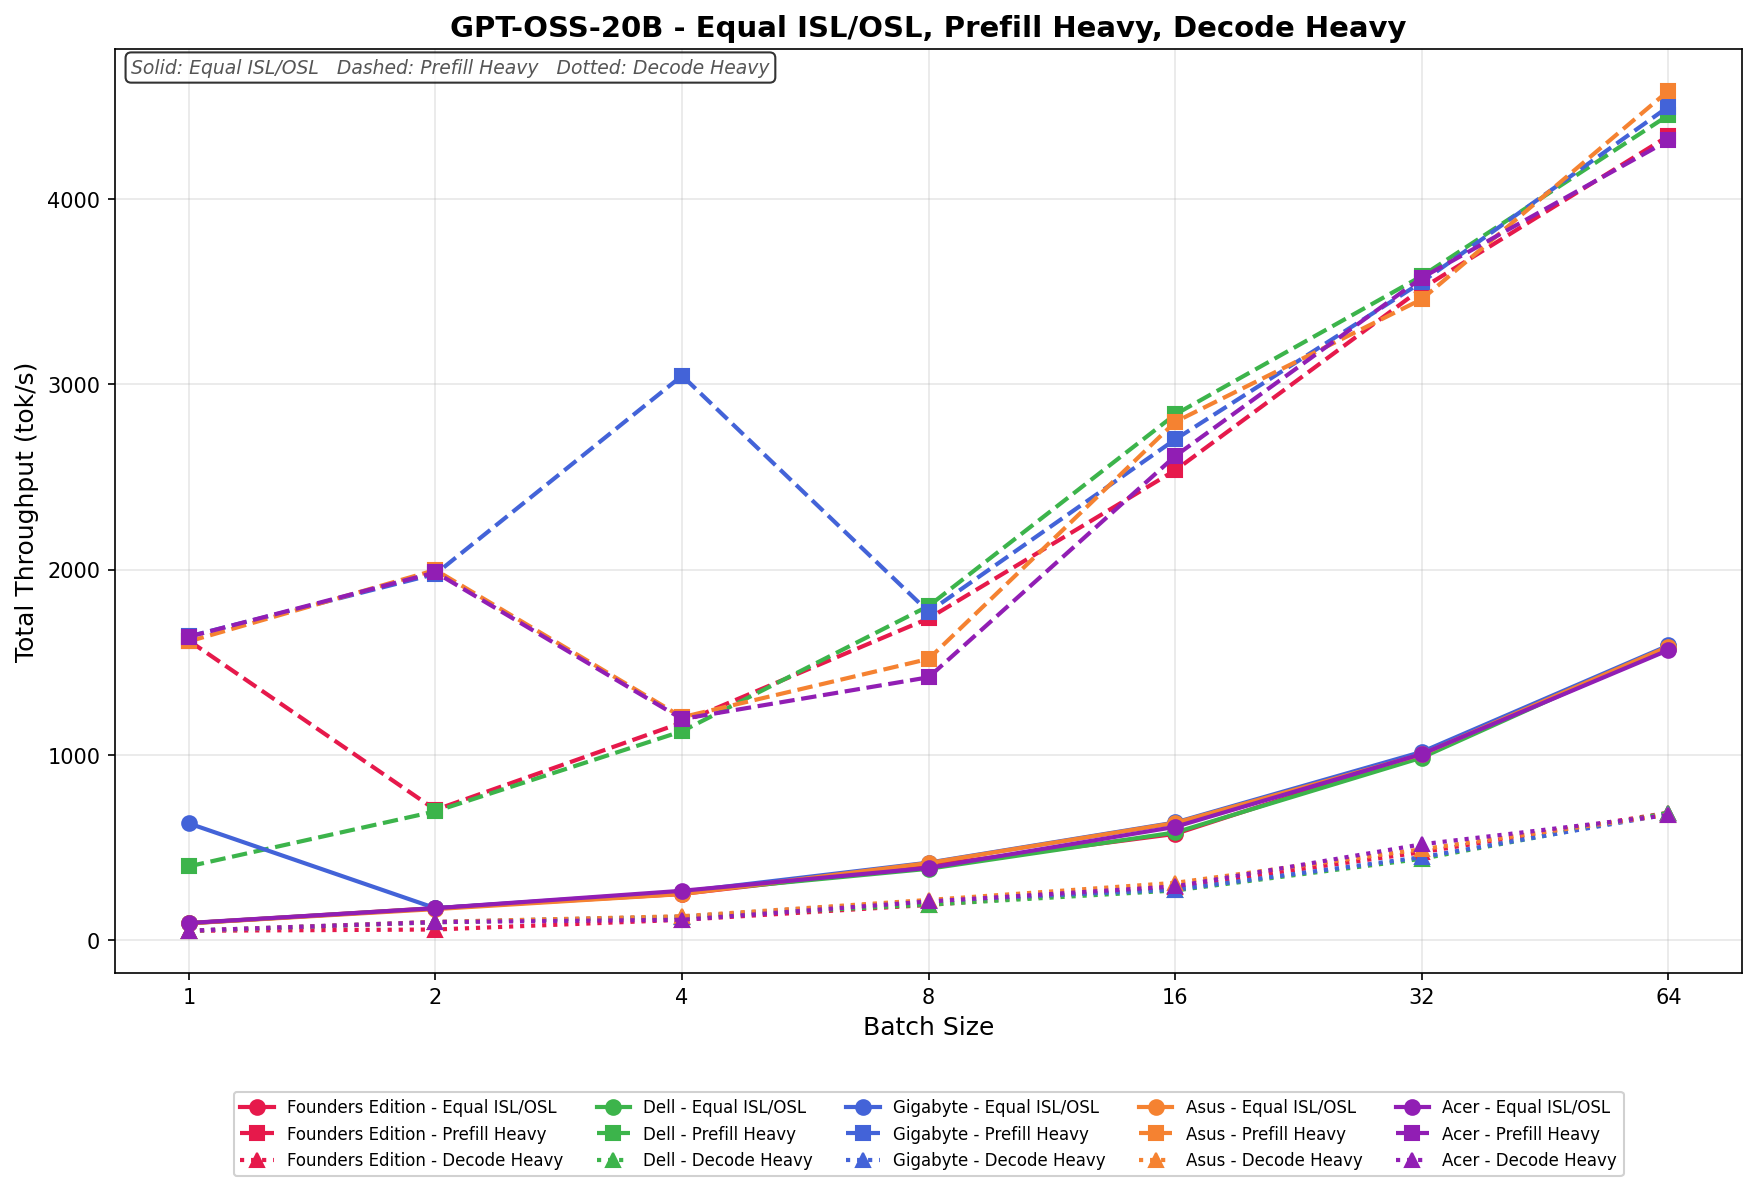
En mode ISL/OSL égal, le débit de l'Acer passe de 91.91 à 1 565,62 tok/s, avec des gains importants et constants sur l'ensemble du cycle de production. Le débit double approximativement entre le lot 1 et le lot 4, puis continue de progresser jusqu'aux lots 32 et 64.
Le pré-remplissage lourd commence à 1 637,72 tok/s et grimpe à 4 317,73 tok/s lorsque la taille du lot passe à 64. La croissance est forte jusqu'au lot 2, se modère au milieu de la plage, puis s'accélère à nouveau aux lots 32 et 64.
Decode Heavy varie de 50.55 à 674.26 tok/s, avec une mise à l'échelle progressive et cohérente sur l'ensemble du balayage par lots.
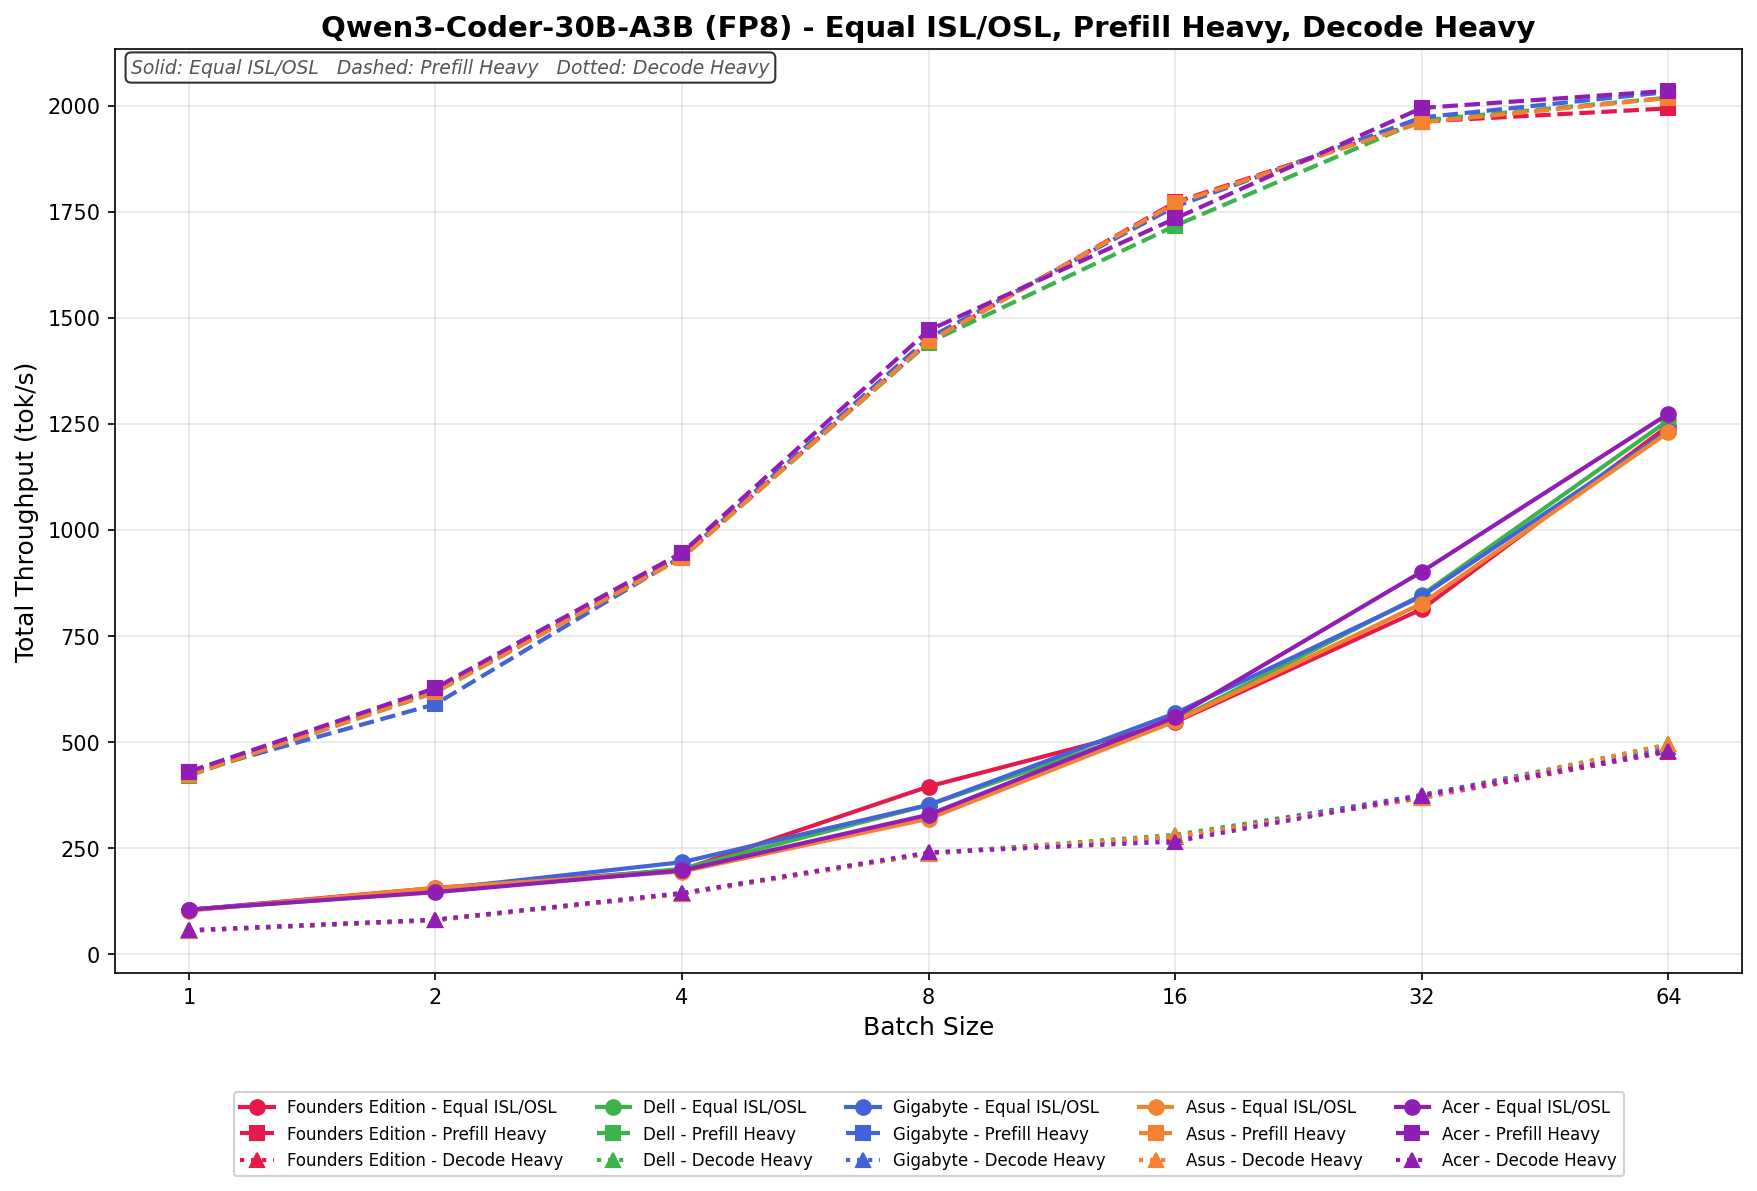
Codeur Qwen3 30B A3B FB8
En mode ISL/OSL égal, le débit de l'Acer passe de 104.64 à 1 273,47 tok/s, avec une croissance régulière et constante tout au long du cycle de production. Le débit double approximativement à chaque étape jusqu'au lot 16, puis continue de progresser jusqu'aux lots 32 et 64.
Le pré-remplissage lourd commence à 429.86 tok/s et passe à 2 034,76 tok/s pour une taille de lot de 64. La mise à l'échelle est forte jusqu'au lot 8, puis se modère à mesure que la charge de travail approche d'un plateau aux lots 32 et 64.
Decode Heavy varie de 55.94 à 478.59 tok/s, avec une mise à l'échelle progressive et cohérente sur l'ensemble du balayage par lots.
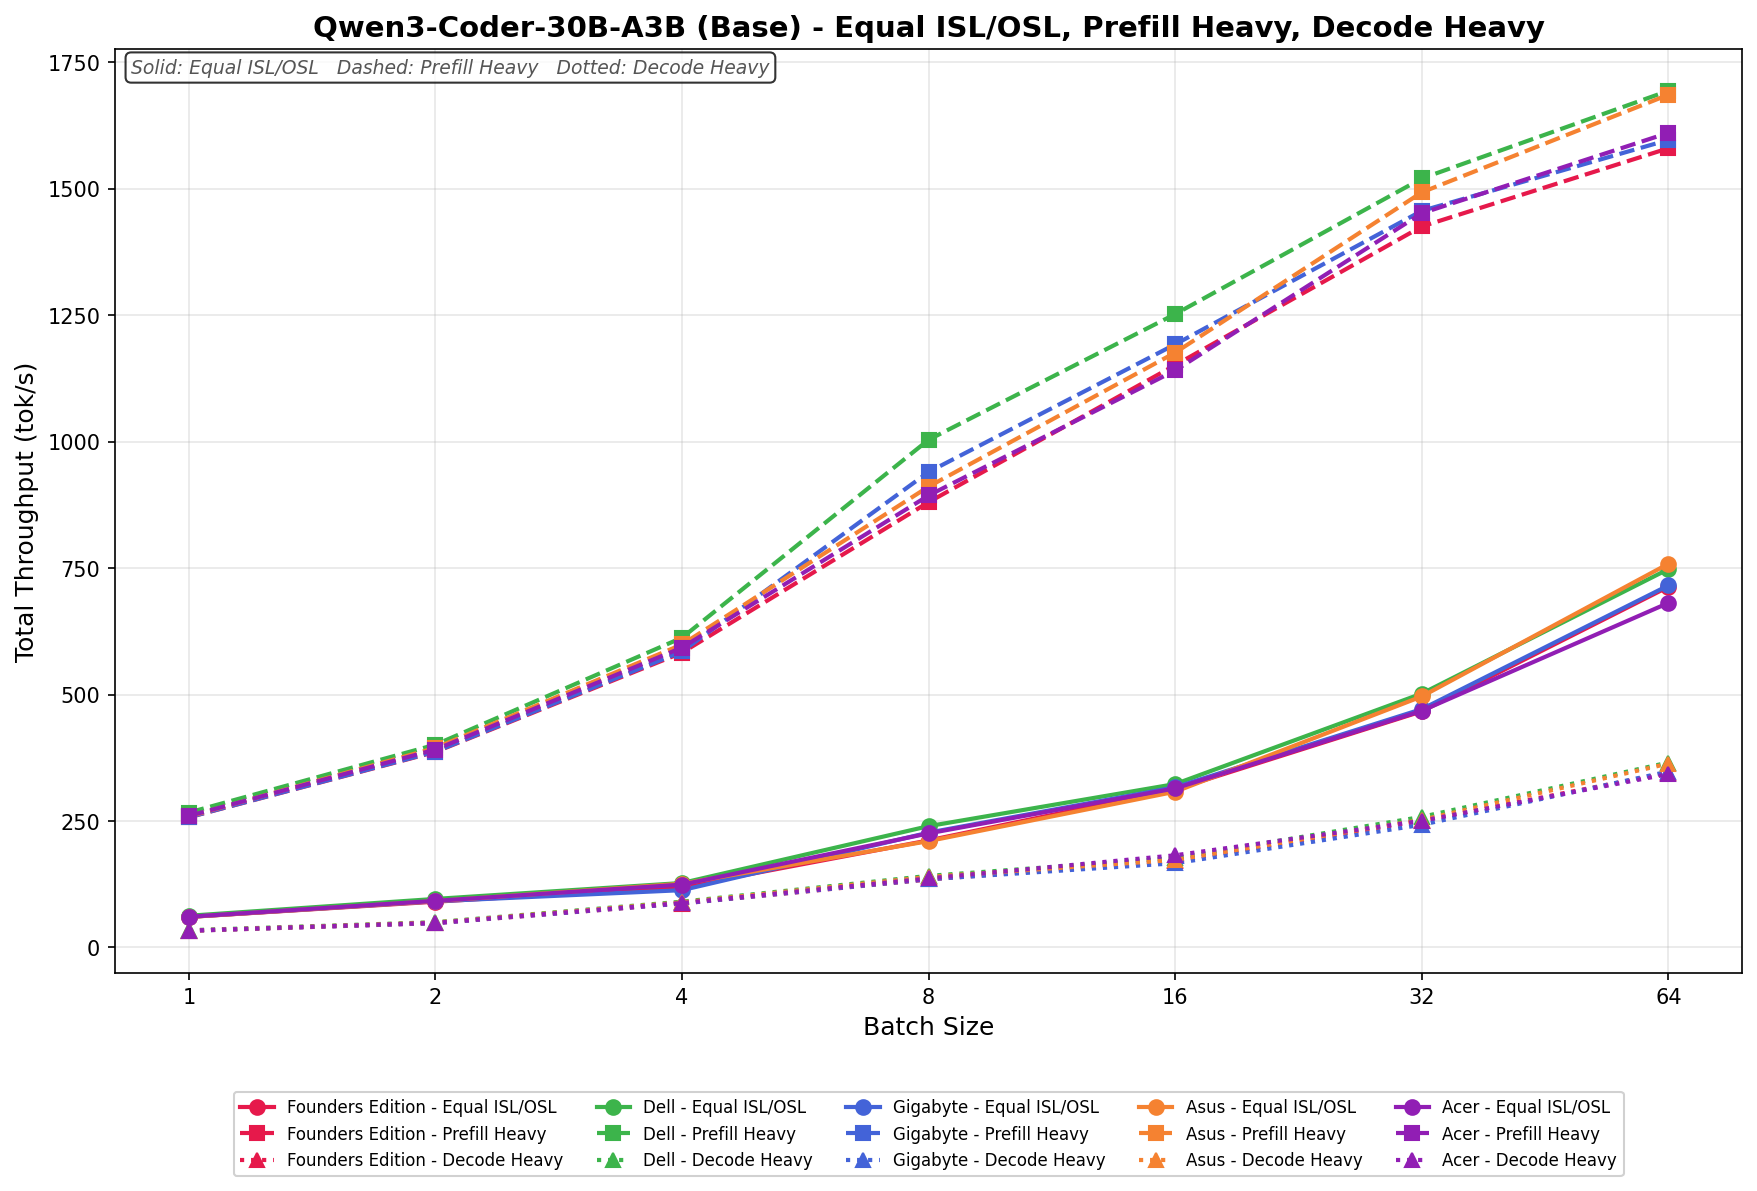
Base de codage Qwen3 30B A3B
En mode ISL/OSL égal, le débit de l'Acer varie de 60.71 à 681.18 tok/s, ce qui représente un débit sensiblement inférieur à celui de la variante FP8 pour toutes les tailles de lots. La croissance est régulière tout au long de la plage de débit, mais l'écart avec la FP8 se creuse pour les lots de grande taille.
Le pré-remplissage lourd commence à 260.11 tok/s et grimpe à 1 610,56 tok/s pour une taille de lot de 64. La mise à l'échelle est cohérente sur toute la plage, bien que le débit soit nettement inférieur à celui de son homologue FP8 pour chaque taille de lot.
Le décodage lourd atteint des débits allant de 33.31 à 342.79 tok/s, avec un rendement inférieur à celui de la variante FP8 sur toute la plage de valeurs. La croissance est progressive et constante quelle que soit la taille du lot.
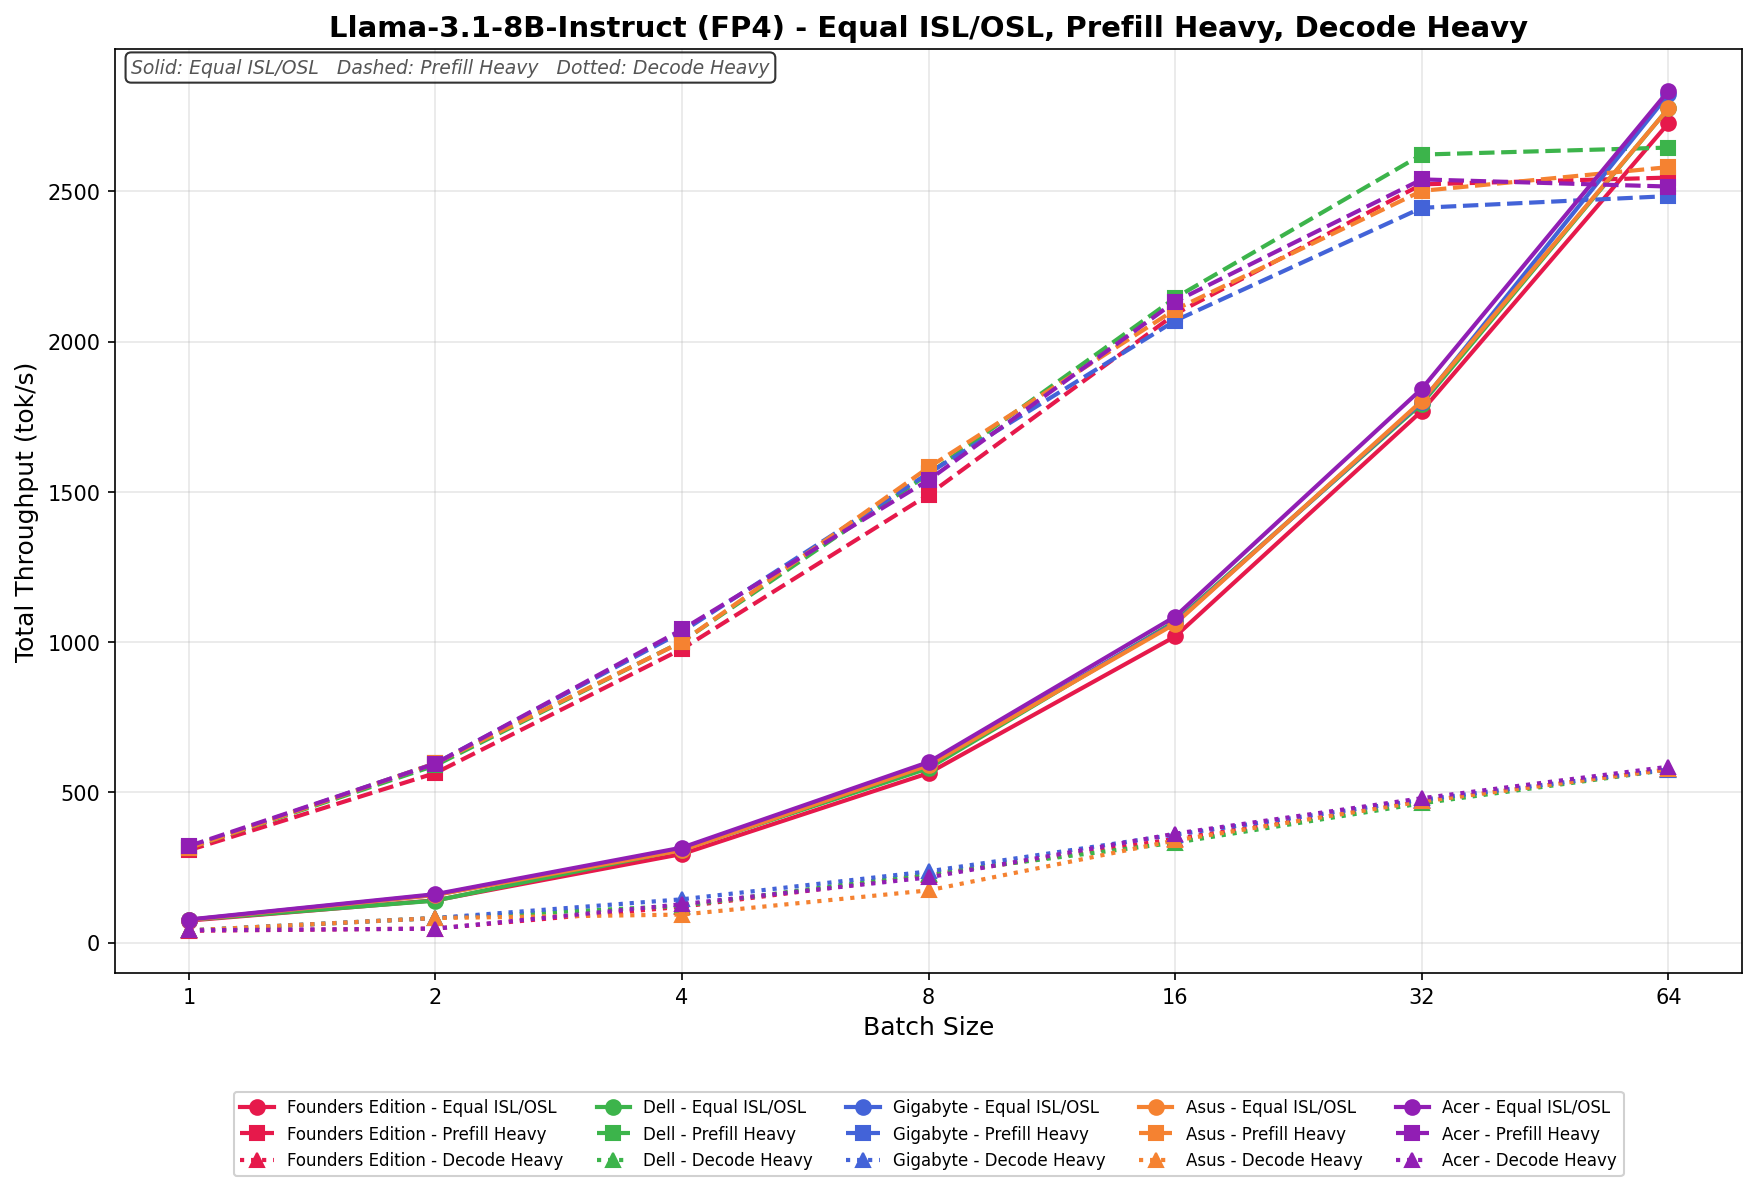
Llama 3.1 8B Instruction FP4
En mode ISL/OSL égal, le débit de l'Acer passe de 77.15 à 2 834,70 tok/s, offrant un net avantage par rapport à la version FP8 pour toutes les tailles de lots. La progression est fluide et linéaire jusqu'au lot 32, avec des gains importants et continus au lot 64.
Le préremplissage lourd commence à 321.54 tok/s et grimpe à 2 539,85 tok/s au lot 32 avant de se stabiliser légèrement à 2 516,13 tok/s au lot 64. Le modèle FP4 maintient un débit supérieur à son homologue FP8 pour les lots de taille moyenne et supérieure.
Le décodage lourd offre des performances allant de 41.21 à 585.63 tok/s, avec un rendement nettement supérieur à celui de la variante FP8 pour toutes les tailles de lots. La croissance est constante sur toute la plage de performances.
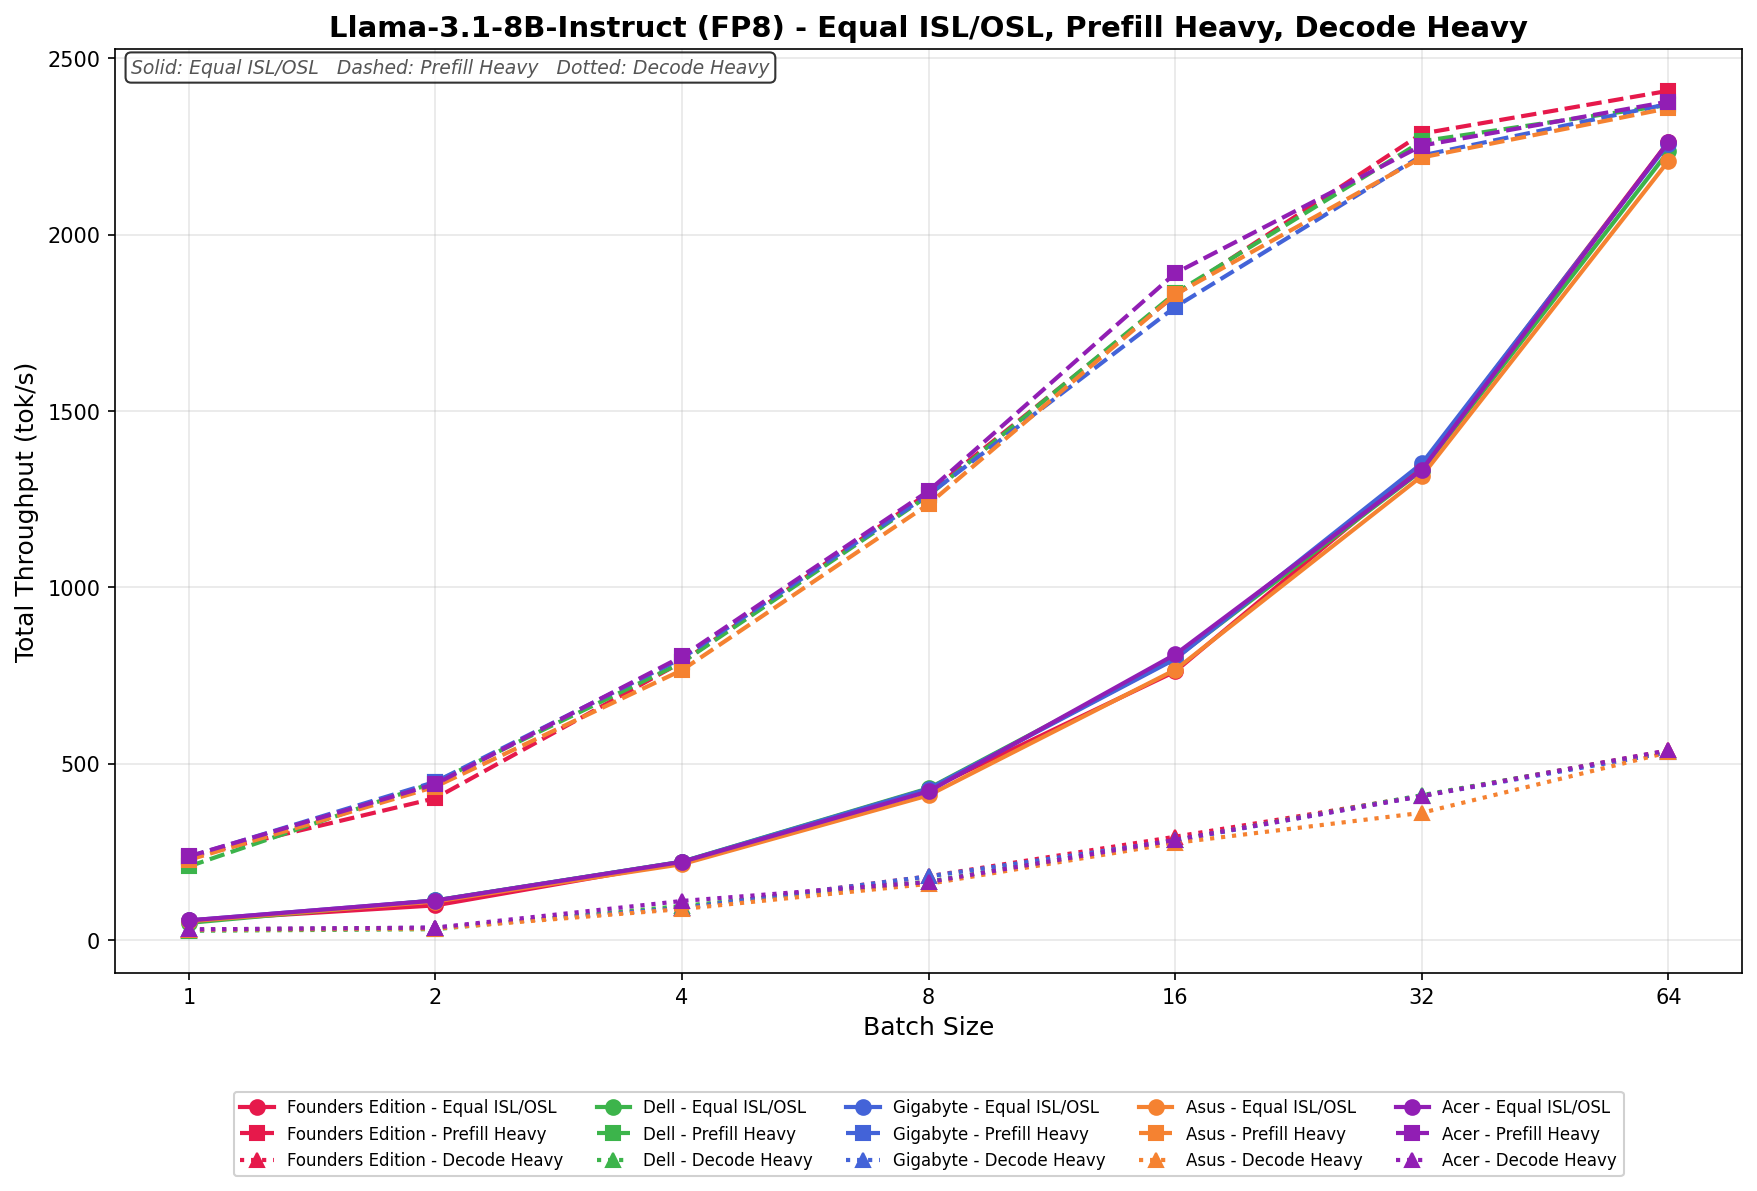
Llama 3.1 8B Instruction FP8
En mode ISL/OSL égal, le débit de l'Acer passe de 55.93 à 2 262,73 tok/s au cours du cycle de traitement par lots, avec des gains constants et réguliers à chaque étape. Le débit double quasiment entre le lot 1 et le lot 8 et continue de progresser jusqu'aux lots 32 et 64 sans aucun signe de saturation.
Le pré-remplissage lourd commence à 237.62 tok/s et passe à 2 376,88 tok/s pour une taille de lot de 64. La mise à l'échelle est forte et progressive tout au long, avec un débit augmentant de manière constante sur l'ensemble du cycle de traitement par lots.
Decode Heavy varie de 30.39 à 538.18 tok/s, avec une croissance constante tout au long du balayage du lot.
Stockage direct du GPU
L'un des tests que nous avons menés sur le Spark était le test MagnumIO GPU Direct Storage (GDS). GDS est une fonctionnalité développée par NVIDIA qui permet aux GPU de contourner le CPU lors de l'accès aux données stockées sur des disques NVMe ou d'autres périphériques de stockage haute vitesse. Au lieu de faire transiter les données par le CPU et la mémoire système, GDS permet une communication directe entre le GPU et le périphérique de stockage, réduisant ainsi considérablement la latence et améliorant le débit.
Acer utilise le SSD Samsung PM9E1 Gen5 de 4 To dans le Veriton GN100 AI, qui est à ce jour le disque M.2 2242 le plus rapide que nous ayons vu sur le marché.
Comment fonctionne le stockage direct GPU
Traditionnellement, lorsqu'un GPU traite des données stockées sur un disque NVMe, ces données doivent d'abord transiter par le CPU et la mémoire système avant d'atteindre le GPU. Ce processus engendre des goulots d'étranglement, le CPU jouant le rôle d'intermédiaire, ce qui ajoute de la latence et consomme des ressources système précieuses. Le GPU Direct Storage élimine cette inefficacité en permettant au GPU d'accéder directement aux données depuis le périphérique de stockage via le bus PCIe. Ce chemin direct réduit la surcharge liée aux transferts de données, permettant ainsi des transferts plus rapides et plus efficaces.
Les charges de travail de l’IA, en particulier celles impliquant l’apprentissage profond, sont très gourmandes en données. La formation de grands réseaux neuronaux nécessite le traitement de téraoctets de données, et tout retard dans le transfert de données peut entraîner une sous-utilisation des GPU et des temps de formation plus longs. Le stockage direct GPU relève ce défi en garantissant que les données sont transmises au GPU le plus rapidement possible, en minimisant les temps d’inactivité et en maximisant l’efficacité de calcul.
En outre, GDS est particulièrement utile pour les charges de travail impliquant la diffusion de grands ensembles de données, comme le traitement vidéo, le traitement du langage naturel ou l'inférence en temps réel. En réduisant la dépendance au processeur, GDS accélère le déplacement des données et libère les ressources du processeur pour d'autres tâches, améliorant ainsi encore les performances globales du système.
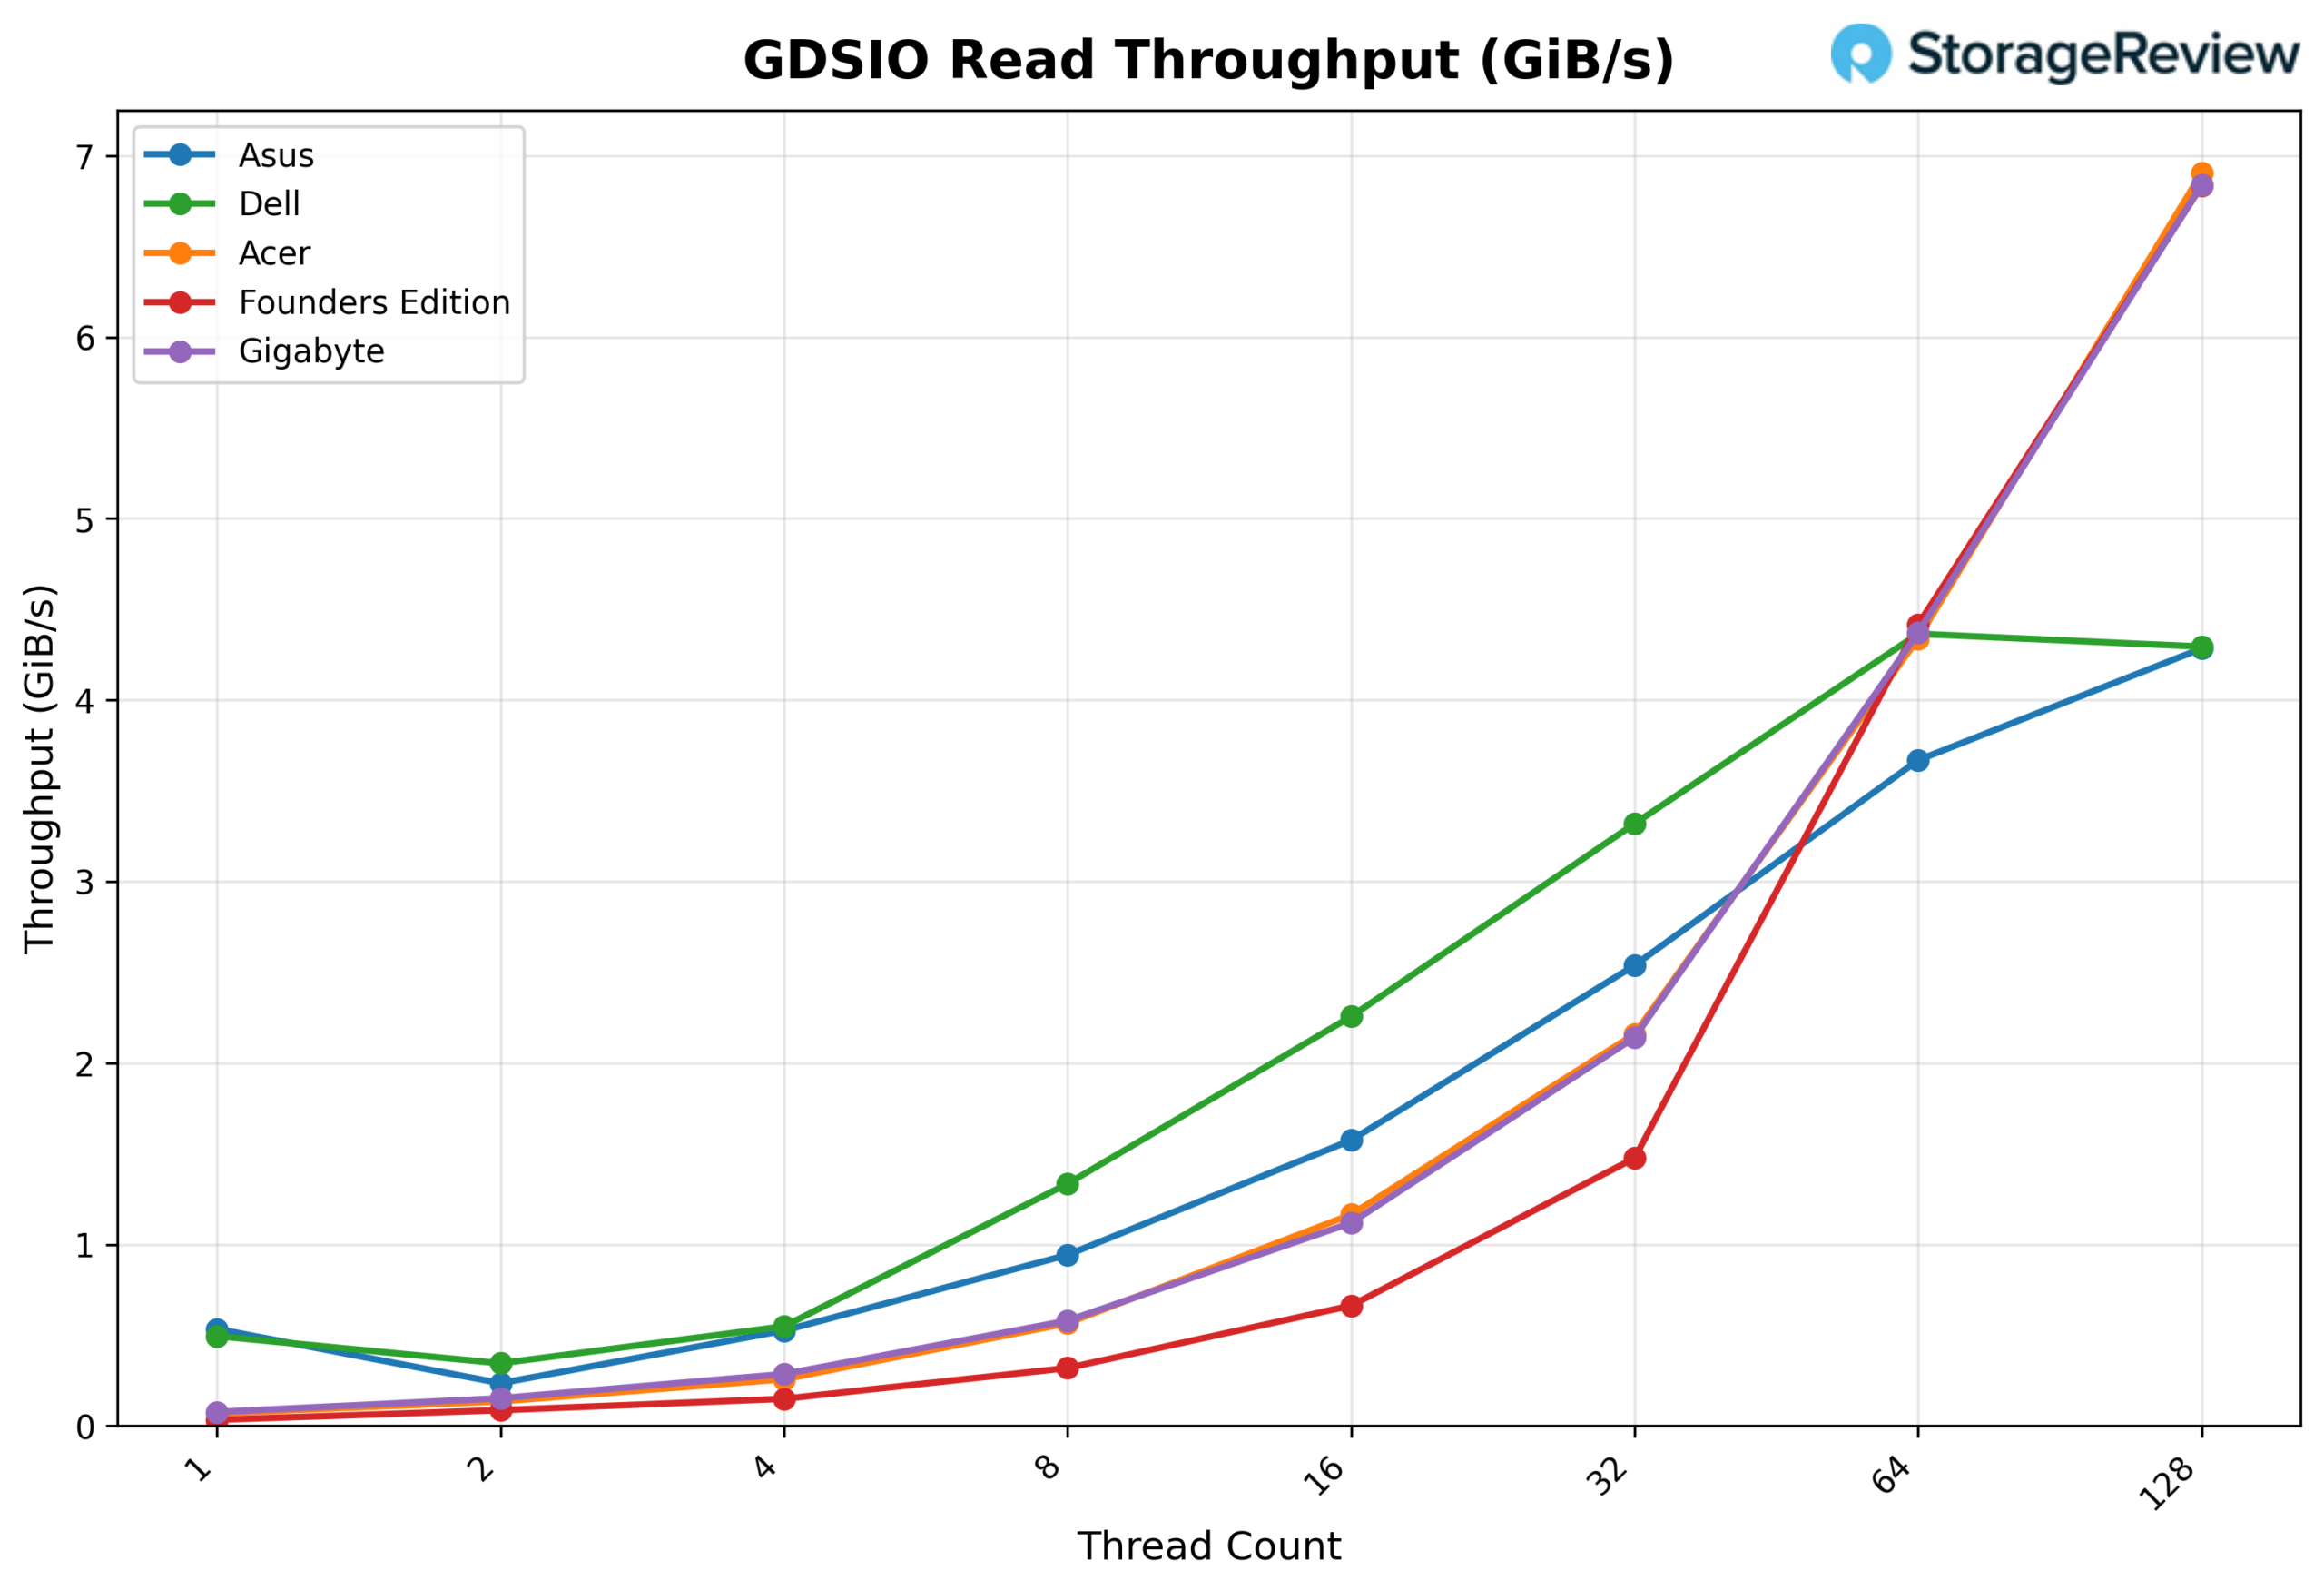
Débit de lecture GDSIO : 16 k
En ce qui concerne le débit de lecture GDSIO 16K, l'Acer affiche un débit initial de 0.07 Gio/s avec 1 thread, puis une augmentation linéaire avec 2 threads (0.13 Gio/s), 4 threads (0.26 Gio/s) et 8 threads (0.57 Gio/s). Le débit continue de progresser avec 16 threads (1.16 Gio/s), 32 threads (2.16 Gio/s) et 64 threads (4.34 Gio/s). À 128 threads, le débit atteint 6.91 Gio/s, soit le résultat le plus élevé observé lors de ce test, sans point de saturation apparent, ce qui indique que la plateforme continue de progresser même avec des E/S de petite taille.
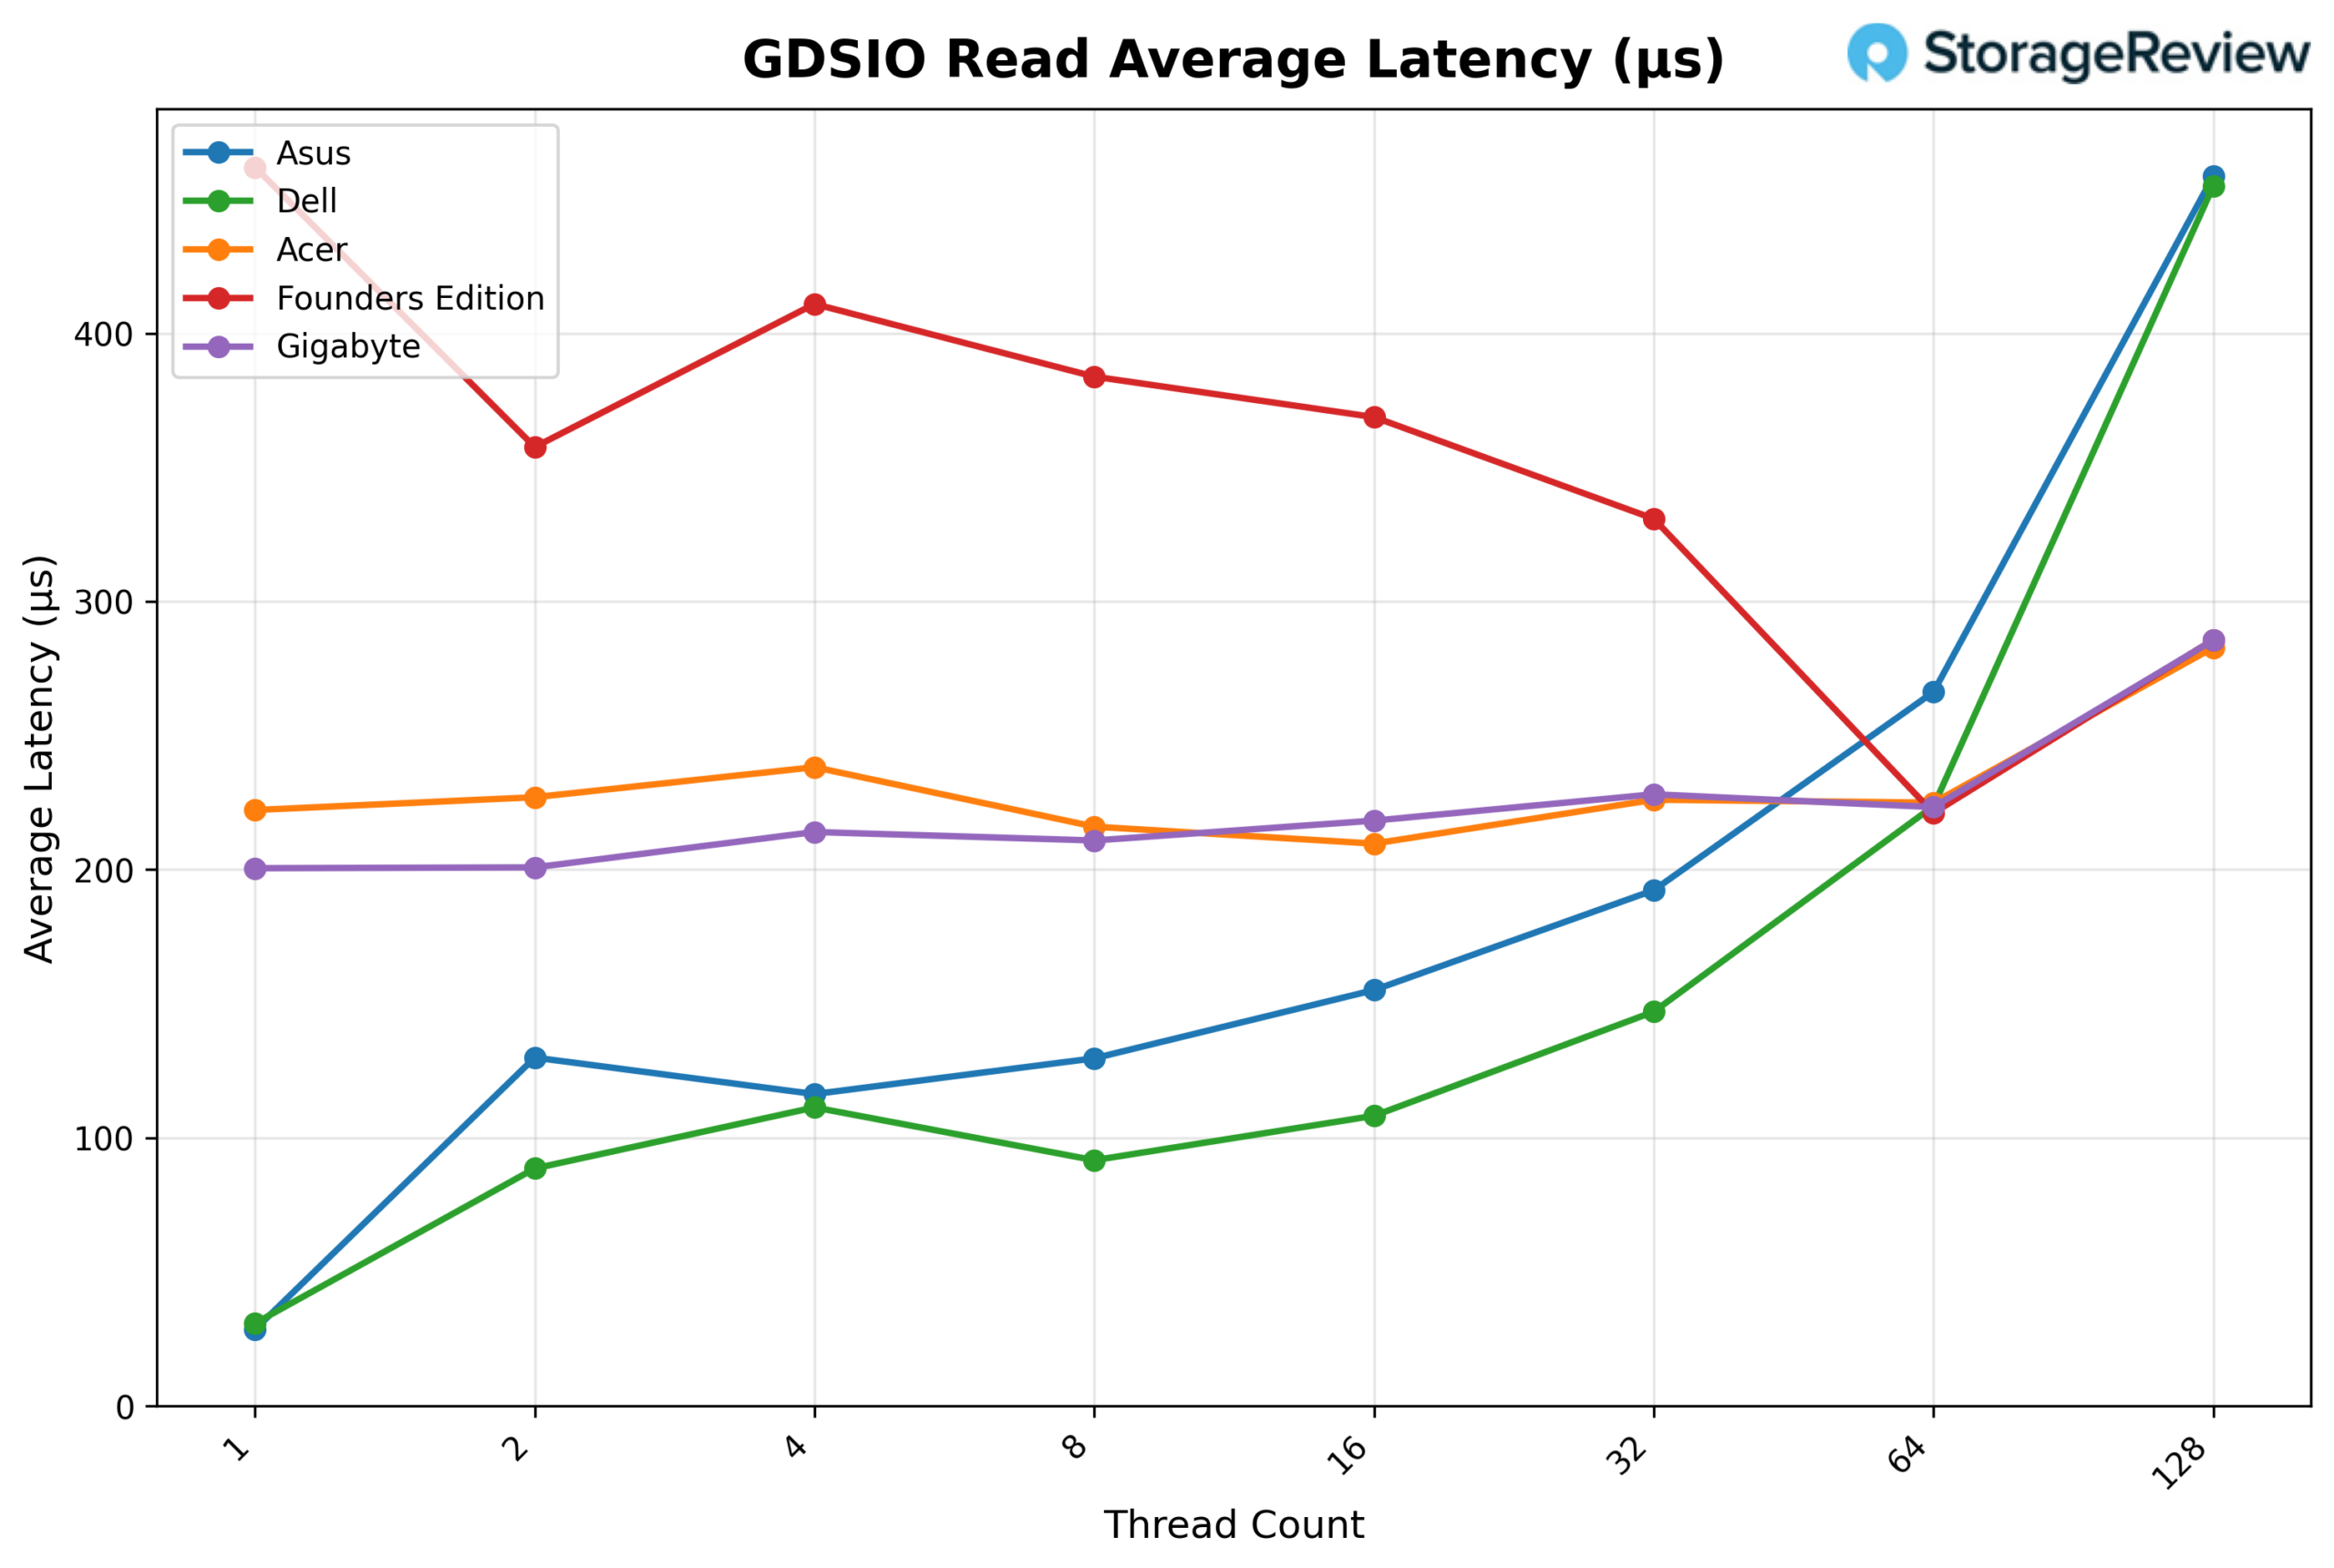
Latence moyenne de lecture GDSIO : 16 Ko
En analysant la latence moyenne de lecture GDSIO (16K), l'Acer affiche une latence d'environ 0.22 ms avec 1 thread et reste remarquablement stable : 0.23 ms avec 2 threads, 0.24 ms avec 4 threads et 0.22 ms avec 8 threads. La latence demeure également stable avec 16 threads (0.21 ms), 32 threads (0.23 ms) et 64 threads (0.22 ms), avant d'augmenter légèrement à 0.28 ms avec 128 threads. Cette latence quasi constante, quel que soit le nombre de threads, reflète l'augmentation continue du débit observée.
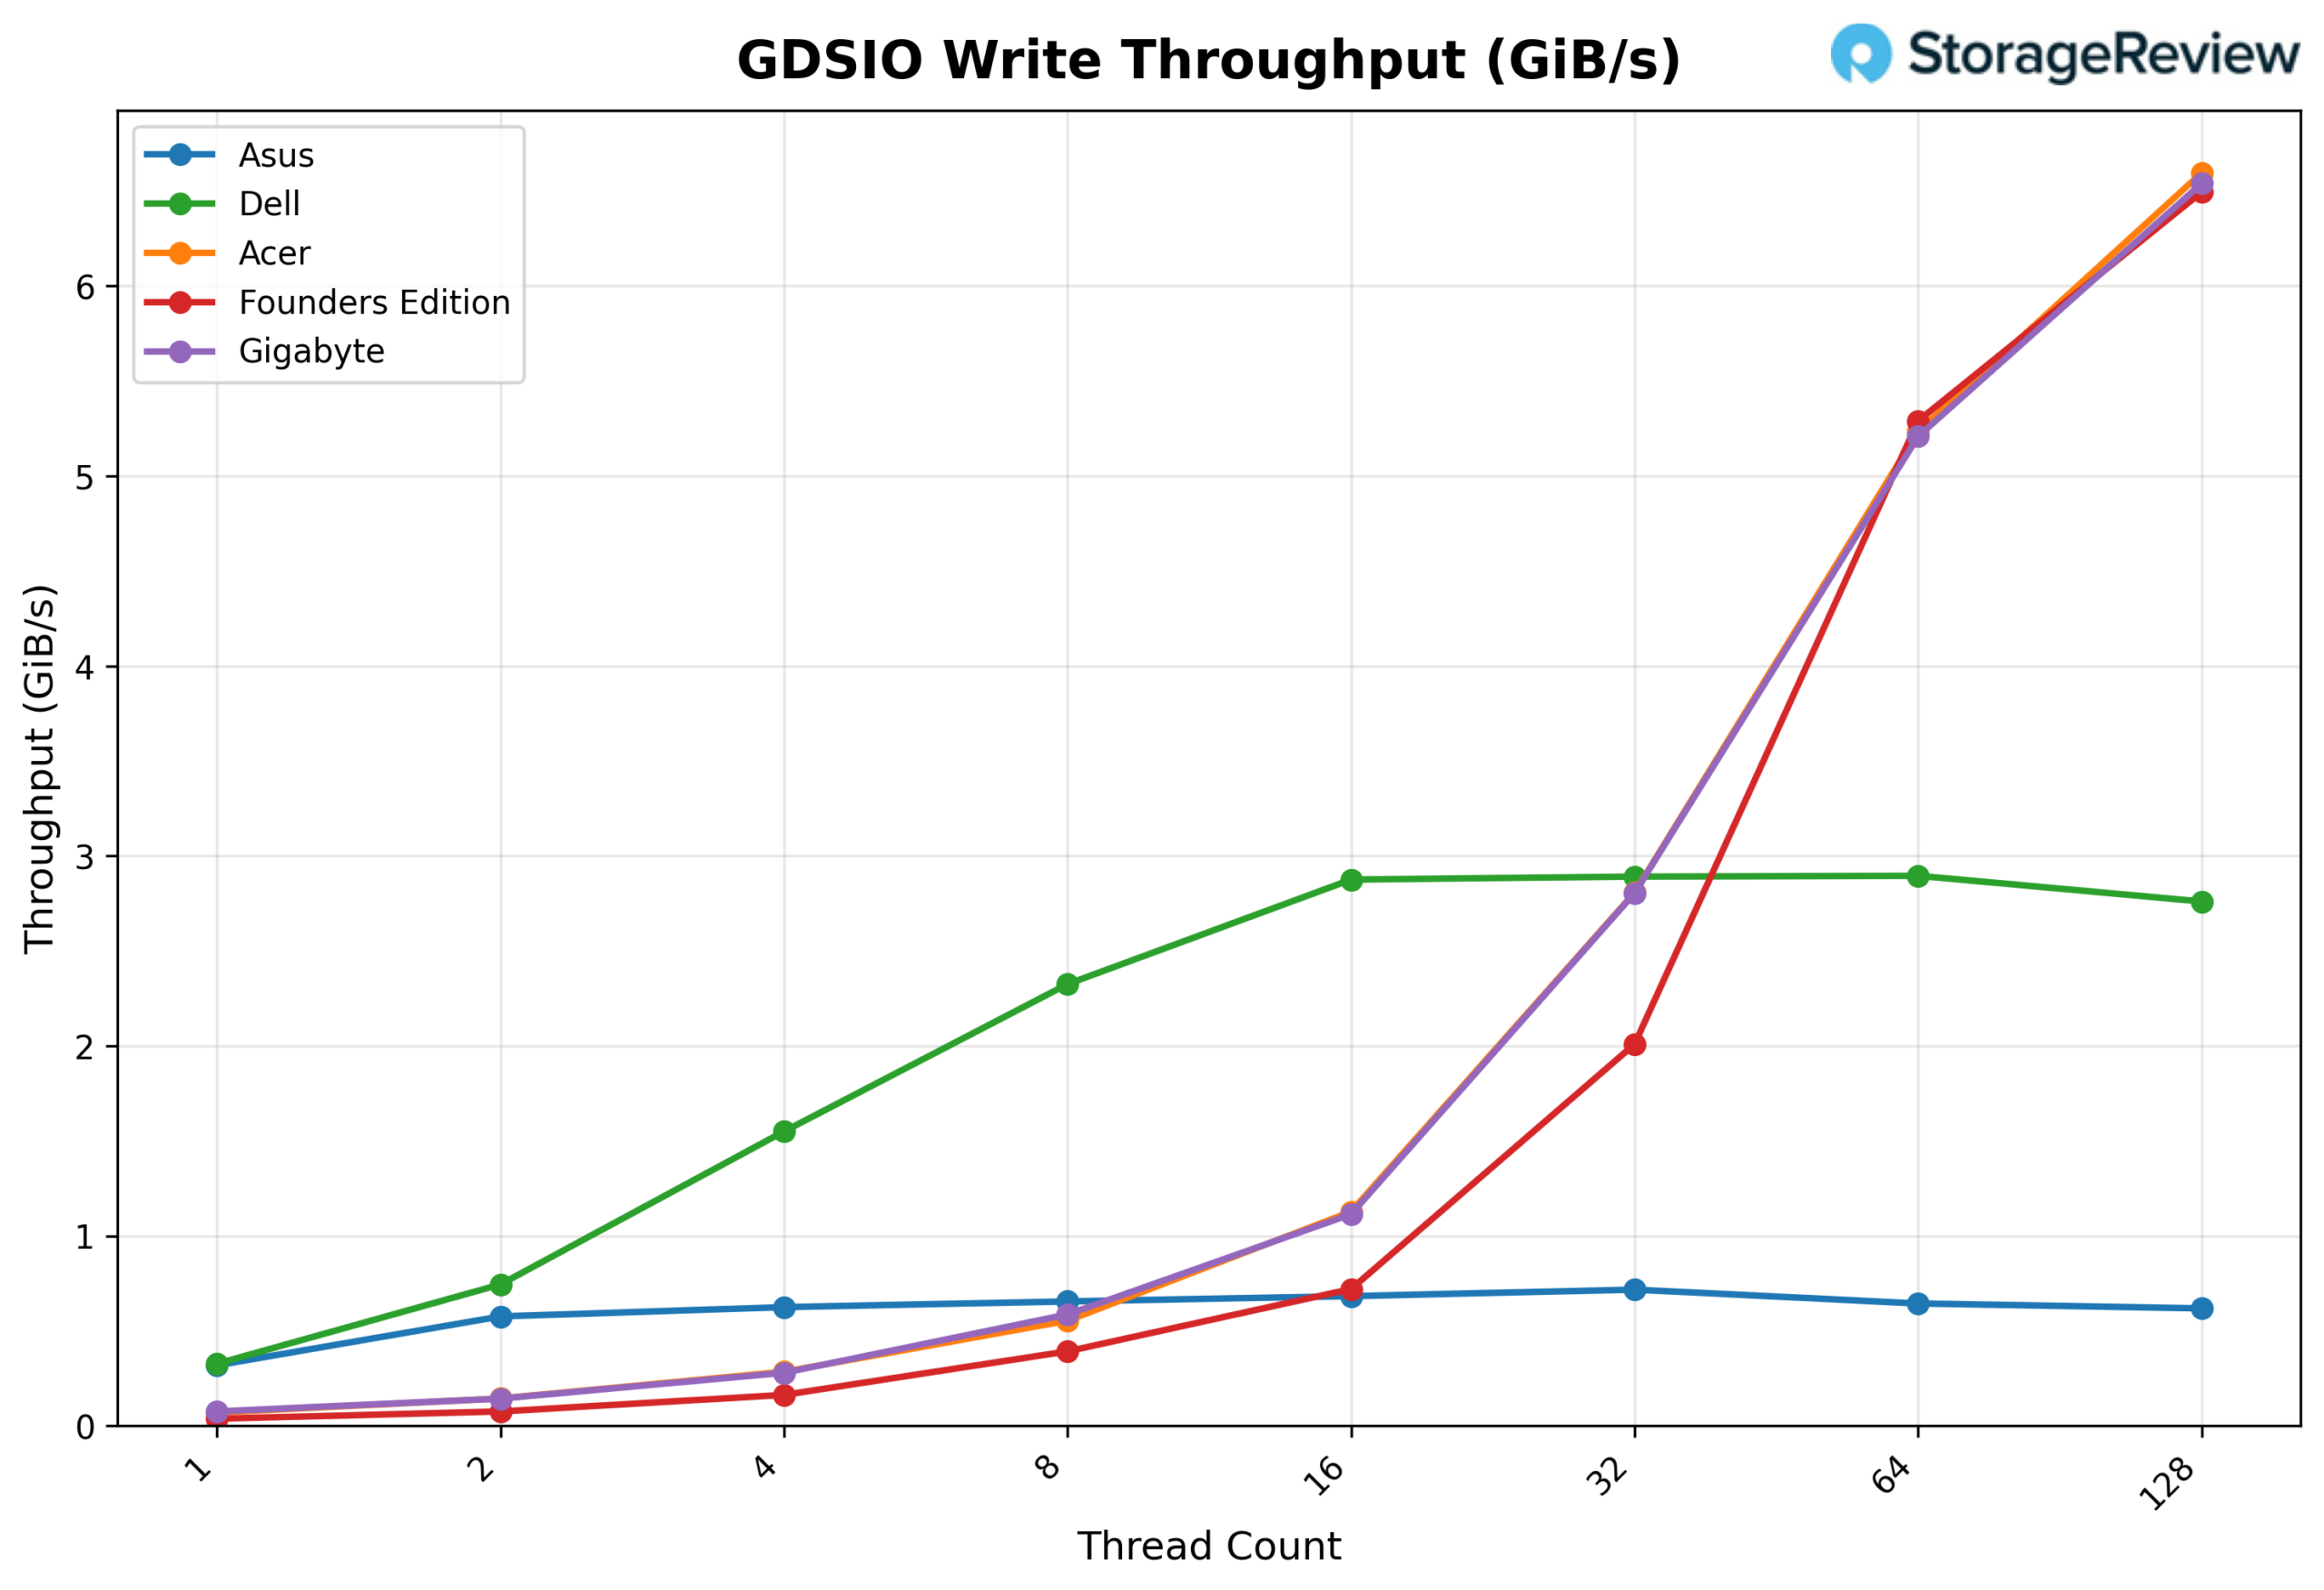
Débit d'écriture GSDIO : 16 Ko
En ce qui concerne le débit d'écriture GDSIO 16K, l'Acer affiche un débit initial de 0.07 Gio/s avec 1 thread, puis augmente progressivement avec 2 threads (0.14 Gio/s), 4 threads (0.28 Gio/s) et 8 threads (0.55 Gio/s). La croissance s'accélère ensuite avec 16 threads (1.13 Gio/s), 32 threads (2.81 Gio/s) et 64 threads (5.23 Gio/s). À 128 threads, le débit atteint 6.60 Gio/s, soit le pic mesuré, ce qui confirme l'absence de saturation et la poursuite de l'augmentation du débit pour les petits blocs.
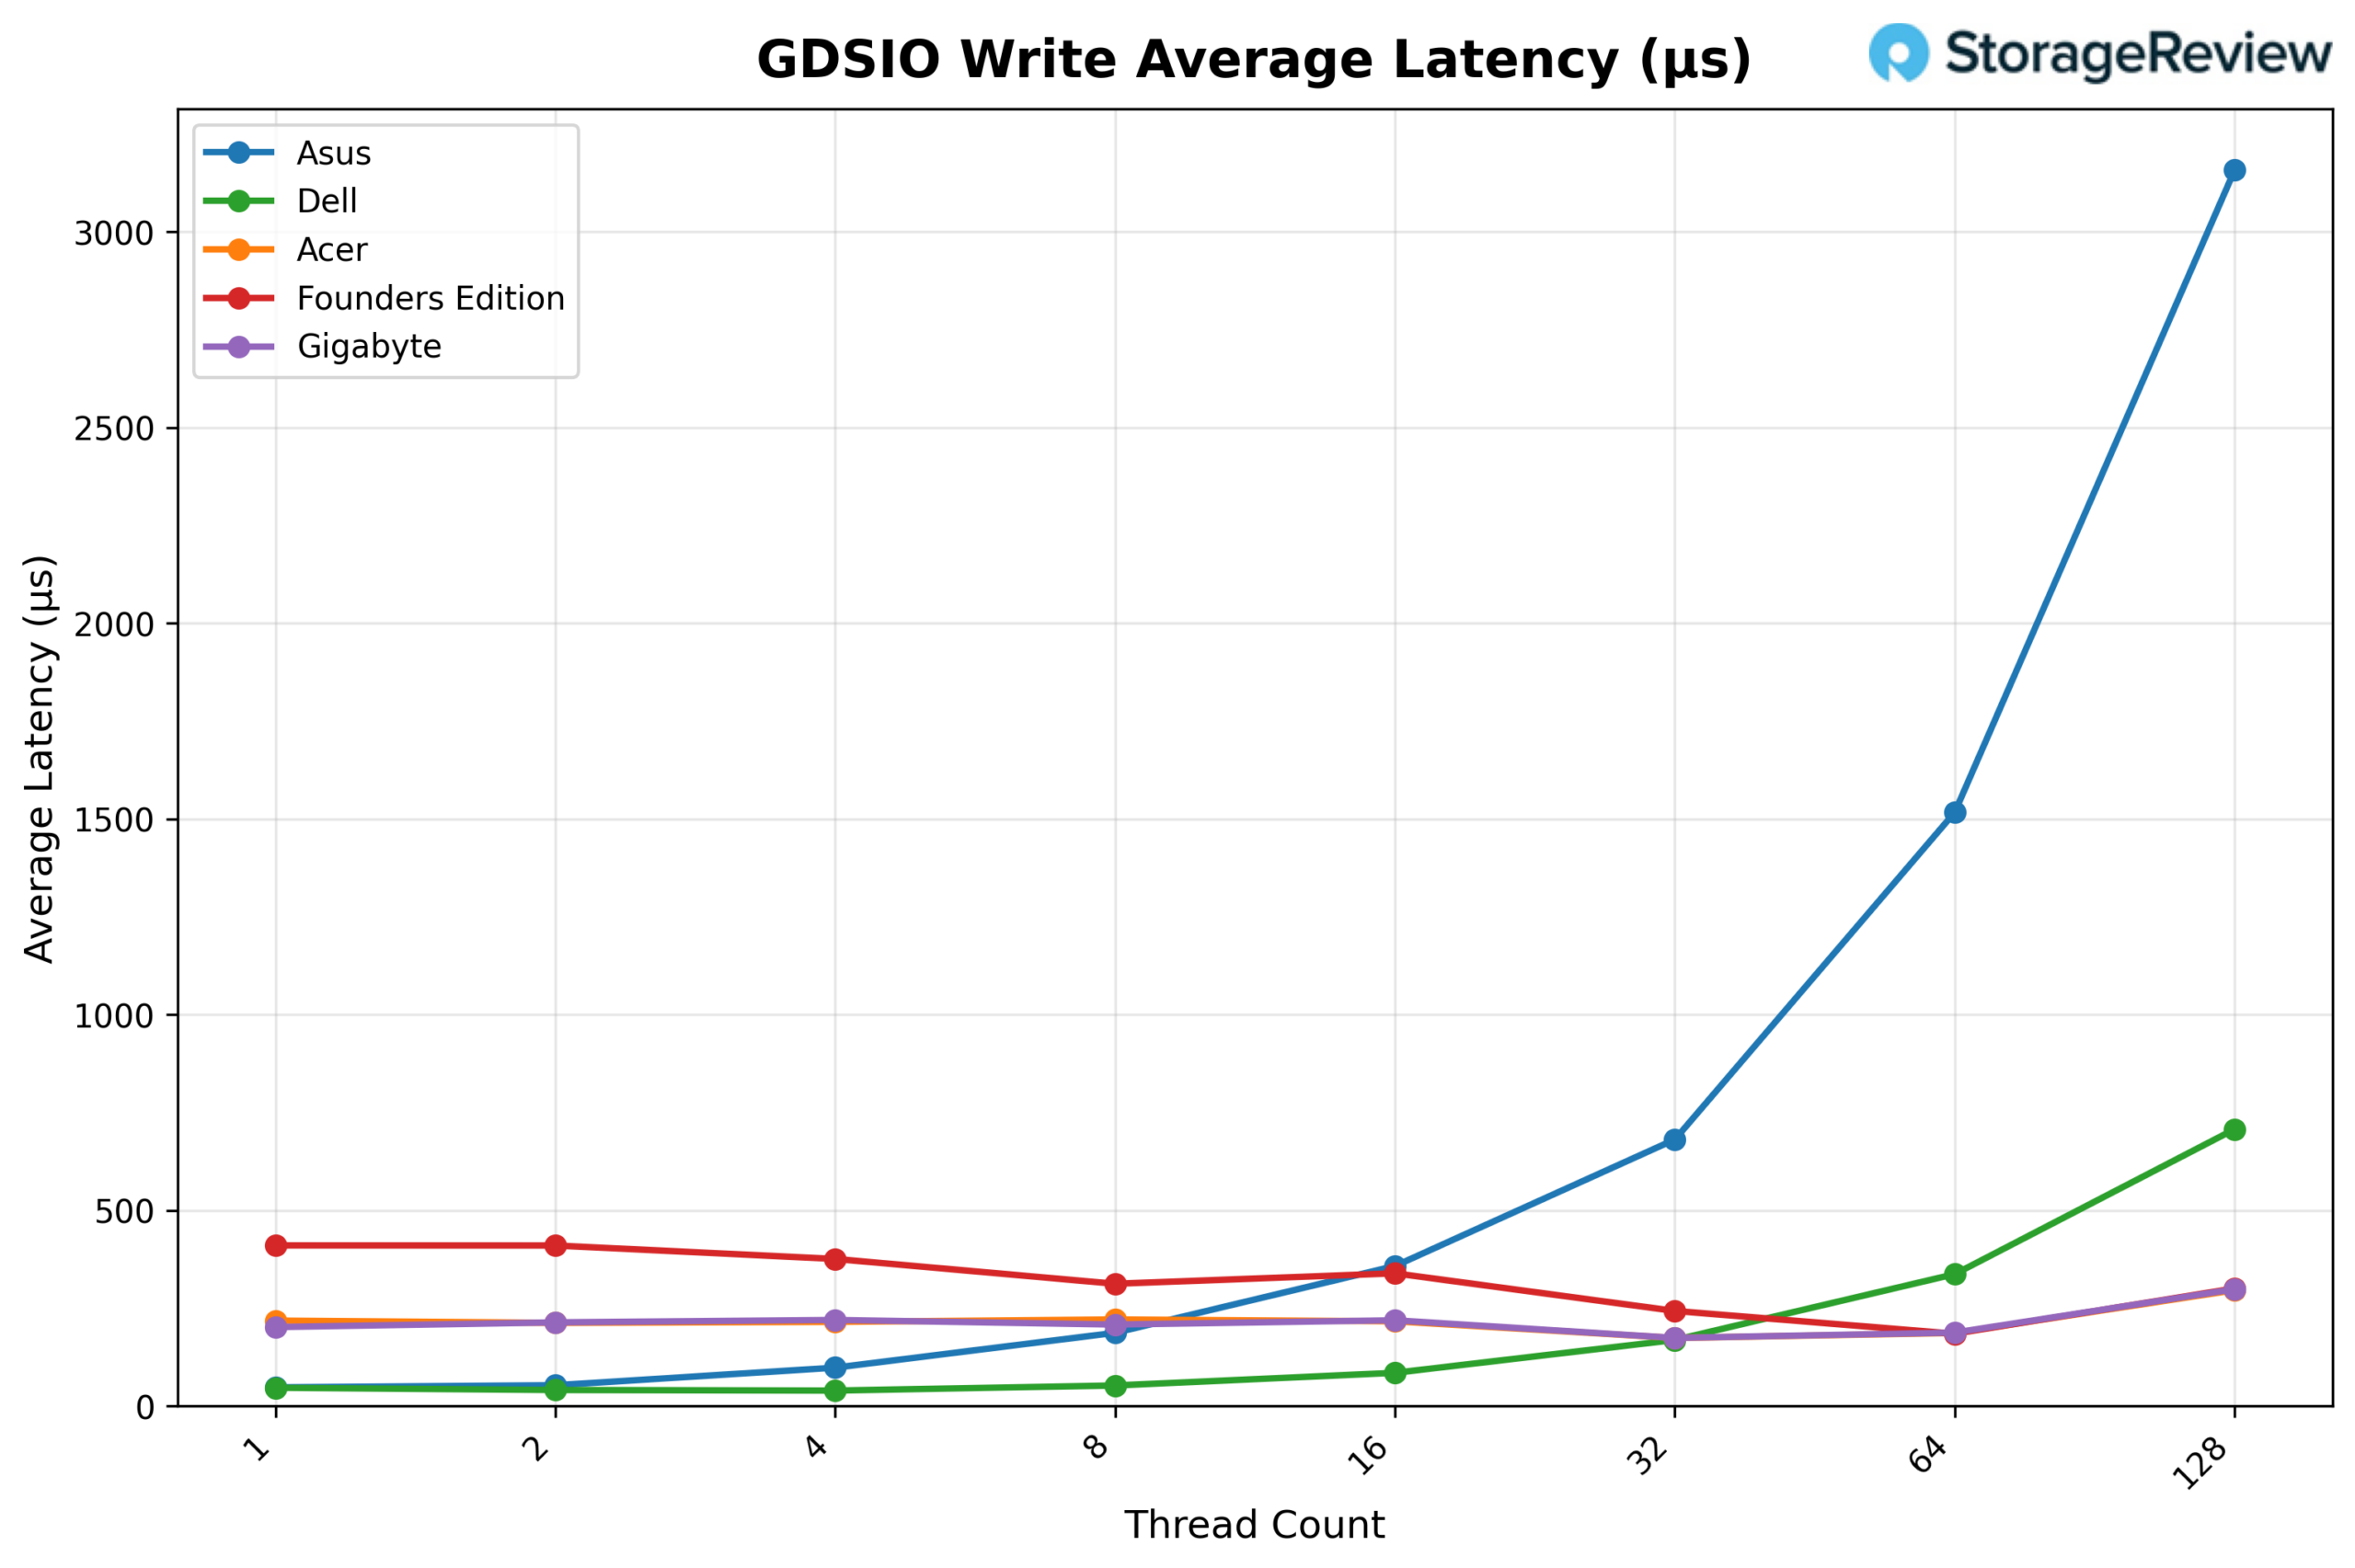
Latence d'écriture moyenne GDSIO : 16 Ko
En analysant la latence d'écriture moyenne GDSIO (16 Ko), l'Acer affiche une latence d'environ 0.22 ms avec 1 thread et reste stable à 2 (0.21 ms), 4 (0.22 ms) et 8 threads (0.22 ms). La latence diminue légèrement à 0.17 ms à 32 threads avant de remonter modestement à 0.19 ms à 64 threads. À 128 threads, la latence grimpe à 0.30 ms, toujours relativement faible comparée aux résultats obtenus avec 1 Mbit/s, ce qui confirme le comportement d'évolution observé pour cette taille d'E/S réduite.
Débit de lecture GDSIO : 1 Mbit/s
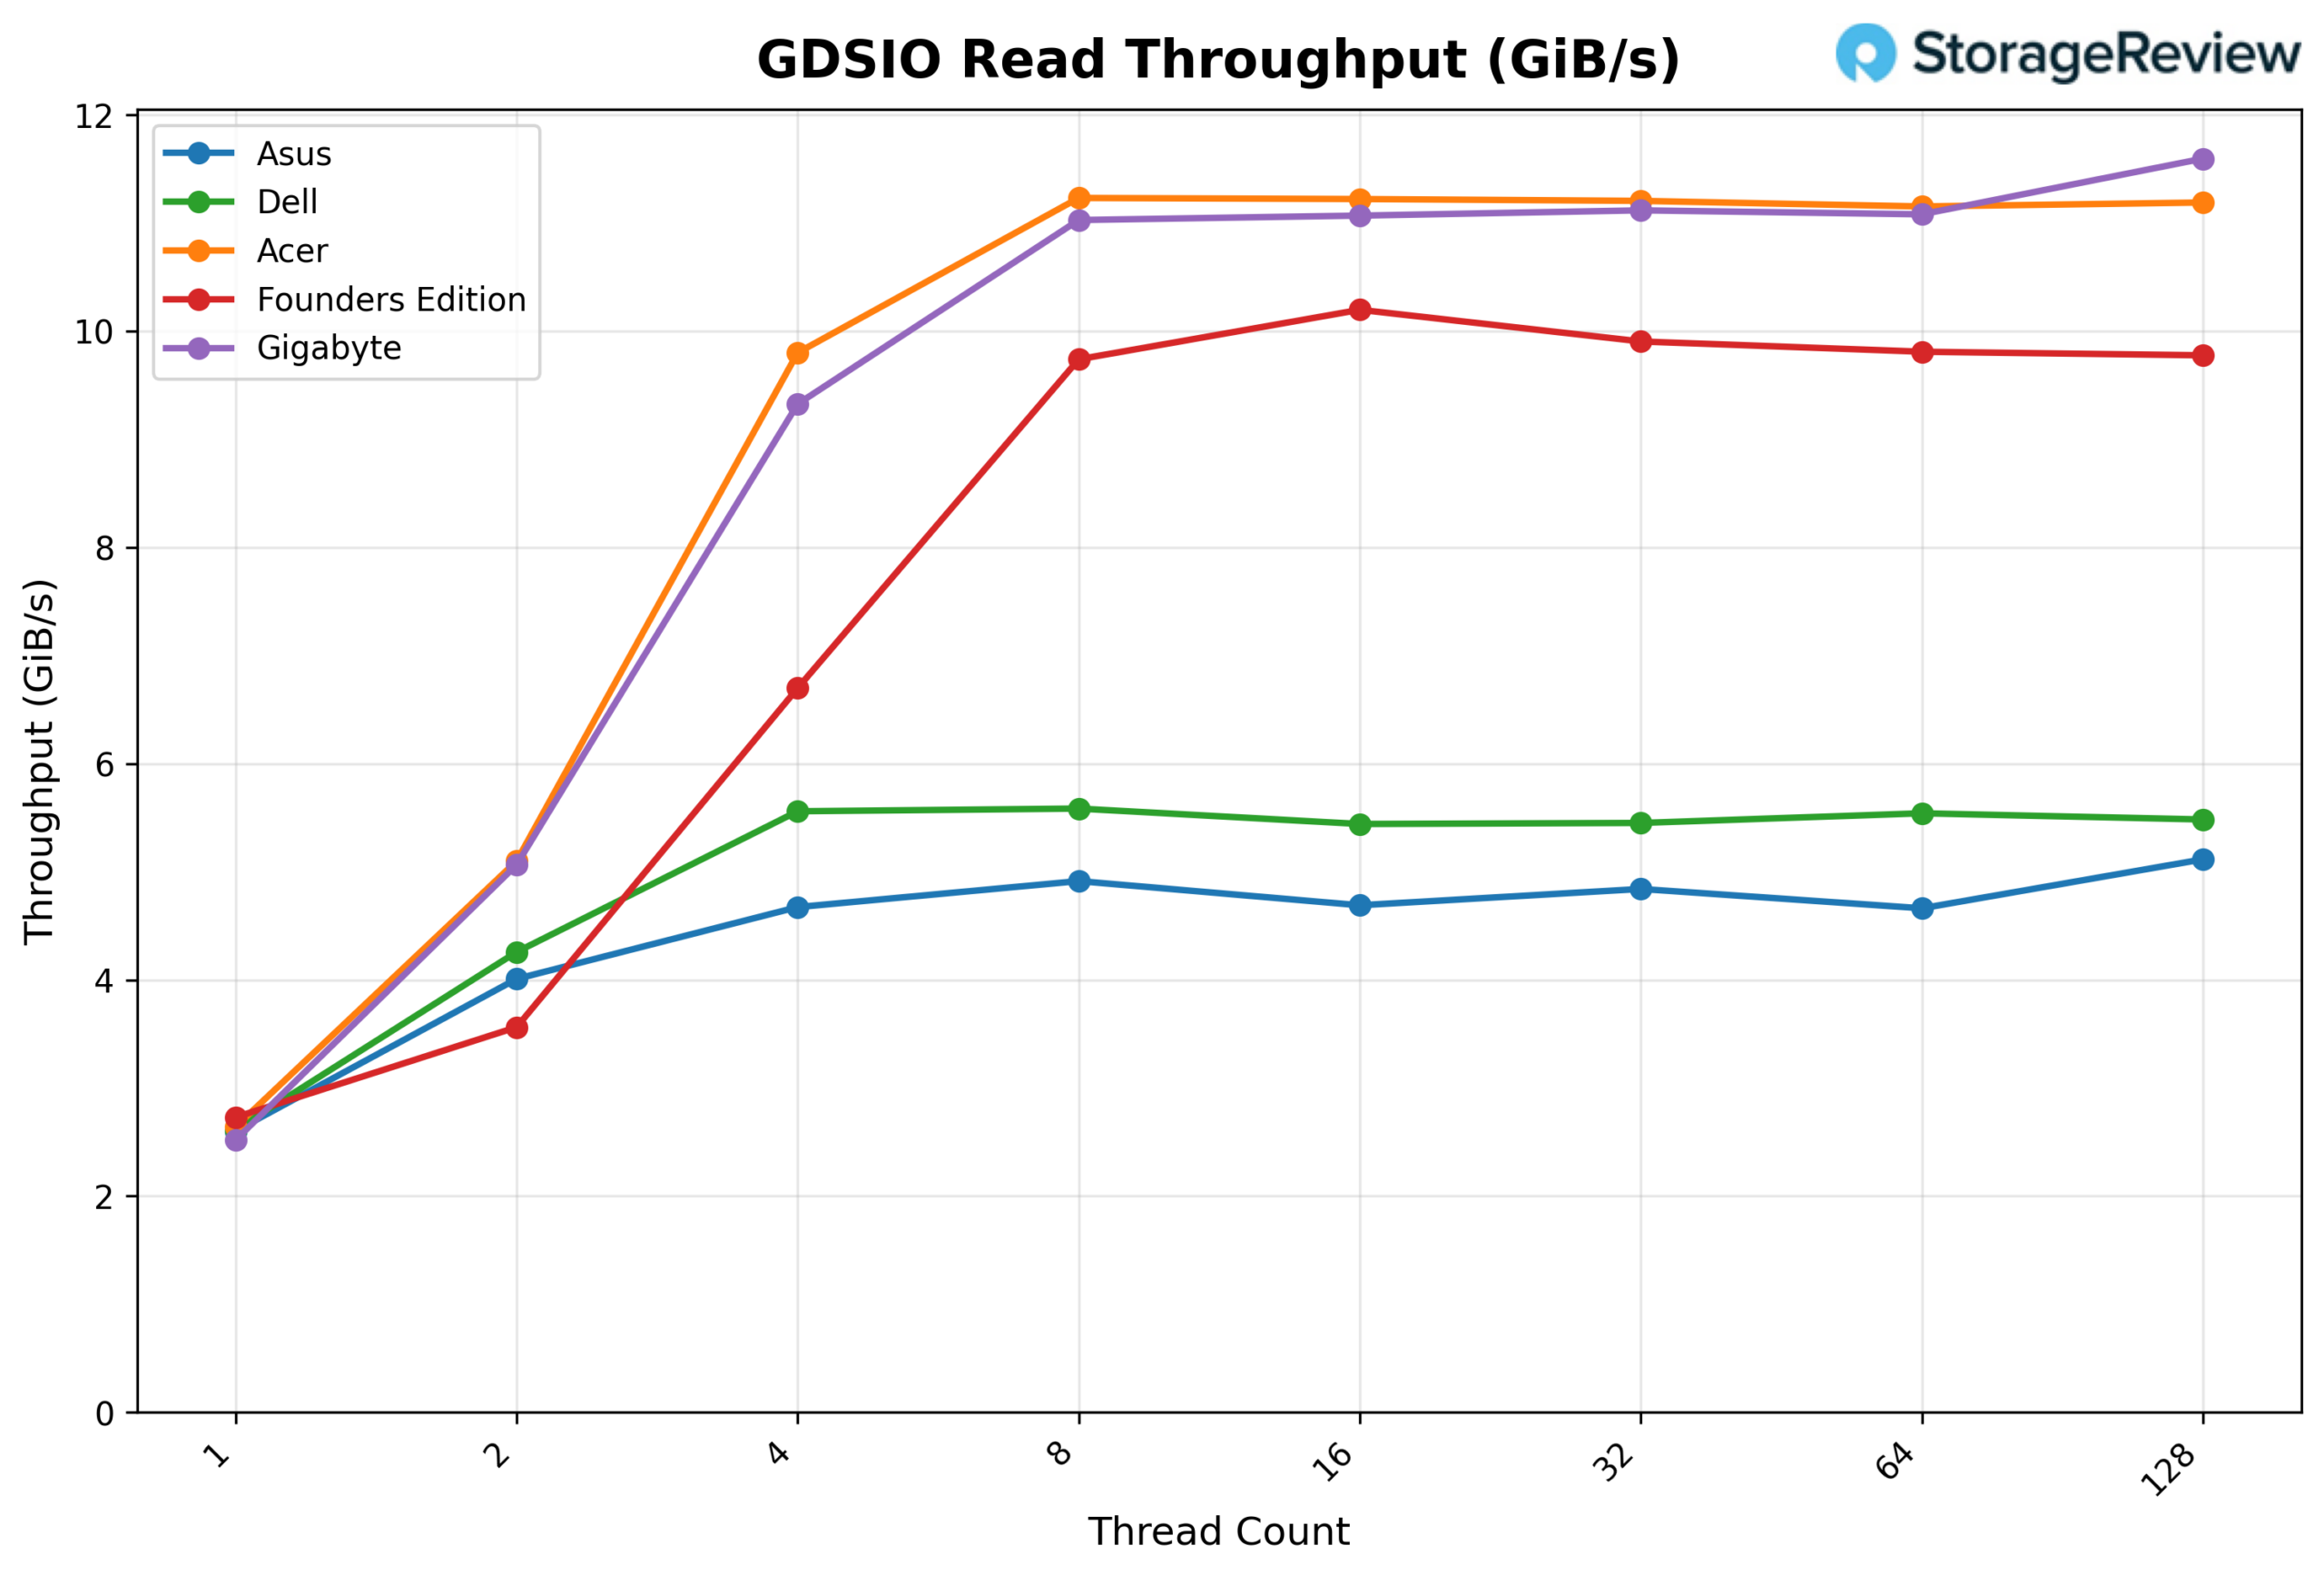
En ce qui concerne le débit de lecture GDSIO à 1 Mo, l'Acer atteint 2.64 Gio/s avec 1 cœur, 5.10 Gio/s avec 2 cœurs et 9.80 Gio/s avec 4 cœurs. À 8 cœurs, le débit atteint 11.23 Gio/s, après quoi la plateforme sature. Les performances restent constantes à 16 cœurs (11.22 Gio/s), 32 cœurs (11.21 Gio/s) et 64 cœurs (11.15 Gio/s), démontrant une stabilité remarquable. À 128 cœurs, le débit se stabilise à 11.19 Gio/s, confirmant ainsi la saturation sur toute la plage de performances.
Latence moyenne de lecture GDSIO : 1 Mbit/s
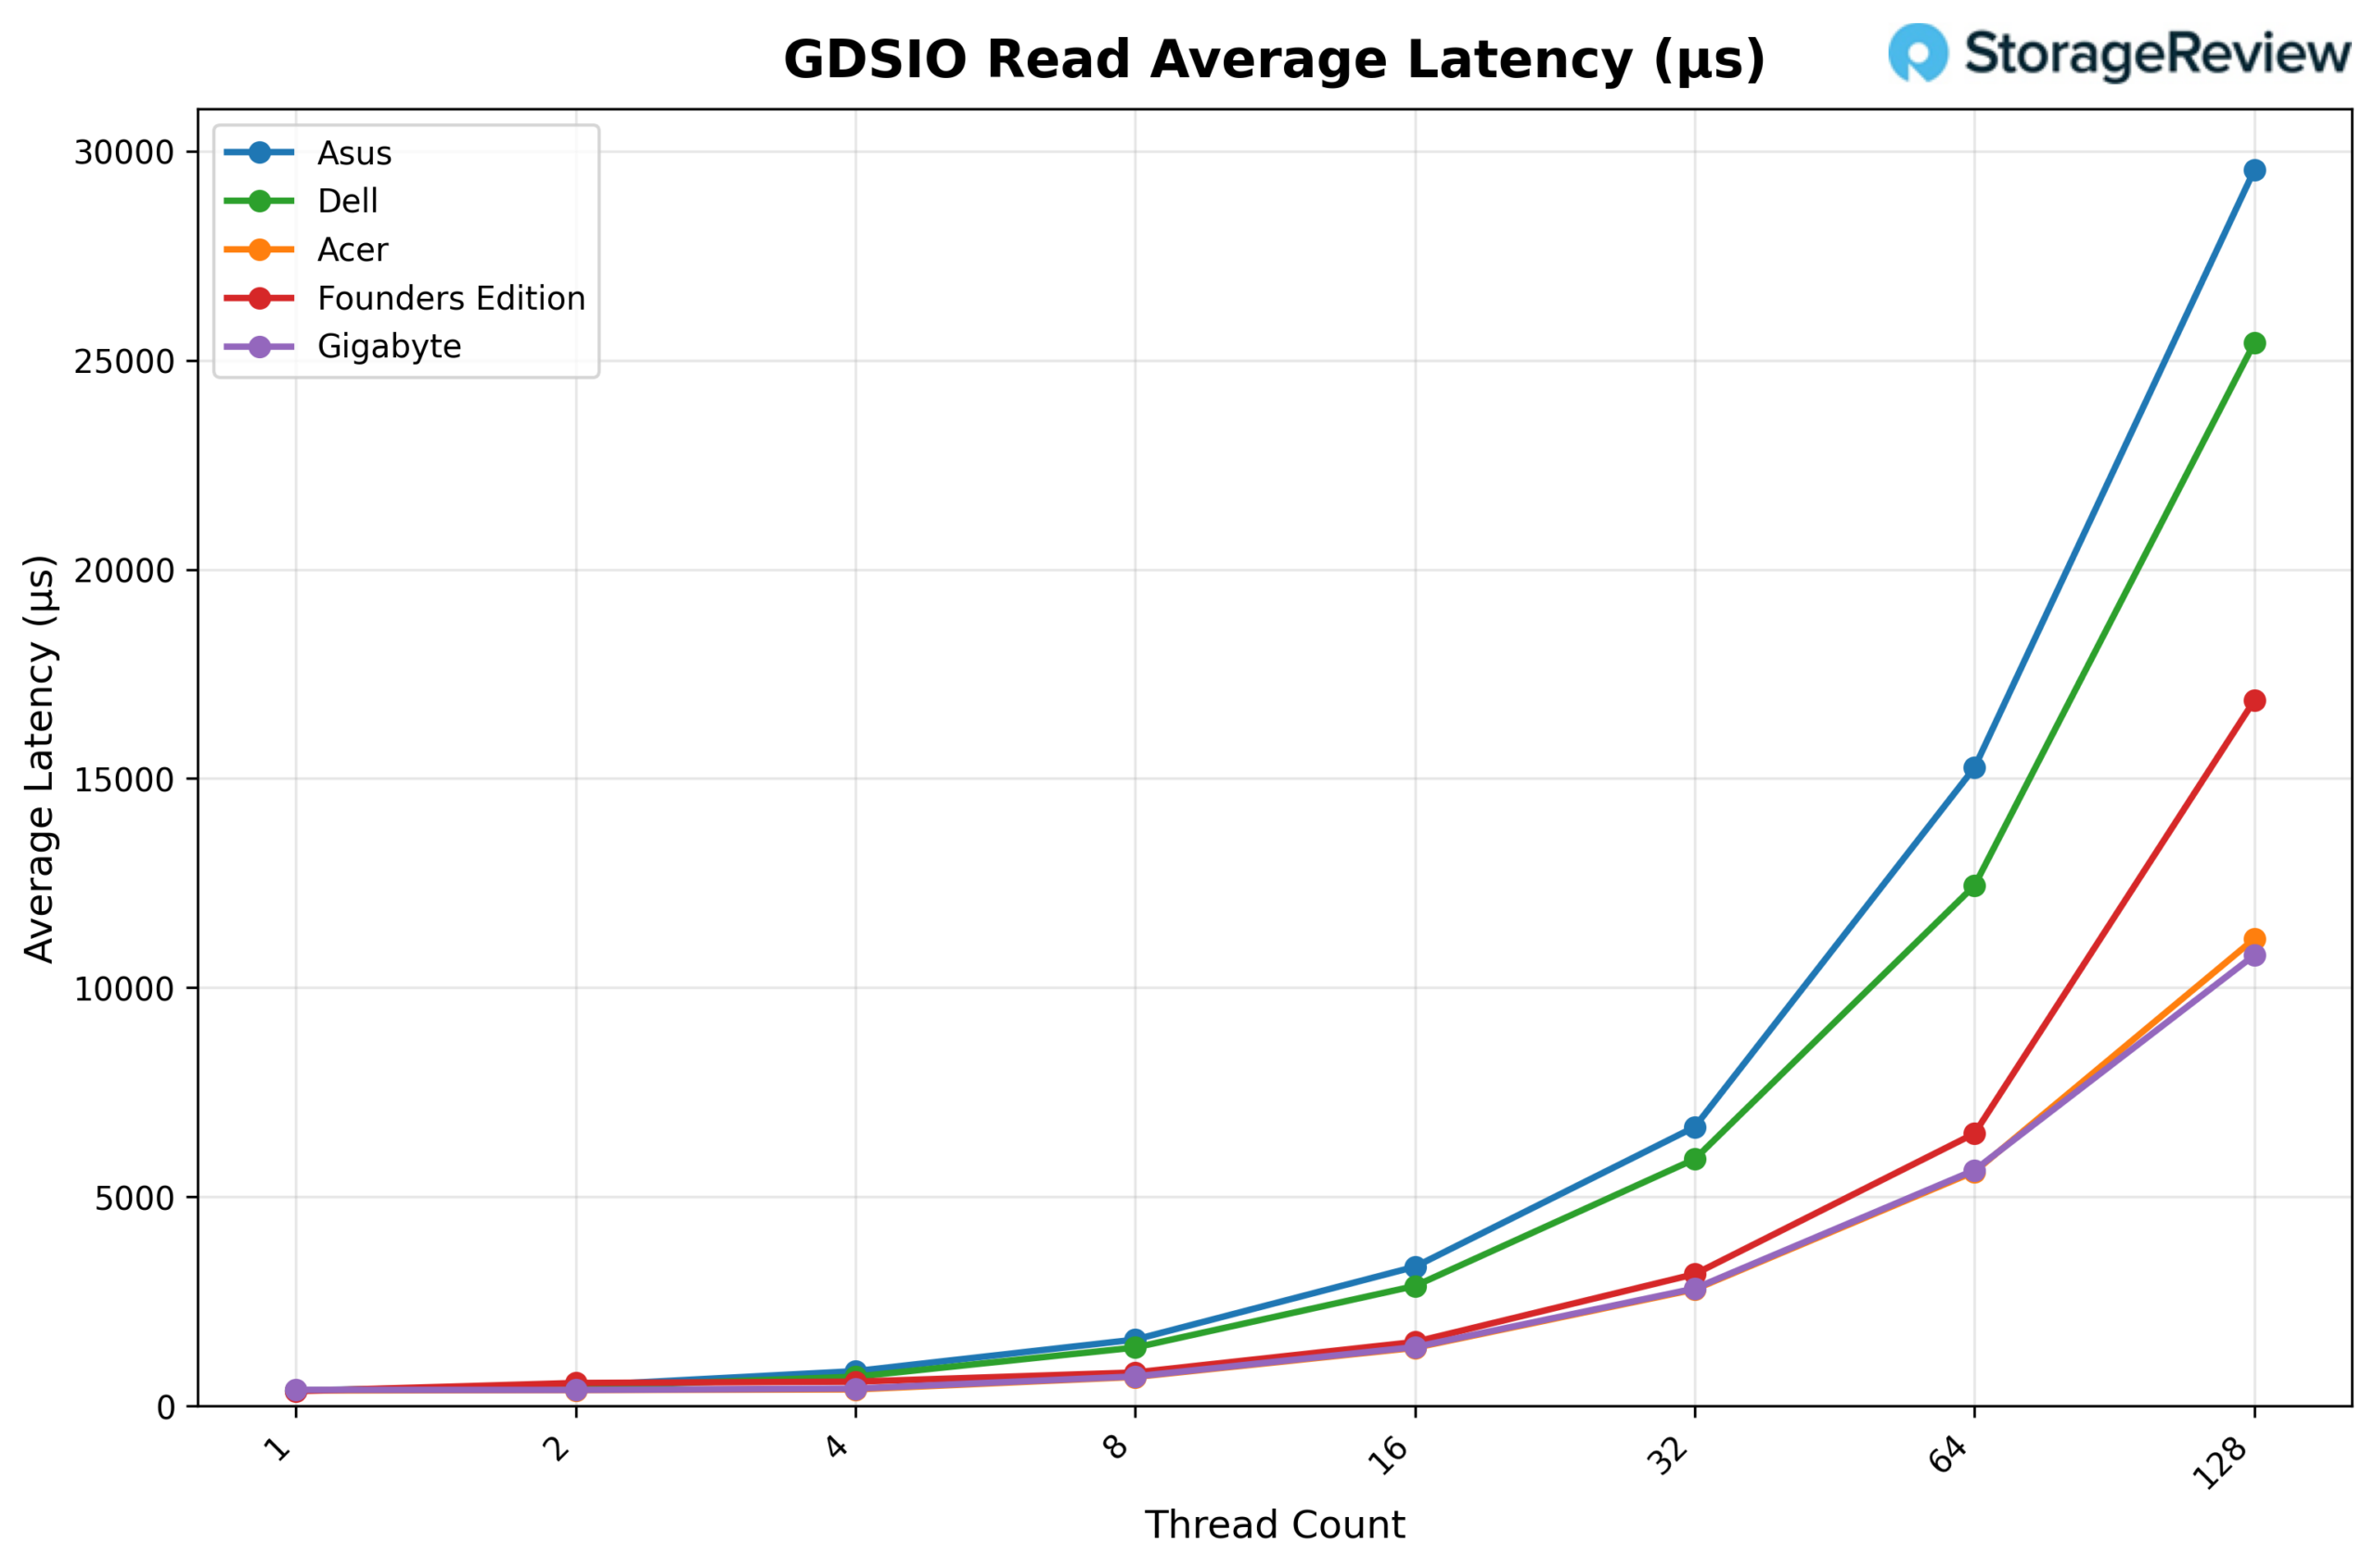
En analysant la latence moyenne de lecture GDSIO (1 Mo), l'Acer affiche environ 0.37 ms avec 1 thread et reste similaire avec 2 threads (0.38 ms) et 4 threads (0.40 ms). La latence augmente avec la concurrence, atteignant 0.70 ms à 8 threads, 1.39 ms à 16 threads et 2.79 ms à 32 threads. Cette tendance à la hausse se poursuit à 64 threads (5.60 ms) et culmine à 11.17 ms à 128 threads, correspondant aux niveaux de concurrence les plus élevés, tandis que le débit reste globalement stable.
Débit d'écriture GDSIO : 1 Mbit/s
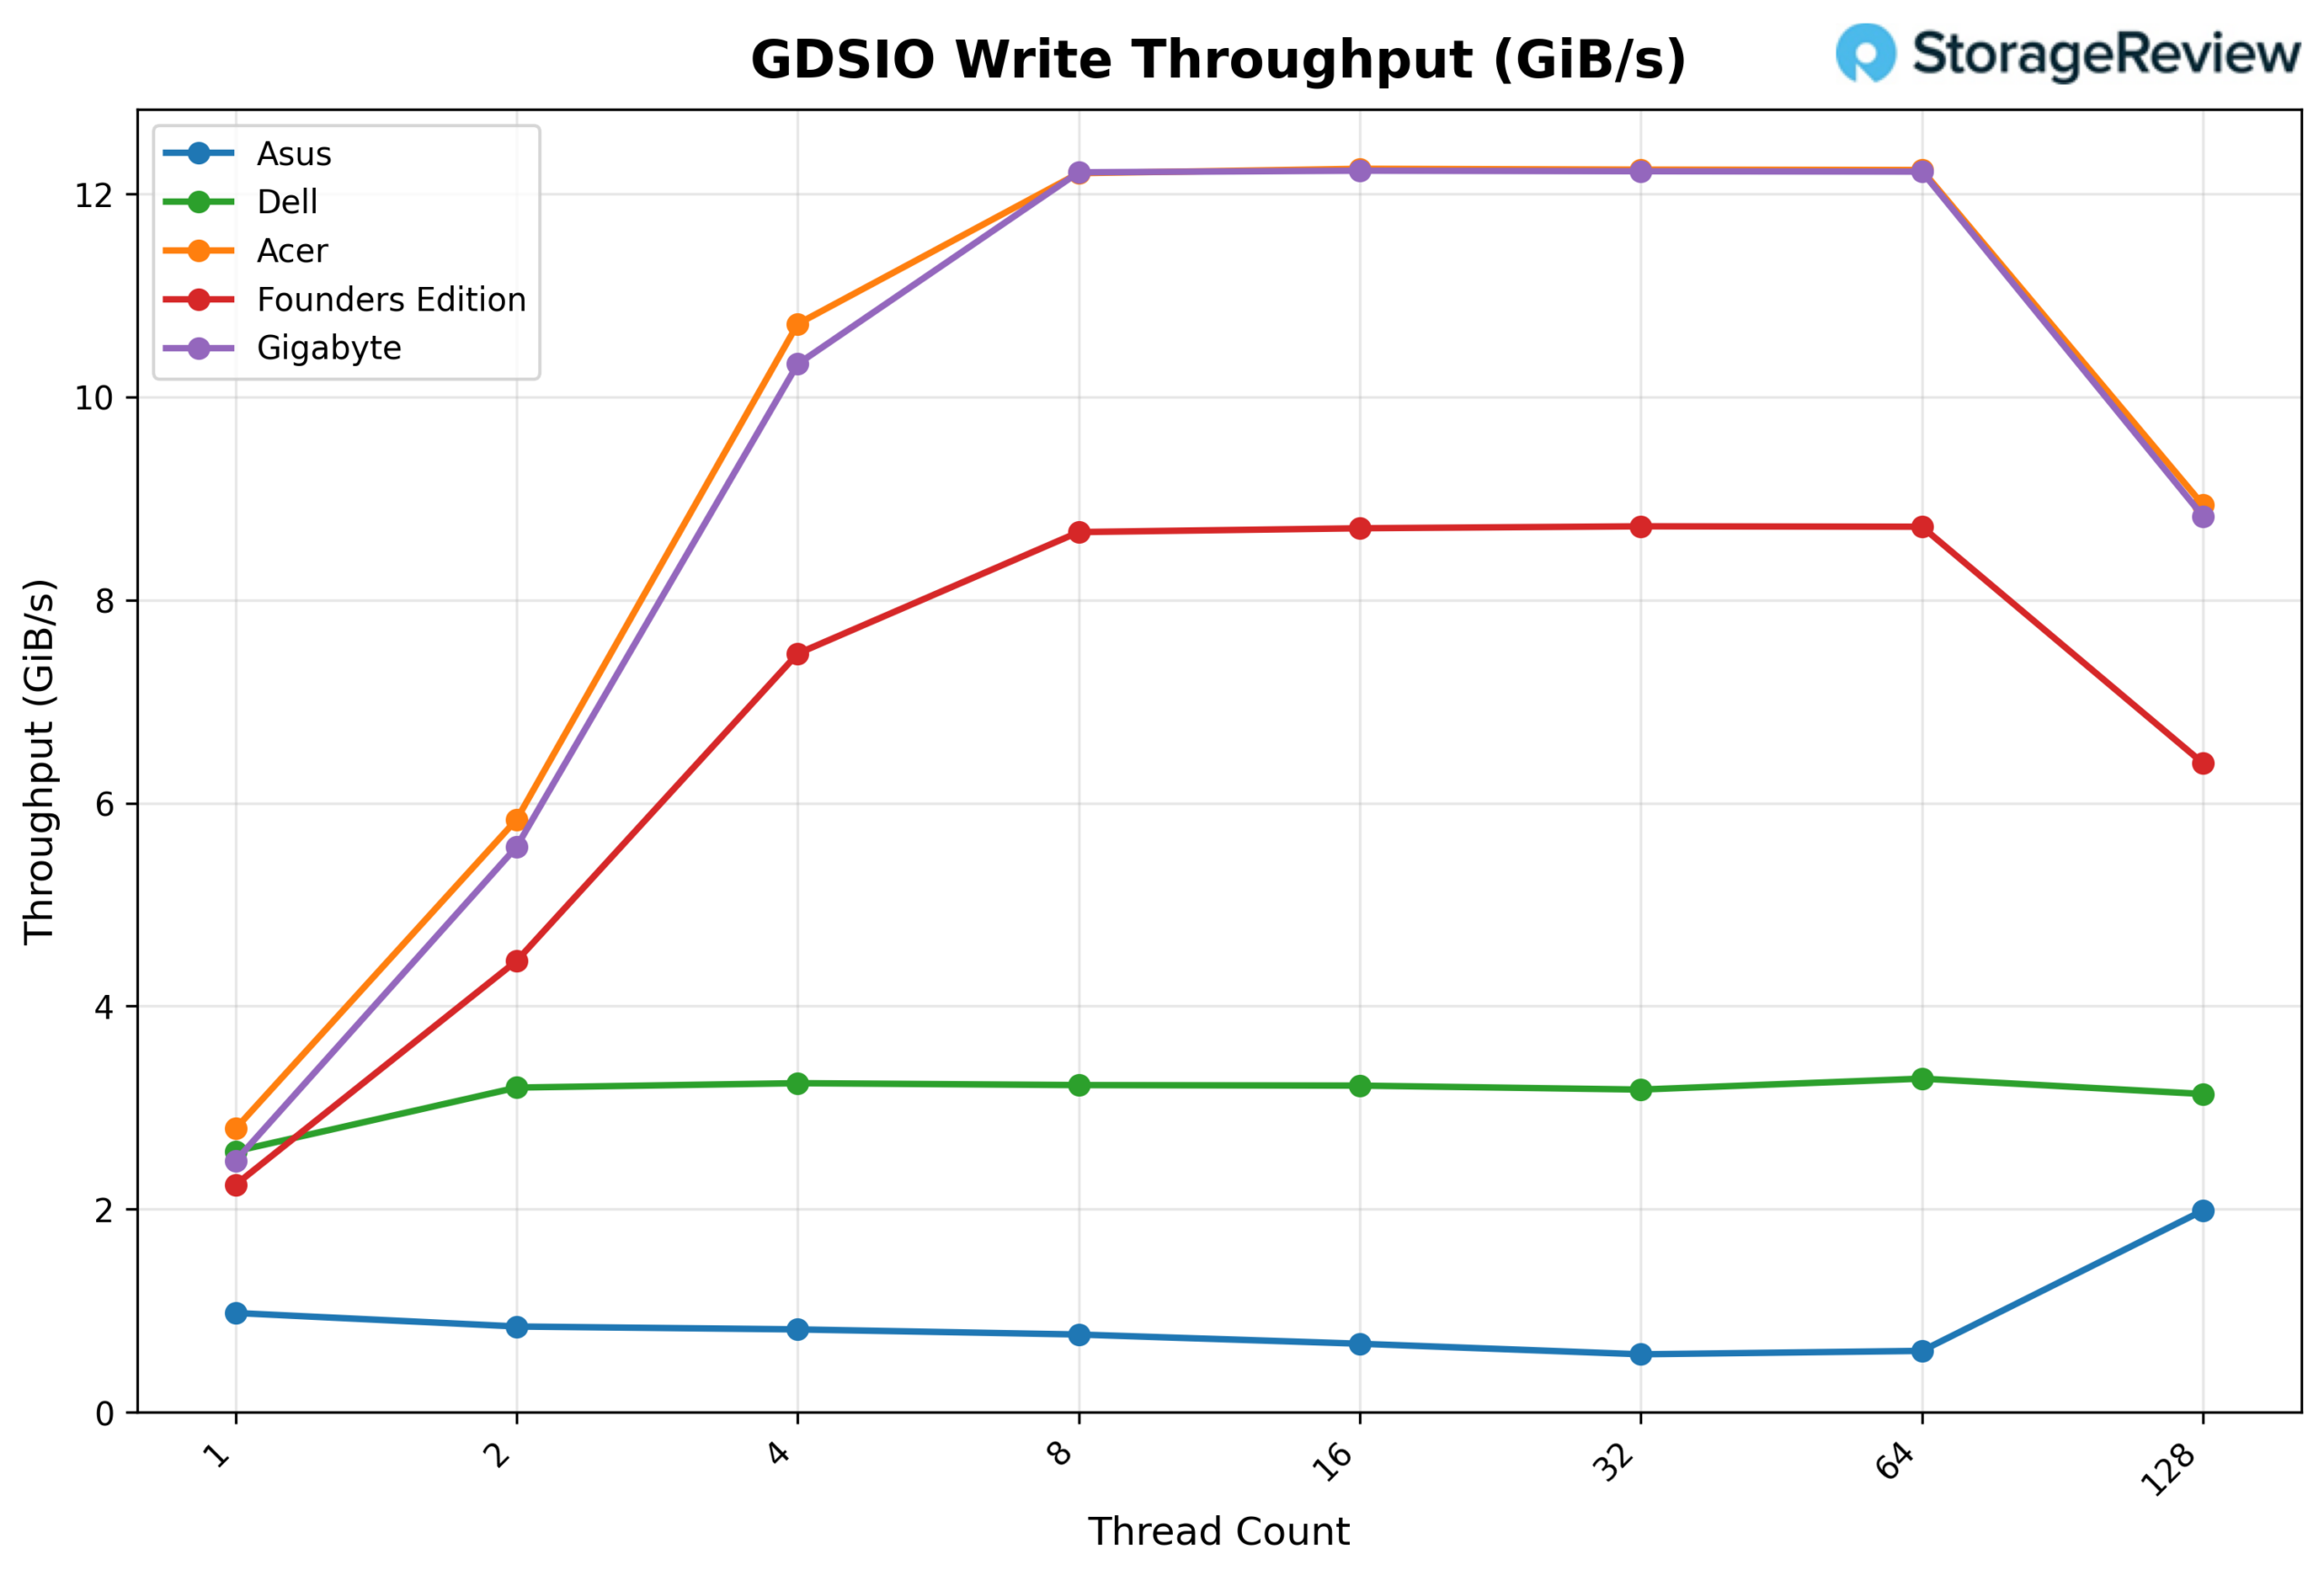
En ce qui concerne le débit d'écriture GDSIO à 1 million de threads, l'Acer atteint 2.79 Gio/s avec un seul thread, puis grimpe nettement à 5.84 Gio/s avec deux threads et à 10.72 Gio/s avec quatre threads. À huit threads, le débit atteint 12.20 Gio/s, et la plateforme sature alors. Les performances restent constantes à 16 threads (12.25 Gio/s), 32 threads (12.24 Gio/s) et 64 threads (12.23 Gio/s), affichant un plateau stable. À 128 threads, le débit chute sensiblement à 8.94 Gio/s, ce qui suggère une contention ou une saturation des ressources au niveau de concurrence maximal.
Latence d'écriture moyenne GDSIO : 1 Mbit/s
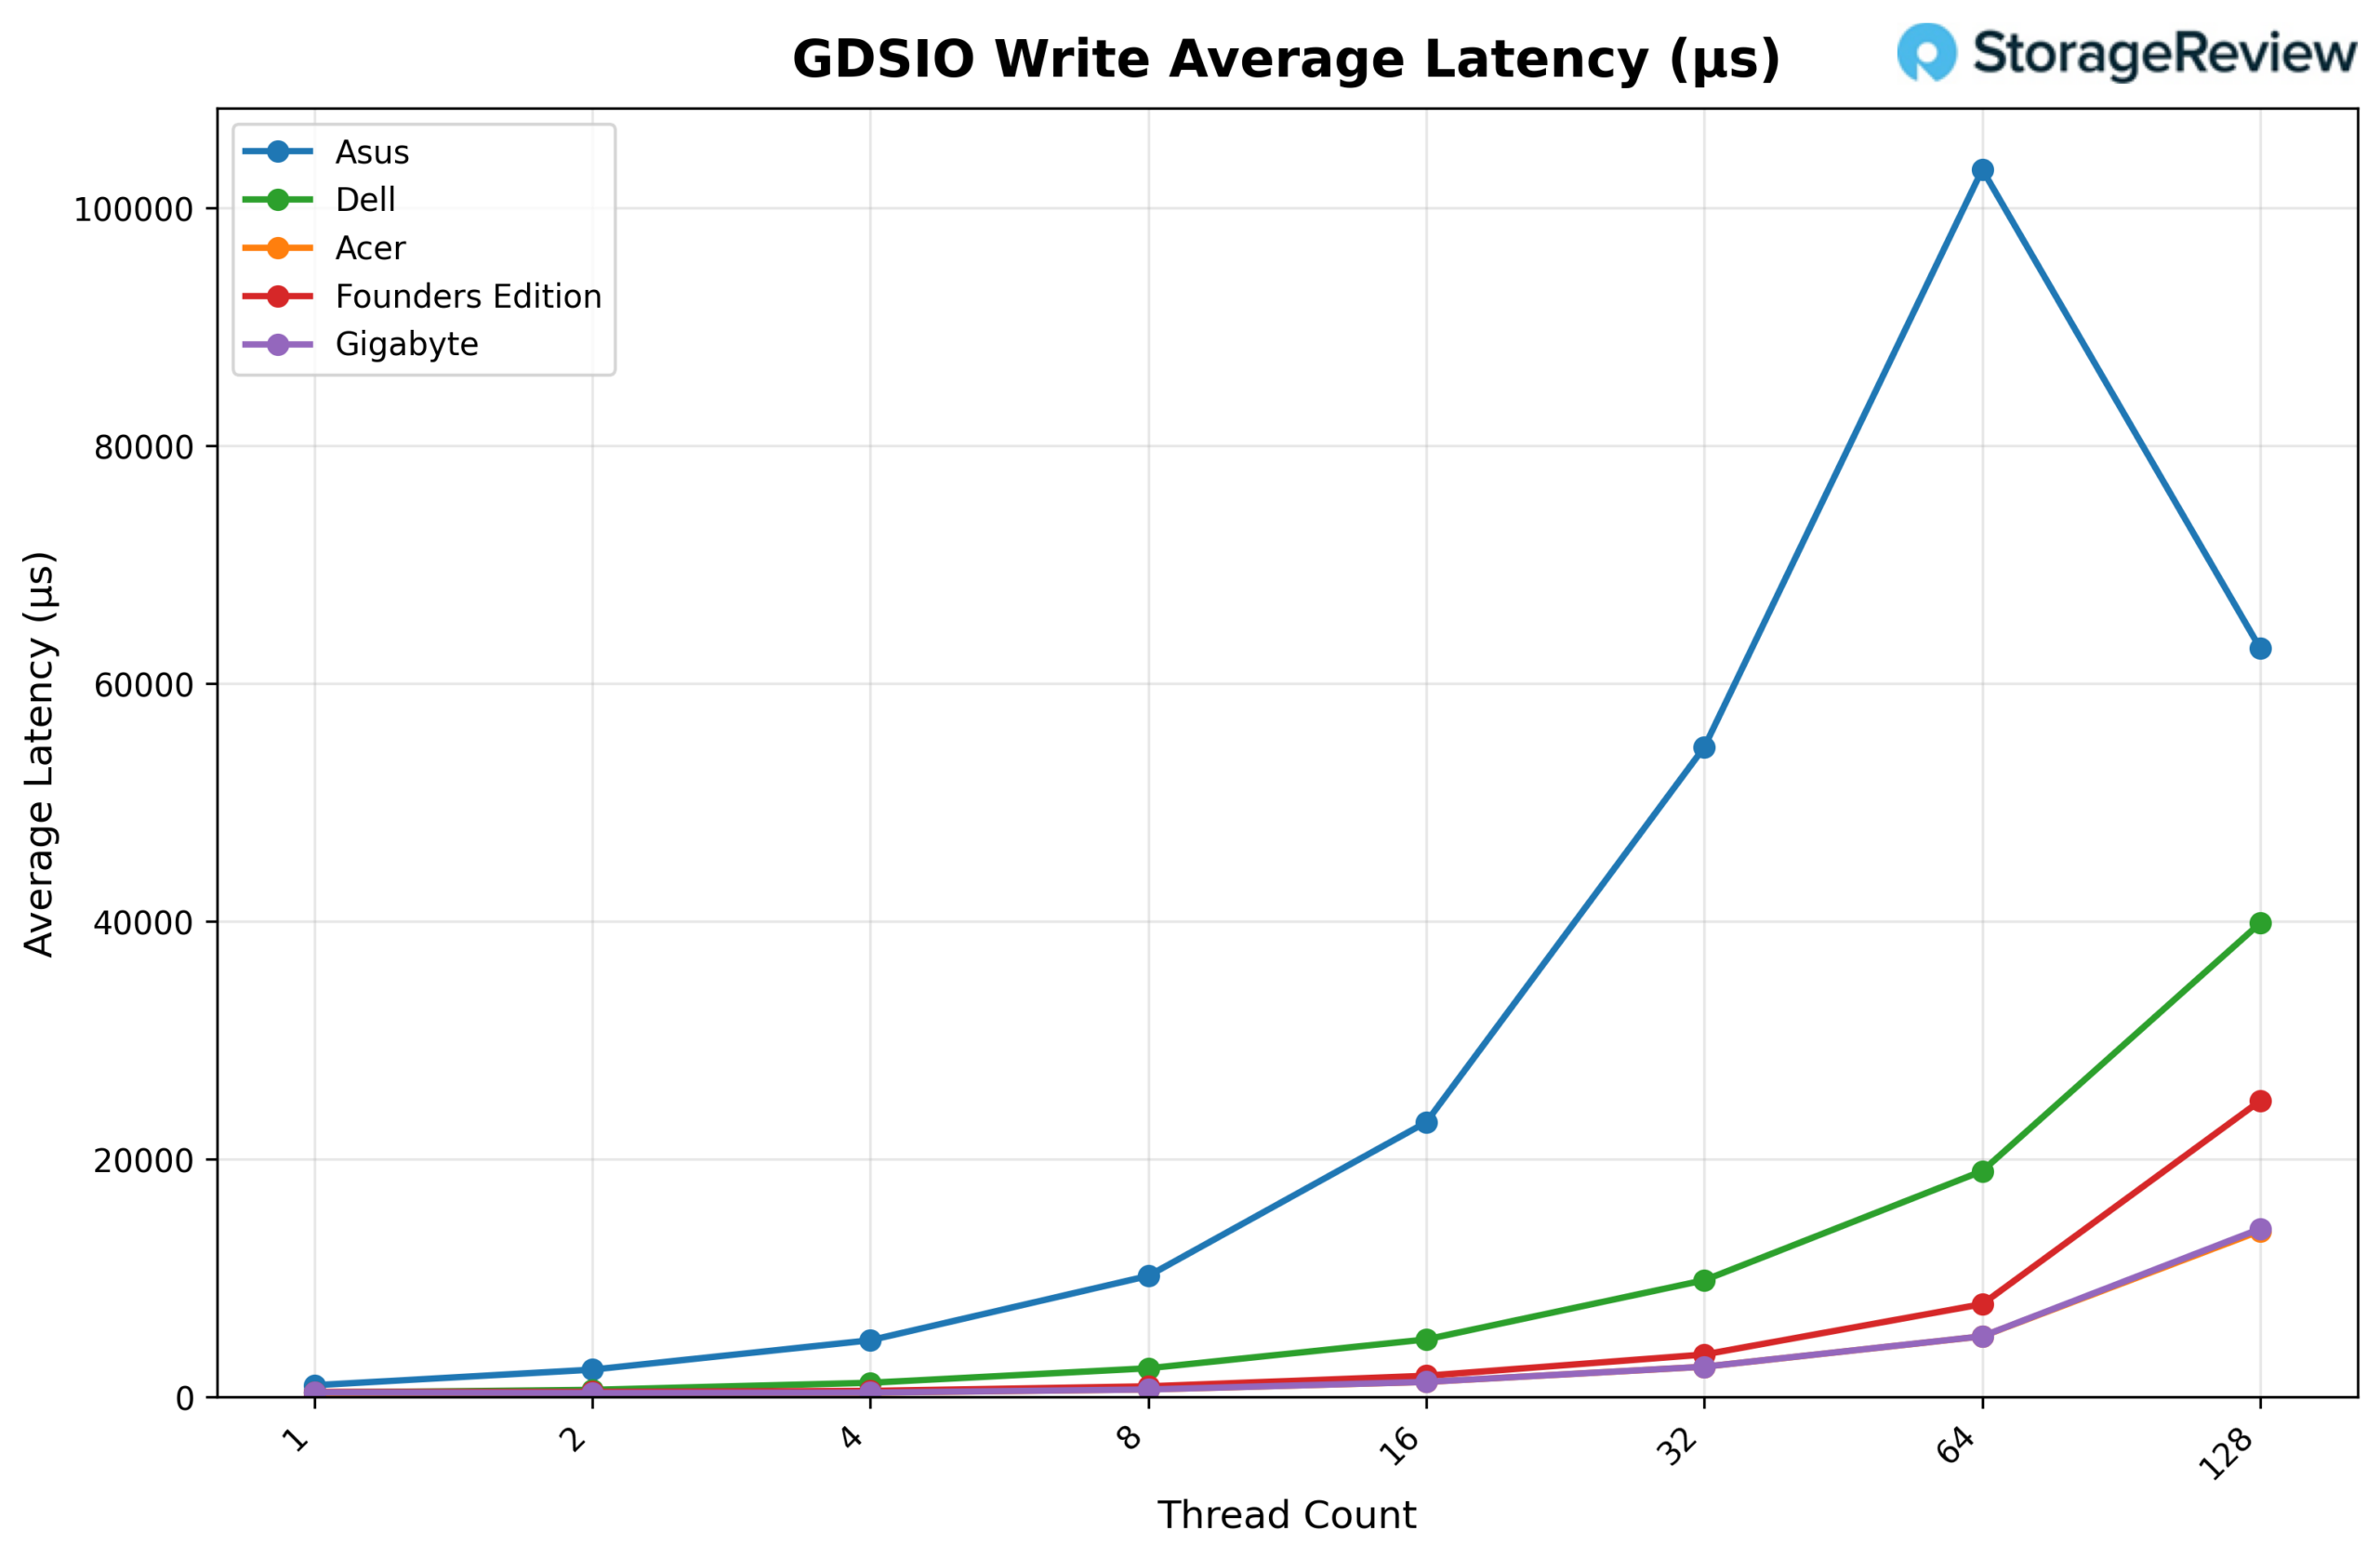
En analysant la latence d'écriture moyenne GDSIO (1 Mo), l'Acer affiche une latence d'environ 0.35 ms avec 1 thread, qui reste faible à 2 threads (0.33 ms) et à 4 threads (0.36 ms). La latence augmente avec la concurrence, atteignant 0.64 ms à 8 threads, 1.28 ms à 16 threads et 2.55 ms à 32 threads. Cette tendance à la hausse se poursuit à 64 threads (5.11 ms) et grimpe brusquement à 13.98 ms à 128 threads, ce qui correspond à la dégradation du débit observée à la concurrence maximale.
Conclusion
L'Acer Veriton GN100 a affiché le meilleur profil thermique global de notre comparatif Spark . Lors des transitions de pré-remplissage intensives et des charges de travail de décodage soutenues, il a constamment maintenu des températures maximales du processeur et du GPU inférieures à celles des autres modèles du groupe. Au lieu de fonctionner dans la partie supérieure des 80 °C en pleine charge, il est resté dans une plage de fonctionnement plus stable tout au long des tests prolongés, ce qui témoigne d'une conception efficace du flux d'air et d'une gestion optimisée de l'alimentation.
Les performances de stockage constituaient un autre atout majeur. Équipé d'un SSD Samsung PM9E1 Gen5 de 4 To, le GN100 offrait la meilleure montée en charge du stockage direct GPU en petits blocs du groupe. Avec des blocs de 16 Ko, la latence de lecture et d'écriture restait remarquablement stable quel que soit le nombre de threads, tandis que le débit progressait de manière constante jusqu'aux sommets du classement. À 1 million de transferts, la plateforme atteignait rapidement sa saturation et conservait des performances compétitives jusqu'à un niveau de concurrence moyen, avant de ralentir aux niveaux de concurrence les plus élevés.
Lors des tests d'inférence vLLM, les performances sont restées globalement similaires à celles de l'écosystème Spark, comme prévu compte tenu de l'architecture GB10 commune. La différence s'est manifestée non pas au niveau de la puissance de calcul brute, mais au niveau de la consommation thermique et du comportement du stockage sous charge.
Au sein de la gamme Spark, la cohérence architecturale garantit des performances d'inférence très homogènes. Le GN100 se distingue par son fonctionnement plus silencieux et stable, associé à d'excellentes performances NVMe Gen5, ce qui en fait l'une des solutions les plus économes en énergie et les plus performantes en stockage que nous ayons testées jusqu'à présent.
Page produit – Acer Veritron GN 100 AI
Classement : L'Acer Veriton GN100 occupe la première place du classement des meilleurs ordinateurs de bureau pour l'IA locale, avec la meilleure implémentation GB10.


 Amazon