

L'ASUS ExpertCenter Pro ET900N G3 est la deuxième station GB300 DGX que nous avons testée et la première que nous avons pu manipuler en laboratoire ; nos tests de la MSI XpertStation WS300 ont été effectués à distance. Elle utilise la même puce NVIDIA que celle testée dans la MSI XpertStation WS300 : un processeur graphique Grace Blackwell Ultra Desktop Superchip avec 72 cœurs Grace, un GPU B300, 252 Go de mémoire HBM3e, 496 Go de mémoire LPDDR5X et une carte réseau ConnectX-8 SuperNIC avec deux ports 400 GbE. ASUS a intégré cette plateforme dans un boîtier tour compact conçu pour l'IA de bureau, en y ajoutant quelques détails absents de la WS300 : deux poignées de transport sur le dessus, un ventilateur dédié aux baies optiques ConnectX-8 et une alimentation de 1 600 W certifiée 80 PLUS Titanium.
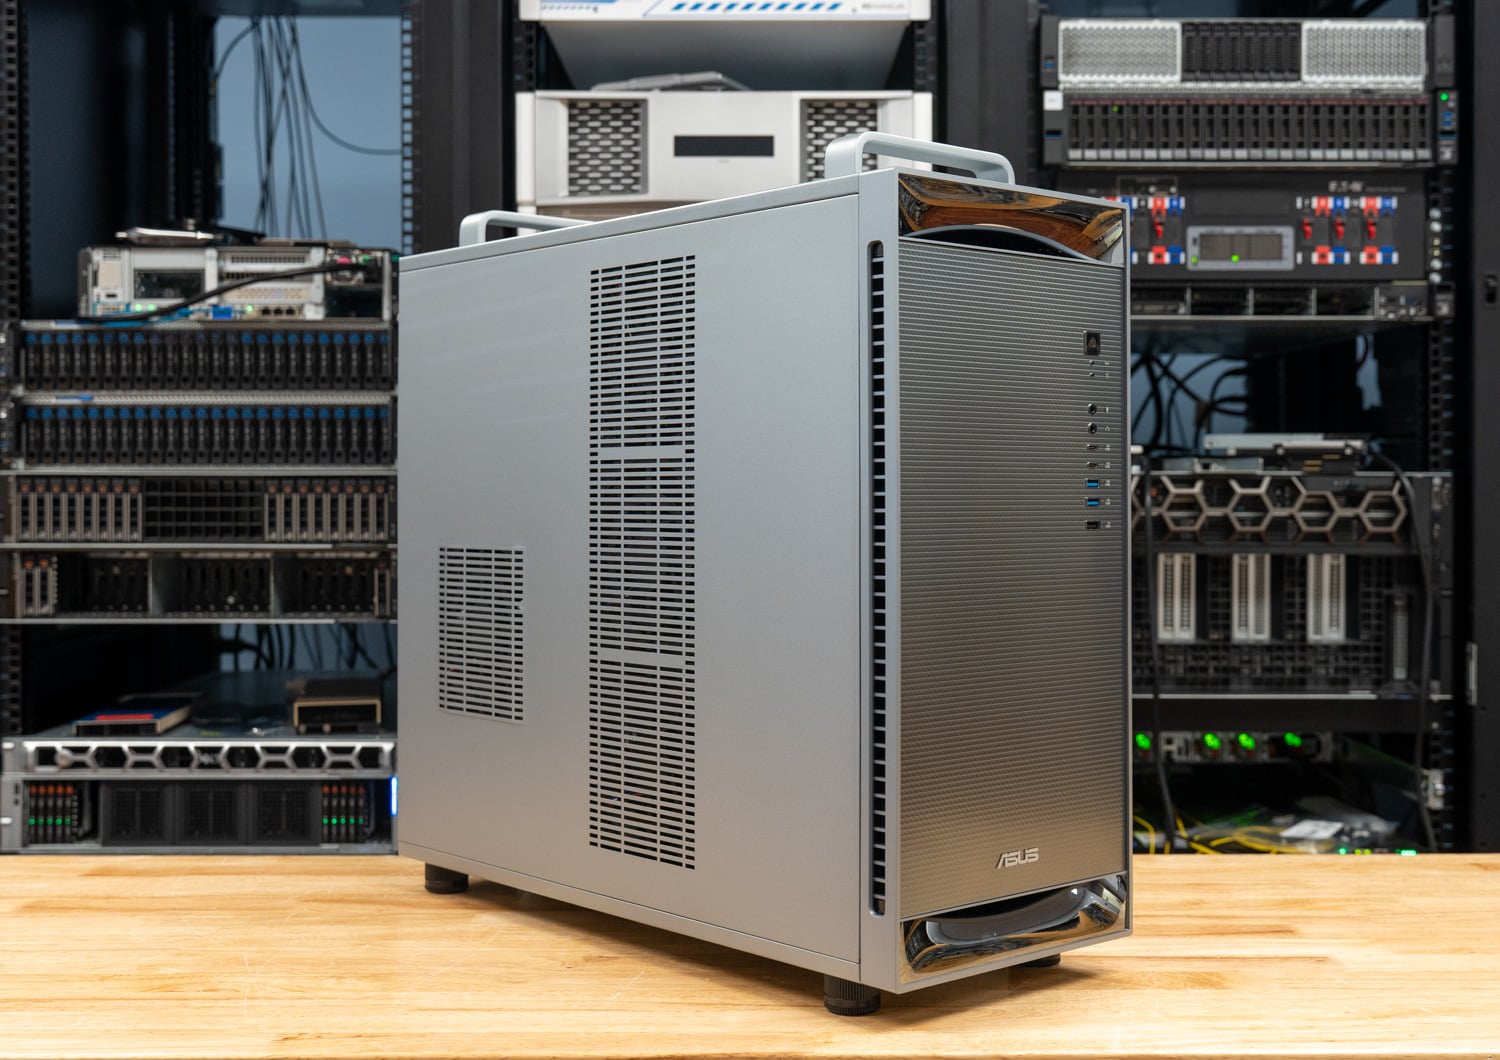
ASUS nous a envoyé le PC portable ET900N G3 pour une semaine de tests de performances, de prises de photos et de vérifications physiques, avec une RTX PRO 2000 installée. Le test du WS300 aborde la plateforme elle-même, la carte mère B300, Grace, NVLink-C2C, MIG et l'utilité de la station DGX. Ce test-ci porte sur les caractéristiques techniques du processeur graphique ASUS et compare ses performances à celles du premier PC portable GB300 que nous avons testé.
Spécifications de l'ASUS ExpertCenter Pro ET900N G3
| Spécifications | ASUS ExpertCenter Pro ET900N G3 |
|---|---|
| En savoir plus sur la plateforme | |
| Superpuce | NVIDIA GB300 Grace Blackwell Superpuce de bureau ultra-performante |
| Processeur | NVIDIA Grace, 72 cœurs Arm Neoverse V2 |
| GPU | NVIDIA Blackwell Ultra (B300), jusqu'à 20 PFLOPS NVFP4 avec sparsité |
| Interconnexion CPU-GPU | NVLink-C2C, 900 Go/s bidirectionnel |
| Mémoire | |
| Mémoire cohérente | 748GB |
| Mémoire GPU | 252 Go HBM3e, 7.1 To/s |
| Mémoire CPU | 496 Go LPDDR5X, 396 Go/s, 4 ports SOCAMM |
| Stockage | |
| Disques de démarrage | 2 emplacements M.2 2280 PCIe 5.0 x4 (clé M), équipés de 2 disques NVMe de 2 To en RAID 1. |
| Entraînements d'expansion | 2 emplacements M.2 2280 (clé M), PCIe 6.0 x4 (norme ASUS), carte mère ouverte. |
| Networking | |
| SuperNIC | NVIDIA ConnectX-8, 2 ports QSFP112 400 GbE |
| Ethernet | 1x Marvell 10GbE 1x Realtek 1GbE (BMC) |
| Expansion | |
| Emplacements PCIe | 1x PCIe 5.0 x16 2 ports PCIe 5.0 x16 (8 signaux x8) |
| Carte graphique additionnelle | Jusqu'à une carte NVIDIA RTX PRO Blackwell ; le modèle testé était équipé d'une RTX PRO 2000 Blackwell. |
| I / O | |
| Avant | 2 ports USB Type-C 10 Gbit/s 2 ports USB 10 Gbit/s de type A 1x USB 2.0 Prises casque et microphone |
| Arrière | 4 ports USB 10 Gbit/s de type A 1x Micro-USB COM (console série BMC) 1x Mini DisplayPort (BMC) 3 prises audio |
| Gestion et sécurité | |
| BMC | ASPEED AST2600 avec firmware AMI MegaRAC, IPMI et Redfish |
| Sécurité | TPM 2.0 intégré |
| Puissance et refroidissement | |
| Alimentation | 1 alimentation ATX de 1 600 W, certification 80 PLUS Titanium |
| Refroidissement | Refroidissement liquide AIO en circuit fermé (selon ASUS) avec plaques froides sur le GB300, le SOCAMM et le ConnectX-8 ; radiateurs avant et supérieur, ventilateur arrière du châssis, ventilateur dédié au-dessus des cages QSFP112 |
| Température de fonctionnement | 10C à 35C |
| Logiciel et facteur de forme | |
| Système d'exploitation | Ubuntu avec les outils de développement IA de NVIDIA ; ASUS annonce un support pour le développement IA sous Windows. |
| Dimensions | 584 x 232 x 565 mm (23.0 x 9.1 x 22.3 pouces), selon ASUS |
| Poids | 27 kg net, 32 kg brut |
Concevoir et construire
ASUS présente l'ET900N G3 comme une station de travail professionnelle, avec un châssis argent brossé, une façade en mesh foncé, un capot et un pied chromés, et le logo ASUS en bas de la façade. Ses dimensions sont conformes à la plateforme : 584 x 232 x 565 mm selon ASUS, soit légèrement plus haut et un peu moins large que le WS300 (529 mm de hauteur, 570 mm de profondeur et 246 mm de largeur). Avec ses 27 kg, ce n'est pas un ordinateur que l'on déplace à la légère, et c'est là qu'intervient la première idée propre à ASUS : deux poignées métalliques sur le bord supérieur, une à l'avant et une à l'arrière, permettent à deux personnes de soulever la tour et de la poser sur un bureau ou un chariot sans avoir à saisir les panneaux. Elles peuvent paraître un peu incongrues sur un ordinateur de bureau, jusqu'à ce qu'on ait déjà eu à transporter une tour GB300 dans un laboratoire.
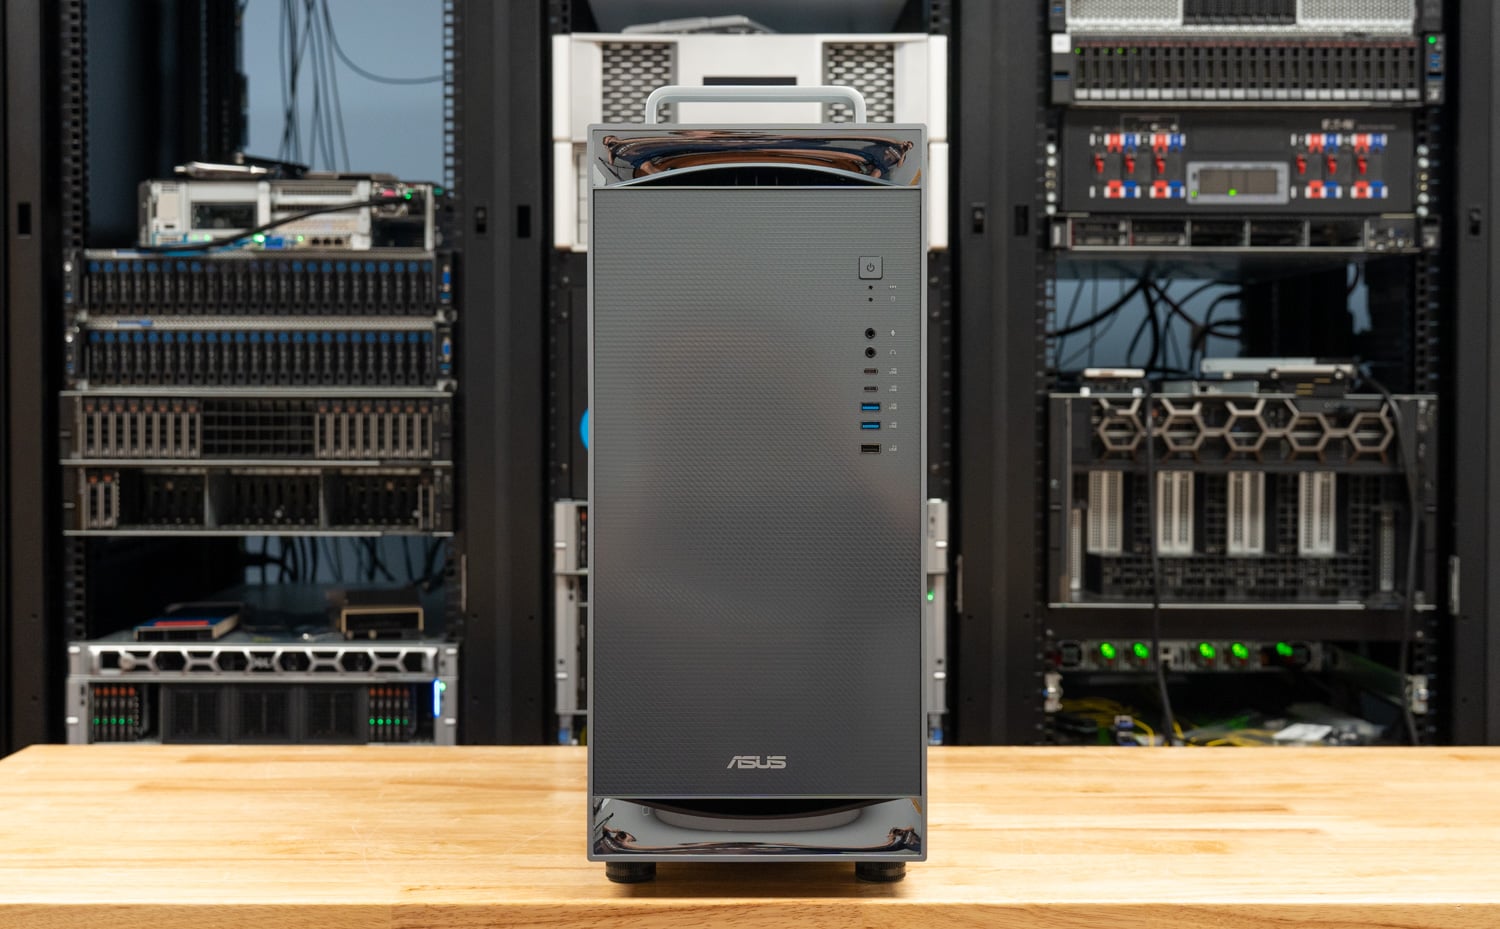
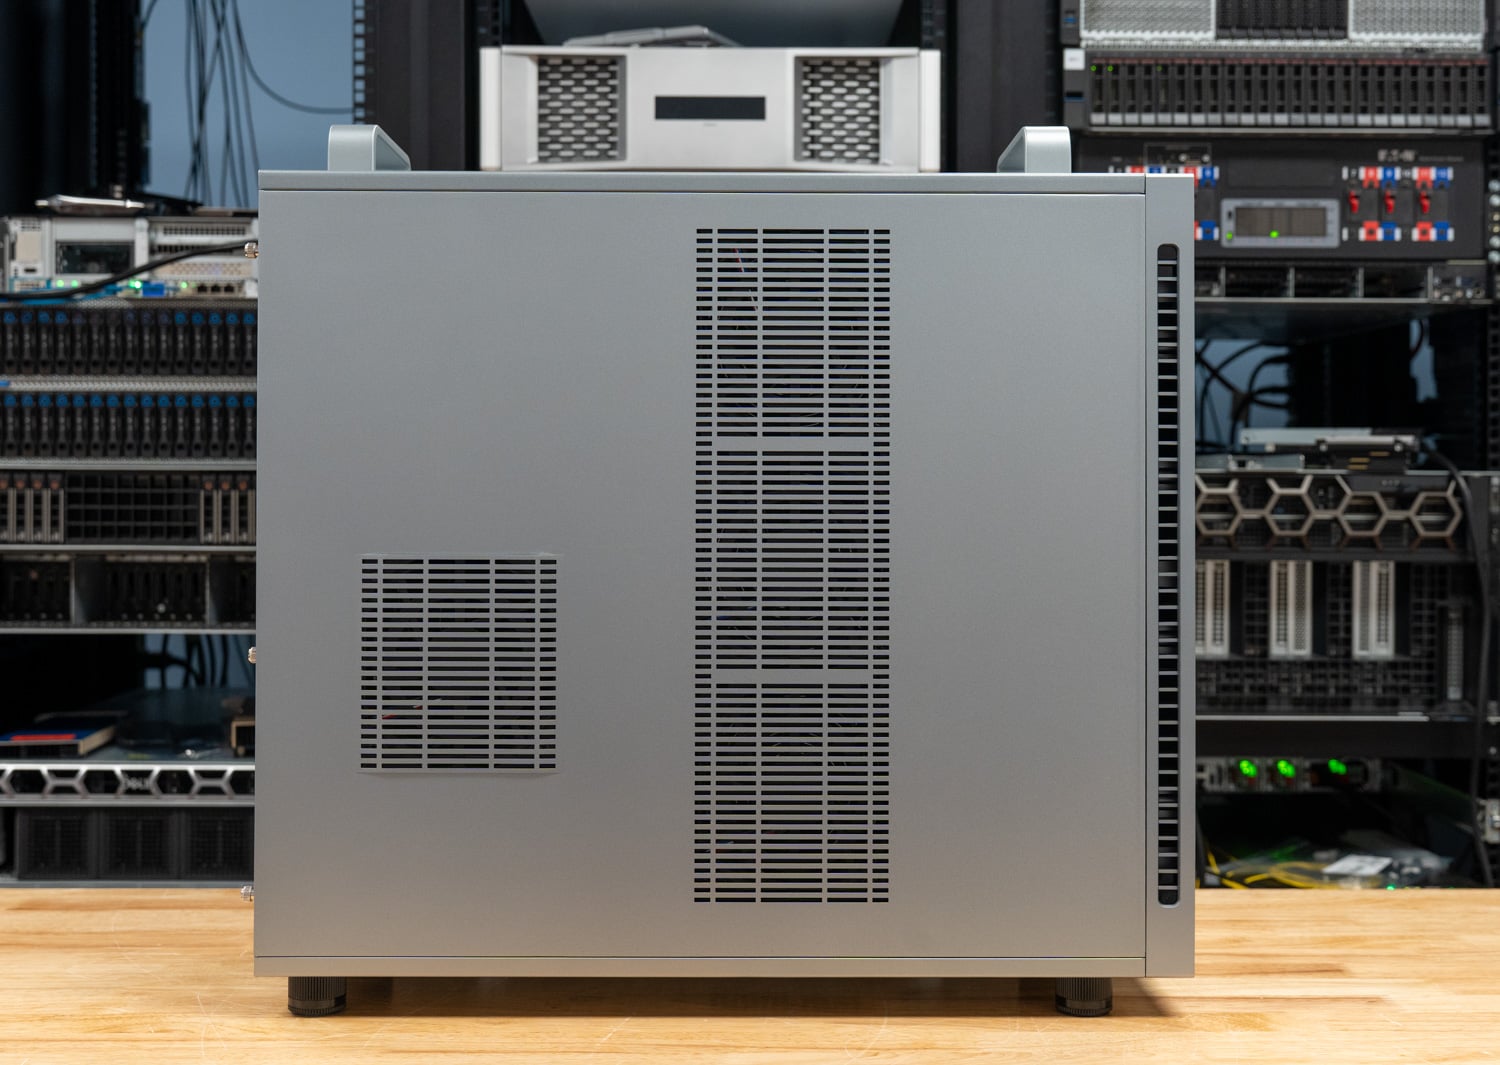
Le panneau avant comprend le bouton d'alimentation, deux ports USB Type-A 10 Gbit/s, deux ports USB Type-C 10 Gbit/s, un port USB 2.0 et des prises casque et microphone séparées, le tout disposé en bande verticale en haut à droite de la grille. Le panneau latéral est une large plaque ventilée, avec une longue colonne perforée à l'avant pour l'entrée d'air du radiateur et une grille carrée plus petite à l'arrière, alignée avec les ventilateurs du système. L'absence de fenêtre et d'éclairage correspond aux attentes de la clientèle visée.
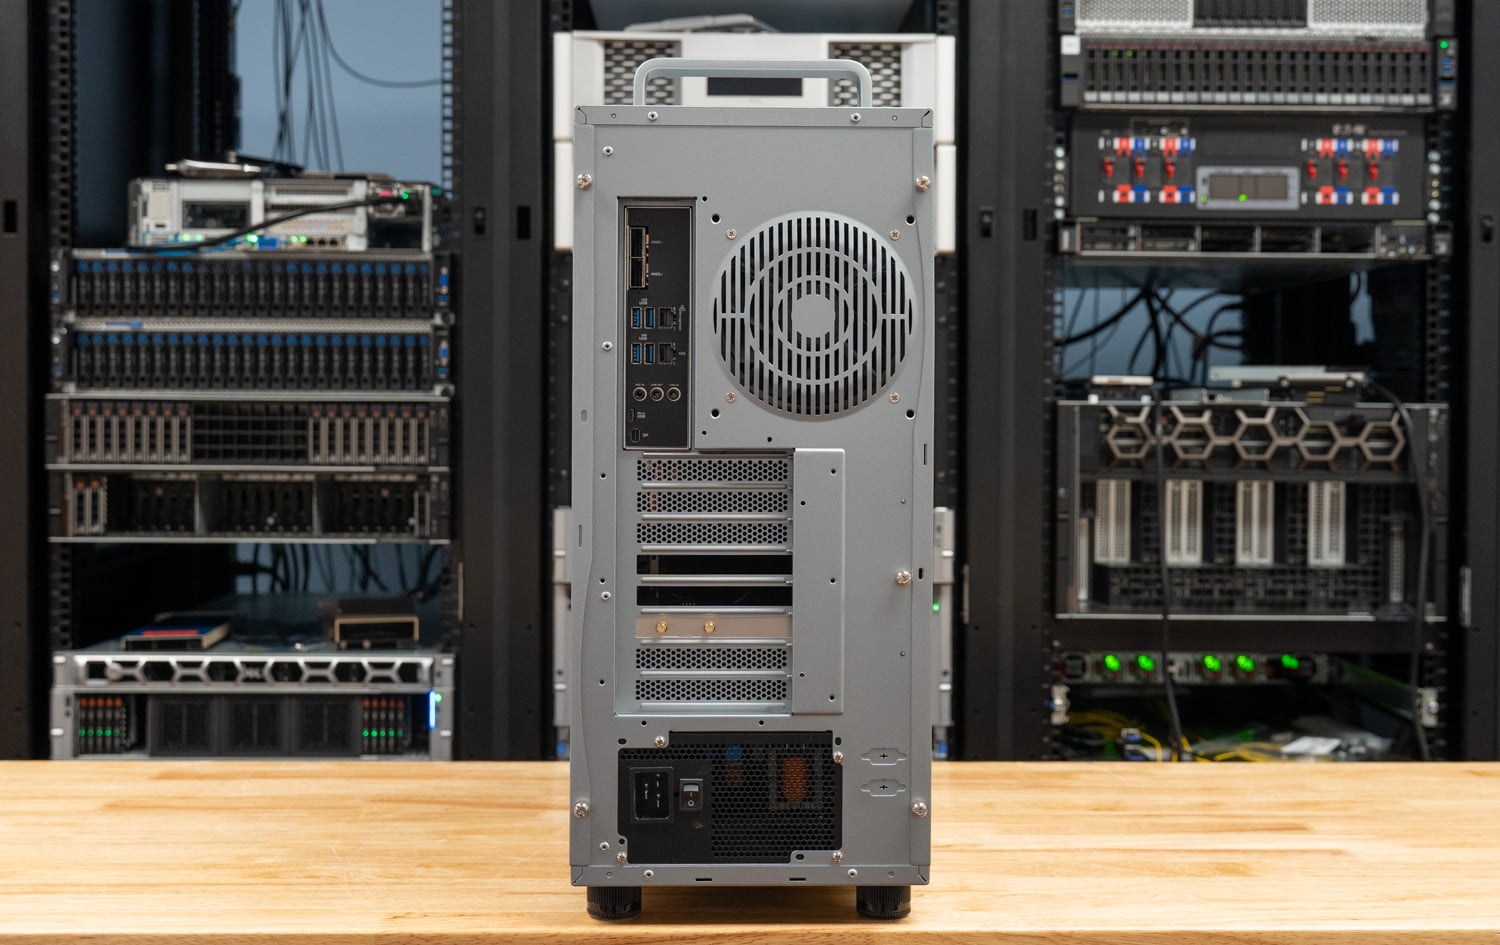
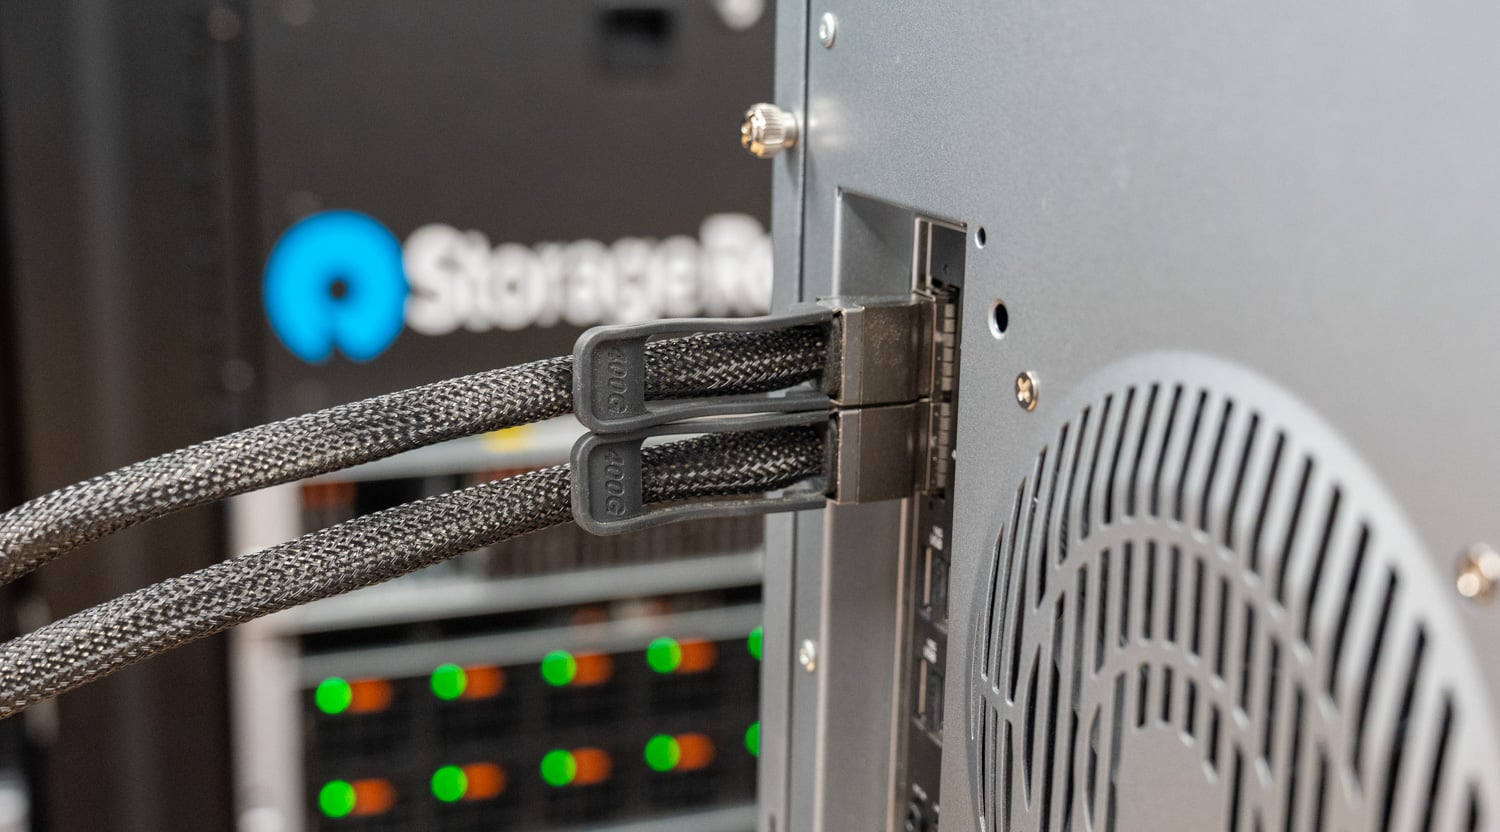
À l'arrière, la configuration sépare les entrées/sorties de la station de travail du matériel serveur situé en dessous. Le bloc supérieur comprend quatre ports USB Type-A 10 Gbit/s, les prises RJ45 10 Gbit/s et 1 Gbit/s, les trois prises audio, le port console micro-USB du BMC et le Mini DisplayPort utilisé par le BMC pour la configuration. Les deux cages QSFP112 pour le ConnectX-8 se trouvent en haut de la plaque d'E/S ; un ventilateur d'extraction est placé à côté ; les caches des trois emplacements d'extension sont disposés au centre ; et l'alimentation avec son connecteur C19 est en bas. Comme sur le WS300, le Mini DisplayPort est une sortie du BMC pour la configuration initiale et le dépannage ; pour utiliser cette machine comme un bureau, il faut une carte graphique RTX PRO.
À l'intérieur du ET900N G3
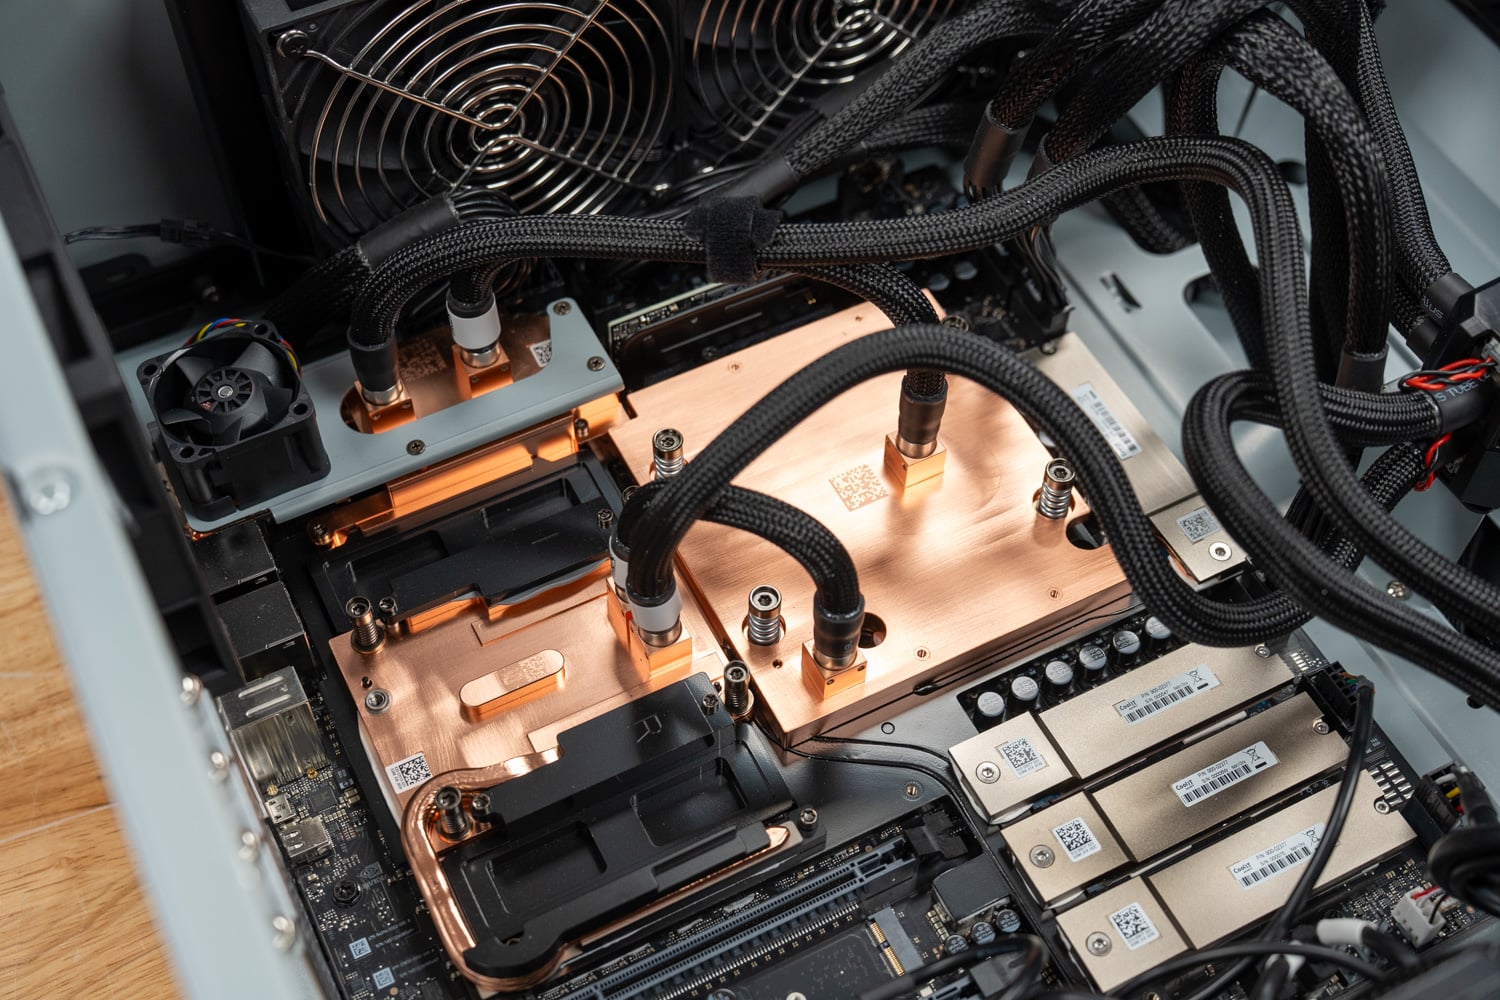
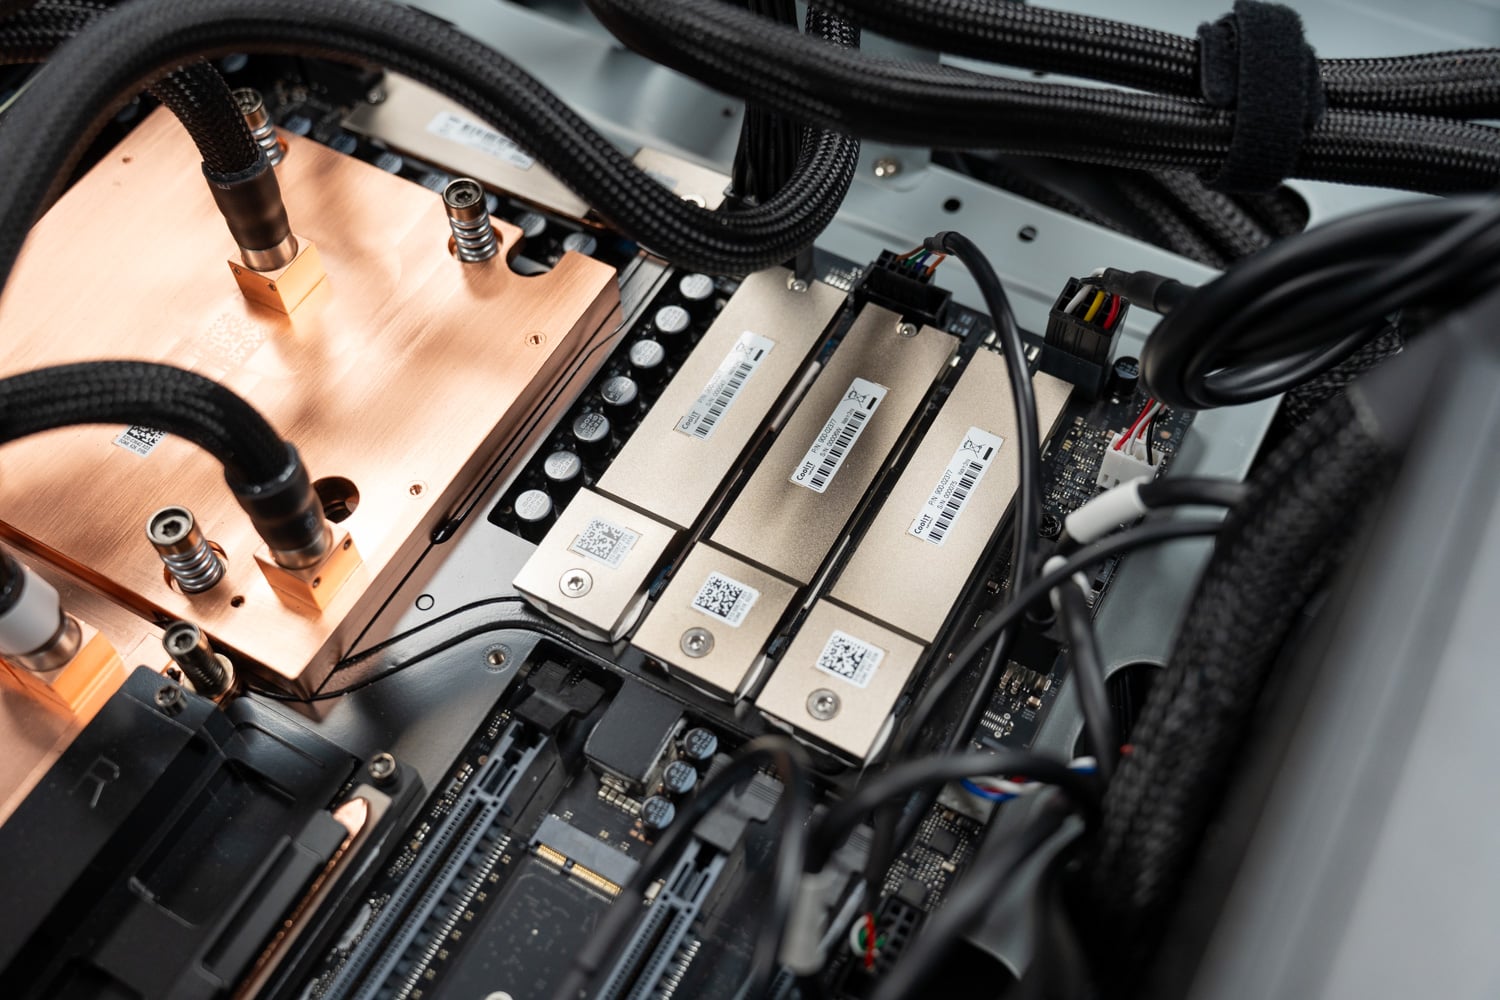
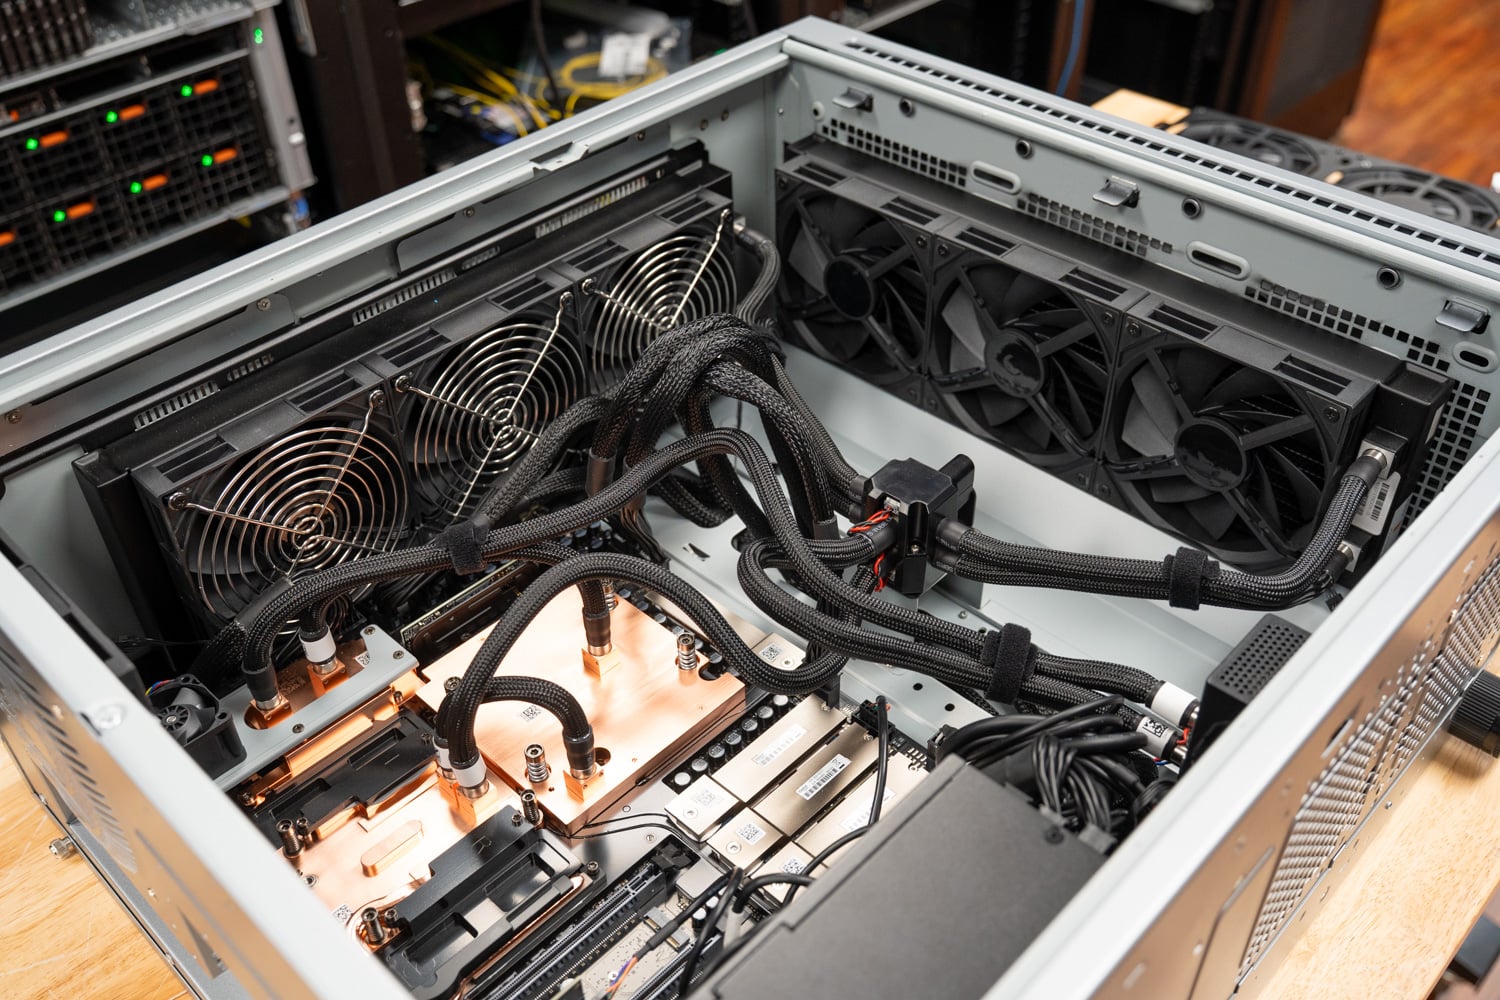
Une fois le panneau latéral retiré, l'ET900N G3 apparaît très proche du WS300, ce qui est logique puisqu'ils partagent la même carte mère NVIDIA. Le Superchip GB300 est placé sous une plaque froide en cuivre, à gauche du châssis. Les modules SOCAMM sont installés sous leurs propres plaques de cuivre à côté, et le ConnectX-8 sous un troisième bloc près des connecteurs d'E/S arrière. Des tubes tressés relient ces blocs à un collecteur de distribution monté sur la traverse du châssis, puis alimentent les radiateurs. Les trois emplacements PCIe pleine longueur se trouvent sous le Superchip, l'alimentation occupe le coin inférieur avant et un cache métallique dissimule le chemin des câbles en bas.
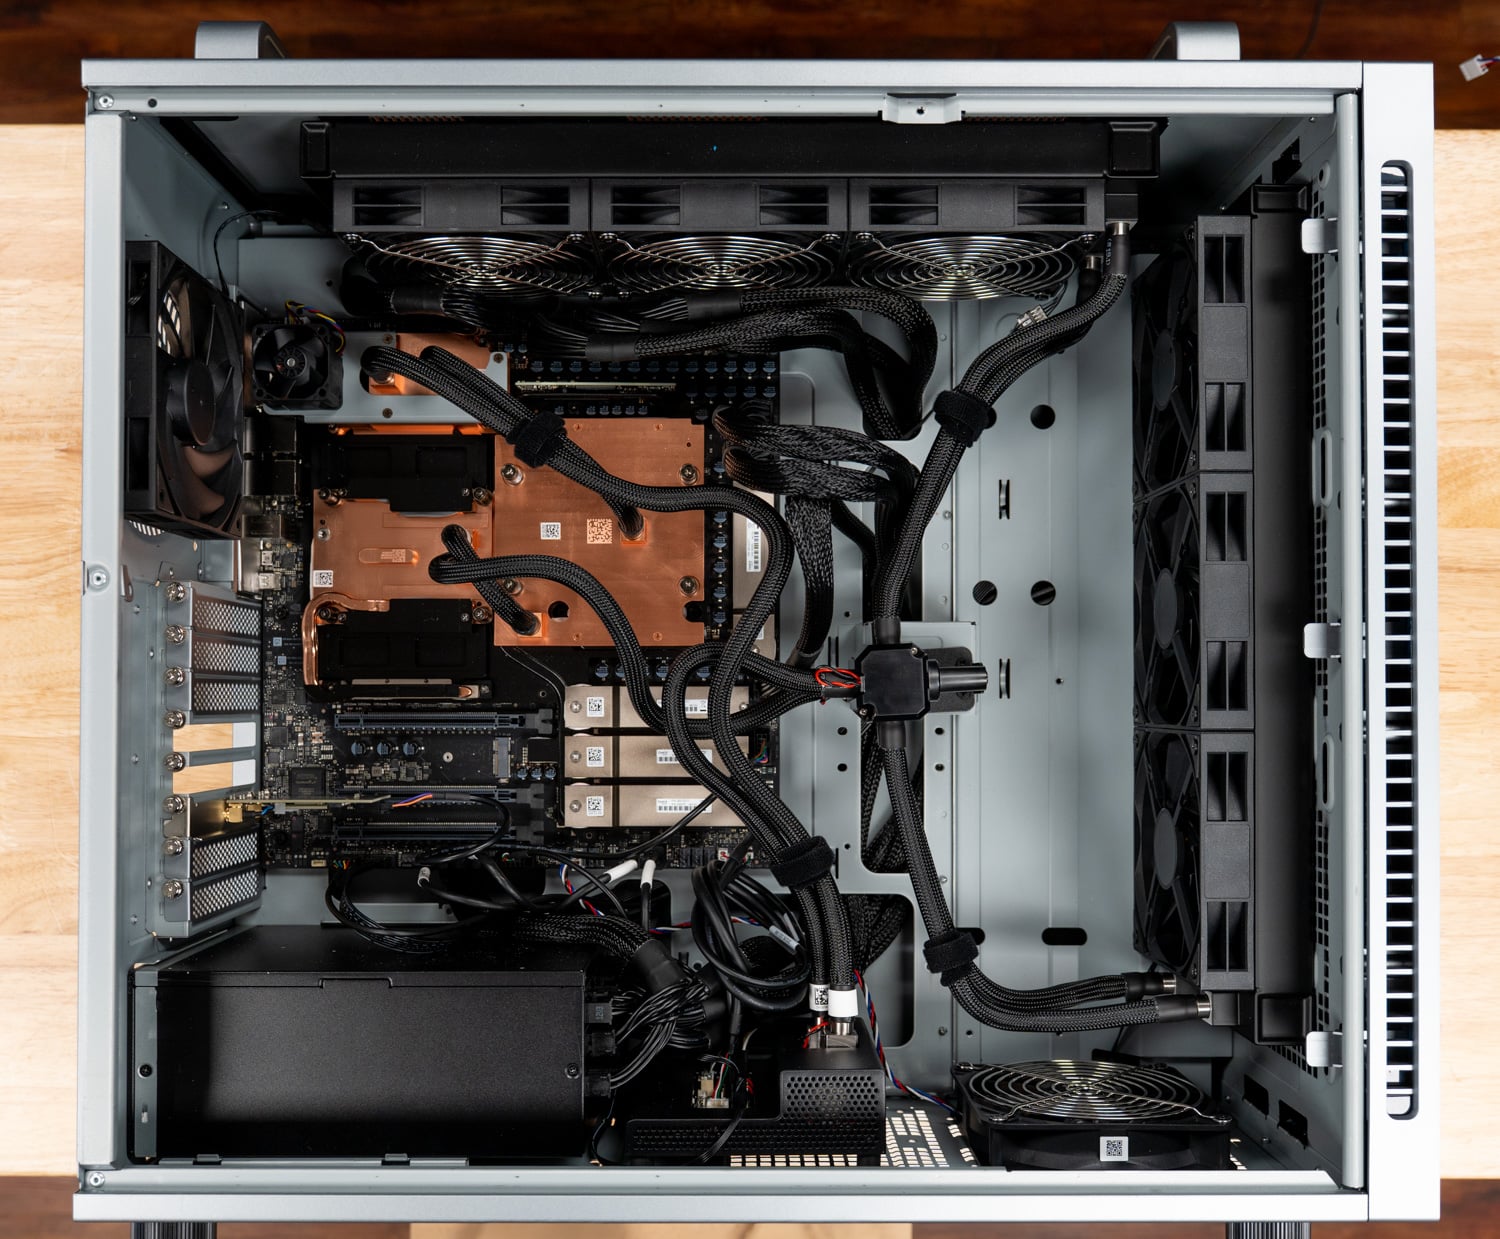
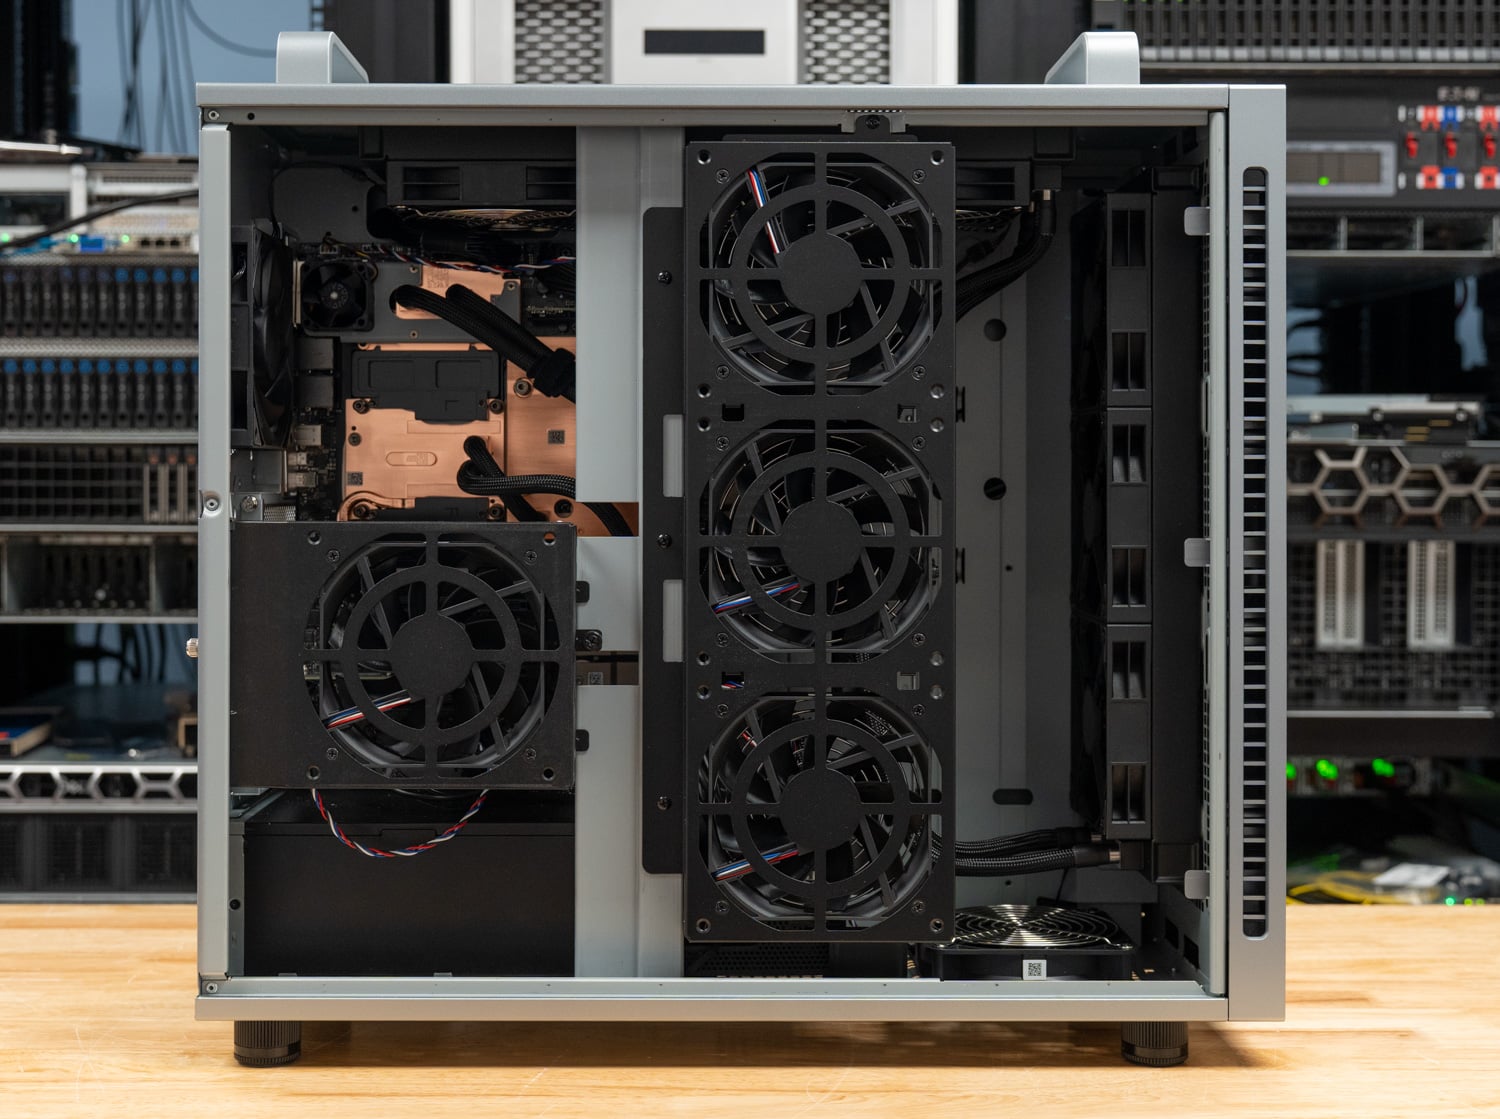
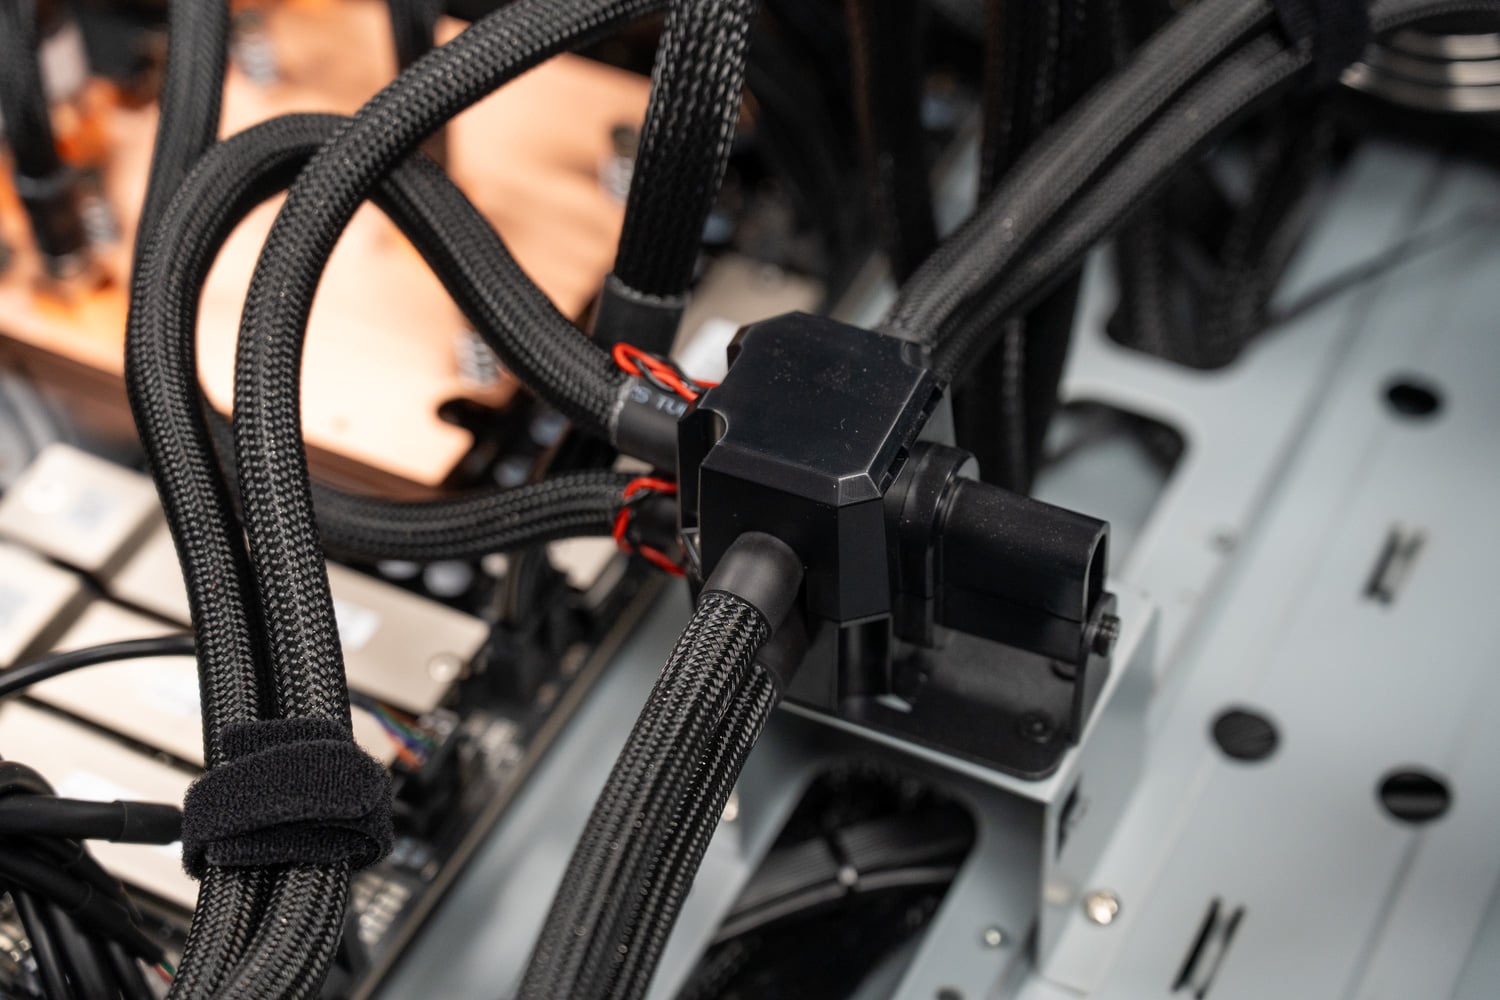
L'agencement interne est identique à celui du WS300 : un radiateur monté verticalement derrière la grille avant et un second en haut, chacun équipé d'une rangée de ventilateurs, plus un ventilateur de châssis à l'arrière. Les conduites de liquide de refroidissement sont gainées et fixées à la traverse par des attaches auto-agrippantes. Le collecteur regroupe les conduites provenant des quatre plaques froides, de sorte que seules deux conduites atteignent chaque radiateur.
Le fan d'optique
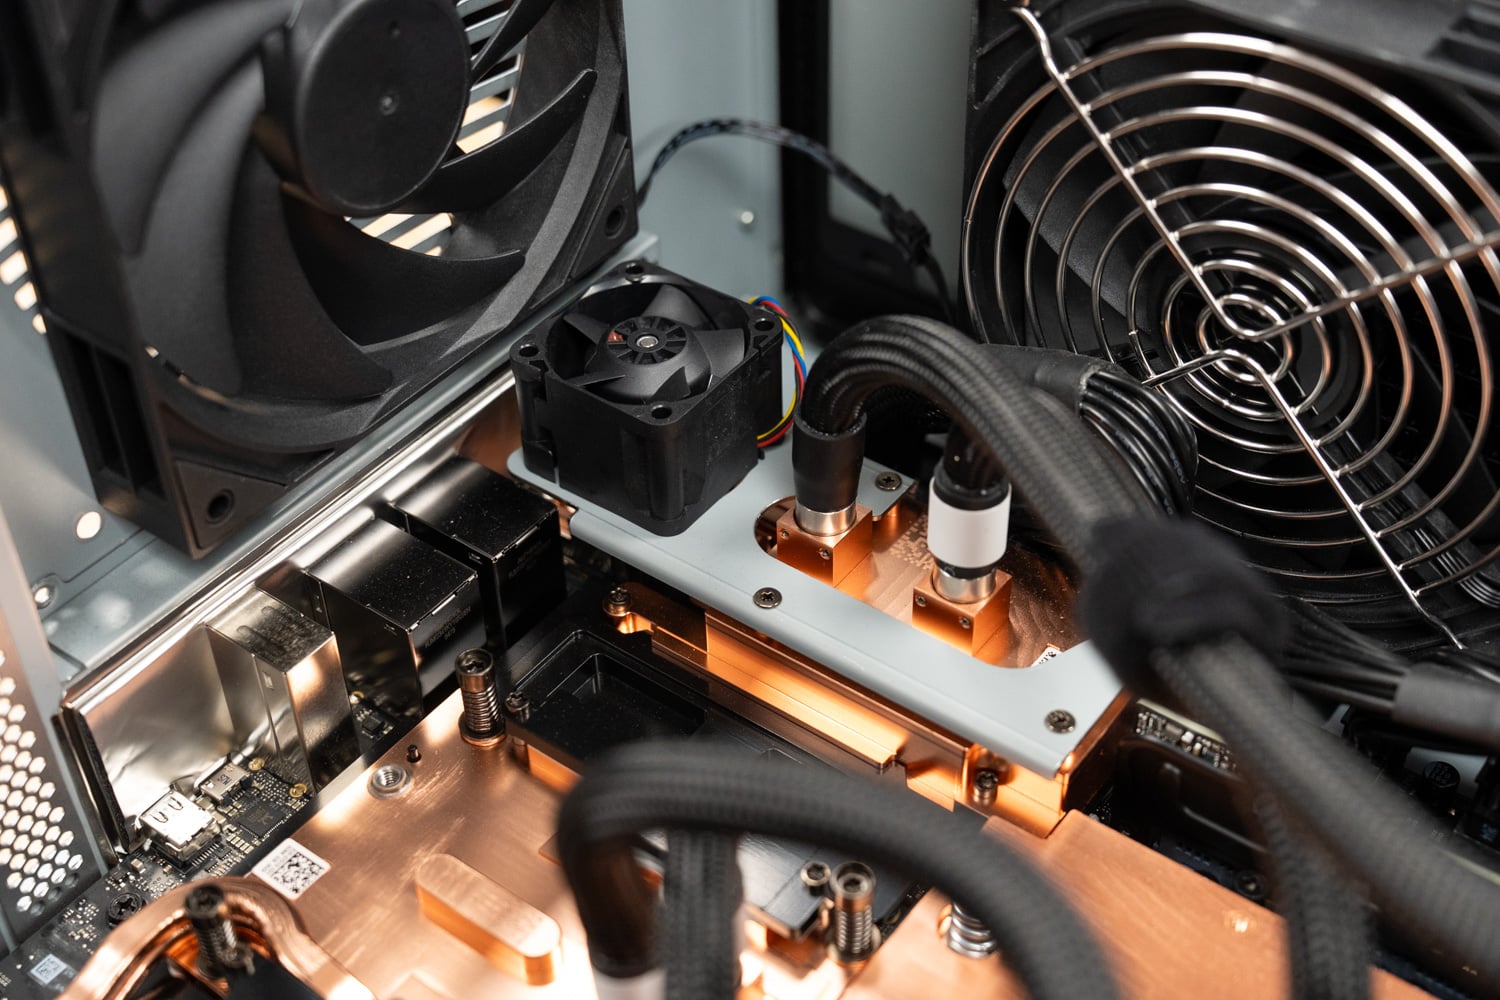
Le seul élément de refroidissement sans équivalent sur le WS300 est un petit ventilateur fixé sur un support au-dessus de la plaque froide du ConnectX-8, orienté vers les cages QSFP112. Le circuit de refroidissement liquide gère la puce SuperNIC, mais les émetteurs-récepteurs optiques 400G génèrent leur propre chaleur et sont logés dans des cages métalliques que la plaque froide ne peut atteindre que par conduction. Lors d'autres tests , nous avons constaté que le ConnectX-8 chauffe sous une charge soutenue et que les composants optiques peuvent également chauffer. Un flux d'air dédié au niveau des cages est donc un atout majeur pour quiconque prévoit d'utiliser l'ET900N G3 sur fibre optique pendant plusieurs heures d'affilée. Avec des convertisseurs numérique-analogique (CNA), comme c'est le cas pour le câblage vers une seconde station GB300 dans le cadre d'une analyse approfondie d'inférence en cluster actuellement en cours, le ventilateur est moins sollicité.
Stockage, extension et alimentation
ASUS a livré le ET900N G3 avec un seul disque NVMe de 2 To pour le système d'exploitation et la suite logicielle NVIDIA, installé dans les deux emplacements M.2 2280 connectés à Grace via PCIe 5.0 x4. La seconde paire d'emplacements est connectée au commutateur PCIe intégré ConnectX-8 et a été livrée vide.
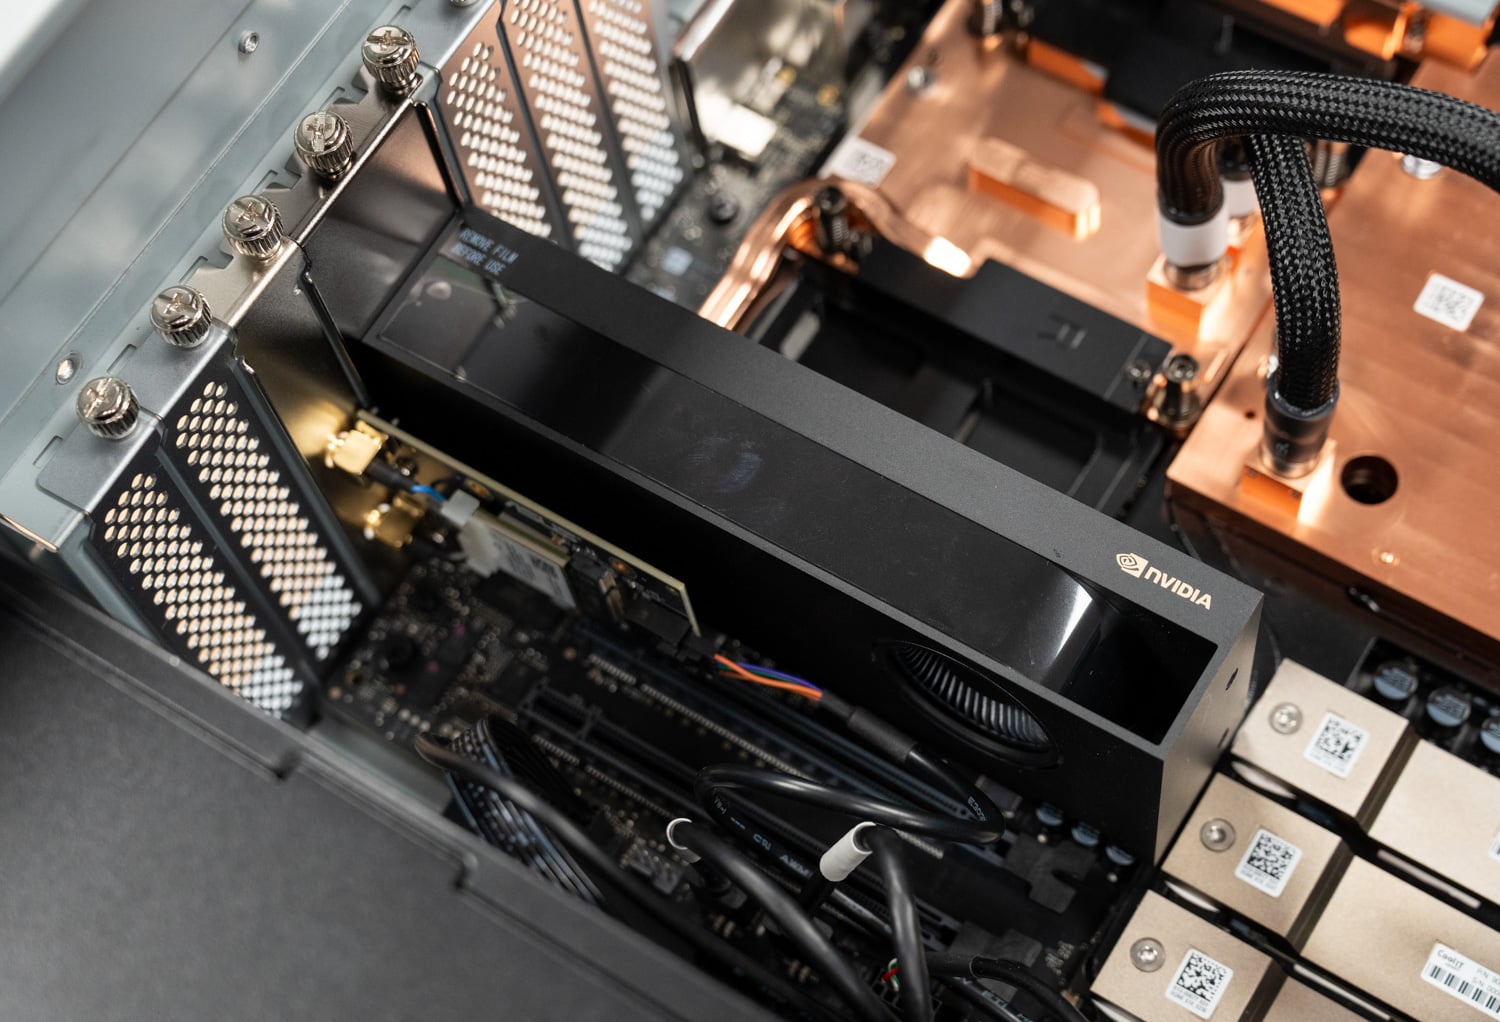
Notre modèle de test était équipé d'une carte graphique NVIDIA RTX PRO 2000 Blackwell installée dans le port PCIe 5.0 x16, une des configurations proposées par ASUS. Cette carte assure l'affichage sans impacter significativement la consommation électrique du GB300, et ASUS indique que le boîtier peut accueillir jusqu'à une carte RTX PRO Blackwell. Nous avons retiré la RTX PRO 2000 avant les tests de performances afin que le Superchip dispose de toute sa puissance d'accélération, comme pour le WS300. Nous n'avons pas testé de carte RTX PRO haute consommation dans ce boîtier ; nous aborderons cette configuration et son impact sur la consommation électrique partagée dans un prochain test du GB300 Station.
L'alimentation est un modèle ATX de 1 600 W certifié 80 PLUS Titanium par ASUS, un niveau supérieur à celui du modèle Platinum du WS300. La certification Titanium exige un rendement de 94 % à 50 % de charge sur une tension d'entrée de 115 V, contre 92 % pour la certification Platinum. C'est la seule certification qui impose une consommation minimale à 10 % de charge ; ainsi, l'ET900N G3 devrait consommer quelques dizaines de watts de moins à la prise murale sous une charge maximale du GB300. La puissance est toujours partagée : le processeur graphique Grace, le B300, les pompes, les ventilateurs, le stockage et toute carte RTX PRO consomment les mêmes 1 600 W. Le service vsloshd de NVIDIA répartit la puissance disponible entre le Superchip et un GPU additionnel en fonction de leur consommation, sans limite fixe pour aucun des deux. Ce principe est détaillé dans le test du WS300 et reste inchangé ici. Un circuit dédié de 20 A est toujours requis pour les installations en Amérique du Nord.
Connectivité
Les deux ports QSFP112 du ConnectX-8 assurent la connexion de l'ET900N G3 à l'ensemble du réseau : stockage, une seconde station DGX ou une infrastructure de cluster. Ces ports sont déjà utilisés en laboratoire, l'ET900N G3 étant connecté à une seconde station GB300 via des convertisseurs N/A 400G pour une analyse approfondie de l'inférence en cluster que nous publierons séparément. Le port Marvell 10 GbE gère le trafic hôte standard, et le port Realtek 1 GbE est dédié au BMC.
Notes de test
Tous les résultats de ce test proviennent de l'unité fournie par ASUS à notre laboratoire, avec sa configuration mémoire d'origine (252 Go de HBM3e et 496 Go de LPDDR5X). Le système a fonctionné sans carte RTX PRO, le Superchip GB300 bénéficiant ainsi de sa pleine capacité d'accélération, comme lors de nos tests du WS300. La pile logicielle, la configuration vLLM, les profils de charge de travail et le balayage de concurrence sont identiques à ceux utilisés pour le WS300, permettant une comparaison directe entre les deux tours. Ce test porte uniquement sur les performances ; nous n'avons pas mesuré la consommation électrique ni la température de cette unité.
Les charges de travail correspondent aux deux mêmes profils d'inférence en direct vLLM que nous exécutons sur chaque système d'IA local : une charge de travail identique avec 512 jetons d'entrée et 512 jetons de sortie, et une charge de travail avec préremplissage important, comprenant 8 192 jetons d'entrée et 1 024 jetons de sortie, répartie de 1 à 128 flux simultanés. Pour les modèles à grande échelle, nous comparons les performances à celles d'un serveur GPU Dell PowerEdge XE7740 équipé de deux ou quatre cartes RTX PRO 6000 , l'alternative monobloc la plus proche pour ces points de contrôle. Pour les modèles plus petits, nous comparons les performances à celles d'une seule carte RTX PRO 6000 dans le même XE7740, d'un seul H200 NVL dans un Dell PowerEdge R770 , et d'un GB10 DGX Spark représenté par l' Acer Veriton GN100 , le même Spark que celui utilisé lors du test du WS300. Les chiffres relatifs à l'ET900N G3 ci-dessous correspondent aux valeurs exactes issues des journaux d'exécution. Les chiffres du système de comparaison sont lus à partir de nos graphiques de résultats.
Performances d'inférence
Modèles de frontière sur le pool de mémoire cohérente
La raison d'être du GB300 est de prendre en charge les modèles situés de part et d'autre de la limite de 252 Go de mémoire HBM3e du B300. Nous commençons donc par quatre points de comparaison : les mémoires DeepSeek V4 Flash et MiniMax M2.7 s'intègrent parfaitement dans la mémoire HBM, les MiniMax M3 y tiennent tout juste et déportent une partie de leurs performances vers la mémoire Grace, et les GLM-5.2 déchargent environ la moitié de leurs performances. De l'autre côté de chaque tableau se trouve l'alternative monobloc la plus proche : les cartes RTX PRO 6000 regroupées dans le PowerEdge XE7740, avec déchargement des performances vers la mémoire hôte lorsque cela est nécessaire.
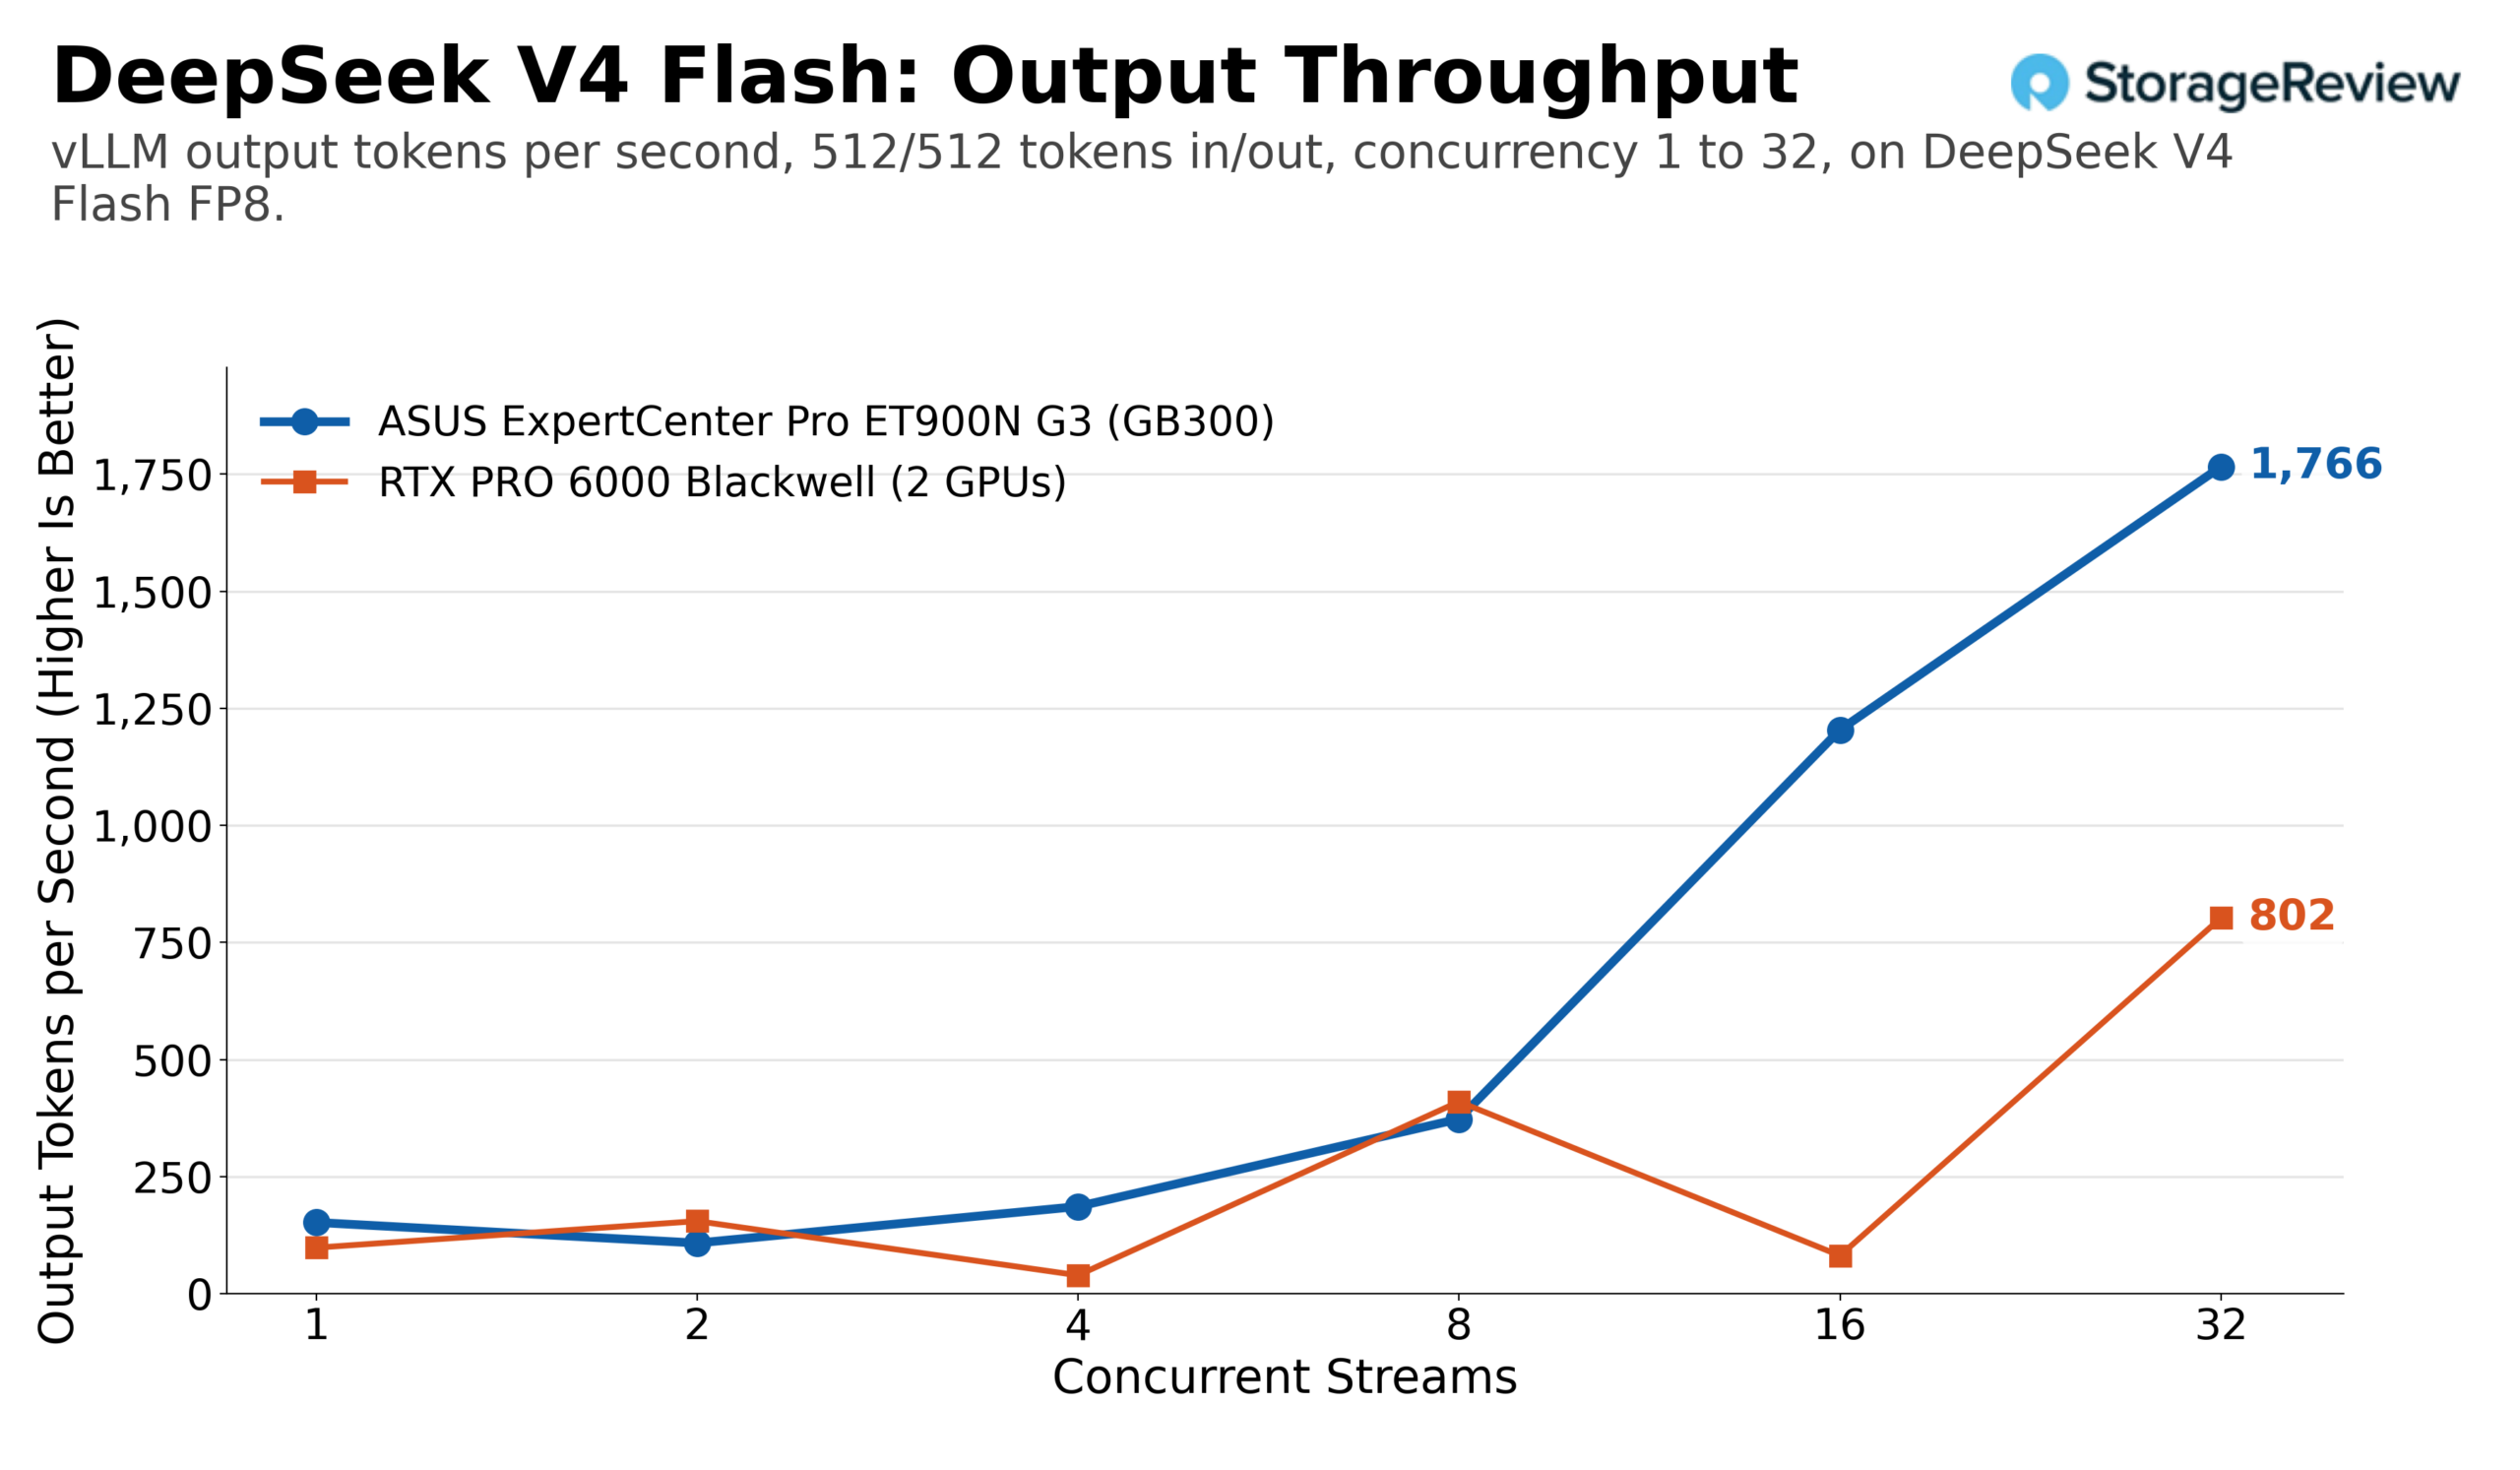
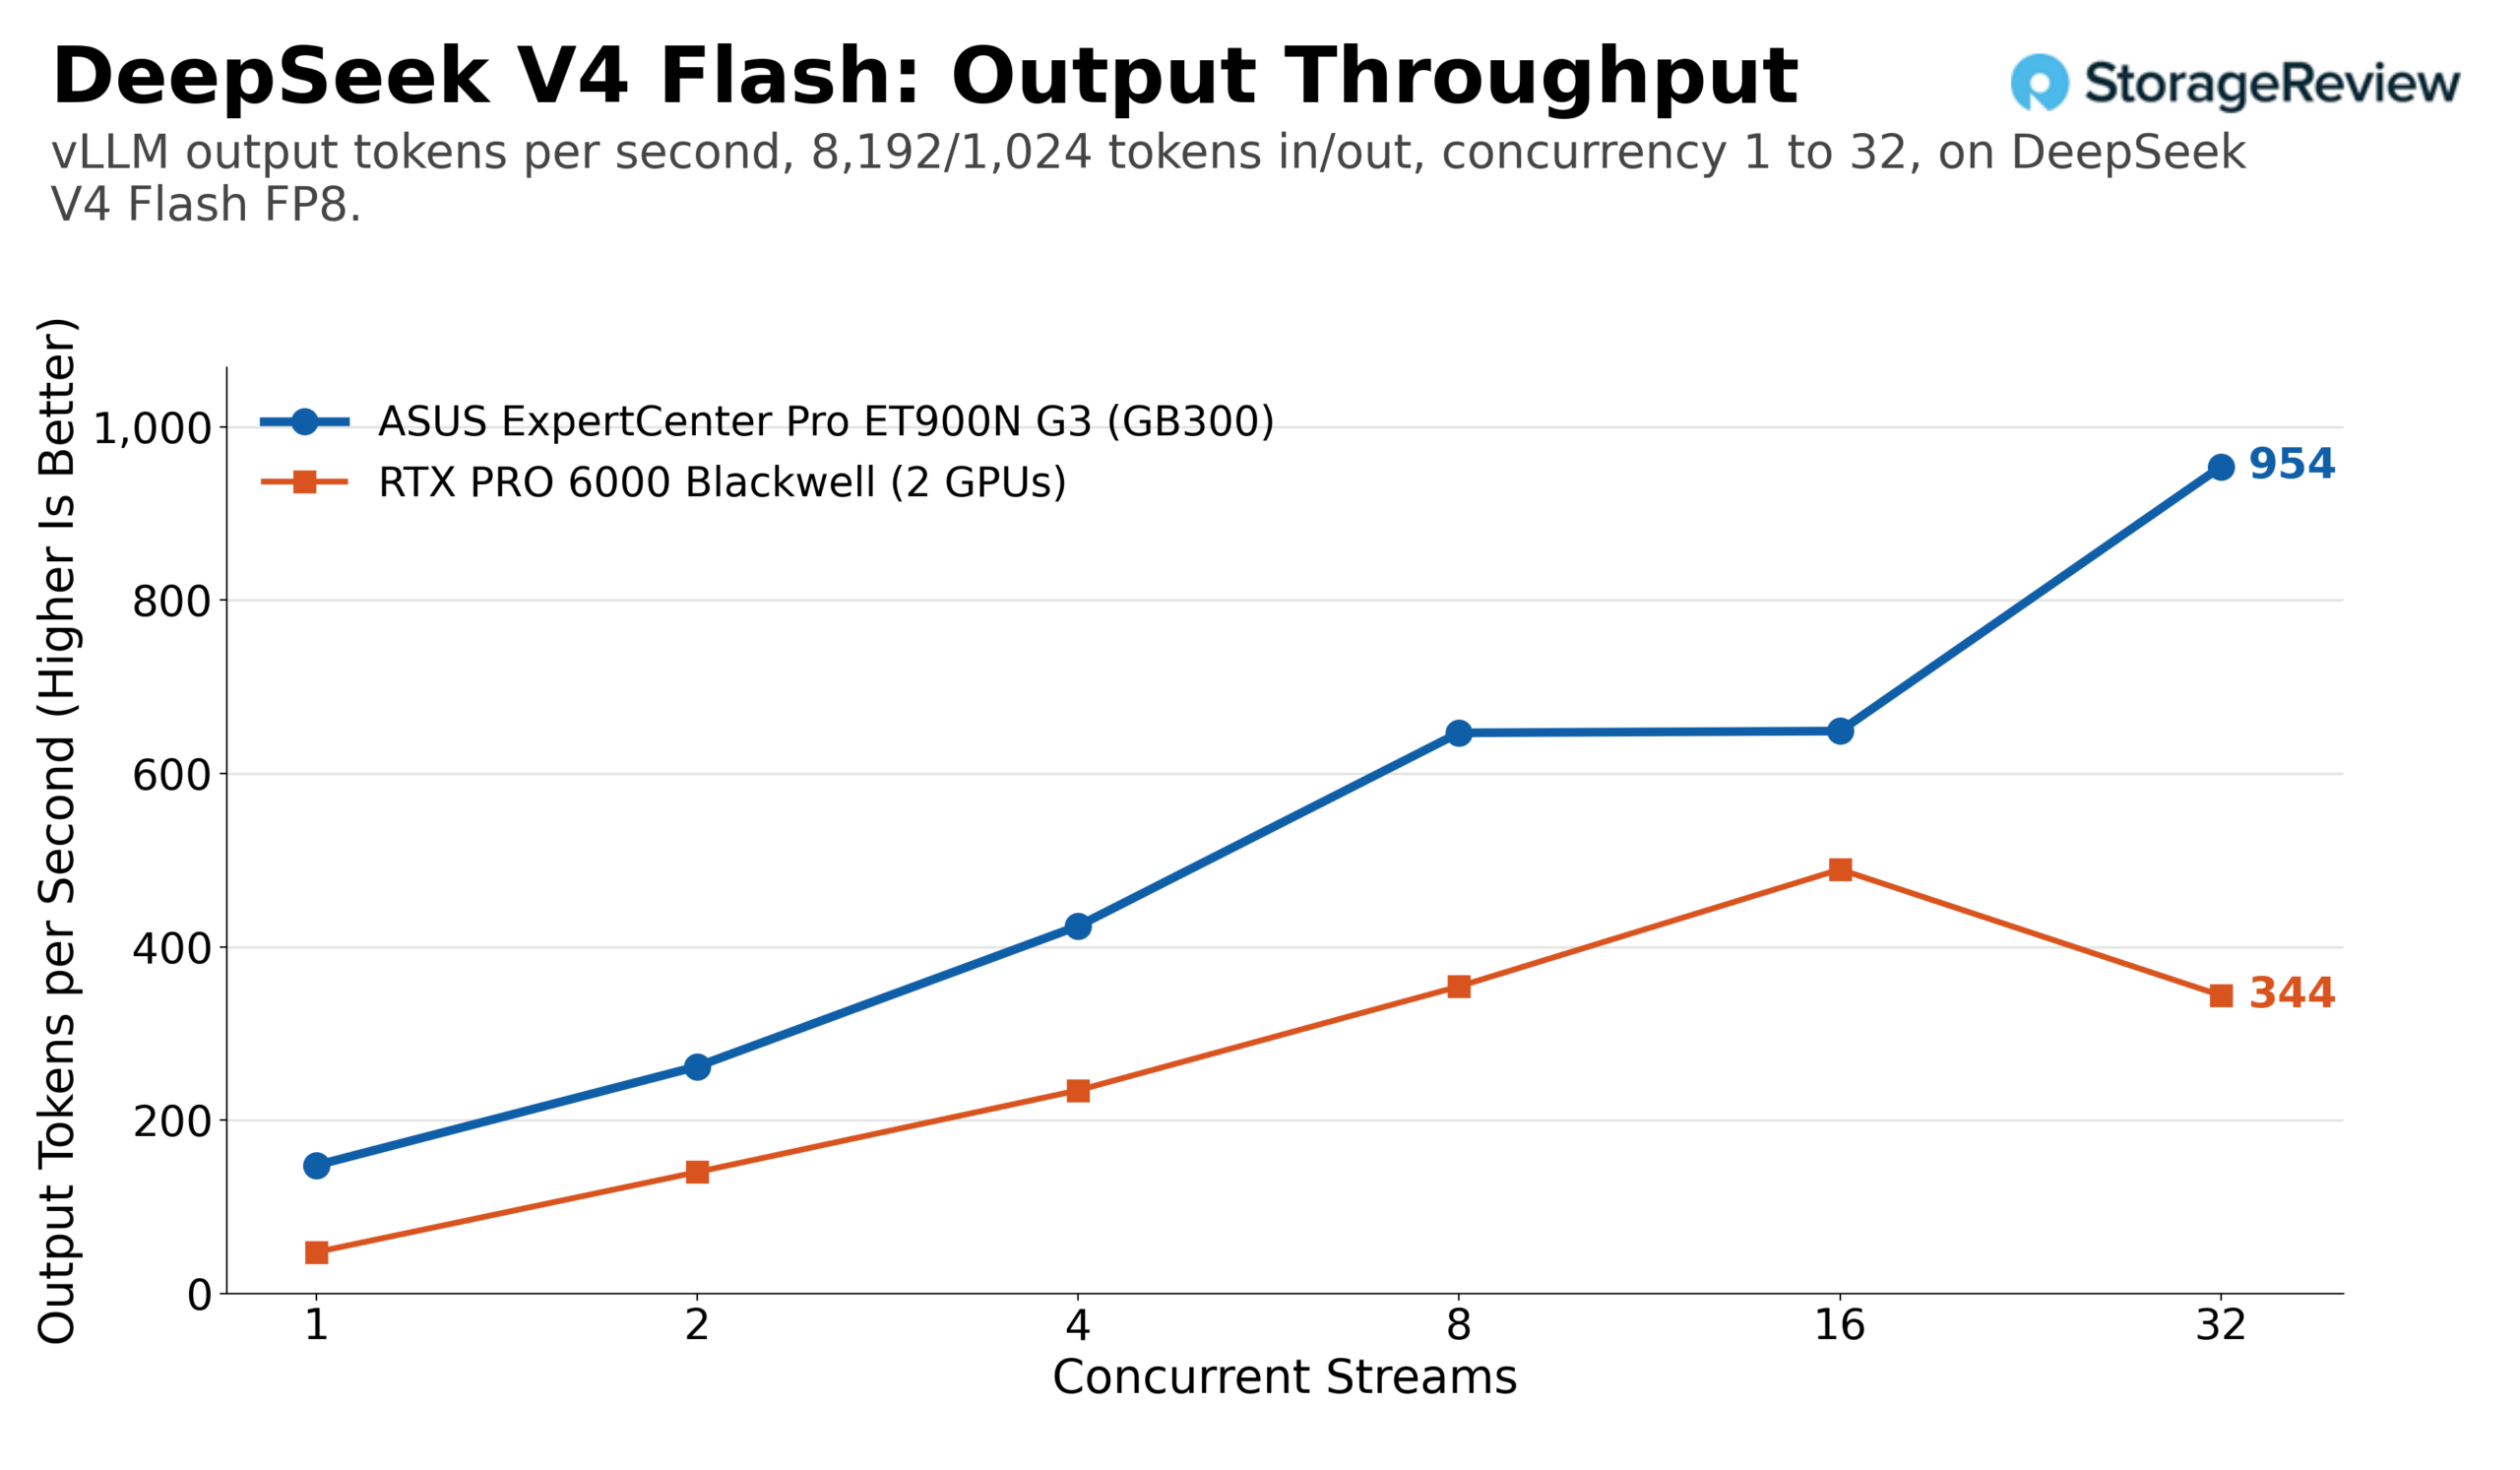
Le cas DeepSeek V4 Flash est simple : un point de contrôle FP8 natif d'environ 20 Go que le B300 gère sans difficulté. Le débit de sortie, pour la même charge de travail, est passé de 152 jetons par seconde avec 1 flux à 1 766 avec 32 flux, pour un débit total de 3 532 jetons par seconde. Avec un profil nécessitant un préremplissage important, l'ET900N G3 a vu son débit passer de 148 à 954 jetons par seconde, pour un total de 8 587 jetons. Deux cartes RTX PRO 6000 ont atteint un pic de près de 800 jetons par seconde pour la même charge de travail et d'environ 490 jetons par seconde avec les requêtes longues, avec une courbe irrégulière en cas de faible concurrence.
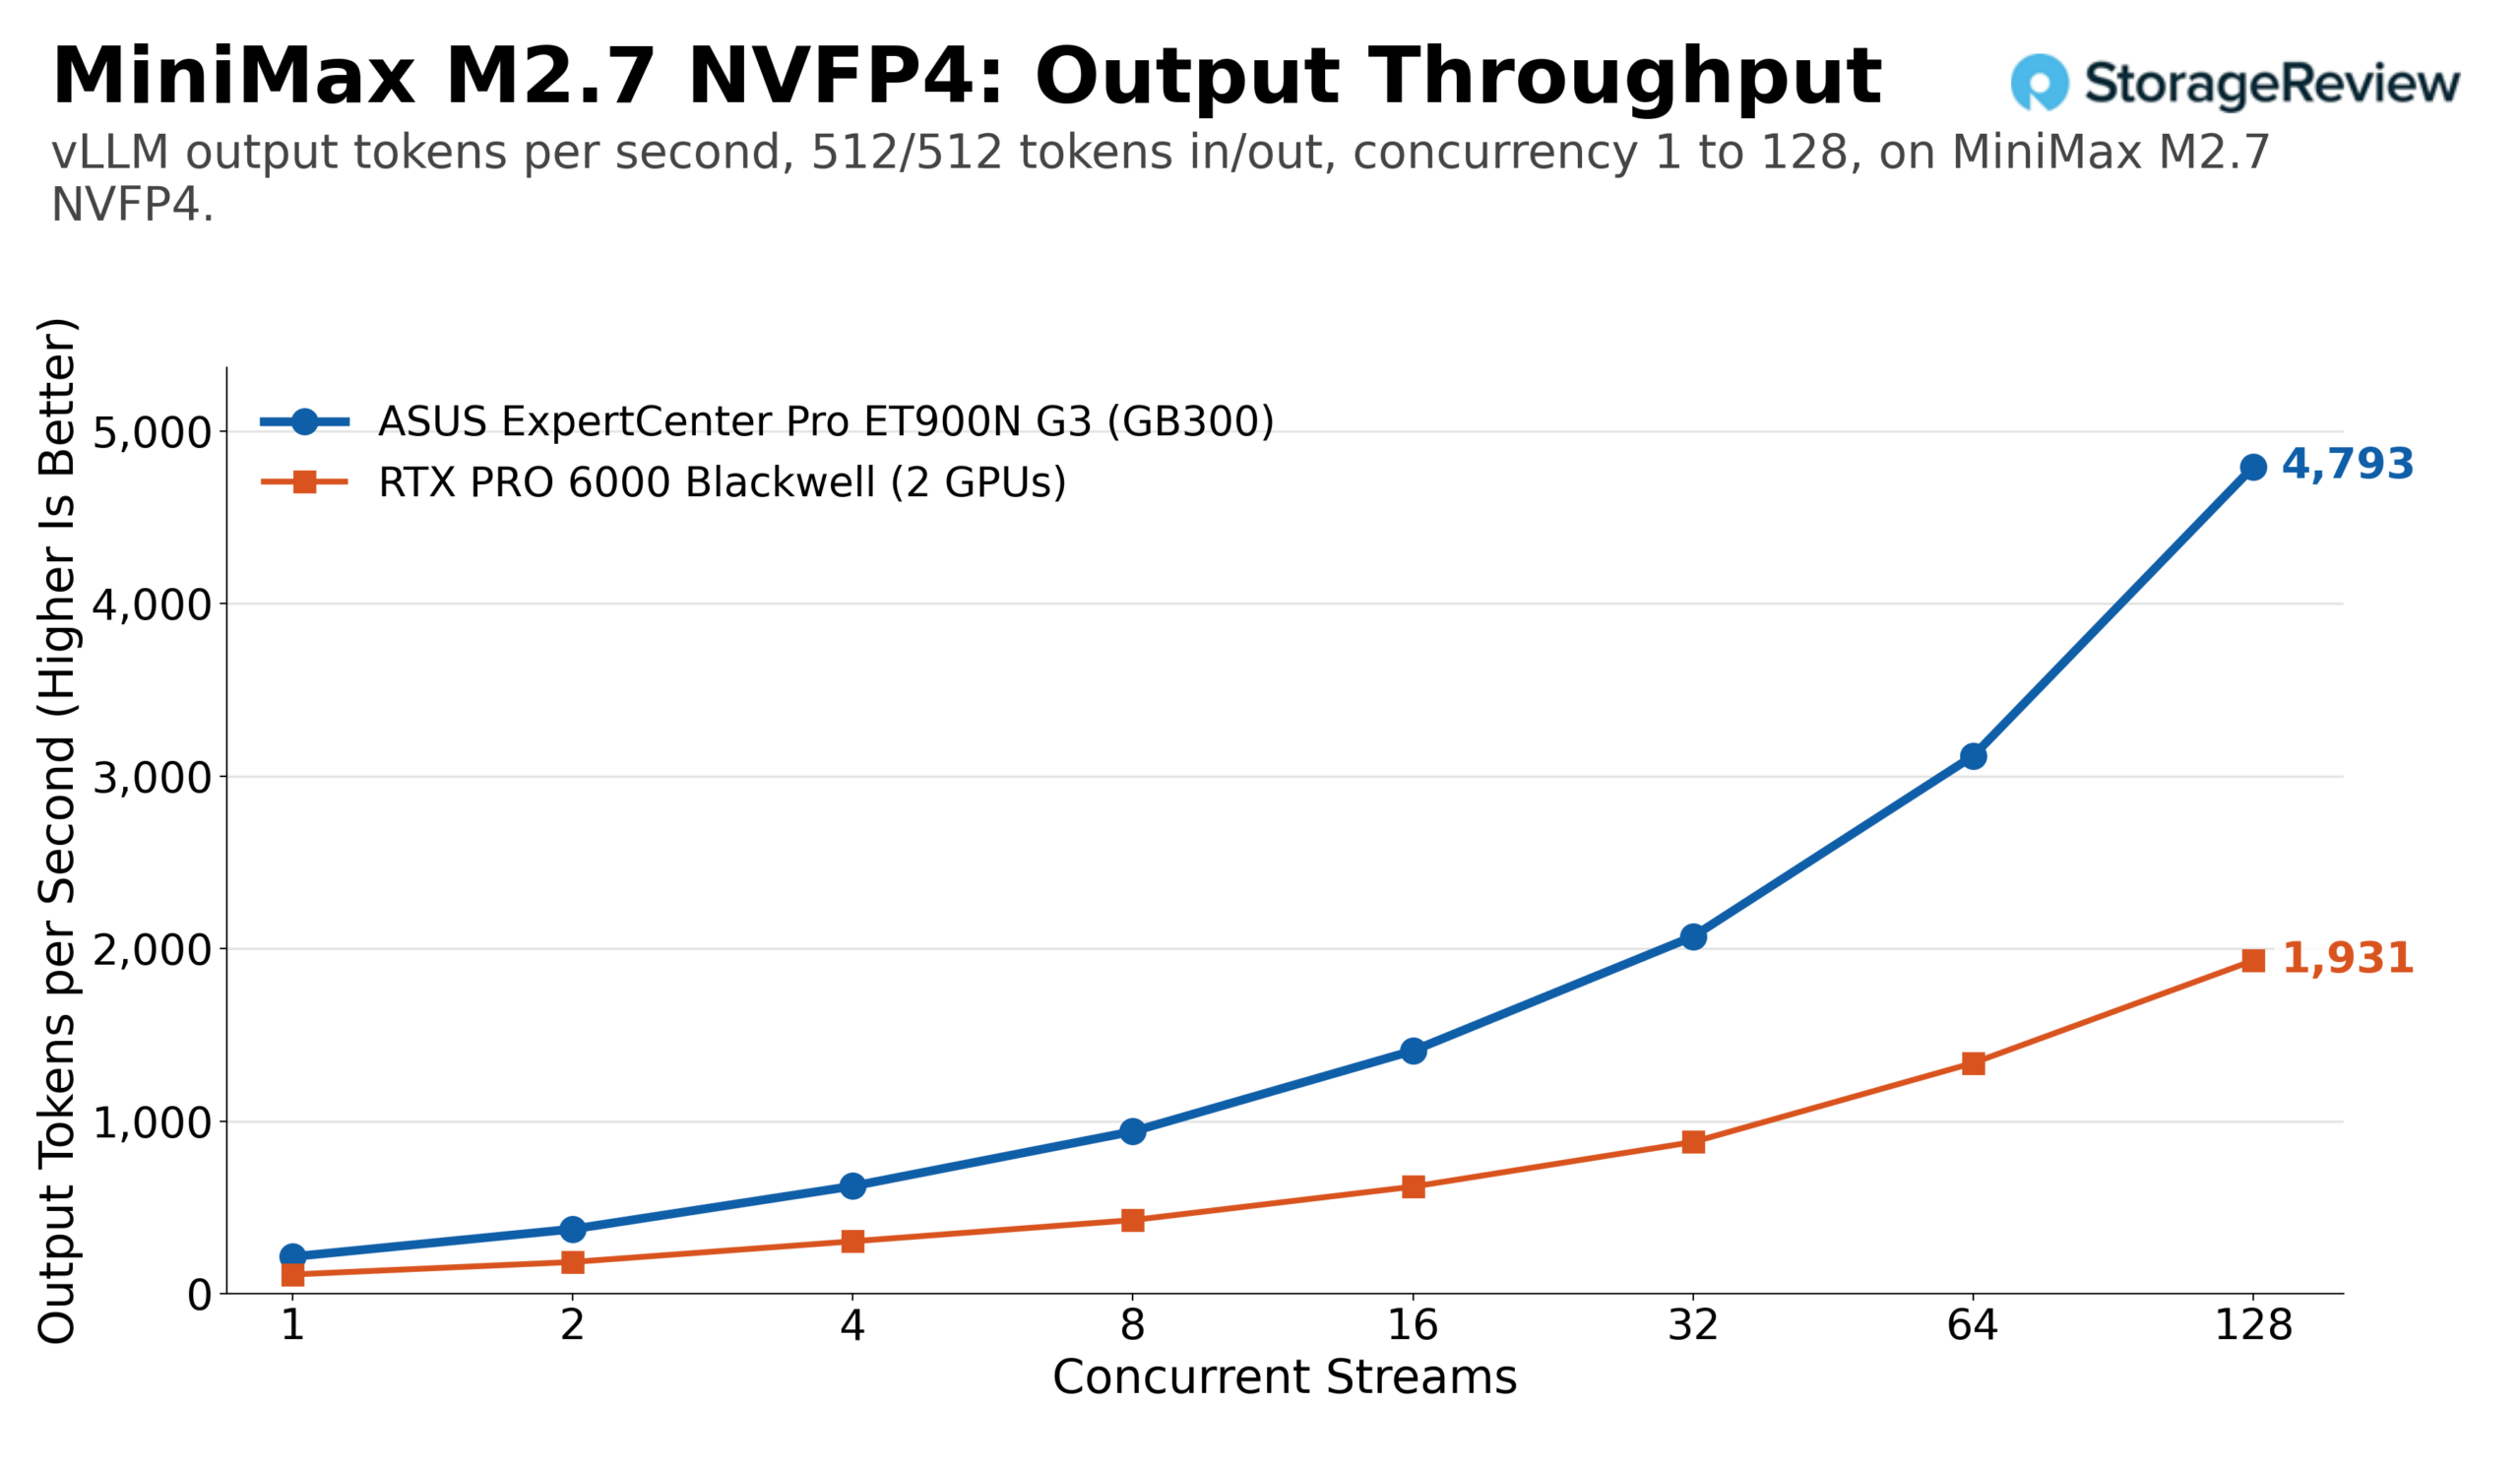
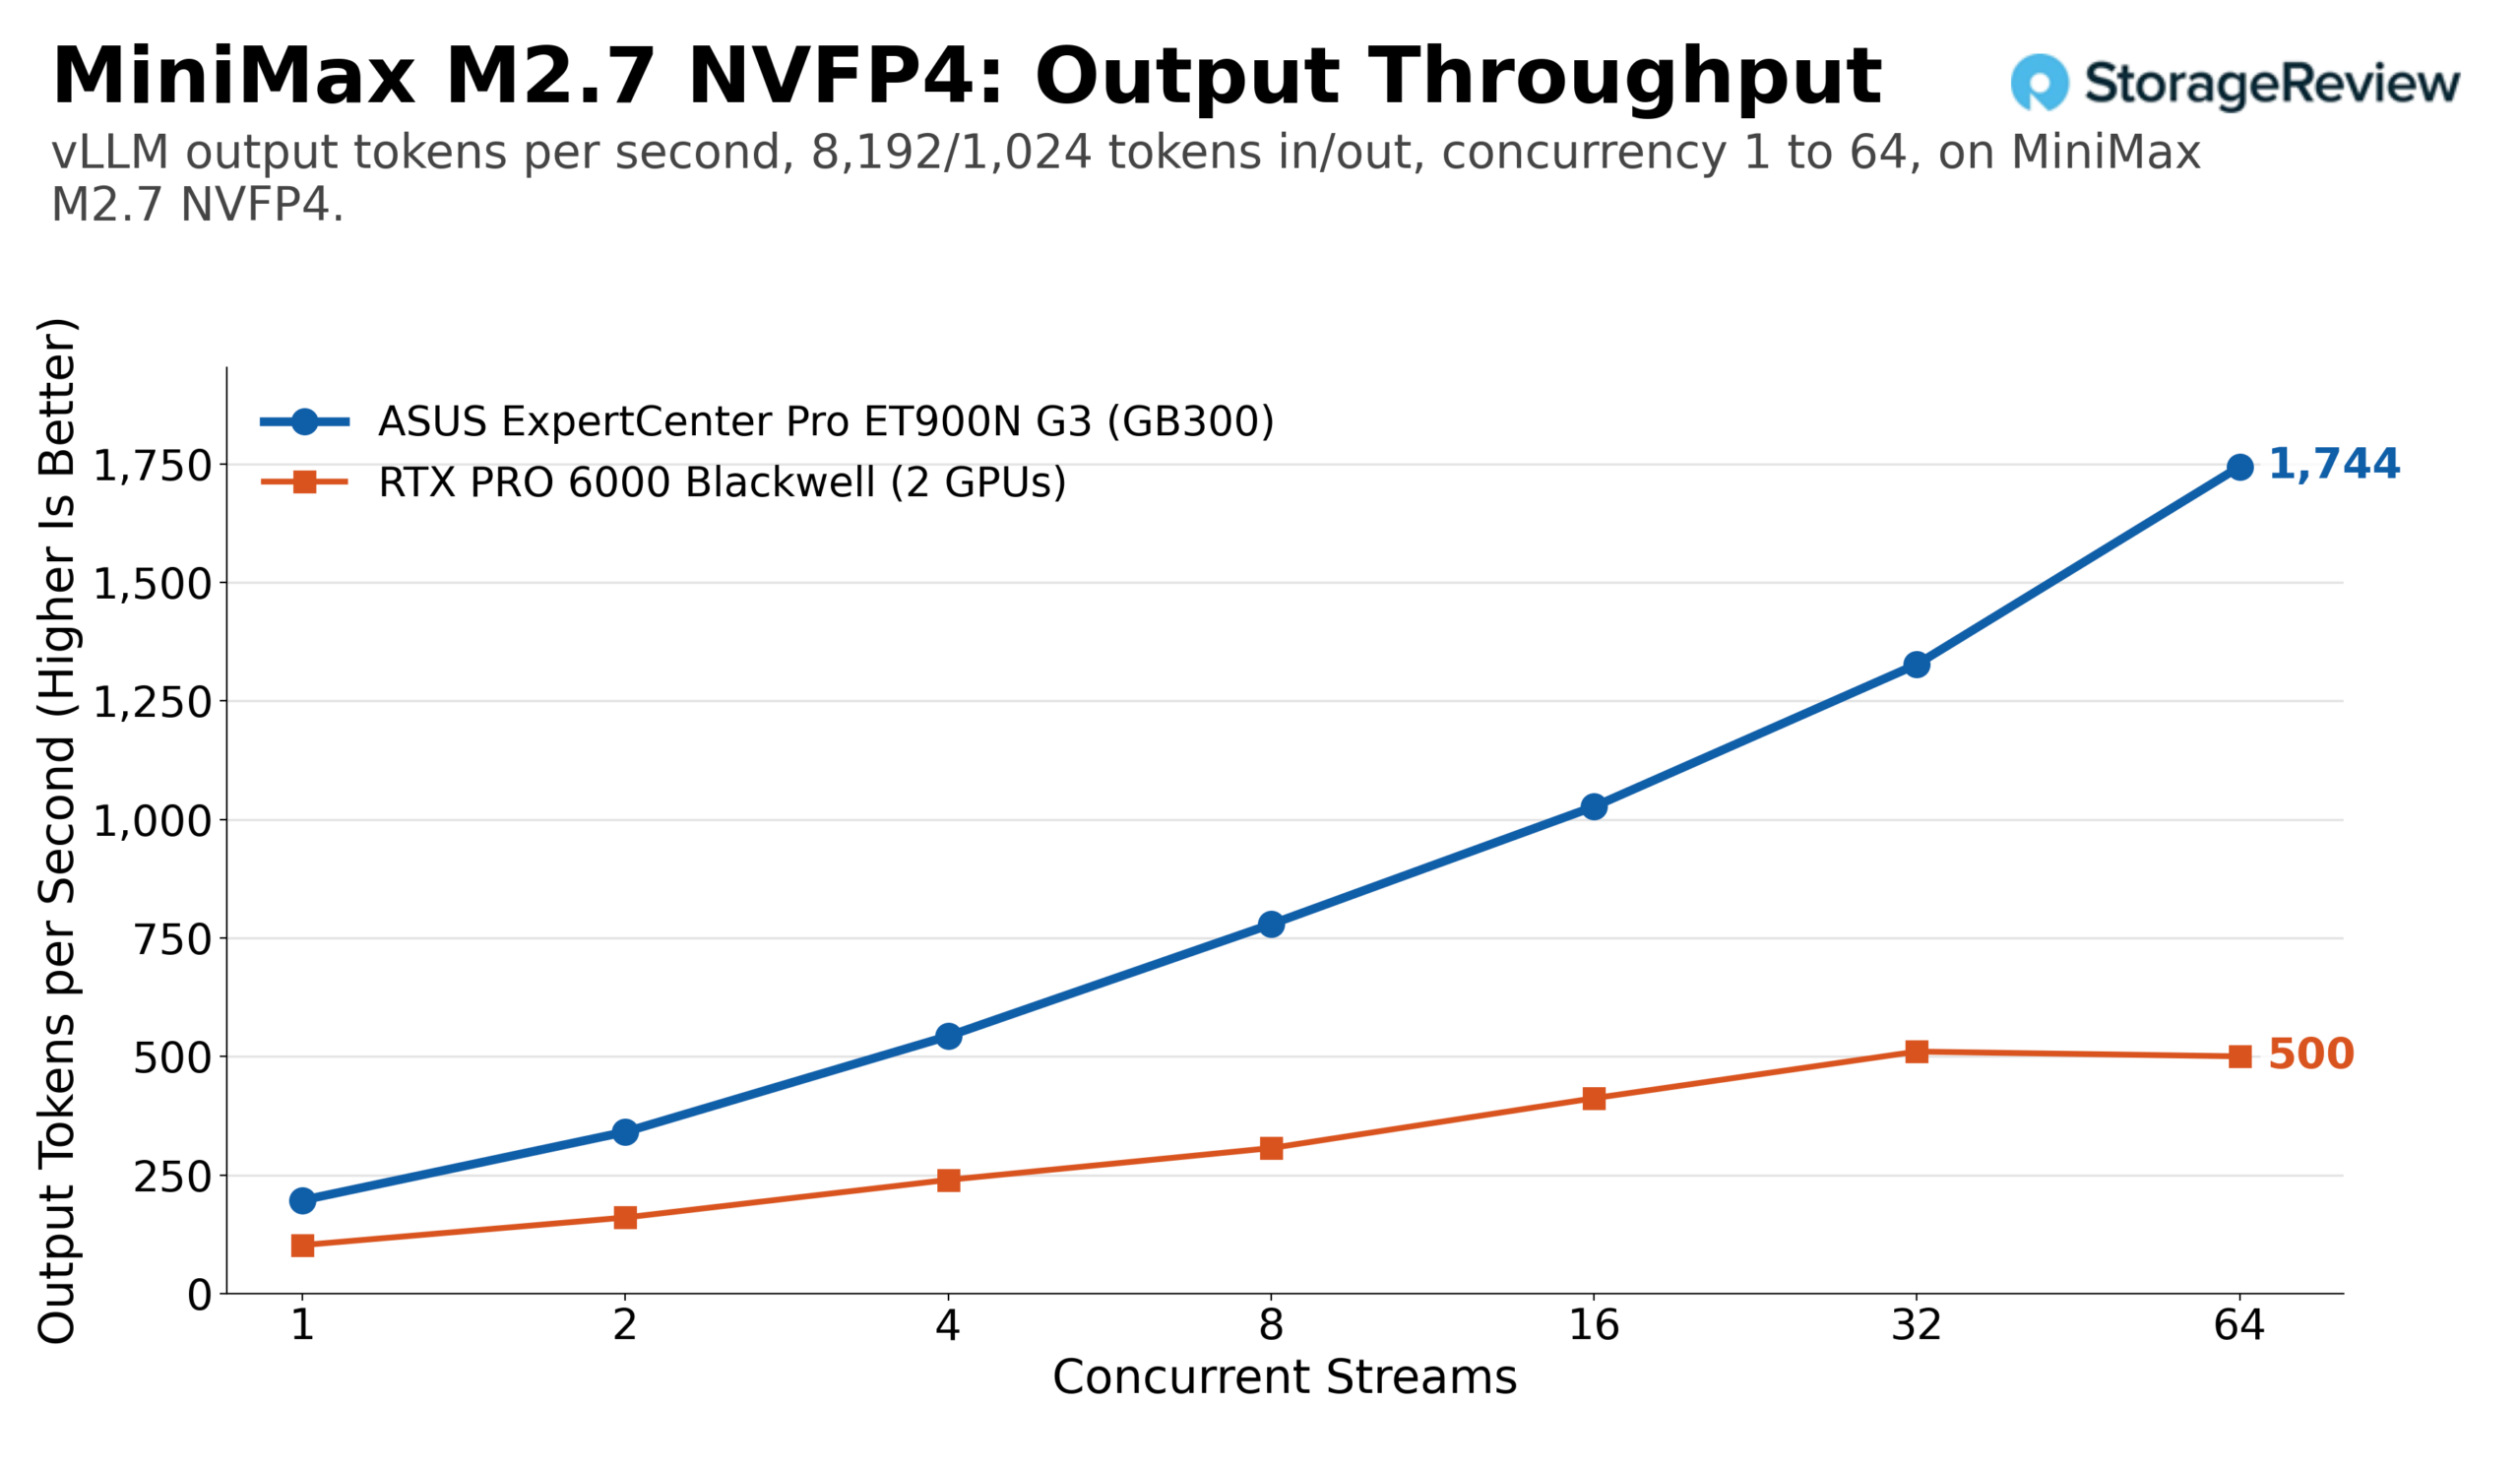
Le MiniMax M2.7, utilisant la quantification NVFP4 de NVIDIA et occupant environ 125 Go de mémoire HBM, a affiché les performances les plus élevées des quatre. À charge de travail égale, le débit est passé de 214 jetons de sortie par seconde sur un flux à 4 793 sur 128 flux, pour un débit total de 9 586. Lors d'une exécution intensive avec préremplissage, le débit a atteint 1 744 jetons de sortie par seconde et 15 700 jetons par seconde au total sur 64 flux. Deux cartes RTX PRO 6000 ont présenté des performances similaires, mais avec une augmentation de débit deux fois moindre, plafonnant à près de 1 930 jetons de sortie par seconde à charge de travail égale et à environ 510 lors des requêtes longues.
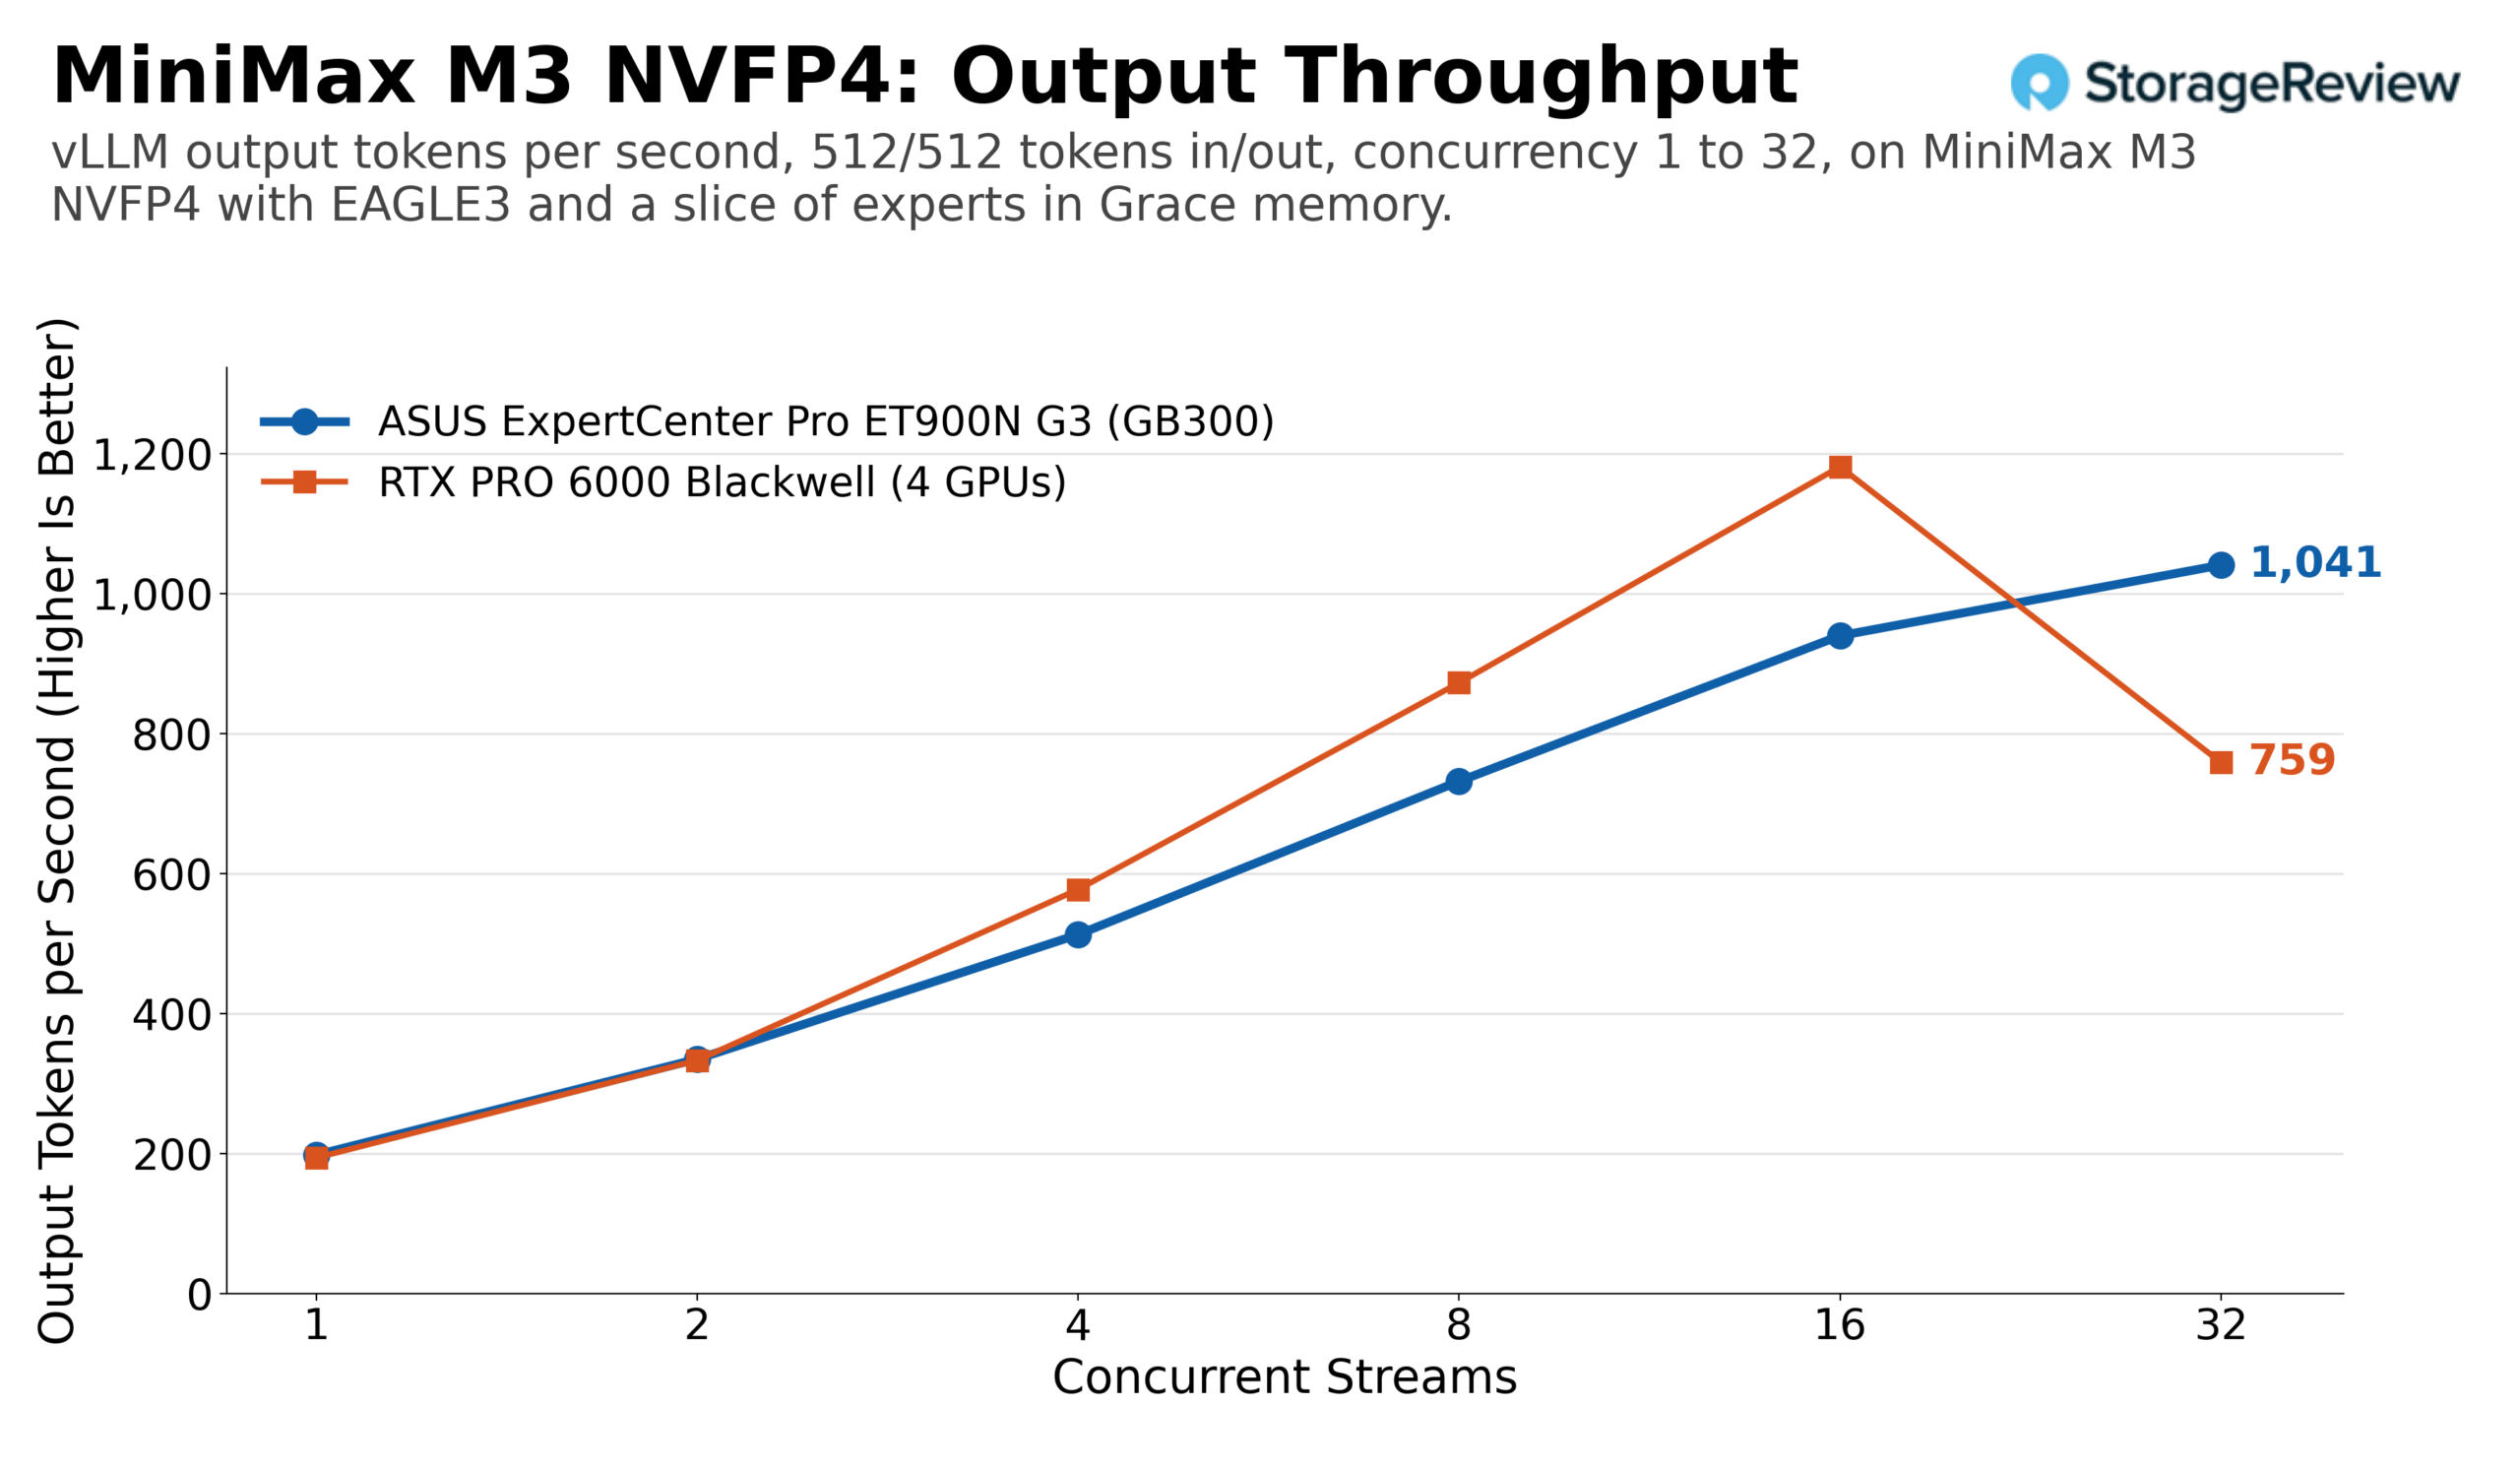
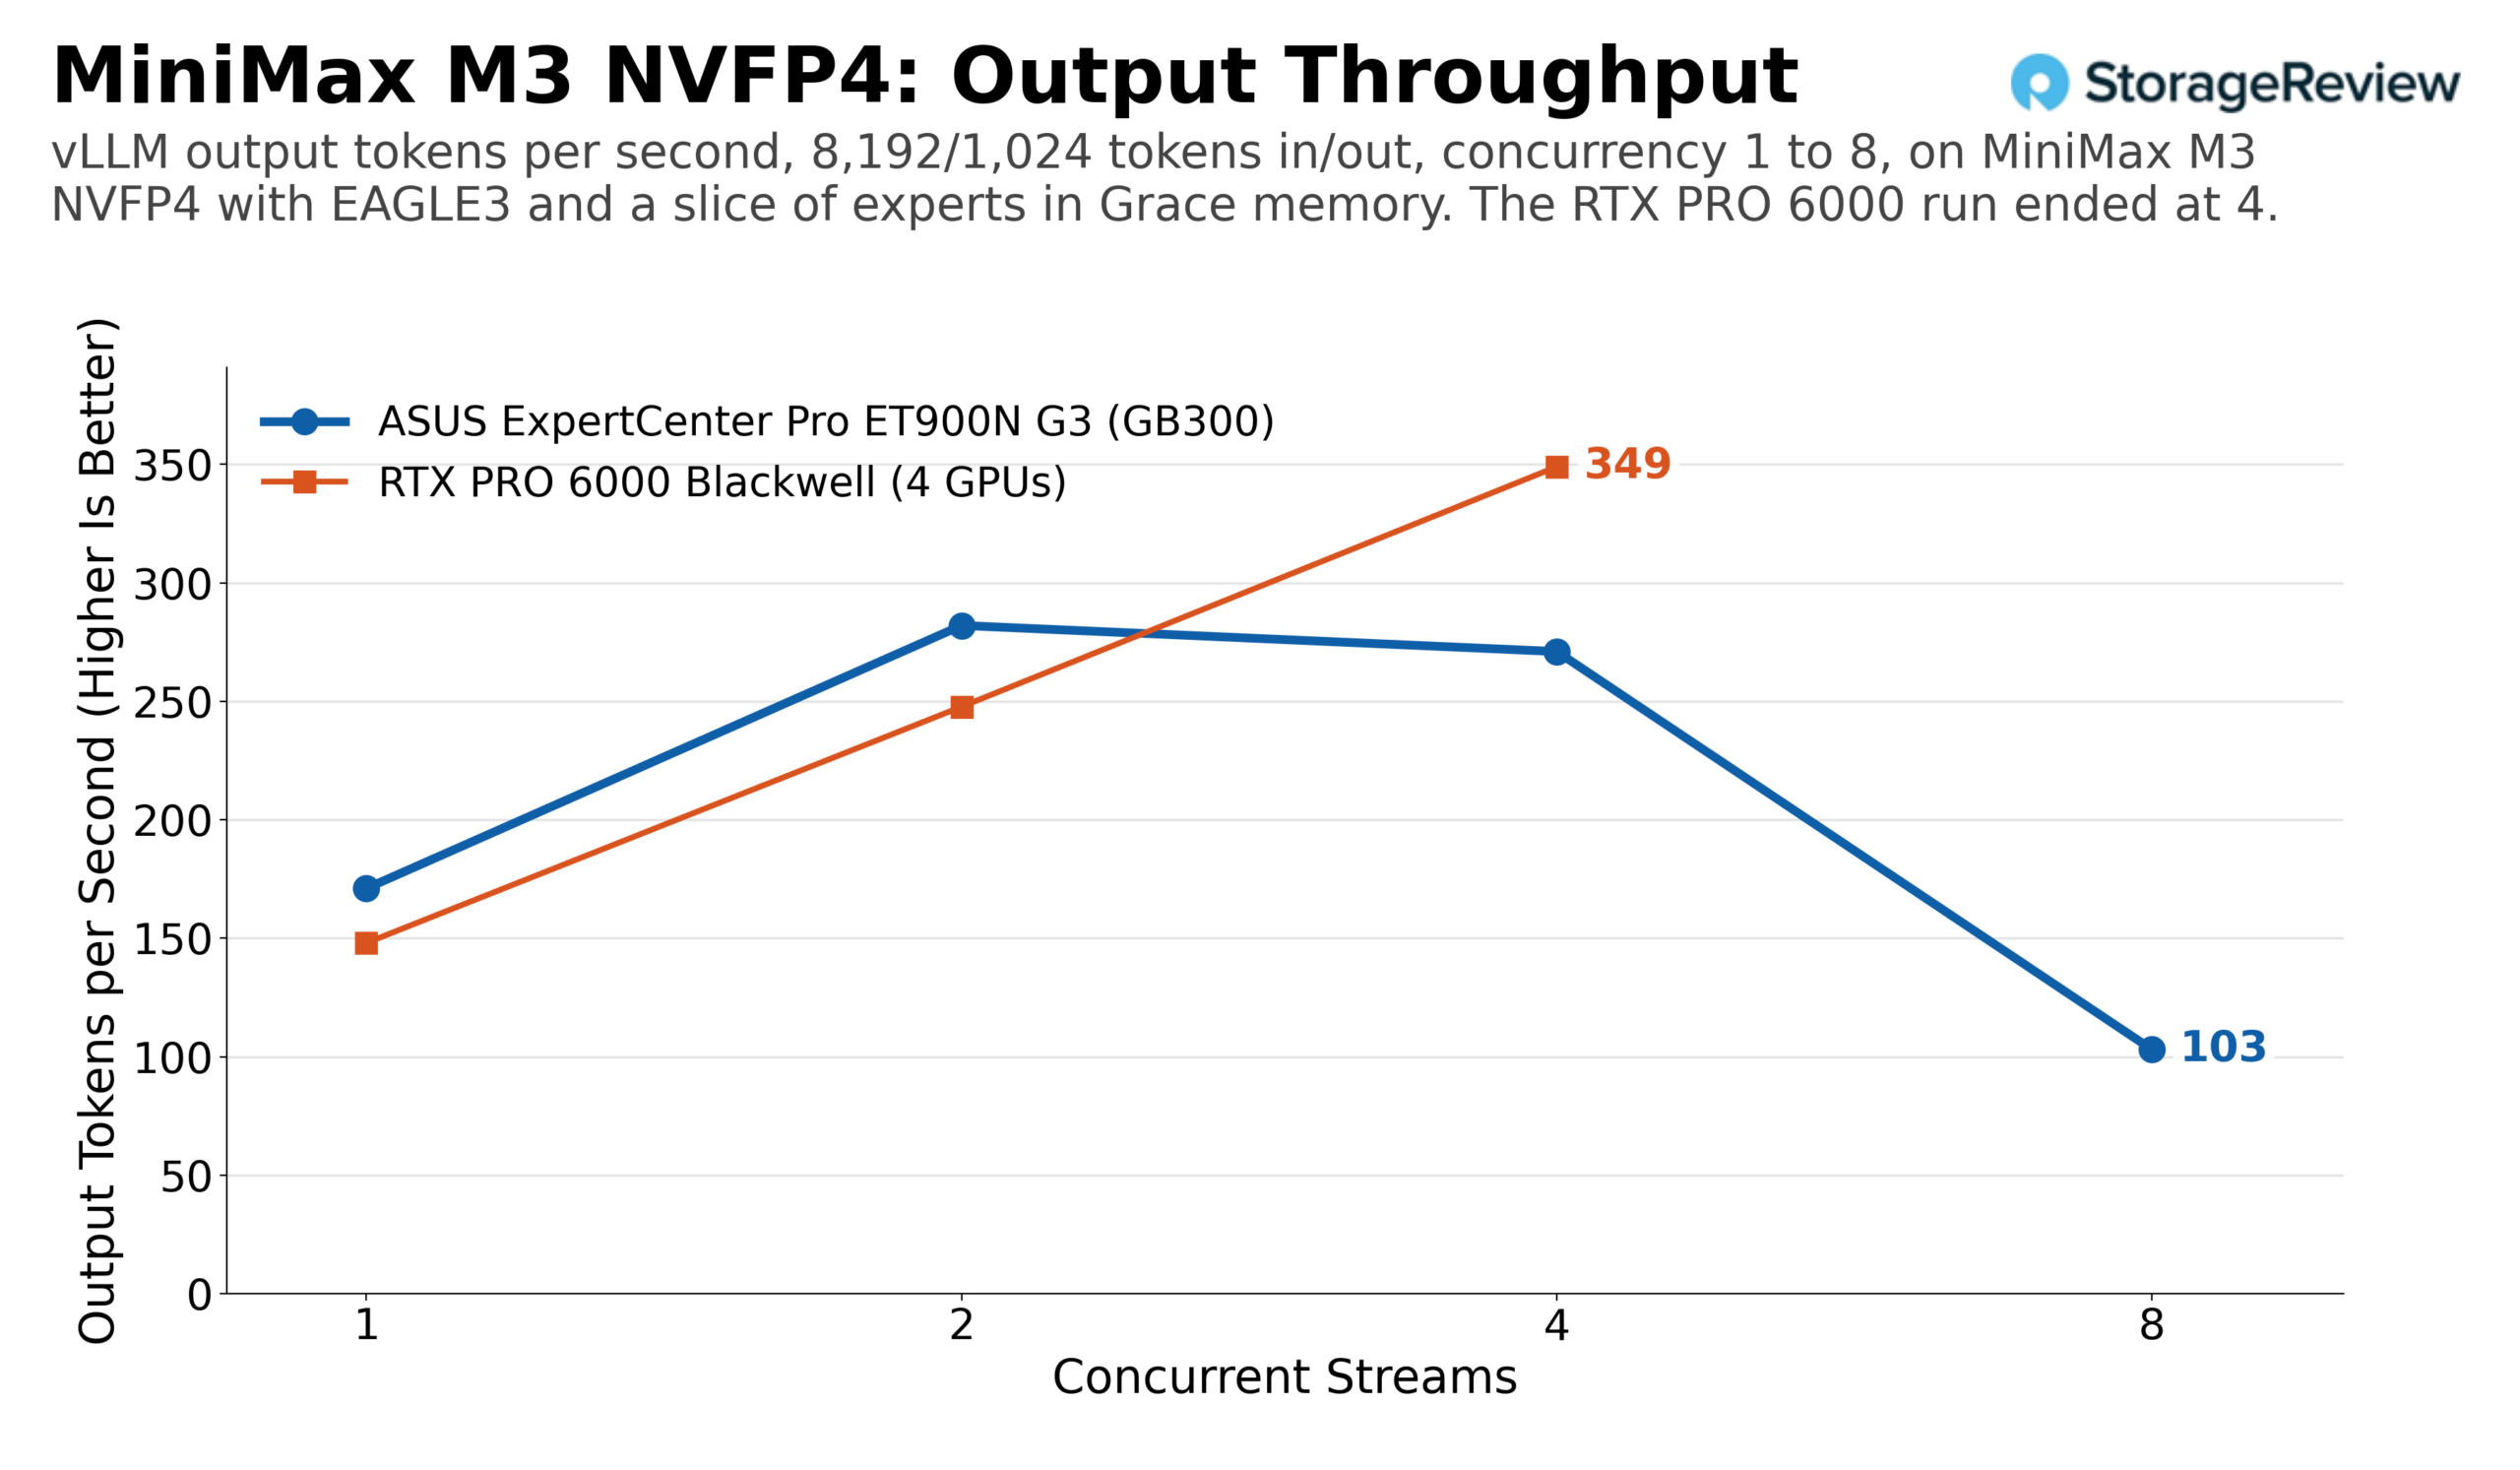
MiniMax M3 illustre les limites de la mémoire. Le point de contrôle NVFP4 est inférieur à 252 Go, mais l'environnement d'exécution et le cache KV nécessitent également de l'espace. Une partie des données est donc stockée dans la mémoire Grace, et chaque étape de décodage les concernant passe par NVLink-C2C. Avec le décodage spéculatif EAGLE3, l'ET900N G3 a atteint 1 041 jetons de sortie par seconde à 32 flux, sous une charge de travail identique. Le profil nécessitant un préremplissage important a culminé à 282 jetons par seconde à deux flux, s'est maintenu à 271 à quatre, puis a chuté à 103 à huit, les longues requêtes consommant le cache restant. Quatre cartes RTX PRO 6000, équipées du même décodeur spéculatif, ont maintenu le rythme jusqu'à huit flux et ont pris l'avantage à 16 flux avec environ 1 180 jetons de sortie par seconde, avant de retomber à environ 760 à 32 flux. Avec un profil de préremplissage important, le boîtier à quatre cartes contenait environ 349 jetons de sortie par seconde sur quatre flux, contre 271 pour la Station. Un modèle situé à la limite de la mémoire HBM est le seul endroit de cet ensemble où 384 Go de VRAM répartis sur quatre cartes rivalisent avec 252 Go de HBM plus déchargement.
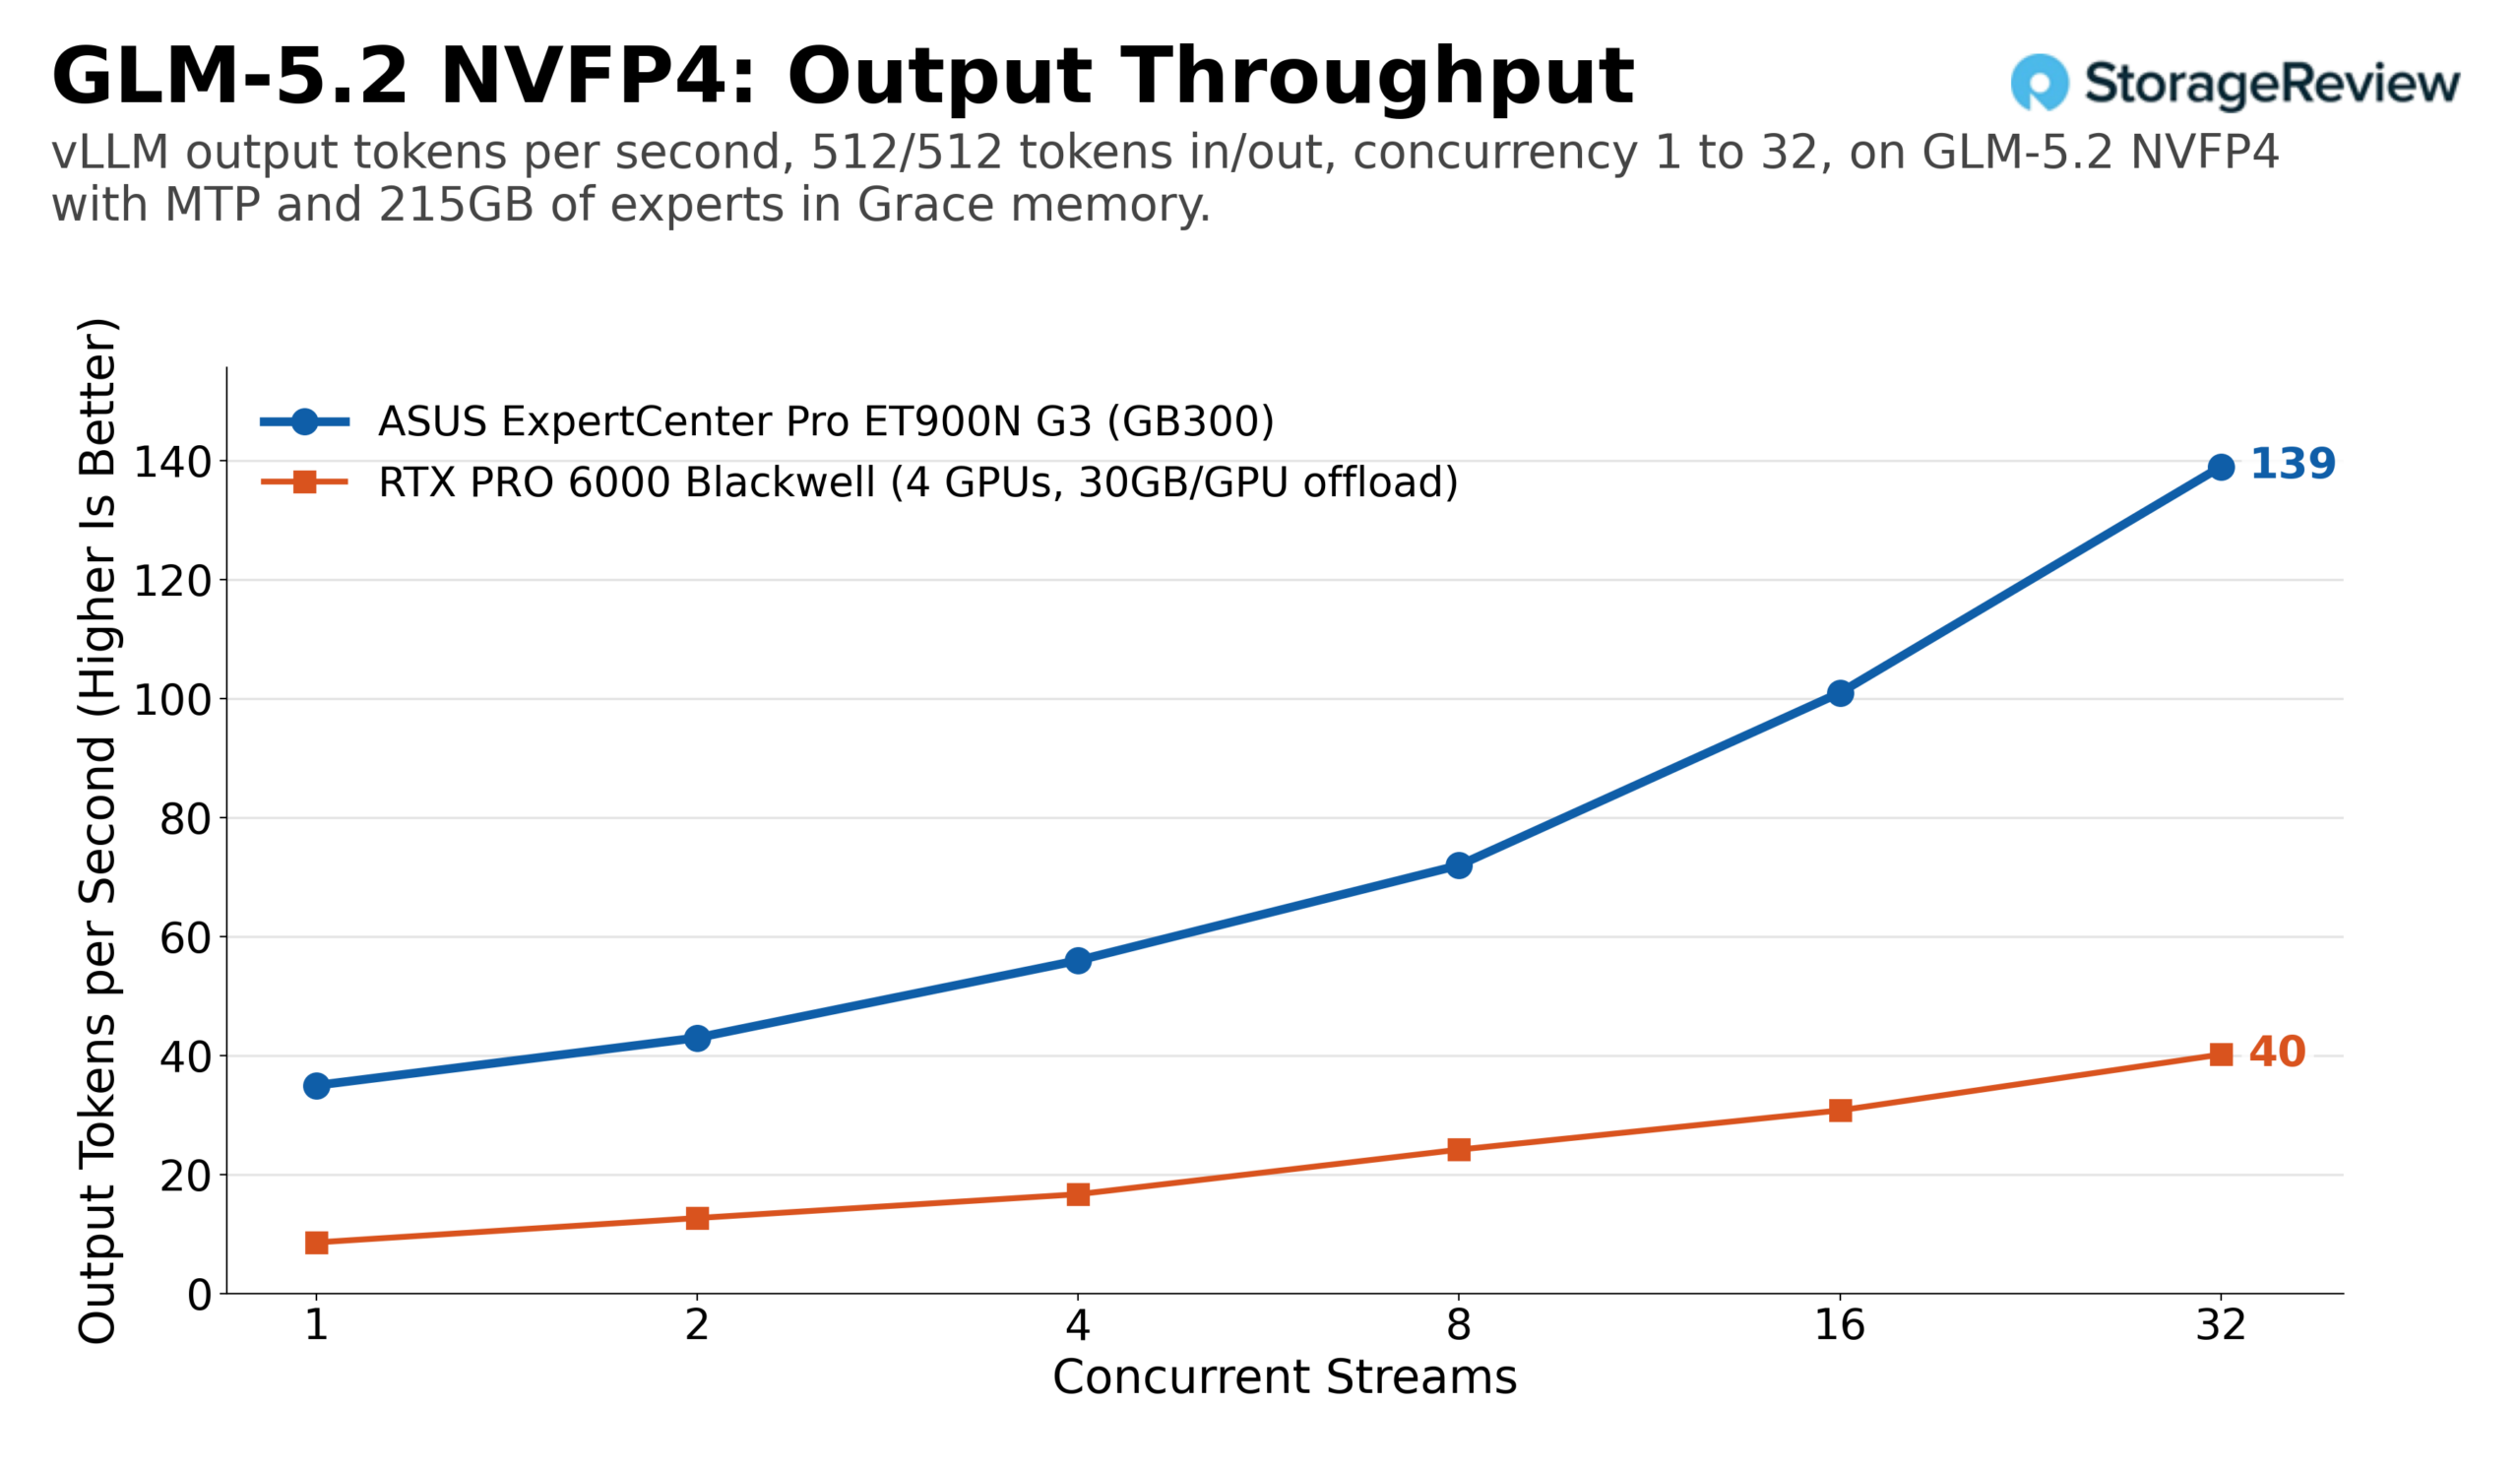
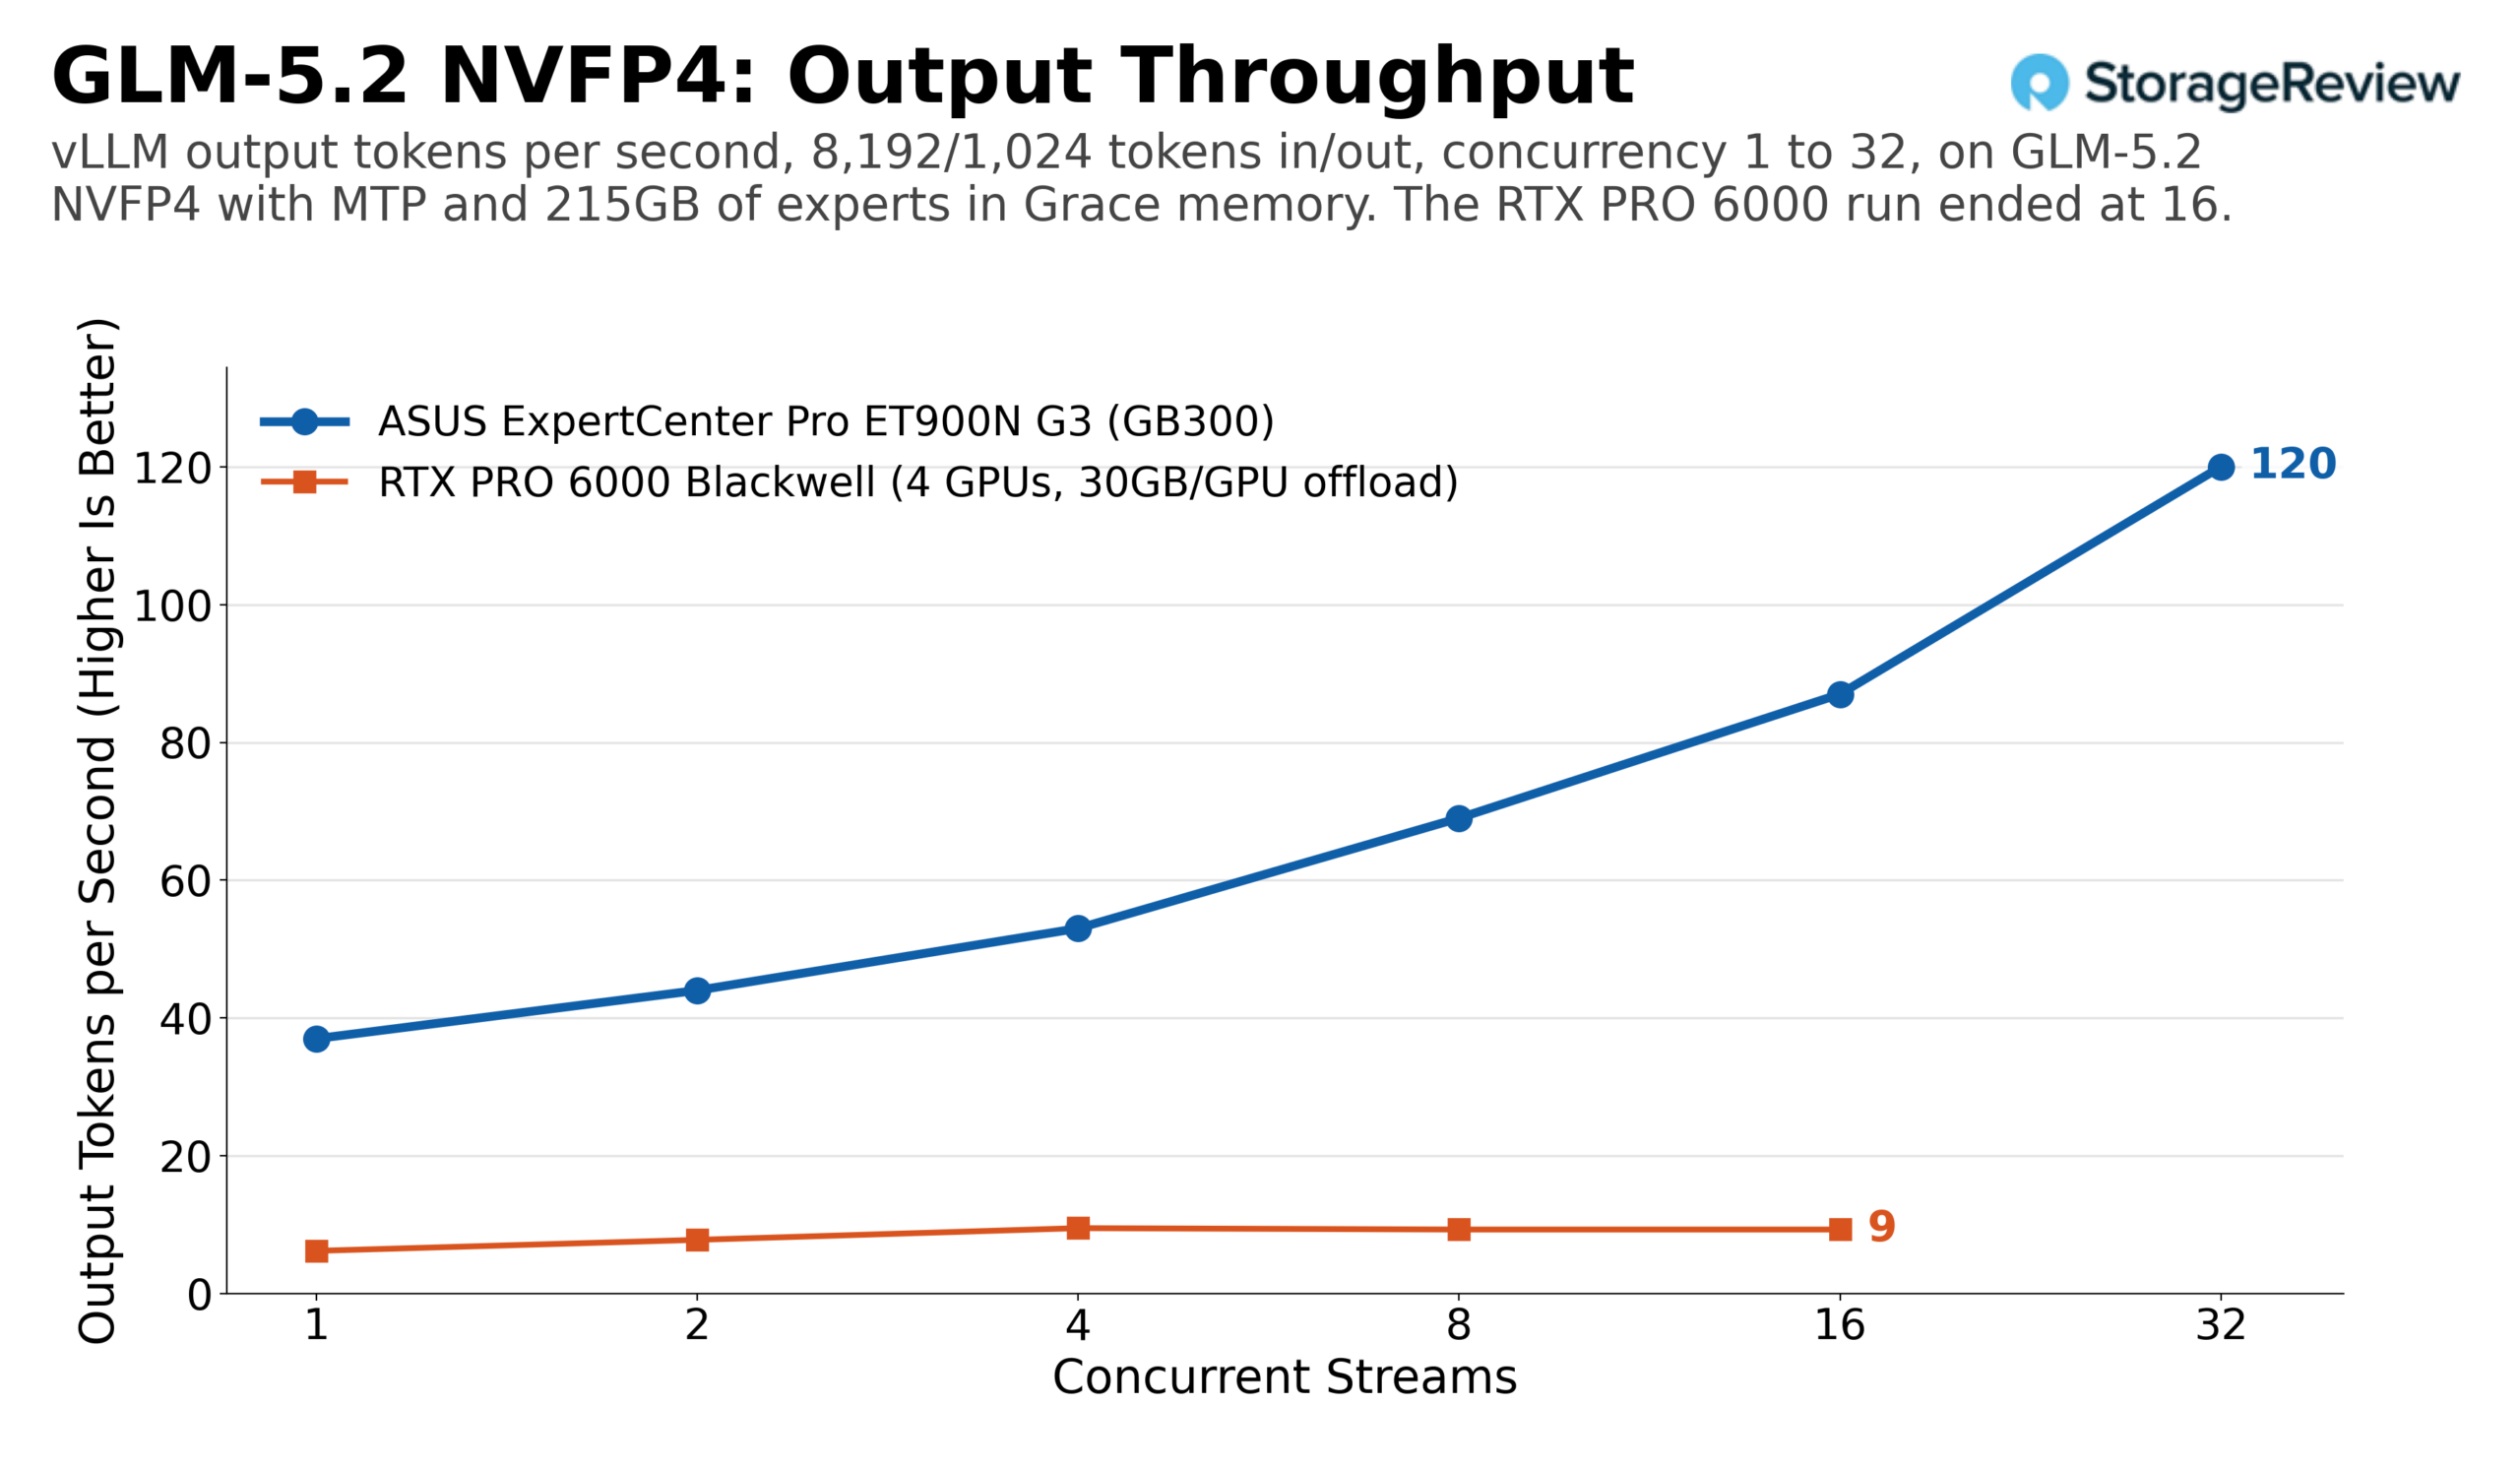
GLM-5.2 est le cas d'utilisation rendu possible uniquement par le pool cohérent. Le point de contrôle NVFP4 conserve environ 215 Go de pondérations d'experts dans la mémoire Grace avec décodage spéculatif MTP. Le processeur ET900N G3 l'a traité à 35 jetons de sortie par seconde pour un flux et à 139 pour 32 flux, avec une charge de travail équivalente et un débit total de 277. Avec un profil de préremplissage intensif, le traitement a été effectué sur 32 flux, atteignant 120 jetons de sortie par seconde et 1 079 jetons au total. Quatre cartes RTX PRO 6000, déchargeant chacune environ 30 Go vers la mémoire hôte, ont géré environ 40 jetons de sortie par seconde à 32 flux, ce débit se stabilisant à environ 9 ou 10 jetons par seconde pour les requêtes longues à partir de quatre flux. Aucun des deux systèmes ne donne l'impression qu'un modèle de 433 Go est rapide, mais le chemin LPDDR5X à 396 Go/s et NVLink-C2C à 900 Go/s du GB300 vers les experts déchargés continue d'évoluer là où la mémoire hôte connectée PCIe sur quatre cartes s'arrête.
Comparé au MSI WS300, les résultats du modèle de frontière de l'ET900N G3 se situent à environ 1 % près sur tous les points que nous pouvons comparer : 1 766 jetons de sortie par seconde sur DeepSeek V4 Flash à 32 flux sur les deux tours, 4 793 contre 4 801 sur MiniMax M2.7 à 128, 1 041 sur MiniMax M3 à 32 sur les deux et 139 sur GLM-5.2 à 32 sur les deux.
Modèles similaires aux RTX PRO 6000, H200 NVL et DGX Spark
La seconde partie des tests de performance utilise des modèles suffisamment compacts pour être pris en charge par tous les systèmes : GPT-OSS-20B et 120B en MXFP4 natif ; Llama 3.1 8B en BF16 et FP8 ; Mistral Small 24B en BF16 et FP8 ; et Qwen3 Coder 30B en BF16 et FP8. Nouveauté depuis le test du WS300 : une carte H200 NVL, la carte Hopper 141 Go de NVIDIA, qui permet de comparer un accélérateur de centre de données d'une génération précédente.
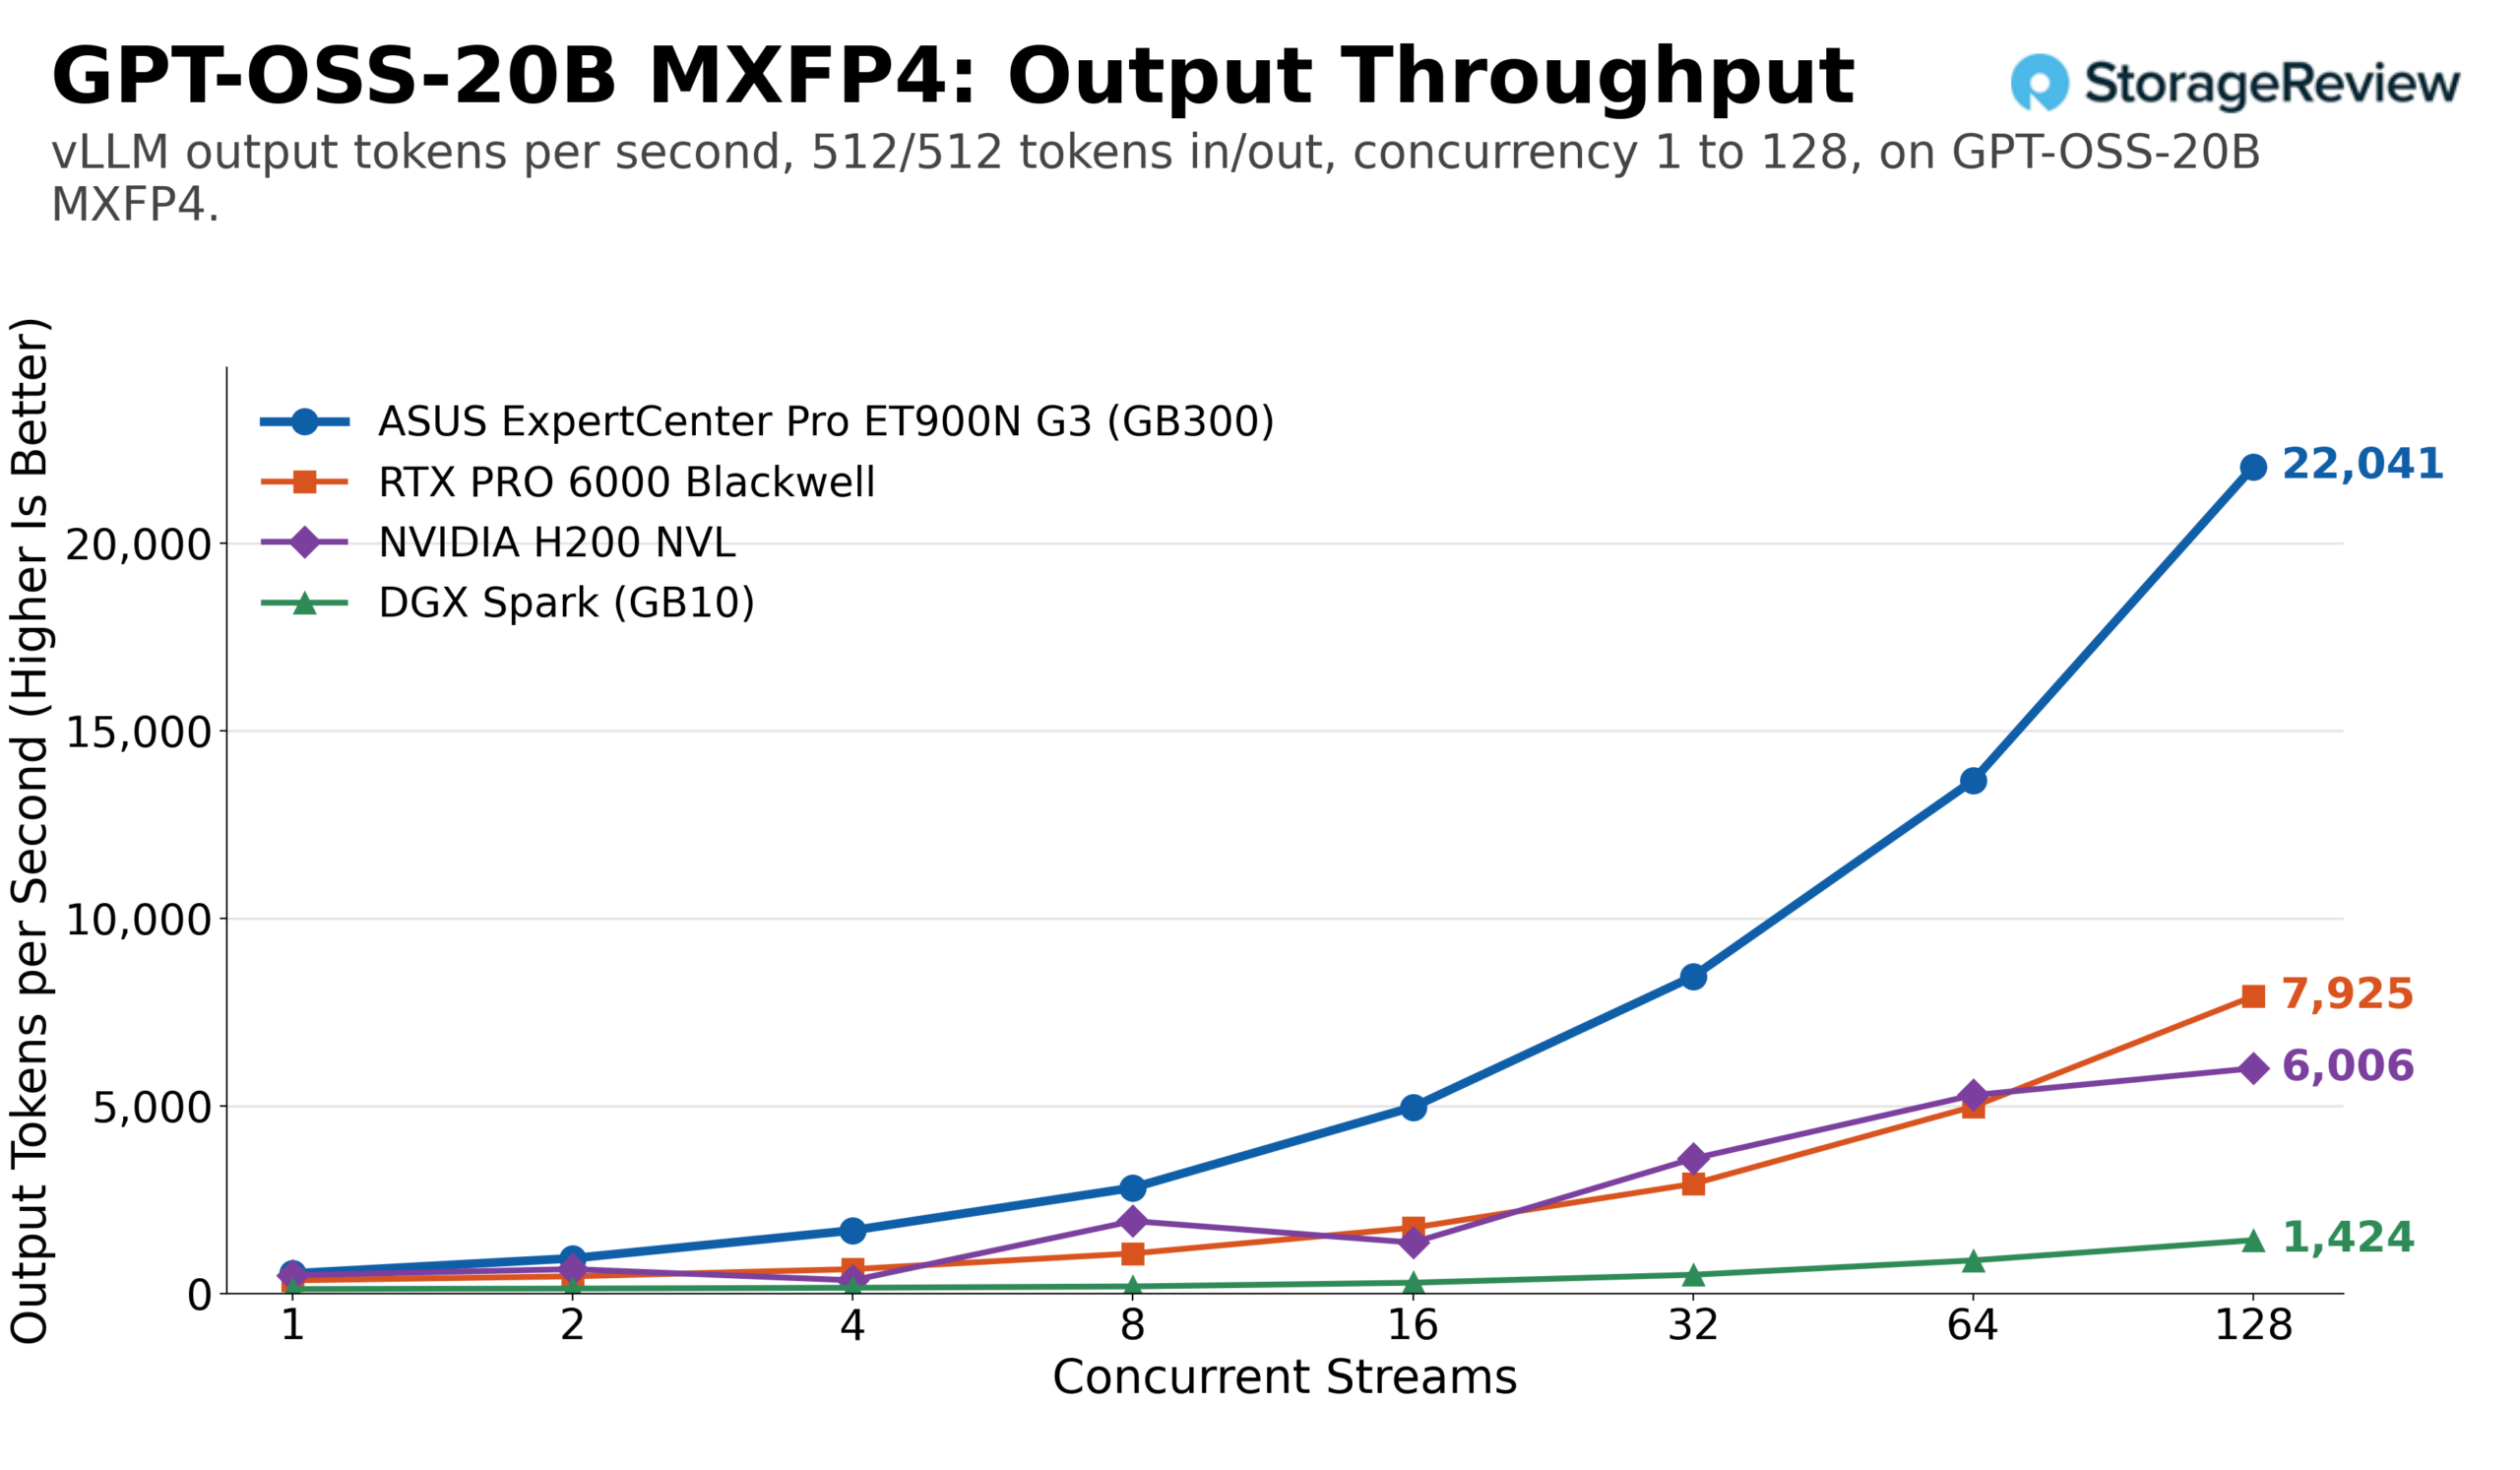
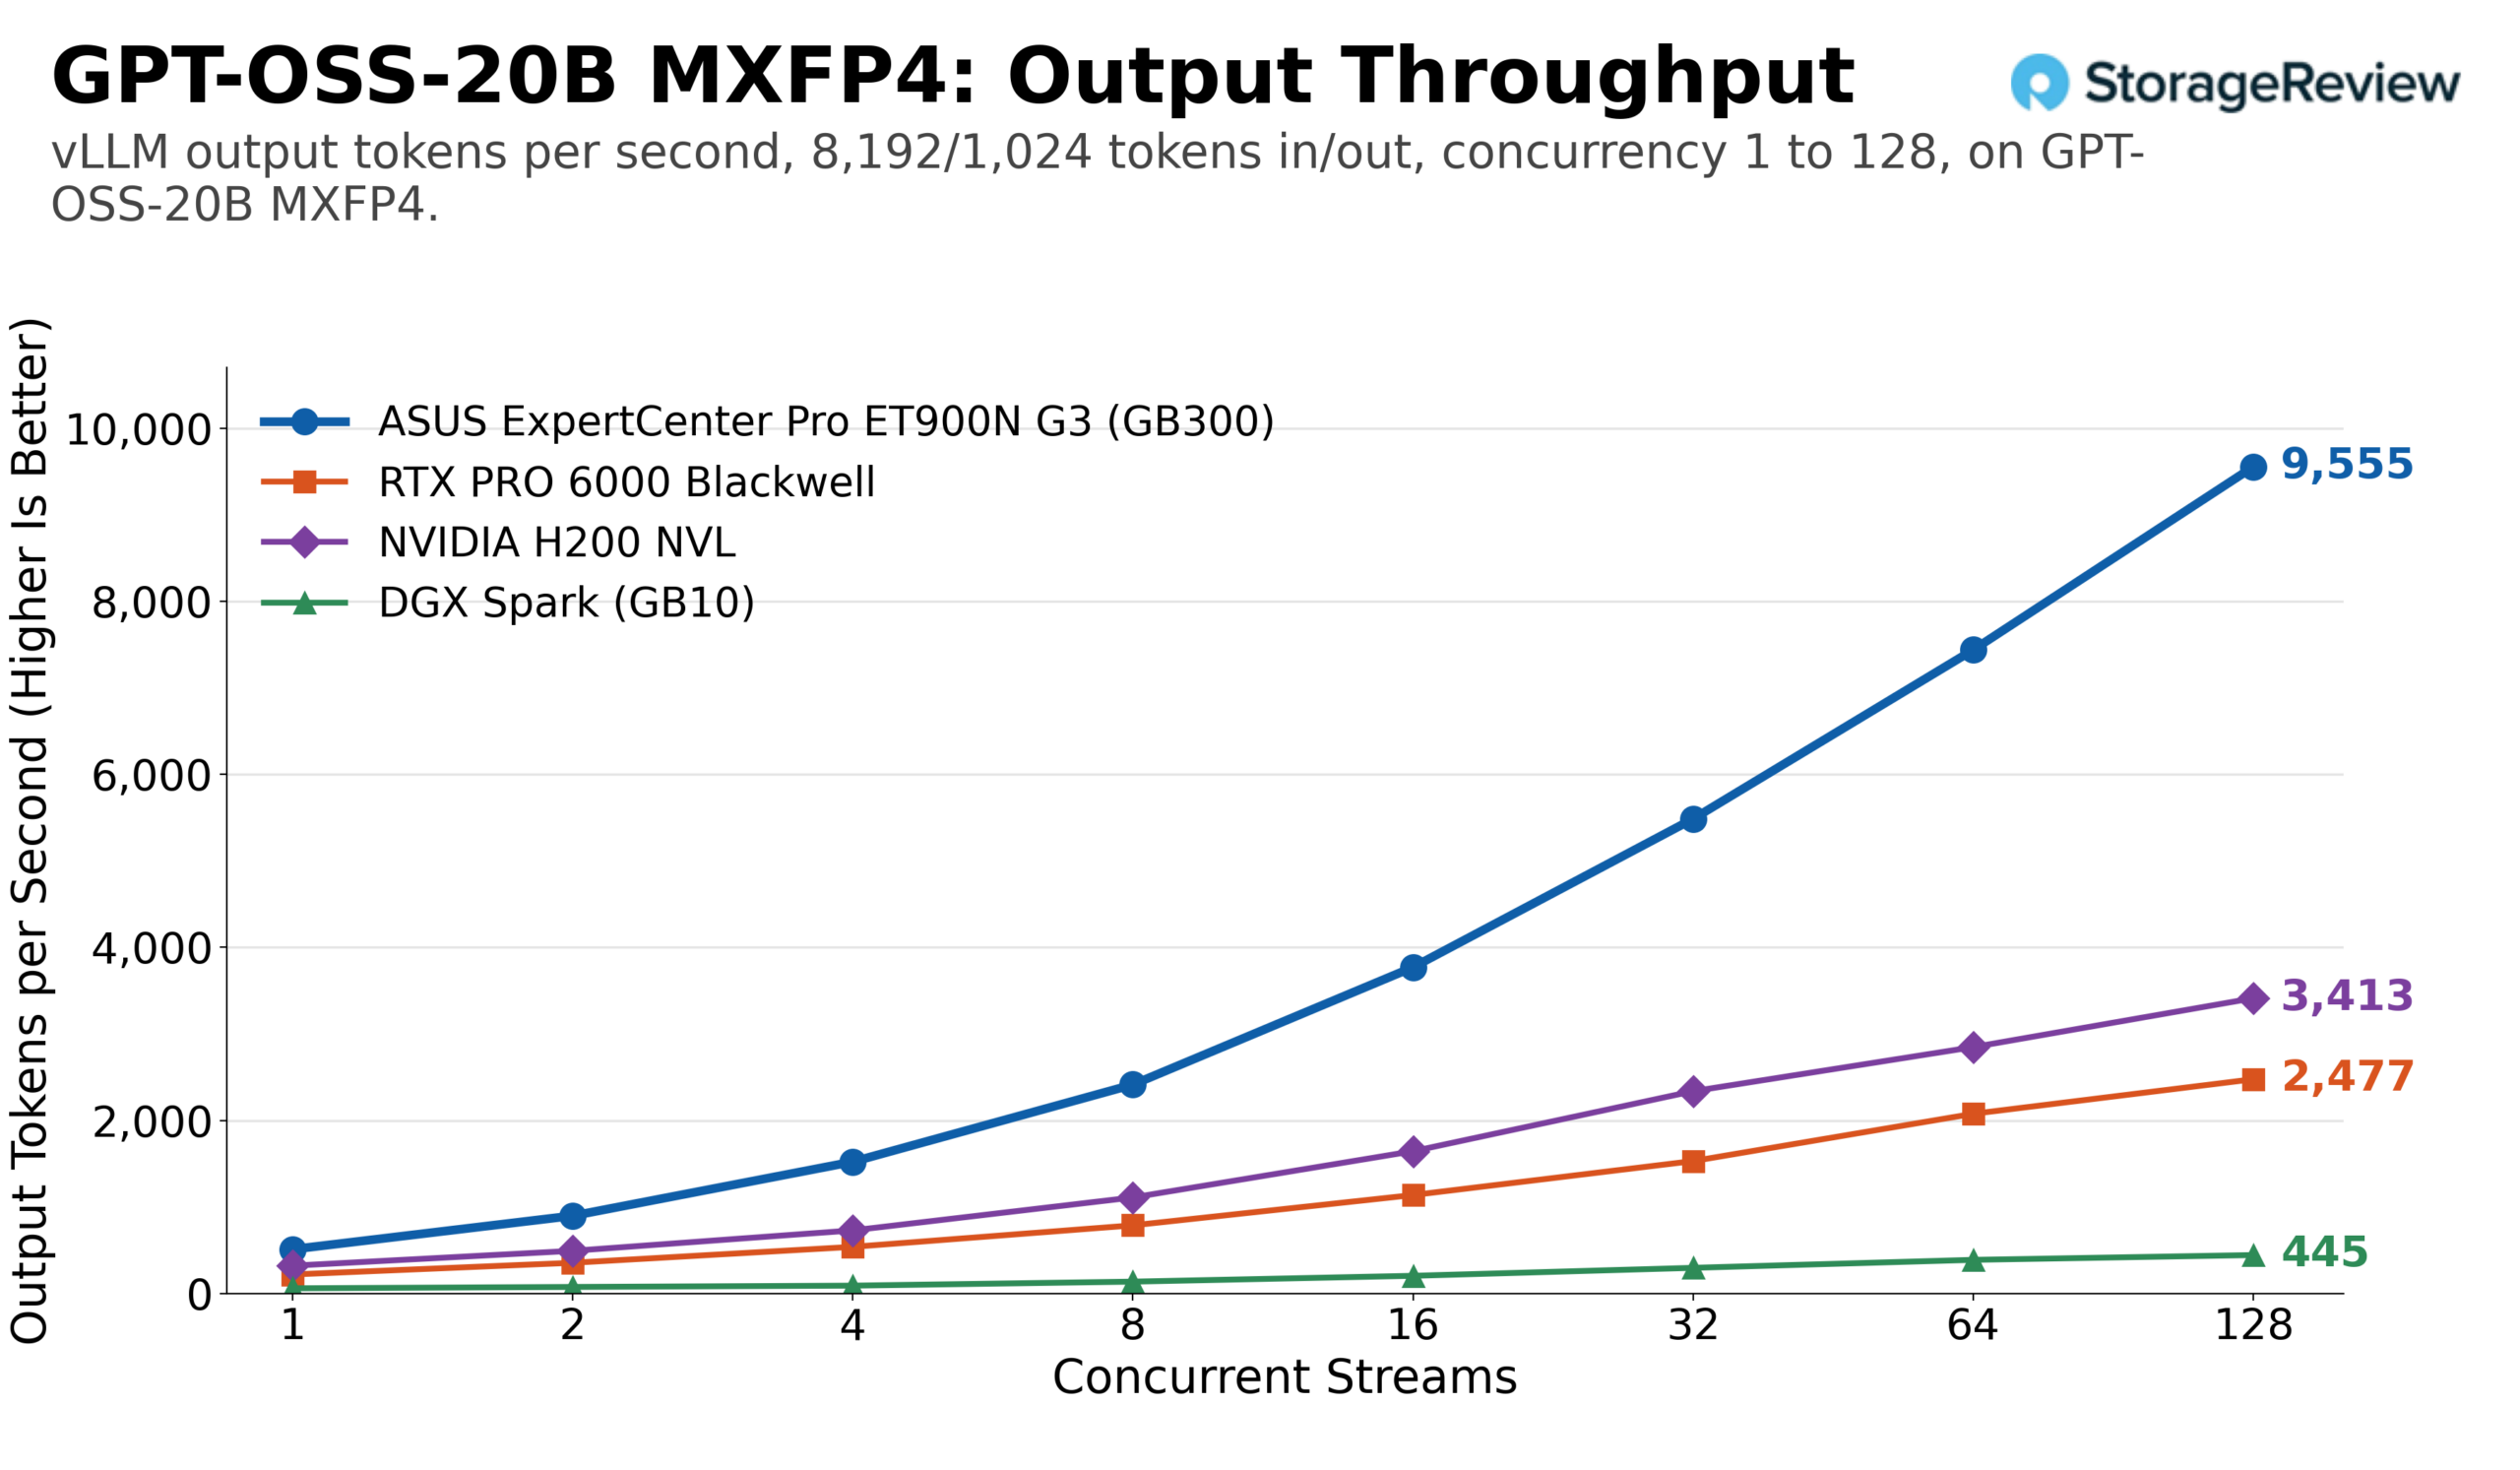
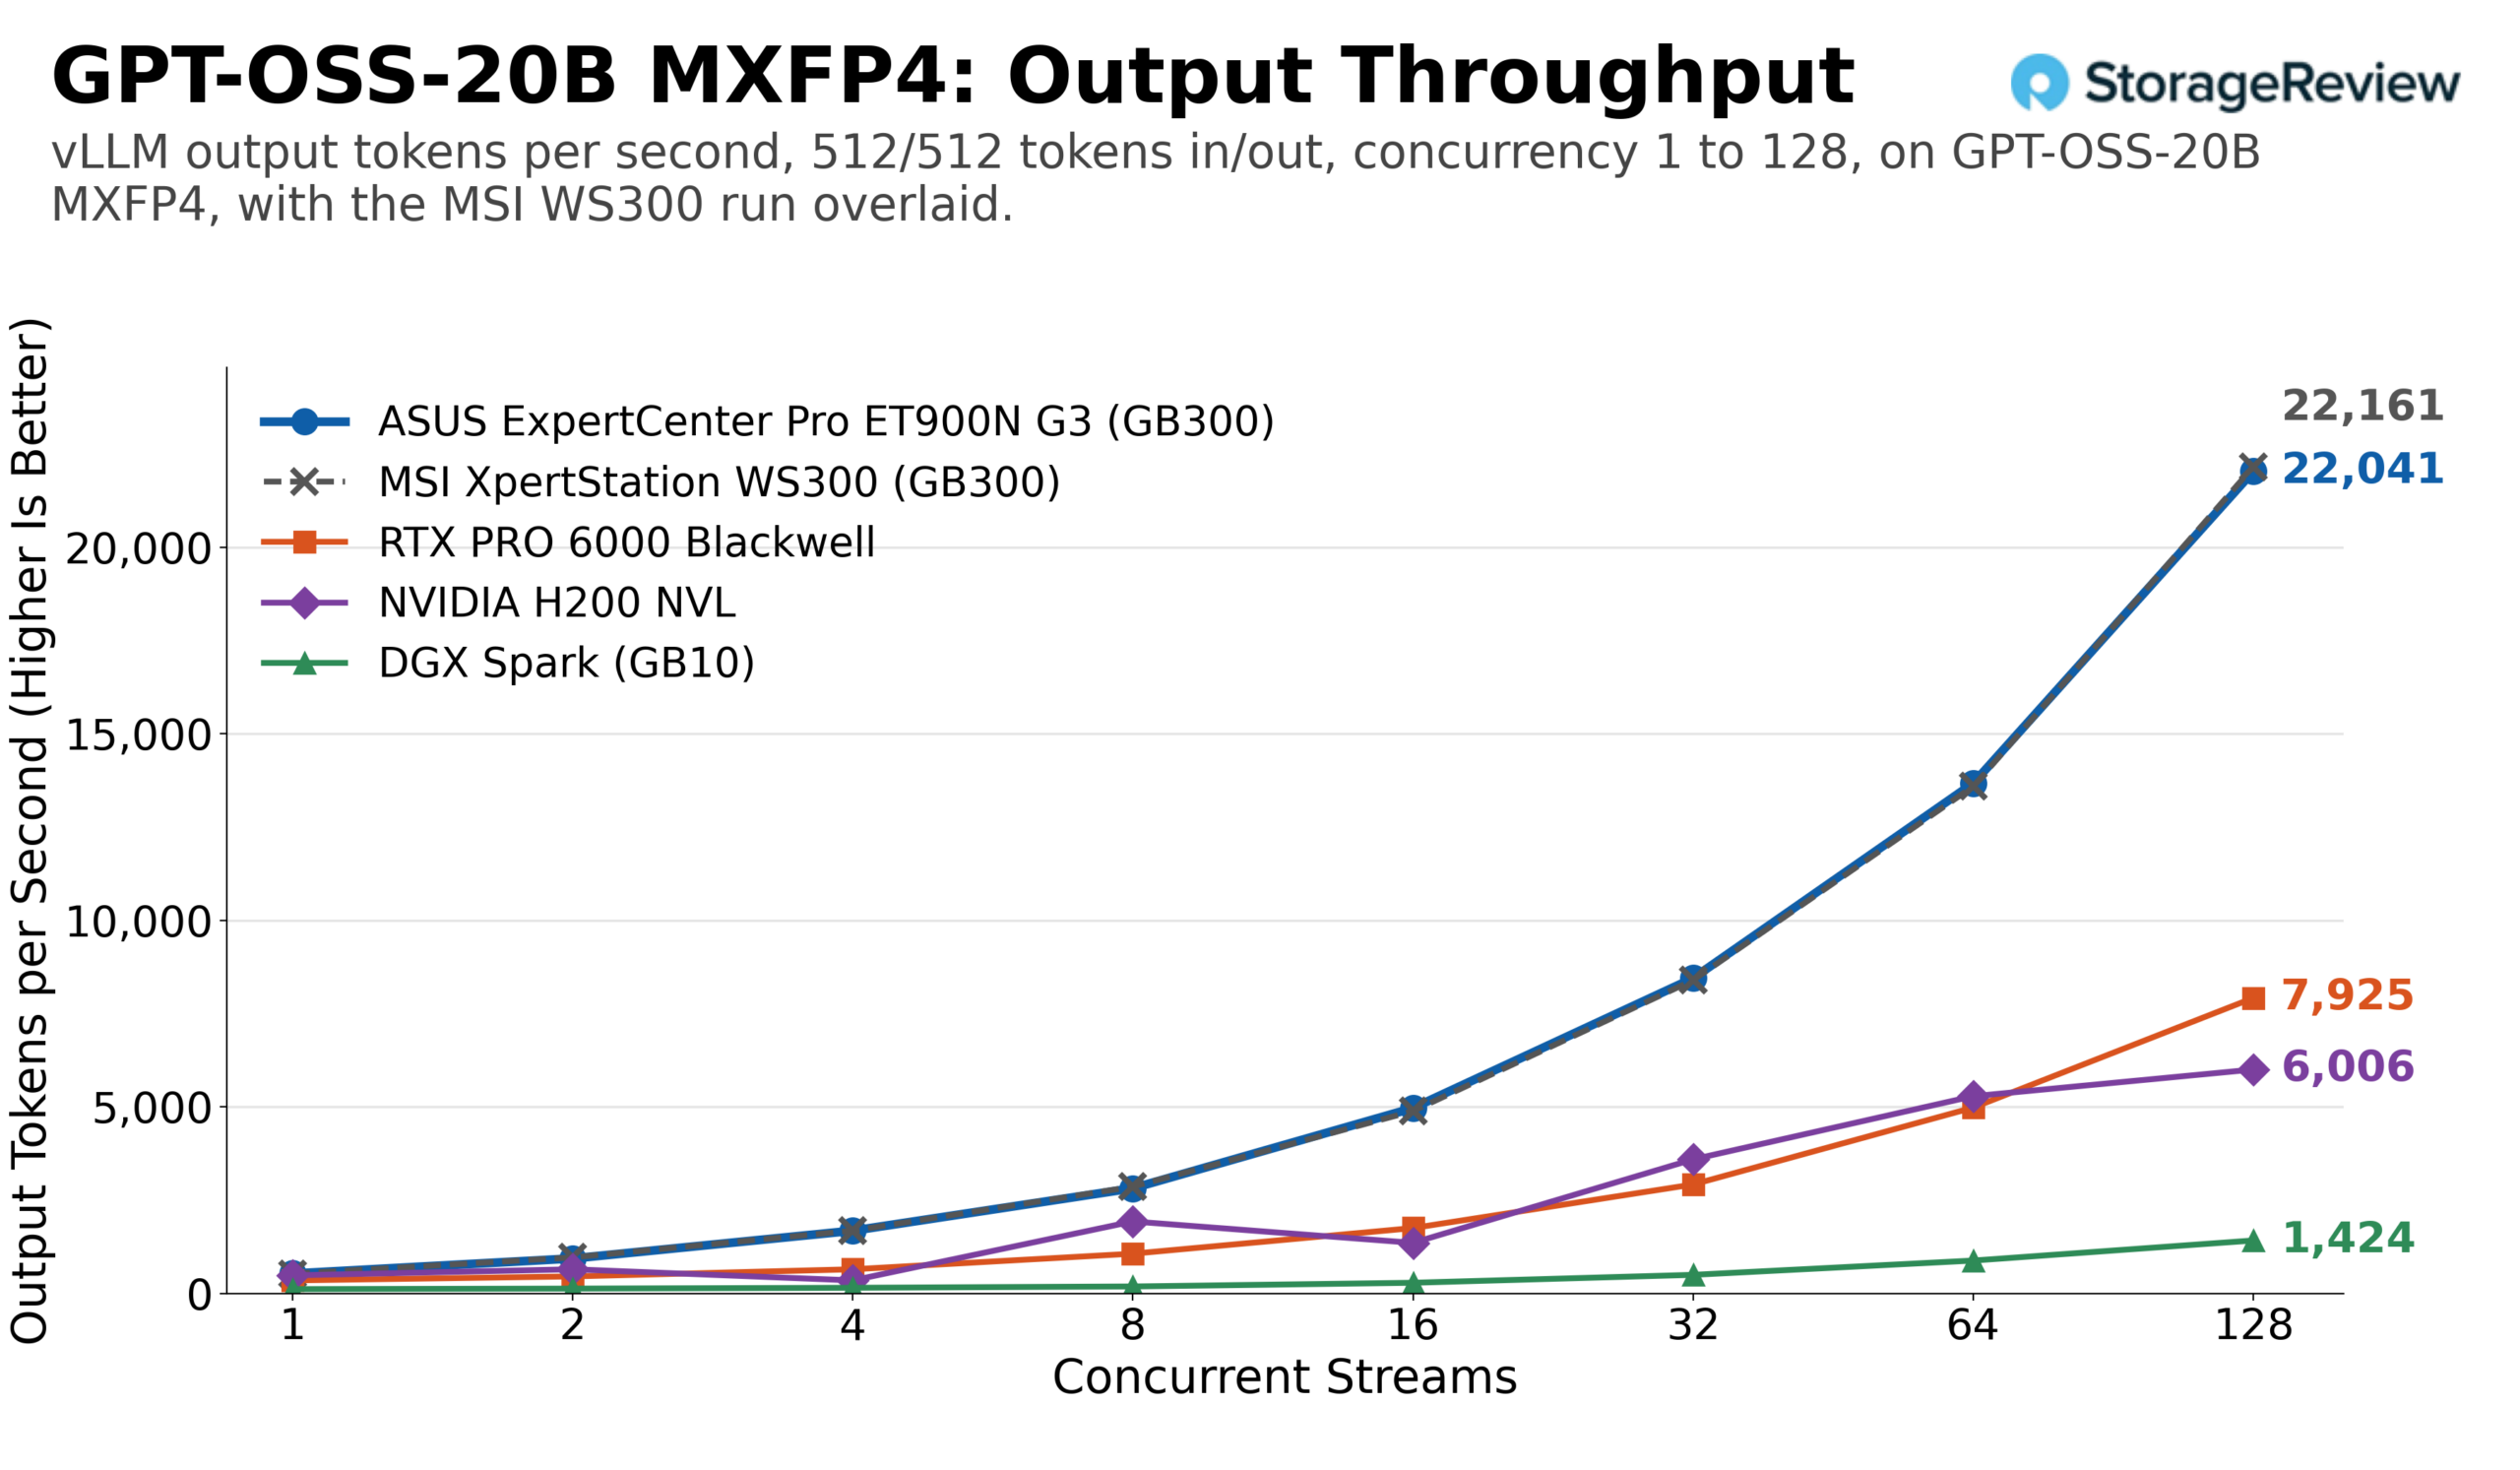
GPT-OSS-20B est le test le plus convivial de l'ensemble, un point de contrôle que chaque système supporte confortablement, et sur la même charge de travail, l'ET900N G3 a atteint 22 041 jetons de sortie par seconde sur 128 flux, soit 44 082 au total, contre environ 7 920 pour le RTX PRO 6000, 6 010 pour le H200 NVL et 1 420 pour le DGX Spark. En mode mono-flux, la Station a produit 536 jetons de sortie par seconde, contre 354 pour la carte, 489 pour le H200 et 120 pour le Spark. Le profil avec pré-remplissage intensif a creusé l'écart : 9 555 jetons de sortie par seconde et 85 994 au total à 128 flux pour la Station, contre environ 2 480 pour la RTX PRO 6000, 3 410 pour le H200 NVL et 445 pour le Spark.
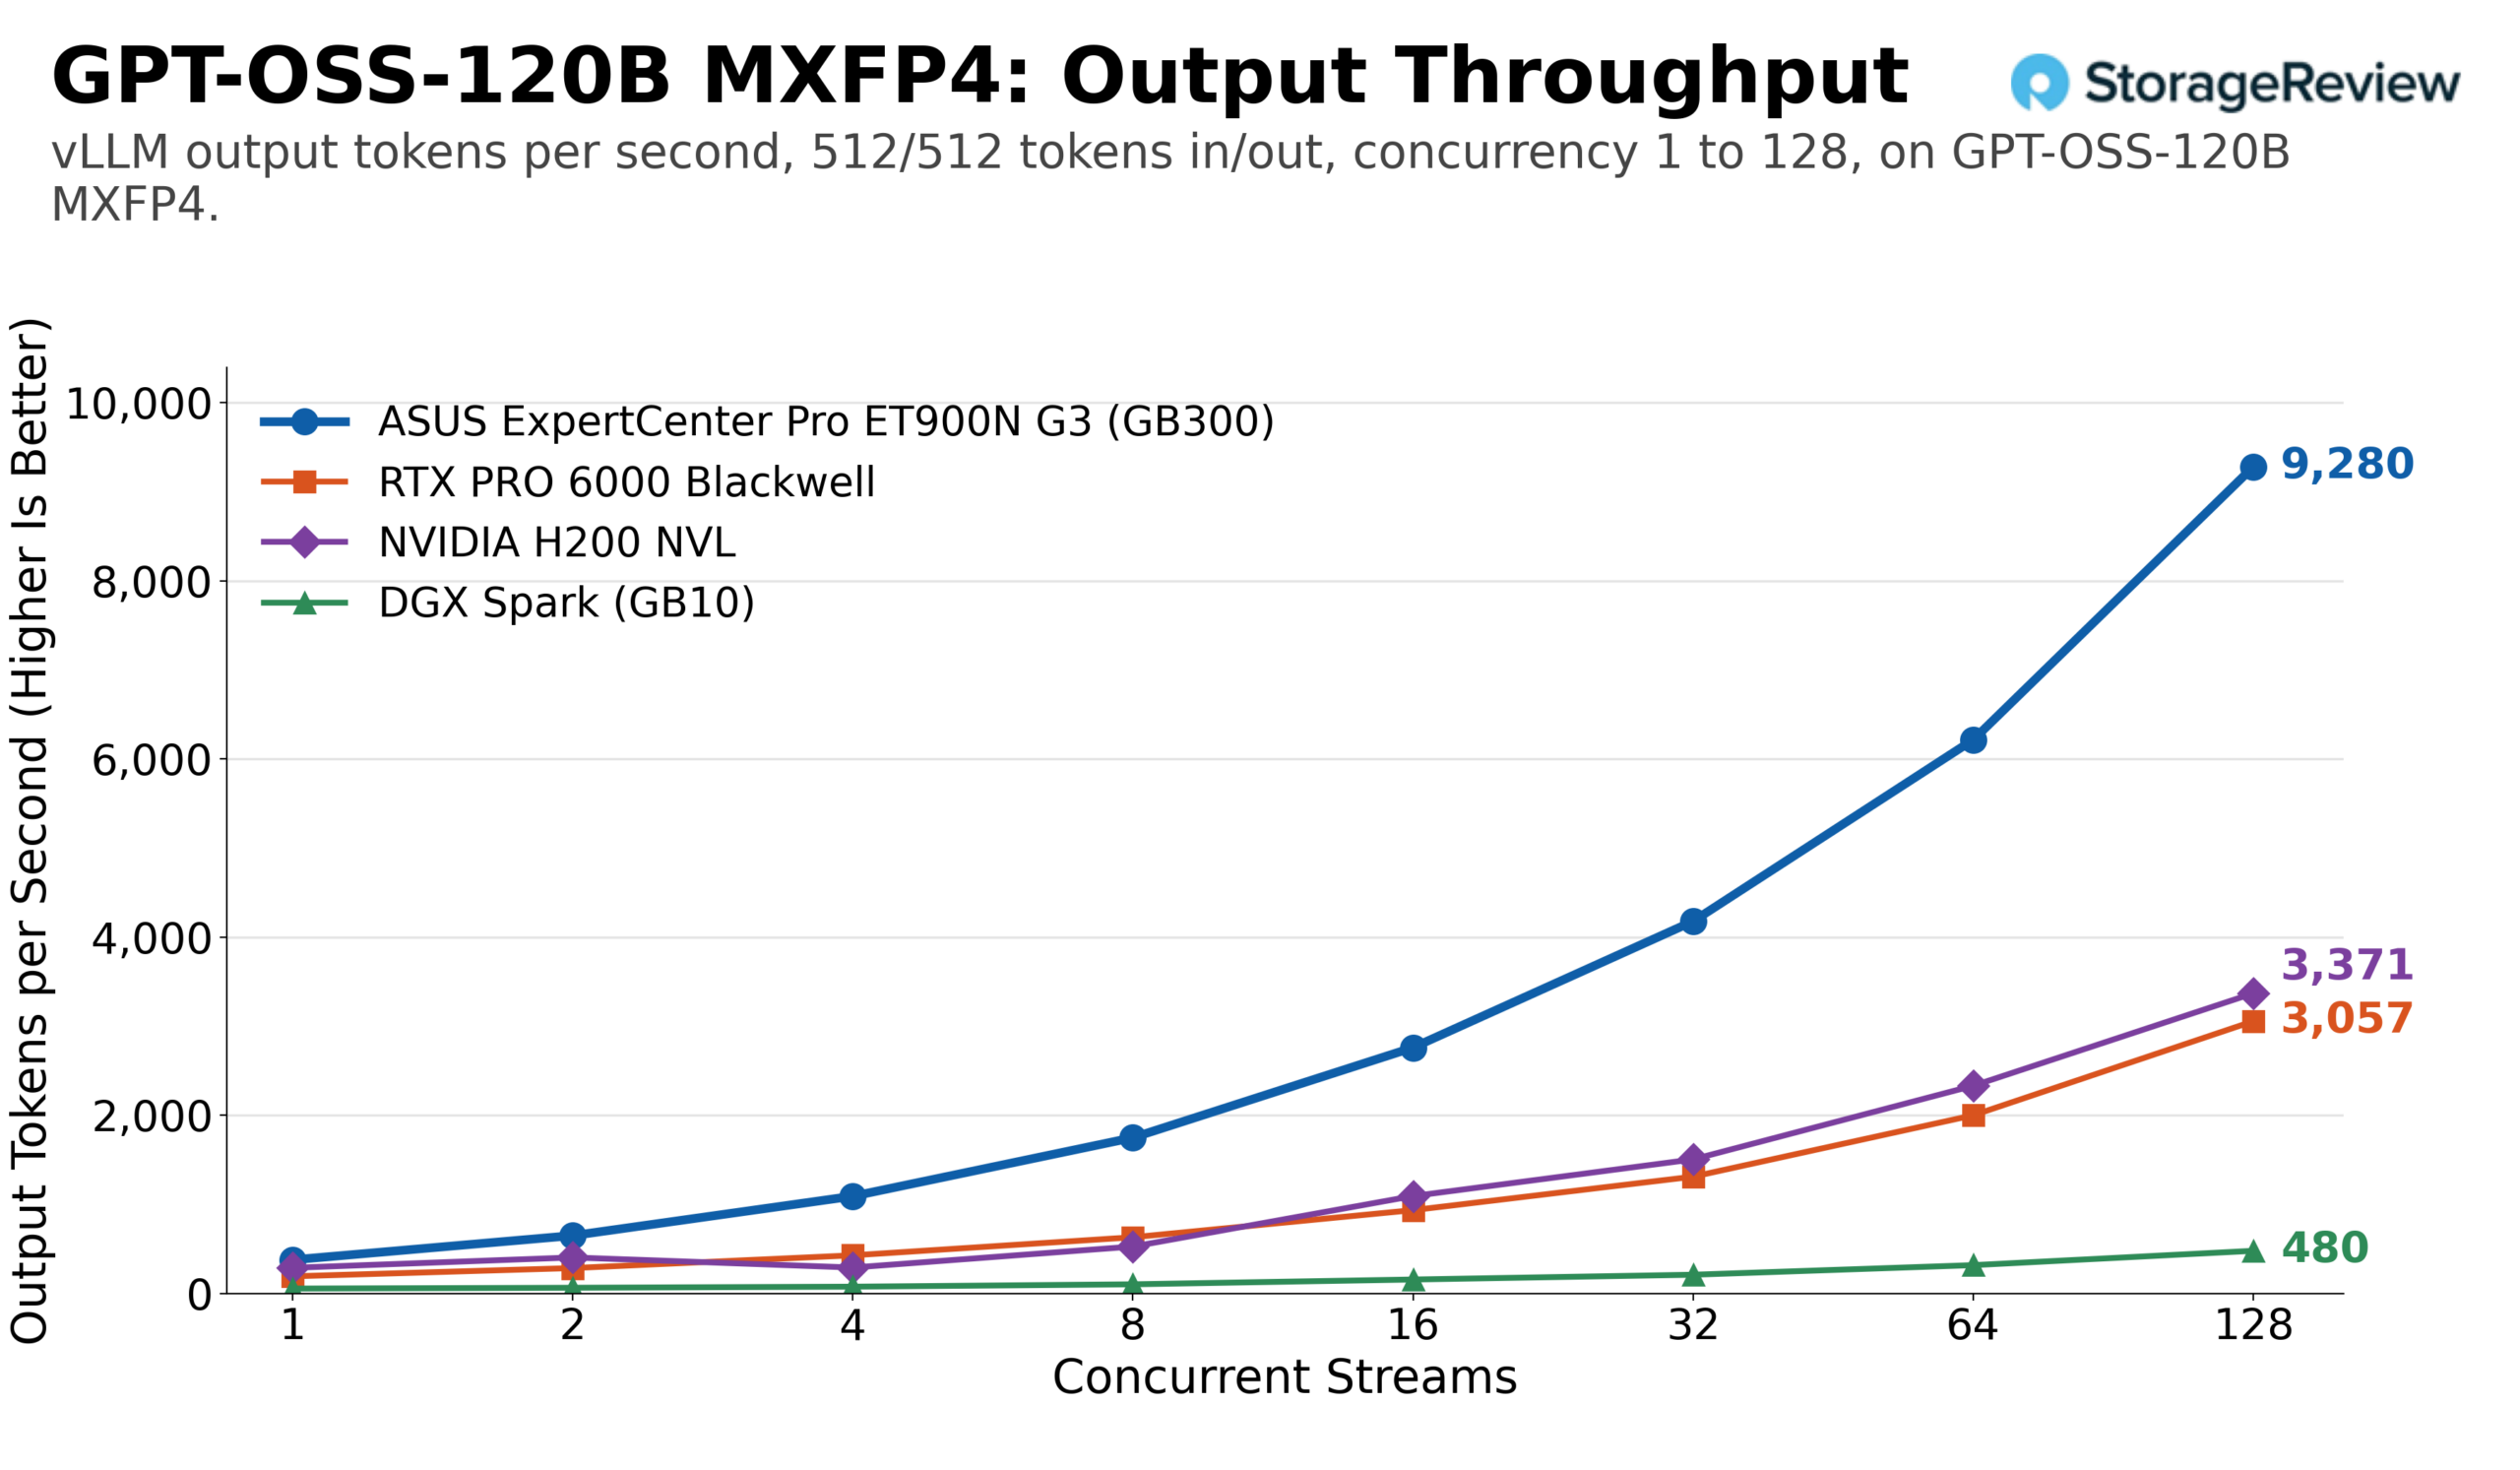
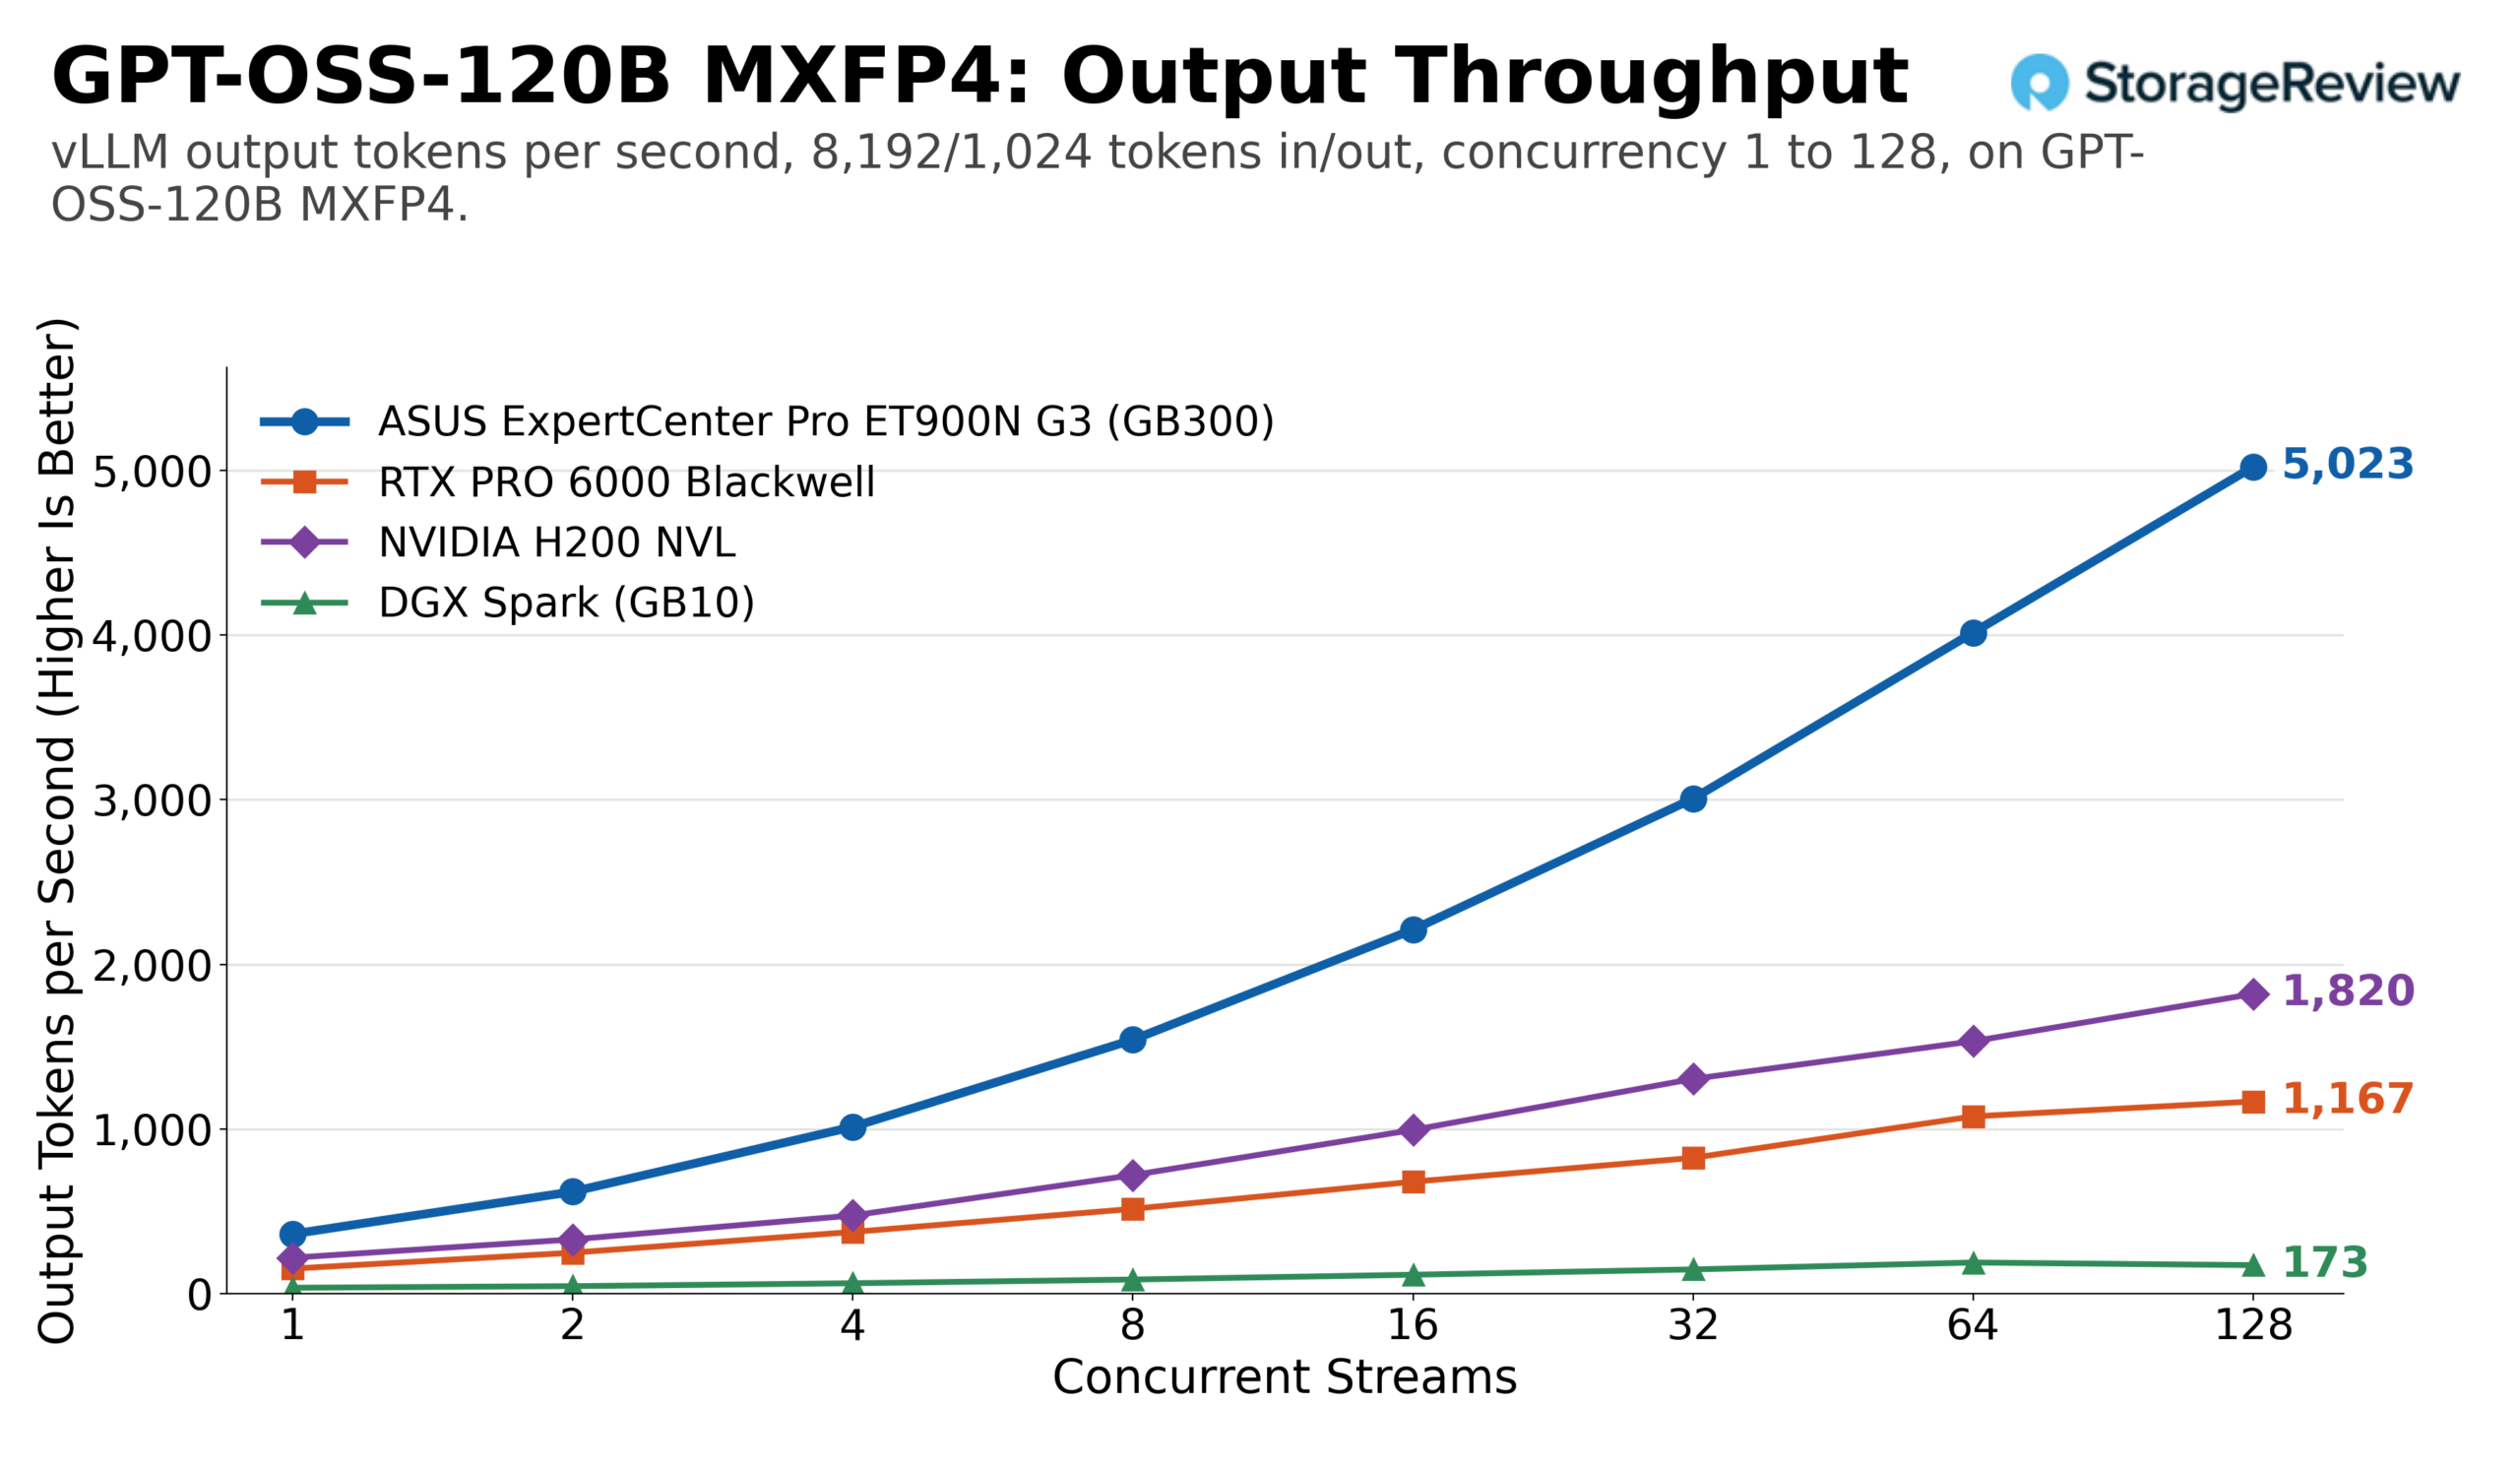
C'est avec GPT-OSS-120B que la mémoire commence à faire la différence. L'ET900N G3 a atteint 9 280 jetons de sortie par seconde avec une charge de travail équivalente et 128 flux, soit environ trois fois plus que la RTX PRO 6000 (3 060), 2.8 fois plus que la H200 NVL (3 370) et plus de 19 fois plus que la Spark (480). Lors de requêtes longues, les systèmes les moins performants ont rapidement saturé leur cache KV : la RTX PRO 6000 a plafonné à environ 1 170 jetons de sortie par seconde et la H200 NVL à près de 1 820, tandis que la Station continuait de progresser avec 128 flux pour atteindre 5 023, avec un débit total de 45 205 jetons par seconde.
Le profil Llama 3.1 8B à FP8 affiche le score le plus élevé de l'ensemble. L'ET900N G3 a généré 25 602 jetons de sortie par seconde sur 128 flux avec une charge de travail équivalente (51 205 au total), contre environ 8 060 pour la RTX PRO 6000 et 11 040 pour le H200 NVL. Le passage de BF16 à FP8 a permis à la Station de gagner environ 50 % de performances (de 17 074 à 25 602), tandis que la RTX PRO 6000 a progressé d'environ 70 % et le H200 NVL d'environ 37 %. Le profil avec préremplissage intensif a entraîné une compression générale, avec 6 164 jetons de sortie par seconde pour la Station, 1 480 pour la carte et 2 040 pour le H200.
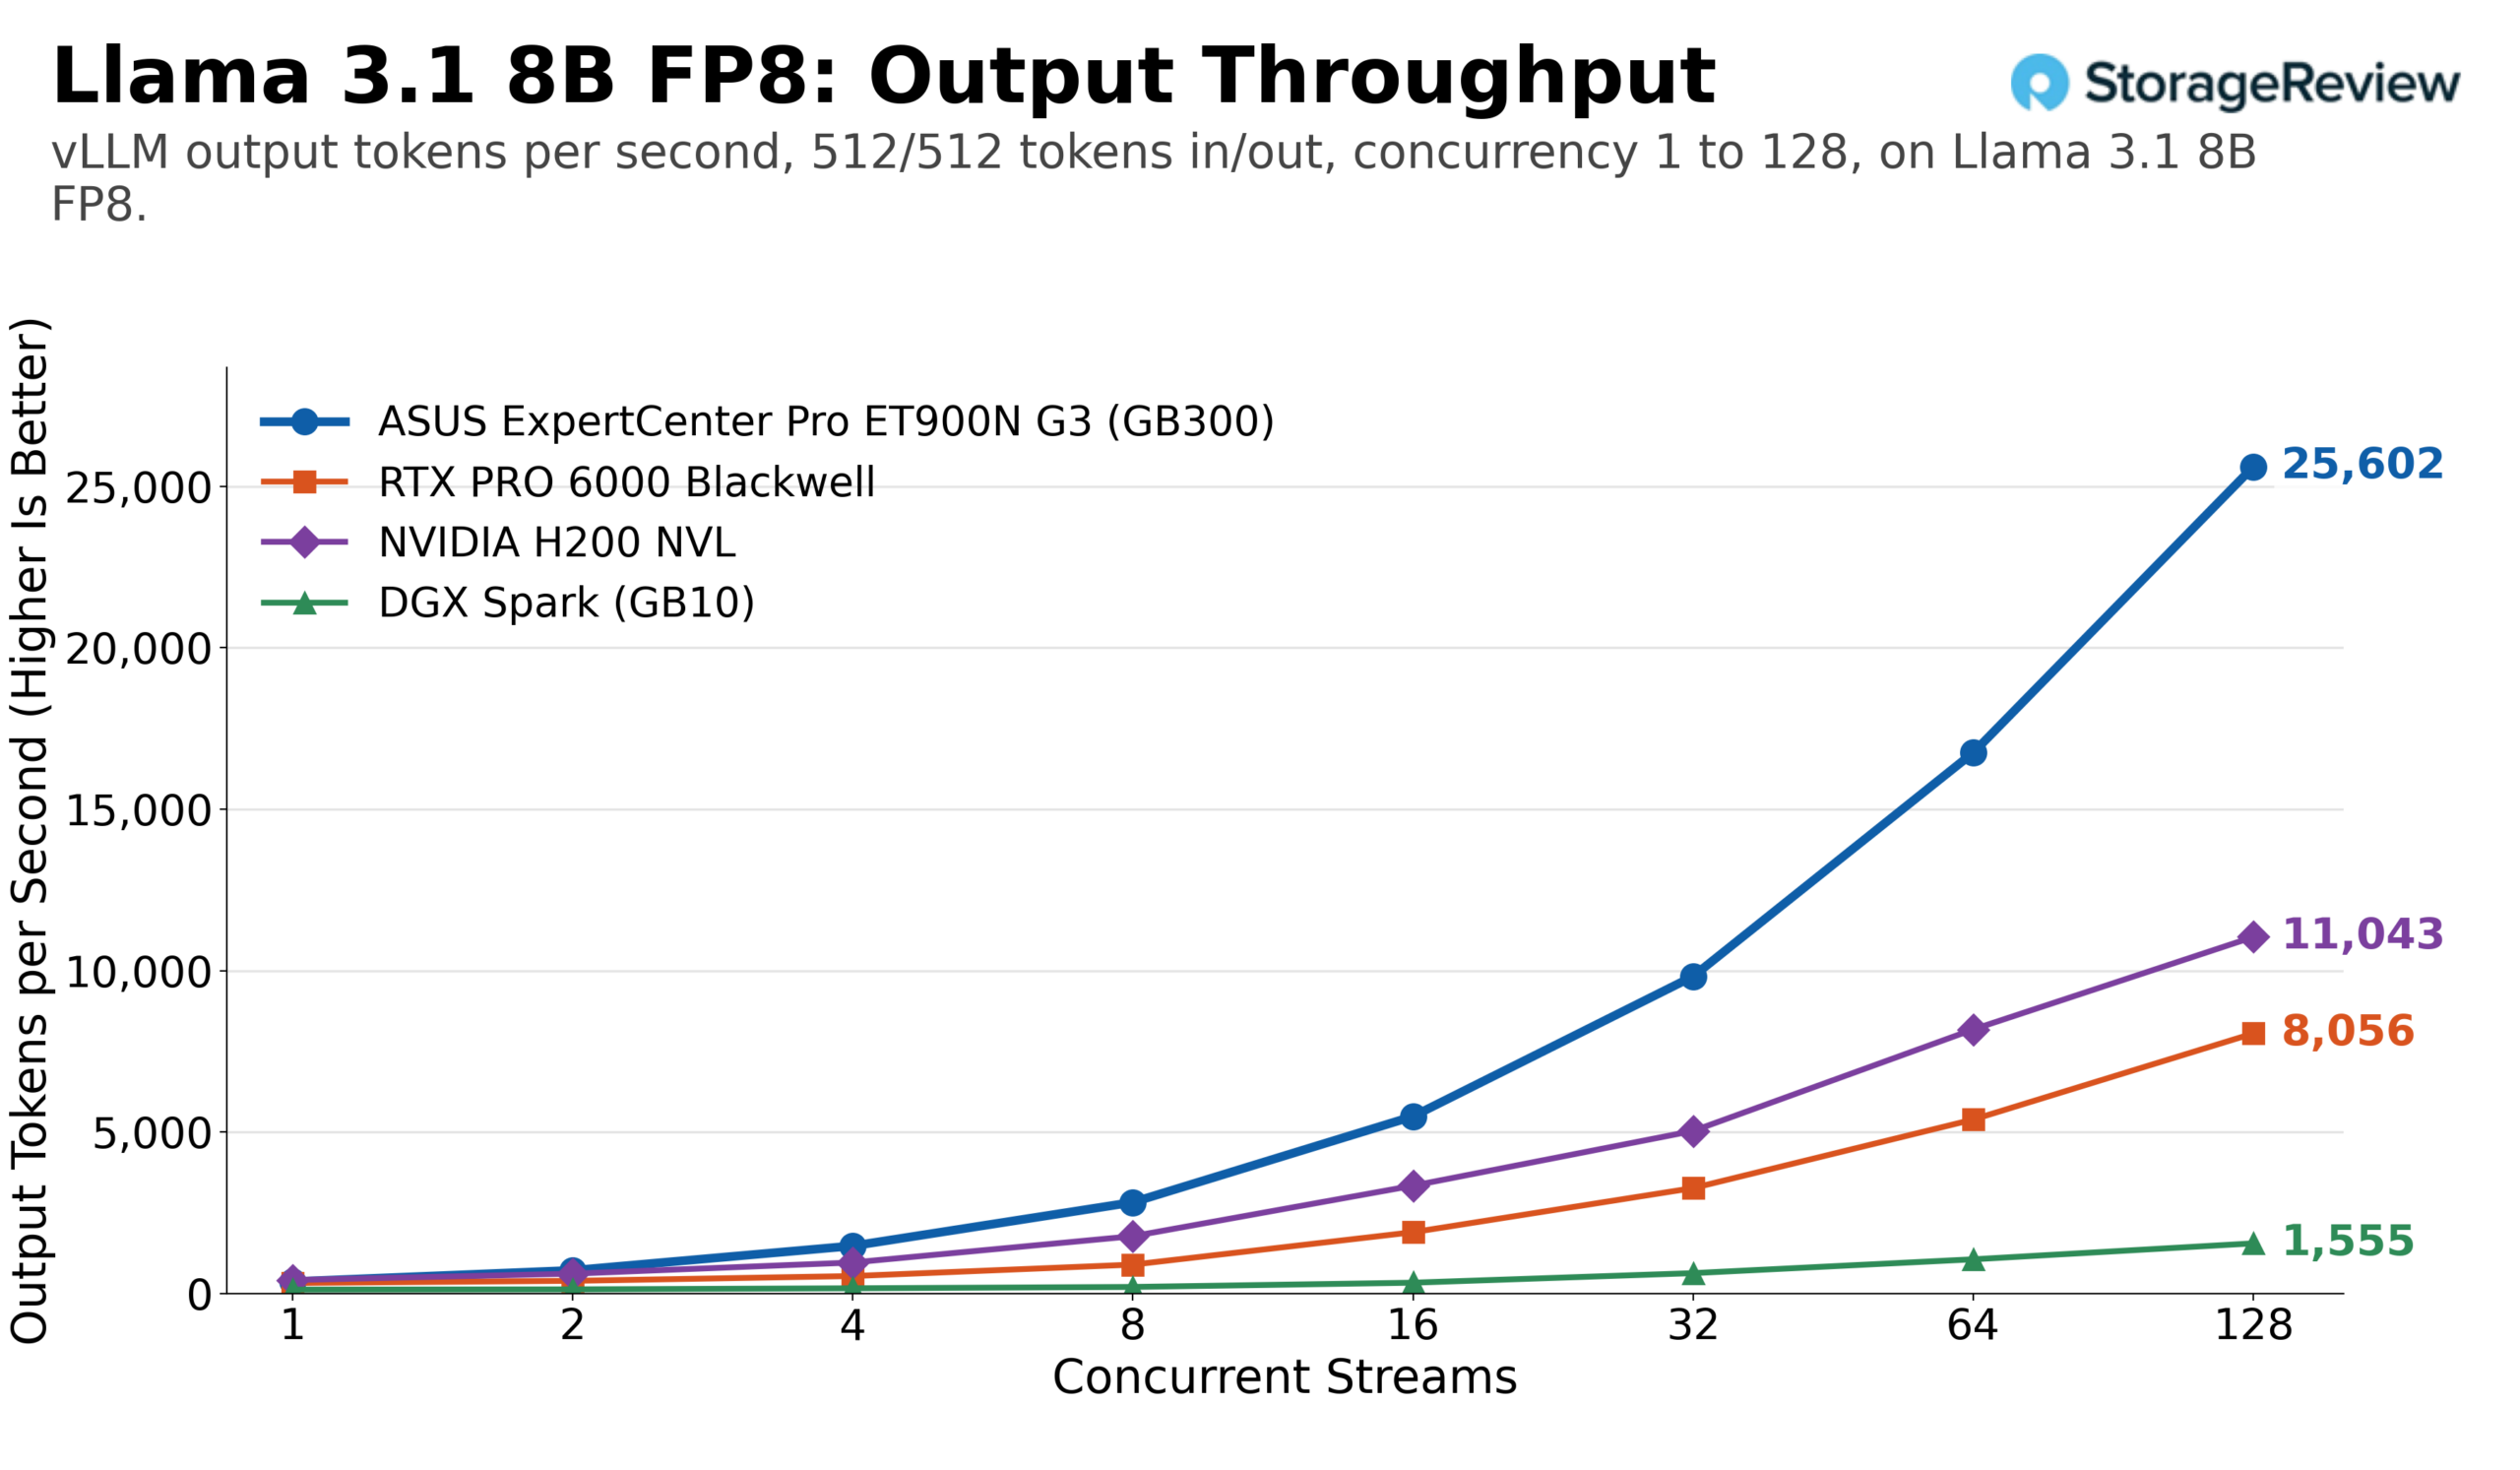
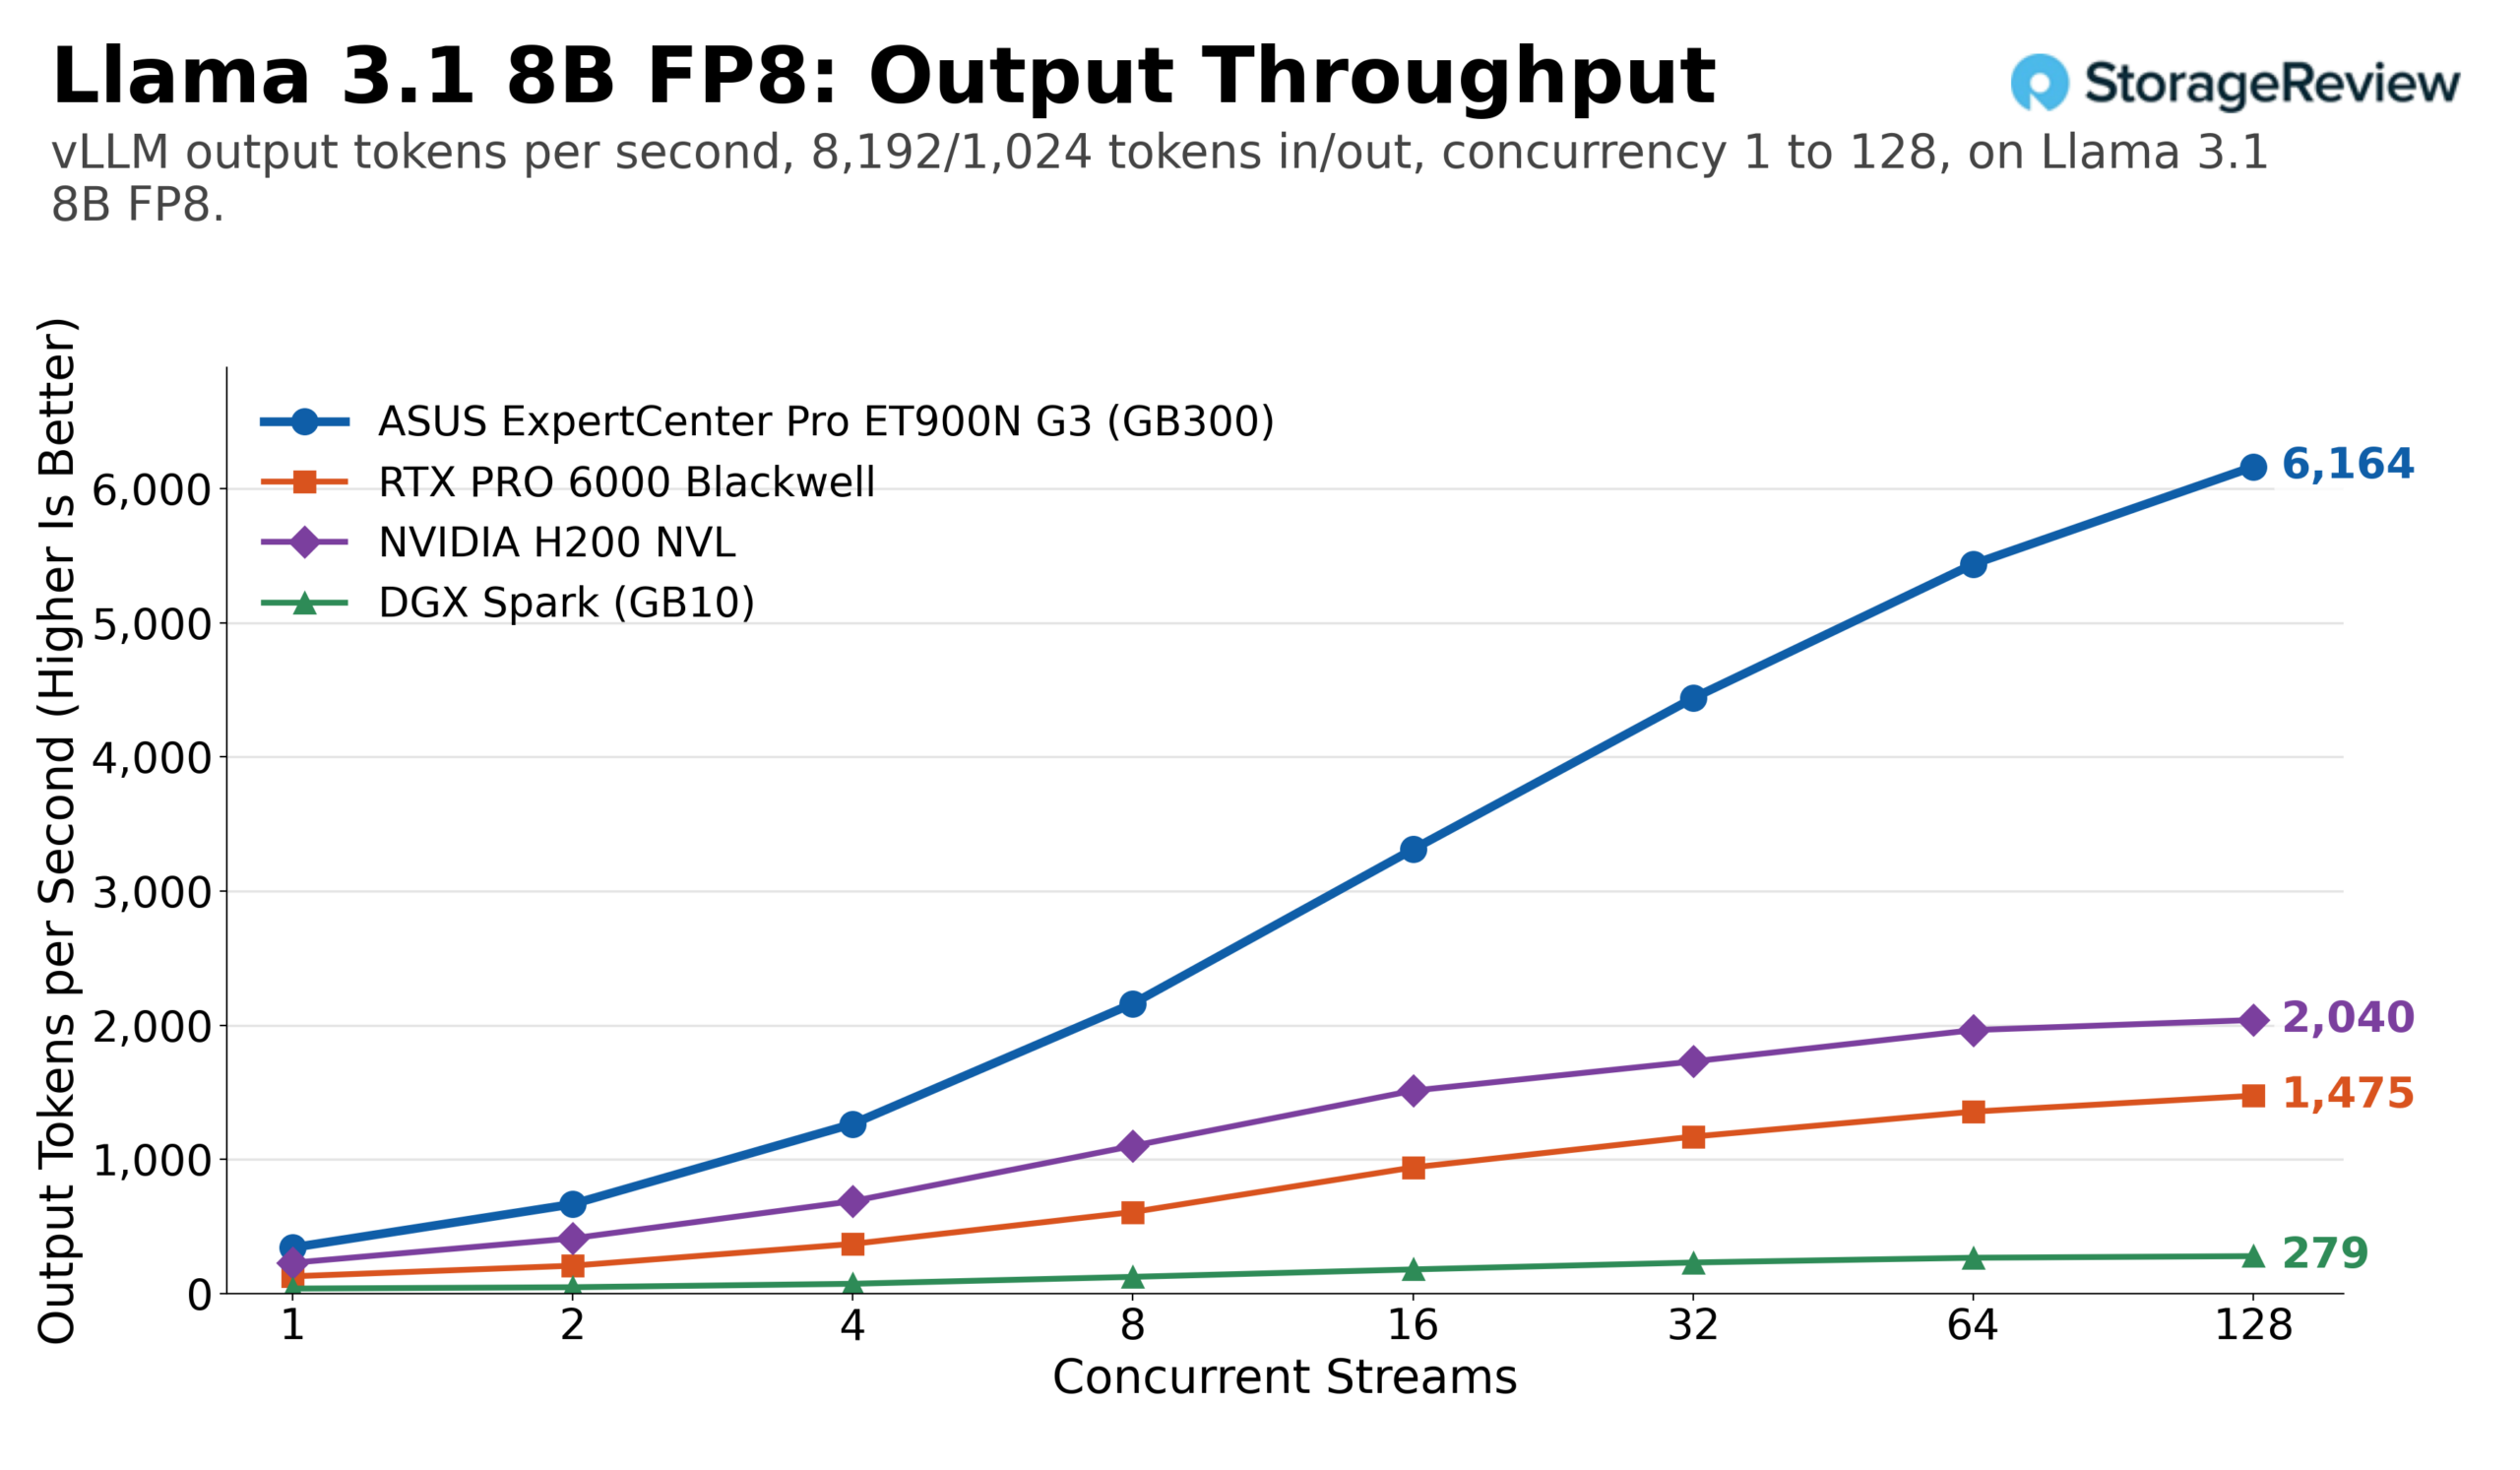
Le Mistral Small 24B en FP8 a affiché les ratios les plus élevés. L'ET900N G3 a atteint un pic de 11 075 jetons de sortie par seconde à charge de travail égale, soit 3.4 fois plus que le RTX PRO 6000 (3 240), 2.4 fois plus que le H200 NVL (4 610) et près de 20 fois plus que le Spark (559). Sous des requêtes longues, le RTX PRO 6000 a culminé à 32 flux et environ 480 jetons de sortie par seconde avant de retomber ; le H200 NVL a atteint un maximum d'environ 854 et la Station a culminé à 2 302 avec 128 flux.


Le modèle Qwen3 Coder 30B, un modèle de type « mix-of-experts » avec un nombre réduit de paramètres actifs, est celui où l'écart en mode mono-flux se réduit. Avec un seul flux et une charge de travail équivalente, la RTX PRO 6000 a fourni environ 232 jetons de sortie par seconde, contre 319 pour la Station et 308 pour le H200 NVL. Le traitement par lots rétablit l'ordre : avec 128 flux, l'ET900N G3 a atteint 12 439 jetons de sortie par seconde en FP8, soit 3.1 fois plus que la carte (3 990) et 1.7 fois plus que le H200 NVL (7 450). Avec un profil de pré-remplissage intensif, la Station a atteint 3 837 jetons de sortie par seconde, tandis que la RTX PRO 6000 a culminé à environ 880 avec 64 flux et le H200 NVL à environ 1 820.


Sur l'ensemble des modèles testés, l'ET900N G3 affiche des performances 2.8 à 3.4 fois supérieures à celles d'une RTX PRO 6000 et 1.7 à 3.7 fois supérieures à celles d'une H200 NVL en pleine charge. L'écart avec les deux modèles s'accroît lors des requêtes longues, lorsque la capacité de leur cache KV atteint ses limites. Face à la WS300, ces quatre modèles présentent des performances similaires, à moins de 1 % près : 22 041 contre 22 161 sur GPT-OSS-20B, 9 280 contre 9 294 sur GPT-OSS-120B, 11 075 contre 11 157 sur Mistral Small FP8 et 12 439 contre 12 425 sur Qwen3 Coder FP8. La comparaison complète portant sur 14 modèles, incluant les trois modèles présentant les écarts les plus importants, est présentée dans la section suivante.
Deux tours, une carte mère : ASUS ET900N G3 contre MSI WS300
Les stations de travail ET900N G3 et MSI XpertStation WS300 sont équipées de la même carte mère NVIDIA GB300 DGX, proposée dans deux châssis OEM différents. Elles ont été soumises aux mêmes 14 modèles, aux mêmes deux charges de travail et au même test de concurrence sur la même version vLLM. Le graphique ci-dessous compare le débit de sortie maximal de l'ET900N G3 avec celui de la WS300 pour l'ensemble des modèles.
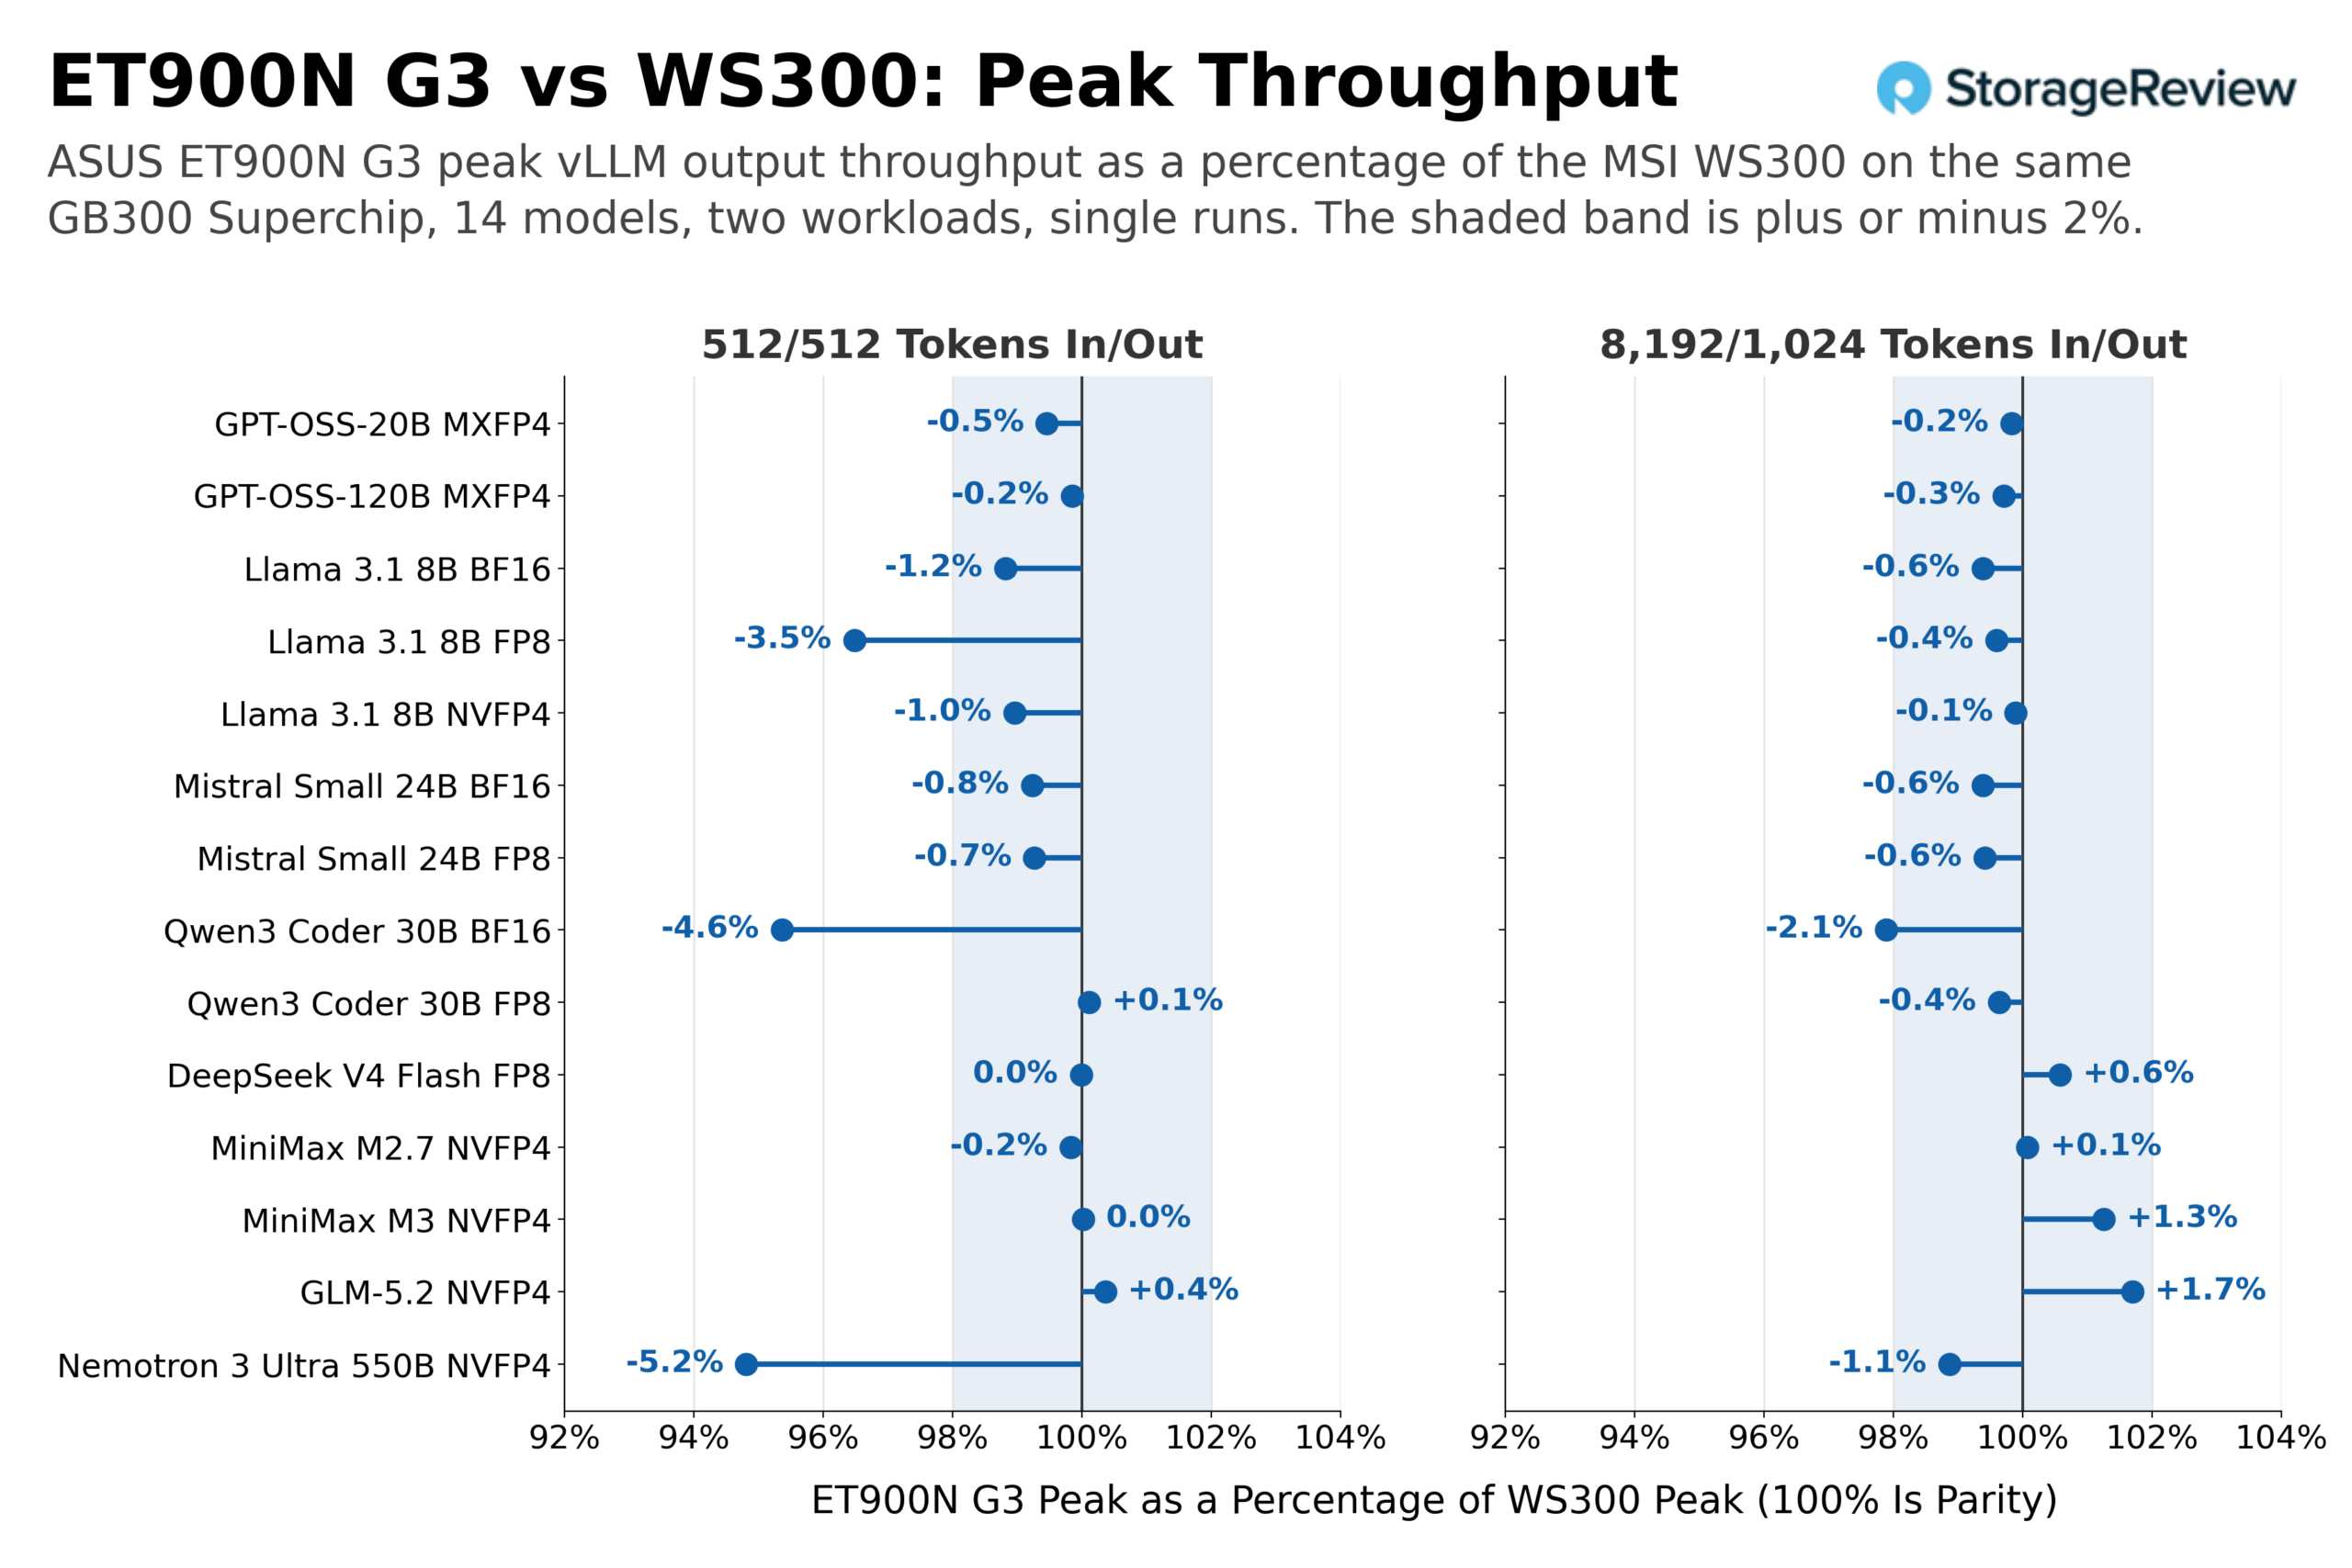
Sur les 28 paires modèle-charge de travail, 24 présentent un écart inférieur à 2 %, la plupart de ces écarts étant de quelques fractions de pour cent en faveur du WS300. Quatre se situent en dehors de cette fourchette, dont trois à charge de travail égale : Llama 3.1 8B FP8 avec un écart de 3.5 % par rapport au WS300 (25 602 contre 26 536 jetons de sortie par seconde), Qwen3 Coder 30B BF16 avec un écart de 4.6 % (10 000 contre 10 486) et Nemotron 3 Ultra 550B avec un écart de 5.2 % (159 contre 168), ainsi que Qwen3 Coder 30B BF16 à nouveau avec un écart de 2.1 % sur les invites longues. Chaque chiffre présenté ici correspond à un seul test sur chaque tour ; par conséquent, un écart de 2 à 5 % entre trois modèles sur 14 ne peut être imputé au châssis. Nous nous contentons de constater les données et l'écart entre les deux. Les modèles qui utilisent le pool de mémoire cohérent, MiniMax M3 et GLM-5.2, affichent des performances équivalentes, voire supérieures, pour les deux charges de travail ; c'est le résultat qui nous semble le plus important pour la plateforme : le chemin de déchargement Grace offre les mêmes performances dans le châssis ASUS que dans celui de MSI.
| Modèle | WS300 512/512 | ET900N G3 8 192/1 024 | Delta | WS300 8,192/1,024 | ET900N G3 8 192/1 024 | Delta |
|---|---|---|---|---|---|---|
| GPT-OSS-20B MXFP4 | 22,161 | 22,041 | -0.5% | 9,572 | 9,555 | -0.2% |
| GPT-OSS-120B MXFP4 | 9,294 | 9,280 | -0.2% | 5,038 | 5,023 | -0.3% |
| Lama 3.1 8B BF16 | 17,278 | 17,074 | -1.2% | 3,520 | 3,498 | -0.6% |
| Llama 3.1 8B FP8 | 26,536 | 25,602 | -3.5% | 6,189 | 6,164 | -0.4% |
| Llama 3.1 8B NVFP4 | 28,698 | 28,400 | -1.0% | 6,744 | 6,737 | -0.1% |
| Mistral Petit 24B BF16 | 7,922 | 7,861 | -0.8% | 1,643 | 1,633 | -0.6% |
| Mistral Small 24B FP8 | 11,157 | 11,075 | -0.7% | 2,316 | 2,302 | -0.6% |
| Codeur Qwen3 30B BF16 | 10,486 | 10,000 | -4.6% | 3,830 | 3,749 | -2.1% |
| Codeur Qwen3 30B FP8 | 12,425 | 12,439 | + 0.1% | 3,851 | 3,837 | -0.4% |
| Flash DeepSeek V4 FP8 | 1,766 | 1,766 | 0.0 % | 948 | 954 | + 0.6% |
| MiniMax M2.7 NVFP4 | 4,801 | 4,793 | -0.2% | 1,743 | 1,744 | + 0.1% |
| MiniMax M3 NVFP4 | 1,041 | 1,041 | 0.0 % | 278 | 282 | + 1.3% |
| GLM-5.2 NVFP4 | 138 | 139 | + 0.4% | 118 | 120 | + 1.7% |
| Nemotron 3 Ultra 550B NVFP4 | 168 | 159 | -5.2% | 142 | 140 | -1.1% |
GPT-OSS-20B, le cas dense à débit le plus élevé de l'ensemble, et GLM-5.2, le cas de déchargement, montrent le chevauchement sans ratio : sur les deux, l'exécution du WS300 suit point par point celle de l'ET900N G3.
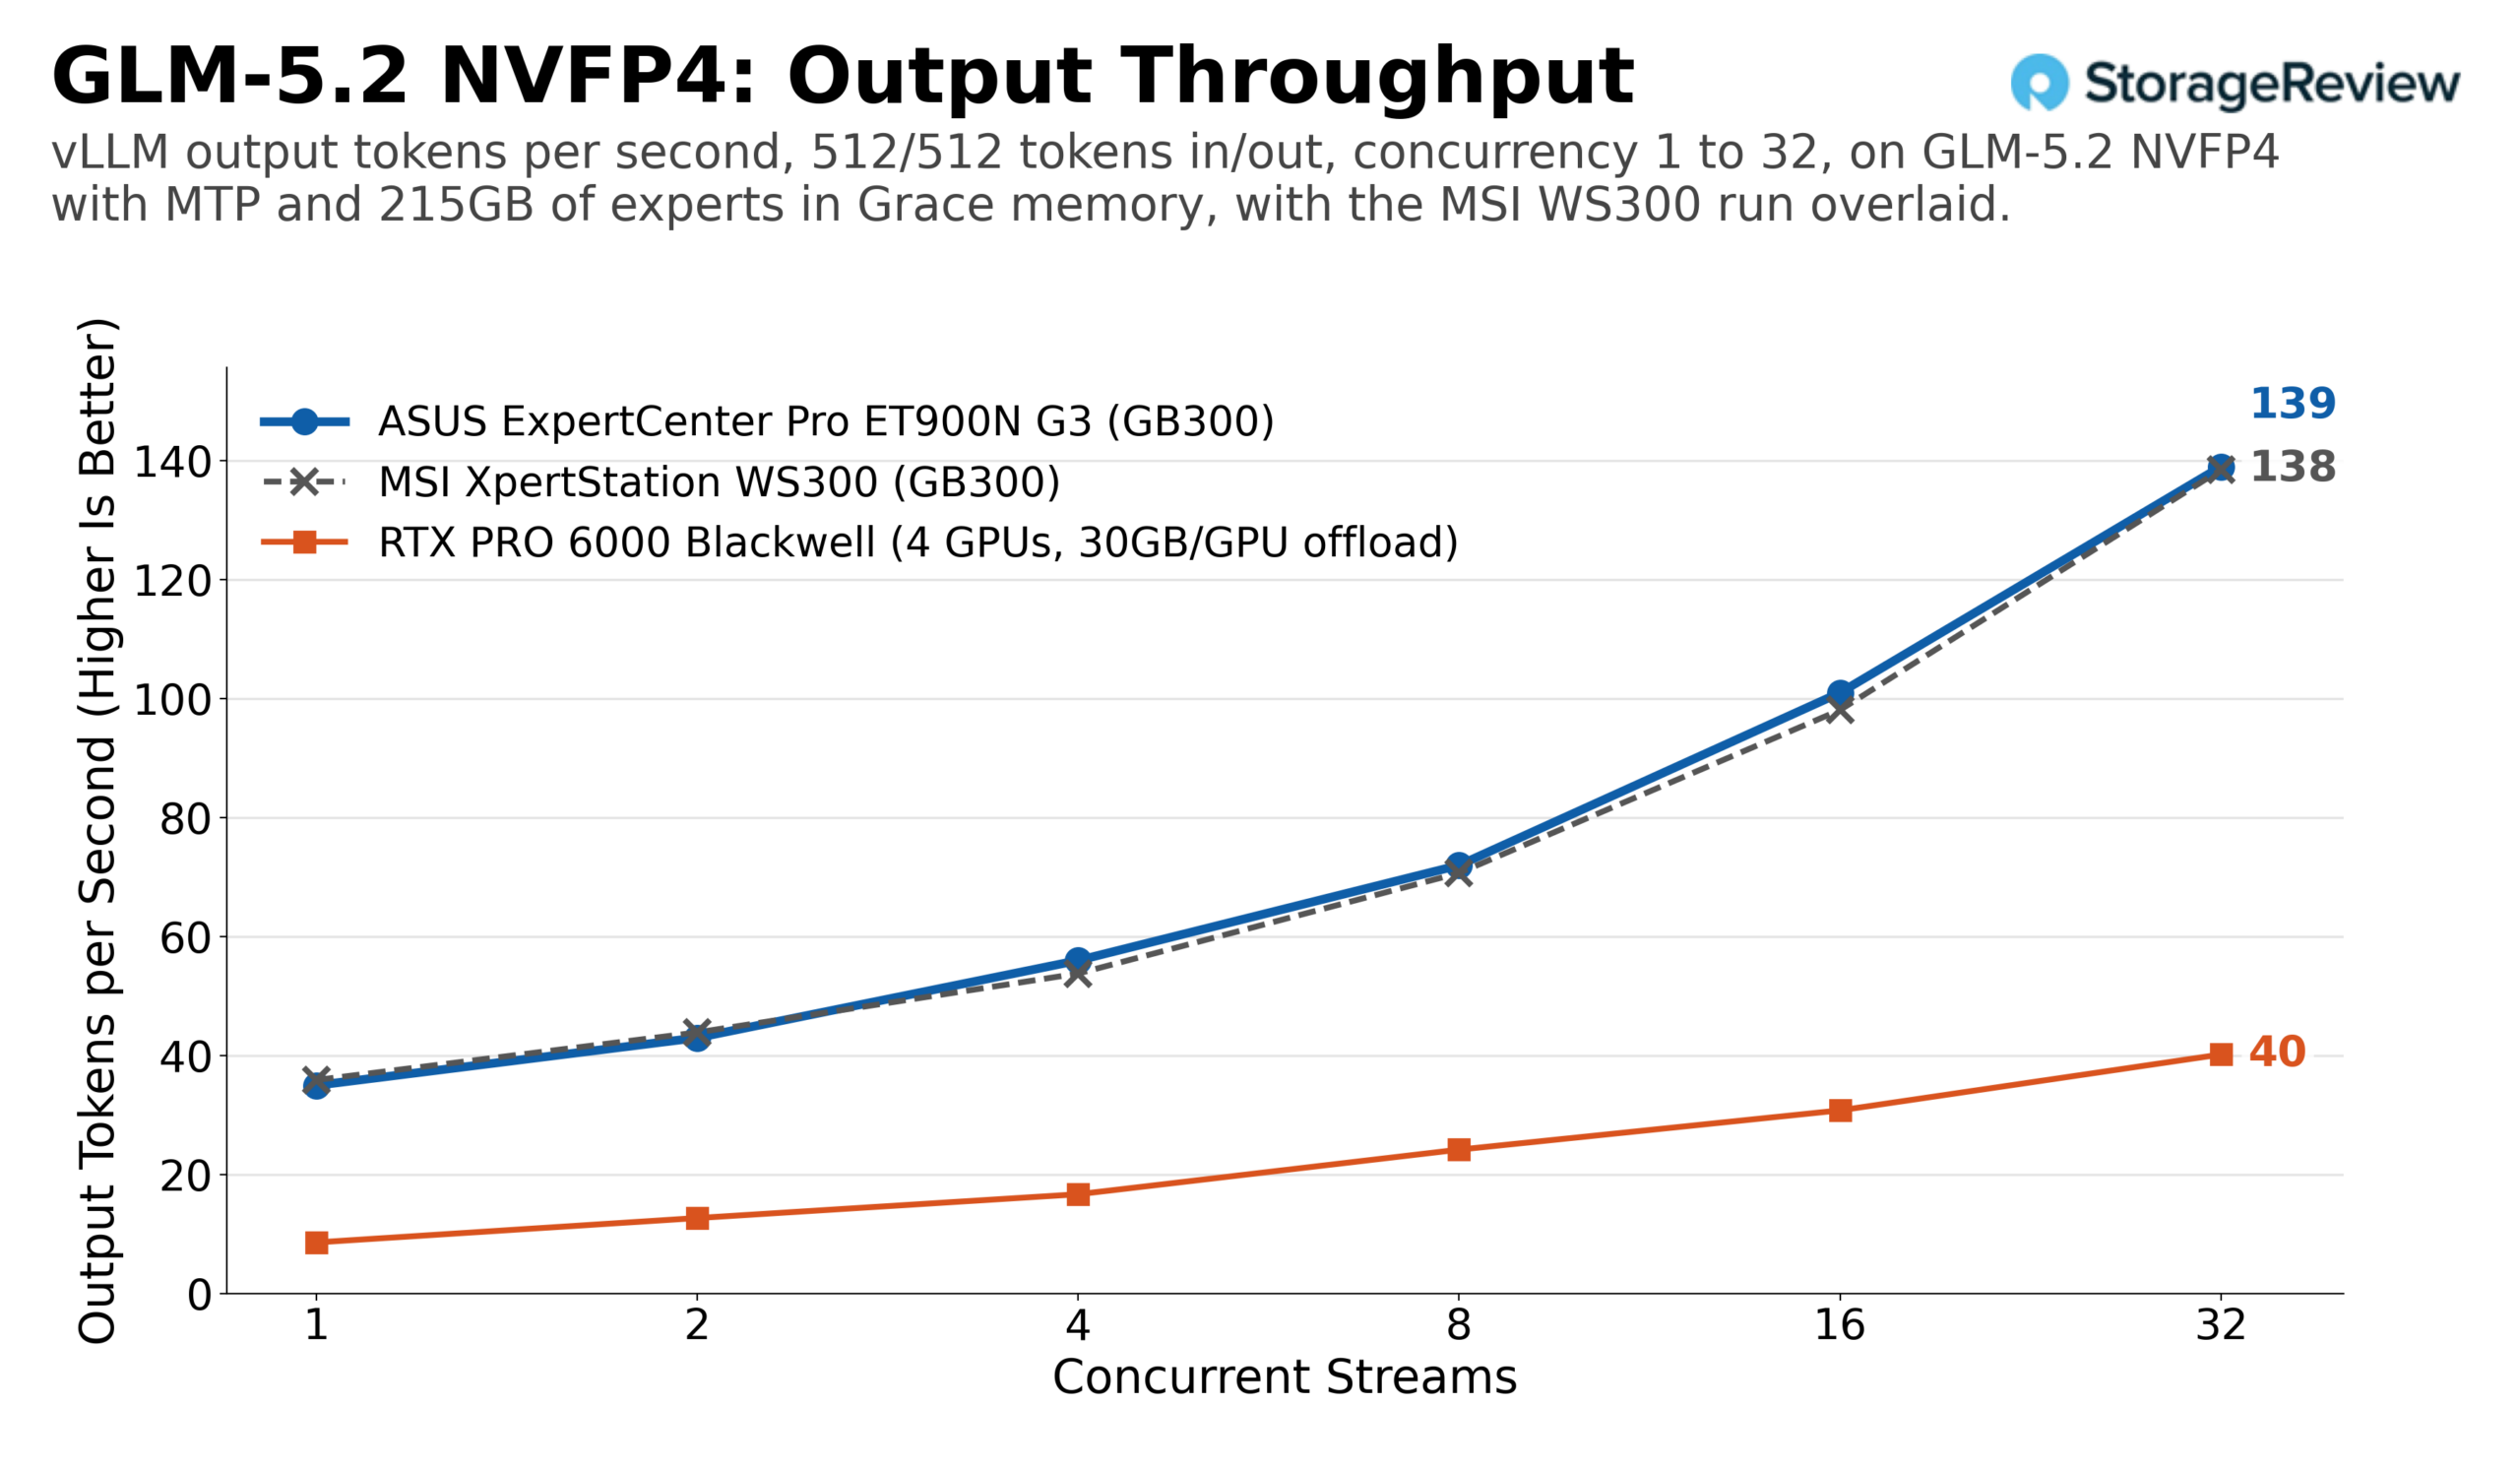
Nous étofferons cette comparaison au fur et à mesure que de nouvelles tours GB300 seront testées au laboratoire. La ZGX de HP sera la prochaine sur la liste, suivie d'autres modèles. Chaque tour sera soumise au même balayage, ce qui permettra de mettre en évidence les différences entre les implémentations des constructeurs, sur un graphique par tour, les graphiques par modèle présentant les courbes brutes.
Conclusion
L'ASUS ExpertCenter Pro ET900N G3 remplit parfaitement son rôle de seconde version d'une plateforme de référence : elle confirme les performances de la première. Sur 14 modèles et deux charges de travail, son débit vLLM maximal s'est avéré inférieur de seulement 2 % à celui du MSI XpertStation WS300 dans 24 des 28 comparaisons, passant de 1 766 jetons de sortie par seconde sur DeepSeek V4 Flash à 22 041 sur GPT-OSS-20B, avec quatre valeurs aberrantes ponctuelles inférieures de 2 à 5 %. De plus, il a géré GLM-5.2 avec 215 Go d'experts dans la mémoire Grace à des débits que quatre cartes RTX PRO 6000 n'ont pas pu atteindre. Le processeur GB300 Superchip établit la norme, et ASUS a réalisé un excellent travail.
Les améliorations apportées par ASUS sont pratiques : les poignées permettent à deux personnes de déplacer une tour de 27 kg sans avoir à saisir les panneaux ; le ventilateur placé au-dessus des cages QSFP112 résout un problème potentiel pour ceux qui utilisent des périphériques optiques 400G pendant des heures ; et l’alimentation Titanium réduit la consommation électrique de quelques watts. Le processeur Arm, le circuit de 20 A, la sortie vidéo uniquement gérée par le BMC et la puissance de 1 600 W partagée lorsqu’une carte graphique de grande taille est installée sont des contraintes techniques communes aux deux tours.
La station GB300 DGX reste le dispositif le plus performant que nous ayons jamais installé sur un bureau, et ASUS propose une version qui constitue un excellent moyen de l'acquérir.
Sur notre Meilleurs ordinateurs de bureau pour l'IA locale leaderboard, the ET900N G3 now stands alongside the WS300 as a tested alternative in the Best GB300 System slot.



 Amazon